| 本篇位置 | 第三部分「技术指标」的第三篇。RSI 用到第 12 篇的 EMA 和第 8 篇的 Wilder 平滑,统计用到第 11 篇的市场状态和「先碰到哪条线」 |
| 用到的数据 | BTCUSDT 现货日线,以及用 1 分钟线合成的 4 小时线和 1 小时线(2017-08 至 2026-08);SPY、AAPL 日线(2016-09 至 2026-09) |
| 动手 | talab.indicators 第四部分:RSI、Stochastic(都和 TA-Lib 一致),附 12 个测试 |
| 读完你能 | 手算 RSI 和 Stochastic;说清楚 RSI 高于 70 在数学上意味着什么、为什么强趋势里它会一直高;按实时的市场状态检验一条振荡器规则,并且认出事后划分状态带来的错觉 |
一、先做一个决定
现在是 2024 年 2 月 20 日 UTC 收盘。
BTC 收在 52,258.80。1 月 23 日它还在 39,897.60,不到一个月涨了 31%。
从 2 月 9 日起,RSI(14) 每天都高于 70,今天是连续第 12 天,读数 77.1。Stochastic(14, 3, 3) 的 %K 是 92.1,2 月 8 日以来每天都在 90 以上。
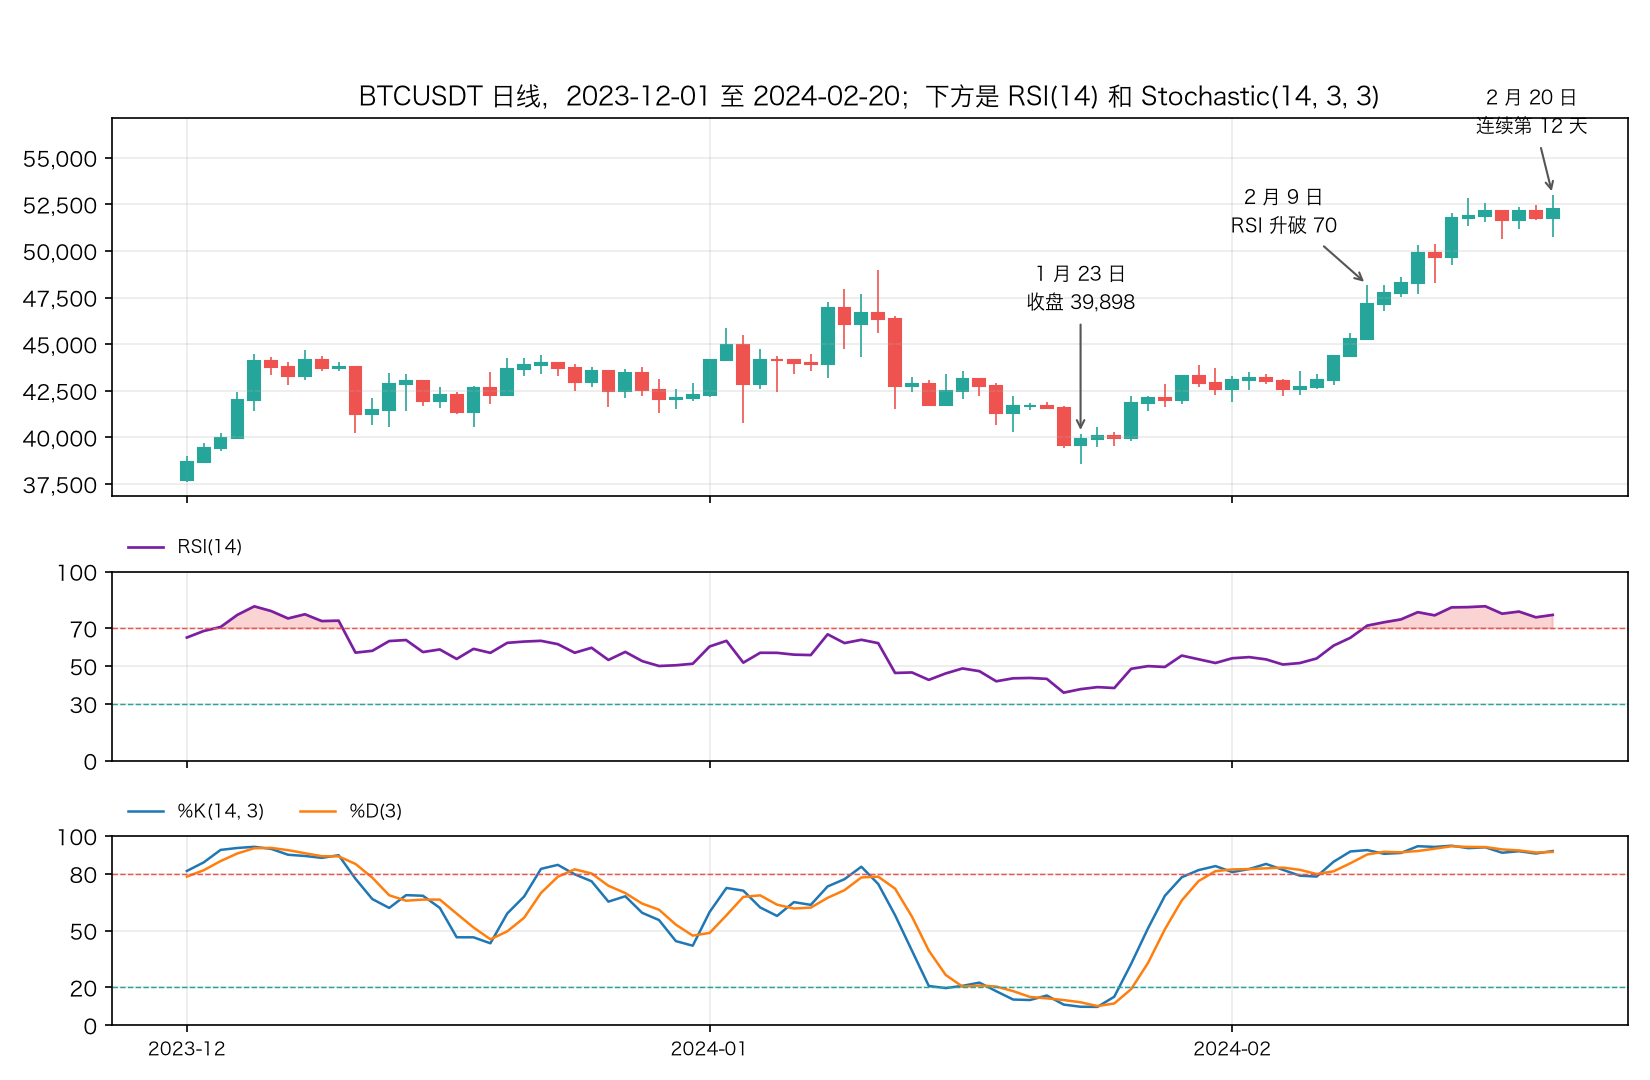
def run_length(flag):
    """flag 连续为真的根数:为真的那一根记 1、2、3……,为假记 0。"""
    group = (~flag).cumsum()
    return flag.astype(int).groupby(group).cumsum()


c = day["close"]
r = I.rsi(c)
st = I.stochastic(day["high"], day["low"], c)
t = pd.Timestamp("2024-02-20", tz="UTC")
above = run_length(r > 70)
table = pd.concat([c, r.rename("rsi"), above.rename("连续天数"), st], axis=1)
print(table.loc["2024-02-05":"2024-02-20"].round(1).to_string())
print(f"2024-01-23 最低收盘 {c['2024-01-23']:,.2f},到 2 月 20 日涨了 {c[t] / c['2024-01-23'] - 1:.2%}")
starts = above[(above == 12)].index
print("此前 BTC 日线 RSI 连续 12 天高于 70 的次数:", int((starts < t).sum()),
      ",最近一次:", starts[starts < t][-1].date())
                             close   rsi  连续天数     k     d
time
2024-02-05 00:00:00+00:00  42708.7  51.6     0  79.1  82.2
2024-02-06 00:00:00+00:00  43099.0  54.1     0  78.6  79.9
2024-02-07 00:00:00+00:00  44349.6  60.8     0  86.4  81.4
2024-02-08 00:00:00+00:00  45288.6  65.0     0  91.9  85.6
2024-02-09 00:00:00+00:00  47132.8  71.4     1  92.6  90.3
2024-02-10 00:00:00+00:00  47751.1  73.2     2  90.6  91.7
2024-02-11 00:00:00+00:00  48300.0  74.7     3  91.1  91.4
2024-02-12 00:00:00+00:00  49917.3  78.5     4  94.6  92.1
2024-02-13 00:00:00+00:00  49699.6  76.9     5  94.3  93.3
2024-02-14 00:00:00+00:00  51795.2  81.1     6  94.9  94.6
2024-02-15 00:00:00+00:00  51880.0  81.2     7  93.6  94.3
2024-02-16 00:00:00+00:00  52124.1  81.7     8  94.1  94.2
2024-02-17 00:00:00+00:00  51642.6  77.7     9  91.2  92.9
2024-02-18 00:00:00+00:00  52137.7  78.9    10  92.0  92.4
2024-02-19 00:00:00+00:00  51774.7  75.8    11  90.8  91.3
2024-02-20 00:00:00+00:00  52258.8  77.1    12  92.1  91.6
2024-01-23 最低收盘 39,897.60,到 2 月 20 日涨了 30.98%
此前 BTC 日线 RSI 连续 12 天高于 70 的次数: 7 ,最近一次: 2023-10-31
教科书上写着:RSI 高于 70 是超买,低于 30 是超卖。连续 12 天超买,而且最近几天价格已经横着走了。
你会怎么做?
- A. 卖出或做空:超买这么久了,该回调了
- B. 继续持有:RSI 一直高,说明趋势很强
- C. 等 RSI 跌回 70 以下再卖:这是很多书推荐的「确认」用法
先写下你的选择。 第六节揭晓之后的走势,第七、八节看这类规则在全部历史上的表现。
二、看一个学生的成绩单
打个比方
想象你是一位老师,手里有一个学生每周小测验的成绩单。
- 价格是每周的分数。
- RSI 像是「最近几周的进步,占全部起伏的比例」:把每周比上周多出来的分数加起来,叫进步;少了的分数加起来,叫退步。RSI = 进步 ÷ (进步 + 退步)。一直在进步的学生,RSI 接近 100;进步和退步一样多,RSI 是 50。
- Stochastic 像是「这周分数在最近 14 次考试里排在什么位置」:最高分记 100,最低分记 0。
- 超买就是:这个学生最近连着好几周进步,老师心里嘀咕,「考这么好,下次该回落了吧」。
这里藏着两种完全不同的学生:
- 正在开窍的学生(趋势):他连着进步,是因为真的学会了。成绩单上 RSI 一直很高,可这不是「该回落」的信号,恰恰是他在变强的证据。这就是钝化:指标一直待在超买区,价格却还在涨。
- 成绩在一个范围里上下晃的学生(震荡):考到自己的高分之后,下次多半回到平均水平。对他来说,「考得太好了,下次会回落」是对的。
所以大家都说:震荡市用超买超卖,趋势市别用。 听起来很合理。问题是,你怎么知道眼前这个学生属于哪一种?
期末翻看整学期的成绩单时,一眼就能分出来:这段是开窍,那段是晃荡。可是在学期中间、只看到今天为止的分数时,你分得出来吗?第七节会发现,这个区别决定了结论。
三、RSI 是怎么算的
定义
RSI(Relative Strength Index,相对强弱指数)由 J. Welles Wilder 在 1978 年的《New Concepts in Technical Trading Systems》里提出。第 8 篇的 ATR、ADX 也出自这本书。
每根 K 线的变化 = 收盘价 - 前一根收盘价。上涨的部分记为 gain(下跌时记 0),下跌的部分取正数记为 loss(上涨时记 0)。
平均 gain、平均 loss:用 Wilder 平滑,alpha = 1 ÷ n,n 通常是 14
RS = 平均 gain ÷ 平均 loss
RSI = 100 - 100 ÷ (1 + RS) = 100 × 平均 gain ÷ (平均 gain + 平均 loss)
第二行的两种写法完全相等(上下同乘平均 loss 就能看出来),后一种更直观,也没有「平均 loss 为 0 时 RS 无穷大」的麻烦。
Wilder 平滑就是第 8 篇的 wilder_smooth,也是第 12 篇 alpha = 1/n 的 ema:第一个值是前 n 个变化的简单平均,之后每次 新值 = 旧值 + (今天 - 旧值) ÷ n。
手算一遍
价格 10、11、10、12、13、12、14,用 RSI(3):
x = pd.Series([10.0, 11, 10, 12, 13, 12, 14])
change = x.diff()
gain, loss = change.clip(lower=0), (-change).clip(lower=0)
small = pd.DataFrame({"收盘价": x, "变化": change, "gain": gain, "loss": loss,
                      "平均 gain": I.ema(gain, 3, alpha=1 / 3), "平均 loss": I.ema(loss, 3, alpha=1 / 3), "RSI(3)": I.rsi(x, 3)})
print(small.round(4).to_string())
    收盘价   变化  gain  loss  平均 gain  平均 loss   RSI(3)
0  10.0  NaN   NaN   NaN      NaN      NaN      NaN
1  11.0  1.0   1.0   0.0      NaN      NaN      NaN
2  10.0 -1.0   0.0   1.0      NaN      NaN      NaN
3  12.0  2.0   2.0   0.0   1.0000   0.3333  75.0000
4  13.0  1.0   1.0   0.0   1.0000   0.2222  81.8182
5  12.0 -1.0   0.0   1.0   0.6667   0.4815  58.0645
6  14.0  2.0   2.0   0.0   1.1111   0.3210  77.5862
一步步来:
- 变化:+1、-1、+2、+1、-1、+2。第一根没有前一根,没有变化。
- 第 4 根(下标 3)是第一个 RSI:前 3 个变化里,gain 是 1、0、2,平均 1;loss 是 0、1、0,平均 1/3。RSI = 100 × 1 ÷ (1 + 1/3) = 75。RSI(n) 需要 n 个变化,也就是 n + 1 根 K 线。
- 第 5 根:变化 +1。平均 gain = (2 × 1 + 1) ÷ 3 = 1,平均 loss = (2 × 1/3 + 0) ÷ 3 = 2/9。RSI = 100 × 1 ÷ (1 + 2/9) = 81.82。
- 第 6 根:变化 -1。平均 gain = (2 × 1 + 0) ÷ 3 = 2/3,平均 loss = (2 × 2/9 + 1) ÷ 3 = 13/27。RSI = 100 × 18 ÷ 31 = 58.06。
- 第 7 根:变化 +2。平均 gain = 10/9,平均 loss = 26/81。RSI = 77.59。
注意第 6 根:一次下跌 1 块钱,RSI 从 81.82 掉到 58.06。周期越短,RSI 越跳。
同一个名字,三种算法
网上的 RSI 代码不全是 Wilder 的算法。常见的还有两种:
- pandas 写法:
ewm(alpha=1/14, adjust=False),用第一个变化做初始值,而不是前 14 个的平均。第 12 篇讲 EMA 时遇到过同样的问题。 - Cutler 的 RSI:把 Wilder 平滑换成 14 根的简单平均。它不依赖很久以前的数据,但它是另一个指标。
d = c.diff()
pandas_style = 100 * d.clip(lower=0).ewm(alpha=1 / 14, adjust=False).mean() / d.abs().ewm(alpha=1 / 14, adjust=False).mean()
cutler = 100 * d.clip(lower=0).rolling(14).mean() / d.abs().rolling(14).mean()
first = r.first_valid_index()
k0 = c.index.get_loc(first)
print(f"第一个 RSI({first.date()}):Wilder {r[first]:.2f},pandas ewm 从第一个变化开始 {pandas_style[first]:.2f},"
      f"Cutler(简单平均){cutler[first]:.2f}")
for k in [30, 100, 200]:
    i = k0 + k
    print(f"再往后 {k} 根:和 pandas ewm 写法相差 {abs(r.iloc[i] - pandas_style.iloc[i]):.4f}")
gap = (r - cutler).abs()
print(f"和 Cutler 写法:相差的中位数 {gap.median():.2f},最大 {gap.max():.2f},"
      f"两者一个高于 70、另一个不高于 70 的天数占 {((r > 70) != (cutler > 70))[r.notna()].mean():.1%}")
第一个 RSI(2017-08-31):Wilder 67.86,pandas ewm 从第一个变化开始 36.96,Cutler(简单平均)67.86
再往后 30 根:和 pandas ewm 写法相差 2.3281
再往后 100 根:和 pandas ewm 写法相差 0.0037
再往后 200 根:和 pandas ewm 写法相差 0.0000
和 Cutler 写法:相差的中位数 5.88,最大 25.29,两者一个高于 70、另一个不高于 70 的天数占 8.5%
- pandas 写法开头差得很远:第一个值 36.96 对 67.86。Wilder 平滑的 alpha 只有 1/14,初始值的影响每根只衰减 1/14,30 根之后还差 2.3,大约 100 根才基本对上。
- Cutler 写法是另一个指标:相差的中位数 5.88,最大 25.29,有 8.5% 的日子一个说超买、另一个说不超买。
⚠️ 和交易软件、别人的回测对账之前,先确认对方用的是哪一种。talab.rsi 和 TA-Lib、也和 Wilder 原书一致。
两个极端情况
- 价格每根都涨:平均 loss 永远是 0,RSI 恒等于 100,不管涨得快还是慢。
- 价格连续 n 根一动不动:平均 gain 和平均 loss 都是 0,RSI 是 0 ÷ 0,没有定义。TA-Lib 记为 0,
talab跟着记为 0。⚠️ 这不是「极度超卖」,停牌、流动性很差的品种上要特别小心。
✋ 小检查 1
(a) 价格每天稳定上涨 1 美元,已经持续了几个月。RSI(14) 是多少?如果每天的最高价比收盘价高 0.5、最低价比收盘价低 0.5,Stochastic 的原始 %K(k = 14)是多少?
(b) 价格一直交替 +2、-1、+2、-1……几个月下来,价格明明一直在涨。RSI(14) 大约在什么范围?会不会高于 70?
(c) 某一天 RSI(14) = 80。按平滑后的数字算,gain 占 gain + loss 的多少?平滑后的「净变化」(gain - loss)占「总路程」(gain + loss)的多少?
答案在文末。
四、RSI 到底在量什么
换个写法
每根 K 线的 gain 和 loss,可以用变化本身和它的绝对值写出来:
gain = (|变化| + 变化) ÷ 2
loss = (|变化| - 变化) ÷ 2
gain + loss = |变化|
平滑是线性的,所以平均 gain = (平均 |变化| + 平均 变化) ÷ 2。代进 RSI 的定义:
RSI = 100 × 平均 gain ÷ 平均 |变化| = 50 + 50 × 平均 变化 ÷ 平均 |变化|
这是恒等式,不是近似。 右边那个比值,分子是这一段走了多远(带方向),分母是这一段一共走了多少路。这正是第 8 篇的效率比,只不过带了方向,用的是 Wilder 平滑而不是固定窗口。
- 一路直线上涨:效率比 = 1,RSI = 100
- 来回晃、没走远:效率比 ≈ 0,RSI ≈ 50
- 一路直线下跌:效率比 = -1,RSI = 0
所以 RSI = 70 意思是:最近这一段,净上涨是总路程的 40%。
再换成收益率
如果每天的收益率大致服从正态分布,平均值是 μ、标准差是 σ,而且 μ 相对 σ 不大,那么平均 |收益| ≈ σ × √(2/π) ≈ 0.8σ。于是:
RSI ≈ 50 + 50 ÷ √(2/π) × μ/σ ≈ 50 + 62.7 × μ/σ
μ/σ 是「平均涨幅相对波动」的比值,也就是一段时间的信噪比。用真实数据检验:
smooth = lambda s: I.ema(s, 14, alpha=1 / 14)
identity = 50 + 50 * smooth(d) / smooth(d.abs())
print(f"RSI 和 50 + 50 × 平滑的变化 ÷ 平滑的 |变化|:最大差 {(identity - r).abs().max():.1e}")
for name, df in markets.items():
    close = df["close"]
    rr = I.rsi(close)
    lr = np.log(close).diff()
    mean = smooth(lr)
    ratio = mean / np.sqrt(smooth(lr ** 2) - mean ** 2)
    ok = rr.notna() & ratio.notna()
    slope, intercept = np.polyfit(ratio[ok], rr[ok], 1)
    print(f"{name}:RSI ≈ {intercept:.1f} + {slope:.1f} × 平均涨幅/波动,相关系数 {np.corrcoef(ratio[ok], rr[ok])[0, 1]:.3f};"
          f"RSI > 70 占 {(rr > 70)[ok].mean():.1%},RSI < 30 占 {(rr < 30)[ok].mean():.1%}")
print(f"正态分布下的斜率 50 ÷ √(2/π) = {50 / np.sqrt(2 / np.pi):.1f};RSI = 70 对应 平均涨幅/波动 = {20 / (50 / np.sqrt(2 / np.pi)):.2f}")
RSI 和 50 + 50 × 平滑的变化 ÷ 平滑的 |变化|:最大差 2.8e-14
SPY:RSI ≈ 50.1 + 62.0 × 平均涨幅/波动,相关系数 0.995;RSI > 70 占 9.3%,RSI < 30 占 1.6%
AAPL:RSI ≈ 50.1 + 64.2 × 平均涨幅/波动,相关系数 0.993;RSI > 70 占 14.0%,RSI < 30 占 2.0%
BTC:RSI ≈ 49.8 + 66.8 × 平均涨幅/波动,相关系数 0.992;RSI > 70 占 11.2%,RSI < 30 占 4.2%
正态分布下的斜率 50 ÷ √(2/π) = 62.7;RSI = 70 对应 平均涨幅/波动 = 0.32
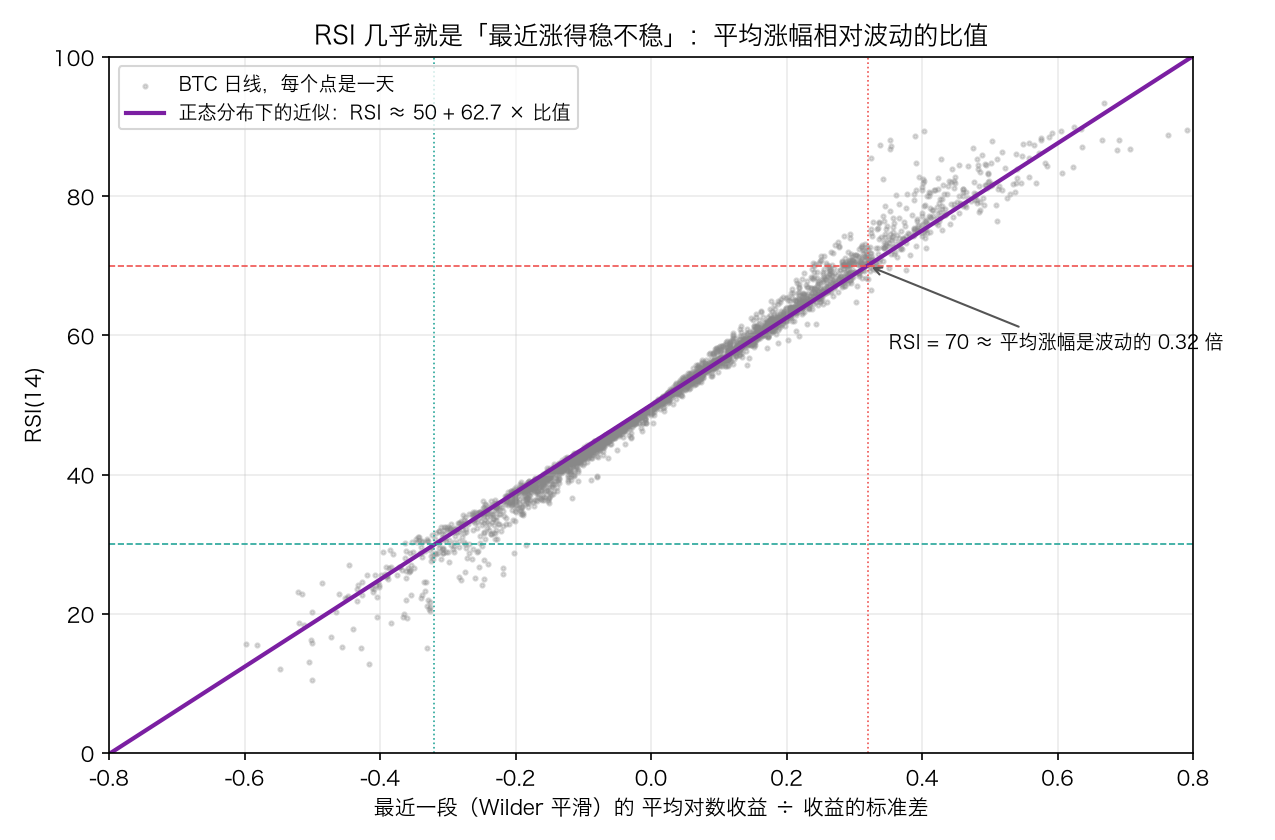
- 恒等式分毫不差:最大误差 2.8e-14,就是浮点数的舍入。
- 近似也很准:三个标的上相关系数都是 0.99 以上,拟合的斜率 62.0、64.2、66.8,和理论值 62.7 很接近。BTC 的斜率偏大,因为肥尾(第 5 篇)让平均 |收益| 比 0.8σ 更小。
- RSI = 70 大约相当于 μ/σ = 0.32:最近两三周里,每天的平均涨幅是每天波动的三分之一。
⚠️ 这件事改变了我们读 RSI 的方式。RSI 高于 70,不是说价格「太高」了,而是说价格最近涨得又多又稳。它不知道价格相对什么「贵」,只知道最近这段路走得直不直。
钝化是定义出来的
现在「钝化」就不神秘了。强趋势是什么?就是平均涨幅相对波动很大的一段行情。按照上面的恒等式,这样的行情里 RSI 必然长时间高于 70。第 13 篇的直线上 MACD 等于 7 倍斜率,这里的直线上 RSI 等于 100,是同一个道理。
用第 11 篇的实时市场状态看一看(阈值和第 11 篇相同:SPY 3%、AAPL 5%、BTC 10%):
thresholds = {"SPY": 0.03, "AAPL": 0.05, "BTC": 0.10}
five = {"up": "上升", "down": "下降", "range": "震荡", "transition_up": "向上过渡", "transition_down": "向下过渡"}
rows = []
for name, df in markets.items():
    close = df["close"]
    rr = I.rsi(close)
    swings = X.zigzag(close, thresholds[name])
    state = X.market_state(X.trend_state(swings, close, close), close).map(five)
    for s in ["上升", "向上过渡", "震荡", "向下过渡", "下降"]:
        m = (state == s) & rr.notna()
        rows.append({"标的": name, "状态": s, "K 线": int(m.sum()), "RSI 平均": rr[m].mean(),
                     "RSI > 70": (rr[m] > 70).mean(), "RSI < 30": (rr[m] < 30).mean()})
print(pd.DataFrame(rows).to_string(index=False, formatters={"RSI 平均": "{:.1f}".format,
                                                             "RSI > 70": "{:.1%}".format, "RSI < 30": "{:.1%}".format}))


def streaks(log_returns, k=12):
    """把对数收益率拼回价格,数 RSI 连续高于 70 至少 k 根的段数。"""
    price = pd.Series(np.exp(np.cumsum(np.asarray(log_returns))))
    return float((run_length(I.rsi(price) > 70) == k).sum())


for name, df in markets.items():
    log_returns = np.log(df["close"]).diff().dropna().reset_index(drop=True)
    res = St.shuffle_test(log_returns, streaks, n=500, seed=0)
    print(f"{name}:RSI 连续 12 根以上高于 70 的段数 {res['实际值']:.0f},打乱后 95% 范围 "
          f"{res['打乱后 2.5% 分位']:.0f} ~ {res['打乱后 97.5% 分位']:.0f},打乱后不少于实际的比例 {res['比例']:.1%}")
  标的   状态  K 线 RSI 平均 RSI > 70 RSI < 30
 SPY   上升 1550   58.3     9.0%     0.5%
 SPY 向上过渡  285   64.6    24.2%     0.0%
 SPY   震荡  260   48.6     0.0%     0.0%
 SPY 向下过渡   50   33.6     0.0%    30.0%
 SPY   下降  207   42.7     1.4%     8.7%
AAPL   上升 1286   58.6    15.7%     1.6%
AAPL 向上过渡  292   66.3    31.2%     0.0%
AAPL   震荡  319   46.4     0.0%     1.3%
AAPL 向下过渡   18   32.7     0.0%    38.9%
AAPL   下降  413   43.8     0.0%     3.6%
 BTC   上升 1115   58.3    19.9%     1.3%
 BTC 向上过渡  458   64.6    27.5%     0.0%
 BTC   震荡  681   48.6     2.3%     1.2%
 BTC 向下过渡  189   36.3     0.0%    14.3%
 BTC   下降  835   43.5     0.5%    10.7%
SPY:RSI 连续 12 根以上高于 70 的段数 3,打乱后 95% 范围 3 ~ 11,打乱后不少于实际的比例 99.6%
AAPL:RSI 连续 12 根以上高于 70 的段数 8,打乱后 95% 范围 2 ~ 10,打乱后不少于实际的比例 28.0%
BTC:RSI 连续 12 根以上高于 70 的段数 9,打乱后 95% 范围 3 ~ 11,打乱后不少于实际的比例 19.4%
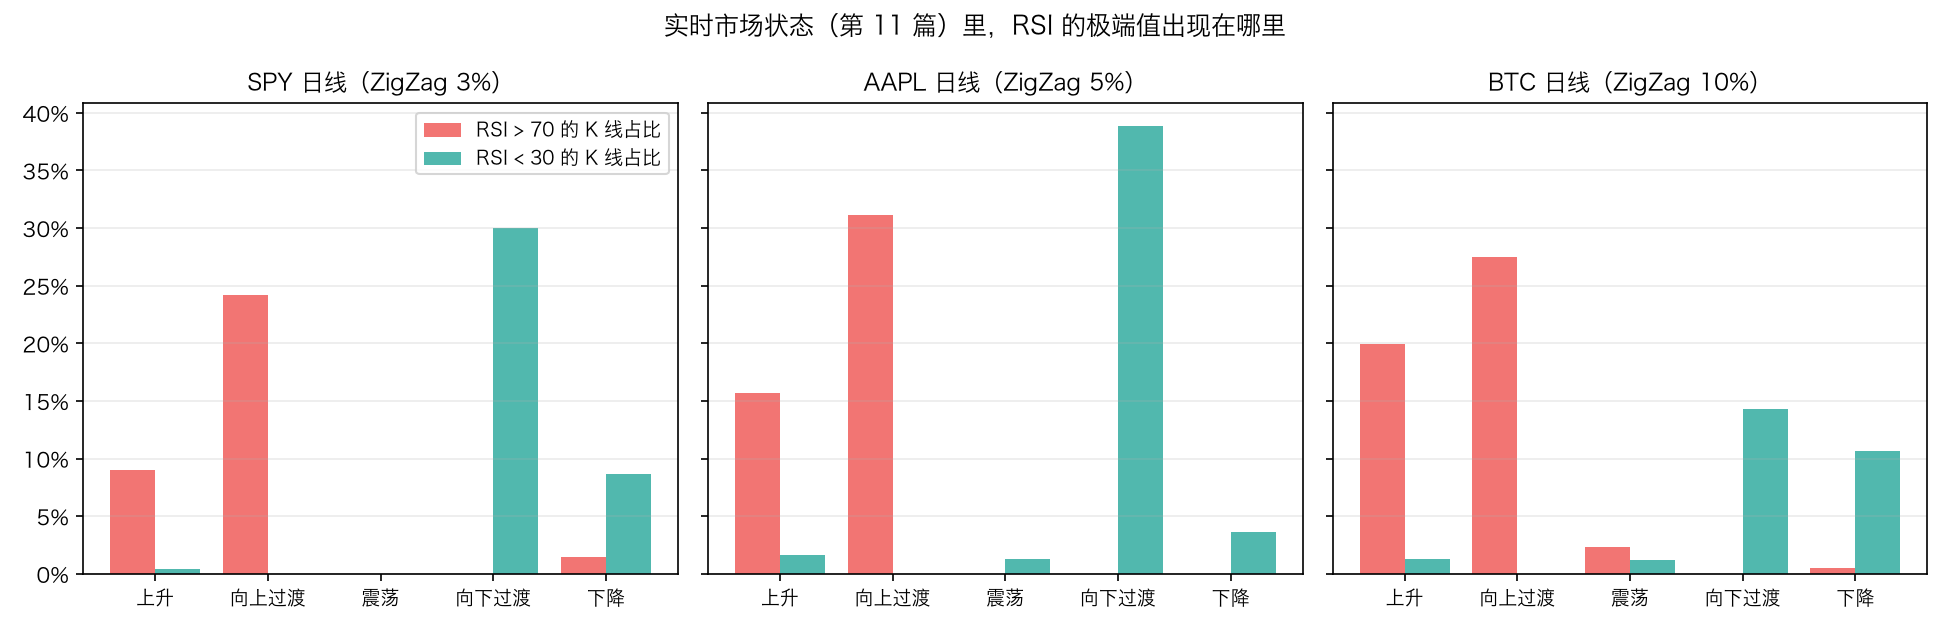
三件事:
- RSI > 70 集中在「上升」和「向上过渡」里,RSI < 30 集中在「下降」和「向下过渡」里。这正是恒等式的推论。
- 实时状态是「震荡」的 K 线里,极端值非常少:SPY 和 AAPL 上 RSI > 70 是 0.0%,BTC 是 2.3%;RSI < 30 是 0.0% 到 1.3%。原因在第 11 篇的定义里:震荡是「收盘价还在最近一个已确认的高点和低点之间」。RSI 要冲到 70 以上,价格得走一段又多又稳的上涨,多半已经越过了最近的高点,状态就变成了「向上过渡」。「只在震荡市里用超买超卖」,按实时状态执行的话,信号几乎不会出现。 第七节会看到这对统计意味着什么。
- 连续 12 天以上高于 70,并不稀罕。把收益率的顺序打乱、拼成没有任何趋势记忆的价格,95% 的情况下也会出现 2 到 11 段(三个标的的范围合在一起)。AAPL 实际 8 段、BTC 9 段,都在打乱的范围内;SPY 只有 3 段,打乱后 99.6% 的情况不比它少,说明 SPY 的强势段比随机的还短,这和第 5 篇看到的 SPY 短期偏反转一致。
所以决策点上的「连续 12 天」,在随机游走里也很常见,不能单凭它说明「这次特别」。
五、Stochastic
定义
Stochastic(随机指标)通常认为由 George Lane 在 1950 年代末推广。它不看涨跌的比例,只看收盘价在最近一段区间里的位置:
原始 %K = 100 × (收盘价 - 最近 k 根的最低价) ÷ (最近 k 根的最高价 - 最近 k 根的最低价)
%K = 原始 %K 的 smooth_k 根简单平均
%D = %K 的 d 根简单平均
- 快速随机指标:smooth_k = 1,%K 就是原始 %K
- 慢速随机指标:smooth_k = 3,最常见的参数是 (14, 3, 3),也就是本篇用的
超买、超卖的线通常画在 80 和 20。
手算一遍
收盘价 5、6、7、6、8、9、7、6,最高价 = 收盘价 + 1,最低价 = 收盘价 - 1,参数 (3, 2, 2):
close = pd.Series([5.0, 6, 7, 6, 8, 9, 7, 6])
high, low = close + 1, close - 1
raw = 100 * (close - low.rolling(3).min()) / (high.rolling(3).max() - low.rolling(3).min())
small = pd.concat([close.rename("收盘价"), high.rolling(3).max().rename("3 根最高"), low.rolling(3).min().rename("3 根最低"),
                   raw.rename("原始 %K"), I.stochastic(high, low, close, k=3, smooth_k=2, d=2)], axis=1)
print(small.round(2).to_string())
for name, df in markets.items():
    s = I.stochastic(df["high"], df["low"], df["close"])
    rr = I.rsi(df["close"])
    ok = s["k"].notna() & rr.notna()
    print(f"{name}:%K 和 RSI 的相关系数 {np.corrcoef(s['k'][ok], rr[ok])[0, 1]:.2f};%K > 80 占 {(s['k'][ok] > 80).mean():.1%},"
          f"%K < 20 占 {(s['k'][ok] < 20).mean():.1%}")
   收盘价  3 根最高  3 根最低  原始 %K      k      d
0  5.0    NaN    NaN    NaN    NaN    NaN
1  6.0    NaN    NaN    NaN    NaN    NaN
2  7.0    8.0    4.0  75.00    NaN    NaN
3  6.0    8.0    5.0  33.33    NaN    NaN
4  8.0    9.0    5.0  75.00  54.17  54.17
5  9.0   10.0    5.0  80.00  77.50  65.83
6  7.0   10.0    6.0  25.00  52.50  65.00
7  6.0   10.0    5.0  20.00  22.50  37.50
SPY:%K 和 RSI 的相关系数 0.85;%K > 80 占 44.4%,%K < 20 占 10.0%
AAPL:%K 和 RSI 的相关系数 0.85;%K > 80 占 35.1%,%K < 20 占 13.3%
BTC:%K 和 RSI 的相关系数 0.82;%K > 80 占 23.7%,%K < 20 占 13.1%
- 第 3 根(下标 2):最近 3 根最高价 8、最低价 4,收盘 7。原始 %K = 100 × (7 - 4) ÷ (8 - 4) = 75。
- 第 4 根:最高 8、最低 5,收盘 6,原始 %K = 100 × 1 ÷ 3 = 33.33。
- %K 的第一个值:(75 + 33.33) ÷ 2 = 54.17,本来在第 4 根就有。
- %D 的第一个值:要两个 %K,在第 5 根:(54.17 + 54.17) ÷ 2 = 54.17。
⚠️ 表里 %K 和 %D 同时从第 5 根开始,第 4 根的 %K 虽然算得出来,也记为 NaN。这是 TA-Lib 的写法,和第 13 篇 MACD 的三列同时出现一样。talab.stochastic 跟着 TA-Lib 做,这样两边逐个数字对得上。
另外两个细节:
- 最近 k 根的最高价等于最低价(价格完全没动)时,分母是 0。TA-Lib 记为 0,
talab一样。 - ⚠️ TA-Lib 的 STOCH 默认 k = 5,不是 14。直接调
talib.STOCH(high, low, close)得到的是 (5, 3, 3)。
和 RSI 是不是一回事
- 相关系数 0.82 到 0.85:大部分时候两者说的是同一件事。
- Stochastic 更容易到极端:SPY 上 %K > 80 的时间占 44.4%,而 RSI > 70 只占 9.3%。原因很简单:只要收盘价贴着最近 14 根的最高价,%K 就接近 100,不管这 14 根涨了多少。在一段慢牛里,收盘价天天贴着区间顶部。
- 在直线上同样钝化:价格每根涨 1、上下影线各 0.5 时,%K 恒等于 96.4(小检查 1)。
第 15 篇的实验二会画出全部指标的相关性矩阵。这里先记住:Stochastic 量的是「位置」,RSI 量的是「走得直不直」,趋势里两者都会钝化。
六、揭晓
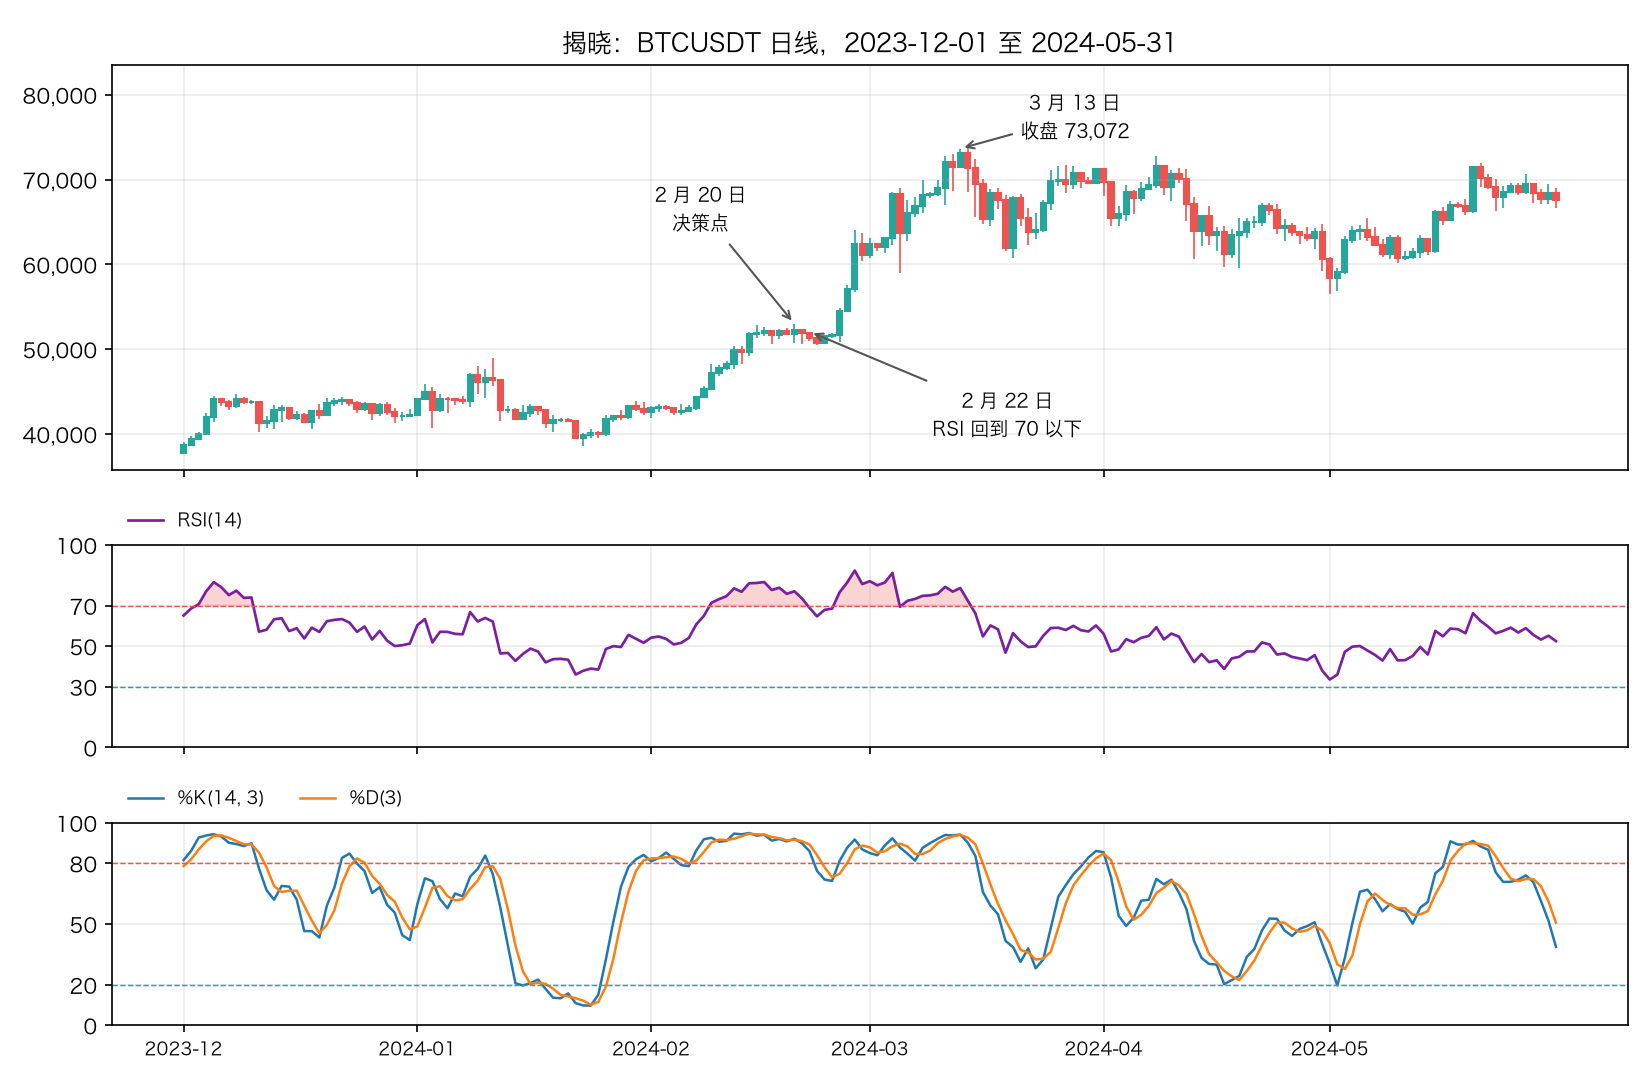
2 月 20 日之后,BTC 先横了几天,然后在三周里又涨了 38%。
i = c.index.get_loc(t)
for n in [1, 5, 10, 20, 60]:
    print(f"{n} 天后({c.index[i + n].date()}):{c.iloc[i + n] / c[t] - 1:+.2%},RSI {r.iloc[i + n]:.1f}")
exit_c = r.loc["2024-02-21":][r.loc["2024-02-21":] <= 70].index[0]
print(f"选 C:RSI 第一次回到 70 以下是 {exit_c.date()},收盘 {c[exit_c]:,.2f}({c[exit_c] / c[t] - 1:+.2%}),RSI {r[exit_c]:.1f}")
peak = c.loc["2024-02-21":"2024-06-30"].idxmax()
low_after = c.loc["2024-02-21":"2024-06-30"].loc[peak:].idxmin()
print(f"之后的最高收盘:{c[peak]:,.2f}({peak.date()},{c[peak] / c[t] - 1:+.2%});"
      f"到 6 月底的最低收盘 {c[low_after]:,.2f}({low_after.date()},{c[low_after] / c[t] - 1:+.2%})")
events = []
for name, df in markets.items():
    close = df["close"]
    count = run_length(I.rsi(close) > 70)
    later = {n: close.shift(-n) / close - 1 for n in [10, 20, 60]}
    for when in count.index[count == 12]:
        events.append({"标的": name, "第 12 天": when.date(), "RSI": I.rsi(close)[when],
                       "10 根后": later[10][when], "20 根后": later[20][when], "60 根后": later[60][when],
                       "同标的任意一天 20 根后": later[20].mean()})
events = pd.DataFrame(events)
print(events.to_string(index=False, formatters={"RSI": "{:.1f}".format} | {k: "{:+.2%}".format for k in events.columns[3:]}))
print(f"20 根后上涨的次数:{int((events['20 根后'] > 0).sum())} / {events['20 根后'].notna().sum()}")
1 天后(2024-02-21):-0.78%,RSI 73.6
5 天后(2024-02-25):-1.01%,RSI 68.5
10 天后(2024-03-01):+19.38%,RSI 82.1
20 天后(2024-03-11):+37.93%,RSI 79.3
60 天后(2024-04-20):+24.27%,RSI 47.4
选 C:RSI 第一次回到 70 以下是 2024-02-22,收盘 51,288.42(-1.86%),RSI 69.0
之后的最高收盘:73,072.41(2024-03-13,+39.83%);到 6 月底的最低收盘 58,364.97(2024-05-01,+11.68%)
  标的     第 12 天  RSI   10 根后   20 根后    60 根后 同标的任意一天 20 根后
 SPY 2017-03-01 82.1  -0.35%  -1.77%   +0.83%        +1.13%
 SPY 2017-10-17 74.2  +0.66%  +0.88%   +8.79%        +1.13%
 SPY 2018-01-19 80.9  -1.77%  -2.60%   -3.64%        +1.13%
AAPL 2017-02-16 89.1  +3.28%  +3.43%  +15.51%        +2.33%
AAPL 2018-08-16 78.2  +5.49%  +4.93%   -3.81%        +2.33%
AAPL 2019-04-17 76.0  +2.96%  -6.06%   +1.41%        +2.33%
AAPL 2019-11-15 78.6  -0.60%  +5.31%  +22.53%        +2.33%
AAPL 2020-01-02 84.6  +4.96%  +3.05%  -14.96%        +2.33%
AAPL 2020-08-27 75.1 -10.41% -10.18%   -5.97%        +2.33%
AAPL 2021-07-16 70.2  -0.36%  +2.00%   -2.30%        +2.33%
AAPL 2026-05-26 77.6  -5.77%  -4.95%   +1.05%        +2.33%
 BTC 2017-12-06 89.7 +40.98% +15.79%  -39.60%        +3.15%
 BTC 2019-05-14 89.1  +0.22%  +2.12%  +42.88%        +3.15%
 BTC 2020-11-01 76.5 +13.97% +35.91% +110.18%        +3.15%
 BTC 2020-11-19 80.6  +2.15%  +4.15% +105.76%        +3.15%
 BTC 2021-01-05 83.3  +8.23%  -4.99%  +43.98%        +3.15%
 BTC 2023-01-22 84.7  +4.51%  -3.72%  +24.61%        +3.15%
 BTC 2023-10-31 82.4  +7.68%  +8.11%  +21.65%        +3.15%
 BTC 2024-02-20 77.1 +19.38% +37.93%  +24.27%        +3.15%
 BTC 2024-11-17 74.2  +6.69% +11.10%  +11.28%        +3.15%
20 根后上涨的次数:13 / 20
- 选 A(卖出或做空)的:头 5 天看起来是对的,跌了 1%。然后 10 天后 +19.38%,20 天后 +37.93%。做空的人如果一直拿着,亏掉了将近四成。
- 选 B(持有)的:3 月 13 日收在 73,072.41,比决策点高 39.83%。之后回撤到 5 月 1 日的 58,364.97,仍比决策点高 11.68%。
- 选 C(等 RSI 回到 70 以下再卖)的:2 月 22 日 RSI 就掉到了 69.0,按规则卖在 51,288.42,比决策点低 1.86%。然后完整错过了之后的 40% 上涨。 RSI 在 2 月底、3 月初又回到了 80 以上。
这一次,超买是强势,不是见顶。
可是一次不说明问题。 表里列出了三个标的上所有「连续第 12 天高于 70」的时刻,一共 20 次:
- 20 根之后上涨 13 次、下跌 7 次,和「任意一天之后 20 天」比,看不出明显的偏向。
- BTC 9 次里 7 次继续涨,2020 年 11 月那两次之后 60 天翻了一倍;但 2017 年 12 月那次,60 天后跌了 39.60%。
- SPY 3 次里 2 次之后下跌,AAPL 2020 年 8 月那次 10 天跌了 10.41%。
20 次太少,分不出什么。要回答「超买之后该怎么做」,需要更多样本,也需要把趋势和震荡分开。这就是下面的动手部分。
七、同一条规则,按市场状态分开统计
规则和打分
两条经典的「反向用法」:
- 超卖买入:RSI(14) 从 30 以上跌破 30 的那一根收盘,做多
- 超买卖出:RSI(14) 从 70 以下升破 70 的那一根收盘,做空
打分用第 11 篇的办法:从信号那根 K 线的收盘价出发,上下各放一条 2 ATR 的线,看之后 20 根 K 线里先碰到顺着交易方向的那条(记 1)还是反方向的那条(记 0),都没碰到不计入。「顺向」列是记 1 的比例。
对照组是同一状态下的全部 K 线:假设每一根都按同一个方向入场,顺向的比例是多少。这样扣掉了「上升状态里做多本来就容易赢」的影响。p 值用第 10 篇的标签打乱:把「是不是信号」的标签在同一状态的 K 线里随机打乱 2000 次。
⚠️ 挨得很近的信号,之后 20 根的窗口会重叠,结果不完全独立,这种打乱检验的 p 值偏乐观。所以下面更看重几组数据的方向是否一致,而不是某一个 p 值。
两种状态
- 实时状态:第 11 篇的
market_state,每根 K 线只用当时已经确认的摆动点。为了让样本不至于太碎,「向上过渡」和「向下过渡」合并成「过渡」。 - 事后状态:同样的分类器,但假装每个摆动点在它出现的那一根就被确认了(把
confirmed_at换成time)。这就是你翻看历史图表时眼睛做的事:高点低点在哪里,一目了然。
ZigZag 阈值和第 11 篇相同:BTC 日线 10%、SPY 3%、AAPL 5%、BTC 4 小时线 4%、BTC 1 小时线 2%。
rng = np.random.default_rng(0)
simple = {"up": "上升", "down": "下降", "range": "震荡", "transition_up": "过渡", "transition_down": "过渡"}


def label_test(values, flag, n=2000):
    """flag 为真的组减去其余的平均值;把标签随机打乱 n 次,看差距不小于实际的比例(第 10 篇)。"""
    v, f = np.asarray(values, float), np.asarray(flag, bool)
    ok = ~np.isnan(v)
    v, f = v[ok], f[ok]
    if f.sum() == 0 or (~f).sum() == 0:
        return np.nan, np.nan
    observed = v[f].mean() - v[~f].mean()
    sims = np.array([v[p].mean() - v[~p].mean() for p in (rng.permutation(f) for _ in range(n))])
    return observed, (np.abs(sims) >= abs(observed)).mean()


def crossed(value, level, downward):
    """value 跌破(downward=True)或升破 level 的那一根。"""
    if downward:
        return (value < level) & (value.shift(1) >= level)
    return (value > level) & (value.shift(1) <= level)


def two_views(df, threshold):
    """实时的市场状态(第 11 篇),和「每个摆动点一出现就知道」的事后状态。"""
    close = df["close"]
    swings = X.zigzag(close, threshold)
    live = X.market_state(X.trend_state(swings, close, close), close).map(simple)
    hindsight_swings = swings.assign(confirmed_at=swings["time"])
    hindsight = X.market_state(X.trend_state(hindsight_swings, close, close), close).map(simple)
    return live, hindsight


def rule_by_state(df, views, flag, direction, which=("实时", "事后")):
    """每一根 K 线都按 direction 入场、看先碰到哪条 2 ATR 线;比较信号 K 线和同状态的全部 K 线。"""
    close = df["close"]
    atr = X.wilder_smooth(X.true_range(df["high"], df["low"], close), 14)
    ok = atr.notna() & views[0].notna() & views[1].notna()
    times = close.index[ok.to_numpy()]
    outcome = pd.Series(X.first_passage(close, df["high"], df["low"], atr, times, [direction] * len(times)), index=times)
    flag = flag.reindex(times).fillna(False).astype(bool)
    rows = []
    for s in ["上升", "震荡", "下降", "过渡"]:
        row = {"状态": s}
        for label, view in zip(("实时", "事后"), views):
            if label not in which:
                continue
            m = (view.reindex(times) == s).to_numpy()
            _, p = label_test(outcome[m], flag[m])
            hit = outcome[m][flag[m]]
            row |= {f"{label} 次数": int(hit.notna().sum()), f"{label} 顺向": hit.mean(),
                    f"{label} 同状态": outcome[m].mean(), f"{label} p": p}
        rows.append(row)
    return pd.DataFrame(rows)


datasets = [("BTC 日线", day, 0.10), ("SPY 日线", spy, 0.03), ("AAPL 日线", aapl, 0.05),
            ("BTC 4 小时线", h4, 0.04), ("BTC 1 小时线", h1, 0.02)]
views = {name: two_views(df, threshold) for name, df, threshold in datasets}
number = lambda v: "" if pd.isna(v) else f"{v:.3f}"


def show(rows):
    table = pd.DataFrame(rows)
    for column in [col for col in table.columns if col.endswith("次数")]:
        table[column] = table[column].astype(int)
    return table.to_string(index=False, float_format=number)


for title, level, downward, direction in [("超卖买入:RSI 跌破 30,做多", 30, True, 1), ("超买卖出:RSI 升破 70,做空", 70, False, -1)]:
    print(title)
    for name, df, threshold in datasets:
        table = rule_by_state(df, views[name], crossed(I.rsi(df["close"]), level, downward), direction)
        table.insert(0, "数据", name)
        print(table.to_string(index=False, float_format=number))
超卖买入
超卖买入:RSI 跌破 30,做多
    数据 状态  实时 次数  实时 顺向  实时 同状态  实时 p  事后 次数  事后 顺向  事后 同状态  事后 p
BTC 日线 上升      2  0.500   0.622 1.000      2  0.500   0.649 1.000
BTC 日线 震荡      1  1.000   0.394 0.382      3  1.000   0.417 0.071
BTC 日线 下降     20  0.500   0.552 0.661     20  0.500   0.463 0.821
BTC 日线 过渡      6  0.333   0.536 0.429      4  0.000   0.595 0.026
    数据 状态  实时 次数  实时 顺向  实时 同状态  实时 p  事后 次数  事后 顺向  事后 同状态  事后 p
SPY 日线 上升      4  0.750   0.558 0.636      4  0.750   0.580 0.647
SPY 日线 震荡      0    NaN   0.564   NaN      1  1.000   0.422 0.425
SPY 日线 下降     11  0.727   0.619 0.534     11  0.727   0.587 0.382
SPY 日线 过渡      7  0.571   0.655 0.704      6  0.500   0.766 0.145
     数据 状态  实时 次数  实时 顺向  实时 同状态  实时 p  事后 次数  事后 顺向  事后 同状态  事后 p
AAPL 日线 上升      9  0.667   0.636 1.000      9  0.667   0.671 1.000
AAPL 日线 震荡      2  1.000   0.436 0.179      3  1.000   0.250 0.021
AAPL 日线 下降      7  0.571   0.659 0.708      7  0.571   0.618 1.000
AAPL 日线 过渡      2  0.500   0.597 1.000      1  0.000   0.770 0.229
       数据 状态  实时 次数  实时 顺向  实时 同状态  实时 p  事后 次数  事后 顺向  事后 同状态  事后 p
BTC 4 小时线 上升     33  0.606   0.530 0.504     38  0.632   0.578 0.512
BTC 4 小时线 震荡     22  0.591   0.490 0.398     33  0.758   0.464 0.000
BTC 4 小时线 下降    142  0.380   0.487 0.007    139  0.367   0.427 0.151
BTC 4 小时线 过渡     56  0.482   0.511 0.691     43  0.326   0.541 0.004
       数据 状态  实时 次数  实时 顺向  实时 同状态  实时 p  事后 次数  事后 顺向  事后 同状态  事后 p
BTC 1 小时线 上升    124  0.395   0.503 0.016    136  0.471   0.557 0.050
BTC 1 小时线 震荡    108  0.519   0.488 0.568    153  0.647   0.462 0.000
BTC 1 小时线 下降    538  0.485   0.494 0.708    533  0.471   0.434 0.097
BTC 1 小时线 过渡    203  0.409   0.505 0.006    151  0.232   0.549 0.000
「次数」只算 20 根以内碰到了某一条线的信号。
先看实时状态(左半边):
- 日线上,震荡状态里几乎没有超卖信号:BTC 1 次,SPY 0 次,AAPL 2 次。第四节已经解释过:RSI 跌破 30 时,价格多半已经跌破了最近的低点,状态是「过渡」或「下降」。
- BTC 4 小时线和 1 小时线上样本够多:震荡状态里顺向 59.1%(22 次)和 51.9%(108 次),同状态全部 K 线是 49.0% 和 48.8%,p 值 0.398 和 0.568,和随便哪一根入场分不出来。
- 显著的几格都是「更差」:4 小时线下降状态 38.0% 对 48.7%(p 0.007)、1 小时线上升状态 39.5% 对 50.3%(p 0.016)、1 小时线过渡状态 40.9% 对 50.5%(p 0.006)。在这几种状态里,超卖之后更容易继续跌。
再看事后状态(右半边):
- BTC 4 小时线,震荡状态里超卖买入顺向 75.8%,对照 46.4%,p 0.000。
- BTC 1 小时线,64.7% 对 46.2%,p 0.000。
- AAPL 日线 3 次全对,对照只有 25.0%,p 0.021。
- 与此同时,事后的「过渡」状态里超卖买入惨不忍睹:1 小时线 23.2%,4 小时线 32.6%,BTC 日线 4 次全错。
这就是教科书那句话的来源:事后看图,震荡段里的超卖买入确实很准,趋势刚发动的过渡段里确实很差。 可是换成当时就能知道的状态,这个差别消失了。
超买卖出
超买卖出:RSI 升破 70,做空
    数据 状态  实时 次数  实时 顺向  实时 同状态  实时 p  事后 次数  事后 顺向  事后 同状态  事后 p
BTC 日线 上升     29  0.276   0.375 0.329     29  0.276   0.348 0.440
BTC 日线 震荡      3  0.333   0.606 0.557      5  0.600   0.583 1.000
BTC 日线 下降      2  0.000   0.445 0.519      3  0.333   0.534 0.598
BTC 日线 过渡     30  0.267   0.463 0.034     27  0.185   0.403 0.026
    数据 状态  实时 次数  实时 顺向  实时 同状态  实时 p  事后 次数  事后 顺向  事后 同状态  事后 p
SPY 日线 上升     42  0.452   0.442 1.000     42  0.452   0.420 0.753
SPY 日线 震荡      0    NaN   0.436   NaN      0    NaN   0.578   NaN
SPY 日线 下降      2  0.500   0.381 1.000      2  0.500   0.413 1.000
SPY 日线 过渡     19  0.316   0.345 0.802     19  0.316   0.234 0.431
     数据 状态  实时 次数  实时 顺向  实时 同状态  实时 p  事后 次数  事后 顺向  事后 同状态  事后 p
AAPL 日线 上升     40  0.425   0.364 0.489     40  0.425   0.329 0.243
AAPL 日线 震荡      0    NaN   0.564   NaN      2  1.000   0.750 1.000
AAPL 日线 下降      0    NaN   0.341   NaN      0    NaN   0.382   NaN
AAPL 日线 过渡     19  0.421   0.403 1.000     17  0.353   0.230 0.237
       数据 状态  实时 次数  实时 顺向  实时 同状态  实时 p  事后 次数  事后 顺向  事后 同状态  事后 p
BTC 4 小时线 上升    196  0.429   0.467 0.298    193  0.420   0.419 1.000
BTC 4 小时线 震荡     19  0.474   0.508 0.830     26  0.615   0.533 0.439
BTC 4 小时线 下降     22  0.455   0.512 0.660     25  0.520   0.573 0.684
BTC 4 小时线 过渡     74  0.392   0.487 0.096     67  0.328   0.456 0.032
       数据 状态  实时 次数  实时 顺向  实时 同状态  实时 p  事后 次数  事后 顺向  事后 同状态  事后 p
BTC 1 小时线 上升    627  0.458   0.492 0.079    624  0.450   0.437 0.492
BTC 1 小时线 震荡     88  0.409   0.509 0.071    130  0.608   0.536 0.106
BTC 1 小时线 下降     80  0.500   0.501 1.000     92  0.576   0.561 0.840
BTC 1 小时线 过渡    284  0.444   0.489 0.142    233  0.326   0.443 0.001
- 实时状态:17 次检验里只有 1 次 p < 0.05,BTC 日线过渡状态,顺向 26.7% 对 46.3%,也是「更差」,超买之后更容易继续涨。
- 事后状态:三组 BTC 数据的「过渡」状态都显著更差(18.5%、32.8%、32.6%),震荡状态里 4 小时线 61.5%、1 小时线 60.8%,高于对照,不过样本少、没有达到显著。
把两张表的实时状态合起来:36 次检验,4 次 p < 0.05,全是「信号比同状态的随便入场更差」,也就是超买超卖之后偏向延续而不是反转。如果全是随机的,平均会出现 1.8 次。这个偏向是不是真的,第八节扣掉同一个月的涨跌之后再看。
事后的状态为什么这么准
拿 BTC 1 小时线的超卖信号,把实时状态和事后状态交叉起来:
close = h1["close"]
atr = X.wilder_smooth(X.true_range(h1["high"], h1["low"], close), 14)
signal = crossed(I.rsi(close), 30, True) & atr.notna()
live, hindsight = (v[signal].rename(k) for k, v in zip(["实时", "事后"], views["BTC 1 小时线"]))
both = pd.concat([live, hindsight], axis=1).dropna()
both["顺向"] = X.first_passage(close, h1["high"], h1["low"], atr, both.index, [1] * len(both))
print("BTC 1 小时线的超卖买入信号:行是实时状态,列是事后状态")
print(pd.crosstab(both["实时"], both["事后"], margins=True, margins_name="合计").to_string())
print("先碰到上方 2 ATR 线的比例:")
print(both.pivot_table(index="实时", columns="事后", values="顺向", aggfunc="mean").to_string(float_format=number))
BTC 1 小时线的超卖买入信号:行是实时状态,列是事后状态
事后   上升   下降   过渡   震荡    合计
实时
上升  146    0    0    4   150
下降    0  599    0   12   611
过渡    0    0  191   57   248
震荡   16    6    0  104   126
合计  162  605  191  177  1135
先碰到上方 2 ATR 线的比例:
事后    上升    下降    过渡    震荡
实时
上升 0.400   NaN   NaN 0.250
下降   NaN 0.474   NaN 1.000
过渡   NaN   NaN 0.232 0.923
震荡 1.000 0.167   NaN 0.453
关键在第三行:实时状态是「过渡」的 248 个信号,事后有 57 个变成了「震荡」。这 57 个顺向比例 92.3%,留在「过渡」的 191 个只有 23.2%。
再往下查(14_oscillators.py 之外的一次核对):这 57 个里有 47 个,信号那根的收盘价正好就是之后被确认的 ZigZag 低点;留在「过渡」的 191 个里,一个都没有。
为什么会变?看一个例子:
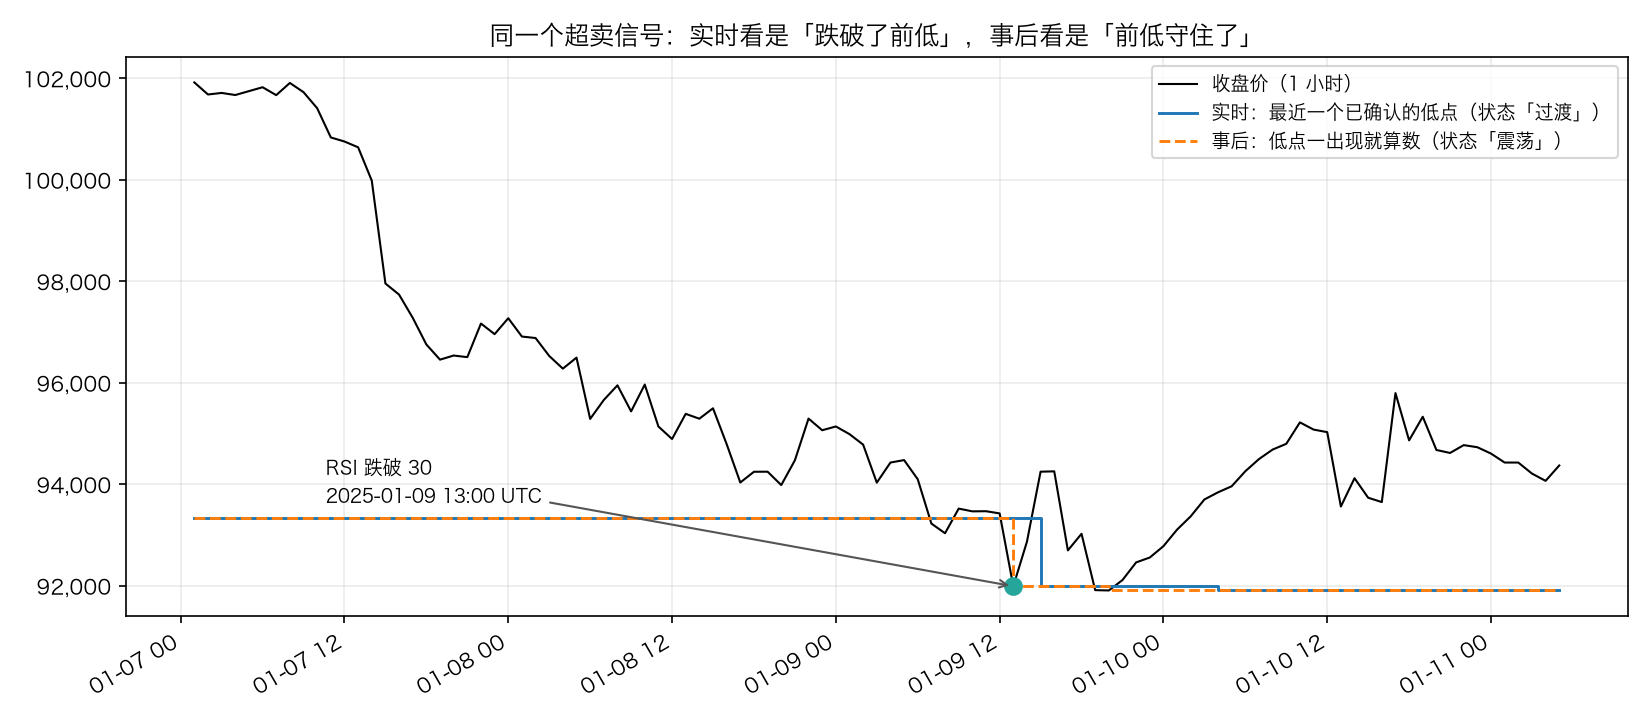
2025-01-09 13:00 UTC,RSI 跌破 30,收盘价 91,986.42 跌破了之前确认的低点 93,326.23,实时状态是「过渡」。
事后状态不一样。这根 K 线的收盘价正好是这一段的最低收盘,之后反弹超过了 2%,它成了一个 ZigZag 低点。事后状态假装这个低点在它出现的那一根就被确认了,于是「最近的低点」就是这根 K 线自己,收盘价没有低于它,状态就是「震荡」。
实时的蓝线要等价格从这里反弹 2%、确认了低点之后才更新,那是 2 个小时以后(15:00)的事。可在 13:00 收盘、要决定买不买的那一刻,没有人知道它会反弹。
换句话说:事后状态里的「震荡」,有一部分就是「这里是底」的另一种说法。 把事后状态当作条件去统计超卖买入,等于先知道了哪些超卖点是底,再说「在底部买入很准」。回到成绩单的比方:期末翻看成绩单,你把「考砸之后反弹」的那几周划成了「成绩起伏期」,把「考砸之后继续下滑」划成了「退步期」。划分本身就用到了后来的分数。
✋ 小检查 2
(a) 实时状态「下降」的 611 个超卖信号里,事后有 12 个变成了「震荡」,顺向 100%。按上面的机制,这 12 个信号有什么共同点?
(b) 第 11 篇的分类器在实时状态下,某根 K 线是「震荡」,而且 RSI(14) 刚升破 70。这根 K 线的收盘价和最近一个已确认的高点是什么关系?为什么这种情况很少见?
(c) 有人说:「我不用 ZigZag,我用 ADX 大于 25 判断趋势,所以没有事后划分的问题。」这句话对吗?他的统计还可能在哪一步用到未来的数据?
答案在文末。
八、换几种用法再看
趋势里的顺势用法
另一派的说法是:趋势里 RSI 不用 70 和 30,而是在上升趋势里等 RSI 回调到 40 附近买入,下降趋势里等反弹到 60 附近卖出。 用实时状态检验:
rows = []
for name, df, threshold in datasets:
    rr = I.rsi(df["close"])
    for label, flag, direction, state in [("上升状态里 RSI 跌破 40,做多", crossed(rr, 40, True), 1, "上升"),
                                          ("下降状态里 RSI 升破 60,做空", crossed(rr, 60, False), -1, "下降")]:
        table = rule_by_state(df, views[name], flag, direction, which=("实时",)).set_index("状态")
        rows.append({"数据": name, "规则": label} | table.loc[state].to_dict())
print(show(rows))
       数据                 规则  实时 次数  实时 顺向  实时 同状态  实时 p
   BTC 日线 上升状态里 RSI 跌破 40,做多     16  0.688   0.622 0.637
   BTC 日线 下降状态里 RSI 升破 60,做空     17  0.647   0.445 0.134
   SPY 日线 上升状态里 RSI 跌破 40,做多     34  0.676   0.558 0.170
   SPY 日线 下降状态里 RSI 升破 60,做空      2  0.000   0.381 0.525
  AAPL 日线 上升状态里 RSI 跌破 40,做多     16  0.562   0.636 0.607
  AAPL 日线 下降状态里 RSI 升破 60,做空      7  0.143   0.341 0.413
BTC 4 小时线 上升状态里 RSI 跌破 40,做多    153  0.490   0.530 0.321
BTC 4 小时线 下降状态里 RSI 升破 60,做空     98  0.500   0.512 0.839
BTC 1 小时线 上升状态里 RSI 跌破 40,做多    540  0.461   0.503 0.054
BTC 1 小时线 下降状态里 RSI 升破 60,做空    460  0.522   0.501 0.403
- 10 次检验,没有一次 p < 0.05。
- 日线上几个数字看起来不错,比如 SPY 上升状态里 RSI 跌破 40 做多,顺向 67.6% 对 55.8%,但只有 34 次,p 0.170。
- 样本最多的 BTC 1 小时线,540 次,46.1% 对 50.3%,p 0.054,方向是更差。
扣掉同一个月
第七节的实时状态表里,BTC 上超买超卖之后偏向延续。可能只是因为信号扎堆出现在大涨大跌的月份里:那个月本来就在跌,超卖之后继续跌、做多先碰到下方的线,一点都不奇怪。
用第 11 篇的办法:把每根 K 线的得分减去同一个月全部 K 线的平均得分,再做检验。
for name, df, threshold in datasets[3:]:
    close = df["close"]
    rr = I.rsi(close)
    atr = X.wilder_smooth(X.true_range(df["high"], df["low"], close), 14)
    times = close.index[(atr.notna() & rr.notna()).to_numpy()]
    month = times.tz_localize(None).to_period("M")
    for label, flag, direction in [("超卖买入", crossed(rr, 30, True), 1), ("超买卖出", crossed(rr, 70, False), -1)]:
        outcome = pd.Series(X.first_passage(close, df["high"], df["low"], atr, times, [direction] * len(times)), index=times)
        f = flag.reindex(times).to_numpy()
        _, p = label_test(outcome, f)
        _, p_month = label_test(outcome - outcome.groupby(month).transform("mean"), f)
        month_average = outcome.groupby(month).transform("mean")[f].mean()
        print(f"{name} {label}:{int(outcome[f].notna().sum())} 次,顺向 {outcome[f].mean():.1%},全部 K 线 {outcome.mean():.1%}(p {p:.3f});"
              f"信号所在月份的全部 K 线 {month_average:.1%},扣掉同月之后 p {p_month:.3f}")
BTC 4 小时线 超卖买入:254 次,顺向 44.9%,全部 K 线 50.8%(p 0.055);信号所在月份的全部 K 线 43.6%,扣掉同月之后 p 0.615
BTC 4 小时线 超买卖出:311 次,顺向 42.4%,全部 K 线 49.0%(p 0.021);信号所在月份的全部 K 线 41.5%,扣掉同月之后 p 0.755
BTC 1 小时线 超卖买入:973 次,顺向 46.1%,全部 K 线 49.7%(p 0.024);信号所在月份的全部 K 线 47.8%,扣掉同月之后 p 0.358
BTC 1 小时线 超买卖出:1079 次,顺向 45.3%,全部 K 线 49.8%(p 0.004);信号所在月份的全部 K 线 47.5%,扣掉同月之后 p 0.197
- 不分状态时,四个结果里三个 p < 0.05:信号之后顺向比全部 K 线低 3.6 到 6.6 个百分点。
- 但信号所在月份的全部 K 线,本来就只有 41.5% 到 47.8%。扣掉同月之后,p 值变成 0.197 到 0.755。
- 「超买超卖之后延续」主要是同一个月的方向,不是信号本身带来的。
⚠️ 日线不做这个扣除:一个月只有二三十根日线,信号那根本身的大涨大跌就会明显拉动整个月的平均值。
换成 Stochastic
把 RSI 换成 %K,升破 80 做空、跌破 20 做多,看震荡、上升、下降三种状态:
for title, column, level, downward, direction in [("%K 跌破 20,做多", "k", 20, True, 1), ("%K 升破 80,做空", "k", 80, False, -1)]:
    print(title)
    rows = []
    for name, df, threshold in datasets:
        s = I.stochastic(df["high"], df["low"], df["close"])
        table = rule_by_state(df, views[name], crossed(s[column], level, downward), direction).set_index("状态")
        rows += [{"数据": name, "状态": state} | table.loc[state].to_dict() for state in ["震荡", "上升", "下降"]]
    print(show(rows))
%K 跌破 20,做多
       数据 状态  实时 次数  实时 顺向  实时 同状态  实时 p  事后 次数  事后 顺向  事后 同状态  事后 p
   BTC 日线 震荡     21  0.524   0.394 0.244     21  0.571   0.417 0.183
   BTC 日线 上升     16  0.750   0.622 0.310     18  0.778   0.649 0.323
   BTC 日线 下降     26  0.462   0.552 0.441     29  0.414   0.463 0.707
   SPY 日线 震荡     12  0.583   0.564 1.000     12  0.500   0.422 0.769
   SPY 日线 上升     33  0.576   0.558 0.876     33  0.606   0.580 0.849
   SPY 日线 下降     10  0.500   0.619 0.511     10  0.500   0.587 0.749
  AAPL 日线 震荡     15  0.467   0.436 1.000     11  0.273   0.250 1.000
  AAPL 日线 上升     27  0.444   0.636 0.046     31  0.516   0.671 0.083
  AAPL 日线 下降     24  0.625   0.659 0.827     24  0.625   0.618 1.000
BTC 4 小时线 震荡     99  0.545   0.490 0.313    125  0.584   0.464 0.006
BTC 4 小时线 上升    143  0.462   0.530 0.107    144  0.507   0.578 0.086
BTC 4 小时线 下降    189  0.476   0.487 0.831    186  0.446   0.427 0.594
BTC 1 小时线 震荡    372  0.503   0.488 0.601    443  0.506   0.462 0.070
BTC 1 小时线 上升    498  0.466   0.503 0.097    528  0.545   0.557 0.598
BTC 1 小时线 下降    733  0.505   0.494 0.543    717  0.471   0.434 0.034
%K 升破 80,做空
       数据 状态  实时 次数  实时 顺向  实时 同状态  实时 p  事后 次数  事后 顺向  事后 同状态  事后 p
   BTC 日线 震荡     17  0.647   0.606 0.791     22  0.636   0.583 0.663
   BTC 日线 上升     43  0.349   0.375 0.739     41  0.317   0.348 0.730
   BTC 日线 下降     25  0.360   0.445 0.432     25  0.440   0.534 0.417
   SPY 日线 震荡      9  0.444   0.436 1.000     11  0.545   0.578 1.000
   SPY 日线 上升     78  0.410   0.442 0.629     76  0.395   0.420 0.741
   SPY 日线 下降      6  0.333   0.381 1.000      8  0.500   0.413 0.731
  AAPL 日线 震荡      6  0.500   0.564 1.000      7  0.857   0.750 0.680
  AAPL 日线 上升     76  0.421   0.364 0.326     77  0.403   0.329 0.165
  AAPL 日线 下降     10  0.300   0.341 1.000     11  0.364   0.382 1.000
BTC 4 小时线 震荡    114  0.535   0.508 0.564    133  0.594   0.533 0.163
BTC 4 小时线 上升    286  0.462   0.467 0.860    285  0.425   0.419 0.849
BTC 4 小时线 下降    111  0.495   0.512 0.774    110  0.564   0.573 0.833
BTC 1 小时线 震荡    405  0.486   0.509 0.365    500  0.562   0.536 0.256
BTC 1 小时线 上升   1015  0.476   0.492 0.311   1001  0.441   0.437 0.842
BTC 1 小时线 下降    457  0.501   0.501 1.000    467  0.559   0.561 0.920
- Stochastic 在实时震荡状态里有样本了:比如 BTC 1 小时线 %K 跌破 20 有 372 次,因为收盘价贴近 14 根的最低价,不需要跌破摆动低点。
- 实时状态:30 次检验,1 次 p < 0.05(AAPL 上升状态里跌破 20 做多,44.4% 对 63.6%,更差)。随机的话平均也会有 1.5 次。
- 事后状态又出现了熟悉的模式:BTC 4 小时线震荡状态里 %K 跌破 20 做多,58.4% 对 46.4%,p 0.006。
结论
- 按实时状态分开,「震荡市里超买卖出、超卖买入」在五组数据上都没有可测量的优势。 日线上,这类信号在实时震荡状态里几乎不出现。
- 趋势里「回调到 40、反弹到 60」的顺势用法,也没有可测量的优势。
- BTC 上超买超卖之后略偏延续,扣掉同一个月之后消失。
- 事后划分状态,会让震荡段里的反向用法看起来非常准,因为事后的「震荡」里混进了「这里是底(顶)」的信息。
⚠️ 这些结论只针对 RSI(14)、Stochastic(14, 3, 3)、70/30 和 80/20 的阈值、第 11 篇的状态定义、2 ATR / 20 根的打分方式。练习 3、4 会换参数。
九、talab.indicators:第四部分
新增了什么
| 函数 | 作用 |
|---|---|
rsi |
Wilder 的 RSI,和 TA-Lib 的 RSI 一致 |
stochastic |
Lane 的随机指标,%K 和 %D 两列,和 TA-Lib 的 STOCH(SMA)一致 |
run_length、two_views、rule_by_state 这些只在这一篇分析用的函数不放进模块,只在 docs/trade-analysis/analysis/14_oscillators.py 里。
代码
# ---------------------------------------------------------------------------
# 六、振荡器:RSI 和 Stochastic(第 14 篇)
# ---------------------------------------------------------------------------

def rsi(close: pd.Series, n: int = 14) -> pd.Series:
    """相对强弱指数(Wilder):平均上涨幅度占「平均上涨幅度 + 平均下跌幅度」的百分比,0 到 100。

    每根 K 线的变化 = 收盘价 - 前一根收盘价,上涨部分记为 gain,下跌部分(取正数)记为 loss。
    平均用 Wilder 平滑(alpha = 1 / n):第一个值是前 n 个变化的简单平均,所以第一个 RSI 出现在第 n + 1 根。
    RSI = 100 × 平均 gain ÷ (平均 gain + 平均 loss),和常见写法 100 - 100 ÷ (1 + RS) 完全相等。
    ⚠️ 价格连续 n 根一动不动时,分母是 0,RSI 没有定义;这里和 TA-Lib 一样记为 0。
    """
    _check_period(n)
    change = close.diff()
    average_gain = ema(change.clip(lower=0), n, alpha=1 / n)
    average_loss = ema((-change).clip(lower=0), n, alpha=1 / n)
    total = average_gain + average_loss
    return (100 * average_gain / total).where(total != 0, 0.0).where(total.notna())


def stochastic(high: pd.Series, low: pd.Series, close: pd.Series,
               k: int = 14, smooth_k: int = 3, d: int = 3) -> pd.DataFrame:
    """随机指标(Lane):收盘价在最近 k 根 K 线最高价和最低价之间的位置,0 到 100。

    原始 %K = 100 × (收盘价 - 最近 k 根的最低价) ÷ (最近 k 根的最高价 - 最近 k 根的最低价)
    k 列:原始 %K 的 smooth_k 根简单平均(smooth_k = 1 就是不平滑的「快速随机指标」)
    d 列:k 列的 d 根简单平均
    和 TA-Lib 的 STOCH(两个 matype 都取 0,即 SMA)一致:两列同时出现,都从第 k + smooth_k + d - 2 根开始。
    ⚠️ TA-Lib 的 STOCH 默认 k = 5,这里默认用更常见的 14、3、3。最近 k 根最高价等于最低价时记为 0,和 TA-Lib 一样。
    """
    for n in (k, smooth_k, d):
        _check_period(n)
    highest, lowest = high.rolling(k).max(), low.rolling(k).min()
    width = highest - lowest
    raw = (100 * (close - lowest) / width).where(width != 0, 0.0).where(width.notna())
    k_line = sma(raw, smooth_k)
    d_line = sma(k_line, d)
    return pd.DataFrame({"k": k_line.where(d_line.notna()), "d": d_line})
读一遍代码
rsi 没有自己写循环。close.diff() 得到变化,clip(lower=0) 取出 gain,(-change).clip(lower=0) 取出 loss,再交给第 12 篇的 ema(..., alpha=1 / n) 做 Wilder 平滑。diff 的第一个值是 NaN,ema 会跳过开头的 NaN,所以第一个平均值正好是前 n 个变化的简单平均,出现在第 n + 1 根。
最后一行的两个 where:分母为 0 的地方记 0(和 TA-Lib 一致),预热期保持 NaN。
stochastic 的 rolling(k).max() 和 rolling(k).min() 算出最近 k 根的最高价和最低价,包括这一根,所以不会用到未来。原始 %K 和 %K 各做一次 sma,最后一行 k_line.where(d_line.notna()) 让两列同时出现。
测试
def test_rsi_by_hand():
    x = hourly([10, 11, 10, 12, 13, 12, 14])
    r = I.rsi(x, 3)
    # 变化:+1、-1、+2、+1、-1、+2
    # 第 4 根:平均 gain (1+0+2)/3 = 1,平均 loss (0+1+0)/3 = 1/3,RSI = 100 × 1 / (4/3) = 75
    # 第 5 根:gain (2×1+1)/3 = 1,loss (2×1/3+0)/3 = 2/9,RSI = 100 × 1 / (11/9) = 81.818
    # 第 6 根:gain (2×1+0)/3 = 2/3,loss (2×2/9+1)/3 = 13/27,RSI = 100 × 18 / 31 = 58.065
    # 第 7 根:gain (2×2/3+2)/3 = 10/9,loss (2×13/27+0)/3 = 26/81,RSI = 100 × 90 / 116 = 77.586
    assert r.iloc[:3].isna().all()
    assert r.iloc[3:].tolist() == pytest.approx([75, 900 / 11, 1800 / 31, 9000 / 116])


def test_rsi_equals_signed_efficiency():
    rng = np.random.default_rng(14)
    x = hourly(100 * np.exp(np.cumsum(rng.normal(0.001, 0.02, 500))))
    change = x.diff()
    smooth = lambda s: I.ema(s, 14, alpha=1 / 14)
    # 上涨部分 = (|变化| + 变化) / 2,所以 RSI = 50 + 50 × 平滑的变化 ÷ 平滑的 |变化|
    np.testing.assert_allclose(I.rsi(x), 50 + 50 * smooth(change) / smooth(change.abs()), rtol=1e-12)


def test_oscillators_on_a_ramp_and_a_flat_line():
    ramp, flat = hourly(np.arange(50.0)), hourly(np.full(50, 7.0))
    assert I.rsi(ramp).dropna().to_numpy() == pytest.approx(100)
    assert (I.rsi(flat).dropna() == 0).all() and I.rsi(flat).notna().sum() == 36
    s = I.stochastic(ramp + 0.5, ramp - 0.5, ramp)
    # 最近 14 根:最高价 t + 0.5,最低价 t - 13.5,宽度 14;收盘价 t 比最低价高 13.5
    assert s["k"].dropna().to_numpy() == pytest.approx(100 * 13.5 / 14)


def test_stochastic_by_hand():
    close = hourly([5, 6, 7, 6, 8, 9, 7, 6])
    s = I.stochastic(close + 1, close - 1, close, k=3, smooth_k=2, d=2)
    # 原始 %K 从第 3 根开始:75、33.33、75、80、25、20
    # k 列(两根平均)从第 4 根开始:54.17、54.17、77.5、52.5、22.5;d 列(再两根平均)从第 5 根开始
    assert s.iloc[:4].isna().all().all()
    assert s["k"].iloc[4:].tolist() == pytest.approx([325 / 6, 77.5, 52.5, 22.5])
    assert s["d"].iloc[4:].tolist() == pytest.approx([325 / 6, 395 / 6, 65, 37.5])


def test_oscillators_stay_between_0_and_100_and_never_use_the_future():
    rng = np.random.default_rng(140)
    close = hourly(100 * np.exp(np.cumsum(rng.normal(0, 0.02, 400))))
    high, low = close * (1 + rng.uniform(0, 0.01, 400)), close * (1 - rng.uniform(0, 0.01, 400))
    r, s = I.rsi(close), I.stochastic(high, low, close)
    assert r.dropna().between(0, 100).all() and s.dropna().stack().between(0, 100).all()
    for k in [30, 200, 399]:
        pd.testing.assert_series_equal(I.rsi(close.iloc[:k]), r.iloc[:k])
        pd.testing.assert_frame_equal(I.stochastic(high.iloc[:k], low.iloc[:k], close.iloc[:k]), s.iloc[:k])


@pytest.mark.parametrize("n", [2, 14, 30])
def test_rsi_matches_talib(n):
    talib = pytest.importorskip("talib")
    rng = np.random.default_rng(n)
    x = hourly(50_000 * np.exp(np.cumsum(rng.normal(0, 0.03, 2000))))
    x.iloc[:3] = np.nan                                                    # 开头的缺失值也要一致
    theirs = talib.RSI(x.to_numpy(), n)
    assert (I.rsi(x, n).isna().to_numpy() == np.isnan(theirs)).all()
    np.testing.assert_allclose(I.rsi(x, n).to_numpy(), theirs, rtol=1e-12, atol=1e-8)


@pytest.mark.parametrize("k,smooth_k,d", [(14, 3, 3), (5, 3, 3), (14, 1, 3), (9, 5, 2)])
def test_stochastic_matches_talib(k, smooth_k, d):
    talib = pytest.importorskip("talib")
    rng = np.random.default_rng(k * 10 + d)
    close = hourly(50_000 * np.exp(np.cumsum(rng.normal(0, 0.03, 2000))))
    high, low = close * (1 + rng.uniform(0, 0.02, 2000)), close * (1 - rng.uniform(0, 0.02, 2000))
    ours = I.stochastic(high, low, close, k, smooth_k, d)
    for column, theirs in zip(["k", "d"], talib.STOCH(high.to_numpy(), low.to_numpy(), close.to_numpy(), k, smooth_k, 0, d, 0)):
        assert (ours[column].isna().to_numpy() == np.isnan(theirs)).all()
        np.testing.assert_allclose(ours[column].to_numpy(), theirs, rtol=1e-12, atol=1e-8)
test_rsi_by_hand:第三节的手算,分数写成精确值。test_rsi_equals_signed_efficiency:第四节的恒等式,在随机价格上误差小于 1e-12。test_oscillators_on_a_ramp_and_a_flat_line:直线上 RSI 恒等于 100、%K 恒等于 96.43;平的价格 RSI 记为 0,而且 50 根里有 36 个值(14 根预热)。test_stochastic_by_hand:第五节的手算,包括两列同时出现。test_oscillators_stay_between_0_and_100_and_never_use_the_future:取值在 0 到 100 之间;截断 3 次,前 k 行必须和全部数据算出的一致。test_rsi_matches_talib:3 个周期,开头 3 个 NaN,和 TA-Lib 逐个数字一致,包括 NaN 的位置。test_stochastic_matches_talib:4 组参数,包括 smooth_k = 1 的快速随机指标。
pytest -q
........................................................................ [ 61%]
..............................................                           [100%]
118 passed in 0.61s
没装 TA-Lib 时,结果是 93 passed、25 skipped。
十、常见误用
1. 把 RSI 高于 70 读成「价格太高了」。 RSI 只量最近这段路走得直不直,等于 50 + 50 × 带方向的效率比。强趋势里它必然长期高于 70。
2. 把「连续很多天超买」当作罕见的信号。 打乱顺序、没有任何趋势记忆的价格,95% 的情况下也会出现 2 到 11 段连续 12 天以上高于 70。
3. 在事后划好的震荡段里统计超卖买入。 BTC 4 小时线上,事后震荡状态里顺向 75.8%,实时状态只有 59.1%,而且和同状态的随便入场分不开。事后的「震荡」里混进了「这里是底」的信息。
4. 把「只在震荡市用超买超卖」当作一条可以执行的规则。 按实时状态执行,日线上 RSI 跌破 30 时几乎不在震荡状态里,这条规则一年也触发不了几次。
5. 用 pandas 的 ewm 或 14 根简单平均算 RSI,再去和交易软件对账。
pandas 写法开头差 30 个点,要 100 根左右才对上;简单平均是 Cutler 的 RSI,8.5% 的日子超买判断不同。
6. 直接调 talib.STOCH(high, low, close)。
它的默认参数是 (5, 3, 3),不是常说的 (14, 3, 3)。
7. 在大涨大跌的月份里统计信号,忘了扣掉那个月本来的方向。 BTC 1 小时线超买卖出,不分状态时 p 0.004,扣掉同一个月之后 p 0.197。
十一、这一篇能回答什么,不能回答什么
| 这一篇能帮你回答 | 这一篇不能回答 |
|---|---|
| RSI 和 Stochastic 的每个数字怎么算,和 TA-Lib 是否一致 | RSI(14)、70/30 是不是最好的参数(练习 3) |
| RSI 高于 70 在数学上等于什么,为什么强趋势里会钝化 | 这一次的强势会持续多久 |
| 按实时状态分开后,反向用法和顺势用法在这五组数据上有没有优势 | 换成别的状态定义、别的打分方式,结论是否一样(练习 4) |
| 事后划分状态会让统计结果虚高多少,机制是什么 | 你在实时交易时,能不能比分类器更早认出震荡和趋势 |
十二、小结
-
RSI = 100 × 平均 gain ÷ (平均 gain + 平均 loss),平均用 Wilder 平滑,初始值是前 n 个变化的简单平均,第一个值在第 n + 1 根。pandas
ewm写法和 Cutler 写法都不是它。 -
RSI = 50 + 50 × 平滑的净变化 ÷ 平滑的总路程,是恒等式。 RSI 就是带方向的效率比;换成收益率,RSI ≈ 50 + 62.7 × μ/σ,三个标的上相关系数 0.99。RSI = 70 大约是平均涨幅等于波动的 0.32 倍。
-
钝化是定义出来的。 强趋势就是 μ/σ 大的行情,RSI 必然长期高于 70。连续 12 天高于 70,在打乱顺序的价格里也很常见。
-
Stochastic 是收盘价在最近 k 根区间里的位置。 慢速 (14, 3, 3) 的 %K 和 %D 在 TA-Lib 里同时出现;TA-Lib 默认 k = 5。它和 RSI 的相关系数 0.82 到 0.85,更容易到 80 以上。
-
实时状态里,RSI 的极端值几乎不在震荡状态出现。 超买在上升和向上过渡里,超卖在下降和向下过渡里。
-
同一条超卖买入、超买卖出规则,按实时状态分开,在五组数据上都没有可测量的优势。 36 次检验 4 次显著,全是偏向延续;BTC 上的延续扣掉同一个月之后消失。顺势用法(40 买、60 卖)和 Stochastic 版本也一样。
-
按事后状态分开,震荡段里的反向用法看起来非常准:BTC 4 小时线 75.8%、1 小时线 64.7%。原因是事后的「震荡」里有一部分就是「这里是底」。
-
决策点那次超买是强势:选 C 在 2 月 22 日卖出,错过了之后 40% 的上涨。但三个标的上 20 次「连续第 12 天」,之后涨跌参半,一次说明不了什么。
最后回到成绩单。RSI 高,说明这个学生最近连续进步(第四节),它不会告诉你他是开窍了还是超常发挥。期末翻成绩单时你分得很清楚(第七节右半边),学期中间你分不清(第七节左半边)。能分清的那一刻,你用的已经是后来的分数了。
下一篇是第 15 篇:波动率:ATR 与布林带。布林带收窄到一年来最窄,你知道要有大行情了,但不知道方向。波动率能帮你定止损、定仓位、判断市场状态吗?主线策略也会加上 ATR 止损。
练习
练习 1(手算) 价格依次是 20、21、23、22、22、25、24,用 RSI(3)。
- (a) 算出每一根的平均 gain、平均 loss 和 RSI。第一个 RSI 在第几根?
- (b) 第 5 根价格没变(22 到 22)。这一根的变化对平均 gain、平均 loss 各有什么影响?RSI 为什么还是变了?
- (c) 如果改用 Cutler 的写法(3 根简单平均),最后一根的 RSI 是多少?
练习 2(推导) 第四节从恒等式推出了 RSI ≈ 50 + 62.7 × μ/σ。
- (a) 对正态分布 N(0, σ²),证明 E|X| = σ√(2/π)。
- (b) 如果收益率服从自由度为 3 的 t 分布(按同样的标准差缩放),斜率会变大还是变小?用
numpy模拟验证,并和 BTC 的 66.8 对比。 - (c) 用第 12 篇的平均滞后公式,算出 alpha = 1/14 的 Wilder 平滑平均滞后几根。「RSI 量的是最近两三周」这个说法对吗?
练习 3(数据) 第八节的结论只针对 RSI(14) 和 70/30。
- (a) 换成 RSI(2) < 10 做多、持有 5 根,在 SPY、AAPL、BTC 日线上和全部日子比较 5 根后的收益。
- (b) (a) 里如果 SPY 显著,去掉 2020 年再做一次。和第 5 篇「去掉 2020 年后滞后 1 天自相关不显著」对照。
- (c) 一共试了几组参数?你找到的最小 p 值说明了什么?
练习 4(数据)
第七节的状态用的是第 11 篇的 market_state。
- (a) 换成第 8 篇的 ADX:ADX > 25 算趋势,否则算震荡,重做超卖买入的实时版本。
- (b) 再做一个「事后 ADX」:用 ADX 往后平移 10 根的值来分状态。事后版本的结果虚高了吗?
- (c) 把打分从 2 ATR 换成 1 ATR 和 3 ATR,实时结论变不变?
练习 5(编程)
写一个 williams_r(high, low, close, n=14)(Williams %R)。
- (a) 证明它等于快速随机指标的原始 %K 减 100。
- (b) 用
talib.WILLR写一个对账测试。
练习 6(思考) 第四节说 SPY 连续 12 天以上高于 70 的段数比打乱后还少。
- (a) 这和第 5 篇「SPY 高低点状态偏反转」、第 13 篇「状态检验与打乱无异」是矛盾还是一致?
- (b) 如果一个指标在打乱后的价格上表现得和真实价格一样,它还能不能帮你交易?分「用来预测」和「用来描述」两种情况回答。
小检查答案
小检查 1
(a) RSI = 100:每根都涨,平均 loss 是 0。原始 %K = 100 × 13.5 ÷ 14 = 96.43:最近 14 根的最高价是今天收盘价 + 0.5,最低价是 13 天前的收盘价 - 0.5,宽度 14,今天收盘价比最低价高 13.5。
(b) 大约在 65.0 到 68.3 之间来回跳,不会高于 70。 平均 gain 约为 (2 + 0) ÷ 2 = 1,平均 loss 约为 (0 + 1) ÷ 2 = 0.5,RSI ≈ 100 × 1 ÷ 1.5 = 66.7。精确地说,刚涨完 2 的那根 RSI = 28/41 ≈ 68.29,刚跌完 1 的那根 RSI = 26/40 = 65.0。价格每两根净涨 1,效率比 1/3,RSI = 50 + 50/3 = 66.7。
(c) gain 占 80%。净变化 ÷ 总路程 = (80 - 20) ÷ 100 = 0.6,也就是 (80 - 50) ÷ 50。
小检查 2
(a) 大部分信号的收盘价,正好是之后被确认的 ZigZag 低点,而且比上一个低点高。 核对下来 12 个里有 9 个是这样。实时状态下,这个低点还没被确认,最近两个低点仍在降低、高点也在降低,所以是「下降」。事后状态假装这个低点当场就被确认:低点变成抬高了,高点还在降低,方向不一致,收盘价又没有低于最近的低点(就是它自己),状态就成了「震荡」。换句话说,事后状态已经知道这里是一个「更高的低点」,之后先碰到上方的线也就不奇怪了。
(b) 收盘价不高于最近一个已确认的高点(否则是「向上过渡」),而且高点和低点方向不一致。RSI 刚升破 70 意味着最近一段涨得又多又稳,价格通常已经越过了最近的高点,所以这种组合很少见。它能出现,一般是最近确认的那个高点离得很远、很高。
(c) 不完全对。 ADX 本身只用当时的数据,这一点比事后画的摆动点好。但如果他是先看了图、再挑「ADX 大于 25」这个阈值和 14 这个周期,或者按统计结果回头调整了阈值,未来的数据就在参数选择这一步进来了(第 13 篇误用 7)。练习 4 (b) 会看到,把状态用的数据往后挪几根,结果能虚高多少。