| 本篇位置 | 第三部分「技术指标」的最后一篇,包含实验二。ATR 用到第 8 篇的真实波幅和 Wilder 平滑,打乱检验沿用第 9、11 篇,主线策略接第 12 篇的 v0 |
| 用到的数据 | BTCUSDT 现货日线,以及用 1 分钟线合成的 4 小时线和 1 小时线(2017-08 至 2026-08);SPY、AAPL 日线(2016-09 至 2026-09) |
| 动手 | talab.indicators 第五部分:ATR、NATR、布林带,附 12 个测试;主线策略 v1;实验二:指标库对账和相关性矩阵 |
| 读完你能 | 手算 ATR 和布林带;说清楚 1 个 ATR 大约是几个标准差、收口之后的「大行情」有多少是真的;用 ATR 定止损和仓位;判断两个指标是不是本质相同 |
一、先做一个决定
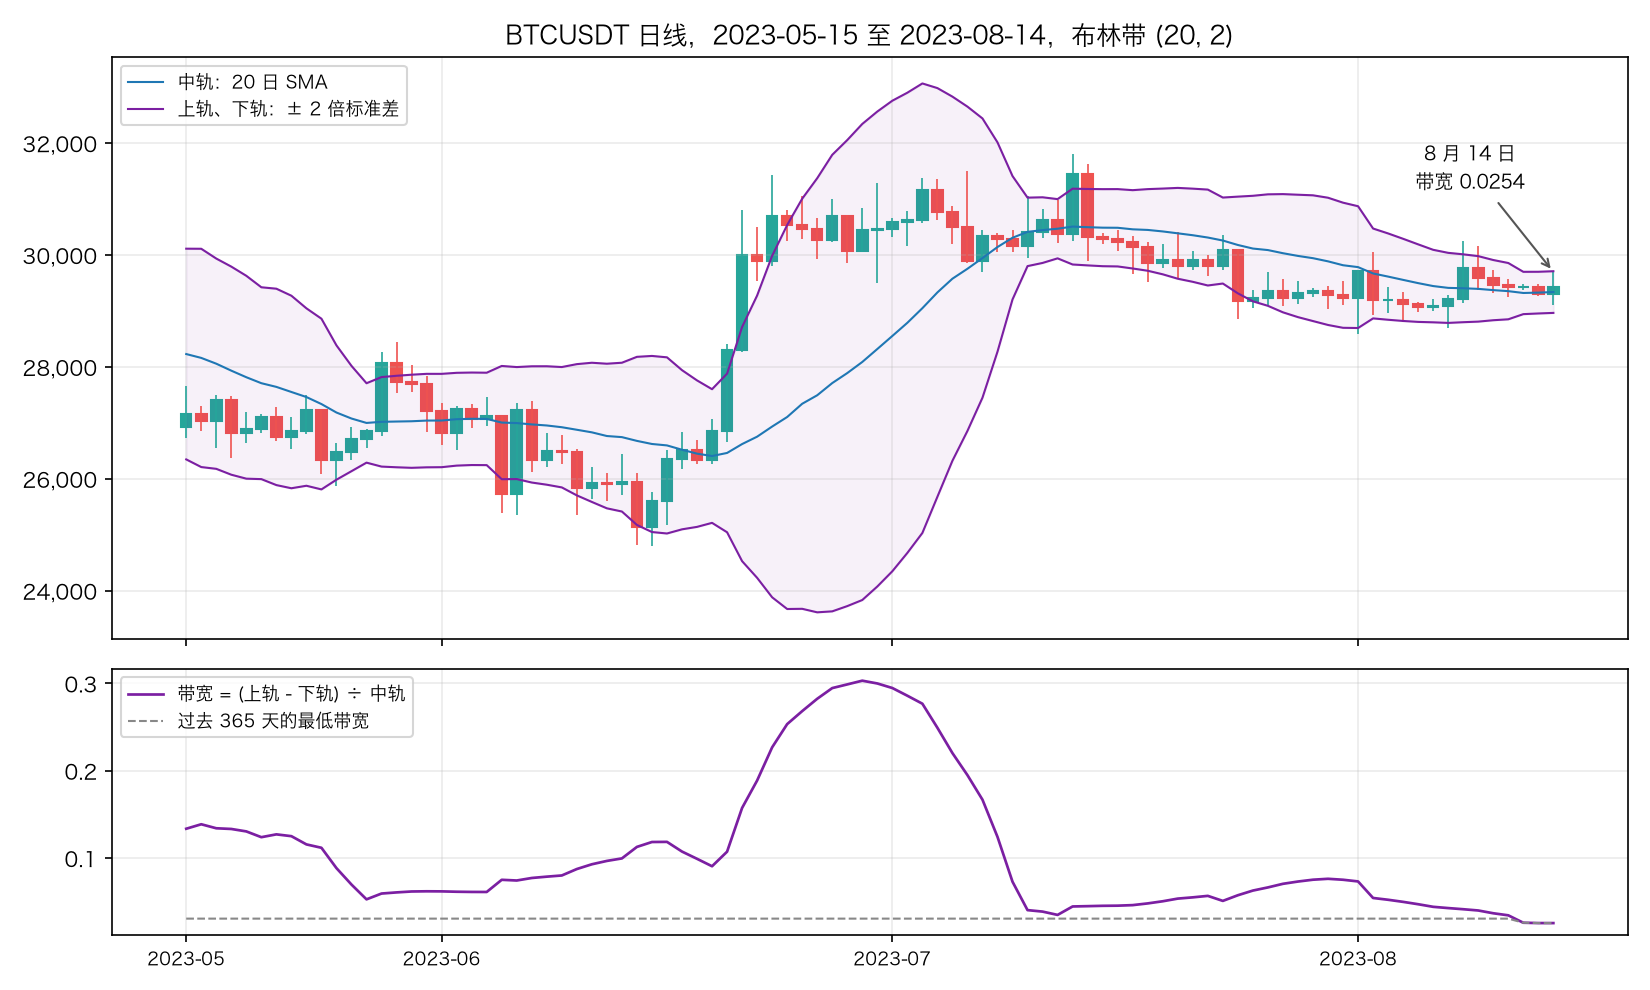
现在是 2023 年 8 月 14 日 UTC 收盘。
BTC 收在 29,431。过去 20 天,收盘价最高 29,770,最低 29,072,只差了 2.4%。对一个年化波动率常年在 50% 以上的资产来说,这几乎是一动不动。
布林带(20, 2)的带宽,也就是上下轨之间的距离占中轨的比例,已经连续三天是 365 天里最窄的,只有 0.0254。ATR 占价格的比例(NATR)是 1.86%,是 1 月以来最低。
c = day["close"]
band = I.bollinger(c)
year_low = band["bandwidth"].rolling(365).min()
t = pd.Timestamp("2023-08-14", tz="UTC")
table = pd.concat([day[["high", "low", "close"]], I.atr(day["high"], day["low"], c).rename("atr"),
                   I.natr(day["high"], day["low"], c).rename("natr"), band[["upper", "lower", "bandwidth"]],
                   year_low.rename("365 天最低带宽")], axis=1)
print(table.loc["2023-08-01":"2023-08-14"].round({"high": 0, "low": 0, "close": 0, "atr": 0, "natr": 2, "upper": 0, "lower": 0,
                                                  "bandwidth": 4, "365 天最低带宽": 4}).to_string())
natr = I.natr(day["high"], day["low"], c)
before = natr.loc[:"2023-08-11"]
print(f"8 月 14 日 NATR {natr[t]:.2f}%,上一次不高于它是 {before[before <= natr[t]].index[-1].date()};"
      f"带宽 {band['bandwidth'][t]:.4f},8 月 11 日之前 365 天里最窄的是 {band['bandwidth'].loc[:'2023-08-11'].iloc[-365:].idxmin().date()}"
      f"({band['bandwidth'].loc[:'2023-08-11'].iloc[-365:].min():.4f});2017 年 8 月以来最窄的是 "
      f"{band['bandwidth'].loc[:'2023-08-11'].idxmin().date()}({band['bandwidth'].loc[:'2023-08-11'].min():.4f})")
print(f"过去 20 天收盘价最高 {c.loc[:t].iloc[-20:].max():,.2f},最低 {c.loc[:t].iloc[-20:].min():,.2f},"
      f"相差 {c.loc[:t].iloc[-20:].max() / c.loc[:t].iloc[-20:].min() - 1:.2%}")
                              high      low    close    atr  natr    upper    lower  bandwidth  365 天最低带宽
time
2023-08-01 00:00:00+00:00  29739.0  28586.0  29706.0  663.0  2.23  30871.0  28694.0     0.0731     0.0305
2023-08-02 00:00:00+00:00  30048.0  28928.0  29186.0  695.0  2.38  30472.0  28865.0     0.0541     0.0305
2023-08-03 00:00:00+00:00  29433.0  28968.0  29194.0  679.0  2.33  30384.0  28841.0     0.0521     0.0305
2023-08-04 00:00:00+00:00  29333.0  28808.0  29114.0  668.0  2.29  30288.0  28820.0     0.0497     0.0305
2023-08-05 00:00:00+00:00  29152.0  28979.0  29072.0  633.0  2.18  30189.0  28803.0     0.0470     0.0305
2023-08-06 00:00:00+00:00  29205.0  28992.0  29088.0  603.0  2.07  30092.0  28795.0     0.0440     0.0305
2023-08-07 00:00:00+00:00  29277.0  28701.0  29211.0  601.0  2.06  30037.0  28785.0     0.0426     0.0305
2023-08-08 00:00:00+00:00  30244.0  29146.0  29770.0  636.0  2.14  30011.0  28797.0     0.0413     0.0305
2023-08-09 00:00:00+00:00  30160.0  29377.0  29582.0  647.0  2.19  29978.0  28808.0     0.0398     0.0305
2023-08-10 00:00:00+00:00  29738.0  29320.0  29456.0  630.0  2.14  29909.0  28833.0     0.0366     0.0305
2023-08-11 00:00:00+00:00  29565.0  29252.0  29426.0  608.0  2.07  29856.0  28849.0     0.0343     0.0305
2023-08-12 00:00:00+00:00  29481.0  29382.0  29430.0  571.0  1.94  29698.0  28942.0     0.0258     0.0258
2023-08-13 00:00:00+00:00  29475.0  29272.0  29304.0  545.0  1.86  29699.0  28954.0     0.0254     0.0254
2023-08-14 00:00:00+00:00  29695.0  29102.0  29431.0  548.0  1.86  29709.0  28964.0     0.0254     0.0254
8 月 14 日 NATR 1.86%,上一次不高于它是 2023-01-11;带宽 0.0254,8 月 11 日之前 365 天里最窄的是 2023-01-04(0.0305);2017 年 8 月以来最窄的是 2023-01-04(0.0305)
过去 20 天收盘价最高 29,770.42,最低 29,072.13,相差 2.40%
交易群里的说法都一样:布林带收口,大行情要来了。可是往上还是往下,没人说得清。
你会怎么做?
- A. 两边挂单:上轨上方挂买入止损单,下轨下方挂卖出止损单,哪边先突破就跟哪边
- B. 等突破确认:等收盘价真的收在带外,再顺着方向进场
- C. 在带里高抛低吸:这么窄的带说明市场没方向,碰上轨卖、碰下轨买
先写下你的选择。 第六节揭晓之后的走势,第七节看「收口之后有大行情」这句话在全部历史上有多少是真的。
二、天气预报
打个比方
想象你在海边开一家出租帆船的小店,每天早上都要看天气预报。
- 价格的波动像风。 有时候风平浪静,有时候大风大浪。
- ATR 像是「最近两周平均每天的最大风力」。 它不管风往哪个方向吹,只管吹得多猛。
- 布林带像是按最近的风力画出来的「正常浪高范围」。 风大的时候范围画得宽,风小的时候画得窄。
- 波动率聚集就是:大风天总是一连好几天,平静的日子也是一连好几天。昨天风大,今天风大的可能性就高。
- 收口就是连续很多天风平浪静。老渔民会说:「暴风雨前的宁静」。
天气预报有两件事做得很不一样:明天风大不大,预报得相当准;明天风往哪边吹,准得多。价格也是这样(第 5 篇):涨跌方向几乎无法从昨天预测,波动大小却可以。
这门手艺有三个用处:
- 决定帐篷的桩打多深(止损放多远):风大的日子桩要打深一点,不然一阵普通的风就把帐篷掀了。
- 决定出海带多少货(仓位多大):风大的时候少带一点,翻船损失小。
- 决定今天适不适合出海(判断市场状态)。
至于「暴风雨前的宁静」,第七节会发现,它有一半是真的,另一半是任何一段平静之后都会发生的事。
三、ATR:为什么要算上跳空
真实波幅
第 8 篇在讲 ADX 时已经用过真实波幅(True Range, TR):
TR = max(最高价 - 最低价,|最高价 - 昨天收盘价|,|最低价 - 昨天收盘价|)
为什么不直接用「最高价 - 最低价」?看一个例子:
small = pd.DataFrame({"open": [100.0, 104, 97, 99], "high": [102.0, 106, 98, 101], "low": [99.0, 103, 94, 98],
                      "close": [101.0, 105, 95, 100]})
small["最高 - 最低"] = small["high"] - small["low"]
small["|最高 - 昨收|"] = (small["high"] - small["close"].shift(1)).abs()
small["|最低 - 昨收|"] = (small["low"] - small["close"].shift(1)).abs()
small["真实波幅"] = X.true_range(small["high"], small["low"], small["close"])
small["ATR(2)"] = I.atr(small["high"], small["low"], small["close"], 2)
print(small.to_string())
    open   high    low  close  最高 - 最低  |最高 - 昨收|  |最低 - 昨收|  真实波幅  ATR(2)
0  100.0  102.0   99.0  101.0      3.0        NaN        NaN   NaN     NaN
1  104.0  106.0  103.0  105.0      3.0        5.0        2.0   5.0     NaN
2   97.0   98.0   94.0   95.0      4.0        7.0       11.0  11.0     8.0
3   99.0  101.0   98.0  100.0      3.0        6.0        3.0   6.0     7.0
- 第 2 根:开盘就从 101 跳到 104,当天只在 103 到 106 之间波动了 3 块钱。可是拿着这只股票过夜的人,从昨天收盘到今天最高点,实实在在经历了 5 块钱的波动。TR = 5。
- 第 3 根:跳空低开,从昨天收盘 105 到今天最低 94,一共 11 块钱。「最高 - 最低」只有 4,漏掉了一大半。TR = 11。
真实波幅量的是「持有过夜的人经历了多大的波动」。跳空的风险是真的,只是没有发生在交易时段里。
三个标的上跳空有多重要
for name, df in markets.items():
    tr = X.true_range(df["high"], df["low"], df["close"])
    gap = (tr - (df["high"] - df["low"]))[tr.notna()]
    share = gap / tr[tr.notna()]
    print(f"{name}:真实波幅大于「最高 - 最低」的日子占 {(gap > 1e-9).mean():.1%},跳空部分占全部真实波幅的 {gap.sum() / tr.sum():.1%};"
          f"跳空占比最大的三天 " + "、".join(f"{d.date()}({v:.0%})" for d, v in share.nlargest(3).items()))
SPY:真实波幅大于「最高 - 最低」的日子占 38.7%,跳空部分占全部真实波幅的 11.0%;跳空占比最大的三天 2017-12-18(70%)、2026-04-08(69%)、2021-06-24(68%)
AAPL:真实波幅大于「最高 - 最低」的日子占 34.5%,跳空部分占全部真实波幅的 9.4%;跳空占比最大的三天 2019-01-03(77%)、2025-04-03(72%)、2024-05-03(69%)
BTC:真实波幅大于「最高 - 最低」的日子占 0.4%,跳空部分占全部真实波幅的 0.0%;跳空占比最大的三天 2017-10-08(1%)、2018-02-09(1%)、2019-06-21(0%)
- SPY、AAPL:超过三分之一的日子有跳空,跳空贡献了全部真实波幅的 9% 到 11%。个别日子跳空占到七成以上,比如 AAPL 的 2019-01-03(前一天盘后下调营收预期)、2024-05-03(前一天盘后发布财报和回购计划)。
- BTC:24 小时交易,Binance 日线的开盘价基本就是前一根的收盘价,跳空几乎不存在,真实波幅等于「最高 - 最低」。
ATR
ATR(Average True Range,平均真实波幅) 和 RSI 一样出自 Wilder 1978 年的书:真实波幅的 n 根 Wilder 平滑,n 通常是 14。
回到上面的表:ATR(2) 的第一个值在第 3 根,是前两个真实波幅的平均 (5 + 11) ÷ 2 = 8;第 4 根 = 8 + (6 - 8) ÷ 2 = 7。真实波幅从第 2 根才有,所以 ATR(n) 的第一个值在第 n + 1 根,和 TA-Lib 一致。
ATR 的单位是价格。BTC 从 4,000 涨到 120,000,ATR 也会跟着大 30 倍。所以跨时间、跨标的比较时,用 NATR(归一化 ATR) = 100 × ATR ÷ 收盘价。
1 个 ATR 是几个标准差
第 5 篇用收益率的标准差衡量波动,这一篇用 ATR。两者是什么关系?
概率论里有一个经典结果:一个没有漂移的连续随机游走,一段时间里「最高点 - 最低点」的平均值,是这段时间标准差的 2√(2/π) ≈ 1.596 倍。
print(f"没有跳空的连续随机游走:一天的 最高 - 最低 平均是标准差的 2√(2/π) = {2 * np.sqrt(2 / np.pi):.3f} 倍")
for name, df in markets.items():
    close = df["close"]
    sd = np.log(close).diff().rolling(20).std()
    hl = ((df["high"] - df["low"]) / close).rolling(20).mean()
    ratio = (I.natr(df["high"], df["low"], close) / 100 / sd).dropna()
    print(f"{name}:NATR ÷ 20 天收益率标准差 中位数 {ratio.median():.2f}(25% ~ 75%:{ratio.quantile(0.25):.2f} ~ {ratio.quantile(0.75):.2f});"
          f"不含跳空的 (最高 - 最低)/收盘 ÷ 标准差 中位数 {(hl / sd).median():.2f}")
没有跳空的连续随机游走:一天的 最高 - 最低 平均是标准差的 2√(2/π) = 1.596 倍
SPY:NATR ÷ 20 天收益率标准差 中位数 1.40(25% ~ 75%:1.25 ~ 1.55);不含跳空的 (最高 - 最低)/收盘 ÷ 标准差 中位数 1.24
AAPL:NATR ÷ 20 天收益率标准差 中位数 1.41(25% ~ 75%:1.27 ~ 1.60);不含跳空的 (最高 - 最低)/收盘 ÷ 标准差 中位数 1.29
BTC:NATR ÷ 20 天收益率标准差 中位数 1.59(25% ~ 75%:1.38 ~ 1.81);不含跳空的 (最高 - 最低)/收盘 ÷ 标准差 中位数 1.58
- BTC:1.59,和理论值 1.596 几乎一样。BTC 全天连续交易,最接近「连续随机游走」。
- SPY、AAPL:1.40 左右。 如果不算跳空,只有 1.24、1.29。原因是日收益率的标准差包含了隔夜的变动,而「最高 - 最低」只覆盖交易时段。真实波幅把跳空加回来一部分,比值就回到了 1.4。
记住一个经验数:1 个 ATR ≈ 1.4 到 1.6 个日收益率标准差。 所以常说的「3 ATR 止损」,大约是 4 到 5 个日标准差。
✋ 小检查 1
(a) 昨天收盘 100,今天最高 97、最低 95。真实波幅是多少?「最高 - 最低」漏掉了多少?
(b) SPY 某段时间的 NATR 是 1.2%。它的日收益率标准差大约是多少?年化波动率大约是多少?
(c) 为什么 BTC 日线的真实波幅几乎总是等于「最高 - 最低」?如果改用美国东部时间 16:00 切日线,还是这样吗?
答案在文末。
四、布林带
定义
布林带(Bollinger Bands)由 John Bollinger 在 1980 年代提出,由三条线组成:
中轨 = 最近 n 个收盘价的简单平均(n 通常是 20)
上轨 = 中轨 + k × 最近 n 个收盘价的标准差(k 通常是 2)
下轨 = 中轨 - k × 同一个标准差
还有两个派生指标:
%b = (收盘价 - 下轨) ÷ (上轨 - 下轨),下轨是 0,上轨是 1
带宽 = (上轨 - 下轨) ÷ 中轨
⚠️ 注意这里的标准差是价格本身在 20 天里的离散程度,不是收益率的标准差。价格一路上涨时,20 个收盘价本来就分得很开,带也就宽。
手算一遍
收盘价 10、11、12、11、13、14,n = 4,k = 2:
x = pd.Series([10.0, 11, 12, 11, 13, 14])
small = I.bollinger(x, n=4, k=2)
small.insert(0, "收盘价", x)
small.insert(2, "总体标准差", x.rolling(4).std(ddof=0))
print(small.round(4).to_string())
wrong = c.rolling(20).mean() + 2 * c.rolling(20).std()
print(f"BTC 日线:用 pandas 默认的 rolling().std()(除以 n - 1),上轨最多高出 {(wrong - band['upper']).max():,.2f},"
      f"带宽平均宽了 {((wrong - c.rolling(20).mean()) / (band['upper'] - band['middle'])).mean() - 1:.2%}")
    收盘价  middle   总体标准差    upper    lower  percent_b  bandwidth
0  10.0     NaN     NaN      NaN      NaN        NaN        NaN
1  11.0     NaN     NaN      NaN      NaN        NaN        NaN
2  12.0     NaN     NaN      NaN      NaN        NaN        NaN
3  11.0   11.00  0.7071  12.4142   9.5858     0.5000     0.2571
4  13.0   11.75  0.8292  13.4083  10.0917     0.8769     0.2823
5  14.0   12.50  1.1180  14.7361  10.2639     0.8354     0.3578
BTC 日线:用 pandas 默认的 rolling().std()(除以 n - 1),上轨最多高出 495.66,带宽平均宽了 2.60%
- 第 4 根:10、11、12、11,平均 11。和平均的差是 -1、0、1、0,平方的平均是 0.5,总体标准差 √0.5 = 0.7071。上轨 11 + 2 × 0.7071 = 12.4142。收盘价 11 正好在中轨,%b = 0.5。带宽 = 4 × 0.7071 ÷ 11 = 0.2571。
- 第 5 根:11、12、11、13,平均 11.75,标准差 0.8292。收盘价 13 在带里 87.7% 的高度。
⚠️ 总体标准差除以 n,不是 n - 1。Bollinger 本人和 TA-Lib 都这样算。pandas 的 rolling().std() 默认除以 n - 1,带会宽 √(20/19) - 1 ≈ 2.6%。BTC 日线上,上轨最多差了 495.66 美元。
收盘价有多少时间跑到带外
常听到的说法是:「价格有 95% 的时间在 ±2 倍标准差的带里。」
for name, df in markets.items():
    close = df["close"]
    b = I.bollinger(close)
    ok = b["upper"].notna()
    identity = (b["percent_b"] - 0.5) * b["bandwidth"] - I.bias(close, b["middle"])
    print(f"{name}:收盘价在上轨上方 {(close > b['upper'])[ok].mean():.1%},在下轨下方 {(close < b['lower'])[ok].mean():.1%}"
          f"(正态分布的说法是各 2.3%);乖离率 = (%b - 0.5) × 带宽 的最大误差 {identity.abs().max():.1e}")

walk = pd.Series(100 * np.exp(np.cumsum(np.random.default_rng(5).normal(0, 0.01, 200_000))))
b = I.bollinger(walk)
print(f"正态随机游走(20 万步):收盘价在上轨上方 {(walk > b['upper'])[b['upper'].notna()].mean():.1%},"
      f"在下轨下方 {(walk < b['lower'])[b['upper'].notna()].mean():.1%}")
SPY:收盘价在上轨上方 6.1%,在下轨下方 4.9%(正态分布的说法是各 2.3%);乖离率 = (%b - 0.5) × 带宽 的最大误差 1.6e-16
AAPL:收盘价在上轨上方 8.6%,在下轨下方 4.5%(正态分布的说法是各 2.3%);乖离率 = (%b - 0.5) × 带宽 的最大误差 1.7e-16
BTC:收盘价在上轨上方 7.4%,在下轨下方 4.9%(正态分布的说法是各 2.3%);乖离率 = (%b - 0.5) × 带宽 的最大误差 2.2e-16
正态随机游走(20 万步):收盘价在上轨上方 6.2%,在下轨下方 5.5%
- 三个标的:收盘价在带外的时间是 11.0% 到 13.1%,是「5%」的两倍多。
- 不是肥尾造成的:用正态分布生成的随机游走,一样有 11.7% 的时间在带外。
原因在定义里。95% 这个数要求「今天的收盘价」和「计算标准差的那 20 个数」来自同一个分布、互相独立。可价格是随机游走:今天的价格是在昨天的基础上走出来的,最新的一个价格离 20 天的平均最远的可能性本来就大,而这 20 个价格彼此挨得很近,标准差偏小。布林带不是一个概率区间,它只是按最近的离散程度画的一个参考范围。
%b、带宽和乖离率
上一段输出的最后一项是一个恒等式:
乖离率 = (收盘价 - 中轨) ÷ 中轨 = (%b - 0.5) × 带宽
证明很短:%b - 0.5 = (收盘价 - 中轨) ÷ (2k × 标准差),带宽 = 2k × 标准差 ÷ 中轨,两者相乘,2k × 标准差约掉。
所以 %b 就是「用波动率量过的乖离率」:价格偏离中轨多少个「带的宽度」。第十节的实验二会看到,%b 和第 12 篇的乖离率、第 14 篇的 RSI,读数高度相关。
五、波动率聚集
眼睛看到的
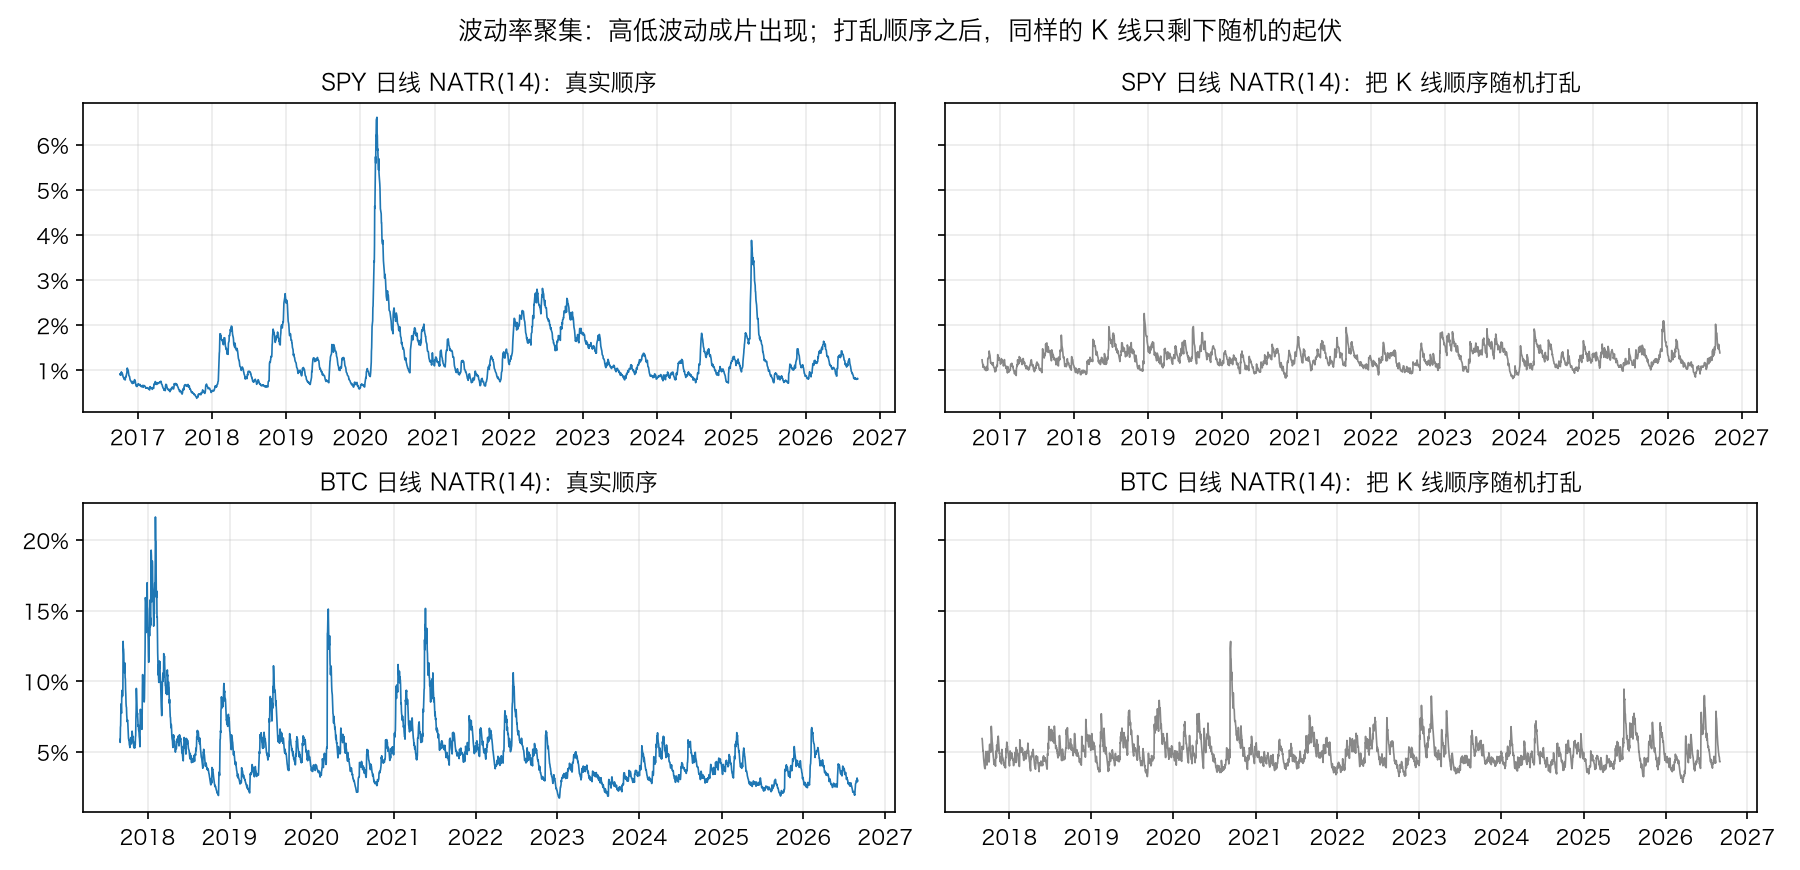
左边是真实的 NATR:SPY 的 2020 年 3 月、2022 年、2025 年 4 月,BTC 的 2018 年初、2020 年 3 月、2021 年 5 月,高波动都是成片出现的。
右边是把同样的 K 线(每根相对前一根收盘价的形状不变)随机打乱顺序之后再算 NATR。每一根 K 线都还在,只是被拆散了:高高低低,没有成片的汛期和旱季。
用数字验证
第 5 篇用收益率绝对值的自相关验证过波动率聚集。这里换一个更直接的问题:现在的 ATR,能预测之后 20 根的波动有多大吗?
def shuffle_bars(df, rng):
    """打乱 K 线顺序:保留每根 K 线相对前一根收盘价的形状,重新拼成价格(第 9 篇)。"""
    rel = np.log(df[cols].div(df["close"].shift(1), axis=0))
    rel = rel.dropna().iloc[rng.permutation(len(df) - 1)].reset_index(drop=True)
    prev_close = df["close"].iloc[0] * np.exp(rel["close"].cumsum().shift(1, fill_value=0))
    out = np.exp(rel[cols]).mul(prev_close, axis=0)
    out.index = df.index[1:]
    return out


def future_mean(x, n=20):
    """之后 n 根(不含这一根)的平均值。"""
    return x[::-1].rolling(n).mean()[::-1].shift(-1)


def forecast_power(df):
    """这一根的 NATR 和之后 20 根的平均真实波幅(占前一根收盘价的比例),两者取对数后的相关系数。"""
    tr_pct = X.true_range(df["high"], df["low"], df["close"]) / df["close"].shift(1)
    now, later = np.log(I.natr(df["high"], df["low"], df["close"])), np.log(future_mean(tr_pct))
    ok = now.notna() & later.notna()
    return np.corrcoef(now[ok], later[ok])[0, 1]


datasets = [("SPY 日线", spy), ("AAPL 日线", aapl), ("BTC 日线", day), ("BTC 4 小时线", h4), ("BTC 1 小时线", h1)]
for name, df in datasets:
    sims = np.array([forecast_power(shuffle_bars(df, rng)) for _ in range(100)])
    print(f"{name}:现在的 NATR 和之后 20 根的平均真实波幅,相关系数 {forecast_power(df):.2f};"
          f"打乱 K 线顺序 100 次:平均 {sims.mean():+.2f},最大 {sims.max():+.2f}")
SPY 日线:现在的 NATR 和之后 20 根的平均真实波幅,相关系数 0.69;打乱 K 线顺序 100 次:平均 -0.01,最大 +0.14
AAPL 日线:现在的 NATR 和之后 20 根的平均真实波幅,相关系数 0.66;打乱 K 线顺序 100 次:平均 -0.02,最大 +0.18
BTC 日线:现在的 NATR 和之后 20 根的平均真实波幅,相关系数 0.67;打乱 K 线顺序 100 次:平均 -0.01,最大 +0.15
BTC 4 小时线:现在的 NATR 和之后 20 根的平均真实波幅,相关系数 0.79;打乱 K 线顺序 100 次:平均 +0.00,最大 +0.06
BTC 1 小时线:现在的 NATR 和之后 20 根的平均真实波幅,相关系数 0.82;打乱 K 线顺序 100 次:平均 +0.00,最大 +0.03
- 五组数据的相关系数在 0.66 到 0.82 之间,1 小时线最高。
- 打乱之后平均约等于 0,100 次里最大也只有 0.18。
- 这个结论比第 5 篇里「方向」的任何检验都稳定得多:波动的大小,确实有记忆。
按现在的波动分组
把每根 K 线按「现在的 NATR 在过去一年里排第几」分成五组(只用到当时为止的数据),看之后 20 根发生了什么:
rows = []
for name, df in markets.items():
    close = df["close"]
    look = periods_per_year[name]
    n = I.natr(df["high"], df["low"], close)
    rank = n.rolling(look).rank(pct=True)                        # 在过去一年里排第几(只用到这一根为止)
    tr_pct = 100 * X.true_range(df["high"], df["low"], close) / close.shift(1)
    later = pd.DataFrame({"组": pd.cut(rank, [0, 0.2, 0.4, 0.6, 0.8, 1.0], labels=["最低 20%", "20-40%", "40-60%", "60-80%", "最高 20%"]),
                          "现在 NATR": n, "之后 20 根平均真实波幅": future_mean(tr_pct),
                          "之后 20 根收益": close.shift(-20) / close - 1}).dropna()
    later["之后 ÷ 现在"] = later["之后 20 根平均真实波幅"] / later["现在 NATR"]
    g = later.groupby("组", observed=True)
    rows.append(pd.DataFrame({"标的": name, "K 线": g.size(), "现在 NATR": g["现在 NATR"].mean(),
                              "之后 20 根平均真实波幅": g["之后 20 根平均真实波幅"].mean(),
                              "之后 ÷ 现在": g["之后 ÷ 现在"].mean(), "之后 20 根收益": g["之后 20 根收益"].mean(),
                              "上涨比例": g["之后 20 根收益"].apply(lambda v: (v > 0).mean())}).reset_index())
print("按「现在的 NATR 在过去一年里的排位」分成五组:")
print(pd.concat(rows).to_string(index=False, formatters={"现在 NATR": "{:.2f}".format, "之后 20 根平均真实波幅": "{:.2f}".format,
                                                          "之后 ÷ 现在": "{:.2f}".format, "之后 20 根收益": "{:+.2%}".format,
                                                          "上涨比例": "{:.1%}".format}))
按「现在的 NATR 在过去一年里的排位」分成五组:
     组   标的  K 线 现在 NATR 之后 20 根平均真实波幅 之后 ÷ 现在 之后 20 根收益  上涨比例
最低 20%  SPY  580    0.90          1.02    1.17    +1.07% 71.6%
20-40%  SPY  346    1.07          1.19    1.20    +0.34% 59.8%
40-60%  SPY  411    1.20          1.24    1.07    +0.81% 71.3%
60-80%  SPY  402    1.42          1.32    0.97    +1.87% 73.9%
最高 20%  SPY  488    2.10          1.98    1.01    +1.31% 61.7%
最低 20% AAPL  435    1.71          1.90    1.13    +2.56% 68.5%
20-40% AAPL  412    1.92          2.14    1.13    +2.87% 68.9%
40-60% AAPL  355    2.09          2.10    1.02    +3.54% 68.2%
60-80% AAPL  459    2.56          2.63    1.06    +2.05% 61.4%
最高 20% AAPL  567    3.17          2.93    0.96    +1.02% 55.7%
最低 20%  BTC  779    3.14          3.58    1.19    +1.40% 50.6%
20-40%  BTC  585    3.83          4.27    1.13    +3.02% 54.0%
40-60%  BTC  516    4.47          4.67    1.06    +2.04% 57.0%
60-80%  BTC  564    5.22          5.04    0.99    +3.37% 54.1%
最高 20%  BTC  460    7.11          5.81    0.84    +5.23% 59.1%
三件事:
- 持续:现在波动越大,之后 20 根的波动也越大。BTC 从最低组的 3.58% 到最高组的 5.81%。
- 回归:看「之后 ÷ 现在」这一列。波动最低的一组,之后平均会放大 13% 到 19%;最高的一组基本不再放大,AAPL 是 0.96 倍,BTC 缩小到 0.84 倍。波动既有记忆,又会向平常水平靠拢。
- 方向看不出来:之后 20 根的收益和上涨比例,在五组之间没有一致的规律。SPY 最低组上涨 71.6%,最高组 61.7%;BTC 正好反过来,最高组 59.1%,最低组 50.6%。
「回归」这一条对第七节很关键。
六、揭晓
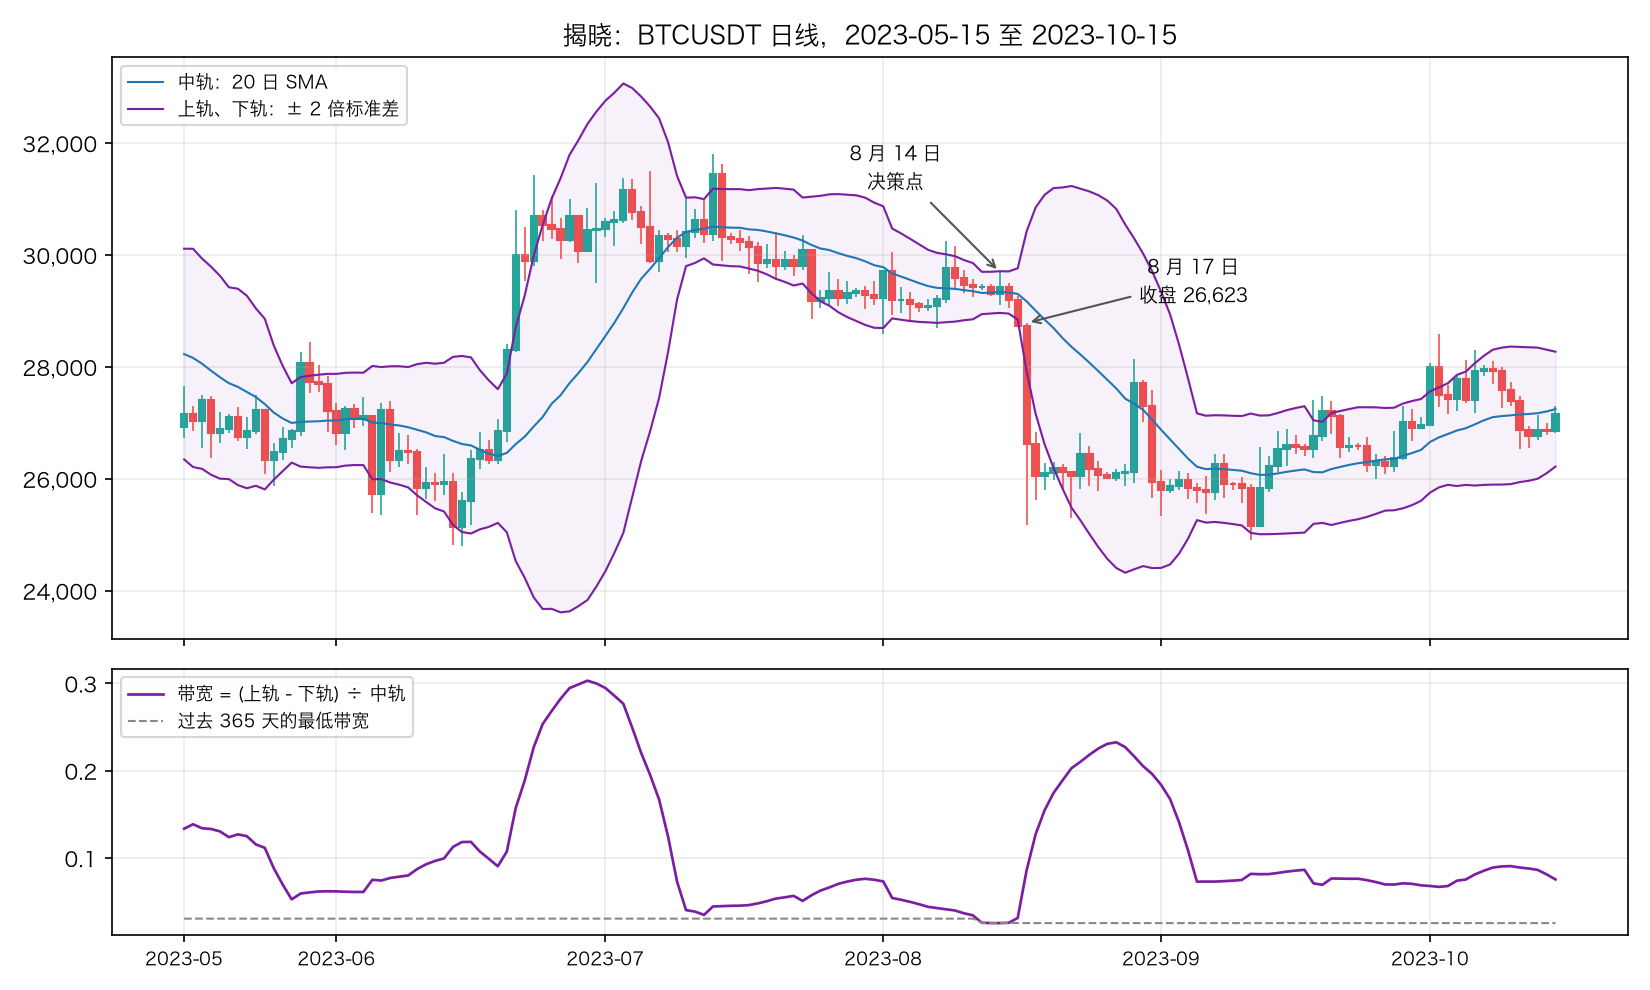
8 月 14 日之后的第三天,BTC 一天跌了 7.3%,盘中最多跌了 12.4%。
i = c.index.get_loc(t)
for n in [1, 2, 3, 5, 10, 20]:
    print(f"{n} 天后({c.index[i + n].date()}):收盘 {c.iloc[i + n]:,.2f}({c.iloc[i + n] / c[t] - 1:+.2%}),"
          f"带宽 {band['bandwidth'].iloc[i + n]:.4f},NATR {natr.iloc[i + n]:.2f}")
crash = pd.Timestamp("2023-08-17", tz="UTC")
row = day.loc[crash]
print(f"8 月 17 日:开盘 {row['open']:,.2f},最低 {row['low']:,.2f}({row['low'] / row['open'] - 1:+.2%}),收盘 {row['close']:,.2f},"
      f"真实波幅是 8 月 16 日 ATR 的 {X.true_range(day['high'], day['low'], c)[crash] / I.atr(day['high'], day['low'], c).iloc[i + 2]:.1f} 倍")
after = c.iloc[i + 1:i + 61]
print(f"之后 60 天:最高收盘 {after.max():,.2f}({after.idxmax().date()}),最低收盘 {after.min():,.2f}({after.idxmin().date()})")
1 天后(2023-08-15):收盘 29,200.00(-0.78%),带宽 0.0257,NATR 1.85
2 天后(2023-08-16):收盘 28,730.51(-2.38%),带宽 0.0312,NATR 1.88
3 天后(2023-08-17):收盘 26,623.41(-9.54%),带宽 0.0860,NATR 2.86
5 天后(2023-08-19):收盘 26,100.01(-11.32%),带宽 0.1546,NATR 2.95
10 天后(2023-08-24):收盘 26,180.05(-11.05%),带宽 0.2181,NATR 2.84
20 天后(2023-09-03):收盘 25,971.21(-11.76%),带宽 0.1410,NATR 2.91
8 月 17 日:开盘 28,730.51,最低 25,166.00(-12.41%),收盘 26,623.41,真实波幅是 8 月 16 日 ATR 的 6.7 倍
之后 60 天:最高收盘 29,200.00(2023-08-15),最低收盘 25,162.52(2023-09-11)
- 8 月 15、16 日还在慢慢往下走,一共跌了 2.4%,带宽几乎没变。
- 8 月 17 日,开盘 28,730.51,盘中最低 25,166,收盘 26,623.41。这一天的真实波幅是前一天 ATR 的 6.7 倍。
- 带宽 10 天里从 0.0254 涨到 0.2181,NATR 从 1.86% 涨到 2.9% 左右。
- 之后 60 天的最高收盘就是 8 月 15 日的 29,200,再也没有回到决策点的 29,431。
三个选择:
- 选 A(两边挂单)的:8 月 15 日收盘后,下轨在 28,951.62。8 月 16 日盘中最低 28,723.08,卖出止损单成交。按下轨价格成交的话,到 8 月 17 日收盘赚了约 8%。
- 选 B(等收盘确认)的:8 月 16 日收盘 28,730.51,已经在下轨 28,846.83 下方。第二天开盘做空,到收盘赚了 7.3%。
- 选 C(带里高抛低吸)的:8 月 16 日在下轨 28,951.62 买入,当天收盘已经亏了;第二天盘中最低 25,166,最多亏了 13.1%。
这一次,「收口之后有大行情」说中了。但一次说明不了什么,下一节看全部历史。
七、收口之后
问题要问清楚
「收口之后有大行情」这句话,至少可以拆成三个问题:
- 之后的波动,比收口时大吗?
- 之后的波动,比平常大吗?
- 突破的方向,比平常的突破更可靠吗?
收口定义为:带宽创出过去一年(日线 252 或 365 根,4 小时线 2,190 根,1 小时线 8,760 根)新低的第一根。对照有两组:带宽排在过去一年最低 10% 的全部 K 线,以及全部 K 线。
def label_test(values, flag, n=2000):
    """flag 为真的组减去其余的平均值;把标签随机打乱 n 次,看差距不小于实际的比例(第 10 篇)。"""
    v, f = np.asarray(values, float), np.asarray(flag, bool)
    ok = ~np.isnan(v)
    v, f = v[ok], f[ok]
    observed = v[f].mean() - v[~f].mean()
    sims = np.array([v[p].mean() - v[~p].mean() for p in (rng.permutation(f) for _ in range(n))])
    return observed, (np.abs(sims) >= abs(observed)).mean()


def squeeze_study(df, look):
    """带宽创出 look 根新低的第一根(收口),和带宽排在过去 look 根最低 10% 的全部 K 线、全部 K 线比较。"""
    close = df["close"]
    b = I.bollinger(close)
    a = I.atr(df["high"], df["low"], close)
    tr = X.true_range(df["high"], df["low"], close)
    lowest = b["bandwidth"].rolling(look).min()
    new_low = (b["bandwidth"] <= lowest) & lowest.notna()
    squeeze = new_low & ~new_low.shift(1, fill_value=False)
    rank = b["bandwidth"].rolling(look).rank(pct=True)
    high_later = df["high"][::-1].rolling(20).max()[::-1].shift(-1)
    low_later = df["low"][::-1].rolling(20).min()[::-1].shift(-1)
    frame = pd.DataFrame({"收口": squeeze, "最低 10%": rank <= 0.1, "之后 ÷ 现在 ATR": future_mean(tr) / a,
                          "之后 20 根高低点距离(ATR)": (high_later - low_later) / a,
                          "之后 20 根平均真实波幅(%)": 100 * future_mean(tr) / close,
                          "之后 20 根上涨": (close.shift(-20) > close).astype(float)}).loc[rank.notna() & high_later.notna()]
    return frame, b, a


rows = []
for (name, df), look in zip(datasets, [252, 252, 365, 365 * 6, 365 * 24]):
    frame, b, a = squeeze_study(df, look)
    low = frame[frame["最低 10%"]]
    _, p = label_test(low["之后 ÷ 现在 ATR"], low["收口"])
    for label, part in [("收口", frame[frame["收口"]]), ("带宽最低 10%", low), ("全部", frame)]:
        rows.append({"数据": name, "组": label, "K 线": len(part)} | part.iloc[:, 2:].mean().to_dict()
                    | {"p(收口 vs 最低 10%)": p if label == "收口" else np.nan})
print(pd.DataFrame(rows).to_string(index=False, float_format=lambda v: "" if pd.isna(v) else f"{v:.2f}"))

print("同样的计算放在打乱 K 线顺序的价格上(没有波动率聚集),各打乱 20 次取平均:")
rows = []
for (name, df), look in list(zip(datasets, [252, 252, 365, 365 * 6]))[:4]:
    sims = []
    for _ in range(20):
        frame, _, _ = squeeze_study(shuffle_bars(df, rng), look)
        sims.append({"收口 次数": frame["收口"].sum(), "收口": frame.loc[frame["收口"], "之后 ÷ 现在 ATR"].mean(),
                     "带宽最低 10%": frame.loc[frame["最低 10%"], "之后 ÷ 现在 ATR"].mean(), "全部": frame["之后 ÷ 现在 ATR"].mean()})
    rows.append({"数据": name} | pd.DataFrame(sims).mean().to_dict())
print("之后 20 根平均真实波幅 ÷ 现在的 ATR:")
print(pd.DataFrame(rows).to_string(index=False, float_format=lambda v: f"{v:.2f}"))
       数据        组   K 线  之后 ÷ 现在 ATR  之后 20 根高低点距离(ATR)  之后 20 根平均真实波幅(%)  之后 20 根上涨  p(收口 vs 最低 10%)
   SPY 日线       收口     9         1.07               5.75              1.16       0.78             0.62
   SPY 日线 带宽最低 10%   256         1.14               5.59              1.12       0.70              NaN
   SPY 日线       全部  2222         1.08               5.55              1.34       0.68              NaN
  AAPL 日线       收口    17         1.02               6.25              2.00       0.82             0.42
  AAPL 日线 带宽最低 10%   251         1.08               6.09              1.99       0.69              NaN
  AAPL 日线       全部  2223         1.06               5.59              2.40       0.64              NaN
   BTC 日线       收口    18         1.35               8.45              3.95       0.33             0.13
   BTC 日线 带宽最低 10%   438         1.16               6.83              3.56       0.45              NaN
   BTC 日线       全部  2899         1.07               5.35              4.59       0.55              NaN
BTC 4 小时线       收口    19         1.32               7.24              1.16       0.63             0.34
BTC 4 小时线 带宽最低 10%  2270         1.22               6.57              1.26       0.53              NaN
BTC 4 小时线       全部 17566         1.05               5.25              1.77       0.53              NaN
BTC 1 小时线       收口    21         1.45               7.92              0.43       0.52             0.07
BTC 1 小时线 带宽最低 10%  8847         1.23               6.52              0.52       0.51              NaN
BTC 1 小时线       全部 70315         1.05               5.21              0.86       0.52              NaN
同样的计算放在打乱 K 线顺序的价格上(没有波动率聚集),各打乱 20 次取平均:
之后 20 根平均真实波幅 ÷ 现在的 ATR:
       数据  收口 次数   收口  带宽最低 10%   全部
   SPY 日线  11.20 1.15      1.13 1.04
  AAPL 日线  10.70 1.15      1.11 1.04
   BTC 日线   8.25 1.20      1.16 1.05
BTC 4 小时线   9.75 1.28      1.18 1.03
问题 1:比收口时大吗?
大。 「之后 20 根的平均真实波幅 ÷ 收口时的 ATR」,BTC 日线 1.35、4 小时线 1.32、1 小时线 1.45。之后 20 根的最高点到最低点,BTC 日线有 8.45 个收口时的 ATR,全部 K 线平均只有 5.35。
可是看第二张表:打乱顺序的价格上,收口之后也放大了 1.15 到 1.28 倍,带宽最低 10% 的也有 1.11 到 1.18 倍。 打乱之后没有任何波动率聚集,也没有「暴风雨前的宁静」,放大照样发生。
原因是第五节的「回归」,加上一个统计上的必然:你挑出来的是 ATR「测量值」最低的时刻。ATR 只是 14 根 K 线的平均,有随机误差。挑出最低的那些,有一部分只是这 14 根碰巧都很平静,之后回到正常水平,看起来就是「放大」。这叫均值回归(regression to the mean):任何带噪声的测量,挑极端值,下一次都会往中间靠。
真实数据比打乱的多出来的部分,才可能和市场本身有关:BTC 日线 1.35 对 1.20,1 小时线收口 1.45 对带宽最低 10% 的 1.23,p 0.07。样本只有十几二十次,分不清。
问题 2:比平常大吗?
不大。 看「之后 20 根平均真实波幅(%)」这一列:
- BTC 日线:收口之后 3.95%,全部 K 线平均 4.59%
- BTC 1 小时线:0.43% 对 0.86%,只有一半
- SPY、AAPL:1.16% 对 1.34%,2.00% 对 2.40%
收口之后的波动比收口时大,但仍然比平常小。第五节说过,波动有记忆,平静之后大概率还是比较平静,只是没那么平静了。
决策点那次,NATR 从 1.86% 涨到 2.9%,按 BTC 的标准,仍然低于全部历史 4.59% 的平均。
问题 3:突破方向更可靠吗?
print("突破方向:收口之后 20 根以内,收盘价第一次越过上轨(做多)或下轨(做空);对照是所有「前一根还在带内、这一根收在带外」的 K 线")
rows = []
for (name, df), look in zip(datasets, [252, 252, 365, 365 * 6, 365 * 24]):
    frame, b, a = squeeze_study(df, look)
    close = df["close"]
    side = np.sign((close > b["upper"]).astype(int) - (close < b["lower"]).astype(int))
    breakout = (side != 0) & (side.shift(1) == 0) & a.notna()
    after_squeeze = pd.Series(False, index=close.index)
    for when in frame.index[frame["收口"]]:
        k = close.index.get_loc(when)
        later = breakout.iloc[k + 1:k + 21]
        if later.any():
            after_squeeze[later.idxmax()] = True
    times = close.index[breakout]
    hit = pd.Series(X.first_passage(close, df["high"], df["low"], a, times, side[times].to_numpy()), index=times)
    _, p = label_test(hit, after_squeeze[times])
    rows.append({"数据": name, "收口后的突破": int(hit[after_squeeze[times]].notna().sum()),
                 "顺向": hit[after_squeeze[times]].mean(), "全部突破": int(hit.notna().sum()), "全部突破 顺向": hit.mean(), "p": p})
print(pd.DataFrame(rows).to_string(index=False, float_format=lambda v: f"{v:.3f}"))
突破方向:收口之后 20 根以内,收盘价第一次越过上轨(做多)或下轨(做空);对照是所有「前一根还在带内、这一根收在带外」的 K 线
       数据  收口后的突破    顺向  全部突破  全部突破 顺向     p
   SPY 日线       7 0.571   148    0.486 0.710
  AAPL 日线       9 0.889   152    0.572 0.083
   BTC 日线      13 0.692   167    0.551 0.384
BTC 4 小时线      15 0.333  1035    0.555 0.119
BTC 1 小时线      12 0.583  4048    0.523 0.758
「突破」是收盘价从带内收到带外的那一根,朝突破方向入场,用第 11 篇的 2 ATR 先碰哪条线打分。
- 收口之后的突破只有 7 到 15 次,顺向比例从 33.3% 到 88.9%,跳来跳去。
- 和全部突破比,5 组都没有 p < 0.05。AAPL 最接近(9 次里 8 次顺向,p 0.083),BTC 4 小时线反而更差(15 次里 5 次)。
结论
- 收口之后波动会放大,但打乱顺序的随机价格也一样,主要是均值回归。
- 收口之后的波动仍然低于平常水平。 「大行情」是相对收口时说的,不是相对平常。
- 收口之后突破的方向,没有比普通突破更可靠,样本也太少。
✋ 小检查 2
(a) 决策点上 BTC 的 ATR 是 548。按第一张表的「之后 ÷ 现在 ATR」= 1.35,之后 20 天平均每天的真实波幅大约是多少?占价格的百分之几?和 BTC 全部历史的平均 4.59% 比呢?
(b) 你连续测了 14 天的体温,平均 36.3℃,是你一年里最低的一次。下一个 14 天的平均体温,大概率更高还是更低?这和「收口之后波动放大」是同一个道理吗?
(c) 有人统计了「带宽创一年新低之后 20 天的最大涨幅和最大跌幅」,发现平均有 12%,得出结论「收口之后必有大行情」。他漏掉了哪两个对照?
答案在文末。
八、波动率的三个用途
用途一:定止损
止损放多远,常见两种做法:固定百分比(比如跌 5% 就走),或者 k 倍 ATR。
做个公平的比较:每个标的上,固定百分比取「3 ATR 占价格比例」的历史中位数,这样两种止损平均距离一样。在每根 K 线收盘买入,看之后 20 根里被打掉的比例,按当时 NATR 在过去一年里的排位分组:
def stop_hit(df, distance, horizon=20):
    """在每根 K 线收盘价买入,止损放在收盘价下方 distance(价格单位),之后 horizon 根里最低价碰到算被打掉。"""
    close, low, dist = df["close"].to_numpy(), df["low"].to_numpy(), distance.to_numpy()
    out = np.full(len(close), np.nan)
    for k in range(len(close) - horizon):
        if not np.isnan(dist[k]):
            out[k] = float((low[k + 1:k + 1 + horizon] <= close[k] - dist[k]).any())
    return pd.Series(out, index=df.index)


rows = []
for name, df in markets.items():
    close = df["close"]
    a = I.atr(df["high"], df["low"], close)
    percent = float((3 * a / close).median())                     # 固定百分比取 3 ATR 的历史中位数,两种止损平均距离相同
    rank = (a / close).rolling(periods_per_year[name]).rank(pct=True)
    frame = pd.DataFrame({"组": pd.cut(rank, [0, 0.2, 0.4, 0.6, 0.8, 1.0], labels=["最低 20%", "20-40%", "40-60%", "60-80%", "最高 20%"]),
                          f"固定 {percent:.2%}": stop_hit(df, close * percent), "3 ATR": stop_hit(df, 3 * a)}).dropna()
    table = frame.groupby("组", observed=True).mean().T
    table.insert(0, "标的", name)
    rows.append(table)
print("20 根以内被打掉的比例,按「现在的 NATR 在过去一年里的排位」分组:")
print(pd.concat(rows).to_string(float_format=lambda v: f"{v:.1%}"))
20 根以内被打掉的比例,按「现在的 NATR 在过去一年里的排位」分组:
组            标的  最低 20%  20-40%  40-60%  60-80%  最高 20%
固定 3.26%    SPY   25.7%   32.4%   35.5%   32.8%   53.3%
3 ATR       SPY   32.2%   31.2%   33.1%   26.9%   33.8%
固定 6.24%   AAPL   27.1%   23.1%   20.8%   37.7%   47.8%
3 ATR      AAPL   34.0%   25.5%   20.8%   32.2%   34.2%
固定 13.19%   BTC   23.5%   26.3%   26.2%   24.5%   26.5%
3 ATR       BTC   29.3%   29.9%   26.0%   15.8%    9.6%
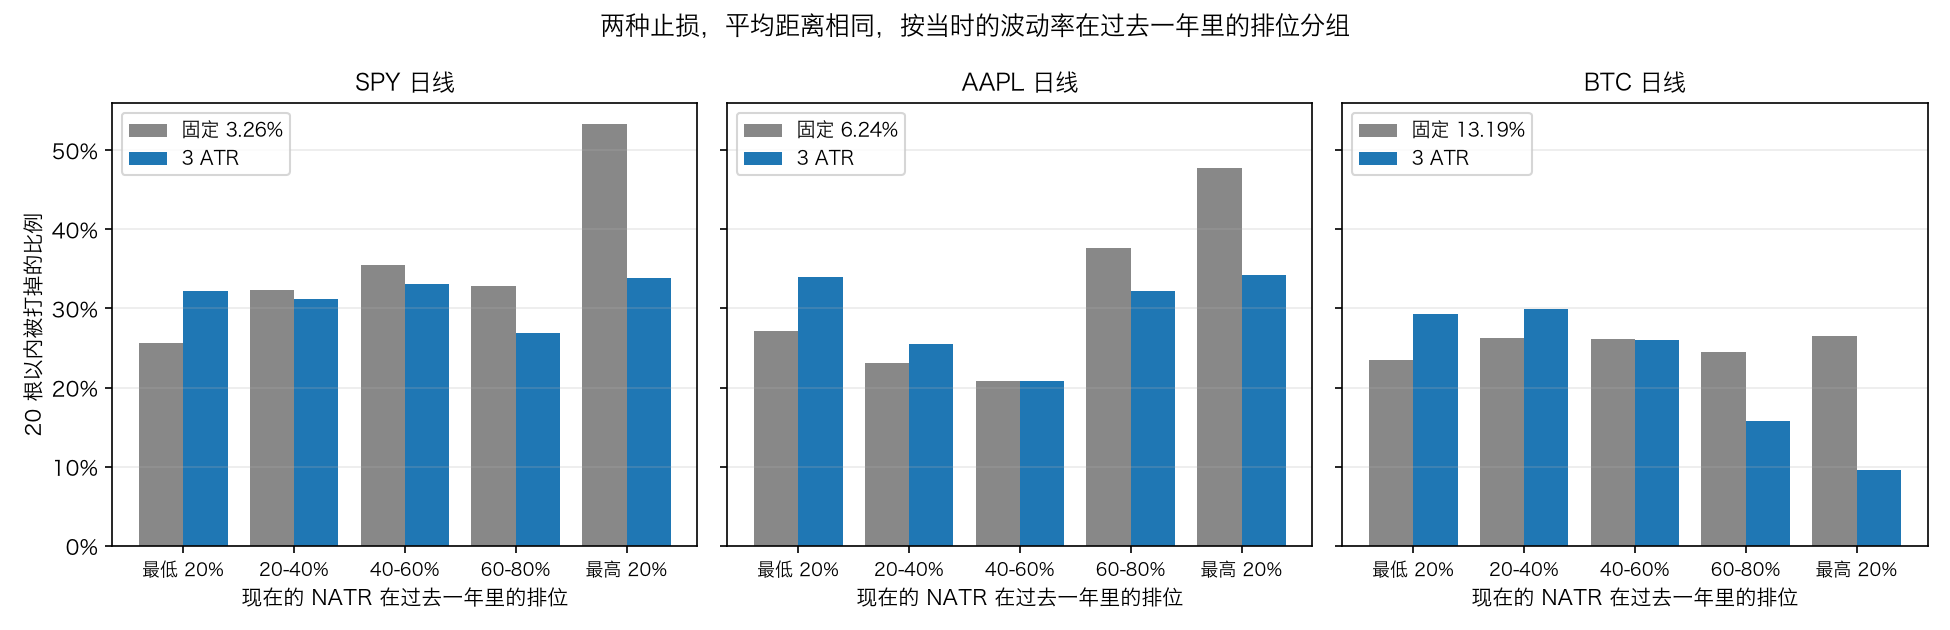
- SPY、AAPL 上,固定百分比止损在高波动时期被打掉的比例翻了一倍:SPY 从最低组的 25.7% 到最高组的 53.3%,AAPL 最低处 20.8%、最高组 47.8%。3 ATR 始终在 21% 到 34% 之间。
- BTC 上情况不一样:固定 13.19% 在各组差不多(23.5% 到 26.5%),3 ATR 反而在高波动组只有 9.6%。原因是第五节的「回归」:BTC 的高波动常常是一两根暴涨暴跌把 ATR 撑大,之后波动很快回落,3 ATR 的止损就显得太远了。
⚠️ ATR 止损的好处是让止损距离跟着当时的风力走,在 SPY、AAPL 上确实让被打掉的比例更稳定。但 ATR 是过去 14 根的平均,它对「波动刚刚开始放大」反应慢,对「波动刚刚开始回落」也反应慢。
用途二:定仓位
同样 1 万块,买 SPY 和买 BTC,每天的盈亏波动差好几倍;同样买 SPY,2017 年和 2020 年也差好几倍。按波动率调整仓位,就是波动大的时候少买,波动小的时候多买,让每天的盈亏幅度大致稳定。
最简单的写法:仓位和前一根的 NATR 成反比,再把平均仓位调到和固定金额一样(最多加到 4 倍,防止极低波动时仓位过大)。按年份看每天收益的年化波动:
rows = []
for name, df in markets.items():
    close = df["close"]
    r = close.pct_change()
    n = I.natr(df["high"], df["low"], close)
    weight = (1.0 / n.shift(1)).clip(upper=4.0 / n.median())       # 前一根的 NATR 越大,这一根拿得越少;最多 4 倍
    weight = weight / weight.mean()                                 # 平均仓位和固定仓位一样
    scaled = (weight * r).dropna()
    fixed = r.loc[scaled.index]
    by_year = pd.DataFrame({"固定金额": fixed, "按 ATR 调整": scaled}).groupby(scaled.index.year).std() * np.sqrt(periods_per_year[name])
    rows.append({"标的": name, "固定金额 最低年份波动": by_year["固定金额"].min(), "最高": by_year["固定金额"].max(),
                 "最高 ÷ 最低": by_year["固定金额"].max() / by_year["固定金额"].min(),
                 "按 ATR 调整 最低": by_year["按 ATR 调整"].min(), "最高 ": by_year["按 ATR 调整"].max(),
                 "最高 ÷ 最低 ": by_year["按 ATR 调整"].max() / by_year["按 ATR 调整"].min()})
print(pd.DataFrame(rows).to_string(index=False, float_format=lambda v: f"{v:.2f}"))
  标的  固定金额 最低年份波动   最高  最高 ÷ 最低  按 ATR 调整 最低  最高   最高 ÷ 最低
 SPY         0.07 0.34     4.95         0.11 0.15      1.29
AAPL         0.16 0.47     2.93         0.19 0.28      1.46
 BTC         0.42 1.16     2.78         0.51 0.67      1.30
- 固定金额:SPY 最平静的一年年化波动 7%,最剧烈的一年 34%,差 4.95 倍;AAPL、BTC 也差 2.8 到 2.9 倍。
- 按 ATR 调整:最高和最低年份只差 1.29 到 1.46 倍。
这只是一个示意。完整的仓位规则(每笔风险多少、杠杆、强平价)在第 26 篇。
用途三:判断市场状态
第五节的分组表已经回答了这个问题:
- 能判断的:现在属于高波动还是低波动时期,之后一段时间的波动大概在什么水平。这对决定止损宽度、仓位大小、要不要降低交易频率,都是有用的信息。
- 判断不了的:高波动或低波动时期,之后是涨还是跌。三个标的上,五组的收益和上涨比例没有一致的规律。
九、主线策略 v1:加上 ATR 止损
规则
第 12 篇的主线 v0:50 日 SMA 在 200 日 SMA 上方就持有,收盘出信号、下一根开盘成交。它在 SPY 上的最大回撤和买入持有一样,都是 -34.1%,因为 2020 年 3 月的暴跌发生在死叉之前。
v1 加上 ATR 吊灯止损(chandelier stop,止损价挂在最高点下方,像吊灯挂在天花板下面):
| 规则 | |
|---|---|
| 入场 | 和 v0 相同 |
| 初始止损 | 买入那一根:开盘价 - 3 × 前一根的 ATR(14) |
| 移动止损 | 之后每一根开盘前:max(原止损价, 买入以来的最高价 - 3 × 前一根的 ATR),只上移、不下移 |
| 止损成交 | 开盘价已经不高于止损价,按开盘价卖出(跳空击穿);否则最低价碰到止损价,按止损价卖出 |
| 趋势出场 | 和 v0 相同:收盘时 50 日不在 200 日上方,下一根开盘卖出 |
| 止损之后 | 趋势还在也不马上买回,要等收盘价高于之前 20 根的最高收盘价,下一根开盘再买 |
最后一条需要解释。如果止损之后马上买回(趋势条件还满足),止损就没有意义了。「创 20 日新高」是一个事先定好、容易验证的「趋势恢复」条件,不是在数据上挑出来的。
3 ATR 这个距离,按第三节的经验数,大约是 4 到 5 个日标准差。所有参数都在看结果之前定好,下面同时列出 2、4、5 ATR,只是为了看结果对参数有多敏感,不是为了挑最好的。
代码
def mainline_v1(df, k=3.0, n_atr=14, breakout=20, fast=50, slow=200):
    """主线策略 v1:v0 加上 ATR 吊灯止损。没有仓位管理、没有成本。

    入场:收盘时快均线在慢均线上方,下一根开盘买入(和 v0 相同)。
    止损:买入那一根的止损价 = 开盘价 - k × 前一根的 ATR。之后每一根开盘前更新:
          止损价 = max(原来的止损价, 买入以来的最高价 - k × 前一根的 ATR),只上移、不下移。
          开盘价已经不高于止损价,按开盘价卖出(跳空击穿);否则最低价碰到止损价,按止损价卖出。
    趋势出场:收盘时快均线不在慢均线上方,下一根开盘卖出(和 v0 相同)。
    止损之后:趋势还在,也不马上买回。要等收盘价高于之前 breakout 根的最高收盘价(创新高),下一根开盘再买。
    返回每根 K 线的收益率、是否持有,以及每笔交易。
    """
    o, h, l, c = (df[x].to_numpy(float) for x in cols)
    a = I.atr(df["high"], df["low"], df["close"], n_atr).to_numpy()
    trend = (I.sma(df["close"], fast) > I.sma(df["close"], slow)).to_numpy()
    first = df.index.get_loc(I.sma(df["close"], slow).first_valid_index())
    r, held, trades = np.zeros(len(c)), np.zeros(len(c)), []
    holding = buy = sell = locked = False
    for i in range(first, len(c)):
        if holding:
            stop, base = max(stop, highest - k * a[i - 1]), c[i - 1]
        elif buy:
            holding, buy, entry, entry_i, highest = True, False, o[i], i, o[i]
            stop, base = o[i] - k * a[i - 1], o[i]
        if holding:
            held[i] = 1
            exit_price = reason = None
            if sell:
                exit_price, reason = o[i], "趋势"
            elif o[i] <= stop:
                exit_price, reason = o[i], "止损(跳空)"
            elif l[i] <= stop:
                exit_price, reason = stop, "止损"
            if reason is None:
                r[i], highest = c[i] / base - 1, max(highest, h[i])
            else:
                r[i] = exit_price / base - 1
                trades.append((df.index[entry_i], entry, df.index[i], exit_price, reason))
                holding, sell, locked = False, False, reason.startswith("止损")
        if holding:                                                   # 收盘时决定下一根做什么
            sell = not trend[i]
        elif locked:
            if trend[i] and c[i] > c[i - breakout:i].max():
                buy, locked = True, False
        else:
            buy = bool(trend[i])
    index = df.index[first:]
    trades = pd.DataFrame(trades, columns=["买入日", "买入价", "卖出日", "卖出价", "原因"])
    trades["收益"] = trades["卖出价"] / trades["买入价"] - 1
    return pd.Series(r[first:], index=index), pd.Series(held[first:], index=index), trades
循环里每一根 K 线分三步:
- 开盘前:持仓中就更新止损价(用到前一根为止的最高价和 ATR);空仓且上一根收盘时决定买入,就在开盘买入、设初始止损。
- 盘中:依次检查趋势出场、跳空击穿、盘中碰到止损。这一根的收益从「前一根收盘价」(买入当天是开盘价)算到卖出价或收盘价。
- 收盘时:决定下一根做什么。
一个检查:把止损距离设成无穷大,v1 应该和 v0 完全一样。
结果
def summary(r, n, held=None, trades=None):
    equity = (1 + r).cumprod()
    out = {"年化": equity.iloc[-1] ** (n / len(r)) - 1, "年化波动": r.std() * np.sqrt(n),
           "最大回撤": (equity / equity.cummax() - 1).min()}
    out["年化 ÷ 波动"] = out["年化"] / out["年化波动"]
    out["年化 ÷ 回撤"] = out["年化"] / -out["最大回撤"]
    if held is not None:
        out["在场时间"] = held.mean()
    if trades is not None:
        out |= {"交易次数": len(trades), "止损出场": int(trades["原因"].str.startswith("止损").sum()),
                "最差一笔": trades["收益"].min()}
    return out


check = []
for name, df in markets.items():
    signal = mainline_v0(df)
    start = signal.first_valid_index()
    d = df.loc[start:]
    v0 = backtest_next_open(d, signal.loc[start:])
    r, held, trades = mainline_v1(df, k=1e12)
    check.append(f"{name} {np.abs(r - v0).max():.1e}")
    rows = {"买入持有": summary(d["close"].pct_change().fillna(0.0), periods_per_year[name]),
            "主线 v0": summary(v0, periods_per_year[name], signal.loc[start:].shift(1).fillna(0.0))}
    for k in [3.0, 2.0, 4.0, 5.0]:
        r, held, trades = mainline_v1(df, k=k)
        rows[f"主线 v1({k:.0f} ATR)"] = summary(r, periods_per_year[name], held, trades)
        if k == 3.0:
            example = trades
    print(f"{name}:{start.date()} 至 {d.index[-1].date()}")
    count = lambda v: "" if pd.isna(v) else f"{v:.0f}"
    print(pd.DataFrame(rows).T.to_string(float_format=lambda v: "" if pd.isna(v) else f"{v:.3f}",
                                         formatters={"交易次数": count, "止损出场": count}))
    if name == "SPY":
        print("SPY 主线 v1(3 ATR)2020 年和 2025 年的交易:")
        print(example[example["买入日"].dt.year.isin([2020, 2025])].round({"买入价": 2, "卖出价": 2, "收益": 4}).to_string(index=False))
print("止损距离设成无穷大时,v1 和 v0 每根 K 线收益率的最大差:", ",".join(check))
SPY:2017-06-30 至 2026-09-15
                年化  年化波动   最大回撤  年化 ÷ 波动  年化 ÷ 回撤  在场时间 交易次数 止损出场   最差一笔
买入持有         0.132 0.186 -0.341    0.711    0.388   NaN  NaN  NaN    NaN
主线 v0        0.085 0.157 -0.341    0.545    0.251 0.816  NaN  NaN    NaN
主线 v1(3 ATR) 0.029 0.071 -0.140    0.414    0.210 0.495   49   49 -0.044
主线 v1(2 ATR) 0.017 0.059 -0.150    0.284    0.113 0.408   76   76 -0.028
主线 v1(4 ATR) 0.048 0.081 -0.126    0.598    0.383 0.561   33   33 -0.061
主线 v1(5 ATR) 0.052 0.089 -0.142    0.587    0.368 0.614   26   25 -0.061
SPY 主线 v1(3 ATR)2020 年和 2025 年的交易:
       买入日    买入价        卖出日    卖出价     原因      收益
2020-02-06 333.91 2020-02-24 323.14 止损(跳空) -0.0323
2020-07-13 320.13 2020-09-03 348.19     止损  0.0877
2020-10-08 342.85 2020-10-26 337.94     止损 -0.0143
2020-11-10 353.49 2021-01-04 366.19     止损  0.0359
2025-01-22 605.92 2025-02-03 590.67     止损 -0.0252
2025-02-19 610.08 2025-02-25 595.55     止损 -0.0238
2025-07-03 622.45 2025-08-01 624.94     止损  0.0040
2025-08-11 637.46 2025-10-10 659.54     止损  0.0346
2025-10-27 682.73 2025-11-06 669.18     止损 -0.0198
2025-12-01 678.81 2026-01-20 679.35     止损  0.0008
AAPL:2017-06-30 至 2026-09-15
                年化  年化波动   最大回撤  年化 ÷ 波动  年化 ÷ 回撤  在场时间 交易次数 止损出场   最差一笔
买入持有         0.284 0.300 -0.385    0.948    0.737   NaN  NaN  NaN    NaN
主线 v0        0.155 0.262 -0.459    0.592    0.338 0.803  NaN  NaN    NaN
主线 v1(3 ATR) 0.092 0.149 -0.213    0.616    0.430 0.430   45   45 -0.078
主线 v1(2 ATR) 0.059 0.127 -0.164    0.465    0.359 0.335   75   75 -0.045
主线 v1(4 ATR) 0.102 0.167 -0.299    0.610    0.340 0.497   33   33 -0.124
主线 v1(5 ATR) 0.106 0.183 -0.379    0.580    0.279 0.553   27   27 -0.124
BTC:2018-03-04 至 2026-08-31
                年化  年化波动   最大回撤  年化 ÷ 波动  年化 ÷ 回撤  在场时间 交易次数 止损出场   最差一笔
买入持有         0.253 0.624 -0.766    0.406    0.331   NaN  NaN  NaN    NaN
主线 v0        0.191 0.476 -0.667    0.401    0.286 0.517  NaN  NaN    NaN
主线 v1(3 ATR) 0.082 0.291 -0.565    0.283    0.146 0.205   41   39 -0.209
主线 v1(2 ATR) 0.176 0.247 -0.351    0.711    0.500 0.155   53   52 -0.140
主线 v1(4 ATR) 0.116 0.324 -0.591    0.359    0.197 0.267   30   28 -0.284
主线 v1(5 ATR) 0.131 0.356 -0.571    0.369    0.230 0.344   24   22 -0.359
止损距离设成无穷大时,v1 和 v0 每根 K 线收益率的最大差: SPY 0.0e+00,AAPL 0.0e+00,BTC 0.0e+00
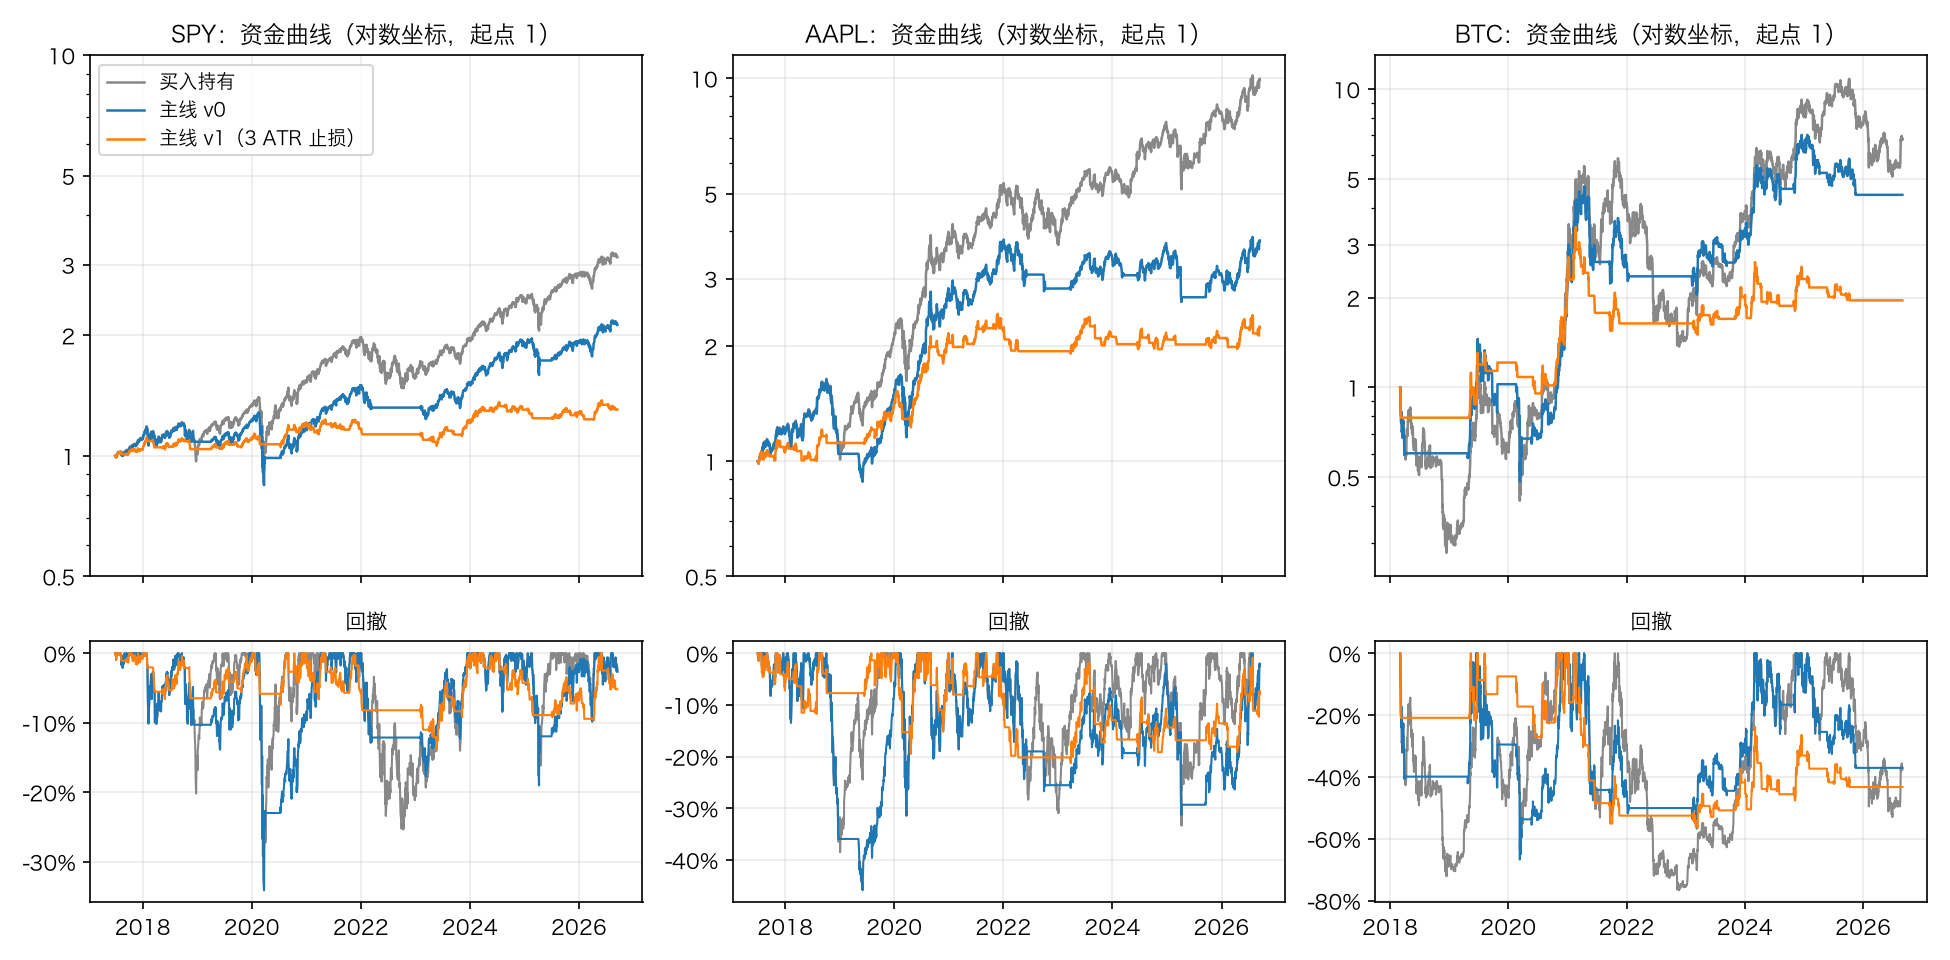
先看检查:止损设成无穷大时,v1 和 v0 每一根的收益率差都是 0,回测逻辑和 v0 一致。
再看 3 ATR 的结果:
- 回撤明显变小:SPY 从 -34.1% 到 -14.0%,AAPL 从 -45.9% 到 -21.3%,BTC 从 -66.7% 到 -56.5%。
- 收益掉得更多:SPY 年化从 8.5% 到 2.9%,AAPL 从 15.5% 到 9.2%,BTC 从 19.1% 到 8.2%。
- 收益 ÷ 波动:AAPL 从 0.592 略升到 0.616,SPY(0.545 → 0.414)和 BTC(0.401 → 0.283)都下降了。
- 在场时间减半:SPY 从 81.6% 到 49.5%,BTC 从 51.7% 到 20.5%。几乎所有交易都是被止损打出来的,SPY 49 笔全部是止损出场,趋势出场一笔都没有。
看 SPY 2020 年的交易:2 月 24 日开盘就跳空击穿止损,卖在 323.14,亏了 3.2%;v0 一直拿到 3 月 31 日死叉之后才卖。这就是回撤从 -34% 降到 -14% 的原因。 可是 2025 年,v1 在 1、2 月两次被上涨途中的回调打掉,各亏 2.4% 左右,又在 7 月之后反复进出。
对参数的敏感度:SPY 上 4、5 ATR 的收益 ÷ 波动比 3 ATR 好,BTC 上 2 ATR 最好(0.711),AAPL 上 3 ATR 最好。三个标的各不相同,看不出一个「正确」的距离。如果只报告 BTC 的 2 ATR,v1 看起来比买入持有还好,这正是第 13 篇误用 7 说的挑选偏差。
读这个结果
止损不是免费的。 它用「频繁地在回调中被打掉、再在更高的价格买回」,换来了「不会在大跌中一路拿到底」。对 SPY、AAPL 这种长期上涨、回调通常很快收复的标的,前者的成本很高;对 BTC 这种大跌可以持续一年的标的,后者的价值更大,但 3 ATR 在 BTC 上又太窄,被正常波动频繁打掉。
⚠️ v1 仍然没有成本。SPY 上 49 笔交易,加上手续费和滑点(第 28 篇)之后,差距还会拉大。v1 也还没有仓位规则(第 26 篇),第 27 到 29 篇会用完整的检验流程重新评估它。
十、实验二:指标库
第 10、12 至 15 篇,加上第 8 篇的 ADX,一共写了十几个指标。实验二要做两件事:
- 所有指标和 TA-Lib 对账,误差控制在 1e-8 以内
- 画出指标相关性矩阵,找出本质相同的指标
对账
用 BTC 日线、SPY 日线、BTC 1 小时线三组真实数据,逐个指标比较:
import talib

rows = []
for name, df in [("BTC 日线", day), ("SPY 日线", spy), ("BTC 1 小时线", h1)]:
    high, low, close = df["high"], df["low"], df["close"]
    H, L, C = (s.to_numpy(float) for s in (high, low, close))
    stoch, band, m = I.stochastic(high, low, close), I.bollinger(close), I.macd(close)
    upper, middle, lower = talib.BBANDS(C, 20, 2, 2, 0)
    pairs = [("SMA(20)", I.sma(close, 20), talib.SMA(C, 20)), ("EMA(20)", I.ema(close, 20), talib.EMA(C, 20)),
             ("WMA(20)", I.wma(close, 20), talib.WMA(C, 20)), ("MACD 线", m["macd"], talib.MACD(C)[0]),
             ("MACD 信号线", m["signal"], talib.MACD(C)[1]), ("MACD 柱", m["hist"], talib.MACD(C)[2]),
             ("RSI(14)", I.rsi(close), talib.RSI(C, 14)), ("Stochastic %K", stoch["k"], talib.STOCH(H, L, C, 14, 3, 0, 3, 0)[0]),
             ("Stochastic %D", stoch["d"], talib.STOCH(H, L, C, 14, 3, 0, 3, 0)[1]),
             ("真实波幅", X.true_range(high, low, close), talib.TRANGE(H, L, C)), ("ATR(14)", I.atr(high, low, close), talib.ATR(H, L, C, 14)),
             ("NATR(14)", I.natr(high, low, close), talib.NATR(H, L, C, 14)),
             ("布林上轨", band["upper"], upper), ("布林中轨", band["middle"], middle), ("布林下轨", band["lower"], lower),
             ("+DI(14)", X.adx(high, low, close)["plus_di"], talib.PLUS_DI(H, L, C, 14)),
             ("-DI(14)", X.adx(high, low, close)["minus_di"], talib.MINUS_DI(H, L, C, 14)),
             ("ADX(14)", X.adx(high, low, close)["adx"], talib.ADX(H, L, C, 14))]
    for label, ours, theirs in pairs:
        ours = ours.to_numpy(float)
        both = ~np.isnan(ours) & ~np.isnan(theirs)
        error = np.abs(ours[both] - theirs[both])
        rows.append({"数据": name, "指标": label, "NaN 位置一致": bool((np.isnan(ours) == np.isnan(theirs)).all()),
                     "最大绝对误差": error.max(), "最大相对误差": (error / np.maximum(np.abs(theirs[both]), 1e-12)).max()})
table = pd.DataFrame(rows)
table["通过(相对误差 ≤ 1e-8)"] = table["NaN 位置一致"] & (table["最大相对误差"] <= 1e-8)
print(table.to_string(index=False, formatters={"最大绝对误差": "{:.1e}".format, "最大相对误差": "{:.1e}".format}))
       数据            指标  NaN 位置一致  最大绝对误差  最大相对误差  通过(相对误差 ≤ 1e-8)
   BTC 日线       SMA(20)      True 1.5e-10 2.4e-15             True
   BTC 日线       EMA(20)      True 0.0e+00 0.0e+00             True
   BTC 日线       WMA(20)      True 4.5e-10 1.3e-14             True
   BTC 日线        MACD 线      True 1.5e-11 7.6e-14             True
   BTC 日线      MACD 信号线      True 5.2e-12 5.3e-14             True
   BTC 日线        MACD 柱      True 1.2e-11 5.1e-13             True
   BTC 日线       RSI(14)      True 4.3e-14 1.6e-15             True
   BTC 日线 Stochastic %K      True 2.1e-13 6.2e-14             True
   BTC 日线 Stochastic %D      True 2.2e-13 3.1e-14             True
   BTC 日线          真实波幅      True 0.0e+00 0.0e+00             True
   BTC 日线       ATR(14)      True 1.4e-12 5.5e-16             True
   BTC 日线      NATR(14)      True 7.1e-15 5.7e-16             True
   BTC 日线          布林上轨      True 2.4e-08 8.6e-13             True
   BTC 日线          布林中轨      True 1.5e-10 2.4e-15             True
   BTC 日线          布林下轨      True 2.4e-08 8.8e-13             True
   BTC 日线       +DI(14)      True 2.8e-01 1.7e-02            False
   BTC 日线       -DI(14)      True 2.3e-01 8.2e-03            False
   BTC 日线       ADX(14)      True 2.5e-01 5.7e-03            False
   SPY 日线       SMA(20)      True 2.2e-12 2.9e-15             True
   SPY 日线       EMA(20)      True 0.0e+00 0.0e+00             True
   SPY 日线       WMA(20)      True 6.5e-12 1.6e-14             True
   SPY 日线        MACD 线      True 0.0e+00 0.0e+00             True
   SPY 日线      MACD 信号线      True 3.2e-15 9.3e-15             True
   SPY 日线        MACD 柱      True 3.2e-15 5.7e-14             True
   SPY 日线       RSI(14)      True 4.3e-14 1.2e-15             True
   SPY 日线 Stochastic %K      True 3.3e-13 1.1e-13             True
   SPY 日线 Stochastic %D      True 3.7e-13 4.7e-14             True
   SPY 日线          真实波幅      True 0.0e+00 0.0e+00             True
   SPY 日线       ATR(14)      True 3.6e-15 4.5e-16             True
   SPY 日线      NATR(14)      True 1.8e-15 5.8e-16             True
   SPY 日线          布林上轨      True 3.3e-10 4.2e-13             True
   SPY 日线          布林中轨      True 2.2e-12 2.9e-15             True
   SPY 日线          布林下轨      True 3.3e-10 4.3e-13             True
   SPY 日线       +DI(14)      True 3.6e-01 2.5e-02            False
   SPY 日线       -DI(14)      True 5.3e-01 1.7e-02            False
   SPY 日线       ADX(14)      True 8.3e-01 4.5e-02            False
BTC 1 小时线       SMA(20)      True 2.6e-10 8.7e-15             True
BTC 1 小时线       EMA(20)      True 1.5e-11 2.2e-16             True
BTC 1 小时线       WMA(20)      True 1.6e-09 2.8e-14             True
BTC 1 小时线        MACD 线      True 9.1e-13 1.5e-14             True
BTC 1 小时线      MACD 信号线      True 2.3e-13 8.0e-12             True
BTC 1 小时线        MACD 柱      True 7.3e-13 3.8e-13             True
BTC 1 小时线       RSI(14)      True 4.3e-14 1.5e-15             True
BTC 1 小时线 Stochastic %K      True 2.3e-12 7.4e-12             True
BTC 1 小时线 Stochastic %D      True 3.3e-12 1.1e-12             True
BTC 1 小时线          真实波幅      True 0.0e+00 0.0e+00             True
BTC 1 小时线       ATR(14)      True 4.5e-13 6.3e-16             True
BTC 1 小时线      NATR(14)      True 3.6e-15 7.9e-16             True
BTC 1 小时线          布林上轨      True 4.5e-06 1.3e-10             True
BTC 1 小时线          布林中轨      True 2.6e-10 8.7e-15             True
BTC 1 小时线          布林下轨      True 4.5e-06 1.3e-10             True
BTC 1 小时线       +DI(14)      True 2.8e-01 1.9e-02            False
BTC 1 小时线       -DI(14)      True 4.0e-01 2.2e-02            False
BTC 1 小时线       ADX(14)      True 3.3e-01 2.9e-02            False
先说误差怎么算。 BTC 1 小时线上,布林上轨的最大绝对误差是 4.5e-6,超过了 1e-8。但 BTC 的价格是几万,4.5e-6 美元相对价格只有 1.3e-10。反过来,RSI 在 0 到 100 之间,1e-8 的绝对误差已经很严格。所以这里用相对误差 ≤ 1e-8 作为标准。
⚠️ 布林带在 BTC 1 小时线上的相对误差(1.3e-10)是所有指标里最大的。TA-Lib 算滚动方差时,用的是「加上新进来的平方、减去移出去的平方」的累加和,BTC 的价格从几千涨到十几万,平方和跨越好几个数量级,舍入误差会慢慢累积。离 1e-8 的标准还差得远。
结果:15 个指标在三组数据上全部通过,NaN 的位置也完全一致。只有 +DI、-DI 和 ADX 不通过,最大差了 0.2 到 0.8。
ADX 差在哪里
第 8 篇的 adx 用 Wilder 平滑:第一个值是前 14 个值的平均。一个猜测是 TA-Lib 的初始值不同。验证方法:照着猜测重写一遍,看能不能和 TA-Lib 完全对上。
high, low, close = day["high"], day["low"], day["close"]
H, L, C = (s.to_numpy(float) for s in (high, low, close))
plus_dm = X.directional_movement(high, low)["plus_dm"].to_numpy()
n = 14
running = np.nansum(plus_dm[1:n])                                  # TA-Lib:先把前 n - 1 个 +DM 加起来
talib_style = np.full(len(plus_dm), np.nan)
for k in range(n, len(plus_dm)):
    running = running - running / n + plus_dm[k]
    talib_style[k] = running
tr = X.true_range(high, low, close).to_numpy()
running = np.nansum(tr[1:n])
talib_tr = np.full(len(tr), np.nan)
for k in range(n, len(tr)):
    running = running - running / n + tr[k]
    talib_tr[k] = running
print(f"按 TA-Lib 的初始值重算 +DI,和 talib.PLUS_DI 的最大差:{np.nanmax(np.abs(100 * talib_style / talib_tr - talib.PLUS_DI(H, L, C, 14))):.1e}")
ours = X.adx(high, low, close)
gap = pd.DataFrame({"+DI": (ours["plus_di"] - talib.PLUS_DI(H, L, C, 14)).abs(), "ADX": (ours["adx"] - talib.ADX(H, L, C, 14)).abs()})
start = gap["+DI"].first_valid_index()
k0 = day.index.get_loc(start)
print(pd.DataFrame({f"第 {k} 根": gap.iloc[k0 + k] for k in [0, 14, 50, 100, 200, 300, 400]}).T
      .to_string(formatters={"+DI": "{:.1e}".format, "ADX": "{:.1e}".format}))
print(f"(13/14)^300 = {(13 / 14) ** 300:.1e}")
按 TA-Lib 的初始值重算 +DI,和 talib.PLUS_DI 的最大差:7.1e-15
            +DI     ADX
第 0 根   1.2e-01     NaN
第 14 根  1.2e-01 1.9e-01
第 50 根  2.2e-02 9.5e-02
第 100 根 1.5e-04 7.7e-03
第 200 根 2.7e-08 5.3e-06
第 300 根 1.1e-10 4.7e-09
第 400 根 4.6e-14 3.7e-12
(13/14)^300 = 2.2e-10
- TA-Lib 的写法:+DM、-DM、TR 先把前 13 个(n - 1 个)加起来,然后每一根做「总和 - 总和 ÷ 14 + 今天的值」。照这样重算,和
talib.PLUS_DI的差是 7.1e-15,完全对上了。 - 两种写法的关系:都是 Wilder 平滑,只是初始值不同。之后每一根,旧的差距乘以 13/14。
- 差距消失得很快:+DI 在第 100 根差 1.5e-4,第 300 根 1.1e-10,和 (13/14)^300 = 2.2e-10 同一个量级。ADX 还要再平滑一次,慢一些,第 300 根 4.7e-9。
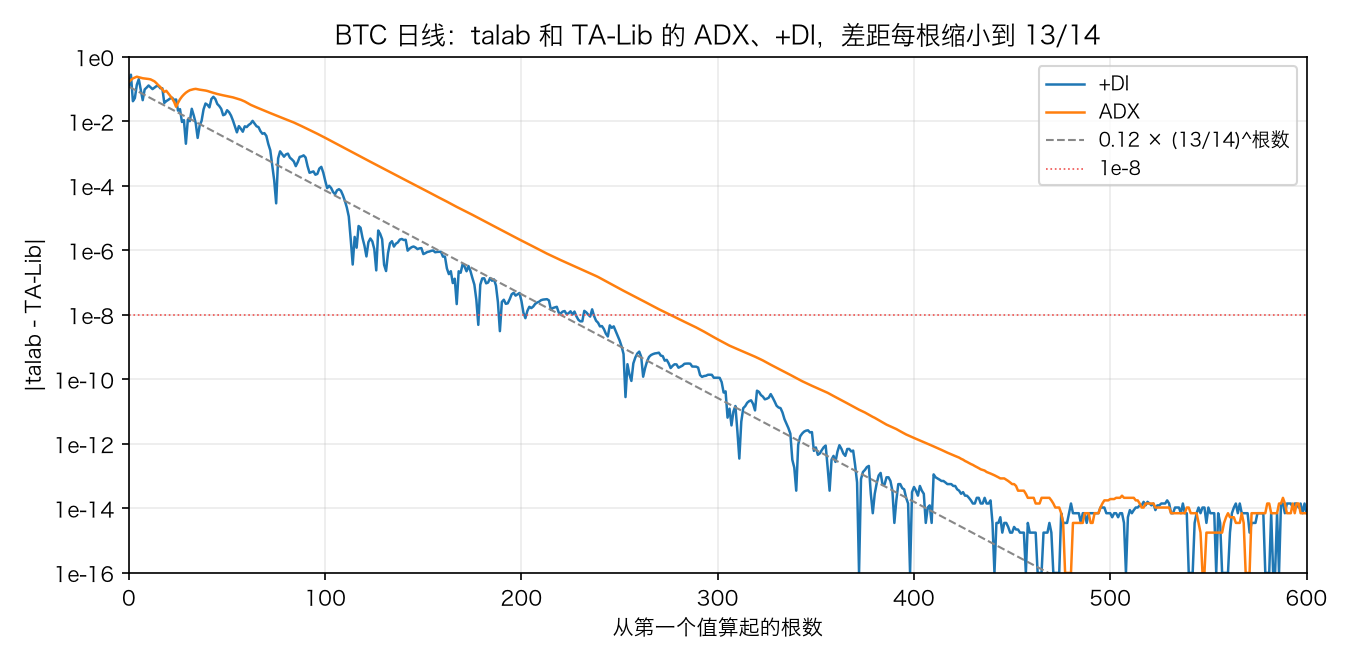
怎么处理? 两种写法都不算错,只是约定不同。talab 保留第 8 篇的写法(前 n 个平均,和 ATR、RSI 的初始值一致),在测试里写明:开头确实不同,500 根之后相对误差小于 1e-8。实际使用时,数据开头的几百根 ADX 不要拿去和别的软件比。
相关性矩阵
选 14 个指标,每个都取「这根 K 线收盘时」的读数:
| 类型 | 指标 |
|---|---|
| 位置和动量 | RSI(14)、Stochastic %K、布林 %b、乖离率(收盘价相对 20 日 SMA)、20 日涨幅、效率比(带方向,20 根)、+DI 减 -DI、MACD 线 ÷ 价格、MACD 柱 ÷ 价格 |
| 趋势强度 | ADX |
| 波动 | NATR、布林带宽、20 日收益率标准差 |
| 成交量 | 相对成交量 |
MACD 除以价格,是因为它的单位是价格(第 13 篇)。用 Spearman 秩相关,不受极端值影响。
def indicator_panel(df):
    """同一组 K 线上的 14 个指标读数,每一列都是「这根 K 线收盘时」的值。"""
    close, high, low = df["close"], df["high"], df["low"]
    m, band, stoch, dmi = I.macd(close), I.bollinger(close), I.stochastic(high, low, close), X.adx(high, low, close)
    change = close.diff()
    return pd.DataFrame({
        "RSI": I.rsi(close), "%K": stoch["k"], "%b": band["percent_b"], "乖离率": I.bias(close, I.sma(close, 20)),
        "20 日涨幅": close.pct_change(20), "效率比": change.rolling(20).sum() / change.abs().rolling(20).sum(),
        "+DI 减 -DI": dmi["plus_di"] - dmi["minus_di"], "MACD 线": m["macd"] / close, "MACD 柱": m["hist"] / close,
        "ADX": dmi["adx"], "NATR": I.natr(high, low, close), "带宽": band["bandwidth"],
        "20 日波动": np.log(close).diff().rolling(20).std(), "相对成交量": I.relative_volume(df["volume"], 20)}).dropna()


for name, df in [("BTC 日线", day), ("SPY 日线", spy)]:
    panel = indicator_panel(df)
    corr = panel.corr(method="spearman")
    print(f"{name}({len(panel)} 根,Spearman 秩相关):")
    print(corr.round(2).to_string())
    linked = corr.abs() >= 0.8
    seen, groups = set(), []
    for column in corr.columns:
        if column in seen:
            continue
        group, todo = [], [column]
        while todo:
            item = todo.pop()
            if item not in seen:
                seen.add(item)
                group.append(item)
                todo += [other for other in corr.columns if linked.loc[item, other] and other not in seen]
        groups.append(group)
    print("   |相关系数| ≥ 0.8 连在一起的组:", " | ".join("、".join(g) for g in groups))
BTC 日线(3269 根,Spearman 秩相关):
            RSI    %K    %b   乖离率  20 日涨幅   效率比  +DI 减 -DI  MACD 线  MACD 柱   ADX  NATR    带宽  20 日波动  相对成交量
RSI        1.00  0.84  0.91  0.93    0.88  0.90       0.94    0.86    0.55  0.08 -0.27  0.08   -0.07   0.05
%K         0.84  1.00  0.89  0.88    0.71  0.74       0.77    0.63    0.76  0.09 -0.17  0.12   -0.01   0.06
%b         0.91  0.89  1.00  0.94    0.77  0.80       0.85    0.63    0.74  0.05 -0.22  0.07   -0.05   0.06
乖离率        0.93  0.88  0.94  1.00    0.85  0.85       0.88    0.72    0.76  0.07 -0.22  0.09   -0.04   0.06
20 日涨幅     0.88  0.71  0.77  0.85    1.00  0.97       0.86    0.86    0.52  0.08 -0.22  0.09   -0.05   0.06
效率比        0.90  0.74  0.80  0.85    0.97  1.00       0.87    0.84    0.53  0.09 -0.24  0.08   -0.08   0.07
+DI 减 -DI  0.94  0.77  0.85  0.88    0.86  0.87       1.00    0.84    0.54  0.05 -0.32  0.04   -0.13   0.05
MACD 线     0.86  0.63  0.63  0.72    0.86  0.84       0.84    1.00    0.26  0.07 -0.23  0.08   -0.07   0.05
MACD 柱     0.55  0.76  0.74  0.76    0.52  0.53       0.54    0.26    1.00  0.07 -0.10  0.10    0.02   0.03
ADX        0.08  0.09  0.05  0.07    0.08  0.09       0.05    0.07    0.07  1.00  0.30  0.53    0.36   0.06
NATR      -0.27 -0.17 -0.22 -0.22   -0.22 -0.24      -0.32   -0.23   -0.10  0.30  1.00  0.69    0.90   0.06
带宽         0.08  0.12  0.07  0.09    0.09  0.08       0.04    0.08    0.10  0.53  0.69  1.00    0.75   0.12
20 日波动    -0.07 -0.01 -0.05 -0.04   -0.05 -0.08      -0.13   -0.07    0.02  0.36  0.90  0.75    1.00   0.02
相对成交量      0.05  0.06  0.06  0.06    0.06  0.07       0.05    0.05    0.03  0.06  0.06  0.12    0.02   1.00
   |相关系数| ≥ 0.8 连在一起的组: RSI、MACD 线、+DI 减 -DI、效率比、20 日涨幅、乖离率、%b、%K | MACD 柱 | ADX | NATR、20 日波动 | 带宽 | 相对成交量
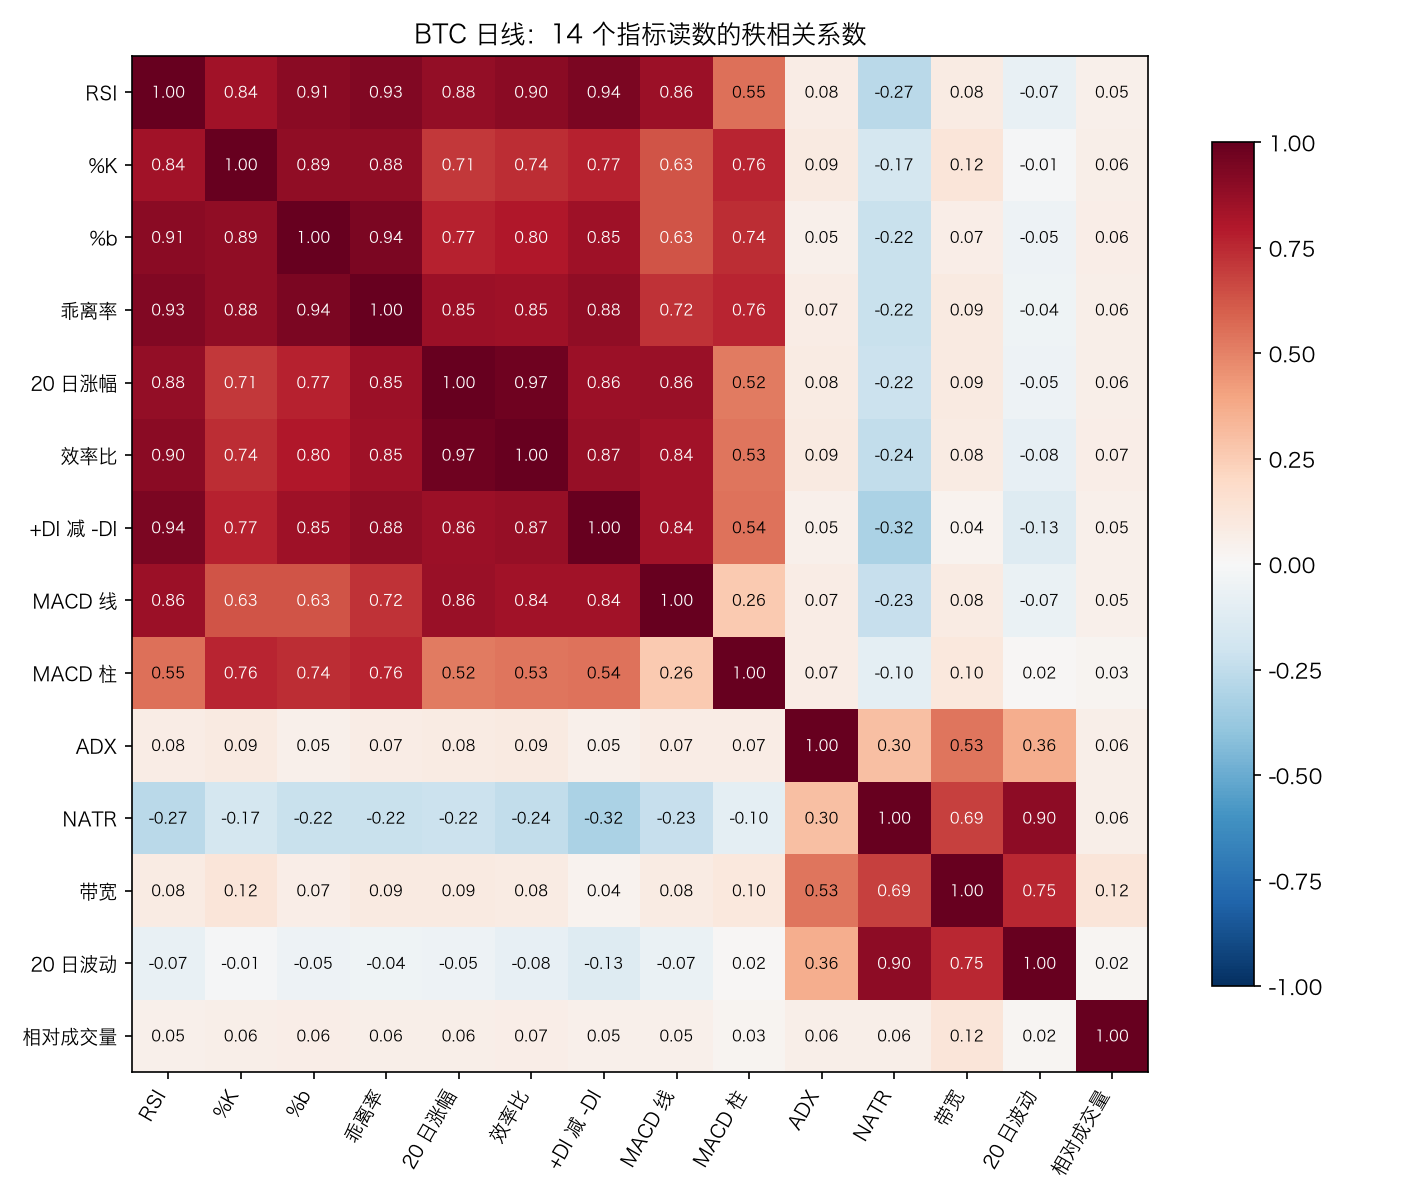
SPY 的矩阵在脚本输出里,结论相同。
把相关系数的绝对值 ≥ 0.8 的指标连起来,14 个指标分成了 5 到 6 组:
- 位置和动量组(8 到 9 个):RSI、%K、%b、乖离率、20 日涨幅、效率比、+DI 减 -DI、MACD 线,SPY 上还有 MACD 柱。它们两两之间的相关系数大多在 0.8 以上,RSI 和 +DI 减 -DI 高达 0.94,20 日涨幅和效率比 0.97。
- MACD 柱:BTC 上单独一组(和其他动量指标 0.5 到 0.76),SPY 上勉强并进第一组。第 13 篇说过,柱对 12 到 61 根的波动最敏感,比其他动量指标更「短」。
- ADX:和谁都不太相关,和带宽 0.32 到 0.53。它量的是「趋势强不强」,不管方向,也不完全等于「波动大不大」。
- NATR 和 20 日波动:0.90 到 0.94,本质相同(第三节:1 ATR ≈ 1.4 到 1.6 个标准差)。
- 带宽:和 NATR 0.69 到 0.75,没有达到 0.8。带宽量的是价格水平的离散程度,趋势本身也会让它变宽(第四节)。
- 相对成交量:自成一组。
实验二的结论
「本质相同」的指标比想象的多。 第一组的 8 个指标,公式看起来五花八门:有的算涨跌之比,有的算区间位置,有的算均线距离,有的算方向运动。但它们回答的是同一个问题:最近价格往哪边走了、走得多坚决。第 14 篇已经证明 RSI 就是带方向的效率比,这一节又证明了 %b 就是用带宽量过的乖离率。
这对后面有两个直接的影响:
- 同时用 RSI、%K、%b 做「三重确认」,确认的是同一件事,不是三个独立的证据。
- 组合指标时,从不同的组里各挑一个:一个方向、一个趋势强度、一个波动、一个成交量,信息才不重复。
⚠️ 相关系数高不代表完全可以互换。RSI 和 %K 相关 0.84,但第 14 篇看到 SPY 上「%K 高于 80」的时间是「RSI 高于 70」的将近 5 倍,阈值和钝化方式都不一样。
十一、talab.indicators:第五部分
新增了什么
| 函数 | 作用 |
|---|---|
atr |
平均真实波幅,第 8 篇的真实波幅加 Wilder 平滑,和 TA-Lib 的 ATR 一致 |
natr |
ATR 占收盘价的百分比,和 TA-Lib 的 NATR 一致 |
bollinger |
布林带的中轨、上轨、下轨、%b、带宽,前三列和 TA-Lib 的 BBANDS 一致 |
indicators 现在从 structure 导入 true_range 和 wilder_smooth,不重复写一遍。mainline_v1、squeeze_study、stop_hit 这些只在这一篇分析用的函数不放进模块,只在 docs/trade-analysis/analysis/15_volatility.py 里;回测函数第 27 到 29 篇才进 talab.backtest。
代码
# ---------------------------------------------------------------------------
# 七、波动率:ATR 和布林带(第 15 篇)
# ---------------------------------------------------------------------------

def atr(high: pd.Series, low: pd.Series, close: pd.Series, n: int = 14) -> pd.Series:
    """平均真实波幅(Wilder):第 8 篇的真实波幅 true_range,用 Wilder 平滑取 n 根的平均。

    真实波幅从第 2 根开始才有(要用前一根收盘价),所以第一个 ATR 出现在第 n + 1 根,是前 n 个真实波幅的平均。
    单位和价格相同。和 TA-Lib 的 ATR 一致。
    """
    _check_period(n)
    return wilder_smooth(true_range(high, low, close), n)


def natr(high: pd.Series, low: pd.Series, close: pd.Series, n: int = 14) -> pd.Series:
    """归一化的 ATR:ATR 占收盘价的百分比,100 × ATR ÷ 收盘价。不同价位、不同标的之间可以比较。和 TA-Lib 的 NATR 一致。"""
    return 100 * atr(high, low, close, n) / close


def bollinger(close: pd.Series, n: int = 20, k: float = 2.0) -> pd.DataFrame:
    """布林带:中轨是 n 根简单平均,上下轨是中轨加减 k 倍标准差。

    ⚠️ 标准差是这 n 个收盘价的总体标准差(除以 n),和 Bollinger 本人、TA-Lib 的 BBANDS 一致;
    pandas 的 rolling().std() 默认除以 n - 1,算出来的带会宽一些。
    返回五列:
    middle、upper、lower
    percent_b:收盘价在带里的位置,(收盘价 - 下轨) ÷ (上轨 - 下轨),下轨是 0、上轨是 1,可以小于 0 或大于 1
    bandwidth:带宽,(上轨 - 下轨) ÷ 中轨,等于 2k 倍标准差占中轨的比例
    前 n - 1 根为 NaN;n 个价格完全相同时,上下轨重合,percent_b 为 NaN。
    """
    _check_period(n)
    middle = sma(close, n)
    width = k * close.rolling(n).std(ddof=0)
    upper, lower = middle + width, middle - width
    spread = upper - lower
    return pd.DataFrame({"middle": middle, "upper": upper, "lower": lower,
                         "percent_b": ((close - lower) / spread).where(spread != 0),
                         "bandwidth": spread / middle})
读一遍代码
atr 只有一行:wilder_smooth(true_range(high, low, close), n)。true_range 第一根是 NaN,wilder_smooth 跳过开头的 NaN,所以第一个 ATR 正好在第 n + 1 根。
bollinger 的关键是 close.rolling(n).std(ddof=0):ddof=0 表示除以 n。percent_b 用 where(spread != 0) 处理 n 个价格完全相同的情况:上下轨重合,位置没有意义,记为 NaN(TA-Lib 没有 %b,这里按定义处理)。
测试
def test_atr_by_hand():
    close = hourly([101, 105, 95, 100])
    high, low = close + [1, 1, 3, 1], close - [2, 2, 1, 2]
    # 真实波幅:第 2 根 max(3, |106 - 101|, |103 - 101|) = 5;第 3 根 max(4, 7, 11) = 11;第 4 根 max(3, 6, 3) = 6
    # ATR(2):第 3 根 (5 + 11) / 2 = 8;第 4 根 8 + (6 - 8) / 2 = 7
    assert I.atr(high, low, close, 2).tolist()[2:] == [8, 7] and I.atr(high, low, close, 2).iloc[:2].isna().all()
    assert I.natr(high, low, close, 2).iloc[3] == pytest.approx(100 * 7 / 100)


def test_bollinger_by_hand():
    b = I.bollinger(hourly([10, 11, 12, 11, 13, 14]), n=4, k=2)
    # 第 4 根:10、11、12、11,平均 11,总体方差 (1 + 0 + 1 + 0) / 4 = 0.5,上下轨 11 ± 2√0.5
    assert b.iloc[:3].isna().all().all()
    assert b["upper"].iloc[3:].tolist() == pytest.approx([12.41421356, 13.40831239, 14.73606798])
    assert b["lower"].iloc[3:].tolist() == pytest.approx([9.58578644, 10.09168761, 10.26393202])
    assert b["percent_b"].iloc[3:].tolist() == pytest.approx([0.5, 0.87688918, 0.83541020])
    assert b["bandwidth"].iloc[3:].tolist() == pytest.approx([0.25712974, 0.28226594, 0.35777088])


def test_bias_equals_percent_b_times_bandwidth():
    rng = np.random.default_rng(15)
    close = hourly(100 * np.exp(np.cumsum(rng.normal(0, 0.02, 300))))
    b = I.bollinger(close)
    # %b - 0.5 = (收盘价 - 中轨) ÷ (4 倍标准差),带宽 = 4 倍标准差 ÷ 中轨,两者相乘就是乖离率
    np.testing.assert_allclose((b["percent_b"] - 0.5) * b["bandwidth"], I.bias(close, b["middle"]), rtol=1e-10, atol=1e-14)


def test_bollinger_on_a_flat_line():
    b = I.bollinger(hourly(np.full(30, 5.0)))
    assert (b["upper"].dropna() == 5).all() and (b["bandwidth"].dropna() == 0).all() and b["percent_b"].isna().all()


def test_volatility_indicators_never_use_the_future():
    rng = np.random.default_rng(150)
    close = hourly(100 * np.exp(np.cumsum(rng.normal(0, 0.02, 400))))
    high, low = close * (1 + rng.uniform(0, 0.01, 400)), close * (1 - rng.uniform(0, 0.01, 400))
    full_atr, full_band = I.atr(high, low, close), I.bollinger(close)
    for k in [30, 200, 399]:
        pd.testing.assert_series_equal(I.atr(high.iloc[:k], low.iloc[:k], close.iloc[:k]), full_atr.iloc[:k])
        pd.testing.assert_frame_equal(I.bollinger(close.iloc[:k]), full_band.iloc[:k])


@pytest.mark.parametrize("n", [2, 14, 50])
def test_atr_and_natr_match_talib(n):
    talib = pytest.importorskip("talib")
    rng = np.random.default_rng(n + 15)
    close = hourly(50_000 * np.exp(np.cumsum(rng.normal(0, 0.03, 2000))))
    high, low = close * (1 + rng.uniform(0, 0.02, 2000)), close * (1 - rng.uniform(0, 0.02, 2000))
    for ours, theirs in [(I.atr(high, low, close, n), talib.ATR(high.to_numpy(), low.to_numpy(), close.to_numpy(), n)),
                         (I.natr(high, low, close, n), talib.NATR(high.to_numpy(), low.to_numpy(), close.to_numpy(), n))]:
        assert (ours.isna().to_numpy() == np.isnan(theirs)).all()
        np.testing.assert_allclose(ours.to_numpy(), theirs, rtol=1e-10, atol=1e-8)


@pytest.mark.parametrize("n,k", [(20, 2.0), (10, 1.5), (50, 2.5)])
def test_bollinger_matches_talib(n, k):
    talib = pytest.importorskip("talib")
    rng = np.random.default_rng(n)
    close = hourly(50_000 * np.exp(np.cumsum(rng.normal(0, 0.03, 2000))))
    ours = I.bollinger(close, n, k)
    for column, theirs in zip(["upper", "middle", "lower"], talib.BBANDS(close.to_numpy(), n, k, k, 0)):
        assert (ours[column].isna().to_numpy() == np.isnan(theirs)).all()
        # TA-Lib 用累加的平方和算方差,价格从 5 万跌到几百时舍入误差会放大到 1e-10 左右,所以这里放宽到 1e-8
        np.testing.assert_allclose(ours[column].to_numpy(), theirs, rtol=1e-8)
def test_adx_converges_to_talib():
    """talab 的 Wilder 平滑用前 n 个值的平均做初始值;TA-Lib 的 +DM、-DM、TR 只用前 n - 1 个(第 15 篇实验二)。
    两者的差每根乘以 (n - 1) / n,开头最多差零点几,几百根之后一致。"""
    talib = pytest.importorskip("talib")
    rng = np.random.default_rng(8)
    close = pd.Series(100 * np.exp(np.cumsum(rng.normal(0, 0.02, 1000))))
    high, low = close * (1 + rng.uniform(0, 0.02, 1000)), close * (1 - rng.uniform(0, 0.02, 1000))
    ours = X.adx(high, low, close)
    H, L, C = high.to_numpy(), low.to_numpy(), close.to_numpy()
    for column, theirs in [("plus_di", talib.PLUS_DI(H, L, C, 14)), ("minus_di", talib.MINUS_DI(H, L, C, 14)),
                           ("adx", talib.ADX(H, L, C, 14))]:
        assert (ours[column].isna().to_numpy() == np.isnan(theirs)).all()
        assert np.nanmax(np.abs(ours[column].to_numpy() - theirs)) > 1e-3             # 开头确实不一样
        np.testing.assert_allclose(ours[column].to_numpy()[500:], theirs[500:], rtol=1e-8)
test_atr_by_hand:第三节的手算,包括跳空和 NATR。test_bollinger_by_hand:第四节的手算,五列都检查。test_bias_equals_percent_b_times_bandwidth:第四节的恒等式。test_bollinger_on_a_flat_line:价格不动时,带宽是 0、%b 是 NaN。test_volatility_indicators_never_use_the_future:截断 3 次,前 k 行必须和全部数据算出的一致。test_atr_and_natr_match_talib、test_bollinger_matches_talib:各 3 组参数,和 TA-Lib 一致,包括 NaN 的位置。test_adx_converges_to_talib(放在test_structure.py):实验二的结论写成测试,开头确实不同,500 根之后一致。
pytest -q
........................................................................ [ 55%]
..........................................................               [100%]
130 passed in 0.46s
没装 TA-Lib 时,结果是 98 passed、32 skipped。
十二、常见误用
1. 用「最高价 - 最低价」代替真实波幅。 SPY、AAPL 上超过三分之一的日子有跳空,跳空贡献了 9% 到 11% 的真实波幅,财报日能占到七成。
2. 用 pandas 默认的 rolling().std() 画布林带。
它除以 n - 1,带宽比 Bollinger 和 TA-Lib 宽 2.6%。
3. 以为价格 95% 的时间在布林带里。 三个标的上是 87% 到 89%,正态随机游走也只有 88%。布林带不是概率区间。
4. 把「收口之后波动放大」当作市场的规律。 打乱顺序、没有任何波动率聚集的价格,收口之后也放大 1.15 到 1.28 倍。挑出测量值最低的时刻,之后往中间靠,这是均值回归。
5. 以为收口之后的波动会「很大」。 收口之后的波动比收口时大,但仍然比平常小:BTC 日线 3.95% 对 4.59%,1 小时线只有平常的一半。
6. 用 ATR 预测方向。 按波动率分组,之后的收益和上涨比例在三个标的上没有一致的规律。ATR 只回答「多大」,不回答「往哪边」。
7. 用 RSI、%K、%b 做「多重确认」。 它们的相关系数在 0.84 到 0.91 之间,量的是同一件事。
8. 在几个止损距离里挑结果最好的一个报告。 BTC 上 2 ATR 的收益 ÷ 波动 0.711,比买入持有还好;但 SPY 上 2 ATR 是最差的。
十三、这一篇能回答什么,不能回答什么
| 这一篇能帮你回答 | 这一篇不能回答 |
|---|---|
| ATR、布林带的每个数字怎么算,和 TA-Lib 是否一致 | 20 和 2、14 和 3 是不是最好的参数 |
| 1 个 ATR 大约是几个标准差,布林带外的时间为什么不是 5% | 下一次跳空会有多大 |
| 波动率能在多大程度上预测,收口之后的放大有多少是均值回归 | 收口之后往哪个方向突破 |
| ATR 止损在这三个标的上,换来了多少回撤的下降,付出了多少收益 | 加上成本、仓位规则之后,v1 值不值得用(第 26 至 29 篇) |
| 哪些指标本质相同 | 哪一组指标对交易最有用 |
十四、小结
-
真实波幅把跳空算进来:SPY、AAPL 上跳空贡献了 9% 到 11% 的真实波幅,BTC 几乎为 0。ATR 是真实波幅的 Wilder 平滑,第一个值在第 n + 1 根;NATR 用来跨时间、跨标的比较。
-
1 个 ATR ≈ 1.4 到 1.6 个日收益率标准差。 BTC 1.59,和连续随机游走的理论值 2√(2/π) ≈ 1.596 几乎一样;美股因为隔夜变动不在交易时段里,是 1.40。
-
布林带用除以 n 的总体标准差。 收盘价在带外的时间是 11% 到 13%,正态随机游走也有 12%,布林带不是概率区间。%b 就是用带宽量过的乖离率:乖离率 = (%b - 0.5) × 带宽。
-
波动率聚集是真的,而且很强。 现在的 NATR 和之后 20 根的波动,相关系数 0.66 到 0.82,打乱顺序之后约等于 0。波动既持续,又向平常水平回归。
-
「收口之后有大行情」只对了一小半。 之后的波动比收口时大,但打乱的价格也一样,主要是均值回归;之后的波动仍然比平常小;突破方向不比普通突破可靠。
-
波动率的三个用途:ATR 止损在 SPY、AAPL 上让被打掉的比例更稳定,BTC 上高波动之后反而太远;按 ATR 调整仓位,让不同年份的波动从相差 2.8 到 5 倍降到 1.3 到 1.5 倍;波动率能判断「之后多大」,不能判断「之后往哪边」。
-
主线 v1 = v0 + 3 ATR 吊灯止损。 回撤明显变小(SPY -34.1% → -14.0%),收益掉得更多(8.5% → 2.9%),在场时间减半,几乎所有交易都是止损出场。参数敏感度在三个标的上各不相同,不能挑最好的报告。
-
实验二:15 个指标和 TA-Lib 的相对误差都在 1e-8 以内;ADX 的差距来自 TA-Lib 用前 n - 1 个值做初始值,每根缩小到 13/14,几百根之后一致。14 个指标里,8 到 9 个位置和动量指标本质相同。
-
决策点那次,收口之后第三天暴跌 7.3%,带宽涨了近 9 倍。但按 BTC 的标准,之后的波动仍然低于平常。
最后回到海边的帆船店。天气预报说明天风会比今天大,这很准(第五节);可是连续平静了两周之后,明天「风会大一点」这件事,就算没有任何天气规律也大概率会发生(第七节)。预报能帮你决定桩打多深、带多少货(第八节),但帮不了你猜风往哪边吹。
下一篇是第 16 篇,进入第四部分「形态」:K 线组合形态。AAPL 在一段下跌之后收出一根标准的锤子线,这是反转信号吗?
练习
练习 1(手算) 四天的 (最高, 最低, 收盘) 依次是 (52, 49, 50)、(55, 51, 54)、(53, 47, 48)、(50, 44, 49)。
- (a) 算出每天的真实波幅和 ATR(2)。
- (b) 用这四个收盘价算 n = 4、k = 2 的布林带:中轨、上下轨、%b、带宽。
- (c) 如果用 pandas 默认的
std(),上轨是多少?
练习 2(推导) 第三节说连续随机游走一天的「最高 - 最低」平均是 1.596σ。
- (a) 用
numpy模拟:每天分成 390 个 1 分钟步长,算「最高 - 最低」的平均,除以日标准差。步长减少到 6.5 个(每小时一个)时,这个比值变成多少? - (b) 用 (a) 的结果解释:为什么用 1 小时线合成的日线算出来的 ATR,会比用 1 分钟线合成的小?
- (c) 如果一天里有一段时间不交易(美股的隔夜),比值会怎么变?
练习 3(数据) 第七节的收口定义是「带宽创一年新低的第一根」。
- (a) 改成「带宽排在过去一年最低 5%,而且之前 20 根都不在最低 5%」,重做三张表。样本多了多少?结论变不变?
- (b) 把带宽换成 NATR,重做一遍。
- (c) 在打乱的价格上,「之后 ÷ 现在 ATR」为什么「全部 K 线」也大于 1(1.03 到 1.05)?提示:比值的平均不等于平均的比值。
练习 4(编程) 第九节的 v1 只有一种止损之后的买回规则。
- (a) 改成「止损之后,等快均线重新从下方上穿慢均线才买回」,重做 SPY 和 BTC 的结果表。
- (b) 改成「止损之后不限制,第二天只要趋势条件满足就买回」。为什么这个版本几乎等于没有止损?用交易次数验证。
- (c) 你在 (a)(b) 和原规则里会选哪个?这个选择是在看结果之前还是之后做的?
练习 5(实验二延伸)
- (a) 把第 10 篇的 VWAP 偏离(收盘价相对当天 VWAP,用 BTC 1 小时线)加进相关性矩阵,它属于哪一组?
- (b) 用 BTC 1 小时线重画相关性矩阵。分组和日线一样吗?
- (c) 用
scipy.cluster.hierarchy对「1 - |相关系数|」做层次聚类,画出树状图,和 0.8 阈值的分组对比。
练习 6(思考) 第八节的仓位调整让不同年份的波动更接近。
- (a) 按 ATR 调整仓位之后,SPY 的年化收益和最大回撤会怎么变?先猜,再算。
- (b) 如果 ATR 在暴跌开始的前一天还很低,按 ATR 调整的仓位反而最大。用 2020 年 2 月的 SPY 验证,并说明这是 ATR 的哪个特点造成的。
小检查答案
小检查 1
(a) 最高 - 最低 = 2;|97 - 100| = 3;|95 - 100| = 5。真实波幅 = 5,「最高 - 最低」漏掉了 3,也就是隔夜跳空的那一段。
(b) 日标准差 ≈ 1.2% ÷ 1.4 ≈ 0.86%,年化 ≈ 0.86% × √252 ≈ 13.6%。
(c) Binance 的日线是连续切出来的:这一根的开盘价就是上一根收盘之后的第一笔成交,中间没有休市,所以几乎没有跳空。换成东部时间 16:00 切日线还是这样,切点只是换了个位置,时间仍然是连续的。只有交易暂停(比如 2023-03-24 的暂停,第 3 篇)才会出现跳空。
小检查 2
(a) 548 × 1.35 ≈ 740,约占价格 29,431 的 2.5%。比决策点的 1.86% 大,但比 BTC 全部历史平均的 4.59% 小得多。(实际上 8 月 17 日之后 NATR 在 2.9% 左右。)
(b) 大概率更高。 一年里最低的一次测量,一部分是体温真的低,一部分是测量碰巧偏低。下一次测量,碰巧的那部分不会重复,平均会往常态靠。是同一个道理:均值回归。它不需要「身体在积蓄能量」这样的解释。
(c) 两个对照:打乱顺序的价格上同样的统计(看有多少是均值回归),以及全部 K 线之后 20 天的最大涨跌幅(看「12%」算不算大)。第七节的表显示,收口之后的波动虽然比收口时大,但比平常小。