| 本篇位置 | 第四部分「形态」的第一篇。位置判断用第 8、9、11 篇的摆动点和市场状态,打分方式沿用第 11 篇的「先碰到哪条 2 ATR 线」 |
| 用到的数据 | SPY、AAPL 日线(2016-09 至 2026-09);BTCUSDT 现货日线,以及用 1 分钟线合成的 4 小时线和 1 小时线(2017-08 至 2026-08) |
| 动手 | 新建 talab.patterns 模块:K 线拆解和六个形态的扫描器,附 9 个测试 |
| 读完你能 | 把「锤子线」这种模糊的说法写成可以运行、可以检验的规则;知道这些形态在五组数据上出现之后会发生什么;看懂两个软件对同一个形态给出不同答案时,差在哪里 |
一、先做一个决定
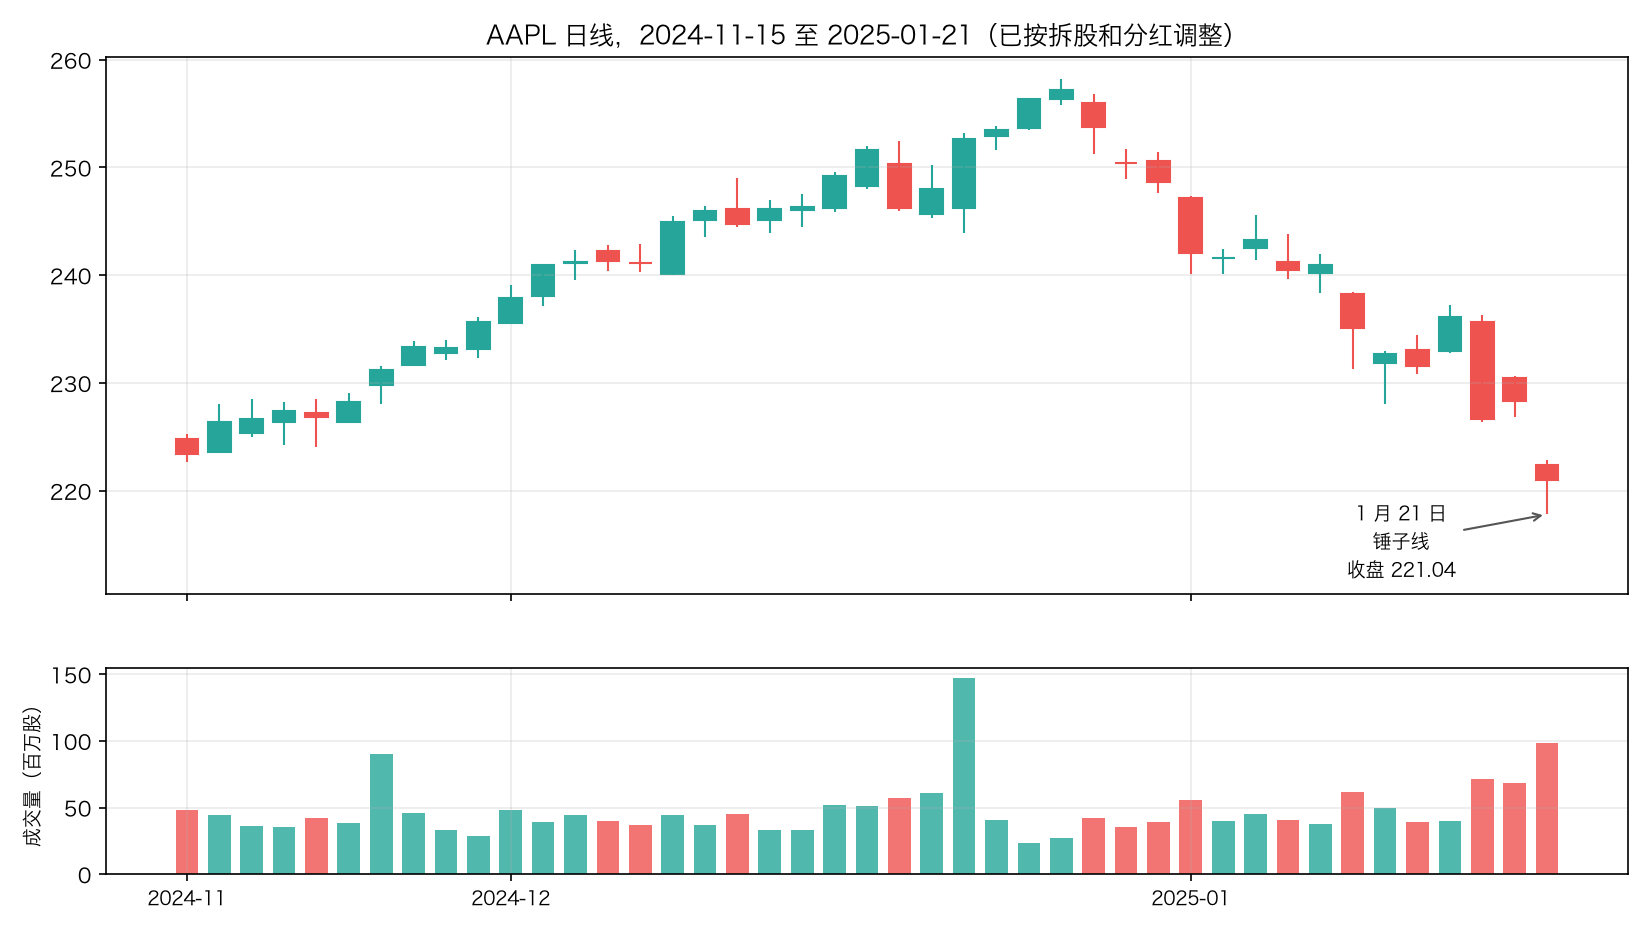
现在是 2025 年 1 月 21 日美股收盘。
AAPL 从 2024 年 12 月 26 日的最高收盘 257.15 一路跌到今天的 221.04,跌了 14.05%。
今天这根 K 线长这样:开盘 222.39,盘中最低跌到 217.80,收盘拉回 221.04。实体只有 1.35 美元,下影线 3.24 美元,是实体的 2.4 倍,上影线只有 0.42 美元。成交量 9,807 万股,是前 20 天平均的 1.91 倍。
这是教科书上标准的锤子线:价格被砸下去,又被买回来。
t = pd.Timestamp("2025-01-21")
window = aapl.loc["2025-01-13":"2025-01-21"]
parts = Pt.parts(window)
table = pd.concat([window[["open", "high", "low", "close"]], parts[["body", "upper", "lower", "range_"]],
                   (window["volume"] / 1e6).rename("成交量(百万股)")], axis=1)
table["锤子形"] = Pt.hammer(aapl).loc[window.index]
print(table.round(2).to_string())
close = aapl["close"]
peak = close.loc[:t].idxmax()
atr = I.atr(aapl["high"], aapl["low"], close)
print(f"1 月 21 日收盘 {close[t]:,.2f},比 {peak.date()} 的最高收盘 {close[peak]:,.2f} 低 {close[t] / close[peak] - 1:.2%};"
      f"当天 ATR {atr[t]:.2f},整根 K 线高度是 ATR 的 {(window['high'][t] - window['low'][t]) / atr[t]:.2f} 倍")
print(f"成交量 {window['volume'][t] / 1e6:.1f} 百万股,是前 20 天平均的 {window['volume'][t] / aapl['volume'].loc[:t].iloc[-21:-1].mean():.2f} 倍")
swings = X.zigzag(close, 0.05)
levels = X.trend_state(swings, close, close)
state = X.market_state(levels, close)
print(f"第 11 篇的市场状态:{state[t]};最近一个已确认的低点 {levels['last_low'][t]:,.2f},"
      f"这根 K 线的最低价 {window['low'][t]:,.2f},相差 {abs(window['low'][t] - levels['last_low'][t]) / atr[t]:.2f} 个 ATR")
              open    high     low   close  body  upper  lower  range_  成交量(百万股)    锤子形
date
2025-01-13  231.85  232.98  228.06  232.71  0.86   0.27   3.78    4.91     49.63   True
2025-01-14  233.06  234.42  230.80  231.60  1.46   1.36   0.80    3.62     39.44  False
2025-01-15  232.94  237.24  232.74  236.16  3.21   1.08   0.20    4.50     39.83  False
2025-01-16  235.64  236.30  226.39  226.62  9.02   0.66   0.23    9.91     71.76  False
2025-01-17  230.44  230.62  226.83  228.32  2.12   0.17   1.49    3.78     68.49  False
2025-01-21  222.39  222.80  217.80  221.04  1.35   0.42   3.24    5.00     98.07   True
1 月 21 日收盘 221.04,比 2024-12-26 的最高收盘 257.15 低 -14.05%;当天 ATR 5.43,整根 K 线高度是 ATR 的 0.92 倍
成交量 98.1 百万股,是前 20 天平均的 1.91 倍
第 11 篇的市场状态:up;最近一个已确认的低点 220.17,这根 K 线的最低价 217.80,相差 0.44 个 ATR
你会怎么做?
- A. 买入:锤子线加放量,跌势结束了
- B. 等确认:等下一根收盘价越过锤子线的最高价再买
- C. 不理它:一根 K 线的形状说明不了什么
先写下你的选择。 第七节揭晓之后的走势,第八到第十节看这三种做法在五组数据上的表现。
二、看脸色
打个比方
一根 K 线是一天交易的表情。
- 长下影线:价格被摁下去过,但收盘前被拉了回来,像一个人被推了一把又站直了。
- 十字星:开盘和收盘几乎一样,一天来回折腾却没结论,像在犹豫。
- 吞没:今天这根实体完全盖住昨天,像对方一句话把你昨天说的全推翻了。
看表情有用,但有三件事要小心:
- 表情的定义是模糊的。 「长下影线」多长算长?下影线是实体的 2 倍,还是整根 K 线的一半?不同的软件有不同的答案(第六节)。
- 同一个表情,在不同场合意思完全不同。 婚礼上的笑和葬礼上的笑不是一回事。同样一根长下影线的 K 线,出现在下跌之后叫锤子线(看涨),出现在上涨之后叫上吊线(看跌),形状一模一样(第九节)。
- 表情能说明当下的情绪,不一定能预测下一步的动作。 这是第八节要用数据回答的问题。
talab.patterns 的设计就按这三条来:形状函数只认形状,位置交给第 11 篇的市场状态和第 8、9 篇的摆动点去判断。
三、把一根 K 线拆开
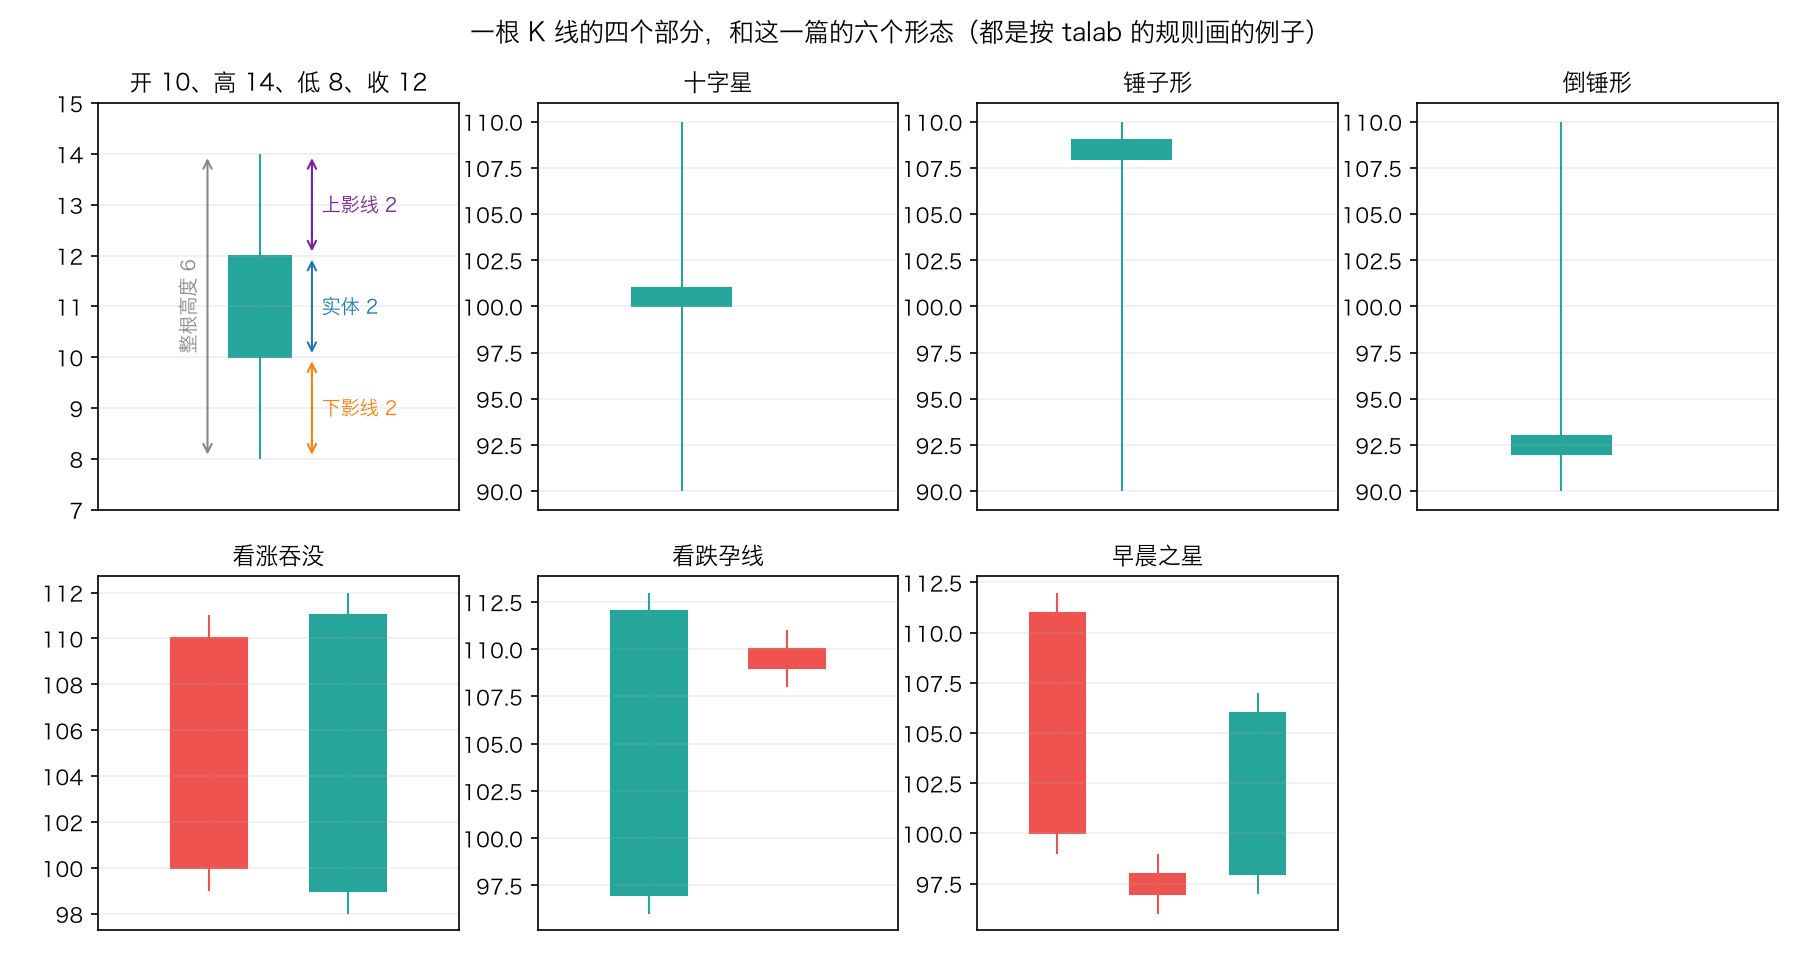
一根 K 线只有四个数字:开、高、低、收。所有形态都是这四个数字的算术:
整根高度 = 最高价 - 最低价
实体 = |收盘价 - 开盘价|
上影线 = 最高价 - 实体上沿,下影线 = 实体下沿 - 最低价
三者相加正好是整根高度
example = pd.DataFrame([(10, 14, 8, 12), (12, 12.4, 11.6, 11.9)], columns=Pt.OHLC,
                       index=pd.date_range("2024-01-01", periods=2, freq="D"))
print(pd.concat([example, Pt.parts(example)], axis=1).to_string())
            open  high   low  close  range_  body  upper  lower   top  bottom     up
2024-01-01    10  14.0   8.0   12.0     6.0   2.0    2.0    2.0  12.0    10.0   True
2024-01-02    12  12.4  11.6   11.9     0.8   0.1    0.4    0.3  12.0    11.9  False
⚠️ 最高价等于最低价(完全没有波动)时,整根高度是 0,所有比例都没法算。这一篇的所有形态在这种 K 线上一律不成立。第 3 篇提到过,Binance 在 2023-03-24 暂停交易时留下过 72 根这样的占位 K 线。
四、六个形态的精确规则
「形态」要变成能运行、能检验的东西,每一条模糊的描述都得换成数字。这一篇用六个:
| 形态 | 规则(talab 的默认参数) |
教科书的说法 |
|---|---|---|
| 十字星 | 实体 ≤ 整根高度的 10% | 多空犹豫 |
| 锤子形 | 实体 ≤ 整根高度的 34%,下影线 ≥ 实体的 2 倍,上影线 ≤ 整根高度的 15% | 下跌后叫锤子线(看涨),上涨后叫上吊线(看跌) |
| 倒锤形 | 锤子形上下颠倒:上影线 ≥ 实体的 2 倍,下影线 ≤ 整根高度的 15% | 下跌后叫倒锤线(看涨),上涨后叫流星线(看跌) |
| 吞没 | 两根颜色相反,这一根的实体完全盖住前一根的实体,两根实体都 ≥ 各自整根高度的 10% | 反转 |
| 孕线 | 前一根实体 ≥ 它整根高度的 60%,这一根实体 ≤ 前一根实体的一半且完全包在里面,颜色相反 | 动能衰竭 |
| 星形 | 第 1 根长实体(≥ 整根高度的 50%),第 2 根小实体(≤ 第 1 根实体的 30%)且整个实体在第 1 根实体外侧,第 3 根反向收复第 1 根实体的一半以上 | 早晨之星(看涨)、黄昏之星(看跌) |
⚠️ 传统的星形要求第 2 根跳空。BTC 24 小时交易,几乎没有跳空(第 15 篇),所以这里把「跳空」放宽成「第 2 根的实体完全在第 1 根实体的外侧」。这是一个选择,不是唯一正确的写法。
用一组手工构造的 K 线检查扫描器:
shapes = pd.DataFrame([(108, 110, 90, 109),      # 锤子形:小实体在上方,长下影
                       (92, 110, 90, 93),        # 倒锤形:小实体在下方,长上影
                       (100, 110, 90, 101),      # 十字星:实体只有整根的 5%
                       (110, 111, 99, 100),      # 长阴线
                       (99, 112, 98, 111),       # 看涨吞没:实体盖住前一根
                       (111, 112, 96, 97),       # 看跌吞没
                       (97, 113, 96, 112),       # 长阳线
                       (110, 111, 108, 109),     # 看跌孕线:小实体包在前一根里
                       (111, 112, 99, 100),      # 长阴线(星形的第 1 根)
                       (98, 99, 96, 97),         # 小实体,整个在前一根实体下方(第 2 根)
                       (98, 107, 97, 106)],      # 阳线,收复第 1 根实体的一半以上:早晨之星
                      columns=Pt.OHLC, index=pd.date_range("2024-02-01", periods=11, freq="D"), dtype=float)
print(pd.concat([shapes, Pt.scan(shapes)], axis=1).to_string())
             open   high    low  close  十字星  锤子形  倒锤形  吞没  孕线  星形
2024-02-01  108.0  110.0   90.0  109.0    1    1    0   0   0   0
2024-02-02   92.0  110.0   90.0   93.0    1    0    1   0   0   0
2024-02-03  100.0  110.0   90.0  101.0    1    0    0   0   0   0
2024-02-04  110.0  111.0   99.0  100.0    0    0    0   0   0   0
2024-02-05   99.0  112.0   98.0  111.0    0    0    0   1   0   0
2024-02-06  111.0  112.0   96.0   97.0    0    0    0  -1   0   0
2024-02-07   97.0  113.0   96.0  112.0    0    0    0   1   0   0
2024-02-08  110.0  111.0  108.0  109.0    0    0    0   0  -1   0
2024-02-09  111.0  112.0   99.0  100.0    0    0    0   0   0   0
2024-02-10   98.0   99.0   96.0   97.0    0    0    0   0   0   0
2024-02-11   98.0  107.0   97.0  106.0    0    0    0   0   0   1
- 第 1 根(108, 110, 90, 109):实体 1,占整根 20 的 5%,所以既是十字星也是锤子形;下影线 18 是实体的 18 倍,上影线 1 只占 5%。
- 第 2 根:上下颠倒,是倒锤形。
- 第 5 根:实体 99 到 111,把第 4 根的 100 到 110 完全盖住,颜色相反,是看涨吞没。
- 第 8 根:小阴线包在前一根长阳线的实体里,是看跌孕线。
- 第 11 根:长阴线 + 小实体 + 收复一半以上,是早晨之星。
约定:十字星、锤子形、倒锤形只记形状(1 或 0),吞没、孕线、星形分方向(1 看涨、-1 看跌、0 没有)。这个区别就是第二节说的第 2 条:锤子线和上吊线是同一个形状,模块不替你决定它看涨还是看跌。
✋ 小检查 1
(a) 开 100、高 108、低 99、收 101 这根 K 线,实体、上影线、下影线各是多少?它是十字星吗?是锤子形吗?
(b) 前一根是开 50、收 46 的阴线(高 51、低 45),这一根开 45.5、收 50.5(高 51、低 45)。这一根的实体盖住前一根了吗?按上面的规则算不算看涨吞没?
(c) 一根 K 线的实体正好是整根高度的 10%,下影线是实体的 3 倍。它会被同时记成十字星和锤子形吗?这会给统计带来什么问题?
答案在文末。
五、形态有多常见
写完扫描器,第一件事不是去统计收益,而是看看它到底扫出了多少东西。
rows = []
for name, df, threshold in datasets:
    found = Pt.scan(df)
    row = {"数据": name, "K 线": len(df)} | {column: (values != 0).mean() for column, values in found.items()}
    row["锤子形里也是十字星"] = (Pt.doji(df) & Pt.hammer(df)).sum() / Pt.hammer(df).sum()
    row["开盘价 = 前一根收盘价"] = (df["open"] == df["close"].shift(1)).mean()
    rows.append(row)
print(pd.DataFrame(rows).to_string(index=False, formatters={c: "{:.1%}".format for c in
                                                            list(Pt.SHAPES) + list(Pt.COMBINATIONS) + ["锤子形里也是十字星", "开盘价 = 前一根收盘价"]}))
       数据   K 线   十字星  锤子形  倒锤形    吞没   孕线   星形 锤子形里也是十字星 开盘价 = 前一根收盘价
   SPY 日线  2512 10.5% 5.6% 2.4%  5.1% 3.9% 1.0%     23.4%         0.2%
  AAPL 日线  2513 10.9% 4.7% 4.2%  5.7% 3.9% 1.0%     20.5%         0.5%
   BTC 日线  3302 11.8% 4.8% 2.3% 13.9% 6.5% 0.2%     17.7%        40.0%
BTC 4 小时线 19794 12.5% 5.0% 3.3% 13.7% 5.9% 0.2%     20.8%        40.5%
BTC 1 小时线 79113 11.2% 5.3% 4.2% 14.0% 6.0% 0.3%     20.6%        40.8%
- 十字星最常见,每 10 根就有 1 根多。 一个「10 根里出现 1 次」的信号,很难说是什么特别的事件。
- 锤子形在 4.7% 到 5.6% 之间,其中五分之一同时也是十字星(蜻蜓十字)。这两类形态本来就重叠,统计时要记住它们不是独立的证据。
- 星形最罕见:美股 1.0%,BTC 日线只有 0.2%(十年 3,302 根里只有 8 次)。样本太少的形态,后面的统计基本说明不了什么。
- BTC 的吞没多得离谱:13.9%,是美股的两倍半。 原因在最后一列:BTC 有 40% 的 K 线,开盘价正好等于前一根的收盘价(24 小时连续交易,两根之间没有间隔)。开盘价等于前收盘,「实体盖住前一根」就只剩下一个条件:这一根的实体比前一根长。美股每天有隔夜跳空,这个条件难得多。
同一套规则,在不同的市场上扫出的东西数量差好几倍。 这不是市场的性质,是定义和交易时段共同造成的。
和打乱顺序的价格比
把 K 线的顺序打乱(每根相对前一根收盘价的形状不变,第 9 篇),再扫一遍:
rows = []
for name, df, threshold in datasets[:3]:
    real = (Pt.scan(df) != 0).mean()
    shuffled = pd.DataFrame([(Pt.scan(shuffle_bars(df, rng)) != 0).mean() for _ in range(30)]).mean()
    rows.append({"数据": name} | {f"{column}": f"{real[column]:.1%} / {shuffled[column]:.1%}" for column in real.index})
print("真实顺序 / 打乱 K 线顺序 30 次的平均:")
print(pd.DataFrame(rows).to_string(index=False))
真实顺序 / 打乱 K 线顺序 30 次的平均:
     数据           十字星         锤子形         倒锤形            吞没          孕线          星形
 SPY 日线 10.5% / 10.5% 5.6% / 5.6% 2.4% / 2.4%   5.1% / 5.6% 3.9% / 3.9% 1.0% / 1.0%
AAPL 日线 10.9% / 10.9% 4.7% / 4.6% 4.2% / 4.2%   5.7% / 5.9% 3.9% / 3.7% 1.0% / 0.9%
 BTC 日线 11.8% / 11.8% 4.8% / 4.8% 2.3% / 2.3% 13.9% / 11.4% 6.5% / 5.0% 0.2% / 0.5%
- 单根形态的频率完全不变:十字星、锤子形、倒锤形只看一根 K 线自己的形状,打乱顺序不改变任何一根的形状。这是一个有用的自检:如果这三列变了,说明扫描器用到了前后的信息。
- 多根形态的频率变了:BTC 的吞没从 13.9% 降到 11.4%,孕线从 6.5% 降到 5.0%,星形从 0.2% 升到 0.5%。真实市场里,大 K 线爱扎堆、小 K 线也爱扎堆(第 15 篇的波动率聚集),所以「一大一小」的组合比随机排列少一些,「一大一大」的组合多一些。
- 美股的差别小得多(SPY 吞没 5.1% 对 5.6%)。
六、同一个名字,两套定义
TA-Lib 里有 61 个 CDL* 函数,也认识锤子线、十字星、吞没。它们和 talab 扫出来的是同一批 K 线吗?
import talib

rows = []
for name, df, threshold in datasets[:3]:
    o, h, l, c = (df[column].to_numpy(float) for column in Pt.OHLC)
    found = Pt.scan(df)
    pairs = [("锤子形", found["锤子形"] > 0, talib.CDLHAMMER(o, h, l, c) > 0),
             ("十字星", found["十字星"] > 0, talib.CDLDOJI(o, h, l, c) > 0),
             ("看涨吞没", found["吞没"] > 0, talib.CDLENGULFING(o, h, l, c) > 0),
             ("看跌吞没", found["吞没"] < 0, talib.CDLENGULFING(o, h, l, c) < 0),
             ("早晨之星", found["星形"] > 0, talib.CDLMORNINGSTAR(o, h, l, c) > 0)]
    for label, ours, theirs in pairs:
        ours, theirs = ours.to_numpy(), np.asarray(theirs)
        rows.append({"数据": name, "形态": label, "talab": int(ours.sum()), "TA-Lib": int(theirs.sum()),
                     "两边都算": int((ours & theirs).sum()), "只有 talab": int((ours & ~theirs).sum()),
                     "只有 TA-Lib": int((~ours & theirs).sum())})
print(pd.DataFrame(rows).to_string(index=False))
     数据   形态  talab  TA-Lib  两边都算  只有 talab  只有 TA-Lib
 SPY 日线  锤子形    141      39    20       121         19
 SPY 日线  十字星    264     355   248        16        107
 SPY 日线 看涨吞没     51      72    51         0         21
 SPY 日线 看跌吞没     76      92    76         0         16
 SPY 日线 早晨之星     12      13     6         6          7
AAPL 日线  锤子形    117      47    28        89         19
AAPL 日线  十字星    275     365   259        16        106
AAPL 日线 看涨吞没     67      91    67         0         24
AAPL 日线 看跌吞没     75     100    75         0         25
AAPL 日线 早晨之星     15      16     9         6          7
 BTC 日线  锤子形    158      78    30       128         48
 BTC 日线  十字星    391     570   369        22        201
 BTC 日线 看涨吞没    250     308   250         0         58
 BTC 日线 看跌吞没    208     280   208         0         72
 BTC 日线 早晨之星      4       6     3         1          3
- 吞没:
talab扫出来的每一根,TA-Lib 都算(「只有 talab」全是 0),TA-Lib 还多出两成到四成,因为它不要求实体占整根的 10%。 - 十字星:TA-Lib 多出一批,它的阈值是「实体 < 最近 10 根平均高度的 10%」,而不是这根自己的 10%。
- 锤子形差得最远:AAPL 上
talab117 根、TA-Lib 47 根,两边都算的只有 28 根。
差在哪里? 和第 15 篇查 ADX 一样,用同样的办法:照着猜测重写一遍,看能不能完全对上。
def talib_hammer(df):
    """按 TA-Lib 的规则重写锤子线:所有阈值都相对「最近几根 K 线的平均值」,而不是这根 K 线自己的高度。

    实体 < 前 10 根实体的平均;下影线 > 这根的实体;上影线 < 前 10 根整根高度平均的 10%;
    实体下沿 ≤ 前一根的最低价 + 「再往前 5 根整根高度平均」的 20%。
    """
    p = Pt.parts(df)
    height = p["range_"].fillna(0.0)
    return ((p["body"] < p["body"].rolling(10).mean().shift(1))
            & (p["lower"] > p["body"])
            & (p["upper"] < 0.1 * height.rolling(10).mean().shift(1))
            & (p["bottom"] <= df["low"].shift(1) + 0.2 * height.rolling(5).mean().shift(2))).fillna(False)


for name, df, threshold in datasets:
    o, h, l, c = (df[column].to_numpy(float) for column in Pt.OHLC)
    same = (talib_hammer(df).to_numpy() == (talib.CDLHAMMER(o, h, l, c) > 0)).all()
    print(f"{name}:按上面的规则重写,和 talib.CDLHAMMER 完全一致 {same}")
SPY 日线:按上面的规则重写,和 talib.CDLHAMMER 完全一致 True
AAPL 日线:按上面的规则重写,和 talib.CDLHAMMER 完全一致 True
BTC 日线:按上面的规则重写,和 talib.CDLHAMMER 完全一致 True
BTC 4 小时线:按上面的规则重写,和 talib.CDLHAMMER 完全一致 True
BTC 1 小时线:按上面的规则重写,和 talib.CDLHAMMER 完全一致 True
五组数据上逐根一致。 所以 TA-Lib 的锤子线是这四条:
- 实体 < 前 10 根实体的平均
- 下影线 > 这根的实体
- 上影线 < 前 10 根整根高度平均的 10%
- 实体下沿 ≤ 前一根的最低价 + 再往前 5 根平均高度的 20%(也就是「这根 K 线要低于前一根」)
关键区别:talab 的阈值都相对这根 K 线自己,TA-Lib 的阈值相对最近几根 K 线的平均。 两种做法各有道理:前者是纯粹的形状,后者考虑了「这根 K 线在最近的行情里算不算小」。TA-Lib 还额外要求位置(第 4 条),所以它的锤子线已经包含了一点「下跌之后」的含义。
看一个具体的分歧:
miss = aapl.loc["2025-03-03":"2025-03-05"]
p = Pt.parts(miss)
print("2025-03-05 这根 K 线:talab 判为锤子形,TA-Lib 不判")
print(pd.concat([miss[["open", "high", "low", "close"]], p[["body", "upper", "lower", "range_"]]], axis=1).round(2).to_string())
height = Pt.parts(aapl)["range_"].fillna(0.0)
limit = 0.1 * height.rolling(10).mean().shift(1)
print(f"talab 的上影线上限:整根高度的 15% = {0.15 * p['range_'].iloc[-1]:.2f};"
      f"TA-Lib 的上限:前 10 根平均高度的 10% = {limit[pd.Timestamp('2025-03-05')]:.2f};实际上影线 {p['upper'].iloc[-1]:.2f}")
2025-03-05 这根 K 线:talab 判为锤子形,TA-Lib 不判
              open    high     low   close  body  upper  lower  range_
date
2025-03-03  240.31  242.54  234.67  236.57  3.74   2.22   1.91    7.87
2025-03-04  236.25  238.60  233.25  234.49  1.76   2.35   1.24    5.36
2025-03-05  233.98  235.10  227.83  234.30  0.32   0.81   6.15    7.28
talab 的上影线上限:整根高度的 15% = 1.09;TA-Lib 的上限:前 10 根平均高度的 10% = 0.54;实际上影线 0.81
2025 年 3 月 5 日,AAPL 收出一根实体 0.32、下影线 6.15 的 K 线。按 talab 的规则,上影线 0.81 不超过整根高度 7.28 的 15%(1.09),是锤子形。按 TA-Lib 的规则,上影线要小于前 10 根平均高度的 10%(0.54),0.81 超了,不算。
⚠️ 看到「某形态的胜率是 X%」这种说法,先问一句:用的是谁的定义。 同一个名字,两套规则,扫出来的 K 线可以差两倍以上。
七、揭晓
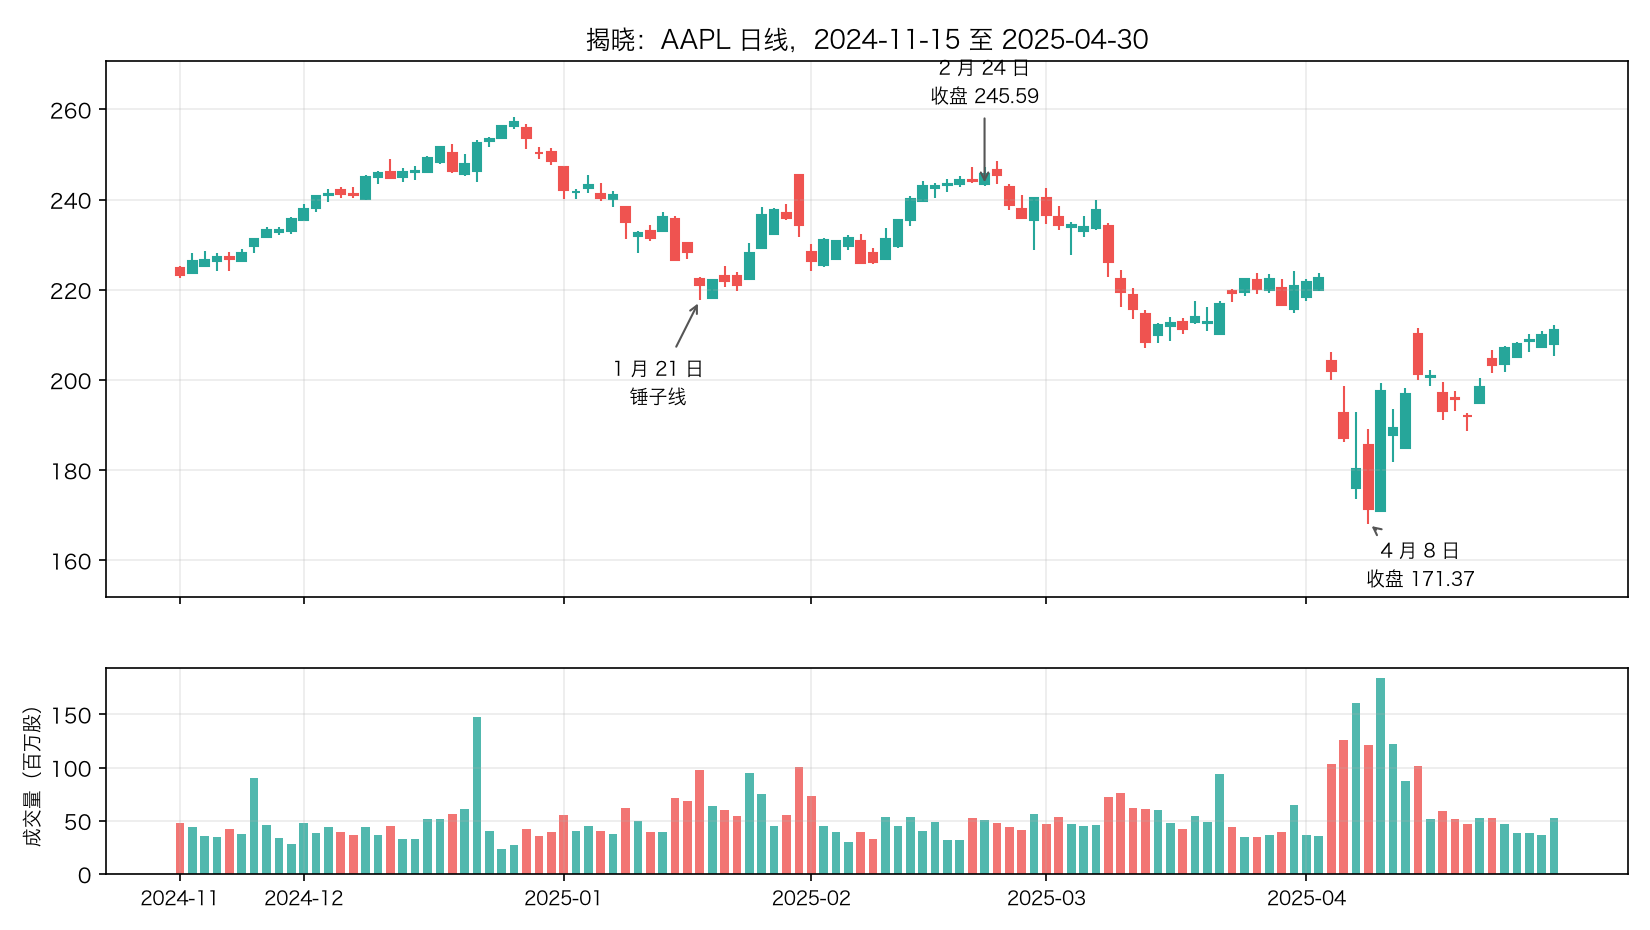
锤子线之后,AAPL 先涨了 10%,然后跌了 20%。
i = close.index.get_loc(t)
for n in [1, 3, 5, 10, 20, 40, 60]:
    print(f"{n} 天后({close.index[i + n].date()}):收盘 {close.iloc[i + n]:,.2f}({close.iloc[i + n] / close[t] - 1:+.2%})")
after = close.iloc[i + 1:i + 61]
print(f"之后 60 天:最高收盘 {after.max():,.2f}({after.idxmax().date()}),最低收盘 {after.min():,.2f}({after.idxmin().date()})")
print(f"这根锤子线的最低价 {aapl['low'][t]:,.2f},之后 60 天里第一次被跌破是 "
      f"{aapl['low'].iloc[i + 1:i + 61][aapl['low'].iloc[i + 1:i + 61] < aapl['low'][t]].index[0].date()}")
1 天后(2025-01-22):收盘 222.22(+0.53%)
3 天后(2025-01-24):收盘 221.17(+0.06%)
5 天后(2025-01-28):收盘 236.54(+7.02%)
10 天后(2025-02-04):收盘 231.12(+4.56%)
20 天后(2025-02-19):收盘 243.37(+10.11%)
40 天后(2025-03-19):收盘 213.92(-3.22%)
60 天后(2025-04-16):收盘 193.08(-12.65%)
之后 60 天:最高收盘 245.59(2025-02-24),最低收盘 171.37(2025-04-08)
这根锤子线的最低价 217.80,之后 60 天里第一次被跌破是 2025-03-11
- 选 A(直接买入)的:头三天几乎没动(+0.53%、+0.06%),第 5 天 +7.02%,20 天后 +10.11%。到 2 月 24 日的 245.59,浮盈 11.1%。
- 然后就反过来了:40 天后 -3.22%,60 天后 -12.65%。锤子线的最低价 217.80 在 3 月 11 日被跌破,4 月 8 日最低收盘 171.37,比锤子线的收盘低了 22.5%。
- 选 B(等确认)的:1 月 22 日收盘 222.22,没有越过锤子线的最高价 222.80,要到 1 月 27 日才确认。
- 选 C(不理它)的:错过了一个月的 10%,也避开了后面的 20%。
一次交易说明不了什么。这一次它「对了」,那是因为我挑了一根「对了」的锤子线给你看 —— 本来也可以挑第六节那根 3 月 5 日的,它之后 5 天跌了 8%。要回答「锤子线到底有没有用」,得把所有锤子线都算一遍。
八、形态之后的走势
怎么打分
沿用第 11 篇的办法:从形态那根 K 线的收盘价出发,上下各放一条 2 ATR 的线,看之后 20 根 K 线里先碰到顺着交易方向的那条(记 1)还是反方向的那条(记 0),都没碰到不计入。
- 十字星、锤子形按教科书最常见的说法(下跌之后看涨)做多打分
- 倒锤形按「流星」的说法做空打分
- 吞没、孕线、星形分看涨版本(做多)和看跌版本(做空)
对照是同一组数据的全部 K 线:每一根都按同一个方向入场,顺向的比例是多少。p 值用第 10 篇的标签打乱(2000 次)。
def label_test(values, flag, n=2000):
    """flag 为真的组减去其余的平均值;把标签随机打乱 n 次,看差距不小于实际的比例(第 10 篇)。"""
    v, f = np.asarray(values, float), np.asarray(flag, bool)
    ok = ~np.isnan(v)
    v, f = v[ok], f[ok]
    if f.sum() == 0 or (~f).sum() == 0:
        return np.nan, np.nan
    observed = v[f].mean() - v[~f].mean()
    sims = np.array([v[p].mean() - v[~p].mean() for p in (rng.permutation(f) for _ in range(n))])
    return observed, (np.abs(sims) >= abs(observed)).mean()


def outcomes(df):
    """每根 K 线都按做多、做空各算一次「先碰到哪条 2 ATR 线」(第 11 篇)。"""
    c = df["close"]
    a = I.atr(df["high"], df["low"], c)
    times = c.index[a.notna().to_numpy()]
    return times, {d: pd.Series(X.first_passage(c, df["high"], df["low"], a, times, [d] * len(times)), index=times)
                   for d in (1, -1)}


# 十字星、锤子形没有方向,按教科书最常见的说法(下跌之后看涨)做多打分;倒锤形按「流星」的说法做空
tests = {"十字星": [(1, "全部")], "锤子形": [(1, "全部")], "倒锤形": [(-1, "全部")],
         "吞没": [(1, "看涨"), (-1, "看跌")], "孕线": [(1, "看涨"), (-1, "看跌")], "星形": [(1, "看涨"), (-1, "看跌")]}
rows = []
for name, df, threshold in datasets:
    times, hit = outcomes(df)
    found = Pt.scan(df).reindex(times)
    for column, cases in tests.items():
        for direction, which in cases:
            values = found[column]
            flag = values != 0 if which == "全部" else (values > 0 if which == "看涨" else values < 0)
            _, p = label_test(hit[direction], flag)
            rows.append({"数据": name, "形态": column, "方向": "做多" if direction == 1 else "做空",
                         "次数": int(hit[direction][flag].notna().sum()), "顺向": hit[direction][flag].mean(),
                         "全部 K 线": hit[direction].mean(), "p": p})
table = pd.DataFrame(rows)
print(table.to_string(index=False, float_format=lambda v: f"{v:.3f}"))
print(f"一共 {table['p'].notna().sum()} 次检验,p < 0.05 的有 {(table['p'] < 0.05).sum()} 次")
       数据  形态 方向   次数    顺向  全部 K 线     p
   SPY 日线 十字星 做多  241 0.622   0.583 0.192
   SPY 日线 锤子形 做多  132 0.561   0.583 0.669
   SPY 日线 倒锤形 做空   54 0.481   0.417 0.392
   SPY 日线  吞没 做多   48 0.479   0.583 0.190
   SPY 日线  吞没 做空   72 0.361   0.417 0.332
   SPY 日线  孕线 做多   46 0.587   0.583 1.000
   SPY 日线  孕线 做空   43 0.558   0.417 0.068
   SPY 日线  星形 做多   11 0.364   0.583 0.214
   SPY 日线  星形 做空   11 0.727   0.417 0.065
  AAPL 日线 十字星 做多  257 0.615   0.613 1.000
  AAPL 日线 锤子形 做多  108 0.611   0.613 1.000
  AAPL 日线 倒锤形 做空  102 0.294   0.387 0.064
  AAPL 日线  吞没 做多   64 0.547   0.613 0.287
  AAPL 日线  吞没 做空   73 0.370   0.387 0.790
  AAPL 日线  孕线 做多   50 0.660   0.613 0.541
  AAPL 日线  孕线 做空   42 0.310   0.387 0.339
  AAPL 日线  星形 做多   14 0.357   0.613 0.062
  AAPL 日线  星形 做空    9 0.444   0.387 0.752
   BTC 日线 十字星 做多  310 0.513   0.539 0.329
   BTC 日线 锤子形 做多  128 0.586   0.539 0.270
   BTC 日线 倒锤形 做空   65 0.462   0.459 1.000
   BTC 日线  吞没 做多  203 0.586   0.539 0.171
   BTC 日线  吞没 做空  170 0.465   0.459 0.873
   BTC 日线  孕线 做多   77 0.455   0.539 0.127
   BTC 日线  孕线 做空   90 0.422   0.459 0.516
   BTC 日线  星形 做多    3 1.000   0.539 0.270
   BTC 日线  星形 做空    4 0.750   0.459 0.356
BTC 4 小时线 十字星 做多 2005 0.498   0.508 0.337
BTC 4 小时线 锤子形 做多  818 0.499   0.508 0.595
BTC 4 小时线 倒锤形 做空  564 0.491   0.490 0.963
BTC 4 小时线  吞没 做多 1123 0.519   0.508 0.433
BTC 4 小时线  吞没 做空 1105 0.472   0.490 0.220
BTC 4 小时线  孕线 做多  451 0.475   0.508 0.150
BTC 4 小时线  孕线 做空  484 0.465   0.490 0.288
BTC 4 小时线  星形 做多   17 0.706   0.508 0.139
BTC 4 小时线  星形 做空   11 0.364   0.490 0.548
BTC 1 小时线 十字星 做多 7050 0.489   0.497 0.141
BTC 1 小时线 锤子形 做多 3272 0.477   0.497 0.019
BTC 1 小时线 倒锤形 做空 2636 0.475   0.498 0.022
BTC 1 小时线  吞没 做多 4440 0.501   0.497 0.603
BTC 1 小时线  吞没 做空 4480 0.483   0.498 0.047
BTC 1 小时线  孕线 做多 1861 0.492   0.497 0.633
BTC 1 小时线  孕线 做空 1949 0.488   0.498 0.394
BTC 1 小时线  星形 做多   63 0.508   0.497 0.893
BTC 1 小时线  星形 做空  114 0.509   0.498 0.843
一共 45 次检验,p < 0.05 的有 3 次
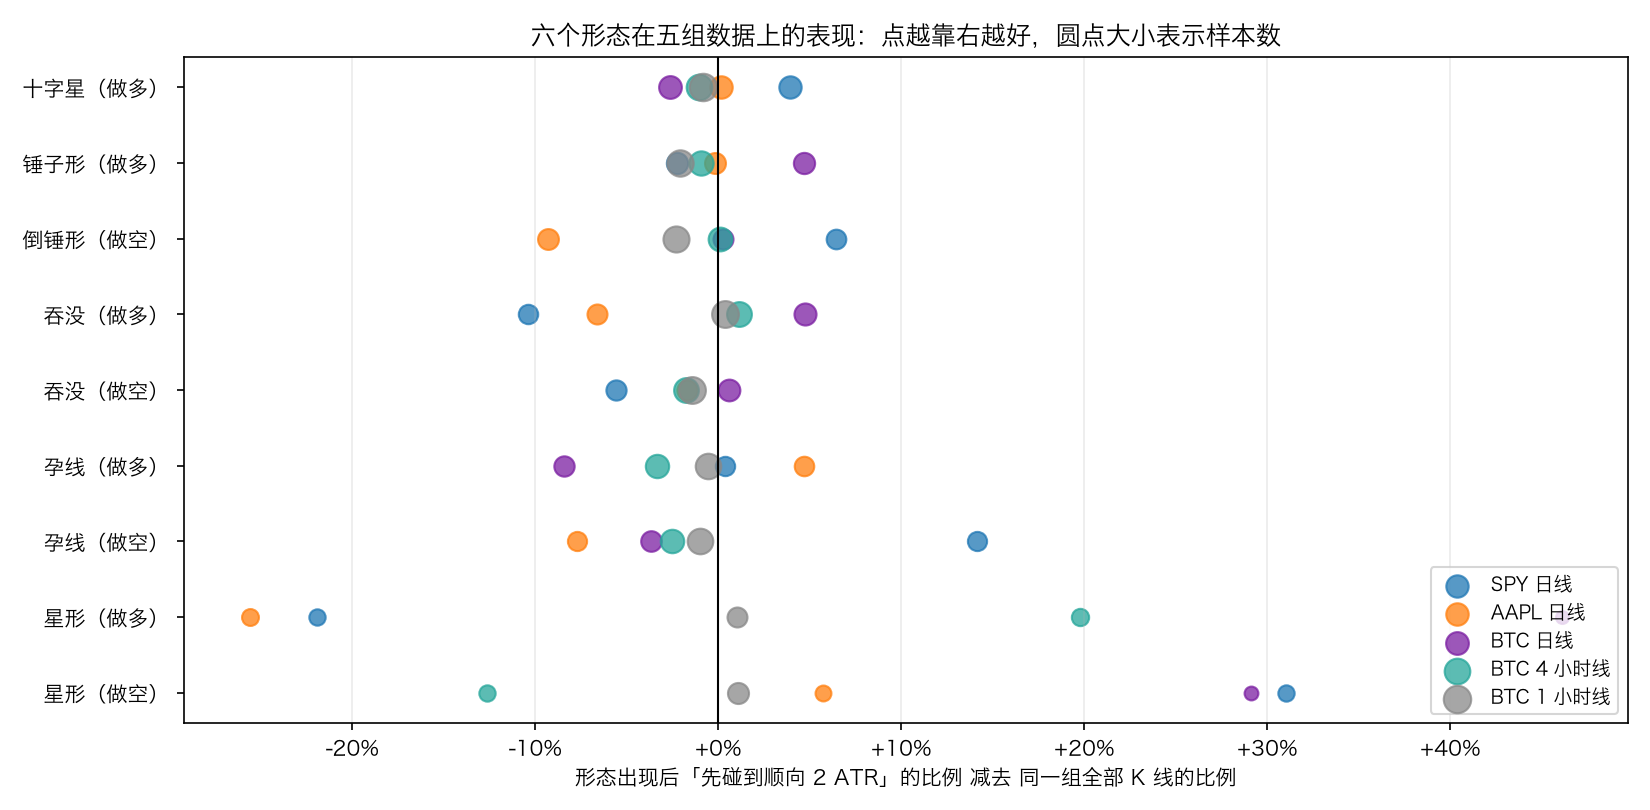
45 次检验,3 次 p < 0.05(随机的话平均 2.3 次),而且这 3 次全在 BTC 1 小时线上,全是比基准更差:
- 锤子形做多 47.7% 对 49.7%(3,272 次,p 0.019)
- 倒锤形做空 47.5% 对 49.8%(2,636 次,p 0.022)
- 看跌吞没做空 48.3% 对 49.8%(4,480 次,p 0.047)
日线上看起来大一些的差距,样本都很小:BTC 日线的星形做多 3 次全中,SPY 的星形做空 11 次里 8 次对,AAPL 的倒锤形做空 29.4% 对 38.7%(102 次,p 0.064)。上面那张图把 45 个结果画在一起:点散在 0 的两侧,离 0 最远的都是最小的点。
结论:六个形态本身,在这五组数据上没有可测量的优势。 那么,是不是因为我们忽略了「位置」?
九、同样的形态,不同的位置
第二节说过,锤子线和上吊线形状一样,区别只在出现的位置。这一节把位置补上。
按市场状态分
用第 11 篇的实时市场状态(只用当时已经确认的摆动点),把锤子形和看涨吞没按状态分组,都按做多打分:
simple = {"up": "上升", "down": "下降", "range": "震荡", "transition_up": "过渡", "transition_down": "过渡"}
rows, near_rows = [], []
for name, df, threshold in datasets:
    c = df["close"]
    a = I.atr(df["high"], df["low"], c)
    swings = X.zigzag(c, threshold)
    levels = X.trend_state(swings, c, c)
    state = X.market_state(levels, c).map(simple)
    near_low = (df["low"] - levels["last_low"]).abs() <= 0.5 * a
    ok = a.notna() & state.notna()
    times = c.index[ok.to_numpy()]
    hit = pd.Series(X.first_passage(c, df["high"], df["low"], a, times, [1] * len(times)), index=times)
    found = Pt.scan(df).reindex(times)
    state, near_low = state.reindex(times), near_low.reindex(times).fillna(False)
    for label, flag in [("锤子形", found["锤子形"] > 0), ("看涨吞没", found["吞没"] > 0)]:
        for group in ["下降", "震荡", "上升", "过渡"]:
            inside = (state == group).to_numpy()
            _, p = label_test(hit[inside], flag[inside])
            rows.append({"数据": name, "形态": label, "状态": group, "次数": int(hit[inside][flag[inside]].notna().sum()),
                         "顺向": hit[inside][flag[inside]].mean(), "同状态全部": hit[inside].mean(), "p": p})
        for where, inside in [("前低附近", near_low.to_numpy()), ("其他位置", ~near_low.to_numpy())]:
            _, p = label_test(hit[inside], flag[inside])
            near_rows.append({"数据": name, "形态": label, "位置": where, "次数": int(hit[inside][flag[inside]].notna().sum()),
                              "顺向": hit[inside][flag[inside]].mean(), "同组全部": hit[inside].mean(), "p": p})
by_state = pd.DataFrame(rows)
print("按第 11 篇的实时市场状态分组(都按做多打分):")
print(by_state.to_string(index=False, float_format=lambda v: f"{v:.3f}"))
print(f"一共 {by_state['p'].notna().sum()} 次检验,p < 0.05 的有 {(by_state['p'] < 0.05).sum()} 次")
按第 11 篇的实时市场状态分组(都按做多打分):
       数据   形态 状态   次数    顺向  同状态全部     p
   SPY 日线  锤子形 下降   10 0.600  0.619 1.000
   SPY 日线  锤子形 震荡   11 0.727  0.564 0.344
   SPY 日线  锤子形 上升   81 0.481  0.558 0.167
   SPY 日线  锤子形 过渡   20 0.750  0.655 0.467
   SPY 日线 看涨吞没 下降    5 0.800  0.619 0.663
   SPY 日线 看涨吞没 震荡    6 0.333  0.564 0.408
   SPY 日线 看涨吞没 上升   25 0.480  0.558 0.546
   SPY 日线 看涨吞没 过渡   11 0.364  0.655 0.051
  AAPL 日线  锤子形 下降   13 0.615  0.659 0.754
  AAPL 日线  锤子形 震荡   10 0.400  0.436 1.000
  AAPL 日线  锤子形 上升   54 0.648  0.636 0.887
  AAPL 日线  锤子形 过渡   23 0.609  0.597 1.000
  AAPL 日线 看涨吞没 下降   10 0.500  0.659 0.319
  AAPL 日线 看涨吞没 震荡   10 0.300  0.436 0.526
  AAPL 日线 看涨吞没 上升   32 0.625  0.636 1.000
  AAPL 日线 看涨吞没 过渡    7 0.571  0.597 1.000
   BTC 日线  锤子形 下降   31 0.581  0.552 0.847
   BTC 日线  锤子形 震荡   24 0.458  0.394 0.505
   BTC 日线  锤子形 上升   49 0.653  0.622 0.643
   BTC 日线  锤子形 过渡   24 0.583  0.536 0.668
   BTC 日线 看涨吞没 下降   51 0.745  0.552 0.005
   BTC 日线 看涨吞没 震荡   36 0.389  0.394 1.000
   BTC 日线 看涨吞没 上升   62 0.597  0.622 0.688
   BTC 日线 看涨吞没 过渡   54 0.556  0.536 0.754
BTC 4 小时线  锤子形 下降  200 0.455  0.487 0.362
BTC 4 小时线  锤子形 震荡  159 0.522  0.490 0.419
BTC 4 小时线  锤子形 上升  359 0.526  0.530 0.915
BTC 4 小时线  锤子形 过渡   96 0.458  0.511 0.300
BTC 4 小时线 看涨吞没 下降  264 0.455  0.487 0.293
BTC 4 小时线 看涨吞没 震荡  238 0.504  0.490 0.679
BTC 4 小时线 看涨吞没 上升  468 0.560  0.530 0.188
BTC 4 小时线 看涨吞没 过渡  151 0.530  0.511 0.663
BTC 1 小时线  锤子形 下降  929 0.499  0.494 0.741
BTC 1 小时线  锤子形 震荡  659 0.476  0.488 0.532
BTC 1 小时线  锤子形 上升 1232 0.481  0.503 0.128
BTC 1 小时线  锤子形 过渡  452 0.418  0.505 0.000
BTC 1 小时线 看涨吞没 下降 1204 0.502  0.494 0.594
BTC 1 小时线 看涨吞没 震荡  956 0.463  0.488 0.101
BTC 1 小时线 看涨吞没 上升 1601 0.512  0.503 0.471
BTC 1 小时线 看涨吞没 过渡  678 0.529  0.505 0.178
一共 40 次检验,p < 0.05 的有 2 次
40 次检验,2 次 p < 0.05,方向还相反:
- BTC 日线,下降状态里的看涨吞没:74.5% 对同状态全部 K 线的 55.2%(51 次,p 0.005)。这是这一篇里最像「有用」的一个结果。
- BTC 1 小时线,过渡状态里的锤子形:41.8% 对 50.5%(452 次,p 0.000),明显更差。
日线上每一格只有几次到几十次,看起来漂亮的数字(SPY 震荡状态的锤子形 72.7%)都建立在 11 次样本上。
按「离前低多远」分
另一种常见说法:形态要出现在关键位置才算数。用第 8 篇的摆动点定义「关键位置」:这根 K 线的最低价,离最近一个已确认的低点在半个 ATR 以内。
按「这根 K 线的最低价离最近一个已确认的低点是不是半个 ATR 以内」分组:
       数据   形态   位置   次数    顺向  同组全部     p
   SPY 日线  锤子形 前低附近    7 0.571 0.542 1.000
   SPY 日线  锤子形 其他位置  115 0.557 0.580 0.635
   SPY 日线 看涨吞没 前低附近    1 0.000 0.542 0.468
   SPY 日线 看涨吞没 其他位置   46 0.478 0.580 0.169
  AAPL 日线  锤子形 前低附近    6 0.500 0.504 1.000
  AAPL 日线  锤子形 其他位置   94 0.617 0.614 1.000
  AAPL 日线 看涨吞没 前低附近    3 0.333 0.504 0.644
  AAPL 日线 看涨吞没 其他位置   56 0.554 0.614 0.402
   BTC 日线  锤子形 前低附近   21 0.762 0.536 0.030
   BTC 日线  锤子形 其他位置  107 0.551 0.541 0.829
   BTC 日线 看涨吞没 前低附近   17 0.529 0.536 1.000
   BTC 日线 看涨吞没 其他位置  186 0.591 0.541 0.170
BTC 4 小时线  锤子形 前低附近   61 0.459 0.472 0.900
BTC 4 小时线  锤子形 其他位置  753 0.503 0.511 0.650
BTC 4 小时线 看涨吞没 前低附近   84 0.440 0.472 0.565
BTC 4 小时线 看涨吞没 其他位置 1037 0.526 0.511 0.334
BTC 1 小时线  锤子形 前低附近  262 0.481 0.474 0.851
BTC 1 小时线  锤子形 其他位置 3010 0.476 0.499 0.010
BTC 1 小时线 看涨吞没 前低附近  356 0.469 0.474 0.867
BTC 1 小时线 看涨吞没 其他位置 4083 0.504 0.499 0.539
- BTC 日线的锤子形:前低附近 76.2%(21 次),其他位置 55.1%(107 次),前者 p 0.030。
- 但 4 小时线和 1 小时线上,前低附近的锤子形是 45.9% 和 48.1%,都不比同组的全部 K 线好。
- 20 次检验里 2 次显著(另一次是 BTC 1 小时线「其他位置」的锤子形更差)。
决策点那根锤子线,最低价 217.80,离最近一个已确认的低点 220.17 只有 0.44 个 ATR,正好属于「前低附近」这一组。这也是它在图上看起来很有说服力的原因之一。
⚠️ 还有一个细节值得注意:第 11 篇的分类器说 2025 年 1 月 21 日 AAPL 的状态是 up(上升),因为最近两个已确认的高点和低点都还在抬高。而教科书说锤子线要出现在「一段下跌之后」——从 12 月 26 日算,价格确实跌了 14%。「下跌之后」这四个字,不同的定义给出不同的答案,这本身就是形态统计难做的原因之一。
十、等确认有没有用
「形态出现不要马上进场,等下一根确认」是最常见的建议。把它写成规则:形态出现后的下一根,收盘价越过形态那根的最高价,就算确认,从确认那一根的收盘开始打分。
这里要小心一个陷阱:确认本身就是一个信号。「收盘价越过前一根的最高价」不管前面有没有形态都可能发生。所以对照组不能是「全部 K 线」,而应该是所有收盘价越过前一根最高价的 K 线。
rows = []
for name, df, threshold in datasets:
    times, hit = outcomes(df)
    found = Pt.scan(df)
    long_hit = hit[1]
    confirm = (df["close"] > df["high"].shift(1)).reindex(times).fillna(False)      # 这一根收盘越过前一根的最高价
    after = {label: (signal.shift(1, fill_value=False).reindex(times).fillna(False) & confirm)
             for label, signal in [("锤子形", found["锤子形"] > 0), ("看涨吞没", found["吞没"] > 0)]}
    _, p = label_test(long_hit, confirm)
    rows.append({"数据": name, "组": "任何一根收盘越过前一根最高价", "次数": int(long_hit[confirm].notna().sum()),
                 "顺向": long_hit[confirm].mean(), "对照": long_hit.mean(), "p": p})
    inside = confirm.to_numpy()
    for label, flag in after.items():
        _, p = label_test(long_hit[inside], flag[inside])
        signal = (found["锤子形"] > 0) if label == "锤子形" else (found["吞没"] > 0)
        rows.append({"数据": name, "组": f"{label}之后的确认根", "次数": int(long_hit[flag].notna().sum()),
                     "顺向": long_hit[flag].mean(), "对照": long_hit[confirm].mean(), "p": p,
                     "等到确认的比例": flag.sum() / signal.reindex(times).fillna(False).sum()})
print("「确认」= 形态出现后的下一根收盘越过形态那根的最高价;从确认那一根收盘开始打分:")
print(pd.DataFrame(rows).to_string(index=False, float_format=lambda v: f"{v:.3f}"))
「确认」= 形态出现后的下一根收盘越过形态那根的最高价;从确认那一根收盘开始打分:
       数据              组    次数    顺向    对照     p  等到确认的比例
   SPY 日线 任何一根收盘越过前一根最高价   795 0.584 0.583 1.000      NaN
   SPY 日线      锤子形之后的确认根    52 0.558 0.584 0.765    0.418
   SPY 日线     看涨吞没之后的确认根    22 0.500 0.584 0.508    0.460
  AAPL 日线 任何一根收盘越过前一根最高价   726 0.614 0.613 0.973      NaN
  AAPL 日线      锤子形之后的确认根    48 0.542 0.614 0.336    0.452
  AAPL 日线     看涨吞没之后的确认根    26 0.654 0.614 0.691    0.403
   BTC 日线 任何一根收盘越过前一根最高价   668 0.549 0.539 0.543      NaN
   BTC 日线      锤子形之后的确认根    47 0.723 0.549 0.015    0.374
   BTC 日线     看涨吞没之后的确认根    56 0.643 0.549 0.164    0.273
BTC 4 小时线 任何一根收盘越过前一根最高价  3557 0.519 0.508 0.146      NaN
BTC 4 小时线      锤子形之后的确认根   280 0.500 0.519 0.527    0.333
BTC 4 小时线     看涨吞没之后的确认根   349 0.516 0.519 0.919    0.317
BTC 1 小时线 任何一根收盘越过前一根最高价 13993 0.502 0.497 0.195      NaN
BTC 1 小时线      锤子形之后的确认根  1190 0.478 0.502 0.077    0.362
BTC 1 小时线     看涨吞没之后的确认根  1446 0.500 0.502 0.866    0.323
两件事:
- 「确认」这个动作本身没有优势:任何一根收盘越过前一根最高价的 K 线,之后先碰到上方 2 ATR 的比例,和全部 K 线几乎一样(SPY 58.4% 对 58.3%,AAPL 61.4% 对 61.3%,BTC 日线 54.9% 对 53.9%)。
- 在这些确认根里,前面有没有形态,大多没有区别:BTC 日线上锤子形之后的确认根 72.3%(47 次,p 0.015)是唯一显著的;BTC 1 小时线上反而是 47.8% 对 50.2%(1,190 次,p 0.077)。
所以「等确认」主要的作用不是提高胜率,而是过滤掉一大半形态(最后一列:只有 27% 到 46% 的形态等到了确认),让你少做几笔交易。决策点那次,确认信号要到 1 月 27 日才出现,收盘 228.20,比锤子线的收盘价高了 3.2%。
✋ 小检查 2
(a) 第八节的 45 次检验里有 3 次显著。如果这 45 次都是纯随机的,平均会出现几次 p < 0.05?
(b) BTC 日线「下降状态里的看涨吞没」74.5% 对 55.2%,p 0.005,样本 51 次。你打算用这个结果去交易吗?在做决定之前,你还想知道什么?
(c) 有人说:「锤子线必须出现在支撑位才有效,我只统计支撑位上的锤子线,胜率 70%。」这个统计里,「支撑位」如果是事后在图上画的,会有什么问题?(提示:第 14 篇第七节)
答案在文末。
十一、talab.patterns:新建模块
新增了什么
| 函数 | 作用 |
|---|---|
parts |
把每根 K 线拆成整根高度、实体、上下影线、实体上下沿 |
doji、hammer、inverted_hammer |
三个单根形状,返回 True / False |
engulfing、harami、star |
三个多根组合,返回 1(看涨)、-1(看跌)、0 |
scan |
一次扫出六列 |
模块只认形状,不认位置:市场状态、支撑位这些交给 talab.structure(第 8、9、11 篇)。
代码
"""talab.patterns:K 线组合形态(第 16 篇)。

所有函数只看形状,不看位置:同样一根长下影线的 K 线,出现在下跌之后叫锤子线,出现在上涨之后叫上吊线,
形状函数不区分这两个名字。位置用 talab.structure 的市场状态、摆动点来判断(第 8、9、11 篇)。

约定和 talab.indicators 相同:输入是一个 OHLC 的 DataFrame,返回同索引的 Series;
数据不够的位置返回 False 或 0;第 k 个值只用到第 k 根及之前的 K 线。
"""
from __future__ import annotations

import numpy as np
import pandas as pd

OHLC = ["open", "high", "low", "close"]


def parts(bars: pd.DataFrame) -> pd.DataFrame:
    """把每根 K 线拆成四个部分,单位都是价格。

    range_:  最高价 - 最低价,整根 K 线的高度
    body:    |收盘价 - 开盘价|,实体的高度
    upper:   最高价 - 实体上沿,上影线
    lower:   实体下沿 - 最低价,下影线
    top / bottom: 实体的上沿和下沿;up: 收盘价是否不低于开盘价
    最高价等于最低价(完全没有波动)时,range_ 记为 NaN,所有比例都无法计算,形态一律不成立。
    """
    o, h, l, c = (bars[name].astype(float) for name in OHLC)
    top, bottom = np.maximum(o, c), np.minimum(o, c)
    return pd.DataFrame({"range_": (h - l).where(h > l), "body": (c - o).abs(), "upper": h - top,
                         "lower": bottom - l, "top": top, "bottom": bottom, "up": c >= o})


# ---------------------------------------------------------------------------
# 一、单根 K 线的形状
# ---------------------------------------------------------------------------

def doji(bars: pd.DataFrame, body_max: float = 0.1) -> pd.Series:
    """十字星:实体不超过整根 K 线高度的 body_max(默认 10%)。开盘和收盘几乎相同。"""
    p = parts(bars)
    return (p["body"] <= body_max * p["range_"]).fillna(False)


def hammer(bars: pd.DataFrame, body_max: float = 0.34, shadow_min: float = 2.0, upper_max: float = 0.15) -> pd.Series:
    """锤子形:小实体在上方,长下影线,几乎没有上影线。

    实体不超过整根高度的 body_max,下影线至少是实体的 shadow_min 倍,上影线不超过整根高度的 upper_max。
    ⚠️ 这是形状,不是名字。下跌之后出现叫锤子线(看涨),上涨之后出现叫上吊线(看跌),形状完全一样。
    实体非常小时,它同时也是十字星(蜻蜓十字)。
    """
    p = parts(bars)
    return ((p["body"] <= body_max * p["range_"]) & (p["lower"] >= shadow_min * p["body"])
            & (p["upper"] <= upper_max * p["range_"])).fillna(False)


def inverted_hammer(bars: pd.DataFrame, body_max: float = 0.34, shadow_min: float = 2.0,
                    lower_max: float = 0.15) -> pd.Series:
    """倒锤形:小实体在下方,长上影线,几乎没有下影线。锤子形上下颠倒。

    ⚠️ 下跌之后出现叫倒锤线(看涨),上涨之后出现叫流星线(看跌)。
    """
    p = parts(bars)
    return ((p["body"] <= body_max * p["range_"]) & (p["upper"] >= shadow_min * p["body"])
            & (p["lower"] <= lower_max * p["range_"])).fillna(False)


# ---------------------------------------------------------------------------
# 二、两根、三根 K 线的组合
# ---------------------------------------------------------------------------

def engulfing(bars: pd.DataFrame, body_min: float = 0.1) -> pd.Series:
    """吞没:这一根的实体完全盖住前一根的实体,而且颜色相反。返回 1(看涨吞没)、-1(看跌吞没)、0。

    看涨吞没:前一根收阴,这一根收阳,这一根的实体下沿不高于前一根的实体下沿、上沿不低于前一根的实体上沿。
    两根的实体都要至少占各自整根高度的 body_min,避免把十字星也算成吞没。
    """
    p = parts(bars)
    before, before_up = p.drop(columns="up").shift(1), p["up"].shift(1, fill_value=False)
    real = (p["body"] >= body_min * p["range_"]) & (before["body"] >= body_min * before["range_"])
    covers = (p["bottom"] <= before["bottom"]) & (p["top"] >= before["top"])
    both = (real & covers).fillna(False)
    return ((both & p["up"] & ~before_up).astype(int) - (both & ~p["up"] & before_up).astype(int)).astype(int)


def harami(bars: pd.DataFrame, body_min: float = 0.6, body_max: float = 0.5) -> pd.Series:
    """孕线:前一根是长实体,这一根的实体完全包在里面,而且颜色相反。返回 1(看涨孕线)、-1(看跌孕线)、0。

    前一根的实体至少占它整根高度的 body_min,这一根的实体不超过前一根实体的 body_max。
    看涨孕线:前一根收阴,这一根收阳。
    """
    p = parts(bars)
    before, before_up = p.drop(columns="up").shift(1), p["up"].shift(1, fill_value=False)
    inside = ((before["body"] >= body_min * before["range_"]) & (p["body"] <= body_max * before["body"])
              & (p["bottom"] >= before["bottom"]) & (p["top"] <= before["top"])).fillna(False)
    return ((inside & p["up"] & ~before_up).astype(int) - (inside & ~p["up"] & before_up).astype(int)).astype(int)


def star(bars: pd.DataFrame, body_min: float = 0.5, small_max: float = 0.3, recover: float = 0.5) -> pd.Series:
    """三根 K 线的星形。返回 1(早晨之星,看涨)、-1(黄昏之星,看跌)、0。

    早晨之星:
    第 1 根:长阴线,实体至少占整根高度的 body_min
    第 2 根:小实体,不超过第 1 根实体的 small_max,而且整个实体低于第 1 根的实体下沿
    第 3 根:阳线,收盘价至少收复第 1 根实体的 recover(默认一半)
    黄昏之星上下颠倒。传统定义要求第 2 根跳空,这里改成「实体完全在外侧」,因为加密货币几乎没有跳空。
    """
    p = parts(bars)
    numbers = p.drop(columns="up")
    one, two = numbers.shift(2), numbers.shift(1)
    one_up = p["up"].shift(2, fill_value=False)
    shape = ((one["body"] >= body_min * one["range_"]) & (two["body"] <= small_max * one["body"])).fillna(False)
    morning = (shape & ~one_up & (two["top"] < one["bottom"]).fillna(False) & p["up"]
               & (bars["close"] >= one["bottom"] + recover * one["body"]).fillna(False))
    evening = (shape & one_up & (two["bottom"] > one["top"]).fillna(False) & ~p["up"]
               & (bars["close"] <= one["top"] - recover * one["body"]).fillna(False))
    return (morning.astype(int) - evening.astype(int)).astype(int)


# ---------------------------------------------------------------------------
# 三、扫描器
# ---------------------------------------------------------------------------

SHAPES = {"十字星": doji, "锤子形": hammer, "倒锤形": inverted_hammer}
COMBINATIONS = {"吞没": engulfing, "孕线": harami, "星形": star}


def scan(bars: pd.DataFrame) -> pd.DataFrame:
    """把六种形态一次扫出来。

    十字星、锤子形、倒锤形只有形状,出现记 1;吞没、孕线、星形分方向,看涨记 1、看跌记 -1。
    返回的每一列都和输入同索引,第 k 行只用到第 k 根及之前的 K 线。
    """
    columns = {name: func(bars).astype(int) for name, func in SHAPES.items()}
    columns |= {name: func(bars) for name, func in COMBINATIONS.items()}
    return pd.DataFrame(columns, index=bars.index)
读一遍代码
parts 是所有形态的基础。(h - l).where(h > l) 让「最高价 = 最低价」的 K 线得到 NaN,后面所有比较都会是 False,形态自然不成立。
多根形态的写法:p.drop(columns="up").shift(1) 把数字列整体往后挪一根,布尔列 up 单独用 shift(1, fill_value=False),因为布尔列 shift 之后会变成含 NaN 的 object 列,不能直接取反。
star 用 shift(2) 和 shift(1) 拿到前两根,判断条件一条一条写出来,和第四节表格里的规则一一对应。
符号约定:engulfing、harami、star 用 astype(int) 相减得到 1 / -1 / 0,看涨和看跌不可能同时成立,所以相减是安全的。
测试
def test_parts_by_hand():
    p = Pt.parts(bars([(10, 14, 8, 12), (12, 12, 12, 12)]))
    assert p["range_"].iloc[0] == 6 and p["body"].iloc[0] == 2
    assert p["upper"].iloc[0] == 2 and p["lower"].iloc[0] == 2          # 实体 10 到 12,上下各留 2
    assert p["top"].iloc[0] == 12 and p["bottom"].iloc[0] == 10 and bool(p["up"].iloc[0])
    assert np.isnan(p["range_"].iloc[1])                                 # 最高价等于最低价


def test_doji_by_hand():
    x = bars([(100, 110, 90, 101), (100, 110, 90, 105), (100, 100.5, 99.5, 100.04)])
    # 第 1 根实体 1,占整根 20 的 5%:是十字星;第 2 根实体 5,占 25%:不是
    assert Pt.doji(x).tolist() == [True, False, True]
    assert Pt.doji(x, body_max=0.3).tolist() == [True, True, True]


def test_hammer_by_hand():
    x = bars([(108, 110, 90, 109),        # 实体 1(占 10%),下影 18 = 18 倍实体,上影 1(占 5%):锤子
              (108, 110, 90, 102),        # 实体 6(占 30%),下影 12 = 2 倍实体,上影 2(占 10%):锤子
              (108, 116, 90, 109),        # 上影 7,占 26%,超过 15%:不是
              (101, 106, 94, 105),        # 实体 4(占 33%),下影 7 < 2 倍实体 8:不是
              (100, 110, 90, 100)])       # 实体 0,下影 10,上影 10 占 50%:不是
    assert Pt.hammer(x).tolist() == [True, True, False, False, False]
    assert Pt.hammer(x, upper_max=0.3).tolist() == [True, True, True, False, False]


def test_inverted_hammer_is_hammer_upside_down():
    rng = np.random.default_rng(16)
    close = 100 * np.exp(np.cumsum(rng.normal(0, 0.02, 500)))
    x = bars([(c * (1 + rng.normal(0, 0.005)), 0, 0, c) for c in close])
    x["high"] = x[["open", "close"]].max(axis=1) * (1 + rng.uniform(0, 0.02, 500))
    x["low"] = x[["open", "close"]].min(axis=1) * (1 - rng.uniform(0, 0.02, 500))
    assert Pt.hammer(x).sum() > 10 and Pt.inverted_hammer(x).sum() > 10
    pd.testing.assert_series_equal(Pt.inverted_hammer(x), Pt.hammer(mirror(x)), check_names=False)


def test_engulfing_by_hand():
    x = bars([(110, 111, 99, 100),        # 长阴线,实体 10
              (99, 112, 98, 111),         # 阳线,实体 99 到 111,盖住 100 到 110:看涨吞没
              (111, 112, 96, 97),         # 阴线,实体 97 到 111,盖住 99 到 111:看跌吞没
              (97, 113, 96, 112),         # 阳线,实体 97 到 112,盖住 97 到 111(下沿相等也算):看涨吞没
              (112, 113, 111, 112.05)])   # 实体只占 5%,太小:不算
    assert Pt.engulfing(x).tolist() == [0, 1, -1, 1, 0]


def test_harami_by_hand():
    x = bars([(110, 111, 99, 100),        # 长阴线,实体 10 占整根 12 的 83%
              (102, 106, 101, 105),       # 阳线,实体 102 到 105 包在 100 到 110 里,实体 3 ≤ 一半:看涨孕线
              (104, 107, 103, 103.5),     # 前一根实体占它自己整根的 60%,也算长实体,这一根包在里面:看跌孕线
              (103, 110, 102, 109),       # 阳线,实体比前一根长:不是孕线
              (104, 105, 103, 103.8)])    # 阴线,实体 0.2 包在前一根阳线的实体里:看跌孕线
    assert Pt.harami(x).tolist() == [0, 1, -1, 0, -1]
    thin = bars([(110, 111, 99, 100), (102, 109, 101, 108)])              # 这一根实体 6 > 前一根实体 10 的一半:不算
    assert Pt.harami(thin).tolist() == [0, 0]


def test_star_by_hand():
    morning = bars([(110, 111, 99, 100),      # 长阴线,实体 100 到 110
                    (98, 99, 96, 97),         # 小实体,整个在 100 下方
                    (98, 106, 97, 106)])      # 阳线,收在 105 = 实体中点之上:早晨之星
    assert Pt.star(morning).tolist() == [0, 0, 1]
    late = morning.copy()
    late.iloc[2, late.columns.get_loc("close")] = 104                     # 收在中点 105 之下
    assert Pt.star(late).tolist() == [0, 0, 0]
    pd.testing.assert_series_equal(Pt.star(mirror(morning)), -Pt.star(morning), check_names=False)


def test_scan_columns_and_flat_bars():
    x = bars([(100, 100, 100, 100)] * 5)
    scan = Pt.scan(x)
    assert list(scan.columns) == ["十字星", "锤子形", "倒锤形", "吞没", "孕线", "星形"]
    assert (scan == 0).all().all()                                        # 完全没有波动的 K 线不产生任何形态
    assert scan.dtypes.map(str).eq("int64").all()


def test_scan_never_uses_the_future():
    rng = np.random.default_rng(160)
    close = 100 * np.exp(np.cumsum(rng.normal(0, 0.02, 400)))
    frame = bars([(c, c, c, c) for c in close])
    frame["open"] = frame["close"].shift(1, fill_value=close[0]) * (1 + rng.normal(0, 0.01, 400))
    frame["high"] = frame[["open", "close"]].max(axis=1) * (1 + rng.uniform(0, 0.015, 400))
    frame["low"] = frame[["open", "close"]].min(axis=1) * (1 - rng.uniform(0, 0.015, 400))
    full = Pt.scan(frame)
    assert (full.abs().sum() > 0).all()
    for k in [50, 200, 399]:
        pd.testing.assert_frame_equal(Pt.scan(frame.iloc[:k]), full.iloc[:k])
test_parts_by_hand:拆解的四个部分,以及「最高价 = 最低价」时整根高度是 NaN。test_doji_by_hand、test_hammer_by_hand:第四节的规则,每个阈值都用一根刚好在边界上的 K 线检查。test_inverted_hammer_is_hammer_upside_down:把价格取相反数、最高最低互换,倒锤形必须等于翻转后的锤子形。这一条比逐个数字检查更强:它保证两个函数的参数和不等号方向完全对称。test_engulfing_by_hand、test_harami_by_hand、test_star_by_hand:手工构造的组合,包括「下沿相等也算」「实体太小不算」「收复不足一半不算」这些边界。星形还检查了翻转后正好是相反的符号。test_scan_columns_and_flat_bars:列名、顺序、整数类型,以及完全没有波动的 K 线不产生任何形态。test_scan_never_uses_the_future:截断 3 次,前 k 行必须和用全部数据算出来的一致。
pytest -q
........................................................................ [ 51%]
...................................................................      [100%]
139 passed in 0.49s
没装 TA-Lib 时,结果是 107 passed、32 skipped。
十二、常见误用
1. 不写下精确规则就统计形态。 「长下影线」「小实体」在代码里必须是数字。换一个阈值,扫出来的 K 线数量能差一倍。
2. 把不同软件的形态统计结果放在一起比。
AAPL 上 talab 扫出 117 根锤子形,TA-Lib 47 根,重合只有 28 根。名字一样,东西不一样。
3. 忽略形态之间的重叠。 五分之一的锤子形同时也是十字星。「十字星 + 锤子线同时出现」不是两个独立的证据。
4. 拿 BTC 的吞没数量和美股比。 BTC 有 40% 的 K 线开盘价等于前一根收盘价,吞没的条件天然更容易满足,频率是美股的两倍半。
5. 在样本只有几次的格子里找规律。 BTC 日线十年只有 8 次星形。3 次全中的「100% 胜率」什么都不说明。
6. 用事后画的支撑位给形态加条件。 第 14 篇已经看过:事后划分的位置,会把「后来涨了」的信息偷偷带进条件里。
7. 把「等确认」当成提高胜率的办法。 确认本身的胜率和全部 K 线几乎一样。它的作用是减少交易次数,代价是入场价更高。
8. 只报告有效的那几格。 这一篇一共做了 120 次检验(45 + 40 + 20 + 15),显著的 8 次里有 5 次是「比基准更差」。如果只挑「BTC 日线下降状态的看涨吞没 74.5%」来讲,就是第 13 篇误用 7 说的挑选偏差。
十三、这一篇能回答什么,不能回答什么
| 这一篇能帮你回答 | 这一篇不能回答 |
|---|---|
| 怎么把一句模糊的形态描述写成可运行、可检验的规则 | 哪一组阈值是「正确」的(练习 3) |
| 这六个形态在五组数据上出现之后会发生什么 | 换成 TA-Lib 的 61 个形态,结论是否一样(练习 5) |
| 同一个形态名字,两个软件为什么给出不同答案 | 人工看图时,你认出的形态和扫描器认出的是不是同一批 |
| 按市场状态、按离前低的距离分组之后,形态有没有变得有用 | 把形态和成交量、更长周期的结构组合起来会怎样(第 17、21 篇) |
十四、小结
-
一根 K 线只有四个数字,所有形态都是整根高度、实体、上下影线之间的算术。
-
形态必须写成精确规则才能检验。 「长下影线」得变成「下影线 ≥ 实体的 2 倍,上影线 ≤ 整根高度的 15%」。
-
形状和位置要分开。 锤子线和上吊线形状完全一样,
talab.patterns只认形状,位置交给第 11 篇的市场状态。 -
形态没有想象中稀有:十字星每 10 根就有 1 根多,锤子形 5% 左右。BTC 的吞没高达 13.9%,因为它有 40% 的 K 线开盘价等于前一根收盘价。
-
同一个名字,两套定义:
talab的阈值相对这根 K 线自己,TA-Lib 的阈值相对最近 10 根的平均,还要求位置。AAPL 上两边的锤子形只有 28 根重合。TA-Lib 的四条规则可以完整反推出来,五组数据上逐根一致。 -
形态本身没有可测量的优势:45 次检验 3 次显著,全在 BTC 1 小时线,全是比基准更差。
-
加上位置也没有救回来:按市场状态分 40 次检验 2 次显著,方向相反;按「离前低半个 ATR」分 20 次检验 2 次显著。BTC 日线上「下降状态的看涨吞没」和「前低附近的锤子形」是仅有的两个正面结果,样本 51 次和 21 次。
-
「等确认」不提高胜率:确认动作本身的胜率和全部 K 线一样,只有 27% 到 46% 的形态能等到确认,代价是入场价更高。
-
决策点那次锤子线,20 天涨了 10.1%,60 天跌了 12.7%。 它同时满足「放量」「前低附近」两个加分项,事后看仍然只对了一个月。
最后回到看脸色。表情确实有信息:一根长下影线告诉你,今天有人在低位接货(第 10 篇的成交量能补充谁在接)。但从「今天有人接货」到「明天会涨」,中间隔着这一篇的 120 次检验。脸色能读,但别用它算命。
下一篇是第 17 篇:经典图表形态。BTC 的右肩已经走出来,价格离颈线还有 2%。头肩形、双顶双底这些形态怎么写成算法?「突破颈线才算形态成立」这条规矩,会让统计结果虚高多少?
练习
练习 1(手算) 三根 K 线依次是 (开 100, 高 101, 低 88, 收 90)、(开 89, 高 92, 低 87, 收 91)、(开 91, 高 99, 低 90, 收 97)。
- (a) 每根的实体、上影线、下影线各是多少?
- (b) 第 2 根是十字星吗?是锤子形吗?
- (c) 这三根构成早晨之星吗?逐条对照第四节的规则。
练习 2(编程)
给 talab.patterns 加一个 marubozu(光头光脚阳线 / 阴线):实体 ≥ 整根高度的 95%。
- (a) 写出函数和两个手算测试。
- (b) 它在五组数据上出现的频率是多少?打乱顺序之后呢?
- (c) 用第八节的办法统计它之后的走势。
练习 3(数据) 第四节的阈值都是拍脑袋定的。
- (a) 把锤子形的「下影线 ≥ 实体的 2 倍」改成 1.5 倍和 3 倍,扫出来的数量各变成多少?
- (b) 三组阈值下,第八节的结论有变化吗?
- (c) 如果你试了 10 组阈值,挑出胜率最高的一组报告,这个胜率高估了多少?用第 13 篇误用 7 的思路说明。
练习 4(数据) 第九节用「离最近一个已确认低点半个 ATR 以内」定义关键位置。
- (a) 换成第 9 篇的
cluster_levels(把多个摆动点聚成价位),重做 BTC 日线的表。 - (b) 把「已确认的低点」换成「事后才知道的低点」(
confirmed_at换成time,第 14 篇的做法),胜率变成多少?虚高了多少?
练习 5(数据)
TA-Lib 有 61 个 CDL* 函数。
- (a) 用 BTC 1 小时线,统计每个函数出现的次数,按次数排序。
- (b) 对出现次数超过 500 次的那些,用第八节的办法算一遍顺向比例,画成第八节那样的点图。
- (c) 你一共做了多少次检验?按 p < 0.05 算,随机情况下会有几次「显著」?
练习 6(思考) 第十节发现「确认」本身没有优势。
- (a) 如果把确认条件改成「下一根收盘价越过形态那根的最高价,而且成交量大于前 20 根平均」,你猜结果会怎样?先猜再算。
- (b) 为什么「确认」会让入场价变高?这对第 15 篇的 ATR 止损意味着什么?
小检查答案
小检查 1
(a) 实体 = |101 - 100| = 1,上影线 = 108 - 101 = 7,下影线 = 100 - 99 = 1,整根高度 = 9。实体占 11.1%,超过 10%,不是十字星(差一点)。下影线 1 = 实体的 1 倍,不到 2 倍;上影线占 77.8%,远超 15%:不是锤子形。它更像倒锤形:上影线 7 是实体的 7 倍,下影线只占 11.1%,小于 15%,是倒锤形。
(b) 这一根的实体是 45.5 到 50.5,前一根的实体是 46 到 50,完全盖住。两根颜色相反(前阴后阳),两根实体分别占各自整根高度的 4/6 = 67% 和 5/6 = 83%,都超过 10%。是看涨吞没。
(c) 会同时记成两个。 十字星的条件是实体 ≤ 10%,锤子形只要求 ≤ 34%,两者本来就有重叠(真实数据里五分之一的锤子形同时是十字星)。问题是:如果把「十字星出现」和「锤子形出现」当成两个独立的证据,就等于把同一根 K 线数了两次;做多重检验的计数时,也不能把它们当成两次独立的检验。
小检查 2
(a) 45 × 0.05 = 2.25 次。实际 3 次,和随机的差别不大。
(b) 至少还想知道三件事:样本怎么来的(51 次分布在哪几年,是不是集中在 2018 或 2022 的某一段);换个阈值还在不在(ZigZag 从 10% 换成 5% 或 20%,状态分组会变);其他四组数据说什么(4 小时线和 1 小时线上同一格是 45.5% 和 50.2%,都不支持)。一个在 5 组数据里只在 1 组出现、又是 40 次检验里挑出来的结果,更可能是噪声。
(c) 事后画的支撑位,是在已经看到后面走势的情况下画的:那些「后来涨回去了」的低点,更容易被画成支撑位。于是「支撑位上的锤子线」这个条件里,已经偷偷含有「后来涨了」的信息。第 14 篇第七节量过这个错觉:同一批超卖信号,用事后状态分组能把胜率从 51.9% 抬到 64.7%。正确的做法是用当时就能知道的位置(第九节用的是「已确认的低点」)。