| 本篇位置 | 第五部分「从信号到交易」的第一篇。前面十八篇都在看一张图,这一篇第一次同时看几百张图 |
| 用到的数据 | Binance U 本位永续合约里所有上过市的 864 个 USDT 交易对的日线(2020-01 至 2026-08,包含已经停止交易的);美股:Nasdaq 筛选接口的全市场名单,加上今天市值最大的 100 只股票和 11 只行业 ETF 的日线(2016-09 至 2026-09) |
| 动手 | 新模块 talab.screen:宽表、成交额、横截面排名、相对强度、每日扫描器、带下架处理的未来收益,附 10 个测试 |
| 读完你能 | 说清楚一个标的池是怎么来的、里面藏着哪些坑;给流动性和波动率定出有理由的门槛;画相对强度线,并知道它在横截面排名里其实不提供新信息;检验「买最强的几个」这类说法 |
一、先做一个决定
现在是 2025 年 11 月 19 日,你在 Binance 做 U 本位永续合约。
这个市场上,历史上一共上市过 864 个 USDT 永续合约,今天还在交易的有 704 个。你不可能每天看 704 张图,所以你写了一个扫描器,每天收盘后跑一遍:
- 最近 20 天的中位成交额至少 1000 万美元(能进能出)
- 上市至少 120 天(有足够的历史)
- 剩下的按过去 60 天涨幅从大到小排
今天通过门槛的有 151 个。前十名是这样的:
2025-11-19 通过门槛的合约:151 个;前十名:
             成交额      涨幅     波动率    上市天数    名次      百分位
ZECUSDT   2929.0  12.321  15.176  2110.0   1.0  100.000
SOONUSDT   137.0   2.548  48.616   181.0   2.0   99.338
DASHUSDT   420.0   2.420  19.205  2116.0   3.0   98.675
HUSDT       50.0   1.411  31.794   148.0   4.0   98.013
ZENUSDT    330.0   0.957  21.482  1817.0   5.0   97.351
STRKUSDT   137.0   0.918  13.489   639.0   6.0   96.689
MERLUSDT    21.0   0.892  10.430   175.0   7.0   96.026
ALCHUSDT    14.0   0.801  11.100   317.0   8.0   95.364
BDXNUSDT    33.0   0.754  28.940   170.0   9.0   94.702
ARCUSDT     12.0   0.522  11.613   307.0  10.0   94.040
表里的「成交额」是最近 20 天的中位数,单位百万美元;「涨幅」是过去 60 天的涨幅(12.321 就是涨了 1232%);「波动率」是第 15 篇的 NATR,单位是百分点;「百分位」是它在当天 151 个候选里的位置。
排第一的 ZEC(Zcash)非常扎眼:
ZEC 的 20 天中位成交额,在当天有成交额的 527 个合约里排第 4:只低于 ETHUSDT, BTCUSDT, SOLUSDT
ZEC:60 天前 50.56 → 决策日 673.52,涨了 1232.1%;同期 BTC 115625 → 91509,-20.9%
60 天涨了 12 倍,而同期 BTC 跌了 21%。 这不是某个没人听过的新币:ZEC 已经上市 2110 天,一天成交 29 亿美元,在当天 527 个有成交的合约里排第 4,只低于 ETH、BTC、SOL——流动性完全挑不出毛病。
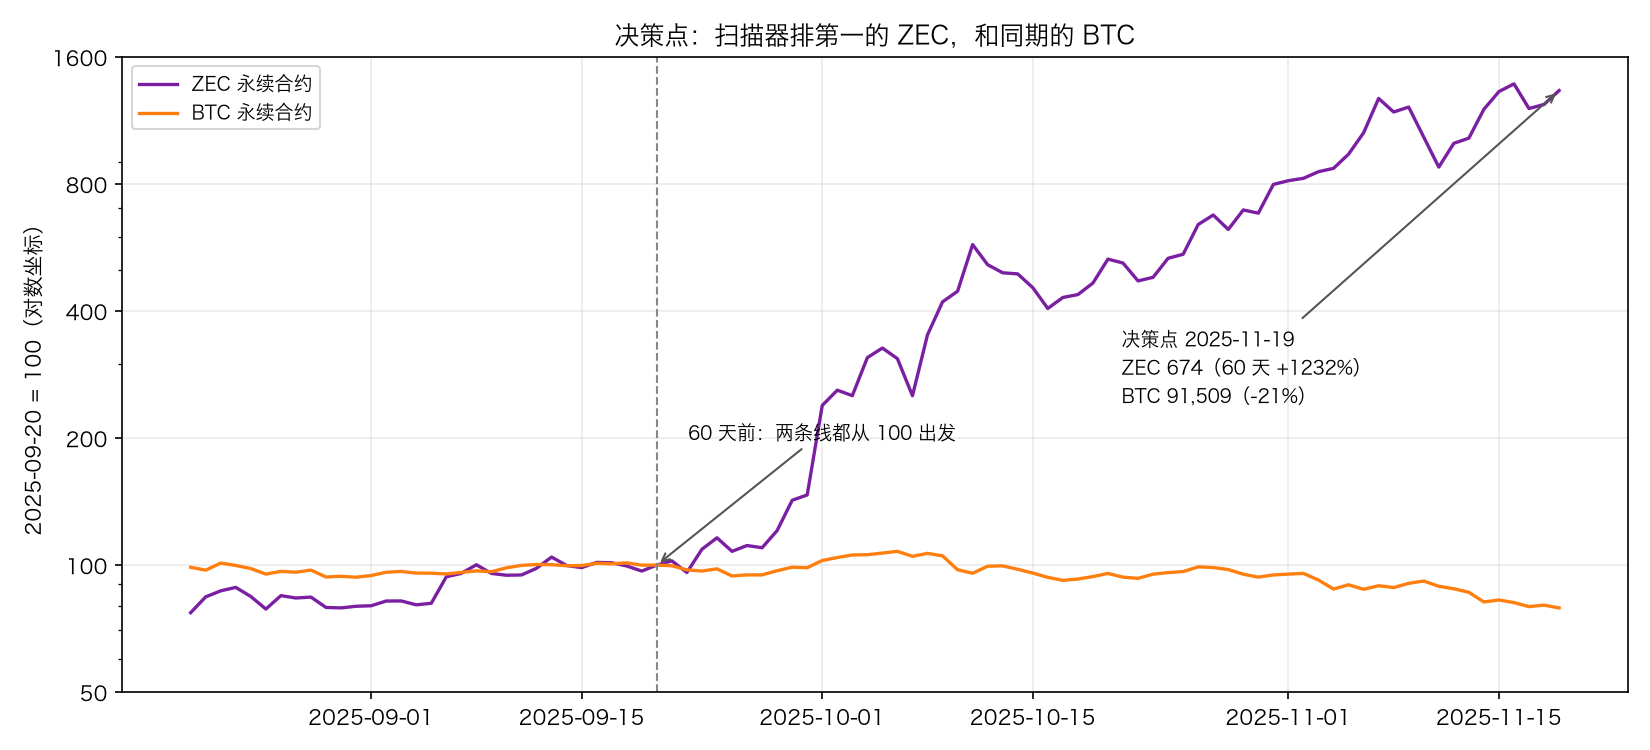
你今天要下注在哪里?
- A. 买第一名:ZEC,最强的那个
- B. 买前十等权:一个都不漏掉,分散一点
- C. 只买 BTC:这些涨疯了的东西不碰
先写下你的选择。 第八节揭晓,第九节看「买最强的」在 864 个合约、六年历史上意味着什么。
二、几千份简历,先筛掉九成
打个比方
你在招人,岗位一个,收到三千份简历。
没有人会把三千份从头读到尾。真实的做法是两步:
- 硬门槛:学历、年限、能不能到岗。这一步不是在挑「最好的人」,而是在排除掉根本没法进入下一步的人。门槛不看你多优秀,只看你合不合规格。
- 排名:剩下的几十份按你在意的维度打分,从高到低面试。
选标的完全一样:
- 硬门槛 = 流动性和波动率。成交额太小的,你买得进卖不出;波动太小的,一天的波动还不够手续费;波动太大的,按风险算出来的仓位小到没意义。这一步和「谁会涨」无关。
- 排名 = 相对强度。在通过门槛的几十上百个里,按「谁比别人强」排序。
这个比方后面会一直用,因为招聘还有一个更隐蔽的坑,正好对应这一篇最重要的一条:
如果你只研究「现在还在公司的人」来总结用人经验,你会得出一套非常乐观的结论。 被裁掉的、自己走的、公司没了的,都不在你的名单里。
选标的里的同一个错误叫幸存者偏差:用今天的标的名单去回测历史。第九节会量出它到底能凭空变出多少收益。
这一篇要解决三件事
| 问题 | 在哪一节 |
|---|---|
| 名单从哪里来?里面有什么坑? | 第三节 |
| 门槛卡在哪里?为什么是这个数? | 第四、五节 |
| 通过门槛的几十个怎么排名? | 第六节 |
三、名单本身要先体检
名单从哪里来
拿到「今天在交易的标的」很容易,交易所首页就有。拿到「历史上所有上过市的标的」才是关键,而这正是大多数人跳过的一步。
加密在这件事上比股票便宜得多:Binance 把公开数据放在一个可以列目录的对象存储上,下架合约的历史文件一直留着。talab.data 里加两个函数就能把名单拉全:
def parse_s3_listing(xml: str, prefix: str) -> tuple[list[str], str | None]:
    """从 S3 列目录返回的 XML 里取出 prefix 下一层的名字,以及下一页的起点(没有下一页时是 None)。"""
    names = re.findall(r"<(?:Prefix|Key)>" + re.escape(prefix) + r"([^<]+?)/?</(?:Prefix|Key)>", xml)
    names = [n for n in names if n]
    if "<IsTruncated>true</IsTruncated>" not in xml:
        return names, None
    marker = re.search(r"<NextMarker>([^<]+)</NextMarker>", xml)
    return names, marker.group(1) if marker else prefix + names[-1]


def list_binance(prefix: str, folders: bool = True) -> list[str]:
    """列出 data.binance.vision 上某个目录下一层的名字(folders=True 列子目录,False 列文件)。"""
    names, marker = [], ""
    while True:
        url = f"{BINANCE_LIST}?prefix={quote(prefix)}&max-keys=1000" + ("&delimiter=/" if folders else "")
        page, marker = parse_s3_listing(_fetch(url + (f"&marker={quote(marker)}" if marker else "")).decode(), prefix)
        names += page
        if marker is None:
            return names


def binance_symbols(market: str = "spot") -> list[str]:
    """所有上过市的交易对,包含已经下架的。⚠️ 只看今天还在交易的那些,统计会有幸存者偏差。"""
    prefix = "spot" if market == "spot" else "futures/um"
    return list_binance(f"data/{prefix}/monthly/klines/")


def binance_months(symbol: str, interval: str, market: str = "spot") -> list[str]:
    """某个交易对有哪些月份的 K 线文件("YYYY-MM"),从上市月到下架月。"""
    prefix = "spot" if market == "spot" else "futures/um"
    names = list_binance(f"data/{prefix}/monthly/klines/{symbol}/{interval}/", folders=False)
    return sorted(n[-11:-4] for n in names if n.endswith(".zip"))
然后按交易对下载它存在过的每一个月(19_download_universe.py,864 个交易对约 21,400 个月度文件、15 分钟):
def one_symbol(symbol: str) -> tuple[str, int]:
    months = [m for m in D.binance_months(symbol, "1d", market="um") if m <= CRYPTO_END]
    if not months:
        return symbol, 0
    paths = D.download_binance_klines(symbol, "1d", months[0], months[-1], market="um",
                                      dest="data/universe", skip_missing=True)
    return symbol, len(paths)
skip_missing 是为了中间缺月份的合约(下架之后又重新上市)不至于整个报错。
⚠️ 美股这边没有这么方便:Nasdaq 的接口只给今天还在上市的公司,退市和被收购的拿不到。这一篇的美股名单是「今天市值最大的 100 只」,第 9.5 节会说明这让那部分统计只能当参考。
把几百个合约读成一张宽表
前面十八篇,每次处理的都是一个标的的一张表。从这一篇起,主角变成宽表:行是时间,列是标的,没上市或者已经停止交易的位置是 NaN。
frames = {folder.name: D.load_binance_klines(folder.glob("1d/*.zip")) for folder in Path("data/universe/um").iterdir()}
volume = S.panel(frames, "volume")
close = S.panel(frames, "close").where(volume > 0)             # ⚠️ 成交量为 0 的是占位 K 线,不是能成交的价格
high, low = S.panel(frames, "high").where(volume > 0), S.panel(frames, "low").where(volume > 0)
dollar = pd.DataFrame({name: S.turnover(df) for name, df in frames.items()}).sort_index(axis=1).where(volume > 0)
print(f"宽表:{close.shape[0]} 行 × {close.shape[1]} 列,{close.index[0].date()} 到 {close.index[-1].date()}")
print(close.loc["2026-08-27":, ["BTCUSDT", "ETHUSDT", "ZECUSDT"]].round(2).to_string())
宽表:2435 行 × 864 列,2020-01-01 到 2026-08-31
                           BTCUSDT  ETHUSDT  ZECUSDT
time
2026-08-27 00:00:00+00:00  80208.9  2509.74   809.60
2026-08-28 00:00:00+00:00  77805.9  2441.90   800.37
2026-08-29 00:00:00+00:00  78200.7  2456.50   841.24
2026-08-30 00:00:00+00:00  77634.6  2415.55   834.63
2026-08-31 00:00:00+00:00  78549.6  2466.53   847.71
注意第三行那个 .where(volume > 0),它不是可有可无的洁癖,理由马上就到。
名单里有多少是「已经不在了」的
trading = close.notna()
first = trading.apply(lambda s: s[s].index[0])
last = trading.apply(lambda s: s[s].index[-1])
stopped = last[last < close.index[-1]]
placeholder = ((volume == 0) & S.panel(frames, "close").notna())
print(f"上过市的 USDT 永续合约:{close.shape[1]} 个;最后一天还在交易的:{int(trading.iloc[-1].sum())} 个;"
      f"中途停止交易的:{len(stopped)} 个")
print("停止交易的按年份:", stopped.dt.year.value_counts().sort_index().to_dict())
print(f"成交量为 0 的占位 K 线:{int(placeholder.to_numpy().sum())} 根,涉及 {int((placeholder.sum() > 0).sum())} 个合约"
      f"(最多的是 {placeholder.sum().idxmax()},{int(placeholder.sum().max())} 根)")
print("每年最后一天在交易的合约数:", trading.sum(axis=1).resample("YE").last().to_dict())
print("寿命(上市到停止交易)的中位数:", int((last - first).dt.days.median()), "天")
print("名字里带非 ASCII 字符的合约:", [c for c in close.columns if not c.isascii()])
上过市的 USDT 永续合约:864 个;最后一天还在交易的:704 个;中途停止交易的:160 个
停止交易的按年份: {2020: 1, 2021: 3, 2022: 14, 2023: 3, 2024: 30, 2025: 47, 2026: 62}
成交量为 0 的占位 K 线:52713 根,涉及 160 个合约(最多的是 BTCSTUSDT,1936 根)
每年最后一天在交易的合约数: {Timestamp('2020-12-31 00:00:00+0000', tz='UTC'): 80, Timestamp('2021-12-31 00:00:00+0000', tz='UTC'): 136, Timestamp('2022-12-31 00:00:00+0000', tz='UTC'): 146, Timestamp('2023-12-31 00:00:00+0000', tz='UTC'): 243, Timestamp('2024-12-31 00:00:00+0000', tz='UTC'): 340, Timestamp('2025-12-31 00:00:00+0000', tz='UTC'): 539, Timestamp('2026-12-31 00:00:00+0000', tz='UTC'): 704}
寿命(上市到停止交易)的中位数: 463 天
名字里带非 ASCII 字符的合约: ['币安人生USDT', '我踏马来了USDT', '牛来USDT', '龙虾USDT']
几个要记住的事实:
- 864 个上过市,704 个还在交易,160 个中途停止了,占 18.5%。而且停止交易的数量逐年增加:2024 年 30 个,2025 年 47 个,2026 年到 8 月已经 62 个。
- 在交易的合约数从 2020 年底的 80 个涨到 2026 年 8 月的 704 个。 今天你面对的选择比五年前多了八倍。
- 一个合约从上市到停止交易,寿命的中位数是 463 天。
「不在名单里了」其实有三种完全不同的情况,混在一起会得出错误的结论:
| 情况 | 例子 | 对你意味着什么 |
|---|---|---|
| 项目本身没了 | LUNAUSDT(2022 年 5 月)、BZRXUSDT、SRMUSDT | 价格归零或接近归零,仓位真的亏光 |
| 改名或迁移 | MATICUSDT(2024-09-04 之后换成 POLUSDT)、RNDRUSDT(2024-07-16 之后换成 RENDERUSDT) | 价格是连续的,只是代码换了;旧代码的历史断在那一天 |
| 成交太少被下架 | 大部分 2024 至 2026 年停止交易的合约 | 下架前往往已经没什么成交,你也未必出得来 |
⚠️ 坑一:停止交易之后,K 线还在继续发布
这是这一篇最实际的一个数据陷阱。52,713 根 K 线的成交量是 0,涉及 160 个合约:
最后一天「有 K 线」的合约 833 个,其中真的有成交的 704 个
停止交易之后,K 线还在继续发布(ALPACAUSDT):
                              open     high      low    close        volume
time
2025-04-29 00:00:00+00:00  0.24454  0.26664  0.06579  0.19187  9.751693e+09
2025-04-30 00:00:00+00:00  0.19190  1.47630  0.18082  1.19000  2.613601e+09
2025-05-01 00:00:00+00:00  1.19000  1.19000  1.19000  1.19000  0.000000e+00
2025-05-02 00:00:00+00:00  1.19000  1.19000  1.19000  1.19000  0.000000e+00
2025-05-03 00:00:00+00:00  1.19000  1.19000  1.19000  1.19000  0.000000e+00
BTCSTUSDT:真正有成交的 9 天,之后跟着 1936 根占位 K 线
改名:MATICUSDT 最后一天 2024-09-04 收 0.3846,POLUSDT 第一天 2024-09-13 收 0.4106
改名:RNDRUSDT 最后一天 2024-07-16 收 6.6161,RENDERUSDT 第一天 2024-07-26 收 6.782
ALPACAUSDT 在 2025 年 4 月 30 日停止交易。那天因为要下架,价格被从 0.19 推到 1.19(第 2 篇讲过的被迫交易者,这里是空头被迫平仓)。之后 Binance 的数据文件里还在每天发布一根「四个价格一模一样、成交量为 0」的占位 K 线,一直发到今天。
极端一点的是 BTCSTUSDT:真正有成交的只有 9 天,后面跟着 1,936 根占位 K 线。
如果不过滤掉它们:
- 「还在交易的合约」会数成 833 个,而不是真实的 704 个;
- ALPACA 会以「60 天涨了 9 倍」的姿态在你的涨幅榜上挂好几个星期,而它根本没法成交;
- 回测会以为你能在 1.19 买卖。
所以宽表的第一步就是 close.where(volume > 0):「有数据」不等于「能成交」。
最后两行是另一件事:改名迁移的合约,价格是接得上的。 MATIC 在 2024-09-04 停在 0.3846,POL 在 9 天后从 0.4106 开始;RNDR 停在 6.6161,RENDER 从 6.782 开始。如果你只看「MATICUSDT 的历史在 2024 年 9 月断了」,很容易误以为它归零了——它只是换了个名字。
⚠️ 坑二:名单是机器给的,不是人给的
上面那行输出里还有四个名字带中文字符的合约。Binance 确实上过这些以中文命名的梗币合约,它们是真实存在的交易对,不是数据错误——但如果你的下载脚本直接把交易对名字拼进 URL,遇到它们会直接报错(URL 里要先做百分号编码)。
名单里还有几类需要你自己决定怎么处理的:
AERGOUSDTSETTLED这种带 SETTLED 后缀的:下架之后又重新上市的合约,旧的那段历史被改名保存,一共 17 个。这一篇把它们排除在外(只取名字以 USDT 结尾的 864 个),因为把两段历史接起来会在中间造一个不存在的跳空。USDC、BUSD结尾的:同一个币、不同的计价货币,算重复。- 美股那边:Nasdaq 的筛选接口今天列出 7,039 只股票,里面有
GOOGL、GOOG、GOOGM、GOOGN这样同一家公司的四个代码。你要么只留一个,要么接受同一个公司在排名里占四个位置。
四、第一道门槛:流动性
成交量不能跨标的比,成交额可以
一只 5 美元的股票成交 1 亿股,和一只 500 美元的股票成交 100 万股,成交量差 100 倍,成交额是一样的:都是 5 亿美元。能不能进出一个仓位,看的是成交额(一天成交了多少钱),不是成交量。
Binance 的 K 线直接给了以 USDT 计价的成交额(quote_volume 这一列),美股数据只有成交股数,用收盘价乘一下即可。talab.screen 里的 turnover 就这两行。
另外两个细节:
- 用最近 20 天的中位数,不用某一天的值,也不用平均值。中位数不会被「某一天突然暴量」带偏——而突然暴量恰恰经常发生在你最不该进场的那一天。
- 门槛卡在 20 天中位成交额,而不是今天的成交额:今天的成交额你要等收盘才知道,而且它本身就是你想筛掉的那种噪声。
几百个合约,能交易的有几十个
recent = features["成交额"].loc["2026-08-31"].dropna()
print(f"2026-08-31 有 20 天成交额的合约:{len(recent)} 个")
print("分位数(百万美元):", (recent.quantile([0.1, 0.25, 0.5, 0.75, 0.9]) / 1e6).round(2).to_dict())
for line in [1e6, 1e7, 1e8, 1e9]:
    passing = recent[recent >= line]
    print(f"  20 天中位成交额 ≥ {line / 1e6:>5.0f} 百万美元:{len(passing):>3} 个,占全市场成交额 {passing.sum() / recent.sum():.1%}")
print("成交额前十(百万美元):", (recent.nlargest(10) / 1e6).round(0).to_dict())
listing = D.load_nasdaq_screener("data/universe_us/screener.json")
us_turnover = (listing["close"] * listing["volume"]).dropna()
print(f"美股:Nasdaq 的筛选接口列出 {len(listing)} 只股票,当天成交额 ≥ 1000 万美元的 {int((us_turnover >= 1e7).sum())} 只,"
      f"中位数 {us_turnover.median() / 1e4:.0f} 万美元,前 100 只占全部成交额的 {us_turnover.nlargest(100).sum() / us_turnover.sum():.1%}")
2026-08-31 有 20 天成交额的合约:680 个
分位数(百万美元): {0.1: 0.74, 0.25: 1.2, 0.5: 2.37, 0.75: 9.62, 0.9: 40.5}
  20 天中位成交额 ≥     1 百万美元:558 个,占全市场成交额 99.8%
  20 天中位成交额 ≥    10 百万美元:165 个,占全市场成交额 97.1%
  20 天中位成交额 ≥   100 百万美元: 39 个,占全市场成交额 88.0%
  20 天中位成交额 ≥  1000 百万美元: 10 个,占全市场成交额 68.7%
成交额前十(百万美元): {'BTCUSDT': 10032.0, 'ETHUSDT': 8098.0, 'SNDKUSDT': 2642.0, 'SOLUSDT': 2025.0, 'XAUUSDT': 1788.0, 'SKHYNIXUSDT': 1390.0, 'XRPUSDT': 1090.0, 'SPCXUSDT': 1067.0, 'ZECUSDT': 1037.0, 'SOXLUSDT': 1008.0}
美股:Nasdaq 的筛选接口列出 7039 只股票,当天成交额 ≥ 1000 万美元的 2613 只,中位数 239 万美元,前 100 只占全部成交额的 52.5%
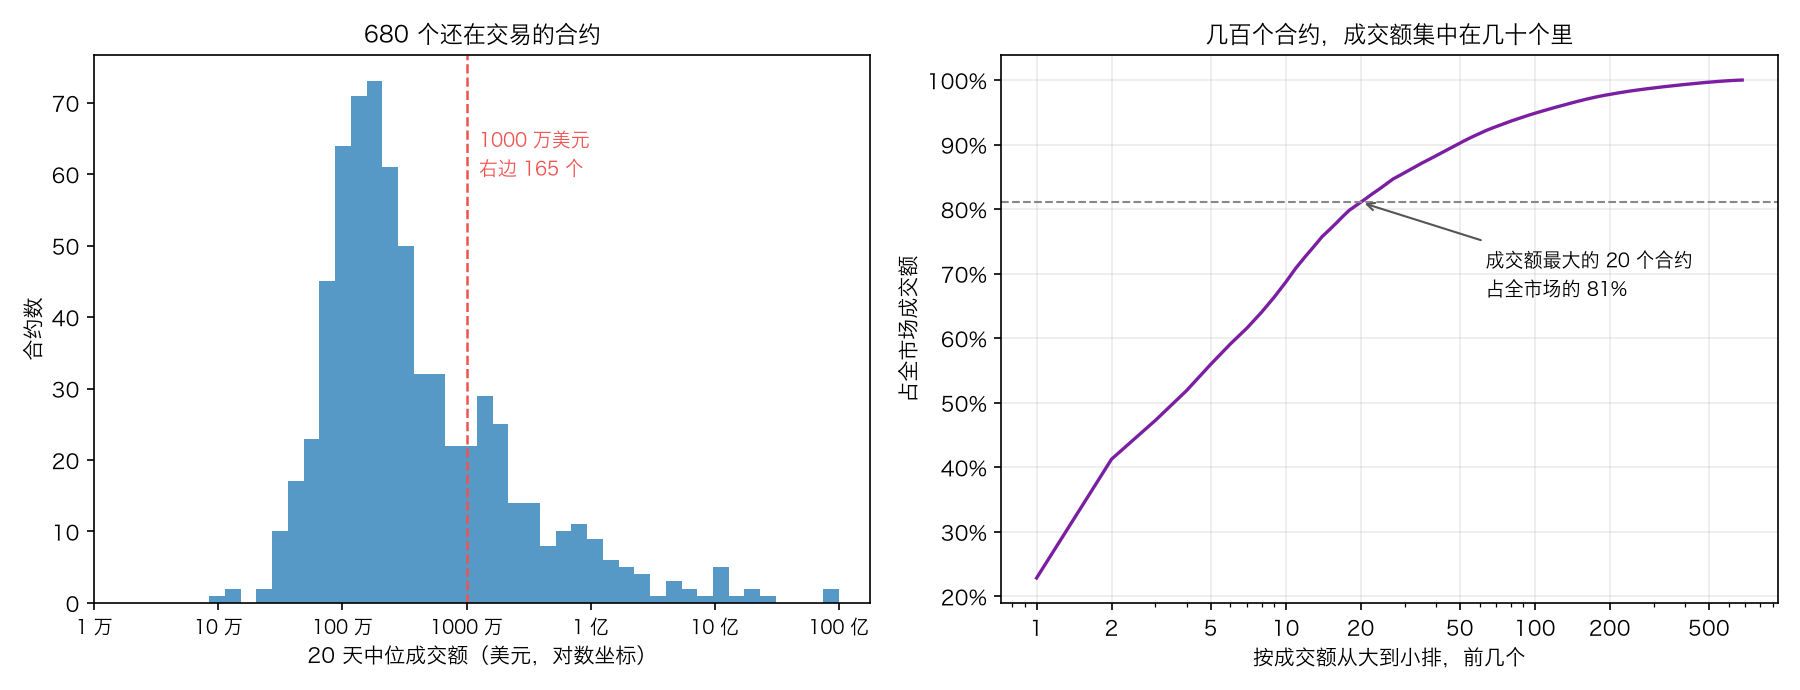
- 680 个还在交易的合约里,中位数只有每天 237 万美元,四分之一的合约一天成交不到 120 万美元。
- 成交额 1000 万美元以上的只有 165 个,但它们占了全市场成交额的 97.1%。
- 前 20 个合约占了 81%,前 10 个占 68.7%。
美股是同一个形状:7,039 只股票里,一天成交额到 1000 万美元的只有 2,613 只,中位数是 239 万美元,成交额最大的 100 只占了全市场的 52.5%。
所以「几千只股票、几百个合约」这个说法,对一个要真金白银进出的人来说是个错觉:真正流动的标的只有几十到几百个。 这一道门槛不是在挑选,是在承认现实。
✋ 小检查 1
(a) 一个合约 20 天中位成交额是 300 万美元。按「仓位不超过日成交额 1%」这条常见的经验规则,你最多能放多少钱进去?
(b) 你的账户 10 万美元,一笔交易最多亏 1%,止损放在 3 个 ATR 之外,这个合约的 NATR 是 10%。按风险算出来的仓位是多少?和 (a) 的上限比,哪个先卡住你?
(c) 账户加到 1000 万美元,答案会变吗?
答案在文末。
五、第二道门槛:波动率
两头都要卡
第 15 篇的 NATR(ATR 除以价格)是这里最顺手的尺子:它是「这个标的最近平均一天走多少个百分点」。
太小不行。 一个一天只动 0.5% 的标的,3 个 ATR 的止损距离是 1.5%,而你一进一出的手续费加滑点可能就有 0.1%——成本占了止损距离的 7%。更麻烦的是,你要的那种「走出一段」的行情,在这个标的上根本不会发生。
太大也不行。 按固定风险定仓位(第 26 篇的主题)时:
仓位金额 = 账户 × 每笔风险 ÷ 止损距离
止损距离 = 3 × NATR
NATR 从 3% 涨到 30%,止损距离从 9% 涨到 90%,同样的 1% 风险,仓位要缩小到十分之一。仓位缩到几百美元,手续费和滑点就开始吃掉你的期望。
逐步算例
账户 10 万美元、一笔最多亏 1%(1000 美元)、止损放 3 个 ATR,在 2026 年 8 月 31 日这一天:
risk, stop_atr, share = 0.01, 3, 0.01          # 一笔最多亏账户的 1%;止损放 3 个 ATR;仓位不超过日成交额的 1%
rows = []
for name in ["BTCUSDT", "SOLUSDT", "ZECUSDT", "MERLUSDT", "ALCHUSDT"]:
    rate, money = natr.loc["2026-08-31", name] / 100, features["成交额"].loc["2026-08-31", name]
    rows.append({"合约": name, "收盘价": close.loc["2026-08-31", name], "NATR": rate,
                 "3 ATR 止损距离": stop_atr * rate, "20 天中位成交额": money,
                 "10 万账户的仓位": risk * 100_000 / (stop_atr * rate),     # 仓位金额 = 能亏的钱 ÷ 止损距离
                 "1000 万账户的仓位": risk * 10_000_000 / (stop_atr * rate),
                 "成交额的 1%": share * money})
sizing = pd.DataFrame(rows).set_index("合约")
print("仓位金额 = 账户 × 1% ÷ 止损距离;最后一列是「不超过日成交额 1%」这条上限:")
print(sizing.to_string(float_format=lambda v: f"{v:,.4f}" if v < 1 else f"{v:,.0f}"))
day = pd.Timestamp("2026-08-31", tz="UTC")
sizes = risk / (stop_atr * natr.loc[day] / 100)                    # 每 1 美元账户对应的仓位
for account in [100_000, 1_000_000, 10_000_000, 100_000_000]:
    fits = candidates.loc[day] & (sizes * account <= share * features["成交额"].loc[day])
    print(f"账户 {account:>11,} 美元:通过门槛、且仓位不超过日成交额 1% 的合约 {int(fits.sum()):>3} 个")
仓位金额 = 账户 × 1% ÷ 止损距离;最后一列是「不超过日成交额 1%」这条上限:
            收盘价   NATR  3 ATR 止损距离      20 天中位成交额  10 万账户的仓位  1000 万账户的仓位     成交额的 1%
合约
BTCUSDT  78,550 0.0298      0.0893 10,031,735,171     11,195    1,119,475 100,317,352
SOLUSDT     103 0.0521      0.1563  2,024,598,790      6,396      639,630  20,245,988
ZECUSDT     848 0.0730      0.2190  1,036,659,677      4,566      456,618  10,366,597
MERLUSDT 0.0203 0.0960      0.2879      1,723,196      3,474      347,368      17,232
ALCHUSDT 0.0303 0.0917      0.2751        596,082      3,635      363,484       5,961
账户     100,000 美元:通过门槛、且仓位不超过日成交额 1% 的合约 128 个
账户   1,000,000 美元:通过门槛、且仓位不超过日成交额 1% 的合约 126 个
账户  10,000,000 美元:通过门槛、且仓位不超过日成交额 1% 的合约  57 个
账户 100,000,000 美元:通过门槛、且仓位不超过日成交额 1% 的合约  12 个
读这张表:
- BTC 的 NATR 是 2.98%,3 ATR 止损距离 8.93%,1000 美元的风险对应 11,195 美元的仓位;ZEC 的 NATR 是 7.30%,同样的风险只能买 4,566 美元。波动越大,仓位越小——这是自动的,不需要你额外判断。
- 最后两列是另一条约束。10 万美元的账户,在 MERL 上的仓位 3,474 美元,而它日成交额的 1% 是 17,232 美元:还早得很。但账户换成 1000 万美元,同样的规则要买 347,368 美元,已经是它日成交额的 20%——这时候卡住你的不是波动率,是流动性。
最后四行把这件事算完了。2026 年 8 月 31 日,同一个扫描器、同一套规则,账户 10 万美元时有 128 个合约可选,1000 万美元时只剩 57 个,1 亿美元时只剩 12 个。
账户越大,能交易的标的越少。 这句话听上去像废话,但它会实实在在地改变你的标的池:一个在小账户上验证过的策略,搬到大账户上时,交易的可能已经是另一批标的了。
⚠️ 波动率门槛不是为了挑出更能涨的标的。第九节会看到,按 NATR 分组之后,高波动那一组的平均收益确实更高,但中位数更差——平均值是被少数几个暴涨的标的拉起来的。门槛的作用是让仓位算得出来、成本占得住。
回到招聘那个比方:两道门槛相当于简历初筛里的「学历」和「能不能到岗」。 它们不预测谁干得好,只保证进入面试的人是能录用的。把门槛当成选股指标用,就像因为「学历高的人平均绩效高一点」就只按学历招人——你会招进一批能到岗但不合适的人,同时漏掉真正合适的。
六、相对强度:和谁比
定义
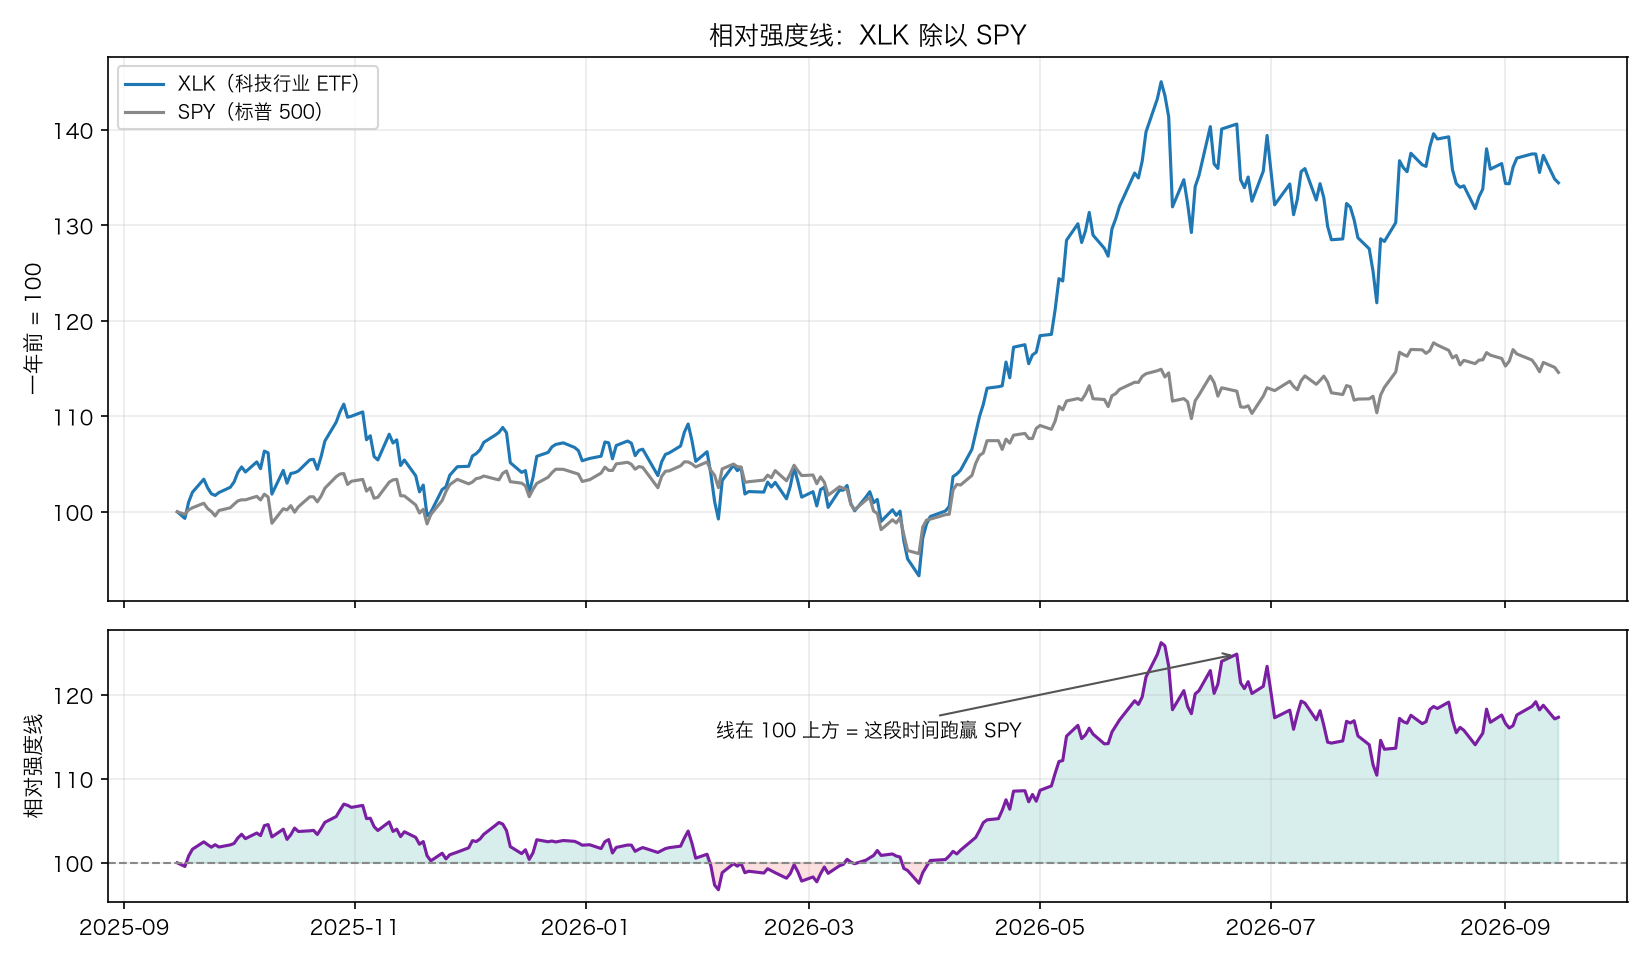
相对强度线(relative strength line)就是两条价格相除:
相对强度线 = 标的价格 ÷ 基准价格,起点换算成 100
基准通常是:美股用 SPY(或者所属行业的 ETF),加密用 BTC。线往上走 = 这段时间跑赢基准,和标的自己是涨是跌无关。
逐步算例
XLK 是科技行业 ETF,基准用 SPY:
               XLK     SPY  XLK ÷ SPY     相对强度线
date
2025-09-15  136.66  660.91     0.2068  100.0000
2026-03-16  138.78  669.03     0.2074  100.3188
2026-09-15  183.74  757.39     0.2426  117.3235
- 一年前:XLK 136.66,SPY 660.91,比值 0.2068,定为 100。
- 半年后(2026-03-16):XLK 138.78,SPY 669.03,比值 0.2074,相对强度线 100.32。半年里 XLK 涨了 1.6%,SPY 涨了 1.2%,几乎打平,所以线几乎没动。
- 一年后:比值 0.2426,相对强度线 117.32。XLK 一年涨 34.5%,SPY 涨 14.6%,跑赢的部分就是这 17.32。
把 11 个行业 ETF 都算一遍,就得到一张「这一年谁强谁弱」的表:
us = {path.name.split("_")[0]: D.load_nasdaq_daily(path) for path in Path("data/universe_us").glob("*_historical.json")}
sectors = ["XLK", "XLF", "XLE", "XLV", "XLI", "XLY", "XLP", "XLU", "XLB", "XLRE", "XLC"]
us_close = S.panel(us, "close")
window = us_close.loc["2025-09-15":"2026-09-15"]
rs = S.relative_strength(window[sectors], window["SPY"])
summary = pd.DataFrame({"一年涨幅": window[sectors].iloc[-1] / window[sectors].iloc[0] - 1,
                        "相对强度线": rs.iloc[-1].round(1)}).sort_values("相对强度线", ascending=False)
print(f"SPY 这一年:{window['SPY'].iloc[0]:.2f} → {window['SPY'].iloc[-1]:.2f},{window['SPY'].iloc[-1] / window['SPY'].iloc[0] - 1:+.1%}")
print(summary.round(3).to_string())
SPY 这一年:660.91 → 757.39,+14.6%
       一年涨幅  相对强度线
XLE   0.493  130.3
XLK   0.345  117.3
XLV   0.224  106.8
XLB   0.116   97.4
XLI   0.109   96.8
XLF   0.059   92.4
XLP   0.055   92.0
XLRE  0.018   88.8
XLU  -0.036   84.1
XLC  -0.042   83.6
XLY  -0.079   80.4
这一年 SPY 涨 14.6%,能源(XLE)涨 49.3%、科技(XLK)涨 34.5%,而可选消费(XLY)跌 7.9%。同一个市场、同一段时间,最强和最弱的行业差了 57 个百分点。
⚠️ 横截面排名的时候,相对强度和绝对涨幅是同一个排名
这是一个很多人没注意到的事实。假设这 60 天基准涨了 b,标的涨了 r:
相对强度(相对涨幅比)= (1 + r) ÷ (1 + b)
同一天,所有标的的 b 是同一个数
除以同一个正数不改变大小顺序。所以在同一天的横截面排名里,按「自己的涨幅」排和按「相对基准的涨幅」排,名次一模一样。实测也是如此:
own = S.momentum(close, 60)
against_btc = (close / close.shift(60)).div(btc / btc.shift(60), axis=0) - 1
by_gain, by_strength = S.cross_rank(own, mask=candidates), S.cross_rank(against_btc, mask=candidates)
print("按自己的涨幅排名,和按「相对 BTC 的涨幅」排名,最大差别:", float((by_gain - by_strength).abs().max().max()))
按自己的涨幅排名,和按「相对 BTC 的涨幅」排名,最大差别: 0.0
六年、每天、几百个标的,两种排名的最大差别是 0。
那相对强度线还有什么用?它多出来的信息在时间序列上,不在横截面上:
- 「价格没创新高,但相对强度线创了新高」——这句话说的是形状,不是名次,横截面排名给不了。
- 基准换一个,故事就换一个:一只股票相对 SPY 在跌、相对所属行业 ETF 在涨,说明它是整个行业的问题,不是它自己的问题。
第九节会检验「强度线创新高」这个时间序列条件到底有没有用。
七、动手:写一个每天能跑的筛选器
新模块 talab/screen.py。它和前面的模块有一个明显不同:输入不再是一个标的的一张表,而是一堆标的。
"""talab.screen:从几百上千个标的里挑出今天要交易的几个。第 19 篇。

这个模块处理的是「一堆标的」,所以主角是一张**宽表**(panel):行是时间,列是标的,
还没上市或者已经下架的位置是 NaN。

约定和前面的模块一样:第 k 行的值只用到第 k 行及之前的数据。唯一的例外是 forward_return,
它看的是未来,名字里写明了,只用来做统计,不能用来做交易决定。
"""
一、把很多标的拼成一张宽表
def panel(frames: dict[str, pd.DataFrame], field: str) -> pd.DataFrame:
    """把 {标的: OHLCV 表} 拼成一张宽表,取每张表的 field 这一列。列按标的名排序。"""
    return pd.DataFrame({name: df[field] for name, df in sorted(frames.items())})


def turnover(df: pd.DataFrame) -> pd.Series:
    """成交额(一天成交了多少钱)。有 quote_volume 就直接用,没有就用收盘价 × 成交量估。

    ⚠️ 成交量(多少股、多少个币)不能跨标的比:1 亿股 5 美元的股票和 100 万股 500 美元的股票,
    成交额一样。能不能进出一个仓位,看的是成交额。
    """
    return df["quote_volume"] if "quote_volume" in df else df["close"] * df["volume"]


def rolling_turnover(dollar_volume: pd.DataFrame, n: int = 20) -> pd.DataFrame:
    """最近 n 天成交额的中位数。用中位数而不是平均,是为了不被某一天的暴量带偏。"""
    return dollar_volume.rolling(n, min_periods=n).median()
二、横截面:同一天,标的之间比
前面十八篇算的都是「这个标的和它自己的过去比」。横截面是另一个方向:同一天,这个标的和别的标的比。
def cross_rank(values: pd.DataFrame, ascending: bool = False, mask: pd.DataFrame | None = None,
               pct: bool = True) -> pd.DataFrame:
    """每一天,在当天有数据的标的之间排名。

    ascending=False(默认)表示值越大排得越前。pct=True 返回 0 到 1 的百分位(1 是最强的那一端),
    pct=False 返回 1、2、3……的名次。mask 给出当天参加排名的标的,没进名单的记 NaN。
    """
    if mask is not None:
        values = values.where(mask)
    if pct:                       # 百分位 = 当天有多少比例的标的排在它后面(含它自己)
        return values.rank(axis=1, ascending=not ascending, pct=True)
    return values.rank(axis=1, ascending=ascending)


def buckets(rank: pd.DataFrame, k: int = 5) -> pd.DataFrame:
    """把 0 到 1 的百分位分成 k 组:1 组是排名最靠后的,k 组是最靠前的。"""
    return np.ceil(rank * k)


def bucket_returns(bucket: pd.DataFrame, forward: pd.DataFrame, k: int = 5) -> pd.DataFrame:
    """每一天每一组的等权平均未来收益。行是时间,列是组号 1 到 k。"""
    rows = {g: forward.where(bucket == g).mean(axis=1) for g in range(1, k + 1)}
    return pd.DataFrame(rows).reindex(columns=range(1, k + 1))
cross_rank 里有一个容易写反的地方:pandas 的 rank(ascending=False) 让最大的值得到名次 1,而我们想要的百分位是「有多少比例的标的排在它后面」,最强的那个应该是 1.0。所以名次和百分位用的是相反的 ascending,测试里把两种都写死了。
三、相对强度
def relative_strength(close: pd.DataFrame | pd.Series, benchmark: pd.Series, base: float = 100.0):
    """相对强度线:标的价格 ÷ 基准价格,第一个能算的位置换算成 base(默认 100)。

    线在涨,说明这段时间跑赢基准,和标的自己是涨是跌无关。
    """
    ratio = close.div(benchmark, axis=0) if isinstance(close, pd.DataFrame) else close / benchmark
    return ratio / ratio.bfill().iloc[0] * base        # bfill().iloc[0] 是每一列第一个能算出来的值


def momentum(close: pd.DataFrame | pd.Series, lookback: int, skip: int = 0):
    """过去 lookback 根 K 线的涨幅;skip 表示跳过最近 skip 根(经典的「12 减 1」动量就是 skip=1 个月)。"""
    recent = close.shift(skip)
    return recent / close.shift(lookback) - 1
四、每日扫描
def passes(features: dict[str, pd.DataFrame], filters: dict[str, tuple]) -> pd.DataFrame:
    """通过全部硬门槛的位置。filters 是 {指标: (下限, 上限)},用 None 表示这一端不限。"""
    ok = None
    for name, (low, high) in filters.items():
        values = features[name]
        good = values.notna()
        if low is not None:
            good &= values >= low
        if high is not None:
            good &= values <= high
        ok = good if ok is None else (ok & good)
    return ok


def scan(as_of, features: dict[str, pd.DataFrame], filters: dict[str, tuple],
         rank_by: str, top: int | None = 10) -> pd.DataFrame:
    """某一天的扫描结果:先过硬门槛,再按 rank_by 从大到小排,取前 top 个(top=None 表示全要)。

    返回一张表,每行一个标的,列是各个指标的值,外加 rank_by 在当天候选里的百分位(%)和名次。
    第 k 天的结果只用到第 k 天及之前的数据。
    """
    ok = passes(features, filters)
    table = pd.DataFrame({name: values.loc[as_of] for name, values in features.items()})
    table["名次"] = cross_rank(features[rank_by], mask=ok, pct=False).loc[as_of]
    table["百分位"] = cross_rank(features[rank_by], mask=ok).loc[as_of] * 100
    table = table[ok.loc[as_of]].sort_values("名次")
    return table if top is None else table.head(top)
filters 里的 (下限, 上限) 用 None 表示这一端不限。这样写的好处是:指标和门槛是分开的。你可以把一个指标放进 features 只为了显示(比如决策点那张表里的「波动率」和「上市天数」),门槛写成 (None, None) 就行。
五、看未来(只用来做统计)
def forward_return(close: pd.DataFrame, horizon: int, exit_on_delisting: bool = True) -> pd.DataFrame:
    """未来 horizon 根 K 线的收益率。

    ⚠️ exit_on_delisting=True(默认)时,中途下架的标的按下架前最后一个价格算收益;
    直接丢掉这些标的会让统计只剩下活到最后的赢家(幸存者偏差)。
    """
    future = (close.ffill() if exit_on_delisting else close).shift(-horizon)
    return (future / close - 1).where(close.notna())
这是整个模块里唯一看未来的函数,也是最容易写错的一个。默认的 exit_on_delisting=True 是在说:一个合约中途停止交易,你手上的仓位按停止前最后一个价格结算。 如果图省事直接丢掉这些标的(exit_on_delisting=False),那些下架前跌了三成的合约就从统计里消失了——第九节会量出这个差别。
跑一天试试
三个指标、两道门槛:
natr = pd.DataFrame({name: I.natr(df["high"], df["low"], df["close"]) for name, df in frames.items()}).sort_index(axis=1)
features = {"成交额": S.rolling_turnover(dollar, 20), "涨幅": S.momentum(close, 60),
            "波动率": natr.where(close.notna()), "上市天数": trading.cumsum().where(close.notna())}
filters = {"成交额": (1e7, None), "上市天数": (120, None), "涨幅": (None, None), "波动率": (None, None)}
candidates = S.passes(features, filters)
print("每年最后一天通过门槛的合约数:", candidates.sum(axis=1).resample("YE").last().to_dict())
for day in ["2023-12-31", "2024-12-31", "2025-12-31", "2026-08-31"]:
    row = features["成交额"].loc[day].dropna()
    print(f"{day}:在交易 {int(close.loc[day].notna().sum()):>3} 个,全市场 20 天中位成交额合计 {row.sum() / 1e8:>5.0f} 亿美元,"
          f"其中成交额前 20 个占 {row.nlargest(20).sum() / row.sum():.1%}")
每年最后一天通过门槛的合约数: {Timestamp('2020-12-31 00:00:00+0000', tz='UTC'): 36, Timestamp('2021-12-31 00:00:00+0000', tz='UTC'): 120, Timestamp('2022-12-31 00:00:00+0000', tz='UTC'): 85, Timestamp('2023-12-31 00:00:00+0000', tz='UTC'): 178, Timestamp('2024-12-31 00:00:00+0000', tz='UTC'): 217, Timestamp('2025-12-31 00:00:00+0000', tz='UTC'): 104, Timestamp('2026-12-31 00:00:00+0000', tz='UTC'): 128}
2023-12-31:在交易 243 个,全市场 20 天中位成交额合计   398 亿美元,其中成交额前 20 个占 73.7%
2024-12-31:在交易 340 个,全市场 20 天中位成交额合计   622 亿美元,其中成交额前 20 个占 73.8%
2025-12-31:在交易 539 个,全市场 20 天中位成交额合计   348 亿美元,其中成交额前 20 个占 84.7%
2026-08-31:在交易 704 个,全市场 20 天中位成交额合计   439 亿美元,其中成交额前 20 个占 81.1%
通过门槛的合约数不是单调增长的:2024 年底有 217 个,2025 年底只剩 104 个,而同期在交易的合约从 340 个涨到 539 个。后面四行给出了原因:全市场的成交额从 622 亿美元掉到 348 亿美元,而成交额前 20 个合约的占比从 73.8% 升到 84.7%。
上市的合约越来越多,能交易的反而越来越少——这是熊市里标的池的典型形状,也是为什么门槛必须每天重算,而不是一年定一次。
扫描一天:
decision = pd.Timestamp("2025-11-19", tz="UTC")
table = S.scan(decision, features, filters, rank_by="涨幅", top=10)
table["成交额"] = (table["成交额"] / 1e6).round(0)                 # 换成百万美元
print(f"{decision.date()} 通过门槛的合约:{int(candidates.loc[decision].sum())} 个;前十名:")
print(table.round(3).to_string())
这就是第一节那张表。
测试
10 个测试,都能手算。其中三个是这一篇特有的:
def test_forward_return_counts_delisting_as_an_exit():
    close = pd.DataFrame({"A": [10.0, 11.0, 12.0, 13.0], "B": [10.0, 8.0, np.nan, np.nan]}, index=DAYS[:4])
    out = S.forward_return(close, 2)
    assert out["A"].iloc[0] == pytest.approx(0.2)
    assert out["B"].iloc[0] == pytest.approx(-0.2)          # 第 3 天下架,按下架前最后的 8 算
    assert np.isnan(out["B"].iloc[2])                       # 已经下架的日子不参加统计
    dropped = S.forward_return(close, 2, exit_on_delisting=False)
    assert np.isnan(dropped["B"].iloc[0])                   # 直接丢掉的话,B 的这笔亏损不会进统计


def test_passes_and_scan_by_hand():
    features = {"成交额": pd.DataFrame({"A": [100.0, 100.0], "B": [10.0, 300.0], "C": [500.0, 500.0]}, index=DAYS[:2]),
                "涨幅": pd.DataFrame({"A": [0.1, 0.1], "B": [0.9, 0.9], "C": [0.5, np.nan]}, index=DAYS[:2])}
    filters = {"成交额": (50, None), "涨幅": (None, None)}
    ok = S.passes(features, filters)
    assert ok.loc[DAYS[0]].tolist() == [True, False, True]           # B 第一天成交额不够
    assert ok.loc[DAYS[1]].tolist() == [True, True, False]           # C 第二天涨幅是 NaN
    table = S.scan(DAYS[0], features, filters, rank_by="涨幅")
    assert table.index.tolist() == ["C", "A"]                        # B 没进名单,C 涨得多排前面
    assert table["名次"].tolist() == [1, 2] and table["百分位"].tolist() == [100.0, 50.0]
    assert S.scan(DAYS[0], features, filters, rank_by="涨幅", top=1).index.tolist() == ["C"]


def test_scan_never_uses_the_future():
    rng = np.random.default_rng(0)
    close = pd.DataFrame(100 * np.exp(np.cumsum(rng.normal(0, 0.02, (8, 4)), axis=0)),
                         index=DAYS, columns=list("ABCD"))
    dv = pd.DataFrame(rng.uniform(1e6, 1e8, (8, 4)), index=DAYS, columns=list("ABCD"))
    features = {"成交额": S.rolling_turnover(dv, n=3), "涨幅": S.momentum(close, 3)}
    filters = {"成交额": (2e6, None), "涨幅": (None, None)}
    full = S.scan(DAYS[5], features, filters, rank_by="涨幅", top=None)
    cut = {name: values.loc[:DAYS[5]] for name, values in
           {"成交额": S.rolling_turnover(dv.loc[:DAYS[5]], n=3), "涨幅": S.momentum(close.loc[:DAYS[5]], 3)}.items()}
    pd.testing.assert_frame_equal(full, S.scan(DAYS[5], cut, filters, rank_by="涨幅", top=None))
最后一个是老规矩:把数据截断到扫描当天,扫描结果必须一模一样。 宽表比单个标的更容易漏进未来数据,因为「今天在名单里的标的」这件事本身就可能是用未来信息决定的。
167 passed in 0.81s
没装 TA-Lib 的环境里是 135 passed、32 skipped(跳过的是和 TA-Lib 对账的那些)。
八、揭晓
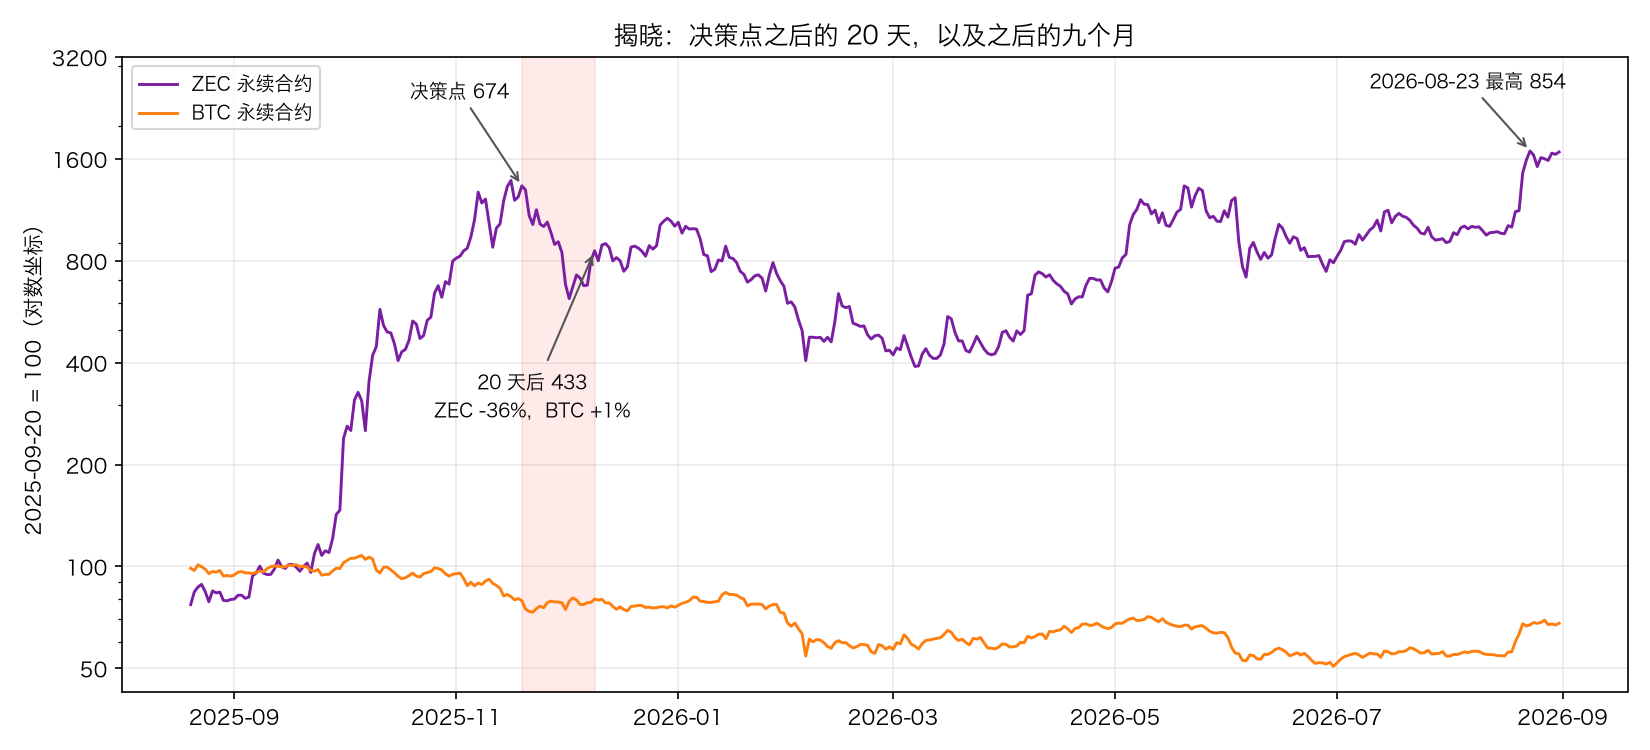
前十里有八个在 20 天内下跌,等权 -31.5%;同期 BTC 涨了 1.2%。
2025-11-19 之后 20 天:
            决策日收盘    20 天后     收益
ZECUSDT   673.520  432.800 -0.357
SOONUSDT    1.233    0.443 -0.640
DASHUSDT   79.560   50.360 -0.367
HUSDT       0.136    0.052 -0.618
ZENUSDT    14.586   10.483 -0.281
STRKUSDT    0.249    0.116 -0.535
MERLUSDT    0.374    0.344 -0.080
ALCHUSDT    0.154    0.194  0.262
BDXNUSDT    0.076    0.020 -0.734
ARCUSDT     0.031    0.037  0.197
前十等权 -31.5%,BTC +1.2%,当天通过门槛的全部合约等权 -1.0%
三个选择:
- 选 A(买第一名 ZEC):673.52 买,20 天后 432.80,-35.7%。
- 选 B(买前十等权):-31.5%。分散并没有帮上忙——十个里八个一起跌,其中六个跌超过三成。
- 选 C(只买 BTC):+1.2%。
而且注意最后一行:当天通过门槛的 151 个合约等权只跌了 1.0%。跌的不是「市场」,是「涨得最多的那十个」。
但是把同一个扫描器往前推一个月
一个月前的 2025-10-15:第一名也是 ZECUSDT,之后 20 天 +91.8%,前十等权 +43.1%,BTC -8.4%
ZEC 后来:2025-12-09 最低收在 432.80,2026-08-23 最高收在 853.69,2026-08-31 收在 847.71(比决策日 +25.9%)
同一个扫描器、同一个第一名 ZEC,一个月前买入的话,20 天赚 91.8%,前十等权赚 43.1%,而同期 BTC 跌了 8.4%。
再往后看:ZEC 从决策日的 673.52 跌到 12 月 9 日的 432.80,然后一路涨回去,2026 年 8 月 23 日最高收在 853.69,8 月 31 日收在 847.71——比你在决策点买入的价格还高 25.9%。如果你 A 方案买了、扛住了中间 36% 的回撤,九个月后是赚钱的;但第 23 篇会讲,扛住 36% 的回撤本身就是一个需要提前规划的决定,不是「拿着不动」四个字。
一次决策点说明不了任何事。 它只能告诉你这件事有多随机。要知道「买最强的几个」到底行不行,只能做统计。
九、数据怎么说
9.1 买最强的几个,有优势吗
检验方法:
- 每天按过去 20 / 60 / 120 天的涨幅,把当天通过门槛的标的排名、分成 5 组(第 5 组最强)。
- 每 20 天调一次仓(不重叠,相邻两次的持有期不交叉),每组等权持有 20 天。
- 记录每组的平均收益,再减去当天全部候选的平均收益——加密市场里所有标的一起涨一起跌,不减掉这个共同部分,你量到的只是大盘。
- 「最强组减最弱组」按调仓日重抽样 2000 次,给出 95% 区间和 p 值。
def bucket_test(close_panel, mask, lookback, horizon=20, k=5, n=2000):
    """按过去 lookback 天的涨幅分成 k 组,每 horizon 天调一次仓,看各组未来 horizon 天的等权收益。"""
    forward = S.forward_return(close_panel, horizon)
    bucket = S.buckets(S.cross_rank(S.momentum(close_panel, lookback), mask=mask), k)
    grouped = S.bucket_returns(bucket, forward, k)
    universe = forward.where(mask).mean(axis=1)
    days = [d for d in close_panel.index[::horizon] if mask.loc[d].sum() >= 50 and grouped.loc[d].notna().all()]
    rows, excess = grouped.loc[days], grouped.loc[days].sub(universe.loc[days], axis=0)
    spread = rows[k] - rows[1]
    boot = np.array([spread.iloc[rng.integers(0, len(spread), len(spread))].mean() for _ in range(n)])
    return {"回看天数": lookback, "调仓次数": len(days)} | {f"第 {g} 组": excess[g].mean() for g in range(1, k + 1)} \
        | {"最强减最弱": spread.mean(), "95% 区间": f"{np.percentile(boot, 2.5):+.3f} ~ {np.percentile(boot, 97.5):+.3f}",
           "p": 2 * min((boot <= 0).mean(), (boot >= 0).mean())}


us_volume, us_trading = S.panel(us, "volume"), us_close.notna()
us_candidates = S.passes({"成交额": S.rolling_turnover(us_close * us_volume, 20),
                          "上市天数": us_trading.cumsum().where(us_close.notna())}, {"成交额": (1e7, None), "上市天数": (120, None)})
stocks = [name for name in us_close.columns if name not in sectors and name != "SPY"]
print("各组的数字是「该组的平均未来 20 天收益 - 当天全部候选的平均」:")
crypto_rows = [bucket_test(close, candidates, lookback) for lookback in [20, 60, 120]]
us_rows = [bucket_test(us_close[stocks], us_candidates[stocks], lookback) for lookback in [20, 60, 120, 250]]
report = pd.DataFrame([{"市场": "BTC 永续合约"} | row for row in crypto_rows]
                      + [{"市场": "美股 100 只"} | row for row in us_rows])
print(report.to_string(index=False, float_format=lambda v: f"{v:.4f}"))
      市场  回看天数  调仓次数   第 1 组   第 2 组   第 3 组   第 4 组   第 5 组   最强减最弱          95% 区间      p
BTC 永续合约    20   102 -0.0081 -0.0051  0.0005  0.0043  0.0081  0.0162 -0.010 ~ +0.046 0.2480
BTC 永续合约    60   102 -0.0030  0.0083  0.0004 -0.0040 -0.0011  0.0019 -0.023 ~ +0.026 0.9150
BTC 永续合约   120   102  0.0028  0.0000  0.0010 -0.0048  0.0005 -0.0023 -0.033 ~ +0.026 0.9390
美股 100 只    20   119  0.0032  0.0009 -0.0011 -0.0058  0.0028 -0.0004 -0.010 ~ +0.011 0.9300
美股 100 只    60   119  0.0014 -0.0008 -0.0052 -0.0011  0.0055  0.0041 -0.007 ~ +0.015 0.4800
美股 100 只   120   119  0.0013 -0.0022 -0.0049 -0.0014  0.0071  0.0058 -0.007 ~ +0.017 0.3390
美股 100 只   250   112  0.0001 -0.0057 -0.0017 -0.0020  0.0068  0.0067 -0.007 ~ +0.020 0.3210
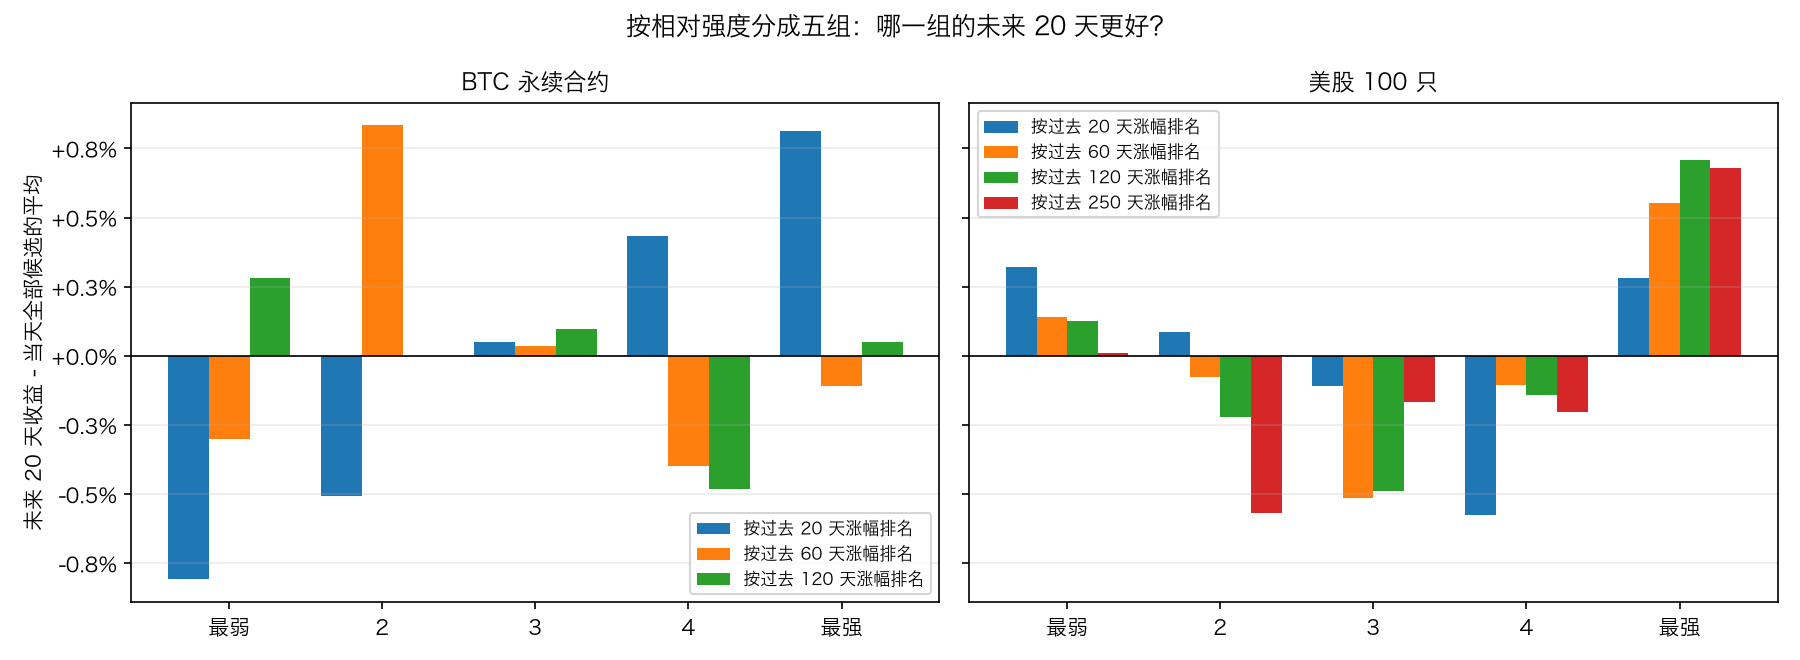
- 加密、回看 20 天:五组是单调的,从最弱组 -0.81% 到最强组 +0.81%,最强减最弱 +1.62%。看起来很像那么回事,但 102 次调仓给出的 95% 区间是 -1.0% 到 +4.6%,p = 0.248。
- 加密、回看 60 天和 120 天:单调性消失,p 分别是 0.915 和 0.939。第一节那个扫描器用的正是 60 天。
- 美股 100 只:回看 120 天和 250 天时最强组稍好(+0.71% 和 +0.68%),但 p 是 0.339 和 0.321;而且两头都比中间好,这更像是「排在两端的股票波动更大」,不是动量。
七次检验,没有一次 p 小于 0.05,最小的是 0.248。 「买最强的」在这两个市场、这段历史上,没有量得出来的优势。
⚠️ 一句必要的说明:这不是在说横截面动量整体无效。学术文献里横截面动量最经典的证据(Jegadeesh 和 Titman 1993 年发表在 Journal of Finance 上的《Returns to Buying Winners and Selling Losers》)用的是纽交所和美交所 1965 至 1989 年的全部股票,后来常用的口径是「12 个月涨幅、跳过最近 1 个月、持有 1 个月」。这里的两个池子都太小(加密平均 130 个、美股 100 只),时间也太短(六年、十年),本来就很难在这种样本上看出每月不到 1% 的差别。这个统计能说的是:你不能指望把它直接搬到一百来个标的的池子上,然后期待它照样有效。
9.2 相对强度线创新高有用吗
第六节说过,相对强度真正多出来的是时间序列上的形状。检验四个条件,看之后 20 天相对全部候选的超额收益:
excess = forward.sub(forward.where(candidates).mean(axis=1), axis=0)
strength = close.div(btc, axis=0)
price_high, strength_high = close >= close.rolling(60).max(), strength >= strength.rolling(60).max()
days = close.index[::horizon]
rows = []
for name, condition in [("价格创 60 天新高", price_high), ("相对 BTC 的强度线创 60 天新高", strength_high),
                        ("强度线新高、价格没新高", strength_high & ~price_high),
                        ("价格新高、强度线没新高", price_high & ~strength_high)]:
    picked = excess.loc[days].where((condition & candidates).loc[days]).stack().dropna()
    boot = np.array([picked.iloc[rng.integers(0, len(picked), len(picked))].mean() for _ in range(2000)])
    rows.append({"条件": name, "次数": len(picked), "超额收益": picked.mean(), "中位数": picked.median(),
                 "p": 2 * min((boot <= 0).mean(), (boot >= 0).mean())})
print(pd.DataFrame(rows).to_string(index=False, float_format=lambda v: f"{v:.4f}"))
                 条件  次数    超额收益     中位数      p
         价格创 60 天新高 600 -0.0012 -0.0700 0.9230
相对 BTC 的强度线创 60 天新高 550 -0.0031 -0.0442 0.8150
        强度线新高、价格没新高 241  0.0150 -0.0186 0.4440
        价格新高、强度线没新高 291  0.0159 -0.0611 0.5590
四个条件,p 最小的是 0.444。「强度线新高但价格没新高」平均超额 +1.5%,听起来像个信号,但它的中位数是 -1.9%:又是被少数几个暴涨的标的拉起来的平均值。
到这里一共 11 次检验(7 次分组 + 4 次新高),没有一次显著。
9.3 成交额小的涨得多?波动大的涨得多?
如果流动性门槛只是为了「能成交」,那被它筛掉的那些标的是不是其实收益更好?
listed = S.passes(features, {"上市天数": (120, None), "成交额": (0, None)})
liquidity_bucket = S.buckets(S.cross_rank(features["成交额"], mask=listed), 5)
days = [d for d in close.index[::horizon] if listed.loc[d].sum() >= 50]
volatility_bucket = S.buckets(S.cross_rank(features["波动率"], mask=listed), 5)
for title, bucket, column in [("按 20 天中位成交额分 5 组(第 5 组成交额最大)", liquidity_bucket, "成交额"),
                              ("按 NATR 分 5 组(第 5 组波动最大)", volatility_bucket, "波动率")]:
    rows = []
    for group in range(1, 6):
        picked = forward.loc[days].where((bucket == group).loc[days]).stack().dropna()
        level = features[column].where(bucket == group).loc[days].median().median()
        rows.append({"组": group, f"{column}中位数": level / 1e6 if column == "成交额" else level,
                     "未来 20 天平均": picked.mean(), "未来 20 天中位数": picked.median(),
                     "涨超过 50% 的比例": (picked > 0.5).mean(), "跌超过 30% 的比例": (picked < -0.3).mean()})
    print(f"{title}:")
    print(pd.DataFrame(rows).to_string(index=False, float_format=lambda v: f"{v:.4f}"))
按 20 天中位成交额分 5 组(第 5 组成交额最大):
 组  成交额中位数  未来 20 天平均  未来 20 天中位数  涨超过 50% 的比例  跌超过 30% 的比例
 1  1.7830     0.0024     -0.0462       0.0407       0.0581
 2  3.3834    -0.0042     -0.0508       0.0435       0.0733
 3  6.8617     0.0067     -0.0504       0.0468       0.0831
 4 16.2919    -0.0107     -0.0584       0.0452       0.0865
 5 63.3513    -0.0137     -0.0505       0.0414       0.0821
按 NATR 分 5 组(第 5 组波动最大):
 组  波动率中位数  未来 20 天平均  未来 20 天中位数  涨超过 50% 的比例  跌超过 30% 的比例
 1  6.0187    -0.0053     -0.0316       0.0244       0.0313
 2  7.3551    -0.0068     -0.0526       0.0345       0.0539
 3  8.3700    -0.0141     -0.0562       0.0412       0.0757
 4  9.7604    -0.0048     -0.0599       0.0488       0.0909
 5 12.9233     0.0111     -0.0657       0.0681       0.1306
两张表都要看两列:平均和中位数说的不是一回事。
- 按成交额分组:五组的中位数全部在 -4.6% 到 -5.8% 之间,几乎没有差别。最小的那一组平均 +0.24%、最大的一组 -1.37%,但这点差别撑不起任何东西——真正的区别是你能不能买。
- 按波动率分组:波动最大的一组平均 +1.11%,是五组里最高的;但它的中位数是 -6.57%,是五组里最低的。原因在最后两列:这一组里 6.81% 的样本在 20 天里涨超过 50%,同时 13.06% 的样本跌超过 30%。少数暴涨的把平均值拉了上去,而你随手买一个,更可能落在中位数附近。
这是选高波动标的的真实图景:不是「收益更高」,是「抽到大奖的概率和爆仓的概率同时变大」,而后者更大。
⚠️ 五组的中位数都是负的,不是统计做错了:这几年(2021 至 2026)永续合约整体在跌,等权买一个随机标的持有 20 天,本来就更可能亏钱。所以第 9.1 节的所有结论都减掉了当天全市场的平均。
9.4 「上市满 120 天」这道门槛是怎么来的
young = pd.DataFrame([{"上市 30 天": (s := close[name].dropna()).iloc[30] / s.iloc[0] - 1,
                       "上市 90 天": s.iloc[90] / s.iloc[0] - 1, "上市 120 天": s.iloc[120] / s.iloc[0] - 1}
                      for name in close.columns if close[name].count() > 130])
print(f"\n{len(young)} 个上市满 130 天的合约,从上市第一天收盘算起:")
print(young.agg(["mean", "median"]).to_string(float_format=lambda v: f"{v:.3f}"))
beaten = [close[name].dropna().iloc[90] / close[name].dropna().iloc[0] < btc.reindex(close[name].dropna().index[:91]).ffill().iloc[-1]
          / btc.reindex(close[name].dropna().index[:91]).ffill().iloc[0] for name in close.columns
          if close[name].count() > 91 and name != "BTCUSDT"]
print(f"其中上市 90 天跑输 BTC 的:{np.mean(beaten):.1%}({len(beaten)} 个合约)")
686 个上市满 130 天的合约,从上市第一天收盘算起:
        上市 30 天  上市 90 天  上市 120 天
mean      0.004    0.258     0.125
median   -0.168   -0.336    -0.352
其中上市 90 天跑输 BTC 的:77.8%(733 个合约)
从上市第一天的收盘价算起,90 天后的中位数是 -33.6%,而平均数是 +25.8%。 中位数和平均数差出 59 个百分点,又是同一个故事:少数几个暴涨的撑起了平均值。
更直接的一个数字:上市 90 天里跑输 BTC 的合约占 77.8%。
一个合约被交易所挂出来,通常是因为它已经热了。你看到它的时候,涨的那一段多半已经发生过了。
9.5 幸存者偏差:换一份名单,凭空多出几个百分点
同一个策略(等权买入当天通过门槛的全部标的,每 20 天调一次仓),只换名单:
- 当时真实的名单:那一天在交易的标的,中途停止交易的按最后价格结算离场;
- 今天还在交易的名单:也就是你今天打开交易所看到的那 704 个。
alive_today = trading.iloc[-1]
for label, mask in [("全部合约(只要上市满 120 天)", listed), ("通过流动性门槛的合约", candidates)]:
    days = [d for d in close.index[::horizon] if mask.loc[d].sum() >= 30]
    years = (days[-1] - days[0]).days / 365.25
    honest = forward.where(mask).loc[days].mean(axis=1)
    survivors = forward.where(mask & alive_today).loc[days].mean(axis=1)
    annual = lambda r: (1 + r).prod() ** (1 / years) - 1
    print(f"{label}:平均每期 {mask.loc[days].sum(axis=1).mean():.0f} 个标的,{len(days)} 期")
    print(f"    当时真实的名单:年化 {annual(honest):+.2%};只用今天还在交易的名单:年化 {annual(survivors):+.2%}"
          f"(凭空多出 {annual(survivors) - annual(honest):.2%})")
全部合约(只要上市满 120 天):平均每期 226 个标的,107 期
    当时真实的名单:年化 +4.17%;只用今天还在交易的名单:年化 +9.69%(凭空多出 5.52%)
通过流动性门槛的合约:平均每期 130 个标的,105 期
    当时真实的名单:年化 -7.39%;只用今天还在交易的名单:年化 -4.02%(凭空多出 3.37%)
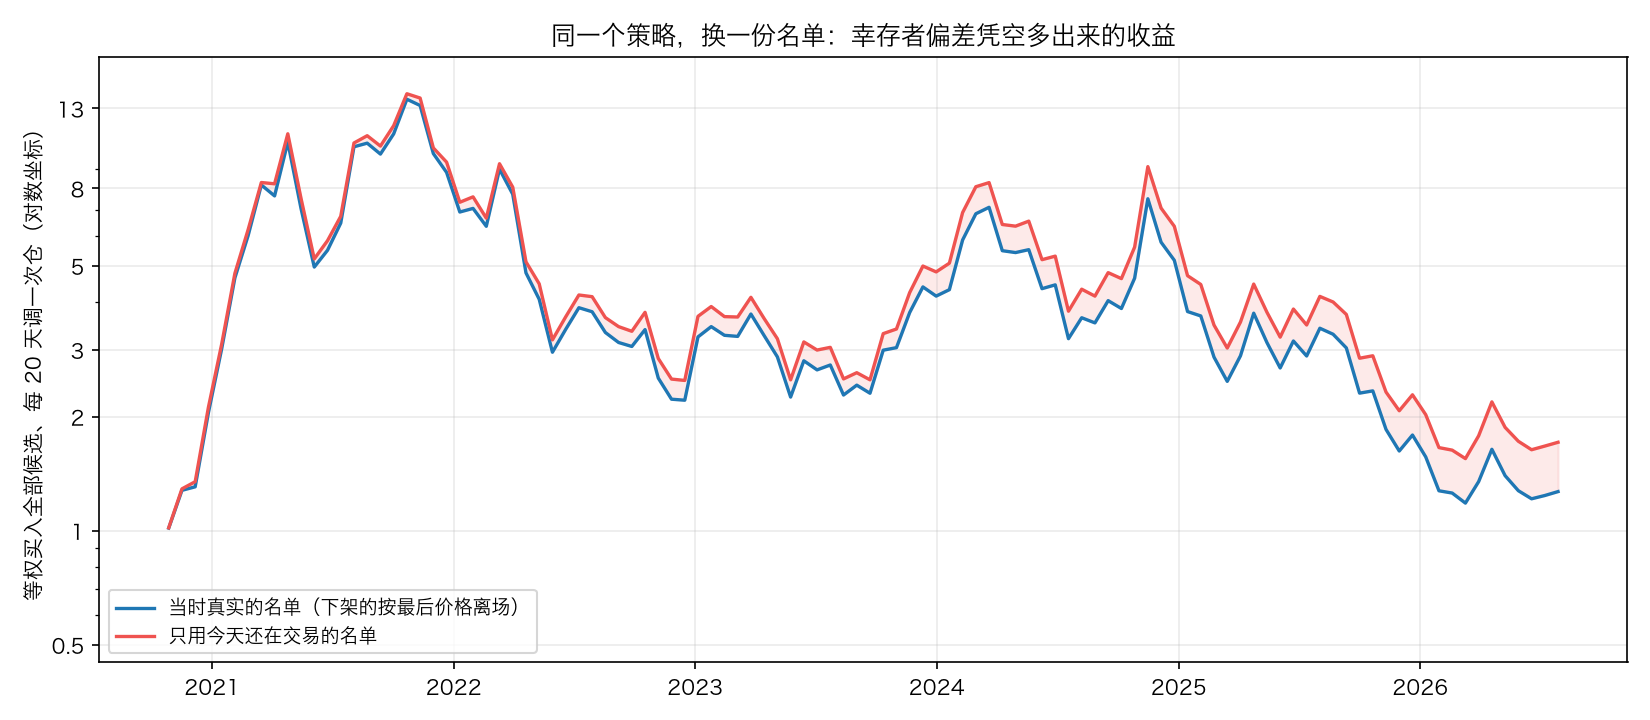
- 不设流动性门槛时,年化从 +4.17% 变成 +9.69%,凭空多出 5.52 个百分点。
- 设了流动性门槛之后,差距缩小到 3.37 个百分点(因为快下架的合约通常已经没什么成交额,本来就被门槛挡掉了一部分)。
这些收益是从哪里「多」出来的?看那些停止交易的合约在停之前发生了什么(160 个里有 158 个历史够长):
158 个停止交易的合约,停之前的表现:
        最后 20 天  最后 60 天
mean     -0.075   -0.247
median   -0.290   -0.392
停止交易前 60 天,中位数跌了 39.2%。 用今天的名单回测,等于把这些跌幅从历史里删掉了。
这正是第二节说的那件事:只统计还在职的员工,你会发现「我们招人的眼光真好」。 被裁掉的那批人,恰恰是你最该研究的样本。
⚠️ 这一篇的美股数据同样有这个问题,而且更严重:Nasdaq 的接口只能给出今天还在上市的公司,退市、被收购、破产的都不在里面。第 9.1 节里美股那四行,用的就是「今天市值最大的 100 只」——十年前它们大多还不是最大的,能撑到今天本身就是一种筛选。美股那几行只能当作参考,不能当作证据。
9.6 名单每天换多少?换手要花多少钱
order = S.cross_rank(features["涨幅"], mask=candidates, pct=False)
top_ten = order <= 10
days = close.index[close.index >= "2021-01-01"]
lists = {day: set(top_ten.columns[top_ten.loc[day]]) for day in days}
overnight = np.mean([len(lists[days[k]] & lists[days[k - 1]]) / 10 for k in range(1, len(days))])
monthly = np.mean([len(lists[days[k]] & lists[days[k - 20]]) / 10 for k in range(20, len(days))])
fee = 0.0005
print(f"前十名单:隔一天还剩 {overnight:.1%},隔 20 天还剩 {monthly:.1%}")
print(f"每天调一次仓:一天换掉 {10 * (1 - overnight):.1f} 个,按每边 {fee:.2%} 手续费,一年光手续费 {2 * fee * (1 - overnight) * 365:.1%}")
print(f"每 20 天调一次仓:一次换掉 {10 * (1 - monthly):.1f} 个,一年 {2 * fee * (1 - monthly) * 365 / 20:.1%}")
daily = np.log(close).diff()


def average_correlation(names, day):
    recent = daily.loc[:day].tail(60)[list(names)].dropna(axis=1, how="any")
    matrix = recent.corr().to_numpy()
    return float(matrix[np.triu_indices_from(matrix, 1)].mean())


sample = days[::20]
picked = [average_correlation(lists[day], day) for day in sample]
random_ten = [average_correlation(rng.choice(list(candidates.columns[candidates.loc[day]]), 10, replace=False), day)
              for day in sample]
print(f"\n前十之间 60 天日收益的平均相关系数 {np.nanmean(picked):.3f};同一天随机挑十个 {np.nanmean(random_ten):.3f}"
      f"({len(sample)} 个取样日)")
前十名单:隔一天还剩 88.2%,隔 20 天还剩 45.3%
每天调一次仓:一天换掉 1.2 个,按每边 0.05% 手续费,一年光手续费 4.3%
每 20 天调一次仓:一次换掉 5.5 个,一年 1.0%

前十之间 60 天日收益的平均相关系数 0.289;同一天随机挑十个 0.563(104 个取样日)
- 前十的名单,隔一天还剩 88.2%,隔 20 天只剩 45.3%。 一个月过去,名单换掉一半以上。
- 如果每天调仓,一年光手续费就要 4.3%(按每边 0.05% 算,还没算滑点和资金费率);改成每 20 天调一次,降到 1.0%。第 9.1 节量到的「最强减最弱 +1.62%(p = 0.248)」,还没扣这些成本。
最后一个数字和直觉相反:
- 前十之间的平均相关系数是 0.289,而同一天随机挑十个是 0.563。 涨得最多的十个彼此更不像——它们各自因为各自的理由在涨,而随便挑十个都跟着 BTC 一起动。
- 但这是平均值。回到决策点那张表:前十里的 ZEC、DASH、ZEN 是三个隐私币,它们之间的平均相关系数是 0.556,之后 20 天分别是 -35.7%、-36.7%、-28.1%。
名单是按名次排的,不是按主题排的,但主题会自己聚在一起。 你以为买了十个标的,实际上可能只下了七八个注。第 26 篇会把这件事变成能算的数字。
十、常见误用
1. 用今天的标的名单回测历史。 最常见、也最贵的一个错误,第 9.5 节量过:不设流动性门槛时能凭空多出 5.52 个百分点的年化收益。加密的好处是交易所把下架合约的历史数据留着,你有办法拿到真实名单;美股要拿到「当时的成分股名单」通常得花钱买。
2. 把「有数据」当成「能交易」。 52,713 根成交量为 0 的占位 K 线会让你的涨幅榜上挂着根本买不到的东西。任何一个宽表,第一步都应该是 where(volume > 0)。
3. 用成交量而不是成交额做流动性门槛。 成交量在不同价格的标的之间没有可比性。
4. 以为相对强度排名比涨幅排名多了信息。 第六节:横截面上两者完全等价,六年数据最大差别是 0。真正多出来的是时间序列上的形状(强度线的高低点),而那部分在第 9.2 节里也没检验出优势。
5. 门槛调到「刚好让我看好的那个标的进来」。 门槛一旦开始为个别标的让路,它就不是门槛了。要么提前定好并且写下来,要么老老实实承认你是在主观挑标的。
6. 用平均收益给一组标的排座次。 第 9.3 和 9.4 节里,高波动组、低成交额组、新上市合约的平均收益都不难看,中位数全都很难看。你交易的是一个个具体的标的,不是平均值。
7. 名单换得太勤。 每天调一次仓的前十名单,一年光手续费 4.3%,而能量到的横截面优势最多 1.6% 且不显著。
十一、小结
- 几百上千个标的是个错觉:永续合约里成交额前 20 个占了全市场的 81%,美股成交额前 100 只占了 52.5%。 真正能进出的只有几十到几百个。
- 筛选分两步:硬门槛(流动性、波动率、上市时间)只负责排除不能交易的,和「谁会涨」无关;排名在通过门槛的标的之间进行。
- 流动性门槛用最近 20 天中位成交额,仓位上限用「不超过日成交额的 1%」。账户越大,能交易的标的越少。
- 波动率门槛两头都卡:太小的走不出行情、成本占比高;太大的仓位被压到没意义。NATR 直接决定了按固定风险算出来的仓位大小。
- 横截面排名时,相对强度和绝对涨幅是同一个排名(实测最大差别 0)。相对强度线的价值在时间序列上,而「强度线创新高」在这份数据上也没检验出优势。
- 「买最强的几个」:7 次分组检验 + 4 次新高检验,没有一次显著,最小的 p 是 0.248。加密回看 20 天时五组是单调的,值得继续观察,但还不到能拿去交易的程度。
- 名单本身是最容易出错的地方:占位 K 线、改名迁移、下架重上,以及最贵的幸存者偏差(凭空多出 5.52 个百分点年化)。
- 平均和中位数要一起看。高波动、低流动性、新上市的标的,平均收益都不差,中位数都很差。
练习
- 换门槛:把成交额门槛从 1000 万美元改成 100 万和 1 亿,重跑第 9.1 节的分组检验。候选数从几十变到几百,结论变了吗?p 值的变化有多少来自样本量、有多少来自标的构成?
- 换排名指标:用第 8 篇的效率比、第 15 篇的 NATR、第 14 篇的 RSI 分别做
rank_by,各跑一次分组检验。记得把总的检验次数加进去一起报告。 - 跳过最近一个月:
S.momentum(close, 250, skip=20)是学术文献里的「12 减 1」写法。在美股 100 只上比较 skip=0 和 skip=20,差别有多大? - 自己造一次幸存者偏差:只用 2026-08-31 还在交易的 704 个合约,按第 9.1 节的方法做分组检验,和用真实名单的结果比。哪一组受的影响最大?
- 账户规模:写一个函数,输入账户金额,输出「按 1% 风险、3 ATR 止损、仓位不超过日成交额 1%」能交易的合约数。画出这条曲线,从 1 万美元到 1 亿美元。
- 行业相对强度:用 11 只行业 ETF,每个月月末按过去 60 天的相对强度排名,买最强的三只持有一个月。和一直持有 SPY 比,扣掉每次 0.05% 的成本之后呢?(提醒:11 只的池子太小,结论要谨慎。)
小检查答案
小检查 1
(a) 300 万 × 1% = 3 万美元。
(b) 止损距离 = 3 × 10% = 30%,仓位 = 10 万 × 1% ÷ 30% = 3,333 美元。远低于 (a) 的 3 万,卡住你的是风险规则,不是流动性。
(c) 会变。1000 万的账户,同样规则算出来的仓位是 33.3 万美元,而流动性上限还是 3 万——这时候流动性先卡住你,这个合约实际上不能交易。账户规模会改变你的标的池。