| 本篇位置 | 第五部分「从信号到交易」第二篇。第 19 篇挑的是「交易哪几个」,这一篇挑的是「什么时候」 |
| 用到的数据 | BTC 现货 1 分钟线(2017-08 至 2026-08,474 万根)合成的小时线和日线;SPY、AAPL 日线;美联储官网的 FOMC 日期;SEC EDGAR 上苹果的财报公告日 |
| 动手 | 新模块 talab.sessions:时段划分、周末、事件日历(第三个周五、月末、FOMC、SEC 备案)、事件研究,附 10 个测试 |
| 主线策略 | v2:止损从「盘中最低价触发」改成「收盘价触发」 |
| 读完你能 | 说清楚一天里哪几个小时最厚、哪几个最薄;判断一个止损位会不会被薄流动性时段打掉;搭一个事件日历,量出事件前后波动放大了多少 |
一、先做一个决定
你在按主线策略 v1(第 15 篇:50/200 均线金叉持有 + 3 个 ATR 的吊灯止损)交易 BTC。
2024 年 4 月 9 日,你在 71,620 买入。接下来几天价格回落,吊灯止损跟到 62,271.55。
4 月 13 日是周六。美股休市,外汇休市,期货休市。加密是这个星期六唯一开着的市场。
北京时间 4 月 14 日凌晨(UTC 4 月 13 日晚上 19 点 45 分之后),伊朗向以色列发射无人机和导弹的消息传出来。接下来 24 分钟:
                               open      high       low     close      成交均价   volume  trades
time
2024-04-13 20:04:00+00:00  63939.99  64222.11  63820.95  64119.33  63995.60   253.44    6785
2024-04-13 20:05:00+00:00  64119.33  64219.61  63701.97  63808.00  63959.77   182.04    7377
2024-04-13 20:06:00+00:00  63808.00  63884.26  63200.00  63441.18  63508.33   457.81   17504
2024-04-13 20:07:00+00:00  63476.12  63559.66  62000.00  62289.67  62711.54  1061.48   39578
2024-04-13 20:08:00+00:00  62287.98  62471.99  61300.00  61300.00  61904.61  1147.36   36381
2024-04-13 20:09:00+00:00  61312.01  61864.99  60660.57  61742.47  61096.35  1230.04   42068
2024-04-13 20:10:00+00:00  61762.43  62797.65  61558.19  61825.71  62161.93   762.74   33444
止损价 62271.55,第一根跌破它的分钟是 2024-04-13 20:07:00+00:00(北京时间 04-14 04:07,周日)
那一分钟:从 63476 跌到 62000,成交 39,578 笔,成交均价 62711.54(比止损价高 +0.71%)
19:45 的 66791 到 20:09 的 60661:24 分钟跌了 -9.2%
当晚 20 点这一小时成交 1,263 百万美元;上一个周六同一小时 29.9 百万美元,差 42 倍
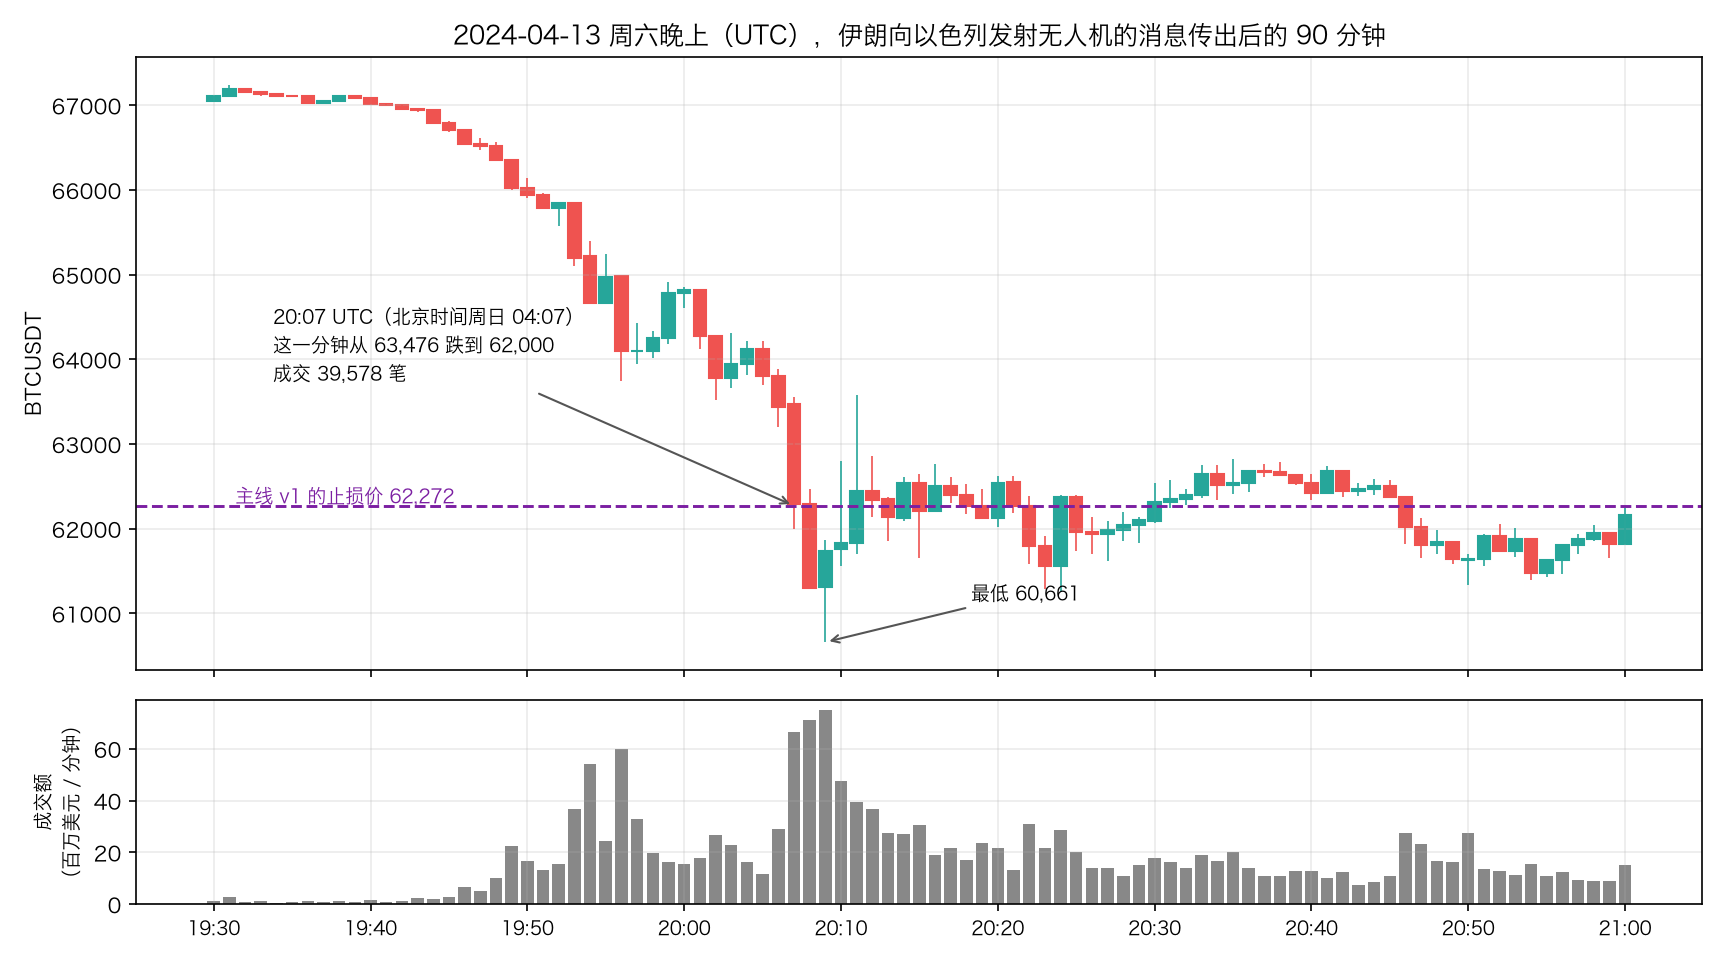
- 20:07 UTC(北京时间周日凌晨 4 点 07 分),价格跌破你的止损价 62,271.55。这一分钟成交了 39,578 笔,价格从 63,476 一路砸到 62,000。
- 两分钟后见底 60,660。从 19:45 的 66,791 算起,24 分钟跌了 9.2%。
- 一个小时后价格回到 62,500 上方;当天收盘 63,924,比你的止损价还高 2.7%。
- 那一小时的成交额是 12.6 亿美元;上一个周六的同一小时只有 2,990 万美元,差了 42 倍。
周日早上你打开手机:仓位没了,成交价在一个只存在了几分钟的价格上,而现在的价格比你出场的地方还高。
你怎么做?
- A. 马上买回:趋势没变,价格也回来了,按原计划重新入场
- B. 按规则等:v1 的规则是止损之后要等收盘创 20 日新高才买回,那就等
- C. 改规则:把止损改成「收盘价跌破才算」,这样周末那根针根本打不掉你
先写下你的选择。 第八节揭晓,第九节在三个标的的全部历史上检验 C 到底值多少。
二、打个比方:深夜的便利店
白天的大超市:十个收银台开着,货架是满的。你要买 200 瓶水,搬走就是了,价格牌不会动。
同一条街,凌晨三点的便利店:一个店员,货架上一共就三十瓶水。你还要买 200 瓶——没有了。你只能把三十瓶买下来,再等补货,或者去别处。你的「买单」本身就把价格推上去了。
市场的一天就是这样:
| 便利店 | 市场 |
|---|---|
| 白天的大超市,十个收银台 | 美股开盘那几个小时,盘口最厚 |
| 凌晨的便利店,一个店员 | 亚洲的凌晨、美股收盘之后,盘口最薄 |
| 周末半数店铺关门,只剩这一家 | 周末:股市、期货、外汇全休市,加密是唯一开着的 |
| 门口有活动散场,人一下子涌过来 | FOMC 公布利率、公司发财报:时间是提前知道的 |
| 你要买 200 瓶水,深夜的价格由你自己推上去 | 同样大小的单子,在薄的时候推动价格更多 |
这一篇要回答的就是三个和时间有关的问题:
| 问题 | 在哪一节 |
|---|---|
| 一天里哪几个小时厚、哪几个薄?周末呢? | 第三节 |
| 美股只开六个半小时,剩下的时间价格去哪了? | 第四节 |
| 哪些日子是提前知道会有事的?事件前后波动大多少? | 第五、六节 |
三、加密的一天和一周
三个时段
加密 24 小时开着,但「开着」不等于「一样」。把九年的小时线按 UTC 小时分组:
hour_of_day = SS.utc_hour(hour.index)
by_hour = pd.DataFrame({"成交额占比": hour.groupby(hour_of_day)["quote_volume"].sum() / hour["quote_volume"].sum(),
                        "平均振幅": ((hour["high"] - hour["low"]) / hour["open"]).groupby(hour_of_day).mean(),
                        "平均笔数": hour.groupby(hour_of_day)["trades"].mean()})
by_hour.index.name = "UTC 小时"
print(by_hour.round(4).to_string())
print("\n按时段:")
print(SS.profile(hour, SS.session_of(hour.index)).round(4).to_string())
         成交额占比    平均振幅         平均笔数
UTC 小时
0       0.0417  0.0107   84601.4100
1       0.0381  0.0096   80878.3617
2       0.0356  0.0088   74694.3775
3       0.0330  0.0081   67448.2103
4       0.0315  0.0081   63270.5006
5       0.0314  0.0079   62825.2382
6       0.0338  0.0081   66662.5184
7       0.0384  0.0083   72101.1112
8       0.0401  0.0090   76126.2374
9       0.0384  0.0086   73652.0537
10      0.0380  0.0088   72602.5188
11      0.0380  0.0089   73134.6875
12      0.0470  0.0103   88964.5258
13      0.0556  0.0112  111887.4154
14      0.0654  0.0121  135253.6426
15      0.0628  0.0115  128922.6241
16      0.0565  0.0114  114548.9312
17      0.0470  0.0100   98362.1088
18      0.0440  0.0096   91786.0400
19      0.0428  0.0096   87672.4321
20      0.0415  0.0101   82115.1355
21      0.0329  0.0095   70264.8788
22      0.0332  0.0097   70103.2518
23      0.0334  0.0093   66759.9806

按时段:
               K线数   成交额占比    平均振幅    平均涨跌   涨跌标准差
组
亚洲 00-07     23042  0.2450  0.0088 -0.0000  0.0073
欧洲 07-13     19778  0.2400  0.0090  0.0001  0.0074
美国 13-21     26393  0.4155  0.0107  0.0001  0.0082
美股收盘后 21-24   9900  0.0996  0.0095  0.0002  0.0076
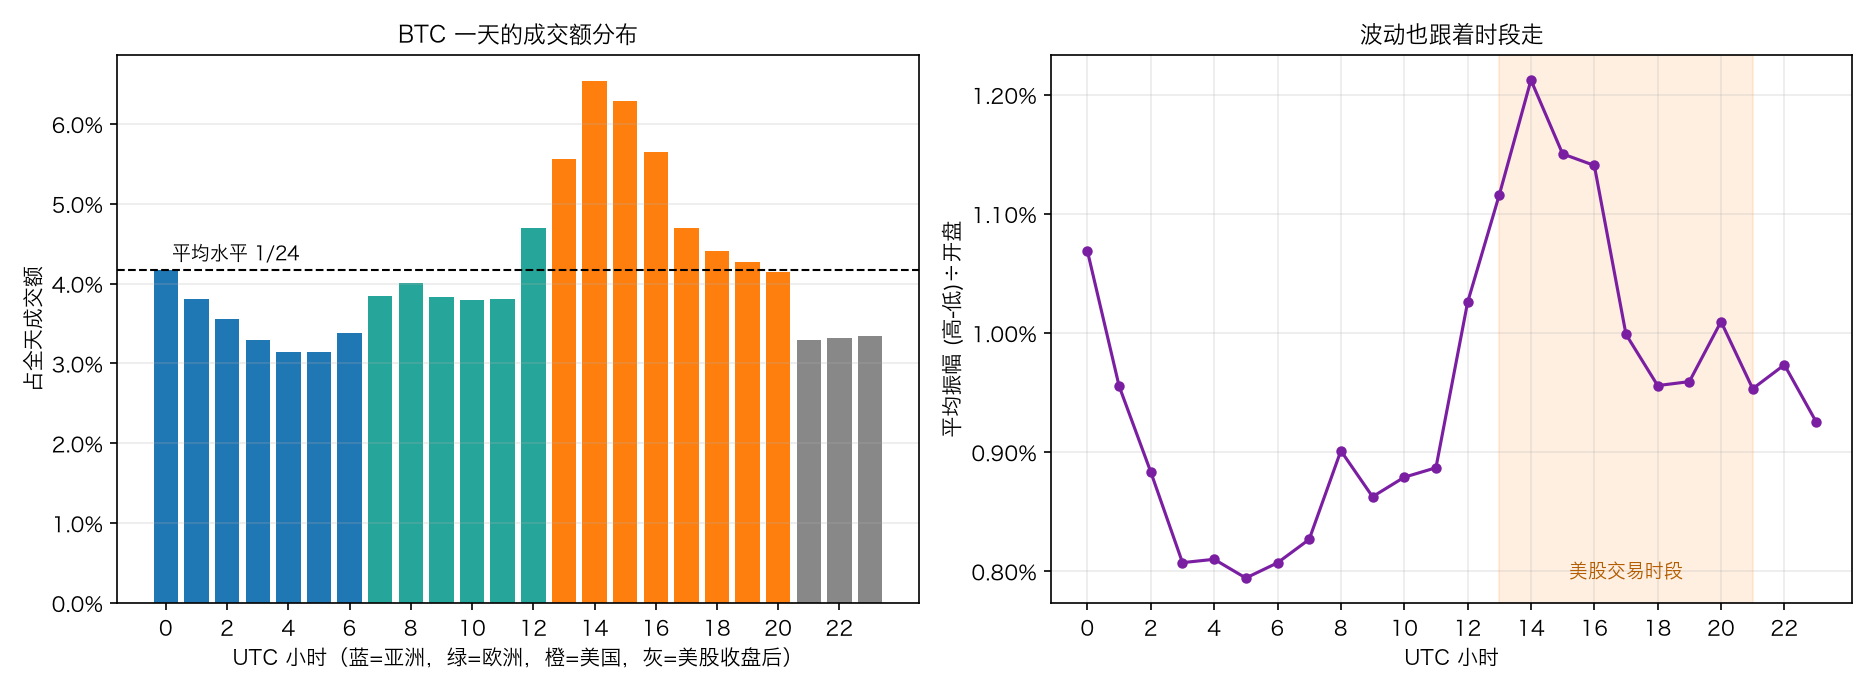
- 最热闹的是 UTC 14 点(美股开盘后半小时),占全天成交额的 6.54%,是平均水平(1/24 = 4.17%)的 1.57 倍。
- 最清淡的是 UTC 5 点(北京时间下午 1 点、纽约凌晨 1 点),3.14%。
- 平均振幅跟着走:UTC 14 点 1.21%,UTC 5 点 0.79%,差 53%。
- 按时段汇总:美国时段占了 33% 的时间、41.6% 的成交额;亚洲和欧洲时段各占两成四。
⚠️ 三个时段其实是重叠的(伦敦和纽约有三小时重叠),这里是按「哪个市场在主导」把一天切成四段,不是交易所的正式定义。
周末:最薄的两天
weekend = SS.is_weekend(hour.index)
print(SS.profile(hour, weekend.map({True: "周六周日", False: "周一到周五"})).round(4).to_string())
impact = (hour["close"] / hour["open"] - 1).abs() / (hour["quote_volume"] / 1e8) * 100   # 每成交 1 亿美元,价格走了百分之几
print("\n价格冲击:这一小时里每成交 1 亿美元,价格平均走了多少(中位数,越大越薄)")
print("  按周末:", impact.groupby(weekend.map({True: "周六周日", False: "周一到周五"}).to_numpy()).median().round(3).to_dict())
print("  按时段:", impact.groupby(SS.session_of(hour.index).to_numpy()).median().round(3).to_dict())
weekend_share = weekend.mean()
print(f"周末占全部小时的 {weekend_share:.1%},但只占成交额的 {hour.loc[weekend.to_numpy(), 'quote_volume'].sum() / hour['quote_volume'].sum():.1%}")
yearly = hour.groupby([hour.index.year, weekend.to_numpy()])["quote_volume"].sum().unstack()
yearly["周末占比"] = yearly[True] / (yearly[True] + yearly[False])
print("\n每年周末成交额占比:", yearly["周末占比"].round(3).to_dict())
         K线数   成交额占比    平均振幅    平均涨跌   涨跌标准差
组
周一到周五  56467  0.8029  0.0102  0.0001  0.0081
周六周日   22646  0.1971  0.0079  0.0000  0.0065

价格冲击:这一小时里每成交 1 亿美元,价格平均走了多少(中位数,越大越薄)
  按周末: {'周一到周五': 0.585, '周六周日': 0.661}
  按时段: {'亚洲 00-07': 0.645, '欧洲 07-13': 0.557, '美国 13-21': 0.57, '美股收盘后 21-24': 0.734}
周末占全部小时的 28.6%,但只占成交额的 19.7%

每年周末成交额占比: {2017: 0.282, 2018: 0.24, 2019: 0.241, 2020: 0.224, 2021: 0.236, 2022: 0.193, 2023: 0.196, 2024: 0.157, 2025: 0.172, 2026: 0.184}
- 周末占全部小时的 28.6%(2/7),却只占成交额的 19.7%。
- 周末的平均振幅 0.79%,工作日 1.02%。平时周末更安静。
- 周末成交额的占比还在往下走:2017 年 28.2%,2024 年只剩 15.7%(2025、2026 回到 17%–18%)。机构进场之后,加密越来越像一个「工作日市场」。
中间那两行才是这一节的核心:价格冲击——同样成交 1 亿美元,价格平均走多远?
- 工作日 0.585%,周末 0.661%:同样的钱,周末推动价格多 13%。
- 按时段:美股收盘后(UTC 21–24 点)最薄,0.734%;欧洲时段最厚,0.557%。第 19 篇用成交额衡量「能不能进出」,这里换一个角度问同一件事:推动价格需要多少钱。
周末不是「波动大」,是「薄」。 平时没事的时候它比工作日安静;一旦有事,同样大小的单子推动价格更多——这正是决策点那一夜发生的事。
✋ 小检查 1
(a) 一根小时 K 线成交额 200 万美元,价格从 60,000 涨到 60,600。按上面的口径,「每成交 1 亿美元价格走多少」是多少?和中位数 0.585% 比,这一小时是厚是薄?
(b) 你的止损在 62,000。触发那一分钟的 K 线是:开 62,288、高 62,472、低 61,300、收 61,300,成交均价 61,905。一张止损市价单大概会成交在什么区间?
(c) 为什么周末的止损更容易被打掉?给出两个不同的理由。
答案在文末。
插针到底在什么时候发生
直觉会说:周末最薄,所以插针都在周末。数一数:
spike = (hour["low"] / hour["open"] - 1 <= -0.03) | (hour["high"] / hour["open"] - 1 >= 0.03)
print(f"一小时内偏离开盘价 3% 以上的小时:{int(spike.sum())} 个,占 {spike.mean():.2%}")
compare = pd.DataFrame({"全部小时": SS.session_of(hour.index).value_counts(normalize=True),
                        "插针小时": SS.session_of(hour.index[spike.to_numpy()]).value_counts(normalize=True)})
compare["插针 ÷ 全部"] = compare["插针小时"] / compare["全部小时"]
print(compare.round(3).to_string())
weekend_spike = SS.is_weekend(hour.index[spike.to_numpy()]).mean()
print(f"插针发生在周末的比例 {weekend_spike:.1%},周末本身占 {weekend_share:.1%}")
thin = hour["quote_volume"].rolling(24 * 7, min_periods=24).median()
print("插针小时的成交额 ÷ 最近一周中位成交额:", round(float((hour["quote_volume"] / thin)[spike.to_numpy()].median()), 2),
      ";普通小时:", round(float((hour["quote_volume"] / thin)[~spike.to_numpy()].median()), 2))
big = hour["quote_volume"] >= hour["quote_volume"].quantile(0.99)     # 成交额最大的 1% 的小时
print(f"成交额最大的 1% 的小时({int(big.sum())} 个)里,平均振幅 {((hour['high'] - hour['low']) / hour['open'])[big.to_numpy()].mean():.2%};"
      f"其中周末的 {((hour['high'] - hour['low']) / hour['open'])[(big & weekend).to_numpy()].mean():.2%},"
      f"工作日的 {((hour['high'] - hour['low']) / hour['open'])[(big & ~weekend).to_numpy()].mean():.2%}")
一小时内偏离开盘价 3% 以上的小时:1684 个,占 2.13%
              全部小时   插针小时  插针 ÷ 全部
美国 13-21     0.334  0.398    1.193
亚洲 00-07     0.291  0.260    0.891
欧洲 07-13     0.250  0.223    0.891
美股收盘后 21-24  0.125  0.120    0.959
插针发生在周末的比例 20.5%,周末本身占 28.6%
插针小时的成交额 ÷ 最近一周中位成交额: 2.93 ;普通小时: 0.99
成交额最大的 1% 的小时(792 个)里,平均振幅 3.06%;其中周末的 3.36%,工作日的 3.03%
直觉错了。 一小时内偏离开盘价 3% 以上的「插针小时」一共 1,684 个:
- 按时段:美国时段最多(占插针的 39.8%,而它只占 33.4% 的小时),亚洲和欧洲时段反而偏少。
- 按周末:插针发生在周末的只有 20.5%,而周末本身占 28.6% 的小时。周末的插针比例低于平均。
原因在下面两行:
- 插针小时的成交额是最近一周中位数的 2.93 倍,普通小时是 0.99 倍。大行情是放量走出来的,不是在没人交易的时候凭空掉下去的。
- 但是:在成交额最大的 1% 的小时里,周末的平均振幅 3.36%,工作日 3.03%。同样是放量,周末走得更远 11%。
所以完整的说法是:大多数插针发生在人最多的时候,因为那时候才有消息和成交;但同一件事在周末发生,价格会走得更远。 决策点那一夜两个条件都满足了:有一件大事,而且它发生在周末。
四、美股的一天:隔夜和日内
美股一天只开六个半小时(夏令时 13:30–20:00 UTC,冬令时往后挪一小时),剩下 17.5 小时价格并没有停止变化——它只是不在你能交易的地方变化。第二天开盘价直接跳到新的位置,这就是隔夜。
⚠️ 这一节只用日线。免费的美股分钟数据拿不到(第 10、11 篇试过:Yahoo 限流、Nasdaq 只有当天、Alpaca 和 Polygon 要注册账号),所以「开盘和收盘前后成交量集中」这种日内结构没法用数据展示。但日线的开盘价和收盘价足够把一天拆成两半:
隔夜收益 = 今天开盘价 ÷ 昨天收盘价 - 1
日内收益 = 今天收盘价 ÷ 今天开盘价 - 1
rows = []
for name, df in [("SPY", spy), ("AAPL", aapl)]:
    overnight = df["open"] / df["close"].shift(1) - 1
    intraday = df["close"] / df["open"] - 1
    total = df["close"].iloc[-1] / df["close"].iloc[0] - 1
    rows.append({"标的": name, "总涨幅": total, "只吃隔夜": (1 + overnight).prod() - 1, "只吃日内": (1 + intraday).prod() - 1,
                 "隔夜平均": overnight.mean(), "日内平均": intraday.mean(),
                 "隔夜标准差": overnight.std(), "日内标准差": intraday.std(),
                 "隔夜方差占比": overnight.var() / (overnight.var() + intraday.var())})
  标的     总涨幅   只吃隔夜    只吃日内   隔夜平均   日内平均  隔夜标准差  日内标准差  隔夜方差占比
 SPY  2.5182 1.3953  0.4848 0.0004 0.0002 0.0073 0.0085  0.4214
AAPL 11.5369 0.1337 10.2246 0.0001 0.0011 0.0117 0.0143  0.3987
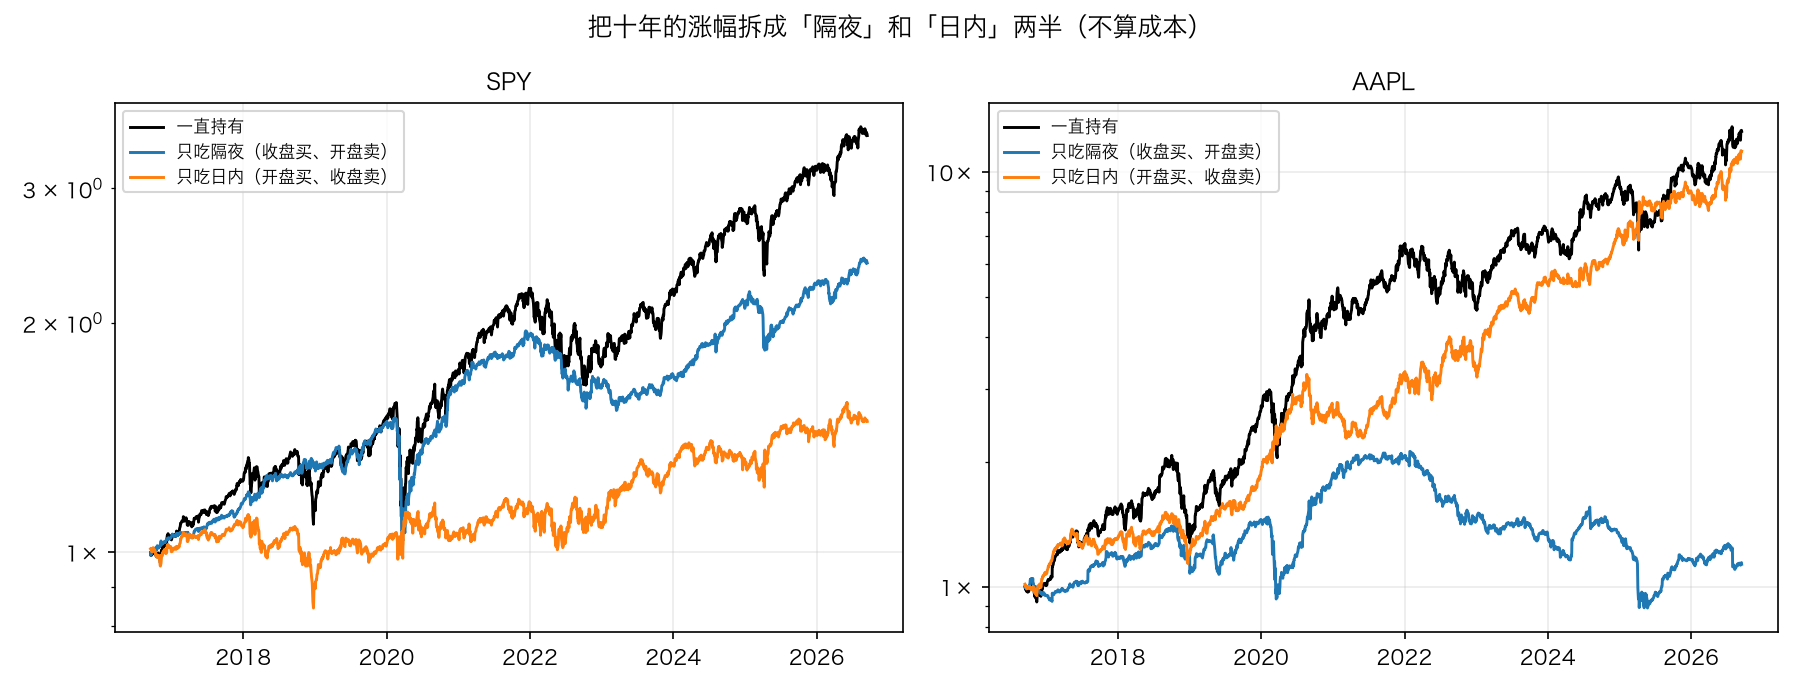
十年下来:
- SPY 总共涨了 252%。只吃隔夜(每天收盘买、开盘卖)涨 140%,只吃日内(开盘买、收盘卖)只涨 48%。 指数的涨幅主要发生在你睡觉的时候。
- AAPL 正好相反:总共涨了 1,154%,只吃隔夜 13%,只吃日内 1,022%。
- 两个标的的隔夜波动都比日内小(SPY 0.73% 对 0.85%),但隔夜贡献了 40% 左右的方差。
「隔夜收益更高」是指数层面的现象,不是每只股票都这样。 个股的隔夜里塞满了财报跳空(第六节),而指数的隔夜是全球市场在消化信息。
⚠️ 这两条曲线都没有算成本。每天开盘卖、收盘买意味着一年 500 次交易,按每边 0.01% 的成本算就要吃掉 5 个百分点——足以把 SPY 的日内那条线压到水面以下。「隔夜溢价」在纸上比在账户里好看得多。
五、日历上的日子
有些日子不需要预测,翻日历就知道:每月第三个周五是美股月度期权到期日,3、6、9、12 月的第三个周五是「四巫日」(股指期货、股指期权、个股期权、个股期货同时到期),月末和季末有基金调仓,感恩节后和圣诞前夕是半日。
sessions = nyse.sessions_in_range("2016-09-15", "2026-09-15")
expiry = SS.third_fridays("2016-09-15", "2026-09-15")
quad = SS.third_fridays("2016-09-15", "2026-09-15", months=(3, 6, 9, 12))
calendar = {"月度期权到期日(第三个周五)": expiry, "四巫日(3/6/9/12 月第三个周五)": quad,
            "月末最后一个交易日": SS.period_ends(sessions), "季末最后一个交易日": SS.period_ends(sessions, "QE"),
            "提前收盘的半日": pd.DatetimeIndex([d.tz_localize(None) for d in nyse.early_closes])}
rows = []
for name, days in calendar.items():
    for symbol, df in [("SPY", spy), ("AAPL", aapl)]:
        relative_volume = df["volume"] / df["volume"].rolling(20).median().shift(1)
        swing = (df["high"] - df["low"]) / df["open"]
        picked = df.index.intersection(pd.DatetimeIndex(days))
        rows.append({"日子": name, "标的": symbol, "天数": len(picked),
                     "成交量 ÷ 前 20 天中位": relative_volume.loc[picked].median(),
                     "平常": relative_volume.median(), "振幅": swing.loc[picked].median(), "平常振幅": swing.median()})
print(pd.DataFrame(rows).to_string(index=False, float_format=lambda v: f"{v:.3f}"))
                  日子   标的  天数  成交量 ÷ 前 20 天中位    平常    振幅  平常振幅
      月度期权到期日(第三个周五)  SPY 116           1.289 0.985 0.009 0.009
      月度期权到期日(第三个周五) AAPL 116           1.197 0.982 0.016 0.018
四巫日(3/6/9/12 月第三个周五)  SPY  39           1.508 0.985 0.010 0.009
四巫日(3/6/9/12 月第三个周五) AAPL  39           1.997 0.982 0.019 0.018
           月末最后一个交易日  SPY 121           1.246 0.985 0.009 0.009
           月末最后一个交易日 AAPL 121           1.143 0.982 0.017 0.018
           季末最后一个交易日  SPY  41           1.247 0.985 0.009 0.009
           季末最后一个交易日 AAPL  41           0.995 0.982 0.017 0.018
             提前收盘的半日  SPY  21           0.585 0.985 0.005 0.009
             提前收盘的半日 AAPL  21           0.527 0.982 0.011 0.018
读这张表(「成交量 ÷ 前 20 天中位」的平常水平是 0.98 左右):
- 四巫日的成交量最夸张:SPY 1.51 倍,AAPL 2.00 倍。
- 月度期权到期日 1.20–1.29 倍,月末最后一个交易日 1.14–1.25 倍。
- 半日只有平常的 53–59%,振幅也只有一半(SPY 0.5% 对 0.9%)。
- 但是振幅几乎没变:到期日、月末的振幅和平常日子差不多。成交量放大不等于波动放大——这些日子多出来的成交是调仓和交割,不是新的方向。
⚠️ 这里的「第三个周五」是日历上的第三个周五。遇到假日(比如 2020 年 4 月 10 日是耶稣受难日)实际到期日会提前一天,third_fridays 的文档字符串里写明了这一点。
六、事件:FOMC 和财报
日历事件是「交易所的规矩」,宏观和公司事件是「外面的世界」。两类事件的共同点是:时间提前知道,内容不知道。
- FOMC(美联储的利率决议):一年八次,日期一年前就公布。
talab.sessions直接从美联储官网抓:会议声明的链接形如/newsevents/pressreleases/monetary20240320a.htm,日期就是公布利率的那一天。 - 财报:美国公司发业绩要向 SEC 提交 8-K,条款 2.02 就是「业绩公告」。EDGAR 的公开接口给出每一次备案的日期,比任何财经网站都准。苹果的 CIK 是 320193。
fomc = SS.fomc_dates(2016, 2026)
earnings = SS.sec_filing_dates(320193)                               # 苹果的 CIK
earnings = earnings[(earnings >= "2016-09-15") & (earnings <= "2026-09-15")]
print(f"FOMC 公布利率的日子 {len(fomc)} 天({fomc[0].date()} 到 {fomc[-1].date()});"
      f"苹果发财报 {len(earnings)} 次(8-K 的 2.02 条款)")
for name, df, events, offset in [("SPY 遇上 FOMC", spy, fomc, 0), ("BTC 遇上 FOMC", day, fomc, 0),
                                 ("AAPL 遇上自己的财报", aapl, earnings, 1)]:
    swing = ((df["high"] - df["low"]) / df["open"]).rename("振幅")
    study = SS.event_study(swing, events, before=3, after=3, offset=offset)
    print(f"\n{name}(振幅 = (最高 - 最低) ÷ 开盘):")
    print(study.to_string(float_format=lambda v: f"{v:.4f}"))
    jump = (df["open"] / df["close"].shift(1) - 1).abs().rename("隔夜跳空")
    window = SS.event_window(jump, events, before=0, after=1, offset=offset)
    print(f"  事件后第一根的隔夜跳空中位数 {window[0].median():.4f},平常 {jump.median():.4f}")
FOMC 公布利率的日子 92 天(2016-01-27 到 2026-09-16);苹果发财报 41 次(8-K 的 2.02 条款)

SPY 遇上 FOMC(振幅 = (最高 - 最低) ÷ 开盘):
       平均    中位数  事件数  平常的平均  平常的中位数
-3 0.0120 0.0088   86 0.0114  0.0088
-2 0.0113 0.0076   86 0.0114  0.0088
-1 0.0118 0.0089   86 0.0114  0.0088
0  0.0153 0.0114   86 0.0114  0.0088
1  0.0141 0.0111   86 0.0114  0.0088
2  0.0144 0.0109   86 0.0114  0.0088
3  0.0126 0.0090   86 0.0114  0.0088
  事件后第一根的隔夜跳空中位数 0.0017,平常 0.0029

BTC 遇上 FOMC(振幅 = (最高 - 最低) ÷ 开盘):
       平均    中位数  事件数  平常的平均  平常的中位数
-3 0.0490 0.0354   78 0.0496  0.0395
-2 0.0600 0.0459   78 0.0496  0.0395
-1 0.0478 0.0402   78 0.0496  0.0395
0  0.0555 0.0457   78 0.0496  0.0395
1  0.0533 0.0466   78 0.0496  0.0395
2  0.0493 0.0426   78 0.0496  0.0395
3  0.0387 0.0298   78 0.0496  0.0395
  事件后第一根的隔夜跳空中位数 0.0000,平常 0.0000

AAPL 遇上自己的财报(振幅 = (最高 - 最低) ÷ 开盘):
       平均    中位数  事件数  平常的平均  平常的中位数
-3 0.0190 0.0168   41 0.0205  0.0176
-2 0.0202 0.0177   41 0.0205  0.0176
-1 0.0206 0.0202   41 0.0205  0.0176
0  0.0349 0.0317   41 0.0205  0.0176
1  0.0263 0.0215   41 0.0205  0.0176
2  0.0215 0.0183   41 0.0205  0.0176
3  0.0223 0.0217   41 0.0205  0.0176
  事件后第一根的隔夜跳空中位数 0.0313,平常 0.0043
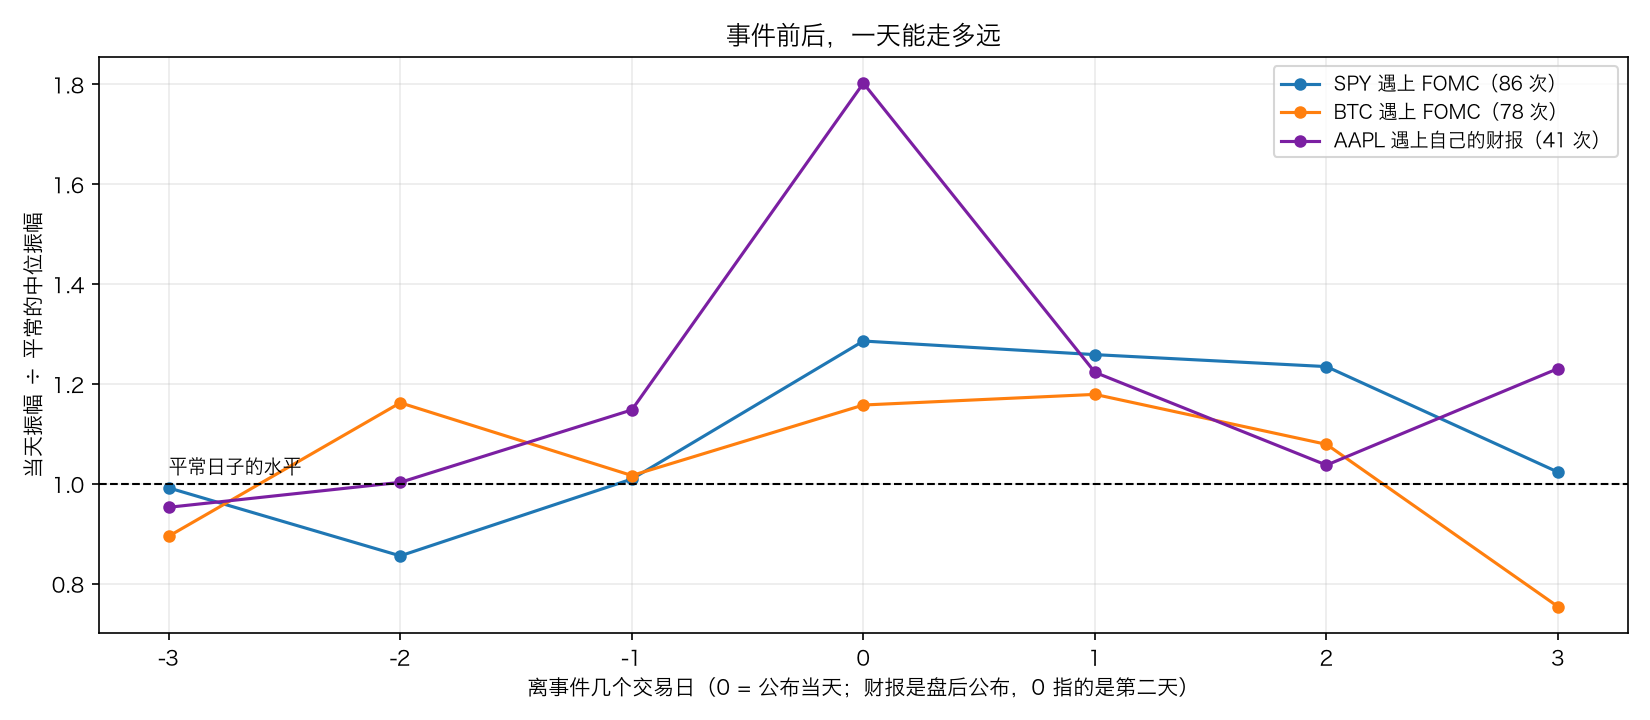
表的最后一列是基准(所有日子的中位数),和第 0 行比:
- SPY 遇上 FOMC:当天振幅中位数 1.14%,平常 0.88%,放大 30%;之后两天还偏高。
- BTC 遇上 FOMC:当天 4.57%,平常 3.95%,只放大 16%,而且前两天比当天还高。同一个事件,对两个市场的分量不一样。
- AAPL 遇上自己的财报:财报是盘后公布的,所以看第二天——振幅中位数 3.17%,平常 1.76%,放大 80%;隔夜跳空的中位数 3.13%,是平常 0.43% 的 7 倍多。
- BTC 那一组的隔夜跳空两行都是 0.0000:24 小时交易的市场没有隔夜,这也是第 15 篇量过的「BTC 的跳空几乎为零」。
一句话:对一只股票来说,它自己的财报比美联储重要得多。
七、动手:talab.sessions
新模块管三件事:时段、事件日历、事件研究。
"""talab.sessions:交易时段与事件日历。第 20 篇。

两件事:

1. **时段**:一天里的每个小时不一样,一周里的每一天也不一样。加密 24 小时开着,但成交量随
   亚洲、欧洲、美国三个时段起落;周末是一周里最薄的时候。
2. **事件**:有些日子是提前知道的——期权到期、月末、FOMC 公布利率、公司发财报。事件日历
   是一张「哪天会有事」的表,事件研究是「事件前后发生了什么」的统计。

时间一律按 UTC。索引带时区的用它自己的时区换算成 UTC,不带时区的当成 UTC。
"""
一、时段
# 三个时段其实是重叠的(伦敦和纽约有三小时重叠),这里按「哪个市场在主导」把一天切成不重叠的四段。
SESSIONS = {"亚洲 00-07": (0, 7), "欧洲 07-13": (7, 13), "美国 13-21": (13, 21), "美股收盘后 21-24": (21, 24)}


def utc_hour(index: pd.DatetimeIndex) -> np.ndarray:
    """每个时间点的 UTC 小时。"""
    index = pd.DatetimeIndex(index)
    return (index.tz_convert("UTC") if index.tz is not None else index).hour.to_numpy()


def session_of(index: pd.DatetimeIndex, sessions: dict = SESSIONS) -> pd.Series:
    """每根 K 线属于哪个时段(按 UTC 小时,左闭右开)。"""
    hour = utc_hour(index)
    out = pd.Series(pd.NA, index=index, dtype="object")
    for name, (start, end) in sessions.items():
        out[(hour >= start) & (hour < end)] = name
    return out
profile 里有一个要留意的地方:振幅和涨跌都用这根 K 线自己的开盘价做分母,不跨根。这样任意分组求平均都成立,不需要担心分组边界。
二、事件日历
def third_fridays(start, end, months: tuple = tuple(range(1, 13))) -> pd.DatetimeIndex:
    """每月第三个周五:美股月度期权到期日。months 只留 3、6、9、12 就是「四巫日」。

    ⚠️ 这是日历上的第三个周五,遇到假日(例如 2020-04-10 耶稣受难日)实际到期日会提前一天,
    用 period_ends 那种「交易日历」口径的函数去对齐。
    """
    days = pd.date_range(start, end, freq="D")
    fridays = days[(days.dayofweek == 4) & days.month.isin(months)]
    order = fridays.to_series().groupby([fridays.year, fridays.month]).cumcount()
    return pd.DatetimeIndex(fridays[order == 2])


def period_ends(sessions: pd.DatetimeIndex, freq: str = "ME") -> pd.DatetimeIndex:
    """每个月(freq="ME")或每个季度(freq="QE")的最后一个交易日。"""
    sessions = pd.DatetimeIndex(sessions)
    return pd.DatetimeIndex(pd.Series(sessions, index=sessions).resample(freq).last().dropna())


def parse_fomc_page(html: str) -> list[str]:
    """从美联储的会议日历页面里取出所有货币政策声明的日期(YYYY-MM-DD)。

    声明的链接形如 /newsevents/pressreleases/monetary20240320a.htm,日期就是会议最后一天,
    也就是利率公布的那一天。
    """
    found = re.findall(r"/newsevents/pressreleases/monetary(\d{8})a\.htm", html)
    return sorted({f"{d[:4]}-{d[4:6]}-{d[6:]}" for d in found})


def fomc_dates(start_year: int = 2016, end_year: int = 2026) -> pd.DatetimeIndex:
    """FOMC 公布利率的日期。近几年在 fomccalendars.htm,更早的在每年一张的历史页面上。"""
    pages = ["https://www.federalreserve.gov/monetarypolicy/fomccalendars.htm"]
    pages += [f"https://www.federalreserve.gov/monetarypolicy/fomchistorical{year}.htm"
              for year in range(start_year, min(end_year, 2021))]
    dates = {d for page in pages for d in parse_fomc_page(_get(page))}
    picked = pd.DatetimeIndex(sorted(dates))
    return picked[(picked.year >= start_year) & (picked.year <= end_year)]
def parse_sec_submissions(payload: dict, form: str = "8-K", item: str | None = None) -> list[str]:
    """从 SEC EDGAR 的备案清单里取出日期。item="2.02" 是「业绩公告」,也就是财报发布日。"""
    filings = payload["filings"]["recent"] if "filings" in payload else payload
    rows = zip(filings["filingDate"], filings["form"], filings.get("items", [""] * len(filings["form"])))
    return sorted({date for date, kind, items in rows if kind == form and (item is None or item in items)})


def sec_filing_dates(cik: int, form: str = "8-K", item: str | None = "2.02") -> pd.DatetimeIndex:
    """一家公司向 SEC 提交某类文件的日期。默认取 8-K 的 2.02 条款:公布季度业绩。

    ⚠️ 备案日是公司发布的那一天。苹果在美股收盘后发财报,所以价格反应在**第二天**。
    """
    base = f"https://data.sec.gov/submissions/CIK{cik:010d}.json"
    payload = json.loads(_get(base))
    dates = set(parse_sec_submissions(payload, form, item))
    for older in payload["filings"].get("files", []):
        dates |= set(parse_sec_submissions(json.loads(_get(f"https://data.sec.gov/submissions/{older['name']}")),
                                           form, item))
    return pd.DatetimeIndex(sorted(dates))


def _get(url: str) -> str:
    request = urllib.request.Request(url, headers={"User-Agent": "talab course (contact: [email protected])"})
    with urllib.request.urlopen(request, timeout=60) as response:
        return response.read().decode("utf-8", "replace")
两个抓网页的函数都拆成了「取回来」和「解析」两半:parse_fomc_page 和 parse_sec_submissions 是纯函数,测试里喂一段假的 HTML 和一段假的 JSON 就能验证,不需要联网。
三、事件研究
def event_window(values: pd.Series, events, before: int = 5, after: int = 5, offset: int = 0) -> pd.DataFrame:
    """把每个事件对齐到同一张表:每行一个事件,列是 -before 到 +after 根 K 线。

    事件日不在索引里(休市、或者 values 是别的市场)时,取它之后第一个有数据的位置。
    offset 用来处理「盘后公布」:offset=1 表示把第 0 根算作事件日的下一根。
    窗口伸出数据范围的事件直接丢掉。
    """
    index = values.index
    rows, kept = [], []
    for event in pd.DatetimeIndex(events):
        when = event.tz_localize(index.tz) if index.tz is not None and event.tz is None else event
        position = index.searchsorted(when) + offset
        if position - before < 0 or position + after >= len(index):
            continue
        rows.append(values.to_numpy()[position - before: position + after + 1])
        kept.append(event)
    return pd.DataFrame(rows, index=pd.DatetimeIndex(kept), columns=range(-before, after + 1))


def event_study(values: pd.Series, events, before: int = 5, after: int = 5, offset: int = 0) -> pd.DataFrame:
    """事件窗口的平均值、中位数和事件数;最后两列是「所有日子」的平均和中位数,用来当基准。"""
    window = event_window(values, events, before, after, offset)
    return pd.DataFrame({"平均": window.mean(), "中位数": window.median(), "事件数": window.count(),
                         "平常的平均": values.mean(), "平常的中位数": values.median()})
event_window 有两个容易出错的地方,都写进了测试:
- 事件日可能不在索引里(当天休市,或者你在看另一个市场的反应)。这里取「它之后第一个有数据的位置」。
- 盘后公布的事件要用
offset=1把第 0 根挪到第二天。苹果的财报就是这样。
测试
10 个测试,其中这三个是这一篇特有的:
def test_parse_fomc_page_by_hand():
    html = ('<a href="/newsevents/pressreleases/monetary20240320a.htm">HTML</a>'
            '<a href="/monetarypolicy/files/monetary20240320a1.pdf">PDF</a>'
            '<a href="/newsevents/pressreleases/monetary20240501a.htm">HTML</a>'
            '<a href="/newsevents/pressreleases/monetary20240320a.htm">重复的链接</a>')
    assert S.parse_fomc_page(html) == ["2024-03-20", "2024-05-01"]     # 去重、排序,PDF 不算


def test_parse_sec_submissions_by_hand():
    payload = {"filings": {"recent": {
        "filingDate": ["2024-05-02", "2024-04-10", "2024-02-01", "2024-01-15"],
        "form": ["8-K", "8-K", "8-K", "10-Q"],
        "items": ["2.02,9.01", "5.02", "2.02,9.01", ""]}}}
    assert S.parse_sec_submissions(payload, item="2.02") == ["2024-02-01", "2024-05-02"]   # 只留业绩公告
    assert len(S.parse_sec_submissions(payload)) == 3                              # 不挑条款就是全部 8-K
    assert S.parse_sec_submissions(payload, form="10-Q") == ["2024-01-15"]


def test_event_window_alignment_by_hand():
    days = pd.date_range("2024-01-01", periods=10, freq="D", tz="UTC")
    values = pd.Series(np.arange(10, dtype=float), index=days)
    window = S.event_window(values, ["2024-01-05"], before=2, after=2)
    assert window.columns.tolist() == [-2, -1, 0, 1, 2]
    assert window.iloc[0].tolist() == [2, 3, 4, 5, 6]                  # 事件日的值是 4(1 月 5 日)
    assert S.event_window(values, ["2024-01-05"], 2, 2, offset=1).iloc[0].tolist() == [3, 4, 5, 6, 7]
    assert len(S.event_window(values, ["2024-01-01"], before=2, after=2)) == 0      # 窗口伸出数据范围,丢掉
    # 事件日不在索引里(当天休市):取之后第一个有数据的位置
    trading = values.drop(days[4])
    assert S.event_window(trading, ["2024-01-05"], 1, 1).iloc[0].tolist() == [3, 5, 6]
177 passed in 0.71s
没装 TA-Lib 的环境里是 145 passed、32 skipped。
八、揭晓
先看回测里发生了什么。第 15 篇的主线 v1 原封不动搬过来,只加两个开关(第九节要用):
def mainline(df, k=3.0, n_atr=14, breakout=20, fast=50, slow=200, trigger="low", skip=None):
    """主线策略 v1(第 15 篇)加两个开关。

    trigger="low":盘中最低价碰到止损价就出场(v1 的做法);trigger="close":只有收盘价跌破才出场。
    skip:一个布尔序列,标出「这根 K 线不许触发止损」的日子(比如周末),这些日子只在收盘时判断。
    """
    o, h, l, c = (df[x].to_numpy(float) for x in OHLC)
    atr = I.atr(df["high"], df["low"], df["close"], n_atr).to_numpy()
    trend = (I.sma(df["close"], fast) > I.sma(df["close"], slow)).to_numpy()
    quiet = np.zeros(len(c), bool) if skip is None else np.asarray(skip, bool)
    first = df.index.get_loc(I.sma(df["close"], slow).first_valid_index())
    r, held, trades = np.zeros(len(c)), np.zeros(len(c)), []
    holding = buy = sell = locked = False
    for i in range(first, len(c)):
        if holding:
            stop, base = max(stop, highest - k * atr[i - 1]), c[i - 1]
        elif buy:
            holding, buy, entry, entry_i, highest = True, False, o[i], i, o[i]
            stop, base = o[i] - k * atr[i - 1], o[i]
        if holding:
            held[i] = 1
            intraday = trigger == "low" and not quiet[i]
            exit_price = reason = None
            if sell:
                exit_price, reason = o[i], "趋势"
            elif o[i] <= stop:
                exit_price, reason = o[i], "止损(跳空)"
            elif intraday and l[i] <= stop:
                exit_price, reason = stop, "止损"
            elif not intraday and c[i] <= stop:
                exit_price, reason = c[i], "止损(收盘)"
            if reason is None:
                r[i], highest = c[i] / base - 1, max(highest, h[i])
            else:
                r[i] = exit_price / base - 1
                trades.append((df.index[entry_i], entry, df.index[i], exit_price, reason, stop))
                holding, sell, locked = False, False, reason.startswith("止损")
        if holding:
            sell = not trend[i]
        elif locked:
            if trend[i] and c[i] > c[i - breakout:i].max():
                buy, locked = True, False
        else:
            buy = bool(trend[i])
    index = df.index[first:]
    trades = pd.DataFrame(trades, columns=["买入日", "买入价", "卖出日", "卖出价", "原因", "止损价"])
    trades["收益"] = trades["卖出价"] / trades["买入价"] - 1
    return pd.Series(r[first:], index=index), pd.Series(held[first:], index=index), trades
returns, holding, trades = mainline(day)
hit = trades[trades["卖出日"] == "2024-04-13"].iloc[0]
print("2024 年 4 月那一笔:")
print(hit.to_string())
print(f"止损价 {hit['止损价']:.2f},那天的收盘价 {day.loc['2024-04-13', 'close']:.2f},"
      f"收盘比止损价高 {day.loc['2024-04-13', 'close'] / hit['止损价'] - 1:.1%}")
print(f"下一次买回:{trades[trades['买入日'] > hit['卖出日']].iloc[0]['买入日'].date()},"
      f"买入价 {trades[trades['买入日'] > hit['卖出日']].iloc[0]['买入价']:.2f}")
2024 年 4 月那一笔:
买入日    2024-04-09 00:00:00+00:00
买入价                      71620.0
卖出日    2024-04-13 00:00:00+00:00
卖出价                 62271.550597
原因                            止损
止损价                 62271.550597
收益                     -0.130528
止损价 62271.55,那天的收盘价 63924.51,收盘比止损价高 2.7%
下一次买回:2024-05-16,买入价 66206.51
这一笔亏了 13.05%,而当天的收盘价比止损价高 2.7%。
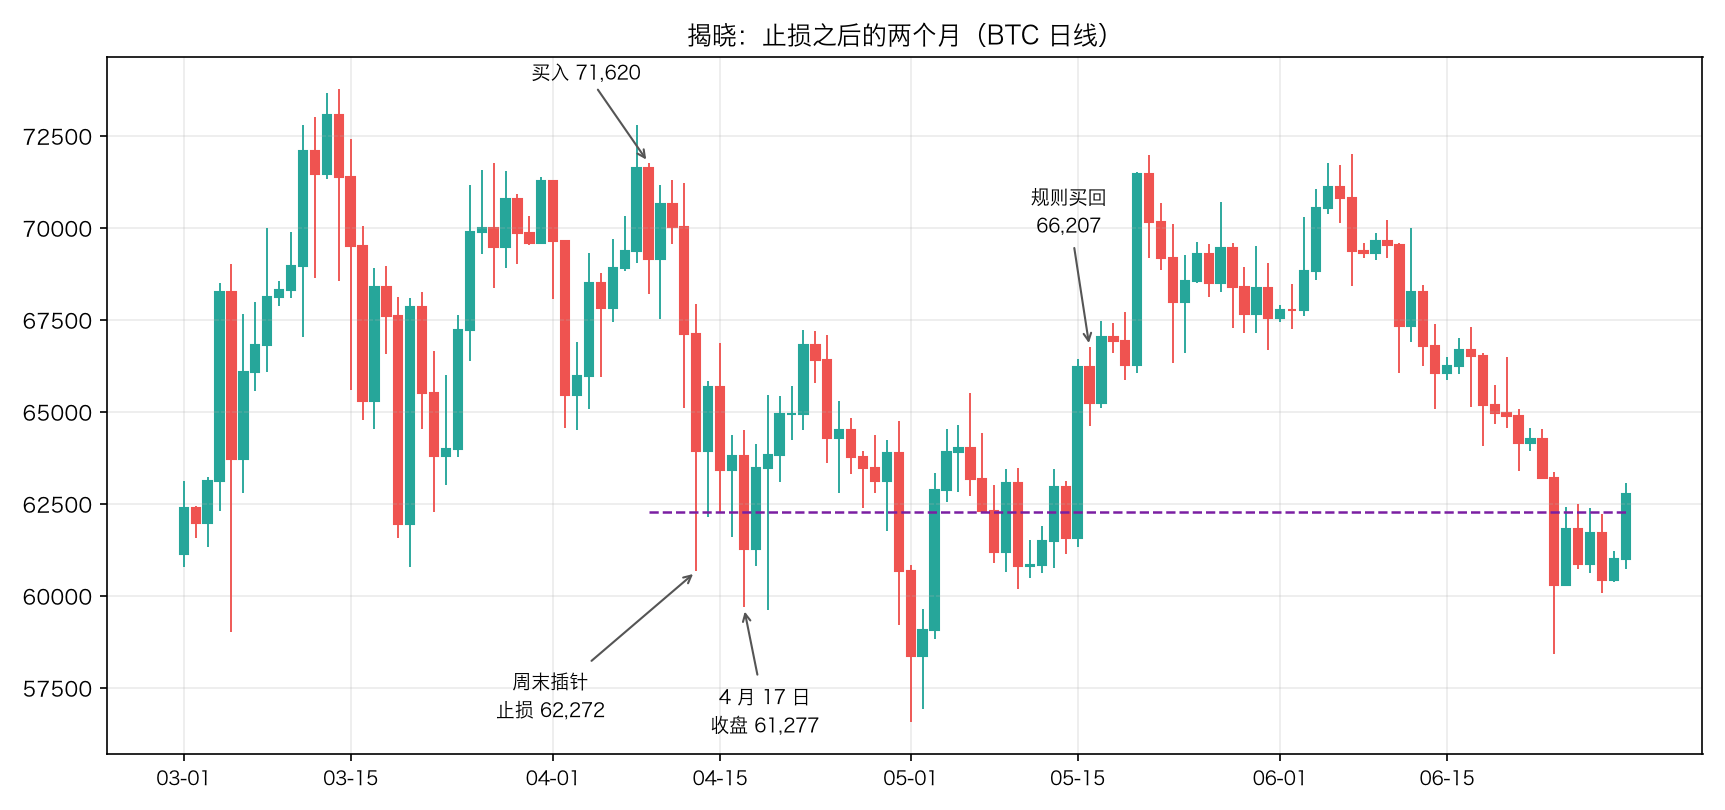
止损之后:4 月 17 日最低收在 61277,4 月 19 日盘中最低 59600,5 月 16 日买回价 66206.51,比止损价高 6.3%
马上买回(4 月 14 日开盘):买入价 63924.52,到 6 月 20 日 64869.99,+1.5%;期间最低收盘 58365
等规则买回(5 月 16 日):买入价 66206.51,到 6 月 20 日 64869.99,-2.0%;期间最低收盘 64870
三个选择:
- 选 A(马上买回):4 月 14 日开盘 63,924 买回。之后 BTC 继续跌,4 月 17 日收在 61,277,5 月 1 日最低收在 58,365——你要再扛一次 8.7% 的回撤,到 6 月 20 日才是 +1.5%。
- 选 B(按规则等):5 月 16 日才等到 20 日新高,买入价 66,207,比你的止损价高 6.3%。到 6 月 20 日是 -2.0%。但这条路上你一天都没有拿过亏损的仓位。
- 选 C(改成收盘价触发):4 月 13 日收盘 63,924 > 62,272,那天根本不会出场。但接下来要问的是:这个改动放到全部历史上,是赚还是亏?
注意这三条路两个月后的结果差不多(+1.5%、-2.0%、继续持有)。一次决策点说明不了任何事。 第九节才是正事。
九、数据怎么说:止损该盯盘中还是盯收盘
9.1 被打掉的止损里,有多少当天就收回来了
print("\n止损之后价格又回到止损价上方的比例:")
rows = []
for name, df in [("SPY", spy), ("AAPL", aapl), ("BTC", day)]:
    _, _, t = mainline(df)
    stops = t[t["原因"].str.startswith("止损")]
    back = {}
    for horizon in [0, 5, 20]:
        hits = []
        for when, level in zip(stops["卖出日"], stops["止损价"]):
            position = df.index.get_loc(when)
            window = df["close"].iloc[position: position + horizon + 1]
            hits.append(bool((window > level).any()))
        back[f"{horizon} 天内"] = np.mean(hits)
    rows.append({"标的": name, "止损次数": len(stops)} | back)
print(pd.DataFrame(rows).to_string(index=False, float_format=lambda v: f"{v:.3f}"))
止损之后价格又回到止损价上方的比例:
  标的  止损次数  0 天内  5 天内  20 天内
 SPY    49 0.592 0.898  0.918
AAPL    45 0.489 0.756  0.844
 BTC    39 0.641 0.846  0.949
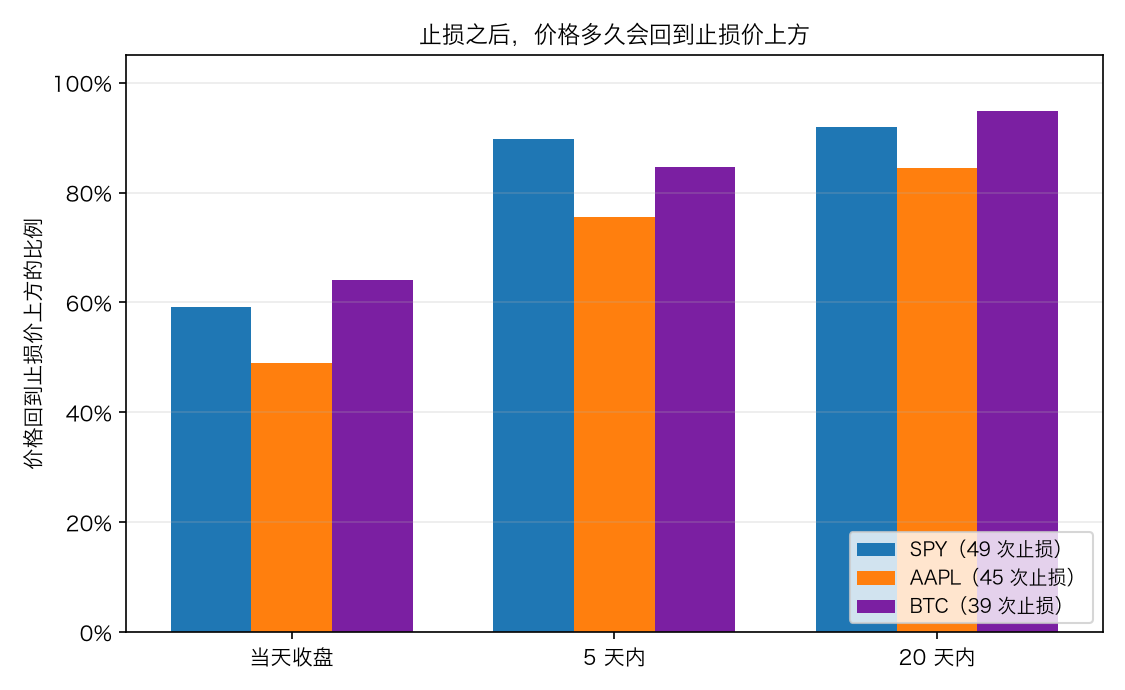
- 止损当天收盘,价格已经回到止损价上方的比例:SPY 59.2%、AAPL 48.9%、BTC 64.1%。
- 5 天内回到止损价上方的:76%–90%。20 天内:84%–95%。
这组数字很容易被读成「止损是错的」。不是。 止损的作用是把亏损的上限锁死,代价就是经常在噪声上出场——这两件事是同一枚硬币。真正值得问的是下一个问题:如果只在收盘时判断,会不会更好?
9.2 把触发方式改成收盘价
第八节那个 mainline 的两个开关:trigger="close" 表示只有收盘价跌破才出场;skip 表示某些日子(比如周末)不许盘中触发,只在收盘时判断。三个标的、三个版本跑一遍:
rows = []
for name, df, periods in [("SPY", spy, 252), ("AAPL", aapl, 252), ("BTC", day, 365)]:
    for label, kwargs in [("v1:盘中触发", {}), ("v2:收盘触发", {"trigger": "close"}),
                          ("v2w:周末只看收盘", {"skip": SS.is_weekend(df.index)})]:
        r, held, t = mainline(df, **kwargs)
        equity = (1 + r).cumprod()
        stops = t[t["原因"].str.startswith("止损")]
        recovered = (df.loc[stops["卖出日"], "close"].to_numpy() > stops["止损价"].to_numpy()).mean() if len(stops) else np.nan
        rows.append({"标的": name, "版本": label, "年化": equity.iloc[-1] ** (periods / len(r)) - 1,
                     "最大回撤": (equity / equity.cummax() - 1).min(), "交易次数": len(t), "止损次数": len(stops),
                     "止损当天收盘又在止损价上方": recovered, "最差一笔": t["收益"].min()})
print(pd.DataFrame(rows).to_string(index=False, float_format=lambda v: f"{v:.3f}"))
  标的         版本    年化   最大回撤  交易次数  止损次数  止损当天收盘又在止损价上方   最差一笔
 SPY    v1:盘中触发 0.029 -0.140    49    49          0.592 -0.044
 SPY    v2:收盘触发 0.039 -0.117    40    40          0.100 -0.053
 SPY v2w:周末只看收盘 0.029 -0.140    49    49          0.592 -0.044
AAPL    v1:盘中触发 0.092 -0.213    45    45          0.489 -0.078
AAPL    v2:收盘触发 0.088 -0.293    39    39          0.154 -0.081
AAPL v2w:周末只看收盘 0.092 -0.213    45    45          0.489 -0.078
 BTC    v1:盘中触发 0.082 -0.565    41    39          0.641 -0.209
 BTC    v2:收盘触发 0.167 -0.531    31    29          0.000 -0.238
 BTC v2w:周末只看收盘 0.095 -0.567    40    38          0.632 -0.209
表面上看,收盘触发赢了:
- BTC:年化从 8.2% 涨到 16.7%,回撤从 -56.5% 降到 -53.1%,止损次数从 39 次降到 29 次。
- SPY:年化 2.9% → 3.9%,回撤 -14.0% → -11.7%。
- 「止损当天收盘又在止损价上方」这一列从 49%–64% 掉到 0%–15%——按定义就该这样:收盘价跌破才出场,当然很少出现「收盘又回到上方」。
- 「周末只看收盘」这个更保守的版本对美股完全没影响(美股没有周末 K 线),对 BTC 只把年化从 8.2% 提到 9.5%。
但是 AAPL 的回撤从 -21.3% 恶化到 -29.3%,年化还降了一点。而且三个标的的「最差一笔」都变大了(BTC -20.9% → -23.8%)——这是必然的:止损晚一天触发,就要多承担一天的下跌。
9.3 同一笔交易,两种触发方式差多少
上面那张表有一个问题:三个标的、三个版本,九个格子里挑好看的说,就是第 17、18、19 篇反复出现的毛病。把同一笔交易配对来比,才看得清:
print("\n同一笔交易,两种触发方式的收益(按买入日配对):")
for name, df in [("SPY", spy), ("AAPL", aapl), ("BTC", day)]:
    _, _, a = mainline(df)
    _, _, b = mainline(df, trigger="close")
    paired = a.set_index("买入日")["收益"].to_frame("v1").join(b.set_index("买入日")["收益"].to_frame("v2"), how="inner")
    diff = paired["v2"] - paired["v1"]
    boot = np.array([diff.iloc[rng.integers(0, len(diff), len(diff))].mean() for _ in range(2000)])
    print(f"{name}:配对上 {len(paired)} 笔,v2 减 v1 平均 {diff.mean():+.4f},中位数 {diff.median():+.4f},"
          f"v2 更好的占 {(diff > 0).mean():.1%},p = {2 * min((boot <= 0).mean(), (boot >= 0).mean()):.3f}")
同一笔交易,两种触发方式的收益(按买入日配对):
SPY:配对上 40 笔,v2 减 v1 平均 +0.0049,中位数 -0.0026,v2 更好的占 17.5%,p = 0.213
AAPL:配对上 39 笔,v2 减 v1 平均 +0.0051,中位数 -0.0074,v2 更好的占 10.3%,p = 0.731
BTC:配对上 31 笔,v2 减 v1 平均 +0.0537,中位数 -0.0135,v2 更好的占 25.8%,p = 0.297
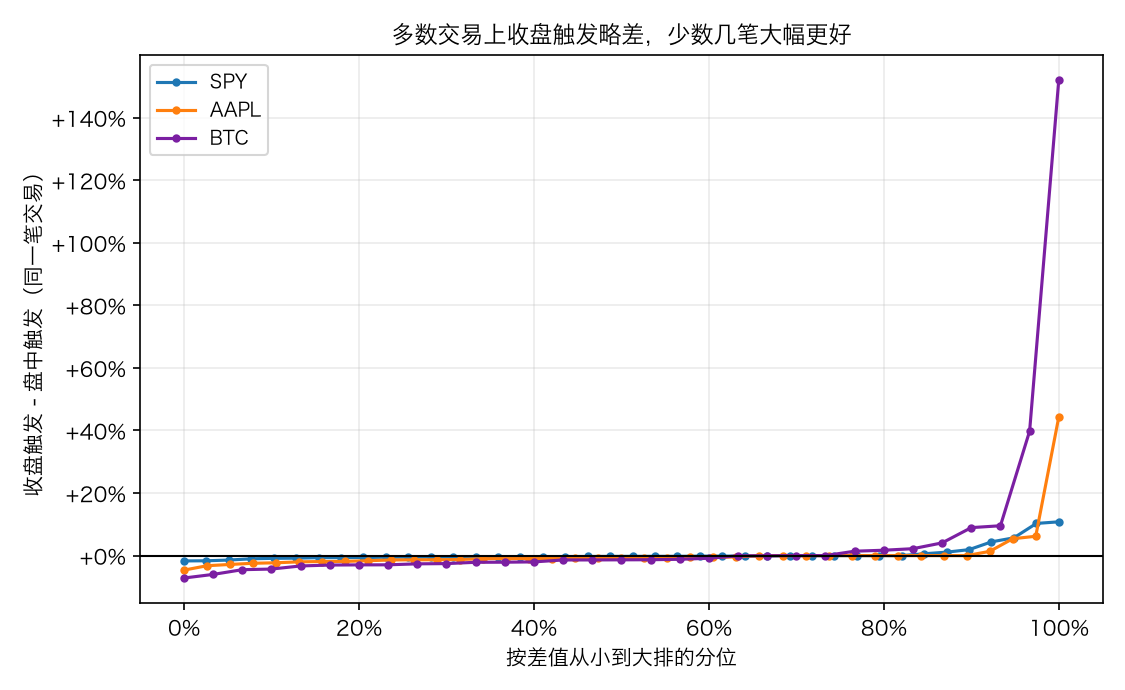
- 三个标的上,收盘触发的平均收益都更高(+0.49%、+0.51%、+5.37%)。
- 但中位数都更低(-0.26%、-0.74%、-1.35%),而且收盘触发更好的交易只占 10%–26%。
- bootstrap 的 p 值是 0.213、0.731、0.297,没有一个显著。
这张图把每一笔的差值从小到大排开,形状一目了然:八成以上的交易上,收盘触发略微差一点(晚一天出场,多亏一点);极少数几笔大幅更好。 最右边那一笔差了 +152%:2020 年 10 月 11 日买入的 BTC,盘中触发在 11 月 26 日被打掉(+49.5%),收盘触发一直拿到 2021 年 1 月 12 日(+201.5%)。
平均被少数几笔拉起来,中位数告诉你日常体验。这和第 19 篇「高波动组平均最高、中位数最低」是同一件事的另一个面孔。
9.4 那还要不要改
要,但理由不是回测数字。
回测数字不显著(三次检验,p 最小 0.213),而且换一个标的(AAPL)方向就反了。真正站得住的理由是机制:
盘中触发的止损,是在「价格碰到某个数」的那一刻按市价成交。那一刻恰好是流动性最差的时候——因为价格正在快速穿过这个区域,而且很可能是在周末的深夜。决策点那一分钟,成交均价比止损价高 0.71%,下一分钟的均价就比它低 0.6%:同一个止损单,成交在哪里靠运气。
收盘价触发把这一层运气拿掉了:你在流动性最好的时刻(收盘附近)成交,代价是止损晚一天、单次亏损更大。这是一个用「结果的方差」换「单次亏损上限」的交易,不是一个提高收益的技巧。
所以主线策略 v2 = v1 + 止损用收盘价触发。把理由写进规则里:不是因为它年化更高,是因为它不再依赖薄流动性时刻的成交价。
9.5 顺便:财报前要不要空仓
第六节量过,苹果财报后第二天的隔夜跳空是平常的 7 倍。听起来应该躲开:
overnight = aapl["open"] / aapl["close"].shift(1) - 1
after_earnings = pd.Series(False, index=aapl.index)
for date in earnings:
    position = aapl.index.searchsorted(date) + 1
    if position < len(aapl):
        after_earnings.iloc[position] = True
print(f"苹果 {len(earnings)} 次财报的第二天:隔夜跳空绝对值中位数 {overnight[after_earnings].abs().median():.2%},"
      f"平常 {overnight[~after_earnings].abs().median():.2%}")
print(f"  这 {int(after_earnings.sum())} 天贡献了全部隔夜收益的 {overnight[after_earnings].sum() / overnight.sum():.1%},"
      f"占天数的 {after_earnings.mean():.1%}")
buy_hold = (1 + aapl["close"].pct_change().fillna(0)).cumprod()
skip_days = after_earnings | after_earnings.shift(-1, fill_value=False)      # 财报当天和第二天都空仓
filtered = (1 + aapl["close"].pct_change().fillna(0).where(~skip_days, 0)).cumprod()
years = len(aapl) / 252
print(f"一直持有 AAPL:年化 {buy_hold.iloc[-1] ** (1 / years) - 1:.2%},最大回撤 {(buy_hold / buy_hold.cummax() - 1).min():.1%}")
print(f"财报当天和第二天空仓:年化 {filtered.iloc[-1] ** (1 / years) - 1:.2%},"
      f"最大回撤 {(filtered / filtered.cummax() - 1).min():.1%},少持有 {skip_days.mean():.1%} 的时间")
苹果 41 次财报的第二天:隔夜跳空绝对值中位数 3.13%,平常 0.42%
  这 41 天贡献了全部隔夜收益的 67.0%,占天数的 1.6%
一直持有 AAPL:年化 28.86%,最大回撤 -38.5%
财报当天和第二天空仓:年化 24.04%,最大回撤 -40.5%,少持有 3.3% 的时间
- 这 41 次财报的第二天,贡献了十年全部隔夜收益的 67%,而它们只占 1.6% 的天数。
- 「财报当天和第二天空仓」:年化从 28.9% 掉到 24.0%,最大回撤反而从 -38.5% 变成 -40.5%。
躲掉的是波动,也是收益。 苹果这十年是涨的,财报跳空整体向上,躲开等于把最重要的几天让出去。
这条过滤不加进主线策略。同一篇里两条过滤,一条加、一条不加,理由都摆在数字旁边——这比「多加几个过滤条件」的直觉可靠。
十、常见误用
1. 把「周末波动大」当成事实。 数据正好相反:周末的平均振幅比工作日低 23%,插针发生在周末的比例(20.5%)还低于周末占的时间比例(28.6%)。周末真正的问题是薄:同样 1 亿美元的成交,价格多走 13%。
2. 用「波动率」衡量流动性。 波动率是结果,流动性是「推动价格需要多少钱」。第三节那个「每成交 1 亿美元价格走多少」才是流动性的度量,它在美股收盘后(UTC 21–24 点)最差。
3. 把止损放在整数关口或者昨天的低点,然后在周末不管它。 这两件事叠加起来就是决策点那一夜:一个别人也看得见的位置,加上一个没人接盘的时段。
4. 以为「隔夜收益更高」是普遍规律。 SPY 是(140% 对 48%),AAPL 完全相反(13% 对 1,022%)。而且这两条曲线都没算成本,一年 500 次交易的成本足以抹平差距。
5. 把「成交量放大」当成「要出大行情」。 四巫日的成交量是平常的 1.5–2 倍,振幅和平常一模一样。多出来的成交是交割和调仓,没有方向。
6. 事件日历只记大事,不记自己的持仓。 对一只股票来说,它自己的财报(振幅放大 80%、跳空 7 倍)比 FOMC(放大 30%)重要得多。
7. 因为「躲开事件」听起来稳健就躲开。 苹果十年隔夜收益的 67% 来自 41 个财报日。躲开波动就是躲开收益。
十一、小结
- 一天不是均匀的:BTC 在 UTC 14 点(美股开盘后)成交额最高(6.5%),UTC 5 点最低(3.1%),平均振幅差 53%。美国时段占 33% 的时间、41.6% 的成交额。
- 周末是薄,不是波动大:占 28.6% 的时间、19.7% 的成交额,平均振幅更低,但同样成交 1 亿美元价格多走 13%。周末成交额占比从 2017 年的 28.2% 降到 2024 年的 15.7%。
- 插针大多发生在人最多的时候(美国时段占插针的 39.8%),因为大行情需要成交量;但同样放量,周末走得更远。
- 美股十年的涨幅里,SPY 的大部分来自隔夜,AAPL 的大部分来自日内。别把指数的规律套到个股上。
- 日历日子里,四巫日成交量最夸张(AAPL 2.0 倍),半日只有平常的一半;但振幅基本不变。
- 事件当天的振幅放大(和平常日子的中位数比):SPY 遇 FOMC +30%、BTC 遇 FOMC +16%、AAPL 遇财报 +80%,财报后的隔夜跳空是平常的 7 倍。
- 止损当天收盘价就回到止损价上方的比例:SPY 59%、AAPL 49%、BTC 64%。改成收盘价触发之后,平均更好、中位数更差、三个标的都不显著——它是用结果方差换单次亏损上限,不是提高收益的技巧。
- 主线 v2 = v1 + 收盘价触发止损;而「财报前空仓」这条过滤不加(年化 28.9% → 24.0%,回撤反而更大)。
练习
- 换时段口径:把
SESSIONS改成交易所常用的重叠口径(亚洲 00–08、欧洲 07–16、美国 13–21),重算第三节的表。重叠的小时同时属于两个时段,结论会变吗? - 换插针的定义:把 3% 换成 1%、5%、10%,重算时段分布。阈值越大,「美国时段更多」这个结论是变强还是变弱?
- 周末的边界:BTC 的周末效应是从周六零点开始的吗?按 UTC 小时把周五晚上到周一早上单独画出来,找出成交额真正掉下去和回来的时刻。
- 半日:
nyse.early_closes给出提前收盘的日子。这些日子的第二天有什么特别的吗? - FOMC 的方向:第六节只看了振幅。FOMC 当天 SPY 的涨跌有没有偏向?分成「加息、降息、不变」三组(需要自己整理利率数据),样本够不够下结论?
- 事件研究的对照:把 FOMC 日期整体平移 7 天,重做一次事件研究。平移后的「假事件」也能看到振幅放大吗?(这是第 9 篇以来一直在用的对照思路。)
- 成本:给第四节的「只吃隔夜」和「只吃日内」加上每边 0.01%、0.05% 的成本,两条曲线还剩下什么?
小检查答案
小检查 1
(a) 200 万美元是 0.02 亿,价格走了 1%,所以「每成交 1 亿美元价格走 1% ÷ 0.02 = 50%」。中位数是 0.585%,这一小时薄得离谱——1% 的移动只用了 200 万美元。
(b) 止损市价单在价格跌破 62,000 的那一刻变成市价单,成交在当时盘口上还剩的价格。这一分钟里价格从 62,288 一路到 61,300,成交均价 61,905,所以合理的预期是成交在 62,000 到 61,300 之间,比止损价低 0.15%–1.1%。想要更确定的成交价就得用限价单,代价是可能不成交(第 22 篇)。
(c) 两个理由:一、薄——同样大小的卖单在周末推动价格更多(0.661% 对 0.585%),价格更容易扫到你的止损位再回来;二、没有对冲的去处——股市、期货、外汇都休市,想对冲风险的人只能在加密市场上操作,所有压力集中到唯一开着的市场。