| 本篇位置 | 第五部分「从信号到交易」第三篇。第 19 篇选标的、第 20 篇挑时间,这一篇把「一个想法」写成「一条规则」 |
| 用到的数据 | SPY、AAPL 日线(2016-09 至 2026-09);BTC 现货日线(2017-08 至 2026-08) |
| 动手 | 新模块 talab.rules:六要素的 Rule、按规则跑一遍历史的 run、条件重合度 overlap 和叠加 stack,附 10 个测试 |
| 主线策略 | v3:六个要素全部写出来,每一格附上选择的理由 |
| 读完你能 | 看到一句交易说法,立刻说出它缺了六要素里的哪几个;量出「同一个信号、不同写法」的结果差多少;判断两个条件叠加是共振还是冗余 |
一、先做一个决定
2025 年 7 月 1 日收盘,SPY 的 50 日均线上穿 200 日均线。
SPY 十年里的金叉: ['2019-04-01', '2020-07-09', '2023-02-02', '2025-07-01']
对应的死叉:     ['2018-12-07', '2020-03-30', '2022-03-14', '2025-04-14']
2025-07-01 收盘:SMA50 583.10 上穿 SMA200 582.04,收盘价 617.65,前一个交易日 SMA50 581.27
              open    high     low   close
date
2025-06-27  612.88  616.39  610.83  614.91
2025-06-30  617.38  619.22  615.04  617.85
2025-07-01  616.36  618.83  615.52  617.65
2025-07-02  617.24  620.49  616.61  620.45
2025-07-03  622.45  626.28  622.43  625.34
2025-07-07  623.36  624.03  617.87  620.68
2025-07-08  621.35  622.11  619.52  620.34
当天的 ATR 6.31(1.02%);50 日均线 583.10 在收盘价下方 5.6%
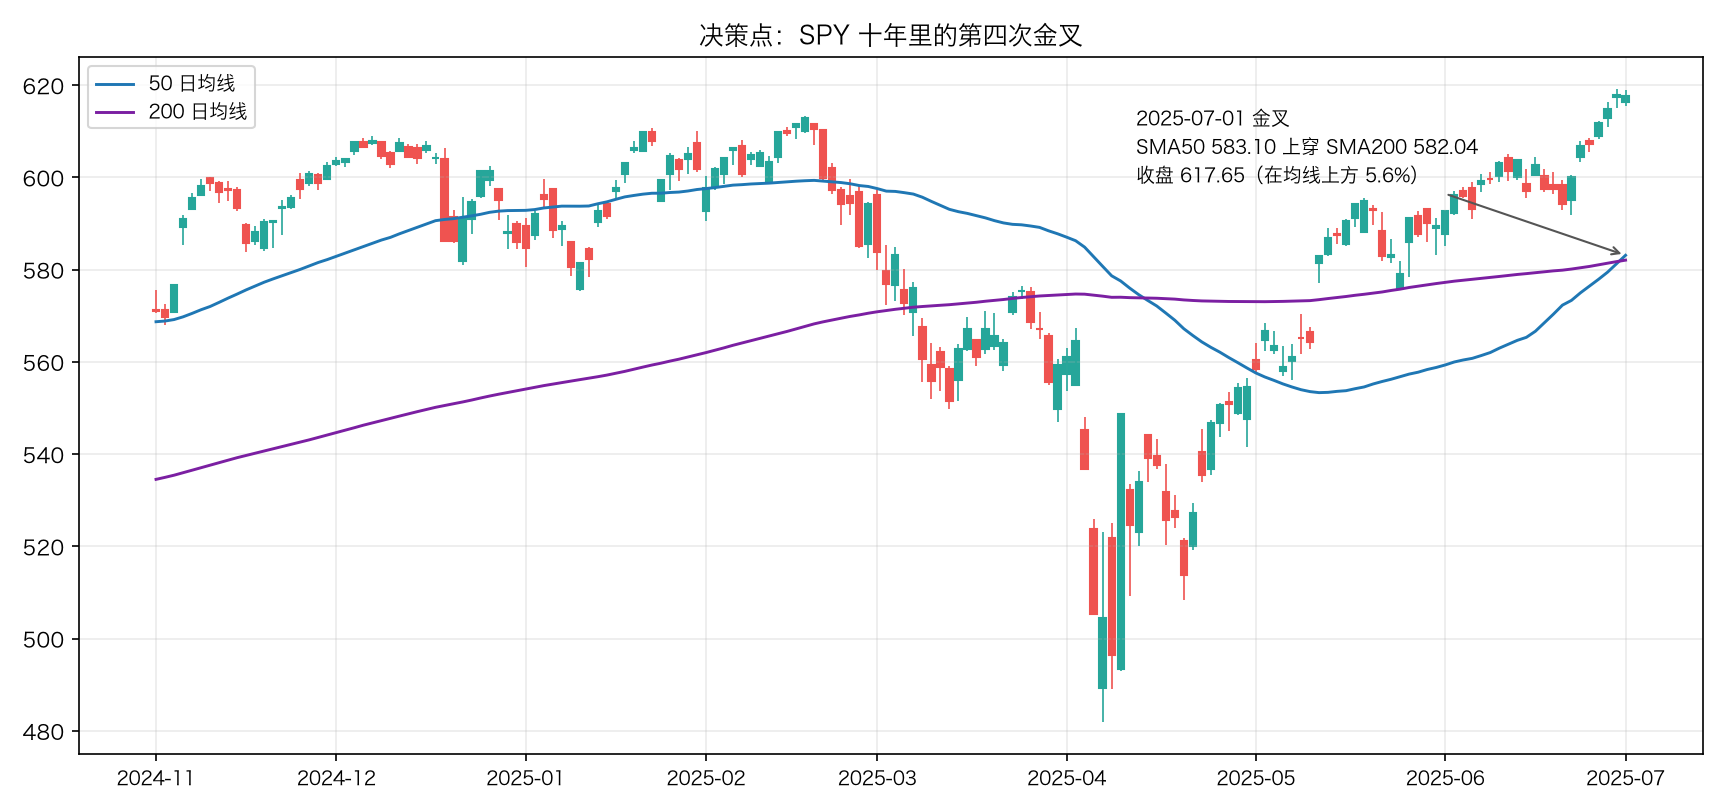
十年只有四次,这是第四次。你信的就是这个信号,现在它来了。
问题是:「金叉买入」这四个字,你没法下单。 打开交易软件,它至少要问你六件事:
| 要填的空 | 「金叉买入」有答案吗 |
|---|---|
| 现在这个市场环境允许开新仓吗? | 没说 |
| 什么算「金叉」?今天收盘确认,还是盘中上穿就算? | 没说 |
| 用什么价格买?今天收盘 617.65,还是明天开盘,还是等回调到 583 的 50 日均线? | 没说 |
| 跌到哪里认错? | 没说 |
| 什么时候正常离场?死叉?还是别的? | 没说 |
| 买多少? | 没说 |
假设你现在必须把它补全,三种常见的写法:
- A. 下一根开盘买入,不设止损,等死叉再卖
- B. 下一根开盘买入,3 个 ATR 的吊灯止损(第 15、20 篇),死叉或止损先到先算
- C. 不追高,挂个限价单等回调到 50 日均线(583.10,比现价低 5.6%),10 天内不来就算了;进场后同样用 3 ATR 吊灯止损
先写下你的选择。 第八节揭晓这三种写法在这次金叉之后各自赚了多少(提前说一句:差得比你想的大),第四到七节先看「补全方式」这件事本身有多重要。
二、打个比方:「盐少许,小火慢炖」
菜谱上写「盐少许,小火慢炖至入味」,你照着做,和作者做出来的味道不一样——这不是你的问题,是菜谱的问题。「少许」是多少?「小火」是几档?「至入味」是几分钟?
一份能复现的菜谱,会把这些空全填上:盐 3 克、中小火、25 分钟、收汁到锅底剩两勺。填空之后你可能不同意(有人觉得 3 克太咸),但至少大家做出来的是同一道菜。
交易规则一模一样:
| 菜谱 | 交易规则 |
|---|---|
| 盐少许 | 买多少?(仓位) |
| 小火慢炖 | 用什么价格买、什么时候卖?(入场方式、出场规则) |
| 至入味 | 跌到哪里认错?(止损) |
| 这道菜什么季节做 | 什么市场环境下才做?(环境过滤) |
| 照着做的人做出同一道菜 | 两个人按同一条规则交易,结果应该相近 |
「金叉买入」是「盐少许」。 这一篇要做的,就是把「少许」变成克数——并且量一量:同样一句「盐少许」,不同的人放不同的量,最后的味道差多少。
三、六个要素
一条能执行的规则至少要回答六个问题:
| # | 要素 | 它回答什么 | 常见的坑 |
|---|---|---|---|
| 一 | 环境过滤 | 什么时候允许开新仓 | 拿它当选股工具(第 19 篇),或者叠一堆高度重合的条件(第六节) |
| 二 | 入场条件 | 什么信号算数 | 信号用到了当根还没走完的数据(第 12 篇的未来函数) |
| 三 | 入场方式 | 用什么价格买 | 「收盘价买入」假设你能在收盘那一刻成交;限价单不写有效期 |
| 四 | 初始止损 | 跌到哪里认错 | 止损和入场条件耦合:止损之后马上按同一个条件买回,等于没止损(第九节) |
| 五 | 出场规则 | 什么时候正常离场 | 只写止损不写出场,赢的单子拿不住也走不掉 |
| 六 | 仓位 | 买多少 | 回测默认满仓,实盘做不到;按风险定仓位要先有止损(第 26 篇) |
talab.rules 把这六个问题写成了六组字段,所以「规则完整吗」这件事可以直接看代码:
entry = (I.sma(spy["close"], 50) > I.sma(spy["close"], 200)) & (spy["close"] >= spy["close"].rolling(20).max())
one = R.Rule(entry=entry, exit=deaths(spy), fill="next_open", stop="chandelier", k=3.0, trigger="close")
print(one.describe().to_string())
returns, held, trades = R.run(spy, one)
print(f"\n这条规则在 SPY 上跑十年:{len(trades)} 笔交易,在场时间 {(held > 0).mean():.1%},"
      f"年化 {(1 + returns).prod() ** (252 / len(returns)) - 1:.2%}")
print(trades.tail(3).to_string())
一、环境过滤                       不过滤
二、入场条件                   给定的信号序列
三、入场方式                    下一根开盘价
四、初始止损    3.0 倍 ATR 吊灯(close 触发)
五、出场规则                   给定的出场信号
六、仓位                          满仓

这条规则在 SPY 上跑十年:39 笔交易,在场时间 49.2%,年化 2.97%
          买入日     买入价        卖出日     卖出价  原因   仓位        收益
36 2026-04-10  681.32 2026-06-05  737.55  止损  1.0  0.082531
37 2026-07-13  752.47 2026-07-29  729.46  止损  1.0 -0.030579
38 2026-08-04  760.63 2026-09-10  757.83  止损  1.0 -0.003681
⚠️ 注意第二行那个入场条件:金叉状态 + 收盘创 20 日新高。第 15 篇的主线 v1 里有一条「止损之后要等收盘创 20 日新高才买回」,那其实是一条藏在状态里的入场条件;现在把它摆到台面上,第一次入场和止损后买回用的是同一句话。第九节会量出这条件在管什么。
✋ 小检查 1
(a) 「RSI 低于 30 就买」这句话,缺了六要素里的哪几个?
(b) 一条规则写着「回调到 50 日均线挂限价单买入」,但没写挂几天。这属于哪个要素?不写会怎么样?
(c) 止损写「进场价下方 10%」,仓位写「一笔最多亏账户的 1%」,账户 10 万美元。这笔该买多少钱的货?
答案在文末。
四、同一个信号,十八种写法
把三个格子各给三个(或两个)常见选项,其他不变:
- 入场方式:当根收盘 / 下一根开盘 / 回调到 50 日均线的限价单(10 天有效)
- 初始止损:不设 / 3 ATR 吊灯 / 进场价 -10%
- 出场规则:死叉 / 跌破 20 日新低
3 × 3 × 2 = 18 种写法,信号完全一样:
FILLS = {"当根收盘": dict(fill="close"), "下一根开盘": dict(fill="next_open"), "回调到 50 日均线": dict(fill="pullback")}
STOPS = {"不设止损": dict(stop="none"), "3 ATR 吊灯": dict(stop="chandelier", k=3.0), "进场价 -10%": dict(stop="percent")}
EXITS = {"死叉出场": "death", "跌破 20 日新低": "low20"}


def variant(df, fill_name, stop_name, exit_name):
    """同一个金叉信号,不同的补全方式。"""
    trend = I.sma(df["close"], 50) > I.sma(df["close"], 200)
    signal = trend & (df["close"] >= df["close"].rolling(20).max())
    leave = deaths(df) if EXITS[exit_name] == "death" else (df["close"] <= df["close"].rolling(20).min())
    options = FILLS[fill_name] | STOPS[stop_name]
    if options.get("fill") == "pullback":
        options["pullback_to"] = I.sma(df["close"], 50)
    return R.Rule(entry=signal, exit=leave.fillna(False), **options)


rows = []
for name, df, periods in markets:
    for fill_name, stop_name, exit_name in itertools.product(FILLS, STOPS, EXITS):
        returns, held, trades = R.run(df, variant(df, fill_name, stop_name, exit_name))
        equity = (1 + returns).cumprod()
        rows.append({"标的": name, "入场方式": fill_name, "止损": stop_name, "出场": exit_name,
                     "年化": equity.iloc[-1] ** (periods / len(returns)) - 1,
                     "最大回撤": (equity / equity.cummax() - 1).min(), "交易次数": len(trades),
                     "在场时间": (held > 0).mean(), "最差一笔": trades["收益"].min() if len(trades) else np.nan})
grid = pd.DataFrame(rows)
print(f"每个标的 {len(FILLS)} × {len(STOPS)} × {len(EXITS)} = {len(FILLS) * len(STOPS) * len(EXITS)} 种写法:")
print(grid.groupby("标的")["年化"].agg(["min", "median", "max"]).round(4).to_string())
for name, _, _ in markets:
    sub = grid[grid["标的"] == name].sort_values("年化")
    print(f"\n{name} 最差和最好的三种写法:")
    print(pd.concat([sub.head(3), sub.tail(3)]).drop(columns="标的").to_string(index=False,
                                                                              float_format=lambda v: f"{v:.3f}"))
每个标的 3 × 3 × 2 = 18 种写法:
         min  median     max
标的
AAPL  0.1075  0.1181  0.1525
BTC  -0.1732  0.1884  0.2352
SPY   0.0010  0.0324  0.0744

SPY 最差和最好的三种写法:
      入场方式       止损        出场    年化   最大回撤  交易次数  在场时间   最差一笔
回调到 50 日均线 进场价 -10% 跌破 20 日新低 0.001 -0.112    12 0.088 -0.051
回调到 50 日均线     不设止损 跌破 20 日新低 0.001 -0.112    12 0.088 -0.051
回调到 50 日均线 3 ATR 吊灯 跌破 20 日新低 0.005 -0.097    12 0.084 -0.057
     下一根开盘 进场价 -10%      死叉出场 0.069 -0.279     5 0.744 -0.133
      当根收盘     不设止损      死叉出场 0.074 -0.341     5 0.749 -0.088
     下一根开盘     不设止损      死叉出场 0.074 -0.341     5 0.749 -0.089
BTC 最差和最好的三种写法:
      入场方式       止损        出场     年化   最大回撤  交易次数  在场时间   最差一笔
回调到 50 日均线     不设止损      死叉出场 -0.173 -0.821     8 0.175 -0.374
回调到 50 日均线 进场价 -10%      死叉出场 -0.129 -0.712    11 0.088 -0.157
回调到 50 日均线 3 ATR 吊灯      死叉出场 -0.121 -0.688    14 0.065 -0.238
      当根收盘 进场价 -10% 跌破 20 日新低  0.222 -0.413    29 0.266 -0.157
      当根收盘 进场价 -10%      死叉出场  0.235 -0.567    10 0.441 -0.139
     下一根开盘 进场价 -10%      死叉出场  0.235 -0.567    10 0.441 -0.139
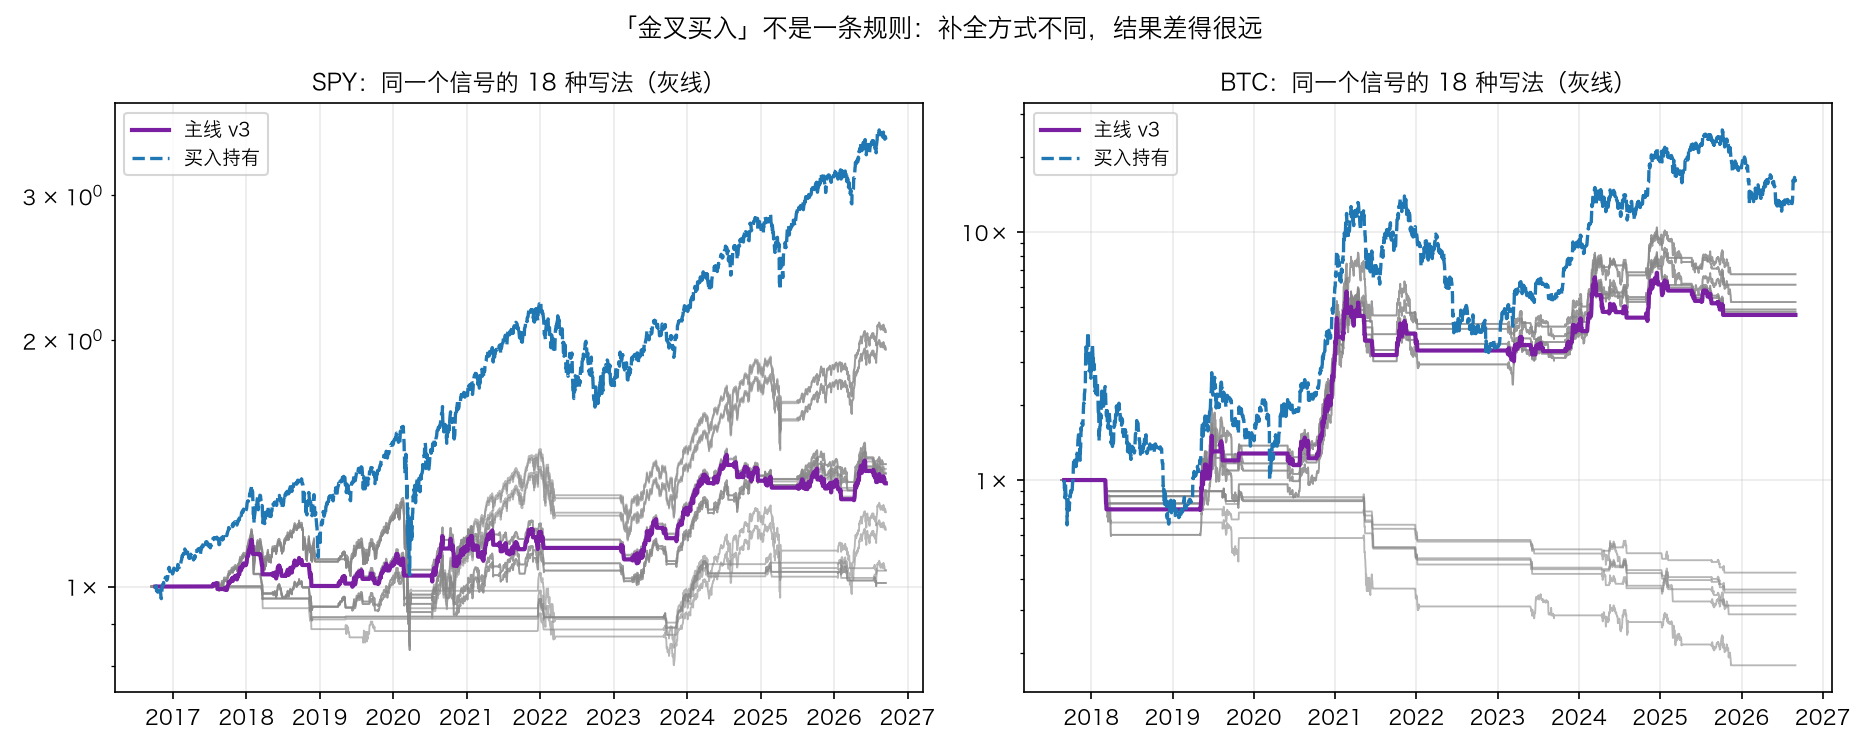
同一个信号,同一段历史,只是补全方式不同:
- SPY:年化从 0.1% 到 7.4%
- AAPL:从 10.8% 到 15.3%
- BTC:从 -17.3% 到 +23.5%——差了 40 个百分点,一个是亏光一半,一个是十年十倍
这就是规则设定风险:你以为在检验「金叉有没有用」,实际上在检验「这一种写法有没有用」。一句「金叉买入回测年化 20%」如果不附上六要素,等于什么都没说。
止损那一格换来了什么
把 18 种写法按「止损」这一格汇总:
按「止损」这一格汇总(每格 6 种写法的平均):
                 年化   最大回撤   最差一笔   交易次数
标的   止损
AAPL 3 ATR 吊灯 0.113 -0.283 -0.080 33.333
     不设止损     0.128 -0.370 -0.110 17.333
     进场价 -10% 0.128 -0.369 -0.106 17.333
BTC  3 ATR 吊灯 0.088 -0.550 -0.229 25.167
     不设止损     0.083 -0.598 -0.305 16.167
     进场价 -10% 0.116 -0.541 -0.146 17.333
SPY  3 ATR 吊灯 0.023 -0.124 -0.058 29.833
     不设止损     0.040 -0.252 -0.071 15.500
     进场价 -10% 0.037 -0.235 -0.093 15.500
- 三个标的上,不设止损的年化都不低(SPY 4.0%、AAPL 12.8%、BTC 8.3%),因为这十年三个标的都是涨的。
- 但最大回撤和最差一笔全都更难看:SPY 最差一笔 -7.1% 对 -5.8%,BTC -30.5% 对 -22.9%,回撤 BTC -59.8% 对 -55.0%。
止损买的不是收益,是「最差一笔」的上限。 这句话在第 15 篇说过,这里是三个标的、18 种写法的版本。
五、在一个标的上挑出来的写法,换个标的还灵吗
既然写法这么重要,那就挑一个最好的?看看这 18 种写法在三个标的上的排名有多一致:
wide = grid.pivot_table(index=["入场方式", "止损", "出场"], columns="标的", values="年化")
print(wide.round(4).to_string())
print("\n三个标的之间,写法排名的秩相关:")
print(wide.rank().corr(method="spearman").round(3).to_string())
best = wide["SPY"].idxmax()
print(f"\nSPY 上最好的写法是 {best}:在 AAPL 上排第 {int(wide['AAPL'].rank(ascending=False)[best])},"
      f"在 BTC 上排第 {int(wide['BTC'].rank(ascending=False)[best])}(共 {len(wide)} 种)")
三个标的之间,写法排名的秩相关:
标的     AAPL    BTC    SPY
标的
AAPL  1.000  0.274  0.327
BTC   0.274  1.000  0.822
SPY   0.327  0.822  1.000

SPY 上最好的写法是 ('下一根开盘', '不设止损', '死叉出场'):在 AAPL 上排第 4,在 BTC 上排第 5(共 18 种)
- AAPL 和 BTC 的写法排名,秩相关只有 0.27;AAPL 和 SPY 是 0.33。只有 SPY 和 BTC 高一些(0.82)。
- 在 SPY 上最好的那种写法,在 AAPL 上排第 4、在 BTC 上排第 5。
排第 4、第 5 听上去还行——但这正是危险的地方:你会觉得「它在别处也不差」,于是把它当成一条规律。而真实的情况是,18 种写法里有一半在换标的之后名次动了 5 位以上。第 30 篇讲样本外检验时会回到这件事。
六、条件叠加:共振还是冗余
「金叉 + 站上 200 日均线 + ADX 大于 20 + RSI 大于 50 + 放量」——这种「多重确认」听起来很稳。先看看这些条件彼此有多像。
6.1 两个条件有多重合
def conditions(df):
    close, high, low = df["close"], df["high"], df["low"]
    return {"金叉状态(50 在 200 上方)": I.sma(close, 50) > I.sma(close, 200),
            "收盘价在 200 日均线上方": close > I.sma(close, 200),
            "收盘创 20 日新高": close >= close.rolling(20).max(),
            "ADX > 20": X.adx(high, low, close)["adx"] > 20,
            "RSI > 50": I.rsi(close) > 50,
            "成交量高于 20 日中位": df["volume"] > df["volume"].rolling(20).median()}


picked = conditions(spy)
print("SPY 上,两两「同时成立」的程度(对角线是各自成立的比例):")
print(R.overlap(picked).round(3).to_string())
pairs = [("金叉状态(50 在 200 上方)", "收盘价在 200 日均线上方"), ("金叉状态(50 在 200 上方)", "RSI > 50"),
         ("收盘创 20 日新高", "成交量高于 20 日中位")]
for a, b in pairs:
    both = X.agreement(picked[a].astype(float), picked[b].astype(float))
    print(f"{a} 对 {b}:一致 {both['share']:.1%},kappa {both['kappa']:.3f}")
SPY 上,两两「同时成立」的程度(对角线是各自成立的比例):
                   金叉状态(50 在 200 上方)  收盘价在 200 日均线上方  收盘创 20 日新高  ADX > 20  RSI > 50  成交量高于 20 日中位
金叉状态(50 在 200 上方)              0.752           0.875       0.227     0.516     0.593         0.431
收盘价在 200 日均线上方                 0.875           0.746       0.258     0.471     0.680         0.415
收盘创 20 日新高                     0.227           0.258       0.233     0.206     0.328         0.142
ADX > 20                       0.516           0.471       0.206     0.604     0.453         0.366
RSI > 50                       0.593           0.680       0.328     0.453     0.711         0.322
成交量高于 20 日中位                   0.431           0.415       0.142     0.366     0.322         0.479
金叉状态(50 在 200 上方) 对 收盘价在 200 日均线上方:一致 90.0%,kappa 0.735
金叉状态(50 在 200 上方) 对 RSI > 50:一致 62.7%,kappa 0.051
收盘创 20 日新高 对 成交量高于 20 日中位:一致 46.5%,kappa -0.094
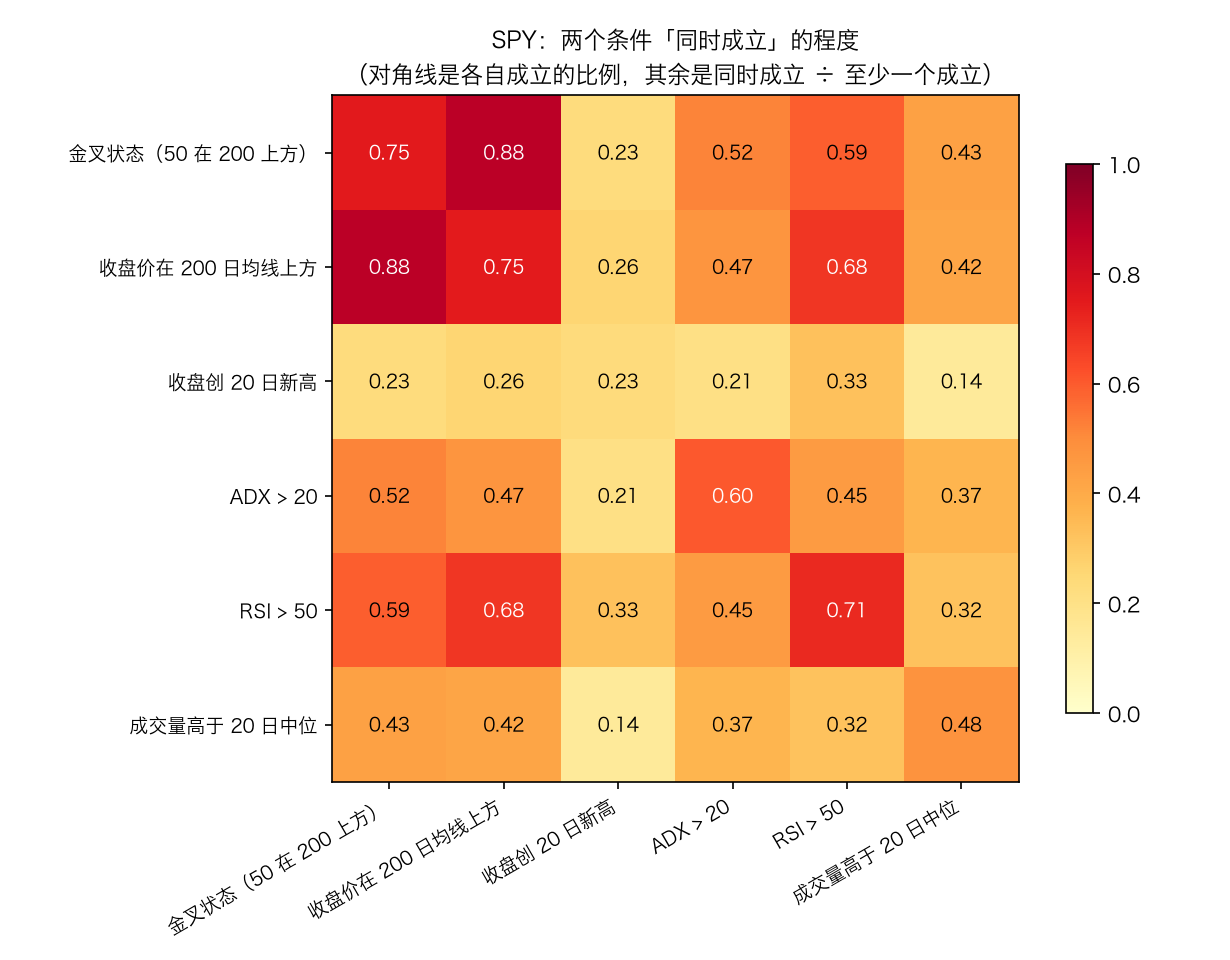
- 「金叉状态」和「收盘价在 200 日均线上方」有 88% 的时间同时成立,逐根比一致率 90.0%、kappa 0.735。这两个条件基本是同一句话说两遍。 叠加它们不会让信号更可靠,只会让交易次数少一点。
- 「金叉状态」和「RSI > 50」的一致率 62.7%,但 kappa 只有 0.051——扣掉「两个条件各自成立的比例本来就高,随便撞也能撞上」之后,它们几乎不相关。这一对是真的在说两件事。
- 「收盘创 20 日新高」和「放量」的 kappa 是 -0.094:在 SPY 上,创新高的那天反而不太放量。
⚠️ 一致率(share)和 kappa 要一起看。两个条件各有七成时间成立,随便撞也有 58% 的一致率;kappa 就是把这部分扣掉之后剩下的。第 11 篇的实验一用过同一个指标比较手工标注和自动标注。
6.2 条件越多,交易越少,结论越不可靠
一条条加上去,每加一条还剩多少根 K 线、还剩多少笔交易:
order = list(picked)
print(R.stack(picked, order).to_string(index=False, float_format=lambda v: f"{v:.3f}"))
rows = []
for depth in range(1, len(order) + 1):
    mask = None
    for name in order[:depth]:
        mask = picked[name] if mask is None else (mask & picked[name])
    rule = R.Rule(entry=mask.fillna(False), exit=deaths(spy), stop="chandelier")
    returns, held, trades = R.run(spy, rule)
    profits = trades["收益"].to_numpy()
    if len(profits) >= 2:
        boot = np.array([rng.choice(profits, len(profits), replace=True).mean() for _ in range(2000)])
        low, high = np.percentile(boot, [2.5, 97.5])
    else:
        low = high = np.nan
    rows.append({"条件数": depth, "最后加的": order[depth - 1], "交易次数": len(trades),
                 "每笔平均收益": profits.mean() if len(profits) else np.nan,
                 "95% 区间": f"{low:+.1%} ~ {high:+.1%}", "区间宽度": high - low,
                 "年化": (1 + returns).prod() ** (252 / len(returns)) - 1, "在场时间": (held > 0).mean()})
print(pd.DataFrame(rows).to_string(index=False, float_format=lambda v: f"{v:.3f}"))
            加上的条件  还剩的 K 线   占全部
金叉状态(50 在 200 上方)     1889 0.752
   收盘价在 200 日均线上方     1757 0.699
       收盘创 20 日新高      458 0.182
         ADX > 20      288 0.115
         RSI > 50      288 0.115
     成交量高于 20 日中位      110 0.044
 条件数              最后加的  交易次数  每笔平均收益        95% 区间  区间宽度    年化  在场时间
   1 金叉状态(50 在 200 上方)    76   0.010 -0.3% ~ +2.4% 0.027 0.061 0.757
   2    收盘价在 200 日均线上方    70   0.009 -0.3% ~ +2.2% 0.026 0.055 0.721
   3        收盘创 20 日新高    39   0.009 -0.5% ~ +2.4% 0.029 0.030 0.492
   4          ADX > 20    30   0.004 -1.1% ~ +2.0% 0.032 0.010 0.334
   5          RSI > 50    30   0.004 -1.1% ~ +2.1% 0.032 0.010 0.334
   6      成交量高于 20 日中位    24   0.001 -1.2% ~ +1.7% 0.029 0.001 0.254
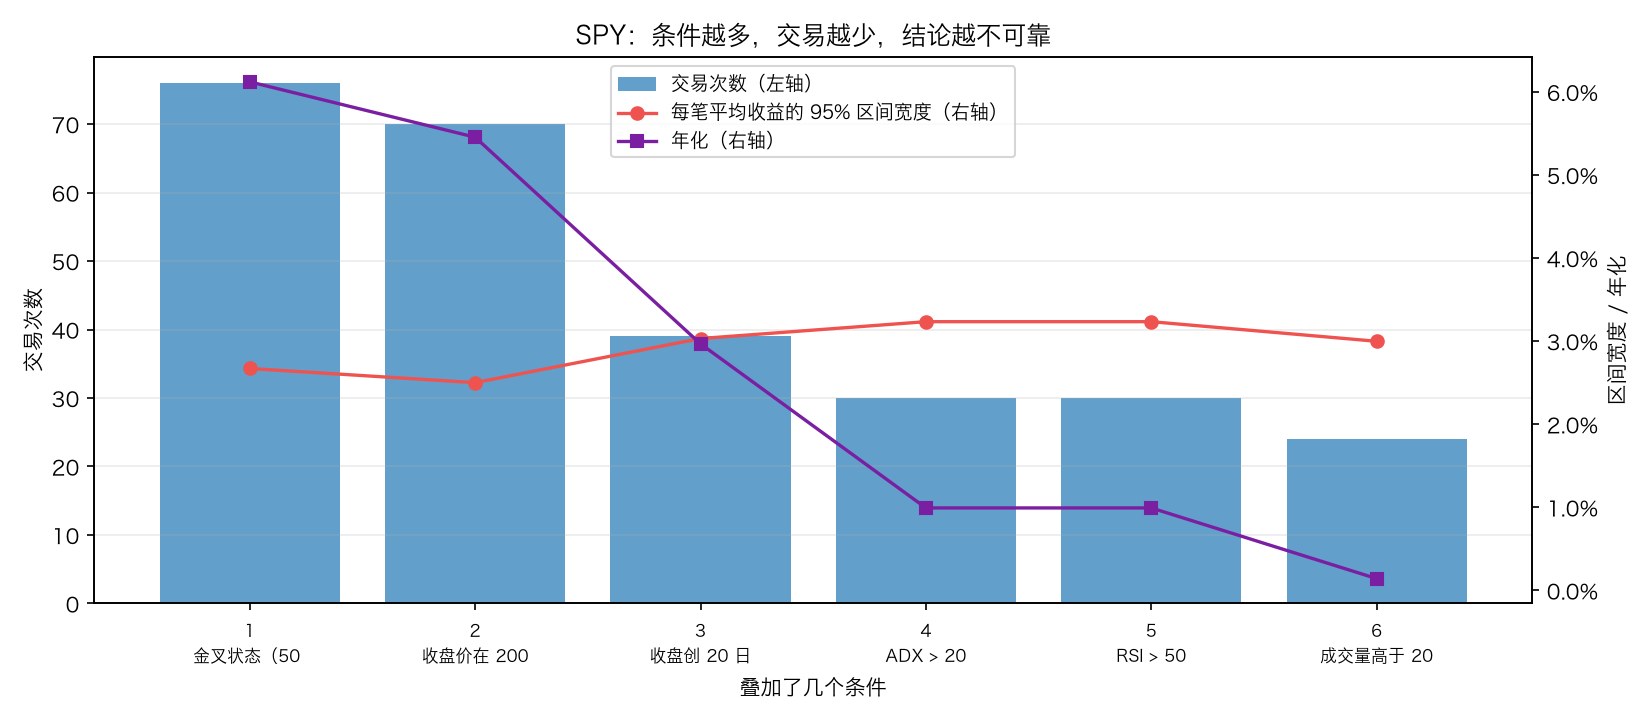
三件事同时发生:
- 有的条件一根 K 线都没删掉。 加到第五条「RSI > 50」时,还剩的 K 线还是 288 根——前四条已经把 RSI 低于 50 的日子全筛掉了。这条件在这里是纯冗余:它让规则看起来更严谨,实际上什么也没做。
- 交易次数从 76 掉到 24。
- 每笔平均收益从 +1.0% 掉到 +0.1%,而 95% 区间从头到尾都跨着零(最窄的一次是 -0.2% 到 +2.2%)。加条件没有让结论变可靠,只是让样本变小。
「多重确认」的真实代价:你用样本量换了一个更好看的故事。 24 笔交易上的任何结论都不足以下判断——第 30 篇会把这件事说透。
七、动手:talab.rules
新模块只做两件事:把六要素写成一个数据结构,以及按它跑一遍历史。
"""talab.rules:把一个想法写成一条能执行的规则。第 21 篇。

「金叉买入」不是规则,是一个想法。规则要能让另一个人(或者一段程序)在不问你的情况下照做,
它至少要回答六个问题:

1. **环境过滤**(environment):什么时候允许开新仓?
2. **入场条件**(entry):什么信号算数?
3. **入场方式**(fill):用什么价格买?
4. **初始止损**(stop):跌到哪里认错?
5. **出场规则**(exit):什么时候正常离场?
6. **仓位**(sizing):买多少?

`Rule` 把这六个问题写成六组字段,`run` 按它跑一遍历史。这里**不算成本、不算滑点**,
也没有做偏差检查——那是第 27 到 29 篇的事。
"""
一、六要素的 Rule
@dataclass
class Rule:
    """一条完整的交易规则(只做多)。

    entry / exit / environment 都是逐根 K 线的布尔序列,第 k 个值只能用第 k 根及之前的数据算出来。
    默认值也是选择:不写 stop 不等于「没想过止损」,而是选了「chandelier」。
    """
    entry: pd.Series                                  # 二、入场条件:收盘时信号成立
    exit: pd.Series                                   # 五、出场规则:收盘时该走了(止损之外的出场)
    environment: pd.Series | None = None              # 一、环境过滤:这根 K 线允许开新仓吗
    fill: str = "next_open"                           # 三、入场方式
    pullback_to: pd.Series | None = None              # fill="pullback" 时的限价(比如 50 日均线)
    pullback_bars: int = 10                           # 限价单挂多少根 K 线,过期不候
    stop: str = "chandelier"                          # 四、初始止损
    k: float = 3.0                                    # chandelier:最高价往下几个 ATR
    stop_percent: float = 0.10                        # percent:进场价往下百分之几
    trigger: str = "close"                            # 止损用收盘价还是盘中最低价触发(第 20 篇)
    sizing: str = "full"                              # 六、仓位
    risk_per_trade: float = 0.01                      # sizing="risk":一笔最多亏账户的百分之几
    atr_period: int = 14

    def __post_init__(self):
        for name, value, allowed in [("fill", self.fill, FILLS), ("stop", self.stop, STOPS),
                                     ("sizing", self.sizing, SIZINGS)]:
            if value not in allowed:
                raise ValueError(f"{name} 只能是 {allowed} 之一,收到 {value!r}")
        if self.fill == "pullback" and self.pullback_to is None:
            raise ValueError("fill=\"pullback\" 要给出挂限价单的价格(pullback_to)")
        if self.sizing == "risk" and self.stop == "none":
            raise ValueError("没有止损就算不出每笔的风险,sizing=\"risk\" 需要一个止损")

    def describe(self) -> pd.Series:
        """把六要素列出来,用来检查「这条规则真的写完了吗」。"""
        return pd.Series({
            "一、环境过滤": "不过滤" if self.environment is None else "有",
            "二、入场条件": "给定的信号序列",
            "三、入场方式": {"close": "当根收盘价", "next_open": "下一根开盘价",
                             "pullback": f"回调到指定价格的限价单,{self.pullback_bars} 根内有效"}[self.fill],
            "四、初始止损": {"none": "没有", "chandelier": f"{self.k} 倍 ATR 吊灯({self.trigger} 触发)",
                             "percent": f"进场价下方 {self.stop_percent:.0%}({self.trigger} 触发)"}[self.stop],
            "五、出场规则": "给定的出场信号",
            "六、仓位": "满仓" if self.sizing == "full" else f"每笔风险 {self.risk_per_trade:.0%}",
        })
三个细节值得说:
- 默认值也是选择。 不写
stop不等于「没想过止损」,而是选了 3 ATR 吊灯。describe()把六格全打印出来,就是为了让你看见自己做了什么选择。 - 有些组合在逻辑上就不成立,直接报错:
fill="pullback"没给限价、sizing="risk"却不设止损(没有止损就算不出每笔的风险)。 - 布尔序列的第 k 个值只能用第 k 根及之前的数据算出来。这是第 12 篇以来的老规矩,
run里的test_run_never_uses_the_future也守着它。
二、按规则跑一遍
def run(df: pd.DataFrame, rule: Rule) -> tuple[pd.Series, pd.Series, pd.DataFrame]:
    """按规则跑一遍历史,返回(每根 K 线的收益率、是否持仓、每笔交易)。

    约定:信号在收盘时算出来,最快也要等到下一根才能成交(fill="close" 是个例外,它假设
    你能在收盘那一刻成交,第 12 篇量过这个假设有多贵)。没有成本、没有滑点。

    最后一根 K 线还持有的仓位会以「未平仓」的名义记进交易表,按最后的收盘价估值——不这样做的话,
    「每笔交易的平均收益」这类统计会悄悄漏掉还没结束的那一笔。

    仓位是进场时算好的一个比例,每根 K 线的收益率 = 仓位比例 × 价格变化。
    ⚠️ 写成这样等于**每根 K 线都把仓位调回那个比例**:满仓时看不出来,不满仓时会和
    「买进之后数量不变」的真实账户差一点点(第 27 篇的引擎把这笔账对出来了,九年差约 0.5%)。
    真正的仓位管理(加仓、减仓、组合风险)是第 26 篇。
    fill="pullback" 的限价挂在**信号那一天**的 pullback_to 上,挂 pullback_bars 根 K 线,过期作废。
    """
    o, h, l, c = (df[x].to_numpy(float) for x in ["open", "high", "low", "close"])
    atr = _atr(df, rule.atr_period) if rule.stop == "chandelier" else np.full(len(c), np.nan)
    entry = rule.entry.reindex(df.index).fillna(False).to_numpy(bool)
    leave = rule.exit.reindex(df.index).fillna(False).to_numpy(bool)
    allowed = (np.ones(len(c), bool) if rule.environment is None
               else rule.environment.reindex(df.index).fillna(False).to_numpy(bool))
    limit = (np.full(len(c), np.nan) if rule.pullback_to is None
             else rule.pullback_to.reindex(df.index).to_numpy(float))
    first = int(np.argmax(~np.isnan(atr))) + 1 if rule.stop == "chandelier" else 1   # 用不到 ATR 就不用等预热
    returns, held, trades = np.zeros(len(c)), np.zeros(len(c)), []
    holding = False
    waiting = -1                                          # 等着成交的信号出现在第几根,-1 是没有
    size = stop_price = entry_price = highest = np.nan
    entry_i = -1

    def stop_level(i: int, previous: float) -> float:
        """止损价。吊灯只上移不下移,所以要和之前的止损价取大。"""
        if rule.stop == "none":
            return -np.inf
        if rule.stop == "percent":
            return entry_price * (1 - rule.stop_percent)
        return max(previous, highest - rule.k * atr[i - 1])

    for i in range(first, len(c)):
        if not holding and waiting >= 0:                  # 这一根尝试成交
            price = None
            if rule.fill == "next_open":
                price = o[i]
            elif rule.fill == "pullback":
                level = limit[waiting]
                if o[i] <= level:
                    price = o[i]                          # 开盘就在限价下方,按开盘价成交
                elif l[i] <= level:
                    price = level
                elif i - waiting >= rule.pullback_bars:
                    waiting = -1                          # 挂单过期
            if price is not None:
                holding, entry_price, entry_i, highest = True, price, i, price
                stop_price = stop_level(i, -np.inf)
                distance = 1 - stop_price / entry_price
                size = 1.0 if rule.sizing == "full" else min(1.0, rule.risk_per_trade / max(distance, 1e-9))
                waiting = -1
        if holding:
            held[i] = size
            stop_price = stop_level(i, stop_price)
            base = entry_price if i == entry_i else c[i - 1]
            price = reason = None
            if leave[i - 1]:                              # 昨天收盘发出的出场信号,今天开盘执行
                price, reason = o[i], "出场信号"
            elif rule.trigger == "low" and l[i] <= stop_price:
                price, reason = (o[i] if o[i] <= stop_price else stop_price), "止损"
            elif rule.trigger == "close" and c[i] <= stop_price:
                price, reason = c[i], "止损"
            if reason is None:
                returns[i], highest = size * (c[i] / base - 1), max(highest, h[i])
            else:
                returns[i] = size * (price / base - 1)
                trades.append((df.index[entry_i], entry_price, df.index[i], price, reason, size))
                holding = False
        if not holding and waiting < 0 and entry[i] and allowed[i]:
            if rule.fill == "close":                      # 当根收盘就买,下一根开始算收益
                holding, entry_price, entry_i, highest = True, c[i], i, c[i]
                stop_price = stop_level(i, -np.inf)
                distance = 1 - stop_price / entry_price
                size = 1.0 if rule.sizing == "full" else min(1.0, rule.risk_per_trade / max(distance, 1e-9))
            else:
                waiting = i
    if holding:                                           # 最后一根还拿着:记成一笔未平仓的交易,按最后的收盘价估值
        trades.append((df.index[entry_i], entry_price, df.index[-1], c[-1], "未平仓", size))
    index = df.index[first:]
    trades = pd.DataFrame(trades, columns=["买入日", "买入价", "卖出日", "卖出价", "原因", "仓位"])
    trades["收益"] = trades["卖出价"] / trades["买入价"] - 1
    return pd.Series(returns[first:], index=index), pd.Series(held[first:], index=index), trades
⚠️ 这里有一个容易漏掉的细节:最后一根 K 线还持有的仓位,要记成一笔「未平仓」的交易。不这样做的话,「每笔平均收益」这类统计会悄悄漏掉还没结束的那一笔——而那一笔往往正是最赚钱的(趋势策略最长的持仓通常还开着)。
三、条件的重合与叠加
def overlap(conditions: dict[str, pd.Series]) -> pd.DataFrame:
    """两两之间「同时成立」的程度:对角线是各自成立的比例,上三角是同时成立占其中之一的比例(Jaccard)。

    两个条件几乎总是一起成立,叠加起来就不增加信息,只是让交易次数变少。
    """
    names = list(conditions)
    out = pd.DataFrame(np.nan, index=names, columns=names, dtype=float)
    for a in names:
        left = conditions[a].fillna(False).to_numpy(bool)
        out.loc[a, a] = left.mean()
        for b in names:
            if a == b:
                continue
            right = conditions[b].reindex(conditions[a].index).fillna(False).to_numpy(bool)
            union = (left | right).sum()
            out.loc[a, b] = (left & right).sum() / union if union else np.nan
    return out


def stack(conditions: dict[str, pd.Series], order: list[str] | None = None) -> pd.DataFrame:
    """按顺序一条条加条件,每加一条还剩多少根 K 线成立。"""
    order = order or list(conditions)
    mask, rows = None, []
    for name in order:
        current = conditions[name].fillna(False)
        mask = current if mask is None else (mask & current.reindex(mask.index).fillna(False))
        rows.append({"加上的条件": name, "还剩的 K 线": int(mask.sum()), "占全部": float(mask.mean())})
    return pd.DataFrame(rows)
测试
10 个测试,都能手算。其中这三个是这一篇的核心:
def test_rule_checks_its_own_fields():
    index = pd.date_range("2024-01-01", periods=3, freq="D", tz="UTC")
    empty = pd.Series(False, index=index)
    with pytest.raises(ValueError, match="fill"):
        R.Rule(entry=empty, exit=empty, fill="随便买")
    with pytest.raises(ValueError, match="pullback"):
        R.Rule(entry=empty, exit=empty, fill="pullback")
    with pytest.raises(ValueError, match="止损"):
        R.Rule(entry=empty, exit=empty, stop="none", sizing="risk")
    described = R.Rule(entry=empty, exit=empty).describe()
    assert len(described) == 6 and described["三、入场方式"] == "下一根开盘价"
    assert described["四、初始止损"] == "3.0 倍 ATR 吊灯(close 触发)"     # 默认值也是选择


def test_next_open_and_close_fills_by_hand():
    df = frame([100, 100, 100, 110, 110, 110, 110, 110, 110, 110, 110, 110, 110, 110, 110, 110],
               opens=[100, 100, 100, 105, 110, 110, 110, 110, 110, 110, 110, 110, 110, 110, 110, 110])
    entry, exit_ = flags(df.index, [2]), flags(df.index, [14])
    _, _, next_open = R.run(df, R.Rule(entry=entry, exit=exit_, stop="none"))
    assert next_open.loc[0, "买入价"] == 105                    # 第 3 根收盘出信号,第 4 根开盘 105 成交
    assert next_open.loc[0, "卖出价"] == 110 and next_open.loc[0, "原因"] == "出场信号"
    _, _, at_close = R.run(df, R.Rule(entry=entry, exit=exit_, fill="close", stop="none"))
    assert at_close.loc[0, "买入价"] == 100                     # 当根收盘就买,便宜 5 块,但假设你能在收盘成交
def test_risk_sizing_is_capped_by_the_stop_distance():
    df = frame([100] * 20)
    rule = R.Rule(entry=flags(df.index, [3]), exit=flags(df.index, [18]), stop="percent", stop_percent=0.10,
                  sizing="risk", risk_per_trade=0.01)
    _, held, trades = R.run(df, rule)
    assert trades.loc[0, "仓位"] == pytest.approx(0.1)          # 1% 风险 ÷ 10% 止损距离 = 10% 仓位
    assert held.max() == pytest.approx(0.1)
    wide = R.Rule(entry=flags(df.index, [3]), exit=flags(df.index, [18]), stop="percent", stop_percent=0.005,
                  sizing="risk", risk_per_trade=0.01)
    assert R.run(df, wide)[2].loc[0, "仓位"] == 1.0             # 1% ÷ 0.5% = 2 倍,封顶在满仓
187 passed in 0.63s
没装 TA-Lib 的环境里是 155 passed、32 skipped。
八、揭晓
金叉之后 SPY:2025-07-01 收盘 617.65 → 2026-09-15 收盘 757.39(+22.6%)
这段里最深的一次回撤 -9.1%(2026-03-30),最低收盘 620.34(2025-07-08)

【下一根开盘 + 不设止损 + 死叉出场】金叉至今累计 +21.7%(同期买入持有 +22.6%)
  2025-07-03 买在 622.45,还拿着(按最后收盘价算),这一笔 +21.7%

【下一根开盘 + 3 ATR 吊灯 + 死叉出场】金叉至今累计 +1.2%(同期买入持有 +22.6%)
  2025-07-03 买在 622.45,2025-08-01 以 621.72 出场(止损),这一笔 -0.1%
  2025-08-11 买在 637.46,2025-10-10 以 653.02 出场(止损),这一笔 +2.4%
  2025-10-27 买在 682.73,2025-11-17 以 665.67 出场(止损),这一笔 -2.5%
  2025-12-01 买在 678.81,2026-01-20 以 677.58 出场(止损),这一笔 -0.2%
  2026-01-28 买在 697.05,2026-02-05 以 677.62 出场(止损),这一笔 -2.8%
  2026-04-10 买在 681.32,2026-06-05 以 737.55 出场(止损),这一笔 +8.3%
  2026-07-13 买在 752.47,2026-07-29 以 729.46 出场(止损),这一笔 -3.1%
  2026-08-04 买在 760.63,2026-09-10 以 757.83 出场(止损),这一笔 -0.4%

【回调到 50 日均线 + 3 ATR 吊灯 + 死叉出场】金叉至今累计 +1.9%(同期买入持有 +22.6%)
  2026-01-20 买在 680.01,2026-02-05 以 677.62 出场(止损),这一笔 -0.4%
  2026-07-17 买在 741.24,2026-09-10 以 757.83 出场(止损),这一笔 +2.2%
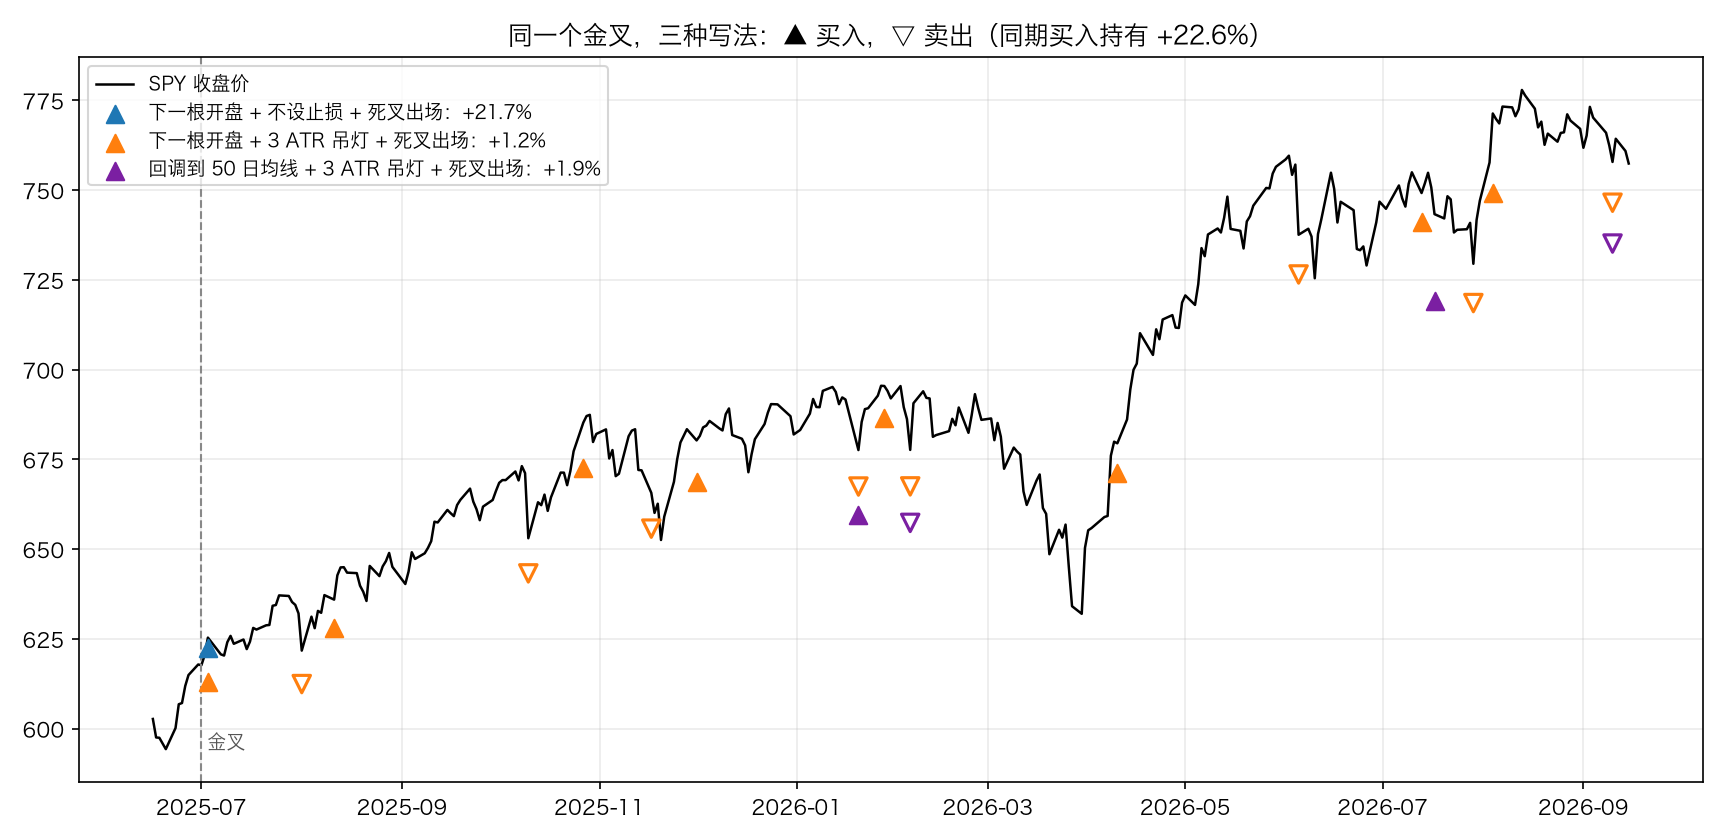
金叉之后这 14 个月,SPY 从 617.65 涨到 757.39(+22.6%),中间最深的一次回撤 -9.1%。三种写法:
- A(不设止损):2025-07-03 以 622.45 买入,一路拿到今天,这一笔 +21.7%,几乎吃到了全部涨幅。
- B(3 ATR 吊灯):同一天以同样的价格买入,一个月后被止损(-0.1%),然后进出了 8 次:-0.1%、+2.4%、-2.5%、-0.2%、-2.8%、+8.3%、-3.1%、-0.4%,累计 +1.2%。
- C(等回调):50 日均线在 5.6% 之下,10 天内没等到,这次金叉直接错过;直到 2026 年 1 月才第一次成交,至今累计 +1.9%。
同一个信号、同一天、同一个标的:+21.7%、+1.2%、+1.9%。 差别全部来自那三个「少许」。
⚠️ 别把这一次的结果读成「止损是错的」。这 14 个月 SPY 涨了 22.6%,在单边上涨里不设止损当然赢——第四节的表已经说了,代价在「最差一笔」和回撤那两列。一次决策点只能告诉你写法有多重要,不能告诉你哪种写法更好。
九、主线策略 v3:六个格子全填上
前面二十篇,主线策略是一格一格长出来的:v0(第 12 篇)填了入场条件和出场规则,v1(第 15 篇)填了止损,v2(第 20 篇)改了止损的触发方式。现在把六格一次写全,每一格附上理由:
def mainline_v3(df):
    """六要素都写出来的主线策略。入场条件把「止损之后要创 20 日新高才买回」这条隐藏规则显式化了。"""
    close = df["close"]
    trend = I.sma(close, 50) > I.sma(close, 200)
    return R.Rule(environment=None,                                  # 一、环境过滤:暂时不加,理由见正文
                  entry=trend & (close >= close.rolling(20).max()),  # 二、入场条件:金叉状态 + 收盘创 20 日新高
                  fill="next_open",                                  # 三、入场方式:下一根开盘市价
                  stop="chandelier", k=3.0, trigger="close",         # 四、初始止损:3 ATR 吊灯,收盘触发(第 20 篇)
                  exit=deaths(df),                                   # 五、出场规则:死叉
                  sizing="full")                                     # 六、仓位:满仓(第 26 篇换成按风险定仓位)
  标的      版本    年化   最大回撤  交易次数  在场时间  买入持有的年化  买入持有的回撤
 SPY v3(六要素) 0.030 -0.123    39 0.492    0.135   -0.341
AAPL v3(六要素) 0.108 -0.279    37 0.434    0.289   -0.385
 BTC v3(六要素) 0.185 -0.477    30 0.238    0.379   -0.832
三个标的上,v3 的年化都低于买入持有(SPY 3.0% 对 13.5%,AAPL 10.8% 对 28.9%,BTC 18.5% 对 37.9%),回撤则小得多(SPY -12.3% 对 -34.1%,BTC -47.7% 对 -83.2%)。这和第 12、15 篇的结论一致:这条主线不是用来赚过买入持有的,它是一个每一步都能被检验的样本。
每一格换一个选择会怎样
    changes = {
        "v3 原样": base,
        "三、入场方式改成当根收盘": R.Rule(**(base.__dict__ | {"fill": "close"})),
        "四、止损改成盘中触发": R.Rule(**(base.__dict__ | {"trigger": "low"})),
        "四、止损从 3 ATR 改成 2 ATR": R.Rule(**(base.__dict__ | {"k": 2.0})),
        "四、止损从 3 ATR 改成 5 ATR": R.Rule(**(base.__dict__ | {"k": 5.0})),
        "五、出场改成跌破 20 日新低": R.Rule(**(base.__dict__ | {"exit": (close <= close.rolling(20).min()).fillna(False)})),
        "二、入场去掉「创 20 日新高」": R.Rule(**(base.__dict__ | {"entry": I.sma(close, 50) > I.sma(close, 200)})),
        "一、加上环境过滤 ADX > 20": R.Rule(**(base.__dict__ | {"environment": X.adx(df["high"], df["low"], close)["adx"] > 20})),
    }
    for label, rule in changes.items():
        returns, held, trades = R.run(df, rule)
        equity = (1 + returns).cumprod()
        rows.append({"标的": name, "改动": label, "年化": equity.iloc[-1] ** (periods / len(returns)) - 1,
                     "最大回撤": (equity / equity.cummax() - 1).min(), "交易次数": len(trades)})
sensitivity = pd.DataFrame(rows).pivot_table(index="改动", columns="标的", values=["年化", "交易次数"])
print(sensitivity.round(3).to_string())

print("\n「创 20 日新高」这条入场条件在管什么:止损出场之后,隔多少根 K 线又买回来")
for name, df, periods in markets:
    close = df["close"]
    for label, rule in [("v3(要等 20 日新高)", mainline_v3(df)),
                        ("去掉这一条", R.Rule(**(mainline_v3(df).__dict__ | {"entry": I.sma(close, 50) > I.sma(close, 200)})))]:
        _, _, trades = R.run(df, rule)
        gaps = []
        for k in range(len(trades) - 1):
            if trades["原因"].iloc[k] == "止损":
                gaps.append(df.index.get_loc(trades["买入日"].iloc[k + 1]) - df.index.get_loc(trades["卖出日"].iloc[k]))
        stops = int((trades["原因"] == "止损").sum())
        print(f"  {name} {label}:{stops} 次止损,之后买回的间隔中位数 {np.median(gaps):.0f} 根,"
              f"3 根之内就买回的占 {np.mean(np.array(gaps) <= 3):.0%}")
                      交易次数                 年化
标的                    AAPL   BTC   SPY   AAPL    BTC    SPY
改动
v3 原样                 37.0  30.0  39.0  0.108  0.185  0.030
一、加上环境过滤 ADX > 20     33.0  25.0  30.0  0.057  0.211  0.010
三、入场方式改成当根收盘          37.0  30.0  39.0  0.116  0.186  0.033
二、入场去掉「创 20 日新高」      73.0  64.0  76.0  0.161  0.179  0.061
五、出场改成跌破 20 日新低       37.0  31.0  39.0  0.112  0.192  0.031
四、止损从 3 ATR 改成 2 ATR  63.0  42.0  61.0  0.054  0.186  0.016
四、止损从 3 ATR 改成 5 ATR  25.0  21.0  25.0  0.111  0.144  0.039
四、止损改成盘中触发            46.0  41.0  49.0  0.090  0.085  0.027
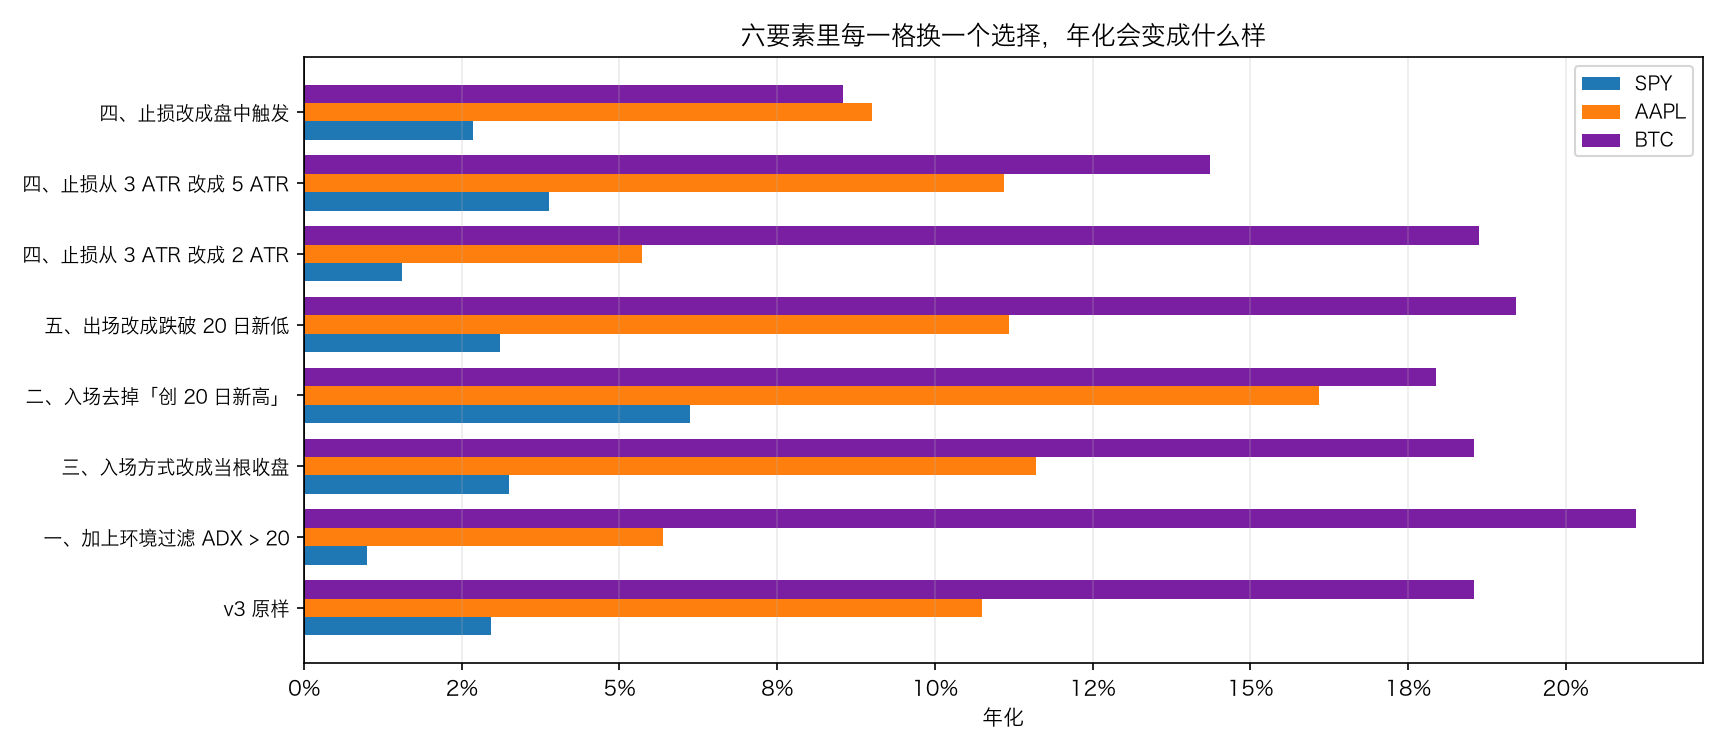
- 「入场去掉创 20 日新高」三个标的的年化都变高了(SPY 3.0% → 6.1%,AAPL 10.8% → 16.1%)。看起来应该去掉。
- 「止损改成盘中触发」三个标的都变差(BTC 18.5% → 8.5%),和第 20 篇的结论一致。
- 「加上 ADX > 20 的环境过滤」在 BTC 上略好(18.5% → 21.1%),在 SPY 和 AAPL 上明显更差(3.0% → 1.0%,10.8% → 5.7%)。一格改动在三个标的上方向不一致,就不该改。
回到第一条:那为什么不去掉「创 20 日新高」?看看去掉之后止损是怎么工作的:
「创 20 日新高」这条入场条件在管什么:止损出场之后,隔多少根 K 线又买回来
  SPY v3(要等 20 日新高):39 次止损,之后买回的间隔中位数 20 根,3 根之内就买回的占 0%
  SPY 去掉这一条:72 次止损,之后买回的间隔中位数 1 根,3 根之内就买回的占 99%
  AAPL v3(要等 20 日新高):36 次止损,之后买回的间隔中位数 18 根,3 根之内就买回的占 3%
  AAPL 去掉这一条:68 次止损,之后买回的间隔中位数 1 根,3 根之内就买回的占 99%
  BTC v3(要等 20 日新高):28 次止损,之后买回的间隔中位数 28 根,3 根之内就买回的占 0%
  BTC 去掉这一条:55 次止损,之后买回的间隔中位数 1 根,3 根之内就买回的占 100%
去掉之后,99%–100% 的止损在 3 根 K 线之内就买回来了,间隔的中位数是 1 根。 也就是说:今天被止损出场,明天就买回来——止损变成了一次来回手续费,什么都没保护到。留着这条件,买回的间隔中位数是 18 到 28 根。
所以 v3 保留它,理由和第 20 篇选收盘价触发一样:不是因为回测数字更好,是因为去掉之后这条规则的另一格(止损)就失效了。六个要素是互相咬合的,不能一格一格单独优化。
v3 的六要素,写下来是这样:
| # | 要素 | v3 的选择 | 理由 |
|---|---|---|---|
| 一 | 环境过滤 | 不过滤 | 加 ADX > 20 在三个标的上方向不一致(第九节) |
| 二 | 入场条件 | 50 日均线在 200 日均线上方,且收盘创 20 日新高 | 第二个条件让止损真的起作用 |
| 三 | 入场方式 | 下一根开盘市价 | 收盘价成交是做不到的假设(第 12 篇) |
| 四 | 初始止损 | 3 ATR 吊灯,收盘价触发 | 收盘触发不在薄流动性的那一分钟成交(第 20 篇) |
| 五 | 出场规则 | 死叉 | 和入场条件同源,不额外引入参数 |
| 六 | 仓位 | 满仓 | 占位:第 26 篇换成按风险定仓位 |
⚠️ 这张表里没有一格是「因为这样回测最好看」。第 27 到 30 篇会讲,用回测结果挑参数是怎么把自己骗进去的。
十、常见误用
1. 把一个想法当成一条规则。 「金叉买入」「突破买入」「超卖买入」都不是规则,是信号。六个格子不填满,两个人做出来的结果可以差 20 个百分点。
2. 报告回测结果时不附规则。 「年化 20%」必须跟着六要素一起出现,否则别人无法复现,你自己三个月后也复现不了。
3. 以为「多重确认」更稳。 金叉和站上 200 日均线有 88% 的时间同时成立(kappa 0.735);在 SPY 上加第五个条件时一根 K 线都没少。冗余条件不增加信息,只减少样本。
4. 一格一格单独优化。 六要素是咬合的:去掉「创 20 日新高」年化更高,但止损随即失效(99% 的止损三天内买回)。改一格之前先问:这一格是在支撑哪一格。
5. 用「不设止损」的回测说服自己不用止损。 在单边上涨的十年里,不设止损当然赢;代价写在「最差一笔」和「最大回撤」那两列里,而下一个十年不保证还是单边上涨。
6. 限价单不写有效期。 「回调到均线买」如果不写「10 天内有效」,回测里就可以无限等下去——等到的永远是「后来涨上去了的那次回调」。
7. 忘了未平仓的那一笔。 趋势策略最长、最赚钱的一笔往往还开着。统计里漏掉它,胜率和平均收益会难看得莫名其妙。
十一、小结
- 一条能执行的规则要回答六个问题:环境过滤、入场条件、入场方式、初始止损、出场规则、仓位。少一个,别人就没法照做。
- 同一个金叉信号,18 种补全方式:SPY 年化 0.1% 到 7.4%,AAPL 10.8% 到 15.3%,BTC -17.3% 到 +23.5%。这叫规则设定风险。
- 这次金叉之后 14 个月:不设止损 +21.7%,3 ATR 吊灯进出八次 +1.2%,等回调错过整段 +1.9%,买入持有 +22.6%。
- 止损买的是「最差一笔」的上限,不是收益:三个标的上不设止损的年化都不低,但最差一笔和最大回撤都更难看。
- 在一个标的上挑出来的写法换个标的就不一定灵:AAPL 和 BTC 的写法排名秩相关只有 0.27。
- 条件叠加先看重合度:金叉和站上 200 日均线 kappa 0.735(几乎同一句话),金叉和 RSI > 50 只有 0.051(真的在说两件事)。加第五个条件时一根 K 线都没少。
- 条件越多,交易次数从 76 掉到 24,每笔平均收益从 +1.0% 掉到 +0.1%,95% 区间始终跨着零。
- 主线 v3 六格全填,每一格写明理由;其中「收盘创 20 日新高」留着不是因为回测好看,而是去掉之后 99% 的止损三天内就买回来,止损形同虚设。
练习
- 补全你自己的想法:挑一句你听过的交易说法(「跌破 20 日均线就卖」「放量突破买入」),用
Rule把六格填满,在三个标的上跑一遍。哪一格最难填? - 扩大网格:把入场方式加一个「突破信号当天最高价」,把出场加一个「持有 60 根 K 线就走」,重跑第四节。年化的分布变宽还是变窄?
- 止损的代价:对 18 种写法,画出「年化」对「最差一笔」的散点图。有没有哪种写法在两个维度上都占优?
- 条件是不是冗余:把第六节的六个条件换成你常用的六个,算重合矩阵和 kappa。有没有两个条件的 kappa 超过 0.7?
- 叠加顺序:第 6.2 节按固定顺序叠加。换几种顺序重跑,「一根都没少」的那一条会变吗?
- 未平仓的影响:把
run里记录未平仓交易的那两行去掉,重算第四节的「最差一笔」和交易次数。哪些数字变了? - 仓位那一格:把 v3 的
sizing换成"risk"(每笔风险 1%),比较资金曲线。年化和回撤各变了多少?(这是第 26 篇的预习。)
小检查答案
小检查 1
(a) 「RSI 低于 30 就买」只填了第二格(入场条件),而且还没写清楚是哪个周期的 RSI、几根 K 线的参数。剩下五格——环境过滤、入场方式、止损、出场规则、仓位——全是空的。顺便:「低于 30」是上穿 30 那一刻买,还是只要低于 30 就一直买?这也没说。
(b) 属于第三格(入场方式)。不写有效期,回测里这张限价单可以无限等下去,最后成交的永远是「后来确实回调了」的那些次——这是一种隐蔽的未来函数。Rule 里的 pullback_bars 就是逼你写出来。
(c) 止损距离 10%,一笔最多亏 1,000 美元,所以仓位 = 1,000 ÷ 10% = 1 万美元(账户的 10%)。注意这和「买 10% 仓位」不是一回事:如果止损距离改成 5%,同样 1% 的风险对应的仓位就变成 2 万美元。