| 本篇位置 | 第五部分「从信号到交易」第七篇。第 24 篇讲杠杆怎么把你赶出场,这一篇讲整个市场的杠杆:有多少、贵不贵、什么时候被清一次 |
| 用到的数据 | BTCUSDT 永续合约的持仓量与多空比(5 分钟一条、63 万条,2020-09 起)、7,305 次资金费率结算、349 万根 1 分钟溢价指数、永续与现货日线 |
| 动手 | 新模块 talab.derivs:align、funding_from_premium、annualize、basis、regimes、deleveraging,附 10 个测试 |
| 读完你能 | 自己把交易所的资金费率算出来;说清持仓量、溢价、费率三者的关系;判断一个「情绪指标」到底在统计什么 |
一、先做一个决定
2021 年 4 月 13 日收盘,你手上没有仓位,屏幕上有三个数:
2021-04-08 00:00:00+00:00  58122.26  0.038     19.344     0.092  0.336
2021-04-09 00:00:00+00:00  58176.03  0.001     18.820     0.068  0.247
2021-04-10 00:00:00+00:00  59832.43  0.028     20.202     0.281  1.027
2021-04-11 00:00:00+00:00  60090.20  0.004     20.727     0.292  1.066
2021-04-12 00:00:00+00:00  59911.18 -0.003     21.499     0.294  1.075
2021-04-13 00:00:00+00:00  63649.71  0.062     24.461     0.297  1.083
2021-04-13:收盘 63,649.71(当天 +6.2%,历史新高),持仓价值 24.46 亿美元
  持仓价值在此前的历史上排第 1 高(也就是新高)
  当天三次结算的资金费合计 0.297%,折成年化 108%,在此前的历史上处于 94.5% 分位
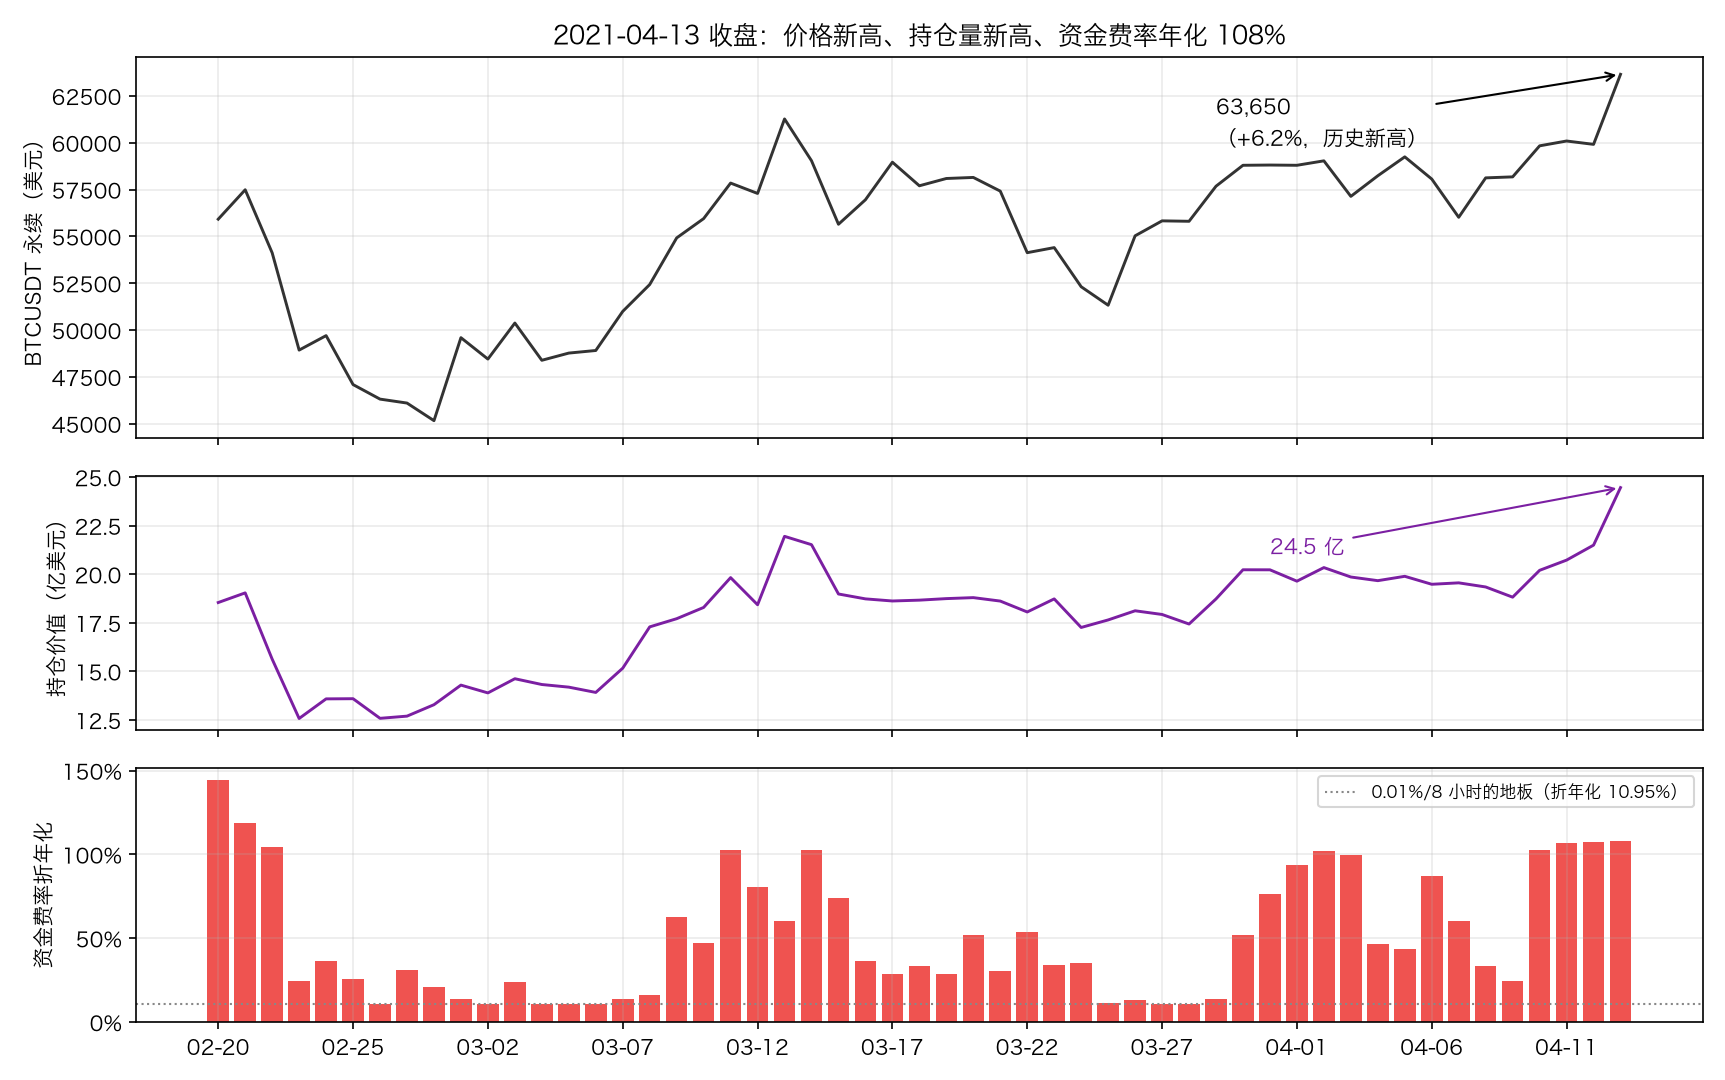
三个数同时在极值上:
- 价格创了历史新高(当天 +6.2%)
- 持仓价值创了历史新高,24.5 亿美元
- 资金费率折成年化 108%——多头每天要付给空头 0.3%
(第二天就是 Coinbase 上市的日子。)
怎么读这三个数?
- A. 趋势确认。价格新高 + 持仓量新高 = 新资金在进场,跟。
- B. 拥挤警告。多头愿意付 108% 的年息也要做多,这是见顶的样子,别碰。
- C. 这三个数说的是同一件事,不能当成三个独立的证据。
先写下你的选择。 第十一节揭晓这一次发生了什么,第七、八节告诉你这种情形一般会发生什么——两者不一样。
二、打个比方:拔河
永续合约市场是一场拔河。
绳子两头各站着一群人。每一张合约都是一个多头和一个空头,所以绳子两边的人数永远严格相等——不是「大致相等」,是恒等式。
于是三个数各有各的含义:
- 持仓量=绳子上一共有多少对人在拉。它要增加,必须同时来一个新的多头和一个新的空头;要减少,必须有一对人同时松手。
- 成交量=这一分钟有多少人换了手。老张走了小王顶上,绳子上还是那么多人——换手不改变人数。这就是为什么持仓量和成交量是两个数,而且可以朝相反的方向动。
- 资金费率=想站多头那边的人太多,绳子被拉偏了(合约价格高于现货),于是多头要掏钱雇人去站空头那边。费率就是这份雇佣费的价钱。
- 强平=有人力气不够被拖倒、被拖出场。他一走,他那一侧的力量突然消失,绳子猛地窜向另一边——这就是第 2 篇说的被迫交易者,只不过这次我们能在数据里看见他们。
这个比方还能解释一个常见的误会。有人说「多空比 2.0,说明散户在疯狂做多」。可绳子两边人数恒等,多空持仓量永远是 1:1,哪来的 2.0?第八节会看到,交易所统计的其实是别的东西。
三、持仓量不是成交量
先把这两个数分清楚,因为后面全靠它。
compare = pd.DataFrame({"收盘": close, "日涨幅": close.pct_change(),
                        "成交额(亿美元)": perp["quote_volume"] / 1e8,
                        "持仓价值(亿美元)": oi_value / 1e8,
                        "持仓量变化": oi_value.pct_change()}).loc["2021-04-16":"2021-04-20"]
print(compare.round(3).to_string())
big = pd.Timestamp("2021-04-18", tz="UTC")
print(f"\n2021-04-18:成交额 {perp['quote_volume'][big] / 1e8:.0f} 亿美元,是前一天的 "
      f"{perp['quote_volume'][big] / perp['quote_volume'][big - pd.Timedelta('1D')]:.1f} 倍;"
      f"持仓价值却从 {oi_value[big - pd.Timedelta('1D')] / 1e8:.1f} 亿掉到 {oi_value[big] / 1e8:.1f} 亿"
      f"({oi_value.pct_change()[big]:.1%})")
print("成交量大=换手多,持仓量掉=仓位在成对离场。同一天两件事可以同时发生。")
2021-04-16 00:00:00+00:00  61424.67 -0.029   157.404     21.421 -0.064
2021-04-17 00:00:00+00:00  60090.14 -0.022   118.625     21.209 -0.010
2021-04-18 00:00:00+00:00  56140.05 -0.066   290.257     15.903 -0.250
2021-04-19 00:00:00+00:00  55634.39 -0.009   159.804     15.099 -0.051
2021-04-20 00:00:00+00:00  56410.56  0.014   179.363     15.892  0.053

2021-04-18:成交额 290 亿美元,是前一天的 2.4 倍;持仓价值却从 21.2 亿掉到 15.9 亿(-25.0%)
成交量大=换手多,持仓量掉=仓位在成对离场。同一天两件事可以同时发生。
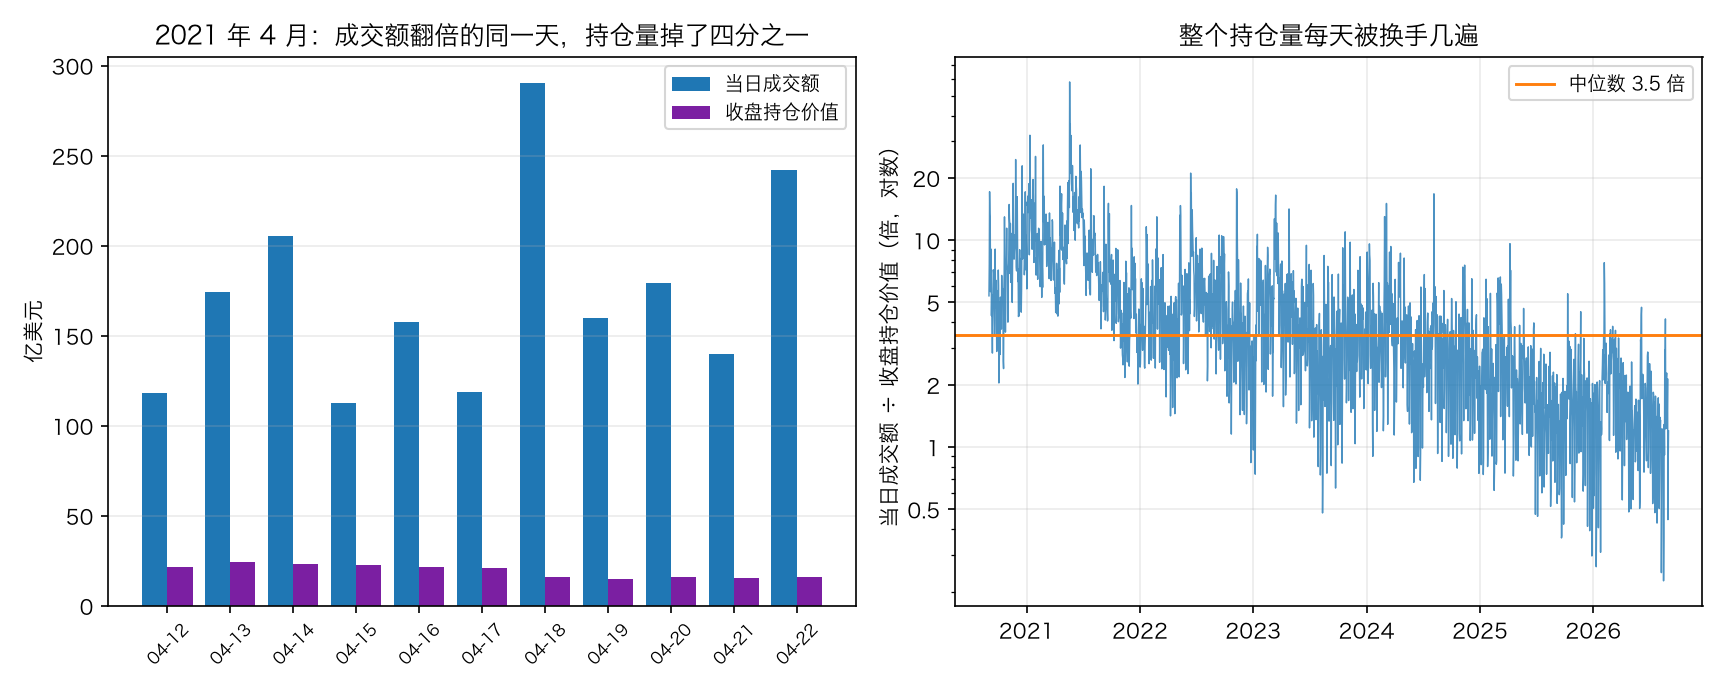
2021 年 4 月 18 日:成交额 290 亿美元,是前一天的 2.4 倍;持仓价值却从 21.2 亿掉到 15.9 亿,一天少了四分之一。
一天之内成交了 290 亿,而绳子上的人少了四分之一——这两件事一点也不矛盾:那 290 亿里有很大一部分是平仓的成交(一个多头和一个空头同时离场,成交量 +1,持仓量 −1)。
右边那张图是这两个数的比值:BTC 永续合约每天的成交额,是收盘持仓价值的好几倍——整条绳子上的人每天要被换掉好几遍。所以「今天成交量创新高」和「现在有多少杠杆挂在市场上」是完全不同的两个问题,后者只有持仓量能回答。
四、价格和持仓量的四种组合
教科书上有一张表,几乎每本讲期货的书里都有:
| 持仓量增加 | 持仓量减少 | |
|---|---|---|
| 价格上涨 | 新多进场,趋势健康 | 空头平仓推动,趋势可疑 |
| 价格下跌 | 新空进场,下跌健康 | 多头平仓,下跌接近尾声 |
这张表的左半边是对的:持仓量增加,确实意味着有新的一对人上场。问题在右半边的那些形容词——「健康」「可疑」「接近尾声」是预测,而上面那句话只是记账。
把它拿到数据上:
regime = V.regimes(close, oi_coins)
print(regime.value_counts().to_string())
rows = []
for label in sorted(regime.dropna().unique()):
    mask = (regime == label).fillna(False)
    starts = mask & ~mask.shift(1, fill_value=False)             # 连着的算一段,只取段首
    for horizon in [1, 5, 20]:
        forward = close.shift(-horizon) / close - 1
        picked, everyone = forward[starts].dropna(), forward.dropna()
        boot = np.array([rng.choice(picked, len(picked)).mean() for _ in range(2000)])
        rows.append({"组合": label, "之后": f"{horizon} 天", "段数": len(picked),
                     "平均": picked.mean(), "中位数": picked.median(), "胜率": (picked > 0).mean(),
                     "同期全样本平均": everyone.mean(),
                     "95% 区间": f"[{np.percentile(boot, 2.5):+.3f}, {np.percentile(boot, 97.5):+.3f}]"})
print()
print(pd.DataFrame(rows).round(4).to_string(index=False))
⚠️ 这里有一个必须处理的技术细节:相邻几天常常落在同一格里,它们的 20 天窗口几乎完全重叠,直接当成独立样本会把不确定性低估好几倍。所以连着的日子只取段首。
          组合   之后  段数     平均     中位数     胜率  同期全样本平均           95% 区间
价涨 + 仓涨:新多进场  1 天 446 0.0007 -0.0006 0.4843   0.0015 [-0.002, +0.003]
价涨 + 仓涨:新多进场  5 天 444 0.0081  0.0024 0.5225   0.0074 [+0.002, +0.014]
价涨 + 仓涨:新多进场 20 天 442 0.0327  0.0073 0.5362   0.0293 [+0.019, +0.047]
价涨 + 仓跌:空头平仓  1 天 404 0.0011  0.0005 0.5124   0.0015 [-0.002, +0.004]
价涨 + 仓跌:空头平仓  5 天 404 0.0070  0.0009 0.5124   0.0074 [+0.000, +0.013]
价涨 + 仓跌:空头平仓 20 天 398 0.0273  0.0077 0.5251   0.0293 [+0.013, +0.042]
价跌 + 仓涨:新空进场  1 天 397 0.0008  0.0010 0.5264   0.0015 [-0.002, +0.004]
价跌 + 仓涨:新空进场  5 天 397 0.0058  0.0051 0.5592   0.0074 [-0.000, +0.012]
价跌 + 仓涨:新空进场 20 天 396 0.0277  0.0080 0.5455   0.0293 [+0.013, +0.042]
价跌 + 仓跌:多头平仓  1 天 444 0.0025  0.0015 0.5180   0.0015 [-0.000, +0.005]
价跌 + 仓跌:多头平仓  5 天 442 0.0097  0.0065 0.5588   0.0074 [+0.003, +0.016]
价跌 + 仓跌:多头平仓 20 天 439 0.0296  0.0108 0.5444   0.0293 [+0.016, +0.044]
四格之后 20 天的平均收益是 2.73% 到 3.27%,而同期全样本是 2.93%——四个 95% 区间全都把 2.93% 包在里面。换句话说:
知道今天落在哪一格,对预测后面 20 天没有任何帮助。
这不是说这张表是错的,而是说它被用错了。它是一句关于刚刚发生了什么的陈述(这根 K 线上动的主要是新开仓还是平仓),不是一句关于接下来会发生什么的预测。第 8 篇讲趋势、第 13 篇讲背离时遇到的是同一件事:描述过去的定义,不会自动变成预测未来的信号。
五、资金费率是一条分段函数
很多人把资金费率当成「市场情绪温度计」。它其实是一条写死的公式,而且我们能用公开数据把它算出来。
公式
Binance 的文档写得很清楚:
资金费率 = 平均溢价指数 + clamp(利率 − 平均溢价指数, −0.05%, +0.05%)
其中利率固定是每 8 小时 0.01%。这个 clamp 有一个非常重要的后果:
只要平均溢价落在 −0.04% 到 +0.06% 之间,括号里的东西就等于「利率 − 溢价」本身,加回去之后费率精确等于 0.01%。 溢价在这个区间里怎么动都不影响费率。
超出这个区间,费率才开始跟着溢价走:溢价高于 0.06% 时费率 = 溢价 − 0.05%,低于 −0.04% 时费率 = 溢价 + 0.05%。最后还有一个 ±0.3% 的上下限。
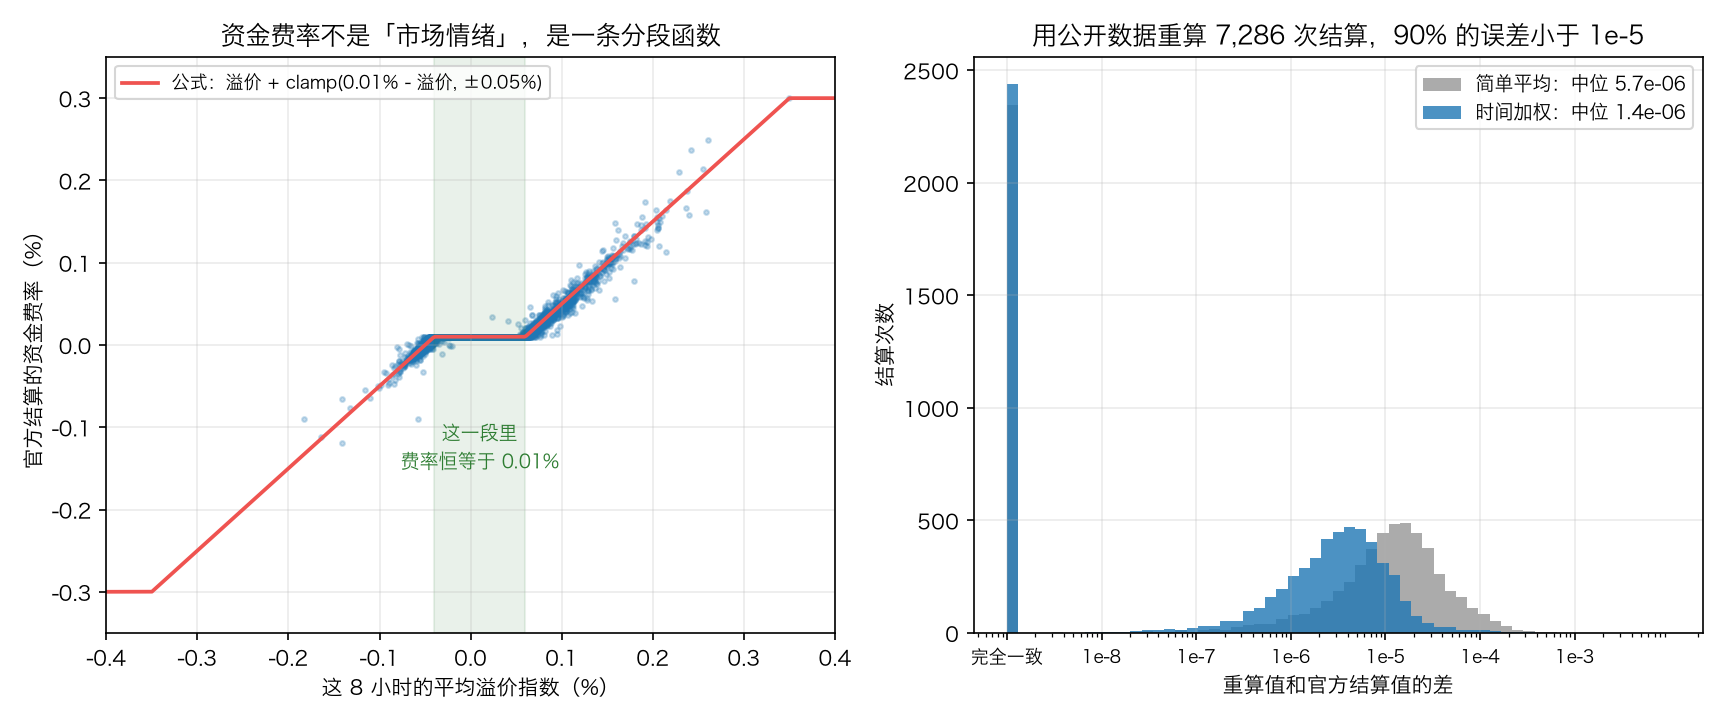
左边那张图就是把七千多次结算画出来:每一个点都落在那条分段折线上,中间那一段平台就是 clamp 造成的。
用公开数据重算一遍
光看公式不算懂。把 349 万根 1 分钟溢价指数拿来,自己算一遍,和官方的结算值对账:
recomputed = V.funding_from_premium(premium)
checked = pd.concat([funding.rename("官方结算"), recomputed.rename("用溢价指数重算")], axis=1).dropna()
error = (checked["用溢价指数重算"] - checked["官方结算"]).abs()
print(f"对上 {len(checked):,} 次结算:中位误差 {error.median():.2e},90% 分位 {error.quantile(.9):.2e},"
      f"最大 {error.max():.2e}")
print(f"误差小于 1e-5(0.001 个百分点)的比例:{(error < 1e-5).mean():.1%}")
simple = premium.resample("8h", label="right", closed="right").mean()
simple.index = simple.index.round("h")
plain = simple + np.clip(V.INTEREST_RATE - simple, -V.CLAMP, V.CLAMP)
plain_error = (np.clip(plain, -V.CAP, V.CAP).reindex(checked.index) - checked["官方结算"]).abs()
print(f"改用简单平均(不按时间加权):中位误差 {plain_error.median():.2e},差了 "
      f"{plain_error.median() / error.median():.1f} 倍")
对上 7,286 次结算:中位误差 1.37e-06,90% 分位 9.99e-06,最大 5.57e-04
误差小于 1e-5(0.001 个百分点)的比例:90.0%
改用简单平均(不按时间加权):中位误差 5.73e-06,差了 4.2 倍
中位误差 1.37e-06——也就是 0.00014 个百分点;90% 的结算误差小于 1e-5。
有一个细节是对账逼出来的:「平均溢价指数」是时间加权的,越靠近结算时刻的那一分钟权重越大(线性递增)。用简单平均也能算个大概,但误差要大 4.2 倍。剩下那一点点误差是因为交易所采样比每分钟一次更密,我们只有 1 分钟的公开数据。
两个能直接验证的推论:
为什么 0.01% 出现得最多:
  平均溢价落在 −0.04% 到 +0.06% 之间的比例:34.53%
  官方费率恰好等于 0.01% 的比例:      34.11%
  资金费率的上下限 ±0.3% = 第一档维持保证金率 0.4% × 0.75(第 24 篇);实际触顶 2 次
- 平均溢价落在 clamp 区间里的比例是 34.53%,而官方费率恰好等于 0.01% 的比例是 34.11%——两个数几乎一样。三分之一的时间里,资金费率根本不含任何信息,它就是那个常数。
- 上下限 ±0.3% 正好是第一档维持保证金率 0.4% 的 0.75 倍(第 24 篇那张分层表)。整整七年只触顶过 2 次。
所以「资金费率是市场情绪」这句话要打个折:三分之一的时间它是常数,剩下的时间它是溢价指数的一个线性变换。 真正的原始数据是溢价指数,资金费率只是它的加工品。
六、溢价、指数、费率:三个数说的是同一件事
既然费率是溢价的变换,那么「永续比现货贵多少」这个数应该和费率高度一致。验证一下——顺便看看自己用最新成交价算的溢价和官方溢价指数差多少:
self_made = V.basis(perp["close"], spot["close"].reindex(perp.index))
premium_day = premium.resample("1D").mean()
three = pd.concat([self_made.rename("自己算的溢价"), premium_day.rename("官方溢价指数"),
                   daily_funding.rename("当日资金费")], axis=1).dropna()
print((three * 100).describe(percentiles=[.01, .5, .99]).round(4).to_string())
print("\n秩相关:")
print(three.rank().corr().round(3).to_string())
          自己算的溢价     官方溢价指数      当日资金费
count  2427.0000  2427.0000  2427.0000
mean     -0.0160    -0.0127     0.0324
std       0.0546     0.0542     0.0582
min      -0.7365    -0.5138    -0.3815
1%       -0.0846    -0.0615    -0.0365
50%      -0.0383    -0.0406     0.0227
99%       0.1459     0.1550     0.3044
max       0.3109     0.2257     0.5119

秩相关:
        自己算的溢价  官方溢价指数  当日资金费
自己算的溢价   1.000   0.803  0.750
官方溢价指数   0.803   1.000  0.954
当日资金费    0.750   0.954  1.000
- 官方溢价指数和当日资金费的秩相关是 0.954——基本是同一个数,正如公式所说。
- 自己用最新成交价算的溢价,和官方溢价指数只有 0.803。 差在哪里?官方用的是一篮子交易所的指数价格(不是 Binance 现货一家),而且用的是冲击价格(买一档和卖一档能吃掉多少量之后的价格),不是最新成交价。第 22 篇讲过同样的事:「价格」从来不是一个数。
这三个数不是三个独立的证据。 回到第一节那个决策点:「持仓量新高」和「资金费率年化 108%」看起来是两条独立的确认,其实费率那一条完全由溢价决定,而溢价和持仓量都是「多头挤」的不同侧面。选项 C 说对了一半。
七、极端资金费率之后
现在做这一篇最核心的检验:资金费率到了极端,之后会发生什么?
规则和第四节一样:连着的日子只取段首,避免重叠窗口;每组都给 bootstrap 的 95% 区间。
def event_starts(mask: pd.Series) -> pd.Series:
    """连着的日子算一段,只取段首:相邻的窗口重叠得太厉害,不能当成独立样本。"""
    mask = mask.fillna(False)
    return mask & ~mask.shift(1, fill_value=False)


rows = []
for quantile, side in [(0.99, "最高 1%"), (0.95, "最高 5%"), (0.05, "最低 5%"), (0.01, "最低 1%")]:
    level = daily_funding.quantile(quantile)
    mask = (daily_funding >= level) if quantile > 0.5 else (daily_funding <= level)
    starts = event_starts(mask)
    for horizon in [5, 20]:
        forward = close.shift(-horizon) / close - 1
        picked, everyone = forward[starts].dropna(), forward.dropna()
        boot = np.array([rng.choice(picked, len(picked)).mean() for _ in range(2000)])
        rows.append({"阈值": f"{side}({level:.3%}/天)", "之后": f"{horizon} 天",
                     "天数": int(mask.sum()), "段数": len(picked), "平均": picked.mean(),
                     "中位数": picked.median(), "胜率": (picked > 0).mean(),
                     "同期全样本": everyone.mean(),
                     "95% 区间": f"[{np.percentile(boot, 2.5):+.3f}, {np.percentile(boot, 97.5):+.3f}]"})
print(pd.DataFrame(rows).round(4).to_string(index=False))
              阈值   之后  天数  段数     平均     中位数     胜率  同期全样本           95% 区间
 最高 1%(0.304%/天)  5 天  25  10 0.0275 -0.0167 0.5000 0.0074 [-0.046, +0.105]
 最高 1%(0.304%/天) 20 天  25  10 0.0054 -0.0553 0.4000 0.0293 [-0.080, +0.102]
 最高 5%(0.140%/天)  5 天 122  46 0.0138  0.0213 0.6087 0.0074 [-0.012, +0.039]
 最高 5%(0.140%/天) 20 天 122  46 0.0258  0.0130 0.5435 0.0293 [-0.040, +0.096]
最低 5%(-0.011%/天)  5 天 122  67 0.0167  0.0154 0.6418 0.0074 [+0.002, +0.031]
最低 5%(-0.011%/天) 20 天 122  67 0.0639  0.0298 0.5970 0.0293 [+0.028, +0.098]
最低 1%(-0.037%/天)  5 天  25  15 0.0496  0.0440 0.6667 0.0074 [+0.013, +0.086]
最低 1%(-0.037%/天) 20 天  25  15 0.1525  0.1836 0.8000 0.0293 [+0.050, +0.260]
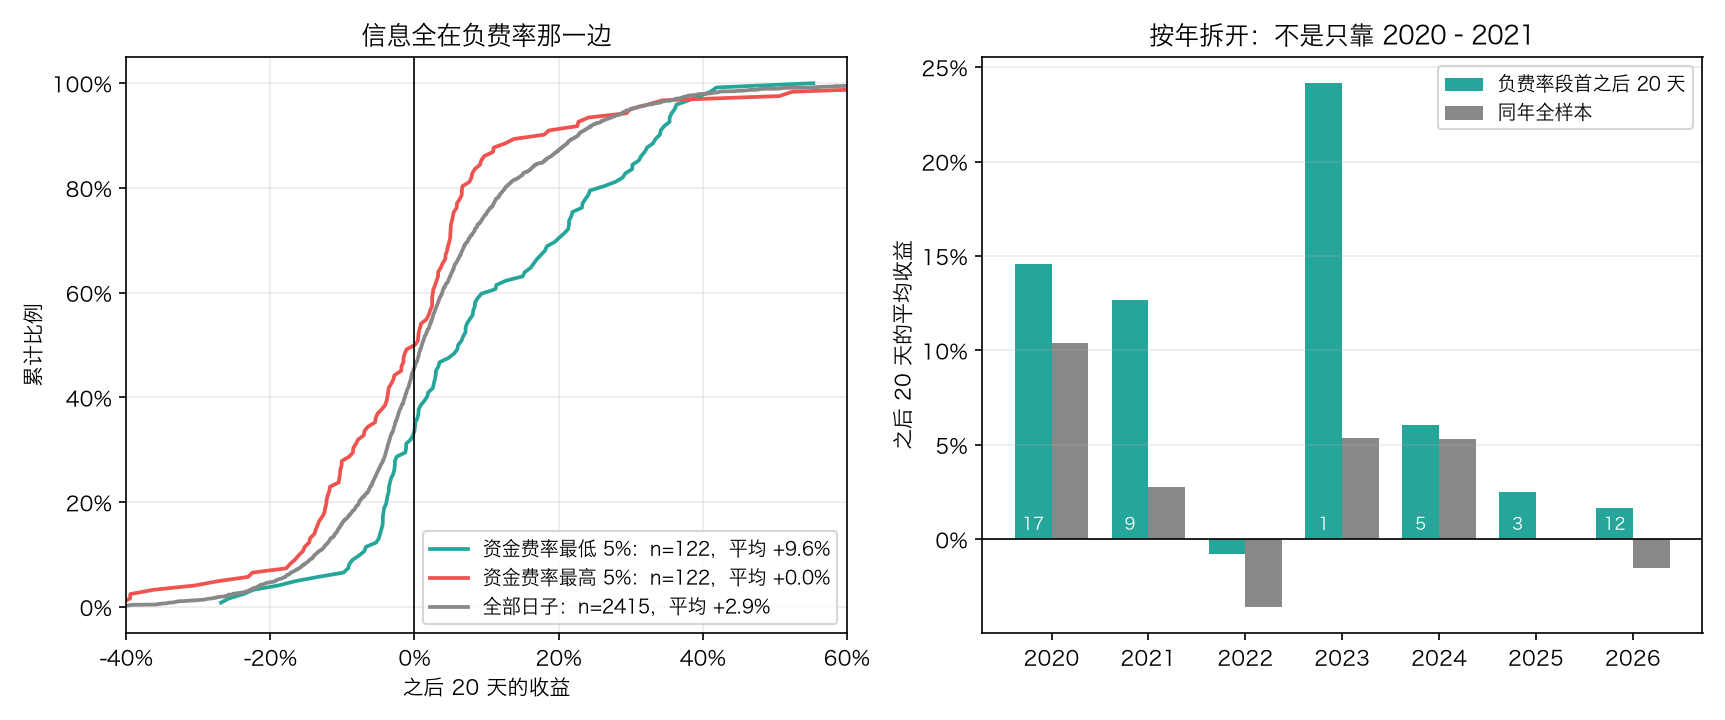
结果是明显不对称的:
高费率那一边:什么也没有。
- 最高 5%(每天 0.14% 以上,年化 51%):46 段,之后 20 天平均 +2.6%,同期全样本 +2.9%——比平常还差一点,95% 区间 [−4.0%, +9.6%] 跨零。
- 最高 1%(每天 0.30% 以上,年化 111%):只有 10 段,20 天平均 +0.5%,中位数 −5.5%,胜率 40%,区间 [−8.0%, +10.2%] 照样跨零。
所以「资金费率极高=见顶」这句话,在 BTC 六年的数据上说不出统计意义。中位数是负的,方向对得上直觉,但 10 段样本撑不起任何结论。
负费率那一边:有东西。
- 最低 5%(费率为负,空头在给多头付钱):67 段,之后 20 天平均 +6.4%,区间 [+2.8%, +9.8%],不跨零。
- 最低 1%:15 段,20 天平均 +15.3%,中位数 +18.4%,胜率 80%。
这是不是只是「跌多了反弹」
负费率出现在什么时候?暴跌之后。那这个结果会不会只是均值回归?做一个对照组:跌幅相当、但资金费率正常的日子。
负费率是不是只是「跌多了反弹」:找出跌幅相当、但资金费率正常的日子做对照
  负费率那些天之前 20 天的涨幅中位数 -5.5%,全样本 1.0%
  之后 5 天:负费率 122 天平均 +3.50%;同样跌幅、费率正常 1818 天平均 +0.36%;差 +3.14%
  之后 20 天:负费率 122 天平均 +9.63%;同样跌幅、费率正常 1810 天平均 +1.33%;差 +8.30%
对照组只有 +1.3%,负费率组 +9.6%,差 8.3 个百分点。 同样是跌了 5% 左右之后,费率转负的那些日子明显不一样。
会不会只是 2020–2021 的大牛市
再拆一次,按年:
      size    mean     全样本
年
2020    17  0.1457  0.1039
2021     9  0.1269  0.0276
2022    20 -0.0079 -0.0357
2023     1  0.2415  0.0537
2024     5  0.0605  0.0531
2025     3  0.0251  0.0002
2026    12  0.0165 -0.0151
每一年都比同年的全样本好,包括 2022 年那个熊年(−0.8% vs −3.6%)。2023 年只有 1 段,不用当真;2024 年只高出 0.7 个百分点;2025、2026 分别高出 2.5 和 3.2 个百分点。优势在缩小,但没有消失。
为什么会这样
机制上讲得通,而且和第 24 篇是同一条线:
资金费率为正是常态(86% 的结算),它只说明「想加杠杆做多的人比想做空的多」——这几乎永远成立,所以它高一点并不特殊。 资金费率为负很罕见,它意味着空头愿意倒贴钱。这只在一种情况下发生:一轮强制去杠杆刚刚结束,多头已经被清干净了,市场上剩下的杠杆全在空头那边。
换句话说,负费率不是「情绪看空」,而是「杠杆已经清完了」的一张收据。
⚠️ 还是要泼一盆冷水:67 段和 15 段的样本,而且这些段在时间上是成簇出现的(2020 年 3–4 月一簇、2021 年 5–7 月一簇、2022 年一簇)。bootstrap 区间假设段与段之间独立,而它们显然不完全独立。这个结论的可信度,比区间看上去的要低。
八、多空比:先搞清楚它统计的是什么
按**张数**算,多头持仓和空头持仓永远相等——一张合约一个多头一个空头。
所以交易所公布的三个比值统计的都不是「多空持仓量」,而是别的东西:
  大户持仓多空比:大户账户里,净多头仓位之和 ÷ 净空头仓位之和
  账户数多空比:  净多头的账户数 ÷ 净空头的账户数
  主动买卖比:    主动买入成交量 ÷ 主动卖出成交量(这是流量,不是存量)
这一段值得慢读。绳子两头人数恒等,所以任何一个不等于 1 的「多空比」,统计的一定不是多空持仓量本身:
- 账户数多空比:数的是人头。100 个散户各拿 1 张多单、1 个机构拿 100 张空单,人头比就是 100:1,而持仓量是 1:1。
- 大户持仓多空比:只看大户账户,算他们净头寸的比。大户之外的仓位不在分母里。
- 主动买卖比:主动买入量 ÷ 主动卖出量,这是流量(这段时间成交了什么),不是存量。
检验一下,规则和前面一样——段首、bootstrap 区间,再加一个**控制住「之前涨跌了多少」**的对照组:
rows = []
for column in ["大户持仓多空比", "账户数多空比", "主动买卖比"]:
    series = V.align(metrics[column], close.index)
    for label, mask in [("最高十分位", series >= series.quantile(.9)),
                        ("最低十分位", series <= series.quantile(.1))]:
        starts = event_starts(mask)
        forward = close.shift(-20) / close - 1
        picked = forward[starts].dropna()
        boot = np.array([rng.choice(picked, len(picked)).mean() for _ in range(2000)])
        lower, upper = past[mask.fillna(False)].quantile(.1), past[mask.fillna(False)].quantile(.9)
        control = (past >= lower) & (past <= upper) & ~mask.fillna(False) & series.notna()
        rows.append({"指标": column, "有数据的天数": int(series.notna().sum()), "分组": label,
                     "段数": len(picked), "之前 20 天涨幅中位数": past[mask.fillna(False)].median(),
                     "之后 20 天平均": picked.mean(),
                     "95% 区间": f"[{np.percentile(boot, 2.5):+.3f}, {np.percentile(boot, 97.5):+.3f}]",
                     "同涨幅对照": forward[control].mean(),
                     "差": picked.mean() - forward[control].mean()})
print()
print(pd.DataFrame(rows).round(4).to_string(index=False))
     指标  有数据的天数    分组  段数  之前 20 天涨幅中位数  之后 20 天平均           95% 区间  同涨幅对照       差
大户持仓多空比    1876 最高十分位  45       -0.0270    -0.0118 [-0.038, +0.015] 0.0334 -0.0452
大户持仓多空比    1876 最低十分位  46        0.0195     0.1156 [+0.056, +0.178] 0.0211  0.0945
 账户数多空比    2172 最高十分位  81       -0.0532    -0.0182 [-0.055, +0.021] 0.0273 -0.0455
 账户数多空比    2172 最低十分位  64        0.1085     0.0336 [+0.005, +0.063] 0.0304  0.0032
  主动买卖比    2063 最高十分位 177        0.0176     0.0504 [+0.027, +0.071] 0.0252  0.0253
  主动买卖比    2063 最低十分位 185        0.0093     0.0432 [+0.022, +0.065] 0.0251  0.0181
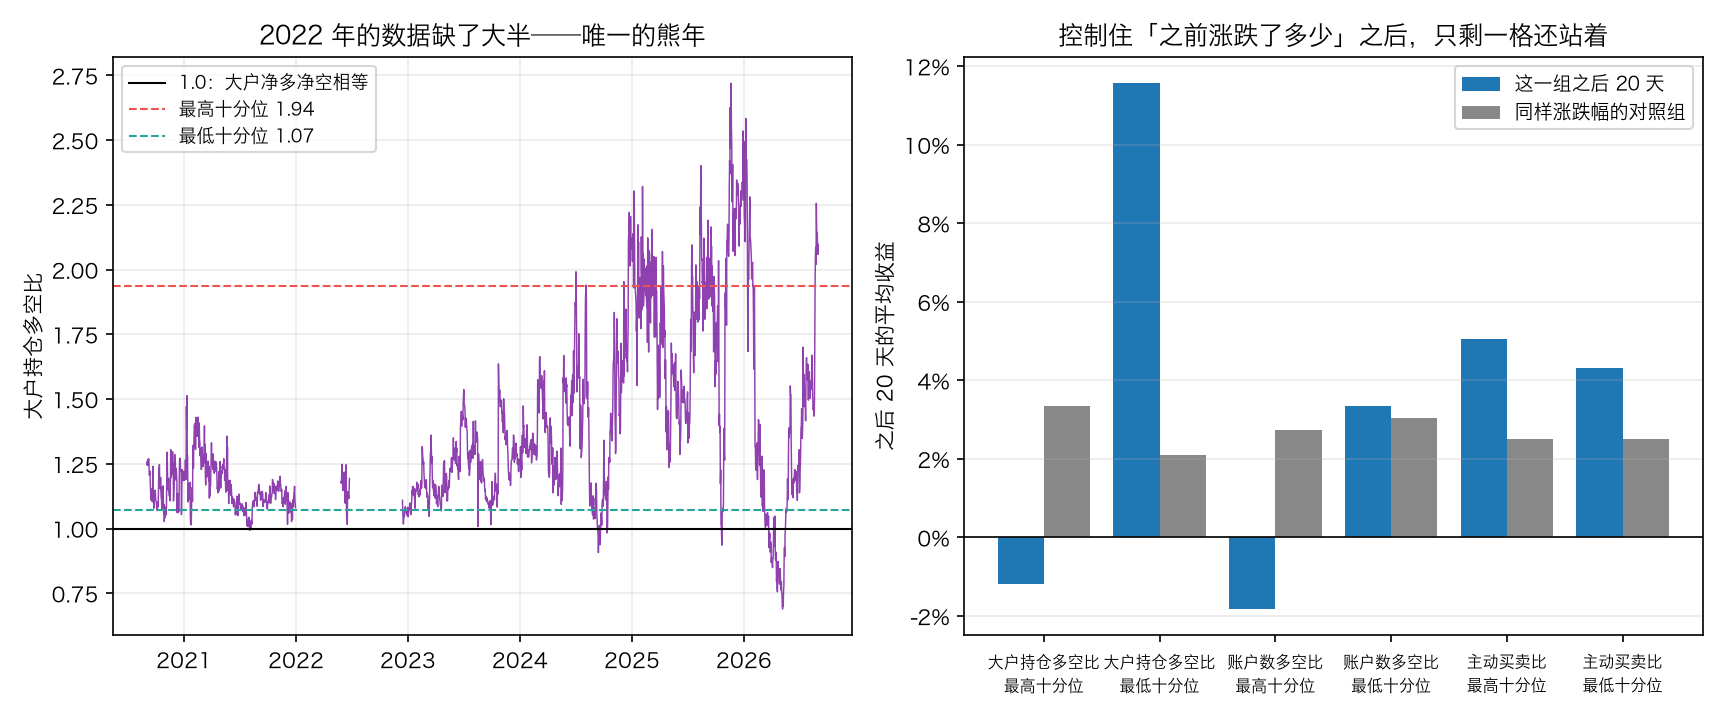
一格一格看:
- 账户数多空比:最低十分位之后 20 天 +3.4%,看起来不错——但同涨跌幅的对照组是 +3.0%,差只有 0.3 个百分点。这个指标的「预测力」,全部来自「它跟着价格动」。
- 主动买卖比:最高和最低十分位之后都是 +4% 到 +5%,两头一样。它标记的是「成交激烈」,不是方向。
- 大户持仓多空比:最高十分位之后 20 天 −1.2%(区间跨零),最低十分位 +11.6%,区间 [+5.6%, +17.8%],对照组只有 +2.1%,差 9.5 个百分点。这一格还站着。
但这一格有一个必须说的问题:
大户持仓多空比缺得最多,按年:{2021: 401, 2022: 91616, 2023: 1, 2024: 11, 2025: 3}——**2022 年(唯一的熊年)缺了大半**
大户持仓多空比在 2022 年缺了 91,616 条——那是这六年里唯一的熊市年。 一个只在牛市和震荡市上检验过的「看空指标」,可信度要打折。
顺便验证一下第六节那个担心:「大户净空」和「负费率」是不是同一件事?
               资金费率最低 5%  大户持仓多空比最低 10%
资金费率最低 5%          0.050          0.115
大户持仓多空比最低 10%      0.115          0.077

同时成立 32 天;只有费率 90 天;只有多空比 156 天——重合度很低,是两件事
Jaccard 只有 0.115,同时成立的只有 32 天。两件事,不是一件事——这让两个结果互相独立,也让它们各自的样本更单薄。
九、去杠杆:被迫交易者留下的痕迹
Binance 从 2024 年起不再公开强平明细(liquidationSnapshot 目录是空的)。但强平一定会留下痕迹:一串仓位被强制平掉,持仓量必然掉,而且掉得比正常平仓快得多。
所以用持仓量的骤降做代理:12 小时内持仓价值掉 5% 以上。
hourly = B.resample_ohlcv(minute, "1h")
oi_hourly = V.align(metrics["持仓价值"], hourly.index)
events = V.deleveraging(oi_hourly, window=12, threshold=0.05)
print(f"持仓量在 12 小时内掉 5% 以上:{int(events.sum())} 次,按年 "
      f"{events[events].index.year.value_counts().sort_index().to_dict()}")
hourly_return = hourly["close"].pct_change()
print(f"事件那一小时的涨跌:中位数 {hourly_return[events].median():+.2%}(全样本 {hourly_return.median():+.2%})")
print(f"事件前 24 小时的涨跌:中位数 {(hourly['close'] / hourly['close'].shift(24) - 1)[events].median():+.2%}")
rows = []
for horizon in [1, 6, 24, 24 * 7]:
    forward = hourly["close"].shift(-horizon) / hourly["close"] - 1
    picked, everyone = forward[events].dropna(), forward.dropna()
    boot = np.array([rng.choice(picked, len(picked)).mean() for _ in range(2000)])
    rows.append({"之后": f"{horizon} 小时", "次数": len(picked), "平均": picked.mean(),
                 "中位数": picked.median(), "胜率": (picked > 0).mean(), "同期全样本": everyone.mean(),
                 "95% 区间": f"[{np.percentile(boot, 2.5):+.4f}, {np.percentile(boot, 97.5):+.4f}]"})
print(pd.DataFrame(rows).round(4).to_string(index=False))
持仓量在 12 小时内掉 5% 以上:916 次,按年 {2020: 81, 2021: 285, 2022: 193, 2023: 119, 2024: 114, 2025: 81, 2026: 43}
事件那一小时的涨跌:中位数 -0.63%(全样本 +0.01%)
事件前 24 小时的涨跌:中位数 -0.83%
    之后  次数      平均    中位数     胜率  同期全样本             95% 区间
  1 小时 916 -0.0001 0.0006 0.5469 0.0001 [-0.0007, +0.0006]
  6 小时 916  0.0004 0.0011 0.5360 0.0004 [-0.0009, +0.0017]
 24 小时 916  0.0025 0.0029 0.5688 0.0015 [+0.0001, +0.0050]
168 小时 915  0.0198 0.0134 0.5738 0.0104 [+0.0136, +0.0260]
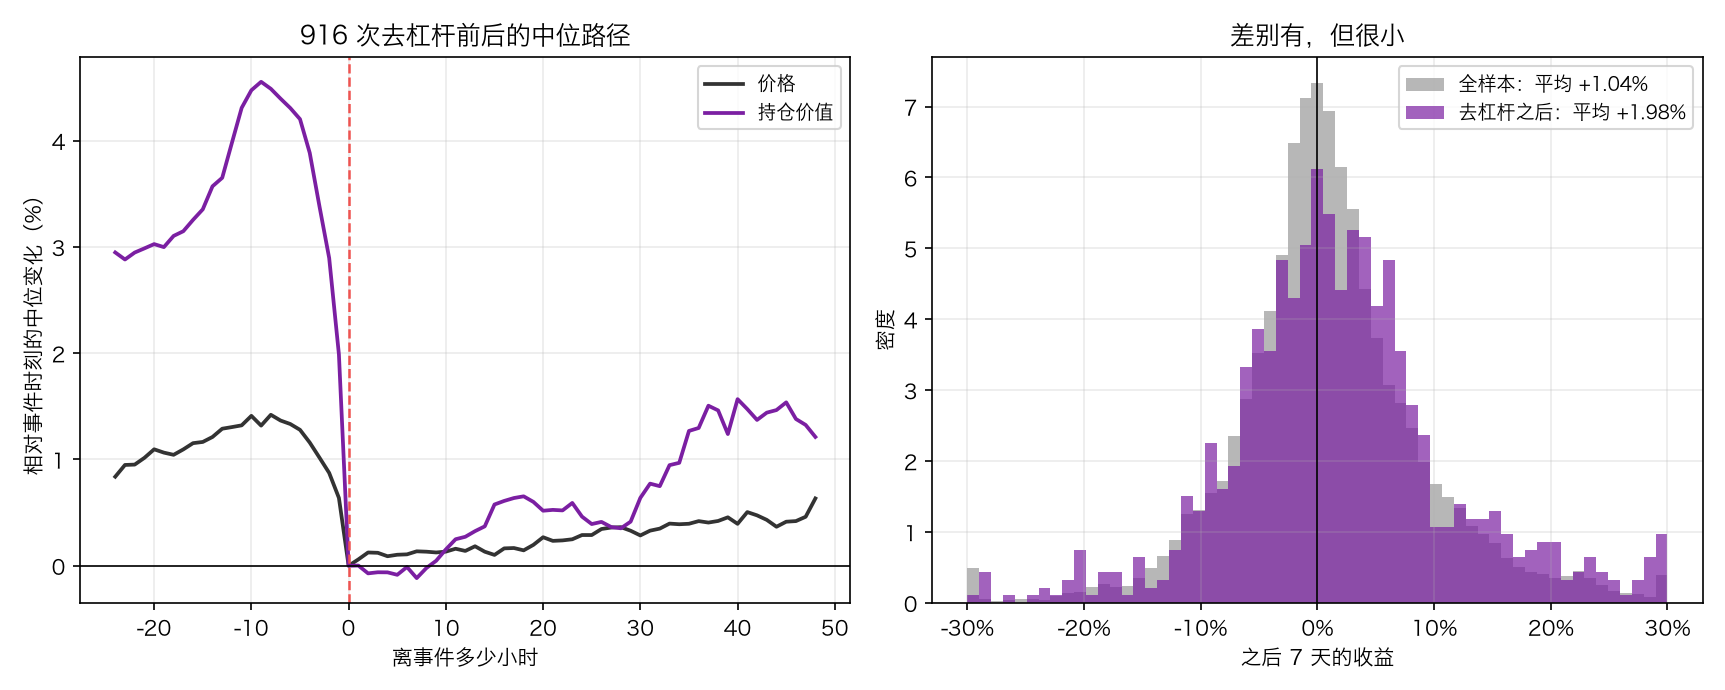
左边那张图是 916 次事件前后的中位路径,形状很典型:
- 事件前 10 小时左右,持仓量还在往上堆(中位 +4.5%),价格也在涨(+1.4%)。
- 然后 10 小时之内,持仓量塌掉。 事件那一小时价格中位数 −0.63%(全样本 +0.01%)。
- 事件之后,持仓量在原地趴着不动,价格慢慢往回爬。
之后的收益:24 小时 +0.25%(全样本 +0.15%),7 天 +1.98%(全样本 +1.04%),两个区间都不跨零,但幅度都很小——大约是把平常的收益翻个倍,不是什么大机会。而且 916 次事件同样是成簇的(2021 年 285 次,2026 年 43 次)。
这一节真正的价值不在那点收益,而在于:第 2 篇说「被迫交易者集中的地方更可能出现可预期的价格行为」,这是这门课第一次能把被迫交易者直接数出来。
十、动手:talab.derivs
新模块。它不生产信号,只把交易所公布的几个数摆正。
对齐
def align(series: pd.Series, index: pd.DatetimeIndex, how: str = "last") -> pd.Series:
    """把细粒度的序列(比如 5 分钟一条的持仓量)对齐到 K 线的索引上。

    默认取每根 K 线**区间内最后一个**值:持仓量是存量,K 线收盘那一刻的存量才和收盘价配对。
    `how="mean"` 取区间平均,用在流量型的数据上。
    ⚠️ 只用区间内的数据,不往后借(那是前视偏差,第 7 篇)。
    """
    if how not in ("last", "mean", "max", "min"):
        raise ValueError(f"how 只能是 last / mean / max / min,收到 {how!r}")
    bucket = pd.cut(series.index, bins=index.append(index[-1:] + (index[1] - index[0])),
                    right=False, labels=index)
    out = series.groupby(bucket, observed=False).agg(how)
    out.index = index
    return out
⚠️ 持仓量是存量,取每根 K 线区间内的最后一个值才和收盘价配对;而且只能用区间内的数据,往后借一条就是前视偏差(第 7 篇)。
资金费率
def funding_from_premium(premium: pd.Series, interval: str = "8h",
                         interest_rate: float = INTEREST_RATE, clamp: float = CLAMP,
                         cap: float = CAP) -> pd.Series:
    """用 1 分钟的溢价指数重算资金费率,交易所的公式是:

    > 资金费率 = 平均溢价指数 + clamp(利率 − 平均溢价指数, −0.05%, +0.05%)

    所以**只要平均溢价落在 −0.04% 到 +0.06% 之间,费率就精确等于利率 0.01%**——
    这就是为什么 0.01% 是出现最多的那个值。超出这个范围,费率才跟着溢价走。
    最后再用 ±0.3% 的上下限夹一次(这个上下限是第一档维持保证金率的 0.75 倍,第 24 篇)。

    「平均溢价指数」是**时间加权**的:越靠近结算时刻的那一分钟,权重越大(线性递增)。
    用简单平均也能算个大概,但和官方结算值的误差会大四倍。
    """
    def weighted(values: np.ndarray) -> float:
        w = np.arange(1, len(values) + 1)
        return float(np.dot(values, w) / w.sum())

    average = premium.resample(interval, label="right", closed="right").apply(
        lambda x: weighted(x.to_numpy()) if len(x) else np.nan)
    average.index = average.index.round("h")
    rate = average + np.clip(interest_rate - average, -clamp, clamp)
    return np.clip(rate, -cap, cap).rename("funding")
def annualize(funding: pd.Series, hours: float = 8.0) -> pd.Series:
    """把「每 8 小时」的费率折成年化,方便和借券费、利率放在一起看。

    用的是单利(× 一年结算多少次),不是复利:资金费按名义价值收,不会自动滚进本金。
    """
    return funding * (365 * 24 / hours)


def basis(perp: pd.Series, spot: pd.Series) -> pd.Series:
    """永续合约相对现货的溢价(正数=合约比现货贵)。两边先按时间对齐。"""
    joined = pd.concat([perp.rename("perp"), spot.rename("spot")], axis=1).dropna()
    return (joined["perp"] / joined["spot"] - 1).rename("basis")
四种组合和去杠杆
REGIMES = {(True, True): "价涨 + 仓涨:新多进场",
           (True, False): "价涨 + 仓跌:空头平仓",
           (False, True): "价跌 + 仓涨:新空进场",
           (False, False): "价跌 + 仓跌:多头平仓"}


def regimes(close: pd.Series, open_interest: pd.Series) -> pd.Series:
    """价格和持仓量的四种组合,教科书上的那张表。

    背后的算术只有一句话:**持仓量要涨,必须同时有一个新的多头和一个新的空头**;
    要跌,必须有一对老仓位同时离场。所以这四格说的是「这根 K 线上,
    动的主要是新开的仓还是平掉的仓」。

    ⚠️ 这只是记账恒等式给出的一种读法,不是预测。第 25 篇把四格之后的收益都统计了一遍。
    """
    price_up = close.diff() > 0
    oi_up = open_interest.reindex(close.index).diff() > 0
    valid = close.diff().notna() & open_interest.reindex(close.index).diff().notna()
    labels = [REGIMES[(bool(p), bool(o))] for p, o in zip(price_up, oi_up)]
    return pd.Series(labels, index=close.index).where(valid).rename("组合")


def deleveraging(open_interest: pd.Series, window: int = 12, threshold: float = 0.05) -> pd.Series:
    """去杠杆事件:持仓量在 `window` 根之内掉了 `threshold` 以上。

    Binance 从 2024 年起不再公开强平明细,所以这里用持仓量的骤降做代理:
    **一串仓位被强制平掉,持仓量一定会掉**,而且掉得比正常平仓快得多。
    返回的是布尔序列,True 表示这一根是事件发生的那一根(事件连成一片时只标第一根)。
    """
    drop = open_interest / open_interest.rolling(window).max() - 1
    hit = (drop <= -threshold).fillna(False)
    return (hit & ~hit.shift(1, fill_value=False)).rename("去杠杆")
下载与体检
talab.data 这一篇加了 download_binance_metrics(两千多个日文件,并发下载并校验)和 load_binance_metrics。数据有三个坑,全都是加载时就要处理的:
三个数据坑:
1. 持仓量为 0 的坏行 473 条,集中在 ['2021-05-22', '2022-03-07', '2022-03-08', '2023-06-06', '2023-08-09', '2023-11-11']
2. 缺失:{'持仓量': 0, '持仓价值': 0, '大户账户数多空比': 92063, '大户持仓多空比': 92032, '账户数多空比': 5754, '主动买卖比': 37154}
   大户持仓多空比缺得最多,按年:{2021: 401, 2022: 91616, 2023: 1, 2024: 11, 2025: 3}——**2022 年(唯一的熊年)缺了大半**
3. 官方文件里每一行都写了两遍,`load_binance_metrics` 里已经去重
最后那一条最阴险:官方文件里每一行都写了两遍,不去重的话所有按条数的统计都会翻倍。
def load_binance_metrics(paths) -> pd.DataFrame:
    """把一组持仓量文件读成一张表,索引是 UTC 时间(5 分钟一条)。

    列:持仓量(币)、持仓价值(USDT)、大户账户数多空比、大户持仓量多空比、
    全部账户数多空比、主动买卖量比。
    """
    paths = sorted(Path(p) for p in paths)
    if not paths:
        raise ValueError("没有找到任何持仓量文件,检查一下路径")
    frames = []
    for path in paths:
        with zipfile.ZipFile(path) as z:
            frames.append(pd.read_csv(z.open(z.namelist()[0])))
    df = pd.concat(frames, ignore_index=True)
    df.index = pd.to_datetime(df.pop("create_time"), format="%Y-%m-%d %H:%M:%S", utc=True)
    df.index.name = "time"
    df = df.drop(columns=["symbol"]).astype(float).sort_index()
    df.columns = ["持仓量", "持仓价值", "大户账户数多空比", "大户持仓多空比", "账户数多空比", "主动买卖比"]
    return df[~df.index.duplicated()]                 # ⚠️ 官方文件里每一行都重复了一遍
测试
10 个,全部手算。最关键的两个是资金费率公式的两段:
def test_funding_equals_the_interest_rate_inside_the_clamp():
    """平均溢价落在 −0.04% 到 +0.06% 之间时,费率精确等于 0.01%。"""
    for level in [-0.0004, 0.0, 0.0003, 0.0006]:
        rate = V.funding_from_premium(minutes([level] * 480))
        assert rate.iloc[0] == pytest.approx(V.INTEREST_RATE)
def test_funding_weights_the_later_minutes_more():
    """前一半 0、后一半 0.2% 的溢价,时间加权的结果要比简单平均(0.1%)更靠近后一半。"""
    premium = minutes([0.0] * 240 + [0.002] * 240)
    weighted = V.funding_from_premium(premium).iloc[0] + V.CLAMP    # 反解出加权平均
    assert weighted > 0.001
    assert weighted == pytest.approx(0.002 * (sum(range(241, 481)) / sum(range(1, 481))))
227 passed in 0.81s
195 passed, 32 skipped in 0.90s
十一、揭晓
2021 年 4 月 13 日之后:
2021-04-14 00:00:00+00:00  63019.10 -0.010     22.998  -0.060     0.304
2021-04-15 00:00:00+00:00  63232.55  0.003     22.874  -0.005     0.269
2021-04-16 00:00:00+00:00  61424.67 -0.029     21.421  -0.064     0.345
2021-04-17 00:00:00+00:00  60090.14 -0.022     21.209  -0.010     0.196
2021-04-18 00:00:00+00:00  56140.05 -0.066     15.903  -0.250     0.150
2021-04-19 00:00:00+00:00  55634.39 -0.009     15.099  -0.051     0.030
2021-04-20 00:00:00+00:00  56410.56  0.014     15.892   0.053     0.030
2021-04-21 00:00:00+00:00  53800.00 -0.046     15.395  -0.031     0.030
2021-04-22 00:00:00+00:00  51714.61 -0.039     16.216   0.053     0.030
2021-04-23 00:00:00+00:00  51122.62 -0.011     16.441   0.014     0.068
2021-04-24 00:00:00+00:00  50092.40 -0.020     16.731   0.018     0.054
2021-04-25 00:00:00+00:00  49063.94 -0.021     16.019  -0.043     0.070
从 2021-04-13 收盘 63,649.71 算起:
  5 天后(2021-04-18):56,140.05,-11.8%
  12 天后(2021-04-25):49,063.94,-22.9%
  20 天后(2021-05-03):57,214.83,-10.1%
  到 2021 年 7 月的最低点 2021-07-20:29,775.90,-53.2%
  持仓价值最大的单日降幅:-25.0%(2021-04-18,从 21.2 亿到 15.9 亿)
  从 4 月 13 日的高点 24.5 亿,到 4 月 19 日的低点 15.1 亿,六天少了 38%
  资金费率在 2021-04-19 掉到 0.030%/天(折年化 11.0%),也就是 0.01% 的地板
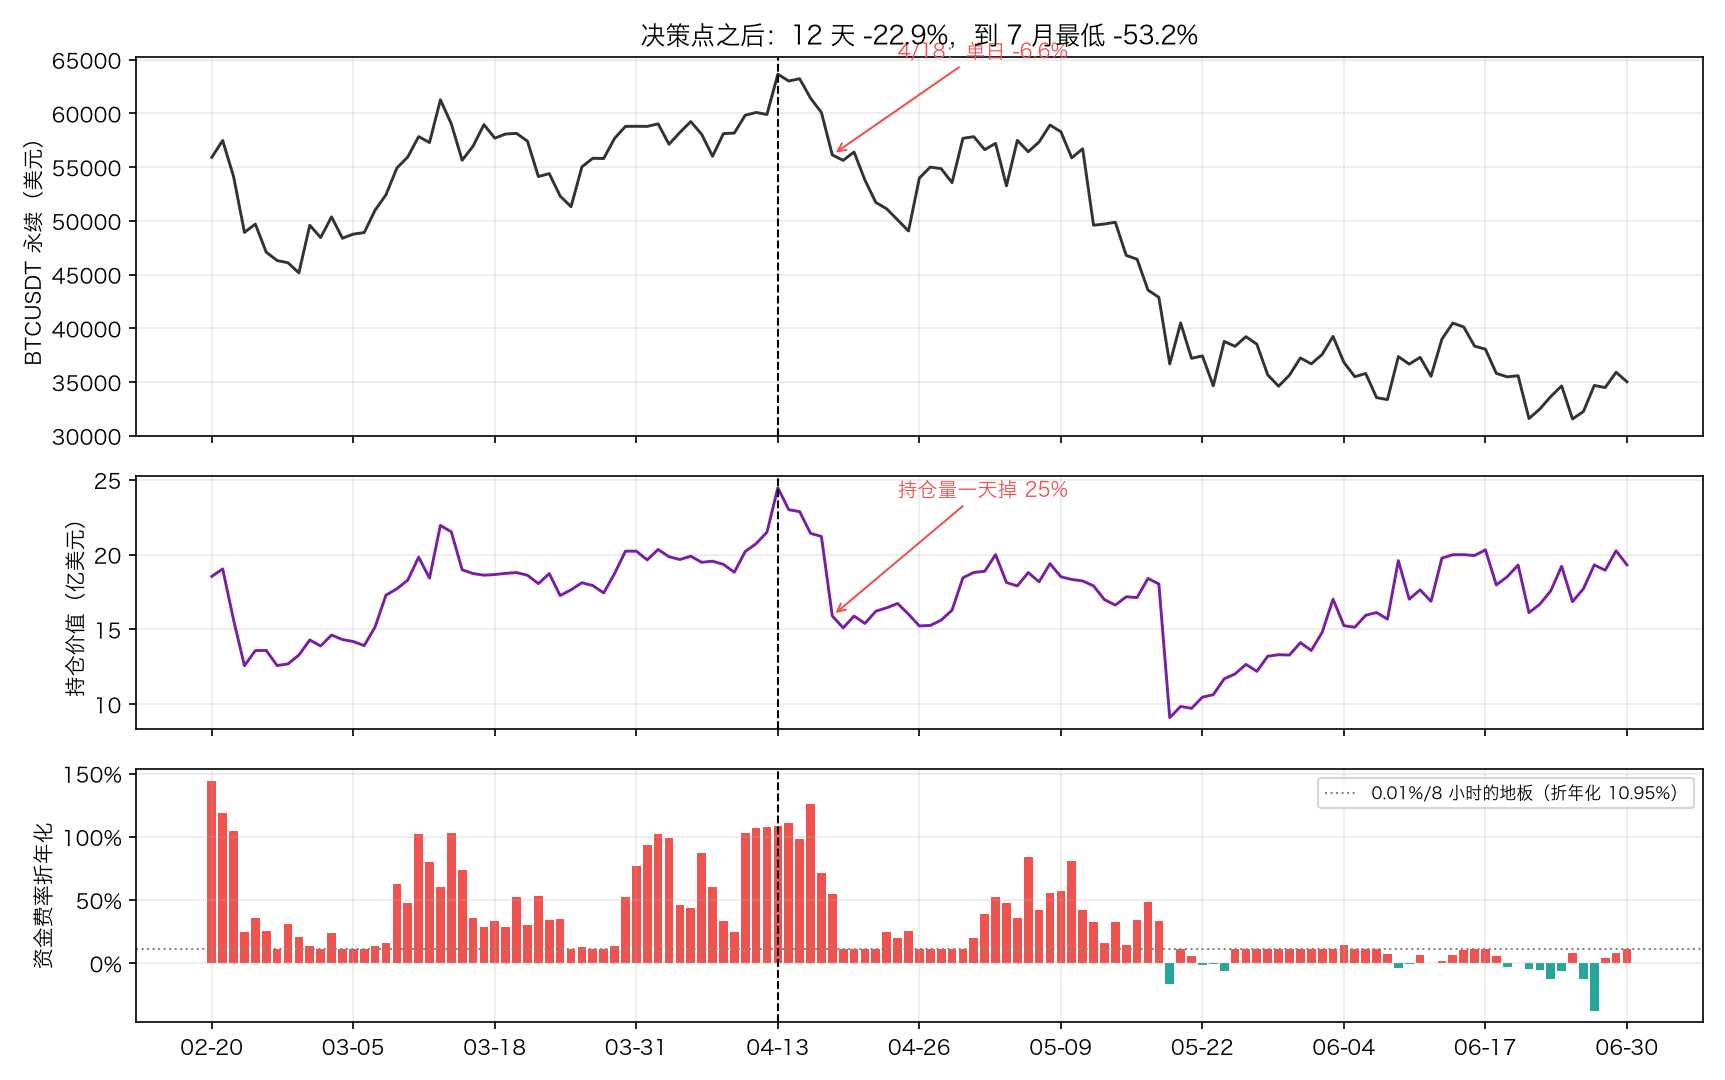
- 5 天后 −11.8%,12 天后 −22.9%,到 7 月 20 日的最低点 −53.2%。
- 4 月 18 日一天,持仓价值掉了 25%(21.2 亿 → 15.9 亿);从 4 月 13 日的 24.5 亿到 4 月 19 日的 15.1 亿,六天少了 38%——绳子上快四成的人被拖走了。
- 资金费率在 4 月 19 日回到 0.01% 的地板,折年化从 108% 掉到 11%。雇佣费一夜之间变成零头。
所以这一次,选 B 的人赢了。
但第七节说得很清楚:这一次不代表一般情况。 同样「资金费率最高 1%」的情形在这六年里出现过 10 段,之后 20 天的平均收益是 +0.5%,95% 区间 [−8.0%, +10.2%]。2021 年 4 月这一段,是那 10 段里最难看的一段,不是典型的一段。
一笔交易证明不了任何事——这句话第 23 篇说过一次,这里再说一次,因为这一次的故事实在太好讲了。
十二、能不能拿来用
最后试一下最直接的用法:把资金费率当成第 21 篇那个一直空着的环境过滤格子。
spot_funding = daily_funding.reindex(spot.index)
mainline = R.Rule(entry=entries(spot), exit=deaths(spot), fill="next_open",
                  stop="chandelier", k=3.0, trigger="close")
rows = []
for label, environment in [("v3 原样(不过滤)", None),
                           ("资金费率高于 95% 分位时不开新仓", (spot_funding < spot_funding.quantile(.95)).fillna(True)),
                           ("资金费率高于 90% 分位时不开新仓", (spot_funding < spot_funding.quantile(.90)).fillna(True)),
                           ("资金费率为负时不开新仓", (spot_funding >= 0).fillna(True))]:
    returns, held, trades = R.run(spot, R.Rule(**(mainline.__dict__ | {"environment": environment})))
    equity = (1 + returns).cumprod()
    rows.append({"环境过滤": label, "交易数": len(trades), "年化": equity.iloc[-1] ** (365 / len(returns)) - 1,
                 "最大回撤": (equity / equity.cummax() - 1).min(), "在场时间": (held > 0).mean()})
print(pd.DataFrame(rows).round(4).to_string(index=False))
              环境过滤  交易数     年化    最大回撤   在场时间
        v3 原样(不过滤)   30 0.1855 -0.4769 0.2376
资金费率高于 95% 分位时不开新仓   23 0.1513 -0.3417 0.2023
资金费率高于 90% 分位时不开新仓   22 0.1579 -0.3334 0.1984
       资金费率为负时不开新仓   25 0.1535 -0.4769 0.2187
⚠️ 资金费率从 2020-01 起才有,现货日线从 2017-08 起:2020 年之前的日子过滤不生效(默认放行)
- 年化从 18.6% 掉到 15.1%–15.8%
- 最大回撤从 −47.7% 改善到 −33.3%
- 交易数从 30 掉到 22–25
主线 v3 不改,三个理由:
- 样本太小。 30 笔交易砍成 22 笔,这个差别在第 21 篇的 bootstrap 区间里根本分不出来。
- 机制上说不通。 第七节的统计说的正是「高费率之后没有信息」。既然如此,拿它当入场过滤就是在拟合这几笔交易,不是在用一个已知的机制(第 20、21、23 篇都是按这个标准做的选择)。
- 它砍掉的不只是回撤,也是收益。 回撤改善来自少做了几笔,而那几笔里既有坏的也有好的。
倒是有一个用法说得通,不过它不属于这一篇:如果你持有的是杠杆多单,资金费率就是你的持仓成本(第 24 篇量过:年化中位数 8.4%,2021 年 30.6%)。那不是信号问题,是成本问题——第 29 篇算成本时会用到。
十三、小检查
- 今天成交量创了历史新高,持仓量却掉了 10%。这一天市场上发生了什么?
- 资金费率连续三天都是 0.01%。这说明市场情绪中性吗?
- 「大户持仓多空比 = 2.5,说明大户重仓做多」——这句话里的「多空」指的是什么的比?绳子两头的持仓量不是永远相等吗?
- 你发现「账户数多空比最低十分位之后 20 天平均涨 3.4%」,打算照着做。还差哪一步检验?
- 为什么第七节要把连着的日子合并成「段」,只取第一天?
十四、常见误用
1. 把持仓量当成成交量的另一种写法。 成交量是流量(这段时间换了多少手),持仓量是存量(现在还有多少对人在场)。BTC 永续每天的成交额是持仓价值的好几倍,两个数可以朝相反方向走——4 月 18 日就是。
2. 用「价格 × 持仓量」的四象限做预测。 那张表是记账,不是预测。四格之后 20 天的收益在 2.73% 到 3.27% 之间,全样本 2.93%,区间全都覆盖它。
3. 把资金费率当成连续的情绪读数。 三分之一的时间它精确等于 0.01%,因为 clamp 把它压平了。在这个区间里,费率从 0.01% 变到 0.01% 不代表任何情绪变化——它根本没有在动。
4. 「资金费率高 = 要见顶」。 资金费率 86% 的时间是正的,高一点是常态。最高 1% 的 10 段之后,95% 区间是 [−8%, +10%]。反过来,负费率那一边倒是有东西——注意方向反了。
5. 把多空比当成持仓量的多空比。 按张数永远是 1:1。交易所公布的是人头比、大户净头寸比、主动成交比,三个统计的是三件不同的事,而且只有一个在控制住「之前涨跌幅」之后还剩点东西。
6. 忘了检查这个指标有没有数据。 大户持仓多空比在 2022 年缺了大半——恰好是唯一的熊年。一个只在牛市上检验过的指标,别拿它去防熊市。
7. 把重叠窗口当成独立样本。 122 个「负费率日」里,相邻日子的 20 天窗口重叠 95% 以上。不合并成段,bootstrap 区间会窄得离谱,什么都显著。
十五、小结
- 每一张合约都有一个多头和一个空头,所以按张数算的多空持仓量永远相等。持仓量是「有多少对人在场」,不是「有多少人看多」。
- 持仓量要增加,必须同时来一个新多和一个新空。 成交量是换手,不改变持仓量——4 月 18 日成交额翻倍而持仓量掉了 25%。
- 教科书上「价格 × 持仓量」的四象限没有预测力:四格之后 20 天的平均收益都在全样本(+2.93%)的 95% 区间里。
- 资金费率 = 平均溢价指数 + clamp(0.01% − 溢价, ±0.05%),上下限 ±0.3%(=第一档维持保证金率的 0.75 倍)。用 1 分钟溢价指数重算 7,286 次结算,中位误差 1.37e-06,90% 小于 1e-5。
- 「平均溢价指数」是时间加权的,越靠近结算时刻权重越大;改用简单平均,误差大 4.2 倍。
- 三分之一的时间资金费率精确等于 0.01%(溢价落在 clamp 区间里的比例 34.53%,官方费率恰好 0.01% 的比例 34.11%)。
- 溢价指数和资金费率的秩相关是 0.954,它们是同一件事;自己用最新成交价算的溢价只有 0.803,因为官方用的是一篮子指数价格和冲击价格。
- 资金费率极高之后没有信息:最高 5% 之后 20 天 +2.6%(全样本 +2.9%),最高 1% 只有 10 段、区间 [−8%, +10%]。
- 资金费率转负之后有信息:最低 5% 的 67 段之后 20 天 +6.4%,区间 [+2.8%, +9.8%];和「同样跌幅但费率正常」的对照组比高 8.3 个百分点;按年拆开每一年都好于同年全样本。机制是「杠杆已经被清完了」,不是「情绪看空」。
- 三个多空比里,两个在控制住前期涨跌幅之后就没了;只有大户持仓多空比的最低十分位还剩 9.5 个百分点,但它在 2022 年缺了大半数据。
- 持仓量骤降是强平的痕迹:12 小时内掉 5% 以上,六年 916 次;事件前持仓量还在堆、价格还在涨,事件后价格慢慢爬回来,7 天 +1.98%(全样本 +1.04%)。
- 主线 v3 不改:把资金费率当环境过滤会让年化掉 3 个百分点、回撤改善 14 个百分点,但样本太小、机制说不通。资金费率对交易者真正确定的用处是成本,不是信号。
练习
- 换个标的:把第七节的检验搬到 ETHUSDT 上(
25_download.py里换个 symbol)。负费率那一边的结论还在吗?两个币的负费率日重合度有多高? - 换个尺度:第七节用的是「当天三次结算合计」。改成按单次结算(8 小时)做事件研究,之后 24 小时、72 小时的收益怎样?
- 溢价的日内节奏:1 分钟溢价指数在一天之内有没有规律(比如结算前后)?用第 20 篇的
sessions.profile按 UTC 小时画一遍。 - 持仓量的相对水平:第四节用的是「今天比昨天涨还是跌」。改成「持仓量相对过去 30 天的分位」,四象限的结论会变吗?
- 去杠杆的阈值:把第九节的 5%/12 小时换成 3%/6 小时和 10%/24 小时,事件数和之后的收益怎么变?有没有一个阈值让信号明显变强?(小心:你正在做第 30 篇要讲的数据窥探。)
- 把成本算进去:第十二节说资金费率的真正用处是成本。给第 23 篇的
risk.run加一个资金费参数,用实际费率重算主线 v3 在永续合约上的收益,年化差多少? - 自己造一个溢价指数:用 Binance 现货和永续的 1 分钟最新价算溢价,和官方溢价指数比。差距主要出现在什么时候?(提示:看第 20 篇的薄流动性时段。)
小检查答案
- 大量的平仓成交。 一个多头和一个空头同时离场,成交量 +1、持仓量 −1。成交量创新高说明换手激烈,持仓量掉 10% 说明净效果是仓位在离场——典型的去杠杆(第九节)。
- 不能这么说。 0.01% 是 clamp 造成的平台:只要平均溢价落在 −0.04% 到 +0.06% 之间,费率就精确等于 0.01%。这三天的溢价可能从 −0.03% 走到 +0.05%,费率一动不动。费率没变不等于溢价没变。
- 它是大户账户的净多头仓位之和 ÷ 净空头仓位之和,分母只包含大户。绳子两头的总持仓量确实永远相等,但那是把所有人加在一起;只看其中一群人,比值可以是任何数——剩下的差额由不在统计里的那群人承担。
- 至少还差两步:(a)把连着的日子合并成段,否则重叠窗口会让区间窄得离谱;(b)做一个「之前涨跌幅相当但指标正常」的对照组。第八节做完这两步之后,这个指标的优势从 +3.4% 掉到 +0.3 个百分点。
- 因为相邻日子的 20 天窗口几乎完全重叠,它们不是独立样本。122 个负费率日合并之后只有 67 段;不合并的话,bootstrap 会把 122 个高度相关的观测当成 122 个独立观测,区间宽度大约会缩到真实值的一半以下,几乎什么都会「显著」。