| 本篇位置 | 第六部分「检验」第一篇。前面二十六篇都在造策略,从这一篇开始检验它 |
| 用到的数据 | BTCUSDT 现货日线 3,302 根 + 1 分钟线 474 万根(用来给盘中路径定真相)、SPY 日线 |
| 动手 | 新模块 talab.backtest:vectorized、lag_test、first_touch、limit_filled、Account、Plan、run、reconcile,附 20 个测试 |
| 读完你能 | 一眼看出一条资金曲线有没有偷看未来;说清向量化回测的适用范围;写一个现金持仓时时自洽的引擎 |
一、先做一个决定
下面这段代码是主线策略的信号(第 21 篇:金叉状态 + 收盘创 20 日新高),跑在 BTC 现货日线上:
btc = D.load_binance_klines(glob.glob("data/binance/spot/BTCUSDT/1d/*.zip"))
close = btc["close"]
signal = ((I.sma(close, 50) > I.sma(close, 200)) & (close >= close.rolling(20).max())).fillna(False)
# ← 这一行
returns = signal * close.pct_change()
equity = (1 + returns.fillna(0)).cumprod()
print(f"{len(btc)} 根日线,{btc.index[0].date()} 到 {btc.index[-1].date()},持仓 {signal.mean():.1%} 的日子")
print(f"年化 {equity.iloc[-1] ** (365 / len(equity)) - 1:.2%}")
print(f"最大回撤 {(equity / equity.cummax() - 1).min():.2%}")
print(f"期末是本金的 {equity.iloc[-1]:,.1f} 倍")
held = returns[signal]
print(f"持仓的 {len(held)} 根 K 线里,上涨的有 {(held > 0).mean():.2%}")
(# ← 这一行 那个标记,就是答案所在的地方——先别往下翻。)
结果:
3302 根日线,2017-08-17 到 2026-08-31,持仓 6.8% 的日子
年化 132.69%
最大回撤 0.00%
期末是本金的 2,080.0 倍
持仓的 226 根 K 线里,上涨的有 100.00%
年化 132.69%,九年把本金变成 2,080 倍,最大回撤 0.00%。
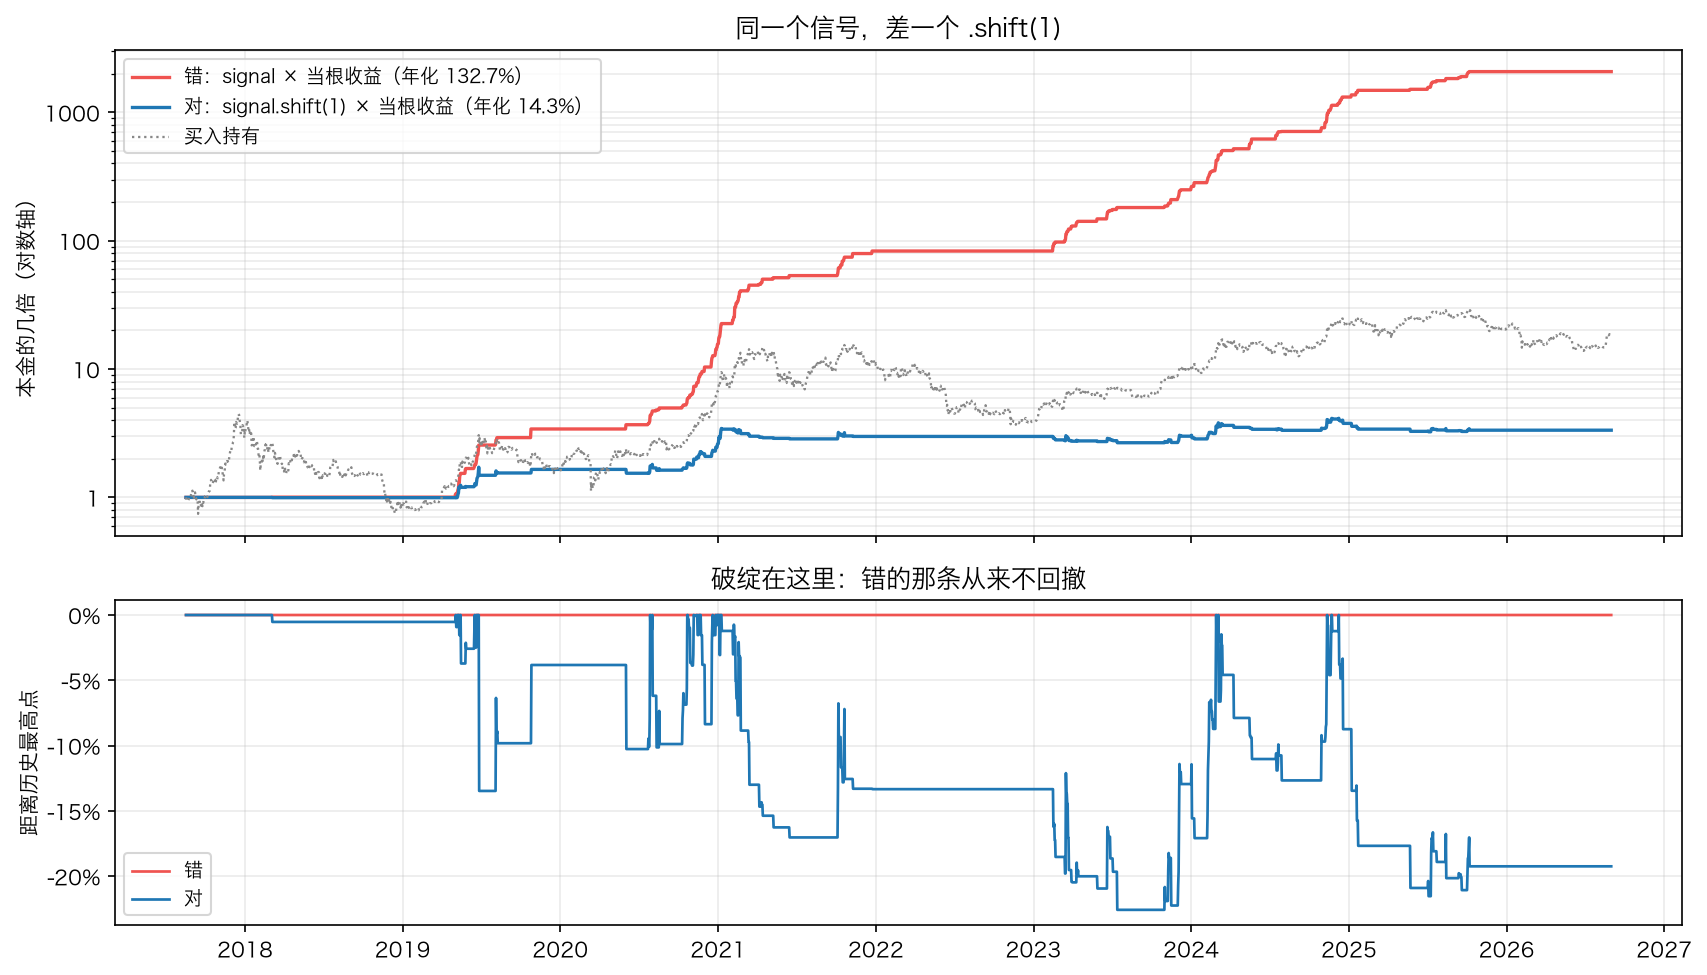
这条曲线是一级一级往上走的台阶,一次都没有往下过。
在相信它之前,先检查哪一行?
二、打个比方:飞行模拟器
回测是一台飞行模拟器:它要在地面上把飞行重演一遍,重演得越像,你在上面练出来的东西才越有用。
模拟器最容易出的毛病不是「画面不够精细」,是它偷偷告诉了你未来。提前三秒提示前方有下沉气流,你当然飞得又稳又好——但那不是飞行,那是背答案。
| 模拟器 | 回测 |
|---|---|
| 时钟:每一帧只能用这一帧之前的传感器读数 | 第 i 根收盘时算出来的东西,最早只能在第 i+1 根成交 |
| 提前告诉你三秒后的气流 | 前视偏差:用未来的数据算今天的仓位 |
| 传感器每分钟只采样四个数 | K 线只有开盘、最高、最低、收盘——中间怎么走的,不知道 |
| 油量表、高度表、速度表必须自洽 | 现金 + 持仓市值 = 权益,每一根都对得上 |
| 跑道上有没有空位 | 限价单排队:碰到限价不等于轮到你 |
这一篇只管把重演做对。偏差的完整清单和真实成本是第 28 篇,怎么评价跑出来的结果是第 29 篇。
三、不用看代码,先做三项体检
代码还没看,先问三个问题。
第一问:最大回撤是多少? 0.00%。任何一条真实的资金曲线都会回撤,哪怕只有一天。一条从不回撤的曲线,不是策略好,是记账方式出了问题。
第二问:持仓的日子里,有多少是上涨的? 226 根里上涨的有 100.00%。没有任何策略能做到每一根持仓 K 线都是正的。
第三问:把仓位往后推一根,结果掉多少?
这一问可以写成一个通用的体检函数。道理是这样的:一条真策略赚的是「信号之后价格继续走」,所以推迟一根只会让它温和地变差;如果推迟一根就塌掉,说明它原来赚的是信号当根自己的涨幅——而那一根的涨幅,正是算出这个信号的原料。
 推迟根数     年化    最大回撤  持仓根里上涨的比例
    0 1.3269  0.0000     1.0000
    1 0.1426 -0.2257     0.5000
    2 0.1799 -0.1637     0.5487
    3 0.1390 -0.1782     0.5221

推迟一根就从 132.69% 塌到 14.26%,而推迟两根、三根都在同一个量级——
真策略赚的是「信号之后价格接着走」,推迟一根只会温和地变差;
这里塌掉的那一截,是**信号当根自己的涨幅**,而那一根正是算出信号的原料。
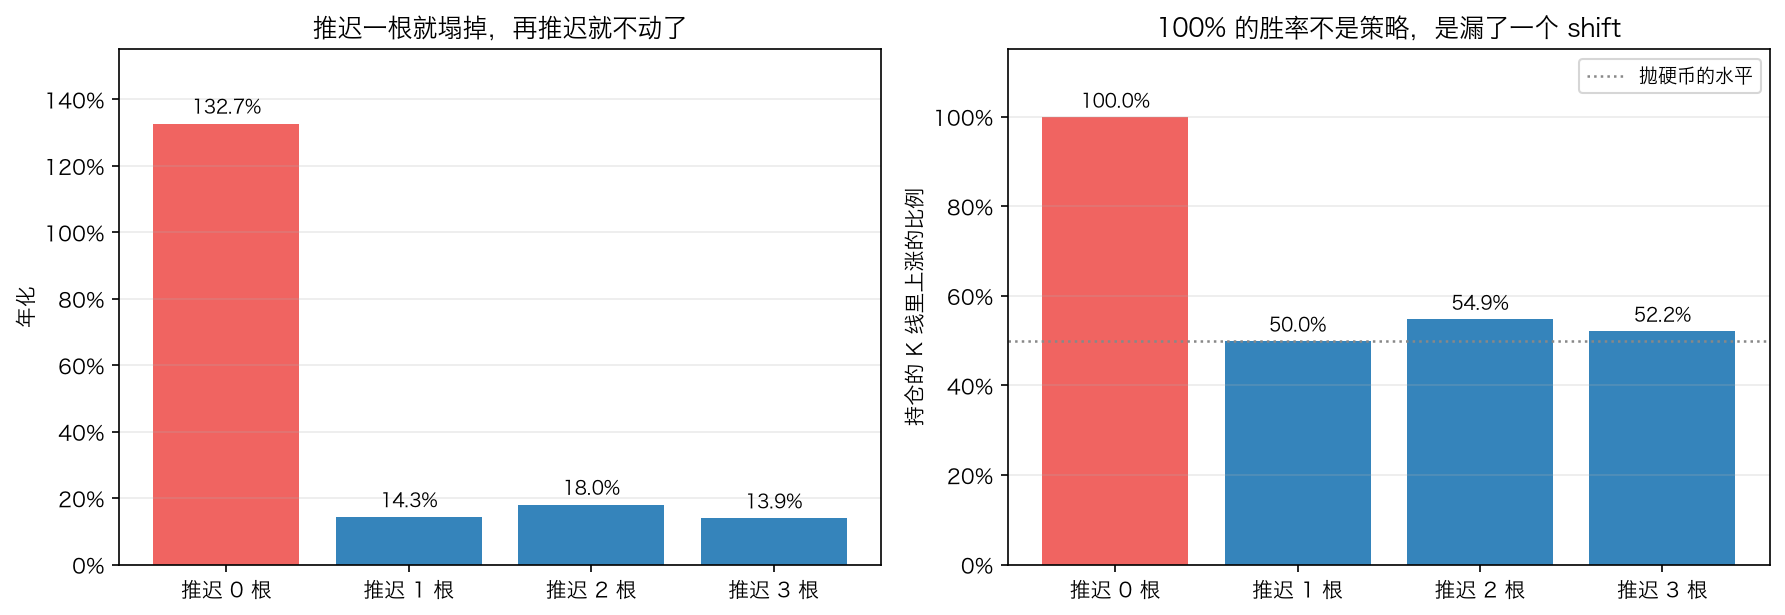
- 推迟 0 根:年化 132.69%,回撤 0.00%,持仓根上涨 100.00%
- 推迟 1 根:年化 14.26%,回撤 −22.57%,持仓根上涨 50.00%
- 推迟 2 根:17.99%,−16.37%,54.87%
- 推迟 3 根:13.90%,−17.82%,52.21%
塌陷只发生在 0 到 1 之间,1、2、3 三档都在同一个量级上下浮动。这就是「偷看未来」的指纹:真实的信息衰减是连续的,作弊的信息断崖是离散的。
lag_test 值得放进你每一次回测的固定流程里——它不需要你读懂策略代码,只要把「仓位序列」和「价格序列」交给它。
四、时钟规矩:一根 K 线上什么时候才知道什么
问题出在一个很容易忽略的地方:一根 K 线上的四个数,不是同时知道的。
     这一根上的数          什么时候知道 能用来下这一根的单吗
   开盘价 open          这一根刚开始          能
   最高价 high           这一根结束         不能
    最低价 low           这一根结束         不能
  收盘价 close           这一根结束         不能
均线、ATR、RSI… 这一根结束(它们都用到收盘价)         不能

所以那条时钟规矩只有一句话:**第 i 根收盘时算出来的东西,最早只能在第 i+1 根上成交。**
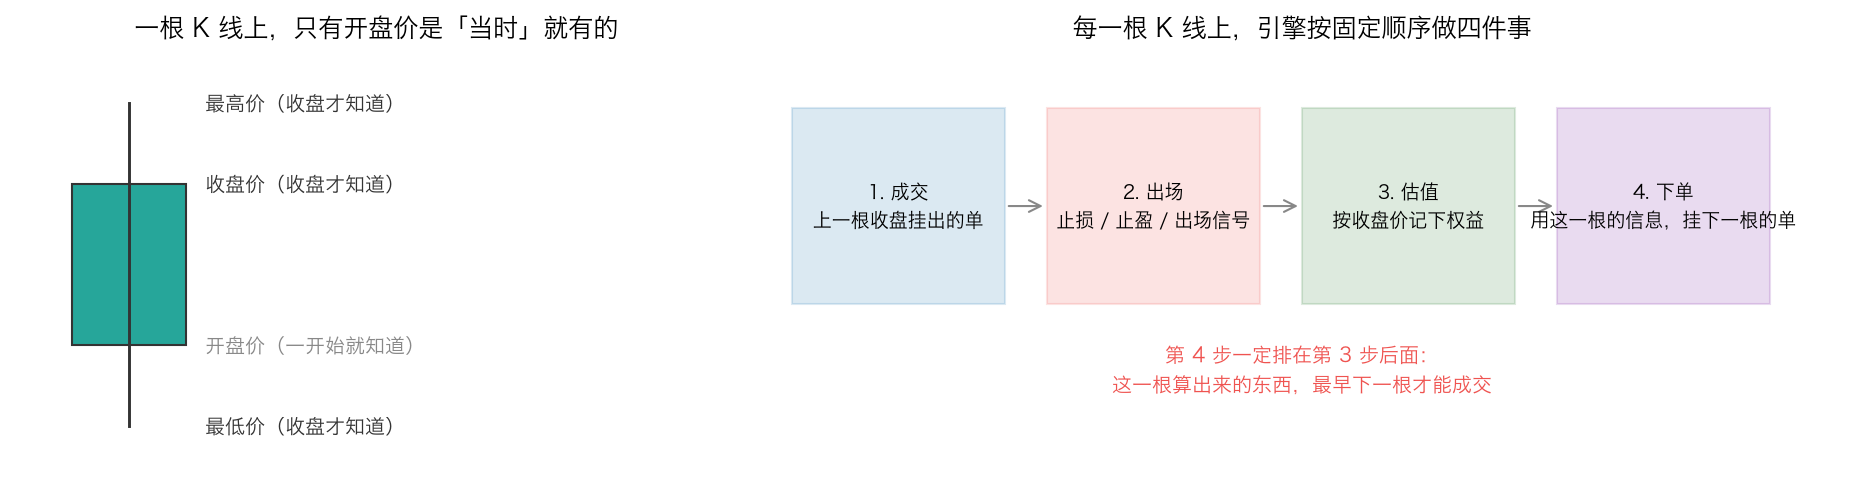
开盘价是这一根刚开始的时候就有的。最高价、最低价、收盘价,都要等这一根结束才知道。而所有指标——均线、ATR、RSI、布林带——都用到了收盘价,所以它们全都属于「收盘才知道」那一栏。
于是整台引擎只需要守住一句话:
第 i 根收盘时算出来的东西,最早只能在第 i+1 根上成交。
回头看决策点那一行:
returns = signal * close.pct_change()
signal[i] 是第 i 根收盘才算出来的(它用到了 close[i]),而 close.pct_change()[i] 是第 i 根一整根的涨幅。把它们相乘,等于声称:这一根收盘才知道的信号,这一根开盘就已经按它建好仓了。
更要命的是,这个信号里有一条「收盘价创 20 日新高」。收盘价是 20 天里最高的,意味着今天一定是涨的(至少高于昨天的收盘)。所以每一根持仓 K 线都是正收益——那条从不回撤的台阶,是这条入场条件和这个 bug 合谋的结果。
五、向量化能表达的,和不能表达的
「仓位乘以收益」这种写法叫向量化回测:一行代码,没有循环,跑得飞快。它不是错的,但它有一个明确的适用范围。
先把它写对:把「信号」变成「仓位」,再加上那个 lag。
def vectorized(close: pd.Series, position: pd.Series, lag: int = 1, fee_rate: float = 0.0) -> pd.Series:
    """向量化回测:仓位乘以收益,一行就算完。

    `position` 是**收盘时算出来的目标仓位**(0 到 1)。`lag=1` 表示它最早在下一根生效——
    这是本模块的时钟规矩。写 `lag=0` 就是声称「今天收盘才算得出来的仓位,今天一整天都拿着」,
    也就是第 27 篇决策点里那一行错误代码。

    手续费按仓位变化收:仓位从 0 变 1 收一次,从 1 变 0 再收一次。
    """
    if lag < 0:
        raise ValueError("lag 不能是负数(那是明目张胆地用未来)")
    held = position.reindex(close.index).fillna(0.0).shift(lag).fillna(0.0)
    turnover = held.diff().abs().fillna(held.abs())
    return (held * close.pct_change().fillna(0.0) - turnover * fee_rate).rename("收益")
lag=0:年化  132.69%  最大回撤    0.00%  期末   2,080.03 倍
lag=1:年化   14.26%  最大回撤  -22.57%  期末       3.34 倍
再看它能表达什么。主线策略的出场是一个信号(死叉),入场也是一个信号,中间的日子沿用上一个状态——这个状态可以用 ffill 算出来:
leave = I.cross_below(I.sma(close, 50), I.sma(close, 200)).fillna(False)
state = pd.Series(np.nan, index=btc.index)
state[signal] = 1.0                                       # 信号成立:目标仓位 1
state[leave] = 0.0                                        # 死叉:目标仓位 0
position = state.ffill().fillna(0.0)                      # 中间的日子沿用上一个状态
vector = (1 + BT.vectorized(close, position, lag=1)).cumprod()
event = BT.run(btc, BT.Plan(entry=signal, exit=leave, fill="close", stop="none", sizing="full"), EQUITY)
event_curve = event["资金曲线"] / EQUITY
print(f"向量化:终值 {vector.iloc[-1]:.6f} 倍,在场 {(position.shift(1) > 0).mean():.2%}")
print(f"事件驱动:终值 {event_curve.iloc[-1]:.6f} 倍,{len(event['交易'])} 笔交易,记账误差 {event['记账误差']:.1e}")
print(f"两条曲线的最大差额:{(event_curve - vector.reindex(event_curve.index)).abs().max():.3e}")
向量化:终值 5.219386 倍,在场 46.03%
事件驱动:终值 5.219386 倍,8 笔交易,记账误差 0.0e+00
两条曲线的最大差额:2.487e-14
两种写法一致到 2.5e-14——浮点数的最后几位。所以在这个设定下,向量化回测是对的,而且快得多。
但加上止损,这个写法就塌了。 止损价要从进场那一根往后推(吊灯止损要跟着进场之后的最高价走),而进场在哪一根,又取决于上一次出场在哪一根。仓位不再是「当根数据的函数」,它是一个状态机。
向量化能表达的是「仓位由当根及之前的数据唯一决定」的策略。止损、目标价、限价挂单、现金约束,全都不是这一类。
这就是要绕一个弯、写事件驱动引擎的唯一理由。
六、记账:现金、持仓、权益
第 21 篇的 rules.run 只算收益率:仓位比例乘以价格变化。它永远「买得起」,也永远不会告诉你手上还有多少现金。
真实账户有一个账本,任何时刻都必须成立:
现金 + 持仓数量 × 当前价格 = 权益
class Account:
    """一个自洽的账本:任何时刻 **现金 + 持仓数量 × 价格 = 权益**。

    `rules.run` 只算收益率,永远「买得起」。真实账户不是:手续费从现金里扣,
    扣完之后能买的数量就少了一点点,这一点点会随着交易次数复利。
    """
    cash: float
    shares: float = 0.0
    fees: float = 0.0

    def equity(self, price: float) -> float:
        return self.cash + self.shares * price

    def affordable(self, price: float, fee_rate: float = 0.0) -> float:
        """现金最多买得起多少(把手续费也算进去)。"""
        return self.cash / (price * (1 + fee_rate))

    def buy(self, price: float, shares: float, fee_rate: float = 0.0) -> float:
        cost = shares * price
        fee = cost * fee_rate
        if cost + fee > self.cash + 1e-9:
            raise ValueError(f"现金不够:要 {cost + fee:.2f},只有 {self.cash:.2f}")
        self.cash -= cost + fee
        self.shares += shares
        self.fees += fee
        return fee
开局:现金 100,000.00,持仓 0.0,权益 100,000.00
以 100 买入(单边费率 0.1%):现金 0.000000,持仓 999.0010 股,权益 99,900.10,已付手续费 99.90
以 110 全部卖出:现金 109,780.22,权益 109,780.22,手续费合计 209.79
价格涨了 10%,账户只涨了 9.7802%——差的就是两次手续费
买超过现金会直接报错:现金不够:要 2000.00,只有 1000.00
注意那几个数:10 万现金,单边费率 0.1%,能买的不是 1,000 股而是 999.0010 股;买完之后权益立刻变成 99,900.10——手续费已经从权益里扣掉了。价格涨 10% 再卖出,账户只涨 9.7802%,差的那 0.22 个百分点是两次手续费。
affordable 这个函数值得单独说一句。它解的是这个方程:
数量 × 价格 × (1 + 费率) = 现金
不是 现金 ÷ 价格。差别很小,但回测里「差一点点」的东西会复利——第十三节会把这笔账算出来。
七、事件驱动:每一根上的四步
有了账本,引擎就是一个循环。每一根 K 线上,按固定顺序做四件事:
- 成交:用上一根收盘时挂出的订单,在这一根上成交
- 出场:检查止损、止盈、出场信号
- 估值:按这一根的收盘价给账户估值,记下权益
- 下单:用截至这一根的数据算信号,挂出下一根的订单
第 4 步必须排在第 3 步后面。 把 3 和 4 调个个儿,或者把第 4 步算出来的信号拿到第 2 步去用,回测立刻变成印钞机——那就是决策点那一行干的事。
    for i in range(first, len(c)):
        # 第 1 步:成交上一根挂出的单
        if pending and account.shares == 0:
            price = o[i] if plan.fill == "next_open" else c[i - 1]
            level = (price * (1 - plan.stop_percent) if plan.stop == "percent"
                     else price - plan.k * atr[i - 1] if plan.stop == "chandelier" else -np.inf)
            if level < price:
                distance = 1 - level / price
                want = (account.equity(price) if plan.sizing == "full"
                        else account.equity(price) * min(1.0, plan.risk_per_trade / max(distance, 1e-9)))
                shares = min(want / price, account.affordable(price, plan.fee_rate))
                if shares > 0:
                    account.buy(price, shares, plan.fee_rate)
                    entry_price, entry_i, risk = price, i, price - level
                    highest, stop_price = price, level
            pending = False

        # 第 2 步:出场
        if account.shares > 0:
            stop_price = stop_level(i, stop_price)
            target = entry_price + plan.target_r * risk if plan.target_r is not None else np.inf
            price = reason = None
            if leave[i - 1] and i > entry_i:                      # 昨天收盘的出场信号,今天成交
                price, reason = (o[i] if plan.fill == "next_open" else c[i - 1]), "出场信号"
            elif plan.trigger == "close":
                if c[i] <= stop_price:
                    price, reason = c[i], "止损"
                elif c[i] >= target:
                    price, reason = c[i], "止盈"
            else:
                bar = {"low": l[i], "high": h[i]}
                touched = first_touch(bar, stop_price, target, plan.path, rng)
                if touched == "止损":
                    price, reason = min(o[i], stop_price), "止损"
                elif touched == "止盈":
                    price, reason = max(o[i], target), "止盈"
            if reason is not None:
                shares = account.shares
                account.sell(price, shares, plan.fee_rate)
                trades.append({"买入日": df.index[entry_i], "买入价": entry_price, "数量": shares,
                               "卖出日": df.index[i], "卖出价": price, "原因": reason,
                               "收益": price / entry_price - 1, "根数": i - entry_i})
            else:
                highest = max(highest, h[i])

        # 第 3 步:估值
        value = account.equity(c[i])
        error = max(error, abs(account.cash + account.shares * c[i] - value))
        curve.append(value)
        cash_path.append(account.cash)
        share_path.append(account.shares)

        # 第 4 步:用这一根收盘的信息下单,最早下一根成交
        if account.shares == 0 and not pending and signal[i]:
            pending = True
每一根上还顺手做了一次自检:
        value = account.equity(c[i])
        error = max(error, abs(account.cash + account.shares * c[i] - value))
这个 记账误差 在所有测试和所有真实数据上都必须是 0。它抓不到逻辑错误,但能抓到「钱凭空多了或少了」这一类——而这一类在自己写的引擎里比想象中常见。
八、对账:两个引擎,一条曲线
现在有两个引擎了:第 21 篇的 rules.run(在收益率空间里算)和这一篇的 backtest.run(有账本)。同样的设定下,它们必须给出同一条资金曲线。
对账是回测唯一能做的自检。 没有「正确答案」可以对照,但两个独立写出来的实现如果吻合到浮点误差,同时出错的概率就低得多。
 标的       仓位  rules.run 交易数  backtest.run 交易数  rules.run 终值  backtest.run 终值  两条曲线最大差额  记账误差
SPY       满仓             39                39      1.336100         1.336100  0.000000   0.0
SPY 每笔风险 10%             39                39      1.336100         1.336100  0.000000   0.0
BTC       满仓             30                30      4.629012         4.629012  0.000000   0.0
BTC 每笔风险 10%             30                30      5.791251         5.818177  0.113952   0.0
满仓那两行差 0.000000(实际是 1e-15 量级),交易数一样,记账误差 0。
但「每笔风险 10%」那一行差了 0.11。 一条九年的曲线差 0.11 倍,不算大,但它不是浮点误差——一定有一个引擎写错了,或者两个引擎在悄悄假设不同的事。
查下去:
挑一笔仓位没顶到满仓的:2021-02-04 以 37,620.26 买入,持有 21 根,涨了 25.13%
  按计划,这笔的仓位占权益 39.69%(= min(1, 10% ÷ 止损距离))
  出场前一根,数量一股没动,但仓位占权益变成了 46.49%——是价格涨上去的
  `rules.run` 里这个比例始终是 39.69%:它每根 K 线都把仓位调回目标比例

九年下来的差额:rules.run 终值 5.7913 倍,backtest.run 5.8182 倍,差 0.46%
两个引擎都能自圆其说,但只有一个对得上真实账户:**你不会每天把仓位调回 39%。**
原因找到了。rules.run 里每根 K 线的收益是 仓位比例 × 价格变化,仓位比例是个常数——这等于每根 K 线都把仓位调回目标比例:涨了就卖掉一点,跌了就补一点。而 backtest.run 买进多少股就拿着多少股,价格涨上去,这笔仓位占权益的比例自然从 39.69% 涨到 46.49%。
两种做法都能自圆其说,但只有一个对得上真实账户。 九年下来差 0.46%,小到不影响第 26 篇的任何结论(v4 在 BTC 上的年化从 21.53% 变成 21.60%),但这不是「可以忽略」的理由,是「必须查清楚」的理由——你不查,就不知道它是 0.46% 还是 46%。
⚠️ rules.py 里那段文档原来写的是「进场之后不再调整」,和实现对不上。对账对出来的第一个东西,往往是一句写错的注释。
九、同一根 K 线里,止损和止盈都碰到了
这是回测引擎里最贵的一个假设,而且它在数据上无解。
你在 100 买入,止损 95,目标 110。这一根 K 线的最高价 112、最低价 94——两个都碰到了。先到哪个?
K 线上有四个数:开盘、最高、最低、收盘。里面没有时间。 这一根内部是先涨到 112 再跌到 94,还是先跌到 94 再涨到 112,从数据上看不出来。
所以它是一个假设,必须显式写出来:
def first_touch(bar, stop: float, target: float, path: str = "pessimistic",
                rng: np.random.Generator | None = None) -> str:
    """一根 K 线上,止损和止盈谁先到(做多的口径)。

    只碰到一个,答案是确定的。**两个都碰到,K 线上就看不出顺序了**——
    开盘、最高、最低、收盘四个数里没有时间。这时按 `path` 给出的假设回答:

    - `"pessimistic"`:算止损先到(回测该用的默认值:宁可低估自己)
    - `"optimistic"`:算止盈先到(回测最常见、也最贵的那个错误)
    - `"coin"`:抛硬币(需要 `rng`;它比前两个都接近真相,但每跑一次结果都不一样)

    ⚠️ 换成更细的 K 线能把「两个都碰到」的比例压下去,但压不到 0:
    只要还是 K 线,就还有这一根内部。
    """
    if path not in PATHS:
        raise ValueError(f"path 只能是 {PATHS} 之一,收到 {path!r}")
    hit_stop, hit_target = bar["low"] <= stop, bar["high"] >= target
    if not hit_stop and not hit_target:
        return "都没碰到"
    if hit_stop and not hit_target:
        return "止损"
    if hit_target and not hit_stop:
        return "止盈"
    if path == "pessimistic":
        return "止损"
    if path == "optimistic":
        return "止盈"
    if rng is None:
        raise ValueError('path="coin" 要给一个 numpy 的随机数发生器,好让结果可复现')
    return "止盈" if rng.random() < 0.5 else "止损"
这件事有多常见?用 BTC 的九年数据扫一遍:每天开盘挂一个 ±k×ATR 的括号单,最多等 20 天,数一数有多少笔栽在「同一根」上。
括号宽度 ±0.25 ATR ±0.5 ATR ±1.0 ATR
K 线
日线      32.00%    6.86%    0.73%
4 小时     4.33%    0.79%    0.06%
1 小时     0.79%    0.09%    0.00%
1 分钟     0.00%    0.00%    0.00%
⚠️ K 线越细,这件事越少,但压不到 0:只要还是 K 线,就还有这一根内部
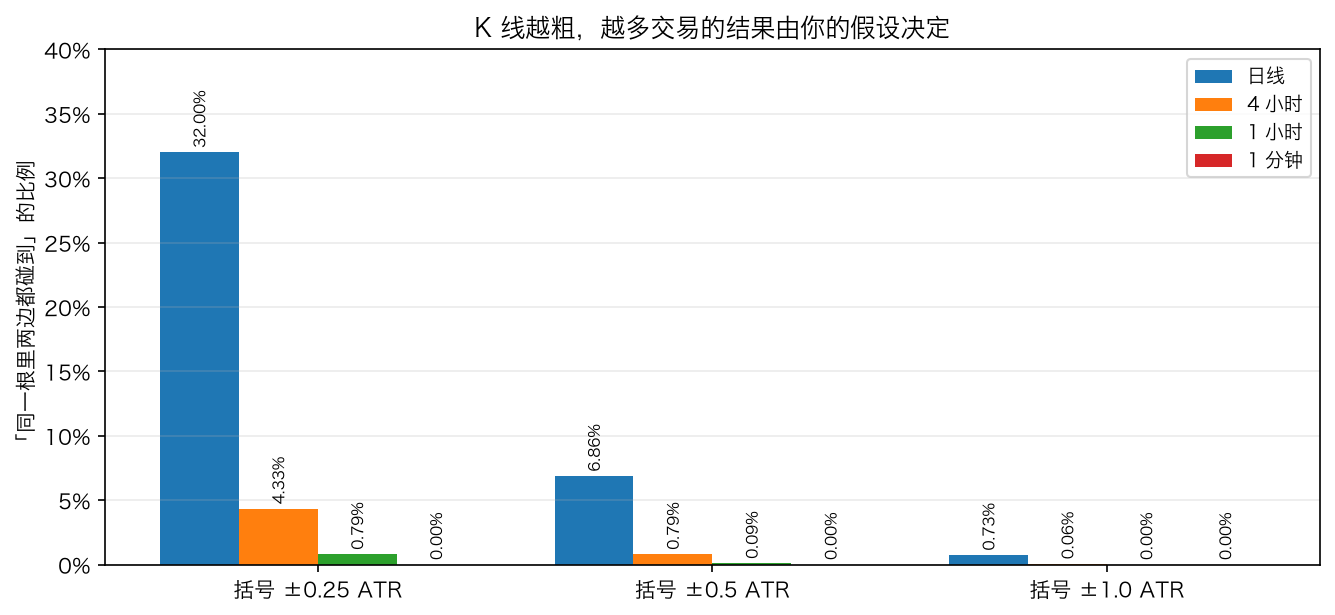
日线上,括号宽度 ±0.25 ATR 时,32.00% 的交易结果由你的假设决定,不由市场决定。 三分之一。
两个方向都很清楚:
- 括号越窄,越糟:±0.25 ATR 是 32.00%,±0.5 ATR 降到 6.86%,±1.0 ATR 只剩 0.73%。做日内、做窄止损的策略,在日线上回测基本是在回测你的假设。
- K 线越细,越好:同样 ±0.25 ATR 的括号,日线 32.00% → 4 小时 4.33% → 1 小时 0.79% → 1 分钟 0.00%。
⚠️ 但 1 分钟那一格的 0.00% 不等于「这个问题消失了」。它只是说「在 BTC 上,一分钟之内同时走过 ±0.25 ATR 的情况没发生过」。只要还是 K 线,就还有这一根内部——换成更窄的括号,一分钟线一样会遇到。
十、这个假设值多少钱
上一节数的是笔数。这一节数钱。
好消息是:这件事有真相可查。日线上「同一根」的那些交易,拆到 1 分钟线上就能看出谁先到。所以可以把四种做法摆在一起:乐观(总是算止盈先到)、悲观(总是算止损先到)、抛硬币,以及分钟线给出的真相。
--- 日线,括号 ±0.25 ATR ---
     同一根里听谁的   笔数  同一根     胜率    合计 R   期末是本金的几倍  比真相多算的 R
   乐观:总是止盈先到 3281 1050 0.6522   999.0 18513.8581    1144.0
   悲观:总是止损先到 3281 1050 0.3322 -1101.0     0.0000    -956.0
         抛硬币 3281 1050 0.4852   -97.0     0.3217      48.0
真相:用 1 分钟线判定 3281 1050 0.4779  -145.0     0.1991       0.0
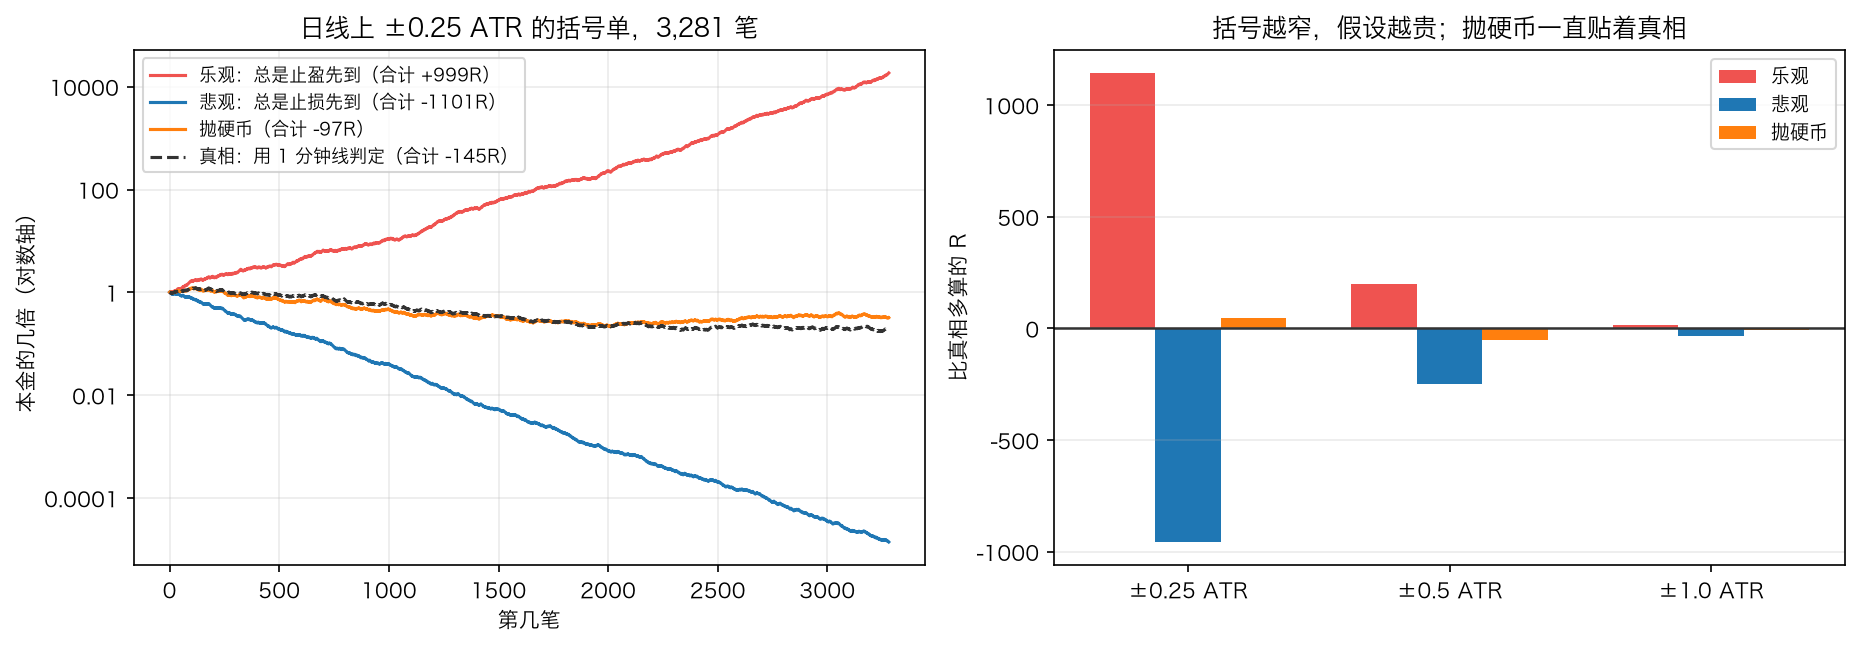
| 同一根里听谁的 | 胜率 | 合计 R | 每笔冒 1% 风险的终值 |
|---|---|---|---|
| 乐观:总是止盈先到 | 65.22% | +999R | 18,513.86 倍 |
| 悲观:总是止损先到 | 33.22% | −1,101R | 0.0000(归零) |
| 抛硬币 | 48.52% | −97R | 0.3217 |
| 真相:用 1 分钟线判定 | 47.79% | −145R | 0.1991 |
一个字的假设,把一条真实合计 −145R 的策略,算成了 +999R;终值从 0.20 倍变成 18,514 倍——五个数量级。
括号放宽之后这个代价迅速缩小:
--- 日线,括号 ±0.5 ATR ---
     同一根里听谁的   笔数  同一根     胜率   合计 R  期末是本金的几倍  比真相多算的 R
   乐观:总是止盈先到 3281  225 0.5300  197.0    6.0861     200.0
   悲观:总是止损先到 3281  225 0.4614 -253.0    0.0676    -250.0
         抛硬币 3281  225 0.4919  -53.0    0.4995     -50.0
真相:用 1 分钟线判定 3281  225 0.4995   -3.0    0.8236       0.0
--- 日线,括号 ±1.0 ATR ---
     同一根里听谁的   笔数  同一根     胜率  合计 R  期末是本金的几倍  比真相多算的 R
   乐观:总是止盈先到 3266   24 0.5288 188.0    5.5664      14.0
   悲观:总是止损先到 3266   24 0.5214 140.0    3.4444     -34.0
         抛硬币 3266   24 0.5257 168.0    4.5574      -6.0
真相:用 1 分钟线判定 3266   24 0.5266 174.0    4.8392       0.0
±1.0 ATR 时乐观只比真相多算 14R(8%),基本可以忽略。贵的不是这个假设本身,是「窄括号 + 粗 K 线」这个组合。
还有一个结论值得单独记下来:
抛硬币一直贴着真相。 ±0.25 ATR 时真相胜率 47.79%、抛硬币 48.52%;±0.5 ATR 时 49.95% 对 49.19%;±1.0 ATR 时 52.66% 对 52.57%。
这不奇怪——同一根里两边都碰到,价格在这一根内部来回走,先碰哪一边本来就接近五五开(真相略偏向止损,因为做多时止损在下方,而下跌来得更急)。所以:
- 日线回测用
pessimistic是安全的默认值(宁可低估自己),但它在窄括号上会把策略压得太惨(−1,101R 对真相的 −145R)。 - 想要接近真相,用
coin,代价是每跑一次结果都不一样(所以Plan里有seed)。 optimistic永远不要用。 它不是「乐观一点」,它是把 32% 的交易全判给你赢。
十一、限价单「碰到就成交」有多真
回测里的限价单默认「价格碰到限价就成交」。真实的限价单要排队:你的单子挂在那个价位上,前面还有别人的单子,碰到不等于轮到你。
订单簿的历史拿不到,但可以用分钟线量一个下界:日线判定成交的那些天,价格在限价或更低的地方停留了多久?
限价挂在开盘价下方 2%,日线判定「成交」的 1392 天(占全部 42.2%):
              天数  分钟数中位  只有1分钟的比例  不超过5分钟  成交额占比中位
穿过多少
≤0.05%(擦一下)   24    1.0    0.7083  0.9583   0.0058
0.05%–0.2%    90    3.0    0.2333  0.7000   0.0118
0.2%–1%      357   37.0    0.0280  0.1457   0.0614
1%–3%        495  341.0    0.0000  0.0040   0.3178
大于 3%        426  751.0    0.0000  0.0000   0.6605
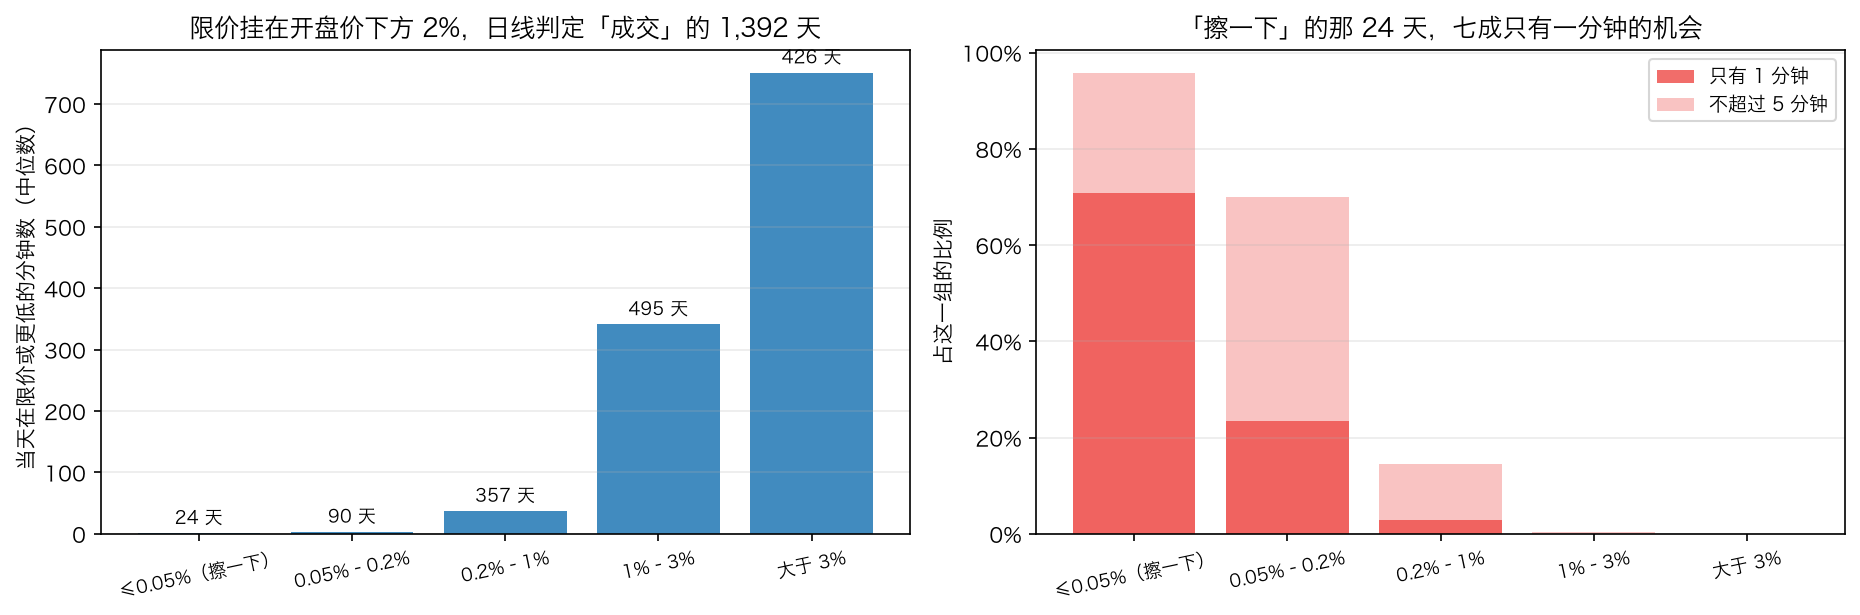
按「价格穿过限价多少」分组,结论很干脆:
| 穿过多少 | 天数 | 在限价或更低的分钟数(中位) | 只有 1 分钟 | 这些分钟的成交额占当天 |
|---|---|---|---|---|
| ≤0.05%(擦一下) | 24 | 1.0 | 70.83% | 0.58% |
| 0.05%–0.2% | 90 | 3.0 | 23.33% | 1.18% |
| 0.2%–1% | 357 | 37.0 | 2.80% | 6.14% |
| 1%–3% | 495 | 341.0 | 0.00% | 31.78% |
| 大于 3% | 426 | 751.0 | 0.00% | 66.05% |
价格明显穿过限价时,「碰到就成交」没问题:穿过 1%–3% 的那 495 天,价格在限价下方待了 341 分钟,这些分钟占当天成交额的 31.78%,你的单子几乎一定成交。
「擦一下」的那 24 天就完全是另一回事:70.83% 只有一分钟的机会,95.83% 不超过五分钟,这些分钟的成交额只占当天的 0.58%。这种成交在回测里是最漂亮的那种(买在当天最低点附近),但它大概率不属于你。
好在这类天数不多(24 / 1,392 = 1.7%)。limit_filled 留了个参数来量它:
def limit_filled(bar, level: float, side: str = "buy", through: float = 0.0) -> bool:
    """限价单在这根 K 线上算不算成交。

    `through=0` 就是回测默认的「碰到就成交」。真实的限价单要排队,**碰到不等于轮到你**:
    价格只是擦了一下限价就掉头,那一分钟的成交量可能根本轮不到你的单子。
    `through=0.001` 表示「价格要穿过限价 0.1% 才算我成交」,用来量这个假设值多少钱。
    """
    if side not in ("buy", "sell"):
        raise ValueError(f"side 只能是 buy 或 sell,收到 {side!r}")
    return bool(bar["low"] <= level * (1 - through) if side == "buy"
                else bar["high"] >= level * (1 + through))
`limit_filled` 里的 through 参数就是用来量这个假设的:
  要求价格穿过限价 0.00% 才算成交:1392 天成交(原来 1392 天),少了 0 天
  要求价格穿过限价 0.05% 才算成交:1368 天成交(原来 1392 天),少了 24 天
  要求价格穿过限价 0.20% 才算成交:1278 天成交(原来 1392 天),少了 114 天
要求穿过 0.2% 才算成交,1,392 天里少掉 114 天——如果一条策略的收益主要来自这 114 天,那它是假的。
十二、成本的接口
引擎里留了一个 fee_rate。真实的费率、滑点、买卖价差是第 28 篇的事,这里只验证一件事:它接得上,而且接上之后不会出错。
 单边费率  交易数     年化        期末账户      手续费合计  手续费占期末账户
0.00%   30 0.2160 581817.7139     0.0000    0.0000
0.02%   30 0.2147 576191.1709  4322.0701    0.0075
0.05%   30 0.2127 567851.8334 10709.4060    0.0189
0.10%   30 0.2094 554216.6887 21103.8915    0.0381
0.20%   30 0.2029 527937.3030 40980.5204    0.0776
⚠️ 真实的费率、滑点、买卖价差是第 28 篇的事,这里只是把口子留出来
30 笔交易、九年,单边 0.05% 的费率吃掉 0.33 个百分点的年化(21.60% → 21.27%),手续费合计 10,709 美元,占期末账户的 1.89%。
这个数看起来很小,但注意它和交易频率的关系:30 笔交易对应 60 次买卖。一条每周调仓的策略,九年是 468 次——同样的费率,代价是这里的 8 倍。这就是为什么第 23 篇说「成本按 R 折算 = 费率 ÷ 止损距离」,以及为什么高频信号在成本面前先死一次。
十三、动手:talab.backtest
新模块 talab.backtest,四部分。
"""talab.backtest:回测引擎。第 27 篇。

回测是一台飞行模拟器:它要在地面上把飞行重演一遍,重演得越像,你在上面练出来的东西才越有用。
模拟器最容易出的毛病不是「不够精细」,是**它偷偷告诉了你未来**——提前三秒提示下沉气流,
你当然飞得又稳又好,但那不是飞行。

所以这个模块的第一条规矩不是关于收益的,是关于时钟的:

> **第 i 根 K 线收盘时算出来的东西,最早只能在第 i+1 根上成交。**

围绕这条规矩,模块分四部分:

1. **向量化**:`vectorized` 和 `lag_test`——一行代码就能写完的回测,以及怎么检查它有没有偷看。
2. **盘中路径**:`first_touch`——同一根 K 线里止损和止盈都被碰到,先算哪个?
   K 线只有四个数,这件事**从数据上无法判断**,所以它是一个假设,必须显式写出来。
3. **记账**:`Account`——现金、持仓、权益三个数必须时时自洽,手续费从现金里扣。
   `rules.run`(第 21 篇)只算收益率,算不出「这笔钱够不够买」。
4. **事件驱动**:`Plan` 和 `run`——一根一根推进,每一根上按固定顺序做四件事。

⚠️ 这个模块只负责**把重演做对**。偏差(幸存者、数据窥探、复权)和真实成本是第 28 篇,
怎么评价跑出来的结果是第 29 篇。`fee_rate` 这个口子留在这里,数字由第 28 篇填。
"""
from __future__ import annotations

from dataclasses import dataclass, field

import numpy as np
import pandas as pd

PATHS = ("pessimistic", "optimistic", "coin")
FILLS = ("next_open", "close")
STOPS = ("none", "chandelier", "percent")
SIZINGS = ("full", "risk")
体检
def lag_test(close: pd.Series, position: pd.Series, lags=(0, 1, 2, 3),
             periods_per_year: int = 365) -> pd.DataFrame:
    """把仓位依次往后推一根,看结果掉得有多快——查「有没有偷看未来」的通用体检。

    一条真策略的收益来自「信号之后价格继续走」,推迟一根只会让它**温和地**变差。
    推迟一根就塌掉,说明原来那个版本赚的是**信号当根自己的涨幅**,
    而那一根的涨幅正是算出信号的原料。
    """
    rows = []
    for lag in lags:
        returns = vectorized(close, position, lag)
        equity = (1 + returns).cumprod()
        in_market = vectorized(close, position, lag) != 0
        rows.append({"推迟根数": lag,
                     "年化": equity.iloc[-1] ** (periods_per_year / len(returns)) - 1,
                     "最大回撤": float((equity / equity.cummax() - 1).min()),
                     "持仓根里上涨的比例": float((returns[in_market] > 0).mean()) if in_market.any() else np.nan})
    return pd.DataFrame(rows)
设定
Plan 的前五项和第 21 篇的 Rule 一一对应,后面几项是这一篇新加的:盘中路径、费率、随机种子。
class Plan:
    """一次回测的全部设定。前五项和第 21 篇的 `Rule` 一一对应,后面几项是这一篇新加的。"""
    entry: pd.Series                       # 收盘时成立的入场信号
    exit: pd.Series                        # 收盘时成立的出场信号
    fill: str = "next_open"                # 下一根开盘成交,还是当根收盘成交
    stop: str = "chandelier"               # none / chandelier / percent
    k: float = 3.0                         # chandelier:最高价往下几个 ATR
    stop_percent: float = 0.10
    trigger: str = "close"                 # 止损用收盘价还是盘中最低价触发(第 20 篇)
    target_r: float | None = None          # 止盈目标,按 R 算(第 23 篇)
    path: str = "pessimistic"              # 同一根里止损和止盈都碰到时听谁的
    sizing: str = "full"                   # full / risk(第 26 篇)
    risk_per_trade: float = 0.10
    fee_rate: float = 0.0                  # 单边费率,数字留给第 28 篇
    atr_period: int = 14
    seed: int = 27                         # path="coin" 时的随机种子

    def __post_init__(self):
        for name, value, allowed in [("fill", self.fill, FILLS), ("stop", self.stop, STOPS),
                                     ("path", self.path, PATHS), ("sizing", self.sizing, SIZINGS)]:
            if value not in allowed:
                raise ValueError(f"{name} 只能是 {allowed} 之一,收到 {value!r}")
        if self.target_r is not None and self.trigger == "close" and self.path != "pessimistic":
            raise ValueError("收盘价触发时一根 K 线只有一个收盘价,不存在先后问题,path 没有意义")
        if self.sizing == "risk" and self.stop == "none":
            raise ValueError('没有止损就算不出每笔的风险,sizing="risk" 需要一个止损')

    def describe(self) -> pd.Series:
        return pd.Series({
            "入场方式": {"close": "当根收盘价", "next_open": "下一根开盘价"}[self.fill],
            "初始止损": {"none": "没有", "chandelier": f"{self.k} 倍 ATR 吊灯",
                         "percent": f"进场价下方 {self.stop_percent:.0%}"}[self.stop],
            "止损触发": {"close": "收盘价", "extreme": "盘中最低价"}[self.trigger],
            "止盈目标": "不设" if self.target_r is None else f"{self.target_r} 个 R",
            "同一根里的顺序": {"pessimistic": "算止损先到", "optimistic": "算止盈先到",
                               "coin": "抛硬币"}[self.path],
            "仓位": "满仓" if self.sizing == "full" else f"每笔风险 {self.risk_per_trade:.0%}",
            "单边费率": f"{self.fee_rate:.4%}",
        })
__post_init__ 里有一条校验值得看一眼:
        if self.target_r is not None and self.trigger == "close" and self.path != "pessimistic":
            raise ValueError("收盘价触发时一根 K 线只有一个收盘价,不存在先后问题,path 没有意义")
用收盘价触发止损和止盈时,一根 K 线只有一个收盘价,不可能两个都碰到(第 20 篇选的就是收盘触发)。这时候设置 path 是在表达一个不存在的选择,直接报错比默默忽略好。
引擎
函数签名、说明和开场(循环体第七节已经逐行看过了):
def run(df: pd.DataFrame, plan: Plan, equity: float = 100_000.0) -> dict:
    """事件驱动回测:一根一根推进,每一根上按**固定顺序**做四件事。

    1. **成交**:用上一根收盘时挂出的订单,在这一根上成交(开盘市价单)
    2. **出场**:检查止损、止盈;两个都碰到时按 `plan.path` 决定顺序
    3. **估值**:按这一根的收盘价给账户估值,记下权益
    4. **下单**:用截至这一根的数据算信号,挂出**下一根**的订单

    第 4 步必须排在第 3 步后面,这就是那条时钟规矩。把 3 和 4 调个个儿,
    或者把第 4 步算出来的信号拿到第 2 步去用,回测立刻变成印钞机。

    返回一个字典:资金曲线、现金、持仓数量、交易表、以及**记账误差**——
    每一根上「现金 + 持仓市值」和权益的最大差额,正常应该是 0。
    """
    from talab import indicators as I

    o, h, l, c = (df[x].to_numpy(float) for x in ["open", "high", "low", "close"])
    atr = (I.atr(df["high"], df["low"], df["close"], plan.atr_period).to_numpy()
           if plan.stop == "chandelier" else np.full(len(c), np.nan))
    signal = plan.entry.reindex(df.index).fillna(False).to_numpy(bool)
    leave = plan.exit.reindex(df.index).fillna(False).to_numpy(bool)
    rng = np.random.default_rng(plan.seed)
    account = Account(cash=float(equity))
    first = int(np.argmax(~np.isnan(atr))) + 1 if plan.stop == "chandelier" else 1

    curve, cash_path, share_path, trades, error = [], [], [], [], 0.0
    pending = False                                   # 上一根收盘挂出的买单还在不在
    entry_price = stop_price = risk = highest = np.nan
    entry_i = -1

    def stop_level(i: int, previous: float) -> float:
        if plan.stop == "none":
            return -np.inf
        if plan.stop == "percent":
            return entry_price * (1 - plan.stop_percent)
        return max(previous, highest - plan.k * atr[i - 1])   # 吊灯只上移
循环跑完之后的收尾:
    if account.shares > 0:                            # 最后一根还拿着:记成「未平仓」,按收盘价估值
        trades.append({"买入日": df.index[entry_i], "买入价": entry_price, "数量": account.shares,
                       "卖出日": df.index[-1], "卖出价": c[-1], "原因": "未平仓",
                       "收益": c[-1] / entry_price - 1, "根数": len(c) - 1 - entry_i})
    index = df.index[first:]
    table = pd.DataFrame(trades, columns=["买入日", "买入价", "数量", "卖出日", "卖出价", "原因", "收益", "根数"])
    return {"资金曲线": pd.Series(curve, index=index, name="权益"),
            "现金": pd.Series(cash_path, index=index, name="现金"),
            "持仓数量": pd.Series(share_path, index=index, name="持仓"),
            "交易": table, "手续费合计": account.fees, "记账误差": error}
⚠️ 最后一根还拿着的仓位要记成一笔「未平仓」的交易,按最后的收盘价估值。不这样做的话,「每笔交易的平均收益」「胜率」这类统计会悄悄漏掉还没结束的那一笔;而趋势跟随策略在历史末尾往往正拿着一笔浮盈,漏掉它会系统性地低估成绩。第 21 篇的 rules.run 也是这么做的——第八节那张对账表里两个引擎的交易数完全一样,就是因为这一条也对齐了。
对账
def reconcile(curves: dict[str, pd.Series]) -> pd.DataFrame:
    """把几条资金曲线摆在一起对账:终值、年化、最大回撤,以及和第一条的最大差额。

    两个引擎在同样的设定下跑出不同的曲线,一定有一个写错了。**对账是回测唯一能做的自检。**
    """
    names = list(curves)
    base = curves[names[0]] / curves[names[0]].iloc[0]
    rows = []
    for name in names:
        series = curves[name] / curves[name].iloc[0]
        aligned = series.reindex(base.index)
        rows.append({"名字": name, "终值(本金的几倍)": float(series.iloc[-1]),
                     "最大回撤": float((series / series.cummax() - 1).min()),
                     f"和「{names[0]}」的最大差额": float((aligned - base).abs().max())})
    return pd.DataFrame(rows)
测试
20 个测试。第一个就是这一篇的主题:
def test_vectorized_lag_is_the_whole_point():
    """「今天涨了」这个信号,lag=0 时每一根都押中,lag=1 时什么也押不中。"""
    close = series([100, 110, 100, 110, 100, 110, 100])
    up = (close.pct_change() > 0).astype(float)
    assert BT.vectorized(close, up, lag=0).sum() == pytest.approx(up.mul(close.pct_change()).sum())
    assert (BT.vectorized(close, up, lag=0) >= 0).all()          # 偷看未来:一根都不亏
    assert BT.vectorized(close, up, lag=1).min() < 0             # 老老实实:会亏
「今天涨了」这个信号,lag=0 时每一根都押中(一根都不亏),lag=1 时会亏——这就是决策点那一行的最小复现。
def test_lag_test_tells_a_peeking_signal_from_a_real_one():
    """偷看未来的信号推迟一根就塌,真信号只是温和变差。"""
    rng = np.random.default_rng(27)
    close = series(100 * np.exp(np.cumsum(rng.standard_normal(800) * 0.01)))
    peeking = (close.pct_change() > 0).astype(float)             # 用当根自己的涨跌当信号
    honest = (close.pct_change().shift(1) > 0).astype(float)     # 用上一根的涨跌当信号
    a = BT.lag_test(close, peeking, lags=(0, 1))
    b = BT.lag_test(close, honest, lags=(0, 1))
    assert a["年化"].iloc[0] > 10 * max(a["年化"].iloc[1], 0.01)  # 塌掉一个数量级
    assert a["持仓根里上涨的比例"].iloc[0] == pytest.approx(1.0)
    assert abs(b["年化"].iloc[0] - b["年化"].iloc[1]) < abs(a["年化"].iloc[0] - a["年化"].iloc[1])
def test_run_never_trades_on_the_signal_bar_itself():
    """价格只在第 5 根跳了一下,信号也在第 5 根:正确的引擎一分钱也赚不到。"""
    df = bars([100, 100, 100, 100, 100, 200, 200, 200])
    entry = flags(8, [5])                                         # 跳的那一根收盘才成立
    result = BT.run(df, BT.Plan(entry=entry, exit=flags(8), stop="none"), 1_000.0)
    assert result["资金曲线"].iloc[-1] == pytest.approx(1_000.0)   # 第 6 根开盘买入,价格已经是 200
    assert result["交易"]["买入价"].iloc[0] == pytest.approx(200.0)
这个测试是时钟规矩的最小复现:价格只在第 5 根跳了一下,信号也在第 5 根收盘才成立——正确的引擎一分钱也赚不到,因为它第 6 根开盘才买,那时价格已经是 200。
def test_run_books_every_bar_exactly():
    df = random_walk()
    entry = (df["close"] >= df["close"].rolling(20).max()).fillna(False)
    exit_ = (df["close"] <= df["close"].rolling(20).min()).fillna(False)
    result = BT.run(df, BT.Plan(entry=entry, exit=exit_, stop="percent", stop_percent=0.10), 100_000.0)
    assert result["记账误差"] == pytest.approx(0.0, abs=1e-9)
    rebuilt = result["现金"] + result["持仓数量"] * df["close"].reindex(result["现金"].index)
    assert (rebuilt - result["资金曲线"]).abs().max() == pytest.approx(0.0, abs=1e-9)
def test_run_agrees_with_the_post21_engine_when_fully_invested():
    """满仓、不收费时,第 27 篇的引擎和第 21 篇的 `rules.run` 必须给出同一条资金曲线。"""
    df = random_walk()
    entry = (df["close"] >= df["close"].rolling(20).max()).fillna(False)
    exit_ = I.cross_below(I.sma(df["close"], 10), I.sma(df["close"], 30)).fillna(False)
    settings = dict(fill="next_open", stop="chandelier", k=3.0, trigger="close")
    old, _, trades = R.run(df, R.Rule(entry=entry, exit=exit_, sizing="full", **settings))
    new = BT.run(df, BT.Plan(entry=entry, exit=exit_, sizing="full", **settings), 1.0)
    assert len(new["交易"]) == len(trades)
    assert ((new["资金曲线"] - (1 + old).cumprod()).abs().max()) < 1e-12
def test_vectorized_and_event_driven_agree_when_there_is_no_stop():
    """没有止损时,仓位就是当根数据的函数,两种写法必须一致。"""
    df = random_walk()
    entry = (df["close"] >= df["close"].rolling(20).max()).fillna(False)
    exit_ = (df["close"] <= df["close"].rolling(20).min()).fillna(False)
    state = pd.Series(np.nan, index=df.index)
    state[entry], state[exit_] = 1.0, 0.0
    vector = (1 + BT.vectorized(df["close"], state.ffill().fillna(0.0), lag=1)).cumprod()
    event = BT.run(df, BT.Plan(entry=entry, exit=exit_, fill="close", stop="none"), 1.0)["资金曲线"]
    assert (event - vector.reindex(event.index)).abs().max() < 1e-12
上面这两个是第五节和第八节那两条结论的测试版本:没有止损时向量化和事件驱动必须一致,满仓时新旧引擎必须一致。 把它们钉成测试,以后谁动了引擎都会立刻知道。
def test_run_with_a_coin_path_is_reproducible():
    df = random_walk()
    entry = (df["close"] >= df["close"].rolling(20).max()).fillna(False)
    plan = dict(entry=entry, exit=flags(len(df)), stop="percent", stop_percent=0.005,
                trigger="extreme", target_r=1.0, path="coin")
    first = BT.run(df, BT.Plan(seed=27, **plan), 1.0)["资金曲线"]
    again = BT.run(df, BT.Plan(seed=27, **plan), 1.0)["资金曲线"]
    other = BT.run(df, BT.Plan(seed=99, **plan), 1.0)["资金曲线"]
    assert (first - again).abs().max() == 0.0                     # 同一个种子,同一条曲线
    assert (first - other).abs().max() > 0.0                      # 换个种子就不一样了
265 passed in 0.88s
没装 TA-Lib 时:
233 passed, 32 skipped in 1.06s
十四、揭晓
错的是这一行:
returns = signal * close.pct_change()
改对只要加一个 .shift(1):
returns = signal.shift(1) * close.pct_change()
错的那一行是:returns = signal * close.pct_change()
改对只要一个 .shift(1):returns = signal.shift(1) * close.pct_change()
                     版本     年化    最大回撤      期末倍数
         错:signal * ret 1.3269  0.0000 2080.0294
对:signal.shift(1) * ret 0.1426 -0.2257    3.3396
| 版本 | 年化 | 最大回撤 | 期末倍数 |
|---|---|---|---|
错:signal * ret |
132.69% | 0.00% | 2,080.03 |
对:signal.shift(1) * ret |
14.26% | −22.57% | 3.34 |
一个 .shift(1),622 倍。
这一行之所以特别隐蔽,是因为它读起来完全合理:「信号成立的日子,我就持有」。问题在于「信号成立的日子」这句话里藏着一个时间点——信号是那一天收盘才成立的,而「持有那一天」意味着你从开盘就在场。这两件事差了一整根 K 线。
而它之所以能造出 0.00% 的回撤,是因为入场条件里有「收盘价创 20 日新高」:收盘价是 20 天最高,就意味着今天一定是涨的。所以「每一根持仓 K 线都上涨」不是巧合,是这条 bug 的必然结果——这也是为什么第三节的体检能不看代码就断定它有问题。
⚠️ 最后诚实地说一句:改对之后的 14.26% 也不是这条策略的真实成绩。它没有止损、没有仓位管理、没有成本,出场是「信号消失就走」而不是主线策略的死叉。真正的 v4 是下一节。
十五、主线策略 v4 搬到新引擎上
第 26 篇定下的 v4:金叉状态 + 收盘创 20 日新高入场,下一根开盘市价,3 ATR 吊灯收盘触发,死叉出场,一笔最多亏账户 10%。把它搬到新引擎上:
入场方式             下一根开盘价
初始止损       3.0 倍 ATR 吊灯
止损触发                收盘价
止盈目标                 不设
同一根里的顺序           算止损先到
仓位             每笔风险 10%
单边费率            0.0000%
                  名字  终值(本金的几倍)      最大回撤  和「第 21 篇的 rules.run」的最大差额
   第 21 篇的 rules.run   5.791251 -0.323122                   0.000000
第 27 篇的 backtest.run   5.818177 -0.323209                   0.113952
       加上 0.05% 单边费率   5.678518 -0.327600                   0.121473
第 21 篇的 rules.run:年化 21.53%,最大回撤 -32.31%
第 27 篇的 backtest.run:年化 21.60%,最大回撤 -32.32%
加上 0.05% 单边费率:年化 21.27%,最大回撤 -32.76%

记账误差 0.0e+00;最后一根上 现金 581,817.71 + 持仓 0.000000 × 78,581.29 = 581,817.71
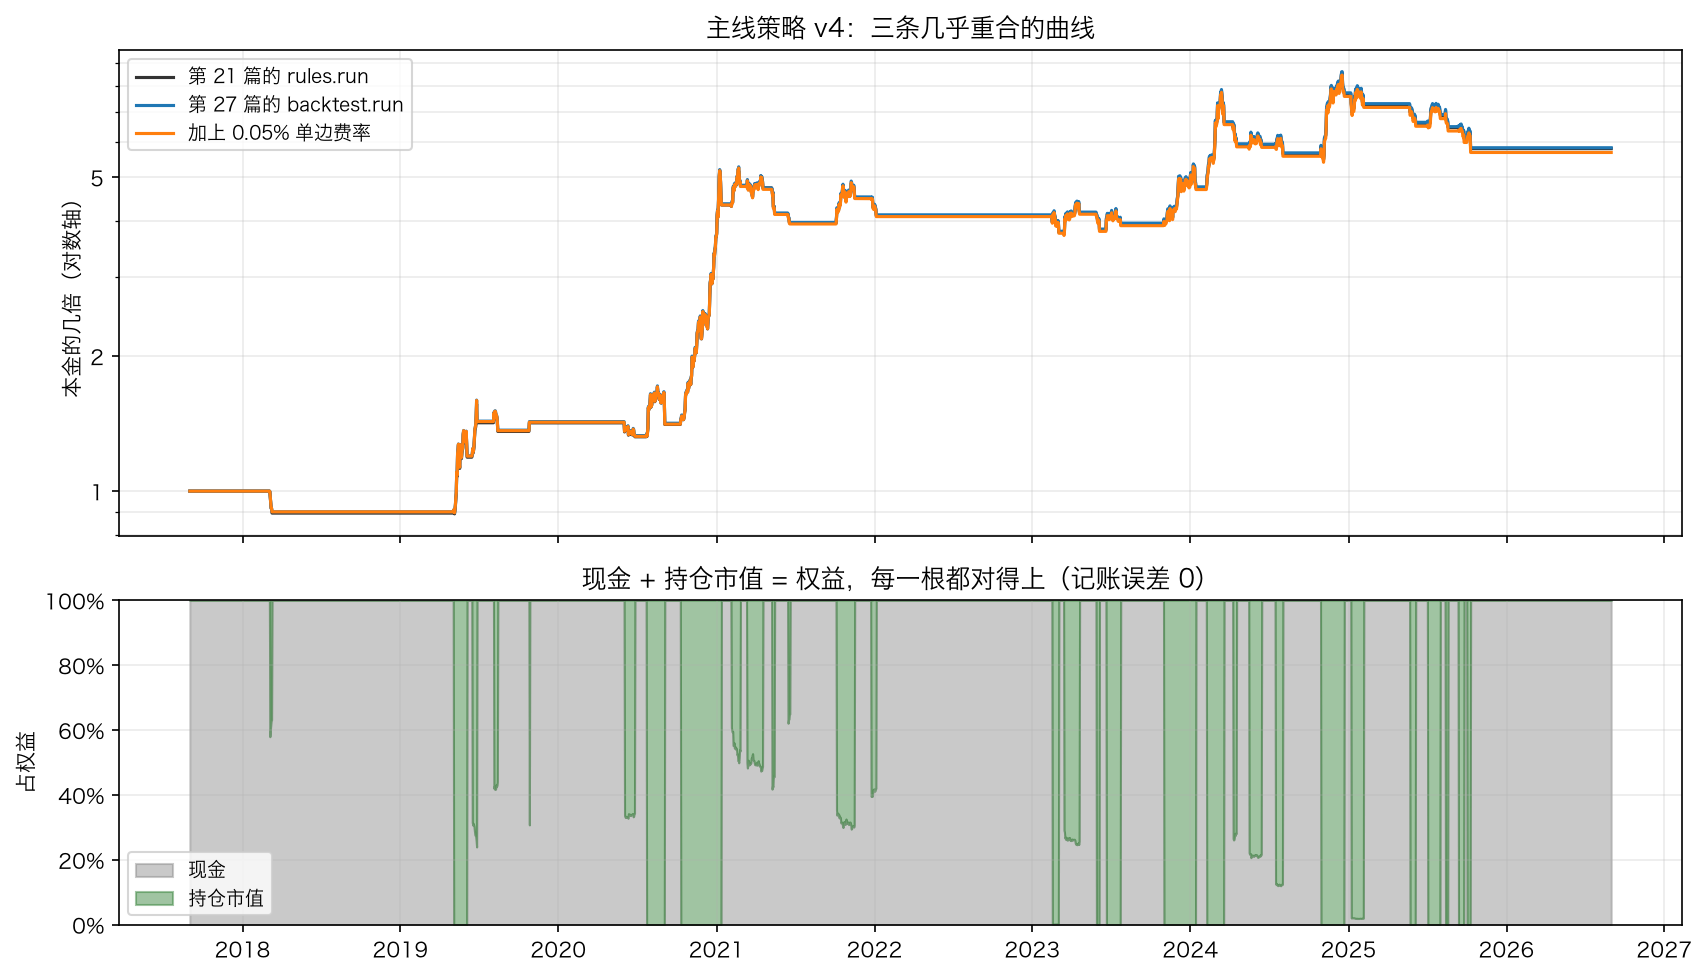
| 引擎 | 年化 | 最大回撤 | 终值 |
|---|---|---|---|
第 21 篇的 rules.run |
21.53% | −32.31% | 5.7913 倍 |
第 27 篇的 backtest.run |
21.60% | −32.32% | 5.8182 倍 |
| 加上 0.05% 单边费率 | 21.27% | −32.76% | 5.6785 倍 |
三条曲线几乎重合,差别全在第八节说清楚的那件事上(再平衡 vs 持有固定数量)和手续费上。
策略本身这一篇不改——这一篇改的是测量工具,不是被测量的东西。但工具变了之后,有三件事现在才能说:
- 每一根上现金 + 持仓市值 = 权益,误差 0。 最后一根上现金 581,817.71、持仓 0 股,因为这条策略最后一笔已经平掉了。
- 主线 v4 对盘中路径完全不敏感:它的止损是收盘价触发(第 20 篇的选择),而且不设止盈目标——一根 K 线只有一个收盘价,第九、十节那 32% 的麻烦在它身上一次都不会发生。这是第 20 篇「按机制选、不按回测数字选」的一次迟到的回报。
- 成本的接口已经接上了,0.05% 单边对应年化 −0.33 个百分点。真实的数字第 28 篇填。
十六、小检查
- 一条回测的资金曲线,最大回撤是 0.00%。不看代码,你会先怀疑什么?
signal.shift(1) * close.pct_change()假设你在什么时候、以什么价格成交?这个假设贵不贵?- 哪一类策略可以用向量化回测写完?举一个不能的例子。
- 止损 95、目标 110,某一根 K 线最高 112、最低 94。回测应该判哪个?为什么这个问题在 1 分钟线上会变小但不会消失?
- 你的引擎和别人的引擎在同一套设定上差了 3%。第一步该做什么?
十七、常见误用
把「回测跑出来的数」当成「策略的成绩」。 它是「策略 + 引擎 + 假设」三者的成绩。第十节那张表里四行用的是同一条策略,成绩从 0.20 倍到 18,514 倍。
在日线上回测窄止损、窄止盈的策略。 ±0.25 ATR 的括号在日线上有 32% 的交易栽在「同一根」里。要么换细 K 线,要么把结果当成「假设的成绩」而不是策略的。
用 optimistic 当默认值。 有些回测框架的默认设定就是「目标优先」,理由是「大多数时候趋势向上」。第十节量过:它在窄括号上把 −145R 算成 +999R。
看到「碰到限价就成交」不当回事。 大部分时候它是对的(价格穿过 1% 以上时,有 341 分钟、31.78% 的成交额),但「擦一下」的那些成交是回测里最漂亮的,也最假。
只写一个引擎。 没有第二个实现,你没有任何办法发现自己写错了。哪怕第二个实现更简陋(比如只能算满仓),它也能钉住一大类错误。
把「记账误差为 0」当成「回测是对的」。 它只能证明钱没有凭空多出来,证明不了事件顺序对。这两类错误要用两套检查抓:账本用 记账误差,顺序用 lag_test。
改了引擎不重跑对账。 第八节那 0.46% 的差额,是在两个引擎都写完之后才发现的。它很小,但发现它之前,没人知道它很小。
十八、小结
- 整台引擎只有一条规矩:第 i 根收盘时算出来的东西,最早只能在第 i+1 根上成交。一根 K 线上只有开盘价是「当时」就有的,其余三个数和所有指标都要等收盘。
- 三项不看代码的体检:最大回撤是不是 0、持仓 K 线里上涨的比例是不是接近 100%、把仓位往后推一根掉多少。决策点那条曲线三项全中(0.00%、100.00%、132.69% → 14.26%)。
lag_test的判据是形状不是数值:真策略的信息衰减是连续的(推迟 1/2/3 根都在一个量级),偷看未来的断崖只发生在 0 到 1 之间。- 向量化回测不是错的,它只能表达「仓位由当根及之前的数据唯一决定」的策略。没有止损时它和事件驱动引擎一致到 2.5e-14;加上止损,仓位变成状态机,就写不出来了。
- 账本必须自洽:现金 + 持仓 × 价格 = 权益,每一根都验一次。手续费要从现金里扣,所以 10 万块在 0.1% 费率下只能买 999.0010 股而不是 1,000 股。
- 每一根四步,顺序固定:成交 → 出场 → 估值 → 下单。第 4 步排在第 3 步后面,就是那条时钟规矩的代码形式。
- 对账是回测唯一能做的自检:两个引擎在满仓设定下吻合到 1e-15;在「每笔风险 10%」上差 0.11,查出来是
rules.run每根都把仓位调回目标比例(九年差 0.46%,第 26 篇的结论不变)。 - 「同一根里止损和止盈都碰到」在数据上无解,它是假设不是事实。日线 ±0.25 ATR 的括号上,32.00% 的交易结果由这个假设决定;±0.5 ATR 降到 6.86%,±1.0 ATR 只剩 0.73%;同样 ±0.25 ATR 换成 4 小时 4.33%、1 小时 0.79%、1 分钟 0.00%。
- 这个假设最贵能有多贵:同一批 3,281 笔交易,乐观 +999R(18,514 倍)、悲观 −1,101R(归零)、抛硬币 −97R、真相(1 分钟线判定)−145R(0.20 倍)。
- 抛硬币一直贴着真相(胜率 48.52% vs 47.79%、49.19% vs 49.95%、52.57% vs 52.66%)。
pessimistic是安全的默认值,optimistic永远不要用。 - 限价单「碰到就成交」分两半看:穿过 1% 以上时价格在限价下方待了 341 分钟、占当天成交额 31.78%,没问题;「擦一下」的那 24 天,70.83% 只有一分钟的机会、成交额只占 0.58%,那些成交大概率不属于你。
- 主线策略 v4 这一篇不改,但换了引擎之后年化 21.53% → 21.60%(差的是再平衡),加 0.05% 单边费率 → 21.27%。v4 对盘中路径完全不敏感,因为它的止损是收盘触发、而且不设止盈——第 20 篇那个选择在这里又付了一次红利。
练习
- 把决策点那一行改成
signal.shift(1)之后,再给它加一条「死叉才走」的出场(而不是「信号消失就走」),年化变成多少?和主线 v4 比差在哪? - 用
lag_test扫一遍第 12 到第 18 篇里出现过的所有信号(均线、MACD、RSI、形态、斐波那契)。有没有哪一个在 lag=0 和 lag=1 之间掉得特别狠? - 第九节的扫描只做了 BTC。在 SPY 和 AAPL 上重做一遍——美股有隔夜跳空,「同一根」的比例会更高还是更低?
- 把
first_touch的coin改成一个更聪明的版本:按这一根的开盘价离哪一边更近来决定顺序。用 1 分钟线检验它比抛硬币好多少。 Account现在只支持做多。加上做空(shares可以是负数),并且把第 24 篇的维持保证金和强平价接进去:现金不够维持保证金时强制平仓。- 给
run加一个limit_entry参数(回调到指定价格才买入,第 21 篇Rule里的fill="pullback"),并且让它支持through。用第十一节的方法量一量:要求穿过 0.2% 才算成交,主线策略的年化掉多少?
小检查答案
- 先怀疑事件顺序写错了,而不是「策略太强」。任何真实的资金曲线都会回撤,哪怕只有一天。接着再看两个数:持仓 K 线里上涨的比例(接近 100% 就基本坐实了),以及把仓位往后推一根之后年化掉多少(断崖式下跌 = 赚的是信号当根自己的涨幅)。
- 假设你在信号那一根的收盘价成交。它不算离谱(第 20 篇选的止损触发也是收盘价),但它假设你能在收盘那一刻拿到收盘价——第 12 篇量过这个假设有多贵。更保守的写法是
fill="next_open":下一根开盘成交。 - 仓位由当根及之前的数据唯一决定的策略可以:均线状态、涨幅排名、波动率目标仓位、「站上 200 日线就满仓」。不能的例子:任何带止损的策略——止损价要从进场那一根往后推,而进场在哪一根取决于上一次出场在哪一根,仓位变成了状态机。
- 应该判止损(
pessimistic),理由是「宁可低估自己」;更接近真相的是抛硬币(第十节:48.52% vs 真相 47.79%)。1 分钟线上变小是因为一分钟之内价格同时走过两边的机会少得多;不会消失是因为只要还是 K 线,就还有这一根内部——把括号收窄到 ±0.05 ATR,一分钟线照样会遇到。 - 第一步是把差额画出来,找到它第一次出现的那一根 K 线,然后把那一根前后的持仓、现金、成交价三样东西逐个对比。第八节就是这么查的:差额不是均匀分布的,它从某一笔交易开始出现,那一笔就是线索。不要先猜原因,先定位。