| 本篇位置 | 第六部分「检验」第二篇。第 27 篇保证引擎是对的,这一篇保证喂进去的数据和挑出来的结论是对的 |
| 用到的数据 | 864 个上过市的 USDT 永续合约日线、BTC 现货与永续日线、AAPL 的拆股与分红、8 天的公开盘口报价(新下载)、现抓的 SEC 与 FINRA 费率 |
| 动手 | 新模块 talab.costs:crypto、us_stock、corwin_schultz、cost_in_r、annual_drag、frequency_table;talab.data 加 download_binance_book_ticker、us_fee_schedule,附 12 个测试 |
| 读完你能 | 认出五种让回测变好看的偏差;知道哪些成本能精确算、哪些只能做敏感性分析 |
一、先做一个决定
一条加密篮子策略,规则一句话说得完:在成交额最大的 20 个永续合约里,谁创了 40 日新高就等权买入,跌破 20 日新低就卖出。
标的:今天成交额最大的 20 个永续合约;门槛:20 日成交额高于全样本中位数 13.8 百万美元
参数:在 20 组(新高 20–120 日 × 新低 10–60 日)里选年化最高的一组 = (40, 20)
2020-01-01 到 2026-08-31,年化 123.53%,最大回撤 -56.73%,期末是本金的 214 倍
平均同时持有 2.6 个,每年换手 57 次
按年: {2020: '221.6%', 2021: '701.9%', 2022: '-20.0%', 2023: '113.5%', 2024: '122.7%', 2025: '105.9%', 2026: '6.0%'} ——七年里 6 年赚钱
年化 123.53%,七年里六年赚钱,期末是本金的 214 倍。
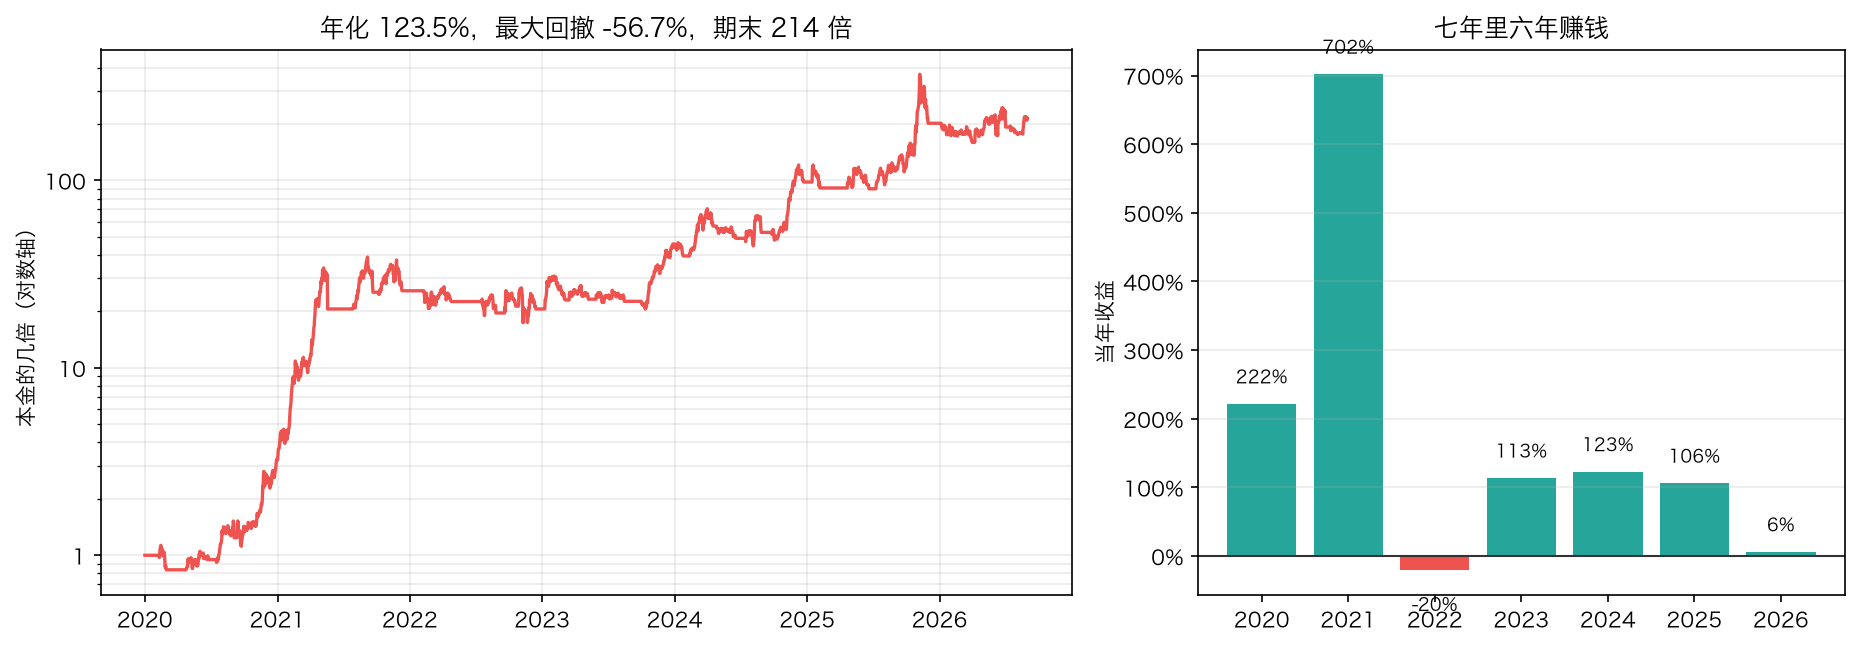
这条曲线里有几个问题?先别往下翻——规则、数据来源、参数怎么定的,上面那段输出全都写清楚了。
二、打个比方:自拍
回测是策略的自拍。
自拍和本人之间隔着一整排滤镜,而且每一个滤镜都不是你有意打开的:
| 滤镜 | 回测里的名字 |
|---|---|
| 先看了照片,再回去摆那个姿势 | 前视偏差:用了当时还不知道的数据 |
| 相册里只留下了拍得好的那些人 | 幸存者偏差:标的池里只有活下来的 |
| 连拍两百张,挑一张发出去 | 数据窥探:参数是在同一批数据上挑的 |
| 换了个滤镜,人没变但肤色全变了 | 复权偏差:同一只股票,三种价格序列三个结果 |
| 事后修图,把不好看的地方改掉 | 重绘偏差:指标在事后会改写自己 |
| 照片不显示你体重多少 | 成本:回测默认手续费、价差、滑点都是 0 |
第 27 篇保证的是相机没坏——快门和时钟是对的。这一篇管的是滤镜。
而实盘是本人到场。这一篇的目的不是让照片好看,是让照片和本人尽量像。
三、第 27 篇的体检过不了关
第 27 篇留了三项不看代码的体检:最大回撤是不是 0、持仓 K 线里上涨的比例是不是接近 100%、把仓位往后推一根掉多少。拿来查这条曲线:
 再往后推几根     年化    最大回撤  持仓日上涨的比例
      0 1.2353 -0.5673    0.5368
      1 1.2452 -0.6548    0.5347
      2 1.1558 -0.6607    0.5386
三项体检全过:回撤不是 0,持仓日上涨的比例在五成出头,再往后推一根也只是温和地变差。
**第 27 篇的体检对这条曲线里的问题一个都查不出来**——它们查的是事件顺序,
而这条策略的事件顺序是对的。错的是数据本身,以及挑数据、挑参数的方式。
三项全过。 最大回撤 −56.73% 很正常,持仓日上涨的比例 53.68%(离五成很近),把仓位再往后推一根甚至还高了一点点(124.52%)。
这一点很重要,值得单独说一句:
第 27 篇的体检查的是「引擎有没有偷看未来」,这一篇的五种偏差查的是「数据和结论是怎么来的」。前者是代码问题,后者是流程问题——它们需要完全不同的检查。
四、偏差一:前视不只是少写一个 shift
第 27 篇那个 .shift(1) 是前视偏差最粗暴的版本。它还有一种更隐蔽的形式:用了一个「只有事后才算得出来」的统计量。
最常见的一种是归一化。把价格缩放到 0 和 1 之间再判断高低,写起来就一行:
# 最常见的一种写法:把价格缩放到 0 和 1 之间。⚠️ 这两个最值要等最后一天才知道。
scaled = (price - price.min()) / (price.max() - price.min())
print(f"全样本归一化:最低 {price.min():,.0f}({price.idxmin().date()})、"
      f"最高 {price.max():,.0f}({price.idxmax().date()});"
      f"2017 年最后一天的归一化值是 {scaled.loc['2017-12-31']:.3f}")
price.min() 和 price.max() 是整段历史的最低价和最高价。2017 年那天你要判断「现在算高还是算低」,用的是 2025 年才出现的最高价:
全样本归一化:最低 3,189(2017-09-14)、最高 124,659(2025-10-06);2017 年最后一天的归一化值是 0.087
          归一化用的最值   在场比例     年化    最大回撤    期末倍数
全样本的最低价和最高价(偷看未来) 0.8035 0.4139 -0.8319 22.9441
  只用到今天为止的最低价和最高价 0.4988 0.2633 -0.7211  8.2825
         买入持有(对照) 1.0000 0.3793 -0.8319 18.3383
⚠️ 偷看版本「跑赢了买入持有」,老实版本跑输——而两者只差一件事:
   那个最高价是 2025 年才出现的,2017 年的你不可能拿它做归一化。
先看一个具体的日子。2017 年 12 月 31 日,BTC 刚从 12 月 16 日 19,102 的泡沫顶上下来、收在 13,716——在当时的全部历史上只有 19 天比它更贵。而按全样本归一化,那一天的值是 0.087:远低于 0.25 的买入线,「便宜得不得了」。之后它一路跌到 2018 年 12 月的 3,212,跌掉 76.6%。
- 偷看版本:年化 41.39%,在场 80.4%,期末 22.94 倍
- 老实版本(只用到今天为止的最值):年化 26.33%,在场 49.9%,期末 8.28 倍
- 买入持有:年化 37.93%
偷看的那个版本「跑赢了买入持有」,老实的版本跑输。 一个策略是不是有价值,结论完全相反——而两者只差「那个最高价什么时候出现」。
⚠️ 而且偷看版本赢的方式一点也不聪明:用 2025 年 10 月的 124,659 做分母,0.25 对应的价格是 33,556——而 BTC 第一次站上这个价是 2021-01-05。换句话说,2017 到 2020 这四年里这条规则从不卖出,它其实是「在 2017 年的顶上满仓买入,然后一直拿着」。它好看,只是因为 BTC 后来涨了十倍。
同一类的写法还有一长串,都长得很无辜:
returns.std()算全样本波动率,再用它做标准化或仓位rsi.quantile(0.1)拿全样本分位数当阈值- 用今天的行业分类、指数成分、市值排名去回测五年前
- 用修正后的财务数据(公司会重述财报,你当时看到的是第一版)
判据只有一个:这个数,在那一天能不能算出来? 算不出来,就得换成滚动窗口或者扩展窗口。
五、偏差二:幸存者
上一节最后那条「用今天的名单回测过去」,单独拿出来就是幸存者偏差。
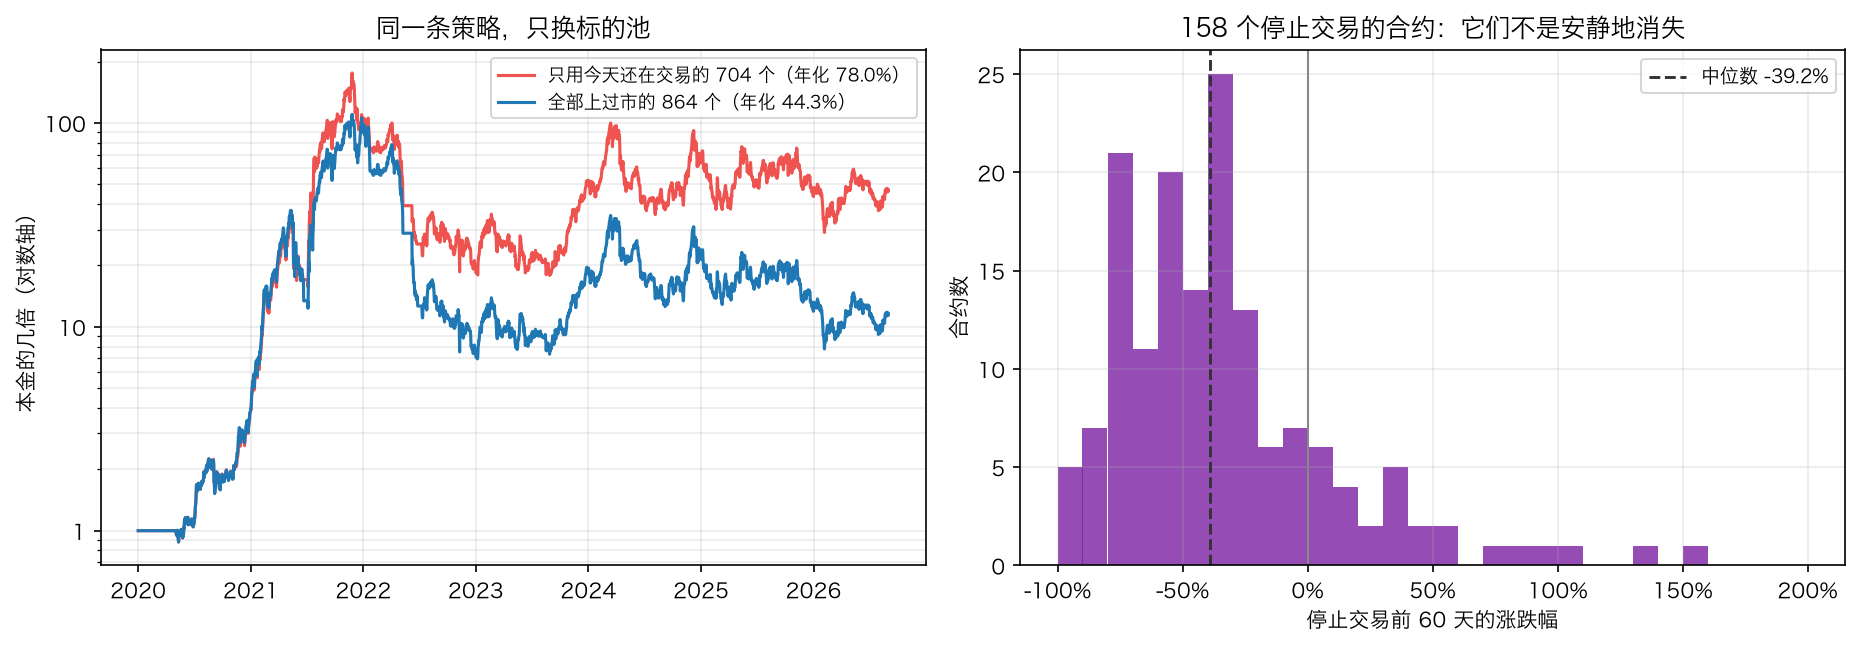
加密市场是量这件事的最好场地:第 19 篇下载过全部 864 个上过市的 USDT 永续合约,其中 160 个已经停止交易。同一条策略(创 60 日新高买、跌破 20 日新低卖,等权持有),只换标的池:
上过市的合约 864 个,最后一天还在交易 704 个,中途停止交易 160 个
            标的池  个数     年化    最大回撤    平均持仓
只用今天还在交易的 704 个 704 0.7801 -0.8984 24.4789
   全部上过市的 864 个 864 0.4434 -0.9368 30.3244
停止交易的合约在最后 60 天里:中位数 -39.2%,平均 -24.7%——**它们不是安静地消失,是先跌掉一半再消失**
| 标的池 | 个数 | 年化 | 最大回撤 |
|---|---|---|---|
| 只用今天还在交易的 | 704 | 78.01% | −89.84% |
| 全部上过市的 | 864 | 44.34% | −93.68% |
年化差 33.7 个百分点。 而且被删掉的那 160 个不是「安静地消失」:它们停止交易前的最后 60 天,中位数跌了 39.2%。
这就是幸存者偏差的机制——被筛掉的样本不是随机的,它们恰好是最难看的那一批。你的回测从来没有见过它们,所以它也从来不知道自己会遇到什么。
⚠️ 美股这边这一篇量不了:手上只有「今天市值前 100」的名单,拿不到退市名单。量不了不等于不存在——美股每年有几百家公司退市,道理完全一样。
六、偏差三:数据窥探
这一种最难防,因为它不需要你做错任何事——你只要多试几次。
把主线策略的四个参数(快慢均线、创新高的窗口、ATR 倍数)摆成一个 228 组的网格,全跑一遍 BTC 日线:
228 组参数跑在 BTC 日线上:
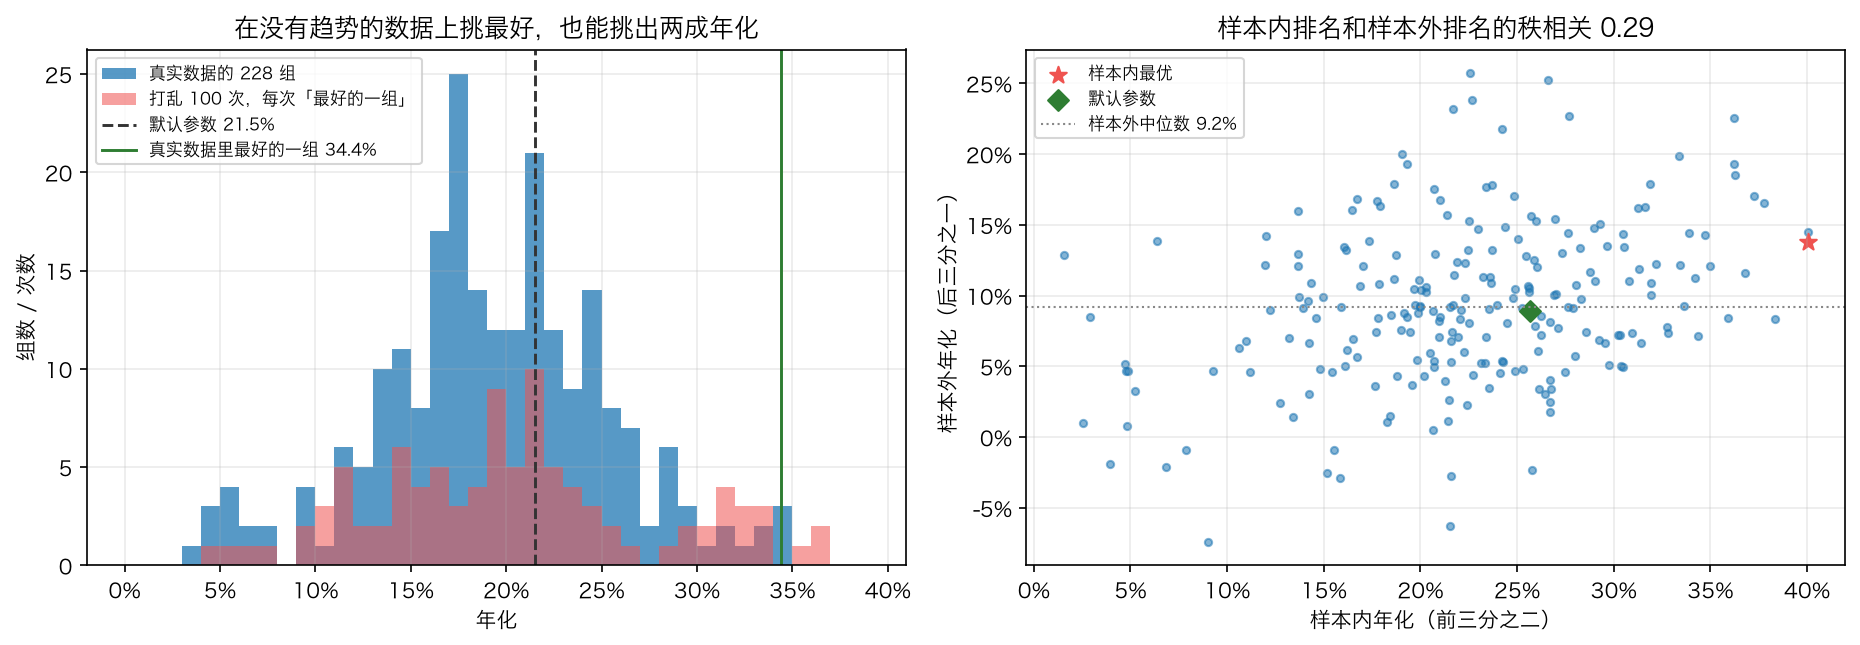
  默认参数 (50, 200, 20, 3)(主线 v4)年化 21.53%,排第 77
  最好的一组 (20, 100, 40, 3) 年化 34.41%
  全部 228 组:中位数 19.06%,四分位 16.02%–23.04%,最差 3.83%,亏钱的组 0.0%
默认参数(主线 v4)年化 21.53%,排第 77;最好的一组是 (20, 100, 40, 3),年化 34.41%。
看起来「挑最好的一组」白赚了 13 个百分点。 但要判断这 13 个百分点是不是真的,得先回答一个问题:在一段完全没有趋势的数据上,「挑 228 组里最好的」能挑出多少?
第 23 篇的手法在这里正好用得上:把 K 线打乱(保留每根相对前一根的形状,只打乱顺序),打乱之后价格里的趋势全没了,然后重扫同样的 228 组。
把 K 线打乱 100 次,每次重扫同样 228 组:
  打乱后「最好的一组」的年化:中位 20.09%,90% 区间 [9.78%, 35.56%]
  打乱后全部组的中位数:5.88%(真实数据是 19.06%)
  打乱之后「最好的一组」超过真实数据最好那组(34.41%)的比例:6.0%
三行数字,每一行都值得停一下:
- 打乱之后「最好的一组」年化中位 20.09%。 而真实数据上 228 组的中位数是 19.06%——在纯随机的数据里挑 228 组的最好,和在真实数据里随便选一组,一样好。
- 打乱后全部组的中位数只有 5.88%(真实 19.06%)。所以趋势确实有信息:中位数对中位数,真实数据高出 13 个百分点。
- 打乱之后「最好的一组」超过 34.41% 的比例是 6.0%。 也就是说,那个 34.41% 大约在「纯挑选效应」分布的 94% 分位上——擦着边显著,远没有它看上去那么硬。
同一件事的另一种看法:样本外
把数据从中间切开,前三分之二挑参数,后三分之一验:
样本内 2017-08-17~2023-08-26,样本外 2023-08-27~2026-08-31
                 这一组参数  样本内年化  样本外年化
样本内最优 (30, 100, 20, 3) 0.4004 0.1377
样本外最优 (20, 250, 60, 3) 0.2255 0.2574
   默认 (50, 200, 20, 3) 0.2569 0.0889
样本内最优的那一组,在样本外排第 47 / 228
样本内排名和样本外排名的秩相关 0.291——**不是 0,但也远不是 1**
样本内前 10 名在样本外的中位数 15.53%,全部 228 组在样本外的中位数 9.18%
| 这一组参数 | 样本内年化 | 样本外年化 |
|---|---|---|
| 样本内最优 (30, 100, 20, 3) | 40.04% | 13.77% |
| 样本外最优 (20, 250, 60, 3) | 22.55% | 25.74% |
| 默认 (50, 200, 20, 3) | 25.69% | 8.89% |
样本内最优的那一组,在样本外掉了 26 个百分点,在 228 组里排第 47。
但也别走到另一个极端。这里有两个数说明挑参数不是完全没用:
- 样本内排名和样本外排名的秩相关是 0.291——不是 0,但也远不是 1
- 样本内前 10 名在样本外的中位数 15.53%,而全部 228 组在样本外的中位数只有 9.18%
参数选择有一点样本外价值,但远小于样本内看起来的那么多。 诚实的做法是:挑完之后,把样本内那个数当成上限而不是预期。
七、偏差四:复权
前面三种都是系统性地让回测变好看。这一种不一样:它可能往两边偏,而且偏得离谱。
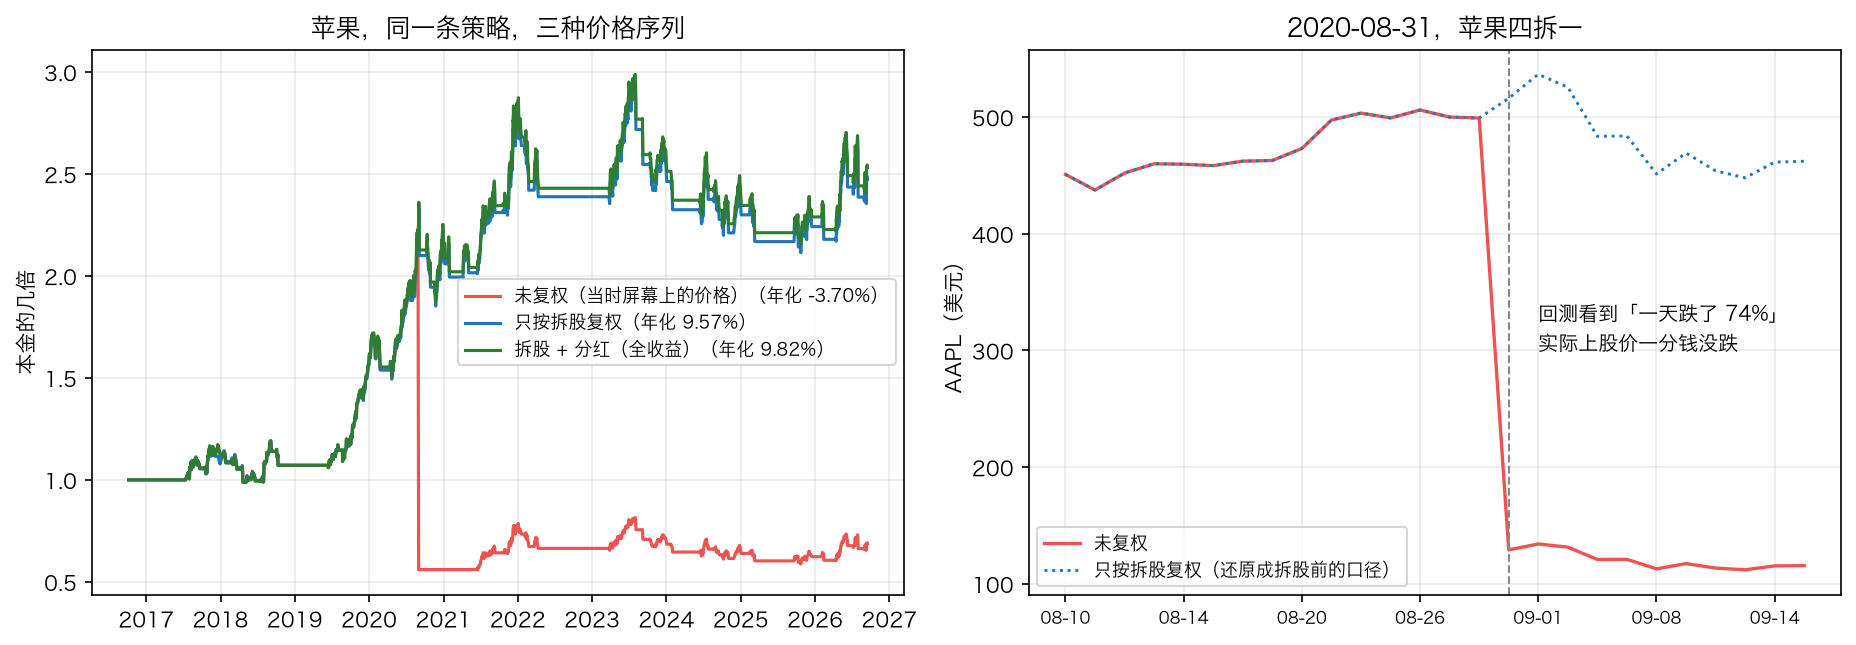
苹果十年里拆过一次股(2020-08-31 四拆一)、分过 83 次红。同一条主线策略,跑在三种价格序列上:
         价格序列      年化    最大回撤  交易数    最差一笔
未复权(当时屏幕上的价格) -0.0370 -0.7456   33 -0.7018
       只按拆股复权  0.0957 -0.2795   37 -0.0826
 拆股 + 分红(全收益)  0.0982 -0.2785   37 -0.0814

2020-08-31 苹果四拆一,未复权的价格序列上那一天长这样:
              open    high     low   close
date
2020-08-27  508.57  509.94  495.33  500.04
2020-08-28  504.05  505.77  498.31  499.23
2020-08-31  127.58  131.00  126.00  129.04
2020-09-01  132.76  134.80  130.53  134.18
回测看到的是「一天跌了 -74.15%」,而实际上股价一分钱没跌
分红:83 次,合计每股 40.13 美元;十年累计 只按拆股复权 1046.8%,全收益 1153.7%
⚠️ 加密没有拆股也没有分红,所以这一种偏差在加密上不存在——它是股票独有的
| 价格序列 | 年化 | 最大回撤 | 最差一笔 |
|---|---|---|---|
| 未复权(当时屏幕上的价格) | −3.70% | −74.56% | −70.18% |
| 只按拆股复权 | 9.57% | −27.95% | −8.26% |
| 拆股 + 分红(全收益) | 9.82% | −27.85% | −8.14% |
同一只股票、同一条策略,只因为价格序列的处理方式,年化从 −3.70% 变成 +9.82%。
原因一眼就能看到:未复权的序列上,2020-08-31 那天的收盘价从 499.23 变成 129.04,回测看到的是「一天跌了 74.15%」,而实际上股价一分钱没跌——只是每股拆成了四股。那一天的止损全部被打掉,「最差一笔亏 70.18%」就是这么来的。
分红那一头的差别小得多但方向一致:83 次分红合计每股 40.13 美元,十年累计 1046.8% vs 1153.7%,年化 9.57% → 9.82%。
⚠️ 加密没有拆股也没有分红,所以这一种偏差在加密上不存在。 它是股票独有的,也是唯一一种「你不处理就一定错,而且可能错得很难看」的偏差。
八、偏差五:重绘
最后一种最有欺骗性,因为画在图上的时候,它看起来完全合理。
ZigZag(第 8 篇)是典型:价格从一个极值反向走够 15%,那个极值才被确认成摆动点。问题是「被确认」发生在「那个极值」之后很久。
15% 的 ZigZag 在 BTC 日线上给出 85 个摆动点,其中低点 43 个
一个低点从**发生**到被**确认**:中位 9 天,平均 13.9 天,最长 52 天
确认那天的价格,已经比那个低点高了:中位 17.43%,平均 17.93%
一个低点从发生到被确认,中位要等 9 天,最长等了 52 天;等确认的时候,价格已经比那个低点高了 17.43%(中位)。
那 17.43% 就是重绘偏差的定价。
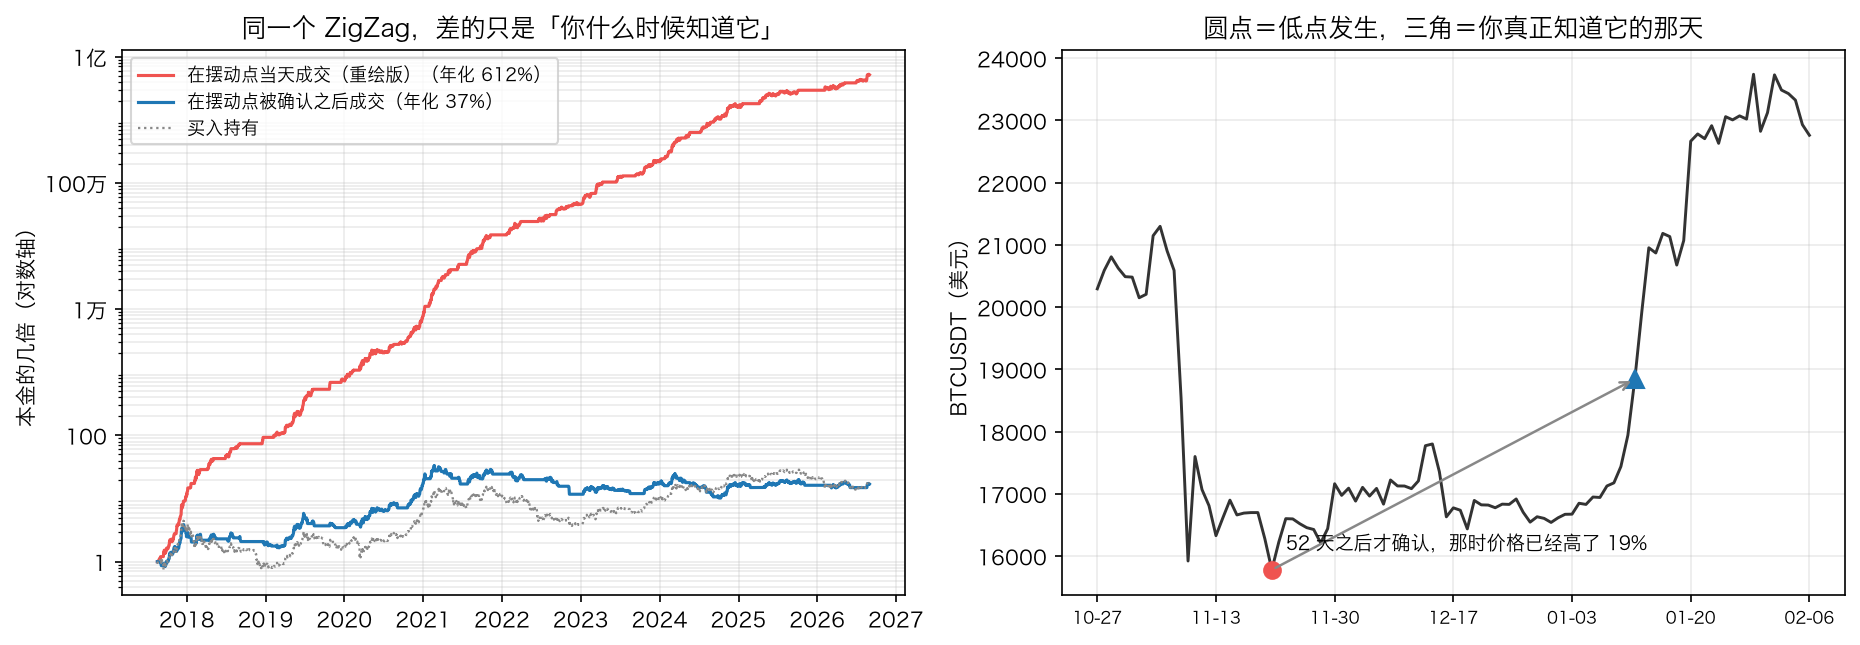
          什么时候成交   在场比例     年化    最大回撤     期末是本金的几倍
   在摆动点当天成交(重绘版) 0.5912 6.1200 -0.1496 5.152677e+07
在摆动点被确认之后成交(老实版) 0.5787 0.3670 -0.6955 1.691330e+01
        买入持有(对照) 1.0000 0.3793 -0.8319 1.833830e+01
| 什么时候成交 | 年化 | 最大回撤 | 期末是本金的几倍 |
|---|---|---|---|
| 在摆动点当天成交(重绘版) | 612.00% | −14.96% | 5,152 万 |
| 在摆动点被确认之后成交 | 36.70% | −69.55% | 16.91 |
| 买入持有(对照) | 37.93% | −83.19% | 18.34 |
重绘版九年 5,152 万倍,老实版 16.91 倍——还跑输买入持有。
⚠️ 重绘不止 ZigZag。任何「回头看才成立」的东西都在这一类里:未确认的摆动点、还没走完的形态、需要右侧确认的分形、用居中窗口算的均线(center=True)、以及所有画在图上会随新数据移动的线。
判据和第四节是同一条:这个值,在那一天能不能算出来? ZigZag 给出了 confirmed_at 这一列,就是为了让你能诚实地回答这个问题。
九、成本一:真实的买卖价差
五种偏差讲完了。现在讲照片里没有的那一项:成本。
一笔交易的成本有四项,它们的可见度差别很大:
| 这一项 | 加密 | 美股 |
|---|---|---|
| 手续费 | 交易所公开费率表,精确 | 主流券商 0 佣金 |
| 监管费 | 没有 | SEC 和 FINRA 的两项,只在卖出时收,费率公开 |
| 买卖价差 | 公开盘口可以量 | 没有公开的历史报价 |
| 滑点 | 用分钟线重放可以量(第 22 篇) | 日线上量不了 |
先量最容易被忽略的那一项:价差。
Binance 公开过 320 天(2023-05-16 到 2024-03-30)的最优买卖报价。原始文件一天 70–300 MB、几百万到几千万行——盘口每变一次写一行。下载完立刻聚合成 1 分钟再删掉原始文件,8 天最后只剩 592 KB:
DAYS = ["2023-08-12",   # 这段时间里最平静的一天(周六,振幅 0.37%)
        "2023-07-19",   # 普通工作日
        "2023-10-23",   # 振幅最大的一天(20.4%,ETF 传闻)
        "2023-12-11",   # 普通工作日
        "2024-01-11",   # 现货 ETF 获批当天
        "2024-02-28",   # 振幅 13.3%,成交额 611 亿
        "2024-03-05",   # 冲上历史新高之后当天跌 6.7%,振幅 15.0%
        "2024-03-30"]   # 这套数据的最后一天(周六)

if __name__ == "__main__":
    paths = D.download_binance_book_ticker("BTCUSDT", DAYS)
    print(f"盘口 1 分钟汇总 {len(paths)} 天:")
    for path in paths:
        print(f"  {path}  {path.stat().st_size / 1024:.0f} KB")
八天是挑过的:最平静的一天、振幅最大的一天、现货 ETF 获批那天、以及两个普通工作日。
8 天的公开盘口(价差的单位是基点,万分之一):
                             平均价差    中位价差    最宽的一分钟  买一金额(万美元)      盘口更新    当天振幅
time
2023-07-19 00:00:00+00:00  0.0339  0.0336    8.9892    38.6910  10613016  0.0145
2023-08-12 00:00:00+00:00  0.0340  0.0340    4.9033    64.9163   6497420  0.0037
2023-10-23 00:00:00+00:00  0.0565  0.0339  161.4750    19.6537  16873909  0.2039
2023-12-11 00:00:00+00:00  0.0414  0.0334   63.0863    16.4272  21887111  0.0823
2024-01-11 00:00:00+00:00  0.0316  0.0251   30.4765    10.6532  33466411  0.0735
2024-02-28 00:00:00+00:00  0.0312  0.0189  105.4453    26.5871  45403980  0.1326
2024-03-05 00:00:00+00:00  0.0465  0.0229   82.3285    16.3951  34588378  0.1499
2024-03-30 00:00:00+00:00  0.0158  0.0150    7.3764    31.9474   7398592  0.0116

全部 11,478 分钟:中位 0.0328 基点,平均 0.0364,95% 分位 0.0527,最宽的一分钟 7.47
最小变动价位 0.1 美元在平均价 46,749 上就是 0.0214 基点——**价差基本上就是一跳**
而永续合约的 taker 手续费是 5 基点,是中位价差的 153 倍
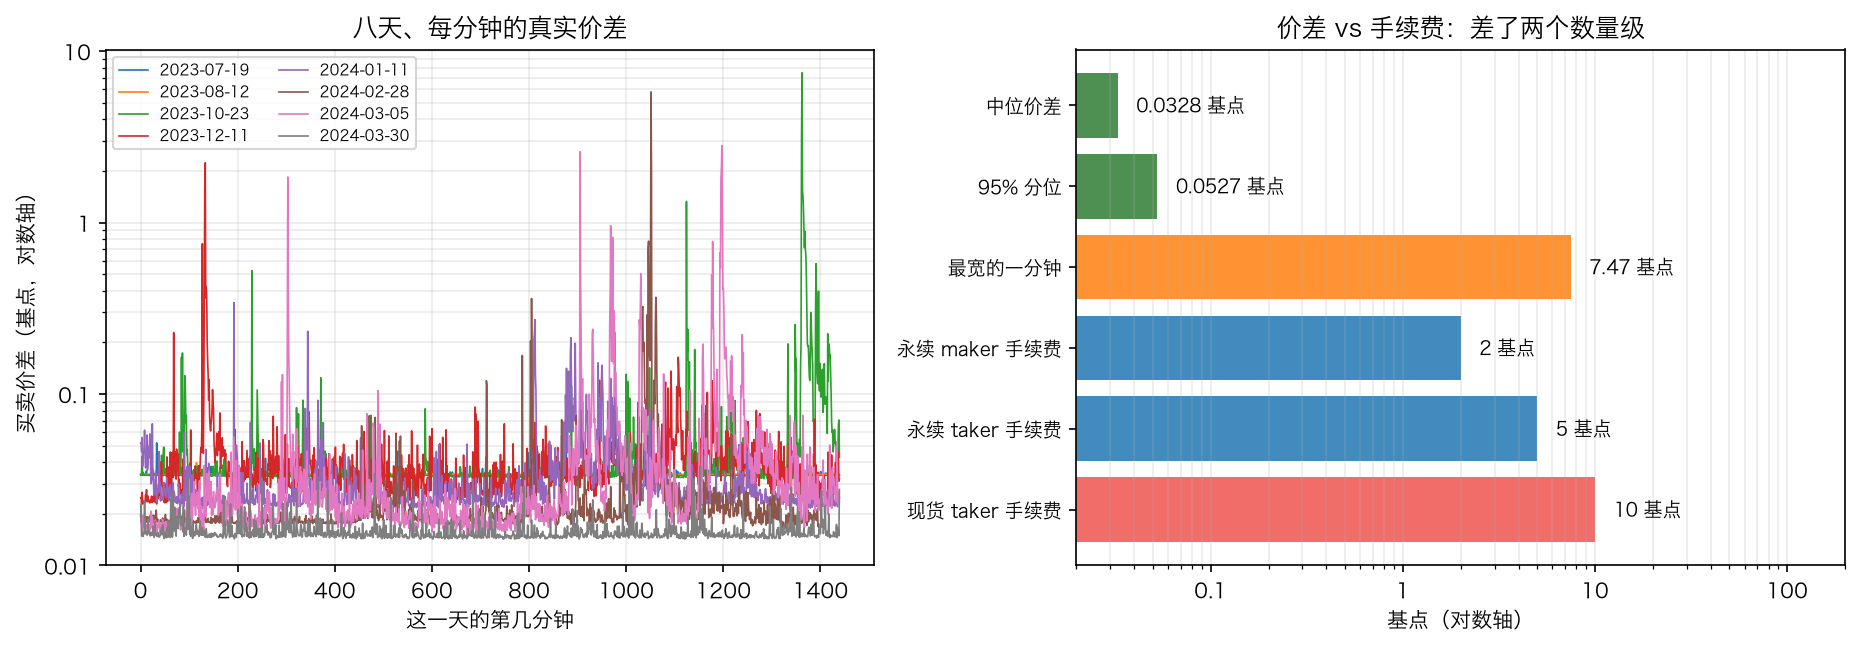
BTC 永续合约的买卖价差,中位数是 0.0328 个基点——万分之零点零三。
几个数放在一起才看得出它有多小:
- 价差基本上就是一跳:最小变动价位是 0.1 美元,在平均价 46,749 上就是 0.0214 个基点
- taker 手续费 5 个基点,是中位价差的 153 倍;现货 taker 10 个基点,是 305 倍
- 最平静那天(2023-08-12,周六)全天的价差几乎是一条直线,标准差只有 0.0003 个基点
- 买一档的金额中位数 10–65 万美元——一笔 10 万美元的单子不用吃第二档
但也有另一半:
- 振幅 20.4% 那天(2023-10-23),有一分钟的平均价差飙到 161.5 个基点,是 taker 费的 32 倍
- 盘口更新次数从平静日的 650 万次涨到 4,540 万次
价差在平时可以忽略,只在崩盘的那几分钟变成主要成本。 而崩盘的那几分钟,正好是止损单被触发的时候(第 22 篇量过那次的滑点)。
十、成本二:没有盘口数据的市场怎么办
美股没有公开的历史报价。学术界为此造了一堆「只用 K 线估价差」的估计量,最有名的是 Corwin–Schultz(2012):连续两根 K 线的单根高低幅里既有波动也有价差,两根合起来的高低幅里波动被放大而价差没有,两者相减就能把价差解出来。
听起来很聪明。但在用它之前,先做一件事:拿到一个有真相的市场上检验它。 BTC 永续正好有——上一节那 8 天的真实价差就是真相。
在**有真相**的市场上检验高低价价差估计量(单位:基点):
                           真实中位价差    高低价估计       高估倍数
time
2023-07-19 00:00:00+00:00   0.034   85.574   2549.390
2023-08-12 00:00:00+00:00   0.034   14.030    412.576
2023-10-23 00:00:00+00:00   0.034 -185.307  -5464.086
2023-12-11 00:00:00+00:00   0.033 -124.179  -3713.018
2024-01-11 00:00:00+00:00   0.025   50.171   1995.273
2024-02-28 00:00:00+00:00   0.019 -656.283 -34728.480
2024-03-05 00:00:00+00:00   0.023  646.970  28246.625
2024-03-30 00:00:00+00:00   0.015   55.132   3664.371

同一段 320 天:估计值中位 68.37 基点,真实 0.0328 基点——**高估约 2087 倍**,而且 25.0% 的日子估出负数
  SPY      估计值中位   -3.98 基点,负数占 51.6%,日均振幅 0.88%
  AAPL     估计值中位    0.99 基点,负数占 49.7%,日均振幅 1.76%
  BTC 永续   估计值中位   67.20 基点,负数占 32.4%,日均振幅 3.76%
**一半的日子估出负数,说明它在这里就是噪声。** 有真相的市场用来检验方法,
没有真相的市场不要硬估——所以美股的价差这一篇不估,改做敏感性分析(片段 12)。
结果很干脆:
- 在 BTC 上高估约 2,087 倍(估计值中位 68.37 个基点,真实 0.0328),而且 25% 的日子估出负数
- SPY 上估计值中位 −3.98 个基点,51.6% 的日子是负数
- AAPL 上 1.07 个基点,49.7% 是负数
一半的日子估出负数,说明它在这里就是噪声。 价差不可能是负的。
这一节的方法论比结论更重要:
有真相的市场用来检验方法,没有真相的市场不要硬估。
所以这一篇不拿这个估计量去估美股的价差。美股那边改做敏感性分析:把价差当成一个未知参数,看它取 1 个基点还是 5 个基点,结论会不会变(第十五节)。
十一、成本三:美股的费率是现抓的
美股主流券商佣金是 0,但有两项监管费。它们的费率每年都会变,所以写死在代码里过两年就是错的——现抓:
def us_fee_schedule() -> pd.Series:
    """现抓美股的两项监管费(第 28 篇):SEC 的 Section 31 费和 FINRA 的 TAF。

    ⚠️ 两项都**只在卖出时收**。它们加起来通常只有成交金额的万分之几,
    真正贵的是买卖价差——而价差没有公开的历史数据。
    """
    links = re.findall(r'href="([^"]*fee-rate-advisories/\d{4}-\d)"',
                       _fetch(SEC_FEE_ADVISORIES, agent=REGULATOR_AGENT).decode())
    for link in links:                                  # 找最近一条 Section 31 的公告
        url = link if link.startswith("http") else "https://www.sec.gov" + link
        page = _fetch(url, agent=REGULATOR_AGENT).decode()
        if "Section 31 Transaction Fee Rate Advisory" in page:
            sec = parse_sec_fee_advisory(page)
            break
    else:
        raise ValueError("没找到 Section 31 的公告")
    finra = parse_finra_taf(_fetch(FINRA_FEE_RULES, agent=REGULATOR_AGENT).decode())
    return pd.concat([sec.rename(lambda k: f"SEC {k}"), finra.rename(lambda k: f"TAF {k}")])
SEC 财年                      2026
SEC 每百万美元                   20.6
SEC 占卖出金额               0.000021
SEC 生效日      2026-04-04 00:00:00
TAF 每股                  0.000166
TAF 每笔上限                     8.3

买入 500 股、200 美元一股(10 万美元),假设价差 1 个基点:
  买入:佣金 0.00,SEC 费 0.00,FINRA TAF 0.00,半个价差 5.00,合计 5.00,占名义价值 0.0050%
  卖出:佣金 0.00,SEC 费 2.06,FINRA TAF 0.08,半个价差 5.00,合计 7.14,占名义价值 0.0071%
⚠️ 两项监管费只在卖出时收,加起来 2.06 + 0.08 = 2.14 美元,不到万分之零点三;
   而 1 个基点的价差就是 5 美元。**零佣金不是没有成本,是把成本挪进了价差。**
- SEC 的 Section 31 费:2026 财年 每百万美元 20.60 美元(占卖出金额 0.00206%),2026-04-04 起生效。⚠️ 有意思的是同一份公告里,2026-04-03 之前的费率是 0.00 美元——这笔费是用来覆盖 SEC 运营预算的,拨款没到位就不收。
- FINRA 的交易活动费(TAF):每股 0.000166 美元,每笔上限 8.30 美元。
两项都只在卖出时收,买入一分不收。
一笔 10 万美元的交易(500 股 × 200 美元):
| 买入 | 卖出 | |
|---|---|---|
| 佣金 | 0.00 | 0.00 |
| SEC 费 | 0.00 | 2.06 |
| FINRA TAF | 0.00 | 0.08 |
| 半个价差(按 1 个基点算) | 5.00 | 5.00 |
| 合计 | 5.00 | 7.14 |
两项监管费加起来 2.14 美元,不到万分之零点三;而 1 个基点的价差就是 5 美元。
这就是订单流付费(PFOF)的真相:券商把你的订单卖给做市商,做市商在价差内给你成交并赚走一部分。你付的不是佣金,是价差里看不见的那一块——而价差恰恰是这一篇唯一量不了的东西。
零佣金不是没有成本,是把成本从看得见的那一栏挪到了看不见的那一栏。
十二、成本四:拆开看,以及频率
把四项拆开,一笔 10 万美元的加密交易:
    怎么成交   手续费   半个价差  滑点       合计  占名义价值
永续 maker  20.0 0.1638 0.0  20.1638 0.0002
永续 taker  50.0 0.1638 0.0  50.1638 0.0005
现货 taker 100.0 0.1638 0.0 100.1638 0.0010
手续费是绝对的大头,价差在小数点后面。 永续 maker 20.16 美元、永续 taker 50.16、现货 taker 100.16——三档之间差 5 倍,而价差那一项在三档里一模一样(0.16 美元)。
然后是频率。成本和交易频率是线性关系,而策略的收益不是:
主线策略在 BTC 现货上,单边成本 0.1002%(taker 手续费 + 半个价差)
 每年交易笔数   每年的成本
      2   0.40%
      6   1.20%
     12   2.40%
     52  10.42%
    250  50.08%
   1000 200.33%
| 每年交易笔数 | 每年的成本 |
|---|---|
| 2(长线波段) | 0.40% |
| 12(每月一次) | 2.40% |
| 52(每周一次) | 10.42% |
| 250(每天一次) | 50.08% |
| 1000(每天四次) | 200.33% |
每天交易一次,光手续费和价差一年就是 50%。 这不是「高频策略不好」,这是高频策略必须先跑赢 50% 才算开始赚钱。
第 23 篇那条折算公式在这里又用上了:
同样的成本,折算成 R(第 23 篇:成本 ÷ 止损距离):
 止损距离  一来一回占几个 R
 0.5%     0.4007
 2.0%     0.1002
 5.0%     0.0401
10.8%     0.0185
20.0%     0.0100
一来一回的成本占几个 R = 2 × 单边成本 ÷ 止损距离
止损放 10.8%(主线在 BTC 上的中位数)时成本只占 0.0185R,止损放 0.5% 时就占 0.40R——日内策略死在这里:它还没开始交易,就已经先亏掉四成的 R。
十三、动手:talab.costs
新模块 talab.costs,把「该往 Plan(fee_rate=...) 里填什么」算出来。
"""talab.costs:成本。第 28 篇。

第 27 篇的引擎里留了一个 `fee_rate`,这个模块负责把它算出来。

一笔交易的成本有四项,它们的可见度差别很大:

| 这一项 | 加密 | 美股 |
|---|---|---|
| **手续费** | 交易所公开费率表,精确 | 主流券商 0 佣金 |
| **监管费** | 没有 | SEC 的 Section 31 费 + FINRA 的 TAF,只在**卖出**时收,费率公开 |
| **买卖价差** | 公开的盘口数据可以量(第 28 篇量了 8 天) | **没有公开的历史报价**,量不了 |
| **滑点** | 用分钟线重放可以量(第 22 篇) | 日线上量不了 |

于是整篇的结论已经写在这张表里:**能精确算的那几项都很小,算不准的那几项才是大头。**
零佣金不是没有成本,它只是把成本从「看得见的佣金」挪到了「看不见的价差」。

所有函数都返回一个**拆开的**成本表,而不是一个总数——你要知道钱花在哪一项上,
才知道该换券商、换订单类型,还是干脆少交易。
"""
from __future__ import annotations

import numpy as np
import pandas as pd

# Binance 公开费率表里的 VIP 0 档(现货和 U 本位永续),单位是占成交名义价值的比例。
# ⚠️ 这是**今天**的费率:档位和优惠会变,拿它去算几年前的交易,算的是「按今天的费率会怎样」。
BINANCE_FEES = {"现货 taker": 0.0010, "现货 maker": 0.0010,
                "永续 taker": 0.0005, "永续 maker": 0.0002}

# 第 28 篇用 8 天的公开盘口量出来的 BTCUSDT 永续价差中位数,单位是基点(万分之一)。
BTC_PERP_SPREAD_BP = 0.033
拆开的成本
def crypto(notional: float, venue: str = "永续 taker", spread_bp: float = BTC_PERP_SPREAD_BP,
           slippage_bp: float = 0.0) -> pd.Series:
    """加密交易所单边的成本拆解(做多的口径,买卖对称)。

    价差只算**一半**:报价的中间价才是「公允价」,你吃掉的是从中间价到卖一的那一半。
    """
    if venue not in BINANCE_FEES:
        raise ValueError(f"venue 只能是 {tuple(BINANCE_FEES)} 之一,收到 {venue!r}")
    fee = notional * BINANCE_FEES[venue]
    spread = notional * spread_bp / 2 / 10_000
    slippage = notional * slippage_bp / 10_000
    total = fee + spread + slippage
    return pd.Series({"名义价值": notional, "手续费": fee, "半个价差": spread, "滑点": slippage,
                      "合计": total, "占名义价值": total / notional})
def us_stock(price: float, shares: float, side: str = "buy", spread_bp: float = 1.0,
             sec_rate: float = 0.0, taf_per_share: float = 0.0, taf_cap: float = np.inf) -> pd.Series:
    """美股单边的成本拆解。费率用 `data.us_fee_schedule()` 现抓,别写死。

    ⚠️ **SEC 的 Section 31 费和 FINRA 的 TAF 只在卖出时收**,买入这两项都是 0。
    佣金按主流零佣金券商算成 0——但那不等于免费:券商把订单卖给做市商(订单流付费,PFOF),
    做市商的钱从价差里赚。所以 `spread_bp` 这一项才是美股真正的成本,而它**没有公开的历史数据**。
    """
    if side not in ("buy", "sell"):
        raise ValueError(f"side 只能是 buy 或 sell,收到 {side!r}")
    notional = price * shares
    commission = 0.0
    sec = notional * sec_rate if side == "sell" else 0.0
    taf = min(shares * taf_per_share, taf_cap) if side == "sell" else 0.0
    spread = notional * spread_bp / 2 / 10_000
    total = commission + sec + taf + spread
    return pd.Series({"名义价值": notional, "佣金": commission, "SEC 费": sec, "FINRA TAF": taf,
                      "半个价差": spread, "合计": total, "占名义价值": total / notional})
两个函数都返回拆开的表而不是一个总数。理由很实际:你要知道钱花在哪一项上,才知道该换券商、换订单类型,还是干脆少交易。
折算和频率
def cost_in_r(one_way: float, stop_distance: float) -> float:
    """把成本折算成 R 倍数(第 23 篇):一来一回的成本 ÷ 止损距离。

    > 一笔交易的成本 = 2 × 单边成本 ÷ 止损距离(单位:R)

    这条式子说明**成本贵不贵取决于止损放得多远**:同样 0.1% 的来回成本,
    止损放 10% 时只占 0.01R,止损放 0.5% 时就占 0.2R——日内策略死在这里。
    """
    if stop_distance <= 0:
        raise ValueError("止损距离要大于 0")
    return 2 * one_way / stop_distance


def annual_drag(one_way: float, trades_per_year: float) -> float:
    """成本每年吃掉多少:`2 × 单边成本 × 每年交易笔数`(一笔进出算两次)。

    这是个近似(没算复利),但它足够回答那个最重要的问题:
    **你的策略一年要跑赢这个数,才刚够把成本挣回来。**
    """
    return 2 * one_way * trades_per_year


def frequency_table(one_way: float, trades_per_year=(2, 6, 12, 52, 250, 1000)) -> pd.DataFrame:
    """同样的单边成本,不同交易频率下每年被吃掉多少。

    成本和频率是**线性**关系,而策略的收益不是——这就是为什么高频信号在成本面前先死一次。
    """
    rows = [{"每年交易笔数": n, "每年的成本": annual_drag(one_way, n)} for n in trades_per_year]
    return pd.DataFrame(rows)
那个不能用的估计量
def corwin_schultz(high: pd.Series, low: pd.Series) -> pd.Series:
    """Corwin–Schultz (2012) 的高低价价差估计量:只用最高价和最低价估买卖价差。

    想法是:连续两根 K 线的**单根**高低幅里既有波动也有价差,**两根合起来**的高低幅里
    波动被放大而价差没有,两者相减就能把价差解出来。

    ⚠️ 第 28 篇在 BTC 上用真实盘口检验过它:**高估约两千倍,而且四分之一的日子估出负数**;
    在 SPY 和 AAPL 上一半的日子是负数。**它在这三个市场上都是噪声。**
    这个函数留在这里,是为了让你自己能重做那次检验——
    **有真相的市场用来检验方法,没有真相的市场不要硬估。**
    """
    beta = (np.log(high / low) ** 2).rolling(2).sum()
    high2 = pd.concat([high, high.shift(1)], axis=1).max(axis=1)
    low2 = pd.concat([low, low.shift(1)], axis=1).min(axis=1)
    gamma = np.log(high2 / low2) ** 2
    k = 3 - 2 * np.sqrt(2)
    alpha = (np.sqrt(2 * beta) - np.sqrt(beta)) / k - np.sqrt(gamma / k)
    return (2 * (np.exp(alpha) - 1) / (1 + np.exp(alpha))).rename("价差估计")
它留在模块里不是为了用,是为了让你自己能重做第十节那次检验。
下载盘口
def download_binance_book_ticker(symbol: str, days, market: str = "um",
                                dest: str = "data/binance") -> list[Path]:
    """下载最优买卖报价(第 28 篇),**下载完立刻聚合成 1 分钟,再把原始文件删掉**。

    原始文件一天 70–300 MB、几百万到几千万行(盘口每变一次就写一行)。留着它没有意义:
    这一篇要回答的是「价差有多宽、买一卖一有多厚」,1 分钟的汇总(一天 1,440 行)就够了。
    想重算别的统计量,重新下载就是了——这里保存的是**结论的原料**,不是原始数据的副本。

    ⚠️ 这套数据只有 **2023-05-16 到 2024-03-30**(320 天)。之前和之后 Binance 都没有公开,
    所以这一篇量到的价差是这 11 个月的事实,不能直接外推到 2017 年或 2026 年。
    """
    folder = Path(dest) / market / symbol / "bookTicker-1m"
    folder.mkdir(parents=True, exist_ok=True)
    paths = []
    for day in days:
        target = folder / f"{symbol}-bookTicker-1m-{day}.csv.gz"
        if not target.exists():
            name = f"{symbol}-bookTicker-{day}.zip"
            url = f"{BINANCE_BASE}/futures/{market}/daily/bookTicker/{quote(symbol)}/{quote(name)}"
            try:
                raw = _fetch(url)
            except urllib.error.HTTPError as e:
                if e.code == 404:                   # 这一天没有公开数据
                    continue
                raise
            with zipfile.ZipFile(io.BytesIO(raw)) as z:
                frame = pd.read_csv(z.open(z.namelist()[0]),
                                    usecols=["best_bid_price", "best_bid_qty", "best_ask_price",
                                             "best_ask_qty", "transaction_time"])
            mid = (frame["best_bid_price"] + frame["best_ask_price"]) / 2
            frame["价差"] = (frame["best_ask_price"] - frame["best_bid_price"]) / mid * 10_000
            frame["中间价"] = mid
            frame["time"] = pd.to_datetime(frame["transaction_time"], unit="ms", utc=True).dt.floor("min")
            minute = frame.groupby("time").agg(
                更新次数=("价差", "size"), 价差=("价差", "mean"), 最宽价差=("价差", "max"),
                买一量=("best_bid_qty", "mean"), 卖一量=("best_ask_qty", "mean"),
                中间价=("中间价", "mean"))
            minute.to_csv(target)
        paths.append(target)
    return paths
⚠️ 这个函数做了一件不太常见的事:下载完立刻聚合,然后把原始文件删掉。原始数据一天几千万行,留着它没有意义——这一篇要的是「价差有多宽、买一卖一有多厚」,1 分钟的汇总就够。想重算别的统计量,重新下载就是了。保存的是结论的原料,不是原始数据的副本。
测试
12 个测试。最漂亮的一个是这样来的:
def test_corwin_schultz_is_exact_when_there_is_no_volatility():
    """价格不动、只有一个固定的价差时,这个估计量应该精确地把价差还原出来。"""
    for spread in [0.001, 0.005, 0.02]:
        price = pd.Series([100.0] * 10)
        high, low = price * (1 + spread / 2), price * (1 - spread / 2)
        estimate = C.corwin_schultz(high, low).dropna()
        assert estimate.to_numpy() == pytest.approx(spread, rel=1e-9)
价格完全不动、只有一个固定价差时,这个估计量能把价差一分不差地还原出来(可以手推:两根 K 线的高低比都是 r,代进公式得 α = ln r,最后 S = 2(r−1)/(1+r) 正好等于那个价差)。
它不是写错了,它只是在波动远大于价差的地方不成立——而真实市场全都是这样:
def test_corwin_schultz_falls_apart_when_volatility_dominates():
    """真实市场上波动远大于价差,估计量会满地负数——第 28 篇量到 SPY 有一半的日子是负的。"""
    rng = np.random.default_rng(28)
    close = pd.Series(100 * np.exp(np.cumsum(rng.standard_normal(2_000) * 0.02)))
    noise = np.abs(rng.standard_normal(2_000)) * 0.02
    estimate = C.corwin_schultz(close * (1 + noise), close * (1 - noise)).dropna()
    assert (estimate < 0).mean() > 0.2                      # 大量负数=它在这里是噪声
def test_us_regulatory_fees_are_charged_on_sales_only():
    """SEC 费和 TAF 只在卖出时收,买入这两项都是 0。"""
    kwargs = dict(price=200.0, shares=500.0, spread_bp=1.0, sec_rate=20.6e-6,
                  taf_per_share=0.000166, taf_cap=8.30)
    buy, sell = C.us_stock(side="buy", **kwargs), C.us_stock(side="sell", **kwargs)
    assert buy["SEC 费"] == 0.0 and buy["FINRA TAF"] == 0.0
    assert sell["SEC 费"] == pytest.approx(100_000 * 20.6e-6)
    assert sell["FINRA TAF"] == pytest.approx(500 * 0.000166)
    assert buy["半个价差"] == sell["半个价差"] == pytest.approx(100_000 * 1.0 / 2 / 10_000)
    assert sell["合计"] > buy["合计"]
    with pytest.raises(ValueError):
        C.us_stock(200.0, 500.0, side="随便")
def test_cost_in_r_depends_on_where_the_stop_is():
    """同样 0.05% 的单边成本,止损放 10% 只占 0.01R,放 0.5% 就占 0.2R。"""
    assert C.cost_in_r(0.0005, 0.10) == pytest.approx(0.01)
    assert C.cost_in_r(0.0005, 0.005) == pytest.approx(0.20)
    with pytest.raises(ValueError):
        C.cost_in_r(0.0005, 0.0)
费率的解析也钉成了测试,用的是两段真实公告的片段:
def test_parse_sec_fee_advisory():
    out = D.parse_sec_fee_advisory(SEC_PAGE)
    assert out["财年"] == 2026
    assert out["每百万美元"] == pytest.approx(20.60)
    assert out["占卖出金额"] == pytest.approx(20.60 / 1e6)
    assert out["生效日"] == pd.Timestamp("2026-04-04")
    with pytest.raises(ValueError):
        D.parse_sec_fee_advisory("<p>今天天气不错</p>")


def test_parse_finra_taf():
    out = D.parse_finra_taf(FINRA_PAGE)
    assert out["每股"] == pytest.approx(0.000166)
    assert out["每笔上限"] == pytest.approx(8.30)
    with pytest.raises(ValueError):
        D.parse_finra_taf("<p>今天天气也不错</p>")
277 passed in 0.91s
没装 TA-Lib 时:
245 passed, 32 skipped in 1.01s
十四、揭晓:四个问题一个一个修
回到第一节那条年化 123.53% 的曲线。它里面有四个问题,前面每一节都讲过其中一个:
- 数据窥探:那个 (40, 20) 是在 20 组参数里挑年化最高的
- 前视:流动性门槛用的是「20 日成交额高于全样本中位数」——全样本中位数 2020 年算不出来
- 幸存者:标的是「今天成交额最大的 20 个永续合约」
- 零成本:手续费、价差一分没算
(第五种偏差——复权——在加密上不存在,第六节那个 ZigZag 的重绘也不在这条策略里。)
一个一个修:
                    修到哪一步      年化    最大回撤   平均持仓     每年换手 赚钱的年份  比上一步掉了
                原样:四个问题都在  1.2353 -0.5673 2.5511  57.2608   6/7     NaN
① 不挑参数,固定 60 日新高 / 20 日新低  1.0765 -0.6778 1.9979  44.8193   5/7  0.1588
            ② 门槛改成当时算得出来的  1.0576 -0.6778 1.9729  44.5195   5/7  0.0189
      ③ 名单改成当时成交额最大的 20 个 -0.2441 -0.9975 5.9667 226.1951   3/7  1.3017
                   ④ 加上成本 -0.2603 -0.9978 5.9667 226.1951   3/7  0.0162
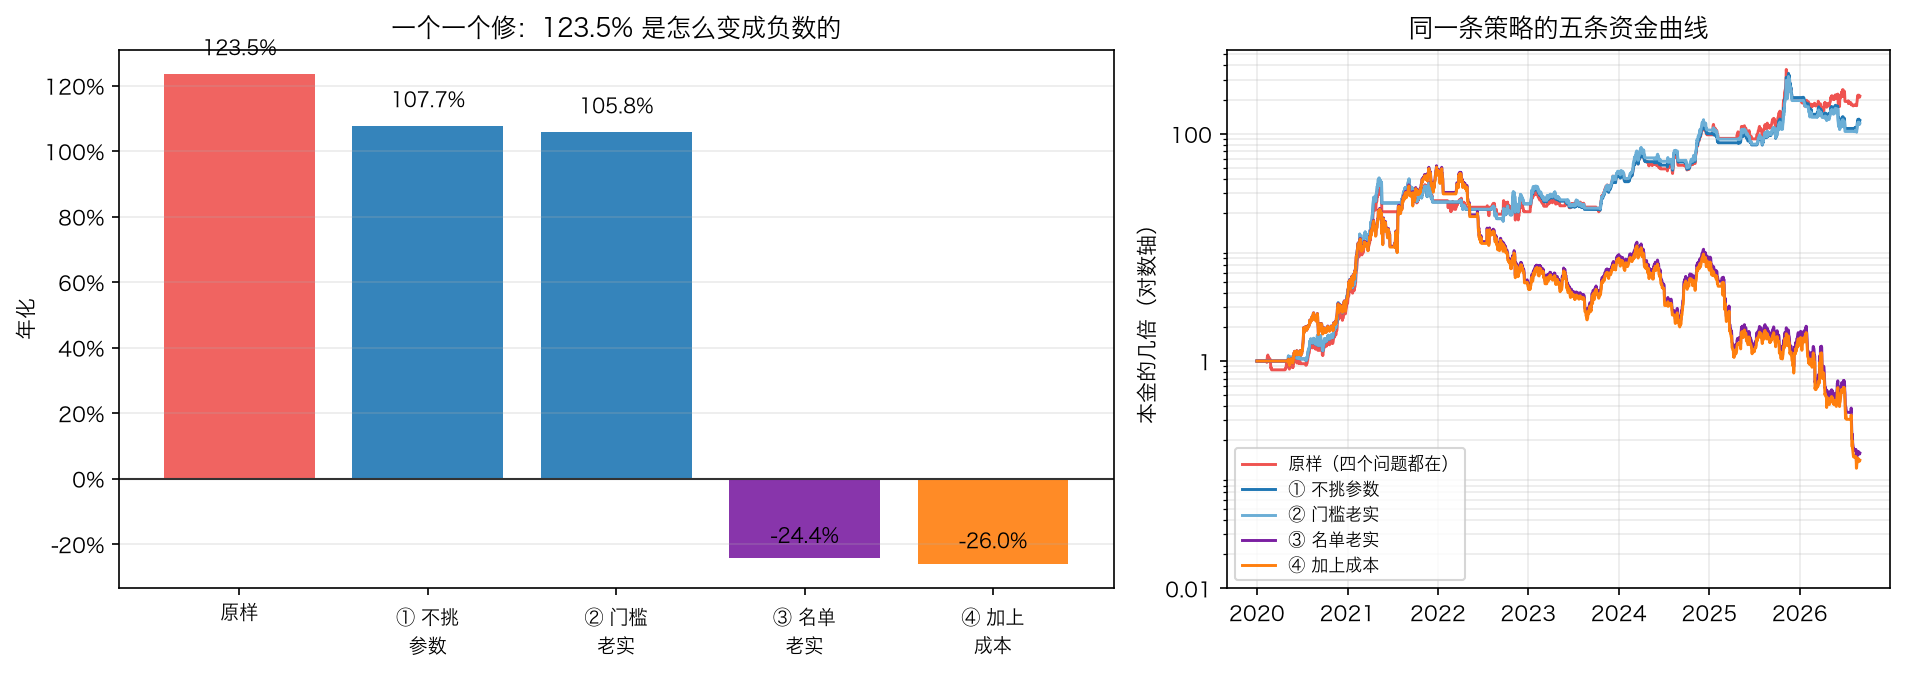
| 修到哪一步 | 年化 | 最大回撤 | 赚钱的年份 | 比上一步掉了 |
|---|---|---|---|---|
| 原样:四个问题都在 | 123.53% | −56.73% | 6/7 | |
| ① 不挑参数,固定 60 日新高 / 20 日新低 | 107.65% | −67.78% | 5/7 | 15.9 个百分点 |
| ② 门槛改成当时算得出来的 | 105.76% | −67.78% | 5/7 | 1.9 个百分点 |
| ③ 名单改成当时成交额最大的 20 个 | −24.41% | −99.75% | 3/7 | 130.2 个百分点 |
| ④ 加上成本 | −26.03% | −99.78% | 3/7 | 1.6 个百分点 |
123.53% → −26.03%。
而且四个问题的权重差得离谱:
- 幸存者一个人就占了 130 个百分点里的全部。把名单从「今天最大的 20 个」换成「当时最大的 20 个」,策略从年化 105.76% 直接掉到 −24.41%。
- 数据窥探占 15.9 个百分点,前视占 1.9 个,成本占 1.6 个。
⚠️ 一句必要的诚实话:第 ③ 步不只去掉了幸存者,它还顺带把策略变成了另一条策略——名单每天轮换,平均持仓从 2.0 个变成 6.0 个,每年换手从 45 次变成 226 次。这两件事在这里分不开,因为「用当时的名单」本来就意味着名单会动。能分开说的是方向:换成诚实的名单之后,它不赚钱了。
这就是这一篇最重要的一句话:
一条回测曲线的好看程度,和它里面有多少问题,往往是同一件事。
十五、主线策略的成绩单换成含成本的
主线策略 v4 这一篇不改——改的还是测量工具。但从今天起,它的成绩单换成含成本的版本:
  标的              成本   单边费率     年化    最大回撤  交易数      手续费合计
 SPY            不算成本 0.0000 0.0297 -0.1235   39     0.0000
 SPY  监管费 + 1 个基点的价差 0.0001 0.0291 -0.1242   39   642.2658
 SPY      价差按 5 个基点算 0.0003 0.0275 -0.1263   39  2435.9111
AAPL            不算成本 0.0000 0.0989 -0.2785   37     0.0000
AAPL  监管费 + 1 个基点的价差 0.0001 0.0983 -0.2796   37  1009.8519
AAPL      价差按 5 个基点算 0.0003 0.0967 -0.2828   37  3818.8418
 BTC            不算成本 0.0000 0.2160 -0.3232   30     0.0000
 BTC 现货 taker + 半个价差 0.0010 0.2094 -0.3320   30 21137.4390
 BTC 再加第 22 篇量到的止损滑点 0.0015 0.2063 -0.3362   30 30925.8513
| 标的 | 成本口径 | 单边费率 | 年化 | 最大回撤 |
|---|---|---|---|---|
| SPY | 不算成本 | 0 | 2.97% | −12.35% |
| SPY | 监管费 + 1 个基点的价差 | 0.0071% | 2.91% | −12.42% |
| SPY | 价差按 5 个基点算 | 0.0271% | 2.75% | −12.63% |
| AAPL | 不算成本 | 0 | 9.89% | −27.85% |
| AAPL | 监管费 + 1 个基点的价差 | 0.0071% | 9.83% | −27.96% |
| AAPL | 价差按 5 个基点算 | 0.0271% | 9.67% | −28.28% |
| BTC | 不算成本 | 0 | 21.60% | −32.32% |
| BTC | 现货 taker + 半个价差 | 0.1002% | 20.94% | −33.20% |
| BTC | 再加第 22 篇量到的止损滑点 | 0.1487% | 20.63% | −33.62% |
成本吃掉 0.2 到 1.0 个百分点的年化。 具体来说:
- SPY 和 AAPL 上几乎看不见:0.06 个百分点(1 个基点价差)到 0.22 个百分点(5 个基点)。第十节说的敏感性分析结论在这里——价差是 1 个基点还是 5 个基点,不改变任何结论,所以「美股的价差量不了」这件事在这条策略上不要紧。
- BTC 上吃掉 0.66 个百分点(21.60% → 20.94%),再加上第 22 篇量到的止损滑点是 0.97 个百分点(→ 20.63%)。九年 30 笔交易,手续费合计 21,137 美元(10 万美元的账户)。
为什么这么小?因为主线策略九年只交易 30 笔。回到第十二节那张频率表:这条策略每年 3.3 笔,落在「0.40%–1.20%」那一行附近。
成本对这条策略不构成威胁,不是因为成本低,是因为它交易得少。
这也是第六部分一路下来的一个侧面回报:第 20 篇选收盘价触发、第 21 篇加「收盘创 20 日新高」、第 23 篇不设固定止盈目标——这三个决定各有各的理由,但它们有一个共同的副作用:交易次数一直没涨上去。
十六、小检查
- 一条回测年化 80%,最大回撤 −35%,事件顺序检查(第 27 篇的三项体检)全过。它还可能哪里有问题?
- 「用全样本的标准差做标准化」和「用全样本的最高价做归一化」是同一类错误吗?判据是什么?
- 你在 500 组参数里挑出年化最高的一组。要判断这个数有多少是真的,你会做什么对照?
- 一条策略用到了 ZigZag 的摆动点。你会怎么改,才能让它变成一条能实盘的策略?
- 券商佣金是 0,回测里的成本写 0 对不对?
十七、常见误用
把第 27 篇的体检当成全部检查。 那三项查的是事件顺序,对这一篇的五种偏差一个都查不出来(第三节:决策点那条曲线三项全过)。
用今天的名单回测过去。 「今天市值前 100」「今天成交额前 20」「今天的指数成分股」——这些名单本身就是一个结果,用它回测等于先知道了谁会活下来。第十四节:这一条在加密篮子上值 130 个百分点。
在同一批数据上挑参数,然后把挑出来的那个数当成预期。 第六节:228 组里最好的那组,在打乱的(没有任何趋势的)数据上有 6% 的概率也能达到;样本内最优在样本外掉了 26 个百分点。挑完之后,把样本内那个数当成上限。
用未复权的价格回测股票。 第七节:苹果在未复权序列上年化 −3.70%,因为 2020-08-31 拆股造出了一天 74% 的假暴跌,止损全被打掉。
用任何「回头看才成立」的指标,却按「当时就知道」去回测。 ZigZag、未确认的摆动点、center=True 的均线、还没走完的形态——判据是同一条:这个值,在那一天能不能算出来?
把「零佣金」当成「零成本」。 第十一节:券商把订单卖给做市商,你付的是价差里看不见的那一块。
用高低价估计量去估价差。 第十节:在有真相的市场上检验过,高估 2,087 倍,一半的日子估出负数。有真相的市场用来检验方法,没有真相的市场不要硬估。
只看成本占名义价值的比例,不看交易频率。 0.1% 听起来很小,每天交易一次就是每年 50%。
十八、小结
- 第 27 篇的体检和这一篇的偏差是两套检查:前者查引擎的事件顺序(代码问题),后者查数据和结论怎么来的(流程问题)。决策点那条年化 123.53% 的曲线,三项体检全过。
- 前视偏差不只是少写一个 shift:用全样本的最值做归一化,年化 41.39%、「跑赢买入持有」;改成只用到当天为止的最值,26.33%、跑输。判据是一句话——这个数,在那一天能不能算出来?
- 幸存者偏差在加密上量得到:864 个上过市的合约里 160 个已经停止交易,同一条策略在 704 个幸存者上年化 78.01%,在全部 864 个上只有 44.34%(差 33.7 个百分点)。被删掉的那些不是随机的:它们停止交易前 60 天中位跌了 39.2%。
- 数据窥探要用打乱做对照:228 组参数里最好的一组年化 34.41%;把 K 线打乱(趋势全没了)重扫同样 228 组,「最好的一组」的中位数是 20.09%,而 6.0% 的打乱能超过 34.41%。
- 「在随机数据里挑 228 组的最好」和「在真实数据里随便选一组」一样好(20.09% vs 19.06%)。
- 参数选择不是完全没用:样本内前 10 名在样本外中位 15.53%,全部 228 组只有 9.18%;样本内外的秩相关 0.291——不是 0,也远不是 1。样本内最优在样本外掉了 26 个百分点。
- 复权偏差是唯一一种可能往两边偏的:苹果同一条策略,未复权 −3.70%、只按拆股复权 9.57%、全收益 9.82%。2020-08-31 四拆一在未复权序列上是「一天跌 74.15%」。加密没有拆股和分红,这一种偏差不存在。
- 重绘偏差的定价是 17.43%:15% 的 ZigZag,一个低点从发生到被确认中位要等 9 天(最长 52 天),确认那天价格已经高了 17.43%。重绘版年化 612%(5,152 万倍),老实版 36.70%(16.91 倍)——还跑输买入持有。
- BTC 永续的真实买卖价差只有 0.0328 个基点,基本就是一个最小变动价位;taker 手续费是它的 153 倍。但振幅 20% 那天有一分钟飙到 161.5 个基点——价差平时可以忽略,只在崩盘那几分钟变成主要成本。
- 高低价价差估计量在这三个市场上都是噪声:BTC 上高估约 2,087 倍、25% 的日子为负,SPY 上 51.6% 为负。有真相的市场用来检验方法,没有真相的市场不要硬估。
- 美股的成本结构是「佣金 0 + 两项很小的监管费 + 看不见的价差」:SEC 的 Section 31 费每百万 20.60 美元、FINRA 的 TAF 每股 0.000166 美元(都只在卖出时收),10 万美元的交易加起来 2.14 美元;而 1 个基点的价差就是 5 美元。零佣金是把成本挪进了价差。
- 成本和交易频率是线性的:BTC 现货单边 0.1002%,每年 12 笔是 2.40%,每年 250 笔是 50.08%。折算成 R 就是「2 × 单边成本 ÷ 止损距离」——止损放 10.8% 时占 0.0185R,放 0.5% 时占 0.40R。
- 四个问题的权重差得离谱:123.53% → 107.65%(不挑参数)→ 105.76%(门槛老实)→ −24.41%(名单老实) → −26.03%(加成本)。幸存者一个人占了全部。
- 主线策略 v4 不改,但成绩单从今天起含成本:SPY 2.97%→2.75%、AAPL 9.89%→9.67%、BTC 21.60%→20.63%。成本只吃掉 0.2–1.0 个百分点,不是因为成本低,是因为它九年只交易 30 笔。
练习
- 把第 19 篇的全市场扫描器(
screen.scan)改成「当时的名单」版本:每天按当天之前的成交额排名选标的。和「今天的前 N 名」比,年化差多少? - 第六节的打乱对照只做了 BTC 日线。在 SPY 和 AAPL 上重做一遍——美股的趋势比加密弱,「挑最好的一组」占的便宜会更大还是更小?
- 给
talab.backtest.Plan加一个spread_bp参数,让引擎在成交价上直接扣半个价差(而不是把它折进fee_rate)。两种写法在主线策略上差多少? - 用
download_binance_book_ticker多下几天(那 320 天随便挑),看看价差和当天振幅的关系能不能拟合成一条曲线。再用它给第 22 篇那 34 次止损估一个「当时的价差」。 - 第七节只比了三种价格序列。造第四种:用今天的复权因子去复权,但只复权到回测的截止日——这是很多数据供应商的默认行为。它和全收益序列差多少?
- 把这一篇的五种偏差写成一个检查清单函数:给它一条策略的代码和数据,它逐条问你问题(名单是怎么来的?参数是怎么定的?用到的统计量是滚动的吗?)。这种东西挡不住有意作弊,但能挡住大部分无意的。
小检查答案
- 还可能有这一篇的五种偏差中的任何一种:标的名单是不是今天选的(幸存者)、参数是不是在同一批数据上挑的(数据窥探)、有没有用到全样本的统计量(前视)、股票价格序列有没有复权(复权)、指标会不会事后改写自己(重绘)。再加上成本——第 27 篇的体检全过只说明引擎对了。
- 是同一类,判据也是同一条:这个数,在那一天能不能算出来? 全样本的标准差和全样本的最高价一样,都要等到最后一天才知道。修法也一样:换成滚动窗口(
rolling)或者扩展窗口(expanding、cummax)。 - 在没有信号的数据上做同样的挑选:把 K 线打乱(保留每根相对前一根的形状,只打乱顺序),重扫同样 500 组,看「最好的一组」能挑出多少。真实数据的最好一组,如果落在打乱后最大值分布的中间,那个数就基本全是挑选效应。再加一个样本外切分做交叉验证。
- 把成交时点从摆动点当天改成
confirmed_at之后的下一根。ZigZag 的输出里有confirmed_at这一列,就是为了这件事。改完之后年化从 612% 变成 36.70%——如果这条策略在老实版本上不赚钱,那它本来就不是一条策略。 - 不对。 佣金只是成本的一项。美股还有两项监管费(卖出时收)和买卖价差,而价差是主要项——零佣金的商业模式正是把成本挪进价差(PFOF)。价差没有公开历史数据,所以正确的做法是敏感性分析:把它当未知参数试几个值,看结论会不会变(第十五节:主线策略上 1 个基点和 5 个基点的差别是 0.16 个百分点,不改变结论)。