| 本篇位置 | 第六部分「检验」第三篇。第 27 篇保证引擎是对的,第 28 篇保证数据是干净的,这一篇保证读数的人没有被自己骗 |
| 用到的数据 | BTC 现货日线与 4 小时线、SPY、AAPL、3 个月国库券收益率(新下载,FRED) |
| 动手 | 新模块 talab.report:metrics、sharpe、sortino、calmar、sharpe_se、years_needed、bootstrap、trade_metrics、by_year、compare、page,附 15 个测试;talab.data 加 download_fred_series / load_fred_series |
| 读完你能 | 给任何一条资金曲线出一页纸的体检报告,并且知道报告上每一个数的误差有多大 |
一、先做一个决定
两条策略,同一个市场(BTC),同一段时间(2017-08-17 到 2026-08-31),都是突破型,都只做多,都不加杠杆:
- A:日线唐奇安 40/20。收盘创 40 日新高就买入,跌破 20 日新低就卖出。
- B:4 小时线突破。收盘创 12 根(两天)新高就买入,持有 3 根(半天)。
两条都按第 27 篇的时钟规矩推迟一根成交,两条的资金曲线都换算成日频再算指标,两条都暂时不算成本。
                    A 日线唐奇安 40/20        B 4 小时创 12 根新高持 3 根
起       2017-08-17 00:00:00+00:00  2017-08-17 00:00:00+00:00
止       2026-08-31 00:00:00+00:00  2026-08-31 00:00:00+00:00
根数                         3302.0                     3302.0
累计收益                    62.406561                  38.725321
年化收益                     0.582219                   0.502495
年化波动                     0.415952                    0.35969
夏普比率                      1.30857                   1.307232
索提诺比率                    2.162212                   2.451077
最大回撤                    -0.525126                  -0.564601
卡玛比率                     1.108723                       0.89
在水下的比例                   0.940036                   0.952756
最长水下根数                      714.0                      998.0
最好的一根                    0.225014                   0.225014
最差的一根                    -0.13981                  -0.109207

A 一共 35 笔,平均持仓 39.3 根日线
B 一共 1061 笔,平均持仓 5.7 根 4 小时线(1.0 天)
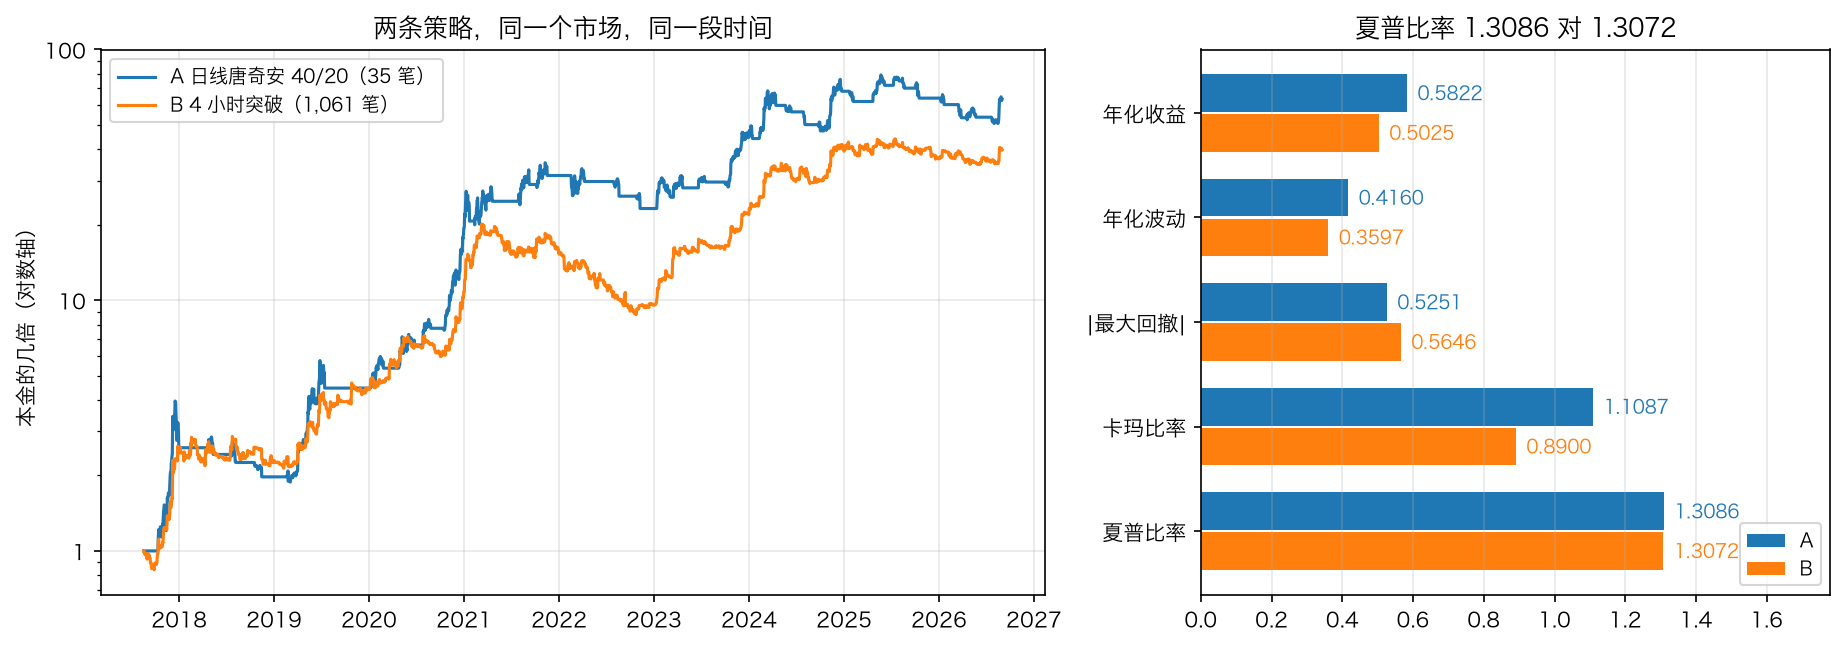
夏普比率 1.3086 对 1.3072。 小数点后三位一模一样。
A 的年化高 8 个百分点,B 的回撤深 4 个百分点,两边各有输赢,唯独那个最常被拿来排名的数字打平了。
差别只在一个地方:A 一共只交易了 35 次,B 交易了 1,061 次。
你手上有 100 万,只能投一条。投哪条?
二、打个比方:体检报告
一条策略的回测结果,是它的体检报告。
体检报告有几个特点,每一个都对得上:
| 体检报告 | 回测报告 |
|---|---|
| 没有哪个医生会只看体重就下结论 | 没有哪个数能单独决定一条策略好不好 |
| 每一项都有参考范围 | 每一个指标都得知道「多少算高」 |
| 每台仪器都有测量误差,报告上不印不代表没有 | 每一个指标都有置信区间,回测软件不印不代表没有 |
| 量一次血压偏高,医生会让你改天再量一次 | 一年的夏普比率 1.5,基本什么都说明不了 |
| 抽了多少血决定了化验结果有多准 | 交易了多少次决定了这些数有多准 |
最后那一行是这一篇的主线。第 27 篇和第 28 篇讲的是「报告别出错」,这一篇讲的是另一件事:报告上的数,误差有多大——以及一件很容易被忽略的事:误差不是由你有多少根 K 线决定的,是由你下了多少次注决定的。
而「投哪一条」这个问题,最后会落在两个方向相反的答案上。先把报告上的每一项拆开。
三、第一个数:年化收益
3.1 算术平均不是年化收益
「日均收益率 0.15%,一年 365 天,那年化就是 1.0015^365 − 1 = 73%。」这句话是错的。
returns_a, returns_b = curve_a.pct_change().dropna(), curve_b.pct_change().dropna()
buy_hold = close_d.pct_change().dropna()
rows = []
for name, series in {"BTC 买入持有": buy_hold, "A": returns_a, "B": returns_b}.items():
    arithmetic = (1 + series.mean()) ** 365 - 1
    geometric = (1 + series).prod() ** (365 / len(series)) - 1
    rows.append({"曲线": name, "日均收益率": series.mean(), "按日均复利": arithmetic,
                 "真实的年化": geometric, "差": arithmetic - geometric,
                 "年化方差的一半": series.var() * 365 / 2})
print(pd.DataFrame(rows).round(6).to_string(index=False))
      曲线    日均收益率    按日均复利    真实的年化        差  年化方差的一半
BTC 买入持有 0.001504 0.730883 0.379409 0.351475 0.224614
       A 0.001491 0.722707 0.582219 0.140488 0.086508
       B 0.001288 0.599827 0.502495 0.097332 0.064688
BTC 买入持有的日均收益率按复利推出来是 73.09%,真实的年化只有 37.94%——差了 35 个百分点。
原因是复利:先涨 50% 再跌 50%,算术平均是 0,实际是亏 25%。波动越大,这个缺口越大。教科书上的近似是「缺口 ≈ 年化方差的一半」,最后一列就是这个近似值。
⚠️ 但请看那一列的数字:BTC 上近似值是 22.46 个百分点,实际差了 35.15 个。这个近似在 BTC 这种波动率上已经不能用了(它是在「每根的收益率很小」的前提下推的,BTC 的日波动率 3.5%、年化 67%,不满足这个前提)。A 和 B 的波动率低一些,近似就准一些(8.65 对 14.05、6.47 对 9.73)——但也只是「一个量级」的准。
结论很简单:年化收益永远用几何的口径算,别自己从日均推。
3.2 它是两个端点的函数
年化收益只用到两个数:期初的权益和期末的权益。中间发生过什么,它一个字都不知道。
shifted = pd.Series({n: RP.annual_return(curve_a.iloc[n:], 365) for n in range(181)})
print(f"起点在最初 180 天里挪一挪:最低 {shifted.min():.2%}(往后挪 {int(shifted.idxmin())} 天)、"
      f"最高 {shifted.max():.2%}(往后挪 {int(shifted.idxmax())} 天)、原样 {shifted.iloc[0]:.2%}")
rows = []
for cut in ["2021-12-31", "2022-12-31", "2023-12-31", "2024-12-31", "2025-12-31", "2026-08-31"]:
    piece = curve_a.loc[:cut]
    rows.append({"报告写到哪天": cut, "年化收益": RP.annual_return(piece, 365),
                 "夏普比率": RP.sharpe(piece.pct_change().dropna(), 365),
                 "最大回撤": RP.max_drawdown(piece), "卡玛比率": RP.calmar(piece, 365)})
print(pd.DataFrame(rows).round(4).to_string(index=False))
起点在最初 180 天里挪一挪:最低 37.47%(往后挪 121 天)、最高 59.46%(往后挪 55 天)、原样 58.22%
    报告写到哪天   年化收益   夏普比率    最大回撤   卡玛比率
2021-12-31 1.1991 1.8199 -0.5251 2.2834
2022-12-31 0.7950 1.4697 -0.5251 1.5140
2023-12-31 0.8150 1.5348 -0.5251 1.5520
2024-12-31 0.7722 1.4986 -0.5251 1.4705
2025-12-31 0.6427 1.3746 -0.5251 1.2240
2026-08-31 0.5822 1.3086 -0.5251 1.1087
同一条策略、同一份数据,起点在最初半年里挪一挪,年化就能从 37.47% 变到 59.46%——挪的不是策略,是日历。
截止日更狠。这条策略写在 2021 年底的报告上是年化 119.91%、卡玛 2.28,写在 2026 年 8 月的报告上是年化 58.22%、卡玛 1.11。中间四年半它没有变坏,它只是回到了自己长期的样子。
⚠️ 看到任何一份漂亮的回测报告,先问两个问题:起点是怎么定的?为什么恰好截在这一天?
四、第二个数:夏普比率
4.1 它是一个信噪比
一条策略平均每天赚 0.15%,另一条平均每天也赚 0.15%,但第一条每天上下抖 1%,第二条抖 6%。第二条要赚到同样的钱,得让你承受六倍的心跳。
夏普比率就是把这件事写成一个比:
夏普比率 = 超额收益的均值 ÷ 超额收益的标准差 × √(一年有几根 K 线)
分子是信号,分母是噪声。那个 √(一年几根) 不是凑出来的,它来自一件很具体的事:把 k 根 K 线合并成一根,均值按 k 长大,标准差只按 √k 长大。
print("分子是「平均每根赚多少」,分母是「这个平均值周围抖多厉害」,比值再按 √(一年几根) 放大。")
rows = []
for k in [1, 5, 10, 20, 60, 120]:
    chunk = returns_a.rolling(k).sum().dropna()
    rows.append({"合并几根": k, "均值": chunk.mean(), "均值 ÷ k": chunk.mean() / k,
                 "标准差": chunk.std(), "标准差 ÷ √k": chunk.std() / np.sqrt(k),
                 "信噪比": chunk.mean() / chunk.std(),
                 "信噪比 ÷ √k": chunk.mean() / chunk.std() / np.sqrt(k)})
print(pd.DataFrame(rows).round(6).to_string(index=False))
 合并几根       均值   均值 ÷ k      标准差  标准差 ÷ √k      信噪比  信噪比 ÷ √k
    1 0.001491 0.001491 0.021772  0.021772 0.068494  0.068494
    5 0.007464 0.001493 0.050814  0.022725 0.146881  0.065687
   10 0.014944 0.001494 0.074276  0.023488 0.201202  0.063626
   20 0.029457 0.001473 0.113697  0.025423 0.259085  0.057933
   60 0.087964 0.001466 0.218243  0.028175 0.403055  0.052034
  120 0.168634 0.001405 0.323744  0.029554 0.520886  0.047550
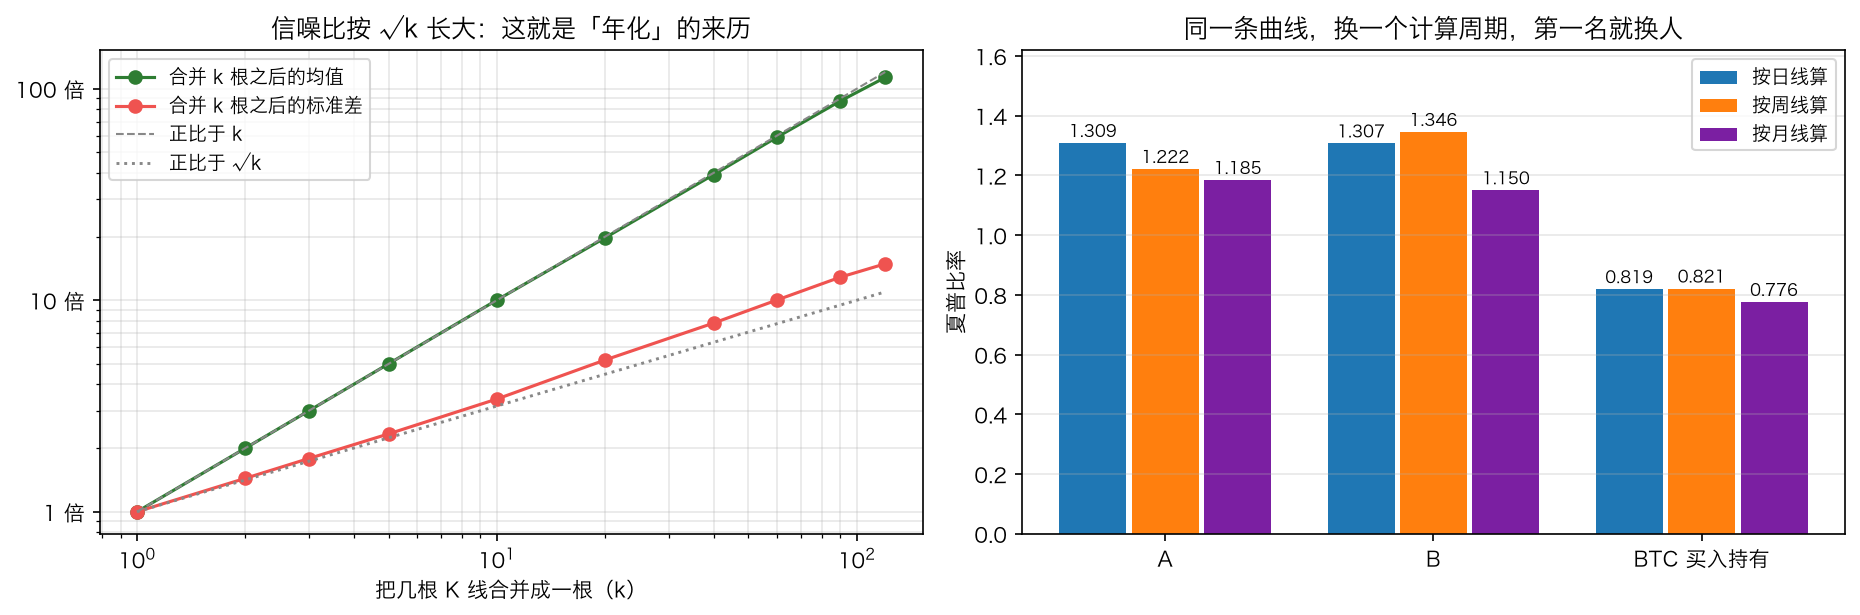
看「均值 ÷ k」那一列:从 1 根到 120 根,它在 0.001405 到 0.001494 之间,基本是一条横线。再看「标准差 ÷ √k」:从 0.021772 涨到 0.029554,涨了 36%。
**信号按 k 长大,噪声只按 √k 长大——所以你等得越久,信噪比越高。**这就是「年化」两个字的全部内容:把单根的信噪比乘上 √(一年几根),等于问「如果这样攒一整年,信噪比是多少」。
⚠️ 但这条式子有个前提:**每根的收益率互相独立。**第 5 篇算过方差比,这里再算一次:
A 的日收益率方差比(第 5 篇):5 天 1.078、20 天 1.297——不等于 1,所以上面那两列不会严丝合缝
方差比 1.297 意味着 20 天的方差比「20 倍的 1 天方差」大三成——涨跌有延续性,标准差长得比 √k 快。所以日线算出来的年化夏普,比真实的长期信噪比要高一点。高多少,下一节直接量。
4.2 骗法一:换一个计算周期,第一名就换人
rows = []
for name, curve in {"A": curve_a, "B": curve_b, "BTC 买入持有": close_d}.items():
    row = {"曲线": name}
    for label, rule, periods in [("日", None, 365), ("周", "W", 52), ("月", "ME", 12)]:
        series = curve if rule is None else curve.resample(rule).last()
        row[f"{label}线算的夏普"] = RP.sharpe(series.pct_change().dropna(), periods)
    rows.append(row)
print(pd.DataFrame(rows).round(4).to_string(index=False))
      曲线  日线算的夏普  周线算的夏普  月线算的夏普
       A  1.3086  1.2218  1.1847
       B  1.3072  1.3457  1.1503
BTC 买入持有  0.8192  0.8211  0.7762
同一条 A,日线算 1.3086、周线算 1.2218、月线算 1.1847。完全一样的资金曲线,只是把收益率按不同的格子切开重新算——掉了 0.12。
这还不是最要命的。看排名:
| A | B | 谁赢 | |
|---|---|---|---|
| 按日线算 | 1.3086 | 1.3072 | A |
| 按周线算 | 1.2218 | 1.3457 | B |
| 按月线算 | 1.1847 | 1.1503 | A |
**换一个计算周期,第一名就换人。**而回测软件默认用哪个周期,通常没人问过。
⚠️ 比两条策略的夏普比率之前,先确认它们是同一个计算周期算出来的。跨周期的夏普比率不可比,跨市场的更不可比(美股一年 252 根、加密 365 根,这两个数直接决定了最后乘的那个 √)。
4.3 骗法二:把净值抹平一下
这一招在基金业里有个中性的名字叫「平滑」:不是每天按市价报净值,而是报一个多日平均——理由通常很正当(「我们的资产流动性差,单日报价噪声太大」)。
rows = []
for window in [1, 2, 3, 5, 10]:
    smooth = returns_a.rolling(window).mean().dropna()
    rows.append({"报告的净值平滑几天": window, "日均收益率": smooth.mean(),
                 "年化波动": RP.annual_vol(smooth, 365), "夏普比率": RP.sharpe(smooth, 365)})
print(pd.DataFrame(rows).round(6).to_string(index=False))
 报告的净值平滑几天    日均收益率     年化波动     夏普比率
         1 0.001491 0.415952 1.308570
         2 0.001490 0.299279 1.817122
         3 0.001491 0.247480 2.198306
         5 0.001493 0.194161 2.806156
        10 0.001494 0.141903 3.843958

分子(日均收益率)几乎没动,分母掉了三分之二——夏普比率就是这样被「抹」出来的。
平滑 10 天之后,收益率的一阶自相关从 0.035 变成 0.920——这是唯一露出来的马脚。
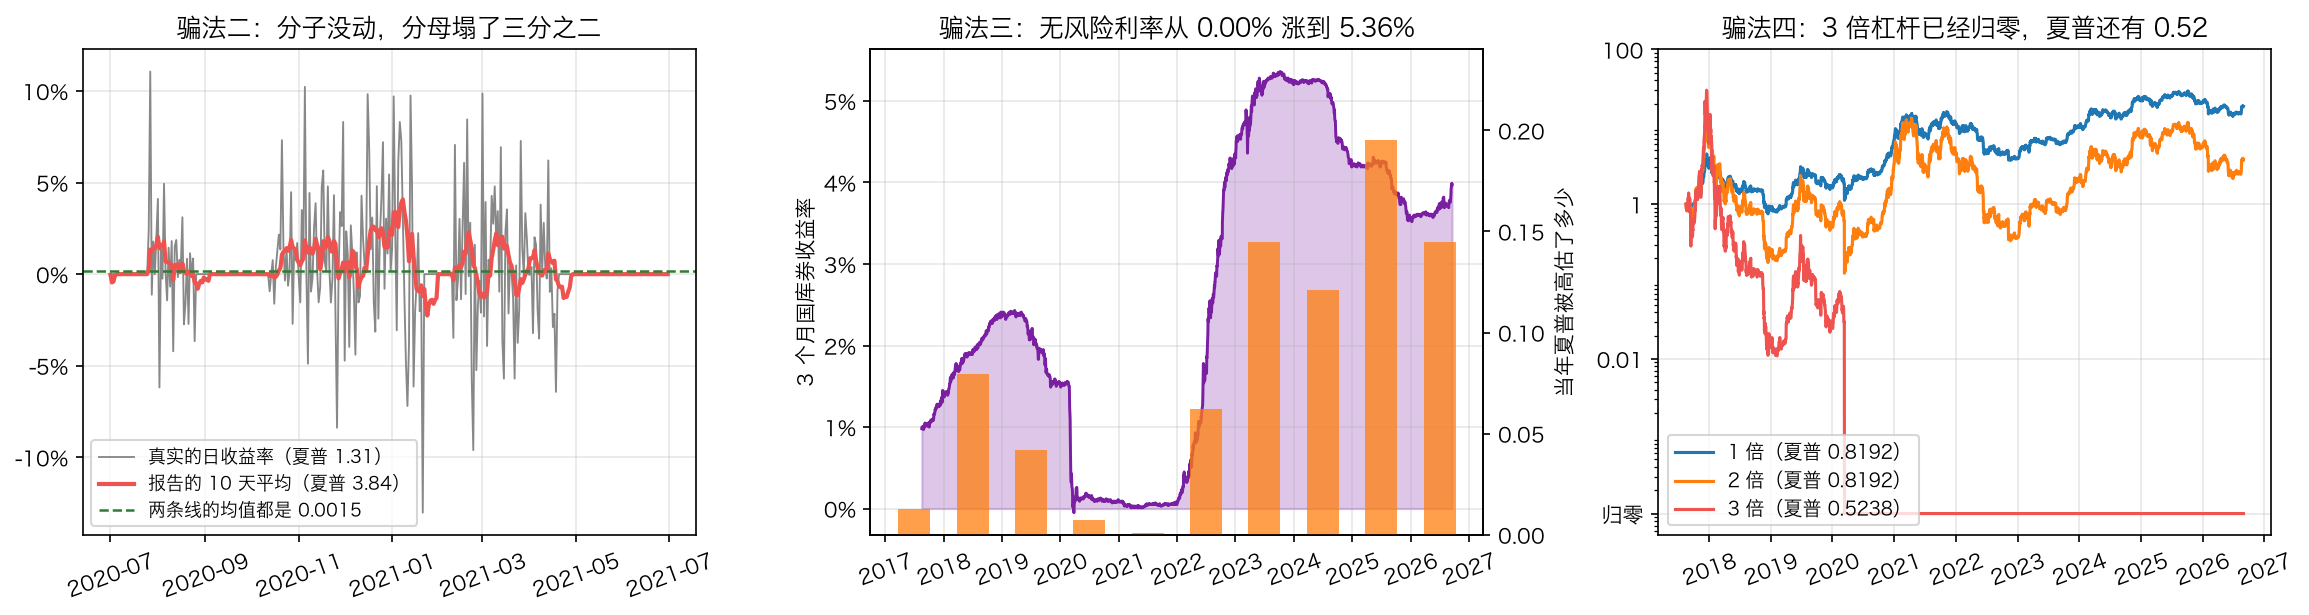
**夏普比率从 1.31 变成 3.84,涨了将近两倍。**而机制清清楚楚地写在表里:
- 分子(日均收益率):0.001491 → 0.001494,纹丝不动
- 分母(年化波动):0.4160 → 0.1419,掉了三分之二
平均值是线性的,滑动平均不会改变它;波动率不是线性的,被平均掉了。左边那张图把这件事画了出来:灰线和红线的中心线(绿色虚线)是同一条,只是红线的抖动小得多。
唯一露出来的马脚是自相关:真实的日收益率一阶自相关 0.035(基本是白噪声),平滑 10 天之后变成 0.920。一条真实的日频净值不会有 0.92 的一阶自相关。
拿到一份夏普比率高得离谱的业绩,先算它日收益率的一阶自相关。这是十几行代码就能做的体检,而它挡掉的是一整类问题。
4.4 骗法三:无风险利率不是 0
夏普比率的分子是超额收益——减掉「什么都不做、把钱放在国库券里」的收益。2021 年这个数确实接近 0,所以很多人养成了不减的习惯。然后 2022 年之后,它不是 0 了。
rf = D.load_fred_series("data/fred/DTB3.csv")
print(f"3 个月国库券:{rf.index[0].date()} 到 {rf.index[-1].date()},"
      f"最低 {rf.min():.2%}({rf.idxmin().date()})、最高 {rf.max():.2%}({rf.idxmax().date()})")
rows = []
for year, chunk in returns_a.groupby(returns_a.index.year):
    aligned = RP.excess(chunk, 365, rf)
    rows.append({"年": year, "当年平均无风险利率": (chunk - aligned).mean() * 365,
                 "夏普(利率当成 0)": RP.sharpe(chunk, 365),
                 "夏普(用真实利率)": RP.sharpe(chunk, 365, rf)})
table = pd.DataFrame(rows)
table["差"] = table["夏普(利率当成 0)"] - table["夏普(用真实利率)"]
print(table.round(4).to_string(index=False))
print(f"\n全程:{RP.sharpe(returns_a, 365):.4f} → {RP.sharpe(returns_a, 365, rf):.4f}")
3 个月国库券:2016-01-04 到 2026-09-17,最低 -0.05%(2020-03-26)、最高 5.36%(2023-10-06)
   年  当年平均无风险利率  夏普(利率当成 0)  夏普(用真实利率)      差
2017     0.0114      3.2510     3.2385 0.0125
2018     0.0192     -0.9898    -1.0693 0.0795
2019     0.0204      1.9157     1.8740 0.0418
2020     0.0036      3.2558     3.2484 0.0074
2021     0.0005      1.2092     1.2083 0.0009
2022     0.0198     -0.7889    -0.8509 0.0620
2023     0.0494      2.0914     1.9465 0.1449
2024     0.0485      1.2469     1.1260 0.1209
2025     0.0398     -0.2088    -0.4041 0.1953
2026     0.0357      0.0663    -0.0787 0.1450

全程:1.3086 → 1.2475
3 个月国库券的收益率在这段样本里从 −0.05%(2020-03-26,是的,真的收过负利率)一直走到 5.36%(2023-10-06)。对应地:
- 2021 年:平均利率 0.05%,夏普差 0.0009——不减完全没关系
- 2025 年:平均利率 3.98%,夏普差 0.1953
- 2026 年:夏普从 +0.0663 变成 −0.0787——跨过了 0
同样一条策略在 2026 年是「小赚」还是「其实跑输了存款」,取决于你有没有减那一项。
⚠️ 在
talab.report里这件事有个很阴的坑:利率序列只有工作日、不带时区,而加密的 K 线天天都有、带 UTC 时区。直接reindex会安安静静地全变成 NaN,一个报错都不给,夏普比率输出nan——如果你的代码恰好把 NaN 当成 0 处理,就更糟了。excess里那几行统一时区的代码就是为这件事写的,测试里也钉了一条。
4.5 骗法四:夏普比率看不见破产
rows = []
for leverage in [1, 2, 3, 5]:
    levered = RP.to_curve((leverage * buy_hold).clip(lower=-1.0))
    daily = levered.pct_change().dropna()
    rows.append({"杠杆": f"{leverage} 倍", "年化收益": RP.annual_return(levered, 365),
                 "年化波动": RP.annual_vol(daily, 365), "夏普比率": RP.sharpe(daily, 365),
                 "最大回撤": RP.max_drawdown(levered), "卡玛比率": RP.calmar(levered, 365),
                 "期末还剩": float(levered.iloc[-1])})
print(pd.DataFrame(rows).round(4).to_string(index=False))
 杠杆    年化收益   年化波动   夏普比率    最大回撤    卡玛比率    期末还剩
1 倍  0.3794 0.6702 0.8192 -0.8319  0.4561 18.3383
2 倍  0.1578 1.3405 0.8192 -0.9908  0.1592  3.7616
3 倍 -1.0000 2.5140 0.5238 -1.0000 -1.0000  0.0000
5 倍 -1.0000 4.1061 0.5977 -1.0000 -1.0000  0.0000
这张表有两件事值得盯着看。
**第一,1 倍和 2 倍的夏普比率完全一样:0.8192 对 0.8192。**这不是巧合,是定义决定的——杠杆把分子和分母同比例放大,比值不变。但最大回撤从 −83.19% 变成 −99.08%,卡玛比率从 0.4561 掉到 0.1592,期末从 18.34 倍掉到 3.76 倍。
夏普比率对「你用了几倍杠杆」完全没有意见。
第二,3 倍杠杆的账户已经归零了,它的夏普比率还有 0.5238。(顺带一提,5 倍的 0.5977 比 3 倍还高。)原因也很朴素:账户归零之后就没有收益率了,序列在那一天戛然而止,夏普比率只能对着它之前的那一段计算。它看不见「游戏结束」这件事。
这就是为什么报告上必须同时有最大回撤。夏普比率负责回答「值不值」,最大回撤负责回答「活不活得到那天」。
五、第三个数:最大回撤
5.1 它是一个极值,样本越长它越深
最大回撤只由一个时刻决定:全程离历史最高点最远的那一刻。它是一个极值统计量,而极值有一个很不直观的性质:同一个随机过程,你观察得越久,见到的极值就越极端。
mu, sigma = returns_a.mean(), returns_a.std()
rows = []
for years in [1, 2, 3, 5, 9, 20]:
    n = int(365 * years)
    draws = np.array([RP.max_drawdown(RP.to_curve(pd.Series(rng.normal(mu, sigma, n),
                                                             index=pd.RangeIndex(n))))
                      for _ in range(N_BOOT)])
    rows.append({"随机游走跑几年": years, "最大回撤中位数": np.median(draws),
                 "5% 分位": np.percentile(draws, 5), "95% 分位": np.percentile(draws, 95)})
print(pd.DataFrame(rows).round(4).to_string(index=False))
 随机游走跑几年  最大回撤中位数   5% 分位  95% 分位
       1  -0.2711 -0.4673 -0.1663
       2  -0.3365 -0.5387 -0.2148
       3  -0.3734 -0.5818 -0.2511
       5  -0.4227 -0.6372 -0.2960
       9  -0.4791 -0.6614 -0.3538
      20  -0.5463 -0.7181 -0.4244
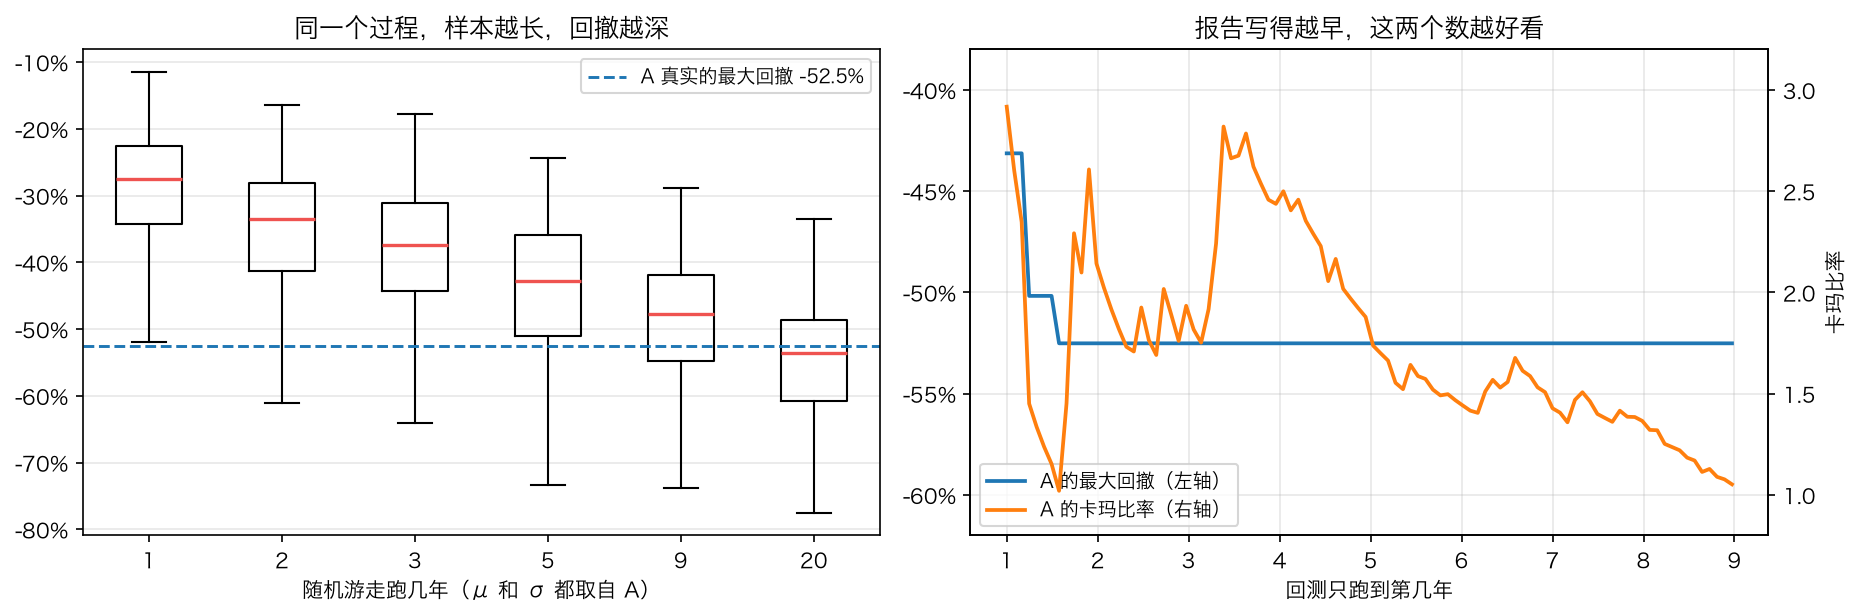
把 A 的日均收益率和日波动率原样抄下来,生成完全没有任何策略、纯随机的价格序列:
- 跑 1 年,最大回撤中位数 −27.11%
- 跑 9 年,−47.91%
- 跑 20 年,−54.63%
过程一个字没变,只是看得久了。
再看 A 自己:
A 真实跑了 9.0 年,最大回撤 -52.51%——落在「同样波动率的随机游走跑九年」的 90% 区间里面,比那个中位数深 4.60 个百分点。
 只看前几年    最大回撤   年化收益   卡玛比率
     1 -0.4313 1.2533 2.9059
     2 -0.5251 1.1123 2.1181
     3 -0.5251 1.0110 1.9252
     5 -0.5251 0.9713 1.8496
     9 -0.5251 0.5475 1.0427
**A 真实的最大回撤是 −52.51%,而「同样波动率的纯随机游走跑九年」的中位数是 −47.91%、90% 区间是 −66.14% 到 −35.38%。**A 比那个中位数只深 4.60 个百分点,离 5% 分位还差 13.63 个。
换句话说:**A 的最大回撤里,几乎没有关于 A 的信息。**它基本就是「一条年化波动 41.6% 的曲线跑九年该有的样子」。
后面那张小表是同一件事的真实版本:只跑到第 1 年,回撤 −43.13%、卡玛 2.91;跑满九年,回撤 −52.51%、卡玛 1.04。报告写得越早,这两个数越好看,而这里面有多少是「策略变差了」、多少是「样本变长了」,光看这两个数分不出来。
5.2 那最大回撤还有什么用
它有用,但用法不是「拿来排名」,是这三条:
- 它是一个体验值:−52% 的意思是你要坐在一个腰斩的账户前面,而且(按第 26 篇的式子)得涨 110.6% 才回本
- 它是一个仓位输入:第 26 篇的风险预算就是从「我能忍多深」倒推回来的
- 它只能和「同样长度、同样波动率」的曲线比
⚠️ 两条长度不同的曲线不能直接比最大回撤,也不能比卡玛比率。要比就把长的那条截到和短的一样长,或者干脆比「回撤 ÷ 年化波动」。
六、第四个数:卡玛比率
卡玛比率把前两个数并成一个:
卡玛比率 = 年化收益 ÷ |最大回撤|
它回答的问题很实在:**「我为了这点年化,最深要忍多深?」**卡玛 1.0 的意思是「年化和最大回撤一样大」。
它的好处是直觉;它的毛病是分母继承了最大回撤的全部毛病——极值、随样本变长、只由一个时刻决定。上面那张表里 A 的卡玛从 2.91 走到 1.04,年化只掉了一半多一点,剩下的全是分母在动。
三个常用的比值型指标摆在一起:
| 指标 | 分母是什么 | 稳不稳 | 它偏向什么样的策略 |
|---|---|---|---|
| 夏普比率 | 全部波动 | 比较稳(下一节给区间) | 平稳的、波动小的 |
| 索提诺比率 | 只算下行波动 | 中等 | 有正偏度的(趋势跟随) |
| 卡玛比率 | 最大回撤(一个极值) | 最不稳 | 运气好、没碰上大回撤的 |
A 的索提诺 2.1622 明显高于它的夏普 1.3086,B 的索提诺 2.4511 更高——两条都是突破型策略,大涨的日子比大跌的日子更极端,而夏普比率把「涨得太猛」也算进了风险里。
七、动手:talab.report 的指标部分
到这里,一页纸报告的上半部分已经齐了。先看整个模块的开场白:
"""talab.report:怎么评价一条策略。第 29 篇。

第 27 篇保证引擎是对的,第 28 篇保证喂进去的数据是干净的。
这个模块回答最后一个问题:**跑出来的这一串数,该怎么读。**

整个模块围绕一件事写:**每一个指标都要带着它的误差一起出现。**
`年化 21%` 是一句话,`年化 21%(90% 区间 3% 到 44%)` 是另一句话,
而它们是同一条资金曲线算出来的。只报前一句不算撒谎,但也不算说清楚。

三组函数:

1. **算指标**:`metrics` 一次给出一页纸上半部分的全部数字
2. **算误差**:`sharpe_se`(解析解)、`bootstrap`(重抽)、`trade_metrics`(交易层面)
3. **排版**:`by_year`、`compare`、`page`
"""
from __future__ import annotations

import math
from statistics import NormalDist

import numpy as np
import pandas as pd

from talab.size import drawdown
第一个函数专门治一个很小但很常见的错:
def to_curve(returns: pd.Series) -> pd.Series:
    """把一串收益率还原成资金曲线,并在**最前面补一个 1**。

    ⚠️ 少补这个 1 是这一篇里最容易犯的小错:`(1 + r).cumprod()` 的第一个点
    已经是「第一根走完之后」了,拿它当期初,整段收益就少算了第一根。
    第一根碰巧是大涨大跌的日子时,年化能差出一个百分点。
    """
    step = returns.index[1] - returns.index[0] if len(returns) > 1 else pd.Timedelta(0)
    head = pd.Series([1.0], index=[returns.index[0] - step])
    return pd.concat([head, (1 + returns).cumprod()])
然后是四个指标本身:
def annual_return(equity: pd.Series, periods_per_year: int) -> float:
    """复合年化收益率(CAGR):`(期末 ÷ 期初) ^ (一年几根 ÷ 总共几根) − 1`。

    ⚠️ 这里用**根数**折算而不是用日历天数,所以它衡量的是「每根 K 线平均涨多少」的复利,
    两条起止日期不同的曲线可以这样比;但它对**起止点本身**极其敏感,见第 29 篇。
    """
    n = len(equity) - 1
    if n <= 0:
        raise ValueError("资金曲线至少要有两个点")
    return float(equity.iloc[-1] / equity.iloc[0]) ** (periods_per_year / n) - 1


def annual_vol(returns: pd.Series, periods_per_year: int) -> float:
    """年化波动率:单根 K 线收益率的标准差 × √(一年几根)。"""
    return float(returns.std()) * math.sqrt(periods_per_year)


def excess(returns: pd.Series, periods_per_year: int, rf: float | pd.Series = 0.0) -> pd.Series:
    """超额收益率:每根 K 线的收益率减去同期无风险利率。

    `rf` 是**年化**利率(4.25% 写 0.0425),可以是一个数,也可以是一条随时间变化的序列
    (`data.load_fred_series` 的输出就是)。换算成单根 K 线用复利口径:`(1+rf)^(1/一年几根) − 1`。

    ⚠️ 对齐这一步最容易出事:利率序列只有工作日,而加密的 K 线天天有,还带 UTC 时区。
    直接 `reindex` 会**安安静静地全变成 NaN**,一个报错都不给。所以这里先统一时区,
    再用「并集 + 前向填充」补齐缺的日子。
    """
    if isinstance(rf, pd.Series):
        index, source = returns.index, rf
        if getattr(source.index, "tz", None) != getattr(index, "tz", None):
            source = source.copy()
            source.index = (source.index.tz_localize(None) if index.tz is None
                            else source.index.tz_localize(index.tz) if source.index.tz is None
                            else source.index.tz_convert(index.tz))
        rf = pd.Series(source.reindex(source.index.union(index)).ffill().bfill()
                       .reindex(index).to_numpy(), index=index)
    per_period = (1 + rf) ** (1 / periods_per_year) - 1
    return returns - per_period
def sharpe(returns: pd.Series, periods_per_year: int, rf: float | pd.Series = 0.0) -> float:
    """夏普比率:`超额收益的均值 ÷ 超额收益的标准差 × √(一年几根)`。

    它是一个**信噪比**:分子是信号(平均每根赚多少),分母是噪声(这个平均值周围抖多厉害)。
    √(一年几根) 来自「独立的收益率相加时,均值按 n 放大、标准差只按 √n 放大」——
    所以时间拉长对信噪比是有利的,这正是夏普比率能被年化的原因,
    也是它**只有在收益率互相独立时才能这样年化**的原因(第 29 篇量了违反的后果)。

    ⚠️ 曲线一动不动(比如那一年从头到尾空仓)时返回 `NaN` 而不是一个数:
    那种情况下分母是 0,而分子是「−无风险利率」,公式会给出一个绝对值极大的负数——
    它在数学上没错,但把它印在报告上只会误导人。该说的是**「这一年没有可比的夏普比率」**。
    """
    e = excess(returns, periods_per_year, rf)
    if len(e) < 2 or e.std() == 0 or returns.std() == 0:
        return np.nan                                 # 见上面那条 ⚠️
    return float(e.mean() / e.std()) * math.sqrt(periods_per_year)


def sortino(returns: pd.Series, periods_per_year: int, rf: float | pd.Series = 0.0) -> float:
    """索提诺比率:分母只算**下行**的波动,上涨的波动不算在风险里。

    下行标准差 = √(所有超额收益里取 min(x, 0) 的平方平均)——注意分母是**全部**根数,
    不是亏损根数,否则一条「很少亏但亏起来很大」的曲线会被算得比实际好。
    """
    e = excess(returns, periods_per_year, rf)
    downside = np.sqrt((np.minimum(e.to_numpy(float), 0.0) ** 2).mean())
    if downside == 0:                                 # 一次都没亏过:分母是 0
        return np.inf if e.mean() > 0 else np.nan
    return float(e.mean() / downside) * math.sqrt(periods_per_year)


def max_drawdown(equity: pd.Series) -> float:
    """最大回撤(负数):全程距离历史最高点最远的那一刻,差了多少。"""
    return float(drawdown(equity).min())


def calmar(equity: pd.Series, periods_per_year: int) -> float:
    """卡玛比率:`年化收益 ÷ |最大回撤|`。

    ⚠️ 它的分母是一个**极值**,只由最坏的那一刻决定,样本越长通常越深(第 29 篇量了)。
    所以卡玛比率不能拿来比两条长度不同的曲线。
    """
    mdd = max_drawdown(equity)
    return annual_return(equity, periods_per_year) / abs(mdd) if mdd < 0 else np.inf


def metrics(equity: pd.Series, periods_per_year: int, rf: float | pd.Series = 0.0) -> pd.Series:
    """一页纸的上半部分:一条资金曲线的全部常规指标。"""
    returns = equity.pct_change().dropna()
    below = drawdown(equity) < -1e-12                 # 每一根:在不在水下
    dry = (~below).cumsum()                           # 每创一次新高,这个编号就加一
metrics 把它们打包成一行一行的体检结果:
    return pd.Series({
        "起": equity.index[0], "止": equity.index[-1], "根数": float(len(equity)),
        "累计收益": float(equity.iloc[-1] / equity.iloc[0]) - 1,
        "年化收益": annual_return(equity, periods_per_year),
        "年化波动": annual_vol(returns, periods_per_year),
        "夏普比率": sharpe(returns, periods_per_year, rf),
        "索提诺比率": sortino(returns, periods_per_year, rf),
        "最大回撤": max_drawdown(equity),
        "卡玛比率": calmar(equity, periods_per_year),
        "在水下的比例": float(below.mean()),
        "最长水下根数": float(below.groupby(dry).sum().max()),
        "最好的一根": float(returns.max()), "最差的一根": float(returns.min()),
    })
⚠️ 注意 sharpe 里那个返回 NaN 的分支。一条一动不动的曲线(比如某一年从头到尾空仓)在数学上是有夏普比率的:分子是「−无风险利率」,分母趋近 0,结果是一个绝对值巨大的负数。我第一版就是这么输出的,报告上写着「2026 年夏普 −1141.56」——数学没错,但那不是一条能读的信息。该说的是「这一年没有可比的夏普比率」。
八、每个数都要带着它的误差
8.1 夏普比率的标准误:一条解析解
夏普比率有一个很好用的近似(Lo 2002):
SE(年化夏普) = √(一年几根) × √((1 + 年化夏普² ÷ (2 × 一年几根)) ÷ 根数)
括号里那一项几乎总是 1 出头(日线上夏普 1.0 时是 1.0014),所以它近似等于:
SE(年化夏普) ≈ 1 ÷ √年数
这条近似简单到可以背下来,而它说的事情相当吓人:**一条年化夏普 1.0 的策略,跑一年,标准误就是 1.0。**也就是说,一年的业绩连「这条策略的夏普是 0 还是 2」都分不出来。
反过来问「要跑多少年才能把 t 值攒到 2」:
年数 ≈ (2 ÷ 年化夏普)²
def sharpe_se(sharpe_value: float, n: int, periods_per_year: int) -> float:
    """年化夏普比率的标准误(Lo 2002,假设每根收益率互相独立且同分布):

    > SE(年化夏普) = √(一年几根) × √((1 + 年化夏普² ÷ (2 × 一年几根)) ÷ 根数)

    括号里那一项几乎总是 1 出头(日线上夏普 1.0 时是 1.0014),所以它近似等于
    **√(一年几根 ÷ 根数) = 1 ÷ √年数**:`一条年化夏普 1.0 的策略,跑一年的标准误就是 1.0`。
    """
    if n <= 0:
        raise ValueError("根数要大于 0")
    per_period = sharpe_value / math.sqrt(periods_per_year)
    return math.sqrt(periods_per_year) * math.sqrt((1 + per_period ** 2 / 2) / n)


def years_needed(sharpe_value: float, t: float = 2.0, periods_per_year: int = 252) -> float:
    """要让「这条策略不是运气」的 t 值达到 `t`,需要跑多少年:

    > 年数 = (t ÷ 年化夏普)² × (1 + 年化夏普² ÷ (2 × 一年几根))

    近似就是 **(t ÷ 夏普)²**:夏普 2.0 要 1 年,夏普 1.0 要 4 年,夏普 0.5 要 16 年。
    所以「夏普 0.5 但我只有两年数据」这句话本身就已经说完了——那两年什么都证明不了。
    """
    if sharpe_value <= 0:
        return np.inf
    return (t / sharpe_value) ** 2 * (1 + sharpe_value ** 2 / (2 * periods_per_year))


def significance_table(sharpes=(0.3, 0.5, 0.8, 1.0, 1.5, 2.0, 3.0), t: float = 2.0,
                       periods_per_year: int = 252) -> pd.DataFrame:
    """不同夏普比率下,要多少年才能把 t 值攒到 `t`。"""
    rows = [{"年化夏普": s, "要跑多少年": years_needed(s, t, periods_per_year),
             "要多少根 K 线": years_needed(s, t, periods_per_year) * periods_per_year}
            for s in sharpes]
    return pd.DataFrame(rows)
 年化夏普  要跑多少年  要多少根 K 线
  0.3  44.45  16224.22
  0.5  16.01   5842.00
  0.8   6.26   2283.25
  1.0   4.01   1462.00
  1.5   1.78    650.89
  2.0   1.01    367.00
  3.0   0.45    164.22
| 年化夏普 | 要跑多少年 |
|---|---|
| 0.3 | 44 年 |
| 0.5 | 16 年 |
| 0.8 | 6.3 年 |
| 1.0 | 4 年 |
| 1.5 | 1.8 年 |
| 2.0 | 1 年 |
| 3.0 | 0.45 年 |
这张表把「回测跑了多久」和「夏普多高」绑在了一起。夏普 0.5 但只有两年数据——那两年什么都没证明。
8.2 自助法:没有公式的时候怎么办
解析解只对夏普比率有。年化收益、最大回撤、卡玛比率没有这么好的公式,而且最大回撤的分布长得一点也不像正态。
这种时候用自助法(bootstrap):把手上这份样本当成「总体」,有放回地重抽一遍,重算一次指标,抽两千次,看这个指标能落在多宽的范围里。
def bootstrap(returns: pd.Series, stat, n: int = 2000, block: int = 1, seed: int = 0,
              level: float = 0.90) -> pd.Series:
    """块自助法:把收益率切成长度 `block` 的小段,有放回地抽回原来的长度,重算 `stat`。

    `stat` 接收一条收益率序列,返回一个数(`lambda r: sharpe(r, 365)` 这样)。

    - `block=1` 就是普通的 i.i.d. 自助法:它假设**先后顺序无关紧要**。
      算均值、夏普比率时这个假设还行;算**最大回撤**时它是错的——
      回撤衡量的恰恰是「坏日子会不会连在一起」,而打散重抽把这件事抹掉了(第 29 篇量了差多少)。
    - `block > 1` 保留每一小段内部的顺序,是回撤类指标该用的口径。
    """
    if block < 1 or block > len(returns):
        raise ValueError("block 要在 1 和样本长度之间")
    values = returns.to_numpy(dtype=float)
    m = len(values)
    rng = np.random.default_rng(seed)
    sims = np.empty(n)
    for i in range(n):
        if block == 1:
            sample = rng.choice(values, size=m, replace=True)
        else:
            starts = rng.integers(0, m - block + 1, size=int(np.ceil(m / block)))
            sample = np.concatenate([values[s:s + block] for s in starts])[:m]
        sims[i] = stat(pd.Series(sample, index=returns.index))
    lo, hi = np.percentile(sims, [(1 - level) * 50, 100 - (1 - level) * 50])
    return pd.Series({"实际值": float(stat(returns)), "自助法中位数": float(np.median(sims)),
                      f"{level:.0%} 下界": float(lo), f"{level:.0%} 上界": float(hi),
                      "标准误": float(sims.std(ddof=1)), "小于 0 的比例": float((sims < 0).mean())})
block 这个参数是这一篇的重点。下一节直接用它。
九、揭晓(上):样本量是笔数,不是根数
回到开头那两条策略。它们的夏普比率一样,而且它们的夏普比率标准误也一样:
rows = []
for name, (series, trades) in {"A": (returns_a, trades_a), "B": (returns_b, trades_b)}.items():
    value = RP.sharpe(series, 365)
    se = RP.sharpe_se(value, len(series), 365)
    stats = RP.trade_metrics(trades["收益"])
    rows.append({"策略": name, "夏普比率": value, "根数": len(series), "夏普的标准误": se,
                 "夏普的 t 值": value / se, "笔数": int(stats["笔数"]),
                 "平均持仓根数": trades["根数"].mean(), "逐笔的 t 值": stats["t 值"]})
print(pd.DataFrame(rows).round(4).to_string(index=False))
策略   夏普比率   根数  夏普的标准误  夏普的 t 值   笔数  平均持仓根数  逐笔的 t 值
 A 1.3086 3301  0.3329   3.9307   35 39.3429   2.4618
 B 1.3072 3301  0.3329   3.9266 1061  5.7248   3.7958
两条都是 3,301 根日收益率,夏普比率都是 1.31,所以标准误都是 0.3329,t 值都是 3.93。按这个口径,两条策略一样可信。
但最后一列说了另一件事:
| 夏普的 t 值(按根数算) | 逐笔的 t 值(按笔数算) | |
|---|---|---|
| A(35 笔,平均持仓 39.3 根) | 3.93 | 2.46 |
| B(1,061 笔,平均持仓 5.7 根) | 3.93 | 3.80 |
B 的两个 t 值几乎相等(3.93 对 3.80),A 的差了一大截(3.93 对 2.46)。
道理其实很朴素。A 的 35 笔每笔平均持仓 39.3 根,加起来正好是 1,377 个持仓日;但那 1,377 天不是 1,377 个独立的观测——它们被绑成了 35 串。同一笔交易里的那四十天,赚不赚钱是同一个判断的结果。而 B 的一笔只有 5.7 根 4 小时线,也就是一天,所以它的「天」和它的「笔」几乎是同一件事。
夏普比率的标准误公式按根数算,所以它在持仓周期长的策略上系统性地偏小。
9.1 用自助法把这件事量出来
把重抽的单位从「一天」换成「一段」再换成「一笔」,区间宽度会怎么变:
YEARS = (d1.index[-1] - d1.index[0]).days / 365.25


def by_trade(trades: pd.DataFrame, n: int = N_BOOT, seed: int = 29) -> np.ndarray:
    """按**交易**重抽:有放回地抽同样笔数的交易,复利连乘,再折算成年化。"""
    values = trades["收益"].to_numpy(float)
    generator = np.random.default_rng(seed)
    return np.array([np.prod(1 + generator.choice(values, size=len(values), replace=True))
                     ** (1 / YEARS) - 1 for _ in range(n)])


rows = []
for name, (series, trades) in {"A 日线唐奇安 40/20": (returns_a, trades_a),
                               "B 4 小时创 12 根新高持 3 根": (returns_b, trades_b)}.items():
    actual = RP.annual_return(RP.to_curve(series), 365)
    for label, block in [("按天重抽", 1), ("按 30 天的块重抽", 30), ("按 90 天的块重抽", 90)]:
        band = RP.bootstrap(series, lambda x: RP.annual_return(RP.to_curve(x), 365),
                            n=N_BOOT, block=block, seed=29)
        rows.append({"策略": name, "重抽单位": label, "实际年化": actual,
                     "5% 分位": band["90% 下界"], "95% 分位": band["90% 上界"],
                     "区间宽度": band["90% 上界"] - band["90% 下界"]})
    sims = by_trade(trades)
    rows.append({"策略": name, "重抽单位": f"按交易重抽({len(trades)} 笔)", "实际年化": actual,
                 "5% 分位": np.percentile(sims, 5), "95% 分位": np.percentile(sims, 95),
                 "区间宽度": np.percentile(sims, 95) - np.percentile(sims, 5)})
print(pd.DataFrame(rows).round(4).to_string(index=False))
                 策略          重抽单位   实际年化  5% 分位  95% 分位   区间宽度
      A 日线唐奇安 40/20          按天重抽 0.5822 0.2698  0.9814 0.7117
      A 日线唐奇安 40/20    按 30 天的块重抽 0.5822 0.2186  1.0449 0.8263
      A 日线唐奇安 40/20    按 90 天的块重抽 0.5822 0.1998  1.1196 0.9199
      A 日线唐奇安 40/20   按交易重抽(35 笔) 0.5822 0.2180  1.1991 0.9811
B 4 小时创 12 根新高持 3 根          按天重抽 0.5025 0.2427  0.8244 0.5817
B 4 小时创 12 根新高持 3 根    按 30 天的块重抽 0.5025 0.2229  0.8870 0.6642
B 4 小时创 12 根新高持 3 根    按 90 天的块重抽 0.5025 0.1856  1.0096 0.8240
B 4 小时创 12 根新高持 3 根 按交易重抽(1061 笔) 0.5025 0.2465  0.8311 0.5846
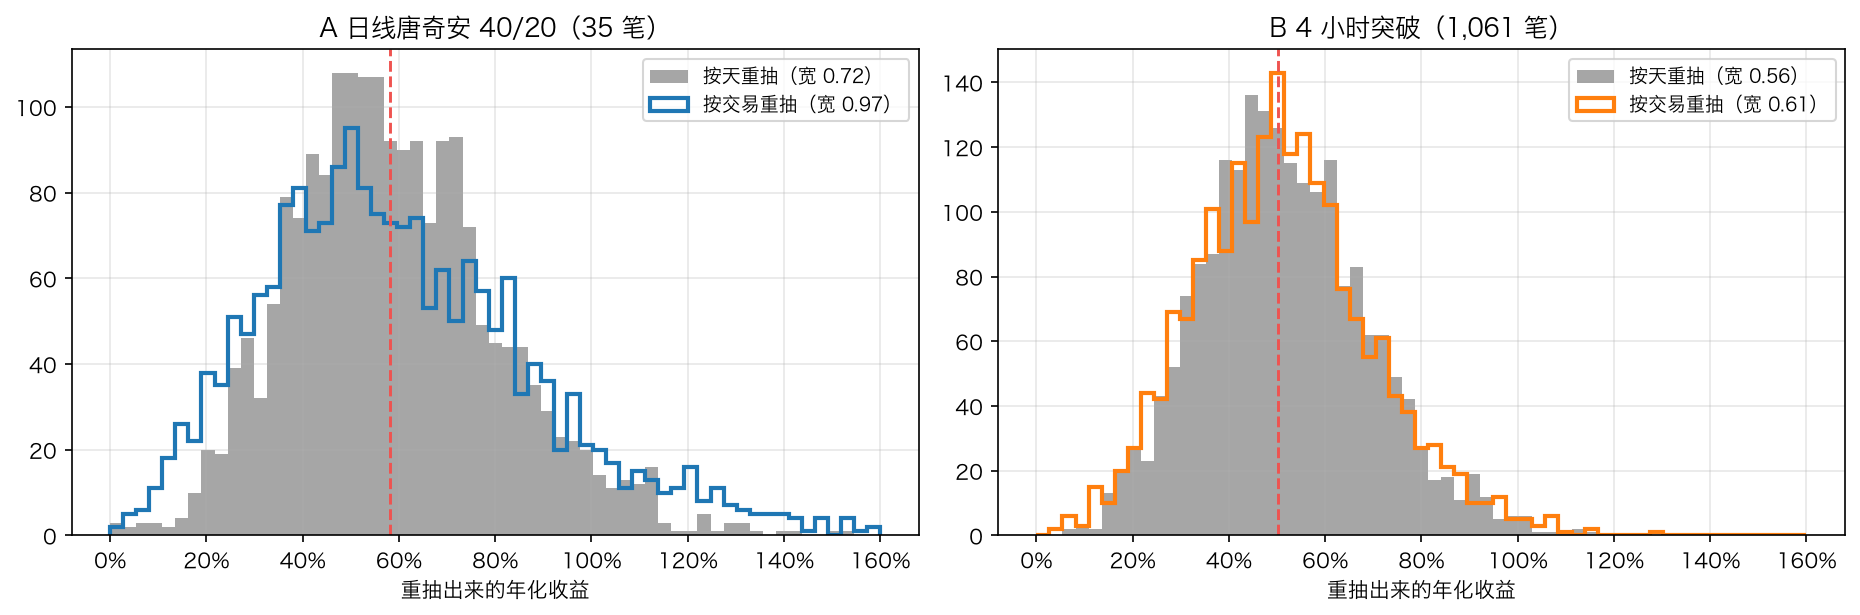
| 重抽单位 | A 的区间宽度 | B 的区间宽度 |
|---|---|---|
| 按天重抽 | 0.7117 | 0.5817 |
| 按 30 天的块重抽 | 0.8263 | 0.6642 |
| 按 90 天的块重抽 | 0.9199 | 0.8240 |
| 按交易重抽 | 0.9811(35 笔) | 0.5846(1,061 笔) |
- A:从按天的 0.7117 宽到按交易的 0.9811,宽了 38%。按天重抽说 A 的年化落在 26.98%–98.14%,按交易重抽说它落在 21.80%–119.91%——后者才是它真正的不确定性。
- B:按天 0.5817、按交易 0.5846,几乎一模一样。因为 B 的一笔就是一天,两种重抽在问同一个问题。
这就是为什么这一节叫「样本量是笔数,不是根数」。
⚠️ 老实说一句:按 90 天的块重抽给 B 的区间也宽到了 0.8240,比它的逐笔区间宽得多。块重抽同时抓了两件事——一是交易把日子绑在一起,二是市场本身有行情段落(一个季度的走势不是九十次独立抛硬币)。第二件事对两条策略都成立,和笔数无关。所以别把这四行读成「块越长越对」,该读成:按天重抽是这四种里唯一一定偏窄的那一种。
9.2 回撤的区间更不能按天重抽
rows = []
for name, series in {"A": returns_a, "B": returns_b}.items():
    actual = RP.max_drawdown(RP.to_curve(series))
    for block in [1, 20, 120]:
        band = RP.bootstrap(series, lambda x: RP.max_drawdown(RP.to_curve(x)),
                            n=N_BOOT, block=block, seed=29)
        values = series.to_numpy(float)
        generator = np.random.default_rng(29)
        deeper = []
        for _ in range(N_BOOT):
            if block == 1:
                sample = generator.choice(values, size=len(values), replace=True)
            else:
                starts = generator.integers(0, len(values) - block + 1, size=int(np.ceil(len(values) / block)))
                sample = np.concatenate([values[s:s + block] for s in starts])[:len(values)]
            deeper.append(RP.max_drawdown(RP.to_curve(pd.Series(sample, index=series.index))) <= actual)
        rows.append({"策略": name, "块长": block, "实际最大回撤": actual,
                     "重抽的中位数": band["自助法中位数"], "5% 分位": band["90% 下界"],
                     "重抽里比它还深的比例": float(np.mean(deeper))})
print(pd.DataFrame(rows).round(4).to_string(index=False))
策略  块长  实际最大回撤  重抽的中位数   5% 分位  重抽里比它还深的比例
 A   1 -0.5251 -0.4537 -0.6402      0.2425
 A  20 -0.5251 -0.4623 -0.6472      0.2770
 A 120 -0.5251 -0.4607 -0.6376      0.2660
 B   1 -0.5646 -0.3826 -0.5536      0.0460
 B  20 -0.5646 -0.3871 -0.5706      0.0555
 B 120 -0.5646 -0.4246 -0.6260      0.1255
最后一列是关键:在重抽出来的两千条曲线里,跌得比真实回撤还深的有多大比例。
- B:按天重抽 4.6%,按 120 天的块重抽 12.6%——差了将近三倍
- A:24.25% → 26.60%,几乎没动
打散日子的顺序,等于假设「坏日子不会连在一起」。而最大回撤衡量的恰恰就是坏日子连在一起的程度——你把要测的东西先抹掉了,再去测它。
⚠️ 这个效应比想象中温和(B 上是 3 倍,A 上几乎看不出来),但方向是确定的,而且它只在一处重要:给回撤类指标做区间,block 别用 1。page 里的默认值是 20,就是因为这个。
9.3 交易层面的统计
def trade_metrics(trade_returns, level: float = 0.95) -> pd.Series:
    """交易层面的统计:**样本量是交易笔数,不是 K 线根数**。

    一条持仓 1,377 天的策略如果只进出了 35 次,它就只下了 35 次注;
    那 1,377 个日收益率不是 1,377 个独立样本,它们被绑成了 35 串。
    夏普比率的标准误按「根数」算,所以它在这种策略上**系统性地偏小**(第 29 篇量了)。

    `t 值` = 平均每笔 ÷ 平均值的标准误。经验上 |t| < 2 就是「这串数和 0 分不开」。
    ⚠️ 区间用的是正态近似,笔数少的时候它偏窄,该以 `bootstrap` 为准。
    """
    r = pd.Series(trade_returns).dropna().astype(float)
    n = len(r)
    if n < 2:
        raise ValueError("至少要有两笔交易")
    se = float(r.std(ddof=1)) / math.sqrt(n)
    z = NORMAL.inv_cdf(0.5 + level / 2)
    streak = longest = 0
    worst = current = 0.0
    for x in r:
        if x <= 0:
            streak += 1
            current += x
            longest, worst = max(longest, streak), min(worst, current)
        else:
            streak, current = 0, 0.0
    return pd.Series({
        "笔数": float(n), "平均每笔": float(r.mean()), "每笔的标准差": float(r.std(ddof=1)),
        "平均值的标准误": se, "t 值": float(r.mean()) / se,
        f"{level:.0%} 下界": float(r.mean()) - z * se, f"{level:.0%} 上界": float(r.mean()) + z * se,
        "最长连亏笔数": float(longest), "连亏最多亏掉": worst,
最长连亏 这一项在报告上经常被省掉,但它是唯一一个直接预测「你会不会在最糟的时候关掉它」的数。年化和夏普都不告诉你这件事。
⚠️ 区间用的是正态近似,笔数少的时候它偏窄——测试里有一条专门量这个:同一串交易重复十遍,区间宽度不是缩到 1/√10 = 0.316,而是 2/7 = 0.286,差在 ddof=1 的自由度修正上。笔数只有个位数的时候,这类修正一点都不小,该以 bootstrap 为准。
十、揭晓(下):成本
到这里,第一个方向的答案已经清楚了:**B 更可信。**1,061 笔 vs 35 笔,逐笔 t 值 3.80 vs 2.46,逐笔区间 0.58 vs 0.98。如果只看统计,该投 B。
然后把第 28 篇量出来的成本放回去。
curves = {}
for name, (df, position) in {"A 日线唐奇安 40/20": (d1, position_a),
                             "B 4 小时创 12 根新高持 3 根": (h4, position_b)}.items():
    for label, cost in [("不含成本", 0.0), ("含成本", ONE_WAY)]:
        curves[f"{name}|{label}"] = build(df, position, cost)[0]
print(f"单边成本 {ONE_WAY:.4%}(现货 taker 0.10% + 半个价差 {C.BTC_PERP_SPREAD_BP / 2:.4f} 基点)")
print(RP.compare(curves, 365).loc[["年化收益", "年化波动", "夏普比率", "最大回撤", "卡玛比率"]].round(4).to_string())
rows = []
for name, (df, position, trades) in {"A": (d1, position_a, trades_a),
                                     "B": (h4, position_b, trades_b)}.items():
    per_year = len(trades) / YEARS
    with_cost = build(df, position, ONE_WAY)[1]       # 同样的交易,逐笔收益扣掉成本
    rows.append({"策略": name, "笔数": len(trades), "每年笔数": per_year,
                 "每年的成本": C.annual_drag(ONE_WAY, per_year),
                 "平均每笔赚": trades["收益"].mean(),
                 "成本占平均每笔": 2 * ONE_WAY / trades["收益"].mean(),
                 "逐笔 t 值(不含成本)": RP.trade_metrics(trades["收益"])["t 值"],
                 "逐笔 t 值(含成本)": RP.trade_metrics(with_cost["收益"])["t 值"]})
print(pd.DataFrame(rows).round(4).to_string(index=False))
单边成本 0.1002%(现货 taker 0.10% + 半个价差 0.0165 基点)
     A 日线唐奇安 40/20|不含成本 A 日线唐奇安 40/20|含成本 B 4 小时创 12 根新高持 3 根|不含成本 B 4 小时创 12 根新高持 3 根|含成本
年化收益           0.582219          0.570242                 0.502495                0.187852
年化波动           0.415952          0.415861                  0.35969                0.361859
夏普比率            1.30857          1.290479                 1.307232                0.651842
最大回撤          -0.525126         -0.528892                -0.564601               -0.704034
卡玛比率           1.108723          1.078181                     0.89                0.266822
策略   笔数     每年笔数  每年的成本  平均每笔赚  成本占平均每笔  逐笔 t 值(不含成本)  逐笔 t 值(含成本)
 A   35   3.8727 0.0078 0.1769   0.0113        2.4618       2.4480
 B 1061 117.3978 0.2352 0.0040   0.4949        3.7958       2.8557
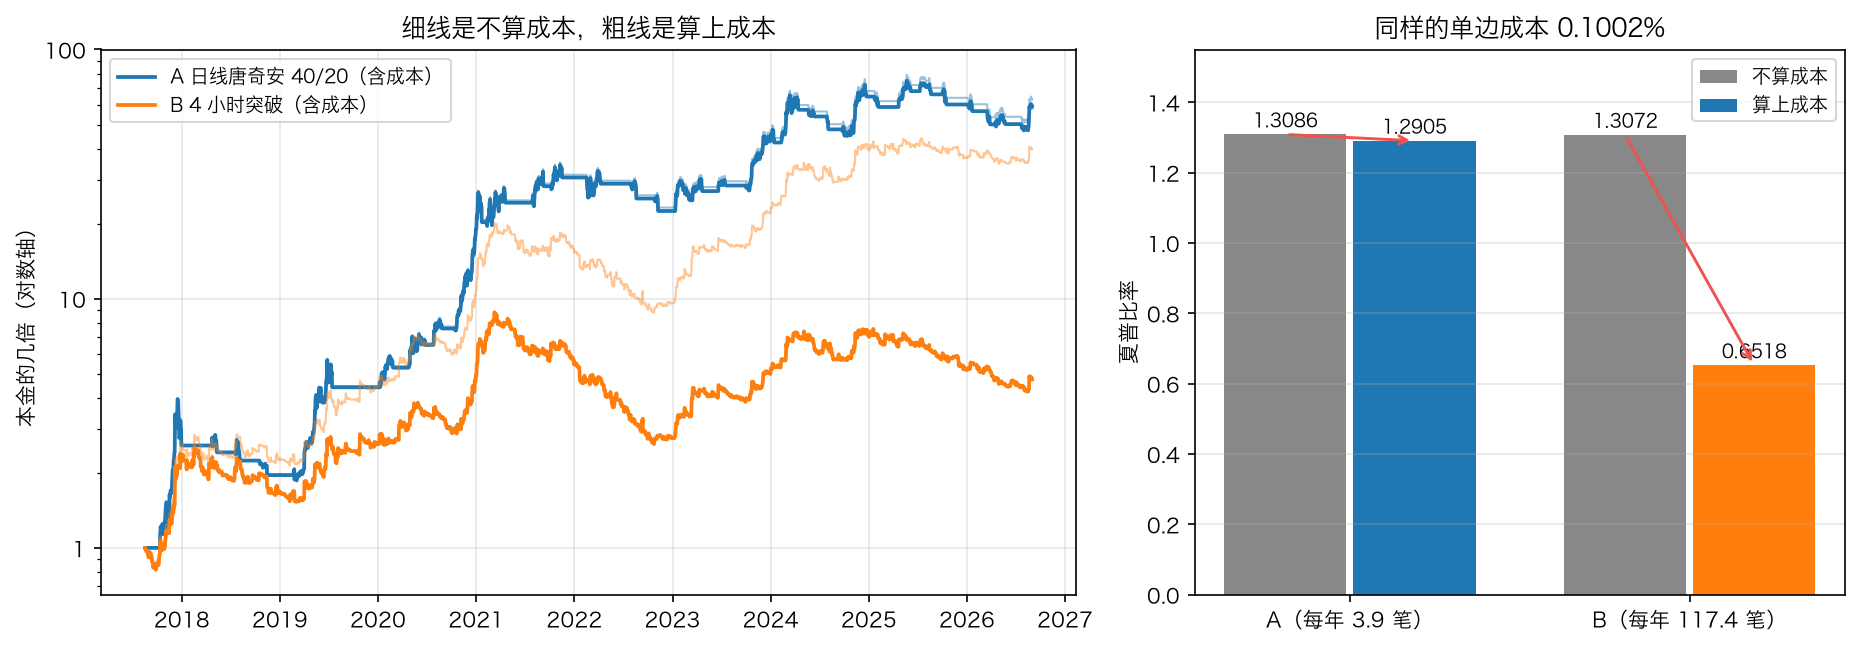
同样的单边成本 0.1002%:
| A | B | |
|---|---|---|
| 每年交易几笔 | 3.9 | 117.4 |
| 每年被成本吃掉 | 0.78% | 23.52% |
| 夏普比率 | 1.3086 → 1.2905 | 1.3072 → 0.6518 |
| 年化收益 | 58.22% → 57.02% | 50.25% → 18.79% |
| 平均每笔赚 | 17.69% | 0.40% |
| 来回成本占平均每笔 | 1.13% | 49.49% |
| 逐笔 t 值 | 2.4618 → 2.4480 | 3.7958 → 2.8557 |
最后一行是整件事的核心:B 平均每笔只赚 0.40%,而一来一回的成本是 0.20%——它赚到的钱有一半要交给交易所。
10.1 所以投哪条
两个方向的答案是相反的:
| A(35 笔) | B(1,061 笔) | |
|---|---|---|
| 这个数字可不可信 | 差(逐笔 t 2.46,区间 0.98 宽) | 好(逐笔 t 3.80,区间 0.58 宽) |
| 这个数字还剩多少 | 好(每年吃掉 0.78 个百分点) | 差(每年吃掉 23.52 个百分点) |
**交易次数同时决定了这两件事,而且方向相反。**多交易让你的统计更可信,也让你的成本更贵。这就是为什么「夏普比率 1.5」这句话单独拿出来没有意义——它没说交易了几次,而交易次数决定了这个 1.5 有多少是真的、又有多少能活到你的账户里。
⚠️ 别把这一节读成「所以低频更好」。真正的结论只有一条:**含成本的夏普比率才是可以比的那个数,而且它旁边必须写着笔数。**A 含成本之后是 1.2905(逐笔 t 2.4480),B 是 0.6518(逐笔 t 2.8557)——在这个口径下 A 的期望更高、B 的证据更硬,两条都还没到可以直接上实盘的程度。第 30 篇会把它们放进样本外检验里再走一遍。
十一、主线策略 v4 的成绩单
现在把同一把尺子量回主线策略。这是它第一次被完整地量。
spy = D.load_nasdaq_daily("data/nasdaq/SPY_historical.json").drop(pd.Timestamp("2026-04-20"))
aapl = D.adjust_total_return(D.unadjust_splits(D.load_nasdaq_daily("data/nasdaq/AAPL_historical.json"),
                                               D.SPLITS["AAPL"]), D.SPLITS["AAPL"],
                             D.load_nasdaq_dividends("data/nasdaq/AAPL_dividends.json"))
schedule = pd.Series({"SEC 占卖出金额": 20.60 / 1e6, "TAF 每股": 0.000166, "TAF 每笔上限": 8.30})
us_cost = C.us_stock(100.0, 100.0, "sell", spread_bp=1.0, sec_rate=schedule["SEC 占卖出金额"],
                     taf_per_share=schedule["TAF 每股"], taf_cap=schedule["TAF 每笔上限"])["占名义价值"]
btc_cost = ONE_WAY + 0.00097 / 2                      # 再加第 22 篇量到的止损滑点
mainline, rows = {}, []
for name, (df, periods, fee) in {"SPY": (spy, 252, us_cost), "AAPL": (aapl, 252, us_cost),
                                 "BTC": (d1, 365, btc_cost)}.items():
    c = df["close"]
    plan = BT.Plan(entry=((I.sma(c, 50) > I.sma(c, 200)) & (c >= c.rolling(20).max())).fillna(False),
                   exit=I.cross_below(I.sma(c, 50), I.sma(c, 200)).fillna(False),
                   fill="next_open", stop="chandelier", k=3.0, trigger="close",
                   sizing="risk", risk_per_trade=0.10, fee_rate=fee)
    result = BT.run(df, plan, 100_000.0)
    mainline[name] = (result, periods)
    m = RP.metrics(result["资金曲线"], periods, rf)
    stats = RP.trade_metrics(result["交易"]["收益"])
    se = RP.sharpe_se(m["夏普比率"], len(result["资金曲线"]) - 1, periods)
    rows.append({"标的": name, "年化收益": m["年化收益"], "最大回撤": m["最大回撤"],
                 "夏普比率": m["夏普比率"], "卡玛比率": m["卡玛比率"], "笔数": int(stats["笔数"]),
                 "夏普的 t 值": m["夏普比率"] / se, "逐笔的 t 值": stats["t 值"],
                 "要跑多少年": RP.years_needed(m["夏普比率"], 2.0, periods)})
print(pd.DataFrame(rows).round(4).to_string(index=False))
  标的   年化收益    最大回撤   夏普比率   卡玛比率  笔数  夏普的 t 值  逐笔的 t 值    要跑多少年
 SPY 0.0291 -0.1242 0.1027 0.2343  39   0.3231   1.1180 379.5122
AAPL 0.0983 -0.2797 0.5396 0.3516  37   1.6980   1.7917  13.7470
 BTC 0.2063 -0.3362 0.7586 0.6137  30   2.2752   1.2769   6.9563
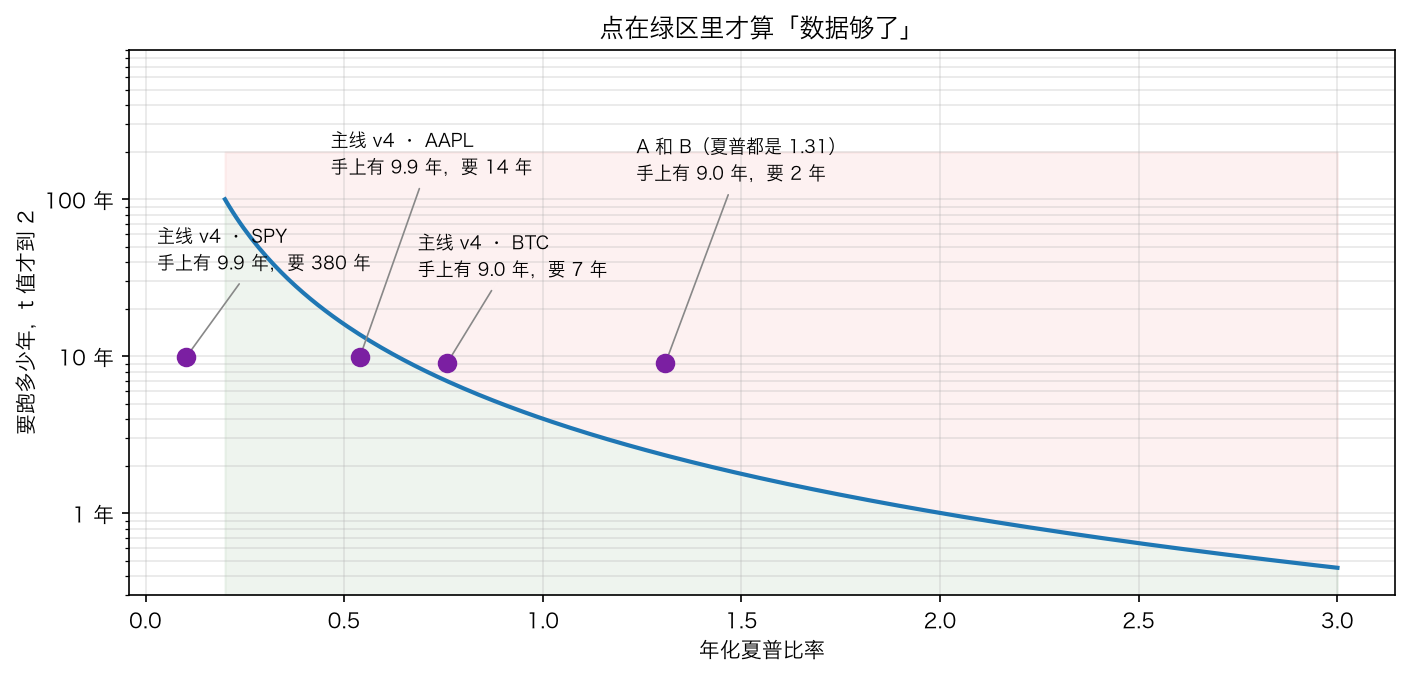
| 标的 | 年化 | 最大回撤 | 夏普 | 卡玛 | 笔数 | 逐笔 t 值 | 要跑多少年 |
|---|---|---|---|---|---|---|---|
| SPY | 2.91% | −12.42% | 0.10 | 0.23 | 39 | 1.12 | 380 年 |
| AAPL | 9.83% | −27.97% | 0.54 | 0.35 | 37 | 1.79 | 13.7 年 |
| BTC | 20.63% | −33.62% | 0.76 | 0.61 | 30 | 1.28 | 7.0 年 |
这张表很难看,但它是诚实的:
- **三个标的,没有一个的逐笔 t 值超过 2。**跑了九到十年、下了三十几次注,最好的一个是 AAPL 的 1.79。
- SPY 上那条策略需要 380 年的数据才能证明它的夏普 0.10 不是运气。十年当然不够,一百年也不够。
- BTC 的夏普 t 值 2.28 看起来过关了,但那是按 3,287 根算的;按 30 笔算是 1.28。哪个对,第九节已经说过了。
这不是一个「策略失败了」的结论,是一句 「凭这些数据,还不能下结论」。这两件事完全不同,而把它们混为一谈正是大多数回测报告在做的事。
十二、一页纸
最后把上面所有东西排成一页:
def by_year(equity: pd.Series, periods_per_year: int, rf: float | pd.Series = 0.0) -> pd.DataFrame:
    """按自然年拆开:每一年的收益、回撤、夏普各是多少。

    单独一年的夏普比率基本没有统计意义(见 `years_needed`),列在这里是为了看**稳不稳**,
    不是为了挑出最好的那一年。
    """
    returns = equity.pct_change().dropna()
    rows = []
    for year, chunk in returns.groupby(returns.index.year):
        curve = to_curve(chunk)
        rows.append({"年": year, "根数": len(chunk), "收益": float(curve.iloc[-1]) - 1,
                     "最大回撤": max_drawdown(curve),
                     "夏普": sharpe(chunk, periods_per_year, rf) if len(chunk) > 1 else np.nan})
    return pd.DataFrame(rows).set_index("年")


def compare(curves: dict[str, pd.Series], periods_per_year: int,
            rf: float | pd.Series = 0.0) -> pd.DataFrame:
    """把几条资金曲线的指标并排放:每一列一条曲线。

    ⚠️ 只有起止时间和 K 线频率都一样的曲线才能这样比。不一样时先各自换算到同一个频率
    (`equity.resample("1D").last()`),再比。
    """
    return pd.DataFrame({name: metrics(curve, periods_per_year, rf)
                         for name, curve in curves.items()})


def page(equity: pd.Series, periods_per_year: int, trades: pd.DataFrame | None = None,
         rf: float | pd.Series = 0.0, name: str = "策略", n_boot: int = 1000,
         block: int = 20, seed: int = 29) -> str:
    """一页纸的回测报告:指标、误差、分年、交易统计,全部折算成能一眼看完的文本。

    三段里最重要的是**中间那段**:同样一条曲线,把它的夏普比率和最大回撤重抽一千次,
    看它们能落在多宽的范围里。上面那段的数字只有配上中间那段才算读得懂。
    """
    returns = equity.pct_change().dropna()
    m = metrics(equity, periods_per_year, rf)
    lines = [f"{'=' * 62}", f"  {name}   {m['起'].date()} → {m['止'].date()}   {int(m['根数'])} 根",
             f"{'=' * 62}", "【一】指标"]
    for key in ["累计收益", "年化收益", "年化波动", "夏普比率", "索提诺比率",
                "最大回撤", "卡玛比率", "在水下的比例"]:
        lines.append(f"  {key:<8}{m[key]:>12.4f}")
    lines.append(f"  {'最长水下':<8}{int(m['最长水下根数']):>12d} 根")

    lines.append("【二】这些数有多准(重抽 %d 次,块长 %d 根)" % (n_boot, block))
    solved = sharpe_se(m["夏普比率"], len(returns), periods_per_year)
    lines.append(f"  夏普比率的标准误(解析解){solved:>10.4f}   "
                 f"t 值 {m['夏普比率'] / solved:>6.2f}   "
                 f"要攒到 t=2 得跑 {years_needed(m['夏普比率'], 2.0, periods_per_year):.1f} 年")
    for label, stat, use_block in [
            ("夏普比率", lambda r: sharpe(r, periods_per_year, rf), 1),
            ("年化收益", lambda r: annual_return(to_curve(r), periods_per_year), 1),
            ("最大回撤", lambda r: max_drawdown(to_curve(r)), block)]:
        b = bootstrap(returns, stat, n=n_boot, block=use_block, seed=seed)
        lines.append(f"  {label:<8}{b['实际值']:>10.4f}   90% 区间 "
                     f"[{b['90% 下界']:.4f}, {b['90% 上界']:.4f}]   块长 {use_block}")

    lines.append("【三】分年")
    lines.append("  " + by_year(equity, periods_per_year, rf).round(4).to_string().replace("\n", "\n  "))

    if trades is not None and len(trades) >= 2:
        t = trade_metrics(trades["收益"])
        lines.append("【四】交易(样本量 = 笔数,不是根数)")
        lines.append(f"  笔数 {int(t['笔数'])}   平均每笔 {t['平均每笔']:.4f}   "
                     f"t 值 {t['t 值']:.2f}   最长连亏 {int(t['最长连亏笔数'])} 笔")
        lines.append(f"  95% 区间 [{t['95% 下界']:.4f}, {t['95% 上界']:.4f}]   "
                     f"连亏最多亏掉 {t['连亏最多亏掉']:.4f}")
    lines.append("=" * 62)
    return "\n".join(lines)
跑出来是这样:
==============================================================
  主线策略 v4 · BTC(含成本)   2017-09-01 → 2026-08-31   3287 根
==============================================================
【一】指标
  累计收益          4.4126
  年化收益          0.2063
  年化波动          0.2567
  夏普比率          0.7586
  索提诺比率         1.2309
  最大回撤         -0.3362
  卡玛比率          0.6137
  在水下的比例        0.9215
  最长水下            1087 根
【二】这些数有多准(重抽 1000 次,块长 20 根)
  夏普比率的标准误(解析解)    0.3334   t 值   2.28   要攒到 t=2 得跑 7.0 年
  夏普比率        0.7586   90% 区间 [0.2251, 1.2863]   块长 1
  年化收益        0.2063   90% 区间 [0.0517, 0.3911]   块长 1
  最大回撤       -0.3362   90% 区间 [-0.6073, -0.2715]   块长 20
【三】分年
         根数      收益    最大回撤      夏普
  年
  2017  121  0.0000  0.0000     NaN
  2018  365 -0.1017 -0.1017 -2.4428
  2019  365  0.5746 -0.1454  1.4963
  2020  366  1.5786 -0.1755  2.6522
  2021  365  0.1411 -0.2521  0.5837
  2022  365 -0.0356 -0.0536 -1.4239
  2023  365  0.1549 -0.1372  0.4905
  2024  366  0.5751 -0.3065  1.2818
  2025  365 -0.2587 -0.2845 -1.6236
  2026  243  0.0000  0.0000     NaN
【四】交易(样本量 = 笔数,不是根数)
  笔数 30   平均每笔 0.0961   t 值 1.28   最长连亏 3 笔
  95% 区间 [-0.0514, 0.2437]   连亏最多亏掉 -0.3579
这一页纸的设计只有一条原则:第二段必须紧跟着第一段。
第一段的「夏普比率 0.7586」单独看是一个不错的数字;配上第二段的「90% 区间 [0.2251, 1.2863]」,它就变成了「这条策略的夏普在 0.23 到 1.29 之间,我说不准」。这两句话描述的是同一份数据,而后一句才是你真正知道的东西。
第三段(分年)里那两个 NaN 也是有意的:2017 年只有 121 根且全程空仓,2026 年同样,这两年没有可比的夏普比率。
第四段的「t 值 1.28」和「95% 区间 [−0.0514, 0.2437]」说的是:这 30 笔交易的平均收益,和 0 分不开。
十三、完整代码与测试
talab/report.py
"""talab.report:怎么评价一条策略。第 29 篇。

第 27 篇保证引擎是对的,第 28 篇保证喂进去的数据是干净的。
这个模块回答最后一个问题:**跑出来的这一串数,该怎么读。**

整个模块围绕一件事写:**每一个指标都要带着它的误差一起出现。**
`年化 21%` 是一句话,`年化 21%(90% 区间 3% 到 44%)` 是另一句话,
而它们是同一条资金曲线算出来的。只报前一句不算撒谎,但也不算说清楚。

三组函数:

1. **算指标**:`metrics` 一次给出一页纸上半部分的全部数字
2. **算误差**:`sharpe_se`(解析解)、`bootstrap`(重抽)、`trade_metrics`(交易层面)
3. **排版**:`by_year`、`compare`、`page`
"""
from __future__ import annotations

import math
from statistics import NormalDist

import numpy as np
import pandas as pd

from talab.size import drawdown

NORMAL = NormalDist()


# ---------------------------------------------------------------------------
# 一、单个指标
# ---------------------------------------------------------------------------

def to_curve(returns: pd.Series) -> pd.Series:
    """把一串收益率还原成资金曲线,并在**最前面补一个 1**。

    ⚠️ 少补这个 1 是这一篇里最容易犯的小错:`(1 + r).cumprod()` 的第一个点
    已经是「第一根走完之后」了,拿它当期初,整段收益就少算了第一根。
    第一根碰巧是大涨大跌的日子时,年化能差出一个百分点。
    """
    step = returns.index[1] - returns.index[0] if len(returns) > 1 else pd.Timedelta(0)
    head = pd.Series([1.0], index=[returns.index[0] - step])
    return pd.concat([head, (1 + returns).cumprod()])


def annual_return(equity: pd.Series, periods_per_year: int) -> float:
    """复合年化收益率(CAGR):`(期末 ÷ 期初) ^ (一年几根 ÷ 总共几根) − 1`。

    ⚠️ 这里用**根数**折算而不是用日历天数,所以它衡量的是「每根 K 线平均涨多少」的复利,
    两条起止日期不同的曲线可以这样比;但它对**起止点本身**极其敏感,见第 29 篇。
    """
    n = len(equity) - 1
    if n <= 0:
        raise ValueError("资金曲线至少要有两个点")
    return float(equity.iloc[-1] / equity.iloc[0]) ** (periods_per_year / n) - 1


def annual_vol(returns: pd.Series, periods_per_year: int) -> float:
    """年化波动率:单根 K 线收益率的标准差 × √(一年几根)。"""
    return float(returns.std()) * math.sqrt(periods_per_year)


def excess(returns: pd.Series, periods_per_year: int, rf: float | pd.Series = 0.0) -> pd.Series:
    """超额收益率:每根 K 线的收益率减去同期无风险利率。

    `rf` 是**年化**利率(4.25% 写 0.0425),可以是一个数,也可以是一条随时间变化的序列
    (`data.load_fred_series` 的输出就是)。换算成单根 K 线用复利口径:`(1+rf)^(1/一年几根) − 1`。

    ⚠️ 对齐这一步最容易出事:利率序列只有工作日,而加密的 K 线天天有,还带 UTC 时区。
    直接 `reindex` 会**安安静静地全变成 NaN**,一个报错都不给。所以这里先统一时区,
    再用「并集 + 前向填充」补齐缺的日子。
    """
    if isinstance(rf, pd.Series):
        index, source = returns.index, rf
        if getattr(source.index, "tz", None) != getattr(index, "tz", None):
            source = source.copy()
            source.index = (source.index.tz_localize(None) if index.tz is None
                            else source.index.tz_localize(index.tz) if source.index.tz is None
                            else source.index.tz_convert(index.tz))
        rf = pd.Series(source.reindex(source.index.union(index)).ffill().bfill()
                       .reindex(index).to_numpy(), index=index)
    per_period = (1 + rf) ** (1 / periods_per_year) - 1
    return returns - per_period


def sharpe(returns: pd.Series, periods_per_year: int, rf: float | pd.Series = 0.0) -> float:
    """夏普比率:`超额收益的均值 ÷ 超额收益的标准差 × √(一年几根)`。

    它是一个**信噪比**:分子是信号(平均每根赚多少),分母是噪声(这个平均值周围抖多厉害)。
    √(一年几根) 来自「独立的收益率相加时,均值按 n 放大、标准差只按 √n 放大」——
    所以时间拉长对信噪比是有利的,这正是夏普比率能被年化的原因,
    也是它**只有在收益率互相独立时才能这样年化**的原因(第 29 篇量了违反的后果)。

    ⚠️ 曲线一动不动(比如那一年从头到尾空仓)时返回 `NaN` 而不是一个数:
    那种情况下分母是 0,而分子是「−无风险利率」,公式会给出一个绝对值极大的负数——
    它在数学上没错,但把它印在报告上只会误导人。该说的是**「这一年没有可比的夏普比率」**。
    """
    e = excess(returns, periods_per_year, rf)
    if len(e) < 2 or e.std() == 0 or returns.std() == 0:
        return np.nan                                 # 见上面那条 ⚠️
    return float(e.mean() / e.std()) * math.sqrt(periods_per_year)


def sortino(returns: pd.Series, periods_per_year: int, rf: float | pd.Series = 0.0) -> float:
    """索提诺比率:分母只算**下行**的波动,上涨的波动不算在风险里。

    下行标准差 = √(所有超额收益里取 min(x, 0) 的平方平均)——注意分母是**全部**根数,
    不是亏损根数,否则一条「很少亏但亏起来很大」的曲线会被算得比实际好。
    """
    e = excess(returns, periods_per_year, rf)
    downside = np.sqrt((np.minimum(e.to_numpy(float), 0.0) ** 2).mean())
    if downside == 0:                                 # 一次都没亏过:分母是 0
        return np.inf if e.mean() > 0 else np.nan
    return float(e.mean() / downside) * math.sqrt(periods_per_year)


def max_drawdown(equity: pd.Series) -> float:
    """最大回撤(负数):全程距离历史最高点最远的那一刻,差了多少。"""
    return float(drawdown(equity).min())


def calmar(equity: pd.Series, periods_per_year: int) -> float:
    """卡玛比率:`年化收益 ÷ |最大回撤|`。

    ⚠️ 它的分母是一个**极值**,只由最坏的那一刻决定,样本越长通常越深(第 29 篇量了)。
    所以卡玛比率不能拿来比两条长度不同的曲线。
    """
    mdd = max_drawdown(equity)
    return annual_return(equity, periods_per_year) / abs(mdd) if mdd < 0 else np.inf


def metrics(equity: pd.Series, periods_per_year: int, rf: float | pd.Series = 0.0) -> pd.Series:
    """一页纸的上半部分:一条资金曲线的全部常规指标。"""
    returns = equity.pct_change().dropna()
    below = drawdown(equity) < -1e-12                 # 每一根:在不在水下
    dry = (~below).cumsum()                           # 每创一次新高,这个编号就加一
    return pd.Series({
        "起": equity.index[0], "止": equity.index[-1], "根数": float(len(equity)),
        "累计收益": float(equity.iloc[-1] / equity.iloc[0]) - 1,
        "年化收益": annual_return(equity, periods_per_year),
        "年化波动": annual_vol(returns, periods_per_year),
        "夏普比率": sharpe(returns, periods_per_year, rf),
        "索提诺比率": sortino(returns, periods_per_year, rf),
        "最大回撤": max_drawdown(equity),
        "卡玛比率": calmar(equity, periods_per_year),
        "在水下的比例": float(below.mean()),
        "最长水下根数": float(below.groupby(dry).sum().max()),
        "最好的一根": float(returns.max()), "最差的一根": float(returns.min()),
    })


# ---------------------------------------------------------------------------
# 二、这些数有多准
# ---------------------------------------------------------------------------

def sharpe_se(sharpe_value: float, n: int, periods_per_year: int) -> float:
    """年化夏普比率的标准误(Lo 2002,假设每根收益率互相独立且同分布):

    > SE(年化夏普) = √(一年几根) × √((1 + 年化夏普² ÷ (2 × 一年几根)) ÷ 根数)

    括号里那一项几乎总是 1 出头(日线上夏普 1.0 时是 1.0014),所以它近似等于
    **√(一年几根 ÷ 根数) = 1 ÷ √年数**:`一条年化夏普 1.0 的策略,跑一年的标准误就是 1.0`。
    """
    if n <= 0:
        raise ValueError("根数要大于 0")
    per_period = sharpe_value / math.sqrt(periods_per_year)
    return math.sqrt(periods_per_year) * math.sqrt((1 + per_period ** 2 / 2) / n)


def years_needed(sharpe_value: float, t: float = 2.0, periods_per_year: int = 252) -> float:
    """要让「这条策略不是运气」的 t 值达到 `t`,需要跑多少年:

    > 年数 = (t ÷ 年化夏普)² × (1 + 年化夏普² ÷ (2 × 一年几根))

    近似就是 **(t ÷ 夏普)²**:夏普 2.0 要 1 年,夏普 1.0 要 4 年,夏普 0.5 要 16 年。
    所以「夏普 0.5 但我只有两年数据」这句话本身就已经说完了——那两年什么都证明不了。
    """
    if sharpe_value <= 0:
        return np.inf
    return (t / sharpe_value) ** 2 * (1 + sharpe_value ** 2 / (2 * periods_per_year))


def significance_table(sharpes=(0.3, 0.5, 0.8, 1.0, 1.5, 2.0, 3.0), t: float = 2.0,
                       periods_per_year: int = 252) -> pd.DataFrame:
    """不同夏普比率下,要多少年才能把 t 值攒到 `t`。"""
    rows = [{"年化夏普": s, "要跑多少年": years_needed(s, t, periods_per_year),
             "要多少根 K 线": years_needed(s, t, periods_per_year) * periods_per_year}
            for s in sharpes]
    return pd.DataFrame(rows)


def bootstrap(returns: pd.Series, stat, n: int = 2000, block: int = 1, seed: int = 0,
              level: float = 0.90) -> pd.Series:
    """块自助法:把收益率切成长度 `block` 的小段,有放回地抽回原来的长度,重算 `stat`。

    `stat` 接收一条收益率序列,返回一个数(`lambda r: sharpe(r, 365)` 这样)。

    - `block=1` 就是普通的 i.i.d. 自助法:它假设**先后顺序无关紧要**。
      算均值、夏普比率时这个假设还行;算**最大回撤**时它是错的——
      回撤衡量的恰恰是「坏日子会不会连在一起」,而打散重抽把这件事抹掉了(第 29 篇量了差多少)。
    - `block > 1` 保留每一小段内部的顺序,是回撤类指标该用的口径。
    """
    if block < 1 or block > len(returns):
        raise ValueError("block 要在 1 和样本长度之间")
    values = returns.to_numpy(dtype=float)
    m = len(values)
    rng = np.random.default_rng(seed)
    sims = np.empty(n)
    for i in range(n):
        if block == 1:
            sample = rng.choice(values, size=m, replace=True)
        else:
            starts = rng.integers(0, m - block + 1, size=int(np.ceil(m / block)))
            sample = np.concatenate([values[s:s + block] for s in starts])[:m]
        sims[i] = stat(pd.Series(sample, index=returns.index))
    lo, hi = np.percentile(sims, [(1 - level) * 50, 100 - (1 - level) * 50])
    return pd.Series({"实际值": float(stat(returns)), "自助法中位数": float(np.median(sims)),
                      f"{level:.0%} 下界": float(lo), f"{level:.0%} 上界": float(hi),
                      "标准误": float(sims.std(ddof=1)), "小于 0 的比例": float((sims < 0).mean())})


def trade_metrics(trade_returns, level: float = 0.95) -> pd.Series:
    """交易层面的统计:**样本量是交易笔数,不是 K 线根数**。

    一条持仓 1,377 天的策略如果只进出了 35 次,它就只下了 35 次注;
    那 1,377 个日收益率不是 1,377 个独立样本,它们被绑成了 35 串。
    夏普比率的标准误按「根数」算,所以它在这种策略上**系统性地偏小**(第 29 篇量了)。

    `t 值` = 平均每笔 ÷ 平均值的标准误。经验上 |t| < 2 就是「这串数和 0 分不开」。
    ⚠️ 区间用的是正态近似,笔数少的时候它偏窄,该以 `bootstrap` 为准。
    """
    r = pd.Series(trade_returns).dropna().astype(float)
    n = len(r)
    if n < 2:
        raise ValueError("至少要有两笔交易")
    se = float(r.std(ddof=1)) / math.sqrt(n)
    z = NORMAL.inv_cdf(0.5 + level / 2)
    streak = longest = 0
    worst = current = 0.0
    for x in r:
        if x <= 0:
            streak += 1
            current += x
            longest, worst = max(longest, streak), min(worst, current)
        else:
            streak, current = 0, 0.0
    return pd.Series({
        "笔数": float(n), "平均每笔": float(r.mean()), "每笔的标准差": float(r.std(ddof=1)),
        "平均值的标准误": se, "t 值": float(r.mean()) / se,
        f"{level:.0%} 下界": float(r.mean()) - z * se, f"{level:.0%} 上界": float(r.mean()) + z * se,
        "最长连亏笔数": float(longest), "连亏最多亏掉": worst,
    })


# ---------------------------------------------------------------------------
# 三、排版
# ---------------------------------------------------------------------------

def by_year(equity: pd.Series, periods_per_year: int, rf: float | pd.Series = 0.0) -> pd.DataFrame:
    """按自然年拆开:每一年的收益、回撤、夏普各是多少。

    单独一年的夏普比率基本没有统计意义(见 `years_needed`),列在这里是为了看**稳不稳**,
    不是为了挑出最好的那一年。
    """
    returns = equity.pct_change().dropna()
    rows = []
    for year, chunk in returns.groupby(returns.index.year):
        curve = to_curve(chunk)
        rows.append({"年": year, "根数": len(chunk), "收益": float(curve.iloc[-1]) - 1,
                     "最大回撤": max_drawdown(curve),
                     "夏普": sharpe(chunk, periods_per_year, rf) if len(chunk) > 1 else np.nan})
    return pd.DataFrame(rows).set_index("年")


def compare(curves: dict[str, pd.Series], periods_per_year: int,
            rf: float | pd.Series = 0.0) -> pd.DataFrame:
    """把几条资金曲线的指标并排放:每一列一条曲线。

    ⚠️ 只有起止时间和 K 线频率都一样的曲线才能这样比。不一样时先各自换算到同一个频率
    (`equity.resample("1D").last()`),再比。
    """
    return pd.DataFrame({name: metrics(curve, periods_per_year, rf)
                         for name, curve in curves.items()})


def page(equity: pd.Series, periods_per_year: int, trades: pd.DataFrame | None = None,
         rf: float | pd.Series = 0.0, name: str = "策略", n_boot: int = 1000,
         block: int = 20, seed: int = 29) -> str:
    """一页纸的回测报告:指标、误差、分年、交易统计,全部折算成能一眼看完的文本。

    三段里最重要的是**中间那段**:同样一条曲线,把它的夏普比率和最大回撤重抽一千次,
    看它们能落在多宽的范围里。上面那段的数字只有配上中间那段才算读得懂。
    """
    returns = equity.pct_change().dropna()
    m = metrics(equity, periods_per_year, rf)
    lines = [f"{'=' * 62}", f"  {name}   {m['起'].date()} → {m['止'].date()}   {int(m['根数'])} 根",
             f"{'=' * 62}", "【一】指标"]
    for key in ["累计收益", "年化收益", "年化波动", "夏普比率", "索提诺比率",
                "最大回撤", "卡玛比率", "在水下的比例"]:
        lines.append(f"  {key:<8}{m[key]:>12.4f}")
    lines.append(f"  {'最长水下':<8}{int(m['最长水下根数']):>12d} 根")

    lines.append("【二】这些数有多准(重抽 %d 次,块长 %d 根)" % (n_boot, block))
    solved = sharpe_se(m["夏普比率"], len(returns), periods_per_year)
    lines.append(f"  夏普比率的标准误(解析解){solved:>10.4f}   "
                 f"t 值 {m['夏普比率'] / solved:>6.2f}   "
                 f"要攒到 t=2 得跑 {years_needed(m['夏普比率'], 2.0, periods_per_year):.1f} 年")
    for label, stat, use_block in [
            ("夏普比率", lambda r: sharpe(r, periods_per_year, rf), 1),
            ("年化收益", lambda r: annual_return(to_curve(r), periods_per_year), 1),
            ("最大回撤", lambda r: max_drawdown(to_curve(r)), block)]:
        b = bootstrap(returns, stat, n=n_boot, block=use_block, seed=seed)
        lines.append(f"  {label:<8}{b['实际值']:>10.4f}   90% 区间 "
                     f"[{b['90% 下界']:.4f}, {b['90% 上界']:.4f}]   块长 {use_block}")

    lines.append("【三】分年")
    lines.append("  " + by_year(equity, periods_per_year, rf).round(4).to_string().replace("\n", "\n  "))

    if trades is not None and len(trades) >= 2:
        t = trade_metrics(trades["收益"])
        lines.append("【四】交易(样本量 = 笔数,不是根数)")
        lines.append(f"  笔数 {int(t['笔数'])}   平均每笔 {t['平均每笔']:.4f}   "
                     f"t 值 {t['t 值']:.2f}   最长连亏 {int(t['最长连亏笔数'])} 笔")
        lines.append(f"  95% 区间 [{t['95% 下界']:.4f}, {t['95% 上界']:.4f}]   "
                     f"连亏最多亏掉 {t['连亏最多亏掉']:.4f}")
    lines.append("=" * 62)
    return "\n".join(lines)
新增的两个数据函数(talab/data.py)
FRED_CSV = "https://fred.stlouisfed.org/graph/fredgraph.csv?id={series}&cosd={start}"
FRED_AGENT = "talab-course/1.0"     # ⚠️ FRED 会把浏览器的 UA 晾着不回应,报个老实的名字反而秒回

# 无风险利率常用的两个序列(都是年化百分数,不是小数)
FRED_SERIES = {"3 个月国库券": "DTB3", "联邦基金有效利率": "DFF"}


def download_fred_series(series: str = "DTB3", start: str = "2016-01-01",
                         dest: str = "data/fred") -> Path:
    """下载圣路易斯联储 FRED 上的一条日频序列,原样保存 CSV(公开接口,不需要注册)。

    默认的 `DTB3` 是 3 个月国库券的二级市场收益率,算夏普比率时最常用的无风险利率。
    """
    path = Path(dest) / f"{series}.csv"
    path.parent.mkdir(parents=True, exist_ok=True)
    path.write_bytes(_fetch(FRED_CSV.format(series=series, start=start), agent=FRED_AGENT))
    return path


def load_fred_series(path) -> pd.Series:
    """读取 FRED 的 CSV,返回**小数形式**的年化利率(4.25% 读成 0.0425)。

    ⚠️ FRED 的利率列写的是百分数,这里除以 100;假日那天是 ".",转成 NaN 之后前向填充。
    """
    df = pd.read_csv(path, parse_dates=[0], index_col=0)
    s = pd.to_numeric(df.iloc[:, 0], errors="coerce") / 100
    s.index.name = "date"
    return s.ffill().rename(df.columns[0])
analysis/29_download.py
"""第 29 篇要用的新数据:无风险利率。其余数据在第 3、19、28 篇已经下载过。"""
from talab import data as D

path = D.download_fred_series("DTB3", start="2016-01-01")
series = D.load_fred_series(path)
print(f"{path}:{path.stat().st_size / 1024:.1f} KB,{len(series)} 个工作日,"
      f"{series.index[0].date()} 到 {series.index[-1].date()}")
print(f"最低 {series.min():.2%}({series.idxmin().date()})、最高 {series.max():.2%}({series.idxmax().date()})")
print(series.resample("1YE").mean().to_frame("当年平均").round(4).to_string())
data/fred/DTB3.csv:43.2 KB,2794 个工作日,2016-01-04 到 2026-09-17
最低 -0.05%(2020-03-26)、最高 5.36%(2023-10-06)
              当年平均
date
2016-12-31  0.0032
2017-12-31  0.0093
2018-12-31  0.0194
2019-12-31  0.0206
2020-12-31  0.0036
2021-12-31  0.0005
2022-12-31  0.0203
2023-12-31  0.0507
2024-12-31  0.0497
2025-12-31  0.0406
2026-12-31  0.0365
talab/tests/test_report.py
"""talab.report 的测试(第 29 篇)。"""
import math

import numpy as np
import pandas as pd
import pytest

from talab import report as RP


def days(n: int, tz=None) -> pd.DatetimeIndex:
    return pd.date_range("2020-01-01", periods=n, freq="D", tz=tz)


def test_to_curve_prepends_one_so_the_first_bar_is_not_lost():
    """少补那个 1,整段收益就少算第一根——这里把两种写法的差摆出来。"""
    r = pd.Series([0.5, 0.1, -0.1], index=days(3))
    curve = RP.to_curve(r)
    assert len(curve) == 4
    assert curve.iloc[0] == 1.0
    assert curve.iloc[-1] == pytest.approx(1.5 * 1.1 * 0.9)
    assert curve.index[0] == r.index[0] - pd.Timedelta(days=1)
    naive = (1 + r).cumprod()                       # 漏掉第一根的写法
    assert float(naive.iloc[-1] / naive.iloc[0]) == pytest.approx(1.1 * 0.9)


def test_annual_return_uses_bar_count_not_calendar():
    """一年 252 根、整段涨一倍,年化就是 100%;跑两年同样涨一倍,年化是 √2 − 1。"""
    one = pd.Series(np.linspace(1, 2, 253), index=days(253))
    assert RP.annual_return(one, 252) == pytest.approx(1.0)
    two = pd.Series(np.linspace(1, 2, 505), index=days(505))
    assert RP.annual_return(two, 252) == pytest.approx(math.sqrt(2) - 1)
    with pytest.raises(ValueError):
        RP.annual_return(pd.Series([1.0], index=days(1)), 252)


def test_annual_vol_scales_with_square_root_of_frequency():
    r = pd.Series([0.01, -0.01] * 50, index=days(100))
    assert RP.annual_vol(r, 252) == pytest.approx(float(r.std()) * math.sqrt(252))
    assert RP.annual_vol(r, 365) / RP.annual_vol(r, 252) == pytest.approx(math.sqrt(365 / 252))


def test_excess_aligns_a_rate_series_across_time_zones_and_weekends():
    """加密 K 线带 UTC 时区、天天都有;利率序列不带时区、只有工作日。

    直接 reindex 会安静地全变成 NaN,这个测试就是为了钉住那个坑。
    """
    r = pd.Series(0.01, index=days(10, tz="UTC"))
    rate = pd.Series([0.05, 0.05], index=pd.to_datetime(["2019-12-31", "2020-01-06"]))
    out = RP.excess(r, 365, rate)
    assert out.notna().all()
    assert out.index.equals(r.index)
    assert out.iloc[0] == pytest.approx(0.01 - (1.05 ** (1 / 365) - 1))
    assert RP.excess(r, 365, 0.0).equals(r)          # rf=0 时原样返回


def test_sharpe_is_mean_over_std_times_root_frequency():
    r = pd.Series([0.02, -0.01, 0.03, 0.00, 0.01], index=days(5))
    assert RP.sharpe(r, 252) == pytest.approx(float(r.mean() / r.std()) * math.sqrt(252))
    rf_only = RP.sharpe(r, 252, 0.10)
    assert rf_only < RP.sharpe(r, 252)               # 扣掉无风险利率只会更低


def test_sharpe_of_a_curve_that_never_moves_is_not_a_number():
    """一年到头空仓:收益率恒等于 0,公式会给出一个绝对值巨大的负数,该给的是 NaN。"""
    flat = pd.Series(0.0, index=days(300, tz="UTC"))
    rate = pd.Series(0.05, index=days(300))
    assert math.isnan(RP.sharpe(flat, 365, rate))
    assert math.isnan(RP.sharpe(flat, 365))


def test_sortino_only_counts_downside_and_divides_by_all_bars():
    r = pd.Series([0.02, -0.01, 0.02, -0.01], index=days(4))
    downside = math.sqrt(((0.01 ** 2) * 2) / 4)      # 分母是 4 根,不是 2 根亏损
    assert RP.sortino(r, 252) == pytest.approx(float(r.mean()) / downside * math.sqrt(252))
    assert RP.sortino(pd.Series([0.01, 0.02], index=days(2)), 252) == np.inf


def test_max_drawdown_and_calmar():
    curve = pd.Series([1.0, 2.0, 1.0, 1.5], index=days(4))
    assert RP.max_drawdown(curve) == pytest.approx(-0.5)
    assert RP.calmar(curve, 252) == pytest.approx(RP.annual_return(curve, 252) / 0.5)
    rising = pd.Series([1.0, 1.1, 1.2], index=days(3))
    assert RP.calmar(rising, 252) == np.inf          # 从没回撤过


def test_metrics_reports_the_longest_underwater_stretch_in_bars():
    curve = pd.Series([1.0, 0.9, 0.8, 1.1, 1.0, 1.2], index=days(6))
    m = RP.metrics(curve, 252)
    assert m["在水下的比例"] == pytest.approx(3 / 6)        # 第 2、3、5 根在水下
    assert m["最长水下根数"] == 2                            # 最长的一段是第 2、3 根
    assert m["最大回撤"] == pytest.approx(-0.2)
    assert m["累计收益"] == pytest.approx(0.2)


def test_sharpe_se_is_about_one_over_root_years():
    """夏普 1.0 跑一年,标准误就是 1.0——所以一年的数据什么都证明不了。"""
    assert RP.sharpe_se(1.0, 252, 252) == pytest.approx(1.0, rel=0.01)
    assert RP.sharpe_se(1.0, 252 * 4, 252) == pytest.approx(0.5, rel=0.01)
    assert RP.sharpe_se(1.0, 252 * 4, 252) < RP.sharpe_se(1.0, 252, 252)
    with pytest.raises(ValueError):
        RP.sharpe_se(1.0, 0, 252)


def test_years_needed_is_t_over_sharpe_squared():
    assert RP.years_needed(2.0, 2.0, 252) == pytest.approx(1.0, rel=0.01)
    assert RP.years_needed(0.5, 2.0, 252) == pytest.approx(16.0, rel=0.02)
    assert RP.years_needed(-0.3) == np.inf
    table = RP.significance_table(periods_per_year=252)
    assert table["要跑多少年"].is_monotonic_decreasing


def test_bootstrap_is_reproducible_and_blocks_keep_the_length():
    r = pd.Series(np.random.default_rng(0).normal(0.001, 0.02, 500), index=days(500))
    stat = lambda x: RP.sharpe(x, 252)
    a = RP.bootstrap(r, stat, n=200, block=1, seed=7)
    b = RP.bootstrap(r, stat, n=200, block=1, seed=7)
    assert a.equals(b)                                      # 同一个 seed 必须给同一个答案
    assert a["90% 下界"] < a["实际值"] < a["90% 上界"]
    block = RP.bootstrap(r, lambda x: float(len(x)), n=5, block=37, seed=1)
    assert block["实际值"] == 500 and block["自助法中位数"] == 500
    with pytest.raises(ValueError):
        RP.bootstrap(r, stat, block=0)
    with pytest.raises(ValueError):
        RP.bootstrap(r, stat, block=501)


def test_trade_metrics_t_value_and_longest_losing_streak():
    r = pd.Series([0.2, -0.1, -0.1, -0.05, 0.3, -0.02])
    out = RP.trade_metrics(r)
    assert out["笔数"] == 6
    assert out["t 值"] == pytest.approx(float(r.mean()) / (float(r.std(ddof=1)) / math.sqrt(6)))
    assert out["最长连亏笔数"] == 3                          # 第 2、3、4 笔
    assert out["连亏最多亏掉"] == pytest.approx(-0.25)
    with pytest.raises(ValueError):
        RP.trade_metrics([0.1])


def test_more_trades_shrink_the_interval_at_the_same_average():
    """同一串交易重复十遍:平均每笔一点没变,区间宽度缩到 2/7。

    直觉上应该缩到 1/√10 = 0.316,实际是 2/7 = 0.286:差在 ddof=1 的自由度修正上
    (5 笔时平方和除以 4,50 笔时除以 49)。笔数少的时候这个修正一点都不小。
    """
    few = pd.Series([0.2, -0.1, 0.15, -0.08, 0.05])
    many = pd.Series(list(few) * 10)
    a, b = RP.trade_metrics(few), RP.trade_metrics(many)
    assert b["平均每笔"] == pytest.approx(a["平均每笔"])
    width = lambda x: x["95% 上界"] - x["95% 下界"]
    assert width(b) / width(a) == pytest.approx(math.sqrt(20 / 245))
    assert width(b) / width(a) == pytest.approx(2 / 7)


def test_by_year_and_compare_and_page_line_up():
    r = pd.Series(np.random.default_rng(29).normal(0.001, 0.02, 800), index=days(800))
    curve = RP.to_curve(r)
    years = RP.by_year(curve, 365)
    assert list(years.index) == [2020, 2021, 2022]
    assert years["根数"].sum() == 800
    side = RP.compare({"甲": curve, "乙": curve * 2}, 365)
    assert list(side.columns) == ["甲", "乙"]
    assert side.loc["夏普比率", "甲"] == pytest.approx(side.loc["夏普比率", "乙"])   # 放大不改信噪比
    text = RP.page(curve, 365, n_boot=50, block=20, name="测试")
    assert "【一】指标" in text and "【三】分年" in text
    assert "【四】交易" not in text                            # 没给交易表就不印第四段
talab/tests/test_data.py 新增的一条
FRED_CSV = """observation_date,DTB3
2020-03-25,0.02
2020-03-26,-0.05
2020-03-27,.
2020-03-30,0.14
"""


def test_load_fred_series_turns_percent_into_decimal_and_fills_holidays(tmp_path):
    """FRED 的利率列写的是百分数,假日写成一个点;负利率是真的出现过的。"""
    path = tmp_path / "DTB3.csv"
    path.write_text(FRED_CSV)
    s = D.load_fred_series(path)
    assert s.name == "DTB3"
    assert s.loc["2020-03-25"] == pytest.approx(0.0002)
    assert s.loc["2020-03-26"] == pytest.approx(-0.0005)          # 2020 年 3 月真的收过负利率
    assert s.loc["2020-03-27"] == pytest.approx(-0.0005)          # "." 前向填充
    assert s.loc["2020-03-30"] == pytest.approx(0.0014)
    assert s.index.tz is None and s.index.name == "date"
两个 venv 的测试结果
293 passed in 1.00s
261 passed, 32 skipped in 1.04s
十四、小检查
- 两条策略在同一个市场、同一段时间上,夏普比率都是 1.4。一条每年交易 6 次,一条每年交易 300 次。你还需要知道哪三件事,才能开始比较它们?
- 一份业绩报告写着「近三年年化 18%、最大回撤 −6%、夏普 2.6」。哪一个数最值得怀疑?你会先算什么来验证?
- 某条策略在 2024 年的夏普是 1.4,2025 年是 0.9。这个下降说明策略变差了吗?
- 你要给一条策略的最大回撤配一个 90% 区间。为什么不能直接把日收益率打散重抽?
- 一条策略的夏普是 0.6,你手上有 5 年数据,t 值算出来是 1.34。这个结果该怎么写进结论?
十五、常见误用
**拿夏普比率给两条策略排名,却不看笔数。**这一篇整篇都在讲这件事。第九节:A 和 B 的夏普 t 值都是 3.93,逐笔 t 值是 2.46 对 3.80。报夏普比率而不报笔数,等于报一个平均值而不报样本量。
**比两条长度不同的曲线的最大回撤或卡玛比率。**第五节:同一个随机过程跑 1 年的回撤中位数是 −27%,跑 20 年是 −55%。长的那条几乎一定更深,这跟策略好坏无关。要比就先截到一样长。
**跨周期、跨市场比夏普比率。**第 4.2 节:同一条曲线按日线算和按月线算差 0.12,而且两条策略的排名会对调。美股一年 252 根、加密 365 根,最后乘的那个 √ 都不一样。
**不减无风险利率。**2021 年无所谓(差 0.0009),2025 年差 0.1953,2026 年直接让正负号翻过来。
在同一份数据上挑参数,然后报告挑出来的那个数的置信区间。那个区间是错的——它只算了「这份样本的抖动」,没算「我挑过」。第 28 篇量过:在完全没有趋势的打乱数据上挑 228 组的最好一组,也能挑出 20% 的年化。第 30 篇正面处理这件事。
**用 block=1 给回撤做区间。**打散日子的顺序,等于假设坏日子不会连在一起;而最大回撤衡量的恰恰就是坏日子连在一起的程度。第 9.2 节:B 上这个差别是三倍。
只报一个数,不报区间。「夏普 0.76」和「夏普 0.76(90% 区间 0.23 到 1.29)」是同一份数据算出来的两句话。只说前一句不算撒谎,但也不算说清楚。
**把单独一年的夏普比率当成信号。**一年的数据对夏普 1.0 的策略来说标准误就是 1.0。by_year 那一栏是用来看稳不稳的,不是用来挑年份的。
**把「证明不了它有效」当成「证明了它无效」。**第十一节:SPY 上那 380 年说的是前者。前者意味着「再等等,或者换一种证据」,后者意味着「扔掉」——搞混了会让你扔掉对的东西,也会让你留下错的东西。
十六、小结
- 年化收益只用到两个端点:起点挪半年能差 22 个百分点,截止日挪四年半能差 62 个。算它永远用几何口径,别从日均推(BTC 上那个差 35 个百分点)。
- 夏普比率是信噪比,√(一年几根) 来自「均值按 k 长大、标准差按 √k 长大」。它至少有四种骗法:换计算周期(排名会换人)、平滑净值(1.31 → 3.84,马脚是一阶自相关 0.92)、不减无风险利率(2026 年从 +0.07 变 −0.08)、加杠杆(1 倍和 2 倍一模一样,3 倍归零了还有 0.52)。
- 最大回撤是极值,同一个随机过程跑 1 年是 −27%、跑 20 年是 −55%。A 真实的 −52.51% 只比「同波动率随机游走跑九年」的中位数(−47.91%)深 4.60 个百分点——它里面几乎没有关于 A 的信息。卡玛比率继承了它的全部毛病。
- 每个数都要带着误差。夏普有解析解(≈ 1/√年数),其余的用自助法。夏普 1.0 要跑 4 年、夏普 0.5 要跑 16 年才能把 t 值攒到 2。
- 样本量是笔数,不是根数。A 和 B 的夏普 t 值都是 3.93,但逐笔 t 值是 2.46 对 3.80;按交易重抽,A 的区间比按天宽 38%,B 的几乎不变。
- 交易次数同时决定「可信度」和「成本」,方向相反。B 每年 117 笔,成本吃掉 23.52%,夏普 1.3072 → 0.6518;A 每年 3.9 笔,1.3086 → 1.2905。
- 主线 v4 第一次被完整地量:SPY 2.91%/夏普 0.10、AAPL 9.83%/0.54、BTC 20.63%/0.76,三个标的的逐笔 t 值都不到 2。这是「证据不够」,不是「策略无效」。
- 新模块
talab.report15 个测试,加上data里新增的 1 个,全课共 293 个(不装 TA-Lib 时 261 通过 + 32 跳过)。
练习
- 把第 4.3 节的平滑检验做成一个函数:给它一条日频净值,返回一阶自相关和「按这个自相关反推,真实夏普大概是多少」。拿它去查第 28 篇那条年化 123% 的篮子曲线。
trade_metrics的区间用的是正态近似。改成用bootstrap重抽交易来算,在主线 v4 的 30 笔上,两个区间差多少?笔数降到 10 笔时呢?- 第五节的随机游走用的是正态分布。换成从 A 的真实日收益率里有放回地抽(保留肥尾),最大回撤随年数变深的那条曲线会不会变?
- 给
page加第五段「对成本的敏感性」:把单边成本从 0 扫到 0.3%,打印年化和夏普各掉多少。拿它跑一遍 A 和 B。 - 第九节比的是「按天」和「按交易」。再加一种:按年重抽(有放回地抽 9 个完整年份重新拼接)。它给出的区间比按交易更宽还是更窄?为什么?
- 索提诺比率的分母口径有好几种(分母是全部根数 / 只有亏损根数 / 用目标收益率代替 0)。把三种都实现,在 SPY、AAPL、BTC 的主线曲线上比一比——差别有多大,够不够改变排名?
- 写一个
compare_fair(curves, ...):它在比较之前自动做三件事(截到共同的时间段、统一到日频、统一无风险利率),做不到就报错而不是默默算。
小检查答案
- 一,笔数背后的逐笔 t 值(夏普比率的标准误按根数算,在持仓周期长的策略上偏小);二,含不含成本(每年 300 次的那条,成本要乘 50 倍);三,两条的计算周期和无风险利率口径是不是一样的。第十节那张表就是这三件事的答案:交易次数同时决定「可不可信」和「还剩多少」,方向相反。
- 最值得怀疑的是夏普 2.6,因为它和 −6% 的回撤放在一起太整齐了。先算日收益率的一阶自相关:如果明显大于 0(比如 0.3 以上),说明净值被平滑过,真实的波动率比报告里的大(第 4.3 节:平滑 10 天能把 1.31 变成 3.84,马脚就是自相关从 0.035 变成 0.920)。再问一句这三年的无风险利率减了没有——2023 年之后这一项值 0.15 个夏普。
- **说明不了。**夏普 1.0 的策略跑一年,标准误就是 1.0(第 8.1 节)。两个单年夏普差 0.5,远在噪声范围内。要判断「变差了」,最少需要「差异本身」的显著性,而那通常要好几年。
- 因为打散重抽等于假设坏日子不会连在一起,而最大回撤衡量的恰恰是它们连在一起的程度——你把要测的东西先抹掉了,再去测它。正确做法是块自助法(
block取几十根),第 9.2 节实测:B 的真实回撤在 i.i.d. 重抽里只有 4.60% 的机会出现,换成块长 120 是 12.55%。 - 写成两句话:**「样本内年化夏普 0.6;按 5 年数据,t = 1.34,不足以排除运气。要把 t 攒到 2,按这个夏普需要约 11 年。」**注意不要写成「这条策略无效」——那是另一个结论,而且这份数据也证明不了它(第十一节)。
第 30 篇讲过拟合与样本外检验。决策点是:均线参数 17/43 回测最好,16/44 却亏钱——这两组参数只差一天,它们中间那条沟意味着什么?内容是参数平原与参数尖峰、样本内与样本外、Walk-forward 滚动检验、蒙特卡洛、多重检验。这一篇量出来的 A 和 B,会在那一篇里被正面地检验一次。