| 本篇位置 | 第六部分「检验」最后一篇。第 27 篇管引擎、第 28 篇管数据、第 29 篇管读数,这一篇管一件事:你挑过多少次 |
| 用到的数据 | BTC 现货日线、SPY、AAPL(都沿用前面几篇,不需要新下载) |
| 动手 | 新模块 talab.validate:surface、neighbourhood、plateaus、split_index、walk_forward、walk_forward_run、stitch、expected_max_sharpe、deflated_sharpe、pbo、synthetic_close,附 15 个测试 |
| 读完你能 | 拿到任何一条「参数选出来的」策略,给它的成绩打一个有根据的折扣 |
一、先做一个决定
一条 BTC 日线策略,规则短到一行:快线在慢线上方就满仓做多,下方就满仓做空。
参数在一万零一百三十组里选(快线 5 到 50,慢线 20 到 250,慢线必须比快线长),选年化最高的那一组。回测两年:2021-01-01 到 2022-12-31。
BTC 2021-01-01 到 2022-12-31:价格 29,332 → 16,542,买入持有年化 -24.93%
在 10,130 组(快线 5–50 × 慢线 20–250)里选年化最高的一组 = (31, 36)
根数         731.0
累计收益      6.4935
年化收益      1.7374
年化波动      0.7271
夏普比率      1.7463
索提诺比率     2.7964
最大回撤     -0.3918
卡玛比率      4.4344
在水下的比例    0.9207
最长水下根数     196.0
最好的一根     0.1954
最差的一根    -0.1302
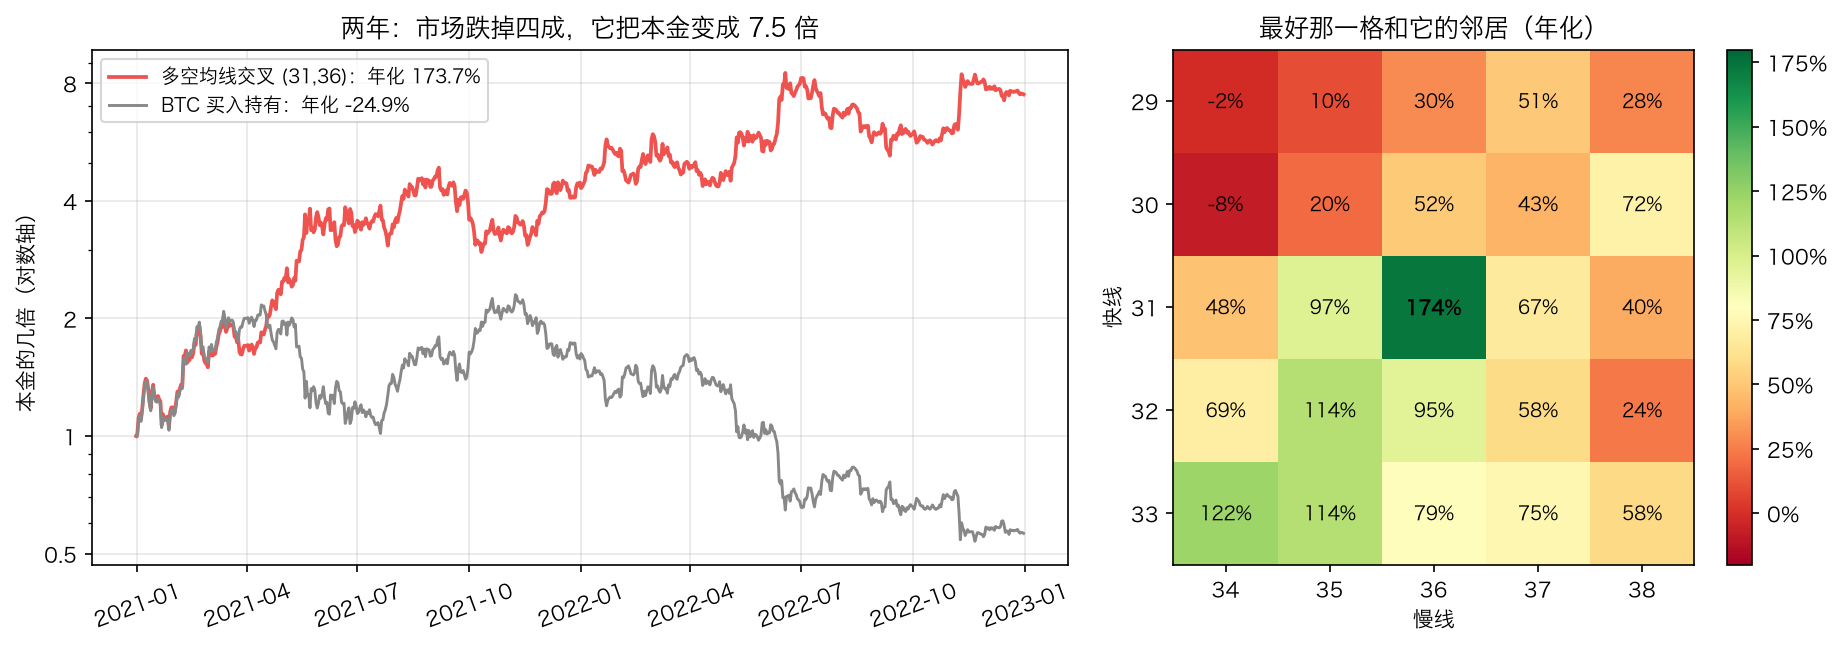
**同一段时间里,BTC 自己从 29,332 跌到 16,542(年化 −24.93%),这条策略把本金变成了 7.5 倍(累计 +649.35%)。**夏普 1.75,最大回撤 −39.18%,卡玛 4.43。
它不做空是赚不到这个钱的——而它确实是一条会做空的策略,代码就那一行。
你会用这组参数上实盘吗?
二、打个比方:背答案
样本内的成绩,是一份你事先看过答案的卷子。
这个比方里的每一样东西后面都会回来:
| 考试 | 回测 |
|---|---|
| 做过的那套卷子 | 样本内:你调参数用的那段数据 |
| 背下「第 17 题选 C」 | 参数尖峰:这一组好,隔壁一组就不行 |
| 真的学懂了这一章 | 参数平原:这一片都好,走错一步没关系 |
| 没见过的新卷子 | 样本外 |
| 每学完一章立刻考一次 | walk-forward 滚动检验 |
| 一道选择题蒙一万次,总有蒙对的 | 多重检验:试了一万组参数 |
| 把题目里的数字全打乱,看你还能不能「做对」 | 蒙特卡洛:在没有规律的假数据上重来一遍 |
有一件事必须先说清楚,因为它是这一篇所有麻烦的根源:
**样本内的成绩永远可以做到任意好。**参数多试几组、规则多加两条,回测收益一定上升。上升本身不携带任何信息。
所以这一篇里没有一个函数是在「算成绩」,它们全都在给成绩打折。下面六节就是六把刀。
三、第一刀:看一眼邻居
最省事的检查不需要任何新数据:把最好那一格周围的八格打印出来。
table = pd.DataFrame({"快线": [f for f, s in PAIRS], "慢线": [s for f, s in PAIRS], "年化": in_annual})
grid = V.surface(table, "快线", "慢线", "年化")
print(grid.loc[29:33, 34:38].round(4).to_string())
print()
print(V.neighbourhood(grid, PAIRS[best]).round(4).to_string())
print(f"\n全网格 {len(PAIRS):,} 格:年化中位 {np.median(in_annual):.2%},"
      f"90% 分位 {np.percentile(in_annual, 90):.2%},亏钱的占 {(in_annual < 0).mean():.1%}")
慢线      34      35      36      37      38
快线
29 -0.0150  0.1036  0.2979  0.5080  0.2802
30 -0.0769  0.1970  0.5162  0.4273  0.7164
31  0.4837  0.9717  1.7374  0.6749  0.3978
32  0.6932  1.1423  0.9502  0.5814  0.2443
33  1.2247  1.1393  0.7853  0.7495  0.5765

这一格     1.7374
邻居数     8.0000
邻居中位    0.6282
邻居最差    0.1970
邻居最好    1.1423
落差      1.1092

全网格 10,130 格:年化中位 13.38%,90% 分位 36.74%,亏钱的占 26.8%
中间那一格是 173.74%。它的八个邻居是 19.70%、51.62%、42.73%、97.17%、67.49%、114.23%、95.02%、58.14%——中位数只有 62.82%。
再往外走一步:把快线改成 30、慢线改成 34,年化是 −7.69%。
**落差 = 这一格 − 邻居中位数。**这里是 1.1092,占了这一格年化的 63.8%。
一条真的有道理的规则,参数改一天不该有这么大反应。33 天的均线和 36 天的均线在经济上是同一件事;如果回测说它们差三倍,那差的不是这条规则,是这两年的价格恰好在哪几天穿过了这两条线。
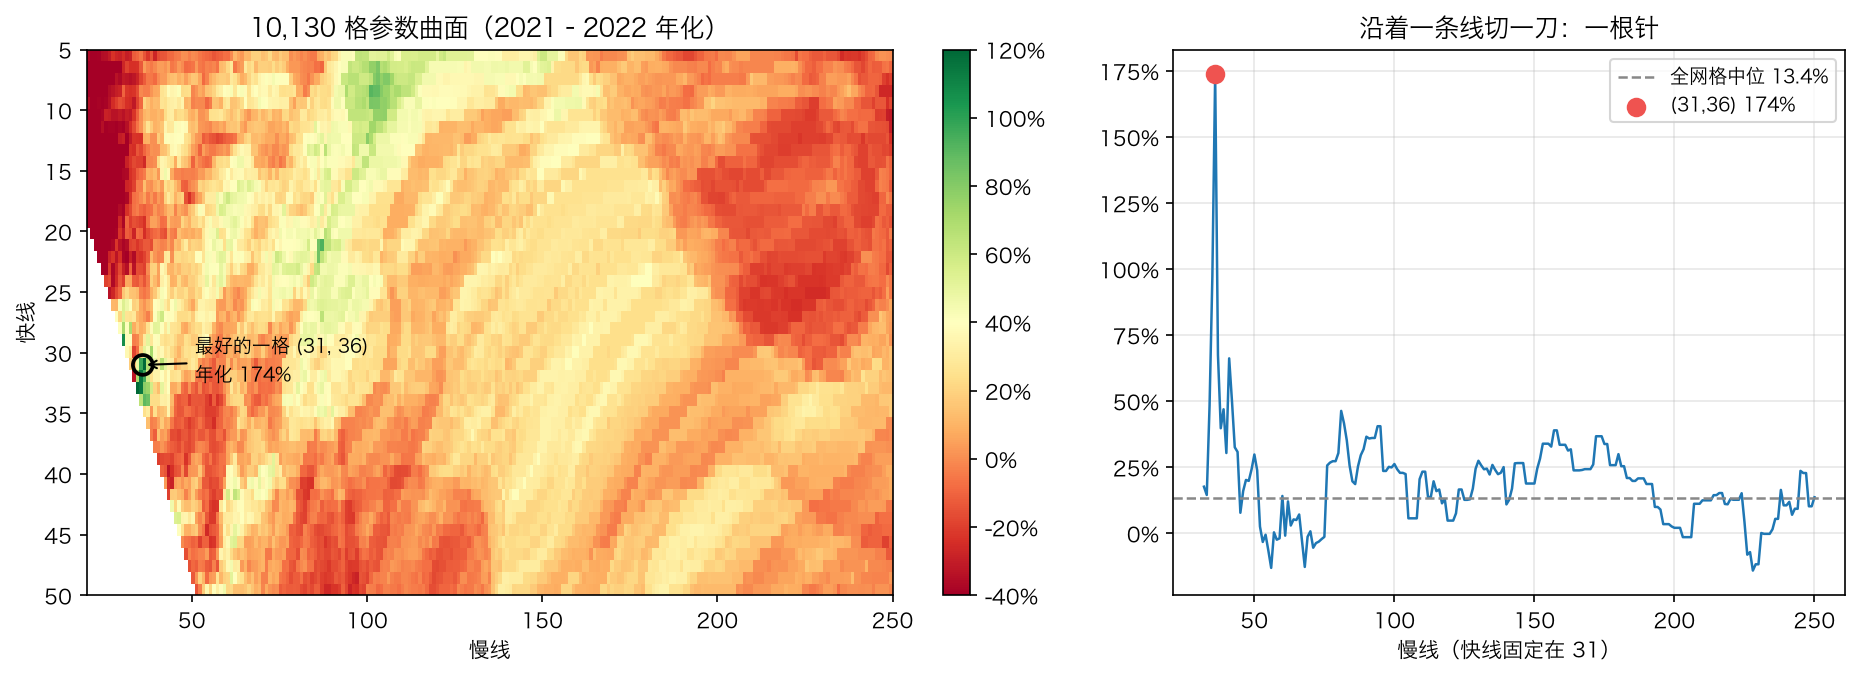
左边是全部 10,130 格。右边沿着「快线固定在 31」切一刀——一根针,周围全是 0% 到 50% 的平地。
⚠️ 一个容易搞混的地方:落差大不等于这一格是错的,它只说明这个数不可信。尖峰和平原的区别不在于哪个收益高,在于哪个的收益是你能重复的。
四、尖峰是样本短的症状
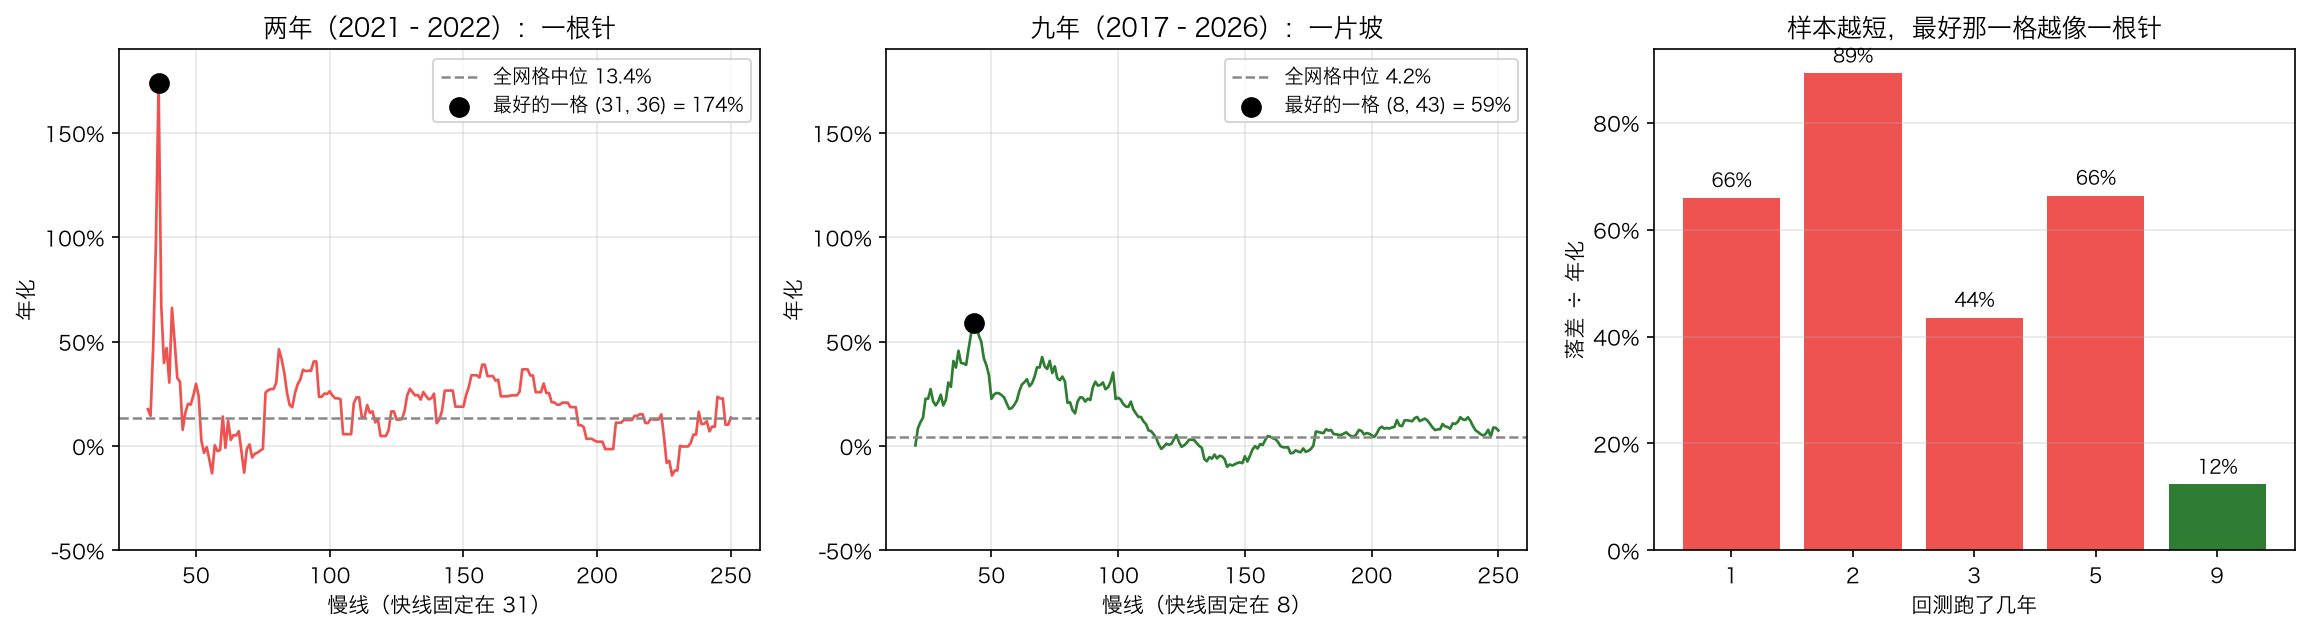
同一个网格、同一个市场,只把回测的长度换一换:
rows = []
for years in [1, 2, 3, 5, 9]:
    piece = DAILY[:, -int(365 * years):]
    values = annual(piece)
    top = int(values.argmax())
    fast, slow = PAIRS[top]
    neighbours = [values[WHERE[(f, s)]] for f in (fast - 1, fast, fast + 1)
                  for s in (slow - 1, slow, slow + 1) if (f, s) != (fast, slow) and (f, s) in WHERE]
    rows.append({"回测几年": years, "最好的一格": f"({fast},{slow})", "年化": values[top],
                 "邻居中位": np.median(neighbours), "落差": values[top] - np.median(neighbours),
                 "落差占年化": (values[top] - np.median(neighbours)) / values[top],
                 "全网格中位": np.median(values)})
print(pd.DataFrame(rows).round(4).to_string(index=False))
 回测几年   最好的一格     年化   邻居中位     落差  落差占年化   全网格中位
    1 (50,55) 0.9023 0.3073 0.5950 0.6594 -0.1355
    2 (21,23) 0.5767 0.0621 0.5146 0.8923 -0.0404
    3 (40,41) 0.5554 0.3134 0.2419 0.4356  0.0471
    5 (26,27) 0.4690 0.1577 0.3113 0.6638  0.0197
    9  (8,43) 0.5930 0.5199 0.0731 0.1233  0.0422
| 回测几年 | 最好的一格 | 年化 | 邻居中位 | 落差占年化 |
|---|---|---|---|---|
| 1 | (50,55) | 90.23% | 30.73% | 65.94% |
| 2 | (21,23) | 57.67% | 6.21% | 89.23% |
| 3 | (40,41) | 55.54% | 31.34% | 43.56% |
| 5 | (26,27) | 46.90% | 15.77% | 66.38% |
| 9 | (8,43) | 59.30% | 51.99% | 12.33% |
回测九年的时候,最好的一格只比邻居高出 12.33%;回测两年的时候,这个数是 89.23%。
图中间那张是九年的切面:一片缓坡,最高点和周围差不了多少。左边那张是两年的:一根针。
道理不难:**尖峰是噪声堆出来的,而噪声不会在长样本里堆得一样高。**样本越长,同一组参数要在越多种行情下都好,运气就越难帮上忙。
⚠️ 反过来说也成立,而且更有用:你看到一个尖峰,第一反应不该是「这组参数很神」,该是「我的样本太短了」。
五、第二刀:样本外
最老实的一刀:留一段数据,调参数的时候不看它。
plateau = V.plateaus(grid)
rows = []
for label, cell in [("按「这一格最高」挑", PAIRS[best]),
                    ("按「邻域中位最高」挑", (int(plateau.iloc[0]["快线"]), int(plateau.iloc[0]["慢线"]))),
                    ("课程默认(第 12 篇的 50/200,没挑过)", (50, 200))]:
    k = WHERE[cell]
    rows.append({"挑法": label, "参数": f"({cell[0]},{cell[1]})", "样本内年化": in_annual[k],
                 "样本外年化": out_annual[k], "样本外排名": int((out_annual > out_annual[k]).sum()) + 1})
rows.append({"挑法": "全网格中位(什么都不挑)", "参数": f"{len(PAIRS):,} 格",
             "样本内年化": np.median(in_annual), "样本外年化": np.median(out_annual),
             "样本外排名": len(PAIRS) // 2})
print(pd.DataFrame(rows).round(4).to_string(index=False))
order = np.argsort(-in_annual)
ladder = [{"样本内前几名": n, "样本外年化中位": np.median(out_annual[order[:n]])}
          for n in [10, 50, 100, 500, 1000, 5000]]
ladder.append({"样本内前几名": len(PAIRS), "样本外年化中位": np.median(out_annual)})
print(pd.DataFrame(ladder).round(4).to_string(index=False))
print(f"\n样本内排名和样本外排名的秩相关:"
      f"{pd.Series(in_annual).rank().corr(pd.Series(out_annual).rank()):.4f}")
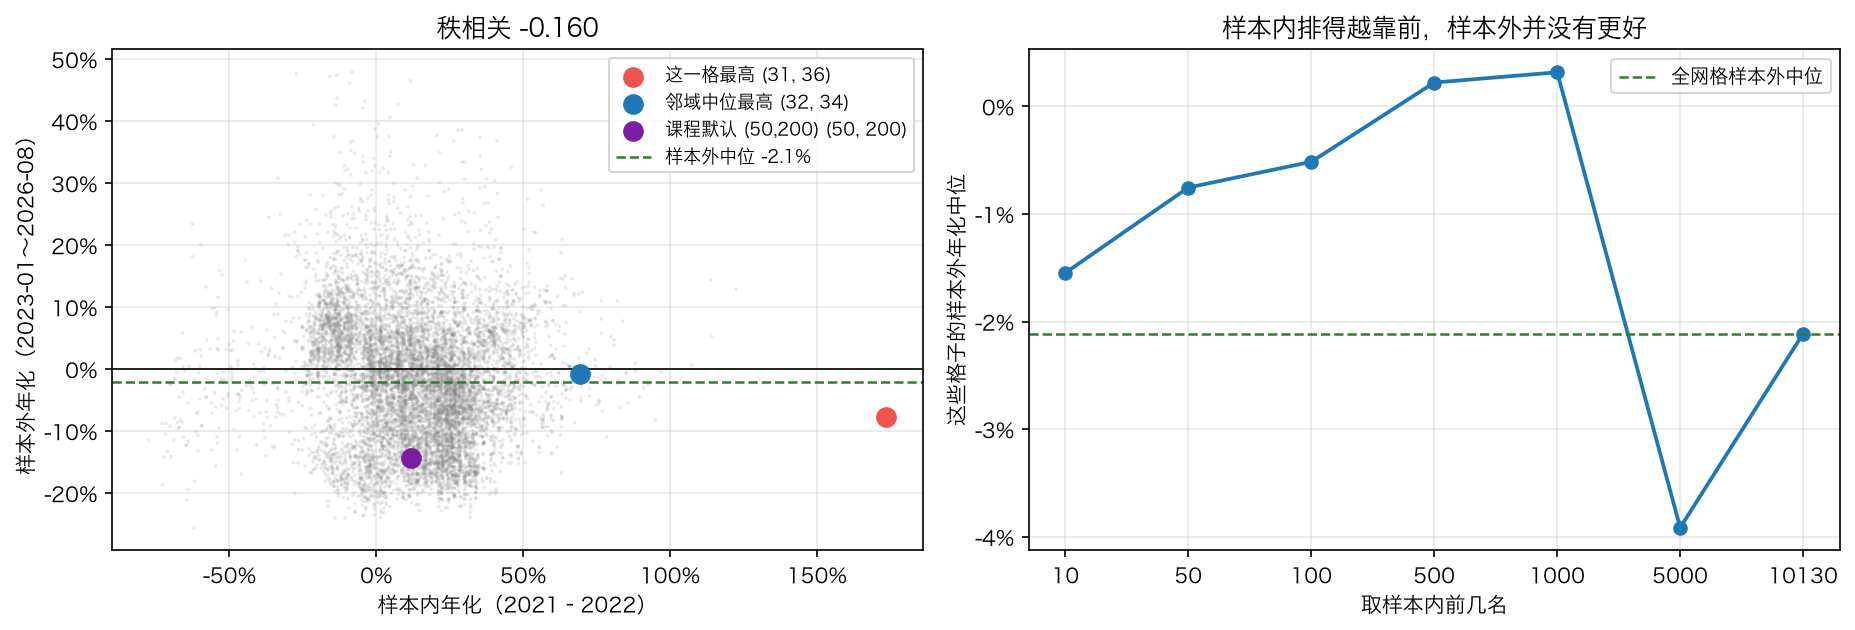
                      挑法       参数  样本内年化   样本外年化  样本外排名
               按「这一格最高」挑  (31,36) 1.7374 -0.0766   7083
              按「邻域中位最高」挑  (32,34) 0.6932 -0.0077   4551
课程默认(第 12 篇的 50/200,没挑过) (50,200) 0.1203 -0.1439   8927
            全网格中位(什么都不挑) 10,130 格 0.1338 -0.0211   5065
 样本内前几名  样本外年化中位
     10  -0.0155
     50  -0.0075
    100  -0.0052
    500   0.0022
   1000   0.0032
   5000  -0.0392
  10130  -0.0211

样本内排名和样本外排名的秩相关:-0.1597
| 挑法 | 参数 | 样本内年化 | 样本外年化 | 样本外排名 |
|---|---|---|---|---|
| 按「这一格最高」挑 | (31,36) | 173.74% | −7.66% | 7,083 / 10,130 |
| 按「邻域中位最高」挑 | (32,34) | 69.32% | −0.77% | 4,551 / 10,130 |
| 课程默认(第 12 篇的 50/200,没挑过) | (50,200) | 12.03% | −14.39% | 8,927 / 10,130 |
| 什么都不挑(全网格中位) | 10,130 格 | 13.38% | −2.11% | 5,065 / 10,130 |
三件事:
- **样本内第一名,样本外排到了后三分之一。**173.74% 变成 −7.66%。
- 按「邻域中位最高」挑确实好一点(排名 4,551 比 7,083 好),但也就是「回到中间」——它没有变成一条好策略,只是没那么难看。
- 秩相关 −0.1597。样本内排名和样本外排名不是弱相关,是负相关。
第三点值得停一下。第 28 篇在另一个网格上算过同一个数,那次是 +0.291。两次一正一负,说的是同一件事:样本内排名携带的样本外信息,小到连符号都不稳定。
下面那个梯子更直白:
 样本内前几名  样本外年化中位
     10  -0.0155
     50  -0.0075
    100  -0.0052
    500   0.0022
   1000   0.0032
   5000  -0.0392
  10130  -0.0211
取样本内前 10 名,它们的样本外年化中位是 −1.55%;取前 1000 名,是 +0.32%;取前 5000 名,是 −3.92%。这条线根本不单调——因为它测的本来就是噪声。
⚠️ 样本外只能用一次。你看了样本外的结果,回去改参数,再看一次——那段数据就已经变成样本内了。这不是道德问题,是定义问题。
六、第三刀:walk-forward
留一段样本外有个毛病:**只考了一次。**万一那段行情刚好特别(比如 2023 年之后 BTC 的均线交叉对谁都不好使),你也说不清是策略不行还是那段特殊。
walk-forward 把这件事做成流水线:**用前面一段挑参数,用紧接着的一段考试;然后整个窗口往前滚,再挑一次、再考一次。**各段的考卷首尾相接、互不重叠,拼起来就是一条每一根都没被看过的资金曲线。
start = int(np.argmax(DATES >= pd.Timestamp("2018-01-01", tz="UTC")))   # 前 250 根留给均线预热
rolling = DAILY[:, start:]
rows = []
for anchored in (False, True):
    for train_bars, test_bars in [(365, 182), (730, 365), (1095, 365)]:
        splits = V.walk_forward(rolling.shape[1], train_bars, test_bars, anchored=anchored)
        picked = V.walk_forward_run(rolling, splits, names=PAIRS)
        stitched = V.stitch(rolling, splits, [PAIRS.index(p) for p in picked["选了谁"]])
        equity = RP.to_curve(pd.Series(stitched, index=pd.RangeIndex(len(stitched))))
        rows.append({"训练窗口": "锚定(越考越长)" if anchored else "滚动(固定长度)",
                     "训练根数": train_bars, "考卷根数": test_bars, "几段": len(splits),
                     "训练期夏普中位": picked["训练期夏普"].median() * np.sqrt(365),
                     "考卷夏普中位": picked["考卷夏普"].median() * np.sqrt(365),
                     "样本外年化": RP.annual_return(equity, 365),
                     "样本外最大回撤": RP.max_drawdown(equity)})
print(pd.DataFrame(rows).round(4).to_string(index=False))
splits = V.walk_forward(rolling.shape[1], 730, 365, anchored=False)
picked = V.walk_forward_run(rolling, splits, names=PAIRS)
picked["训练期夏普"] *= np.sqrt(365)
picked["考卷夏普"] *= np.sqrt(365)
print()
print(picked.round(4).to_string(index=False))
first_test = DATES[start:][splits[0][1].start]
tail = window(str(first_test.date()))
print(f"\n同一段({first_test.date()} 起)的对照:")
for label, pair in [("课程默认 (50,200)", (50, 200)), ("九年全样本最好的 (8,43)(这是作弊)", (8, 43)),
                    ("决策点那一组 (31,36)", (31, 36))]:
    piece = DAILY[WHERE[pair], tail]
    equity = RP.to_curve(pd.Series(piece, index=pd.RangeIndex(len(piece))))
    print(f"  {label:<34} 年化 {RP.annual_return(equity, 365):>8.2%}   "
          f"夏普 {RP.sharpe(equity.pct_change().dropna(), 365):.4f}")
print(f"  {'买入持有':<34} 年化 {RP.annual_return(close.loc[first_test:], 365):>8.2%}   "
      f"夏普 {RP.sharpe(close.loc[first_test:].pct_change().dropna(), 365):.4f}")
    训练窗口  训练根数  考卷根数  几段  训练期夏普中位  考卷夏普中位   样本外年化  样本外最大回撤
滚动(固定长度)   365   182  15   2.2397  0.1065 -0.0379  -0.7897
滚动(固定长度)   730   365   6   1.6923  0.2493  0.0875  -0.8473
滚动(固定长度)  1095   365   5   1.5992 -0.1388 -0.1634  -0.8042
锚定(越考越长)   365   182  15   1.2128 -0.0799  0.0547  -0.8909
锚定(越考越长)   730   365   6   1.1574  0.6620  0.1806  -0.8826
锚定(越考越长)  1095   365   5   1.0290  0.3004 -0.1398  -0.8826
**六种切法,训练期夏普中位在 1.03 到 2.24 之间,考卷夏普中位在 −0.14 到 0.66 之间。**没有一种切法能让考卷成绩接近训练成绩。
拆开看最主流的那一种(训练两年、考一年、往前滚):
 第几段      选了谁  训练期夏普    考卷夏普    考卷收益  训练根数  考卷根数
   1 (18, 20) 1.5455  2.6860  4.7503   730   365
   2 (16, 20) 2.4000 -1.0929 -0.7029   730   365
   3 (29, 30) 2.0341  0.5620  0.1685   730   365
   4 (31, 36) 1.7514  1.0642  0.4533   730   365
   5 (50, 56) 1.6333 -0.5748 -0.3615   730   365
   6 (44, 46) 1.5577 -0.0634 -0.1072   730   365
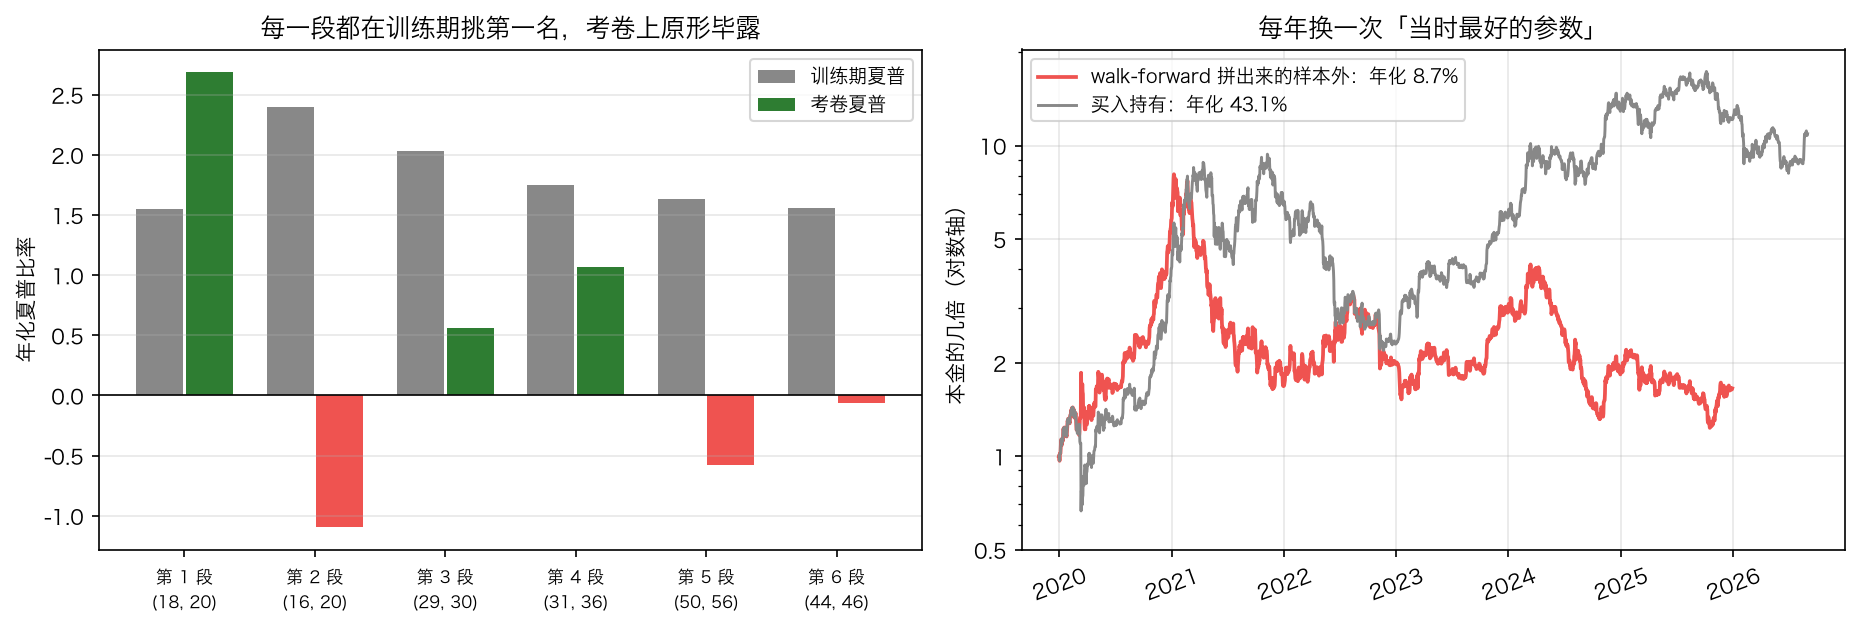
六段里,**每一段挑出来的都是训练期夏普 1.5 以上的「优等生」,考卷成绩从 +2.69 到 −1.09,三段亏钱。**第 2 段挑的 (16,20) 在训练期夏普 2.40,考卷上 −1.09,那一年亏掉 70.29%。
第 4 段挑到的恰好是决策点那一组 (31,36)——它在 2023 年确实赚了 45.33%。一组参数在某一年好,和它可靠,是两件事。
再看对照:
同一段(2020-01-01 起)的对照:
  课程默认 (50,200)                      年化   -5.65%   夏普 0.2123
  九年全样本最好的 (8,43)(这是作弊)              年化   43.01%   夏普 0.8905
  决策点那一组 (31,36)                     年化   42.76%   夏普 0.8865
  买入持有                               年化   43.10%   夏普 0.9015
- walk-forward 拼出来的样本外:年化 8.75%,最大回撤 −84.73%
- 买入持有:年化 43.10%
每年勤勤恳恳地重新挑一次「当时最好的参数」,六年下来跑输躺着不动 34 个百分点。
⚠️ 注意那一行「九年全样本最好的 (8,43)」:它年化 43.01%,和买入持有几乎一样。那还是作弊的成绩(用了 2026 年的数据去选 2020 年的参数)。也就是说:**在 BTC 上,均线交叉这件事本身——不管参数怎么选,甚至允许你偷看未来——都赢不了买入持有。**这个结论和参数无关,第 31 篇会正面处理它。
七、第四刀:蒙特卡洛
前面三刀都在问「这组参数行不行」。第四刀换一个问法:假如这个市场本来就没有任何规律,我在一万组里挑最好的一组,能挑出多好?
做法是造假数据:把 BTC 的日收益率重新抽一遍,拼成一条同分布、但没有原来那段走势的假价格,然后在假价格上重扫同样的 10,130 组。
warm = close.loc["2020-11-01":"2022-12-31"]          # 多留 250 根给均线预热
real_annual, real_sharpe = in_annual[best], in_sharpe[best]
rows = []
for block, label in [(1, "打散(连波动率聚集也没了)"), (20, "20 天的块(波动率聚集还在)")]:
    tops_annual, tops_sharpe = [], []
    for path in V.synthetic_close(warm, n=N_PATHS, block=block, seed=30):
        piece = grid_returns(path, PAIRS)[:, -730:]
        tops_annual.append(annual(piece).max())
        tops_sharpe.append(sharpe(piece).max())
    tops_annual, tops_sharpe = np.array(tops_annual), np.array(tops_sharpe)
    beaten = float((tops_annual >= real_annual).mean())
    rows.append({"假数据怎么造的": label, "「最好一组」年化中位": np.median(tops_annual),
                 "90% 分位": np.percentile(tops_annual, 90), "最大": tops_annual.max(),
                 "比真实还好的比例": beaten, "夏普中位": np.median(tops_sharpe),
                 "夏普比真实还好的比例": float((tops_sharpe >= real_sharpe).mean())})
print(f"真实数据上「最好的一组」:年化 {real_annual:.2%},夏普 {real_sharpe:.4f}")
monte_carlo = pd.DataFrame(rows)
print(monte_carlo.round(4).to_string(index=False))
真实数据上「最好的一组」:年化 173.74%,夏普 1.7463
        假数据怎么造的  「最好一组」年化中位  90% 分位     最大  比真实还好的比例   夏普中位  夏普比真实还好的比例
  打散(连波动率聚集也没了)      0.9359  2.0401 5.9279     0.185 1.2862       0.200
20 天的块(波动率聚集还在)      1.1552  2.6750 6.7283     0.270 1.4275       0.265
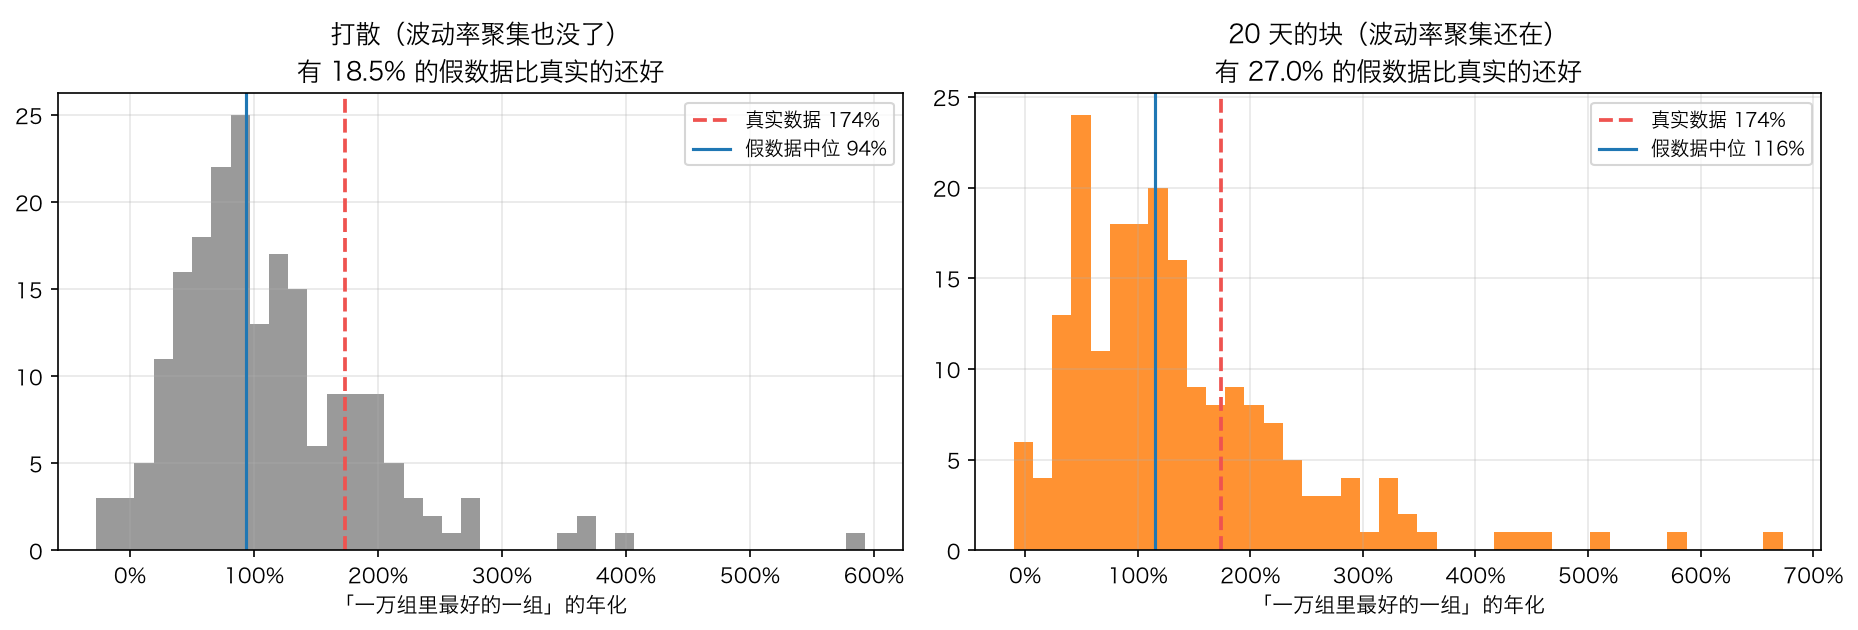
**在完全没有趋势的假数据上,「一万组里最好的一组」的年化中位数是 115.52%。**而真实数据给的是 173.74%——有 27.0% 的假数据比它还好。
换句话说:p ≈ 0.27。这个 173.74% 连「和噪声分得开」都谈不上。
这里还有一个方法上的细节值得记住:
| 假数据怎么造的 | 「最好一组」年化中位 | 比真实还好的比例 |
|---|---|---|
| 打散(把日收益率完全打乱,波动率聚集也没了) | 93.59% | 18.5% |
| 20 天的块(保留波动率聚集) | 115.52% | 27.0% |
**越像真市场的假数据,越容易「挑出」好成绩。**打散会把波动率聚集一起破坏掉,于是对照组变弱、白捡的部分被低估。第 28 篇用的是打散,那是个偏保守的对照——做这类检验,块自助法才是该用的那个。
八、第五刀:多重检验
蒙特卡洛需要把一万组在假数据上重跑两百次。有没有不用重跑的办法?有,而且只要一个数:你试了多少次。
完全没本事时,试 N 次,「最好的那次」夏普的期望 ≈ 标准差 × [(1 − γ)·Φ⁻¹(1 − 1/N) + γ·Φ⁻¹(1 − 1/(N·e))]
γ 是欧拉常数 0.5772,Φ⁻¹ 是标准正态的分位数函数,标准差是这一万次试验的夏普比率彼此之间的标准差。这是 Bailey 和 López de Prado 的写法,talab.validate 里叫 expected_max_sharpe。
print(f"{len(PAIRS):,} 组参数的夏普比率:中位 {np.median(in_sharpe):.4f},"
      f"标准差 {in_sharpe.std():.4f},最大 {in_sharpe.max():.4f}")
print(f"完全没本事时,试 {len(PAIRS):,} 次「最好的那次」期望是 "
      f"{V.expected_max_sharpe(len(PAIRS), in_sharpe.std()):.4f}")
rows = [V.deflated_sharpe(real_sharpe, n, train.shape[1], in_sharpe.std(),
                          skew=float(pd.Series(train[best]).skew()),
                          kurtosis=float(pd.Series(train[best]).kurt()) + 3,
                          periods_per_year=365).rename(f"试了 {n:,} 次")
        for n in [2, 100, 1000, len(PAIRS)]]
print(pd.concat(rows, axis=1).round(4).to_string())
10,130 组参数的夏普比率:中位 0.5357,标准差 0.2829,最大 1.7463
完全没本事时,试 10,130 次「最好的那次」期望是 1.0931
            试了 2 次  试了 100 次  试了 1,000 次  试了 10,130 次
年化夏普        1.7463    1.7463      1.7463       1.7463
试验次数        2.0000  100.0000   1000.0000   10130.0000
白捡的门槛(年化)   0.1470    0.7159      0.9209       1.0931
超过门槛多少      1.5992    1.0303      0.8254       0.6532
t 值         2.2922    1.4768      1.1830       0.9362
打过折的夏普 DSR  0.9891    0.9301      0.8816       0.8254
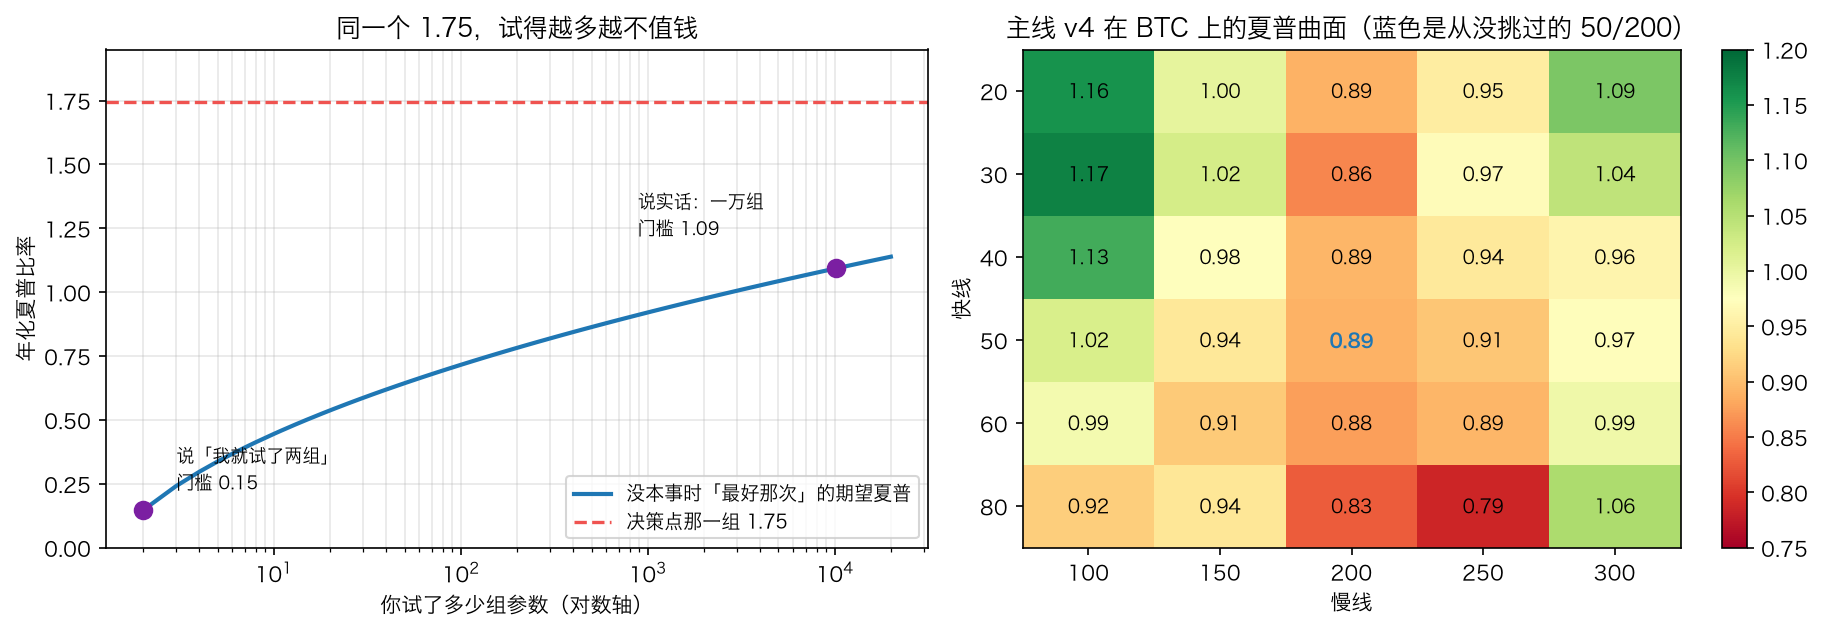
**一万零一百三十组参数的夏普彼此之间标准差 0.2829,所以「完全没本事时最好的那次」期望就有 1.0931。**而这条策略是 1.7463——它只比「白捡的」高出 0.65。
再往下一行是打过折的夏普比率(DSR):把「试了很多次」和「收益率不是正态」都扣掉之后,这条策略的夏普真的大于 0 的概率。
| 你说你试了几次 | 2 | 100 | 1,000 | 10,130 |
|---|---|---|---|---|
| 白捡的门槛(年化夏普) | 0.1470 | 0.7159 | 0.9209 | 1.0931 |
| 打过折的夏普 DSR | 0.9891 | 0.9301 | 0.8816 | 0.8254 |
**同一条曲线、同一个 1.7463。**你说你只试了两组,DSR 是 0.9891,过关;你说实话试了一万组,DSR 是 0.8254,不过关。
数字一个字没变,结论相反——差别只在于你报不报试验次数。这就是为什么「我试了一万组参数」这句话必须和「最好的那组夏普 1.75」一起说出来。
⚠️ 两个诚实的限制:
- 这一万组不是一万次独立试验。(31,36) 和 (31,37) 高度相关,等效的独立次数远小于一万。好在公式里的「标准差」用的是这批试验彼此之间的散布,相关性高的时候它自己会变小,所以这个偏差是部分自我修正的——但只是部分。
n_trials要报你真正试过的次数,包括你试完觉得不行、连结果都没保存的那些。这一项没人能替你查。
九、第六刀:回测过拟合概率
前面五刀评的都是「这一组参数」。最后一刀评的是另一样东西:「挑第一名」这个动作本身。
做法(Bailey 等人的 CSCV):把时间切成若干块,穷举所有「一半当样本内、一半当样本外」的分法;每一种分法里选出样本内夏普最高的那一列,看它在样本外排第几。如果这个第一名经常掉到中位数以下,说明挑第一名就是在挑噪声。
PBO = 样本内第一名在样本外掉到中位数以下的分法比例
rows = [V.pbo(train, chunks).rename(f"切成 {chunks} 块") for chunks in (8, 12, 16)]
print(pd.concat(rows, axis=1).round(4).to_string())
               切成 8 块     切成 12 块     切成 16 块
试验次数       10130.0000  10130.0000  10130.0000
切成几块           8.0000     12.0000     16.0000
一共几种分法        70.0000    924.0000  12870.0000
样本外分位中位数       0.3222      0.4332      0.5209
过拟合概率 PBO      0.6143      0.5357      0.4886
logit 中位数     -0.7444     -0.2687      0.0838
切成 16 块(12,870 种分法)时,PBO = 0.4886。
翻译成人话:在这个网格上,「用样本内最好去挑参数」和抛硬币的效果一样。
⚠️ 八块、十二块、十六块给出的是 0.6143、0.5357、0.4886——PBO 对块数是敏感的,别拿一个数当铁证。块少的时候每一块太长、分法太少(8 块只有 70 种),块多的时候每一块太短、夏普估得不准。16 块是原文的建议,也是一个折中。
十、动手:talab.validate
六把刀对应六组函数。先看整个模块要干的事:
"""talab.validate:过拟合与样本外检验。第 30 篇。

第 27 篇保证引擎对、第 28 篇保证数据干净、第 29 篇保证读数不被自己骗。
这个模块回答最后一个也是最难的问题:**这条策略是学会了,还是把答案背下来了。**

难在哪里:**样本内的成绩永远可以做到任意好。**参数多试几组、规则多加几条,
回测收益一定上升——上升本身不携带任何信息。所以这里的每一个函数都不是在「算成绩」,
而是在**给成绩打折**:

1. **参数曲面**(`surface`、`neighbourhood`、`plateaus`):这一格好,是因为它周围一片都好,
   还是因为它自己恰好踩中了?后者叫尖峰,它在样本外几乎必然塌。
2. **切分**(`split_index`、`walk_forward`、`walk_forward_run`):拿一段没看过的数据当考卷。
3. **多重检验**(`expected_max_sharpe`、`deflated_sharpe`):你试了一万次,
   「最好的那次」本来就该很好看——先把这个白捡的部分减掉。
4. **回测过拟合概率**(`pbo`):把时间切成块,反复交换样本内外,
   数一数「样本内第一名在样本外落到中位数以下」的比例。
"""
from __future__ import annotations

import itertools
import math
from statistics import NormalDist

import numpy as np
import pandas as pd

NORMAL = NormalDist()
EULER = 0.5772156649015329                       # 欧拉常数,`expected_max_sharpe` 要用
参数曲面
def surface(table: pd.DataFrame, index: str, columns: str, values: str) -> pd.DataFrame:
    """把「一行一组参数」的长表摊成二维曲面,行列都是参数值。

    摊成二维之后才能问「这一格的邻居怎么样」——而那正是这一篇的核心问题。
    """
    return table.pivot(index=index, columns=columns, values=values).sort_index().sort_index(axis=1)


def neighbourhood(grid: pd.DataFrame, cell: tuple, radius: int = 1) -> pd.Series:
    """一格和它周围一圈的成绩:本格、邻居的中位数 / 最差 / 最好,以及落差。

    `落差` = 本格 − 邻居中位数。它是这一篇最省事的过拟合警报:
    **落差越大,说明这一格越像是踩中的,而不是踩在一片实地上。**

    ⚠️ 邻居按**网格上的位置**算,不按参数值相差多少。参数网格常常不是等距的
    (5、10、20、40、60 这种),这时候「走错一步」的正确含义是「换成表里相邻的那个值」,
    不是「加一减一」。
    """
    row, column = cell
    i, j = grid.index.get_loc(row), grid.columns.get_loc(column)
    block = grid.iloc[max(i - radius, 0):i + radius + 1, max(j - radius, 0):j + radius + 1]
    here = float(grid.iloc[i, j])
    others = block.to_numpy(float).ravel()
    others = np.delete(others, list(block.index).index(row) * block.shape[1]
                       + list(block.columns).index(column))
    others = others[~np.isnan(others)]
    if not len(others):
        raise ValueError("这一格周围没有有效的邻居")
    return pd.Series({"这一格": here, "邻居数": float(len(others)),
                      "邻居中位": float(np.median(others)), "邻居最差": float(others.min()),
                      "邻居最好": float(others.max()), "落差": here - float(np.median(others))})


def plateaus(grid: pd.DataFrame, radius: int = 1) -> pd.DataFrame:
    """给每一格配上它邻域的中位数,按**邻域中位数**从高到低排序。

    这是「不挑尖峰」的选参数方法:不要问「哪一格最高」,要问
    **「哪一片地最高」**——站在一片高地上,走错一步还在高地上。
    """
    rows = []
    for row in grid.index:
        for column in grid.columns:
            if np.isnan(grid.loc[row, column]):
                continue
            stats = neighbourhood(grid, (row, column), radius)
            rows.append({grid.index.name or "行": row, grid.columns.name or "列": column,
                         "这一格": stats["这一格"], "邻域中位": stats["邻居中位"],
                         "落差": stats["落差"]})
    return pd.DataFrame(rows).sort_values("邻域中位", ascending=False).reset_index(drop=True)
⚠️ neighbourhood 里那条注释是踩过的坑:第一版按「参数值相差不超过 radius」找邻居,在均线网格(5、10、20、40、60 这种不等距的表)上一个邻居都找不到,因为 10 和 20 的差是 10。「走错一步」的正确含义是「换成表里相邻的那个值」,所以要按位置算。
切分与 walk-forward
def split_index(n: int, fraction: float = 0.5) -> tuple[slice, slice]:
    """把 n 根 K 线按时间顺序切成前后两段:前面选参数,后面当考卷。

    ⚠️ 只能按**时间顺序**切。随机抽一半当样本外是错的——
    相邻两天的行情高度相关,随机抽等于让考卷和复习资料互相抄。
    """
    if not 0 < fraction < 1:
        raise ValueError("fraction 要在 0 和 1 之间")
    cut = int(n * fraction)
    if cut < 1 or cut >= n:
        raise ValueError("切出来的两段都要至少有一根")
    return slice(0, cut), slice(cut, n)


def walk_forward(n: int, train: int, test: int, anchored: bool = False) -> list[tuple[slice, slice]]:
    """滚动检验的切分:每一段用前 `train` 根挑参数,紧接着的 `test` 根拿来考试。

    - `anchored=False`(默认):训练窗口长度固定,整段往前滚
    - `anchored=True`:训练窗口从第一根开始,越考越长(更像真实的积累过程)

    各段的考卷首尾相接、互不重叠,把它们拼起来就是一条**每一根都没被看过**的资金曲线。
    """
    if train < 1 or test < 1:
        raise ValueError("train 和 test 都要至少是 1")
    out, start = [], 0
    while start + train + test <= n:
        out.append((slice(0 if anchored else start, start + train),
                    slice(start + train, start + train + test)))
        start += test
    if not out:
        raise ValueError(f"{n} 根放不下一次 {train}+{test} 的切分")
    return out


def walk_forward_run(returns: np.ndarray, splits, names=None, min_bars: int = 2) -> pd.DataFrame:
    """在每一段上选出训练期里夏普最高的那一列,记下它在考卷上的表现。

    `returns` 是 `(试验数, 根数)` 的每根收益矩阵——一行一组参数。
    返回一张表:每一段选了谁、训练期分数、考卷分数,以及**这一段的考卷收益**。
    """
    rows = []
    for k, (train, test) in enumerate(splits):
        inside, outside = returns[:, train], returns[:, test]
        if inside.shape[1] < min_bars or outside.shape[1] < min_bars:
            raise ValueError("某一段太短,算不出标准差")
        score = inside.mean(axis=1) / np.where(inside.std(axis=1) > 0, inside.std(axis=1), np.nan)
        pick = int(np.nanargmax(score))
        rows.append({"第几段": k + 1, "选了谁": names[pick] if names is not None else pick,
                     "训练期夏普": float(score[pick]),
                     "考卷夏普": float(outside[pick].mean() / outside[pick].std()),
                     "考卷收益": float(np.prod(1 + outside[pick]) - 1),
                     "训练根数": inside.shape[1], "考卷根数": outside.shape[1]})
    return pd.DataFrame(rows)


def stitch(returns: np.ndarray, splits, picks) -> np.ndarray:
    """把各段考卷上被选中那一列的收益首尾接起来,得到一条完整的样本外收益序列。"""
    return np.concatenate([returns[int(p), test] for (_, test), p in zip(splits, picks)])
walk_forward_run 的输入是一个 (试验数, 根数) 的矩阵——一行一组参数的每根收益。一万次回测不用跑一万遍,这一篇的扫描器就是这么写的:
def sma_matrix(values: np.ndarray, windows) -> np.ndarray:
    """一次算出所有窗口长度的简单移动平均,返回 `(窗口个数, 根数)`。"""
    cumulative = np.concatenate([[0.0], np.cumsum(values)])
    out = np.full((len(windows), len(values)), np.nan)
    for k, n in enumerate(windows):
        out[k, n - 1:] = (cumulative[n:] - cumulative[:-n]) / n
    return out
均线只有 277 种(5 到 50 加 20 到 250),先全算出来,剩下的一万次只是比大小。全部 10,130 组在九年日线上跑完要 0.1 秒。
多重检验与 PBO
def expected_max_sharpe(n_trials: int, sharpe_std: float) -> float:
    """**完全没有本事**的情况下,试 `n_trials` 次,「最好的那次」夏普期望是多少
    (Bailey & López de Prado 2014):

    > E[最大值] ≈ 标准差 × [(1 − γ)·Φ⁻¹(1 − 1/N) + γ·Φ⁻¹(1 − 1/(N·e))]

    γ 是欧拉常数 0.5772。`sharpe_std` 是这一万次试验的夏普比率**彼此之间**的标准差。
    直觉:N 越大,最大值越往右跑——**「我试了一万组,最好的那组夏普 1.5」这句话里,
    「一万组」和「1.5」一样重要。**
    """
    if n_trials < 2:
        raise ValueError("至少要有两次试验")
    high = NORMAL.inv_cdf(1 - 1 / n_trials)
    low = NORMAL.inv_cdf(1 - 1 / (n_trials * math.e))
    return sharpe_std * ((1 - EULER) * high + EULER * low)


def deflated_sharpe(sharpe: float, n_trials: int, n_obs: int, sharpe_std: float,
                    skew: float = 0.0, kurtosis: float = 3.0,
                    periods_per_year: int = 252) -> pd.Series:
    """打过折的夏普比率(DSR):把「试了很多次」和「收益率不是正态」都扣掉之后,
    这条策略的夏普**真的大于 0** 的概率。

    两步:先用 `expected_max_sharpe` 算出「没本事时白捡的那一截」当作门槛,
    再问「观察到的夏普超过这个门槛」有多显著:

    > DSR = Φ( (夏普 − 门槛) × √(根数 − 1) ÷ √(1 − 偏度×夏普 + (峰度−1)/4 × 夏普²) )

    式子里的夏普都是**单根**的(不年化)。`kurtosis` 传的是原始峰度(正态是 3),
    不是超额峰度。DSR 低于 0.95 就该当成「还没排除运气」。
    """
    per_period = sharpe / math.sqrt(periods_per_year)
    threshold = expected_max_sharpe(n_trials, sharpe_std / math.sqrt(periods_per_year))
    spread = math.sqrt(max(1 - skew * per_period + (kurtosis - 1) / 4 * per_period ** 2, 1e-12))
    z = (per_period - threshold) * math.sqrt(max(n_obs - 1, 1)) / spread
    return pd.Series({"年化夏普": sharpe, "试验次数": float(n_trials),
                      "白捡的门槛(年化)": threshold * math.sqrt(periods_per_year),
                      "超过门槛多少": sharpe - threshold * math.sqrt(periods_per_year),
                      "t 值": z, "打过折的夏普 DSR": NORMAL.cdf(z)})


# ---------------------------------------------------------------------------
# 四、回测过拟合概率(CSCV)
# ---------------------------------------------------------------------------

def pbo(returns: np.ndarray, n_chunks: int = 8) -> pd.Series:
    """回测过拟合概率(Bailey 等 2017 的 CSCV)。

    做法:把时间切成 `n_chunks` 块,穷举所有「一半当样本内、另一半当样本外」的分法;
    每一种分法里选出样本内夏普最高的那一列,看它**在样本外排第几**。
    如果这个第一名在样本外经常掉到中位数以下,说明「挑第一名」这个动作本身就是在挑噪声。

    > PBO = 样本内第一名在样本外掉到中位数以下的分法比例

    ⚠️ 它衡量的是**挑选流程**,不是某一组参数。PBO 高不代表这些参数都没用,
    代表「用样本内最优去选参数」这件事在这批数据上不管用。
    n_chunks 要是偶数;16 块有 12,870 种分法,8 块只有 70 种,慢和稳之间自己选。
    """
    if n_chunks % 2 or n_chunks < 4:
        raise ValueError("n_chunks 要是不小于 4 的偶数")
    n_trials, n_bars = returns.shape
    if n_trials < 2:
        raise ValueError("至少要有两列试验")
    edges = np.linspace(0, n_bars, n_chunks + 1).astype(int)
    counts = np.diff(edges).astype(float)
    total = np.array([returns[:, edges[i]:edges[i + 1]].sum(axis=1) for i in range(n_chunks)])
    square = np.array([(returns[:, edges[i]:edges[i + 1]] ** 2).sum(axis=1) for i in range(n_chunks)])

    def score(keys) -> np.ndarray:                 # 任意几块合起来的夏普,O(试验数)
        n = counts[list(keys)].sum()
        mean = total[list(keys)].sum(axis=0) / n
        var = square[list(keys)].sum(axis=0) / n - mean ** 2
        return mean / np.sqrt(np.maximum(var, 1e-300))

    logits, ranks = [], []
    everything = range(n_chunks)
    for inside in itertools.combinations(everything, n_chunks // 2):
        outside = tuple(k for k in everything if k not in inside)
        best = int(np.argmax(score(inside)))
        outside_score = score(outside)
        rank = int((outside_score < outside_score[best]).sum()) + 1      # 1 最差,n_trials 最好
        omega = rank / (n_trials + 1)
        ranks.append(omega)
        logits.append(math.log(omega / (1 - omega)))
    logits = np.array(logits)
    return pd.Series({"试验次数": float(n_trials), "切成几块": float(n_chunks),
                      "一共几种分法": float(len(logits)),
                      "样本外分位中位数": float(np.median(ranks)),
                      "过拟合概率 PBO": float((logits <= 0).mean()),
                      "logit 中位数": float(np.median(logits))})
蒙特卡洛
def synthetic_close(close: pd.Series, n: int = 100, block: int = 1, seed: int = 0) -> np.ndarray:
    """造 n 条「和原序列同分布、但没有原来那段走势」的假价格,返回 `(n, 根数)`。

    `block=1` 是把日收益率完全打散(波动率聚集也一起没了);
    `block > 1` 用块自助法,保留每一小段内部的顺序,**波动率聚集还在,趋势没了**。
    拿这些假价格重跑一遍同样的参数扫描,就知道「最好的一组」里有多少是白捡的。
    """
    values = close.pct_change().dropna().to_numpy(float)
    m = len(values)
    if block < 1 or block > m:
        raise ValueError("block 要在 1 和样本长度之间")
    rng = np.random.default_rng(seed)
    out = np.empty((n, m + 1))
    for i in range(n):
        if block == 1:
            sample = rng.choice(values, size=m, replace=True)
        else:
            starts = rng.integers(0, m - block + 1, size=int(np.ceil(m / block)))
            sample = np.concatenate([values[s:s + block] for s in starts])[:m]
        out[i] = float(close.iloc[0]) * np.concatenate([[1.0], np.cumprod(1 + sample)])
    return out
测试
十五个测试里最该看的是这一条——公式算出来的「白捡的最大值」要对得上真的抽一万次:
def test_expected_max_sharpe_matches_a_simulation():
    """这是整个模块最该钉住的一条:公式算出来的「白捡的最大值」要对得上真的抽一万次。"""
    rng = np.random.default_rng(30)
    for n_trials in (50, 1000, 10_000):
        draws = rng.normal(0.0, 0.3, size=(400, n_trials)).max(axis=1)
        assert V.expected_max_sharpe(n_trials, 0.3) == pytest.approx(draws.mean(), rel=0.05)
还有这两条,它们钉住了 PBO 的两头:
def test_pbo_is_a_coin_flip_on_pure_noise():
    """一堆互相没区别的随机策略,样本内第一名在样本外就是随机的——PBO 该在 0.5 附近。"""
    returns = np.random.default_rng(1).normal(0.0, 0.01, (100, 800))
    out = V.pbo(returns, 8)
    assert out["一共几种分法"] == 70
    assert out["过拟合概率 PBO"] == pytest.approx(0.5, abs=0.2)


def test_pbo_is_near_zero_when_one_strategy_is_genuinely_better():
    returns = np.random.default_rng(2).normal(0.0, 0.01, (40, 800))
    returns[7] += 0.01                                      # 第 7 列全程真的更好
    out = V.pbo(returns, 8)
    assert out["过拟合概率 PBO"] < 0.05
    assert out["样本外分位中位数"] > 0.9
    with pytest.raises(ValueError):
        V.pbo(returns, 7)                                   # 块数要是偶数
十一、揭晓:六刀砍完,还剩什么
verdict = pd.DataFrame([
    {"检查": "① 邻居(落差 ÷ 年化)", "这条策略": f"{V.neighbourhood(grid, PAIRS[best])['落差'] / real_annual:.1%}",
     "该是多少": "越接近 0 越好", "过了吗": "否"},
    {"检查": "② 样本外年化", "这条策略": f"{out_annual[best]:.2%}",
     "该是多少": f"网格中位 {np.median(out_annual):.2%}", "过了吗": "否"},
    {"检查": "③ walk-forward 考卷夏普中位", "这条策略": f"{picked['考卷夏普'].median():.4f}",
     "该是多少": f"训练期是 {picked['训练期夏普'].median():.4f}", "过了吗": "否"},
    {"检查": "④ 蒙特卡洛:没有趋势的假数据也能做到",
     "这条策略": f"{monte_carlo['比真实还好的比例'].max():.1%}", "该是多少": "低于 5%", "过了吗": "否"},
    {"检查": "⑤ 多重检验:白捡的门槛(年化夏普)",
     "这条策略": f"{real_sharpe:.4f}", "该是多少": f"门槛 {V.expected_max_sharpe(len(PAIRS), in_sharpe.std()):.4f}",
     "过了吗": "勉强"},
    {"检查": "⑥ 回测过拟合概率 PBO", "这条策略": f"{V.pbo(train, 16)['过拟合概率 PBO']:.4f}",
     "该是多少": "低于 0.5 才有意义", "过了吗": "否"},
])
print(verdict.to_string(index=False))
                   检查   这条策略        该是多少 过了吗
        ① 邻居(落差 ÷ 年化)  63.8%    越接近 0 越好   否
              ② 样本外年化 -7.66% 网格中位 -2.11%   否
③ walk-forward 考卷夏普中位 0.2493 训练期是 1.6923   否
  ④ 蒙特卡洛:没有趋势的假数据也能做到  27.0%       低于 5%   否
   ⑤ 多重检验:白捡的门槛(年化夏普) 1.7463   门槛 1.0931  勉强
        ⑥ 回测过拟合概率 PBO 0.4886 低于 0.5 才有意义   否
| 检查 | 这条策略 | 该是多少 | 过了吗 |
|---|---|---|---|
| ① 邻居:落差 ÷ 年化 | 63.8% | 越接近 0 越好 | ❌ |
| ② 样本外年化 | −7.66% | 网格中位 −2.11% | ❌ |
| ③ walk-forward 考卷夏普 | 0.2493 | 训练期是 1.6923 | ❌ |
| ④ 蒙特卡洛:没有趋势的假数据也能做到 | 27.0% | 低于 5% | ❌ |
| ⑤ 多重检验:白捡的门槛 | 夏普 1.7463 | 门槛 1.0931 | ⚠️ 勉强 |
| ⑥ 回测过拟合概率 PBO | 0.4886 | 低于 0.5 才有意义 | ❌ |
年化 173.74%、夏普 1.75、两年 7.5 倍,六刀砍完什么都没剩下。
那它两年里真的赚到的那 6.5 倍是假的吗?不是——那两年里,如果你真的按 (31,36) 交易,你真的会赚到那么多。问题不在过去,在于这个数对未来没有任何预测力:样本外 −7.66%,和网格中位数 −2.11% 相比还更差。
这两句话的区别,就是这一篇全部的内容。
十二、主线策略 v4 走一遍
现在用同一把尺子量一量主线策略。它有四个参数:快线 50、慢线 200、突破窗口 20 日新高、吊灯止损 3 ATR。
⚠️ 先说一件对这一节至关重要的事:**这四个数从来没有被挑过。**50/200 是第 12 篇按机制选的(最常被引用的一对),20 日新高是第 21 篇为了咬住止损加的,3 ATR 是第 15 篇的默认值。这一节是第一次把它们放进网格里看。
spy = D.load_nasdaq_daily("data/nasdaq/SPY_historical.json").drop(pd.Timestamp("2026-04-20"))
aapl = D.adjust_total_return(D.unadjust_splits(D.load_nasdaq_daily("data/nasdaq/AAPL_historical.json"),
                                               D.SPLITS["AAPL"]), D.SPLITS["AAPL"],
                             D.load_nasdaq_dividends("data/nasdaq/AAPL_dividends.json"))
MAIN = [(f, s, b, k) for f in [20, 30, 40, 50, 60, 80] for s in [100, 150, 200, 250, 300]
        for b in [5, 10, 20, 40, 60] for k in [2.0, 2.5, 3.0, 3.5, 4.0]]
DEFAULT = (50, 200, 20, 3.0)
print(f"主线网格 {len(MAIN)} 组(快线 × 慢线 × 突破窗口 × 吊灯倍数),默认那一组是 {DEFAULT}")
rows, surfaces = [], {}
for name, frame, periods in [("SPY", spy, 252), ("AAPL", aapl, 252), ("BTC", btc, 365)]:
    price = frame["close"]
    curves = []
    for fast, slow, breakout, k in MAIN:
        plan = BT.Plan(entry=((I.sma(price, fast) > I.sma(price, slow))
                              & (price >= price.rolling(breakout).max())).fillna(False),
                       exit=I.cross_below(I.sma(price, fast), I.sma(price, slow)).fillna(False),
                       stop="chandelier", k=k, trigger="close", sizing="risk", risk_per_trade=0.10)
        curves.append(BT.run(frame, plan, 100_000.0)["资金曲线"].pct_change().fillna(0).to_numpy())
    matrix = np.array(curves)
    scores = sharpe(matrix, periods)
    here = MAIN.index(DEFAULT)
    slice_table = pd.DataFrame([{"快线": f, "慢线": s, "夏普": scores[k]}
                                for k, (f, s, b, kk) in enumerate(MAIN)
                                if (b, kk) == (DEFAULT[2], DEFAULT[3])])
    face = V.surface(slice_table, "快线", "慢线", "夏普")
    surfaces[name] = face
    around = V.neighbourhood(face, (DEFAULT[0], DEFAULT[1]))
    rows.append({"标的": name, "默认那一组的夏普": scores[here],
                 "排第几": f"{int((scores > scores[here]).sum()) + 1}/{len(MAIN)}",
                 "邻居中位": around["邻居中位"], "落差": around["落差"],
                 "网格最好": scores.max(), "白捡的门槛": V.expected_max_sharpe(len(MAIN), scores.std()),
                 "最好的 DSR": V.deflated_sharpe(scores.max(), len(MAIN), matrix.shape[1],
                                               scores.std(), periods_per_year=periods)["打过折的夏普 DSR"],
                 "PBO": V.pbo(matrix, 16)["过拟合概率 PBO"]})
print(pd.DataFrame(rows).round(4).to_string(index=False))
主线网格 750 组(快线 × 慢线 × 突破窗口 × 吊灯倍数),默认那一组是 (50, 200, 20, 3.0)
  标的  默认那一组的夏普     排第几   邻居中位      落差   网格最好  白捡的门槛  最好的 DSR    PBO
 SPY    0.4261 518/750 0.4534 -0.0273 0.8275 0.4834   0.8604 0.7476
AAPL    0.7011 416/750 0.6089  0.0922 1.1732 0.5979   0.9647 0.4324
 BTC    0.8903 282/750 0.9088 -0.0186 1.1908 0.5977   0.9623 0.5211
| 标的 | 默认那一组的夏普 | 排第几 | 邻居中位 | 落差 | 网格最好 | 白捡的门槛 | 最好的 DSR | PBO |
|---|---|---|---|---|---|---|---|---|
| SPY | 0.4261 | 518/750 | 0.4534 | −0.0273 | 0.8275 | 0.4834 | 0.8604 | 0.7476 |
| AAPL | 0.7011 | 416/750 | 0.6089 | +0.0922 | 1.1732 | 0.5979 | 0.9647 | 0.4324 |
| BTC | 0.8903 | 282/750 | 0.9088 | −0.0186 | 1.1908 | 0.5977 | 0.9623 | 0.5211 |
四件事:
**一,默认那一组在三个标的上分别排 518、416、282——全在中游甚至中下游。**这正是「没挑过」该有的样子。如果它排第一,那才该怀疑。
**二,落差是 −0.027、+0.092、−0.019,基本是 0。**对比一下决策点那一组的 1.1092。它站在平地上,不是站在针尖上。
BTC 上固定「突破 20 日新高、吊灯 3 ATR」时的夏普曲面(行是快线,列是慢线):
慢线    100    150    200    250    300
快线
20  1.159  1.004  0.890  0.950  1.094
30  1.174  1.023  0.858  0.970  1.043
40  1.131  0.976  0.894  0.944  0.960
50  1.020  0.943  0.890  0.908  0.973
60  0.988  0.910  0.875  0.894  0.993
80  0.915  0.940  0.828  0.787  1.058
整张曲面在 0.79 到 1.17 之间,没有哪一格特别突出。
**三,如果当初挑了,能挑到多少?**BTC 上最好的一组夏普 1.1908,比默认的 0.8903 高出三分之一。它的 DSR 是 0.9623,勉强过 0.95 那条线。
**但同一张表的最后一列说:BTC 的 PBO 是 0.5211。**这两个数不矛盾,它们回答的是两个问题——DSR 问「这个夏普本身能不能排除运气」,PBO 问「用样本内最优去挑参数这个流程可不可靠」。前者勉强过关,后者是抛硬币。
四,SPY 上的情况最难看:网格最好只有 0.8275,白捡的门槛就有 0.4834,DSR 0.8604 不过关,PBO 0.7476——**在 SPY 上,这个策略族里挑出来的任何东西都不该被相信。**这和第 29 篇的结论对得上(SPY 上要跑 380 年)。
**主线 v4 这一篇一个字不改。**这一节查的是「挑参数挑过头了没有」,而它从来没挑过,所以查不出病。它的病在第 29 篇:证据不够。
十三、实验三:找出问题
现在角色对调。假设有人把下面这条策略交给你:
FAST3 = [10, 20, 30, 40, 50, 60, 80, 100]
SLOW3 = [100, 120, 150, 180, 200, 220, 250, 300]
COMBOS = [(f, s, h, l) for f in FAST3 for s in SLOW3 if s > f
          for h in [10, 20, 40, 60, 90] for l in [10, 20, 40, 60, 90]]
values = close.to_numpy()
averages = {n: close.rolling(n).mean().to_numpy() for n in set(FAST3) | set(SLOW3)}
highs = {n: close.rolling(n).max().to_numpy() for n in [10, 20, 40, 60, 90]}
lows = {n: close.rolling(n).min().to_numpy() for n in [10, 20, 40, 60, 90]}
step = np.diff(values) / values[:-1]
EXP3 = np.empty((len(COMBOS), len(step)))
for k, (fast, slow, high, low) in enumerate(COMBOS):
    state = np.full(len(values), np.nan)
    state[values >= highs[high]] = 1.0                 # 创新高就进
    state[values <= lows[low]] = 0.0                   # 破新低就走
    holding = pd.Series(state).ffill().fillna(0.0).to_numpy() * (averages[fast] > averages[slow])
    holding[np.isnan(averages[fast]) | np.isnan(averages[slow])] = 0.0
    EXP3[k] = holding[:-1] * step
LOW3, HIGH3 = "2018-01-01", "2021-12-31"
inside3, outside3 = window(LOW3, HIGH3), window("2022-01-01")
train3, test3 = EXP3[:, inside3], EXP3[:, outside3]
scores3, annual3, out3 = sharpe(train3), annual(train3), annual(test3)
pick = int(scores3.argmax())
curve3 = RP.to_curve(pd.Series(train3[pick], index=close.index[1:][inside3]))
print("「我做了一条 BTC 日线策略:快线在慢线上方(大方向向上)、收盘创 N 日新高就买入,")
print(f"  跌破 M 日新低就卖出。四个参数在 {len(COMBOS):,} 组里选夏普最高的一组 = {COMBOS[pick]},")
print(f"  {LOW3} 到 {HIGH3} 的成绩是这样,你看有没有问题?」")
print(RP.metrics(curve3, 365).drop(["起", "止"]).round(4).to_string())
print(f"\n同期买入持有:年化 {RP.annual_return(close.loc[LOW3:HIGH3], 365):.2%}、"
      f"夏普 {RP.sharpe(close.loc[LOW3:HIGH3].pct_change().dropna(), 365):.4f}、"
      f"最大回撤 {RP.max_drawdown(close.loc[LOW3:HIGH3]):.2%}")
「我做了一条 BTC 日线策略:快线在慢线上方(大方向向上)、收盘创 N 日新高就买入,
  跌破 M 日新低就卖出。四个参数在 1,575 组里选夏普最高的一组 = (30, 120, 40, 20),
  2018-01-01 到 2021-12-31 的成绩是这样,你看有没有问题?」
根数        1462.0
累计收益      9.5645
年化收益      0.8021
年化波动       0.399
夏普比率      1.6744
索提诺比率     2.7632
最大回撤     -0.2655
卡玛比率      3.0211
在水下的比例    0.6436
最长水下根数     400.0
最好的一根      0.172
最差的一根    -0.1347

同期买入持有:年化 36.33%、夏普 0.7963、最大回撤 -81.18%
年化 80.21%、夏普 1.6744、最大回撤只有 −26.55%、期末 10.56 倍,而同期买入持有是年化 36.33%、夏普 0.7963、回撤 −81.18%。
在往下看之前,先自己列一张单子:你会查什么?
查完的结果
holding3 = (train3[pick] != 0).astype(int)
edges = np.diff(np.concatenate([[0], holding3]))
opens, closes = np.where(edges == 1)[0], np.where(edges == -1)[0]
if len(closes) < len(opens):
    closes = np.append(closes, len(holding3))
path = curve3.to_numpy()
trades = pd.Series([path[b] / path[a] - 1 for a, b in zip(opens, closes)])
slice3 = pd.DataFrame([{"快线": f, "慢线": s, "夏普": scores3[k]} for k, (f, s, h, l) in enumerate(COMBOS)
                       if (h, l) == (COMBOS[pick][2], COMBOS[pick][3])])
face3 = V.surface(slice3, "快线", "慢线", "夏普")
checks = pd.DataFrame([
    {"查什么": "第 27 篇:最大回撤是不是 0", "结果": f"{RP.max_drawdown(curve3):.2%}", "判定": "过"},
    {"查什么": "第 27 篇:持仓日上涨的比例",
     "结果": f"{float((train3[pick][train3[pick] != 0] > 0).mean()):.2%}", "判定": "过"},
    {"查什么": "① 参数曲面的落差",
     "结果": f"{V.neighbourhood(face3, COMBOS[pick][:2])['落差']:.4f}(邻居中位 "
             f"{V.neighbourhood(face3, COMBOS[pick][:2])['邻居中位']:.4f})", "判定": "过(是平原)"},
    {"查什么": "② 多重检验:白捡的门槛",
     "结果": f"夏普 {scores3[pick]:.4f} vs 门槛 "
             f"{V.expected_max_sharpe(len(COMBOS), scores3.std()):.4f},"
             f"DSR {V.deflated_sharpe(scores3[pick], len(COMBOS), train3.shape[1], scores3.std(), periods_per_year=365)['打过折的夏普 DSR']:.4f}",
     "判定": "过(勉强)"},
    {"查什么": "③ 回测过拟合概率 PBO",
     "结果": f"{V.pbo(train3, 16)['过拟合概率 PBO']:.4f}", "判定": "过"},
    {"查什么": "④ 整个网格的成绩",
     "结果": f"{len(COMBOS):,} 组里夏普大于 1 的占 {(scores3 > 1).mean():.1%},亏钱的占 {(annual3 < 0).mean():.1%}",
     "判定": "不过"},
    {"查什么": "⑤ 第 29 篇:逐笔的 t 值",
     "结果": f"{len(trades)} 笔,平均每笔 {trades.mean():.2%},t 值 "
             f"{RP.trade_metrics(trades)['t 值']:.4f},95% 区间下界 {RP.trade_metrics(trades)['95% 下界']:.2%}",
     "判定": "不过"},
    {"查什么": "⑥ 样本外(2022-01 到 2026-08)",
     "结果": f"年化 {out3[pick]:.2%},排 {int((out3 > out3[pick]).sum()) + 1}/{len(COMBOS):,},"
             f"网格中位 {np.median(out3):.2%},买入持有 {RP.annual_return(close.loc['2022-01-01':], 365):.2%}",
     "判定": "不过"},
])
print(checks.to_string(index=False))
                     查什么                                            结果     判定
        第 27 篇:最大回撤是不是 0                                       -26.55%      过
         第 27 篇:持仓日上涨的比例                                        57.27%      过
               ① 参数曲面的落差                           0.1732(邻居中位 1.5012) 过(是平原)
            ② 多重检验:白捡的门槛             夏普 1.6744 vs 门槛 0.7893,DSR 0.9614  过(勉强)
           ③ 回测过拟合概率 PBO                                        0.4408      过
               ④ 整个网格的成绩             1,575 组里夏普大于 1 的占 51.4%,亏钱的占 0.1%     不过
        ⑤ 第 29 篇:逐笔的 t 值     9 笔,平均每笔 37.68%,t 值 1.9902,95% 区间下界 0.57%     不过
⑥ 样本外(2022-01 到 2026-08) 年化 8.89%,排 1129/1,575,网格中位 12.83%,买入持有 11.28%     不过
| 查什么 | 结果 | 判定 |
|---|---|---|
| 第 27 篇:最大回撤是不是 0 | −26.55% | ✅ |
| 第 27 篇:持仓日上涨的比例 | 57.27% | ✅ |
| ① 参数曲面的落差 | 0.1733(邻居中位 1.5018) | ✅ 是平原 |
| ② 多重检验:白捡的门槛 | 夏普 1.6750 vs 门槛 0.7895,DSR 0.9614 | ✅ 勉强 |
| ③ 回测过拟合概率 PBO | 0.4408 | ✅ |
| ④ 整个网格的成绩 | 1,575 组里夏普大于 1 的占 51.5%,亏钱的占 0.1% | ❌ |
| ⑤ 第 29 篇:逐笔的 t 值 | 9 笔,平均每笔 37.68%,t 值 1.9902,95% 区间下界 0.57% | ❌ |
| ⑥ 样本外(2022-01 到 2026-08) | 年化 8.89%,排 1,129/1,575,网格中位 12.83%,买入持有 11.28% | ❌ |
**前五项全过,后三项全不过。**这才是这个实验真正的意思。
- 第 ④ 项是关键。这个网格里 1,575 组参数,一半以上的夏普都大于 1,亏钱的只有 0.1%。也就是说:这四年你随便挑一组都能得到一条漂亮曲线。「我挑到了夏普 1.675」这件事本身没有任何信息量——赚钱的不是这条规则,是 2018 到 2021 年 BTC 涨了十倍。
- 第 ⑤ 项是第 29 篇的老问题:四年只交易了 9 笔,t 值 1.99,95% 区间的下界只有 0.57%。九次下注证明不了任何事。
- 第 ⑥ 项:样本外年化 8.89%,不但输给网格中位数 12.83%,还输给买入持有 11.28%。
还有一件被交卷的人「顺手」做掉的事:
截止日挪一挪,同一组参数:
  截到 2020-12-31:年化  94.60%,夏普 1.9921
  截到 2021-06-30:年化  90.00%,夏普 1.7884
  截到 2021-12-31:年化  80.21%,夏普 1.6744
  截到 2022-06-30:年化  68.00%,夏普 1.5637
  截到 2022-12-31:年化  59.44%,夏普 1.4824
截到 2020 年底是年化 94.60%,截到 2022 年底是 59.44%——一路单调下降。选 2021-12-31 当截止日不是中立的选择,那是 BTC 那一轮牛市的尾巴(第 29 篇第 3.2 节)。
这个实验的结论
参数曲面平、DSR 过关、PBO 不高——这三项全过的策略,照样可以是错的。
因为这三项查的是同一件事:**你在这份数据里挑过头了没有。**它们查不出另一件事:这份数据本身的行情会不会重来。
这就是第六部分的边界。检验能告诉你「这条曲线里有多少是你挑出来的」,不能告诉你「这个市场明年还是不是这个样子」。后面那个问题,第七部分(策略原型)和第八部分(实盘)会换一种方式去处理——不是继续检验,是准备好在它不重来的时候仍然活着。
十四、小检查
- 你在 500 组参数里挑出年化最高的一组,落差(这一格减邻居中位)几乎是 0。这说明它可靠吗?
- 一份报告写着「样本外年化 22%」。你还需要问哪两个问题,才知道这个 22% 算不算数?
- walk-forward 的训练期夏普中位 1.69、考卷夏普中位 0.25。这个落差能说明策略是假的吗?
- 两个人扫同一个网格、用同一份数据,一个说「我试了 5 组」,一个说「我试了 5,000 组」,挑出来的最好一组一模一样。他们该报同一个 DSR 吗?
- PBO 算出来是 0.15,很低。这是不是说明挑出来的那组参数可以上实盘了?
十五、常见误用
**只报最好的那一组,不报试了多少组。**第八节:同一个夏普 1.7463,说试了 2 组 DSR 是 0.9891,说试了 10,130 组是 0.8254。试验次数是这个数的一部分,不是背景信息。
**看到尖峰以为捡到宝。**第三节:落差占年化 63.8%。一条讲得通的规则,参数改一天不该有三倍的反应。看到尖峰,先怀疑样本太短(第四节:九年是 12.33%,两年是 89.23%)。
用随机抽样切样本外。相邻两天的行情高度相关,随机抽一半当考卷等于让考卷和复习资料互相抄。只能按时间顺序切,split_index 就是这么写的。
**样本外看完不满意,回去改参数再看一次。**那段数据从你第一次看它开始就已经是样本内了。这不是道德问题,是定义问题——样本外只能用一次。
把 walk-forward 当成万能药。第六节:六种切法的考卷夏普中位全在 0.66 以下,而且拼出来的曲线跑输买入结有 34 个百分点。walk-forward 是一种诚实的度量,不是一种能提高收益的方法。
**用打散的数据做蒙特卡洛对照。**第七节:打散会把波动率聚集一起破坏掉,对照组变弱,于是白捡的部分被低估(18.5% 对 27.0%)。块自助法才是该用的那个。
**拿 PBO 的一个数当铁证。**第九节:8 块、12 块、16 块给出 0.6143、0.5357、0.4886。报它的时候要把块数一起报。
**把「参数稳健」当成「策略有效」。**第十三节:那条交上来的策略曲面很平、DSR 过关、PBO 也不高,照样样本外跑输买入持有——因为整个网格有一半的格子夏普都大于 1,赚钱的是那四年的行情,不是那条规则。
**忘了第 29 篇。**第十三节第 ⑤ 项:四年 9 笔交易,t 值 1.99。过拟合检验做得再漂亮,也补不上样本量。
十六、小结
- 样本内的成绩永远可以做到任意好,所以这一篇的每一个函数都不是在算成绩,是在给成绩打折。
- 第一刀,看邻居:落差 = 这一格 − 邻居中位。决策点那一组的落差占年化 63.8%,主线 v4 在三个标的上是 −0.027 / +0.092 / −0.019。
- 尖峰是样本短的症状:同一个网格,落差占年化 从九年的 12.33% 涨到两年的 89.23%。
- 第二刀,样本外:173.74% → −7.66%,排 7,083/10,130;秩相关 −0.1597(第 28 篇那次是 +0.291,连符号都不稳定)。
- 第三刀,walk-forward:六段全挑训练期夏普 1.5 以上的优等生,考卷 +2.69 到 −1.09,三段亏钱;拼出来年化 8.75%,而买入持有 43.10%。
- 第四刀,蒙特卡洛:在完全没有趋势的假数据上重扫一万组,「最好的一组」年化中位 115.52%,27.0% 的假数据比真实的还好。⚠️ 块自助法(保留波动率聚集)给出的对照比打散更强,后者会低估白捡的部分。
- 第五刀,多重检验:一万组试验的夏普标准差 0.2829,白捡的门槛就有 1.0931;同一个 1.7463,报「试了 2 组」DSR 0.9891,报「试了 10,130 组」DSR 0.8254。
- 第六刀,PBO:16 块时 0.4886——「挑样本内第一名」和抛硬币一样。
- 主线 v4 一个字不改:它的参数从来没被挑过,所以排在 518/416/282,落差接近 0,这一篇查不出它的病。它的病在第 29 篇:证据不够。
- 实验三:一条曲面平、DSR 过关、PBO 不高的策略,样本外照样跑输买入持有——因为 1,575 组里 51.5% 的夏普都大于 1,赚的是行情不是规则;而且四年只有 9 笔交易。
- 新模块
talab.validate15 个测试,全课共 308 个(不装 TA-Lib 时 276 通过 + 32 跳过)。
十七、完整代码与测试
talab/validate.py
"""talab.validate:过拟合与样本外检验。第 30 篇。

第 27 篇保证引擎对、第 28 篇保证数据干净、第 29 篇保证读数不被自己骗。
这个模块回答最后一个也是最难的问题:**这条策略是学会了,还是把答案背下来了。**

难在哪里:**样本内的成绩永远可以做到任意好。**参数多试几组、规则多加几条,
回测收益一定上升——上升本身不携带任何信息。所以这里的每一个函数都不是在「算成绩」,
而是在**给成绩打折**:

1. **参数曲面**(`surface`、`neighbourhood`、`plateaus`):这一格好,是因为它周围一片都好,
   还是因为它自己恰好踩中了?后者叫尖峰,它在样本外几乎必然塌。
2. **切分**(`split_index`、`walk_forward`、`walk_forward_run`):拿一段没看过的数据当考卷。
3. **多重检验**(`expected_max_sharpe`、`deflated_sharpe`):你试了一万次,
   「最好的那次」本来就该很好看——先把这个白捡的部分减掉。
4. **回测过拟合概率**(`pbo`):把时间切成块,反复交换样本内外,
   数一数「样本内第一名在样本外落到中位数以下」的比例。
"""
from __future__ import annotations

import itertools
import math
from statistics import NormalDist

import numpy as np
import pandas as pd

NORMAL = NormalDist()
EULER = 0.5772156649015329                       # 欧拉常数,`expected_max_sharpe` 要用


# ---------------------------------------------------------------------------
# 一、参数曲面:平原还是尖峰
# ---------------------------------------------------------------------------

def surface(table: pd.DataFrame, index: str, columns: str, values: str) -> pd.DataFrame:
    """把「一行一组参数」的长表摊成二维曲面,行列都是参数值。

    摊成二维之后才能问「这一格的邻居怎么样」——而那正是这一篇的核心问题。
    """
    return table.pivot(index=index, columns=columns, values=values).sort_index().sort_index(axis=1)


def neighbourhood(grid: pd.DataFrame, cell: tuple, radius: int = 1) -> pd.Series:
    """一格和它周围一圈的成绩:本格、邻居的中位数 / 最差 / 最好,以及落差。

    `落差` = 本格 − 邻居中位数。它是这一篇最省事的过拟合警报:
    **落差越大,说明这一格越像是踩中的,而不是踩在一片实地上。**

    ⚠️ 邻居按**网格上的位置**算,不按参数值相差多少。参数网格常常不是等距的
    (5、10、20、40、60 这种),这时候「走错一步」的正确含义是「换成表里相邻的那个值」,
    不是「加一减一」。
    """
    row, column = cell
    i, j = grid.index.get_loc(row), grid.columns.get_loc(column)
    block = grid.iloc[max(i - radius, 0):i + radius + 1, max(j - radius, 0):j + radius + 1]
    here = float(grid.iloc[i, j])
    others = block.to_numpy(float).ravel()
    others = np.delete(others, list(block.index).index(row) * block.shape[1]
                       + list(block.columns).index(column))
    others = others[~np.isnan(others)]
    if not len(others):
        raise ValueError("这一格周围没有有效的邻居")
    return pd.Series({"这一格": here, "邻居数": float(len(others)),
                      "邻居中位": float(np.median(others)), "邻居最差": float(others.min()),
                      "邻居最好": float(others.max()), "落差": here - float(np.median(others))})


def plateaus(grid: pd.DataFrame, radius: int = 1) -> pd.DataFrame:
    """给每一格配上它邻域的中位数,按**邻域中位数**从高到低排序。

    这是「不挑尖峰」的选参数方法:不要问「哪一格最高」,要问
    **「哪一片地最高」**——站在一片高地上,走错一步还在高地上。
    """
    rows = []
    for row in grid.index:
        for column in grid.columns:
            if np.isnan(grid.loc[row, column]):
                continue
            stats = neighbourhood(grid, (row, column), radius)
            rows.append({grid.index.name or "行": row, grid.columns.name or "列": column,
                         "这一格": stats["这一格"], "邻域中位": stats["邻居中位"],
                         "落差": stats["落差"]})
    return pd.DataFrame(rows).sort_values("邻域中位", ascending=False).reset_index(drop=True)


# ---------------------------------------------------------------------------
# 二、切分:样本内、样本外、walk-forward
# ---------------------------------------------------------------------------

def split_index(n: int, fraction: float = 0.5) -> tuple[slice, slice]:
    """把 n 根 K 线按时间顺序切成前后两段:前面选参数,后面当考卷。

    ⚠️ 只能按**时间顺序**切。随机抽一半当样本外是错的——
    相邻两天的行情高度相关,随机抽等于让考卷和复习资料互相抄。
    """
    if not 0 < fraction < 1:
        raise ValueError("fraction 要在 0 和 1 之间")
    cut = int(n * fraction)
    if cut < 1 or cut >= n:
        raise ValueError("切出来的两段都要至少有一根")
    return slice(0, cut), slice(cut, n)


def walk_forward(n: int, train: int, test: int, anchored: bool = False) -> list[tuple[slice, slice]]:
    """滚动检验的切分:每一段用前 `train` 根挑参数,紧接着的 `test` 根拿来考试。

    - `anchored=False`(默认):训练窗口长度固定,整段往前滚
    - `anchored=True`:训练窗口从第一根开始,越考越长(更像真实的积累过程)

    各段的考卷首尾相接、互不重叠,把它们拼起来就是一条**每一根都没被看过**的资金曲线。
    """
    if train < 1 or test < 1:
        raise ValueError("train 和 test 都要至少是 1")
    out, start = [], 0
    while start + train + test <= n:
        out.append((slice(0 if anchored else start, start + train),
                    slice(start + train, start + train + test)))
        start += test
    if not out:
        raise ValueError(f"{n} 根放不下一次 {train}+{test} 的切分")
    return out


def walk_forward_run(returns: np.ndarray, splits, names=None, min_bars: int = 2) -> pd.DataFrame:
    """在每一段上选出训练期里夏普最高的那一列,记下它在考卷上的表现。

    `returns` 是 `(试验数, 根数)` 的每根收益矩阵——一行一组参数。
    返回一张表:每一段选了谁、训练期分数、考卷分数,以及**这一段的考卷收益**。
    """
    rows = []
    for k, (train, test) in enumerate(splits):
        inside, outside = returns[:, train], returns[:, test]
        if inside.shape[1] < min_bars or outside.shape[1] < min_bars:
            raise ValueError("某一段太短,算不出标准差")
        score = inside.mean(axis=1) / np.where(inside.std(axis=1) > 0, inside.std(axis=1), np.nan)
        pick = int(np.nanargmax(score))
        rows.append({"第几段": k + 1, "选了谁": names[pick] if names is not None else pick,
                     "训练期夏普": float(score[pick]),
                     "考卷夏普": float(outside[pick].mean() / outside[pick].std()),
                     "考卷收益": float(np.prod(1 + outside[pick]) - 1),
                     "训练根数": inside.shape[1], "考卷根数": outside.shape[1]})
    return pd.DataFrame(rows)


def stitch(returns: np.ndarray, splits, picks) -> np.ndarray:
    """把各段考卷上被选中那一列的收益首尾接起来,得到一条完整的样本外收益序列。"""
    return np.concatenate([returns[int(p), test] for (_, test), p in zip(splits, picks)])


# ---------------------------------------------------------------------------
# 三、多重检验:你试了多少次
# ---------------------------------------------------------------------------

def expected_max_sharpe(n_trials: int, sharpe_std: float) -> float:
    """**完全没有本事**的情况下,试 `n_trials` 次,「最好的那次」夏普期望是多少
    (Bailey & López de Prado 2014):

    > E[最大值] ≈ 标准差 × [(1 − γ)·Φ⁻¹(1 − 1/N) + γ·Φ⁻¹(1 − 1/(N·e))]

    γ 是欧拉常数 0.5772。`sharpe_std` 是这一万次试验的夏普比率**彼此之间**的标准差。
    直觉:N 越大,最大值越往右跑——**「我试了一万组,最好的那组夏普 1.5」这句话里,
    「一万组」和「1.5」一样重要。**
    """
    if n_trials < 2:
        raise ValueError("至少要有两次试验")
    high = NORMAL.inv_cdf(1 - 1 / n_trials)
    low = NORMAL.inv_cdf(1 - 1 / (n_trials * math.e))
    return sharpe_std * ((1 - EULER) * high + EULER * low)


def deflated_sharpe(sharpe: float, n_trials: int, n_obs: int, sharpe_std: float,
                    skew: float = 0.0, kurtosis: float = 3.0,
                    periods_per_year: int = 252) -> pd.Series:
    """打过折的夏普比率(DSR):把「试了很多次」和「收益率不是正态」都扣掉之后,
    这条策略的夏普**真的大于 0** 的概率。

    两步:先用 `expected_max_sharpe` 算出「没本事时白捡的那一截」当作门槛,
    再问「观察到的夏普超过这个门槛」有多显著:

    > DSR = Φ( (夏普 − 门槛) × √(根数 − 1) ÷ √(1 − 偏度×夏普 + (峰度−1)/4 × 夏普²) )

    式子里的夏普都是**单根**的(不年化)。`kurtosis` 传的是原始峰度(正态是 3),
    不是超额峰度。DSR 低于 0.95 就该当成「还没排除运气」。
    """
    per_period = sharpe / math.sqrt(periods_per_year)
    threshold = expected_max_sharpe(n_trials, sharpe_std / math.sqrt(periods_per_year))
    spread = math.sqrt(max(1 - skew * per_period + (kurtosis - 1) / 4 * per_period ** 2, 1e-12))
    z = (per_period - threshold) * math.sqrt(max(n_obs - 1, 1)) / spread
    return pd.Series({"年化夏普": sharpe, "试验次数": float(n_trials),
                      "白捡的门槛(年化)": threshold * math.sqrt(periods_per_year),
                      "超过门槛多少": sharpe - threshold * math.sqrt(periods_per_year),
                      "t 值": z, "打过折的夏普 DSR": NORMAL.cdf(z)})


# ---------------------------------------------------------------------------
# 四、回测过拟合概率(CSCV)
# ---------------------------------------------------------------------------

def pbo(returns: np.ndarray, n_chunks: int = 8) -> pd.Series:
    """回测过拟合概率(Bailey 等 2017 的 CSCV)。

    做法:把时间切成 `n_chunks` 块,穷举所有「一半当样本内、另一半当样本外」的分法;
    每一种分法里选出样本内夏普最高的那一列,看它**在样本外排第几**。
    如果这个第一名在样本外经常掉到中位数以下,说明「挑第一名」这个动作本身就是在挑噪声。

    > PBO = 样本内第一名在样本外掉到中位数以下的分法比例

    ⚠️ 它衡量的是**挑选流程**,不是某一组参数。PBO 高不代表这些参数都没用,
    代表「用样本内最优去选参数」这件事在这批数据上不管用。
    n_chunks 要是偶数;16 块有 12,870 种分法,8 块只有 70 种,慢和稳之间自己选。
    """
    if n_chunks % 2 or n_chunks < 4:
        raise ValueError("n_chunks 要是不小于 4 的偶数")
    n_trials, n_bars = returns.shape
    if n_trials < 2:
        raise ValueError("至少要有两列试验")
    edges = np.linspace(0, n_bars, n_chunks + 1).astype(int)
    counts = np.diff(edges).astype(float)
    total = np.array([returns[:, edges[i]:edges[i + 1]].sum(axis=1) for i in range(n_chunks)])
    square = np.array([(returns[:, edges[i]:edges[i + 1]] ** 2).sum(axis=1) for i in range(n_chunks)])

    def score(keys) -> np.ndarray:                 # 任意几块合起来的夏普,O(试验数)
        n = counts[list(keys)].sum()
        mean = total[list(keys)].sum(axis=0) / n
        var = square[list(keys)].sum(axis=0) / n - mean ** 2
        return mean / np.sqrt(np.maximum(var, 1e-300))

    logits, ranks = [], []
    everything = range(n_chunks)
    for inside in itertools.combinations(everything, n_chunks // 2):
        outside = tuple(k for k in everything if k not in inside)
        best = int(np.argmax(score(inside)))
        outside_score = score(outside)
        rank = int((outside_score < outside_score[best]).sum()) + 1      # 1 最差,n_trials 最好
        omega = rank / (n_trials + 1)
        ranks.append(omega)
        logits.append(math.log(omega / (1 - omega)))
    logits = np.array(logits)
    return pd.Series({"试验次数": float(n_trials), "切成几块": float(n_chunks),
                      "一共几种分法": float(len(logits)),
                      "样本外分位中位数": float(np.median(ranks)),
                      "过拟合概率 PBO": float((logits <= 0).mean()),
                      "logit 中位数": float(np.median(logits))})


# ---------------------------------------------------------------------------
# 五、蒙特卡洛:如果这个市场本来就没有规律
# ---------------------------------------------------------------------------

def synthetic_close(close: pd.Series, n: int = 100, block: int = 1, seed: int = 0) -> np.ndarray:
    """造 n 条「和原序列同分布、但没有原来那段走势」的假价格,返回 `(n, 根数)`。

    `block=1` 是把日收益率完全打散(波动率聚集也一起没了);
    `block > 1` 用块自助法,保留每一小段内部的顺序,**波动率聚集还在,趋势没了**。
    拿这些假价格重跑一遍同样的参数扫描,就知道「最好的一组」里有多少是白捡的。
    """
    values = close.pct_change().dropna().to_numpy(float)
    m = len(values)
    if block < 1 or block > m:
        raise ValueError("block 要在 1 和样本长度之间")
    rng = np.random.default_rng(seed)
    out = np.empty((n, m + 1))
    for i in range(n):
        if block == 1:
            sample = rng.choice(values, size=m, replace=True)
        else:
            starts = rng.integers(0, m - block + 1, size=int(np.ceil(m / block)))
            sample = np.concatenate([values[s:s + block] for s in starts])[:m]
        out[i] = float(close.iloc[0]) * np.concatenate([[1.0], np.cumprod(1 + sample)])
    return out
talab/tests/test_validate.py
"""talab.validate 的测试(第 30 篇)。"""
import math

import numpy as np
import pandas as pd
import pytest

from talab import validate as V


def make_surface(values) -> pd.DataFrame:
    frame = pd.DataFrame(values, index=[10, 20, 30], columns=[100, 200, 300])
    frame.index.name, frame.columns.name = "快线", "慢线"
    return frame


def test_surface_spreads_a_long_table_into_two_dimensions():
    table = pd.DataFrame({"快线": [20, 10, 20, 10], "慢线": [200, 200, 100, 100],
                          "年化": [0.4, 0.3, 0.2, 0.1]})
    grid = V.surface(table, "快线", "慢线", "年化")
    assert list(grid.index) == [10, 20] and list(grid.columns) == [100, 200]
    assert grid.loc[20, 200] == 0.4 and grid.loc[10, 100] == 0.1


def test_neighbourhood_is_the_ring_around_one_cell():
    grid = make_surface([[0.1, 0.2, 0.3], [0.4, 1.0, 0.5], [0.6, 0.7, 0.8]])
    out = V.neighbourhood(grid, (20, 200))
    assert out["这一格"] == 1.0 and out["邻居数"] == 8
    assert out["邻居中位"] == pytest.approx(0.45)          # 0.1…0.8 去掉中心的中位数
    assert out["邻居最差"] == pytest.approx(0.1)
    assert out["邻居最好"] == pytest.approx(0.8)
    assert out["落差"] == pytest.approx(0.55)
    corner = V.neighbourhood(grid, (10, 100))              # 角上只有三个邻居
    assert corner["邻居数"] == 3


def test_neighbourhood_counts_steps_on_the_grid_not_parameter_distance():
    """参数网格常常不等距(5、10、20、40、60),「走错一步」指的是换成表里相邻的那个值。"""
    frame = pd.DataFrame([[0.0, 0.0, 0.0], [0.0, 1.0, 0.2], [0.0, 0.0, 0.0]],
                         index=[5, 10, 200], columns=[20, 40, 1000])
    out = V.neighbourhood(frame, (10, 40))
    assert out["邻居数"] == 8                               # 值差 960 的那一列也算邻居
    assert out["邻居最好"] == pytest.approx(0.2)


def test_plateaus_ranks_by_the_neighbourhood_not_by_the_cell():
    """一根针(自己高、周围低)要排在一片高地(自己一般、周围都不错)后面。"""
    grid = make_surface([[0.5, 0.5, 0.0], [0.5, 0.5, 0.0], [0.0, 0.0, 9.0]])
    ranked = V.plateaus(grid)
    top = ranked.iloc[0]
    assert (top["快线"], top["慢线"]) != (30, 300)          # 9.0 那根针不是第一
    needle = ranked[(ranked["快线"] == 30) & (ranked["慢线"] == 300)].iloc[0]
    assert needle["这一格"] == 9.0 and needle["落差"] == pytest.approx(9.0)
    assert ranked["邻域中位"].is_monotonic_decreasing


def test_split_index_cuts_in_time_order():
    inside, outside = V.split_index(100, 0.7)
    assert (inside.start, inside.stop) == (0, 70)
    assert (outside.start, outside.stop) == (70, 100)
    with pytest.raises(ValueError):
        V.split_index(100, 1.0)
    with pytest.raises(ValueError):
        V.split_index(3, 0.01)


def test_walk_forward_windows_do_not_overlap_and_cover_in_order():
    splits = V.walk_forward(1000, train=300, test=100)
    assert len(splits) == 7
    tests = [test for _, test in splits]
    assert tests[0].start == 300 and tests[-1].stop == 1000
    for a, b in zip(tests, tests[1:]):
        assert a.stop == b.start                            # 考卷首尾相接、不重叠
    for train, test in splits:
        assert train.stop == test.start and train.stop - train.start == 300
    with pytest.raises(ValueError):
        V.walk_forward(100, train=300, test=100)


def test_walk_forward_anchored_keeps_growing_the_training_window():
    rolling = V.walk_forward(1000, 300, 100, anchored=False)
    anchored = V.walk_forward(1000, 300, 100, anchored=True)
    assert [t for _, t in rolling] == [t for _, t in anchored]        # 考卷完全一样
    assert all(train.start == 0 for train, _ in anchored)
    lengths = [train.stop - train.start for train, _ in anchored]
    assert lengths == sorted(lengths) and lengths[0] == 300 < lengths[-1]


def test_walk_forward_run_picks_the_best_of_the_training_window():
    rng = np.random.default_rng(0)
    returns = rng.normal(0, 0.01, (4, 400))
    returns[1, :200] += 0.05                                # 第 1 列只在前半段好
    returns[2, 200:] += 0.05                                # 第 2 列只在后半段好
    splits = V.walk_forward(400, 200, 200)
    out = V.walk_forward_run(returns, splits, names=list("甲乙丙丁"))
    assert len(out) == 1 and out.loc[0, "选了谁"] == "乙"      # 训练期挑的是乙
    assert out.loc[0, "训练期夏普"] > out.loc[0, "考卷夏普"]    # 考卷上乙已经不行了


def test_stitch_joins_the_test_windows_end_to_end():
    returns = np.arange(30, dtype=float).reshape(3, 10)
    splits = V.walk_forward(10, 4, 3)
    joined = V.stitch(returns, splits, [0, 2])
    assert len(joined) == sum(test.stop - test.start for _, test in splits)
    assert joined[0] == returns[0, splits[0][1].start]
    assert joined[-1] == returns[2, splits[1][1].stop - 1]


def test_expected_max_sharpe_matches_a_simulation():
    """这是整个模块最该钉住的一条:公式算出来的「白捡的最大值」要对得上真的抽一万次。"""
    rng = np.random.default_rng(30)
    for n_trials in (50, 1000, 10_000):
        draws = rng.normal(0.0, 0.3, size=(400, n_trials)).max(axis=1)
        assert V.expected_max_sharpe(n_trials, 0.3) == pytest.approx(draws.mean(), rel=0.05)


def test_expected_max_sharpe_grows_with_trials_and_scales_with_spread():
    assert V.expected_max_sharpe(10, 1.0) < V.expected_max_sharpe(1000, 1.0)
    assert V.expected_max_sharpe(1000, 2.0) == pytest.approx(2 * V.expected_max_sharpe(1000, 1.0))
    with pytest.raises(ValueError):
        V.expected_max_sharpe(1, 1.0)


def test_deflated_sharpe_falls_as_you_admit_more_trials():
    same = dict(sharpe=1.5, n_obs=1000, sharpe_std=0.4, periods_per_year=252)
    few = V.deflated_sharpe(n_trials=2, **same)
    many = V.deflated_sharpe(n_trials=10_000, **same)
    assert few["年化夏普"] == many["年化夏普"] == 1.5          # 夏普一个字没变
    assert few["白捡的门槛(年化)"] < many["白捡的门槛(年化)"]
    assert few["打过折的夏普 DSR"] > many["打过折的夏普 DSR"]
    assert 0 <= many["打过折的夏普 DSR"] <= 1


def test_pbo_is_a_coin_flip_on_pure_noise():
    """一堆互相没区别的随机策略,样本内第一名在样本外就是随机的——PBO 该在 0.5 附近。"""
    returns = np.random.default_rng(1).normal(0.0, 0.01, (100, 800))
    out = V.pbo(returns, 8)
    assert out["一共几种分法"] == 70
    assert out["过拟合概率 PBO"] == pytest.approx(0.5, abs=0.2)


def test_pbo_is_near_zero_when_one_strategy_is_genuinely_better():
    returns = np.random.default_rng(2).normal(0.0, 0.01, (40, 800))
    returns[7] += 0.01                                      # 第 7 列全程真的更好
    out = V.pbo(returns, 8)
    assert out["过拟合概率 PBO"] < 0.05
    assert out["样本外分位中位数"] > 0.9
    with pytest.raises(ValueError):
        V.pbo(returns, 7)                                   # 块数要是偶数


def test_synthetic_close_keeps_the_length_and_the_starting_price():
    close = pd.Series(np.cumprod(1 + np.random.default_rng(3).normal(0, 0.02, 500)) * 100,
                      index=pd.date_range("2020-01-01", periods=500, freq="D"))
    paths = V.synthetic_close(close, n=5, block=20, seed=3)
    assert paths.shape == (5, len(close))
    assert np.allclose(paths[:, 0], float(close.iloc[0]))
    assert not np.allclose(paths[0], close.to_numpy())       # 是新造的,不是原样抄回来
    fast = V.synthetic_close(close, n=3, block=1, seed=3)
    assert fast.shape == (3, len(close))
    with pytest.raises(ValueError):
        V.synthetic_close(close, block=10_000)
两个 venv 的测试结果
308 passed in 1.07s
276 passed, 32 skipped in 1.15s
练习
- 把第三节的「看邻居」做成一个装饰在任何网格上的检查:给它一张参数表和一个成绩列,返回「最好那一格的落差占比」。在第 28 篇那 228 组参数上跑一遍,落差是多少?
- 第四节按「回测几年」看落差。换一个切法:固定长度(比如两年),但起点从 2017 年一路滑到 2024 年,落差会怎么变?它和当时的市场状态(第 11 篇)有关系吗?
walk_forward_run现在按训练期夏普挑第一名。改成按plateaus的「邻域中位」挑,六段的考卷成绩会变好吗?expected_max_sharpe假设一万次试验互相独立。写一个模拟来量这个假设的代价:造 N 条相关系数为 ρ 的随机序列,比较公式值和真实的最大值期望,看 ρ 从 0 涨到 0.9 时差多少。- 把
pbo的「样本内第一名」换成「样本内前十名的等权组合」,PBO 会降下来吗?降多少? - 第七节的假数据保留了波动率聚集,但没保留「趋势」。再造第三种:用块自助法但块长取 250 天(一整年),这时候趋势也部分保留了。对照会变得多强?
- 把第十三节那张检查表写成一个函数
audit(returns_matrix, pick, names, ...):给它一个网格的收益矩阵和你挑中的那一列,它把这一篇加上第 27、28、29 篇的检查逐条跑一遍,输出一张表。
小检查答案
- 不能。落差小只说明它不是一根针,不说明它是对的。第十三节那条交上来的策略落差只有 0.1733(平原),样本外照样跑输买入持有——因为整个网格都在赚那四年的行情。落差是必要条件,不是充分条件。还要问:试了多少组?样本外呢?整个网格的中位数是多少?
- 一,样本外是不是真的只看了一次(看完回去改参数再看,那段就变成样本内了);二,这 22% 和「什么都不挑」比怎么样——第五节里样本内第一名的样本外是 −7.66%,而全网格中位是 −2.11%,光看一个正数不知道它算好算坏。补充第三个更好:样本外那一段有多长、包含几次交易(第 29 篇)。
- 不能直接说是假的,但能说这个 1.69 不能用来预期未来。训练期夏普天然偏高(它是挑出来的那一组的成绩),考卷夏普才是无偏的。真正的判据是考卷成绩本身够不够好:这里考卷夏普中位 0.25、拼出来年化 8.75% 跑输买入持有 43.10%,所以结论是「不行」——但这个结论来自考卷,不是来自落差。
- 不该。DSR 的输入里
n_trials是你真正试过的次数,不是你保留下来的次数。试了 5,000 组的人门槛高得多,同一个夏普对他来说更不值钱。这件事没人能替他查,只能靠他自己报——这也是为什么「试验次数」应该和成绩一起写进报告。 - **不能这么推。**PBO 低只说明「挑第一名」这个流程在这批数据上不是纯噪声,它没说这组参数在未来管用。而且 PBO 对块数敏感(第九节:0.61 / 0.54 / 0.49),一个数不够。上实盘之前还要过样本外、蒙特卡洛对照、交易笔数(第 29 篇)和成本(第 28 篇)——而最后还有一件检验回答不了的事:这个市场明年是不是还这样。
第 31 篇开始第七部分「策略原型」,讲趋势跟随与突破。决策点是:唐奇安通道 20 日突破买入,而过去 10 次突破里有 7 次是假的——为什么这样的规则还能赚钱?内容是海龟交易法则与唐奇安通道、区间突破、低胜率高盈亏比的收益结构、它在什么样的市场环境里成立,最后用第六部分这四篇的全套方法完整检验一次,并和主线策略对照。第六节那句「均线交叉在 BTC 上赢不了买入持有」,也会在那里被正面回答。