| 本篇位置 | 第八部分「实盘」第一篇。前面三十二篇在问「这条规则值不值得做」,从这一篇开始问「你能不能照着做」 |
| 用到的数据 | SPY、AAPL、BTC 日线(全部沿用前面几篇,不需要新下载) |
| 动手 | 新模块 talab.journal:streaks、expected_longest、streak_distribution、streak_alarm、shuffled、normal_range、detection_size、pause_after_losses、pause_table、interfere、interference_table、Entry + Journal、reconcile,附 16 个测试 |
| 读完你能 | 算出你这条策略的「正常连亏」和「正常回撤」,并把实盘和回测的差额拆成五块 |
这一篇从头到尾用同一个比方:自动驾驶,和你那只悬在刹车上的脚。
车在开,你坐在驾驶位上。系统按它的规则变道、跟车、刹车,而你全程盯着——随时可以接管。
自动驾驶公司很早就知道,「系统开得好不好」这个问题没法靠感觉回答,所以他们做了一件很笨的事:每一次人类接管,都要记一笔。什么时候、在哪条路上、为什么接管、接管之后又怎么样了。这份记录叫脱离报告。
这一篇要做的就是这件事,只不过换成你的账户。而第一个要记的,是你最想接管的那个时刻——
一、2022 年 7 月 26 日
你从 2017 年就开始在 BTC 上跑第 31 篇那套海龟法则。九年,一个参数没改过。
今天是 2022 年 7 月 26 日。你刚刚平掉第七笔连续亏损的交易:
       进场日        出场日  单位数   原因        盈亏     R
2021-11-08 2021-11-12    2   止损  -9678.42 -1.78
2021-12-27 2021-12-29    1   止损  -5354.53 -1.00
2022-02-07 2022-02-17    3   止损 -12025.37 -2.27
2022-03-24 2022-04-06    4 通道出场  -3652.43 -0.71
2022-05-31 2022-06-10    1 通道出场  -4299.06 -0.84
2022-07-08 2022-07-13    1   止损  -5101.22 -1.00
2022-07-18 2022-07-26    3   止损 -11733.77 -2.32

这 7 笔:合计 -9.91R,合计 -51,845 美元,历时 260 天
账户:峰值 574,350 → 现在 493,287,回撤 -14.11%
这条策略九年 70 笔,胜率 32.9%,到今天为止合计 192.68R
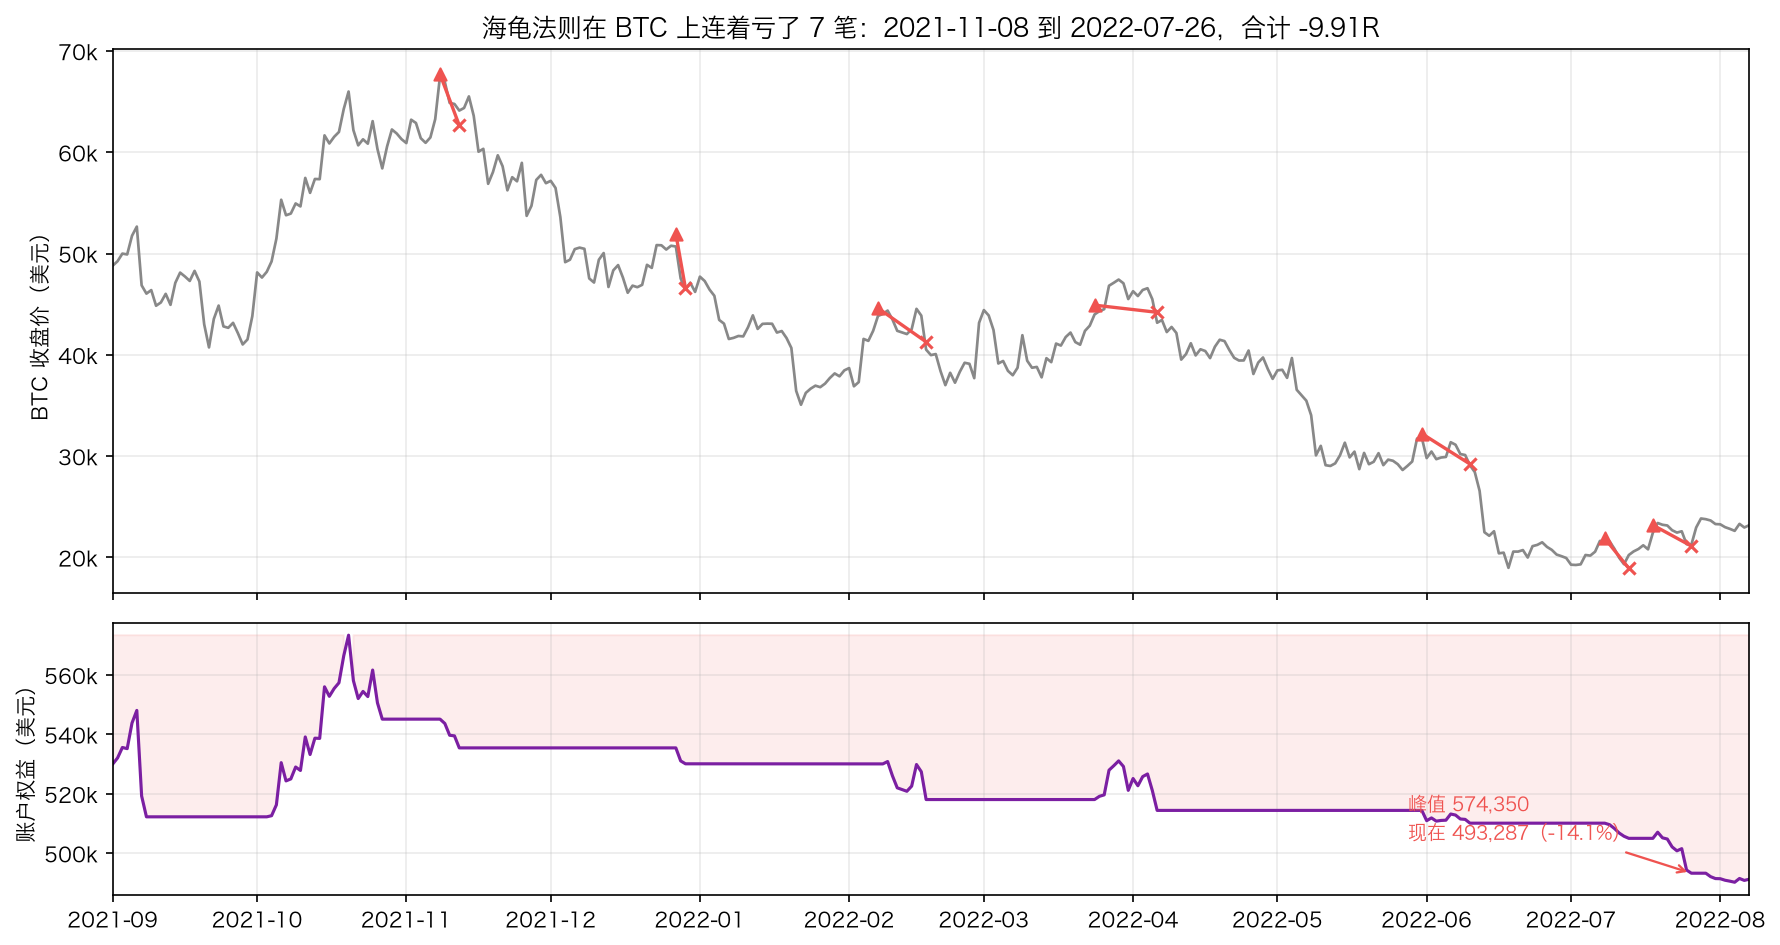
**七笔,一笔没赚。**从 2021 年 11 月 8 日买在 67,000 开始,八个半月,260 天。合计 −9.91R,账户从峰值 574,350 掉到 493,287,回撤 14.11%。
更难受的是每一笔的样子:五笔是被止损打掉的,两笔是通道出场。没有哪一笔是灾难,每一笔都只亏一到两个 R——它们只是一笔接一笔,没完没了。
你手上有三个选项:
A. 什么都不做,第八笔来了照做。 B. 停一停,等策略连赚两笔再回来。 C. 认了,这套 1983 年的老规矩在 2022 年的 BTC 上已经不管用了,关掉。
脚已经悬在刹车上了。踩不踩?
二、先别揭晓:连亏七笔的概率是多少
回答这个问题之前,先算一个数。
这条策略九年做了 70 笔,胜率只有 32.9%——第 31 篇量过,趋势跟随的招牌就是低胜率高盈亏比。那么问题是:
一条胜率 32.9% 的策略,做 70 笔,「最长的一段连亏」应该是多少笔?
这个数有公式。把每一笔当成一次独立的下注,亏的概率是 67.1%,那么 n 次下注里最长连亏的期望是(Schilling 1990):
E[最长连击] ≈ log(n × (1 − p)) ÷ log(1/p) + γ ÷ ln(1/p) − 1/2
其中 p 是「亏」的概率,γ 是欧拉常数 0.5772
代进去:
公式给的期望(70 笔、胜率 32.9%):最长连亏 8.82 笔
笔数        70.000
胜率         0.329
平均最长连亏     8.796
公式给的期望     8.820
50% 分位     8.000
75% 分位    10.000
90% 分位    12.000
95% 分位    14.000
99% 分位    18.000
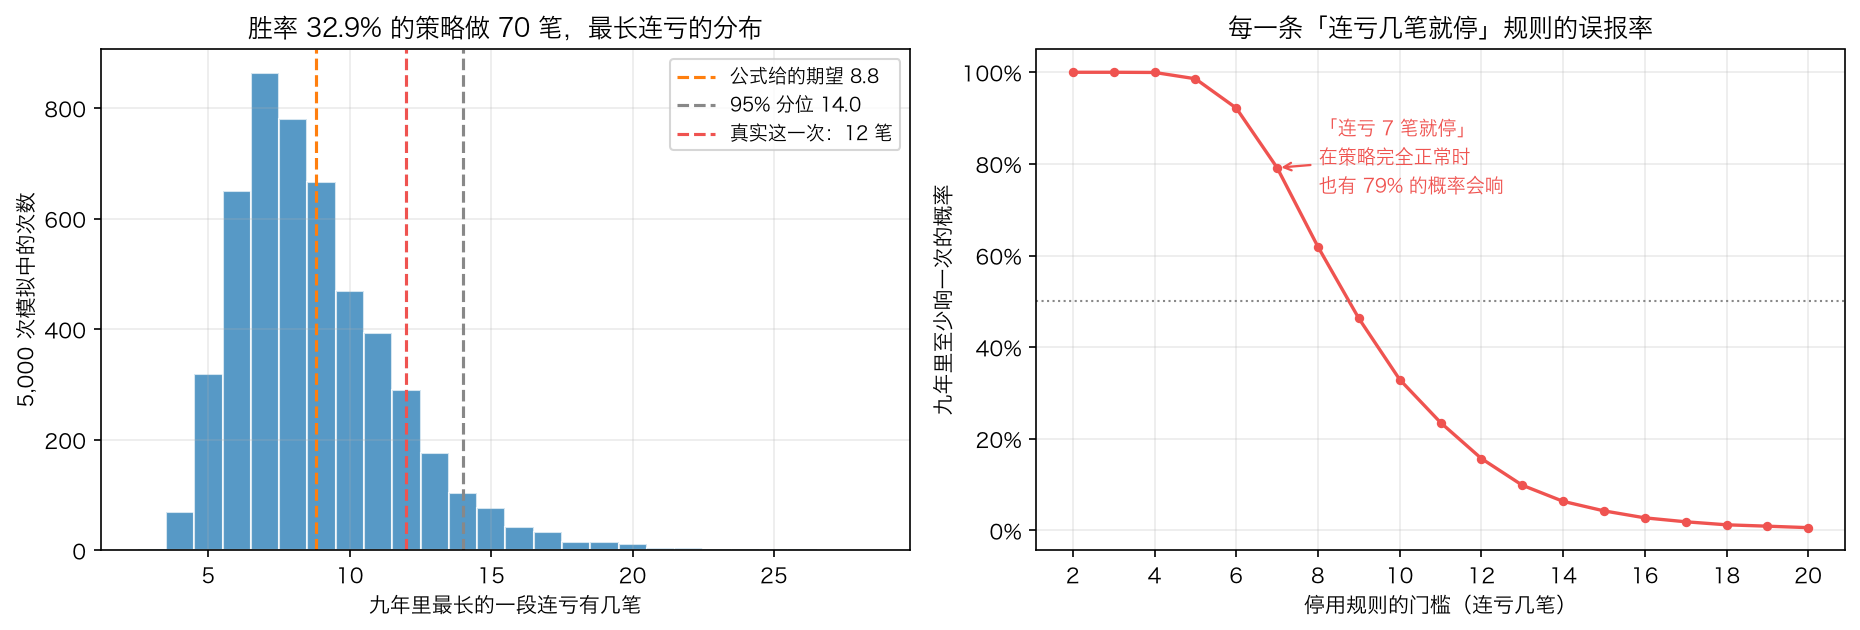
8.82 笔。
不是 2 笔,不是 3 笔。**这条策略在九年里出现一段八九笔的连亏,是设计的一部分,不是出了事。**蒙特卡洛跑五千次得到的平均值是 8.796,和公式对到小数点后一位。而分布的右边比你想的还要长:90% 分位是 12 笔,99% 分位是 18 笔。
再看下面那张表,它回答的是另一个问题:「连亏 k 笔就停手」这条规则,在策略完全正常的时候会响几次?
 门槛(连亏几笔)  至少响一次的概率  平均响几次
        3    1.0000 6.9768
        4    0.9996 4.6162
        5    0.9858 3.0558
        6    0.9218 2.0054
        7    0.7916 1.3190
        8    0.6190 0.8610
       10    0.3294 0.3764
       12    0.1570 0.1640
- 「连亏 3 笔就停」:九年里必然会响,平均响 6.98 次
- 「连亏 5 笔就停」:98.6% 会响
- 「连亏 7 笔就停」:79.2% 会响
- 「连亏 12 笔就停」:15.7% 会响
⚠️ 这张表里没有一行是在说「策略坏了」。它们全都是在策略完全正常的假设下算出来的。
所以你现在手上这个「连亏 7 笔」,不是证据。它是一条胜率 32.9% 的策略在九年里大概率会发生的事——你只是终于攒够了笔数,撞上了它。
一条误报率 79% 的规则不叫谨慎,它只是保证了你一定会在某个时刻停手。
回到那辆车:连着几次急刹之后你想接管。但如果这条路上本来每公里就有两次急刹,那你接管的依据不是「系统出问题了」,而是:「我没料到这条路长这样」。
三、揭晓
2022-07-29 2022-08-19    2   止损  -8097.95 -1.64
2022-09-12 2022-09-13    1   止损  -4851.89 -1.00
2022-09-13 2022-09-14    1   止损  -5990.62 -1.25
2022-10-26 2022-11-08    4   止损 -12017.43 -2.53
2022-12-05 2022-12-16    4   止损 -11813.89 -2.56
2023-01-08 2023-02-09    4 通道出场 134106.89 29.77

连亏没有在第 7 笔停下:一共 12 笔,合计 -18.89R、-94,617 美元,从 2021-11-08 一直亏到 2022-12-16,403 天
账户 574,350 → 450,515,回撤 -21.56%

然后是第 40 笔:2023-01-08 进场 17,061.27,2023-02-09 以 22,500.00 通道出场,+29.77R、+134,107 美元
这一笔一个人赚回了前面 12 笔亏掉的 94,617 美元,还多出 39,490;它在九年 70 笔里排第 4
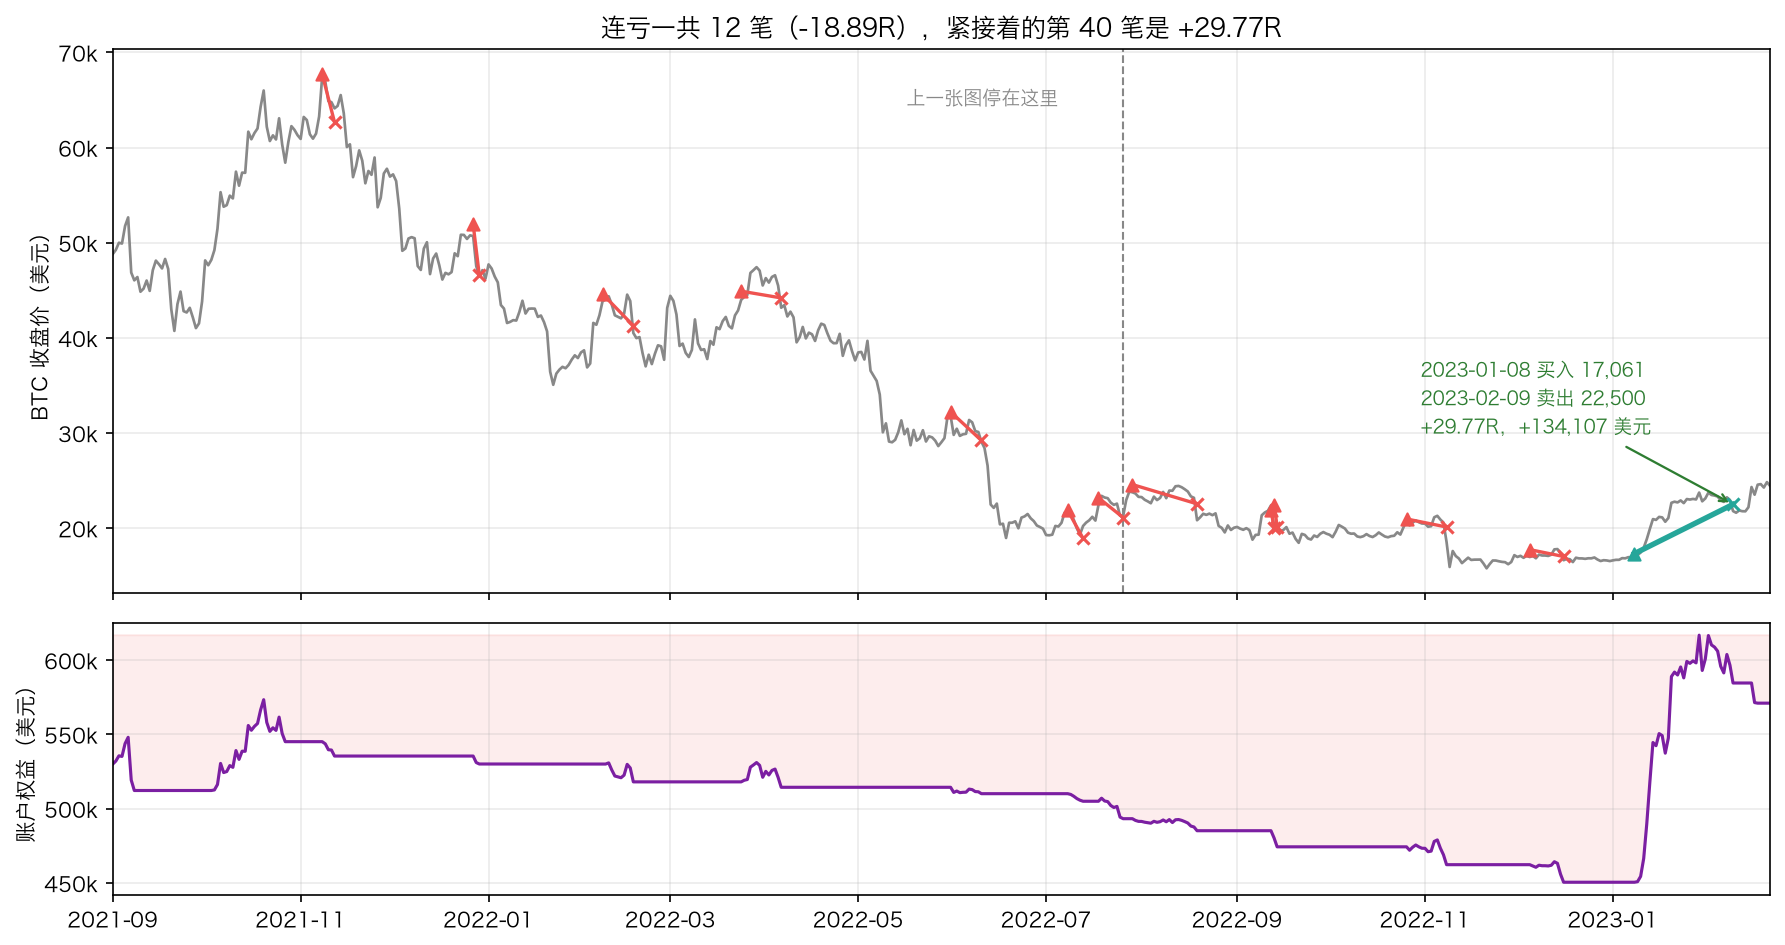
第一层:连亏没有在第七笔停下。
后面还有五笔,全是止损。一共 12 笔、−18.89R、−94,617 美元,从 2021 年 11 月 8 日一直亏到 2022 年 12 月 16 日,403 天。账户从 574,350 掉到 450,515,回撤 −21.56%——这就是这条策略九年的最大回撤,你正站在它的最底下。
如果你在第七笔停手,你确实躲过了后面那五笔的 −8.98R。
第二层:然后是第 40 笔。
2023 年 1 月 8 日买在 17,061.27,2 月 9 日按 10 日通道下轨出在 22,500.00。+29.77R,+134,107 美元。
这一笔一个人赚回了前面十二笔亏掉的 94,617 美元,还多出 39,490。它在九年 70 笔里排第 4。
看那张图下半部分的账户曲线:从 2021 年 11 月一路往下磨了十三个月的那条线,在 2023 年 1 月被一根近乎垂直的线拉了回去。
这就是为什么「停不停手」是一个比它看起来危险得多的问题。第 31 篇已经量过一次:**拿掉最赚的 10 笔,BTC 九年的收益只剩 −2.3%。**而这一篇给出了那条结论的执行版本——
你在连亏之后停手,停掉的不是「亏损」,是「亏损之后的那一段」。而收益全在那一段里。
四、正常范围:把同一批交易重排一遍
上一节的公式只能算连亏。但你真正会看的东西不止连亏——还有回撤有多深、水下要待多久。
这两个量没有公式,但有一个很朴素的办法:把同一批交易的顺序重新排一遍。
同样这 70 笔交易,还是这 70 个结果,只是发生的先后换一换。合计 R 一个字不变(加法可交换),变的只有路径。而你会不会中途停手,只取决于路径。
def shuffled(r, trials: int = 2000, seed: int = 0) -> pd.DataFrame:
    """把同一批交易**重新排一遍顺序**,看每一种顺序下的连亏、回撤和水下时间。

    这是第 29 篇自助法的一个特例,但问的问题不一样:那里问「这条策略的夏普可信吗」,
    这里问「**同样这批交易,换个顺序发生,我会看到多难看的一段**」。

    合计和顺序无关(加法可交换),所以每一次重抽的终点都一样——
    **变的只有路径。而你会不会中途停手,只取决于路径。**

    ⚠️ 这里**一律用加法**:曲线就是每笔结果的累加,相当于「每笔都按初始本金的固定比例下注」。
    喂 R 倍数进去,回撤的单位就是 R;喂每笔的账户收益率进去,单位就是百分点。
    不用复利是故意的——要看的是顺序效应,复利会把顺序效应和「越赚越大」搅在一起。
    """
    r = pd.Series(r).dropna().astype(float).to_numpy()
    if len(r) < 2:
        raise ValueError("至少要有两笔交易")
    rng = np.random.default_rng(seed)
    rows = []
    for _ in range(trials):
        path = rng.permutation(r)
        curve = np.cumsum(path)
        peak = np.maximum.accumulate(np.concatenate([[0.0], curve]))[1:]
        under = curve < peak
        rows.append({"最长连亏": longest_streak(path), "最深回撤": float((curve - peak).min()),
                     "最长水下(笔)": int(_longest_true(under)), "合计": float(curve[-1])})
    return pd.DataFrame(rows)
跑两千次,把每一次的最长连亏、最深回撤、最长水下段记下来,就得到一张「正常范围表」:
—— SPY(海龟,67 笔,单位是 R)
            这一次    重抽平均  比这一次还难看的比例  50% 分位  90% 分位  95% 分位  99% 分位
最长连亏      6.000   6.102       0.589   6.000     8.0   9.000  11.000
最深回撤    -12.557  -9.054       0.097  -8.585   -12.5 -13.882 -16.872
最长水下(笔)  29.000  16.619       0.060  15.000    26.0  29.000  37.000
—— AAPL(海龟,59 笔,单位是 R)
            这一次    重抽平均  比这一次还难看的比例  50% 分位  90% 分位  95% 分位  99% 分位
最长连亏      5.000   5.748       0.786   5.000   8.000   9.000  11.000
最深回撤     -8.329 -10.300       0.741  -9.797 -14.138 -15.575 -18.839
最长水下(笔)  10.000   9.491       0.401   9.000  14.000  16.000  21.000
—— BTC(海龟,70 笔,单位是 R)
            这一次    重抽平均  比这一次还难看的比例  50% 分位  90% 分位  95% 分位  99% 分位
最长连亏     12.000   8.640       0.115   8.000  12.000  13.000  16.000
最深回撤    -18.886 -15.683       0.197 -14.911 -21.403 -24.253 -30.206
最长水下(笔)  12.000  13.802       0.624  13.000  20.000  23.000  29.000
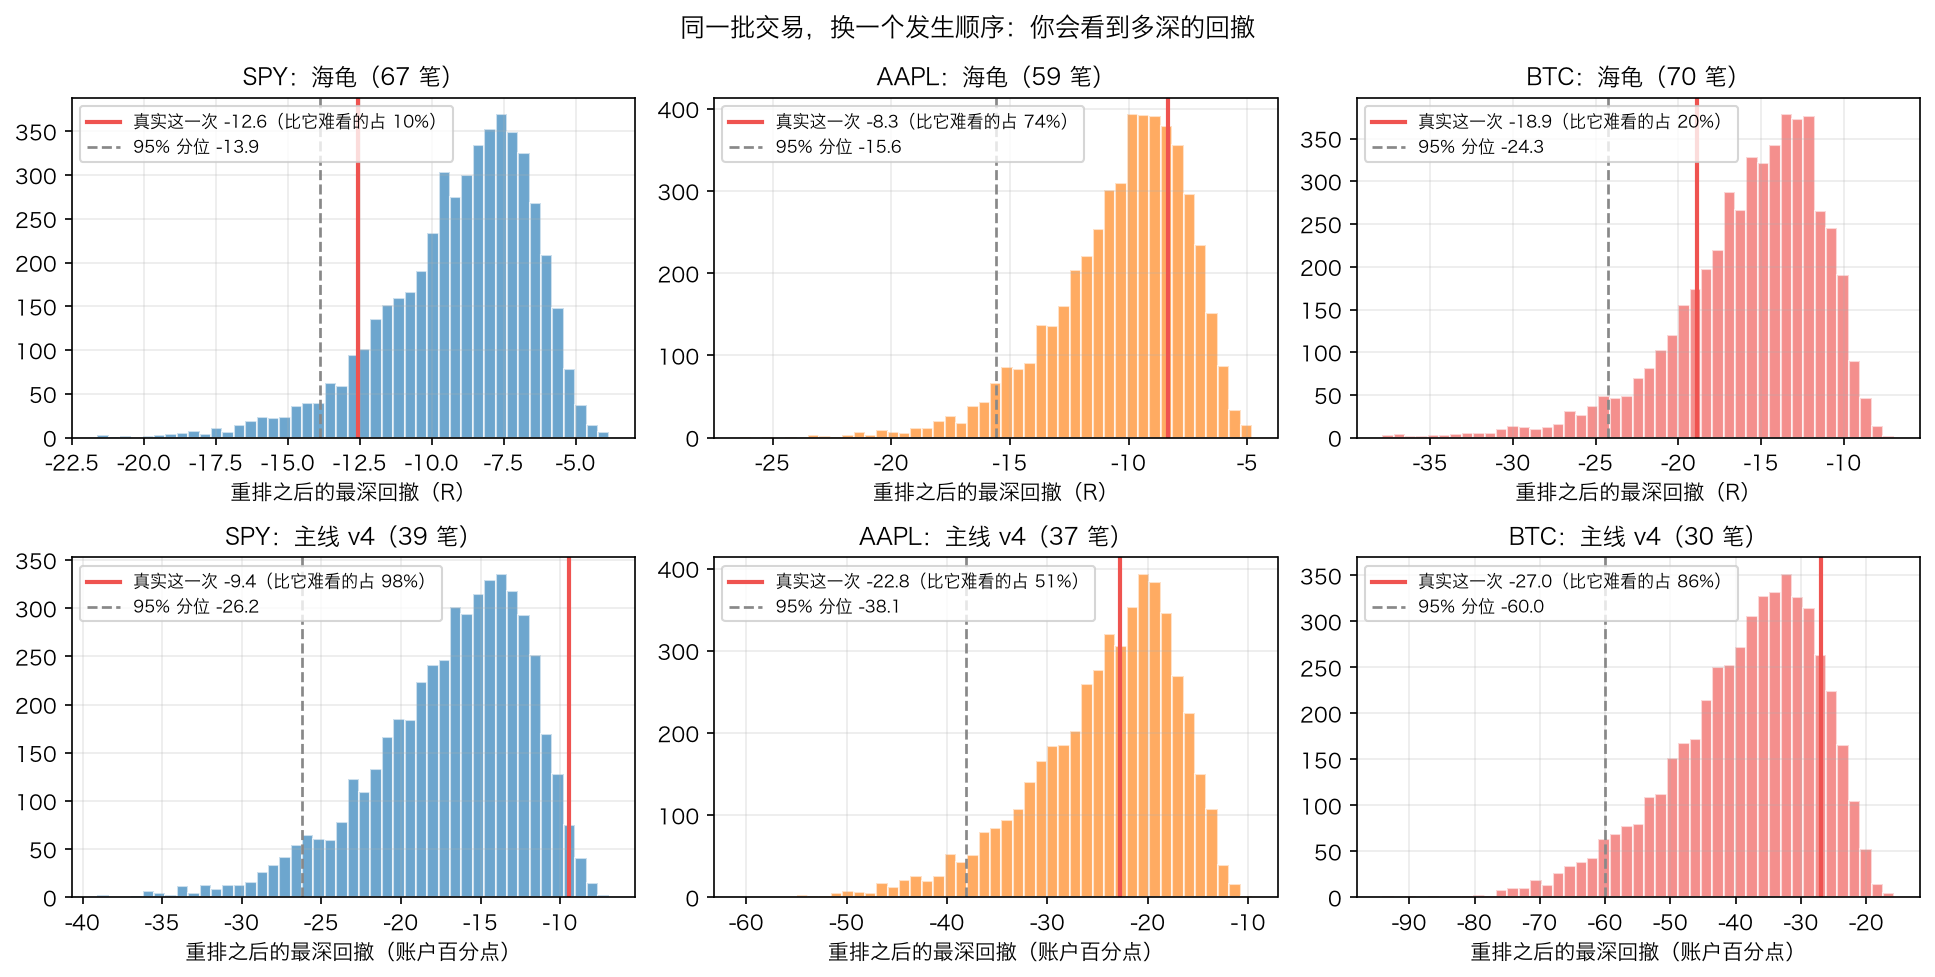
读这张表最有用的是这一列——「比这一次还难看的比例」:
| 真实这一次 | 比它还难看的重排占 | 95% 分位 | |
|---|---|---|---|
| SPY 最深回撤 | −12.56R | 9.7% | −13.88R |
| AAPL 最深回撤 | −8.33R | 74.1% | −15.58R |
| BTC 最深回撤 | −18.89R | 19.7% | −24.25R |
| BTC 最长连亏 | 12 笔 | 11.5% | 13 笔 |
**BTC 上那段让人绝望的十二连亏,在两千次重排里排在第 88.5 个百分位;−18.89R 的回撤排在第 80.3 个百分位。**难看,但没有难看到该关掉的程度——回撤的 95% 分位是 −24.25R,比你真的经历过的还要深 28%。
换句话说:你真正该准备好的那个数字,比你在回测报告上看到的那个数字更难看。
⚠️ 一个容易错的地方:这里的回撤一律用加法算(曲线就是 R 的累加),相当于「每笔都按初始本金的固定比例下注」。不用复利是故意的——复利会把顺序效应和「越赚越大」搅在一起,而这一节要看的就是纯粹的顺序效应。
五、你在回测里看到的回撤,未必是你会遇到的回撤
把同一张表算在主线策略 v4 上(第 26 篇定下来的那一版,一个字没改):
—— SPY(主线 v4,39 笔,单位是账户的百分点)
           这一次   重抽平均  比这一次还难看的比例  50% 分位  90% 分位  95% 分位  99% 分位
最长连亏      3.00   5.40        1.00    5.00    8.00    8.00   10.00
最深回撤     -9.44 -16.87        0.98  -16.04  -23.48  -26.24  -31.71
最长水下(笔)  12.00  15.55        0.73   15.00   24.00   26.05   31.00
—— AAPL(主线 v4,37 笔,单位是账户的百分点)
           这一次   重抽平均  比这一次还难看的比例  50% 分位  90% 分位  95% 分位  99% 分位
最长连亏      3.00   4.31        0.98    4.00    6.00    7.00    8.00
最深回撤    -22.75 -24.26        0.51  -22.87  -34.06  -38.09  -46.27
最长水下(笔)  15.00  10.92        0.18   10.00   17.00   19.00   23.01
—— BTC(主线 v4,30 笔,单位是账户的百分点)
          这一次   重抽平均  比这一次还难看的比例  50% 分位  90% 分位  95% 分位  99% 分位
最长连亏      3.0   4.94        1.00     5.0    7.00    8.00    9.00
最深回撤    -27.0 -38.58        0.86   -36.7  -54.16  -59.96  -70.63
最长水下(笔)   9.0   9.98        0.59     9.0   15.00   17.00   21.00
这张表比上一张更值得看,因为它指向一个相反方向的问题:
| 主线 v4 | 回测报告上的回撤 | 比它还难看的重排占 | 95% 分位 |
|---|---|---|---|
| SPY | −9.44 | 98% | −26.24 |
| AAPL | −22.75 | 51% | −38.09 |
| BTC | −27.00 | 86% | −59.96 |
SPY 上主线 v4 的历史回撤只有 −9.44 个百分点,而两千次重排里有 98% 比它更难看。它的最长连亏只有 3 笔,而重排的中位数是 5 笔。
这不是说主线 v4 有问题。这是说:**它走过的那条路径,是所有可能路径里偏幸运的一条。**同样这 39 笔交易,换个顺序发生,95% 的把握下你该准备的是 −26 个百分点,不是 −9.4。
⚠️ 这是这一节唯一的结论,也是这一篇最该贴在屏幕上的一句话:**回测报告上的最大回撤是一个样本,不是一个上限。**第 29 篇教过「每台仪器都有测量误差」,这里是同一件事的另一个面——最大回撤这台仪器的误差,比夏普比率还大,因为它是一个极值统计量,只由一条路径的一小段决定。
三个标的六条策略,没有一个的真实回撤触到过 95% 分位。你从来没有见过你该准备的那个数。
六、「策略真的坏了」要多少笔才认得出来
到这里为止都是在说「别急着停手」。但总有真的坏掉的时候。那怎么认?
这个问题有一个精确的答案,而且这个答案是坏消息。
假设策略的期望值真的掉到了 0。要想以 80% 的把握、在 5% 的显著性水平上认出这件事,需要的笔数是:
笔数 ≈ [ (z₁₋α + z_power) × 每笔标准差 ÷ 每笔期望 ]²
注意分母被平方了一次。而交易这件事的特点恰恰是:单笔收益的标准差是期望的好几倍。
def detection_size(mean: float, std: float, drop: float = 1.0,
                   alpha: float = 0.05, power: float = 0.8) -> float:
    """要**多少笔**交易,才能以 `power` 的把握、在 `alpha` 的水平上,
    认出「每笔的期望值掉了 `drop` 倍」(`drop=1.0` 就是掉到 0):

    > 笔数 ≈ [ (z₁₋α + z_power) × 标准差 ÷ (期望 × drop) ]²

    这是第 29 篇「要跑多少年」的交易版本,结论也一样难看:
    **单笔收益的标准差通常是期望的好几倍,于是分母被平方一次,笔数就上了三位数。**
    连亏 7 笔提供的信息量,和这个数字比起来约等于 0。
    """
    if mean <= 0 or std <= 0 or drop <= 0:
        raise ValueError("期望、标准差、drop 都要是正数")
    z = NORMAL.inv_cdf(1 - alpha) + NORMAL.inv_cdf(power)
    return (z * std / (mean * drop)) ** 2
  标的          策略  笔数  每笔期望  每笔标准差  标准差是期望的几倍  认出「掉到 0」要几笔  认出「掉一半」要几笔  按历史速度要跑几年
 SPY       海龟(R)  67  0.71   2.61       3.68        83.57      334.29      11.23
 SPY 主线 v4(账户 %)  39  0.85   4.75       5.59       192.92      771.70      44.52
AAPL       海龟(R)  59  2.83   6.22       2.20        29.96      119.83       4.57
AAPL 主线 v4(账户 %)  37  3.03  10.58       3.49        75.21      300.83      18.29
 BTC       海龟(R)  70  4.23  12.93       3.06        57.86      231.43       7.44
 BTC 主线 v4(账户 %)  30  9.94  40.05       4.03       100.29      401.15      30.09
| 标准差是期望的几倍 | 认出「掉到 0」要几笔 | 按历史速度要跑几年 | |
|---|---|---|---|
| SPY 海龟 | 3.68 | 84 笔 | 11.2 年 |
| AAPL 海龟 | 2.20 | 30 笔 | 4.6 年 |
| BTC 海龟 | 3.06 | 58 笔 | 7.4 年 |
| SPY 主线 v4 | 5.59 | 193 笔 | 44.5 年 |
| BTC 主线 v4 | 4.03 | 100 笔 | 30.1 年 |
**最快的那个也要四年半。**而「只掉了一半」比「掉到 0」还难四倍——SPY 上的海龟要 334 笔。
这和第 29 篇那个「SPY 上的主线要跑 380 年才能证明夏普大于 0」是同一件事的两个说法。你手上这七笔连亏,提供的信息量和这些数字比起来约等于零。
所以「连亏几笔就认定策略失效」这条路是走不通的——不是因为它不严谨,是因为在你收集到足够证据之前,策略要么已经把你的账户毁了,要么已经赚回来了。
那还剩什么?三条,都不靠统计:
- 正常范围表(第四节那张)。落在范围里就继续,这不需要推断,只需要事先算好。
- 超出范围的时候降级——⚠️ 注意这句话的意思:超出 99% 分位不等于统计上证明了策略失效,它只是你上线之前和自己约好的那条线。约定不需要是对的,只需要是事先定好的。(怎么降级、降到哪一级,是第 34 篇的内容。)
- 机制还在不在。第 32 篇留下的那个数就是给这一步用的:趋势跟随赌的是方差比大于 1。方差比变了,前提就变了——这不需要等 58 笔。
回到那辆车:判断系统行不行,看的是每次接管之间跑了多少公里,不是你今天觉得它开得怎么样。而你今天觉得它开得不好,要攒到七年才够格变成一个统计结论。
七、连亏之后停手,值多少钱
说了这么多「不该停」,直接量一下。
规则很简单:**连亏 N 笔就停 M 笔,之后照旧。**被跳过的那几笔的结果照样记账——不然你永远不知道停手是赚了还是亏了。
def pause_after_losses(r, after: int = 3, pause: int = 3) -> np.ndarray:
    """「连亏 `after` 笔就停 `pause` 笔」这条规则,实际会跳过哪几笔。

    返回一串 True/False:True = 这一笔做了,False = 被规则拦下了。
    ⚠️ 被拦下的那几笔的**结果照样要记**——不然你永远不知道停手是赚了还是亏了。
    """
    r = pd.Series(r).dropna().astype(float).to_numpy()
    if after < 1 or pause < 0:
        raise ValueError("after 至少是 1,pause 不能是负数")
    taken = np.ones(len(r), dtype=bool)
    losses = skip = 0
    for i, value in enumerate(r):
        if skip > 0:
            taken[i] = False
            skip -= 1
            continue
        losses = losses + 1 if value <= 0 else 0
        if losses >= after:
            skip, losses = pause, 0
    return taken
BTC 上十二种组合:
 连亏几笔  停几笔  做了几笔   合计 R  跳过的那些笔   最深回撤  比一笔不落差多少
    0    0    70 295.93    0.00 -18.89      0.00
    2    1    56 270.20   25.73 -16.01    -25.73
    2    3    40 143.81  152.12 -15.08   -152.12
    2    5    30 200.59   95.34 -10.72    -95.34
    3    1    61 267.51   28.42 -13.98    -28.42
    3    3    49 176.61  119.32 -15.04   -119.32
    3    5    45 201.11   94.82 -13.93    -94.82
    4    1    65 224.79   71.14 -16.80    -71.14
    4    3    55 187.02  108.91 -12.17   -108.91
    4    5    50 198.93   97.00 -12.08    -97.00
    5    1    66 280.04   15.89 -15.33    -15.89
    5    3    61 285.91   10.02 -13.92    -10.02
    5    5    55 267.49   28.44 -15.14    -28.44
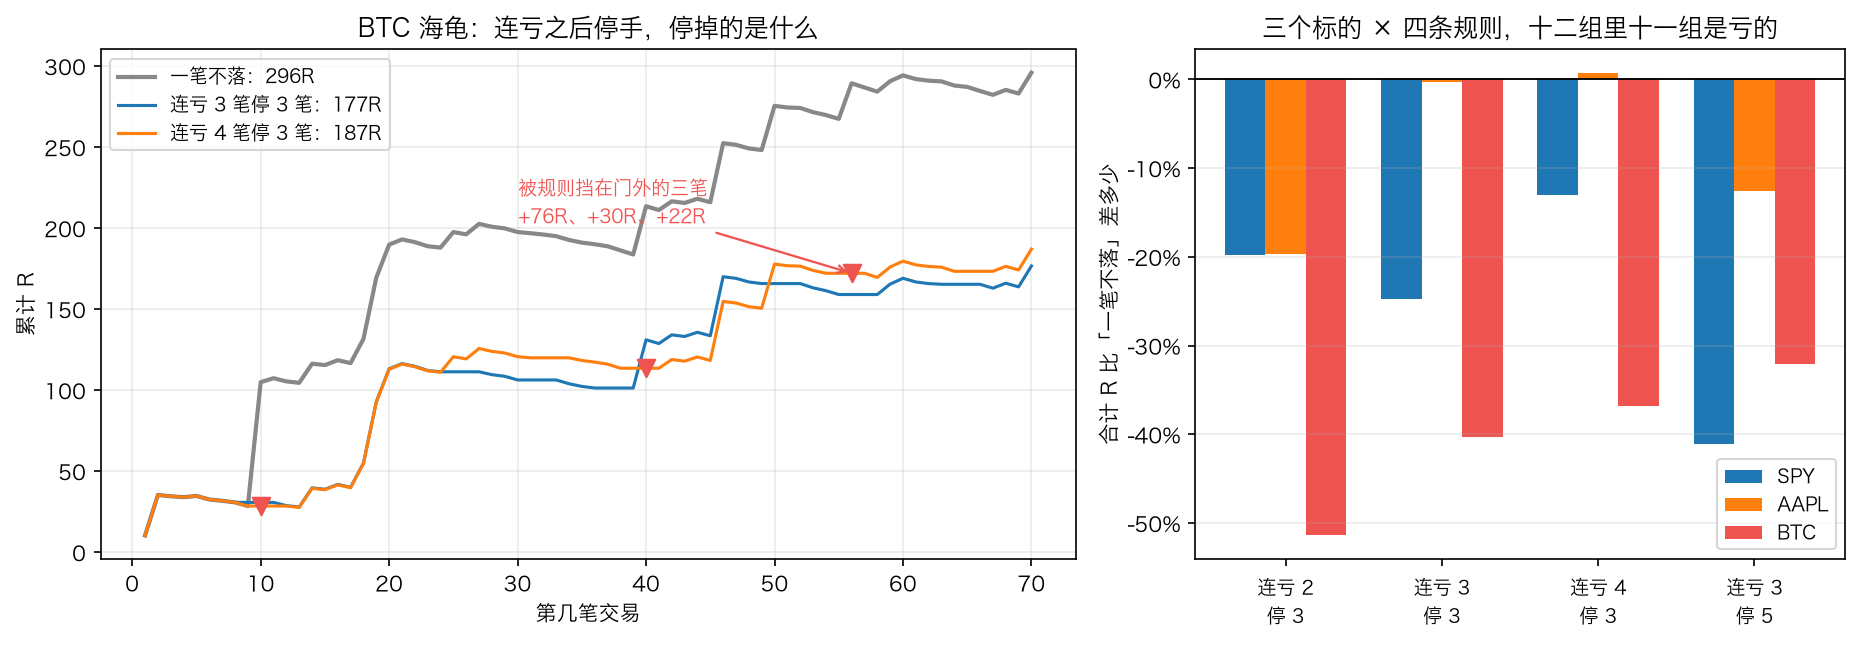
**十二条规则,没有一条是赚的。**最狠的那条(连亏 2 笔停 3 笔)把九年从 295.93R 砍到 143.81R——少了一半还多。
看「跳过的那些笔」那一列:它们全是正数。连亏 2 停 3 那一行跳过的交易合计 +152.12R——你停手的那段时间里,市场把这些钱发给了别人。
回撤倒是真的变浅了(十二行里最浅的一行是 −10.72R,比 −18.89R 少了四成)。⚠️ 但那是因为你交易得更少了,不是因为你避开了坏的。用第 26 篇的话说,这等于把风险预算调小——调小风险预算当然能压回撤,而且有比「连亏之后停手」直接得多的办法(直接把每笔的风险从 1% 改成 0.5%),代价还更小。
三个标的两条策略的汇总:
  标的          策略   一笔不落  连亏 2 停 3  连亏 3 停 3  连亏 4 停 3  连亏 3 停 5
 SPY       海龟(R)  47.50     -9.38    -11.74     -6.18    -19.52
 SPY 主线 v4(账户 %)  33.19     -4.27      0.24      0.00     -5.23
AAPL       海龟(R) 166.85    -32.83     -0.48      1.26    -21.05
AAPL 主线 v4(账户 %) 112.21     -8.97     -9.37      0.00    -61.69
 BTC       海龟(R) 295.93   -152.12   -119.32   -108.91    -94.82
 BTC 主线 v4(账户 %) 298.30    -21.87    -18.67      0.00    -18.70
十二组里十一组是亏的,唯一的例外是 AAPL 上的「连亏 4 笔停 3 笔」,赚了 +1.26R(0.8%)——在这个量级上,它和 0 没有区别。
⚠️ 主线 v4 那三行的「连亏 4 停 3」全是 0.00,原因很实在:**主线 v4 九年的最长连亏只有 3 笔,这条规则一次都没触发过。**一条从来不响的规则当然没有代价——但它也没有用。
那按当天亏损停呢?「单日亏损超过 X% 就清仓,停 N 天」是另一条常见的执行规则。量一下:
  标的 单日亏多少就停  停几天  被触发几次  真正被砍掉的天数     年化    最大回撤
 SPY      不停    0      0         0 0.0468 -0.1711
 SPY      3%    5      3         2 0.0496 -0.1519
 SPY      3%   20      3         2 0.0496 -0.1519
 SPY      5%    5      0         0 0.0468 -0.1711
 SPY      5%   20      0         0 0.0468 -0.1711
AAPL      不停    0      0         0 0.1690 -0.1187
AAPL      3%    5      8        28 0.1550 -0.1187
AAPL      3%   20      7        85 0.1382 -0.1211
AAPL      5%    5      2         1 0.1703 -0.1187
AAPL      5%   20      2         1 0.1703 -0.1187
 BTC      不停    0      0         0 0.3160 -0.2156
 BTC      3%    5     30       107 0.2749 -0.2143
 BTC      3%   20     21       232 0.2968 -0.2143
 BTC      5%    5     13        37 0.3075 -0.2143
 BTC      5%   20     12       105 0.3111 -0.2170
SPY 那四行很有意思:「单日亏 3% 就停 5 天」九年只触发了 3 次,而且真正被砍掉的只有 2 天——因为触发的那一天止损已经把仓位平掉了,后面那几天本来就是空仓。「单日亏 5%」一次都没触发过。
**对一条日线波段策略来说,每日亏损上限基本是个摆设。**它是给日内高频交易设计的——那里一天可以开几十笔,一天的亏损才有可能失控。在这里,止损已经干了这件事。
BTC 上倒是真的会触发(3% 的门槛九年 30 次),但结果一样难看:年化从 31.60% 掉到 27.49%,最大回撤从 −21.56% 只压到 −21.43%——几乎没动,因为最大的那次回撤是十二笔交易慢慢磨出来的,不是哪一天砸出来的。
八、连亏之后的下一笔,有什么不一样吗
上一节说「停手是亏的」。但那只是总账。有没有可能,连亏之后的那几笔确实质量更差,只是被别的东西盖过去了?
直接查:
  标的           这一笔的处境  笔数   平均 R    胜率  最大一笔 R
 SPY               全部  67  0.709 0.448   7.651
 SPY           前一笔是亏的  37  0.889 0.405   7.624
 SPY       前面连亏 ≥ 3 笔  13  1.691 0.538   7.623
 SPY       前面连亏 ≥ 5 笔   3  2.755 0.667   7.623
 SPY 最赚的 10 笔,前一笔是亏的占  10  5.579 0.700   7.651
AAPL               全部  59  2.828 0.458  18.051
AAPL           前一笔是亏的  31  3.223 0.516  17.649
AAPL       前面连亏 ≥ 3 笔   5  0.544 0.400   3.947
AAPL       前面连亏 ≥ 5 笔   1  1.667 1.000   1.667
AAPL 最赚的 10 笔,前一笔是亏的占  10 14.591 0.600  18.051
 BTC               全部  70  4.228 0.329  76.442
 BTC           前一笔是亏的  47  4.683 0.340  76.442
 BTC       前面连亏 ≥ 3 笔  22  6.342 0.273  76.442
 BTC       前面连亏 ≥ 5 笔  12  3.132 0.250  29.767
 BTC 最赚的 10 笔,前一笔是亏的占  10 30.289 0.700  76.442
| BTC | 笔数 | 平均 R | 胜率 |
|---|---|---|---|
| 全部 | 70 | 4.228 | 32.9% |
| 前一笔是亏的 | 47 | 4.683 | 34.0% |
| 前面连亏 ≥ 3 笔 | 22 | 6.342 | 27.3% |
| 前面连亏 ≥ 5 笔 | 12 | 3.132 | 25.0% |
**连亏之后的那些笔,平均 R 不比别的差,甚至还高一点。**胜率略低、平均 R 略高,这正好是趋势跟随该有的样子——⚠️ 但样本只有十几二十笔,这个方向不能当成结论(第 29 篇:样本量是笔数不是根数)。
真正能当结论的是最后那一行:**BTC 上最赚的 10 笔里,70% 的「前一笔」是亏的。**而全样本里「前一笔是亏的」本来就占 67.1%(47/70)。
70% 对 67%。一点信息都没有。
SPY 上是 70% 对 55.2%,AAPL 上是 60% 对 52.5%——三个标的,没有一个方向一致、幅度够大。
**大赚的那几笔,前面是连亏还是连赚,完全没有规律。**所以不存在「先躲开坏的、再回来接好的」这种走法——你要么都做,要么都不做。
这就是自动驾驶那个比方里最不舒服的一条:**你接管的那几次,事后看绝大多数是不必要的。**而你没法事先知道哪几次是必要的。
九、六种手动调整的价目表
停手只是众多「接管」里的一种。把常见的几种一起标上价:
def interfere(r, kind: str, level: float = 2.0) -> np.ndarray:
    """在一串 R 倍数上施加一次常见的「手动调整」,返回调整之后的 R。

    前四种只动**仓位**或者**做不做**,所以是精确的:

    - `skip_after_loss`:亏一笔之后,下一笔不敢做了
    - `double_after_loss`:亏一笔之后,下一笔加倍下注(想一把捞回来)
    - `half_after_loss`:亏一笔之后,下一笔只做一半(怯场)
    - `double_after_win`:赚一笔之后,下一笔加倍下注(觉得手感来了)

    后两种动的是**出场**,只能给一个方向确定的估计:

    - `cap`:浮盈到 `level` 个 R 就提前走人 → `min(r, level)`。
      ⚠️ 这是**代价的上界**:真实的提前止盈还会把一部分最终亏损的交易救成小赚,
      所以真实代价比这里算出来的小。
    - `widen`:眼看要止损,把止损往外挪,最后照样止损 → 亏的那些乘以 `level`。
      ⚠️ 这也是**上界**:挪远之后会有一部分活过来变成盈利。
      想要不含上界的那个数,就直接改引擎里的止损参数重跑一遍——两个数一夹,真相在中间。
    """
    r = pd.Series(r).dropna().astype(float).to_numpy()
    if kind not in KINDS:
        raise ValueError(f"kind 只能是 {KINDS} 之一,收到 {kind!r}")
    if kind == "cap":
        return np.minimum(r, level)
    if kind == "widen":
        return np.where(r <= 0, r * level, r)
    previous = np.concatenate([[np.nan], r[:-1]])
    after_loss, after_win = previous <= 0, previous > 0
    scale = np.ones(len(r))
    if kind == "skip_after_loss":
        scale[after_loss] = 0.0
    elif kind == "double_after_loss":
        scale[after_loss] = 2.0
    elif kind == "half_after_loss":
        scale[after_loss] = 0.5
    else:
        scale[after_win] = 2.0
    return r * scale
—— SPY(海龟)
            怎么改的  合计 R   最深回撤  差多少 R 按每笔冒 1% 折算
           一个字不改 47.50 -12.56   0.00      +0.0%
         亏了之后不敢做 14.61 -11.94 -32.89     -32.9%
          亏了之后加倍 80.39 -16.94  32.89     +32.9%
          亏了之后减半 31.05 -11.75 -16.45     -16.4%
          赚了之后加倍 58.20 -23.50  10.70     +10.7%
        浮盈 2R 就走  5.56 -18.02 -41.94     -41.9%
要止损了把止损挪远(亏的 ×2)  4.93 -39.11 -42.57     -42.6%
—— AAPL(海龟)
            怎么改的   合计 R   最深回撤   差多少 R 按每笔冒 1% 折算
           一个字不改 166.85  -8.33    0.00      +0.0%
         亏了之后不敢做  66.93  -8.84  -99.92     -99.9%
          亏了之后加倍 266.77 -15.14   99.92     +99.9%
          亏了之后减半 116.89  -5.63  -49.96     -50.0%
          赚了之后加倍 232.17 -11.26   65.33     +65.3%
        浮盈 2R 就走   0.65 -14.17 -166.20    -166.2%
要止损了把止损挪远(亏的 ×2) 117.07 -18.32  -49.78     -49.8%
—— BTC(海龟)
            怎么改的   合计 R   最深回撤   差多少 R 按每笔冒 1% 折算
           一个字不改 295.93 -18.89    0.00      +0.0%
         亏了之后不敢做  75.81 -15.74 -220.12    -220.1%
          亏了之后加倍 516.05 -36.00  220.12    +220.1%
          亏了之后减半 185.87 -10.33 -110.06    -110.1%
          赚了之后加倍 361.46 -20.66   65.53     +65.5%
        浮盈 2R 就走 -30.67 -40.37 -326.60    -326.6%
要止损了把止损挪远(亏的 ×2) 220.49 -37.77  -75.44     -75.4%
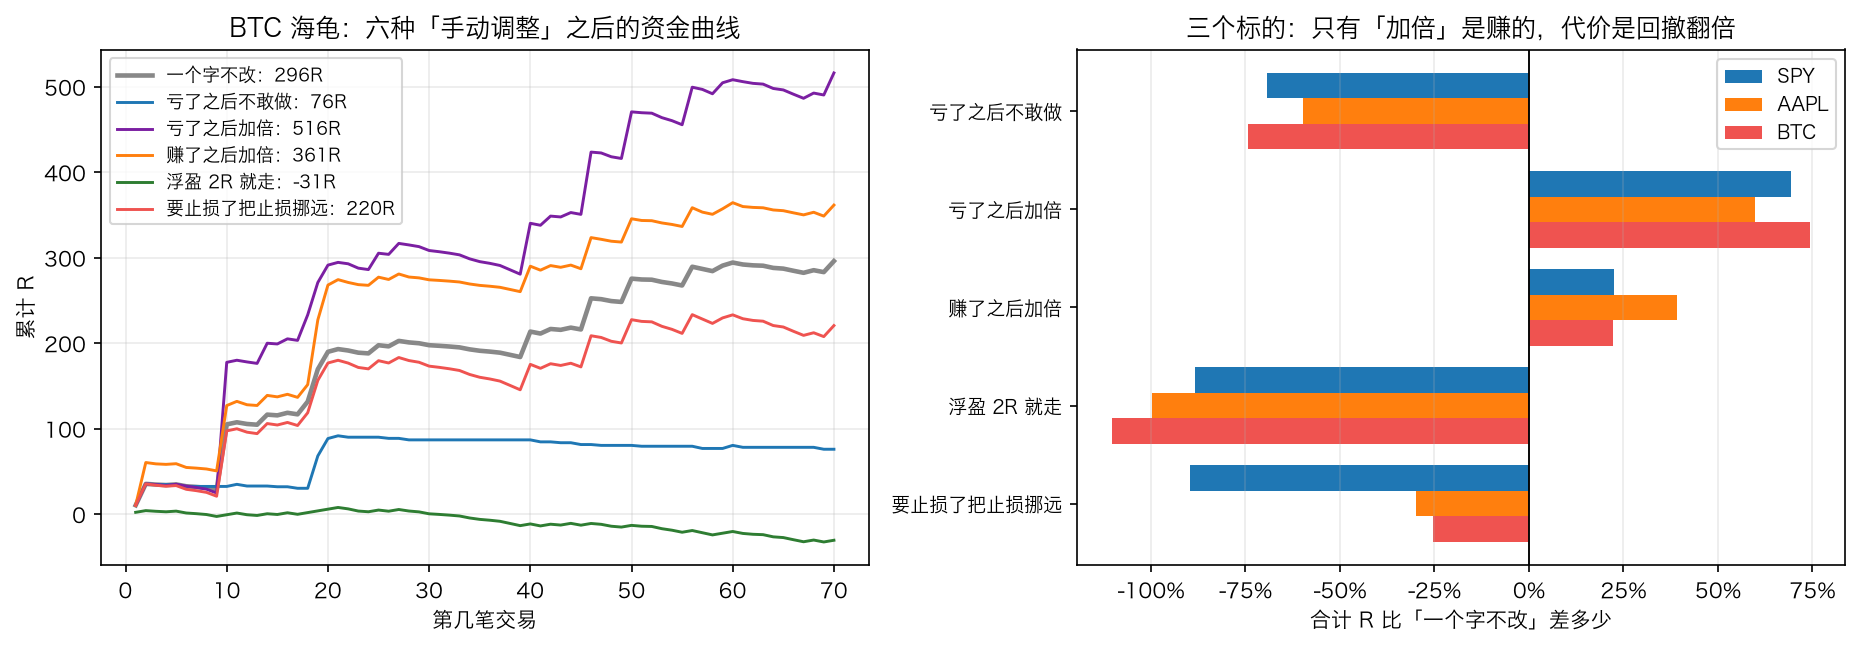
BTC 上的价目表(九年合计 295.93R,每笔冒账户 1%,所以 1R 大致就是 1 个百分点):
| 你做的事 | 合计 R | 最深回撤 | 差多少 |
|---|---|---|---|
| 一个字不改 | 295.93 | −18.89 | — |
| 亏了之后不敢做 | 75.81 | −15.74 | −220.12R |
| 亏了之后加倍 | 516.05 | −36.00 | +220.12R |
| 亏了之后减半 | 185.87 | −10.33 | −110.06R |
| 赚了之后加倍 | 361.46 | −20.66 | +65.53R |
| 浮盈 2R 就走 | −30.67 | −40.37 | −326.60R |
| 要止损了把止损挪远 | 220.49 | −37.77 | −75.44R |
三件事值得说:
**第一,「浮盈 2R 就走」是全表最贵的一条。**它把九年从 +295.93R 变成 −30.67R——九年白干还倒亏。这不奇怪:第 31 篇量过,BTC 上最大的一笔是 +76.44R,而这条规则会在 +2R 的地方把它砍掉。趋势跟随的全部收益都在右尾上,提前止盈是专门用来剪右尾的剪刀。
⚠️ 这个数是代价的上界:真实的提前止盈还会把一部分最终亏损的交易救成小赚(浮盈到过 2R 又跌回去的那些),所以真实代价比 −326.60R 小。但方向没有疑问。
第二,「亏了之后加倍」在历史上是赚的(+220.12R),而「亏了之后不敢做」亏掉的正好是同一个数。这不是巧合,是算术:两者动的是同一批交易,一个乘 2 一个乘 0,相对基准的偏移必然大小相等方向相反。
所以千万别把 +220.12R 读成「报复性交易有道理」。**它赚的原因只是:这条策略每一笔的期望本来就是正的,你把任何一组交易加倍都会赚更多。**真正的代价在旁边那一列:最深回撤从 −18.89R 变成 −36.00R,差不多翻倍。用第 26 篇的话说——加倍不增加优势,它只增加杠杆,而且是在你账户最虚弱的时刻加杠杆。
第三,三个标的的形状完全一致(右边那张图):「不敢做」和「浮盈就走」在三个标的上都是大负数,「挪止损」都是负数。这三条是真正的执行失误。而「加倍」那两条的正号,在三个标的上都伴随着回撤的显著恶化。
十、「一开始就放远」和「临时挪远」是两件事
上表里「把止损挪远」只亏了 75.44R,看起来比「不敢做」轻得多。这个数容易被误读成「止损放远一点也没什么」。
放远和挪远是两件完全不同的事。直接把引擎里的止损参数改掉重跑一遍,就能看出区别:
  标的               止损  笔数     年化    最大回撤     合计 R
 SPY       2N(一开始就定好)  67 0.0468 -0.1711  47.5013
 SPY       3N(一开始就定好)  63 0.0485 -0.1025  48.7796
 SPY       4N(一开始就定好)  63 0.0432 -0.1027  43.2927
 SPY 临时挪远(亏的 ×1.5,上界)  67    NaN     NaN  26.2169
 SPY   临时挪远(亏的 ×2,上界)  67    NaN     NaN   4.9325
AAPL       2N(一开始就定好)  59 0.1690 -0.1187 166.8484
AAPL       3N(一开始就定好)  55 0.1250 -0.1028 123.8316
AAPL       4N(一开始就定好)  55 0.0933 -0.0752  92.4573
AAPL 临时挪远(亏的 ×1.5,上界)  59    NaN     NaN 141.9603
AAPL   临时挪远(亏的 ×2,上界)  59    NaN     NaN 117.0722
 BTC       2N(一开始就定好)  70 0.3160 -0.2156 295.9295
 BTC       3N(一开始就定好)  65 0.2009 -0.1693 188.2643
 BTC       4N(一开始就定好)  65 0.1480 -0.1563 138.0073
 BTC 临时挪远(亏的 ×1.5,上界)  70    NaN     NaN 258.2086
 BTC   临时挪远(亏的 ×2,上界)  70    NaN     NaN 220.4877
| SPY | 笔数 | 年化 | 最大回撤 |
|---|---|---|---|
| 2N(原版) | 67 | 4.68% | −17.11% |
| 3N(一开始就定好) | 63 | 4.85% | −10.25% |
| 4N(一开始就定好) | 63 | 4.32% | −10.27% |
**SPY 上「一开始就把止损放到 3N」年化更高、回撤几乎减半。**这是一个合理的参数选择,不是错误。
而同一个账户上「临时挪远」的结果是:合计 R 从 47.50 掉到 4.93。
区别在哪?仓位。
- 一开始就放远:止损距离变大 → 按第 26 篇的固定风险公式,仓位自动变小 → 每笔的风险还是账户的 1%,一个字没变
- 临时挪远:仓位在进场那一刻就定死了 → 止损距离变大 → 每笔的风险直接翻倍
**「挪止损」的真正问题不是止损放在哪里,是它在不改仓位的前提下改风险——而且只在你正在亏钱的那些笔上改。**它等于一条「只在坏情况下加倍下注」的规则,比上一节那条「亏了之后加倍」还要糟,因为它连"下一笔"都等不及。
⚠️ 读这张表要小心一个陷阱:不同止损宽度下 R 的定义是不一样的(1R 就是止损距离),所以「合计 R」那一列只能竖着和自己比,横着比要看年化和最大回撤。AAPL 和 BTC 上 3N/4N 的年化都明显更低(BTC 31.60% → 20.09% → 14.80%),说明 2N 在那两个标的上是更好的选择——这也说明第 31 篇那个「(20,10) 是高地不是针」的结论对止损宽度同样成立:换一个数不会塌,但也不是随便换。
十一、交易日志该记什么
到这里,所有该量的都量完了。剩下的问题是:你怎么知道自己有没有照做?
答案不能靠回忆。回忆这东西有一个特别恶劣的性质:你记得住那几次「幸亏我没做」,记不住那几十次「幸亏我做了」。
所以要记账。而交易日志的核心只有一件事:
计划和实际并排放。
只记实际成交价的日志是没有用的——它能告诉你赚了多少,不能告诉你为什么和回测不一样。券商对账单已经把「实际」那一半给你了,你要补的是另外那一半——计划,以及两者不一样时的原因。
@dataclass
class Entry:
    """日志里的一行。核心是一件事:**计划和实际并排放。**

    只记实际成交价的日志没有用——它能告诉你赚了多少,不能告诉你**为什么和回测不一样**。
    `reconcile` 要拆的那几块,全都藏在「计划」和「实际」的差里。

    `fill_*` 留空表示「和计划完全一样」。`qty` 为 0 的一行表示**这笔计划里的交易你没做**,
    照样要记——第四节的 `pause_table` 已经说明了为什么。
    """
    time: pd.Timestamp                    # 计划进场的那一根
    symbol: str                           # 标的
    plan_entry: float                     # 计划进场价
    plan_stop: float                      # 计划止损价
    plan_qty: float                       # 计划数量
    side: str = "long"
    plan_exit: float = np.nan             # 计划出场价(回测给的)
    fill_entry: float | None = None       # 实际成交价
    fill_qty: float | None = None         # 实际数量(0 = 没做)
    fill_exit: float | None = None
    exit_time: pd.Timestamp | None = None
    fee: float = 0.0                      # 实际付出的手续费
    plan_fee: float = 0.0
    basis: str = "规则"                   # 依据:规则 / 我觉得 / 别人说的
    note: str = ""                        # 偏离计划的原因,一句话

    def __post_init__(self):
        if self.side not in SIDES:
            raise ValueError(f"side 只能是 {tuple(SIDES)} 之一,收到 {self.side!r}")
        if not self.plan_qty > 0:
            raise ValueError("计划数量要大于 0")
        if SIDES[self.side] * (self.plan_stop - self.plan_entry) >= 0:
            raise ValueError("止损放错了方向:做多的止损要低于进场价,做空的要高于")
        if self.fill_qty is not None and self.fill_qty < 0:
就用决策点之后那三笔真实交易记一遍:
2023-01-08 BTC  多 17325.35 17325.35 16616.33 25.92 25.92 22500.00 22500.00 2023-02-09   0.0  0.0 134106.89 134106.89  规则
2023-02-15 BTC  多 24625.73 24639.13 23252.52 11.90 11.90 23486.09 23470.11 2023-02-17   0.0 44.0 -13564.07 -13957.75  规则 进场晚了 13 美元,出场滑了 16 美元
2023-03-14 BTC  多 25384.24 25384.24 23409.30 11.00  0.00 28170.00 28170.00 2023-04-20   0.0  0.0  30640.61      0.00 我觉得          刚被止损两次,这次不敢做

记了几笔              3.00
没做                1.00
成交价和计划不一样         1.00
数量和计划不一样          0.00
依据不是规则            1.00
第三行就是第一节那个人的选择:2023 年 3 月 14 日,刚被止损两次,这次不敢做。日志把它记成一行——计划数量 11.00,实际数量 0.00,依据那一栏写的不是「规则」,而是:「我觉得」;备注那一栏写的是理由。
这一笔计划里该赚 30,640.61 美元。三笔加起来,计划盈亏 151,183.44,实际盈亏 120,149.14,差了 31,034.29。
summary() 给的那几个数里,最后一个是整本日志唯一不能从券商对账单里算出来的东西:
依据不是规则 1.00
「我觉得」这一类,只有你自己记才数得出来。这就是记日志的全部理由——它不是为了复盘行情,是为了让接管这件事有一个计数器。
自动驾驶公司提交的脱离报告里最关键的字段从来不是速度和位置,而是:「为什么」。
十二、对账:把差额拆干净
有了「计划」和「实际」两张表,就可以问那个最实在的问题:
我今年比回测少赚的那一截,到底是从哪来的?
这个问题有一个精确的答案。差额可以被完整地拆成五块,五块之和恰好等于总差额,一分钱不剩:
def reconcile(planned: pd.DataFrame, actual: pd.DataFrame, key: str = "买入日",
              entry_col: str = "买入价", exit_col: str = "卖出价", qty_col: str = "数量",
              fee_col: str = "费用", side_col: str = "方向") -> dict:
    """实盘和回测差的那一截,是从哪来的。

    两张表按 `key`(默认进场日)对齐,把总差额拆成五块:

    | 这一块 | 怎么算 | 说的是 |
    |---|---|---|
    | 漏做 | −Σ 回测那笔的盈亏 | 计划里有、你没做 |
    | 多做 | +Σ 实盘那笔的盈亏 | 计划里没有、你做了 |
    | 进场滑点 | Σ 方向 × 计划量 ×(计划进场价 − 实际进场价) | 买贵了 / 卖便宜了 |
    | 出场滑点 | Σ 方向 × 计划量 ×(实际出场价 − 计划出场价) | 走早了 / 走晚了 |
    | 仓位差 | Σ 方向 ×(实际量 − 计划量)×(实际出场价 − 实际进场价) | 做大了 / 做小了 |
    | 费用差 | −Σ(实际费用 − 计划费用) | 手续费和回测里假设的不一样 |

    这不是近似:**六块之和恒等于「实盘合计 − 回测合计」**(`差额核对` 那一项就是用来看这个的,
    正常应该是 0)。代数上它是把 q(x−e) 的差分三步展开,每一步只动一个量。

    ⚠️ **拆开之后最该看的是「漏做」那一格。** 滑点是几个基点的事,
    漏做一笔是整整一笔的事——而第 31 篇已经量过,一笔可以占九年收益的 14%。
    """
    def prep(table: pd.DataFrame) -> pd.DataFrame:
        out = table.copy()
        if fee_col not in out:
            out[fee_col] = 0.0
        out["_side"] = (out[side_col].map(SIDES).astype(float) if side_col in out else 1.0)
        out["_pnl"] = out["_side"] * out[qty_col] * (out[exit_col] - out[entry_col]) - out[fee_col]
        return out.set_index(key)

    left, right = prep(planned), prep(actual)
    both = left.index.intersection(right.index)
    missing, extra = left.drop(both), right.drop(both)
    p, a = left.loc[both], right.loc[both]

    sign, q_p, q_a = p["_side"], p[qty_col], a[qty_col]
    slip_in = sign * q_p * (p[entry_col] - a[entry_col])
    slip_out = sign * q_p * (a[exit_col] - p[exit_col])
    size_gap = sign * (q_a - q_p) * (a[exit_col] - a[entry_col])
    fee_gap = -(a[fee_col] - p[fee_col])
    parts = pd.Series({
        "漏做": -float(missing["_pnl"].sum()), "多做": float(extra["_pnl"].sum()),
        "进场滑点": float(slip_in.sum()), "出场滑点": float(slip_out.sum()),
        "仓位差": float(size_gap.sum()), "费用差": float(fee_gap.sum()),
    })
    total = float(right["_pnl"].sum() - left["_pnl"].sum())
    parts["合计"] = float(parts.sum())
    parts["实盘 − 回测"] = total
    parts["差额核对"] = parts["合计"] - total
    by_trade = pd.DataFrame({"进场滑点": slip_in, "出场滑点": slip_out,
                             "仓位差": size_gap, "费用差": fee_gap,
                             "这一笔差多少": a["_pnl"] - p["_pnl"]})
    return {"归因": parts, "逐笔": by_trade.sort_index(),
拆法本身是一个代数恒等式:每一笔的盈亏是「方向 × 数量 × 价差 − 费用」,三步展开,每一步只动一个量。所以 差额核对 那一项必须是 0,不是 0 就是代码写错了。
现在造一个「实盘」来试。它和回测有三处不一样,外加一个人的决定:
- 单边 0.05% 的滑点(买的时候买贵,卖的时候卖便宜)
- 数量随机差 ±10%(手滑、凑整、余额不够)
- 单边 0.10% 的手续费(Binance 现货 taker 的标准费率,而回测里假设是 0)
- 外加第一节那个人的行为:连亏 4 笔就停 3 笔
SLIP_BP, FEE_BP = 5e-4, 1e-3


def as_table(trades: pd.DataFrame) -> pd.DataFrame:
    """把海龟的交易表整理成 `reconcile` 认识的样子(费率是 0,所以数量能精确反推)。"""
    sign = np.where(trades["方向"] == "多", 1.0, -1.0)
    qty = trades["盈亏"].to_numpy() / (sign * (trades["出场价"] - trades["平均价"]).to_numpy())
    return trades.assign(数量=qty, 费用=0.0)[["进场日", "方向", "平均价", "出场价", "数量", "费用"]]


planned = as_table(trades)
sign = np.where(planned["方向"] == "多", 1.0, -1.0)
rng = np.random.default_rng(33)
live = planned.assign(
    平均价=planned["平均价"] * (1 + sign * SLIP_BP),            # 买的时候买贵一点
    出场价=planned["出场价"] * (1 - sign * SLIP_BP),            # 卖的时候卖便宜一点
    数量=planned["数量"] * (1 + rng.normal(0, 0.10, len(planned))),
)
live["费用"] = live["数量"] * (live["平均价"] + live["出场价"]) * FEE_BP
taken = JN.pause_after_losses(trades["R"], after=4, pause=3)    # 决策点那个人的行为
live = live[taken]
「实盘」的三处不一样:单边 0.05% 滑点、数量随机差 ±10%、单边 0.10% 手续费,外加「连亏 4 笔就停 3 笔」跳过了 15 笔

漏做         -275,133
多做               +0
进场滑点         -7,003
出场滑点         -7,405
仓位差          +8,437
费用差         -29,069
合计         -310,175
实盘 − 回测    -310,175
差额核对             +0
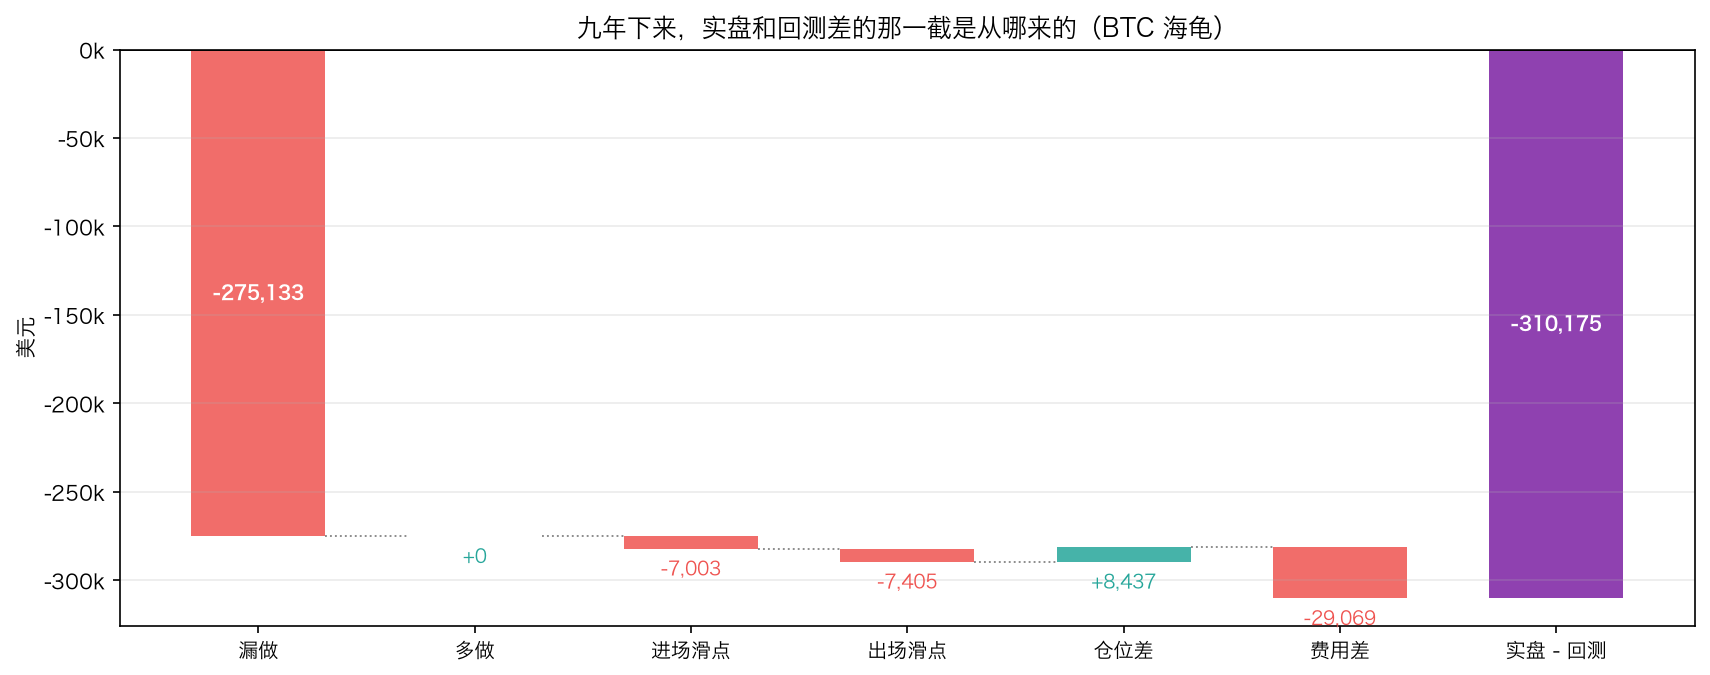
九年下来,实盘比回测少赚 310,175 美元。拆开:
| 金额 | 占差额 | |
|---|---|---|
| 漏做 | −275,133 | 88.7% |
| 费用差 | −29,069 | 9.4% |
| 出场滑点 | −7,405 | 2.4% |
| 进场滑点 | −7,003 | 2.3% |
| 仓位差 | +8,437 | −2.7% |
| 多做 | +0 | 0% |
| 合计 | −310,175 | 100% |
进场滑点加出场滑点一共 14,408 美元,占 4.6%。漏做那一格是 275,133,占 88.7%——是滑点的 19 倍。
看看被跳过的是哪几笔:
跳过的那 15 笔:
       进场日        出场日   原因        盈亏     R
2019-03-21 2019-06-04 通道出场  98354.06 76.44
2019-06-16 2019-07-02 通道出场   5580.90  2.46
2019-08-05 2019-08-14   止损  -4616.47 -1.98
2022-05-31 2022-06-10 通道出场  -4299.06 -0.84
2022-07-08 2022-07-13   止损  -5101.22 -1.00
2022-07-18 2022-07-26   止损 -11733.77 -2.32
2022-12-05 2022-12-16   止损 -11813.89 -2.56
2023-01-08 2023-02-09 通道出场 134106.89 29.77
2023-02-15 2023-02-17   止损 -13564.07 -2.32
2024-09-17 2024-10-01   止损 -22222.73 -2.37
2024-10-14 2024-12-05 通道出场 201393.91 21.95
2024-12-05 2024-12-19   止损 -28821.26 -2.58
2025-12-09 2025-12-14 通道出场  -9428.24 -0.86
2026-01-02 2026-01-20   止损 -27320.96 -2.51
2026-03-04 2026-03-19   止损 -25380.75 -2.39
十五笔里十一笔是亏的,合计 −164,302 美元——跳过它们确实省下了这些钱。
另外四笔是赚的,合计 +439,436 美元,其中三笔是:
| 被跳过的交易 | 盈亏 | R | 在九年 70 笔里排第几 |
|---|---|---|---|
| 2019-03-21 → 2019-06-04 | +98,354 | +76.44R | 7 |
| 2023-01-08 → 2023-02-09 | +134,107 | +29.77R | 5 |
| 2024-10-14 → 2024-12-05 | +201,394 | +21.95R | 3 |
一减一加,净下来就是归因表上那个 −275,133。
那条「保护你」的规则省下了十一笔小亏,代价是挡住了九年里排第 3、第 5、第 7 的那三笔。
这不是巧合,但也不是什么神秘规律。趋势跟随的大赚交易出现在一段趋势的开头,而趋势的开头前面通常是一段没有方向的震荡——而震荡正是连亏的来源(第 31 篇量过:BTC 的 20 日通道突破有 41.74% 是假的,真按规则交易亏钱的比例是 55%–67%)。连亏和大赚在时间上是挨着的。
⚠️ 但第八节已经证明了这件事的另一半:这种「挨着」没有方向性——最赚的 10 笔里前一笔是亏的占 70%,而基准就是 67.1%。它足以解释为什么停手一定会亏,但不足以让你反过来在连亏之后加仓。
「连亏之后停手」这条规则,是专门用来错过它们的。
十三、漏做一笔,相当于多少滑点
上一节的对比值得单独量一次,因为它决定了你该把精力花在哪。
  标的   九年成交名义金额     九年总盈亏  单边 1 个基点滑点  漏做赚得最多的那一笔  一笔顶多少个基点的滑点
 SPY 15129801.4   57179.1     -1513.0    -11034.9          7.3
AAPL 22951801.3  368098.0     -2295.2    -64022.4         27.9
 BTC 38297191.1 1079570.8     -3829.7   -217853.3         56.9
| 九年成交名义金额 | 单边 1 个基点滑点 | 漏做赚得最多的那一笔 | 一笔顶多少个基点 | |
|---|---|---|---|---|
| SPY | 15,129,801 | −1,513 | −11,035 | 7.3 |
| AAPL | 22,951,801 | −2,295 | −64,022 | 27.9 |
| BTC | 38,297,191 | −3,830 | −217,853 | 56.9 |
在 BTC 上,漏做那一笔的代价,等于九年里每一笔交易都多付 56.9 个基点的滑点。
56.9 个基点是什么概念?第 28 篇量过:BTC 永续的真实买卖价差中位数只有 0.0328 个基点,现货 taker 费率是 10 个基点。也就是说,手一抖漏做一笔,等于把九年的交易成本变成原来的六倍还多。
⚠️ 而 BTC 上那一笔是哪一笔?2023 年 10 月 16 日买在 28,580、12 月 29 日出场,+36.43R、+217,853 美元——正是第 31 篇那个决策点里「前面十次突破七次是假的、你还做不做第十一次」的答案。
最后把四种偏差各自单独放进对账里,看它们各值多少:
  标的       实盘和回测哪里不一样           差额  占九年总盈亏  拆出来对不对得上
 SPY   只有滑点(单边 5 个基点)   -7564.9007 -0.1323       0.0
 SPY   只有仓位差(每笔 ±10%)    4572.5774  0.0800       0.0
 SPY      只漏做赚得最多的那一笔  -11034.9390 -0.1930       0.0
 SPY 只跳过「连亏 4 笔」之后的三笔   -9121.0623 -0.1595       0.0
AAPL   只有滑点(单边 5 个基点)  -11475.9007 -0.0312      -0.0
AAPL   只有仓位差(每笔 ±10%)   -8135.5451 -0.0221      -0.0
AAPL      只漏做赚得最多的那一笔  -64022.4361 -0.1739       0.0
AAPL 只跳过「连亏 4 笔」之后的三笔    1566.2606  0.0043      -0.0
 BTC   只有滑点(单边 5 个基点)  -19148.5956 -0.0177       0.0
 BTC   只有仓位差(每笔 ±10%)  -23250.9964 -0.0215      -0.0
 BTC      只漏做赚得最多的那一笔 -217853.3122 -0.2018      -0.0
 BTC 只跳过「连亏 4 笔」之后的三笔 -275133.3341 -0.2549      -0.0
| 占九年总盈亏 | SPY | AAPL | BTC |
|---|---|---|---|
| 只有滑点(单边 5 个基点) | −13.2% | −3.1% | −1.8% |
| 只有仓位差(每笔 ±10%) | +8.0% | −2.2% | −2.2% |
| 只漏做赚得最多的那一笔 | −19.3% | −17.4% | −20.2% |
| 只跳过「连亏 4 笔」之后的三笔 | −16.0% | +0.4% | −25.5% |
「拆出来对不对得上」那一列全是 0.0——十二次对账,一分钱都没有拆丢。
⚠️ 仓位差那一行在三个标的上符号不一致(SPY 是 +8.0%),因为它是随机的:做大了还是做小了,事后看是运气。这恰恰说明它不是一个该优先修的问题——该优先修的是那些符号永远为负的。
按这张表排优先级,答案很清楚:
- 别漏做(−16% 到 −25%)
- 把手续费算进回测(上一节 9.4%)
- 滑点(−2% 到 −13%,⚠️ SPY 那 13.2% 是因为它九年只赚了 5.7 万美元,分母太小)
- 仓位精度(符号都不确定)
而第 1 条不是技术问题。
十四、talab.journal 的完整代码
"""talab.journal:执行纪律与交易日志。第 33 篇。

前面三十二篇在回答同一个问题:**这条规则值不值得做。**
这一篇换一个问题:**规则已经定好了,你能不能照着做。**

两个问题的难点完全不同。前一个难在统计,后一个难在——你会想改。
而「想改」几乎总是发生在同一个时刻:**连着亏了几笔之后。**

所以这一篇的第一件事,是把「连着亏几笔」从一种感受变成一个可以算的数:

| 你想知道的 | 这里用什么算 |
|---|---|
| 连亏 7 笔正常吗 | `expected_longest`、`streak_distribution` |
| 回撤 20% 正常吗 | `shuffled`、`normal_range` |
| 连亏几笔才算策略坏了 | `streak_alarm`(先看这条规则会误报多少次)、`detection_size` |
| 连亏之后停手划不划算 | `pause_after_losses`、`pause_table` |
| 我那几次「手动调整」花了多少钱 | `interfere`、`interference_table` |
| 实盘和回测差的那一截是从哪来的 | `Entry`、`Journal`、`reconcile` |

最后一行是这一篇真正的落点。**回测和实盘的差额可以被完整地拆开**——
拆成成交价、仓位、漏做、多做、费用五块,五块之和**恰好**等于总差额,一分钱不剩。
拆不开的差额不存在;拆开之后你会发现,最大的一块通常不是滑点。
"""
from __future__ import annotations

import math
from dataclasses import dataclass, field
from statistics import NormalDist

import numpy as np
import pandas as pd

NORMAL = NormalDist()
EULER = 0.5772156649015329
SIDES = {"long": 1, "short": -1, "多": 1, "空": -1}
KINDS = ("skip_after_loss", "double_after_loss", "half_after_loss",
         "double_after_win", "cap", "widen")


# ---------------------------------------------------------------------------
# 一、连亏:正常范围是算出来的,不是感觉出来的
# ---------------------------------------------------------------------------

def streaks(results) -> pd.DataFrame:
    """把一串交易结果切成连胜段和连亏段。

    `results` 可以是收益、R 倍数或者 True/False,**大于 0 算赚**(和 `trend.r_profile` 同一个口径,
    所以正好打平的那一笔算在亏的那一边)。返回每一段的方向、起止序号和长度。
    """
    wins = pd.Series(results).to_numpy()
    wins = wins if wins.dtype == bool else wins > 0
    if len(wins) == 0:
        return pd.DataFrame(columns=["方向", "起", "止", "长度"])
    edges = np.flatnonzero(np.diff(wins)) + 1
    starts = np.concatenate([[0], edges])
    ends = np.concatenate([edges - 1, [len(wins) - 1]])
    return pd.DataFrame({"方向": np.where(wins[starts], "赚", "亏"),
                         "起": starts, "止": ends, "长度": ends - starts + 1})


def longest_streak(results, winning: bool = False) -> int:
    """最长的一段连亏(`winning=True` 时是最长连胜)有多少笔。没有这样的段就是 0。"""
    table = streaks(results)
    picked = table[table["方向"] == ("赚" if winning else "亏")]
    return int(picked["长度"].max()) if len(picked) else 0


def expected_longest(n: int, p: float) -> float:
    """`n` 次独立的下注里,概率为 `p` 的那一面**最长连续出现多少次**(Schilling 1990 的近似):

    > E[最长连击] ≈ log(n·(1−p)) ÷ log(1/p) + γ ÷ ln(1/p) − 1/2

    γ 是欧拉常数 0.5772。这个式子说的事情很朴素:**笔数越多,最长连亏越长,而且是必然变长。**
    一条胜率 33% 的策略做 70 笔,最长连亏的期望接近 9——
    **你以为的「不正常」,只是笔数攒够了。**
    """
    if not 0 < p < 1:
        raise ValueError("p 要在 0 和 1 之间")
    if n < 1:
        raise ValueError("至少要有一次下注")
    log_inv = math.log(1 / p)
    return math.log(max(n * (1 - p), 1e-12)) / log_inv + EULER / log_inv - 0.5


def streak_distribution(n: int, win_rate: float, trials: int = 10_000, seed: int = 0,
                        levels=(0.5, 0.75, 0.9, 0.95, 0.99)) -> pd.Series:
    """蒙特卡洛:胜率 `win_rate` 的策略做 `n` 笔,**最长连亏**的分布。

    `expected_longest` 给的是期望,这里给的是整条分布——
    因为你关心的从来不是「平均会连亏几笔」,而是**「我这次碰上的这个数,算不算离谱」**。
    """
    rng = np.random.default_rng(seed)
    wins = rng.random((trials, n)) < win_rate
    # 逐行求最长的一段 False:把连续的 False 累加,遇到 True 清零,取每行最大值
    longest = np.zeros(trials, dtype=int)
    current = np.zeros(trials, dtype=int)
    for k in range(n):
        current = np.where(wins[:, k], 0, current + 1)
        longest = np.maximum(longest, current)
    out = {"笔数": float(n), "胜率": float(win_rate), "平均最长连亏": float(longest.mean()),
           "公式给的期望": expected_longest(n, 1 - win_rate)}
    out.update({f"{level:.0%} 分位": float(np.quantile(longest, level)) for level in levels})
    return pd.Series(out)


def streak_alarm(n: int, win_rate: float, thresholds=(3, 4, 5, 6, 7, 8, 10, 12),
                 trials: int = 10_000, seed: int = 0) -> pd.DataFrame:
    """「连亏 k 笔就认定策略坏了」——**这条规则在策略完全正常的时候,会误报多少次。**

    这是判断任何停用规则的第一步,也是唯一一步:先问它的误报率。
    一条误报率 90% 的规则不是谨慎,它只是**保证你会在某个时刻停手**。
    """
    rng = np.random.default_rng(seed)
    wins = rng.random((trials, n)) < win_rate
    rows = []
    for k in thresholds:
        current = np.zeros(trials, dtype=int)
        hits = np.zeros(trials, dtype=int)
        for j in range(n):
            current = np.where(wins[:, j], 0, current + 1)
            hits += (current == k)                      # 只在刚好凑满 k 笔那一下记一次
        rows.append({"门槛(连亏几笔)": k, "至少响一次的概率": float((hits > 0).mean()),
                     "平均响几次": float(hits.mean())})
    return pd.DataFrame(rows)


# ---------------------------------------------------------------------------
# 二、回撤:把交易的顺序重抽一遍
# ---------------------------------------------------------------------------

def shuffled(r, trials: int = 2000, seed: int = 0) -> pd.DataFrame:
    """把同一批交易**重新排一遍顺序**,看每一种顺序下的连亏、回撤和水下时间。

    这是第 29 篇自助法的一个特例,但问的问题不一样:那里问「这条策略的夏普可信吗」,
    这里问「**同样这批交易,换个顺序发生,我会看到多难看的一段**」。

    合计和顺序无关(加法可交换),所以每一次重抽的终点都一样——
    **变的只有路径。而你会不会中途停手,只取决于路径。**

    ⚠️ 这里**一律用加法**:曲线就是每笔结果的累加,相当于「每笔都按初始本金的固定比例下注」。
    喂 R 倍数进去,回撤的单位就是 R;喂每笔的账户收益率进去,单位就是百分点。
    不用复利是故意的——要看的是顺序效应,复利会把顺序效应和「越赚越大」搅在一起。
    """
    r = pd.Series(r).dropna().astype(float).to_numpy()
    if len(r) < 2:
        raise ValueError("至少要有两笔交易")
    rng = np.random.default_rng(seed)
    rows = []
    for _ in range(trials):
        path = rng.permutation(r)
        curve = np.cumsum(path)
        peak = np.maximum.accumulate(np.concatenate([[0.0], curve]))[1:]
        under = curve < peak
        rows.append({"最长连亏": longest_streak(path), "最深回撤": float((curve - peak).min()),
                     "最长水下(笔)": int(_longest_true(under)), "合计": float(curve[-1])})
    return pd.DataFrame(rows)


def _longest_true(flags: np.ndarray) -> int:
    longest = current = 0
    for flag in flags:
        current = current + 1 if flag else 0
        longest = max(longest, current)
    return longest


def normal_range(r, trials: int = 2000, seed: int = 0,
                 levels=(0.5, 0.9, 0.95, 0.99)) -> pd.DataFrame:
    """一张「正常范围」表:真实这一次的连亏、回撤、水下时间,各自落在重抽分布的第几分位。

    这张表是这一篇唯一的可执行结论:**上线之前把它打印出来贴在屏幕上。**
    在范围内的难看是设计的一部分,超出范围才值得重新检查——
    ⚠️ 而且「超出范围」也只是**你事先约好的降级线**,不等于统计上证明了策略失效
    (要多少笔才能证明,看 `detection_size`)。
    """
    r = pd.Series(r).dropna().astype(float)
    table = shuffled(r, trials=trials, seed=seed)
    curve = r.cumsum().to_numpy()
    peak = np.maximum.accumulate(np.concatenate([[0.0], curve]))[1:]
    real = {"最长连亏": longest_streak(r), "最深回撤": float((curve - peak).min()),
            "最长水下(笔)": int(_longest_true(curve < peak))}
    rows = []
    for name, value in real.items():
        column = table[name]
        # 回撤是负数:越小越难看,所以分位要反过来数
        worse = (column <= value).mean() if "回撤" in name else (column >= value).mean()
        row = {"这一次": value, "重抽平均": float(column.mean()),
               "比这一次还难看的比例": float(worse)}
        for level in levels:
            q = 1 - level if "回撤" in name else level
            row[f"{level:.0%} 分位"] = float(np.quantile(column, q))
        rows.append(pd.Series(row, name=name))
    return pd.DataFrame(rows)


# ---------------------------------------------------------------------------
# 三、这是正常波动,还是策略真的坏了
# ---------------------------------------------------------------------------

def detection_size(mean: float, std: float, drop: float = 1.0,
                   alpha: float = 0.05, power: float = 0.8) -> float:
    """要**多少笔**交易,才能以 `power` 的把握、在 `alpha` 的水平上,
    认出「每笔的期望值掉了 `drop` 倍」(`drop=1.0` 就是掉到 0):

    > 笔数 ≈ [ (z₁₋α + z_power) × 标准差 ÷ (期望 × drop) ]²

    这是第 29 篇「要跑多少年」的交易版本,结论也一样难看:
    **单笔收益的标准差通常是期望的好几倍,于是分母被平方一次,笔数就上了三位数。**
    连亏 7 笔提供的信息量,和这个数字比起来约等于 0。
    """
    if mean <= 0 or std <= 0 or drop <= 0:
        raise ValueError("期望、标准差、drop 都要是正数")
    z = NORMAL.inv_cdf(1 - alpha) + NORMAL.inv_cdf(power)
    return (z * std / (mean * drop)) ** 2


# ---------------------------------------------------------------------------
# 四、执行规则:连亏之后停手,值多少钱
# ---------------------------------------------------------------------------

def pause_after_losses(r, after: int = 3, pause: int = 3) -> np.ndarray:
    """「连亏 `after` 笔就停 `pause` 笔」这条规则,实际会跳过哪几笔。

    返回一串 True/False:True = 这一笔做了,False = 被规则拦下了。
    ⚠️ 被拦下的那几笔的**结果照样要记**——不然你永远不知道停手是赚了还是亏了。
    """
    r = pd.Series(r).dropna().astype(float).to_numpy()
    if after < 1 or pause < 0:
        raise ValueError("after 至少是 1,pause 不能是负数")
    taken = np.ones(len(r), dtype=bool)
    losses = skip = 0
    for i, value in enumerate(r):
        if skip > 0:
            taken[i] = False
            skip -= 1
            continue
        losses = losses + 1 if value <= 0 else 0
        if losses >= after:
            skip, losses = pause, 0
    return taken


def pause_table(r, afters=(2, 3, 4, 5), pauses=(1, 3, 5)) -> pd.DataFrame:
    """把「连亏几笔停几笔」的各种组合摆在一起,和「一笔不落地做」比。

    `跳过的那些笔` 这一列是全表最值得看的一列:它是**你停手的那段时间里,市场发给别人的钱**。
    """
    r = pd.Series(r).dropna().astype(float)
    total = float(r.sum())
    rows = [{"连亏几笔": 0, "停几笔": 0, "做了几笔": len(r), "合计 R": total,
             "跳过的那些笔": 0.0, "最深回撤": _depth(r.to_numpy())}]
    for after in afters:
        for pause in pauses:
            taken = pause_after_losses(r, after, pause)
            kept = r.to_numpy() * taken
            rows.append({"连亏几笔": after, "停几笔": pause, "做了几笔": int(taken.sum()),
                         "合计 R": float(kept.sum()),
                         "跳过的那些笔": float(r.to_numpy()[~taken].sum()),
                         "最深回撤": _depth(kept)})
    return pd.DataFrame(rows)


def _depth(r: np.ndarray) -> float:
    curve = np.cumsum(r)
    peak = np.maximum.accumulate(np.concatenate([[0.0], curve]))[1:]
    return float((curve - peak).min()) if len(curve) else 0.0


# ---------------------------------------------------------------------------
# 五、手动调整的代价
# ---------------------------------------------------------------------------

def interfere(r, kind: str, level: float = 2.0) -> np.ndarray:
    """在一串 R 倍数上施加一次常见的「手动调整」,返回调整之后的 R。

    前四种只动**仓位**或者**做不做**,所以是精确的:

    - `skip_after_loss`:亏一笔之后,下一笔不敢做了
    - `double_after_loss`:亏一笔之后,下一笔加倍下注(想一把捞回来)
    - `half_after_loss`:亏一笔之后,下一笔只做一半(怯场)
    - `double_after_win`:赚一笔之后,下一笔加倍下注(觉得手感来了)

    后两种动的是**出场**,只能给一个方向确定的估计:

    - `cap`:浮盈到 `level` 个 R 就提前走人 → `min(r, level)`。
      ⚠️ 这是**代价的上界**:真实的提前止盈还会把一部分最终亏损的交易救成小赚,
      所以真实代价比这里算出来的小。
    - `widen`:眼看要止损,把止损往外挪,最后照样止损 → 亏的那些乘以 `level`。
      ⚠️ 这也是**上界**:挪远之后会有一部分活过来变成盈利。
      想要不含上界的那个数,就直接改引擎里的止损参数重跑一遍——两个数一夹,真相在中间。
    """
    r = pd.Series(r).dropna().astype(float).to_numpy()
    if kind not in KINDS:
        raise ValueError(f"kind 只能是 {KINDS} 之一,收到 {kind!r}")
    if kind == "cap":
        return np.minimum(r, level)
    if kind == "widen":
        return np.where(r <= 0, r * level, r)
    previous = np.concatenate([[np.nan], r[:-1]])
    after_loss, after_win = previous <= 0, previous > 0
    scale = np.ones(len(r))
    if kind == "skip_after_loss":
        scale[after_loss] = 0.0
    elif kind == "double_after_loss":
        scale[after_loss] = 2.0
    elif kind == "half_after_loss":
        scale[after_loss] = 0.5
    else:
        scale[after_win] = 2.0
    return r * scale


def interference_table(r, cap: float = 2.0, widen: float = 2.0) -> pd.DataFrame:
    """把几种手动调整一次算完:合计 R、最深回撤、以及**和「一个字不改」差了多少**。

    这张表的用法是把最后一列读成钱:每笔冒账户 1%,差 10R 就是差 10 个百分点。
    """
    r = pd.Series(r).dropna().astype(float)
    base = float(r.sum())
    names = {"skip_after_loss": "亏了之后不敢做", "double_after_loss": "亏了之后加倍",
             "half_after_loss": "亏了之后减半", "double_after_win": "赚了之后加倍",
             "cap": f"浮盈 {cap:g}R 就走", "widen": f"要止损了把止损挪远(亏的 ×{widen:g})"}
    rows = [{"怎么改的": "一个字不改", "合计 R": base, "最深回撤": _depth(r.to_numpy()),
             "差多少 R": 0.0}]
    for kind, label in names.items():
        changed = interfere(r, kind, cap if kind == "cap" else widen)
        rows.append({"怎么改的": label, "合计 R": float(changed.sum()),
                     "最深回撤": _depth(changed), "差多少 R": float(changed.sum() - base)})
    return pd.DataFrame(rows)


# ---------------------------------------------------------------------------
# 六、交易日志:一行记两遍
# ---------------------------------------------------------------------------

@dataclass
class Entry:
    """日志里的一行。核心是一件事:**计划和实际并排放。**

    只记实际成交价的日志没有用——它能告诉你赚了多少,不能告诉你**为什么和回测不一样**。
    `reconcile` 要拆的那几块,全都藏在「计划」和「实际」的差里。

    `fill_*` 留空表示「和计划完全一样」。`qty` 为 0 的一行表示**这笔计划里的交易你没做**,
    照样要记——第四节的 `pause_table` 已经说明了为什么。
    """
    time: pd.Timestamp                    # 计划进场的那一根
    symbol: str                           # 标的
    plan_entry: float                     # 计划进场价
    plan_stop: float                      # 计划止损价
    plan_qty: float                       # 计划数量
    side: str = "long"
    plan_exit: float = np.nan             # 计划出场价(回测给的)
    fill_entry: float | None = None       # 实际成交价
    fill_qty: float | None = None         # 实际数量(0 = 没做)
    fill_exit: float | None = None
    exit_time: pd.Timestamp | None = None
    fee: float = 0.0                      # 实际付出的手续费
    plan_fee: float = 0.0
    basis: str = "规则"                   # 依据:规则 / 我觉得 / 别人说的
    note: str = ""                        # 偏离计划的原因,一句话

    def __post_init__(self):
        if self.side not in SIDES:
            raise ValueError(f"side 只能是 {tuple(SIDES)} 之一,收到 {self.side!r}")
        if not self.plan_qty > 0:
            raise ValueError("计划数量要大于 0")
        if SIDES[self.side] * (self.plan_stop - self.plan_entry) >= 0:
            raise ValueError("止损放错了方向:做多的止损要低于进场价,做空的要高于")
        if self.fill_qty is not None and self.fill_qty < 0:
            raise ValueError("实际数量不能是负数")

    def actual(self, name: str):
        """实际值;没填就是和计划一样。"""
        filled = getattr(self, f"fill_{name}")
        return getattr(self, f"plan_{name}") if filled is None else filled

    def pnl(self, planned: bool = False) -> float:
        """这一行的盈亏。`planned=True` 给的是回测里那一笔。"""
        sign = SIDES[self.side]
        if planned:
            return sign * self.plan_qty * (self.plan_exit - self.plan_entry) - self.plan_fee
        return sign * self.actual("qty") * (self.actual("exit") - self.actual("entry")) - self.fee

    def row(self) -> dict:
        return {"时间": self.time, "标的": self.symbol,
                "方向": "多" if SIDES[self.side] > 0 else "空",
                "计划进场价": self.plan_entry, "实际进场价": self.actual("entry"),
                "计划止损价": self.plan_stop,
                "计划数量": self.plan_qty, "实际数量": self.actual("qty"),
                "计划出场价": self.plan_exit, "实际出场价": self.actual("exit"),
                "出场时间": self.exit_time, "计划费用": self.plan_fee, "费用": self.fee,
                "计划盈亏": self.pnl(planned=True), "实际盈亏": self.pnl(),
                "依据": self.basis, "备注": self.note}


@dataclass
class Journal:
    """一本日志:`Entry` 的列表,加上一张能直接喂给 `reconcile` 的表。"""
    entries: list = field(default_factory=list)

    def add(self, entry: Entry) -> "Journal":
        self.entries.append(entry)
        return self

    def frame(self) -> pd.DataFrame:
        columns = ["时间", "标的", "方向", "计划进场价", "实际进场价", "计划止损价",
                   "计划数量", "实际数量", "计划出场价", "实际出场价", "出场时间",
                   "计划费用", "费用", "计划盈亏", "实际盈亏", "依据", "备注"]
        return pd.DataFrame([e.row() for e in self.entries], columns=columns)

    def summary(self) -> pd.Series:
        """日志自己的体检:有多少笔没按计划走,以及**有多少笔的依据不是「规则」**。

        最后那个数是这本日志唯一不能从券商对账单里算出来的东西,
        也是记日志的全部理由——**「我觉得」这一类,只有你自己记才数得出来。**
        """
        table = self.frame()
        if not len(table):
            return pd.Series(dtype=float)
        skipped = table["实际数量"] == 0
        off_price = table["实际进场价"] != table["计划进场价"]
        off_qty = (table["实际数量"] != table["计划数量"]) & ~skipped
        return pd.Series({
            "记了几笔": float(len(table)), "没做": float(skipped.sum()),
            "成交价和计划不一样": float(off_price.sum()),
            "数量和计划不一样": float(off_qty.sum()),
            "依据不是规则": float((table["依据"] != "规则").sum()),
            "计划盈亏合计": float(table["计划盈亏"].sum()),
            "实际盈亏合计": float(table["实际盈亏"].sum()),
            "差额": float(table["实际盈亏"].sum() - table["计划盈亏"].sum()),
        })


# ---------------------------------------------------------------------------
# 七、对账:把差额拆干净
# ---------------------------------------------------------------------------

def reconcile(planned: pd.DataFrame, actual: pd.DataFrame, key: str = "买入日",
              entry_col: str = "买入价", exit_col: str = "卖出价", qty_col: str = "数量",
              fee_col: str = "费用", side_col: str = "方向") -> dict:
    """实盘和回测差的那一截,是从哪来的。

    两张表按 `key`(默认进场日)对齐,把总差额拆成五块:

    | 这一块 | 怎么算 | 说的是 |
    |---|---|---|
    | 漏做 | −Σ 回测那笔的盈亏 | 计划里有、你没做 |
    | 多做 | +Σ 实盘那笔的盈亏 | 计划里没有、你做了 |
    | 进场滑点 | Σ 方向 × 计划量 ×(计划进场价 − 实际进场价) | 买贵了 / 卖便宜了 |
    | 出场滑点 | Σ 方向 × 计划量 ×(实际出场价 − 计划出场价) | 走早了 / 走晚了 |
    | 仓位差 | Σ 方向 ×(实际量 − 计划量)×(实际出场价 − 实际进场价) | 做大了 / 做小了 |
    | 费用差 | −Σ(实际费用 − 计划费用) | 手续费和回测里假设的不一样 |

    这不是近似:**六块之和恒等于「实盘合计 − 回测合计」**(`差额核对` 那一项就是用来看这个的,
    正常应该是 0)。代数上它是把 q(x−e) 的差分三步展开,每一步只动一个量。

    ⚠️ **拆开之后最该看的是「漏做」那一格。** 滑点是几个基点的事,
    漏做一笔是整整一笔的事——而第 31 篇已经量过,一笔可以占九年收益的 14%。
    """
    def prep(table: pd.DataFrame) -> pd.DataFrame:
        out = table.copy()
        if fee_col not in out:
            out[fee_col] = 0.0
        out["_side"] = (out[side_col].map(SIDES).astype(float) if side_col in out else 1.0)
        out["_pnl"] = out["_side"] * out[qty_col] * (out[exit_col] - out[entry_col]) - out[fee_col]
        return out.set_index(key)

    left, right = prep(planned), prep(actual)
    both = left.index.intersection(right.index)
    missing, extra = left.drop(both), right.drop(both)
    p, a = left.loc[both], right.loc[both]

    sign, q_p, q_a = p["_side"], p[qty_col], a[qty_col]
    slip_in = sign * q_p * (p[entry_col] - a[entry_col])
    slip_out = sign * q_p * (a[exit_col] - p[exit_col])
    size_gap = sign * (q_a - q_p) * (a[exit_col] - a[entry_col])
    fee_gap = -(a[fee_col] - p[fee_col])
    parts = pd.Series({
        "漏做": -float(missing["_pnl"].sum()), "多做": float(extra["_pnl"].sum()),
        "进场滑点": float(slip_in.sum()), "出场滑点": float(slip_out.sum()),
        "仓位差": float(size_gap.sum()), "费用差": float(fee_gap.sum()),
    })
    total = float(right["_pnl"].sum() - left["_pnl"].sum())
    parts["合计"] = float(parts.sum())
    parts["实盘 − 回测"] = total
    parts["差额核对"] = parts["合计"] - total
    by_trade = pd.DataFrame({"进场滑点": slip_in, "出场滑点": slip_out,
                             "仓位差": size_gap, "费用差": fee_gap,
                             "这一笔差多少": a["_pnl"] - p["_pnl"]})
    return {"归因": parts, "逐笔": by_trade.sort_index(),
            "漏做的": missing.drop(columns=["_side"]), "多做的": extra.drop(columns=["_side"])}
十五、测试
"""talab.journal 的测试(第 33 篇)。交易序列全部手工构造,每个数都能自己算一遍。"""
import numpy as np
import pandas as pd
import pytest

from talab import journal as J


def frame(rows) -> pd.DataFrame:
    """一张最小的交易表,列名和第 27 篇 `backtest.run` 的输出一致。"""
    return pd.DataFrame(rows, columns=["买入日", "方向", "买入价", "卖出价", "数量", "费用"])


def test_streaks_cuts_a_sequence_into_runs():
    table = J.streaks([1.0, -1, -1, 2, 3, -1])
    assert list(table["方向"]) == ["赚", "亏", "赚", "亏"]
    assert list(table["长度"]) == [1, 2, 2, 1]
    assert list(table["起"]) == [0, 1, 3, 5]
    assert list(table["止"]) == [0, 2, 4, 5]
    assert len(J.streaks([])) == 0


def test_a_breakeven_trade_counts_as_a_loss():
    # 口径和 trend.r_profile 一致:大于 0 才算赚,正好打平算在亏的那一边
    assert J.longest_streak([-1, 0.0, -1, 5]) == 3
    assert J.longest_streak([-1, 0.0, -1, 5], winning=True) == 1
    assert J.longest_streak([1, 2, 3]) == 0                   # 一笔没亏过


def test_expected_longest_matches_the_monte_carlo():
    # 抛 200 次硬币,最长连续正面的期望:公式和一万次模拟应该对得上
    formula = J.expected_longest(200, 0.5)
    simulated = J.streak_distribution(200, 0.5, trials=5000, seed=1)["平均最长连亏"]
    assert abs(formula - simulated) < 0.3
    # 笔数翻一倍,最长连亏只多出 log2(2) = 1 笔左右——**它随笔数增长得很慢,但一定在长**
    assert 0.8 < J.expected_longest(400, 0.5) - formula < 1.2


def test_a_long_losing_streak_is_ordinary_when_the_win_rate_is_low():
    out = J.streak_distribution(70, 0.33, trials=5000, seed=2)
    assert out["平均最长连亏"] > 8                             # 胜率 33% 做 70 笔,期望就有八九笔
    assert out["90% 分位"] >= 11                               # 连亏 11 笔以上也在正常范围里
    assert out["50% 分位"] <= out["95% 分位"]


def test_streak_alarm_tells_you_the_false_alarm_rate():
    table = J.streak_alarm(70, 0.33, thresholds=(4, 8, 15), trials=3000, seed=3)
    probability = table.set_index("门槛(连亏几笔)")["至少响一次的概率"]
    assert probability.loc[4] > 0.98                           # 「连亏 4 笔就停」几乎必然会响
    assert probability.loc[4] > probability.loc[8] > probability.loc[15]
    assert (table["平均响几次"] >= table["至少响一次的概率"]).all()


def test_shuffling_keeps_the_total_and_changes_only_the_path():
    r = pd.Series([3.0, -1, -1, -1, 5, -1, -1, 2, -1, -1])
    table = J.shuffled(r, trials=200, seed=4)
    assert np.allclose(table["合计"], r.sum())                 # 加法可交换:终点永远一样
    assert table["最深回撤"].nunique() > 1                     # 但路径不一样
    assert (table["最深回撤"] <= 0).all()
    assert table["最长连亏"].max() >= 5                        # 六笔亏损挤到一起是可能的
    with pytest.raises(ValueError):
        J.shuffled([1.0])


def test_normal_range_locates_this_run_in_the_distribution():
    r = pd.Series([2.0, -1, -1, -1, -1, 4, -1, -1, 3, -1])
    table = J.normal_range(r, trials=300, seed=5)
    assert list(table.index) == ["最长连亏", "最深回撤", "最长水下(笔)"]
    assert table.loc["最长连亏", "这一次"] == 4
    assert 0 <= table.loc["最深回撤", "比这一次还难看的比例"] <= 1
    # 回撤那一行的分位是反着数的:99% 分位比 50% 分位更深(更负)
    assert table.loc["最深回撤", "99% 分位"] <= table.loc["最深回撤", "50% 分位"]


def test_detection_size_grows_with_the_square_of_the_noise():
    small = J.detection_size(mean=0.5, std=3.0)
    assert J.detection_size(mean=0.5, std=6.0) == pytest.approx(small * 4)
    assert J.detection_size(mean=1.0, std=3.0) == pytest.approx(small / 4)
    # 只想认出「掉了一半」,需要的笔数是「掉到 0」的四倍
    assert J.detection_size(0.5, 3.0, drop=0.5) == pytest.approx(small * 4)
    with pytest.raises(ValueError):
        J.detection_size(mean=-0.1, std=1.0)


def test_pause_after_losses_skips_exactly_the_right_trades():
    r = [-1.0, -1, 5, -1, -1, 3, 4, -1]
    taken = J.pause_after_losses(r, after=2, pause=2)
    # 前两笔连亏触发规则 → 跳过第 3、4 笔(其中第 3 笔是 +5R,这就是停手的代价)
    assert list(taken) == [True, True, False, False, True, True, True, True]
    assert list(J.pause_after_losses(r, after=2, pause=0)) == [True] * 8
    with pytest.raises(ValueError):
        J.pause_after_losses(r, after=0)


def test_pause_table_accounts_for_every_trade():
    r = pd.Series([-1.0, -1, 5, -1, -1, 3, 4, -1, -1, -1, 6])
    table = J.pause_table(r, afters=(2, 3), pauses=(1, 2))
    assert table.iloc[0]["合计 R"] == pytest.approx(r.sum())
    # 做了的 + 跳过的 = 全部,一笔都不许丢
    assert np.allclose(table["合计 R"] + table["跳过的那些笔"], r.sum())
    assert (table["做了几笔"] <= len(r)).all()


def test_interfere_only_touches_the_trade_after_the_trigger():
    r = [-2.0, 4, -1, 6]
    assert list(J.interfere(r, "skip_after_loss")) == [-2, 0, -1, 0]
    assert list(J.interfere(r, "double_after_loss")) == [-2, 8, -1, 12]
    assert list(J.interfere(r, "half_after_loss")) == [-2, 2, -1, 3]
    assert list(J.interfere(r, "double_after_win")) == [-2, 4, -2, 6]
    # 第一笔永远不变:它前面没有交易
    assert all(J.interfere(r, kind)[0] == -2 for kind in ("double_after_loss", "double_after_win"))
    with pytest.raises(ValueError):
        J.interfere(r, "去掉最差的那笔")


def test_cap_and_widen_are_both_upper_bounds_on_the_damage():
    r = np.array([-2.0, 4, -1, 6, 0.5])
    assert list(J.interfere(r, "cap", 2.0)) == [-2, 2, -1, 2, 0.5]
    assert list(J.interfere(r, "widen", 2.0)) == [-4, 4, -2, 6, 0.5]   # 赚的那几笔一个字不动
    # 两种改法都只会让每一笔变差或者不变,所以算出来的代价是上界
    assert (J.interfere(r, "cap", 2.0) <= r).all()
    assert (J.interfere(r, "widen", 2.0) <= r).all()


def test_entry_rejects_a_stop_on_the_wrong_side():
    ok = dict(time=pd.Timestamp("2024-01-02"), symbol="BTC", plan_entry=100.0,
              plan_stop=95.0, plan_qty=2.0, plan_exit=110.0)
    assert J.Entry(**ok).pnl(planned=True) == pytest.approx(20.0)
    with pytest.raises(ValueError):
        J.Entry(**{**ok, "plan_stop": 105.0})                  # 做多的止损放到了进场价上面
    with pytest.raises(ValueError):
        J.Entry(**{**ok, "plan_qty": 0.0})
    with pytest.raises(ValueError):
        J.Entry(**{**ok, "side": "两边都做"})
    # 做空:止损在上面才对
    short = J.Entry(**{**ok, "side": "short", "plan_stop": 105.0, "plan_exit": 90.0})
    assert short.pnl(planned=True) == pytest.approx(20.0)


def test_journal_counts_the_rows_you_did_not_follow():
    book = J.Journal()
    common = dict(symbol="SPY", plan_entry=100.0, plan_stop=95.0, plan_qty=10.0, plan_exit=110.0)
    book.add(J.Entry(time=pd.Timestamp("2024-01-02"), **common))                    # 完全照做
    book.add(J.Entry(time=pd.Timestamp("2024-02-02"), fill_entry=101.0, **common))  # 买贵了
    book.add(J.Entry(time=pd.Timestamp("2024-03-02"), fill_qty=0.0,
                     basis="我觉得", note="连亏三笔,这次不敢做", **common))          # 干脆没做
    out = book.summary()
    assert out["记了几笔"] == 3 and out["没做"] == 1
    assert out["成交价和计划不一样"] == 1 and out["依据不是规则"] == 1
    assert out["计划盈亏合计"] == pytest.approx(300.0)
    assert out["实际盈亏合计"] == pytest.approx(100.0 + 90.0 + 0.0)
    assert out["差额"] == pytest.approx(-110.0)
    assert list(book.frame().columns)[:3] == ["时间", "标的", "方向"]


def test_reconcile_splits_the_gap_into_pieces_that_add_up_exactly():
    planned = frame([
        [pd.Timestamp("2024-01-01"), "多", 100.0, 110.0, 10.0, 1.0],    # +99
        [pd.Timestamp("2024-02-01"), "空", 200.0, 190.0, 5.0, 2.0],     # +48
        [pd.Timestamp("2024-03-01"), "多", 100.0, 90.0, 4.0, 0.0],      # −40,实盘没做
    ])
    actual = frame([
        [pd.Timestamp("2024-01-01"), "多", 101.0, 109.0, 12.0, 2.0],    # 买贵、走早、做大
        [pd.Timestamp("2024-02-01"), "空", 201.0, 191.0, 5.0, 2.0],
        [pd.Timestamp("2024-04-01"), "多", 100.0, 105.0, 3.0, 0.0],     # 计划里没有
    ])
    out = J.reconcile(planned, actual)
    parts = out["归因"]
    assert parts["实盘 − 回测"] == pytest.approx(50.0)
    assert parts["差额核对"] == pytest.approx(0.0, abs=1e-9)             # 拆得干干净净
    assert parts["漏做"] == pytest.approx(40.0)                          # 躲过一笔亏损,反而是加分项
    assert parts["多做"] == pytest.approx(15.0)
    assert parts["进场滑点"] == pytest.approx(-5.0)
    assert parts["出场滑点"] == pytest.approx(-15.0)
    assert parts["仓位差"] == pytest.approx(16.0)
    assert parts["费用差"] == pytest.approx(-1.0)
    assert len(out["漏做的"]) == 1 and len(out["多做的"]) == 1
    assert out["逐笔"]["这一笔差多少"].sum() == pytest.approx(-5.0)      # 两笔共同的交易差了多少


def test_reconcile_is_exact_on_random_tables():
    # 随机造两张表,六块之和必须永远等于总差额——这是代数恒等式,不是近似
    rng = np.random.default_rng(33)
    days = pd.date_range("2024-01-01", periods=40, freq="D")
    def build(pick):
        return frame([[days[i], "多" if i % 3 else "空", 100 + rng.normal(),
                       100 + rng.normal(0, 5), 1 + rng.random() * 9, rng.random()]
                      for i in pick])
    planned, actual = build(range(0, 30)), build(range(10, 40))
    parts = J.reconcile(planned, actual)["归因"]
    assert parts["差额核对"] == pytest.approx(0.0, abs=1e-9)
    assert parts["合计"] == pytest.approx(parts["实盘 − 回测"])
16 passed in 0.23s
351 passed in 0.92s
没装 TA-Lib 的环境里:
319 passed, 32 skipped in 1.29s
十六、小检查
- 一条胜率 40% 的策略做 100 笔。用第二节那个公式估一估,它在这 100 笔里「最长的一段连亏」大概是几笔?
- 第二节那张误报率表里,「连亏 6 笔就停」在九年里至少响一次的概率是 92.2%。这个数字是在什么前提下算出来的?它能不能用来说明「这条策略很危险」?
- 主线 v4 在 SPY 上的历史最大回撤是 9.44 个百分点,而重排之后的 95% 分位是 26.24 个百分点。你在上线之前该按哪个数准备资金?为什么两个数会差这么多?
- 「一开始就把止损放到 3N」和「眼看要被止损时把止损挪到 3N」,在账户层面最关键的区别是哪一个量?
- 一次对账拆出来的五块里,「仓位差」是 +8,437 美元(正的)。这能说明你的仓位管理比回测做得好吗?
十七、常见误用
把连亏当成「策略失效」的证据。第二节那张表是专门用来堵这条路的:一条胜率 32.9% 的策略做 70 笔,「连亏 7 笔」在策略完全正常的前提下也有 79.2% 的概率至少发生一次,最长连亏的期望本来就是 8.82 笔。而第六节给出了代价:真要在统计上认出「期望值掉到 0」,SPY 上的海龟需要 84 笔、11.2 年。你手上那几笔连亏携带的信息量,在这个尺度面前约等于零。
用「连亏之后暂停」来控制回撤。第七节量过十二种组合,十一种是亏的,最狠的一种把 BTC 九年从 295.93R 砍到 143.81R。回撤确实变浅了(最浅的一行 −10.72R),但那是因为你交易得更少——想要同样的效果,把每笔风险从 1% 改成 0.5% 更直接、代价更小。⚠️ 而第十二节展示了真正的账单:那条规则精确地挡住了九年里赚得最多的三笔。
**把「亏了之后加倍」在历史上赚钱,读成它有道理。**第九节的表里这一行是 +220.12R,看上去很诱人。它赚的唯一原因是这条策略每笔的期望本来就是正的——**把任何一组交易加倍都会赚更多。**真正的代价在旁边那一列:**最深回撤从 −18.89R 变成 −36.00R。**加倍不增加优势,它只增加杠杆,而且是在账户最虚弱的时刻加。
**把回测报告上的最大回撤当成上限。**第五节里,主线 v4 在 SPY 上的历史回撤只有 9.44 个百分点,而 98% 的重排比它更难看,95% 分位是 26.24。最大回撤是一个极值统计量,只由一条路径里的一小段决定——它是一个样本,不是一个上限。三个标的六条策略,没有一条的真实回撤触到过自己的 95% 分位。
以为「止损放远一点」和「临时挪止损」差不多。第十节把两者分开量了:SPY 上一开始就用 3N 止损,年化从 4.68% 升到 4.85%、回撤从 −17.11% 降到 −10.25%;而同一个账户上临时挪远,合计 R 从 47.50 掉到 4.93。区别在仓位——事先放远会让仓位自动变小、每笔风险不变;临时挪远时仓位已经定死了,风险直接翻倍,而且只在你正在亏钱的那些笔上翻。
只记实际成交价的日志。券商对账单已经把「实际」那一半给你了。第十一节那张表里唯一算不出来的是这一格——「依据不是规则」——它是整本日志的全部理由。少了「计划」那一列,第十二节的五块归因一块也拆不出来。
**把精力全花在滑点上。**第十二节的九年对账里,进场加出场滑点一共 14,408 美元,占总差额的 4.6%;漏做那一格是 275,133 美元,占 88.7%,是滑点的 19 倍。第十三节把它换算成了同一把尺子:BTC 上漏做最赚的那一笔,等于九年每一笔都多付 56.9 个基点。
**拿「每日最大亏损」当保险。**第七节量过:SPY 上「单日亏 3% 就停 5 天」九年只触发 3 次,真正被砍掉的只有 2 天(触发那天止损已经平仓了);「单日亏 5%」九年一次都没响过。BTC 上触发得多,结果是年化从 31.60% 掉到 27.49%,而最大回撤只从 −21.56% 动到 −21.43%——因为那次回撤是十二笔交易慢慢磨出来的,不是哪一天砸出来的。每日亏损上限是给日内设计的。
十八、小结
- **连亏的长度是算得出来的。**胜率 p 的策略做 n 笔,最长连亏的期望 ≈ log(n(1−p))/log(1/p) + γ/ln(1/p) − 1/2。BTC 海龟九年 70 笔、胜率 32.9%,期望就是 8.82 笔,90% 分位 12 笔,99% 分位 18 笔。你以为的「不正常」,通常只是笔数攒够了。
- 任何停用规则的第一步是算它的误报率。「连亏 7 笔就停」在策略完全正常时有 79.2% 的概率会响。一条误报率 79% 的规则不叫谨慎,它只是保证了你一定会停手。
- **回撤和水下时间没有公式,但可以重排。**同一批交易换个顺序,合计一个字不变,路径完全不同。BTC 海龟真实的 −18.89R 落在第 88 个百分位,95% 分位是 −24.25R。
- ⚠️ **回测报告上的最大回撤是一个样本,不是一个上限。**主线 v4 在 SPY 上的 −9.44 个百分点,比 98% 的重排都浅。三个标的六条策略,没有一个的真实回撤触到过自己的 95% 分位。
- **「策略真的坏了」认不出来。**要以 80% 的把握认出期望值掉到 0,SPY 海龟要 84 笔(11.2 年)、SPY 主线 v4 要 193 笔(44.5 年)。剩下能做的只有三件:事先算好正常范围、事先约定降级线、检查机制(方差比)还在不在。
- 连亏之后停手是亏的。三个标的 × 四条规则,十二组里 十一组是亏的;BTC 上最狠的一条砍掉一半收益。被跳过的交易合计全是正数。
- **原因是结构性的,不是运气。**大赚的交易必然出现在趋势的开头,而趋势的开头必然紧跟在震荡后面——**而震荡正是连亏的来源。**连亏和大赚是相邻的。九年对账里那条规则挡住的三笔,正是赚得最多的三笔。
- 手动调整的价目表(BTC 海龟,九年 295.93R):浮盈 2R 就走 −326.60R(九年倒亏)、亏了之后不敢做 −220.12R、临时挪止损 −75.44R。「亏了之后加倍」+220.12R 是个陷阱——它把最深回撤从 −18.89R 变成 −36.00R。
- **交易日志的核心是「计划和实际并排放」。**只记实际的日志算不出归因,也数不出有多少笔写的其实是「我觉得」。
- 实盘和回测的差额可以被完整拆开:漏做、多做、进场滑点、出场滑点、仓位差、费用差,六块之和恒等于总差额(代数恒等式,
差额核对必须是 0)。九年 −310,175 美元的差额里,漏做占 88.7%,滑点只占 4.6%。 - 按这张表排优先级:别漏做 > 把手续费算进回测 > 滑点 > 仓位精度。⚠️ 而第一条不是技术问题——它就是这一篇从头到尾在讲的那件事。
下一篇(第 34 篇)把这些串成一条流程:回测 → 模拟盘 → 小资金实盘 → 逐步加资金,每一步的升级条件和降级条件,以及上线之前就得写死的停用规则。这一篇算出来的那张「正常范围表」,就是那些条件的输入。
练习
- 用
expected_longest算一算:胜率 50%、60%、70% 的策略各做 200 笔,最长连亏的期望分别是多少?把三个数画在一张图上,横轴是胜率。你会发现它在胜率很低的那一段涨得特别快——解释一下为什么。 - 把
streak_alarm用在你自己关心的一条策略上(或者用第 32 篇的均值回归,胜率 70%–76%)。找出一个「误报率低于 10%」的连亏门槛。它是几笔?这个门槛实用吗? normal_range默认重抽 2000 次。改成 200 次和 20000 次各跑一遍,看 99% 分位那一列抖动多大。分位越靠尾部,需要的重抽次数越多——给出一个你能接受的次数,并说明理由。- 第五节发现主线 v4 走过的是一条偏幸运的路径。把三个标的六条策略的「比这一次还难看的比例」列成一张表,看看有没有哪一条是偏不幸的(比例低于 20%)。如果一条策略的历史路径特别不幸,这对你的期待意味着什么?
pause_after_losses现在是「连亏 N 笔停 M 笔」。改写一个pause_after_drawdown(r, depth, pause):回撤超过depth个 R 就停pause笔。在三个标的上量一遍——它比按连亏停更好还是更差?为什么?interfere里的cap是「代价的上界」。用第 27 篇的事件驱动引擎把真正的提前止盈跑出来(backtest.Plan(target_r=2.0)),和cap的结果比一比,看上界高估了多少。- 给
reconcile加一个新的归因项:时间差。实盘比回测晚一根 K 线进场时,这一块该怎么算,才能保证六块之和仍然恰好等于总差额?(提示:先写出这一笔盈亏的表达式,再看你新加的量该从哪一步里分出来。)
小检查答案
- 大约 5 笔。代进公式:p(亏的概率)= 0.6,n = 100。log(100 × 0.4) / log(1/0.6) = log(40)/log(1.667) = 3.689/0.511 = 7.22;γ/ln(1/0.6) = 0.577/0.511 = 1.13;再减 0.5。合计约 7.85 笔。⚠️ 如果你算成 5,多半是把 p 当成了胜率——公式里的 p 是亏的概率。顺带一提,胜率 40% 比胜率 32.9% 只高了 7 个百分点,最长连亏的期望就从 8.82 掉到 7.85,而笔数还多了 30 笔。
- 前提是「策略完全正常」。那张表里的每一个数都是用「胜率恒为 32.9% 的独立下注」模拟出来的,里面没有任何「策略变坏」的成分。所以 92.2% 说的是误报率,它不能用来说明策略危险——**它说明的是这条规则危险。**一条在正常情况下就有九成概率会响的警报,响了之后不携带任何信息。
- 按 26.24 准备。两个数差这么多,是因为最大回撤是一个极值统计量:它只由整条路径里最难看的那一小段决定,所以对交易发生的顺序极其敏感。39 笔交易的顺序有天文数字种可能,历史只实现了其中一种,而这一种恰好比 98% 的其他顺序都温和。⚠️ 注意 26.24 也不是上限,它只是 95% 分位——99% 分位是 31.71。
- **仓位。**按第 26 篇的固定风险公式,仓位 = 账户 × 风险比例 ÷ 止损距离。一开始就把止损放到 3N,止损距离变大 → 仓位自动变小 → 每笔的风险仍然是账户的 1%。而临时挪远时仓位在进场那一刻已经定死,止损距离变大 → 每笔风险直接翻倍。前者是参数选择(SPY 上还更好:年化 4.85% vs 4.68%),后者是执行失误(SPY 上 47.50R → 4.93R)。
- **不能。**仓位差是随机的:第十三节那张表里,同一条「每笔 ±10%」的扰动在 SPY 上是 +8.0%、在 AAPL 和 BTC 上都是 −2.2%。**做大了还是做小了,事后看是运气。**这恰恰说明它不该被优先处理——该优先修的是那些符号永远为负的(滑点、费用、漏做)。一个符号随机的偏差项,正号那一次不是成绩,负号那一次也不是失误。