| 本篇位置 | 第八部分「实盘」第二篇。第 33 篇讲「你能不能照着做」,这一篇讲你该怎么开始做 |
| 用到的数据 | SPY、AAPL、BTC 日线,外加 Binance 两个公开接口的快照(exchangeInfo、ticker/price,不需要账号) |
| 动手 | 新模块 talab.live:Order + Runner + replay + agrees、Filters + apply_filters + min_account、starts + start_risk、Stage + ladder + run_ladder、Guard + stage_range + guards_from_range,附 17 个测试 |
| 读完你能 | 写出一份和回测逐根对得上的实盘执行器,并给自己定一份有数字支撑的上线方案 |
这一篇从头到尾用同一个比方:新药的临床试验分期。
一种药在实验室里的数据再好看,也不会直接给一万个人吃。它要先做 I 期——很少的人、很小的剂量,而且目的不是证明它有效,是看清楚它会不会伤人。然后 II 期看有没有效,III 期放大到足够的人数。
这套流程里最值得学的其实不是「分几期」,是另外两条规矩:
- 每一期的入组条件和终止条件,都写在方案里,而且写在开始之前。
- 上市之后还要继续监测——因为试验里的人和真实世界里的人不是同一批。
这一篇要做的就是把这两条规矩搬到你的账户上。而第一步,是先看清楚「直接上市」会发生什么。
一、2021 年 11 月 8 日
你花了几个月,把第 31 篇那套海龟法则在 BTC 上从头检验了一遍。今天是 2021 年 11 月 8 日,你手上的回测是这样的:
手上的回测:BTC 日线 2017-08-17 → 2021-11-07,1544 根
年化          0.5018
最大回撤       -0.1834
夏普          1.6900
卡玛          2.7359
笔数         27.0000
胜率          0.4815
逐笔的 t 值     2.3025
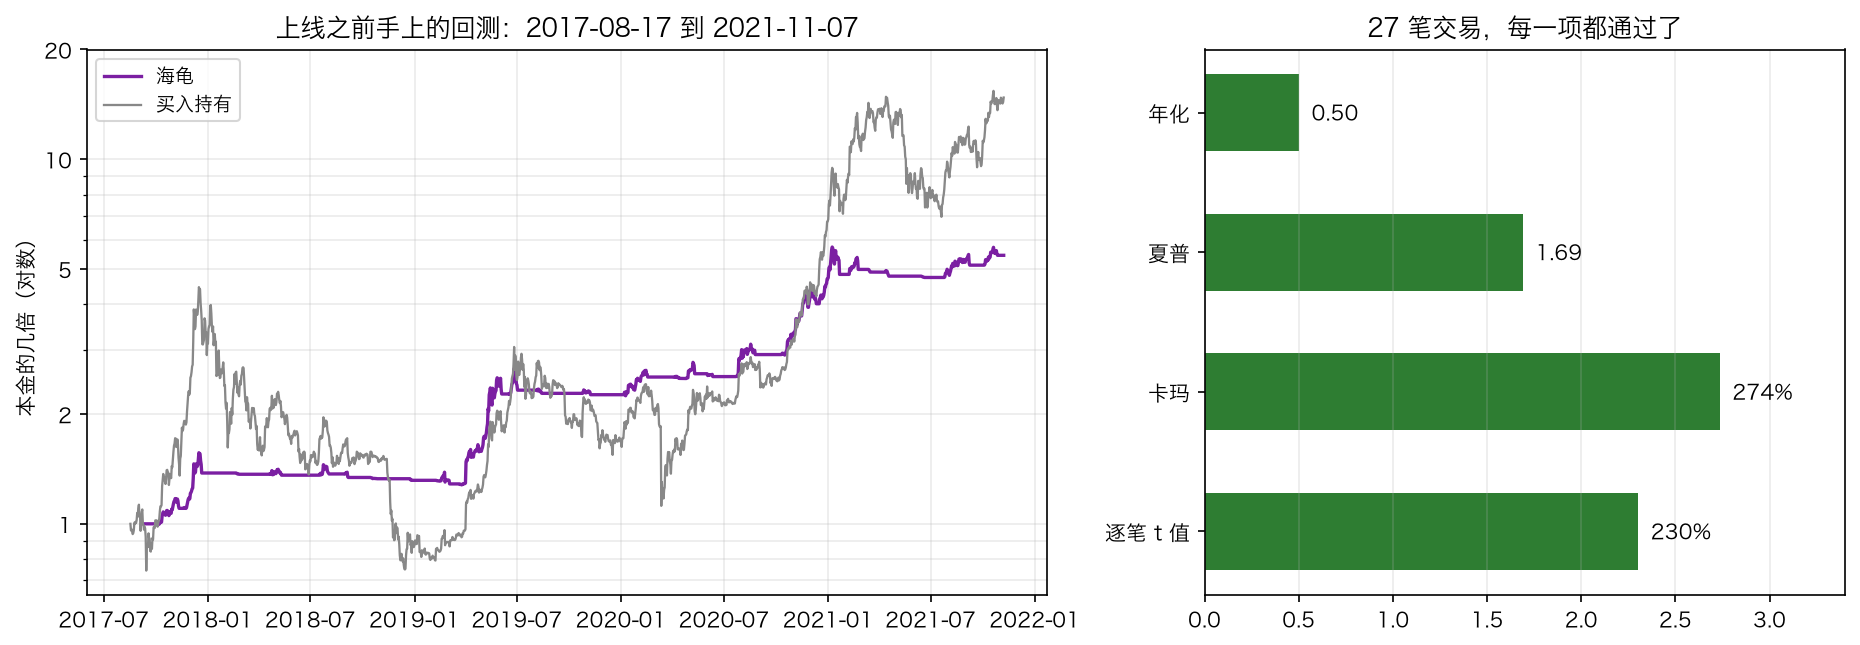
**年化 50.18%、最大回撤 −18.34%、夏普 1.69、卡玛 2.74。**四年多 27 笔交易,逐笔的 t 值 2.30——第 29 篇那条线是 2,它过了。
不止这些:
前面几篇的检验也都过了:第 30 篇的曲面落差 +0.15~+0.20(高地不是针)、每年重挑参数跑不赢固定参数、蒙特卡洛 300 条假数据 0 条比真实的好;
第 33 篇的正常范围表也算好了。账户 10 万美元。全投吗?
- 第 30 篇的六刀:曲面落差只有 +0.15~+0.20(是高地不是针)、每年重挑参数反而跑不赢固定参数、块自助法造的 300 条假数据没有一条比真实的好
- 第 31 篇:这是全课第一条逐笔 t 值全部超过 2 的策略
- 第 33 篇:正常连亏和正常回撤的范围也都算好了,贴在屏幕上
参数是 1983 年定下来的,一个字没动过。代码写完了,跑得通。账户里有 10 万美元。
全投吗?
二、揭晓
  上线之后第一年:-13.97%,期间最深 -13.97%
  上线之后头 403 天:-16.36%,期间最深 -16.36%

策略一个字没错——这正是第 33 篇那段十二连亏,它从 2021-11-08 开始。
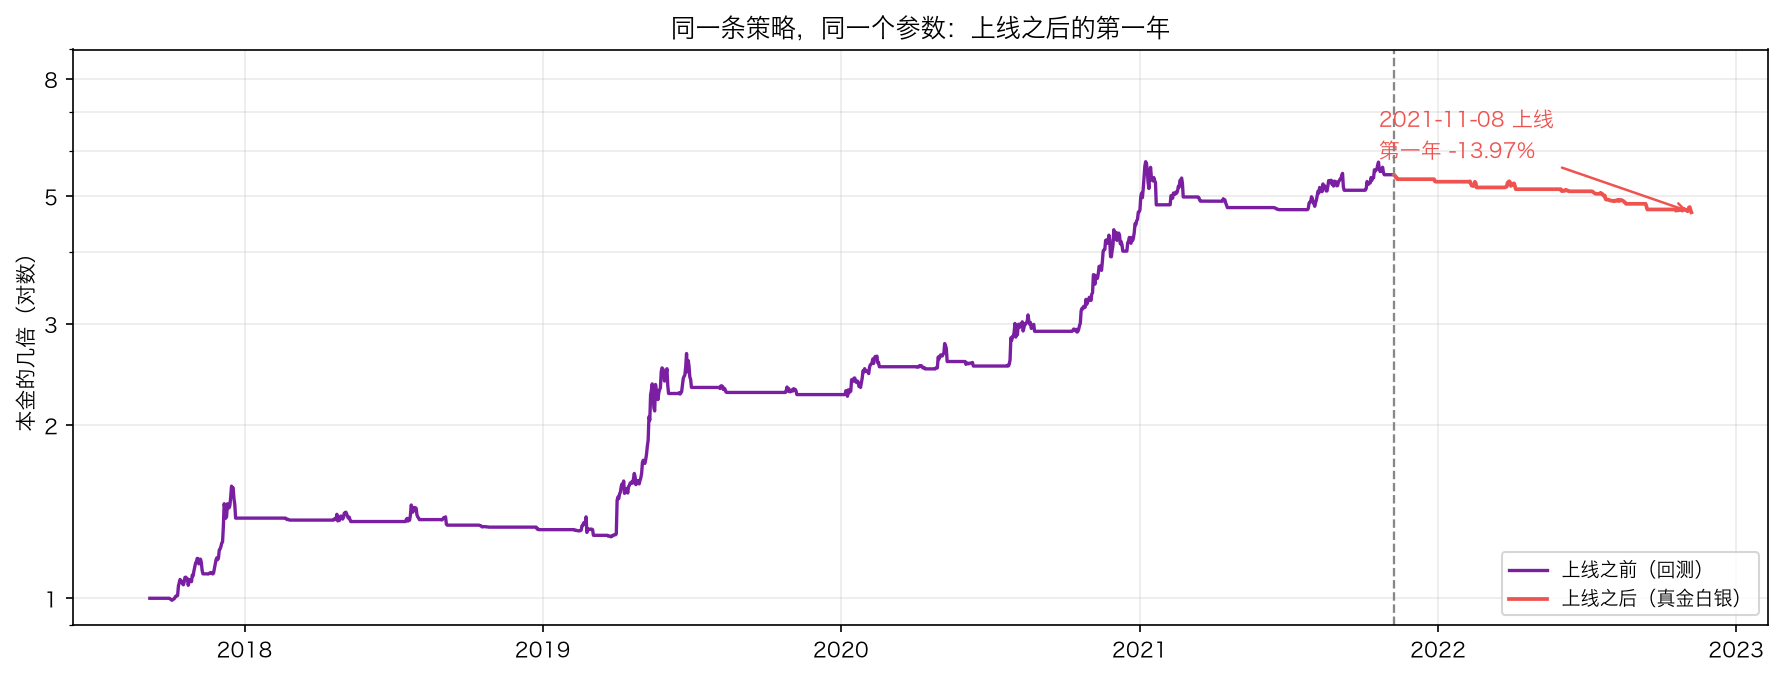
第一年 −13.97%。
策略没有失效,代码没有写错,参数没有动过。这一年就是第 33 篇那段连亏十二笔的开头——你在第 33 篇里是坐在旁边看的,这一次你是当事人,而且你刚刚把全部身家投进去。
你可能会想:那只是运气不好。
对,就是运气不好。而这一篇要量的,正是「运气不好」这件事有多大。
三、你上线的那一天是随便抽的
把问题换一个问法:从九年里的每一天开始上线,第一年各赚多少?
这里必须真的重跑引擎,不能拿整条资金曲线滚动相除——因为「从今天开始」意味着你此刻是空仓的,而连续跑下来的那条曲线在同一时刻多半正拿着一笔仓:
def starts(df: pd.DataFrame, run, window: int, step: int = 5,
           warmup: int = 250) -> pd.DataFrame:
    """**从每一个可能的日子开始上线**,各跑 `window` 根,看第一段的成绩。

    `run` 是一个函数,收到一段 K 线、返回一条资金曲线。这里必须**真的重跑引擎**,
    不能拿整条曲线去滚动相除——因为「从今天开始」意味着你此刻是空仓的,
    而连续跑下来的那条曲线在同一时刻多半正拿着一笔仓。

    ⚠️ 这张表回答的问题和「九年年化多少」完全不同:
    **年化是一个九年才收敛的数,而你的第一年只有一次。**
    """
    if window < 2 or step < 1:
        raise ValueError("window 至少是 2,step 至少是 1")
    rows = []
    for begin in range(warmup, len(df) - window, step):
        piece = df.iloc[begin - warmup:begin + window]
        curve = run(piece)
        curve = curve.iloc[-window:] if len(curve) > window else curve
        if len(curve) < 2:
            continue
        peak = curve.cummax()
        rows.append({"上线日": df.index[begin], "第一段收益": float(curve.iloc[-1] / curve.iloc[0] - 1),
                     "期间最大回撤": float((curve / peak - 1).min())})
    return pd.DataFrame(rows)
起点个数      538.0000
赚钱的起点占      0.8457
平均          0.3666
最差         -0.1727
最好          1.5124
5% 分位      -0.0936
25% 分位      0.0764
50% 分位      0.2774
75% 分位      0.6753
95% 分位      0.9356
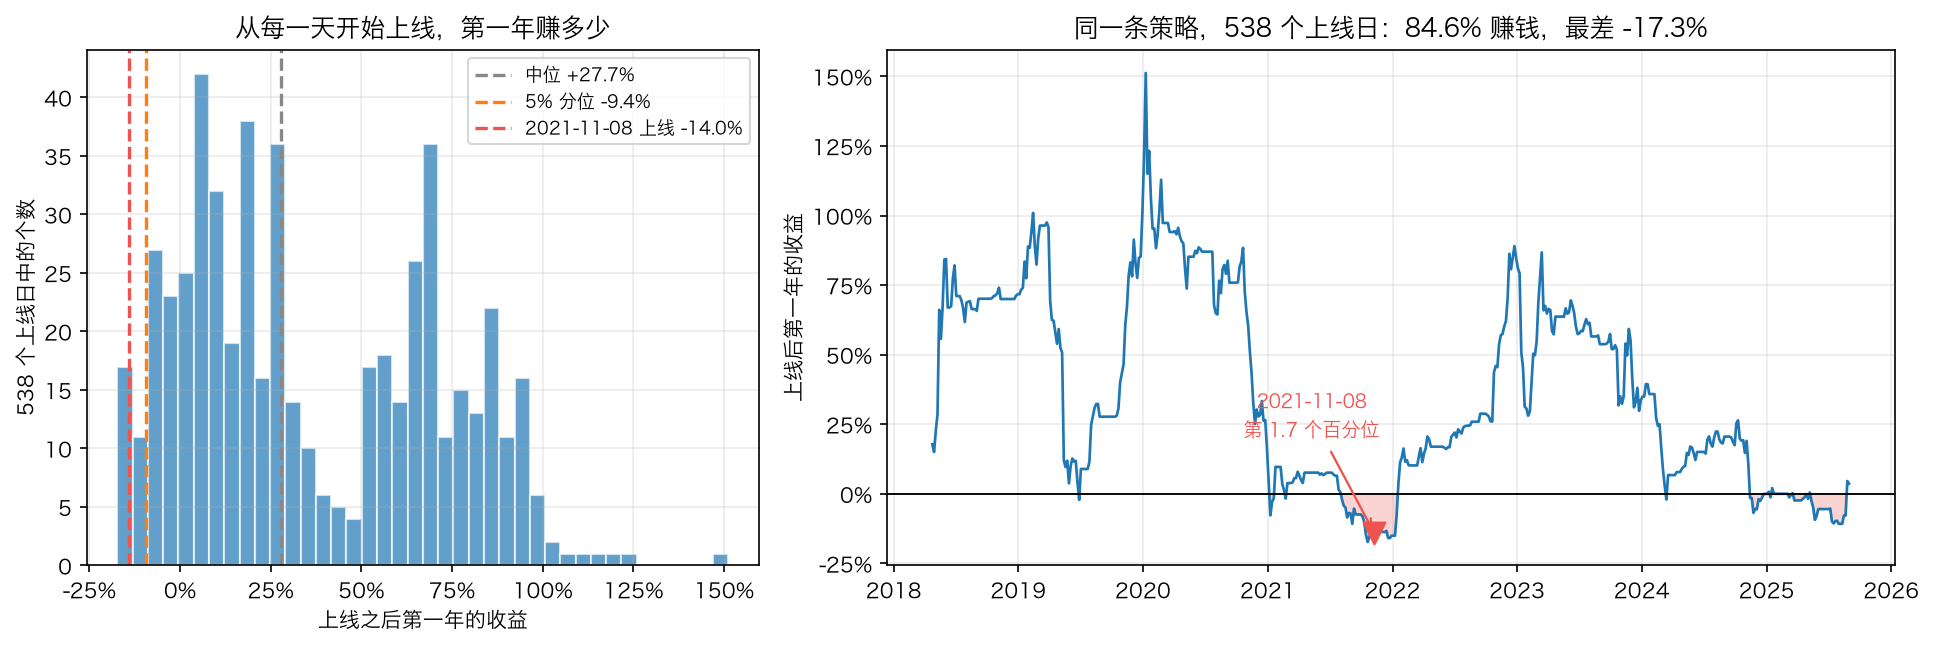
538 个上线日,每个往后跑 365 根:
| 上线后第一年 | |
|---|---|
| 赚钱的起点占 | 84.6% |
| 平均 | +36.66% |
| 中位 | +27.74% |
| 5% 分位 | −9.36% |
| 最差 | −17.27% |
九年年化 31.60% 的策略,有 15.4% 的上线日在第一年是亏钱的,最差的那个亏 17.27%。
而 2021 年 11 月 8 日那一天:
最差的 5 个上线日(共 538 个):
       上线日   第一段收益  期间最大回撤
2021-10-20 -0.1727 -0.1727
2021-12-24 -0.1586 -0.1586
2021-12-19 -0.1586 -0.1586
2021-10-25 -0.1554 -0.1554
2021-12-29 -0.1501 -0.1517

2021-11-08 落在第 1.7 个百分位——538 个起点里最差的那一撮。
**排第 1.7 个百分位。**最差的五个上线日里有四个落在 2021 年 10 月到 12 月这两个月里——你不是运气一般差,你是撞上了九年里最不该开始的那两个月。
再看第一年的回撤:
第一年的最大回撤(⚠️ 回撤全是负数,这里只看分位):
起点个数      538.0000
平均         -0.1278
最差         -0.1748
最好         -0.0794
5% 分位      -0.1748
25% 分位     -0.1573
50% 分位     -0.1242
75% 分位     -0.1028
95% 分位     -0.0794
**538 个起点,没有一个的第一年是不回撤的。**中位数 −12.42%,最好的一个也有 −7.94%。
⚠️ 这张表和第 33 篇第五节那张是同一件事的两面:那里说的是「回测报告上的最大回撤是一个样本」,这里说的是「年化收益也是一个样本,而你的第一年只有一次」。
年化是一个要跑九年才收敛的数。你的第一年只有一年。
这就是为什么不能直接全投。但在谈怎么分批之前,还有两件更基础的事没做完。
四、模拟盘到底能查出什么
大多数人对模拟盘的理解是「先跑跑看,赚钱了再投真钱」。
第 33 篇第六节已经把这条路堵死了:要以 80% 的把握认出「策略的期望值掉到 0」,SPY 上的海龟需要 84 笔、11.2 年,主线 v4 在 SPY 上需要 193 笔、44.5 年。跑三个月的模拟盘能证明的东西,约等于零。
所以模拟盘不是用来验证策略的。它是 I 期临床——目的不是证明有效,是看清楚会不会伤人。具体到交易,它能查出来的是三件事,而且这三件事都和收益无关:
| 能查出来 | 查不出来 |
|---|---|
| 代码和回测跑的不是同一件事(第五节) | 策略有没有效 |
| 上线时带的历史不够,指标是错的(第七节) | 未来的收益率 |
| 下的单交易所根本不接受(第八节) | 滑点、冲击(模拟盘的成交是假的) |
这三件事的共同点是:它们不是概率,是有和没有。代码写错了就是写错了,查出来就归零;没查出来,它会在第一笔就吃掉你,而且吃掉多少和你投了多少钱没有关系——一个死循环可以在三秒钟里下两百张单。
下面三节就是这三件事,一件一件查。
五、把回测改成一根一根喂,然后逐根对账
回测引擎拿到的是整条历史,实盘拿到的是「又收了一根」。两者必须做同一件事,但写法完全不同:回测可以先把 ATR 算完再开始循环,实盘只能每收一根算一次。
所以实盘执行器是另一份代码。而另一份代码就意味着另一份 bug。
Runner 把第 27 篇那个四步循环改写成一根一根的版本,每收到一根 K 线就按同样的顺序做同样的四件事:
    def on_bar(self, time, bar) -> list[Order]:
        bar = {name: float(bar[name]) for name in COLUMNS}
        orders: list[Order] = []
        self.seen += 1
        atr = self.atr                                     # 算到上一根为止,这一根还没收进来

        # 第 1 步:成交上一根挂出的单
        if self.pending is not None and self.account.shares == 0:
            price = bar["open"]
            level = (price * (1 - self.stop_percent) if self.stop == "percent"
                     else price - self.k * atr if self.stop == "chandelier" else -np.inf)
            if level < price:
                distance = 1 - level / price
                want = (self.account.equity(price) if self.sizing == "full"
                        else self.account.equity(price)
                        * min(1.0, self.risk_per_trade / max(distance, 1e-9)))
                shares = min(want / price, self.account.affordable(price, self.fee_rate))
                if shares > 0:
                    self.account.buy(price, shares, self.fee_rate)
                    self.entry_price, self.entry_time = price, time
                    self.entry_index = self.seen
                    self.risk, self.highest, self.stop_price = price - level, price, level
            self.pending = None

        # 第 2 步:出场
        if self.account.shares > 0:
            if self.stop == "percent":
                self.stop_price = self.entry_price * (1 - self.stop_percent)
            elif self.stop == "chandelier":
                self.stop_price = max(self.stop_price, self.highest - self.k * atr)
            price = reason = None
            if self.exit_signal and time != self.entry_time:
                price, reason = bar["open"], "出场信号"
            elif self.stop != "none" and bar["close"] <= self.stop_price:
                price, reason = bar["close"], "止损"
            if reason is not None:
                shares = self.account.shares
                self.account.sell(price, shares, self.fee_rate)
                self.trades.append({"买入日": self.entry_time, "买入价": self.entry_price,
                                    "数量": shares, "卖出日": time, "卖出价": price,
                                    "原因": reason, "收益": price / self.entry_price - 1,
                                    "根数": self.seen - self.entry_index})
                orders.append(Order(time, "sell", shares, reason, price))
            else:
                self.highest = max(self.highest, bar["high"])

        # 第 3 步:估值
        value = self.account.equity(bar["close"])
        self.error = max(self.error, abs(self.account.cash
                                         + self.account.shares * bar["close"] - value))
        self.curve.append((time, value))
        self.last = (time, bar["close"])

        # 第 4 步:把这一根收进历史,重算信号,挂出下一根的单
        self.times.append(time)
        self._push(bar)
        entry, self.exit_signal = self.signal(self._frame())
        if self.account.shares == 0 and self.pending is None and entry:
            self.pending = Order(time, "buy", 1.0, "进场信号", bar["close"])
            orders.append(self.pending)
        return orders
两个地方值得停一下。
**第一,指标必须能增量算。**回测里 I.atr(df) 一行就完事,实盘里跑十年、每根都重算一遍整条历史是 O(n²)。Wilder 平滑本来就是递推的,天生适合实盘:
    def _push(self, bar: dict):
        """把这一根收进缓冲区,并用 Wilder 平滑把 ATR 往前推一格。

        ⚠️ 这里不能重算整条历史:实盘跑十年,每根都重算一遍是 O(n²)。
        Wilder 平滑本来就是递推的(`新值 = 旧值 + (这一根 − 旧值) / n`),天生适合实盘。
        """
        previous = self.bars[-1]["close"] if self.bars else np.nan
        if not np.isnan(previous):                         # 第一根没有真实波幅(要用前一根收盘)
            true_range = max(bar["high"] - bar["low"], abs(bar["high"] - previous),
                             abs(bar["low"] - previous))
            if self._tr_n < self.atr_period:               # 预热:先攒满 n 根取平均
                self._tr_sum += true_range
                self._tr_n += 1
                if self._tr_n == self.atr_period:
                    self.atr = self._tr_sum / self.atr_period
            else:
                self.atr += (true_range - self.atr) / self.atr_period
        self.bars.append(bar)
**第二,Order 里那个 client_id。**它是你自己生成的编号,发单时一起带上,第十四节会说明为什么这是整条流程里最不能省的一个字段。
现在把整段历史一根一根喂进去,然后和回测引擎逐根对账:
def replay(df: pd.DataFrame, runner: Runner, start: int = 0) -> dict:
    """把一段历史一根一根喂给 `Runner`,就像它是实时到达的一样。

    这是**唯一**能验证实盘代码的办法:让它重放历史,然后和回测引擎逐根对账。
    对不上就是有一边写错了——第 27 篇那句话在这里还成立:**对账是回测唯一能做的自检。**
    """
    for position in range(start, len(df)):
        runner.on_bar(df.index[position], df.iloc[position])
    return runner.result()
plan = mainline_plan(btc)
engine = BT.run(btc, plan, 100_000.0)
runner = L.Runner(mainline_signal, stop="chandelier", k=3.0, sizing="risk",
                  risk_per_trade=0.10, equity=100_000.0, warmup=400)
streamed = L.replay(btc, runner)
print(L.agrees(engine["资金曲线"], streamed["资金曲线"]).to_string())
print(f"\n回测 {len(engine['交易'])} 笔,实盘 {len(streamed['交易'])} 笔;"
      f"两张交易表完全一样:{engine['交易'][['买入日', '卖出日', '原因']].reset_index(drop=True).equals(streamed['交易'][['买入日', '卖出日', '原因']].reset_index(drop=True))}")
print(f"记账误差:回测 {engine['记账误差']:.2e},实盘 {streamed['记账误差']:.2e}")
重叠根数       3287.0
最大绝对差         0.0
最大相对差         0.0
对不上的根数        0.0
第一根对不上的       NaT

回测 30 笔,实盘 30 笔;两张交易表完全一样:True
记账误差:回测 0.00e+00,实盘 0.00e+00
3,287 根 K 线,最大相对差 0.0;30 笔交易,两张表一模一样。
⚠️ 判据用的是相对差不是绝对差。同样的浮点噪声,10 万美元的账户上是 1e-9,1,000 万的账户上就是 1e-7——换一个本金就要换一次阈值的判据不是判据:
def agrees(a: pd.Series, b: pd.Series, tolerance: float = 1e-9) -> pd.Series:
    """两条资金曲线逐根对账:重叠的根数、最大绝对差、最大相对差、第一根对不上的时间。

    ⚠️ 「差不多」不算数。同一套规则、同一段数据,两份代码的资金曲线应该差在浮点误差量级。
    差 0.1% 不是「实现细节不同」,是**其中一份有 bug**,而你还不知道是哪一份。

    ⚠️ 判据用的是**相对**差不是绝对差:绝对差会随账户大小变——
    同样的浮点噪声,10 万美元的账户上是 1e-9,1000 万的账户上就是 1e-7,
    换一个本金就要换一次阈值的判据不是判据。
    """
    common = a.index.intersection(b.index)
    both = pd.DataFrame({"A": a.reindex(common), "B": b.reindex(common)}).dropna()
    if not len(both):
        raise ValueError("两条曲线没有重叠的时间")
    gap = (both["A"] - both["B"]).abs()
    relative = gap / both["B"].abs().clip(lower=1e-12)
    off = both.index[relative > tolerance]
    return pd.Series({"重叠根数": float(len(both)), "最大绝对差": float(gap.max()),
「差不多」不算数。同一套规则、同一段数据,两份代码的资金曲线应该差在浮点误差量级。差千分之一不是「实现细节不同」,是其中一份有 bug,而你还不知道是哪一份。
六、上线要带多少根历史
第二件事。你今天启动进程,手上有多少根历史 K 线?
直觉的答案是「指标周期是多少就带多少」——ATR(14) 带 14 根、SMA(200) 带 200 根。这个答案对一半,错一半,而且错的那一半错得很离谱。
指标分两类,预热的性质完全不同。
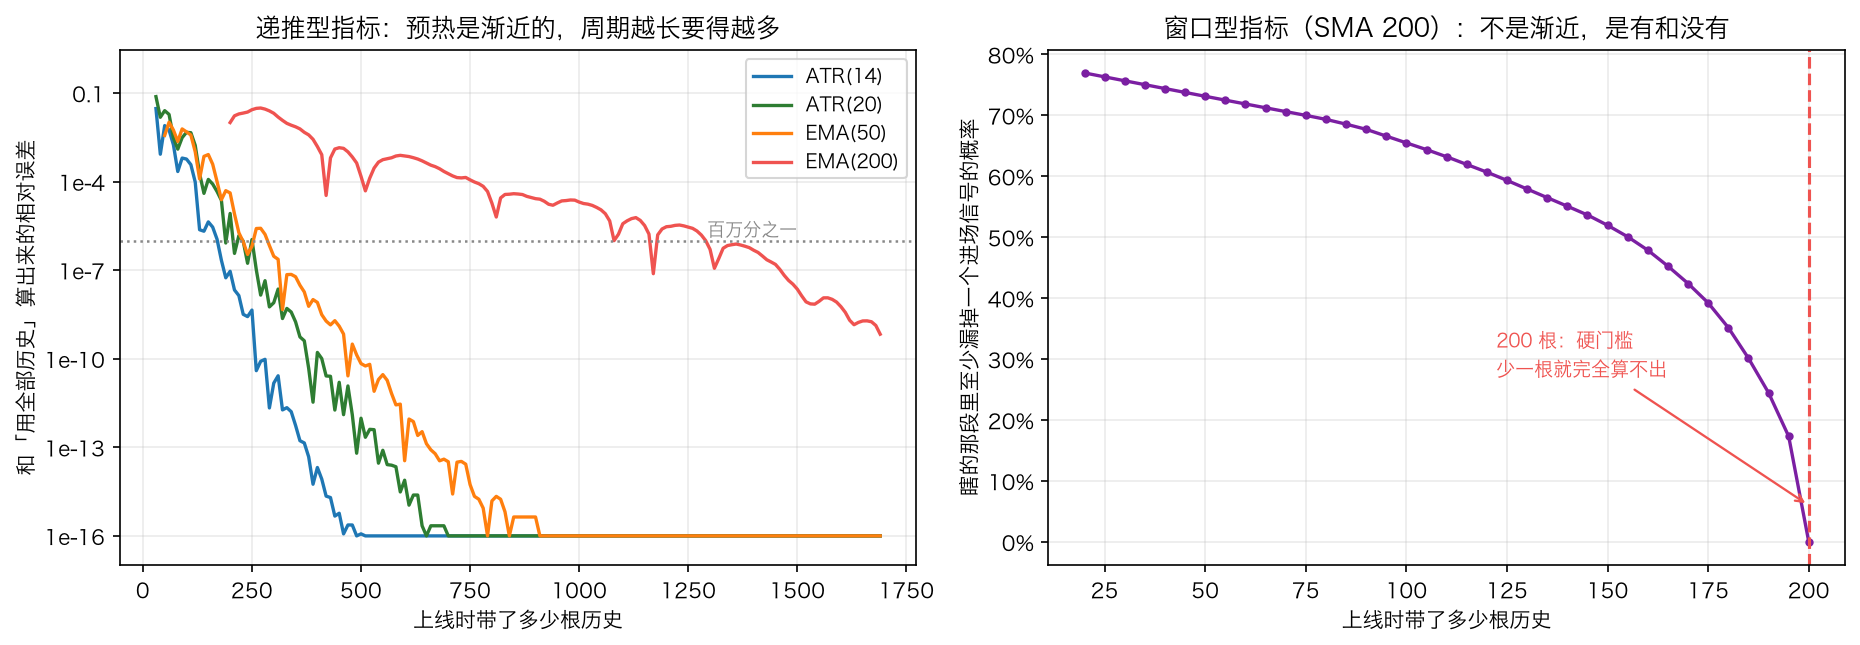
第一类是递推型(Wilder 平滑、EMA)。它们没有「窗口」,每一个新值都是旧值的加权修正,所以第一根历史的影响永远不会完全消失,只会指数衰减。衰减的速度就是平滑系数:
      指标  每多带一根,误差乘   带 50 根  带 100 根      带 200 根      带 400 根      带 800 根     带 1600 根
 ATR(14)   0.928571 0.007948 0.000583 9.180569e-08 2.074202e-14 0.000000e+00 0.000000e+00
 ATR(20)   0.950000 0.025412 0.004698 8.386581e-06 1.638872e-10 0.000000e+00 0.000000e+00
 EMA(50)   0.960784 0.003685 0.004858 4.148195e-05 8.122611e-09 1.529234e-15 0.000000e+00
EMA(200)   0.990050      NaN      NaN 1.005010e-02 1.548293e-03 1.873057e-05 5.832913e-09
| 指标 | 每多带一根误差乘 | 带 200 根 | 带 800 根 |
|---|---|---|---|
| ATR(14) | 0.9286 | 9.2e-08 | 0 |
| ATR(20) | 0.9500 | 8.4e-06 | 0 |
| EMA(50) | 0.9608 | 4.1e-05 | 1.5e-15 |
| EMA(200) | 0.9901 | 1.0e-02 | 1.9e-05 |
**EMA(200) 带 200 根历史上线,第一天算出来的值和「用全部历史」差 1%。**一个 200 日均线差 1%,足够把金叉死叉翻个个儿。要把误差压到百万分之一,它要带将近一千根——是周期的五倍。
⚠️ 这不是 bug,是 EMA 的定义。第 12 篇量过:200 日 EMA 的实测滞后是 72–79 根,它的记忆本来就比周期长得多。
第二类是窗口型(SMA、滚动最高价、唐奇安通道)。它们的预热不是渐近的,是有和没有:少一根,值就是 NaN,信号就是 False。
主线 v4 的进场条件里有 SMA(200),所以它的硬门槛是 200 根。带得不够会怎么样?
主线 v4 的进场信号在九年 3302 根里出现 226 次(6.8% 的日子)
  带  60 根历史上线:瞎 140 根,随便挑一天上线,瞎的那段里至少漏掉一个进场信号的概率 71.9%
  带 100 根历史上线:瞎 100 根,随便挑一天上线,瞎的那段里至少漏掉一个进场信号的概率 65.5%
  带 150 根历史上线:瞎  50 根,随便挑一天上线,瞎的那段里至少漏掉一个进场信号的概率 52.0%
  带 199 根历史上线:瞎   1 根,随便挑一天上线,瞎的那段里至少漏掉一个进场信号的概率 7.3%
  带 200 根历史上线:一根都不瞎
  带 250 根历史上线:一根都不瞎
带 150 根历史上线,你会瞎 50 根;随便挑一天上线,这 50 根里至少漏掉一个进场信号的概率是 52.0%。
而第 33 篇已经量过漏掉一笔值多少钱:BTC 上漏做赚得最多的那一笔,等于九年里每一笔都多付 56.9 个基点。
**两类指标放在一起,结论是:带你最长的那个周期的五倍。**主线 v4 用 SMA(200),带 1,000 根;如果它用的是 EMA(200),那就必须带 1,000 根,200 根是不够的。
七、交易所不接受你回测里的那个数量
第三件事。回测算出来要买 25.916137 个 BTC——交易所会说什么?
Binance 的 exchangeInfo 是公开接口,不需要账号也不需要密钥,把每个交易对的下单规矩写得明明白白:
def download_binance_public(endpoint: str, name: str, dest: str = "data/binance") -> Path:
    """下载 Binance 的一个**公开**接口(不需要账号、不需要密钥),原样保存 JSON。第 34 篇。

    这一篇只用两个:

    - `exchangeInfo`:每个交易对的下单规矩(tickSize、stepSize、minNotional……)
    - `ticker/price`:现在的价格,用来把 stepSize 换算成钱

    ⚠️ 和 `download_binance_brackets` 一样,拿到的是**今天**的规矩。交易所随时会改,
    所以这个文件要和回测结果一起存档——不然过两个月你复现不出自己的数。
    """
    path = Path(dest) / f"{name}.json"
    path.parent.mkdir(parents=True, exist_ok=True)
    path.write_bytes(_fetch(BINANCE_API + endpoint, agent=BINANCE_API_AGENT))
    return path
"""第 34 篇的数据:Binance 的两个公开接口(不需要账号)。在 talab 项目根目录运行。

- `exchangeInfo`:每个交易对的下单规矩(tickSize、stepSize、minQty、minNotional、maxQty)
- `ticker/price`:现在的价格,用来把 stepSize 换算成钱

⚠️ 两个文件都是**今天**的快照。交易所随时会改这些数,所以它们要和回测结果一起存档。
"""
from talab import data as D

for endpoint, name in [("exchangeInfo", "exchange_info"), ("ticker/price", "ticker_price")]:
    path = D.download_binance_public(endpoint, name)
    print(f"{endpoint:>14} → {path}({path.stat().st_size / 1024:.0f} KB)")
全市场 3705 个交易对,其中还在交易的 USDT 交易对 493 个
                   价格  tickSize  stepSize  minNotional  一个 step 值多少钱
交易对
BTCUSDT   80362.01000   0.01000   0.00001          5.0      0.803620
ETHUSDT    2574.92000   0.01000   0.00010          5.0      0.257492
SOLUSDT     108.15000   0.01000   0.00100          5.0      0.108150
DOGEUSDT      0.08475   0.00001   1.00000          1.0      0.084750

minNotional 的取值:
minNotional
5.0    463
1.0     30

stepSize 的取值:
stepSize
0.00001      3
0.00010      8
0.00100     70
0.01000    100
0.10000    188
1.00000    124
四个规矩:tickSize(价格必须是它的整数倍)、stepSize(数量必须是它的整数倍)、minQty / maxQty(单张单的数量上下限)、minNotional(单张单的金额下限)。
@dataclass
class Filters:
    """交易所对一张单的硬性要求。回测里没有这些东西,实盘里每一张单都要过这一关。

    - `tick_size`:价格必须是它的整数倍
    - `step_size`:数量必须是它的整数倍(**向下取整**,因为买多了会超出风险预算)
    - `min_qty` / `max_qty`:单张单的数量上下限
    - `min_notional`:单张单的金额下限——**小账户真正的门槛在这里,不在数量精度上**
    """
    tick_size: float = 0.01
    step_size: float = 1e-5
    min_qty: float = 1e-5
    max_qty: float = np.inf
    min_notional: float = 5.0

    @classmethod
    def from_binance(cls, payload: dict) -> "Filters":
        """从 `api.binance.com/api/v3/exchangeInfo` 的一个 symbol 里读出来(公开接口,不用账号)。"""
        found = {f["filterType"]: f for f in payload["filters"]}
        price, lot = found["PRICE_FILTER"], found["LOT_SIZE"]
        notional = found.get("NOTIONAL", found.get("MIN_NOTIONAL", {}))
        return cls(tick_size=float(price["tickSize"]), step_size=float(lot["stepSize"]),
                   min_qty=float(lot["minQty"]), max_qty=float(lot["maxQty"]),
                   min_notional=float(notional.get("minNotional", 0.0)))

    @staticmethod
    def _floor(value: float, unit: float) -> float:
        if unit <= 0:
            return float(value)
        # 先除再取整会被浮点误差咬:0.29/0.01 在双精度里是 28.999999999999996
        return math.floor(round(value / unit, 9)) * unit

    def round_qty(self, qty: float) -> float:
        """数量向下取到 `step_size` 的整数倍。**向下**不是随手选的:向上取整会让这一笔
        的风险超过你定的预算,而超出的部分正好落在你最不希望它出现的时候。"""
        return self._floor(qty, self.step_size)

    def round_price(self, price: float) -> float:
        return self._floor(price, self.tick_size)

    def accepts(self, price: float, qty: float) -> str:
        """这张单能不能发出去。返回空字符串表示可以,否则是被拒绝的理由。"""
        if qty < self.min_qty:
            return f"数量不足 minQty({qty:.8f} < {self.min_qty:g})"
        if qty > self.max_qty:
            return f"数量超过 maxQty({qty:.8f} > {self.max_qty:g})"
        if price * qty < self.min_notional:
            return f"金额不足 minNotional({price * qty:.2f} < {self.min_notional:g})"
        return ""
⚠️ 数量一律向下取整,不是四舍五入。向上取整会让这一笔的风险超过你定的预算,而超出的部分正好落在你最不希望它出现的时候。
⚠️ 还有一个浮点坑:0.29 / 0.01 在双精度里是 28.999999999999996,直接 floor 会变成 0.28。_floor 里那个 round(value / unit, 9) 就是为这个写的。
那么取整到底吃掉多少钱?
count    493.0000
mean       0.1103
std        0.2272
min        0.0000
50%        0.0136
90%        0.3537
99%        1.0002
max        1.4383
  一个 step 超过 0.1 美元的交易对:116 个(23.5%)
  一个 step 超过 1 美元的交易对:8 个(1.6%)
  一个 step 超过 10 美元的交易对:0 个(0.0%)
  最粗的一个是 ZECUSDT:一个 step 值 1.44 美元,落在 1,000 美元的仓位上是 0.072% 的误差
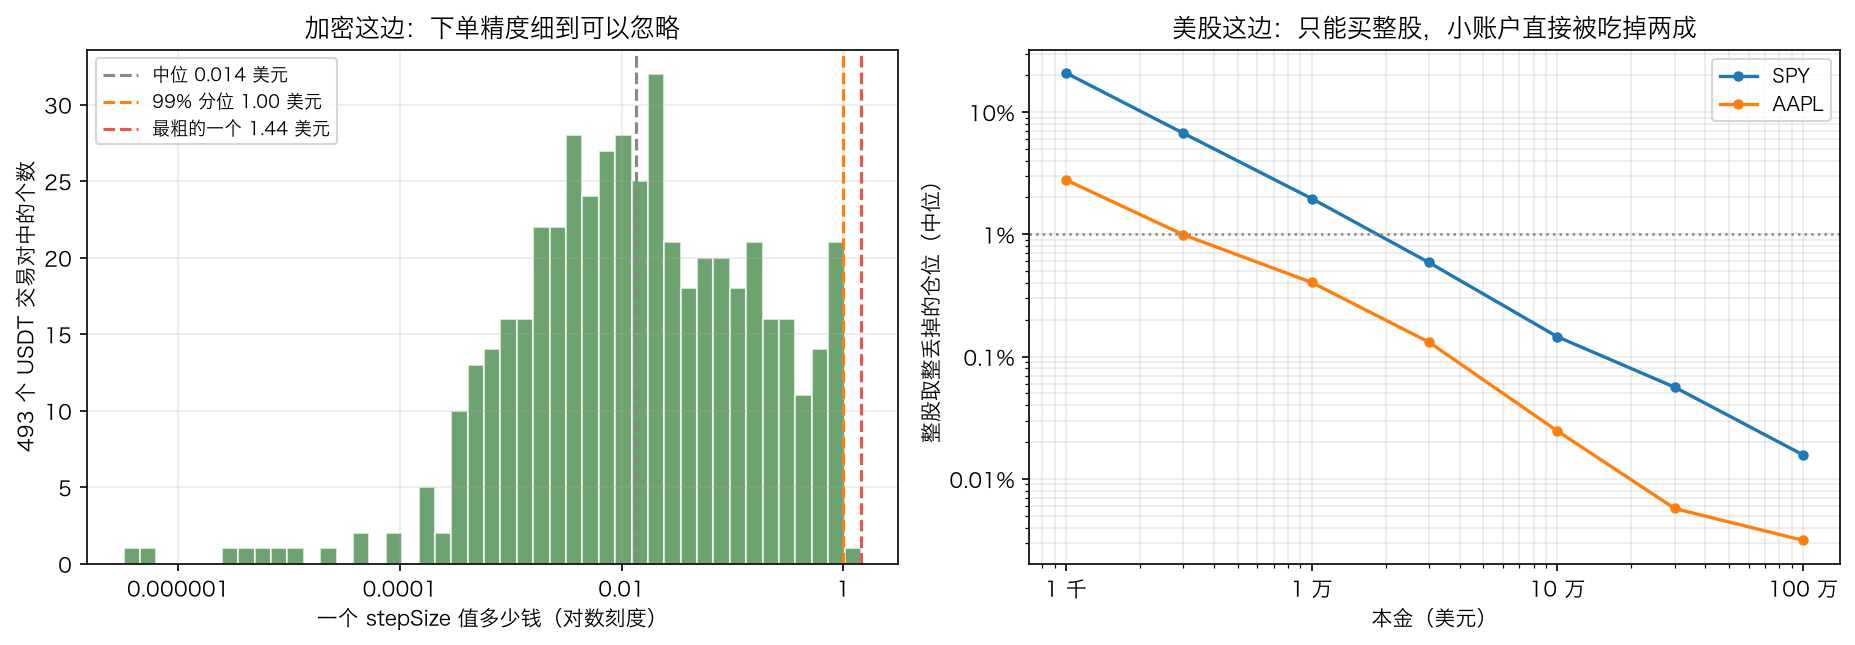
**结论是反直觉的:加密这边的下单精度根本不是问题。**493 个还在交易的 USDT 交易对里,一个 stepSize 的中位数只值 1.4 美分,99% 分位 1 美元,最粗的一个(ZECUSDT)也只有 1.44 美元——落在 1,000 美元的仓位上是 0.072% 的误差。minNotional 更宽松:463 个交易对是 5 美元,30 个是 1 美元。
但这不等于这段代码可以不写。因为取整错了的代价不是精度,是拒单:
BTCUSDT:Filters(tick_size=0.01, step_size=1e-05, min_qty=1e-05, max_qty=9000.0, min_notional=5.0)
一张单发出去之前要过的三关(拿一笔 0.123456789 BTC 的单试):
  原始数量 0.123456789  →  取整后 0.12345  →  可以发出去
  原始数量 5e-05  →  取整后 5e-05  →  金额不足 minNotional(4.02 < 5)
  不取整直接发 0.123456789 → 交易所按 LOT_SIZE 拒单,这一笔就**没有了**
数量不取整,交易所按 LOT_SIZE 直接拒掉——这一笔就没有了。而第 33 篇那张归因表里最贵的一格正是「漏做」,九年 −310,175 美元的差额里它占 88.7%。
精度误差是 0.07%,拒单是 100%。这段代码要写的理由从来不是前者。
八、美股这边,整股是真的会咬人
加密可以买 0.00001 个 BTC,美股的默认规矩是只能买整股。同一条主线策略,换几个本金:
  标的      本金  笔数     平均每笔几股  取整丢掉的仓位(中位)  取整丢掉的仓位(最大)  发不出去的单
 SPY    1000  39     2.8044       0.2090       0.4945       0
 SPY   10000  39    28.0444       0.0196       0.0455       0
 SPY  100000  39   280.4438       0.0015       0.0046       0
 SPY 1000000  39  2804.4383       0.0002       0.0004       0
AAPL    1000  37    16.4590       0.0279       0.1203       0
AAPL   10000  37   164.5899       0.0040       0.0110       0
AAPL  100000  37  1645.8986       0.0002       0.0009       0
AAPL 1000000  37 16458.9858       0.0000       0.0001       0
| SPY | 平均每笔几股 | 取整丢掉的仓位(中位) | 最大 |
|---|---|---|---|
| 本金 1,000 | 2.80 | 20.90% | 49.45% |
| 本金 10,000 | 28.04 | 1.96% | 4.55% |
| 本金 100,000 | 280.44 | 0.15% | 0.46% |
| 本金 1,000,000 | 2,804.44 | 0.02% | 0.04% |
一千美元的账户做 SPY,整股取整中位数吃掉 20.9% 的仓位,最狠的一笔吃掉 49.45%——你以为自己按 10% 的风险在交易,实际只有 5%。
AAPL 好一些(股价低、股数多),但本金一千时中位数也有 2.79%。
⚠️ 这个数是上界:现在不少券商支持零股,能买 2.8 股就按 2.8 股买。但零股通常只能走市价单、不一定能参与盘前盘后——它换来的精度,可能被换掉的成交方式吃回去。这一节要说的是那个机制:你的本金和标的股价的比值,决定了你的仓位控制有多精确。本金一千做一只 600 美元的 ETF,仓位这个概念基本不存在。
九、最小账户和最大账户
把上面的规矩倒过来用,可以直接问:这条策略在这个市场上,最少要多大的账户才跑得动?
def min_account(filters: Filters, price: float, risk_per_trade: float = 0.10,
                stop_fraction: float = 0.15) -> pd.Series:
    """**这条策略在这个市场上,最少要多大的账户才跑得动。**

    两个门槛,取大的那个:

    - `minNotional`:一笔的金额不能低于它
    - `step_size`:一笔的数量取整之后,误差不能大到把仓位算错

    仓位 = 账户 × 风险预算 ÷ 止损距离(第 26 篇),所以账户 = 仓位金额 × 止损距离 ÷ 风险预算。
    ⚠️ 这个数是**下限不是建议**:刚好够下单,不等于够分散、够扛回撤。
    """
    if not 0 < risk_per_trade <= 1 or not 0 < stop_fraction <= 1:
        raise ValueError("风险预算和止损距离都要在 0 和 1 之间")
    ratio = min(1.0, risk_per_trade / stop_fraction)       # 仓位占账户的比例
    by_notional = filters.min_notional / ratio
    # 让取整误差不超过仓位的 1%:仓位金额至少要是 100 个 step 的钱
    by_step = 100 * filters.step_size * price / ratio
    return pd.Series({"仓位占账户": ratio, "按 minNotional 算": by_notional,
                      "按 step_size 算(误差 < 1%)": by_step,
                      "最小账户": max(by_notional, by_step)})
仓位占账户                       0.67
按 minNotional 算             7.50
按 step_size 算(误差 < 1%)    120.54
最小账户                      120.54

另一头:MARKET_LOT_SIZE 的 maxQty = 118.80 BTC = 9.55 百万美元
主线 v4 的仓位占账户 66.67%,所以账户超过 14.3 百万美元时,一张市价单发不完,必须拆单
BTC 现货上,跑主线 v4 的最小账户是 121 美元。(⚠️ 这是能不能下单的下限,不是建议——够下单不等于够分散、够扛第 33 篇那张正常范围表里的回撤。)
另一头也有墙:MARKET_LOT_SIZE 的 maxQty 是 118.80 个 BTC ≈ 955 万美元。主线 v4 的仓位占账户 66.67%,所以账户超过 1,430 万美元时,一张市价单就发不完了,必须拆单——而拆单会改变你的成交价,于是第 28 篇那套成本假设要重做一遍。
规模是策略的一个参数,和均线周期一样。
十、阶梯:把第 33 篇的正常范围表变成警戒线
三件事都查完了,现在才轮到「分几期」。
一条阶梯就是几级台阶,每一级用多少钱、跑满多少笔才能升上去:
class Stage:
    """一级台阶:用多少钱、跑满多少笔才能升级。

    `fraction` 是**这一级实际投入的资金占目标资金的比例**。0 代表模拟盘——
    一分钱不投,但每一笔都照样记账、照样对账。
    """
    name: str
    fraction: float
    trades_to_promote: int

    def __post_init__(self):
        if not 0 <= self.fraction <= 1:
            raise ValueError("fraction 要在 0 和 1 之间")
        if self.trades_to_promote < 1:
            raise ValueError("至少要跑满一笔才能升级")


DEFAULT_LADDER = (Stage("模拟盘", 0.00, 10), Stage("小资金", 0.10, 15),
                  Stage("半仓", 0.35, 20), Stage("目标", 1.00, 1))
 第几级  名字  投入比例  跑满几笔升级
   1 模拟盘  0.00      10
   2 小资金  0.10      15
   3  半仓  0.35      20
   4  目标  1.00       1
⚠️ 第一级的投入比例是 0——那就是模拟盘:一分钱不投,但每一笔都照样记账、照样对账。
降级的条件从哪来?从第 33 篇那张正常范围表。但不能直接抄,因为那张表是按「九年 70 笔」算出来的,而你在一级台阶上只跑十几笔——第 33 篇第二节那个公式说得很清楚:最长连亏随笔数增长。十几笔里的正常回撤,比七十笔里的浅得多。
所以要按这一级实际要跑的笔数重新算一遍:
def stage_range(r, n_trades: int, trials: int = 2000, seed: int = 0,
                levels=(0.5, 0.9, 0.95, 0.99)) -> pd.DataFrame:
    """**按一级台阶实际要跑的笔数**算正常范围,而不是按整段历史。

    第 33 篇那张表是按「九年 70 笔」算出来的,而你在一级台阶上只跑十几笔——
    **十几笔里的正常回撤,比七十笔里的浅得多**(`expected_longest` 说的就是这件事:
    最长连亏随笔数增长)。拿七十笔的阈值去守十五笔的台阶,等于没有阈值。

    做法:从历史的 R 分布里**有放回地**抽 `n_trades` 笔,重复 `trials` 次。
    ⚠️ 有放回是故意的:这里问的是「下一段十五笔可能长什么样」,不是「历史那十五笔怎么排」。
    """
    from talab.journal import longest_streak

    values = pd.Series(r).dropna().astype(float).to_numpy()
    if len(values) < 2 or n_trades < 2:
        raise ValueError("至少要有两笔历史和两笔台阶长度")
    rng = np.random.default_rng(seed)
    picks = rng.choice(values, size=(trials, n_trades), replace=True)
    curve = np.cumsum(picks, axis=1)
    peak = np.maximum.accumulate(np.concatenate([np.zeros((trials, 1)), curve], axis=1), axis=1)[:, 1:]
    deepest = (curve - peak).min(axis=1)
    longest = np.array([longest_streak(row) for row in picks])
    rows = {"最长连亏": longest, "最深回撤": deepest}
    out = []
    for name, sample in rows.items():
        row = {"台阶长度": float(n_trades), "平均": float(sample.mean())}
        for level in levels:
            row[f"{level:.0%} 分位"] = float(np.quantile(sample, 1 - level if "回撤" in name else level))
        out.append(pd.Series(row, name=name))
    return pd.DataFrame(out)
—— 台阶长度 10 笔
      台阶长度    平均  50% 分位  90% 分位  95% 分位  99% 分位
最长连亏  10.0  4.15    4.00    7.00    8.00   10.00
最深回撤  10.0 -7.03   -6.41  -11.78  -13.43  -17.25
—— 台阶长度 15 笔
      台阶长度   平均  50% 分位  90% 分位  95% 分位  99% 分位
最长连亏  15.0  5.1     5.0    8.00    9.00   12.00
最深回撤  15.0 -8.8    -7.9  -14.42  -16.75  -21.45
—— 台阶长度 20 笔
      台阶长度     平均  50% 分位  90% 分位  95% 分位  99% 分位
最长连亏  20.0   5.77    5.00    9.00    10.0   13.00
最深回撤  20.0 -10.09   -9.19  -16.15   -18.7  -23.77
—— 台阶长度 70 笔
      台阶长度     平均  50% 分位  90% 分位  95% 分位  99% 分位
最长连亏  70.0   8.84     8.0   13.00   14.00   18.00
最深回撤  70.0 -16.28   -15.1  -24.12  -27.68  -35.39

按「一级台阶十五笔」定出来的警戒线:
  回撤超过 -21.45(drawdown,阈值 -21.45,降级)
  连亏超过 12 笔(streak,阈值 12.00,降级)

⚠️ 如果拿整段历史(70 笔)的 99% 分位去守一级十五笔的台阶,阈值会松成这样:
  回撤超过 -35.39
  连亏超过 18 笔
| 台阶长度 | 最长连亏 99% 分位 | 最深回撤 99% 分位 |
|---|---|---|
| 10 笔 | 10 笔 | −17.25R |
| 15 笔 | 12 笔 | −21.45R |
| 20 笔 | 13 笔 | −23.77R |
| 70 笔(整段历史) | 18 笔 | −35.39R |
拿整段历史的 99% 分位(连亏 18 笔、回撤 −35.39R)去守一级十五笔的台阶,等于没有阈值——那一级一共才十五笔,凑不出十八笔连亏。
⚠️ 而警戒线的动作必须写死。一条只说「情况不对」而不说「那就做什么」的规则,在情况真的不对的那一天等于没有——因为那一天你会自己发明一个动作。
十一、走一遍阶梯
把阶梯和警戒线挂上,在 BTC 海龟的九年 70 笔上跑一遍:
def run_ladder(r, stages=DEFAULT_LADDER, guards=(), start: int = 0) -> dict:
    """按阶梯走一遍:每笔按当前这一级的比例缩放,跑满笔数升一级,触发警戒线降一级。

    ⚠️ 这里有一个**必须**这样写的地方:降级用的警戒线看的是**这一级自己**的成绩,
    不是从头到尾的总成绩。上一级的坑不该算在这一级头上——否则你刚升上去就被降回来。
    """
    r = pd.Series(r).dropna().astype(float).to_numpy()
    level, since, rows = start, [], []
    for i, value in enumerate(r):
        stage = stages[level]
        taken = value * stage.fraction
        since.append(value)
        triggered = [g.name for g in guards if g.fires(np.array(since))]
        note = ""
        if triggered and level > 0:
            level, since, note = level - 1, [], "降级:" + "、".join(triggered)
        elif triggered:
            note = "触发但已在最低一级:" + "、".join(triggered)
        elif len(since) >= stage.trades_to_promote and level < len(stages) - 1:
            level, since, note = level + 1, [], "升级"
        rows.append({"第几笔": i + 1, "这一级": stage.name, "投入比例": stage.fraction,
                     "这一笔的 R": value, "记进账户的": taken, "发生了什么": note})
    table = pd.DataFrame(rows)
    return {"逐笔": table, "合计": float(table["记进账户的"].sum()),
            "一次全投": float(r.sum()), "最后停在": stages[level].name,
            "升级次数": int(table["发生了什么"].eq("升级").sum()),
            "降级次数": int(table["发生了什么"].str.startswith("降级").sum())}
合计       22.191742
一次全投    295.929454
最后停在            半仓
升级次数             3
降级次数             1

同一条阶梯,如果不挂警戒线:合计 95.69R(挂了是 22.19R)——一次降级花掉 73.50R

发生过事情的那几笔:
 第几笔 这一级  投入比例  这一笔的 R  记进账户的        发生了什么
  10 模拟盘  0.00   76.44   0.00           升级
  25 小资金  0.10    9.56   0.96           升级
  39  半仓  0.35   -2.56  -0.89 降级:连亏超过 12 笔
  54 小资金  0.10   -1.78  -0.18           升级
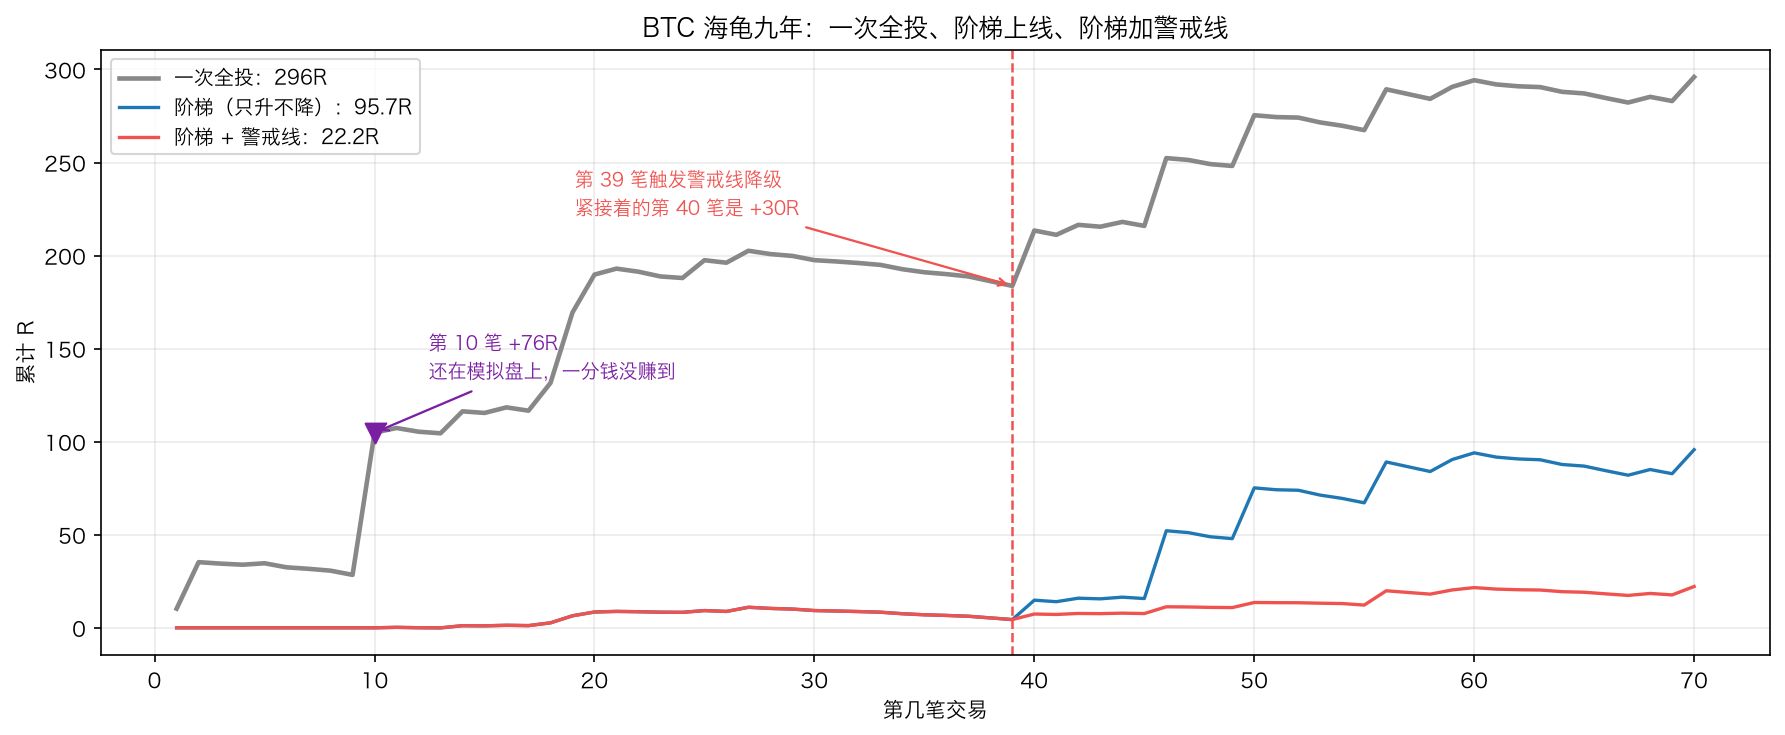
九年下来,一次全投是 295.93R,走阶梯是 22.19R。
两件事同时发生了,而且都不是巧合。
第一,第 10 笔是 +76.44R——九年里最大的一笔——它落在模拟盘阶段,投入比例 0%,一分钱没赚到。
第二,第 39 笔触发了「连亏超过 12 笔」的警戒线,降级;而紧接着的第 40 笔是 +29.77R。
第 39 笔是哪一笔?2022 年 12 月 16 日,第 33 篇那段十二连亏的最后一笔。第 40 笔是哪一笔?2023 年 1 月 8 日那笔 +134,107 美元的交易。
⚠️ 所以警戒线犯的是和第 33 篇那条停手规则完全一样的病:它在最深的那个坑底降级,而坑底的下一笔正是最赚的那一笔。这不是运气——第 33 篇第十二节已经解释过原因:大赚出现在趋势的开头,趋势的开头紧跟着震荡,而震荡正是连亏的来源。
同一条阶梯,如果不挂警戒线:合计 95.69R(挂了是 22.19R)——一次降级花掉 73.50R
一次降级花掉 73.50R。
十二、阶梯到底买到了什么
上一节只是一条路径。把它摊开:从每一个可能的起点开始,头 15 笔走完,看五条不同的阶梯各自拿到什么。
          怎么上线   平均仓位  平均收益 R     最差 R  平均是全投的  最差是全投的
          一次全投 1.0000 62.7591  -4.2560  1.0000  1.0000
教科书阶梯 10/15/20 0.0333  1.5941  -0.8978  0.0254  0.2109
    快阶梯 5/8/10 0.1000  5.4975  -2.8832  0.0876  0.6774
      更快 3/5/6 0.2400 13.1944  -6.6248  0.2102  1.5566
    先观望 5 笔再全投 0.6667 38.9864 -16.1102  0.6212  3.7853
   先观望 10 笔再全投 0.3333 15.9407  -8.9776  0.2540  2.1094
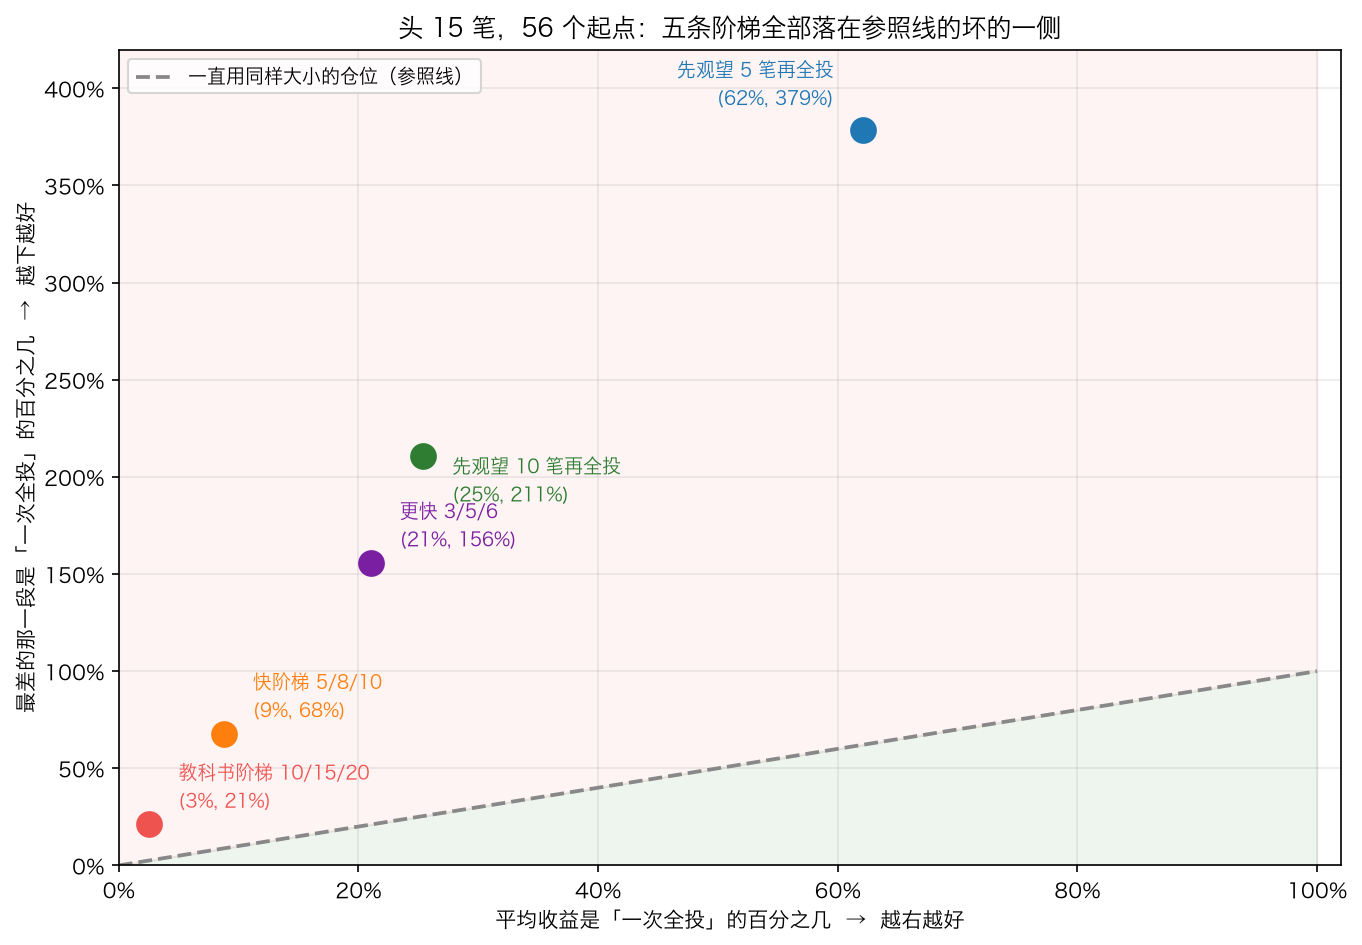
这张图的横轴是「平均收益还剩百分之几」(越右越好),纵轴是「最差的那一段还剩百分之几」(越下越好)。那条虚线是一直用同样大小的仓位:因为 R 是加法,固定仓位就是把整条分布乘一个数,所以平均和最差缩水的比例恰好相等,它必然落在 45 度线上。
五条阶梯,全部落在线的上方——也就是坏的一侧。
最刺眼的是那个大多数人真正在做的方案:
| 先观望 5 笔再全投 | |
|---|---|
| 平均收益 | 全投的 62.1% |
| 最差的那一段 | 全投的 378.5% |
**它拿到了六成的平均收益,却把最差情况放大到三倍半——比一开始就全投还难看。**原因很简单:你观望的那五笔里如果是赚的,你一分没拿;等你投进去,亏的那几笔一分不少。
再和「同样的平均仓位一直不动」正面比一次:
教科书阶梯在头 15 笔里的平均仓位是 3.33%。
拿同样仓位「一直不动」做对照(R 是加法,固定仓位就是整条分布乘一个数):
        怎么上线    平均 R    最差 R
        一次全投 62.7591 -4.2560
一直用 3.33% 仓位  2.0920 -0.1419
       教科书阶梯  1.5941 -0.8978

阶梯 vs 同样仓位一直不动:平均少赚 23.8%,最差还难看 +532.8%
原因和第 33 篇那条停手规则一模一样:九年最大的一笔 +76.44R 是第 10 笔,而教科书阶梯的前 10 笔在模拟盘上
**教科书阶梯的平均仓位是 3.33%。**拿「一直用 3.33% 仓位」做对照:平均 2.09R、最差 −0.14R。而阶梯是平均 1.59R、最差 −0.90R——平均少赚 23.8%,最差还难看 532.8%。
换几个窗口长度再验一遍:
 窗口(笔)  起点个数             阶梯  平均仓位  阶梯平均 R  同仓位不动 平均 R  阶梯最差 R  同仓位不动 最差 R  阶梯平均更低  阶梯最差更难看
    10    61     快阶梯 5/8/10 0.050   2.087       2.137  -0.898      -0.806    True     True
    10    61       更快 3/5/6 0.120   5.048       5.130  -2.502      -1.933    True     True
    15    56 教科书阶梯 10/15/20 0.033   1.594       2.092  -0.898      -0.142    True     True
    15    56     快阶梯 5/8/10 0.100   5.498       6.276  -2.883      -0.426    True     True
    15    56       更快 3/5/6 0.240  13.194      15.062  -6.625      -1.021    True     True
    25    46 教科书阶梯 10/15/20 0.059   4.552       5.878  -1.889       1.556    True     True
    25    46     快阶梯 5/8/10 0.252  19.133      24.903  -6.601       6.592    True     True
    25    46       更快 3/5/6 0.544  43.375      53.760  -6.327      14.230    True     True
    40    31 教科书阶梯 10/15/20 0.152  17.102      22.794   0.542      12.123    True     True
    40    31     快阶梯 5/8/10 0.525  63.272      78.562  30.240      41.784    True     True
    40    31       更快 3/5/6 0.679  83.905     101.652  55.667      54.065    True    False

11 组对照里:阶梯的平均更低的有 11 组,阶梯的最差更难看的有 10 组
11 组对照里,阶梯的平均收益全部更低(11/11),最差 10 组更难看。
所以必须把话说清楚:
阶梯上线在历史数据上没有任何一项指标比「一直用同样大小的仓位」更好。它不产生免费的风险调整收益。
那为什么还要做?
因为阶梯买的东西根本不在这张表里。这张表是用历史的 R 序列算的,而 R 序列里没有:代码写错、数据有洞、你自己在第一次真金白银的回撤里做出的动作。第四节那三件事,一件都不在里面。
而这三件事有一个共同的性质:它们和仓位无关。一个下单循环写错了,它在 10% 仓位上和在 100% 仓位上都会把你的账户打穿;只有在模拟盘那一级,它的代价才真的是零。
于是这一篇最后的结论只剩一句:
阶梯的每一级,升级条件都不该是「赚了几笔」,该是「没有出错」。
「赚了 10 笔」提供的信息量约等于零(第 33 篇第六节:认出策略坏了要 84 笔)。而「连续三十天对账差 0」提供的信息量是 100%——代码没问题就是没问题。
换句话说:模拟盘那一级的全部价值,来自第五、六、七节那几个数,而不是来自它赚了多少。
十三、宕机、限流、断线:以交易所为准
上市之后还要继续监测。交易这边对应的是三件具体的事。
第一,权重。exchangeInfo 的第一行就写着限流规则:每分钟 6,000 的请求权重、每 10 秒 100 张单、每天 20 万张单。一条日线策略一天只需要几次请求,但一个写错的重试循环可以在一分钟里用完全部权重——然后你在最需要下单的那一分钟被限流。
**第二,幂等。**这就是 Order 里那个 client_id:
class Order:
    """一张要发给交易所的单。

    `client_id` 是**你自己**生成的编号,发单时一起带上。它的唯一用途出现在断线之后:
    重连时用同一个 `client_id` 再发一次,交易所会认出这是同一张单而不是第二张——
    **幂等**。第十三节会说明为什么这是整条流程里最不能省的一个字段。
    """
    time: pd.Timestamp
    side: str
    qty: float
    reason: str = ""
    price: float = np.nan                  # 只是发单那一刻的参考价,市价单不带价格
    client_id: str = ""

    def __post_init__(self):
        if self.side not in SIDES:
            raise ValueError(f"side 只能是 {SIDES} 之一,收到 {self.side!r}")
        if not self.qty > 0:
            raise ValueError("数量要大于 0")
        if not self.client_id:
            self.client_id = f"{pd.Timestamp(self.time).value}-{self.side}-{self.reason}"
发单之后网络断了,你收不到回执。这张单到底进没进交易所?**不知道。**这时候只有两种做法:
- 不带
client_id:你只能猜。重发可能变成两张单,不重发可能一张都没有 - 带
client_id:重连之后用同一个编号再发一次,交易所认出这是同一张单,不会变成第二张
⚠️ 注意 client_id 的生成规则里只用了时间、方向和原因——没有随机数。随机数会让「同一张单」变成「每次都是新单」,幂等就没了。
**第三,对账,而且以交易所为准。**断线重连之后,你本地记的仓位和交易所的仓位可能不一样。这时候唯一正确的动作是:把本地的状态扔掉,重新拉一次交易所的持仓和挂单,以它为准。
理由不复杂:交易所那边的数字会真的扣你的钱,你本地那个不会。
而「拉回来之后怎么算差多少」,第 33 篇的 journal.reconcile 已经写好了——六块归因,六块之和恒等于总差额。第 33 篇那本日志在这里才真正开始用:它不是复盘工具,它是断线之后你唯一能拿来和交易所核对的东西。
十四、三个标的的上线方案
把这一篇的每一节压成一张表,就是一份可以直接用的上线方案:
  标的 逐根对账(最大相对差)  预热硬门槛  九年笔数  一年几笔  走完教科书阶梯要几年  台阶警戒线·回撤(账户百分点)  台阶警戒线·连亏(笔)
 SPY     0.0e+00    200    39 3.912      11.502          -28.277          9.0
AAPL     0.0e+00    200    37 3.710      12.128          -45.226          8.0
 BTC     0.0e+00    200    30 3.316      13.570          -73.783         10.0
| SPY | AAPL | BTC | |
|---|---|---|---|
| 逐根对账(最大相对差) | 0.0 | 0.0 | 0.0 |
| 预热硬门槛 | 200 根 | 200 根 | 200 根 |
| 九年笔数 | 39 | 37 | 30 |
| 一年几笔 | 3.91 | 3.71 | 3.32 |
| 走完教科书阶梯要几年 | 11.5 | 12.1 | 13.6 |
| 台阶警戒线·回撤(账户百分点) | −28.28 | −45.23 | −73.78 |
| 台阶警戒线·连亏 | 9 笔 | 8 笔 | 10 笔 |
⚠️ 倒数第三行是这张表里最该盯的一个数:走完教科书阶梯要十一到十四年——比你的回测还长。
这不是阶梯设计得不好,是阶梯的代价和策略的交易频率成反比。一条一年只交易三四笔的策略,按笔数升级的阶梯根本走不完。
两条出路,都要明说代价:
- 按时间升级,不按笔数。「跑满三个月、对账没有差错」就升一级。代价是你升级的时候手上仍然只有三五笔的证据——但第十二节已经说明了,十笔证据和三笔证据都约等于零,所以这个代价是假的。
- **接受它。**一年三笔的策略,本来就该用「一直用一个小仓位」而不是阶梯——第十二节那条 45 度参照线就是它。
⚠️ 最后一行那三个回撤阈值差很远(−28.28 / −45.23 / −73.78 个账户百分点),原因是主线 v4 每笔冒账户 10% 的风险,而三个标的的单笔波动完全不同(第 26 篇)。阈值必须一个标的一个标的地算,抄不得。
十五、talab.live 的完整代码
"""talab.live:从回测走到实盘。第 34 篇。

第 33 篇问「你能不能照着做」。这一篇问更早的一个问题:**你该怎么开始做。**

回测通过了、样本外通过了、正常范围表也算好了——然后呢?把全部资金投进去?

这一篇的答案是「不」,而且理由不是谨慎,是三件可以量出来的事:

| 事 | 用什么量 | 在这里 |
|---|---|---|
| **你上线的那一天是随便抽的** | `starts`、`start_risk` | 第三节 |
| **回测的代码和实盘的代码不是同一份** | `Runner`、`replay`、`agrees` | 第五、六节 |
| **交易所不接受你回测里的那个数量** | `Filters`、`apply_filters`、`min_account` | 第八、九节 |

前两件不解决,第四件就无从谈起:**按台阶一级一级加钱**(`Stage`、`ladder`、`run_ladder`),
每一级的升级条件和降级条件**在上线之前就写死**(`Guard`、`guards_from_range`)。

⚠️ 这一篇里没有任何一个函数在提高策略的收益。它们全都在**减少你把一条对的策略执行坏的概率**。
"""
from __future__ import annotations

import math
from collections import deque
from dataclasses import dataclass, field

import numpy as np
import pandas as pd

from talab.backtest import Account

SIDES = ("buy", "sell")
STOPS = ("none", "chandelier", "percent")
ACTIONS = ("降级", "停用")
COLUMNS = ("open", "high", "low", "close")


# ---------------------------------------------------------------------------
# 一、把回测改成一根一根喂
# ---------------------------------------------------------------------------

@dataclass
class Order:
    """一张要发给交易所的单。

    `client_id` 是**你自己**生成的编号,发单时一起带上。它的唯一用途出现在断线之后:
    重连时用同一个 `client_id` 再发一次,交易所会认出这是同一张单而不是第二张——
    **幂等**。第十三节会说明为什么这是整条流程里最不能省的一个字段。
    """
    time: pd.Timestamp
    side: str
    qty: float
    reason: str = ""
    price: float = np.nan                  # 只是发单那一刻的参考价,市价单不带价格
    client_id: str = ""

    def __post_init__(self):
        if self.side not in SIDES:
            raise ValueError(f"side 只能是 {SIDES} 之一,收到 {self.side!r}")
        if not self.qty > 0:
            raise ValueError("数量要大于 0")
        if not self.client_id:
            self.client_id = f"{pd.Timestamp(self.time).value}-{self.side}-{self.reason}"


class Runner:
    """第 27 篇那个四步循环的**一根一根**版本。

    回测引擎拿到的是整条历史,实盘拿到的是「又收了一根」。两者必须做同一件事,
    但写法完全不同:回测可以先把 ATR 算完再开始循环,实盘只能**每收一根算一次**。

    每收到一根 K 线,`on_bar` 按固定顺序做四件事,和 `backtest.run` 逐字对应:

    1. **成交**:把上一根收盘时挂出的单,按这一根的开盘价成交
    2. **出场**:检查昨天的出场信号和止损
    3. **估值**:按这一根的收盘价记一次权益
    4. **下单**:把这一根收进历史,重算信号,挂出**下一根**的单

    `signal` 是一个函数,收到「到目前为止的全部 K 线」,返回 `(进场, 出场)` 两个布尔值。
    ⚠️ 它拿到的是 `Runner` 自己的缓冲区,而缓冲区只有 `warmup` 根——
    **这正是第七节要量的那件事:上线时你需要带多少根历史。**
    """

    def __init__(self, signal, stop: str = "chandelier", k: float = 3.0,
                 stop_percent: float = 0.10, atr_period: int = 14,
                 sizing: str = "risk", risk_per_trade: float = 0.10,
                 fee_rate: float = 0.0, equity: float = 100_000.0,
                 warmup: int | None = None):
        if stop not in STOPS:
            raise ValueError(f"stop 只能是 {STOPS} 之一,收到 {stop!r}")
        if sizing not in ("full", "risk"):
            raise ValueError("sizing 只能是 full 或 risk")
        if sizing == "risk" and stop == "none":
            raise ValueError('没有止损就算不出每笔的风险,sizing="risk" 需要一个止损')
        self.signal, self.stop, self.k, self.stop_percent = signal, stop, k, stop_percent
        self.atr_period, self.sizing = atr_period, sizing
        self.risk_per_trade, self.fee_rate = risk_per_trade, fee_rate
        self.warmup = warmup
        self.account = Account(cash=float(equity))
        self.bars: deque = deque(maxlen=warmup)
        self.times: deque = deque(maxlen=warmup)
        self.atr = np.nan                  # 算到**上一根**为止的 ATR
        self._tr_sum = self._tr_n = 0
        self.pending = None                # 上一根挂出的单
        self.exit_signal = False           # 上一根收盘时成立的出场信号
        self.entry_price = self.stop_price = self.risk = self.highest = np.nan
        self.entry_time = None
        self.seen = -1                     # 收到的第几根(从 0 开始)
        self.entry_index = -1
        self.last = (None, np.nan)         # 最后一根的时间和收盘价
        self.curve: list = []
        self.trades: list = []
        self.error = 0.0

    # -- 增量指标 ----------------------------------------------------------
    def _push(self, bar: dict):
        """把这一根收进缓冲区,并用 Wilder 平滑把 ATR 往前推一格。

        ⚠️ 这里不能重算整条历史:实盘跑十年,每根都重算一遍是 O(n²)。
        Wilder 平滑本来就是递推的(`新值 = 旧值 + (这一根 − 旧值) / n`),天生适合实盘。
        """
        previous = self.bars[-1]["close"] if self.bars else np.nan
        if not np.isnan(previous):                         # 第一根没有真实波幅(要用前一根收盘)
            true_range = max(bar["high"] - bar["low"], abs(bar["high"] - previous),
                             abs(bar["low"] - previous))
            if self._tr_n < self.atr_period:               # 预热:先攒满 n 根取平均
                self._tr_sum += true_range
                self._tr_n += 1
                if self._tr_n == self.atr_period:
                    self.atr = self._tr_sum / self.atr_period
            else:
                self.atr += (true_range - self.atr) / self.atr_period
        self.bars.append(bar)

    def _frame(self) -> pd.DataFrame:
        return pd.DataFrame(list(self.bars), index=pd.DatetimeIndex(list(self.times)))

    # -- 四步 --------------------------------------------------------------
    def on_bar(self, time, bar) -> list[Order]:
        bar = {name: float(bar[name]) for name in COLUMNS}
        orders: list[Order] = []
        self.seen += 1
        atr = self.atr                                     # 算到上一根为止,这一根还没收进来

        # 第 1 步:成交上一根挂出的单
        if self.pending is not None and self.account.shares == 0:
            price = bar["open"]
            level = (price * (1 - self.stop_percent) if self.stop == "percent"
                     else price - self.k * atr if self.stop == "chandelier" else -np.inf)
            if level < price:
                distance = 1 - level / price
                want = (self.account.equity(price) if self.sizing == "full"
                        else self.account.equity(price)
                        * min(1.0, self.risk_per_trade / max(distance, 1e-9)))
                shares = min(want / price, self.account.affordable(price, self.fee_rate))
                if shares > 0:
                    self.account.buy(price, shares, self.fee_rate)
                    self.entry_price, self.entry_time = price, time
                    self.entry_index = self.seen
                    self.risk, self.highest, self.stop_price = price - level, price, level
            self.pending = None

        # 第 2 步:出场
        if self.account.shares > 0:
            if self.stop == "percent":
                self.stop_price = self.entry_price * (1 - self.stop_percent)
            elif self.stop == "chandelier":
                self.stop_price = max(self.stop_price, self.highest - self.k * atr)
            price = reason = None
            if self.exit_signal and time != self.entry_time:
                price, reason = bar["open"], "出场信号"
            elif self.stop != "none" and bar["close"] <= self.stop_price:
                price, reason = bar["close"], "止损"
            if reason is not None:
                shares = self.account.shares
                self.account.sell(price, shares, self.fee_rate)
                self.trades.append({"买入日": self.entry_time, "买入价": self.entry_price,
                                    "数量": shares, "卖出日": time, "卖出价": price,
                                    "原因": reason, "收益": price / self.entry_price - 1,
                                    "根数": self.seen - self.entry_index})
                orders.append(Order(time, "sell", shares, reason, price))
            else:
                self.highest = max(self.highest, bar["high"])

        # 第 3 步:估值
        value = self.account.equity(bar["close"])
        self.error = max(self.error, abs(self.account.cash
                                         + self.account.shares * bar["close"] - value))
        self.curve.append((time, value))
        self.last = (time, bar["close"])

        # 第 4 步:把这一根收进历史,重算信号,挂出下一根的单
        self.times.append(time)
        self._push(bar)
        entry, self.exit_signal = self.signal(self._frame())
        if self.account.shares == 0 and self.pending is None and entry:
            self.pending = Order(time, "buy", 1.0, "进场信号", bar["close"])
            orders.append(self.pending)
        return orders

    def result(self) -> dict:
        """当前的账本。⚠️ 还拿着的那一笔记成「未平仓」,按最后一根的收盘价估值——
        和 `backtest.run` 同一个口径,**但它是估值不是成交**,明天开盘就不是这个数了。"""
        curve = pd.Series([v for _, v in self.curve],
                          index=pd.DatetimeIndex([t for t, _ in self.curve]), name="权益")
        trades = list(self.trades)
        if self.account.shares > 0:
            time, close = self.last
            trades.append({"买入日": self.entry_time, "买入价": self.entry_price,
                           "数量": self.account.shares, "卖出日": time, "卖出价": close,
                           "原因": "未平仓", "收益": close / self.entry_price - 1,
                           "根数": self.seen - self.entry_index})
        return {"资金曲线": curve,
                "交易": pd.DataFrame(trades, columns=["买入日", "买入价", "数量", "卖出日",
                                                      "卖出价", "原因", "收益", "根数"]),
                "手续费合计": self.account.fees, "记账误差": self.error}


def replay(df: pd.DataFrame, runner: Runner, start: int = 0) -> dict:
    """把一段历史一根一根喂给 `Runner`,就像它是实时到达的一样。

    这是**唯一**能验证实盘代码的办法:让它重放历史,然后和回测引擎逐根对账。
    对不上就是有一边写错了——第 27 篇那句话在这里还成立:**对账是回测唯一能做的自检。**
    """
    for position in range(start, len(df)):
        runner.on_bar(df.index[position], df.iloc[position])
    return runner.result()


def agrees(a: pd.Series, b: pd.Series, tolerance: float = 1e-9) -> pd.Series:
    """两条资金曲线逐根对账:重叠的根数、最大绝对差、最大相对差、第一根对不上的时间。

    ⚠️ 「差不多」不算数。同一套规则、同一段数据,两份代码的资金曲线应该差在浮点误差量级。
    差 0.1% 不是「实现细节不同」,是**其中一份有 bug**,而你还不知道是哪一份。

    ⚠️ 判据用的是**相对**差不是绝对差:绝对差会随账户大小变——
    同样的浮点噪声,10 万美元的账户上是 1e-9,1000 万的账户上就是 1e-7,
    换一个本金就要换一次阈值的判据不是判据。
    """
    common = a.index.intersection(b.index)
    both = pd.DataFrame({"A": a.reindex(common), "B": b.reindex(common)}).dropna()
    if not len(both):
        raise ValueError("两条曲线没有重叠的时间")
    gap = (both["A"] - both["B"]).abs()
    relative = gap / both["B"].abs().clip(lower=1e-12)
    off = both.index[relative > tolerance]
    return pd.Series({"重叠根数": float(len(both)), "最大绝对差": float(gap.max()),
                      "最大相对差": float(relative.max()),
                      "对不上的根数": float(len(off)),
                      "第一根对不上的": off[0] if len(off) else pd.NaT})


# ---------------------------------------------------------------------------
# 二、交易所的硬约束
# ---------------------------------------------------------------------------

@dataclass
class Filters:
    """交易所对一张单的硬性要求。回测里没有这些东西,实盘里每一张单都要过这一关。

    - `tick_size`:价格必须是它的整数倍
    - `step_size`:数量必须是它的整数倍(**向下取整**,因为买多了会超出风险预算)
    - `min_qty` / `max_qty`:单张单的数量上下限
    - `min_notional`:单张单的金额下限——**小账户真正的门槛在这里,不在数量精度上**
    """
    tick_size: float = 0.01
    step_size: float = 1e-5
    min_qty: float = 1e-5
    max_qty: float = np.inf
    min_notional: float = 5.0

    @classmethod
    def from_binance(cls, payload: dict) -> "Filters":
        """从 `api.binance.com/api/v3/exchangeInfo` 的一个 symbol 里读出来(公开接口,不用账号)。"""
        found = {f["filterType"]: f for f in payload["filters"]}
        price, lot = found["PRICE_FILTER"], found["LOT_SIZE"]
        notional = found.get("NOTIONAL", found.get("MIN_NOTIONAL", {}))
        return cls(tick_size=float(price["tickSize"]), step_size=float(lot["stepSize"]),
                   min_qty=float(lot["minQty"]), max_qty=float(lot["maxQty"]),
                   min_notional=float(notional.get("minNotional", 0.0)))

    @staticmethod
    def _floor(value: float, unit: float) -> float:
        if unit <= 0:
            return float(value)
        # 先除再取整会被浮点误差咬:0.29/0.01 在双精度里是 28.999999999999996
        return math.floor(round(value / unit, 9)) * unit

    def round_qty(self, qty: float) -> float:
        """数量向下取到 `step_size` 的整数倍。**向下**不是随手选的:向上取整会让这一笔
        的风险超过你定的预算,而超出的部分正好落在你最不希望它出现的时候。"""
        return self._floor(qty, self.step_size)

    def round_price(self, price: float) -> float:
        return self._floor(price, self.tick_size)

    def accepts(self, price: float, qty: float) -> str:
        """这张单能不能发出去。返回空字符串表示可以,否则是被拒绝的理由。"""
        if qty < self.min_qty:
            return f"数量不足 minQty({qty:.8f} < {self.min_qty:g})"
        if qty > self.max_qty:
            return f"数量超过 maxQty({qty:.8f} > {self.max_qty:g})"
        if price * qty < self.min_notional:
            return f"金额不足 minNotional({price * qty:.2f} < {self.min_notional:g})"
        return ""


def apply_filters(trades: pd.DataFrame, filters: Filters, qty_col: str = "数量",
                  price_col: str = "买入价") -> pd.DataFrame:
    """把一张交易表里的每一笔按交易所的规矩过一遍:取整之后剩多少、有几笔根本发不出去。

    `丢掉的比例` 那一列是取整吃掉的仓位。它在 BTC 上小到可以忽略,
    但**它和账户大小成反比**——同样的 `step_size`,账户越小丢得越多。
    """
    qty = trades[qty_col].astype(float)
    price = trades[price_col].astype(float)
    rounded = qty.map(filters.round_qty)
    rejected = [filters.accepts(p, q) for p, q in zip(price, rounded)]
    return trades.assign(**{"取整后数量": rounded,
                            "丢掉的比例": (qty - rounded) / qty.where(qty != 0),
                            "被拒绝": rejected})


def min_account(filters: Filters, price: float, risk_per_trade: float = 0.10,
                stop_fraction: float = 0.15) -> pd.Series:
    """**这条策略在这个市场上,最少要多大的账户才跑得动。**

    两个门槛,取大的那个:

    - `minNotional`:一笔的金额不能低于它
    - `step_size`:一笔的数量取整之后,误差不能大到把仓位算错

    仓位 = 账户 × 风险预算 ÷ 止损距离(第 26 篇),所以账户 = 仓位金额 × 止损距离 ÷ 风险预算。
    ⚠️ 这个数是**下限不是建议**:刚好够下单,不等于够分散、够扛回撤。
    """
    if not 0 < risk_per_trade <= 1 or not 0 < stop_fraction <= 1:
        raise ValueError("风险预算和止损距离都要在 0 和 1 之间")
    ratio = min(1.0, risk_per_trade / stop_fraction)       # 仓位占账户的比例
    by_notional = filters.min_notional / ratio
    # 让取整误差不超过仓位的 1%:仓位金额至少要是 100 个 step 的钱
    by_step = 100 * filters.step_size * price / ratio
    return pd.Series({"仓位占账户": ratio, "按 minNotional 算": by_notional,
                      "按 step_size 算(误差 < 1%)": by_step,
                      "最小账户": max(by_notional, by_step)})


# ---------------------------------------------------------------------------
# 三、起点风险:你上线的那一天是随便抽的
# ---------------------------------------------------------------------------

def starts(df: pd.DataFrame, run, window: int, step: int = 5,
           warmup: int = 250) -> pd.DataFrame:
    """**从每一个可能的日子开始上线**,各跑 `window` 根,看第一段的成绩。

    `run` 是一个函数,收到一段 K 线、返回一条资金曲线。这里必须**真的重跑引擎**,
    不能拿整条曲线去滚动相除——因为「从今天开始」意味着你此刻是空仓的,
    而连续跑下来的那条曲线在同一时刻多半正拿着一笔仓。

    ⚠️ 这张表回答的问题和「九年年化多少」完全不同:
    **年化是一个九年才收敛的数,而你的第一年只有一次。**
    """
    if window < 2 or step < 1:
        raise ValueError("window 至少是 2,step 至少是 1")
    rows = []
    for begin in range(warmup, len(df) - window, step):
        piece = df.iloc[begin - warmup:begin + window]
        curve = run(piece)
        curve = curve.iloc[-window:] if len(curve) > window else curve
        if len(curve) < 2:
            continue
        peak = curve.cummax()
        rows.append({"上线日": df.index[begin], "第一段收益": float(curve.iloc[-1] / curve.iloc[0] - 1),
                     "期间最大回撤": float((curve / peak - 1).min())})
    return pd.DataFrame(rows)


def start_risk(table: pd.DataFrame, column: str = "第一段收益",
               levels=(0.05, 0.25, 0.5, 0.75, 0.95)) -> pd.Series:
    """把 `starts` 的结果压成一行:赚钱的起点占多少,以及各个分位。"""
    values = table[column].dropna()
    out = {"起点个数": float(len(values)), "赚钱的起点占": float((values > 0).mean()),
           "平均": float(values.mean()), "最差": float(values.min()), "最好": float(values.max())}
    out.update({f"{level:.0%} 分位": float(values.quantile(level)) for level in levels})
    return pd.Series(out)


# ---------------------------------------------------------------------------
# 四、阶梯上线
# ---------------------------------------------------------------------------

@dataclass
class Stage:
    """一级台阶:用多少钱、跑满多少笔才能升级。

    `fraction` 是**这一级实际投入的资金占目标资金的比例**。0 代表模拟盘——
    一分钱不投,但每一笔都照样记账、照样对账。
    """
    name: str
    fraction: float
    trades_to_promote: int

    def __post_init__(self):
        if not 0 <= self.fraction <= 1:
            raise ValueError("fraction 要在 0 和 1 之间")
        if self.trades_to_promote < 1:
            raise ValueError("至少要跑满一笔才能升级")


DEFAULT_LADDER = (Stage("模拟盘", 0.00, 10), Stage("小资金", 0.10, 15),
                  Stage("半仓", 0.35, 20), Stage("目标", 1.00, 1))


def ladder(stages=DEFAULT_LADDER) -> pd.DataFrame:
    """把一条阶梯打印成一张表,贴在上线方案的第一页。"""
    rows = [{"第几级": k + 1, "名字": s.name, "投入比例": s.fraction,
             "跑满几笔升级": s.trades_to_promote} for k, s in enumerate(stages)]
    return pd.DataFrame(rows)


def run_ladder(r, stages=DEFAULT_LADDER, guards=(), start: int = 0) -> dict:
    """按阶梯走一遍:每笔按当前这一级的比例缩放,跑满笔数升一级,触发警戒线降一级。

    ⚠️ 这里有一个**必须**这样写的地方:降级用的警戒线看的是**这一级自己**的成绩,
    不是从头到尾的总成绩。上一级的坑不该算在这一级头上——否则你刚升上去就被降回来。
    """
    r = pd.Series(r).dropna().astype(float).to_numpy()
    level, since, rows = start, [], []
    for i, value in enumerate(r):
        stage = stages[level]
        taken = value * stage.fraction
        since.append(value)
        triggered = [g.name for g in guards if g.fires(np.array(since))]
        note = ""
        if triggered and level > 0:
            level, since, note = level - 1, [], "降级:" + "、".join(triggered)
        elif triggered:
            note = "触发但已在最低一级:" + "、".join(triggered)
        elif len(since) >= stage.trades_to_promote and level < len(stages) - 1:
            level, since, note = level + 1, [], "升级"
        rows.append({"第几笔": i + 1, "这一级": stage.name, "投入比例": stage.fraction,
                     "这一笔的 R": value, "记进账户的": taken, "发生了什么": note})
    table = pd.DataFrame(rows)
    return {"逐笔": table, "合计": float(table["记进账户的"].sum()),
            "一次全投": float(r.sum()), "最后停在": stages[level].name,
            "升级次数": int(table["发生了什么"].eq("升级").sum()),
            "降级次数": int(table["发生了什么"].str.startswith("降级").sum())}


# ---------------------------------------------------------------------------
# 五、警戒线:上线之前就写死
# ---------------------------------------------------------------------------

@dataclass
class Guard:
    """一条**事先写好**的警戒线:看哪个量、超过多少、然后做什么。

    三个字段里最重要的是第三个。一条只说「情况不对」而不说「那就做什么」的规则,
    在情况真的不对的那一天等于没有——**因为那一天你会自己发明一个动作。**
    """
    name: str
    kind: str                              # drawdown / streak
    threshold: float
    action: str = "降级"

    def __post_init__(self):
        if self.kind not in ("drawdown", "streak"):
            raise ValueError("kind 只能是 drawdown 或 streak")
        if self.action not in ACTIONS:
            raise ValueError(f"action 只能是 {ACTIONS} 之一,收到 {self.action!r}")
        if self.kind == "drawdown" and self.threshold >= 0:
            raise ValueError("回撤的阈值要是负数")
        if self.kind == "streak" and self.threshold < 1:
            raise ValueError("连亏的阈值至少是 1 笔")

    def fires(self, r: np.ndarray) -> bool:
        """这一段成绩有没有踩线。⚠️ 传进来的应该是**当前这一级**的成绩。"""
        if not len(r):
            return False
        if self.kind == "streak":
            run = 0
            for value in r:
                run = run + 1 if value <= 0 else 0
            return run >= self.threshold
        curve = np.cumsum(r)
        peak = np.maximum.accumulate(np.concatenate([[0.0], curve]))[1:]
        return bool((curve - peak).min() <= self.threshold)


def stage_range(r, n_trades: int, trials: int = 2000, seed: int = 0,
                levels=(0.5, 0.9, 0.95, 0.99)) -> pd.DataFrame:
    """**按一级台阶实际要跑的笔数**算正常范围,而不是按整段历史。

    第 33 篇那张表是按「九年 70 笔」算出来的,而你在一级台阶上只跑十几笔——
    **十几笔里的正常回撤,比七十笔里的浅得多**(`expected_longest` 说的就是这件事:
    最长连亏随笔数增长)。拿七十笔的阈值去守十五笔的台阶,等于没有阈值。

    做法:从历史的 R 分布里**有放回地**抽 `n_trades` 笔,重复 `trials` 次。
    ⚠️ 有放回是故意的:这里问的是「下一段十五笔可能长什么样」,不是「历史那十五笔怎么排」。
    """
    from talab.journal import longest_streak

    values = pd.Series(r).dropna().astype(float).to_numpy()
    if len(values) < 2 or n_trades < 2:
        raise ValueError("至少要有两笔历史和两笔台阶长度")
    rng = np.random.default_rng(seed)
    picks = rng.choice(values, size=(trials, n_trades), replace=True)
    curve = np.cumsum(picks, axis=1)
    peak = np.maximum.accumulate(np.concatenate([np.zeros((trials, 1)), curve], axis=1), axis=1)[:, 1:]
    deepest = (curve - peak).min(axis=1)
    longest = np.array([longest_streak(row) for row in picks])
    rows = {"最长连亏": longest, "最深回撤": deepest}
    out = []
    for name, sample in rows.items():
        row = {"台阶长度": float(n_trades), "平均": float(sample.mean())}
        for level in levels:
            row[f"{level:.0%} 分位"] = float(np.quantile(sample, 1 - level if "回撤" in name else level))
        out.append(pd.Series(row, name=name))
    return pd.DataFrame(out)


def guards_from_range(table: pd.DataFrame, level: str = "99% 分位",
                      action: str = "降级") -> list[Guard]:
    """**直接把第 33 篇那张正常范围表变成警戒线。**

    这是这一篇和上一篇的接口,也是整条流程里唯一一处「阈值不是拍脑袋定的」:
    回撤线取重抽分布的 99% 分位,连亏线同理。
    ⚠️ 踩线**不等于**策略失效(第 33 篇第六节:那需要几十年的样本),
    它等于「我事先答应过自己,到这里就降一级」。
    """
    if level not in table.columns:
        raise ValueError(f"表里没有 {level!r} 这一列")
    return [Guard(f"回撤超过 {table.loc['最深回撤', level]:.2f}", "drawdown",
                  float(table.loc["最深回撤", level]), action),
            Guard(f"连亏超过 {table.loc['最长连亏', level]:.0f} 笔", "streak",
                  float(table.loc["最长连亏", level]), action)]
⚠️ talab.data 这一篇新增的两个函数(公开接口的下载和 JSON 读取)在第七节已经贴过,不重复。
十六、测试
"""talab.live 的测试(第 34 篇)。价格全部手工构造,每个数都能自己算一遍。"""
import numpy as np
import pandas as pd
import pytest

from talab import backtest as BT
from talab import indicators as I
from talab import live as L


def frame(closes, spread: float = 0.005, opens=None) -> pd.DataFrame:
    close = np.asarray(closes, dtype=float)
    open_ = close if opens is None else np.asarray(opens, dtype=float)
    return pd.DataFrame({"open": open_, "high": np.maximum(close, open_) * (1 + spread),
                         "low": np.minimum(close, open_) * (1 - spread), "close": close},
                        index=pd.date_range("2024-01-01", periods=len(close), freq="D"))


def zigzag(n: int, low: float = 100.0, step: float = 3.0, drift: float = 1.0) -> np.ndarray:
    """锯齿向上:**必须有起伏**,一条水平线的真实波幅全是 0,ATR 也是 0,止损就贴在进场价上。"""
    return np.array([low + drift * i + (step if i % 2 else 0.0) for i in range(n)])


def test_order_checks_itself_and_makes_its_own_id():
    order = L.Order(pd.Timestamp("2024-01-02"), "buy", 1.5, "进场信号")
    assert order.client_id                                   # 没给就自己生成一个
    assert L.Order(pd.Timestamp("2024-01-02"), "buy", 1.5, "进场信号").client_id == order.client_id
    with pytest.raises(ValueError):
        L.Order(pd.Timestamp("2024-01-02"), "长", 1.0)
    with pytest.raises(ValueError):
        L.Order(pd.Timestamp("2024-01-02"), "buy", 0.0)


def test_the_runner_matches_the_backtest_engine_bar_by_bar():
    """这一篇最重要的一个测试:**两份代码、同一段数据,资金曲线必须逐根相等。**"""
    df = frame(zigzag(120))
    close = df["close"]
    entry = (close >= close.rolling(10).max()).fillna(False)
    leave = (close < I.sma(close, 10)).fillna(False)
    plan = BT.Plan(entry=entry, exit=leave, stop="chandelier", k=2.0, trigger="close",
                   sizing="risk", risk_per_trade=0.10, atr_period=14)

    def signal(history):
        price = history["close"]
        if len(price) < 10:
            return False, False
        return (bool(price.iloc[-1] >= price.rolling(10).max().iloc[-1]),
                bool(price.iloc[-1] < I.sma(price, 10).iloc[-1]))

    engine = BT.run(df, plan, 50_000.0)
    streamed = L.replay(df, L.Runner(signal, stop="chandelier", k=2.0, sizing="risk",
                                     risk_per_trade=0.10, atr_period=14, equity=50_000.0,
                                     warmup=60))
    checked = L.agrees(engine["资金曲线"], streamed["资金曲线"])
    assert checked["对不上的根数"] == 0
    assert checked["最大相对差"] < 1e-12
    assert len(engine["交易"]) == len(streamed["交易"]) > 0
    assert list(engine["交易"]["原因"]) == list(streamed["交易"]["原因"])


def test_the_runner_places_at_the_close_and_fills_at_the_next_open():
    # 第 27 篇那条时钟规矩:第 i 根收盘算出来的东西,最早第 i+1 根成交
    df = frame(zigzag(60), opens=zigzag(60) * 0.99)
    seen = []

    def signal(history):
        return len(history) == 30, False                     # 只在第 30 根收盘发一次进场信号

    runner = L.Runner(signal, stop="percent", stop_percent=0.10, sizing="full", equity=10_000.0)
    for position in range(len(df)):
        for order in runner.on_bar(df.index[position], df.iloc[position]):
            seen.append((position, order.side))
    assert seen[0] == (29, "buy")                            # 第 30 根(下标 29)收盘挂单
    assert runner.trades[0]["买入日"] == df.index[30] if runner.trades else True
    assert runner.account.shares > 0 or runner.trades


def test_agrees_judges_by_relative_difference_not_absolute():
    index = pd.date_range("2024-01-01", periods=5)
    base = pd.Series([1e6, 1.1e6, 1.2e6, 1.3e6, 1.4e6], index=index)
    noisy = base * (1 + 1e-13)                               # 纯浮点噪声
    assert (noisy - base).abs().max() > 1e-9                  # 按绝对阈值 1e-9 会全部判成 bug
    assert L.agrees(base, noisy)["对不上的根数"] == 0         # 相对差看,什么事都没有
    real = base.copy()
    real.iloc[3] *= 1.001                                    # 千分之一:这是 bug 不是噪声
    out = L.agrees(base, real)
    assert out["对不上的根数"] == 1
    assert out["第一根对不上的"] == index[3]
    with pytest.raises(ValueError):
        L.agrees(base, base.shift(10, freq="YE"))


def test_filters_round_down_because_rounding_up_breaks_the_risk_budget():
    filters = L.Filters(tick_size=0.01, step_size=0.001, min_qty=0.001, min_notional=10.0)
    assert filters.round_qty(1.23456) == pytest.approx(1.234)
    assert filters.round_qty(1.2349) == pytest.approx(1.234)  # 向下,不是四舍五入
    assert filters.round_price(101.999) == pytest.approx(101.99)
    # 浮点陷阱:0.29 / 0.01 在双精度里是 28.999999999999996,直接取整会变成 0.28
    assert L.Filters(step_size=0.01).round_qty(0.29) == pytest.approx(0.29)
    assert L.Filters(step_size=0.1).round_qty(2.7) == pytest.approx(2.7)


def test_filters_read_from_the_real_binance_payload():
    payload = {"symbol": "BTCUSDT", "filters": [
        {"filterType": "PRICE_FILTER", "tickSize": "0.01000000"},
        {"filterType": "LOT_SIZE", "stepSize": "0.00001000", "minQty": "0.00001000",
         "maxQty": "9000.00000000"},
        {"filterType": "NOTIONAL", "minNotional": "5.00000000"}]}
    filters = L.Filters.from_binance(payload)
    assert (filters.tick_size, filters.step_size) == (0.01, 1e-5)
    assert filters.min_notional == 5.0 and filters.max_qty == 9000.0


def test_accepts_says_which_rule_the_order_broke():
    filters = L.Filters(step_size=1e-5, min_qty=1e-5, max_qty=100.0, min_notional=5.0)
    assert filters.accepts(80_000.0, 0.001) == ""            # 80 美元,过
    assert "minQty" in filters.accepts(80_000.0, 1e-6)
    assert "maxQty" in filters.accepts(80_000.0, 200.0)
    assert "minNotional" in filters.accepts(80_000.0, 5e-5)  # 4 美元,不够


def test_apply_filters_marks_the_orders_that_cannot_be_sent():
    trades = pd.DataFrame({"买入价": [100.0, 100.0], "数量": [2.6, 0.02]})
    out = L.apply_filters(trades, L.Filters(step_size=1.0, min_qty=1.0, min_notional=0.0))
    assert list(out["取整后数量"]) == [2.0, 0.0]
    assert out["丢掉的比例"].iloc[0] == pytest.approx((2.6 - 2) / 2.6)
    assert out["被拒绝"].iloc[0] == "" and "minQty" in out["被拒绝"].iloc[1]


def test_min_account_takes_the_larger_of_the_two_thresholds():
    cheap = L.Filters(step_size=1e-5, min_qty=1e-5, min_notional=5.0)
    out = L.min_account(cheap, price=80_000.0, risk_per_trade=0.10, stop_fraction=0.15)
    assert out["仓位占账户"] == pytest.approx(2 / 3)
    assert out["按 minNotional 算"] == pytest.approx(7.5)
    assert out["最小账户"] == pytest.approx(max(out["按 minNotional 算"],
                                                out["按 step_size 算(误差 < 1%)"]))
    # 止损越近,仓位占账户越大,最小账户就越小
    closer = L.min_account(cheap, 80_000.0, 0.10, 0.05)
    assert closer["最小账户"] < out["最小账户"]
    with pytest.raises(ValueError):
        L.min_account(cheap, 80_000.0, risk_per_trade=0.0)


def test_starts_really_reruns_from_each_day():
    df = frame(zigzag(200))
    got = []

    def run(piece):
        got.append(len(piece))
        return piece["close"] / piece["close"].iloc[0]

    table = L.starts(df, run, window=40, step=10, warmup=50)
    assert len(table) == len(got) > 0
    assert set(got) == {90}                                  # 每次都是 warmup + window 根
    assert list(table.columns) == ["上线日", "第一段收益", "期间最大回撤"]
    assert (table["期间最大回撤"] <= 0).all()
    with pytest.raises(ValueError):
        L.starts(df, run, window=1)


def test_start_risk_counts_the_starts_that_made_money():
    table = pd.DataFrame({"第一段收益": [-0.2, -0.1, 0.1, 0.3, 0.5]})
    out = L.start_risk(table)
    assert out["起点个数"] == 5 and out["赚钱的起点占"] == pytest.approx(0.6)
    assert out["最差"] == pytest.approx(-0.2) and out["最好"] == pytest.approx(0.5)
    assert out["50% 分位"] == pytest.approx(0.1)


def test_stage_and_ladder_check_themselves():
    assert list(L.ladder()["名字"]) == ["模拟盘", "小资金", "半仓", "目标"]
    assert L.ladder()["投入比例"].iloc[0] == 0.0             # 模拟盘一分钱不投
    with pytest.raises(ValueError):
        L.Stage("太大", 1.5, 10)
    with pytest.raises(ValueError):
        L.Stage("零笔", 0.5, 0)


def test_run_ladder_promotes_after_enough_trades():
    stages = (L.Stage("模拟盘", 0.0, 3), L.Stage("小资金", 0.5, 3), L.Stage("目标", 1.0, 1))
    out = L.run_ladder([1.0] * 9, stages)
    # 前 3 笔 0%、接着 3 笔 50%、剩下 3 笔 100%
    assert list(out["逐笔"]["记进账户的"]) == [0, 0, 0, 0.5, 0.5, 0.5, 1, 1, 1]
    assert out["合计"] == pytest.approx(4.5)
    assert out["一次全投"] == pytest.approx(9.0)
    assert out["升级次数"] == 2 and out["降级次数"] == 0
    assert out["最后停在"] == "目标"


def test_run_ladder_demotes_when_a_guard_fires():
    stages = (L.Stage("模拟盘", 0.0, 2), L.Stage("小资金", 0.5, 99))
    guard = L.Guard("连亏 3 笔", "streak", 3)
    out = L.run_ladder([1.0, 1.0, -1.0, -1.0, -1.0, 2.0], stages, [guard])
    assert out["升级次数"] == 1 and out["降级次数"] == 1
    assert out["最后停在"] == "模拟盘"
    # 降级之后那一笔 +2R 落在模拟盘上,一分钱没赚到——和第 33 篇停手规则是同一个病
    assert out["逐笔"]["记进账户的"].iloc[-1] == 0.0


def test_guard_refuses_a_threshold_that_points_the_wrong_way():
    assert L.Guard("回撤 5R", "drawdown", -5.0).fires(np.array([-2.0, -2.0, -2.0]))
    assert not L.Guard("回撤 5R", "drawdown", -5.0).fires(np.array([-2.0, 3.0, -2.0]))
    assert L.Guard("连亏 3 笔", "streak", 3).fires(np.array([1.0, -1, -1, -1]))
    assert not L.Guard("连亏 3 笔", "streak", 3).fires(np.array([1.0, -1, -1, 1, -1]))
    assert not L.Guard("连亏 3 笔", "streak", 3).fires(np.array([]))
    with pytest.raises(ValueError):
        L.Guard("回撤写成正的", "drawdown", 5.0)
    with pytest.raises(ValueError):
        L.Guard("看不懂的量", "夏普", 1.0)
    with pytest.raises(ValueError):
        L.Guard("动作看不懂", "streak", 3, action="加仓")


def test_stage_range_gets_worse_as_the_stage_gets_longer():
    rng = np.random.default_rng(0)
    r = rng.normal(0.3, 1.0, 200)
    short = L.stage_range(r, 10, trials=800, seed=1)
    long = L.stage_range(r, 40, trials=800, seed=1)
    # 笔数越多,最长连亏越长、最深回撤越深——这正是第 33 篇 expected_longest 说的事
    assert long.loc["最长连亏", "平均"] > short.loc["最长连亏", "平均"]
    assert long.loc["最深回撤", "99% 分位"] < short.loc["最深回撤", "99% 分位"]
    with pytest.raises(ValueError):
        L.stage_range(r, 1)


def test_guards_from_range_reads_the_table_it_is_given():
    table = L.stage_range(np.array([1.0, -1.0, 2.0, -1.5, 0.5] * 20), 15, trials=500, seed=2)
    guards = L.guards_from_range(table, "95% 分位", action="停用")
    assert [g.kind for g in guards] == ["drawdown", "streak"]
    assert guards[0].threshold == pytest.approx(table.loc["最深回撤", "95% 分位"])
    assert all(g.action == "停用" for g in guards)
    with pytest.raises(ValueError):
        L.guards_from_range(table, "没有这一列")
17 passed in 0.46s
368 passed in 1.27s
没装 TA-Lib 的环境里:
336 passed, 32 skipped in 1.62s
十七、小检查
- 这条策略九年年化 31.60%,而 538 个上线日里有 15.4% 在第一年是亏钱的,最差的一个亏 17.27%。这两个数矛盾吗?
- 你的策略用 EMA(200),上线时带了 200 根历史。第一天算出来的 EMA 和「用全部历史」差多少?这个误差之后会不会自己消失?
- Binance 上一个 stepSize 的中位数只值 1.4 美分,落在 1,000 美元的仓位上误差不到千分之一。既然这么小,下单取整这段代码为什么还是必须写?
- 「先观望五笔,确认没问题再全投」听起来比一上来就满仓稳。实测它的最差情况是「一开始就全投」的几倍?为什么会这样?
- 一级台阶只跑 15 笔,你要给它定一条回撤警戒线。直接抄第 33 篇那张按九年 70 笔算出来的表里的 99% 分位(−35.39R),会发生什么?
十八、常见误用
**用模拟盘验证策略有没有效。**模拟盘是 I 期临床,它的目的不是证明有效,是看清楚会不会伤人。第 33 篇第六节已经把这条路堵死了:要以 80% 的把握认出「期望值掉到 0」,SPY 上的海龟需要 84 笔、11.2 年,主线 v4 在 SPY 上需要 193 笔、44.5 年。跑三个月模拟盘能证明的东西约等于零——它能证明的是第五、六、七节那三件事,而那三件事一件都和收益无关。
**以为「指标周期是多少就带多少根历史」。**这句话对窗口型指标(SMA、滚动最高价)成立,对递推型指标(EMA、Wilder 平滑)完全不成立。第六节实测:EMA(200) 带 200 根历史上线,第一天的值就差 1%,要压到百万分之一得带将近一千根,是周期的五倍。而 200 日均线差 1% 足够把金叉死叉翻个个儿。
**历史带得不够,然后以为「反正前几天不开仓而已」。**第六节量过:主线 v4 带 150 根历史上线会瞎 50 根,随便挑一天上线,这 50 根里至少漏掉一个进场信号的概率是 52.0%。而第 33 篇算过漏一笔值多少钱——BTC 上等于九年里每一笔都多付 56.9 个基点。
觉得下单取整无所谓。第七节的结论确实是「加密这边精度不是问题」:stepSize 的中位数只值 1.4 美分,最粗的一个落在 1,000 美元仓位上也只有 0.072% 的误差。但取整错了的代价不是精度,是拒单——交易所按 LOT_SIZE 直接拒掉,这一笔就没有了。0.07% 和 100% 不是一个量级的问题。
**小账户还按比例算仓位。**第八节:本金 1,000 美元做 SPY,整股取整中位数吃掉 20.90% 的仓位,最狠的一笔吃掉 49.45%——你以为在按 10% 的风险交易,实际只有 5%。本金和标的股价的比值,决定了你的仓位控制有多精确。
**「先观望几笔,确认没问题再全投」。**第十二节实测,这是五个方案里最差的一个:平均收益拿到全投的 62.1%,最差的那一段却是全投的 378.5%。原因很直白——观望期里赚的那几笔你一分没拿,等你投进去,亏的那几笔一分不少。
把阶梯当成风险调整收益的改进。第十二节那张图里,五条阶梯全部落在「一直用同样大小的仓位」这条 45 度参照线的坏的一侧;换四个窗口长度重做,11 组对照里阶梯的平均收益全部更低(11/11),最差 10 组更难看。阶梯买的是历史 R 序列里根本没有的东西(代码、数据、你自己),不是更好的夏普。
拿整段历史的分位去守一级台阶。第十节:九年 70 笔的最长连亏 99% 分位是 18 笔,而一级台阶只跑 15 笔——凑不出 18 笔连亏,这条警戒线一辈子不会响。按台阶自己的笔数重算是 12 笔。⚠️ 反过来说,按 15 笔算出来的阈值也不能拿去守整段历史,那样会一路降级到底。
断线之后以本地记录为准。第十三节:交易所那边的数字会真的扣你的钱,本地那个不会。重连之后正确的动作是把本地状态扔掉、重新拉一次持仓和挂单,然后用第 33 篇的 journal.reconcile 算差额。⚠️ 还有一条更隐蔽的:client_id 里不能带随机数,带了幂等就没了,重发会变成第二张单。
十九、小结
- **你上线的那一天是随便抽的。**同一条策略、同一个参数,538 个上线日里 84.6% 第一年赚钱、中位 +27.74%,但 5% 分位 −9.36%、最差 −17.27%;没有一个起点的第一年是不回撤的,中位数 −12.42%。而 2021-11-08 排在第 1.7 个百分位。
- ⚠️ **年化是一个要跑九年才收敛的数,你的第一年只有一次。**这和第 33 篇「最大回撤是一个样本不是上限」是同一件事的两面。
- 模拟盘不是用来验证策略的,它只能查三件事:代码和回测跑的不是同一件事、带的历史不够、下的单交易所不接受。这三件事和仓位无关,也和收益无关——它们不是概率,是有和没有。
- 实盘执行器是另一份代码,必须和回测逐根对账。
Runner把第 27 篇那个四步循环改成一根一根的版本,3,287 根 K 线上和引擎的最大相对差是 0,30 笔交易一模一样。⚠️ 判据要用相对差:绝对阈值会随本金变,换一个本金就要换一次阈值的判据不是判据。 - 预热分两类:窗口型(SMA、通道)是硬门槛,少一根就是
NaN;递推型(EMA、Wilder)是渐近的,误差每多带一根乘一个固定系数。EMA(200) 带 200 根差 1%,要带近一千根。带你最长周期的五倍。 - **交易所的规矩要写进代码,但理由不是精度。**493 个 USDT 交易对里 stepSize 中位数只值 1.4 美分;取整错了的代价是拒单,而拒单就是第 33 篇那张归因表里最贵的一格(漏做占 88.7%)。美股那边整股是真的会咬人:本金 1,000 做 SPY 丢掉 20.9% 的仓位。
- 规模是策略的一个参数:BTC 现货上主线 v4 的最小账户是 121 美元,而账户超过 1,430 万美元时一张市价单发不完,必须拆单——拆单又会改变成本假设。
- **台阶的警戒线要按这一级自己的笔数算。**九年 70 笔的最长连亏 99% 分位是 18 笔,15 笔的台阶是 12 笔——抄整段历史的阈值等于没有阈值。
- ⚠️ **阶梯上线在历史数据上没有任何一项比「一直用同样大小的仓位」更好。**五条阶梯全部落在 45 度参照线的坏的一侧;11 组对照里平均收益 11/11 更低、最差 10/11 更难看;「先观望 5 笔再全投」拿到 62.1% 的平均却把最差放大到 378.5%。
- 而且警戒线会犯和第 33 篇停手规则一样的病:BTC 上它在第 39 笔(那段十二连亏的最后一笔)降级,而第 40 笔是 +29.77R——一次降级花掉 73.50R。
- 所以阶梯的每一级,升级条件都不该是「赚了几笔」,该是「没有出错」。「赚了 10 笔」的信息量约等于零,「连续三十天对账差 0」的信息量是 100%。
- ⚠️ 按笔数升级的阶梯在低频策略上走不完:主线 v4 一年三四笔,走完教科书阶梯要 11.5 到 13.6 年,比回测还长。要么改成按时间升级,要么老老实实一直用一个小仓位。
下一篇(第 35 篇)是毕业项目:挑一个自己的想法,按这三十四篇的流程完整走一遍——分析交易对手、定义结构、写成规则、定仓位、回测、样本外检验、定上线方案、写报告,并且回顾主线策略从第 12 篇的 v0 到今天的完整演化。
练习
- 把
starts用在第 32 篇的均值回归上(SPY,ReversionPlan默认参数)。它的「赚钱的起点占」和海龟差多少?⚠️ 均值回归一年只上场十来天,窗口该取多长才有意义?说明你的选择。 - 第三节用的是
step=5(每五个交易日取一个起点)。改成step=1和step=20各跑一遍,看分位数抖动多大。相邻的起点是高度重叠的——这会让「538 个起点」这个数字在多大程度上虚高? - 给
Runner加一个warmup_bars参数:前 N 根只喂数据、不下单。然后写一个测试,证明「带 150 根历史启动」和「带 400 根历史启动」在同一段行情上会做出不同的交易。 Filters.round_qty向下取整。写一个实验:改成四舍五入,在主线 v4 的 SPY 交易上(本金 1,000)量一量每笔的实际风险超出 10% 预算多少。- 第十二节的结论是「阶梯不如固定仓位」。那么什么情况下阶梯会赢?造一段人工的 R 序列,让教科书阶梯落在 45 度线的好的一侧,并说明你造的那个性质在真实市场里成不成立。
- 给
Guard加第三种kind:"deviation"——当journal.reconcile的「实盘 − 回测」差额超过阈值时触发。这条警戒线和另外两条有一个本质区别,说出来是什么。 - 第十四节说「按时间升级,不按笔数」。把
Stage.trades_to_promote换成days_to_promote,在三个标的上重跑第十一节那张表。走完阶梯要多久?这条改动有没有把第十二节那个结论改掉?
小检查答案
- **不矛盾,它们量的是两件事。**年化 31.60% 是九年 3,300 根 K 线、70 笔交易一起收敛出来的一个数;而「第一年」只有 365 根、七八笔交易。第 29 篇量过夏普的标准误,第 33 篇量过最大回撤的分布,这里量的是年化的分布——同一条策略在不同的一年里,年化从 −17.27% 到 +151.24% 都出现过。⚠️ 真正该改的是期待:你签的不是「年化 31.6%」这份合同,你签的是「从这条分布里抽一次」。
- **差 1.00%(第六节实测)。**不会自己消失,但会指数衰减——EMA(200) 的平滑系数是 1 − 2/201 = 0.9901,所以误差每多带一根历史乘 0.9901。带 400 根还有 0.15%,带 800 根 1.9e-05,要带 1,600 根才到 5.8e-09。⚠️ 这和窗口型指标完全不同:SMA(200) 带 200 根就精确相等,带 199 根就是
NaN,中间没有过渡。 - **因为取整错了的代价不是精度,是拒单。**数量不是 stepSize 的整数倍,交易所按
LOT_SIZE直接拒单——这一笔就没有了,代价是一整笔交易而不是 0.07% 的仓位。第 33 篇那张归因表里,滑点占九年差额的 4.6%,漏做占 88.7%。这段代码要写的理由从来不是精度。 - 最差是全投的 378.5%,也就是三倍半还多(第十二节,头 15 笔、56 个起点)。原因是它把仓位和时间反着挂上了:观望那五笔如果是赚的,你一分没拿;等你满仓进场,后面亏的那几笔一分不少。⚠️ 它同时还是五个方案里「平均收益」最高的(62.1%)——这正是它骗人的地方:看上去只是少赚了一点,实际上把左尾放大了三倍半。
- **这条警戒线一辈子不会响。**九年 70 笔的最长连亏 99% 分位是 18 笔、最深回撤 99% 分位是 −35.39R,而一级台阶一共才跑 15 笔——凑不出 18 笔连亏,回撤也很难到 −35R。按台阶自己的笔数(15 笔)重算,阈值是连亏 12 笔、回撤 −21.45R。⚠️ 反过来也一样错:拿 15 笔的阈值去守整段历史,会一路降级到底。笔数变了,正常范围就变了——这就是第 33 篇
expected_longest那个公式说的事。