| 本篇位置 | 第八部分「实盘」第三篇,也是这门课的最后一篇正文 |
| 用到的数据 | SPY、AAPL、BTC 日线(全部沿用前面几篇,不需要新下载) |
| 动手 | 新模块 talab.project:Idea、checklist、Gate + audit + verdict、against、edge_vs_luck、evolution、one_pager,附 11 个测试;实验四:一份可复现的策略报告 |
| 读完你能 | 把一个想法从头走到底,并且在它骗过你之前拦住它 |
这一篇从头到尾用同一个比方:法庭上的举证责任。
在法庭上,举证责任在原告。原告说「被告欠我钱」,得拿出证据;被告什么都不用做,只要说一句「你没证明」,官司就打不下去。
你的策略就是原告。它要证明自己比「什么都不做」和「一个更简单的做法」更好——而不是等着别人来证明它不行。
| 这一篇的东西 | 法庭上的 |
|---|---|
| 六格登记表 | 起诉状:告谁、凭什么、要什么 |
| 检查单 | 证据规则:哪些证据算数 |
| 一道一道的关 | 一条一条过证据 |
| 对照组 | 被告的抗辩:「同样的结果,不用你也能得到」 |
| 一页纸报告 | 判决书 |
这里面有一条很不舒服的性质:**你同时是原告的律师、被告的律师和法官。**这一篇就是关于这件事的。
一、一份看起来无懈可击的报告
第 32 篇留下了一个数:**60 天方差比。**SPY 是 0.616、AAPL 0.852、BTC 1.270;而趋势跟随的夏普是 0.682 / 1.260 / 1.367,均值回归是 0.725 / 0.527 / 0.193——方差比从 0.616 走到 1.270,两条策略的强弱就掉了个个儿。
那一篇末尾写了一句话:⚠️ 三个标的算不出规律,它是解释不是筛选器。
毕业项目就拿这句话开刀:如果把方差比做成滚动的,用它在两条腿之间切换呢?
规则很简单:每根收盘算一次滚动方差比(回看 window 根、用 k 天收益率),高于阈值就在下一根上用海龟的仓位,否则用 RSI(2) 的仓位。三个参数:window、k、阈值。
⚠️ 那个 shift(1) 是全部数字的前提——方差比用到当根收盘价,所以它最早只能在下一根上用来做决定(第 27 篇的时钟规矩):
def rolling_variance_ratio(close: pd.Series, window: int, k: int) -> pd.Series:
    """滚动方差比:第 5 篇那个 `stats.variance_ratio` 的滚动版本。

    ⚠️ 最后那个 `shift(1)` 是这一篇全部数字的前提:方差比用到当根收盘价,
    所以它最早只能在**下一根**上用来做决定(第 27 篇的时钟规矩)。
    """
    log_returns = np.log(close).diff()
    k_day = log_returns.rolling(k).sum()
    return (k_day.rolling(window).var() / (k * log_returns.rolling(window).var())).shift(1)
在 SPY 上扫一遍 180 格参数(window 六个 × k 六个 × 阈值五个),最好的那一格是:
                              策略     年化    最大回撤     夏普     卡玛  参数个数
按方差比切换(window=250, k=60, 阈值=0.8) 0.0643 -0.1006 1.0176 0.6392   3.0
                  只做趋势跟随(第 31 篇) 0.0468 -0.1711 0.6822 0.2737   0.0
                  只做均值回归(第 32 篇) 0.0415 -0.1163 0.7246 0.3564   0.0
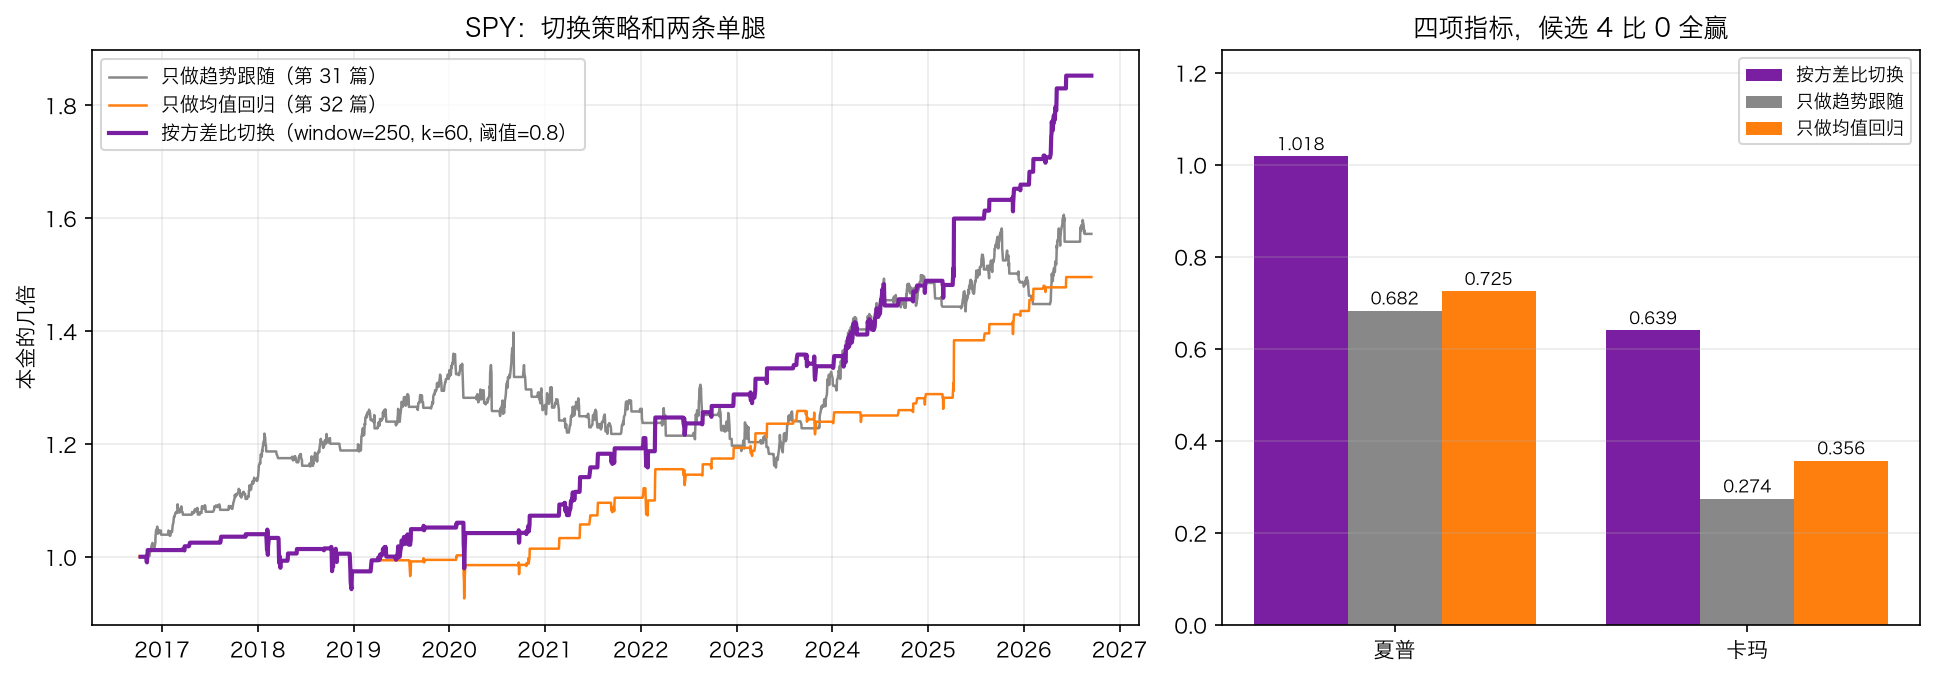
**四项指标,对两条单腿都是 4 比 0 全赢。**年化更高、回撤更浅、夏普更高、卡玛更高。
而且第 30 篇那六刀也都过了:
网格一共几格           180.0000
亏钱的格子              0.0000
最好的一格夏普            1.0176
邻域中位               0.8264
落差                 0.1913
落差占最好那格的           0.1879
样本内挑的那格·样本内夏普      0.5344
样本内挑的那格·样本外夏普      1.5510
它在样本外排第几           1.0000
样本内外秩相关            0.1379
PBO                0.0000
| 第 30 篇的检验 | 结果 | 对比 |
|---|---|---|
| 180 格里亏钱的 | 0 格 | 第 31 篇的海龟也是 0 |
| 曲面落差占最好那格的 | 18.8% | 第 30 篇那根针是 63.8% |
| 样本内挑的那格,样本外排第几 | 1/180 | 第 30 篇那根针是 7,083/10,130 |
| PBO | 0.00 | 门槛是 0.50 |
样本外不但没塌,还是 180 格里最好的一格。
账户里有钱,代码写好了,第 33 篇的正常范围表也算好了,第 34 篇的阶梯也画好了。
上线吗?
二、它和什么比了
先别急着回答。把上一节那张表再看一遍,然后问一个问题:
它赢了谁?
它赢了「只做趋势跟随」和「只做均值回归」。
而第 32 篇的最后一节给过另一个东西——把两条腿五五开放进同一个账户,每月再平衡。那条东西有几个参数?
零个。
把它加进去:
                      年化    最大回撤      夏普      卡玛  参数个数  候选赢了几项  一共几项
策略
候选                0.0643 -0.1006  1.0176  0.6392   3.0     NaN   NaN
只做趋势跟随            0.0468 -0.1711  0.6822  0.2737   0.0     4.0   4.0
只做均值回归            0.0415 -0.1163  0.7246  0.3564   0.0     4.0   4.0
五五开每月再平衡(第 32 篇)  0.0451 -0.0630  0.9806  0.7163   0.0     2.0   4.0
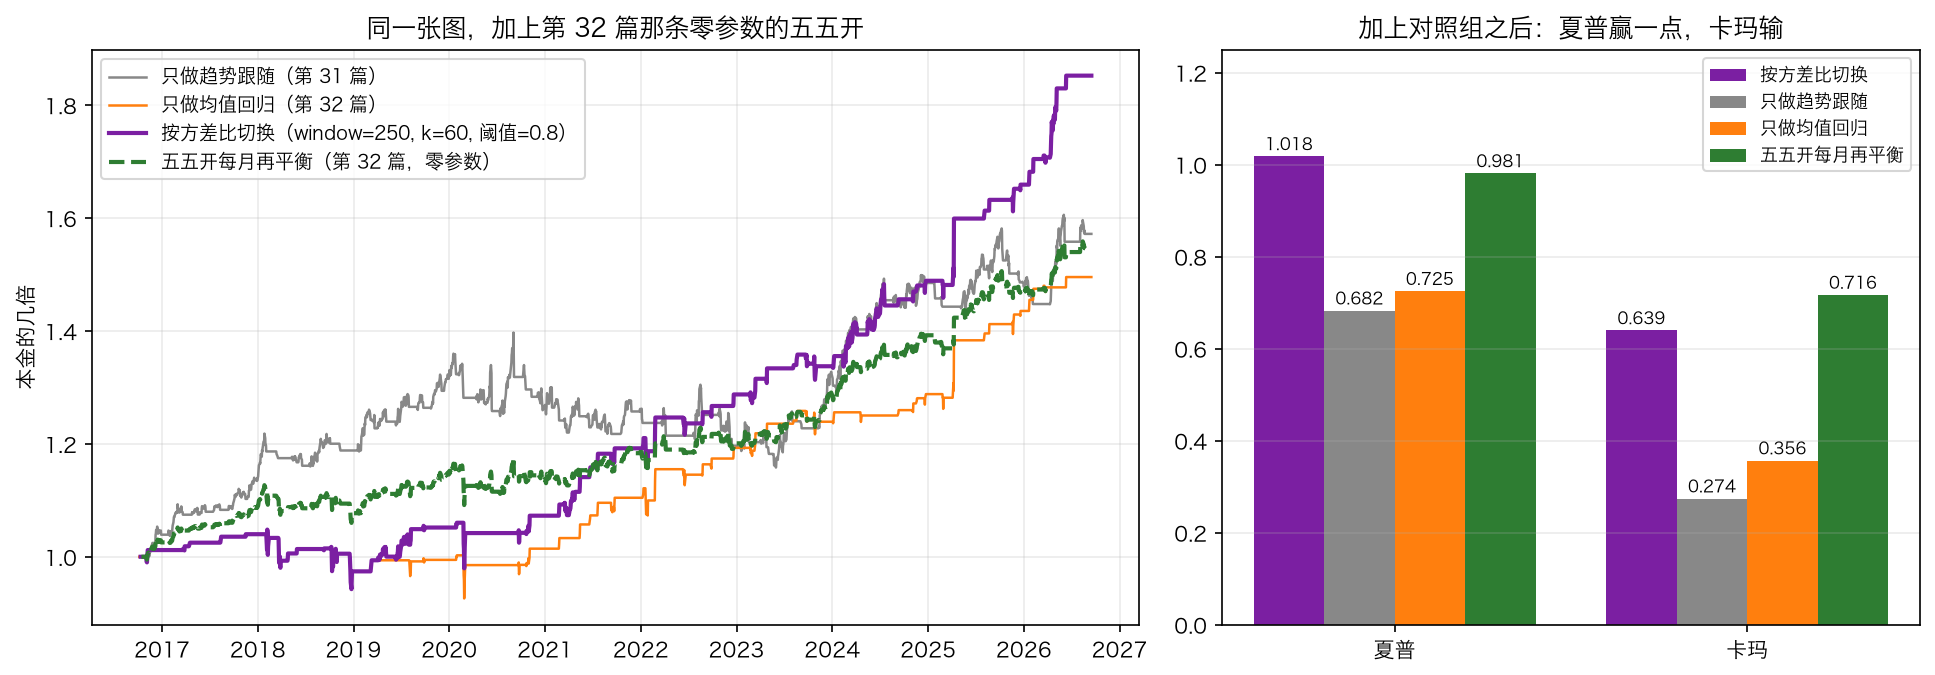
| 年化 | 最大回撤 | 夏普 | 卡玛 | 参数 | |
|---|---|---|---|---|---|
| 按方差比切换 | 6.43% | −10.06% | 1.0176 | 0.6392 | 3 |
| 五五开每月再平衡 | 4.51% | −6.30% | 0.9806 | 0.7163 | 0 |
**4 比 0 变成了 2 比 2。**年化和夏普赢,最大回撤和卡玛输——而且回撤输得不小:−10.06% 对 −6.30%,深了六成。
这就是那份报告里少的那一行。它的每一个数字都是对的,四项指标也确实全都比两条单腿好。它只是和更差的东西比了。
⚠️ 注意这不是「对照组没选」,是对照组选错了。第 30 篇那六刀查的是「这个结果是不是参数凑出来的」,查不出「这个结果是不是别的更简单的东西也能给你」。这是两个不同的问题,而后一个问题一旦答错,前一个问题的答案就没有意义。
三、优势,和「试了 180 次白捡的量」
还有更不客气的一刀。
夏普那一项,切换是 1.0176、五五开是 0.9806,赢了 0.0371。
但这两个数不是同一个起跑线上来的:切换试了 180 次,五五开一次都没试。
第 30 篇算过这件事:完全没有本事的情况下试 N 次,「最好的那一次」的夏普期望已经是一个正数。这一篇把它做成一个函数:
def edge_vs_luck(candidate_sharpe: float, control_sharpe: float, n_trials: int,
                 sharpe_std: float) -> pd.Series:
    """候选比对照组多出来的那一截,和**「试了 n_trials 次白捡的那一截」**比。

    第 30 篇算过:完全没有本事的情况下试 N 次,「最好的那次」的夏普期望
    就已经是一个正数(`expected_max_sharpe`)。所以「候选比对照组高 0.04」
    这句话本身不携带信息——**要看它高出来的量,和白捡的量,哪个大**。

    ⚠️ 对照组的参数个数如果是 0,它一次都没试过,这个门槛全算在候选头上。
    """
    if n_trials < 2 or sharpe_std <= 0:
        raise ValueError("试验次数至少是 2,夏普标准差要大于 0")
    threshold = expected_max_sharpe(n_trials, sharpe_std)
    edge = candidate_sharpe - control_sharpe
    return pd.Series({
        "候选夏普": candidate_sharpe, "对照组夏普": control_sharpe, "优势": edge,
        "试了几次": float(n_trials), "这些试验的夏普标准差": sharpe_std,
        "白捡的门槛": threshold, "优势是门槛的几成": edge / threshold,
        "结论": "优势大于白捡的量" if edge > threshold else "优势小于白捡的量,不算数",
    })
候选夏普          1.0176
对照组夏普         0.9806
优势            0.0371
试了几次           180.0
这些试验的夏普标准差    0.0889
白捡的门槛         0.2429
优势是门槛的几成      0.1526
结论:优势小于白捡的量,不算数
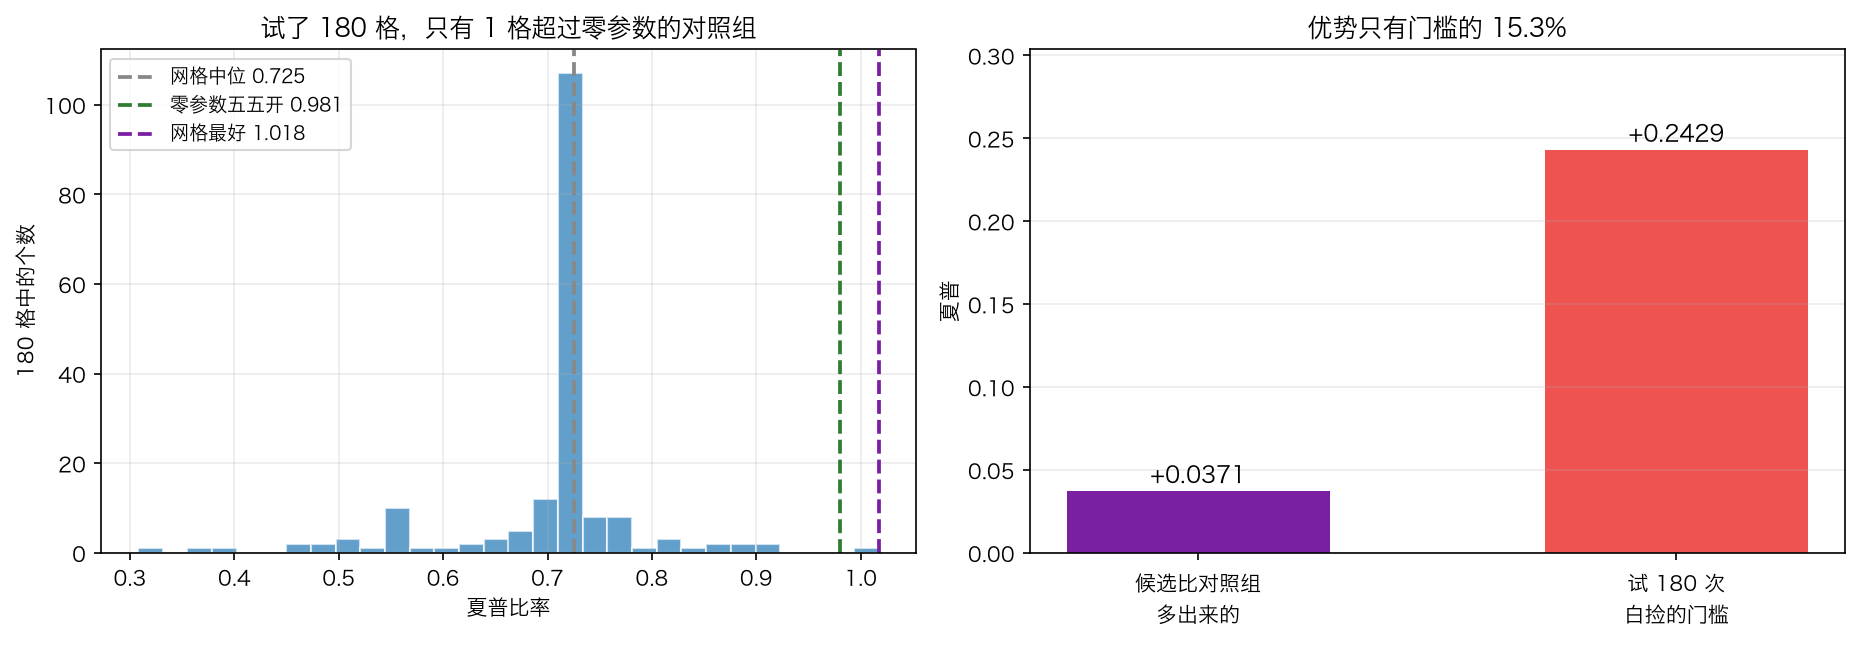
优势 0.0371,而试 180 次白捡的门槛是 0.2429。优势只有门槛的 15.3%。
换成人话:一条完全没有本事的策略,只要允许它试 180 组参数,「最好的那一组」平均就能白捡到 0.24 的夏普。而这条切换策略比零参数的对照组只多出 0.04。
⚠️ 这不等于「它一定没本事」。它等于:你手上这个 0.0371,从统计上分不出是本事还是挑出来的。而分不出来的时候,举证责任在原告。
四、挑参数的那一段,一格都没赢过
再退一步。上面那些都是用全样本算的,而全样本里已经混进了「你知道后面会发生什么」。
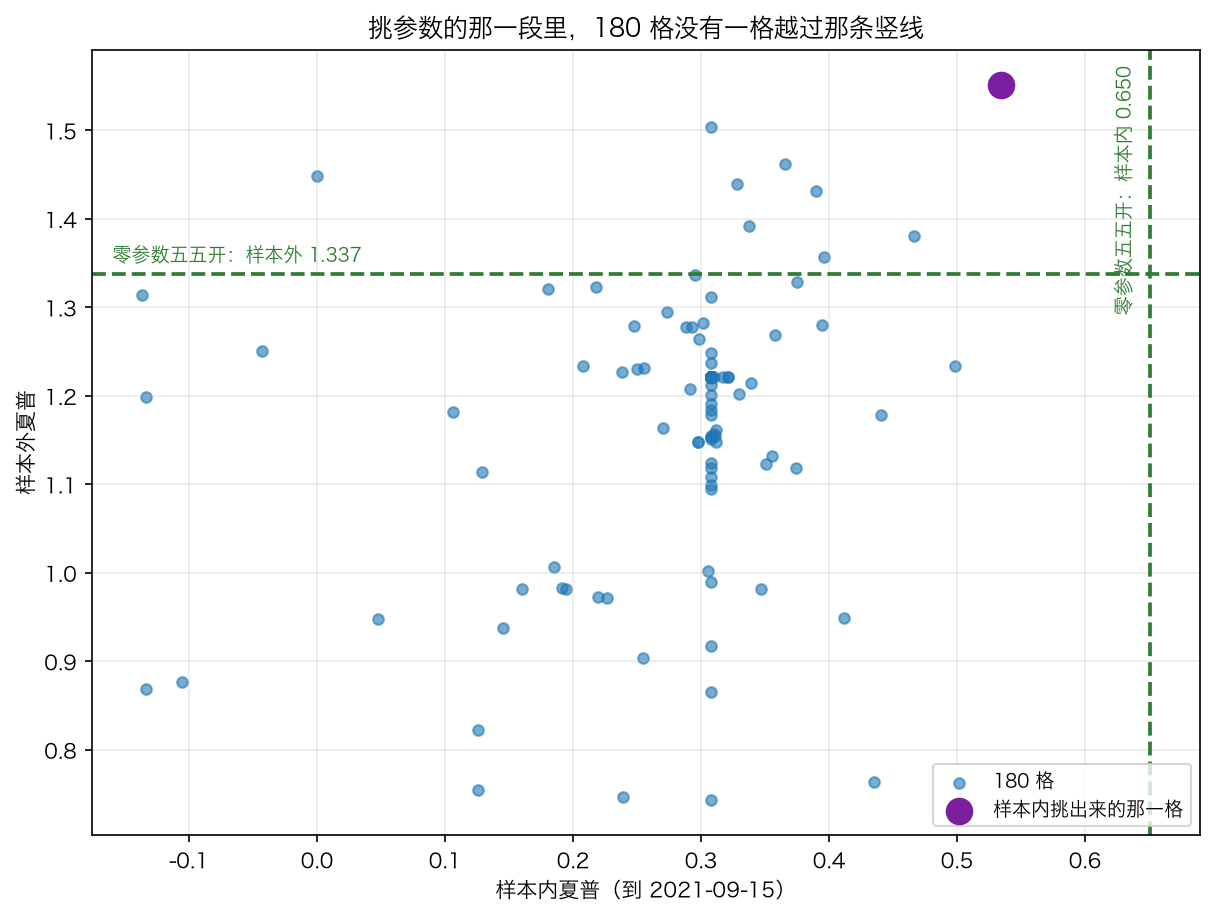
老老实实按第 30 篇的规矩做:拿前面一半(到 2021-09-15)挑参数,后面一半验证。
样本内(挑参数那一段)·网格最好    0.5344
样本内·网格中位            0.3081
样本内·零参数五五开          0.6503
样本内超过五五开的格子         0.0000
全样本·网格最好            1.0176
全样本·零参数五五开          0.9806
全样本超过五五开的格子         1.0000
| 到 2021-09-15 为止 | 夏普 |
|---|---|
| 180 格里最好的 | 0.5344 |
| 180 格的中位 | 0.3081 |
| 零参数的五五开 | 0.6503 |
| 超过五五开的格子 | 0 格 |
在你挑参数的那一刻,180 格里没有一格的夏普超过那条零参数的对照组。
那张散点图里那条竖着的绿线,是五五开的样本内夏普。180 个点,没有一个在它右边。
也就是说:如果你老老实实在 2021 年 9 月做这件事,你根本不会把这条想法拿出来——它在当时的数据上连对照组都打不过。今天看上去好看,是因为你多看了四年半。
五、换两个市场,和它到底在做什么
第 31 篇立过一条规矩:**一条规则值不值得信,看它换个市场还成不成立。**海龟那一组 (20,10) 在三个标的上分别排 1/33、2/33、6/33。
把 SPY 挑出来的那一格原样搬到 AAPL 和 BTC 上:
  标的                                    策略  在趋势腿上的天数     年化    最大回撤     夏普     卡玛  参数个数
 SPY SPY 挑出来的那一格(window=250, k=60, 阈值=0.8)    0.1036 0.0643 -0.1006 1.0176 0.6392   3.0
 SPY                         五五开每月再平衡(零参数)       NaN 0.0451 -0.0630 0.9806 0.7163   0.0
AAPL SPY 挑出来的那一格(window=250, k=60, 阈值=0.8)    0.3110 0.0932 -0.1264 0.9811 0.7378   3.0
AAPL                         五五开每月再平衡(零参数)       NaN 0.1026 -0.0972 1.3430 1.0559   0.0
 BTC SPY 挑出来的那一格(window=250, k=60, 阈值=0.8)    0.5928 0.1745 -0.1748 0.9402 0.9985   3.0
 BTC                         五五开每月再平衡(零参数)       NaN 0.1659 -0.1330 1.3237 1.2477   0.0
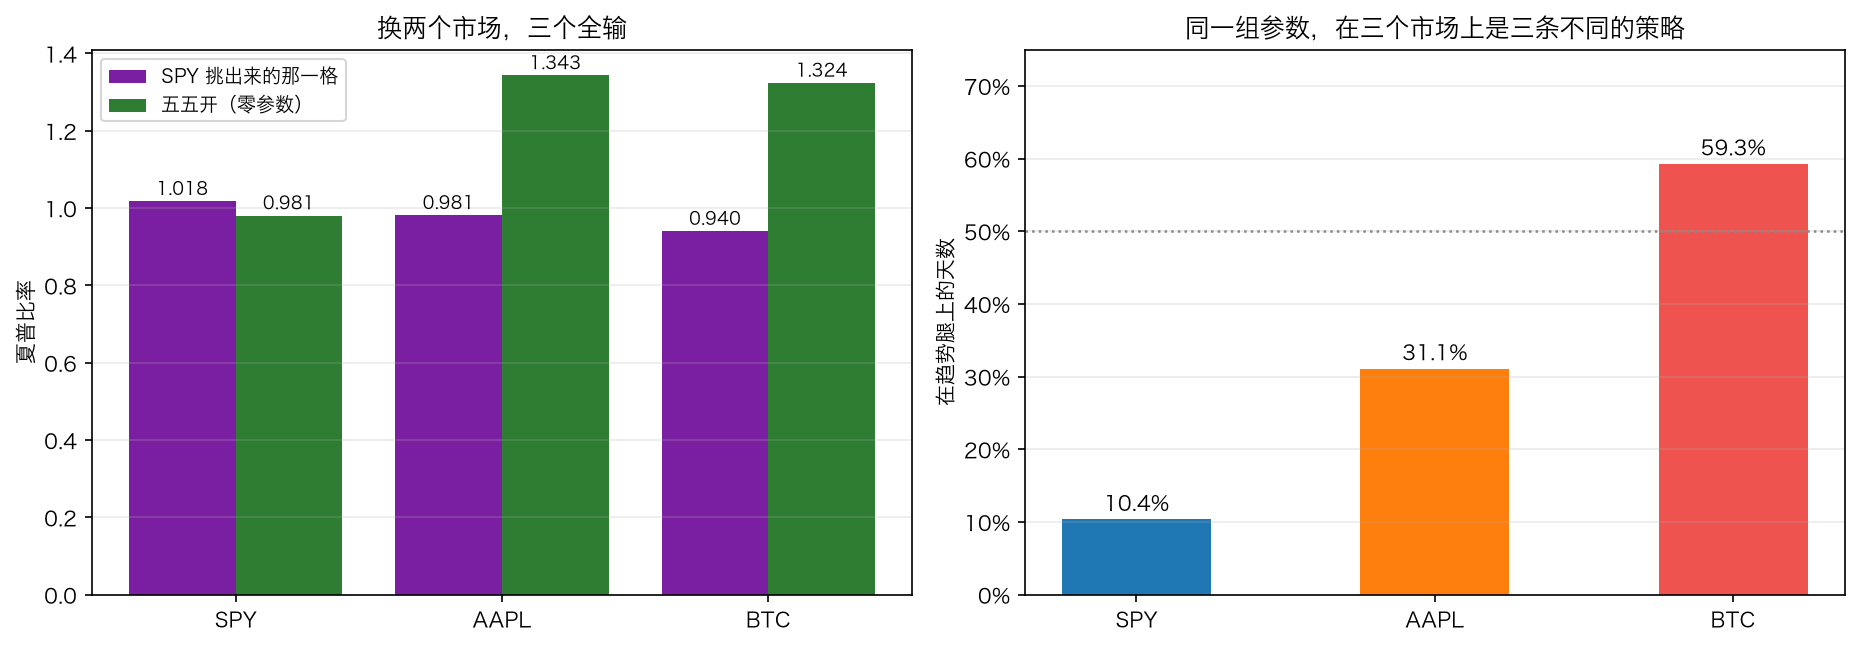
| 夏普 | 按方差比切换 | 五五开(零参数) |
|---|---|---|
| SPY | 1.0176 | 0.9806 |
| AAPL | 0.9811 | 1.3430 |
| BTC | 0.9402 | 1.3237 |
三个标的,切换赢了一个、输了两个,而且输的那两个输得很难看。
再看它到底在做什么:
  标的  在趋势腿上的天数  和趋势腿的相关  和均值回归腿的相关  一年切换几次
 SPY    0.1036   0.1507     0.9022  1.2140
AAPL    0.3110   0.4412     0.5782  1.0112
 BTC    0.5928   0.7944     0.1999  4.8948
| 在趋势腿上的天数 | 和趋势腿的相关 | 和均值回归腿的相关 | |
|---|---|---|---|
| SPY | 10.4% | 0.151 | 0.902 |
| AAPL | 31.1% | 0.441 | 0.578 |
| BTC | 59.3% | 0.794 | 0.200 |
在 SPY 上,它 89.6% 的时间就是均值回归那条腿(相关 0.902);在 BTC 上它主要是趋势跟随(相关 0.794)。
这就是这条想法真正的样子:**它不是一条策略,它是「按市场选一条腿」——而选中的那条腿,正好是第 32 篇早就告诉你的那条。**第 32 篇量出 SPY 方差比 0.616(适合均值回归)、BTC 1.270(适合趋势跟随),这条切换策略绕了三个参数、180 格网格,最后得出的就是同一个答案。
一年切换 1.0 到 4.9 次。三个参数,九年里做了十几个决定。
六、六格登记表
上面四节里的每一刀,都可以在写第一行代码之前就挥出去。
区别只在于有没有一张表逼你写下来:
class Idea:
    """一条想法在开始写代码之前必须填完的六格。

    六格的顺序就是这门课的顺序,而且**是有依赖的**:
    没有第一格就写不出第三格(不知道谁在被迫交易,就不知道该在哪一根进场),
    没有第四格,后面所有的数字都失去意义。

    ⚠️ 允许填「不知道」,但**不允许留空,也不允许写「待定」**——
    「不知道」是一个可以推进的答案(去查),「待定」不是。
    """
    name: str                              # 一句话说清这条想法
    counterparty: str                      # 谁被迫交易,为什么(第 2 篇)
    mechanism: str                         # 这件事凭什么会发生(第 8–20 篇)
    rules: str                             # 六要素(第 21 篇)
    control: str                           # 对照组:它要打败谁(这一篇)
    sample: str                            # 多少笔、多长、哪些市场(第 29 篇)
    deployment: str                        # 上线方案(第 34 篇)

    FIELDS = {"name": "一句话", "counterparty": "谁被迫交易", "mechanism": "机制",
              "rules": "规则(六要素)", "control": "对照组", "sample": "样本",
              "deployment": "上线方案"}

    def __post_init__(self):
        for key in self.FIELDS:
            value = str(getattr(self, key)).strip()
            if not value:
                raise ValueError(f"「{self.FIELDS[key]}」这一格不能空")
            if value in ("待定", "TBD", "?", "略"):
                raise ValueError(f"「{self.FIELDS[key]}」写的是 {value!r}——"
                                 "不知道就写「不知道」,那是一个可以推进的答案")

    def describe(self) -> pd.Series:
        return pd.Series({label: getattr(self, key) for key, label in self.FIELDS.items()})
六格填完是这样:
一句话                                    用滚动方差比,在趋势跟随和均值回归之间切换
谁被迫交易      不知道。第 31、32 篇说清楚了两条腿各自的对手(被迫平仓的趋势者 / 被迫止损的散户),...
机制         第 32 篇量到 60 天方差比 0.616 / 0.852 / 1.270 和两条腿的强弱...
规则(六要素)    每根收盘算滚动方差比(window, k),高于阈值则下一根用海龟的仓位,否则用 RSI(2...
对照组                   第 32 篇的五五开每月再平衡——**零参数**,而且已经在同样的数据上量过
样本          SPY / AAPL / BTC 日线,约 2,500–3,300 根,两条腿合计约 300 笔
上线方案                        第 34 篇的阶梯;警戒线按台阶笔数用第 33 篇的正常范围表算
第一格就卡住了:说不出谁被迫交易。
第 31 篇和第 32 篇各自说得很清楚:趋势跟随赚的是「被迫平仓的人」的钱,均值回归赚的是「被迫止损的人」的钱(第 2 篇的框架)。但「方差比从 0.9 变成 1.1」这件事本身,对应谁在被迫做什么?
答不上来。而第二格(机制)的答案里,第 32 篇那句原话还在:三个标的算不出规律,它是解释不是筛选器。
⚠️ 登记表允许写「不知道」,但不允许写「待定」——「不知道」是一个可以推进的答案(去查),「待定」不是。
七、全课的检查单
把三十四篇的判据压成一张表:
def checklist() -> pd.DataFrame:
    """全课的检查单:每一关查什么、判据是什么、出自第几篇。

    ⚠️ 这张表的顺序是有讲究的:**越靠前的关,越便宜、越致命**。
    对照组选错了,后面十关全部白查;而「夏普够不够高」排在很后面,
    因为它是这张表里**最不重要**的一个数。
    """
    rows = [
        ("想法", "谁被迫交易", "说得出具体是谁、为什么非交易不可", "第 2 篇"),
        ("想法", "对照组", "说得出「不用这条想法的更简单做法」是什么", "第 35 篇"),
        ("结构", "这个数在那一刻算得出来吗", "所有输入只用到当根及之前的数据", "第 27、28 篇"),
        ("结构", "指标能不能增量算", "实盘每收一根算一次,不是重算整条历史", "第 34 篇"),
        ("规则", "六要素填满了吗", "环境、入场、成交、止损、出场、仓位,一格不空", "第 21 篇"),
        ("回测", "引擎对账", "和另一份实现逐根相对差 < 1e-9", "第 27、34 篇"),
        ("回测", "记账自洽", "现金 + 持仓市值 = 权益,误差 0", "第 27 篇"),
        ("回测", "推迟一根塌不塌", "lag 0→1 只温和变差,不塌陷", "第 27 篇"),
        ("回测", "成本算进去了吗", "手续费 + 价差 + 滑点,按 R 折算", "第 28 篇"),
        ("评估", "笔数够不够", "样本量看**笔数**不看根数", "第 29 篇"),
        ("评估", "逐笔 t 值", "大于 2", "第 29、31 篇"),
        ("检验", "曲面是高地还是针", "落差占年化的比例越小越好", "第 30 篇"),
        ("检验", "样本外", "样本内挑的那一格,样本外排名不塌", "第 30 篇"),
        ("检验", "多重检验", "扣掉「试了几次」白捡的那一截还剩多少", "第 30、35 篇"),
        ("检验", "打乱对照", "块自助法造的假数据里,多少比真实的好", "第 30、32 篇"),
        ("检验", "赢过对照组了吗", "**和对照组比,不是和更差的东西比**", "第 35 篇"),
        ("上线", "正常范围表", "连亏、回撤、水下时间的分位数算好了", "第 33 篇"),
        ("上线", "预热要几根", "窗口型看硬门槛,递推型带周期的五倍", "第 34 篇"),
        ("上线", "交易所收不收这张单", "tickSize / stepSize / minNotional 过了", "第 34 篇"),
        ("上线", "警戒线和动作", "阈值按台阶笔数算,动作写死", "第 33、34 篇"),
    ]
    return pd.DataFrame(rows, columns=["阶段", "查什么", "判据", "出处"])
阶段          查什么                                   判据        出处
想法        谁被迫交易                     说得出具体是谁、为什么非交易不可     第 2 篇
想法          对照组                 说得出「不用这条想法的更简单做法」是什么    第 35 篇
结构 这个数在那一刻算得出来吗                      所有输入只用到当根及之前的数据 第 27、28 篇
结构     指标能不能增量算                   实盘每收一根算一次,不是重算整条历史    第 34 篇
规则      六要素填满了吗               环境、入场、成交、止损、出场、仓位,一格不空    第 21 篇
回测         引擎对账                   和另一份实现逐根相对差 < 1e-9 第 27、34 篇
回测         记账自洽                  现金 + 持仓市值 = 权益,误差 0    第 27 篇
回测      推迟一根塌不塌                    lag 0→1 只温和变差,不塌陷    第 27 篇
回测      成本算进去了吗                 手续费 + 价差 + 滑点,按 R 折算    第 28 篇
评估        笔数够不够                       样本量看**笔数**不看根数    第 29 篇
评估       逐笔 t 值                                 大于 2 第 29、31 篇
检验     曲面是高地还是针                         落差占年化的比例越小越好    第 30 篇
检验          样本外                     样本内挑的那一格,样本外排名不塌    第 30 篇
检验         多重检验                   扣掉「试了几次」白捡的那一截还剩多少 第 30、35 篇
检验         打乱对照                   块自助法造的假数据里,多少比真实的好 第 30、32 篇
检验      赢过对照组了吗                  **和对照组比,不是和更差的东西比**    第 35 篇
上线        正常范围表                    连亏、回撤、水下时间的分位数算好了    第 33 篇
上线        预热要几根                    窗口型看硬门槛,递推型带周期的五倍    第 34 篇
上线    交易所收不收这张单 tickSize / stepSize / minNotional 过了    第 34 篇
上线       警戒线和动作                        阈值按台阶笔数算,动作写死 第 33、34 篇
这张表的顺序是有讲究的:越靠前的关,越便宜、越致命。
- 「对照组」排在第二行,也就是写代码之前
- 「夏普够不够高」根本没进这张表——它是这些检验的输入,不是判据
八、这条想法的体检表
一道关就是「看哪个数、门槛多少、谁大谁好、出自第几篇」,外加一个 must——一票否决:
class Gate:
    """一道关:看哪个数、门槛多少、谁大谁好、出自第几篇。

    `must=True` 是**一票否决**:这一道没过,前面过了多少道都不算数。
    整条流水线上只有很少几道该是一票否决的,而它们几乎都不是「收益够不够」。
    """
    name: str
    value: float
    threshold: float
    better: str = "高"
    source: str = ""
    must: bool = False

    def __post_init__(self):
        if self.better not in BETTER:
            raise ValueError(f"better 只能是 {BETTER} 之一,收到 {self.better!r}")

    @property
    def passed(self) -> bool:
        if np.isnan(self.value):
            return False                   # 算不出来就是没过,不是「暂且算过」
        return self.value >= self.threshold if self.better == "高" else self.value <= self.threshold

    def row(self) -> dict:
        return {"这一关": self.name, "量到的": self.value, "门槛": self.threshold,
                "谁大谁好": self.better, "一票否决": self.must,
                "结论": "过" if self.passed else "没过", "出处": self.source}
⚠️ 算不出来的那一关算没过,不算「暂且算过」。
                   这一关    量到的   门槛 谁大谁好  一票否决 结论        出处
              说得出谁被迫交易 0.0000  1.0    高  True 没过     第 2 篇
             网格里亏钱的格子占 0.0000  0.1    低 False  过    第 31 篇
            曲面落差占最好那格的 0.1879  0.3    低 False  过    第 30 篇
           样本外排名(越小越好) 1.0000 90.0    低 False  过    第 30 篇
                   PBO 0.0000  0.5    低 False  过    第 30 篇
          夏普优势 ÷ 白捡的门槛 0.1526  1.0    高  True 没过 第 30、35 篇
       赢过对照组的项数(共 4 项) 2.0000  4.0    高  True 没过    第 35 篇
换市场还成立吗(三个标的里赢过对照组的个数) 0.0000  2.0    高 False 没过    第 31 篇
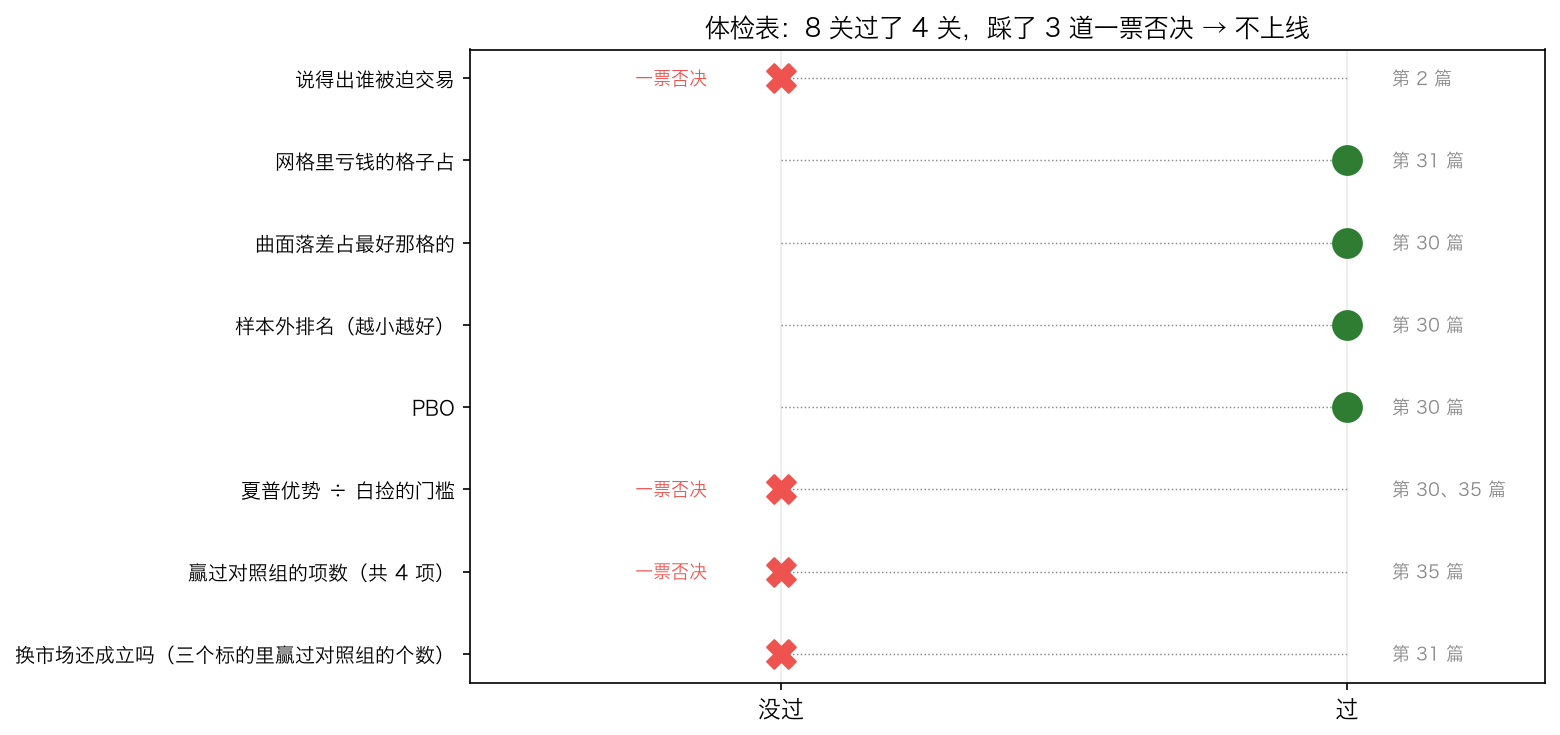
一共几关                                                      8.0
过了几关                                                      4.0
没过几关                                                      4.0
踩了几道一票否决                                                  3.0
没过的         说得出谁被迫交易、夏普优势 ÷ 白捡的门槛、赢过对照组的项数(共 4 项)、换市场还成立吗(...
结论                                                        不上线
八关过了四关,踩了三道一票否决。
⚠️ 注意结论不是「过了一半」。一票否决踩了一道,结论就是不上线——这正是把它叫做一票否决的原因:
def verdict(gates) -> pd.Series:
    """几道过、几道没过,以及**一票否决有没有被踩**。

    ⚠️ 结论不是「过了几道」的加权平均。一票否决踩了一道,结论就是不上线——
    **这正是把它叫做一票否决的原因**。
    """
    gates = list(gates)
    failed = [g for g in gates if not g.passed]
    blocked = [g for g in failed if g.must]
    return pd.Series({
        "一共几关": float(len(gates)), "过了几关": float(len(gates) - len(failed)),
        "没过几关": float(len(failed)), "踩了几道一票否决": float(len(blocked)),
        "没过的": "、".join(g.name for g in failed) or "(没有)",
        "结论": "不上线" if blocked else ("可以进模拟盘" if not failed else "补完再说"),
    })
而过了的那四关,全都是第 30 篇那套「查参数是不是凑出来的」。这条想法的参数不是凑出来的,它只是没有本事。这是两回事,而第 30 篇那套刀只能查前一件。
九、实验四:一页纸策略报告
把上面的东西自动拼成一页纸,就是这门课的最后一个实验:
def one_pager(idea: Idea, gates, comparison: pd.DataFrame,
              luck: pd.Series | None = None) -> str:
    """实验四的产出:一页纸策略报告(Markdown 文本)。

    这份报告刻意做得很短。它不是用来说服别人的,是用来**在半年之后说服你自己**:
    半年后你会忘记当时为什么这么定,而这页纸上每一行都能一句话答上来。
    """
    table = audit(gates)
    result = verdict(gates)
    lines = [f"# 策略报告:{idea.name}", ""]
    lines.append("## 一、登记表")
    lines.append("")
    lines.append("| 格 | 填的什么 |")
    lines.append("|---|---|")
    for key, label in idea.FIELDS.items():
        if key == "name":
            continue
        lines.append(f"| {label} | {getattr(idea, key)} |")
    lines.append("")
    lines.append("## 二、和对照组并排")
    lines.append("")
    lines.append(_markdown(comparison, index=True))
    if luck is not None:
        lines.append("")
        lines.append(f"> 优势 {luck['优势']:+.4f},而试 {int(luck['试了几次'])} 次白捡的门槛是 "
                     f"{luck['白捡的门槛']:.4f}——**{luck['结论']}**")
    lines.append("")
    lines.append("## 三、过关情况")
    lines.append("")
    lines.append(_markdown(table[["这一关", "量到的", "门槛", "结论", "出处"]]))
    lines.append("")
    lines.append("## 四、结论")
    lines.append("")
    lines.append(f"- 一共 {int(result['一共几关'])} 关,过了 {int(result['过了几关'])} 关,"
                 f"没过 {int(result['没过几关'])} 关")
    lines.append(f"- 踩了 {int(result['踩了几道一票否决'])} 道一票否决")
    lines.append(f"- 没过的是:{result['没过的']}")
    lines.append(f"- **结论:{result['结论']}**")
    return "\n".join(lines)
产出:
# 策略报告:用滚动方差比,在趋势跟随和均值回归之间切换

## 一、登记表

| 格 | 填的什么 |
|---|---|
| 谁被迫交易 | 不知道。第 31、32 篇说清楚了两条腿各自的对手(被迫平仓的趋势者 / 被迫止损的散户),但说不出「方差比变了」这件事本身对应谁在被迫交易 |
| 机制 | 第 32 篇量到 60 天方差比 0.616 / 0.852 / 1.270 和两条腿的强弱一一对应,⚠️ 但那一篇明确写了「三个标的算不出规律,它是解释不是筛选器」 |
| 规则(六要素) | 每根收盘算滚动方差比(window, k),高于阈值则下一根用海龟的仓位,否则用 RSI(2) 的仓位 |
| 对照组 | 第 32 篇的五五开每月再平衡——**零参数**,而且已经在同样的数据上量过 |
| 样本 | SPY / AAPL / BTC 日线,约 2,500–3,300 根,两条腿合计约 300 笔 |
| 上线方案 | 第 34 篇的阶梯;警戒线按台阶笔数用第 33 篇的正常范围表算 |

## 二、和对照组并排

| 策略 | 年化 | 最大回撤 | 夏普 | 卡玛 | 参数个数 | 候选赢了几项 | 一共几项 |
|---|---|---|---|---|---|---|---|
| 候选 | 0.0643 | -0.1006 | 1.0176 | 0.6392 | 3.0000 | — | — |
| 只做趋势跟随 | 0.0468 | -0.1711 | 0.6822 | 0.2737 | 0.0000 | 4.0000 | 4.0000 |
| 只做均值回归 | 0.0415 | -0.1163 | 0.7246 | 0.3564 | 0.0000 | 4.0000 | 4.0000 |
| 五五开每月再平衡(第 32 篇) | 0.0451 | -0.0630 | 0.9806 | 0.7163 | 0.0000 | 2.0000 | 4.0000 |

> 优势 +0.0371,而试 180 次白捡的门槛是 0.2429——**优势小于白捡的量,不算数**

## 三、过关情况

| 这一关 | 量到的 | 门槛 | 结论 | 出处 |
|---|---|---|---|---|
| 说得出谁被迫交易 | 0.0000 | 1.0000 | 没过 | 第 2 篇 |
| 网格里亏钱的格子占 | 0.0000 | 0.1000 | 过 | 第 31 篇 |
| 曲面落差占最好那格的 | 0.1879 | 0.3000 | 过 | 第 30 篇 |
| 样本外排名(越小越好) | 1.0000 | 90.0000 | 过 | 第 30 篇 |
| PBO | 0.0000 | 0.5000 | 过 | 第 30 篇 |
| 夏普优势 ÷ 白捡的门槛 | 0.1526 | 1.0000 | 没过 | 第 30、35 篇 |
| 赢过对照组的项数(共 4 项) | 2.0000 | 4.0000 | 没过 | 第 35 篇 |
| 换市场还成立吗(三个标的里赢过对照组的个数) | 0.0000 | 2.0000 | 没过 | 第 31 篇 |

## 四、结论

- 一共 8 关,过了 4 关,没过 4 关
- 踩了 3 道一票否决
- 没过的是:说得出谁被迫交易、夏普优势 ÷ 白捡的门槛、赢过对照组的项数(共 4 项)、换市场还成立吗(三个标的里赢过对照组的个数)
- **结论:不上线**
这份报告刻意做得很短。它不是用来说服别人的,是用来在半年之后说服你自己——半年后你会忘记当时为什么这么定,而这页纸上每一行都能一句话答上来。
⚠️ 它还刻意不好看:没有资金曲线、没有分年收益、没有月度热力图。那些东西的作用是让人相信,而这页纸的作用是让人能复查。
十、主线策略 v0 → v4,和一张对不上的账
这门课从第 12 篇开始,还有一条主线策略一路长到今天。把它从头跑一遍,一次只改一件事:
def mainline(frame, version: str, fee_rate: float = 0.0):
    price = frame["close"]
    cross = (I.sma(price, 50) > I.sma(price, 200)).fillna(False)
    high20 = (price >= price.rolling(20).max()).fillna(False)
    exit_signal = I.cross_below(I.sma(price, 50), I.sma(price, 200)).fillna(False)
    settings = {
        "v0(第 12 篇)": dict(entry=cross, stop="none", sizing="full"),
        "v1(第 15 篇)": dict(entry=cross, stop="chandelier", trigger="extreme", sizing="full"),
        "v2(第 20 篇)": dict(entry=cross, stop="chandelier", trigger="close", sizing="full"),
        "v3(第 21 篇)": dict(entry=cross & high20, stop="chandelier", trigger="close", sizing="full"),
        "v4(第 26 篇)": dict(entry=cross & high20, stop="chandelier", trigger="close",
                              sizing="risk", risk_per_trade=0.10),
    }[version]
    return BT.run(frame, BT.Plan(exit=exit_signal, k=3.0, fee_rate=fee_rate, **settings), 100_000.0)
                               这一版改了什么    SPY 年化    SPY 回撤   AAPL 年化   AAPL 回撤    BTC 年化    BTC 回撤
版本
v0(第 12 篇)  50/200 均线金叉持有、死叉出场,满仓,没有止损  0.078486 -0.341047  0.142124 -0.458686  0.178714 -0.667126
v1(第 15 篇)       + 3 ATR 吊灯止损(盘中最低价触发)   0.05093 -0.302586  0.107885 -0.494335  0.169372  -0.62659
v2(第 20 篇)                   止损改成收盘价触发  0.061231 -0.390697  0.160965 -0.459928  0.179442 -0.667627
v3(第 21 篇)           入场加一条:收盘要创 20 日新高  0.029686 -0.123455  0.107552 -0.278521  0.185552 -0.476909
v4(第 26 篇)           仓位改成「一笔最多亏账户 10%」  0.029686 -0.123455  0.098912 -0.278521  0.216047 -0.323209
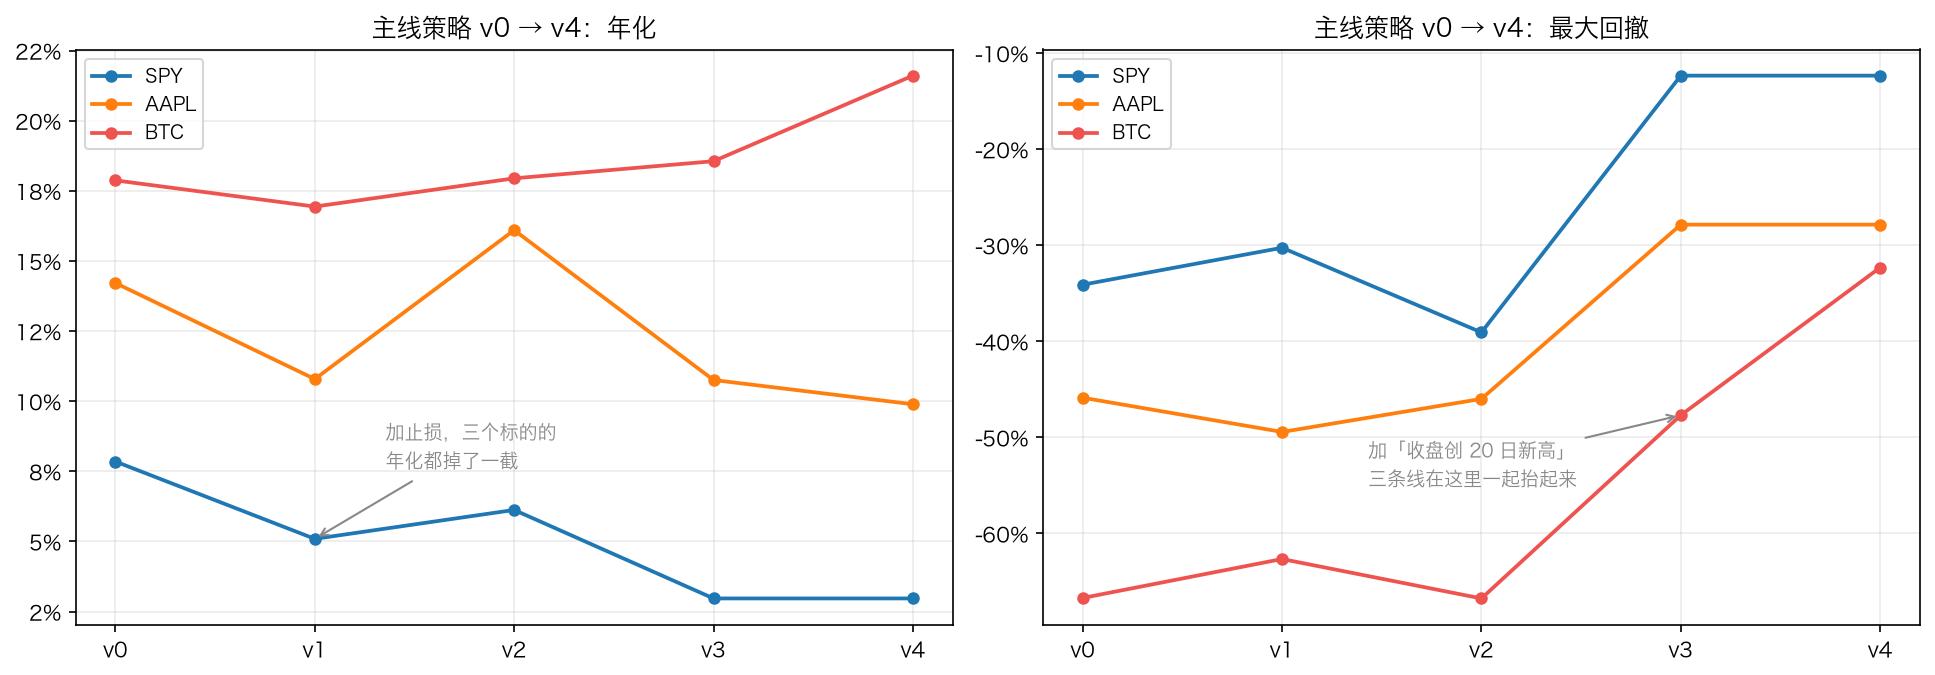
两件事一眼看得出来:
第一,加止损让三个标的的年化都掉了一截(SPY 7.85% → 5.09%、AAPL 14.21% → 10.79%、BTC 17.87% → 16.94%)。止损买的从来不是收益,是最差那一笔的上限(第 23 篇)。
第二,回撤那张图上三条线在 v3 一起抬起来:SPY −39.07% → −12.35%、AAPL −45.99% → −27.85%、BTC −66.76% → −47.69%。v3 改的只有一件事——入场加一条「收盘要创 20 日新高」。
⚠️ 然后是一张对不上的账
把这张表和当年那几篇报的数字核对一下:
        版本  当年报的  这张表重算的  差多少个百分点
v0(第 12 篇) 0.085  0.0785  -0.6514
v1(第 15 篇) 0.029  0.0509   2.1930
v2(第 20 篇) 0.039  0.0612   2.2231
v3(第 21 篇) 0.030  0.0297  -0.0314
v4(第 26 篇) 0.030  0.0297  -0.0314
| 版本 | 当年报的 SPY 年化 | 今天重算的 | 差 |
|---|---|---|---|
| v0(第 12 篇) | 8.5% | 7.85% | −0.65 个百分点 |
| v1(第 15 篇) | 2.9% | 5.09% | +2.19 |
| v2(第 20 篇) | 3.9% | 6.12% | +2.22 |
| v3(第 21 篇) | 3.0% | 2.97% | −0.03 |
| v4(第 26 篇) | 3.0% | 2.97% | −0.03 |
v3 和 v4 对到小数点后两位,v1 和 v2 差了 2.2 个百分点。
差的是什么?当年的 v1 里还捆着一条规则:**止损之后要收盘创 20 日新高才买回。**那条规则一直到第 21 篇写「六要素」的时候才被显式化,变成入场条件的一部分——也就是这张表里的 v3。
所以这张表的 v1、v2 是把那条规则拿掉之后的版本,当年的 v1、v2 是捆着它的版本。两个都对,只是不是同一个东西。
⚠️ 这件事值得单独记一笔,因为它就是这门课后来要把引擎(第 27 篇)和六要素(第 21 篇)都写成代码的原因:
一条描述不清的策略,三年之后你连自己当初算的是什么都说不清。
而这正是实验四那份一页纸报告存在的理由。
十一、主线 v4 自己走一遍同一条流水线
对切换策略这么狠,对自家的主线策略呢?
同一条流水线,对照组换成买入持有(零参数,而且是每个人都能直接做到的那条):
  标的     年化    最大回撤     夏普     卡玛  参数个数   笔数  逐笔 t 值  买入持有·年化  买入持有·夏普  赢过买入持有的项数
 SPY 0.0291 -0.1242 0.4184 0.2343   4.0 39.0  1.1180   0.1352   0.7929        1.0
AAPL 0.0983 -0.2797 0.6975 0.3516   4.0 37.0  1.7917   0.2926   1.0254        1.0
 BTC 0.2063 -0.3362 0.8577 0.6137   4.0 30.0  1.2769   0.3630   0.8012        3.0
| 主线 v4(含成本) | SPY | AAPL | BTC |
|---|---|---|---|
| 年化 | 2.91% | 9.83% | 20.63% |
| 买入持有 | 13.52% | 29.26% | 36.30% |
| 逐笔 t 值 | 1.12 | 1.79 | 1.28 |
| 赢过买入持有的项数(共 4 项) | 1/4 | 1/4 | 3/4 |
**主线 v4 也过不了这条流水线。**三个标的的逐笔 t 值全都不到 2(第 29 篇那条线),年化全面跑输买入持有,只有 BTC 上靠回撤和卡玛赢了三项。
⚠️ 这和第 31 篇的结论是一致的:能赢的那条是海龟,不是主线——海龟在三个标的上逐笔 t 值 2.21 / 3.48 / 2.70,而且赢的方式是「用四分之一的回撤赚到差不多的钱」。
主线策略从第 12 篇一路长到第 26 篇,它的价值从来不是「能赚钱」,是它是这门课的实验台:每一篇改它一格,就能看清楚那一格到底值多少。它是一条用来教学的策略,不是一条用来交易的策略,而这句话本身就该写进它的一页纸报告里。
十二、那要是真想改进那条零参数的对照组呢
五五开、每月再平衡——权重和周期都是随手定的。挑一挑会不会更好?
再平衡             ME      QE       W
标的   趋势腿权重
AAPL 0.3    1.1959  1.1857  1.2175
     0.5    1.3430  1.3275  1.2561
     0.7    1.3327  1.3211  1.2612
BTC  0.3    1.1392  1.1314  1.1454
     0.5    1.3237  1.3027  1.3408
     0.7    1.3649  1.3511  1.3769
SPY  0.3    0.9531  0.9629  0.9494
     0.5    0.9806  0.9878  0.9503
     0.7    0.8796  0.8823  0.8468
27 组里夏普超过「五五开 + 每月再平衡」的有 5 组:
 标的  趋势腿权重 再平衡     夏普     卡玛  五五开每月
SPY    0.5  QE 0.9878 0.7206 0.9806
BTC    0.5   W 1.3408 1.2462 1.3237
BTC    0.7   W 1.3769 1.3587 1.3237
BTC    0.7  ME 1.3649 1.3696 1.3237
BTC    0.7  QE 1.3511 1.3947 1.3237
**27 组里有 5 组比「五五开 + 每月」更好。**但看看是哪 5 组:
- SPY 上一组:五五开 + 每季度,夏普 0.9878 对 0.9806——赢了 0.007
- BTC 上四组:全都是趋势腿权重 0.7
BTC 上多压趋势腿当然更好——第 31 篇早就量过 BTC 上趋势跟随夏普 1.367、均值回归只有 0.193。这不是「挑出了更好的参数」,这是「事后知道哪条腿更强」,换个市场就反过来(AAPL 上 0.7 权重比 0.5 差)。
⭐ 所以零参数的对照组难打败,不是因为它有多好,是因为:
它没有被挑过。而你手上那条被挑过的,必须先还掉「挑」这件事借来的那一截。
这就是第三节那个 0.2429。
十三、这门课造出来的东西
        模块  行数  函数  类
  backtest 333   6  2
      bars 157   6  0
     costs 118   6  0
      data 683  40  0
    derivs 111   6  0
indicators 329  22  0
   journal 491  15  2
      live 534  10  5
    orders 135   7  0
  patterns 390  17  0
      plot 162   5  0
   project 291   8  2
    report 326  17  0
 reversion 299   7  1
      risk 320  10  1
     rules 199   4  1
    screen 130  11  0
  sessions 164  13  0
      size 269  15  0
     stats 171  16  0
 structure 433  19  0
timeframes  45   2  0
     trend 386   7  1
  validate 270  11  0

合计:24 个模块、6,746 行、280 个函数、15 个类;24 个测试文件、344 个测试函数(其中 10 处 parametrize,所以 pytest 数出来的用例比函数多)
  标的  K 线根数          从          到   年数
 SPY 2512.0 2016-09-15 2026-09-15 9.97
AAPL 2513.0 2016-09-15 2026-09-15 9.97
 BTC 3302.0 2017-08-17 2026-08-31 9.05

另外:BTC 1 分钟线 109 个月度文件;第 19、28 篇的全市场名单 864 个合约;第 34 篇的 exchangeInfo 快照 3,705 个交易对
三十五篇下来,talab 有 24 个模块、6,746 行、280 个函数、15 个类,配 24 个测试文件、344 个测试函数。
⚠️ 行数不是成绩。这些代码里真正值钱的部分,是每一个函数的文档字符串里写着的那句「为什么要这么写」——_floor 里那个 round(value / unit, 9)、excess 里那三行时区对齐、sharpe 里那个「一整年空仓要返回 NaN」。代码会被重写,这些坑不会重新消失。
十四、这门课检验过的说法
最后一张表,把三十五篇里检验过的教科书说法列出来。⚠️ 「不成立」的意思是「在这门课的数据和口径下没测出来」,不是「永远不成立」——举证责任的规矩对这张表本身同样有效。
| 说法 | 结论 | 出处 |
|---|---|---|
| K 线形态能预测下一根 | 不成立(120 次检验 8 次显著,其中 5 次是「比基准更差」) | 第 16 篇 |
| 头肩顶 / 双顶按教科书交易 | 只在 BTC 1 小时线上显著,且 2022 年之后消失 | 第 17 篇 |
| 上升三角形多数向上突破 | 反过来:多数向下(打乱之后仍然如此,是识别几何) | 第 17 篇 |
| 斐波那契回撤位是支撑阻力 | 不成立:和左右对称的邻居比例没有差别 | 第 18 篇 |
| MACD 背离预示转折 | 日线无差别;20 次检验 2 次显著,且方向不一 | 第 13 篇 |
| 超卖买入 / 超买卖出 | 36 次检验 4 次显著,而且全都偏延续 | 第 14 篇 |
| 均线金叉是买点 | 金叉状态 / 多头排列 / 乖离率,三个标的都与打乱无异 | 第 12 篇 |
| 布林带收口之后波动放大 | 成立,但打乱后的价格上同样出现(所以不是价格的性质) | 第 15 篇 |
| 缺口会回补 | 和「开盘价另一侧同样距离」的对照组相近 | 第 9 篇 |
| 整数关口有痕迹 | 成立:日线高低点正好落在千位整数上是普通价格的 13–14 倍 | 第 9 篇 |
| 前一天的 POC 会被碰到 | 成立(z = 3.04),而 VWAP、中点没有 | 第 10 篇 |
| 横截面动量(相对强度) | 7 次分组检验无一显著,最小 p = 0.248 | 第 19 篇 |
| 「价格 × 持仓量」四象限 | 不成立:四格之后 20 天 2.73%–3.27%,全样本 2.93% | 第 25 篇 |
| 危机时相关性上升 | 一半是挑选效应(按波动筛出来的 0.846,正态对照里是 0.876) | 第 26 篇 |
| 趋势跟随(通道突破 + 2N 止损) | 成立:全课唯一一条逐笔 t 值三个标的全部超过 2 的 | 第 31 篇 |
| 均值回归(RSI(2)) | 弱效应:只有 SPY 勉强过蒙特卡洛(p = 0.01) | 第 32 篇 |
| 连亏之后暂停 | 有害:三标的 × 四规则,12 组里 11 组是亏的 | 第 33 篇 |
| 阶梯上线能改善风险收益 | 不成立:五条阶梯全部落在「同样仓位一直不动」的坏的一侧 | 第 34 篇 |
这张表里「成立」的只有四条,而且每一条都朴素得没法拿去卖课。
⚠️ 但这张表真正的用处不在它的结论,在它的方法:每一行背后都有一个对照组。没有对照组的那些行,一行都没写进来。
十五、talab.project 的完整代码
"""talab.project:把前面三十四篇串成一条流水线。第 35 篇(毕业项目)。

这个模块里没有一个函数在计算收益。它们全都在回答同一个问题:

> **这条想法,凭什么值得你把钱放进去。**

在法庭上,举证责任在原告。你的策略就是原告:它要证明自己比「什么都不做」和
「一个更简单的做法」更好——**而不是等着别人来证明它不行**。

| 这里的东西 | 对应法庭上的 |
|---|---|
| `Idea` 六格登记表 | 起诉状:告谁、凭什么、要什么 |
| `checklist` | 证据规则:哪些证据算数 |
| `Gate` / `audit` | 一条一条过证据 |
| **`against`** | **被告的抗辩:「同样的结果,不用你也能得到」** |
| `edge_vs_luck` | 「这点差别,随便试试也能试出来」 |
| `one_pager` | 判决书 |

⚠️ 整条流水线里最容易被跳过、而且一跳过就全白做的是 `against` 那一格:
**你和什么比。**一份把候选和「更差的东西」比出来的报告,每一个数字都可以是对的,
而整份报告没有任何意义。
"""
from __future__ import annotations

from dataclasses import dataclass, field

import numpy as np
import pandas as pd

from talab.validate import expected_max_sharpe

BETTER = ("高", "低")
STAGES = ("想法", "结构", "规则", "回测", "评估", "检验", "上线")


# ---------------------------------------------------------------------------
# 一、想法登记表:六格,一格都不能空
# ---------------------------------------------------------------------------

@dataclass
class Idea:
    """一条想法在开始写代码之前必须填完的六格。

    六格的顺序就是这门课的顺序,而且**是有依赖的**:
    没有第一格就写不出第三格(不知道谁在被迫交易,就不知道该在哪一根进场),
    没有第四格,后面所有的数字都失去意义。

    ⚠️ 允许填「不知道」,但**不允许留空,也不允许写「待定」**——
    「不知道」是一个可以推进的答案(去查),「待定」不是。
    """
    name: str                              # 一句话说清这条想法
    counterparty: str                      # 谁被迫交易,为什么(第 2 篇)
    mechanism: str                         # 这件事凭什么会发生(第 8–20 篇)
    rules: str                             # 六要素(第 21 篇)
    control: str                           # 对照组:它要打败谁(这一篇)
    sample: str                            # 多少笔、多长、哪些市场(第 29 篇)
    deployment: str                        # 上线方案(第 34 篇)

    FIELDS = {"name": "一句话", "counterparty": "谁被迫交易", "mechanism": "机制",
              "rules": "规则(六要素)", "control": "对照组", "sample": "样本",
              "deployment": "上线方案"}

    def __post_init__(self):
        for key in self.FIELDS:
            value = str(getattr(self, key)).strip()
            if not value:
                raise ValueError(f"「{self.FIELDS[key]}」这一格不能空")
            if value in ("待定", "TBD", "?", "略"):
                raise ValueError(f"「{self.FIELDS[key]}」写的是 {value!r}——"
                                 "不知道就写「不知道」,那是一个可以推进的答案")

    def describe(self) -> pd.Series:
        return pd.Series({label: getattr(self, key) for key, label in self.FIELDS.items()})


def checklist() -> pd.DataFrame:
    """全课的检查单:每一关查什么、判据是什么、出自第几篇。

    ⚠️ 这张表的顺序是有讲究的:**越靠前的关,越便宜、越致命**。
    对照组选错了,后面十关全部白查;而「夏普够不够高」排在很后面,
    因为它是这张表里**最不重要**的一个数。
    """
    rows = [
        ("想法", "谁被迫交易", "说得出具体是谁、为什么非交易不可", "第 2 篇"),
        ("想法", "对照组", "说得出「不用这条想法的更简单做法」是什么", "第 35 篇"),
        ("结构", "这个数在那一刻算得出来吗", "所有输入只用到当根及之前的数据", "第 27、28 篇"),
        ("结构", "指标能不能增量算", "实盘每收一根算一次,不是重算整条历史", "第 34 篇"),
        ("规则", "六要素填满了吗", "环境、入场、成交、止损、出场、仓位,一格不空", "第 21 篇"),
        ("回测", "引擎对账", "和另一份实现逐根相对差 < 1e-9", "第 27、34 篇"),
        ("回测", "记账自洽", "现金 + 持仓市值 = 权益,误差 0", "第 27 篇"),
        ("回测", "推迟一根塌不塌", "lag 0→1 只温和变差,不塌陷", "第 27 篇"),
        ("回测", "成本算进去了吗", "手续费 + 价差 + 滑点,按 R 折算", "第 28 篇"),
        ("评估", "笔数够不够", "样本量看**笔数**不看根数", "第 29 篇"),
        ("评估", "逐笔 t 值", "大于 2", "第 29、31 篇"),
        ("检验", "曲面是高地还是针", "落差占年化的比例越小越好", "第 30 篇"),
        ("检验", "样本外", "样本内挑的那一格,样本外排名不塌", "第 30 篇"),
        ("检验", "多重检验", "扣掉「试了几次」白捡的那一截还剩多少", "第 30、35 篇"),
        ("检验", "打乱对照", "块自助法造的假数据里,多少比真实的好", "第 30、32 篇"),
        ("检验", "赢过对照组了吗", "**和对照组比,不是和更差的东西比**", "第 35 篇"),
        ("上线", "正常范围表", "连亏、回撤、水下时间的分位数算好了", "第 33 篇"),
        ("上线", "预热要几根", "窗口型看硬门槛,递推型带周期的五倍", "第 34 篇"),
        ("上线", "交易所收不收这张单", "tickSize / stepSize / minNotional 过了", "第 34 篇"),
        ("上线", "警戒线和动作", "阈值按台阶笔数算,动作写死", "第 33、34 篇"),
    ]
    return pd.DataFrame(rows, columns=["阶段", "查什么", "判据", "出处"])


# ---------------------------------------------------------------------------
# 二、一道一道过关
# ---------------------------------------------------------------------------

@dataclass
class Gate:
    """一道关:看哪个数、门槛多少、谁大谁好、出自第几篇。

    `must=True` 是**一票否决**:这一道没过,前面过了多少道都不算数。
    整条流水线上只有很少几道该是一票否决的,而它们几乎都不是「收益够不够」。
    """
    name: str
    value: float
    threshold: float
    better: str = "高"
    source: str = ""
    must: bool = False

    def __post_init__(self):
        if self.better not in BETTER:
            raise ValueError(f"better 只能是 {BETTER} 之一,收到 {self.better!r}")

    @property
    def passed(self) -> bool:
        if np.isnan(self.value):
            return False                   # 算不出来就是没过,不是「暂且算过」
        return self.value >= self.threshold if self.better == "高" else self.value <= self.threshold

    def row(self) -> dict:
        return {"这一关": self.name, "量到的": self.value, "门槛": self.threshold,
                "谁大谁好": self.better, "一票否决": self.must,
                "结论": "过" if self.passed else "没过", "出处": self.source}


def audit(gates) -> pd.DataFrame:
    """把若干道关摆成一张表。"""
    gates = list(gates)
    if not gates:
        raise ValueError("至少要有一道关")
    return pd.DataFrame([gate.row() for gate in gates])


def verdict(gates) -> pd.Series:
    """几道过、几道没过,以及**一票否决有没有被踩**。

    ⚠️ 结论不是「过了几道」的加权平均。一票否决踩了一道,结论就是不上线——
    **这正是把它叫做一票否决的原因**。
    """
    gates = list(gates)
    failed = [g for g in gates if not g.passed]
    blocked = [g for g in failed if g.must]
    return pd.Series({
        "一共几关": float(len(gates)), "过了几关": float(len(gates) - len(failed)),
        "没过几关": float(len(failed)), "踩了几道一票否决": float(len(blocked)),
        "没过的": "、".join(g.name for g in failed) or "(没有)",
        "结论": "不上线" if blocked else ("可以进模拟盘" if not failed else "补完再说"),
    })


# ---------------------------------------------------------------------------
# 三、对照组:这一篇的主角
# ---------------------------------------------------------------------------

def against(candidate: dict, controls: dict[str, dict], keys=None) -> pd.DataFrame:
    """把候选和对照组**并排**放,并数清楚它赢了几项。

    每一个字典是一条策略的成绩单(`report.metrics` 的输出就能直接用),
    外加一个 `参数个数`——**这一列是整张表里最容易被省掉、也最要命的一列**:
    一条零参数的对照组和一条三参数的候选比,候选必须赢**得够多**才算赢
    (多出来的那一截该有多大,交给 `edge_vs_luck`)。

    ⚠️ 默认比的四项全是**越大越好**:最大回撤是负数,所以「大」就是「浅」。
    `参数个数` 这一列不参与比较,它只是摆在那里提醒你两边不是同一个起跑线。
    """
    keys = [key for key in (keys or ["年化", "最大回撤", "夏普", "卡玛"])]
    table = pd.DataFrame({name: pd.Series(values) for name, values in
                          {"候选": candidate, **controls}.items()}).T
    missing = [key for key in keys if key not in table.columns]
    if missing:
        raise ValueError(f"成绩单里没有这几项:{missing}")
    wins = [np.nan if name == "候选"
            else float(sum(table.loc["候选", key] > table.loc[name, key] for key in keys))
            for name in table.index]
    table["候选赢了几项"] = wins
    table["一共几项"] = [np.nan if name == "候选" else float(len(keys)) for name in table.index]
    table.index.name = "策略"
    return table


def edge_vs_luck(candidate_sharpe: float, control_sharpe: float, n_trials: int,
                 sharpe_std: float) -> pd.Series:
    """候选比对照组多出来的那一截,和**「试了 n_trials 次白捡的那一截」**比。

    第 30 篇算过:完全没有本事的情况下试 N 次,「最好的那次」的夏普期望
    就已经是一个正数(`expected_max_sharpe`)。所以「候选比对照组高 0.04」
    这句话本身不携带信息——**要看它高出来的量,和白捡的量,哪个大**。

    ⚠️ 对照组的参数个数如果是 0,它一次都没试过,这个门槛全算在候选头上。
    """
    if n_trials < 2 or sharpe_std <= 0:
        raise ValueError("试验次数至少是 2,夏普标准差要大于 0")
    threshold = expected_max_sharpe(n_trials, sharpe_std)
    edge = candidate_sharpe - control_sharpe
    return pd.Series({
        "候选夏普": candidate_sharpe, "对照组夏普": control_sharpe, "优势": edge,
        "试了几次": float(n_trials), "这些试验的夏普标准差": sharpe_std,
        "白捡的门槛": threshold, "优势是门槛的几成": edge / threshold,
        "结论": "优势大于白捡的量" if edge > threshold else "优势小于白捡的量,不算数",
    })


# ---------------------------------------------------------------------------
# 四、回顾与交付
# ---------------------------------------------------------------------------

def evolution(versions: dict[str, dict]) -> pd.DataFrame:
    """把一条策略每一版的成绩摆在一起,并标出**每一版只改了哪一件事**。

    ⚠️ 一次只改一件事,否则你分不清是哪一改起的作用——
    这和第 21 篇「六要素是咬合的,不能一格一格单独优化」不矛盾:
    那里说的是**别单独最优化**,这里说的是**别一次改两件**。
    """
    table = pd.DataFrame(versions).T
    table.index.name = "版本"
    return table


def _markdown(table: pd.DataFrame, index: bool = False) -> str:
    """把一张表写成 Markdown。自己写是为了不引入 `tabulate` 这个依赖。

    ⚠️ 单元格里的竖线要转义,否则它会把一列劈成两列(这门课的正文里踩过)。
    """
    frame = table.reset_index() if index else table
    def cell(value):
        if isinstance(value, float):
            return "—" if np.isnan(value) else f"{value:.4f}"
        return str(value).replace("|", "\\|")

    text = frame.astype(object).map(cell)
    header = "| " + " | ".join(str(name).replace("|", "\\|") for name in text.columns) + " |"
    rule = "|" + "---|" * len(text.columns)
    body = ["| " + " | ".join(row) + " |" for row in text.to_numpy()]
    return "\n".join([header, rule] + body)


def one_pager(idea: Idea, gates, comparison: pd.DataFrame,
              luck: pd.Series | None = None) -> str:
    """实验四的产出:一页纸策略报告(Markdown 文本)。

    这份报告刻意做得很短。它不是用来说服别人的,是用来**在半年之后说服你自己**:
    半年后你会忘记当时为什么这么定,而这页纸上每一行都能一句话答上来。
    """
    table = audit(gates)
    result = verdict(gates)
    lines = [f"# 策略报告:{idea.name}", ""]
    lines.append("## 一、登记表")
    lines.append("")
    lines.append("| 格 | 填的什么 |")
    lines.append("|---|---|")
    for key, label in idea.FIELDS.items():
        if key == "name":
            continue
        lines.append(f"| {label} | {getattr(idea, key)} |")
    lines.append("")
    lines.append("## 二、和对照组并排")
    lines.append("")
    lines.append(_markdown(comparison, index=True))
    if luck is not None:
        lines.append("")
        lines.append(f"> 优势 {luck['优势']:+.4f},而试 {int(luck['试了几次'])} 次白捡的门槛是 "
                     f"{luck['白捡的门槛']:.4f}——**{luck['结论']}**")
    lines.append("")
    lines.append("## 三、过关情况")
    lines.append("")
    lines.append(_markdown(table[["这一关", "量到的", "门槛", "结论", "出处"]]))
    lines.append("")
    lines.append("## 四、结论")
    lines.append("")
    lines.append(f"- 一共 {int(result['一共几关'])} 关,过了 {int(result['过了几关'])} 关,"
                 f"没过 {int(result['没过几关'])} 关")
    lines.append(f"- 踩了 {int(result['踩了几道一票否决'])} 道一票否决")
    lines.append(f"- 没过的是:{result['没过的']}")
    lines.append(f"- **结论:{result['结论']}**")
    return "\n".join(lines)
十六、测试
"""talab.project 的测试(第 35 篇)。数字全部手工构造,每一个都能自己算一遍。"""
import re

import numpy as np
import pandas as pd
import pytest

from talab import project as PJ
from talab import validate as V

FILLED = dict(name="一句话说清", counterparty="月末被迫调仓的基金", mechanism="第 20 篇的月末效应",
              rules="六要素填满了", control="买入持有", sample="SPY 十年 2,512 根",
              deployment="第 34 篇的阶梯")


def card(annual, drawdown, sharpe, calmar, n_params):
    return {"年化": annual, "最大回撤": drawdown, "夏普": sharpe, "卡玛": calmar,
            "参数个数": float(n_params)}


def test_idea_refuses_an_empty_box():
    assert len(PJ.Idea(**FILLED).describe()) == 7
    with pytest.raises(ValueError, match="谁被迫交易"):
        PJ.Idea(**{**FILLED, "counterparty": "   "})
    # 「不知道」可以,「待定」不行——前者是一个能推进的答案
    assert PJ.Idea(**{**FILLED, "counterparty": "不知道"}).counterparty == "不知道"
    with pytest.raises(ValueError, match="对照组"):
        PJ.Idea(**{**FILLED, "control": "待定"})


def test_the_checklist_puts_the_control_group_near_the_front():
    table = PJ.checklist()
    assert list(table.columns) == ["阶段", "查什么", "判据", "出处"]
    assert set(table["阶段"]) <= set(PJ.STAGES)
    # 对照组排在「想法」这一段,也就是写代码之前——这是整张表的重点
    assert table.loc[table["查什么"] == "对照组", "阶段"].iloc[0] == "想法"
    assert table.index[table["查什么"] == "对照组"][0] < 3


def test_gate_knows_which_direction_is_better():
    assert PJ.Gate("夏普", 1.2, 1.0, "高").passed
    assert not PJ.Gate("夏普", 0.8, 1.0, "高").passed
    assert PJ.Gate("PBO", 0.2, 0.5, "低").passed
    assert not PJ.Gate("PBO", 0.7, 0.5, "低").passed
    assert PJ.Gate("刚好卡线", 1.0, 1.0, "高").passed          # 等于门槛算过
    # 算不出来就是没过,不是「暂且算过」
    assert not PJ.Gate("算不出来", np.nan, 1.0, "高").passed
    with pytest.raises(ValueError):
        PJ.Gate("方向写错", 1.0, 1.0, "越大越好")


def test_audit_turns_gates_into_a_table():
    gates = [PJ.Gate("甲", 2.0, 1.0, "高", "第 1 篇"), PJ.Gate("乙", 2.0, 1.0, "低", "第 2 篇")]
    table = PJ.audit(gates)
    assert list(table["结论"]) == ["过", "没过"]
    assert list(table["出处"]) == ["第 1 篇", "第 2 篇"]
    with pytest.raises(ValueError):
        PJ.audit([])


def test_one_failed_veto_sinks_everything_else():
    passing = [PJ.Gate(f"第 {i} 关", 2.0, 1.0, "高") for i in range(7)]
    assert PJ.verdict(passing)["结论"] == "可以进模拟盘"
    assert PJ.verdict(passing)["过了几关"] == 7
    soft = passing + [PJ.Gate("差一点", 0.5, 1.0, "高")]
    assert PJ.verdict(soft)["结论"] == "补完再说"
    assert PJ.verdict(soft)["踩了几道一票否决"] == 0
    veto = passing + [PJ.Gate("赢过对照组", 0.5, 1.0, "高", must=True)]
    out = PJ.verdict(veto)
    # 七关全过、只踩一道一票否决,结论仍然是不上线——这正是叫它一票否决的原因
    assert out["过了几关"] == 7 and out["踩了几道一票否决"] == 1
    assert out["结论"] == "不上线"
    assert "赢过对照组" in out["没过的"]


def test_against_counts_wins_with_drawdown_as_bigger_is_better():
    candidate = card(0.10, -0.20, 1.0, 0.5, 3)
    controls = {"更差的": card(0.05, -0.30, 0.8, 0.3, 0),
                "零参数对照组": card(0.08, -0.10, 1.1, 0.8, 0)}
    table = PJ.against(candidate, controls)
    assert table.loc["更差的", "候选赢了几项"] == 4.0        # 回撤 -0.20 > -0.30,也算赢
    assert table.loc["零参数对照组", "候选赢了几项"] == 1.0  # 只赢年化
    assert np.isnan(table.loc["候选", "候选赢了几项"])
    assert table.index.name == "策略"
    with pytest.raises(ValueError, match="索提诺"):
        PJ.against(candidate, controls, keys=["索提诺"])


def test_edge_vs_luck_compares_the_edge_to_the_free_lunch():
    out = PJ.edge_vs_luck(candidate_sharpe=1.05, control_sharpe=1.00,
                          n_trials=200, sharpe_std=0.10)
    assert out["优势"] == pytest.approx(0.05)
    assert out["白捡的门槛"] == pytest.approx(V.expected_max_sharpe(200, 0.10))
    assert out["优势是门槛的几成"] == pytest.approx(0.05 / out["白捡的门槛"])
    assert out["结论"].startswith("优势小于")
    # 试的次数越少,白捡的门槛越低,同样的优势就越站得住
    few = PJ.edge_vs_luck(1.05, 1.00, n_trials=2, sharpe_std=0.10)
    assert few["白捡的门槛"] < out["白捡的门槛"]
    assert PJ.edge_vs_luck(1.60, 1.00, 200, 0.10)["结论"].startswith("优势大于")
    with pytest.raises(ValueError):
        PJ.edge_vs_luck(1.0, 0.9, n_trials=1, sharpe_std=0.1)
    with pytest.raises(ValueError):
        PJ.edge_vs_luck(1.0, 0.9, n_trials=100, sharpe_std=0.0)


def test_evolution_keeps_one_row_per_version():
    table = PJ.evolution({"v0": {"改了什么": "第一版", "年化": 0.08},
                          "v1": {"改了什么": "加止损", "年化": 0.05}})
    assert list(table.index) == ["v0", "v1"]
    assert table.index.name == "版本"
    assert table.loc["v1", "年化"] == 0.05


def test_markdown_escapes_pipes_and_shows_missing_values():
    table = pd.DataFrame({"名字": ["带 | 竖线的"], "数": [np.nan]})
    text = PJ._markdown(table)
    assert text.splitlines()[1] == "|---|---|"
    assert r"\|" in text                                      # 竖线被转义了
    assert "—" in text                                        # 缺失值不写成 nan
    # 数「没被转义的竖线」:表头和数据行必须一样多,否则那一行会被劈成多一列
    bars = lambda line: len(re.findall(r"(?<!\\)\|", line))
    assert bars(text.splitlines()[0]) == bars(text.splitlines()[2]) == 3


def test_one_pager_carries_the_six_boxes_and_the_verdict():
    idea = PJ.Idea(**FILLED)
    gates = [PJ.Gate("过了的", 2.0, 1.0, "高", "第 1 篇"),
             PJ.Gate("赢过对照组", 0.5, 1.0, "高", "第 35 篇", must=True)]
    comparison = PJ.against(card(0.10, -0.20, 1.0, 0.5, 3),
                            {"买入持有": card(0.12, -0.15, 1.2, 0.9, 0)})
    luck = PJ.edge_vs_luck(1.0, 1.2, 100, 0.1)
    text = PJ.one_pager(idea, gates, comparison, luck)
    for label in PJ.Idea.FIELDS.values():
        if label != "一句话":
            assert label in text
    assert "结论:不上线" in text
    assert "买入持有" in text and "白捡的门槛" in text
    assert PJ.one_pager(idea, gates, comparison).count("白捡的门槛") == 0


def test_a_report_that_only_beats_worse_things_still_fails():
    """这一篇的主张:只和更差的东西比出来的报告,每个数字都对,整份报告没有意义。"""
    candidate = card(0.0643, -0.1006, 1.0176, 0.6392, 3)
    legs = {"只做趋势跟随": card(0.0468, -0.1711, 0.6822, 0.2737, 0),
            "只做均值回归": card(0.0415, -0.1163, 0.7246, 0.3564, 0)}
    blend = {"五五开(零参数)": card(0.0451, -0.0630, 0.9806, 0.7163, 0)}
    only_legs = PJ.against(candidate, legs)
    assert (only_legs["候选赢了几项"].dropna() == 4.0).all()   # 两条单腿,四项全赢
    full = PJ.against(candidate, {**legs, **blend})
    assert full.loc["五五开(零参数)", "候选赢了几项"] == 2.0  # 加上对照组只赢两项
    luck = PJ.edge_vs_luck(1.0176, 0.9806, 180, 0.0889)
    assert luck["优势是门槛的几成"] < 0.2
    gates = [PJ.Gate("赢过对照组的项数", 2.0, 4.0, "高", must=True),
             PJ.Gate("优势 ÷ 白捡的门槛", luck["优势是门槛的几成"], 1.0, "高", must=True)]
    assert PJ.verdict(gates)["结论"] == "不上线"
11 passed in 0.14s
379 passed in 1.23s
没装 TA-Lib 的环境里:
347 passed, 32 skipped in 1.66s
十七、小检查
- 那条切换策略在 SPY 上四项指标对两条单腿 4 比 0 全赢,第 30 篇那六刀也全过。最后是哪一件事把它否掉的?
- 它的夏普比零参数的五五开高 0.0371。为什么这个正数不能直接读成「它更好」?
- 在 2021 年 9 月那个时点(也就是你真的要挑参数的那一刻),180 格里有几格的夏普超过了零参数的对照组?这个数说明什么?
- 主线 v1 当年(第 15 篇)报的 SPY 年化是 2.9%,今天用同一个引擎重算是 5.09%。差的那 2.2 个百分点是什么?
- 体检表八关过了四关,只踩了一道一票否决。为什么结论不是「过了一半,再改改」?
十八、常见误用
只和更差的东西比。这是这一篇的主角。第二节那张表里,候选对「只做趋势跟随」和「只做均值回归」是 4 比 0 全赢,加上第 32 篇那条零参数的五五开之后变成 2 比 2,而且输掉的是最大回撤(−10.06% 对 −6.30%)和卡玛。每一个数字都是对的,整份报告没有意义。
**把第 30 篇那六刀当成全部的检验。**第八节那张体检表里,过了的四关全部来自第 30 篇(网格里没有亏钱的格子、落差 18.8%、样本外排 1/180、PBO 0.00)。那六刀查的是「这个结果是不是参数凑出来的」,查不出「这个结果是不是别的更简单的东西也能给你」。这条想法的参数确实不是凑出来的,它只是没有本事。
忽略「你试了多少次」。第三节:优势 0.0371,而试 180 次白捡的门槛是 0.2429——优势只有门槛的 15.3%。⚠️ 对照组那边试了 0 次,所以这个门槛全算在候选头上。
**用全样本挑完参数,再拿全样本的成绩当证据。**第四节:老老实实用前一半挑参数,180 格里没有一格的夏普超过零参数的对照组(最好 0.5344 对 0.6503)。今天好看是因为你多看了四年半。
一次改两件事。第十节那张对不上的账:v1、v2 差了 2.2 个百分点,v3、v4 差 0.03。差的是「止损之后要创 20 日新高才买回」那条规则——当年它被捆在 v1 里,第 21 篇才把它单独拎出来。⚠️ 这和第 21 篇「六要素是咬合的,不能一格一格单独优化」不矛盾:那里说的是别单独最优化,这里说的是别一次改两件。
**因为它有名字,就以为它是一条策略。**第五节:那条「按方差比切换」在 SPY 上和均值回归腿的相关是 0.902(在趋势腿上只待 10.4% 的天数),在 BTC 上和趋势腿的相关是 0.794。它在三个市场上是三条不同的东西,只是共用一个名字——而它选中的那条腿,正好是第 32 篇早就告诉你的那条。
**给零参数的对照组加参数,然后说「你看还能更好」。**第十二节:27 组里只有 5 组超过「五五开 + 每月再平衡」,其中 4 组是 BTC 上把趋势腿权重压到 0.7——而第 31 篇早就量过 BTC 上趋势跟随夏普 1.367、均值回归 0.193。那不是挑出了更好的参数,那是事后知道哪条腿更强,换到 AAPL 上就反过来。
**把行数和测试数当成成绩。**第十三节那 6,746 行代码里真正值钱的不是行数,是每个函数文档里写着的那句「为什么要这么写」。⚠️ 同样地,通过的关数也不是成绩——八关过四关,结论仍然是不上线。
**把「不成立」读成「永远不成立」。**第十四节那张表里每一个「不成立」的准确意思是:在这门课的数据、口径和对照组下没测出来。举证责任的规矩对这张表本身同样有效——它也只是一份证据,不是判决。
十九、小结
- **举证责任在原告。**你的策略要证明自己比「什么都不做」和「一个更简单的做法」更好,而不是等着别人证明它不行。而你同时是原告的律师、被告的律师和法官——这就是为什么要有一张写在前面的检查单。
- 整条流水线上最先该做、也最常被跳过的一步,是「和什么比」。候选对两条单腿 4 比 0 全赢,对那条零参数的五五开只有 2 比 2;第 30 篇的六刀全过,因为那六刀查的是另一个问题。
- ⚠️ **优势要和「试了多少次白捡的量」比。**0.0371 对 0.2429——优势只有门槛的 15.3%,从统计上分不出是本事还是挑出来的。对照组试了 0 次,门槛全算在候选头上。
- ⚠️ **最狠的一刀是时点。**在 2021 年 9 月你真的要挑参数的那一刻,180 格里没有一格越过那条零参数的竖线。今天好看,是因为你多看了四年半。
- 换个市场就现原形:SPY 1.0176 对 0.9806(赢),AAPL 0.9811 对 1.3430、BTC 0.9402 对 1.3237(全输)。而且它在 SPY 上和均值回归腿相关 0.902、在 BTC 上和趋势腿相关 0.794——三个市场三条策略,共用一个名字。
- 六格登记表在写第一行代码之前就能拦住它:第一格「谁被迫交易」答不上来,第二格的答案里第 32 篇那句「它是解释不是筛选器」还在原处。⚠️ 可以写「不知道」,不可以写「待定」。
- 一票否决踩了一道,结论就是不上线,不管另外几关过了多少——这正是把它叫做一票否决的原因。
- 主线策略 v0 → v4:加止损让三个标的的年化都掉一截(止损买的是最差那一笔的上限,不是收益);回撤在 v3 一起抬起来(SPY −39.07% → −12.35%),改的只有「收盘要创 20 日新高」这一条。
- ⚠️ 而 v1、v2 和当年报的数字对不上 2.2 个百分点,因为当年那两版里捆着一条第 21 篇才显式化的规则。一条描述不清的策略,三年之后你连自己当初算的是什么都说不清——这就是实验四那份一页纸报告存在的理由。
- 主线 v4 自己也过不了这条流水线:三个标的逐笔 t 值 1.12 / 1.79 / 1.28 全都不到 2,年化全面跑输买入持有。它是一条用来教学的策略,不是一条用来交易的策略,而这句话本身就该写进它的报告里。
- **零参数的对照组难打败,不是因为它有多好,是因为它没有被挑过。**而你手上那条被挑过的,必须先还掉「挑」这件事借来的那一截。
三十五篇走完了
这门课从第 1 篇的「一张图到底记录了什么」开始,到这里结束。回头看,它其实只教了三件事:
- **一切都要能算出来。**指标、形态、规则、仓位、成本、报告,一样不落地写成代码,而且带测试——不然三年后你说不清自己当初算的是什么。
- **一切都要有对照组。**打乱的 K 线、块自助法造的假数据、「同样距离但在另一侧」的缺口、相关性恒定不变的模拟世界、零参数的五五开。这门课量到的每一个「成立」,背后都有一个它打败过的对照组。
- 然后按算出来的结果办事——哪怕结果是「这条想法不上线」,哪怕那条想法是你自己的。
第十四节那张表里「成立」的只有四条。⚠️ 这不是说技术分析没用,是说能被这套方法验证的部分比大多数书上写的少得多,而剩下的那几条,每一条都朴素到让人失望。
而那四条,加上把它们执行下去的那套流程,就是这门课全部的产出。
练习
- 把第五节那个「它到底在做什么」的检查做成一个函数:给一条候选策略和几条已知策略,算出候选和每一条的相关系数,并给出一句结论。⚠️ 相关系数多高才该说「它其实就是那一条」?给出你的门槛和理由。
- 第三节的
edge_vs_luck用的是网格自己的夏普标准差。如果你只试了 3 组参数,这个标准差估得准吗?造一个实验说明它在小样本上会偏向哪一边。 - 给
checklist()加一行:你自己踩过而这张表上没有的坑。⚠️ 判据那一列必须写成可以量的东西,不能写「注意某某」。 - 挑一条你自己相信的想法,把六格登记表填完。第一格(谁被迫交易)如果写的是「不知道」,先别写代码——花两个小时去查,然后回来看第二格还站不站得住。
- 把第十一节那张表做成一个函数:给一条策略和一个市场,自动生成「对买入持有」的对照表和体检表。**⚠️ 想清楚一件事:买入持有是不是每一条策略的正确对照组?**什么时候不是?
- 第十节说「一次只改一件事」。回头看主线策略 v0 → v4,第 21 篇那一版(v3)其实同时改了入场条件和它带来的止损行为。设计一个实验,把这两件事拆开量。
- 用
one_pager给第 31 篇的海龟写一份报告:对照组用买入持有,一票否决用「逐笔 t 值 > 2」和「三个标的里至少两个赢过对照组」。它过吗?⚠️ 和第十一节主线 v4 那份比,差别在哪一关?
小检查答案
- 对照组。它赢的是「只做趋势跟随」和「只做均值回归」,而正确的对照组是第 32 篇那条零参数的五五开——换成它之后 4 比 0 变成 2 比 2,最大回撤和卡玛都输。⚠️ 注意第 30 篇那六刀一刀都没白挥:它们证明了这条想法的参数不是凑出来的。它只是没有本事——这是两件事,而第 30 篇那套刀只能查前一件。
- **因为它和对照组不是同一个起跑线上来的。**候选试了 180 组参数,对照组试了 0 组。第 30 篇算过:完全没有本事的策略,只要允许它试 180 次,「最好的那一次」平均就能白捡 0.2429 的夏普。而这里的优势只有 0.0371,是门槛的 15.3%。⚠️ 这不等于「它一定没本事」,它等于「你手上这个数分不出是本事还是挑出来的」——而分不出来的时候,举证责任在原告。
- **0 格。**180 格里最好的那一格样本内夏普是 0.5344,而零参数的五五开是 0.6503。这说明:如果你老老实实在 2021 年 9 月做这件事,你根本不会把这条想法拿出来。⚠️ 它今天好看,全部来自那之后四年半的数据——而那四年半,在你做决定的那一刻是不存在的。
- 一条被捆进去的规则:止损之后要收盘创 20 日新高才买回。那条规则在第 15 篇的 v1 里就有,但一直到第 21 篇写「六要素」时才被显式化成入场条件——也就是今天这张表里的 v3。所以今天的 v1、v2 是拿掉它的版本,当年的是捆着它的版本。证据是 v3 和 v4 对到 0.03 个百分点,而 v1、v2 差 2.2 个百分点。
- **因为一票否决不是投票,是门槛。**结论不是「过了几关」的加权平均:那道没过的关叫「赢过对照组的项数」,而它的含义是「同样的结果,一个更简单的东西也能给你」。这句话成立的时候,前面过了多少关都不改变结论——你没有理由为一条更复杂的东西付出复杂度的代价。⚠️ 同理,第十一节里主线 v4 八项里赢了一两项,结论也一样。