这一讲要回答三个问题:
- 我们一直在用的那些"小例子",也就是模型,到底是什么?为什么故意把它们画得和现实不一样?
- 一个争论里,哪些部分是事实问题,哪些部分是价值判断?
- 怎么才能证明 A 导致了 B,而不只是 A 和 B 一起出现?
前三讲,我们用二手自行车、小岛、你和小周这几个小例子,得出了不少结论。现在我要停下来,把这些结论背后的"方法"摊开给你看。这是 Unit 1 的最后一讲,也是你以后读任何经济学论断时,最该带着的一副眼镜。
一、辅导班真的有用吗?
你有一个孩子,上小学。邻居给你看了一份调查:上过辅导班的孩子,平均成绩比没上过的高 12 分。(这是一个编出来的例子。)
辅导班一个学期要花 8000 块。你会花这笔钱吗?
先停一下,想想你的第一反应。大多数人会说:12 分,这不是很明显吗?辅导班有用。
可是等一等。我想让你问自己一个问题:这 12 分,真的是辅导班"带来"的吗?
想一想,哪些家庭会给孩子报辅导班?大概是更重视教育的家庭。这样的家庭,平时也更会盯着孩子写作业、更愿意买书、更常和老师沟通。就算没有辅导班,这些孩子的成绩可能也本来就更高。
先猜一猜。 如果辅导班的真实作用其实很小,比如只有 2 分,那这份调查里的 12 分,剩下的 10 分是从哪来的?
这一讲结束的时候,你会亲手算出答案。
二、模型:一张故意画"错"的地图
2.1 为什么需要一个"错"的东西
回头看前三讲:二手自行车市场只有 8 个买家和 8 个卖家;小岛上只有稻和鱼两样东西;你和小周的世界里只有网页和海报。
现实里有成千上万种商品,每个买家都不一样。我们为什么要把世界画得这么简单?
想象你要去一个陌生的城市。有人递给你一张 1:1 的地图,每一块砖、每一棵树都画得清清楚楚。这张地图完美地还原了城市,可你根本用不了:它和城市一样大。
好的地图,是故意舍掉细节的:只画主干道,不画每棵树。正因为简化了,你才能一眼看出怎么走。
经济学里的**模型(model)**就是这样的地图。统计学家 George Box 有一句常被引用的话:所有的模型都是错的,但有些是有用的。 它"错"在简化了现实,“有用"在帮你看清最重要的那几条线。
2.2 一个模型由什么组成
一个模型,通常有三个部分:
- 假设:我们先决定世界是什么样的。
- 推导:在这些假设下,逻辑上必然得到什么。
- 预测:推导出来、可以拿去和现实对照的结论。
拿一个二手自行车市场来看(第 7 讲,会把它讲透):
- 假设:每个买家最多买一辆,每个卖家最多卖一辆;每个人有自己固定的愿付价或成本;价格对大家公开。
- 推导:价格过高会过剩,推动降价;价格过低会短缺,推动涨价;两种压力都消失的地方是均衡。
- 预测:如果所有买家的愿付价都上升了(需求增加),均衡价格会上涨,成交量也会上升。
最后这一句,是可以拿去和现实对照的。如果现实里"需求增加却没有涨价”,我们就要怀疑:是模型错了,还是有别的东西同时在变。
2.3 “其他条件不变”
模型里有一个你已经用过很多次的小技巧:其他条件不变(拉丁文叫 ceteris paribus)。
比如,讨论"需求增加"时(第 5、7 讲会详细讲),我们只让买家的愿付价变,卖家的成本一点都没动。这样,价格和数量的变化,就只能是需求变化造成的。
这有点像物理里的受控实验:一次只拧一个旋钮,其他旋钮都锁死。这样你才能看清,每个旋钮到底管什么。
但是,请注意这里藏着一个问题:现实里的旋钮是一起转的。 需求在变的同时,供给也在变;政策在变的同时,天气、利率、人们的心情也在变。“其他条件不变"在模型里是一个思想实验,在现实里几乎从不成立。
这个落差,是这一讲后半段要处理的核心难题。
2.4 怎么评价一个模型
那么,一个"错"的模型,凭什么说它有用?
一个常见的回答来自 Milton Friedman 1953 年的文章《实证经济学的方法论》:评价一个模型,主要看它的预测准不准,而不是看它的假设像不像现实。
这个主张一直有争议。批评者认为:如果一个假设严重偏离现实,即使碰巧预测对了一次,也可能在别的地方把你带进沟里。
一个比较稳妥的做法是两头都看:
- 看预测有没有被证据支持;
- 问”哪些假设是关键的?放松它们会怎样?"
这正是后面,第 7 讲结尾,会做的事:那一讲,给你的是一个基准,再往后的讲,会看"偏离这个基准的时候,会发生什么"。垄断、寡头、信息不对称,都是在放松基准模型里的某条假设。
2.5 一个检验模型的例子
模型能不能拿去检验?第 7 讲,会提到 Vernon Smith 1962 年的实验。他让参与者扮演买家和卖家,每个人只知道自己的价值或成本,在规则下报价、成交。如果供需的均衡模型是对的,价格应该靠近我们算出来的均衡价。结果是:确实很快靠近了。
这就是"把理论搬进实验室,看它的预测是否成立"。这也是经济学从纯理论走向实证的一条路。
小结: 模型是故意画"错"的地图:舍掉细节,才能看清主干。它由假设、推导和预测构成。“其他条件不变"是一个思想实验。评价模型,要看预测是否被证据支持,也要问哪些假设是关键的。
三、事实问题 vs. 价值判断
3.1 两个人在吵同一件事吗?
现在换一个场景。两个朋友在争论最低工资:
甲:“提高最低工资会让一些低技能的工人失业。” 乙:“最低工资应该提高。”
你觉得他们是在争同一个问题吗?
仔细看,他们说的是两种不同的话。
甲在说事情是怎样的:提高最低工资,会不会导致失业?这是个可以拿数据去检验的问题,原则上有对错之分。
乙在说事情应该怎样:最低工资该不该提高?这取决于你看重什么:你更在乎已经有工作的人收入提高,还是更担心少数人失去工作?不同的价值观会给出不同的答案,这不是靠数据能直接判定的。
3.2 两个名词
经济学里把这两类陈述分得很清楚:
实证陈述(positive statement):描述”是什么"。原则上可以用证据检验对错。 规范陈述(normative statement):表达"应该怎样"。涉及价值判断。
有一个很容易被误解的地方:实证陈述不等于"正确的陈述"。 “提高最低工资会让所有人失业"也是一个实证陈述,它完全可能是错的。判断标准不是对不对,而是原则上能不能用证据来检验。
3.3 练一练
先自己判断,每句话是实证的还是规范的,再看答案:
| 陈述 | 类型 | 说明 |
|---|---|---|
| “租金管制会减少出租房的供给。” | 实证 | 可以用数据检验,可能对也可能错 |
| “房租应该便宜。” | 规范 | 取决于你看重谁的利益 |
| “某城市去年的房价上涨了。” | 实证 | 一个可以核对的事实 |
| “政府应该禁止商家涨价。” | 规范 | 但它往往暗含一些实证判断,比如"禁止涨价不会造成短缺” |
| “央行降息会刺激企业投资。” | 实证 | 可以检验,也有争议 |
| “收入不平等是一个严重的问题。” | 规范(含实证成分) | “严重"是价值判断,“不平等有多大"是事实 |
注意第 4 行和最后一行:很多规范的主张,背后藏着实证的前提。 一个人说"应该禁止涨价”,他可能默认了"禁止涨价不会造成短缺”。如果这个前提是错的,他的结论就站不住,哪怕他的价值观没有问题。
3.4 一个政策争论的"拆解图"
一个政策争论,可以拆成两块:
事实判断(这个政策会带来什么结果?) + 价值判断(这些结果,哪个更重要?) = “应该这样做"的结论
两个人观点不同,可能是因为:
- 他们对事实的判断不同(一个认为失业会明显增加,另一个认为不会);
- 他们的价值观不同(一个更看重已有工作者的收入,另一个更担心失业者);
- 或者两者都不同。
搞清楚分歧在哪一块,是讨论的第一步。 如果分歧在事实,可以拿证据说话;如果分歧在价值观,再多的数据也不能直接说服对方。
3.5 经济学家之间的分歧,有多少来自事实?
这是一个很值得问的问题。有两项调查可以参考。
第一项是芝加哥大学布斯商学院的 IGM 专家小组。2013 年 2 月,它问了一批经济学家一个实证问题:把联邦最低工资提高到每小时 9 美元,是否会让低技能工人明显更难找到工作?结果大致是:约 34% 同意,约 32% 不同意,约 24% 不确定。差不多三分天下。
同一次调查还问了一个带价值判断的问题:这个政策的好处是否大到足以抵消代价,让它值得去做?据对这次调查的转述,大约 47% 的专家同意,只有约 11% 不同意。
需要诚实地说:这个调查的样本很小(来源说法不一,不到 50 位专家),转述的数字也要谨慎对待。但它至少说明一件事:在同一次调查里,事实问题上分歧很大,而在"值不值得"这个问题上,却没有那么分裂。
第二项是 Victor Fuchs、Alan Krueger 和 James Poterba 1998 年发表在 Journal of Economic Literature 上的研究。他们调查了美国 40 所顶尖大学里的劳动经济学家和公共经济学家,让他们对一些经济参数给出估计,同时回答了关于价值观的问题(比如效率与公平孰轻孰重)。他们发现:经济学家的政策立场,与他们的价值观的关系,比与他们对经济参数的估计的关系更紧密。 另外,不同经济学家对同一参数的估计差异很大,而且他们往往比这些差异所允许的更有把握。
这两项调查合起来,说明了一件重要的事: 经济学家之间的分歧,并不都来自"谁懂得更多”。有相当一部分来自价值观。
3.6 这门课怎么处理争议话题
所以,从这一讲起,我会在这门课里一以贯之地这样写有争议的话题:
- 理论预测什么;
- 证据怎么说,这些证据有什么局限;
- 分歧在哪;
- 价值判断,留给你自己做。
我会尽量把"是什么"和"应该怎样"分开写,不替你下结论。
小结: 实证陈述说"是什么",原则上可检验;规范陈述说"应该怎样",涉及价值。很多规范主张背后藏着实证前提。政策争论由事实判断和价值判断共同构成,搞清楚分歧在哪一块,是讨论的第一步。
四、因果:为什么这么难
4.1 三种可能
回到辅导班。“上辅导班的孩子成绩更高”,有三种可能的解释:
- 辅导班提高了成绩(A 导致 B)。
- 成绩好的孩子更愿意报辅导班(B 导致 A,这叫反向因果)。
- 有第三个因素,同时影响了两者,比如家庭对教育的重视程度(这叫混杂因素)。
我们看到的,只是"一起出现",也就是相关。相关不等于因果。
4.2 看不见的另一条时间线
要说清"辅导班到底提高了多少分",我们需要比较的是:
同一个孩子,上了辅导班的成绩 − 同一个孩子,没上辅导班的成绩。
这个差值,才是辅导班真正的作用,叫因果效应。
麻烦在于:同一个孩子,不可能既上又不上辅导班。 你只能看到其中一个版本。另一条时间线,是"如果没有发生会怎样",经济学里叫反事实,它是永远看不见的。统计学家 Paul Holland 把这个困难叫做因果推断的根本问题。
你可能觉得这个说法似曾相识。它和第 1 讲里的机会成本是同一类东西:机会成本,是没选的那条路;因果效应,是没发生的那条路。第 1 讲里我们讲过 Bastiat 的故事:代价往往是看不见的,因为它是"没有发生的事"。因果推断,就是想办法把这条看不见的路,估计出来。
4.3 让代码替你算一遍
我们来做一个"上帝视角"的实验。在模拟里,我们知道辅导班的真实作用(我设成了 2 分),也知道每个家庭的重视程度。这样,我们就能检验不同的算法,到底能不能把这个 2 分算出来。
(再强调一次:这里的"2 分"是我编的数字,用来演示方法,不是对真实辅导班效果的结论。)
import numpy as np

rng = np.random.default_rng(0)
n = 100_000
true_effect = 2.0                                   # 辅导班真实的作用:平均多考 2 分

motivation = rng.normal(0, 1, n)                    # 家庭对学习的重视程度(现实里看不见、也没法量)
noise = rng.normal(0, 10, n)                        # 其他各种随机因素

# 现实:越重视学习的家庭,越可能给孩子报辅导班
p_tutor = 1 / (1 + np.exp(-2 * motivation))
tutor = rng.random(n) < p_tutor
score = 70 + 8 * motivation + true_effect * tutor + noise     # 重视程度本身也会提高成绩

naive = score[tutor].mean() - score[~tutor].mean()
print(f"真实作用:+{true_effect:.1f} 分")
print(f"直接比较「上辅导班的」和「没上的」:+{naive:.1f} 分")

# 如果能看见"重视程度",只比较重视程度差不多的孩子(现实里往往看不见)
bins = np.quantile(motivation, np.linspace(0, 1, 21))
idx = np.clip(np.digitize(motivation, bins[1:-1]), 0, 19)
diffs = [score[(idx == b) & tutor].mean() - score[(idx == b) & ~tutor].mean() for b in range(20)]
print(f"只比较重视程度相近的孩子(分 20 档,档内比较再平均):+{np.mean(diffs):.1f} 分")

# 实验:抛硬币决定谁上辅导班,和重视程度无关
tutor_rct = rng.random(n) < 0.5
score_rct = 70 + 8 * motivation + true_effect * tutor_rct + noise
rct = score_rct[tutor_rct].mean() - score_rct[~tutor_rct].mean()
print(f"抛硬币随机分配后再比较:+{rct:.1f} 分")
输出:
真实作用:+2.0 分
直接比较「上辅导班的」和「没上的」:+11.7 分
只比较重视程度相近的孩子(分 20 档,档内比较再平均):+2.2 分
抛硬币随机分配后再比较:+2.1 分
画出来:
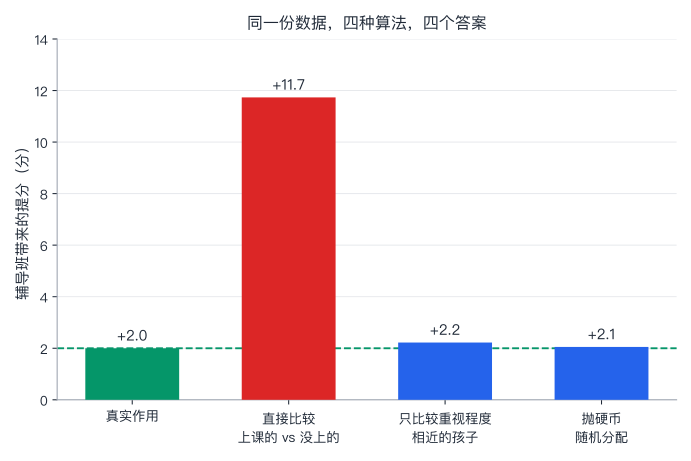
回答开头的问题:直接比较,得到 11.7 分,而真实作用只有 2 分。 剩下的将近 10 分,来自"本来就更重视学习的家庭"。你邻居给你看的那份调查,就是这种直接比较。
另外两种算法都把答案找回来了:
- 只比较重视程度相近的孩子:+2.2 分。意思是:既然重视程度会同时影响"是否报班"和"成绩",那我们就只在重视程度相近的孩子里比较,把这个因素"控制"住。
- 抛硬币随机分配:+2.1 分。
第一种方法有一个致命的问题:它需要你能看见那个混杂因素。 在模拟里我们能看见"重视程度",现实里你没法给一个家庭的重视程度打分。你控制得了你能看见的因素,却控制不了看不见的。
第二种方法的神奇之处,就在于它不需要看见任何东西。抛硬币和家庭的重视程度、孩子的天赋、性格、一切别的因素,统统无关。 所以,只要人数足够多,两组孩子"平均来说"除了辅导班,其他地方是一样的,包括所有你看不见的东西。这种做法叫随机对照实验(randomized controlled trial,RCT)。
4.4 现实里往往不能抛硬币
可是,很多时候我们没法抛硬币。你不可能随机地给一些州提高最低工资,给另一些州不提。你也不能随机让一些国家加息。
这时候,经济学家会去找自然实验:现实里碰巧发生的、“很像"随机分配的情形。
最有名的例子之一,是 David Card 和 Alan Krueger 1994 年发表在 American Economic Review 上的研究。
背景:1992 年 4 月 1 日,美国新泽西州把最低工资从每小时 4.25 美元提高到 5.05 美元。邻居宾夕法尼亚州没有变。
做法:他们分别在政策前(1992 年 2 到 3 月)和政策后(1992 年 11 到 12 月),调查了两个州的快餐店。
结论:他们没有发现新泽西的快餐店就业相对宾州下降。作者说,这个结果挑战了"最低工资上涨一定会让就业减少"这一传统看法。
我们先放下这个结论,只看它的方法,因为这个方法特别巧妙,叫双重差分。
4.5 双重差分:用对照组补上看不见的那条线
你想知道:政策到底让新泽西的就业变化了多少?
你有三个很自然的想法,但它们都有问题:
- 只看新泽西的前后变化。 问题:就算没有政策,就业也可能因为淡季、整体经济而变化。你把这个变化全算在政策头上了。
- 只比较政策之后两个州。 问题:新泽西和宾州本来就不一样(店的规模、顾客不同)。你把这个"本来就有的差别"也算在政策头上了。
- 双重差分:先看新泽西前后变了多少,再看宾州前后变了多少,两个变化再相减。
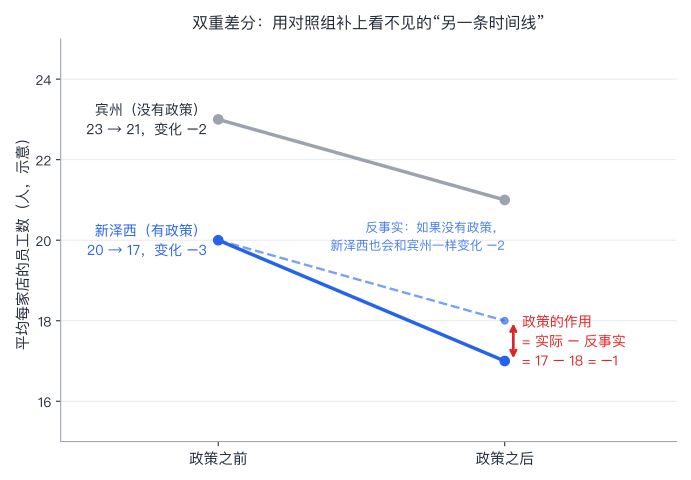
为什么相减有用?宾州没有政策,它前后的变化,代表了”如果没有政策,大家共同遇到的那个变化"。这就是新泽西看不见的那条时间线(反事实)的估计。
用一个示意的数字(不是真实数据):
- 宾州:23 人 → 21 人,变化 −2
- 新泽西:20 人 → 17 人,变化 −3
- 新泽西如果没有政策,应该也像宾州一样变化 −2,也就是 20 → 18
- 所以政策的作用 = 17 − 18 = −1 = (−3) − (−2)
4.6 让代码替你算一遍,而且让它"出错"
我们再做一个"上帝视角"的模拟:政策的真实作用是 −1 人/店,两个州本来的基础水平不同,还有一个共同的变化 −2。看三种算法各自给出什么。然后我们再设计一种让这个方法失效的情形。
import numpy as np

rng = np.random.default_rng(1)
n = 400                                              # 每个州 400 家店,前后各调查一次

def survey(effect, nj_own_trend=0.0):
    """返回 (宾州前, 宾州后, 新泽西前, 新泽西后) 的平均每店员工数。"""
    pa0 = 23 + rng.normal(0, 4, n)                   # 宾州:每店 23 人
    nj0 = 20 + rng.normal(0, 4, n)                   # 新泽西:每店 20 人(两个州本来就不一样)
    common = -2                                      # 两州共同遇到的变化(比如淡季)
    pa1 = pa0 + common + rng.normal(0, 2, n)
    nj1 = nj0 + common + nj_own_trend + effect + rng.normal(0, 2, n)   # 新泽西多了政策的作用
    return pa0.mean(), pa1.mean(), nj0.mean(), nj1.mean()

def report(title, effect, nj_own_trend=0.0):
    pa0, pa1, nj0, nj1 = survey(effect, nj_own_trend)
    print(f"{title}(政策的真实作用:{effect:+.1f} 人/店)")
    print(f"  只看新泽西前后:        {nj1 - nj0:+.2f}")
    print(f"  只比较政策后两个州:    {nj1 - pa1:+.2f}")
    print(f"  双重差分(前后之差再作差):{(nj1 - nj0) - (pa1 - pa0):+.2f}")

report("情形一:两州趋势本来一样", effect=-1.0)
print()
report("情形二:新泽西本来就有自己的下行趋势 -1.5", effect=-1.0, nj_own_trend=-1.5)
输出:
情形一:两州趋势本来一样(政策的真实作用:-1.0 人/店)
  只看新泽西前后:        -2.95
  只比较政策后两个州:    -3.81
  双重差分(前后之差再作差):-0.92

情形二:新泽西本来就有自己的下行趋势 -1.5(政策的真实作用:-1.0 人/店)
  只看新泽西前后:        -4.42
  只比较政策后两个州:    -5.74
  双重差分(前后之差再作差):-2.45
我们逐条看:
情形一:两个州的趋势本来一样。
- 只看新泽西前后:−2.95,把共同的变化 −2 也算成了政策的作用,错得很远。
- 只比较政策后两个州:−3.81,把"两个州本来就差 3 人"也算进去了,错得更远。
- 双重差分:−0.92,非常接近真实的 −1。
情形二:新泽西本来就有自己的下行趋势。 比如新泽西的快餐业本来就在萎缩,和政策无关。
- 双重差分给出 −2.45,而真实作用仍然是 −1。多出来的 −1.45,几乎等于新泽西自己的那个趋势(−1.5)。
这是双重差分的关键弱点:它假设如果没有政策,两个州的趋势会一样。这叫平行趋势假设。这个假设是无法被证明的(因为"没有政策的新泽西"永远看不到),你只能找证据让人觉得它合理,比如检查政策之前,两个州的趋势是不是本来就平行。
这就是为什么,“用了一个很聪明的方法"不等于"结论一定对”。每一种因果推断的方法,背后都藏着一个无法完全证明的假设。 读研究时,最重要的问题之一就是:它的这个假设,站得住吗?
4.7 这个争论,后来怎么样了
回到 Card 和 Krueger 的研究。它发表后,引起了很大的争论。
2000 年,David Neumark 和 William Wascher 在同一份杂志(American Economic Review 第 90 卷第 5 期)上发表评论,用快餐店的工资单记录重新估计,得出了相反的结论:就业有所下降。Card 和 Krueger 在同一期杂志上回应,质疑对方样本的代表性,并用其他数据重新分析。
这场争论并没有让一方完全说服另一方。2013 年那次 IGM 调查里“三分天下”的结果,也说明至少在当时,经济学家当中对这个问题没有一致的看法。
我们在这里要学的,不是"谁赢了",而是几件事:
- 同样的政策,不同的数据来源、不同的样本,可以得出不同的结论;
- 单个研究很少是定论;
- 即使是顶级研究者,面对同一份证据,也会有不同的判断。
这类研究方法,对整个领域的影响是深远的。2021 年的诺贝尔经济学奖,一半授予 David Card,“因为他对劳动经济学的实证贡献”;另一半授予 Joshua Angrist 和 Guido Imbens,“因为他们对因果关系分析的方法论贡献”,也就是教会研究者,怎样从自然实验里读出因果。2019 年的诺贝尔奖则授予 Abhijit Banerjee、Esther Duflo 和 Michael Kremer,表彰他们用实验方法缓解全球贫困的研究。因果推断,已经成为现代实证经济学的核心。
4.8 还有哪些工具
除了随机实验和双重差分,经济学家还有其他几种常用的工具。这里只用一句话讲清它们的思路,后面遇到的时候再用:
- 工具变量:找一个"外力",它只通过 X 去影响 Y,不会直接影响 Y。比如,想知道"上大学"对收入的影响,可以找一个影响上不上大学、但和收入没有其他关系的因素(比如家离大学的远近)。
- 断点回归:比较刚好过线和刚好没过线的人。比如录取分数线两边,一个考了 600 分、一个考了 599 分的学生,几乎一样,但一个被录取、另一个没有。比较这两群人的后续结果,就接近于一次随机实验。
小结: 相关不等于因果。因果效应要比较"实际发生的"和"如果没发生会怎样",后者永远看不见。随机对照实验靠抛硬币解决这个问题;现实里不能抛硬币时,要找自然实验,比如双重差分。每种方法都有一个无法完全证明的假设,读研究时,一定要问这个假设站不站得住。
五、证据、局限与争议
5.1 结果能推广吗
新泽西快餐店的结果,能推广到别的行业吗?涨幅更大的时候呢?别的国家呢?
这叫外部有效性的问题:一项研究,可能在它的情境里是对的,但不一定能搬到别的地方。随机实验也一样:在肯尼亚一个村里做的实验,不能直接当成对整个国家的结论。
5.2 宏观问题几乎不能做实验
最低工资还可以找邻州当对照。可是宏观问题呢?央行该不该加息?一个国家的政府债务多高会出问题?
你没有第二个"平行的美国"可以拿来做对照,也不能随机让一些国家加息。数据很少(一个国家一年一个观测值),同时有太多因素在变。这是为什么宏观经济学里的争论,通常比微观经济学里更多、更久。我们在 Unit 7 和 Unit 8 会反复遇到这件事。
5.3 研究结果可靠吗
即使是发表在顶级期刊上的研究,也需要被重复检验。
Colin Camerer 等人 2016 年在 Science 上发表了一项研究:他们选了 2011 到 2014 年发表在 American Economic Review 和 Quarterly Journal of Economics 上的 18 项实验室经济学实验,严格地重新做了一遍。结果是:11 项(约 61%)得到了与原研究方向一致、统计上显著的结果;平均而言,重复出来的效应大小,约为原研究的 66%。
这说明两件事:多数结果经得起重复,这是好消息;但并非全部,而且重复出来的效应往往比原来小。所以,不要因为"有一项研究证明了"就下定论。要看多个研究、多种方法得到的结论是否一致。
5.4 经济学家不是价值中立的
前面我们区分了实证和规范。但这个区分是理想化的:研究者选择研究什么问题、怎么解读结果、强调什么,都可能受价值观影响。Fuchs 等人的调查也表明了这一点。
这并不意味着实证研究"没有意义"。它意味着:你要同时看证据本身,和提出证据的人的立场。 这也是为什么这门课会把"事实"和"价值"分开写,让你自己做判断。
5.5 常见的误用
| 误用 | 正确的想法 |
|---|---|
| “两个东西一起变化,所以一个导致了另一个” | 相关不等于因果。可能是反向因果,也可能有混杂因素 |
| “政策前后一比较,就知道政策的效果” | 前后的变化里,混着其他同时发生的事。需要对照组 |
| “模型的假设不真实,所以结论不可信” | 看预测是否被证据支持,也看哪些假设是关键的 |
| “黑板上推出来了,现实里就一定这样” | 模型是一张简化的地图。现实里"其他条件不变"几乎从不成立 |
| “经济学家们都同意(或都不同意)这件事” | 有的问题上有共识,有的问题上分歧很大。要看具体问题和证据 |
| “有一项研究证明了……” | 单个研究很少是定论。看多个研究、多种方法 |
| “既然证据显示是这样,那就应该这样做” | 证据回答"是什么",不能直接回答"应该怎样"。后者还需要价值判断 |
| “随机实验永远是最好的” | 它也有局限:外部有效性、伦理、规模、成本。很多重要问题没法做 |
六、小结
这一讲有五个想法,请带走:
- 模型是故意画"错"的地图:舍掉细节,才能看清主干。它由假设、推导和预测构成,要拿预测去和证据对照。
- “其他条件不变"是思想实验,现实里几乎从不成立,这是实证研究要面对的核心难题。
- 实证陈述说"是什么”,规范陈述说"应该怎样"。政策争论由事实判断和价值判断共同构成,搞清楚分歧在哪一块,是讨论的第一步。
- 相关不等于因果。 因果效应要比较"实际发生的"和"如果没发生会怎样",后者永远看不见。随机实验、双重差分这些工具,是在想办法估计它。
- 每种方法都有一个无法完全证明的假设,单个研究也很少是定论。读到"研究表明"时,多问一句:它怎么知道的?它的假设站得住吗?
到这里,Unit 1 学完了。我们有了四样东西:机会成本(第 1 讲)、边际思维与激励(第 2 讲)、比较优势(第 3 讲)、读证据的方法(本讲)。
从下一讲起,我们进入 Unit 2:价格与市场。接下来,我们会把供给和需求,拆开来,一块一块讲清楚,到第 7 讲,再把两边合起来,看均衡的样子。先从买家这一边开始:第 5 讲,需求,人们愿意付多少。
思考题
1. 判断下面每句话是实证陈述还是规范陈述,并把其中一句改写成另一种类型:(a)“提高烟草税会减少吸烟。"(b)“吸烟的人应该为自己造成的医疗负担多付钱。"(c)“去年我国的出口增长了。"(d)“政府应该给低收入家庭补贴。”
提示:(a)实证,可检验。(b)规范,涉及"应该”。(c)实证,一个可核对的事实。(d)规范。改写示例:把(d)改成实证,“给低收入家庭补贴,会提高他们的消费水平”,就成了可检验的陈述。注意(b)和(d)背后,往往藏着实证前提,比如"补贴不会让人不愿意工作”。
2. 有一项调查发现:每天喝咖啡的人,平均寿命比不喝的人更长。请至少列出三种"咖啡并没有让人长寿"的可能解释,再想想怎么检验。
提示:(1)混杂因素:喝咖啡的人可能收入更高、生活方式不同。(2)反向因果:身体健康的人更能喝咖啡,有慢性病的人被医生要求戒咖啡。(3)选择偏差:调查对象本身可能不具代表性。检验思路:随机实验难做(时间长、难以长期随机分配);可以找自然实验,或者在观察数据里尽可能控制可见的混杂因素,但要承认看不见的因素控制不了。
3. 某城市 A 推出一项外卖骑手保险政策,某项指标从 80 变成 84;对照城市 B 没有政策,同一指标从 70 变成 72。用双重差分估计政策的作用。如果政策出台之前,A 城这个指标每期本来就上涨 3,而 B 城每期上涨 2(趋势不平行),真实作用大约是多少?
提示:双重差分 = (84 − 80) − (72 − 70) = 4 − 2 = +2。如果 A 城本来每期就涨 3,那么这一期就算没有政策也会涨 3,真实作用约是 4 − 3 = +1。双重差分的 +2 高估了 1,这个多出来的 1 正好是两城本来趋势的差(3 − 2)。这说明平行趋势假设有多重要。
4. 某市推出汽车"以旧换新"补贴,之后一个月汽车销量比上个月涨了 10%。官员说:“补贴让销量涨了 10%。“你觉得这个说法缺了什么?
提示:缺的是反事实:如果没有补贴,销量会涨多少?上个月可能是淡季,下个月本来就会涨;全国整体可能也在涨。更可靠的做法是找一个对照城市做双重差分。另外还有一种可能:补贴只是让人们把未来要买的车提前买了,之后几个月销量反而下降,这也是只看一个月无法发现的。
5. 供需模型预测:供给减少会让价格上涨(第 7 讲,会详细讲)。如果你在现实数据里看到某商品价格下降、成交量也下降,这能说明模型错了吗?
提示:不能直接这样说。如果需求同时减少,而且减少得比供给更多,那么价格下降、数量也下降。你看到的是两条曲线都在动的结果。想检验模型,需要想办法分清是哪条曲线在动,这就是"识别"问题,也是实证研究最难的地方之一。
参考与延伸
- Friedman, M. (1953). The Methodology of Positive Economics. In Essays in Positive Economics. University of Chicago Press.
- Holland, P. W. (1986). Statistics and Causal Inference. Journal of the American Statistical Association, 81(396).
- Card, D., & Krueger, A. B. (1994). Minimum Wages and Employment: A Case Study of the Fast-Food Industry in New Jersey and Pennsylvania. American Economic Review, 84(4), 772–793.
- Neumark, D., & Wascher, W. (2000). Minimum Wages and Employment: A Case Study of the Fast-Food Industry in New Jersey and Pennsylvania: Comment. American Economic Review, 90(5), 1362–1396;Card, D., & Krueger, A. B. (2000). Reply, 1397–1420.
- Fuchs, V. R., Krueger, A. B., & Poterba, J. M. (1998). Economists’ Views about Parameters, Values, and Policies: Survey Results in Labor and Public Economics. Journal of Economic Literature, 36(3), 1387–1425.
- Camerer, C. F., et al. (2016). Evaluating replicability of laboratory experiments in economics. Science, 2016.
- IGM Forum(Booth School of Business, University of Chicago):2013 年 2 月关于联邦最低工资的专家小组调查。