这一讲要回答五个问题:
- 为什么同一场囚徒困境,只玩一次和反复玩,结果可能不同?
- 如果知道哪一轮是最后一轮,合作还能维持吗?
- 如果不知道什么时候结束,合作靠什么维持?要多有耐心才够?
- 以牙还牙为什么在有名的循环赛里表现好?出了差错时它会怎样?
- 企业之间不签协议的默契合谋、价格战,以及算法定价,怎么用这套想法来看?
第 18 讲里,所有的博弈都只玩一次,囚徒困境的结论很悲观:每个人都背叛,大家一起变糟。可是你每天的生活并不是这样:你会天天见到同一个邻居、同一个同事、同一家供应商。第 16 讲里,我说默契合谋靠"反复互动"维持,第 18 讲末尾,我又说"当未来的惩罚成为可能,合作可以靠自己的利益维持下去"。这一讲,就把这句话讲清楚:它什么时候成立,什么时候不成立。
一、天天见面的老主顾
你在小区门口开一家早餐摊。每天早上,那几十个邻居会来买包子。某天你发现:往馅里多掺一点便宜的菜,每个包子能省几分钱,没人吃得出来。
再想象另一个你:在景区门口卖包子。来的都是游客,一辈子可能只来一次,你也再不会见到他们。同样的办法,省同样的几分钱。
先停一下:这两个"你",掺不掺菜?为什么?
你大概会觉得,景区里的那个更可能掺。这不一定是因为他"品德更差",而是因为他的处境不同:他今天占的便宜,没有后账。 邻居不一样:包子味道不对,明天他们就换一家,还会告诉别的邻居。你今天省的几分钱,后面要用很多天的生意来还。
两个人面对的是同一场博弈(掺菜还是老实做,顾客买还是不买),区别只有一个:还有没有下一次。 下一次的存在,让今天的行为有了后果。这一讲要研究的,就是这件事:把博弈重复起来,会发生什么。
(注意:这只是一个理想化的对比。景区的摊主也可能诚实,因为有人监管、有平台评价,或者他自己在乎;小区的摊主也可能掺菜。重复博弈要说的是:激励不一样了。)
二、把博弈重复起来
2.1 几个概念
- 阶段博弈:每一轮玩的那个博弈。这一讲,我们一直用第 18 讲的囚徒困境(每格:我的收益,对方的收益):
| 对方合作 | 对方背叛 | |
|---|---|---|
| 我合作 | 3,3 | 0,5 |
| 我背叛 | 5,0 | 1,1 |
- 重复博弈:同样的两个人,把这个阶段博弈玩很多轮。每一轮之前,大家都看得到以前发生了什么。
- 策略:现在,策略不再是"这一轮选什么",而是一个完整的计划:根据到目前为止的历史,每一轮选什么。 比如"第一轮合作,之后对方上一轮做什么我就做什么"。
- 总收益:各轮收益的总和(后面会加上"未来不如现在值钱"的折算)。
2.2 多出来的东西:奖励和惩罚
一次性的博弈里,我这一轮的选择,不会影响你下一轮的选择,因为没有下一轮。重复博弈里不一样:我今天的做法,可以改变你明天的做法。 我今天合作,你明天可以用合作回报我;我今天背叛,你明天可以惩罚我。
这样,“现在背叛占的便宜"就要和"以后被惩罚付的代价"放在一起比较。这是这一讲的全部核心想法。
2.3 两种重复:知道结束,还是不知道
重复博弈有一个关键的区别:
- 有限次重复:大家都知道一共玩 T 轮(比如恰好 10 轮)。
- 无限次重复,或者不知道哪轮结束:每一轮之后,还有一定的可能性再来一轮,但没有人知道哪一轮是最后一轮。
下面你会看到,这个区别带来很不一样的结论。
三、知道最后一轮:合作的"拆线”
3.1 倒着想
假设你和对方玩 10 轮囚徒困境,大家都知道是 10 轮。
- 第 10 轮(最后一轮):后面没有任何未来,这一轮就是一次性的囚徒困境。背叛是占优策略,所以两个人都背叛。
- 第 9 轮:你想,“我现在合作,是为了让对方第 10 轮也合作吗?” 可是第 10 轮对方一定背叛,不管我现在做什么。所以第 9 轮合作换不来任何好处,第 9 轮也背叛。
- 第 8 轮:同样的道理,因为第 9、10 轮已经定了,第 8 轮也背叛。
- 一路倒推,第 1 轮就背叛。
这和第 18 讲讲过的逆向归纳是同一种想法。结论很干脆:只要重复的次数是有限的、而且所有人都知道,囚徒困境的唯一均衡结果,仍然是每一轮都背叛。 不管重复 10 次,还是 1000 次。
3.2 这个结论让人不安
你可能觉得哪里不对:玩 1000 轮,还是每一轮都背叛?这和日常经验不符。经济学家也这样觉得。Reinhard Selten 在 1978 年提出过一个有名的版本,叫"连锁店悖论":一家连锁店在很多个城市面对一个又一个潜在进入者,逆向归纳说它每次都该接受进入,可是直觉上,它应该前面几次狠狠地打价格战,建立"我不好惹"的名声。
怎么办?实验室里的数据是第一个线索。Selten 和 Stoecker 1986 年(Journal of Economic Behavior and Organization,7 卷 1 期)让 35 个被试,每人玩 25 局"10 轮的囚徒困境"(每一局换一个匿名对手)。主要发现是:有经验的被试,会一直合作到快结束时,才转向背叛。理论上的"从第 1 轮就背叛",没有出现。
3.3 两条出路
第一,信息不是完全的。 Kreps、Milgrom、Roberts 和 Wilson 1982 年(Journal of Economic Theory,27 卷 2 期)指出:只要稍微放松"所有人都完全知道对方是什么人"这个假设,哪怕只有很小的可能性,对方是一个愿意用以牙还牙来回应你的人,即使是完全理性、自私的人,也会选择假装那样的人,合作直到快结束。因为"建立好名声"是有价值的。Andreoni 和 Miller 1993 年(Economic Journal,103 卷 418 期)用实验检验了这个想法,发现被试的行为和这种声誉解释大体吻合,同时他们认为,人们本来就有一定的合作倾向(他们称为"自带的利他")。
第二,现实里很少有人清楚地知道哪一轮是最后一轮。 你和邻居、和同事、和供应商的关系,往往没有人说得清会持续到什么时候。这就把我们带到下一节。
声誉的想法,我们在第 20 讲讲"信息不对称"时会再来。现在先看"不知道哪一轮最后"的情形。
小结: 有限次重复,而且大家都知道次数时,逆向归纳把合作"一轮一轮拆掉",只剩每轮背叛。可是实验里,人们会合作到接近结束。可能的原因:对对方的类型有一点不确定(声誉),或者人们本来就有合作的倾向。
四、不知道哪一轮最后:未来的阴影
4.1 继续玩下去的概率
设想你和对方的关系是这样的:每一轮结束后,有 δ 的概率还有下一轮,没有 δ 的概率关系就结束了(δ 是个 0 到 1 之间的数)。你不知道哪一轮最后。
δ 越大,关系持续得越久:平均一共会玩 1/(1 − δ) 轮。δ = 0.5,平均玩 2 轮;δ = 0.9,平均玩 10 轮。
δ 也可以理解为"你有多看重未来":未来的钱不如现在的钱值钱(第 36 讲讲折现时会细讲),关系结束的风险、你的耐心程度,都可以装进这一个数里。经济学里把它叫折现因子。
4.2 冷酷触发策略
我们来看一个最简单、也最严厉的策略:
冷酷触发(grim trigger):第一轮合作;只要对方一直合作,我就一直合作;只要对方背叛过一次,我从此永远背叛。
假设对方用的就是冷酷触发。你该怎么选? 你有两条路:
- 一直合作:每轮得 3,永远。如果每轮之后继续的概率是 δ,那么预期总得分是 3 + 3δ + 3δ² + …… = 3 ÷ (1 − δ)。
- 在第一轮就背叛:这一轮得 5(对方合作了)。从下一轮开始,对方永远背叛,你最好的回应也是背叛,每轮得 1。预期总得分是 5 + δ × 1 ÷ (1 − δ)。
两者相等时:3 ÷ (1 − δ) = 5 + δ ÷ (1 − δ),两边乘 (1 − δ):3 = 5(1 − δ) + δ = 5 − 4δ,所以 δ = 1/2。
δ 比 1/2 大,一直合作更划算;比 1/2 小,背叛更划算。(在中间任何一轮背叛,结论一样,因为每一轮看到的"未来"都是一样的。)
用代码核对,并且用"随机结束"的模拟再验证一遍公式:
import random

# 囚徒困境(第 18 讲):合作 3,3;我背叛对方合作 5;我合作对方背叛 0;双方背叛 1
R, T, S, P = 3, 5, 0, 1

# 一、永远合作 vs 背叛一次:对方用"只要你背叛过,我就永远背叛"(冷酷触发)
def coop_value(delta):  return R / (1 - delta)                      # 每期 3,永远
def deviate_value(delta): return T + delta * P / (1 - delta)        # 今天得 5,之后每期 1
print("每期之后以概率 delta 再来一轮(折现因子 delta):永远合作 vs 背叛一次")
for d in (0.3, 0.4, 0.5, 0.6, 0.9):
    c, v = coop_value(d), deviate_value(d)
    print(f"  delta={d}:合作得 {c:.2f},背叛得 {v:.2f},{'合作更好' if c > v else ('一样' if abs(c - v) < 1e-9 else '背叛更好')}")
print(f"门槛 delta* = (T-R)/(T-P) = ({T}-{R})/({T}-{P}) = {(T - R) / (T - P):.2f}")

# 二、用随机结束的模拟核对:每轮结束后以 delta 的概率继续,平均一共玩 1/(1-delta) 轮
random.seed(19)
def play(delta, deviate_at=None):
    total, t = 0, 0
    while True:
        t += 1
        if deviate_at is None: total += R
        elif t < deviate_at: total += R
        elif t == deviate_at: total += T
        else: total += P
        if random.random() > delta: return total
for d in (0.4, 0.6):
    n = 200000
    avg_c = sum(play(d) for _ in range(n)) / n
    avg_d = sum(play(d, deviate_at=1) for _ in range(n)) / n
    print(f"模拟 delta={d}({n} 局):永远合作平均 {avg_c:.2f}(公式 {coop_value(d):.2f}),第一轮就背叛平均 {avg_d:.2f}(公式 {deviate_value(d):.2f})")

# 三、门槛随"诱惑"和"惩罚"怎么变
print("\n门槛 delta* = (T-R)/(T-P):诱惑越大、惩罚越轻,需要越有耐心")
for T2, P2 in ((5, 1), (7, 1), (5, 2), (5, 0)):
    print(f"  背叛时得 {T2}(比合作多 {T2 - R}),被惩罚时每期得 {P2}(比合作少 {R - P2}):delta* = {(T2 - R) / (T2 - P2):.2f}")
输出:
每期之后以概率 delta 再来一轮(折现因子 delta):永远合作 vs 背叛一次
  delta=0.3:合作得 4.29,背叛得 5.43,背叛更好
  delta=0.4:合作得 5.00,背叛得 5.67,背叛更好
  delta=0.5:合作得 6.00,背叛得 6.00,一样
  delta=0.6:合作得 7.50,背叛得 6.50,合作更好
  delta=0.9:合作得 30.00,背叛得 14.00,合作更好
门槛 delta* = (T-R)/(T-P) = (5-3)/(5-1) = 0.50
模拟 delta=0.4(200000 局):永远合作平均 5.01(公式 5.00),第一轮就背叛平均 5.66(公式 5.67)
模拟 delta=0.6(200000 局):永远合作平均 7.51(公式 7.50),第一轮就背叛平均 6.50(公式 6.50)

门槛 delta* = (T-R)/(T-P):诱惑越大、惩罚越轻,需要越有耐心
  背叛时得 5(比合作多 2),被惩罚时每期得 1(比合作少 2):delta* = 0.50
  背叛时得 7(比合作多 4),被惩罚时每期得 1(比合作少 2):delta* = 0.67
  背叛时得 5(比合作多 2),被惩罚时每期得 2(比合作少 1):delta* = 0.67
  背叛时得 5(比合作多 2),被惩罚时每期得 0(比合作少 3):delta* = 0.40
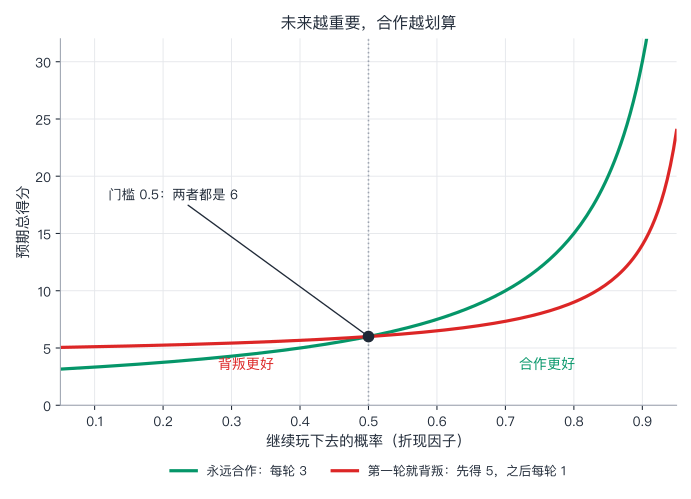
- 门槛:δ* = (T − R) ÷ (T − P) = (5 − 3) ÷ (5 − 1) = 0.5。δ 达到 0.5,以冷酷触发为回应时,合作就是你的最佳选择。
- 公式和模拟吻合:随机结束的 20 万局平均,和公式给出的数几乎一样。
- 影响门槛的三样东西:
- 背叛的诱惑(T − R = 5 − 3 = 2):背叛一次,当期多得多少。诱惑越大,门槛越高(诱惑从 2 增到 4,门槛从 0.5 升到 0.67)。
- 惩罚的力度(R − P = 3 − 1 = 2):被惩罚之后,每期比合作时少得多少。惩罚越轻,门槛越高。
- 耐心 δ:未来有多重要。
4.3 为什么这个惩罚是可信的
回想第 18 讲的"可信威胁":靠事后没人愿意兑现的威胁撑起来的均衡,会被逆向归纳排除。冷酷触发的"永远背叛",是不是这样的空头威胁?
不是。对方背叛之后,“永远背叛"恰好是一次性囚徒困境的均衡:对方既然已经开始背叛,你继续合作只会吃亏,所以你自己也愿意背叛。你不需要狠心,只需要做对你自己最有利的事,惩罚就自动发生了。这就是为什么这个威胁可信(这样的均衡,叫子博弈完美均衡,第 18 讲提过名字)。
还有一点很值得想:在均衡里,惩罚从来不会真正发生。 因为大家都知道背叛不划算,所以没人背叛,也就没人被惩罚。惩罚是"存在于威胁里"的,不是"发生在现实里"的。(这和第 16 讲的进入威慑是同一个道理:威慑成功时,进入者根本不会来,你也看不到价格战。)
4.4 隐含的两个条件
上面的推导,悄悄用了两个条件:
- 背叛能被发现。 如果我背叛了,你却不知道,你就没法惩罚我。第 16 讲里,价格透明、互动频繁的行业合谋更容易,就是这个原因。
- 关系有足够的未来。 δ 太小(关系马上要结束了、或者你非常着急),合作就维持不住。比如一家企业如果预计明年就要退出这个市场,它的 δ 就很低。
小结: 不知道哪一轮最后时,合作可以靠"背叛了就被惩罚"来维持:背叛的一次性好处,要小于以后每期损失的总和。这要求关系有足够的未来(δ 足够大)、背叛能被发现,并且惩罚是可信的(回到一次性博弈的均衡)。对我们的囚徒困境,冷酷触发维持合作的门槛是 δ ≥ 1/2。
五、民间定理:好消息,也是坏消息
5.1 什么都可能
冷酷触发只是维持合作的一种办法。把这件事想得更一般:什么样的结果,可以在无限重复博弈里成为均衡?
答案有点让人吃惊,叫民间定理(folk theorem,“民间"是因为它在被正式写下来以前,已经在博弈论研究者之间口耳相传):
只要大家足够有耐心(δ 足够接近 1),任何一个"每人平均每轮得到的,比自己最坏情形下也能保住的更多"的收益组合,只要它是能做到的,都可以成为无限重复博弈的均衡。
在我们的囚徒困境里,“最坏情形下也能保住的"是 1:因为不管对方怎么惩罚我,我总可以背叛,至少得到 1。所以,只要两个人平均每轮都至少得 1,而且这个组合是做得到的,就可以成为均衡。
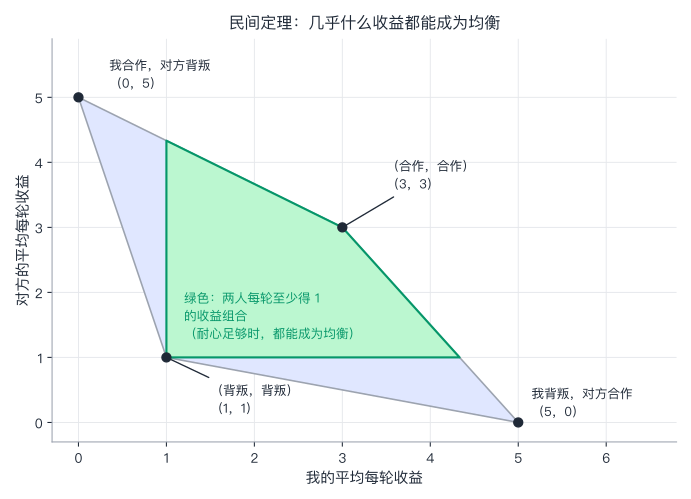
图里蓝色的整块,是所有"做得到"的平均收益组合(四个角分别是四种一次性的结果,中间是它们的"混合”)。绿色是其中两人都至少得 1 的那一块。民间定理说:绿色里的每一点,耐心足够时,都是某个均衡的结果。
较早给出正式结果的,有 James Friedman 1971 年(Review of Economic Studies,38 卷 1 期),用的就是冷酷触发这一类策略;Fudenberg 和 Maskin 1986 年(Econometrica,54 卷 3 期)把它推进到了"惩罚也必须是事后可信的"那个更严格的版本(要满足一定的条件,两个参与者的情形就满足)。
5.2 好消息和坏消息
好消息:(合作,合作),平均每轮 (3,3),是绿色区域里的一点,所以合作可以成为均衡。 囚徒困境不是注定的。
坏消息有两个:
- (背叛,背叛)每轮 (1,1) 也是均衡(图里绿色区域的左下角):永远背叛,也是一个互相都不想改的状态。耐心足够,不意味着合作一定出现。
- 什么都可能,等于什么都不能预测。 绿色区域里,还有"我每轮得 3.5,你每轮得 1.5"这样很不平等的点,也是均衡。
这又回到第 18 讲遇到过的老问题:多重均衡。 博弈论说"合作是可能的”,却不说"合作一定出现”、更没说出现的是哪种合作。要挑出一个,还得靠聚点、历史、惯例、沟通和预期。
小结: 民间定理:无限重复、足够耐心时,几乎所有"两人至少都得到最坏情形下能保住的"收益组合,都可以成为均衡。好消息是合作可以是均衡;坏消息是永远背叛也是,而且理论没法告诉你最后会落在哪一个。
六、实验室里的证据:理论成立,人们就合作吗
理论预测什么:如果 δ 超过门槛,合作是一个均衡;δ 越大,合作越容易。
证据怎么说:Pedro Dal Bó 2005 年(American Economic Review,95 卷 5 期)在实验室里做了"每轮结束后以一定概率继续"的囚徒困境,发现继续玩下去的概率越高,合作越多。Dal Bó 和 Fréchette 2011 年(American Economic Review,101 卷 1 期)进一步追踪被试随着经验的变化:当合作无法成为均衡时,合作随经验增加而减少;可是合作能成为均衡,并不保证合作随经验而增加;只有当合作的收益够大、未来也够重要时,被试才会学会合作。两位作者后来写过一篇综述(Journal of Economic Literature,56 卷 1 期),结论是:合作更容易出现在"它能成为均衡"的情形里,但“能成为均衡"并不保证多数人会合作,只有当参数让合作很稳固时,才会看到很高的合作率。
局限:这些实验的被试大多是大学生,博弈是高度简化的,参加的人也不一定"永远"重复(实验总要结束)。实验里的数字(收益多大、δ 多高)会影响结果,所以结论是"理论的方向大体对,但要出现高水平的合作,条件比理论的门槛更严”,而不是"到处合作都像理论说的那样"。
七、以牙还牙与 Axelrod 的循环赛
7.1 一场邀请赛
冷酷触发太严厉了。有没有更"好说话"的策略?1980 年前后,政治学家 Robert Axelrod 想知道:在反复的囚徒困境里,什么样的策略表现最好? 他的办法很有趣:邀请各路专家,各自提交一个策略(一段程序),让它们两两比赛,看谁总分最高。
第一次(Journal of Conflict Resolution,24 卷 1 期,1980),有 14 个策略参赛,外加一个随机出手的"策略";每两个策略对打 200 轮,收益就是我们一直在用的 3、0、5、1。第二次(同一刊物 24 卷 3 期,1980),Axelrod 把第一次的结果公布出去,吸引了 62 个策略参赛(外加随机出手的那个),每场比赛的长度改成随机的(避免"最后一轮背叛"的拆线效应)。
两次的冠军,是同一个策略,由心理学家 Anatol Rapoport 提交,也是所有参赛策略里最简单的之一:
以牙还牙(tit for tat):第一轮合作;以后每一轮,都做对方上一轮做的事。
Axelrod 在总结时(1984 年的书《合作的进化》),归纳出表现好的策略的几个特点:
- 善良:从不第一个背叛;
- 会报复:对方背叛了,立刻回敬;
- 宽容:对方回头合作了,自己也很快回到合作,不记仇;
- 清楚:行为简单易懂,对方一看就明白"这样做会得到什么回应"。
7.2 自己跑一个小循环赛
我们自己做一个小的。8 个策略:永远合作、永远背叛、以牙还牙、冷酷触发、宽容以牙还牙(对方连续两次背叛才报复)、赢留输变(上一轮得了 3 或 5 就不变,得了 0 或 1 就换一个选择)、偷偷背叛的以牙还牙(以牙还牙,但对方合作时有 10% 的概率偷偷背叛)、随机。每对打 200 轮,每对重复 20 次取平均。(实验 73 会用更大的名单、更长的比赛,把这个循环赛做得更完整。)
import random
random.seed(19)
C, D = 0, 1
PAY = {(C, C): (3, 3), (C, D): (0, 5), (D, C): (5, 0), (D, D): (1, 1)}   # 第 18 讲的囚徒困境

# 每个策略:看"我的历史"和"对方的历史",决定这一轮合作(C)还是背叛(D)
def allc(me, op):  return C
def alld(me, op):  return D
def tft(me, op):   return C if not op else op[-1]                       # 第一轮合作,之后照抄对方上一轮
def grim(me, op):  return D if D in op else C                           # 只要对方背叛过,永远背叛
def tf2t(me, op):  return D if op[-2:] == [D, D] else C                 # 对方连续背叛两次才报复
def pavlov(me, op):                                                     # 赢留输变:上一轮得了 3 或 5 就不变,得了 0 或 1 就换
    if not me: return C
    got = PAY[(me[-1], op[-1])][0]
    return me[-1] if got >= 3 else 1 - me[-1]
def joss(me, op):  return D if (op and op[-1] == C and random.random() < 0.1) else (C if not op else op[-1])   # 以牙还牙,但偶尔偷偷背叛
def rand(me, op):  return random.choice((C, D))

STRATS = {"永远合作": allc, "永远背叛": alld, "以牙还牙": tft, "冷酷触发": grim,
          "宽容以牙还牙": tf2t, "赢留输变": pavlov, "偷偷背叛的以牙还牙": joss, "随机": rand}

def match(f, g, rounds=200):
    h1, h2, s1, s2 = [], [], 0, 0
    for _ in range(rounds):
        a, b = f(h1, h2), g(h2, h1)
        p, q = PAY[(a, b)]
        s1 += p; s2 += q; h1.append(a); h2.append(b)
    return s1 / rounds, s2 / rounds                                    # 每轮平均得分

names = list(STRATS)
REP = 20
M = {a: {b: 0.0 for b in names} for a in names}                         # M[a][b]:a 对 b 的每轮平均得分
for a in names:
    for b in names:
        M[a][b] = sum(match(STRATS[a], STRATS[b])[0] for _ in range(REP)) / REP

# 一、循环赛:每个策略和所有策略(含自己的复制品)各打 200 轮
print("循环赛(8 个策略,每对打 200 轮,含和自己打;数字是平均每轮得分):")
avg = {a: sum(M[a][b] for b in names) / len(names) for a in names}
for rank, a in enumerate(sorted(names, key=avg.get, reverse=True), 1):
    print(f"  第 {rank} 名:{a},平均每轮 {avg[a]:.2f}")
print(f"以牙还牙对永远背叛:{M['以牙还牙']['永远背叛']:.2f} 对 {M['永远背叛']['以牙还牙']:.2f}(单场它从来没赢过对手)")
print(f"永远背叛对永远合作:{M['永远背叛']['永远合作']:.2f} 对 {M['永远合作']['永远背叛']:.2f}")

# 二、同一批策略,换一个"人群比例":每个策略在人群中占多大比例,就以多大概率碰到它
def score_in(mix):
    return {a: sum(mix[b] * M[a][b] for b in names) for a in names}
def show(title, mix):
    sc = score_in(mix); best = max(sc, key=sc.get)
    print(f"{title}:得分最高的是「{best}」{sc[best]:.2f};永远背叛 {sc['永远背叛']:.2f},以牙还牙 {sc['以牙还牙']:.2f}")
print("\n同样的策略,换人群比例:")
show("各占 1/8", {a: 1 / 8 for a in names})
show("九成是永远合作", {a: (0.9 if a == "永远合作" else 0.1 / 7) for a in names})
show("四成是永远背叛", {a: (0.4 if a == "永远背叛" else 0.6 / 7) for a in names})

# 三、让人群"演化":得分高的比例上升(复制者动态),看谁留下来
mix = {a: 1 / 8 for a in names}
for gen in range(1, 401):
    sc = score_in(mix); mean = sum(mix[a] * sc[a] for a in names)
    mix = {a: mix[a] * sc[a] / mean for a in names}
    if gen in (1, 20, 400):
        print(f"演化第 {gen:>3} 代:永远背叛占 {mix['永远背叛']:.1%},以牙还牙占 {mix['以牙还牙']:.1%},冷酷触发占 {mix['冷酷触发']:.1%},宽容以牙还牙占 {mix['宽容以牙还牙']:.1%}")

# 四、合作能从一片背叛者里长出来吗?一小群以牙还牙互相打交道,要占多少比例才不吃亏(解析计算)
print("\n一小群以牙还牙混在一片永远背叛者里,要占多大比例,才和永远背叛者得分一样:")
for n in (2, 10, 50, 200):
    tt, td = 3.0, (n - 1) / n                    # 以牙还牙对自己人 3;对永远背叛者:第一轮 0,之后每轮 1
    dt, dd = (5 + (n - 1)) / n, 1.0              # 永远背叛者对以牙还牙:第一轮 5,之后每轮 1;对自己人 1
    p = (dd - td) / ((tt - dt) + (dd - td))
    print(f"  每对打 {n:>3} 轮:{'永远不够(需要 100%)' if p >= 0.9999 else f'占 {p:.1%} 以上就够了'}")
输出:
循环赛(8 个策略,每对打 200 轮,含和自己打;数字是平均每轮得分):
  第 1 名:宽容以牙还牙,平均每轮 2.54
  第 2 名:冷酷触发,平均每轮 2.50
  第 3 名:赢留输变,平均每轮 2.46
  第 4 名:以牙还牙,平均每轮 2.44
  第 5 名:永远合作,平均每轮 2.40
  第 6 名:随机,平均每轮 2.13
  第 7 名:永远背叛,平均每轮 2.01
  第 8 名:偷偷背叛的以牙还牙,平均每轮 1.91
以牙还牙对永远背叛:0.99 对 1.02(单场它从来没赢过对手)
永远背叛对永远合作:5.00 对 0.00

同样的策略,换人群比例:
各占 1/8:得分最高的是「宽容以牙还牙」2.54;永远背叛 2.01,以牙还牙 2.44
九成是永远合作:得分最高的是「永远背叛」4.66;永远背叛 4.66,以牙还牙 2.94
四成是永远背叛:得分最高的是「宽容以牙还牙」2.05;永远背叛 1.70,以牙还牙 1.98
演化第   1 代:永远背叛占 11.0%,以牙还牙占 13.2%,冷酷触发占 13.6%,宽容以牙还牙占 13.8%
演化第  20 代:永远背叛占 0.0%,以牙还牙占 19.0%,冷酷触发占 23.0%,宽容以牙还牙占 22.0%
演化第 400 代:永远背叛占 0.0%,以牙还牙占 19.0%,冷酷触发占 23.2%,宽容以牙还牙占 22.1%

一小群以牙还牙混在一片永远背叛者里,要占多大比例,才和永远背叛者得分一样:
  每对打   2 轮:永远不够(需要 100%)
  每对打  10 轮:占 5.9% 以上就够了
  每对打  50 轮:占 1.0% 以上就够了
  每对打 200 轮:占 0.3% 以上就够了
逐段看:
- 循环赛:前五名都是"善良"的策略(从不第一个背叛),后三名是"随机"“永远背叛"“偷偷背叛”。这和 Axelrod 的发现一致:善良的策略整体表现好。
- 但是,以牙还牙在这里只排第四,不是冠军,前几名的差距也不大(2.54 到 2.44)。名次,取决于参赛名单。 注意"永远合作"排第五,分数只比以牙还牙低 0.04:因为名单里的"剥削者"很少(只有永远背叛、偷偷背叛和随机),傻乎乎的合作者没有被占多少便宜。
- 换名单,名次就变:如果人群里九成是永远合作的老好人,永远背叛得分最高(4.66,以牙还牙是 2.94);可是如果四成是永远背叛,善良的策略仍然得分更高(以牙还牙 1.98,永远背叛 1.70)。
- 以牙还牙从来没在单场比赛里赢过对手:它对永远背叛是 0.99 对 1.02,略输一点点。它靠的不是"赢过谁”,而是"和愿意合作的对手相处得很好"。所以,问"哪个策略最好",要先问"和谁比"、“比什么”。
- 演化:让得分高的策略比例上升、得分低的比例下降,永远背叛很快被淘汰(第 1 代占 11.0%,到第 20 代约为 0),剩下的都是善良策略。
- 合作能从一片背叛者里长出来吗? 最后一段是解析计算:如果以牙还牙和永远背叛者每对打 200 轮,一小群以牙还牙只要占人群的 0.3% 以上,它们的得分就不输给永远背叛者,因为它们之间能互相合作,对永远背叛者只吃第一轮的亏。只打 2 轮时,这个门槛是 100%,永远不够。关系持续得越久,合作越容易在背叛的世界里站稳脚跟,但前提是这一小群合作者彼此能经常碰到。
7.3 以牙还牙是"最好的策略"吗
不是,需要谨慎。
- 取决于比赛的设计。 Rapoport、Seale 和 Colman 2015 年(PLoS ONE,10 卷 7 期)重新分析了 Axelrod 的数据,认为以牙还牙的好成绩,取决于比赛怎么设计、怎么衡量"成功",以及囚徒困境里具体的收益数字。换个设计,名次就可能变。
- 它不擅长处理错误。 下一节讲。
- 更好的策略。 Nowak 和 Sigmund 1993 年(Nature,364 卷)在带有突变和选择的进化模拟里,发现"赢留输变"(上面的第六个策略)比以牙还牙更稳健:它能从偶尔的错误中恢复,还能占永远合作者的便宜。
所以,把 Axelrod 的结论读成"善良、报复、宽容、清楚的策略,在那样的比赛里表现好"就够了,不要读成"以牙还牙永远最好"。
小结: Axelrod 的循环赛显示:反复的囚徒困境里,善良、会报复、宽容、简单的策略表现好;以牙还牙靠和愿意合作的对手相处得好而胜出,而不是赢过谁。但名次取决于参赛名单和比赛设计。合作可以从一小群彼此经常碰面的合作者中,在背叛者的世界里扎下根。
八、犯了错,怎么办:宽容的价值
8.1 手滑
现实里,合作者也会犯错:快递晚到了一天、报价被误读、一句话说得不好听。想象一下:每一次出手,都有一小点概率"手滑"做反了,而对方看到的只是你做了什么,不知道你是不是故意的。
import random
random.seed(19)
C, D = 0, 1
PAY = {(C, C): (3, 3), (C, D): (0, 5), (D, C): (5, 0), (D, D): (1, 1)}

def tft(me, op):   return C if not op else op[-1]
def tf2t(me, op):  return D if op[-2:] == [D, D] else C
def gtft(me, op):  return C if not op else (C if op[-1] == C or random.random() < 1 / 3 else D)   # 对方背叛时,三次里原谅一次
def grim(me, op):  return D if D in op else C
def pavlov(me, op):
    if not me: return C
    return me[-1] if PAY[(me[-1], op[-1])][0] >= 3 else 1 - me[-1]

def self_play(f, eps, rounds=5000):
    """两个同样的策略对打;每个人想做的动作,有 eps 的概率手滑做反了。返回平均每轮得分"""
    h1, h2, tot = [], [], 0
    for _ in range(rounds):
        a, b = f(h1, h2), f(h2, h1)
        if random.random() < eps: a = 1 - a
        if random.random() < eps: b = 1 - b
        tot += PAY[(a, b)][0] + PAY[(a, b)][1]; h1.append(a); h2.append(b)
    return tot / (2 * rounds)

print("两个同样的策略互相打,每次有 eps 的概率手滑做反了(平均每人每轮得分,理想是 3):")
for name, f in (("以牙还牙", tft), ("宽容以牙还牙", tf2t), ("三次原谅一次", gtft), ("冷酷触发", grim), ("赢留输变", pavlov)):
    cells = []
    for eps in (0.0, 0.01, 0.05, 0.1):
        r = sum(self_play(f, eps) for _ in range(20)) / 20
        cells.append(f"eps={eps}: {r:.2f}")
    print(f"  {name}:" + ";".join(cells))
输出:
两个同样的策略互相打,每次有 eps 的概率手滑做反了(平均每人每轮得分,理想是 3):
  以牙还牙:eps=0.0: 3.00;eps=0.01: 2.21;eps=0.05: 2.26;eps=0.1: 2.24
  宽容以牙还牙:eps=0.0: 3.00;eps=0.01: 2.99;eps=0.05: 2.94;eps=0.1: 2.87
  三次原谅一次:eps=0.0: 3.00;eps=0.01: 2.97;eps=0.05: 2.86;eps=0.1: 2.74
  冷酷触发:eps=0.0: 3.00;eps=0.01: 1.05;eps=0.05: 1.15;eps=0.1: 1.29
  赢留输变:eps=0.0: 3.00;eps=0.01: 2.95;eps=0.05: 2.78;eps=0.1: 2.60
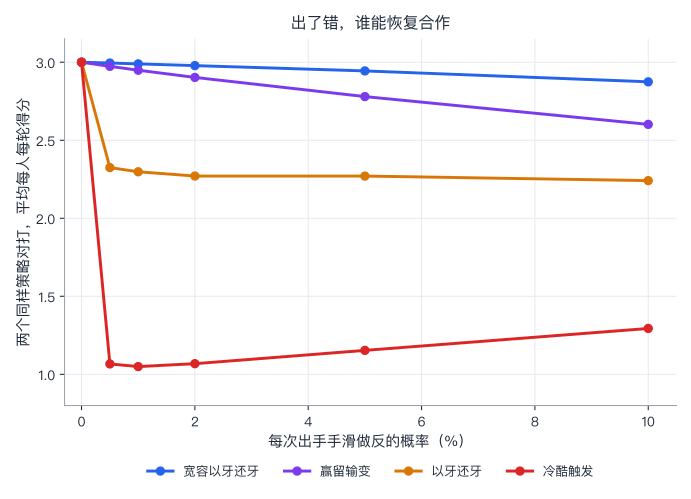
- 没有错误(eps = 0):五个策略自己和自己打,都是每轮 3,完美合作。
- 一旦有错误,差别就出来了:
- 冷酷触发一次错误之后,就是永远背叛:得分掉到约 1.05–1.29,几乎崩溃。
- 以牙还牙掉到约 2.2:一次手滑,引发了你来我往的互相报复(一个背叛,另一个回敬,再回敬……),直到又一次错误把它们拉回合作或者互相背叛。它的得分,接近"四种结局各占四分之一"的平均 2.25。
- 宽容以牙还牙(连续两次背叛才报复)和赢留输变,大体保住了合作:错误来了,很快就恢复(手滑概率高到 10% 时,前者仍有 2.87,后者降到 2.60)。
- 原因:以牙还牙和冷酷触发的"惩罚",没有出口:没有一条路能让双方回到合作。宽容的策略,给惩罚留了出口。
8.2 宽容的代价
宽容不是免费的。对方如果故意利用你的宽容,你就吃亏。 比如,宽容以牙还牙(连续两次背叛才报复)面对一个"隔一轮背叛一次"的对手,永远等不到连续两次背叛,于是永远不报复,白白被占便宜(这里没有跑这个对手,但从策略的定义可以直接看出来)。
所以,惩罚要有力度,也要有出口:太轻,没有威慑;太重而且没有出口,一次误会就把关系毁了。真实的合作关系,往往靠这个平衡:合同里的违约金、通融一次、“下不为例”。
小结: 现实里有误会、有错误。惩罚没有出口的策略(冷酷触发、以牙还牙),一次错误就可能把合作拖垮;宽容的策略能恢复合作,但可能被利用。惩罚要有力度,也要有出口。
九、回到企业:默契合谋、价格战与算法
9.1 烤肠摊的门槛
第 16 讲的两家烤肠摊(需求 P = 11 − 0.01Q,边际成本 2):联手压产量,每家 1012.5;各自"自己干",每家 900;偷偷多卖,当期能得 1125。第 16 讲思考题 4 里,我们算过:一次性的好处 112.5,之后每期损失 112.5。现在,把"未来的钱不如现在的钱"也算进去,并且看企业数量怎么影响门槛:
# 第 16 讲的烤肠摊:需求 P = 11 - 0.01Q,边际成本 2,没有固定成本
A, B, MC = 11.0, 0.01, 2.0
def profit(q, others):                       # 我卖 q,别人一共卖 others
    return (A - B * (q + others) - MC) * q

Q_MONO = (A - MC) / (2 * B)                  # 垄断总量 450
print(f"垄断总量 {Q_MONO:.0f},垄断总利润 {profit(Q_MONO, 0):.0f}")

def threshold(n):
    """n 家企业约定平分垄断产量;有人违约就永远回到 Cournot 竞争(冷酷触发)。返回能维持合谋的最低 delta"""
    q_c = Q_MONO / n                                         # 守约:每家卖 450/n
    pi_coop = profit(q_c, Q_MONO - q_c)
    others = Q_MONO - q_c                                    # 别人都守约时,违约者的最佳卖量
    q_d = (A - MC - B * others) / (2 * B)
    pi_dev = profit(q_d, others)
    q_n = (A - MC) / (B * (n + 1))                           # Cournot:每家卖 900/(n+1)
    pi_nash = profit(q_n, (n - 1) * q_n)
    delta = (pi_dev - pi_coop) / (pi_dev - pi_nash)
    return pi_coop, pi_dev, pi_nash, delta

print("永远合作 vs 违约一次再永远被惩罚:每家的利润(元/天)和最低耐心程度")
for n in (2, 3, 4, 5, 10):
    c, d, nn, delta = threshold(n)
    print(f"  {n} 家:守约每家 {c:.1f},偷偷多卖一次得 {d:.1f},被惩罚后每家 {nn:.1f};要有 delta >= {delta:.3f} 才不想违约")

# 耐心程度给定时,最多几家能靠这种惩罚维持合谋?
for delta in (0.55, 0.6, 0.7, 0.9):
    n, ok = 2, 0
    while threshold(n)[3] <= delta: ok = n; n += 1
    print(f"耐心 delta={delta}:{'连 2 家都不行' if ok == 0 else f'最多 {ok} 家能靠这种惩罚维持合谋'}")
输出:
垄断总量 450,垄断总利润 2025
永远合作 vs 违约一次再永远被惩罚:每家的利润(元/天)和最低耐心程度
  2 家:守约每家 1012.5,偷偷多卖一次得 1139.1,被惩罚后每家 900.0;要有 delta >= 0.529 才不想违约
  3 家:守约每家 675.0,偷偷多卖一次得 900.0,被惩罚后每家 506.2;要有 delta >= 0.571 才不想违约
  4 家:守约每家 506.2,偷偷多卖一次得 791.0,被惩罚后每家 324.0;要有 delta >= 0.610 才不想违约
  5 家:守约每家 405.0,偷偷多卖一次得 729.0,被惩罚后每家 225.0;要有 delta >= 0.643 才不想违约
  10 家:守约每家 202.5,偷偷多卖一次得 612.6,被惩罚后每家 66.9;要有 delta >= 0.752 才不想违约
耐心 delta=0.55:最多 2 家能靠这种惩罚维持合谋
耐心 delta=0.6:最多 3 家能靠这种惩罚维持合谋
耐心 delta=0.7:最多 7 家能靠这种惩罚维持合谋
耐心 delta=0.9:最多 33 家能靠这种惩罚维持合谋
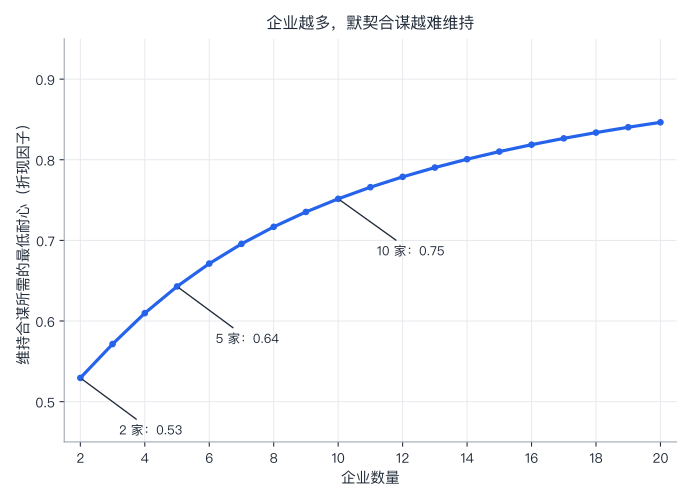
- 2 家:偷偷多卖的最好结果是 1139.1(第 16 讲里的 1125,是简化成"只能选 225 或 300"之后的数;两家都能随意选量时,对方守约时我的最好选择是多卖到 337.5)。门槛 δ ≥ 0.529。如果只限于 225 或 300 两个选择,门槛恰好是 112.5 ÷ 225 = 0.5。
- 企业越多,门槛越高:3 家要 0.571,5 家要 0.643,10 家要 0.752。原因是:企业越多,每家守约时分到的越少,而偷偷多卖当期能多得的却越来越多(2 家多得 126.6,10 家多得 410.1),被惩罚之后每期比守约时少得的,却增加得慢得多(2 家少 112.5,10 家少 135.6)。
- 这和第 16 讲的观察相符:企业少、产品同质、价格透明时,更容易合谋。
- 一个提醒:这个模型里,δ = 0.9 时,33 家企业也还能维持合谋,而现实里,企业多到那个程度,合谋几乎做不到。因为模型假设所有人都能立刻看到对方偷偷多卖、而且大家完全一样。现实里,监测困难(你看不到别人到底卖了多少)、企业不一样(成本、产品、目标各不同)、协调困难(谁先让一步、怎么分蛋糕),这些都不在模型里,而它们才是更难的部分。
9.2 价格战:合谋的一部分
第 16 讲的常见误用表里说过:价格战对企业好不好,要看它是不是用短期的投入换长期的地位,这个问题留给了这一讲。重复博弈给了一个有意思的回答:价格战可以是合谋的一部分。
Edward Green 和 Robert Porter 1984 年(Econometrica,52 卷 1 期)设想了这样一种情形:企业看不见对手卖了多少,只看得到市场价格;而价格还受到需求波动的影响。价格跌了,是因为有人偷偷多卖,还是因为这一天需求不好?分不清。结果是:为了让背叛不划算,企业约定"价格一旦跌到某个线以下,大家就进入一段价格战"。这样,即使没有任何人背叛,只因为需求碰巧不好,也会偶尔爆发价格战。 价格战不是合谋破裂的标志,而是合谋为了维持下去付出的代价。
证据怎么说:Robert Porter 1983 年(Bell Journal of Economics,14 卷 2 期)用 19 世纪 80 年代美国铁路货运联合卡特尔(Joint Executive Committee,1880–1886)的周数据,检验价格是否在合谋期和竞争期之间切换,结果拒绝了"始终同一种行为"的假设:数据像是在合谋期和价格战期之间交替。Margaret Levenstein 1997 年(Journal of Industrial Economics,45 卷 2 期)研究 1885–1914 年美国的溴行业,发现有些价格战,的确像是由监测不完全引起的,但比这类模型预测的温和;而较严重的价格战,更像是企业重新谈判怎么分利润的手段。
局限和分歧:两项研究都是特定行业的历史案例,它们是否代表现在的行业,没有定论;价格战究竟是"监测不完全造成的误伤",还是"谈判的筹码",同一个案例,也可以有不同解读。
9.3 算法定价会"学会"默契合谋吗
这是一个目前还在争论的话题。按照"理论预测 → 证据与局限 → 分歧在哪 → 价值判断留给读者"来写。
理论预测什么:上面的逻辑说,默契合谋需要两样东西:能快速发现对方降价,和能迅速、可信地回应。算法定价软件恰好可能让这两样都变得更容易:它每秒钟盯着对手的价格,调价也快。所以有人推测,算法定价会让企业更容易走到高价上,甚至不需要任何沟通。
证据怎么说:
- 模拟:Calvano、Calzolari、Denicolò 和 Pastorello 2020 年(American Economic Review,110 卷 10 期)让会"学习"的人工智能定价算法(Q-learning),在一个重复的价格竞争模型里反复交手。结果是:这些算法一贯学会了高于竞争水平的价格,它们之间不交流,却靠"有限期的惩罚、再逐步回到合作"的策略维持高价。作者报告,结论对成本或需求的不对称、企业数量的变化和多种不确定性,也大体成立。
- 真实数据:Assad、Clark、Ershov 和 Xu(Journal of Political Economy,2024)研究德国零售加油站,算法定价软件从 2017 年前后开始广泛可用。作者推断各站点采用软件的时间,据他们的工作论文版本摘要,采用后,有竞争对手的加油站利润率上升,而垄断的加油站没有;在只有两家加油站的市场里,两家都采用后,利润率才上升。(具体数字请以正式版为准。)
局限:模拟里的算法是研究者设定的简单学习算法,市场是高度简化的(少数企业、特定的需求形式),而且学会合谋需要非常多次的试错,真实的企业未必能做到;加油站研究里,采用时间是推断出来的,利润率上升和默契合谋是相容的,但单凭它,并不能证明算法达成了合谋,还可能有别的渠道,这里不展开。
分歧在哪:一是事实:现实里的算法,到底多大程度上会这样做?二是法律:中国《反垄断法》(2022 年修正)把垄断协议定义为排除、限制竞争的协议、决定或者其他协同行为(第十六条)。市场监管总局的《禁止垄断协议规定》(2023 年 4 月 15 日起施行)说明,“其他协同行为"是指经营者之间虽然没有明确订立协议或者决定,但实质上存在协调一致的行为(第五条);认定时要考虑市场行为是否一致、有没有意思联络或信息交流、能不能对行为的一致性作出合理解释,以及市场结构和竞争状况等(第六条);还规定,不得利用数据和算法、技术以及平台规则等方式达成垄断协议(第十三条)。可是,如果几家企业的算法各自独立学出了高价,没有任何人联络过、交换过信息,这算不算"协同”?这是一个仍然开放的问题。美国最高法院 2007 年在 Bell Atlantic v. Twombly 案(550 U.S. 544)里也说过,起诉书里只指出企业行为一致还不够,还要有让"存在协议"显得合理的事实。
价值判断(留给你):
- 法律应该盯着行为(有没有沟通、有没有协议),还是盯着结果(价格是不是高于竞争水平)?
- 算法的设计者和使用者,没有合谋的意图,却造成了类似的结果,谁该负责?
- 限制算法定价,可能同时限制了它带来的好处(价格更灵活、对成本和需求的反应更快),这个代价值不值得?
这些问题,经济学可以帮你把代价和证据讲清楚,但不能替你回答。
十、不只在企业之间
重复博弈的想法,也用来理解很多不靠法律的合作。下面几个例子,各有争议或限定:
- 声誉与商人:Avner Greif 1989 年(Journal of Economic History,49 卷 4 期)用开罗 Geniza 文献,研究 11 世纪地中海的马格里布商人:商人把货物交给海外代理人,代理人如果欺骗,整个商人"联盟"都会拒绝再雇用他。这是"背叛会被一群人一起惩罚"的例子。不过,这项研究有争议:Edwards 和 Ogilvie 2008 年的一篇工作论文(CESifo)认为,这样的"联盟"并不存在,商人主要依靠正式的法律制度。
- 公共资源:第 18 讲的公共品博弈里,每个人都想搭便车。Elinor Ostrom 1990 年的《公共事务的治理之道》(Governing the Commons)研究了一些长期存续的公共资源管理,她归纳出它们反复出现的特点,包括有人监督和分级的惩罚(轻微违规先警告,再逐步加重)。这和重复博弈的逻辑相符:互动长期持续,监测可行,惩罚有分级。第 26 讲讲制度时会再回到这里。
- 熟人社会:费孝通在《乡土中国》里描述的"熟人社会",人们世世代代住在一起,低头不见抬头见。用重复博弈的语言,这是一个 δ 很高、背叛很容易被发现和议论的环境。(这是一种解读:解释这些现象,还可以用血缘、规范、共同价值,它们并不互相排斥。)
- 反过来看:当交易变得匿名、一次性(陌生城市的游客、网上的陌生卖家),重复博弈的力量就变弱了。很多现代的制度,在做的就是把一次性的交易,变回被记录的重复博弈:评价系统、信用记录、品牌。这些怎样起作用,第 20、21 讲讲信息不对称时会细讲。
十一、证据、局限与常见的误用
11.1 重复博弈解释的是"可能",不是"必然"
- 多重均衡:民间定理说合作可以是均衡,永远背叛也可以。现实里合作发生与否,要看预期、历史、聚点。
- 条件很多:要有足够的未来、背叛能被发现、惩罚可信。任何一条不成立,合作就可能散。
- 实验:理论成立,不保证人们合作(第六节)。
- 名次依赖背景:循环赛的名次依赖参赛名单和比赛设计(第七节)。
11.2 常见的误用
| 误用 | 正确的想法 |
|---|---|
| “重复玩,合作就一定出现” | 合作只是可能的均衡之一,永远背叛也是;还要看耐心、监测和预期 |
| “以牙还牙是最好的策略” | 它在某些比赛里表现好;换名单、换规则、加入错误,结果会变 |
| “知道对方会合作,我就该合作” | 要看背叛会不会被发现、被惩罚;对"老好人",背叛反而得分最高 |
| “惩罚越重越好” | 没有出口的重惩罚,一次误会就毁掉合作;要有力度,也要有出口 |
| “默契合谋不需要任何条件” | 需要:企业少、产品同质、价格透明、能快速发现和回应、足够的未来 |
| “价格战就是合谋破裂” | 在一些模型里,价格战是合谋为了维持而付出的代价 |
| “有限次重复,合作就必然拆线” | 理论上在完全信息下如此;有一点不确定性、或不知道哪轮最后,结论就变 |
| “熟人社会的诚信是因为人好” | 这是一种解读:重复互动让背叛不划算,也是一部分原因;两者可以同时成立 |
十二、小结
这一讲有六个想法,请带走:
- 重复博弈里,今天的行为可以改变明天对方的行为,所以"现在背叛的好处"要和"以后被惩罚的代价"放在一起比。
- 知道最后一轮时,逆向归纳把合作一轮一轮拆掉;实验里人们会合作到接近结束,可能的原因是有一点类型的不确定(声誉)。
- 不知道哪一轮最后时,合作可以靠惩罚维持:对我们的囚徒困境,冷酷触发要 δ ≥ 1/2。门槛取决于背叛的诱惑、惩罚的力度和耐心;惩罚可信,因为回到(背叛,背叛)本身就是一次性博弈的均衡。
- 民间定理:耐心足够时,几乎所有"两人至少都得到最坏情形下能保住的"收益,都能成为均衡。合作是可能的,永远背叛也是,理论没法告诉你落在哪里。
- 以牙还牙与循环赛:善良、会报复、宽容、清楚的策略表现好,但名次依赖名单与设计;有误会时,惩罚要有力度也要有出口。
- 企业与更多场景:企业越多,默契合谋越难维持;价格战可以是合谋的一部分;算法定价会不会学会合谋,是一个仍在争论的问题。
到这里,我们默认了一件事:博弈的双方,知道对方是谁、知道对方的收益。可是现实里,你买一辆二手车,卖家知道车况,你不知道;你雇一个人,他知道自己有多努力,你不知道。当一方知道的,比另一方多的时候,市场会出什么问题? 这就是下一讲:第 20 讲:信息不对称(一):逆向选择与柠檬市场。 你会看到,为什么二手车的价格里,总像有一点"怕买到坏车"的折扣,以及为什么有时候好车会被挤出市场。
思考题
1. 一场囚徒困境,收益是:(合作,合作)各 4;我背叛、对方合作,我得 6、对方得 0;(背叛,背叛)各 1。两人用冷酷触发。δ 至少多大,合作才能维持?如果背叛的诱惑从 6 增加到 8,门槛是多少?
提示:冷酷触发的门槛 δ* = (T − R) ÷ (T − P) = (6 − 4) ÷ (6 − 1) = 0.4。诱惑增加到 8:δ* = (8 − 4) ÷ (8 − 1) = 4/7 ≈ 0.57。诱惑越大,需要越有耐心。
2. 一个供应商的合同明天到期,不再续约,今天的交货质量,你预计会怎样?用 3.1 节的"倒着想"来说明。怎样的合同安排,可以让"最后一天"问题缓和?
提示:合同明天到期,今天的交货就是"最后一轮":没有未来可以失去,质量最容易放松。再往前一天,对方知道你会知道这件事,也可能提前放松……一路倒推。缓和的办法,是让"最后一天"变得不清楚、或者让结束之后仍有后果:长期合同加续约条件、保留一部分货款到质保期结束后再付(押金或质保金)、行业内的声誉(今天的表现,会被别的客户知道)。
3. 9.1 节的两家烤肠摊,δ = 0.6。如果惩罚不是"永远回到竞争",而是"只惩罚 k 轮,然后恢复合谋",k 至少是多少才能维持合谋?(两家都能随意选量,对方守约时偷偷多卖的最好结果是 1139.06,守约每轮 1012.5,被惩罚时每轮 900。)
提示:偷偷多卖当期多得 1139.06 − 1012.5 = 126.56;惩罚期内每期少得 1012.5 − 900 = 112.5,折现后 k 期的总损失是 112.5 × (0.6 + 0.6² + …+ 0.6^k):k = 1 是 67.5,k = 2 是 108.0,k = 3 是 132.3。所以 k 至少是 3(132.3 > 126.56;k = 2 时 108.0 < 126.56 不够)。永远惩罚的损失是 112.5 × 0.6 ÷ 0.4 = 168.75。
4. 8.1 节里,为什么两个"以牙还牙"对打,一次手滑之后,得分会掉到 2.2 左右?用"(背叛,合作)→(合作,背叛)→……“这条链来说明;再说说为什么"赢留输变"能避开这个问题。
提示:一次手滑:一方本想合作却背叛了,下一轮对方照抄,变成(合作,背叛)……双方轮流"报复”,每个人平均每轮 (0 + 5) ÷ 2 = 2.5,比 3 低;再来一次手滑,又可能进入互相背叛(1,1),要等又一次手滑才有机会回到合作,所以长期平均约 2.2–2.3。赢留输变不一样:如果我手滑背叛、对方合作,我得 5,下一轮保持背叛;对方得 0,下一轮改成背叛;于是(背叛,背叛),双方都只得 1,各自"输了就换",下一轮同时变回合作,两轮就回到合作。
5. 很多网上平台会显示卖家的历史评分和评价。用本讲的想法,说说它在做什么,它在什么情况下会失效?
提示:评价系统在做的,是把一次性的交易变成"被记录的重复博弈":卖家的历史评分,是他未来生意的"抵押",一次欺骗会让他损失以后的买家(背叛被发现,并被惩罚)。会失效的情形:(1)能刷单、买好评,伪造历史;(2)差评会招来报复,或买家懒得写(写评价对别人有益、对自己没好处,又是一个公共品问题);(3)卖家可以关店换个名字重开,历史被重置(δ 很低,等于关系没有未来);(4)评价被平台算法或商家规则扭曲。
参考与延伸
- Axelrod, R. (1980). Effective Choice in the Prisoner’s Dilemma. Journal of Conflict Resolution, 24(1), 3–25.
- Axelrod, R. (1980). More Effective Choice in the Prisoner’s Dilemma. Journal of Conflict Resolution, 24(3), 379–403.
- Axelrod, R. (1984). The Evolution of Cooperation. Basic Books.
- Selten, R., & Stoecker, R. (1986). End Behavior in Sequences of Finite Prisoner’s Dilemma Supergames. Journal of Economic Behavior and Organization, 7(1), 47–70.
- Selten, R. (1978). The Chain Store Paradox. Theory and Decision.
- Kreps, D., Milgrom, P., Roberts, J., & Wilson, R. (1982). Rational Cooperation in the Finitely Repeated Prisoners’ Dilemma. Journal of Economic Theory, 27(2), 245–252.
- Andreoni, J., & Miller, J. H. (1993). Rational Cooperation in the Finitely Repeated Prisoner’s Dilemma: Experimental Evidence. Economic Journal, 103(418), 570–585.
- Friedman, J. W. (1971). A Non-cooperative Equilibrium for Supergames. Review of Economic Studies, 38(1), 1–12.
- Fudenberg, D., & Maskin, E. (1986). The Folk Theorem in Repeated Games with Discounting or with Incomplete Information. Econometrica, 54(3), 533–554.
- Dal Bó, P. (2005). Cooperation under the Shadow of the Future: Experimental Evidence from Infinitely Repeated Games. American Economic Review, 95(5), 1591–1604.
- Dal Bó, P., & Fréchette, G. R. (2011). The Evolution of Cooperation in Infinitely Repeated Games: Experimental Evidence. American Economic Review, 101(1), 411–429.
- Dal Bó, P., & Fréchette, G. R. (2018). On the Determinants of Cooperation in Infinitely Repeated Games: A Survey. Journal of Economic Literature, 56(1).
- Rapoport, A., Seale, D. A., & Colman, A. M. (2015). Is Tit-for-Tat the Answer? On the Conclusions Drawn from Axelrod’s Tournaments. PLoS ONE, 10(7), e0134128.
- Nowak, M., & Sigmund, K. (1993). A Strategy of Win-Stay, Lose-Shift That Outperforms Tit-for-Tat in the Prisoner’s Dilemma Game. Nature, 364, 56–58.
- Green, E. J., & Porter, R. H. (1984). Noncooperative Collusion under Imperfect Price Information. Econometrica, 52(1), 87–100.
- Porter, R. H. (1983). A Study of Cartel Stability: The Joint Executive Committee, 1880–1886. Bell Journal of Economics, 14(2), 301–314.
- Levenstein, M. C. (1997). Price Wars and the Stability of Collusion: A Study of the Pre-World War I Bromine Industry. Journal of Industrial Economics, 45(2), 117–137.
- Calvano, E., Calzolari, G., Denicolò, V., & Pastorello, S. (2020). Artificial Intelligence, Algorithmic Pricing, and Collusion. American Economic Review, 110(10), 3267–3297.
- Assad, S., Clark, R., Ershov, D., & Xu, L. (2024). Algorithmic Pricing and Competition: Empirical Evidence from the German Retail Gasoline Market. Journal of Political Economy, 132(3), 723–771.
- Greif, A. (1989). Reputation and Coalitions in Medieval Trade: Evidence on the Maghribi Traders. Journal of Economic History, 49(4).
- Edwards, J., & Ogilvie, S. (2008). Contract Enforcement, Institutions and Social Capital: The Maghribi Traders Reappraised. CESifo Working Paper.
- Ostrom, E. (1990). Governing the Commons. Cambridge University Press.
- 《中华人民共和国反垄断法》(2022 年修正,2022 年 8 月 1 日起施行);《禁止垄断协议规定》(国家市场监督管理总局令第 65 号,2023 年 4 月 15 日起施行)。