这一讲要回答六个问题:
- 市场会失灵,政府能纠正吗?政府失灵有哪几种来源?
- 投票为什么不一定反映大家的偏好?谁赢,为什么常常取决于"中间"那个人,有时又取决于谁控制了议程?
- 为什么少数人比多数人更容易让政府为自己说话?
- 寻租:争夺垄断许可、关税保护这类"好处",要花掉多少资源?
- 官员的激励:考核什么,官员就把精力放在什么上?
- 制度到底是什么?为什么它决定了前面所有问题的答案?
前三讲(第 23 到 25 讲),我们看到市场在外部性、公共品那里不够用,办法多半是:政府出面,征税,定标准,提供公共品。这一讲,我们把镜头转向政府自己。政府不是一个"仁慈的、什么都知道的计划者",它也是一群人:官员、议员、选民、各种利益团体,每个人都有自己的目标和信息。当这些人互相作用时,政府会做出什么?
这一类研究,叫公共选择(public choice):用分析市场里人们行为的方法,来分析政治里人们的行为。James Buchanan 因为在这方面的贡献,获得了 1986 年的诺贝尔经济学奖。
一、政府失灵
1.1 一个场景
你是一座城市的市长,手里有一笔钱:该修地铁、建公园,还是补贴老人?
先停一下:你要做出好决定,需要知道什么?你知道吗?你自己的目标,一定和市民的福利一致吗?
你需要知道的,至少有三样:
- 市民真正想要什么、愿意付多少(信息,第 20、21 讲的问题,也是第 7 讲说的:价格把分散的信息压缩成一个数,而政府的决策,往往没有这个数);
- 怎么做,才能用最少的钱达到目标(技术和执行);
- 你自己,以及你手下的人,有没有动力去做对(激励)。
三样,都不一定满足。政府失灵(government failure):政府的干预,没有达到目标,或者结果比不干预更糟。它和市场失灵对称,也有几个来源:
| 来源 | 意思 | 本讲的位置 |
|---|---|---|
| 信息 | 政府不知道市民的偏好、企业的成本、政策的真实效果 | 第三节的"理性无知";第 20、21 讲 |
| 政治过程 | 投票的规则,让结果不一定反映偏好;少数人更容易影响决策 | 第二、三、四节 |
| 官员的激励 | 官员有自己的目标,被考核的才被重视 | 第五节 |
| 执行 | 好的政策纸面上有,执行不了(印度的水污染,第 23 讲) | 第 23 讲 |
二、投票:多数票不一定有"赢家"
2.1 孔多塞循环
想象 3 个选民,3 个方案 X、Y、Z(比如三种修路方案),每个人的排序,左边更喜欢:甲:X > Y > Z;乙:Y > Z > X;丙:Z > X > Y。
from itertools import permutations

# 一、三个选民,三个方案 X、Y、Z:每人的排序(左边更喜欢)
prefs = {"甲": ["X", "Y", "Z"], "乙": ["Y", "Z", "X"], "丙": ["Z", "X", "Y"]}
def beats(a, b):
    """多数票:喜欢 a 胜过 b 的人,是否比喜欢 b 胜过 a 的多"""
    votes_a = sum(r.index(a) < r.index(b) for r in prefs.values())
    return votes_a > len(prefs) - votes_a, votes_a, len(prefs) - votes_a

print("两两比多数票:")
for a, b in (("X", "Y"), ("Y", "Z"), ("Z", "X")):
    win, va, vb = beats(a, b)
    print(f"  {a} 对 {b}:{va} 比 {vb},{a if win else b} 胜")
print("X 胜 Y,Y 胜 Z,Z 又胜 X:社会的'多数偏好'绕了一圈,没有最后的赢家(孔多塞循环)")

print("\n分两轮投票:先比两个,赢的再和剩下的比。谁先比,结果就不同(议程操纵):")
for first, second, last in permutations("XYZ", 3):
    if first > second: continue                       # (X,Y) 和 (Y,X) 是同一场,只列一次
    w1 = first if beats(first, second)[0] else second
    w2 = w1 if beats(w1, last)[0] else last
    print(f"  先比 {first} 和 {second},赢家再对 {last}:最终 {w2}")

# 二、选民的偏好"单峰":每个人心里有个最理想的位置,离得越近越喜欢(比如政府规模,1 最小,10 最大)
ideal = [1, 2, 3, 3, 4, 6, 8, 9, 10]
def majority(p, q):
    """位置 p 对位置 q:更喜欢 p(离 p 更近)的人数,对更喜欢 q 的人数"""
    vp = sum(abs(v - p) < abs(v - q) for v in ideal)
    vq = sum(abs(v - q) < abs(v - p) for v in ideal)
    return vp, vq
median, mean = sorted(ideal)[len(ideal) // 2], sum(ideal) / len(ideal)
print(f"\n9 个选民的理想位置 {ideal}:中位数 {median},平均数 {mean:.2f}")
beaten_by = [q for q in range(1, 11) if q != median and majority(q, median)[0] > majority(q, median)[1]]
print(f"位置 {median} 和其他位置比多数票:被谁打败过?{beaten_by or '没有人能打败它'}")
print(f"  位置 {median} 对平均数附近的 5:{majority(median, 5)[0]} 比 {majority(median, 5)[1]}({median} 胜)")

# 三、两个只想赢的候选人,每次把自己的立场调到"得票最多"的位置(选民投给离自己近的)
def share(a, b):
    va = sum(abs(v - a) < abs(v - b) for v in ideal) + sum(abs(v - a) == abs(v - b) for v in ideal) / 2
    return va
left, right = 1.0, 10.0
grid = [x / 2 for x in range(2, 21)]
for step in range(30):
    left = max(grid, key=lambda a: share(a, right))
    right = max(grid, key=lambda b: share(b, left))
    if step in (0, 1, 2, 5, 29): print(f"  第 {step + 1:>2} 轮调整后:候选人甲 {left},候选人乙 {right}")
输出:
两两比多数票:
  X 对 Y:2 比 1,X 胜
  Y 对 Z:2 比 1,Y 胜
  Z 对 X:2 比 1,Z 胜
X 胜 Y,Y 胜 Z,Z 又胜 X:社会的'多数偏好'绕了一圈,没有最后的赢家(孔多塞循环)

分两轮投票:先比两个,赢的再和剩下的比。谁先比,结果就不同(议程操纵):
  先比 X 和 Y,赢家再对 Z:最终 Z
  先比 X 和 Z,赢家再对 Y:最终 Y
  先比 Y 和 Z,赢家再对 X:最终 X

9 个选民的理想位置 [1, 2, 3, 3, 4, 6, 8, 9, 10]:中位数 4,平均数 5.11
位置 4 和其他位置比多数票:被谁打败过?没有人能打败它
  位置 4 对平均数附近的 5:5 比 4(4 胜)
  第  1 轮调整后:候选人甲 8.5,候选人乙 8.0
  第  2 轮调整后:候选人甲 4.5,候选人乙 4.0
  第  3 轮调整后:候选人甲 4.0,候选人乙 4.0
  第  6 轮调整后:候选人甲 4.0,候选人乙 4.0
  第 30 轮调整后:候选人甲 4.0,候选人乙 4.0
逐段看:
- 多数票绕了一圈:X 胜 Y(甲、丙),Y 胜 Z(甲、乙),Z 胜 X(乙、丙)。社会的"多数偏好"不是一个传递的排序:没有一个方案,能在多数票上,打败所有别的方案。这叫孔多塞循环(法国数学家孔多塞 1785 年描述了它)。
- 议程决定结果:如果规则是"先比两个,赢家再和剩下的比",谁先比,结果就不同:先比 X 和 Y,最后是 Z;先比 X 和 Z,最后是 Y;先比 Y 和 Z,最后是 X。每个选民的偏好,一个都没变。 谁控制了议程(决定先比哪两个),谁就有很大的权力。
- Arrow 的不可能定理:Kenneth Arrow 1951 年(《社会选择与个人价值》)证明:只要方案多于两个,就没有任何一种把个人的排序,汇总成社会排序的规则,能同时满足几条看起来很合理的要求(比如:不限制个人可以有什么偏好;如果所有人都更喜欢 a,那社会也更喜欢 a;不能由一个人说了算;两个方案之间的社会排序,只取决于人们对这两个方案的排序)。这不是说投票没用,而是说,没有一种"完美"的投票规则。
2.2 中间选民
好在,现实里,循环不总是出现。如果选民的偏好是单峰的(每个人都有一个最理想的位置,离得越远越不喜欢),比如,大家在"政府规模"这条线上有不同的立场,那么就有一个确定的赢家:中间那个人的位置。Duncan Black 1948 年(Journal of Political Economy,56 卷 1 期)证明了:在这个条件下,中位数选民的理想位置,能在多数票上,打败任何别的位置。
2.1 节那段代码的后半部分,验证了这一点,并且让两个只想赢的候选人,去调整立场:
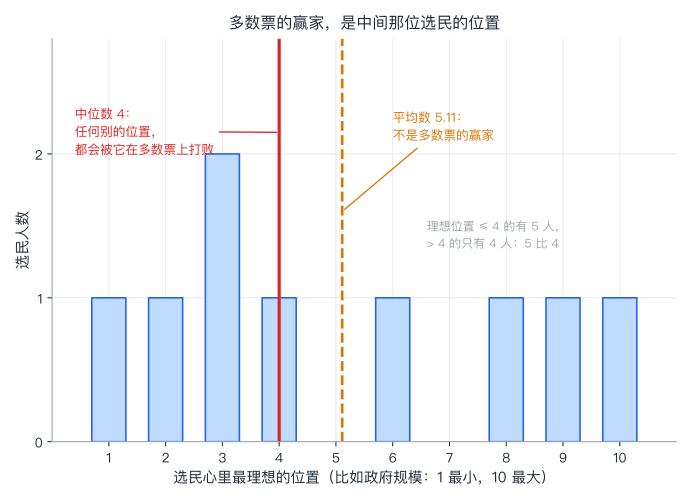
- 9 个选民,理想位置从 1 到 10;中位数是 4,平均数是 5.11。位置 4,没有任何位置能在多数票上打败它。位置 4 对 5:5 比 4,4 胜(那个理想位置正好是 4 的选民,也投给 4)。
- 平均数不是赢家:是中位数。极端的选民(比如理想位置是 10 的人)怎么想,对赢家没有影响:把他的理想位置,从 10 改到 100,中位数不变。
- 两个候选人的竞争:每个人都想赢,每一轮把立场,调到"此刻得票最多"的位置。几轮之后,两个人都站到了中位数 4。这是 Anthony Downs 1957 年(《民主的经济理论》)的想法:两个只想赢的政党,会向中间靠拢。
局限:这个结论需要几个条件:单一维度(只有一个议题)、选民偏好单峰、只有两个候选人、选民诚实地投给离自己近的人。现实里,政策是多维的,多维时,一般不再有稳定的"中间";候选人也不只想赢,他们自己也有立场;选民也可能不投票。(我们这里的代码,是一个高度简化的演示,不是对任何一个国家选举的描述。)
小结: 多数票不一定有赢家:孔多塞循环,议程决定结果;Arrow 证明没有"完美"的汇总规则。偏好单峰时,赢家是中位数选民的位置,两个想赢的候选人会向中间靠拢,但这需要很强的条件。
三、选民与利益集团
3.1 理性无知
你知道本市的公共交通预算是多少吗?知道你的议员,在上一次预算投票里,投了什么吗?
大多数人不知道。这不一定是懒:你花很多时间去了解一项政策,对结果的影响,微乎其微(你只是几百万票中的一票),而所有的好处,要等大家一起享受。这叫理性无知(Downs 1957):对选民来说,了解政治,成本不低,个人的好处接近于零,所以,不了解,是理性的。
3.2 集中的好处,分散的成本
Mancur Olson 1965 年(《集体行动的逻辑》)进一步指出:一个小而集中的群体,更容易组织起来去影响政策,一个大而分散的群体,更难(第 25 讲的搭便车问题:每个人都想让别人去出力)。
用一个例子:对进口钢材加关税。5 家钢厂,每家多赚 1,200,000;100 万消费者,每人多付 10。
- 一家钢厂,最多愿意花 1,200,000 去争取这项关税,每个消费者,最多愿意花 10 去反对:单个人的利害,相差 12 万倍。
- 钢厂的好处合计 600 万,消费者的损失合计 1000 万:总的损失,更大。可是,谁会去游说、捐款、组织起来?钢厂。消费者每人只多付 10,不会为此花一个下午。
- 结果:一项净损失的政策,因为好处集中、成本分散,可能获得通过。(这是一个逻辑上的例子;现实里,有没有、有多少,要看具体的政策。)
小结: 理性无知:选民了解政治的成本高、个人的好处小,所以不了解是理性的。集中的好处、分散的成本,让小群体更容易影响政策,即使总的成本大于总的好处。
四、寻租
4.1 争夺"好处"本身,要花资源
第 14 讲提过:垄断利润很值钱,所以人们会花资源去争取它:游说、打点、诉讼。Gordon Tullock 1967 年(Western Economic Journal)指出,传统的无谓损失三角形,漏掉了这块;Richard Posner 1975 年(Journal of Political Economy,83 卷 4 期)接着论证:如果争夺很激烈,争夺花掉的资源,可能接近垄断利润本身。Anne Krueger 1974 年(American Economic Review,64 卷 3 期)把这类现象,起名叫寻租(rent seeking):为了获得政府创造的"租"(超出正常回报的好处,比如垄断许可、进口配额),而花掉的资源。
4.2 一个竞赛模型
用第 14 讲的景区水店:谁拿到唯一的经营许可,每天赚 1300(垄断利润),另外,顾客那边有 800 的无谓损失。n 家公司争这张许可:每家花 x_i 去游说,拿到许可的概率 = 自己花的 ÷ 大家花的总数(这是 Tullock 1980 年提出的竞赛模型)。
# 寻租:第 14 讲的景区水店。谁拿到"唯一一家"的经营许可,谁每天赚 1300(垄断利润);顾客那边另有 800 的无谓损失。
# n 家公司争这张许可。每家花 x_i 去游说(请客、打点、诉讼……),拿到许可的概率 = 自己花的 / 大家花的总数(Tullock 的竞赛模型)。
PRIZE = 1300.0

def expected_profit(x_i, others, prize=PRIZE):
    total = x_i + others
    return (x_i / total if total > 0 else 0.0) * prize - x_i

def best_response(others, prize=PRIZE):
    """令 d/dx [x/(x+O) × R - x] = 0,得 x = sqrt(R × O) - O;O=0 时,花很少一点就能独占,取 0.25(网格的最小单位)"""
    return max(0.0, (prize * others) ** 0.5 - others) if others > 0 else 0.25

# 先用笔算的公式,核对一遍:对方一共花 325 时,自己在 0.25 的网格上试一遍,最好的是不是 sqrt(R×O) - O?
grid_best = max((k / 4 for k in range(0, 5201)), key=lambda c: expected_profit(c, 325.0))
print(f"核对:对方花 325,网格搜索最好的花费 {grid_best:.2f},公式 {best_response(325.0):.2f}")

def equilibrium(n, prize=PRIZE):
    x = [prize / 10] * n
    for _ in range(5000):
        for i in range(n): x[i] = best_response(sum(x) - x[i], prize)
    return x

print(f"\n许可的价值 {PRIZE:.0f}。n 家公司互相盯着,各自选游说花多少(轮流选最佳反应,直到谁也不想改):")
for n in (2, 4, 10, 50):
    x = equilibrium(n)
    total = sum(x)
    print(f"  n={n:>2}:每家花 {x[0]:.1f}(公式 R(n-1)/n^2 = {PRIZE * (n - 1) / n ** 2:.1f}),一共花 {total:.1f},占许可价值的 {total / PRIZE:.0%}(公式 (n-1)/n = {(n - 1) / n:.0%});"
          f"社会成本 = 无谓损失 800 + 争夺花掉的 {total:.0f} = {800 + total:.0f}(只算三角形是 800)")
输出:
核对:对方花 325,网格搜索最好的花费 325.00,公式 325.00

许可的价值 1300。n 家公司互相盯着,各自选游说花多少(轮流选最佳反应,直到谁也不想改):
  n= 2:每家花 325.0(公式 R(n-1)/n^2 = 325.0),一共花 650.0,占许可价值的 50%(公式 (n-1)/n = 50%);社会成本 = 无谓损失 800 + 争夺花掉的 650 = 1450(只算三角形是 800)
  n= 4:每家花 243.8(公式 R(n-1)/n^2 = 243.8),一共花 975.0,占许可价值的 75%(公式 (n-1)/n = 75%);社会成本 = 无谓损失 800 + 争夺花掉的 975 = 1775(只算三角形是 800)
  n=10:每家花 117.0(公式 R(n-1)/n^2 = 117.0),一共花 1170.0,占许可价值的 90%(公式 (n-1)/n = 90%);社会成本 = 无谓损失 800 + 争夺花掉的 1170 = 1970(只算三角形是 800)
  n=50:每家花 25.5(公式 R(n-1)/n^2 = 25.5),一共花 1274.0,占许可价值的 98%(公式 (n-1)/n = 98%);社会成本 = 无谓损失 800 + 争夺花掉的 1274 = 2074(只算三角形是 800)
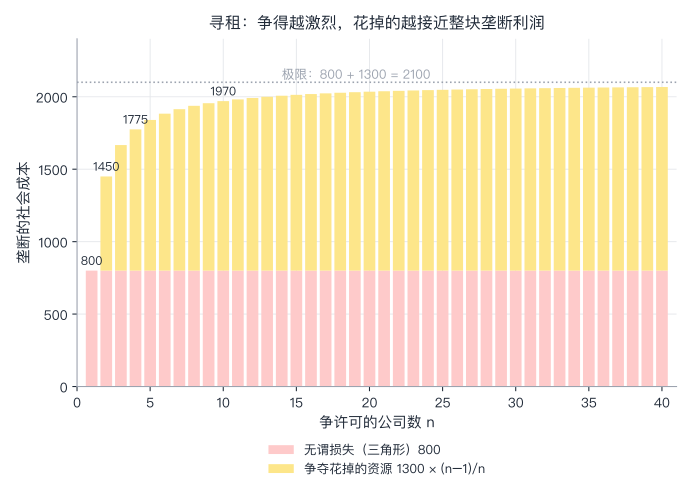
代码用轮流选"最佳反应"的办法,把这个模型算了(先核对了公式:对方花 325 时,网格搜索的最好花费,和公式一致):
- n = 2:每家花 325,一共 650,是许可价值的 50%;
- n = 4:每家花 243.8,一共 975,75%;
- n = 10:一共 1170,90%;
- n = 50:一共 1274,98%。公式是:总共花 R × (n − 1) ÷ n。争的人越多,花掉的,越接近许可本身的价值。
图里,粉色是传统的无谓损失三角形(800),黄色是争夺花掉的资源:n = 4 时,社会成本从 800 变成 1775(是三角形的两倍多);n 很大时,趋近 2100。这就是 Tullock 和 Posner 的意思:垄断的社会成本,可以远大于三角形。
局限:这个模型假设,大家都不怕风险,获胜的概率,正好是花费的比例;“利润全部被花掉”,只是特定假设下的结论。实验和现实里,花掉的比例,可能更大、更小,也取决于许可是怎么分配的(抽签、拍卖,还是游说)。不同的分配方式,花费的资源不同(第 22 讲的拍卖,可以把"争夺"变成向政府付钱,而不是花在游说上;这是一个推论,现实里还有别的问题)。
4.3 寻租有多大
Krueger 1974 年估计:印度 1964 年,政府的管制创造的"租",约占国民收入的 7.3%;土耳其 1968 年,仅进口许可一项的租,约占国民生产总值的 15%。注意:这两个数字,是"租"本身的大小,不是"为争夺它而花掉的资源"(她没有去估计有多少被花掉了)。
寻租,不只在垄断:关税、进口配额、价格管制、补贴、牌照,都在创造"租";第 9 讲讲价格管制时的排队、黑市,第 24 讲里"争夺初始产权要花资源",也是同一类现象。
小结: 寻租:为了获得政府创造的好处,而花掉的资源。竞赛模型里,花掉的约等于许可价值的 (n − 1)/n;争的人越多,越接近全部。所以垄断和管制的社会成本,可能远大于传统的三角形。创造"租"的政策,几乎总会引来争夺它的活动。
五、官员的激励
5.1 考核什么,就用力在什么
官员,也在对激励做出反应(第 2 讲)。第 21 讲讲过多任务:如果你只考核容易度量的那一项,代理人就会把精力放在它身上,难度量的那项,被挤出去。
用一个示意模型算一下:一位官员有 10 单位精力,分给两件事:任务 1促进经济增长(容易度量,产出 √e₁);任务 2环境、民生、公共服务(难度量,产出 √e₂)。对社会来说,两件事的价值权重是 1 和 1.5。官员的升迁,取决于"被度量到的":增长权重 1,第二件事只被度量到一部分,权重 m。
# 官员的激励(示意模型,借第 21 讲的"多任务"):一位官员有 10 单位精力,分给两件事:
#   任务 1:促进经济增长(容易度量,产出 g = sqrt(e1));任务 2:环境、民生、公共服务(难度量,产出 o = sqrt(e2))。
# 对社会来说,两件事的价值权重是 1 和 1.5(他的上级、也是我们假设的"社会",更看重第二件)。
# 官员自己的升迁,取决于"被度量到的":增长按权重 w 计,第二件事只被度量到一部分,权重 m。他最大化 w*g + m*o。
import math

def split(w, m, total=10.0):
    """官员的最优:w/(2 sqrt(e1)) = m/(2 sqrt(e2)) => e2/e1 = (m/w)^2"""
    if m == 0: return total, 0.0
    ratio = (m / w) ** 2
    e1 = total / (1 + ratio)
    return e1, total - e1

print("社会最优的分法(价值权重 1 和 1.5):")
e1, e2 = split(1, 1.5)
print(f"  增长 {e1:.2f},其他 {e2:.2f}(其他占 {e2 / 10:.0%})")

print("\n官员按'被度量到的'来分(增长权重 w=1):")
for m in (0, 0.3, 0.5, 1.0, 1.5):
    e1, e2 = split(1, m)
    # 验证:网格上试一遍,是不是这个分法使他的目标最大
    best = max((k / 100 for k in range(0, 1001)), key=lambda a: math.sqrt(a) + m * math.sqrt(10 - a))
    soc = math.sqrt(e1) + 1.5 * math.sqrt(e2)
    print(f"  第二件事被度量到的权重 m={m}:增长 {e1:.2f}(网格 {best:.2f}),其他 {e2:.2f}(占 {e2 / 10:.0%});社会价值 {soc:.2f}(最优 {math.sqrt(split(1, 1.5)[0]) + 1.5 * math.sqrt(split(1, 1.5)[1]):.2f})")
输出:
社会最优的分法(价值权重 1 和 1.5):
  增长 3.08,其他 6.92(其他占 69%)

官员按'被度量到的'来分(增长权重 w=1):
  第二件事被度量到的权重 m=0:增长 10.00(网格 10.00),其他 0.00(占 0%);社会价值 3.16(最优 5.70)
  第二件事被度量到的权重 m=0.3:增长 9.17(网格 9.17),其他 0.83(占 8%);社会价值 4.39(最优 5.70)
  第二件事被度量到的权重 m=0.5:增长 8.00(网格 8.00),其他 2.00(占 20%);社会价值 4.95(最优 5.70)
  第二件事被度量到的权重 m=1.0:增长 5.00(网格 5.00),其他 5.00(占 50%);社会价值 5.59(最优 5.70)
  第二件事被度量到的权重 m=1.5:增长 3.08(网格 3.08),其他 6.92(占 69%);社会价值 5.70(最优 5.70)
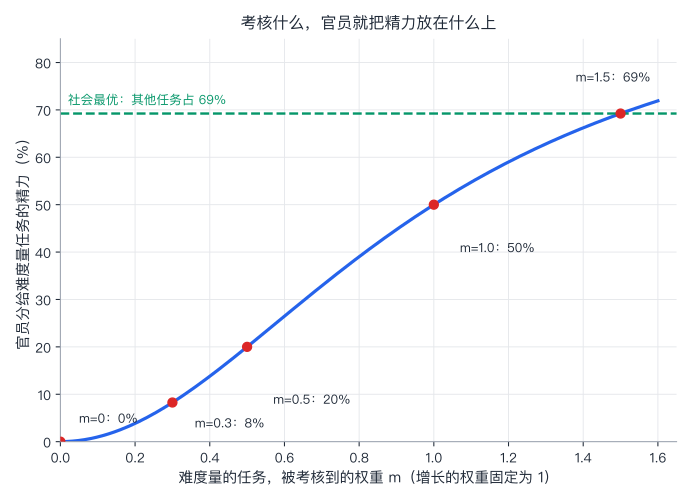
- m = 0(第二件事完全不考核):官员把全部精力,放在增长上,其他得 0。
- m = 0.3:其他只占 8%;m = 1.0:50%;只有 m = 1.5(考核权重和社会价值一致)时,才和社会最优一致(69%)。
- 社会价值:m = 0 时 3.16,m = 1.5 时 5.70(最优)。考核漏掉的东西,代价是真实的。
- 为什么不把 m 定到 1.5? 因为难度量,意味着度量本身,成本高、容易被操纵;而这里的模型假设 m 是"被度量到的权重",它不是政府想定多少就能定的。
这是第 21 讲 Holmström–Milgrom 的结论,用在了政府上:不是"激励越强越好",而是"激励要和你想要的一致"。
5.2 一个有争议的问题:地方官员的晋升与经济增长
中国地方官员的晋升,在多大程度上,和地方的经济增长挂钩?这种挂钩,有什么好处和代价?按"理论预测 → 证据与局限 → 分歧在哪 → 价值判断留给读者"来写。
理论预测什么:如果晋升取决于经济增长,官员有动力促进增长(好处);同时,他们会把精力放在被考核的指标上,而忽视没被考核的(代价,5.1 节)。
证据怎么说:Hongbin Li 和 Li-An Zhou 2005 年(Journal of Public Economics,89 卷 9–10 期)用 1979 到 1995 年的省级主要领导人数据发现:省的经济增长越好,领导人晋升的可能性越高,被免职的可能性越低;而且,对任期内的平均业绩,比对单一年份的业绩,更敏感。作者的解读是:中国用人事控制,来激励官员去追求经济增长。
局限:这是特定时期(1979 到 1995 年)、特定层级(省级)的结果;后来有研究认为,派系关系、政治可靠性、社会稳定,也可能影响晋升(据转述,请读原文);也有研究指出,当晋升取决于容易度量的指标时,可能出现数据上的美化(据转述,我没有逐一核对)。
分歧在哪:
- 事实上的分歧:晋升,到底有多大程度,取决于增长?还是取决于关系和别的因素?不同时期、不同层级,结果可能不同。
- 价值上的分歧:下面的问题,数据回答不了。
价值判断(留给你):
- 官员应该为什么负责?增长、就业、环境、民生、债务:这些目标,该各占多大的权重?
- 谁来评价官员:上级、本地的居民、还是第三方?不同的人评价,会得到不同的激励。
- 如果某些目标很难度量(比如居民的长期福祉),宁可少考核、还是宁可考核得粗一点?
经济学能告诉你,每一种考核办法,会让官员把精力放在哪里,代价是什么;该给每个目标多大的权重,是你的价值判断。
5.3 监督有没有用
Benjamin Olken 2007 年(Journal of Political Economy,115 卷 2 期)在印度尼西亚的 600 多个村庄道路项目里,做了一个随机实验:把政府审计的概率,从 4% 提高到 100%,使官方报的成本,和独立工程师估计的成本之间的差距(“失踪的支出”),减少了 8 个百分点;而鼓励村民参与监督,平均来说,效果很小,只有在搭便车和精英控制不严重的地方才有用。结论:自上而下的监督,在腐败严重的环境里,也有作用。(这是印度尼西亚的村庄道路,不代表所有国家和所有项目。)
小结: 官员对考核做出反应:考核什么,精力就放在什么上;难度量的目标被挤出去。晋升与增长挂钩,有激励的好处,也有多任务的代价。监督,有时有用(Olken)。该给每个目标多大的权重,是价值判断。
六、制度
6.1 制度是什么
我们已经说了很多次"制度"(第 18 讲的规范和制度、第 19 讲的声誉、第 24 讲的产权、第 25 讲的社区规则)。现在给它一个定义。Douglass North 1990 年(《制度、制度变迁与经济绩效》)说:
制度,是一个社会的游戏规则,或者说,是人们设计出来、约束人们互动的限制。
它包括正式的(法律、产权、合同、宪法)和非正式的(惯例、规范、信任)。North 因为用经济理论和量化方法解释经济和制度的变迁,与 Robert Fogel 一起,获得了 1993 年的诺贝尔经济学奖。
6.2 制度回答了前面的哪些问题
回头看,从第 18 讲到第 26 讲,我们遇到的每一个困境,都对应一种制度:
| 问题 | 困境 | 制度怎么回答 |
|---|---|---|
| 囚徒困境(第 18 讲) | 人人背叛,大家都差 | 合同、声誉、惩罚(第 19 讲) |
| 逆向选择(第 20 讲) | 好货被挤出去 | 披露、第三方检测、质保(第 20、21 讲) |
| 道德风险(第 21 讲) | 行动看不到 | 免赔额、激励合同、监督(第 21 讲) |
| 外部性(第 23 讲) | 价格没反映社会成本 | 税、总量控制与交易、产权(第 23、24 讲) |
| 公共资源(第 25 讲) | 过度使用 | 社区规则、监督、分级惩罚(第 25 讲) |
| 政府失灵(本讲) | 官员、选民、集团的激励 | 宪法的约束、投票规则、独立监督、问责 |
好的制度,做两件事:
- 让个人的利益,和社会的利益一致(激励相容,第 21、22 讲)。
- 约束掌权的人:让他们的承诺可信,没法随意改变规则(第 18 讲的可信威胁)。一个政府,如果可以随时没收你的投资,你就不敢投资。
6.3 制度重要吗
第 29 讲会专门讲经济增长的来源:技术、人力资本,以及制度。关于制度的重要性,有很多有名的研究,也有激烈的争论,到那里我们再讲。这里先留下一个想法:同样的人、同样的资源,放在不同的规则里,结果会很不一样。 这是为什么,经济学不只问"人们会怎么选",还问"规则是什么"。
七、局限、常见误用
7.1 局限
- 政府失灵,不等于"政府不该管":它只是说,要把政府的缺陷,也算进去,和市场的缺陷比较(第 24 讲 Coase 的思路)。
- 公共选择的模型很简化:假设人们都追求自己的利益,忽略了公共精神、规范,实际上,很多官员和选民,并不只是这样。
- 证据有限:很多结论,来自特定国家、特定时期;寻租的大小,难以直接测量。
- 制度难以改变:知道好制度是什么,不等于能建立它。
7.2 常见的误用
| 误用 | 正确的想法 |
|---|---|
| “市场失灵了,政府就该管” | 要比较:政府有没有信息、有没有动力、会不会被集团俘获 |
| “政府失灵了,就该完全靠市场” | 同样,要比较两者的成本;外部性、公共品,市场也做不好 |
| “多数票就是民意” | 孔多塞循环、议程操纵、Arrow 定理说明:汇总个人偏好,没有完美的办法 |
| “选民不了解政策,是他们蠢” | 理性无知:了解的成本高、个人好处小 |
| “游说都是坏事” | 寻租是花资源去争夺转移;有些游说提供信息;要区分 |
| “考核越多越好” | 考核什么,就把精力放在什么上;漏掉的目标,会被挤出去 |
| “好的制度,抄过来就行” | 制度和当地的条件、非正式规范相互作用,难以简单移植 |
八、小结
这一讲有六个想法,请带走:
- 政府失灵:信息、政治过程、官员的激励、执行,四类来源。它和市场失灵对称,要两边比较。
- 投票:多数票可能循环,议程决定结果,Arrow 证明没有完美的汇总规则。偏好单峰时,赢家是中位数选民,两个候选人向中间靠拢,但条件很强。
- 选民与利益集团:理性无知;集中的好处、分散的成本,让小群体更容易影响政策。
- 寻租:争夺政府创造的"租",要花资源;竞赛模型里,花掉约 (n − 1)/n 的价值。垄断和管制的社会成本,可能远大于三角形。
- 官员的激励:考核什么,精力放在什么上;多任务的代价。晋升与增长挂钩,有好处也有代价,该怎么权衡是价值判断。
- 制度:社会的游戏规则;好的制度,让个人利益和社会利益一致,并约束掌权者。前面八讲的每个困境,都对应一种制度。
到这里,前六个 Unit,也就是微观经济学的主体,就讲完了。 从稀缺和权衡出发,我们讲了需求、供给、均衡、消费者、企业、市场结构、博弈和信息、外部性和公共品,最后是政府自己。一直以来,我们看的,是一个市场、一个企业、一群人。下一讲,我们换一个尺度:整个经济。一个国家一年生产多少东西?物价涨了多少?有多少人找不到工作?第 27 讲:衡量一个经济:GDP、通胀与失业。 你会看到,这些大家天天听到的数字,到底是怎么算出来的,它们告诉了我们什么、又漏掉了什么。
思考题
1. 2.1 节的三个选民(甲:X > Y > Z;乙:Y > Z > X;丙:Z > X > Y)。如果规则是"先比 Y 和 Z,赢家再比 X",最后是谁?如果你想让 Z 赢,你该怎么安排议程?
提示:先比 Y 和 Z:Y 胜(甲、乙);Y 再比 X:X 胜(甲、丙);最后是 X。想让 Z 赢:先比 X 和 Y(X 胜),再让 X 对 Z(Z 胜,乙、丙),最后是 Z。三个选民的偏好,一个都没变,只是议程不同。谁控制议程,谁就有权力。
2. 2.2 节的 9 个选民,如果理想位置是 10 的那位,改成 100;中位数和平均数,分别怎么变?这说明了什么?
提示:中位数还是 4(排序后的第 5 个人,没有变);平均数从 5.11 变成 (1 + 2 + 3 + 3 + 4 + 6 + 8 + 9 + 100) ÷ 9 ≈ 15.1。中位数对极端值不敏感,平均数很敏感。 多数票的赢家取决于中位数,所以"最极端的人",没法靠把立场推得更极端,去改变结果;他们能做的,是去影响议程、去游说、或者去改变中间选民的想法。
3. 4.2 节的竞赛:如果奖品价值是 1000,有 5 家公司争:每家花多少?总共花多少?如果奖品涨到 2000 呢?只有 2 家公司呢?
提示:每家花 R(n − 1) ÷ n²:n = 5,R = 1000:每家 1000 × 4 ÷ 25 = 160,总共 800(80%)。奖品涨到 2000:每家 320,总共 1600。只有 2 家:每家 1000 × 1 ÷ 4 = 250,总共 500(50%)。奖品越大、争的人越多,花掉的越多;花掉的比例,是 (n − 1) ÷ n。
4. 3.2 节的关税,如果是 10 家钢厂,每家多赚 3,000,000;300 万消费者,每人多付 12。(a)总的好处和总的损失各是多少?(b)单个钢厂和单个消费者的利害,相差多少倍?(c)这项政策,更可能通过,还是更可能被否决?为什么?
提示:(a)钢厂的总好处 10 × 3,000,000 = 30,000,000;消费者的总损失 3,000,000 × 12 = 36,000,000(净损失 6,000,000)。(b)单个钢厂 3,000,000,单个消费者 12,相差 3,000,000 ÷ 12 = 250,000 倍。(c)更可能通过:好处集中在 10 家企业,它们有强烈的动力去游说、也容易组织;成本分散在 300 万人身上,每个人只多付 12,没人愿意为此花时间(理性无知,加上搭便车)。这是逻辑上的结论;现实里还有别的力量(媒体、竞争性的利益集团、选举的压力),结果要看具体情形。
5. 5.1 节的官员,如果第二件事被度量到的权重 m = 0.5:他会把多少精力,分给第二件事?为什么政府不直接把 m 定到 1.5?
提示:m = 0.5:e₂ ÷ e₁ = (0.5 ÷ 1)² = 0.25,e₁ = 10 ÷ 1.25 = 8,e₂ = 2(占 20%)。(代码里 m = 0.5 一行:增长 8.00,其他 2.00。)为什么不直接把 m 定到 1.5:因为难度量,意味着度量本身有成本、容易被操纵、也不容易被上级观察到;“权重"不是说定就能定的,只有能被度量到的部分,才能被考核。可以做的,是改进度量(引入居民满意度、第三方评估),或者让官员对本地的居民负责,而不是只对上级负责,但每一种办法,又有各自的问题。
参考与延伸
- Black, D. (1948). On the Rationale of Group Decision-making. Journal of Political Economy, 56(1), 23–34.
- Arrow, K. J. (1951). Social Choice and Individual Values. Wiley.
- Downs, A. (1957). An Economic Theory of Democracy. Harper & Row.
- Buchanan, J. M., & Tullock, G. (1962). The Calculus of Consent. University of Michigan Press.
- Olson, M. (1965). The Logic of Collective Action. Harvard University Press.
- Tullock, G. (1967). The Welfare Costs of Tariffs, Monopolies, and Theft. Western Economic Journal, 5(3), 224–232.
- Krueger, A. O. (1974). The Political Economy of the Rent-Seeking Society. American Economic Review, 64(3), 291–303.
- Posner, R. A. (1975). The Social Costs of Monopoly and Regulation. Journal of Political Economy, 83(4), 807–827.
- Tullock, G. (1980). Efficient Rent Seeking. In Buchanan, Tollison & Tullock (Eds.), Toward a Theory of the Rent-Seeking Society. Texas A&M University Press.
- Holmström, B., & Milgrom, P. (1991). Multitask Principal–Agent Analyses. Journal of Law, Economics, and Organization, 7 (special issue), 24–52.
- North, D. C. (1990). Institutions, Institutional Change and Economic Performance. Cambridge University Press.
- Li, H., & Zhou, L.-A. (2005). Political Turnover and Economic Performance: The Incentive Role of Personnel Control in China. Journal of Public Economics, 89(9–10), 1743–1762.
- Olken, B. A. (2007). Monitoring Corruption: Evidence from a Field Experiment in Indonesia. Journal of Political Economy, 115(2), 200–249.