这一讲要回答五个问题:
- GDP 是什么?为什么用三种方法,能算出同一个数?
- 名义和实际有什么区别?为什么要剔除价格?
- 通胀怎么量?为什么不同的价格指数,答案不同?
- 失业怎么量?为什么失业率下降,不一定是好消息?
- 这些数字漏掉了什么?它们有多可靠?
前面二十六讲,我们看的,都是一个市场、一个企业、一群人。从这一讲起,我们换一个尺度:整个经济。宏观经济学要回答的,是这样一些问题:一个国家一年生产多少东西?生活水平为什么在长期里越来越高?为什么有时经济会衰退,大家一起失业?物价为什么会涨?央行和政府能做什么?这些问题,都要先有数字。这一讲,先把三个最基本的数字:GDP、通胀、失业,是怎么量出来的,讲清楚。
数字有两种用法:用来理解(过去发生了什么),用来决策(接下来该做什么)。两者都要求你知道:这个数字,到底量的是什么,没量的是什么。
一、新闻里的三个数
新闻里,经常出现这样的话:
- “全年国内生产总值同比增长 5%";
- “居民消费价格同比上涨 0.1%";
- “城镇调查失业率 5.2%"。
先停一下:一个国家,一年生产了成千上万种东西,苹果、汽车、理发、手机、教育、医疗。怎么把它们加成"一个数”?苹果和汽车,怎么能加?
答案,是用价格当共同的单位:苹果 5 元一斤,卖了 1 亿斤,就是 5 亿元;汽车 10 万元一辆,卖了 300 万辆,就是 3000 亿元。加起来,就是一个数。这既是 GDP 的巧妙之处,也是它的局限所在:凡是价格能衡量的,它都能加;凡是没有价格的,它都看不见。
二、GDP:一年里生产的东西,值多少钱
2.1 定义
国内生产总值(Gross Domestic Product,GDP):在一定时期内(通常是一年),一个国家(或地区)的常住单位,生产的所有最终产品和服务的市场价值。
这句话里,有几个词,值得一个一个地看:
- 最终:只算最终卖给使用者的,不算中间品(否则,会重复计算);
- 生产:只算今年生产的,不算二手货;
- 市场价值:用市场价格来衡量;没有市场交易的,一般不算;
- 国内:在本国领土上生产的,不管是谁生产的(相对于"国民”:本国国民,不管在哪生产)。
2.2 一座小岛
我们用一座小岛,把 GDP 算清楚。小岛上,有三家企业:农场(种小麦)、设备厂(造烤箱)、面包房(做面包)。单位:万元。
# 一座小岛,一年里有三家企业:农场(种小麦)、设备厂(造烤箱)、面包房(做面包)。单位:万元。
# 每家企业:产出 = 卖给谁;增加值 = 产出 - 中间投入;增加值 = 工资 + 利润 + 折旧 + 生产税(净额)
firms = {
    "农场":   dict(output=400, intermediate=0,   wages=250, profit=130, depreciation=10, tax=10),
    "设备厂": dict(output=150, intermediate=0,   wages=100, profit=30,  depreciation=10, tax=10),
    "面包房": dict(output=700, intermediate=350, wages=170, profit=150, depreciation=10, tax=20),   # 中间投入:小麦 300(本岛农场)+ 进口白糖 50
}
# 最终去向(支出法)
C = 500                     # 家庭买面包
G = 100                     # 政府买面包(学校午餐)
I = 150 + 100               # 面包房买新烤箱 150;面包房有 100 的面包没卖出去,进了库存(库存增加也算投资)
X = 100                     # 农场把小麦卖给国外
M = 50                      # 面包房从国外进口白糖(中间投入)

# 1) 生产法:各企业增加值之和
added = {k: f["output"] - f["intermediate"] for k, f in firms.items()}
gdp_production = sum(added.values())
# 2) 支出法:C + I + G + (X - M)
gdp_expenditure = C + I + G + (X - M)
# 3) 收入法:工资 + 利润 + 折旧 + 生产税(净额)
gdp_income = sum(f["wages"] + f["profit"] + f["depreciation"] + f["tax"] for f in firms.values())

print("各企业的增加值(产出 - 中间投入):", added)
print(f"生产法 {gdp_production};支出法 C{C}+I{I}+G{G}+(X{X}-M{M}) = {gdp_expenditure};收入法 = {gdp_income}")
for k, f in firms.items():
    print(f"  检查 {k}:增加值 {added[k]} = 工资 {f['wages']} + 利润 {f['profit']} + 折旧 {f['depreciation']} + 税 {f['tax']} = {f['wages'] + f['profit'] + f['depreciation'] + f['tax']}")

# 常见的错误:把所有企业的产出直接加起来
total_sales = sum(f["output"] for f in firms.values())
print(f"\n错误做法:把三家企业的产出加起来 = {total_sales},比 GDP 多出 {total_sales - gdp_production}:多算的是 小麦 300(卖给面包房,已经含在面包的价值里)和 进口白糖 50(国外创造的价值)")

# 规则:只算今年生产的最终产品和服务
print("\n哪些东西不算今年的 GDP?")
print("  - 二手烤箱转手卖 20:不是今年生产的(但中介的佣金,是今年提供的服务,算)")
print("  - 政府给老人发养老金:转移支付,没有换来今年的生产(但政府买学校午餐,算)")
print("  - 买一只股票:金融资产的交易,不是产品")
print("  - 家人自己做饭:没有市场交易,不算(餐馆做的饭,算)")
输出:
各企业的增加值(产出 - 中间投入): {'农场': 400, '设备厂': 150, '面包房': 350}
生产法 900;支出法 C500+I250+G100+(X100-M50) = 900;收入法 = 900
  检查 农场:增加值 400 = 工资 250 + 利润 130 + 折旧 10 + 税 10 = 400
  检查 设备厂:增加值 150 = 工资 100 + 利润 30 + 折旧 10 + 税 10 = 150
  检查 面包房:增加值 350 = 工资 170 + 利润 150 + 折旧 10 + 税 20 = 350

错误做法:把三家企业的产出加起来 = 1250,比 GDP 多出 350:多算的是 小麦 300(卖给面包房,已经含在面包的价值里)和 进口白糖 50(国外创造的价值)

哪些东西不算今年的 GDP?
  - 二手烤箱转手卖 20:不是今年生产的(但中介的佣金,是今年提供的服务,算)
  - 政府给老人发养老金:转移支付,没有换来今年的生产(但政府买学校午餐,算)
  - 买一只股票:金融资产的交易,不是产品
  - 家人自己做饭:没有市场交易,不算(餐馆做的饭,算)
逐段看:
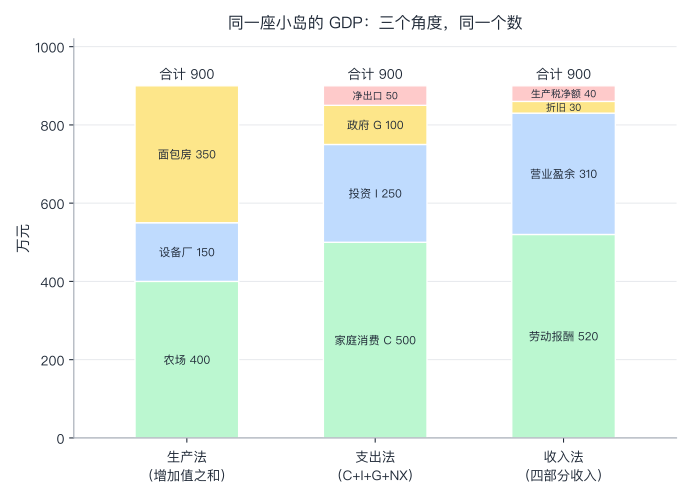
- 生产法:每家企业,创造了多少增加值(产出减去买来的中间投入)。农场 400,设备厂 150,面包房 350(产出 700,减去买来的小麦 300 和进口的白糖 50),加起来 900。
- 支出法:这些东西,最后被谁买走了?家庭消费 C = 500;投资 I = 250(面包房买新烤箱 150,加上卖不出去的 100 的面包,进了库存);政府购买 G = 100;净出口 = 出口 100 − 进口 50 = 50。加起来,900。
- 收入法:生产出来的价值,变成了谁的收入?劳动报酬 520,营业盈余(利润)310,固定资产折旧 30,生产税净额 40。加起来,900。
- 为什么三个数一样:每一笔交易,都有两面:一个人的支出,是另一个人的收入;一家企业创造的增加值,必然变成给工人的工资、给老板的利润、给设备的折旧、给政府的税。所以,从三个角度数同一笔钱,当然是同一个数。(实际统计里,由于数据来源不同,三个数会有误差,需要调整;国家统计局公布的 GDP,就是从生产、收入、使用三个角度核算的。)
- 常见的错误:把所有企业的产出,直接加起来:1250,多算了 350,多算的是小麦 300(已经含在面包的价值里)和进口白糖 50(国外创造的价值)。这就是为什么,只算增加值,或者只算最终产品。
2.3 哪些东西,不算
GDP 有几条规矩,常常让人意外:
- 二手货的转手不算(不是今年生产的),但中介的佣金,是今年提供的服务,算;
- 转移支付(养老金、救济金)不算,它们没有换来今年的生产;政府买学校午餐、修路,算;
- 金融资产的买卖(买股票)不算,不是产品;
- 家务劳动、自己做饭,没有市场交易,不算;餐馆做的饭,算;
- 地下经济、非法交易,一般不在统计里(有些国家,会对它们做估算)。
小结: GDP:一年里,生产的所有最终产品和服务的市场价值。三种算法,生产法(增加值之和)、支出法(C + I + G + 净出口)、收入法(工资 + 利润 + 折旧 + 生产税),从不同角度量同一笔钱。只算最终产品,否则重复计算;不算二手货、转移支付、金融资产交易、没有市场交易的家务。
三、名义与实际:剔除价格
3.1 为什么要剔除价格
新闻说,今年 GDP 比去年多了 10%。是生产了更多东西,还是东西变贵了?
- 名义 GDP:当年的产量,乘当年的价格。价格涨,它就涨,哪怕一件东西都没多生产。
- 实际 GDP:把价格固定在某个基期,只让产量变化。它衡量的,是产量的变化。
我们用一座只生产面包和奶茶的小岛,看三年的数据:
# 一座小岛只生产面包和奶茶,三年的价格和产量:
years = ["第 1 年", "第 2 年", "第 3 年"]
price = {"面包": [2.0, 2.2, 2.4], "奶茶": [8.0, 10.0, 12.0]}
qty   = {"面包": [100, 110, 130],  "奶茶": [50, 40, 36]}

def value(p_year, q_year):                              # 用第 p_year 年的价格,算第 q_year 年的产量值多少钱
    return sum(price[g][p_year] * qty[g][q_year] for g in price)

nominal = [value(t, t) for t in range(3)]
print("名义 GDP(当年产量 × 当年价格):", [round(v, 1) for v in nominal])
print("  名义增长:", [f"{(nominal[t] / nominal[t - 1] - 1):+.1%}" for t in (1, 2)])

# 实际 GDP:把价格固定在某一年,只看产量变了多少
real_base1 = [value(0, t) for t in range(3)]
real_base3 = [value(2, t) for t in range(3)]
print(f"\n实际 GDP,按第 1 年价格:{[round(v, 1) for v in real_base1]};增长 {[f'{real_base1[t] / real_base1[t - 1] - 1:+.1%}' for t in (1, 2)]}")
print(f"实际 GDP,按第 3 年价格:{[round(v, 1) for v in real_base3]};增长 {[f'{real_base3[t] / real_base3[t - 1] - 1:+.1%}' for t in (1, 2)]}")
print("  同样的产量,用哪一年的价格来衡量,增长率不一样(奶茶涨得多、产量降得多,用后期价格看,降得更狠)")

# 链式:每年用"上一年"的价格,把相邻两年的增长连起来(Fisher:两个方向的几何平均)
import math
def fisher_growth(t):
    laspeyres = value(t - 1, t) / value(t - 1, t - 1)   # 用上一年价格
    paasche = value(t, t) / value(t, t - 1)             # 用本年价格
    return math.sqrt(laspeyres * paasche) - 1, laspeyres - 1, paasche - 1
for t in (1, 2):
    f, l, p = fisher_growth(t)
    print(f"第 {t + 1} 年的实际增长:上一年价格 {l:+.2%},本年价格 {p:+.2%},Fisher(几何平均){f:+.2%}")

# 价格指数:同一批数据,GDP 平减指数 = 名义 ÷ 实际;CPI = 固定一篮子(第 1 年的消费量)的价格
deflator = [nominal[t] / real_base1[t] for t in range(3)]
cpi = [sum(price[g][t] * qty[g][0] for g in price) / sum(price[g][0] * qty[g][0] for g in price) for t in range(3)]
print(f"\nGDP 平减指数(第 1 年=1):{[round(d, 3) for d in deflator]}")
print(f"CPI(固定第 1 年的篮子:100 个面包、50 杯奶茶;第 1 年=1):{[round(c, 3) for c in cpi]}")
fisher_price = math.sqrt(cpi[2] * deflator[2])
print(f"第 3 年相对第 1 年:固定篮子(Laspeyres)说物价涨了 {cpi[2] - 1:.1%},平减指数(用第 3 年的消费量)说 {deflator[2] - 1:.1%},两者的几何平均(Fisher){fisher_price - 1:.1%}")
print("  奶茶涨价最多,但人们已经少买奶茶、多买面包:固定篮子假设人们不会改变消费,所以会高估生活成本的上涨(替代偏差)")
输出:
名义 GDP(当年产量 × 当年价格): [600.0, 642.0, 744.0]
  名义增长: ['+7.0%', '+15.9%']

实际 GDP,按第 1 年价格:[600.0, 540.0, 548.0];增长 ['-10.0%', '+1.5%']
实际 GDP,按第 3 年价格:[840.0, 744.0, 744.0];增长 ['-11.4%', '+0.0%']
  同样的产量,用哪一年的价格来衡量,增长率不一样(奶茶涨得多、产量降得多,用后期价格看,降得更狠)
第 2 年的实际增长:上一年价格 -10.00%,本年价格 -10.83%,Fisher(几何平均)-10.42%
第 3 年的实际增长:上一年价格 +0.62%,本年价格 +0.00%,Fisher(几何平均)+0.31%

GDP 平减指数(第 1 年=1):[1.0, 1.189, 1.358]
CPI(固定第 1 年的篮子:100 个面包、50 杯奶茶;第 1 年=1):[1.0, 1.2, 1.4]
第 3 年相对第 1 年:固定篮子(Laspeyres)说物价涨了 40.0%,平减指数(用第 3 年的消费量)说 35.8%,两者的几何平均(Fisher)37.9%
  奶茶涨价最多,但人们已经少买奶茶、多买面包:固定篮子假设人们不会改变消费,所以会高估生活成本的上涨(替代偏差)
逐段看:
- 名义 GDP:600、642、744,每年都涨。
- 实际 GDP(按第 1 年的价格):600、540、548:第 2 年,名义涨了 7.0%,实际却降了 10.0%:奶茶减产得多,而奶茶价值高。名义的增长,几乎全是价格上涨造成的。
- 基期怎么选,结果会不同:同样的产量,按第 1 年的价格,第 2 年实际降 10.0%;按第 3 年的价格,降 11.4%。因为奶茶涨价多、产量降得多,用后期的价格来看,这个下降更重。所以,许多国家的统计机构,改用"链式"的办法:每年用相邻两年的价格,把增长连起来(代码里的 Fisher 指数,是用上一年和本年价格算的增长,取几何平均)。
- 价格指数:名义 ÷ 实际,得到 GDP 平减指数:第 3 年是 1.358,也就是物价总体上涨了 35.8%。
3.2 通胀:CPI 和平减指数
通胀(物价总体水平的上涨),主要用两个指数来量:
- GDP 平减指数:覆盖所有在国内生产的东西(消费品、投资品、出口品),篮子随每年的产量变;
- 居民消费价格指数(CPI):只看居民消费的一篮子东西,篮子固定(在某个基期选定),看这一篮子,现在要花多少钱。
代码的最后一部分,把两个方法,放在同一个例子里:第 3 年相对第 1 年,固定篮子的 CPI 说涨了 40.0%,用第 3 年的消费量(平减指数)是 35.8%,两者的几何平均是 37.9%。差别从哪来? 奶茶涨价最多,人们已经少买奶茶、多买面包;固定篮子假设人们不会改变消费,所以高估了生活成本的上涨。这叫替代偏差。
除了替代偏差,新产品的出现、质量的提高,也会让 CPI 有偏差:你的手机比十年前便宜很多、功能强很多,但"一部手机"的价格,没有降多少。1996 年,美国参议院任命的 Boskin 委员会估计,美国的 CPI 每年高估物价上涨约 1.1 个百分点(合理范围 0.8 到 1.6);其中替代偏差约占 0.4,质量改进和新产品占约 0.6。(这是美国 1990 年代的估计,之后统计方法已经改进;这里是说明偏差的来源,不是说今天的 CPI 仍有这么大的偏差。)
3.3 中国的 CPI
国家统计局的 CPI,按 8 个大类(食品烟酒及在外餐饮、衣着、居住、生活用品及服务、交通通信、教育文化娱乐、医疗保健、其他用品及服务)来调查(名称各期略有不同)。篮子每五年更新一次:逢"5"和"0"的年份作基期,在基期年选定"一篮子"商品和服务,五年内保持不变。据国家统计局 2026 年 2 月的解读,2021 到 2025 年用的是 2020 年基期,从 2026 年起改用 2025 年为基期;这一轮,服务的权重上升,调查网点和商品规格也扩大了。
另外还有几个常见的相关指标:核心 CPI(剔除价格波动大的食品和能源)、PPI(工业生产者出厂价格,看的是上游,不是消费者)。
小结: 名义 GDP 受价格影响;实际 GDP 把价格固定在基期,只看产量;基期不同,增长率会不同,所以常用链式的办法。通胀用 CPI(固定篮子)或平减指数(所有产出)量,两者不同;CPI 有替代偏差、质量和新产品的偏差。
四、真实数据:中国的增长与物价
我们来看真实的数字。下面的数据,来自世界银行的 World Development Indicators(2026 年 10 月 8 日更新的版本,原始数据来自各国的官方统计)。官方数据会修订,小数点后的数字,可能和当年第一次公布的有出入。
# 真实数据:中国的实际 GDP 年增长率(%)、名义 GDP 年增长率(%)、CPI 通胀(%)。
# 来源:世界银行 World Development Indicators(各国官方统计的汇编),2026 年 10 月 8 日更新的版本;后来的修订可能让小数点后的数字有出入。
growth = {1979: 7.59, 1980: 7.84, 1981: 5.11, 1982: 9.02, 1983: 10.77, 1984: 15.19, 1985: 13.43, 1986: 8.94, 1987: 11.66, 1988: 11.22, 1989: 4.21, 1990: 3.92, 1991: 9.38, 1992: 14.30, 1993: 13.93, 1994: 13.08, 1995: 11.02, 1996: 9.97, 1997: 9.30, 1998: 7.92, 1999: 7.74, 2000: 8.57, 2001: 8.32, 2002: 9.24, 2003: 10.11, 2004: 10.14, 2005: 11.45, 2006: 12.68, 2007: 14.15, 2008: 9.67, 2009: 9.41, 2010: 10.59, 2011: 9.46, 2012: 7.86, 2013: 7.78, 2014: 7.46, 2015: 6.98, 2016: 6.77, 2017: 6.89, 2018: 6.76, 2019: 6.07, 2020: 2.34, 2021: 8.57, 2022: 3.13, 2023: 5.42, 2024: 4.96, 2025: 4.96}
nominal_growth = {2018: 10.46, 2019: 7.46, 2020: 2.88, 2021: 13.43, 2022: 5.13, 2023: 4.88, 2024: 4.16, 2025: 3.99}
cpi = {2018: 2.07, 2019: 2.90, 2020: 2.42, 2021: 0.98, 2022: 1.97, 2023: 0.23, 2024: 0.22, 2025: 0.06}

def avg(a, b): return sum(growth[y] for y in range(a, b + 1)) / (b - a + 1)
print("中国实际 GDP 增长率,各时期的平均(%):")
for a, b in ((1979, 1989), (1990, 1999), (2000, 2009), (2010, 2019), (2020, 2025)):
    vals = [growth[y] for y in range(a, b + 1)]
    print(f"  {a}–{b}:平均 {avg(a, b):.2f},最低 {min(vals):.2f}({min(range(a, b + 1), key=lambda y: growth[y])} 年),最高 {max(vals):.2f}({max(range(a, b + 1), key=lambda y: growth[y])} 年)")

import math
print("\n翻一番要多少年?(按这些平均增速,保持不变;约等于 70 ÷ 增速)")
for a, b in ((1979, 1989), (2010, 2019), (2020, 2025)):
    r = avg(a, b) / 100
    print(f"  {a}–{b} 的平均增速 {avg(a, b):.1f}%:{math.log(2) / math.log(1 + r):.1f} 年(70 ÷ {avg(a, b):.1f} = {70 / avg(a, b):.1f})")

print("\n名义增长、实际增长、平减指数、CPI:")
for y in range(2018, 2026):
    deflator = ((1 + nominal_growth[y] / 100) / (1 + growth[y] / 100) - 1) * 100       # 平减指数的变化:名义 ÷ 实际
    print(f"  {y}:实际 {growth[y]:5.2f},名义 {nominal_growth[y]:5.2f},平减指数 {deflator:+5.2f},CPI {cpi[y]:5.2f}")
print("  2023 到 2025 年,名义增速低于实际增速:平减指数连续三年为负,而 CPI 仍然是小幅为正")
输出:
中国实际 GDP 增长率,各时期的平均(%):
  1979–1989:平均 9.54,最低 4.21(1989 年),最高 15.19(1984 年)
  1990–1999:平均 10.06,最低 3.92(1990 年),最高 14.30(1992 年)
  2000–2009:平均 10.37,最低 8.32(2001 年),最高 14.15(2007 年)
  2010–2019:平均 7.66,最低 6.07(2019 年),最高 10.59(2010 年)
  2020–2025:平均 4.90,最低 2.34(2020 年),最高 8.57(2021 年)

翻一番要多少年?(按这些平均增速,保持不变;约等于 70 ÷ 增速)
  1979–1989 的平均增速 9.5%:7.6 年(70 ÷ 9.5 = 7.3)
  2010–2019 的平均增速 7.7%:9.4 年(70 ÷ 7.7 = 9.1)
  2020–2025 的平均增速 4.9%:14.5 年(70 ÷ 4.9 = 14.3)

名义增长、实际增长、平减指数、CPI:
  2018:实际  6.76,名义 10.46,平减指数 +3.47,CPI  2.07
  2019:实际  6.07,名义  7.46,平减指数 +1.31,CPI  2.90
  2020:实际  2.34,名义  2.88,平减指数 +0.53,CPI  2.42
  2021:实际  8.57,名义 13.43,平减指数 +4.48,CPI  0.98
  2022:实际  3.13,名义  5.13,平减指数 +1.94,CPI  1.97
  2023:实际  5.42,名义  4.88,平减指数 -0.51,CPI  0.23
  2024:实际  4.96,名义  4.16,平减指数 -0.76,CPI  0.22
  2025:实际  4.96,名义  3.99,平减指数 -0.92,CPI  0.06
  2023 到 2025 年,名义增速低于实际增速:平减指数连续三年为负,而 CPI 仍然是小幅为正
逐段看:
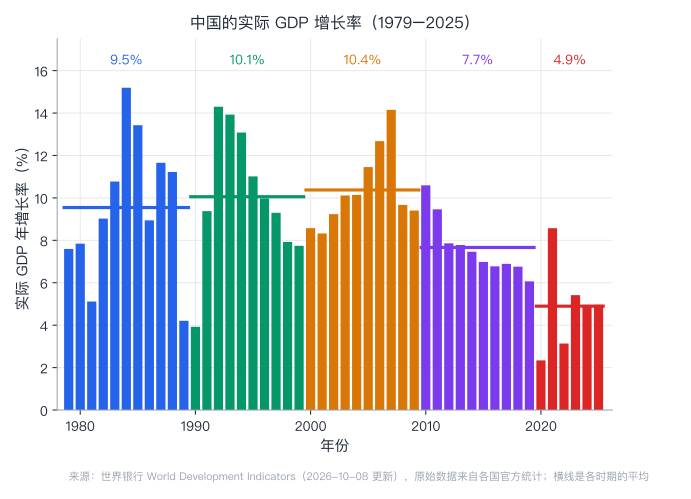
- 增长的阶梯:1979 到 1989 年,平均每年增长 9.5%;1990 到 1999 年 10.1%;2000 到 2009 年 10.4%;2010 到 2019 年 7.7%;2020 到 2025 年 4.9%(含 2020 年疫情的 2.3% 和 2021 年的反弹 8.6%)。增长率,在这几十年里,是阶梯式下降的。
- 翻一番要多久:按 9.5% 增长,约 7.6 年翻一番;7.7%,约 9.4 年;4.9%,约 14.5 年。(经验法则:70 ÷ 增速。)这说明,增速的小变化,在长期里,差别巨大,这是第 28 讲讲长期增长的起点。
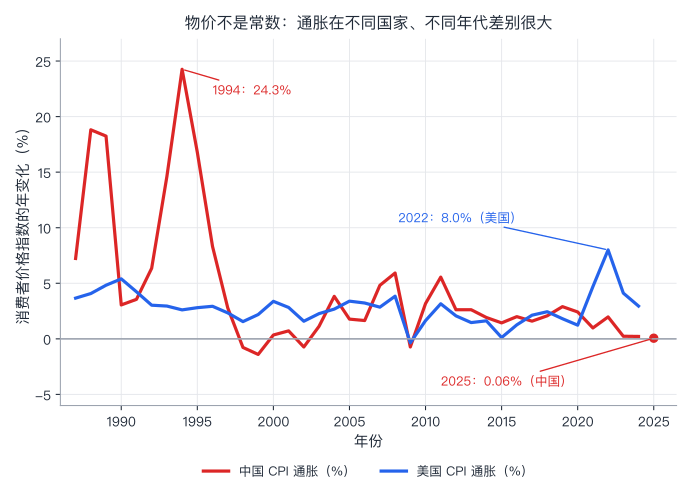
- 通胀不是常数:中国的 CPI 通胀,1988 年 18.8%,1994 年 24.3%,1998 到 1999 年为负,2000 年代到 2010 年代,大多在 0 到 6% 之间,近年来很低:2023 年 0.23%,2024 年 0.22%,2025 年 0.06%。美国,2022 年到了 8.0%。同一个国家,不同年代;不同国家,同一年代,通胀可以差别很大。
- 平减指数和 CPI 可以讲不同的故事:2023 到 2025 年,名义 GDP 增速(4.88%、4.16%、3.99%)低于实际增速(5.42%、4.96%、4.96%):由此反推,GDP 平减指数连续三年是负的(−0.51%、−0.76%、−0.92%),而 CPI 仍然小幅为正。(平减指数是我根据名义和实际增速反推的,覆盖所有产出,包括投资品和出口品;CPI 只看居民消费的那一篮子。所以两者可以不同。这些年的价格为什么这样变化,是第 32、33 讲要讨论的问题;这里只是提醒:看物价,要看是哪一个指数。)
五、失业
5.1 怎么定义
失业,看起来很简单:没有工作的人。可是,一个 80 岁的老人、一个在家带孩子的人、一个大学生,都没有工作,他们算失业吗?
统计上的定义,是:
- 就业:调查参考周内,为取得劳动报酬或经营收入,工作了 1 小时及以上;
- 失业:16 岁及以上的人里,同时满足三个条件:(1)调查参考周内没有工作;(2)调查前 3 个月内找过工作;(3)如果有合适的工作,2 周内能立刻开始。(这是国家统计局 2024 年版本的说明。)
- 劳动力 = 就业 + 失业。不在劳动力里的人(学生、退休者、没有在找工作的人):不算失业,也不算就业。
- 失业率 = 失业 ÷ 劳动力。劳动参与率 = 劳动力 ÷ 16 岁及以上人口。
按这个口径(国际劳工组织推荐的标准,国际可比),国家统计局每月通过劳动力调查(据统计局发言人介绍,每月随机抽取约 34 万个住户)来测算调查失业率,自 2018 年 4 月起,按月公布全国城镇调查失业率和 31 个大城市的调查失业率。这和以前常用的城镇登记失业率不同:登记失业,只统计在政府部门登记了的人,而调查失业率,不要求登记,也不限户籍。
5.2 用代码算一算
# 一座 1000 人的小镇,16 岁以上的人。国家统计局口径:失业 = 参考周内没有工作 + 前 3 个月内找过工作 + 有合适工作的话 2 周内能上岗。
# 就业 = 参考周内为取得报酬工作了 1 小时及以上。
def classify(p):
    if p["worked_hours"] >= 1: return "就业"
    if p["searched_in_3_months"] and p["available_in_2_weeks"]: return "失业"
    return "非劳动力"

def rates(people):
    c = {"就业": 0, "失业": 0, "非劳动力": 0}
    for p in people: c[classify(p)] += 1
    labor = c["就业"] + c["失业"]
    return c, c["失业"] / labor, labor / len(people)

def person(n, hours, searched, available):
    return [dict(worked_hours=hours, searched_in_3_months=searched, available_in_2_weeks=available) for _ in range(n)]

# 一、一座 1000 人的小镇
town = person(540, 40, False, False) + person(60, 0, True, True) + person(400, 0, False, False)
c, u, lfp = rates(town)
print(f"小镇:{c};劳动力 {c['就业'] + c['失业']},失业率 {u:.1%},劳动参与率 {lfp:.1%}")

# 二、20 个失业的人,找了很久没找到,不再找了("灰心丧气的工人"):他们不再被算作失业
town2 = person(540, 40, False, False) + person(40, 0, True, True) + person(420, 0, False, False)
c2, u2, lfp2 = rates(town2)
print(f"20 人放弃找工作后:{c2};失业率 {u2:.1%}(原来 {u:.1%}),劳动参与率 {lfp2:.1%}:没有人多了一份工作,失业率却'下降'了")

# 三、同样是 1000 个 16 到 24 岁的年轻人(假想的数字):680 个在校生、320 个不在校生。口径不同,失业率就不同
students = person(60, 5, False, False) + person(30, 0, True, True) + person(590, 0, False, False)       # 在校生里,60 人兼职、30 人在找实习或兼职且随时能上岗
graduates = person(200, 40, False, False) + person(40, 0, True, True) + person(80, 0, False, False)     # 不在校:200 就业、40 失业、80 不在劳动力
for name, group in (("包含在校生", students + graduates), ("不含在校生", graduates)):
    c3, u3, lfp3 = rates(group)
    print(f"{name}:就业 {c3['就业']},失业 {c3['失业']},失业率 {u3:.1%},参与率 {lfp3:.1%}")
print("  (这是假想的数字,用来说明:口径不同,同一批人算出的失业率就不同)")
输出:
小镇:{'就业': 540, '失业': 60, '非劳动力': 400};劳动力 600,失业率 10.0%,劳动参与率 60.0%
20 人放弃找工作后:{'就业': 540, '失业': 40, '非劳动力': 420};失业率 6.9%(原来 10.0%),劳动参与率 58.0%:没有人多了一份工作,失业率却'下降'了
包含在校生:就业 260,失业 70,失业率 21.2%,参与率 33.0%
不含在校生:就业 200,失业 40,失业率 16.7%,参与率 75.0%
  (这是假想的数字,用来说明:口径不同,同一批人算出的失业率就不同)
- 小镇:1000 人里,540 人有工作,60 人在找工作,400 人不在劳动力里。劳动力 600,失业率 60 ÷ 600 = 10.0%,劳动参与率 60.0%。
- 灰心丧气的工人:20 个失业的人,找了很久没找到,不再找了。他们不再被算作失业:失业率变成 6.9%,下降了,可是,没有人多了一份工作,劳动参与率降到 58.0%。失业率下降,不一定是好消息:要同时看参与率。
- 口径一变,数字就变:假想的 1000 个 16 到 24 岁的年轻人,其中 680 个在校生,320 个不在校生。把在校生(其中有人在找实习或兼职)算进劳动力,失业率 21.2%;不含在校生,失业率 16.7%。这是假想的数字,用来说明:同一批人,口径不同,失业率就不同。
这不只是一个假想的问题。国家统计局原来公布分年龄段的城镇调查失业率,2023 年 8 月起暂停发布;统计局发言人当时解释,其中一个问题是在校生的规模:2022 年,16 到 24 岁的城镇青年有 9600 多万人,其中在校学生 6500 多万;对于毕业前就在找工作的学生,是否应当计入劳动力,各方看法不一。2023 年 12 月起,统计局改为发布不包含在校生的 16 到 24 岁、25 到 29 岁、30 到 59 岁劳动力的失业率。新旧口径下的数字,不能直接比较。
5.3 失业的种类
- 摩擦性失业:换工作、刚毕业、找合适的岗位,需要时间;
- 结构性失业:技能和岗位不匹配,或者行业在衰落;
- 周期性失业:经济衰退,企业不招人。
经济再好,也不会有"零失业”:总有人在换工作。自然失业率,就是没有周期性失业时的那个失业率(第 33 讲会讲)。失业的统计,不会告诉你:这份工作好不好、工资多高、工时是否足够。失业率低,不等于就业质量高。
小结: 失业:没有工作、近期找过、随时能上岗。失业率 = 失业 ÷ 劳动力。灰心丧气的工人退出劳动力,失业率会下降,要同时看参与率。口径(比如是否含在校生)会改变失业率;新旧口径不能直接比较。失业率不反映就业质量。
六、这些数字漏掉了什么
6.1 GDP 不等于福祉
美国经济学家 Simon Kuznets,是国民收入统计的奠基人之一。他 1934 年给美国国会的报告里,就提醒过:一个国家的福祉,很难从国民收入的数字里推断出来。GDP 的"盲区",大致有:
- 没有市场交易的:家务、照顾老人孩子、志愿服务;
- 地下经济;
- 自然资源和环境的损耗:砍掉一片森林,卖木材,GDP 增加;森林的价值减少,不扣;
- 分配:GDP 是总量或平均数,不告诉你,谁得到了多少;
- 闲暇:多工作一小时,GDP 增加;闲暇的价值,不算;
- 质量和新产品:手机变得更好,GDP 里不一定充分反映;
- 伤害性的产出:车祸之后修车、治病,增加 GDP,但没有人因此更幸福。
按"预测 → 证据与局限 → 分歧在哪 → 价值判断留给读者",来写一个有争议的问题:GDP 能不能当作福祉的近似?
理论预测什么:GDP 衡量的是产出的市场价值,不是福祉。如果一国的福祉,与 GDP 同步变化,那么 GDP 是个好的近似;如果不同步,就会误导。
证据怎么说:Charles Jones 和 Peter Klenow 2016 年(American Economic Review,106 卷 9 期)构造了一个福祉指标,把消费、闲暇、预期寿命、不平等,都放进去,比较各国。他们发现:福祉和人均 GDP 高度相关,但偏离常常很大:西欧的福祉,比它的人均 GDP 显示的更接近美国;新兴的亚洲经济体,没有 GDP 显示的追得那么多;在各个组成部分里,预期寿命(死亡率)最重要。
局限:这个指标,要假设:怎么给闲暇、寿命、不平等"估价",以及各国居民的偏好是否一样;这些假设,可以不同,结果也会随之变化。
分歧在哪:
- 事实上的分歧:人均 GDP,在多大程度上,抓住了福祉?相关性高,说明它大致能用;偏离大,说明它在比较具体国家时,会误导。不同的研究者,看重的点不同。
- 价值上的分歧:下面的问题,数据回答不了。
价值判断(留给你):
- 衡量一个社会的"进步",该包括什么:收入、寿命、闲暇、平等、环境、自由?
- 如果这些东西,互相冲突(比如更高的收入、更长的工作时间),权重怎么给?
- 一个数(GDP),还是一组数(“仪表盘”)?(2009 年,由 Joseph Stiglitz、Amartya Sen 和 Jean-Paul Fitoussi 主持的一个委员会,建议超越单一的 GDP,用一组指标;我没有逐条核对报告的建议。)
经济学可以告诉你,每种衡量,把什么算进去、什么漏掉了;该给每一项多大的权重,是你的价值判断。
6.2 数据可靠吗:中国 GDP 的争论
另一个问题:官方公布的数字,有多准?也按四步来写。
理论预测什么:任何国家的统计,都有误差;如果统计的结果,和官员的考核、奖励联系在一起(第 26 讲),就有人为美化的动机。
证据怎么说:这个问题,在中国,有两个方向相反的研究。
- Wei Chen、Xilu Chen、Chang-Tai Hsieh 和 Zheng Song 2019 年的研究(NBER 工作论文 25754,《对中国国民账户的法证式检查》),认为:地方政府因为增长和投资的目标,有动机多报;国家统计局对地方数据的修正,在 2008 年之前大致准确,之后修正偏小,并且越拉越大。他们估计,官方的增长率,在 2008 到 2016 年间,平均高估了约 1.7 个百分点(不同的报道、不同的时期,数字略有出入)。
- Hunter Clark、Maxim Pinkovskiy 和 Xavier Sala-i-Martin(NBER 工作论文 23323,后发表于 China Economic Review 2020 年 62 卷),用卫星拍到的夜间灯光强度,作为独立的参照,结论是:夜间灯光的证据,与中国的增长高于官方数字相一致,并不支持 2015 年底经济大幅收缩的说法。
局限:两个研究,用的证据和方法,都不同,也各有假设:夜间灯光只是产出的近似,各自对数据的处理,也有争议。两篇文章,不是直接矛盾的,它们回答的,是不同时期、不同角度的问题。
分歧在哪:主要是事实和方法的分歧:官方的增长数字,是偏高、偏低,还是大体可信?不同的研究者,得到了不同的结论,没有公认的答案。
价值判断:这里几乎没有价值判断,主要是事实问题。你需要自己权衡的,是:当数字有争议时,该多大程度地依赖单一的数字(用多个指标互相印证更稳妥)?统计机构,应该有多独立、多透明?
要说明的是:这类争论,在各国都有,不是中国独有(据我所知,也有研究用夜间灯光等方法,检验别的国家的 GDP 数据,这里没有逐篇核对);而且,所有国家的统计,都在不断修订、改进。
七、局限、常见误用
7.1 局限
- GDP 是总量:看一个国家的富裕程度,要看人均,也要看分配。
- 价格指数是平均数:每个人的篮子不同(老人和年轻人、城市和农村),“你感受到的物价”,可能和 CPI 不一样。
- 失业率只是一个数:不告诉你就业的质量,也不包括灰心丧气者。
- 口径会变:统计方法在改进,比较不同时期的数字,要看口径是否一致。
- 数据会修订:第一次公布的数字,之后可能被修订。
7.2 常见的误用
| 误用 | 正确的想法 |
|---|---|
| “GDP 增长了,生活就好了” | GDP 是产出的市场价值,不是福祉;还要看人均、分配、环境、闲暇 |
| “名义 GDP 增长 10%,经济就增长了 10%” | 要剔除价格:实际增长,才是产量的变化 |
| “CPI 就是我感受到的物价” | CPI 是一篮子的平均,每个人的篮子不同;还有替代偏差 |
| “通胀低(接近零),就一定是好事” | 低通胀,也可能意味着需求不足;要和别的指标一起看(第 32、33 讲) |
| “失业率下降,就是找到工作的人多了” | 也可能是灰心丧气的人退出了劳动力;要看参与率 |
| “新旧口径的失业率,可以直接比” | 口径变了,数字不能直接比较 |
| “二手车卖出去,也是 GDP” | 不是今年生产的,不算;中介的佣金才算 |
| “GDP 越大,国家越富” | 总量大,不等于人均高;要看人均 |
八、小结
这一讲有六个想法,请带走:
- GDP:一年里,生产的所有最终产品和服务的市场价值。三种算法:生产法(增加值)、支出法(C + I + G + 净出口)、收入法(工资 + 利润 + 折旧 + 生产税),从不同角度量同一笔钱,所以相等。只算最终产品,否则重复计算。
- 名义与实际:名义受价格影响,实际固定价格,只看产量。基期不同,增长率不同,所以常用链式。
- 通胀:CPI(固定篮子)和平减指数(所有产出)不同;CPI 有替代偏差和新产品、质量的偏差。中国 CPI 每五年更新基期,2026 年起以 2025 年为基期。
- 真实数据:中国的实际 GDP 增长率,从 1980 年代的 9.5%,到 2020 到 2025 年的 4.9%,阶梯式下降;通胀有大起大落;2023 到 2025 年,平减指数为负(2026 年第二季度,据报道转正,见第 33 讲),而 CPI 小幅为正,看物价,要看是哪个指数。
- 失业:就业、失业、非劳动力;失业率 = 失业 ÷ 劳动力;灰心丧气的工人会让失业率下降;口径(比如是否含在校生)会改变数字。
- 漏掉的与可靠性:GDP 漏掉了家务、环境、分配、闲暇;福祉与人均 GDP 高度相关但偏离常常很大;数据的可靠性有争议,不同的研究,得到不同的结论。
有了这三个数字,我们可以问宏观经济学最大的问题之一:一个国家,为什么能长期变富? 同样是 1980 年,有的国家,今天的人均收入,翻了很多倍,有的国家,几乎没变。第 28 讲:长期增长:Solow 模型。 你会看到,一个只有几个变量的简单模型,如何解释"为什么积累资本,会让人均产出上升,但不会永远上升",以及"为什么落后的国家,有时能追上来,有时追不上"。
思考题
1. 判断下面哪些计入今年的 GDP:(a)你把用了两年的手机,以 800 元卖给别人;(b)中介公司收取的 80 元撮合佣金;(c)政府发放的养老金;(d)你自己在家做饭;(e)一家公司,新建了一座厂房;(f)一家餐馆的外卖。
提示:(a)不计入:不是今年生产的(二手货转手)。(b)计入:撮合佣金,是今年提供的服务。(c)不计入:养老金是转移支付,没有换来今年的生产。(d)不计入:没有市场交易。(e)计入:新建厂房,是今年生产的投资品。(f)计入:餐馆的外卖,是今年提供的产品和服务。
2. 一座岛上只生产面包和奶茶。第 1 年:面包 100 个,每个 2 元;奶茶 50 杯,每杯 8 元。第 2 年:面包 110 个,每个 2.2 元;奶茶 40 杯,每杯 10 元。算:名义 GDP 的增长;按第 1 年价格的实际 GDP 增长。为什么两者的方向不同?
提示:第 1 年名义 = 100 × 2 + 50 × 8 = 600;第 2 年名义 = 110 × 2.2 + 40 × 10 = 242 + 400 = 642,增长 +7.0%。按第 1 年价格的实际 GDP:第 2 年 = 110 × 2 + 40 × 8 = 220 + 320 = 540,增长 −10.0%。方向不同,是因为价格上涨(面包涨 10%,奶茶涨 25%)把名义值推高了,而奶茶产量下降了 20%,它的价值又大:实际的产量变化,是下降的。
3. 用第 2 题的数据,算第 1 年到第 2 年的物价指数:(a)用第 1 年的篮子(第 1 年的消费量);(b)用第 2 年的篮子;(c)两者的几何平均(Fisher)。为什么(a)比(b)高?
提示:(a)第 1 年的篮子(100 个面包、50 杯奶茶),在第 2 年的价格下:100 × 2.2 + 50 × 10 = 720,对 600,指数 1.200(+20.0%)。(b)第 2 年的篮子(110、40):按第 2 年价格 642,按第 1 年价格 540,指数 642 ÷ 540 ≈ 1.189(+18.9%)。(c)Fisher = √(1.200 × 1.189) ≈ 1.194(+19.4%)。(a)比(b)高:奶茶涨得最多(+25%),第 1 年的篮子里奶茶多(50 杯),第 2 年人们少买奶茶(40 杯),固定的篮子没有反映这个替代,所以高估了。
4. 一个地方 16 岁以上的人口 1000 人:就业 700,失业 100,不在劳动力的 200。(a)失业率和劳动参与率各是多少?(b)如果有 30 个失业者找到了工作;(c)如果有 30 个失业者放弃找工作。分别比较(b)和(c)的失业率和参与率,哪一种更"好"?
提示:(a)劳动力 700 + 100 = 800,失业率 100 ÷ 800 = 12.5%,参与率 800 ÷ 1000 = 80%。(b)30 人找到工作:就业 730,失业 70,劳动力仍是 800:失业率 70 ÷ 800 = 8.75%,参与率 80% 不变。(c)30 人放弃找工作:就业 700,失业 70,劳动力 770:失业率 70 ÷ 770 ≈ 9.09%,参与率 770 ÷ 1000 = 77%。两种情形,失业率都下降了,但(b)是真的有 30 人多了一份工作,参与率不变;(c)没有人多一份工作,参与率下降了 3 个百分点。(b)更好。只看失业率,会分不出这两种情形。
5. 家务劳动(做饭、带孩子、照顾老人),应不应该算进 GDP?如果算,会怎样?这个问题里,哪些是事实问题,哪些是价值判断?
提示:不算的理由:家务没有市场价格,难以衡量,GDP 的定义是市场交易的价值。算的理由:它是真实的、有价值的生产,和你花钱雇人做同样的事没有区别;不算,会让那些把家务交给市场(点外卖、请保姆)的社会,GDP 看起来更高,却并没有生产更多。如果算,GDP 会增加,增加多少,取决于怎么估价:按雇人做这些事的工资(替代成本),还是按做家务的人放弃的工资(机会成本,第 1 讲),两者差别可以很大。事实问题:家务劳动有多少小时、值多少钱,怎么估计。价值判断:GDP 的目的,应该只是衡量市场产出,还是应当尽量涵盖所有对人有价值的生产;谁来做家务,谁的劳动应被"看见"。
参考与延伸
- 国家统计局:国内生产总值核算、居民消费价格指数、调查失业率的说明与历年解读(以国家统计局官网为准)。
- 世界银行:World Development Indicators(本讲的数据,2026 年 10 月 8 日更新的版本)。
- Kuznets, S. (1934). National Income, 1929–1932. Senate Document No. 124, 73rd Congress, 2nd Session.
- Boskin, M. J., Dulberger, E. R., Gordon, R. J., Griliches, Z., & Jorgenson, D. W. (1996). Toward a More Accurate Measure of the Cost of Living: Final Report to the Senate Finance Committee.
- Jones, C. I., & Klenow, P. J. (2016). Beyond GDP? Welfare across Countries and Time. American Economic Review, 106(9), 2426–2457.
- Chen, W., Chen, X., Hsieh, C.-T., & Song, Z. (2019). A Forensic Examination of China’s National Accounts. NBER Working Paper 25754.
- Clark, H., Pinkovskiy, M., & Sala-i-Martin, X. (2020). China’s GDP Growth May Be Understated. China Economic Review, 62. (NBER Working Paper 23323)
- Stiglitz, J. E., Sen, A., & Fitoussi, J.-P. (2009). Report by the Commission on the Measurement of Economic Performance and Social Progress.