这一讲要回答六个问题:
- 增长核算怎么把一个国家的增长,拆成资本、劳动、人力资本和"效率"?拆出来的"效率"是什么?
- 富国和穷国的收入差距,有多少来自机器和学历,有多少来自"效率"?
- 想法和面包有什么不同?为什么这让增长有可能"内生"?
- 技术会不会让更多人失去工作?
- 多读一年书,因果上值多少?
- 制度是不是最深的原因?这场争论到底在争什么?
上一讲,Solow 模型留下了一个大问题:持续的人均增长只能来自技术进步 g,可是 g 是天上掉下来的。这一讲,我们打开这个黑箱。你会看到,这是宏观经济学里证据最多、争论也最多的地方之一。所以,我们会比平时更小心地区分:哪些是会计,哪些是因果,哪些是我们不知道的。
一、一个思想实验
先做一个思想实验。
把全世界所有的机器、厂房、道路,按工人的人数平分,每个工人拿到一样多。再让每个国家的工人,都读到同样多年的书。其他什么都不动:技术、制度、气候、人们的习惯,都不变。
先停一下:做完这个实验,富国和穷国人均产出的差距,会怎样?
- A. 差距几乎消失;
- B. 差距缩小一半左右;
- C. 差距缩小一些,但大部分还在。
写下你的答案。这一讲的第三节,会用 2019 年的真实数据,给你一个数。
这个思想实验,在增长经济学里有个名字,叫发展核算(development accounting)。它的姿势很朴素:不问"为什么",先问"差在哪"。 先把差距拆开,看清楚哪一块最大,再去问那一块背后是什么。第 28 讲的 Solow 模型里,产出由资本 K、劳动 L 和技术 A 决定。这一讲,我们先量一量,A 到底有多重要。
二、增长核算:把增长拆开
2.1 公式
回忆第 28 讲的生产函数:产出由资本、劳动和效率共同决定。这一讲,我们把劳动拆成两部分:工作的时间 L,和每小时工作的人力资本 h(受过多少教育、有多少技能)。写成:
Y = A × K^α × (h × L)^(1 − α)
这里 A 是效率:同样多的资本和劳动,能生产出多少。α 是资本的份额。把两边取对数,再看"一年里的变化"(增长率,用百分数表示),就得到:
产出增长 ≈ α × 资本增长 + (1 − α) × (工时增长 + 人力资本增长) + 效率增长
前面三项,都是可以量出来的投入。最后一项"效率增长",是剩下的那一块:产出增长里,投入解释不了的部分。这就是索洛残差,也叫全要素生产率(total factor productivity,TFP)的增长。
为什么能用"份额"当权数?因为在竞争的市场里,每种投入拿到的报酬,等于它的边际产量(第 12、13 讲)。资本拿到总收入的 α,就说明多一单位资本,对产出的贡献,大约是 α 这个比例。这是 Robert Solow 1957 年那篇文章(Review of Economics and Statistics,39 卷 3 期)的聪明之处:你不必知道生产函数的细节,只要看收入里多少给了资本、多少给了劳动。 条件也要说清楚:这个算法假设市场足够竞争、规模报酬不变(第 14 讲的垄断,会让一部分"资本的收入"其实是垄断利润,权数就不准了)。
2.2 手算一个例子
一个国家,一年里:产出增长 5%,资本增长 6%,工时增长 1%,人力资本增长 0.5%,资本份额 α = 0.4。
- 资本的贡献:0.4 × 6 = 2.4 个百分点;
- 劳动和人力资本的贡献:0.6 × (1 + 0.5) = 0.9 个百分点;
- 投入合计:3.3;
- 效率的增长:5 − 3.3 = 1.7 个百分点,占产出增长的 34%。
注意,“1.7"不是我们量出来的,是减出来的。这一点,后面会反复用到。
2.3 这个"残差"叫什么名字
残差的来历,有一段有意思的历史。
Moses Abramovitz 1956 年(美国国家经济研究局 NBER 的一份报告,后来也在 American Economic Review 上发表)比较美国 1870 年以来的产出和投入,发现产出的增长,远远快于可量的投入。他写道:既然我们对生产率提高的原因知之甚少,这个"残差"的大小,可以看成是我们对美国经济增长原因的无知的一种度量。
Solow 1957 年用同样的方法,算 1909 到 1949 年美国非农业部门的数据:每工时的产出翻了一番,其中约 7/8(87.5%)归于"技术变化”,只有约 1/8 归于资本的增加。(Solow 自己提醒过:这里的"技术变化",是任何让生产函数移动的东西的简称,教育的改善也混在里面。)
可是,残差有多大,取决于你怎么量投入。 Dale Jorgenson 和 Zvi Griliches 1967 年(Review of Economic Studies,34 卷 3 期)的回答是:把资本的使用量和劳动的质量量得更仔细,残差会小很多。据一份综述转述,在他们的修正下,美国 1945 到 1965 年的残差,从每年 1.6% 降到了接近 0.1%。(这个数字我没有读原文,请核对。)Edward Denison 对此提出了批评,后来双方的观点又走近了一些。他们的核心意思是:把残差叫作"技术进步",并没有解释任何东西,它只是一个会计上的余项。
下面,我们自己动手算一次,看这个余项有多"软"。
2.4 代码验证:七个国家的增长核算
数据来自 Penn World Table 11.0(下面简称 PWT,Robert Feenstra、Robert Inklaar 和 Marcel Timmer 2015 年,American Economic Review,105 卷 10 期,是这套数据的标准引用)。我已经把 1990 到 2019 年的年均增长率算好,写在代码里。
# 增长核算:把产出增长拆成"资本、劳动、人力资本、效率(全要素生产率,TFP)"。
# 数据:Penn World Table 11.0,1990–2019 年的年均对数增长率(%)。
# 每项:(实际 GDP, 资本存量, 资本服务, 总工时=就业×年均工时, 人力资本指数, 资本份额=1-劳动份额的平均, PWT 自己算的 TFP)
data = {
    "中国":   (9.079, 10.658, 10.865,  0.744, 1.110, 0.421,  3.413),
    "印度":   (6.050,  6.525,  7.434,  1.770, 1.305, 0.438,  0.971),
    "韩国":   (4.933,  6.338,  6.858,  0.313, 0.929, 0.458,  1.158),
    "日本":   (0.906,  1.739,  2.313, -0.514, 0.424, 0.434, -0.024),
    "德国":   (1.521,  1.708,  2.103, -0.033, 0.238, 0.358,  0.662),
    "美国":   (2.492,  2.242,  2.998,  0.890, 0.302, 0.394,  0.604),
    "巴西":   (2.291,  2.818,  3.067,  1.124, 2.028, 0.451, -0.824),
}

def decompose(y, k, hours, h, a):
    """y = a*k + (1-a)*(hours + h) + 效率。返回各项对增长的贡献(百分点)和"效率"一项"""
    return a * k, (1 - a) * hours, (1 - a) * h, y - a * k - (1 - a) * (hours + h)

print("基准算法:资本用资本存量,劳动用总工时,人力资本用 PWT 的指数,资本份额取各国自己的数。")
print("单位:百分点/年。产出增长 = 资本 + 劳动 + 人力资本 + 效率")
for name, (y, k, ks, hours, h, a, tfp_pwt) in data.items():
    ck, cl, ch, res = decompose(y, k, hours, h, a)
    print(f"{name}:产出 {y:5.2f} = 资本 {ck:5.2f} + 劳动 {cl:5.2f} + 人力资本 {ch:4.2f} + 效率 {res:5.2f}(效率占 {res / y:4.0%})")

print("\n换几种算法,'效率'一项会变多少(百分点/年)?")
print("  A 基准;B 资本份额都取 1/3;C 资本换成资本服务;D 不单独算人力资本(并入效率);E PWT 自己算的 TFP")
for name, (y, k, ks, hours, h, a, tfp_pwt) in data.items():
    A = decompose(y, k, hours, h, a)[3]
    B = decompose(y, k, hours, h, 1 / 3)[3]
    C = decompose(y, ks, hours, h, a)[3]
    D = y - a * k - (1 - a) * hours
    E = tfp_pwt
    vals = [A, B, C, D, E]
    print(f"{name}:A {A:5.2f}  B {B:5.2f}  C {C:5.2f}  D {D:5.2f}  E {E:5.2f}   最小到最大:{min(vals):5.2f} 到 {max(vals):5.2f}")
输出:
基准算法:资本用资本存量,劳动用总工时,人力资本用 PWT 的指数,资本份额取各国自己的数。
单位:百分点/年。产出增长 = 资本 + 劳动 + 人力资本 + 效率
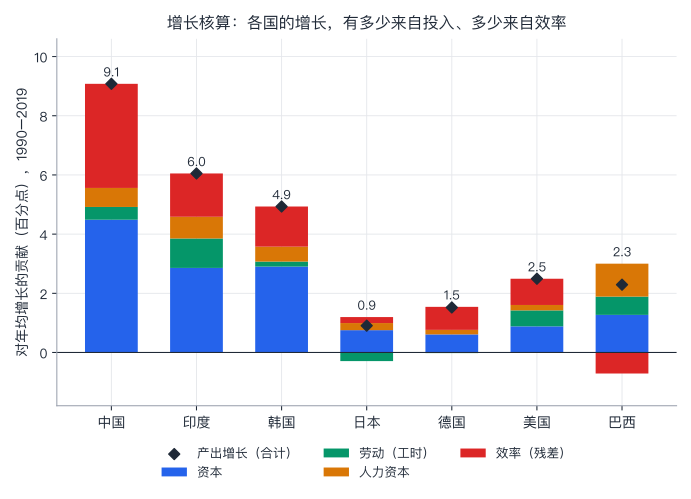
中国:产出  9.08 = 资本  4.49 + 劳动  0.43 + 人力资本 0.64 + 效率  3.52(效率占  39%)
印度:产出  6.05 = 资本  2.86 + 劳动  0.99 + 人力资本 0.73 + 效率  1.46(效率占  24%)
韩国:产出  4.93 = 资本  2.90 + 劳动  0.17 + 人力资本 0.50 + 效率  1.36(效率占  28%)
日本:产出  0.91 = 资本  0.75 + 劳动 -0.29 + 人力资本 0.24 + 效率  0.20(效率占  22%)
德国:产出  1.52 = 资本  0.61 + 劳动 -0.02 + 人力资本 0.15 + 效率  0.78(效率占  51%)
美国:产出  2.49 = 资本  0.88 + 劳动  0.54 + 人力资本 0.18 + 效率  0.89(效率占  36%)
巴西:产出  2.29 = 资本  1.27 + 劳动  0.62 + 人力资本 1.11 + 效率 -0.71(效率占 -31%)

换几种算法,'效率'一项会变多少(百分点/年)?
  A 基准;B 资本份额都取 1/3;C 资本换成资本服务;D 不单独算人力资本(并入效率);E PWT 自己算的 TFP
中国:A  3.52  B  4.29  C  3.43  D  4.16  E  3.41   最小到最大: 3.41 到  4.29
印度:A  1.46  B  1.82  C  1.07  D  2.20  E  0.97   最小到最大: 0.97 到  2.20
韩国:A  1.36  B  1.99  C  1.12  D  1.86  E  1.16   最小到最大: 1.12 到  1.99
日本:A  0.20  B  0.39  C -0.05  D  0.44  E -0.02   最小到最大:-0.05 到  0.44
德国:A  0.78  B  0.81  C  0.64  D  0.93  E  0.66   最小到最大: 0.64 到  0.93
美国:A  0.89  B  0.95  C  0.59  D  1.07  E  0.60   最小到最大: 0.59 到  1.07
巴西:A -0.71  B -0.75  C -0.82  D  0.40  E -0.82   最小到最大:-0.82 到  0.40
逐段看:
- 中国:产出每年增长 9.08%,其中资本贡献 4.49 个百分点(约一半),效率贡献 3.52 个百分点(约 39%)。不是"要么靠投资、要么靠效率":在这个算法下,两样都很大。 换几种算法,效率一项在 3.41 到 4.29 之间。这和第 28 讲里的争论是同一个问题:高投资率的贡献有多大,效率的贡献有多大?不同研究给出不同的比例,我们这个表也是其中一种。(第 28 讲提到的 Zhu 2012 研究的是 1978 到 2007 年,口径和时期都不同,不能和这张表直接拼在一起。)
- 韩国:效率只占约 28%(换算法后 23% 到 40%)。第 28 讲提过 Young 1995 的结论:东亚的"奇迹",主要是要素积累。我这里算的是 1990 到 2019 年,和他研究的时期不同,只能说结构上有相似之处,不能说"验证"了他。
- 德国、美国:效率占了一半和三分之一多。越接近技术前沿的国家,增长越靠想法(样本很小,只是一个迹象)。 这和 Solow 模型的结论一致:资本积累有边际报酬递减,长期的人均增长,只来自 g。
- 巴西:效率的贡献是 −0.71。这是不是说,巴西的"技术"三十年在倒退?不要读得这么直白。 看后面的敏感性:同一个国家,A 到 E 五种算法,效率一项在 −0.82 到 +0.40 之间,连符号都变了。残差里有资源配置是否合理、资本使用率、测量误差,也有技术。
- 敏感性:同一个国家,换一种算法,效率贡献的范围,中国 3.41 到 4.29,印度 0.97 到 2.20,韩国 1.12 到 1.99。残差是一个会计结果,不是一个被测到的"技术"。 读它的时候,要看范围,不要看一个点。
还有一个小提醒:这里的中国数字,是 PWT 自己的版本。第 27 讲用世界银行的数据,算过 1990 年代、2000 年代、2010 年代三个十年的实际增长(10.1%、10.4%、7.7%),简单平均约 9.4%,比 PWT 的 9.08% 高一点。PWT 11.0 的使用指南里写到,这一版修改了对中国的数据。两个来源口径不同,数字略有差别,是正常的。
小结: 增长核算:产出增长 = 资本、工时、人力资本的贡献,加上残差(效率)。权数是投入的收入份额。残差是减出来的,对数据和算法敏感,叫它"技术进步"之前要小心。
三、发展核算:富国和穷国,差在哪
3.1 把"增长"换成"水平"
增长核算比较的是一个国家不同年份。发展核算比较的是不同国家的同一年。写法类似,只是换成水平。从 Y = A K^α (h L)^(1−α) 出发,两边除以 L,再把资本写成"资本产出比" K/Y,可以整理成:
每个工人的产出 = (K/Y)^(α/(1−α)) × h × A
(推导:把两边都除以 Y^α,再开 1/(1−α) 次方。)每个国家的这四个量,都相对美国来比。把差距取对数,三项就可以加起来:资本、人力资本、效率,各占多少。
为什么用资本产出比,而不是直接用人均资本?因为效率高的国家,也会积累更多资本。用资本产出比,把"效率高所以资本多"的那部分,算在效率名下。这是一个设计选择,不是唯一的选择。
3.2 代码验证:45 个大国,2019 年
数据还是 PWT 11.0。样本:2019 年人口不少于 3000 万、数据完整的 45 个国家(这是一个按规则选出来的样本,不是随机样本)。
import math

# 发展核算:用 2019 年的横截面,看各国人均产出的差距,有多少来自资本、多少来自人力资本、多少来自"效率"。
# 样本:2019 年人口不少于 3000 万、数据完整的 45 个国家(规则选的,不是随机样本)。数据来源:Penn World Table 11.0。
# 每项:(每个就业者的产出(千美元,2021 年购买力平价), 资本存量 ÷ 产出, 人力资本指数)
data = {
    "COD": (3.3, 4.95, 1.80), "ETH": (5.3, 2.51, 1.46), "YEM": (6.0, 14.38, 1.84), "UGA": (7.6, 2.33, 2.44),
    "TZA": (7.8, 2.62, 1.72), "KEN": (14.4, 2.41, 2.35), "GHA": (14.6, 2.88, 2.53), "MMR": (15.4, 2.52, 1.84),
    "BGD": (15.6, 3.58, 2.10), "NGA": (16.1, 5.17, 1.97), "AGO": (16.1, 4.97, 1.48), "IND": (19.4, 3.76, 2.17),
    "VNM": (20.0, 3.21, 2.60), "PAK": (21.0, 1.60, 1.77), "SDN": (24.2, 2.11, 1.61), "PHL": (25.1, 3.32, 2.71),
    "IDN": (25.9, 6.17, 2.29), "PER": (26.0, 4.06, 2.84), "MAR": (27.6, 4.57, 1.94), "CHN": (33.2, 4.80, 2.70),
    "COL": (37.2, 3.29, 2.60), "BRA": (37.4, 4.40, 3.09), "UKR": (37.4, 14.58, 3.29), "THA": (38.4, 3.79, 2.76),
    "ZAF": (44.9, 3.68, 2.77), "MEX": (46.9, 4.36, 2.78), "IRN": (48.4, 6.97, 2.52), "DZA": (51.9, 4.58, 2.38),
    "ARG": (53.6, 3.65, 3.10), "IRQ": (57.6, 2.13, 2.29), "EGY": (61.8, 1.55, 2.68), "MYS": (62.2, 4.12, 3.08),
    "RUS": (68.2, 5.76, 3.31), "POL": (81.3, 2.53, 3.40), "JPN": (81.6, 5.37, 3.59), "TUR": (84.6, 3.75, 2.51),
    "KOR": (96.3, 5.03, 3.73), "GBR": (101.4, 4.87, 3.77), "ESP": (104.3, 6.11, 2.99), "CAN": (104.7, 4.87, 3.72),
    "ITA": (109.7, 6.73, 3.16), "DEU": (109.8, 4.01, 3.68), "FRA": (119.5, 6.06, 3.23), "USA": (139.2, 3.31, 3.75),
    "SAU": (151.5, 3.32, 2.84),
}
alpha = 1 / 3

def split(codes, alpha):
    """每个国家相对美国:ln(人均产出) = alpha/(1-alpha) * ln(资本产出比) + ln(人力资本) + ln(效率)。返回各国的四个对数值"""
    us = data["USA"]
    out = {}
    for c in codes:
        y, ky, h = data[c]
        ly = math.log(y / us[0])
        cap = alpha / (1 - alpha) * math.log(ky / us[1])
        hum = math.log(h / us[2])
        out[c] = (ly, cap, hum, ly - cap - hum)
    return out

def mean(xs): xs = list(xs); return sum(xs) / len(xs)
def cov(a, b): ma, mb = mean(a), mean(b); return mean((x - ma) * (z - mb) for x, z in zip(a, b))

codes = list(data)
parts = split(codes, alpha)
ranked = sorted(codes, key=lambda c: data[c][0])
poor, rich = ranked[:9], ranked[-9:]
print(f"{len(codes)} 个国家。最穷的 9 个:{' '.join(poor)}")
print(f"最富的 9 个:{' '.join(rich)}")
names = ["人均产出", "资本", "人力资本", "效率"]
diff = [mean(parts[c][i] for c in rich) - mean(parts[c][i] for c in poor) for i in range(4)]
print("最富 9 国 对 最穷 9 国(取对数后各国的平均差):")
for n, d in zip(names, diff):
    print(f"  {n}:差 {d:5.2f},相当于 {math.exp(d):5.1f} 倍" + ("" if n == "人均产出" else f"(占总差距的 {d / diff[0]:.0%})"))
print(f"  检验:{math.exp(diff[1]):.2f} × {math.exp(diff[2]):.2f} × {math.exp(diff[3]):.2f} = {math.exp(diff[1]) * math.exp(diff[2]) * math.exp(diff[3]):.1f}")

ly = [parts[c][0] for c in codes]
print("\n另一种看法:全部 45 国,各因素在人均产出的'方差'里占多大比例(资本+人力资本+效率 = 100%)")
for i, n in enumerate(names[1:], start=1):
    print(f"  {n}:{cov(ly, [parts[c][i] for c in codes]) / cov(ly, ly):.0%}")

print("\n结果对什么敏感?(效率占总差距的比例,最富 9 国对最穷 9 国)")
for a in (0.25, 1 / 3, 0.4, 0.5):
    p = split(codes, a)
    d = [mean(p[c][i] for c in rich) - mean(p[c][i] for c in poor) for i in (0, 3)]
    print(f"  资本份额取 {a:.2f}:效率占 {d[1] / d[0]:.0%}")
bad = [c for c in codes if data[c][1] > 10]
keep = [c for c in codes if c not in bad]
p = split(keep, alpha); rk = sorted(keep, key=lambda c: data[c][0]); pr, rr = rk[:9], rk[-9:]
d = [mean(p[c][i] for c in rr) - mean(p[c][i] for c in pr) for i in (0, 3)]
print(f"  去掉资本产出比超过 10 的 {' '.join(bad)}(战乱或数据问题)后:效率占 {d[1] / d[0]:.0%}")

print("\n几个国家(美国 = 1):人均产出,资本,人力资本,效率")
for c in ("CHN", "IND", "BRA", "KOR", "JPN", "NGA"):
    ly_, cap, hum, tfp = parts[c]
    print(f"  {c}:{math.exp(ly_):.2f} = {math.exp(cap):.2f} × {math.exp(hum):.2f} × {math.exp(tfp):.2f}")
输出:
45 个国家。最穷的 9 个:COD ETH YEM UGA TZA KEN GHA MMR BGD
最富的 9 个:KOR GBR ESP CAN ITA DEU FRA USA SAU
最富 9 国 对 最穷 9 国(取对数后各国的平均差):
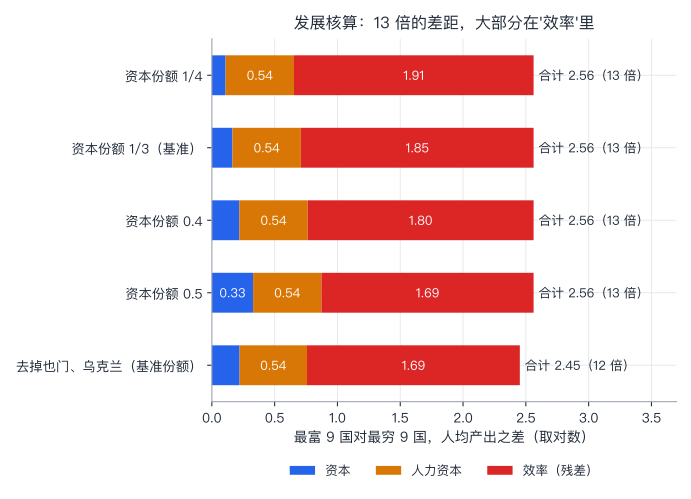
  人均产出:差  2.56,相当于  13.0 倍
  资本:差  0.16,相当于   1.2 倍(占总差距的 6%)
  人力资本:差  0.54,相当于   1.7 倍(占总差距的 21%)
  效率:差  1.85,相当于   6.4 倍(占总差距的 72%)
  检验:1.18 × 1.72 × 6.38 = 13.0

另一种看法:全部 45 国,各因素在人均产出的'方差'里占多大比例(资本+人力资本+效率 = 100%)
  资本:3%
  人力资本:22%
  效率:75%

结果对什么敏感?(效率占总差距的比例,最富 9 国对最穷 9 国)
  资本份额取 0.25:效率占 74%
  资本份额取 0.33:效率占 72%
  资本份额取 0.40:效率占 70%
  资本份额取 0.50:效率占 66%
  去掉资本产出比超过 10 的 YEM UKR(战乱或数据问题)后:效率占 69%

几个国家(美国 = 1):人均产出,资本,人力资本,效率
  CHN:0.24 = 1.20 × 0.72 × 0.28
  IND:0.14 = 1.07 × 0.58 × 0.23
  BRA:0.27 = 1.15 × 0.82 × 0.28
  KOR:0.69 = 1.23 × 0.99 × 0.56
  JPN:0.59 = 1.27 × 0.96 × 0.48
  NGA:0.12 = 1.25 × 0.53 × 0.18
逐段看:
- 回到开头的思想实验。最富的 9 个国家,每个工人的产出是最穷 9 个国家的 13 倍。把机器和学历都拉平,只能解释其中的 1.18 × 1.72 ≈ 2 倍。剩下的约 6.4 倍,在"效率"里。所以,答案是 C:差距会缩小一些,但大部分还在。
- 不是我们算出来的孤例。Robert Hall 和 Charles Jones 1999 年(Quarterly Journal of Economics,114 卷 1 期)比较了 1988 年的各国:美国每个工人的产出,是尼日尔的 35 倍以上;其中,资本密度的差异贡献了约 1.5 倍,教育的差异贡献了约 3.1 倍。按这三个数倒推,剩下的约 7.5 倍,在生产率里。他们用的样本、年份和方法都和我们不同,但结论的形状一样:资本和教育有作用,但解释不了大部分差距。
- 两种看法:不只看最富和最穷两组,用 45 个国家全部的数据算"方差的占比":资本约 3%,人力资本约 22%,效率约 75%。
- 敏感性:资本份额取 1/4 到 0.5,效率占差距的 66% 到 74%。去掉资本产出比超过 10 的也门和乌克兰(战乱或数据问题,这两个数值让人怀疑),效率占 69%。结论的大方向,不依赖这些选择。
3.3 但"效率"到底是什么
不要把这里的"效率"读成"技术"。 它是投入解释不了的所有东西:
- 技术:知道怎么做;
- 资源配置:同样的资本和工人,放在对的地方还是错的地方;
- 制度和环境:产权有没有保障、合同能不能执行、电力稳不稳定、路好不好;
- 测量误差:资本存量是估出来的,不同国家的价格也不好比;
- 我们没算到的投入:比如自然资源,比如教育的质量。PWT 的人力资本指数,只用了受教育的年数,再乘一个假定的回报率(据对 PWT 方法的描述,对前 4 年用 13.4%,5 到 8 年用 10.1%,8 年以上用 6.8%),没有算学校的质量。如果穷国一年的书,教得比富国少很多,我们低估了人力资本的差距,高估了"效率"的差距。
还有一点:这种拆法,假设投入和效率可以分开相加。现实里,它们可能互相放大:没有好的机器,高学历也派不上用场;没有会操作的人,好机器也是废铁。如果是这样,“哪一块占多少”,就没有唯一的答案。
所以,发展核算告诉我们的是:问题大部分不在"缺机器"和"缺学历"这两项(至少按这种量法)。它没有告诉我们,那一大块"效率"里,到底是什么。 接下来三节,就是三个候选:想法、人力资本的质量和用法、制度。
小结: 发展核算:把各国收入差距拆成资本、人力资本和效率。2019 年 45 个大国,最富 9 国对最穷 9 国,13 倍的差距里,资本约 1.2 倍、人力资本约 1.7 倍,效率约 6.4 倍。结论对份额和样本不敏感,但"效率"是个大口袋。
四、想法:为什么增长可以"内生"
4.1 想法和面包
先停一下:你今天吃的面包和今天用的一个想法,有什么区别?
你吃了一个面包,别人就吃不了这一个。面包是竞争性的(第 25 讲)。可是,一个想法,比如勾股定理,或者一道菜的做法,或者一段软件的代码,你用了,我照样可以用。 想法是非竞争性的(nonrival):同一个想法,可以被无数人同时使用,不会"用完"。
要小心,非竞争性不等于不可排他。 第 25 讲讲过,竞争性和排他性是两个维度。一个想法能不能排他,取决于法律和技术:专利药的配方,法律排他,成了俱乐部物品;加密的软件,技术排他;一个公开发表的数学定理,没法排他,是纯公共品。
4.2 复制论证:为什么想法让增长有"规模效应"
回忆第 28 讲:资本和劳动都翻一倍,产出翻一倍(规模报酬不变)。这是"复制论证":复制一个工厂,雇一批一样的工人,能生产一样多。
现在想想"想法"。你复制一个工厂,不用复制一遍想法:它们同一份就够了。所以,如果把所有投入,包括想法一起算,经济的规模报酬是递增的:想法不变,资本和劳动翻倍,产出翻倍;资本、劳动和想法一起翻倍,产出会超过翻倍。
这有两个后果。
第一,对增长: 想法不会因为用得多而变少,所以积累想法,没有资本那样的边际报酬递减(至少,没有那么明显)。持续的增长,有了来源。
第二,对市场: 第 12 讲讲过,完全竞争的企业,价格等于边际成本。可是,想法的成本是这样的:第一个要花很多钱,多用一次,几乎不花钱(边际成本约为零,第 14、15 讲讲过数字产品)。价格如果等于边际成本,发明想法的人,永远收不回当初的花费。所以,要有人愿意去发明,必须允许他在一段时间里,定高于边际成本的价格:某种程度的垄断力量,比如专利、先发优势、商业秘密。
这是 Paul Romer 1990 年那篇文章(《内生技术变化》,Journal of Political Economy,98 卷 5 期,增刊)的思路:企业追求垄断利润,所以去研发;研发产生想法;想法让整个经济更有效率。技术变化成了经济系统内部的产物,不再是外生的。因为这项工作,Romer 与 William Nordhaus 分享了 2018 年的诺贝尔经济学奖,获奖理由是把技术创新放进了长期宏观经济分析。
可这里有一个第 14 讲留下的权衡:垄断定价会让当下的使用者少用想法(静态的无谓损失),换来未来更多的新想法(动态的好处)。 第 14 讲讲基因组计划的证据时,你已经看到,知识产权的保护,在不同的情形里,对后续创新的影响不同:Heidi Williams 2013 年发现,Celera 公司以合同的方式对其基因序列主张的权利,使后续的研究和产品开发降低了约 20% 到 30%,而 Sampat 和 Williams 2019 年发现,基因专利对后续创新没有明显的阻碍。该保护多强、保护多久,没有放之四海皆准的答案,要看具体的领域。
还有一点,第 23 讲讲过的外部性,在这里出现了:一个想法被发明出来,会帮助后来的人,这些好处,发明者拿不全。所以,私人的研发,可能比社会最优的少;但也有相反的力量(比如,企业为了抢夺对手的生意,而重复研发同一件事)。理论上,两种力量都有,哪个更大,是实证问题。
4.3 一个小模型:研究投入,改变的是水平,还是增长率
想法的数量 A,怎么增长?一个简单的设定:
新想法 = δ × 研究者人数 × A^φ
φ 是一个关键的参数,它描述"已有的想法,让新想法更容易找,还是更难找":
- φ = 1(Romer 型):站在巨人的肩膀上,已有想法越多,找新想法越容易。想法的增长率,正比于研究者的人数:多雇研究者,增长率永久提高。
- φ < 1(Charles Jones 1995 年,Journal of Political Economy,103 卷 4 期,这类模型叫"半内生"增长):好找的想法被先找走了,已有想法越多,再找越难。这时,长期的增长率由人口增长率 n 决定:g = n ÷ (1 − φ)。研究投入的增加,只提高水平,不提高长期的增长率。
你应该已经觉得眼熟了:这和第 28 讲里储蓄率的结论,是同一个形状。 储蓄率,在 Solow 里改变水平;研究投入,在 Jones 里改变水平,在 Romer 里改变增长率。哪一个对,取决于 φ 是不是 1:一个事实问题。
import math

# 想法的生产:新想法的数量 = delta × 研究者数量 × (已有想法存量)^phi
#   phi = 1:站在巨人肩膀上,已有想法让新想法的产生一样容易(Romer 型)
#   phi < 1:好找的想法先被找走了,已有想法越多,再找越难(Jones 型)
# 每一年:A(下一年) = A + delta × 研究者 × A^phi。A 是"想法存量"(效率),增长率 g = A 的增长率。

def romer(years, researchers0=100, boost_year=0, factor=2.0, delta=0.0002):
    """phi = 1,研究者数量固定;第 boost_year 年起,研究者变成 factor 倍"""
    A, gs, As = 1.0, [], [1.0]
    for t in range(years):
        L_A = researchers0 * (factor if t >= boost_year else 1.0)
        gs.append(delta * L_A)                        # phi = 1 时,增长率 = delta × 研究者
        A *= 1 + gs[-1]; As.append(A)
    return gs, As

def jones(years, s0=0.05, s1=0.10, phi=0.5, n=0.01, L0=100.0, delta=0.004):
    """phi < 1,总人口以 n 增长,研究者占比 s。第 0 年起,研究者占比从 s0 变成 s1。
    起点选在 s0 的稳态:A0 = 1 时,增长率 = delta × s0 × L0 / A0^(1-phi) = 2%"""
    def run(s):
        A, L, gs, As = 1.0, L0, [], [1.0]
        for t in range(years):
            g = delta * s * L * A ** (phi - 1)
            gs.append(g); A *= 1 + g; L *= 1 + n; As.append(A)
        return gs, As
    return run(s1), run(s0)

print("A. Romer 型(phi = 1):第 0 年起研究者翻倍")
gs, As = romer(200)
for t in (0, 10, 50, 100, 199):
    print(f"  第 {t:>3} 年:想法的增长率 {gs[t]:.2%}")
print(f"  前后的差:翻倍之前是 {0.0002 * 100:.2%},之后一直是 {gs[-1]:.2%}")

print("\nB. Jones 型(phi = 0.5,人口每年增长 1%):第 0 年起,研究者占人口的比例从 5% 提高到 10%")
(g1, A1), (g0, A0) = jones(400)
for t in (0, 1, 10, 30, 100, 200, 399):
    print(f"  第 {t:>3} 年:增长率 {g1[t]:.2%}(不提高时 {g0[t]:.2%}),想法存量是不提高时的 {A1[t] / A0[t]:.2f} 倍")
print(f"  长期:增长率回到 (1+n)^(1/(1-phi)) - 1 = {1.01 ** 2 - 1:.2%}(连续时间里就是 n/(1-phi) = 2%);水平比不提高时高 2^(1/(1-phi)) = {2 ** (1 / (1 - 0.5)):.2f} 倍")

print("\nC. 同样是 Jones 型,如果人口增长率从 1% 提高到 1.5%(研究者占比不变)")
def jones_n(n_new, years=400):
    A, L, gs = 1.0, 100.0, []
    for t in range(years):
        g = 0.004 * 0.05 * L * A ** (0.5 - 1); gs.append(g); A *= 1 + g; L *= 1 + n_new
    return gs
gn = jones_n(0.015)
for t in (0, 30, 100, 399):
    print(f"  第 {t:>3} 年:增长率 {gn[t]:.2%}")
print(f"  长期:(1+n)^(1/(1-phi)) - 1 = {1.015 ** 2 - 1:.2%}(约等于 n/(1-phi) = 3%)")

print("\nD. 想法越来越难找:一个算术例子")
fold, years = 18, 2014 - 1971
rate = math.log(fold) / years
print(f"  如果让芯片密度翻倍所需的研究者人数,从 1970 年代初到 2014 年(我取 1971 到 2014,共 {years} 年)变成了 {fold} 倍,相当于每年增加 {rate:.1%},约每 {math.log(2) / rate:.0f} 年翻一番")
print(f"  这等于说,'每个研究者带来的进步'每年约下降 {1 - math.exp(-rate):.1%}")
print(f"  如果经济整体也这样:要让增长率不掉下来,50 年里研究者要变成 {math.exp(0.07 * 50):.0f} 倍(取每年 7%);而人口每年只增长 1%:50 年 {math.exp(0.01 * 50):.1f} 倍")
输出:
A. Romer 型(phi = 1):第 0 年起研究者翻倍
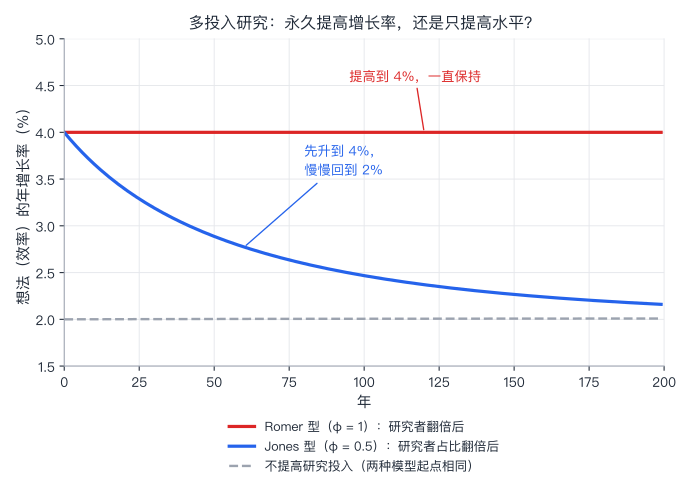
  第   0 年:想法的增长率 4.00%
  第  10 年:想法的增长率 4.00%
  第  50 年:想法的增长率 4.00%
  第 100 年:想法的增长率 4.00%
  第 199 年:想法的增长率 4.00%
  前后的差:翻倍之前是 2.00%,之后一直是 4.00%

B. Jones 型(phi = 0.5,人口每年增长 1%):第 0 年起,研究者占人口的比例从 5% 提高到 10%
  第   0 年:增长率 4.00%(不提高时 2.00%),想法存量是不提高时的 1.00 倍
  第   1 年:增长率 3.96%(不提高时 2.00%),想法存量是不提高时的 1.02 倍
  第  10 年:增长率 3.66%(不提高时 2.00%),想法存量是不提高时的 1.20 倍
  第  30 年:增长率 3.19%(不提高时 2.00%),想法存量是不提高时的 1.58 倍
  第 100 年:增长率 2.47%(不提高时 2.01%),想法存量是不提高时的 2.65 倍
  第 200 年:增长率 2.16%(不提高时 2.01%),想法存量是不提高时的 3.46 倍
  第 399 年:增长率 2.03%(不提高时 2.01%),想法存量是不提高时的 3.92 倍
  长期:增长率回到 (1+n)^(1/(1-phi)) - 1 = 2.01%(连续时间里就是 n/(1-phi) = 2%);水平比不提高时高 2^(1/(1-phi)) = 4.00 倍

C. 同样是 Jones 型,如果人口增长率从 1% 提高到 1.5%(研究者占比不变)
  第   0 年:增长率 2.00%
  第  30 年:增长率 2.28%
  第 100 年:增长率 2.71%
  第 399 年:增长率 3.02%
  长期:(1+n)^(1/(1-phi)) - 1 = 3.02%(约等于 n/(1-phi) = 3%)

D. 想法越来越难找:一个算术例子
  如果让芯片密度翻倍所需的研究者人数,从 1970 年代初到 2014 年(我取 1971 到 2014,共 43 年)变成了 18 倍,相当于每年增加 6.7%,约每 10 年翻一番
  这等于说,'每个研究者带来的进步'每年约下降 6.5%
  如果经济整体也这样:要让增长率不掉下来,50 年里研究者要变成 33 倍(取每年 7%);而人口每年只增长 1%:50 年 1.6 倍
逐段看:
- A 部分(Romer 型):研究者翻倍,想法的增长率从 2% 一下子变成 4%,而且一直保持。
- B 部分(Jones 型,φ = 0.5):研究者占人口的比例翻倍,增长率先跳到 4%,然后慢慢回落,第 399 年已经接近 2%。但是,想法的存量,比"不提高"的情形,长期高出 2^(1/(1−φ)) = 4 倍。水平的好处是永久的,增长率的好处是暂时的,这是 Solow 的储蓄率的故事,换成了研究。
- C 部分:同样是 Jones 型,如果人口增长率从 1% 提高到 1.5%,长期的增长率会从约 2% 提高到约 3%。在 Jones 型里,决定长期增长率的,不是研究的强度,是人的数量在增长多快。 这听上去很奇怪,但这正是它的含义:每个新增的人,都是一个潜在的发明者。
- D 部分(算术,不是估计):下面第 4.4 节会解释它。
4.4 证据:想法是越来越好找,还是越来越难找
理论预测什么:Romer 型预测,规模效应:一个经济里的研究者越多,增长越快。Jones 型预测,增长不随研究者的人数提高。
证据怎么说:
- Jones 1995 年的出发点是:美国的研究人员数量,从 1950 年代到 1980 年代稳步增加,可是全要素生产率的增长,并没有出现明显的上升趋势。这和 Romer 型的规模效应不符。(这是对他论证的概括,请读原文。)
- Michael Kremer 1993 年(Quarterly Journal of Economics,108 卷 3 期)把时间拉长到公元前一百万年到 1990 年。他的模型预测,历史的大部分时间里,人口的增长率正比于人口的水平;他发现,在没有技术接触的各个社会之间,初始人口越多的,技术变化和人口增长越快。这支持"人多想法多"。
- Nicholas Bloom、Charles Jones、John Van Reenen 和 Michael Webb 2020 年(American Economic Review,110 卷 4 期)的发现更直接:研究投入在大幅上升,而研究的生产率在大幅下降。他们最有名的例子是摩尔定律:要让芯片的密度翻一番,今天需要的研究者人数,比 1970 年代初多了 18 倍以上。他们也在整体经济、农业、药物研发等领域,看到了类似的下降(具体数字请读原文)。他们的概括是:增长之所以还能保持稳定,是因为研究投入的指数增长,抵消了研究生产率的下降。
代码的 D 部分,用他们这个数字做了一道算术:18 倍,如果是从 1971 年到 2014 年(我取的这两个年份是个近似,请以原文为准),相当于研究者人数每年增加约 6.7%,每 10 年翻一番。换一个说法:每个研究者带来的进步,每年下降约 6.5%。如果整个经济都这样,要保持增长率不掉,50 年里研究者要变成 33 倍(我取每年 7%),而人口每年只增长 1%,50 年只增加 1.6 倍。差的那一部分,只能靠"研究者占人口的比例"不断提高来补;这个比例不可能无限提高。 所以,这是一个关于"增长能否长期保持当前速度"的担忧。
局限:(1)“想法的产出"本身很难量。Bloom 等人用的是增长率(比如芯片密度的翻倍速度),当作想法的产出;这个测量是否合适,有讨论空间。(2)研究者的"有效人数"怎么算(只算研发人员,还是也算别的)?(3)这些发现主要来自发达国家和少数行业,不一定适用于所有国家。
分歧在哪:事实上的分歧是:φ 到底是多少?研究生产率的下降,是想法"变难找”,还是别的原因(比如企业组织的变化、资源配置不当)?这些,数据还没有给出一个公认的答案。价值判断很少,这主要是事实问题。 但有一个涉及价值的相关问题:既然想法有外溢,该不该用公共资源补贴研究?补贴多少?(第 23 讲讲过正外部性下补贴的逻辑,只是外部性的大小,要用证据说话。)
4.5 想法是非竞争性的,穷国为什么不直接用
既然想法人人可用,穷国为什么不直接拿富国的技术来用?这是个好问题。常见的几类解释(它们不互相排斥,各自的证据强弱,也不一样):
- 要有配套:好技术往往需要熟练的工人、稳定的电、够用的道路(回到人力资本和基础设施)。
- 要适合本地:富国的技术,是为富国的要素价格设计的(劳动贵、资本便宜),搬到劳动便宜的地方,未必最合适。
- 要有动力:采用新技术,常常要重新安排生产,动到既得利益。企业有没有动力这么做,取决于竞争和规则,也就是制度(第七节)。
这给第 28 讲的"条件趋同",补上了一块:参数不同,稳态不同,其中一部分参数,就是"采用技术的能力和动力"。
小结: 想法是非竞争性的:用得多不会变少,所以复制论证给出递增报酬;要有人去发明,需要一定的垄断力量,这带来静态损失与动态收益的权衡。φ = 1 时,研究投入永久提高增长率;φ < 1 时,只提高水平,长期增长率由人口增长决定。证据混合:Jones 的发现不支持规模效应,Kremer 支持长期里人多想法多,Bloom 等人发现想法越来越难找,需要越来越多的研究者。
4.6 创造性破坏:2025 年的诺贝尔奖,奖励了什么
柯达,1975 年,就做出了世界上第一台数码相机的原型;2012 年 1 月,它申请了破产保护。数码相机,把胶卷,变成了一门越来越小的生意。这不是一个企业的失败,这是增长的另一面:新的东西,取代旧的东西。
4.2 节的 Romer 模型里,想法,只会加上去:新想法,让整个经济,更有效率,没有谁,因此,被淘汰。可是,Joseph Schumpeter,早就说过:资本主义的核心,是"创造性破坏":新的产品、新的方法,取代旧的,旧的企业,和旧的工作,随之消失。
2025 年 10 月 13 日,诺贝尔经济学奖,颁给了三个人:Joel Mokyr 得一半,Philippe Aghion 和 Peter Howitt 共得另一半。瑞典皇家科学院,把他们的贡献,概括为:解释了创新驱动的经济增长。(据 NBER 等对公告的转述。)
- Aghion 和 Howitt:1992 年(Econometrica,60 卷 2 期,323–351 页)的《通过创造性破坏的增长模型》:把"创造性破坏",写成了一个数学模型:每一次创新,让某个行业的质量,提高一个台阶;成功的创新者,赚到利润,直到,被下一个创新者,取代。
- Mokyr:经济史学家。他讲的是另一件事:为什么,持续的增长,会出现在 18 世纪以后的欧洲。据对他的研究的介绍:他区分了两种"有用的知识":命题性的知识(为什么,它有效:自然界的规律),和规范性的知识(怎么做,才有效:配方、图纸、操作手册)。工业革命以前,创新,主要靠后一种:人们知道,这样做有用,但不知道为什么;科学的发展,让两种知识,互相促进,创新,才能够持续。他强调,鼓励人们,去寻找、去使用知识的制度和文化,很重要。(他 2016 年的书,第 43 讲会讲到。)
这一节,只讲 Aghion–Howitt 那一半,用两个很小的计算,看创造性破坏,意味着什么。
import numpy as np

# 创造性破坏:一项创新,能赚多久的利润,取决于,下一个创新者,多快到来。
# 设:每次创新,让质量乘以 γ;创新,以到达率 μ(每年的概率强度)出现;
# 一个成功的创新者,每年得到利润 π,直到被下一个创新者取代;折现率 r。
r, pi, gamma = 0.05, 1.0, 1.10
print("一、创新越快,每一项创新能赚的钱越少(π = 1,r = 5%,γ = 1.10)")
print("  到达率 μ   经济的增长率 g = μ·ln γ   一项创新的价值 V = π/(r+μ)   占'没人来取代'时的比例")
V0 = pi / r
for mu in (0.0, 0.1, 0.2, 0.4, 0.8):
    g, V = mu * np.log(gamma), pi / (r + mu)
    print(f"  {mu:7.1f}   {g:20.2%}   {V:24.2f}   {V / V0:20.0%}")

# 二、模拟:100 个行业,50 年,每年,每个行业,以概率 1 - exp(-μ),出现一次创新,由新进入者取得领先。
rng = np.random.default_rng(29)
mu, N, T = 0.2, 100, 50
quality = np.zeros(N)                    # ln(质量)
leader = np.arange(N)                    # 当前领先企业的编号
leader0 = leader.copy()
next_id = N
same_after = {}
for t in range(1, T + 1):
    hit = rng.random(N) < 1 - np.exp(-mu)
    quality[hit] += np.log(gamma)
    leader[hit] = np.arange(next_id, next_id + hit.sum()); next_id += hit.sum()
    if t in (10, 20, 50): same_after[t] = (leader == leader0).mean()
print("\n二、模拟:100 个行业,μ = 0.2,每次创新,由新进入者取得领先")
print(f"  50 年里,平均每年,质量(对数)增长 {quality.mean() / T:.2%}(理论值 μ·ln γ = {mu * np.log(gamma):.2%},用 1-exp(-μ) 代替 μ,会略低)")
for t, v in same_after.items():
    print(f"  {t} 年后,领先者,还是最初那一家的行业,占 {v:.0%}(理论值 exp(-μ·t) = {np.exp(-mu * t):.0%})")
输出:
一、创新越快,每一项创新能赚的钱越少(π = 1,r = 5%,γ = 1.10)
  到达率 μ   经济的增长率 g = μ·ln γ   一项创新的价值 V = π/(r+μ)   占'没人来取代'时的比例
      0.0                  0.00%                      20.00                   100%
      0.1                  0.95%                       6.67                    33%
      0.2                  1.91%                       4.00                    20%
      0.4                  3.81%                       2.22                    11%
      0.8                  7.62%                       1.18                     6%

二、模拟:100 个行业,μ = 0.2,每次创新,由新进入者取得领先
  50 年里,平均每年,质量(对数)增长 1.74%(理论值 μ·ln γ = 1.91%,用 1-exp(-μ) 代替 μ,会略低)
  10 年后,领先者,还是最初那一家的行业,占 19%(理论值 exp(-μ·t) = 14%)
  20 年后,领先者,还是最初那一家的行业,占 2%(理论值 exp(-μ·t) = 2%)
  50 年后,领先者,还是最初那一家的行业,占 0%(理论值 exp(-μ·t) = 0%)
逐段看:
- 第一部分:创新来得越快(μ 越大),经济的增长率越高(g = μ ln γ:μ = 0.4,增长 3.81%);可是,每一项创新,能赚的钱,越少:μ = 0.4 时,一项创新的价值,只有"没人来取代"时的 11%。因为,你的利润,只能持续,到下一个创新者,出现的时候:创新,越快,你就越像是,在用一个更高的折现率,计算自己的未来(π/(r + μ):μ,像是加在 r 上的"被取代的风险")。
- 第二部分:模拟,100 个行业,μ = 0.2:50 年里,质量每年平均提高约 1.7%(理论值 1.9%;差别,是因为,我让每个行业,一年里,最多,出现一次创新);最初的领先企业,20 年后,只剩下约 2% 的行业,仍然领先;50 年后,一家都没有。这就是"破坏":领先的位置,不断,易主。 (10 年的那一行,模拟 19%、理论 14%,是因为样本只有 100 个行业,有随机的误差。)
理论预测什么:文献里,常说研发,有三种效应,方向,不同(据对 Aghion–Howitt 模型的转述):
- 挣不到全部好处:一项创新,给消费者,带来的好处,发明者,拿不全(4.2 节:知识的外部性);这使得,私人的研发,可能太少。
- 后人踩着你的肩膀:你的创新,抬高了台阶,后来的创新者,从更高的起点出发,这个好处,永远留在社会里;而你,只能拿到,自己这一级的利润,直到被取代(第一部分:利润期,很短)。这也使得,私人的研发,可能太少。
- 抢别人的生意:一项创新的利润,有一部分,是从被取代的企业那里,转过来的,不是社会,凭空多出来的;新的创新者,不会把这部分损失,算进自己的成本。这使得,私人的研发,可能太多。
三种效应,净的方向,是不确定的:研发,是太多,还是太少,要看具体的情形,是实证问题。(据报道,科学院对这个模型的说明,也指出了这样的"相反的力量"。4.2 节,已经说过一半:两种力量,都有;这里,说得更具体。)
证据怎么说:一个经常被提到的问题:竞争,是促进创新,还是阻碍创新?
- Aghion、Bloom、Blundell、Griffith 和 Howitt 2005 年(Quarterly Journal of Economics,120 卷 2 期,701–728 页):据摘要,用英国企业的数据,发现,竞争和创新(用专利数衡量),是倒 U 形的关系:竞争很弱时,增加一点,会促进创新;竞争,已经很强时,再增加,反而,抑制创新。
- Hashmi 2013 年(Review of Economics and Statistics,95 卷 5 期,1653–1668 页):据摘要,用美国上市制造业企业的数据,发现,竞争和创新(用被引用加权的专利数衡量),是轻微的负相关;他提出,一个可能的解释:英国的行业,比美国的行业,更"势均力敌",所以,两个结果,可以用同一个模型,解释。(这个解释,我没有检验,请以原文为准。)
局限:(1)专利数,只是创新的一种衡量,很多创新,没有专利;(2)两篇研究,国家、年代、竞争的衡量方法,都不同,不能直接比较;(3)倒 U 形,是不是一个"普遍规律",研究者,还在争论。
分歧在哪:事实上的分歧:竞争,对创新,到底是什么方向;研发,是太多,还是太少。价值判断,很大:创造性破坏,有赢家,也有输家:被淘汰的企业,失去的岗位(第 5 节:技术与失业;第 40 讲:中国冲击,恢复,很慢)。要增长,还是,要保护现有的企业和工作?要保护多少?谁来补偿?据报道,科学院评奖委员会的成员,在公布奖项时,强调:增长,不是理所当然的,要维护,让创造性破坏,能发生的那些机制,否则,可能,回到停滞。怎么理解,“那些机制”,包括什么,是有争议的:你,怎么看?
五、一个有争议的问题:技术会不会让更多人失去工作
第 13 讲讲劳动的需求时,留下了一个问题:机器变便宜了,是替代工人,还是让工人更有生产率?第 13 讲说,技术会不会让整体上更少人有工作,是一个有大量争论的问题,这一讲回来。按"理论预测 → 证据与局限 → 分歧在哪 → 价值判断留给读者"来写。
理论预测什么:技术对劳动,有两股相反的力量:
- 替代:机器做了原来工人做的任务,对这些任务的劳动需求下降;
- 互补和扩张:技术让产出更多、价格更低,人们买得更多,对劳动的需求增加;机器让没被替代的任务更有价值;新的技术,还会创造出新的任务和新的职业。
总的效果,取决于哪股力量更强。理论本身,不能事先说哪个大。
证据怎么说:
- David Autor 2015 年(Journal of Economic Perspectives,29 卷 3 期)回顾了历史:自动化确实在替代劳动,但同时,它也和劳动互补,提高产出,从而提高对劳动的需求,劳动的供给也会跟着调整。这是他对"为什么今天还有这么多工作"的回答。据我看到的摘要片段,他认为评论者常常夸大机器取代工作的程度。
- Daron Acemoglu 和 Pascual Restrepo 2020 年(Journal of Political Economy,128 卷 6 期)看了 1990 年代以来的美国,比较机器人"暴露度"不同的地区(通勤区):每一千名工人多一台工业机器人,当地的就业占人口比例下降约 0.2 个百分点,工资下降约 0.42%。(工作论文版给的是一个区间:就业占比下降 0.18 到 0.34 个百分点,工资下降 0.25% 到 0.5%,正式版给了具体点。)他们说,这个效果,和中国进口的冲击等其他因素有区别。
- Georg Graetz 和 Guy Michaels 2018 年(Review of Economics and Statistics,100 卷 5 期)用 17 个国家 1993 到 2007 年的数据,发现机器人的使用,让每年的劳动生产率增长约提高了三分之一个百分点(论文的不同版本写作 0.36 或 0.37),对总就业没有显著影响,但降低了低技能工人在就业中的份额。
局限:
- 三项研究看的是不同的层次:Acemoglu 和 Restrepo 比较的是美国各个地区,Graetz 和 Michaels 比较的是各国的行业。地区之间的比较,抓不到工人换地方、换行业的调整;国家层面的比较,又抓不到某个地方的痛苦。
- 机器人只是技术的一种:它们是容易数的一种。其他技术(软件、算法等)的效果,不能直接套用。
- 样本期有限:几十年的数据,看不见更长期的调整,也看不见将来还没出现的技术。
分歧在哪:
- 事实上的分歧:总就业会不会下降,还是主要改变工作的种类?研究的结论并不一致,这和上面三项研究的层次、方法有关。更长的历史看,总就业没有被消灭(Autor 的论点),但这并不保证未来也一样。
- 预测上的分歧:未来的技术,会不会和过去的有本质的不同?这是对未来的判断,现有的数据证明不了,也证伪不了。
价值判断(留给你):
- 谁得到好处,谁承担代价:技术带来的好处(更便宜的产品、更高的总产出)和代价(某些岗位消失、某些地区衰落),常常落在不同的人身上。第 3、4 讲说过,“总体受益"不等于"人人受益”。该不该补偿受损的人? 你怎么看?
- 怎么补偿:补偿可以是再培训、失业保险、迁移补贴、地区投资,每一种的成本、效果和公平性都不同(第 9 讲和第 26 讲讲过,政策本身有成本,也会失灵)。
- 要不要放慢技术:如果转型的痛苦很集中,社会是该保护现有的工作,还是让技术快速推进、再去补偿?
经济学能告诉你每一种选择的代价和可能的后果;该怎么选,是你的价值判断。
六、人力资本:教育到底值多少钱
6.1 把人看作资本
你读书,有成本:学费,加上那几年本可以挣的工资(第 1 讲的机会成本);有回报:以后更高的工资。这和买一台机器是同一个逻辑:花钱现在,收益在将来(第 36 讲会讲怎么把将来的钱折成今天的钱)。所以,经济学家把教育和技能,叫作人力资本。
衡量回报最常用的办法,是 Jacob Mincer 1974 年提出的工资方程:
ln(工资) = 常数 + r × 受教育年数 + ……
r 就是每多读一年书,工资(取对数)增加的比例。如果 r = 0.09,多读一年,工资高约 9%;读四年大学,高 e^(0.09 × 4) − 1 ≈ 43%。
George Psacharopoulos 和 Harry Patrinos 2018 年(Education Economics,26 卷 5 期)汇总了 1950 到 2014 年、139 个国家的 1120 个估计,得到全球平均的私人回报约每年 9%。这是个人的回报,不等于社会的回报。
6.2 但这是"因果"吗:能力偏误
先停一下:如果你只比较"读书多的人"和"读书少的人"的工资,得到的差别,全是教育的功劳吗?
不全是。能力强、家境好、更有毅力的人,既更可能读更多书,也更可能挣更多钱。这些我们看不见(或没法完全控制)的东西,会混在教育的"回报"里。这叫能力偏误(ability bias):直接比较,会高估教育的因果回报。(第 4 讲说过:因果效应 = 实际发生的 − 反事实。你需要知道"如果这个人少读一年,他会怎样",而你只能看到一个版本。)
第 4 讲说过,工具变量是一种办法,当时只用了一句话讲思路,说"真遇到时再用"。现在,我们遇到了。
思路:找一个东西 z(工具),它满足两个条件:
- 相关性:它会影响一个人读多少年书(叫作第一阶段);
- 排他性:它只通过教育影响工资,没有别的渠道。
如果两条都成立,z 引起的教育变化,就像一个"自然实验":它和能力无关。比较 z 不同的人群的工资,再除以他们读书年数的差别,就得到教育的回报。
Joshua Angrist 和 Alan Krueger 1991 年(Quarterly Journal of Economics,106 卷 4 期)用的工具,是出生的季度。美国的义务教育法规定,到了某个年龄就可以退学,所以年初出生的孩子,入学时年龄较大,到了可以退学的年龄时,读的书更少。出生的季度,和能力没什么关系,却会影响读书年数。他们的结论是,工具变量估计和普通回归接近,这说明,至少在他们的数据里,能力偏误不是很大。
可是,Bound、Jaeger 和 Baker 1995 年(Journal of the American Statistical Association,90 卷 430 期)重新审视这个例子,发现:工具和教育的相关性很弱时,工具变量估计会有很大的问题:哪怕样本很大,也可能有偏、不一致。他们建议,做工具变量时,要常规地报告第一阶段的 F 统计量。
我们用一个模拟,把这两点都演示一遍。
import numpy as np

# 模拟:多读一年书,工资真的会高多少?
# 真实世界里,能力强的人读书更多,工资也更高;能力我们看不见。
rng = np.random.default_rng(29)
TRUE = 0.08                                     # 设定:每多读一年书,工资(取对数)真的高 0.08,也就是约 8%

def make(n, first, direct):
    ability = rng.normal(size=n)                          # 看不见的能力
    z = rng.integers(0, 2, size=n)                        # 工具:比如"义务教育年限延长之后上学的那批人",随机地 0 或 1
    school = 12 + 1.0 * ability + first * z + rng.normal(0, 1.5, size=n)          # 能力强的人读得多;z 让人多读 first 年
    logwage = 1.5 + TRUE * school + 0.10 * ability + direct * z + rng.normal(0, 0.3, size=n)   # 能力每高一个标准差,工资(对数)高 0.10
    return school, logwage, z

def ols(school, logwage):
    return np.cov(school, logwage)[0, 1] / np.var(school, ddof=1)

def iv(school, logwage, z):
    return np.cov(z, logwage)[0, 1] / np.cov(z, school)[0, 1]          # 只有一个工具时:简化形式 ÷ 第一阶段

N = 2_000_000
print(f"设定的真实回报:每多读一年,工资(对数)高 {TRUE}")
s, w, z = make(N, first=0.8, direct=0.0)
bias_formula = 0.10 * 1.0 / (1.0 + 0.8 ** 2 * 0.25 + 1.5 ** 2)         # 0.10 × cov(读书年数, 能力) ÷ var(读书年数)
print(f"\n1. 不控制能力的普通回归(OLS):{ols(s, w):.3f}(比真实值高 {ols(s, w) - TRUE:.3f};公式:0.10 × 1.0 ÷ var(读书年数) = {bias_formula:.3f})")
print(f"   能力强的人读得多、挣得也多,被算到了教育头上。用工具变量(工具对工资没有直接影响):{iv(s, w, z):.3f}")

print("\n2. 工具如果对工资有直接影响(违反'排他性'):IV 的偏差 = 直接影响 ÷ 第一阶段(工具让人多读几年)")
for first, direct in ((0.8, 0.00), (0.8, 0.02), (0.8, 0.05), (0.2, 0.02), (0.2, 0.05)):
    s, w, z = make(N, first, direct)
    print(f"   第一阶段 {first:.1f} 年,直接影响 {direct:.2f}:IV = {iv(s, w, z):.3f}(公式:{TRUE} + {direct}/{first} = {TRUE + direct / first:.3f})")

print("\n3. 小样本里,弱工具会让估计非常不稳:每次抽 300 人,重复 2000 次(直接影响为 0)")
for first in (0.8, 0.2, 0.05):
    ests = []
    for _ in range(2000):
        s, w, z = make(300, first, 0.0)
        ests.append(iv(s, w, z))
    lo, mid, hi = np.percentile(ests, [5, 50, 95])
    print(f"   第一阶段 {first:.2f} 年:IV 估计的中位数 {mid:.3f},90% 的估计落在 {lo:.3f} 到 {hi:.3f} 之间")
输出:
设定的真实回报:每多读一年,工资(对数)高 0.08

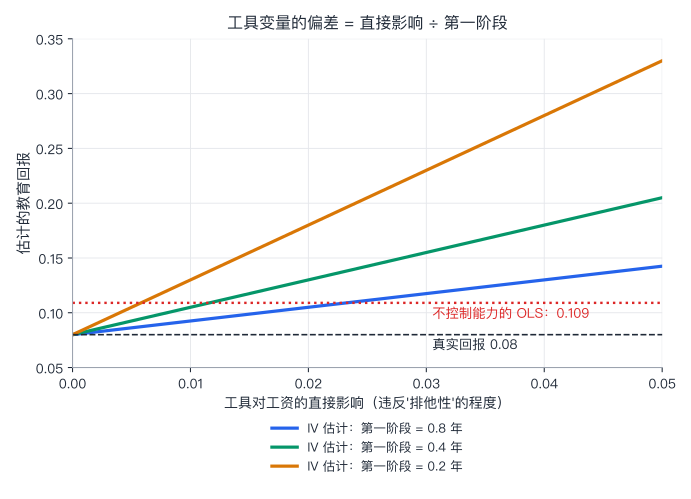
1. 不控制能力的普通回归(OLS):0.109(比真实值高 0.029;公式:0.10 × 1.0 ÷ var(读书年数) = 0.029)
   能力强的人读得多、挣得也多,被算到了教育头上。用工具变量(工具对工资没有直接影响):0.079

2. 工具如果对工资有直接影响(违反'排他性'):IV 的偏差 = 直接影响 ÷ 第一阶段(工具让人多读几年)
   第一阶段 0.8 年,直接影响 0.00:IV = 0.081(公式:0.08 + 0.0/0.8 = 0.080)
   第一阶段 0.8 年,直接影响 0.02:IV = 0.105(公式:0.08 + 0.02/0.8 = 0.105)
   第一阶段 0.8 年,直接影响 0.05:IV = 0.143(公式:0.08 + 0.05/0.8 = 0.143)
   第一阶段 0.2 年,直接影响 0.02:IV = 0.182(公式:0.08 + 0.02/0.2 = 0.180)
   第一阶段 0.2 年,直接影响 0.05:IV = 0.333(公式:0.08 + 0.05/0.2 = 0.330)

3. 小样本里,弱工具会让估计非常不稳:每次抽 300 人,重复 2000 次(直接影响为 0)
   第一阶段 0.80 年:IV 估计的中位数 0.079,90% 的估计落在 -0.010 到 0.160 之间
   第一阶段 0.20 年:IV 估计的中位数 0.091,90% 的估计落在 -0.603 到 0.743 之间
   第一阶段 0.05 年:IV 估计的中位数 0.112,90% 的估计落在 -0.941 到 1.130 之间
逐段看:
- 1:设定真实回报是 0.08。不控制能力的普通回归(OLS)得到 0.109,高了约 0.029。偏差的大小,等于能力对工资的影响(0.10),乘上"读书年数和能力的关系"占读书年数总方差的比例。用上一个"干净"的工具,估计回到了约 0.08。
- 2:如果工具违反排他性(它对工资有直接影响,比如,延长义务教育的同时,别的什么也变了),工具变量的偏差 = 直接影响 ÷ 第一阶段。第一阶段是 0.8 年、直接影响 0.02,估计变成 0.105;第一阶段只有 0.2 年,同样的直接影响,估计变成 0.182,比不用工具的 0.109 更糟。工具越弱,一点点违反排他性,就会被放大。 图上,三条线就是这个公式。
- 3:弱工具让估计非常不稳。第一阶段 0.8 年时,每次抽 300 个人,估计大多落在 −0.01 到 0.16 之间;第一阶段只有 0.2 年,落在大约 −0.6 到 0.7 之间,几乎什么都说不了。这就是 Bound 等人担心的:弱工具既不稳,又会偏向 OLS 的方向。
- 一个提醒:工具变量估计的,是被这个工具改变了行为的那些人的回报(比如,如果不是法律强制,本来会早点退学的人)。这和"全体人口的平均回报",不一定相同。
排他性,永远没法用数据完全证明,只能用理由和各种检验去支持。后面我们会用同样的逻辑,去看制度的那篇论文。
6.3 教育是技能,还是信号
即使因果回报是 9% 左右,它从哪来?第 21 讲讲过 Spence 的信号模型:教育也可能只是证明"我本来就更有能力",而不是教会了我什么。第 13 讲留下的问题"教育的回报,有多少来自技能,有多少来自向雇主证明自己",这里的回答,和第 21 讲一样:两者可能都有,各占多少,没有定论。
这对社会回报很重要。个人读书,如果一部分是在"证明自己",对个人有利,对社会的总产出,未必有同样大的好处。第 23 讲讲外部性时提过,Acemoglu 和 Angrist 2000 年用各州的义务教育法,估计教育的外部收益大约是 1%,统计上和零差别不显著(方法也有争议)。
6.4 教育与国家的增长(四步)
如果每个人读书,工资都高 9%,那么,一个国家多办教育,增长会更快吗?
理论预测什么:人力资本是生产的投入(第 28 讲提到的 Mankiw、Romer 和 Weil 1992,把人力资本加进 Solow 模型,解释了约 80% 的人均收入差异);它还可能帮助吸收和创造新技术(第四节)。
证据怎么说:
- Mark Bils 和 Peter Klenow 2000 年(American Economic Review,90 卷 5 期)的问题是:国家层面,教育和增长的强相关,有多少是"教育带来增长",有多少是"预期增长高,所以人们多读书"?他们用劳动经济学里关于教育回报的估计,加上各国教育的数据来校准,发现"教育 → 增长"这条渠道,太弱,解释不了 Barro 1991 年那个相关系数的一半。他们的结论是:反向的渠道,也就是预期增长影响读书,可能起了重要的作用。
- Eric Hanushek 和 Ludger Woessmann 2012 年(Journal of Economic Growth,17 卷 4 期)认为,关键不是读了多少年,而是学到了什么:他们用国际测试的成绩,衡量认知技能,发现认知技能和增长的关系,非常稳健;他们用多种方法(工具变量、对美国移民的双重差分、技能变化与增长率变化的纵向分析)去缩小可能的解释,结论没有变。发表的版本,对因果的表述,比早期的工作论文谨慎。
局限:Bils 和 Klenow 的校准,依赖对教育回报和教育结构的假设;Hanushek 和 Woessmann 的国家层面回归,也要小心测试成绩和增长受共同的未观测因素影响(他们用上面提到的几种方法去检验过这一点)。两篇文章,用的是不同的方法,回答的问题也不完全一样,不是互相矛盾的。
分歧在哪:事实上的分歧居多:年限和质量,哪个更关键?因果的方向,是教育 → 增长,还是反过来,还是两者互相促进?第三节,我们对人力资本的量法(只用年限),可能低估了质量差距的作用。
价值判断:这个问题里,价值的成分较少。真正涉及价值的,是教育资源怎么分配:优先给谁、学什么,这是政策问题,经济学只能告诉你各种选择可能的后果。
小结: 教育的私人回报,全球平均约每年 9%。直接比较会高估(能力偏误);工具变量是一种办法,但依赖排他性,工具弱时更危险(偏差 = 直接影响 ÷ 第一阶段)。教育是技能还是信号,两者都有。国家层面,教育和增长的关系,因果方向和年限与质量,仍有争论。
七、制度:最深的原因吗
7.1 近因和深层原因
到现在,我们讲了资本(第 28 讲)、人力资本和想法。经济学家把它们叫作增长的近因(proximate causes)。可是,每个"近因",立刻引出一个新问题:为什么有的国家积累了资本、教育和想法,有的国家没有?
回答这个问题的是深层原因(fundamental causes)。最常被提的有三个:
- 地理:气候、疾病、与海的距离;
- 文化:价值观和信念;
- 制度:第 26 讲讲过:North 的定义是"人们设计的、约束人们互动的游戏规则",既包括正式的规则,也包括非正式的。
第 26 讲留下过一个想法:同样的人、同样的资源,放在不同的规则里,结果会很不一样。 好的制度做两件事:让激励相容;约束掌权者,使承诺可信。这一节,我们看关于制度最有名的一项研究,以及对它的争论。
7.2 Acemoglu、Johnson 和 Robinson 的论证
Daron Acemoglu、Simon Johnson 和 James Robinson 2001 年(《殖民起源与比较发展:一项实证研究》,American Economic Review,91 卷 5 期,下面简称 AJR)想回答:制度对今天的收入,有多大的因果影响?
直接比较制度好的国家和制度差的国家,有三个麻烦:
- 反向因果:富的国家,可能有更多的资源去建好制度。
- 遗漏变量:文化、地理,可能同时影响制度和收入。
- 测量误差:“制度"很难量,量出来的指数,有噪声。
他们的办法,也是工具变量。论证的链条是:
- 欧洲人在不同的殖民地,死亡率差别很大。有的地方(比如热带非洲)疾病让欧洲人大量死亡,有的地方(比如北美、澳大利亚)和欧洲差不多。
- 死亡率高的地方,欧洲人不会大量定居,更可能建立榨取型的制度:为了运走资源,少数人掌权,对产权保护很少。死亡率低的地方,欧洲人定居下来,要求保护产权、限制权力的制度。
- 这些早期的制度,一直延续到今天(路径依赖)。
- 所以,早期的欧洲人死亡率,可以当作今天制度的工具变量。
AJR 所用的"制度"指标,是"产权保护"指数(防止被征收风险的平均得分,0 到 10,越高越好);收入用的是 1995 年的人均 GDP(取对数);工具是早期欧洲人(士兵、主教等)在殖民地的死亡率(取对数)。下面,我们拿他们公开的数据,自己重跑一遍(数据用两位小数,和原文有 0.01 左右的差别)。
7.3 代码验证:重跑 AJR
import numpy as np

# 重跑 Acemoglu–Johnson–Robinson(2001)的核心回归。数据:他们公开的"基准样本",64 个前殖民地。
# 每项:(产权保护指数 avexpr,0 到 10,越高越保护;1995 年人均 GDP 的对数;早期欧洲殖民者死亡率的对数;是否非洲;是否亚洲;离赤道的纬度(0 到 1))
data = {
    "AUS": (9.32, 9.90, 2.15, 0, 0, 0.300), "NZL": (9.73, 9.76, 2.15, 0, 0, 0.456), "HKG": (8.14, 10.05, 2.70, 0, 1, 0.246),
        "USA": (10.00, 10.22, 2.71, 0, 0, 0.422), "ZAF": (6.86, 8.89, 2.74, 1, 0, 0.322), "CAN": (9.73, 9.99, 2.78, 0, 0, 0.667),
        "MLT": (7.23, 9.43, 2.79, 0, 0, 0.394), "SGP": (9.32, 10.15, 2.87, 0, 1, 0.014), "MYS": (7.95, 8.89, 2.87, 0, 1, 0.026),
        "ETH": (5.73, 6.11, 3.26, 1, 0, 0.089), "GUY": (5.89, 7.90, 3.47, 0, 0, 0.056), "PAK": (6.05, 7.35, 3.61, 0, 1, 0.333),
        "IND": (8.27, 7.33, 3.88, 0, 1, 0.222), "TUN": (6.45, 8.48, 4.14, 1, 0, 0.378), "EGY": (6.77, 7.95, 4.22, 1, 0, 0.300),
        "ARG": (6.39, 9.13, 4.23, 0, 0, 0.378), "CHL": (7.82, 9.34, 4.23, 0, 0, 0.333), "LKA": (6.05, 7.73, 4.25, 0, 1, 0.078),
        "GTM": (5.14, 8.29, 4.26, 0, 0, 0.170), "MEX": (7.50, 8.94, 4.26, 0, 0, 0.256), "ECU": (6.55, 8.47, 4.26, 0, 0, 0.022),
        "BOL": (5.64, 7.93, 4.26, 0, 0, 0.189), "PER": (5.77, 8.40, 4.26, 0, 0, 0.111), "BRA": (7.91, 8.73, 4.26, 0, 0, 0.111),
        "COL": (7.32, 8.81, 4.26, 0, 0, 0.044), "URY": (7.00, 9.03, 4.26, 0, 0, 0.367), "BGD": (5.14, 6.88, 4.27, 0, 1, 0.267),
        "VEN": (7.14, 9.07, 4.36, 0, 0, 0.089), "PRY": (6.95, 8.21, 4.36, 0, 0, 0.256), "HND": (5.32, 7.69, 4.36, 0, 0, 0.167),
        "CRI": (7.05, 8.79, 4.36, 0, 0, 0.111), "SLV": (5.00, 7.95, 4.36, 0, 0, 0.150), "DZA": (6.50, 8.39, 4.36, 1, 0, 0.311),
        "MAR": (7.09, 8.04, 4.36, 1, 0, 0.356), "BHS": (7.50, 9.29, 4.44, 0, 0, 0.268), "TTO": (7.45, 8.77, 4.44, 0, 0, 0.122),
        "SDN": (4.00, 7.31, 4.48, 1, 0, 0.167), "JAM": (7.09, 8.19, 4.87, 0, 0, 0.202), "HTI": (3.73, 7.15, 4.87, 0, 0, 0.211),
        "DOM": (6.18, 8.36, 4.87, 0, 0, 0.211), "VNM": (6.41, 7.28, 4.94, 0, 1, 0.178), "KEN": (6.05, 7.06, 4.98, 1, 0, 0.011),
        "NIC": (5.23, 7.54, 5.10, 0, 0, 0.144), "PAN": (5.91, 8.84, 5.10, 0, 0, 0.100), "SEN": (6.00, 7.40, 5.10, 1, 0, 0.156),
        "IDN": (7.59, 8.07, 5.14, 0, 1, 0.056), "ZAR": (3.50, 6.87, 5.48, 1, 0, 0.000), "COG": (4.68, 7.42, 5.48, 1, 0, 0.011),
        "GAB": (7.82, 8.91, 5.63, 1, 0, 0.011), "BFA": (4.45, 6.85, 5.63, 1, 0, 0.144), "CMR": (6.45, 7.50, 5.63, 1, 0, 0.067),
        "UGA": (4.45, 6.97, 5.63, 1, 0, 0.011), "TZA": (6.64, 6.25, 5.63, 1, 0, 0.067), "AGO": (5.36, 7.77, 5.63, 1, 0, 0.137),
        "NER": (5.00, 6.73, 5.99, 1, 0, 0.178), "GIN": (6.55, 7.49, 6.18, 1, 0, 0.122), "SLE": (5.82, 6.25, 6.18, 1, 0, 0.092),
        "MDG": (4.45, 6.84, 6.28, 1, 0, 0.222), "GHA": (6.27, 7.37, 6.50, 1, 0, 0.089), "CIV": (7.00, 7.44, 6.50, 1, 0, 0.089),
        "TGO": (6.91, 7.22, 6.50, 1, 0, 0.089), "GMB": (8.27, 7.27, 7.29, 1, 0, 0.148), "NGA": (5.55, 6.81, 7.60, 1, 0, 0.111),
        "MLI": (4.00, 6.57, 7.99, 1, 0, 0.189)
}
codes = list(data)
col = lambda i, cs: np.array([data[c][i] for c in cs])

def tsls(cs, controls=()):
    """被解释变量 y = 人均 GDP 的对数;内生变量 x = 制度指数;工具 z = 殖民者死亡率的对数;controls = 外生控制变量的列号"""
    y, x, z = col(1, cs), col(0, cs), col(2, cs)
    W = np.column_stack([np.ones(len(cs))] + [col(i, cs) for i in controls])
    Z, X = np.column_stack([W, z]), np.column_stack([W, x])
    first = np.linalg.lstsq(Z, x, rcond=None)[0]                          # 第一阶段:x 对 z 和控制变量
    r1 = x - Z @ first
    se1 = np.sqrt((r1 @ r1 / (len(cs) - Z.shape[1])) * np.linalg.inv(Z.T @ Z)[-1, -1])
    xhat = Z @ first
    Xh = np.column_stack([W, xhat])
    b = np.linalg.lstsq(Xh, y, rcond=None)[0]                             # 第二阶段
    e = y - X @ b                                                         # 标准误用真实的 x 算残差
    se = np.sqrt((e @ e / (len(cs) - X.shape[1])) * np.linalg.inv(Xh.T @ Xh)[-1, -1])
    return b[-1], se, first[-1], (first[-1] / se1) ** 2                   # IV 系数、标准误、第一阶段系数、第一阶段 F

def ols(cs):
    y, x = col(1, cs), col(0, cs)
    return np.polyfit(x, y, 1)[0]

print(f"{len(codes)} 个国家。普通回归(OLS):制度指数每高 1 点,人均 GDP 高 {ols(codes):.2f}(对数)")
print("工具变量(2SLS):")
def show(label, cs, controls=()):
    b, se, f1, F = tsls(cs, controls)
    print(f"  {label}({len(cs)} 国):系数 {b:5.2f}(标准误 {se:4.2f}),第一阶段系数 {f1:5.2f},第一阶段 F = {F:4.1f}")
show("基准", codes)
show("去掉澳、新、美、加", [c for c in codes if c not in ("AUS", "NZL", "USA", "CAN")])
show("去掉非洲国家", [c for c in codes if data[c][3] == 0])
show("加纬度", codes, controls=(5,))
show("加非洲、亚洲虚拟变量", codes, controls=(3, 4))

print("\n每次去掉一个国家,系数的变化范围(基准样本):")
est = []
for c in codes:
    b, se, f1, F = tsls([k for k in codes if k != c])
    est.append((b, c, F))
lo, hi = min(est), max(est)
print(f"  最小 {lo[0]:.2f}(去掉 {lo[1]}),最大 {hi[0]:.2f}(去掉 {hi[1]});第一阶段 F 最小 {min(e[2] for e in est):.1f}")
输出:
64 个国家。普通回归(OLS):制度指数每高 1 点,人均 GDP 高 0.52(对数)
工具变量(2SLS):
  基准(64 国):系数  0.94(标准误 0.16),第一阶段系数 -0.61,第一阶段 F = 23.0
  去掉澳、新、美、加(60 国):系数  1.28(标准误 0.36),第一阶段系数 -0.39,第一阶段 F =  8.7
  去掉非洲国家(37 国):系数  0.58(标准误 0.10),第一阶段系数 -1.21,第一阶段 F = 30.6
  加纬度(64 国):系数  1.00(标准误 0.22),第一阶段系数 -0.51,第一阶段 F = 13.1
  加非洲、亚洲虚拟变量(64 国):系数  0.84(标准误 0.19),第一阶段系数 -0.53,第一阶段 F = 11.0

每次去掉一个国家,系数的变化范围(基准样本):
  最小 0.84(去掉 GMB),最大 1.01(去掉 NZL);第一阶段 F 最小 18.7
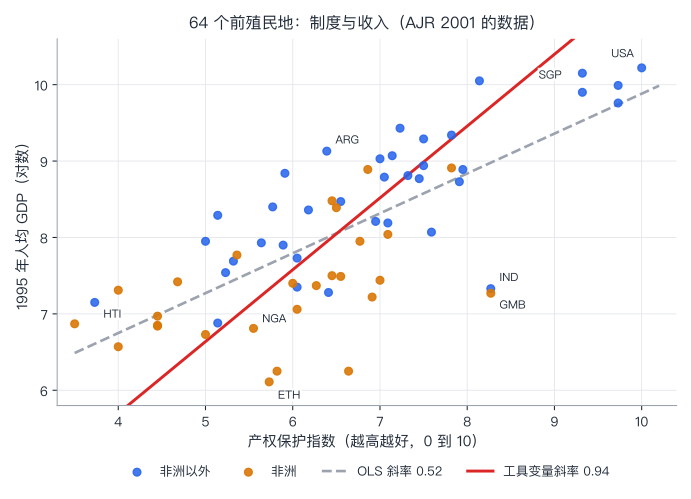
逐段看:
- 基准结果:OLS 0.52,工具变量 0.94(标准误 0.16)。制度指数每高 1 点,人均 GDP 高约 0.94(对数),约 2.6 倍。工具变量的估计,比 OLS 大:AJR 的解释是,指数有测量误差,OLS 被拉低了。(别的解释也有,比如我们在上面的 D 部分里,看到过工具违反排他性会推高估计。)
- 第一阶段:死亡率的对数每高 1 点,制度指数低约 0.61;F = 23.0。常用的经验法则是,第一阶段 F 低于 10 时,要小心弱工具。
- 稳健性:去掉澳大利亚、新西兰、美国、加拿大(欧洲人大量定居的地方),估计变成 1.28,但标准误变成 0.36,第一阶段 F 降到 8.7;去掉非洲国家,估计 0.58(标准误 0.10);加上纬度、加上洲的虚拟变量,估计在 0.84 到 1.00 之间。留一法(每次去掉一个国家):0.84 到 1.01。
- 怎么读:点估计在 0.6 到 1.3 之间摆动,方向和显著性很稳定;但是第一阶段在去掉那 4 个国家后明显变弱。这说明,死亡率和制度之间的关系,有相当一部分,来自那几个"欧洲人大量定居"的国家。(这是我从数据里读出来的,不是 AJR 的说法。)
- 重要的限制:这个重跑,没法检验数据本身对不对,也没法检验排他性。下面就是争论的焦点。
7.4 一个有争议的问题:制度,到底是不是最深的原因(四步)
理论预测什么:保护产权、约束掌权者的包容性制度,让人们有动力投资、创新、积累;榨取性制度,让少数人拿走多数人的成果,没有动力。因此,制度好的国家,长期更富。
证据怎么说:
- AJR 2001(上面)。
- AJR 2002 年(《命运的逆转》,Quarterly Journal of Economics,117 卷 4 期):在被欧洲人殖民的地方,1500 年相对富裕的(用城市化和人口密度来代表),今天反而相对穷。他们把这个"逆转”,归因于欧洲人在原来较穷的地方更倾向于引入鼓励投资的制度(“制度的逆转”)。他们用这个来反对"地理决定论"。
- Melissa Dell 2010 年(《秘鲁矿业 mita 的持续影响》,Econometrica,78 卷 6 期):用断点回归,比较历史上被强制服劳役(mita,1573 到 1812 年)和没有被强制的邻近地区,发现今天被 mita 覆盖的地区,家庭消费低约四分之一,儿童发育迟缓的比例高约 6 个百分点;她认为,渠道包括土地所有制和公共品的提供。这是一个历史上的制度,影响持续到今天的例子,识别比 AJR 更局部、更干净,但它比较的是秘鲁的一个地区,推到整个世界要小心。
- Rodrik、Subramanian 和 Trebbi 2004 年(Journal of Economic Growth,9 卷 2 期):控制了制度之后,地理对收入的直接影响很弱,贸易也常常不显著;他们的结论是"制度说了算"。
- 2024 年,Acemoglu、Johnson 和 Robinson 因"对制度如何形成、如何影响繁荣的研究",获得诺贝尔经济学奖。
局限与批评:
- 数据(Albouy 2012 年,American Economic Review,102 卷 6 期):David Albouy 重新检查了 AJR 的死亡率数据,指出,64 个国家中,有 36 个的死亡率,是从别的国家"分配"来的,常常基于错误或冲突的证据;用的死亡率,混合了不同人群(劳工、主教、行军中的士兵)的数据,这些人群的死亡率不可比;他认为,处理这些问题之后,死亡率与产权保护之间的关系不稳健,工具变量的估计变得不可靠(有时置信区间是无限的)。AJR 的回答(同期,American Economic Review,102 卷 6 期)认为,欧洲人在拉丁美洲和非洲的死亡率,有大量的历史资料,Albouy 的处理没有道理;他的"战役"虚拟变量,编码有误;限制异常值的影响,会让原来的结果更强。双方对数据的处理,各有各的理由,这是一场到今天还没有完全了结的技术争论。
- 排他性(Jeffrey Sachs 2003 年,NBER 工作论文 9490):疟疾等疾病,直接影响人的劳动能力和收入,不必经过制度。如果高死亡率的地方,也是疟疾多的地方,那么,死亡率作为工具,就违反了排他性。Sachs 的论文,用疟疾的传播强度,说明在控制制度之后,它仍然直接影响人均收入。回到代码 D 的公式:偏差 = 直接影响 ÷ 第一阶段。死亡率的直接影响是负的(疾病拉低收入),第一阶段也是负的(死亡率高、制度差),相除是正的:把疾病的直接作用算在制度头上,会高估制度的效应。(这是对方向的推理,不是对大小的估计;大小如何,AJR 的回应和后续研究给出了不同的看法。)
- 谁在前,谁在后(Edward Glaeser、Rafael La Porta、Florencio Lopez-de-Silanes 和 Andrei Shleifer 2004 年,Journal of Economic Growth,9 卷 3 期):他们认为,常用的制度指标,在概念上不适合拿来证明"制度导致增长"。我的理解是,这类指标衡量的常常是结果,不是规则:比如"产权被征收的风险",富国当然更低(这是我对他们论点的概括,请读原文)。而且,人力资本的积累,可能比制度更先出现:穷国先靠还不错的政策(往往是独裁者推行的)脱贫,之后政治制度才改善。(这是他们工作论文版摘要里的概括。)
分歧在哪:
- 事实上的分歧:(1)死亡率的数据,质量够不够?(2)死亡率是否只通过制度起作用?(3)制度和人力资本、增长,谁先谁后?
- 概念上的分歧:“制度"是什么?是书面的规则,还是实际执行的规则?是政治上的,还是经济上的?一个 0 到 10 的指数,能不能代表这些?
- 没有分歧的部分:几乎没有人认为制度不重要。争论的是:它是最深的原因吗?我们能不能用现有的证据,把它的作用,量清楚?
价值判断(留给你):
事实争论清楚之后,还有一些问题,数据回答不了:
- 如果你相信制度很重要,谁有权利、有责任去改变一个国家的制度? 一个国家内部的人?外部的援助者和国际机构?(AJR 的故事本身,就是外部者当年留下的制度,延续到了今天。)
- 改革的速度和代价:制度的变化,常常伴随不确定和痛苦,赢家和输家都有。你愿意为长期的好处,承担多大的过渡成本?
- 经济上的好制度(保护产权),和政治上的权利(参与、表达),是不是一回事,是不是总是同时出现?如果两者在某个时期不一致,你怎么权衡?
7.5 中国:一个不容易放进框架的例子
制度的争论,绕不开中国。中国 1990 到 2019 年均增长 9% 左右(本讲 PWT 的数字是 9.08%,第 27 讲世界银行口径三个十年的简单平均约 9.4%),这支持制度重要论,还是挑战它? 这是个复杂的问题,我们按同样的四步写,并且尽量克制。
理论预测什么:据对 Acemoglu 和 Robinson 2012 年《国家为什么会失败》一书的介绍,他们的看法是:在榨取型的政治制度下,增长是可能出现的(比如,从很低的起点,把资源动员起来),但很难持续,因为持续的增长需要"创造性破坏”(新企业取代旧企业),而既得利益者会阻止它。(这是对该书观点的二手概括,请读原文。)
证据怎么说:
- Chenggang Xu 2011 年(Journal of Economic Literature,49 卷 4 期)用"区域分权的威权体制“来概括中国:中央掌握人事,地方政府管理大部分经济,并且发起、协商、执行或抵制改革;他认为,增长的成就和严重的问题,都由这个治理结构决定。第 26 讲讲的官员晋升研究,说的是同一个结构的一个侧面。
- 本讲的增长核算:1990 到 2019 年,中国的增长,约一半来自资本积累,约四成来自效率(不同算法 3.4 到 4.3 个百分点)。第 27 讲的数据:2010 年代增速降到约 7.7%,2020 到 2025 年约 4.9%。
局限:
- 一个国家,一个案例:我们没法观察"如果中国的制度不同,会怎样”(第 4 讲的反事实)。
- “能不能持续"是对未来的预测,只能事后验证。上面那本书出版于 2012 年,我没有查到可靠的、对这个预测的系统检验。增速放缓,有多种可能的解释(人口结构、资本报酬递减、外部环境、效率增长放慢,第 28 讲讲过前面几种),单凭增速,分不出是哪一种。
- “制度"的粒度:经济制度和政治制度要分开看;书面规则和实际执行也要分开看。把中国整体归为"包容"或"榨取”,都可能过于粗糙,研究者对此也有批评。
分歧在哪:事实上,分歧在:增长的主要来源是什么?是不是可持续?可持续的条件是什么?概念上,分歧在:好制度的关键,是政治上的包容,还是对产权和合同的有效保护、对掌权者的可信约束(第 26 讲提到的两件事)?不同的研究者,有不同的回答。
价值判断(留给你):除了上面第 7.4 节的三个问题,再加一个:当不同的目标(收入的增长、稳定、政治参与、环境、分配)出现冲突时,你把哪个放在前面?这是价值判断,经济学帮你看清各个选择的代价,不替你选。
7.6 制度从哪来
最后,有一个让人不太舒服的问题:制度不是天上掉下来的。 它是由当时掌权的人选的,会反映他们的利益。第 26 讲讲过,好的制度,要约束掌权者;而掌权者,通常不愿意约束自己。所以,“穷国应该改善制度"这句话,几乎是一句废话,它没有回答"怎么改、谁来改、为什么他们愿意改”。
经济学对"制度重要"的了解,比对"怎么把差的制度变成好的制度"的了解,要多得多。没有一个公认的配方。 请记住这一点:它是对任何"只要改了制度,就会……“这种说法的一剂解毒药。
小结: 制度,是增长的"深层原因"之一。AJR 用殖民者死亡率做工具,估计出制度对今天收入的大影响;我们用公开数据重跑,复现了 OLS 0.52、工具变量 0.94。争论在于:死亡率数据是否可靠(Albouy)、死亡率是否只通过制度起作用(Sachs 的疟疾)、制度和人力资本谁先谁后(Glaeser 等)。中国的例子,说明"制度"需要分得更细,对"能不能持续"的预测,现在还不能下结论。
八、把线索放在一起
| 因素 | 它怎么进入增长 | 本课的位置 | 证据与争论 |
|---|---|---|---|
| 资本 | 积累有边际报酬递减,只改变水平 | 第 28 讲 | 增长核算里占比大,发展核算里解释的差距小 |
| 人力资本 | 提高工人的生产率,帮助吸收技术 | 第六节 | 私人回报约 9%;国家层面,年限还是质量、因果方向有争论 |
| 想法 | 非竞争性,让持续增长成为可能 | 第四节 | φ 是多少?想法是否越来越难找? |
| 制度 | 决定人们有没有动力去积累和创新 | 第七节 | 因果的识别、数据质量、“制度"的定义有争论 |
这四项不是互相替代的。资本需要人力资本去用,想法需要制度去激励,制度需要人去运行。没有一个"增长的配方”。 经济学家了解各个部分怎么运转,也知道哪里的证据比较强,哪里的争论还没有结论。
九、局限、常见误用
9.1 局限
- 增长核算和发展核算是会计,不是因果:它们告诉你"差在哪”,不告诉你"为什么”。
- 残差是个大口袋:技术、资源配置、测量误差、未算到的投入,都在里面。
- 数据的质量:PWT 的资本存量、人力资本,都是估出来的(人力资本只算了年限);样本里,有些国家的资本产出比,高得不合理。
- 模型是简化的:4.3 节的想法模型里,没有企业的进入和退出(4.6 节,用两个很小的计算,补了一部分创造性破坏),也没有想法在国家之间怎么扩散的细节;本讲没有讲环境、不平等这些增长的代价(第 23 讲讲过外部性,第 42、43 讲会再碰到)。
- 重跑 AJR,不等于验证 AJR:我们没有查数据本身对不对,也无法检验排他性。
9.2 常见的误用
| 误用 | 正确的想法 |
|---|---|
| “全要素生产率就是技术进步” | 它是残差:技术、资源配置、测量误差、未算到的投入,都在里面 |
| “中国的增长,只是靠投资” 或 “主要是效率” | 在这个核算里两者都很大,比例取决于数据和算法,有争议 |
| “给穷国多买机器、多建学校,差距就消失” | 发展核算:这两项只解释差距的一小部分,大部分在"效率"里 |
| “想法人人可用,所以穷国能轻易追上” | 要有配套、要适合本地、要有动力 |
| “研究投入越多,增长就越快” | 取决于 φ:φ = 1 时是,φ < 1 时只提高水平 |
| “技术一定会让大量的人失业” 或 “一定不会” | 证据不一致,要看层次、技术和时期;收益和代价常常落在不同的人身上 |
| “多读一年书,工资就因果地高 9%” | 9% 是平均的私人回报;直接比较有能力偏误,教育也可能一部分是信号 |
| “工具变量能解决内生性” | 依赖排他性,且工具弱时更危险:偏差 = 直接影响 ÷ 第一阶段 |
| “制度决定一切” 或 “制度不重要” | 制度重要,但"最深的原因"这个说法有争议,因果识别也有争议 |
| “AJR 被推翻了” 或 “AJR 是定论” | 都不准确:数据和排他性有争论,也有回应;这是一个没有了结的争论 |
十、小结
这一讲有八个想法,请带走:
- 增长核算:产出增长 = α × 资本增长 + (1 − α) × (工时增长 + 人力资本增长) + 效率增长。权数是投入的收入份额;效率是减出来的残差,对数据和算法敏感。
- 发展核算:2019 年 45 个大国,最富 9 国对最穷 9 国,13 倍的差距里,资本约 1.2 倍、人力资本约 1.7 倍,效率约 6.4 倍。机器和学历只解释一小部分。
- 想法是非竞争性的:用得多不会变少,所以有递增报酬;要有人去发明,需要一定的垄断力量,带来静态损失与动态收益的权衡。
- φ:φ = 1 时,研究投入永久提高增长率;φ < 1 时,只提高水平,长期增长率由人口增长决定。证据混合,想法似乎越来越难找。
- 技术与工作:有替代,也有互补和扩张。研究的结论不一致;收益和代价常常落在不同的人身上,该怎么处理,是价值判断。
- 教育的回报:私人回报全球平均约 9%;能力偏误会让直接比较高估;工具变量依赖排他性,偏差 = 直接影响 ÷ 第一阶段。
- 制度:很重要,但"最深的原因"这个说法,有数据、排他性和先后顺序上的争论;“怎么把差的制度变好”,没有公认的配方。
- 创造性破坏(2025 年诺贝尔奖):创新越快,每一项创新的利润期越短(V = π/(r + μ)),领先者不断易主;研发可能太多,也可能太少,竞争和创新的关系,证据不一致。
增长就讲到这里。从下一讲起,我们的视线,从"几十年的趋势",转向"货币和金融":钱到底是什么?银行为什么能"创造"钱? 下一讲:第 30 讲:货币、银行与信用创造。 实验 77,会让你亲手跑一个 Solow 模拟,再用真实数据校准。
思考题
1. 一个国家一年里,产出增长 6%,资本增长 8%,工时增长 1%,人力资本增长 1%,资本份额 α = 0.4。求效率的增长。如果 α 取 1/3 呢?
提示:效率增长 = 6 − 0.4 × 8 − 0.6 × (1 + 1) = 6 − 3.2 − 1.2 = 1.6 个百分点,占产出增长的约 27%。α = 1/3 时:6 − (1/3) × 8 − (2/3) × 2 = 6 − 2.67 − 1.33 = 2.0。同样的数据,α 从 0.4 变成 1/3,效率的增长,从 1.6 变成 2.0:对算法敏感。
2. 国家 A 的人均产出,是国家 B 的 8 倍;两国的资本产出比相同,A 的人力资本是 B 的 1.5 倍。A 的"效率"是 B 的多少倍?效率占对数差距的多少?如果把 B 的人力资本,提到和 A 一样,B 的人均产出,会是 A 的多少?
提示:由 人均产出 = (K/Y)^(α/(1−α)) × h × A:资本产出比相同,这一项两国相同。8 = 1.5 × (A 的效率 ÷ B 的效率),所以效率比是 8 ÷ 1.5 ≈ 5.33 倍。对数差距:ln 8 = 2.08,其中效率 ln 5.33 = 1.67,占 约 80%。把 B 的人力资本提高到 A 的水平(1.5 倍),B 的产出变成原来的 1.5 倍,是 A 的 1.5 ÷ 8 ≈ 19%。
3. 想法模型:n = 2%(连续时间),比较 φ = 0、0.5、0.75 三种情形:长期的增长率 n ÷ (1 − φ) 各是多少?研究者占人口的比例翻倍,长期水平会变成多少倍(2^(1/(1−φ)))?
提示:φ = 0:增长率 2% ÷ 1 = 2%,水平 2^1 = 2 倍;φ = 0.5:2% ÷ 0.5 = 4%,水平 2^2 = 4 倍;φ = 0.75:2% ÷ 0.25 = 8%,水平 2^4 = 16 倍。φ 越接近 1,好找的想法"越不会被找完",人口的增长和研究的投入,影响越大。φ = 1 时,公式不再适用(对应 Romer 型,长期增长率取决于研究者的人数,而不是人口增长率)。
4. 6.2 节的模拟里,真实回报是 0.08,不控制能力的 OLS 是 0.109。如果一个工具的第一阶段是 0.5 年,直接影响是 0.01,工具变量估计是多少?直接影响是 0.015 呢?这个工具比 OLS 好吗?
提示:偏差 = 直接影响 ÷ 第一阶段。直接影响 0.01:0.08 + 0.01 ÷ 0.5 = 0.10,比 OLS 的 0.109 稍好;直接影响 0.015:0.08 + 0.015 ÷ 0.5 = 0.11,比 OLS 还差。结论:一个并不完美的工具,不一定比 OLS 好,要看违反排他性的程度,和第一阶段的强度。
5. Sachs 说,疟疾直接降低收入。如果这对 AJR 成立,会让他们对制度作用的估计偏高还是偏低?用 6.2 节的公式解释。再想一想:什么样的证据,能让你判断这个偏差有多大?
提示:偏差 = 直接影响 ÷ 第一阶段。工具(死亡率的对数)的直接影响是负的(疾病拉低收入,对数死亡率越高,收入越低),第一阶段也是负的(死亡率越高,制度指数越低),相除得正:把疾病的直接作用,当成制度的作用,会让制度效应偏高。要判断偏差多大,需要知道:疾病在控制制度之后,对收入的直接作用有多大(Sachs 用疟疾的传播强度来估计,AJR 和别的研究者有不同的回应);也可以用别的、不经过疾病渠道的工具,看估计是否相近。这些都不是一次回归就能回答的,这正是争论持续的原因。
参考与延伸
- Abramovitz, M. (1956). Resource and Output Trends in the United States since 1870. NBER Occasional Paper 52.
- Solow, R. M. (1957). Technical Change and the Aggregate Production Function. Review of Economics and Statistics, 39(3), 312–320.
- Jorgenson, D. W., & Griliches, Z. (1967). The Explanation of Productivity Change. Review of Economic Studies, 34(3).
- Feenstra, R. C., Inklaar, R., & Timmer, M. P. (2015). The Next Generation of the Penn World Table. American Economic Review, 105(10), 3150–3182.
- Hall, R. E., & Jones, C. I. (1999). Why Do Some Countries Produce So Much More Output Per Worker Than Others? Quarterly Journal of Economics, 114(1), 83–116.
- Romer, P. M. (1990). Endogenous Technological Change. Journal of Political Economy, 98(5), S71–S102.
- Jones, C. I. (1995). R&D-Based Models of Economic Growth. Journal of Political Economy, 103(4), 759–784.
- Kremer, M. (1993). Population Growth and Technological Change: One Million B.C. to 1990. Quarterly Journal of Economics, 108(3), 681–716.
- Bloom, N., Jones, C. I., Van Reenen, J., & Webb, M. (2020). Are Ideas Getting Harder to Find? American Economic Review, 110(4), 1104–1144.
- Autor, D. H. (2015). Why Are There Still So Many Jobs? The History and Future of Workplace Automation. Journal of Economic Perspectives, 29(3), 3–30.
- Acemoglu, D., & Restrepo, P. (2020). Robots and Jobs: Evidence from US Labor Markets. Journal of Political Economy, 128(6), 2188–2244.
- Graetz, G., & Michaels, G. (2018). Robots at Work. Review of Economics and Statistics, 100(5), 753–768.
- Mincer, J. (1974). Schooling, Experience, and Earnings. Columbia University Press(NBER)。
- Psacharopoulos, G., & Patrinos, H. A. (2018). Returns to Investment in Education: A Decennial Review of the Global Literature. Education Economics, 26(5), 445–458.
- Angrist, J. D., & Krueger, A. B. (1991). Does Compulsory School Attendance Affect Schooling and Earnings? Quarterly Journal of Economics, 106(4), 979–1014.
- Bound, J., Jaeger, D. A., & Baker, R. M. (1995). Problems with Instrumental Variables Estimation When the Correlation between the Instruments and the Endogenous Explanatory Variable Is Weak. Journal of the American Statistical Association, 90(430), 443–450.
- Bils, M., & Klenow, P. J. (2000). Does Schooling Cause Growth? American Economic Review, 90(5), 1160–1183.
- Hanushek, E. A., & Woessmann, L. (2012). Do Better Schools Lead to More Growth? Cognitive Skills, Economic Outcomes, and Causation. Journal of Economic Growth, 17(4), 267–321.
- Acemoglu, D., Johnson, S., & Robinson, J. A. (2001). The Colonial Origins of Comparative Development: An Empirical Investigation. American Economic Review, 91(5), 1369–1401.
- Acemoglu, D., Johnson, S., & Robinson, J. A. (2002). Reversal of Fortune: Geography and Institutions in the Making of the Modern World Income Distribution. Quarterly Journal of Economics, 117(4), 1231–1294.
- Albouy, D. Y. (2012). The Colonial Origins of Comparative Development: An Empirical Investigation: Comment. American Economic Review, 102(6), 3059–3076;以及 Acemoglu, Johnson, Robinson 同期的回复(American Economic Review, 102(6))。
- Sachs, J. D. (2003). Institutions Don’t Rule: Direct Effects of Geography on Per Capita Income. NBER Working Paper 9490.
- Glaeser, E. L., La Porta, R., Lopez-de-Silanes, F., & Shleifer, A. (2004). Do Institutions Cause Growth? Journal of Economic Growth, 9(3), 271–303.
- Rodrik, D., Subramanian, A., & Trebbi, F. (2004). Institutions Rule: The Primacy of Institutions over Geography and Integration in Economic Development. Journal of Economic Growth, 9(2), 131–165.
- Dell, M. (2010). The Persistent Effects of Peru’s Mining Mita. Econometrica, 78(6), 1863–1903.
- Xu, C. (2011). The Fundamental Institutions of China’s Reforms and Development. Journal of Economic Literature, 49(4), 1076–1151.
- Acemoglu, D., & Robinson, J. A. (2012). Why Nations Fail. Crown.
- Penn World Table 11.0(本讲的数据;Groningen Growth and Development Centre)。
- AJR 2001 的公开数据(本讲第 7.3 节重跑所用,采用第三方镜像的拷贝)。
- 瑞典皇家科学院:2025 年诺贝尔经济学奖(2025 年 10 月 13 日,据 NBER 等机构的转述)。
- Aghion, P., & Howitt, P. (1992). A Model of Growth Through Creative Destruction. Econometrica, 60(2), 323–351.
- Aghion, P., Bloom, N., Blundell, R., Griffith, R., & Howitt, P. (2005). Competition and Innovation: An Inverted-U Relationship. Quarterly Journal of Economics, 120(2), 701–728.
- Hashmi, A. R. (2013). Competition and Innovation: The Inverted-U Relationship Revisited. Review of Economics and Statistics, 95(5), 1653–1668.
- Mokyr, J. (2002). The Gifts of Athena: Historical Origins of the Knowledge Economy. Princeton University Press(“有用的知识"的两种分类,据转述)。