这一讲要回答六个问题:
- 不平等,怎么测?一个数字(基尼系数),够不够?
- 全世界的贫困,在发生什么?谁,在减少,谁,没有?
- 发展,只是收入吗?寿命呢?
- 国家,富了,不平等,会不会,先升,后降?(库兹涅茨曲线)
- 穷人的世界,怎么变好?(随机实验)
- 不平等,为什么上升?再分配,有什么代价?(有争议)
第 28、29 讲,我们讲了增长:为什么,有的国家,富,有的国家,穷;第 40 讲,贸易,让总蛋糕变大,却不是人人受益;第 4 讲,我们区分了"事实"和"价值判断":说"收入不平等是一个严重的问题",“不平等有多大”,是事实,“严重”,是价值判断。这一讲,把这些,接起来。
一、三个问题
先停一下:请先凭直觉,回答下面三个问题。
问题 1: 全世界,每天的生活费,不到 3 美元的"极端贫困"人口,从 1990 年到 2022 年,是增加了,还是减少了?减少的话,最大的功劳,来自哪里?
问题 2: 一个国家,从很穷,变得富了,收入的不平等,会怎么变?
问题 3: 政府,从富人手里,征 1 元的税,转给穷人,穷人,能拿到 1 元吗?如果拿不到,值不值得?
先记下答案。问题 1,在第三节;问题 2,在第五节;问题 3,在第七节。
二、怎么测不平等
2.1 洛伦兹曲线,和基尼系数
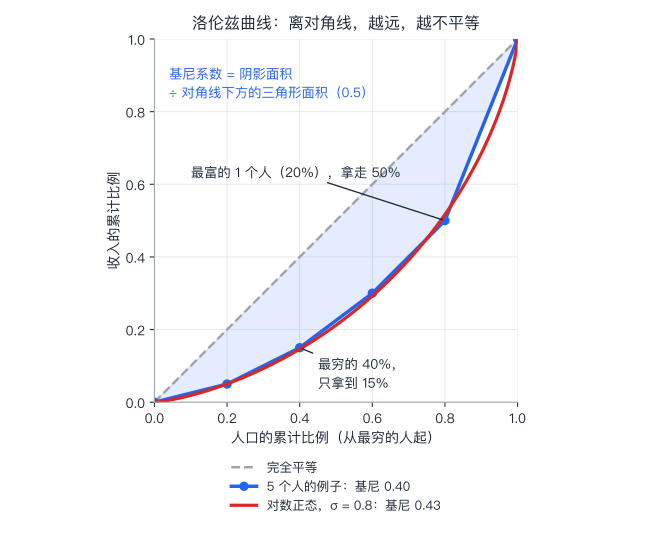
要谈不平等,先要有一把尺子。最常用的,是洛伦兹曲线:把所有人,按收入,从低到高,排队;横轴,是人口的累计比例;纵轴,是这些人,拿到的收入的累计比例。如果,人人收入一样,它就是一条对角线;越不平等,曲线,越往下弯。
基尼系数:对角线,和洛伦兹曲线,之间,的面积,除以,对角线下方,三角形的面积(0.5)。0,是人人一样;越接近 1,越是少数人,拿走了几乎全部。等价的算法:所有"两个人配对"的收入差的平均,再除以 2 倍的平均收入。
import itertools, math
from fractions import Fraction
from statistics import NormalDist

def gini(y):
    """基尼系数:所有"两个人配对"的收入差的平均,再除以 2 倍的平均收入。0 = 人人一样;趋近 1 = 一个人拿走了全部。"""
    y = sorted(y); n = len(y); mu = sum(y) / n
    cum = sum((2 * (i + 1) - n - 1) * v for i, v in enumerate(y))      # 排序之后的等价算法
    return cum / (n * n * mu)

# 一、一个手算的例子:5 个人,月收入(千元)
inc = [1, 2, 3, 4, 10]
tot = sum(inc)
print(f"一、5 个人的收入:{inc},合计 {tot},平均 {tot / 5:.1f}")
print("  洛伦兹曲线:人口,从最穷的人,累计,到最富的人,累计的收入份额")
cum = 0
for k, v in enumerate(inc, 1):
    cum += v
    print(f"    最穷的 {k} 个人({k / 5:>4.0%}):拿到 {cum / tot:>5.0%}")
pairs = sum(abs(a - b) for a in inc for b in inc)
print(f"  基尼系数 = 所有配对(含自己和自己)的收入差之和 ÷ (2 × n² × 平均) = {pairs} ÷ (2 × 25 × {tot / 5:.1f}) = {pairs / (2 * 25 * tot / 5):.3f}(排序算法:{gini(inc):.3f})")
print(f"  最富的 1 个人(20%),拿走 {inc[-1] / tot:.0%};最穷的 2 个人(40%),只有 {(inc[0] + inc[1]) / tot:.0%}")

# 二、基尼系数的两个性质,和一个盲点
print("\n二、基尼系数:(1)所有人的收入,翻一倍,基尼系数,不变;(2)人口,复制一倍,不变")
print(f"  {inc} → {[2 * v for v in inc]}:{gini(inc):.3f} → {gini([2 * v for v in inc]):.3f};人口复制一倍:{gini(inc * 2):.3f}")

# 盲点:不同的分布,可以有,同样的基尼系数。在"5 个人,收入合计 20(正整数)"的分布里,找基尼系数,完全相等,但,形状差别最大的一对
groups = {}
for c in itertools.combinations_with_replacement(range(1, 17), 5):
    if sum(c) == 20:
        g = Fraction(sum(abs(a - b) for a in c for b in c), 2 * 25 * Fraction(sum(c), 5))
        groups.setdefault(g, []).append(c)
best = None
for g, lst in groups.items():
    if len(lst) >= 2:
        top = [max(x) / 20 for x in lst]; bot = [x[0] / 20 for x in lst]
        spread = max(top) - min(top)
        a = lst[top.index(max(top))]; b = lst[top.index(min(top))]
        if best is None or spread > best[0]:
            best = (spread, g, a, b)
_, g, a, b = best
print(f"  盲点:基尼系数相同(都是 {float(g):.3f}),形状,却不同:")
print(f"    分布 {a}:最富的人,拿走 {max(a) / 20:.0%},最穷的人,拿 {min(a) / 20:.0%}")
print(f"    分布 {b}:最富的人,拿走 {max(b) / 20:.0%},最穷的人,拿 {min(b) / 20:.0%}")
print("  所以,一个数字,不能代替,分布的整体:常要,同时,看,最富的 10%、最穷的 50% 拿多少,和 P90/P10 之类的比。")

# 三、一个常用的"标准分布":对数正态(收入的对数,服从正态分布,标准差 σ)。基尼系数,只由 σ 决定:G = 2Φ(σ/√2) − 1
print("\n三、对数正态分布的收入(σ 越大,越不平等):用 10 万个等间隔的分位点,计算")
N = 100000
nd = NormalDist()
print(f"  {'σ':>5}{'基尼(计算)':>12}{'基尼(公式)':>12}{'最富 10% 的份额':>16}{'最穷 50% 的份额':>16}{'P90/P10':>9}")
for sigma in (0.4, 0.6, 0.8, 1.0, 1.2):
    y = [math.exp(sigma * nd.inv_cdf((i + 0.5) / N)) for i in range(N)]
    tot_y = sum(y)
    top10 = sum(y[int(0.9 * N):]) / tot_y; bot50 = sum(y[: N // 2]) / tot_y
    p90_p10 = y[int(0.9 * N)] / y[int(0.1 * N)]
    print(f"  {sigma:>5.1f}{gini(y):>12.3f}{2 * nd.cdf(sigma / math.sqrt(2)) - 1:>12.3f}{top10:>16.1%}{bot50:>16.1%}{p90_p10:>9.1f}")
输出:
一、5 个人的收入:[1, 2, 3, 4, 10],合计 20,平均 4.0
  洛伦兹曲线:人口,从最穷的人,累计,到最富的人,累计的收入份额
    最穷的 1 个人( 20%):拿到    5%
    最穷的 2 个人( 40%):拿到   15%
    最穷的 3 个人( 60%):拿到   30%
    最穷的 4 个人( 80%):拿到   50%
    最穷的 5 个人(100%):拿到  100%
  基尼系数 = 所有配对(含自己和自己)的收入差之和 ÷ (2 × n² × 平均) = 80 ÷ (2 × 25 × 4.0) = 0.400(排序算法:0.400)
  最富的 1 个人(20%),拿走 50%;最穷的 2 个人(40%),只有 15%

二、基尼系数:(1)所有人的收入,翻一倍,基尼系数,不变;(2)人口,复制一倍,不变
  [1, 2, 3, 4, 10] → [2, 4, 6, 8, 20]:0.400 → 0.400;人口复制一倍:0.400
  盲点:基尼系数相同(都是 0.400),形状,却不同:
    分布 (2, 2, 2, 2, 12):最富的人,拿走 60%,最穷的人,拿 10%
    分布 (1, 1, 3, 7, 8):最富的人,拿走 40%,最穷的人,拿 5%
  所以,一个数字,不能代替,分布的整体:常要,同时,看,最富的 10%、最穷的 50% 拿多少,和 P90/P10 之类的比。

三、对数正态分布的收入(σ 越大,越不平等):用 10 万个等间隔的分位点,计算
      σ      基尼(计算)      基尼(公式)      最富 10% 的份额      最穷 50% 的份额  P90/P10
    0.4       0.223       0.223           18.9%           34.5%      2.8
    0.6       0.329       0.329           24.8%           27.4%      4.7
    0.8       0.428       0.428           31.5%           21.2%      7.8
    1.0       0.520       0.520           38.9%           15.9%     13.0
    1.2       0.604       0.604           46.7%           11.5%     21.7
逐段看:
- 手算:5 个人,月收入(千元)1、2、3、4、10:合计 20,平均 4。洛伦兹曲线,上的点:最穷的 1 个人(20%),拿 5%;2 个人(40%),拿 15%;3 个人,30%;4 个人,50%。基尼系数 = 0.400(两种算法,一致)。最富的那 1 个人(20%),拿走 50%;最穷的 2 个人(40%),只有 15%。
- 性质:所有人的收入,翻一倍,基尼,不变;人口,复制一倍,也不变。它,只看相对的分布。
- 盲点:基尼系数,相同(0.400),形状,可以,完全不同。(2, 2, 2, 2, 12):最富的人,拿 60%,其余人,都一样;(1, 1, 3, 7, 8):最富的人,拿 40%,最穷的人,只拿 5%。一个数字,不能代替,分布的整体:所以,常常,还要同时看:最富的 10%,拿多少;最穷的 50%,拿多少;P90/P10(收入,第 90 百分位,比,第 10 百分位,的倍数)。
- 一个"标准分布":对数正态(收入的对数,服从正态分布,标准差 σ)。σ = 0.8 时,基尼 0.428(和公式 2Φ(σ/√2) − 1 一致),最富的 10%,拿 31.5%,最穷的 50%,拿 21.2%,P90/P10 = 7.8;σ = 1.0,基尼 0.520,最富的 10% 拿 38.9%;σ = 1.2,基尼 0.604,最富的 10% 拿 46.7%,最穷的一半,只有 11.5%。后面,我们,会,用 σ = 0.8,做一个再分配的模拟。
2.2 收入、财富、机会
要小心:“不平等”,有很多种。收入的不平等,和财富的不平等,不一样(财富,通常,集中得多);“结果"的不平等,和"机会"的不平等,也不一样。一个国家,可以,收入,相当平等,却,机会,很不平等;也可以,反过来。这一讲,主要谈收入;财富、机会,我们,只在"价值判断"里,碰到。
三、贫困:世界,在变好,可是,不均匀
3.1 怎么算"极端贫困”
国际贫困线:世界银行,用来比较各国的、一条很低的线:每天生活费,低于某个金额(按各国的购买力,换算)。2025 年 6 月,世界银行,把它,从每天 2.15 美元(2017 年购买力平价),更新成,每天 3.00 美元(2021 年购买力平价)。世界银行自己,强调,这是"一个极低的标准",各国,用来制定政策的,应该,是本国的贫困线。
数字,会随着,线,和价格的更新,改变:2025 年的更新,使得 2022 年的极端贫困人口,从约 7.13 亿(旧线),上调到约 8.38 亿(新线)(据世界银行的说明)。所以,读新闻时,要看清楚,用的是哪一条线。
3.2 贫困,在发生什么
# 数据:世界银行 WDI(贫困率来自世界银行的"贫困与不平等平台")。个别年份,没有数据(需要调查)。
POVERTY = {   # 人口中,每天生活费低于 3.00 美元(2021 年购买力平价)的比例(%)
    "WLD": {1990: 43.4, 1991: 43.1, 1992: 42.5, 1993: 42.1, 1994: 40.7, 1995: 39.4, 1996: 38.1, 1997: 37.7, 1998: 37.9, 1999: 37.3, 2000: 36.2, 2001: 35.3, 2002: 33.7, 2003: 32.2, 2004: 30.3, 2005: 28.3, 2006: 27.0, 2007: 25.3, 2008: 24.1, 2009: 23.1, 2010: 21.0, 2011: 19.1, 2012: 17.8, 2013: 15.5, 2014: 14.5, 2015: 13.4, 2016: 12.6, 2017: 11.8, 2018: 11.1, 2020: 11.4, 2021: 11.3, 2022: 10.9, 2023: 10.5},
    "CHN": {1990: 83.1, 1993: 77.3, 1996: 62.6, 1999: 58.5, 2002: 47.8, 2005: 32.9, 2008: 26.1, 2010: 20.6, 2011: 15.3, 2012: 12.9, 2013: 6.0, 2014: 4.6, 2015: 2.9, 2016: 2.1, 2017: 1.6, 2018: 0.7, 2019: 0.0, 2020: 0.0, 2021: 0.0, 2022: 0.0},
    "SSF": {1990: 61.5, 1991: 62.8, 1992: 63.8, 1993: 64.5, 1994: 64.6, 1995: 64.4, 1996: 63.9, 1997: 63.5, 1998: 63.4, 1999: 63.1, 2000: 62.4, 2001: 61.2, 2002: 60.8, 2003: 59.9, 2004: 56.9, 2005: 55.4, 2006: 54.3, 2007: 53.1, 2008: 51.9, 2009: 51.4, 2010: 49.4, 2011: 48.4, 2012: 47.2, 2013: 46.1, 2014: 45.3, 2015: 45.4, 2016: 45.1, 2017: 44.6, 2018: 44.1, 2019: 43.9, 2020: 46.0, 2021: 46.2, 2022: 45.6, 2023: 45.5},
    "LCN": {1990: 20.7, 1991: 20.1, 1992: 20.2, 1993: 20.1, 1994: 19.5, 1995: 18.5, 1996: 19.9, 1997: 19.4, 1998: 19.2, 1999: 19.5, 2000: 18.1, 2001: 17.9, 2002: 17.1, 2003: 16.6, 2004: 15.3, 2005: 14.2, 2006: 12.0, 2007: 10.8, 2008: 9.9, 2009: 9.5, 2010: 8.5, 2011: 7.7, 2012: 7.5, 2013: 6.8, 2014: 6.5, 2015: 6.0, 2016: 6.2, 2017: 6.2, 2018: 6.1, 2019: 6.2, 2020: 5.8, 2021: 6.2, 2022: 5.0, 2023: 4.6},
    "EAS": {1990: 67.0, 1991: 66.0, 1992: 64.4, 1993: 62.8, 1994: 59.2, 1995: 55.7, 1996: 52.0, 1997: 51.3, 1998: 51.6, 1999: 49.1, 2000: 46.6, 2001: 44.1, 2002: 40.0, 2003: 36.2, 2004: 32.9, 2005: 28.9, 2006: 27.7, 2007: 25.0, 2008: 23.4, 2009: 21.4, 2010: 18.9, 2011: 15.3, 2012: 13.2, 2013: 9.0, 2014: 7.8, 2015: 6.1, 2016: 5.0, 2017: 4.1, 2018: 3.3, 2019: 2.6, 2020: 2.7, 2021: 2.6, 2022: 2.4, 2023: 2.2},
}
POP = {   # 总人口(百万)
    "WLD": {1990: 5299.0, 1991: 5388.2, 1992: 5476.8, 1993: 5564.5, 1994: 5650.5, 1995: 5736.2, 1996: 5822.3, 1997: 5908.2, 1998: 5993.7, 1999: 6078.1, 2000: 6161.5, 2001: 6244.7, 2002: 6327.2, 2003: 6409.4, 2004: 6492.4, 2005: 6575.4, 2006: 6659.5, 2007: 6744.0, 2008: 6830.1, 2009: 6916.2, 2010: 7000.9, 2011: 7086.7, 2012: 7176.5, 2013: 7265.4, 2014: 7353.5, 2015: 7441.1, 2016: 7528.2, 2017: 7613.8, 2018: 7696.2, 2019: 7777.2, 2020: 7853.9, 2021: 7919.6, 2022: 7988.6, 2023: 8062.9},
    "CHN": {1990: 1135.2, 1991: 1150.8, 1992: 1165.0, 1993: 1178.4, 1994: 1191.8, 1995: 1204.9, 1996: 1217.5, 1997: 1230.1, 1998: 1241.9, 1999: 1252.7, 2000: 1262.6, 2001: 1271.8, 2002: 1280.4, 2003: 1288.4, 2004: 1296.1, 2005: 1303.7, 2006: 1311.0, 2007: 1317.9, 2008: 1324.7, 2009: 1331.3, 2010: 1337.7, 2011: 1345.0, 2012: 1354.2, 2013: 1363.2, 2014: 1371.9, 2015: 1379.9, 2016: 1387.8, 2017: 1396.2, 2018: 1402.8, 2019: 1407.7, 2020: 1411.1, 2021: 1412.4, 2022: 1412.2, 2023: 1410.7},
    "SSF": {1990: 521.0, 1991: 535.3, 1992: 550.0, 1993: 565.3, 1994: 580.5, 1995: 596.1, 1996: 612.3, 1997: 628.6, 1998: 645.5, 1999: 662.9, 2000: 680.8, 2001: 699.2, 2002: 718.3, 2003: 737.9, 2004: 758.2, 2005: 779.2, 2006: 800.8, 2007: 823.1, 2008: 846.2, 2009: 869.9, 2010: 894.3, 2011: 919.1, 2012: 944.5, 2013: 970.7, 2014: 997.4, 2015: 1024.7, 2016: 1052.2, 2017: 1080.2, 2018: 1109.2, 2019: 1138.5, 2020: 1168.1, 2021: 1198.1, 2022: 1228.2, 2023: 1258.8},
    "LCN": {1990: 441.0, 1991: 449.1, 1992: 457.2, 1993: 465.3, 1994: 473.3, 1995: 481.3, 1996: 489.2, 1997: 497.1, 1998: 505.0, 1999: 512.7, 2000: 520.3, 2001: 527.6, 2002: 534.7, 2003: 541.6, 2004: 548.5, 2005: 555.1, 2006: 561.8, 2007: 568.3, 2008: 574.9, 2009: 581.4, 2010: 587.8, 2011: 594.1, 2012: 600.4, 2013: 606.7, 2014: 612.8, 2015: 618.9, 2016: 624.7, 2017: 630.4, 2018: 635.8, 2019: 641.0, 2020: 645.5, 2021: 649.2, 2022: 653.1, 2023: 657.6},
    "EAS": {1990: 1817.7, 1991: 1844.2, 1992: 1869.1, 1993: 1893.3, 1994: 1917.4, 1995: 1941.2, 1996: 1964.8, 1997: 1988.1, 1998: 2010.4, 1999: 2030.9, 2000: 2050.1, 2001: 2068.7, 2002: 2086.1, 2003: 2102.8, 2004: 2118.7, 2005: 2134.6, 2006: 2150.7, 2007: 2167.0, 2008: 2183.5, 2009: 2199.1, 2010: 2214.6, 2011: 2230.8, 2012: 2249.1, 2013: 2267.1, 2014: 2284.4, 2015: 2300.8, 2016: 2317.1, 2017: 2333.5, 2018: 2347.6, 2019: 2359.8, 2020: 2369.4, 2021: 2375.1, 2022: 2379.6, 2023: 2384.4},
}
names = {"WLD": "全世界", "CHN": "中国", "EAS": "东亚和太平洋", "SSF": "撒哈拉以南非洲", "LCN": "拉美和加勒比"}

def poor(k, y):                                   # 极端贫困人口(百万)= 贫困率 × 人口
    return POVERTY[k][y] / 100 * POP[k][y]

# 一、贫困率,和贫困人口
print("一、极端贫困:每天生活费,低于 3.00 美元(2021 年购买力平价)")
yrs = (1990, 2002, 2010, 2022)
print(f"  {'':<10}" + "".join(f"{y:>16}" for y in yrs))
for k in ("WLD", "CHN", "EAS", "SSF", "LCN"):
    cells = [f"{POVERTY[k][y]:>5.1f}% /{poor(k, y):>6.0f}百万" for y in yrs]
    print(f"  {names[k]:<8}" + "".join(f"{c:>16}" for c in cells))
print("  (每格:贫困率 / 贫困人口)")

# 二、世界上,贫困人口的减少,是从哪里来的?
d_w = poor("WLD", 1990) - poor("WLD", 2022)
print(f"\n二、1990 → 2022 年:全世界的极端贫困人口,从 {poor('WLD', 1990):.0f} 百万,到 {poor('WLD', 2022):.0f} 百万,减少 {d_w:.0f} 百万")
d_c = poor("CHN", 1990) - poor("CHN", 2022)
print(f"  中国:{poor('CHN', 1990):.0f} → {poor('CHN', 2022):.0f} 百万,减少 {d_c:.0f} 百万,占全世界减少量的 {d_c / d_w:.0%}(WDI 里,中国 2019–2022 年的数字,是 0.0;可能是,四舍五入,我没有核对原始数值)")
d_s = poor("SSF", 2022) - poor("SSF", 1990)
print(f"  撒哈拉以南非洲:{poor('SSF', 1990):.0f} → {poor('SSF', 2022):.0f} 百万,反而,增加 {d_s:.0f} 百万(相当于,抵消了,全世界减少量的 {d_s / d_w:.0%})")
rest = d_w - (poor("CHN", 1990) - poor("CHN", 2022))
print(f"  不含中国:全世界,减少 {rest:.0f} 百万(1990 年,不含中国:{poor('WLD', 1990) - poor('CHN', 1990):.0f} 百万 → 2022 年 {poor('WLD', 2022) - poor('CHN', 2022):.0f} 百万)")
print(f"  撒哈拉以南非洲:贫困率,{POVERTY['SSF'][1990]:.1f}% → {POVERTY['SSF'][2022]:.1f}%(下降),可是,人口,{POP['SSF'][1990]:.0f} → {POP['SSF'][2022]:.0f} 百万({POP['SSF'][2022] / POP['SSF'][1990]:.1f} 倍),贫困人口,反而,增加了")
print(f"  2022 年,全世界的极端贫困人口中,在撒哈拉以南非洲的占 {poor('SSF', 2022) / poor('WLD', 2022):.0%}")
输出:
一、极端贫困:每天生活费,低于 3.00 美元(2021 年购买力平价)
                        1990            2002            2010            2022
  全世界      43.4% /  2300百万 33.7% /  2132百万 21.0% /  1470百万 10.9% /   871百万
  中国       83.1% /   943百万 47.8% /   612百万 20.6% /   276百万  0.0% /     0百万
  东亚和太平洋   67.0% /  1218百万 40.0% /   834百万 18.9% /   419百万  2.4% /    57百万
  撒哈拉以南非洲  61.5% /   320百万 60.8% /   437百万 49.4% /   442百万 45.6% /   560百万
  拉美和加勒比   20.7% /    91百万 17.1% /    91百万  8.5% /    50百万  5.0% /    33百万
  (每格:贫困率 / 贫困人口)

二、1990 → 2022 年:全世界的极端贫困人口,从 2300 百万,到 871 百万,减少 1429 百万
  中国:943 → 0 百万,减少 943 百万,占全世界减少量的 66%(WDI 里,中国 2019–2022 年的数字,是 0.0;可能是,四舍五入,我没有核对原始数值)
  撒哈拉以南非洲:320 → 560 百万,反而,增加 240 百万(相当于,抵消了,全世界减少量的 17%)
  不含中国:全世界,减少 486 百万(1990 年,不含中国:1356 百万 → 2022 年 871 百万)
  撒哈拉以南非洲:贫困率,61.5% → 45.6%(下降),可是,人口,521 → 1228 百万(2.4 倍),贫困人口,反而,增加了
  2022 年,全世界的极端贫困人口中,在撒哈拉以南非洲的占 64%
逐段看:
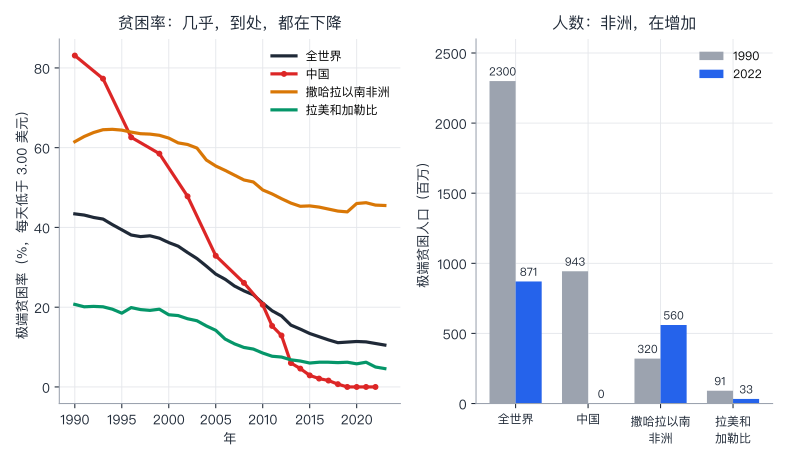
- 回答问题 1:全世界,极端贫困(每天低于 3.00 美元)的人,1990 年,约 23 亿(43.4%),到 2022 年,约 8.7 亿(10.9%):减少了约 14.3 亿。(世界银行的说明,给出,2022 年约 8.38 亿;我用的是 WDI 的贫困率,乘以人口,数字略不同,差别,来自,人口数据的版本等;以官方的为准。)
- 中国:贫困率,从 83.1%(1990 年),降到 WDI 里的 0.0%(2019 年起);贫困人口,从约 9.4 亿,到 0:占了全世界减少量的 66%。不含中国,全世界,减少约 4.9 亿。
- 东亚和太平洋:从 67.0% 到 2.4%。拉美和加勒比:从 20.7% 到 5.0%。
- 撒哈拉以南非洲:贫困率,从 61.5%,降到 45.6%,可是,人口,从 5.2 亿,增长到 12.3 亿(2.4 倍),贫困人口,反而,从约 3.2 亿,增加到约 5.6 亿(增加 2.4 亿,相当于抵消了全世界减少量的 17%)。2022 年,全世界的极端贫困人口里,64% 在撒哈拉以南非洲。
- 怎么读:(1)“贫困率下降”,和"贫困人口减少",是两件事,人口增长得快,会让后者,不降反升;(2)最大的减少,来自一个国家;这是第 29 讲,增长的故事:快速的增长,常被认为,是最有效的减贫办法之一(但,不是唯一,也不是,每个国家,都一样);(3)撒哈拉以南非洲,是,下一个阶段,最难的地方;(4)中国 2019–2022 年的 0.0,可能是,四舍五入,我没有核对原始数值;印度,因为,调查年份稀疏,这里没有列。
四、发展,不只是收入
收入,不是,生活的全部。预期寿命,是一个,被广泛使用的"另一个维度"(第 27 讲:Jones 和 Klenow 2016 年的福祉指标,发现,预期寿命,最重要)。
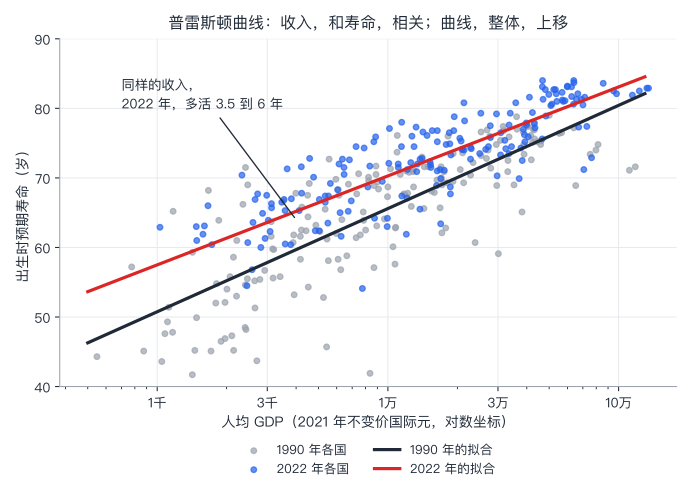
Samuel Preston 1975 年(《死亡率和经济发展水平之间,关系的变化》,Population Studies;2007 年重印于 International Journal of Epidemiology,36 卷 3 期,484–490 页)画了一张图:把各国,预期寿命,对人均收入,画出来:收入高的国家,人活得久;曲线,是向上弯的(收入越高,边际的好处越小);更重要的是:不同年代,画出来的曲线,在整体上,往上移了:同样的收入,后来的人,活得更久。据对论文的转述,Preston 估计,1938 到 1963 年,如果只靠收入增长,预期寿命,应该,增加约 2.5 岁,而实际增加了 12.2 岁,所以,大部分,是曲线,整体,上移(他,归因于,医学的进步,等;也强调了,这是"关联",不一定是"因果")。
我们,用 1990 年,和 2022 年的数据,重画一次。
import math
import numpy as np

# 数据:世界银行 WDI。每个国家:(1990 年人均 GDP(2021 年不变价国际元,购买力平价),1990 年出生时预期寿命(岁),2022 年人均 GDP,2022 年预期寿命)。共 185 个国家。
DATA = {
    "ABW": (33147, 72.5, 39083, 76.2), "AGO": (8366, 41.9, 8751, 64.2), "ALB": (5561, 72.7,
    19389, 78.8), "AND": (50036, 79.0, 63913, 84.0), "ARE": (111377, 71.1, 70076, 80.5), "ARG":
    (17007, 71.6, 27825, 75.8), "ARM": (6138, 67.5, 17886, 74.8), "ATG": (21075, 73.6, 27786,
    77.5), "AUS": (36268, 77.0, 60029, 83.2), "AUT": (43258, 75.6, 65694, 81.3), "AZE": (10776,
    62.8, 21051, 74.1), "BDI": (1456, 45.2, 1028, 62.9), "BEL": (41640, 76.1, 62603, 81.7),
    "BEN": (2207, 53.0, 3588, 60.5), "BFA": (1108, 49.3, 2469, 60.7), "BGD": (2070, 55.8, 7888,
    74.3), "BGR": (14954, 71.6, 32434, 74.2), "BHR": (41857, 72.6, 57573, 81.0), "BHS": (33072,
    70.9, 34343, 74.5), "BIH": (2414, 71.5, 19298, 76.8), "BLR": (12352, 70.8, 26538, 74.1),
    "BLZ": (8252, 69.6, 12565, 72.2), "BMU": (79751, 74.0, 97943, 82.1), "BOL": (6247, 56.8,
    11488, 67.4), "BRA": (12633, 65.9, 18554, 74.9), "BRB": (19196, 73.5, 20495, 75.7), "BRN":
    (118164, 71.6, 76358, 72.9), "BTN": (3411, 55.8, 14061, 72.8), "BWA": (10521, 60.1, 18647,
    68.7), "CAF": (1481, 49.9, 1137, 18.8), "CAN": (40475, 77.4, 58583, 81.1), "CHE": (63921,
    77.2, 85762, 83.6), "CHL": (10955, 73.7, 29560, 79.2), "CHN": (1667, 68.2, 21499, 78.2),
    "CIV": (5256, 52.8, 6272, 61.6), "CMR": (4518, 54.3, 4844, 62.4), "COD": (2404, 48.5, 1484,
    61.0), "COG": (8700, 57.1, 6205, 65.0), "COL": (9999, 68.7, 18459, 76.5), "COM": (3179,
    55.6, 3466, 66.5), "CPV": (1849, 63.9, 8850, 75.9), "CRI": (10980, 76.1, 25290, 79.3),
    "CYP": (27667, 76.0, 50841, 80.4), "CZE": (27918, 71.4, 48391, 78.9), "DEU": (42355, 75.1,
    63778, 80.6), "DMA": (11312, 70.5, 17551, 71.1), "DNK": (45944, 74.8, 69089, 81.3), "DOM":
    (7328, 67.7, 22987, 74.2), "DZA": (11729, 67.7, 14782, 76.1), "ECU": (9105, 68.4, 14187,
    76.6), "EGY": (8007, 62.5, 16360, 71.0), "ESP": (31773, 76.8, 46733, 83.1), "EST": (19161,
    69.5, 43125, 77.8), "ETH": (874, 45.1, 2656, 66.9), "FIN": (38807, 74.8, 57068, 81.2),
    "FJI": (7821, 65.1, 12118, 67.1), "FRA": (38656, 76.6, 53674, 82.1), "FSM": (3120, 63.7,
    3816, 67.0), "GAB": (23885, 60.7, 18662, 67.7), "GBR": (33531, 75.9, 53980, 81.0), "GEO":
    (12917, 68.7, 20967, 74.1), "GHA": (2786, 55.4, 6728, 65.2), "GIN": (2106, 47.3, 3792,
    60.4), "GMB": (2654, 51.3, 2863, 64.9), "GNB": (1968, 46.9, 2601, 63.6), "GNQ": (1123, 51.4,
    16933, 63.4), "GRC": (26916, 76.9, 35828, 80.8), "GRD": (8884, 70.5, 16376, 75.2), "GRL":
    (38138, 65.1, 70681, 71.2), "GTM": (7595, 61.8, 12144, 71.2), "GUY": (5074, 62.3, 37068,
    69.9), "HKG": (31599, 77.4, 64036, 83.7), "HND": (1172, 65.2, 6353, 72.7), "HRV": (23400,
    72.2, 39864, 77.6), "HTI": (3923, 53.2, 3030, 63.9), "HUN": (21297, 69.3, 40611, 75.9),
    "IDN": (4873, 63.2, 13334, 70.9), "IND": (2140, 58.6, 8347, 71.7), "IRL": (29505, 74.8,
    123007, 82.5), "IRN": (9656, 64.1, 16378, 76.8), "IRQ": (10735, 57.6, 13433, 72.0), "ISL":
    (43100, 78.0, 66581, 82.1), "ISR": (25341, 76.6, 48132, 82.7), "ITA": (42657, 77.0, 52333,
    82.7), "JAM": (8880, 71.7, 11097, 71.5), "JOR": (8242, 70.1, 10158, 77.1), "JPN": (36138,
    78.8, 46819, 84.0), "KAZ": (16838, 65.7, 33506, 73.5), "KEN": (4177, 58.3, 5492, 63.5),
    "KGZ": (6096, 68.3, 6140, 72.0), "KHM": (2646, 55.2, 6458, 70.5), "KIR": (2214, 61.0, 3127,
    66.3), "KNA": (14326, 65.6, 29750, 70.3), "KOR": (14378, 71.6, 53229, 82.7), "KWT": (38933,
    73.4, 51380, 80.6), "LAO": (2006, 54.0, 8183, 68.7), "LBN": (5346, 65.5, 11475, 78.0),
    "LBR": (1866, 37.6, 1579, 61.9), "LBY": (18127, 69.3, 11450, 74.5), "LCA": (17057, 70.0,
    22811, 72.7), "LKA": (4562, 69.2, 13249, 77.3), "LSO": (1422, 59.3, 2578, 56.8), "LTU":
    (20594, 71.2, 46643, 75.6), "LUX": (81455, 74.8, 132571, 82.9), "LVA": (17509, 69.3, 37719,
    74.3), "MAC": (55301, 76.4, 59921, 83.1), "MAR": (4419, 62.4, 8690, 75.2), "MDA": (15903,
    67.9, 15350, 71.5), "MDG": (1968, 52.1, 1602, 63.1), "MDV": (8946, 63.1, 21358, 80.8),
    "MEX": (17170, 69.0, 21392, 74.0), "MHL": (3906, 61.8, 6938, 66.7), "MKD": (12904, 71.2,
    22822, 74.4), "MLI": (1891, 46.5, 2814, 60.0), "MLT": (18208, 76.0, 56874, 82.3), "MMR":
    (775, 57.2, 5350, 66.5), "MNG": (6638, 58.8, 15310, 71.9), "MOZ": (548, 44.3, 1477, 63.0),
    "MRT": (5520, 58.1, 6053, 68.3), "MUS": (8986, 69.4, 25005, 73.5), "MWI": (1047, 43.6, 1660,
    66.0), "MYS": (12014, 71.0, 32129, 75.4), "NAM": (7282, 61.4, 9953, 64.2), "NER": (1420,
    41.7, 1725, 60.4), "NGA": (5424, 45.7, 7752, 54.1), "NIC": (4218, 62.5, 7278, 74.5), "NLD":
    (43128, 76.9, 71324, 81.6), "NOR": (56608, 76.5, 95110, 82.5), "NPL": (1808, 54.8, 4763,
    70.1), "NRU": (30127, 59.1, 12019, 61.9), "NZL": (30786, 75.4, 49843, 82.0), "OMN": (35202,
    69.0, 39780, 77.9), "PAK": (3200, 59.7, 5526, 67.4), "PAN": (10264, 71.3, 33915, 79.3),
    "PER": (6316, 64.0, 15567, 76.8), "PHL": (4504, 64.4, 9457, 69.5), "PLW": (17808, 62.8,
    16259, 68.9), "PNG": (3165, 59.8, 4126, 65.3), "POL": (12821, 70.9, 43405, 77.2), "PRI":
    (26739, 72.8, 42311, 79.4), "PRT": (27191, 74.0, 41071, 81.6), "PRY": (9961, 67.3, 15223,
    72.3), "QAT": (75304, 73.4, 114740, 81.9), "ROU": (16317, 69.7, 39257, 75.2), "RUS": (29644,
    68.9, 38215, 72.5), "RWA": (1166, 47.8, 2983, 67.5), "SAU": (65197, 68.9, 67179, 77.3),
    "SDN": (2460, 55.5, 3132, 65.7), "SEN": (2923, 56.7, 4229, 67.8), "SGP": (45961, 75.3,
    134828, 82.9), "SLB": (2353, 66.2, 2330, 70.4), "SLE": (2704, 43.7, 2935, 61.3), "SLV":
    (5976, 62.0, 11086, 72.0), "STP": (3883, 60.7, 5632, 69.2), "SUR": (17138, 62.1, 18743,
    73.3), "SVK": (17521, 70.9, 38649, 77.0), "SVN": (25350, 73.2, 47059, 81.3), "SWE": (40200,
    77.5, 62545, 83.1), "SWZ": (5448, 61.2, 9928, 63.0), "SYC": (15479, 68.1, 27276, 74.5),
    "SYR": (5952, 69.8, 4579, 72.8), "TCD": (1711, 45.1, 2449, 54.5), "TGO": (2409, 54.6, 3086,
    62.3), "THA": (8703, 68.9, 20768, 75.3), "TJK": (4173, 61.6, 4214, 71.6), "TKM": (7851,
    63.9, 16944, 69.9), "TLS": (2144, 45.2, 5348, 67.4), "TON": (4488, 67.5, 6811, 72.6), "TTO":
    (11870, 67.6, 30784, 73.3), "TUN": (6743, 69.1, 12712, 76.0), "TUR": (12184, 67.8, 33521,
    77.6), "TUV": (3120, 61.6, 5045, 66.9), "TZA": (1794, 52.0, 3547, 66.9), "UGA": (1080, 47.6,
    2725, 67.7), "UKR": (22816, 70.4, 13787, 72.7), "URY": (14061, 73.0, 30840, 76.5), "USA":
    (44384, 75.2, 72829, 77.4), "UZB": (4240, 65.8, 10091, 72.1), "VCT": (7467, 70.6, 16835,
    71.2), "VNM": (2468, 69.0, 12980, 74.5), "VUT": (3532, 66.7, 3659, 71.3), "WSM": (3991,
    67.8, 6450, 71.5), "ZAF": (10811, 62.9, 13767, 65.5), "ZMB": (2425, 48.2, 3585, 65.3),
    "ZWE": (6083, 58.3, 5037, 62.4)
}
codes = sorted(DATA)
g0 = np.array([DATA[k][0] for k in codes]); l0 = np.array([DATA[k][1] for k in codes])
g1 = np.array([DATA[k][2] for k in codes]); l1 = np.array([DATA[k][3] for k in codes])
x0, x1 = np.log(g0), np.log(g1)
print(f"{len(codes)} 个国家:1990 年,和 2022 年")

# 一、预期寿命,和收入:两个年份的"普雷斯顿曲线"(预期寿命 = a + b × ln(人均 GDP))
b0, a0 = np.polyfit(x0, l0, 1); b1, a1 = np.polyfit(x1, l1, 1)
r0 = np.corrcoef(x0, l0)[0, 1] ** 2; r1 = np.corrcoef(x1, l1)[0, 1] ** 2
print(f"\n一、预期寿命 = a + b × ln(人均 GDP):1990 年 b = {b0:.1f}(R² = {r0:.2f});2022 年 b = {b1:.1f}(R² = {r1:.2f})")
print(f"  {'人均 GDP(国际元)':<18}{'1990 年曲线上的预期寿命':>22}{'2022 年曲线上的':>16}{'同样的收入,多活':>16}")
for inc in (2000, 5000, 10000, 20000, 40000):
    p0, p1 = a0 + b0 * math.log(inc), a1 + b1 * math.log(inc)
    print(f"  {inc:<18,}{p0:>22.1f}{p1:>16.1f}{p1 - p0:>16.1f}")

# 二、1990 → 2022 年,预期寿命,增加了多少?多少,来自收入增长,多少,是"曲线,整体,上移"?
dl = l1 - l0; dx = x1 - x0
print(f"\n二、1990 → 2022:各国预期寿命,平均,增加 {dl.mean():.1f} 岁(中位数 {np.median(dl):.1f});人均 GDP(对数),平均,增加 {dx.mean():.2f}(约 {math.expm1(dx.mean()):.0%})")
income_part = b0 * dx.mean()
print(f"  如果,按 1990 年的曲线,只靠收入增长:预期,增加 {income_part:.1f} 岁,约占实际的 {income_part / dl.mean():.0%};其余 {dl.mean() - income_part:.1f} 岁,是曲线,整体,上移(同样的收入,活得更久)")
poor90 = np.argsort(g0)[: len(codes) // 4]
print(f"  1990 年最穷的 1/4({len(poor90)} 个国家,人均 GDP 在 {g0[poor90].min():,.0f}–{g0[poor90].max():,.0f}):预期寿命,平均,从 {l0[poor90].mean():.1f},到 {l1[poor90].mean():.1f}(+{dl[poor90].mean():.1f} 岁);人均 GDP,中位数,增长 {math.expm1(np.median(dx[poor90])):.0%}")
rich90 = np.argsort(g0)[-len(codes) // 4:]
print(f"  1990 年最富的 1/4:预期寿命,平均,从 {l0[rich90].mean():.1f},到 {l1[rich90].mean():.1f}(+{dl[rich90].mean():.1f} 岁)")
print(f"  各国之间,预期寿命的标准差:1990 年 {l0.std(ddof=1):.1f} 岁,2022 年 {l1.std(ddof=1):.1f} 岁;人均 GDP(对数)的标准差:{x0.std(ddof=1):.2f} → {x1.std(ddof=1):.2f}")
low = [k for k in codes if l1[codes.index(k)] < l0[codes.index(k)]]
print(f"  预期寿命,在 1990–2022 年,反而,下降的国家:{len(low)} 个({'、'.join(low[:8])}{'……' if len(low) > 8 else ''})")
输出:
185 个国家:1990 年,和 2022 年

一、预期寿命 = a + b × ln(人均 GDP):1990 年 b = 6.4(R² = 0.64);2022 年 b = 5.6(R² = 0.64)
  人均 GDP(国际元)               1990 年曲线上的预期寿命      2022 年曲线上的        同样的收入,多活
  2,000                               55.2            61.3             6.1
  5,000                               61.1            66.4             5.3
  10,000                              65.6            70.3             4.7
  20,000                              70.1            74.1             4.1
  40,000                              74.5            78.0             3.5

二、1990 → 2022:各国预期寿命,平均,增加 7.8 岁(中位数 6.6);人均 GDP(对数),平均,增加 0.54(约 72%)
  如果,按 1990 年的曲线,只靠收入增长:预期,增加 3.5 岁,约占实际的 45%;其余 4.3 岁,是曲线,整体,上移(同样的收入,活得更久)
  1990 年最穷的 1/4(46 个国家,人均 GDP 在 548–3,200):预期寿命,平均,从 53.6,到 65.1(+11.5 岁);人均 GDP,中位数,增长 68%
  1990 年最富的 1/4:预期寿命,平均,从 73.9,到 79.9(+6.0 岁)
  各国之间,预期寿命的标准差:1990 年 9.6 岁,2022 年 7.9 岁;人均 GDP(对数)的标准差:1.18 → 1.15
  预期寿命,在 1990–2022 年,反而,下降的国家:3 个(CAF、JAM、LSO)
逐段看:
- 曲线:预期寿命 = a + b × ln(人均 GDP):1990 年,b = 6.4(R² = 0.64);2022 年,b = 5.6(R² = 0.64):收入,翻一倍,预期寿命,平均,多约 4 岁,而且,越富,越不明显。
- 整体上移:同样是人均 GDP 2,000 国际元,1990 年的曲线,对应 55.2 岁,2022 年,61.3 岁:多活 6.1 年;5,000 元,多 5.3 年;10,000 元,4.7 年;20,000 元,4.1 年;40,000 元,3.5 年。穷的地方,上移得更多。
- 分解:1990 到 2022 年,各国,预期寿命,平均,增加 7.8 岁(中位数 6.6),人均 GDP,平均,增长约 72%。如果,按 1990 年的曲线,只靠收入增长:增加约 3.5 岁,占 45%;其余的 4.3 岁,是曲线,整体上移。
- 穷国,追上来:1990 年,最穷的 1/4(46 个国家),预期寿命,从 53.6,到 65.1(+11.5 岁);最富的 1/4,从 73.9,到 79.9(+6.0 岁)。各国之间,预期寿命的标准差,从 9.6 岁,到 7.9 岁:寿命,在收敛;而人均 GDP(对数)的标准差,几乎没变(1.18,1.15):寿命的收敛,比收入的收敛,快得多。
- 反例:1990–2022 年,预期寿命,反而下降的,有 3 个国家(中非共和国、牙买加、莱索托)。(2022 年的数字,还包含新冠疫情的影响;我没有把它,分开。)
- 怎么读:(1)这是关联,不是因果:收入,影响寿命,寿命(健康),也影响收入;(2)“曲线上移”,常被归因于,医学、公共卫生、知识的传播(疫苗、抗生素、洗手),是想法,在扩散(第 29 讲:想法,是非竞争性的),不是,收入本身;(3)所以,一个国家,不必,等到,变富,再改善健康。
五、不平等,和收入
5.1 库兹涅茨曲线:富了,不平等,会先升后降吗
Simon Kuznets 1955 年(《经济增长和收入不平等》,American Economic Review,1955 年 3 月号)的猜想:一个国家,工业化的早期,劳动力,从低收入的农业,转到高收入的工业,不平等,先上升;等到,多数人,进入了高收入的部门,不平等,再下降。画出来,是一个"倒 U"。(他自己,用的证据,很少,也很谨慎。)
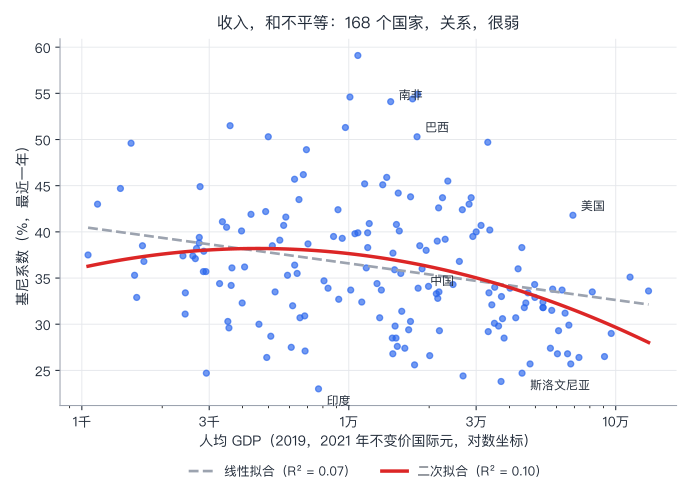
这个预测,很容易,用一个"跨国的散点图",来检验:横轴,人均收入;纵轴,基尼系数。倒 U,应该,表现为:二次项,是负的。
import math
import numpy as np

# 数据:世界银行 WDI。每个国家:(基尼系数(%,每个国家,取最近一年有数据的),那一年,2019 年的人均 GDP(2021 年不变价国际元,购买力平价))。共 168 个国家。
# 注意:基尼系数,各国的调查年份,不一样;有的,按收入算,有的,按消费算(消费的基尼,通常,比收入的低)。
DATA = {
    "AGO": (51.3, 2018, 9713), "ALB": (29.4, 2020, 16761), "ARE": (26.4, 2018, 72823), "ARG":
    (42.4, 2024, 26630), "ARM": (27.4, 2024, 16215), "AUS": (33.8, 2020, 58049), "AUT": (31.2,
    2023, 64609), "AZE": (26.6, 2005, 20101), "BDI": (37.5, 2020, 1055), "BEL": (26.8, 2023,
    60480), "BEN": (34.4, 2021, 3281), "BFA": (37.4, 2021, 2392), "BGD": (30.9, 2022, 6838),
    "BGR": (39.5, 2023, 29150), "BIH": (30.3, 2021, 17029), "BLR": (24.4, 2020, 26799), "BLZ":
    (39.9, 2018, 11766), "BOL": (40.9, 2024, 11931), "BRA": (50.3, 2024, 18019), "BRB": (34.1,
    2016, 19890), "BTN": (28.5, 2022, 14555), "BWA": (54.9, 2015, 18106), "CAF": (43.0, 2021,
    1145), "CAN": (31.5, 2022, 57584), "CHE": (33.5, 2023, 81695), "CHL": (43.0, 2024, 28228),
    "CHN": (36.0, 2022, 18821), "CIV": (35.3, 2021, 5895), "CMR": (42.2, 2021, 4882), "COD":
    (44.7, 2020, 1395), "COG": (48.9, 2011, 6939), "COL": (54.4, 2024, 17337), "COM": (30.3,
    2024, 3523), "CPV": (42.4, 2015, 9112), "CRI": (45.5, 2025, 23497), "CYP": (31.8, 2023,
    45454), "CZE": (25.7, 2023, 47764), "DEU": (33.7, 2022, 62950), "DJI": (41.6, 2017, 5809),
    "DNK": (29.9, 2023, 66759), "DOM": (39.0, 2024, 21451), "DZA": (27.6, 2011, 15199), "ECU":
    (45.9, 2025, 13870), "EGY": (28.5, 2021, 15027), "ESP": (33.4, 2023, 46896), "EST": (30.7,
    2023, 42215), "ETH": (31.1, 2021, 2438), "FIN": (27.4, 2023, 56922), "FJI": (30.7, 2019,
    13056), "FRA": (31.8, 2023, 53449), "FSM": (40.1, 2013, 3965), "GAB": (38.0, 2017, 19491),
    "GBR": (32.4, 2021, 53374), "GEO": (33.9, 2024, 18187), "GHA": (43.5, 2016, 6508), "GIN":
    (29.6, 2018, 3557), "GMB": (38.8, 2020, 2751), "GNB": (33.4, 2021, 2442), "GNQ": (38.5,
    2022, 18447), "GRC": (33.4, 2023, 33503), "GRD": (43.8, 2018, 17037), "GTM": (45.2, 2023,
    11466), "GUY": (45.1, 1998, 13402), "HND": (45.7, 2024, 6264), "HRV": (30.1, 2023, 35123),
    "HTI": (41.1, 2012, 3362), "HUN": (30.6, 2017, 37663), "IDN": (34.4, 2025, 12758), "IND":
    (23.0, 2023, 7702), "IRL": (29.0, 2023, 96206), "IRN": (35.9, 2023, 14841), "IRQ": (29.8,
    2023, 14910), "ISL": (26.8, 2019, 65995), "ISR": (38.3, 2022, 44492), "ITA": (34.3, 2023,
    49691), "JAM": (39.9, 2021, 10816), "JOR": (33.7, 2010, 10168), "JPN": (32.3, 2020, 46055),
    "KAZ": (29.2, 2021, 33298), "KEN": (38.5, 2022, 5172), "KGZ": (27.5, 2024, 6088), "KIR":
    (24.7, 2023, 2927), "KOR": (32.9, 2021, 49791), "LAO": (34.7, 2024, 8075), "LBN": (35.5,
    2022, 15660), "LBR": (35.3, 2016, 1576), "LCA": (43.7, 2015, 22445), "LKA": (37.7, 2019,
    14637), "LSO": (44.9, 2017, 2773), "LTU": (36.0, 2023, 43079), "LUX": (33.6, 2023, 132725),
    "LVA": (34.0, 2023, 35208), "MAR": (39.5, 2013, 8768), "MDA": (26.8, 2024, 14621), "MDG":
    (36.8, 2021, 1708), "MDV": (29.3, 2019, 21856), "MEX": (42.6, 2024, 21704), "MHL": (35.5,
    2019, 6406), "MKD": (33.5, 2019, 21767), "MLI": (35.7, 2021, 2916), "MLT": (31.8, 2023,
    53393), "MMR": (30.7, 2017, 6563), "MNE": (34.3, 2021, 24585), "MNG": (31.4, 2022, 15791),
    "MOZ": (49.6, 2022, 1529), "MRT": (32.0, 2019, 6162), "MUS": (36.8, 2017, 25958), "MWI":
    (38.5, 2019, 1687), "MYS": (40.7, 2021, 31301), "NAM": (59.1, 2015, 10813), "NER": (32.9,
    2021, 1605), "NGA": (33.9, 2022, 8362), "NIC": (46.2, 2014, 6757), "NLD": (25.7, 2021,
    67848), "NOR": (26.5, 2023, 90773), "NPL": (30.0, 2022, 4608), "NRU": (32.4, 2012, 11185),
    "PAK": (33.5, 2024, 5296), "PAN": (49.7, 2024, 33164), "PER": (40.1, 2024, 15461), "PHL":
    (39.3, 2023, 9452), "PNG": (41.9, 2009, 4302), "POL": (28.5, 2023, 38182), "PRT": (33.9,
    2023, 40188), "PRY": (44.2, 2024, 15319), "PSE": (36.4, 2023, 6270), "QAT": (35.1, 2017,
    113161), "ROU": (29.8, 2023, 36399), "RUS": (33.0, 2023, 37319), "RWA": (39.4, 2023, 2754),
    "SDN": (34.2, 2014, 3626), "SEN": (36.2, 2021, 4071), "SLB": (37.1, 2012, 2662), "SLE":
    (35.7, 2018, 2853), "SLV": (39.8, 2023, 10544), "SRB": (32.8, 2023, 21541), "STP": (40.7,
    2017, 5702), "SUR": (39.2, 2022, 22967), "SVK": (23.8, 2023, 37194), "SVN": (24.7, 2023,
    44578), "SWE": (29.3, 2023, 61071), "SWZ": (54.6, 2016, 10100), "SYC": (32.1, 2018, 34346),
    "SYR": (26.4, 2022, 4928), "TCD": (37.4, 2022, 2605), "TGO": (37.9, 2021, 2863), "THA":
    (33.3, 2024, 21280), "TJK": (36.1, 2024, 3650), "TKM": (40.8, 1998, 15081), "TLS": (28.7,
    2014, 5103), "TON": (27.1, 2021, 6860), "TTO": (40.2, 1992, 33749), "TUN": (33.7, 2021,
    13244), "TUR": (43.7, 2023, 28741), "TUV": (39.1, 2010, 5516), "TZA": (40.5, 2018, 3485),
    "UGA": (38.2, 2023, 2689), "UKR": (25.6, 2020, 17637), "URY": (40.0, 2024, 30011), "USA":
    (41.8, 2024, 69121), "UZB": (32.7, 2025, 9169), "VNM": (36.1, 2022, 11629), "VUT": (32.3,
    2019, 3987), "WSM": (38.7, 2013, 7034), "XKX": (38.3, 2022, 11774), "ZAF": (54.1, 2022,
    14353), "ZMB": (51.5, 2022, 3592), "ZWE": (50.3, 2019, 4994)
}
codes = sorted(DATA)
gini = np.array([DATA[k][0] for k in codes]); year = np.array([DATA[k][1] for k in codes]); gdp = np.array([DATA[k][2] for k in codes])
x = np.log(gdp)
print(f"{len(codes)} 个国家;基尼系数的年份:{year.min()}–{year.max()},中位数 {int(np.median(year))} 年")

# 一、库兹涅茨曲线:收入低的时候,不平等,随着收入上升而上升;到了一定的收入,反过来下降。检验:基尼 = a + b ln(y) + c [ln(y)]²,c < 0 才是倒 U
def fit(deg):
    co = np.polyfit(x, gini, deg); res = gini - np.polyval(co, x)
    return co, 1 - (res @ res) / ((gini - gini.mean()) @ (gini - gini.mean()))
c1, r1 = fit(1); c2, r2 = fit(2)
print(f"\n一、线性:基尼 = {c1[1]:.1f} + ({c1[0]:.2f}) × ln(y),R² = {r1:.3f}")
print(f"    二次:二次项 c = {c2[0]:.2f},R² = {r2:.3f}" + (f",倒 U 的顶点,在人均 GDP = {math.exp(-c2[1] / (2 * c2[0])):,.0f}" if c2[0] < 0 else "(c > 0:不是倒 U,是 U)"))
rng = np.random.default_rng(42)
cs = []
for _ in range(2000):
    idx = rng.integers(0, len(codes), len(codes)); cs.append(np.polyfit(x[idx], gini[idx], 2)[0])
lo, hi = np.percentile(cs, [2.5, 97.5])
print(f"    自助法 2000 次,二次项的 95% 区间 [{lo:.2f}, {hi:.2f}]:{'包含 0' if lo <= 0 <= hi else '不包含 0'}")

# 二、按收入,分成 4 组
order = np.argsort(gdp)
print("\n二、按人均 GDP,分 4 组:基尼的平均、最小、最大")
print(f"  {'组':<10}{'人均 GDP 范围':>20}{'基尼 平均':>10}{'最小':>6}{'最大':>6}")
for name, g in zip(("最穷 1/4", "较穷 1/4", "较富 1/4", "最富 1/4"), np.array_split(order, 4)):
    print(f"  {name:<8}{gdp[g].min():>10,.0f}–{gdp[g].max():<9,.0f}{gini[g].mean():>10.1f}{gini[g].min():>6.1f}{gini[g].max():>6.1f}")
print("  基尼最高的 5 个:" + ",".join(f"{codes[i]}({gini[i]:.1f})" for i in np.argsort(-gini)[:5]))
print("  基尼最低的 5 个:" + ",".join(f"{codes[i]}({gini[i]:.1f})" for i in np.argsort(gini)[:5]))
rich = order[-len(codes) // 4:]
print(f"  最富的 1/4 之内:基尼,从 {gini[rich].min():.1f} 到 {gini[rich].max():.1f},差 {gini[rich].max() - gini[rich].min():.1f} 个点:同样的收入水平,不平等,可以,很不同(政策、制度的选择)")
输出:
168 个国家;基尼系数的年份:1992–2025,中位数 2022 年

一、线性:基尼 = 52.4 + (-1.72) × ln(y),R² = 0.072
    二次:二次项 c = -0.90,R² = 0.100,倒 U 的顶点,在人均 GDP = 4,561
    自助法 2000 次,二次项的 95% 区间 [-1.77, -0.22]:不包含 0

二、按人均 GDP,分 4 组:基尼的平均、最小、最大
  组                    人均 GDP 范围     基尼 平均    最小    最大
  最穷 1/4       1,055–5,702          37.3  24.7  51.5
  较穷 1/4       5,809–14,637         38.4  23.0  59.1
  较富 1/4      14,841–33,164         37.4  24.4  54.9
  最富 1/4      33,298–132,725        31.3  23.8  41.8
  基尼最高的 5 个:NAM(59.1),BWA(54.9),SWZ(54.6),COL(54.4),ZAF(54.1)
  基尼最低的 5 个:IND(23.0),SVK(23.8),BLR(24.4),KIR(24.7),SVN(24.7)
  最富的 1/4 之内:基尼,从 23.8 到 41.8,差 18.0 个点:同样的收入水平,不平等,可以,很不同(政策、制度的选择)
逐段看:
- 关系,很弱:线性:基尼 = 52.4 − 1.72 × ln(y),R² 只有 0.072;二次:R² 0.100。二次项,是负的(c = −0.90),自助法的 95% 区间 [−1.77, −0.22],不含 0:有一点"倒 U"的形状;可是,顶点,在人均 GDP 约 4,561 国际元(很低),也就是说,在多数国家,所处的收入范围里,基尼,是下降的,而不是,库兹涅茨说的,“先升”。
- 分组:最穷的 1/4,基尼平均 37.3;较穷的,38.4;较富的,37.4;最富的 1/4,31.3。
- 差别,很大:基尼最高的,纳米比亚(59.1)、博茨瓦纳、斯威士兰、哥伦比亚、南非(54.1);最低的,印度(23.0)、斯洛伐克、白俄罗斯、基里巴斯、斯洛文尼亚。最富的 1/4 之内,基尼,从 23.8,到 41.8,差 18 个点:同样的收入水平,不平等,可以,很不同。
- 要小心:(1)这是一个时点的跨国比较,库兹涅茨说的,是一个国家,随时间的变化;(2)基尼的口径,不统一:有的,按收入,有的,按消费(印度,是按消费算的,所以,偏低);(3)调查年份,从 1992 到 2025,不一样;(4)后来,用同一个国家的多年数据(面板)、控制国家的固定特征,检验倒 U 的研究,结论,常被概括为,支持,很弱(据二手转述;常被提到的数据集,是 Klaus Deininger 和 Lyn Squire 1996 年,World Bank Economic Review,10 卷 3 期,565–591 页)。
所以,“富了,不平等,会自动,先升后降”,没有,得到,数据的支持。 更像是,政策和制度,在塑造不平等(第 26 讲)。
5.2 美国:1968 年以来
import numpy as np

# 数据:美国人口调查局(Census)的家庭收入基尼系数(税前的货币收入,不含资本利得,不含非现金福利),1947–2025,经 FRED(GINIALLRF)发布。
GINI = {1947: 0.376, 1948: 0.371, 1949: 0.378, 1950: 0.379, 1951: 0.363, 1952: 0.368, 1953:
0.359, 1954: 0.371, 1955: 0.363, 1956: 0.358, 1957: 0.351, 1958: 0.354, 1959: 0.361, 1960:
0.364, 1961: 0.374, 1962: 0.362, 1963: 0.362, 1964: 0.361, 1965: 0.356, 1966: 0.349, 1967:
0.358, 1968: 0.348, 1969: 0.349, 1970: 0.353, 1971: 0.355, 1972: 0.359, 1973: 0.356, 1974:
0.355, 1975: 0.357, 1976: 0.358, 1977: 0.363, 1978: 0.363, 1979: 0.365, 1980: 0.365, 1981:
0.369, 1982: 0.380, 1983: 0.382, 1984: 0.383, 1985: 0.389, 1986: 0.392, 1987: 0.393, 1988:
0.395, 1989: 0.401, 1990: 0.396, 1991: 0.397, 1992: 0.404, 1993: 0.429, 1994: 0.426, 1995:
0.421, 1996: 0.425, 1997: 0.429, 1998: 0.430, 1999: 0.429, 2000: 0.433, 2001: 0.435, 2002:
0.434, 2003: 0.436, 2004: 0.438, 2005: 0.440, 2006: 0.444, 2007: 0.432, 2008: 0.438, 2009:
0.443, 2010: 0.440, 2011: 0.450, 2012: 0.451, 2013: 0.455, 2014: 0.452, 2015: 0.448, 2016:
0.452, 2017: 0.458, 2018: 0.452, 2019: 0.454, 2020: 0.458, 2021: 0.462, 2022: 0.458, 2023:
0.452, 2024: 0.457, 2025: 0.460}
yrs = sorted(GINI)
v = np.array([GINI[y] for y in yrs])
lo, hi = int(np.argmin(v)), int(np.argmax(v))
print(f"一、美国,家庭收入的基尼系数,{yrs[0]}–{yrs[-1]}:")
print(f"  最低 {v[lo]:.3f}({yrs[lo]} 年),最高 {v[hi]:.3f}({yrs[hi]} 年);{yrs[0]} 年 {v[0]:.3f},{yrs[-1]} 年 {v[-1]:.3f}")
for a, b in ((1947, 1968), (1968, 2000), (2000, 2025)):
    ia, ib = yrs.index(a), yrs.index(b)
    print(f"  {a}–{b}:{v[ia]:.3f} → {v[ib]:.3f}({v[ib] - v[ia]:+.3f}),每年 {(v[ib] - v[ia]) / (b - a):+.4f}")
# 二、一个简单的"事实分解":1968 → 2025,上升了多少?
rise = v[-1] - v[yrs.index(1968)]
print(f"\n二、1968 → {yrs[-1]}:基尼,上升 {rise:.3f}(相当于,在 1968 年的基础上,上升 {rise / v[yrs.index(1968)]:.0%})")
print("  口径提醒:这是,税前、货币收入的基尼;税和转移(税后收入),会,让它,更低;资本利得,不在里面;高收入者,在调查里,常被'顶部编码'(为保护隐私,截断),所以,顶部,常被认为,被低估。")
输出:
一、美国,家庭收入的基尼系数,1947–2025:
  最低 0.348(1968 年),最高 0.462(2021 年);1947 年 0.376,2025 年 0.460
  1947–1968:0.376 → 0.348(-0.028),每年 -0.0013
  1968–2000:0.348 → 0.433(+0.085),每年 +0.0027
  2000–2025:0.433 → 0.460(+0.027),每年 +0.0011

二、1968 → 2025:基尼,上升 0.112(相当于,在 1968 年的基础上,上升 32%)
  口径提醒:这是,税前、货币收入的基尼;税和转移(税后收入),会,让它,更低;资本利得,不在里面;高收入者,在调查里,常被'顶部编码'(为保护隐私,截断),所以,顶部,常被认为,被低估。
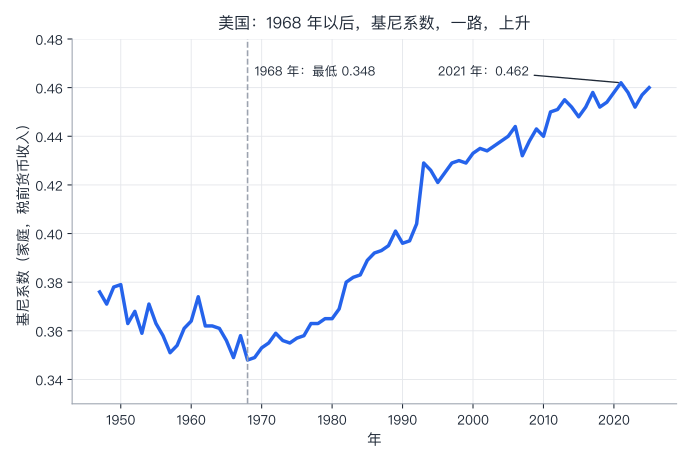
逐段看:
- U 形:1947 年 0.376,下降到 1968 年的 0.348(最低);然后,一路上升:1968–2000,上升 0.085(每年 0.0027);2000–2025,再上升 0.027;2021 年,0.462(最高)。1968 到 2025 年,上升了 0.112,约 32%。
- 这和 Thomas Piketty 和 Emmanuel Saez 2003 年(Quarterly Journal of Economics,118 卷 1 期,1–41 页),用税务数据,得到的美国最高收入者的份额,是一个方向:据摘要,最高收入的份额,在 20 世纪,呈 U 形:大萧条,和二战,使得,最高的资本收入,永久性地,下降;美国的最高工资收入者的份额,战前,大致,平,战争中,大降,从 1960 年代末起,回升,现在,超过了战前,所以,他们,是"工作的富人"(working rich),而不是,靠资本收入的食利者。
- 口径提醒:这是税前、货币收入的基尼;税和转移,会让它更低;资本利得,不在里面;高收入者,在调查里,常被"顶部编码"(为保护隐私,截断),所以,顶部,常被认为,被低估;FRED 的这条序列,在不同的年份,调查的方法,也有改版,我没有逐一核对;世界银行,同时,给的美国基尼(2023 年,41.8),口径,不同(可支配收入),数字,不能直接比。
六、穷人的世界,怎么变好
增长,是最大的力量(第 29 讲)。可是,对一个具体的穷人,一个具体的村子,“该做什么”,不是,增长理论,能回答的。2019 年的诺贝尔经济学奖,给了 Abhijit Banerjee、Esther Duflo 和 Michael Kremer,“因为,他们,用实验的方法,来缓解全球的贫困”。想法:把"如何消除贫困"这个大问题,拆成,更小的、可检验的问题(哪种办法,最能提高学生的成绩、改善儿童的健康),然后,用随机对照实验(第 4 讲)回答。
两个例子:
- 直接给钱:Johannes Haushofer 和 Jeremy Shapiro 2016 年(Quarterly Journal of Economics,131 卷 4 期,1973–2042 页):在肯尼亚农村,对贫困家庭,随机,发放,无条件的现金(来自慈善机构 GiveDirectly);据摘要,9 个月之后,家庭每月的消费,从 158 美元(购买力平价),增加到 193 美元;心理健康,明显改善;压力激素(皮质醇),没有总体的变化;每月发放,更多改善食品安全,一次性发放,更多花在耐用品上,说明,家庭,面临储蓄和信贷的约束。后来,Dennis Egger 等人 2022 年(Econometrica,90 卷 6 期,2603–2643 页):给了 653 个村子,超过 1 万个家庭,每户约 1000 美元(占当地 GDP 的 15% 以上);据摘要,对未受益的家庭和企业,也有溢出,物价,几乎没有上涨;估计,本地的转移乘数,约 2.5(呼应第 34 讲的乘数)。
- 小额信贷:曾经,被寄予很高的期望。Banerjee、Duflo、Glennerster 和 Kinnan 2015 年(《小额信贷的奇迹?》,American Economic Journal: Applied Economics,7 卷 1 期,22–53 页):在印度海得拉巴,随机选了 52 个社区,开展小额贷款;据摘要,借贷,增加了 8.4 个百分点;已有小生意的投资和利润,增加;可是,消费,没有显著增加;健康、教育、妇女赋权,也没有显著变化;两年后,差别,大多消失。
怎么读:(1)这类研究,给出的,是**“某个办法,在某个地方,有没有用”**的、可信的证据;(2)局限:外部有效性:肯尼亚的结果,能不能,推到别处?小实验,能不能,解决,宏观的大问题?(3)小额信贷:不是"奇迹",也不是"无用",是,效果,温和;(4)这与第 4 讲,是同一个思路:因果,很难,要靠设计。
七、一个有争议的问题:不平等,为什么上升,再分配,有什么代价
按"理论预测 → 证据与局限 → 分歧在哪 → 价值判断留给读者"来写。这里,有两个问题。
7.1 问题 A:美国的不平等,为什么上升
理论预测什么:几个常被提到的力量:
- 技术:技术进步,增加了,对高技能劳动的需求,提高了"技能溢价"(第 13 讲:工资,由供给和需求决定;第 29 讲);
- 贸易:进口竞争,伤害了,某些地方、某些工人(第 40 讲:中国冲击);
- 制度和政策:税收的累进程度、工会、最低工资、金融监管(第 26 讲,制度);
- 资本回报:Thomas Piketty 2014 年的书(《21 世纪资本论》):如果,资本的回报率 r,长期,高于,经济增长率 g(第 34 讲,同一对字母,r 和 g),财富,就会,越来越,集中在,资本的所有者手里。
证据怎么说:
- 技术:David Autor 2014 年(Science,344 卷 6186 期,843–851 页):据摘要,对于"其余 99%",不平等上升的一个更大的驱动,是,受教育程度,和认知能力,带来的工资溢价,上升;技能的供给和需求,共同塑造;他,也讨论了,政策,在促进技能形成,和保持社会流动上的作用。
- 贸易:第 40 讲,局部,受重创,恢复很慢;
- 制度:Piketty 和 Saez 2003 年,把,美国最高收入份额的下降,部分,归因于,累进的所得税、遗产税(据摘要);
- r > g:Daron Acemoglu 和 James Robinson 2015 年(Journal of Economic Perspectives,29 卷 1 期,3–28 页)的批评:据摘要,他们用回归,发现,r − g,不能解释,历史上的不平等(尤其是,最高收入者的份额);他们强调,制度和技术,不能被"一般规律",所取代,并用南非和瑞典的例子,来说明。Matthew Rognlie 2015 年(Brookings Papers on Economic Activity,2015 年春季号):据摘要,资本的净份额的上升,主要来自住房;而且,资本积累,越多,资本的净回报,下降得更多,所以,“资本越多,资本份额越大”,需要,不太可能的替代弹性。
局限:(1)每一种力量,都难以,被单独,识别;它们,同时,发生;(2)数据,口径,不同(税前、税后;收入、财富;家庭、个人);(3)我这里,没有,系统地,比较,它们的大小,没有,一个,被公认的分解。
分歧在哪:事实上,各种力量的相对大小;理论上,r > g,是不是"规律",还是,取决于制度和技术;这和第 34 讲,债务动态的 r − g,相似:r − g,不是,常数。
7.2 问题 B:再分配,有什么代价
理论预测什么:Arthur Okun 1975 年,用一个"漏桶"的比喻:把钱,从富人,运给穷人,桶,会漏:税,让人,少工作、少投资、少报收入(第 9 讲:税,有无谓损失;第 13 讲:劳动供给)。漏,多少,是事实;漏了,还值不值得,是价值判断。
我们,用一个最简单的模型,把这两者,分开:σ = 0.8 的收入分布,统一税率 t,人人一份的转移;人们,会,根据税率,调整,应税的收入(弹性 e)。
import math
from statistics import NormalDist

# 一个"漏桶":对所有人的收入,征一个统一的税率 t,把税收,平均发给每个人(人人一份的转移)。
# 税,会让人少挣一点:税后的"留存比例"是 (1 − t),应税收入,按弹性 e 减少:y' = y × (1 − t)^e(e = 0:没有行为反应)。
N = 100000
nd = NormalDist(); SIGMA = 0.8                         # 收入:对数正态,σ = 0.8(基尼 0.43),税前平均 = 1
raw = [math.exp(SIGMA * nd.inv_cdf((i + 0.5) / N)) for i in range(N)]
mean0 = sum(raw) / N
y0 = [v / mean0 for v in raw]                          # 已经从小到大排好

def gini(y):
    n = len(y); mu = sum(y) / n
    return sum((2 * (i + 1) - n - 1) * v for i, v in enumerate(sorted(y))) / (n * n * mu)

def outcome(t, e):
    k = (1 - t) ** e
    y1 = [v * k for v in y0]                           # 税后,行为反应之后的税前收入
    R = t * sum(y1) / N                                # 人均税收 = 人均转移
    post = [(1 - t) * v + R for v in y1]               # 税后收入(含转移)
    bottom20 = sum(post[: N // 5]) / (N // 5)
    mean_log = sum(math.log(v) for v in post) / N
    return gini(post), sum(post) / N, bottom20, mean_log, R

print(f"一、基尼,从 {gini(y0):.3f} 起步;税率 t,人人一份的转移;e = 行为反应的弹性")
print(f"  {'t':>5}{'e':>5}{'税后基尼':>9}{'人均收入':>9}{'最穷 20% 的平均':>14}{'人均转移':>9}{'漏掉的比例':>10}")
for e in (0.0, 0.5):
    for t in (0.0, 0.2, 0.4, 0.6, 0.8):
        g, m, b, _, R = outcome(t, e)
        leak = 1 - R / t if t > 0 else 0.0
        print(f"  {t:>5.0%}{e:>5.1f}{g:>9.3f}{m:>9.3f}{b:>14.3f}{R:>9.3f}{leak:>10.1%}")
print("  e = 0:税后基尼 = (1 − t) × 税前基尼,人均收入,不变;e = 0.5:收入,被'漏掉'了一部分")

print("\n二、同样的事实(e = 0.5),不同的价值判断,会选出不同的税率:")
grid = [k / 100 for k in range(0, 100)]
for name, idx, desc in (("只看平均收入(每一元,一样重)", 1, "平均收入"), ("看最穷 20% 的平均收入(罗尔斯式:只看最差的人)", 2, "最穷 20% 的平均收入"), ("看'收入的对数'的平均(穷人的 1 元,比富人的 1 元,更重要)", 3, "收入对数的平均")):
    best = max(grid, key=lambda t: outcome(t, 0.5)[idx])
    v = outcome(best, 0.5)
    print(f"  {name}:最优税率 t = {best:.0%};那时,基尼 {v[0]:.3f},人均收入 {v[1]:.3f},最穷 20% 的平均 {v[2]:.3f}")
rev = max(grid, key=lambda t: outcome(t, 0.5)[4])
print(f"  顺便:税收最大的税率(拉弗曲线的顶点)t = {rev:.0%}(公式:1 ÷ (1 + e) = {1 / 1.5:.0%});人均税收 {outcome(rev, 0.5)[4]:.3f}")
print("  事实(e = 0.5 的漏桶)完全一样;价值判断不同,最优的税率,从 0%、14%,到 55%。")
输出:
一、基尼,从 0.428 起步;税率 t,人人一份的转移;e = 行为反应的弹性
      t    e     税后基尼     人均收入    最穷 20% 的平均     人均转移     漏掉的比例
     0%  0.0    0.428    1.000         0.252    0.000      0.0%
    20%  0.0    0.343    1.000         0.401    0.200      0.0%
    40%  0.0    0.257    1.000         0.551    0.400      0.0%
    60%  0.0    0.171    1.000         0.701    0.600      0.0%
    80%  0.0    0.086    1.000         0.850    0.800      0.0%
     0%  0.5    0.428    1.000         0.252    0.000      0.0%
    20%  0.5    0.343    0.894         0.359    0.179     10.6%
    40%  0.5    0.257    0.775         0.427    0.310     22.5%
    60%  0.5    0.171    0.632         0.443    0.379     36.8%
    80%  0.5    0.086    0.447         0.380    0.358     55.3%
  e = 0:税后基尼 = (1 − t) × 税前基尼,人均收入,不变;e = 0.5:收入,被'漏掉'了一部分

二、同样的事实(e = 0.5),不同的价值判断,会选出不同的税率:
  只看平均收入(每一元,一样重):最优税率 t = 0%;那时,基尼 0.428,人均收入 1.000,最穷 20% 的平均 0.252
  看最穷 20% 的平均收入(罗尔斯式:只看最差的人):最优税率 t = 55%;那时,基尼 0.193,人均收入 0.671,最穷 20% 的平均 0.445
  看'收入的对数'的平均(穷人的 1 元,比富人的 1 元,更重要):最优税率 t = 14%;那时,基尼 0.368,人均收入 0.927,最穷 20% 的平均 0.331
  顺便:税收最大的税率(拉弗曲线的顶点)t = 67%(公式:1 ÷ (1 + e) = 67%);人均税收 0.385
  事实(e = 0.5 的漏桶)完全一样;价值判断不同,最优的税率,从 0%、14%,到 55%。
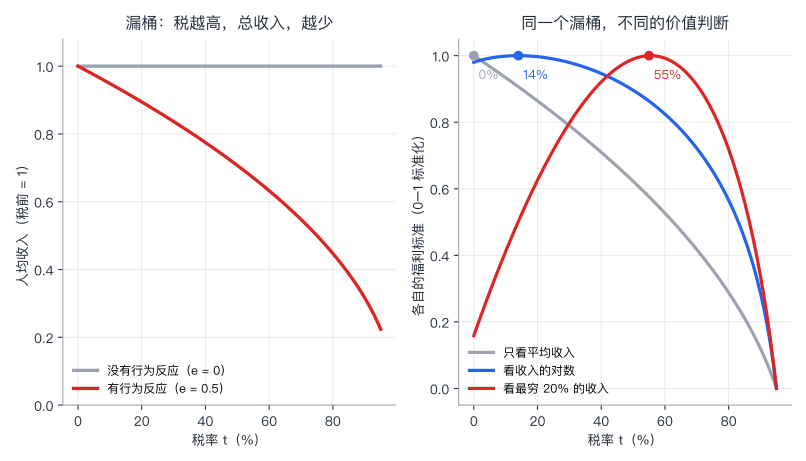
逐段看:
- 没有行为反应(e = 0):税后基尼 = (1 − t) × 税前基尼:t = 40%,基尼,从 0.428,降到 0.257;人均收入,不变;最穷的 20%,从 0.252,升到 0.551。这是一个"没有漏"的桶。
- 有行为反应(e = 0.5):t = 40%:基尼,还是 0.257;可是,人均收入,只剩 0.775;最穷 20%,到 0.427;人均转移 0.310,漏掉了 22.5%(即,每 1 元税,只有 0.775 元,被转出去)。t = 60%:漏掉 36.8%;t = 80%:漏掉 55.3%,最穷的 20%,反而,下降到 0.380(比 60% 时的 0.443 更差)。税,有一个"税收最大"的点(拉弗曲线的顶点):t = 67% = 1 ÷ (1 + e),再往上,税收,反而,减少。
- 回答问题 3:拿不到 1 元;在这个模型里,每 1 元,到穷人手里,大约 0.78(t = 40%);值不值得,取决于你,怎么,权衡,穷人的 1 元,和富人的 1 元。
- 第二部分的核心:同样的事实(e = 0.5),不同的价值判断,选出了不同的税率:(a)只看平均收入(每一元,一样重):最优 t = 0%;(b)看"收入的对数"的平均(穷人的 1 元,比富人的 1 元,更重要):最优 t = 14%;(c)只看最穷 20% 的收入(罗尔斯式:只看最差的人):最优 t = 55%,那时,基尼 0.193,人均收入 0.671,最穷 20% 的平均 0.445(比 0 税率时的 0.252,高 77%)。
局限:(1)这是一个极度简化的模型:统一税率,人人一份;没有,对"增长"、“投资”、“人力资本"的动态影响;(2)弹性 e,是假设的,真实的弹性,要靠,实证研究,估计,且,不同的人群,不同;(3)“人人一份"的转移,不一定,是,真实的政策;(4)我没有引用,具体的税收的弹性估计。
分歧在哪:事实上:e 有多大,漏,有多少;价值上:你,怎么权衡,平均的收入、最差的人的收入,和平等本身。
价值判断(留给你):
- 不平等,本身,是不是问题? 如果,所有人,都在变好,只是,富人,变得更快,这是问题吗?还是,只有,“穷人,过得太差”,才是问题?(第 39 讲:对不平等的反感,是一种偏好,该不该写进政策?)
- 结果的平等,还是机会的平等? 经济学,能告诉你,各种政策,对收入分布、对增长,大约有什么后果;你更看重哪一种平等,是价值判断。
- 该不该,无条件地,给穷人钱? 事实:第六节,有一些随机实验的证据,现金,改善了消费和心理状态,物价,没有大涨;价值:该不该,附加条件(第 39 讲:家长主义)?谁来出钱?
- 全球的穷人,和本国的穷人,谁更重要? 国家,该把,多少资源,用于,本国的再分配,多少,用于,援助别国的穷人?
经济学,能告诉你:每一种做法,大约有什么后果;你把多大的权重,给最差的人,是你的价值判断。
八、局限、常见误用
8.1 局限
- 数据:贫困线、购买力平价、调查的口径,会更新,也会不一致;基尼,有收入、消费、税前、税后的不同;
- 模型:再分配的模型,是极度简化的;数字,是虚构的假设;
- 文献:多数,只引用了摘要,没有重做;Kuznets 1955、Preston 1975 的卷期页,没有核对;
- 这一讲没有讲:财富不平等;代际流动;性别不平等;教育、健康的细致模型;援助的有效性之争;气候变化对穷人的影响;中国的区域差距、城乡差距的具体数据;
- 本讲,不是政策建议。
8.2 常见的误用
| 误用 | 正确的想法 |
|---|---|
| “基尼系数,就是不平等” | 基尼,是一个数字,有盲点;要看,最富、最穷的份额,和整个分布 |
| “贫困率下降了,穷人,就少了” | 人口,在增长:撒哈拉以南非洲,贫困率,降了,人数,反而,增加了 2.4 亿 |
| “国家,富了,不平等,会自动,先升,后降” | 数据,支持很弱;最富的国家之内,基尼,可以差 18 个点 |
| “国际贫困线,是穷人的生活标准” | 它是,一个极低的、用来比较的线;各国的政策,用本国的线 |
| “发展,就是,收入” | 寿命、教育,是另外的维度;同样的收入,现在的人,活得更久 |
| “再分配,一定,降低效率” | 要看,漏多少(弹性);也要看,穷人的 1 元,和富人的 1 元,你怎么权衡 |
| “不平等,是技术,(或贸易,或税收)造成的” | 各种力量,同时,在起作用;没有,被公认的分解 |
| “随机实验,证明了,某个办法,处处有效” | 它,证明的,是,一个地方、一个时期;外部有效性,要另外,检验 |
九、小结
这一讲有六个想法,请带走:
- 测不平等:洛伦兹曲线,基尼系数;5 个人(1, 2, 3, 4, 10)的基尼,是 0.400;基尼,有盲点,相同的基尼,可以,对应,非常不同的分布。
- 贫困:全世界,极端贫困,从 23 亿,到 8.7 亿;中国,占减少量的 66%;撒哈拉以南非洲,贫困率,下降,人数,反而,增加 2.4 亿(人口,2.4 倍)。
- 发展,不只是收入:同样的收入,2022 年,比 1990 年,多活 3.5 到 6 年;预期寿命,增加的 45%,来自收入,其余,是整条曲线,上移。
- 库兹涅茨曲线:数据,支持,很弱;美国,基尼,1968 年(0.348)之后,一路上升,到 2021 年的 0.462。
- 小实验:现金转移,改善了消费,没有,引起,物价上涨;小额信贷,效果,温和;外部有效性,是个问题。
- 有争议:不平等,为何上升,没有,被公认的分解;再分配,有"漏”:同样的事实,不同的价值判断,最优的税率,从 0%、14%,到 55%。
下一讲,是这门课的最后一讲:大历史。我们,把前面所有的东西,放到,长长的时间里:为什么,工业革命,发生在,18 世纪的英国;为什么,欧洲,和中国,走上了,不同的路(大分流);中国的改革开放,发生了什么。下一讲:第 43 讲:大历史中的经济:工业革命、大分流与中国改革开放。
思考题
1. 4 个人,收入 1、1、1、5。基尼系数,是多少?最富的人,拿走了多少比例?
提示:所有配对(含自己)的收入差之和 = 2 × (3 × 4) = 24(3 个"1”,各和"5"配对,差 4,每对,算两次);平均 = 2;基尼 = 24 ÷ (2 × 16 × 2) = 0.375。最富的人,拿 5 ÷ 8 = 62.5%。
2. 一个国家,人口 1 亿,极端贫困率 50%(5000 万人)。后来,人口,增长到 2.4 亿,贫困率,降到 37%。贫困人口,是多少?这和撒哈拉以南非洲,有什么关系?
提示:0.37 × 2.4 亿 = 8880 万,比原来的 5000 万,多。这就是"贫困率下降,人数增加",撒哈拉以南非洲,人口,增长到 2.4 倍,贫困率,从 61.5% 降到 45.6%,人数,增加。
3. 用 1990 年的普雷斯顿曲线(b = 6.4):如果,一个国家的人均 GDP,翻一倍,仅靠收入,预期寿命,多多少?如果,实际,多了 8 岁,多少,是整条曲线,上移?
提示:6.4 × ln 2 = 6.4 × 0.693 ≈ 4.4 岁;其余,8 − 4.4 = 3.6 岁,是曲线,上移(医学、公共卫生,等)。
4. 7.2 节的漏桶:e = 0.5,t = 40%:每 1 元税,有多少,到了转移?如果,社会认为,穷人的 1 元,比富人的 1 元,重要 1.5 倍,这个税,值得吗?“盈亏平衡"的权重,是多少?
提示:留存的比例 = (1 − 0.4)^0.5 ≈ 0.775,漏了 22.5%。1 元,变成 0.775 元,给穷人,按 1.5 倍的权重,价值 0.775 × 1.5 ≈ 1.16 > 1,值得(在这个简化的意义上)。盈亏平衡的权重 = 1 ÷ 0.775 ≈ 1.29:只要,穷人的 1 元,比富人的 1 元,重要 1.29 倍以上,就值得。这个"权重”,是价值判断。
5. (开放题)一项政策,把最富的 10% 的税,提高,用来,增加,最穷的 20% 的收入。请把下面的说法,分成事实问题和价值判断:(a)这会让基尼系数,下降;(b)这会让总收入,下降 3%;(c)最穷 20% 的收入,增加,值得,总收入的下降;(d)应该,优先,关心,最穷的人。
提示:(a)(b)是事实,可以用数据和模型检验(b 取决于,弹性 e,和,政策的细节);(c)(d)是价值判断:怎么权衡,最差的人,和平均;这取决于你对,罗尔斯式、功利式(平均)、“收入的对数"等不同标准的选择(7.2 节,同样的事实,最优税率,从 0% 到 55%)。
参考与延伸
- Kuznets, S. (1955). Economic Growth and Income Inequality. American Economic Review(1955 年 3 月号;卷期页,没有核对)。
- Deininger, K., & Squire, L. (1996). A New Data Set Measuring Income Inequality. World Bank Economic Review, 10(3), 565–591.
- Preston, S. H. (1975). The Changing Relation between Mortality and Level of Economic Development. Population Studies(卷期页没有核对)。重印:International Journal of Epidemiology, 36(3), 484–490 (2007).
- Piketty, T., & Saez, E. (2003). Income Inequality in the United States, 1913–1998. Quarterly Journal of Economics, 118(1), 1–41.
- Piketty, T. (2014). Capital in the Twenty-First Century. Harvard University Press.
- Acemoglu, D., & Robinson, J. A. (2015). The Rise and Decline of General Laws of Capitalism. Journal of Economic Perspectives, 29(1), 3–28.
- Rognlie, M. (2015). Deciphering the Fall and Rise in the Net Capital Share. Brookings Papers on Economic Activity(2015 年春季号)。
- Autor, D. H. (2014). Skills, Education, and the Rise of Earnings Inequality among the “Other 99 Percent”. Science, 344(6186), 843–851.
- Okun, A. M. (1975). Equality and Efficiency: The Big Tradeoff. Brookings Institution Press.
- Haushofer, J., & Shapiro, J. (2016). The Short-Term Impact of Unconditional Cash Transfers to the Poor: Experimental Evidence from Kenya. Quarterly Journal of Economics, 131(4), 1973–2042.
- Egger, D., Haushofer, J., Miguel, E., Niehaus, P., & Walker, M. (2022). General Equilibrium Effects of Cash Transfers: Experimental Evidence from Kenya. Econometrica, 90(6), 2603–2643.
- Banerjee, A., Duflo, E., Glennerster, R., & Kinnan, C. (2015). The Miracle of Microfinance? Evidence from a Randomized Evaluation. American Economic Journal: Applied Economics, 7(1), 22–53.
- 世界银行(2025 年 6 月):《全球贫困线更新》(June 2025 update to global poverty lines,说明)。
- 世界银行 WDI:贫困率(SI.POV.DDAY)、基尼系数(SI.POV.GINI)、人口(SP.POP.TOTL)、预期寿命(SP.DYN.LE00.IN)、人均 GDP(NY.GDP.PCAP.PP.KD),2026 年 10 月通过 API 下载,已嵌入代码。
- FRED(圣路易斯联储):GINIALLRF(美国家庭的基尼系数,美国人口调查局),已嵌入代码。