这一讲是综合应用,是第 29 讲第五节(“技术会不会让更多人失去工作”)的延续:那一节,用的是机器人的证据,这一讲,换成生成式 AI。它会用到:弹性(第 8 讲)、劳动的派生需求和工资(第 13 讲)、技术、人力资本和增长(第 29 讲)、失业和通胀(第 27、33 讲)、对"因果"的警惕(第 4 讲)、税收和再分配的取舍(第 9 讲、第 34 讲)。
这一讲要回答六个问题:
- 一项技术,让人工作得更快,对"雇多少人",有什么影响?为什么没有一个统一的答案?
- 经济学家,怎样用"任务",来想自动化?为什么,“AI 比人好一点”,也可能,压低工资?
- AI,到底,让个人的生产率,提高了多少?实验,说了什么?
- 整个经济,生产率,提高了多少?数据,和估算,说了什么?
- 年轻人的就业,有没有被 AI 影响?证据,为什么,互相打架?
- 中国,有什么事实?谁受益?该怎么办?
先说清楚三件事。 第一,这一讲不预测,也不给你职业建议(该学什么、该不该转行):这取决于你的情况和你对未来的判断。第二,这一讲的证据,大多数,是 2023 年以后的,很多,还是工作论文,结论,在快速变化;数字,截至 2026 年 10 月中旬;你读到的时候,可能,已经更新。第三,事实和价值判断,分开写:数据,能回答的,我用数据;谁该受益、谁该补偿,留给你。
一、同样的 40%,雇的人,是变多还是变少
你是一家公司的经理。你的三个初级分析师,每周,要写报告。现在,有一个 AI 工具,能让每份报告的撰写时间,减少 40%。
先停一下:你该少雇 40% 的人吗?
想一想:这取决于,你卖的这种报告,需求的弹性(第 8 讲),和人工,占成本的比例(第 13 讲:对劳动的需求,是派生需求,来自对产品的需求)。如果,报告变便宜了,客户,会买多得多,你需要的人,可能,更多;如果,客户的需求,几乎不变,你就用不了那么多人。
# 同样让"每份报告的人工时间"减少 40%,雇的人会变多还是变少?取决于:对这种产出的需求,富不富有弹性(第 8 讲);
# 以及,人工,占产品成本的比例(第 13 讲:对劳动的需求,是派生需求)。
# 简化:价格 = 成本;需求 Q = Q0 × (P / P0) ^ (-弹性);人工的总需求 = Q × 每份产出的人工时。
saving = 0.40
print("人工占成本的比例 = 100%(价格,跟着人工时,一起降 40%):")
for eps in (0.5, 1.0, 2.0):
    price = 1 - saving
    q = price ** (-eps)
    print(f"   需求弹性 {eps}:产量变成 {q:.2f} 倍,所需的人工时变成 {q * (1 - saving):.2f} 倍")
print("人工占成本的比例 = 50%(价格,只降 20%):")
for eps in (0.5, 1.0, 2.0):
    price = 1 - saving * 0.5
    q = price ** (-eps)
    print(f"   需求弹性 {eps}:产量变成 {q:.2f} 倍,所需的人工时变成 {q * (1 - saving):.2f} 倍")
输出:
人工占成本的比例 = 100%(价格,跟着人工时,一起降 40%):
   需求弹性 0.5:产量变成 1.29 倍,所需的人工时变成 0.77 倍
   需求弹性 1.0:产量变成 1.67 倍,所需的人工时变成 1.00 倍
   需求弹性 2.0:产量变成 2.78 倍,所需的人工时变成 1.67 倍
人工占成本的比例 = 50%(价格,只降 20%):
   需求弹性 0.5:产量变成 1.12 倍,所需的人工时变成 0.67 倍
   需求弹性 1.0:产量变成 1.25 倍,所需的人工时变成 0.75 倍
   需求弹性 2.0:产量变成 1.56 倍,所需的人工时变成 0.94 倍
逐段看:
- 人工,就是全部的成本(价格,跟着人工时,一起降 40%):需求弹性 0.5(需求,缺乏弹性):产量,增加 29%,所需的人工时,降到原来的 0.77 倍,少了 23%;弹性 1:产量增加 67%,人工时,不变;弹性 2:产量增加 178%,人工时,增加 67%。
- 人工,只占成本的一半(价格,只降 20%):同样的弹性,所需的人工时,更少:弹性 1,是 0.75 倍;弹性 2,是 0.94 倍。人工,占的比例,越低,节省人工,带来的降价,越小,“以量补价”,越难。
- 所以:同样的"让人快 40%",对就业的影响,可以,是减少、不变,或者增加,取决于需求的弹性,和人工的成本占比。这是为什么,没有一个"AI 一定增加或减少就业"的答案。(历史上,类似的现象,叫杰文斯悖论:技术,让资源的使用更有效率,用量,可能,反而增加。注意:它是"可能",不是"一定"。)
这一节,还漏了一件事:谁,拿到了那些"人工时"。 如果,AI,让一个有经验的人,做了原来三个人的活,那么,减少的,是初级的岗位;增加的,是对有经验的人的需求。下面,会看到,这和数据,有关。
二、任务:自动化,不只是"替代"
2.1 一个想法
经济学家,把一个工作,看作一束任务(Autor、Levy 和 Murnane 2003 年,Quarterly Journal of Economics,118 卷 4 期,1279–1333 页):据摘要,计算机资本,在有明确规则的任务上,替代工人;在非常规的问题解决和复杂沟通的任务上,补充工人。Acemoglu 和 Restrepo 2018 年(American Economic Review,108 卷 6 期,1488–1542 页)和 2019 年(Journal of Economic Perspectives,33 卷 2 期,3–30 页,副标题:技术怎样替代和恢复劳动),把它,写成了一个模型。三股力量:
- 替代效应(displacement):机器做了原来人做的任务:对这些任务的劳动需求,下降,劳动份额,下降;
- 生产率效应:机器让成本降低,产出增加,对还由人做的任务的需求,增加;
- 恢复效应(reinstatement):技术,创造出新的任务,人,在这些新任务上,有比较优势,对劳动的需求,增加。
总的结果,取决于,三者的相对大小。下面,用一个最简化的玩具,把它们,算出来。
# 任务模型(Acemoglu 和 Restrepo 的想法,我做了最简化):生产,是一束"任务",编号 i 在 [N-1, N] 里,总量是 1。
# 编号小的任务,被自动化了(由资本/AI 做):i <= I;编号大的任务,由人做:I < i <= N。
# 产出 Y = exp( 对所有任务 ln y(i) 的积分 ):每个任务,分到产出里同样大的份额(所以,劳动份额 = 由人做的任务的量 = N - I)。
# 人做任务 i 的生产率,是 e^(theta × i)(新的任务,编号大,对人的要求更高、生产率更高);AI 在自动化的任务上的生产率,是 psi。
# L = K = 1。这是一个玩具,数字只显示机制。
import math
THETA = 2.0
def economy(N, I, psi, L=1.0, K=1.0):
    lab, aut = N - I, I - (N - 1)
    ln_y = THETA * (N ** 2 - I ** 2) / 2 + lab * math.log(L / lab) + aut * (math.log(psi) + math.log(K / aut))
    y = math.exp(ln_y)
    return y, lab, y * lab / L          # 产出,劳动份额,工资(劳动的总收入 ÷ L)

print("一、自动化加深:被自动化的任务,从 30% 增加到 40%、50%、60%、70%(以 30% 时为 100)")
for psi, label in ((2, "AI 只比人好一点(psi = 2)"), (4, "AI 比人好不少(psi = 4)"), (16, "AI 比人好得多(psi = 16)")):
    base = economy(1.0, 0.3, psi)
    print(f"   {label}")
    for I in (0.4, 0.5, 0.6, 0.7):
        y, lab, w = economy(1.0, I, psi)
        print(f"      自动化到 {I:.0%}:产出 {100 * y / base[0]:4.0f},工资 {100 * w / base[2]:4.0f},劳动份额 {lab:.0%}")
print("二、在 psi = 4 时,已经自动化了 60% 的任务(I = 0.6)。这时,创造新任务:N 从 1.0 增加到 1.1、1.2、1.3(新任务,对人的生产率更高)")
psi = 4
orig = economy(1.0, 0.3, psi)
after_auto = economy(1.0, 0.6, psi)
print(f"   起点:自动化前(I = 0.3):产出 100,工资 100,份额 {orig[1]:.0%}。自动化后(I = 0.6):产出 {100 * after_auto[0] / orig[0]:.0f},工资 {100 * after_auto[2] / orig[2]:.0f},份额 {after_auto[1]:.0%}")
for N in (1.1, 1.2, 1.3):
    y, lab, w = economy(N, 0.6, psi)
    print(f"   加上新任务 N = {N}:产出 {100 * y / orig[0]:3.0f},工资 {100 * w / orig[2]:3.0f},份额 {lab:.0%}")
输出:
一、自动化加深:被自动化的任务,从 30% 增加到 40%、50%、60%、70%(以 30% 时为 100)
   AI 只比人好一点(psi = 2)
      自动化到 40%:产出  106,工资   91,劳动份额 60%
      自动化到 50%:产出  106,工资   76,劳动份额 50%
      自动化到 60%:产出  100,工资   57,劳动份额 40%
      自动化到 70%:产出   88,工资   38,劳动份额 30%
   AI 比人好不少(psi = 4)
      自动化到 40%:产出  114,工资   98,劳动份额 60%
      自动化到 50%:产出  122,工资   87,劳动份额 50%
      自动化到 60%:产出  123,工资   70,劳动份额 40%
      自动化到 70%:产出  117,工资   50,劳动份额 30%
   AI 比人好得多(psi = 16)
      自动化到 40%:产出  131,工资  112,劳动份额 60%
      自动化到 50%:产出  161,工资  115,劳动份额 50%
      自动化到 60%:产出  187,工资  107,劳动份额 40%
      自动化到 70%:产出  203,工资   87,劳动份额 30%
二、在 psi = 4 时,已经自动化了 60% 的任务(I = 0.6)。这时,创造新任务:N 从 1.0 增加到 1.1、1.2、1.3(新任务,对人的生产率更高)
   起点:自动化前(I = 0.3):产出 100,工资 100,份额 70%。自动化后(I = 0.6):产出 123,工资 70,份额 40%
   加上新任务 N = 1.1:产出 135,工资  96,份额 50%
   加上新任务 N = 1.2:产出 145,工资 124,份额 60%
   加上新任务 N = 1.3:产出 152,工资 152,份额 70%
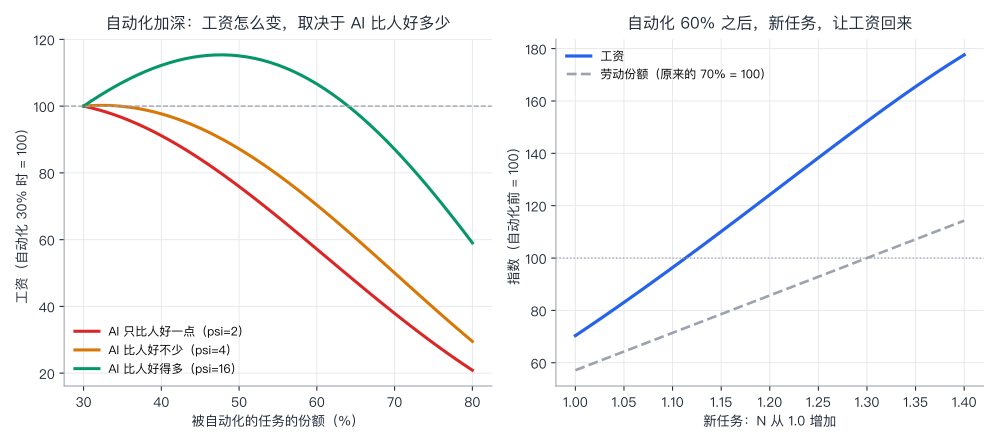
逐段看:
- 第一部分:自动化,从 30% 的任务,加深到 70%。劳动份额,一定下降(从 70% 到 30%):被自动化的任务,不再付工资。工资,怎样变,取决于 AI 比人好多少:
- AI 只比人好一点(psi = 2):自动化到 60%,产出,几乎没有增加(100),工资,却降到 57。这就是 Acemoglu 和 Restrepo 说的"so-so 自动化":它替代了劳动,却没有带来足够大的生产率提高。
- AI 比人好得多(psi = 16):产出,大幅增加,工资,先升后降:自动化到 50%,工资升到 115;到 70%,反而,降到 87。生产率效应,先压过替代效应;自动化越深,替代效应,越大。
- 第二部分:自动化了 60% 的任务之后(工资,降到 70),创造新任务(N,从 1.0 增加到 1.3),工资,回来了:N = 1.2,124;N = 1.3,152。劳动份额,也恢复。这就是"恢复效应":新任务,对人的需求,抵消了替代。
这个玩具,给了我们一个直觉:AI 对工资的影响,不是一个符号。它取决于(1)AI 比人好多少(生产率提高,够不够大);(2)有没有新任务出现;(3)收益,分给了谁(劳动份额,下降,意味着,更多的收入,归资本)。历史上的经验(第 29 讲)说,新任务,一直在出现;但是,它们,出现得够不够快,没有保证。
2.2 一个提醒
玩具模型,把"任务",处理得很干净:每个任务,要么,由人做,要么,由 AI 做;没有"人和 AI 一起做"(互补);也没有,学习、转行的成本、地区和行业的差别。这是示意,不是预测。
三、AI 暴露:谁的任务,可能,被影响
要研究影响,先要有一个"暴露度"(exposure):一个职业,有多少任务,是 AI 能做、或者能帮上忙的?Eloundou 等人(OpenAI 和宾夕法尼亚大学的研究者)的一项研究(据预印本的摘要,请核对最终发表的版本):大约 80% 的美国工人,至少有 10% 的任务,会受到 GPT 类工具的影响,约 19% 的工人,至少 50% 的任务,会受影响;各个工资水平,都有暴露,高收入的职业,暴露,可能,更高。
两点提醒:(1)暴露,不等于被替代:它,只是说,AI,能碰到这些任务,没有说,是替代,还是辅助(这篇研究,自己也这么说);(2)度量,是拿 AI 的能力,去"对照"任务描述,有很多主观的判断,不同的方法,得到的暴露度,不同。
四、个人层面:AI,让人,快了多少
4.1 几个随机实验
| 研究 | 设计 | 结果(据摘要) | 要小心 |
|---|---|---|---|
| Noy 和 Zhang 2023 年(Science,381 卷) | 453 名受过大学教育的专业人员,做写作任务,随机一半,可以用 ChatGPT | 平均用时,减少约 40%;质量,提高约 18% | 任务是单次的、有界的写作;没有核查内容的准确性(据媒体) |
| Brynjolfsson、Li 和 Raymond 2025 年(QJE,140 卷 2 期) | 一家公司的 5172 名客服,逐步,引入 AI 助手 | 每小时,解决的问题,平均,增加 15%;(2023 年的工作论文版本:14%,新手,34%,有经验的,几乎,没有变化) | 一个公司,一类工作;长期的效果,不知道 |
| Dell’Acqua 等人 2023 年(哈佛商学院的工作论文,后来,发表在 Organization Science) | 758 名 BCG 的咨询师,18 个现实任务,随机分配 | AI 能做的范围之内:完成的任务,多约 12.2%,快约 25.1%,质量,高 40% 以上;水平,低于平均的人,进步,更大(43%,对 17%);AI 能做的范围之外:用 AI 的人,答对的概率,低 19 个百分点 | “参差不齐的边界”:看上去,难度差不多的任务,有的在边界之内,有的在边界之外,人,很难,事先分清 |
| METR 2025 年 7 月 | 16 名有经验的开源项目的开发者,246 个任务,在自己熟悉的代码库里,随机,允许或禁止用 AI | 用 AI,多花了约 19% 的时间;而他们,事前,预期,会快 24%,事后,仍然,认为快了约 20% | 样本很小;是 2025 年初的工具;2026 年 2 月的后续(57 名开发者,800 多个任务):估计,用时,减少,但是,统计上不显著,METR 自己,认为,不可靠(因为,很多人,避开了他们不想在没有 AI 的情况下做的任务),正在重新设计 |
4.2 这些实验,说了什么,没说什么
- 在 AI 能做好的任务上,增益,可以很大(前三项)。
- 新手、能力弱的人,得益更大(Brynjolfsson 等人,Dell’Acqua 等人):AI,在个人之间,压缩了差距。但是,这并不自动意味着,对初级岗位,是好事:如果,新手,借助 AI,能做原来,需要更多经验的事,那么,公司,对新手的需求,也可能,变少(第一节)。
- 边界之外,会更糟(Dell’Acqua 等人):人,不知道,AI 什么时候不行。
- 感觉,和测量,可能,不一致(METR):这提醒我们:调查里,“我觉得我快了”,不是证据。
- 共同的局限:(1)实验,是短期的、单个任务的;(2)任务,是研究者选的,往往,是 AI 擅长的、容易衡量的;(3)个人快了,不等于企业,或者经济,快了:企业,要重新组织工作;(4)没有一个,统一的数:不同的研究,不同的任务、不同的衡量,不能,直接比较(Noy 和 Zhang 的 18%,和 Dell’Acqua 的 40%,来自不同的任务、评分和模型)。
五、整个经济:生产率,提高了多少
5.1 一个"信封背面"的估算
从个人的实验,到整个经济,要做的,是一个加总。Acemoglu 2024 年(《AI 的简单宏观经济学》,Economic Policy,40 卷 121 期,13–58 页)给了一个很简单的算术:如果,AI 的影响,来自任务层面的成本节省,那么,总的生产率提高 ≈ 被影响的任务的份额 × 这些任务上的平均成本节省(Hulten 定理)。
# Acemoglu(2024 年,《AI 的简单宏观经济学》,Economic Policy)的"信封背面"的算术。他用的是 Hulten 定理:
# 总的生产率提高 ≈ 被影响的任务的份额 × 这些任务上的平均成本节省。输入(据他的论文):
exposed, profitable = 0.20, 0.23            # 20% 的任务暴露于 AI(Eloundou 等人,按工资总额加权);其中,23% 在 10 年内,自动化是划算的(Svanberg 等人)
labor_cost_saving, labor_share = 0.27, 0.535  # 平均节省 27% 的人工成本(Noy–Zhang 和 Brynjolfsson 等人的实验的平均);暴露任务所在行业的人工成本占比 0.535
capital_share = 0.40
tasks_affected = exposed * profitable
cost_saving = labor_cost_saving * labor_share
tfp = tasks_affected * cost_saving
print(f"一、被影响的任务的份额 = {exposed:.0%} × {profitable:.0%} = {tasks_affected:.1%}")
print(f"   总成本节省 = {labor_cost_saving:.0%} × {labor_share} = {cost_saving:.1%}")
print(f"   10 年的 TFP 提高 = {tasks_affected:.1%} × {cost_saving:.1%} = {tfp:.2%}(论文:不超过 0.66%);约合每年 {100 * tfp / 10:.2f} 个百分点")
print(f"   GDP 的提高 ≈ TFP ÷ (1 - 资本份额) = {tfp:.2%} ÷ {1 - capital_share:.1f} = {tfp / (1 - capital_share):.2%}")
easy, hard_ratio = 0.73, 0.25
adj = tfp * (easy + (1 - easy) * hard_ratio)
print(f"二、再考虑:目前的实验,来自'容易学'的任务(上限 73%);难的任务上的收益,大约是容易的任务的 1/4:")
print(f"   TFP = {tfp:.2%} × ({easy:.0%} + {1 - easy:.0%} × {hard_ratio}) = {adj:.2%}(论文:不超过 0.53%);GDP ≈ {adj / (1 - capital_share):.2%}(论文,还更新了资本产出比,给的上界是 0.90%)")
print("三、敏感性:如果,被影响的任务,是 2 倍、成本节省,是 2 倍:")
for k_tasks, k_save in ((1, 1), (2, 1), (1, 2), (2, 2), (3, 3)):
    print(f"   任务份额 × {k_tasks},成本节省 × {k_save}:10 年的 TFP 提高 = {tfp * k_tasks * k_save:.2%}")
输出:
一、被影响的任务的份额 = 20% × 23% = 4.6%
   总成本节省 = 27% × 0.535 = 14.4%
   10 年的 TFP 提高 = 4.6% × 14.4% = 0.66%(论文:不超过 0.66%);约合每年 0.07 个百分点
   GDP 的提高 ≈ TFP ÷ (1 - 资本份额) = 0.66% ÷ 0.6 = 1.11%
二、再考虑:目前的实验,来自'容易学'的任务(上限 73%);难的任务上的收益,大约是容易的任务的 1/4:
   TFP = 0.66% × (73% + 27% × 0.25) = 0.53%(论文:不超过 0.53%);GDP ≈ 0.88%(论文,还更新了资本产出比,给的上界是 0.90%)
三、敏感性:如果,被影响的任务,是 2 倍、成本节省,是 2 倍:
   任务份额 × 1,成本节省 × 1:10 年的 TFP 提高 = 0.66%
   任务份额 × 2,成本节省 × 1:10 年的 TFP 提高 = 1.33%
   任务份额 × 1,成本节省 × 2:10 年的 TFP 提高 = 1.33%
   任务份额 × 2,成本节省 × 2:10 年的 TFP 提高 = 2.66%
   任务份额 × 3,成本节省 × 3:10 年的 TFP 提高 = 5.98%
逐段看:
- 第一部分:20% 的任务,暴露于 AI;其中,23%,在 10 年内,自动化是划算的:4.6% 的任务,会被影响;平均,节省 27% 的人工成本,乘以人工在成本里的占比(0.535),是 14.4% 的总成本节省;两者相乘,10 年的 TFP,提高 0.66%,约合,每年 0.07 个百分点。GDP,提高约 1.1%。
- 第二部分:他再,调低:目前的实验,来自"容易学"的任务;将来,要处理"难"的任务(没有客观的结果,可以学习),收益,会小得多:TFP,不超过 0.53%,GDP,不超过约 0.9%。
- 第三部分:敏感性:任务的份额,和成本节省,各翻一倍,结果,翻 4 倍,也只是 2.66%。结论,对输入,很敏感;他的数,是一个比较保守的、有明确假设的估算,不是预言。
这个估算,有两个重要的前提:(1)AI 的作用,只是节省现有任务的成本;它不包括,AI,创造新任务、新产品、新科学发现(那是"恢复效应"和"增长",Acemoglu 自己,也承认,“新任务,可以显著提高生产率”,但是,其中一部分,可能,没有社会价值,比如,操纵性的内容);(2)被影响的任务的份额,用的是2023–2024 年的暴露度和采用情况,是会变的。
5.2 数据,怎么说
美国劳动生产率(非农商业部门,每小时的产出),按时期,年均的增速(美国劳工统计局,美联储圣路易斯分行 FRED):
# 真实数据:美国。来源:美联储圣路易斯分行 FRED(数据来自美国劳工统计局),2026 年 10 月下载。
# 一、非农商业部门的劳动生产率(每小时产出的指数,OPHNFB):只放每个时期的起点和终点的季度值。
OPHNFB = {"1947Q1": 22.256, "1973Q1": 46.272, "1995Q1": 62.642, "2004Q1": 81.825, "2019Q4": 105.103, "2022Q4": 110.047, "2026Q2": 120.017}
def years(a, b):
    return (int(b[:4]) - int(a[:4])) + (int(b[-1]) - int(a[-1])) / 4
def growth(a, b):
    return (OPHNFB[b] / OPHNFB[a]) ** (1 / years(a, b)) - 1
print("一、劳动生产率,年均增速(按时期):")
for a, b, name in (("1947Q1", "1973Q1", "战后到 1973 年"), ("1973Q1", "1995Q1", "1973 到 1995 年('生产率下降')"), ("1995Q1", "2004Q1", "1995 到 2004 年(互联网和 IT 的投资热)"),
                   ("2004Q1", "2019Q4", "2004 到疫情前"), ("2019Q4", "2022Q4", "疫情,到 ChatGPT 发布前后"), ("2022Q4", "2026Q2", "ChatGPT 发布以来(2022Q4–2026Q2)")):
    print(f"   {a} 到 {b}:{100 * growth(a, b):.2f}%  {name}")
# 二、总就业(PAYEMS,千人,季节调整):ChatGPT 发布(2022 年 11 月 30 日)前后的各 3 年零 10 个月。
PAYEMS = {"2015-11": 142808, "2019-09": 151365, "2022-11": 154242, "2026-09": 159044}
for a, b, name in (("2015-11", "2019-09", "疫情前的 3 年零 10 个月"), ("2022-11", "2026-09", "ChatGPT 发布以来")):
    print(f"二、总就业,{a} 到 {b}({name}):{PAYEMS[a]:,} -> {PAYEMS[b]:,} 千人,增长 {PAYEMS[b] / PAYEMS[a] - 1:.1%}")
# 三、失业率(月度数据的年内平均,%):总体(UNRATE)、20–24 岁(LNS14024887)、25–34 岁(LNS14000089)。
# 2025 年缺 10 月(那个月,联邦政府停摆,家庭调查没有数据),2026 年是 1–9 月。
UNEMP = {2015: (5.27, 11.62, 5.50), 2016: (4.88, 10.43, 5.06), 2017: (4.36, 9.24, 4.57), 2018: (3.89, 8.60, 3.96), 2019: (3.68, 8.39, 3.72),
         2020: (8.10, 15.17, 8.47), 2021: (5.35, 9.72, 5.71), 2022: (3.65, 8.11, 3.88), 2023: (3.62, 7.93, 3.93), 2024: (4.02, 8.94, 4.27),
         2025: (4.26, 9.95, 4.31), 2026: (4.24, 9.17, 4.64)}
print("三、年度失业率(%):")
for y, (u, a, b) in UNEMP.items():
    print(f"   {y} 年:总体 {u:.2f},20–24 岁 {a:5.2f},25–34 岁 {b:.2f};20–24 岁比总体高 {a - u:.2f} 个百分点")
print(f"   2022 到 2025 年:20–24 岁,比总体,高出的幅度,从 {UNEMP[2022][1] - UNEMP[2022][0]:.2f} 到 {UNEMP[2025][1] - UNEMP[2025][0]:.2f},再到 2026 年的 {UNEMP[2026][1] - UNEMP[2026][0]:.2f}(个百分点)")
输出:
一、劳动生产率,年均增速(按时期):
   1947Q1 到 1973Q1:2.86%  战后到 1973 年
   1973Q1 到 1995Q1:1.39%  1973 到 1995 年('生产率下降')
   1995Q1 到 2004Q1:3.01%  1995 到 2004 年(互联网和 IT 的投资热)
   2004Q1 到 2019Q4:1.60%  2004 到疫情前
   2019Q4 到 2022Q4:1.54%  疫情,到 ChatGPT 发布前后
   2022Q4 到 2026Q2:2.51%  ChatGPT 发布以来(2022Q4–2026Q2)
二、总就业,2015-11 到 2019-09(疫情前的 3 年零 10 个月):142,808 -> 151,365 千人,增长 6.0%
二、总就业,2022-11 到 2026-09(ChatGPT 发布以来):154,242 -> 159,044 千人,增长 3.1%
三、年度失业率(%):
   2015 年:总体 5.27,20–24 岁 11.62,25–34 岁 5.50;20–24 岁比总体高 6.35 个百分点
   2016 年:总体 4.88,20–24 岁 10.43,25–34 岁 5.06;20–24 岁比总体高 5.55 个百分点
   2017 年:总体 4.36,20–24 岁  9.24,25–34 岁 4.57;20–24 岁比总体高 4.88 个百分点
   2018 年:总体 3.89,20–24 岁  8.60,25–34 岁 3.96;20–24 岁比总体高 4.71 个百分点
   2019 年:总体 3.68,20–24 岁  8.39,25–34 岁 3.72;20–24 岁比总体高 4.71 个百分点
   2020 年:总体 8.10,20–24 岁 15.17,25–34 岁 8.47;20–24 岁比总体高 7.07 个百分点
   2021 年:总体 5.35,20–24 岁  9.72,25–34 岁 5.71;20–24 岁比总体高 4.37 个百分点
   2022 年:总体 3.65,20–24 岁  8.11,25–34 岁 3.88;20–24 岁比总体高 4.46 个百分点
   2023 年:总体 3.62,20–24 岁  7.93,25–34 岁 3.93;20–24 岁比总体高 4.31 个百分点
   2024 年:总体 4.02,20–24 岁  8.94,25–34 岁 4.27;20–24 岁比总体高 4.92 个百分点
   2025 年:总体 4.26,20–24 岁  9.95,25–34 岁 4.31;20–24 岁比总体高 5.69 个百分点
   2026 年:总体 4.24,20–24 岁  9.17,25–34 岁 4.64;20–24 岁比总体高 4.93 个百分点
   2022 到 2025 年:20–24 岁,比总体,高出的幅度,从 4.46 到 5.69,再到 2026 年的 4.93(个百分点)
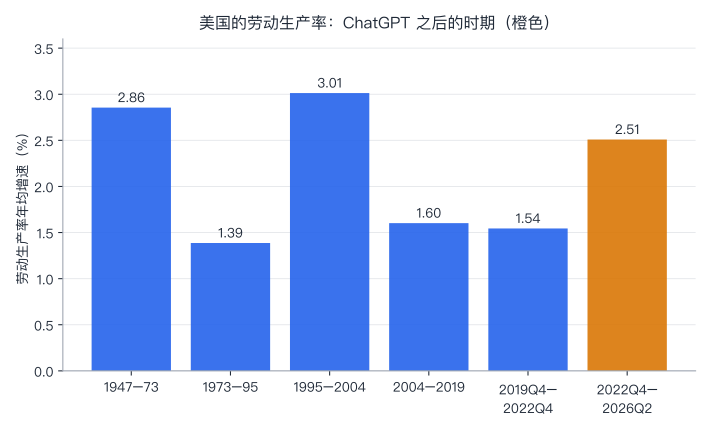
逐段看(先看第一、二部分):
- 第一部分:生产率。2022 年第四季度到 2026 年第二季度,年均增速,2.51%,高于 2004 到 2019 年的 1.60%(高出约 0.9 个百分点),接近 1995 到 2004 年的 3.01%(互联网和 IT 的投资热的时期)。劳工统计局,也给出:2025 年,年均,+2.1%,2026 年第二季度,同比,+2.2%。
- 总就业:2022 年 11 月到 2026 年 9 月,增长 3.1%;疫情前,对应的 3 年零 10 个月,增长 6.0%。就业的增长,慢了,但是,没有下降:没有"广泛的、总量上的失业"。(疫情后的恢复,劳动力供给,利率,都在里面,不能,全归给 AI。)
怎么读?
- 时间上,和 AI 吻合,不等于是 AI:疫情后的资源重新配置、劳动力构成的变化、商业周期、别的技术,都在里面。Acemoglu 的估算,AI 的贡献,每年,约 0.07 个百分点,而数据里,比 2004–2019 年,高出约 0.9 个百分点:两者,差了一个数量级;要么,别的因素,是大头,要么,AI 的实际效应,比他的估算,大得多。数据,现在,分不开。
- 一个"悖论":Robert Solow 在 1987 年,说过一句很有名的话(大意):你到处,都能看到计算机时代,除了,生产率的统计里。Brynjolfsson、Rock 和 Syverson 2021 年(American Economic Journal: Macroeconomics,13 卷 1 期,333–372 页)提出了**“生产率的 J 曲线”:通用技术,需要大量的、没有被测量的无形投资(流程重组、培训),所以,早期,生产率,被低估**;等到收获期,又可能被高估。按这个故事,AI 的生产率,要等几年。Brynjolfsson,自己,据报道,认为,2025 年的生产率,提高,是"收获期"开始的迹象,同时,也说,需要更多时期,才能确认。这是一个有争议的解释:它,不容易被证伪(因为,“还没到收获期”,总是可以,说)。
- 宏观数据,是总体的:看不出,谁,得到了好处,谁,受了损失。下面,看这一点。
六、一个有争议的问题:AI,是不是正在拿走年轻人的工作
按"理论预测 → 证据与局限 → 分歧在哪 → 价值判断留给读者"来写。
理论预测什么:
- AI,替代初级工作:初级的工作,常常,是有明确规则的、可检查的任务(整理资料、起草文件、写基础的代码):这正是 AI,擅长的。公司,可能,少招新人(第一节);
- AI,让新人更快上手(第四节:新手,得益更大):这可能,降低,对经验的要求,反而,增加对新人的需求;
- 别的因素:远程办公,让带新人更难;利率上升,让企业,缩减招聘;科技行业,疫情期间,过度招聘,等等。
证据怎么说(美国):
- Brynjolfsson、Chandar 和 Chen(斯坦福,“煤矿里的金丝雀”,2026 年 8 月更新,用 ADP 的薪资数据,覆盖数百万工人,到 2026 年 6 月):(1)没有,广泛的、整体的失业;(2)22–25 岁、在AI 暴露的职业里的就业,比"如果,和不太暴露的同龄人,保持同样的速度",低了 19%;有经验的工人,没有类似的缺口;(3)2022 年 11 月到 2026 年 6 月,22–25 岁,在最暴露的两个五分位里,减少了约 11%;在最不暴露的三个五分位里,增加了约 10%;(4)主要,通过少招新人,不是更多地裁员;(5)下降,集中在,AI 的使用,替代人的任务的职业里;在 AI 辅助人的职业里,就业,持平,或者上升;(6)调整,发生在就业上,不是基础工资上。他们,自己强调:这是描述性的、早期的指标,不是因果估计;缺口,在控制教育后,会减弱;在 2022 年之前,有一些,已经分开的趋势;在 ADP 的样本里,比在全国调查里,更明显。
- Yale 预算实验室(持续更新,2026 年 9 月,用到 2026 年 8 月的 CPS 数据):没有,清楚的证据,表明,劳动力市场的职业结构,在以和 AI 相符的方式,变化;流动、暴露的失业者的比例,都在历史范围内;他们,也提醒,这可能,随新数据,而变。
- Humlum 和 Vestergaard(丹麦,NBER 工作论文 33777):用丹麦的行政数据,加上采用情况的调查(11 个暴露的职业,约 2.5 万名工人),发现,聊天机器人的采用,对收入和工时,没有明显的影响,排除了两年后,大于 2% 的平均影响;节省的时间,约 3%,也部分,被新的工作(整合、监督),抵消。
- Frank 等人(预印本,2026 年 1 月):用失业保险记录和 LinkedIn 数据,发现,暴露的职业里,失业的风险,从 2022 年初,就开始上升,比 ChatGPT 发布(2022 年底),早几个月;2021 届以后的毕业生,进入暴露的职业的比例,也更低,差距,在 2022 年底之前,就出现了。他们的结论:这些趋势的力量,早于生成式 AI。
- 纽约联储(Emanuel、Harrington 和 Pallais,2026 年 6 月):用 CPS 数据,估计,远程办公,大致,可以解释,疫情以来,年轻大学毕业生失业上升的 64%(他们,自己说,这是"信封背面"的估算);理由是,远程,让带新人、给反馈,更难;他们,也说,AI 和别的因素,将来,可能,对年轻人,更重要。纽约联储,同期的统计:最近的大学毕业生,失业率,约 5.6% 到 5.7%(2026 年上半年),而全体工人,是 4.2%;这些毕业生的"就业不足",约 42%。
- 芝加哥联储(据报道):2019 到 2024 年,在最暴露于 AI 的职业里,就业,增加了约 4%;它,强调,暴露度,不直接对应失业。
我们自己的数据(代码 4 的第三部分):
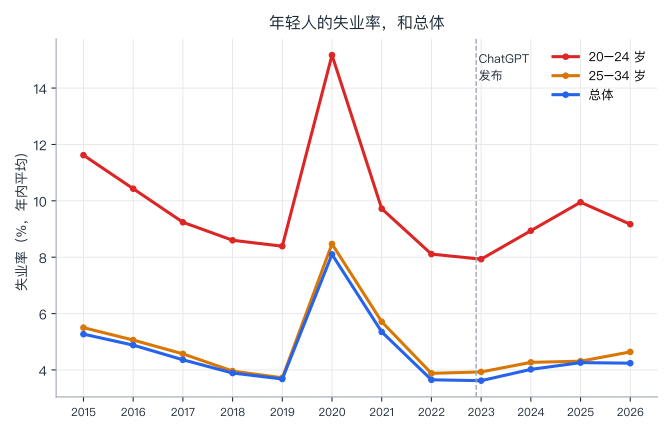
- 20–24 岁的失业率,比总体,高出的幅度,2022 年,是 4.46 个百分点;2025 年,5.69(2025 年,缺 10 月的数据:联邦政府停摆,家庭调查,没有做);2026 年(1–9 月),4.93。2023 到 2025 年,扩大了;2026 年,又缩小了一些。 25–34 岁,也,从 2023 年的 3.93%,升到 2026 年的 4.64%。
- 注意:20–24 岁,包括没有大学学历的、在校的;它,不是"大学毕业生";而总体,失业率,也在升(2023 年 3.62%,2026 年 4.24%)。这些,不能,区分,AI、远程办公、利率,和别的因素。
这个"19%",能不能归给 AI?看代码 5:
# "没有 AI 的话,会怎样"(反事实):怎么影响,我们对 AI 的效应的判断。
# Brynjolfsson 等人(2026 年 8 月):2022 年 11 月到 2026 年 6 月,22–25 岁的人,在最暴露于 AI 的两个五分位的职业里,就业下降约 11%;在最不暴露的三个五分位里,增长约 10%。
import math
exposed, others = 0.89, 1.10
shortfall = 1 - exposed / others
log_gap = math.log(exposed / others)
T = 3 + 7 / 12                                   # 2022 年 11 月 到 2026 年 6 月,约 3.6 年
print(f"一、'没有跟上同龄的、不暴露的人'的缺口 = 1 - {exposed} ÷ {others} = {shortfall:.1%};取对数:{log_gap:.3f};时间跨度 {T:.2f} 年")
print("二、这个缺口,有多少,能归给 AI?取决于,你假设,'如果没有 AI,暴露组的就业,本来,会比对照组,每年慢多少'(对数点,约等于百分点):")
for slow in (0, 1, 2, 3, 4):
    non_ai = -slow / 100 * T
    ai = log_gap - non_ai
    print(f"   没有 AI 时,本来,每年慢 {slow} 个点:非 AI 的部分 {100 * non_ai:6.1f},AI 的部分 {100 * ai:6.1f}(占缺口的 {ai / log_gap:5.1%})")
print("三、同样的 19%,可以对应,几乎全部是 AI,也可以对应,主要不是 AI:数据,本身,不能区分;要靠别的证据:")
print("   (a)缺口,是不是在 2022 年 11 月之前,就已经出现(正文里,提到的 Frank 等人的研究,认为:暴露的职业里,失业风险,从 2022 年初,就已经上升);")
print("   (b)它,是不是,集中在'AI 替代'的职业里,而不是'AI 辅助'的职业里(Brynjolfsson 等人,认为是);")
print("   (c)换一种,度量 AI 暴露度的办法,结论,是否不变;控制了远程办公、利率敏感度、教育之后,是否还在(他们报告:控制了远程办公和利率敏感度,缺口还在;控制教育,缺口会减弱)。")
输出:
一、'没有跟上同龄的、不暴露的人'的缺口 = 1 - 0.89 ÷ 1.1 = 19.1%;取对数:-0.212;时间跨度 3.58 年
二、这个缺口,有多少,能归给 AI?取决于,你假设,'如果没有 AI,暴露组的就业,本来,会比对照组,每年慢多少'(对数点,约等于百分点):
   没有 AI 时,本来,每年慢 0 个点:非 AI 的部分    0.0,AI 的部分  -21.2(占缺口的 100.0%)
   没有 AI 时,本来,每年慢 1 个点:非 AI 的部分   -3.6,AI 的部分  -17.6(占缺口的 83.1%)
   没有 AI 时,本来,每年慢 2 个点:非 AI 的部分   -7.2,AI 的部分  -14.0(占缺口的 66.2%)
   没有 AI 时,本来,每年慢 3 个点:非 AI 的部分  -10.8,AI 的部分  -10.4(占缺口的 49.3%)
   没有 AI 时,本来,每年慢 4 个点:非 AI 的部分  -14.3,AI 的部分   -6.9(占缺口的 32.3%)
三、同样的 19%,可以对应,几乎全部是 AI,也可以对应,主要不是 AI:数据,本身,不能区分;要靠别的证据:
   (a)缺口,是不是在 2022 年 11 月之前,就已经出现(正文里,提到的 Frank 等人的研究,认为:暴露的职业里,失业风险,从 2022 年初,就已经上升);
   (b)它,是不是,集中在'AI 替代'的职业里,而不是'AI 辅助'的职业里(Brynjolfsson 等人,认为是);
   (c)换一种,度量 AI 暴露度的办法,结论,是否不变;控制了远程办公、利率敏感度、教育之后,是否还在(他们报告:控制了远程办公和利率敏感度,缺口还在;控制教育,缺口会减弱)。
逐段看:
- 19.1% 的缺口(对数,−0.212),要拆成两部分:如果,没有 AI,本来也会有的部分,和AI 的部分。拆多少,取决于,你,对"没有 AI 时,会怎样"的假设,而它,看不见。
- 如果,没有 AI,本来,暴露组,也不会,比对照组慢(0):AI,解释 100%;如果,本来,每年,慢 2 个点:AI,解释约 66%;每年,慢 4 个点:约 32%。同样的数据,可以,支持"几乎都是 AI",也可以,支持"AI,占不到一半"。
- 这是第 4 讲,讲过的"平行趋势":双重差分,需要,两组人,在没有处理时,趋势,是平行的。Brynjolfsson 等人,自己,说了:有一些,早于 AI 的分开的趋势;所以,他们,把这些,当作描述。
局限:(1)暴露度,是度量出来的:不同的度量,结论,可能,不同;(2)ADP 的样本,不是随机的;(3)因果,难:AI、远程、利率、行业周期,同时发生;(4)时间还短:3 年多;企业,还在学习怎样用 AI;(5)这些,都是美国的数据。
分歧在哪:
- 事实上的分歧:缺口,有多大,是不是,被 AI 造成;是已经出现的变化,还是更早就开始的趋势;AI,是替代,还是辅助,对不同的人群,影响,是否不同。
- 预测上的分歧:现在的 AI,会不会,快速变强(那么,今天的证据,低估了);还是,会遇到瓶颈(那么,今天的证据,高估了)。这是对未来的判断,数据,证明不了,也证伪不了。
价值判断(留给你):
- 谁,该承担过渡期的代价:刚毕业的人,错过了"第一份工作",可能,影响长期的收入(第 13 讲、第 29 讲:人力资本,和经验的价值)。该,由他们自己、企业、学校,还是政府,来承担?
- 要不要,保护初级岗位:可以,通过政策,鼓励企业,雇新人,但是,这有成本(第 9 讲)。你怎么看?
- 要不要,放慢 AI 的采用:如果,过渡期的痛苦,集中在某些人,社会,是该,放慢,还是,加快、再补偿?
七、中国:几个事实
这一节,只说事实。中国,在这个问题上的严格的研究,还很少;下面,是我能查到的。
- 青年的失业率(国家统计局,2026 年 8 月,不含在校生):16–24 岁,18.9%,比上月,高 1 个百分点,与上年同期持平(统计局,2024 年起,按"不含在校生"的新口径,公布以来,最高的水平);25–29 岁,7.5%;30–59 岁,3.9%;全国城镇调查失业率,5.3%。统计局的发言人,解释,8 月的上升,主要来自应届毕业生,集中进入劳动力市场的季节性因素。据媒体,2026 届毕业生,约 1270 万人(我没有在教育部的原始发布里,核实)。这些数字,和 AI,有没有关系,我没有找到可靠的证据:青年失业率,在 2023 年,就是一个争论的话题(第 27 讲,口径,也在变)。
- 政策:2025 年 8 月,国务院,印发《关于深入实施"人工智能+“行动的意见》,提出,到 2027 年,新一代智能终端、智能体等的应用普及率,超过 70%,到 2030 年,超过 90%(据报道;“应用普及率”,是官方的指标)。我没有找到,这份文件,有具体的就业目标。
- 企业,采用得有多快:世界银行,和北京大学的研究者(2026 年 7 月,为《2026 年世界发展报告》写的背景论文):用 7200 万条招聘广告,追踪 2015 到 2025 年,5000 多家上市公司,和约 250 万家非上市公司:到 2025 年底,21% 的上市公司,0.2% 的非上市公司,招聘过,和生成式 AI 相关的岗位;DeepSeek-R1 发布之后,采用,加速;大公司、技术先进的公司,采用得更多。注意:这个指标,是"招聘广告里,出现 AI 的技能”,是采用的一个代理变量,不是全部。
- 招聘广告的研究(多为预印本,没有经过同行评审):用智联招聘的约 163 万条广告,构造了一个 AI 暴露度,发现,暴露度越高的职业,对初级求职者的门槛越高;另一些,用 2018–2024 年的广告,发现,对高暴露职业的需求下降。广告,衡量的是"招聘需求",不是裁员,也不是个人的职业路径;暴露度,常常,是用美国的任务描述构造的。
- 我没有找到:一个严格的、追踪中国年轻工人就业的、同行评审的研究;所以,“AI 在中国,正在取代年轻人的工作”,现在,既没有被证实,也没有被证伪。你可以问:要判断,我会想看什么数据?(提示:分行业、分职业、分年龄的就业;招聘广告里,初级岗位的数量和要求;毕业生的去向和起薪;企业,实际使用 AI 的程度;以及,对照,没有 AI 的同类趋势。)
八、谁受益:生产率,和分配
即使,总的生产率,提高了,好处,怎么分,是另一个问题。
- 劳动份额,和资本份额(本讲 2.1 节):自动化,降低劳动份额。Acemoglu 2024 年的论文,认为,AI,预计会扩大资本收入,和劳动收入之间的差距(据摘要)。
- 个人之间:第四节的实验,发现,新手、能力弱的人,进步更大:同一个职业,内部,差距,可能,缩小;但是,AI,更多的好处,可能,归拥有 AI 的企业,和有能力监督、整合 AI 的人。我没有找到,足够可靠的、关于"总的收入分配"的证据。
- 地区和国家之间:谁有算力、谁有数据、谁有人才。(第 42 讲,发展和不平等。)
政策工具(每一种,都有代价,第 9、26、34 讲):
| 工具 | 想解决什么 | 要问的问题 |
|---|---|---|
| 教育和再培训 | 让人,适应新任务 | 培训,有没有用?(证据,不一致);谁出钱? |
| 失业保险、社保 | 缓冲过渡的痛苦 | 钱,从哪来?对工作的激励? |
| 对资本、对劳动的税制 | 让技术的选择,不被税制扭曲 | 谁,该多交税?会不会,减少投资? |
| 对 AI 的监管 | 避免有害的使用 | 谁来定规则?会不会,限制有益的使用? |
| 鼓励"新任务" | 恢复效应 | 政府,知道,哪些是新任务吗?(第 26 讲:政府失灵) |
经济学,能告诉你:每一种工具,改变了谁的激励,成本,落在谁身上。选哪一种,是价值判断。
九、局限、常见误用
9.1 局限
- 时间太短:生成式 AI,才三年多;企业,还在学习怎样用它;
- 证据,大多数是工作论文、预印本,没有经过同行评审;结论,会变;
- 暴露度,是度量出来的;不同的度量,结论,不同;
- 因果,难:AI,和远程办公、利率、行业周期、政策,同时发生(第 4 讲);
- 玩具模型:2.1 节的模型,是示意的,参数,是编的;
- 没有讲:AI 对教育的影响、对垄断和竞争的影响(第 14、17 讲)、对不同职业的详细分析、AI 的风险和安全、版权、AI 在科学发现里的作用;
- 不是预测,不是职业建议。
9.2 常见的误用
| 误用 | 正确的想法 |
|---|---|
| “AI 提高了 X% 的效率,所以会少雇 X% 的人” | 取决于需求的弹性,和人工的成本占比(第一节) |
| “暴露度高,就是会被替代” | 暴露,只说明,AI 能碰到这些任务;可能,是辅助 |
| “实验里快了 40%,整个经济,也会快 40%” | 个人,不等于企业,更不等于经济;任务,是被挑选的;加总,要看份额 |
| “某个研究,找到了差距,所以是 AI 造成的” | 要问,没有 AI,会怎样(反事实);看 5 节的代码 5 |
| “总就业没降,所以没有影响” | 影响,可能,集中在某些人(年轻人、某些职业) |
| “年轻人失业率高,所以是 AI” | 远程办公、利率、周期,也有;要比较、要控制 |
| “生产率没提高,所以 AI 没用” | J 曲线:早期,可能,被低估;也有,别的解释 |
| “AI 一定带来繁荣” 或者 “一定带来失业” | 取决于,替代、生产率、新任务的相对大小;历史上,没有保证 |
十、小结
这一讲有七个想法,请带走:
- “让人快 40%",对就业,没有统一的答案:需求弹性,和人工的成本占比,决定了,就业,是减少、不变,还是增加;
- 任务模型:替代、生产率、恢复三种效应;“so-so 自动化”,可以,压低工资;新任务,可以让工资回来;
- 暴露,不等于替代:大约 80% 的工人,至少 10% 的任务,暴露;
- 个人的实验:在 AI 能做的任务上,快 12% 到 40%,新手,得益更大;在边界之外,会更糟;有经验的开发者,在 2025 年的一项实验里,慢了 19%(后续,不确定);
- 宏观:Acemoglu 的估算:10 年,TFP,不超过 0.66%(调整后 0.53%);而美国的生产率,2022 年底以来,年均 2.51%,高于 2004–2019 年的 1.60%:时间吻合,不等于因果;
- 年轻人:Brynjolfsson 等人,发现,19% 的缺口;Yale、Humlum–Vestergaard、纽约联储,Frank 等人,给出了不同的、或者更早的解释;缺口,能归给 AI 多少,取决于一个看不见的反事实;
- 中国:青年失业率 18.9%(2026 年 8 月,不含在校生);企业的 GenAI 采用,还很低(非上市公司 0.2%);严格的研究,很少。事实,我用数据;价值,留给你。
AI,是一项新技术怎样改变劳动的故事;下一讲,换一个,新技术,改变货币的故事:稳定币。 下一讲:第 47 讲:稳定币。
思考题
1. 用第一节的公式:人工时,减少 50%,人工,占成本的 60%,需求的弹性,是 1.5。所需的人工时,变成原来的多少倍?
提示:价格,降 0.5 × 0.6 = 30%:P = 0.7;产量 = 0.7^(−1.5) ≈ 1.71 倍;人工时 = 1.71 × 0.5 ≈ 0.85 倍,少了约 15%。如果弹性,是 2:0.7^(−2) = 2.04;× 0.5 = 1.02,几乎不变。
2. 为什么,2.1 节的玩具里,“AI 只比人好一点”(psi = 2),自动化到 60% 时,产出,几乎没有增加,工资,却降到 57?
提示:自动化,把原来,由人做的任务,转给了 AI,但是,AI,并没有,比人好很多:产出,没有明显增加;而被自动化的那部分任务,不再付工资:劳动份额,从 70% 降到 40%。同样的总产出,分给劳动的少了,工资(劳动的总收入 ÷ 工人)就降了。这是"so-so 自动化”。
3. 用 Acemoglu 的算术:如果被影响的任务份额,不是 4.6%,而是 10%,成本节省还是 14.4%:10 年的 TFP,提高多少?GDP,大约,提高多少(资本份额,0.4)?
提示:TFP = 0.10 × 0.144 = 1.44%;GDP ≈ 1.44% ÷ 0.6 = 2.4%。仍然,小于,2022 年底以来,生产率,高于 2004–2019 年的部分的累计(约 0.9 个百分点,每年,乘以 3.6 年,约 3.3%):这说明,数据里,大部分,可能,不是(这一类)AI,或者,AI 的效应,比他的估算大。不能,下结论。
4. 用代码 5:如果,没有 AI,暴露组本来,每年,比对照组,慢 1.5 个点,那么,19.1% 的缺口里,AI 的部分,占多少?
提示:T = 3.58 年:非 AI 的部分 = −1.5 × 3.58 ≈ −5.4(对数点,约 %);缺口,−21.2:AI 的部分 = −15.8,占 74.6%。如果,每年,慢 3 个点,占 49.3%。所以,要报告一个"AI 的份额",必须,先说清,你对"没有 AI,会怎样"的假设。
5. (开放题)下面的说法,哪些是事实问题,哪些是价值判断?(a)2022 年 11 月以来,22–25 岁的人,在最暴露的职业里的就业,减少了 11%;(b)政府,应该保护初级岗位;(c)远程办公,解释了年轻人失业上升的 64%;(d)AI,会造成大规模失业;(e)企业,有责任培训新人。
提示:(a)事实(Brynjolfsson 等人的数据,描述性的);(b)价值判断;(c)事实问题,但是,是"信封背面"的估算,不是严格的因果;(d)对未来的预测:它不是价值判断,但是,现有的数据,既不能证实,也不能证伪;(e)价值判断。
参考与延伸
- Autor, D. H., Levy, F., & Murnane, R. J. (2003). The Skill Content of Recent Technological Change: An Empirical Exploration. Quarterly Journal of Economics, 118(4), 1279–1333.
- Acemoglu, D., & Restrepo, P. (2018). The Race between Man and Machine: Implications of Technology for Growth, Factor Shares, and Employment. American Economic Review, 108(6), 1488–1542.
- Acemoglu, D., & Restrepo, P. (2019). Automation and New Tasks: How Technology Displaces and Reinstates Labor. Journal of Economic Perspectives, 33(2), 3–30.
- Acemoglu, D. (2024/2025). The Simple Macroeconomics of AI. NBER Working Paper 32487;Economic Policy, 40(121), 13–58(本讲的数,来自 2024 年 5 月的版本)。
- Eloundou, T., Manning, S., Mishkin, P., & Rock, D. GPTs are GPTs: An Early Look at the Labor Market Impact Potential of Large Language Models(预印本,据摘要)。
- Noy, S., & Zhang, W. (2023). Experimental Evidence on the Productivity Effects of Generative Artificial Intelligence. Science, 381.
- Brynjolfsson, E., Li, D., & Raymond, L. (2025). Generative AI at Work. Quarterly Journal of Economics, 140(2).
- Dell’Acqua, F., et al. (2023). Navigating the Jagged Technological Frontier: Field Experimental Evidence of the Effects of AI on Knowledge Worker Productivity and Quality. Harvard Business School Working Paper(后来发表于 Organization Science,据转述)。
- METR (2025). Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity(2025 年 7 月;2026 年 2 月的后续,据报道)。
- Brynjolfsson, E., Rock, D., & Syverson, C. (2021). The Productivity J-Curve: How Intangibles Complement General Purpose Technologies. American Economic Journal: Macroeconomics, 13(1), 333–372.
- Brynjolfsson, E., Chandar, B., & Chen, R. (2026, August). Canaries in the Coal Mine? Six Facts about the Recent Employment Effects of Artificial Intelligence. Stanford Digital Economy Lab.
- Yale Budget Lab. Tracking the Impact of AI on the Labor Market(2026 年 9 月更新)。
- Humlum, A., & Vestergaard, E. (2025). Large Language Models, Small Labor Market Effects. NBER Working Paper 33777。
- Frank, M. R., Javadian Sabet, A., Simon, L., Bana, S. H., & Yu, R. (2026). AI-exposed Jobs Deteriorated before ChatGPT. arXiv:2601.02554。
- Emanuel, N., Harrington, E., & Pallais, A. (2026, June). Remote Work Leaves Younger Workers Sidelined. Federal Reserve Bank of New York, Liberty Street Economics;纽约联储:最近的大学毕业生的劳动力市场(2026 年第一、二季度)。
- 美国劳工统计局,美联储圣路易斯分行 FRED:OPHNFB(劳动生产率)、PAYEMS、UNRATE、LNS14024887、LNS14000089(本讲的数据,2026 年 10 月下载);劳工统计局:生产率和成本(2025 年全年,2026 年第二季度)。
- 国家统计局:2026 年 8 月分年龄组失业率(2026 年 9 月 17 日,据报道);国务院:《关于深入实施"人工智能+“行动的意见》(2025 年 8 月,据报道)。
- Li, L., Liu, Z., Wang, A., Wang, H., & Yu, S. (2026, July). Now Hiring: Firm-Level Adoption of Generative AI in China. 世界银行,《2026 年世界发展报告》背景论文。
- 本讲第一节、2.1 节和 5.1 节的模型和算术,参数是示意的(5.1 节,用的是 Acemoglu 论文里的输入);5.2 节和第六节的数据,来自美国劳工统计局和 FRED。