这是第六个实验。第 22 讲给了两个干净的结论:二价拍卖里,说真话是占优策略;一价拍卖里,n 个竞拍者的估值在 0 到 1 之间均匀分布时,均衡的出价是 (n − 1) ÷ n 乘以估值。 公式很漂亮,但它有一个我们没追问的前提:竞拍者已经知道这个公式,或者说,已经"在均衡上"了。
现实里没有人会先解出均衡,再去出价。这个实验要做的,是不告诉竞拍者公式,让他们:
- 反复对别人当前的出价,做最好反应,看会不会走到公式;
- 或者只靠试错,一点一点地调整出价,看一价和二价拍卖里,学得一样快、一样准吗?
然后,再看三个第 22 讲的公式没有覆盖的情形:竞拍者强弱不同,价值是共同的,以及多请一个人,对比最优的保留价。
怎么用:和前面的实验一样,代码块是接着往下写的:后面的块会用到前面块里定义的东西。把它们依次拼成一个文件(比如 lab75.py),用 python lab75.py 运行,约 20 秒;也可以一段一段地在 Python 里依次运行。只需要 Python 3 和 NumPy。实验里有随机数,但种子都固定了,所以你跑出来的数字,会和下面的输出一模一样。
一、五个问题
先停一下:请先凭直觉,回答下面五个问题,写下来。
问题 1: 一价拍卖,竞拍者不知道均衡公式,一开始都"说真话"(出价 = 估值)。然后大家反复做同一件事:假设别人都按现在的出价方式出价,我最好怎么出价?这个过程,会走到 (n − 1) ÷ n 吗?
问题 2: 如果竞拍者连"期望"都不会算,只会试错:把出价的比例调高一点、调低一点,看哪个赚得多,就往哪个方向走。一价和二价拍卖里,他们学得一样快、一样准吗?
问题 3: 两个竞拍者,一个"弱"(估值在 0 到 1 之间),一个"强"(估值在 0 到 2 之间)。一价拍卖和二价拍卖,哪个让卖家收入更高?哪个更容易把东西给估值最高的人?
问题 4: 价值是共同的(比如油田),每个人只有一个带误差的估计。均衡的时候,一价拍卖里该压多少价?一价和二价,哪个卖家收入高?
问题 5: 卖家有两个选择:花力气设计最优的保留价,或者什么也不设,只是多请一个竞拍者。哪个更值钱?
我们会一个一个回来。
二、实验的设计
2.1 拍卖
- 一件东西,n 个竞拍者,各自独立,估值都在 0 到 1 之间均匀分布(第三步、第四步会换),卖家自己对东西的估值是 0。
- 一价拍卖:出价最高的赢,付自己的出价。二价拍卖:出价最高的赢,付第二高的出价。
2.2 一个竞拍者的"策略"是什么
是一个出价函数 b(v):估值是 v 的时候,出价多少。我们用 401 个格子表示估值和出价。
手抖:在第一步里,我们让每个人的出价,带一点点随机的小误差(很小,约 0.01)。这是一个数值技巧:如果不这样,很多人在同一个价格上,打成平局,反复做最好反应的过程就会卡在原地。有一点点手抖,别人的出价就有了平滑的分布,平局不会卡住。代价是,算出来的均衡,会和公式差一点点。
2.3 “最好反应"迭代
每一轮:假设别人都用上一轮的出价函数,对每一个估值 v,算出让期望好处最大的出价,大家都朝它改一小步。这和第 18 讲的"最佳反应”、实验 72 里摊主"对眼前做最好反应",是同一件事。(实验 72 里,同时调整、企业多的时候,会不收敛;这里也要小心:只改一小步(10%),才收敛。)
三、第一步:不告诉公式,竞拍者能自己走到吗
import numpy as np

# n 个竞拍者,估值各自独立、在 0 到 1 之间均匀分布,最高出价者赢(只拍一件东西,卖家自己的估值是 0)。
# 一个竞拍者的「策略」,是一个出价函数 b(v):估值是 v 时,出价多少。我们用 401 个格子表示估值和出价。
K = 401
GRID = np.linspace(0, 1, K)                         # 估值的格子,也是出价的格子

TREMBLE = 0.01                                     # 每个人的出价,都有一点点小误差(手抖):这样别人的出价有一个平滑的分布,平局不会卡住迭代

def others_bid_cdf(beta, n):
    """其余 n-1 个人都按出价函数 beta 出价(再加一点点手抖)。返回 G(b):他们的出价「全都低于 b」的概率。
    一个人的出价低于 b 的概率 = 对他的估值(均匀分布)取平均的 P(beta(v) + 手抖 < b);手抖取 logistic 分布。"""
    def G(b):
        b = np.atleast_1d(b)
        one = (1 / (1 + np.exp(-(b[:, None] - beta[None, :]) / TREMBLE))).mean(axis=1)
        return one ** (n - 1)
    return G

def best_response_first_price(beta, n):
    """一价拍卖:别人都按 beta 出价时,估值为 v 的人,出价 b 的期望好处 = (v - b) × G(b)。对每个 v,在格子上找最好的 b。"""
    G = others_bid_cdf(beta, n)
    payoff = (GRID[:, None] - GRID[None, :]) * G(GRID)[None, :]    # 行:估值 v;列:出价 b
    payoff = np.where(GRID[None, :] <= GRID[:, None] + 1e-12, payoff, -np.inf)   # 不会出价高于自己的估值
    return GRID[np.argmax(payoff, axis=1)]

def payoff_second_price(beta, n):
    """二价拍卖:赢了,付的是别人的最高出价 m。返回矩阵(行:估值 v;列:出价 b):期望好处 = Σ_{m ≤ b} (v - m) × P(别人的最高出价落在 m 附近)。"""
    G = others_bid_cdf(beta, n)
    mass = np.diff(G(GRID), prepend=0.0)                           # 别人的最高出价落在每一格的概率
    return np.cumsum((GRID[:, None] - GRID[None, :]) * mass[None, :], axis=1)

def best_response_second_price(beta, n):
    return GRID[np.argmax(payoff_second_price(beta, n), axis=1)]

def iterate(best_response, start, n, rounds=300, damping=0.1):
    """从一个起点出发,反复:「假设别人都用上一轮的出价函数,我的最好反应是什么」,大家都往它的方向改一小步(damping = 0.1:只改 10%,免得来回摆)"""
    beta, path = start.copy(), [start.copy()]
    for _ in range(rounds):
        beta = (1 - damping) * beta + damping * best_response(beta, n)
        beta = np.maximum.accumulate(beta)                         # 出价函数保持递增
        path.append(beta.copy())
    return beta, path

# 一价拍卖:不告诉任何人公式,从「说真话」(b = v)出发,让大家反复调整,看会走到哪里
print("一价拍卖:从「说真话」出发,反复做最好反应。估值 0.8 的人的出价,和公式 (n-1)/n × 0.8:")
first = {}
for n in (2, 3, 5, 10):
    beta, path = iterate(best_response_first_price, GRID.copy(), n)
    first[n] = (beta, path)
    gap = np.abs(beta - (n - 1) / n * GRID)[GRID >= 0.2].max()
    print(f"  n={n:>2}:第 0、1、5、20、100、300 轮的出价 " + "、".join(f"{path[r][int(0.8 * (K - 1))]:.3f}" for r in (0, 1, 5, 20, 100, 300)) + f";公式 {(n - 1) / n * 0.8:.3f};估值 0.2 以上的各点,和公式的最大差距 {gap:.3f}")

# 换一个很不一样的起点:出价只有估值的 10%
beta, path = iterate(best_response_first_price, 0.1 * GRID, 5)
print(f"\n起点换成「出价 = 估值的 10%」(n=5):300 轮后,估值 0.8 的出价 {beta[int(0.8 * (K - 1))]:.3f}(公式 0.640)")

# 二价拍卖:不管别人怎么出价,说真话都是最好反应之一。检验:对别人的几种很不一样的出价方式,
# 算出每个估值 v 的「说真话的遗憾」= 最好的出价能得到的期望好处 - 说真话得到的期望好处
print("\n二价拍卖:说真话(b = v)的遗憾,对别人的各种出价方式(估值 0.2 以上的所有 v 里,最大的那个遗憾):")
rivals = {"出估值的一半": 0.5 * GRID, "出估值的 2 倍": 2.0 * GRID, "按一价拍卖的均衡压价": 0.8 * GRID, "出估值的平方": GRID ** 2, "出价永远是 0.3": np.full(K, 0.3) + 1e-9 * GRID}
for n in (2, 5):
    cells = []
    for name, other in rivals.items():
        pay = payoff_second_price(np.maximum.accumulate(other), n)
        regret = pay.max(axis=1) - pay[np.arange(K), np.arange(K)]
        cells.append(f"{name}:{regret[GRID >= 0.2].max():.5f}")
    print(f"  n={n}:" + ";".join(cells))
pay = payoff_second_price(0.5 * GRID, 2); v8 = int(0.8 * (K - 1))
print(f"\n再看一个具体的例子(n=2,对方出估值的一半,估值 0.8):出价 0.8 的期望好处 {pay[v8, v8]:.4f};出价 0.6 {pay[v8, int(0.6 * (K - 1))]:.4f};出价 0.4 {pay[v8, int(0.4 * (K - 1))]:.4f};出价 1.0 {pay[v8, K - 1]:.4f}")
输出:
一价拍卖:从「说真话」出发,反复做最好反应。估值 0.8 的人的出价,和公式 (n-1)/n × 0.8:
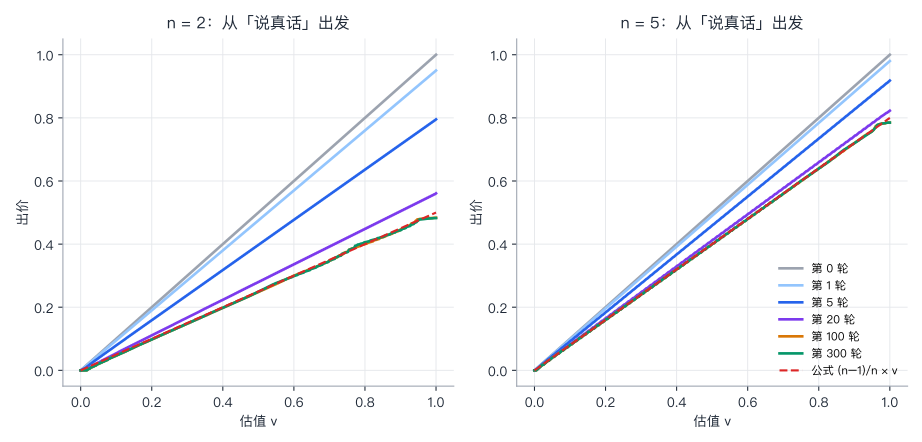
  n= 2:第 0、1、5、20、100、300 轮的出价 0.800、0.760、0.636、0.449、0.400、0.406;公式 0.400;估值 0.2 以上的各点,和公式的最大差距 0.018
  n= 3:第 0、1、5、20、100、300 轮的出价 0.800、0.773、0.690、0.565、0.531、0.531;公式 0.533;估值 0.2 以上的各点,和公式的最大差距 0.017
  n= 5:第 0、1、5、20、100、300 轮的出价 0.800、0.784、0.734、0.659、0.640、0.639;公式 0.640;估值 0.2 以上的各点,和公式的最大差距 0.015
  n=10:第 0、1、5、20、100、300 轮的出价 0.800、0.792、0.767、0.730、0.720、0.720;公式 0.720;估值 0.2 以上的各点,和公式的最大差距 0.012

起点换成「出价 = 估值的 10%」(n=5):300 轮后,估值 0.8 的出价 0.639(公式 0.640)

二价拍卖:说真话(b = v)的遗憾,对别人的各种出价方式(估值 0.2 以上的所有 v 里,最大的那个遗憾):
  n=2:出估值的一半:0.00000;出估值的 2 倍:0.00000;按一价拍卖的均衡压价:0.00000;出估值的平方:0.00000;出价永远是 0.3:0.00000
  n=5:出估值的一半:0.00000;出估值的 2 倍:0.00000;按一价拍卖的均衡压价:0.00000;出估值的平方:0.00000;出价永远是 0.3:0.00000

再看一个具体的例子(n=2,对方出估值的一半,估值 0.8):出价 0.8 的期望好处 0.5486;出价 0.6 0.5486;出价 0.4 0.4790;出价 1.0 0.5486
逐段看:
- 一价拍卖:走到了公式。 估值 0.8 的人,n = 5 的出价,从 0.800(说真话),到第 1 轮 0.784,第 20 轮 0.659,第 100 轮 0.640,第 300 轮 0.639,公式是 0.640。n = 2、3、10 也一样:300 轮之后,估值 0.2 以上的各点,和公式的最大差距,都在 0.02 以内(0.018、0.017、0.015、0.012)。
- 换一个很不一样的起点(出价只有估值的 10%):也走到了 0.639。起点不重要。
- 二价拍卖:说真话的"遗憾"是 0。 对别人的五种很不一样的出价方式(出估值的一半、2 倍、一价拍卖的均衡出价、估值的平方、永远出 0.3),估值在 0.2 以上的各个 v 里,说真话比最好的出价少赚的,最大是 0.00000。这就是占优:不管别人怎么做,说真话都是最好反应之一。
- “之一”:看具体的例子(n = 2,对方出估值的一半,我的估值 0.8):出价 0.8、0.6、1.0,期望好处都是 0.5486;出价 0.4 才降到 0.4790。原因是,对方最多出 0.5,我只要出价高过 0.5,就一定赢,付的钱和我自己的出价无关。说真话是最好的之一,不是唯一最好的。 这一点,下一步会用到。
问题 1 的答案:会。不用公式,只要反复做最好反应(而且走小步),就走到 (n − 1) ÷ n。
四、第二步:只会试错,学得一样吗
上一步,竞拍者要算"期望好处",这需要知道别人出价的整个分布。现实里的人没这个本事。我们换一种更"笨"的学习:
- 每个竞拍者只有一个旋钮 α:出价 = α × 估值。
- 每一代,他在 M 场拍卖里,试一次"α 稍微大一点",再在另外 M 场拍卖里,试一次"α 稍微小一点"(和现实一样:你没法在同一批估值上试两遍)。哪个赚得多,就往哪个方向动一点点。
- 其余的人,这一代保持不变。
# 第二步:不会算期望的竞拍者,靠试错能学会吗?
# 每个竞拍者只有一个旋钮 α:出价 = α × 估值。每一代,每个人在 M 场拍卖里,试一试「α 稍微大一点」和「α 稍微小一点」,
# 哪个赚得多,就往哪个方向动一点点(其余的人这一代保持不变)。没有人知道公式。
rng = np.random.default_rng(75)

def auction_payoffs(values, bids, fmt):
    """values、bids:M × n 的数组(M 场拍卖,n 个人)。最高出价者赢;一价付自己的出价,二价付第二高的出价。返回 M × n:每个人每场的好处"""
    win = bids == bids.max(axis=1, keepdims=True)
    if fmt == "first": price = bids.max(axis=1, keepdims=True)
    else: price = np.sort(bids, axis=1)[:, -2:-1]
    return np.where(win, values - price, 0.0)

def learn(n, fmt, alpha0, gens=400, M=2000, step=0.05, eta=0.02):
    """返回每一代,每个人的 α(gens + 1 行 × n 列)"""
    alpha = np.array(alpha0, dtype=float).copy(); hist = [alpha.copy()]
    for _ in range(gens):
        new = alpha.copy()
        for i in range(n):
            gains = []
            for delta in (+step, -step):                           # 两种试法,各自碰上不同的 M 场拍卖(和现实一样:你没法在同一批估值上试两遍)
                values = rng.random((M, n))
                a = alpha.copy(); a[i] += delta
                gains.append(auction_payoffs(values, a * values, fmt)[:, i].mean())
            new[i] += eta * np.sign(gains[0] - gains[1])           # 哪个方向赚得多,就往哪个方向动 eta
        alpha = np.clip(new, 0.05, 2.0); hist.append(alpha.copy())
    return np.array(hist)

print("每个竞拍者靠试错调整 α,起点都是 1.0(说真话)。10 次独立的学习,每次 250 代;")
print("每代每种试法,各碰上 M 场拍卖(M 大 = 经验多,反馈准;M 小 = 经验少,反馈嘈杂)。最后 100 代的 α:")
print("  n   拍卖   M     10 次的平均 α    10 次之间的标准差    理论值")
learned = {}
for M in (1000, 100):
    for n in (2, 5):
        for fmt in ("first", "second"):
            runs = [learn(n, fmt, np.full(n, 1.0), gens=250, M=M) for _ in range(10)]
            finals = np.array([h[-100:].mean() for h in runs]); learned[(M, n, fmt)] = runs[0]
            target = (n - 1) / n if fmt == "first" else 1.0
            print(f"  {n}   {'一价' if fmt == 'first' else '二价'}   {M:>4}   {finals.mean():>10.3f}   {finals.std():>14.3f}          {target:.3f}")

# 为什么二价拍卖里学得又慢又不准:算一算,我的 α 偏离最优,要损失多少?(其余的人都用最优 α;我的估值随机)
M = 400000
mults = (0.5, 0.8, 0.9, 1.0, 1.1, 1.25, 1.5)
print("\n偏离最优,损失多少?我的 α = 最优的若干倍,平均每场的好处(占最优时的 %):")
for n in (2, 5):
    print(f"  n={n}:我的 α 是最优的   " + "  ".join(f"{m:>6.2f}倍" for m in mults))
    for fmt in ("first", "second"):
        best_a = (n - 1) / n if fmt == "first" else 1.0
        values = rng.random((M, n)); out = []
        for m in mults:
            al = np.full(n, best_a); al[0] = best_a * m
            out.append(auction_payoffs(values, al * values, fmt)[:, 0].mean())
        base = auction_payoffs(values, np.full(n, best_a) * values, fmt)[:, 0].mean()
        print(f"      {'一价' if fmt == 'first' else '二价'}(最优 α = {best_a:.2f})   " + "  ".join(f"{100 * o / base:7.1f}" for o in out))
输出:
每个竞拍者靠试错调整 α,起点都是 1.0(说真话)。10 次独立的学习,每次 250 代;
每代每种试法,各碰上 M 场拍卖(M 大 = 经验多,反馈准;M 小 = 经验少,反馈嘈杂)。最后 100 代的 α:
  n   拍卖   M     10 次的平均 α    10 次之间的标准差    理论值
  2   一价   1000        0.478            0.005          0.500
  2   二价   1000        1.015            0.042          1.000
  5   一价   1000        0.780            0.002          0.800
  5   二价   1000        1.003            0.005          1.000
  2   一价    100        0.473            0.011          0.500
  2   二价    100        1.027            0.093          1.000
  5   一价    100        0.774            0.006          0.800
  5   二价    100        0.994            0.011          1.000

偏离最优,损失多少?我的 α = 最优的若干倍,平均每场的好处(占最优时的 %):
  n=2:我的 α 是最优的     0.50倍    0.80倍    0.90倍    1.00倍    1.10倍    1.25倍    1.50倍
      一价(最优 α = 0.50)      74.8     96.1     98.9    100.0     97.8     88.6     64.0
      二价(最优 α = 1.00)      74.9     96.0     99.0    100.0     99.2     96.0     88.9
  n=5:我的 α 是最优的     0.50倍    0.80倍    0.90倍    1.00倍    1.10倍    1.25倍    1.50倍
      一价(最优 α = 0.80)      18.2     73.6     91.6    100.0     81.0      0.0   -211.5
      二价(最优 α = 1.00)      18.7     73.8     91.9    100.0     91.7     60.3     -9.8
逐段看:
-
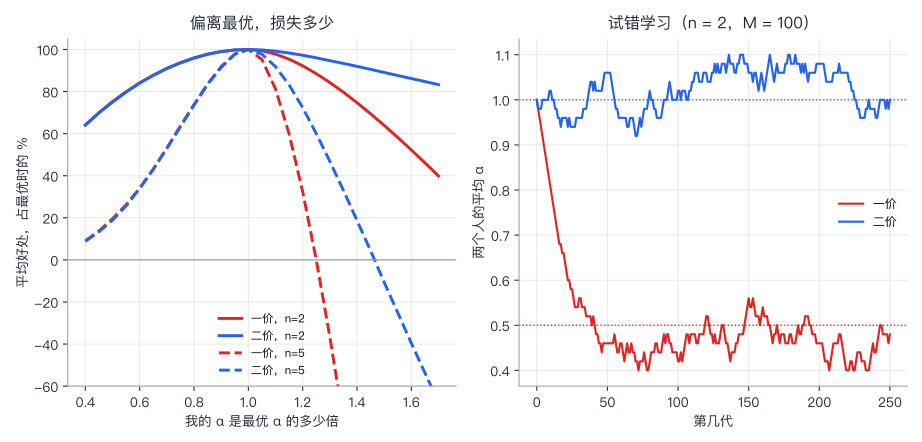
一价拍卖:学得又快又准。 起点是"说真话"(α = 1),n = 2 的平均 α 掉到 0.478(理论 0.500),n = 5 掉到 0.780(理论 0.800)。10 次独立学习之间,几乎没有差别(标准差 0.002 到 0.011)。(比理论值低一点点:步长是 0.05,学习本身有抖动。)
-
二价拍卖:学得不准。 平均 α 在 1 附近(n = 5,是 1.003 和 0.994),可是 10 次学习之间的差别大得多:n = 2、M = 1000 时,标准差 0.042,是一价拍卖(0.005)的约 8 倍;M = 100(经验少,反馈嘈杂)时,标准差 0.093,是一价拍卖(0.011)的约 8 倍。而且 n = 2 时,平均 α 稍微偏高(1.015、1.027):竞拍者在二价拍卖里,出价略高于估值。这个方向,和第 22 讲提到的实验室里二价拍卖常见的"过度出价"(Kagel、Harstad 和 Levin 1987,二手转述)一致。
-
为什么:看左图:我的 α 偏离最优,损失多少?
- n = 2:高报 25%,一价损失 11.4%,二价只损失 4.0%;
- n = 5:高报 25%,一价一分钱也赚不到(0.0%),二价还有 60.3%。
- 低报,两种拍卖的损失差不多:只有最优的 0.5 倍,n = 2 时,两个都是损失约 25%(74.8% 和 74.9%)。
二价拍卖里,高报是便宜的错误:你多付的,只在"别人恰好出价在你的真实估值和你的高报之间"的时候才发生。所以,学习的压力弱,错误留得久。(我们模拟的是最简单的学习者,不是对实验室里人的行为的解释。)
问题 2 的答案:不一样。一价拍卖,学得又快又准;二价拍卖,平均来说,会走到说真话附近,可是学得更慢、更不准,而且倾向于高报。
五、第三步:竞拍者不一样
第 22 讲的收益等价,要求竞拍者的估值来自同一个分布。现在,让两个竞拍者不一样:A 的估值在 0 到 1 之间均匀分布(弱),B 的估值在 0 到 2 之间均匀分布(强)。一价拍卖里,均衡的出价,要靠两条出价函数互相做最好反应来求;二价拍卖,说真话就是均衡。
# 第三步:竞拍者不一样。两个竞拍者:A 的估值在 0 到 1 之间均匀分布(「弱」),B 的估值在 0 到 2 之间均匀分布(「强」)。
UPPER = {"A": 1.0, "B": 2.0}
VGRID = {k: np.linspace(0, u, K) for k, u in UPPER.items()}          # 各自估值的格子
BGRID = np.linspace(0, 1.0, K)                                       # 出价的格子(两个人的出价都在 0 到 1 之间)

def rival_bid_cdf(beta_rival, rival):
    """对手按出价函数 beta_rival 出价(加一点点手抖)时,他的出价低于 b 的概率(对手的估值在 [0, UPPER[rival]] 上均匀分布)"""
    def G(b):
        return (1 / (1 + np.exp(-(b[:, None] - beta_rival[None, :]) / TREMBLE))).mean(axis=1)
    return G

def best_reply_asym(me, beta_rival, rival):
    """一价:估值 v 的我,出价 b 的期望好处 = (v - b) × P(对手出价低于 b)"""
    G = rival_bid_cdf(beta_rival, rival)(BGRID)
    pay = (VGRID[me][:, None] - BGRID[None, :]) * G[None, :]
    pay = np.where(BGRID[None, :] <= VGRID[me][:, None] + 1e-12, pay, -np.inf)
    return BGRID[np.argmax(pay, axis=1)]

def solve_asym(rounds=800, damping=0.1):
    bA, bB = 0.5 * VGRID["A"], 0.5 * VGRID["B"]
    for _ in range(rounds):
        nA = best_reply_asym("A", bB, "B"); nB = best_reply_asym("B", bA, "A")
        bA = np.maximum.accumulate((1 - damping) * bA + damping * nA); bB = np.maximum.accumulate((1 - damping) * bB + damping * nB)
    return bA, bB

bA, bB = solve_asym()
print("一价拍卖,A ~ U[0, 1](弱),B ~ U[0, 2](强)。均衡的出价(反复做最好反应得到):")
print("  估值    A 的出价   A 的出价/估值    |  估值    B 的出价   B 的出价/估值")
for vA, vB in ((0.2, 0.4), (0.5, 1.0), (0.8, 1.6), (1.0, 2.0)):
    ia, ib = int(round(vA / 1.0 * (K - 1))), int(round(vB / 2.0 * (K - 1)))
    print(f"  {vA:>4.1f}     {bA[ia]:.3f}        {bA[ia] / vA:5.2f}       |  {vB:>4.1f}     {bB[ib]:.3f}        {bB[ib] / vB:5.2f}")
# 检验:把这两条出价函数当成「别人的做法」,每个类型自己最好能多赚多少?(均衡里,应该几乎为 0)
def regret(me, beta_me, beta_rival, rival):
    G = rival_bid_cdf(beta_rival, rival)(BGRID)
    pay = (VGRID[me][:, None] - BGRID[None, :]) * G[None, :]
    mine = np.array([np.interp(beta_me[i], BGRID, pay[i]) for i in range(K)])
    return pay.max(axis=1) - mine
print(f"均衡的检验:每个类型,换成最好的出价,最多能多赚(最大值):A {regret('A', bA, bB, 'B').max():.4f},B {regret('B', bB, bA, 'A').max():.4f}(它们的好处,在 0.1 到 0.5 的量级)")
print("(弱的 A:出价占估值的比例,随估值升高而上升(0.49 → 0.64);强的 B:随估值升高而下降(0.48 → 0.32)。强者压价更多,弱者压价更少。)")

# 用这两条出价函数,算一价拍卖的结果;二价拍卖(说真话)作对照。用同一批随机估值。
rs = np.random.default_rng(75); M = 400000
vA, vB = rs.random(M) * 1.0, rs.random(M) * 2.0
bidA, bidB = np.interp(vA, VGRID["A"], bA), np.interp(vB, VGRID["B"], bB)
a_wins_first = bidA > bidB
rev_first = np.where(a_wins_first, bidA, bidB)
a_wins_second = vA > vB
rev_second = np.minimum(vA, vB)
eff_first = np.mean(np.where(a_wins_first, vA, vB) >= np.maximum(vA, vB) - 1e-12)
surplus = lambda aw: np.mean(np.where(aw, vA, vB))
print(f"\n模拟 {M} 场拍卖:")
print(f"  一价:卖家收入 {rev_first.mean():.4f};估值最高的人赢的比例 {eff_first:.1%};赢家的平均估值(总剩余){surplus(a_wins_first):.4f};A 赢的比例 {a_wins_first.mean():.1%}")
print(f"  二价:卖家收入 {rev_second.mean():.4f};估值最高的人赢的比例 100.0%;赢家的平均估值(总剩余){surplus(a_wins_second):.4f};A 赢的比例 {a_wins_second.mean():.1%}")
print(f"  A 的平均好处:一价 {np.where(a_wins_first, vA - bidA, 0).mean():.4f},二价 {np.where(a_wins_second, vA - vB, 0).mean():.4f}")
print(f"  B 的平均好处:一价 {np.where(~a_wins_first, vB - bidB, 0).mean():.4f},二价 {np.where(~a_wins_second, vB - vA, 0).mean():.4f}")
输出:
一价拍卖,A ~ U[0, 1](弱),B ~ U[0, 2](强)。均衡的出价(反复做最好反应得到):
  估值    A 的出价   A 的出价/估值    |  估值    B 的出价   B 的出价/估值
   0.2     0.098         0.49       |   0.4     0.193         0.48
   0.5     0.263         0.53       |   1.0     0.440         0.44
   0.8     0.454         0.57       |   1.6     0.580         0.36
   1.0     0.643         0.64       |   2.0     0.647         0.32
均衡的检验:每个类型,换成最好的出价,最多能多赚(最大值):A 0.0104,B 0.0072(它们的好处,在 0.1 到 0.5 的量级)
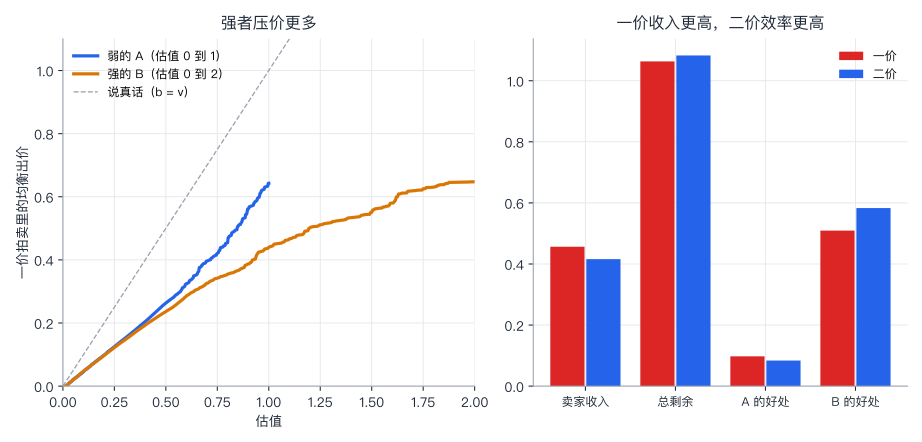
(弱的 A:出价占估值的比例,随估值升高而上升(0.49 → 0.64);强的 B:随估值升高而下降(0.48 → 0.32)。强者压价更多,弱者压价更少。)

模拟 400000 场拍卖:
  一价:卖家收入 0.4565;估值最高的人赢的比例 91.8%;赢家的平均估值(总剩余)1.0634;A 赢的比例 33.3%
  二价:卖家收入 0.4158;估值最高的人赢的比例 100.0%;赢家的平均估值(总剩余)1.0827;A 赢的比例 25.1%
  A 的平均好处:一价 0.0976,二价 0.0839
  B 的平均好处:一价 0.5092,二价 0.5830
逐段看:
- 强的 B 压价更多,弱的 A 压价更少。 估值从低到高,A 的出价占估值的比例,从 0.49 升到 0.64;B 的,从 0.48 降到 0.32。直觉是:A 的对手比它强,所以 A 必须出得更凶,才有机会赢;B 面对的对手比自己弱,可以大胆压价。(这个结论和一个检验有关:把这两条出价函数,当成"别人的做法",每个类型自己最好最多能多赚 0.010(A)和 0.007(B),好处本身在 0.1 到 0.5 的量级,所以这是一个很接近均衡的结果。)
- 一价拍卖,卖家收入更高:0.4565,二价是 0.4158,高 9.8%。 原因:弱的 A 出得更凶,让强的 B 不得不也出得高一些。
- 可是一价拍卖,不一定把东西给估值最高的人。 估值最高的人赢的比例,二价是 100%,一价只有 91.8%;赢家的平均估值(总剩余):二价 1.0827,一价 1.0634,少了 1.8%。弱的 A 赢的机会,也从 25.1% 变成了 33.3%。
- 谁赚谁亏:A 的平均好处,一价 0.0976,二价 0.0839;B 的,一价 0.5092,二价 0.5830。一价拍卖,是弱者的福音,强者的负担。
问题 3 的答案:这个例子里,一价拍卖卖家收入更高(高 9.8%),二价拍卖更有效率(总是估值最高的赢)。 这是收益等价,在竞拍者不对称时,失效的一个具体的样子。Vickrey 1961 年的文章里,已经有这样的两人例子(据二手转述,一个估值在 [0, 1]、一个在 [0, a],a 不同,收入的排序可以不同);Maskin 和 Riley 2000 年(Review of Economic Studies,67 卷 3 期,413–438 页),系统地研究了强弱竞拍者下,一价和二价的收入排序。(我只核对了出处和摘要。)
价值判断,留给你:卖家如果只要收入,这个例子里,该选一价;可是,如果卖的是一份应该给最需要它的人的东西(比如频谱、公共资源),“估值最高的人赢”,会不会比卖家多拿的 9.8% 更重要?经济学能帮你把两者的差距数出来,不能替你选。
局限:我们只算了一个具体的例子(a = 2)。练习 3 让你换 a。现实里,强者和弱者可能事后转卖,一价拍卖里的低效率,可能被转卖补回一部分;这里没有算。
六、第四步:共同价值
第 22 讲的赢者诅咒,是在"每个人都按自己的估计出价"的情形下算的。现在,让竞拍者学聪明:每个人都按"估计减去 δ"出价,δ 是压价的幅度,均衡时,如果别人都压 δ,我最好的压价也是 δ。
一块油田,真实价值 V 在 0 到 200 之间均匀分布;每个人的估计 = V + 误差,误差在 −20 到 20 之间均匀分布。
# 第四步:共同价值。一块油田,真实价值 V 对每个人都一样,但没人知道:V 在 0 到 200 之间均匀分布。
# 每个竞拍者做一次勘探,得到估计 s = V + 误差,误差在 -20 到 20 之间均匀分布。大家都按「估计 - δ」出价:δ 是压价的幅度。
NOISE, S = 20.0, 100000
rc = np.random.default_rng(75)
V_true = rc.uniform(0, 200, S)                                       # 每场拍卖的真实价值
SIGNALS = {n: V_true[:, None] + rc.uniform(-NOISE, NOISE, (S, n)) for n in (2, 3, 5, 10)}   # 每个人的估计(所有比较共用同一批)

def my_gain(n, fmt, shade_me, shade_others):
    """第 0 个人压价 shade_me,其余 n-1 个人都压 shade_others 时,第 0 个人每场的平均好处"""
    s = SIGNALS[n]
    top_other = (s[:, 1:] - shade_others).max(axis=1)
    win = (s[:, 0] - shade_me) > top_other
    pay = (s[:, 0] - shade_me) if fmt == "first" else top_other           # 一价付自己的出价;二价付别人的最高出价
    return np.where(win, V_true - pay, 0.0).mean()

def seller_revenue(n, fmt, shade):
    bids = np.sort(SIGNALS[n] - shade, axis=1)
    return (bids[:, -1] if fmt == "first" else bids[:, -2]).mean()

def equilibrium_shading(n, fmt, grid=np.arange(0.0, 40.01, 0.5), rounds=15):
    """对称均衡:如果别人都压 δ,我最好的压价也是 δ。从 δ = 0(按估计出价)出发,反复做最好反应(每次改一半)"""
    delta = 0.0
    for _ in range(rounds):
        best = grid[np.argmax([my_gain(n, fmt, d, delta) for d in grid])]
        delta = 0.5 * delta + 0.5 * best
    return delta

print("共同价值拍卖(真实价值平均 100)。每个人按「估计 - δ」出价:δ = 0 的下场,和均衡的压价 δ*:")
print("  n   拍卖   δ=0:每人每场的平均好处   δ*     δ* 时:每人的平均好处    卖家的平均收入")
cv = {}
for n in (2, 3, 5, 10):
    for fmt in ("first", "second"):
        d = equilibrium_shading(n, fmt)
        cv[(n, fmt)] = (d, my_gain(n, fmt, d, d), seller_revenue(n, fmt, d))
        print(f"  {n:>2}  {'一价' if fmt == 'first' else '二价'}   {my_gain(n, fmt, 0.0, 0.0):+9.3f}               {d:5.2f}   {cv[(n, fmt)][1]:+9.3f}            {cv[(n, fmt)][2]:8.3f}")
输出:
共同价值拍卖(真实价值平均 100)。每个人按「估计 - δ」出价:δ = 0 的下场,和均衡的压价 δ*:
  n   拍卖   δ=0:每人每场的平均好处   δ*     δ* 时:每人的平均好处    卖家的平均收入
   2  一价      -3.338               20.01      +6.695              86.522
   2  二价      +3.365                0.02      +3.373              93.188
   3  一价      -3.335               19.98      +3.344              89.859
   3  二价      +0.016                6.31      +2.125              93.536
   5  一价      -2.639               20.07      +1.339              93.124
   5  二价      -1.308               10.87      +0.846              95.632
  10  一价      -1.663               20.00      +0.366              96.235
  10  二价      -1.293               15.94      +0.324              96.659
逐段看:
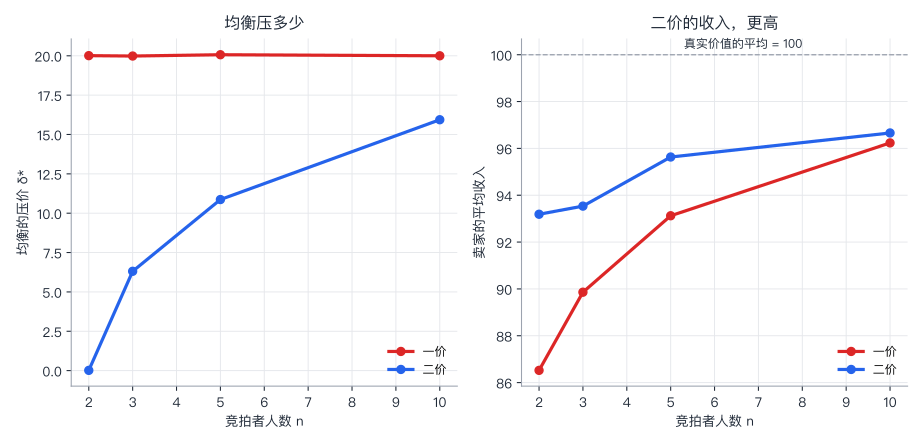
- 按自己的估计出价(δ = 0)的下场:一价拍卖,每个人每场平均亏 3.3(n = 2、3)、2.6(n = 5)、1.7(n = 10)。(“每人每场”,是把没赢的场次,也算成 0,所以数字看起来不大;赢家平均亏的,是这个数乘以 n。)二价拍卖,n = 2 反而赚(+3.4:说真话就是均衡),n = 3 约等于 0,n = 5、10 也亏(−1.3)。赢者诅咒,在二价拍卖里,也会发生,只是人要多一些。
- 一价拍卖的均衡压价,在这个例子里,几乎恰好等于误差的宽度:δ* ≈ 20.0,和人数无关(n = 2、3、5、10 都是 20.0 到 20.1)。这时赢家付的,是"自己的估计减 20",也就是在他的估计下,真实价值可能的最低值,所以赢了基本不会亏。(练习 4 把误差宽度改成 10,δ* 约是 10。注意:我们只在"出价 = 估计 − δ"这一类策略里找均衡,不是在所有的出价方式里找。)
- 二价拍卖的均衡压价,随人数增加: n = 2 是 0.02(几乎说真话),n = 3 是 6.3,n = 5 是 10.9,n = 10 是 15.9。人越多,“赢了"这件事,越是一个坏消息,要压得越多。
- 卖家收入:二价都比一价高:n = 2 是 93.2 对 86.5,n = 3 是 93.5 对 89.9,n = 5 是 95.6 对 93.1,n = 10 是 96.7 对 96.2。人越多,两者越接近,也越接近真实价值(平均 100)。
- 竞拍者的好处,一价更多:n = 2,一价 6.70,二价 3.37;人一多,好处都被竞争吃光(n = 10 时,只有 0.37 和 0.32)。
这个结果,和 Milgrom 和 Weber 1982 年的结论(第 22 讲 4.2 节)一致:当竞拍者的信息互相关联(这里是:大家的估计,都围绕着同一个真实价值)时,二价(英式)拍卖的期望收入,高于一价。一个直觉(据 Milgrom 和 Weber 的"联系原理”)是:二价拍卖里,赢家付的钱,和别人手里的信息挂钩,所以赢家能留下的"信息租金",比一价拍卖里少。
问题 4 的答案:一价拍卖,压价约等于误差的宽度(20),而且和人数无关;二价拍卖,人越多压得越多。二价拍卖,卖家收入更高。
七、第五步:多请一个人,还是设计保留价
第 22 讲 4.3 节算出,二价拍卖,估值 0 到 1 均匀分布,卖家自己的估值是 0,最优保留价是 0.5,与人数无关。那么:花力气设最优的保留价,和什么也不设、只是多请一个人,哪个更值钱?
# 第五步:多请一个人,还是把规则设计到最好?二价拍卖(一价拍卖在这里收入相同),估值在 0 到 1 之间均匀分布,卖家自己的估值是 0。
# 设保留价 r:出价都低于 r,就不卖;卖的话,价格 = max(第二高的出价, r)。
rb = np.random.default_rng(75); T = 1000000
VALS = rb.random((T, 7))                                              # 每场拍卖最多 7 个人;n 个人的拍卖,用前 n 个

def revenue(n, r):
    v = np.sort(VALS[:, :n], axis=1)
    top, second = v[:, -1], (v[:, -2] if n > 1 else np.zeros(T))
    return np.where(top >= r, np.maximum(second, r), 0.0).mean()

print("n 个人 + 最优保留价 0.5,和 n + 1 个人 + 不设保留价:卖家的平均收入")
print("  n   n 个人、不设保留价   n 个人、保留价 0.5   n + 1 个人、不设保留价     多请一个人,比最优保留价多赚")
for n in range(1, 6):
    a, b, c = revenue(n, 0.0), revenue(n, 0.5), revenue(n + 1, 0.0)
    print(f"  {n}        {a:.4f}              {b:.4f}               {c:.4f}(公式 {n / (n + 2):.4f})         {c - b:+.4f}")
输出:
n 个人 + 最优保留价 0.5,和 n + 1 个人 + 不设保留价:卖家的平均收入
  n   n 个人、不设保留价   n 个人、保留价 0.5   n + 1 个人、不设保留价     多请一个人,比最优保留价多赚
  1        0.0000              0.2502               0.3334(公式 0.3333)         +0.0833
  2        0.3334              0.4169               0.5002(公式 0.5000)         +0.0833
  3        0.5002              0.5316               0.6002(公式 0.6000)         +0.0686
  4        0.6002              0.6129               0.6668(公式 0.6667)         +0.0539
  5        0.6668              0.6722               0.7144(公式 0.7143)         +0.0422
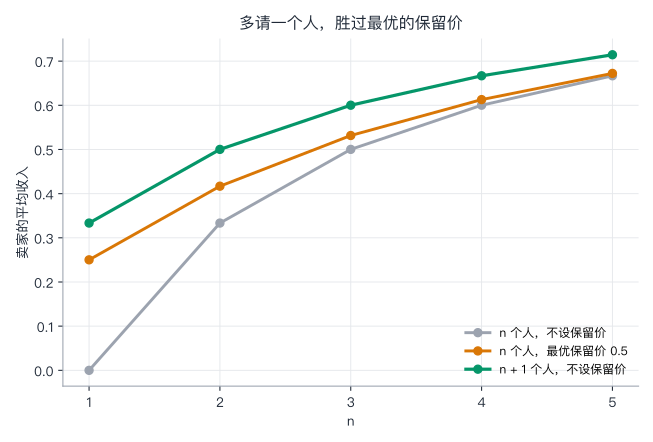
逐段看:
- n = 1(只有一个买家):不设保留价,卖家一分钱也拿不到;设保留价 0.5,收入 0.2502;多请一个人(2 个人、不设保留价):0.3334,比最优保留价多 0.0833。
- n = 2:保留价 0.5 的收入 0.4169(对照第 22 讲的 0.4167);3 个人、不设保留价:0.5002,多 0.0833。
- n = 3、4、5:多请一个人,比最优保留价,仍然多(+0.0686、+0.0539、+0.0422),差距在缩小,但一直是正的。
- 3 个人、不设保留价的收入 0.5002,和公式 n ÷ (n + 2) = 0.5000 一致。
问题 5 的答案:多请一个人更值钱。 这是 Bulow 和 Klemperer 1996 年(American Economic Review,86 卷 1 期,180–194 页)的一个结果:在一个标准的模型里,一场不设保留价、但多了一个竞拍者的拍卖,比"最优设计、少一个竞拍者"的拍卖,期望收入更高。他们的结论是:竞争的价值,大于谈判技巧、规则设计的价值。(我只核对了这篇文章的出处和摘要;这个结果依赖模型的假设,比如竞拍者是对称的、估值独立。这里我们用的,是最简单的情形。)
八、这个实验说明了什么,没说明什么
说明了:
- 均衡不必先被"算出来",反复做最好反应,竞拍者可以自己走到。 一价拍卖里,从说真话出发,走到 (n − 1) ÷ n;二价拍卖里,说真话是最好反应之一。
- 同样的"理论上的最好",学起来的难度很不一样。 一价拍卖,偏离代价大,学得又快又准;二价拍卖,偏离(尤其是高报)的代价小,学得慢,容易留在一个偏高的出价上。
- 收益等价是条件结论。 竞拍者强弱不同,一价拍卖卖家收入更高,二价拍卖更有效率;价值是共同的、估计互相关联,二价拍卖卖家收入更高。
- 竞争,往往比设计更值钱:多请一个竞拍者,比最优保留价还多赚。
没说明:
- 现实里的竞拍者,不是这样学的。 我们的学习者,是最简单的一维试错;我们没有说,实验室里的人为什么在二价拍卖里过度出价,只是说,这个方向和我们的简单学习者一致。
- 不对称竞拍者的例子,只有一个(a = 2);Vickrey、Maskin 和 Riley 的结论更一般,也更复杂。
- 共同价值的均衡,只在"出价 = 估计 − δ"这一类策略里找,不是所有策略;δ* ≈ 误差宽度这个漂亮的结果,不一定是一般规律。
- 多请一个人的好处,不计"多请一个人的成本"(宣传、进入的门槛);也假设竞拍者是对称的。
九、和前面、后面的联系
- 第 18 讲:纳什均衡,和"最佳反应"。第一步,是把最佳反应,当成一个迭代的过程。
- 第 22 讲:3.1 节的 (n − 1) ÷ n,4.1 节的收益等价,4.2 节的例外,4.3 节的保留价,5 节的赢者诅咒,在这个实验里,都被"走"了一遍,或者被推广了一步。
- 实验 70:一群没有智力的交易者,也能把市场带到均衡。这里,只会试错的竞拍者,也能学会一价拍卖里的压价。
- 实验 72:同时做最好反应,可能不收敛;这里需要小步(10%)才收敛。
- 实验 76:公地悲剧与 Schelling 隔离模型。
十、练习
下面的练习,都可以在上面的代码上改几个数字做出来。提示里的数字,都是我跑过的。
练习 1(步子迈多大)。 第一步里,把 iterate 的 damping,从 0.1 改成 0.5。n = 5,估值 0.8 的人,最后 50 轮的出价,在什么范围里摆动?
提示:
damping = 0.5时,最后 50 轮(第 250 到 300 轮)的出价,在 0.611 到 0.665 之间摆动;damping = 0.1时,只在 0.639 到 0.641 之间。步子大了,迭代就来回摆,和实验 72 里"同时调整,企业多了,就摆"是同一类现象。
练习 2(经验太少)。 第二步里,先运行 rng = np.random.default_rng(75),再把 M 改成 20(每种试法,只有 20 场拍卖的经验),n = 2,一价和二价各学 10 次,最后的平均 α 和 10 次之间的标准差是多少?
提示:一价:平均 0.450,标准差 0.047(理论 0.500);二价:平均 1.016,标准差 0.115(说真话 = 1)。经验少,一价学得偏低(压得太多),二价乱得更厉害。
练习 3(强者有多强)。 第三步里,把 B 的估值上限,从 2 改成 1.5 和 3(改 UPPER["B"],并重新生成 VGRID,再运行 solve_asym()),一价和二价的卖家收入各是多少?
提示:a = 1.5:一价 0.4023,二价 0.3880,一价估值最高的人赢的比例 93.5%;a = 3:一价 0.5360,二价 0.4439,估值最高的人赢的比例 91.7%。这两个例子里,一价的收入都高;强者越强(a 越大),一价比二价高得越多。(a = 1 时,两人一样,两种拍卖的收入相等。)
练习 4(误差变小)。 第四步里,把误差宽度 NOISE 从 20 改成 10,然后先 rc = np.random.default_rng(75),再重新运行 V_true = ... 和 SIGNALS = ... 两行,n = 3,一价和二价的均衡压价和卖家收入是多少?
提示:一价 δ* = 10.0(等于误差的宽度),卖家收入 94.86;二价 δ* = 3.30,卖家收入 96.56。二价收入仍然更高,但误差变小,两种拍卖的收入,都更接近真实价值 100。
练习 5(保留价)。 第五步里,n = 3 的二价拍卖,把保留价 r 从 0.3 扫到 0.7,哪个 r 的收入最高?
提示:r = 0.30、0.40、0.50、0.60、0.70 的收入,分别是 0.5151、0.5259、0.5316、0.5222、0.4835:最高在 r = 0.5,和人数无关(第 22 讲)。注意,即使是最优的 0.5316,也比"4 个人、不设保留价"的 0.6002 差得多。
练习 6(手抖多大)。 第一步里,把 TREMBLE 从 0.01 改成 0.03 和 0.003,n = 5,估值 0.8 的出价和"估值 0.2 以上的最大差距"是多少?
提示:
TREMBLE = 0.03:出价 0.640,最大差距 0.035;0.003:出价 0.637,最大差距 0.007。手抖越小,越接近公式,但迭代越容易卡住(平局多);手抖越大,越平滑,但结果和公式差得越多。
十一、局限
- 学习者:最简单的一维试错;没有记忆,没有对别人的推断。
- 数值技巧:第一步、第三步用了"手抖"和格子,结果和公式有小的差距(0.01 到 0.02 的量级)。
- 第三步只算了一个不对称的例子;第四步只在线性的压价策略里找均衡;第五步只考虑对称竞拍者。
- 没有:风险厌恶(第 22 讲 4.2 节算过)、预算约束、合谋(竞拍者联手压价)、事后转卖、竞拍者人数是随机的。
- 价格是一次性的:真实的拍卖,往往是反复进行的,竞拍者会学习、会记仇,也可能合谋(第 19 讲)。
参考
- Vickrey, W. (1961). Counterspeculation, auctions, and competitive sealed tenders. Journal of Finance, 16(1), 8–37.
- Milgrom, P. R., & Weber, R. J. (1982). A theory of auctions and competitive bidding. Econometrica, 50(5), 1089–1122.
- Maskin, E., & Riley, J. (2000). Asymmetric auctions. Review of Economic Studies, 67(3), 413–438.
- Bulow, J., & Klemperer, P. (1996). Auctions versus negotiations. American Economic Review, 86(1), 180–194.
- Kagel, J. H., Harstad, R. M., & Levin, D. (1987). Information impact and allocation rules in auctions with affiliated private values: A laboratory study. Econometrica, 55(6), 1275–1304.