这是第八个实验,也是 Unit 7 的收尾。第 28 讲,我们用一个简单的 Solow 模型讲了增长:资本积累有边际报酬递减,储蓄率决定稳态的水平,长期的增长靠技术。第 28 讲还留了一个承诺:做一个 Solow 模拟,并且和真实数据校准。 这就是这个实验。
“校准"和"回归"不一样。回归是让数据决定参数,使拟合最好;校准是从数据里直接读出参数(资本份额、折旧率、投资率、人口增长),不去调它们,然后让模型自己走,再看它的预测和现实差多少。这样做的好处是:模型的哪些预测对得上、哪些对不上,一目了然。校准的价值,有一半在于发现"对不上”。 这个实验里,就会碰上一个。
怎么用:和前面的实验一样,代码块是接着往下写的:后面的块会用到前面块里定义的东西。把它们依次拼成一个文件(比如 lab77.py),用 python lab77.py 运行,不到 2 秒;也可以一段一段地在 Python 里依次运行。只需要 Python 3 和 NumPy。真实数据,已经整理成了几十行数字,直接写在了代码里(来自 Penn World Table 11.0)。这个实验里没有随机数,所以你跑出来的数字,会和下面的输出一模一样。
一、六个问题
先停一下:请先凭直觉,回答下面六个问题,写下来。
问题 1: 用各国真实的投资率、人口增长率和折旧率,Solow 模型预测的"稳态资本产出比",和实际的资本产出比,对得上吗?
问题 2: 给所有国家同一个效率增速(g = 2%),让模型从 1990 年的实际起点出发,一年一年地走到 2019 年。能预测各国的增长吗?预测不了的,是哪些国家?
问题 3: 中国 1990 到 2019 年,每个工人的产出年均增长 8.5%。其中,多少是资本积累推动的,多少是"效率"?
问题 4: 如果一个国家从 1990 年起,投资率比实际少两成,到 2019 年,每个工人的产出会少多少?
问题 5: 各国的投资率,离"黄金律"(投资率 = 资本份额)还有多远?有没有国家存得太多?
问题 6: 把样本扩大到 58 个国家,Solow 模型对"水平"和"增长"的预测,对得上吗?把人力资本加进去,会好吗?
我们会一个一个回来。
二、实验的设计
2.1 模型
和第 28 讲一样:每有效劳动的产出 y = k^α,k 的变化 = s k^α − (n + g + δ) k。不同的是,这里的 α、s、n、δ,不再是"取一个数",而是从数据里读出来,每个国家一份。
2.2 数据
Penn World Table 11.0(Feenstra、Inklaar 和 Timmer 2015 年,American Economic Review,105 卷 10 期,是这套数据的标准引用;第 29 讲用过同一套数据),1990 到 2019 年。我们用的变量:
| 要的东西 | PWT 变量 | 怎么用 |
|---|---|---|
| 每个工人的产出 | 实际 GDP ÷ 就业人数 | 各国自己的不变价格(只比较自己的增长,不比较国家之间的水平);第五步比较水平时,改用 PPP 价格的产出法 GDP |
| 投资率 s | 总资本形成占 GDP 的比例(csh_i) |
1990–2019 年平均 |
| 就业增长 n | 就业人数 | 对数增长率 |
| 折旧率 δ | delta |
1990–2019 年平均 |
| 资本份额 α | 1 − 劳动份额(labsh) |
1990–2019 年平均 |
| 资本产出比 K/Y | 实际资本存量 ÷ 实际 GDP | 同一套不变价格;1990 年和 2019 年 |
七个国家:中国、印度、韩国、日本、德国、美国、巴西(和第 29 讲的增长核算,同一批)。
2.3 要注意的
- 这里的"效率增速 g",是劳动增进型的(k = K ÷ (A L),A 以速度 g 增长),而且包含人力资本的增长(因为我们用的是"每个工人",而不是"每个有效劳动")。它大约等于第 29 讲里的"效率"(全要素生产率)增速,除以 (1 − α),再加上人力资本指数的增速。
- PWT 的数据,是估算出来的,有修订;资本存量尤其难估。所以,下面的每一个结论,都要带着"数据本身有不确定性"来读。
三、第一步:把模型搭起来,先对一遍第 28 讲
import numpy as np

# Solow 模型,每「有效劳动」的量:k = K / (A L),y = Y / (A L) = k^α。
#   k 的变化 = s k^α − (n + g + δ) k       (投资,减去折旧和稀释)
# 参数(第 28 讲的):α = 1/3,δ = 5%,n = 1%(劳动增长),g = 2%(效率增长),s 是储蓄率。一年一步。
ALPHA, DELTA, N, G = 1 / 3, 0.05, 0.01, 0.02

def steady_k(s, alpha=ALPHA, n=N, g=G, delta=DELTA):
    return (s / (n + g + delta)) ** (1 / (1 - alpha))

def simulate_k(k0, s, years, alpha=ALPHA, n=N, g=G, delta=DELTA):
    """返回 years + 1 个 k:第 0 年是 k0"""
    k = np.empty(years + 1); k[0] = k0
    for t in range(years): k[t + 1] = k[t] + s * k[t] ** alpha - (n + g + delta) * k[t]
    return k

print("稳态:储蓄率 s -> k*、y*、人均消费 c* = (1 - s) y*")
for s in (0.1, 0.2, 0.3, 0.4, 0.5):
    k = steady_k(s); print(f"  s = {s}:k* = {k:5.2f},y* = {k ** ALPHA:4.2f},c* = {(1 - s) * k ** ALPHA:4.2f}")
ss = np.linspace(0.01, 0.99, 981); c_star = [(1 - s) * steady_k(s) ** ALPHA for s in ss]
print(f"消费最大的储蓄率(黄金律):s = {ss[int(np.argmax(c_star))]:.3f}(α = {ALPHA:.3f}),c* = {max(c_star):.3f}")

# 储蓄率翻倍:从 s = 0.2 的稳态出发,突然变成 0.4
k_old, k_new = steady_k(0.2), steady_k(0.4)
path = simulate_k(k_old, 0.4, 100)
print(f"\n储蓄率 0.2 -> 0.4:稳态的 y 高 {(k_new / k_old) ** ALPHA - 1:.1%}(公式 2^(α/(1−α)) = {2 ** (ALPHA / (1 - ALPHA)):.3f})")
print("  第 10、20、50、100 年的 y,是旧稳态的:" + "、".join(f"{(path[t] / k_old) ** ALPHA:.3f}" for t in (10, 20, 50, 100)))
print(f"  前 10 年,y 每年多增长约 {((path[10] / k_old) ** ALPHA) ** (1 / 10) - 1:.2%}(之后慢慢回到每年 g = {G:.0%})")

# 追赶:一个穷国,k 只有稳态的 10%
k_star = steady_k(0.3); poor = simulate_k(0.1 * k_star, 0.3, 60)
share = (poor / k_star) ** ALPHA
print(f"\n穷国(k = 稳态的 10%,y = 稳态的 {share[0]:.0%}):10、20、30 年后,y 是稳态的 " + "、".join(f"{share[t]:.0%}" for t in (10, 20, 30)))
growth = G + poor[1] ** ALPHA / poor[0] ** ALPHA - 1
print(f"  起点,每工人的增速 {growth:.1%};公式 g + α(n+g+δ)((k*/k)^(1-α) - 1) = {G + ALPHA * (N + G + DELTA) * ((1 / 0.1) ** (1 - ALPHA) - 1):.1%}(一阶近似)")
lam = (1 - ALPHA) * (N + G + DELTA)
print(f"  收敛速度 λ = (1 - α)(n + g + δ) = {lam:.3f},缺口减半要 {np.log(2) / lam:.1f} 年")
def half_life(k_start, s_=0.3):
    """从 k_start 出发,产出和稳态之间的(对数)差距缩小一半,用了几年"""
    kk = simulate_k(k_start, s_, 400); ks_ = steady_k(s_)
    gap = np.log(ks_ ** ALPHA) - ALPHA * np.log(kk)
    return int(np.argmax(gap <= 0.5 * gap[0]))
near = 0.8 ** (1 / ALPHA) * k_star                                 # y 刚好是稳态的 80% 时的 k
print(f"  模拟里,产出的缺口减半,用了:离稳态近(y = 稳态的 80%){half_life(near)} 年,离稳态远(y = 稳态的 46%){half_life(0.1 * k_star)} 年")

# 稳态的资本产出比:K / Y = s / (n + g + δ)
print("\n稳态的资本产出比 K/Y = k / y = s / (n + g + δ):")
for s in (0.2, 0.3, 0.4):
    k = steady_k(s); print(f"  s = {s}:模拟的稳态 k / y = {k / k ** ALPHA:.3f},公式 s / (n + g + δ) = {s / (N + G + DELTA):.3f}")
输出:
稳态:储蓄率 s -> k*、y*、人均消费 c* = (1 - s) y*
  s = 0.1:k* =  1.40,y* = 1.12,c* = 1.01
  s = 0.2:k* =  3.95,y* = 1.58,c* = 1.26
  s = 0.3:k* =  7.26,y* = 1.94,c* = 1.36
  s = 0.4:k* = 11.18,y* = 2.24,c* = 1.34
  s = 0.5:k* = 15.62,y* = 2.50,c* = 1.25
消费最大的储蓄率(黄金律):s = 0.333(α = 0.333),c* = 1.361

储蓄率 0.2 -> 0.4:稳态的 y 高 41.4%(公式 2^(α/(1−α)) = 1.414)
  第 10、20、50、100 年的 y,是旧稳态的:1.191、1.290、1.391、1.413
  前 10 年,y 每年多增长约 1.77%(之后慢慢回到每年 g = 2%)

穷国(k = 稳态的 10%,y = 稳态的 46%):10、20、30 年后,y 是稳态的 74%、86%、92%
  起点,每工人的增速 10.9%;公式 g + α(n+g+δ)((k*/k)^(1-α) - 1) = 11.7%(一阶近似)
  收敛速度 λ = (1 - α)(n + g + δ) = 0.053,缺口减半要 13.0 年
  模拟里,产出的缺口减半,用了:离稳态近(y = 稳态的 80%)11 年,离稳态远(y = 稳态的 46%)8 年

稳态的资本产出比 K/Y = k / y = s / (n + g + δ):
  s = 0.2:模拟的稳态 k / y = 2.500,公式 s / (n + g + δ) = 2.500
  s = 0.3:模拟的稳态 k / y = 3.750,公式 s / (n + g + δ) = 3.750
  s = 0.4:模拟的稳态 k / y = 5.000,公式 s / (n + g + δ) = 5.000
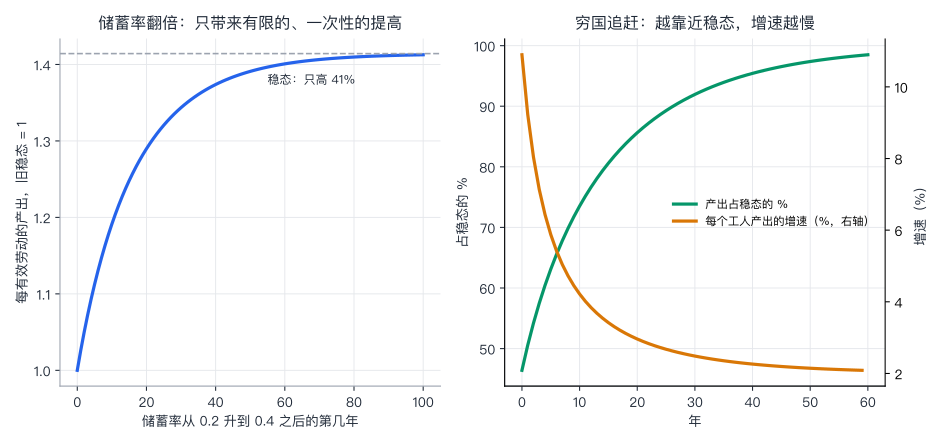
逐段看:
- 稳态:s = 0.1、0.2、0.3、0.4、0.5,k* = 1.40、3.95、7.26、11.18、15.62;y* = 1.12、1.58、1.94、2.24、2.50;人均消费 c* = 1.01、1.26、1.36、1.34、1.25,消费最大的储蓄率是 s = 1/3 = α(黄金律)。和第 28 讲完全一样。
- 储蓄率翻倍(0.2 → 0.4):稳态的 y 高 41.4%(= 2^(α/(1−α)) = 1.414);第 10、20、50、100 年,是旧稳态的 1.191、1.290、1.391、1.413 倍;前 10 年,每年多增长约 1.77 个百分点,之后慢慢回到每年 g = 2%。
- 穷国追赶:k 只有稳态的 10%(y 是稳态的 46%):10、20、30 年后,y 是稳态的 74%、86%、92%;起点,每个工人的增速 10.9%(公式的一阶近似是 11.7%);收敛速度 λ = (1 − α)(n + g + δ) = 0.053,缺口减半要 13.0 年;模拟里,离稳态近(80%)时,减半要 11 年,离稳态远(46%)时,8 年。
- 稳态的资本产出比:K/Y = s ÷ (n + g + δ)。模拟的结果,和公式,一模一样(s = 0.2、0.3、0.4 时,是 2.5、3.75、5.0)。这一条,是下面第二步要用的。
四、第二步:对准七个真实国家
# 第二步:把模型对准真实的国家。数据:Penn World Table 11.0(Feenstra、Inklaar 和 Timmer,AER 2015 年的数据集,第 29 讲用过),七个国家,1990 到 2019 年。
# 每个国家八个数:
#   每个工人的实际 GDP,1990 年、2019 年(实际 GDP ÷ 就业人数;用各国自己的不变价格,所以只比较自己的增长,不比较国家之间的水平;单位:2021 年美元)
#   投资率 s(总资本形成占 GDP 的比例,1990–2019 年的平均)
#   就业人数的年均增长率 n(对数)
#   折旧率 δ(PWT 估计的平均折旧率,1990–2019 年平均)
#   资本份额 α = 1 - 劳动份额(1990–2019 年平均)
#   资本产出比 K/Y,1990 年、2019 年(实际资本存量 ÷ 实际 GDP,同一套不变价格)
COUNTRIES = {
    "中国": (2869, 33749, 0.3724, 0.00579, 0.0540, 0.4210, 3.108, 4.913),
    "印度": (5629, 20828, 0.2475, 0.01538, 0.0464, 0.4379, 3.150, 3.615),
    "韩国": (35391, 99218, 0.3747, 0.01379, 0.0472, 0.4582, 3.233, 4.860),
    "日本": (65460, 81408, 0.2956, 0.00154, 0.0391, 0.4343, 4.219, 5.372),
    "德国": (81826, 111356, 0.2330, 0.00459, 0.0349, 0.3577, 3.736, 3.943),
    "美国": (89403, 139229, 0.2392, 0.00965, 0.0394, 0.3936, 3.560, 3.311),
    "巴西": (30253, 38483, 0.1915, 0.01461, 0.0467, 0.4510, 3.751, 4.371),
}
KEYS = ("y0", "y1", "s", "n", "delta", "alpha", "ky0", "ky1")
DATA = {name: dict(zip(KEYS, row)) for name, row in COUNTRIES.items()}
YEARS = 29                                                     # 1990 到 2019
for d in DATA.values(): d["growth"] = np.log(d["y1"] / d["y0"]) / YEARS      # 每个工人的实际 GDP 的年均增长(对数)

print("七个国家的「校准」参数(来自 PWT 11.0,1990–2019 年):")
print("  国家    每工人年均增长   投资率 s   就业增长 n   折旧 δ   资本份额 α   K/Y:1990 → 2019")
for name, d in DATA.items():
    print(f"  {name}      {d['growth']:6.2%}       {d['s']:6.1%}      {d['n']:6.2%}     {d['delta']:5.1%}     {d['alpha']:5.3f}      {d['ky0']:.2f} → {d['ky1']:.2f}")

# 第一个检验:稳态的资本产出比。Solow 模型说,稳态里 K/Y = s / (n + g + δ)。g 取 2%(第 28 讲),每个国家用自己的 s、n、δ,
# 和 2019 年实际的 K/Y 比一比。
print("\n稳态的资本产出比 s / (n + g + δ)(g = 2%),和 PWT 里 2019 年实际的 K/Y:")
print("  国家    模型的稳态 K/Y    2019 年实际 K/Y    实际 ÷ 模型")
for name, d in DATA.items():
    ky_star = d["s"] / (d["n"] + G + d["delta"])
    print(f"  {name}        {ky_star:5.2f}             {d['ky1']:5.2f}            {d['ky1'] / ky_star:5.2f}")
输出:
七个国家的「校准」参数(来自 PWT 11.0,1990–2019 年):
  国家    每工人年均增长   投资率 s   就业增长 n   折旧 δ   资本份额 α   K/Y:1990 → 2019
  中国       8.50%        37.2%       0.58%      5.4%     0.421      3.11 → 4.91
  印度       4.51%        24.8%       1.54%      4.6%     0.438      3.15 → 3.62
  韩国       3.55%        37.5%       1.38%      4.7%     0.458      3.23 → 4.86
  日本       0.75%        29.6%       0.15%      3.9%     0.434      4.22 → 5.37
  德国       1.06%        23.3%       0.46%      3.5%     0.358      3.74 → 3.94
  美国       1.53%        23.9%       0.97%      3.9%     0.394      3.56 → 3.31
  巴西       0.83%        19.1%       1.46%      4.7%     0.451      3.75 → 4.37

稳态的资本产出比 s / (n + g + δ)(g = 2%),和 PWT 里 2019 年实际的 K/Y:
  国家    模型的稳态 K/Y    2019 年实际 K/Y    实际 ÷ 模型
  中国         4.67              4.91             1.05
  印度         3.03              3.62             1.19
  韩国         4.63              4.86             1.05
  日本         4.87              5.37             1.10
  德国         3.92              3.94             1.01
  美国         3.46              3.31             0.96
  巴西         2.36              4.37             1.86
逐段看:
- 投资率:中国 37.2%、韩国 37.5%,最高;印度 24.8%;美国 23.9%,德国 23.3%;巴西 19.1%,最低。就业增长:印度 1.54%、巴西 1.46%、韩国 1.38%;中国只有 0.58%,日本 0.15%。资本份额 α,在 0.36(德国)到 0.46(韩国)之间,比第 28 讲取的 1/3 高。(这个份额里,包含了土地租金、垄断利润等,不全是"资本"的份额,所以它可能偏高。)
- 稳态的资本产出比:把每个国家自己的 s、n、δ,加上 g = 2%,代进 s ÷ (n + g + δ),和 PWT 里 2019 年实际的 K/Y 比:
- 德国 3.92 对 3.94,美国 3.46 对 3.31(实际 ÷ 模型 = 1.01、0.96),对得很好;
- 中国 4.67 对 4.91,韩国 4.63 对 4.86,日本 4.87 对 5.37(1.05、1.05、1.10),不错;
- 印度 3.03 对 3.62(1.19),偏离;
- 巴西 2.36 对 4.37(1.86),差很多。
问题 1 的答案:大多数对得上,不是所有。五个国家,模型预测的稳态资本产出比,和实际相差在 10% 左右。这是一个很强的检验:模型没有用任何关于 K/Y 的数据来定参数,只用了投资率、人口增长和折旧。巴西对不上:它的实际资本产出比,比模型说的高得多。可能的原因很多(它的投资率变化大,资本存量的估算,或者它的 g 其实很低,等等),这里不展开。
五、第三步:动态,从 1990 年走到 2019 年
静态的检验,只看终点。现在让模型从 1990 年的实际 K/Y 出发(模型里 K/Y = k^(1−α),所以起点 k0 = (K/Y)^(1/(1−α))),按每个国家自己的 s、n、δ、α,一年一年地走到 2019 年。
# 第三步:动态。从 1990 年实际的 K/Y 出发(模型里 K/Y = k^(1-α),所以 k0 = (K/Y)^(1/(1-α))),按模型一年一年地走到 2019 年,
# 看资本积累,能把每个工人的产出,推到多高。
def run_country(d, g, s=None, years=YEARS):
    """返回 k 的路径(years + 1 个)。s 默认是这个国家自己的名义投资率"""
    alpha = d["alpha"]; s = d["s"] if s is None else s
    k = np.empty(years + 1); k[0] = d["ky0"] ** (1 / (1 - alpha))
    for t in range(years): k[t + 1] = k[t] + s * k[t] ** alpha - (d["n"] + g + d["delta"]) * k[t]
    return k

def model_growth(d, g, s=None):
    """模型预测的,每个工人的产出的年均增长(对数)= 效率增长 g + 每有效劳动产出 k^α 的增长"""
    k = run_country(d, g, s); return g + d["alpha"] * np.log(k[-1] / k[0]) / YEARS

def solve_g(d, s=None):
    """二分法:找一个效率增速 g,让模型预测的增长,正好等于实际的增长"""
    lo, hi = -0.05, 0.15
    for _ in range(60):
        mid = (lo + hi) / 2
        if model_growth(d, mid, s) < d["growth"]: lo = mid
        else: hi = mid
    return mid

# 先用名义投资率 s 试一试:要让模型的增长和实际对上,需要多大的效率增速 g?这时,模型走到 2019 年的 K/Y,和实际比,怎么样?
print("用 PWT 的名义投资率 s:")
print("  国家     实际增长    需要的 g    这时模型的 2019 年 K/Y    实际的 2019 年 K/Y")
for name, d in DATA.items():
    g_i = solve_g(d); k = run_country(d, g_i)
    print(f"  {name}     {d['growth']:6.2%}     {g_i:6.2%}            {k[-1] ** (1 - d['alpha']):5.2f}                  {d['ky1']:5.2f}")

# 中国、印度、巴西,对不上:增长这么快,名义投资率撑不起实际资本存量的积累。反过来,问一个问题:
# 要让资本存量,从 1990 年的 K/Y 走到 2019 年的 K/Y,同时 GDP 按实际速度增长,每年需要一个占 GDP 多少的(不变价格下的)投资率 s_eff?
def implied_s(d, years=YEARS):
    gamma = d["growth"] + d["n"]                                    # GDP 总量的增长
    t = np.arange(years)
    need = d["ky1"] * np.exp(gamma * years) - (1 - d["delta"]) ** years * d["ky0"]     # 2019 年的资本,减去 1990 年的资本剩下的(都除以 1990 年的 GDP)
    return need / ((1 - d["delta"]) ** (years - 1 - t) * np.exp(gamma * t)).sum()
for d in DATA.values(): d["s_eff"] = implied_s(d)
print("\n反推:让资本存量走到实际的 2019 年水平,需要的投资率 s_eff,和 PWT 的名义投资率 s:")
print("  国家    名义投资率 s    反推的 s_eff    s_eff ÷ s")
for name, d in DATA.items():
    print(f"  {name}       {d['s']:6.1%}         {d['s_eff']:6.1%}        {d['s_eff'] / d['s']:5.2f}")

# 用 s_eff 重来一遍:现在,模型里资本的积累,和 PWT 的资本存量,是一致的
print("\n用 s_eff:模型预测的,每个工人的产出的年均增长,效率增速 g 对所有国家都一样:")
print("  国家      实际      g = 1%    g = 2%    g = 3%    g = 4%")
for name, d in DATA.items():
    print(f"  {name}     {d['growth']:6.2%}    " + "    ".join(f"{model_growth(d, g, d['s_eff']):6.2%}" for g in (0.01, 0.02, 0.03, 0.04)))

print("\n反过来:要让模型和实际对上,每个国家需要多大的效率增速 g?剩下的,就是资本积累推动的:")
print("  国家     实际增长    需要的 g    资本积累的贡献    这时模型的 2019 年 K/Y    实际的 2019 年 K/Y")
need = {}
for name, d in DATA.items():
    g_i = solve_g(d, d["s_eff"]); need[name] = g_i; k = run_country(d, g_i, d["s_eff"])
    print(f"  {name}     {d['growth']:6.2%}     {g_i:6.2%}        {d['growth'] - g_i:6.2%}              {k[-1] ** (1 - d['alpha']):5.2f}                  {d['ky1']:5.2f}")
输出:
用 PWT 的名义投资率 s:
  国家     实际增长    需要的 g    这时模型的 2019 年 K/Y    实际的 2019 年 K/Y
  中国      8.50%      9.02%             2.53                   4.91
  印度      4.51%      5.37%             2.29                   3.62
  韩国      3.55%      3.00%             3.91                   4.86
  日本      0.75%     -0.07%             5.76                   5.37
  德国      1.06%      0.72%             4.47                   3.94
  美国      1.53%      1.44%             3.70                   3.31
  巴西      0.83%      1.63%             2.83                   4.37

反推:让资本存量走到实际的 2019 年水平,需要的投资率 s_eff,和 PWT 的名义投资率 s:
  国家    名义投资率 s    反推的 s_eff    s_eff ÷ s
  中国        37.2%          73.6%         1.98
  印度        24.8%          39.5%         1.60
  韩国        37.5%          48.5%         1.29
  日本        29.6%          27.7%         0.94
  德国        23.3%          20.1%         0.86
  美国        23.9%          21.1%         0.88
  巴西        19.1%          31.2%         1.63

用 s_eff:模型预测的,每个工人的产出的年均增长,效率增速 g 对所有国家都一样:
  国家      实际      g = 1%    g = 2%    g = 3%    g = 4%
  中国      8.50%     3.45%     4.26%     5.07%     5.89%
  印度      4.51%     2.13%     2.90%     3.68%     4.47%
  韩国      3.55%     2.64%     3.40%     4.18%     4.96%
  日本      0.75%     1.41%     2.13%     2.86%     3.60%
  德国      1.06%     1.10%     1.87%     2.65%     3.44%
  美国      1.53%     1.01%     1.76%     2.53%     3.30%
  巴西      0.83%     1.30%     2.05%     2.80%     3.55%

反过来:要让模型和实际对上,每个国家需要多大的效率增速 g?剩下的,就是资本积累推动的:
  国家     实际增长    需要的 g    资本积累的贡献    这时模型的 2019 年 K/Y    实际的 2019 年 K/Y
  中国      8.50%      7.14%         1.36%               5.36                   4.91
  印度      4.51%      4.05%         0.46%               3.74                   3.62
  韩国      3.55%      2.20%         1.36%               5.15                   4.86
  日本      0.75%      0.08%         0.67%               5.44                   5.37
  德国      1.06%      0.95%         0.11%               3.96                   3.94
  美国      1.53%      1.69%        -0.16%               3.31                   3.31
  巴西      0.83%      0.35%         0.48%               4.44                   4.37
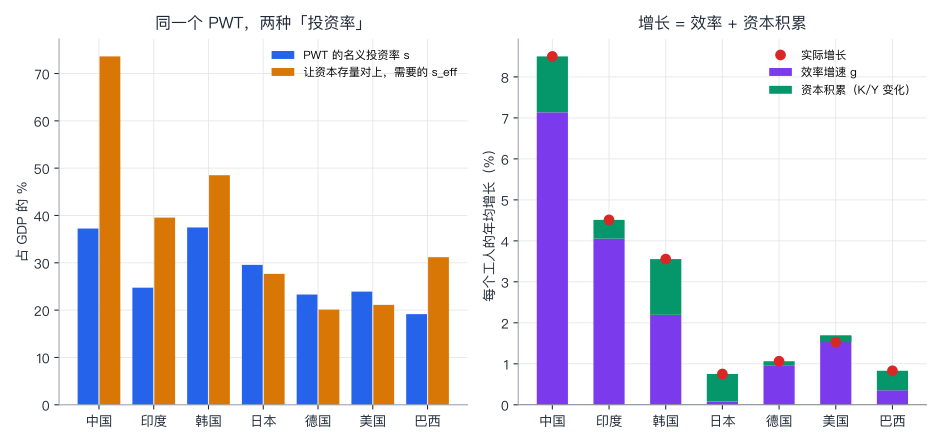
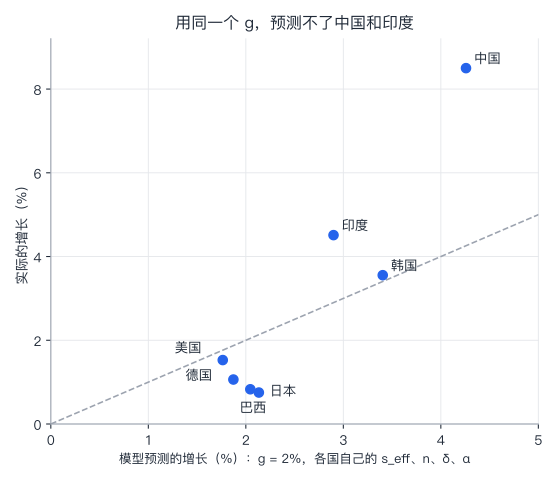
逐段看,这一步有三个发现:
发现一:用名义投资率,对不上。 先用 PWT 的名义投资率 s,要让模型的增长,和实际的增长对上,需要多大的效率增速 g?中国需要 9.02%,比它实际的增长(8.5%)还高:也就是说,资本积累的贡献是负的(−0.52 个百分点),这不合常理;这时,模型走到 2019 年的资本产出比是 2.53,而实际是 4.91。印度(需要 5.37%,K/Y 2.29 对 3.62)、巴西(1.63%,2.83 对 4.37)也一样。名义投资率,撑不起 PWT 里实际的资本存量的积累。 这就是校准里"对不上"的那个地方。
发现二:反推一个"有效投资率"。 换一个问法:要让资本存量,从 1990 年的 K/Y,走到 2019 年的 K/Y,同时 GDP 按实际的速度增长,每年需要多大的(不变价格下的)投资率 s_eff?
- 中国 73.6%(是名义投资率的 1.98 倍)、印度 39.5%(1.60 倍)、巴西 31.2%(1.63 倍)、韩国 48.5%(1.29 倍);
- 日本 27.7%(0.94 倍)、德国 20.1%(0.86 倍)、美国 21.1%(0.88 倍):接近或略低于名义投资率。
增长越快的国家,差得越多。可能的原因,至少有三个:(1)PWT 的名义投资率,是按国际(PPP)价格算的占 GDP 的比例,而资本存量,是按各国自己的不变价格算的;投资品相对价格,在不同国家、不同时期不一样,两种口径下的"投资率",可以差很多(Hsieh 和 Klenow 2007 年,American Economic Review,97 卷 3 期,562–585 页,研究过投资品的相对价格,和各国 PPP 投资率的关系;我只核对了摘要);(2)资本存量的估算(初始值、折旧、价格指数),本身有很大的不确定性,尤其是增长很快的国家;(3)模型太简单(比如没有区分设备和建筑,没有国外资本)。这个实验,不能区分这三个原因。
发现三:用 s_eff 重来一遍。 现在,模型里资本积累的方程,和 PWT 的资本存量,是一致的(模型走到 2019 年的 K/Y,和实际在 9% 以内:中国 5.36 对 4.91,印度 3.74 对 3.62,美国 3.31 对 3.31)。
- 同一个 g = 2%,预测不了: 中国预测 4.26%,实际 8.5%;印度 2.90% 对 4.51%;而日本预测 2.13%,实际只有 0.75%;巴西 2.05% 对 0.83%。看图:中国和印度,远远高于对角线。
- 各国需要的效率增速 g: 中国 7.14%,印度 4.05%,韩国 2.20%,美国 1.69%,德国 0.95%,巴西 0.35%,日本 0.08%。
- 资本积累的贡献(实际增长 − 需要的 g):中国 1.36、韩国 1.36、日本 0.67、巴西 0.48、印度 0.46、德国 0.11,美国 −0.16 个百分点。在这个模型里,资本积累(K/Y 的变化),只解释了每个工人增长的一小部分;中国 8.5% 里,约 7.1 个百分点,是"效率"(包含人力资本)。
问题 2 的答案:预测不了中国和印度。同一个 g,把所有国家,都当成"技术进步速度一样",预测的是 1.8% 到 4.3%;实际是 0.75% 到 8.5%。差别,几乎都在"效率"。
问题 3 的答案:大部分是"效率"(含人力资本):中国约 7.1 个百分点,资本积累只有约 1.4。这个结果,对口径很敏感:用名义投资率,会得出一个资本积累的贡献是负的、荒谬的结果;用反推的 s_eff,才一致。
和第 29 讲的增长核算对一下:第 29 讲里,“效率”(全要素生产率)的贡献,中国 3.52、印度 1.46、韩国 1.36、美国 0.89、德国 0.78、日本 0.20、巴西 −0.71(百分点),而这里需要的 g,中国最高,印度第二,然后是韩国、美国、德国:排序大体一致,只是最后两名对调了(日本 0.08 < 巴西 0.35)。原因之一:这里的 g,包含人力资本的增长(巴西的人力资本指数,每年涨 2% 以上,第 29 讲里把它单独列出来了);另外,第 29 讲的"效率",是希克斯中性的、对总产出的,这里是劳动增进型的、对每个工人的,要除以 (1 − α) 才能对上。(数字不能严格对比,只看大小和顺序。)
六、第四步:反事实,和黄金律
校准好的模型,可以回答"如果……会怎样"。每个国家,保持 1990 年的起点、自己的 n、δ、α,和上一步需要的效率增速 g,只把投资率改一改:
# 第四步:反事实。校准好的模型,可以回答「如果……会怎样」。每个国家,保持 1990 年的起点、自己的 n、δ、α,
# 和上一步需要的效率增速 g(用 s_eff 反推的那一个),只把投资率改一改,看 2019 年每个工人的产出。
def counterfactual(name, factor):
    d = DATA[name]; g_i = need[name]
    base = run_country(d, g_i, d["s_eff"]); alt = run_country(d, g_i, d["s_eff"] * factor)
    level = (alt[-1] / base[-1]) ** d["alpha"] - 1                                    # 2019 年每个工人的产出,变了百分之几
    growth = d["alpha"] * (np.log(alt[-1]) - np.log(base[-1])) / YEARS                # 年均增长,变了几个百分点
    steady = factor ** (d["alpha"] / (1 - d["alpha"])) - 1                            # 稳态的产出,变了百分之几(公式)
    return level, growth, steady

print("1990 年起,投资率比实际低两成(×0.8)或高两成(×1.2),2019 年每个工人的产出变多少?")
print("  国家     ×0.8:产出  年均增长       ×1.2:产出  年均增长       稳态的变化(×0.8 / ×1.2)    每年向稳态靠近的速度 λ    缺口减半(年)")
for name, d in DATA.items():
    lo, hi = counterfactual(name, 0.8), counterfactual(name, 1.2)
    lam = (1 - d["alpha"]) * (d["n"] + need[name] + d["delta"])
    print(f"  {name}     {lo[0]:+6.1%}  {100 * lo[1]:+5.2f}pp      {hi[0]:+6.1%}  {100 * hi[1]:+5.2f}pp       {lo[2]:+6.1%} / {hi[2]:+6.1%}            {lam:6.3f}              {np.log(2) / lam:5.1f}")

# 黄金律:投资率 = 资本份额 α 时,稳态的消费最大。各国的投资率,离它还差多少?(也等于比较:资本的收入 αY,和投资 sY,哪个大)
# 名义投资率 s,和上一步反推的有效投资率 s_eff,各比一遍。
print("\n黄金律:投资率 ÷ 资本份额 α(< 1:还没存到黄金律;> 1:存得太多):")
print("  国家    名义 s    α      s ÷ α    s_eff ÷ α")
for name, d in DATA.items(): print(f"  {name}   {d['s']:5.1%}   {d['alpha']:5.3f}    {d['s'] / d['alpha']:5.2f}      {d['s_eff'] / d['alpha']:5.2f}")
输出:
1990 年起,投资率比实际低两成(×0.8)或高两成(×1.2),2019 年每个工人的产出变多少?
  国家     ×0.8:产出  年均增长       ×1.2:产出  年均增长       稳态的变化(×0.8 / ×1.2)    每年向稳态靠近的速度 λ    缺口减半(年)
  中国     -14.0%  -0.52pp      +13.3%  +0.43pp       -15.0% / +14.2%             0.076                9.1
  印度     -13.5%  -0.50pp      +13.0%  +0.42pp       -16.0% / +15.3%             0.058               12.1
  韩国     -14.3%  -0.53pp      +13.9%  +0.45pp       -17.2% / +16.7%             0.045               15.4
  日本      -9.5%  -0.34pp       +9.2%  +0.30pp       -15.7% / +15.0%             0.023               29.6
  德国      -7.2%  -0.26pp       +6.8%  +0.23pp       -11.7% / +10.7%             0.031               22.0
  美国      -8.9%  -0.32pp       +8.5%  +0.28pp       -13.5% / +12.6%             0.040               17.3
  巴西     -11.7%  -0.43pp      +11.4%  +0.37pp       -16.7% / +16.2%             0.036               19.5

黄金律:投资率 ÷ 资本份额 α(< 1:还没存到黄金律;> 1:存得太多):
  国家    名义 s    α      s ÷ α    s_eff ÷ α
  中国   37.2%   0.421     0.88       1.75
  印度   24.8%   0.438     0.57       0.90
  韩国   37.5%   0.458     0.82       1.06
  日本   29.6%   0.434     0.68       0.64
  德国   23.3%   0.358     0.65       0.56
  美国   23.9%   0.394     0.61       0.54
  巴西   19.1%   0.451     0.42       0.69
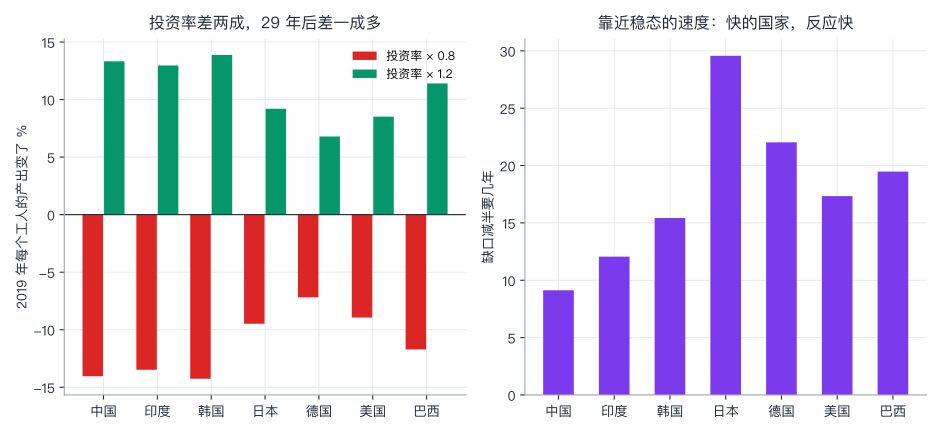
逐段看:
- 投资率少两成(×0.8): 2019 年每个工人的产出,中国少 14.0%(年均少 0.52 个百分点),印度 13.5%,韩国 14.3%,美国 8.9%,日本 9.5%,德国 7.2%,巴西 11.7%。多两成(×1.2): 对称地多 7% 到 14%。
- 和稳态比: 稳态的变化,是 ×0.8 时少 11.7% 到 17.2%(公式 0.8^(α/(1−α)) − 1)。29 年里,走到的比例,各国不一样:中国(λ = 0.076,缺口减半 9.1 年)少 14.0%,已经走了稳态变化(15.0%)的 93%;日本(λ = 0.023,缺口减半 29.6 年)只少 9.5%,只有稳态变化(15.7%)的六成。增长慢的国家,反应也慢:投资率的变化,要很久才反映到产出上。
- 黄金律:各国名义投资率 ÷ 资本份额,0.42(巴西)到 0.88(中国),都小于 1:按这个口径,没有国家"存得太多"。Abel、Mankiw、Summers 和 Zeckhauser 1989 年(Review of Economic Studies,56 卷 1 期)的"动态效率"检验,比较的就是资本的收入(αY),和投资(sY):资本收入大于投资,说明经济是动态有效的,没有"存得过多"。他们的结论是,美国和其他主要的发达国家,是动态有效的。(我只核对了摘要。)
- 但是,口径一换,结论就变: 如果用上一步反推的 s_eff,s_eff ÷ α,中国是 1.75,韩国 1.06,印度 0.90,巴西 0.69,日本 0.64,德国 0.56,美国 0.54。中国和韩国,超过 1。 这个实验无法裁决哪个口径才对:它说的是,“存得是不是太多"这个结论,对"投资率"怎么算,非常敏感。 这正是第 28 讲第八节里,中国高投资率之争的一个原因(那一节,按"理论预测 → 证据与局限 → 分歧在哪 → 价值判断留给读者"写的,价值判断三问,在那里)。
问题 4 的答案:少两成,29 年后少 7% 到 14%,视国家而定;快速增长的国家,影响更大,也更快。
问题 5 的答案:按名义口径,都没有存得太多(0.42 到 0.88);按有效口径,中国、韩国超过了。结论取决于口径。
七、第五步:58 个国家
七个国家,太少。现在,把样本扩大:58 个人口 2000 万以上、数据齐全的国家(规则选样,不是我挑的)。检验 Solow 模型的两个预测:
- 水平:稳态的 ln y = 常数 + α/(1−α) × [ln s − ln(n + g + δ)];α = 1/3 时,斜率应该是 0.5;
- 增长:离稳态越远,增长越快;控制 s、n 之后,起点越高,增长越慢(条件趋同)。
# 第五步:不只七个国家。58 个人口 2000 万以上、数据齐全的国家(PWT 11.0,规则选样,不是我挑的),检验 Solow 模型的两个预测:
#   水平:稳态的 ln y = 常数 + α/(1-α) × [ln s - ln(n + g + δ)];α = 1/3 时,斜率应该是 0.5
#   增长:离稳态越远,增长越快;控制 s、n 之后,起点越高,增长越慢(条件趋同)
# 每个国家五个数:每个工人的实际 GDP(按 PPP 算的产出法 GDP ÷ 就业,国家之间可以比较水平),1990 年、2019 年(2021 年美元);
# 投资率 s(1990–2019 平均);就业年均增长 n(对数);人力资本指数 hc(PWT:受教育年限和教育回报,1990–2019 平均)
CROSS = {
    "AGO": (7140, 16759, 0.3624, 0.03240, 1.336),
    "ARG": (19299, 54348, 0.1586, 0.01925, 2.774),
    "AUS": (70505, 116653, 0.2648, 0.01694, 3.482),
    "BFA": (2752, 6580, 0.1513, 0.02104, 1.128),
    "BGD": (4254, 15654, 0.2059, 0.01694, 1.756),
    "BRA": (17059, 37786, 0.1915, 0.01461, 2.291),
    "CAN": (80329, 106579, 0.2464, 0.01300, 3.548),
    "CHN": (3427, 33413, 0.3724, 0.00579, 2.359),
    "CIV": (8607, 15788, 0.0931, 0.03446, 1.476),
    "CMR": (8734, 13318, 0.1285, 0.02676, 1.767),
    "COD": (4325, 3295, 0.1201, 0.02778, 1.586),
    "COL": (26717, 37676, 0.1993, 0.02459, 2.262),
    "DEU": (62511, 111298, 0.2330, 0.00459, 3.587),
    "DZA": (58760, 53111, 0.3007, 0.02958, 1.949),
    "EGY": (11789, 62012, 0.1037, 0.02433, 2.158),
    "ESP": (58283, 105193, 0.2781, 0.01292, 2.711),
    "ETH": (2009, 5346, 0.1508, 0.03112, 1.241),
    "FRA": (73765, 120702, 0.2393, 0.00664, 2.983),
    "GBR": (64561, 102220, 0.2138, 0.00698, 3.556),
    "GHA": (7533, 14801, 0.2772, 0.02470, 2.188),
    "IDN": (9443, 26072, 0.2504, 0.02018, 2.221),
    "IND": (3989, 19443, 0.2475, 0.01538, 1.843),
    "IRN": (15271, 49225, 0.2613, 0.02405, 1.913),
    "IRQ": (36685, 59489, 0.1959, 0.03245, 1.991),
    "ITA": (76250, 110681, 0.2600, 0.00426, 2.867),
    "JPN": (64867, 82378, 0.2956, 0.00154, 3.404),
    "KEN": (7173, 14466, 0.1299, 0.02430, 2.033),
    "KOR": (37238, 97267, 0.3747, 0.01379, 3.300),
    "LKA": (12590, 40859, 0.2297, 0.01668, 2.814),
    "MAR": (15898, 27682, 0.2780, 0.01315, 1.636),
    "MDG": (3306, 3223, 0.1051, 0.03458, 1.568),
    "MEX": (43386, 47408, 0.1918, 0.02313, 2.493),
    "MLI": (2630, 8766, 0.1425, 0.02866, 1.198),
    "MMR": (2238, 15676, 0.1585, 0.01297, 1.609),
    "MOZ": (2159, 4286, 0.2530, 0.02666, 1.159),
    "MYS": (28546, 62965, 0.3007, 0.02862, 2.701),
    "NER": (3024, 3796, 0.1668, 0.03113, 1.140),
    "NGA": (3482, 16198, 0.2081, 0.03171, 1.595),
    "NPL": (3184, 8882, 0.2094, 0.02545, 1.497),
    "PAK": (11944, 21041, 0.1222, 0.02736, 1.668),
    "PER": (11783, 26308, 0.2140, 0.02784, 2.613),
    "PHL": (12897, 25222, 0.1801, 0.02305, 2.497),
    "POL": (24351, 82290, 0.1799, 0.00236, 3.108),
    "RUS": (37269, 69788, 0.1965, -0.00144, 3.141),
    "SAU": (115322, 156374, 0.2921, 0.04861, 2.373),
    "SDN": (8912, 24335, 0.1367, 0.02362, 1.440),
    "SYR": (6221, 20644, 0.0901, 0.01305, 2.233),
    "THA": (13228, 38779, 0.2733, 0.00981, 2.386),
    "TUR": (42432, 85239, 0.2464, 0.01913, 2.107),
    "TWN": (59037, 109872, 0.2417, 0.00999, 2.886),
    "TZA": (2784, 7787, 0.2466, 0.02520, 1.531),
    "UGA": (2737, 7575, 0.1694, 0.03164, 1.848),
    "UKR": (27142, 37910, 0.1484, -0.01385, 3.105),
    "USA": (88589, 139675, 0.2392, 0.00965, 3.620),
    "VEN": (29144, 1140, 0.1803, 0.02854, 2.348),
    "VNM": (3157, 20126, 0.2249, 0.02025, 2.165),
    "YEM": (3449, 5993, 0.1312, 0.02697, 1.327),
    "ZAF": (30371, 45391, 0.1597, 0.01308, 2.284),
}
codes = list(CROSS)
y0, y1, s_, n_, h_ = (np.array([CROSS[c][i] for c in codes], float) for i in range(5))
print(f"样本:{len(codes)} 个国家;每个工人的 GDP,2019 年最高 {codes[int(np.argmax(y1))]}({y1.max():,.0f} 美元),最低 {codes[int(np.argmin(y1))]}({y1.min():,.0f}),相差 {y1.max() / y1.min():.0f} 倍")

def ols(y, cols):
    X = np.column_stack([np.ones(len(y))] + cols); b = np.linalg.lstsq(X, y, rcond=None)[0]; fit = X @ b
    return b, 1 - ((y - fit) ** 2).sum() / ((y - y.mean()) ** 2).sum()

ly = np.log(y1); x_s = np.log(s_); x_n = np.log(n_ + 0.05)                   # g + δ 取 0.05(MRW 的做法)
print("\n一、水平:ln y(2019) 对 ln s 和 ln(n + 0.05)")
b, r2 = ols(ly, [x_s, x_n]);     print(f"  不加约束:ln s 的系数 {b[1]:+.2f},ln(n + 0.05) 的系数 {b[2]:+.2f},R² = {r2:.2f}(模型预测:两个系数大小相等、符号相反)")
b, r2 = ols(ly, [x_s - x_n]);    slope = b[1]
print(f"  加上约束(系数相等,符号相反):斜率 {slope:.2f},R² = {r2:.2f};隐含的 α = 斜率 ÷ (1 + 斜率) = {slope / (1 + slope):.2f}(α = 1/3 预测的斜率是 {ALPHA / (1 - ALPHA):.2f})")
b2, r2h = ols(ly, [x_s - x_n, np.log(h_)])
print(f"  再加上人力资本指数 ln hc:斜率 {b2[1]:.2f},hc 的系数 {b2[2]:.2f},R² = {r2h:.2f}(斜率降到了 α = 1/3 的预测 0.5 附近,R² 从 {r2:.2f} 升到 {r2h:.2f})")

print("\n二、增长:每个工人的年均增长,对 ln y(1990)、ln s、ln(n + 0.05)")
gr = np.log(y1 / y0) / 29; l0 = np.log(y0)
b, r2 = ols(gr, [l0]);                      print(f"  无条件趋同:ln y(1990) 的系数 {b[1]:+.4f},R² = {r2:.2f}")
b, r2 = ols(gr, [l0, x_s, x_n]);            print(f"  控制 s、n:ln y(1990) 的系数 {b[1]:+.4f}(每年收敛约 {-b[1]:.1%}),ln s 的系数 {b[2]:+.4f},R² = {r2:.2f}")
b, r2 = ols(gr, [l0, x_s, x_n, np.log(h_)]); print(f"  再控制 ln hc:ln y(1990) 的系数 {b[1]:+.4f}(每年收敛约 {-b[1]:.1%}),R² = {r2:.2f}")
print(f"  对照:Solow 模型(α = 1/3,n = 1%,g = 2%,δ = 5%)预测的收敛速度 λ = {(1 - ALPHA) * (N + G + DELTA):.3f}")

# 稳健性:委内瑞拉 2019 年每个工人的产出只有 1990 年的 4%(恶性通胀和经济崩溃),是个极端的点。去掉它,再算一遍。
keep = np.array([c != "VEN" for c in codes])
ly_k, xs_k, xn_k, h_k = ly[keep], x_s[keep], x_n[keep], np.log(h_[keep])
b, r2 = ols(ly_k, [xs_k - xn_k]);        print(f"\n去掉委内瑞拉({keep.sum()} 个国家):水平,斜率 {b[1]:.2f}(隐含 α = {b[1] / (1 + b[1]):.2f}),R² = {r2:.2f}")
b, r2 = ols(ly_k, [xs_k - xn_k, h_k]);   print(f"  加上 ln hc:斜率 {b[1]:.2f},hc 的系数 {b[2]:.2f},R² = {r2:.2f}")
gr_k, l0_k = gr[keep], l0[keep]
b, r2 = ols(gr_k, [l0_k, xs_k, xn_k]);   print(f"  增长,控制 s、n:ln y(1990) 的系数 {b[1]:+.4f}(每年收敛约 {-b[1]:.1%}),R² = {r2:.2f}")
b, r2 = ols(gr_k, [l0_k, xs_k, xn_k, h_k]); print(f"  再控制 ln hc:ln y(1990) 的系数 {b[1]:+.4f}(每年收敛约 {-b[1]:.1%}),R² = {r2:.2f}")
输出:
样本:58 个国家;每个工人的 GDP,2019 年最高 SAU(156,374 美元),最低 VEN(1,140),相差 137 倍

一、水平:ln y(2019) 对 ln s 和 ln(n + 0.05)
  不加约束:ln s 的系数 +1.25,ln(n + 0.05) 的系数 -2.75,R² = 0.37(模型预测:两个系数大小相等、符号相反)
  加上约束(系数相等,符号相反):斜率 1.60,R² = 0.33;隐含的 α = 斜率 ÷ (1 + 斜率) = 0.62(α = 1/3 预测的斜率是 0.50)
  再加上人力资本指数 ln hc:斜率 0.57,hc 的系数 2.27,R² = 0.63(斜率降到了 α = 1/3 的预测 0.5 附近,R² 从 0.33 升到 0.63)

二、增长:每个工人的年均增长,对 ln y(1990)、ln s、ln(n + 0.05)
  无条件趋同:ln y(1990) 的系数 -0.0081,R² = 0.16
  控制 s、n:ln y(1990) 的系数 -0.0125(每年收敛约 1.2%),ln s 的系数 +0.0182,R² = 0.29
  再控制 ln hc:ln y(1990) 的系数 -0.0170(每年收敛约 1.7%),R² = 0.32
  对照:Solow 模型(α = 1/3,n = 1%,g = 2%,δ = 5%)预测的收敛速度 λ = 0.053

去掉委内瑞拉(57 个国家):水平,斜率 1.53(隐含 α = 0.60),R² = 0.35
  加上 ln hc:斜率 0.41,hc 的系数 2.43,R² = 0.74
  增长,控制 s、n:ln y(1990) 的系数 -0.0101(每年收敛约 1.0%),R² = 0.38
  再控制 ln hc:ln y(1990) 的系数 -0.0156(每年收敛约 1.6%),R² = 0.47
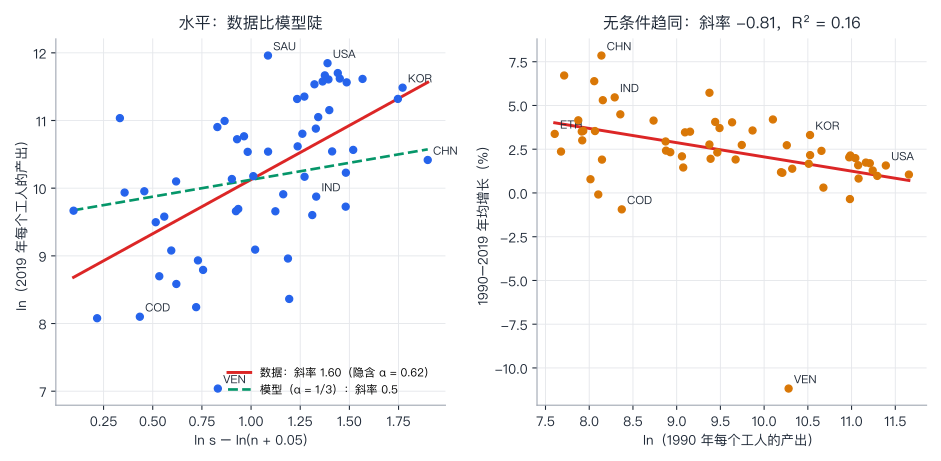
逐段看:
- 水平: ln y(2019) 对 ln s 的系数 +1.25,对 ln(n + 0.05) 的系数 −2.75:符号和模型一致(投资率越高越富,人口增长越快越穷),大小相差很远(模型预测两个系数大小相等)。加上约束,斜率 1.60,R² = 0.33;隐含的 α = 0.62。模型(α = 1/3)预测的斜率,是 0.5。
- 加上人力资本: 把 ln hc(PWT 的人力资本指数)加进去,斜率降到 0.57,非常接近模型预测的 0.5,R² 从 0.33 升到 0.63。这就是 Mankiw、Romer 和 Weil 1992 年(第 28 讲)的发现:不加人力资本的 Solow 模型,高估了储蓄和人口增长的效应(隐含的资本份额约 0.6);加了之后,一致得多。
- 增长: 无条件趋同,ln y(1990) 的系数 −0.0081(R² = 0.16):穷国平均增长得快一点,很弱。控制 s、n 后,−0.0125,每年收敛约 1.2%,R² = 0.29;再控制人力资本,1.7%,R² = 0.32。Solow 模型(α = 1/3)预测的收敛速度是每年约 5.3%。 和第 28 讲 45 个国家的结果(约 1.0%)、文献里常见的约 2%(据转述),是同一个量级:数据里的收敛,比模型说的慢得多。
- 稳健性: 委内瑞拉 2019 年每个工人的产出,只有 1990 年的 4%(恶性通胀和经济崩溃),是一个极端的点。去掉它:水平的斜率 1.53(隐含 α = 0.60),R² = 0.35;加上人力资本,斜率 0.41,R² 升到 0.74;增长的收敛速度,1.0%(控制 s、n),1.6%(再加人力资本)。结论的方向不变,数字会动:一个点,就让 R² 从 0.63 变成 0.74(和第 30 讲里,那个把货币和通胀的相关系数,从 0.80 拉到 0.20 的点,是同一个教训)。
问题 6 的答案:水平和增长的方向,对得上;大小对不上;加上人力资本,对得上很多。
八、这个实验说明了什么,没说明什么
说明了:
- Solow 模型的稳态预测,相当有用:只用投资率、人口增长和折旧,预测的资本产出比,在五个国家里,和实际相差 10% 左右。
- 模型能解释的,是"资本积累"那一部分;各国增长的差别,大部分是"效率”。 同一个 g,预测不了中国和印度。
- 校准会暴露数据和模型对不上的地方。 名义投资率,撑不起 PWT 的资本存量积累;“存得是不是太多”,对口径很敏感。
- 模型对水平的预测,方向对,大小不对,加上人力资本就好很多;对收敛速度的预测,比数据快得多。
- 起点不同,反应的速度也不同。 同样少两成的投资率,快速增长的国家,29 年里就走完了大部分的影响,增长慢的国家,只走了一半多。
没说明:
- 效率为什么不同。 g 是"需要的"、反推出来的,不是被解释的:这是第 29 讲、内生增长、制度等等的话题。
- 名义投资率为什么撑不起资本存量。 三个可能的原因,这里没有区分。
- 因果。 跨国回归,不是因果;投资率本身,是内生的(增长快,投资率就高)。
- 模型是封闭经济的:投资等于国内储蓄。开放经济里,投资率和储蓄率可以差很多。
九、和前面、后面的联系
- 第 27 讲:增长率、GDP 的衡量。
- 第 28 讲:这个实验的第一步,是第 28 讲的模拟;第五步,是第 28 讲 7 节检验的 PWT 版。第 28 讲预告的"Solow 模拟与真实数据校准",在这里兑现。
- 第 29 讲:增长核算。这里的"需要的 g",是同一个量,换了一种算法。
- 第 36 讲:黄金律的取舍,涉及当代人和后代人,要用折现来讲(第 36 讲讲折现)。
- 实验 78:银行挤兑,Diamond–Dybvig。
十、练习
下面的练习,都可以在上面的代码上改几个数字做出来。提示里的数字,都是我跑过的。
练习 1(α 变大)。 第一步里,把 ALPHA 从 1/3 改成 0.5(别的不变):收敛速度 λ、缺口减半的年数、储蓄率翻倍后稳态的提高,各是多少?
提示:λ = (1 − 0.5) × (0.01 + 0.02 + 0.05) = 0.04,缺口减半 17.3 年;储蓄率翻倍,稳态提高 2^(0.5/0.5) − 1 = 100%。α 越大,资本的边际报酬递减得越慢,追赶越慢,但储蓄率对稳态的影响也越大。
练习 2(什么样的 g,能让稳态的 K/Y 对上)。 第二步里,对美国,g = 2% 时,稳态 K/Y 是 3.46,实际是 3.31。g 取多少,才能让稳态 K/Y 正好等于 3.31?中国、印度、巴西呢?
提示:稳态 K/Y = s ÷ (n + g + δ) = 实际 K/Y,所以 g = s ÷ K/Y − n − δ:美国 2.32%,中国 1.60%,印度 0.67%,巴西 −1.75%。巴西的 g 是负数,说明这个模型和巴西的资本存量数据,对不上(要么存量估得太高,要么它离稳态很远)。
练习 3(α 取多少)。 第三步里,对中国,把 α 从 0.421 改成 1/3 和 0.5(DATA["中国"]["alpha"] = ...,再重新算 s_eff、solve_g),需要的 g 和资本积累的贡献,各是多少?
提示:α = 0.421(基准):g = 7.14%,资本贡献 1.36;α = 1/3:g = 7.59%,资本贡献 0.91;α = 0.5:g = 6.57%,资本贡献 1.93。α 越大,资本的贡献越大;但中国 8.5% 的增长里,不管 α 取多少,大部分都是"效率"(6.6% 到 7.6%)。
练习 4(中国的投资率降到美国的水平)。 第四步里,让中国 1990 年起的投资率(有效投资率),乘以 美国名义投资率 ÷ 中国名义投资率 = 0.642。2019 年每个工人的产出,变多少?年均增长少多少?
提示:
counterfactual("中国", 0.642):2019 年的产出少 25.8%,年均增长少 1.03 个百分点;稳态的变化是 −27.5%。(这是一个简单的反事实:假设"效率增速不变"。真实的世界里,投资可能同时带来技术进步,那样,影响会更大。)
练习 5(g + δ 取多少)。 第五步里,把 ln(n + 0.05) 里的 0.05(即 g + δ),改成 0.03 和 0.08,水平检验的斜率、隐含的 α、R²,有什么变化?再去掉委内瑞拉和沙特,结果呢?
提示:0.03:斜率 1.46,α 0.59,R² 0.35;加上 hc:斜率 0.48,R² 0.62。0.08:斜率 1.64,α 0.62,R² 0.30;加 hc:斜率 0.61,R² 0.63。去掉委内瑞拉和沙特(56 个国家):斜率 1.53,R² 0.37;加 hc:斜率 0.43,R² 0.76。g + δ 取多少,影响不大;去掉极端的点,影响更大。
练习 6(穷的一半,富的一半)。 第五步里,按 1990 年每个工人的产出的中位数,把 58 个国家分成穷的一半和富的一半,各自做无条件趋同的回归(增长对 ln y(1990)),斜率和 R² 是多少?
提示:穷的一半(29 个):斜率 −0.0044,R² 0.02;富的一半(29 个):斜率 −0.0068,R² 0.03。在每一半内部,几乎看不到趋同;整体的 −0.0081,主要来自"穷的一半,平均增长得比富的一半快"。这和第 28 讲说的,“趋同不是所有穷国的事”,是一个意思。
十一、局限
- 模型:一个部门、封闭经济、没有人力资本(它被放进了 g 里)、没有政府;α、δ、s、n 都取 1990–2019 年的平均,不随时间变。
- 数据:PWT 的资本存量、投资率,是估算出来的,有修订;名义投资率和资本存量,口径不一致(第三步已经看到);资本份额里,包含了不是资本的收入。
- 校准:只有一个自由参数 g,而且它是"反推"的;用同一个 g,预测不了;换成各国自己的 g,等于是把残差,吸收进了 g。
- 跨国回归:58 个国家,是一个规则选出的、不随机的样本;投资率是内生的;一个极端的点,就能改变 R²。
参考
- Solow, R. M. (1956). A contribution to the theory of economic growth. Quarterly Journal of Economics, 70(1), 65–94.
- Mankiw, N. G., Romer, D., & Weil, D. N. (1992). A contribution to the empirics of economic growth. Quarterly Journal of Economics, 107(2), 407–437.
- Feenstra, R. C., Inklaar, R., & Timmer, M. P. (2015). The next generation of the Penn World Table. American Economic Review, 105(10), 3150–3182.
- Hsieh, C.-T., & Klenow, P. J. (2007). Relative prices and relative prosperity. American Economic Review, 97(3), 562–585.
- Abel, A. B., Mankiw, N. G., Summers, L. H., & Zeckhauser, R. J. (1989). Assessing dynamic efficiency: Theory and evidence. Review of Economic Studies, 56(1), 1–19.
- Phelps, E. S. (1961). The golden rule of accumulation: A fable for growthmen. American Economic Review, 51(4), 638–643.