这是第十个、也是最后一个实验。第 38 讲,我们用美国股市的月度收益,检验过"价格的历史,能不能预测未来":自相关很小,一条规则的夏普比率,略高于买入持有。第 38 讲还留了一个承诺:用真实数据,把这个检验做大:方差比、游程、带成本的回测。 这就是这个实验。
这个实验,用的是真实的数据:Kenneth French 数据库里,1927 年到 2025 年,美国股市的月度收益(1188 个月),和日度收益(26,001 个交易日)。这是对历史数据的统计检验,不是投资建议。
怎么用:和前面的实验一样,代码块是接着往下写的:后面的块会用到前面块里定义的东西。把它们依次拼成一个文件(比如 lab79.py),用 python lab79.py 运行,约 25 秒。只需要 Python 3 和 NumPy;第一块代码,会自己从网上下载数据(和第 38 讲一样,需要联网;数据库偶尔修订,小数位可能有极小的差别)。随机数的种子,都固定了。
一、六个问题
先停一下:请先凭直觉,回答下面六个问题,写下来。
问题 1: “随机游走”,是在说什么?如果把真实的收益顺序,打乱,哪些统计量会变,哪些不变?
问题 2: 方差比检验:q 个月的收益的方差,是不是 1 个月的 q 倍?真实的数据,拒绝随机游走吗?
问题 3: 如果波动有"聚集"(大波动之后,还是大波动),普通的检验,会不会冤枉好人?
问题 4: 22 条技术分析规则(移动平均、动量),一次全试,大多数能比买入持有更好吗?挑出来最好的那条,是本事,还是运气?
问题 5: 这个"好处",是什么?稳不稳?样本外、扣了交易成本之后呢?
问题 6: 如果市场真的有一点点可预测性,这 99 年的数据,测得出来吗?
我们会一个一个回来。
二、实验的设计
2.1 数据
Kenneth French 数据库里的 Fama/French 三因子文件:市场的超额收益(Mkt−RF),和无风险利率(RF,一个月国库券)。市场的总收益 = 超额收益 + 无风险利率。 这是美国所有上市股票的市值加权收益。
2.2 “随机游走"有三种强度
第 38 讲讲过:有效市场假说,说的是价格反映了信息,没有人能系统地靠信息赚到超额收益。检验它,常用的工具,是"随机游走”:
- 最强的版本:每期的收益,互相独立,分布一样。昨天发生了什么,对今天,毫无影响。
- 中等的版本:收益不相关(可以互相依赖,比如波动的大小)。
- 最弱的版本:给定过去的信息,未来收益的期望,不变(鞅的差)。
这个实验,会看到:真实的收益,满足中等和最弱的版本(大致),不满足最强的版本。
2.3 工具
- 自相关:这一期和 k 期之前的收益,相关吗?
- 方差比(Lo 和 MacKinlay 1988):q 期的收益的方差 ÷(q × 1 期的方差)。独立时应该 ≈ 1。
- 游程检验:涨跌的符号,连在一起的"段",是不是太少或者太多?
- 排列检验:把月份的顺序,打乱,看"随机"能做到多好。
- 技术规则的回测:用信号,决定持有股票还是国库券。
三、第一步:真实的收益,和"打乱顺序"的收益
import io, math, urllib.request, zipfile
import numpy as np

# 数据:Kenneth French 数据库(Fama/French 三因子,月度和日度;CRSP 的美国股市,市值加权)。1927 年 1 月到 2025 年 12 月,和第 38 讲一样。
# 代码会自己下载(需要联网)。数据库偶尔修订,小数位可能有极小差别。
BASE = "https://mba.tuck.dartmouth.edu/pages/faculty/ken.french/ftp/"

def load_french(zip_name, csv_name, ncols, date_len, first, last):
    raw = urllib.request.urlopen(BASE + zip_name, timeout=60).read()
    text = zipfile.ZipFile(io.BytesIO(raw)).read(csv_name).decode("latin-1")
    rows = []
    for line in text.splitlines():
        p = [x.strip() for x in line.split(",")]
        if len(p) == ncols and len(p[0]) == date_len and p[0].isdigit() and first <= int(p[0]) <= last:
            rows.append((int(p[0]), *map(float, p[1:])))
    return rows

monthly = load_french("F-F_Research_Data_Factors_CSV.zip", "F-F_Research_Data_Factors.csv", 5, 6, 192701, 202512)
daily = load_french("F-F_Research_Data_Factors_daily_CSV.zip", "F-F_Research_Data_Factors_daily.csv", 5, 8, 19270101, 20251231)
RM = np.array([r[1] + r[4] for r in monthly]) / 100                  # 月度:市场总收益 = 超额收益 + 无风险利率
RFM = np.array([r[4] for r in monthly]) / 100
RD = np.array([r[1] + r[4] for r in daily]) / 100                    # 日度
RFD = np.array([r[4] for r in daily]) / 100
DATES_M = np.array([r[0] for r in monthly]); DATES_D = np.array([r[0] for r in daily])
print(f"月度:{monthly[0][0]} 至 {monthly[-1][0]},{len(RM)} 个月;月平均 {RM.mean():.2%},月标准差 {RM.std(ddof=1):.2%}")
print(f"日度:{daily[0][0]} 至 {daily[-1][0]},{len(RD)} 个交易日;日平均 {RD.mean():.3%},日标准差 {RD.std(ddof=1):.2%}")
print(f"日度里,最坏的一天 {RD.min():.1%}({DATES_D[int(np.argmin(RD))]}),最好的一天 {RD.max():.1%}({DATES_D[int(np.argmax(RD))]})")

# 一、"随机游走",是在说什么?一种说法:每天(月)的收益,是互相独立的:昨天发生了什么,对今天,毫无影响。
# 我们拿真实的收益,把顺序打乱:打乱以后,每个收益都还在,分布完全一样,只是顺序,没有任何规律。
def acf(x, k):
    x = x - x.mean(); return float((x[k:] * x[:-k]).sum() / (x * x).sum())

def kurtosis(x):
    x = x - x.mean(); return float((x ** 4).mean() / (x ** 2).mean() ** 2)

rng = np.random.default_rng(79)
shuffles = [rng.permutation(RD) for _ in range(500)]
print("\n一、日度收益:真实的顺序,和打乱顺序(500 次)之后:")
print(f"  峰度(正态分布是 3):真实 {kurtosis(RD):.1f};打乱之后一样(分布没有变):{kurtosis(shuffles[0]):.1f}")
print("  自相关(如果收益互相独立,应该在 0 附近;±2/√n 是随机波动的范围):")
band = 2 / math.sqrt(len(RD))
print(f"    ±{band:.3f}:" + ";".join(f"滞后 {k}:真实 {acf(RD, k):+.3f}" for k in (1, 2, 3, 5)))
print("  收益的绝对值(衡量「波动」)的自相关:")
for k in (1, 2, 5, 10, 20):
    sh = [acf(np.abs(s), k) for s in shuffles[:200]]
    print(f"    滞后 {k:>2}:真实 {acf(np.abs(RD), k):+.3f};打乱之后的 95% 范围 {np.quantile(sh, 0.025):+.3f} 到 {np.quantile(sh, 0.975):+.3f}")
print("  → 收益的方向,几乎没有自相关;可是「波动」,有很强的自相关:大波动之后,还是大波动。")
输出:
月度:192701 至 202512,1188 个月;月平均 0.96%,月标准差 5.31%
日度:19270103 至 20251231,26001 个交易日;日平均 0.043%,日标准差 1.08%
日度里,最坏的一天 -17.4%(19871019),最好的一天 15.7%(19330315)

一、日度收益:真实的顺序,和打乱顺序(500 次)之后:
  峰度(正态分布是 3):真实 19.1;打乱之后一样(分布没有变):19.1
  自相关(如果收益互相独立,应该在 0 附近;±2/√n 是随机波动的范围):
    ±0.012:滞后 1:真实 +0.046;滞后 2:真实 -0.025;滞后 3:真实 -0.001;滞后 5:真实 +0.006
  收益的绝对值(衡量「波动」)的自相关:
    滞后  1:真实 +0.299;打乱之后的 95% 范围 -0.012 到 +0.012
    滞后  2:真实 +0.332;打乱之后的 95% 范围 -0.011 到 +0.012
    滞后  5:真实 +0.309;打乱之后的 95% 范围 -0.011 到 +0.011
    滞后 10:真实 +0.256;打乱之后的 95% 范围 -0.011 到 +0.013
    滞后 20:真实 +0.225;打乱之后的 95% 范围 -0.012 到 +0.012
  → 收益的方向,几乎没有自相关;可是「波动」,有很强的自相关:大波动之后,还是大波动。
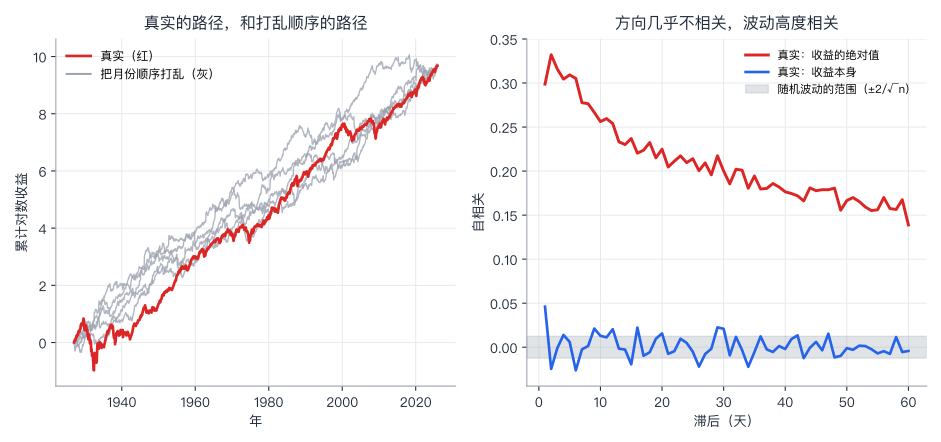
逐段看:
- 数据:月度 1188 个月,月平均 0.96%,月标准差 5.31%(和第 38 讲一致);日度 26,001 个交易日,日平均 0.043%,日标准差 1.08%。最坏的一天,−17.4%(1987 年 10 月 19 日);最好的一天,+15.7%(1933 年 3 月 15 日)。
- 峰度 19.1(正态分布是 3):日度收益,极端值的概率,比正态分布高得多。打乱顺序,分布没有变,峰度还是 19.1。
- 收益的方向,几乎不相关:滞后 1 天,+0.046;滞后 2、3、5 天,−0.025、−0.001、+0.006。(随机波动的范围,是 ±0.012:滞后 1 天,统计上显著;可是,+0.046 的相关,只能解释第二天收益的 0.2%(0.046²),经济上很小。)
- 波动,高度相关: 收益的绝对值,滞后 1、2、5、10、20 天的自相关,是 +0.299、+0.332、+0.309、+0.256、+0.225;打乱顺序之后,只有 ±0.012。大波动之后,还是大波动。
- 左图:真实的路径(红),混在打乱顺序的路径(灰)里,肉眼分不出;可是右图,真实的数据里,有一个打乱顺序之后,完全消失的结构:波动聚集。
问题 1 的答案:打乱顺序,分布不变(峰度、均值、标准差),方向的自相关,本来就接近 0;变的,是波动的聚集。 真实的收益,不是独立的(最强的版本不成立),可是,方向几乎不相关(中等的版本,大致成立)。
四、第二步:方差比,和一个必须知道的陷阱
Lo 和 MacKinlay 1988 年(Review of Financial Studies,1 卷 1 期,41–66 页)的方差比:如果每期的收益互相独立,q 期的收益的方差,应该正好是 1 期的方差的 q 倍,VR(q) ≈ 1。VR > 1:涨了还涨(动量);VR < 1:涨了会回来(均值回归)。
陷阱:普通的检验(同方差的标准误),假设了每期的波动一样大。真实的数据里,波动聚集:这会让检验,冤枉好人。Lo 和 MacKinlay 给出了异方差稳健的版本(z*)。我们先检验这两个检验本身。
# 第二步:方差比检验(Lo 和 MacKinlay 1988 年,Review of Financial Studies,1 卷 1 期,41–66 页)。
# 想法:如果每期的收益互相独立,q 期的收益的方差,应该正好是 1 期的方差的 q 倍。VR(q) = Var(q 期收益) ÷ (q × Var(1 期收益)) 应该约等于 1。
#   VR(q) > 1:收益有「动量」(涨了还涨);VR(q) < 1:收益有「均值回归」(涨了会跌回来)。
def variance_ratio(r, q):
    """r:每期的对数收益(T 个)。返回 VR(q),同方差下的 z,异方差稳健的 z*(都是标准正态分布,在「收益互相独立」的原假设下)"""
    r = np.asarray(r); T = len(r); mu = r.mean()
    a = ((r - mu) ** 2).sum() / (T - 1)                                     # 1 期方差(无偏)
    rq = np.convolve(r, np.ones(q), mode="valid")                            # 重叠的 q 期收益,共 T - q + 1 个
    m = q * (T - q + 1) * (1 - q / T)
    c = ((rq - q * mu) ** 2).sum() / m                                       # q 期方差,除以 q 之前
    vr = c / a
    z = (vr - 1) * math.sqrt(T) / math.sqrt(2 * (2 * q - 1) * (q - 1) / (3 * q))     # 同方差的标准误
    d = (r - mu) ** 2; denom = d.sum() ** 2
    theta = sum((2 * (q - j) / q) ** 2 * T * (d[j:] * d[:-j]).sum() / denom for j in range(1, q))   # 异方差稳健的标准误
    z_star = (vr - 1) * math.sqrt(T) / math.sqrt(theta)
    return vr, z, z_star

# 先检验这个检验本身:用「一定是独立的」数据,看它会不会冤枉好人。5% 水平:|z| > 1.96 就拒绝。
def garch_series(T, rng, omega=1e-6, alpha=0.10, beta=0.88):
    """波动有聚集(大波动之后,还是大波动),但是收益的方向,完全不可预测"""
    r = np.empty(T); var = omega / (1 - alpha - beta)
    for t in range(T):
        r[t] = math.sqrt(var) * rng.standard_normal(); var = omega + alpha * r[t] ** 2 + beta * var
    return r

rng = np.random.default_rng(79); q = 12; T = 1188; reps = 1000
rej = {"独立、同方差": [0, 0], "方向不可预测,波动聚集(GARCH)": [0, 0]}
for rep in range(reps):
    for name, x in (("独立、同方差", rng.standard_normal(T)), ("方向不可预测,波动聚集(GARCH)", garch_series(T, rng))):
        _, z, zs = variance_ratio(x, q); rej[name][0] += abs(z) > 1.96; rej[name][1] += abs(zs) > 1.96
print(f"一、检验会不会冤枉好人?用「方向不可预测」的数据,T = {T},q = {q},{reps} 次,名义上 5% 的拒绝率:")
for name, (a, b) in rej.items(): print(f"  {name}:同方差的 z 拒绝 {a / reps:.1%},稳健的 z* 拒绝 {b / reps:.1%}")

def report(label, r, qs):
    print(f"  {label}({len(r)} 个):" + "   ".join(f"q={qq}: VR {v:.2f} (z {z:+.1f}, z* {zs:+.1f})" for qq in qs for v, z, zs in [variance_ratio(r, qq)]))

print("\n二、真实的数据(对数收益)。VR > 1:涨了还涨;VR < 1:涨了会回来。(z:同方差;z*:异方差稳健;|z| > 1.96,是 5% 水平上的显著)")
LM, LD = np.log1p(RM), np.log1p(RD)
print("月度,1927–2025:")
report("全部", LM, (2, 3, 6, 12, 24, 36))
for lo, hi in ((192701, 196212), (196301, 199212), (199301, 202512)):
    sel = (DATES_M >= lo) & (DATES_M <= hi); report(f"  {lo}–{hi}", LM[sel], (2, 6, 12, 24))
print("日度,1927–2025:")
report("全部", LD, (2, 5, 10, 20))
for lo, hi in ((19270101, 19621231), (19630101, 19921231), (19930101, 20251231)):
    sel = (DATES_D >= lo) & (DATES_D <= hi); report(f"  {lo // 10000}–{hi // 10000}", LD[sel], (2, 5, 10, 20))

# 三、游程检验(Wald–Wolfowitz):把每个月,记成涨(+)或者跌(-)。连在一起的相同符号,叫一个「游程」。
#   如果涨跌互相独立,游程的个数,大约是 2 n₊ n₋ ÷ n + 1。游程太少:同一个方向,连得太久(动量);太多:来回切换(反转)。
def runs_test(x):
    s = x > 0; n1, n2 = int(s.sum()), int((~s).sum()); n = n1 + n2
    runs = 1 + int((s[1:] != s[:-1]).sum())
    mean = 2 * n1 * n2 / n + 1; var = 2 * n1 * n2 * (2 * n1 * n2 - n) / (n ** 2 * (n - 1))
    return runs, mean, (runs - mean) / math.sqrt(var)
print("\n三、游程检验(涨 / 跌的符号):")
for label, x in (("月度", RM - RFM), ("日度", RD - RFD)):
    runs, mean, z = runs_test(x); print(f"  {label}:游程 {runs} 个,独立时的期望 {mean:.1f} 个,z = {z:+.2f}")
输出:
一、检验会不会冤枉好人?用「方向不可预测」的数据,T = 1188,q = 12,1000 次,名义上 5% 的拒绝率:
  独立、同方差:同方差的 z 拒绝 5.1%,稳健的 z* 拒绝 5.1%
  方向不可预测,波动聚集(GARCH):同方差的 z 拒绝 11.6%,稳健的 z* 拒绝 5.2%

二、真实的数据(对数收益)。VR > 1:涨了还涨;VR < 1:涨了会回来。(z:同方差;z*:异方差稳健;|z| > 1.96,是 5% 水平上的显著)
月度,1927–2025:
  全部(1188 个):q=2: VR 1.09 (z +3.0, z* +1.8)   q=3: VR 1.10 (z +2.4, z* +1.4)   q=6: VR 1.09 (z +1.2, z* +0.7)   q=12: VR 1.19 (z +1.7, z* +1.1)   q=24: VR 1.19 (z +1.2, z* +0.8)   q=36: VR 1.10 (z +0.5, z* +0.3)
    192701–196212(432 个):q=2: VR 1.12 (z +2.6, z* +1.5)   q=6: VR 1.12 (z +1.0, z* +0.6)   q=12: VR 1.32 (z +1.8, z* +1.1)   q=24: VR 1.43 (z +1.6, z* +1.0)
    196301–199212(360 个):q=2: VR 1.07 (z +1.3, z* +1.1)   q=6: VR 1.08 (z +0.6, z* +0.6)   q=12: VR 1.02 (z +0.1, z* +0.1)   q=24: VR 0.87 (z -0.5, z* -0.4)
    199301–202512(396 个):q=2: VR 1.03 (z +0.7, z* +0.5)   q=6: VR 1.08 (z +0.6, z* +0.5)   q=12: VR 1.19 (z +1.0, z* +0.8)   q=24: VR 1.29 (z +1.1, z* +0.9)
日度,1927–2025:
  全部(26001 个):q=2: VR 1.05 (z +7.7, z* +3.2)   q=5: VR 1.06 (z +4.1, z* +1.7)   q=10: VR 1.06 (z +3.1, z* +1.3)   q=20: VR 1.12 (z +3.8, z* +1.7)
    1927–1962(10145 个):q=2: VR 1.08 (z +8.5, z* +3.4)   q=5: VR 1.10 (z +4.6, z* +1.9)   q=10: VR 1.15 (z +4.5, z* +2.0)   q=20: VR 1.27 (z +5.4, z* +2.5)
    1963–1992(7549 个):q=2: VR 1.20 (z +17.0, z* +8.0)   q=5: VR 1.31 (z +12.5, z* +5.1)   q=10: VR 1.38 (z +9.9, z* +4.1)   q=20: VR 1.44 (z +7.6, z* +3.5)
    1993–2025(8307 个):q=2: VR 0.93 (z -6.0, z* -2.7)   q=5: VR 0.88 (z -4.9, z* -2.2)   q=10: VR 0.81 (z -5.1, z* -2.3)   q=20: VR 0.80 (z -3.7, z* -1.7)

三、游程检验(涨 / 跌的符号):
  月度:游程 527 个,独立时的期望 567.8 个,z = -2.48
  日度:游程 11895 个,独立时的期望 12920.3 个,z = -12.80
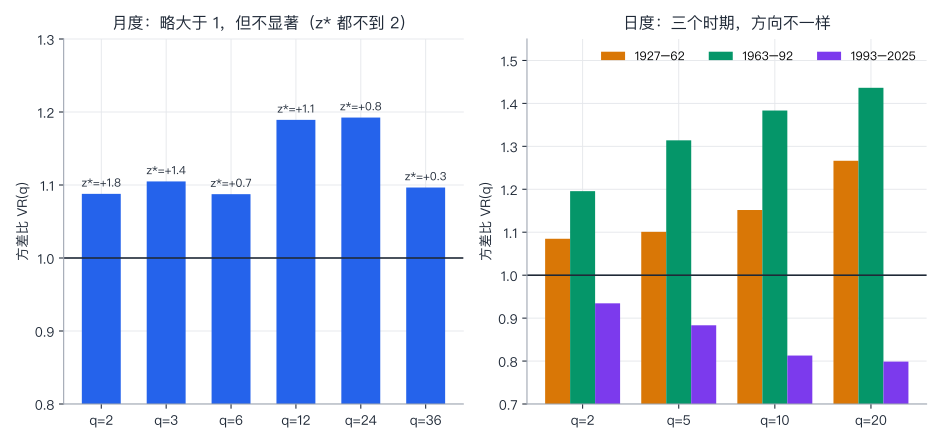
逐段看:
- 检验会不会冤枉好人? 用"方向一定不可预测"的数据(T = 1188,q = 12,1000 次):
- 独立、同方差:普通的 z 和稳健的 z*,拒绝率,都是 5.1%(名义上是 5%):都没问题。
- 方向不可预测,但是波动聚集(GARCH):普通的 z,拒绝 11.6%(是名义上的 2 倍多!);稳健的 z*,5.2%。(用的是我按 Lo–MacKinlay 的公式写的实现,上面的模拟,是我对它的检验;我没有对照原文的表格。)
- 月度,1927–2025(1188 个月):VR(2) = 1.09、VR(3) = 1.10、VR(6) = 1.09、VR(12) = 1.19、VR(24) = 1.19、VR(36) = 1.10,略大于 1;稳健的 z* 是 +1.8、+1.4、+0.7、+1.1、+0.8、+0.3,都不到 1.96:不显著。(要是用普通的 z:q = 2,+3.0,就会"显著";这是波动聚集造成的假警报。)三个时期:1927–62,VR(12) = 1.32;1963–92,1.02;1993–2025,1.19;z* 都不显著。
- 日度,1927–2025(26,001 天):VR(2) = 1.05(z* = +3.2,显著),VR(5) = 1.06、VR(10) = 1.06、VR(20) = 1.12(z* 1.7、1.3、1.7,不显著)。但分三个时期,方向不一样:
- 1927–62:VR(2) = 1.08(z* +3.4)、VR(20) = 1.27(+2.5):大于 1;
- 1963–92:VR(2) = 1.20(+8.0)、VR(5) = 1.31(+5.1)、VR(10) = 1.38(+4.1)、VR(20) = 1.44(+3.5):明显大于 1;
- 1993–2025:VR(2) = 0.93(−2.7)、VR(5) = 0.88(−2.2)、VR(10) = 0.81(−2.3)、VR(20) = 0.80(−1.7):小于 1。
- 游程检验:月度,涨跌的符号,一共 527 个游程,独立时的期望是 567.8,z = −2.48(游程偏少:同一个方向,连得更久);日度,11,895 对 12,920.3,z = −12.80。
问题 2 的答案:月度:不拒绝随机游走(稳健的 z*);日度:拒绝,而且,方向取决于时期:1927–1992,是"涨了还涨"(VR > 1),1993 年以后,是"涨了会回来"(VR < 1)。 为什么?这里没有检验;常见的猜测:日度的指数,是许多股票的加权平均,小股票交易不频繁,价格对信息的反应会慢半拍(“非同步交易”),会让指数的收益,带上正的自相关;后来,交易更快、成本更低,这种影响变小,甚至反过来。这些都只是猜测。
问题 3 的答案:会。 波动聚集,让普通的方差比检验,拒绝率从 5% 涨到 11.6%。读检验的结果,先问:它的假设,满足吗?
证据:Lo 和 MacKinlay 1988 年,用 1962 到 1985 年的周度收益,拒绝了随机游走;据摘要,拒绝,主要来自小股票,也不能完全归因于不频繁交易或波动变化;而且,拒绝随机游走,不等于支持"均值回归"的模型。(我只核对了摘要。)
五、第三步:22 条技术分析规则,一次全试
第 38 讲,我们试了一条规则(上个月涨,持股;跌,持有国库券)。一条规则的 p 值,有一个问题:你是事先选好了它。如果试几百条,挑最好的,这个 p 值,就不能这么读了(多重检验)。现在,一次试 22 条,再问:挑出来最好的那条,是本事,还是运气?
规则的世界:每个月底,看信号;信号是"是",下个月持有股票;是"否",下个月持有国库券。
- 移动平均规则 MA(k):价格高于最近 k 个月月末价格的平均,k = 3, 4, …, 12(10 条);
- 动量规则 MOM(k):最近 k 个月的累计收益大于 0,k = 1, 2, …, 12(12 条;MOM(1) 就是第 38 讲那条)。
对"挑最好的",我们用两个对照来检验:打乱月份顺序(任何顺序里的规律都没了,波动聚集也没了);保留波动聚集、符号随机(保留每个月收益的绝对值,所以大波动,还是连在一起,只把涨跌的符号随机地重新安排,涨的概率,取到让平均收益和真实一样)。
# 第三步:技术分析的规则,能不能赚钱?一条规则,我们在第 38 讲试过(上月涨就持股,上月跌就持有国库券)。现在,一次试 22 条,再问:
# 「挑出来最好的那条」,是本事,还是运气?
# 规则的世界:每个月底,看信号;信号是「是」,下个月持有股票;是「否」,下个月持有国库券(无风险利率)。
#   移动平均规则 MA(k):价格高于最近 k 个月月末价格的平均,k = 3, 4, ..., 12(10 条)
#   动量规则 MOM(k):最近 k 个月累计收益大于 0,k = 1, 2, ..., 12(12 条;MOM(1) 就是第 38 讲那条)
RULES = [("MA", k) for k in range(3, 13)] + [("MOM", k) for k in range(1, 13)]
WARM = 12                                                              # 前 12 个月,用来算信号;从 1928 年 1 月开始,计入成绩

def positions(r, rule):
    """第 t 个月月底的信号 -> 第 t + 1 个月持有股票(1)还是国库券(0)。返回长度 T - WARM 的数组,对应第 WARM, WARM + 1, ..., T - 1 个月"""
    kind, k = rule; T = len(r); price = np.concatenate([[1.0], np.cumprod(1 + r)])        # price[t + 1] = 第 t 个月月底的价格
    out = np.empty(T - WARM, dtype=bool)
    for t in range(WARM, T):                                                               # 用到第 t - 1 个月月底为止的信息,决定第 t 个月的持仓
        end = t                                                                             # price[end] = 第 t - 1 个月月底的价格
        out[t - WARM] = price[end] > price[end - k + 1:end + 1].mean() if kind == "MA" else price[end] > price[end - k]
    return out

def strategy_returns(r, rf, pos, cost):
    """每个月的收益:持股就拿 r,否则拿 rf;每次换仓(股票 <-> 国库券),扣掉 cost(占财富的比例)"""
    r, rf = r[WARM:], rf[WARM:]
    gross = np.where(pos, r, rf)
    switch = np.concatenate([[False], pos[1:] != pos[:-1]])
    return (1 + gross) * np.where(switch, 1 - cost, 1.0) - 1

def sharpe(x, rf):
    ex = x - rf; return ex.mean() / ex.std(ddof=1) * math.sqrt(12)

def rule_table(r, rf, cost):
    """每条规则相对买入持有的夏普之差,和换仓的次数"""
    bh = sharpe(r[WARM:], rf[WARM:]); out = []
    for rule in RULES:
        pos = positions(r, rule); x = strategy_returns(r, rf, pos, cost)
        out.append((sharpe(x, rf[WARM:]) - bh, int((pos[1:] != pos[:-1]).sum()), float(np.prod(1 + x))))
    return bh, out

bh0, tab0 = rule_table(RM, RFM, 0.0)
print(f"一、22 条规则,1928–2025({len(RM) - WARM} 个月),不计交易成本:买入持有的夏普比率 {bh0:.3f},1 元变成 {np.prod(1 + RM[WARM:]):,.0f} 元")
print("  规则       夏普之差(规则 − 买入持有)   换仓次数    1 元变成")
for rule, (d, sw, w) in zip(RULES, tab0):
    print(f"  {rule[0]}({rule[1]:>2})        {d:+.3f}                 {sw:>4}      {w:>8,.0f}")
diffs0 = np.array([d for d, _, _ in tab0]); best0 = int(np.argmax(diffs0))
print(f"  22 条里,夏普比买入持有高的有 {int((diffs0 > 0).sum())} 条;最好的是 {RULES[best0][0]}({RULES[best0][1]}),高 {diffs0[best0]:+.3f}")

print("\n二、交易成本:每次换仓,扣掉财富的 c。夏普比买入持有高的规则有几条?最好的那条还高多少?")
costs = (0.0, 0.001, 0.0025, 0.005, 0.01)
tabs = {c: rule_table(RM, RFM, c)[1] for c in costs}
for c in costs:
    d = np.array([x[0] for x in tabs[c]]); i = int(np.argmax(d))
    print(f"  c = {c:.2%}:有 {int((d > 0).sum()):>2} 条规则的夏普高于买入持有;最好的是 {RULES[i][0]}({RULES[i][1]}),高 {d[i]:+.3f};规则的平均夏普之差 {d.mean():+.3f}")

# 三、「挑出来最好的」是不是本事?用排列检验:把月份的顺序打乱(收益和国库券利率一起打乱),任何「顺序里的规律」都没了;
# 在每一个打乱之后的数据上,把 22 条规则都试一遍,记下「最好的那条的夏普之差」。看真实数据里,最好的那条,在这些「随机的最好」里,排第几。
# 但是,打乱顺序,也抹掉了「波动聚集」。所以,再做第二个对照:保留每个月的绝对大小(所以大波动还是连在一起),只把涨跌的符号,随机地重新安排
# (涨的概率,取到让平均收益和真实一样):方向完全不可预测,波动聚集。
rng = np.random.default_rng(79); n_perm = 1000
i_mom1 = RULES.index(("MOM", 1)); best_shuf = np.empty(n_perm); mom1_shuf = np.empty(n_perm)
for i in range(n_perm):
    p = rng.permutation(len(RM)); d = np.array([x[0] for x in rule_table(RM[p], RFM[p], 0.0)[1]]); best_shuf[i] = d.max(); mom1_shuf[i] = d[i_mom1]
p_up = (RM.mean() / np.abs(RM).mean() + 1) / 2
n_sign = 500; best_sign = np.empty(n_sign)
for i in range(n_sign):
    fake = np.abs(RM) * np.where(rng.random(len(RM)) < p_up, 1.0, -1.0); best_sign[i] = max(x[0] for x in rule_table(fake, RFM, 0.0)[1])
print(f"\n三、「挑最好的」,是本事,还是运气?")
print(f"  只看 MOM(1)(事先选好的一条):真实 {diffs0[i_mom1]:+.3f};打乱月份顺序 {n_perm} 次,随机地不小于它的比例 = {(mom1_shuf >= diffs0[i_mom1]).mean():.3f}")
print(f"  22 条里挑最好的({RULES[best0][0]}({RULES[best0][1]}),{diffs0[best0]:+.3f}):")
print(f"    对照一,打乱顺序({n_perm} 次):「随机的最好」中位数 {np.median(best_shuf):+.3f},95% 分位数 {np.quantile(best_shuf, 0.95):+.3f},不小于真实的比例 {(best_shuf >= diffs0[best0]).mean():.3f}")
print(f"    对照二,保留波动聚集、符号随机({n_sign} 次):中位数 {np.median(best_sign):+.3f},95% 分位数 {np.quantile(best_sign, 0.95):+.3f},不小于真实的比例 {(best_sign >= diffs0[best0]).mean():.3f}")
输出:
一、22 条规则,1928–2025(1176 个月),不计交易成本:买入持有的夏普比率 0.437,1 元变成 12,031 元
  规则       夏普之差(规则 − 买入持有)   换仓次数    1 元变成
  MA( 3)        +0.001                  392         2,473
  MA( 4)        -0.033                  304         1,804
  MA( 5)        +0.024                  260         3,435
  MA( 6)        +0.068                  214         6,141
  MA( 7)        +0.084                  192         5,816
  MA( 8)        +0.058                  172         4,436
  MA( 9)        +0.086                  162         6,529
  MA(10)        +0.107                  144         8,523
  MA(11)        +0.127                  134        10,803
  MA(12)        +0.110                  130         9,040
  MOM( 1)        +0.053                  512         5,281
  MOM( 2)        -0.100                  354           828
  MOM( 3)        +0.011                  252         3,361
  MOM( 4)        +0.066                  200         4,427
  MOM( 5)        +0.090                  166         7,152
  MOM( 6)        +0.074                  146         5,842
  MOM( 7)        +0.121                  124         9,500
  MOM( 8)        +0.109                  116        11,998
  MOM( 9)        +0.103                  108        12,006
  MOM(10)        +0.170                   88        26,245
  MOM(11)        +0.113                   90        14,031
  MOM(12)        +0.119                   76        12,455
  22 条里,夏普比买入持有高的有 20 条;最好的是 MOM(10),高 +0.170

二、交易成本:每次换仓,扣掉财富的 c。夏普比买入持有高的规则有几条?最好的那条还高多少?
  c = 0.00%:有 20 条规则的夏普高于买入持有;最好的是 MOM(10),高 +0.170;规则的平均夏普之差 +0.071
  c = 0.10%:有 18 条规则的夏普高于买入持有;最好的是 MOM(10),高 +0.163;规则的平均夏普之差 +0.055
  c = 0.25%:有 16 条规则的夏普高于买入持有;最好的是 MOM(10),高 +0.153;规则的平均夏普之差 +0.032
  c = 0.50%:有 13 条规则的夏普高于买入持有;最好的是 MOM(10),高 +0.136;规则的平均夏普之差 -0.008
  c = 1.00%:有  8 条规则的夏普高于买入持有;最好的是 MOM(10),高 +0.101;规则的平均夏普之差 -0.088

三、「挑最好的」,是本事,还是运气?
  只看 MOM(1)(事先选好的一条):真实 +0.053;打乱月份顺序 1000 次,随机地不小于它的比例 = 0.010
  22 条里挑最好的(MOM(10),+0.170):
    对照一,打乱顺序(1000 次):「随机的最好」中位数 -0.018,95% 分位数 +0.065,不小于真实的比例 0.000
    对照二,保留波动聚集、符号随机(500 次):中位数 -0.018,95% 分位数 +0.075,不小于真实的比例 0.002
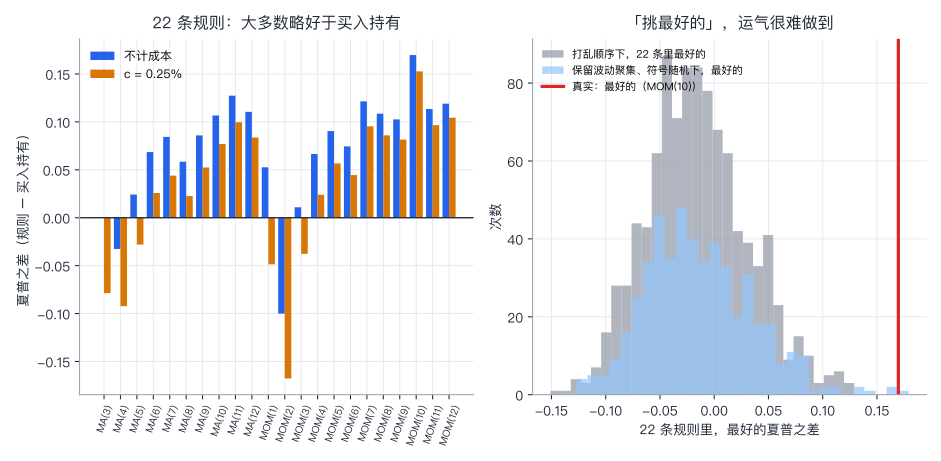
逐段看:
- 不计成本:22 条规则里,20 条的夏普比率,比买入持有(0.437)高;最好的是 MOM(10),高 +0.170。不如买入持有的,只有 MA(4)(−0.033)和 MOM(2)(−0.100);MA(3) 几乎一样(+0.001)。它们换仓最勤(392、304、354 次,是 98 年里的数)。规则越"慢"(k 越大,换仓越少),越好。
- 成本:每次换仓,扣掉财富的 c。c = 0.10%:18 条规则胜出;c = 0.25%:16 条,平均的夏普之差 +0.032;c = 0.50%:13 条,平均 −0.008;c = 1.00%:8 条,平均 −0.088。最好的 MOM(10),成本到 1% 时,仍然高 +0.101(它一共只换仓 88 次,98 年里,约每年不到 1 次)。
- “挑最好的”,是运气吗?
- 只看 MOM(1)(事先选好的一条):真实 +0.053;打乱顺序 1000 次,随机地不小于它的比例 0.010(和第 38 讲的 0.011 一致)。
- 22 条里挑最好的(MOM(10),+0.170):“随机的最好”,打乱顺序下,中位数 −0.018,95% 分位数 +0.065,1000 次里,没有一次,不小于 +0.170;保留波动聚集、符号随机下,95% 分位数 +0.075,500 次里,不小于 +0.170 的,比例是 0.002。
- 也就是说,用这两个对照,“挑最好的"之后,+0.170 还是很难靠运气做到。
问题 4 的答案:大多数规则,比买入持有好;挑最好的,也不是运气(在这两个对照下)。 这和"收益的方向,几乎不可预测”,似乎矛盾。下一步,看这个"好处",是什么。
证据:Brock、Lakonishok 和 LeBaron 1992 年(Journal of Finance,47 卷 5 期,1731–1764 页),用 1897 到 1986 年的道琼斯指数,检验了移动平均和"交易区间突破"两类规则,用自助法,发现买入信号之后的收益,高于卖出信号之后的,也不符合他们检验的四个模型(随机游走、AR(1)、GARCH-M、指数 GARCH)。Sullivan、Timmermann 和 White 1999 年(Journal of Finance,54 卷 5 期,1647–1691 页)把规则的范围,扩展到了更多,用"现实检验"(reality check)的自助法,处理数据窥探。(我只核对了摘要和出处,没读到后者的结论;这里的"挑最好的",是它们要处理的同一类问题的一个简化版本。)
六、第四步:这个"好处",是什么?稳不稳?样本外呢?
# 第四步:这个「好处」,到底是什么?稳不稳?样本外呢?
bh_r, bh_rf = RM[WARM:], RFM[WARM:]; dates = DATES_M[WARM:]
def max_drawdown(x):
    w = np.cumprod(1 + x); return float((w / np.maximum.accumulate(w) - 1).min())

pos10 = positions(RM, ("MOM", 10)); x10 = strategy_returns(RM, RFM, pos10, 0.0)
print("一、拆开看 MOM(10)(在 22 条里最好的那条),不计成本:")
print(f"  {'':<14}  年均超额收益   年化波动    夏普    最大回撤    最差的一个月   在股市里的时间")
print(f"  买入持有        {12 * (bh_r - bh_rf).mean():8.2%}    {bh_r.std(ddof=1) * math.sqrt(12):8.2%}   {sharpe(bh_r, bh_rf):5.2f}   {max_drawdown(bh_r):8.1%}    {bh_r.min():8.1%}        100%")
print(f"  MOM(10)         {12 * (x10 - bh_rf).mean():8.2%}    {x10.std(ddof=1) * math.sqrt(12):8.2%}   {sharpe(x10, bh_rf):5.2f}   {max_drawdown(x10):8.1%}    {x10.min():8.1%}       {pos10.mean():4.0%}")
print("  → 平均的超额收益几乎一样;夏普高,是因为波动小、回撤浅:躲开了大熊市。")

print("\n二、稳不稳?分三段看,所有 22 条规则的平均夏普之差(不计成本),和 MOM(10):")
pos_all = {rule: positions(RM, rule) for rule in RULES}
for lo, hi in ((192801, 196212), (196301, 199212), (199301, 202512)):
    sel = np.flatnonzero((dates >= lo) & (dates <= hi)); a, b = sel[0], sel[-1] + 1
    ds = []
    for rule in RULES:
        x = strategy_returns(RM, RFM, pos_all[rule], 0.0); ds.append(sharpe(x[a:b], bh_rf[a:b]) - sharpe(bh_r[a:b], bh_rf[a:b]))
    print(f"  {lo}–{hi}({b - a} 个月):22 条规则里 {sum(d > 0 for d in ds)} 条夏普高于买入持有,平均之差 {np.mean(ds):+.3f};MOM(10) {ds[RULES.index(('MOM', 10))]:+.3f}")

# 三、样本外:每年 1 月,用过去 20 年(240 个月)的成绩,在 22 条规则里,选夏普最高的那条,用它做接下来的 12 个月。
# 这样,每一个月的持仓,都只用到了「当时已经知道」的信息。
def walk_forward(cost, train=240, step=12):
    out = []; n = len(RM) - WARM
    series = {rule: strategy_returns(RM, RFM, pos_all[rule], cost) for rule in RULES}
    for s0 in range(train, n, step):
        best = max(RULES, key=lambda rule: sharpe(series[rule][s0 - train:s0], bh_rf[s0 - train:s0]))
        out.append((s0, best, series[best][s0:s0 + step]))
    return out

print("\n三、样本外:每年用过去 20 年的成绩,在 22 条规则里选最好的,用一年:")
for cost in (0.0, 0.0025, 0.005):
    wf = walk_forward(cost); xs = np.concatenate([o[2] for o in wf]); s0 = wf[0][0]; L = len(xs)
    r_, f_ = bh_r[s0:s0 + L], bh_rf[s0:s0 + L]
    print(f"  c = {cost:.2%}:{dates[s0]} 起 {L} 个月,样本外的夏普 {sharpe(xs, f_):.3f},买入持有 {sharpe(r_, f_):.3f};1 元变成 {np.prod(1 + xs):,.0f} 元,买入持有 {np.prod(1 + r_):,.0f} 元")
wf = walk_forward(0.0); counts = {}
for _, rule, _ in wf: counts[rule] = counts.get(rule, 0) + 1
print("  选出来最多的规则(不计成本):" + ",".join(f"{r[0]}({r[1]}) {c} 次" for r, c in sorted(counts.items(), key=lambda kv: -kv[1])[:4]) + f"(一共选了 {len(wf)} 次,用过 {len(counts)} 条不同的规则)")
输出:
一、拆开看 MOM(10)(在 22 条里最好的那条),不计成本:
                  年均超额收益   年化波动    夏普    最大回撤    最差的一个月   在股市里的时间
  买入持有           8.08%      18.44%    0.44     -83.7%      -28.7%        100%
  MOM(10)            8.05%      13.24%    0.61     -41.7%      -22.6%        75%
  → 平均的超额收益几乎一样;夏普高,是因为波动小、回撤浅:躲开了大熊市。

二、稳不稳?分三段看,所有 22 条规则的平均夏普之差(不计成本),和 MOM(10):
  192801–196212(420 个月):22 条规则里 18 条夏普高于买入持有,平均之差 +0.105;MOM(10) +0.233
  196301–199212(360 个月):22 条规则里 11 条夏普高于买入持有,平均之差 -0.020;MOM(10) +0.065
  199301–202512(396 个月):22 条规则里 19 条夏普高于买入持有,平均之差 +0.110;MOM(10) +0.172

三、样本外:每年用过去 20 年的成绩,在 22 条规则里选最好的,用一年:
  c = 0.00%:194801 起 936 个月,样本外的夏普 0.640,买入持有 0.552;1 元变成 2,445 元,买入持有 5,157 元
  c = 0.25%:194801 起 936 个月,样本外的夏普 0.536,买入持有 0.552;1 元变成 1,312 元,买入持有 5,157 元
  c = 0.50%:194801 起 936 个月,样本外的夏普 0.522,买入持有 0.552;1 元变成 1,425 元,买入持有 5,157 元
  选出来最多的规则(不计成本):MOM(1) 25 次,MOM(4) 13 次,MOM(10) 12 次,MOM(7) 7 次(一共选了 78 次,用过 10 条不同的规则)
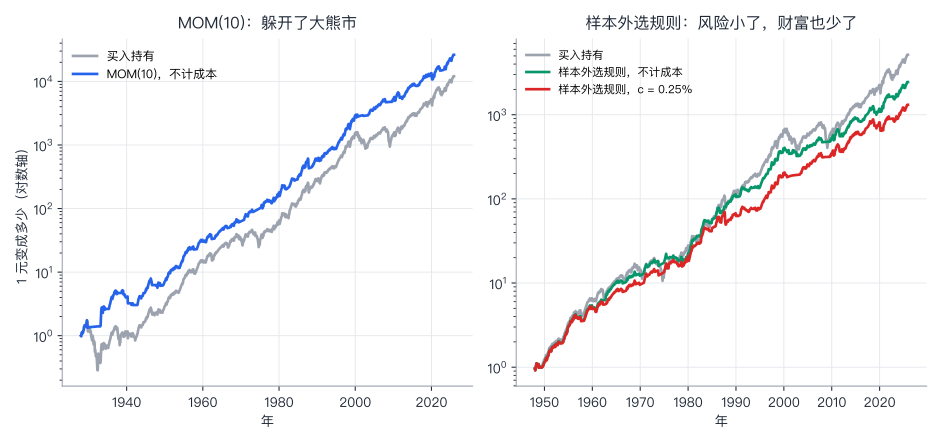
逐段看:
- 拆开看 MOM(10):年均超额收益,8.05%,和买入持有的 8.08% 几乎一样;年化波动,13.24%,对买入持有的 18.44%;夏普 0.61 对 0.44;最大回撤,−41.7%,对 −83.7%;最差的一个月,−22.6%,对 −28.7%;在股市里的时间,75%。规则的好处,不是收益更高,而是风险更小:躲开了大熊市(1929 到 1932 年的大萧条,是买入持有的最大回撤)。 这和第 38 讲的发现一致:波动,可以预测;收益的方向,几乎不能。
- 稳不稳? 分三段,22 条规则的平均夏普之差:
- 1928–1962:18 条规则胜出,平均 +0.105;
- 1963–1992:只有 11 条,平均 −0.020(MOM(10) 还是 +0.065);
- 1993–2025:19 条,平均 +0.110。 好处,集中在两个时期,不是每个时期都有。 中间这三十年,没有。
- 样本外: 每年用过去 20 年的成绩,在 22 条规则里选夏普最高的那条,用一年。这样,每个月的持仓,只用到当时已经知道的信息。1948 年起,936 个月:
- 不计成本:样本外的夏普 0.640,买入持有 0.552;
- c = 0.25%:0.536,低于买入持有(0.552);c = 0.50%:0.522。
- 1 元变成多少: 不计成本 2,445 元,c = 0.25% 时 1,312 元,买入持有 5,157 元:规则里,有一部分时间,持有国库券,所以,总财富,更少。
- 选出来最多的规则,是 MOM(1)(25 次)、MOM(4)(13 次)、MOM(10)(12 次);一共选了 78 次,用过 10 条不同的规则:哪条规则最好,不是一成不变的。
问题 5 的答案:这个好处,是"风险更小",不是"收益更高";它不是每个时期都有;样本外,不计成本时,夏普有一点高(0.64 对 0.55);一加上成本,就不高了(0.54 对 0.55),而且总财富更少。
怎么读:有效市场假说,说的是,没有人能靠公开的信息,系统地赚到风险调整之后、扣掉成本之后的超额收益。这里:规则的夏普,在样本内高;在样本外,不计成本时高,加成本后不高;它降低了风险,没有提高收益。这和有效市场假说,不矛盾;也不能说,它证明了市场有效。更准确的说法是:这个实验,没有找到"公开的、可以靠历史价格实现的"、扣掉成本之后的免费午餐。
还要小心:(1)我们看的,是一段历史(1927 到 2025 年),其中大萧条的回撤,占了很大的分量;(2)成本,我们用的是一个整数(0.1% 到 1%),历史上的成本,在不同时期,差别很大;(3)税、冲击成本、杠杆,都没有算。
七、第五步:检验的"检验力"
最后一步,反过来问:如果市场真的有一点点可预测性,这 99 年的数据,测得出来吗?
做法:自己造数据,注入一个已知的可预测性:r_t = μ + ρ (r_{t−1} − μ) + 噪声(月度,均值和标准差,取真实的 0.96% 和 5.31%)。ρ = 0 就是随机游走。再用两个检验去测,看每个 ρ 下,测出来的比例。
# 第五步:检验的「检验力」。如果市场真的有一点点可预测性,我们这 99 年的数据,测得出来吗?
# 做法:自己造数据,注入一个已知的可预测性:r_t = μ + ρ (r_{t-1} - μ) + 噪声(月度,均值和标准差,取真实的 0.96% 和 5.31%)。ρ = 0 就是随机游走。
# 再用两个检验去测:(1)一阶自相关超出 ±2/√n;(2)q = 12 的方差比,异方差稳健的 |z*| > 1.96。看每个 ρ 下,测出来的比例(5% 水平)。
def ar1_series(T, rho, rng, mu=0.0096, sd=0.0531):
    e = rng.standard_normal(T + 200) * sd * math.sqrt(1 - rho ** 2); x = np.empty(T + 200); x[0] = 0.0
    for t in range(1, T + 200): x[t] = rho * x[t - 1] + e[t]
    return mu + x[200:]                                                      # 前 200 个月,丢掉(让序列进入稳态)

rng = np.random.default_rng(79); reps = 600
print("一、有可预测性(一阶自相关 ρ)时,两个检验能测出来的比例(600 次;5% 水平;每格:自相关检验 / 方差比检验):")
print("  样本长度           ρ = 0(假警报)   ρ = 0.05     ρ = 0.10     ρ = 0.20")
power = {}
for T, label in ((120, "10 年(120 个月)"), (360, "30 年(360 个月)"), (1188, "99 年(1188 个月)")):
    row = []
    for rho in (0.0, 0.05, 0.10, 0.20):
        a = b = 0
        for _ in range(reps):
            x = ar1_series(T, rho, rng); a += abs(acf(x, 1)) > 2 / math.sqrt(T); b += abs(variance_ratio(np.log1p(x), 12)[2]) > 1.96
        row.append((a / reps, b / reps))
    power[T] = row
    print(f"  {label:<14}  " + "    ".join(f"{a:4.0%} / {b:4.0%}" for a, b in row))

# 二、这点可预测性,值多少钱? 同一个 AR(1),用「上月涨就持股,上月跌就持国库券」,夏普比率比买入持有,高多少?(1188 个月,无成本,rf 取 0.3%/月)
print("\n二、如果收益有一阶自相关 ρ,那条「上月涨就持股」的规则,夏普比率比买入持有高多少?(1188 个月,200 次平均,不计成本)")
rng = np.random.default_rng(79); sharpe_gap = {}
for rho in (0.0, 0.05, 0.10, 0.20, 0.30):
    gaps = []
    for _ in range(200):
        x = ar1_series(1188, rho, rng); rf = np.full(len(x), 0.003)
        hold = np.where(x[:-1] > 0.003, x[1:], rf[1:]); gaps.append(sharpe(hold, rf[1:]) - sharpe(x[1:], rf[1:]))
    sharpe_gap[rho] = (float(np.mean(gaps)), float(np.std(gaps)))
    print(f"  ρ = {rho:.2f}:夏普之差的平均 {sharpe_gap[rho][0]:+.3f},标准差 {sharpe_gap[rho][1]:.3f}(单次,大约会在 {sharpe_gap[rho][0] - 2 * sharpe_gap[rho][1]:+.2f} 到 {sharpe_gap[rho][0] + 2 * sharpe_gap[rho][1]:+.2f} 之间)")
print("  对照:真实数据里,这条规则的夏普之差是 +0.047(第 38 讲)。")
输出:
一、有可预测性(一阶自相关 ρ)时,两个检验能测出来的比例(600 次;5% 水平;每格:自相关检验 / 方差比检验):
  样本长度           ρ = 0(假警报)   ρ = 0.05     ρ = 0.10     ρ = 0.20
  10 年(120 个月)      5% /   6%      7% /   8%     16% /  13%     50% /  30%
  30 年(360 个月)      4% /   6%     13% /   9%     40% /  21%     95% /  53%
  99 年(1188 个月)     5% /   5%     39% /  17%     93% /  47%    100% /  94%

二、如果收益有一阶自相关 ρ,那条「上月涨就持股」的规则,夏普比率比买入持有高多少?(1188 个月,200 次平均,不计成本)
  ρ = 0.00:夏普之差的平均 -0.108,标准差 0.067(单次,大约会在 -0.24 到 +0.03 之间)
  ρ = 0.05:夏普之差的平均 -0.021,标准差 0.072(单次,大约会在 -0.16 到 +0.12 之间)
  ρ = 0.10:夏普之差的平均 +0.074,标准差 0.075(单次,大约会在 -0.08 到 +0.22 之间)
  ρ = 0.20:夏普之差的平均 +0.256,标准差 0.081(单次,大约会在 +0.09 到 +0.42 之间)
  ρ = 0.30:夏普之差的平均 +0.439,标准差 0.081(单次,大约会在 +0.28 到 +0.60 之间)
  对照:真实数据里,这条规则的夏普之差是 +0.047(第 38 讲)。
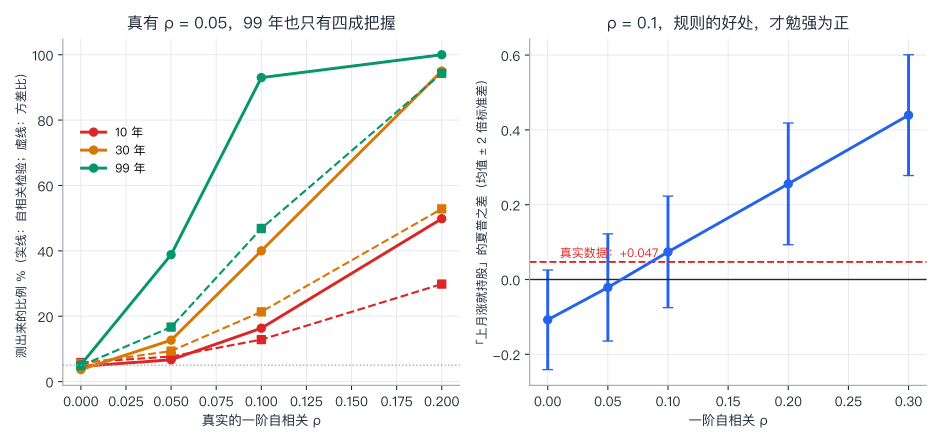
逐段看:
- 假警报:ρ = 0 时,两个检验的拒绝率,都在 5% 左右(4% 到 6%):检验是"诚实"的。
- ρ = 0.05(一阶自相关 0.05,也就是,这个月的收益,只能解释下个月收益的 0.25%):
- 10 年的数据:测出来的,只有 7%(自相关检验)、8%(方差比);
- 30 年:13%、9%;
- 99 年:39%、17%。
- ρ = 0.10:99 年的数据,自相关检验,测出来 93%,方差比 47%;30 年:40%、21%。
- ρ = 0.20:99 年,100%、94%。
- “上月涨就持股"的规则,值多少钱? ρ = 0:夏普之差的平均是 −0.108(随机游走里,这条规则,平均比买入持有差);ρ = 0.05:−0.021;ρ = 0.10:+0.074;ρ = 0.20:+0.256;ρ = 0.30:+0.439。真实数据里,这条规则的夏普之差,是 +0.047(第 38 讲),大约对应 ρ ≈ 0.09;但是单次的波动范围(±2 倍标准差),在 ρ = 0.10 时,是 −0.08 到 +0.22,+0.047 在 ρ = 0、0.05、0.10 的范围里,都有可能。
问题 6 的答案:测得出来大的,测不出来小的。 一阶自相关 0.05,99 年的数据,也只有 39% 的把握,用方差比,只有 17%。“检验不出可预测性”,不等于"没有可预测性”。 反过来,一个 ρ = 0.05 的可预测性,对一条简单的规则的价值,也很小(夏普之差 −0.02):即使存在,也很难赚到钱。 这是有效市场假说,很难被证伪,也很难被证实的一个原因(第 38 讲 6 节说的"联合假设":检验的,是"市场有效 + 定价模型"这两件事一起)。
八、这个实验说明了什么,没说明什么
说明了:
- 收益的方向,几乎不相关;波动,高度相关。 随机游走的"最强版本"(独立同分布),不成立;“中等版本”(不相关),大致成立。
- 检验要先检验: 波动聚集,让普通的方差比检验,假警报率翻倍。
- 日度的数据,在不同的时期,表现不同:1927–1992,正的自相关;1993 年之后,负的。
- 一次试很多规则,挑最好的,要用恰当的对照来检验。 22 条规则里最好的,用两个对照,都不容易靠运气做到。
- 规则的好处,是风险更小,不是收益更高;样本外,加上成本,就看不到好处了。
- 检验力有限: 小的可预测性,99 年也测不出来;测不出来,不等于没有。
没说明:
- 为什么日度的方差比,会随时期变号。 我们只提了猜测,没有检验。
- 为什么趋势规则有好处。 “风险降低,收益不变”,可以用几种理论来解释(波动的时变、风险溢价的时变、行为偏差),这个实验没有区分。
- 未来。 一段历史的结果,不是未来的承诺;市场在变,规则也会被套利。
- 其他市场、其他资产、中国股市。 我们只看了美国股市的指数。
九、和前面、后面的联系
- 第 4 讲:研究结果可靠吗,多重检验。
- 第 37 讲:风险和分散,夏普比率。
- 第 38 讲:这个实验,是它 3 节的扩展,第 38 讲预告的"方差比、游程、带成本的回测",在这里兑现。
- 第 39 讲:行为经济学,动量、过度反应,是对"市场不完全有效"的行为解释。
- 实验 70、73、78:简单的规则、集体的行为,怎样产生复杂的整体结果;这里,是反过来:从整体的数据里,找简单规则的痕迹。
十、练习
下面的练习,都可以在上面的代码上改几个数字做出来。提示里的数字,都是我跑过的。
练习 1(更长的期限)。 第二步里,把月度的 q 改成 48 和 60,VR 和稳健的 z* 是多少?
提示:
variance_ratio(LM, 48):VR = 1.04,z* = +0.11;variance_ratio(LM, 60):VR = 0.96,z* = −0.09。期限越长,VR 越回到 1 附近,检验力也越低(用到的独立样本,越来越少)。
练习 2(近 30 年的游程)。 第二步里,只用 1993 年以后的数据,做游程检验,月度和日度,z 各是多少?
提示:月度 1993–2025:游程 174 个,期望 183.2,z = −1.00;日度:4,207 个,期望 4,130.7,z = +1.68。符号反过来了(游程偏多,来回切换),和日度方差比(1993 年以后,VR < 1)一致;但不显著(|z| < 1.96)。
练习 3(成本再高一点)。 第三步里,把成本改成 0.75%,22 条规则里,夏普高于买入持有的有几条?最好的是哪条?平均夏普之差是多少?
提示:
rule_table(RM, RFM, 0.0075):9 条;最好的还是 MOM(10),高 +0.118;22 条的平均夏普之差 −0.048。
练习 4(训练期短一点)。 第四步里,把 walk_forward(cost) 的训练期,从 240 个月,改成 120 个月(10 年):样本外的夏普,不计成本和 c = 0.25%,各是多少?
提示:
walk_forward(cost, train=120):样本外从 1938 年 1 月起:不计成本,夏普 0.579;c = 0.25%,0.485(买入持有,0.552)。训练期短,选出来的规则,更不稳定,成本的影响更大。
练习 5(只用 1963 年以后)。 第四步里,只用 1963 年 1 月以后的数据,22 条规则里,夏普高于买入持有的有几条?平均夏普之差是多少?最好的是哪条?
提示:19 条,平均 +0.039,最好的是 MOM(10),高 +0.115。(对比:1963–1992 这一段,只有 11 条,平均 −0.020;好处,主要来自 1993 年以后。)
练习 6(很小的可预测性)。 第五步里,先运行 rng = np.random.default_rng(79),再把 ρ 改成 0.02 和 0.03,只做 T = 1188(99 年)那一行(每格 600 次),两个检验能测出来的比例,各是多少?
提示:ρ = 0.02:自相关检验 10.8%,方差比 9.5%(假警报是 5%);ρ = 0.03:15.5%、12.2%。非常小的可预测性,几乎测不出来;也几乎赚不到钱。
十一、局限
- 只有美国股市的指数;日度的数据,早期的构造(比如周六交易、价格的记录),和后期不同;市值加权,大公司的分量大。
- 规则只有 22 条,都是最简单的;更复杂的规则、不同的频率,没有试。
- 对照:打乱顺序、保留波动聚集的符号随机,是两个简化的对照;没有包含杠杆效应(下跌时,波动更大)。
- 成本是一个固定的比例,没有考虑税、价差随时间的变化。
- 夏普比率,是一个粗糙的风险调整;不同的风险衡量(回撤、偏度),可能给出不同的排序。
- 检验力的模拟,用的是正态的、AR(1);真实的可预测性,可能是别的形式(比如,只在某些状态下才有)。
参考
- Lo, A. W., & MacKinlay, A. C. (1988). Stock market prices do not follow random walks: Evidence from a simple specification test. Review of Financial Studies, 1(1), 41–66.
- Brock, W., Lakonishok, J., & LeBaron, B. (1992). Simple technical trading rules and the stochastic properties of stock returns. Journal of Finance, 47(5), 1731–1764.
- Sullivan, R., Timmermann, A., & White, H. (1999). Data-snooping, technical trading rule performance, and the bootstrap. Journal of Finance, 54(5), 1647–1691.
- Fama, E. F. (1970). Efficient capital markets: A review of theory and empirical work. Journal of Finance, 25(2), 383–417.
- Fama, E. F., & French, K. R. Data Library(Kenneth R. French’s data library):Fama/French 3 Factors(月度和日度)。