这是第五套、也是最后一套习题,对应 Unit 9 和 Unit 10,也就是第 36 讲到第 43 讲:钱和时间、风险和保险、市场有没有效率、人为什么不像计算机,然后走出国门:贸易、汇率、发展、不平等,最后是几百年的大历史。一共 31 道题,每道题都有完整的解答。
这一部分有很多"算一算"的题(贴现、债券、关税、汇率),数字不难,但容易在单位和方向上犯错:是名义还是实际,是升值还是贬值,是年利率还是月利率。解答里会尽量把这些容易错的地方标出来。
怎么用这套题
先做,再看。 每道题先写下"这是哪一讲的哪个公式",估一估答案的大小和方向,再动手算。估计和计算差得很远的时候,往往是哪里弄反了。
难度。
- ★ 巩固:直接用一个定义,或者一步计算。
- ★★ 标准:两三步,或者要你自己把一段现实的话翻译成模型。
- ★★★ 挑战:要把几讲拼在一起,或者里面藏着一个陷阱。
题型。 判断辨析、计算、建模、四道代码题(标"代码")、两道四步写作题、一道综合题。代码题的代码是独立的完整程序,只需要 Python 3(都没有用到 NumPy),不需要联网。
解答。 每题分四步:思路、过程、答案、常见错误。
关于现实中的政策与投资。 这套题里有几道涉及投资、房贷、关税、汇率。所有数字都是为练习设计的,不是投资建议,也不是对任何政策的评价。 凡是涉及有争论的问题(保护战略行业、养老金默认选项、逆差是不是问题),解答只给事实部分和不同立场的逻辑,价值判断留给你。
数字。 所有计算题的数字都用代码核对过;代码题的输出就是代码实际跑出来的。题里的场景和数字都是为练习设计的示意,不对应真实的统计数据。
| 题号 | 主题 | 对应讲 |
|---|---|---|
| 1–6 | 复利与现值、房贷、债券、NPV/IRR、长期折现、现在偏向 | 第 36 讲 |
| 7–9 | 期望效用、保险公司、分散 | 第 37 讲 |
| 10–13 | 运气与技能、费用、CAPM、养老金默认选项 | 第 38 讲 |
| 14–16 | 前景理论、默认选项、公平 | 第 39 讲 |
| 17–19 | 关税、关税战、保护战略行业 | 第 40 讲 |
| 20–23 | 实际汇率、马歇尔–勒纳、经常账户、货币危机 | 第 41 讲 |
| 24–27 | 基尼、贫困、再分配的漏桶、普雷斯顿曲线 | 第 42 讲 |
| 28–30 | 马尔萨斯陷阱、历史上的增速与追赶、综合题 | 第 43 讲、全课 |
| 31 | 判断题 | 第 36–43 讲 |
题目
第一部分 时间的价值(第 36 讲)
题 1(★)复利与现值
(1)现在存 50 万元,年利率 5%,30 年后是多少?
(2)现在存 1 万元,年利率 3%,40 年后是多少?
(3)年利率 6% 时,大约多少年翻一番?用 72 法则,再和精确值比一比。
(4)20 年后的 100 万元,年利率 4% 时,今天值多少?
(5)实际利率 3%,通胀 2%,名义利率约是多少?精确值是多少?
(6)有人给你两个选择:今天拿 100 万,或者 5 年后拿 130 万。他隐含的年利率是多少?
题 2(★★)房贷与提前还贷
借 80 万元,25 年,等额本息,年利率 4.2%,按月还。
(1)每月还多少?25 年一共付多少利息?
(2)如果现在提前还 10 万元(期限不变),月供变成多少?每月少付多少?
(3)这 10 万元如果不还房贷,放在别处年收益 1%、3%、4.2%、5%,那么"每月少付的钱"折成今天的价值(按这个收益率折现),各是多少?和 10 万比,哪边更划算?
(4)临界的收益率是多少?这说明了什么?(这只是算术,不是任何建议。)
题 3(★★)债券的价格
一张 10 年期债券,面值 100,每年付息 4(息票率 4%)。
(1)市场收益率是 3%、4%、5%、6% 时,价格各是多少?
(2)收益率从 4% 升到 6%,剩余期限是 2 年、5 年、10 年、30 年的这种债券,价格各跌百分之几?
(3)2020 年买入一张 10 年期、息票率 1.5% 的债券,面值 100。三年后市场收益率升到 4.5%,剩余 7 年。它的价格是多少?账面亏了多少?
(4)这和第 35 讲的硅谷银行有什么关系?
题 4(★★★)代码:NPV 与 IRR
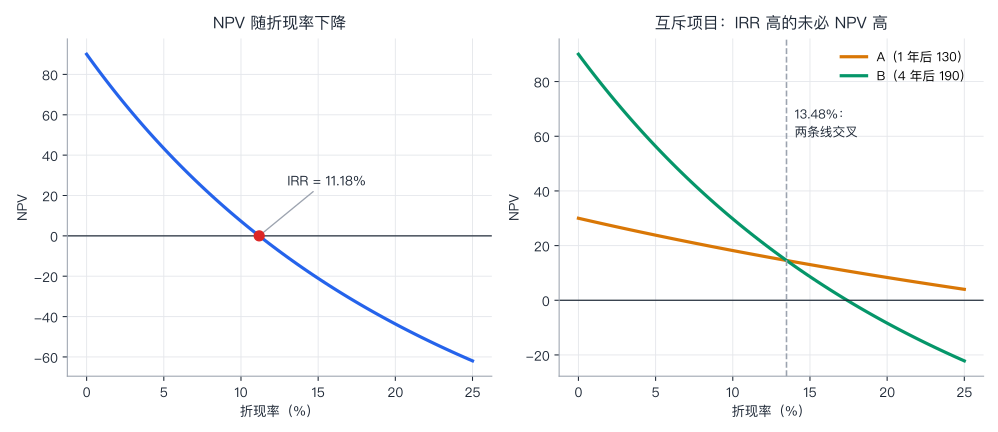
(1)一个项目:现在花 200,之后 6 年每年收 45,最后一年再多收 20(残值)。写代码,算折现率 3%、6%、9%、12%、15% 时的 NPV,并用二分法求 IRR。
(2)两个互斥项目,都要现在投入 100:A 一年后还 130;B 四年后还 190。折现率 5%、10%、15%、20% 时,各自的 NPV,选哪个?两个项目的 IRR 各是多少?
(3)NPV 相等的折现率是多少?这说明为什么"比较互斥项目要用 NPV,不能用 IRR"?
题 5(★★)长期折现:100 年后的代价,今天值多少
拉姆齐公式:折现率 r = ρ + η × g,ρ 是纯时间偏好,η 是对不平等的厌恶,g 是未来的人均消费增长,设 g = 2%。
(1)三组设定:(ρ = 0.1%,η = 1)、(ρ = 1%,η = 1.5)、(ρ = 2%,η = 2)。折现率各是多少?
(2)80 年后的 1 亿元损害,三组设定下今天的现值各是多少?
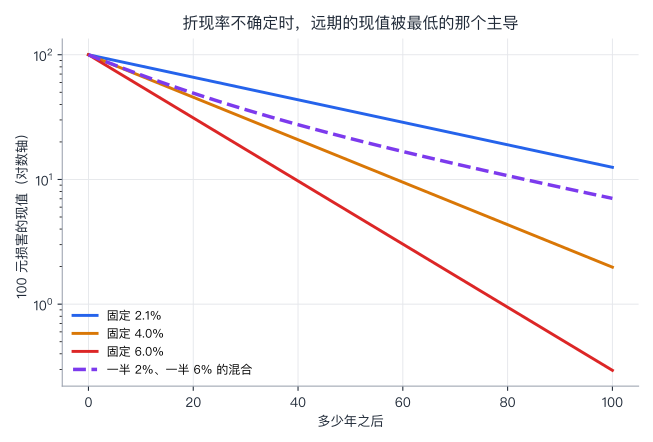
(3)如果不确定该用哪个折现率,一半的可能是 2%,一半是 6%。20、50、100 年后,混合的"等价折现率"各是多少?
(4)这说明了什么?
题 6(★★★)现在偏向:计划,和到时候的改主意
一个人的月度折现因子 δ = 0.96,现在偏向系数 β = 0.6(只对"现在 vs 将来"的比较起作用)。
(1)今天拿 100,或者一个月后拿 112。指数折现者(β = 1)怎么选?β–δ 的人怎么选?
(2)12 个月后拿 100,或者 13 个月后拿 112。从今天看,两种人各怎么选?
(3)12 个月后真的到了,β–δ 的人面对"当天拿 100 还是一个月后拿 112",会怎么选?这和(2)里他今天的计划一致吗?
(4)这个人愿意花多少钱,买一个"锁定"(今天就把选择定死、将来无法改)?
第二部分 风险、保险与分散(第 37 讲)
题 7(★★)期望效用与保险
一个人的效用是 ln(财富)。
(1)财富 80 万元,抛一枚硬币:正面赢 30 万,反面输 30 万。这个赌局对他的确定性等价是多少?风险溢价多少?
(2)他有一套价值 120 万元的房子,一年里被烧毁的概率 0.5%。公平保费是多少?
(3)他其他财富是 100 万元时,最多愿意付多少保费?其他财富是 1000 万元时呢?
(4)保险公司收 0.65 万元,两种人各买不买?
题 8(★★★)代码:保险公司什么时候不会亏
保险公司卖保单:每份保单出险概率 2%,出险赔 50,保费 1.2(平均赔付 1.0,所以有 20% 的安全垫)。
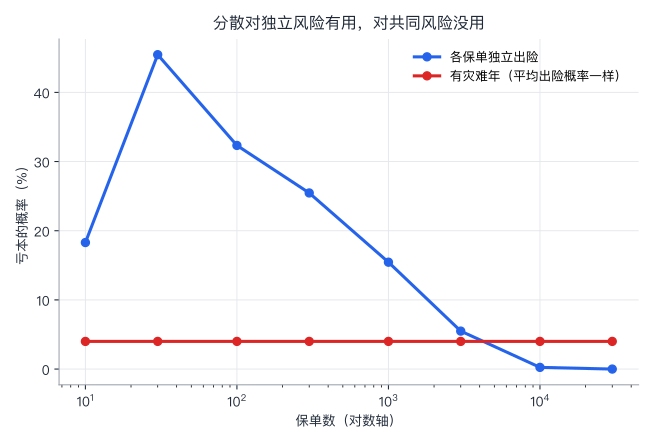
(1)写代码:保单数 10、100、1000、1 万、10 万时,“赔付总额超过收到的保费"的概率是多少(各保单独立出险)?
(2)换一种风险:4% 的年份是灾难年,灾难年里每份保单 50% 出险,其他年份没有出险(平均出险概率也是 2%)。亏本概率呢?
(3)这两列数字说明了什么?
题 9(★★)分散
(1)资产 1 的年波动 20%,资产 2 的波动 30%,相关系数 0.3。各投一半,组合的波动是多少?
(2)波动最小的组合,资产 1 的权重是多少?波动是多少?
(3)相关系数是 1 和 −0.5 时,各投一半,波动各是多少?
(4)N 个资产,每个波动 25%,两两相关 0.4,等权。N = 1、4、25、100、无穷时,组合波动各是多少?
第三部分 有效市场(第 38 讲)
题 10(★★)运气与技能
5000 位基金经理,每年每人有 50% 的概率跑赢市场,彼此独立,完全凭运气。
(1)连续 3、5、8、10、12 年跑赢的人,预计各有几位?
(2)连赢 5 年的那些人,第 6 年继续跑赢的概率是多少?
(3)一位经理真的有技能:每年平均跑赢市场 1.5%,跟踪误差(每年的随机波动)5%。要几年才能让 t 统计量达到 2?
题 11(★)费用
一个人投资 50 万元,25 年。市场的平均年收益是 8%(费用前)。
(1)低成本指数基金费率每年 0.2%,主动基金每年 1.5%。25 年后各是多少?
(2)主动基金少了百分之几?
(3)这个比较的前提是什么?
题 12(★★)CAPM
无风险利率 2%,市场风险溢价 5.5%。
(1)β = 1.3 的股票,CAPM 的预期收益是多少?
(2)60% 投这只股票,40% 投无风险资产,组合的 β 和预期收益是多少?
(3)两只股票,β 分别是 0.8 和 1.4,各投一半,β 是多少?
(4)这只 β = 1.3 的股票,过去 25 年平均收益 11%,年波动 30%。它的"α"是多少?这个估计可靠吗?
题 13(★★★)养老金的默认选项:用四步写一段话
有人建议:员工加入养老金计划时,默认的投资选项设为低成本的指数基金(员工可以改选别的)。
请按"理论预测 → 证据与局限 → 分歧在哪 → 价值判断留给读者"写一段话。注意区分事实和价值判断。(这不是投资建议。)
第四部分 行为经济学(第 39 讲)
题 14(★★★)代码:前景理论
价值函数:收益 v(x) = x^α,损失 v(x) = −λ(−x)^α。概率权重 w(p) = p^γ / (p^γ + (1 − p)^γ)^(1/γ)。一组虚构的参数:α = 0.8,λ = 2.0,γ(收益)= 0.65,γ(损失)= 0.70。
(1)一个赌局:50% 赢 G,50% 输 100。G 要多大才愿意接受?分三种情形:只有损失厌恶(价值函数是线性的);加上价值函数的曲度;再加上概率权重。
(2)“四重模式”:5% 赢 200、95% 赢 200、5% 输 200、95% 输 200,每个赌局对你值多少钱(确定性等价)?和期望值比一比。
(3)每一行说明了什么?
题 15(★★)默认选项:有时更好,有时更糟
一个养老金计划。员工 i 参加的"净好处"是 B(可正可负,员工自己知道)。所有人面对的麻烦(办手续的成本)是 30(只要有动作就付)。B 在员工中均匀分布。
- 自愿加入:只有 B > 30 的人才去办手续加入。
- 默认加入:人人自动加入;想退出的人要付 30 的手续成本。
总好处 = 所有人的净好处之和(参加的人得到 B,办手续的人付 30)。
(1)B 均匀分布在 −20 到 100:两种办法下,参与率和人均总好处各是多少?
(2)B 均匀分布在 −100 到 40:呢?
(3)B 均匀分布在 −100 到 20:呢?
(4)这说明默认选项的好处取决于什么?
题 16(★★)公平:提议者该提多少
最后通牒博弈:提议者拿 10 元分给回应者,回应者接受或拒绝(拒绝则双方都是 0)。回应者的效用:自己得到 s,提议者得到 10 − s,效用 = s − A × max(10 − 2s, 0)(A 是对"自己比别人少"的反感)。分布:A = 0 占 20%,A = 0.3 占 30%,A = 1 占 40%,A = 3 占 10%。
(1)各类回应者的最低接受额是多少?
(2)提议者的最优提议是多少?期望所得多少?
(3)纯自利的提议者以为所有人 A = 0,会提多少?实际期望所得多少?
第五部分 国际贸易(第 40 讲)
题 17(★★★)一项关税
小国模型:本国需求 Q = 100 − P,本国供给 Q = 2P − 20(P ≥ 10),世界价格 20(可以无限进口)。
(1)自由贸易:国内销量、国产量、进口量、各方的剩余?
(2)征关税 t = 5、10、15、20 时,国内价格、国产量、进口量、消费者剩余、生产者剩余、关税收入和净损失各是多少?
(3)t = 5 时,消费者损失的钱里,多少变成了生产者的所得,多少变成了政府的收入,多少是净损失?
(4)多高的关税是"禁止性"的?
(5)一个国家进口占 GDP 的 20%,需求弹性 ε = 4 或 8,开放的得益大约是 GDP 的多少?(用第 40 讲的近似:(1 − 进口占比)^(−1/ε) − 1。)
题 18(★★)关税战
两个国家,每国可以选"自由"或"加税”。收益(甲,乙):(自由,自由)(100, 100);(加税,自由)(115, 70);(自由,加税)(70, 115);(加税,加税)(85, 85)。
(1)找出占优策略和纳什均衡。这是什么博弈?
(2)如果这个博弈重复无数次,下一期继续的概率是 δ,用冷酷触发,δ 要多大,“自由"才能维持?
(3)如果两国大小不一样,会怎样?
(4)这和 WTO 一类的国际规则有什么关系?
题 19(★★★)该不该保护"战略行业”:用四步写一段话
一个国家的某个行业被认为是"战略性的"(比如关系国家安全或未来的技术)。有人主张用关税或补贴保护它,有人反对。
请按"理论预测 → 证据与局限 → 分歧在哪 → 价值判断留给读者"写一段话。
第六部分 汇率与国际收支(第 41 讲)
题 20(★★)汇率与实际汇率
(1)汇率(每 1 美元合多少人民币)从 6.50 变成 6.89。美元升值了百分之几?人民币贬值了百分之几?为什么两个数不一样?
(2)名义汇率保持 6.50 不变。8 年里,国内通胀每年 6%,美国每年 2%。实际汇率 q = eP*/P 怎么变?本币实际升值还是贬值了?
(3)要保持实际汇率不变,名义汇率要变成多少?
题 21(★★)马歇尔–勒纳
本币贬值 10%。简化模型:出口的本币价格不变,出口数量 × 1.1^η_x(η_x 是出口对汇率的弹性);进口的外币价格不变,本币价格 × 1.1,进口数量 × 1.1^(−η_m)。初始出口 = 进口 = 100(本币)。
(1)η_x = η_m = 0.2、0.5、0.8、1.5 时,贸易余额的变化各是多少?
(2)η_x = 0.1,η_m = 0.3 呢?
(3)马歇尔–勒纳条件是什么?
(4)为什么短期里,贬值之后贸易余额可能先恶化(J 曲线)?
题 22(★★)经常账户恒等式
一个经济:消费 600,投资 180,政府购买 150,出口 130,进口 60。
(1)GDP、储蓄、净出口、经常账户各是多少?验证 CA = S − I。
(2)投资增加 40,储蓄不变。经常账户怎么变?
(3)政府多支出 50(其他不变,私人储蓄不变)。经常账户怎么变?
(4)有人说"经常账户逆差就是坏事"。这个恒等式能回答吗?
题 23(★★★)货币危机:第一代模型
固定汇率制。货币供给 M̄ = 120,国内信贷 D0 = 50,外汇储备 R0 = 70(M̄ = D + R)。国内信贷每年增长 μ,D(t) = D0 × e^(μt)。(第 41 讲的简化结论:投机攻击比储备耗尽提前 α 年,α 是货币需求对预期贬值的半弹性。)α = 4。
(1)μ = 6%:储备什么时候耗尽?攻击什么时候发生?攻击时剩余储备多少?
(2)μ = 10% 呢?
(3)为什么政府看着储备还有 25–40,投机者却攻击了?
第七部分 发展与不平等(第 42 讲)
题 24(★★)基尼系数
(1)五个人的收入 (2, 3, 5, 8, 22)。基尼系数是多少?最穷 40% 和最富 20% 各拿总收入的几成?
(2)收入对数正态分布,σ = 0.9,基尼系数是多少?(公式 G = 2Φ(σ/√2) − 1。)
(3)两个国家基尼系数相同,收入分布一定一样吗?
题 25(★★)增长和分配,谁减贫更多
一个国家的日收入服从对数正态分布,中位数 6,σ = 0.8。贫困线是每天 3 元。
(1)贫困率是多少?
(2)所有人的收入增长 10%(中位数 6.6),σ 不变。贫困率呢?
(3)收入增长 10%,但不平等同时上升:σ 变成 1.0。贫困率呢?
(4)σ = 1.0 时,中位数要多高,才能让贫困率回到(1)的水平?
题 26(★★★)代码:再分配的漏桶
税前收入对数正态(σ = 0.7),均值标准化为 1。政府征统一税率 t,把全部税收平分给每个人。税会使税前收入减少:税前收入 = y × (1 − t)^e,e = 1.0。税后收入 = 税前收入 × (1 − t) + 人均转移。
(1)写代码:t = 0、20%、40%、50%、60%、80% 时,人均收入、最穷 20% 的平均收入、基尼系数、人均转移、“漏掉的比例"各是多少?
(2)哪个税率让最穷 20% 的平均收入最高?哪个让全体平均收入最高?税收最大的税率是多少?
(3)这说明了什么?它回答了"税率该多高"吗?
题 27(★★)普雷斯顿曲线:寿命提高了多少来自收入
预期寿命 ≈ a + b × ln(人均收入),b = 6。一个国家 1990 年人均收入 2000 元,预期寿命 55 岁;2020 年人均收入 6000 元,预期寿命 68 岁。
(1)这 13 岁里,沿着同一条曲线、因为收入增加带来的是多少岁?
(2)剩下的是什么?占多大比例?
(3)这说明了什么?
第八部分 大历史与综合(第 43 讲、全课)
题 28(★★)马尔萨斯陷阱与逃离
马尔萨斯模型:人均收入 y = A × N^(−α),人口增长率与(y − y0)成正比(比例系数 ε),y0 = 1 是"勉强维持"的水平。设 α = 0.5,ε = 0.3,每"代"为单位。
(1)一次性的技术进步使 A 提高 60%。长期里,人口和人均收入各变成原来的多少倍?
(2)技术持续进步,每代 +g。长期的稳态人均收入 y = 1 + ln(1 + g)/(αε),人口每代增长 (1 + g)^(1/α) − 1。g = 5%、10%、20% 时,各是多少?
(3)为什么在这个模型里,一次性的进步只带来更多人口,而持续的进步才能带来更高的收入?
(4)模型没有说明什么?
题 29(★★)历史上的增速与追赶
(1)英国 1830–1870 年人均收入年均增长 1.25%,40 年后是原来的多少倍?
(2)中国 1978 年人均收入 1744,2022 年 19238(同一套价格,国际元)。年均增长多少?翻一番要几年?
(3)假设中国未来每年增长 3%、4%、5%,英国每年增长 1%,中国要多少年才追上英国 2022 年的 38407?(这是算术,不是预测。)
(4)韩国 1952–1996 年人均收入增长 19.5 倍,年均多少?
(5)这些算术说明了什么?没说明什么?
题 30(★★★)一道综合题:用权衡、激励、均衡三个想法
一个城市限制网约车的数量,只发一定数量的牌照,牌照可以转让。
请用本课的三个想法(权衡、激励、均衡)和你在前面学到的具体模型,分析这件事:谁得益,谁受损,会发生什么意想不到的事,哪些是事实问题,哪些是价值问题。说明你用到了哪几讲的内容。
题 31(★)判断题:这些话对吗
判断对错,并说明理由。
(a)已经发行的债券,市场收益率上升时,它的价格会下降。
(b)两个互斥项目,IRR 高的 NPV 一定高。
(c)折现率越高,100 年后的损害的现值越小。
(d)分散投资可以消除所有风险。
(e)有效市场假说说的是:没有人能赚到钱。
(f)前景理论认为,同样的金额,损失带来的痛苦大于收益带来的快乐。
(g)默认选项总是让人们的境况变好。
(h)小国征收进口关税,国内消费者的损失大于生产者的所得。
(i)本币贬值一定改善贸易余额。
(j)两个国家基尼系数相同,收入分布就相同。
(k)马尔萨斯模型里,一次性的技术进步会让人均收入永久提高。
(l)预期寿命随收入上升,说明收入是寿命提高的唯一原因。
解答
第一部分 时间的价值
题 1 解答
思路。 终值 = 现值 × (1 + r)^n;现值 = 终值 ÷ (1 + r)^n。
过程与答案。
(1)50 × 1.05^30 ≈ 216.1 万元。
(2)1 × 1.03^40 ≈ 3.26 万元。
(3)72 法则:72 ÷ 6 = 12 年。精确:ln 2 ÷ ln 1.06 ≈ 11.9 年。
(4)100 ÷ 1.04^20 ≈ 45.6 万元。
(5)近似:3% + 2% = 5%。精确:1.03 × 1.02 − 1 = 5.06%。
(6)(130/100)^(1/5) − 1 ≈ 5.39%。
常见错误。 把单利和复利混用;把名义利率和实际利率直接相加(它们要相乘)。
题 2 解答
思路。 等额本息的月供 = 本金 × r ÷ (1 − (1 + r)^−n),r 是月利率,n 是期数。
过程与答案。
(1)月利率 0.042/12 = 0.35%,n = 300:月供 = 80 万 × 0.0035 ÷ (1 − 1.0035^−300) ≈ 4311.54 元。总还款 4311.54 × 300 ≈ 129.3 万,利息 ≈ 49.35 万元。
(2)提前还 10 万,剩余 70 万、期限 25 年不变:月供 ≈ 3772.60 元,每月少付 538.94 元。
(3)把"每月少付 538.94,共 300 个月"按收益率折现(月利率 = 年收益率 ÷ 12):1%:14.30 万;3%:11.37 万;4.2%:10.00 万;5%:9.22 万。和提前还掉的 10 万比:收益率低于 4.2%,“提前还"值得(省下的现值大于 10 万);高于 4.2%,放在别处更划算。
(4)临界收益率就是房贷利率 4.2%:提前还贷的收益,等于"以 4.2% 的无风险收益把钱放着”。这只是算术:它没有考虑别处的收益是否有风险、流动性(要不要留现金备用)、税、能不能再借出来等等,所以不是任何建议。
常见错误。 用年利率直接当月利率;忘了提前还贷以后期限是不变的(只有月供下降)。
题 3 解答
思路。 债券价格 = 各期现金流的现值之和(用市场收益率折现)。
过程与答案。
(1)息票率 4%,10 年:收益率 3% → 108.53;4% → 100.00;5% → 92.28;6% → 85.28。
(2)收益率 4% → 6%,剩余期限 2、5、10、30 年:价格分别跌 3.7%、8.4%、14.7%、27.5%。期限越长,利率变动的冲击越大。
(3)息票率 1.5%,7 年,收益率 4.5%:价格 ≈ 82.32,账面亏 17.7%(相对面值 100)。
(4)银行买了大量低息票的长债,利率上升后,这些债的市价下跌(如(3))。如果银行必须在这时卖掉它们,就要把账面上的亏损变成真亏。第 35 讲讲的硅谷银行,就是在存款人撤走、被迫出售证券时,亏损显现(据报道)。这里的数字是练习用的,不是硅谷银行的实际数据。
常见错误。 以为债券的价格只和息票率有关;忘了收益率上升,价格下跌。
题 4 解答
思路。 NPV 是把各年现金流用折现率折成今天的和。IRR 是使 NPV = 0 的折现率。
def npv(rate, flows):
    """flows[t] 是第 t 年末的现金流,第 0 年是现在。"""
    return sum(cf / (1 + rate) ** t for t, cf in enumerate(flows))


def irr(flows, lo=-0.5, hi=2.0):
    """二分法:找让 NPV = 0 的折现率(NPV 随折现率下降时有效)。"""
    for _ in range(100):
        mid = (lo + hi) / 2
        lo, hi = (mid, hi) if npv(mid, flows) > 0 else (lo, mid)
    return (lo + hi) / 2


# 项目:现在花 200,之后 6 年每年收 45,最后一年再多收 20(残值)
project = [-200] + [45] * 5 + [65]
print("折现率   NPV")
for r in (0.03, 0.06, 0.09, 0.12, 0.15):
    print(f"{r:6.0%}  {npv(r, project):8.2f}")
print(f"IRR = {irr(project):.2%}")

# 两个互斥项目:A 一年后还 130,B 四年后还 190,都要现在投入 100
a, b = [-100, 130], [-100, 0, 0, 0, 190]
print("折现率   NPV(A)   NPV(B)  选哪个")
for r in (0.05, 0.10, 0.15, 0.20):
    na, nb = npv(r, a), npv(r, b)
    print(f"{r:6.0%}  {na:7.2f}  {nb:7.2f}  {'A' if na > nb else 'B'}")
print(f"IRR(A) = {irr(a):.2%},IRR(B) = {irr(b):.2%}")
cross = (190 / 130) ** (1 / 3) - 1
print(f"两个项目 NPV 相等的折现率:{cross:.2%}(低于它选 B,高于它选 A)")
输出:
折现率   NPV
    3%     60.52
    6%     35.38
    9%     13.79
   12%     -4.85
   15%    -21.05
IRR = 11.18%
折现率   NPV(A)   NPV(B)  选哪个
    5%    23.81    56.31  B
   10%    18.18    29.77  B
   15%    13.04     8.63  A
   20%     8.33    -8.37  A
IRR(A) = 30.00%,IRR(B) = 17.41%
两个项目 NPV 相等的折现率:13.48%(低于它选 B,高于它选 A)
过程与答案。
(1)折现率 3%:NPV 60.52;6%:35.38;9%:13.79;12%:−4.85;15%:−21.05。IRR = 11.18%:折现率低于它,值得做;高于它,不值得做。
(2)折现率 5%:NPV(A) 23.81,NPV(B) 56.31,选 B;10%:18.18 对 29.77,B;15%:13.04 对 8.63,A;20%:8.33 对 −8.37,A。IRR(A) = 30.00%,IRR(B) = 17.41%。
(3)NPV 相等的折现率:(190/130)^(1/3) − 1 ≈ 13.48%。折现率低于它,选 B;高于它,选 A。但 IRR(A)(30%)一直高于 IRR(B)(17.4%),如果按 IRR 比较,永远选 A,折现率在 13.48% 以下时,选错了:B 的资金占用时间更长,在低折现率下这些"更多的钱"更值钱。互斥项目,要比 NPV,不能比 IRR。
常见错误。 以为 IRR 越高越好;忘了 IRR 不考虑项目的规模和时间长短。
题 5 解答
过程与答案。
(1)r = ρ + η × g:第一组 0.1% + 1 × 2% = 2.1%;第二组 1% + 1.5 × 2% = 4.0%;第三组 2% + 2 × 2% = 6.0%。
(2)1 亿 ÷ (1 + r)^80:2.1% → 1896 万;4.0% → 434 万;6.0% → 94.5 万。同样的 80 年后的损害,现值可以差 20 倍。
(3)混合:一半的可能 2%,一半 6%,T 年后的平均现值 = ½/1.02^T + ½/1.06^T,等价折现率 = (平均现值)^(−1/T) − 1:20 年:3.61%;50 年:3.14%;100 年:2.69%。(平均是 4%,但年数越长,等价折现率越低。)
(4)折现率的不确定,会让远期的现值被低的折现率主导:100 年后,6% 的现值只有 0.29%,2% 的有 13.8%,两者平均 7.05%,几乎全部来自 2% 那一半。这是第 36 讲里 Weitzman 的论证:不确定下,远期应该用更低的折现率。该用哪组设定,涉及价值判断(后代的福利是否同等重要)。
常见错误。 把"平均折现率"当成"平均现值的折现率”;以为折现率是个纯技术问题。
题 6 解答
思路。 β–δ:现在的奖励不打折,将来的奖励要乘 β;所以"现在 vs 将来"的比较偏向现在。
过程与答案。
(1)今天 100 对一个月后 112:指数折现者:112 × 0.96 = 107.5 > 100,等。β–δ 的人:0.6 × 0.96 × 112 = 64.5 < 100,选今天拿。
(2)12 个月后拿 100,或者 13 个月后拿 112:两个都在将来,β 对两边都打(只改变现在 vs 将来的比较),比较的是 100 × 0.96^12 对 112 × 0.96^13:36.76 对 39.53(都乘 β = 0.6),选等(13 个月后拿 112)。指数折现者也选等。
(3)12 个月后真的到了,问题变成(1):当天拿 100,或者一个月后拿 112。β–δ 的人这时会选当天拿。和今天的计划不一致:今天他计划等,到时候改主意。
(4)今天评价:等的话 39.53,改主意拿早的 36.76,差 2.77(今天效用单位)。他今天愿意为"锁定"最多付 2.77。
常见错误。 以为 β–δ 的人"总是没耐心":他在遥远的将来是有耐心的,只是临近时变没耐心;以为这是"非理性":它描述的是计划的不一致。
第二部分 风险、保险与分散
题 7 解答
过程与答案。
(1)期望效用 = ½ ln 110 + ½ ln 50。确定性等价 = e^(期望效用) = √(110 × 50) = √5500 ≈ 74.16。风险溢价 = 80 − 74.16 ≈ 5.84 万。
(2)公平保费 = 0.5% × 120 = 0.6 万元。
(3)总财富 = 其他财富 + 房子。不买保险的期望效用 = 0.995 ln(W) + 0.005 ln(W − 120)。愿付的最高保费 π 满足 ln(W − π) = 这个期望效用。其他财富 100 万(W = 220):π ≈ 0.866 万;其他财富 1000 万(W = 1120):π ≈ 0.634 万。
(4)收 0.65 万:其他财富 100 万的人愿付 0.866 > 0.65,买;其他财富 1000 万的人愿付 0.634 < 0.65,不买。不买不是不理性:他自己就能承担这个损失,保险对他的价值,低于保险公司要的价格。
常见错误。 以为风险厌恶的人一定愿意买任何保险;愿付价取决于其他财富。
题 8 解答
思路。 独立风险,保单越多,平均赔付越接近 1.0,就越不容易超过 1.2。共同风险不会被"平均掉"。
from math import lgamma, log, exp

POLICIES_PAYOUT, PREMIUM, P_CLAIM = 50, 1.2, 0.02          # 每份保单赔付 50,保费 1.2,出险概率 2%(平均赔付 1.0)
Q_CAT = 0.04                                                # 相关风险的版本:4% 的年份是灾难年,那年每份保单 50% 出险


def binom_pmf(k, n, p):
    return exp(lgamma(n + 1) - lgamma(k + 1) - lgamma(n - k + 1) + k * log(p) + (n - k) * log(1 - p))


def loss_probability_independent(n):
    """各保单独立出险:赔付总额超过收到的保费的概率。"""
    limit = PREMIUM * n / POLICIES_PAYOUT                   # 出险份数超过 limit 就亏
    return max(0.0, 1 - sum(binom_pmf(k, n, P_CLAIM) for k in range(0, int(limit) + 1)))


def loss_probability_correlated(n):
    """灾难年(概率 Q_CAT)每份 50% 出险,其余年份不出险(平均出险概率 = 0.04 * 0.5 = 2%,和独立版一样)。"""
    limit = PREMIUM * n / POLICIES_PAYOUT
    p_loss_in_cat = 1 - sum(binom_pmf(k, n, 0.5) for k in range(0, int(limit) + 1))
    return Q_CAT * p_loss_in_cat


print("保单数   平均赔付/份   亏本概率(独立)   亏本概率(有灾难年)")
for n in (10, 100, 1000, 10000, 100000):
    print(f"{n:7d}   {P_CLAIM * POLICIES_PAYOUT:8.2f}     {loss_probability_independent(n):12.4%}     {loss_probability_correlated(n):12.4%}")
输出:
保单数   平均赔付/份   亏本概率(独立)   亏本概率(有灾难年)
     10       1.00         18.2927%          3.9961%
    100       1.00         32.3314%          4.0000%
   1000       1.00         15.4515%          4.0000%
  10000       1.00          0.2434%          4.0000%
 100000       1.00          0.0000%          4.0000%
过程与答案。
(1)见输出(独立):10 份:18.3%;100 份:32.3%;1000 份:15.5%;1 万份:0.24%;10 万份:0.00%。先升后降(图里 30 份时更高,约 45%):份数很少时,“一张都不出险"的概率本身就大;份数增加到一定程度,大数定律才起作用。
(2)有灾难年:亏本概率始终约 4.0%(等于灾难年的概率),不随保单数下降:灾难年里一半的保单出险,赔付远远超过保费。
(3)分散对独立的风险有用,对共同的风险没用。 保险公司要靠保单数量把独立风险"平均掉”;对共同风险(地震、系统性危机),多卖保单没用,需要再保险或者政府(第 37 讲,第 35 讲的存款保险、第 34 讲的自动稳定器)。
常见错误。 以为保单越多越安全;把"平均出险概率"相同当成"风险相同"。
题 9 解答
思路。 组合方差 = w1²σ1² + w2²σ2² + 2 w1 w2 ρ σ1 σ2。
过程与答案。
(1)½ 对 ½:方差 = 0.25 × 400 + 0.25 × 900 + 2 × 0.25 × 0.3 × 20 × 30 = 100 + 225 + 90 = 415,波动 20.37%。
(2)最小方差的权重 w1 = (σ2² − ρσ1σ2) ÷ (σ1² + σ2² − 2ρσ1σ2) = (900 − 180) ÷ (400 + 900 − 360) = 720/940 ≈ 0.766。波动 ≈ 18.67%,比两个资产单独的最小波动(20%)还低。
(3)ρ = 1:25%(没有分散的好处);ρ = −0.5:13.23%。
(4)N 个资产等权,σ_p = σ√(ρ + (1 − ρ)/N):N = 1:25%;4:18.5%;25:16.3%;100:15.9%;无穷:σ√ρ = 25 × √0.4 ≈ 15.8%。分散可以去掉"特有风险",去不掉"共同风险"(相关性)。
常见错误。 以为分散以后风险趋于零;把 ρ 当成可以忽略的项。
第三部分 有效市场
题 10 解答
过程与答案。
(1)5000 / 2^k:k = 3:625;5:156;8:19.5;10:4.9;12:1.2。纯靠运气也会有一批人连赢很多年,这批人里没有一个是有技能的。
(2)50%。他们前 5 年的连赢和第 6 年独立,运气不会"延续"。(这是识别"运气"的办法:看过去的连赢,能不能预测将来。)
(3)t 统计量 = (平均超额收益 ÷ 跟踪误差) × √年数。要 t = 2:年数 = (2 × 5 ÷ 1.5)² ≈ 44.4 年。要用几十年的数据,才能确认一位真有技能的经理。
常见错误。 以为连赢的人更可能继续赢;以为 10 年的业绩足以区分技能和运气。
题 11 解答
过程与答案。
(1)0.2%:50 × (1.08 − 0.002)^25 = 50 × 1.078^25 ≈ 326.9 万;1.5%:50 × 1.065^25 ≈ 241.4 万。(没有费用:50 × 1.08^25 ≈ 342.4 万。)
(2)主动基金少了 (326.9 − 241.4) ÷ 326.9 ≈ 26.2%。每年 1.3 个百分点的费用差,25 年复利下,终值少了四分之一。
(3)前提:主动基金费用前的收益和指数基金一样(8%)。如果主动经理有足够的技能,扣费后也能跑赢,结论就不成立。第 38 讲讨论的证据是:平均而言,主动基金扣费后没有跑赢(Sharpe 的算术),但每一个具体的基金,你事先不知道。(这不是投资建议。)
常见错误。 以为 1.3% 的费用差"很小";忘了复利。
题 12 解答
过程与答案。
(1)预期收益 = 2% + 1.3 × 5.5% = 9.15%。
(2)组合 β = 0.6 × 1.3 = 0.78;预期收益 = 2% + 0.78 × 5.5% = 6.29%。
(3)β = 0.5 × 0.8 + 0.5 × 1.4 = 1.1。组合的 β 是各自 β 的加权平均。
(4)α = 实际 − CAPM 预期 = 11% − 9.15% = 1.85%。但这个估计不可靠:年波动 30%,25 年平均的标准误 = 30% ÷ √25 = 6%,t = 1.85/6 ≈ 0.31,远远达不到统计显著。一个 1.85% 的"α",完全可能是运气。(第 38 讲:估计 α 需要很长的数据。)
常见错误。 以为 α > 0 就是有技能;把 CAPM 当成对"所有风险都有补偿"的证明(它只说共同风险有补偿)。
题 13 解答
说明。 开放题,参考写法。
理论预测: 如果员工大多不会主动改默认选项(第 39 讲:默认选项的作用来自"省麻烦"和"拖延"),那么把默认设为低成本、分散的指数基金,会让大多数员工的投资落在"费用低、分散好"的组合上。从第 38 讲的逻辑看,主动管理的基金平均扣费后跑不赢指数,所以默认指数基金,平均会让员工少付费用,复利下差别可以很大(题 11)。证据与局限: 第 39 讲提到的研究,发现自动加入大幅提高了参与率;对默认投资选项的长期结果,需要比较员工的最终财富,而且要看他们会不会改。局限:指数基金不是没有风险(股市会下跌);对某些人(比如临近退休的人),“年轻人适用的默认"可能不合适;“低成本"的好处是平均的,不是对每个人。分歧在哪: 事实分歧:默认的选择会不会让更多人持有风险过大(或过小)的组合;员工是否真的"选不了”。价值分歧:谁来设默认:雇主、政府,还是员工自己?设默认是不是一种温和的家长主义(“助推”),还是对选择自由的侵犯?指数基金"最好"的前提,是否把一种投资观念(市场有效)当成了默认?价值判断留给读者: 数据能说明大致的好处和风险;该不该由别人为你设定默认,是你的判断。(这不是投资建议。)
常见错误。 把"平均更好"说成"对每个人都更好”;把"默认"说成"强制"(员工可以改)。
第四部分 行为经济学
题 14 解答
思路。 价值函数是"对参照点的损益";概率权重把小概率放大、大概率缩小。
ALPHA, LAMBDA = 0.8, 2.0                    # 价值函数的曲度、损失厌恶(一组虚构的参数)
GAMMA_GAIN, GAMMA_LOSS = 0.65, 0.70         # 概率权重函数的参数(收益、损失)


def v(x):
    return x ** ALPHA if x >= 0 else -LAMBDA * (-x) ** ALPHA


def w(p, gamma):
    return p ** gamma / (p ** gamma + (1 - p) ** gamma) ** (1 / gamma)


def certainty_equivalent(p, x):
    """一个"概率 p 得到 x,否则 0"的赌局,对你值多少钱。"""
    gamma = GAMMA_GAIN if x >= 0 else GAMMA_LOSS
    value = w(p, gamma) * v(x)
    return value ** (1 / ALPHA) if value >= 0 else -((-value) / LAMBDA) ** (1 / ALPHA)


# 1. 50% 赢 G、50% 输 100:G 多大才愿意接受?
only_loss_aversion = LAMBDA * 100
with_curvature = LAMBDA ** (1 / ALPHA) * 100
weighted = ((LAMBDA * w(0.5, GAMMA_LOSS) * 100 ** ALPHA) / w(0.5, GAMMA_GAIN)) ** (1 / ALPHA)
print(f"只有损失厌恶(线性价值函数):G = {only_loss_aversion:.1f}")
print(f"加上价值函数的曲度:G = {with_curvature:.1f}")
print(f"再加上概率权重:G = {weighted:.1f}")

# 2. 四重模式
print("概率   金额   对你值多少(确定性等价)   期望值")
for p, x in ((0.05, 200), (0.95, 200), (0.05, -200), (0.95, -200)):
    print(f"{p:4.0%}  {x:5d}   {certainty_equivalent(p, x):8.1f}                {p * x:7.1f}")
输出:
只有损失厌恶(线性价值函数):G = 200.0
加上价值函数的曲度:G = 237.8
再加上概率权重:G = 250.5
概率   金额   对你值多少(确定性等价)   期望值
  5%    200       14.4                   10.0
 95%    200      157.0                  190.0
  5%   -200      -12.5                  -10.0
 95%   -200     -164.6                 -190.0
过程与答案。
(1)只有损失厌恶(线性):50% 赢 G、50% 输 100,要 0.5G ≥ 0.5 × λ × 100,G = 200。加上价值函数的曲度:G^α ≥ λ × 100^α,G = λ^(1/α) × 100 = 237.8。再加概率权重(这组参数下 w(0.5) 在收益侧是 0.439、损失侧是 0.457:收益被打折得更多,损失被打折得少一点):G = 250.5。每一层都让"接受赌局"更难。
(2)确定性等价:5% 赢 200:期望 10,值 14.4(冒险:愿意为小概率的大奖多付);95% 赢 200:期望 190,值 157.0(保守:愿意为确定性放弃一些);5% 输 200:期望 −10,值 −12.5(保险:愿意付更多来避免小概率的大损失);95% 输 200:期望 −190,值 −164.6(冒险:比期望的损失更愿意赌)。
(3)这是"四重模式":对小概率的收益冒险(彩票),对大概率的收益保守,对小概率的损失保守(买保险),对大概率的损失冒险。期望效用理论(题 7)会预测对所有赌局都风险厌恶,前景理论能同时解释买彩票和买保险。(参数是虚构的,模式的方向是前景理论的核心预测,具体数字取决于参数。)
常见错误。 把"损失厌恶"当成"风险厌恶"(它们是两件事);忘了参照点是什么。
题 15 解答
思路。 默认选项的好处,取决于大多数人真正想要的是什么。
过程与答案。
(1)B ~ U[−20, 100]:自愿:B > 30 的人加入,参与率 (100 − 30)/120 = 58.3%,人均总好处 = ∫(B − 30)dB ÷ 120 = 70²/2 ÷ 120 ≈ 20.4。默认:想退出的人要付 30,但没有人的 B < −30,所以所有人都留着,参与率 100%,人均好处 = B 的平均 = 40.0。默认更好(因为大多数人的 B 是正的)。
(2)B ~ U[−100, 40]:自愿:参与率 (40 − 30)/140 = 7.1%,人均好处 0.36。默认:B < −30 的人退出,其他留下,参与率 50%,人均好处 = ∫_{−30}^{40} B dB ÷ 140 = 2.5。默认更好,但好处很小。
(3)B ~ U[−100, 20]:自愿:没有人 B > 30,参与率 0,好处 0。默认:B < −30 的人退出(手续成本 30),其余 B 在 [−30, 20] 的人留下(其中一些 B 为负),参与率 41.7%,人均好处 = ∫_{−30}^{20} B dB ÷ 120 = −2.08。默认更糟:默认让一部分"其实不该加入"的人被留在里面(因为退出要付手续费)。
(4)默认选项的好处取决于:大多数人的"真实"偏好是什么、改变的成本(手续费)。如果默认设在大多数人想要的位置上,它帮了大忙;如果设错了位置,“麻烦"会把人困在一个对他不好的选项里。(第 39 讲:默认的好处主要来自"省去麻烦”,不是纠正拖延;是否好,要看默认设得对不对。)
常见错误。 以为默认总是好的;忘了"退出"本身要花成本。
题 16 解答
过程与答案。
(1)最低接受额 s = 10A ÷ (1 + 2A):A = 0:0;A = 0.3:1.875;A = 1:3.333;A = 3:4.286。
(2)提议者的提议,只会定在某个阈值上(再多给就浪费了):给 0:被 20% 接受,期望 10 × 0.2 = 2.0;给 1.875:被 50% 接受,期望 (10 − 1.875) × 0.5 = 4.06;给 3.333:被 90% 接受,期望 6.667 × 0.9 = 6.0;给 4.286:被 100% 接受,期望 5.714。最优是给 3.333(约 1/3),期望 6.0。
(3)纯自利的提议者以为所有人 A = 0:给 0(或接近 0),实际只有 20% 的人接受,期望 2.0,比最优的 6.0 少很多。把别人想成纯自利的,反而吃亏(第 39 讲:公平感不是"非理性",它是对手的真实偏好,提议者要考虑它)。
常见错误。 把最低接受额当成"被拒绝的概率";以为提议者给得越少越好。
第五部分 国际贸易
题 17 解答
思路。 小国:世界价格是给定的。关税 t 使国内价格 = 20 + t(不超过没有贸易时的价格)。
过程与答案。
(1)自由贸易,P = 20:需求 80,国产量 2 × 20 − 20 = 20,进口 60。消费者剩余 = ½ × 80 × 80 = 3200,生产者剩余 = ½ × 20 × (20 − 10) = 100。总 3300。
(2)
| 关税 t | 国内价格 | 国产量 | 进口 | 消费者剩余 | 生产者剩余 | 关税收入 | 总剩余 | 净损失 |
|---|---|---|---|---|---|---|---|---|
| 0 | 20 | 20 | 60 | 3200 | 100 | 0 | 3300 | 0 |
| 5 | 25 | 30 | 45 | 2812.5 | 225 | 225 | 3262.5 | 37.5 |
| 10 | 30 | 40 | 30 | 2450 | 400 | 300 | 3150 | 150 |
| 15 | 35 | 50 | 15 | 2112.5 | 625 | 225 | 2962.5 | 337.5 |
| 20 | 40 | 60 | 0 | 1800 | 900 | 0 | 2700 | 600 |
(3)t = 5:消费者少了 3200 − 2812.5 = 387.5;生产者多了 225 − 100 = 125;政府收入 225;净损失 387.5 − 125 − 225 = 37.5(= ½ × 5 × (30 − 20) + ½ × 5 × (80 − 75) = 25 + 12.5)。消费者的损失,是生产者所得的 3 倍多。
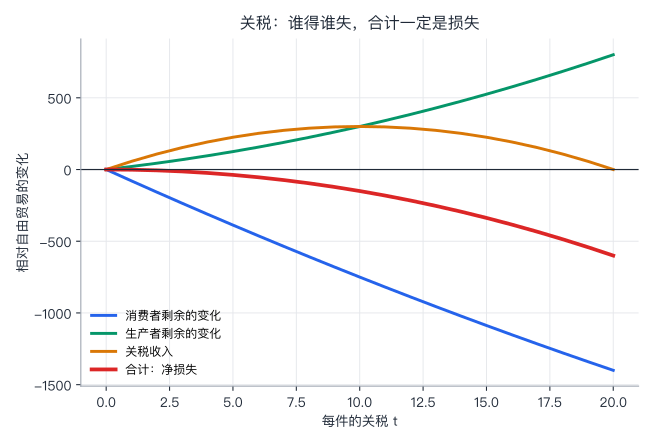
(4)进口降到 0 的关税是禁止性的:没有贸易时国内价格 P = 40(100 − P = 2P − 20),所以 t ≥ 20,关税收入为零,净损失 600,是最大的。
(5)(1 − 0.2)^(−1/4) − 1 ≈ 5.7%(ε = 4);(1 − 0.2)^(−1/8) − 1 ≈ 2.8%(ε = 8)。需求对价格越敏感(ε 大),得益越小;这只是一个粗糙的量级(第 40 讲)。
常见错误。 把关税收入当成"白得"(它是消费者付的);忘了国产量也会上升,所以国内价格 25 时生产者的得益不只是 5 × 20。
题 18 解答
过程与答案。
(1)甲:对方自由,加税得 115 > 100;对方加税,加税得 85 > 70。“加税"是占优策略,乙也一样。纳什均衡:(加税,加税)(85, 85),比(自由,自由)(100, 100) 差:这是囚徒困境。
(2)冷酷触发:合作(自由)永远得 100/(1 − δ);背叛得 115 + 85δ/(1 − δ)。条件:100 ≥ 115(1 − δ) + 85δ = 115 − 30δ,δ ≥ 0.5。
(3)如果两国大小不同,大国的最优关税更高(它能压低世界价格),大国从关税战里可能得益,小国则可能损失很大(第 40 讲,“可能性定理”)。所以对称的囚徒困境只是一个起点:不对称时,合作更难,因为大国没有那么强的动机。
(4)WTO 之类的国际规则,起到的是:让"加税"被发现并被惩罚(重复博弈里的监督和惩罚),把一次性的囚徒困境,变成重复的、有未来的关系(第 19 讲、第 40 讲)。
常见错误。 以为"自由"是占优策略(只有在两国合作时它才是好结果)。
题 19 解答
说明。 开放题,参考写法。
理论预测: 在竞争性模型里,保护一个行业会让国内价格上升、消费者受损,净损失为正(题 17:消费者的损失是生产者所得的几倍)。支持保护的理论论据主要有几类:幼稚产业(短期亏损、长期有规模经济和学习曲线)、外部性(比如技术外溢,第 23 讲的正外部性)、国家安全(不依赖别国供应)、战略性贸易政策(在不完全竞争的行业里,先发优势可能让补贴有利,第 16 讲的先行者)。证据与局限: 第 40 讲提到:很多国家保护"幼稚产业”,但多少真的成长起来,证据不一;把保护的成本算清楚,要知道消费者多付了多少、保护了多少岗位(每岗位的成本可能高于该岗位的工资,第 40 讲的算术);国家安全的理由,难以用经济数据衡量,但可以比较不同手段的成本(储备、多元化供应、补贴 vs 关税)。分歧在哪: 事实分歧:这个行业是否真的有学习效应或外部性;政府能否挑对赢家(第 26 讲:政府失灵、寻租);对方会不会报复(题 18)。价值分歧:安全 vs 效率:愿意为多出来的安全付多少代价;谁承担成本(消费者)和谁得益(行业里的工人和企业);保护要不要附带补偿和退出时间表。价值判断留给读者: 数据能说明成本的大致量级和可能的替代手段,该为"战略"付多少代价,是你的判断。
常见错误。 一边倒地"自由贸易最好"或"保护最好";用"战略性"三个字代替论证。
第六部分 汇率与国际收支
题 20 解答
过程与答案。
(1)每 1 美元合人民币 6.50 → 6.89:美元升值 6.89/6.50 − 1 = 6.0%;人民币贬值(1 美元换得更多人民币,意味着 1 元人民币换得的美元变少):1 − 6.50/6.89 ≈ 5.66%。两个数不一样,因为基准不同:一个以美元为基准,一个以人民币为基准。
(2)实际汇率 q = e P*/P。名义汇率 e 不变,国内通胀 6%,美国 2%:q 变成 (1.02/1.06)^8 ≈ 0.735,下降 26.5%。国内物价比外国涨得快,本币实际升值(国内的东西变得相对更贵,出口更难、进口更便宜)。
(3)要保持 q 不变,名义汇率要贬值:e × (1.06/1.02)^8 = 6.50 × 1.3525 ≈ 8.84。(这就是购买力平价的直觉:长期里,汇率会向"抵消通胀差"的方向走。第 41 讲的数据:通胀差对汇率的解释力很强,但年度波动里,短期预测很差。)
常见错误。 把"美元升值 6%“当成"人民币贬值 6%";忘了实际汇率里"国内物价 P"在分母上。
题 21 解答
过程与答案。
(1)贸易余额变化 = 100 × 1.1^η_x − 100 × 1.1^(1 − η_m):η = 0.2/0.2(弹性之和 0.4):−6.0;0.5/0.5(和 1.0):0.0;0.8/0.8(和 1.6):+6.0;1.5/1.5(和 3.0):+20.0。
(2)η_x = 0.1,η_m = 0.3(和 0.4):−5.9。
(3)马歇尔–勒纳条件:出口弹性和进口弹性(绝对值)之和大于 1,贬值才会改善贸易余额。等于 1 时,没有变化。
(4)短期里,合同已经签了,消费习惯也没变,数量几乎不动(弹性很小),而进口的本币价格已经上升,所以先恶化;数月或数季之后,数量慢慢调整(弹性变大),余额才改善:J 曲线(第 41 讲)。
(本题的设定和第 41 讲略有不同,数字不会完全一样,但结论一致:弹性之和越大,贬值越改善余额,和为 1 是分界线。)
常见错误。 以为贬值一定改善贸易余额;忘了进口的本币价格上升了。
题 22 解答
过程与答案。
(1)GDP = C + I + G + X − M = 600 + 180 + 150 + 130 − 60 = 1000。储蓄 S = GDP − C − G = 250(这里指全社会的储蓄,含政府)。净出口 = 130 − 60 = 70。CA = S − I = 250 − 180 = 70,和净出口一致 ✓。
(2)投资增加 40,储蓄不变:CA = 250 − 220 = 30。多出来的投资,靠外国的储蓄来融资(经常账户顺差减少,资本流入增加)。
(3)政府多支出 50(私人储蓄不变):全社会储蓄 = 250 − 50 = 200,CA = 200 − 180 = 20。(所谓"双赤字"的逻辑:财政赤字扩大,经常账户顺差减小,但第 41 讲没有引用具体研究来证明这一点,这里只是恒等式的算术。)
(4)不能。 恒等式说的是:经常账户逆差 = 投资超过储蓄的部分,由外国储蓄补上。是不是"坏事”,取决于逆差用来干什么(投资于有回报的项目,还是消费),以及资本流入的稳定性(第 41 讲:逆差是不是问题,是一个有争议的话题,没有统一的答案)。
常见错误。 以为逆差和顺差是"赢和输";用恒等式推出因果。
题 23 解答
思路。 国内信贷 D 不断增长,储备 R = M̄ − D 不断减少。投机者预见到储备会被耗尽,会提前攻击。
过程与答案。
(1)μ = 6%:储备耗尽:D(T) = M̄,T = ln(M̄/D0)/μ = ln(2.4)/0.06 ≈ 14.6 年。攻击提前 α = 4 年:10.6 年。攻击时 D = 50 × e^(0.06 × 10.6) ≈ 94.4,剩余储备 = 120 − 94.4 ≈ 25.6(公式 M̄(1 − e^(−μα)) = 120 × (1 − e^(−0.24)) = 25.6)。
(2)μ = 10%:耗尽 T = ln 2.4/0.1 ≈ 8.75 年,攻击 4.75 年,剩余储备 120 × (1 − e^(−0.4)) ≈ 39.6。增长越快,攻击越早,攻击时剩下的储备越多。
(3)政府看到的是"储备还有 25–40",但投机者看的是未来:储备和国内信贷的趋势,决定了固定汇率不可能维持。当投机者预期汇率将贬值,他们就在贬值之前抢先卖出本币换外汇:每个人的最佳反应,会把崩溃提前到储备耗尽之前。(第 41 讲的第一代模型;真实的危机还有别的类型,如第二代的自我实现,和第 35 讲的挤兑同构。)
常见错误。 以为危机在储备用完时才发生;把这个简化模型当成对某次具体危机的解释。
第七部分 发展与不平等
题 24 解答
过程与答案。
(1)平均 8,基尼 = Σ|xi − xj| ÷ (2n² × 平均) = 0.45。最富 20%(22)拿 22/40 = 55%;最穷 40%(2 + 3)拿 5/40 = 12.5%。
(2)G = 2Φ(0.9/√2) − 1 = 2Φ(0.636) − 1 ≈ 0.475。
(3)不一定。 基尼系数是一个数,压缩了整个分布。同样的基尼,可以是"最富的一小撮人拿得很多",也可以是"中间被掏空"(第 42 讲:相同基尼、不同形状)。
常见错误。 把基尼系数当成"不平等的全部";忘了基尼与"最富 1%“份额是不同的信息。
题 25 解答
过程与答案。
(1)贫困率 = Φ(ln(3/6)/0.8) = Φ(−0.866) ≈ 19.3%。
(2)中位数 6.6:Φ(ln(3/6.6)/0.8) = Φ(−0.986) ≈ 16.2%。
(3)中位数 6.6,σ = 1.0:Φ(ln(3/6.6)/1.0) = Φ(−0.788) ≈ 21.5%。收入增长 10%,贫困率反而比起点(19.3%)更高,因为不平等上升,分布的左尾变厚了。
(4)σ = 1.0,要回到 19.3%:中位数 = 3 × e^(0.866 × 1.0) ≈ 7.14,需要增长约 19%。
要点。 减贫取决于增长和分配两样;同样的增长,不平等上升会抵消它的减贫效果。(模型是对数正态的简化,第 42 讲。)
常见错误。 以为增长一定减贫;忘了贫困线处在分布的左尾,对 σ 很敏感。
题 26 解答
思路。 税降低税前收入(漏桶),转移是人均的。
from statistics import NormalDist

SIGMA, E = 0.7, 1.0                         # 税前收入对数正态(σ = 0.7),均值标准化为 1;收入对 (1-t) 的弹性 e = 1.0
N = 20000                                   # 用 20000 个分位点代表整个人群
Z = NormalDist()
base = [Z.inv_cdf((i + 0.5) / N) for i in range(N)]
from math import exp
mean_raw = sum(exp(SIGMA * z) for z in base) / N
income0 = sorted(exp(SIGMA * z) / mean_raw for z in base)     # 没有税时的收入,均值 1


def gini(xs):
    xs = sorted(xs)
    n, total = len(xs), sum(xs)
    return sum((2 * (i + 1) - n - 1) * x for i, x in enumerate(xs)) / (n * total)


def after_tax(t):
    """统一税率 t,所有人拿到同样的转移;税后收入 y*(1-t)^e*(1-t) + 转移,转移 = 税收总额的人均。"""
    pre = [y * (1 - t) ** E for y in income0]                  # 税前收入因为税而减少
    transfer = t * sum(pre) / N
    return [y * (1 - t) + transfer for y in pre], transfer


print("税率   人均收入   最穷20%   基尼    人均转移   漏掉的比例")
for t in (0.0, 0.2, 0.4, 0.5, 0.6, 0.8):
    post, transfer = after_tax(t)
    mean = sum(post) / N
    poorest = sum(post[: N // 5]) / (N // 5)
    leak = 1 - transfer / (t * 1.0) if t > 0 else 0.0           # 每征 1 元(按没有税时的收入算),最终转移到手的比例
    print(f"{t:4.0%}   {mean:7.3f}   {poorest:7.3f}   {gini(post):5.3f}   {transfer:7.3f}   {leak:6.1%}")

best_poorest = max(((sum(after_tax(t / 100)[0][: N // 5]) / (N // 5), t) for t in range(0, 100)))
best_mean = max(((sum(after_tax(t / 100)[0]) / N, t) for t in range(0, 100)))
print(f"最穷 20% 的平均收入最高:税率 {best_poorest[1]}%({best_poorest[0]:.3f});全体平均收入最高:税率 {best_mean[1]}%")
print(f"税收最大的税率 = 1/(1+e) = {1 / (1 + E):.0%}")
输出:
税率   人均收入   最穷20%   基尼    人均转移   漏掉的比例
  0%     1.000     0.308   0.379     0.000     0.0%
 20%     0.800     0.357   0.303     0.160    20.0%
 40%     0.600     0.351   0.228     0.240    40.0%
 50%     0.500     0.327   0.190     0.250    50.0%
 60%     0.400     0.289   0.152     0.240    60.0%
 80%     0.200     0.172   0.076     0.160    80.0%
最穷 20% 的平均收入最高:税率 28%(0.361);全体平均收入最高:税率 0%
税收最大的税率 = 1/(1+e) = 50%
过程与答案。
(1)见输出:t = 0:人均 1.000,最穷 20% 0.308,基尼 0.379;t = 20%:0.800 / 0.357 / 0.303;40%:0.600 / 0.351 / 0.228;50%:0.500 / 0.327 / 0.190;60%:0.400 / 0.289 / 0.152;80%:0.200 / 0.172 / 0.076。“漏掉的比例”= t(因为 e = 1,每征 1 元,到手只有 (1 − t))。
(2)最穷 20% 的平均收入最高:税率 28%(0.361,比 t = 0 的 0.308 高 17%)。全体平均收入最高:税率 0%。税收最大的税率 = 1/(1 + e) = 50%(人均转移 0.25)。
(3)再分配有一个最优点:税率太低,穷人得到的转移少;税率太高,“桶漏得太厉害”,蛋糕缩得太小,穷人的收入反而下降(t = 80% 时,最穷 20% 只有 0.172,比不征税还低)。但这个模型只回答了"最穷 20% 的收入最大"这一个目标。目标换成"全体平均”,最优是 0%;换成"基尼最小",最优是更高的税率(但蛋糕更小)。该用哪个目标,是价值判断(第 42 讲)。另外,税后收入对税率的反应 e,在不同国家、不同税种里差别很大,这里是虚构的参数。
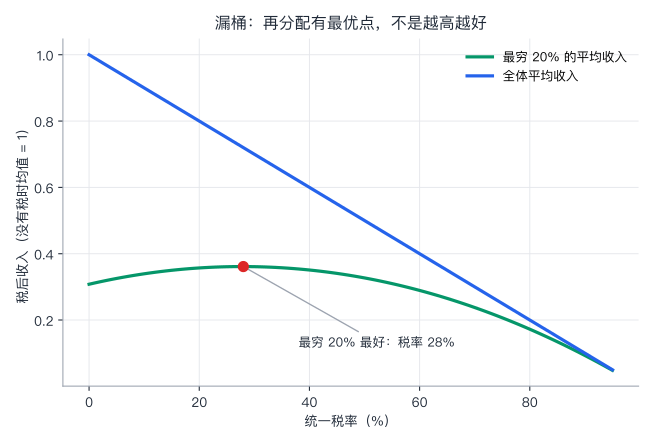
常见错误。 把"税收最大的税率"当成"最优税率";把"最穷 20% 最好的税率"当成"社会最好的税率"。
题 27 解答
过程与答案。
(1)沿着同一条曲线:6 × ln(6000/2000) = 6 × ln 3 ≈ 6.59 岁。
(2)剩下 13 − 6.59 ≈ 6.41 岁,占 49%,是曲线整体上移:同样的收入下,今天的人比 1990 年的人活得更久(医疗知识、公共卫生、疫苗、抗生素、营养等)。
(3)预期寿命的提高,大约一半来自收入增长,一半来自"同样的收入能买到更好的健康"。这是普雷斯顿的洞察(第 42 讲):不能只看收入。(模型很简化,两部分的比例取决于 b 的取值,不同国家和时期差别很大。)
常见错误。 把寿命提高全部归因于收入;忘了曲线本身会移动。
第八部分 大历史与综合
题 28 解答
思路。 人口会增长到人均收入回落到 y0 = 1 为止。
过程与答案。
(1)长期人均收入回到 1 倍;人口:A ↑ 60%,N* = (A/y0)^(1/α),变成 1.6^(1/0.5) = 1.6² = 2.56 倍。
(2)稳态人均收入 y = 1 + ln(1 + g)/(αε) = 1 + ln(1 + g)/0.15:g = 5%:1.325;g = 10%:1.635;g = 20%:2.215。人口每代增长 (1 + g)² − 1:10.25%、21%、44%。
(3)一次性的进步,只提高一次"产出",人口随后增长,把人均收入压回 1。持续的进步,使人口增长追不上技术进步,人均收入才能留在更高的水平。(要达到"收入持续上升",需要人口增长率不再随收入上升而上升,即"逃离",第 43 讲:人口转型。)
(4)没说明:技术进步为什么在 18–19 世纪的英国开始加速;人口转型为什么发生(生育率为什么下降);制度、文化、能源的角色(第 43 讲:为什么是英国,是一个有争议的问题)。模型只是一个逻辑,不是历史解释。
常见错误。 以为技术进步总会提高人均收入(在马尔萨斯的世界里,不一定)。
题 29 解答
过程与答案。
(1)1.0125^40 ≈ 1.64 倍。
(2)(19238/1744)^(1/44) − 1 = 11.03^(1/44) − 1 ≈ 5.6%/年。翻一番:ln 2 ÷ ln 1.056 ≈ 12.7 年。
(3)中国增速 g_c,英国 1%:追上要 ln(38407/19238)/ln((1 + g_c)/1.01):g_c = 3%:35.3 年;4%:23.6 年;5%:17.8 年。(只是算术:它没有说中国会不会这样增长,英国会不会只增长 1%,也没有考虑"追赶"的速度通常会随收入上升而放慢。)
(4)19.5^(1/44) − 1 ≈ 7.0%/年。(第 43 讲:东亚的追赶,包含战后恢复。)
(5)说明:复利下,每年相差几个百分点,几十年后差别巨大(11 倍与 1.6 倍);追赶是可能的(日本、韩国、台湾、中国)。没说明:追赶为什么发生(要素积累、技术、制度,第 29 讲);能否持续(第 28 讲的收敛:越靠近前沿,速度越慢);增速的代价与分配(第 42 讲)。
常见错误。 把算术当成预测;把"年均增长率"和"总增长率"混淆。
题 30 解答
说明。 开放题,参考写法。没有唯一答案,重点是用本课的工具把问题拆开,并分清事实和价值判断。
权衡。 限牌的好处(司机收入更稳、拥堵更少、安全监管更容易)和代价(乘客等得更久、价格更高、新进入者进不来)之间要权衡。没有免费的午餐:每个人的得益,是别人的成本。
激励与均衡。
- 价格管制与牌照的价值(第 9 讲、第 14 讲、第 26 讲):限制数量,会使价格高于没有限制时(短缺);牌照本身有了价值(它代表未来的垄断租金),牌照持有人的得益,是乘客多付的钱。如果牌照是免费发放的,争夺牌照是寻租(第 26 讲,题 27 类似);如果是拍卖或可以转让,租金变成了牌照的价格,由买牌照的人付出,最后一个买牌照的人,只赚正常利润(第 12 讲:长期零利润)。
- 平台与网络效应(第 17 讲):叫车平台有双边的网络效应,规模大了,对乘客和司机的价值都高;限牌会影响平台撮合的质量,也可能让大平台更强。
- 信息不对称(第 20、21 讲):乘客看不到司机的质量,评价系统是一种信号;牌照制度本身也可以是一种质量筛选,但监管的成本和寻租的风险要计入。
- 博弈与重复(第 18、19 讲):司机之间、平台之间、监管者之间,是反复的互动,会有各种策略性行为(比如绕开规则)。
事实问题。 限牌之后,价格、等待时间、司机收入、事故率各变了多少?没有限牌的相似城市可以做对照(第 4 讲,双重差分);牌照的价格是否显示了租金有多大。
价值问题。 谁的利益优先:乘客、司机、牌照持有人、纳税人;效率 vs 公平(第 9 讲):保护现有的司机,是否合理;过渡安排:如果取消限牌,已经花钱买牌照的人怎么办。
用到的讲:第 5–9 讲(供需、价格管制)、第 12 讲、第 14 讲、第 17 讲、第 20–21 讲、第 26 讲、第 4 讲。
常见错误。 只谈一方的利益;只谈价值不谈事实;漏掉牌照价格(租金)这个关键信号。
题 31 解答
(a)对。 收益率上升,已发行的低息票债券的价格下跌(题 3)。
(b)错。 互斥项目要比较 NPV;IRR 高的未必 NPV 高(题 4:IRR(A) 30% 对 17.4%,但折现率低于 13.48% 时 B 的 NPV 更高)。
(c)对。 折现率越高,远期的现值越小(题 5:6% 下,100 年后只剩 0.29%)。
(d)错。 分散去掉特有风险,去不掉共同风险(题 9:σ√ρ)。
(e)错。 有效市场假说说的是:价格已经反映了信息,很难系统地靠已知信息赚取超额收益,不是说没有人能赚钱(市场有正的平均收益,风险有补偿,第 38 讲)。
(f)对。 损失厌恶(题 14,λ > 1)。
(g)错。 取决于默认设在哪里,以及改变的成本(题 15:默认可能更好,也可能更糟)。
(h)对。 小国模型里,消费者的损失 = 生产者所得 + 政府收入 + 净损失,所以大于生产者的所得(题 17)。
(i)错。 取决于弹性之和是否大于 1(马歇尔–勒纳),短期还有 J 曲线(题 21)。
(j)错。 同样的基尼,可以对应不同形状的分布(题 24)。
(k)错。 一次性的进步,长期只增加人口,人均收入回到 y0(题 28)。
(l)错。 普雷斯顿曲线本身也在移动:寿命的提高,约一半来自曲线上移(技术、公共卫生)(题 27)。
做完之后
数一数你错在哪里。
- 第一部分(题 1–6)错得多:重读第 36 讲:名义配名义、实际配实际;债券价格与收益率反向;比较互斥项目用 NPV;折现率的选择是价值判断。
- 第二部分(题 7–9)错得多:重读第 37 讲:风险厌恶的愿付价取决于其他财富;分散去掉独立风险,去不掉共同风险。
- 第三部分(题 10–13)错得多:重读第 38 讲:运气会造成连赢;α 需要很长的数据才能估;费用在复利下很重要。
- 第四部分(题 14–16)错得多:重读第 39 讲:前景理论的四重模式、默认选项的两面、公平感是真实的偏好。
- 第五、六部分(题 17–23)错得多:重读第 40、41 讲:关税的账、囚徒困境、实际汇率与名义汇率、马歇尔–勒纳、CA = S − I。
- 第七、八部分(题 24–31)错得多:重读第 42、43 讲:基尼的局限、增长与分配、漏桶的最优点、曲线的移动、模型的逻辑与历史的解释不是一回事。
全套习题到这里结束。 五套题(习题 80–84)对应整门课的十个 Unit。如果你把它们都做完了,回头看一眼各套"做完之后"里反复出现的几类错误:把转移当成损失(习题 81)、把"每个人理性"当成"结果好"(习题 82)、把模型的结论当成现实的结论(习题 83),以及这一套里的把算术当成预测、把平均当成每个人。它们是同一件事的不同面孔:模型是一张故意画错的地图,用它之前要问,它画错的是什么。
参考
这套习题只用到前面各讲已经引用过的概念和文献,没有引入新的文献。题中的所有场景和数字都是为练习设计的示意,不对应真实的统计数据,也不是投资建议或政策评价。需要核对原始文献的地方,请回到对应的那一讲。