| 本篇位置 | 第一部分「地基」的第三篇。前两篇用了大量数据,这一篇回头检查数据本身 |
| 用到的数据 | AAPL、SPY 日线(Nasdaq 公开接口,2016-09-15 至 2026-09-15)和 AAPL 分红记录;Binance BTCUSDT 现货 1 分钟线(2017-08 至 2026-08,全部 4,746,079 根);Coinbase BTC-USD、USDT-USD 1 分钟线(若干时段,用于交叉核对) |
| 动手 | 建立 talab.data 模块:下载并校验数据、加载、拆股和分红调整、体检、复现指纹 |
| 读完你能 | 看出一份数据经过了哪种调整;知道回测、看图、算指标分别该用哪种价格;拿到任何数据先做体检,并判断体检结果是真问题还是真行情 |
一、先做一个决定
你在写第一个回测。规则很简单:
收盘价跌破过去 20 个交易日的最低收盘价,就卖出。
你先拿 AAPL 在 2020 年的数据试一下。手边有两个平台的数据,画出来是这样的:
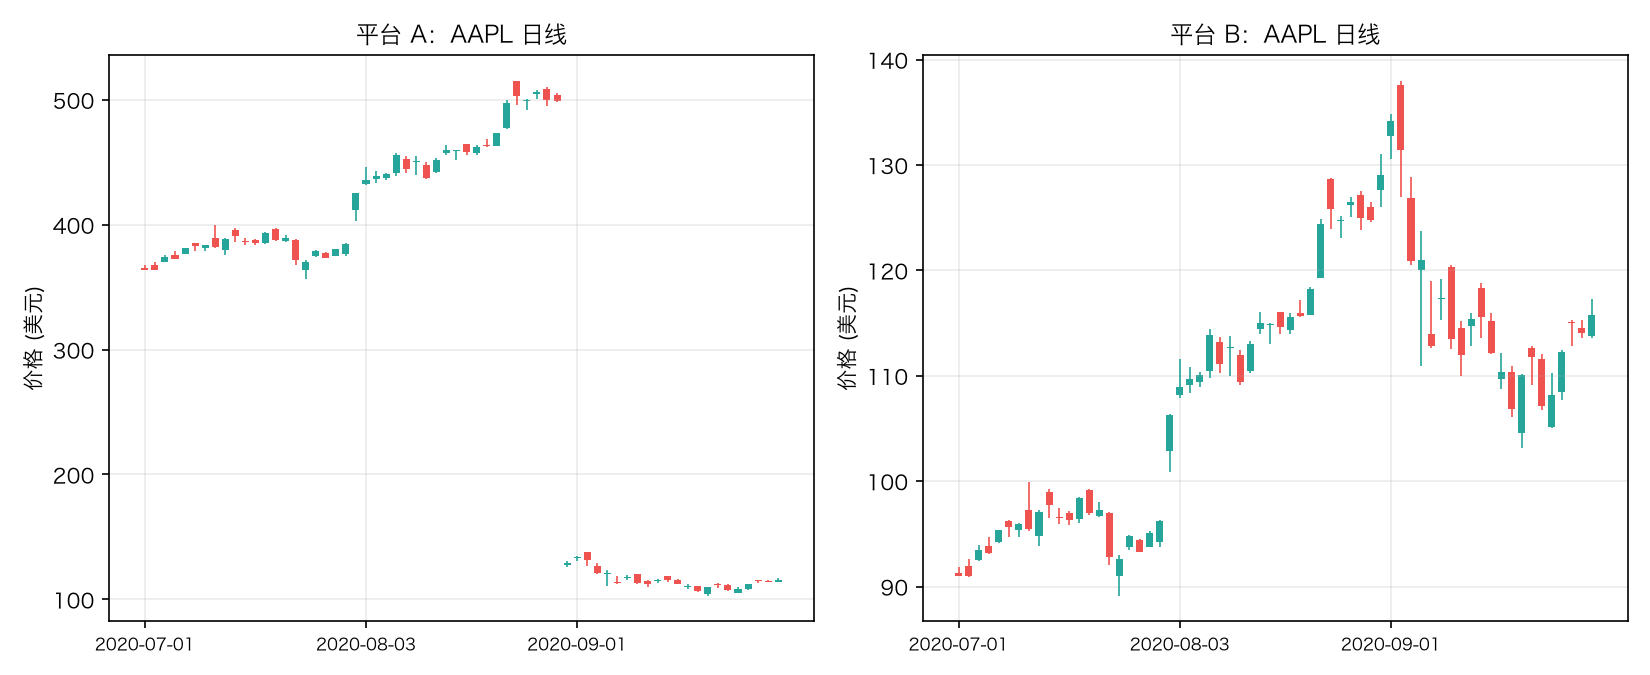
同一只股票,同一段时间,两张图完全不一样:
| 平台 A | 平台 B | |
|---|---|---|
| 2020 年 8 月的最高价 | 515.14(8 月 24 日) | 131.00(8 月 31 日) |
| 8 月 28 日收盘价 | 499.23 | 124.81 |
| 8 月 31 日收盘价 | 129.04 | 129.04 |
| 8 月 31 日这一天的涨跌 | −74.2% | +3.4% |
用平台 A 的数据,你的回测会在 8 月 31 日触发卖出:收盘价 129.04,远远低于过去 20 天的最低收盘价。用平台 B 的数据,这一天什么也不会发生。
更麻烦的是,如果你再打开第三个平台,还会看到第三个数字:8 月的最高价是 126.96。
你的回测该用哪一份数据?
- A. 平台 A,515.14 才是当时真实的成交价
- B. 平台 B,价格走势是连续的,看起来更合理
- C. 第三个平台
- D. 取决于你要用它做什么
先把你的选择写下来。 这一篇会把这三个数字各自是怎么来的讲清楚。读完之后,你会发现这三个数字全都是对的,只是它们回答的是三个不同的问题。
二、K 线的每个字段是怎么来的
在讨论数据会出什么问题之前,先把一根 K 线的五个字段说准确。你每天看到它们,但很少有人细想它们具体是怎么算出来的。
美股日线
以 AAPL 的一根日线为例:
| 字段 | 含义 | 从哪里来 |
|---|---|---|
| 开盘价(open) | 这一天的第一个价格 | 美股正常交易时段从美东时间 9:30 开始。主要上市交易所会在开盘时做一次开盘集合竞价:把开盘前积累的买单和卖单放在一起,撮合出一个价格。AAPL 在 Nasdaq 上市,它的官方开盘价就是 Nasdaq 开盘集合竞价的成交价 |
| 最高价(high) | 这一天正常交易时段里成交过的最高价格 | 所有交易场所的成交 |
| 最低价(low) | 这一天正常交易时段里成交过的最低价格 | 所有交易场所的成交 |
| 收盘价(close) | 这一天的最后一个价格 | 美东时间 16:00,主要上市交易所做一次收盘集合竞价。官方收盘价就是这次竞价的成交价(第 2 篇里,指数基金就是在这次竞价里买入特斯拉的) |
| 成交量(volume) | 这一天成交了多少股 | 不同数据商口径不一样:有的只统计主要交易所,有的统计全市场所有交易场所(包括暗池和场外成交) |
注意「正常交易时段」这几个字。美股在正常时段之外,还有盘前交易(最早从美东时间 4:00 开始)和盘后交易(到 20:00 结束)。绝大多数日线数据不包括盘前盘后的成交。第六节会讲这件事会带来什么后果。
加密货币的 K 线
加密市场 24 小时交易,没有开盘和收盘,也没有集合竞价。一根 K 线的五个字段,完全由这段时间里这一个交易所、这一个市场的成交决定:
- 开盘价:这段时间里第一笔成交的价格
- 最高价、最低价:这段时间里成交过的最高、最低价格
- 收盘价:这段时间里最后一笔成交的价格
- 成交量:这段时间里所有成交的数量之和
Binance 的 K 线数据,除了这五个字段,还有几个额外的字段:成交额(按报价货币计,比如 USDT)、成交笔数、主动买入量、主动买入额(第 1 篇用过)。
每根 K 线用它开始的时刻来标记。比如「2025-10-10 21:20」这根 1 分钟 K 线,包含的是 21:20:00 到 21:20:59.999 之间的成交。
长周期 K 线是怎么合成的
一根日线,可以由这一天的 1,440 根 1 分钟 K 线合成出来。规则是:
| 字段 | 合成规则 |
|---|---|
| 开盘价 | 第一根 1 分钟 K 线的开盘价 |
| 最高价 | 所有 1 分钟 K 线最高价里的最大值 |
| 最低价 | 所有 1 分钟 K 线最低价里的最小值 |
| 收盘价 | 最后一根 1 分钟 K 线的收盘价 |
| 成交量 | 所有 1 分钟 K 线成交量之和 |
这个规则看起来简单,但它隐含了一个前提:你得先决定「这一天」从几点开始、到几点结束。第七节会看到,这个决定能让同一天的 K 线从大阳线变成大阴线。
✋ 小检查
一根 BTC 日线的开盘价是 60,000,收盘价是 61,000。另一个交易所同一天的日线,开盘价是 60,050,收盘价是 60,900。这两根 K 线,至少有哪两个可能的原因导致它们不一样?
答案在本篇最后。
三、拆股:同一个披萨,切成了四块
打个比方
你和三个朋友合买了一个披萨,花了 100 块钱。披萨没切,整个儿放在盒子里,你们说好了「这个披萨值 100 块」。
后来店员拿起刀,把它切成了 4 块。
现在每一块值多少钱?25 块。
披萨变小了吗?没有。你们拥有的东西变少了吗?也没有。只是一个整块,变成了四小块,所以「每块的价格」变成了原来的四分之一。
拆股就是这么回事。
苹果的拆股
2020 年 7 月,苹果宣布 1 拆 4:每持有 1 股,变成 4 股。拆股后的股票从 2020 年 8 月 31 日开始交易。
| 日期 | 真实成交的收盘价 | 你持有的股数 | 你持有的市值 |
|---|---|---|---|
| 8 月 28 日(拆股前最后一个交易日) | 499.23 | 100 股 | 49,923 |
| 8 月 31 日(拆股后第一个交易日) | 129.04 | 400 股 | 51,616 |
每股价格从 499.23 变成 129.04,看起来跌了 74.2%。但你的股数从 100 股变成了 400 股,市值实际上从 49,923 涨到了 51,616,涨了 3.4%。
这就是开头那个问题里,平台 A 和平台 B 的区别:
- 平台 A 给你的是真实成交价:8 月 28 日当天,市场上真的是以 499.23 成交的
- 平台 B 给你的是拆股调整后的价格:把拆股之前的所有价格都除以 4,让它们和拆股之后的价格可以直接比较
拆股调整怎么算
规则只有一条:
某一天的拆股调整价格 = 这一天的真实价格 ÷ 这一天之后发生的所有拆股倍数的乘积
算一下。苹果在 2014 年 6 月 9 日还有过一次 1 拆 7。所以:
| 日期 | 这一天之后发生过的拆股 | 系数 | 真实收盘价 | 拆股调整价 |
|---|---|---|---|---|
| 2014 年 6 月 6 日 | 1 拆 7、1 拆 4 | 7 × 4 = 28 | 真实价格 | 真实价格 ÷ 28 |
| 2020 年 8 月 28 日 | 1 拆 4 | 4 | 499.23 | 499.23 ÷ 4 = 124.8075 |
| 2020 年 8 月 31 日 | 无 | 1 | 129.04 | 129.04 |
成交量正好反过来:价格要除以系数,成交量要乘以系数。8 月 28 日真实成交了 4,690.7 万股,拆股调整后是 4,690.7 万 × 4 = 1.876 亿股。道理还是那个披萨:一块变成四块,成交的「块数」就是原来的四倍。
你拿到的数据是哪一种?
大多数平台和数据接口不会明确告诉你,它给的价格是不是调整过的。你得自己查。
方法很简单:找一个已知的拆股日,看价格有没有断崖。
这门课用的 Nasdaq 公开接口,给出的 AAPL 2020 年 8 月 28 日收盘价是 124.8075,正好是 499.23 ÷ 4。8 月 31 日前后价格是连续的。所以这份数据已经按拆股调整过了。
再往前看一眼:它给出的 2016 年 9 月 15 日收盘价是 28.8925。当天 AAPL 真实的收盘价是 115.57,而 115.57 ÷ 4 = 28.8925。这说明它只按 2020 年那次拆股做了调整(2014 年的拆股在这之前,本来就已经体现在 115.57 里了),没有按分红做任何调整。下一节会讲,按分红调整的价格会比这个数略低。
什么时候该用哪一种
⚠️ 这里是最容易搞反的地方:调整后的价格不是「更正确」的价格,真实成交价也不是「过时」的价格。它们各有各的用途。
必须用拆股调整价(或者下一节的总收益调整价)的场景:
- 回测:否则就会像开头那样,看到一次根本不存在的 74% 暴跌
- 计算收益率、波动率
- 计算均线、MACD 这类指标:否则 20 日均线在拆股日前后会断崖式下跌
必须用真实成交价的场景:
- 研究当时的市场参与者在想什么。第 1 篇讲过,人会在整数价位挂单。2020 年 8 月,AAPL 交易员盯着的整数关口是 500 美元,不是拆股调整后的 125 美元。如果你要研究「整数关口附近发生了什么」,只能用当时真实的价格。
- 核对历史成交记录:你的券商对账单上写的是当时的真实成交价。
四、分红:从披萨上切下一块发给你
继续那个披萨
现在,披萨店每个季度会从你的披萨上切下一小块,装进盒子里交给你。
切完之后,盒子里的披萨变小了,所以「盒子里的披萨」值的钱也少了一点。但切下来的那一小块在你手里,你拥有的总量没变。
分红就是这样:公司把一部分现金发给股东。发完之后,公司账上的现金少了,股价通常也会相应地下跌一点。
除息日:价格为什么会跳一下
分红有一个关键日期,叫除息日(ex-dividend date)。在除息日之前买入并持有的人,能拿到这次分红;从除息日开始才买入的人,拿不到。
所以,除息日开盘时,股票的「内容」少了一次分红,价格会相应地往下调一些。
看苹果 2020 年 8 月 7 日的除息(这时还没有拆股,所以都是拆股前的真实价格):
| 数值 | |
|---|---|
| 除息日前一天(8 月 6 日)收盘价 | 455.61 |
| 每股分红 | 0.82 |
| 除息日(8 月 7 日)收盘价 | 444.45 |
如果只看价格,这一天跌了:
444.45 ÷ 455.61 − 1 = −2.45%
但如果你在 8 月 6 日收盘时持有 1 股,到 8 月 7 日收盘,你手上有一股价值 444.45 的股票,外加 0.82 元的分红。你的真实收益是:
(444.45 + 0.82) ÷ 455.61 − 1 = −2.27%
两者差了 0.18 个百分点,正好是这次分红占股价的比例(0.82 ÷ 455.61 = 0.18%)。
一次分红差 0.18%,看起来很小。但苹果每年分红四次,十年就是 40 次。
分红调整怎么算
分红调整的目标是:让调整后的价格序列里,相邻两天的价格之比,等于一个持有者真实的总收益。
标准的算法是这样的。对每一次分红:
- 找到除息日前一个交易日的真实收盘价,记作 P
- 这次分红的金额,记作 D
- 算出这次分红的系数:1 − D ÷ P
- 把除息日之前的所有价格,都乘以这个系数
如果有多次分红,除息日之前的价格要把之后所有分红的系数连乘起来。
用 2020 年 8 月 7 日这次分红算一遍:
系数 = 1 − 0.82 ÷ 455.61 = 1 − 0.0017998 = 0.9982002
8 月 6 日及之前的所有价格,都要乘以 0.9982002。于是 8 月 6 日的调整后价格变成 455.61 × 0.9982002 = 454.79。
现在再算除息日这一天的「调整后涨跌幅」:
444.45 ÷ 454.79 − 1 = −2.2736%
⚠️ 这里有一个细节,第一次读会觉得别扭:这个数和上面直接算出来的真实收益 −2.2695% 不完全一样,差了 0.004 个百分点。
这不是算错了。两种算法对「分红怎么再投资」的假设略有不同:
- 直接算 (444.45 + 0.82) ÷ 455.61,假设分红拿在手里,按除息日收盘价计入
- 系数法 444.45 ÷ (455.61 − 0.82),等价于假设分红在除息日开盘前就按 455.61 − 0.82 的价格再投资了回去
两种假设都说得通,系数法是行业里最常用的约定,因为它只需要把历史价格乘以一个系数,不用单独记录分红现金。它们的差别,只有在除息日当天价格剧烈波动时才会稍微明显一点。重要的不是选哪种,而是知道你的数据用的是哪种,并且始终用同一种。
十年累积下来
我们把 AAPL 从 2016 年 9 月 15 日到 2026 年 9 月 15 日的数据,分别按「只调整拆股」和「拆股 + 分红都调整」算一遍:
| 调整方式 | 十年里价格变成了原来的多少倍 |
|---|---|
| 只调整拆股 | 11.47 倍 |
| 拆股 + 分红(这十年里有 40 次分红) | 12.54 倍 |
两者差了一倍多。苹果的分红率其实不高(这十年里每年大约在 0.4% 到 2% 之间),分红率高的股票或 ETF,这个差距会大得多。
如果你的回测只调整了拆股,你会系统性地低估「一直持有」的收益。 拿一个主动交易策略去和「买入持有」比较时,这个低估会让你的策略显得比实际更好。
三个数字,三个问题
现在可以回答开头的问题了。用 talab.data(第十节会给出完整代码)把同一段时间的三种价格放在一起:
aapl = D.load_nasdaq_daily("data/nasdaq/AAPL_historical.json")        # 拆股调整后的价格
divs = D.load_nasdaq_dividends("data/nasdaq/AAPL_dividends.json")     # 分红记录
raw = D.unadjust_splits(aapl, D.SPLITS["AAPL"])                       # 还原成当时的真实价格
total = D.adjust_total_return(raw, D.SPLITS["AAPL"], divs)            # 拆股 + 分红调整
table = pd.DataFrame({
    "真实成交价": raw["close"],
    "拆股调整": aapl["close"],
    "拆股+分红调整": total["close"],
})
print(table.loc["2020-08-26":"2020-09-01"].round(2))
输出:
             真实成交价    拆股调整  拆股+分红调整
date
2020-08-26  506.09  126.52   122.62
2020-08-27  500.04  125.01   121.15
2020-08-28  499.23  124.81   120.96
2020-08-31  129.04  129.04   125.06
2020-09-01  134.18  134.18   130.04
所以开头那三个「8 月最高价」:
| 数字 | 是什么 | 回答的问题 |
|---|---|---|
| 515.14 | 真实成交价 | 2020 年 8 月,市场上真实成交过的最高价格是多少? |
| 131.00 | 拆股调整价 | 如果只考虑拆股,把价格放到同一把尺子上,8 月的最高点在哪? |
| 126.96 | 拆股 + 分红调整价 | 如果要计算一个持有者的真实总收益,这个价格序列应该是什么样? |
开头那道题的答案是 D。你的回测规则是「收盘价跌破 20 日最低就卖出」,这是在比较不同日子的价格高低,所以至少要用拆股调整价。如果还要算回测收益,并和买入持有比较,就要用拆股 + 分红调整价。
| 用途 | 该用的价格 |
|---|---|
| 回测的收益计算、和买入持有比较 | 拆股 + 分红调整 |
| 计算指标(均线、MACD、ATR 等)、比较不同日子的价格高低 | 至少拆股调整;追求严格就用拆股 + 分红调整 |
| 研究当时的整数关口、历史成交价位 | 真实成交价 |
| 核对券商的历史成交记录 | 真实成交价 |
五、「调整后的价格」每次下载都不一样
一个会让你困惑很久的现象
假设你在 2021 年下载了一份 AAPL 的总收益调整价格,记下了 2020 年 8 月 28 日的收盘价。今年你又下载了一份,发现同一天的调整后收盘价变了。
这是数据出错了吗?不是。这是分红调整的算法必然会产生的结果。
回头看上一节的规则:每次分红,都要把除息日之前的所有价格乘以一个小于 1 的系数。苹果每个季度分红一次,所以每过三个月,所有历史价格都会被整体再乘一次系数,往下降一点点。
我们来模拟:假设你分别在四个不同的日子下载数据,2020 年 8 月 28 日的总收益调整收盘价会是多少?
for cutoff in ["2021-09-15", "2023-09-15", "2025-09-15", "2026-09-15"]:
    part = raw.loc[:cutoff]
    adj = D.adjust_total_return(part, D.SPLITS["AAPL"], divs[divs.index <= cutoff])
    print(cutoff, "下载时,2020-08-28 的调整后收盘价 =", round(adj.loc["2020-08-28", "close"], 2))
输出:
2021-09-15 下载时,2020-08-28 的调整后收盘价 = 124.01
2023-09-15 下载时,2020-08-28 的调整后收盘价 = 122.59
2025-09-15 下载时,2020-08-28 的调整后收盘价 = 121.4
2026-09-15 下载时,2020-08-28 的调整后收盘价 = 120.96
同一天、同一只股票,因为下载的时间不同,调整后的价格从 124.01 一路变到 120.96。以后每发一次分红,它还会继续变。
回到披萨:每次店员从你的披萨上切下一块,为了让「今天的披萨」和「过去的披萨」能直接比较,你就得把过去每一天记录的披萨大小,都按比例重新缩小一遍。
这带来的两个问题
第一,你的回测结果没法复现。 你今天跑出的结果,和一年后别人用「同样的数据」跑出来的结果不一样。
第二,拆股调整也有同样的问题。 如果一只股票以后再拆股,所有历史的拆股调整价格也会再变一次。
这门课的做法
所以这门课不直接保存调整后的价格,而是保存两样不会变的东西:
- 原始数据,以及它是在什么时候、从哪里下载的
- 拆股和分红记录
调整后的价格每次都由 talab.data 自己算出来。只要原始数据和公司行为记录一样,算出来的结果就一样。
为了让你能确认自己的数据和正文用的一样,每个关键结果都会附一个复现指纹:数据的行数、起止时间、收盘价之和。你算出来的指纹和正文一致,就说明数据一致。
六、盘后的消息,第二天的跳空
一根日线看不到的东西
2019 年 1 月 2 日,美股正常收盘之后,苹果 CEO 蒂姆·库克发布了一封致投资者的信,把公司当季的收入预期从 890 亿到 930 亿美元,下调到约 840 亿美元(Apple Newsroom)。
看这两天的日线(真实成交价):
| 日期 | 开盘 | 最高 | 最低 | 收盘 | 成交量 |
|---|---|---|---|---|---|
| 2019-01-02 | 154.89 | 158.85 | 154.23 | 157.92 | 3,564 万股 |
| 2019-01-03 | 143.98 | 145.72 | 142.00 | 142.19 | 9,111 万股 |
1 月 2 日的日线,完全看不出任何异常:收盘 157.92,比开盘还涨了一点。
但消息在收盘后公布,盘后交易时段里价格已经跌下去了。这些成交不包括在 1 月 2 日的日线里。
第二天开盘价 143.98,比前一天收盘价低了 8.8%。全天收盘 142.19,跌了 9.96%,是苹果自 2013 年 1 月以来单日跌幅最大的一天(CNBC)。
在日线图上,这看起来就是一个跳空:前一天收盘和第二天开盘之间,出现了一段没有任何成交的空白。但实际上,这段价格并不是「跳」过去的,它在盘后交易里一步步走完了,只是日线数据没有记录。
这会影响什么
不同平台画出来的图不一样。 有的看盘软件会把盘前盘后的成交也画进 K 线里,这时 1 月 2 日的最低价会远远低于 154.23,1 月 3 日的开盘价也不是 143.98。你在两个软件上看到不同的最高价、最低价,这是一个常见原因。
止损没法在你设定的价格成交。 假设你在 1 月 2 日持有 AAPL,止损设在 150。1 月 2 日正常时段里价格从没碰到 150。等到 1 月 3 日开盘,价格已经是 143.98,你的止损单最早只能在 143.98 附近成交,比你设定的价格低了 4%。第 20 篇和第 22 篇会专门讲跳空对止损的影响。
回测会高估止损的效果。 如果回测程序假设「价格跌到止损价就按止损价成交」,在跳空的日子里它会给出一个现实中拿不到的价格。
七、加密市场:一天从几点开始
切披萨,从哪里下刀
还是那个披萨。一个完整的圆形披萨,要切成 8 块。你可以从 12 点钟方向下第一刀,也可以从 1 点半方向下第一刀。
两种切法,切出来的都是 8 块,披萨的总量完全一样。但每一块具体是哪一部分,完全不同。某一块上恰好有一大片香肠,换一种切法,这片香肠可能就被分到了两块上。
加密市场 24 小时不停,就像这个没有天然切口的披萨。「一天」从哪里开始,是人为规定的。
两种常见的切法
- UTC 0 点:Binance、Coinbase 等主流交易所和绝大多数数据源的默认切法
- 北京时间 0 点(也就是 UTC 16 点):很多中文看盘软件和用户习惯的切法
这两种切法,只是下刀的位置差了 8 个小时。结果差多少?
我们用 BTC 从 2018 年 1 月 2 日到 2026 年 8 月 31 日的全部 1 分钟数据,分别按 UTC 0 点和北京时间 0 点合成日线,比较同一个日期的两根 K 线是阳线还是阴线:
bars = btc.copy()
bars.index = bars.index.floor("1min")                     # 先把没对齐的时间戳对齐(第九节会讲为什么)
bars = bars[~bars.index.duplicated(keep="last")]
agg = {"open": "first", "high": "max", "low": "min", "close": "last"}
utc_day = bars.loc["2018-01-02":"2026-08-31"].resample("1D").agg(agg)
bj_day = bars.tz_convert("Asia/Shanghai").resample("1D").agg(agg).loc["2018-01-02":"2026-08-31"]
utc_day.index = utc_day.index.date
bj_day.index = bj_day.index.date
days = utc_day.join(bj_day, lsuffix="_utc", rsuffix="_bj", how="inner")
up_utc = days["close_utc"] > days["open_utc"]
up_bj = days["close_bj"] > days["open_bj"]
print("天数:", len(days), " 阴阳不同的天数:", (up_utc != up_bj).sum(), f"({(up_utc != up_bj).mean():.1%})")
输出:
天数: 3164 阴阳不同的天数: 912 (28.8%)
3,164 天里,有 912 天,两种切法得出的 K 线一根是阳线、一根是阴线。 差不多每 3.5 天就有一天。
最极端的一天
还记得第 1 篇里的 2020 年 3 月 13 日吗?那一天 BTC 日线涨了 16.2%,是 Binance 上历史涨幅第五大的一天。
那是按 UTC 切出来的日线。换成按北京时间切:
| 按 UTC 切 | 按北京时间切 | |
|---|---|---|
| 这一天覆盖的时段(UTC) | 3 月 13 日 00:00 至 24:00 | 3 月 12 日 16:00 至 3 月 13 日 16:00 |
| 开盘价 | 4,800.01 | 6,132.13 |
| 最高价 | 5,955.00 | 6,229.97 |
| 最低价 | 3,782.13 | 3,782.13 |
| 收盘价 | 5,578.60 | 5,212.37 |
| 涨跌 | +16.2% | −15.0% |
同一个日期,一根是涨 16.2% 的大阳线,一根是跌 15.0% 的大阴线。 两者的最低价完全一样,因为 3 月 13 日凌晨那次暴跌同时落在了两种切法的「这一天」里。区别只在于:按北京时间切,这一天是从暴跌之前的 6,132 开始的;按 UTC 切,这一天是从暴跌进行到一半的 4,800 开始的。
那片香肠,被两种刀法分到了不同的块里。
这会影响什么
- 所有基于日线的指标都会不同:日线收盘价不同,20 日均线就不同,RSI 就不同
- 「日线收盘站上某个价位」这类规则的触发时间不同
- 周线和月线也一样:一周从周一 UTC 0 点开始,还是从周日开始,结果不同
⚠️ 这里没有哪种切法「更正确」。它只要求你做到一件事:回测用哪种切法,实盘看盘和下单就用哪种切法。 这门课统一使用 UTC 0 点,因为 Binance 的原始数据和绝大多数加密数据源都用它。
八、同一个资产,不同的市场
两个披萨店
第 1 篇看过,同一个交易所里,BTC 现货和永续合约的价格可以在同一分钟里相差 1,312 美元。换成两个不同的交易所,差距可能更大。
就像两家披萨店卖同一种披萨。平时价格差不多,因为顾客会比价。但某家店门口突然排起长队,它可能在一段时间里比另一家贵很多。
2025 年 10 月 10 日那次暴跌(第 2 篇详细讲过),对比 Binance 和 Coinbase:
| Binance BTCUSDT 现货 | Coinbase BTC-USD | |
|---|---|---|
| 最低价 | 102,000.00 | 107,000.00 |
| 最低价出现的时间(UTC) | 21:20 | 21:26 |
| 21:19 这一分钟的收盘价 | 103,975.26 | 108,922.31 |
两个交易所的最低价相差 5,000 美元。21:19 这一分钟,收盘价相差 4,947 美元。(顺便一提:两个最低价都是整数。)
USDT 不是美元
表里还有一个容易忽略的地方:Binance 的价格是用 USDT 计价的,Coinbase 是用美元计价的。
USDT 是一种和美元挂钩的稳定币,平时 1 USDT 非常接近 1 美元,但不是永远精确等于 1 美元。在上面这两个多小时里(UTC 20:40 到 23:00),Coinbase 上 USDT 兑美元的 1 分钟 K 线,最低价是 1.0001,最高价是 1.0726。
所以,比较不同交易所的价格时,不但要问「是哪个交易所」,还要问「用什么计价」。
插针,常常只发生在一个交易所
所谓插针,是指价格在极短时间里突然冲到一个极端位置,又马上回来,在 K 线上留下一根很长的影线。
插针通常是某个交易所的订单簿在某一瞬间变得很薄,一笔大单(或者一串强平单)穿透了好几档价格造成的。所以它经常只出现在一个交易所。
用 Coinbase 的数据,核对 Binance 历史上两根最长的插针:
| 时间(UTC) | Binance BTCUSDT 这一分钟 | Coinbase BTC-USD 同一分钟 |
|---|---|---|
| 2021-01-04 10:19 | 开盘 28,729.95,最高 31,099.52,收盘 29,104.98 | 开盘 28,800.27,最高 29,391.56,收盘 29,091.26 |
| 2019-10-26 00:40 | 开盘 9,319.98,最低 8,470.38,收盘 9,240.00 | 开盘 9,397.36,最低 9,224.85,收盘 9,240.66 |
2021 年 1 月 4 日那一分钟,Binance 的最高价比开盘价高了 8.2%,Coinbase 同一分钟只高了 2.1%。两个交易所的收盘价几乎一样,差距全在那根针上。
规则
你的策略在哪个市场执行,数据就必须来自那个市场。
用 Coinbase 的数据回测,却在 Binance 上交易,你的止损可能会在一根 Coinbase 上根本不存在的针上被打掉,回测里却看不到这件事。
九、给数据做体检
前面几节讲的,都是「数据本身没错,但你可能用错了」。这一节讲另一类问题:数据本身就有错,或者有你没想到的奇怪之处。
我们用 talab.data 里的 health_check 函数,对真实数据逐项检查。检查的项目有:
| 检查项 | 为什么要查 |
|---|---|
| 重复时间戳 | 同一根 K 线出现两次,重采样和回测都会出错 |
| 时间没有按顺序排列 | 很多计算默认数据是按时间排好的 |
| 有空值的行 | 空值会让指标计算中断,或者悄悄传播到后面 |
| 高低价自相矛盾 | 最高价低于开盘价或收盘价、最低价高于开盘价或收盘价,都不可能是真实数据 |
| 价格不为正 | 价格为零或负数,肯定是错误 |
| 成交量为零 | 可能是没人交易,也可能是占位数据 |
| 四价相同 | 开盘、最高、最低、收盘完全相同,可能是真的没有波动,也可能是填充出来的数据 |
| 时间戳没有对齐 | 比如 1 分钟 K 线的时间戳不在整分钟上 |
| 缺失的 K 线 / 缺失的交易日 | 有的时间段没有数据 |
| 日历之外多出来的日子 | 休市日出现了数据 |
| 可疑插针 | 影线长度远远超过最近的典型波幅 |
| 成交量异常偏低 | 成交量远低于最近的正常水平 |
⚠️ 在看结果之前,先说清楚一件最重要的事:体检报告给出的是「线索」,不是「结论」。 一条被标出来的记录,可能是数据错误,也可能是一段真实发生过的极端行情。每一条都要你去判断。
SPY 日线:两处真实的数据错误
spy = D.load_nasdaq_daily("data/nasdaq/SPY_historical.json")
sessions = xc.get_calendar("XNYS").sessions_in_range("2016-09-15", "2026-09-15")   # 纽交所交易日历
report = D.health_check(spy, sessions=sessions, wick_k=8, wick_window=250, low_volume_ratio=0.3)
print(D.summarize(report))
输出:
重复时间戳         0
时间没有按顺序排列     0
有空值的行         1
高低价自相矛盾       0
价格不为正         0
成交量为零         0
四价相同          1
缺失的交易日        0
日历之外多出来的日子    0
可疑插针          1
成交量异常偏低       1
Name: 数量, dtype: int64
这份数据和纽交所的交易日历完全吻合,没有缺失的交易日,也没有多出来的日子。但有四条记录被标了出来。逐条看。
「有空值的行」「四价相同」「成交量异常偏低」,指向的是连续的两天:
              open     high     low   close      volume
date
2026-04-15  695.26  700.280  694.20  699.94  58240380.0
2026-04-16  701.06  702.780  698.53  701.66  49972360.0
2026-04-17  706.14  712.390  705.76  710.14   9999999.0
2026-04-20  710.14  710.140  710.14  710.14         NaN
2026-04-21  710.28  711.275  702.64  704.08  58941380.0
2026-04-22  709.15  711.450  708.22  711.21  42518500.0
- 2026 年 4 月 17 日,成交量是 9,999,999。前后几天的成交量都在 4,000 万到 6,000 万股之间,而且这一天是一个月的第三个周五,是期权到期日,成交量通常比平时更大。9,999,999 这个数字本身就很可疑:它很像某个系统在拿不到真实数字时填进去的占位值。判断:数据错误。
- 2026 年 4 月 20 日,这是一个正常的周一交易日。但四个价格全部等于前一天的收盘价 710.14,成交量是空值。SPY 是全美国成交最活跃的 ETF,一整天价格纹丝不动是不可能的。判断:数据错误,这一天的数据是用前一天的收盘价填出来的。
这两天的错误如果不处理:用 4 月 20 日算日收益率,会得到一个 0%;用它算波动率,会让波动率偏低;如果你的策略在这天有交易信号,会用一个假价格成交。
「可疑插针」 标出的是 2020 年 3 月 16 日:开盘 241.18,最高 256.90,最低 237.36,收盘 239.85。上影线非常长。
但这一天是真实的:那是新冠疫情引发美股暴跌的时期,3 月 16 日美股开盘不久就触发了熔断,全天剧烈波动。判断:真实行情,不是错误,应该保留。
BTC 1 分钟数据:全部历史
D.download_binance_klines("BTCUSDT", "1m", "2017-08", "2026-08")
btc = D.load_binance_klines(glob.glob("data/binance/spot/BTCUSDT/1m/*.zip"))
print(D.fingerprint(btc))
report = D.health_check(btc, freq="1min")
print(D.summarize(report))
输出:
{'行数': 4746079, '起点': '2017-08-17 04:00:00+00:00', '终点': '2026-08-31 23:59:00+00:00', '收盘价之和': 183332267178.49}
重复时间戳            0
时间没有按顺序排列        0
有空值的行            0
高低价自相矛盾          0
价格不为正            0
成交量为零        24003
四价相同         56731
时间戳没有对齐      21602
缺失的 K 线       8562
可疑插针         13052
Name: 数量, dtype: int64
第一行就是这份数据的复现指纹。如果你下载的数据算出来也是这几个数,说明你的数据和正文完全一样。
没有重复、没有乱序、没有空值、没有自相矛盾的价格。但下面几项,每一项都值得细看。
发现一:21,602 根 K 线的时间戳没有对齐
1 分钟 K 线的时间戳,应该都在整分钟上,比如 06:00:00、06:01:00。看 2017 年 12 月 4 日早上:
                                      open     close    volume
time
2017-12-04 05:58:00+00:00         11489.02  11460.02  2.532981
2017-12-04 05:59:00+00:00         11460.02  11459.98  1.732709
2017-12-04 06:00:00+00:00         11476.87  11478.00  0.289485
2017-12-04 06:00:20.799000+00:00  11478.00  11478.00  0.000000
2017-12-04 06:01:20.799000+00:00  11478.00  11478.00  0.000000
2017-12-04 06:02:20.799000+00:00  11478.00  11478.00  0.000000
从 06:00:20.799 开始,每根 K 线的时间戳都偏移了 20.799 秒。而且 06:00 这一分钟,出现了两根 K 线:一根在 06:00:00,一根在 06:00:20.799。
这种偏移一直持续到 2017 年 12 月 18 日 10:00:20.799,一共 20,401 根。之后在 2018 年 2 月 9 日 09:59 到 2 月 10 日 05:59 之间,又出现了一段偏移 14.789 秒的,一共 1,201 根。
这会造成什么问题? 如果不做对齐,直接找「缺失的 1 分钟 K 线」,这两周会被判定为几乎全部缺失(因为没有一根时间戳落在整分钟上)。如果直接用它合成日线,也会因为重叠的 K 线出现轻微的偏差。
处理方法:把时间戳向下取整到整分钟,遇到重叠的,保留一根。第七节合成日线时,第一步就是这么做的。
发现二:34 段缺口,一共 8,562 分钟
runs = D.missing_runs(report["缺失的 K 线"], "1min")
print("一共", len(runs), "段缺口,", runs["缺失根数"].sum(), "根 K 线")
print(runs.sort_values("缺失根数", ascending=False).head(6).to_string(index=False))
输出:
一共 34 段缺口, 8562 根 K 线
                       开始                        结束  缺失根数
2018-02-08 00:29:00+00:00 2018-02-09 09:58:00+00:00  2010
2018-06-26 02:00:00+00:00 2018-06-26 11:59:00+00:00   600
2019-05-15 03:00:00+00:00 2019-05-15 12:59:00+00:00   600
2019-08-15 02:00:00+00:00 2019-08-15 09:59:00+00:00   480
2018-07-04 00:23:00+00:00 2018-07-04 07:59:00+00:00   457
2017-09-06 16:00:00+00:00 2017-09-06 22:59:00+00:00   420
最长的一段缺口,从 2018 年 2 月 8 日 00:29 到 2 月 9 日 09:58,超过 33 个小时没有任何数据。
这些缺口是交易所停止交易了,还是数据归档漏掉了?K 线数据本身回答不了,要用别的数据源交叉核对。以 2019 年 5 月 15 日那段缺口为例:同一时间,Coinbase 的 BTC-USD 数据是完整的(我们核对了 03:00 到 06:59 这 4 个小时,240 分钟一分钟不缺)。比特币本身一直在交易,所以这段缺口是 Binance 这一个交易所没有交易或没有数据。
这会造成什么问题?
- 用 1 分钟数据合成日线时,缺口所在的那一天,成交量会偏小,最高价和最低价可能不准
- 用「过去 60 根 K 线」计算指标时,如果中间有 10 个小时的缺口,这 60 根 K 线实际上跨越了 11 个小时,指标含义已经变了
- 回测里,如果你的持仓刚好跨过一个缺口,缺口前后的价格可能差得很远,而你在缺口期间根本没法交易
发现三:交易暂停时留下的占位 K 线
2018 年以后,成交量为零的 1 分钟 K 线一共只有 307 根,而且全部集中在少数几天里:
| 日期 | 成交量为零的分钟数 |
|---|---|
| 2018-03-04 | 20 |
| 2019-06-07 | 73 |
| 2019-11-13 | 3 |
| 2020-12-21 | 50 |
| 2021-01-11 | 8 |
| 2021-02-11 | 81 |
| 2023-03-24 | 72 |
像 BTCUSDT 这样全世界成交最活跃的交易对之一,正常情况下不可能连续几十分钟一笔成交都没有。
看 2023 年 3 月 24 日。这一天,Binance 因为追踪止损单功能的一个程序错误,暂停了现货交易,UTC 14:00 恢复(CoinDesk、Cointelegraph)。数据里是这样的:
                               open     close     volume
time
2023-03-24 12:38:00+00:00  28080.00  28080.00    0.00000
2023-03-24 12:39:00+00:00  28080.00  28080.00    0.00000
2023-03-24 14:00:00+00:00  28079.99  27925.59  293.30587
2023-03-24 14:01:00+00:00  27925.60  27850.00  237.33799
从 11:28 到 12:39,是 72 根四价全部等于 28,080.00、成交量为零的占位 K 线;从 12:40 到 13:59,是 80 分钟完全没有数据;14:00 交易恢复。
⚠️ 注意这个细节:同一次交易暂停,在数据里被记录成了两种完全不同的样子,前一段是占位 K 线,后一段是缺失。如果你只检查缺失的 K 线,会漏掉前面那 72 分钟;如果只检查零成交量,会漏掉后面那 80 分钟。这就是为什么体检要同时查很多项。
这会造成什么问题? 占位 K 线的波动为零。用这段数据算波动率会偏低;如果你的策略在这 72 分钟里产生了交易信号,回测会以 28,080 成交,而现实中你根本下不了单。
发现四:「成交量为零」和「四价相同」大部分来自 2017 年
在 24,003 根零成交量的 K 线里,有 23,696 根出现在 2017 年。那时 Binance 刚上线几个月,BTCUSDT 的交易还很清淡,很多分钟里确实没有一笔成交,价格也就没有变化。
判断:大部分是真实情况,不是错误。 但它意味着 2017 年的 1 分钟数据,和后来的数据性质不同:同样是「1 分钟 K 线」,2017 年的很多根里其实没有任何交易。如果你的研究用到 1 分钟数据,最好从 2018 年开始。
发现五:「可疑插针」的数量说明了这项检查的局限
这项检查标出了 13,052 根 K 线。按年份分布:
| 年份 | 2017 | 2018 | 2019 | 2020 | 2021 | 2022 | 2023 | 2024 | 2025 | 2026 |
|---|---|---|---|---|---|---|---|---|---|---|
| 可疑插针数 | 10,904 | 4 | 16 | 18 | 8 | 7 | 969 | 157 | 356 | 613 |
这个分布本身就说明了问题。这项检查的判断标准是「影线长度超过最近一天典型波幅的 20 倍」。在市场很平静的时期(比如 2023 年的部分时间),典型波幅非常小,一根普通的长影线就会超过 20 倍;在 2017 年交易清淡的时期,大量分钟里波幅为零,也让标准失去了意义。
所以这项检查标出来的,大部分不是数据错误。它更像一个「值得看一眼」的清单。真正有用的做法,是按影线长度排序,只看最极端的那几根,再用别的交易所核对,就像第八节做的那样。
⚠️ 这件事值得记住:一个检查规则的阈值,永远是在「漏报」和「误报」之间做取舍。 阈值定得宽,会漏掉真正的问题;定得严,会被大量正常数据淹没。
发现问题之后怎么办
| 处理方式 | 适用的情况 | 例子 |
|---|---|---|
| 删除 | 确定是错误,而且没有办法修正 | SPY 2026-04-20 的填充数据 |
| 修正 | 确定是错误,而且有可靠的正确值 | 时间戳偏移:取整对齐 |
| 标记 | 数据是真实的,但使用时要特别处理 | 交易暂停期间的占位 K 线、缺口 |
| 保留 | 确认是真实行情 | SPY 2020-03-16 的剧烈波动 |
最危险的做法,是不看就删。 删掉所有「可疑插针」,你会把 2020 年 3 月、2025 年 10 月这些最重要的极端行情全部删掉,你的回测会活在一个从来不会暴跌的市场里。
十、动手:talab.data
准备
这门课的所有代码都放在一个叫 talab 的项目里。第 4 篇会完整搭建项目结构、测试和绘图环境。这一篇先建第一个模块,你需要:
- Python 3.11 或更高版本
- 安装三个库:
pip install pandas numpy exchange_calendars
然后建一个目录,结构如下:
talab/
└── talab/
    ├── __init__.py      # 空文件
    └── data.py          # 这一节写的模块
在外层的 talab/ 目录里运行代码,下载的数据会放在 data/ 子目录下。
⚠️ 第一次下载 BTC 全部历史的 1 分钟数据,需要逐月下载 109 个文件,每个文件还要单独下载一个校验文件,网络慢的时候可能要十几分钟。之后再运行,已经校验通过的文件会直接跳过。
data.py 分四个部分:下载、加载、价格调整、体检。下面逐段给出完整代码。
第一部分:下载
"""talab.data:下载、加载、体检、价格调整。第 3 篇。"""
from __future__ import annotations

import hashlib
import json
import time
import urllib.request
import zipfile
from pathlib import Path

import numpy as np
import pandas as pd

BINANCE_BASE = "https://data.binance.vision/data"
BINANCE_COLUMNS = [
    "open_time", "open", "high", "low", "close", "volume", "close_time",
    "quote_volume", "trades", "taker_buy_base", "taker_buy_quote", "ignore",
]
USER_AGENT = "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/126 Safari/537.36"


def _fetch(url: str, retries: int = 3) -> bytes:
    req = urllib.request.Request(url, headers={"User-Agent": USER_AGENT})
    for i in range(retries):
        try:
            with urllib.request.urlopen(req, timeout=120) as r:
                return r.read()
        except Exception:
            if i == retries - 1:
                raise
            time.sleep(2 ** i)


def download_binance_klines(symbol: str, interval: str, start: str, end: str,
                            market: str = "spot", dest: str = "data/binance") -> list[Path]:
    """按月下载 Binance 公开 K 线压缩包,并用官方 .CHECKSUM 文件校验。

    market: "spot"(现货)或 "um"(U 本位永续合约)
    start / end: "YYYY-MM",包含两端
    """
    prefix = "spot" if market == "spot" else "futures/um"
    folder = Path(dest) / market / symbol / interval
    folder.mkdir(parents=True, exist_ok=True)
    paths = []
    for month in pd.period_range(start, end, freq="M"):
        name = f"{symbol}-{interval}-{month}.zip"
        path = folder / name
        url = f"{BINANCE_BASE}/{prefix}/monthly/klines/{symbol}/{interval}/{name}"
        expected = _fetch(url + ".CHECKSUM").decode().split()[0]
        if not (path.exists() and hashlib.sha256(path.read_bytes()).hexdigest() == expected):
            content = _fetch(url)
            actual = hashlib.sha256(content).hexdigest()
            if actual != expected:
                raise ValueError(f"{name} 校验失败:期望 {expected},实际 {actual}")
            path.write_bytes(content)
        paths.append(path)
    return paths


def download_nasdaq(symbol: str, kind: str, dest: str = "data/nasdaq",
                    assetclass: str = "stocks", start: str = "2016-01-01", end: str | None = None) -> Path:
    """从 Nasdaq 公开接口下载日线(kind="historical")或分红记录(kind="dividends"),原样保存 JSON。"""
    end = end or pd.Timestamp.today().strftime("%Y-%m-%d")
    base = f"https://api.nasdaq.com/api/quote/{symbol}/{kind}?assetclass={assetclass}"
    url = base + (f"&fromdate={start}&todate={end}&limit=9999" if kind == "historical" else "")
    path = Path(dest) / f"{symbol}_{kind}.json"
    path.parent.mkdir(parents=True, exist_ok=True)
    path.write_bytes(_fetch(url))
    return path
几个值得注意的地方:
校验。 Binance 为每个数据文件都提供了一个 .CHECKSUM 文件,里面是这个文件的 SHA-256 摘要。下载完之后,我们自己算一遍摘要,和官方给的比较。两者一致,才说明文件在下载过程中没有损坏、没有被截断。如果本地已经有一个校验通过的文件,就不再重复下载。
原样保存。 Nasdaq 的数据,我们把接口返回的 JSON 原样存下来,不做任何处理。这对应第五节说的原则:保存不会变的原始数据,所有处理都在读取时进行。
⚠️ Nasdaq 公开接口有两个限制,要心里有数:它最多只能回溯大约 10 年(所以 start 写 2016-01-01,实际拿到的数据从 2016-09-15 开始);它给出的价格已经按拆股调整过,但没有按分红调整(第三节我们验证过)。另外,接口要求请求带上浏览器的 User-Agent,否则可能拒绝响应。
第二部分:加载
def load_binance_klines(paths) -> pd.DataFrame:
    """把一组 Binance K 线压缩包读成一张表,索引是 UTC 时间(K 线开始的时刻)。"""
    paths = sorted(Path(p) for p in paths)
    if not paths:
        raise ValueError("没有找到任何 K 线文件,检查一下路径")
    frames = []
    for path in paths:
        with zipfile.ZipFile(path) as z:
            df = pd.read_csv(z.open(z.namelist()[0]), header=None)
        if not str(df.iloc[0, 0]).isdigit():        # 部分文件第一行是表头
            df = df.iloc[1:]
        df.columns = BINANCE_COLUMNS
        frames.append(df)
    df = pd.concat(frames, ignore_index=True)
    t = df["open_time"].astype("int64")
    # ⚠️ 现货数据从 2025-01-01 起时间戳是微秒(16 位),之前是毫秒(13 位)
    t = np.where(t > 10**14, t // 1000, t)
    df.index = pd.to_datetime(t, unit="ms", utc=True)
    df.index.name = "time"
    num = ["open", "high", "low", "close", "volume", "quote_volume", "taker_buy_base", "taker_buy_quote"]
    df[num] = df[num].astype(float)
    df["trades"] = df["trades"].astype("int64")
    return df.drop(columns=["open_time", "close_time", "ignore"])


def load_nasdaq_daily(path) -> pd.DataFrame:
    """读取 Nasdaq 日线。⚠️ 这个接口给出的价格和成交量已经按拆股调整过,但没有按分红调整。"""
    rows = json.loads(Path(path).read_text())["data"]["tradesTable"]["rows"]
    df = pd.DataFrame(rows)
    df.index = pd.to_datetime(df.pop("date"), format="%m/%d/%Y")
    df.index.name = "date"
    for c in ["open", "high", "low", "close", "volume"]:
        df[c] = pd.to_numeric(df[c].str.replace(r"[$,]", "", regex=True), errors="coerce")  # "N/A" → NaN
    return df[["open", "high", "low", "close", "volume"]].sort_index()


def load_nasdaq_dividends(path) -> pd.Series:
    """读取现金分红记录:索引是除息日,值是每股分红(当时的原始金额,没有按之后的拆股调整)。"""
    rows = json.loads(Path(path).read_text())["data"]["dividends"]["rows"]
    df = pd.DataFrame(rows)
    df = df[df["type"] == "Cash"]
    s = pd.Series(pd.to_numeric(df["amount"].str.replace("$", ""), errors="coerce").values,
                  index=pd.to_datetime(df["exOrEffDate"], format="%m/%d/%Y"), name="dividend")
    return s.sort_index()
加载时处理了三个真实存在的格式问题:
时间戳的单位变了。 Binance 现货数据从 2025 年 1 月 1 日起,时间戳从毫秒(13 位数字)改成了微秒(16 位数字)。如果不处理,2025 年以后的时间会被解析到几万年以后。判断方法是看数字大小:大于 10¹⁴ 的就是微秒。
有的文件带表头,有的不带。 读进来之后,如果第一行第一个值不是数字,就把它当成表头去掉。
价格里带着美元符号和千位分隔符。 Nasdaq 返回的价格是 "$129.04"、成交量是 "225,702,700" 这样的字符串,要先去掉 $ 和 , 再转成数字。像 SPY 那一行的 "N/A",会被转成空值(NaN),这样体检时才能被发现。
⚠️ 分红记录里的金额是当时发放的原始金额。苹果 2020 年 8 月 7 日的分红记录是 0.82 美元,这是拆股前每股发的钱,没有被除以 4。下面的分红调整算法要求的正是这个原始金额,因为它要和当时的真实价格相除。
第三部分:价格调整
# 拆股记录:(拆股后第一个交易日,1 股变成几股)
SPLITS = {
    "AAPL": [("1987-06-16", 2), ("2000-06-21", 2), ("2005-02-28", 2), ("2014-06-09", 7), ("2020-08-31", 4)],
    "TSLA": [("2020-08-31", 5), ("2022-08-25", 3)],
    "SPY": [],
}

PRICE_COLS = ["open", "high", "low", "close"]


def split_factor(index: pd.DatetimeIndex, splits) -> pd.Series:
    """每一天的「拆股系数」:这一天之后一共拆了多少倍。拆股后第一天及以后为 1。"""
    f = pd.Series(1.0, index=index)
    for day, ratio in splits:
        f[index < pd.Timestamp(day)] *= ratio
    return f


def unadjust_splits(df: pd.DataFrame, splits) -> pd.DataFrame:
    """把按拆股调整过的价格还原成当时真实成交的价格。"""
    f = split_factor(df.index, splits)
    raw = df.copy()
    raw[PRICE_COLS] = df[PRICE_COLS].mul(f, axis=0)
    raw["volume"] = df["volume"] / f
    return raw


def adjust_splits(raw: pd.DataFrame, splits) -> pd.DataFrame:
    """把真实成交价格按拆股调整:拆股之前的价格除以之后累计的拆股倍数。"""
    f = split_factor(raw.index, splits)
    adj = raw.copy()
    adj[PRICE_COLS] = raw[PRICE_COLS].div(f, axis=0)
    adj["volume"] = raw["volume"] * f
    return adj


def dividend_factor(raw_close: pd.Series, dividends: pd.Series) -> pd.Series:
    """每一天的「分红系数」。

    对每个除息日 e,分红 D,除息日前一个交易日的真实收盘价 P:
        这次分红的系数 = 1 - D / P
    除息日之前的每一天,都要乘上这个系数;多次分红的系数连乘。
    """
    f = pd.Series(1.0, index=raw_close.index)
    for ex_date, amount in dividends.items():
        before = raw_close.index[raw_close.index < ex_date]
        if len(before) == 0 or ex_date > raw_close.index[-1]:
            continue                                   # 数据范围之外的分红
        prev_close = raw_close[before[-1]]
        f[raw_close.index < ex_date] *= 1 - amount / prev_close
    return f


def adjust_total_return(raw: pd.DataFrame, splits, dividends: pd.Series) -> pd.DataFrame:
    """同时按拆股和分红调整。调整后,相邻两天价格之比 = 持有者真实的总收益(含分红再投资)。"""
    adj = adjust_splits(raw, splits)
    f = dividend_factor(raw["close"], dividends)
    adj[PRICE_COLS] = adj[PRICE_COLS].mul(f, axis=0)
    return adj
对照第三、四节的规则读这段代码:
split_factor 对每个拆股记录,把拆股日之前的所有日子乘上拆股倍数。AAPL 有两次拆股落在我们的数据范围里,所以 2014 年 6 月 9 日之前的日子系数是 28,2014 年 6 月 9 日到 2020 年 8 月 28 日之间是 4,之后是 1。
unadjust_splits 和 adjust_splits 是一对互逆的操作:一个乘、一个除。我们的数据源给的是调整后的价格,所以先用 unadjust_splits 还原出真实价格;需要调整后的价格时,再从真实价格算回去。这样,「真实价格 + 公司行为记录」始终是计算的起点。
dividend_factor 就是第四节那四步算法的直接翻译。注意它用的是真实收盘价 raw_close 和原始分红金额,两者都是当时的数字,所以不需要考虑拆股。
⚠️ SPLITS 这张表是手工整理的,来自苹果和特斯拉官方公布的拆股记录。这门课只用到这三个标的,所以手工维护是可行的。如果你要处理成百上千只股票,就需要一个可靠的公司行为数据源,这通常要付费。
第四部分:体检
def health_check(df: pd.DataFrame, freq: str | None = None, sessions: pd.DatetimeIndex | None = None,
                 wick_k: float = 20.0, wick_window: int = 1440,
                 low_volume_ratio: float | None = None, volume_window: int = 20) -> dict[str, pd.DataFrame | pd.Index]:
    """检查一张 OHLCV 表的常见问题,返回每类问题对应的行。

    freq:      固定周期(如 "1min"、"1D"),用来找缺失的 K 线(适合 24 小时交易的市场)
    sessions:  交易日历(适合有休市的市场),用来找缺失和多出来的交易日
    wick_k:    影线长度超过「过去 wick_window 根 K 线典型波幅」的多少倍,算作可疑插针
    low_volume_ratio: 成交量低于「过去 volume_window 根 K 线中位数」的这个比例,算作可疑(适合日线)
    """
    report = {}
    report["重复时间戳"] = df.index[df.index.duplicated()]
    report["时间没有按顺序排列"] = df.index[1:][df.index[1:] <= df.index[:-1]]
    report["有空值的行"] = df[df[PRICE_COLS + ["volume"]].isna().any(axis=1)]
    body_hi = df[["open", "close"]].max(axis=1)
    body_lo = df[["open", "close"]].min(axis=1)
    report["高低价自相矛盾"] = df[(df["high"] < body_hi) | (df["low"] > body_lo) | (df["low"] > df["high"])]
    report["价格不为正"] = df[(df[PRICE_COLS] <= 0).any(axis=1)]
    report["成交量为零"] = df[df["volume"] == 0]
    report["四价相同"] = df[(df["open"] == df["high"]) & (df["high"] == df["low"]) & (df["low"] == df["close"])]

    if freq is not None:
        report["时间戳没有对齐"] = df.index[df.index != df.index.floor(freq)]
        full = pd.date_range(df.index[0].floor(freq), df.index[-1], freq=freq)
        report["缺失的 K 线"] = full.difference(df.index.floor(freq))
    if sessions is not None:
        report["缺失的交易日"] = sessions.difference(df.index)
        report["日历之外多出来的日子"] = df.index.difference(sessions)

    # 可疑插针:影线远远长于最近的典型波幅
    typical = ((df["high"] - df["low"]) / df["close"]).rolling(wick_window, min_periods=wick_window // 2).median().shift(1)
    upper = (df["high"] - body_hi) / df["close"]
    lower = (body_lo - df["low"]) / df["close"]
    report["可疑插针"] = df[(upper > wick_k * typical) | (lower > wick_k * typical)]

    if low_volume_ratio is not None:
        usual = df["volume"].rolling(volume_window, min_periods=volume_window // 2).median().shift(1)
        report["成交量异常偏低"] = df[df["volume"] < low_volume_ratio * usual]
    return report


def summarize(report: dict) -> pd.Series:
    """把体检报告压缩成「每类问题有多少条」。"""
    return pd.Series({k: len(v) for k, v in report.items()}, name="数量")


def missing_runs(missing: pd.DatetimeIndex, freq: str) -> pd.DataFrame:
    """把一个个缺失的时间点,合并成一段段连续的缺口。"""
    if len(missing) == 0:
        return pd.DataFrame(columns=["开始", "结束", "缺失根数"])
    step = pd.Timedelta(freq)
    s = pd.Series(missing)
    group = (s.diff() != step).cumsum()
    runs = s.groupby(group).agg(["first", "last", "count"])
    runs.columns = ["开始", "结束", "缺失根数"]
    return runs.reset_index(drop=True)


def fingerprint(df: pd.DataFrame) -> dict:
    """复现指纹:你算出来的这几个数和正文一致,说明数据一致。"""
    return {
        "行数": len(df),
        "起点": str(df.index[0]),
        "终点": str(df.index[-1]),
        "收盘价之和": round(float(df["close"].sum()), 2),
    }
几个设计上的考虑:
缺失的 K 线,是在对齐之后找的。 full.difference(df.index.floor(freq)) 先把时间戳取整,再找缺口。这样 2017 年 12 月那两周时间戳偏移的数据,就不会被误判成缺失,而是单独出现在「时间戳没有对齐」里。
两种找缺失的方式。 加密市场 24 小时交易,用固定周期 freq 生成完整的时间序列来对比。美股有周末和节假日,不能用固定周期,要用交易所的交易日历 sessions 来对比。exchange_calendars 这个库提供了全球主要交易所的交易日历,"XNYS" 是纽约证券交易所。
「典型波幅」用的是中位数,而且往后移了一根。 .shift(1) 保证判断某根 K 线时,只用它之前的数据,不用它自己。用中位数而不用平均数,是因为平均数会被几根极端的 K 线拉高,而我们要找的恰恰是极端的 K 线。
插针阈值是参数。 1 分钟数据默认用「过去 1,440 根(一天)的典型波幅的 20 倍」;日线数据用「过去 250 根(大约一年)的 8 倍」。第九节已经看到,这个阈值没有完美的取值。
十一、数据能回答什么,不能回答什么
| 数据体检能告诉你 | 数据体检不能告诉你 |
|---|---|
| 数据里有哪些不符合规则的地方 | 一条可疑记录是错误还是真实行情(需要你判断,或者交叉核对) |
| 你的数据是否经过拆股调整(在已知拆股日检查) | 数据源内部用了什么分红调整约定(需要查文档或自己算) |
| 数据的时间范围、行数、复现指纹 | 数据源以后会不会悄悄修改历史数据 |
| 缺口在哪里 | 缺口期间真实发生了什么(需要别的数据源) |
十二、小结
-
K 线的五个字段各有来源。 美股的官方开盘价和收盘价来自主要上市交易所的集合竞价,日线通常不包括盘前盘后。加密 K 线完全由一个交易所、一个市场在这段时间里的成交决定。
-
拆股调整:拆股之前的价格除以之后的累计拆股倍数,成交量乘以同一个倍数。不调整,回测会看到根本不存在的暴跌(AAPL 2020-08-31 的 −74.2%)。
-
分红调整:每次分红,把除息日之前的价格乘以 1 − 分红 ÷ 前一日收盘价。AAPL 十年里,只调整拆股是 11.47 倍,加上分红调整是 12.54 倍。
-
三种价格回答三个问题:真实成交价回答「当时成交在哪」,拆股调整价让不同日子的价格可以比较,拆股 + 分红调整价回答「持有者的真实收益」。回测用调整后的价格,研究当时的整数关口用真实价格。
-
调整后的价格会随着新的分红和拆股不断变化。 所以要保存原始数据和公司行为记录,每次自己算,并用复现指纹核对。
-
盘后公布的消息会变成第二天的跳空,止损没法在设定的价格成交。
-
加密市场的「一天」是人为切出来的。 按 UTC 和按北京时间切,3,164 天里有 912 天(28.8%)阴阳相反;2020 年 3 月 13 日,一种切法 +16.2%,另一种 −15.0%。回测和实盘必须用同一种切法。
-
同一个资产,不同市场的价格可以差很多。 2025 年 10 月 10 日,Binance 和 Coinbase 的最低价差了 5,000 美元;插针常常只出现在一个交易所。策略在哪里执行,数据就要来自哪里。
-
拿到任何数据,先体检。 真实数据里发现了:SPY 一个 9,999,999 的假成交量和一整天的填充数据;BTC 两段时间戳偏移、34 段缺口、交易暂停时的占位 K 线。体检报告是线索,不是结论,不看就删最危险。
最后回到披萨。拆股是把披萨切成更多块,分红是从披萨上切一块给你,日线切点是从哪里下刀,不同交易所是不同的披萨店。你看到的每一张价格图,都是有人按某种方式切好、称好、摆好的披萨。 下一次看图之前,先问一句:这个披萨是谁切的,怎么切的?
下一篇,我们把 talab 搭成一个完整的项目,然后不用任何绘图库,亲手画出第一根 K 线。
练习
练习 1(计算) 特斯拉在 2020 年 8 月 31 日进行了 1 拆 5 的拆股,2022 年 8 月 25 日进行了 1 拆 3 的拆股。某一天特斯拉的真实收盘价是 1,500 美元,这一天在 2020 年 8 月 31 日之前。它的拆股调整价格是多少?如果这一天真实成交了 1,000 万股,拆股调整后的成交量是多少?
练习 2(计算) 某只股票的除息日是 3 月 10 日,每股分红 2 元。3 月 9 日收盘价 100 元,3 月 10 日收盘价 99 元。
- (a) 3 月 10 日的价格涨跌幅是多少?
- (b) 用系数法,3 月 9 日的分红调整价格是多少?3 月 10 日的调整后涨跌幅是多少?
- (c) 如果直接用「(当日收盘价 + 分红) ÷ 前一日收盘价 − 1」计算,结果是多少?和 (b) 差多少?
练习 3(判断) 下面每种情况,应该用真实成交价、拆股调整价,还是拆股 + 分红调整价?
- (a) 计算 AAPL 过去 10 年买入持有的年化收益率
- (b) 研究 2020 年 8 月 AAPL 在 500 美元附近的成交量分布
- (c) 计算 AAPL 的 200 日均线
- (d) 比较一个 AAPL 交易策略和买入持有 AAPL 的收益
练习 4(编程)
用 talab.data 下载 BTCUSDT 永续合约(market="um")2025 年全年的 1 分钟数据,做一次体检。和现货的体检结果比较,有哪些不同?
练习 5(编程) 用第七节的方法,统计 BTC 按 UTC 0 点和按 UTC 8 点(也就是北京时间 16 点)切出来的日线,阴阳不同的天数占比是多少?和按北京时间 0 点切的 28.8% 相比,你觉得这个比例和两种切法相差的小时数有什么关系?
练习 6(思考) 第九节说「体检报告是线索,不是结论」。假设你的体检标出了某只股票某一天的「可疑插针」:最低价比开盘价低了 30%,收盘价又回到了开盘价附近。请列出至少三种你可以用来判断它是数据错误还是真实行情的方法。
小检查答案
第二节小检查
至少有两个可能的原因:
- 两个交易所是两个独立的市场。 每个交易所的 K 线只由它自己的成交决定。同一时刻,两个交易所的成交价本来就可能不同,开盘价和收盘价自然也不同。
- 两个交易所的「一天」可能切在不同的时刻。 比如一个按 UTC 0 点切,另一个按北京时间 0 点切,这两根「同一天」的 K 线,覆盖的其实是不同的 24 小时。
另外还可能有计价货币不同(USDT 和美元)的原因。