| 本篇位置 | 第一部分「地基」的第四篇。搭好之后,这门课的每一篇都在这个实验台上完成 |
| 用到的数据 | Binance BTCUSDT 现货日线(2017-08 至 2026-08);SPY 日线(2025-12 至 2026-01) |
| 动手 | 把 talab 建成完整项目:虚拟环境、依赖、数据下载脚本、测试;写 talab.plot 模块 |
| 读完你能 | 在自己的电脑上复现这门课的全部数据和结果;说清一根 K 线的每一笔是怎么画出来的;知道什么时候必须用对数坐标,以及换坐标会怎样改变你看到的「趋势」 |
一、先做一个决定
下面是 BTC 从 2017 年 8 月到 2026 年 8 月的周线图。每根 K 线代表一周。
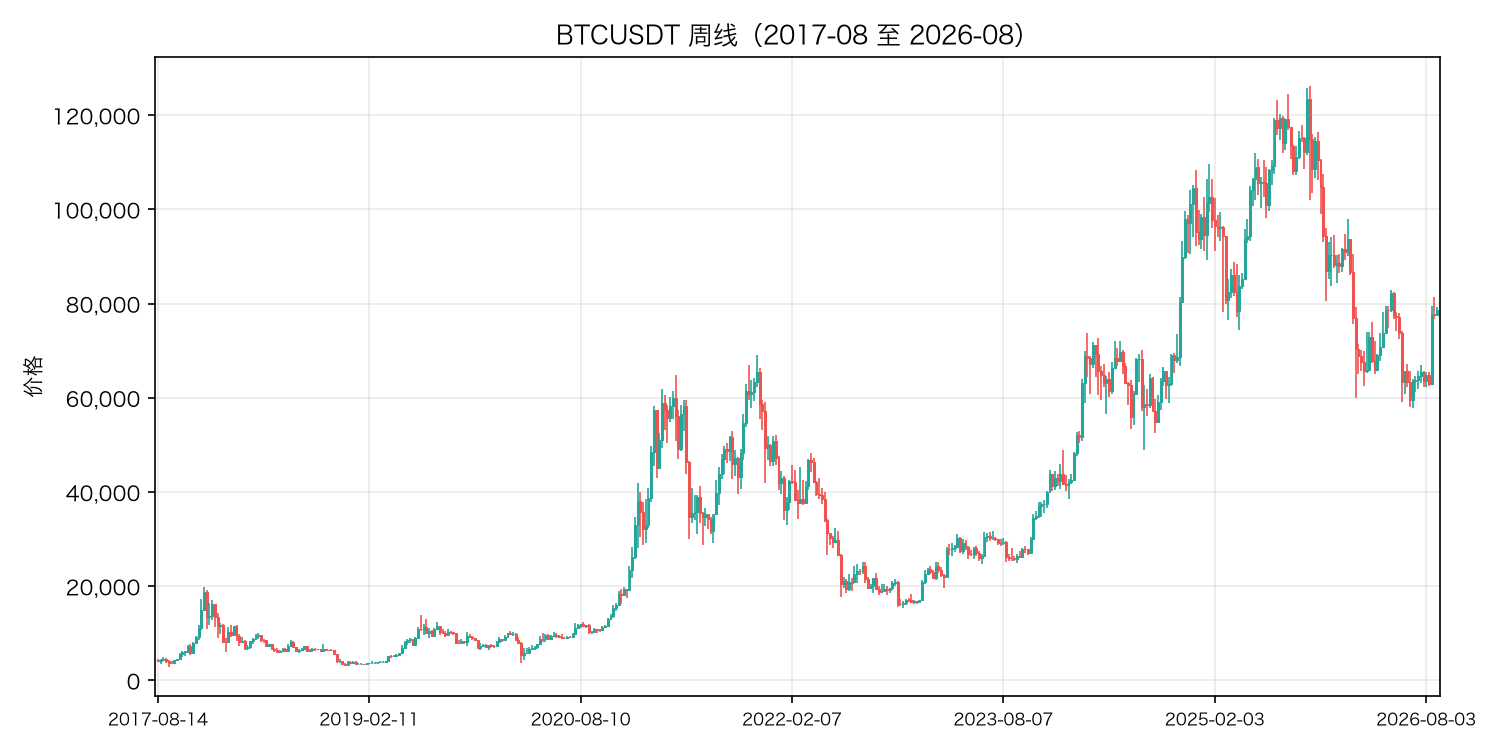
在这九年里,BTC 经历了三次大的下跌:
- 第一次,2017 年底到 2018 年底
- 第二次,2021 年底到 2022 年底
- 第三次,2025 年 10 月到 2026 年 7 月
只看这张图,哪一次跌得最狠?
- A. 第一次(2017 到 2018)
- B. 第二次(2021 到 2022)
- C. 第三次(2025 到 2026)
先把你的选择写下来。 第六节会揭晓答案,并且解释为什么这张图会误导你。
不过在那之前,我们要先搭好一个实验台。这张图是用代码画出来的,你将亲手写出画它的每一行代码。
二、搭一个实验台
为什么要搭成一个「项目」
第 3 篇写了 talab.data 模块,当时只是一个放在目录里的 Python 文件。接下来的 31 篇,还会陆续加入绘图、结构识别、指标、形态、风险、回测、报告等模块。
如果每篇的代码都零散地放在不同地方,很快就会遇到这些问题:
- 第 12 篇想用第 3 篇写的函数,找不到,或者找到了一个旧版本
- 改了第 3 篇的一个函数,不知道会不会让第 9 篇的结果悄悄变掉
- 换了一台电脑,装的 pandas 版本不同,跑出来的数字和正文对不上
所以这一篇要把 talab 变成一个正式的项目,解决三件事:
- 环境可以复现:固定每个库的版本
- 数据可以复现:一个脚本下载全部课程数据,并用复现指纹核对
- 代码可以信任:每个函数都有测试,改动之后跑一遍就知道有没有改坏
Python 和虚拟环境
这门课的代码在 Python 3.14.7 上运行过。最低需要 Python 3.11(pandas 3 要求的最低版本)。
先检查你的 Python 版本:
python3 --version
然后创建一个虚拟环境。虚拟环境是一个独立的 Python 安装目录:你在里面装的库,不会影响电脑上的其他 Python 项目,其他项目也不会影响它。
在 talab 项目目录里执行(macOS 和 Linux):
python3 -m venv .venv
source .venv/bin/activate
Windows 上,第二条命令换成 .venv\Scripts\activate。
激活之后,命令行前面会出现 (.venv)。之后每次打开新的终端窗口,都要先激活一次,否则用的是系统的 Python,装的库也找不到。这是新手最常遇到的问题。
项目结构
talab/
├── pyproject.toml              # 项目的描述:名字、依赖、测试设置
├── requirements.txt            # 精确的依赖版本
├── .gitignore                  # 不纳入版本管理的文件
├── talab/                      # 代码本体
│   ├── __init__.py
│   ├── data.py                 # 第 3 篇:下载、加载、调整、体检
│   └── plot.py                 # 第 4 篇:K 线绘图
├── tests/                      # 测试
│   ├── test_data.py
│   └── test_plot.py
├── scripts/
│   └── fetch_course_data.py    # 下载全部课程数据
├── data/                       # 下载的数据(不纳入版本管理)
└── figures/                    # 生成的图(不纳入版本管理)
外层的 talab/ 是项目目录,里面的 talab/ 是代码包。所有命令都在项目目录里执行。
依赖和安装
pyproject.toml 描述这个项目:
[build-system]
requires = ["setuptools>=68"]
build-backend = "setuptools.build_meta"

[project]
name = "talab"
version = "0.1.0"
description = "交易技术分析课程的实验工具库"
requires-python = ">=3.11"
dependencies = [
    "pandas>=3.0",
    "numpy>=2.0",
    "matplotlib>=3.9",
    "exchange_calendars>=4.5",
]

[project.optional-dependencies]
dev = ["pytest>=8"]

[tool.setuptools]
packages = ["talab"]

[tool.pytest.ini_options]
testpaths = ["tests"]
filterwarnings = ["ignore:Glyph .* missing from font"]    # 测试环境里没有配置中文字体,不影响结果
requirements.txt 记录的是正文所有结果实际运行时的精确版本:
# 正文里所有代码的实际运行环境(Python 3.14.7)
pandas==3.0.5
numpy==2.5.3
matplotlib==3.11.2
exchange_calendars==4.13.2
pytest==9.1.1
为什么有两份?pyproject.toml 里写的是「至少需要什么版本」,让项目在较新的环境里也能装上;requirements.txt 里写的是「正文用的到底是哪个版本」。如果你跑出来的数字和正文不一样,第一件事就是用 requirements.txt 装一个完全相同的环境再试。
安装(在激活了虚拟环境的终端里):
pip install -r requirements.txt
pip install -e .
第二条命令里的 -e 表示可编辑安装。它不会把 talab 复制一份装进虚拟环境,而是让虚拟环境直接指向你的项目目录。这样你修改 talab/plot.py 之后,不需要重新安装,下次 import talab 用的就是改过的代码。
装好之后,在任何目录里运行 Python,都可以 from talab import data。
下载全部课程数据
scripts/fetch_course_data.py 负责下载这门课用到的全部基础数据:
"""下载这门课用到的全部基础数据,并打印复现指纹。

在项目根目录运行:python scripts/fetch_course_data.py
"""
from concurrent.futures import ThreadPoolExecutor
from pathlib import Path

import pandas as pd

from talab import data as D

CRYPTO_START, CRYPTO_END = "2017-08", "2026-08"          # 加密数据:按月,包含两端
US_START, US_END = "2016-01-01", "2026-09-15"            # 美股数据:Nasdaq 接口最多回溯约 10 年
US_SYMBOLS = {"SPY": "etf", "AAPL": "stocks", "TSLA": "stocks"}


def fetch_binance(interval: str) -> None:
    months = [str(m) for m in pd.period_range(CRYPTO_START, CRYPTO_END, freq="M")]
    # 按月并行下载;每个月都会校验官方 SHA-256,已经下载且校验通过的会跳过
    with ThreadPoolExecutor(max_workers=8) as pool:
        list(pool.map(lambda m: D.download_binance_klines("BTCUSDT", interval, m, m), months))


def main() -> None:
    for interval in ["1d", "1m"]:
        print(f"下载 BTCUSDT {interval} ……", flush=True)
        fetch_binance(interval)
    for symbol, assetclass in US_SYMBOLS.items():
        print(f"下载 {symbol} 日线 ……", flush=True)
        D.download_nasdaq(symbol, "historical", assetclass=assetclass, start=US_START, end=US_END)
    D.download_nasdaq("AAPL", "dividends")

    print("\n复现指纹:")
    for interval in ["1d", "1m"]:
        df = D.load_binance_klines(Path("data/binance/spot/BTCUSDT", interval).glob("*.zip"))
        print(f"BTCUSDT {interval}:", D.fingerprint(df))
    for symbol in US_SYMBOLS:
        df = D.load_nasdaq_daily(f"data/nasdaq/{symbol}_historical.json")
        print(f"{symbol}:", D.fingerprint(df))


if __name__ == "__main__":
    main()
第 3 篇的 download_binance_klines 是一个月接一个月地下载,109 个月的 1 分钟数据要很久。这里用 ThreadPoolExecutor 同时下载 8 个月份。下载数据时,时间主要花在等网络上,不是花在计算上,所以多开几个线程同时等,总时间能缩短好几倍。
运行:
python scripts/fetch_course_data.py
输出的最后一部分是复现指纹:
复现指纹:
BTCUSDT 1d: {'行数': 3302, '起点': '2017-08-17 00:00:00+00:00', '终点': '2026-08-31 00:00:00+00:00', '收盘价之和': 127457855.94}
BTCUSDT 1m: {'行数': 4746079, '起点': '2017-08-17 04:00:00+00:00', '终点': '2026-08-31 23:59:00+00:00', '收盘价之和': 183332267178.49}
SPY: {'行数': 2513, '起点': '2016-09-15 00:00:00', '终点': '2026-09-15 00:00:00', '收盘价之和': 1036175.29}
AAPL: {'行数': 2513, '起点': '2016-09-15 00:00:00', '终点': '2026-09-15 00:00:00', '收盘价之和': 338953.22}
TSLA: {'行数': 2513, '起点': '2016-09-15 00:00:00', '终点': '2026-09-15 00:00:00', '收盘价之和': 442548.68}
把你的输出和这五行逐个对照。 完全一致,说明你的数据和这门课用的数据一模一样,后面每一篇的结果你都应该能复现出来。
⚠️ 两种可能对不上的情况:
- BTC 的指纹对不上:Binance 的历史数据文件是固定的,而且每个文件都做了 SHA-256 校验,正常情况下不会出现差异。如果对不上,先检查下载有没有中途失败(脚本会抛出错误)。
- 美股的指纹对不上:Nasdaq 接口给出的是按拆股调整后的价格。如果 SPY、AAPL 或 TSLA 在 2026 年 9 月 15 日之后又拆股了,历史价格会整体变化(第 3 篇第五节讲过原因),指纹就会变。另外,数据商偶尔也会修正历史数据。遇到这种情况,行数和起止日期应该仍然一致,只有收盘价之和不同。
整个下载第一次运行需要几分钟到十几分钟,取决于网络速度。1 分钟数据一共约 200 MB。
测试
这门课里的每一个数字,都是代码算出来的。如果代码有错,数字就是错的,而你很可能看不出来。
测试就是一段专门用来检查代码的代码:给函数一个你事先手算过答案的输入,看它的输出和你的答案是否一致。
测试的数据要尽量小、尽量简单,小到你可以在纸上算出每一个结果。下面是 tests/test_data.py:
"""talab.data 的测试。全部使用手工构造的小数据,不需要联网,也不需要下载任何文件。"""
import io
import zipfile

import numpy as np
import pandas as pd
import pytest

from talab import data as D


def make_bars(n=5, start="2024-01-01", freq="1min"):
    idx = pd.date_range(start, periods=n, freq=freq, tz="UTC")
    return pd.DataFrame({"open": 100.0, "high": 101.0, "low": 99.0, "close": 100.5, "volume": 10.0}, index=idx)


# ---------- 加载 ----------

def write_kline_zip(path, rows):
    buf = io.StringIO()
    pd.DataFrame(rows).to_csv(buf, header=False, index=False)
    with zipfile.ZipFile(path, "w") as z:
        z.writestr(path.stem + ".csv", buf.getvalue())


def kline_row(open_time):
    return [open_time, "1", "2", "0.5", "1.5", "10", open_time + 59_999, "15", 3, "4", "6", "0"]


def test_load_handles_millisecond_and_microsecond_timestamps(tmp_path):
    ms = 1735689540000          # 2024-12-31 23:59:00 UTC,毫秒
    us = 1735689600000000       # 2025-01-01 00:00:00 UTC,微秒
    write_kline_zip(tmp_path / "a-2024-12.zip", [kline_row(ms)])
    write_kline_zip(tmp_path / "a-2025-01.zip", [kline_row(us)])
    df = D.load_binance_klines(tmp_path.glob("*.zip"))
    assert list(df.index) == [pd.Timestamp("2024-12-31 23:59", tz="UTC"), pd.Timestamp("2025-01-01 00:00", tz="UTC")]


def test_load_raises_when_no_files(tmp_path):
    with pytest.raises(ValueError):
        D.load_binance_klines(tmp_path.glob("*.zip"))


# ---------- 价格调整 ----------

def daily(prices, start="2020-08-26"):
    idx = pd.bdate_range(start, periods=len(prices))
    p = pd.Series(prices, index=idx, dtype=float)
    return pd.DataFrame({"open": p, "high": p, "low": p, "close": p, "volume": 1000.0})


def test_split_roundtrip_restores_original():
    raw = daily([500.0, 510.0, 130.0, 131.0])                 # 第三天起 1 拆 4
    splits = [(raw.index[2].strftime("%Y-%m-%d"), 4)]
    adj = D.adjust_splits(raw, splits)
    assert adj["close"].tolist() == [125.0, 127.5, 130.0, 131.0]
    assert adj["volume"].tolist() == [4000.0, 4000.0, 1000.0, 1000.0]
    pd.testing.assert_frame_equal(D.unadjust_splits(adj, splits), raw)


def test_dividend_factor_matches_hand_calculation():
    # 第 3 篇练习 2:3 月 9 日收盘 100,3 月 10 日除息,每股分红 2
    idx = pd.to_datetime(["2026-03-09", "2026-03-10"])
    close = pd.Series([100.0, 99.0], index=idx)
    f = D.dividend_factor(close, pd.Series([2.0], index=[pd.Timestamp("2026-03-10")]))
    assert f.tolist() == pytest.approx([0.98, 1.0])
    # 调整后的涨跌幅 = 99 / (100 × 0.98) − 1
    assert 99.0 / (100.0 * f.iloc[0]) - 1 == pytest.approx(0.010204, abs=1e-6)


def test_dividend_outside_data_range_is_ignored():
    close = daily([100.0, 101.0])["close"]
    later = pd.Series([1.0], index=[close.index[-1] + pd.Timedelta(days=30)])
    assert (D.dividend_factor(close, later) == 1.0).all()


# ---------- 体检 ----------

def test_health_check_on_clean_data_finds_nothing():
    report = D.health_check(make_bars(10), freq="1min", wick_window=4)
    assert D.summarize(report).sum() == 0


def test_health_check_finds_planted_problems():
    df = make_bars(10)
    df.iloc[2, df.columns.get_loc("high")] = 99.5                        # 最高价低于开盘价
    df.iloc[3, df.columns.get_loc("volume")] = 0.0                        # 零成交量
    df.iloc[4, df.columns.get_loc("close")] = np.nan                      # 空值
    df = df.drop(df.index[6])                                             # 缺一根
    shifted = df.index.tolist()
    shifted[-1] = shifted[-1] + pd.Timedelta(seconds=20)                  # 最后一根时间戳偏移
    df.index = pd.DatetimeIndex(shifted)
    df = pd.concat([df, df.iloc[[0]]]).sort_index()                       # 重复一根

    s = D.summarize(D.health_check(df, freq="1min", wick_window=4))
    assert s["高低价自相矛盾"] == 1
    assert s["成交量为零"] == 1
    assert s["有空值的行"] == 1
    assert s["缺失的 K 线"] == 1
    assert s["时间戳没有对齐"] == 1
    assert s["重复时间戳"] == 1


def test_missing_runs_groups_consecutive_gaps():
    idx = pd.DatetimeIndex(["2024-01-01 00:03", "2024-01-01 00:04", "2024-01-01 00:05", "2024-01-01 00:09"], tz="UTC")
    runs = D.missing_runs(idx, "1min")
    assert runs["缺失根数"].tolist() == [3, 1]


def test_fingerprint():
    fp = D.fingerprint(make_bars(3))
    assert fp["行数"] == 3 and fp["收盘价之和"] == 301.5
这些测试背后有几个值得学的思路:
针对真实踩过的坑写测试。 test_load_handles_millisecond_and_microsecond_timestamps 对应第 3 篇里 Binance 数据从 2025 年起时间戳改成微秒的问题。它造了两个最小的压缩包,一个用毫秒,一个用微秒,确认两个时间都被正确解析。以后如果有人改了加载函数,不小心把这个处理删掉,这个测试会立刻失败。
「埋雷」测试。 test_health_check_finds_planted_problems 先造一份干净的数据,然后故意埋进去六种问题:最高价低于开盘价、零成交量、空值、缺一根、时间戳偏移、重复一根。再检查体检函数是不是恰好把每一种都找出来了,一个不多、一个不少。只测「干净的数据报告没问题」是不够的,一个什么都不检查的函数也能通过那个测试。
用手算的数字做答案。 test_dividend_factor_matches_hand_calculation 用的就是第 3 篇练习 2 的数字:分红系数应该是 1 − 2 ÷ 100 = 0.98,调整后的涨跌幅应该是 99 ÷ 98 − 1 = 1.0204%。
互逆操作做往返检查。 test_split_roundtrip_restores_original 先按拆股调整,再还原,检查结果和最初的数据完全相同。
运行全部测试:
pytest -q
输出:
...............                                                          [100%]
15 passed in 0.29s
15 个测试里,9 个来自 test_data.py,6 个来自下面第四、五节会讲的 test_plot.py。每一个点代表一个通过的测试。如果有测试失败,对应位置会出现 F,下面会打印出失败的原因。
⚠️ 一个习惯要尽早养成:每次修改 talab 里的代码之后,都跑一遍 pytest。 这门课后面的模块会越来越多,互相依赖越来越深,靠眼睛检查不出哪里被改坏了。
三、一根 K 线是怎么变成像素的
实验台搭好了,现在开始画图。
我们每天看 K 线图,但很少有人想过:屏幕上那个绿色的小矩形,它的上边缘为什么在那个位置?它为什么是这个高度?
这一节把这件事彻底讲清楚。弄懂了它,后面讲对数坐标就非常自然。
屏幕的坐标
屏幕上每一个点,用两个数字表示位置:横坐标 x 和纵坐标 y,单位是像素。
⚠️ 这里有一个反直觉的地方:在屏幕坐标里,y 是从上往下增大的。 左上角是 (0, 0),越往下 y 越大。这和数学课上的坐标系正好相反。
而价格是越高越应该画在上面。所以换算的时候,最高价对应最小的 y,最低价对应最大的 y。
价格换算成纵坐标
想象一支温度计。刻度从 −10 度到 40 度,玻璃管长 25 厘米。20 度的刻度应该画在哪里?
20 度离顶端的 40 度差了 20 度,占整个刻度范围 50 度的 40%,所以它应该画在从顶端往下 25 × 40% = 10 厘米的位置。
价格换算成像素,是完全一样的道理。假设画图区域从 y = top 开始,高度是 height 像素,图里所有 K 线的最低价是 lo,最高价是 hi:
价格 p 的纵坐标 = top + (hi − p) ÷ (hi − lo) × height
(hi − p) ÷ (hi − lo) 算的是「p 离最高价有多远,占整个价格范围的几成」,再乘以高度,就是离画图区域顶端的像素数。
算一个真实的例子
用 BTC 在 2020 年 3 月的 31 根日线。画布是 800 × 400 像素,四周各留 20 像素的边,所以画图区域从 y = 20 开始,高度是 400 − 40 = 360 像素。
这个月的最低价是 3,782.13(3 月 13 日),最高价是 9,188.00(3 月 7 日),价格范围是 9,188.00 − 3,782.13 = 5,405.87。
我们来算 3 月 13 日这根 K 线。它的开盘 4,800.01,最高 5,955.00,最低 3,782.13,收盘 5,578.60。
最高价 5,955.00:
y = 20 + (9,188.00 − 5,955.00) ÷ 5,405.87 × 360
= 20 + 3,233.00 ÷ 5,405.87 × 360
= 20 + 0.59806 × 360
= 20 + 215.30 = 235.30
收盘价 5,578.60:
y = 20 + (9,188.00 − 5,578.60) ÷ 5,405.87 × 360 = 260.37
开盘价 4,800.01:
y = 20 + (9,188.00 − 4,800.01) ÷ 5,405.87 × 360 = 312.22
最低价 3,782.13: 它就是整张图的最低价,所以 y = 20 + 1 × 360 = 380.00,正好在画图区域的最底端。
横坐标。 800 像素宽,减去两边各 20 像素,剩下 760 像素,分给 31 根 K 线,每根占 760 ÷ 31 = 24.52 像素。3 月 13 日是第 13 根,从 0 开始数是第 12 根,它的中心在:
x = 20 + 24.52 × (12 + 0.5) = 326.45
实体宽度取每根所占宽度的 70%,也就是 17.16 像素,剩下的 30% 留作 K 线之间的空隙。
把这些数字组合成两个图形:
- 影线:一条竖线,从 (326.45, 235.30) 画到 (326.45, 380.00),也就是从最高价画到最低价
- 实体:一个矩形,左上角在 (326.45 − 17.16 ÷ 2, 260.37) = (317.87, 260.37),宽 17.16,高 312.22 − 260.37 = 51.85
收盘价高于开盘价,是阳线,用上涨的颜色。
这就是一根 K 线的全部。一张 K 线图,就是把这个过程重复几十次、几百次。
talab.plot 里的 price_to_y 函数就是上面那个公式(log 参数第六节会讲):
def price_to_y(price: float, lo: float, hi: float, top: float, height: float, log: bool = False) -> float:
    """把价格换算成图上的纵坐标(像素)。屏幕坐标向下增大,所以最高价在最上面。

    算术坐标:按价格的「差」等比例分配高度
    对数坐标:按价格的「比」等比例分配高度
    """
    if log:
        frac = (math.log(hi) - math.log(price)) / (math.log(hi) - math.log(lo))
    else:
        frac = (hi - price) / (hi - lo)
    return top + frac * height
用它验证一下手算的结果:
btc = D.load_binance_klines(glob.glob("data/binance/spot/BTCUSDT/1d/*.zip"))
march = btc.loc["2020-03-01":"2020-03-31"]
lo, hi = march["low"].min(), march["high"].max()
print("最低价", lo, "最高价", hi, "K 线根数", len(march))
bar = march.loc["2020-03-13"]
for name in ["high", "close", "open", "low"]:
    y_lin = P.price_to_y(bar[name], lo, hi, top=20, height=360)
    y_log = P.price_to_y(bar[name], lo, hi, top=20, height=360, log=True)
    print(f"{name:>5} {bar[name]:>9.2f}  算术坐标 y = {y_lin:6.2f}  对数坐标 y = {y_log:6.2f}")
输出:
最低价 3782.13 最高价 9188.0 K 线根数 31
 high   5955.00  算术坐标 y = 235.30  对数坐标 y = 195.89
close   5578.60  算术坐标 y = 260.37  对数坐标 y = 222.37
 open   4800.01  算术坐标 y = 312.22  对数坐标 y = 283.34
  low   3782.13  算术坐标 y = 380.00  对数坐标 y = 380.00
算术坐标这一列,和手算的完全一致。右边的对数坐标这一列,先留着,第六节再看。
✋ 小检查
用同样的画布(从 y = 20 开始,高 360 像素,价格范围 3,782.13 到 9,188.00),价格 6,485.07 应该画在哪个 y?(提示:它正好在最高价和最低价的正中间。)
答案在本篇最后。
四、不用绘图库,手画一张 K 线图
现在把上一节的计算写成代码,而且不用任何绘图库,直接生成一张图。
SVG:用文字描述的图
SVG 是一种图片格式,但它不是像 PNG 那样一个像素一个像素地存颜色,而是用文字描述图形:「在这里画一条线」「在那里画一个矩形」。浏览器读到这些文字,就把图形画出来。
比如上一节算出来的影线和实体,写成 SVG 就是:
<line x1="326.45" y1="235.30" x2="326.45" y2="380.00" stroke="#26a69a" stroke-width="1"/>
<rect x="317.87" y="260.37" width="17.16" height="51.85" fill="#26a69a"/>
每个数字你都已经在上一节亲手算过。
代码
# 涨跌颜色。国际惯例:涨绿跌红;中国大陆惯例:涨红跌绿
STYLES = {
    "international": {"up": "#26a69a", "down": "#ef5350"},
    "china": {"up": "#ef5350", "down": "#26a69a"},
}


def candles_svg(df: pd.DataFrame, width: int = 800, height: int = 400, log: bool = False,
                style: str = "international", pad: int = 20) -> str:
    """不用任何绘图库,直接生成一张 K 线图的 SVG 文本。"""
    colors = STYLES[style]
    lo, hi = df["low"].min(), df["high"].max()
    n = len(df)
    slot = (width - 2 * pad) / n                 # 每根 K 线占的水平宽度
    body_w = slot * 0.7                          # 实体宽度,留 30% 做间隔
    y = lambda p: price_to_y(p, lo, hi, pad, height - 2 * pad, log)

    parts = [f'<svg xmlns="http://www.w3.org/2000/svg" width="{width}" height="{height}">',
             f'<rect width="{width}" height="{height}" fill="white"/>']
    for i, (o, h, l, c) in enumerate(df[["open", "high", "low", "close"]].itertuples(index=False)):
        color = colors["up"] if c >= o else colors["down"]
        x_mid = pad + slot * (i + 0.5)
        # 影线:从最高价画到最低价的一条竖线
        parts.append(f'<line x1="{x_mid:.2f}" y1="{y(h):.2f}" x2="{x_mid:.2f}" y2="{y(l):.2f}" stroke="{color}" stroke-width="1"/>')
        # 实体:开盘价和收盘价之间的矩形;开盘等于收盘时至少画 1 像素高
        top, bottom = y(max(o, c)), y(min(o, c))
        parts.append(f'<rect x="{x_mid - body_w / 2:.2f}" y="{top:.2f}" width="{body_w:.2f}" '
                     f'height="{max(bottom - top, 1):.2f}" fill="{color}"/>')
    parts.append("</svg>")
    return "\n".join(parts)
把它和第三节的手算对照:slot 是每根 K 线占的宽度(24.52),x_mid 是中心横坐标(326.45),body_w 是实体宽度(17.16);影线从 y(h) 画到 y(l);实体的上边缘是开盘价和收盘价里较高的那个,下边缘是较低的那个。
生成并保存:
Path("figures").mkdir(exist_ok=True)
svg = P.candles_svg(march)
Path("figures/hand-drawn.svg").write_text(svg)
lines = svg.splitlines()
print(len(lines), "行")
print(lines[26])          # 3 月 13 日的影线
print(lines[27])          # 3 月 13 日的实体
输出:
65 行
<line x1="326.45" y1="235.30" x2="326.45" y2="380.00" stroke="#26a69a" stroke-width="1"/>
<rect x="317.87" y="260.37" width="17.16" height="51.85" fill="#26a69a"/>
65 行:开头 2 行(SVG 声明和白色背景),31 根 K 线每根 2 行共 62 行,最后 1 行结束标签。第 27、28 行(从 0 数是 26、27)正是 3 月 13 日那根 K 线,和第三节手算的数字一个不差。
用浏览器打开 figures/hand-drawn.svg:
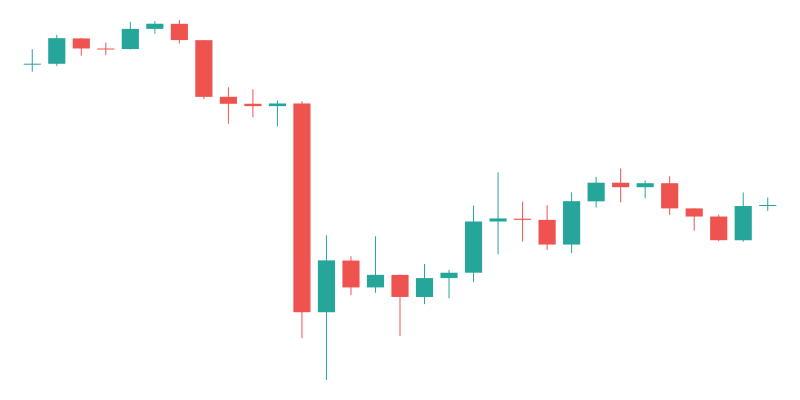
这就是你亲手画出的第一张 K 线图。没有坐标轴、没有日期标签,但每一根 K 线的每一个位置,你都知道是怎么来的。
几个细节
开盘价等于收盘价时,实体高度是 0。 这种 K 线叫十字星,实体是一条横线。如果按公式算,矩形高度为 0,屏幕上什么都看不见。所以代码里用 max(bottom - top, 1) 保证实体至少有 1 像素高。图上 3 月 1 日那根几乎看不到实体的 K 线就是这样画出来的。
开盘价等于收盘价时算阳线还是阴线? 代码里用的是 c >= o,等于的时候按阳线画。这只是一个约定,不同软件的处理不完全一样。
颜色的约定,东西方正好相反。
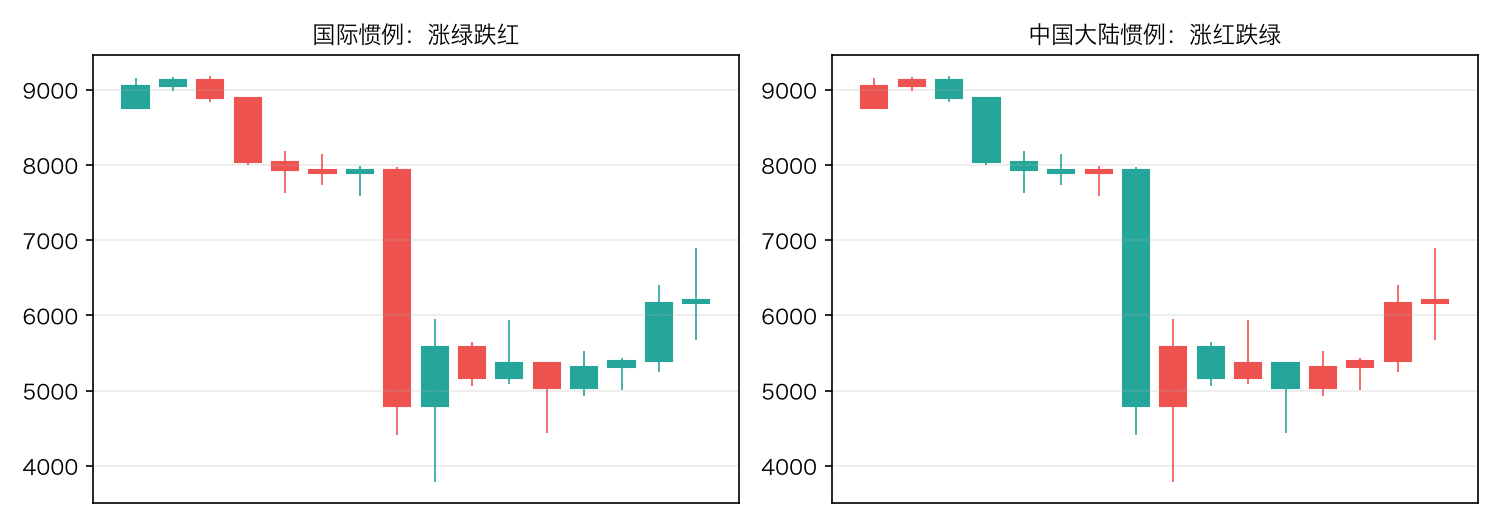
国际上大多数交易软件和平台默认涨绿跌红;中国大陆的股票软件习惯涨红跌绿。这门课的图一律使用涨绿跌红。如果你习惯另一种,调用时传入 style="china" 就行。
⚠️ 在不同的软件之间切换时,一定要先看清它用的是哪种颜色约定。一眼把大跌看成大涨,是真实发生过的操作失误。
五、talab.plot:之后每一篇都要用的绘图函数
手写 SVG 让你看清了原理。但实际使用时,我们还需要坐标轴、日期标签、成交量、均线、标注,这些都自己写太费事了。所以 talab.plot 用 matplotlib 来画,但画 K 线的方式和上一节完全一样:一根竖线加一个矩形。
代码
def plot_candles(df: pd.DataFrame, *, title: str | None = None, volume: bool = True, log: bool = False,
                 time_axis: str = "bars", style: str = "international",
                 overlays: dict[str, pd.Series] | None = None,
                 hlines: dict[str, float] | None = None,
                 marks: list[tuple] | None = None,
                 figsize=(10, 6), dpi: int = 150):
    """画 K 线图,返回 (fig, 价格子图, 成交量子图或 None)。

    time_axis: "bars" 每根 K 线等距排列(休市时段不留空白);"real" 按真实时间排列
    overlays:  叠加在价格上的曲线,比如均线 {"MA20": series}
    hlines:    水平线 {"说明": 价格}
    marks:     标注点 [(时间, 价格, "文字"), ...]
    """
    colors = STYLES[style]
    if volume:
        fig, (ax, av) = plt.subplots(2, 1, figsize=figsize, dpi=dpi, sharex=True,
                                     gridspec_kw={"height_ratios": [3, 1]})
    else:
        fig, ax = plt.subplots(figsize=figsize, dpi=dpi)
        av = None

    if time_axis == "bars":
        xs = list(range(len(df)))
        width = 0.7
    elif time_axis == "real":
        xs = list(df.index)
        step = pd.Series(df.index).diff().median()      # 相邻两根 K 线通常相隔多久
        width = step * 0.7
    else:
        raise ValueError('time_axis 只能是 "bars" 或 "real"')
    x_of = dict(zip(df.index, xs))

    for x, (o, h, l, c, v) in zip(xs, df[["open", "high", "low", "close", "volume"]].itertuples(index=False)):
        color = colors["up"] if c >= o else colors["down"]
        ax.vlines(x, l, h, color=color, linewidth=0.8)
        ax.add_patch(Rectangle((x - width / 2, min(o, c)),
                               width, abs(c - o), facecolor=color, edgecolor=color, linewidth=0.5))
        if av is not None:
            av.bar(x, v, width=width, color=color)

    for name, series in (overlays or {}).items():
        s = series.reindex(df.index)
        ax.plot(xs, s.values, linewidth=1.2, label=name)
    for name, price in (hlines or {}).items():
        ax.axhline(price, linestyle=":", linewidth=1.2, color="#1f77b4")
        ax.annotate(name, (xs[0], price), textcoords="offset points", xytext=(2, 3), fontsize=9, color="#1f77b4")
    for t, price, text in (marks or []):
        # 文字放在点的下方,箭头向上指着这个价格
        ax.annotate(text, (x_of[pd.Timestamp(t, tz=df.index.tz) if df.index.tz else pd.Timestamp(t)], price),
                    textcoords="offset points", xytext=(0, -32), ha="center", fontsize=9,
                    arrowprops={"arrowstyle": "->", "color": "#555"})

    ax.autoscale_view()
    if log:
        ax.set_yscale("log")
        lo, hi = ax.get_ylim()
        # 价格跨度超过 20 倍时,刻度只放在 1、2、5 的倍数上;跨度小时放在 1~9 的倍数上,否则刻度太少
        subs = (1.0, 2.0, 5.0) if hi / lo > 20 else tuple(range(1, 10))
        ax.yaxis.set_major_locator(LogLocator(base=10, subs=subs))
        ax.yaxis.set_minor_locator(LogLocator(base=10, subs=()))
    # 刻度显示成带千位分隔的普通数字,不用 10 的几次方
    ax.yaxis.set_major_formatter(FuncFormatter(lambda v, _: f"{v:,.0f}" if v >= 100 else f"{v:g}"))
    if time_axis == "bars":
        ticks = _date_ticks(df.index)
        (av or ax).set_xticks(ticks)
        (av or ax).set_xticklabels([df.index[i].strftime("%Y-%m-%d") for i in ticks], fontsize=8)
        ax.set_xlim(-1, len(df))
    else:
        locator = mdates.AutoDateLocator(maxticks=8)
        (av or ax).xaxis.set_major_locator(locator)
        (av or ax).xaxis.set_major_formatter(mdates.ConciseDateFormatter(locator))
    if overlays:
        ax.legend(fontsize=9, loc="upper left")
    if title:
        ax.set_title(title, fontsize=12)
    ax.set_ylabel("价格")
    if av is not None:
        av.set_ylabel("成交量")
        av.yaxis.set_major_formatter(FuncFormatter(lambda v, _: f"{v:,.0f}"))
    for a in (ax, av):
        if a is not None:
            a.grid(alpha=0.25)
    fig.tight_layout()
    return fig, ax, av


def _date_ticks(index: pd.DatetimeIndex, n: int = 6) -> list[int]:
    """在等距排列的 K 线里,挑出大约 n 个位置放日期标签。"""
    step = max(1, len(index) // n)
    return list(range(0, len(index), step))


def use_chinese_font(path: str = "/System/Library/Fonts/Hiragino Sans GB.ttc") -> None:
    """让 matplotlib 能显示中文。默认路径是 macOS 自带字体;Windows 可以用 C:/Windows/Fonts/msyh.ttc。"""
    from matplotlib import font_manager
    font_manager.fontManager.addfont(path)
    plt.rcParams["font.family"] = font_manager.FontProperties(fname=path).get_name()
    plt.rcParams["axes.unicode_minus"] = False
文件开头的导入是:
"""talab.plot:K 线绘图。第 4 篇。"""
from __future__ import annotations

import math

import matplotlib.dates as mdates
import matplotlib.pyplot as plt
import pandas as pd
from matplotlib.patches import Rectangle
from matplotlib.ticker import FuncFormatter, LogLocator
对照手写版读这段代码:ax.vlines(x, l, h) 就是影线,Rectangle((x - width / 2, min(o, c)), width, abs(c - o)) 就是实体,和 SVG 里的 <line> 和 <rect> 一一对应。区别只在于,matplotlib 替我们做了第三节那个「价格换算成像素」的计算:我们直接给它价格,它自己换算。
overlays、hlines、marks 这三个参数,是为后面的篇目准备的:叠加均线、画支撑阻力位、标注信号点。
用一下
P.use_chinese_font()
fig, ax, av = P.plot_candles(march, title="BTCUSDT 日线(2020 年 3 月),用 talab.plot 画")
fig.savefig("figures/talab-plot.png")
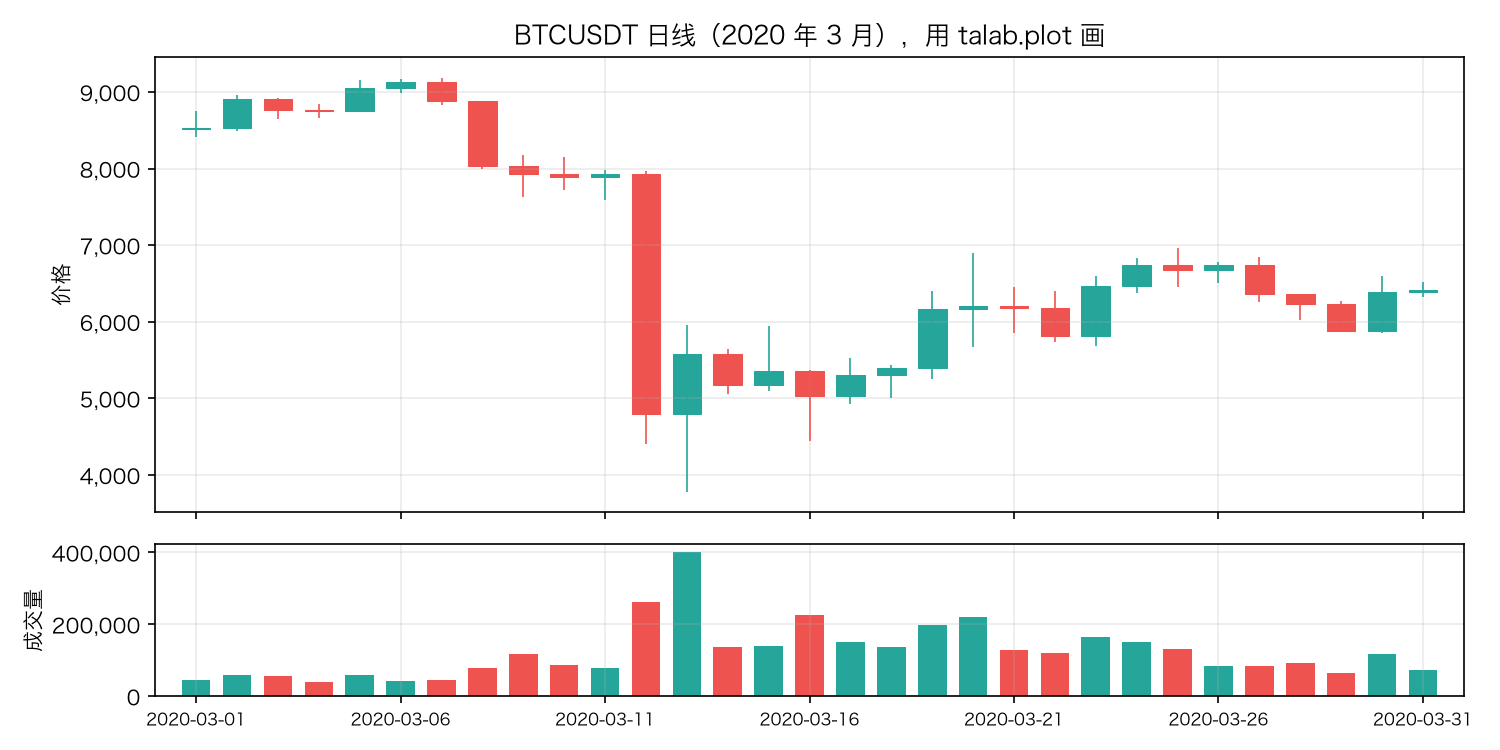
和第四节手写的 SVG 放在一起比,K 线的形状一模一样,多了坐标轴、日期和成交量。
⚠️ use_chinese_font 的默认字体路径是 macOS 自带的冬青黑体。如果你用 Windows,调用时传入 path="C:/Windows/Fonts/msyh.ttc"(微软雅黑);如果用 Linux,需要先安装一个中文字体(比如 Noto Sans CJK),再传入它的路径。不设置中文字体,标题和坐标轴上的中文会显示成方框。
时间轴:休市的时间要不要留空白
美股周末和节假日休市。画美股 K 线时有一个选择:按真实时间排列,还是每根 K 线等距排列?
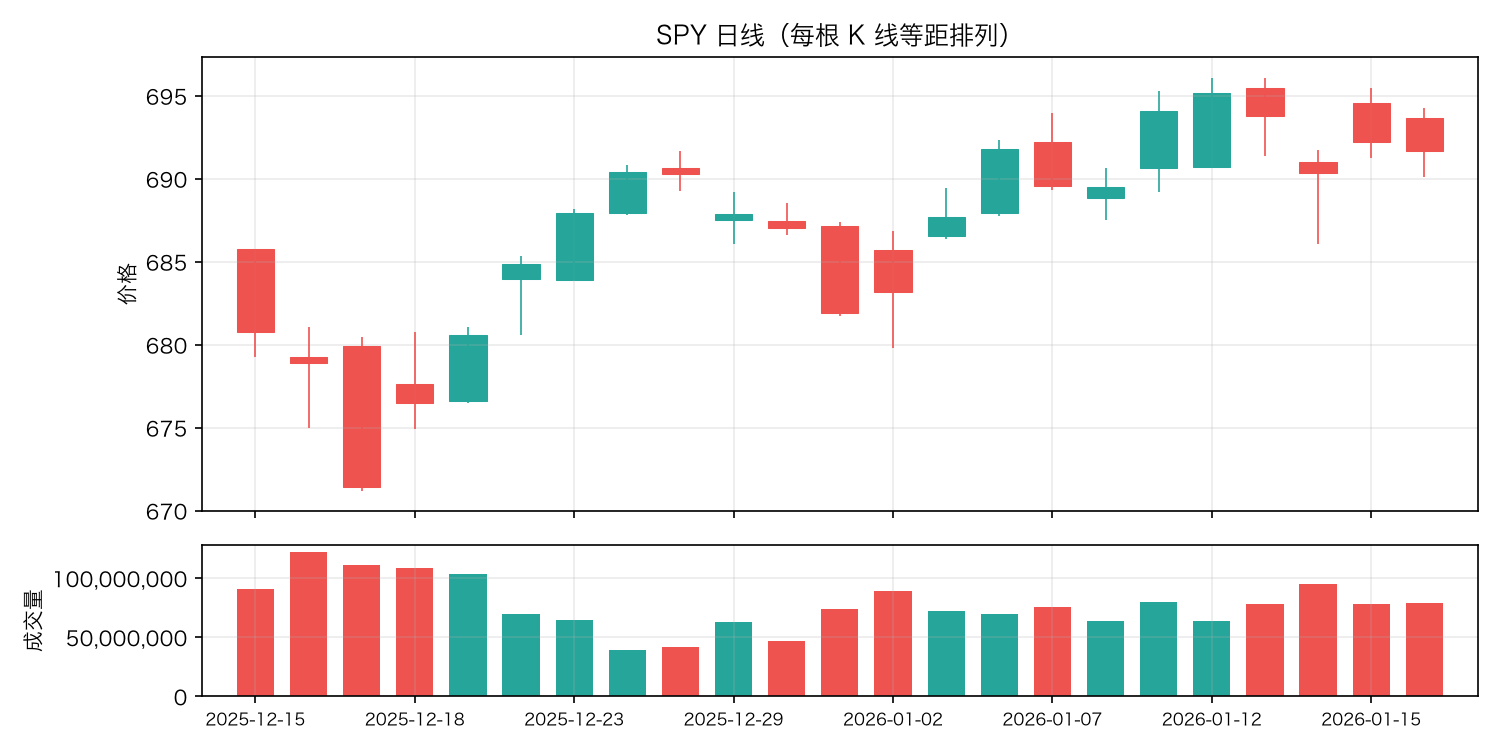
看 SPY 在 2025 年 12 月中旬到 2026 年 1 月中旬的日线:
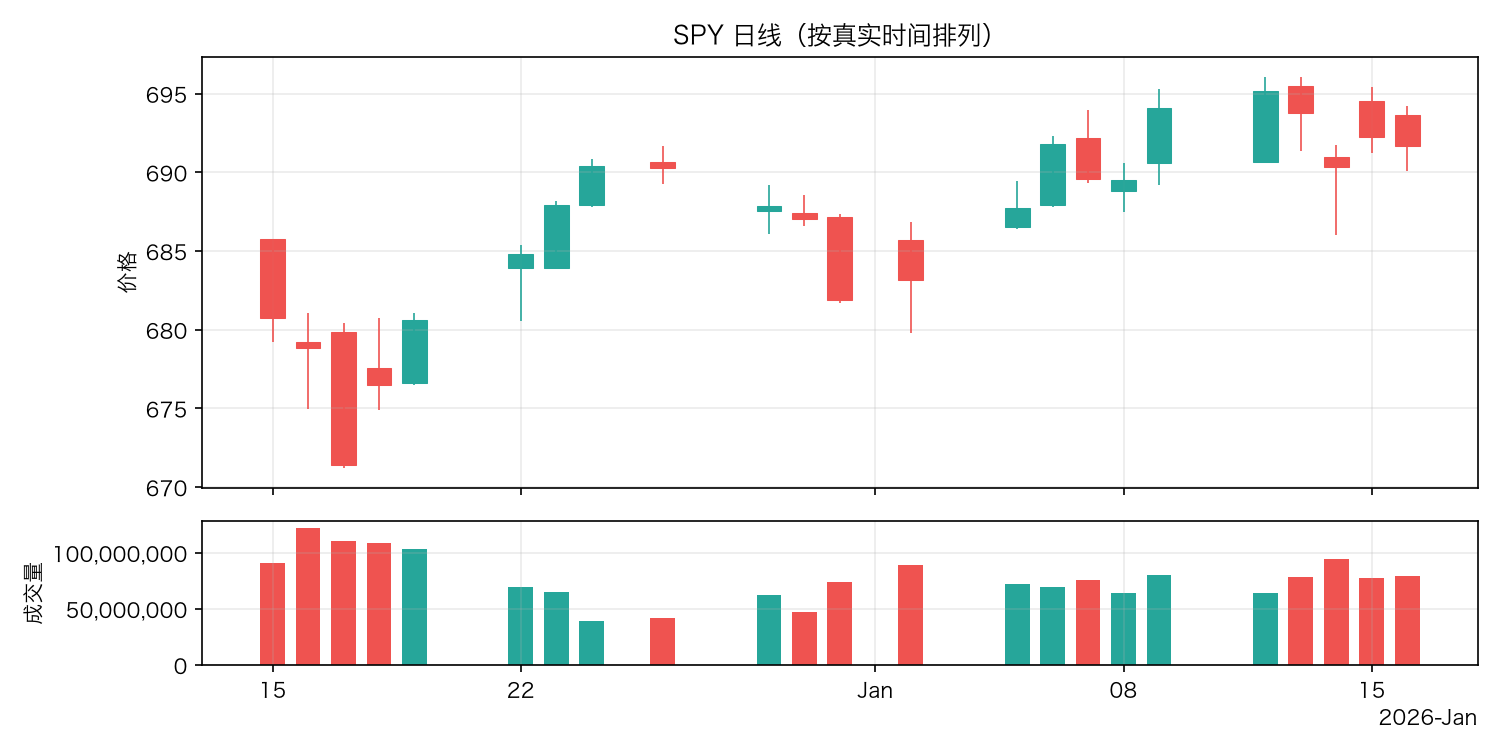
按真实时间排列(time_axis="real"):每个周末都留下两天的空白,12 月 25 日圣诞节和 1 月 1 日元旦休市,也各自留下了空白。图上的距离忠实地反映了时间的长短,但 K 线之间断断续续,不方便看连续的走势。
每根 K 线等距排列(time_axis="bars"):休市的时间被「折叠」掉了,每根 K 线紧挨着上一根。走势看起来连续,所以绝大多数看盘软件默认用这种方式。
⚠️ 等距排列有一个代价:它把时间也折叠掉了。 周五收盘和周一开盘之间隔了两天半,期间可能发生了任何事情,但在图上它们紧挨着,和周二到周三没有区别。如果你看到周一开盘出现了跳空,要记得这个跳空背后是整整一个周末。
talab.plot 默认使用 "bars"。加密市场 24 小时交易,没有休市,两种方式画出来的结果几乎一样,除非数据本身有缺口(第 3 篇第九节)。
另一个选择:mplfinance
如果你不想自己维护绘图代码,mplfinance 是 matplotlib 官方组织维护的金融绘图库,几行代码就能画出 K 线图:
pip install mplfinance==0.12.10b0
import mplfinance as mpf
mpf.plot(march, type="candle", volume=True, style="yahoo", savefig="figures/mplfinance.png")
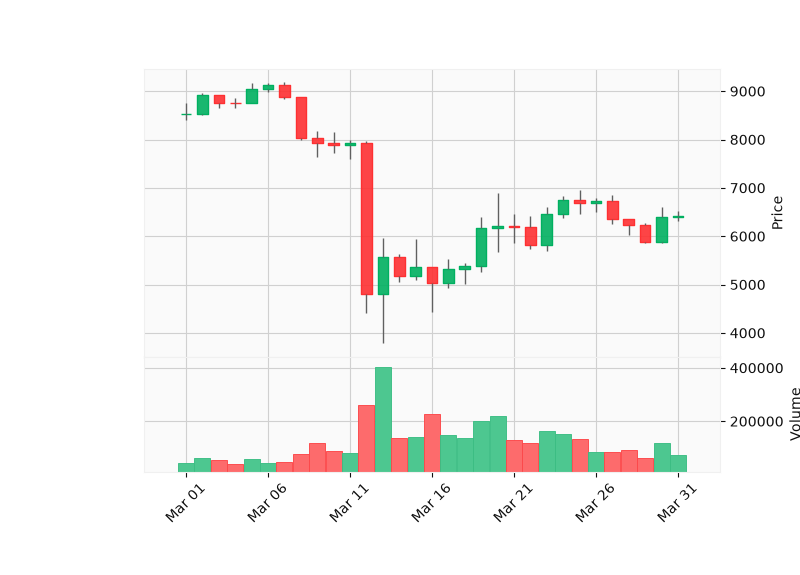
它能直接读取 talab.data 加载出来的数据(列名是小写的 open、high、low、close、volume)。这门课仍然使用自己写的 talab.plot,原因是后面的篇目需要在图上画各种自定义的东西(摆动点、形态、信号标注、回测交易记录),自己写的代码更容易改。而且,你已经知道每一根 K 线是怎么画出来的了。
⚠️ mplfinance 的最新版本号带着 b0,意思是 beta 测试版,它已经很久没有发布正式版了。上面的代码在本文的环境里测试通过,但以后的 pandas 或 matplotlib 升级可能会让它出问题。
test_plot.py
绘图函数也要测试。图画得对不对,很难用代码判断,但换算公式对不对、图形数量对不对是可以精确检查的:
"""talab.plot 的测试。"""
import math

import matplotlib
import pandas as pd
import pytest

matplotlib.use("Agg")                 # 不弹出窗口

from talab import plot as P


def test_price_to_y_linear_endpoints_and_middle():
    # 价格区间 100~200,画在从像素 20 开始、高 400 的区域里
    assert P.price_to_y(200, 100, 200, 20, 400) == 20            # 最高价在最上面
    assert P.price_to_y(100, 100, 200, 20, 400) == 420           # 最低价在最下面
    assert P.price_to_y(150, 100, 200, 20, 400) == 220           # 算术中点在正中间


def test_price_to_y_log_puts_geometric_mean_in_the_middle():
    mid = math.sqrt(100 * 200)                                    # 141.42
    assert P.price_to_y(mid, 100, 200, 20, 400, log=True) == pytest.approx(220)


def test_log_scale_gives_equal_ratios_equal_distances():
    d1 = P.price_to_y(10, 10, 1000, 0, 300, log=True) - P.price_to_y(20, 10, 1000, 0, 300, log=True)
    d2 = P.price_to_y(100, 10, 1000, 0, 300, log=True) - P.price_to_y(200, 10, 1000, 0, 300, log=True)
    assert d1 == pytest.approx(d2)


def bars():
    idx = pd.date_range("2024-01-01", periods=3, freq="1D", tz="UTC")
    return pd.DataFrame({"open": [10, 12, 11], "high": [13, 13, 12], "low": [9, 10, 10],
                         "close": [12, 11, 11], "volume": [5, 6, 7]}, index=idx, dtype=float)


def test_candles_svg_draws_one_line_and_one_body_per_bar():
    svg = P.candles_svg(bars())
    assert svg.count("<line") == 3
    assert svg.count("<rect") == 3 + 1                            # 3 个实体 + 1 个白色背景


def test_candles_svg_colors_follow_style():
    svg = P.candles_svg(bars(), style="china")
    # 第一根收盘高于开盘,第三根收盘等于开盘(也按阳线画),每根的影线和实体各用一次颜色
    assert svg.count(P.STYLES["china"]["up"]) == 4
    assert svg.count(P.STYLES["china"]["down"]) == 2


def test_plot_candles_log_axis_and_volume():
    fig, ax, av = P.plot_candles(bars(), log=True)
    assert ax.get_yscale() == "log"
    assert len(ax.patches) == 3 and len(av.patches) == 3
matplotlib.use("Agg") 让 matplotlib 在后台画图,不弹出窗口,这样测试可以在没有显示器的环境里运行。
第二、三个测试检查的是对数坐标的两个关键性质,下一节马上就会讲到。
六、对数坐标和算术坐标
打个比方:两个人的涨薪
你的月薪从 3,000 元涨到了 6,000 元。你的朋友月薪从 30,000 元涨到了 60,000 元。
谁涨得更多?
如果问「多了多少钱」,朋友多了 30,000,你多了 3,000,朋友是你的 10 倍。
如果问「翻了几倍」,你们都是翻了一倍。对你来说,这次涨薪对生活的改变,和朋友那次对他生活的改变,大致是同一个量级。
这就是两种坐标的区别:
- 算术坐标问的是「多了多少钱」:价格每差 1 元,在图上的距离都一样
- 对数坐标问的是「翻了几倍」:价格每翻一倍,在图上的距离都一样
数学上的区别
回到第三节的公式。算术坐标的换算:
离顶端的比例 = (hi − p) ÷ (hi − lo)
对数坐标的换算,只是把每个价格换成它的对数:
离顶端的比例 = (ln hi − ln p) ÷ (ln hi − ln lo)
为什么换成对数,「翻倍」就会变成「相同的距离」?因为对数有一个性质:ln(b) − ln(a) = ln(b ÷ a)。两个价格在对数坐标上的距离,只取决于它们的比值,不取决于它们的差值。10 到 20 的比值是 2,100 到 200 的比值也是 2,所以它们在图上的距离一样。
用代码验证:在一张价格范围 10 到 2,000、高 300 像素的图上,分别看三次「翻倍」的距离:
for a, b in [(10, 20), (100, 200), (1000, 2000)]:
    d_lin = P.price_to_y(a, 10, 2000, 0, 300) - P.price_to_y(b, 10, 2000, 0, 300)
    d_log = P.price_to_y(a, 10, 2000, 0, 300, log=True) - P.price_to_y(b, 10, 2000, 0, 300, log=True)
    print(f"{a:>5} → {b:<5} 算术坐标上相距 {d_lin:6.2f} 像素,对数坐标上相距 {d_log:6.2f} 像素")
输出:
   10 → 20    算术坐标上相距   1.51 像素,对数坐标上相距  39.25 像素
  100 → 200   算术坐标上相距  15.08 像素,对数坐标上相距  39.25 像素
 1000 → 2000  算术坐标上相距 150.75 像素,对数坐标上相距  39.25 像素
同样是翻倍,算术坐标上的距离从 1.51 像素变成 150.75 像素,差了 100 倍;对数坐标上,三次翻倍都是 39.25 像素。
现在回头看第三节那张表的右边一列。3 月 13 日的四个价格,在对数坐标上的位置全都比算术坐标上更靠上(y 更小),只有最低价两边相同。原因是:在对数坐标里,低价区域被「拉开」了,高价区域被「压缩」了。第二个测试 test_price_to_y_log_puts_geometric_mean_in_the_middle 检查的就是这件事:在对数坐标上,正中间的价格不是算术平均数 150,而是几何平均数 √(100 × 200) = 141.42。
揭晓:哪次下跌最狠
回到开头那张图。在算术坐标上,2025 到 2026 年的那次下跌,从图上看是一段巨大的跌幅;2017 到 2018 年那次,挤在图的左下角,几乎看不出来。
换成对数坐标:
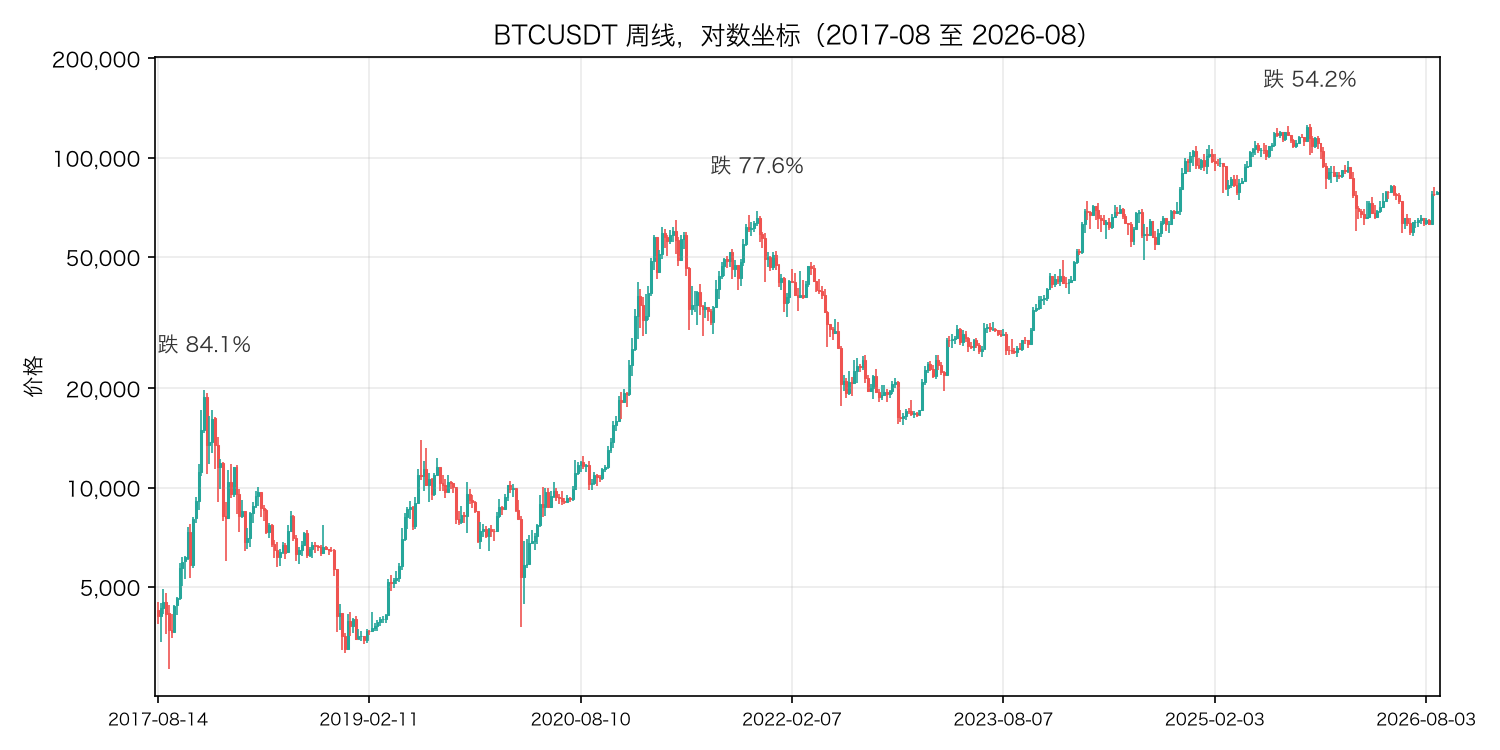
三次下跌的真实数据:
| 下跌 | 最高价(日期) | 之后的最低价(日期) | 跌了多少钱 | 跌了百分之多少 |
|---|---|---|---|---|
| 第一次 | 19,798.68(2017-12-17) | 3,156.26(2018-12-15) | 16,642 | −84.1% |
| 第二次 | 69,000.00(2021-11-10) | 15,476.00(2022-11-21) | 53,524 | −77.6% |
| 第三次 | 126,199.63(2025-10-06) | 57,800.19(2026-07-01) | 68,399 | −54.2% |
开头那道题的答案是 A。跌得最狠的是第一次,跌去了 84.1%。第三次在算术坐标上看起来最吓人,因为它跌掉的钱最多,但按比例只跌了 54.2%,是三次里最轻的。
回到涨薪的比方。一个人的月薪从 20,000 降到 3,200,另一个人从 126,000 降到 58,000。前者少了 16,800,后者少了 68,000。但前者的生活水平下降了 84%,后者下降了 54%。对一个持有者来说,真正重要的是比例。 你在 19,798 买入 1 万元的 BTC,到 3,156 时剩下 1,594 元;你在 126,199 买入 1 万元,到 57,800 时剩下 4,580 元。
⚠️ 这是在很长时间、很大价格跨度上看图时最容易犯的错误:在算术坐标上,越晚发生的波动,看起来越剧烈。原因不是市场变得更疯狂了,而是价格本身变高了,同样的百分比波动对应的金额变大了。
同一条趋势线,两个不同的突破日
对数坐标和算术坐标的区别,不只影响「看起来」怎么样,还会直接改变交易信号。
趋势线是技术分析里最常用的工具之一:把两个高点(或两个低点)连成一条直线,向后延伸。价格收盘突破这条线,常被当作一个信号。(趋势线的完整讲解在第 8 篇。)
问题是:「直线」在哪种坐标下是直的?
我们连接 BTC 在 2025 年 10 月 6 日的最高价 126,199.63 和 2026 年 1 月 14 日的最高价 97,924.49,画一条下降趋势线。
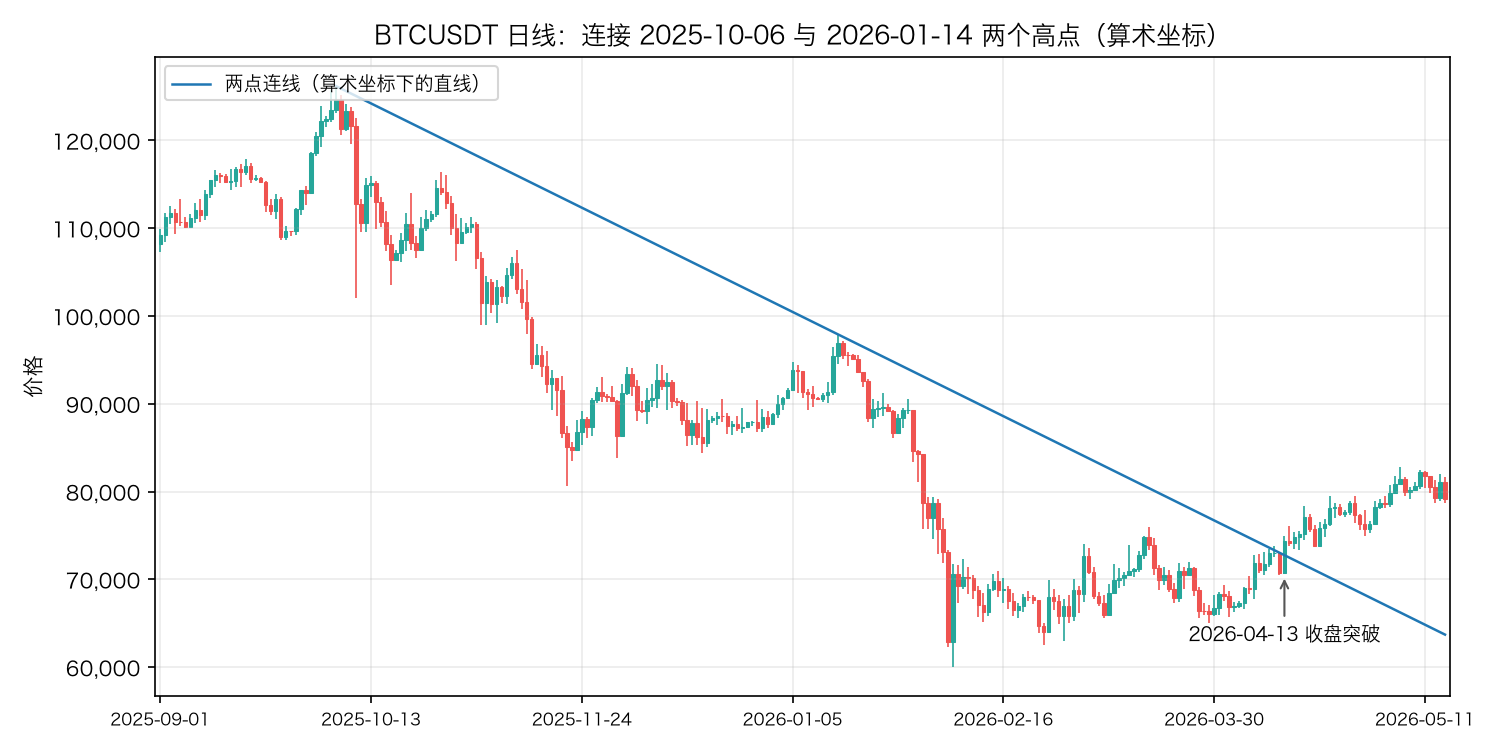
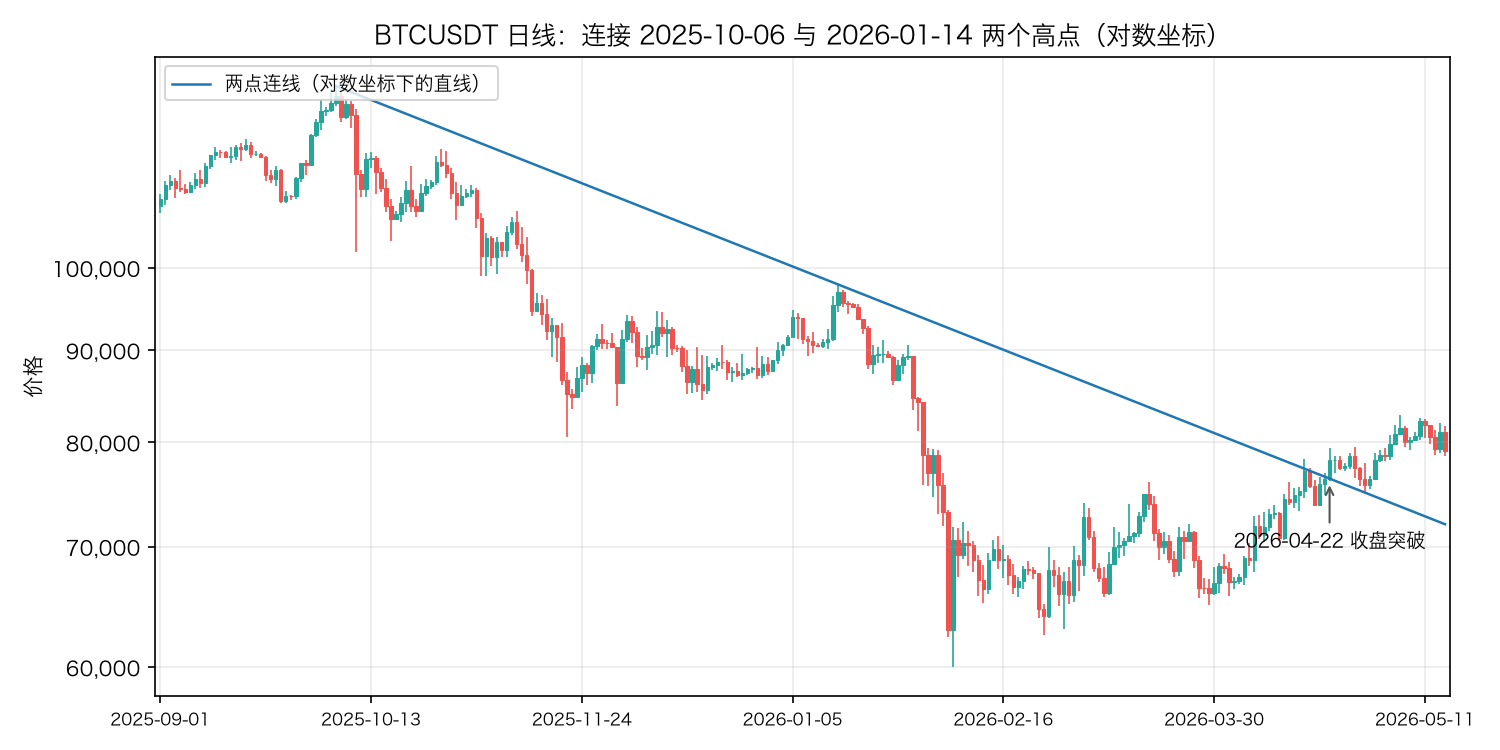
两张图里的线,连接的是完全相同的两个点。但一条是算术坐标下的直线,一条是对数坐标下的直线。
x = btc.loc["2025-09-01":"2026-05-15"]
t1, p1 = pd.Timestamp("2025-10-06", tz="UTC"), btc.loc["2025-10-06", "high"]
t2, p2 = pd.Timestamp("2026-01-14", tz="UTC"), btc.loc["2026-01-14", "high"]
a = (x.index - t1) / (t2 - t1)                   # 第一个高点记为 0,第二个高点记为 1
linear = pd.Series(p1 + (p2 - p1) * a, index=x.index)
logline = pd.Series(np.exp(np.log(p1) + (np.log(p2) - np.log(p1)) * a), index=x.index)
after = x.index > t2
first_lin = x.index[after & (x["close"] > linear)][0]
first_log = x.index[after & (x["close"] > logline)][0]
print("两个高点:", p1, p2)
for day in [first_lin, first_log]:
    print(day.date(), "收盘", x.loc[day, "close"], " 算术直线", round(linear[day], 2), " 对数直线", round(logline[day], 2))
zero_day = t1 + (t2 - t1) * (p1 / (p1 - p2))
print("算术直线降到 0 的日期:", zero_day.date())
输出:
两个高点: 126199.63 97924.49
2026-04-13 收盘 74417.99  算术直线 72759.62  对数直线 78134.51
2026-04-22 收盘 78178.23  算术直线 70214.85  对数直线 76370.9
算术直线降到 0 的日期: 2026-12-26
解释一下代码。a 是一个时间刻度:第一个高点那天是 0,第二个高点那天是 1,之后的日子大于 1。
- 算术直线:价格 = p1 + (p2 − p1) × a。每过相同的天数,价格减少相同的金额。
- 对数直线:ln 价格 = ln p1 + (ln p2 − ln p1) × a。每过相同的天数,价格减少相同的比例。
结果:
| 算术坐标 | 对数坐标 | |
|---|---|---|
| 第一次收盘突破趋势线的日期 | 2026-04-13 | 2026-04-22 |
| 那一天趋势线的位置 | 72,759.62 | 76,370.90 |
| 那一天的收盘价 | 74,417.99 | 78,178.23 |
同样的两个高点,按算术坐标画线,4 月 13 日就发出突破信号;按对数坐标画线,要再等 9 天,到 4 月 22 日才突破,而且突破时的价格高了将近 3,800 美元。 4 月 13 日那一天,收盘价 74,417.99 在算术直线之上,却还在对数直线之下 3,700 多美元。
两个交易员看同一张图、连同样两个点,却在不同的日子、不同的价格上得出「突破了」的结论。区别只在于他们的软件用的是哪种坐标。
为什么算术坐标下的下降趋势线会跌到零
输出的最后一行值得停下来看:算术直线会在 2026 年 12 月 26 日降到 0。
这条线每天减少相同的金额(大约每天 283 美元)。照这个速度,446 天后价格就会减到零,再往后就是负数。价格不可能是负数,所以这条线在更长的时间尺度上本身就没有意义。
对数直线不会这样。它每天减少相同的比例,永远只会越来越接近零,但不会到达零。
回到涨薪的比方:「每年减薪 3,000 元」,几年之后工资就会变成零甚至负数;「每年减薪 10%」,工资会越来越少,但永远不会变成零。价格的变化,更像后一种。
⚠️ 这里第一次读会有一个疑问:那是不是应该一直用对数坐标?
不一定。这个问题取决于图的价格跨度有多大。
什么时候两种坐标的差别可以忽略
两种坐标的差别,来自价格跨度。如果图上的最高价只比最低价高一点点,两种坐标几乎没有区别。
衡量差别有一个直观的办法:看算术中点(最高价和最低价的算术平均数)在对数坐标上画在哪里。在算术坐标上,它永远在正中间(50%)。在对数坐标上,它会往上偏。偏得越多,两种坐标的差别越大。
用 BTC 在不同周期、不同时间范围上的典型价格跨度来算:
| 场景 | 最高价 ÷ 最低价 | 算术中点在对数坐标上的高度 | 偏离正中间 |
|---|---|---|---|
| 1 分钟线看一天(2025 年,中位数) | 1.030 | 50.4% | 0.4% |
| 1 小时线看一个月(2025 年,中位数) | 1.214 | 52.4% | 2.4% |
| 日线看 2025 年全年 | 1.694 | 56.5% | 6.5% |
| 周线看 2017 至 2026 全部历史 | 44.8 | 82.4% | 32.4% |
- 看一天的 1 分钟线,差别不到图高度的 0.5%,肉眼看不出来,用哪种都行
- 看一个月的小时线,差别 2.4%,基本可以忽略
- 看一年的日线,差别 6.5%,开始影响趋势线和关键位置的判断
- 看九年的周线,算术中点被推到了图的 82.4% 高度,两张图看起来完全是两回事
一个实用的经验:最高价和最低价相差不到 20%,两种坐标可以互换;相差一倍以上,必须明确你用的是哪一种。
所以,问题不是「哪种坐标对」,而是:
- 看长期、大跨度的走势,比较不同时期的涨跌幅,用对数坐标。 这时你关心的是比例。
- 画趋势线、判断突破时,必须知道自己用的是哪种坐标,并且始终用同一种。 回测里用哪种画线,实盘看盘就用哪种。
- 跨度很小时,两种坐标没有实际区别。
talab.plot 画图时,传入 log=True 就是对数坐标。
七、这一篇能回答什么,不能回答什么
| 这一篇能帮你回答 | 这一篇不能回答 |
|---|---|
| 你的环境和数据,是不是和课程完全一致 | 你的代码逻辑是否在所有情况下都正确(测试只能覆盖你想到的情况) |
| 一根 K 线的每个部分在图上为什么在那个位置 | 看到一根 K 线之后该怎么交易 |
| 一段跌幅在比例上到底有多大 | 下跌之后会不会继续跌 |
| 同一条趋势线在两种坐标下分别在哪天被突破 | 哪一种突破信号更可靠(这需要第六部分的检验) |
八、小结
-
把代码搭成项目。 虚拟环境隔离依赖,
requirements.txt固定版本,pip install -e .让修改立即生效,scripts/fetch_course_data.py一次下载全部课程数据。 -
用复现指纹核对数据。 BTC 1 分钟数据:4,746,079 行,收盘价之和 183,332,267,178.49。和正文一致,就说明数据一致。
-
测试用手算过答案的小数据。 针对真实踩过的坑写测试;「埋雷」测试检查函数能不能找出每一种问题;每次改代码后跑一遍
pytest。 -
价格换算成像素:y = top + (hi − p) ÷ (hi − lo) × height。屏幕的 y 向下增大,所以最高价在最上面。一根 K 线就是一条从最高价到最低价的竖线,加上一个从开盘价到收盘价的矩形。
-
颜色约定东西方相反。 国际上多用涨绿跌红,中国大陆多用涨红跌绿。这门课用涨绿跌红。
-
时间轴有两种排法。 等距排列让走势连续,但会把休市时间折叠掉;按真实时间排列保留了时间长短,但图会断开。
-
算术坐标看「多了多少钱」,对数坐标看「翻了几倍」。 BTC 三次大跌,算术坐标上看起来最凶的一次(2025 至 2026,−54.2%),其实是最轻的;最凶的是 2017 至 2018 年(−84.1%)。
-
坐标的选择会改变交易信号。 连接同样两个高点的趋势线,算术坐标下 2026-04-13 被突破,对数坐标下要到 04-22;算术坐标下的下降趋势线在 2026-12-26 会降到零。
-
价格跨度决定坐标选择是否重要。 高低价相差不到 20%,两种坐标可以互换;相差一倍以上,必须明确用的是哪种。
最后回到涨薪。每天都有人拿着一张算术坐标的长期走势图,说「最近这波行情太疯狂了,比以前任何时候都猛」。他看到的,是朋友那 30,000 元的涨薪;他没看到的,是你那 3,000 元其实也翻了一倍。下次看到一张跨度很大的价格图,先看一眼纵坐标是怎么画的。
下一篇进入第一部分的最后一篇:统计基础。我们要回答一个前面几篇一直在用、却从没仔细讲过的问题:「涨了 5%」和「波动很大」,到底该怎么准确地度量?
练习
练习 1(环境)
按第二节的步骤搭好 talab 项目,运行 scripts/fetch_course_data.py 和 pytest -q。把你的五行复现指纹和正文逐个对照。如果有对不上的,按第二节的说明排查原因。
练习 2(计算) 一张 K 线图的画图区域从 y = 50 开始,高 500 像素。图上的最低价是 100,最高价是 400。
- (a) 在算术坐标下,价格 200 的 y 坐标是多少?
- (b) 在对数坐标下,价格 200 的 y 坐标是多少?
- (c) 在对数坐标下,哪个价格正好画在画图区域的正中间?
练习 3(编程)
给 candles_svg 增加成交量:在 K 线图的下方,用高度正比于成交量的矩形画出每根 K 线的成交量。写一个测试,检查生成的 SVG 里矩形的数量是否正确。
练习 4(编程)
为 talab.plot 写一个新的测试:构造一根开盘价等于收盘价的 K 线,用 candles_svg 画出来,检查它的实体高度是不是 1 像素。
练习 5(数据)
用 talab.plot 画出 AAPL 从 2016 年 9 月到 2026 年 9 月的周线,分别用算术坐标和对数坐标。在算术坐标上,哪一段下跌看起来最严重?用数据算出 AAPL 这十年里最大的三次回撤(从高点到之后最低点的跌幅),和你的目测结果对比。
练习 6(思考) 第六节说,算术坐标下的下降趋势线会跌到零,所以在长时间尺度上没有意义。那么上升趋势线呢?连接两个低点、向上延伸的算术直线和对数直线,在很长时间之后分别会发生什么?哪一种的问题更严重?
小检查答案
第三节小检查
价格 6,485.07 正好是最高价和最低价的算术中点:(9,188.00 + 3,782.13) ÷ 2 = 6,485.065。
y = 20 + (9,188.00 − 6,485.07) ÷ 5,405.87 × 360 = 20 + 0.5 × 360 = 200.00
它正好画在画图区域(20 到 380)的正中间。
顺便想一想:在对数坐标上,它还在正中间吗?不在。根据第六节,对数坐标的正中间是几何平均数 √(9,188.00 × 3,782.13) ≈ 5,895,比 6,485 低。所以 6,485 在对数坐标上会画在正中间偏上的位置。