| 本篇位置 | 第三部分「技术指标」的第一篇。这一篇定下所有指标共用的约定,第 13 到 15 篇的 MACD、RSI、ATR、布林带都按这套约定写进 talab.indicators;课程的主线策略也在这一篇诞生 |
| 用到的数据 | SPY、AAPL 日线(2016-09 至 2026-09);BTCUSDT 现货日线(2017-08 至 2026-08) |
| 动手 | talab.indicators 第二部分:SMA、EMA、WMA、平均滞后、上穿下穿、乖离率,附 24 个测试(其中 15 个和 TA-Lib 自动对账);主线策略 v0 |
| 读完你能 | 手算三种均线,说出它们各自的滞后;写一个不偷看未来的指标,并用测试证明它和 TA-Lib 一致;识别回测里最常见的两种未来函数;知道金叉、多头排列、乖离率在数据上有多少支持 |
一、先做一个决定
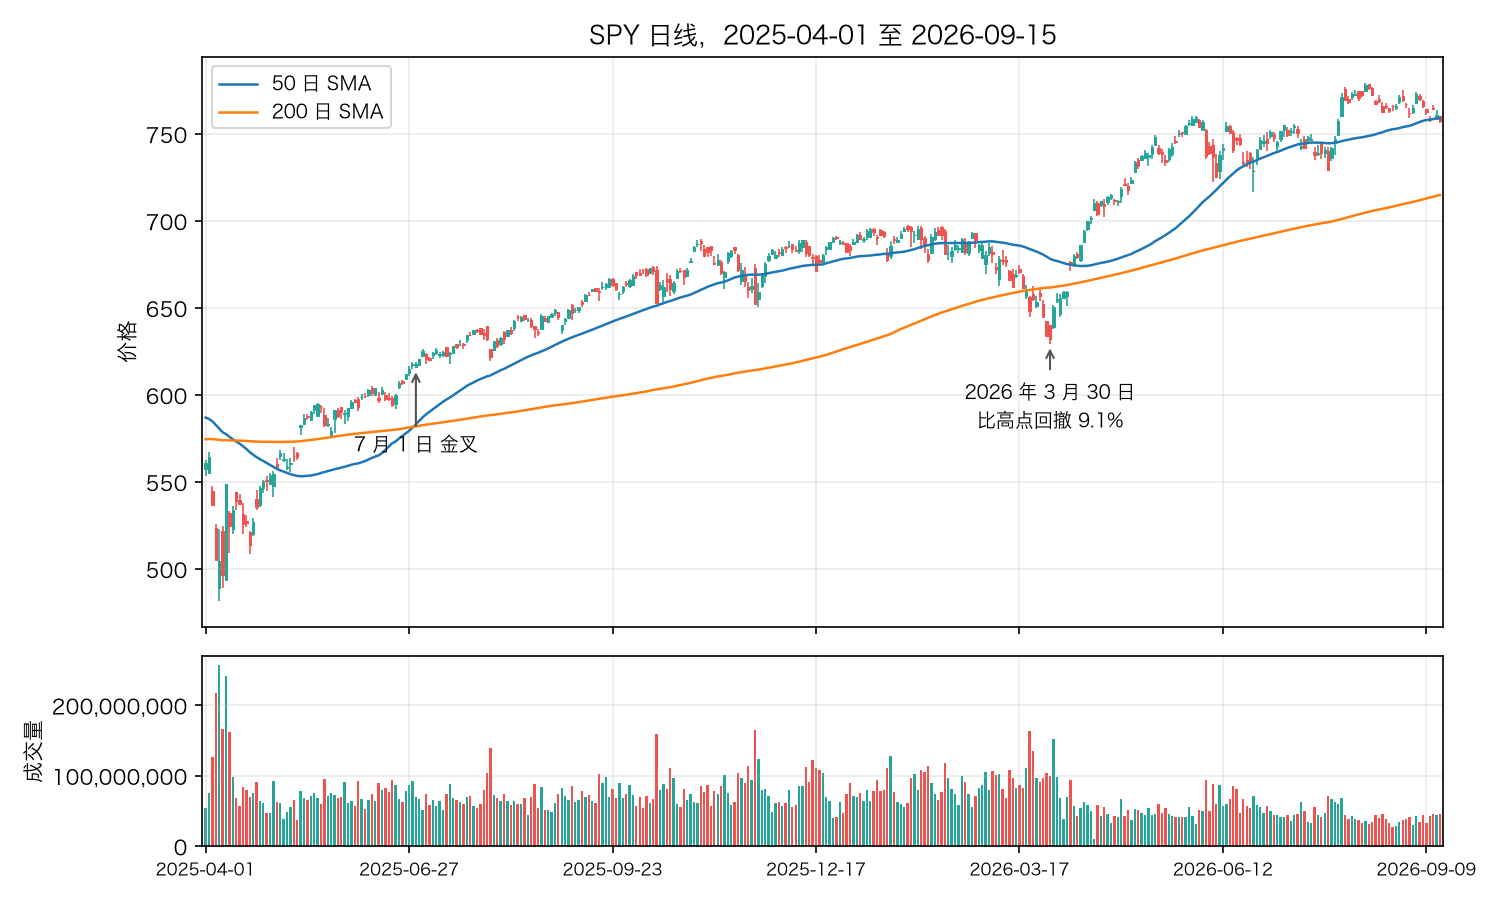
现在是 2025 年 7 月 1 日收盘。
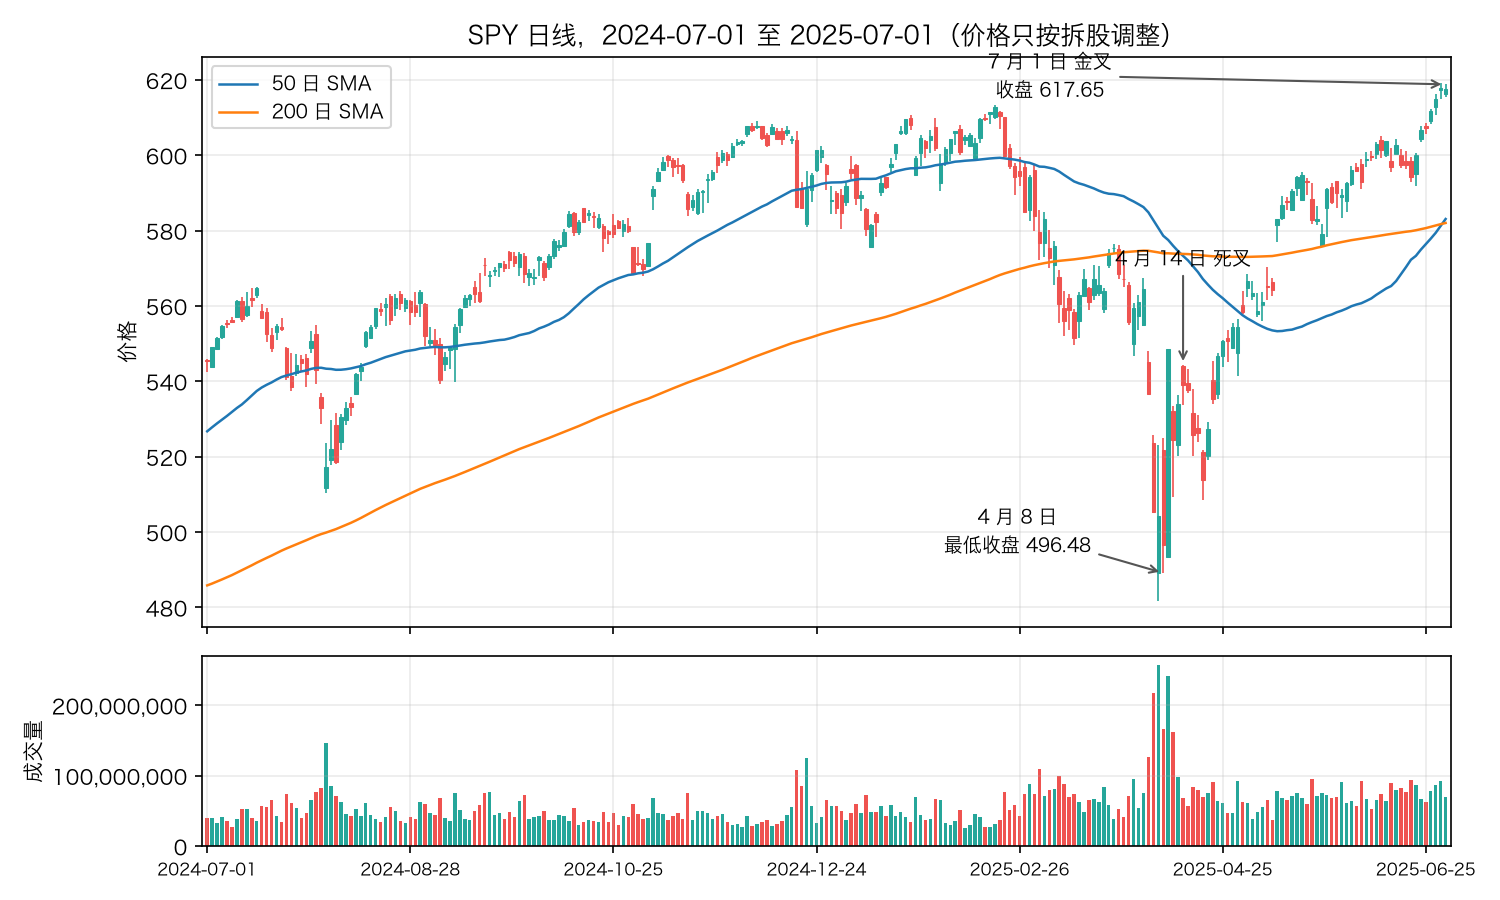
SPY 的 50 日均线(583.10)刚刚上穿 200 日均线(582.04)。这就是交易者常说的「黄金交叉」(golden cross):短期平均成本超过了长期平均成本,很多人把它当作牛市确认的信号。
                收盘   SMA50  SMA200
date
2025-06-26  611.87  577.88  581.04
2025-06-27  614.91  579.43  581.38
2025-06-30  617.85  581.27  581.73
2025-07-01  617.65  583.10  582.04
4 月最低收盘:2025-04-08 496.48,到决策点涨了 24.4%,相隔 57 个交易日
上一次死叉:2025-04-14 收盘 539.12,到决策点涨了 14.6%
决策点之前的最高收盘:617.85(2025-06-30),更早的高点 612.93(2025-02-19)
收盘价第一次站上 50 日均线:2025-05-01
收盘价第一次站上 200 日均线:2025-05-12
决策点的乖离率(相对 200 日均线):+6.1%,在 SPY 全部历史里的分位 48%
再看几个事实:
- 4 月 14 日,也就是 4 月关税冲击引发的暴跌之后,50 日均线跌破了 200 日均线(死叉)。那天收盘 539.12。
- 4 月 8 日是最低收盘 496.48。到今天,57 个交易日里 SPY 已经涨了 24.4%。
- 昨天(6 月 30 日)收盘 617.85,超过了 2 月 19 日的 612.93,是这份数据里的最高收盘价。
- 收盘价早在 5 月 1 日就站上了 50 日均线,5 月 12 日站上了 200 日均线。今天的金叉,比价格站上两条均线晚了一个多月。
你会怎么做?
- A. 买入:金叉确认了上升趋势,而且价格创了新高
- B. 不追:已经涨了 24%,金叉来得太晚,等回调
- C. 不看这个信号:两条均线交叉本身说明不了什么
先写下你的选择。 第六节揭晓之后的走势,第七节看金叉在三个标的的全部历史上的表现。
二、每天称体重
打个比方
假设你在减肥,每天早上称一次体重。
- 每天的读数跳来跳去。 昨晚吃咸了、喝水多了,体重能差一两斤。单看一天的数字,看不出你到底有没有在瘦。价格也是这样。
- 最近 7 天的平均就平稳多了,这就是简单移动平均(SMA)。
- 平均是有代价的。 你从今天开始认真节食,体重真的在降,可 7 天平均里还混着 6 天前的数字,要过几天才看得出来。这就是滞后。平均的天数越多,曲线越平稳,反应也越慢。
- 越近的日子越重要,那就给昨天更大的权重、给一周前更小的权重。这是 WMA 和 EMA 的想法。
- 刚开始称的前 6 天,算不出 7 天平均。 这是预热期。
- 事后画一张漂亮的体重曲线,每一天都取「前后各 3 天」的平均,曲线会恰好在你开始节食的那天拐弯。可这张图要等到一周以后才画得出来,拿它来判断「今天要不要节食」就是作弊。这是未来函数。
- 30 天平均跌破 90 天平均,你会说「这一个月确实在瘦」。这就是均线的交叉。
这一篇的每个概念,都可以回到这台秤上来理解。
三、指标是怎么造出来的
对 OHLCV 做变换
所有技术指标都是同一件事:拿开高低收和成交量这几列数字,按固定的公式变换出一列新的数字。 均线是对收盘价做平均;第 9 篇的 ATR 是对最高、最低、前收盘做变换;第 10 篇的 VWAP 是价格和成交量一起变换。
所以理解一个指标,只要回答四个问题:
- 它用了哪几列数据,做了什么运算?
- 它平滑掉了什么,代价是多少滞后?
- 预热期多长? 数据不够时它输出什么?
- 第 k 根的值有没有用到第 k 根之后的数据?
平滑和滞后的矛盾
平均的天数越多,随机的起伏被抵消得越多,曲线越平;但用到的旧数据越多,反应越慢。同一种均线,平滑和及时不可能同时变好。 第五节会把这个矛盾算成具体的数字。
预热期
200 日均线要有 200 根 K 线才能算出第一个值。在那之前该输出什么?常见的错误做法有两种:补 0,或者用已有的几根凑一个「不满 200 天的平均」。前者会在图上画出一根从 0 冲上来的线,后者让最初的值和后面的值不是同一个东西。
talab 的约定是:预热期一律输出 NaN,后面用到它的计算自然会跳过这些位置。
未来函数
未来函数指的是,一个指标或信号在第 k 根的值,用到了第 k 根之后才知道的数据。它在图上看不出来,在回测里却会制造出惊人的收益。
看同一条最简单的规则:SPY 收盘价在 5 日均线上方就持有,否则空仓。 用三种方式回测:
- 正确:第 k 根收盘时算出信号,第 k + 1 根开盘成交。
- 错误 1:当天的信号吃当天的收益。 用第 k 根的收盘价算出「持有」,却把第 k 根当天的涨幅也算进收益。可你要等到收盘才知道收盘价在不在均线上方,那一天的涨幅已经发生了。
- 错误 2:居中的均线。 pandas 的
rolling(5, center=True)取前后各 2 天的平均,画出来的线最贴合价格,但它用到了后面 2 天。哪怕信号往后挪了一天,还是偷看了 1 天的未来。
def backtest_next_open(df, signal):
    """收盘时算出 signal(1 持有、0 空仓),下一根开盘成交。返回每根 K 线的收益率。"""
    held = signal.shift(1).fillna(0.0)                      # 这一根是否持有
    before = held.shift(1).fillna(0.0)                      # 上一根是否持有
    o, close, prev = df["open"], df["close"], df["close"].shift(1)
    r = np.select([(held == 1) & (before == 1), (held == 1) & (before == 0), (held == 0) & (before == 1)],
                  [close / prev - 1, close / o - 1, o / prev - 1], 0.0)
    return pd.Series(r, index=df.index).fillna(0.0)


def annual(r, n):
    return (1 + r).prod() ** (n / len(r)) - 1


for name, df in markets.items():
    start = I.sma(df["close"], 200).first_valid_index()       # 和后面的主线策略用同一个起点
    d = df.loc[start:]
    for n in [5, 20]:
        signal = (df["close"] > I.sma(df["close"], n)).astype(float).loc[start:]
        right = backtest_next_open(d, signal)
        same_day = (signal * d["close"].pct_change()).fillna(0.0)          # 错误 1:当天收盘才知道的信号,吃了当天的收益
        centered = df["close"].rolling(n, center=True).mean()               # 错误 2:居中的均线,用到了后面 n / 2 天
        rising = (centered.diff() > 0).astype(float).loc[start:]
        peek = (rising.shift(1) * d["close"].pct_change()).fillna(0.0)
        print(f"{name} 收盘价在 {n} 日均线上方就持有:正确 {annual(right, periods_per_year[name]):.1%},"
              f"当天信号 {annual(same_day, periods_per_year[name]):.1%},"
              f"居中均线向上就持有 {annual(peek, periods_per_year[name]):.1%},"
              f"买入 {int((signal.diff() == 1).sum())} 次(年化收益)")
SPY 收盘价在 5 日均线上方就持有:正确 4.4%,当天信号 116.6%,居中均线向上就持有 66.4%,买入 300 次(年化收益)
SPY 收盘价在 20 日均线上方就持有:正确 6.8%,当天信号 50.5%,居中均线向上就持有 37.5%,买入 115 次(年化收益)
AAPL 收盘价在 5 日均线上方就持有:正确 2.3%,当天信号 281.2%,居中均线向上就持有 143.3%,买入 292 次(年化收益)
AAPL 收盘价在 20 日均线上方就持有:正确 26.7%,当天信号 110.7%,居中均线向上就持有 70.0%,买入 96 次(年化收益)
BTC 收盘价在 5 日均线上方就持有:正确 24.1%,当天信号 2042.7%,居中均线向上就持有 632.4%,买入 417 次(年化收益)
BTC 收盘价在 20 日均线上方就持有:正确 31.4%,当天信号 450.0%,居中均线向上就持有 210.0%,买入 177 次(年化收益)
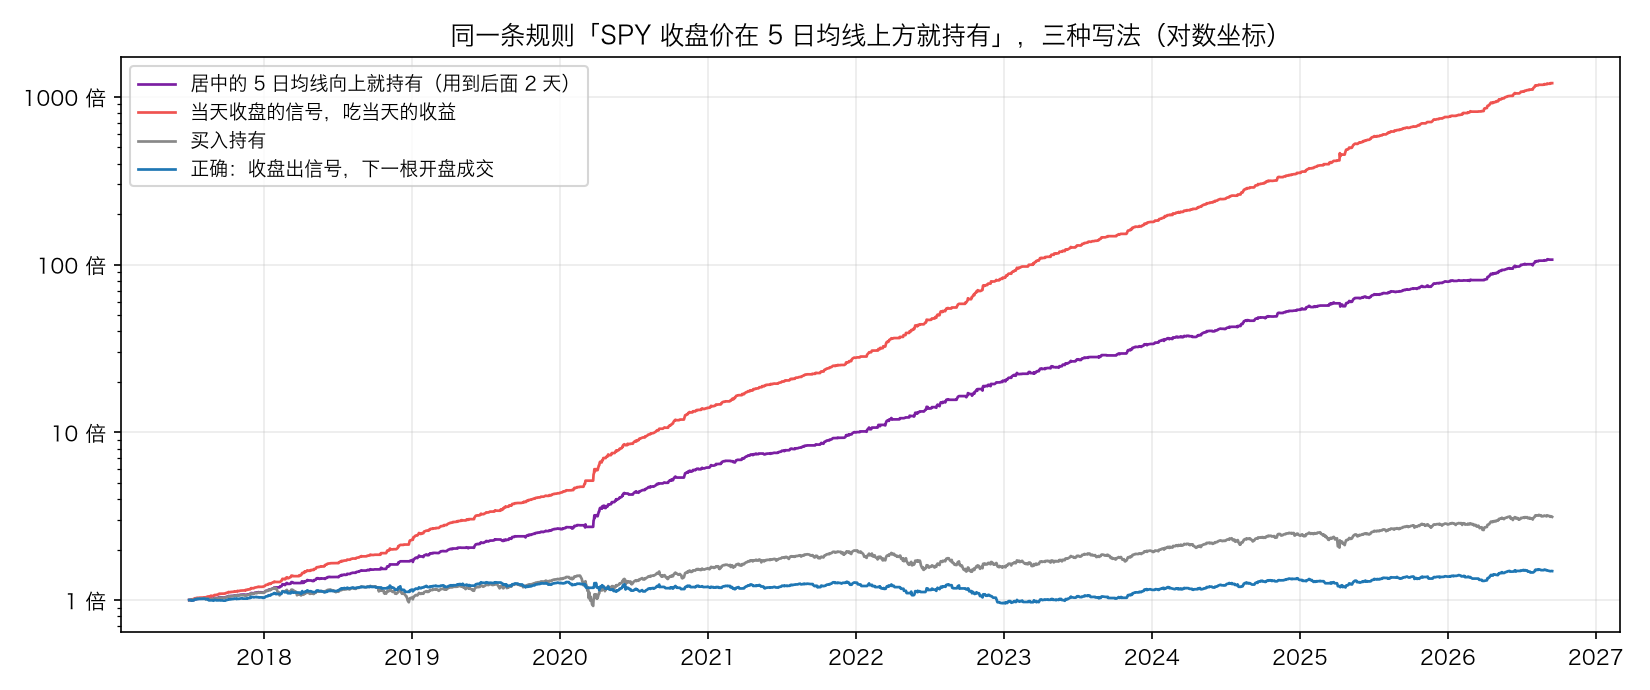
SPY 上正确的年化收益是 4.4%,偷看当天的收盘价变成 116.6%,BTC 变成了 2042.7%。 规则一模一样,差别全在「什么时候知道什么」。信号换得越频繁,未来函数制造的假收益越大:5 日均线这条规则 9 年里买入了 300 次,每一次都偷看了一点。
⚠️ 如果一个回测结果好得让你兴奋,第一件事就是检查未来函数。
统一的指标接口
为了从源头上避免这些问题,从这一篇起,talab.indicators 里的每个指标函数都遵守同一套约定:
| 约定 | 为什么 |
|---|---|
| 输入一个 Series 和参数,返回一个索引完全相同的 Series | 可以直接和价格对齐、相减、比较,不会错位 |
| 预热期返回 NaN | 不补 0,也不用更短的窗口凑数 |
| 用前 k 个数据算出的结果,和用全部数据算出的前 k 个完全一样 | 这就是「没有未来函数」的可检验定义,这一篇起的每个指标都有一个测试逐段截断数据来检查 |
| 结果和 TA-Lib 的同名函数一致 | TA-Lib 是用得最广的技术指标库,对上账说明公式、预热期、初始值都没有理解错 |
四、三种均线
定义
以 n = 3 为例,今天的价格记为 P₀,昨天 P₁,前天 P₂。
SMA(简单移动平均):最近 n 个价格的算术平均,每个价格的权重都是 1/n。
SMA = (P₀ + P₁ + P₂) ÷ 3
WMA(加权移动平均):最近的价格权重是 n,往前依次是 n - 1、…、1,再除以权重之和 n(n + 1) ÷ 2。
WMA = (3 × P₀ + 2 × P₁ + 1 × P₂) ÷ 6
EMA(指数移动平均):每天把旧的 EMA 往今天的价格拉近一个固定的比例 α,默认 α = 2 ÷ (n + 1)。
EMA今天 = EMA昨天 + α × (P₀ - EMA昨天)
n = 3 时 α = 2 ÷ 4 = 0.5
展开来看,EMA 给今天的权重是 α,昨天是 α(1 - α),前天是 α(1 - α)²……权重按固定比例一直衰减下去,没有截止,理论上所有过去的价格都在里面。
手算一遍
六天的价格是 10、11、12、11、13、16,n = 3:
x = pd.Series([10.0, 11, 12, 11, 13, 16])
print(pd.DataFrame({"价格": x, "SMA3": I.sma(x, 3), "WMA3": I.wma(x, 3), "EMA3": I.ema(x, 3)}).round(4).to_string())
     价格     SMA3     WMA3  EMA3
0  10.0      NaN      NaN   NaN
1  11.0      NaN      NaN   NaN
2  12.0  11.0000  11.3333  11.0
3  11.0  11.3333  11.3333  11.0
4  13.0  12.0000  12.1667  12.0
5  16.0  13.3333  14.1667  14.0
逐个验算第 2 根(第三个价格 12):
- SMA3 = (10 + 11 + 12) ÷ 3 = 11.00
- WMA3 = (1 × 10 + 2 × 11 + 3 × 12) ÷ 6 = 68 ÷ 6 = 11.33
- EMA3 的第一个值没有「昨天的 EMA」,用前 3 个价格的简单平均:11.00
第 5 根(价格 16):
- SMA3 = (11 + 13 + 16) ÷ 3 = 40 ÷ 3 = 13.33
- WMA3 = (1 × 11 + 2 × 13 + 3 × 16) ÷ 6 = 85 ÷ 6 = 14.17
- EMA3:第 3 根 11 + 0.5 × (11 - 11) = 11;第 4 根 11 + 0.5 × (13 - 11) = 12;第 5 根 12 + 0.5 × (16 - 12) = 14.00
价格最后一天跳到 16,WMA 和 EMA 跟得比 SMA 快,因为它们给最近的价格更大的权重。
EMA 的第一个值从哪来
EMA 的公式需要「昨天的 EMA」,第一天没有。常见的初始化有两种:
- TA-Lib(以及
talab):前 n 个价格的简单平均,出现在第 n 根。之前是 NaN。 - pandas 的
ewm(span=n, adjust=False):直接用第一个价格当初始值,从第 1 根就有值。
两者在开头不一样,差距按 (1 - α) 的速度衰减:
ours = I.ema(c, 50)
pandas_style = c.ewm(span=50, adjust=False).mean()
diff = (ours - pandas_style).abs()
print(f"第 50 根(第一个值):talab {ours.iloc[49]:.2f},pandas {pandas_style.iloc[49]:.2f},相差 {diff.iloc[49]:.2f}")
for k in [100, 200, 400]:
    print(f"第 {k} 根:相差 {diff.iloc[k - 1]:.4f}")
print(f"相差第一次小于 0.01:第 {int(np.argmax((diff < 0.01).to_numpy())) + 1} 根")
第 50 根(第一个值):talab 214.88,pandas 215.44,相差 0.55
第 100 根:相差 0.0746
第 200 根:相差 0.0014
第 400 根:相差 0.0000
相差第一次小于 0.01:第 151 根
SPY 的 50 日 EMA,两种写法在第 50 根差 0.55,到第 151 根才小于 0.01。⚠️ 如果你用 pandas 算 EMA 去和 TradingView、TA-Lib 或别人的结果对账,开头那一段对不上是正常的;只看开头几十根就下结论「公式错了」,或者反过来把开头那一段当成有效数据用进回测,都是常见的坑。
第 8 篇的 wilder_smooth 其实就是 α = 1/n 的 EMA,初始化方式相同。第十节有一个测试专门检查两者完全一致。
✋ 小检查 1
价格依次是 20、22、21、23、24、30,n = 4。
(a) 最后一天的 SMA4 和 WMA4 是多少?
(b) EMA4 的 α 是多少?第一个值出现在第几根、是多少?最后一天是多少?
(c) 三种 4 日均线的平均滞后各是多少根?(下一节的公式)
答案在文末。
五、滞后可以算出来
平均滞后
一条均线用到的每个价格都「过去了若干天」:今天是 0,昨天是 1……把这些天数按权重加权平均,就是这条均线的平均滞后。
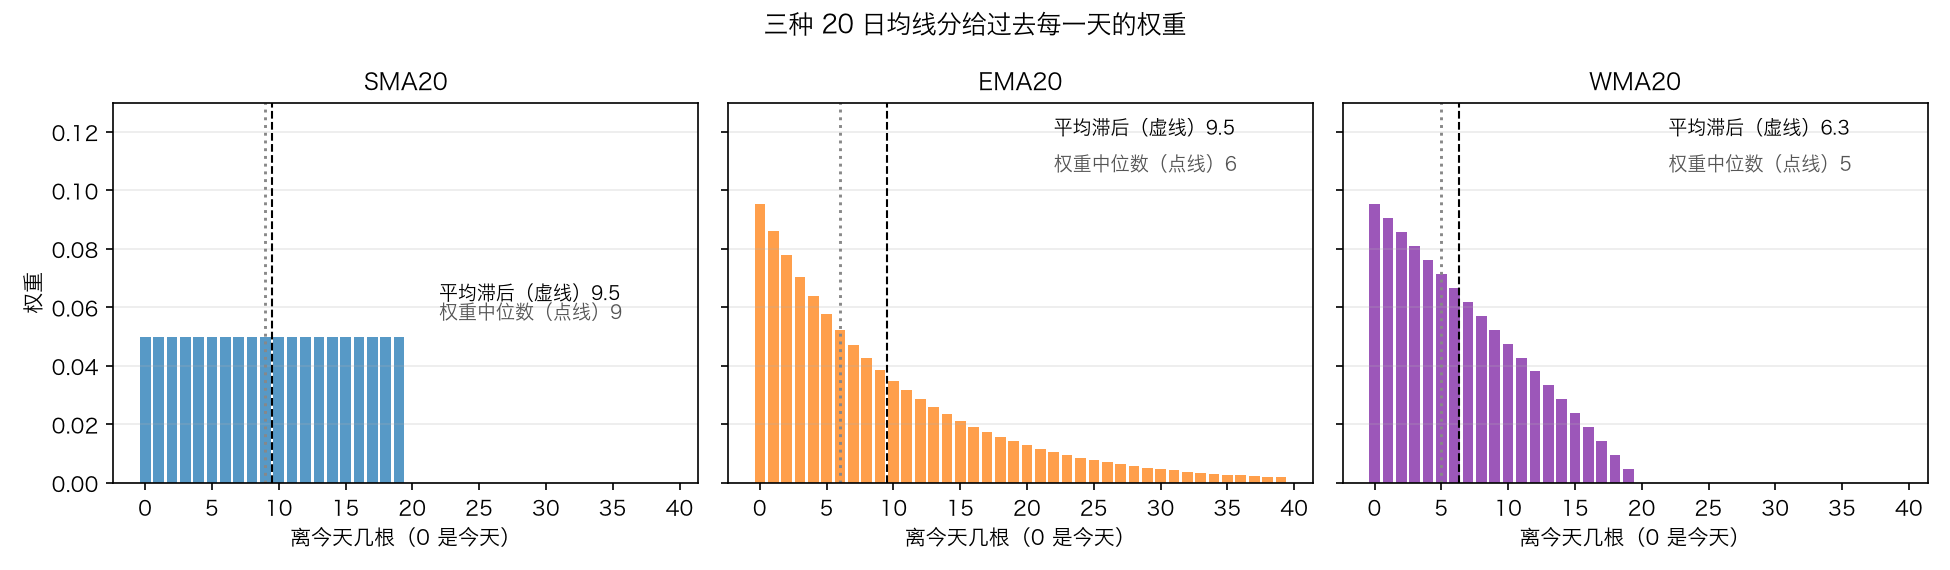
SMA:权重都是 1/n,平均滞后 = (0 + 1 + … + (n - 1)) ÷ n = (n - 1) ÷ 2
WMA:权重 n, n - 1, …, 1,平均滞后 = (n - 1) ÷ 3
EMA:权重 α(1 - α)ᵏ,平均滞后 = (1 - α) ÷ α。代入 α = 2 ÷ (n + 1),正好也是 (n - 1) ÷ 2
最后一行解释了 α = 2 ÷ (n + 1) 这个看起来很随意的数字:它让 n 日 EMA 和 n 日 SMA 的平均滞后完全相同。 所以「20 日 EMA」和「20 日 SMA」是可以放在一起比较的。
talab.indicators.average_lag 直接按定义计算:
rows = []
for n in [20, 50, 200]:
    alpha = 2 / (n + 1)
    rows.append({"n": n, "SMA": I.average_lag(np.ones(n)), "EMA": I.average_lag((1 - alpha) ** np.arange(5000)),
                 "WMA": I.average_lag(np.arange(n, 0, -1))})
print(pd.DataFrame(rows).round(2).to_string(index=False))
ramp = pd.Series(np.arange(300, dtype=float))
for name, f in [("SMA", I.sma), ("EMA", I.ema), ("WMA", I.wma)]:
    lag = (ramp - f(ramp, 30)).dropna()
    print(f"斜坡上的 {name}30:价格减均线 最小 {lag.min():.4f},最大 {lag.max():.4f}")
  n  SMA  EMA   WMA
 20  9.5  9.5  6.33
 50 24.5 24.5 16.33
200 99.5 99.5 66.33
斜坡上的 SMA30:价格减均线 最小 14.5000,最大 14.5000
斜坡上的 EMA30:价格减均线 最小 14.5000,最大 14.5000
斜坡上的 WMA30:价格减均线 最小 9.6667,最大 9.6667
在一条匀速上涨的直线上,滞后正好等于公式。 价格每天涨 1,30 日 SMA 和 EMA 永远比价格低 14.5,WMA 低 9.67。换句话说,均线画的是 14.5 天前(WMA 是 9.67 天前)的价格。
在真实价格上实测
真实价格不是直线。换一个办法实测:把价格往后平移 k 根,看 k 取多少时,平移后的价格和均线最贴合(平方误差最小)。这个 k 就是均线「实际上」落后了多少根。
def weight_median(weights):
    """权重从最新往前累加,第一次达到一半的位置。"""
    w = np.asarray(weights, dtype=float)
    return int(np.searchsorted(np.cumsum(w) / w.sum(), 0.5 - 1e-9))          # 减一点点,避免浮点误差让 0.5 被算成不到一半


rows = []
for name, df in markets.items():
    log_price = np.log(df["close"])
    for n in [20, 50, 200]:
        alpha = 2 / (n + 1)
        for kind, ma, weights in [("SMA", I.sma(log_price, n), np.ones(n)),
                                  ("EMA", I.ema(log_price, n), (1 - alpha) ** np.arange(5000)),
                                  ("WMA", I.wma(log_price, n), np.arange(n, 0, -1))]:
            error = {k: ((ma - log_price.shift(k)) ** 2).iloc[400:].mean() for k in range(int(0.8 * n))}
            rows.append({"市场": name, "n": n, "均线": kind, "平均滞后": I.average_lag(weights),
                         "权重中位数": weight_median(weights), "最贴合的平移": min(error, key=error.get)})
print(pd.DataFrame(rows).round(1).to_string(index=False))
  市场   n  均线  平均滞后  权重中位数  最贴合的平移
 SPY  20 SMA   9.5      9       9
 SPY  20 EMA   9.5      6       7
 SPY  20 WMA   6.3      5       6
 SPY  50 SMA  24.5     24      24
 SPY  50 EMA  24.5     17      15
 SPY  50 WMA  16.3     14      14
 SPY 200 SMA  99.5     99      99
 SPY 200 EMA  99.5     69      79
 SPY 200 WMA  66.3     58      55
AAPL  20 SMA   9.5      9      10
AAPL  20 EMA   9.5      6       7
AAPL  20 WMA   6.3      5       6
AAPL  50 SMA  24.5     24      25
AAPL  50 EMA  24.5     17      18
AAPL  50 WMA  16.3     14      15
AAPL 200 SMA  99.5     99      99
AAPL 200 EMA  99.5     69      75
AAPL 200 WMA  66.3     58      57
 BTC  20 SMA   9.5      9       9
 BTC  20 EMA   9.5      6       7
 BTC  20 WMA   6.3      5       6
 BTC  50 SMA  24.5     24      24
 BTC  50 EMA  24.5     17      18
 BTC  50 WMA  16.3     14      15
 BTC 200 SMA  99.5     99      99
 BTC 200 EMA  99.5     69      72
 BTC 200 WMA  66.3     58      60
SMA 和公式完全吻合:20 日是 9 或 10,50 日是 24 或 25,200 日是 99。
EMA 和 WMA 实测的滞后比公式短,而且很接近另一个数:权重中位数,也就是从今天往前累加权重,第一次累加到一半的位置。200 日 EMA 的公式是 99.5,实测是 72 到 79,权重中位数是 69。
原因在于这两种「滞后」回答的是不同的问题:
- 平均滞后是价格匀速变化时,均线落后的根数。直线上两者一样。
- 价格像随机游走一样忽上忽下时,可以证明:平移后最贴合均线的位置,是权重中位数。SMA 的权重是对称的,中位数和平均值一样,所以两种算法一致;EMA 的权重有一条很长的尾巴,尾巴把「平均」拉远了,却对「中位数」影响不大。
真实价格既不是直线也不是纯粹的随机游走,实测值落在两者之间,更靠近中位数。
⚠️ 所以「20 日 EMA 和 20 日 SMA 滞后相同」只在平均滞后的意义上成立。在实际的价格上,EMA 跟得更紧,200 日 EMA 大约只落后公式值的四分之三。
同样的滞后,谁更平滑
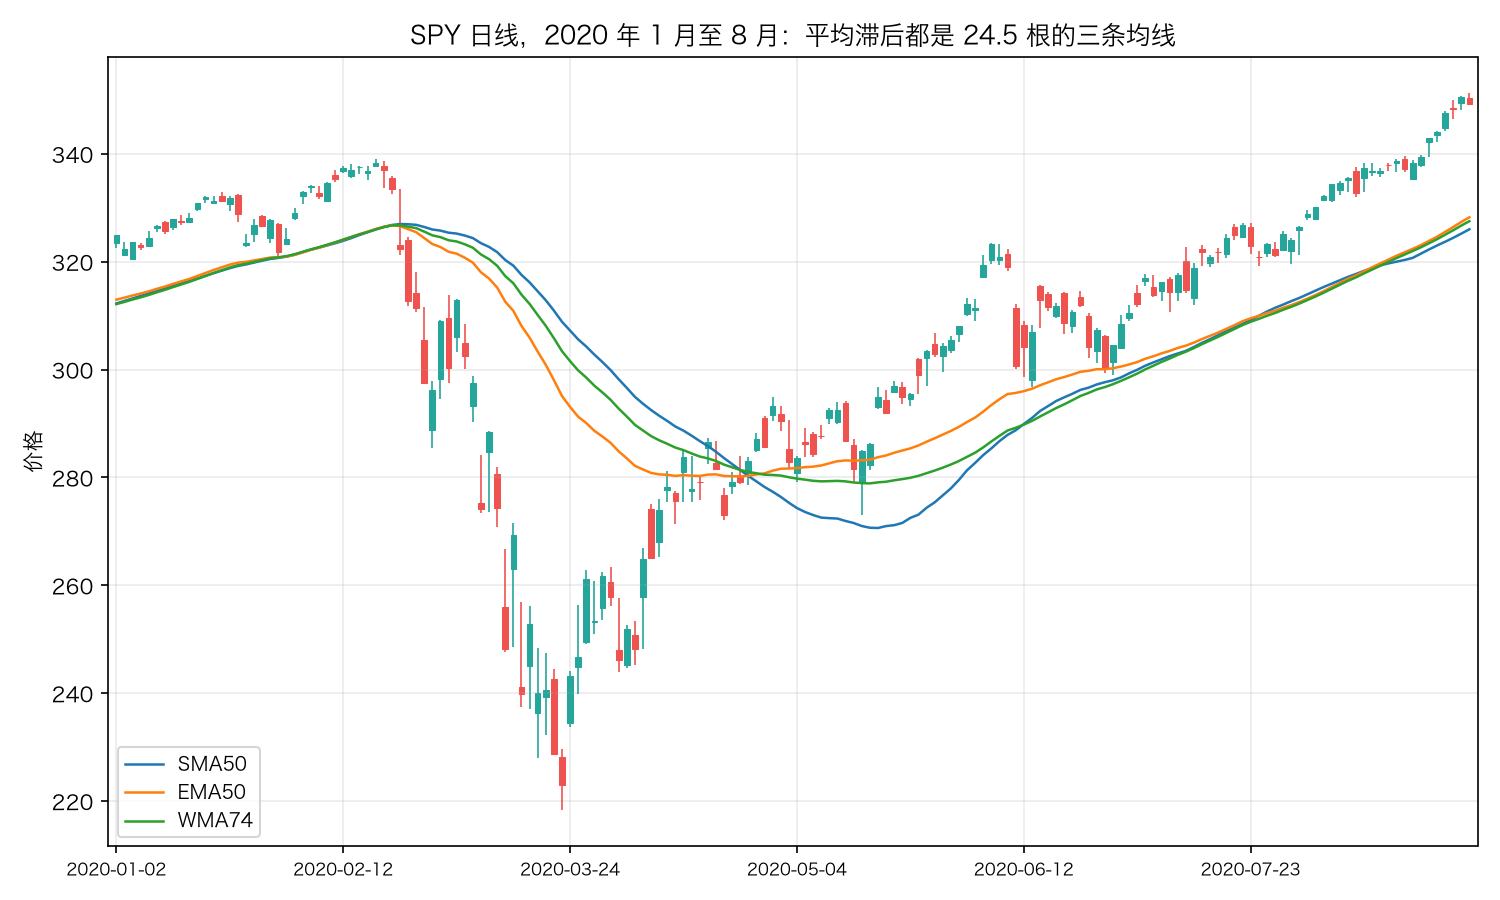
滞后相同的前提下,哪种均线更平?把平均滞后固定在 9.5 根(SMA20、EMA20、WMA30)和 24.5 根(SMA50、EMA50、WMA74),比较两件事:
- 粗糙度:均线每天变化的标准差,除以价格每天变化的标准差。越小越平。对随机游走可以直接算出理论值:SMA 和 EMA 都是 1 ÷ √n;WMA 是 √(2(2n + 1) ÷ (3n(n + 1)))。
- 每年拐头次数:均线的方向(向上还是向下)每年改变几次。
rows = []
for name, df in markets.items():
    log_price = np.log(df["close"])
    step = log_price.diff().std()
    for lag in [9.5, 24.5]:
        n_even, n_wma = int(2 * lag + 1), int(round(3 * lag + 1))          # 平均滞后相同的周期
        a = 2 / (n_even + 1)
        for kind, ma, n, theory in [("SMA", I.sma(log_price, n_even), n_even, 1 / np.sqrt(n_even)),
                                    ("EMA", I.ema(log_price, n_even), n_even, np.sqrt(a / (2 - a))),
                                    ("WMA", I.wma(log_price, n_wma), n_wma,
                                     np.sqrt(2 * (2 * n_wma + 1) / (3 * n_wma * (n_wma + 1))))]:
            move = ma.diff().iloc[250:]
            turns = (np.sign(move) != np.sign(move.shift(1))).iloc[1:].sum()
            rows.append({"市场": name, "平均滞后": lag, "均线": f"{kind}{n}", "实测粗糙度": move.std() / step,
                         "随机游走理论": theory, "每年拐头次数": turns / (len(move) / periods_per_year[name])})
print(pd.DataFrame(rows).round(3).to_string(index=False))
  市场  平均滞后    均线  实测粗糙度  随机游走理论  每年拐头次数
 SPY   9.5 SMA20  0.211   0.224  19.496
 SPY   9.5 EMA20  0.209   0.224  28.408
 SPY   9.5 WMA30  0.195   0.209  19.273
 SPY  24.5 SMA50  0.119   0.141  10.027
 SPY  24.5 EMA50  0.122   0.141  16.599
 SPY  24.5 WMA74  0.111   0.134  11.809
AAPL   9.5 SMA20  0.216   0.224  20.378
AAPL   9.5 EMA20  0.217   0.224  26.392
AAPL   9.5 WMA30  0.203   0.209  18.262
AAPL  24.5 SMA50  0.135   0.141  13.140
AAPL  24.5 EMA50  0.133   0.141  16.035
AAPL  24.5 WMA74  0.127   0.134  12.249
 BTC   9.5 SMA20  0.215   0.224  38.031
 BTC   9.5 EMA20  0.213   0.224  39.466
 BTC   9.5 WMA30  0.201   0.209  31.094
 BTC  24.5 SMA50  0.143   0.141  22.603
 BTC  24.5 EMA50  0.142   0.141  23.440
 BTC  24.5 WMA74  0.136   0.134  17.461
读这张表:
- SMA 和 EMA 的粗糙度几乎一样,这和理论值相同(都是 1 ÷ √n)。实测值和理论值很接近,SPY 和 AAPL 上略低一些,说明真实价格和纯粹的随机游走并不完全一样。
- WMA 在同样的平均滞后下最平滑,粗糙度比 SMA 低 5% 到 8%。
- EMA 拐头最频繁。 SPY 上 EMA20 每年拐头 28.4 次,SMA20 是 19.5 次。原因藏在公式里:EMA 今天的变化是 α × (今天的价格 - 昨天的 EMA),只要价格穿过 EMA,EMA 就会掉头;SMA 今天的变化是 (今天的价格 - n 天前的价格) ÷ n,要今天的价格和 n 天前比才掉头。
上面那张 2020 年的图能看到这些差别:同样是平均滞后 24.5 根,EMA50 在 3 月的暴跌里最先拐下去,在 4 月的反弹里最先拐上来;SMA50 最晚。
没有哪一种均线在所有方面都更好。 选均线就是在「跟得紧」「曲线平」「少掉头」之间做取舍。
六、揭晓
2025 年 7 月 1 日的金叉之后,SPY 一路上涨。
i = c.index.get_loc(t)
for n in [20, 60, 120, 250]:
    print(f"{n} 个交易日后({c.index[i + n].date()}):{c.iloc[i + n] / c[t] - 1:+.2%}")
after = c.iloc[i:]
drawdown = after / after.cummax() - 1
print(f"之后最大回撤 {drawdown.min():.1%}({drawdown.idxmin().date()}),{c.index[-1].date()} 收盘 {c.iloc[-1]:.2f},"
      f"比决策点 {c.iloc[-1] / c[t] - 1:+.1%}")
f50, f200 = I.sma(c, 50), I.sma(c, 200)
print("决策点之后的交叉:", list(c.index[(I.cross_above(f50, f200) | I.cross_below(f50, f200)) & (c.index > t)].date))
20 个交易日后(2025-07-30):+2.72%
60 个交易日后(2025-09-25):+6.54%
120 个交易日后(2025-12-19):+10.19%
250 个交易日后(2026-07-01):+20.74%
之后最大回撤 -9.1%(2026-03-30),2026-09-15 收盘 757.39,比决策点 +22.6%
决策点之后的交叉: []
- 20 个交易日后 +2.72%,250 个交易日(一年)后 +20.74%。
- 之后最大的回撤是 2026 年 3 月 30 日的 9.1%,价格一度跌破 200 日均线,但 50 日均线始终没有跌破 200 日均线。
- 到数据最后一天(2026-09-15),比决策点高 22.6%,金叉状态一直持续。
选 A(买入)的,这一次赚了;选 B 等回调的,要等到 2026 年 3 月才等到一次像样的回调,那时价格已经比 7 月 1 日高了一截。
但这只是一次。这次金叉之前 57 天,价格已经从低点涨了 24.4%,这段涨幅金叉完全没有吃到。这一次金叉之后涨了,和「金叉是一个有用的信号」是两件事。 下一节看全部历史。
七、均线交叉、多头排列和乖离率
三个说法
- 金叉和死叉:短均线上穿长均线是金叉,看涨;下穿是死叉,看跌。最有名的是 50 日和 200 日。
- 多头排列:收盘价 > 20 日均线 > 50 日均线 > 200 日均线,短的在上、长的在下,说明各个周期的平均成本都在抬高,看涨。反过来是空头排列。
- 乖离率:收盘价偏离均线的比例,收盘价 ÷ 均线 - 1。常见的说法是乖离率太大,价格会被「拉回」均线。
金叉有多少次
def rebuild(log_returns):
    return pd.Series(np.exp(np.cumsum(np.asarray(log_returns))))


def golden_gap(log_returns, horizon=20):
    """50 日均线在 200 日均线上方的日子,减去下方的日子:之后 horizon 天的平均对数收益。"""
    p = rebuild(log_returns)
    fast, slow = I.sma(p, 50), I.sma(p, 200)
    later = np.log(p.shift(-horizon) / p)
    return later[fast > slow].mean() - later[fast < slow].mean()


def stack_gap(log_returns, horizon=20):
    """多头排列(收盘 > 20 日 > 50 日 > 200 日均线)的日子,减去其余有 200 日均线的日子。"""
    p = rebuild(log_returns)
    m20, m50, m200 = I.sma(p, 20), I.sma(p, 50), I.sma(p, 200)
    stacked = (p > m20) & (m20 > m50) & (m50 > m200)
    later = np.log(p.shift(-horizon) / p)
    return later[stacked].mean() - later[~stacked & m200.notna()].mean()


def bias_gap(log_returns, horizon=60):
    """相对 200 日均线的乖离率最高 20% 的日子,减去最低 20% 的日子。"""
    p = rebuild(log_returns)
    rank = I.bias(p, I.sma(p, 200)).rank(pct=True)
    later = np.log(p.shift(-horizon) / p)
    return later[rank > 0.8].mean() - later[rank <= 0.2].mean()


for name, df in markets.items():
    close = df["close"]
    fast, slow = I.sma(close, 50), I.sma(close, 200)
    events = close.index[I.cross_above(fast, slow) | I.cross_below(fast, slow)]
    lasted = np.diff(np.r_[[close.index.get_loc(e) for e in events], len(close) - 1])
    stacked = (close > I.sma(close, 20)) & (I.sma(close, 20) > fast) & (fast > slow)
    print(f"{name}:金叉 {int(I.cross_above(fast, slow).sum())} 次,死叉 {int(I.cross_below(fast, slow).sum())} 次,"
          f"每次交叉之后维持的天数 {lasted.tolist()}")
    print(f"   50 日在 200 日上方的时间 {(fast > slow)[slow.notna()].mean():.1%},多头排列的时间 {stacked[slow.notna()].mean():.1%}")
    log_returns = np.log(close).diff().dropna().reset_index(drop=True)
    for label, stat in [("50 日在上方减下方,之后 20 天", golden_gap), ("多头排列减其余,之后 20 天", stack_gap),
                        ("乖离率最高 20% 减最低 20%,之后 60 天", bias_gap)]:
        res = St.shuffle_test(log_returns, stat, n=1000, seed=0)
        print(f"   {label}:{res['实际值']:+.2%},打乱后 95% 范围 {res['打乱后 2.5% 分位']:+.2%} ~ "
              f"{res['打乱后 97.5% 分位']:+.2%},打乱后不小于实际的比例 {res['比例']:.1%}")
SPY:金叉 4 次,死叉 4 次,每次交叉之后维持的天数 [77, 251, 70, 423, 224, 550, 53, 302]
   50 日在 200 日上方的时间 81.7%,多头排列的时间 47.7%
   50 日在上方减下方,之后 20 天:-0.79%,打乱后 95% 范围 -2.10% ~ +1.66%,打乱后不小于实际的比例 45.3%
   多头排列减其余,之后 20 天:-0.86%,打乱后 95% 范围 -1.62% ~ +1.50%,打乱后不小于实际的比例 29.7%
   乖离率最高 20% 减最低 20%,之后 60 天:-1.75%,打乱后 95% 范围 -8.61% ~ +5.76%,打乱后不小于实际的比例 65.4%
AAPL:金叉 5 次,死叉 5 次,每次交叉之后维持的天数 [91, 777, 78, 9, 113, 246, 63, 203, 110, 251]
   50 日在 200 日上方的时间 80.3%,多头排列的时间 37.0%
   50 日在上方减下方,之后 20 天:-2.17%,打乱后 95% 范围 -3.63% ~ +2.90%,打乱后不小于实际的比例 22.0%
   多头排列减其余,之后 20 天:-0.72%,打乱后 95% 范围 -2.56% ~ +2.29%,打乱后不小于实际的比例 55.9%
   乖离率最高 20% 减最低 20%,之后 60 天:-8.29%,打乱后 95% 范围 -13.56% ~ +9.75%,打乱后不小于实际的比例 18.8%
BTC:金叉 8 次,死叉 9 次,每次交叉之后维持的天数 [389, 185, 115, 36, 57, 394, 88, 121, 389, 217, 48, 285, 79, 161, 45, 178, 288]
   50 日在 200 日上方的时间 51.7%,多头排列的时间 20.3%
   50 日在上方减下方,之后 20 天:+1.52%,打乱后 95% 范围 -5.40% ~ +4.59%,打乱后不小于实际的比例 56.9%
   多头排列减其余,之后 20 天:+4.08%,打乱后 95% 范围 -5.14% ~ +4.45%,打乱后不小于实际的比例 8.9%
   乖离率最高 20% 减最低 20%,之后 60 天:+0.37%,打乱后 95% 范围 -23.41% ~ +17.42%,打乱后不小于实际的比例 96.4%
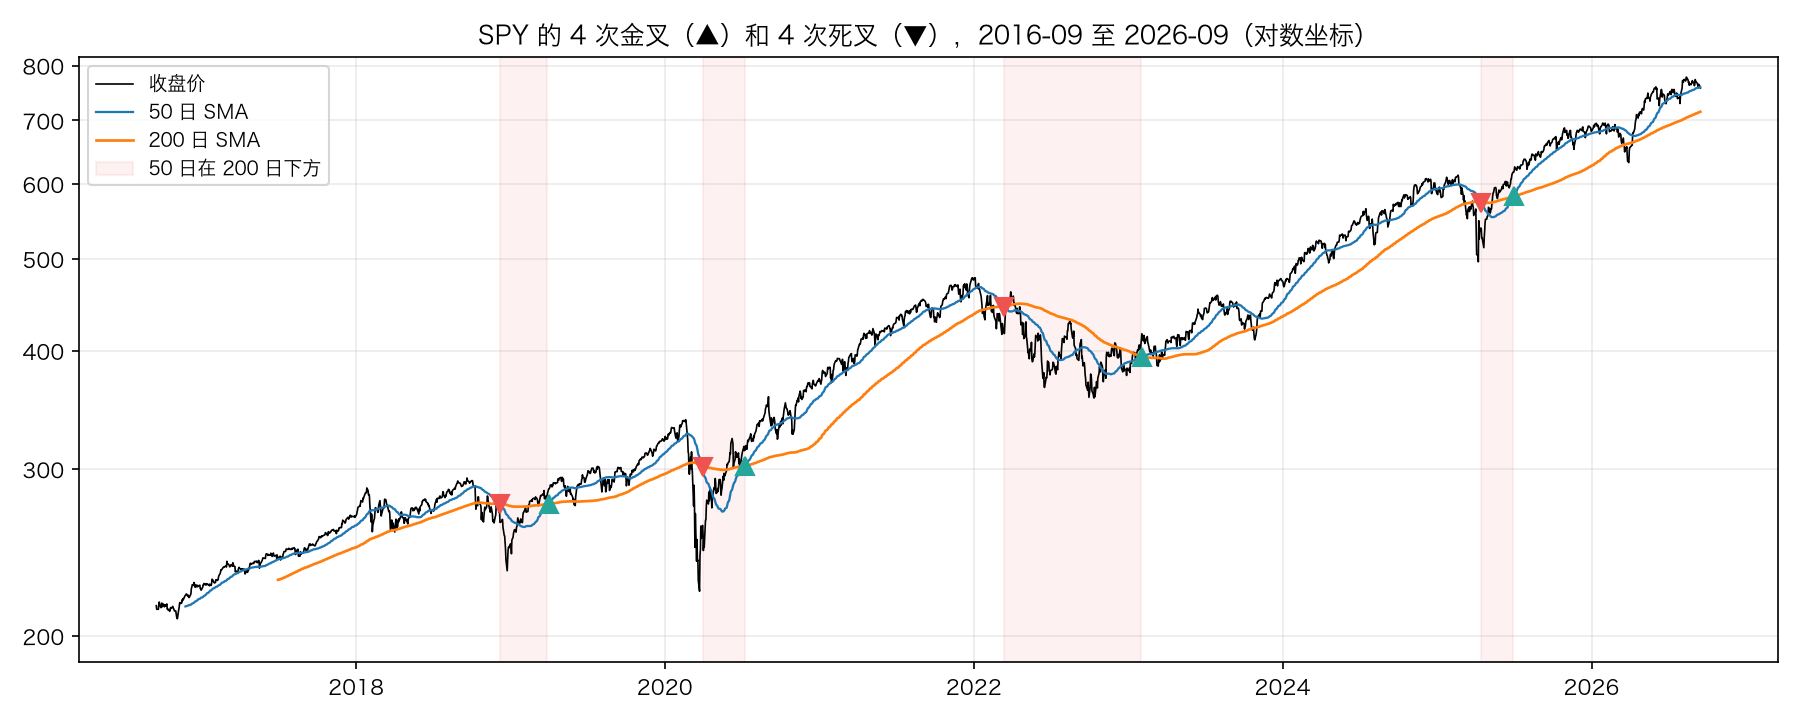
10 年里,SPY 只有 4 次金叉、4 次死叉,AAPL 各 5 次,BTC 8 次金叉、9 次死叉。 要评价一个 10 年只出现 4 次的信号,样本少到几乎做不了任何统计。
所以换一个角度:不看交叉的那一天,而是看状态。每一天都处在「50 日在 200 日上方」或者「下方」之中,比较两种状态之后 20 天的平均收益,差距和打乱顺序的随机价格相比如何(和第 8 篇的检验方法一样)。
读这个结果
三种说法,在三个标的上都和随机价格没有区别。
- 金叉状态:SPY 和 AAPL 在金叉状态下,之后 20 天的收益反而低于死叉状态(-0.79% 和 -2.17%),但都在打乱后的范围之内。原因不难理解:死叉通常出现在大跌之后(2020 年 3 月 30 日、2025 年 4 月 14 日),而大跌之后往往有强反弹。BTC 是 +1.52%,同样在范围之内。
- 多头排列:BTC 的差距最大(+4.08%),打乱后不小于它的比例是 8.9%,还够不上显著。SPY 和 AAPL 都是负数。
- 乖离率:乖离率最高的 20% 日子减最低的 20%,之后 60 天的收益,三个标的都落在打乱后的范围里。决策点那天 SPY 相对 200 日均线的乖离率是 +6.1%,在 SPY 全部历史里排在 48% 的位置,一点也不极端。
还要注意 50 日在 200 日上方的时间:SPY 81.7%、AAPL 80.3%。十年里有八成时间是「金叉状态」,这个状态本身就是「长期在涨的市场,大部分时间都在涨」的另一种说法。BTC 只有 51.7%。
回到体重秤:30 天平均低于 90 天平均,确实说明这一个月瘦了,这是对过去的准确描述。但它不能告诉你下个月会不会继续瘦。
✋ 小检查 2
连续 4 天的 50 日均线是 99、100、101、100.5,200 日均线是 100、100、100.2、100.6。
(a) 用 cross_above 和 cross_below 的定义,哪一天是金叉、哪一天是死叉?
(b) 按主线策略 v0(第九节)的规则,什么时候买入、什么时候卖出?
(c) 第 2 到第 4 天(从 0 开始数)的开盘价是 104、102、101,收盘价是 104、103、100。v0 这笔交易的收益是多少?如果写成「当天的信号吃当天的收益」(用收盘价计算),收益又是多少?前一天(第 1 天)收盘价是 100。
答案在文末。
八、常用参数的由来
50 和 200
- 200 日均线的流行可以追溯到 1968 年 William Gordon 的书《The Stock Market Indicators》。他用道琼斯工业指数检验了「指数在 200 日均线上方买入、下方卖出」这类规则。
- 美股一年大约 252 个交易日,200 日差不多是 40 周,也就是周线图上的 40 周均线;50 日约等于 10 周。这两个数字在日线和周线之间很好换算。
- 更短的参数也有来历。20 世纪 50 年代,Richard Donchian 讨论过用 5 日和 20 日均线的交叉交易商品期货。20 个交易日大约是一个月。
这些数字的来历是方便和传统,不是某种最优化的结果。它们流行起来的时候,还没有人能在电脑上轻松地检验成百上千组参数。
换一组参数会怎样
把快均线取 5、10、20、50、100,慢均线取 20、50、100、150、200、250,一共 30 组,都用和主线策略相同的规则回测(下一节):
fasts, slows = [5, 10, 20, 50, 100], [20, 50, 100, 150, 200, 250]
for name, df in markets.items():
    start = df.index[250]                                     # 所有组合用同一个起点:最长的 250 日均线算出来之后
    d = df.loc[start:]
    hold = summary(d["close"].pct_change().fillna(0.0), periods_per_year[name])
    grid = pd.DataFrame(index=pd.Index(fasts, name="快"), columns=pd.Index(slows, name="慢"), dtype=float)
    for fast in fasts:
        for slow in slows:
            if fast < slow:
                s = mainline_v0(df, fast, slow).loc[start:]
                grid.loc[fast, slow] = summary(backtest_next_open(d, s), periods_per_year[name])["年化"]
    values = grid.stack()
    print(f"{name}({start.date()} 起):买入持有年化 {hold['年化']:.1%};30 组参数年化收益(%):")
    print((grid * 100).round(1).to_string())
    print(f"   50/200 排第 {int(values.rank(ascending=False)[(50, 200)])} 名;超过买入持有的组合 {int((values > hold['年化']).sum())} 组;"
          f"最好 {int(values.idxmax()[0])}/{int(values.idxmax()[1])} {values.max():.1%},"
          f"最差 {int(values.idxmin()[0])}/{int(values.idxmin()[1])} {values.min():.1%}")
SPY(2017-09-13 起):买入持有年化 13.1%;30 组参数年化收益(%):
慢     20   50   100   150   200  250
快
5    10.7  5.7  7.2  10.3  11.4  9.1
10    5.5  6.4  9.5   7.3  10.4  9.6
20    NaN  7.8  7.5   8.4   9.2  6.9
50    NaN  NaN  4.9   6.5   8.4  9.6
100   NaN  NaN  NaN   8.5   9.3  9.5
   50/200 排第 14 名;超过买入持有的组合 0 组;最好 5/200 11.4%,最差 50/100 4.9%
AAPL(2017-09-13 起):买入持有年化 27.6%;30 组参数年化收益(%):
慢     20    50    100   150   200   250
快
5    21.7  16.3  15.1  14.0  19.7  19.8
10   18.5  16.4  13.5  15.0  21.8  18.6
20    NaN  14.1  14.8  15.7  18.7  18.0
50    NaN   NaN  17.5  14.0  14.6  14.2
100   NaN   NaN   NaN  15.7  15.8  17.8
   50/200 排第 19 名;超过买入持有的组合 0 组;最好 10/200 21.8%,最差 10/100 13.5%
BTC(2018-04-24 起):买入持有年化 28.6%;30 组参数年化收益(%):
慢     20    50    100   150   200   250
快
5    28.7  41.7  51.3  48.9  32.2  32.5
10   26.3  38.2  32.0  31.3  33.8  31.2
20    NaN  31.2  30.5  29.7  26.6  27.1
50    NaN   NaN  25.1  23.6  27.0  22.3
100   NaN   NaN   NaN  28.1  25.5  28.4
   50/200 排第 18 名;超过买入持有的组合 14 组;最好 5/100 51.3%,最差 50/250 22.3%
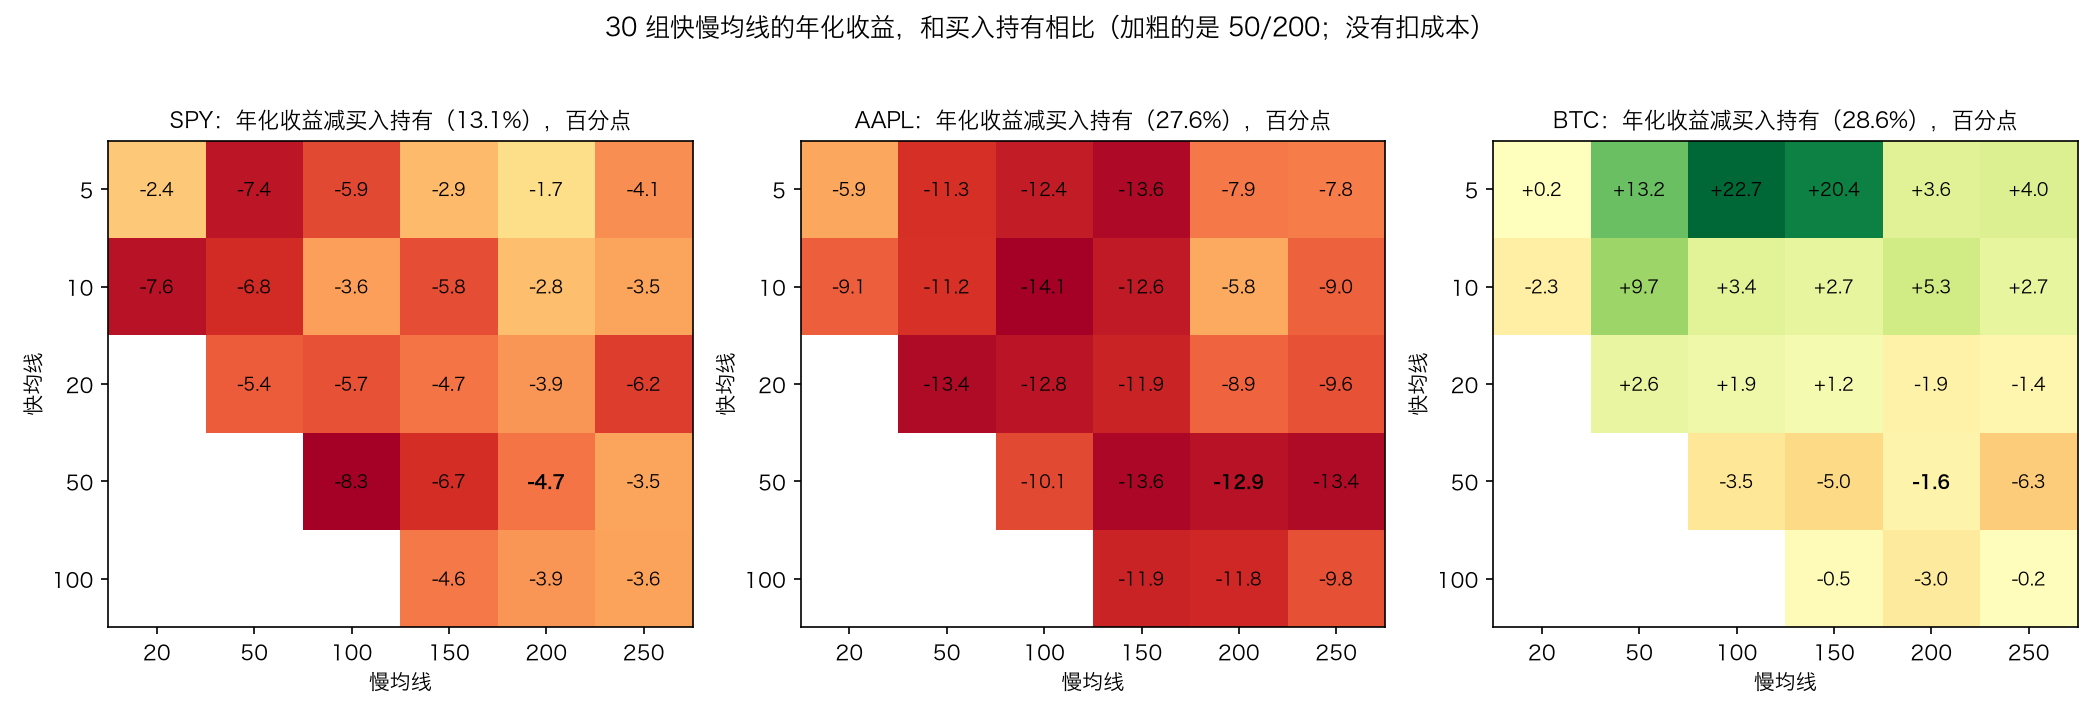
- SPY 和 AAPL 上,30 组参数没有一组超过买入持有。 50/200 分别排第 14 和第 19 名。
- BTC 上有 14 组超过了买入持有,最好的 5/100 年化 51.3%,比买入持有高出 22.7 个百分点。50/200 排第 18 名,比买入持有低 1.6 个百分点。
- 同一个标的,相邻的参数结果可以差很多。BTC 的 5/100 是 51.3%,5/200 只有 32.2%;AAPL 的 10/200 是 21.8%,10/100 是 13.5%。
⚠️ 不要从这张表里挑出最好的一组。 30 组里挑最好的,就像考 30 次试只报最高分。BTC 的 5/100 很可能只是恰好躲过了某几次暴跌。怎么判断一个参数是「平原」还是「尖峰」、怎么用样本外数据检验,是第 30 篇的内容。这里只需要记住:50/200 在三个标的上都排在中间,它没有什么特别之处,也没有什么特别的问题。
九、主线策略诞生
为什么需要一条主线策略
从这一篇开始,课程有一条跟着内容一起长大的策略。它的第一版故意很简单,之后每学一样东西就给它加一样:第 15 篇加 ATR 止损,第 20 篇加时段过滤,第 21 篇补全成完整的交易规则,第 26 篇加仓位管理,第 27 到 30 篇做严格的回测、加成本、做样本外检验。
每一步都能看到:加上的这样东西,到底让结果变好了多少。
v0 的规则
每天收盘时判断:50 日 SMA 在 200 日 SMA 上方,就持有;否则空仓。
信号在收盘后才知道,所以在下一根 K 线的开盘价成交。
没有止损,没有仓位管理(持有时就是全仓),也没有扣任何成本。
def mainline_v0(df, fast=50, slow=200):
    """主线策略 v0:快均线在慢均线上方就持有,否则空仓。收盘时判断,下一根开盘成交。没有止损、没有仓位管理、没有成本。"""
    close = df["close"]
    signal = (I.sma(close, fast) > I.sma(close, slow)).astype(float)
    return signal.where(I.sma(close, slow).notna())


def summary(r, n, held=None):
    equity = (1 + r).cumprod()
    out = {"总收益": equity.iloc[-1] - 1, "年化": equity.iloc[-1] ** (n / len(r)) - 1,
           "年化波动": r.std() * np.sqrt(n), "最大回撤": (equity / equity.cummax() - 1).min()}
    if held is not None:
        out["在场时间"] = held.mean()
        out["买入次数"] = int((held.diff() == 1).sum() + (held.iloc[0] == 1))
    return out


results = {}
for name, df in markets.items():
    signal = mainline_v0(df)
    start = signal.first_valid_index()
    d, s = df.loc[start:], signal.loc[start:]
    held = s.shift(1).fillna(0.0)
    r = backtest_next_open(d, s)
    results[name] = r
    rows = {"买入持有": summary(d["close"].pct_change().fillna(0.0), periods_per_year[name]),
            "主线 v0": summary(r, periods_per_year[name], held),
            "主线 v0(未来函数:当天信号)": summary((s * d["close"].pct_change()).fillna(0.0), periods_per_year[name], s)}
    print(f"{name}:{start.date()} 至 {d.index[-1].date()}")
    print(pd.DataFrame(rows).T.to_string(float_format=lambda v: f"{v:.3f}"))
    buys, sells = d.index[held.diff() == 1], d.index[held.diff() == -1]
    print("   买入:", [b.date().isoformat() for b in buys], "卖出:", [e.date().isoformat() for e in sells])
成交的细节写在 backtest_next_open 里(第三节):
- 前一根和这一根都持有:收益是收盘到收盘;
- 这一根刚买入:收益从开盘价算到收盘价;
- 这一根刚卖出:收益从前一根收盘价算到开盘价。
成绩单
SPY:2017-06-30 至 2026-09-15
                   总收益    年化  年化波动   最大回撤  在场时间  买入次数
买入持有             2.132 0.132 0.186 -0.341   NaN   NaN
主线 v0            1.122 0.085 0.157 -0.341 0.816 5.000
主线 v0(未来函数:当天信号) 1.119 0.085 0.156 -0.341 0.817 5.000
   买入: ['2017-07-03', '2019-04-02', '2020-07-10', '2023-02-03', '2025-07-02'] 卖出: ['2018-12-10', '2020-03-31', '2022-03-15', '2025-04-15']
AAPL:2017-06-30 至 2026-09-15
                   总收益    年化  年化波动   最大回撤  在场时间  买入次数
买入持有             8.925 0.284 0.300 -0.385   NaN   NaN
主线 v0            2.759 0.155 0.262 -0.459 0.803 6.000
主线 v0(未来函数:当天信号) 3.306 0.172 0.261 -0.443 0.803 6.000
   买入: ['2017-07-03', '2019-05-07', '2022-09-27', '2023-03-23', '2024-06-14', '2025-09-16'] 卖出: ['2018-12-24', '2022-06-06', '2022-10-10', '2024-03-15', '2025-04-08']
BTC:2018-03-04 至 2026-08-31
                   总收益    年化  年化波动   最大回撤  在场时间  买入次数
买入持有             5.824 0.253 0.624 -0.766   NaN   NaN
主线 v0            3.422 0.191 0.476 -0.667 0.517 9.000
主线 v0(未来函数:当天信号) 3.333 0.188 0.476 -0.673 0.517 9.000
   买入: ['2018-03-05', '2019-04-25', '2020-02-19', '2020-05-22', '2021-09-16', '2023-02-08', '2023-10-31', '2024-10-29', '2025-05-23'] 卖出: ['2018-04-01', '2019-10-27', '2020-03-26', '2021-06-20', '2022-01-15', '2023-09-13', '2024-08-11', '2025-04-08', '2025-11-17']
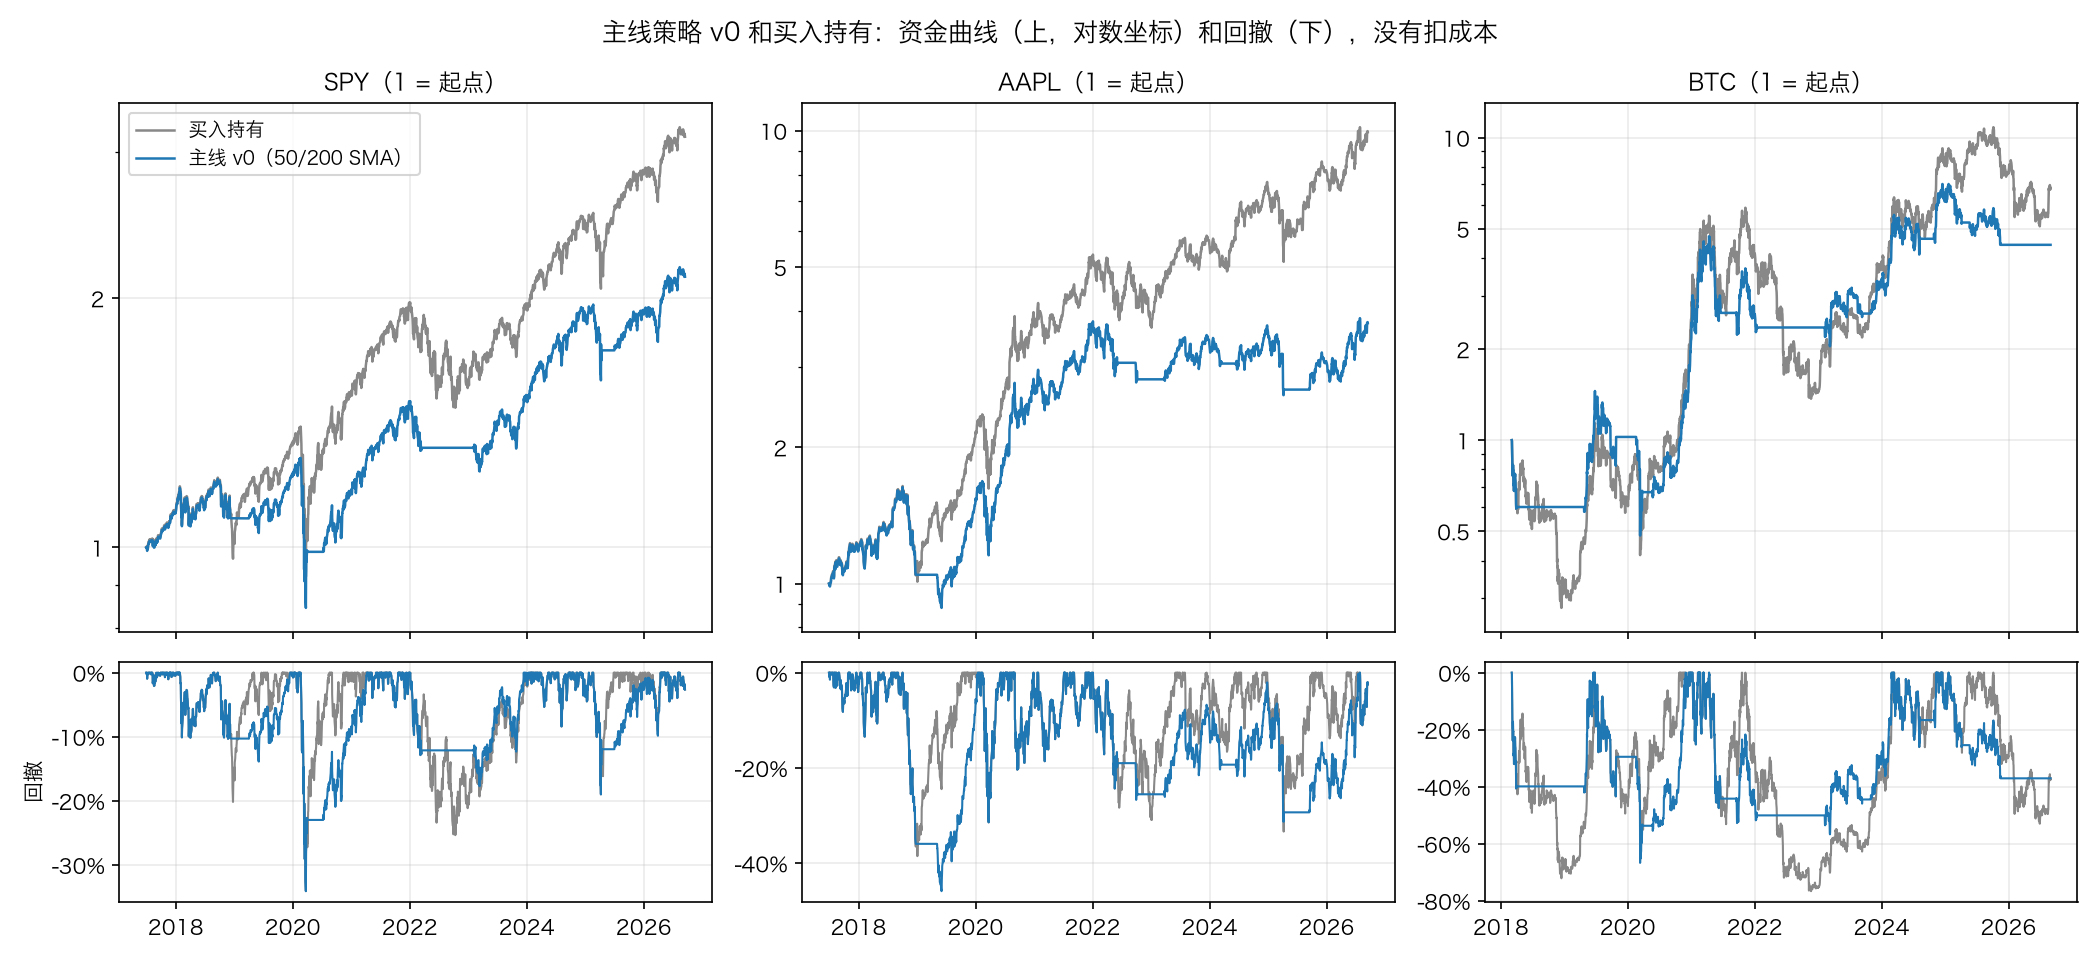
三个标的上,v0 的年化收益都低于买入持有:
| 买入持有 年化 | v0 年化 | 买入持有 最大回撤 | v0 最大回撤 | v0 在场时间 | |
|---|---|---|---|---|---|
| SPY | 13.2% | 8.5% | -34.1% | -34.1% | 81.6% |
| AAPL | 28.4% | 15.5% | -38.5% | -45.9% | 80.3% |
| BTC | 25.3% | 19.1% | -76.6% | -66.7% | 51.7% |
逐个看:
- SPY:收益少了三分之一多,回撤一点没少。 2020 年 3 月,v0 在 3 月 31 日才卖出,暴跌已经跌完了;7 月 10 日才买回来,反弹已经涨了一大段。最大回撤和买入持有完全一样,都是 2020 年那一次。
- AAPL:收益少了一半,回撤反而更大。 回撤 -45.9% 发生在 2019 年,v0 在 2018 年 12 月 24 日底部附近卖出,2019 年 5 月 7 日买回之后又赶上了一次下跌。
- BTC:唯一有一点正面效果的地方。 年化少了 6 个百分点,最大回撤从 -76.6% 降到 -66.7%,波动从 62% 降到 48%。2022 年的熊市里 v0 大部分时间空仓。
关于未来函数: 表里第三行是「当天的信号吃当天的收益」。SPY 和 BTC 上和正确版几乎一样,AAPL 从 15.5% 变成 17.2%。均线交叉 9 年只换手 5 到 9 次,偷看的机会很少,所以虚高得不多,和第三节 5 日均线的 116.6% 形成鲜明对比。换手越少的策略,对未来函数越不敏感;但不敏感不等于没有。
⚠️ 两个没算进去的东西: 一是成本,v0 交易很少,成本影响不大,第 28 篇会加上;二是 SPY 的分红,这份数据的 SPY 价格没有按分红调整(第 3 篇),买入持有每年大约少算 1.2% 到 2% 的股息,v0 空仓的时候也少拿了这部分,两边都被低估了。
v0 就是起点
这个成绩单不好看,这正是一个好的起点。它把问题摆得很清楚:
- 进出场太晚:金叉和死叉的滞后,让 v0 错过了反弹的开头,也躲不开暴跌的主体(第五节算过为什么)。
- 没有止损:跌到死叉之前,什么都不做。
- 全仓进出:只有「100%」和「0」两种状态。
接下来的每一篇,都会针对其中一个问题做一次修改,并且和这一版对比。
十、talab.indicators:第二部分
新增了什么
| 函数 | 作用 |
|---|---|
sma、wma、ema |
三种移动平均,和 TA-Lib 的 SMA、WMA、EMA 一致 |
average_lag |
一组权重的平均滞后 |
cross_above、cross_below |
上穿、下穿 |
bias |
乖离率 |
requirements.txt 加了一行 TA-Lib==0.8.0。TA-Lib 的 Python 包现在自带编译好的 C 库,pip install TA-Lib 就能装上。没装的话,和 TA-Lib 对账的测试会自动跳过,其余测试照常运行。
# 正文里所有代码的实际运行环境(Python 3.14.7)
pandas==3.0.5
numpy==2.5.3
matplotlib==3.11.2
exchange_calendars==4.13.2
pytest==9.1.1
TA-Lib==0.8.0
回测函数 backtest_next_open 和 mainline_v0 不放进模块,只在 docs/trade-analysis/analysis/12_moving_averages.py 里。回测是第 27 到 29 篇的 talab.backtest,那时候会写一个完整的版本。
代码
# ---------------------------------------------------------------------------
# 四、移动平均线(第 12 篇)
# ---------------------------------------------------------------------------
#
# 这一部分起,所有指标函数遵守同一套约定:
# 1. 输入一个 Series(通常是收盘价)和参数,返回一个和输入索引完全相同的 Series
# 2. 数据还不够算出第一个值的位置(预热期)返回 NaN,不补 0、不用更短的窗口凑
# 3. 第 k 个值只用到第 k 个及之前的输入:用前 k 个数据算出的结果,和用全部数据算出的前 k 个完全一样
# 4. 结果和 TA-Lib 的同名函数一致(有差异的地方在文档里写明)

def _check_period(n: int) -> None:
    if not isinstance(n, (int, np.integer)) or n < 1:
        raise ValueError(f"周期 n 必须是正整数,收到的是 {n!r}")


def sma(x: pd.Series, n: int) -> pd.Series:
    """简单移动平均:最近 n 个值的算术平均。前 n - 1 个为 NaN;窗口里有 NaN 时结果也是 NaN。"""
    _check_period(n)
    return x.rolling(n).mean()


def wma(x: pd.Series, n: int) -> pd.Series:
    """加权移动平均:最近一个值的权重是 n,往前依次是 n - 1、…、1,再除以权重之和 n(n + 1) / 2。"""
    _check_period(n)
    weights = np.arange(1, n + 1, dtype=float)
    return x.rolling(n).apply(lambda w: np.dot(w, weights), raw=True) / weights.sum()


def ema(x: pd.Series, n: int, alpha: float | None = None) -> pd.Series:
    """指数移动平均:新值 = 旧值 + alpha × (今天 - 旧值),默认 alpha = 2 / (n + 1)。

    第一个值是前 n 个有效值的简单平均(和 TA-Lib 一样),出现在第 n 个有效值的位置,之前为 NaN。
    开头的 NaN 会被跳过,所以可以直接对另一个指标的结果(开头有预热期)再求 EMA。
    alpha = 1 / n 时就是第 8 篇 structure.wilder_smooth 的 Wilder 平滑。
    ⚠️ pandas 的 x.ewm(span=n, adjust=False).mean() 用第一个值做初始值,前面一段和这里不同。
    """
    _check_period(n)
    a = 2 / (n + 1) if alpha is None else alpha
    v = x.to_numpy(dtype=float)
    out = np.full(len(v), np.nan)
    valid = np.flatnonzero(~np.isnan(v))
    if len(valid) >= n:
        start = valid[0] + n - 1
        out[start] = v[valid[0]:start + 1].mean()
        for i in range(start + 1, len(v)):
            out[i] = out[i - 1] + a * (v[i] - out[i - 1])
    return pd.Series(out, index=x.index)


def average_lag(weights) -> float:
    """一组权重的平均滞后:每个值「过去了几根」按权重加权平均。weights[0] 是最新的一根(滞后 0)。

    SMA 是 (n - 1) / 2;WMA 是 (n - 1) / 3;EMA 是 (1 - alpha) / alpha,alpha = 2 / (n + 1) 时正好也是 (n - 1) / 2。
    """
    w = np.asarray(weights, dtype=float)
    return float(np.dot(np.arange(len(w)), w) / w.sum())


def cross_above(a: pd.Series, b: pd.Series) -> pd.Series:
    """a 从不高于 b 变成高于 b 的那一根为 True(上穿)。前一根或这一根有 NaN 时为 False。"""
    return (a > b) & (a.shift(1) <= b.shift(1))


def cross_below(a: pd.Series, b: pd.Series) -> pd.Series:
    """a 从不低于 b 变成低于 b 的那一根为 True(下穿)。"""
    return (a < b) & (a.shift(1) >= b.shift(1))


def bias(close: pd.Series, ma: pd.Series) -> pd.Series:
    """乖离率:收盘价偏离均线的比例,close / ma - 1。"""
    return close / ma - 1
读一遍代码
_check_period 拒绝 0、负数和小数。周期写错是很常见的笔误,在入口检查,报错信息能直接说清楚是周期不对。
sma 就是 rolling(n).mean()。pandas 的滚动平均内部用累加和累减,长序列上会积累极小的浮点误差(BTC 日线上是 1e-10 量级),这就是为什么和 TA-Lib 对账时要允许一点点误差。
wma 用 rolling(n).apply(np.dot, raw=True) 把每个窗口和权重 1, 2, …, n 做点积。raw=True 让窗口以 numpy 数组传进来,比传 Series 快得多。权重的顺序很重要:窗口里最后一个是最新的价格,所以权重 n 放在最后。
ema 和第 8 篇的 wilder_smooth 结构一样:先找出第一个有效值,用前 n 个有效值的平均作为初始值,然后逐根递推。跳过开头的 NaN,是为了能直接对另一个指标的结果再求 EMA,第 13 篇的 MACD 信号线就是这样算的。
average_lag 就是按定义做加权平均。EMA 的权重没有截止,测试里用 2000 项近似。
cross_above 的条件是「这一根 a > b,而上一根 a ≤ b」。用「≤」而不是「<」,是为了处理两条线恰好相等的那一天:从相等变成高于,也算一次上穿;否则会漏掉。
测试
def test_moving_averages_by_hand():
    x = hourly([2, 4, 6, 8, 4])
    assert I.sma(x, 3).iloc[2:].tolist() == pytest.approx([4, 6, 6])
    # 权重 1、2、3:(2 + 8 + 18) / 6,(4 + 12 + 24) / 6,(6 + 16 + 12) / 6
    assert I.wma(x, 3).iloc[2:].tolist() == pytest.approx([28 / 6, 40 / 6, 34 / 6])
    # alpha = 2 / 4 = 0.5;第一个值是前 3 个的平均 4,然后 4 + 0.5 × (8 - 4) = 6,6 + 0.5 × (4 - 6) = 5
    assert I.ema(x, 3).iloc[2:].tolist() == pytest.approx([4, 6, 5])
    for f in (I.sma, I.wma, I.ema):
        assert f(x, 3).iloc[:2].isna().all()                        # 预热期是 NaN,不是 0


def test_average_lag_formulas():
    n = 20
    assert I.average_lag(np.ones(n)) == pytest.approx((n - 1) / 2)
    assert I.average_lag(np.arange(n, 0, -1)) == pytest.approx((n - 1) / 3)
    alpha = 2 / (n + 1)
    assert I.average_lag((1 - alpha) ** np.arange(2000)) == pytest.approx((n - 1) / 2)


def test_moving_averages_lag_exactly_on_a_ramp():
    ramp = hourly(np.arange(300))
    n = 30
    assert (ramp - I.sma(ramp, n)).dropna().to_numpy() == pytest.approx((n - 1) / 2)
    assert (ramp - I.wma(ramp, n)).dropna().to_numpy() == pytest.approx((n - 1) / 3)
    assert (ramp - I.ema(ramp, n)).dropna().to_numpy() == pytest.approx((n - 1) / 2)


def test_ema_skips_leading_nan_and_matches_wilder_smooth():
    x = hourly([np.nan, np.nan, 1, 2, 3, 4])
    assert I.ema(x, 2).iloc[3:].tolist() == pytest.approx([1.5, 2.5, 3.5])
    rng = np.random.default_rng(12)
    y = hourly(100 + np.cumsum(rng.normal(0, 1, 200)))
    pd.testing.assert_series_equal(I.ema(y, 14, alpha=1 / 14), X.wilder_smooth(y, 14))


def test_cross_and_bias_by_hand():
    a = hourly([1, 2, 3, 2, 2, 1])
    b = hourly([2, 2, 2, 2, 2, 2])
    # 2 → 3 是从「等于」变成「高于」,算上穿;3 → 2 → 1 是从「高于」到「等于」再到「低于」,在最后一根算下穿
    assert I.cross_above(a, b).tolist() == [False, False, True, False, False, False]
    assert I.cross_below(a, b).tolist() == [False, False, False, False, False, True]
    assert I.bias(hourly([110, 90]), hourly([100, 100])).tolist() == pytest.approx([0.10, -0.10])


def test_period_must_be_a_positive_integer():
    for bad in (0, -3, 2.5):
        with pytest.raises(ValueError):
            I.sma(hourly([1, 2, 3]), bad)


@pytest.mark.parametrize("name", ["sma", "ema", "wma"])
def test_moving_averages_never_use_the_future(name):
    rng = np.random.default_rng(3)
    x = hourly(100 * np.exp(np.cumsum(rng.normal(0, 0.02, 400))))
    f = getattr(I, name)
    full = f(x, 50)
    for k in [60, 177, 399]:
        pd.testing.assert_series_equal(f(x.iloc[:k], 50), full.iloc[:k])


@pytest.mark.parametrize("name", ["SMA", "EMA", "WMA"])
@pytest.mark.parametrize("n", [1, 2, 9, 50, 200])
def test_moving_averages_match_talib(name, n):
    talib = pytest.importorskip("talib")
    rng = np.random.default_rng(n)
    x = hourly(50_000 * np.exp(np.cumsum(rng.normal(0, 0.03, 3000))))
    ours = getattr(I, name.lower())(x, n).to_numpy()
    theirs = getattr(talib, name)(x.to_numpy(), timeperiod=n)
    assert (np.isnan(ours) == np.isnan(theirs)).all()                 # 预热期一样长
    np.testing.assert_allclose(ours, theirs, rtol=1e-12, atol=1e-8)
test_moving_averages_by_hand:三种均线各算一遍,并检查预热期是 NaN。test_average_lag_formulas和test_moving_averages_lag_exactly_on_a_ramp:第五节的公式,和斜坡上的实测。test_ema_skips_leading_nan_and_matches_wilder_smooth:开头有 NaN 的输入;以及 α = 1/n 时和第 8 篇的wilder_smooth完全相同。test_cross_and_bias_by_hand:包括两条线恰好相等的情况。test_period_must_be_a_positive_integer:0、负数、小数都要报错。test_moving_averages_never_use_the_future:三种均线各截断 3 次,前 k 个结果必须和全部数据算出的一致。test_moving_averages_match_talib:三种均线 × 5 个周期(1、2、9、50、200),一共 15 个。价格是 5 万左右、每天波动 3% 的随机游走,要求预热期长度相同,数值误差在相对 1e-12、绝对 1e-8 以内。
pip install -r requirements.txt
pytest -q
........................................................................ [ 75%]
........................                                                 [100%]
96 passed in 0.46s
没有装 TA-Lib 时:
..................................sssssssssssssss....................... [ 75%]
........................                                                 [100%]
81 passed, 15 skipped in 0.53s
十一、常见误用
1. 回测里用当天收盘才知道的信号,吃当天的收益。 SPY「收盘价在 5 日均线上方就持有」,正确回测年化 4.4%,这样写变成 116.6%。
2. 用居中的均线(center=True)做信号,或者用它画出来的图判断拐点。
居中的均线最贴合价格,因为它用到了未来。同一条规则,SPY 上变成年化 66.4%。
3. 用 pandas 的 ewm 算 EMA,拿开头那一段去和别的软件对账,或者直接用进回测。
50 日 EMA 的两种初始化,在 SPY 上要到第 151 根才相差小于 0.01。
4. 预热期补 0 或者用不满 n 天的数据凑平均。 预热期应该是 NaN。
5. 认为 n 日 EMA 和 n 日 SMA 在实际价格上滞后一样。 平均滞后一样,但 EMA 实际上跟得更紧;200 日 EMA 实测只落后 72 到 79 根,SMA 是 99 根。
6. 把金叉当作一个经过验证的买入信号。 SPY 十年只有 4 次金叉;看状态,金叉状态之后的收益和随机价格没有区别,SPY 和 AAPL 上甚至低于死叉状态。
7. 从参数网格里挑出最好的一组。 BTC 上 5/100 年化 51.3%,5/200 只有 32.2%。挑最好的那一组,挑出来的主要是运气。
8. 拿「这一次金叉之后涨了」来证明金叉有效。 决策点那次金叉之后一年涨了 20.7%,但金叉之前 57 天已经涨了 24.4%。
十二、这一篇能回答什么,不能回答什么
| 这一篇能帮你回答 | 这一篇不能回答 |
|---|---|
| 一条均线的值是怎么算出来的,和 TA-Lib 是否一致 | 哪种均线、哪个参数「最好」(没有唯一答案,第 30 篇讲怎么检验) |
| 一条均线大约落后价格多少根 | 价格接下来会不会拐头 |
| 一个回测里有没有未来函数 | 一个没有未来函数的策略能不能赚钱(还要加成本、做样本外检验) |
| 金叉、多头排列、乖离率在这三个标的上和随机价格有没有区别 | 在别的标的、别的周期上是不是一样(需要自己检验) |
| 主线策略 v0 在历史上的表现 | 加上止损、仓位、过滤之后会怎样(后面各篇) |
十三、小结
-
指标是对 OHLCV 的变换。 理解一个指标要问四件事:用了什么数据、平滑了什么、预热期多长、有没有用到未来。
-
未来函数能制造惊人的假收益。 「收盘价在 5 日均线上方就持有」,SPY 上正确年化 4.4%;当天信号吃当天收益变成 116.6%,BTC 变成 2042.7%。换手越频繁,虚高越多。
-
talab.indicators的统一约定: 输出和输入索引相同、预热期是 NaN、前 k 个结果不受后面数据影响、和 TA-Lib 一致。每一条都有测试。 -
SMA、WMA、EMA 的平均滞后分别是 (n - 1)/2、(n - 1)/3、(n - 1)/2。 α = 2/(n + 1) 就是为了让 EMA 和 SMA 的平均滞后相同。在直线上滞后正好等于公式;在真实价格上,SMA 仍然吻合,EMA 和 WMA 实测更短,接近权重中位数。
-
同样的平均滞后,WMA 最平滑,EMA 拐头最频繁。 SMA 和 EMA 的粗糙度相同,都是 1/√n。
-
EMA 的初始值有两种写法。 TA-Lib 用前 n 个的平均,pandas 用第一个值;SPY 的 50 日 EMA 要 151 根才对上。
-
金叉、多头排列、乖离率,在 SPY、AAPL、BTC 上都和随机价格没有区别。 SPY 十年只有 4 次金叉;金叉状态之后 20 天的收益,SPY 和 AAPL 上还低于死叉状态。
-
50 和 200 是传统,不是最优。 30 组参数里,50/200 在三个标的上都排在中间;SPY 和 AAPL 没有一组超过买入持有。
-
主线策略 v0 诞生了:50 日 SMA 在 200 日 SMA 上方就持有,下一根开盘成交。 三个标的上年化收益都低于买入持有;只有 BTC 的回撤和波动明显降低。它的问题(进出太晚、没有止损、全仓进出)就是后面各篇要解决的。
最后回到体重秤。7 天平均比每天的读数可信,这是平滑的好处;可它总是晚几天才告诉你变化,这是滞后的代价(第五节)。事后画的那条居中的曲线最好看,但只能用来回顾,不能用来决定今天吃什么(第三节)。30 天平均跌破 90 天平均,准确地告诉你过去一个月瘦了,却不能告诉你下个月会怎样(第七节)。而「30 天和 90 天」这两个数字,只是大家习惯这么用(第八节)。
下一篇是第 13 篇:MACD。它是两条 EMA 之差,本质上是一个带通滤波器。BTC 创了新高,MACD 柱却没有,所有人都在说「顶背离」:这一次,我们把背离写成算法。
练习
练习 1(手算) 价格依次是 50、52、51、55、53、58、60,n = 5。
- (a) 算出最后两天的 SMA5、WMA5、EMA5。
- (b) 如果价格从第 3 天起每天涨 2(直线),第 20 天时三条均线分别比价格低多少?
练习 2(证明) 第五节说,EMA 的平均滞后是 (1 - α) ÷ α。
- (a) 用等比级数求和 Σ k α(1 - α)ᵏ,推出这个结果。
- (b) 算出 EMA 的权重中位数(累加权重第一次达到一半的位置)的公式。n = 200 时是多少?和第五节的实测比较。
练习 3(编程)
给 talab.indicators 加一个 hma(Hull 移动平均):HMA(n) = WMA(2 × WMA(n/2) - WMA(n), √n),其中 n/2 和 √n 取整。
- (a) 写出实现,补一个手算测试和一个「不用未来数据」的测试。
- (b) 用第五节的方法,在 SPY 上实测 HMA20 的滞后和粗糙度,和 SMA20 比较。
- (c) TA-Lib 0.8.0 有
HMA函数。把你的实现和它对账:预热期一样长吗?数值一致吗?如果不一致,差别来自哪里?
练习 4(数据) 第七节只检验了 50/200。
- (a) 对 20/50 和 10/30 重复金叉状态的打乱检验。
- (b) 把「之后 20 天」换成「之后 60 天」和「之后 120 天」,结论变不变?
练习 5(编程) 第九节的主线策略用 SMA。
- (a) 把两条均线换成 EMA(50 和 200),在三个标的上重新回测,列出和 v0 相同的指标。
- (b) 换成 EMA 之后,买入次数变多还是变少?结合第五节「EMA 拐头更频繁」解释。
练习 6(思考) 第八节的参数网格里,BTC 的 5/100 年化 51.3%。
- (a) 把数据分成 2018–2021 和 2022–2026 两段,分别在两段上跑网格。第一段里最好的参数,在第二段里排第几?
- (b) 结合 (a) 的结果,谈谈「从历史数据里选出最好的参数」有什么问题。
小检查答案
小检查 1
(a) SMA4 = (21 + 23 + 24 + 30) ÷ 4 = 98 ÷ 4 = 24.5。WMA4 = (1 × 21 + 2 × 23 + 3 × 24 + 4 × 30) ÷ 10 = (21 + 46 + 72 + 120) ÷ 10 = 25.9。
(b) α = 2 ÷ (4 + 1) = 0.4。第一个值出现在第 4 个价格(23)那一天,是前 4 个价格的平均 (20 + 22 + 21 + 23) ÷ 4 = 21.5。之后:21.5 + 0.4 × (24 - 21.5) = 22.5;22.5 + 0.4 × (30 - 22.5) = 25.5。
(c) SMA4:(4 - 1) ÷ 2 = 1.5 根;WMA4:(4 - 1) ÷ 3 = 1 根;EMA4:(1 - 0.4) ÷ 0.4 = 1.5 根。
小检查 2
(a) 第 1 天 50 日均线等于 200 日均线(100 = 100),不算在上方。第 2 天 101 > 100.2,前一天 100 ≤ 100:第 2 天金叉。第 3 天 100.5 < 100.6,前一天 101 ≥ 100.2:第 3 天死叉。
(b) 第 2 天收盘出现持有信号,第 3 天开盘买入;第 3 天收盘变成空仓信号,第 4 天开盘卖出。
(c) v0:第 3 天开盘 102 买入,第 4 天开盘 101 卖出,收益 101 ÷ 102 - 1 = -0.98%。
「当天的信号吃当天的收益」:第 2 天信号是持有,就把第 2 天的涨幅算进来,104 ÷ 100 - 1 = +4.00%;第 3 天信号是空仓,不算第 3 天。收益是 +4.00%。
同一个金叉,正确的写法亏了 0.98%,偷看的写法赚了 4%:第 2 天那 4% 的涨幅,正是让 50 日均线穿过 200 日均线的原因,可你要等收盘才知道它发生了。