| 本篇位置 | 第五部分「从信号到交易」第五篇。第 21 篇把规则的六个要素填满,第 22 篇看止损单在交易所里怎么执行,这一篇回到规则本身:出场那两格该怎么填 |
| 用到的数据 | SPY、AAPL 日线(十年),BTCUSDT 现货日线、4 小时线、1 小时线(九年),合计 3,426 笔交易 |
| 动手 | 新模块 talab.risk:r_multiple、Exit、initial_stop、run、expectancy,附 16 个测试 |
| 读完你能 | 把任何一笔交易的成绩换算成 R;说清一套出场方案的四个答案;判断一个止盈目标改变的是期望值还是只是分布的形状 |
一、先做一个决定
2020 年 10 月 10 日,你按第 21 篇那条主线规则买入了 BTC:金叉状态、收盘创 20 日新高,第二天开盘市价成交。
买入日 2020-10-10,开盘价买入 11050.64
初始止损 10126.43,一个 R = 924.21(占进场价 8.36%)
  +1R = 11974.85
  +2R = 12899.06
  +3R = 13823.26
止损是 3 倍 ATR 的吊灯止损,挂在 10,126.43。进场价和止损价之间差 924.21 美元——这笔交易你打算最多亏这么多,占进场价的 8.36%。
接下来十二天,价格慢慢往上走,然后 10 月 21 日跳了一大步:
                               open      high       low     close  浮盈 R
time
2020-10-10 00:00:00+00:00  11050.64  11491.00  11050.51  11293.22  0.26
2020-10-11 00:00:00+00:00  11293.22  11445.00  11221.00  11369.02  0.34
2020-10-12 00:00:00+00:00  11369.02  11720.01  11172.00  11528.25  0.52
2020-10-13 00:00:00+00:00  11528.24  11557.00  11300.00  11420.56  0.40
2020-10-14 00:00:00+00:00  11420.57  11547.98  11280.00  11417.89  0.40
2020-10-15 00:00:00+00:00  11417.89  11617.34  11250.83  11505.12  0.49
2020-10-16 00:00:00+00:00  11505.13  11541.15  11200.00  11319.32  0.29
2020-10-17 00:00:00+00:00  11319.24  11402.42  11255.00  11360.20  0.33
2020-10-18 00:00:00+00:00  11360.31  11505.00  11346.22  11503.14  0.49
2020-10-19 00:00:00+00:00  11503.14  11823.99  11407.96  11751.47  0.76
2020-10-20 00:00:00+00:00  11751.46  12038.38  11677.59  11909.99  0.93
2020-10-21 00:00:00+00:00  11910.00  13217.68  11886.95  12780.96  1.87
2020-10-22 00:00:00+00:00  12780.75  13185.00  12678.08  12968.52  2.08
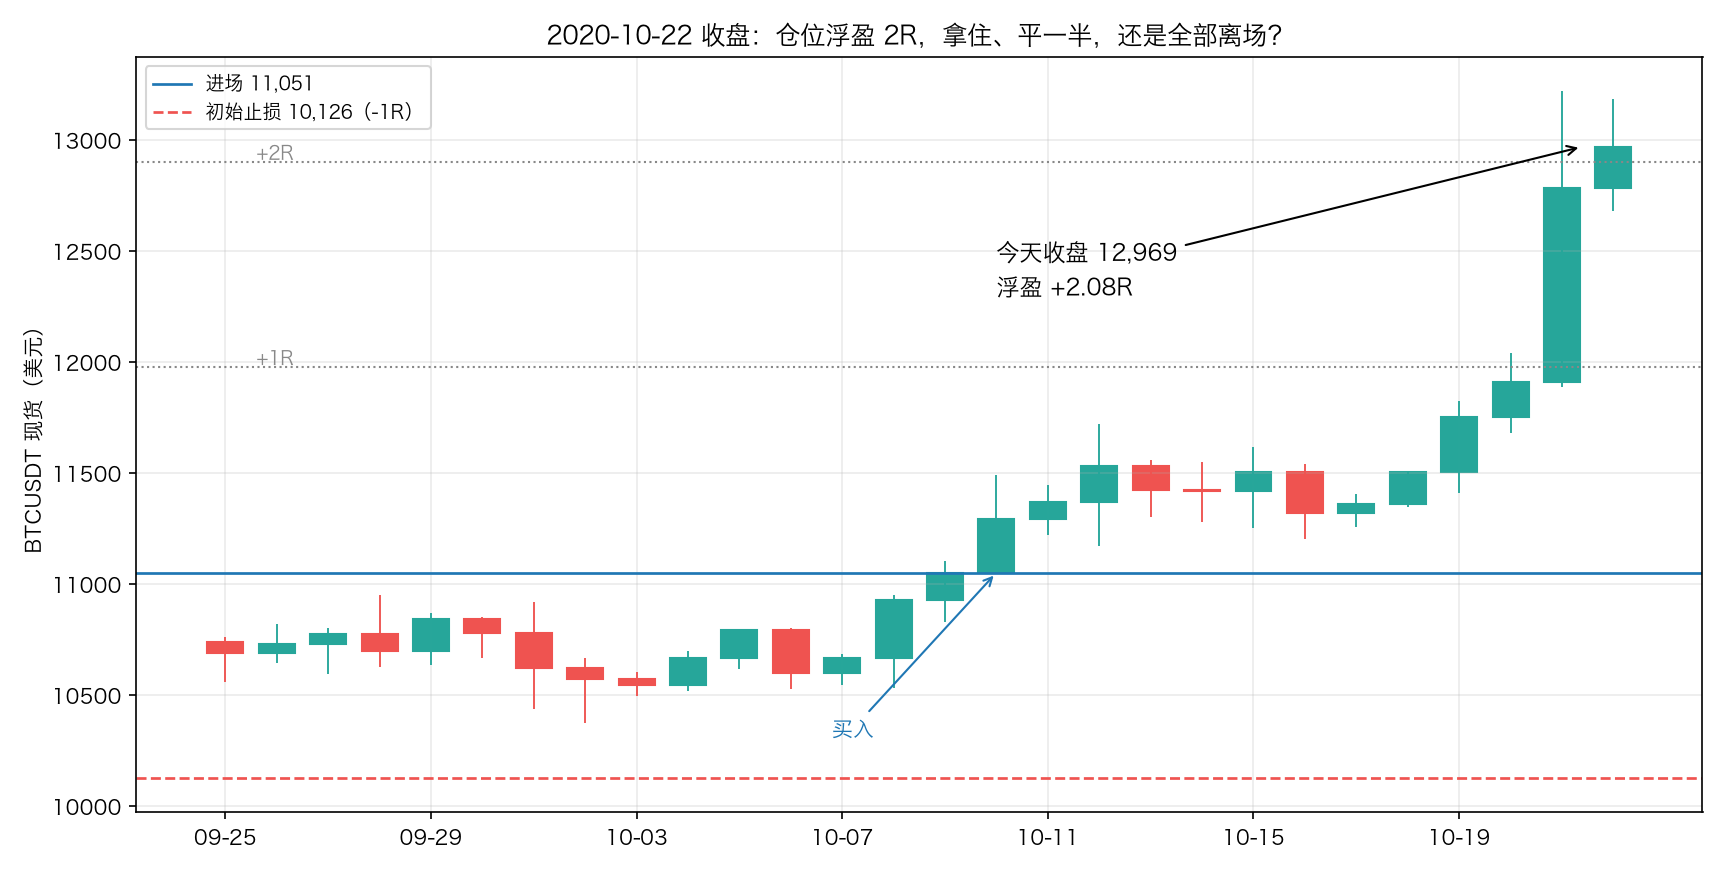
今天收盘 12,968.52。浮盈 1,917.88 美元,正好是你当初那个止损距离的 2.08 倍。
现在怎么办?
- A. 拿住。趋势还在,止损线已经跟着抬上来了,让它自己走完
- B. 平一半。锁住一半利润,剩下一半接着跑
- C. 全部离场。两倍于风险的利润,见好就收
先写下你的选择。 第十节揭晓这一笔后来怎么样了——但更重要的是第十一节:同样的决定,在五个序列上一共出现过 205 次。
二、先换一把尺子:一个 R
上面那段话里有个东西一直在出现:「当初那个止损距离的 2.08 倍」。
这不是巧合,是这一篇的记分方式。
一个 R = 进场价 − 初始止损价
R 是 risk 的 R。它是你在开仓那一刻就已经决定好、并且写在订单里的数字:如果我看错了,我认输的距离有多远。
之后这笔交易的一切都按这把尺子量:
一个 R = 进场价 − 初始止损价 = 11050.64 − 10126.43 = 924.21
  决策点收盘   12968.52 → +2.08 R
  最后出场    34051.24 → +24.89 R
  刚好打到止损  10126.43 → -1.00 R

换成别的标的也一样:SPY 2023-11-08 那一笔
  进场 437.55,止损 421.57,一个 R = 15.98 美元(3.65%);出场 510.85 → +4.59 R
  两笔交易的止损距离差 58 倍,换成 R 之后才能放在一起比:BTC 那笔 24.9 R,SPY 这笔 4.6 R
为什么非要换算?因为不换算就没法比较。BTC 那笔的止损距离是 924 美元,SPY 那笔是 15.98 美元,差 58 倍;而且 BTC 这九年从三千多美元走到十二万美元,同一个「3 ATR」的绝对值本身就在变。换成 R 之后,所有交易都站在同一条起跑线上:每一笔都是「拿 1 个单位的风险,去博几个单位的回报」。
有三件事要说清楚:
- R 只按初始止损算。 止损后来抬到哪里都不改 R——它衡量的是你当初冒的风险,不是你后来冒的风险。
- 亏一笔不一定正好是 −1R。 第 20 篇给主线选的是收盘价触发:等收盘确认,价格往往已经穿到止损下方去了。这一篇后面会量到,真实的平均亏损是 1.1 到 1.3 个 R,不是 1.0。
- R 不是钱。 「这笔赚了 3R」要变成「这笔赚了多少钱」,还差一步:一个 R 到底是账户的百分之几。那是第 26 篇的事。这一篇先只管形状。
三、打个比方:放风筝
入场只有一个决定:买不买。出场看起来也只有一个决定:卖不卖。但只要你真去写代码,就会发现它是四个互相独立的决定。
想象你在公园放风筝。
风筝飞起来之后,你手里有一卷线。你要决定留多长的线——线放得短,风筝一沉就得往回收;线放得长,风筝能飞得更高,但一阵乱风也可能把它带到你看不见的地方。这卷线就是你的止损距离。
风筝越飞越高,你要决定线要不要跟着往外放,以及往回收多少。老手的做法是:只随着风筝升高往外放,绝不在风筝往下掉的时候把线又缩回去——那样只会让它掉得更快。这就是跟踪止损,而且是「只上移、不下移」的那种。
再往上,你要决定收不收线。飞到楼顶那么高就够了吗,还是一直放到线轴见底?收得早,每次都能把风筝完好地收回来,但它从来没飞高过;放到底,多数时候风一停就栽下来,偶尔一只能飞得比楼还高。这就是止盈目标,以及后面要证明的那件事:收得早胜率高、收得晚盈亏比高,这两头必然此消彼长。
最后,天要黑了。风筝既没飞高也没掉下来,就那么在半空中飘着——你总得回家。这就是时间止损。
四句话,四个问题:
| 问题 | 它管的是 | 参数 |
|---|---|---|
| 一、初始止损放在哪 | 这笔交易最多亏多少(一个 R 有多大) | stop |
| 二、止损要不要跟着走 | 赚了之后能不能变成不亏 | trail |
| 三、有没有目标价 | 赚到多少就收 | target_r |
| 四、最多拿多久 | 不涨不跌的仓位什么时候放弃 | max_bars |
这四个问题互相独立:你可以选「结构止损 + 不跟踪 + 2R 目标 + 40 根封顶」,也可以选「ATR 止损 + 吊灯跟踪 + 不设目标 + 不限时间」。第 21 篇的主线规则填的是后者。
下面四节一个一个来。
四、第一个问题:初始止损放在哪
止损价要回答的问题是:跌到哪里,我就承认这笔交易的理由已经不成立了。
注意它不是「跌到哪里我受不了了」。止损价是价格图上的一个位置,不是你心跳的一个读数。常见的定法有三种。
结构止损:贴着图上的位置放
第 9 篇讲过支撑位是怎么来的:前低、整数关口、成交密集区。结构止损把止损放在最近一个结构位的下方——比如「前 20 根 K 线的最低点,再往下 0.5 个 ATR」。
它的逻辑很直白:如果你买入的理由是「上升趋势里的回调结束了」,那么价格跌破前一个低点,这个理由就不成立了(第 8 篇的趋势定义)。多留 0.5 个 ATR 是因为前低那个位置本来就堆着别人的止损单(第 2 篇的被迫交易者),差一点点被扫到不值得。
优点:止损价有含义,它对应着一个具体的「我看错了」。 缺点:距离完全由行情决定。刚从一个大箱体突破出来的时候,最近的结构位可能远在 20% 之外。
波动率止损:按这几天的风力放线
第 15 篇的做法:止损 = 进场价 − k × ATR。ATR 是最近 14 根 K 线的平均真实波幅,它直接回答「这个标的现在每天晃多大」。
波动大的时候止损自动放远,波动小的时候自动收近——回到风筝的比方,这是按今天的风力决定留多长的线。k 一般取 2 到 4;主线策略用的是 3。
优点:距离随波动率自动伸缩,不同标的、不同时期能用同一个参数。 缺点:止损价在图上不对应任何东西。它是一条算出来的线,不是一个位置。
固定比例止损:一刀切
止损 = 进场价 × (1 − 10%)。简单,但它假设所有标的、所有时期的波动率都一样。
三种放在一起量一量。对每个入场信号,分别算出三种止损离进场价有多远:
METHODS = {"结构:前 20 根低点再往下 0.5 ATR": K.Exit(stop="structure", lookback=20, buffer=0.5),
           "波动率:进场价往下 3 ATR": K.Exit(stop="atr", k=3.0),
           "固定比例:进场价往下 10%": K.Exit(stop="percent", percent=0.10)}
rows = []
for name, (df, _) in MARKETS.items():
    signal = entries(df).to_numpy()
    where = np.flatnonzero(signal[:-1]) + 1                     # 信号的下一根,就是进场的那一根
    where = where[where > 200]
    opens = df["open"].to_numpy()[where]
    atr = I.atr(df["high"], df["low"], df["close"]).to_numpy()   # 算一次,别在循环里反复算
    distances = {label: 1 - np.array([K.initial_stop(df, i, price, plan, atr)
                                      for i, price in zip(where, opens)]) / opens
                 for label, plan in METHODS.items()}
    for label, distance in distances.items():
        rows.append({"标的": name, "初始止损": label, "进场点": len(where), "距离中位数": np.median(distance),
                     "最近": distance.min(), "最远": distance.max(),
                     "比 3 ATR 远的比例": np.mean(distance > distances["波动率:进场价往下 3 ATR"])})
print(pd.DataFrame(rows).round(3).to_string(index=False))
      标的                   初始止损  进场点  距离中位数    最近    最远  比 3 ATR 远的比例
  SPY 日线 结构:前 20 根低点再往下 0.5 ATR  458  0.053 0.013 0.124         0.996
  SPY 日线        波动率:进场价往下 3 ATR  458  0.027 0.011 0.061         0.000
  SPY 日线         固定比例:进场价往下 10%  458  0.100 0.100 0.100         1.000
 AAPL 日线 结构:前 20 根低点再往下 0.5 ATR  385  0.110 0.047 0.289         0.982
 AAPL 日线        波动率:进场价往下 3 ATR  385  0.056 0.036 0.143         0.000
 AAPL 日线         固定比例:进场价往下 10%  385  0.100 0.100 0.100         0.984
  BTC 日线 结构:前 20 根低点再往下 0.5 ATR  225  0.216 0.076 0.495         0.987
  BTC 日线        波动率:进场价往下 3 ATR  225  0.113 0.061 0.262         0.000
  BTC 日线         固定比例:进场价往下 10%  225  0.100 0.100 0.100         0.356
BTC 4 小时 结构:前 20 根低点再往下 0.5 ATR 1360  0.081 0.018 0.359         0.968
BTC 4 小时        波动率:进场价往下 3 ATR 1360  0.048 0.018 0.228         0.000
BTC 4 小时         固定比例:进场价往下 10% 1360  0.100 0.100 0.100         0.949
BTC 1 小时 结构:前 20 根低点再往下 0.5 ATR 4735  0.039 0.003 0.224         0.942
BTC 1 小时        波动率:进场价往下 3 ATR 4735  0.024 0.004 0.135         0.000
BTC 1 小时         固定比例:进场价往下 10% 4735  0.100 0.100 0.100         0.996
三件事:
- 结构止损比 3 ATR 远得多,而且是压倒性的:五个序列里 94% 到 99.6% 的进场点上,结构止损的距离都更远(SPY 日线 5.3% 对 2.7%,BTC 日线 21.6% 对 11.3%)。原因在入场条件里——主线策略要求「收盘创 20 日新高」,创新高那一刻,前 20 根的最低点必然在下面很远的地方。入场条件会决定止损距离,这两格不是独立的。
- 结构止损的距离散得吓人:BTC 1 小时线上最近的只有 0.3%,最远的 22.4%,两头差了几十倍。同一条规则,有的交易冒的风险比另一笔大几十倍——如果你按固定金额下单,那就等于随机决定每笔押多少。
- 固定 10% 完全跟时间尺度脱节:在 BTC 日线上它比 3 ATR 近(10% 对 11.3%),在 1 小时线上它远得离谱(10% 对 2.4%),结果是 1 小时线上只有 4.4% 的交易被止损打掉——那不叫止损,那叫没有止损。
同一套入场信号,只换初始止损(跟踪、目标、时间都不设,出场信号仍是死叉):
      标的                   初始止损  交易数  被止损出场  每笔期望 R    合计 R
  SPY 日线 结构:前 20 根低点再往下 0.5 ATR    5  0.200   2.312  11.560
  SPY 日线        波动率:进场价往下 3 ATR    7  0.429   2.831  19.817
  SPY 日线         固定比例:进场价往下 10%    5  0.200   1.559   7.796
 AAPL 日线 结构:前 20 根低点再往下 0.5 ATR    5  0.200   3.681  18.406
 AAPL 日线        波动率:进场价往下 3 ATR    5  0.200   6.579  32.893
 AAPL 日线         固定比例:进场价往下 10%    5  0.200   4.831  24.154
  BTC 日线 结构:前 20 根低点再往下 0.5 ATR    9  0.222   2.014  18.123
  BTC 日线        波动率:进场价往下 3 ATR   10  0.400   2.782  27.825
  BTC 日线         固定比例:进场价往下 10%   10  0.500   3.691  36.914
BTC 4 小时 结构:前 20 根低点再往下 0.5 ATR   57  0.351   3.315 188.951
BTC 4 小时        波动率:进场价往下 3 ATR   62  0.468   3.704 229.646
BTC 4 小时         固定比例:进场价往下 10%   53  0.226   1.315  69.685
BTC 1 小时 结构:前 20 根低点再往下 0.5 ATR  263  0.433   0.778 204.510
BTC 1 小时        波动率:进场价往下 3 ATR  301  0.555   0.887 266.942
BTC 1 小时         固定比例:进场价往下 10%  225  0.044   0.182  40.953
⚠️ 止损距离必须和时间尺度匹配。 同一个百分比,在日线上是「正常回调」,在 1 小时线上是「这辈子都碰不到」。按 ATR 定的止损自动做到了这件事,按结构定的止损也做到了(结构本身随尺度缩放),只有固定比例做不到。
五、第二个问题:止损跟不跟着走
初始止损只解决了「最坏情况」。它没解决第二个问题:赚了之后怎么办。
这就是放线的那只手。三种常见做法:
- 吊灯止损(chandelier):止损 = 买入以来的最高价 − k × ATR,只上移不下移。第 15 篇建的,主线策略一直在用。名字来自「从天花板上吊下来」——它挂在最高点下方,最高点越高,它跟着越高。
- 跟前 N 根的最低点:止损 = 前 20 根 K 线的最低价,同样只上移。这是结构止损的跟踪版。
- 保本止损(breakeven):浮盈到 1 个 R 就把止损提到成本价,之后不动。听起来很美:这笔交易从此不可能亏钱了。
「只上移」这三个字是机制,不是风格。 允许下移的止损不是止损:价格往下走,你把线往下放,那条线就永远不会被碰到。
吊灯止损有一个必须先讲清楚的性质:它一定要还回去一部分利润。 它是跟着最高价走的,所以出场时必然低于最高价至少 k 个 ATR。还回去多少?把五个序列上主线策略的 1,119 笔交易按「最大浮盈」分组,看看最后留住了几成:
跟踪止损注定要还回去一部分:按最大浮盈分组,最后留住了多少
  最大浮盈 [0, 1) R: 676 笔,最终 R 中位数  -0.59,(浮盈没到 1R,谈不上留住多少)
  最大浮盈 [1, 2) R: 212 笔,最终 R 中位数   0.21,留住比例中位数 0.17
  最大浮盈 [2, 3) R:  87 笔,最终 R 中位数   1.16,留住比例中位数 0.47
  最大浮盈 [3, 5) R:  81 笔,最终 R 中位数   2.21,留住比例中位数 0.61
  最大浮盈 [5, 1000) R:  63 笔,最终 R 中位数   4.59,留住比例中位数 0.69
浮盈到过 2 到 3 个 R 的交易,最后中位数只留住了 47%;浮盈到过 5 个 R 以上的留住 69%。换句话说,吊灯止损的「代价」大约是峰值利润的三到五成。
这个代价不是缺陷,是定价。第 21 篇量过:不设止损的写法年化并不低,但最差的一笔和最大回撤都糟得多。止损买的是最差那一笔的上限,价钱是峰值利润的三到五成。
六、第三个问题:有没有目标价
现在到了这一篇最值得算清楚的地方。
先看一个几乎所有人都会问的问题:「我该在 2R 止盈还是 3R 止盈?」
先在一个没有任何规律的市场里试
把真实市场放一边,先做一个思想实验。
假设价格是一个无漂移的随机游走:每一步等概率往上或往下走一小格,往上和往下完全对称,没有趋势,没有均值回归,什么都没有。你在某个价格买入,止损放在下方 1 个 R,目标放在上方 x 个 R。先碰到哪个算哪个。
胜率是多少?
这是概率论里的经典问题(赌徒破产问题),答案是:
胜率 = 止损距离 ÷(止损距离 + 目标距离)= 1 ÷ (1 + x)
目标放在 1R,胜率 50%;放在 2R,胜率 33%;放在 10R,胜率 9%。模拟一下:
def race(target, stop=1.0, paths=10000, step=0.05, chunk=1000, seed=23):
    """无漂移随机游走:每步等概率走 ±step 个 R,先碰到 +target 记 target,先碰到 −stop 记 −stop。"""
    rng = np.random.default_rng(seed)
    out, level, alive = np.zeros(paths), np.zeros(paths), np.ones(paths, bool)
    while alive.any():
        idx = np.flatnonzero(alive)
        walk = level[idx, None] + np.cumsum(rng.choice([-step, step], (len(idx), chunk)), axis=1)
        up, down = walk >= target, walk <= -stop
        first_up = np.where(up.any(1), up.argmax(1), chunk)
        first_down = np.where(down.any(1), down.argmax(1), chunk)
        done = np.minimum(first_up, first_down) < chunk
        out[idx[done]] = np.where(first_up < first_down, target, -stop)[done]
        level[idx], alive[idx] = walk[:, -1], ~done
    return out


rows = []
for target in [0.5, 1, 2, 3, 5, 10]:
    r = race(target)
    win = (r > 0).mean()
    rows.append({"目标": f"{target}R", "实测胜率": win, "理论胜率 = 1 ÷ (1 + 目标)": 1 / (1 + target),
                 "盈亏比": target, "胜率 × 盈亏比": win * target, "败率 × 1": 1 - win, "平均 R": r.mean()})
print(pd.DataFrame(rows).round(4).to_string(index=False))
  目标   实测胜率  理论胜率 = 1 ÷ (1 + 目标)  盈亏比  胜率 × 盈亏比  败率 × 1    平均 R
0.5R 0.6515               0.6667  0.5    0.3258  0.3485 -0.0228
  1R 0.5005               0.5000  1.0    0.5005  0.4995  0.0010
  2R 0.3361               0.3333  2.0    0.6722  0.6639  0.0083
  3R 0.2516               0.2500  3.0    0.7548  0.7484  0.0064
  5R 0.1694               0.1667  5.0    0.8470  0.8306  0.0164
 10R 0.0932               0.0909 10.0    0.9320  0.9068  0.0252
看最后两列。「胜率 × 盈亏比」和「败率 × 1」这两个数在每一行都几乎相等——这就是期望值等于零。目标从 0.5R 挪到 10R,胜率从 65% 掉到 9%,盈亏比从 0.5 涨到 10,两边的变化恰好抵消。
(0.5R 那一行实测 65.2% 比理论的 66.7% 低一点点,因为每一步走 0.05 个 R,碰到 0.5R 的目标时容易「走过头」,而走过头对近目标的影响相对更大。)
这就是胜率和盈亏比此消彼长的来源:它是算术,不是市场性质。 在一个没有任何规律的价格序列上,你挪动目标价,只是在重新切分同一条收益分布——切成「常赢小钱」或者「偶尔赢大钱」,而总量不变。
由此得到一条比「胜率」有用得多的线:
打平需要的胜率 = 平均亏损 ÷(平均亏损 + 平均盈利)
一个胜率 30% 的策略是好是坏?光看这个数没法回答。要和它自己的盈亏比比:盈亏比 5 的时候,打平只需要 16.7% 的胜率,30% 就很不错;盈亏比 1.5 的时候,打平需要 40%,30% 就是在亏钱。
再回到真实市场
现在把同一件事搬到真实数据上。止损固定在 3 ATR 不动,目标从 0.5R 挪到 10R:
TARGETS = [0.5, 1, 1.5, 2, 3, 4, 6, 8, 10]
COST = 0.001                                                    # 一来一回 0.1%,第 29 篇才认真算成本
scans = {}
rng = np.random.default_rng(23)
for name in ["SPY 日线", "BTC 日线", "BTC 4 小时", "BTC 1 小时"]:
    df = MARKETS[name][0]
    shuffled = [shuffle_bars(df, rng) for _ in range(5)]
    rows = []
    for target in TARGETS:
        plan = K.Exit(stop="atr", k=3.0, trail="none", target_r=target)
        t = K.run(df, entries(df), plan)
        score = K.expectancy(t["R 倍数"])
        cost = (COST / (t["R"] / t["买入价"])).sum()             # 每笔的成本折算成几个 R,再加起来
        fake = [K.expectancy(K.run(s, entries(s), plan)["R 倍数"]) for s in shuffled]
        rows.append({"目标": f"{target}R", "交易数": int(score["交易数"]), "胜率": score["胜率"],
                     "平均盈利": score["平均盈利"], "平均亏损": score["平均亏损"],
                     "打平需要的胜率": score["平均亏损"] / (score["平均亏损"] + score["平均盈利"]),
                     "每笔期望 R": score["期望值"], "合计 R": t["R 倍数"].sum(), "成本合计 R": cost,
                     "扣成本后合计 R": t["R 倍数"].sum() - cost,
                     "打乱后的胜率": np.mean([f["胜率"] for f in fake]),
                     "打乱后的每笔期望 R": np.mean([f["期望值"] for f in fake])})
    scans[name] = pd.DataFrame(rows)
    print(f"\n--- {name} ---")
    print(scans[name].round(3).to_string(index=False))
--- BTC 4 小时 ---
  目标  交易数    胜率   平均盈利  平均亏损  打平需要的胜率  每笔期望 R    合计 R  成本合计 R  扣成本后合计 R  打乱后的胜率  打乱后的每笔期望 R
0.5R  448 0.710  0.726 1.196    0.622   0.168  75.426   9.931    65.496   0.658       0.061
  1R  293 0.601  1.248 1.204    0.491   0.269  78.882   6.527    72.355   0.542       0.106
1.5R  208 0.543  1.790 1.210    0.403   0.420  87.327   4.662    82.664   0.463       0.152
  2R  165 0.491  2.291 1.192    0.342   0.518  85.515   3.511    82.004   0.410       0.188
  3R  123 0.431  3.314 1.204    0.267   0.743  91.328   2.614    88.713   0.344       0.317
  4R   95 0.389  4.348 1.246    0.223   0.933  88.625   2.113    86.512   0.295       0.379
  6R   89 0.326  6.258 1.208    0.162   1.225 109.032   1.844   107.188   0.243       0.558
  8R   66 0.303  8.369 1.220    0.127   1.686 111.244   1.372   109.872   0.210       0.700
 10R   60 0.250 10.133 1.288    0.113   1.567  94.039   1.289    92.750   0.182       0.798
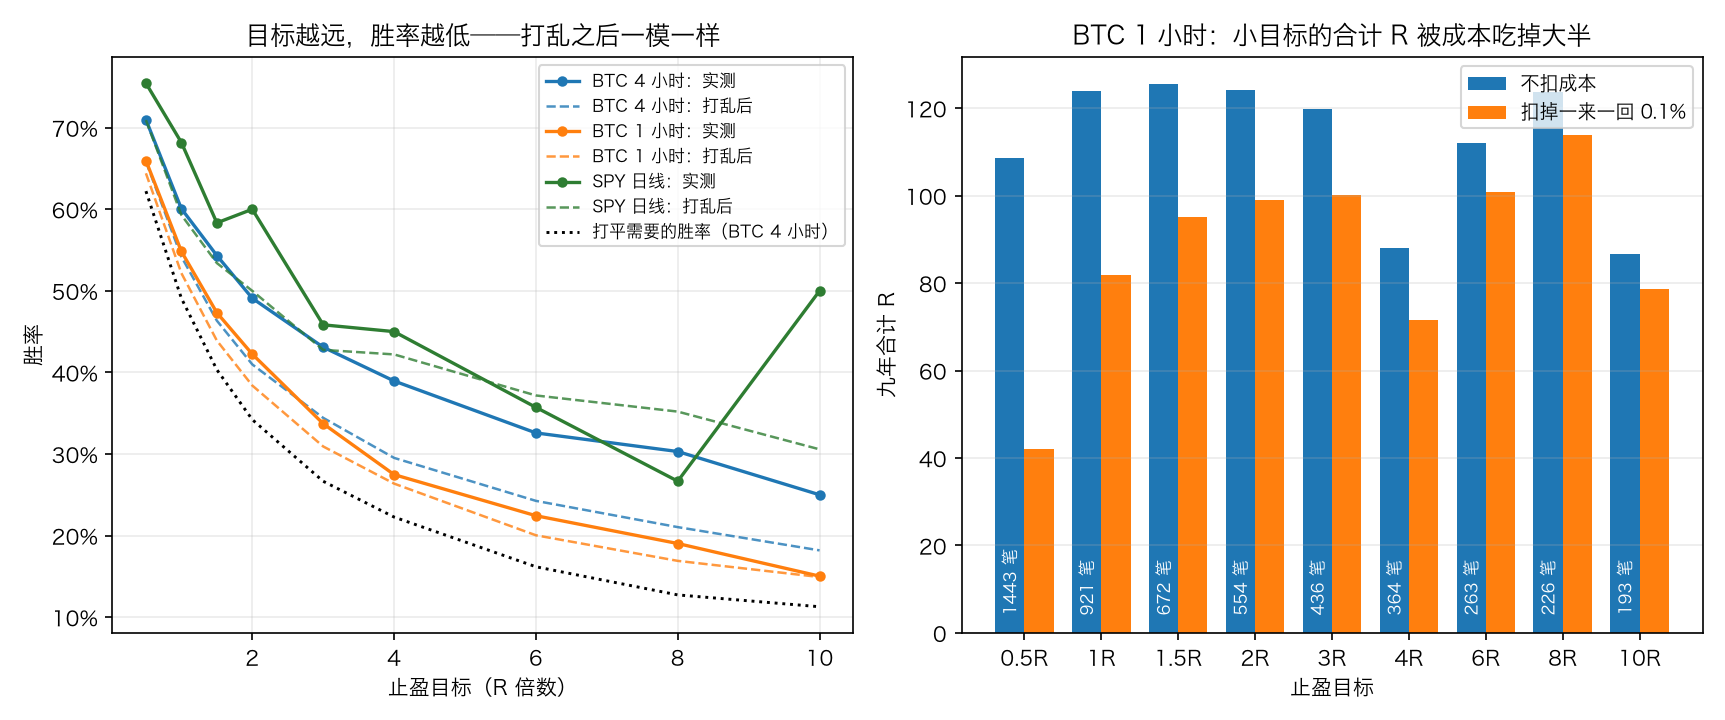
四件事:
- 胜率单调下降,从 71.0% 到 25.0%,而且一路压在「打平需要的胜率」那一列上方(62.2% → 11.3%)。中间隔着的那段距离,就是这个市场给的全部优势——它没有随目标变远而消失,但也没有变大多少。
- 平均亏损纹丝不动,一直在 1.19 到 1.29 个 R 之间。目标价只动盈利那一边,亏损那一边是初始止损管的。(顺便回答了第二节留下的问题:为什么平均亏损不是 1.0——收盘触发的止损平均要多付 20% 到 30%。)
- 打乱之后的胜率曲线形状一模一样(图里的虚线)。把 K 线的顺序打乱、只保留每根的形状(第 9 篇的做法),胜率还是 65.8%、54.2%、46.3%……一路掉到 18.2%,只是整体比真实低 5 到 9 个百分点。这条此消彼长的曲线不是 BTC 的性质,是止盈目标这个动作本身的性质。
- 每笔期望值随目标上升(0.168 → 1.567),但打乱后的数据上同样在上升(0.061 → 0.798)。所以「目标放远一点期望值更高」这句话里,有相当一部分只是「这九年 BTC 在涨」——而不是「趋势会延续」。真实减去打乱的那部分才是趋势给的,它确实存在,但只有一半左右。
成本:小目标那一端会塌掉
上面全是不算成本的。加上成本,结论会变。
成本按 R 折算很简单:一来一回的费率 ÷ 止损距离占进场价的比例。BTC 1 小时线上止损距离中位数只有 2.4%,那么 0.1% 的来回成本就是 0.045 个 R——听起来很小,但小目标意味着交易次数多:
      标的   目标  交易数  止损距离中位数  每笔成本折合    合计 R  成本合计 R  成本吃掉
  SPY 日线 0.5R  110    0.028   0.038  18.213   4.152 0.228
  SPY 日线   2R   35    0.030   0.036  25.914   1.273 0.049
  SPY 日线  10R    6    0.030   0.034  22.669   0.205 0.009
  BTC 日线 0.5R   85    0.116   0.009  14.965   0.744 0.050
  BTC 日线   2R   29    0.134   0.008  18.375   0.238 0.013
  BTC 日线  10R   14    0.140   0.008  30.684   0.108 0.004
BTC 1 小时 0.5R 1443    0.024   0.046 108.577  66.444 0.612
BTC 1 小时   2R  554    0.025   0.045 124.086  25.116 0.202
BTC 1 小时  10R  193    0.027   0.041  86.678   7.918 0.091
BTC 1 小时线、0.5R 目标:九年 1,443 笔交易,合计 108.6 个 R,光成本就 66.4 个 R,吃掉 61%。同样的数据换成 10R 目标:193 笔交易,成本只占 9%。
SPY 日线上 0.5R 那一行的止损距离是 2.8%,同样 0.1% 的成本折合 0.038 个 R,110 笔交易一共 4.2 个 R,占 23%——低得多,但也不是可以忽略的。
⚠️ 这里用的 0.1% 是个偏乐观的数字,而且只算了手续费,没算滑点(第 22 篇量过,主线 v3 的滑点年化约 1.1 个百分点)。认真算成本是第 29 篇。这里只要记住方向:止损距离越近、交易次数越多,成本占 R 的比例越高。
七、第四个问题:最多拿多久
天黑了要回家。
时间止损的机制和前三个完全不同:前三个盯的是价格,时间止损盯的是机会成本。一个不涨也不跌的仓位没有在亏钱,但它占着你的资金和注意力,而且它对应的那个入场理由——「刚刚创了 20 日新高」——正在一天天过期。
拿满 N 根就走,N 从 5 试到 100:
for name in ["SPY 日线", "BTC 日线", "BTC 4 小时"]:
    df = MARKETS[name][0]
    rows = []
    for bars in [5, 10, 20, 40, 60, 100, None]:
        t = K.run(df, entries(df), K.Exit(stop="atr", k=3.0, trail="none", max_bars=bars), exits=deaths(df))
        score = K.expectancy(t["R 倍数"])
        rows.append({"最多拿": "不限" if bars is None else f"{bars} 根", "交易数": int(score["交易数"]),
                     "胜率": score["胜率"], "盈亏比": score["盈亏比"], "每笔期望 R": score["期望值"],
                     "合计 R": t["R 倍数"].sum(), "在场时间": t["根数"].sum() / len(df),
                     "被时间赶出来的": (t["原因"] == "时间到").mean()})
    print(f"\n--- {name} ---")
    print(pd.DataFrame(rows).round(3).to_string(index=False))
--- BTC 4 小时 ---
  最多拿  交易数    胜率    盈亏比  每笔期望 R    合计 R  在场时间  被时间赶出来的
  5 根  526 0.504  1.601   0.124  65.090 0.130    0.937
 10 根  390 0.538  1.593   0.209  81.409 0.185    0.859
 20 根  294 0.524  1.857   0.339  99.575 0.259    0.762
 40 根  203 0.537  2.069   0.562 114.107 0.311    0.616
 60 根  163 0.528  2.385   0.743 121.078 0.349    0.546
100 根  131 0.435  3.752   1.032 135.221 0.388    0.427
   不限   62 0.387 10.890   3.704 229.646 0.457    0.000
又是同一条此消彼长:拿得越短,胜率越高、盈亏比越低。BTC 4 小时线上,5 根封顶的胜率 50.4%、盈亏比 1.60;不限时间的胜率 38.7%、盈亏比 10.89。
但这一次还多了一个东西:合计 R 单调上升(65 → 230)。时间止损砍掉的全是右边那条尾巴——一笔要走成 10R 的交易,必然要拿很久。
它有用的场合是别的:在场时间那一列。5 根封顶只占用 13% 的时间就拿到 65 个 R,不限时间要占用 45.7% 的时间才拿到 230 个 R。如果你手上同时有别的机会(第 26 篇的组合),「单位时间的 R」才是要比的东西。
八、把四个答案变成一个数:期望值
四个问题都回答完了,怎么判断这套出场好不好?
期望值。
期望值 = 胜率 × 平均盈利 − 败率 × 平均亏损(单位都是 R)
用主线策略在五个序列上的 1,119 笔交易算一遍:
sample = pd.concat(distributions["C 3 ATR 吊灯跟踪"], ignore_index=True)
score = K.expectancy(sample)
print(score.round(3).to_string())
print(f"\n把公式拆开算一遍:{score['胜率']:.4f} × {score['平均盈利']:.4f} − "
      f"{1 - score['胜率']:.4f} × {score['平均亏损']:.4f} = {score['期望值']:.4f}")
print(f"直接对这 {len(sample)} 个 R 取平均:{sample.mean():.4f}(两者相等,期望值就是平均 R)")
print(f"中位数却是 {sample.median():.3f}:一半以上的交易在亏钱,靠的是右边那条尾巴")
print(f"打平需要的胜率 = 平均亏损 ÷(平均亏损 + 平均盈利)= "
      f"{score['平均亏损']:.3f} ÷ ({score['平均亏损']:.3f} + {score['平均盈利']:.3f}) = "
      f"{score['平均亏损'] / (score['平均亏损'] + score['平均盈利']):.1%},实测胜率 {score['胜率']:.1%}")
交易数      1119.000
胜率          0.399
平均盈利        1.641
平均亏损        0.647
盈亏比         2.535
期望值         0.265
中位数        -0.233
最好的一笔      24.887
最差的一笔      -3.218

把公式拆开算一遍:0.3986 × 1.6408 − 0.6014 × 0.6471 = 0.2648
直接对这 1119 个 R 取平均:0.2648(两者相等,期望值就是平均 R)
中位数却是 -0.233:一半以上的交易在亏钱,靠的是右边那条尾巴
打平需要的胜率 = 平均亏损 ÷(平均亏损 + 平均盈利)= 0.647 ÷ (0.647 + 1.641) = 28.3%,实测胜率 39.9%
三件事值得停一下:
- 期望值就是平均 R。 那条公式算出来的 0.2648,和直接对这 1,119 个数取平均,是同一个数——它本来就是把平均数按正负拆成两半再拼回去。那条公式不提供任何新信息,它的用处是告诉你能从哪两头去改。
- 中位数是 −0.233。 一半以上的交易在亏钱,整条策略靠的是右边那条尾巴。这不是这条策略的毛病,这是趋势跟随的形状——第十一节会看到,21.5% 的交易贡献了一半的 R。
- 打平需要 28.3% 的胜率,实测 39.9%。 这 11.6 个百分点就是这条规则在这五个序列上的全部优势。
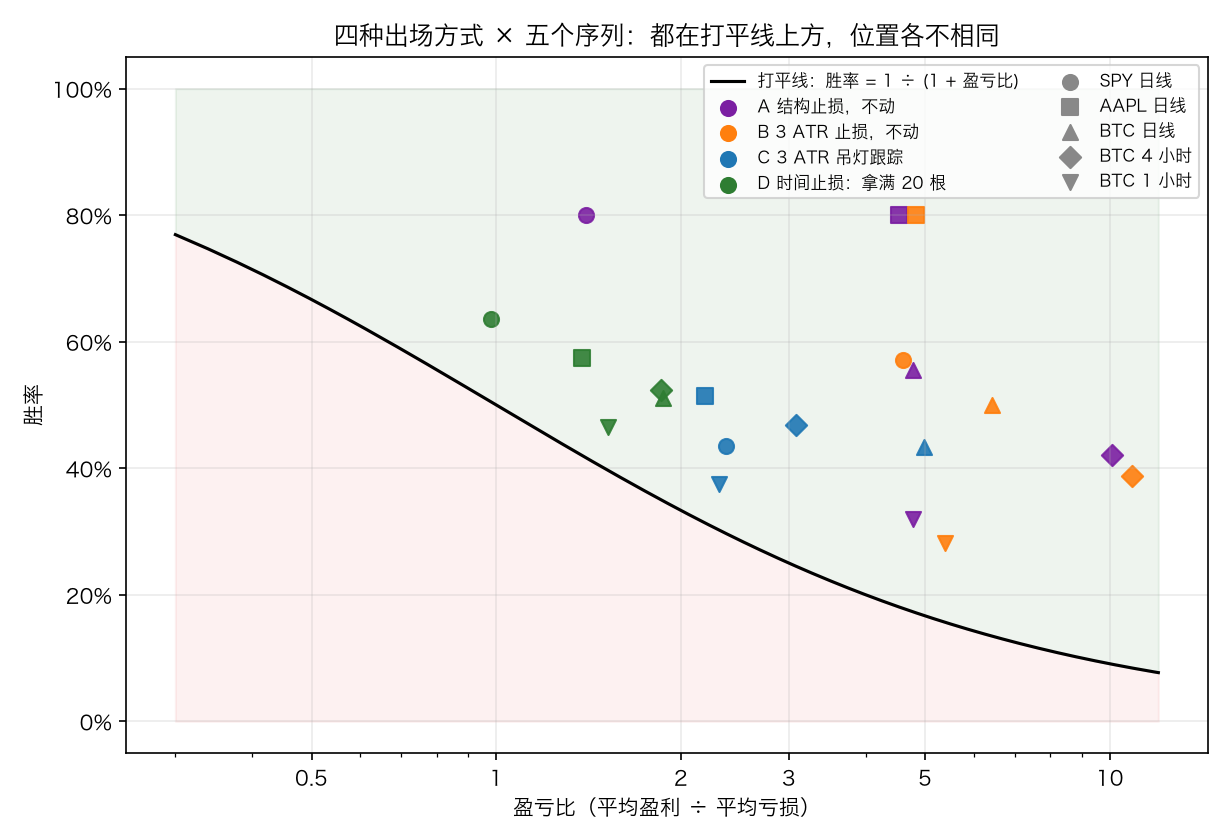
这张图把四种出场方式在五个序列上的 20 个组合都画了出来,横轴是盈亏比(对数刻度),纵轴是胜率,黑线是打平线。20 个点全在线的上方,但位置差得很远:左上角是「常赢小钱」,右下角是「偶尔赢大钱」。它们不是四种好坏不同的方法,是同一条分布的四种切法。
九、动手:talab.risk
新模块。四个问题填进一个 Exit,run 按它跑一遍历史。
R 倍数
def r_multiple(entry_price: float, stop_price: float, exit_price: float) -> float:
    """这笔交易赚了(亏了)几个 R。

    R = 进场价 − 初始止损价,是开仓那一刻就定下来的、你打算认输的距离。
    严格按初始止损算:止损后来上移了多少,不改变这笔交易当初冒的风险。
    """
    risk = entry_price - stop_price
    if risk <= 0:
        raise ValueError(f"止损价要在进场价下方(进场 {entry_price},止损 {stop_price})")
    return (exit_price - entry_price) / risk
risk <= 0 直接报错,而不是返回一个负的 R——止损放在进场价上方的「交易」没有意义,让它早点炸出来比让它悄悄污染统计好。
四个答案
@dataclass
class Exit:
    """一套出场方案:四个问题各一个答案。"""
    stop: str = "atr"                 # 一、初始止损:atr / structure / percent
    k: float = 3.0                    #     atr:进场价往下几个 ATR
    lookback: int = 20                #     structure:往前看几根找最低点
    buffer: float = 0.5               #     structure:在那个最低点再往下几个 ATR
    percent: float = 0.10             #     percent:进场价往下百分之几
    trail: str = "none"               # 二、止损要不要跟着走
    trail_k: float = 3.0              #     chandelier:最高价往下几个 ATR
    trail_bars: int = 20              #     low:跟着前几根的最低点走
    trail_r: float = 1.0              #     breakeven:浮盈几个 R 之后把止损提到成本价
    target_r: float | None = None     # 三、目标价:赚到几个 R 就收(None = 不设目标)
    partial_r: float | None = None    #     浮盈几个 R 时先平掉一部分(None = 不分批)
    partial_fraction: float = 0.5     #     分批平掉多少
    max_bars: int | None = None       # 四、最多拿几根 K 线(None = 不限)
    trigger: str = "close"            # 止损和目标用收盘价触发,还是用盘中最高最低价
    atr_period: int = 14

    def __post_init__(self):
        for name, value, allowed in [("stop", self.stop, STOPS), ("trail", self.trail, TRAILS),
                                     ("trigger", self.trigger, TRIGGERS)]:
            if value not in allowed:
                raise ValueError(f"{name} 只能是 {allowed} 之一,收到 {value!r}")
        if not 0 < self.partial_fraction < 1:
            raise ValueError("partial_fraction 要在 0 和 1 之间")
        if self.partial_r is not None and self.target_r is not None and self.partial_r >= self.target_r:
            raise ValueError("分批止盈的位置要在最终目标下方,否则它永远轮不到")

    def describe(self) -> pd.Series:
        """把四个答案列出来,用来检查「这套出场真的想全了吗」。"""
        first = {"atr": f"进场价下方 {self.k} 倍 ATR",
                 "structure": f"前 {self.lookback} 根的最低点再往下 {self.buffer} 倍 ATR",
                 "percent": f"进场价下方 {self.percent:.0%}"}[self.stop]
        second = {"none": "不动,一直用初始止损",
                  "chandelier": f"吊灯:最高价往下 {self.trail_k} 倍 ATR,只上移",
                  "low": f"跟着前 {self.trail_bars} 根的最低点走,只上移",
                  "breakeven": f"浮盈 {self.trail_r} 个 R 之后提到成本价,再不动"}[self.trail]
        third = "不设目标,让它自己走完" if self.target_r is None else f"赚到 {self.target_r} 个 R 就全部离场"
        if self.partial_r is not None:
            third += f";浮盈 {self.partial_r} 个 R 时先平 {self.partial_fraction:.0%}"
        fourth = "不限" if self.max_bars is None else f"最多 {self.max_bars} 根 K 线"
        return pd.Series({"一、初始止损": first, "二、止损跟不跟": second,
                          "三、目标价": third, "四、最多拿多久": fourth})
describe() 和第 21 篇 Rule.describe() 的用途一样:把默认值也摆出来。不写 trail 不等于「没想过要不要跟踪」,而是选了「不跟踪」。
初始止损
def initial_stop(df: pd.DataFrame, i: int, entry_price: float, plan: Exit,
                 atr: np.ndarray | None = None) -> float:
    """第 i 根 K 线上按 `plan` 算初始止损价。

    只用第 i−1 根及之前的数据:ATR 取前一根的值,结构低点取前 `lookback` 根的最低价,
    都不含第 i 根自己——第 i 根的最低价要等收盘才知道,进场那一刻还没有。
    """
    if plan.stop == "percent":
        return entry_price * (1 - plan.percent)
    if atr is None:
        from talab import indicators as I
        atr = I.atr(df["high"], df["low"], df["close"], plan.atr_period).to_numpy()
    if plan.stop == "atr":
        return entry_price - plan.k * atr[i - 1]
    low = df["low"].to_numpy(float)[max(0, i - plan.lookback):i].min()
    return low - plan.buffer * atr[i - 1]
⚠️ 这里有个容易写错的地方:结构低点取的是 [i - lookback : i],不含第 i 根自己。第 i 根的最低价要等它收盘才知道,而你是在第 i 根的开盘价买入的——把它算进去就是前视偏差(第 7 篇)。
跑一遍历史
def run(df: pd.DataFrame, entries: pd.Series, plan: Exit | None = None,
        exits: pd.Series | None = None) -> pd.DataFrame:
    """按一套出场方案跑一遍历史,每笔交易一行。

    `exits` 是策略自己的出场信号(比如主线策略的死叉),它和 `plan` 里的四个答案并存:
    谁先到就听谁的,出场信号排在最前面判断。不给 `exits` 就只靠止损、目标和时间出场。

    约定和第 21 篇一致:信号在收盘时成立,下一根开盘市价成交;持仓期间不接新信号。
    进场的那一根也可能就把你打掉——买在开盘价,这根 K 线剩下的时间照样会走。

    止损和目标同时在一根 K 线里被碰到时(只有 `trigger="extreme"` 才可能发生),
    按**止损**算,并在「原因」里记成「同一根」——K 线看不出谁先到(第 22 篇),
    这里选保守的那一边,并且把它数出来,而不是假装没发生。

    返回的表里,「R 倍数」是这笔交易的最终成绩;分批止盈时它是两段的加权平均。
    「最大浮盈」和「最大浮亏」是持仓期间盘中到过的最好和最差的浮动盈亏(MFE 和 MAE),
    它们回答「这笔交易有没有给过你机会」和「你离被打掉有多近」。进场那一根按整根的
    最高最低价算,所以最大浮亏可能比你实际经历的更难看一点。
    """
    plan = plan or Exit()
    from talab import indicators as I
    atr = I.atr(df["high"], df["low"], df["close"], plan.atr_period).to_numpy()
    o, h, l, c = (df[x].to_numpy(float) for x in ["open", "high", "low", "close"])
    signal = entries.reindex(df.index).fillna(False).to_numpy(bool)
    leave = (np.zeros(len(c), bool) if exits is None
             else exits.reindex(df.index).fillna(False).to_numpy(bool))
    rows, holding = [], False
    entry_price = entry_i = risk = highest = best = worst = done = left = np.nan
    start = int(np.argmax(~np.isnan(atr))) + 2
    for i in range(start, len(c)):
        if not holding and signal[i - 1]:                             # 昨天收盘的信号,今天开盘成交
            price = o[i]
            level = initial_stop(df, i, price, plan, atr)
            if level < price:                                         # 止损要在进场价下方,否则这笔跳过
                holding, entry_price, entry_i, risk = True, price, i, price - level
                stop_price, highest, done, left, best, worst = level, price, 0.0, 1.0, 0.0, 0.0
        if not holding:
            continue
        if plan.trail == "chandelier":
            stop_price = max(stop_price, highest - plan.trail_k * atr[i - 1])
        elif plan.trail == "low":
            stop_price = max(stop_price, l[max(0, i - plan.trail_bars):i].min())
        elif plan.trail == "breakeven" and highest >= entry_price + plan.trail_r * risk:
            stop_price = max(stop_price, entry_price)
        best = max(best, (h[i] - entry_price) / risk)
        worst = min(worst, (l[i] - entry_price) / risk)
        target = entry_price + plan.target_r * risk if plan.target_r is not None else np.inf
        price = reason = None
        if leave[i - 1] and i > entry_i:                               # 昨天收盘的出场信号,今天开盘执行
            price, reason = o[i], "出场信号"
        elif plan.trigger == "close":
            if c[i] <= stop_price:
                price, reason = c[i], "止损"
            elif c[i] >= target:
                price, reason = c[i], "止盈"
        else:
            hit_stop, hit_target = l[i] <= stop_price, h[i] >= target
            if hit_stop and hit_target:
                price, reason = (o[i] if o[i] <= stop_price else stop_price), "同一根"
            elif hit_stop:
                price, reason = (o[i] if o[i] <= stop_price else stop_price), "止损"
            elif hit_target:
                price, reason = (o[i] if o[i] >= target else target), "止盈"
        if reason is None and plan.max_bars is not None and i - entry_i >= plan.max_bars:
            price, reason = c[i], "时间到"
        if reason is None and i == len(c) - 1:
            price, reason = c[i], "未平仓"
        if reason is None and left == 1.0 and plan.partial_r is not None:   # 先平一部分,剩下的接着走
            level = entry_price + plan.partial_r * risk
            got = c[i] if plan.trigger == "close" and c[i] >= level else (max(o[i], level) if plan.trigger == "extreme" and h[i] >= level else None)
            if got is not None:
                done, left = plan.partial_fraction * (got - entry_price) / risk, 1 - plan.partial_fraction
        highest = max(highest, h[i])
        if reason is None:
            continue
        rows.append({"买入日": df.index[entry_i], "买入价": entry_price, "初始止损": entry_price - risk,
                     "R": risk, "卖出日": df.index[i], "卖出价": price, "原因": reason,
                     "R 倍数": done + left * (price - entry_price) / risk,
                     "最大浮盈": best, "最大浮亏": worst, "根数": i - entry_i})
        holding = False
    return pd.DataFrame(rows, columns=["买入日", "买入价", "初始止损", "R", "卖出日", "卖出价", "原因",
                                       "R 倍数", "最大浮盈", "最大浮亏", "根数"])
几个决定:
- 出场信号排在最前面判断。主线策略自己有一个出场规则(死叉),它和四个答案并存,谁先到听谁的。
trigger="extreme"时,止损和目标在同一根里都被碰到,记成「同一根」并按止损算。这是第 22 篇那个括号单问题:K 线看不出谁先到。选保守的一边,并且把它数出来,而不是假装没发生。- 进场的那一根也可能把你打掉。买在开盘价,这根 K 线剩下的时间照样会走。
最大浮盈/最大浮亏就是 MFE 和 MAE,第十三节全靠它们。
成绩单
def expectancy(r: pd.Series | np.ndarray) -> pd.Series:
    """一串 R 倍数的成绩单。

    期望值 = 胜率 × 平均盈利 − 败率 × 平均亏损,它算出来就是这串 R 的平均数——
    那条公式没有多给出任何信息,它的用处是告诉你**能从哪两头去改**:
    提高胜率,或者提高盈亏比。第 23 篇的数据说明这两头往往是此消彼长的。
    """
    r = pd.Series(r).dropna()
    wins, losses = r[r > 0], r[r <= 0]
    win_rate = len(wins) / len(r) if len(r) else np.nan
    avg_win = wins.mean() if len(wins) else 0.0
    avg_loss = -losses.mean() if len(losses) else 0.0
    return pd.Series({
        "交易数": float(len(r)),
        "胜率": win_rate,
        "平均盈利": avg_win,
        "平均亏损": avg_loss,
        "盈亏比": avg_win / avg_loss if avg_loss else np.inf,
        "期望值": win_rate * avg_win - (1 - win_rate) * avg_loss,
        "中位数": r.median(),
        "最好的一笔": r.max(),
        "最差的一笔": r.min(),
    })
测试
16 个,全部手算。几个关键的:
def test_stop_fills_at_the_close_that_broke_it():
    bars = frame(FLAT + [(100, 103, 99, 102), (102, 103, 88, 89), (89, 90, 85, 86)])
    trades = K.run(bars, pd.Series([False] * 5 + [True] + [False] * 3, index=bars.index),
                   K.Exit(**PERCENT, trail="none"))
    one = trades.iloc[0]
    assert one["原因"] == "止损" and one["卖出价"] == pytest.approx(89.0)
    assert one["R 倍数"] == pytest.approx(-1.1)                       # 收盘触发会穿过去,亏的比 1R 多
    assert one["最大浮亏"] == pytest.approx(-1.2)                     # 盘中一度到过 88
def test_same_bar_is_counted_as_a_stop():
    plan = K.Exit(**PERCENT, trail="none", target_r=1.0, trigger="extreme")
    bars = frame(FLAT + [(100, 103, 99, 102), (102, 111, 89, 95)])
    trades = K.run(bars, pd.Series([False] * 5 + [True] + [False] * 2, index=bars.index), plan)
    one = trades.iloc[0]
    assert one["原因"] == "同一根"                                     # 110 和 90 在同一根里都碰到了
    assert one["卖出价"] == pytest.approx(90.0)                        # 按止损算,保守的那一边
最后一个是和第 21 篇对账:同样的入场、同样的 3 ATR 吊灯、同样的收盘触发,risk.run 和 rules.run 必须给出同一批交易。两个模块看同一件事的不同侧面,它们不能互相矛盾。
def test_agrees_with_rules_run_on_the_same_setup():
    """同样的入场、同样的 3 ATR 吊灯、同样的收盘触发,两个模块应该给出同一批交易。"""
    rng = np.random.default_rng(23)
    steps = rng.normal(0.0005, 0.02, 600)
    close = pd.Series(100 * np.exp(np.cumsum(steps)),
                      index=pd.date_range("2020-01-01", periods=600, freq="D"))
    df = pd.DataFrame({"open": close.shift(1).bfill(), "high": close * 1.01,
                       "low": close * 0.99, "close": close})
    entry = (close >= close.rolling(20).max()).fillna(False)
    never = pd.Series(False, index=df.index)
    mine = K.run(df, entry, K.Exit(stop="atr", k=3.0, trail="chandelier", trail_k=3.0, trigger="close"))
    theirs = R.run(df, R.Rule(entry=entry, exit=never, fill="next_open",
                              stop="chandelier", k=3.0, trigger="close"))[2]
    assert len(mine) == len(theirs) > 5
    assert list(mine["买入日"]) == list(theirs["买入日"])
    assert mine["卖出价"].to_numpy() == pytest.approx(theirs["卖出价"].to_numpy())
210 passed in 0.79s
没装 TA-Lib 时,对账测试自动跳过:
178 passed, 32 skipped in 0.75s
十、揭晓
回到 2020 年 10 月 22 日。
这笔交易最后在 2021-01-12 以 34051.24 出场,止损,24.89 个 R,持有 94 根 K 线
期间盘中最高到过 33.43 个 R(41950.00),最大浮亏 -0.0001 个 R(最低 11050.51,就在买入的那一根上)

三种做法在这一笔上的结果(决策点收盘 12968.52,2.08 R):
全部离场     2.08
平一半     13.48
拿住      24.89
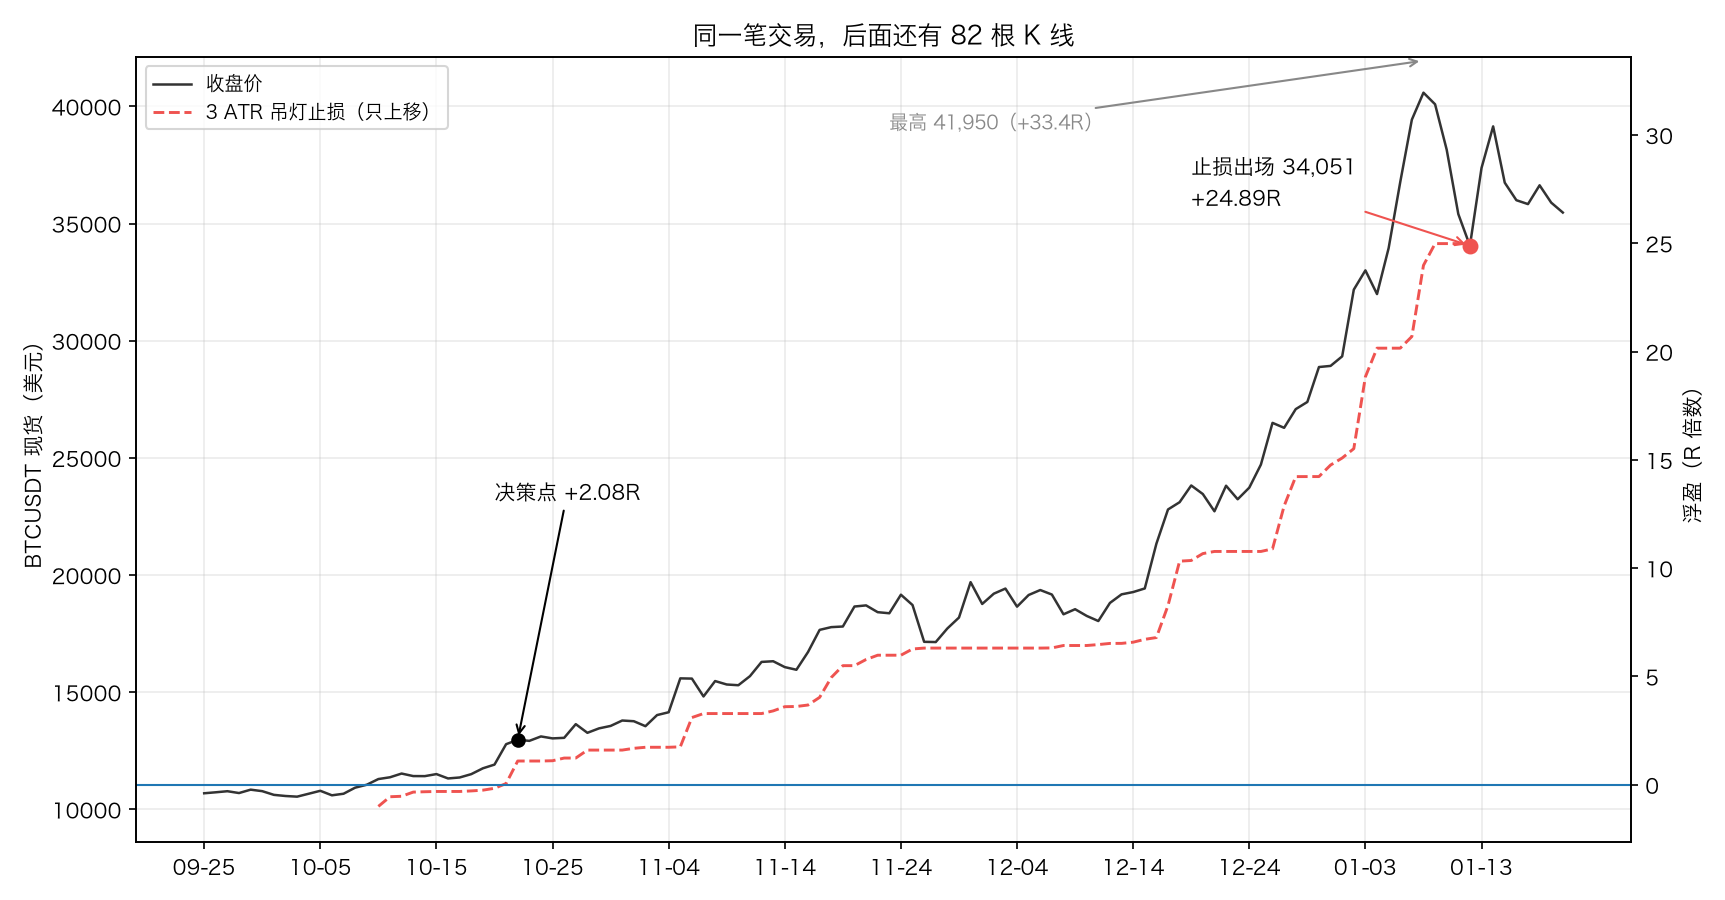
+24.89 个 R。
那天之后又走了 82 根 K 线。价格从 12,968 一路涨到 41,950(浮盈 +33.4R),吊灯止损跟着抬到 34,142.79;2021 年 1 月连着两天下跌,1 月 12 日收盘 34,051.24 跌到止损下方,这笔交易以收盘价出场(主线用的是收盘触发,第 20 篇的选择)。
- 选 C(全部离场):+2.08R
- 选 B(平一半):+13.48R
- 选 A(拿住):+24.89R
还有一个细节:这笔交易的最大浮亏是 −0.0001 个 R,出现在买入的那一根上(最低 11,050.51,比开盘价低 13 美分)。它从进场那一刻起就没回过头。
但是。
如果我挑的是同一批交易里的另外三笔:
同一批交易里,另外三笔也在某一天到过 +2R:
  2019-06-16 买入,2019-06-25 收盘 2.33 R,最后 1.95 R(止损,又拿了 2 根)
  2020-07-23 买入,2020-07-27 收盘 2.43 R,最后 1.00 R(止损,又拿了 38 根)
  2021-02-04 买入,2021-02-21 收盘 2.09 R,最后 1.00 R(止损,又拿了 4 根)
三笔都是「拿住」输给「当场走」,其中 2020 年 7 月那笔最难受:浮盈到过 2.43R,又拿了 38 根 K 线,最后只剩 1.00R。
一笔交易——哪怕是四笔——证明不了任何事。 这就是为什么下一节要把它做成统计。
十一、浮盈 2R 之后:205 笔交易
规则:在五个序列上跑主线策略,找出所有在某一根收盘时浮盈到过 +2R 的交易,然后对每一笔算三个数——当场全走能拿到多少、拿住最后拿到多少、平一半是多少。
⚠️ 这三个数算在同一笔交易内部,不考虑「早出场就能早点开下一笔」。那是策略层面的比较,第十二节做。
rows = []
for name, (df, _) in MARKETS.items():
    t = K.run(df, entries(df), CHANDELIER, exits=deaths(df))
    close = df["close"]
    for _, x in t.iterrows():
        i, j = df.index.get_loc(x["买入日"]), df.index.get_loc(x["卖出日"])
        r = (close.iloc[i:j + 1].to_numpy() - x["买入价"]) / x["R"]
        hit = np.nonzero(r >= 2.0)[0]
        if len(hit):
            rows.append({"标的": name, "买入日": x["买入日"], "到 2R 那根": df.index[i + hit[0]],
                         "全部离场": r[hit[0]], "拿住": x["R 倍数"], "还要拿几根": j - i - int(hit[0])})
reached = pd.DataFrame(rows)
reached["平一半"] = (reached["全部离场"] + reached["拿住"]) / 2
五个序列合计 205 笔交易在某一根收盘时浮盈到过 +2R
          交易数   拿住平均  拿住中位数   最好的一笔  不如直接走
标的
SPY 日线      8  2.332  1.717   5.309  0.625
AAPL 日线    11  2.371  2.106   6.366  0.455
BTC 日线      9  4.914  2.223  24.887  0.556
BTC 4 小时   45  3.434  2.049  17.546  0.533
BTC 1 小时  132  2.979  2.244  21.134  0.538
       到 2R 就全部离场      平一半       拿住
交易数       205.000  205.000  205.000
胜率          1.000    1.000    0.995
平均盈利        2.377    2.742    3.122
平均亏损        0.000    0.000    0.038
盈亏比           inf      inf   81.517
期望值         2.377    2.742    3.106
中位数         2.179    2.280    2.209
最好的一笔       8.453   13.844   24.887
最差的一笔       2.001    1.004   -0.038
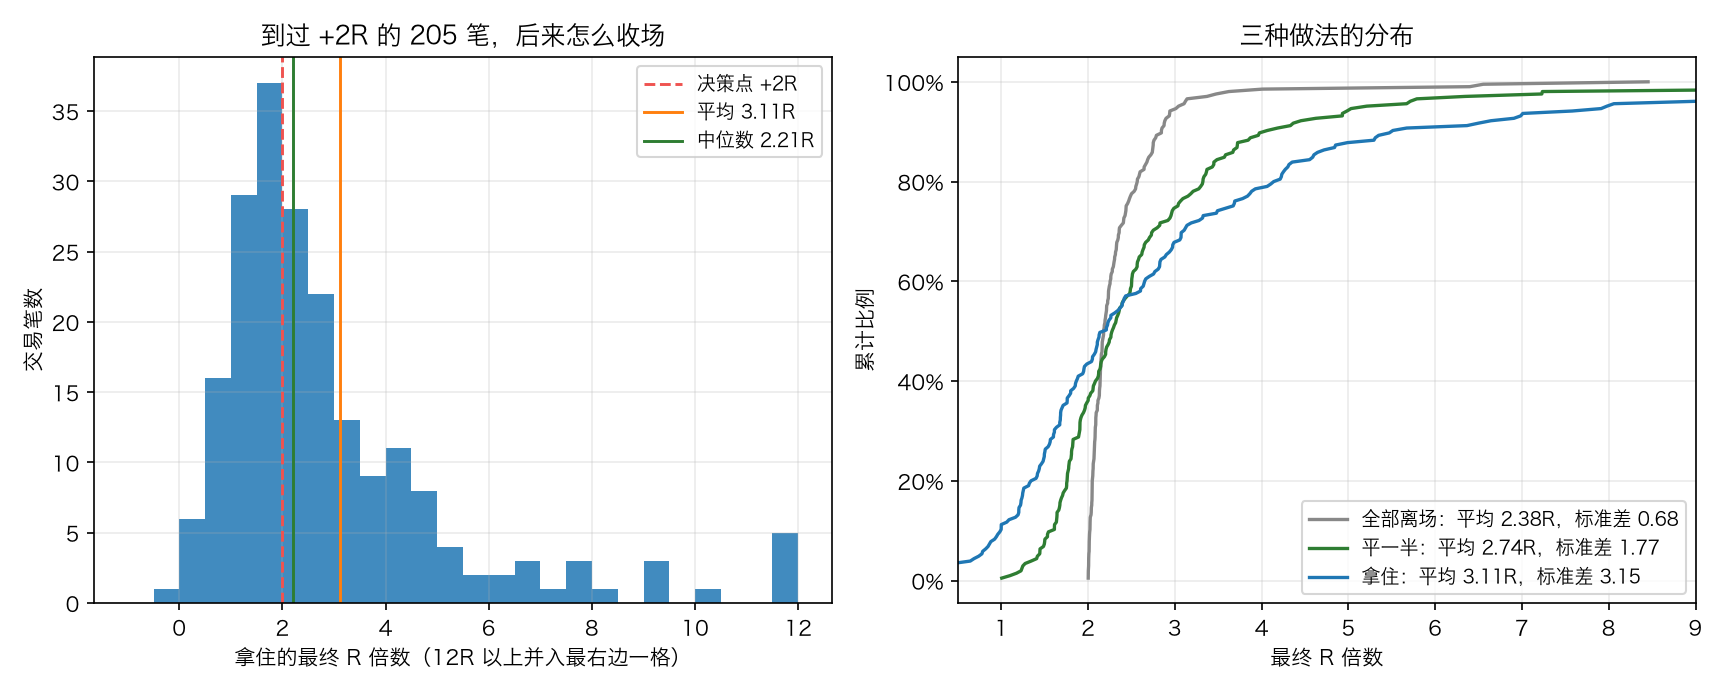
拿住比直接走更差的比例:53.7%
最终不到 2R 的:43.4%;不到 1R 的:11.2%;倒亏的:0.5%
最终 ≥ 4R 的只有 21.5%,但它们贡献了「拿住」全部 R 的 50.3%
三种做法的标准差:全部离场 0.68,平一半 1.78,拿住 3.16
这组数字值得慢慢看:
| 到 2R 就全走 | 平一半 | 拿住 | |
|---|---|---|---|
| 平均 | 2.38R | 2.74R | 3.11R |
| 中位数 | 2.18R | 2.28R | 2.21R |
| 标准差 | 0.68 | 1.78 | 3.16 |
| 最好的一笔 | 8.45R | 13.84R | 24.89R |
| 最差的一笔 | 2.00R | 1.00R | −0.04R |
- 平均数归「拿住」,中位数归「平一半」。 拿住的平均成绩最好(3.11R),但它的中位数(2.21R)反而被平一半(2.28R)压了一头。这不是巧合:拿住的好成绩全挤在右边那条尾巴上。
- 53.7% 的时候,拿住不如当场就走。 一半以上的次数你会后悔。
- 43.4% 的交易最终不到 2R,11.2% 不到 1R,但只有 0.5% 最后是亏的——跟踪止损在这个阶段已经抬到成本价上方了。
- 21.5% 的交易最后 ≥ 4R,它们贡献了「拿住」全部 R 的 50.3%。 一半的收益来自五分之一的交易。
- 「平一半」的平均值正好是另外两个的中点(2.38 和 3.11 的平均是 2.74)。这是定义决定的,不是发现:你把仓位一半按 A 做、一半按 C 做,期望值当然是两者的平均。它真正改变的是标准差:从 3.16 降到 1.78,降了 44%,而期望值只从 3.11 降到 2.74,降了 12%。
所以开头那个问题的答案是:
三个选项都对,它们在不同的维度上对。 拿住的期望值最高;全部离场的确定性最高;平一半用 12% 的期望值换掉 44% 的波动。你要在哪个维度上优化,取决于你能承受多少次「本来有 2R 结果只剩 1R」——而这不是这张图能告诉你的。
图里右边那张累计分布图把这件事画得最清楚:三条线在 2.2R 附近交叉。在交叉点左边,拿住更差;在交叉点右边,拿住更好。 你选的不是哪条线更高,而是你关心交叉点的哪一边。
十二、主线策略换四种出场方式
第十一节比的是「同一笔交易内部怎么收场」。这一节比的是整条策略:入场信号不变、出场信号(死叉)不变,只换出场那套机器。
- A 结构止损,不动:前 20 根低点再往下 0.5 ATR,止损不跟
- B 3 ATR 止损,不动:进场价往下 3 ATR,止损不跟
- C 3 ATR 吊灯跟踪:主线现在的写法
- D 时间止损:拿满 20 根:3 ATR 初始止损 + 20 根封顶
PLANS = {"A 结构止损,不动": K.Exit(stop="structure", lookback=20, buffer=0.5, trail="none"),
         "B 3 ATR 止损,不动": K.Exit(stop="atr", k=3.0, trail="none"),
         "C 3 ATR 吊灯跟踪": K.Exit(stop="atr", k=3.0, trail="chandelier", trail_k=3.0),
         "D 时间止损:拿满 20 根": K.Exit(stop="atr", k=3.0, trail="none", max_bars=20)}
rng = np.random.default_rng(23)
rows, distributions = [], {}
for name, (df, periods) in MARKETS.items():
    years = len(df) / periods
    for label, plan in PLANS.items():
        t = K.run(df, entries(df), plan, exits=deaths(df))
        r = t["R 倍数"]
        score = K.expectancy(r)
        curve = r.cumsum()
        boot = np.array([rng.choice(r, len(r)).sum() for _ in range(2000)])
        distributions.setdefault(label, []).append(r)
        rows.append({"标的": name, "出场方式": label, "交易数": int(score["交易数"]), "胜率": score["胜率"],
                     "平均盈利": score["平均盈利"], "平均亏损": score["平均亏损"], "盈亏比": score["盈亏比"],
                     "每笔期望 R": score["期望值"], "合计 R": r.sum(),
                     "合计 R 的 95% 区间": f"[{np.percentile(boot, 2.5):.0f}, {np.percentile(boot, 97.5):.0f}]",
                     "最大回撤 R": (curve - curve.cummax()).min(), "在场时间": t["根数"].sum() / len(df),
                     "平均持有根数": t["根数"].mean(), "最大一笔占合计": r.max() / r.sum(),
                     "满仓复利年化": (t["卖出价"] / t["买入价"]).prod() ** (1 / years) - 1})
compare = pd.DataFrame(rows)
--- BTC 日线 ---
          出场方式  交易数    胜率  平均盈利  平均亏损   盈亏比  每笔期望 R   合计 R 合计 R 的 95% 区间  最大回撤 R  在场时间  平均持有根数  最大一笔占合计  满仓复利年化
     A 结构止损,不动    9 0.556 4.352 0.909 4.787   2.014 18.123      [-3, 48]  -1.737 0.454 166.556    0.771   0.191
 B 3 ATR 止损,不动   10 0.500 6.589 1.024 6.437   2.782 27.825      [-2, 65]  -2.241 0.442 145.900    0.605   0.213
  C 3 ATR 吊灯跟踪   30 0.433 3.581 0.719 4.979   1.144 34.329      [-3, 92]  -3.597 0.227  25.033    0.725   0.185
D 时间止损:拿满 20 根   45 0.511 1.712 0.917 1.867   0.427 19.200      [-2, 44]  -5.036 0.234  17.156    0.281   0.113
五个序列的交易合起来:
       A 结构止损,不动  B 3 ATR 止损,不动  C 3 ATR 吊灯跟踪  D 时间止损:拿满 20 根
交易数      339.000        385.000      1119.000        1583.000
胜率         0.357          0.317         0.399           0.489
平均盈利       5.313          7.097         1.641           1.169
平均亏损       0.923          1.098         0.647           0.750
盈亏比        5.754          6.465         2.535           1.560
期望值        1.303          1.499         0.265           0.189
中位数       -0.468         -1.015        -0.233          -0.026
最好的一笔     55.965         75.302        24.887          13.451
最差的一笔     -2.516         -4.072        -3.218          -4.286
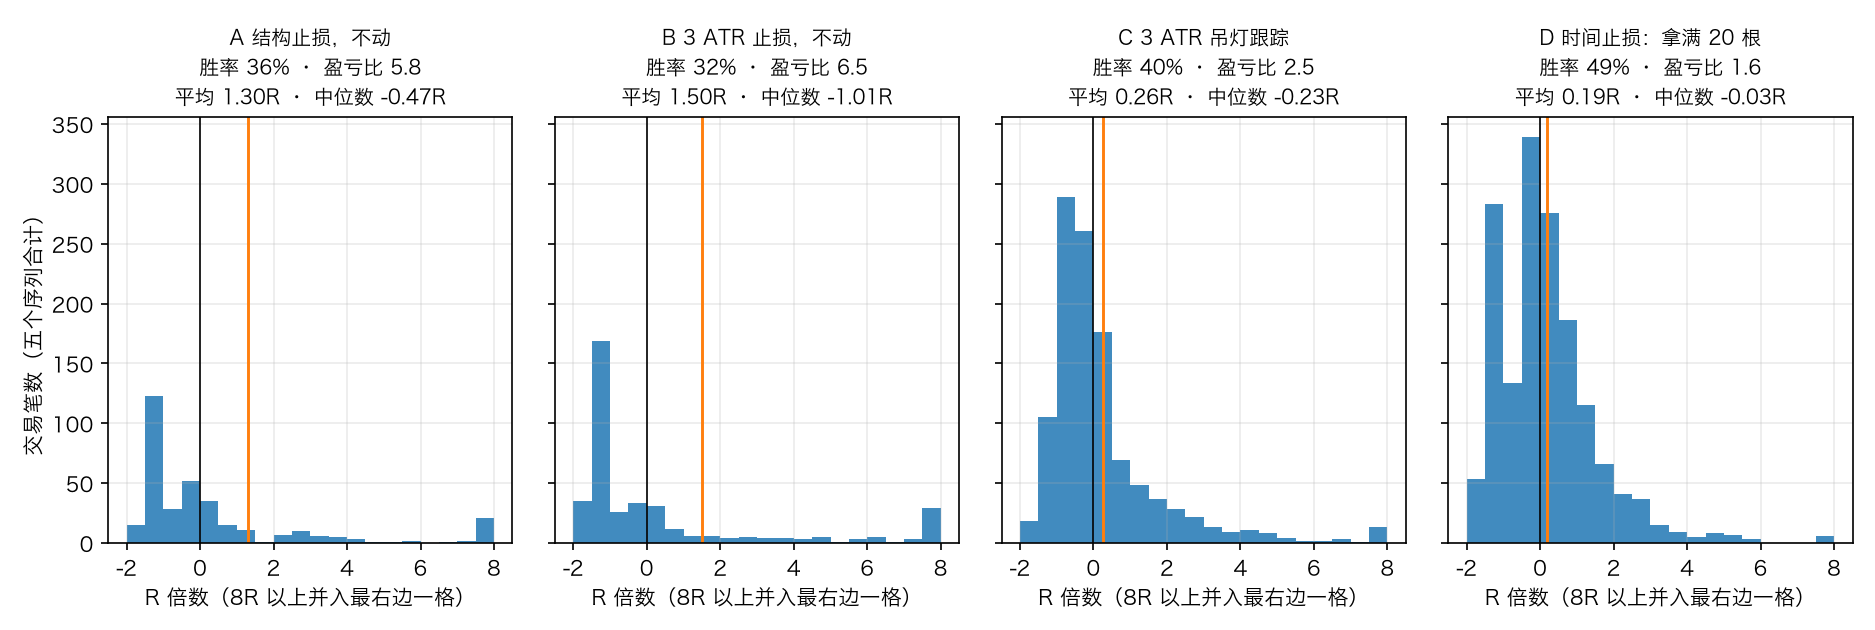
读这张表要小心三件事。
第一,别只看「每笔期望 R」。 A 和 B 每笔的期望值是 C 和 D 的五到十倍,但它们每笔要拿一百多到三百多根 K 线。SPY 日线上,B 一共只做了 7 笔交易,平均每笔拿 262 个交易日。每笔赚得多,只是因为每笔拿得久。
第二,要看「合计 R」,因为四种写法跑的是同一段历史。 交易不重叠,所以九到十年下来的总 R 是可比的:
| 序列 | A 结构 | B 3 ATR | C 吊灯 | D 时间 |
|---|---|---|---|---|
| SPY 日线 | 11.6 | 19.8 | 11.0 | 16.1 |
| AAPL 日线 | 18.4 | 32.9 | 17.0 | 17.5 |
| BTC 日线 | 18.1 | 27.8 | 34.3 | 19.2 |
| BTC 4 小时 | 189.0 | 229.6 | 105.5 | 99.6 |
| BTC 1 小时 | 204.5 | 266.9 | 128.4 | 146.0 |
B 在五个序列里赢了四个。看起来结论很清楚。
第三,看 95% 区间。 把每个序列的交易重抽 2,000 次:SPY 上 B 的合计 R 区间是 [-0, 38],C 是 [-5, 29]——两个区间几乎完全重叠,而且都跨过零。BTC 4 小时线上 B 是 [67, 436],C 是 [48, 173],还是重叠。
这些数据分不出四种出场方式的高下。 交易次数太少(SPY 上 A 和 B 各只有 5 到 7 笔),单笔尾部太肥(AAPL 上 B 的最大一笔占了合计的 82.7%)。
那它们到底改变了什么?看那张分布图:
- A、B 的形状:左边一堆 −1R 附近的小亏,右边拖着一条极长的尾巴,中位数是 −0.47R 和 −1.01R。绝大多数交易在亏钱。
- D 的形状:集中在 0 附近,中位数 −0.03R,最好的一笔 13.5R。
- C 在中间。
四种出场方式改变的是收益分布的形状,不是它的高低。 这和第六节那个随机游走结论是同一件事,只不过这次是在真实数据上、用四种完全不同的出场机制看到的。
主线策略这一篇不改
      标的  交易数    胜率   盈亏比  每笔期望 R    合计 R 合计 R 的 95% 区间  最大回撤 R
  SPY 日线   39 0.436 2.367   0.282  11.017      [-5, 29]  -2.685
 AAPL 日线   37 0.514 2.192   0.458  16.952      [-1, 37]  -3.724
  BTC 日线   30 0.433 4.979   1.144  34.329      [-3, 92]  -3.597
BTC 4 小时  186 0.468 3.077   0.567 105.530     [48, 173] -10.744
BTC 1 小时  827 0.375 2.307   0.155 128.445     [37, 225] -20.263
主线 v3 保持原样,理由和第 20、21 篇一样:按机制选,不按回测数字选。
- B 的合计 R 更高,但它不设跟踪止损。 这意味着一笔浮盈 10R 的交易可以一路跌回 −1R 才出场(AAPL 日线上 B 的最大回撤 −1.79R 看起来很小,是因为它总共只有 5 笔交易)。第 21 篇选吊灯止损的理由是「止损买的是最差一笔的上限」,这个理由没有变。
- 固定目标(2R 止盈)和趋势跟随的逻辑直接冲突。 主线策略赚钱靠的就是那条右尾:1,119 笔交易里中位数是 −0.23R,全靠 21.5% 的大赢家。砍掉尾巴,这条策略的理由就没了。
- 时间止损在这里没有位置。 主线是波段策略,没有「资金紧张、要腾位置」的问题(同时只有一个仓位)。等到第 26 篇引入组合,时间止损才有讨论的意义。
所以 v3 的四个答案是:
一、初始止损            进场价下方 3.0 倍 ATR
二、止损跟不跟    吊灯:最高价往下 3.0 倍 ATR,只上移
三、目标价                 不设目标,让它自己走完
四、最多拿多久                        不限
十三、最大浮盈和最大浮亏
run 返回的表里还有两列没用过:最大浮盈(MFE)和最大浮亏(MAE)。它们回答两个问题:这笔交易有没有给过你机会?你离被打掉有多近?
pool = []
for name, (df, _) in MARKETS.items():
    t = K.run(df, entries(df), CHANDELIER, exits=deaths(df))
    t["标的"] = name
    pool.append(t)
all_trades = pd.concat(pool, ignore_index=True)
winners = all_trades[all_trades["R 倍数"] > 0]
losers = all_trades[all_trades["R 倍数"] <= 0]
print(f"五个序列合计 {len(all_trades)} 笔:赚钱 {len(winners)} 笔,亏钱 {len(losers)} 笔")
print(pd.DataFrame({"赚钱的交易 · 最大浮亏": winners["最大浮亏"].quantile([.5, .75, .9, .95]),
                    "亏钱的交易 · 最大浮亏": losers["最大浮亏"].quantile([.5, .75, .9, .95]),
                    "亏钱的交易 · 最大浮盈": losers["最大浮盈"].quantile([.5, .75, .9, .95])}).round(2).to_string())
五个序列合计 1119 笔:赚钱 446 笔,亏钱 673 笔
      赚钱的交易 · 最大浮亏  亏钱的交易 · 最大浮亏  亏钱的交易 · 最大浮盈
0.50         -0.26         -0.80          0.40
0.75         -0.13         -0.55          0.67
0.90         -0.06         -0.36          0.93
0.95         -0.03         -0.28          1.16
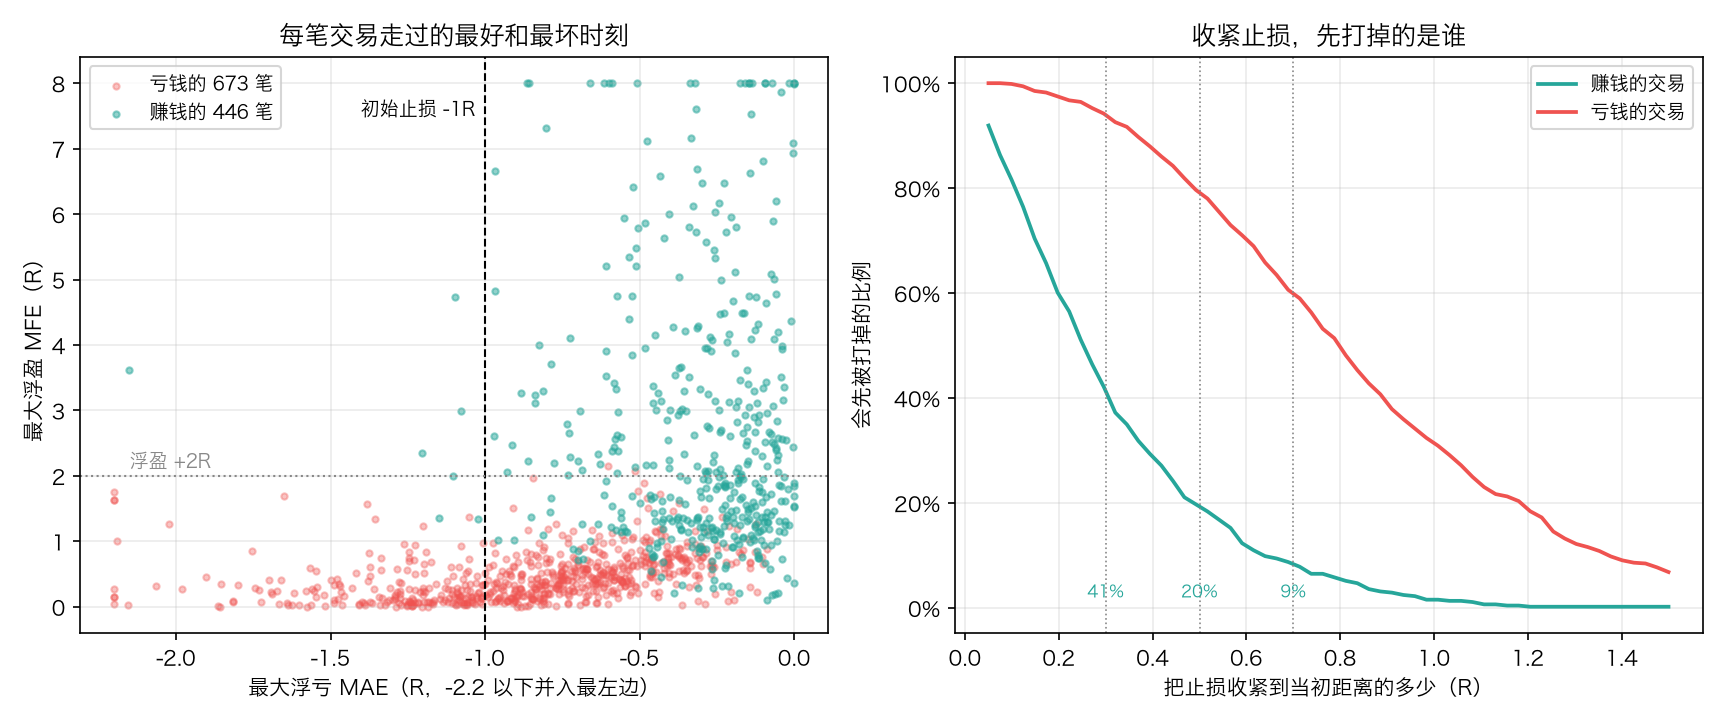
左边那张散点图是这一节的全部内容:赚钱的交易(绿)挤在右上角,亏钱的交易(红)摊在左下角。
赚钱的交易几乎不怎么逆行。 它们的最大浮亏中位数只有 −0.26R,80.5% 的赢家从来没跌超过 0.5 个 R。
看到这个数,第一反应通常是:那把止损收到 0.5R 不就行了吗?风险砍一半,赢家还基本都留着。
赚钱的交易里,最大浮亏没超过 0.5R 的占 80.5%
但把止损收紧,代价是打掉一部分赢家:
  止损改放在 −0.3R(当初距离的 30%),赢家里有 41.5% 会先被打掉
  止损改放在 −0.5R(当初距离的 50%),赢家里有 19.5% 会先被打掉
  止损改放在 −0.7R(当初距离的 70%),赢家里有 8.5% 会先被打掉
  止损改放在 −1.0R(当初距离的 100%),赢家里有 1.6% 会先被打掉
亏钱的交易里,浮盈到过 1R 的只有 7.7%,到过 2R 的只有 0.3%
全部交易里最大浮亏跌穿 1R 的有 19.7%——收盘触发的止损盘中会被穿过去(第 20 篇的选择)
把止损收到当初距离的一半,确实只打掉 19.5% 的赢家——但那 19.5% 不是随机抽的。赢家里排在最前面的那几笔,正好是持有时间最长、也最有机会在中途回撤过的。这是一笔要算的账,不是一个免费的改进。(右边那张图画的就是这笔账:两条曲线的垂直距离,是收紧止损时「甩掉输家」和「误伤赢家」的比例差;距离越大,收紧越划算。)
后面那两行还说了两件事:
- 亏钱的交易里,浮盈到过 1R 的只有 7.7%,到过 2R 的只有 0.3%。 在这套跟踪止损下,浮盈 2R 之后几乎不可能再变成亏损——这印证了第十一节的 0.5%。
- 19.7% 的交易最大浮亏跌穿了 1R。 这是第 20 篇那个选择的代价:收盘触发的止损,盘中会被穿过去。它也解释了为什么第六节里平均亏损总是 1.1 到 1.3 个 R。
十四、小检查
- 你以 50 美元买入,止损放在 46 美元,最后在 62 美元出场。这笔赚了几个 R?如果止损当初放在 48 美元呢?
- 一条策略胜率 35%,平均盈利 2.4R,平均亏损 1.1R。期望值是多少?打平需要多少胜率?
- 某条策略的止盈目标从 3R 改成 1R 之后,胜率从 40% 涨到 65%。这是改进吗?
- 为什么「浮盈到过 5R 的交易,最后中位数只留住 69%」不是吊灯止损的缺陷?
- 一套出场方案只写了「止损 3 ATR」。另外三个问题的答案是什么?
十五、常见误用
1. 用「胜率」单独评价一条策略。 胜率脱离盈亏比没有意义。第六节的随机游走里,胜率 9% 和胜率 65% 的两条规则期望值完全一样(都是 0)。要比就比「实测胜率 − 打平需要的胜率」。
2. 按账户的浮亏定止损。 「我最多能忍受亏 5%,所以止损放 5%」——这把第一个问题(止损放哪)和第六个问题(仓位买多少)混成了一个。正确的顺序是:先按图上的结构或波动率定止损距离,再按能承受的风险倒推买多少。第 26 篇讲后半句。
3. 止损往下移。 「再给它一点空间」。允许下移的止损不是止损。这不是纪律问题,是定义问题:一条会往下让的线,价格永远碰不到它。
4. 把 R 按「当前止损」算。 止损抬到成本价之后,有人开始说「现在我一分钱风险都没有,所以 R 是零,收益是无穷倍」。R 永远按初始止损算——它衡量的是你当初冒的风险。
5. 拿事后的 MFE 当目标。 「这笔交易最高到过 5R,我本来该在 5R 出场的」——最大浮盈只有在交易结束后才知道。第十三节的统计能告诉你「浮盈到过 2R 的交易平均最后留住 47%」,不能告诉你这一笔的最高点在哪。
6. 用小样本挑出场方式。 第十二节的 95% 区间是这一篇最该记住的一张表:SPY 上四种出场方式的合计 R 区间全都跨过零。7 笔交易挑出来的「最优出场」,换一个标的大概率就不是最优(第 21 篇量过,写法排名跨标的的秩相关只有 0.27 到 0.82)。
7. 时间止损设在「我不耐烦了」。 时间止损的理由是入场理由过期,不是持有者的心情。设它的时候要能说出:我的入场信号大概在多少根 K 线内兑现?超过这个数,这个信号还成立吗?
十六、小结
- 一个 R = 进场价 − 初始止损价。 所有交易换成 R 之后才能放在一起比。R 只按初始止损算,止损后来抬到哪里都不改它。
- 出场是四个互相独立的问题:初始止损放在哪、止损跟不跟着走、有没有目标价、最多拿多久。不回答等于用了默认值。
- 三种初始止损:结构(贴着图上的位置)、波动率(按 ATR 伸缩)、固定比例(不随尺度变,最容易出事)。在主线的入场条件下,结构止损比 3 ATR 远得多——入场条件会决定止损距离。
- 跟踪止损必然还回去一部分利润:浮盈到过 2–3R 的交易,中位数只留住 47%;到过 5R 以上的留住 69%。这是止损的价钱,不是它的毛病。
- 胜率和盈亏比必然此消彼长:在无漂移随机游走上,目标放在 x 个 R,胜率恰好是 1÷(1+x),期望值恒为零。真实数据上这条曲线和打乱后的价格几乎重合——它是算术,不是市场性质。
- 打平需要的胜率 = 平均亏损 ÷(平均亏损 + 平均盈利)。 判断一条策略,要比的是实测胜率和这个数的差。
- 期望值就是平均 R。 那条拆开的公式不提供新信息,它的用处是指出能改的两头。
- 成本按 R 折算 = 费率 ÷ 止损距离。 BTC 1 小时线上 0.5R 的目标,九年合计 108.6R,成本吃掉 61%。
- 四种出场方式改变的是收益分布的形状,不是高低:合计 R 的 95% 区间在五个序列上全部重叠,几乎全部跨零。
- 浮盈 2R 的那 205 笔:拿住平均 3.11R、中位数 2.21R;当场走平均 2.38R;平一半平均 2.74R、中位数最高、标准差比拿住低 44%。拿住有 53.7% 的次数不如当场走,但 21.5% 的交易贡献了一半的 R。
- 赢家几乎不逆行(最大浮亏中位数 −0.26R),但收紧止损不是免费的:收到 0.5R 会打掉 19.5% 的赢家。
- 主线策略这一篇不改,理由是机制:固定目标和趋势跟随的逻辑冲突,时间止损要等第 26 篇有了组合才有意义。
练习
- 换一把尺子:把第十一节的「浮盈 2R」换成 1R 和 3R 重做一遍。「拿住不如当场走」的比例怎么变?交叉点移到哪里去了?
- 保本止损的代价:
Exit(trail="breakeven", trail_r=1.0)在五个序列上跑一遍,和吊灯跟踪比。它把多少笔本来的赢家提前打掉了?把trail_r从 0.5 调到 3,画出「被提前打掉的赢家比例」和「最差一笔」的取舍曲线。 - 分批的粒度:
partial_r从 1R 调到 5R,partial_fraction从 0.25 调到 0.75,画出期望值和标准差的散点图。有没有哪个组合同时改善了两者? - 目标 + 跟踪一起用:第六节的目标扫描是在「不跟踪」的前提下做的。加上吊灯跟踪再扫一遍,结论还成立吗?为什么跟踪止损会让远目标变得几乎没用?
- 按 MAE 定止损:用第十三节的思路,在前一半历史上算出赢家的 MAE 分布,取 90% 分位作为止损距离,在后一半历史上检验。这个「数据驱动的止损」比 3 ATR 好吗?(注意这是第 30 篇样本外检验的预演。)
- 随机游走的漂移:给第六节的
race加一个漂移项(每步向上的概率是 0.51 而不是 0.5),重画胜率曲线。多大的漂移能让 10R 目标的期望值变正? - 单位时间的 R:第七节说「单位时间的 R 才是要比的东西」。把第十二节四种出场方式的「合计 R ÷ 在场根数」算出来,排名和「合计 R」的排名一样吗?
小检查答案
- 3 个 R((62−50) ÷ (50−46) = 12 ÷ 4)。止损放在 48 时,一个 R 是 2 美元,同样的出场价就是 7 个 R——同一笔交易,成绩差一倍多。这说明 R 是相对于你自己定的风险的,不是市场给的。
- 期望值 = 0.35 × 2.4 − 0.65 × 1.1 = 0.125R。打平需要 1.1 ÷ (1.1 + 2.4) = 31.4% 的胜率,实测 35%,还剩 3.6 个百分点的优势。
- 看不出来。 胜率涨是必然的(第六节),关键是盈亏比掉了多少。如果盈亏比从 3 掉到 1,那么打平胜率从 25% 升到 50%,65% 的胜率反而比原来的 40% 更接近打平线。还要加上一条:目标从 3R 改成 1R 会让交易次数大约翻一倍,成本也跟着翻一倍。
- 因为吊灯止损是跟着最高价走的,它出场时必然低于最高价 k 个 ATR。不还回去就意味着你精确地卖在了最高点——那需要知道最高点在哪,而最高点只有事后才知道(这也是第十五节第 5 条)。
- 默认值替你回答了:
trail="none"(止损不动)、target_r=None(没有目标)、max_bars=None(不限时间)。第十二节的 B 就是这套写法:它的中位数是 −1.01R,赚钱靠 32% 的交易,最长的一笔拿了两年多。你也许想要这个,但你应该是选了它,而不是默认到了它。