这一讲要回答五个问题:
- 一个博弈由哪些部分组成?
- 什么是占优策略?为什么每个人都做对自己最好的选择,结果会比大家合作更糟?(囚徒困境不只出现在企业身上)
- 什么是纳什均衡?怎么找?一个博弈有好几个均衡时怎么办?
- 点球时守门员该往哪边扑?为什么最好的策略是随机?
- 双方不是同时行动,而是一先一后,会怎样?什么样的威胁才可信?
第 16 讲,我们已经玩过博弈了:两家烤肠摊,每家的最佳选择取决于对方怎么选;我们说"两家都已经是对方的最佳反应时,谁也不想单独改变",叫均衡,并且提到过囚徒困境。第 17 讲结尾,我说囚徒困境不只出现在企业身上。这一讲把这些零散的想法,整理成一套工具。你会发现,它的用处远远超出了企业定价。
一、约好了见面,却没说在哪儿
你和朋友约好周末在北京见面,却忘了说具体地点,两个人的手机又都没电了,没法联系。你们都想见到对方,见得到比见不到好,但没有人在乎具体在哪里。
先停一下:你会去哪儿?
你大概会想:他会去哪儿?他大概会想:她会去哪儿?你们都在猜对方的猜测。最后,你们可能都去一个最显眼的地方,比如北京站或者天安门。你们没商量,却走到了同一个地方,因为那里"最容易想到"。
经济学家 Thomas Schelling 在 1960 年的《冲突的策略》里用过类似的例子(纽约的版本),并把这种"大家都会往那里去"的、显眼的选择,叫做聚点(focal point)。
这个小问题,已经包含了博弈论的核心:你的最佳选择,取决于你认为对方会怎么选;而对方的选择,也取决于他认为你会怎么选。 这就是博弈。
二、博弈的要素
一个博弈由这几样东西组成:
- 参与者:谁在做决定(两家烤肠摊、两个囚犯、你和朋友)。
- 策略:每个参与者可以选的完整计划(卖多少、定什么价、去哪儿)。
- 收益:每个组合下,每个人得到什么。收益不一定是钱,可以是任何你在乎的东西:利润、安全、面子、对公平的在乎。
- 行动的顺序和信息:大家同时选,还是一先一后?每个人知道什么?(信息不一样多的情形,第 20 讲会讲。)
两个人、每人两个选择的博弈,最方便的写法,是一张收益矩阵:每个格子里,写出(行玩家的收益,列玩家的收益)。
这一讲还默认一件事:每个参与者都想让自己的收益最大,而且知道对方也在这样想。
三、占优策略与囚徒困境
3.1 占优策略
第 16 讲的两家烤肠摊,每家有两个选择:守约(只卖 225 根,两家合起来是垄断量)和自己干(卖 300 根)。我们换成最简单的数字,写成矩阵(每格:我的收益,对方的收益):
| 对方合作 | 对方背叛 | |
|---|---|---|
| 我合作 | 3,3 | 0,5 |
| 我背叛 | 5,0 | 1,1 |
看"我":
- 对方合作时,我背叛得 5,合作得 3,背叛更好;
- 对方背叛时,我背叛得 1,合作得 0,背叛更好。
不管对方怎么选,背叛都更好。 这样的策略叫占优策略(dominant strategy):不管别人怎么选,它都不比别的策略差,并且至少有一种情形严格更好。对方也一样,所以两人都背叛,各得 1,比两人都合作的 3 还少。这就是囚徒困境。
之所以叫囚徒困境,来自一个故事:两个嫌疑人被分开审讯,每个人都可以"招供"(背叛同伙)或者"不招"(合作)。不管同伙怎么选,招供都对自己更有利;可是两个人都招供,比两个人都不招要糟得多。
3.2 困境从哪里来
为什么会这样?因为我的选择,影响了你的收益,但我不为这个影响付任何代价(第 23 讲会讲的"外部性")。我背叛,我得到了好处,成本却由你承担。双方都这样做,就都吃亏。
要走出困境,需要有办法让承诺可信,或者改变收益:具有约束力的合同、反复打交道时的惩罚(第 19 讲)、声誉、规范和制度(第 26 讲)。
3.3 囚徒困境的家族
这个结构,到处都是,不只在企业身上:
- 价格战、产量竞争(第 16 讲):各家都想多卖,结果价格和利润都下去了。
- 军备竞赛:两个国家,每个都可以选择"扩军"或"不扩军"。不管对方怎么选,扩军都让自己更安全;可是两国都扩军,两国都更穷,也没有更安全(和都不扩军相比)。(现实里的安全问题复杂得多,威慑有时能阻止战争。这里只是说这种结构。)
- 公共品与搭便车:见下面的例子。
- 公共卫生:传染病接近消灭时,如果多数人都接种,没接种的人也受保护(群体免疫)。每个人都想"让别人去接种,我搭便车"。不过要注意:接种对个人自己也有好处,如果这个好处大于风险,每个人会自己接种,那就不是囚徒困境;只有当接种对自己的好处小、对别人的好处大时,搭便车才成为问题。
- 相对地位的竞争:如果好处取决于相对排名(谁考得更好、谁更晚下班),每个人加码,都只是为了"不落后";大家都加码后,排名没变,成本却都上升了。(这是对一类现象的一种模型解读,不是被测量出来的结论;现实里加码也可能提高了真实的技能或产出。)
我们用一个公共品博弈,把这个结构算清楚:
# 4 个人,每人有 10 元,可以投入 0 到 10 元到"公共池"。池里的钱乘以 1.6,再平均分给 4 个人(不管你投没投)。
N, ENDOW, MULT = 4, 10, 1.6
def payoff(my, others_total):
    """我投 my,别人一共投 others_total:我留下的 + 我分到的"""
    return (ENDOW - my) + MULT * (my + others_total) / N

print("别人一共投 others,我投 0 和投 10 各得多少:")
for others in (0, 10, 20, 30):
    print(f"  别人一共投 {others:>2}:我投 0 得 {payoff(0, others):5.1f},我投 10 得 {payoff(10, others):5.1f}")
print(f"\n每多投 1 元,我自己只分回 {MULT / N:.1f} 元,所以投 0 是占优策略;但是:")
print(f"  四个人都投 0:每人 {payoff(0, 0):.0f};四个人都投 10:每人 {payoff(10, 30):.0f}")
print(f"  池子乘数要超过 {N},每人才会愿意投(每投 1 元自己能分回 > 1 元)")
输出:
别人一共投 others,我投 0 和投 10 各得多少:
  别人一共投  0:我投 0 得  10.0,我投 10 得   4.0
  别人一共投 10:我投 0 得  14.0,我投 10 得   8.0
  别人一共投 20:我投 0 得  18.0,我投 10 得  12.0
  别人一共投 30:我投 0 得  22.0,我投 10 得  16.0

每多投 1 元,我自己只分回 0.4 元,所以投 0 是占优策略;但是:
  四个人都投 0:每人 10;四个人都投 10:每人 16
  池子乘数要超过 4,每人才会愿意投(每投 1 元自己能分回 > 1 元)
- 不管别人投多少,我投 0 总比投 10 多得 6 元(比如别人一共投 30,我投 0 得 22,投 10 得 16)。每多投 1 元,社会总收益多 0.6 元(乘数 1.6 减去投出去的 1 元),我自己只分回 0.4 元。
- 所以"投 0"是占优策略,四个人都投 0,每人只有 10 元;可是四个人都投 10,每人能得 16 元。
- 如果乘数超过 4,每多投 1 元自己能分回超过 1 元,投入就成了占优策略,困境消失。困境的存在,取决于"我分回的"比"我付出的"少。
小结: 占优策略:不管别人怎么选都不比别的差。囚徒困境:人人都有占优策略(背叛),结果比人人合作更糟。根源是我的选择影响了别人,我却不付代价。它出现在价格战、军备、公共品、公共卫生等很多场景。
四、纳什均衡
4.1 定义
大多数博弈,并没有占优策略。这时,怎么预测会发生什么?
数学家 John Nash 1950 年(Proceedings of the National Academy of Sciences,36 卷 1 期)的想法是:
纳什均衡:一组策略,其中每个参与者的策略,都是对其他人策略的最佳反应。也就是说:在这个状态下,没有任何一个人,能靠单独改变自己的选择,得到更多。
这和第 16 讲的"均衡"是一回事。它不是说结果好,只是说结果稳定:没有人想单独离开。
4.2 怎么找:划线法
在矩阵里:对每一列,在行玩家的最大收益下面划一道线;对每一行,在列玩家的最大收益下面划一道线。两个数下面都有线的格子,就是纳什均衡。代码把这件事做了,我们看五个有名的博弈:
# 二人博弈:每个格子是(行玩家的收益,列玩家的收益)
games = {
    "囚徒困境": (["合作", "背叛"], ["合作", "背叛"],
                 [[(3, 3), (0, 5)],
                  [(5, 0), (1, 1)]]),
    "协调博弈(靠哪边开)": (["靠左", "靠右"], ["靠左", "靠右"],
                 [[(1, 1), (0, 0)],
                  [(0, 0), (1, 1)]]),
    "猎鹿博弈": (["猎鹿", "抓兔"], ["猎鹿", "抓兔"],
                 [[(4, 4), (0, 3)],
                  [(3, 0), (3, 3)]]),
    "斗鸡博弈": (["让", "不让"], ["让", "不让"],
                 [[(2, 2), (0, 4)],
                  [(4, 0), (-5, -5)]]),
    "石头剪刀布": (["石头", "剪刀", "布"], ["石头", "剪刀", "布"],
                 [[(0, 0), (1, -1), (-1, 1)],
                  [(-1, 1), (0, 0), (1, -1)],
                  [(1, -1), (-1, 1), (0, 0)]]),
}

def pure_nash(rows, cols, pay):
    """找出所有"谁也不想单独改变"的格子:行玩家在这一列里是最优,列玩家在这一行里也是最优"""
    found = []
    for i in range(len(rows)):
        for j in range(len(cols)):
            row_best = all(pay[i][j][0] >= pay[k][j][0] for k in range(len(rows)))
            col_best = all(pay[i][j][1] >= pay[i][k][1] for k in range(len(cols)))
            if row_best and col_best: found.append((i, j))
    return found

def dominant(rows, cols, pay):
    """行玩家有没有一个策略,不管对方怎么选都不比别的差(而且至少有一次更好)?"""
    for i in range(len(rows)):
        if all(all(pay[i][j][0] >= pay[k][j][0] for j in range(len(cols))) and
               any(pay[i][j][0] > pay[k][j][0] for j in range(len(cols))) for k in range(len(rows)) if k != i):
            return rows[i]
    return None

for name, (rows, cols, pay) in games.items():
    eq = pure_nash(rows, cols, pay)
    desc = ";".join(f"({rows[i]},{cols[j]})收益 {pay[i][j]}" for i, j in eq) or "没有"
    print(f"{name}:纯策略纳什均衡 {len(eq)} 个:{desc};行玩家的占优策略:{dominant(rows, cols, pay) or '没有'}")
输出:
囚徒困境:纯策略纳什均衡 1 个:(背叛,背叛)收益 (1, 1);行玩家的占优策略:背叛
协调博弈(靠哪边开):纯策略纳什均衡 2 个:(靠左,靠左)收益 (1, 1);(靠右,靠右)收益 (1, 1);行玩家的占优策略:没有
猎鹿博弈:纯策略纳什均衡 2 个:(猎鹿,猎鹿)收益 (4, 4);(抓兔,抓兔)收益 (3, 3);行玩家的占优策略:没有
斗鸡博弈:纯策略纳什均衡 2 个:(让,不让)收益 (0, 4);(不让,让)收益 (4, 0);行玩家的占优策略:没有
石头剪刀布:纯策略纳什均衡 0 个:没有;行玩家的占优策略:没有
逐个看:
- 囚徒困境:唯一的均衡是(背叛,背叛),收益(1,1)。它比(合作,合作)的(3,3)差:均衡不一定是好的结果。
- 协调博弈:两个人都开车,需要约定靠左还是靠右开。(靠左,靠左)和(靠右,靠右)都是均衡,收益一样;(靠左,靠右)这种不一致的,会撞车。选哪个无所谓,但必须一致。一个社会里,谁来决定靠哪边?靠惯例,和谢林说的聚点。(中国靠右行驶,是一个惯例,不是自然法则。)
- 猎鹿博弈:两个猎人,可以一起去猎鹿(需要两人合作,收益大,各得 4),或者各自去抓兔子(稳妥,各得 3);一个人去猎鹿、另一个去抓兔,猎鹿的人一无所获(0)。(猎鹿,猎鹿)和(抓兔,抓兔)都是均衡。 前者对双方更好(4 > 3),后者更安全。选哪个,取决于你信不信对方会来。这和第 17 讲的网络效应、多重均衡,是同一个结构:同样的偏好,两种稳定的结局,取决于预期。
- 斗鸡博弈:两辆车迎头冲过来,每人可以让或不让。都不让会撞车,大家都损失惨重(−5)。(让,不让)和(不让,让)是均衡:一方让,一方不让。问题是:谁让? 双方都想做那个不让的。如果一方能够可信地"扔掉方向盘"(让对方相信自己绝不会让),对方就会让。这是"承诺“的价值,和第 16 讲先动者的优势是同一个想法。
- 石头剪刀布:没有纯策略的均衡。不管你出什么,对方都有办法赢你。这是下一节要讲的。
John Nash 证明过:只要参与者和策略的数目是有限的,就至少存在一个均衡,不过可能需要允许"混合策略”(下一节)。
4.3 多重均衡怎么办
猎鹿、协调、斗鸡,都有不止一个均衡。这是博弈论最让人头疼的地方:均衡的概念不告诉你,最后会落在哪一个。 经济学家的回答,是引进别的东西:
- 聚点(谢林):显眼的、有共同认知的选择。
- 历史和惯例:以前怎么做,现在就怎么做。
- 沟通和承诺:事先商量、做出可信的承诺。
- 预期:大家相信别人会怎么选。
这提醒我们:博弈论更擅长告诉你"哪些结果是稳定的",不总能告诉你"哪个会发生"。
小结: 纳什均衡:每个人的策略,都是对其他人策略的最佳反应,没有人想单独改变。它是"稳定",不是"好"。囚徒困境的均衡比合作差;协调、猎鹿、斗鸡有好几个均衡,要靠聚点、惯例、承诺、预期来挑。
五、混合策略:为什么要随机
5.1 点球
石头剪刀布没有纯策略的均衡,因为任何可预测的做法,都会被对方利用。真正的博弈里,这个问题很常见:点球。
球员选踢左或踢右,守门员选扑左或扑右(同时选,因为球太快,守门员没法等看清方向再动)。下面是进球的概率(示意数字,球员希望它大,守门员希望它小):
| 守门员扑左 | 守门员扑右 | |
|---|---|---|
| 球员踢左 | 0.6 | 0.9 |
| 球员踢右 | 1.0 | 0.7 |
先停一下:如果你是球员,你会总是踢同一边吗?
不会。如果你总是踢左,守门员就会总是扑左,你的进球率只有 0.6;总踢右,守门员总扑右,进球率 0.7。只要你的选择可以预测,对方就能针对你。 最好的办法,是以一定的概率随机地选,让守门员无法预测。这叫混合策略(mixed strategy)。
5.2 怎么算:让对方"选哪个都一样"
关键的想法有点反直觉:你随机化的概率,不是由你自己的收益决定的,而是由"要让对方在两个选择之间无差别"决定的。
- 球员要选一个"踢左的概率",使得守门员扑左、扑右的结果一样;
- 守门员要选一个"扑左的概率",使得球员踢左、踢右的进球率一样。
守门员扑左的概率设为 g,球员踢左的进球率是 0.6g + 0.9(1 − g),踢右是 1.0g + 0.7(1 − g),令它们相等:0.9 − 0.3g = 0.7 + 0.3g,所以 g = 1/3。同理,球员踢左的概率 k = 1/2。
import numpy as np

# 点球:球员选踢左/踢右,守门员选扑左/扑右。格子里是"进球的概率"(球员想要它大,守门员想要它小)。示意数字:
#             扑左   扑右
#   踢左      0.6    0.9
#   踢右      1.0    0.7
score = np.array([[0.6, 0.9],
                  [1.0, 0.7]])

# 一、混合策略均衡:让对方"选哪个都一样"
g = (score[1, 1] - score[0, 1]) / (score[0, 0] - score[0, 1] - score[1, 0] + score[1, 1])   # 守门员扑左的概率
k = (score[1, 1] - score[1, 0]) / (score[0, 0] - score[0, 1] - score[1, 0] + score[1, 1])   # 球员踢左的概率
print(f"守门员扑左的概率 {g:.3f},球员踢左的概率 {k:.3f}")
print(f"球员踢左的进球率 {score[0, 0] * g + score[0, 1] * (1 - g):.3f},踢右的进球率 {score[1, 0] * g + score[1, 1] * (1 - g):.3f}(一样)")
print(f"守门员扑左时对方的进球率 {score[0, 0] * k + score[1, 0] * (1 - k):.3f},扑右时 {score[0, 1] * k + score[1, 1] * (1 - k):.3f}(一样)")

# 二、把一个选择钉死,会怎样:球员总是踢左,守门员会怎么应对?
print(f"\n如果球员总是踢左:守门员扑左的进球率 {score[0, 0]},扑右 {score[0, 1]},所以守门员会一直扑左,球员进球率只有 {score[0, 0]}(比 {score[0, 0] * g + score[0, 1] * (1 - g):.1f} 低)")

# 三、均衡是怎么"学出来"的:双方每一轮都对"对方到目前为止的出手频率"选自己的最佳应对
rounds = 20000
kick_left = np.zeros(rounds + 1); dive_left = np.zeros(rounds + 1)
kl, dl = 1, 1                                          # 各自"左"出现的次数;一开始各有一个(避免除以零)
kr, dr = 1, 1
for t in range(rounds):
    p_dive_left = dl / (dl + dr)                       # 球员估计的守门员扑左概率
    p_kick_left = kl / (kl + kr)                       # 守门员估计的球员踢左概率
    kick = 0 if score[0, 0] * p_dive_left + score[0, 1] * (1 - p_dive_left) >= score[1, 0] * p_dive_left + score[1, 1] * (1 - p_dive_left) else 1
    dive = 0 if score[0, 0] * p_kick_left + score[1, 0] * (1 - p_kick_left) <= score[0, 1] * p_kick_left + score[1, 1] * (1 - p_kick_left) else 1
    kl += kick == 0; kr += kick == 1; dl += dive == 0; dr += dive == 1
    kick_left[t + 1] = kl / (kl + kr); dive_left[t + 1] = dl / (dl + dr)
for n in (10, 100, 1000, 20000):
    print(f"  前 {n:>5} 轮:球员踢左的频率 {kick_left[n]:.3f},守门员扑左的频率 {dive_left[n]:.3f}")
print(f"(均衡:球员 {k:.3f},守门员 {g:.3f})")
输出:
守门员扑左的概率 0.333,球员踢左的概率 0.500
球员踢左的进球率 0.800,踢右的进球率 0.800(一样)
守门员扑左时对方的进球率 0.800,扑右时 0.800(一样)

如果球员总是踢左:守门员扑左的进球率 0.6,扑右 0.9,所以守门员会一直扑左,球员进球率只有 0.6(比 0.8 低)
  前    10 轮:球员踢左的频率 0.583,守门员扑左的频率 0.333
  前   100 轮:球员踢左的频率 0.490,守门员扑左的频率 0.402
  前  1000 轮:球员踢左的频率 0.480,守门员扑左的频率 0.341
  前 20000 轮:球员踢左的频率 0.503,守门员扑左的频率 0.333
(均衡:球员 0.500,守门员 0.333)
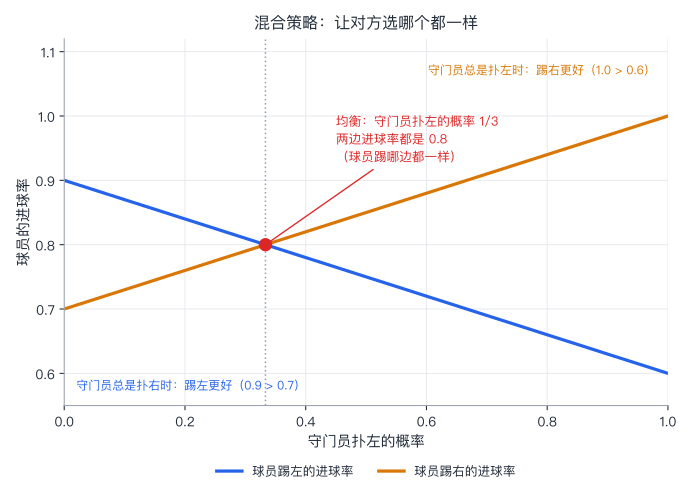
- 均衡:守门员 1/3 的概率扑左,球员 1/2 的概率踢左。这时球员踢左、踢右的进球率都是 0.8,守门员扑左、扑右时,对方的进球率也都是 0.8:每个人都"选哪个都一样",所以谁也不想改变。
- 钉死的代价:如果球员总是踢左,守门员会一直扑左,进球率只有 0.6,比均衡里的 0.8 低。
- 学习:代码的第三部分,不假设任何人知道均衡。双方每一轮,只是对"对方到目前为止的出手频率"选自己的最佳应对。结果,出手的频率慢慢走向均衡(球员踢左的频率走到约 0.50,守门员扑左的频率走到约 0.33)。(对这类零和博弈,可以证明这样的"互相适应"会收敛到均衡。)
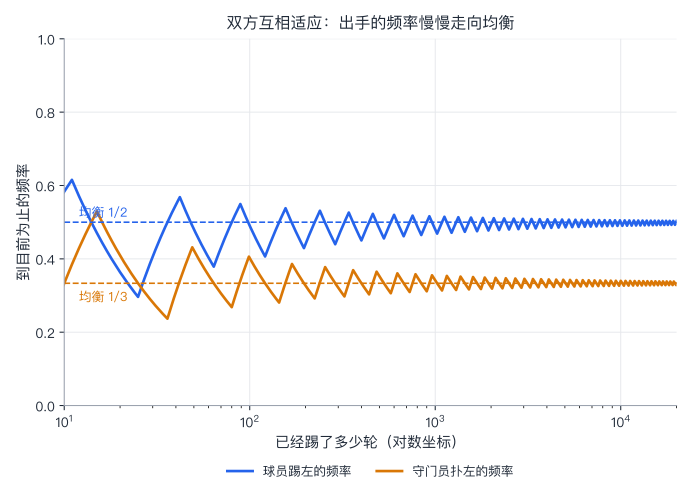
这说明:均衡不一定要求参与者"算出"最优策略,也可以是长期互相适应的结果。
5.3 证据:职业球员真的这样吗
证据怎么说:Ignacio Palacios-Huerta 2003 年(Review of Economic Studies,70 卷 2 期)用职业足球比赛里的点球数据,检验这个理论的两个预测:(1)球员踢左或踢右,进球率应该差不多(否则有一边更好,该多踢那边);(2)每次的选择,应该没有规律(不能被预测)。他发现,两个预测大体上都得到支持。Chiappori、Levitt 和 Groseclose 2002 年(American Economic Review,92 卷 4 期)用法国、意大利的数据,也发现球员的行为与混合策略的预测大体一致,并且特别处理了不同球员的差别。
局限:这是少数几个职业选手的真实数据;同样的分析,换成实验室里的普通学生,结果常常离理论预测更远。关于职业选手在实验室里是不是也这样,后续研究之间有争论(Palacios-Huerta 和 Volij 发现他们接近;Levitt、List 和 Reiley 没有)。所以更稳妥的结论是:在经验丰富、反复面对同一个博弈、而且有强烈动机的人那里,混合策略的预测相当好;在别的人群、别的情境里,不一定。
小结: 没有纯策略均衡时,均衡里每个人以一定概率随机选择,概率由"让对方选哪个都一样"决定(不是由自己的收益决定)。随机是为了不被预测。均衡可以是互相适应的结果。职业球员的点球数据,大体支持这一点。
六、一先一后:博弈树与可信威胁
6.1 逆向归纳
前面的博弈,大家同时行动。如果是一先一后,后行动的人看得到先行动的人做了什么,就要用博弈树。解法很自然:从最后一步倒着想(逆向归纳)。
回到第 16 讲的一个问题:新企业要不要进入一个已经有在位企业的市场?在位企业放狠话:“你进来我就打价格战。” 可信吗?
博弈树:新企业先选进来或不进来;如果进来,在位企业再选开战或接受。收益是(新企业,在位企业),单位百万元:不进来(0,10);进来后开战(−3,2);进来后接受(3,5)。
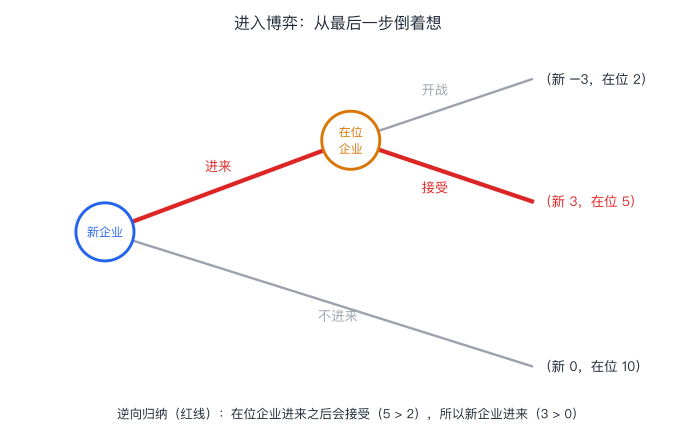
倒着想:如果新企业进来了,在位企业会选什么? 开战得 2,接受得 5,接受更好。新企业预见到这一点,进来能得 3,比不进来的 0 高,所以进来。结果是(进来,接受)。
6.2 为什么"开战"的威胁不可信
我们用代码,把这个博弈用"事先定好计划"的方式再写一遍,找出纳什均衡,再对比逆向归纳:
from itertools import product

# 一、进入博弈:新企业先决定进不进;如果进来,在位企业再决定"开战(打价格战)"还是"接受"。收益是(新企业,在位企业),单位:百万元
OUT = (0, 10)            # 不进来:新企业 0,在位企业独享 10
FIGHT = (-3, 2)          # 进来了,在位企业开战:双方都亏,在位企业剩 2
ACCEPT = (3, 5)          # 进来了,在位企业接受:两家分享

# 先看"事先定好计划"的写法(标准式):新企业的策略 = 进/不进;在位企业的策略 = 如果进来就开战/就接受
def payoff(entrant, incumbent):
    if entrant == "不进": return OUT
    return FIGHT if incumbent == "开战" else ACCEPT

strategies_e, strategies_i = ["进", "不进"], ["开战", "接受"]
print("纳什均衡(谁也不想单独改计划):")
for e, i in product(strategies_e, strategies_i):
    pe, pi = payoff(e, i)
    e_ok = all(pe >= payoff(e2, i)[0] for e2 in strategies_e)
    i_ok = all(pi >= payoff(e, i2)[1] for i2 in strategies_i)
    if e_ok and i_ok: print(f"  新企业「{e}」、在位企业「如果进来就{i}」:收益 {payoff(e, i)}")

# 逆向归纳:先看最后一步,在位企业"进来之后"会怎么选?再倒推新企业
best_after_entry = max([("开战", FIGHT), ("接受", ACCEPT)], key=lambda x: x[1][1])
entrant_value_if_enter = best_after_entry[1][0]
print(f"\n逆向归纳:如果新企业进来,在位企业会选「{best_after_entry[0]}」({best_after_entry[1][1]} > {FIGHT[1] if best_after_entry[0] == '接受' else ACCEPT[1]});"
      f"新企业预期进来能得 {entrant_value_if_enter},比不进来的 {OUT[0]} 高,所以「进来」,结果 {best_after_entry[1]}")
print("  那个「不进、开战」的均衡,靠的是一个事后没人愿意兑现的威胁")

# 二、最后通牒:甲有 10 元,提议给乙 x 元(整数),乙接受就按提议分,拒绝就两人都得 0
print("\n最后通牒博弈(10 元,只能出整数):乙接受的条件是得到的比 0 多")
accept = lambda x: x > 0                                # 乙:任何比 0 多的钱,都比拒绝(得 0)好
best_offer = max(range(0, 11), key=lambda x: (10 - x) if accept(x) else 0)
print(f"  逆向归纳:甲提议给乙 {best_offer} 元(自己留 {10 - best_offer} 元),乙接受")
输出:
纳什均衡(谁也不想单独改计划):
  新企业「进」、在位企业「如果进来就接受」:收益 (3, 5)
  新企业「不进」、在位企业「如果进来就开战」:收益 (0, 10)

逆向归纳:如果新企业进来,在位企业会选「接受」(5 > 2);新企业预期进来能得 3,比不进来的 0 高,所以「进来」,结果 (3, 5)
  那个「不进、开战」的均衡,靠的是一个事后没人愿意兑现的威胁

最后通牒博弈(10 元,只能出整数):乙接受的条件是得到的比 0 多
  逆向归纳:甲提议给乙 1 元(自己留 9 元),乙接受
注意:这个博弈有两个纳什均衡:
- (进来,如果进来就接受):和逆向归纳的结果一样;
- (不进来,如果进来就开战):新企业怕你开战,所以不进来;而因为它不进来,你的"开战"计划永远没有被检验过,所以没有人想改。
第二个均衡,靠的是一个"不可信的威胁":如果新企业真的进来了,在位企业事后算一算,接受(5)比开战(2)更好,它不会兑现狠话。新企业如果理性,就不会被吓住。逆向归纳把这种靠不可信威胁撑起来的均衡,排除掉了(这样挑出来的均衡,叫子博弈完美均衡,可以先记住这个名字)。
这正好解释了第 16 讲的一个结论:口头威胁不可信,有效的是提前做出的、收不回来的投入。比如,在位企业如果提前建好了巨大的产能,打价格战的事后收益就变了(开战从 2 变成更高,甚至超过接受),威胁才变得可信。
6.3 最后通牒:理论和现实的距离
代码的第二部分,是一个有名的博弈:最后通牒博弈。甲有 10 元,提议给乙 x 元;乙可以接受(按提议分),也可以拒绝(两人都得 0)。
理论预测什么:逆向归纳:乙面对任何大于 0 的数,接受比拒绝(得 0)更好;所以甲只需要给最小的一份(这里是 1 元),自己留 9 元。
证据怎么说:Güth、Schmittberger 和 Schwarze 1982 年(Journal of Economic Behavior and Organization,3 卷 4 期)做了最早的实验之一,发现人们的行为和这个预测差很远:据二手转述,最常见的提议是对半分,平均给对方约 37%,并且一部分低的提议被拒绝了。(他们的样本不大,二手转述的比例请以原文为准。)后来,Henrich 等人 2001 年(American Economic Review 论文集,91 卷 2 期)在 15 个小型社会里做了类似的实验:不同社会的出价和拒绝行为差别很大(据二手转述,有的社会典型出价只占 15% 到 25%,有的社会多数人出价一半或更多),但没有一个社会符合"纯粹自利"的预测。
分歧在哪:怎么解释?一种解释是:人们不只在乎自己拿多少,也在乎公平,愿意付出代价惩罚不公平(所以收益里应该包含这一项)。另一种解释是:实验里的人没有完全理解,或者习惯了日常生活里"反复打交道"的规则,把它带到了一次性的实验里。还有人指出,不同社会的差别,反映了各自的日常经济互动方式。这些解释各有证据,没有哪一个让所有人满意。
价值判断:该不该把"对不公平的反感"当作"非理性"?还是当作人们真实在乎的东西,应该写进收益里?这是价值判断。(第 39 讲讲行为经济学时会回到它。)留给你判断。
小结: 一先一后的博弈用博弈树,从最后一步倒着想(逆向归纳)。靠不可信的威胁撑起来的均衡,会被它排除。有效的威胁需要承诺:提前做出的、收不回来的投入。实验里,人们在最后通牒博弈中的行为,和纯自利的预测差得很远。
七、证据、局限与常见的误用
7.1 均衡靠谱吗
- 多重均衡:很多博弈有好几个均衡,均衡概念本身不告诉你会落在哪个。
- 对理性的要求很高:假设每个人都最大化自己的收益,并且知道别人也这样,并且知道别人知道……(“共同知识”)。现实里,人们的推理层级有限。
- 收益要写对:如果收益里漏掉了人们在乎的东西(公平、面子),预测就会出错,这不一定是博弈论错了,而可能是收益设错了。
- 实验的警示:Goeree 和 Holt 2001 年(American Economic Review,91 卷 5 期)做了一组实验,发现:在基准情形里,行为和纳什均衡(或它的精炼)吻合得不错;可是只要把一个与均衡预测无关的收益参数改一改,人们的行为就会大幅变化。这说明,均衡预测在某些情形下很准,在另一些情形下,人们对收益的"直觉"会盖过理论的预测。
- 均衡是怎么达到的:互相适应(5.2 节)、演化、长期互动。这类"学习"的视角,第 19 讲和实验 73、76 会继续用。
所以,更合适的态度是:把纳什均衡当作一个重要的参照点和一套有用的语言,而不是对人类行为的预言。
7.2 常见的误用
| 误用 | 正确的想法 |
|---|---|
| “纳什均衡就是最好的结果” | 它是稳定的结果,不一定好:囚徒困境的均衡比合作差 |
| “博弈论假设每个人都自私” | 收益可以包含公平、面子、他人的福祉;但要把它们写进收益里 |
| “每个博弈都有占优策略” | 多数博弈没有;占优策略是特殊情形 |
| “混合策略就是乱来” | 是精确的概率,由让对方无差别决定;目的是不被预测 |
| “说了狠话,对手就会让步” | 威胁必须可信:事后兑现要对自己有利,通常需要提前的、收不回来的投入 |
| “博弈论是研究零和的(你赢我输)” | 大多数有意思的博弈不是零和:合作、协调、信任,都在其中 |
| “实验里行为偏离均衡,博弈论就被推翻了” | 可能是收益设置不对、还没有学会,或情境不同;要具体分析 |
| “囚徒困境里,只要沟通就能解决” | 如果事后没有办法让承诺兑现,沟通可能也没用(廉价的话) |
八、小结
这一讲有六个想法,请带走:
- 博弈由参与者、策略、收益、行动顺序和信息组成。你的最佳选择,取决于你认为对方会怎么选。
- 占优策略与囚徒困境:人人都有占优策略(背叛),结果比人人合作更糟,根源是我的选择影响别人、我却不付代价。它出现在价格战、军备、公共品、公共卫生等场景里。
- 纳什均衡:每个人的策略都是对其他人策略的最佳反应,没有人想单独改变。它是稳定,不是"好"。多重均衡时,靠聚点、惯例、承诺、预期来挑。
- 混合策略:没有纯策略均衡时,随机是为了不被预测,概率由"让对方选哪个都一样"决定。均衡可以是互相适应的结果。
- 一先一后与可信威胁:从最后一步倒着想;靠不可信的威胁撑起来的均衡会被排除;有效的威胁需要承诺。
- 局限:多重均衡、对理性要求高、收益要写对;实验里行为常偏离纯自利的预测。均衡是参照点,不是预言。
这一讲里,所有的博弈都只玩一次。可是现实里,人们往往会反复打交道:同一个供应商每个月都要进货,同一家企业每天都要定价,同事每天都要合作。如果这场博弈会重复很多次,囚徒困境还会不会成为困境? 这就是下一讲:第 19 讲:重复博弈:合作是怎么出现的。 你会看到,当"未来的惩罚"成为可能,合作可以靠自己的利益维持下去;你还会看到一个有名的循环赛,各种策略在里面互相竞争,结果出人意料。
思考题
1. 一对朋友决定周末活动:一个更想看电影,一个更想看展,但两个人都更想在一起。收益矩阵(甲选行,乙选列;格子里是甲,乙):
| 乙看电影 | 乙看展 | |
|---|---|---|
| 甲看电影 | 2,1 | 0,0 |
| 甲看展 | 0,0 | 1,2 |
(a)找出所有纯策略纳什均衡。(b)有没有混合策略均衡?双方各以多大概率选自己更想去的?每人的期望收益是多少?
提示:(a)(电影,电影)(2,1)和(展,展)(1,2)是均衡;不一致的格子(0,0)没人想待。(b)设甲看电影的概率是 p,使乙对两个选择无差别:乙看电影得 1 × p,看展得 2 × (1 − p),p = 2(1 − p),p = 2/3;设乙看电影的概率 q,使甲无差别:2q = 1 × (1 − q),q = 1/3。所以甲以 2/3 概率选电影(自己更想去的),乙以 1/3 概率选电影,即 2/3 概率选展(自己更想去的)。每人的期望收益是 2 × 1/3 = 2/3,比任何一个纯策略均衡里的收益(1 或 2)都低:随机选,有时候会错开。
2. 本讲 3.3 节的公共品博弈(4 人,每人 10 元,乘数 1.6)。如果别人三个人一共投了 30 元,我投 0 和投 10 分别得多少?乘数要多大,才会让"投 10"成为占优策略?
提示:我投 0:(10 − 0) + 1.6 × (0 + 30) ÷ 4 = 10 + 12 = 22;我投 10:0 + 1.6 × 40 ÷ 4 = 16。每投 1 元,我自己分回 乘数 ÷ 4;它要大于 1,乘数要大于 4(乘数大于 4 时,每多投 1 元,我自己分回的多于我付出的)。
3. 6.2 节的进入博弈。如果在位企业开战的收益变成(−3,6)(不是 2,因为它已经提前投资,打价格战对它自己没那么亏),其余不变。用逆向归纳,结果是什么?这说明了什么?
提示:在位企业进来之后:开战得 6,接受得 5,开战更好。新企业预见到,进来得 −3,不进来得 0,所以不进来,在位企业拿 10。威胁变得可信了:因为提前的投资,改变了事后的收益。(对应第 16 讲:提前定死产能,阻止进入。)
4. 5.2 节的点球,如果球员"踢左遇到守门员扑左"的进球率从 0.6 降到 0.4(其余不变)。均衡里,守门员扑左的概率和球员踢左的概率各是多少?球员的进球率呢?
提示:设守门员扑左的概率 g:踢左 0.4g + 0.9(1 − g),踢右 1.0g + 0.7(1 − g);令相等:0.9 − 0.5g = 0.7 + 0.3g,g = 1/4。设球员踢左的概率 k:守门员扑左时进球率 0.4k + 1.0(1 − k),扑右时 0.9k + 0.7(1 − k);令相等:1 − 0.6k = 0.7 + 0.2k,k = 3/8。进球率 = 0.4 × 1/4 + 0.9 × 3/4 = 0.775(比原来的 0.8 低)。注意一个有意思的现象:球员"踢左遇到扑左"变差了,球员踢左更少(3/8 < 1/2),而守门员扑左也更少(1/4 < 1/3):均衡里,自己收益的变化,影响的是对方的随机概率。
5. 囚徒困境里,如果两个人签了一份有法律约束力的合同,规定"谁背叛,要赔给对方 3 元"(两人都背叛时互相赔,抵消)。收益矩阵怎么变?困境还存在吗?现实里,没有这样的合同时,还有哪些办法能让人们合作?
提示:新的收益:(合作,合作)仍是(3,3);我合作、对方背叛:我 0 + 3 = 3,对方 5 − 3 = 2;我背叛、对方合作:我 5 − 3 = 2,对方 0 + 3 = 3;(背叛,背叛):各 1 − 3 + 3 = 1。对方合作时,我合作得 3,背叛得 2;对方背叛时,我合作得 3,背叛得 1。不管对方怎么选,合作都更好:合作成了占优策略,困境消失。 现实里没有这样的合同时:反复互动和惩罚(第 19 讲)、声誉、规范和习俗、第三方监督(第 26 讲)。关键是:让背叛的代价,大于背叛的好处。
参考与延伸
- Schelling, T. C. (1960). The Strategy of Conflict. Harvard University Press.
- Nash, J. F. (1950). Equilibrium Points in N-Person Games. Proceedings of the National Academy of Sciences, 36(1), 48–49.
- Palacios-Huerta, I. (2003). Professionals Play Minimax. Review of Economic Studies, 70(2), 395–415.
- Chiappori, P.-A., Levitt, S., & Groseclose, T. (2002). Testing Mixed-Strategy Equilibria When Players Are Heterogeneous: The Case of Penalty Kicks in Soccer. American Economic Review, 92(4), 1138–1151.
- Güth, W., Schmittberger, R., & Schwarze, B. (1982). An Experimental Analysis of Ultimatum Bargaining. Journal of Economic Behavior and Organization, 3(4), 367–388.
- Henrich, J., Boyd, R., Bowles, S., Camerer, C., Fehr, E., Gintis, H., & McElreath, R. (2001). In Search of Homo Economicus: Behavioral Experiments in 15 Small-Scale Societies. American Economic Review (Papers and Proceedings), 91(2), 73–78.
- Goeree, J. K., & Holt, C. A. (2001). Ten Little Treasures of Game Theory and Ten Intuitive Contradictions. American Economic Review, 91(5), 1402–1422.