这一讲要回答五个问题:
- 什么是信息不对称?它有哪两种?
- 二手车市场里,买家看不出车的好坏,会发生什么?为什么好车会被"挤出去"?
- 保险市场里,同样的结构怎么出现?
- 现实里,这种"逆向选择"到底有多严重?有没有证据?
- 人们用什么办法对付它?这些办法各有什么代价?
前面的十九讲里,我们几乎一直默认一件事:买家和卖家知道的一样多,至少对商品本身的好坏没有分歧。第 7 讲说价格会传递信息;第 18、19 讲里,博弈的参与者也知道对方的收益。这一讲,我们把这个默认拿掉:一方知道的,比另一方多。 你会发现,一个很自然的问题,会让整个市场出毛病。
一、一辆二手车
你想买一辆三年车龄的二手车。看中的这辆,标价 8 万,车主说:“自己上下班开的,从没出过事故,保养都是按时做的。” 外观很干净,试驾也没发现问题。
先停一下:你会放心掏钱吗?如果你犹豫,是在犹豫什么?
你可能会想到几件事:
- 车主知道这辆车的真实情况,你不知道;
- 车主说"没出过事故",他有动机这样说,不管是不是真的;
- 一辆好车,车主为什么要卖?也许他要换车、要出国、要用钱;但也可能因为他发现这辆车的毛病越来越多。
注意最后一条:“愿意卖"本身,就是一个让你起疑的信息。 一辆毫无毛病的车,如果主人不急着用钱,他大概会继续开。
第 7 讲说,价格把分散的信息压缩成一个数;那一讲的结尾还预告过:买卖双方的信息不一样多时,市场甚至可能崩塌。这里反过来:价格和"愿不愿意卖”,也在向你传递你不想听的信息。 这一讲就从这个直觉出发。
1.1 信息不对称
信息不对称(asymmetric information):交易的一方,比另一方更了解交易的对象,或者更了解自己。
它有两种常见的形式,区别在什么时候出现:
| 什么不对称 | 出现的时间 | 例子 | 叫什么 | |
|---|---|---|---|---|
| 隐藏的信息 | 一方知道对象或自己的"类型",另一方不知道 | 交易之前 | 二手车的车况;买保险的人自己的健康 | 逆向选择 |
| 隐藏的行动 | 一方的行为,另一方看不到 | 交易之后 | 买了保险的人,是不是更不小心了;员工在没人看时有多努力 | 道德风险 |
这一讲讲第一种:逆向选择(adverse selection)。“逆向"的意思是:来到市场上的,恰好是你最不希望遇到的那些。 第二种,道德风险,留给第 21 讲。
二、一个最小的例子:好车与"柠檬”
美国俚语里,“柠檬”(lemon)指有毛病的车。经济学家 George Akerlof 1970 年(Quarterly Journal of Economics,84 卷 3 期)的《“柠檬"市场》,用二手车讲了这个故事。(据 Akerlof 自己后来的回忆,这篇文章先后被几家期刊以"太琐碎"或"不对"为由退稿,最后在 QJE 发表。2001 年,他和 Michael Spence、Joseph Stiglitz 一起获得了诺贝尔经济学奖,奖励他们对信息不对称市场的研究。)
我们用一个能手算的版本。
2.1 设定
二手车有两种:
- 好车:卖家最低愿意以 8 万卖,买家觉得值 10 万;
- 柠檬(有毛病的车):卖家最低 3 万,买家觉得值 4 万。
每一辆车,买家的估值都比卖家高,所以只要成交,对双方都有好处:好车成交的好处是 10 − 8 = 2 万,柠檬是 4 − 3 = 1 万。如果买家一眼就看得出好坏,所有车都会成交。
问题:买家看不出哪辆是好车、哪辆是柠檬,只知道好车占的比例 s。会发生什么?
2.2 买家愿付多少
买家看不出来,只能按平均出价(简单起见,假设买家不在乎风险,而且买家之间相互竞争,所以愿意出的价就是平均估值):
愿付价 = s × 10 + (1 − s) × 4
好车的卖家要价至少 8 万。如果愿付价低于 8 万,他们就不卖,好车退出市场。
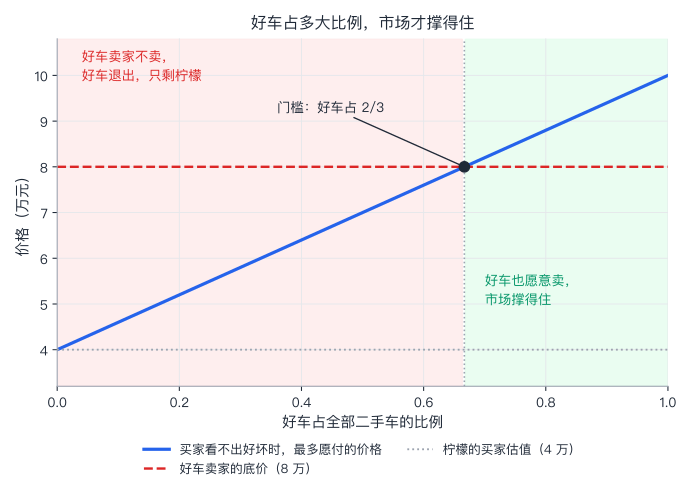
愿付价 ≥ 8,要求 10s + 4(1 − s) ≥ 8,也就是 s ≥ 2/3。
- 好车占 2/3 以上:买家愿付的平均价够好车卖家接受,所有车都成交。
- 好车占不到 2/3:好车卖家宁可不卖,市场上只剩下柠檬。买家猜得到这一点(理性的买家会想:既然市场上只剩柠檬,那就只能按柠檬出价),所以出价只有 4 万。好车消失了。
用代码看每种情形:
# 二手车市场:好车的卖家最低愿意卖 8 万,买家觉得值 10 万;柠檬(有毛病的车)的卖家最低 3 万,买家觉得值 4 万。
# 每辆车,买家的估值都比卖家高,所以任何一辆车成交,对双方都有好处。
GOOD_SELL, GOOD_BUY = 8, 10
LEMON_SELL, LEMON_BUY = 3, 4

def market(share_good, informed):
    """100 辆车,好车占 share_good。informed=True:买家一眼看出好坏;False:买家只知道好车的比例。返回(好车是否卖、价格说明、成交数、总剩余)"""
    n_good, n_lemon = round(100 * share_good), 100 - round(100 * share_good)
    if informed:
        surplus = n_good * (GOOD_BUY - GOOD_SELL) + n_lemon * (LEMON_BUY - LEMON_SELL)
        return True, f"好车 {GOOD_BUY}、柠檬 {LEMON_BUY}", 100, surplus
    pooled = share_good * GOOD_BUY + (1 - share_good) * LEMON_BUY      # 看不出来时,买家最多愿付"平均值"
    if pooled >= GOOD_SELL:                                            # 好车的卖家也肯卖:所有车都在市场上
        surplus = n_good * (GOOD_BUY - GOOD_SELL) + n_lemon * (LEMON_BUY - LEMON_SELL)
        return True, f"统一价 {pooled:.2f}", 100, surplus
    # 平均值低于好车的底价:好车退出。买家知道市场上只剩柠檬,最多只愿付 4
    return False, f"买家只愿付 {pooled:.2f} < {GOOD_SELL},好车退出,剩下柠檬的价格 {LEMON_BUY}", n_lemon, n_lemon * (LEMON_BUY - LEMON_SELL)

print("买家看不出好坏时:好车占多大比例,市场才能撑住?")
print(f"  门槛:{GOOD_BUY}s + {LEMON_BUY}(1-s) >= {GOOD_SELL}  =>  s >= {(GOOD_SELL - LEMON_BUY) / (GOOD_BUY - LEMON_BUY):.3f}\n")
for s in (0.9, 0.7, 0.67, 0.66, 0.5, 0.3):
    full = market(s, True)[3]
    ok, desc, n, surplus = market(s, False)
    print(f"好车占 {s:.0%}:{'好车和柠檬都成交' if ok else '好车没了'};{desc};成交 {n} 辆;总好处 {surplus:.0f}(买家看得出好坏时是 {full:.0f},损失 {full - surplus:.0f})")

# 好车占比刚好够的时候,好车的卖家其实在"补贴"柠檬的卖家(假设买家之间竞争,价格等于买家的估值)
s = 0.7
pooled = s * GOOD_BUY + (1 - s) * LEMON_BUY
print(f"\n好车占 {s:.0%}、统一价 {pooled:.2f} 时:好车卖家比看得出好坏时少卖 {GOOD_BUY - pooled:.2f} 万,柠檬卖家比看得出好坏时多卖 {pooled - LEMON_BUY:.2f} 万")
输出:
买家看不出好坏时:好车占多大比例,市场才能撑住?
  门槛:10s + 4(1-s) >= 8  =>  s >= 0.667

好车占 90%:好车和柠檬都成交;统一价 9.40;成交 100 辆;总好处 190(买家看得出好坏时是 190,损失 0)
好车占 70%:好车和柠檬都成交;统一价 8.20;成交 100 辆;总好处 170(买家看得出好坏时是 170,损失 0)
好车占 67%:好车和柠檬都成交;统一价 8.02;成交 100 辆;总好处 167(买家看得出好坏时是 167,损失 0)
好车占 66%:好车没了;买家只愿付 7.96 < 8,好车退出,剩下柠檬的价格 4;成交 34 辆;总好处 34(买家看得出好坏时是 166,损失 132)
好车占 50%:好车没了;买家只愿付 7.00 < 8,好车退出,剩下柠檬的价格 4;成交 50 辆;总好处 50(买家看得出好坏时是 150,损失 100)
好车占 30%:好车没了;买家只愿付 5.80 < 8,好车退出,剩下柠檬的价格 4;成交 70 辆;总好处 70(买家看得出好坏时是 130,损失 60)

好车占 70%、统一价 8.20 时:好车卖家比看得出好坏时少卖 1.80 万,柠檬卖家比看得出好坏时多卖 4.20 万
逐段看:
- 好车占 67% 的时候,统一价 8.02 万,刚好够好车卖家接受,所有车成交。好车占 66%,愿付价 7.96 万,差了 0.04 万,好车就全部退出,成交的只剩 34 辆柠檬,总好处从 166 掉到 34。1 个百分点的差别,市场就从"全部成交"变成"只剩柠檬”。
- 总好处的损失,是好车被挤出去的那部分好处。每一笔好车交易,本来对双方都有 2 万的好处,现在都没有了,而且没有人做错任何事:卖家没有说谎,买家没有糊涂,每个人都在做对自己最好的选择。
- 好车占 70% 时,市场虽然撑住了,但暗地里有一笔补贴:好车卖家只拿到 8.20 万(看得出好坏时是 10 万),少拿 1.80 万;柠檬的卖家拿到 8.20 万(看得出时是 4 万),多拿 4.20 万。好车的卖家,在补贴柠檬的卖家。 这和第 18 讲的囚徒困境一样,一方的选择,把成本转嫁给了另一方(外部性,第 23 讲会专门讲)。
这就是逆向选择:因为买家看不出好坏,价格只能反映平均质量,于是质量高于平均的卖家觉得不划算,退出市场;剩下的,平均质量更低;价格再降,又有一批退出……
三、价格螺旋:好车一轮一轮退出
上面的例子只有两种车。现实里车的质量是连续的。我们换成连续的版本,看看"一轮一轮退出"是怎么发生的。
3.1 设定
- 车的质量 q 在 0 到 1 之间均匀分布,卖家对质量 q 的车的估值是 10q 万元;
- 买家的估值是卖家的 g 倍(g > 1,买家总是更看重):g = 1.5 就是买家比卖家多看重 50%;
- 买家看不出 q,只知道此刻在市场上的车的平均质量。
3.2 螺旋怎么转
假设价格是 p:只有估值 10q ≤ p 的卖家肯卖,也就是质量 q ≤ p/10 的车;这些车的平均估值是 p/2。买家愿付 g × p/2。如果 g = 1.5,下一轮价格就是 0.75p:比 p 低。 价格一低,又有一批更好的车退出;剩下的车平均更差,价格再低……
# 连续版本:车的质量 q 在 0 到 1 之间均匀分布,卖家估值 = 10q(万元),买家估值 = g × 10q(g > 1,买家总是更看重)。买家看不出 q,只知道"此刻在市场上的车"的平均值。
def next_price(p, g, k=1):
    """k=1:质量均匀分布;k 越大,高质量车越多(质量的分布函数是 q 的 k 次方)。
    价格是 p 时,只有估值 10q <= p 的车肯卖;买家出的价 = g × 这些车的平均估值"""
    cap = min(p, 10.0)
    return g * cap * k / (k + 1)

def run(g, k=1, rounds=40, p0=10.0):
    p = p0
    for _ in range(rounds): p = next_price(p, g, k)
    return p

print("每一轮:买家按上一轮在卖的车的平均质量出价,卖家只卖估值不超过这个价的车(g=1.5,均匀分布)")
p = 10.0
for t in range(0, 31):
    if t in (0, 1, 2, 3, 5, 10, 20, 30):
        on_market = min(p, 10.0) / 10
        print(f"  第 {t:>2} 轮:价格 {p:6.3f} 万,市场上还有 {on_market:6.1%} 的车")
    p = next_price(p, 1.5)

print("\n买家的估值是卖家的 g 倍,40 轮之后(起点 10 万,所有车都在卖,均匀分布):")
for g in (1.2, 1.5, 1.9, 2.0, 2.2):
    p = run(g)
    print(f"  g={g}:价格 {p:.3f} 万,市场上还有 {min(p, 10.0) / 10:.1%} 的车")

print("\n崩溃的门槛:g < (k+1)/k 时崩溃。好车越多(k 越大),门槛越低:")
for k in (1, 2, 3, 5):
    th = (k + 1) / k
    p = run(1.4, k)
    print(f"  k={k}:g 要达到 {th:.2f} 才撑得住;g=1.4 时 40 轮后价格 {p:.3f} 万,市场上还有 {(min(p, 10.0) / 10) ** k:.1%} 的车")   # 质量低于 p/10 的车占 (p/10)^k

print(f"\n买家平均比卖家多看重 50% 时,每辆车成交的好处平均是 {0.5 * 5:.2f} 万;崩溃以后,市场上这笔好处是 0")

# 换一种分布:三成是有毛病的车(估值 0 到 3 万均匀),七成是好车(估值 7 到 10 万均匀)。看"从哪里出发"
def next_price_mix(p, g):
    p = min(p, 10.0)
    m_l = 0.3 * min(p, 3.0) / 3.0                                   # 在卖的柠檬占全部车的比例
    m_g = 0.7 * max(0.0, min(p, 10.0) - 7.0) / 3.0                  # 在卖的好车占全部车的比例
    if m_l + m_g == 0: return 0.0
    avg = (m_l * min(p, 3.0) / 2 + m_g * (7.0 + p) / 2) / (m_l + m_g)
    return g * avg

print("\n两头的分布(三成柠檬、七成好车),g=1.6:同样的参数,结局取决于出发点")
for p0 in (10.0, 3.0):
    p = p0
    for _ in range(200): p = next_price_mix(p, 1.6)
    print(f"  起点:价格 {p0} 万 -> 200 轮后价格 {p:.3f} 万,{'所有车都成交' if p >= 10 else '市场塌掉了'}")
输出:
每一轮:买家按上一轮在卖的车的平均质量出价,卖家只卖估值不超过这个价的车(g=1.5,均匀分布)
  第  0 轮:价格 10.000 万,市场上还有 100.0% 的车
  第  1 轮:价格  7.500 万,市场上还有  75.0% 的车
  第  2 轮:价格  5.625 万,市场上还有  56.2% 的车
  第  3 轮:价格  4.219 万,市场上还有  42.2% 的车
  第  5 轮:价格  2.373 万,市场上还有  23.7% 的车
  第 10 轮:价格  0.563 万,市场上还有   5.6% 的车
  第 20 轮:价格  0.032 万,市场上还有   0.3% 的车
  第 30 轮:价格  0.002 万,市场上还有   0.0% 的车

买家的估值是卖家的 g 倍,40 轮之后(起点 10 万,所有车都在卖,均匀分布):
  g=1.2:价格 0.000 万,市场上还有 0.0% 的车
  g=1.5:价格 0.000 万,市场上还有 0.0% 的车
  g=1.9:价格 1.285 万,市场上还有 12.9% 的车
  g=2.0:价格 10.000 万,市场上还有 100.0% 的车
  g=2.2:价格 11.000 万,市场上还有 100.0% 的车

崩溃的门槛:g < (k+1)/k 时崩溃。好车越多(k 越大),门槛越低:
  k=1:g 要达到 2.00 才撑得住;g=1.4 时 40 轮后价格 0.000 万,市场上还有 0.0% 的车
  k=2:g 要达到 1.50 才撑得住;g=1.4 时 40 轮后价格 0.633 万,市场上还有 0.4% 的车
  k=3:g 要达到 1.33 才撑得住;g=1.4 时 40 轮后价格 10.500 万,市场上还有 100.0% 的车
  k=5:g 要达到 1.20 才撑得住;g=1.4 时 40 轮后价格 11.667 万,市场上还有 100.0% 的车

买家平均比卖家多看重 50% 时,每辆车成交的好处平均是 2.50 万;崩溃以后,市场上这笔好处是 0

两头的分布(三成柠檬、七成好车),g=1.6:同样的参数,结局取决于出发点
  起点:价格 10.0 万 -> 200 轮后价格 10.240 万,所有车都成交
  起点:价格 3.0 万 -> 200 轮后价格 0.000 万,市场塌掉了
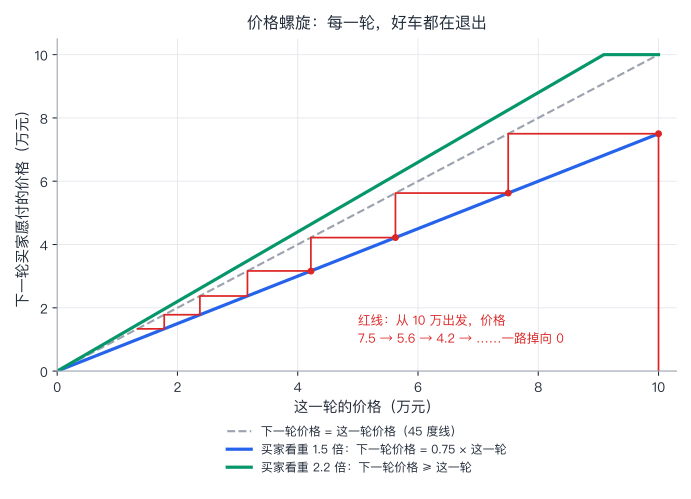
- g = 1.5:价格从 10 万掉到 7.5、5.6、4.2……,第 10 轮只剩 5.6% 的车,第 30 轮几乎归零。而这个市场里,每一辆车,买家的估值都比卖家高,每笔交易本来都有好处:平均每辆 2.5 万。崩溃之后,这笔好处全都没了。
- 门槛:对均匀分布,只有 g ≥ 2 的时候,市场才撑得住(买家平均要比卖家多看重一倍以上)。g = 1.9,市场虽然没有立即崩溃,但每一轮仍在萎缩(40 轮后只剩 12.9%);g = 2.0 刚好撑住,价格不再下降。
- 好车越多,越撑得住:如果车的质量分布偏向好的一端(k 越大,好车越多),门槛 (k + 1)/k 越低。在 g = 1.4 时,k = 1 很快崩溃,k = 2 仍在萎缩,k = 3 就撑住了。同样的买家估值,好车比例的高低,决定了市场的生死。
- 两头的分布,结局取决于出发点:如果三成是有毛病的车(卖家估值 0 到 3 万)、七成是好车(7 到 10 万),中间没有,g = 1.6 时,从"所有车都在卖"出发,市场撑住;从"只有便宜车在卖"出发,市场塌掉。这和第 17 讲的临界规模是同一类结构:预期,决定了你落在哪个均衡。 实验 74 会用大量买家和卖家的模拟,看崩溃是怎么一步一步发生的。
这个模型的结论比较极端:完全崩溃。现实里,二手车市场并没有消失,而且很大。这是为什么,下面几节会讲:一部分是因为别的机制在起作用(第六节),一部分是因为这个模型是故意简化的(第九节)。
小结: 逆向选择:卖家比买家更了解质量,买家只能按平均质量出价,质量高于平均的卖家觉得不划算而退出,平均质量下降,价格下降,更多的好货退出。门槛取决于买家比卖家多看重多少、好货占多大比例。损失是:本来对双方都有好处的交易没有发生,而且没有人做错任何事。
四、保险:同一个故事
4.1 买保险的人最清楚自己
保险市场里,买家比卖家更了解情况。你知道自己的身体、生活习惯、家族病史;保险公司只能看到有限的信息。
假设:
- 每个人预期一年的医疗支出 c(万元),在 0 到 1 之间均匀分布,只有本人知道;
- 每个人愿意为保险付的最高价,是 (1 + λ)c:多出来的 λ,是"怕风险"的价值(比如预期每年花 1 万医疗费的人,愿意付到 1.3 万的保费,换来"不用再担心",这里 λ = 0.3);
- 保险公司看不出每个人的 c,所有人都付同样的保费;公司之间竞争,保费 = 实际参保者的平均支出(不赚不亏)。
起初,假设所有人都参保,保费 = 全体平均支出 = 0.5。可是支出低于 0.5 ÷ 1.3 ≈ 0.385 的人,觉得不划算,退出。留下的人,平均支出更高,保费就要涨……
# 医疗保险:每个人的"预期医疗支出"c(万元/年)在 0 到 1 之间均匀分布,只有本人知道;保险公司看不出来,所有人付同样的保费。
# 每个人愿意为保险付的最高价 = (1 + lam) × c:多出来的 lam 是"怕风险"的价值。保险公司之间竞争,保费 = 实际参保者的平均支出(不赚不亏)。
def round_up(P, lam):
    """保费是 P 时,谁会买?(1+lam)c >= P 的人,即 c >= P/(1+lam)。下一轮保费 = 这些人的平均支出"""
    c_min = min(P / (1 + lam), 1.0)
    return (c_min + 1) / 2, 1 - c_min             # 新保费,参保比例

lam = 0.3
P, share = 0.5, 1.0                                # 起点:所有人都投保,保费 = 全体平均 0.5
print(f"lam={lam}:保费从全体平均 0.5 出发,一轮一轮往上走")
for t in range(0, 31):
    if t in (0, 1, 2, 3, 5, 10, 30):
        c_min = P / (1 + lam)
        print(f"  第 {t:>2} 轮:保费 {P:.4f},愿意买的人(c >= {c_min:.3f})占 {1 - min(c_min, 1.0):.1%}")
    P, share = round_up(P, lam)

print("\n均衡(保费 = 实际参保者的平均支出):保费 (1+lam)/(1+2lam),参保比例 2lam/(1+2lam)")
for lam in (0.1, 0.3, 0.5, 1.0):
    P = (1 + lam) / (1 + 2 * lam); s = 2 * lam / (1 + 2 * lam)
    c_min = 1 - s
    total_gain = lam * (1 - c_min ** 2) / 2                       # 参保者每人好处 lam×c,对 c 积分
    full_gain = lam * 0.5                                         # 所有人都参保时的总好处:lam × 平均 c
    print(f"  lam={lam}:保费 {P:.4f},参保比例 {s:.1%};总好处 {total_gain:.4f}(人人参保时 {full_gain:.4f},损失 {1 - total_gain / full_gain:.0%})")

lam = 0.3
print(f"\n强制所有人参保、统一保费 0.5(lam={lam}):")
worse = 0.5 / (1 + lam)                                           # c < 0.385 的人,保险对他们的价值不到 0.5
print(f"  总好处 {lam * 0.5:.4f};但 c < {worse:.3f} 的那 {worse:.1%} 的人,觉得保费高于保险的价值,比不参保更差")
print(f"  这些人平均每人亏 {0.5 - (1 + lam) * worse / 2:.4f};其余的人平均每人净得 {(1 + lam) * (1 + worse) / 2 - 0.5:.4f}")
输出:
lam=0.3:保费从全体平均 0.5 出发,一轮一轮往上走
  第  0 轮:保费 0.5000,愿意买的人(c >= 0.385)占 61.5%
  第  1 轮:保费 0.6923,愿意买的人(c >= 0.533)占 46.7%
  第  2 轮:保费 0.7663,愿意买的人(c >= 0.589)占 41.1%
  第  3 轮:保费 0.7947,愿意买的人(c >= 0.611)占 38.9%
  第  5 轮:保费 0.8099,愿意买的人(c >= 0.623)占 37.7%
  第 10 轮:保费 0.8125,愿意买的人(c >= 0.625)占 37.5%
  第 30 轮:保费 0.8125,愿意买的人(c >= 0.625)占 37.5%

均衡(保费 = 实际参保者的平均支出):保费 (1+lam)/(1+2lam),参保比例 2lam/(1+2lam)
  lam=0.1:保费 0.9167,参保比例 16.7%;总好处 0.0153(人人参保时 0.0500,损失 69%)
  lam=0.3:保费 0.8125,参保比例 37.5%;总好处 0.0914(人人参保时 0.1500,损失 39%)
  lam=0.5:保费 0.7500,参保比例 50.0%;总好处 0.1875(人人参保时 0.2500,损失 25%)
  lam=1.0:保费 0.6667,参保比例 66.7%;总好处 0.4444(人人参保时 0.5000,损失 11%)

强制所有人参保、统一保费 0.5(lam=0.3):
  总好处 0.1500;但 c < 0.385 的那 38.5% 的人,觉得保费高于保险的价值,比不参保更差
  这些人平均每人亏 0.2500;其余的人平均每人净得 0.4000
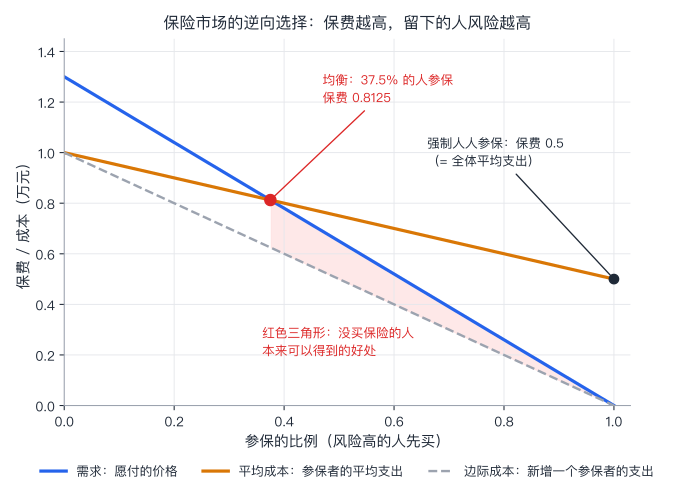
- 一轮一轮上涨:保费从 0.5 涨到 0.69、0.77、0.79,最后稳定在 0.8125,这时只有 37.5% 的人(预期支出 c ≥ 0.625 的)还在买。这个螺旋,在医疗保险的讨论里常被叫做"死亡螺旋"。
- 损失:保险对每个人都有价值((1 + λ)c > c),人人参保时,总好处是 0.15;螺旋后只有 0.0914,损失 39%。图里的红色三角形,就是没买保险的人本来可以得到的好处。
- λ 越大,参保的人越多:怕风险的程度越高,愿意付的保费越高于平均支出,螺旋停得越早。λ = 0.1 时只有 16.7% 的人参保,λ = 1.0 时有 66.7%。
- 强制人人参保,统一保费 0.5:总好处回到 0.15(比自愿参保时的 0.0914 高)。但是,预期支出低于 0.385 的那 38.5% 的人,觉得保费高于保险对自己的价值,比不参保更差(平均每人亏 0.25);其余的人平均每人净得 0.40。总好处变大了,但不是每个人都变好。 这是一个效率和公平的取舍,第七节会专门讨论。
逆向选择的关键是价格本身: 保费升高,赶走的是低风险的人,让留下来的人更危险。这和二手车一样:价格降低,赶走的是好车。
五、证据:逆向选择真的发生吗
理论预测什么:
- 二手车:被转手的车,质量比同龄但没被转手的车更差;
- 保险:买保险(或买更多保障)的人,事后的风险更高。
证据怎么说:这方面的实证研究很多,结果参差不齐:
- 二手车:Eric Bond 1982 年(American Economic Review,72 卷 4 期)用皮卡车的维修记录检验。据后来文献的转述,十年以内的车,买新车的和买二手车的,维修情况没有明显差别,更旧的车里,刚转手的反而修得更多。David Genesove 1993 年(Journal of Political Economy,101 卷 4 期)用批发二手车拍卖的数据检验,据后来的综述转述,证据较弱。后来有论文总结,对车龄一年以上的车,逆向选择的证据是缺乏的,或者很弱。(这是二手转述,请以原文为准。)
- 汽车保险:Chiappori 和 Salanié 2000 年(Journal of Political Economy,108 卷 1 期)用法国的数据,检验"保障更全面的人,事故风险更高",没发现两者有系统的关系。
- 年金:Finkelstein 和 Poterba 2004 年(Journal of Political Economy,112 卷 1 期)研究英国的年金市场,发现合同的一些特征(比如付款的时间安排、是否在去世时付给遗产)和事后的死亡率有系统的关系,符合逆向选择;但在年金金额的大小上,没发现这种关系。一个维度上没有选择,不代表别的维度上也没有。
- 有利选择:Fang、Keane 和 Silverman 2008 年(Journal of Political Economy,116 卷 2 期)研究美国老年人的补充医疗保险(Medigap),发现买保险的人,反而比没买的人更健康、医疗支出更低。这和逆向选择的预测相反,叫有利选择(advantageous selection)。作者发现,来源包括收入、教育、对寿命的预期、理财的眼光等,其中认知能力尤其重要,而风险偏好并不是主要来源。
- 福利损失有多大:Einav、Finkelstein 和 Cullen 2010 年(Quarterly Journal of Economics,125 卷 3 期)研究美国一家大公司(Alcoa)员工的医疗保险选择,利用价格的变化,同时估计了需求和成本。他们检测到了逆向选择,但估计这个案例里,由此造成的福利损失很小,而且不一定能用常见的公共政策补救。
局限:
- 没看到崩溃,不等于没有逆向选择。 第六节的各种办法,可能已经把它缓和了;我们看到的,是"办法之后"的结果。
- 检验方法有前提。 比如"保障多的人事故更多"这种检验,当人们还有别的私人信息(比如对风险的态度)时,会被抵消;有利选择就是一个例子。
- 研究集中在少数市场(美国、欧洲、一两个具体的保险产品)。中国的系统证据,据我查到的资料,不多,所以这里不下结论。
分歧在哪:事实层面的分歧是:逆向选择在现实里,多严重?哪些市场严重,哪些市场不严重?这是一个还在积累证据的问题。理论说得清楚机制,证据说的是"有,但不总是,也不一定像模型那样极端"。
六、怎么办:对付逆向选择的办法
如果问题的根源是"买家看不出好坏",办法大致有三类:让信息流动(让知道的一方说出来、让第三方来判断)、让好货能证明自己(质保、品牌)、改变规则(让所有人都进来)。
6.1 让信息流动:披露与第三方
- 强制披露:我国的《二手车流通管理办法》(2005 年发布,2017 年修订)规定,二手车卖方应当向买方提供车辆的使用、修理、事故、检验,以及是否办理抵押登记、交纳税费、报废期等真实情况和信息(第十四条)。
- 第三方鉴定:同一个办法规定,二手车鉴定评估机构要遵循客观、真实、公正和公开的原则,并对评估报告中车辆的技术状况(包括是否属于事故车辆等)承担法律责任(第二十五条)。让一个有责任的第三方来看车,买家就不再只能听卖家的。
代价:检测要花钱;披露的真实性要靠监管;第三方也可能不独立。
6.2 让好货证明自己:质保与信号
办法还规定,二手车经销企业销售二手车时,应当向买方提供质量保证及售后服务承诺,并在经营场所明示(第十五条)。
质保为什么有用? 因为它是一个可信的承诺:车如果真有毛病,修理费要卖家付。车况好的卖家,修理的预期支出小,给得起质保;柠檬的卖家,一出毛病就要大笔赔付,给不起(或不愿给)。所以,愿意给长质保,本身就是"我的车好"的证据。 这类"好货主动证明自己"的行为,叫信号,第 21 讲会系统讲;反过来,“让对方主动暴露类型"的办法叫筛选。
6.3 声誉:反复交易的力量
第 19 讲说过:重复互动,让一次性的欺骗变得不划算。二手车市场里,个人卖家一辈子可能只卖一两辆车,欺骗没有后果;经销商每年卖几百辆车,一旦以次充好被发现,就会失去未来的生意。
用第 19 讲的想法算一下:假设经销商每辆车以次充好,能多赚 b = 2 万;如果不骗,每一期的正常利润是 m = 0.5 万;骗一次,顾客(和顾客的口碑)从此不再来。继续做下去的折现因子是 δ。不骗的条件:未来的正常利润的总和,不小于一次欺骗的好处:
m × δ ÷ (1 − δ) ≥ b,即 δ ≥ b ÷ (b + m) = 2 ÷ 2.5 = 0.8
δ 够大(生意做得长久、口碑有价值),经销商就不会骗。个人卖家的 δ 接近 0,几乎没有这种约束。这就是为什么,买二手车的人往往更相信"有牌子的经销商”、愿意多付一点钱,也是为什么,网上平台要显示卖家的评分和评价:它们在把一次性的交易,变成"被记录的重复博弈"。 它们哪里会失效:评价可以被刷,差评可能招来报复,卖家关店换个名字就能重置历史(等于 δ 骤然降到接近 0)。第 21 讲还会回来。
还有一个更细的想法:如果买家不确定卖家是不是老实人,即使是想投机的卖家,也会装成老实人,以保住声誉的价值(第 19 讲提过 Kreps 等人的结果)。
6.4 改变规则:让所有人都进来
对保险,常见的做法是强制参保:低风险的人也必须进来,不让他们退出,螺旋就转不起来。我国的《社会保险法》(2010 年通过,2018 年修正)规定,职工应当参加职工基本医疗保险,由用人单位和职工按照国家规定共同缴纳基本医疗保险费(第二十三条);无雇工的个体工商户、未在用人单位参加职工基本医疗保险的非全日制从业人员和其他灵活就业人员,则可以参加,由个人缴费。
需要说明:强制参保的理由,不止一个,防止逆向选择只是其中之一(还有"保障基本医疗"的公平、“没钱看病的人最终要社会来兜底"的考虑等)。我们不能说这条法律"是为了"解决逆向选择。
6.5 一个总表
| 办法 | 做什么 | 代价或问题 |
|---|---|---|
| 披露 | 让卖家说出真实情况 | 说谎难查,要靠监管 |
| 第三方检测 | 让有责任的第三方判断 | 要花钱;第三方可能不独立 |
| 质保、退货 | 好货的卖家用承诺证明自己 | 条款可能很刁钻;卖家可能跑路 |
| 品牌、声誉、评价 | 把一次性的交易变成重复博弈 | 评价可能被刷;新进入者没有声誉 |
| 强制参保 | 让低风险的人也进来 | 低风险的人付出更多;限制了选择自由 |
| 按风险定价 | 用可观察的信息(年龄、记录)分类定价 | 高风险的人保费很高;有公平问题 |
七、保险该不该按风险定价
最后一行,“按风险定价”,是一个有争议的话题。按"理论预测 → 证据与局限 → 分歧在哪 → 价值判断留给读者"来写。
理论预测什么:对同一个保险市场,不同的规则,结果不同:
- 自愿参保 + 统一保费:像第四节,出现螺旋,只有一部分人参保,总好处有损失。
- 强制参保 + 统一保费:人人参保,总好处最大(第四节的代码:0.15);但低风险的人净付出,高风险的人净得到。
- 按风险定价:用年龄、驾驶记录等可观察的信息分组定价,可以减轻逆向选择(同一组里的人风险更接近);但高风险组的保费可能很高,甚至买不起。
证据怎么说,局限在哪:Einav、Finkelstein 和 Cullen 在一个雇主里发现,逆向选择存在,但福利损失不大;Fang 等人发现,在另一个市场里,实际上出现了有利选择;Finkelstein 和 Poterba 发现,英国的年金市场里,选择有,但是沿着合同的某些特征。这些发现的共同之处是:结论取决于具体的市场、具体的产品。 它们不能直接推到所有保险市场。
分歧在哪:
- 事实上的分歧:逆向选择造成的损失,在具体的市场里有多大?强制参保能挽回多少?这是可以用证据缩小分歧的问题。
- 价值上的分歧:下面三个问题,数据回答不了。
价值判断(留给你):
- 人与人之间的风险差异,该由个人承担(风险高的人付得多),还是社会共担(大家付差不多)?
- 风险的来源,要不要区别对待?先天的因素(年龄、遗传)和可以选择的行为(吸烟),在你看来是不是一回事?
- 强制参保,在你看来是合理的公共安排,还是对个人选择的限制?
经济学可以告诉你每种安排的代价:谁多付、谁少付、总好处多一点还是少一点。选哪一种,是你的价值判断。
八、不只是二手车和保险
逆向选择的结构,在很多地方出现过:
- 信贷:Stiglitz 和 Weiss 1981 年(American Economic Review,71 卷 3 期)的想法是:银行提高利率时,稳妥的借款人觉得不划算,退出;留下的,是愿意冒更大风险的人。结果,银行的预期收益,可能在某个利率之后反而下降,银行宁愿限量放贷(信贷配给),也不涨价。这个结论有争议:有研究(如 de Meza 和 Webb 1987 年)指出,在别的假设下,同样的信息问题,也可能导致放贷过多。
- 拍卖里的"赢者诅咒”:竞拍者不知道物品的真实价值,赢的人往往是估价最乐观的那个。第 22 讲会讲。
- 工作岗位:企业不知道求职者的能力,求职者知道。第 21 讲讲信号时会回到这里。
九、局限、常见误用
9.1 这个模型的局限
- 买家并不是完全看不出来。 现实里,买家有经验、能试驾、能请人检测,很多情形是"看出一部分",结果介于"完全崩溃"和"完全没问题"之间。
- 买卖双方常常都不完全清楚。 卖家也不一定了解车况,买家也可能有自己的信息。
- 质量的分布和估值差,决定结局。 第三节的结果表明:好车越多、买家估值越高,市场越能撑住。
- 现实里市场没有崩溃。 这说明模型里没写进去的机制(第六节),在现实里起作用;它不说明"逆向选择不重要":它也可能只是被办法缓和了。
9.2 常见的误用
| 误用 | 正确的想法 |
|---|---|
| “二手车都是柠檬” | 模型说的是买家看不出来时的压力;有很多机制缓和它;而且市场上有大量好车在成交 |
| “逆向选择是有人骗人” | 不需要任何人说谎:只要买家看不出好坏,就足以让好货退出 |
| “买家只要小心点就行” | 理性的买家知道"愿意卖"本身是信息,反而会压低出价,加重问题 |
| “保险公司歧视,所以要禁止分类定价” | 分类定价有公平的问题,也有效率的作用;取舍包含价值判断,要把两面都看清 |
| “强制保险一定好” | 总好处可能更高,但有人会变差;要看谁受益、谁付出,以及别的办法 |
| “质保和品牌只是营销” | 它们也是有成本的信号:成本的差别,把好货和差货区分开 |
| “有了评价,欺骗就没了” | 评价可以被刷,也可以被报复;它让欺骗更贵,不是不可能 |
十、小结
这一讲有六个想法,请带走:
- 信息不对称分两种:交易前的隐藏信息(逆向选择),和交易后的隐藏行动(道德风险,第 21 讲)。
- 逆向选择:买家看不出好坏,价格只反映平均质量,好货的卖家觉得不划算而退出,平均质量下降,如此循环。
- 门槛:好货占的比例,和买家比卖家多看重多少,决定了市场撑得住还是萎缩。我们的例子里,好车占 2/3 是门槛;连续版本里,买家要多看重一倍。
- 保险是同样的结构:保费越高,留下的人风险越高。强制参保能提高总好处,但有人会变差,这是效率与公平的取舍。
- 证据是参差的:有些市场有逆向选择,有些没有,甚至相反(有利选择);即使有,损失也不一定大。
- 办法:披露、第三方、质保与信号、声誉、强制参保、分类定价;每种都有代价。
这一讲讲的是交易之前的信息问题。可是很多信息问题,出现在交易之后:你给自己的车买了全险,是不是会开得更随意?你雇了一个员工,没人盯着的时候他有多努力?当一方的行动看不到时,怎么设计合同? 另外,上面说的"质保是信号",怎么才算一个可信的信号?这就是下一讲:第 21 讲:信息不对称(二):道德风险、信号与筛选。
思考题
1. 2.1 节的二手车市场,如果好车占 60%(买家估值:好车 10 万、柠檬 4 万;卖家底价:好车 8 万、柠檬 3 万),买家看不出好坏。(a)市场会怎样?(b)如果好车卖家的底价降到 7 万(比如急用钱),结果会怎样?(c)如果好车在买家眼里值 12 万(底价仍是 8 万),结果呢?
提示:(a)愿付价 = 0.6 × 10 + 0.4 × 4 = 7.6 万 < 8 万,好车卖家不卖,好车退出,剩下柠檬按 4 万成交(成交的好处只有 40,原来是 160)。(b)好车底价 7 万:7.6 ≥ 7,好车也愿意卖,所有车成交。(c)好车估值 12 万:愿付价 = 0.6 × 12 + 0.4 × 4 = 8.8 ≥ 8,所有车成交。市场撑得住还是崩溃,取决于好车的比例、卖家的底价和买家的估值,不是"二手车就一定会崩"。
2. 3.2 节的连续版本,如果 g = 1.8、质量均匀分布:(a)每一轮价格变成上一轮的多少?10 轮之后、20 轮之后,市场上还有多少比例的车?(b)如果好车更多(k = 3),门槛 g 是多少?g = 1.5 时市场撑得住吗?
提示:(a)下一轮价格 = g × p ÷ 2 = 0.9p。10 轮后,市场上还有 0.9^10 ≈ 34.9% 的车,20 轮后 0.9^20 ≈ 12.2%,一直萎缩,不会自己停下来(g 要到 2 才停)。(b)门槛 g = (k + 1) ÷ k = 4 ÷ 3 ≈ 1.33。g = 1.5 > 1.33,撑得住:每一轮价格 = 1.5 × 0.75 × 10 = 11.25 万,所有车都成交。
3. 4.1 节的保险市场,如果怕风险的程度 λ = 0.6:均衡的保费是多少?参保的比例是多少?总好处损失了多少?
提示:均衡保费 = (1 + λ) ÷ (1 + 2λ) = 1.6 ÷ 2.2 ≈ 0.727;参保比例 = 2λ ÷ (1 + 2λ) = 1.2 ÷ 2.2 ≈ 54.5%。总好处 ≈ 0.238,人人参保时是 λ × 0.5 = 0.30,损失 ≈ 21%。(代码里按 4.1 节的迭代跑到稳定,也是 0.7273。)怕风险的程度越高,损失越小。
4. 6.3 节的经销商:如果以次充好多赚 b = 2 万,每期的正常利润是 m = 0.5 万。(a)δ 至少多大,他才不会骗?(b)如果每期的正常利润是 m = 1 万,门槛是多少?(c)为什么说,个人卖家比经销商更容易骗?
提示:(a)不骗的条件:m × δ ÷ (1 − δ) ≥ b,即 δ ≥ b ÷ (b + m) = 2 ÷ 2.5 = 0.8。(b)m = 1:δ ≥ 2 ÷ 3 ≈ 0.67,正常利润越高,欺骗的代价越大,门槛越低。(c)个人卖家几乎只卖一两辆车,δ 接近 0(没有"以后"),欺骗的代价几乎为零;经销商每年卖很多车,口碑决定未来的生意,δ 高。
5. 为什么"愿意提供一年质保",能让买家更相信这辆车是好车?在什么情形下,质保不能帮到买家?
提示:质保是一个有成本、而且成本因类型而异的承诺:车如果真有毛病,修理费要卖家付。车况好的卖家,修理的预期支出小,给得起;柠檬的卖家,预期支出大,如果大过质保能让他多卖的价钱,他就不愿给。所以"愿意给质保"能区分好车和柠檬。失效的情形:(1)质保条款很刁钻(排除大部分故障,或者要买家自己证明是原来就有的毛病);(2)卖家出了问题就跑路、关店,质保兑现不了;(3)对柠檬的卖家来说,质保的成本小于它让他多卖的价钱(比如修理很便宜,或者卖家打算让买家吃哑巴亏),这时好车和柠檬都给质保,就不能区分了。
参考与延伸
- Akerlof, G. A. (1970). The Market for “Lemons”: Quality Uncertainty and the Market Mechanism. Quarterly Journal of Economics, 84(3), 488–500.
- Akerlof, G. A. (2001). 个人回忆文章 Writing the “The Market for ‘Lemons’"(诺贝尔奖官方网站)。
- Bond, E. W. (1982). A Direct Test of the “Lemons” Model: The Market for Used Pickup Trucks. American Economic Review, 72(4), 836–840.
- Genesove, D. (1993). Adverse Selection in the Wholesale Used Car Market. Journal of Political Economy, 101(4), 644–665.
- Chiappori, P.-A., & Salanié, B. (2000). Testing for Asymmetric Information in Insurance Markets. Journal of Political Economy, 108(1), 56–78.
- Finkelstein, A., & Poterba, J. (2004). Adverse Selection in Insurance Markets: Policyholder Evidence from the U.K. Annuity Market. Journal of Political Economy, 112(1), 183–208.
- Fang, H., Keane, M. P., & Silverman, D. (2008). Sources of Advantageous Selection: Evidence from the Medigap Insurance Market. Journal of Political Economy, 116(2), 303–350.
- Einav, L., Finkelstein, A., & Cullen, M. R. (2010). Estimating Welfare in Insurance Markets Using Variation in Prices. Quarterly Journal of Economics, 125(3), 877–921.
- Einav, L., & Finkelstein, A. (2011). Selection in Insurance Markets: Theory and Empirics in Pictures. Journal of Economic Perspectives, 25(1), 115–138.
- Stiglitz, J. E., & Weiss, A. (1981). Credit Rationing in Markets with Imperfect Information. American Economic Review, 71(3), 393–410.
- 《二手车流通管理办法》(商务部、公安部、工商总局、税务总局令 2005 年第 2 号,2017 年修订)。
- 《中华人民共和国社会保险法》(2010 年通过,2018 年修正,自 2011 年 7 月 1 日起施行)。