这一讲要回答六个问题:
- 为什么人们厌恶风险?期望值,为什么不够?
- 保险为什么存在?一个人愿意付多少保费?
- 保险公司怎么靠大数定律赚钱?什么时候,大数定律失效?
- 分散能降低多少风险?降不掉的,是什么?
- 风险值多少钱?(有争议)
- 个人和社会,该怎么对付风险?
第 36 讲,我们讲了"时间":今天和明天。这一讲,加上"不确定性":明天是什么样,我们不知道。第 10 讲留下过"没有风险(第 37 讲)",第 36 讲说"承诺的钱,可能收不回来",也留给了这一讲:折现率里,除了时间,还有风险。
一、一套值 100 万元的房子
你有一套房子,值 100 万元。一年之内,它被烧毁的概率,是 1%。保险公司说,保费是 1.2 万元,烧毁了,赔 100 万。
先停一下:1% 的概率,100 万元的损失,期望的损失是 1 万元。你付 1.2 万,比"期望的损失"还多。你还会买吗?
想一想:你多半会买。1% 听上去很小,可是,一旦发生,你失去的,是你家最大的一笔财产,几乎是一场灾难。付 1.2 万,换来"睡得着觉"。这不是算错了账,是因为,对你来说,100 万的损失,比 1.2 万的小开支,痛得多,不止多 100 倍。
这就是风险厌恶:同样的期望值,一个确定的结果,比一个有风险的结果,更好。
二、期望效用:为什么期望值不够
2.1 圣彼得堡游戏
1738 年,Daniel Bernoulli 讨论过一个游戏(后来叫圣彼得堡悖论):抛硬币,直到出现正面为止;第 n 次才出现正面,奖金 2^n 元。你愿意付多少钱来玩?
期望奖金:(1/2) × 2 + (1/4) × 4 + (1/8) × 8 + …… = 1 + 1 + 1 + ……,无穷大。可是,没有人愿意付一大笔钱来玩。
Bernoulli 的解释:钱给人的满足感(效用),不和钱成正比:第 100 万元,比第 1 万元,带来的满足感,要小。如果用"财富的对数"来衡量,这个游戏的期望效用,是有限的。(Bernoulli 的论文,最初用拉丁文,1738 年发表于圣彼得堡科学院的《评论集》,英文译本,刊于 Econometrica,1954 年,22 卷 1 期,译者 Louise Sommer。)
2.2 风险厌恶 = 凹的效用
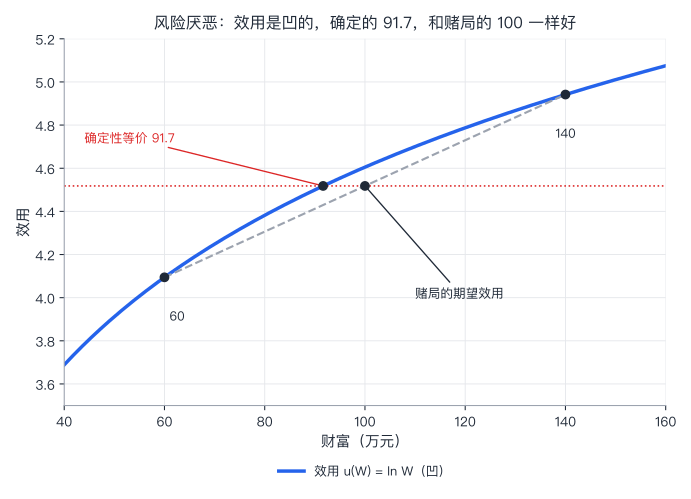
如果一个人的效用,是凹的(财富越多,每多一块钱,增加的满足感,越小),那么,他就是风险厌恶的:
- 期望效用:不是"期望的财富"的效用,而是,每种可能的结果的效用,按概率加权的平均;
- 确定性等价:一个"确定的财富",使你觉得,和这个有风险的赌局,一样好;
- 风险溢价:期望的财富,减去确定性等价,就是你为了避免风险,愿意放弃的。
import math

# 一、圣彼得堡悖论:抛硬币,直到出现正面为止。第 n 次才出现正面,奖金 2^n 元。你愿意付多少钱来玩?
print("一、圣彼得堡游戏:期望奖金是多少?")
for cap_n in (10, 20, 30, 40):
    ev = sum((0.5 ** n) * (2 ** n) for n in range(1, cap_n + 1))      # 每一项都是 1:(1/2)^n × 2^n
    print(f"  如果最多抛 {cap_n} 次(庄家最多付 2^{cap_n} 元):期望奖金 = {ev:.0f} 元(每多允许抛一次,期望多 1 元;不设上限,就是无穷大)")
# 对数效用:用"财富的对数"来衡量满足感(Bernoulli 的想法)。从 0 元起步,奖金 2^n 的效用 = ln(2^n) = n ln 2
eu = sum((0.5 ** n) * (n * math.log(2)) for n in range(1, 200))
print(f"  对数效用下,这个游戏的期望效用 = {eu:.4f}(= 2 ln 2);对应的确定性等价 = e^({eu:.4f}) = {math.exp(eu):.2f} 元:一个理性的、风险厌恶的人,只愿意付约 4 元")

# 二、风险厌恶:效用是凹的。用 u(W) = ln W
u = math.log
def certainty_equivalent(outcomes, probs):
    return math.exp(sum(p * u(w) for w, p in zip(outcomes, probs)))

print("\n二、你有 100 万元,一个赌局:一半的机会赢 40 万,一半的机会输 40 万。期望值是 0,你愿意玩吗?")
W = 100.0
ce = certainty_equivalent([W + 40, W - 40], [0.5, 0.5])
print(f"  玩的结果:140 万或 60 万,期望财富 {0.5 * 140 + 0.5 * 60:.0f} 万,确定性等价 {ce:.2f} 万:比不玩的 100 万少 {W - ce:.2f} 万,这就是'风险溢价':为了避免这个赌局,你愿意放弃最多 {W - ce:.2f} 万")

print("\n三、买保险:你有一套房子,值 100 万,一年内被毁的概率是 1%;你另外还有 W 万的其他财富。保险公平的价格是多少?你最多愿意付多少?(对数效用)")
for other in (100, 200, 1000, 10000):
    Wt = other + 100                                                    # 总财富
    # 愿付的最高保费 P:确定地付 P(房子总是被保住),和不买保险(1% 失去房子)一样好:ln(Wt - P) = 0.99 ln Wt + 0.01 ln(Wt - 100)
    target = 0.99 * u(Wt) + 0.01 * u(Wt - 100)
    P = Wt - math.exp(target)
    print(f"  其他财富 {other:>5} 万:公平保费 1.0000 万;最多愿付 {P:.4f} 万(比公平保费,多 {P - 1:.4f} 万)")
print("  其他财富越少,越怕那 1% 的损失,愿意多付;其他财富越多,越接近'风险中性',只愿意付接近公平的价格")

print("\n四、为什么有保险这门生意:保险费,高于公平价格,只要不高于'最多愿付',买卖双方,都变好了:")
fair = 1.0
Wt0 = 200.0                                                           # 房子 100 万 + 其他财富 100 万
wtp = Wt0 - math.exp(0.99 * u(Wt0) + 0.01 * u(Wt0 - 100))
loading = 1.15
print(f"  公平保费 {fair:.2f} 万;公司收 {fair * loading:.2f} 万(加价 {loading - 1:.0%},用于成本和利润);其他财富 100 万的人,愿付到 {wtp:.2f} 万:1.15 < {wtp:.2f},买卖成交,双方都得到好处;其他财富 1000 万的人,只愿付到 1.05 万 < 1.15,不会买")
输出:
一、圣彼得堡游戏:期望奖金是多少?
  如果最多抛 10 次(庄家最多付 2^10 元):期望奖金 = 10 元(每多允许抛一次,期望多 1 元;不设上限,就是无穷大)
  如果最多抛 20 次(庄家最多付 2^20 元):期望奖金 = 20 元(每多允许抛一次,期望多 1 元;不设上限,就是无穷大)
  如果最多抛 30 次(庄家最多付 2^30 元):期望奖金 = 30 元(每多允许抛一次,期望多 1 元;不设上限,就是无穷大)
  如果最多抛 40 次(庄家最多付 2^40 元):期望奖金 = 40 元(每多允许抛一次,期望多 1 元;不设上限,就是无穷大)
  对数效用下,这个游戏的期望效用 = 1.3863(= 2 ln 2);对应的确定性等价 = e^(1.3863) = 4.00 元:一个理性的、风险厌恶的人,只愿意付约 4 元

二、你有 100 万元,一个赌局:一半的机会赢 40 万,一半的机会输 40 万。期望值是 0,你愿意玩吗?
  玩的结果:140 万或 60 万,期望财富 100 万,确定性等价 91.65 万:比不玩的 100 万少 8.35 万,这就是'风险溢价':为了避免这个赌局,你愿意放弃最多 8.35 万

三、买保险:你有一套房子,值 100 万,一年内被毁的概率是 1%;你另外还有 W 万的其他财富。保险公平的价格是多少?你最多愿意付多少?(对数效用)
  其他财富   100 万:公平保费 1.0000 万;最多愿付 1.3815 万(比公平保费,多 0.3815 万)
  其他财富   200 万:公平保费 1.0000 万;最多愿付 1.2139 万(比公平保费,多 0.2139 万)
  其他财富  1000 万:公平保费 1.0000 万;最多愿付 1.0479 万(比公平保费,多 0.0479 万)
  其他财富 10000 万:公平保费 1.0000 万;最多愿付 1.0049 万(比公平保费,多 0.0049 万)
  其他财富越少,越怕那 1% 的损失,愿意多付;其他财富越多,越接近'风险中性',只愿意付接近公平的价格

四、为什么有保险这门生意:保险费,高于公平价格,只要不高于'最多愿付',买卖双方,都变好了:
  公平保费 1.00 万;公司收 1.15 万(加价 15%,用于成本和利润);其他财富 100 万的人,愿付到 1.38 万:1.15 < 1.38,买卖成交,双方都得到好处;其他财富 1000 万的人,只愿付到 1.05 万 < 1.15,不会买
逐段看:
- 圣彼得堡:不设上限,期望奖金无穷大;设一个上限(最多抛 10 次、20 次、40 次),期望奖金,只有 10、20、40 元,因为每多允许抛一次,期望只多 1 元。用对数效用,期望效用是 2 ln 2,确定性等价是 4 元:一个风险厌恶的人,只愿意付约 4 元。
- 一个赌局:你有 100 万,一半的机会赢 40 万,一半的机会输 40 万。期望财富 100 万,确定性等价只有 91.65 万:为了避免这个赌局,你愿意放弃最多 8.35 万。风险厌恶的人,宁愿要一个确定的 91.65 万,而不要这个赌局。(用对数效用,是一个常见的简化,不是唯一的选择。)
2.3 买保险
现在,回到你的房子。代码的第三部分,用对数效用,算:你最多愿意付多少保费?
- 如果你另外还有 100 万的其他财富(总财富 200 万):最多愿付 1.3815 万,比公平保费 1.0 万,多 0.38 万。
- 其他财富 200 万:1.2139 万;1000 万:1.0479 万;10000 万:1.0049 万。其他财富越多,越接近"风险中性",愿意付的,越接近公平保费。
- 保险为什么是一门生意:公平保费是 1.0 万(期望的损失)。保险公司收 1.15 万(加价 15%,用来付成本和利润)。其他财富 100 万的人,愿意付到 1.38 万,1.15 < 1.38:买卖成交,双方都变好。可是,其他财富 1000 万的人,只愿意付到 1.05 万,低于 1.15,不会买。
保险,是风险的"交易":把风险,从厌恶它的人,转给更能承担它的人(或者,把很多人的风险,汇在一起)。
2.4 期望效用的局限
- 同一个人,既买保险(厌恶风险),又买彩票(喜欢风险),怎么解释?Milton Friedman 和 Leonard Savage 1948 年(Journal of Political Economy,56 卷 4 期)就问过这个问题。
- 人们对概率,常常判断不准,对"损失"和"收益"的感受,不对称(第 39 讲会讲前景理论)。
- 所以,期望效用,是一个标准的、好用的基准,不是对人类行为的完整描述。
小结: 风险厌恶:效用是凹的。确定性等价低于期望财富,差额是风险溢价。因此,人们愿意付高于"公平价格"的保费;其他财富越少,越愿意付。
三、保险公司:大数定律,和它的边界
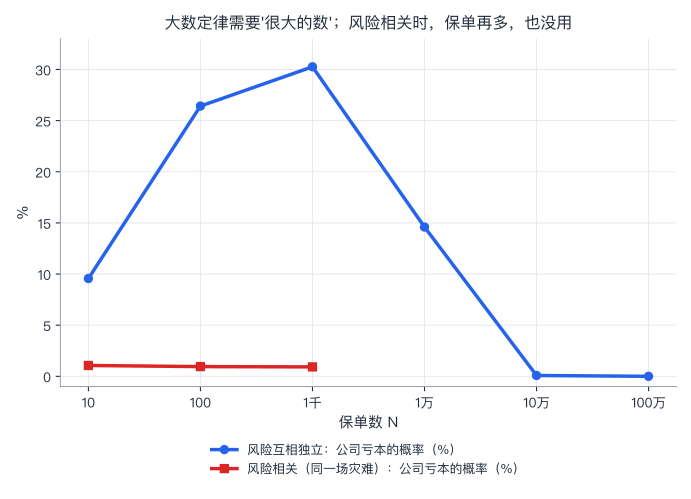
保险公司,不"厌恶"那 1% 的风险,因为,它的客户很多。大数定律:很多互相独立的小风险,加起来,平均的损失,会很接近期望值。
import math, random

# 保险公司:靠"大数定律"赚钱。每份保单:一年内,概率 p = 1% 要赔 100(万元),收保费 1.1(比公平保费 1.0,加价 10%)。
# 问:保单数 N 越多,公司"亏本"(赔的钱,超过收的保费)的概率,是不是越小?
p, L, premium = 0.01, 100.0, 1.1

def binom_tail(n, p, k):
    """P(赔付的份数 >= k):二项分布,精确计算(用对数,避免数字太大)"""
    total = 0.0
    for i in range(k, n + 1):
        logterm = math.lgamma(n + 1) - math.lgamma(i + 1) - math.lgamma(n - i + 1) + i * math.log(p) + (n - i) * math.log(1 - p)
        term = math.exp(logterm)
        total += term
        if i > k + 20 and term < 1e-18 * max(total, 1e-300): break
    return total

print("一、风险是互相独立的(每份保单,自己着火):公司亏本的概率")
for n in (10, 100, 1000, 10000, 100000, 1000000):
    k = math.floor(n * premium / L) + 1                       # 赔付的份数,达到 k 份,赔的钱 k × L,才会超过收到的保费 n × 1.1
    sd = math.sqrt(p * (1 - p) / n) * L
    print(f"  N = {n:>7}:每份保单的平均赔付,标准差 {sd:7.4f}(期望 {p * L:.2f},保费 {premium:.2f});公司亏本的概率 {binom_tail(n, p, k):.4%}")

print("\n二、风险是相关的(比如,同一场洪水,同时淹了很多房子):每年有 1% 的概率发生一场灾难;灾难发生时,每份保单,各自有 p_c = 50% 的概率受损;平时,没有别的损失。")
print("  这样,每份保单的平均赔付概率,也是 1% × 50% = 0.5%(比上面的更低,保费更宽裕)")
rng = random.Random(37)
def sim_correlated(n, years=20000, q=0.01, pc=0.5):
    bad = 0
    for _ in range(years):
        if rng.random() < q:                                   # 这一年,有灾难
            claims = sum(1 for _ in range(n) if rng.random() < pc)
            if claims * L > n * premium: bad += 1
    return bad / years
for n in (10, 100, 1000):
    print(f"  N = {n:>5}:公司亏本的概率约 {sim_correlated(n):.2%}(模拟 20000 年)")
print("  保单越多,亏本的概率,不再变小,而是停在 1% 附近(灾难的概率):风险是'相关'的时候,分散,不管用")
print("  第 35 讲:银行的资产,如果是相关的(同时发生违约),分散,也救不了你;这是'系统性风险'")
输出:
一、风险是互相独立的(每份保单,自己着火):公司亏本的概率
  N =      10:每份保单的平均赔付,标准差  3.1464(期望 1.00,保费 1.10);公司亏本的概率 9.5618%
  N =     100:每份保单的平均赔付,标准差  0.9950(期望 1.00,保费 1.10);公司亏本的概率 26.4238%
  N =    1000:每份保单的平均赔付,标准差  0.3146(期望 1.00,保费 1.10);公司亏本的概率 30.2650%
  N =   10000:每份保单的平均赔付,标准差  0.0995(期望 1.00,保费 1.10);公司亏本的概率 14.5960%
  N =  100000:每份保单的平均赔付,标准差  0.0315(期望 1.00,保费 1.10);公司亏本的概率 0.0821%
  N = 1000000:每份保单的平均赔付,标准差  0.0099(期望 1.00,保费 1.10);公司亏本的概率 0.0000%

二、风险是相关的(比如,同一场洪水,同时淹了很多房子):每年有 1% 的概率发生一场灾难;灾难发生时,每份保单,各自有 p_c = 50% 的概率受损;平时,没有别的损失。
  这样,每份保单的平均赔付概率,也是 1% × 50% = 0.5%(比上面的更低,保费更宽裕)
  N =    10:公司亏本的概率约 1.06%(模拟 20000 年)
  N =   100:公司亏本的概率约 0.95%(模拟 20000 年)
  N =  1000:公司亏本的概率约 0.92%(模拟 20000 年)
  保单越多,亏本的概率,不再变小,而是停在 1% 附近(灾难的概率):风险是'相关'的时候,分散,不管用
  第 35 讲:银行的资产,如果是相关的(同时发生违约),分散,也救不了你;这是'系统性风险'
逐段看:
- 第一部分(风险互相独立):每份保单,1% 的概率赔 100,收保费 1.1。每份保单的平均赔付的标准差,随 N 变大,快速变小:N = 10:3.15;N = 1000:0.315;N = 100 万:0.0099。可是,公司亏本的概率,不是一路下降:N = 10:9.56%(只要有一份赔付就亏);N = 100:26.4%;N = 1000:30.3%;N = 10000:14.6%;N = 10 万:0.08%;N = 100 万:几乎为零。为什么先升后降:保费只比期望高 10%,这个"安全垫",要比平均赔付的标准差大,才管用:N 太小,标准差比安全垫大得多,亏本的概率,主要看"会不会赔上一两份";到了 N 很大,标准差,才小于安全垫。靠大数定律赚钱,要"大数":而且,实际上,保险公司,还要留资本,做缓冲。
- 第二部分(风险相关):假设每年,有 1% 的概率,发生一场灾难(比如,一场洪水),灾难发生时,每份保单,各自有 50% 的概率,受损。每份保单的平均赔付概率,是 0.5%,比第一部分更低,保费更宽裕。可是,N = 10、100、1000:公司亏本的概率,是 1.06%、0.95%、0.92%:不再下降,停在灾难的概率 1% 附近。风险相关时,分散不管用:保单越多,灾难一来,亏得越多。(第 35 讲:银行的资产,如果同时违约,也是一样的道理。)
3.1 什么风险,可以被保险
从这里,可以看到,保险的几个条件(这是一种常见的总结,不是每个保险都完全满足):
- 风险基本独立:不是同时发生;
- 概率可以估计:保险公司,要定价;
- 损失可以核实:不会被轻易地"制造"出来。
当这些条件有问题,保险就会不存在,或者不完整:
- 逆向选择(第 20 讲):买保险的人,比保险公司更了解自己的风险,高风险的人,更愿意买,保费涨,低风险的人退出;
- 道德风险(第 21 讲):投保之后,人们不那么小心了;所以,保险常常有免赔额和共同支付;
- 系统性风险:灾难、金融危机,是相关的:私人保险,很难承担,常常要政府来做(比如,第 34 讲的自动稳定器,第 35 讲的存款保险)。
小结: 保险公司靠大数定律:独立的小风险汇在一起,平均损失接近期望。但是,它需要很大的数,也需要风险互相独立;相关的风险,分散不了。
四、分散:几乎免费的午餐
4.1 两个资产
你有两项投资,每一项的年度波动是 σ,两者的相关系数是 ρ,各投一半:
组合的波动 = σ × √[(1 + ρ) ÷ 2]
- ρ = 1(完全同步):σ,不降;
- ρ = 0.5:0.87σ;
- ρ = 0(互相独立):0.71σ;
- ρ = −1(完全相反):0,风险完全消除。
关键:只要两者不完全同步,混在一起,风险就比单独持有的平均风险小。
4.2 真实的数据:美国 10 个行业
import itertools
import numpy as np

# 分散化:美国 10 个行业,1970–2025 年的年度收益率(%,市值加权,含股息)。来源:Kenneth French 数据库(Dartmouth)的"10 Industry Portfolios",我把月度收益,复利成了日历年度收益。
# 行业依次是:日用消费品、耐用消费品、制造业、能源、高科技、电信、零售、医疗、公用事业、其他。
industries = ["日用消费品", "耐用消费品", "制造业", "能源", "高科技", "电信", "零售", "医疗", "公用事业", "其他"]
data = {
    1970: (5.5, 13.6, -3.1, 15.8, -20.4, 5.7, 4.6, -6.2, 16.6, -6.5),
        1971: (19.4, 19.4, 17.7, 7.5, 13.2, 3.1, 36.5, 23.4, 2.1, 22.1),
        1972: (11.7, 11.8, 21.8, 21.7, 18.0, 20.5, 10.3, 28.7, 10.1, 9.0),
        1973: (-27.6, -35.4, -15.2, 9.8, -23.3, -9.2, -36.5, -15.0, -18.7, -23.7),
        1974: (-26.6, -32.9, -28.1, -25.8, -34.2, -7.6, -33.0, -22.2, -19.7, -32.8),
        1975: (53.2, 65.4, 43.0, 24.4, 47.7, 25.4, 66.9, 9.4, 45.1, 30.8),
        1976: (19.2, 40.2, 20.7, 39.3, 30.1, 35.9, 15.5, 0.7, 31.5, 33.0),
        1977: (-0.3, -9.2, -11.2, -2.3, 0.6, 3.5, -7.6, -4.4, 7.1, 1.1),
        1978: (8.2, 1.0, 10.2, 8.1, 15.4, 8.3, -0.7, 16.8, -3.5, 11.3),
        1979: (15.1, 11.7, 19.6, 59.2, 11.7, -0.8, 15.8, 19.8, 13.5, 30.7),
        1980: (19.3, 14.7, 27.6, 68.1, 32.9, 8.5, 17.9, 30.1, 19.1, 34.3),
        1981: (15.8, -2.2, -5.4, -21.0, -13.6, 33.8, 12.9, 4.0, 6.1, 2.7),
        1982: (40.0, 57.8, 14.0, -14.0, 43.3, 19.8, 62.9, 32.0, 22.7, 21.1),
        1983: (25.0, 33.0, 26.8, 27.7, 21.1, 11.9, 26.3, 3.0, 18.3, 23.0),
        1984: (12.2, 1.4, -1.6, 12.4, -10.0, 24.7, -0.5, 1.9, 19.7, 3.6),
        1985: (44.3, 21.6, 29.7, 20.1, 20.7, 40.2, 40.8, 40.6, 30.6, 40.1),
        1986: (29.7, 16.2, 19.9, 15.6, -3.5, 19.5, 17.8, 27.6, 26.9, 12.9),
        1987: (7.6, 7.8, 8.7, 7.1, 8.1, 10.0, -5.7, 4.5, -7.2, -7.3),
        1988: (31.8, 19.4, 14.0, 21.1, 0.9, 23.3, 28.8, 12.8, 17.8, 18.0),
        1989: (36.1, 3.1, 25.7, 37.3, -3.1, 58.6, 24.8, 44.8, 32.3, 28.1),
        1990: (5.3, -21.8, -6.5, -1.2, -0.9, -15.3, -5.4, 16.9, -1.1, -19.0),
        1991: (45.4, 18.2, 29.6, 6.8, 27.5, 15.0, 56.6, 63.5, 24.4, 43.5),
        1992: (4.9, 37.8, 10.1, 4.6, 10.3, 16.7, 16.4, -15.1, 8.5, 22.5),
        1993: (-2.8, 43.9, 16.9, 13.7, 20.4, 20.0, 3.3, -7.1, 12.8, 13.3),
        1994: (2.4, -14.8, 5.6, 2.6, 18.4, -5.2, -8.0, 7.4, -11.2, -4.3),
        1995: (35.5, 14.2, 31.2, 28.4, 42.9, 40.3, 18.0, 56.7, 31.8, 45.0),
        1996: (22.6, 18.4, 26.0, 27.7, 30.0, 0.5, 16.7, 17.0, 6.3, 25.2),
        1997: (31.7, 29.0, 23.9, 20.1, 21.1, 41.8, 32.1, 37.6, 27.7, 42.0),
        1998: (10.1, 27.8, 6.1, -1.5, 62.8, 47.2, 42.1, 38.1, 11.1, 8.2),
        1999: (-14.7, -4.1, 25.5, 19.8, 81.3, 35.1, 13.1, -2.7, -14.0, 2.7),
        2000: (22.6, -16.5, -0.4, 22.4, -37.7, -40.1, -10.5, 35.4, 50.4, 11.9),
        2001: (-0.7, 6.2, -6.9, -7.1, -25.3, -15.9, 4.8, -12.0, -9.8, -5.0),
        2002: (-3.2, -14.9, -6.9, -8.3, -38.1, -31.4, -21.2, -22.7, -22.1, -15.3),
        2003: (19.5, 48.4, 32.6, 27.0, 48.4, 15.8, 29.7, 21.3, 25.6, 33.4),
        2004: (10.3, 8.2, 15.9, 32.6, 4.9, 9.3, 12.2, 0.3, 24.8, 15.1),
        2005: (2.3, -20.5, 7.3, 32.7, 1.3, -6.7, 6.1, 4.7, 17.6, 6.9),
        2006: (18.5, 22.0, 19.2, 22.1, 9.3, 36.9, 10.5, 8.0, 20.9, 15.8),
        2007: (12.1, -4.2, 20.9, 31.5, 16.9, -1.8, -3.6, 3.7, 18.4, -8.7),
        2008: (-23.5, -59.5, -40.4, -32.6, -42.1, -34.4, -22.0, -17.4, -28.2, -46.8),
        2009: (26.1, 82.3, 34.6, 13.4, 57.7, 25.5, 29.4, 20.2, 14.9, 19.0),
        2010: (19.0, 52.5, 25.8, 21.0, 15.3, 22.3, 18.9, 4.6, 8.2, 16.7),
        2011: (15.0, -25.4, -0.9, 4.7, -1.1, 6.2, 11.2, 10.6, 20.9, -11.1),
        2012: (11.8, 24.3, 15.0, 3.7, 13.7, 29.5, 18.2, 20.4, 3.6, 23.0),
        2013: (26.8, 45.6, 37.1, 25.5, 32.0, 36.1, 35.5, 41.6, 16.5, 41.0),
        2014: (13.3, 6.9, 7.5, -11.4, 16.8, 6.2, 13.0, 24.6, 23.4, 11.4),
        2015: (9.7, -6.1, -6.9, -19.4, 4.7, -0.9, 7.7, 5.8, -13.9, -0.5),
        2016: (7.6, 10.6, 17.4, 26.2, 12.6, 21.0, 3.5, -2.1, 22.5, 20.0),
        2017: (13.5, 13.9, 30.4, 1.0, 35.6, 3.9, 23.1, 22.3, 9.9, 22.1),
        2018: (-14.2, -19.4, -12.4, -17.7, 0.2, -3.8, 4.5, 4.7, 1.5, -9.8),
        2019: (24.4, 30.1, 27.4, 7.7, 44.6, 29.6, 26.3, 20.1, 24.3, 30.6),
        2020: (9.2, 165.8, 14.3, -32.8, 45.2, 11.7, 35.9, 18.7, -4.0, 9.0),
        2021: (11.9, 42.2, 22.5, 61.7, 31.4, -7.0, 19.1, 13.6, 20.2, 26.1),
        2022: (1.3, -55.7, -11.4, 64.6, -32.3, -23.3, -24.5, -5.7, 3.0, -13.8),
        2023: (-0.8, 65.6, 14.2, -1.2, 54.5, 8.5, 31.3, 4.4, -4.7, 19.3),
        2024: (3.5, 46.2, 7.2, 1.7, 35.7, 15.4, 29.6, 6.3, 29.2, 24.0),
        2025: (5.3, 13.9, 16.5, 7.8, 24.8, 6.9, 6.5, 23.3, 14.1, 12.7)
}
A = np.array([data[y] for y in sorted(data)])                   # 56 年 × 10 个行业
years = sorted(data)
vol = A.std(axis=0, ddof=1)
print(f"{len(years)} 年({years[0]}–{years[-1]}),10 个行业,年度收益率的平均值(%)和波动(标准差,%):")
for name, m, s in zip(industries, A.mean(axis=0), vol):
    print(f"  {name}:平均 {m:5.1f},波动 {s:5.1f}")
C = np.corrcoef(A.T)
avg_corr = (C.sum() - 10) / 90
print(f"\n10 个行业,两两之间,相关系数的平均值:{avg_corr:.2f}(最低 {C[C < 0.999].min():.2f},最高 {C[C < 0.999].max():.2f})")

print("\n把钱平均分在 k 个行业上,组合的年度波动(对所有的 k 个行业的搭配,取平均;括号里是最低和最高的搭配):")
for k in range(1, 11):
    v = [A[:, list(sub)].mean(axis=1).std(ddof=1) for sub in itertools.combinations(range(10), k)]
    print(f"  k = {k:>2}:{np.mean(v):5.2f}({min(v):5.2f} 到 {max(v):5.2f})")
floor = vol.mean() * np.sqrt(avg_corr)
print(f"\n理论:k 个'一样'的资产,波动 σ,两两相关 ρ:组合波动² = σ² × [ρ + (1 − ρ) ÷ k];k 很大时,下限 = σ × √ρ")
print(f"  平均波动 {vol.mean():.2f},平均相关 {avg_corr:.2f}:下限 ≈ {floor:.2f};k = 10 时,实际 {A.mean(axis=1).std(ddof=1):.2f}")
print("  分散化,消除的是'行业自己的运气'(特有风险);剩下的,是所有行业一起涨跌的部分(系统性风险):分散不掉")
输出:
56 年(1970–2025),10 个行业,年度收益率的平均值(%)和波动(标准差,%):
  日用消费品:平均  12.9,波动  16.7
  耐用消费品:平均  15.5,波动  35.4
  制造业:平均  12.2,波动  16.8
  能源:平均  13.0,波动  22.2
  高科技:平均  14.3,波动  26.9
  电信:平均  11.6,波动  20.5
  零售:平均  13.9,波动  21.2
  医疗:平均  12.8,波动  18.8
  公用事业:平均  11.7,波动  16.7
  其他:平均  12.1,波动  19.6

10 个行业,两两之间,相关系数的平均值:0.53(最低 -0.02,最高 0.86)

把钱平均分在 k 个行业上,组合的年度波动(对所有的 k 个行业的搭配,取平均;括号里是最低和最高的搭配):
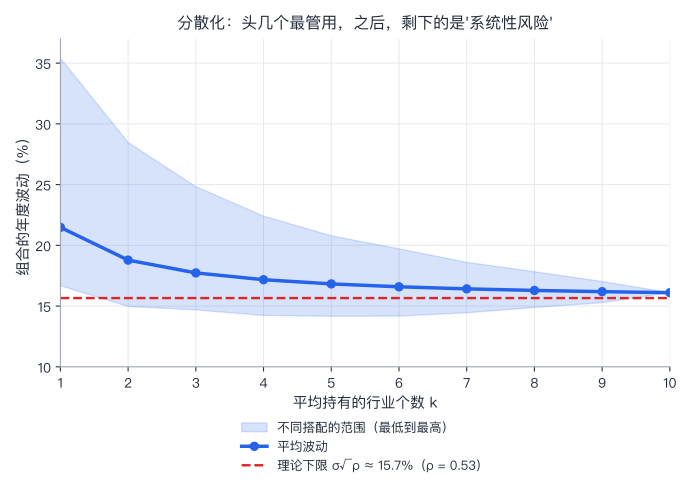
  k =  1:21.48(16.68 到 35.41)
  k =  2:18.78(14.97 到 28.46)
  k =  3:17.73(14.68 到 24.83)
  k =  4:17.17(14.23 到 22.41)
  k =  5:16.82(14.16 到 20.78)
  k =  6:16.59(14.17 到 19.71)
  k =  7:16.42(14.45 到 18.60)
  k =  8:16.29(14.89 到 17.83)
  k =  9:16.19(15.28 到 17.03)
  k = 10:16.10(16.10 到 16.10)

理论:k 个'一样'的资产,波动 σ,两两相关 ρ:组合波动² = σ² × [ρ + (1 − ρ) ÷ k];k 很大时,下限 = σ × √ρ
  平均波动 21.48,平均相关 0.53:下限 ≈ 15.66;k = 10 时,实际 16.10
  分散化,消除的是'行业自己的运气'(特有风险);剩下的,是所有行业一起涨跌的部分(系统性风险):分散不掉
逐段看:
- 单个行业:1970 到 2025 年,56 年,10 个行业,年度收益的波动:最低 16.7%(日用消费品、公用事业),最高 35.4%(耐用消费品);平均 21.5%。
- 相关系数:两两之间,平均只有 0.53(最低 −0.02,最高 0.86):不是完全同步。
- 分散的效果:只持有 1 个行业,平均波动 21.48%;2 个:18.78%;3 个:17.73%;5 个:16.82%;10 个:16.10%。头几个,最管用:从 1 个到 2 个,降了 2.7 个百分点;从 5 个到 10 个,只降了 0.7 个百分点。
- 降不掉的部分:理论:下限 = σ × √ρ = 21.48 × √0.53 ≈ 15.66;10 个行业的实际,16.10,很接近。这降不掉的部分,是所有行业一起涨跌的:系统性风险。行业自己的运气(特有风险),分散掉了。
- 不同的搭配,差别很大:只持有 2 个行业,波动的范围,14.97% 到 28.46%:选得好,比 10 个行业还稳,但是,选得不好,会比平均高很多。分散,是降低你运气坏的概率,不是保证不亏。
4.3 特有风险和系统性风险
- 特有风险(idiosyncratic risk):只和某一家公司、某一个行业有关的风险:可以通过分散消除。
- 系统性风险(systematic risk):影响所有资产的:不能通过分散消除。
理论的一个有名的预测(Harry Markowitz 1952 年,Journal of Finance,7 卷 1 期,的组合理论,William Sharpe 1964 年,Journal of Finance,19 卷 3 期,的资本资产定价模型):既然特有风险,可以免费地分散掉,市场不会因此给你补偿;只有系统性风险,才会被"定价"。这个预测,第 38 讲会讲,它有多少证据支持。
4.4 人们真的分散了吗
Laurent Calvet、John Campbell 和 Paolo Sodini 2007 年(Journal of Political Economy,115 卷 5 期)用瑞典全体家庭的详细数据,研究家庭投资中的"错误"。据摘要:(1)只有一部分家庭,分散严重不足,大多数家庭,通过国际分散,表现比本国股指更好;(2)不参与风险资产市场,带来的福利损失,在考虑了"不参与的人,即使参与,也未必投资得好"之后,几乎少了一半;(3)更有金融知识的家庭,投资更有效,也更激进,所以,它们在效率上的"福利成本"更高。(我只引用摘要的概括,请读原文。)
小结: 分散化:只要资产不完全同步,混在一起,风险就降低。10 个行业的数据:从 21.5% 降到 16.1%,之后降不动,因为剩下的,是系统性风险。头几个最管用。
五、风险值多少钱
5.1 风险溢价
第 36 讲,我们说,折现率,反映时间。如果现金流是有风险的,折现率,还要加上风险溢价:
折现率 = 无风险利率 + 风险溢价
风险越大的现金流,要求的回报越高,所以,现值越低。
5.2 真实的数据:美国股市 99 年
import numpy as np

# 风险的价格:美国股市,1927–2025 年,每个日历年。
# 来源:Kenneth French 数据库(Dartmouth)的"Fama/French Research Data Factors":每月的市场收益(市值加权,含股息)和 1 个月期国库券收益,我复利成了日历年度。
# 每项:年份: (股市全年收益 %,国库券全年收益 %)。
data = {
    1927: (32.6, 3.1), 1928: (39.1, 3.5), 1929: (-14.9, 4.7), 1930: (-28.7, 2.4), 1931: (-43.8, 1.1),
        1932: (-8.7, 0.9), 1933: (56.8, 0.3), 1934: (3.3, 0.2), 1935: (45.0, 0.1), 1936: (32.2, 0.2),
        1937: (-34.7, 0.3), 1938: (28.2, -0.0), 1939: (2.5, 0.0), 1940: (-7.2, -0.0), 1941: (-10.6, 0.0),
        1942: (16.5, 0.3), 1943: (28.3, 0.4), 1944: (21.3, 0.3), 1945: (38.7, 0.3), 1946: (-6.4, 0.4),
        1947: (3.4, 0.5), 1948: (1.9, 0.8), 1949: (20.2, 1.1), 1950: (30.1, 1.2), 1951: (20.7, 1.5),
        1952: (13.5, 1.7), 1953: (0.7, 1.8), 1954: (50.3, 0.9), 1955: (25.4, 1.6), 1956: (8.3, 2.5),
        1957: (-10.0, 3.2), 1958: (45.0, 1.5), 1959: (12.8, 3.0), 1960: (1.2, 2.7), 1961: (26.9, 2.1),
        1962: (-10.2, 2.7), 1963: (21.0, 3.1), 1964: (16.1, 3.5), 1965: (14.4, 3.9), 1966: (-8.8, 4.8),
        1967: (28.7, 4.2), 1968: (14.1, 5.2), 1969: (-11.0, 6.6), 1970: (0.1, 6.5), 1971: (16.2, 4.4),
        1972: (16.9, 3.8), 1973: (-19.3, 6.9), 1974: (-27.8, 8.0), 1975: (38.3, 5.8), 1976: (27.0, 5.1),
        1977: (-3.1, 5.1), 1978: (8.2, 7.2), 1979: (23.5, 10.4), 1980: (33.3, 11.3), 1981: (-3.3, 14.7),
        1982: (21.5, 10.5), 1983: (22.6, 8.8), 1984: (3.9, 9.8), 1985: (32.6, 7.7), 1986: (16.4, 6.2),
        1987: (1.6, 5.5), 1988: (18.0, 6.4), 1989: (28.9, 8.4), 1990: (-6.0, 7.8), 1991: (34.8, 5.6),
        1992: (9.8, 3.5), 1993: (11.2, 2.9), 1994: (-0.1, 3.9), 1995: (36.9, 5.6), 1996: (21.2, 5.2),
        1997: (31.2, 5.3), 1998: (24.3, 4.9), 1999: (25.2, 4.7), 2000: (-11.6, 5.9), 2001: (-11.2, 3.8),
        2002: (-21.1, 1.6), 2003: (31.7, 1.0), 2004: (11.9, 1.2), 2005: (6.1, 3.0), 2006: (15.4, 4.8),
        2007: (5.7, 4.7), 2008: (-36.7, 1.6), 2009: (28.6, 0.1), 2010: (17.4, 0.1), 2011: (0.5, 0.0),
        2012: (16.3, 0.1), 2013: (35.2, 0.0), 2014: (11.7, 0.0), 2015: (0.2, 0.0), 2016: (13.6, 0.2),
        2017: (22.3, 0.8), 2018: (-5.0, 1.8), 2019: (30.6, 2.1), 2020: (24.1, 0.5), 2021: (23.9, 0.0),
        2022: (-19.9, 1.4), 2023: (26.7, 4.9), 2024: (25.0, 5.3), 2025: (17.5, 4.3)
}
ys = sorted(data)
mkt = np.array([data[y][0] for y in ys]); rf = np.array([data[y][1] for y in ys])
ex = mkt - rf
print(f"{len(ys)} 年({ys[0]}–{ys[-1]}):")
print(f"  股市年收益的平均 {mkt.mean():.1f}%,国库券 {rf.mean():.1f}%;超额收益(风险溢价)的平均 {ex.mean():.2f}%,波动 {ex.std(ddof=1):.1f}%")
print(f"  夏普比率 = 平均超额收益 ÷ 波动 = {ex.mean() / ex.std(ddof=1):.2f}(每承担 1 份风险,换来的额外收益)")
geo_m = (np.prod(1 + mkt / 100) ** (1 / len(ys)) - 1) * 100; geo_r = (np.prod(1 + rf / 100) ** (1 / len(ys)) - 1) * 100
print(f"  几何平均(每年复利):股市 {geo_m:.1f}%,国库券 {geo_r:.1f}%")
worst = min(ys, key=lambda y: data[y][0]); best = max(ys, key=lambda y: data[y][0])
print(f"  最差的一年:{worst}:{data[worst][0]:.1f}%;最好的一年:{best}:{data[best][0]:.1f}%;下跌的年份 {int((mkt < 0).sum())} 个({(mkt < 0).mean():.0%})")

print("\n持有时间越长,股市跑赢国库券的比例(所有重叠的窗口,复利):")
for H in (1, 5, 10, 20):
    n = len(ys) - H + 1
    wins = sum(1 for i in range(n) if np.prod(1 + mkt[i:i + H] / 100) > np.prod(1 + rf[i:i + H] / 100))
    print(f"  持有 {H:>2} 年:{n} 个窗口里,跑赢 {wins} 个({wins / n:.0%})")
print("  (这是美国 99 年的经验;窗口是重叠的,不是独立的实验;美国是 20 世纪的'赢家',别的国家,经历不同)")
输出:
99 年(1927–2025):
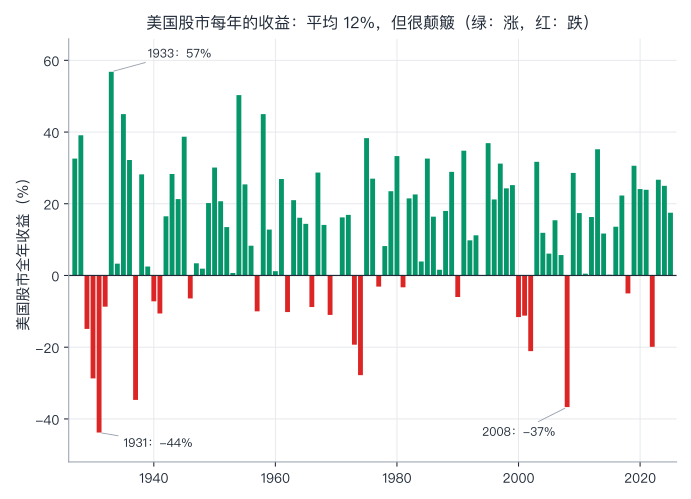
  股市年收益的平均 12.2%,国库券 3.3%;超额收益(风险溢价)的平均 8.86%,波动 20.1%
  夏普比率 = 平均超额收益 ÷ 波动 = 0.44(每承担 1 份风险,换来的额外收益)
  几何平均(每年复利):股市 10.3%,国库券 3.3%
  最差的一年:1931:-43.8%;最好的一年:1933:56.8%;下跌的年份 24 个(24%)

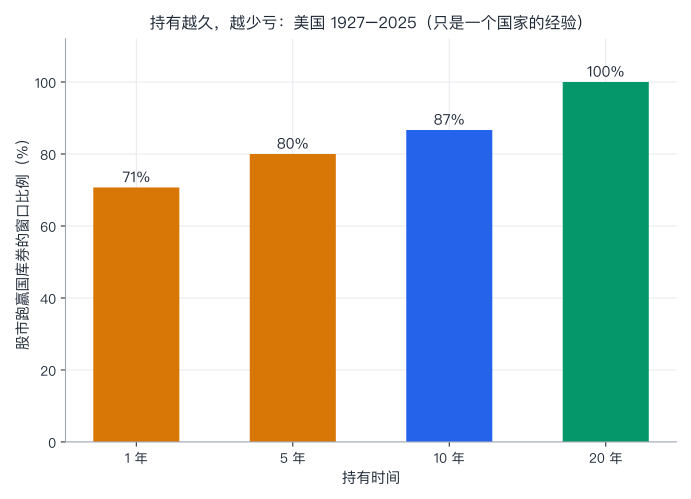
持有时间越长,股市跑赢国库券的比例(所有重叠的窗口,复利):
  持有  1 年:99 个窗口里,跑赢 70 个(71%)
  持有  5 年:95 个窗口里,跑赢 76 个(80%)
  持有 10 年:90 个窗口里,跑赢 78 个(87%)
  持有 20 年:80 个窗口里,跑赢 80 个(100%)
  (这是美国 99 年的经验;窗口是重叠的,不是独立的实验;美国是 20 世纪的'赢家',别的国家,经历不同)
逐段看:
- 风险溢价:1927 到 2025 年,99 年:股市每年平均 12.2%,国库券 3.3%,超额收益的平均是 8.86%,波动 20.1%;夏普比率 0.44(每承担 1 份风险,换来的额外收益)。几何平均(每年复利):股市 10.3%,国库券 3.3%。
- 很颠簸:最差的一年,1931 年:−43.8%;最好的一年,1933 年:+56.8%;下跌的年份,24 个,几乎每 4 年有 1 年。
- 持有越久,越少亏:持有 1 年,跑赢国库券的比例,71%(99 个窗口里,70 个);5 年,80%;10 年,87%;20 年,100%(80 个窗口,全部)。
- 要小心:(1)窗口是重叠的,不是独立的实验:99 年的数据,大约只有 4 到 5 个互不重叠的 20 年;(2)这是美国一个国家的经验,美国是 20 世纪的"赢家",别的国家,不一定;(3)过去的收益,不保证未来。
5.3 一个有争议的问题:股权溢价之谜
按"理论预测 → 证据与局限 → 分歧在哪 → 价值判断留给读者"来写。
理论预测什么:Rajnish Mehra 和 Edward Prescott 1985 年(《股权溢价:一个谜》,Journal of Monetary Economics,15 卷 2 期)的发现:用一个标准的、校准过的一般均衡模型,在"合理"的风险厌恶程度下,模型给出的股权溢价,远低于数据里的数字(据对论文的转述,模型的溢价,不到 1%,数据里,约 6%;不同的转述,具体的数字不一致,请读原文)。要解释数据里的这么高的溢价,需要,极高的风险厌恶。这就是"谜"。
证据怎么说(几种常被提到的解释,不互相排斥):
- 罕见的灾难:Robert Barro 2006 年(Quarterly Journal of Economics,121 卷 3 期)认为,我们没有把"罕见的、严重的经济灾难"(20 世纪全球历史里的:第一次世界大战、大萧条、第二次世界大战)的概率,放进模型;放进去之后,可以解释高股权溢价、低无风险利率和股市的高波动。
- 习惯形成:John Campbell 和 John Cochrane 1999 年(《出于习惯的力量》,Journal of Political Economy,107 卷 2 期):人们的效用,取决于消费相对于一个"习惯水平";在衰退时,消费接近习惯,人们对风险格外敏感,要求更高的补偿。(卷期页,我没有在这里核对到;请核对期刊。)
- 其他:幸存者偏差(我们看的美国,是 20 世纪的赢家)、市场摩擦、人们的偏好(第 39 讲)。
局限:(1)每一种解释,都有后续的争论(比如,罕见灾难的概率,怎么估,是一个难题);(2)数据里的溢价,本身,随时期和国家而变,用的是美国 99 年;(3)它是一个"校准的模型,和数据对不上"的问题,不是一个直接的因果问题。
分歧在哪:事实上,股权溢价,到底是"风险的补偿"(罕见灾难、习惯),还是"人们的错误"(行为金融),还是"样本的运气"(幸存者偏差)。这些,数据里,很难完全分开。
价值判断(留给你):这个问题,事实的成分居多。涉及价值的,是它在现实里,带来的选择:
- 风险该由谁承担:养老金,是由个人自己投资、自己承担(市场的颠簸),还是由集体、雇主、政府来分担?你觉得,多大的风险,该让个人自己承担?
- 安全和回报:一个 20 年的长期投资者,历史上,股市从没有输给国库券(美国的数据),但是,这不是保证;你愿意为了更高的预期回报,承担多大的颠簸?
- 灾难的保险:罕见的灾难,谁来买保险?只有政府,能承担吗?
经济学能告诉你:每一种风险和回报的组合,大约是什么;你愿意承担多大的风险,是你的价值判断(和你的处境)。
六、个人和社会,怎么对付风险
四种办法:
- 自己承担:留一笔储蓄做缓冲(经济学里叫"预防性储蓄");
- 分散:把鸡蛋,放在不同的篮子里(第四节);
- 买保险:把风险,转给能承担的人(第二、三节);
- 社会保险:由政府组织,强制参加,汇集风险(比如,基本医疗保险、养老保险、失业保险)。
为什么有的保险,由政府强制?常被提到的理由(第 20、21 讲):
- 逆向选择:如果自愿,健康的人,会退出,保费涨,保险就崩溃;强制,让所有人,都进来;
- 近视(第 36 讲、第 39 讲):人们可能,低估将来的需要;
- 系统性风险:私人,难以承担。
价值判断(留给你):
- 强制,还是自愿:强制参加,减少了逆向选择,也减少了人们的选择自由。你觉得,该强制到什么程度?
- 谁来付钱:保险的成本,由个人缴费,还是由政府补贴(也就是,由别的纳税人)?
- 道德风险:慷慨的保障,也可能让人们不够小心(第 21 讲):你怎么权衡"保障"和"激励"?
七、局限、常见误用
7.1 局限
- 期望效用,是一个基准:人们的真实行为,更复杂(第 39 讲)。
- 对数效用,只是一个常见的简化。
- 保险模拟:参数是虚构的;真实的保险公司,有资本、再保险,监管。
- 美国的数据,不一定适用于别国;过去的收益,不等于未来。
- 这一讲没有讲:衍生品、期权、风险的更细的衡量、中国的保险和资本市场的具体情况。
7.2 常见的误用
| 误用 | 正确的想法 |
|---|---|
| “期望值最大的选择,就是最好的” | 风险厌恶的人,要看效用;确定性等价,比期望值低 |
| “买保险,是亏的,因为保费高于期望的赔付” | 保费高于期望的赔付,仍然可以划算:它买的,是风险的转移 |
| “保险公司,保单越多越安全” | 要看风险是不是独立;相关的风险,保单再多,也没用 |
| “多买几只股票,就分散了” | 如果它们同步涨跌,分散不了多少;10 个行业,平均相关 0.53 |
| “分散化,可以消除所有的风险” | 只能消除特有风险;系统性风险,分散不掉 |
| “持有 20 年,股票就不会输” | 美国 99 年的重叠窗口,是个经验,不是保证 |
| “风险高的资产,一定有高回报” | 只有"系统性风险",理论上才会被补偿;而且,回报是预期的,不是保证的 |
| “股权溢价,就是风险的补偿,没有谜” | 标准的模型,给不出这么高的溢价;几种解释,各有争论 |
八、小结
这一讲有六个想法,请带走:
- 风险厌恶:效用是凹的;确定性等价,低于期望财富;差额是风险溢价。
- 保险:风险的交易;人们愿意付高于公平保费的价格(其他财富越少,越愿意),保险公司,加价之后,双方都变好。
- 大数定律:独立的小风险,汇在一起,平均损失接近期望;需要很大的数,也需要风险独立;相关的风险(灾难、危机),分散不了。
- 分散:资产不完全同步,混在一起,风险降低;10 个行业,从 21.5% 到 16.1%,之后降不动;剩下的,是系统性风险。
- 风险值钱:美国股市 99 年,平均超额收益 8.86%,波动 20.1%,24 年下跌,最差 −43.8%;持有 20 年,没输给国库券,但这只是一个国家的经验。
- 股权溢价之谜:标准模型,解释不了这么高的溢价;罕见灾难、习惯形成等几种解释,各有争论。
下一讲,我们问:市场上的价格,反映了所有的信息吗? 如果是,你能不能靠分析,战胜市场?下一讲:第 38 讲:有效市场假说及其争议。
思考题
1. 对数效用,你有 100 万元,一半的机会赢 20 万,一半的机会输 20 万。确定性等价是多少?风险溢价是多少?
提示:确定性等价 = exp(0.5 × ln 120 + 0.5 × ln 80) = √(120 × 80) = √9600 ≈ 97.98 万;风险溢价 = 100 − 97.98 ≈ 2.02 万。赌局的赢亏,越大,风险溢价越大(比较 2.2 节:±40 万,8.35 万)。
2. 两个资产,波动都是 20%,各投一半。相关系数是 0.5、0、−0.5 时,组合的波动是多少?
提示:组合波动 = σ × √[(1 + ρ) ÷ 2]:ρ = 0.5:20 × √0.75 ≈ 17.3%;ρ = 0:20 × √0.5 ≈ 14.1%;ρ = −0.5:20 × √0.25 = 10%。相关系数越低,分散的效果,越好。
3. 一个保险公司:每份保单,2% 的概率赔 50,保费 1.2。N = 10000 份,风险互相独立。(用正态分布近似)每份保单平均赔付的标准差是多少?公司亏本的概率,大约是多少?
提示:期望赔付 = 0.02 × 50 = 1.0;每份保单的赔付的标准差 = √(0.02 × 0.98) × 50 ≈ 7.0;平均赔付的标准差 = 7.0 ÷ √10000 = 0.07。安全垫 = 1.2 − 1.0 = 0.2,约 2.86 个标准差;亏本的概率,约 0.2%。
4. 本讲的美国股市数据:平均超额收益 8.86%,波动 20.1%,夏普比率 0.44。如果你,一半的钱买股市,一半买国库券(无风险),组合的超额收益、波动、夏普比率,是多少?
提示:超额收益 = 0.5 × 8.86 = 4.43%;波动 = 0.5 × 20.1 = 10.05%(国库券无风险);夏普比率 = 4.43 ÷ 10.05 = 0.44:不变。把钱,在"无风险资产"和"风险资产"之间分配,改变的是风险的大小,不是每单位风险的回报。
5. (开放题)“美国股市,持有 20 年,80 个窗口里,赢了 80 次,所以,长期持有股票,没有风险。“这个推理,有什么问题?
提示:(1)窗口是重叠的:99 年里,只有大约 4 到 5 个互不重叠的 20 年,80 个窗口,不是 80 次独立的实验;(2)一个国家的经验,美国是 20 世纪的赢家,别的国家的经历,不一定;(3)“没输给国库券”,不等于"没有风险”:你的 20 年,可能,真的是一个糟糕的 20 年,而你的人生,只有一个 20 年;(4)未来不保证,(5)你能不能撑过中间的下跌(比如,亏 44% 的一年),也影响你的真实结果。
参考与延伸
- Bernoulli, D. (1954). Exposition of a New Theory on the Measurement of Risk (L. Sommer, Trans.). Econometrica, 22(1), 23–36.(原文发表于 1738 年。)
- Friedman, M., & Savage, L. J. (1948). The Utility Analysis of Choices Involving Risk. Journal of Political Economy, 56(4), 279–304.
- Markowitz, H. (1952). Portfolio Selection. Journal of Finance, 7(1), 77–91.
- Sharpe, W. F. (1964). Capital Asset Prices: A Theory of Market Equilibrium under Conditions of Risk. Journal of Finance, 19(3), 425–442.
- Mehra, R., & Prescott, E. C. (1985). The Equity Premium: A Puzzle. Journal of Monetary Economics, 15(2), 145–161.
- Campbell, J. Y., & Cochrane, J. H. (1999). By Force of Habit: A Consumption-Based Explanation of Aggregate Stock Market Behavior. Journal of Political Economy, 107(2).
- Barro, R. J. (2006). Rare Disasters and Asset Markets in the Twentieth Century. Quarterly Journal of Economics, 121(3), 823–866.
- Calvet, L. E., Campbell, J. Y., & Sodini, P. (2007). Down or Out: Assessing the Welfare Costs of Household Investment Mistakes. Journal of Political Economy, 115(5), 707–747.
- Kenneth R. French 数据库(达特茅斯学院):“Fama/French Research Data Factors”、“10 Industry Portfolios”(本讲的数据,2026 年 10 月下载)。