这一讲要回答六个问题:
- 价格里,装着什么信息?有效市场假说,说了什么,没说什么?
- 价格的历史,能不能预测未来?(随机游走)
- 你能不能靠选股、选基金,战胜市场?怎么分清运气和技能?
- 风险,有没有被"定价"?(第 37 讲留下的预测,这一讲检验)
- 市场,到底有效吗?(有争议)
- 如果市场,大体有效,对个人,意味着什么?
第 36 讲,我们说,一项资产的价格,等于未来现金流的现值。第 37 讲,我们说,风险是要补偿的,可是,只有分散不掉的风险,才会被补偿,并说,这个预测,要靠真实的数据来检验。这一讲,就来做这件事;做之前,先把前两讲的结论合在一起:既然价格,是对未来的预期,那么,价格里,已经有多少信息?
一、一个连赢 5 年的基金经理
朋友给你推荐了一个基金经理。他管的基金,连续 5 年,每一年,都跑赢了市场。朋友说:这个人,是有真本事的。
先停一下:一个人,每年有 50% 的概率,跑赢市场(比如,他其实,完全靠抛硬币)。如果有 1 万个这样的"经理",5 年里,会有多少个人,每一年,都跑赢?
先想一想,再往下读。答案,我们在第四节,用模拟来看。这一节,先记住一件事:当人很多的时候,“连赢”,不稀奇。稀奇的,是你只看到了赢家。
二、有效市场假说:说了什么,没说什么
2.1 价格,是"预期"的
第 7 讲,我们说,价格,传递信息。第 36 讲,我们说,股票的价格,是未来现金流的现值。把它们合起来:今天的股价,已经包含了大家,对公司未来的预期。
设想一家公司,明天公布利润:
- 大家预期,是 10 亿。公布出来,正是 10 亿:股价,几乎不动:因为,10 亿,早就在价格里了;
- 公布出来,是 12 亿:比预期多:股价上涨;
- 公布出来,是 8 亿:比预期少:股价下跌。
所以,推动价格变化的,不是"利润好",而是**“比预期更好”**,也就是"意外"。而"意外",按定义,不能被预测:如果你能预测它,它就不是意外,早就进了价格。
这就是整个想法的核心:价格的变化,来自新的信息;新的信息,是不可预测的;所以,价格的变化,是不可预测的。
竞争,让这件事,成立:如果有一条公开的规则,能稳赚(比如,“每次,某类消息出现,就买”),大家会涌进来用它,把价格,推到那条规则,不再赚钱的地方。这和第 12 讲的逻辑,是一回事:自由进入,把超额的利润,压到零。
2.2 定义
有效市场假说(Efficient Market Hypothesis, EMH):价格,已经充分反映了可以得到的信息。Eugene Fama 1970 年的综述(Journal of Finance,25 卷 2 期,383–417 页),把它,按"可得的信息"的范围,分成三种:
| 形式 | 价格,已反映的信息 | 如果成立,这类分析,赚不到超额收益 |
|---|---|---|
| 弱式 | 过去的价格、成交量 | 技术分析(看走势图、找形态) |
| 半强式 | 所有公开的信息(财报、新闻、宏观数据) | 基本面分析(读财报选股) |
| 强式 | 所有的信息,包括内部的、私人的 | 连内幕信息,也赚不到 |
强式,一般被认为,不成立(否则,就不需要,禁止内幕交易的法律了);它更像一个对照的基准。真正有争论的,是前两种,尤其是半强式。
早在 1900 年,法国数学家 Louis Bachelier 的博士论文,就用"随机游走",描述价格。后来,Paul Samuelson 1965 年的《正确预期的价格,随机波动的证明》(Industrial Management Review,6 卷 2 期,41 页起),说明了:在竞争的市场里,价格的变化,“不可预测”,不是市场出了问题,恰恰是,它运转得好的标志。
2.3 它没有说什么
这是最容易误解的地方。有效市场假说没有说:
- 价格永远"正确"。 它只说,你很难,系统地,比价格,知道得更多;价格,可以错,只是,你不知道,往哪边错。
- 没有人,能赚到钱。 你可以赚到钱,只是,大体上,你赚的,是风险的补偿(第 37 讲),而不是"免费的午餐"。
- 投资者,都是理性的。 它只要求,错误,没有系统的方向,或者,错误,被别人,套利掉。
- 价格,是随便定的。 价格,是被信息,推动的;只是,信息,是随机到来的。
另外,这里的"有效",是信息意义上的有效,和第 12 讲说的"资源配置的效率",是两个概念,不要混为一谈。
2.4 一个悖论:完全有效,不可能
Sanford Grossman 和 Joseph Stiglitz 1980 年,(《论信息有效市场的不可能性》,American Economic Review,70 卷 3 期,393–408 页),提出了一个问题:
如果,价格,已经,完全反映了所有的信息,那么,花钱收集信息,就赚不到任何东西。没有人,会去收集。没有人收集,价格,就不再反映信息。
所以,“完全有效”,自己,推翻自己。均衡里,市场,只能,“几乎有效”:差多少,等于,收集信息的成本。
举一个示意的小模型(不是他们原来的模型,原来的,复杂得多):
- 收集信息的成本,每年 2 万元;
- 如果,一个人,是市场上,唯一知情的人,他每年,能多赚 10 万元;
- 知情的人,越多,价格,反映的信息,越多,每个知情的人,能多赚的,越少:假设,知情者的占比是 λ,每个人多赚的,是 10 × (1 − λ) 万元。
均衡,是,多赚的钱,等于成本:10 × (1 − λ) = 2,所以,λ = 80%:80% 的人,选择花钱收集信息;另外 20%,不收集,直接相信价格。价格还没有反映的那一部分,正好,够补偿收集信息的成本。如果成本,降到 0.5 万,λ = 95%:信息,越便宜,市场,越有效。(思考题 5 会回到这里。)
三、弱式:价格的历史,能预测未来吗
3.1 怎么检验
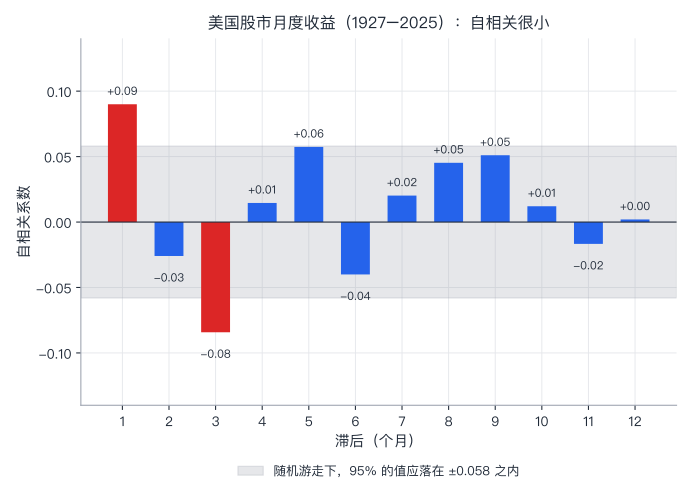
如果价格的变化,不可预测,那么,这个月的收益,和上个月的收益,没有关系。我们用自相关来看:把每个月的收益,和 k 个月之前的收益,算一个相关系数。如果完全没有关系,它应该,很接近 0:具体地说,n 个月的数据,大约 95% 的情况,落在 ±2/√n 之内。
我们用 1927 年 1 月到 2025 年 12 月,美国股市的月度收益(Kenneth French 数据库,共 1188 个月)。
import io, math, urllib.request, zipfile
import numpy as np

# 数据:Kenneth French 数据库(Fama/French 三因子,月度,1926-07 起;本讲用 1927-01 至 2025-12)。
# 代码会自己下载(需要联网)。数据库偶尔修订,小数位可能有极小差别。
URL = "https://mba.tuck.dartmouth.edu/pages/faculty/ken.french/ftp/F-F_Research_Data_Factors_CSV.zip"
raw = urllib.request.urlopen(URL, timeout=60).read()
text = zipfile.ZipFile(io.BytesIO(raw)).read("F-F_Research_Data_Factors.csv").decode("latin-1")

rows = []
for line in text.splitlines():
    parts = [p.strip() for p in line.split(",")]
    if len(parts) == 5 and len(parts[0]) == 6 and parts[0].isdigit():
        rows.append((int(parts[0]), *map(float, parts[1:])))
rows = [r for r in rows if 192701 <= r[0] <= 202512]
mkt = np.array([r[1] + r[4] for r in rows]) / 100      # 市场的总收益 = 超额收益 + 无风险利率
rf = np.array([r[4] for r in rows]) / 100
n = len(mkt)
print(f"数据:美国股市(市值加权),{rows[0][0]} 至 {rows[-1][0]},共 {n} 个月")
print(f"  月平均收益 {mkt.mean():.2%},月标准差 {mkt.std(ddof=1):.2%}")

# 一、自相关:这个月的收益,和 k 个月之前的收益,有多相关?
def acf(x, k):
    x = x - x.mean()
    return float((x[k:] * x[:-k]).sum() / (x * x).sum())

band = 2 / math.sqrt(n)
print(f"\n一、月度收益的自相关(如果完全没有可预测性,大约 95% 的值会落在 ±{band:.3f} 之内)")
for k in range(1, 7):
    a = acf(mkt, k)
    flag = "  ← 超出" if abs(a) > band else ""
    print(f"  滞后 {k} 个月:{a:+.3f}{flag}")

# 分时期看一阶自相关(仍然属于"一")
for lo, hi in ((192701, 196212), (196301, 202512)):
    sub = np.array([r[1] + r[4] for r in rows if lo <= r[0] <= hi]) / 100
    print(f"  一阶自相关,{lo}–{hi}({len(sub)} 个月):{acf(sub, 1):+.3f}(±{2 / math.sqrt(len(sub)):.3f})")

# 二、"上个月涨了,这个月会怎样?":用排列检验看这点差别有多大是运气
prev, nxt = mkt[:-1], mkt[1:]
up = prev > 0
diff = nxt[up].mean() - nxt[~up].mean()
print(f"\n二、上个月涨 / 跌之后,下个月的平均收益")
print(f"  上月涨({int(up.sum())} 次)之后:{nxt[up].mean():.2%};上月跌({int((~up).sum())} 次)之后:{nxt[~up].mean():.2%};差 {diff:+.2%}")
rng = np.random.default_rng(38)
count = 0
n_perm = 20000
for _ in range(n_perm):
    sh = rng.permutation(mkt)                    # 把月份顺序打乱:任何"顺序里的规律"都被抹掉
    d = sh[1:][sh[:-1] > 0].mean() - sh[1:][sh[:-1] <= 0].mean()
    count += abs(d) >= abs(diff)
print(f"  打乱月份顺序 {n_perm} 次,差的绝对值不小于 {abs(diff):.2%} 的比例(排列 p 值)= {count / n_perm:.3f}")

# 三、能赚钱吗?规则:上个月涨,这个月持有股票;上个月跌,这个月持有国库券。不计交易成本和税。
hold = np.where(up, nxt, rf[1:])
def stats(r, rfr):
    ann = np.exp(np.log1p(r).mean() * 12) - 1        # 年化几何收益
    ex = r - rfr
    sharpe = ex.mean() / ex.std(ddof=1) * math.sqrt(12)
    return ann, sharpe, float(np.prod(1 + r))
a1, s1, w1 = stats(nxt, rf[1:])
a2, s2, w2 = stats(hold, rf[1:])
print(f"\n三、一条规则:上月涨就持有股票,上月跌就持有国库券(没有交易成本、没有税)")
print(f"  买入并持有:年化 {a1:.2%},夏普比率 {s1:.2f},1 元变成 {w1:,.0f} 元")
print(f"  这条规则  :年化 {a2:.2%},夏普比率 {s2:.2f},1 元变成 {w2:,.0f} 元;在股票上的时间占 {up.mean():.0%}")

# 四、这条规则的夏普比率,比买入并持有高 0.05;这是本事,还是运气?
#     把月份顺序打乱 5000 次,每次都用同一条规则,看"规则的夏普 − 买入持有的夏普"能随机地大到多少。
def sharpe_gap(m, r):
    up_ = m[:-1] > 0
    rule = np.where(up_, m[1:], r[1:])
    return stats(rule, r[1:])[1] - stats(m[1:], r[1:])[1]
gap = s2 - s1
rng = np.random.default_rng(38)
idx = np.arange(n)
cnt = 0
n_perm = 5000
for _ in range(n_perm):
    p = rng.permutation(idx)                 # 月份(收益和对应的无风险利率)一起被打乱
    cnt += sharpe_gap(mkt[p], rf[p]) >= gap
print(f"\n四、夏普比率之差 = {gap:+.3f};打乱月份顺序 {n_perm} 次,随机得到不小于它的比例 = {cnt / n_perm:.3f}")

for lo, hi in ((192701, 196212), (196301, 202512)):
    sel = [i for i, r in enumerate(rows) if lo <= r[0] <= hi]
    m_, r_ = mkt[sel], rf[sel]
    up_ = m_[:-1] > 0
    rule = np.where(up_, m_[1:], r_[1:])
    _, sb, _ = stats(m_[1:], r_[1:])
    _, sr, _ = stats(rule, r_[1:])
    print(f"  {lo}–{hi}:买入持有夏普 {sb:.2f},规则夏普 {sr:.2f},之差 {sr - sb:+.2f}")

# 五、好处从哪来?看"上月涨 / 跌之后",下个月的波动(标准差)是否一样
sd_up, sd_dn = nxt[up].std(ddof=1), nxt[~up].std(ddof=1)
print(f"\n五、下个月的标准差:上月涨之后 {sd_up:.2%},上月跌之后 {sd_dn:.2%}(后者是前者的 {sd_dn / sd_up:.2f} 倍)")
cnt = 0
rng = np.random.default_rng(38)
for _ in range(n_perm):
    sh = rng.permutation(mkt)
    u = sh[:-1] > 0
    cnt += abs(sh[1:][~u].std(ddof=1) / sh[1:][u].std(ddof=1) - 1) >= abs(sd_dn / sd_up - 1)
print(f"  打乱月份顺序 {n_perm} 次,比例之差不小于它的占 {cnt / n_perm:.4f}:波动是可以预测的,收益的方向,这点证据弱得多")
输出:
数据:美国股市(市值加权),192701 至 202512,共 1188 个月
  月平均收益 0.96%,月标准差 5.31%

一、月度收益的自相关(如果完全没有可预测性,大约 95% 的值会落在 ±0.058 之内)
  滞后 1 个月:+0.090  ← 超出
  滞后 2 个月:-0.026
  滞后 3 个月:-0.084  ← 超出
  滞后 4 个月:+0.015
  滞后 5 个月:+0.057
  滞后 6 个月:-0.040
  一阶自相关,192701–196212(432 个月):+0.132(±0.096)
  一阶自相关,196301–202512(756 个月):+0.037(±0.073)

二、上个月涨 / 跌之后,下个月的平均收益
  上月涨(746 次)之后:1.11%;上月跌(441 次)之后:0.70%;差 +0.41%
  打乱月份顺序 20000 次,差的绝对值不小于 0.41% 的比例(排列 p 值)= 0.198

三、一条规则:上月涨就持有股票,上月跌就持有国库券(没有交易成本、没有税)
  买入并持有:年化 10.28%,夏普比率 0.45,1 元变成 15,920 元
  这条规则  :年化 9.21%,夏普比率 0.50,1 元变成 6,118 元;在股票上的时间占 63%

四、夏普比率之差 = +0.047;打乱月份顺序 5000 次,随机得到不小于它的比例 = 0.011
  192701–196212:买入持有夏普 0.44,规则夏普 0.46,之差 +0.02
  196301–202512:买入持有夏普 0.46,规则夏普 0.56,之差 +0.09

五、下个月的标准差:上月涨之后 4.70%,上月跌之后 6.21%(后者是前者的 1.32 倍)
  打乱月份顺序 5000 次,比例之差不小于它的占 0.0004:波动是可以预测的,收益的方向,这点证据弱得多
逐段看:
- 自相关很小,但不是 0:滞后 1 个月,+0.090,超出了 ±0.058;滞后 3 个月,−0.084,也超出了。其余的,都在区间里。要小心:我们看了 6 个滞后,纯靠运气,至少有 1 个超出的概率,是 1 − 0.95^6 ≈ 26%,所以,超出一两个,不稀奇。
- 分时期看:1927–1962,一阶自相关 +0.132(区间 ±0.096),超出;1963–2025,+0.037(±0.073),落回区间内。早期更强。为什么,这里没有检验;常见的猜测,有数据的构造方式、市场的摩擦、后来交易的成本和速度的变化;都只是猜测。
- 上个月涨了,下个月呢? 涨之后,下个月平均 1.11%;跌之后,0.70%;差 +0.41 个百分点。可是,把月份顺序,打乱 20000 次,随机得到这么大的差的,有 19.8%:不显著。
- 一条规则:“上个月涨,这个月持有股票;上个月跌,持有国库券”(不计成本)。买入并持有:年化 10.28%,夏普比率 0.45,1 元,变成 15,920 元。这条规则:年化 9.21%,夏普比率 0.50,1 元,变成 6,118 元,在股票里的时间,占 63%。(夏普比率 0.45,和第 37 讲的 0.44,略有不同:那里,用的是日历年度的数据,这里是月度数据,年化。)赚得更少,夏普比率,略高。
- 这点夏普比率的优势,是运气吗? 差 +0.047;打乱月份顺序 5000 次,随机得到不小于它的,只有 1.1%。分时期:1927–1962 之差 +0.02;1963–2025,+0.09。
- 好处,从哪里来? 上个月涨了之后,下个月的标准差,是 4.70%;上个月跌了之后,是 6.21%:高 1.32 倍;随机,几乎不可能做到(比例 0.0004)。也就是说,规则的好处,很可能,主要来自躲开了波动大的月份,而不是预测对了涨跌的方向。
最后这一点,是这一节,最重要的结论:收益的方向,几乎不可预测;风险(波动),是可以预测的。 这和有效市场假说,不矛盾:它谈的,是"预期的收益",没有说,波动,不能预测(第 37 讲:风险,本来就是要补偿的东西)。
三个提醒:(1)我只试了一条规则。 如果,试几百条,挑最好的,这样的 p 值,就不能这么读了:这叫"多重检验":试的次数多了,总会碰到"显著"的;它也是第 4 讲(研究结果可靠吗)里,“重复出来的效应,往往比原来小"的一个常被提到的原因;(2)没有交易成本,没有税;(3)这是整个美国股市,一个指数,不是单只股票。实验 79,会把这一节,扩展成更严格的检验(方差比、游程检验、带成本的回测)。
四、运气和技能
4.1 回到那个连赢 5 年的经理
现在,回答第一节的问题。
import math
import numpy as np

rng = np.random.default_rng(38)

# 一、1 万个"基金经理",每年有 50% 的概率跑赢市场,完全靠运气(抛硬币),各年、各人彼此独立。看 10 年。
n_mgr, n_years = 10000, 10
win = rng.random((n_mgr, n_years)) < 0.5

# 每个人"从第 1 年起,连续跑赢了几年"
streak = np.zeros(n_mgr, dtype=int)
alive = np.ones(n_mgr, dtype=bool)
for y in range(n_years):
    alive &= win[:, y]
    streak += alive

print("一、全靠抛硬币的 1 万个基金经理,前 10 年里,从第 1 年起连续跑赢市场的人数")
print(f"  {'连赢年数':<8}{'模拟人数':>8}{'理论期望':>10}")
for k in (3, 5, 7, 10):
    sim = int((streak >= k).sum())
    exp = n_mgr / 2 ** k
    print(f"  ≥ {k:<5d}{sim:>10d}{exp:>12.1f}")

# 前 5 年都跑赢的人,第 6 年呢?
five = win[:, :5].all(axis=1)
print(f"\n  前 5 年连赢的有 {int(five.sum())} 人;其中第 6 年继续跑赢的占 {win[five, 5].mean():.1%}(运气没有'惯性':还是约 50%)")

# 二、如果真有技能呢?要多少年的数据,才分得清?
# 一个真有技能的经理:每年比基准多赚 alpha = 2%;每年相对基准的"跟踪误差"(上下波动)= 6%。
alpha, te = 0.02, 0.06
print("\n二、一个每年真的多赚 2%(扣费后)、跟踪误差 6% 的经理,要观察几年,才能让 t 值(均值 ÷ 标准误)到 2?")
for t_years in (3, 5, 10, 20, 36, 50):
    t_mean = alpha / (te / math.sqrt(t_years))
    print(f"  观察 {t_years:>2d} 年:t 值的平均水平 = {t_mean:.2f}")
need = (2 * te / alpha) ** 2
print(f"  t 值的平均水平要到 2,需要 {need:.0f} 年")

# 三、一个有"技能"的人群里,挑出"t > 2"的,真有技能的占多大比例?
# 1 万个经理,其中 5% 真有技能(alpha=2%),95% 零技能(扣费后);都观察 10 年,各年的超额收益 ~ N(alpha, 6%)
n_skill = int(0.05 * n_mgr)
true_alpha = np.zeros(n_mgr)
true_alpha[:n_skill] = alpha
excess = rng.normal(true_alpha[:, None], te, size=(n_mgr, n_years))
t_stat = excess.mean(axis=1) / (excess.std(axis=1, ddof=1) / math.sqrt(n_years))
flag = t_stat > 2
print(f"\n三、1 万个经理,5% 真有技能,其余零技能;观察 10 年后,t 值 > 2 的人:")
print(f"  真有技能被挑出:{int(flag[:n_skill].sum())} 人(占技能者的 {flag[:n_skill].mean():.1%})")
print(f"  零技能却被挑出:{int(flag[n_skill:].sum())} 人(占零技能者的 {flag[n_skill:].mean():.1%})")
print(f"  被挑出的 {int(flag.sum())} 人里,真有技能的只占 {flag[:n_skill].sum() / flag.sum():.1%}")
输出:
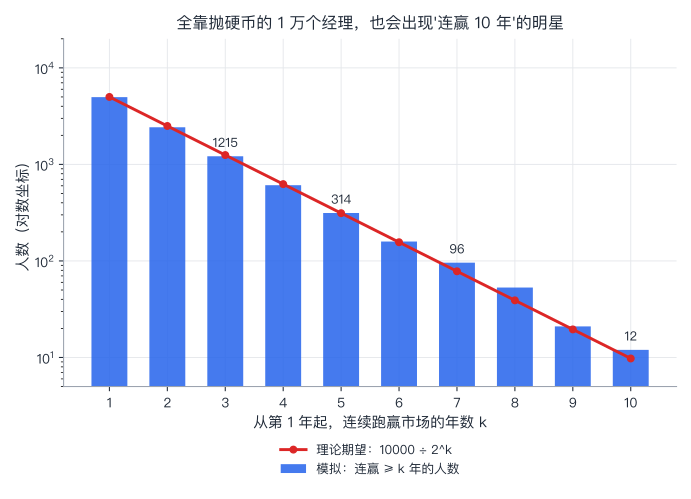
一、全靠抛硬币的 1 万个基金经理,前 10 年里,从第 1 年起连续跑赢市场的人数
  连赢年数        模拟人数      理论期望
  ≥ 3          1215      1250.0
  ≥ 5           314       312.5
  ≥ 7            96        78.1
  ≥ 10           12         9.8

  前 5 年连赢的有 314 人;其中第 6 年继续跑赢的占 50.6%(运气没有'惯性':还是约 50%)

二、一个每年真的多赚 2%(扣费后)、跟踪误差 6% 的经理,要观察几年,才能让 t 值(均值 ÷ 标准误)到 2?
  观察  3 年:t 值的平均水平 = 0.58
  观察  5 年:t 值的平均水平 = 0.75
  观察 10 年:t 值的平均水平 = 1.05
  观察 20 年:t 值的平均水平 = 1.49
  观察 36 年:t 值的平均水平 = 2.00
  观察 50 年:t 值的平均水平 = 2.36
  t 值的平均水平要到 2,需要 36 年

三、1 万个经理,5% 真有技能,其余零技能;观察 10 年后,t 值 > 2 的人:
  真有技能被挑出:95 人(占技能者的 19.0%)
  零技能却被挑出:370 人(占零技能者的 3.9%)
  被挑出的 465 人里,真有技能的只占 20.4%
逐段看:
- 全靠抛硬币的 1 万个人,前 5 年,连赢的,有 314 人(理论期望,312.5);连赢 10 年的,有 12 人(理论,9.8)。所以,你看到一个"连赢 5 年"的经理,这件事,本身,几乎,说明不了什么:只要经理够多,一定有人。
- 运气,没有惯性:这 314 人里,第 6 年继续跑赢的,50.6%:还是一半。
- 分清技能,要很久:一个真的每年多赚 2%(扣费后)、上下波动 6% 的经理,要观察 36 年,t 值的平均水平,才到 2。我们的一生,也就这么长。
- 挑出来的人,多半,是运气:1 万个经理,5% 真有技能,其余零技能。观察 10 年,t 值大于 2 的,有 465 人:其中,只有 95 个,是真有技能的(占 20.4%);370 个,是零技能的,被运气,选了出来(零技能者里,有 3.9% 被选中:这比正态分布的 2.3% 高,因为,只有 10 个样本,用样本标准差算 t 值,t 分布,尾巴更厚)。技能者里,也只有 19.0% 被选中:真有技能的,大多数,还没被看出来。
这和第 20 讲的"柠檬”,有点像:你看到的,是一个被筛选过的结果。
4.2 真实的证据
- Michael Jensen 1968 年(Journal of Finance,23 卷 2 期,389–416 页):研究了 1945 到 1964 年的 115 只共同基金,发现,平均来说,它们的预测能力,不足以跑赢"买入并持有市场",即使不扣除管理费,也是这样;也很少有基金,比"碰运气",更好。
- Eugene Fama 和 Kenneth French 2010 年(《共同基金收益的横截面:运气与技能》,Journal of Finance,65 卷 5 期,1915–1947 页):把所有主动管理的美国股票基金,合在一起,持有的,差不多,就是整个市场;可是,高成本,让投资者,得到的收益,更低。用自助法模拟,发现,只有很少的基金,在基准调整之后,预期的收益,足够覆盖成本;如果,把费用,加回去,在分布的两个极端,既有"差得显著"的,也有"好得显著"的证据。(后来,有研究批评,这个方法,可能会低估技能,如 Harvey 和 Liu 2022;我没有逐项核对。)
- Brad Barber 和 Terrance Odean 2000 年(Journal of Finance,55 卷 2 期,773–806 页):6.6 万多个,美国一家折扣券商的家庭账户,1991–1996 年;据摘要,家庭的平均收益,16.4%,市场,17.9%;交易最频繁的那一组,11.4%。作者认为,是过度自信(第 39 讲会讲)。(批评:样本,只来自一家券商;也有人,提出了不同的解释。)
注意措辞:这些,是一般的模式,不是对每一只基金、每一个人的判断。
4.3 为什么,平均来说,一定是这样:主动管理的算术
William Sharpe 1991 年,写了一篇三页的文章(《主动管理的算术》,Financial Analysts Journal,47 卷 1 期,7–9 页)。想法很简单:
把市场上的人,分成两类:被动的(买下整个市场,不动),主动的(其余所有人)。两类人,加起来,就是整个市场。被动的,扣费前,恰好,赚到市场的收益;所以,主动的人,作为一个整体,扣费前,也,必然,恰好,赚到市场的收益:他们中,有人,赢了别人,有人,输给别人,合起来,是零和的。扣费之后:主动的成本,更高,所以,主动的整体,扣费后,一定,少于被动的。
# 一、主动管理的算术(Sharpe, 1991):一个只有两种人的市场
#     "被动"的人,买下整个市场;"主动"的人,剩下的所有人。两类人加起来,就是整个市场。
market_return = 0.07           # 假设:扣费之前,整个市场每年赚 7%
cost_passive, cost_active = 0.001, 0.015       # 假设:被动每年总成本 0.1%,主动每年总成本(管理费、交易成本等)1.5%
w_passive = 0.3                # 假设:市场里,被动持有者占 30% 的钱

# 被动的人,扣费前恰好赚到市场的收益(因为他们买的就是市场)。所以主动的人"合起来"扣费前,也必然恰好赚到市场的收益。
active_before = (market_return - w_passive * market_return) / (1 - w_passive)
print("一、一个只有两类人的市场(假设:市场扣费前年收益 7%,被动 0.1% 成本,主动 1.5% 成本)")
print(f"  被动的人,扣费前 {market_return:.2%},扣费后 {market_return - cost_passive:.2%}")
print(f"  主动的人,作为一个整体:扣费前 {active_before:.2%}(和市场一样,其中有人赢,有人输),扣费后 {active_before - cost_active:.2%}")
print(f"  不管被动占多少钱:主动的整体,每年都比被动少赚 {cost_active - cost_passive:.2%}(= 成本之差)")

# 二、费用的复利
print("\n二、10 万元,每年毛收益 7%,只差每年的费用,30 年后")
base = 100000 * 1.07 ** 30
print(f"  {'年费用':<8}{'30 年后':>12}{'比 0 费用少':>12}")
for fee in (0.0, 0.001, 0.005, 0.01, 0.02):
    v = 100000 * (1 + 0.07 - fee) ** 30
    print(f"  {fee:<8.1%}{v:>12,.0f}{1 - v / base:>12.1%}")
输出:
一、一个只有两类人的市场(假设:市场扣费前年收益 7%,被动 0.1% 成本,主动 1.5% 成本)
  被动的人,扣费前 7.00%,扣费后 6.90%
  主动的人,作为一个整体:扣费前 7.00%(和市场一样,其中有人赢,有人输),扣费后 5.50%
  不管被动占多少钱:主动的整体,每年都比被动少赚 1.40%(= 成本之差)

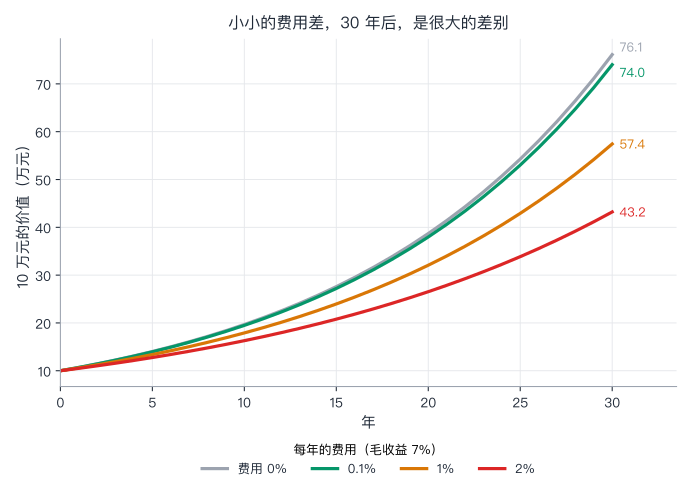
二、10 万元,每年毛收益 7%,只差每年的费用,30 年后
  年费用            30 年后     比 0 费用少
  0.0%         761,226        0.0%
  0.1%         740,169        2.8%
  0.5%         661,437       13.1%
  1.0%         574,349       24.5%
  2.0%         432,194       43.2%
逐段看:
- 算术,不依赖,谁聪明:不管被动的人,占多少钱,主动的整体,每年,都比被动的,少赚"成本之差":这里,是 1.40 个百分点。
- 费用,是复利的:每年,只差 1%,30 年后,少了 24.5%;每年差 2%,少了 43.2%。
- 这个算术,有前提:被动的人,持有的,是整个市场,并且,不动。后来,也有人,讨论放宽前提的情形(例如,Lasse Pedersen 2018 年,Financial Analysts Journal)。
4.4 这对你,意味着什么(描述,不是投资建议)
如果上面的结论,大体成立:
- 你能控制的,是费用,不是市场;费用的差别,是确定的,复利的;
- “过去的业绩”,是一个很弱的信号(4.1 节:运气,没有惯性);
- 交易得多,不等于赚得多(4.2 节:Barber–Odean);
- 第 37 讲的结论,仍然成立:你选择的,主要是,风险的大小,不是,“哪个基金经理,更聪明”。
以上,是在讲一个一般的模式,不是针对任何一个人的建议。你的处境(收入、年龄、需要用钱的时间),是你自己的事。
五、风险,被"定价"了吗:CAPM 的预测
5.1 预测是什么
第 37 讲说:分散,可以免费地,消除特有风险;所以,市场,不会因为你承担了特有风险,而补偿你;只有系统性风险,才会被补偿。
William Sharpe 1964 年(Journal of Finance,19 卷 3 期,425–442 页)的资本资产定价模型(CAPM),把它,写成了一个具体的公式:
一项资产的预期超额收益 = β × 市场的预期超额收益(“超额”,是减去无风险利率)。
β,是这项资产的收益,对市场收益的敏感度:市场涨 1%,它平均涨 1.2%,β 就是 1.2。β 高,意味着,系统性风险大。CAPM 的预测,是:
- 预期收益,和 β,成正比(线性,过原点);
- 除了 β,没有别的东西(规模、估值、特有风险),能解释预期收益。
5.2 在真实的数据里检验
我们用美国 49 个行业,1970 年到 2025 年的月度收益(Kenneth French 数据库),和整个市场的收益,估计每个行业的 β,看它,能不能解释,各个行业的平均收益。
import io, math, urllib.request, zipfile
import numpy as np

# 数据:Kenneth French 数据库的 49 个行业组合(市值加权,月度),和三因子文件里的市场收益、无风险利率。
BASE = "https://mba.tuck.dartmouth.edu/pages/faculty/ken.french/ftp/"
def read_zip(name, member):
    raw = urllib.request.urlopen(BASE + name, timeout=60).read()
    return zipfile.ZipFile(io.BytesIO(raw)).read(member).decode("latin-1").splitlines()

# 市场(Mkt-RF)与无风险利率(RF)
fac = {}
for line in read_zip("F-F_Research_Data_Factors_CSV.zip", "F-F_Research_Data_Factors.csv"):
    p = [x.strip() for x in line.split(",")]
    if len(p) == 5 and len(p[0]) == 6 and p[0].isdigit():
        fac[int(p[0])] = (float(p[1]), float(p[4]))

# 49 个行业,月度、市值加权的第一张表
lines = read_zip("49_Industry_Portfolios_CSV.zip", "49_Industry_Portfolios.csv")
start = next(i for i, l in enumerate(lines) if "Average Value Weighted Returns -- Monthly" in l)
names = [x.strip() for x in lines[start + 1].split(",")[1:]]
ind = {}
for l in lines[start + 2:]:
    p = [x.strip() for x in l.split(",")]
    if not (len(p) == len(names) + 1 and len(p[0]) == 6 and p[0].isdigit()):
        break
    ind[int(p[0])] = [float(x) for x in p[1:]]

months = [m for m in sorted(ind) if 197001 <= m <= 202512]
R = np.array([ind[m] for m in months])                     # 月 × 行业,单位 %
mk = np.array([fac[m][0] for m in months])                  # 市场超额收益(%)
rf = np.array([fac[m][1] for m in months])
ok = (R > -99).all(axis=0)                                   # 去掉在这段时间里有缺失值的行业
names = [nm for nm, k in zip(names, ok) if k]
X = R[:, ok] - rf[:, None]                                   # 各行业的超额收益
print(f"{months[0]}–{months[-1]},{len(months)} 个月;49 个行业里,数据完整的有 {len(names)} 个")

def betas_and_means(x, m):
    mc = m - m.mean()
    beta = (mc[:, None] * (x - x.mean(axis=0))).sum(axis=0) / (mc @ mc)
    return beta, x.mean(axis=0)

def slope(beta, mean):
    bc = beta - beta.mean()
    return float((bc * (mean - mean.mean())).sum() / (bc @ bc))

# 一、同一段数据里:β 和平均超额收益
beta, mean = betas_and_means(X, mk)
s = slope(beta, mean)
print(f"\n一、全样本:{len(names)} 个行业的 β 范围 {beta.min():.2f}–{beta.max():.2f},平均 {beta.mean():.2f}")
print(f"  市场的平均月超额收益 = {mk.mean():.2f}%(CAPM 的预测:行业的平均月超额收益 = β × {mk.mean():.2f}%,即直线的斜率应该是这个数)")
print(f"  实际:平均月超额收益对 β 的回归斜率 = {s:.2f}%/月,相关系数 {np.corrcoef(beta, mean)[0, 1]:.2f}")

# 二、对月份做自助重抽样(bootstrap):β 和平均收益每次一起重新估计,看斜率有多不确定
rng = np.random.default_rng(38)
sl = []
for _ in range(2000):
    idx = rng.integers(0, len(months), len(months))
    b, mm = betas_and_means(X[idx], mk[idx])
    sl.append(slope(b, mm))
lo, hi = np.percentile(sl, [2.5, 97.5])
print(f"  自助法 2000 次,斜率的 95% 区间 = [{lo:.2f}, {hi:.2f}]%/月;CAPM 预测的 {mk.mean():.2f}% {'在' if lo <= mk.mean() <= hi else '不在'}区间里;0 {'在' if lo <= 0 <= hi else '不在'}区间里")

# 三、更严格:用前半段(1970–1997)估 β,看后半段(1998–2025)的收益
half = len(months) // 2
b1, _ = betas_and_means(X[:half], mk[:half])
_, mean2 = betas_and_means(X[half:], mk[half:])
order = np.argsort(b1)
groups = np.array_split(order, 5)
print(f"\n二、用 {months[0]}–{months[half - 1]} 估计 β,把行业按 β 分成 5 组,看 {months[half]}–{months[-1]} 的平均月超额收益")
print(f"  {'组':<4}{'前半段 β':>9}{'后半段平均超额收益(%/月)':>24}")
for k, g in enumerate(groups, 1):
    print(f"  {k:<4}{b1[g].mean():>9.2f}{mean2[g].mean():>24.2f}")
mk2 = mk[half:].mean()
print(f"  后半段市场平均月超额收益 = {mk2:.2f}%;CAPM 预测,第 5 组应是第 1 组的 {b1[groups[4]].mean() / b1[groups[0]].mean():.1f} 倍,实际是 {mean2[groups[4]].mean() / mean2[groups[0]].mean():.1f} 倍")
输出:
197001–202512,672 个月;49 个行业里,数据完整的有 49 个

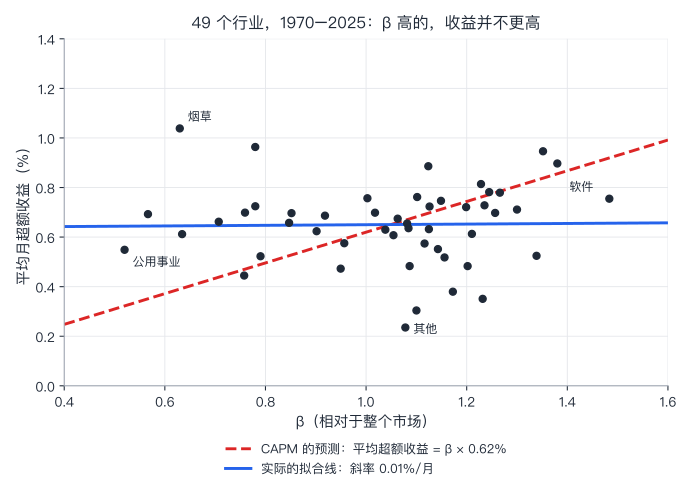
一、全样本:49 个行业的 β 范围 0.52–1.48,平均 1.04
  市场的平均月超额收益 = 0.62%(CAPM 的预测:行业的平均月超额收益 = β × 0.62%,即直线的斜率应该是这个数)
  实际:平均月超额收益对 β 的回归斜率 = 0.01%/月,相关系数 0.02
  自助法 2000 次,斜率的 95% 区间 = [-0.54, 0.55]%/月;CAPM 预测的 0.62% 不在区间里;0 在区间里

二、用 197001–199712 估计 β,把行业按 β 分成 5 组,看 199801–202512 的平均月超额收益
  组       前半段 β          后半段平均超额收益(%/月)
  1        0.82                    0.66
  2        1.02                    0.70
  3        1.09                    0.84
  4        1.20                    0.76
  5        1.37                    0.75
  后半段市场平均月超额收益 = 0.68%;CAPM 预测,第 5 组应是第 1 组的 1.7 倍,实际是 1.1 倍
逐段看:
- β 的范围,不大:从 0.52 到 1.48(公用事业,最低;软件,最高)。平均,1.04。
- 斜率,几乎是 0:CAPM 预测,行业的平均月超额收益,等于 β × 0.62%,所以,斜率应该,是 0.62;实际是 0.01%/月,相关系数 0.02。图里,蓝线,几乎是水平的;红色虚线,是 CAPM 的预测。烟草,β 只有 0.63,平均收益,是 49 个行业里,最高的。
- 有多不确定:自助法 2000 次,斜率的 95% 区间,[−0.54, 0.55]。CAPM 预测的 0.62,刚好,在区间外面一点点;0,在区间里面。也就是说,这些数据,既不支持"斜率是 0.62",也不能排除,斜率,其实不大;我们不能说,β 一点用,也没有。
- 用前半段估 β,看后半段的收益:按前半段(1970–1997)的 β,分成 5 组,后半段(1998–2025)的平均月超额收益,从最低 β 组,到最高 β 组,是 0.66、0.70、0.84、0.76、0.75。CAPM 预测,最高组,是最低组的 1.7 倍;实际,是 1.1 倍。有一点,向上的趋势,但,远没有预测的那么陡。
5.3 这说明了什么,不说明什么
- 说明:在这套数据里,“β,是唯一的、被补偿的风险"这个说法,没有被支持。Fama 和 French 1992 年(Journal of Finance,47 卷 2 期,427–465 页),用更多股票的数据,得到相似的结论:β 和平均收益的关系,是平的;规模和账面市值比,解释得更多。更早的一些检验(例如,Fama 和 MacBeth 1973 年,Journal of Political Economy,81 卷 3 期,607–636 页),常被引用,作为相对更支持 CAPM 的证据;后来的数据,让情况,变了。
- 不说明:“风险,没有被定价”。它说明的,是这一个模型(只有一个因子:市场 β),太简化。后来,Fama 和 French,把规模、价值,加进模型(1993 年,三因子模型);也有人,提出了别的因子。
- 要小心:(1)这里,只有 49 个行业,β 的范围,又不大;(2)β,是估计出来的,有误差;(3)“市场”,在 CAPM 里,应该是,所有的财富(股票、债券、房产、人力资本……),我们用的,只是美国的股票指数:Richard Roll 1977 年,(只写年份,没有核对期刊信息)指出,这使得,CAPM,几乎没法被严格地检验;(4)这里,没有检验,“特有风险,不被补偿"这一半:49 个行业,本来,就已经是分散过的组合。
- 后来常被提到的现象:“低 β"的股票,收益,不比高 β 的低,甚至更高(例如,Frazzini 和 Pedersen 2014 年,Journal of Financial Economics)。这又引出了,下一节的问题:这是风险的补偿,还是市场的错误?
六、一个有争议的问题:市场,有效吗
按"理论预测 → 证据与局限 → 分歧在哪 → 价值判断留给读者"来写。
6.1 理论预测什么
有效市场假说,加上,一个"预期收益该是多少"的模型(比如,CAPM),可以得到,具体的、能被检验的预测:
- 预期收益,只取决于风险;
- 没有任何,公开的信息,可以,系统地,让你赚到超出风险补偿的收益;
- 价格的变化,不可预测;价格,围绕"基本价值”,随机地波动。
这里,藏着一个,最难绕开的问题:联合假设。你检验的,永远是,“市场有效”,加上“我的预期收益模型,是对的”。如果,检验失败了,你不知道,是市场,不有效,还是你的模型,错了。Fama 自己,在 1991 年的综述(Journal of Finance,46 卷 5 期,1575–1617 页)里,谈到过这一点:(据对原文的转述)因为联合假设,“市场有效”,本身,没法被检验。
6.2 证据怎么说
(一)异象,和它们的"衰减”。 研究者,找到过很多,不符合 CAPM 的规律:小公司,平均收益,更高(规模);账面市值比高的"价值股”,平均收益,更高(价值)。我们,看看,它们,在不同的时期,表现如何。
import io, math, urllib.request, zipfile
import numpy as np

# 数据:Kenneth French 数据库,三因子(月度)。SMB = 小公司减大公司,HML = 高账面市值比("价值股")减低账面市值比("成长股"),单位 %。
URL = "https://mba.tuck.dartmouth.edu/pages/faculty/ken.french/ftp/F-F_Research_Data_Factors_CSV.zip"
raw = urllib.request.urlopen(URL, timeout=60).read()
text = zipfile.ZipFile(io.BytesIO(raw)).read("F-F_Research_Data_Factors.csv").decode("latin-1")
rows = []
for line in text.splitlines():
    p = [x.strip() for x in line.split(",")]
    if len(p) == 5 and len(p[0]) == 6 and p[0].isdigit():
        rows.append((int(p[0]), float(p[1]), float(p[2]), float(p[3])))
rows = [r for r in rows if 192701 <= r[0] <= 202512]
dates = np.array([r[0] for r in rows])
fac = {"市场超额收益": np.array([r[1] for r in rows]),
       "规模 SMB": np.array([r[2] for r in rows]),
       "价值 HML": np.array([r[3] for r in rows])}

# 三个时期。1963–1990 年,是 Fama–French(1992)当年所用数据的大致范围;1927–1962 在他们的样本之前;1993 年以后,在论文发表之后。
periods = [("1927–1962", 192701, 196212), ("1963–1992", 196301, 199212), ("1993–2025", 199301, 202512)]
print("平均月收益(%)、年化(月均值×12)、t 值(均值 ÷ 标准误)")
print(f"  {'因子':<8}{'时期':<11}{'月数':>5}{'月均值':>8}{'年化':>8}{'t 值':>7}")
for name, x in fac.items():
    for label, lo, hi in periods:
        sel = (dates >= lo) & (dates <= hi)
        v = x[sel]
        t = v.mean() / (v.std(ddof=1) / math.sqrt(len(v)))
        print(f"  {name:<8}{label:<11}{len(v):>5d}{v.mean():>8.2f}{v.mean() * 12:>7.1f}%{t:>7.2f}")

# 把"规模"和"价值"在整个 99 年里的累计表现,也看一眼:1 元投 SMB、HML 多空组合(每月全部再投入,不计成本)
print("\n多空组合的累计:1927 年初的 1 元,到 1962 / 1992 / 2025 年底")
for name in ("规模 SMB", "价值 HML"):
    g = np.cumprod(1 + fac[name] / 100)
    outs = []
    for end in (196212, 199212, 202512):
        outs.append(g[np.where(dates == end)[0][0]])
    print(f"  {name}:{outs[0]:.2f} → {outs[1]:.2f} → {outs[2]:.2f}")

# 近十年的 HML:近年的"价值",好不好?
for label, lo, hi in (("2007–2025", 200701, 202512), ("2007–2020", 200701, 202012)):
    sel = (dates >= lo) & (dates <= hi)
    v = fac["价值 HML"][sel]
    print(f"  HML {label}:月均值 {v.mean():.2f}%,t 值 {v.mean() / (v.std(ddof=1) / math.sqrt(len(v))):.2f}")
输出:
平均月收益(%)、年化(月均值×12)、t 值(均值 ÷ 标准误)
  因子      时期            月数     月均值      年化    t 值
  市场超额收益  1927–1962    432    0.84   10.1%   2.65
  市场超额收益  1963–1992    360    0.43    5.2%   1.83
  市场超额收益  1993–2025    396    0.76    9.1%   3.42
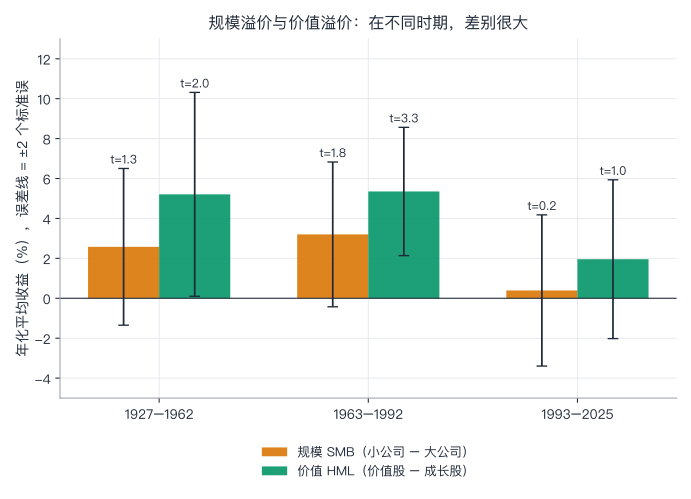
  规模 SMB  1927–1962    432    0.21    2.6%   1.31
  规模 SMB  1963–1992    360    0.27    3.2%   1.76
  规模 SMB  1993–2025    396    0.03    0.4%   0.21
  价值 HML  1927–1962    432    0.43    5.2%   2.04
  价值 HML  1963–1992    360    0.45    5.4%   3.33
  价值 HML  1993–2025    396    0.16    2.0%   0.98

多空组合的累计:1927 年初的 1 元,到 1962 / 1992 / 2025 年底
  规模 SMB:2.00 → 4.51 → 4.23
  价值 HML:4.39 → 19.43 → 29.93
  HML 2007–2025:月均值 -0.15%,t 值 -0.68
  HML 2007–2020:月均值 -0.44%,t 值 -1.99
逐段看:
- 价值溢价(HML):1927–1962,年化 5.2%(t 值 2.04);1963–1992,5.4%(t 值 3.33);1993–2025,2.0%(t 值 0.98)。1963–1992,大致,是 Fama–French 1992 年当时,用的数据;1927–1962,是他们的样本之前,可以当作一个"样本外"的检验:价值溢价,仍然是正的。
- 规模溢价(SMB):2.6%(t 值 1.31)→ 3.2%(1.76)→ 0.4%(0.21)。
- 最近这段,弱了很多。可是:统计上,我们不能说,它"消失"了:1993–2025 年,价值溢价的 95% 区间,大约是 −2% 到 +6%,既包含 0,也包含,之前的 5%。
- 结论,对起止点,很敏感:2007–2025,HML 的月均值,−0.15%(t 值 −0.68);2007–2020,−0.44%(t 值 −1.99)。多加了 5 年,差别很大。
这和一个,更大的研究,是一致的:David McLean 和 Jeffrey Pontiff 2016 年(Journal of Finance,71 卷 1 期,5–32 页):研究了 97 个,被学术论文,发现的、能预测股票收益的变量,样本外的收益,低了 26%,论文发表之后,低了 58%(据摘要)。他们的解读:26%,是"数据挖掘"的上限;多出来的 32%,是,知情的投资者,从论文里学会了,并且,把它,交易掉了。
(二)估值,和长期收益。 如果价格,只是随机的,那么,价格"贵不贵",应该,对未来的收益,没有预测力。Robert Shiller 的数据,可以检验:周期调整市盈率(CAPE):价格,除以,过去 10 年,平均的、剔除通胀的盈利。用 1881 年到 2023 年的数据,看:CAPE 高的时候,之后 10 年的收益,是不是更低?
import math
import numpy as np

# 年份:1881–2023,每年 1 月的数据;cape = 周期调整市盈率(价格 ÷ 过去 10 年平均的、剔除通胀的盈利);
# tr = 剔除通胀后的"含股息再投资的价格指数",以 1881 年 1 月 = 1。数据来自 Robert Shiller 网站公布的 ie_data.xls(美国股市,2023 年 9 月更新)。
years = list(range(1881, 2024))
cape = [
    18.47, 15.68, 15.27, 14.43, 13.13, 16.69, 17.51, 15.36, 15.8, 17.22, 15.43, 19.02,
    17.66, 15.74, 16.52, 16.58, 17.03, 19.25, 22.93, 18.67, 20.98, 22.34, 20.32, 15.86,
    18.46, 20.13, 17.22, 11.9, 14.76, 14.55, 14.05, 13.79, 13.15, 11.64, 10.36, 12.54,
    10.99, 6.64, 6.1, 5.99, 5.12, 6.29, 8.15, 8.07, 9.69, 11.34, 13.19, 18.81, 27.08, 22.31,
    16.71, 9.31, 8.73, 13.03, 11.5, 17.09, 21.62, 13.51, 15.6, 16.38, 13.9, 10.1, 10.15,
    11.05, 11.96, 15.62, 11.47, 10.42, 10.25, 10.75, 11.9, 12.53, 13.01, 12.0, 15.99, 18.29,
    16.72, 13.79, 17.98, 18.34, 18.47, 21.2, 19.26, 21.63, 23.27, 24.06, 20.43, 21.51,
    21.19, 17.09, 16.46, 17.26, 18.71, 13.53, 8.92, 11.19, 11.44, 9.24, 9.26, 8.85, 9.26,
    7.39, 8.76, 9.89, 10.0, 11.72, 14.92, 13.9, 15.09, 17.05, 15.61, 19.77, 20.32, 21.41,
    20.22, 24.76, 28.33, 32.86, 40.58, 43.77, 36.98, 30.28, 22.9, 27.66, 26.59, 26.47,
    27.21, 24.02, 15.17, 20.53, 22.98, 21.21, 21.9, 24.86, 26.49, 24.21, 28.06, 33.31,
    28.38, 30.99, 34.51, 36.94, 28.33
]
tr = [
    1.0, 0.93, 0.98, 1.0, 0.98, 1.32, 1.48, 1.4, 1.51, 1.7, 1.56, 1.97, 1.94, 1.82, 1.97,
    2.03, 2.16, 2.53, 3.22, 2.86, 3.54, 4.13, 4.08, 3.54, 4.57, 5.54, 5.34, 4.14, 5.58,
    5.86, 6.07, 6.35, 6.35, 5.92, 5.54, 7.07, 6.8, 4.63, 4.64, 4.74, 4.14, 5.13, 6.66, 6.82,
    8.67, 10.55, 12.04, 16.7, 24.94, 22.59, 18.78, 11.64, 12.1, 18.53, 16.55, 25.27, 32.82,
    22.13, 26.33, 27.33, 24.55, 20.05, 22.65, 27.19, 31.82, 43.36, 32.29, 30.07, 32.53,
    39.07, 48.65, 56.84, 64.94, 66.16, 97.87, 125.72, 130.47, 118.61, 164.2, 174.94, 183.27,
    216.81, 208.44, 248.6, 285.61, 312.79, 282.98, 317.04, 335.96, 289.36, 295.55, 326.25,
    371.02, 283.98, 200.52, 261.55, 276.54, 235.56, 250.64, 257.82, 290.64, 248.86, 312.26,
    360.79, 376.15, 457.7, 592.82, 556.22, 626.86, 732.97, 688.02, 884.88, 923.3, 1006.02,
    989.96, 1304.13, 1612.12, 2030.27, 2626.24, 2954.46, 2699.66, 2309.55, 1798.04, 2268.3,
    2336.38, 2474.7, 2749.12, 2598.75, 1672.31, 2171.46, 2486.73, 2498.39, 2858.2, 3534.33,
    4014.31, 3823.65, 4517.98, 5532.65, 5189.47, 6488.96, 7542.63, 8576.65, 7092.03
]
cape, tr = np.array(cape), np.array(tr)
H = 10                                             # 往后看 10 年

start = np.arange(len(years) - H)                  # 起点:1881 … 2013
fwd = (tr[start + H] / tr[start]) ** (1 / H) - 1   # 之后 10 年的年化实际总收益
x = np.log(cape[start])
print(f"样本:起点 {years[0]}–{years[start[-1]]},共 {len(start)} 个起点(但相邻起点的 10 年窗口大量重叠,彼此远不独立:约 {len(start) / H:.0f} 个互不重叠的窗口)")
print(f"  之后 10 年年化实际收益:平均 {fwd.mean():.2%},最低 {fwd.min():.2%}({years[int(fwd.argmin())]} 年起),最高 {fwd.max():.2%}({years[int(fwd.argmax())]} 年起)")

# 一、回归:之后 10 年的收益 = a + b × ln(CAPE)
def ols(x, y):
    xc = x - x.mean()
    b = (xc * (y - y.mean())).sum() / (xc @ xc)
    a = y.mean() - b * x.mean()
    res = y - a - b * x
    r2 = 1 - (res @ res) / (((y - y.mean()) ** 2).sum())
    return a, b, r2, res, xc

a, b, r2, res, xc = ols(x, fwd)
n = len(x)
se_naive = math.sqrt((res @ res) / (n - 2) / (xc @ xc))
# Newey–West 标准误(滞后 10 个起点),考虑重叠窗口带来的相关
u = xc * res
S = (u @ u)
for L in range(1, 11):
    S += 2 * (1 - L / 11) * (u[L:] @ u[:-L])
se_nw = math.sqrt(S) / (xc @ xc)
print(f"\n一、全样本:之后 10 年年化实际收益 = {a:.3f} + ({b:.3f}) × ln(CAPE),R² = {r2:.2f},相关系数 {np.corrcoef(x, fwd)[0, 1]:.2f}")
print(f"  斜率的 t 值:朴素算法 {b / se_naive:.1f};考虑重叠(Newey–West,滞后 10){b / se_nw:.1f}")

# 二、分三档看:开始时 CAPE 低 / 中 / 高
order = np.argsort(cape[start])
print("\n二、按起点的 CAPE,分成 3 档,看之后 10 年的年化实际收益")
for name, g in zip(("最低 1/3", "中间 1/3", "最高 1/3"), np.array_split(order, 3)):
    print(f"  {name}:CAPE {cape[start][g].min():.1f}–{cape[start][g].max():.1f},平均之后 10 年 {fwd[g].mean():.2%}(最差 {fwd[g].min():.2%},最好 {fwd[g].max():.2%})")

# 三、前一半 vs 后一半样本,关系稳不稳?
mid = n // 2
for label, sl in ((f"{years[0]}–{years[mid - 1]} 起点", slice(0, mid)), (f"{years[mid]}–{years[n - 1]} 起点", slice(mid, n))):
    _, bb, rr, _, _ = ols(x[sl], fwd[sl])
    print(f"  {label}:斜率 {bb:.3f},R² = {rr:.2f}")

# 四、样本外:站在每一年,只用"那时已经知道的 10 年结果",预测下一个 10 年;对比"只用历史平均"
sse_m = sse_0 = 0.0
cnt = 0
for t in range(30 + H - 1, n):                    # 至少有 30 对"起点–10年结果"才开始预测
    known = np.arange(0, t - H + 1)               # 起点 s 的 10 年结果,要到 s+10 年才知道
    a_, b_, _, _, _ = ols(x[known], fwd[known])
    pred_m = a_ + b_ * x[t]
    pred_0 = fwd[known].mean()
    sse_m += (fwd[t] - pred_m) ** 2
    sse_0 += (fwd[t] - pred_0) ** 2
    cnt += 1
print(f"\n三、样本外:{years[30 + H - 1]}–{years[n - 1]} 起点共 {cnt} 个预测,用 CAPE 的回归 vs 用历史平均")
print(f"  样本外 R² = 1 − SSE(回归) / SSE(历史平均) = {1 - sse_m / sse_0:.3f}(> 0 才说明回归比历史平均更好)")
输出:
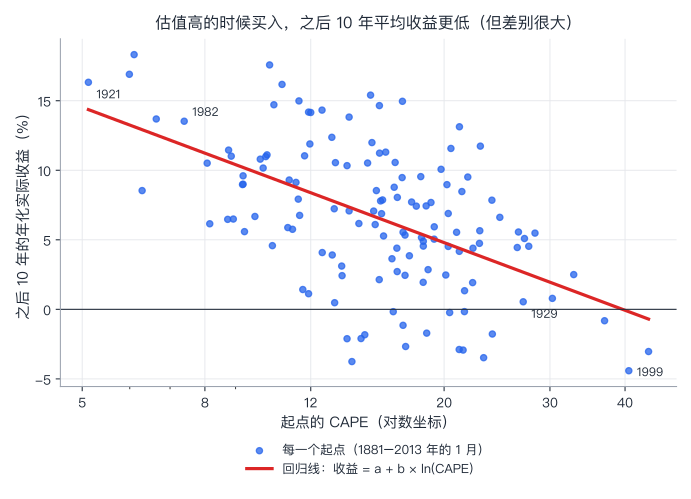
样本:起点 1881–2013,共 133 个起点(但相邻起点的 10 年窗口大量重叠,彼此远不独立:约 13 个互不重叠的窗口)
  之后 10 年年化实际收益:平均 6.65%,最低 -4.41%(1999 年起),最高 18.31%(1919 年起)

一、全样本:之后 10 年年化实际收益 = 0.258 + (-0.070) × ln(CAPE),R² = 0.29,相关系数 -0.53
  斜率的 t 值:朴素算法 -7.2;考虑重叠(Newey–West,滞后 10)-5.8

二、按起点的 CAPE,分成 3 档,看之后 10 年的年化实际收益
  最低 1/3:CAPE 5.1–13.2,平均之后 10 年 9.82%(最差 0.48%,最好 18.31%)
  中间 1/3:CAPE 13.5–18.5,平均之后 10 年 6.08%(最差 -3.75%,最好 15.40%)
  最高 1/3:CAPE 18.5–43.8,平均之后 10 年 3.99%(最差 -4.41%,最好 13.13%)
  1881–1946 起点:斜率 -0.070,R² = 0.32
  1947–2013 起点:斜率 -0.087,R² = 0.38

三、样本外:1920–2013 起点共 94 个预测,用 CAPE 的回归 vs 用历史平均
  样本外 R² = 1 − SSE(回归) / SSE(历史平均) = 0.076(> 0 才说明回归比历史平均更好)
逐段看:
- 有关系,而且,不弱:CAPE 最低的 1/3,之后 10 年,年化实际收益,平均 9.82%;中间 1/3,6.08%;最高的 1/3,3.99%。回归的 R²,0.29。前一半样本(1881–1946 起点)和后一半(1947–2013 起点)的斜率,接近:−0.070 和 −0.087。
- 要小心统计:相邻起点的 10 年窗口,重叠,所以,133 个起点,只相当于,约 13 个独立的窗口;朴素的 t 值,−7.2,考虑重叠之后(Newey–West),−5.8;别把这样的 t 值,当作,很强的证据。
- 样本外:站在每一年,只用,那时已经知道的结果,预测下一个 10 年:样本外 R² = 0.076,> 0,比"只用历史平均",好一点;但,只有一点。
- 极端的例子:1999 年 1 月,CAPE 是 40.6;之后 10 年,年化实际收益,−4.41%。1929 年 1 月,CAPE,27.1;之后,+0.54%。
这和几个,有名的结果,是一个方向:Shiller 1981 年(《股票价格的波动,是不是,大过了后来股息的变化,所能解释的?》,American Economic Review,71 卷 3 期,421–436 页):价格的波动,比,用后来的股息,算出的"合理价格"的波动,大得多;Fama 和 French 1988 年(Journal of Financial Economics,22 卷 1 期,3–25 页):股息率,对股票收益的预测力,随着期限变长,增强。2013 年的诺贝尔经济学奖,同时,给了 Fama、Shiller 和 Lars Hansen,奖励的是,“对资产价格的实证分析”;据瑞典皇家科学院的说明,短期的价格,没法预测,但是,长期的大方向,可以。
可是,另一方面,Amit Goyal 和 Ivo Welch 2008 年(Review of Financial Studies,21 卷 4 期,1455–1508 页)重新检验了,一大批,被用来预测股票收益的变量,结论(据摘要)是:它们中的许多,不论,样本内、还是样本外,30 年来,表现都很差,并且,不稳定。我们这里,只有一个变量、美国一个国家,样本外的 R² 是正的,不能,推广成,“估值,可以用来择时”。
(三)泡沫。 价格,会不会,远远偏离,基本价值?1990 年代末,美国的科技股,涨到了很高的位置,之后,大跌。这是不是泡沫?
- 事后的低收益(上面的 1999 年),两派,都能解释:泡沫,破了;或者,是投资者,当时,对这些公司的未来,很不确定,要求更高的价格,来补偿"高增长的可能性",后来,没有实现。
- Lubos Pástor 和 Pietro Veronesi 2006 年,(Journal of Financial Economics,81 卷 1 期,61–100 页),问:《1990 年代末,纳斯达克,有泡沫吗?》,答案,是"不一定":他们的模型认为,对未来利润的不确定性,越大,公司的价值,反而越高,而 1990 年代末,这种不确定性,很高;他们,并没有说,一定没有泡沫,只是说,泡沫,不是唯一的解释。
- 据评论,Fama,怀疑"泡沫"这个词,有没有被清楚地定义;Shiller,认为,一些资产的价格,确实,被泡沫,抬高了。(这里的概括,来自对两位的评论,不是他们的原话。)
6.3 分歧在哪
两派,在事实上,其实,有不少,共同的地方:
- 短期(天、周、月)的收益,几乎没法预测;
- 主动管理的基金,平均,扣费之后,跑不赢市场;
- 价格,不是随便定的。
分歧,主要在,怎么解释,剩下的那些规律(异象、长期的可预测性、泡沫):
| 有效市场一派(Fama 一路) | 行为金融一派(Shiller 一路) | |
|---|---|---|
| 异象,是什么 | 风险的补偿(模型,不完整);或,数据挖掘 | 错误定价(投资者的偏差) |
| 估值,能预测长期收益 | 预期收益,随时间变化:经济差的时候,人们更怕风险,价格更低,之后的收益更高 | 情绪、过度反应、均值回归 |
| 泡沫 | 事前,很难识别;名词,不清楚 | 存在,在某些情形,部分可识别 |
| 为什么,错误,没被套利掉 | 其实,被套利了(异象,发表后衰减) | 套利,是有限的:见下 |
三个,让分歧,很难解决的原因:
- 联合假设:同一个数据,同时,符合两种解释:CAPE 高的时候,之后的收益低,既可以说,是"价格,太高,之后回落",也可以说,是"人们,这时候,更不怕风险,所以,要求的补偿,更低"。没有一个,独立的"预期收益"的模型,没法,分开。
- 套利,有限度:Andrei Shleifer 和 Robert Vishny 1997 年(《套利的限度》,Journal of Finance,52 卷 1 期,35–55 页):真实世界的套利,需要资本,也有风险,而且,通常,是少数专业人士,用别人的钱,来做。当价格,进一步,偏离基本价值的时候,他们,可能,被迫,平仓。这和第 35 讲的"贱卖",是同一个逻辑。所以,价格,可以错,并且,错得,比你能撑的时间,更久。
- 数据,太少:美国一个国家,99 年;约 13 个互不重叠的 10 年;研究者,又在同一份数据上,不断地,试各种变量(多重检验,见第三节);第 4 讲说过,研究的结果,要经得起重复。
6.4 价值判断(留给你)
有效市场假说,本身,是一个关于"价格如何形成"的描述,不含价值判断。涉及价值的,是它在现实中,引出的选择:
- 金融交易,该有多大的规模? 事实问题:市场的价格发现,有多大的社会价值;大量的短线交易,消耗了多少资源。价值问题:该不该,限制、或者,对短线交易征税?你怎么,权衡"价格更准"和"资源的消耗"?
- 该不该,保护"普通的投资者"? 如果,主动管理,平均,不如被动,是否,应该把低成本的指数基金,设为养老金的默认选项?这样,是保护,还是家长主义(第 36 讲的默认选项)?
- 泡沫时,监管者,该不该干预? 如果,泡沫,事前,很难识别,央行,该不该,去管资产的价格(第 31 讲的泰勒规则,和房地产泡沫的争论)?
经济学,能告诉你:每一种选择,大约,有什么后果;你更看重哪一个后果,是你的价值判断。
七、局限、常见误用
7.1 局限
- 数据:全部,来自美国;时期,是 1927–2025(或 1881–2023);美国,是 20 世纪的赢家(第 37 讲);
- 检验:月度数据,市场指数,行业组合;没有,单只股票、日内数据、交易成本;
- CAPE 的部分:窗口重叠,独立的窗口,约 13 个;样本外,只有一个变量;
- 基金:只引用了研究的摘要,没有,自己重做;
- 这一讲没有讲:中国股市的证据(我没有查到,可以核对的数据),衍生品和高频交易,事件研究(公告之后,价格多快调整),行为金融的解释(第 39 讲会讲);
- 本讲,不是投资建议。
7.2 常见的误用
| 误用 | 正确的想法 |
|---|---|
| “有效市场,意味着价格永远正确” | 它只说,你很难系统地,比价格,知道得更多;价格,可以错 |
| “市场有效,所以,没人需要研究” | Grossman–Stiglitz:没人研究,价格,就不反映信息;有效,是靠有人研究,才得到的 |
| “随机游走,就是,什么规律也没有” | 收益的方向,很难预测;波动,是可以预测的(第三节) |
| “这个经理,连赢了 5 年,所以,他有本事” | 经理够多,就一定有人;运气,没有惯性(第四节) |
| “指数基金,一定,比主动基金好” | 平均来说,扣费后,主动的整体,少于被动的(算术);不是每一只;也不是对你的建议 |
| “历史回测,显示有效,所以,一定能赚钱” | 样本内,没有成本,发表后会衰减(McLean–Pontiff) |
| “崩盘,证明市场无效” | 事后的下跌,不等于,事前,可以识别;联合假设 |
| “CAPM 失败了,所以,风险不被定价” | 失败的,是这个模型(只有市场 β);风险,仍然,可能被定价 |
| “CAPE 高,所以,明年要跌” | 之后 10 年的平均,有关系;对某一年的预测,几乎没有用 |
八、小结
这一讲有六个想法,请带走:
- 有效市场假说:价格,已经反映了可得的信息,价格的变化,来自"意外",所以,不可预测;分为弱式、半强式、强式;它不说,价格永远正确。
- 悖论:完全有效,不可能(Grossman–Stiglitz):均衡,是"几乎有效",信息,越便宜,越有效。
- 随机游走:美国股市月度收益的自相关,很小;收益的方向,几乎,不可预测;波动,是可以预测的。
- 运气和技能:1 万个靠抛硬币的经理,前 5 年连赢的,有 314 个;要分清技能,需要几十年;主动管理,作为整体,扣费后,一定少于被动的;费用,是复利的。
- CAPM:预测,只有市场 β,被补偿;在 49 个行业里,斜率约 0(预测,0.62);这个模型,太简化,不等于,风险不被定价。
- 有争议:异象、估值对长期收益的预测、泡沫;两派,分歧,在怎么解释:风险的补偿,还是错误;联合假设,让它,很难被检验。
下一讲,我们问:如果,市场的价格,有系统的"错误",那是谁的错? 人,是不是,一台理性的计算机?我们会看,前景理论、过度自信、框架效应,和第 36 讲留下的"现在偏向"的证据。下一讲:第 39 讲:行为经济学:人不是理性计算机。
思考题
1. 1000 个经理,每年各有 50% 的概率,跑赢市场,彼此独立。5 年连赢的人数,期望是多少?8 年呢?如果,一家基金公司,同时,发起 20 只基金,每只,每年有 50% 的概率,跑赢市场,彼此独立,至少有一只,连赢 5 年的概率,是多少?
提示:1000 ÷ 2^5 = 31.25 人;1000 ÷ 2^8 ≈ 3.9 人。一只基金,连赢 5 年的概率,是 1/32;20 只里,至少有一只,是 1 − (31/32)^20 ≈ 47.0%;如果是 100 只,95.8%。这就是,“成立很多基金,只宣传最好的那只”,为什么,不说明什么。
2. 一个经理,每年,扣费后,多赚 1%,上下波动(跟踪误差)4%。要观察多少年,t 值的平均水平,才到 2?如果,是每年多赚 3%,波动 6%,呢?
提示:年数 = (2 × 跟踪误差 ÷ 每年多赚的)²。第一个:(2 × 4 ÷ 1)² = 64 年。第二个:(2 × 6 ÷ 3)² = 16 年。多赚得越少、波动越大,越分不清楚。
3. 10 万元,毛收益每年 7%,持有 40 年。年费用 0、年费用 1.5%,分别,变成多少?费用,让最后的钱,少了多少?
提示:0 费用:10 万 × 1.07^40 ≈ 149.7 万;1.5% 费用:10 万 × 1.055^40 ≈ 85.1 万;少了 1 − 85.1 ÷ 149.7 ≈ 43.1%。一年,只差 1.5 个百分点,40 年,差了快一半。
4. 你只有 25 年(300 个月)的数据,算出,月度收益的一阶自相关,是 +0.09。显著吗?为什么,1188 个月的数据里,同样的数,是显著的?
提示:300 个月的区间,±2 ÷ √300 ≈ ±0.115;0.09,在区间里面,不显著。1188 个月,区间 ±0.058;0.09 在外面。样本越大,越小的差别,也能被看出来;不显著,不等于没有,可能,只是数据,不够。
5. (开放题)用第 2.4 节的小模型:如果,随着技术进步,收集信息的成本,从 2 万元,降到 0.5 万元,市场,会变得更有效、还是更没效?这对"个人投资者,该不该自己选股",意味着什么?从中,分出哪些,是事实,哪些,是价值判断。
提示:事实部分:均衡,λ = 1 − c ÷ 10:c = 2 → 80%;c = 0.5 → 95%;信息,越便宜,价格,反映的信息越多,每个知情的人,能多赚的越少。注意,这是示意的小模型,不是真实的估计。含义:靠"信息优势"选股,越来越难(事实,在这个模型里)。价值判断部分:个人,有没有权利,把钱,用在自己选的股票上?该不该,因为平均不赚钱,就限制?你愿意,为"我自己选的",付多少代价?
参考与延伸
- Fama, E. F. (1970). Efficient Capital Markets: A Review of Theory and Empirical Work. Journal of Finance, 25(2), 383–417.
- Fama, E. F. (1991). Efficient Capital Markets: II. Journal of Finance, 46(5), 1575–1617.
- Samuelson, P. A. (1965). Proof That Properly Anticipated Prices Fluctuate Randomly. Industrial Management Review, 6(2), 41 页起(终页,没有核对)。
- Bachelier, L. (1900). Théorie de la spéculation(博士论文)。
- Kendall, M. G. (1953). The Analysis of Economic Time-Series—Part I: Prices. Journal of the Royal Statistical Society, Series A(卷期页,没有核对)。
- Grossman, S. J., & Stiglitz, J. E. (1980). On the Impossibility of Informationally Efficient Markets. American Economic Review, 70(3), 393–408.
- Jensen, M. C. (1968). The Performance of Mutual Funds in the Period 1945–1964. Journal of Finance, 23(2), 389–416.
- Fama, E. F., & French, K. R. (2010). Luck versus Skill in the Cross-Section of Mutual Fund Returns. Journal of Finance, 65(5), 1915–1947.
- Barber, B. M., & Odean, T. (2000). Trading Is Hazardous to Your Wealth: The Common Stock Investment Performance of Individual Investors. Journal of Finance, 55(2), 773–806.
- Sharpe, W. F. (1991). The Arithmetic of Active Management. Financial Analysts Journal, 47(1), 7–9.
- Pedersen, L. H. (2018). Sharpening the Arithmetic of Active Management. Financial Analysts Journal, 74(1), 21–36.
- Sharpe, W. F. (1964). Capital Asset Prices: A Theory of Market Equilibrium under Conditions of Risk. Journal of Finance, 19(3), 425–442.
- Fama, E. F., & MacBeth, J. D. (1973). Risk, Return, and Equilibrium: Empirical Tests. Journal of Political Economy, 81(3), 607–636.
- Fama, E. F., & French, K. R. (1992). The Cross-Section of Expected Stock Returns. Journal of Finance, 47(2), 427–465.
- Frazzini, A., & Pedersen, L. H. (2014). Betting Against Beta. Journal of Financial Economics(卷期页,没有核对)。
- McLean, R. D., & Pontiff, J. (2016). Does Academic Research Destroy Stock Return Predictability? Journal of Finance, 71(1), 5–32.
- Shiller, R. J. (1981). Do Stock Prices Move Too Much to be Justified by Subsequent Changes in Dividends? American Economic Review, 71(3), 421–436.
- Fama, E. F., & French, K. R. (1988). Dividend Yields and Expected Stock Returns. Journal of Financial Economics, 22(1), 3–25.
- Goyal, A., & Welch, I. (2008). A Comprehensive Look at the Empirical Performance of Equity Premium Prediction. Review of Financial Studies, 21(4), 1455–1508.
- Pástor, Ľ., & Veronesi, P. (2006). Was There a Nasdaq Bubble in the Late 1990s? Journal of Financial Economics, 81(1), 61–100.
- Shleifer, A., & Vishny, R. W. (1997). The Limits of Arbitrage. Journal of Finance, 52(1), 35–55.
- Kenneth R. French 数据库(达特茅斯学院):“Fama/French Research Data Factors”、“49 Industry Portfolios”(CRSP 2026 年 8 月版,2026 年 10 月下载)。
- Robert J. Shiller 的数据(Irrational Exuberance 所用的股票市场数据,ie_data.xls,更新至 2023 年 9 月):本讲,只用每年 1 月的 CAPE 和实际的含股息再投资价格指数,已嵌在代码里。