这是第四个实验。第 19 讲 7 节,我们跑过一个小循环赛:8 个策略,两两打 200 轮。那个比赛告诉我们三件事:善良的策略整体表现好;名次取决于参赛名单;让人群演化,背叛者很快被淘汰。可是 8 个策略的比赛太小,也太"干净":没有噪声,名单是我们挑的,策略也是我们事先写好的。
这个实验把比赛做大,再一层一层地放松这些限制:名单随机换会怎样?有手滑会怎样?不给现成的策略,让它们自己长出来,会怎样?不让所有人都见面,只和邻居打交道,又会怎样?
怎么用:和前面的实验一样,代码块是接着往下写的:后面的块会用到前面块里定义的东西。把它们依次拼成一个文件(比如 lab73.py),用 python lab73.py 运行,约 30 秒;也可以一段一段地在 Python 里依次运行。只需要 Python 3 和 NumPy。实验里有随机数(有的策略本身就带随机,演化里有变异),但种子都固定了,所以你跑出来的数字,会和下面的输出一模一样。
一、五个问题
先停一下:请先凭直觉,回答下面五个问题,写下来。
问题 1: 18 个策略两两对打 200 轮,冠军会是以牙还牙吗?以牙还牙在单场对打里,会赢过几个对手?
问题 2: 从这 18 个策略里随机抽 8 个组成名单,重新比赛,以牙还牙的名次稳定吗?
问题 3: 如果每个人的每个动作,都有 5% 的概率"手滑"做反了,名次会怎么变?冷酷触发和永远合作,各会怎样?
问题 4: 不给任何现成的策略,只给一群随机的"记忆一轮"的策略,让得分高的被复制、偶尔变异。合作会自己长出来吗?长出来以后稳固吗?
问题 5: 把人放到格子上,每个人只和 8 个邻居打交道,而且只有"永远合作"和"永远背叛"两种做法,没有任何报复。合作者能不能在背叛者的包围里活下来?
我们会一个一个回来。
二、实验的设计
2.1 囚徒困境和比赛的规则
收益和第 18 讲、第 19 讲一样:互相合作各得 3,互相背叛各得 1,我合作、对方背叛,我得 0、对方得 5。每对策略打 200 轮,打 10 场取平均(有随机的策略,每场会不一样);每个策略的成绩,是它对所有策略(包括自己的复制品)的平均每轮得分。
每个策略,每一轮,看到双方到目前为止实际做出的动作,然后决定这一轮做什么。
2.2 18 个策略
善良的(从不第一个背叛):
| 策略 | 做法 |
|---|---|
| 永远合作 | 无论如何都合作 |
| 以牙还牙 | 第一轮合作,之后照抄对方上一轮 |
| 宽容以牙还牙 | 对方连续两次背叛,才报复 |
| 以牙还两牙 | 对方背叛一次,连续报复两次 |
| 冷酷触发 | 对方背叛过一次,就永远背叛 |
| 赢留输变 | 上一轮得了 3 或 5,就不变;得了 0 或 1,就换 |
| 慷慨以牙还牙 | 以牙还牙,但对方背叛时,三次里原谅一次 |
| 试用期合作 | 前 10 轮无条件合作;之后,对方背叛过,就永远背叛 |
| 渐进报复 | 对方第 n 次背叛,就连续报复 n 次,再合作两次安抚 |
| 多数派 | 对方背叛得比合作多,就背叛 |
| 强硬以牙还牙 | 对方最近两轮里背叛过,就背叛 |
不善良的(会第一个背叛,或者会占便宜):
| 策略 | 做法 |
|---|---|
| 永远背叛 | 无论如何都背叛 |
| 疑心以牙还牙 | 第一轮先背叛,之后照抄 |
| 随机 | 各一半 |
| 偷偷背叛的以牙还牙 | 以牙还牙,但对方刚合作过时,有 10% 的概率偷偷背叛 |
| 试探者 | 第一轮背叛;对方回敬,就道歉并以牙还牙;不回敬,就隔一轮背叛一次 |
| 探针 | 开局背叛、合作、合作;对方前两次都没回敬,就永远背叛;否则以牙还牙 |
| 交替 | 合作、背叛、合作、背叛…… |
这些策略是我们自己写的实现。有的名字和 Axelrod 比赛里的参赛者思路相近,但它们不是那些参赛程序的复刻。
2.3 四种"赛场"
- 循环赛:每个策略和所有策略各打一遍,比总分。
- 生态演化:得分高的策略,下一代占的比例更大(第 19 讲 7.2 节用过)。
- 自己长出来的策略:不事先写策略,用 4 个概率描述一个"记忆一轮"的策略,让它们复制、变异。
- 格子:只和邻居打交道。
三、第一步:18 个策略的循环赛
import random
import numpy as np

C, D = 0, 1                                            # 0 = 合作,1 = 背叛
R, S, T, P = 3, 0, 5, 1                                # 第 18 讲的囚徒困境:互相合作 3,被骗 0,骗人 5,互相背叛 1
PAY = {(C, C): (R, R), (C, D): (S, T), (D, C): (T, S), (D, D): (P, P)}
rng = random.Random(73)                                # 全实验共用一个随机数发生器,固定种子

class Strategy:
    """一个策略:每一轮看双方到目前为止「实际做出」的动作,决定这一轮做什么。"""
    name = ""
    def reset(self): pass
    def move(self, t, my, op): raise NotImplementedError

class AllC(Strategy):
    name = "永远合作"
    def move(self, t, my, op): return C
class AllD(Strategy):
    name = "永远背叛"
    def move(self, t, my, op): return D
class TFT(Strategy):
    name = "以牙还牙"
    def move(self, t, my, op): return C if t == 0 else op[-1]
class SuspiciousTFT(Strategy):
    name = "疑心以牙还牙"                               # 第一轮先背叛,之后照抄
    def move(self, t, my, op): return D if t == 0 else op[-1]
class TF2T(Strategy):
    name = "宽容以牙还牙"                               # 对方连续两次背叛才报复
    def move(self, t, my, op): return D if t >= 2 and op[-1] == D and op[-2] == D else C
class TwoTitsForTat(Strategy):
    name = "以牙还两牙"                                 # 对方背叛一次,连续报复两次
    def reset(self): self.k = 0
    def move(self, t, my, op):
        if t > 0 and op[-1] == D: self.k = 2
        if self.k > 0: self.k -= 1; return D
        return C
class Grim(Strategy):
    name = "冷酷触发"
    def move(self, t, my, op): return D if D in op else C
class Pavlov(Strategy):
    name = "赢留输变"                                   # 上一轮得了 3 或 5:不变;得了 0 或 1:换
    def move(self, t, my, op):
        if t == 0: return C
        return my[-1] if PAY[(my[-1], op[-1])][0] >= R else 1 - my[-1]
class Random50(Strategy):
    name = "随机"
    def move(self, t, my, op): return rng.choice((C, D))
class Joss(Strategy):
    name = "偷偷背叛的以牙还牙"                         # 以牙还牙,但对方刚合作过时,有 10% 的概率偷偷背叛
    def move(self, t, my, op):
        if t == 0: return C
        return D if (op[-1] == C and rng.random() < 0.1) else op[-1]
class GTFT(Strategy):
    name = "慷慨以牙还牙"                               # 以牙还牙,但对方背叛时,三次里原谅一次
    def move(self, t, my, op):
        if t == 0: return C
        return C if (op[-1] == C or rng.random() < 1 / 3) else D
class Probation(Strategy):
    name = "试用期合作"                                 # 前 10 轮无条件合作;之后,对方背叛过,就永远背叛
    def move(self, t, my, op): return C if t < 10 else (D if D in op else C)
class Tester(Strategy):
    name = "试探者"                                     # 第一轮背叛试一试;对方回敬,就道歉并以牙还牙;不回敬,就隔一轮背叛一次
    def reset(self): self.retaliated = False
    def move(self, t, my, op):
        if t == 0: return D
        if t == 1: self.retaliated = (op[0] == D)
        if self.retaliated: return C if t == 1 else op[-1]
        return C if t % 2 == 1 else D
class Prober(Strategy):
    name = "探针"                                       # 开局 背叛、合作、合作;对方前两次都没回敬,就永远背叛;否则以牙还牙
    def move(self, t, my, op):
        if t < 3: return (D, C, C)[t]
        return D if (op[1] == C and op[2] == C) else op[-1]
class Gradual(Strategy):
    name = "渐进报复"                                   # 对方第 n 次背叛,就连续报复 n 次,再合作两次安抚
    def reset(self): self.n = 0; self.queue = []
    def move(self, t, my, op):
        if t > 0 and op[-1] == D and not self.queue_active():
            self.n += 1; self.queue = [D] * self.n + [C, C]
        return self.queue.pop(0) if self.queue else C
    def queue_active(self): return bool(self.queue)
class Majority(Strategy):
    name = "多数派"                                     # 对方背叛得比合作多,就背叛
    def move(self, t, my, op): return D if sum(op) > t - sum(op) else C
class HardTFT(Strategy):
    name = "强硬以牙还牙"                               # 对方最近两轮里背叛过,就背叛
    def move(self, t, my, op): return D if D in op[-2:] else C
class Alternate(Strategy):
    name = "交替"
    def move(self, t, my, op): return C if t % 2 == 0 else D

ROSTER = [AllC, AllD, TFT, SuspiciousTFT, TF2T, TwoTitsForTat, Grim, Pavlov, Random50, Joss, GTFT,
          Probation, Tester, Prober, Gradual, Majority, HardTFT, Alternate]
NAMES = [cls.name for cls in ROSTER]

def match(a, b, rounds=200, eps=0.0):
    """两个策略对打 rounds 轮。每个人想做的动作,有 eps 的概率手滑做反了;双方看到的,是实际做出的动作。返回每轮平均得分。"""
    a.reset(); b.reset(); ha, hb, sa, sb = [], [], 0, 0
    for t in range(rounds):
        x, y = a.move(t, ha, hb), b.move(t, hb, ha)
        if eps and rng.random() < eps: x = 1 - x
        if eps and rng.random() < eps: y = 1 - y
        pa, pb = PAY[(x, y)]; sa += pa; sb += pb; ha.append(x); hb.append(y)
    return sa / rounds, sb / rounds

def round_robin(roster, rounds=200, reps=10, eps=0.0):
    """M[i][j]:策略 i 对策略 j 的每轮平均得分(每对打 reps 场取平均;含和自己打)"""
    n = len(roster); M = np.zeros((n, n))
    for i in range(n):
        for j in range(i, n):
            s_i = s_j = 0.0
            for _ in range(reps):
                x, y = match(roster[i](), roster[j](), rounds, eps); s_i += x; s_j += y
            M[i, j] += s_i / reps
            if i != j: M[j, i] += s_j / reps
            else: M[i, i] = (s_i + s_j) / (2 * reps)
    return M

M0 = round_robin(ROSTER)
avg = M0.mean(axis=1)                                  # 每个策略对所有 18 个策略(含自己)的平均每轮得分
order = np.argsort(-avg)
print(f"循环赛:{len(ROSTER)} 个策略,每对打 200 轮 × 10 场,含和自己打;数字是平均每轮得分")
for rank, i in enumerate(order, 1):
    print(f"  第 {rank:>2} 名  {avg[i]:.3f}  {NAMES[i]}")

i_tft = NAMES.index("以牙还牙")
beaten = sum(M0[i_tft, j] > M0[j, i_tft] + 1e-9 for j in range(len(ROSTER)) if j != i_tft)
lost = sum(M0[i_tft, j] < M0[j, i_tft] - 1e-9 for j in range(len(ROSTER)) if j != i_tft)
print(f"\n以牙还牙在单场对打里:赢了 {beaten} 个对手,输了 {lost} 个,其余平手")
j = NAMES.index("永远背叛")
print(f"永远背叛对永远合作:{M0[j, 0]:.2f} 对 {M0[0, j]:.2f};对以牙还牙:{M0[j, i_tft]:.2f} 对 {M0[i_tft, j]:.2f}")
输出:
循环赛:18 个策略,每对打 200 轮 × 10 场,含和自己打;数字是平均每轮得分
  第  1 名  2.774  渐进报复
  第  2 名  2.693  多数派
  第  3 名  2.670  慷慨以牙还牙
  第  4 名  2.669  以牙还牙
  第  5 名  2.565  赢留输变
  第  6 名  2.559  冷酷触发
  第  7 名  2.552  试用期合作
  第  8 名  2.543  强硬以牙还牙
  第  9 名  2.540  以牙还两牙
  第 10 名  2.528  宽容以牙还牙
  第 11 名  2.399  永远合作
  第 12 名  2.109  交替
  第 13 名  2.029  疑心以牙还牙
  第 14 名  2.016  试探者
  第 15 名  2.009  探针
  第 16 名  1.985  随机
  第 17 名  1.924  偷偷背叛的以牙还牙
  第 18 名  1.696  永远背叛

以牙还牙在单场对打里:赢了 0 个对手,输了 4 个,其余平手
永远背叛对永远合作:5.00 对 0.00;对以牙还牙:1.02 对 0.99
逐段看:
- 前十一名,全是善良的策略;不善良的七个,占了后面七名。善良的策略和善良的策略碰面,一直合作,每轮拿 3;不善良的策略,不管占了谁的便宜,碰到会报复的就拿不到好分。这和 Axelrod 的发现一致:善良,是区分好坏的第一条线。
- 以牙还牙排第四,和慷慨以牙还牙并列(2.669 对 2.670)。冠军是渐进报复(2.774)。以牙还牙不是冠军,这份名单里没有。
- 以牙还牙在单场对打里,一个对手也没赢过:赢 0 个,输 4 个,其余打平。(它对永远背叛是 0.99 对 1.02,输一点点。)它的总分高,靠的是"和愿意合作的人相处得好",不是"打败谁"。
- 永远背叛对永远合作,是 5.00 对 0.00,被占便宜的惨;可是永远背叛的总分最低(1.696):因为它和大多数策略,都只能拿到互相背叛的 1。
问题 1 的答案:不一定是以牙还牙。在这份名单里,它是第四名。
不要把渐进报复读成"最好的策略":它只是在这份名单里最好。下一步,我们就换名单。
四、第二步:名单一换,名次就变
从 18 个策略里随机抽 8 个组成一场比赛(只和名单里的对手比,含自己),抽 5000 次,看谁赢得多:
# 名单一换,名次就变吗?从 18 个策略里随机抽 8 个组成一场比赛(只和名单里的对手比,含自己),抽 5000 次
def run_roster(idx, M):
    return M[np.ix_(idx, idx)].mean(axis=1)           # 名单里每个策略的平均每轮得分

draws = np.random.default_rng(73)
wins = np.zeros(len(ROSTER)); appear = np.zeros(len(ROSTER)); ranks_tft = []
for _ in range(5000):
    idx = draws.choice(len(ROSTER), size=8, replace=False)
    sc = run_roster(idx, M0); top = sc >= sc.max() - 1e-9          # 并列第一,都算夺冠
    wins[idx[top]] += 1; appear[idx] += 1
    if i_tft in idx: ranks_tft.append(1 + (sc > sc[list(idx).index(i_tft)] + 1e-9).sum())

print("随机抽 8 个策略组成名单,抽 5000 次。每个策略:入选时夺冠(含并列)的比例")
for i in np.argsort(-wins / appear):
    print(f"  {wins[i] / appear[i]:6.1%}  (入选 {int(appear[i])} 次)  {NAMES[i]}")
ranks_tft = np.array(ranks_tft)
print(f"\n以牙还牙入选 {len(ranks_tft)} 次:夺冠 {np.mean(ranks_tft == 1):.1%},进前三 {np.mean(ranks_tft <= 3):.1%},垫底 {np.mean(ranks_tft == 8):.1%},平均名次 {ranks_tft.mean():.2f}")

# 名次取决于名单里「不善良」的策略有多少?「善良」= 从不第一个背叛
nice = [i for i, cls in enumerate(ROSTER) if cls in (AllC, TFT, TF2T, TwoTitsForTat, Grim, Pavlov, GTFT, Probation, Gradual, Majority, HardTFT)]
nasty = [i for i in range(len(ROSTER)) if i not in nice]
sub = M0[np.ix_(nice, nice)]
print(f"\n善良策略互相之间(含和自己)的平均每轮得分:最低 {sub.min():.3f},最高 {sub.max():.3f}")
print(f"\n18 个策略里,善良的 {len(nice)} 个,不善良的 {len(nasty)} 个。名单 = 以牙还牙 + (7 - k) 个别的善良策略 + k 个不善良策略:")
tft_by_k = {}
for k in range(0, 7):
    rk = []
    for _ in range(2000):
        good = draws.choice([i for i in nice if i != i_tft], size=7 - k, replace=False)
        bad = draws.choice(nasty, size=k, replace=False) if k else np.array([], dtype=int)
        idx = np.concatenate([[i_tft], good, bad]).astype(int)
        sc = run_roster(idx, M0); rk.append(1 + (sc > sc[0] + 1e-9).sum())
    rk = np.array(rk); tft_by_k[k] = rk
    print(f"  k = {k}:以牙还牙的平均名次 {rk.mean():.2f},夺冠(含并列){np.mean(rk == 1):6.1%},进前三 {np.mean(rk <= 3):6.1%}")
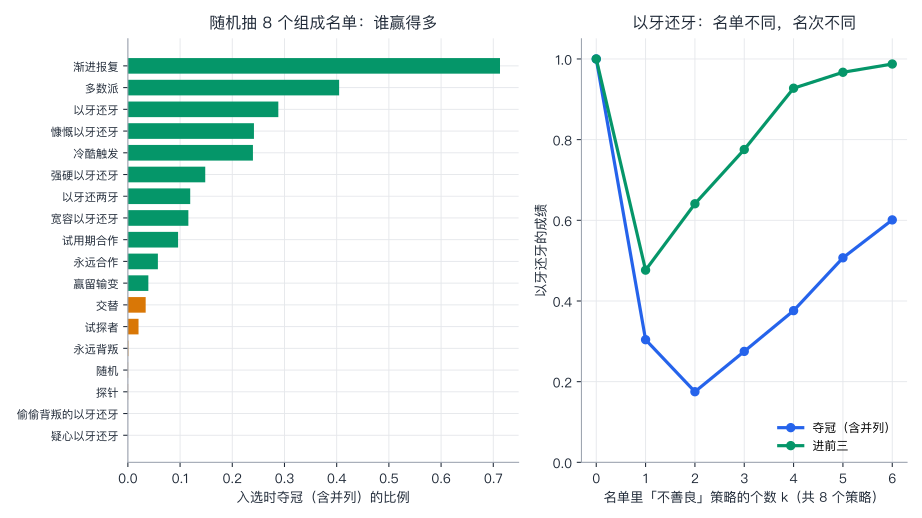
输出:
随机抽 8 个策略组成名单,抽 5000 次。每个策略:入选时夺冠(含并列)的比例
   71.3%  (入选 2222 次)  渐进报复
   40.5%  (入选 2172 次)  多数派
   28.8%  (入选 2283 次)  以牙还牙
   24.2%  (入选 2182 次)  慷慨以牙还牙
   24.0%  (入选 2208 次)  冷酷触发
   14.8%  (入选 2186 次)  强硬以牙还牙
   11.9%  (入选 2244 次)  以牙还两牙
   11.6%  (入选 2304 次)  宽容以牙还牙
    9.6%  (入选 2214 次)  试用期合作
    5.8%  (入选 2226 次)  永远合作
    3.9%  (入选 2218 次)  赢留输变
    3.4%  (入选 2140 次)  交替
    2.0%  (入选 2155 次)  试探者
    0.1%  (入选 2183 次)  永远背叛
    0.0%  (入选 2241 次)  随机
    0.0%  (入选 2257 次)  探针
    0.0%  (入选 2311 次)  疑心以牙还牙
    0.0%  (入选 2254 次)  偷偷背叛的以牙还牙

以牙还牙入选 2283 次:夺冠 28.8%,进前三 77.0%,垫底 0.0%,平均名次 2.50

善良策略互相之间(含和自己)的平均每轮得分:最低 3.000,最高 3.000

18 个策略里,善良的 11 个,不善良的 7 个。名单 = 以牙还牙 + (7 - k) 个别的善良策略 + k 个不善良策略:
  k = 0:以牙还牙的平均名次 1.00,夺冠(含并列)100.0%,进前三 100.0%
  k = 1:以牙还牙的平均名次 3.13,夺冠(含并列) 30.4%,进前三  47.6%
  k = 2:以牙还牙的平均名次 3.11,夺冠(含并列) 17.5%,进前三  64.1%
  k = 3:以牙还牙的平均名次 2.42,夺冠(含并列) 27.5%,进前三  77.5%
  k = 4:以牙还牙的平均名次 1.96,夺冠(含并列) 37.6%,进前三  92.8%
  k = 5:以牙还牙的平均名次 1.67,夺冠(含并列) 50.7%,进前三  96.7%
  k = 6:以牙还牙的平均名次 1.58,夺冠(含并列) 60.1%,进前三  98.8%
逐段看:
- 没有"永远的冠军":渐进报复入选时夺冠 71.3%,是最稳的,可也不是 100%;多数派 40.5%,以牙还牙 28.8%。不善良的策略几乎不会夺冠。
- 以牙还牙:入选的 2283 次里,28.8% 夺冠(含并列),77.0% 进前三,从来没有垫底。它不是最好的,但很少是坏的。这是 Axelrod 比赛里它赢了两次的原因之一:稳。
- 名单里不善良的策略有多少,影响很大,而且不是单调的:
- k = 0(名单全是善良的):大家互相合作,每人都是 3 分,并列第一,名次没有意义。
- k = 1、2:以牙还牙的平均名次掉到 3.1,夺冠的比例只有 30.4% 和 17.5%。
- k = 4、5、6:名单里坏策略多了,反而对以牙还牙有利(平均名次 1.96、1.67、1.58)。
- 为什么:善良的策略互相之间,一直拿 3 分,没有任何区别(代码里打印的那一行:善良策略互相之间的得分,最低和最高都是 3.000)。所以,善良策略之间的名次,完全取决于它们怎么对付名单里那几个不善良的。名单里只有一两个坏策略时,“一被背叛就狠狠报复"的策略(冷酷触发、强硬以牙还牙)吃的亏最少,容易夺冠;坏策略多了,需要的是又能识别、又能原谅的策略。以牙还牙在中间,两边都不输。
问题 2 的答案:不稳定。名次取决于名单,这也是第 19 讲 7.3 节说的"别把 Axelrod 的结论读成’以牙还牙永远最好’“的理由:Rapoport、Seale 和 Colman(2015 年,PLoS ONE)重新分析 Axelrod 的数据,也认为以牙还牙的成功,取决于比赛的设计。
五、第三步:生态演化
Axelrod 还做了另一件事:让得分高的策略,下一代占的比例更大,看谁最后留下来。第 19 讲 7.2 节做过 8 个策略的版本。现在,用 18 个策略:
# 生态模拟(Axelrod 的做法):得分高的策略,下一代占的比例更大
def ecology(M, x0, gens=2000):
    x = np.array(x0, dtype=float); hist = [x.copy()]
    for _ in range(gens):
        f = M @ x                                       # 每个策略,在当前人群里的平均得分
        x = x * f / (x @ f); hist.append(x.copy())
    return np.array(hist)

n = len(ROSTER)
H = ecology(M0, np.full(n, 1 / n))
print("18 个策略各占 1/18,演化:每个策略的占比(%)")
print("  第几代:" + "  ".join(f"{g:>5}" for g in (0, 5, 20, 50, 200, 2000)))
for i in np.argsort(-H[-1]):
    if H[[0, 5, 20, 50, 200, 2000], i].max() > 0.002:
        print(f"  {NAMES[i]:<12}" + "  ".join(f"{100 * H[g, i]:5.1f}" for g in (0, 5, 20, 50, 200, 2000)))
alive = [NAMES[i] for i in range(n) if H[-1, i] > 0.005]
print(f"2000 代之后占比超过 0.5% 的策略:{'、'.join(alive)}")
print(f"人群的平均得分:第 0 代 {H[0] @ M0 @ H[0]:.3f},第 20 代 {H[20] @ M0 @ H[20]:.3f},第 2000 代 {H[-1] @ M0 @ H[-1]:.3f}")

# 换一个出发点:随机的人群比例,演化 500 次,看每个策略最后留下的次数
draws = np.random.default_rng(73)
stay = np.zeros(n); final_share = np.zeros(n)
for _ in range(500):
    h = ecology(M0, draws.dirichlet(np.ones(n)), gens=1500)[-1]
    stay += h > 0.005; final_share += h
print("\n随机出发点,演化 500 次:每个策略最后还留在人群里(占比 > 0.5%)的次数、平均最终占比")
for i in np.argsort(-final_share):
    if stay[i] > 0: print(f"  {int(stay[i]):>3} 次  平均占比 {final_share[i] / 500:5.1%}  {NAMES[i]}")
输出:
18 个策略各占 1/18,演化:每个策略的占比(%)
  第几代:    0      5     20     50    200   2000
  渐进报复          5.6   10.1   12.4   12.4   12.4   12.4
  多数派           5.6    9.0   10.6   10.6   10.6   10.6
  慷慨以牙还牙        5.6    8.8   10.4   10.4   10.4   10.4
  以牙还牙          5.6    8.8   10.4   10.4   10.4   10.4
  赢留输变          5.6    7.7    8.7    8.7    8.7    8.7
  冷酷触发          5.6    7.6    8.4    8.4    8.4    8.4
  试用期合作         5.6    7.5    8.3    8.3    8.3    8.3
  强硬以牙还牙        5.6    7.5    8.2    8.2    8.2    8.2
  以牙还两牙         5.6    7.4    8.2    8.2    8.2    8.2
  宽容以牙还牙        5.6    7.2    7.9    7.9    7.9    7.9
  永远合作          5.6    6.2    6.5    6.5    6.5    6.5
  探针            5.6    2.1    0.0    0.0    0.0    0.0
  疑心以牙还牙        5.6    2.0    0.0    0.0    0.0    0.0
  交替            5.6    2.3    0.0    0.0    0.0    0.0
  偷偷背叛的以牙还牙     5.6    1.6    0.0    0.0    0.0    0.0
  永远背叛          5.6    0.7    0.0    0.0    0.0    0.0
  试探者           5.6    1.7    0.0    0.0    0.0    0.0
  随机            5.6    1.7    0.0    0.0    0.0    0.0
2000 代之后占比超过 0.5% 的策略:永远合作、以牙还牙、宽容以牙还牙、以牙还两牙、冷酷触发、赢留输变、慷慨以牙还牙、试用期合作、渐进报复、多数派、强硬以牙还牙
人群的平均得分:第 0 代 2.348,第 20 代 2.999,第 2000 代 3.000

随机出发点,演化 500 次:每个策略最后还留在人群里(占比 > 0.5%)的次数、平均最终占比
  478 次  平均占比 13.0%  渐进报复
  481 次  平均占比 11.4%  慷慨以牙还牙
  469 次  平均占比 11.1%  以牙还牙
  489 次  平均占比  9.9%  多数派
  471 次  平均占比  8.6%  冷酷触发
  479 次  平均占比  8.5%  赢留输变
  456 次  平均占比  8.4%  以牙还两牙
  461 次  平均占比  8.3%  强硬以牙还牙
  471 次  平均占比  8.2%  试用期合作
  472 次  平均占比  7.4%  宽容以牙还牙
  461 次  平均占比  5.3%  永远合作
逐段看:
- 七个不善良的策略,在 20 代之内全部消失(永远背叛,几代就掉到 0.7%)。留下来的,正是十一个善良的策略。
- 留下来的比例,一开始就定了:第 20 代到第 2000 代,几乎没变(渐进报复 12.4%,多数派 10.6%,以牙还牙 10.4%……)。因为十一个善良策略互相碰面,都是 3 分,没人比别人强,所以没有"淘汰”:它们是中性的。人群的平均得分,从 2.348 升到 3.000。
- 随机出发 500 次:每个善良策略,都有 456 到 489 次留在了人群里(永远合作 461 次,以牙还牙 469 次,渐进报复 478 次);七个不善良的策略,一次也没有留下来。(没有留下来的那几十次,我们没有逐个去查原因。)
这是个很强的结论,但它有一个前提:没有噪声。下一步,我们把噪声打开。
六、第四步:手滑
每个动作,有 eps 的概率做反了。对方只看得到你实际做了什么,不知道你是不是故意的。我们试 eps = 0.01 和 0.05:
# 噪声:每个人,每一轮,有 eps 的概率手滑做反了
Mn = {0.0: M0}
for eps in (0.01, 0.05):
    Mn[eps] = round_robin(ROSTER, eps=eps, reps=20)

print("循环赛的名次,随噪声怎么变(括号里是平均每轮得分):")
print("  无噪声                  eps = 0.01              eps = 0.05")
ords = {eps: np.argsort(-Mn[eps].mean(axis=1)) for eps in Mn}
for r in range(n):
    cells = [f"{NAMES[ords[eps][r]]}({Mn[eps].mean(axis=1)[ords[eps][r]]:.2f})" for eps in Mn]
    print(f"{r + 1:>2}. " + " | ".join(cells))

print("\n几个策略自己和自己打(理想是 3):")
for name in ("以牙还牙", "冷酷触发", "宽容以牙还牙", "慷慨以牙还牙", "赢留输变", "渐进报复", "永远合作"):
    i = NAMES.index(name)
    print(f"  {name:<10}" + "   ".join(f"eps = {eps}: {Mn[eps][i, i]:.2f}" for eps in Mn))

H5 = ecology(Mn[0.05], np.full(n, 1 / n))
print("\neps = 0.05 时,各占 1/18 出发,演化 2000 代后占比超过 0.5% 的策略:")
for i in np.argsort(-H5[-1]):
    if H5[-1, i] > 0.005: print(f"  {H5[-1, i]:5.1%}  {NAMES[i]}")
输出:
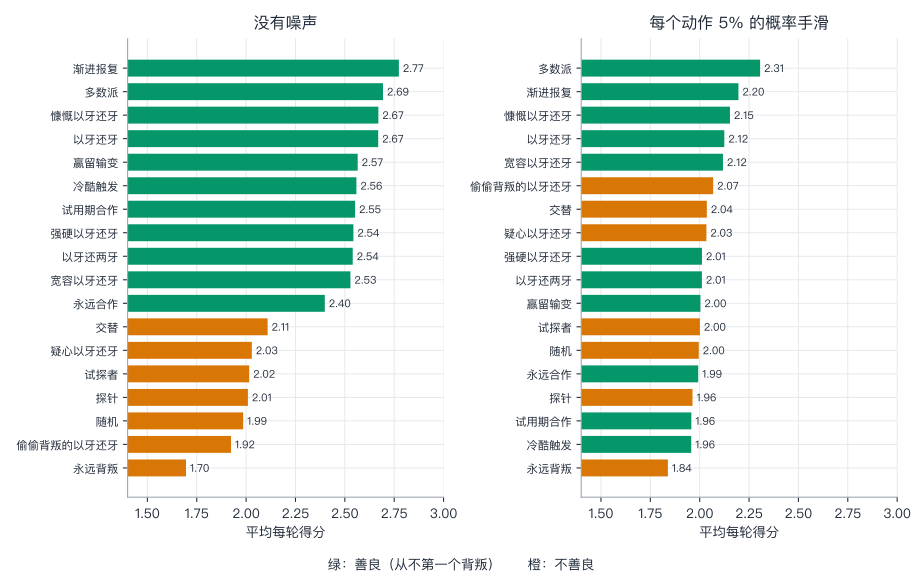
循环赛的名次,随噪声怎么变(括号里是平均每轮得分):
  无噪声                  eps = 0.01              eps = 0.05
 1. 渐进报复(2.77) | 多数派(2.44) | 多数派(2.31)
 2. 多数派(2.69) | 渐进报复(2.40) | 渐进报复(2.20)
 3. 慷慨以牙还牙(2.67) | 慷慨以牙还牙(2.39) | 慷慨以牙还牙(2.15)
 4. 以牙还牙(2.67) | 宽容以牙还牙(2.27) | 以牙还牙(2.12)
 5. 赢留输变(2.57) | 以牙还牙(2.25) | 宽容以牙还牙(2.12)
 6. 冷酷触发(2.56) | 赢留输变(2.14) | 偷偷背叛的以牙还牙(2.07)
 7. 试用期合作(2.55) | 永远合作(2.14) | 交替(2.04)
 8. 强硬以牙还牙(2.54) | 强硬以牙还牙(2.09) | 疑心以牙还牙(2.03)
 9. 以牙还两牙(2.54) | 冷酷触发(2.06) | 强硬以牙还牙(2.01)
10. 宽容以牙还牙(2.53) | 交替(2.06) | 以牙还两牙(2.01)
11. 永远合作(2.40) | 疑心以牙还牙(2.04) | 赢留输变(2.00)
12. 交替(2.11) | 试用期合作(2.03) | 试探者(2.00)
13. 疑心以牙还牙(2.03) | 随机(2.03) | 随机(2.00)
14. 试探者(2.02) | 以牙还两牙(2.02) | 永远合作(1.99)
15. 探针(2.01) | 试探者(2.00) | 探针(1.96)
16. 随机(1.99) | 偷偷背叛的以牙还牙(1.99) | 试用期合作(1.96)
17. 偷偷背叛的以牙还牙(1.92) | 探针(1.98) | 冷酷触发(1.96)
18. 永远背叛(1.70) | 永远背叛(1.73) | 永远背叛(1.84)

几个策略自己和自己打(理想是 3):
  以牙还牙      eps = 0.0: 3.00   eps = 0.01: 2.55   eps = 0.05: 2.39
  冷酷触发      eps = 0.0: 3.00   eps = 0.01: 1.55   eps = 0.05: 1.28
  宽容以牙还牙    eps = 0.0: 3.00   eps = 0.01: 2.99   eps = 0.05: 2.94
  慷慨以牙还牙    eps = 0.0: 3.00   eps = 0.01: 2.97   eps = 0.05: 2.84
  赢留输变      eps = 0.0: 3.00   eps = 0.01: 2.95   eps = 0.05: 2.79
  渐进报复      eps = 0.0: 3.00   eps = 0.01: 2.93   eps = 0.05: 2.25
  永远合作      eps = 0.0: 3.00   eps = 0.01: 2.99   eps = 0.05: 2.95

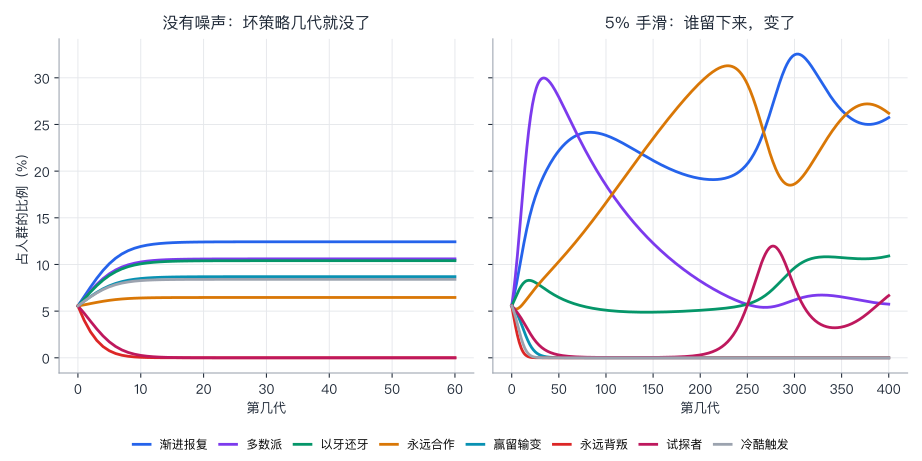
eps = 0.05 时,各占 1/18 出发,演化 2000 代后占比超过 0.5% 的策略:
  30.1%  渐进报复
  27.0%  永远合作
  14.9%  宽容以牙还牙
  13.3%  以牙还牙
   7.2%  多数派
   3.4%  试探者
   2.2%  慷慨以牙还牙
   2.0%  探针
逐段看:
- 整张名次表,洗了一遍牌。eps = 0.05 时,所有的分数都挤在 1.84 到 2.31 之间;偷偷背叛的以牙还牙(2.07)、交替(2.04)、疑心以牙还牙(2.03)这些不善良的策略,排到了冷酷触发(1.96)、试用期合作(1.96)、永远合作(1.99)这些善良的前面。
- 冷酷触发垮得最惨:自己和自己打,没有噪声时 3.00,eps = 0.01 时只有 1.55,eps = 0.05 时 1.28。一次手滑,就是永远背叛。(练习 4 让你估计这个数。)
- 以牙还牙:2.55(eps = 0.01)、2.39(0.05),掉得明显:一次手滑,引发来回报复。
- 宽容的、能"恢复"的:宽容以牙还牙 2.99 → 2.94,永远合作 2.99 → 2.95,慷慨以牙还牙 2.97 → 2.84,赢留输变 2.95 → 2.79,没怎么掉。渐进报复,在 eps = 0.05 时掉到 2.25,因为它报复的次数,随着错误一路增加。
- 生态演化也变了:eps = 0.05 时,2000 代之后,永远合作占了 27.0%(没有噪声时,它是被"白占便宜"的)。因为噪声里,善良且宽容的,反而最稳;渐进报复占 30.1%,宽容以牙还牙 14.9%,以牙还牙 13.3%。试探者(3.4%)和探针(2.0%)这两个会占便宜的,也留了下来:永远合作多了,它们就有了猎物。(这正是第 19 讲 7.3 节里,Nowak 和 Sigmund 说的:永远合作者,会招来背叛者。)
问题 3 的答案:名次会洗牌。冷酷触发一遇到手滑,就崩溃;永远合作自己和自己打时几乎不受影响(但在整个比赛里,它的总分仍从 2.40 掉到 1.99,因为不善良的对手占它的便宜);宽容的、能恢复的策略,占上风。第 19 讲 8 节的结论,在一个 18 个策略的大名单里,同样成立:惩罚要有力度,也要有出口。
七、第五步:不给策略,让策略自己长出来
到现在为止,所有策略,都是我们写的。能不能不事先写,让它们自己"长"出来?
我们用一类简单而一般的策略:记忆一轮。一个策略,用 4 个概率 (pCC, pCD, pDC, pDD) 描述:上一轮是"互相合作”(CC)、“我合作、对方背叛”(CD)、“我背叛、对方合作”(DC)、“互相背叛”(DD)时,这一轮合作的概率。比如:
- 以牙还牙:(1, 0, 1, 0)
- 永远背叛:(0, 0, 0, 0);永远合作:(1, 1, 1, 1)
- 赢留输变:(1, 0, 0, 1)
- 慷慨以牙还牙:(1, 1/3, 1, 1/3)
两个这样的策略对打,会形成一个"状态"(CC、CD、DC、DD)的随机过程,长期来看,每个状态占一定的比例,平均得分可以直接算出来(解一个 4 × 4 的线性方程组),不用一轮一轮地模拟。
# 不预先挑策略:让策略自己"长"出来。
# 「记忆一轮」的策略:只看上一轮(我做了什么、对方做了什么),用 4 个概率 (pCC, pCD, pDC, pDD) 决定这一轮合作的概率。
# 例如:以牙还牙 = (1, 0, 1, 0),永远背叛 = (0, 0, 0, 0),赢留输变 = (1, 0, 0, 1),慷慨以牙还牙 = (1, 1/3, 1, 1/3)
PAYOFF = np.array([R, S, T, P], dtype=float)           # 状态顺序:CC, CD, DC, DD(前一个字母是我,后一个是对方)

def long_run_payoffs(X, eps):
    """X:K × 4 的数组,每行是一个策略。返回 K × K 矩阵:策略 i 对策略 j,打无限多轮之后,平均每轮得分。
    每个动作有 eps 的概率手滑做反(所以每个状态都会出现,长期平均是确定的数)。"""
    K = len(X)
    Q = X * (1 - eps) + (1 - X) * eps                  # 手滑之后,实际合作的概率
    swap = [0, 2, 1, 3]                                # 对方眼里的状态:CD 变成 DC
    pi = Q[:, None, :]                                 # 我在 4 个状态下合作的概率(i 的)
    pj = Q[None, :, :][:, :, swap]                     # 对方在"他眼里的"4 个状态下合作的概率
    pi = np.broadcast_to(pi, (K, K, 4)); pj = np.broadcast_to(pj, (K, K, 4))
    Tm = np.zeros((K, K, 4, 4))                        # 转移矩阵:从状态 s 到状态 s'
    for s2, (a, b) in enumerate(((C, C), (C, D), (D, C), (D, D))):
        Tm[:, :, :, s2] = (pi if a == C else 1 - pi) * (pj if b == C else 1 - pj)
    A = np.swapaxes(Tm, 2, 3) - np.eye(4)
    A[:, :, 3, :] = 1.0                                # 用"概率之和 = 1"替换最后一个方程
    rhs = np.zeros((K, K, 4)); rhs[:, :, 3] = 1.0
    v = np.linalg.solve(A, rhs[..., None])[..., 0]     # 长期处于每个状态的比例
    return v @ PAYOFF

# 先检验:几个熟悉的策略,两两对打,每轮的平均得分(eps = 0.01)
named = {"以牙还牙": (1, 0, 1, 0), "永远背叛": (0, 0, 0, 0), "永远合作": (1, 1, 1, 1),
         "赢留输变": (1, 0, 0, 1), "慷慨以牙还牙": (1, 1 / 3, 1, 1 / 3)}
Xn = np.array(list(named.values()), dtype=float); G = long_run_payoffs(Xn, 0.01)
print("无限多轮、eps = 0.01:行策略对列策略的平均每轮得分")
print("              " + "  ".join(f"{k:>8}" for k in named))
for k, row in zip(named, G):
    print(f"{k:<10}" + "  ".join(f"{v:8.2f}" for v in row))

# 现在,让策略自己演化。一个 100 人的人群,每个人带一个随机的 (pCC, pCD, pDC, pDD)。
# 每一代:每个人和所有人(无限多轮、eps = 0.01)对打,得分平均;得分高的更可能被"复制"到下一代;
# 复制时,每个后代有 3% 的概率"变异"(4 个概率各加一点随机扰动)。
def evolve(seed, K=100, gens=2000, eps=0.01, mu=0.03, sigma=0.08):
    g = np.random.default_rng(seed)
    X = np.clip(g.random((K, 4)), 0.01, 0.99); rec = []
    for _ in range(gens):
        f = long_run_payoffs(X, eps).mean(axis=1)
        rec.append((f.mean(), *X.mean(axis=0)))
        w = np.exp(f - f.max()); w /= w.sum()                  # 得分高的,被复制的机会大
        X = X[g.choice(K, size=K, p=w)]
        mutant = g.random(K) < mu
        X = np.where(mutant[:, None], np.clip(X + sigma * g.standard_normal((K, 4)), 0.01, 0.99), X)
    return np.array(rec)                                      # 每代:人群平均得分,和 4 个概率的人群平均值

known = {"以牙还牙": (1, 0, 1, 0), "永远背叛": (0, 0, 0, 0), "永远合作": (1, 1, 1, 1), "赢留输变": (1, 0, 0, 1), "慷慨以牙还牙": (1, 1 / 3, 1, 1 / 3)}
evo = {}
print("\n5 次独立的演化(每次 100 人、2000 代;理想的合作得分是 3,互相背叛是 1):")
print("  种子  平均得分  合作的代数占比(人群得分 > 2.4)  第一次合作出现在  合作期的人群平均策略 (pCC, pCD, pDC, pDD)  最像")
for seed in range(5):
    rec = evolve(seed); evo[seed] = rec; coop = rec[:, 0] > 2.4
    if coop.any():
        mean_x = rec[coop, 1:].mean(axis=0); first = f"第 {int(np.argmax(coop))} 代"
        nearest = min(known, key=lambda k: np.linalg.norm(mean_x - np.array(known[k])))
        text = f"({', '.join(f'{v:.2f}' for v in mean_x)})  {nearest}"
    else:
        first, text = "没有出现", "—"
    print(f"  {seed:>4}  {rec[:, 0].mean():6.2f}  {coop.mean():>18.0%}  {first:>16}  {text}")
输出:
无限多轮、eps = 0.01:行策略对列策略的平均每轮得分
                  以牙还牙      永远背叛      永远合作      赢留输变    慷慨以牙还牙
以牙还牙          2.25      1.02      3.01      2.25      2.97
永远背叛          1.07      1.03      4.94      2.99      2.36
永远合作          2.96      0.04      2.99      1.52      2.97
赢留输变          2.25      0.54      3.96      2.95      2.93
慷慨以牙还牙        2.92      0.69      3.00      2.77      2.97

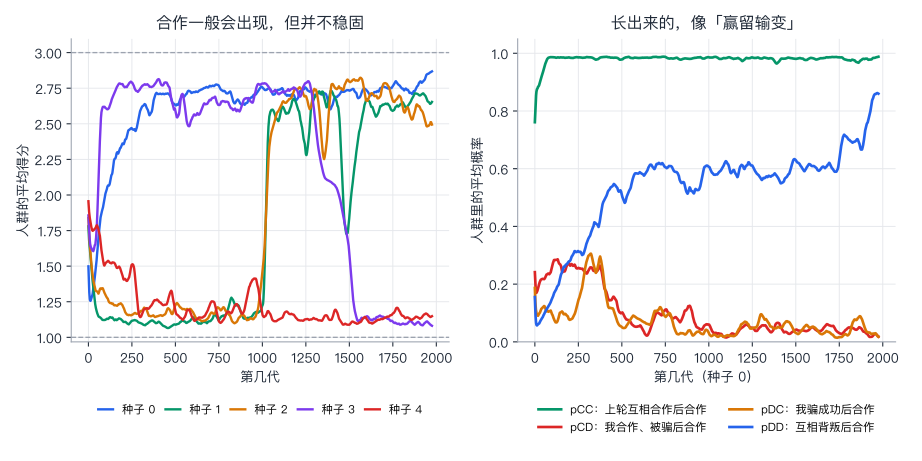
5 次独立的演化(每次 100 人、2000 代;理想的合作得分是 3,互相背叛是 1):
  种子  平均得分  合作的代数占比(人群得分 > 2.4)  第一次合作出现在  合作期的人群平均策略 (pCC, pCD, pDC, pDD)  最像
     0    2.62                 89%           第 212 代  (0.98, 0.08, 0.07, 0.58)  赢留输变
     1    1.83                 42%          第 1039 代  (0.98, 0.39, 0.21, 0.38)  赢留输变
     2    1.91                 46%          第 1054 代  (0.98, 0.40, 0.36, 0.41)  慷慨以牙还牙
     3    2.22                 62%            第 76 代  (0.98, 0.22, 0.22, 0.51)  赢留输变
     4    1.23                  0%              没有出现  —
先看上半部分(核对):行对列的得分。永远背叛对永远合作 4.94,永远合作对永远背叛 0.04;赢留输变对永远合作 3.96,说明它会占永远合作者的便宜;以牙还牙自己对自己 2.25(有噪声)。
再看 5 次独立的演化:
- 五次里,四次出现了合作,一次没有(种子 4,2000 代里,人群得分一直在 1.2 左右)。出现合作的时间,差别很大:第 76 代、第 212 代、第 1039 代、第 1054 代。
- 合作出现之后,并不稳固:看图的左边,种子 1、2、3 在达到 2.75 左右的高位后,有时又跌回 1.1,隔一阵子又升上去。合作期占 42%、46%、62%、89%。
- 长出来的是什么:四个概率,在合作期的人群平均值,四次都是 pCC ≈ 0.98(互相合作之后,继续合作);pCD 和 pDC 都比较低(0.07 到 0.40);pDD 在 0.38 到 0.58 之间(图里,种子 0 的 pDD,后来还升到了 0.8 以上)。这很像赢留输变 (1, 0, 0, 1):互相合作(得 3,赢),就继续合作;我合作、被对方骗了(得 0,输),就换成背叛;我骗成功了(得 5,赢),就继续背叛;互相背叛(得 1,输),就换成合作。这和 Nowak 和 Sigmund 1993 年在 Nature 上(364 卷,56–58 页)报告的结论一致:在带有突变和选择的模拟中,赢留输变,比以牙还牙更能胜出。(他们的模拟设定和我们的不完全相同;而且,据二手转述,如果两个人是轮流出手而不是同时,结果会偏向慷慨以牙还牙,所以这不是普遍的规律。我只核对了摘要。)
要小心:表里的"人群平均值",是 100 个人的平均,不是某一个人的策略;“最像赢留输变”,只是最近的一个,不是说人群里每个人都是赢留输变。种子 2 里,最近的是慷慨以牙还牙。
问题 4 的答案:会,但不是每次都会,也不是永远。合作可以从随机的策略里长出来,而且长出来的,大体是"会恢复"的那一类;可是人群里总有变异的"坏人",随时可能让合作崩溃。
八、第六步:把人放到格子上
最后一个想法:之前所有的合作,都靠报复:你背叛,我就回敬。有没有一种合作,根本不需要报复?
Nowak 和 May 1992 年(Nature,359 卷,826–829 页)给了一个出人意料的答案:把人放到格子上。每个人固定住在一个格子里,只和周围 8 个邻居(以及自己)玩一次囚徒困境,而且只有两种做法:永远合作,永远背叛,没有记忆,没有报复。然后,每个人学习周围得分最高的那个人的做法。收益取最简单的形式:互相合作各得 1,背叛的人碰到合作者得 b(b > 1),其余都是 0。
# 把人放到格子上:每个人只和邻居打交道。(Nowak 和 May 的"空间囚徒困境",收益取最简单的:
# 互相合作各得 1;背叛的人碰到合作者,得 b(b > 1);其余都是 0)
def spatial_step(coop, b):
    """coop:布尔数组,True = 合作者。每个人和周围 8 个邻居(以及自己)各玩一次;然后,每个人学习「自己和 8 个邻居」里得分最高的那个人的做法。边界首尾相连。"""
    shifts = [(dx, dy) for dx in (-1, 0, 1) for dy in (-1, 0, 1)]
    rolled = lambda Z, dx, dy: np.roll(np.roll(Z, dx, 0), dy, 1)
    n_coop = sum(rolled(coop.astype(float), dx, dy) for dx, dy in shifts)      # 自己和邻居里,合作者的个数
    score = np.where(coop, n_coop, n_coop * b)                                 # 合作者:每个合作者对手给 1;背叛者:给 b
    best, best_coop = score.copy(), coop.copy()
    for dx, dy in shifts:
        s2, c2 = rolled(score, dx, dy), rolled(coop, dx, dy)
        better = s2 > best
        best, best_coop = np.where(better, s2, best), np.where(better, c2, best_coop)
    return best_coop

def spatial_run(b, steps=300, size=100, seed=73, frac_defect=0.1):
    g = np.random.default_rng(seed)
    coop = g.random((size, size)) > frac_defect; hist = [coop.mean()]
    for _ in range(steps):
        coop = spatial_step(coop, b); hist.append(coop.mean())
    return coop, np.array(hist)

print("100 × 100 的格子,开始时随机 10% 是背叛者,演化 300 步:合作者的比例")
print("   诱惑 b    第 0 步   第 10 步   第 50 步   第 300 步   最后 100 步的范围")
spatial = {}
for b in (1.2, 1.5, 1.8, 1.95, 2.3, 3.0):
    coop, h = spatial_run(b); spatial[b] = (coop, h)
    print(f"   {b:>5.2f}   {h[0]:7.1%}   {h[10]:7.1%}   {h[50]:7.1%}   {h[300]:8.1%}   {h[-100:].min():.1%} 到 {h[-100:].max():.1%}")

# 对照:同样的收益,但人群里每个人随机碰面(没有格子)。合作者的比例 x 怎么变?
print("\n对照:不分格子,随机碰面,b = 1.2:合作者比例 x 的变化(得分高的,比例上升)")
x = 0.9
for step in range(0, 301):
    if step in (0, 10, 50, 100, 300): print(f"  第 {step:>3} 步:x = {x:.3f}")
    f_c, f_d = x * 1.0, x * 1.2                               # 合作者平均得 x,背叛者平均得 b·x
    x = x * f_c / (x * f_c + (1 - x) * f_d)
输出:
100 × 100 的格子,开始时随机 10% 是背叛者,演化 300 步:合作者的比例
   诱惑 b    第 0 步   第 10 步   第 50 步   第 300 步   最后 100 步的范围
    1.20     89.9%     91.8%     92.0%      92.0%   88.9% 到 92.0%
    1.50     89.9%     78.1%     83.1%      86.1%   85.0% 到 87.8%
    1.80     89.9%     43.4%     39.4%      38.4%   37.2% 到 44.0%
    1.95     89.9%     37.4%     32.0%      32.5%   28.0% 到 34.6%
    2.30     89.9%      0.0%      0.0%       0.0%   0.0% 到 0.0%
    3.00     89.9%      0.0%      0.0%       0.0%   0.0% 到 0.0%

对照:不分格子,随机碰面,b = 1.2:合作者比例 x 的变化(得分高的,比例上升)
  第   0 步:x = 0.900
  第  10 步:x = 0.592
  第  50 步:x = 0.001
  第 100 步:x = 0.000
  第 300 步:x = 0.000
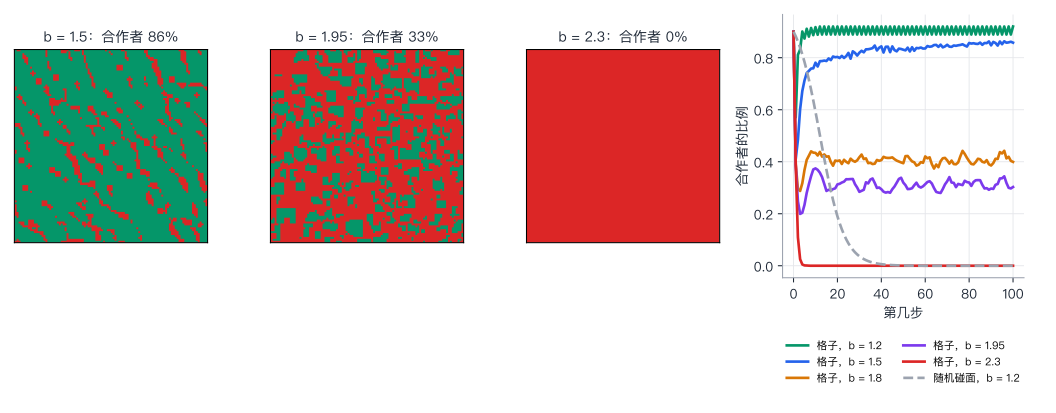
逐段看:
- 诱惑小(b = 1.2、1.5):合作者占了绝大多数(92%、86%)。背叛者虽然在每次碰面时占便宜,但它周围,也都是背叛者,大家都拿不到好分;合作者成群结队,互相拿 1,集体得分高。
- b = 1.8、1.95:合作者占 38%、32%,比例不断小幅波动,格子的图案,是一片一片的绿块,和一片一片的红块,边界不断移动。
- b ≥ 2.3:合作者一步步被吃光,几步之内变成 0。
- 对照:不分格子,随机碰面(b = 1.2):合作者比例从 0.9 开始,第 10 步 0.592,第 50 步 0.001,直至 0。同样的收益,同样的学习规则,随机碰面时,合作者全部消失;放到格子上,92% 留下来。
这是一个很干净的结论:让合作活下来的,是"谁和谁碰面"的结构。格子上,合作者的邻居也多是合作者,它们互相取暖;随机碰面时,每个合作者都可能碰到背叛者。
问题 5 的答案:能,只要诱惑 b 不太大(这个例子里,b 在 2 以下)。不需要记忆,也不需要报复。
注意:这是一个有名的、但也很特殊的结果。它依赖:格子的形状(8 个邻居)、“学习周围得分最高者"这条规则(决定性的)、同步更新。换成别的更新规则、别的邻居结构,数字和图案会变。文献里,常引用的一个数是:在一个对称的初始图案下,合作者的长期平均比例约是 12 ln 2 − 8 ≈ 0.318(据二手转述,我没有读到原文的这个数;练习 5 让你算一个对称初始图案,看看我们得到什么)。
九、这个实验说明了什么,没说明什么
说明了:
- 善良,是区分好坏的第一条线,在这个 18 个策略的比赛里,前十一名全是善良的。但善良策略之间的名次,要看名单、噪声和比赛设计:以牙还牙稳,但不一定是冠军。
- 噪声会洗牌。没有噪声时,冷酷触发和以牙还牙都不错;有手滑,它们就崩溃,宽容的、能恢复的更胜一筹。
- 合作可以自己长出来,从随机的记忆一轮策略中,长出像赢留输变的东西,但不稳固。
- 合作有两种来路:靠未来(重复博弈,报复的威胁,第 19 讲);靠结构(格子,邻居固定,不需要任何报复)。
没说明:
- 现实里的人,不是这 18 个策略。我们的策略都是写死的规则,没有学习,没有沟通,没有声誉。
- 名次的细节,取决于我们写的这份名单。换另一份,数字会变(问题 2 就是证明)。
- 演化的部分,选择规则(按得分的指数加权)、变异率、种群大小,都是我们选的,不同的选择,会有不同的演化故事。我们只跑了 5 个种子。
- 格子上的结果,对更新规则很敏感,也没有考虑人会移动、会换邻居。
十、和前面、后面的联系
- 第 18 讲:囚徒困境的收益,和纳什均衡,以及"学习”(5.2 节)。
- 第 19 讲:7 节的小循环赛,是这个实验的第一步;8 节的"犯了错怎么办",是第四步;7.3 节里 Nowak 和 Sigmund 的赢留输变,在第五步里,被重新发现了一次。
- 第 16 讲、实验 72:企业的合谋,是囚徒困境的一个具体案例;合谋靠的是重复和惩罚。
- 实验 76:公地悲剧与 Schelling 隔离模型。我们会再次把人放到格子上,看一个同样简单的规则,能带来什么意外的宏观结果。
十一、练习
下面的练习,都可以在上面的代码上改几个数字做出来。有随机的练习,先运行 rng.seed(73) 再比赛,数字才会和提示一致。
练习 1(比赛的长度)。 把每对对打的轮数,从 200 改成 10,再改成 1000。前几名是谁?以牙还牙、冷酷触发、永远背叛的名次,各是多少?
提示:
rng.seed(73); round_robin(ROSTER, rounds=10):前四名是以牙还牙(2.71)、多数派(2.68)、冷酷触发(2.67)、强硬以牙还牙(2.66)。以牙还牙第 1、冷酷触发第 3,永远背叛第 18。1000 轮:渐进报复(2.78)、多数派(2.68)、以牙还牙(2.65)、慷慨以牙还牙(2.64);以牙还牙第 3,冷酷触发第 6,永远背叛第 18。轮数短的时候,“一开始的善良"占的比重大,冷酷触发这样"一次就翻脸"的策略,吃亏的机会还没有来。
练习 2(诱惑加大)。 把诱惑的收益,从 5 改成 8(PAY.update({(C, D): (S, 8), (D, C): (8, S)})),其余不变。名次怎么变?为什么?
提示:前五名是渐进报复(2.98)、以牙还牙(2.97)、交替(2.96)、多数派(2.90)、赢留输变(2.85)。永远背叛仍是最后一名。交替,原来排第 12(2.11),现在冲到第 3:T = 8 时,2R = 6 < T + S = 8,两个人轮流占便宜,每轮平均得 4,比一直合作的 3 还高。囚徒困境通常要求 2R > T + S(Axelrod 1984 的书里这样要求),就是为了排除这种情形。
练习 3(赢留输变的弱点)。 赢留输变对永远背叛,每轮平均得多少?手算,再用 match(Pavlov(), AllD(), 200) 检验。
提示:赢留输变第一轮合作(被骗,得 0,输,换)→ 背叛(互相背叛,得 1,仍是输,再换)→ 合作 → ……两轮一个循环:(0 + 1) ÷ 2 = 0.5;永远背叛得 (5 + 1) ÷ 2 = 3.0。代码输出是 (0.5, 3.0)。所以赢留输变对永远背叛,要比以牙还牙(0.99)吃亏得多,它的优势,要靠周围有会合作的人。
练习 4(冷酷触发 + 手滑)。 每个动作 1% 的手滑,两个冷酷触发互相打 200 轮,估计一下平均每轮的得分(理想是 3,崩溃后是 1)。
提示:每一轮,至少有一个人手滑的概率约是 1 − 0.99² ≈ 0.0199。第一次手滑之后,两个人就永远背叛。前 t 轮没有手滑的概率是 0.9801ᵗ,200 轮平均,合作的时间占比约 (1 − 0.9801²⁰⁰) ÷ (200 × 0.0199) ≈ 0.247。所以得分约 3 × 0.247 + 1 × 0.753 ≈ 1.49。代码里是 1.55,差一点,因为手滑那一轮的得分是 0 和 5 的平均 2.5,不是 1。
练习 5(一个背叛者,会不会毁掉整个格子?)。 99 × 99 的格子,全部是合作者,只在正中间放一个背叛者。分别令 b = 1.7、1.9,演化 200 步,最后 100 步合作者的平均比例是多少?再用随机初始(10% 背叛者)看 b = 2.0 和 2.05。
提示:中间一个背叛者:b = 1.7,合作者比例几乎一直是 99.9%(背叛者传不开);b = 1.9,一路扩散,最后 100 步的平均比例是 0.299(文献里常引用的近似值是 0.318,我们的格子是有限的,也不一定对称)。随机初始:b = 2.0 时,合作者在 2.4% 左右;b = 2.05 时,4.3%,也就是说,在 b 刚过 2 的时候,合作者没有马上消失,而是剩下很少的一点。
练习 6(傻好人太多)。 在第三步的生态演化里,让永远合作一开始就占 50%,其余 17 个策略平分剩下的 50%。不善良的七个策略,总占比怎么变?
提示:一开始七个不善良的共占 20.6%;第 2 代 23.4%,第 5 代 29.0%,第 10 代涨到 35.5%;之后,善良的报复型策略,把它们挤出去:第 20 代 14.8%,第 50 代 0.6%,最后是 0。2000 代之后:永远合作 4.6%,以牙还牙 21.3%,渐进报复 27.9%。老好人太多,反而给了坏人一段"好日子”。
十二、局限
- 策略是我们写的,18 个,不是 Axelrod 比赛的参赛程序,也没有覆盖所有可能的策略。
- 比赛设计(200 轮、10 场取平均、含自我对打)影响名次,练习 1 已经看到。
- 噪声只考虑了"动作做反"这一种,没有考虑"看错对方做了什么"(观察错误)。
- 演化用的是一个简单的、带指数加权的复制和变异;只跑了 5 个种子,每个 2000 代,结果的波动很大;“合作期占多少”,不能当成一个精确的数。
- 格子:邻居结构固定,决定性的更新,没有移动。
- 这个实验里,所有人都能立刻看到对方做了什么。第 19 讲 9.2 节说过,现实里的监测,往往是不完全的。
参考
- Axelrod, R. (1980). Effective choice in the prisoner’s dilemma. Journal of Conflict Resolution, 24(1), 3–25.
- Axelrod, R. (1980). More effective choice in the prisoner’s dilemma. Journal of Conflict Resolution, 24(3), 379–403.
- Axelrod, R. (1984). The Evolution of Cooperation. Basic Books.
- Nowak, M. A., & May, R. M. (1992). Evolutionary games and spatial chaos. Nature, 359, 826–829.
- Nowak, M., & Sigmund, K. (1992). Tit for tat in heterogeneous populations. Nature, 355, 250–253.
- Nowak, M., & Sigmund, K. (1993). A strategy of win-stay, lose-shift that outperforms tit-for-tat in the Prisoner’s Dilemma game. Nature, 364, 56–58.
- Rapoport, A., Seale, D. A., & Colman, A. M. (2015). Is tit-for-tat the answer? On the conclusions drawn from Axelrod’s tournaments. PLoS ONE, 10(7).