| 本篇位置 | 第二部分「读懂价格行为」的第一篇。后面所有关于 K 线、形态、止损的讨论,都要先知道 K 线记录了什么、丢掉了什么 |
| 用到的数据 | BTCUSDT 现货日线和 1 分钟线(2017-08 至 2026-08);SPY、AAPL 日线(2016-09 至 2026-09) |
| 动手 | 写 talab.bars 模块:K 线合成、实体影线拆解、日内最高最低价的先后、止损止盈谁先触发、Heikin-Ashi、Renko,附 10 个测试 |
| 读完你能 | 正确地把小周期合成大周期;说出一根 K 线丢掉了哪些信息,以及它们在回测里造成的误差有多大;知道 Heikin-Ashi 和 Renko 画出来的价格为什么不能用来成交、算止损 |
一、先做一个决定
下面是两根 BTC 日线。为了去掉价格高低的影响,两根都把开盘价记为 100:
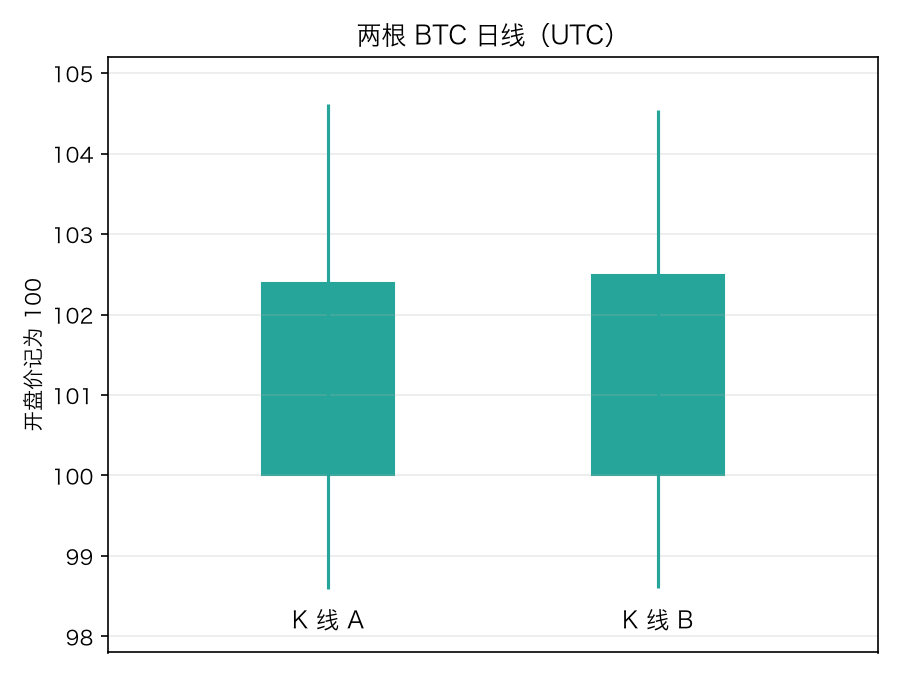
| 开盘 | 最高 | 最低 | 收盘 | |
|---|---|---|---|---|
| K 线 A | 100 | 104.62 | 98.59 | 102.39 |
| K 线 B | 100 | 104.54 | 98.61 | 102.49 |
四个数字,最大的差距是 0.10。在图上,它们几乎是同一根 K 线:一根中等大小的阳线,上影线比下影线长,收在当天范围的上 60% 左右。
如果只看这两根 K 线,你没有任何理由对它们做出不同的判断。
现在把 K 线「打开」,看看这一天里价格是怎么走的:
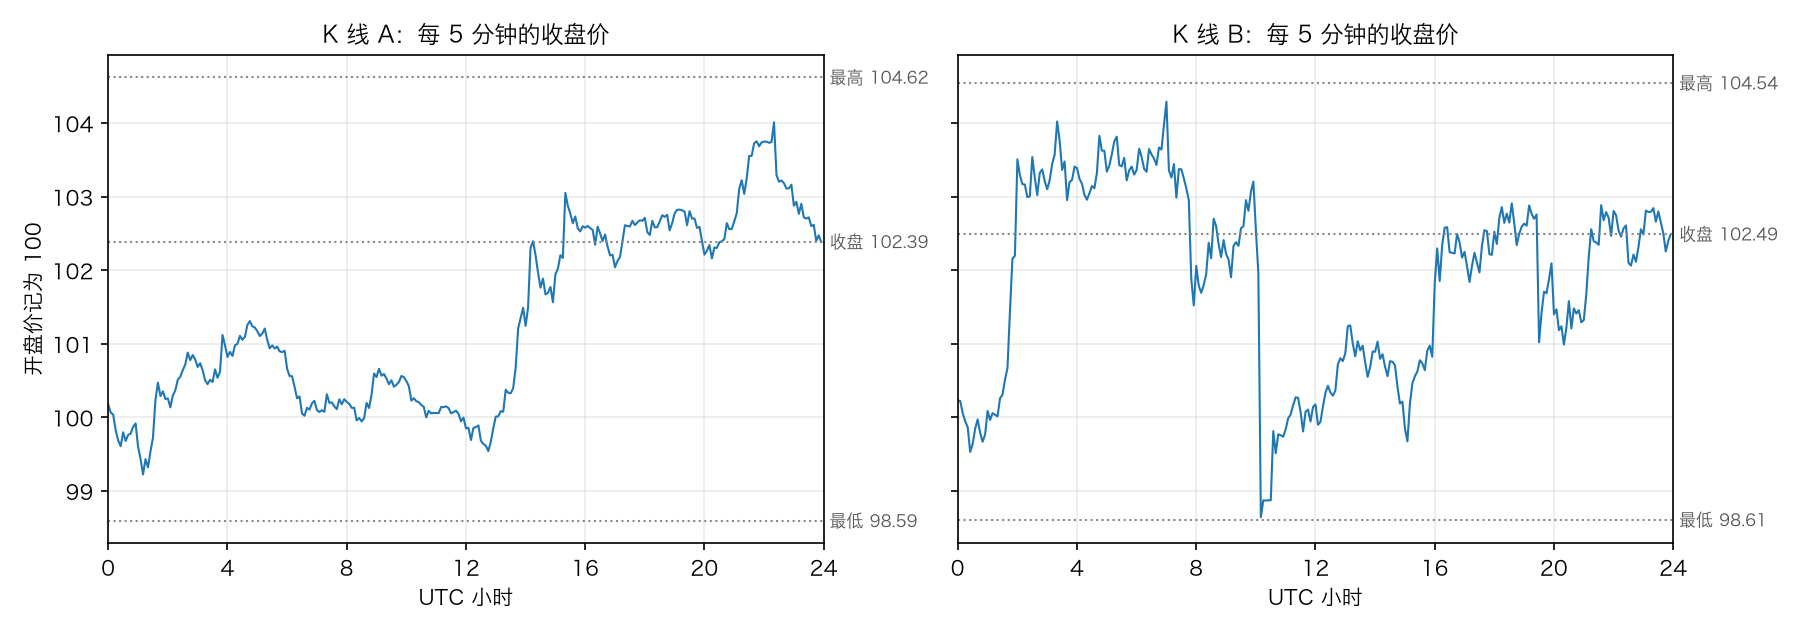
- K 线 A:前半天在 100 附近来回震荡,凌晨 1 点多创出当天最低价。UTC 13 点之后开始上涨,22 点 21 分冲到当天最高价 104.62,然后在最后一个半小时里回落到 102.39 收盘。
- K 线 B:开盘后两小时内急涨到 103 以上,早上 7 点创出当天最高价 104.54。上午 10 点多突然暴跌,几分钟内跌到当天最低价 98.61。之后整个下午和晚上逐步收复失地,收在 102.49。
第二天开盘,对这两根 K 线,你分别会怎么做?
- 追:买入,认为接下来还会涨
- 跑:卖出或不碰,认为接下来要跌
- 不确定
先为 A 和 B 各写下一个选择。 第四节会揭晓它们的日期,以及之后 10 天发生了什么。
不管你怎么选,有一件事已经很清楚:同一根 K 线,背后可以是完全不同的一天。 这一篇要回答三个问题:
- 一根 K 线是怎么从成千上万笔成交里「压缩」出来的?
- 压缩的时候丢掉了什么?丢掉的东西重要吗?
- Heikin-Ashi、Renko 这些「改造过的 K 线」,又额外丢掉或者编造了什么?
二、一根 K 线是怎么合成的
打个比方:一场篮球赛的比分摘要
这一篇用一个比方:一场篮球赛的比分摘要。
假设你没看比赛,只拿到四个数字:
- 开场分差:0
- 全场最多领先:+4.6 分
- 全场最多落后:−1.4 分
- 终场分差:+2.4 分
这就是一根 K 线:开盘、最高、最低、收盘。
两场比赛可以有完全相同的摘要,过程却截然不同:
- 比赛 A:前三节和对手僵持不下,一度落后 1.4 分。第四节发力,终场前一分钟领先到 4.6 分,最后被对手追回一点,赢了 2.4 分。
- 比赛 B:开场一波流领先 4.5 分,第二节被对手打出一波高潮反超 1.4 分,下半场慢慢追回来,赢了 2.5 分。
解说员对这两场比赛的评价会完全不同,但摘要一模一样。摘要是有损压缩:它保留了几个关键数字,丢掉了比赛的过程。
这一节先看摘要是怎么做出来的。
合成规则
交易所记录的原始数据是一笔一笔的成交。每一根 K 线,都是把一段时间里的成交压缩成五个数字:
| 字段 | 规则 |
|---|---|
| 开盘价 | 这段时间里第一笔成交的价格 |
| 最高价 | 这段时间里最高的成交价格 |
| 最低价 | 这段时间里最低的成交价格 |
| 收盘价 | 这段时间里最后一笔成交的价格 |
| 成交量 | 这段时间里所有成交数量的总和 |
同样的规则也能把小周期的 K 线合成大周期的 K 线:开盘取第一根的开盘价,最高取所有最高价中的最大值,最低取所有最低价中的最小值,收盘取最后一根的收盘价,成交量求和。
用 K 线 A 那天(后面会揭晓是 2026 年 7 月 1 日)创出最高价的 5 分钟来手算一遍:
| 时间(UTC) | 开盘 | 最高 | 最低 | 收盘 | 成交量 |
|---|---|---|---|---|---|
| 22:20 | 60,819.01 | 60,836.00 | 60,819.00 | 60,835.99 | 9.65999 |
| 22:21 | 60,835.99 | 61,334.00 | 60,833.16 | 61,053.85 | 522.40477 |
| 22:22 | 61,053.86 | 61,184.11 | 60,899.81 | 61,175.99 | 252.26388 |
| 22:23 | 61,176.00 | 61,188.15 | 61,052.00 | 61,056.01 | 36.88026 |
| 22:24 | 61,056.00 | 61,056.01 | 60,940.00 | 60,976.00 | 45.51218 |
合成的 5 分钟 K 线:
- 开盘:第一根的开盘价,60,819.01
- 最高:五个最高价里最大的,22:21 的 61,334.00
- 最低:五个最低价里最小的,22:20 的 60,819.00
- 收盘:最后一根的收盘价,60,976.00
- 成交量:9.65999 + 522.40477 + 252.26388 + 36.88026 + 45.51218 = 866.72108
用 talab.bars.resample_ohlcv 验证:
five = minute.loc["2026-07-01 22:20":"2026-07-01 22:24", ["open", "high", "low", "close", "volume"]]
print(B.resample_ohlcv(five, "5min"))
                               open     high      low    close     volume
time
2026-07-01 22:20:00+00:00  60819.01  61334.0  60819.0  60976.0  866.72108
注意时间戳是 22:20,也就是这根 5 分钟 K 线的开始时间。它包含 22:20:00 这一刻,不包含 22:25:00 这一刻。这是 Binance 和大多数数据源的约定,resample_ohlcv 用 label="left", closed="left" 明确指定了这一点。如果你用的数据源把时间戳标在结束时间,合成时必须换成对应的设置,否则每根 K 线都会错位一个周期。第 7 篇讲多周期时,这个细节会变得非常重要。
用 1 分钟线合成日线,和官方日线对得上吗
规则很简单。那么,把 BTC 全部 474 万根 1 分钟 K 线合成日线,结果应该和 Binance 官方的日线完全一样。实际试一下:
cols = ["open", "high", "low", "close"]
for traded_only in [False, True]:
    rebuilt = B.resample_ohlcv(minute, "1D", traded_only=traded_only)
    both = day[cols].join(rebuilt[cols], rsuffix="_合成")
    wrong = pd.DataFrame({c: (both[c] - both[c + "_合成"]).abs() > 1e-8 for c in cols})
    bad = wrong.any(axis=1)
    print(f"traded_only={traded_only}:价格对不上的日子 {bad.sum()} 天,按字段 {wrong.sum().to_dict()}")
    print("   按年:", bad.groupby(both.index.year).sum()[lambda s: s > 0].to_dict())
traded_only=False:价格对不上的日子 43 天,按字段 {'open': 41, 'high': 1, 'low': 1, 'close': 11}
   按年: {2017: 41, 2018: 2}
traded_only=True:价格对不上的日子 16 天,按字段 {'open': 14, 'high': 1, 'low': 1, 'close': 11}
   按年: {2017: 14, 2018: 2}
先看第一行(traded_only=False):3,302 天里有 43 天对不上,其中 41 天是开盘价不一样,全部集中在 2017 年和 2018 年初。
看其中一天,2017 年 8 月 20 日:
                              open     high      low    close    volume
time
2017-08-20 00:04:00+00:00  4139.98  4139.98  4139.98  4139.98  0.000000
2017-08-20 00:05:00+00:00  4139.98  4139.98  4139.98  4139.98  0.000000
2017-08-20 00:06:00+00:00  4120.98  4139.98  4120.98  4139.98  0.575365
2017-08-20 00:07:00+00:00  4139.98  4139.98  4139.98  4139.98  0.000000
官方日线 2017-08-20 开盘: 4120.98
2017 年 BTC 在 Binance 上的成交还很稀疏,午夜前后常常几分钟没有一笔成交。这些分钟仍然有一根 K 线,但成交量是 0,四个价格都沿用上一笔成交的价格。第 3 篇把它们叫作占位 K 线。
官方日线的开盘价是当天第一笔真实成交的价格 4,120.98,出现在 00:06。而直接合成时,第一根 1 分钟 K 线是 00:00 的占位 K 线,开盘价 4,139.98 其实是前一天最后一笔成交的价格。
所以正确的合成方式是:先去掉成交量为 0 的占位 K 线,再合成。这就是 traded_only=True。改完之后,对不上的日子从 43 天降到 16 天。
剩下的 16 天是 2017 年 12 月 4 日到 18 日之间的 14 天,以及 2018 年 2 月 9 日、10 日。这两段正是第 3 篇发现的时间戳偏移时期:1 分钟 K 线的时间戳偏移了 20.799 秒和 14.789 秒。每天第一根 1 分钟 K 线里,混进了前一天最后几十秒的成交,边界自然就对不上了。这 16 天无法从 1 分钟数据修复,只能接受。
成交量也有对不上的:
成交量相差超过百万分之一的日子 53 天,其中相差的中位数 0.0057%,最大 4.58%(2021-04-23)
大部分差距只有十万分之几,最大的一天是 4.58%。其中一部分发生在有缺失分钟或时间戳偏移的日子,另一部分从公开数据里看不出原因。
这个检查说明了两件事:
- 合成规则本身很简单,但原始数据里的每一个坑,都会传递到合成结果里。 占位 K 线让 41 天的开盘价出错,时间戳偏移让 16 天的边界出错。
- 能拿官方的大周期数据来核对时,一定要核对。 这门课后面需要 4 小时线、周线时,都会从 1 分钟线或日线合成,并且用这种方式检查。
三、实体和影线
四个部分
一根 K 线由四个部分组成。以 K 线 A 为例(真实价格):
| 部分 | 定义 | K 线 A |
|---|---|---|
| 实体 | 收盘 − 开盘(正数为阳线) | 60,024.00 − 58,624.71 = +1,399.29 |
| 上影线 | 最高 − max(开盘, 收盘) | 61,334.00 − 60,024.00 = 1,310.00 |
| 下影线 | min(开盘, 收盘) − 最低 | 58,624.71 − 57,800.19 = 824.52 |
| 全长 | 最高 − 最低 | 61,334.00 − 57,800.19 = 3,533.81 |
实体、上影线、下影线加起来正好是全长:1,399.29 + 1,310.00 + 824.52 = 3,533.81。
由于绝对的价格差不能跨时期比较(第 5 篇),通常再算两个比例:
- 实体占比 = |实体| ÷ 全长 = 1,399.29 ÷ 3,533.81 = 0.396
- 收盘位置 = (收盘 − 最低) ÷ 全长 = (60,024.00 − 57,800.19) ÷ 3,533.81 = 0.629
收盘位置为 0,表示收在全天最低;为 1,表示收在全天最高。
for name, t in [("A", A), ("B", Bday)]:
    print(name, B.anatomy(day.loc[[t]]).round(4).iloc[0].to_dict())
A {'body': 1399.29, 'upper_shadow': 1310.0, 'lower_shadow': 824.52, 'range': 3533.81, 'body_ratio': 0.396, 'clv': 0.6293}
B {'body': 304.81, 'upper_shadow': 251.32, 'lower_shadow': 170.6, 'range': 726.73, 'body_ratio': 0.4194, 'clv': 0.6542}
K 线 B 的价格低得多(1.2 万美元左右),所以绝对值小得多;但两个比例和 A 几乎一样:实体占比 0.40 和 0.42,收盘位置 0.63 和 0.65。
三个标的的 K 线长什么样
rows = {}
for k, df in {"SPY": spy, "AAPL": aapl, "BTC": day}.items():
    a = B.anatomy(df)
    rows[k] = {"实体占比中位数": a["body_ratio"].median(), "十字星(实体<10%)": (a["body_ratio"] < 0.1).mean(),
               "光头光脚(实体>90%)": (a["body_ratio"] > 0.9).mean(), "收盘位置中位数": a["clv"].median()}
print(pd.DataFrame(rows).round(3))
                SPY   AAPL    BTC
实体占比中位数       0.473  0.458  0.413
十字星(实体<10%)   0.105  0.109  0.118
光头光脚(实体>90%)  0.038  0.030  0.018
收盘位置中位数       0.592  0.544  0.549
- 实体通常只占全长的 40% 多。一半以上的价格波动在影线里。
- 十字星(实体不到全长的 10%)大约每 9 到 10 天出现一次。它很常见,单独出现一根几乎不说明什么。第 16 篇讲 K 线组合时会检验它的意义。
- 光头光脚(几乎没有影线)很少见,BTC 不到 2%。
- 收盘位置的中位数都略高于 0.5,和这段时间三个标的都在上涨一致。
K 线的颜色不等于当天涨跌
这是一个非常容易被忽略、影响却很大的事实。
阳线的定义是「收盘高于开盘」,而当天上涨的定义是「收盘高于前一天收盘」。如果今天的开盘价和昨天的收盘价不一样,两者就可能矛盾。
for k, df in {"SPY": spy, "AAPL": aapl, "BTC": day}.items():
    ret = df["close"].pct_change()
    green_down = ((df["close"] > df["open"]) & (ret < 0)).sum()
    red_up = ((df["close"] < df["open"]) & (ret > 0)).sum()
    gap = df["open"] / df["close"].shift() - 1
    print(f"{k:4s} 阳线但下跌 {green_down} 天,阴线但上涨 {red_up} 天,占 {(green_down + red_up) / (len(df) - 1):.1%};"
          f"跳空超过 0.5% 的日子 {(gap.abs() > 0.005).mean():.1%}")
SPY  阳线但下跌 240 天,阴线但上涨 267 天,占 20.2%;跳空超过 0.5% 的日子 29.1%
AAPL 阳线但下跌 220 天,阴线但上涨 213 天,占 17.2%;跳空超过 0.5% 的日子 44.9%
BTC  阳线但下跌 2 天,阴线但上涨 2 天,占 0.1%;跳空超过 0.5% 的日子 0.4%
SPY 有 20.2% 的日子,K 线的颜色和当天的涨跌是反的。 平均每五天就有一天。
一个典型的例子:
              open    high     low   close       volume
date
2025-04-04  523.67  525.87  505.06  505.28  217965100.0
2025-04-07  489.19  523.17  481.80  504.38  256611400.0
2025 年 4 月 7 日(周一),SPY 开盘 489.19,比上周五收盘 505.28 跳空低开 3.2%。盘中一度跌到 481.80,之后大幅反弹,收在 504.38。
在 K 线图上,这是一根实体 3.1% 的大阳线。但这一天 SPY 实际下跌了 0.18%。只看颜色,你会以为这是强势的一天。
原因是美股不是连续交易的。每天收盘后到第二天开盘前,新闻、财报、其他市场的走势都在累积,开盘价会直接跳到新的位置。这段隔夜的涨跌,不在任何一根 K 线的实体里,只体现为两根 K 线之间的缺口。
BTC 24 小时交易,前一天的收盘和第二天的开盘只隔一瞬间,所以几乎没有这个问题(3,302 天里只有 4 天)。
隔夜和日内:K 线实体没有告诉你的一半
既然每天的涨跌分成「隔夜」和「日内」两部分,那么一个标的十年的涨幅,分别来自哪一部分?
for k, df in {"SPY": spy, "AAPL": aapl, "BTC": day}.items():
    overnight = np.log(df["open"] / df["close"].shift()).dropna()        # 昨天收盘 → 今天开盘
    intraday = np.log(df["close"] / df["open"]).iloc[1:]                 # 今天开盘 → 今天收盘
    print(f"{k:4s} 隔夜累计 ×{math.exp(overnight.sum()):.2f}   日内累计 ×{math.exp(intraday.sum()):.2f}   "
          f"合计 ×{math.exp(overnight.sum() + intraday.sum()):.2f}")
(这里用了第 5 篇的性质:对数收益率可以沿时间相加。所以隔夜和日内的对数收益率之和,正好等于整段的对数收益率。)
SPY  隔夜累计 ×2.40   日内累计 ×1.47   合计 ×3.52
AAPL 隔夜累计 ×1.04   日内累计 ×11.06   合计 ×11.47
BTC  隔夜累计 ×0.98   日内累计 ×18.74   合计 ×18.34
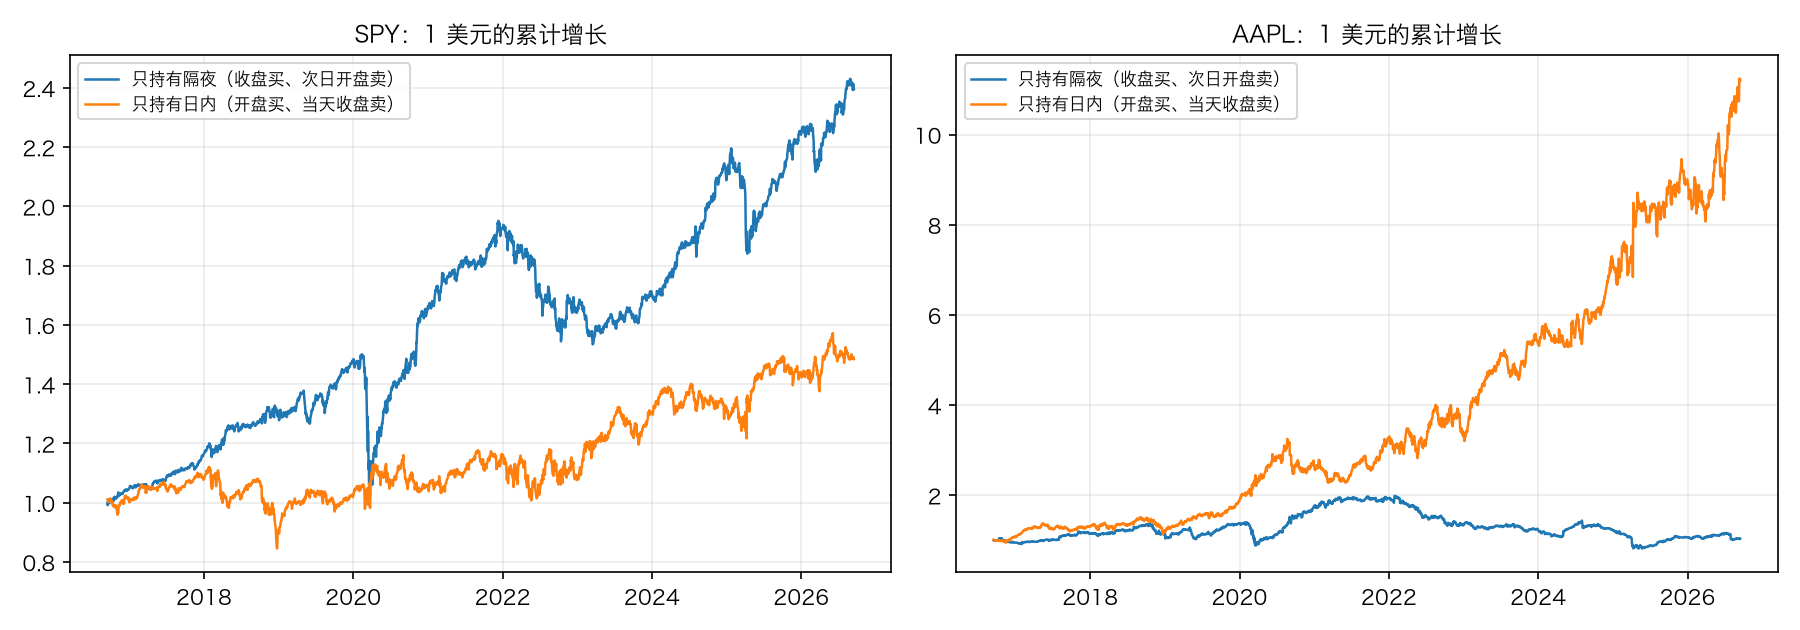
- SPY:十年涨了 3.52 倍。只在隔夜持有(每天收盘买、第二天开盘卖)能涨 2.40 倍;只在日内持有只涨 1.47 倍。SPY 的涨幅,大部分发生在 K 线实体之外。
- AAPL:正好相反,隔夜只有 1.04 倍,几乎全部涨幅(11.06 倍)来自日内。
- BTC:没有真正的「隔夜」,日内就是全部。
(SPY 和 AAPL 的价格没有做分红调整。除息日开盘价会下跌,这部分会计入隔夜。SPY 的年股息率约 1.5%,所以它真实的隔夜收益比 2.40 倍还要高一些。)
这个结果不是要你去做「隔夜策略」:它没有扣除成本,第 28 篇会讲每天两次交易的成本有多高。它要说明的是:只看 K 线的实体来判断一个标的「强不强」,在美股上会漏掉一大块信息。 SPY 过去十年的日 K 线,如果你只数阳线和阴线,看到的主要是日内那 1.47 倍的部分。
✋ 小检查 1
某天 AAPL 前一天收盘 200,当天开盘 206,最高 208,最低 199,收盘 201。
- (a) 这根 K 线是阳线还是阴线?当天涨了还是跌了?
- (b) 计算实体、上影线、下影线、实体占比和收盘位置。
- (c) 当天的涨跌里,隔夜部分和日内部分分别是多少(用简单收益率)?
答案在文末。
⚠️ 坦白一个现实。 很多看盘软件在显示美股 K 线时,会用「收盘价高于前一天收盘价」来决定颜色,而不是「收盘价高于开盘价」。同一根 K 线,在不同软件里可能是不同的颜色。用任何软件之前,先找一根跳空的 K 线确认它用的是哪种规则。这门课的 talab.plot 一律按「收盘价高于开盘价」上色。
四、K 线丢掉的路径
回到比分摘要。四个数字丢掉了比赛的过程。具体来说,一根 K 线丢掉了:
- 最高价和最低价谁先出现
- 它们出现在什么时候
- 两者之间价格走了怎样的路径
- 成交量集中在哪个价位、哪个时间(第 10 篇讲成交量分布时再谈)
有 1 分钟数据,就能把前三样找回来。这一节看看它们到底有多重要。
最高价和最低价,谁先出现
ex = B.intraday_extremes(minute)
d = day.join(ex)
up, down = d["close"] > d["open"], d["close"] < d["open"]
print(f"全部日子:最高价先出现 {d['high_first'].mean():.1%}")
print(f"阳线:最高价先出现 {d.loc[up, 'high_first'].mean():.1%},最低价先出现 {1 - d.loc[up, 'high_first'].mean():.1%}")
print(f"阴线:最高价先出现 {d.loc[down, 'high_first'].mean():.1%}")
全部日子:最高价先出现 50.3%
阳线:最高价先出现 13.4%,最低价先出现 86.6%
阴线:最高价先出现 89.1%
- 阳线里,86.6% 是先出现最低价、后出现最高价(开盘 → 最低 → 最高 → 收盘)。
- 阴线里,89.1% 是先出现最高价、后出现最低价(开盘 → 最高 → 最低 → 收盘)。
这很符合直觉:阳线收得比开盘高,价格更可能是「先探底、再上涨」。但仍然有 13.4% 的阳线是反过来的:先冲到最高,再跌到最低,最后又涨回来收成阳线。K 线 B 就是其中之一。
这个比例在回测里非常重要,后面马上会用到。
最高价出现在一天中的什么时候
theory = [(2 / math.pi) * (math.asin(math.sqrt((h + 1) / 24)) - math.asin(math.sqrt(h / 24))) for h in range(24)]
hours = pd.DataFrame({
    "最高价": ex["time_of_high"].dt.hour.value_counts(normalize=True).sort_index(),
    "最低价": ex["time_of_low"].dt.hour.value_counts(normalize=True).sort_index(),
    "随机游走理论": theory,
})
print((hours * 100).round(1).T.to_string())
          0    1    2    3    4    5    6    7    8    9    10   11   12   13   14   15   16   17   18   19   20   21   22    23
最高价     15.7  6.0  3.5  2.7  2.4  2.2  2.4  2.4  2.7  2.3  2.2  2.0  3.9  4.1  4.5  4.4  4.9  3.2  3.5  3.4  4.5  4.1  5.0   8.0
最低价     15.6  5.8  3.8  3.2  3.2  2.6  2.4  2.4  2.5  2.4  2.5  2.6  3.3  4.2  5.2  4.5  4.6  3.5  3.6  3.3  4.8  3.6  4.0   6.4
随机游走理论  13.1  5.6  4.4  3.8  3.4  3.2  3.0  2.9  2.8  2.7  2.7  2.7  2.7  2.7  2.7  2.8  2.9  3.0  3.2  3.4  3.8  4.4  5.6  13.1
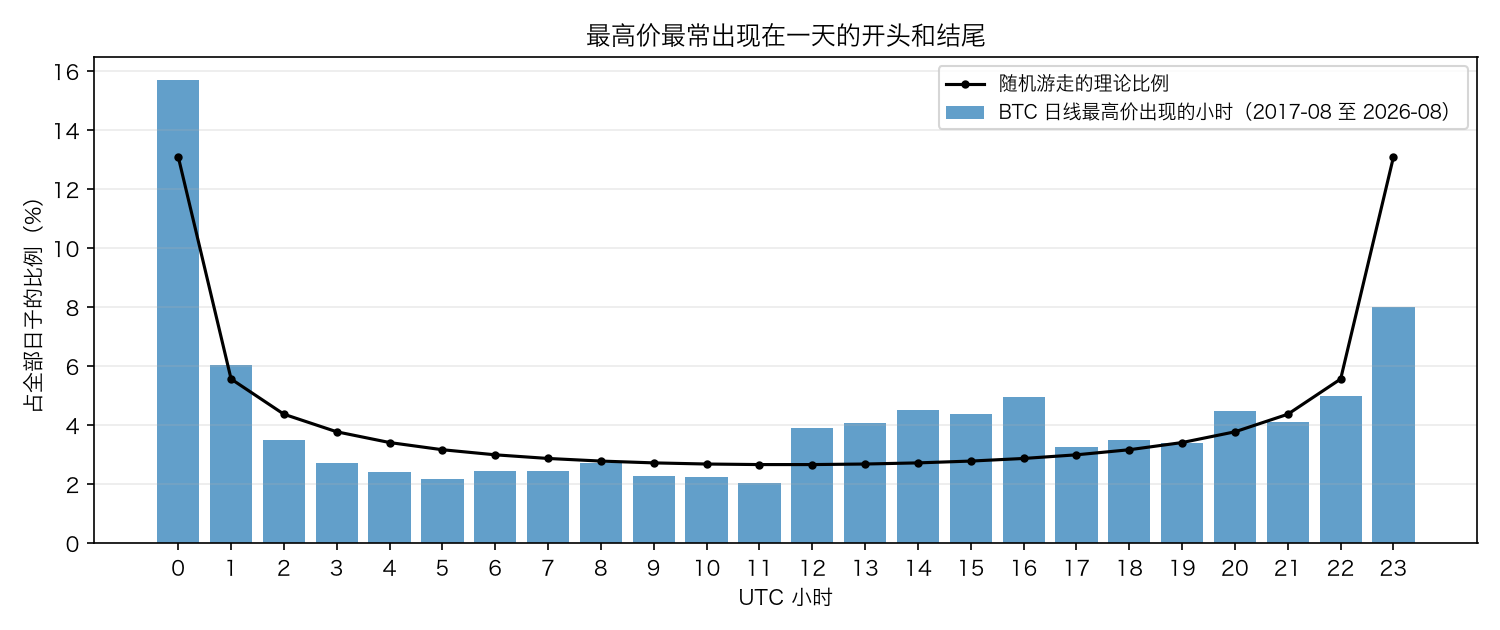
15.7% 的日子,最高价出现在 UTC 0 点到 1 点之间,也就是一天的第一个小时。中间的小时通常只有 2% 到 3%。
看到这个结果,很容易得出「开盘第一个小时特别重要」的结论。先别急。 看表里第三行。
它来自一个纯数学的结果:假设价格是一个随机游走(每一刻涨跌都是随机的,互相独立),那么一段时间里的最高价出现在哪个位置,并不是均匀分布的,而是集中在开头和结尾。这叫反正弦定律(arcsine law),落在前 x 比例时间里的概率是 (2/π) × arcsin(√x)。
直觉上可以这样理解:一天中间某个时刻的价格要成为全天最高,需要它之前的价格都比它低,它之后的价格也都比它低,两个条件要同时成立。而开盘那一刻只需要满足后一个条件:只要这一天价格离开起点后大部分时间在下方,开盘附近就是全天最高。收盘那一刻同理,只需要满足前一个条件。所以极值天然更容易出现在两端。
按这个公式,即使价格完全随机,第一个小时和最后一个小时也各占 13.1%,中间的小时只有 2.7% 左右。
所以正确的读法是:
- U 形的主体是数学决定的,不是市场的特殊规律。
- 在数学之上的偏离,才可能是市场的特征:UTC 12 点到 16 点(美股开盘前后)的比例明显高于理论值,和这个时段 Binance 的成交额占比最高(6.5% 左右)一致。UTC 21 点到 23 点(美股收盘后、亚洲开盘前)则低于理论值,这几个小时的成交额占比也是全天最低的 3.3%。
- 第一个小时比理论值还高、最后一个小时比理论值低很多,这个不对称从这张表里看不出原因,留作练习。
⚠️ 这是这门课第二次遇到「先和随机情况比一比」(第一次是第 5 篇的打乱检验)。看到任何「规律」,先问:如果市场完全随机,会不会也出现这个结果? 很多所谓的规律,是随机性本身的数学性质。
日线回测的致命歧义:止损和止盈都在一根 K 线里
现在进入这一节最实用的部分。
假设你在回测一个非常简单的规则:每天开盘买入,止盈设在 +2%,止损设在 −2%,都没触发就收盘卖出。
对大部分日子,日线就足够判断结果:
- 最高价没到 +2%,最低价没到 −2%:收盘卖出
- 只有最高价到了 +2%:止盈,赚 2%
- 只有最低价到了 −2%:止损,亏 2%
但如果最高价到了 +2%,最低价也到了 −2% 呢?你是先止盈了,还是先止损了?日线不知道。 这正是 K 线丢掉的第一样东西:最高价和最低价谁先出现。
这种日子有多少?用 1 分钟数据查出真实答案,和各种假设对比:
for k in [0.02, 0.03, 0.05]:
    truth = B.first_touch(minute, k, k)
    hit_up = day["high"] >= day["open"] * (1 + k)
    hit_down = day["low"] <= day["open"] * (1 - k)
    ambiguous = hit_up & hit_down
    only_up, only_down, neither = hit_up & ~hit_down, hit_down & ~hit_up, ~hit_up & ~hit_down
    base = k * only_up.sum() - k * only_down.sum() + (day["close"] / day["open"] - 1)[neither].sum()
    t = truth[ambiguous]
    guess = np.where(day.loc[ambiguous, "close"] >= day.loc[ambiguous, "open"], "down", "up")   # 阳线假设先低后高
    n = ambiguous.sum()
    print(f"±{k:.0%}:{len(day)} 天里,只碰到止盈 {only_up.sum()} 天,只碰到止损 {only_down.sum()} 天,都没碰到 {neither.sum()} 天,两个都碰到 {n} 天")
    print(f"   两个都碰到的 {n} 天里,1 分钟数据显示先碰到止盈 {(t == 'up').sum()} 天,先碰到止损 {(t == 'down').sum()} 天,同一分钟 {(t == 'same_bar').sum()} 天")
    print(f"   收益率之和:假设先止盈 {(base + k * n):+.1%}   假设先止损 {(base - k * n):+.1%}   "
          f"按阴阳线猜 {(base + k * (guess == 'up').sum() - k * (guess == 'down').sum()):+.1%}(猜对 {(guess == t.values).mean():.1%})   "
          f"真实 {(base + k * (t == 'up').sum() - k * (t == 'down').sum()):+.1%}")
±2%:3302 天里,只碰到止盈 959 天,只碰到止损 1001 天,都没碰到 951 天,两个都碰到 391 天
   两个都碰到的 391 天里,1 分钟数据显示先碰到止盈 191 天,先碰到止损 200 天,同一分钟 0 天
   收益率之和:假设先止盈 +745.0%   假设先止损 -819.0%   按阴阳线猜 -83.0%(猜对 74.2%)   真实 -55.0%
±3%:3302 天里,只碰到止盈 722 天,只碰到止损 768 天,都没碰到 1666 天,两个都碰到 146 天
   两个都碰到的 146 天里,1 分钟数据显示先碰到止盈 77 天,先碰到止损 69 天,同一分钟 0 天
   收益率之和:假设先止盈 +422.5%   假设先止损 -453.5%   按阴阳线猜 -87.5%(猜对 75.3%)   真实 +8.5%
±5%:3302 天里,只碰到止盈 378 天,只碰到止损 384 天,都没碰到 2508 天,两个都碰到 32 天
   两个都碰到的 32 天里,1 分钟数据显示先碰到止盈 14 天,先碰到止损 18 天,同一分钟 0 天
   收益率之和:假设先止盈 +315.6%   假设先止损 -4.4%   按阴阳线猜 +75.6%(猜对 68.8%)   真实 +135.6%
(「收益率之和」是把 3,302 笔交易每笔的收益率直接相加,只用来比较不同假设之间的差距,不代表复利后的账户收益。)
读这张表:
±2% 时,有 391 天(11.8%)止损和止盈都被碰到。 这 391 天,日线无法判断结果。
不同的假设,结果天差地别:
- 假设这些天都先止盈:3,302 笔交易的收益率之和是 +745.0%
- 假设这些天都先止损:−819.0%
- 真实结果(用 1 分钟数据查):−55.0%
同一个规则、同一段数据,回测结果可以是大赚,也可以是大亏,完全取决于你对那 11.8% 的日子做了什么假设。
很多回测工具会用一个「聪明」的猜法:阳线假设走势是开盘 → 最低 → 最高 → 收盘,阴线假设是开盘 → 最高 → 最低 → 收盘。这个猜法有道理,前面刚算过阳线里 86.6% 是先低后高。但在这些「两个都碰到」的日子里,它只猜对了 74.2%,结果是 −83.0%,和真实的 −55.0% 仍然差了 28 个百分点。±3% 时更糟:真实结果是 +8.5%,猜法给出 −87.5%,连正负都猜反了。
为什么在歧义日里猜对率比 86.6% 低?因为能同时碰到 +2% 和 −2% 的日子,本身就是剧烈震荡、来回拉扯的日子,走势更不像「一路探底再一路上涨」。越是需要猜的日子,越难猜。
这件事对后面的课程有直接影响:
- 止损和止盈距离越近,歧义日越多,日线回测越不可信。 ±2% 时歧义日占 11.8%,±3% 降到 4.4%,±5% 只有 1.0%。但即使只有 32 天,不同假设之间也差了 320 个百分点:歧义日越少,每一天的分量越重。
- 能用更小周期的数据核对时,就要核对。 第 27 篇写回测引擎时,会支持「用 1 分钟数据判断同一根日线里的触发顺序」。
- 没有更小周期的数据时,要用悲观假设(先触发止损),并且知道这个结果偏保守。美股就是这种情况:我们只有日线。
路径能预测第二天吗
K 线丢掉的路径对回测很重要。那么对预测呢?K 线 A 是「先低后高」,K 线 B 是「先高后低」,这个区别能告诉你第二天的走势吗?
d["next"] = d["close"].pct_change().shift(-1)
for name, mask in [("阳线", up), ("阴线", down)]:
    a = d.loc[mask & (d["high_first"] == True), "next"].dropna()
    b = d.loc[mask & (d["high_first"] == False), "next"].dropna()
    t_stat = (a.mean() - b.mean()) / math.sqrt(a.var() / len(a) + b.var() / len(b))
    print(f"{name}:先高后低 {len(a)} 天,次日平均 {a.mean():+.3%};先低后高 {len(b)} 天,次日平均 {b.mean():+.3%};t = {t_stat:.2f}")
阳线:先高后低 226 天,次日平均 +0.276%;先低后高 1463 天,次日平均 +0.090%;t = 0.75
阴线:先高后低 1436 天,次日平均 +0.224%;先低后高 175 天,次日平均 -0.109%;t = 1.33
t 值是两组平均值的差距,除以这个差距的标准误差。粗略地说,t 的绝对值小于 2,就不能排除差距只是随机造成的。
- 阳线里,「先高后低」的次日平均涨 0.276%,「先低后高」的次日平均涨 0.090%。看起来 K 线 B 那种更好。但 t = 0.75,差距完全在随机范围内。
- 阴线里,t = 1.33,同样不显著。
再试一个更具体的路径特征:收盘前最后两小时的涨跌。很多人会认为「尾盘拉升」是强势、「尾盘跳水」是弱势:
最后两小时涨跌 vs 次日涨跌:相关系数 -0.056,界限 ±0.034
   2017–2019:-0.077(867 天)
   2020–2020:-0.197(366 天)
   2021–2023:+0.053(1095 天)
   2024–2026:-0.060(973 天)
   去掉 2020 年:-0.027
全样本的相关系数是 −0.056,超出了界限,看起来「尾盘跳水第二天反而涨」。但你已经在第 5 篇见过这个剧本了:2020 年一年是 −0.197,去掉 2020 年就只剩 −0.027,回到界限之内;2021 到 2023 年甚至是正的。
所以,至少在这些简单的路径特征上:K 线丢掉的路径,对预测第二天的涨跌没有稳定的价值。
揭晓
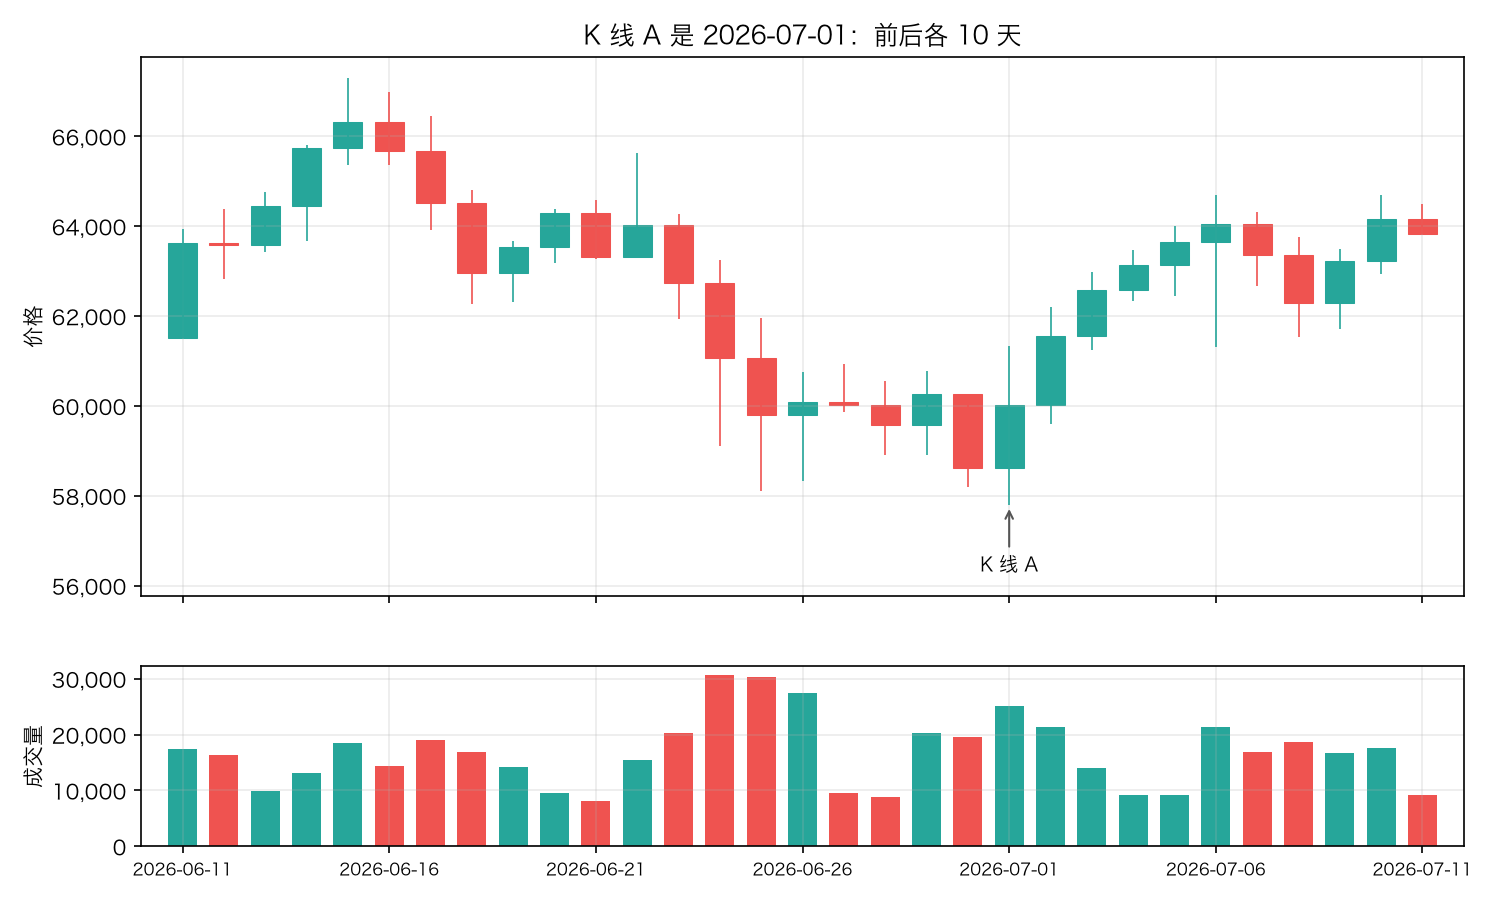
K 线 A 是 2026 年 7 月 1 日。 它的最低价 57,800.19,正是第 4 篇里那次从 126,199.63 开始、跌了 54.2% 的熊市的最低点,到 2026 年 8 月底都没有再跌破。之后 10 天:
A 2026-07-01 {'1 天后': '+2.56%', '3 天后': '+5.20%', '7 天后': '+3.78%', '10 天后': '+6.32%'}
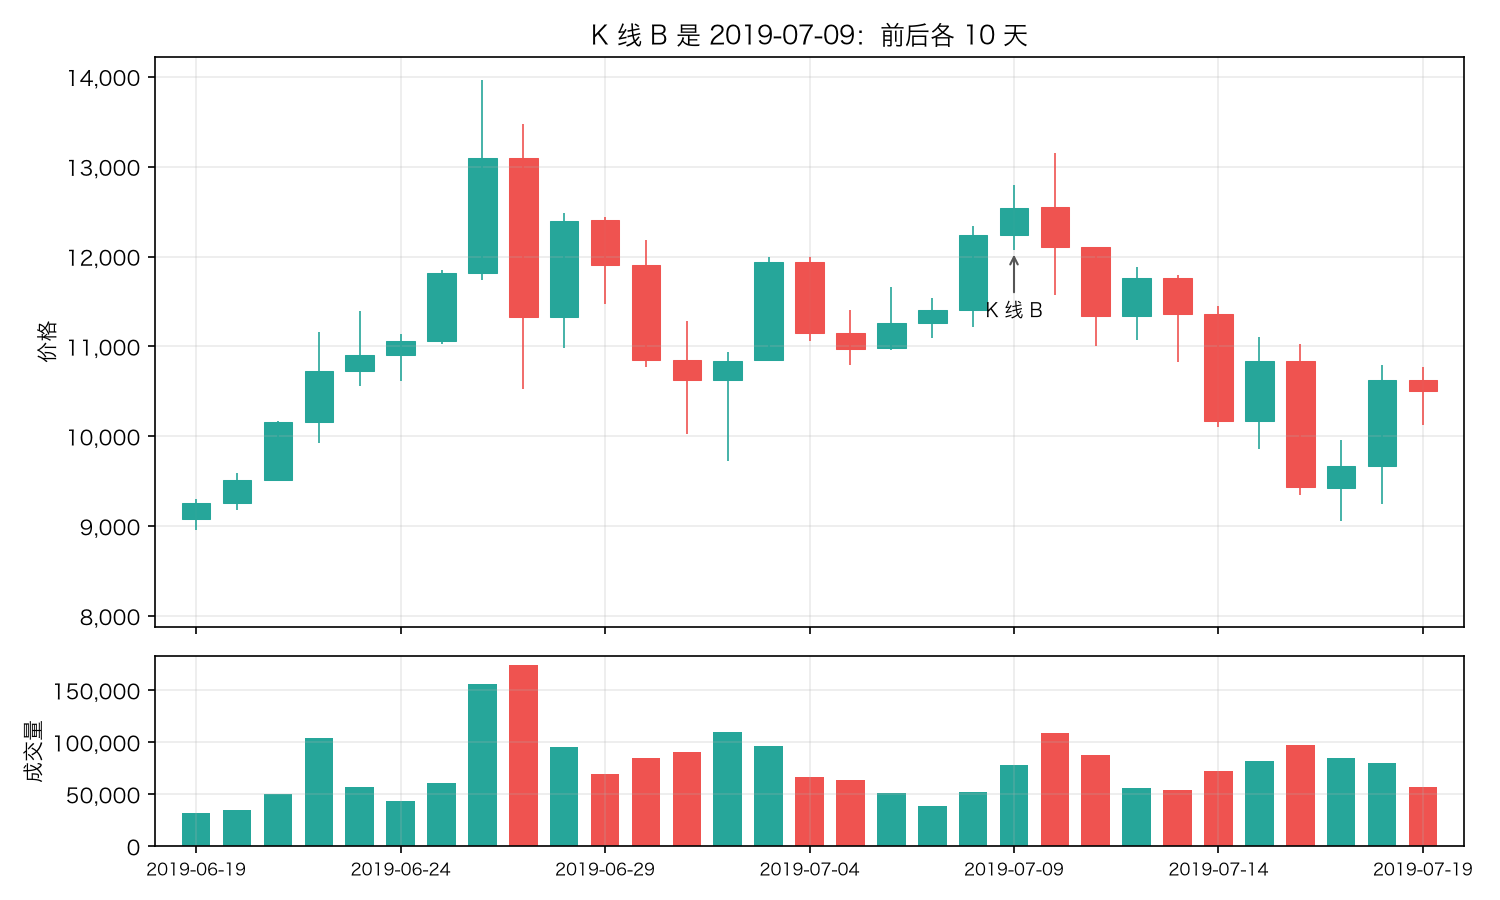
K 线 B 是 2019 年 7 月 9 日。 两周前,BTC 刚在 6 月 26 日创出 13,970 的年内高点。之后 10 天:
B 2019-07-09 {'1 天后': '-3.47%', '3 天后': '-6.27%', '7 天后': '-24.74%', '10 天后': '-16.26%'}
7 天后跌了 24.74%,7 月 17 日最低到 9,060。
回到你的选择。你可能觉得 K 线 A「尾盘冲高回落,很弱」、K 线 B「暴跌后全天收复,承接很强」;也可能正好相反。不管你怎么选,上一小节的统计已经说明:这些日内路径的特征,在全部历史上都没有稳定的预测力。 A 之后涨、B 之后跌,只是两个例子。
真正决定 A 和 B 之后走势的,更可能是它们所处的位置:A 在一轮 54% 下跌的末尾,B 在一轮大涨之后刚刚见顶回落。同样的 K 线,放在不同的位置,意义完全不同。 第 8、9 篇讲趋势和支撑阻力,就是在研究「位置」。
那么这个决策点真正要教的是什么?是上一小节「止损和止盈都在一根 K 线里」的问题。如果你在 K 线 A 或 B 那天开盘买入,止盈 +3%、止损 −3%:
- K 线 A:最低只到 98.59,没碰到 −3%;下午 15 点 23 分涨过 +3%,止盈。
- K 线 B:凌晨 2 点就涨过 +3%,止盈。之后跌到 98.61,但你已经离场了。
两天在日线上都是「碰到 +3%,没碰到 −3%」,这次没有歧义。但如果止盈和止损都设在 ±1%:
for name, t in [("A", A), ("B", Bday)]:
    m = minute.loc[t]
    print(name, {f"±{k:.0%}": B.first_touch(m, k, k).iloc[0] for k in [0.01, 0.03]})
A {'±1%': 'down', '±3%': 'up'}
B {'±1%': 'up', '±3%': 'up'}
- K 线 A:UTC 1 点 12 分跌破 −1%,先止损。
- K 线 B:UTC 1 点 46 分就涨过了 +1%,先止盈,远早于 10 点 13 分的暴跌。
两天在日线上都是「最高超过 +1%、最低低于 −1%」,一模一样。同一根 K 线、同样的止损止盈,结果可以相反,而日线完全无法区分。
五、Heikin-Ashi:平均出来的 K 线
它是什么
Heikin-Ashi(日语「平均足」,下面简称 HA)是一种「改造过的 K 线」。它不直接画每根 K 线的开高低收,而是用平均值重新计算四个价格:
HA 收盘 = (开盘 + 最高 + 最低 + 收盘) ÷ 4
HA 开盘 = (前一根的 HA 开盘 + 前一根的 HA 收盘) ÷ 2
HA 最高 = max(最高, HA 开盘, HA 收盘)
HA 最低 = min(最低, HA 开盘, HA 收盘)
第一根 K 线没有「前一根」,HA 开盘用 (开盘 + 收盘) ÷ 2。
回到比分摘要的比方。真实 K 线是每场比赛的实际比分;HA 更像是解说员给球队打的近期状态分:这场比赛的平均分差,再和上一场的状态分做平均。状态分让「这支队伍最近是上升还是下滑」变得一目了然,但它不是任何一场比赛的实际比分。你不能拿状态分去兑奖。
手算三天
用 SPY 2025 年 4 月初那几天。先看代码算出的完整结果:
ha = B.heikin_ashi(spy)
print(pd.concat([spy[cols], ha.add_prefix("ha_")], axis=1).loc["2025-04-02":"2025-04-10"].round(4))
              open     high     low   close   ha_open   ha_high  ha_low  ha_close
date
2025-04-02  555.05  567.420  554.81  564.52  559.2092  567.4200  554.81  560.4500
2025-04-03  545.11  547.970  536.70  536.70  559.8296  559.8296  536.70  541.6200
2025-04-04  523.67  525.870  505.06  505.28  550.7248  550.7248  505.06  514.9700
2025-04-07  489.19  523.170  481.80  504.38  532.8474  532.8474  481.80  499.6350
2025-04-08  521.86  524.980  489.16  496.48  516.2412  524.9800  489.16  508.1200
2025-04-09  493.44  548.620  493.05  548.62  512.1806  548.6200  493.05  520.9325
2025-04-10  532.17  533.495  509.32  524.58  516.5565  533.4950  509.32  524.8912
以 4 月 3 日的 HA 值为起点(HA 开盘 559.8296,HA 收盘 541.6200),手算后面三天。
4 月 4 日(真实 K 线:开 523.67,高 525.87,低 505.06,收 505.28)
- HA 收盘 = (523.67 + 525.87 + 505.06 + 505.28) ÷ 4 = 2,059.88 ÷ 4 = 514.97
- HA 开盘 = (559.8296 + 541.62) ÷ 2 = 550.7248
- HA 最高 = max(525.87, 550.7248, 514.97) = 550.7248
- HA 最低 = min(505.06, 550.7248, 514.97) = 505.06
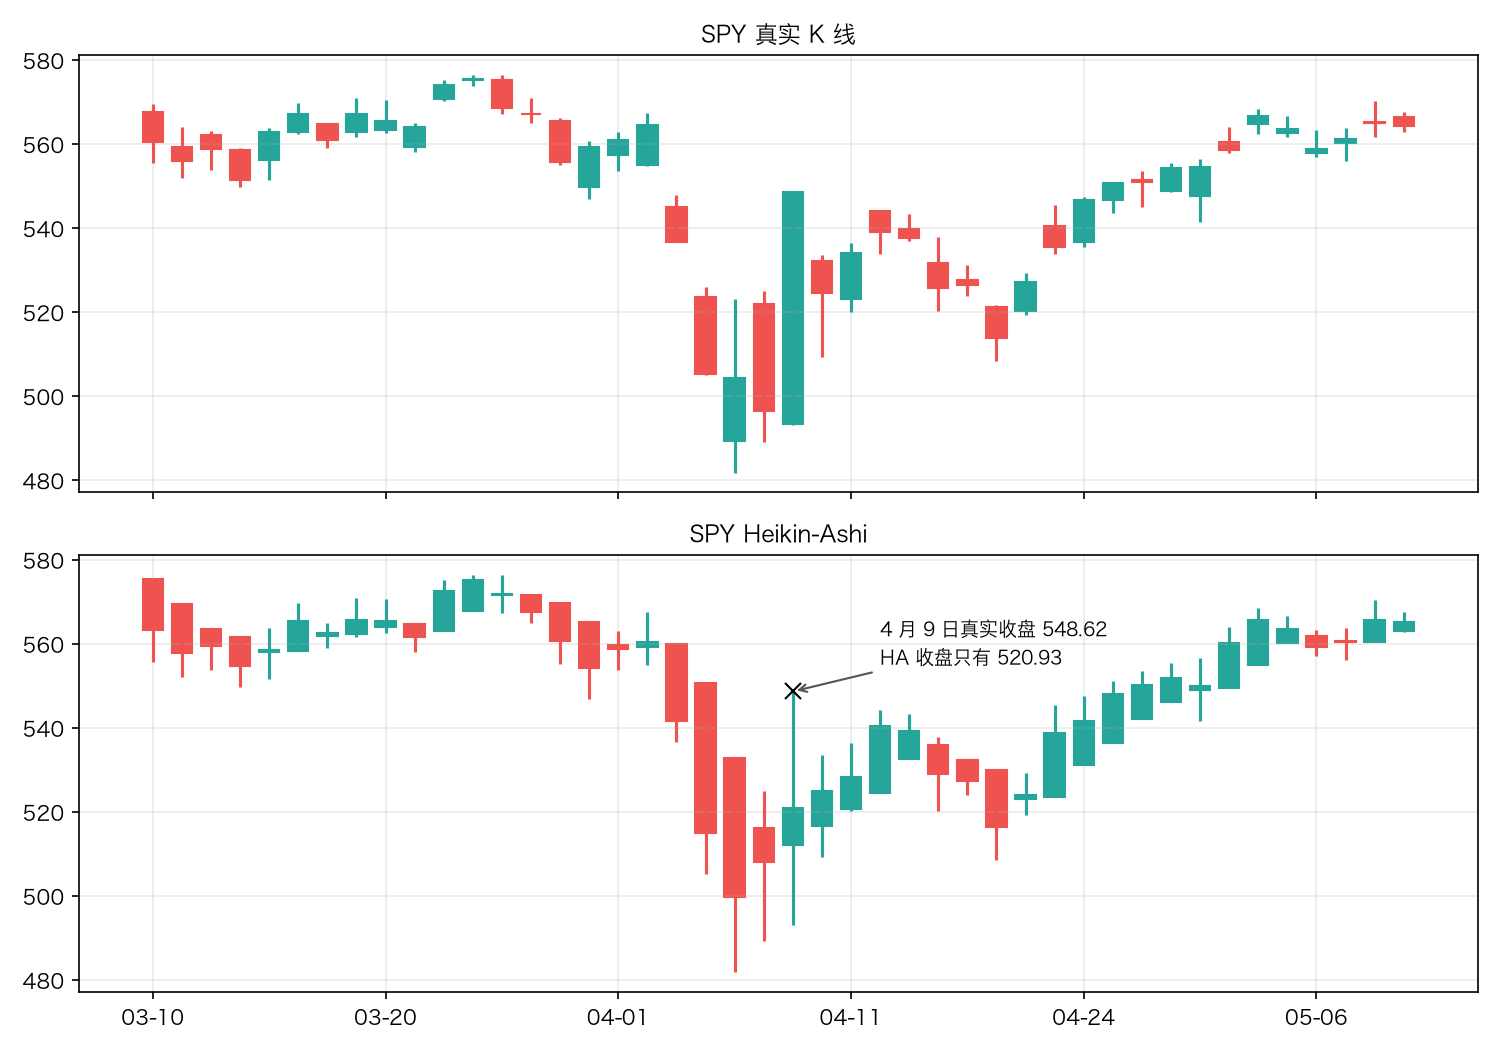
注意 HA 最高 550.7248:这一天 SPY 的真实最高价只有 525.87,550.72 这个价格当天根本没有出现过。它来自 HA 开盘,而 HA 开盘是前几天价格的平均。
4 月 7 日(真实 K 线:开 489.19,高 523.17,低 481.80,收 504.38)
- HA 收盘 = (489.19 + 523.17 + 481.80 + 504.38) ÷ 4 = 1,998.54 ÷ 4 = 499.635
- HA 开盘 = (550.7248 + 514.97) ÷ 2 = 532.8474
- HA 最高 = max(523.17, 532.8474, 499.635) = 532.8474
- HA 最低 = min(481.80, 532.8474, 499.635) = 481.80
第三节讲过,这一天真实 K 线是一根实体 3.1% 的大阳线(开 489.19,收 504.38)。而 HA 开盘 532.85 高于 HA 收盘 499.64,HA 是一根阴线。当天跳空低开 3.2% 的缺口,在 HA 上也消失了:HA 开盘永远在前一根 HA 实体的中点,HA 图上不会有跳空。
4 月 9 日(真实 K 线:开 493.44,高 548.62,低 493.05,收 548.62)
- HA 收盘 = (493.44 + 548.62 + 493.05 + 548.62) ÷ 4 = 2,083.73 ÷ 4 = 520.9325
- HA 开盘 = (516.2412 + 508.12) ÷ 2 = 512.1806
- HA 最高 = max(548.62, 512.1806, 520.9325) = 548.62
- HA 最低 = min(493.05, 512.1806, 520.9325) = 493.05
这是第 5 篇提到的暂缓关税那天,SPY 涨了 10.5%,收在当天最高价 548.62。HA 收盘却只有 520.93,比真实收盘低了 5.0%。如果你看着 HA 图,你会以为 SPY 这一天收在 521 附近。
HA 开盘是一条均线
把 HA 开盘的公式展开:
HA开盘ₜ = ½ HA收盘ₜ₋₁ + ½ HA开盘ₜ₋₁
= ½ HA收盘ₜ₋₁ + ¼ HA收盘ₜ₋₂ + ¼ HA开盘ₜ₋₂
= ½ HA收盘ₜ₋₁ + ¼ HA收盘ₜ₋₂ + ⅛ HA收盘ₜ₋₃ + …
HA 开盘是过去所有 HA 收盘的加权平均,权重每往前一天减半。 这正是第 12 篇要讲的指数移动平均(EMA)的形式。
所以 HA 的颜色(HA 收盘是否高于 HA 开盘)的真正含义是:今天四个价格的平均值,是否高于过去几天四价平均值的指数均线。它本质上是一个很短的均线交叉信号。这解释了 HA 为什么「看起来更顺」:均线天然会把来回震荡抹平。
展开式还说明了另一件事:HA 开盘依赖全部历史,起点不同,算出来的值就不同。不过权重每天减半,起点的影响消失得很快:
从不同的起点开始算,HA 开盘的差距: ['1.0331%', '0.5162%', '0.2604%', '0.1301%', '0.0642%', '0.0318%', '0.0156%', '0.0075%']
(这是用 BTC 全部历史算的 HA,和只从 2020 年 1 月 1 日开始算的 HA,在 2020 年头几天的差距。)
差距每天减半,一周后不到 0.01%。实际使用时,只要在需要的日期之前多算两周,起点就无关紧要。
HA 画出来的价格有多少是真的
for k, df in {"SPY": spy, "AAPL": aapl, "BTC": day}.items():
    h = B.heikin_ashi(df)
    outside = ((h["open"] > df["high"]) | (h["open"] < df["low"])).mean()
    close_gap = (h["close"] / df["close"] - 1).abs()
    print(f"{k:4s} HA 开盘在真实最高最低之外 {outside:.1%};HA 收盘偏离真实收盘 中位数 {close_gap.median():.2%} 最大 {close_gap.max():.1%};"
          f"同色连续根数 平均 真实 {runs(np.sign(df['close'] - df['open'])).mean():.2f} / HA {runs(np.sign(h['close'] - h['open'])).mean():.2f}")
(runs 把连续同色的 K 线分成一段一段,返回每段的长度,定义见 06_bars.py。)
SPY  HA 开盘在真实最高最低之外 57.7%;HA 收盘偏离真实收盘 中位数 0.21% 最大 5.0%;同色连续根数 平均 真实 2.00 / HA 3.77
AAPL HA 开盘在真实最高最低之外 57.6%;HA 收盘偏离真实收盘 中位数 0.40% 最大 6.6%;同色连续根数 平均 真实 1.98 / HA 4.00
BTC  HA 开盘在真实最高最低之外 46.5%;HA 收盘偏离真实收盘 中位数 0.76% 最大 30.8%;同色连续根数 平均 真实 1.88 / HA 4.24
HA 得到的:同色 K 线连续出现的平均根数,从真实 K 线的约 2 根,变成了约 4 根。上涨时一路绿、下跌时一路红,趋势看起来清楚得多。这是 HA 流行的原因。
HA 付出的代价:
- 一半左右的日子,HA 开盘价落在当天真实最高价和最低价之外,也就是这一天根本没有成交过的价格。
- HA 收盘价通常偏离真实收盘价,BTC 的中位数是 0.76%,最大的一天偏离了 30.8%。
- 从公式可以看出,HA 最高 ≥ 真实最高,HA 最低 ≤ 真实最低。HA 的影线只会比真实影线更长,多出来的部分同样是没有成交过的价格。
HA 作为「看趋势的辅助图」没有问题。问题出在把 HA 的价格当成真实价格来用。下面是两种最常见、代价最大的误用。
误用一:用 HA 价格回测
规则很简单:HA 变绿就买入,HA 变红就卖出(只做多)。
如果回测时直接用 HA 收盘价作为买入和卖出的价格,会得到什么结果?对比三种成交价:
for k, df in {"SPY": spy, "AAPL": aapl, "BTC": day}.items():
    years = len(df) / (365 if k == "BTC" else 252)
    n, f, fc, r, rc, no, noc, bh = ha_backtest(df, years)
    print(f"{k:4s} {n} 笔:按 HA 收盘价 ×{f:,.2f}(年化 {fc:.1%})  按真实收盘价 ×{r:.2f}({rc:.1%})  "
          f"按次日开盘价 ×{no:.2f}({noc:.1%})  一直持有 ×{bh:.2f}")
(ha_backtest 的完整代码在 06_bars.py 里:找出每一段「HA 连续为绿」的区间,分别用三种价格计算每笔交易的收益并连乘。)
SPY  333 笔:按 HA 收盘价 ×8.97(年化 24.6%)  按真实收盘价 ×2.01(7.2%)  按次日开盘价 ×1.80(6.1%)  一直持有 ×3.52
AAPL 314 笔:按 HA 收盘价 ×59.59(年化 50.7%)  按真实收盘价 ×4.43(16.1%)  按次日开盘价 ×1.46(3.8%)  一直持有 ×11.47
BTC  389 笔:按 HA 收盘价 ×131,537.90(年化 268.0%)  按真实收盘价 ×32.48(46.9%)  按次日开盘价 ×32.57(47.0%)  一直持有 ×18.34
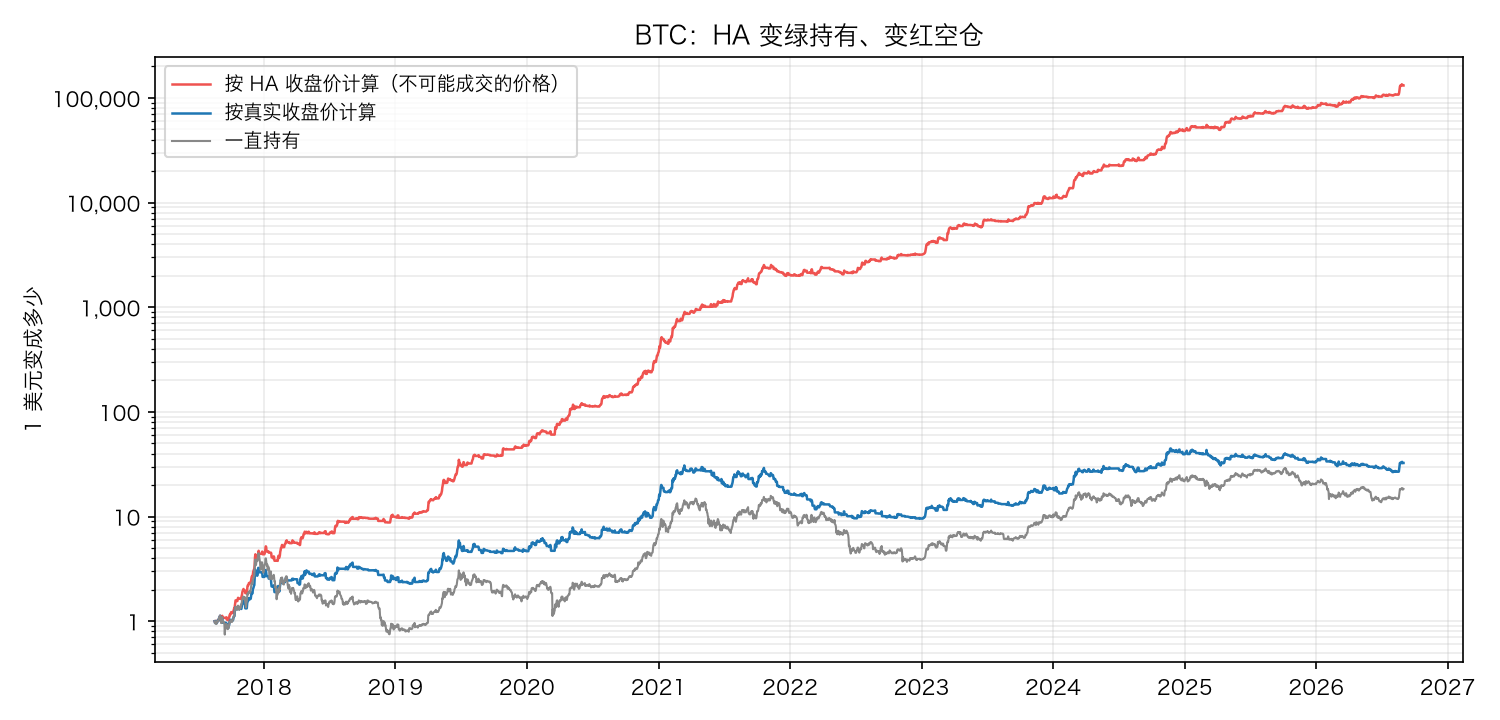
同一个规则,按 HA 收盘价回测,BTC 九年变成 131,538 倍;按真实收盘价,只有 32 倍。 SPY 从「年化 24.6%,远超一直持有」变成「年化 7.2%,远不如一直持有」。
为什么差这么多?想想 HA 变绿的那一刻:价格刚刚开始上涨,今天的真实收盘价是四个价格里最高的之一,而 HA 收盘是四个价格的平均,一定比真实收盘低。所以「按 HA 收盘价买入」,等于以低于市价的价格买到。卖出时正好相反:价格刚开始下跌,HA 收盘高于真实收盘,等于以高于市价的价格卖出。
每笔交易都凭空多赚一点。算一下 BTC 平均每笔多赚了多少:
假收益 ÷ 真收益 = 131,537.90 ÷ 32.48 ≈ 4,050
每笔平均多赚 = 4,050 的 389 次方根 − 1 = e^(ln 4,050 ÷ 389) − 1 = e^(8.306 ÷ 389) − 1 ≈ 2.2%
每笔交易凭空多出 2.2%,389 笔复利下来,就是 4,050 倍的差距。 这就是第 5 篇讲的复利:一个很小的偏差,重复几百次,结果会完全失真。
还要注意 AAPL 的最后两列:按真实收盘价 4.43 倍,按次日开盘价只有 1.46 倍。信号要等收盘才能确定,而美股收盘之后到第二天开盘之前无法交易,这中间的跳空(第三节)会改变每一笔的成交价。「在信号出现的那根 K 线收盘价成交」本身也是一个需要检验的假设,第 28 篇会专门讲。BTC 24 小时交易,收盘价和下一根的开盘价几乎一样,所以两列结果非常接近。
误用二:用 HA 价格算风险
另一种误用更隐蔽:用 HA 价格来计算仓位和风险。
假设你的规则是「止损放在 HA 最低价,每笔风险控制在账户的 1%」。你需要知道买入价到止损价的距离,才能算出买多少。
2025 年 4 月 9 日收盘,HA 变绿,你决定买入 SPY:
真实收盘 548.62  HA 收盘 520.9325  止损放在 HA 最低 493.05
以为的风险 27.8825(5.35%)  实际的风险 55.5700(10.13%)
- 看着 HA 图,你以为自己在 520.93 附近买入,止损 493.05,每股风险 27.88 美元。按 1% 的账户风险,10 万美元的账户可以买 1,000 ÷ 27.88 ≈ 35 股。
- 实际上你只能按真实价格 548.62 买入,每股风险是 55.57 美元。35 股的实际风险是 35 × 55.57 = 1,945 美元,接近计划的两倍。
这不是个例:
SPY  实际风险 ÷ 以为的风险:大于 1.5 倍 16.5%,小于 1/1.5 24.0%
AAPL 实际风险 ÷ 以为的风险:大于 1.5 倍 17.4%,小于 1/1.5 26.0%
BTC  实际风险 ÷ 以为的风险:大于 1.5 倍 17.7%,小于 1/1.5 24.3%
大约 17% 的日子,实际风险比以为的高出 50% 以上;另外约 25% 的日子,实际风险不到以为的三分之二。 仓位管理的全部意义在于控制每笔交易的风险,而用 HA 价格计算,四成以上的交易,实际风险和计划相差悬殊:要么高出一半以上,要么只有计划的三分之二不到。
规则:HA 可以用来看趋势、产生信号,但一切价格(成交价、止损价、风险、盈亏)都必须用真实 K 线。
✋ 小检查 2
前一根 HA 开盘 98,HA 收盘 102。接下来两根真实 K 线:
| 开盘 | 最高 | 最低 | 收盘 | |
|---|---|---|---|---|
| 第 1 根 | 100 | 110 | 95 | 105 |
| 第 2 根 | 105 | 108 | 98 | 100 |
- (a) 算出两根 HA 的开高低收。
- (b) 第 2 根真实 K 线是什么颜色?HA 是什么颜色?
六、Renko:去掉时间轴的砖块图
它是什么
Renko(来自日语「炼瓦」,砖块)走得比 HA 更远:它完全去掉了时间轴。
回到比分摘要的比方。Renko 就像一种特殊的记分方式:不管比赛打了多久,只在分差每拉开 5 分时记一笔。领先从 0 到 5 分,记一笔「+」;再到 10 分,再记一笔「+」。如果对手追回来,要追到比最后一笔的起点再少 5 分,才记一笔「−」。比赛前十分钟打出 20 分的领先,记四笔;之后半小时两队交替得分、分差在 15 到 20 之间来回,一笔不记。
Renko 的规则:
- 选一个砖块大小,比如 1,000 美元。
- 从起点价格开始。价格顺着当前方向每走满一块砖,画一块砖。
- 要反向,价格必须越过最后一块砖的另一端,再走满一块砖。也就是说,离最后一块砖的收盘价两块砖远。
- 没走满一块砖的价格变动,完全不画。
通常用收盘价来构造(也有用最高最低价的版本,这里不展开)。
手算一段
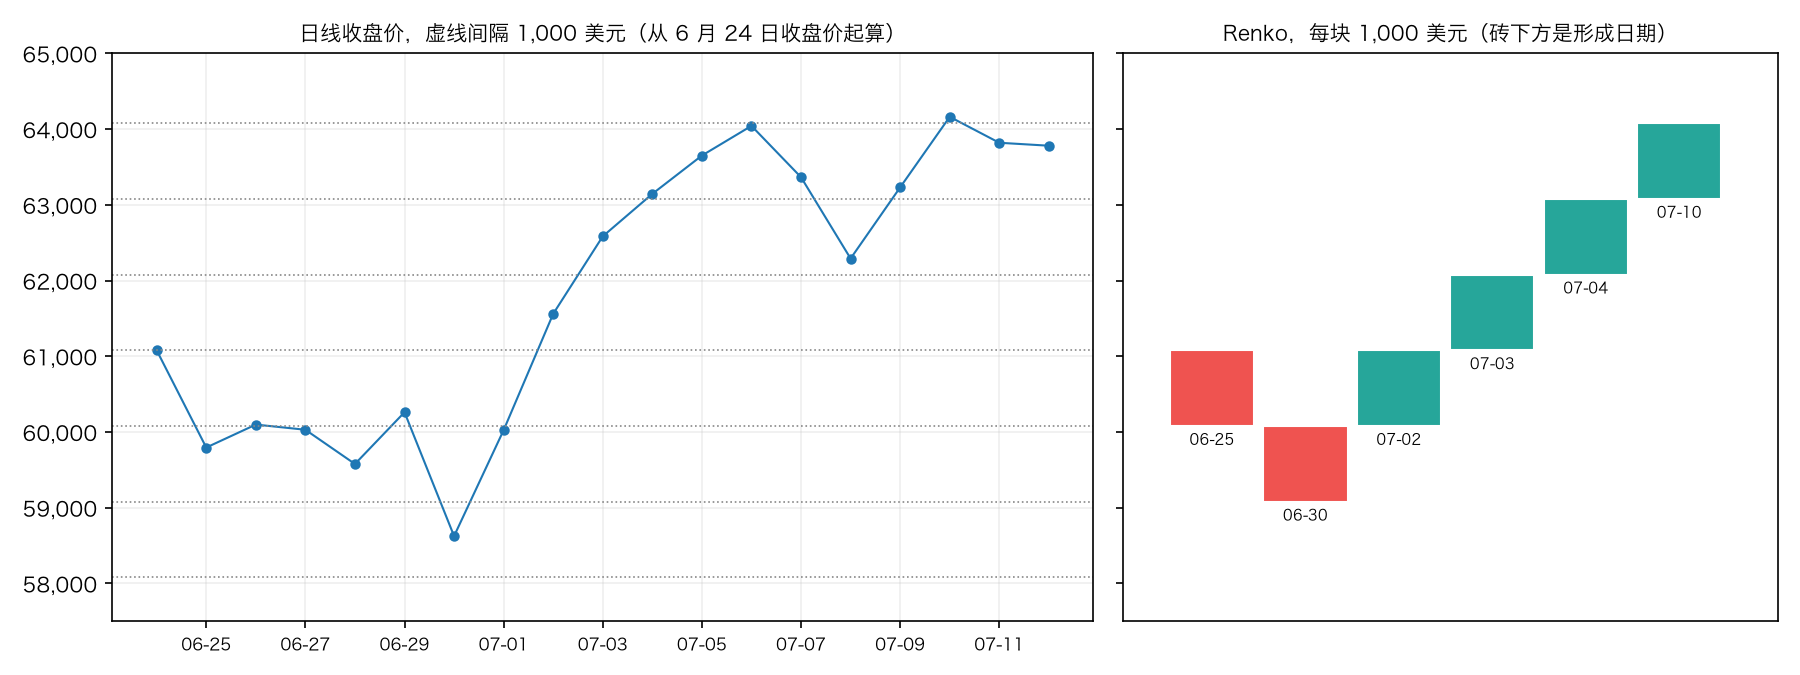
用 BTC 2026 年 6 月 24 日到 7 月 12 日的日线收盘价,砖块大小 1,000 美元,起点是 6 月 24 日的收盘价 61,077.99:
| 日期 | 收盘价 | 最后一块砖 | 下一块向上的砖需要 | 下一块向下的砖需要 | 画了什么 |
|---|---|---|---|---|---|
| 6-24 | 61,077.99 | (起点) | ≥ 62,077.99 | ≤ 60,077.99 | 起点 |
| 6-25 | 59,794.00 | — | ≥ 62,077.99 | ≤ 60,077.99 | ↓ 61,077.99 → 60,077.99 |
| 6-26 | 60,097.27 | ↓ 60,077.99 | ≥ 62,077.99 | ≤ 59,077.99 | 无 |
| 6-27 | 60,029.00 | ↓ 60,077.99 | ≥ 62,077.99 | ≤ 59,077.99 | 无 |
| 6-28 | 59,577.01 | ↓ 60,077.99 | ≥ 62,077.99 | ≤ 59,077.99 | 无 |
| 6-29 | 60,260.21 | ↓ 60,077.99 | ≥ 62,077.99 | ≤ 59,077.99 | 无 |
| 6-30 | 58,624.71 | ↓ 60,077.99 | ≥ 62,077.99 | ≤ 59,077.99 | ↓ 60,077.99 → 59,077.99 |
| 7-01 | 60,024.00 | ↓ 59,077.99 | ≥ 61,077.99 | ≤ 58,077.99 | 无 |
| 7-02 | 61,560.00 | ↓ 59,077.99 | ≥ 61,077.99 | ≤ 58,077.99 | ↑ 60,077.99 → 61,077.99 |
| 7-03 | 62,583.26 | ↑ 61,077.99 | ≥ 62,077.99 | ≤ 59,077.99 | ↑ 61,077.99 → 62,077.99 |
| 7-04 | 63,144.01 | ↑ 62,077.99 | ≥ 63,077.99 | ≤ 60,077.99 | ↑ 62,077.99 → 63,077.99 |
| 7-05 | 63,650.00 | ↑ 63,077.99 | ≥ 64,077.99 | ≤ 61,077.99 | 无 |
| 7-06 | 64,042.02 | ↑ 63,077.99 | ≥ 64,077.99 | ≤ 61,077.99 | 无(差 35.97) |
| 7-07 | 63,363.99 | ↑ 63,077.99 | ≥ 64,077.99 | ≤ 61,077.99 | 无 |
| 7-08 | 62,290.00 | ↑ 63,077.99 | ≥ 64,077.99 | ≤ 61,077.99 | 无 |
| 7-09 | 63,230.00 | ↑ 63,077.99 | ≥ 64,077.99 | ≤ 61,077.99 | 无 |
| 7-10 | 64,161.72 | ↑ 63,077.99 | ≥ 64,077.99 | ≤ 61,077.99 | ↑ 63,077.99 → 64,077.99 |
几个值得注意的地方:
- 7 月 2 日的反向:最后一块砖是向下的 60,077.99 → 59,077.99。反向需要越过这块砖的另一端(60,077.99),再走一块砖,也就是 ≥ 61,077.99。7 月 1 日的 60,024.00 不够,7 月 2 日的 61,560.00 够了。新砖从 60,077.99 画到 61,077.99,起点是上一块砖的顶部,不是底部。
- 7 月 8 日跌到 62,290,比 7 月 6 日的 64,042 跌了 2.7%,但没有画任何砖:向下反向需要 ≤ 61,077.99。
- 7 月 6 日的 64,042.02 只差 35.97 美元就能画一块新砖,但 Renko 不管差多少,没走满就是没有。
- 19 天画了 6 块砖:6 月 25 日到 29 日、7 月 5 日到 9 日这两段,Renko 上什么都没有发生。
closes = day["close"].loc["2026-06-24":"2026-07-12"]
print(B.renko(closes, 1000))
                  formed_at      open     close  direction
0 2026-06-25 00:00:00+00:00  61077.99  60077.99         -1
1 2026-06-30 00:00:00+00:00  60077.99  59077.99         -1
2 2026-07-02 00:00:00+00:00  60077.99  61077.99          1
3 2026-07-03 00:00:00+00:00  61077.99  62077.99          1
4 2026-07-04 00:00:00+00:00  62077.99  63077.99          1
5 2026-07-10 00:00:00+00:00  63077.99  64077.99          1
按比例的砖块
1,000 美元的砖块,在 BTC 价格 6 万时是 1.7%,在 4,000 时是 25%。和第 4 篇的算术坐标一样,固定金额的砖块不能跨越很大的价格范围。
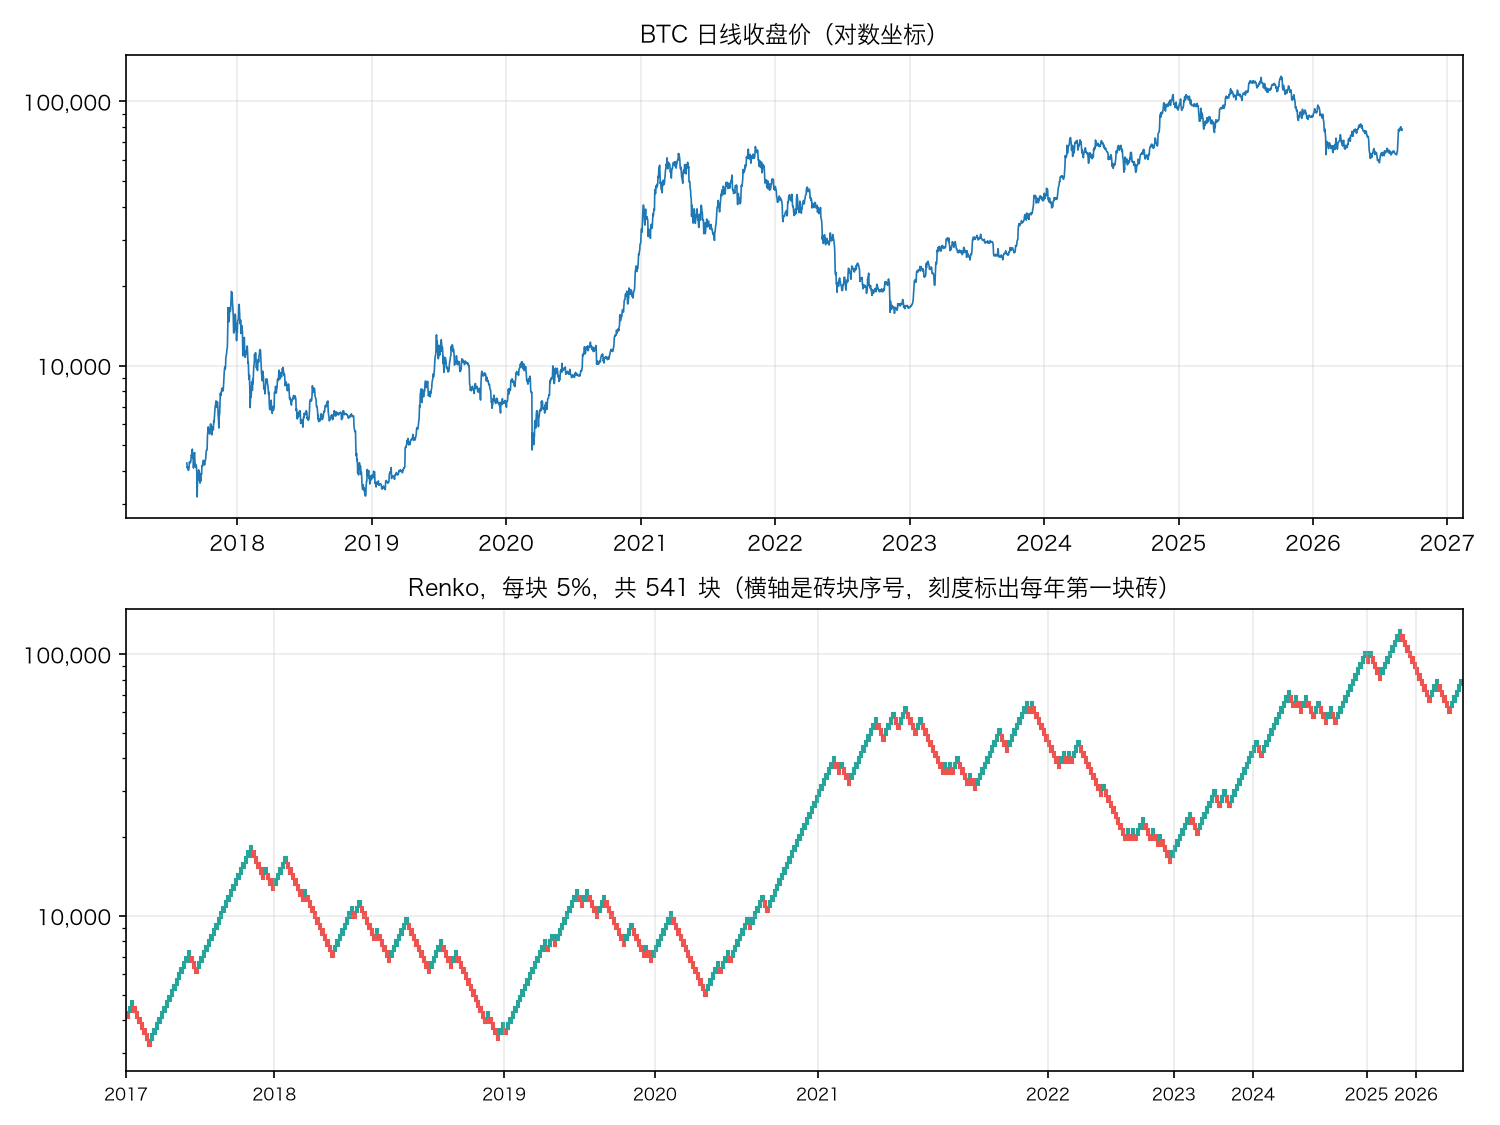
解决办法和第 4 篇一样:用比例。每块砖代表价格变动 5%,等价于在对数坐标上用固定大小的砖。renko(close, 0.05, log=True) 就是这样构造的。另一种常见做法是用 ATR(平均真实波幅,第 15 篇)来定砖块大小,让砖块随波动率变化。
Renko 得到了什么,失去了什么
得到的:小的来回震荡全部被过滤掉,只剩下「走满一块砖」级别的趋势。上图里,2020 年底到 2021 年初的上涨、2022 年的下跌,都变成了清晰的阶梯。
失去的,比看起来多:
daily_bricks = B.renko(day["close"], 0.05, log=True)
minute_bricks = B.renko(minute["close"], 0.05, log=True)
for name, bricks in [("日线收盘价", daily_bricks), ("1 分钟收盘价", minute_bricks)]:
    reversals = (bricks["direction"] != bricks["direction"].shift()).sum() - 1
    print(f"用 {name}:{len(bricks)} 块砖,{reversals} 次反向")
用 日线收盘价:541 块砖,123 次反向
用 1 分钟收盘价:972 块砖,300 次反向
两块砖之间最长隔了 85 天: 2025-07-13 → 2025-10-06
一天里最多画了 10 块砖: 2020-03-12
起点从 2017-08-17 换成 2017-08-18: 541 块 → 524 块
(后三行来自 06_bars.py 片段 18 的其余代码。)
1. 时间消失了。 2025 年 7 月 13 日到 10 月 6 日,85 天里一块砖都没有画;2020 年 3 月 12 日一天画了 10 块。在 Renko 图上,这 85 天和那一天占的宽度差不多。你无法从 Renko 图上知道一段走势用了多久,而「用了多久」对持仓成本、资金费率(第 25 篇)、机会成本都很重要。
2. 结果取决于用什么价格构造。 同样是每块 5%,用日线收盘价构造是 541 块砖、123 次反向;用 1 分钟收盘价构造是 972 块砖、300 次反向。日线收盘价看不到盘中的剧烈来回,1 分钟收盘价能看到。两张 Renko 图给出的「趋势」完全不同,而它们描述的是同一个市场。
3. 结果取决于起点。 只把起点往后挪一天,541 块砖就变成了 524 块。砖块的边界全部跟着起点移动,哪一天画砖、哪一天反向都会改变。
4. 砖块的价格不是成交价。 这和 HA 的问题一样,而且更严重:
形成砖块的那天,真实收盘价比最后一块砖的收盘价多走了:中位数 1.42%,最大 4.95%
砖块转为向上就买、转为向下就卖(只做多),62 笔:按砖块价格 ×281.81(年化 86.6%)  按真实收盘价 ×14.71(年化 34.6%)
砖块只有在价格越过边界之后才会画出来,而那一刻的真实价格已经超出边界一段距离了。7 月 2 日那块向上的砖,砖块价格是 61,077.99,而当天真实收盘价是 61,560.00。
用砖块价格回测「转为向上就买、转为向下就卖」:281.81 倍,年化 86.6%。按真实收盘价:14.71 倍,年化 34.6%,甚至不如一直持有的 18.34 倍。
5. 最后一块砖永远「还没画完」。 实时看盘时,价格在两个边界之间来回,Renko 图上什么都不显示。你看到的 Renko,总是落后于真实价格最多将近两块砖(反向时)。
✋ 小检查 3
收盘价依次是:50、52、54.5、53、51、49.5、47、48。砖块大小 2,起点 50。
- (a) 一共画了几块砖?分别是什么方向,在第几个价格形成?
- (b) 价格从 54.5 跌到 51,跌了 6.4%,为什么没有画出向下的砖?
七、talab.bars:把这一篇写成模块
放在哪里
talab/
├── talab/
│   ├── __init__.py
│   ├── data.py
│   ├── plot.py
│   ├── stats.py
│   └── bars.py          ← 新增
├── tests/
│   ├── test_data.py
│   ├── test_plot.py
│   ├── test_stats.py
│   └── test_bars.py     ← 新增
├── scripts/
│   └── fetch_course_data.py
├── pyproject.toml
└── requirements.txt
不需要新的依赖。1 分钟数据在第 4 篇已经用 scripts/fetch_course_data.py 下载好了。
准备数据
import glob
import math

import numpy as np
import pandas as pd
from talab import bars as B, data as D

day = D.load_binance_klines(glob.glob("data/binance/spot/BTCUSDT/1d/*.zip"))
minute = D.load_binance_klines(sorted(glob.glob("data/binance/spot/BTCUSDT/1m/*.zip")))
spy = D.load_nasdaq_daily("data/nasdaq/SPY_historical.json").drop(pd.Timestamp("2026-04-20"))
aapl = D.load_nasdaq_daily("data/nasdaq/AAPL_historical.json")
print("BTC 日线", len(day), "根,1 分钟线", len(minute), "根")
A, Bday = "2026-07-01", "2019-07-09"
cols = ["open", "high", "low", "close"]
BTC 日线 3302 根,1 分钟线 4746079 根
474 万根 1 分钟 K 线,在写这门课的电脑上加载用了约 2.4 秒,DataFrame 占用内存约 380 MB。内存较小的电脑可以只加载需要的年份。
这一篇的 SPY 和 AAPL 用的是只按拆股调整、没有按分红调整的价格,因为这里研究的是 K 线本身的形状,需要的是当天图上的真实开高低收(第 3 篇讲过,分红调整会把历史价格整体缩小,但不改变同一天四个价格之间的比例;而隔夜收益受分红影响,前面已经单独说明)。
代码
"""talab.bars:K 线的构造与拆解。第 6 篇。"""
from __future__ import annotations

import math

import numpy as np
import pandas as pd

OHLCV = {"open": "first", "high": "max", "low": "min", "close": "last", "volume": "sum"}
SUMMABLE = ["quote_volume", "trades", "taker_buy_base", "taker_buy_quote"]


# ---------------------------------------------------------------------------
# 一、合成:小周期 → 大周期
# ---------------------------------------------------------------------------

def resample_ohlcv(df: pd.DataFrame, rule: str, traded_only: bool = False) -> pd.DataFrame:
    """把小周期 K 线合成大周期 K 线。

    开盘取第一根的开盘价,最高取最大值,最低取最小值,收盘取最后一根的收盘价,量类字段求和。
    每根大 K 线的时间戳是它的开始时间,包含开始时刻、不包含结束时刻。
    traded_only=True 时先去掉成交量为 0 的占位 K 线,否则占位 K 线的价格会被当成真实成交价。
    一根成交也没有的时间段不会出现在结果里。
    """
    src = df[df["volume"] > 0] if traded_only else df
    rules = dict(OHLCV)
    rules.update({c: "sum" for c in SUMMABLE if c in src.columns})
    out = src.resample(rule, label="left", closed="left").agg(rules)
    return out.dropna(subset=["open"])


# ---------------------------------------------------------------------------
# 二、拆解:实体和影线
# ---------------------------------------------------------------------------

def anatomy(df: pd.DataFrame) -> pd.DataFrame:
    """每根 K 线的各个部分。

    body          实体:收盘 − 开盘(带符号,正数是阳线)
    upper_shadow  上影线:最高 − max(开盘, 收盘)
    lower_shadow  下影线:min(开盘, 收盘) − 最低
    range         全长:最高 − 最低
    body_ratio    实体占全长的比例,0~1
    clv           收盘位置:(收盘 − 最低) ÷ 全长,0 表示收在最低,1 表示收在最高
    """
    o, h, l, c = df["open"], df["high"], df["low"], df["close"]
    rng = h - l
    safe = rng.where(rng > 0)                                 # 全长为 0 时比例没有意义,记为 NaN
    return pd.DataFrame({
        "body": c - o,
        "upper_shadow": h - np.maximum(o, c),
        "lower_shadow": np.minimum(o, c) - l,
        "range": rng,
        "body_ratio": (c - o).abs() / safe,
        "clv": (c - l) / safe,
    }, index=df.index)


# ---------------------------------------------------------------------------
# 三、K 线丢掉的路径:用小周期找回来
# ---------------------------------------------------------------------------

def intraday_extremes(minute: pd.DataFrame, rule: str = "1D") -> pd.DataFrame:
    """每个大周期里,最高价和最低价分别出现在哪根小 K 线。

    同一个最高价出现多次时取第一次。high_first 为 True 表示最高价先于最低价出现;
    两者出现在同一根小 K 线里时,小 K 线本身也分不清先后,记为 NA。
    """
    period = minute.index.floor(rule)
    t_high = minute["high"].groupby(period).idxmax()
    t_low = minute["low"].groupby(period).idxmin()
    out = pd.DataFrame({"time_of_high": t_high, "time_of_low": t_low})
    out["high_first"] = (out["time_of_high"] < out["time_of_low"]).astype("boolean")
    out.loc[out["time_of_high"] == out["time_of_low"], "high_first"] = pd.NA
    return out


def first_touch(minute: pd.DataFrame, up: float, down: float, rule: str = "1D") -> pd.Series:
    """以每个大周期的开盘价为基准,价格先碰到 +up 还是 −down(都是比例,比如 0.03)。

    返回每个周期的结果:"up" 先碰到上方,"down" 先碰到下方,"none" 两边都没碰到,
    "same_bar" 两边在同一根小 K 线里都碰到了(小 K 线也分不清先后)。
    """
    period = minute.index.floor(rule)
    base = minute["open"].groupby(period).transform("first")          # 每个周期的开盘价
    hit_up = minute["high"] >= base * (1 + up)
    hit_down = minute["low"] <= base * (1 - down)
    times = minute.index.to_series(index=minute.index)
    first_up = times[hit_up].groupby(period[hit_up.to_numpy()]).first()      # 第一次碰到上方的时间
    first_down = times[hit_down].groupby(period[hit_down.to_numpy()]).first()
    days = pd.Index(period.unique())
    fu, fd = first_up.reindex(days), first_down.reindex(days)
    result = pd.Series("none", index=days, dtype=object)
    result[fu.notna() & (fd.isna() | (fu < fd))] = "up"
    result[fd.notna() & (fu.isna() | (fd < fu))] = "down"
    result[fu.notna() & fd.notna() & (fu == fd)] = "same_bar"
    return result


# ---------------------------------------------------------------------------
# 四、Heikin-Ashi:平均出来的 K 线
# ---------------------------------------------------------------------------

def heikin_ashi(df: pd.DataFrame) -> pd.DataFrame:
    """Heikin-Ashi K 线。

    HA 收盘 = (开 + 高 + 低 + 收) ÷ 4
    HA 开盘 = (前一根 HA 开盘 + 前一根 HA 收盘) ÷ 2;第一根用 (开 + 收) ÷ 2
    HA 最高 = max(最高, HA 开盘, HA 收盘)
    HA 最低 = min(最低, HA 开盘, HA 收盘)
    ⚠️ 这些价格大多不是真实成交过的价格。
    """
    o, h, l, c = (df[k].to_numpy(dtype=float) for k in ["open", "high", "low", "close"])
    ha_close = (o + h + l + c) / 4
    ha_open = np.empty(len(df))
    ha_open[0] = (o[0] + c[0]) / 2
    for i in range(1, len(df)):
        ha_open[i] = (ha_open[i - 1] + ha_close[i - 1]) / 2
    return pd.DataFrame({
        "open": ha_open,
        "high": np.maximum.reduce([h, ha_open, ha_close]),
        "low": np.minimum.reduce([l, ha_open, ha_close]),
        "close": ha_close,
    }, index=df.index)


# ---------------------------------------------------------------------------
# 五、Renko:去掉时间轴的砖块图
# ---------------------------------------------------------------------------

def renko(close: pd.Series, brick: float, log: bool = False) -> pd.DataFrame:
    """用收盘价构造 Renko 砖块。

    brick: 砖块大小。log=False 时是价格单位(比如 1000 美元);
           log=True 时是比例(比如 0.05 表示每块 5%),砖块在对数坐标上等高。
    规则:第一个价格是起点。顺着当前方向,每走满一块砖就画一块;
         要反向,价格必须越过当前这块砖的另一端再走满一块砖(也就是离最后一块砖的收盘两块砖远)。
    返回每块砖:formed_at(形成这块砖的那根 K 线的时间)、open、close、direction(+1 或 −1)。
    """
    step = math.log(1 + brick) if log else brick
    xs = np.log(close.to_numpy(dtype=float)) if log else close.to_numpy(dtype=float)
    rows = []
    lo = hi = xs[0]                  # 最后一块砖的下沿和上沿;还没有砖时两者都是起点
    for t, x in zip(close.index, xs):
        # 价格比最后一块砖的上沿高出一块砖:画一块向上的砖。
        # 如果最后一块砖是向下的,它的上沿就是它的开盘价,所以这正好是「离收盘两块砖」的反向条件
        while x >= hi + step:
            rows.append((t, hi, hi + step, 1))
            lo, hi = hi, hi + step
        # 价格比最后一块砖的下沿低出一块砖:画一块向下的砖(道理同上)
        while x <= lo - step:
            rows.append((t, lo, lo - step, -1))
            lo, hi = lo - step, lo
    out = pd.DataFrame(rows, columns=["formed_at", "open", "close", "direction"])
    if log:
        out[["open", "close"]] = np.exp(out[["open", "close"]])
    return out
读一遍代码
resample_ohlcv 的核心是 pandas 的 resample(...).agg(...),把第二节的规则写成一个字典。两个参数值得注意:
label="left", closed="left":时间戳标在开始时间,区间左闭右开。pandas 对不同的周期有不同的默认值(比如按月、按周合成时默认标在结束时间),所以这里明确写出来,不依赖默认值。traded_only:先用df[df["volume"] > 0]去掉占位 K 线。最后的dropna(subset=["open"])去掉一笔成交都没有的时间段,比如 2023 年 3 月 24 日暂停交易的那一段(第 3 篇)。
anatomy 里,rng.where(rng > 0) 把全长为 0 的 K 线(四价相同)的比例设成 NaN,避免除以 0。
intraday_extremes 用 groupby(period).idxmax() 找每天最高价第一次出现的那一分钟。idxmax 在有多个相同最大值时返回第一个。high_first 用 pandas 的可空布尔类型 "boolean",这样最高价和最低价出现在同一分钟时可以记为 pd.NA:同一根 1 分钟 K 线里,1 分钟数据本身也分不清先后。
first_touch 是第四节歧义分析的核心。它的思路是:
transform("first")给每一分钟标上所属那一天的开盘价- 分别找出每一分钟是否碰到了上方和下方的价位
- 对碰到的分钟按天分组,取第一个时间
- 比较两个时间:谁早谁先;一样早就是
"same_bar";都没有就是"none"
注意第 3 步用的是 first(),而不是 idxmax 之类的函数,因为经过筛选之后,每一组里都是「碰到了」的分钟,第一行就是最早的一次。
heikin_ashi 里 HA 开盘必须用循环计算,因为每一根依赖前一根的结果。3,302 根日线很快;如果要对 474 万根 1 分钟线计算,可以改写成第 12 篇会讲的 EMA 形式,用 pandas 的 ewm 一次算完。
renko 只维护两个状态:最后一块砖的下沿 lo 和上沿 hi。回想第六节的反向规则:
- 最后一块砖向上(
lo→hi):继续向上需要 ≥hi+ 砖;反向需要 ≤lo− 砖,也就是离收盘价hi两块砖。 - 最后一块砖向下(
hi→lo):继续向下需要 ≤lo− 砖;反向需要 ≥hi+ 砖,也就是离收盘价lo两块砖。
两种情况下,条件都是「≥ hi + 砖」或「≤ lo − 砖」。所以代码里不需要记住当前方向,两个 while 循环就够了。用 while 而不是 if,是因为一天可能画出好几块砖(2020 年 3 月 12 日画了 10 块)。
log=True 时,先把价格取对数,砖块大小变成 ln(1 + 5%),在对数空间里构造,最后再把砖块的价格用 exp 换回来。这正是第 4 篇「对数坐标上,相同的比例是相同的距离」的直接应用。
测试
"""talab.bars 的测试。"""
import numpy as np
import pandas as pd
import pytest

from talab import bars as B


def minutes(rows, start="2024-01-01 00:00"):
    idx = pd.date_range(start, periods=len(rows), freq="1min", tz="UTC")
    return pd.DataFrame(rows, columns=["open", "high", "low", "close", "volume"], index=idx, dtype=float)


def test_resample_ohlcv_by_hand():
    m = minutes([
        [10, 12, 9, 11, 1],       # 00:00
        [11, 15, 11, 14, 2],      # 00:01  最高价 15
        [14, 14, 8, 9, 3],        # 00:02  最低价 8
        [9, 10, 9, 10, 4],        # 00:03
        [10, 11, 10, 11, 5],      # 00:04  收盘 11
        [11, 13, 11, 12, 6],      # 00:05  属于下一根 5 分钟 K 线
    ])
    out = B.resample_ohlcv(m, "5min")
    assert len(out) == 2
    assert out.iloc[0].tolist() == [10, 15, 8, 11, 15]
    assert out.index[1] == pd.Timestamp("2024-01-01 00:05", tz="UTC")   # 时间戳是开始时间


def test_resample_traded_only_ignores_placeholder_bars():
    m = minutes([
        [100, 100, 100, 100, 0],  # 没有成交的占位 K 线,价格沿用上一分钟的收盘价
        [98, 101, 97, 99, 2],     # 第一笔真实成交在这里
    ])
    assert B.resample_ohlcv(m, "1D").iloc[0]["open"] == 100
    assert B.resample_ohlcv(m, "1D", traded_only=True).iloc[0]["open"] == 98


def test_anatomy_by_hand():
    df = minutes([[100, 110, 95, 104, 1], [50, 50, 50, 50, 1]])
    a = B.anatomy(df)
    first = a.iloc[0]
    assert first["body"] == 4
    assert first["upper_shadow"] == 6            # 110 − 104
    assert first["lower_shadow"] == 5            # 100 − 95
    assert first["range"] == 15
    assert first["body_ratio"] == pytest.approx(4 / 15)
    assert first["clv"] == pytest.approx(9 / 15)
    assert np.isnan(a.iloc[1]["clv"])            # 四价相同,全长为 0


def test_intraday_extremes_order():
    day1 = [[10, 10, 9, 9, 1], [9, 9, 5, 6, 1], [6, 12, 6, 12, 1]]        # 先低后高
    day2 = [[10, 20, 10, 18, 1], [18, 18, 3, 4, 1], [4, 6, 4, 5, 1]]      # 先高后低
    day3 = [[10, 30, 1, 10, 1], [10, 11, 9, 10, 1], [10, 11, 9, 10, 1]]   # 高低在同一分钟
    m = pd.concat([minutes(day1, "2024-01-01"), minutes(day2, "2024-01-02"), minutes(day3, "2024-01-03")])
    ex = B.intraday_extremes(m)
    assert ex["high_first"].iloc[0] == False
    assert ex["high_first"].iloc[1] == True
    assert pd.isna(ex["high_first"].iloc[2])
    assert ex["time_of_low"].iloc[0] == pd.Timestamp("2024-01-01 00:01", tz="UTC")


def test_first_touch_all_outcomes():
    up = [[100, 101, 99, 100, 1], [100, 104, 100, 102, 1], [102, 102, 96, 97, 1]]    # 先 +3%,后 −3%
    down = [[100, 100, 96, 97, 1], [97, 104, 97, 103, 1], [103, 103, 103, 103, 1]]  # 先 −3%,后 +3%
    none = [[100, 102, 98, 100, 1]] * 3
    both = [[100, 104, 96, 100, 1]] * 3                                             # 同一分钟两边都碰到
    m = pd.concat([minutes(up, "2024-01-01"), minutes(down, "2024-01-02"),
                   minutes(none, "2024-01-03"), minutes(both, "2024-01-04")])
    assert B.first_touch(m, 0.03, 0.03).tolist() == ["up", "down", "none", "same_bar"]


def test_heikin_ashi_by_hand():
    df = minutes([[10, 14, 8, 12, 1], [12, 16, 11, 15, 1], [15, 15, 9, 10, 1]])
    ha = B.heikin_ashi(df)
    # 第一根:HA 开盘 = (10 + 12) ÷ 2 = 11,HA 收盘 = (10 + 14 + 8 + 12) ÷ 4 = 11
    assert ha.iloc[0].tolist() == [11, 14, 8, 11]
    # 第二根:HA 开盘 = (11 + 11) ÷ 2 = 11,HA 收盘 = (12 + 16 + 11 + 15) ÷ 4 = 13.5
    assert ha.iloc[1].tolist() == [11, 16, 11, 13.5]
    # 第三根:HA 开盘 = (11 + 13.5) ÷ 2 = 12.25,HA 收盘 = (15 + 15 + 9 + 10) ÷ 4 = 12.25
    assert ha.iloc[2].tolist() == [12.25, 15, 9, 12.25]


def test_heikin_ashi_range_always_covers_real_range():
    rng = np.random.default_rng(3)
    close = 100 * np.exp(np.cumsum(rng.normal(0, 0.02, 500)))
    open_ = np.r_[100, close[:-1]]
    high = np.maximum(open_, close) * (1 + rng.uniform(0, 0.01, 500))
    low = np.minimum(open_, close) * (1 - rng.uniform(0, 0.01, 500))
    df = pd.DataFrame({"open": open_, "high": high, "low": low, "close": close})
    ha = B.heikin_ashi(df)
    assert (ha["high"] >= df["high"]).all() and (ha["low"] <= df["low"]).all()


def test_renko_by_hand():
    close = pd.Series([100, 105, 111, 121, 115, 99, 100], dtype=float)
    bricks = B.renko(close, 10)
    # 111 → 画 100~110;121 → 画 110~120;115 不够;99 跌破 110 − 10 = 100,反向画 110~100
    assert bricks[["open", "close", "direction"]].values.tolist() == [[100, 110, 1], [110, 120, 1], [110, 100, -1]]
    assert bricks["formed_at"].tolist() == [2, 3, 5]


def test_renko_needs_two_bricks_to_reverse():
    close = pd.Series([100, 110, 101, 100.5, 90], dtype=float)
    bricks = B.renko(close, 10)
    # 110 画出 100~110 的砖。跌到 101、100.5 都不反向:反向要跌到 110 − 2 × 10 = 90
    assert bricks["direction"].tolist() == [1, -1]
    assert bricks["formed_at"].tolist() == [1, 4]


def test_renko_log_bricks_are_equal_ratios():
    close = pd.Series([100, 122, 99], dtype=float)
    bricks = B.renko(close, 0.10, log=True)
    assert bricks["close"].iloc[0] == pytest.approx(110)
    assert bricks["close"].iloc[1] == pytest.approx(121)
    assert bricks["direction"].tolist() == [1, 1, -1]          # 跌到 99,低于 110 ÷ 1.1 = 100,反向一块
几个测试的设计意图:
test_resample_traded_only_ignores_placeholder_bars:第二节 2017 年 8 月 20 日那个坑的最小复现。test_intraday_extremes_order:三天分别是「先低后高」「先高后低」「同一分钟」,覆盖全部三种结果。test_first_touch_all_outcomes:四天覆盖"up"、"down"、"none"、"same_bar"全部四种结果。test_heikin_ashi_range_always_covers_real_range:用 500 根随机 K 线,检查「HA 最高 ≥ 真实最高、HA 最低 ≤ 真实最低」这个一定成立的性质。这种性质测试不检查具体数字,而是检查无论输入是什么都必须成立的关系。test_renko_needs_two_bricks_to_reverse:专门检查两块砖反向的规则。价格从 110 跌到 100.5,已经跌了一块砖的距离,但不能反向。
pytest -q
.....................................                                    [100%]
37 passed in 0.40s
八、数据怎么说
把这一篇的统计汇总在一起:
| SPY | AAPL | BTC | |
|---|---|---|---|
| 实体占全长比例(中位数) | 0.47 | 0.46 | 0.41 |
| 十字星(实体 < 10%)的比例 | 10.5% | 10.9% | 11.8% |
| K 线颜色和当天涨跌相反的日子 | 20.2% | 17.2% | 0.1% |
| 十年涨幅:隔夜 / 日内 | ×2.40 / ×1.47 | ×1.04 / ×11.06 | —— / ×18.74 |
| HA 开盘价落在真实价格范围之外 | 57.7% | 57.6% | 46.5% |
| HA 同色连续根数(真实 K 线) | 3.77(2.00) | 4.00(1.98) | 4.24(1.88) |
| HA 变色策略:HA 价格 / 真实收盘 / 次日开盘 | ×8.97 / ×2.01 / ×1.80 | ×59.59 / ×4.43 / ×1.46 | ×131,538 / ×32.48 / ×32.57 |
| 用 HA 价格算风险,实际风险偏高 50% 以上 | 16.5% | 17.4% | 17.7% |
只有 BTC 有 1 分钟数据的统计:
| 结果 | |
|---|---|
| 阳线里先低后高的比例 / 阴线里先高后低的比例 | 86.6% / 89.1% |
| 最高价出现在第一个小时(随机游走理论) | 15.7%(13.1%) |
| 止损止盈 ±2% 都被碰到的日子 | 391 天(11.8%) |
| 这些日子里:假设先止盈 / 假设先止损 / 按阴阳线猜 / 真实 | +745.0% / −819.0% / −83.0% / −55.0% |
| 「先高后低」和「先低后高」的阳线,次日收益差异的 t 值 | 0.75(不显著) |
| 最后两小时涨跌和次日涨跌的相关系数(去掉 2020 年) | −0.056(−0.027) |
| 每块 5% 的 Renko:日线收盘构造 / 1 分钟收盘构造 | 541 块、123 次反向 / 972 块、300 次反向 |
| Renko 变色策略:砖块价格 / 真实收盘 | ×281.81 / ×14.71 |
从这两张表可以读出:
- K 线丢掉的路径,对回测的影响远大于对预测的影响。 日内路径没有稳定地预测第二天,但它决定了止损止盈谁先触发,让同一个回测的结果在 ±800% 之间摇摆。
- 美股的 K 线实体漏掉了隔夜。 SPY 每五天就有一天颜色和涨跌相反,十年涨幅的大部分发生在收盘到开盘之间。
- 任何「改造过的价格」都不能用来成交。 HA 和 Renko 的回测,按图上价格算和按真实价格算,差距从几倍到几千倍。
⚠️ 美股这一篇只能做日线层面的分析:免费的公开数据里没有 SPY 和 AAPL 的分钟线。所以「止损止盈谁先触发」的歧义,在美股上无法用真实数据核对,回测时只能用悲观假设。
九、常见误用
1. 合成大周期时,把占位 K 线的价格当成成交价。 2017 年的 BTC 数据里,直接合成会让 41 天的开盘价出错。先去掉成交量为 0 的 K 线再合成。
2. 合成时不确认时间戳标在开始还是结束。 标错会让每一根 K 线错位一个周期。第 7 篇会展示这个错误在回测里造成的后果。
3. 把美股 K 线的颜色当成当天的涨跌。 SPY 有 20.2% 的日子两者相反。2025 年 4 月 7 日是一根实体 3.1% 的大阳线,当天却下跌了 0.18%。
4. 用日线回测止损和止盈距离很近的规则,而不说明对歧义日的假设。 ±2% 时,同一个回测可以是 +745% 也可以是 −819%。至少要用悲观假设,最好用更小周期的数据核对。
5. 以为「阳线先低后高、阴线先高后低」的猜法足够准确。 在真正需要猜的歧义日里,它只猜对 74%,±3% 时连结果的正负都猜反了。
6. 看到最高价、最低价集中在开盘和收盘附近,就认为开盘和收盘有特殊意义。 随机游走本身就会产生这种 U 形分布。先和随机情况比较,再谈规律。
7. 用 Heikin-Ashi 的价格回测。 BTC 上同一个规则,按 HA 收盘价是 131,538 倍,按真实收盘价是 32 倍。
8. 用 Heikin-Ashi 的价格计算止损距离和仓位。 大约 17% 的交易实际风险比计划高出 50% 以上,另有约 25% 不到计划的三分之二。
9. 用 Renko 砖块的价格回测,或者忽略 Renko 对数据源和起点的依赖。 砖块价格回测是 281.81 倍,真实价格是 14.71 倍。换成 1 分钟数据构造,反向次数从 123 变成 300;起点挪一天,砖块数从 541 变成 524。
十、这一篇能回答什么,不能回答什么
| 这一篇能帮你回答 | 这一篇不能回答 |
|---|---|
| 一根 K 线的每个数字是怎么来的,合成时要注意什么 | 某种 K 线形状之后会涨还是会跌(第 16 篇检验 K 线组合) |
| 一根日线丢掉了哪些信息 | 在 K 线位置不同时,同样的形状意味着什么(第 8、9 篇) |
| 日线回测里止损止盈的歧义有多大 | 美股的歧义有多大(没有免费的分钟数据) |
| HA 和 Renko 的价格偏离真实价格多少 | HA 或 Renko 的信号本身有没有价值(需要第六部分的方法检验) |
| 美股的涨幅在隔夜和日内之间怎么分配 | 隔夜和日内的差异能不能在扣除成本后交易(第 28 篇) |
十一、小结
-
K 线是有损压缩。 开盘是第一笔成交,最高、最低是极值,收盘是最后一笔成交,成交量是总和。合成大周期时规则相同,时间戳要明确标在开始还是结束。
-
原始数据的坑会传递到合成结果。 用 BTC 1 分钟线合成日线,占位 K 线让 41 天的开盘价出错,去掉之后剩下 16 天,都在时间戳偏移的时期。
-
实体通常只占全长的 40% 多。 一半以上的波动在影线里。
-
K 线颜色 ≠ 当天涨跌。 阳线比的是开盘,涨跌比的是前一天收盘。SPY 有 20.2% 的日子两者相反,BTC 几乎没有。
-
美股的一大块涨幅在 K 线实体之外。 SPY 十年 3.52 倍,隔夜 2.40 倍、日内 1.47 倍;AAPL 正好相反。
-
K 线丢掉了路径。 阳线里 86.6% 先低后高,但仍有 13.4% 是反过来的。最高最低价集中在一天的两端,主要是随机游走的数学性质。
-
路径对回测影响巨大,对预测几乎没有稳定作用。 ±2% 止损止盈时,11.8% 的日子无法从日线判断结果,不同假设让回测在 +745% 和 −819% 之间摇摆;而日内路径特征对次日涨跌的预测,要么不显著,要么只来自 2020 年。
-
Heikin-Ashi 是平均出来的 K 线。 HA 开盘是 HA 收盘的指数均线,所以 HA 的颜色本质上是一个短均线信号。它让趋势看起来更连续,代价是一半左右的 HA 开盘价从未成交过。
-
不要用 HA 的价格成交、回测、算风险。 BTC 回测从 32 倍虚增到 13 万倍;用 HA 价格算仓位,四成以上交易的实际风险和计划相差悬殊。
-
Renko 去掉了时间。 它过滤了小的震荡,但也丢掉了「用了多久」;结果取决于构造用的数据和起点;砖块价格同样不能用来成交。
最后回到那场篮球赛。比分摘要告诉你谁赢了、赢了多少、最多领先和落后多少,这些信息是真实可靠的,它就是真实 K 线。状态分(HA)和「每 5 分记一笔」(Renko)能帮你更快地看出趋势,但它们是解读,不是记录。而无论是摘要还是解读,都没有告诉你比赛是怎么打的。当你的交易规则依赖「比赛过程」时(先碰到止损还是先碰到止盈),你需要的是录像,也就是更小周期的数据,而不是更漂亮的摘要。
下一篇继续讨论周期:周线在涨,小时线在跌,该听谁的? 以及把不同周期的 K 线放在一起时,一个几乎所有人都犯过的前视偏差。
练习
练习 1(手算) 下面是某天 6 根 1 小时 K 线(UTC 0 点到 6 点),第 3 根的成交量为 0:
| 小时 | 开盘 | 最高 | 最低 | 收盘 | 成交量 |
|---|---|---|---|---|---|
| 0 | 100 | 102 | 99 | 101 | 50 |
| 1 | 101 | 101 | 97 | 98 | 80 |
| 2 | 98 | 98 | 98 | 98 | 0 |
| 3 | 98.5 | 103 | 98 | 102 | 120 |
| 4 | 102 | 104 | 101 | 101.5 | 60 |
| 5 | 101.5 | 102 | 100 | 100.5 | 40 |
- (a) 把它们合成两根 3 小时 K 线(0–2 点、3–5 点)。
- (b) 如果第 0 根也是成交量为 0 的占位 K 线,开盘价 99.5,合成结果的哪个数字会变?
traded_only=True时又是多少? - (c) 合成一根 6 小时 K 线,计算它的实体占比和收盘位置。它是先出现最高价还是最低价?
练习 2(数据) 对 AAPL 和 SPY,按年统计「K 线颜色和当天涨跌相反」的比例。哪些年份最高?这和那一年的波动率(第 5 篇)有什么关系?
练习 3(数据)
用 BTC 的 1 分钟数据,对止损 −2%、止盈 +4%(不对称)重复第四节的歧义分析。歧义日有多少?「按阴阳线猜」的准确率是多少?再把日线换成 4 小时线(先用 resample_ohlcv 从 1 分钟合成),每根 4 小时 K 线开盘买入,止损止盈 ±1%,歧义的比例是更高还是更低?
练习 4(数据 + 思考) 第四节发现,最高价出现在第一个小时的比例(15.7%)比随机游走理论(13.1%)高,出现在最后一个小时的比例(8.0%)比理论低得多。
- (a) 把「一天」的切点换成北京时间 0 点(UTC 16 点),重新统计。U 形的不对称还在吗?
- (b) 结合第 2 篇讲的「整点的被迫交易」和这一篇的成交额分布,提出一个解释,并设计一个统计来检验它。
练习 5(编程)
给 talab.bars 增加一个函数 heikin_ashi_fast(df),不用循环,用 pandas 的 ewm 计算 HA 开盘。提示:HA 开盘是 HA 收盘向后错一位之后的指数加权平均,alpha=0.5,并且要正确处理第一根的初始值。写一个测试,检查它和 heikin_ashi 在 1,000 根随机 K 线上的结果完全一致(误差小于 1e-9)。
练习 6(编程 + 数据) 第六节的 Renko 策略按真实收盘价只有 14.71 倍,不如一直持有。把砖块大小分别换成 3%、5%、8%、12%,重新计算按砖块价格和按真实收盘价的结果。
- (a) 砖块越大,「砖块价格」和「真实价格」之间的差距是变大还是变小?为什么?
- (b) 对每个砖块大小,再把起点从 2017-08-17 依次挪到之后的 10 天,看看按真实价格计算的结果变化有多大。这说明了什么?
小检查答案
小检查 1
(a) 收盘 201 < 开盘 206,是阴线。收盘 201 > 前一天收盘 200,当天上涨 0.5%。颜色和涨跌相反。
(b)
- 实体 = 201 − 206 = −5(阴线)
- 上影线 = 208 − max(206, 201) = 2
- 下影线 = min(206, 201) − 199 = 2
- 全长 = 208 − 199 = 9(验证:5 + 2 + 2 = 9)
- 实体占比 = 5 ÷ 9 = 0.556
- 收盘位置 = (201 − 199) ÷ 9 = 0.222
(c) 隔夜:206 ÷ 200 − 1 = +3.00%。日内:201 ÷ 206 − 1 = −2.43%。合计:1.03 × 0.9757 − 1 = +0.50%,和 (a) 一致。这一天的上涨全部来自隔夜,K 线实体显示的是日内的下跌。
小检查 2
(a) 第 1 根:
- HA 收盘 = (100 + 110 + 95 + 105) ÷ 4 = 102.5
- HA 开盘 = (98 + 102) ÷ 2 = 100
- HA 最高 = max(110, 100, 102.5) = 110
- HA 最低 = min(95, 100, 102.5) = 95
第 2 根:
- HA 收盘 = (105 + 108 + 98 + 100) ÷ 4 = 102.75
- HA 开盘 = (100 + 102.5) ÷ 2 = 101.25
- HA 最高 = max(108, 101.25, 102.75) = 108
- HA 最低 = min(98, 101.25, 102.75) = 98
(b) 第 2 根真实 K 线收盘 100 < 开盘 105,是阴线。HA 收盘 102.75 > HA 开盘 101.25,是阳线。真实价格已经从 105 跌到 100,HA 仍然显示上涨,这就是 HA 的滞后:它的开盘是过去价格的均线,要等平均值真正跌下来,颜色才会变。
小检查 3
(a) 一共 4 块砖:
| 价格 | 判断 | 结果 |
|---|---|---|
| 50 | 起点 | —— |
| 52 | ≥ 50 + 2 | ↑ 50 → 52(第 2 个价格) |
| 54.5 | ≥ 52 + 2 | ↑ 52 → 54(第 3 个价格) |
| 53 | 向上需要 ≥ 56,反向需要 ≤ 50 | 无 |
| 51 | 同上 | 无 |
| 49.5 | ≤ 50 | ↓ 52 → 50(第 6 个价格) |
| 47 | ≤ 50 − 2 = 48 | ↓ 50 → 48(第 7 个价格) |
| 48 | 继续向下需要 ≤ 46,反向需要 ≥ 50 + 2 = 52 | 无 |
(b) 最后一块砖是 52 → 54 的向上砖。向下反向要越过这块砖的另一端(52),再走一块砖,也就是 ≤ 50。51 离 50 还差 1,所以不画。从 54.5 算起跌了 6.4%,但 Renko 只看砖块的边界,不看从最高点跌了多少。