| 本篇位置 | 第二部分「读懂价格行为」的第三篇。第 9 篇的支撑阻力、第 11 篇的市场状态、第 16–18 篇的形态识别,都建立在这一篇的摆动点上 |
| 用到的数据 | BTCUSDT 现货日线(2017-08 至 2026-08);SPY、AAPL 日线(2016-09 至 2026-09) |
| 动手 | 写 talab.structure 模块:分形、ZigZag、趋势状态、效率比、回归斜率、ADX,附 11 个测试 |
| 读完你能 | 用代码找出摆动点并说清它什么时候才被确认;把「上升趋势」写成一条不依赖眼睛的规则;识别回测里的摆动点前视偏差;读懂三种趋势强度指标,知道它们在随机数据里会给出什么数字 |
一、先做一个决定
现在是 2024 年 10 月 16 日 UTC 24:00,BTC 日线刚刚收盘,收在 67,620.01。你和朋友在看同一张图:
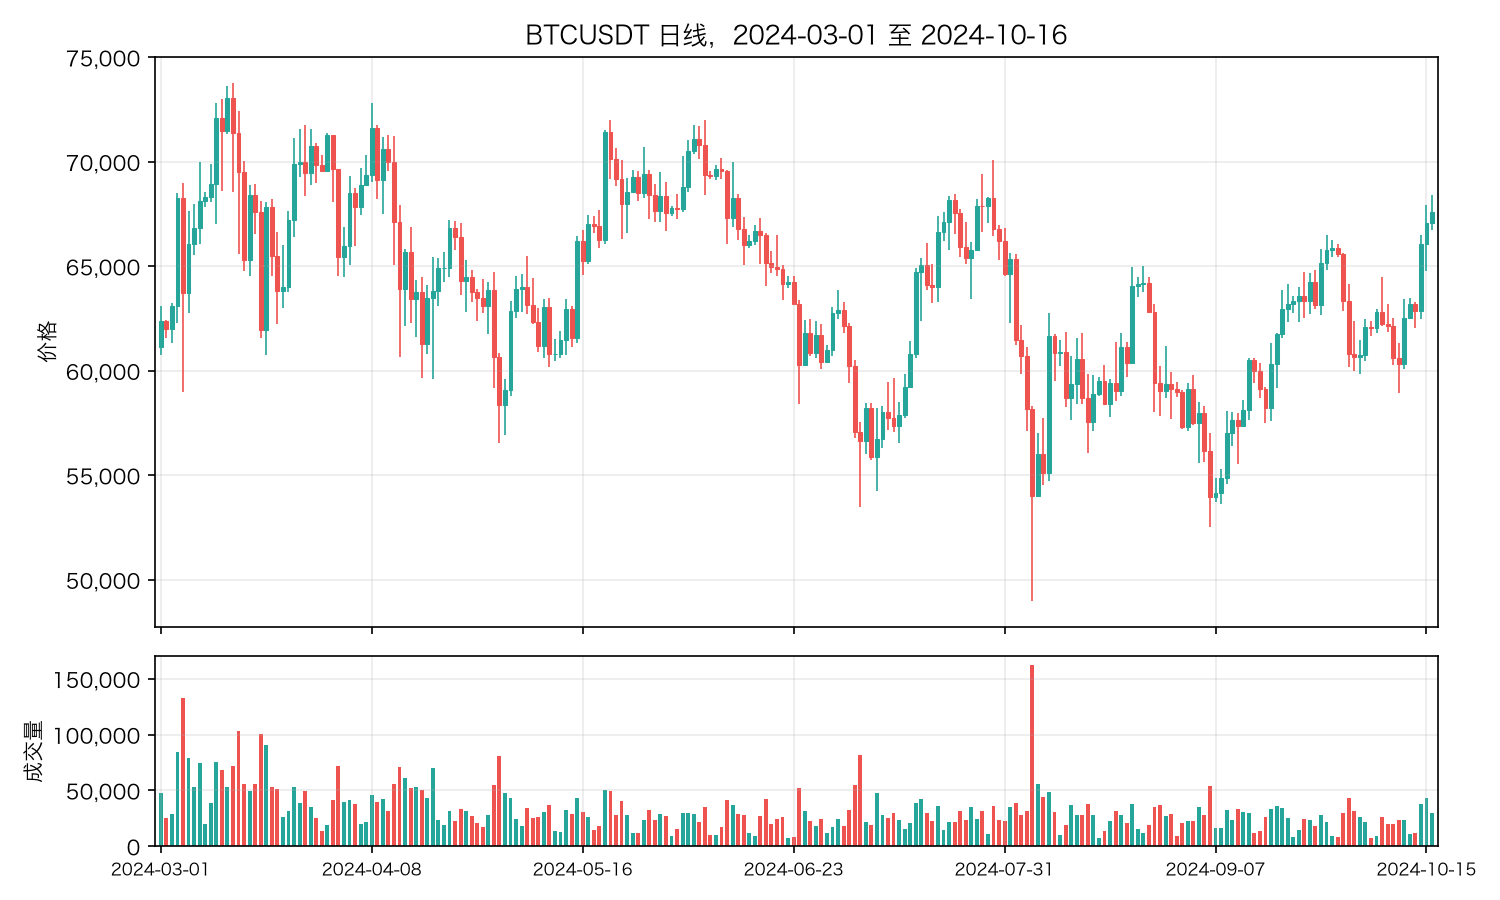
你说:这是上升趋势。 8 月 5 日全球股市暴跌那天,BTC 最低跌到 49,000;9 月 6 日的低点是 52,550;10 月 10 日的低点是 58,946。低点一个比一个高。这几天连涨三天,已经越过了 9 月底的高点。
朋友说:这是震荡。 3 月 14 日创下 73,777 的历史最高价之后,整整 7 个月,价格一直在 49,000 到 73,777 之间来回。现在的价格在区间的中上部,离 3 月的高点还差 9%。7 个月没有新高,怎么能叫上升趋势?
你们都有道理,也都是「看出来」的。你会怎么做?
- A. 按上升趋势做:买入或者继续持有,止损放在 10 月 10 日的低点下方
- B. 按震荡做:价格已经在区间的上半部分,不追,甚至准备在 70,000 以上减仓
- C. 等:等价格突破 73,777 再说
先写下你的选择。 第七节会揭晓之后的走势。
在揭晓之前,这一篇要回答一个更基本的问题:「趋势」能不能有一个算得出来的定义? 如果能,你和朋友之间的分歧,就可以变成「你们用的是哪一个定义」这样一个可以核对的问题。
二、趋势到底指什么
打个比方:登山
想象你在一条山脊上徒步。脚下的路一会儿上坡、一会儿下坡,你经过一座又一座山峰,也穿过一个又一个山谷。
- 如果每一座山峰都比上一座高,每一个山谷也比上一个高,你就是在往上走,哪怕此刻脚下正在下坡
- 如果山峰和山谷都一个比一个低,你就是在往下走
- 如果山峰越来越低、山谷却越来越高,或者反过来,你很难说自己在往哪个方向走
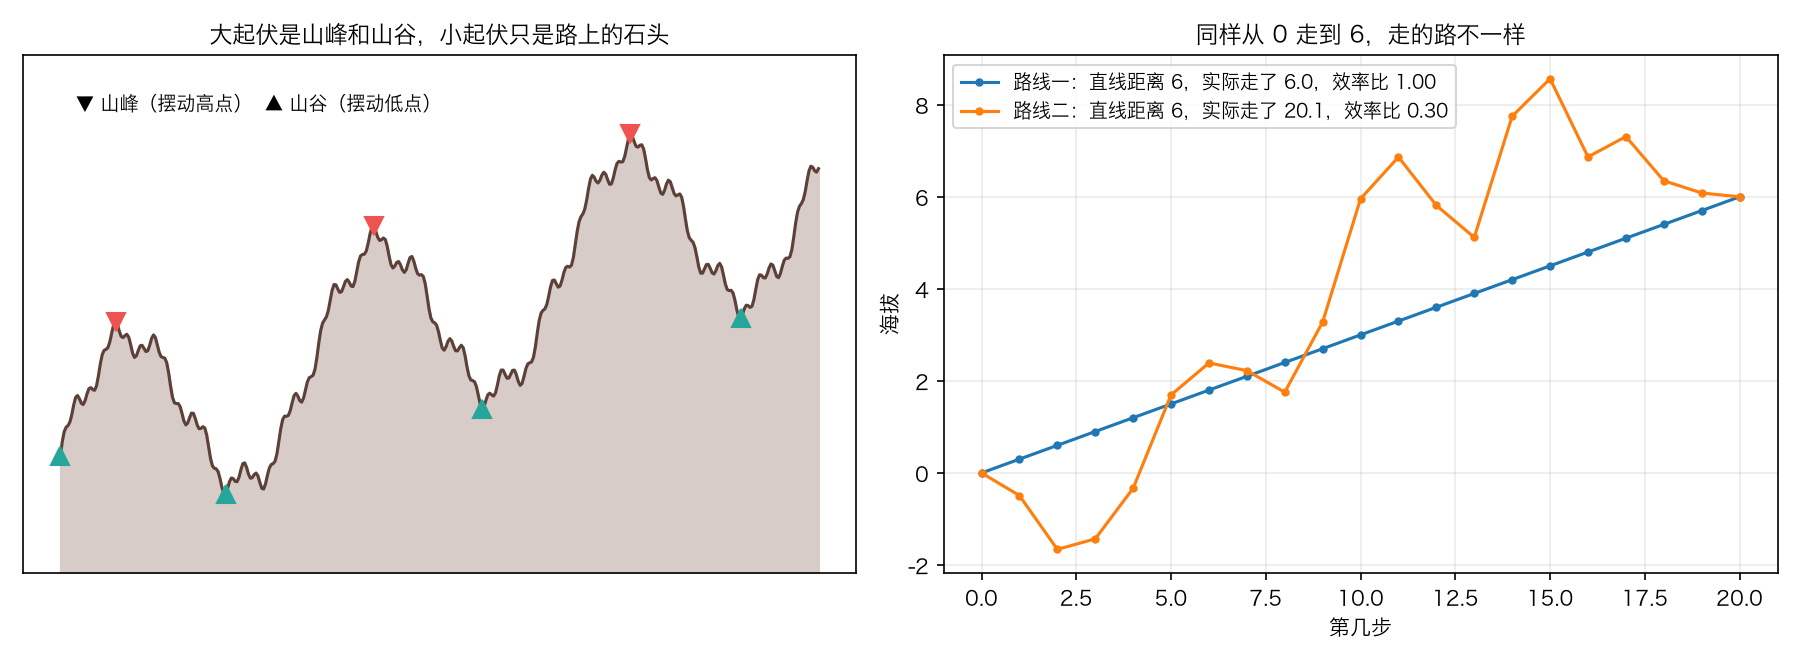
这就是技术分析里最古老的趋势定义。道氏理论(第 18 篇会讲)用高点和低点来描述趋势:上升趋势是高点和低点都在抬高,下降趋势是高点和低点都在降低。 这一篇里,价格图上的「山峰」叫摆动高点,「山谷」叫摆动低点。
这个定义听起来很清楚,但一写成代码,马上会遇到三个问题。
问题一:多高的起伏才算一座山
路上的一块石头也会让你先上后下,但你不会把它叫作一座山。左边那张图里,只有大的起伏被标成了山峰和山谷,小的起伏只是路上的石头。
价格也一样。BTC 日线几乎每天都在上下波动,每一个小波动都算摆动点吗?如果算,高低点结构每几天就会变一次;如果只算大的,多大才算大?
问题二:什么时候才知道那是山顶
你走在山路上,到达最高点的那一刻,你并不知道这是山顶。你要往下走一段,才能确定刚才那里是最高点。往下走多远才能确定?走一步不够,前面可能只是一个小坑。
价格图上也一样。一个摆动高点,必须等价格离开它一段距离之后才能被确认。确认之前,它不存在;确认之后,它已经是过去的事了。
问题三:方向不一致算什么
高点在降低、低点却在抬高(价格在收窄),或者高点在抬高、低点却在降低(价格在放大),这些都不是上升或下降。这一篇把它们统称为「震荡」,第 11 篇会把它们细分成更多的市场状态。
接下来三节,依次回答前两个问题:先介绍两种找摆动点的算法(第三、四节),再讲摆动点的确认和重绘(第五节)。第六节把高低点变成趋势状态。
三、摆动点算法一:分形
定义
分形(fractal)来自 Bill Williams 1995 年的《Trading Chaos》。最常见的版本用 5 根 K 线:
中间那根 K 线的最高价,高于左边 2 根和右边 2 根的最高价,它就是一个摆动高点。
中间那根 K 线的最低价,低于左边 2 根和右边 2 根的最低价,它就是一个摆动低点。
左右各几根,是一个参数。这一篇把它写成 left 和 right。
还有一个细节:两根 K 线的最高价相同时怎么办? talab 的规则是:左边要「严格高于」,右边只要「不低于」。这样连续几根最高价相同时,只有第一根算高点,结果是确定的。
手算一遍
下面是 9 根 K 线(左右各 2 根):
| 下标 | 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 |
|---|---|---|---|---|---|---|---|---|---|
| 最高价 | 10 | 11 | 13 | 12 | 11 | 12 | 12 | 11 | 10 |
| 最低价 | 9 | 10 | 12 | 11 | 8 | 10 | 11 | 10 | 9 |
- 下标 2:最高价 13,高于左边的 10、11,也不低于右边的 12、11。摆动高点。
- 下标 4:最低价 8,低于左边的 12、11,也不高于右边的 10、11。摆动低点。
- 下标 5 和 6:最高价都是 12。下标 5 左边 2 根里有下标 3 的 12,下标 6 左边 2 根里有下标 5 的 12,都不是「严格高于」,所以都不算高点。
- 下标 0、1、7、8:左边或右边不够 2 根,没法判断。
最关键的是确认时间。下标 2 的高点,要等右边的下标 3 和下标 4 都收盘,才知道它们的最高价不超过 13。所以这个高点在下标 4 收盘时才被确认,比它出现晚了 2 根 K 线。同理,下标 4 的低点在下标 6 收盘时确认。
分形的确认滞后是固定的,等于 right。
在真实数据上
f2 = X.fractals(before["high"], before["low"], 2, 2)
print(f2[f2["time"] >= "2024-09-01"].to_string(index=False))
                     time    price  kind              confirmed_at
2024-09-03 00:00:00+00:00 59809.65     1 2024-09-05 00:00:00+00:00
2024-09-06 00:00:00+00:00 52550.00    -1 2024-09-08 00:00:00+00:00
2024-09-09 00:00:00+00:00 58088.00     1 2024-09-11 00:00:00+00:00
2024-09-13 00:00:00+00:00 60625.00     1 2024-09-15 00:00:00+00:00
2024-09-16 00:00:00+00:00 57493.30    -1 2024-09-18 00:00:00+00:00
2024-09-20 00:00:00+00:00 64133.32     1 2024-09-22 00:00:00+00:00
2024-09-26 00:00:00+00:00 62670.00    -1 2024-09-28 00:00:00+00:00
2024-09-27 00:00:00+00:00 66498.00     1 2024-09-29 00:00:00+00:00
2024-10-03 00:00:00+00:00 59828.11    -1 2024-10-05 00:00:00+00:00
2024-10-07 00:00:00+00:00 64478.19     1 2024-10-09 00:00:00+00:00
2024-10-10 00:00:00+00:00 58946.00    -1 2024-10-12 00:00:00+00:00
每一行是一个摆动点:time 是它所在的 K 线,kind 是 1(高点)或 −1(低点),confirmed_at 是确认的那根 K 线。before 是截止到 10 月 16 日的日线(before = day.loc[:t]),所以这里只会出现 10 月 16 日之前已经确认的摆动点。
注意 9 月 9 日和 9 月 13 日:连续两个高点,中间没有低点。 分形只看局部的 5 根 K 线,不保证高点和低点交替出现。
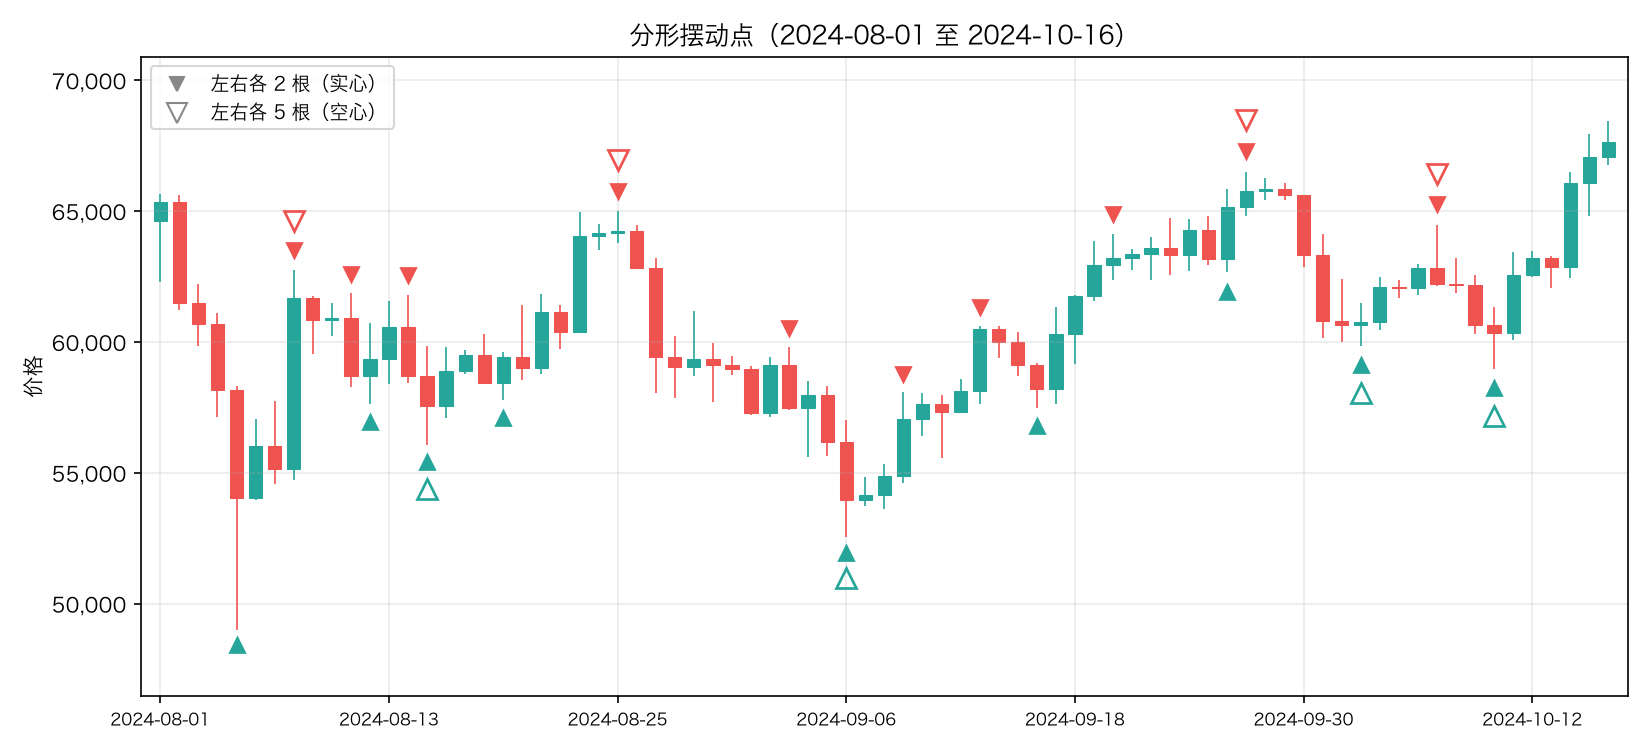
把参数调大,摆动点会变少,但这个问题不会消失:
for n in [2, 5, 10]:
    f = X.fractals(day["high"], day["low"], n, n)
    kinds = f["kind"].to_numpy()
    repeats = int((kinds[1:] == kinds[:-1]).sum())
    print(f"左右各 {n} 根:{len(f)} 个摆动点(高点 {(f['kind'] == 1).sum()},低点 {(f['kind'] == -1).sum()}),"
          f"相邻两个是同一种的 {repeats} 次")
左右各 2 根:903 个摆动点(高点 448,低点 455),相邻两个是同一种的 184 次
左右各 5 根:405 个摆动点(高点 193,低点 212),相邻两个是同一种的 74 次
左右各 10 根:209 个摆动点(高点 101,低点 108),相邻两个是同一种的 37 次
9 年的 BTC 日线,左右各 2 根的分形找出了 903 个摆动点,平均 3.7 天一个。这更像是路上的石头,而不是山峰。
分形的问题在于:它只用「几根 K 线」来衡量大小,不看价格走了多远。 一段 2% 的小波动和一段 30% 的大行情,只要形状符合,都算一个摆动点。
四、摆动点算法二:ZigZag
定义
ZigZag 换了一个角度:不数 K 线,而是看价格从极值反向走了多远。它可以追溯到 Arthur Merrill 1977 年的《Filtered Waves》:只研究超过一定百分比的波动,更小的波动当作噪声过滤掉。
规则只有一句话:
价格从最近的最高点回落了
threshold(比如 10%),这个最高点就被确认为摆动高点,然后开始寻找下一个最低点;价格从最近的最低点反弹了threshold,这个最低点就被确认为摆动低点,然后开始寻找下一个最高点。
回到登山:你只把「往下走了至少 100 米」之前的那个最高点叫作山顶。 100 米就是阈值。阈值越大,被算作山的起伏越少。
这个定义自动保证了高点和低点交替出现:确认一个高点之后,只寻找低点,直到低点被确认。
手算一遍
阈值 10%,8 天的收盘价:
| 第几天 | 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 |
|---|---|---|---|---|---|---|---|---|
| 收盘价 | 100 | 105 | 112 | 108 | 100 | 95 | 104 | 110 |
一步一步走:
- 第 0 天:只有一个价格,最高点和最低点都是 100。
- 第 1、2 天:最高点更新为 105、112。第 2 天的 112 比最低点 100 高了 12%,超过 10%。第 0 天的 100 被确认为摆动低点(第 2 天确认)。现在开始寻找高点,候选是第 2 天的 112。
- 第 3 天:108,没有超过 112,也没有比 112 低 10%(要跌到 100.8 以下)。
- 第 4 天:100,比 112 低了 10.7%。第 2 天的 112 被确认为摆动高点(第 4 天确认)。开始寻找低点,候选是 100。
- 第 5 天:95,更低,候选低点更新为 95。
- 第 6 天:104,比 95 高 9.5%,还不够 10%(要涨到 104.5)。
- 第 7 天:110,比 95 高 15.8%。第 5 天的 95 被确认为摆动低点(第 7 天确认)。
结果是三个摆动点:100(第 0 天,第 2 天确认)、112(第 2 天,第 4 天确认)、95(第 5 天,第 7 天确认)。
两件事值得注意:
- 第一个摆动点是序列的第一天。 在它之前没有数据,算法只能把起点当作第一个低点。真实数据足够长时,这不影响后面的结果。
- 确认滞后不是固定的。 112 等了 2 天,95 也等了 2 天,但如果价格慢慢回落,可能要等几十天。
用收盘价,还是用最高价和最低价
上面的例子只用了收盘价。很多图表软件的 ZigZag 用最高价找高点、用最低价找低点,看起来更贴近 K 线。talab 选择只用一个价格序列,原因是第 6 篇讲过的问题:一根 K 线里,最高价和最低价的先后顺序是不知道的。
如果某一天创了新高,同一天的最低价又比这个新高低了 10% 以上,那么「先涨到新高、再回落 10%」和「先回落、再涨到新高」是两种完全不同的走法。前一种应该确认高点,后一种不应该。只看日线,分不清。
这种情况有多常见?用最高价和最低价的 ZigZag 数一下:
for th in [0.05, 0.10, 0.20]:
    found, unclear = zigzag_high_low(day["high"], day["low"], th)
    print(f"阈值 {th:.0%}:{found} 个摆动点,其中 {unclear} 个在同一根 K 线里分不清先后({unclear / found:.1%})")
阈值 5%:1645 个摆动点,其中 617 个在同一根 K 线里分不清先后(37.5%)
阈值 10%:542 个摆动点,其中 144 个在同一根 K 线里分不清先后(26.6%)
阈值 20%:132 个摆动点,其中 14 个在同一根 K 线里分不清先后(10.6%)
(zigzag_high_low 只在核对脚本 docs/trade-analysis/analysis/08_structure.py 里,用来数这个次数,不放进模块。)
10% 阈值下,超过四分之一的摆动点卡在这种分不清的 K 线上。用收盘价就没有这个问题:每天只有一个价格,先后顺序是确定的,而且收盘那一刻就是你能做决定的时刻。代价是:收盘价的 ZigZag 会忽略盘中的影线,比如 8 月 5 日的最低价是 49,000,收盘价是 54,018.81。
在真实数据上
z10 = X.zigzag(before["close"], 0.10)
print(z10.tail(6).to_string(index=False))
                     time    price  kind              confirmed_at
2024-05-20 00:00:00+00:00 71446.62     1 2024-06-21 00:00:00+00:00
2024-07-07 00:00:00+00:00 55857.81    -1 2024-07-15 00:00:00+00:00
2024-07-28 00:00:00+00:00 68249.88     1 2024-08-03 00:00:00+00:00
2024-08-05 00:00:00+00:00 54018.81    -1 2024-08-08 00:00:00+00:00
2024-08-25 00:00:00+00:00 64220.00     1 2024-09-01 00:00:00+00:00
2024-09-06 00:00:00+00:00 53962.97    -1 2024-09-13 00:00:00+00:00
截止到 10 月 16 日,10% ZigZag 最后一个已确认的摆动点是 9 月 6 日的低点 53,962.97。之后价格涨到了 67,620.01,但还没有从某个高点回落 10%,所以这一段上涨的最高点还没有被确认。
不同阈值下,摆动点的数量和确认滞后:
pos = pd.Series(np.arange(len(day)), index=day.index)
for th in [0.05, 0.10, 0.20, 0.30]:
    z = X.zigzag(day["close"], th)
    lag = pos[z["confirmed_at"]].to_numpy() - pos[z["time"]].to_numpy()
    print(f"阈值 {th:.0%}:{len(z)} 个摆动点,平均 {len(day) / len(z):.1f} 天一个;"
          f"确认滞后 中位数 {np.median(lag):.0f} 天,平均 {lag.mean():.1f} 天,最长 {lag.max()} 天")
阈值 5%:344 个摆动点,平均 9.6 天一个;确认滞后 中位数 3 天,平均 3.5 天,最长 25 天
阈值 10%:159 个摆动点,平均 20.8 天一个;确认滞后 中位数 5 天,平均 7.1 天,最长 35 天
阈值 20%:53 个摆动点,平均 62.3 天一个;确认滞后 中位数 15 天,平均 19.3 天,最长 71 天
阈值 30%:24 个摆动点,平均 137.6 天一个;确认滞后 中位数 28 天,平均 37.2 天,最长 114 天
阈值每翻一倍,摆动点的数量变成原来的一半到三分之一,确认滞后变长 1.7 到 3 倍。你想看的山越大,确认山顶要走的下坡路就越长。
⚠️ 阈值没有「正确」的值。 10% 对 BTC 日线来说是中等大小的波动,对 SPY 来说是一次大调整。第五篇讲过,BTC 的年化波动率大约是 SPY 的 3.7 倍,所以后面比较三个标的时,BTC 用 10%、AAPL 用 5%、SPY 用 3%,大致按波动率成比例。这是一种合理的选择,不是唯一的选择。
五、重绘:最后一个点的问题
图上的最后一段是假的吗
打开任何一个图表软件的 ZigZag 指标,你会看到折线一直连到最新的价格附近。但按照定义,最后一个极值还没有被确认。软件画出来的最后一段,连的是「到目前为止的最高点(或最低点)」,它随时可能被替换。
这就是 ZigZag 被称为会重绘(repaint)的指标的原因:昨天图上的最后一个点,今天可能移到了别的地方。
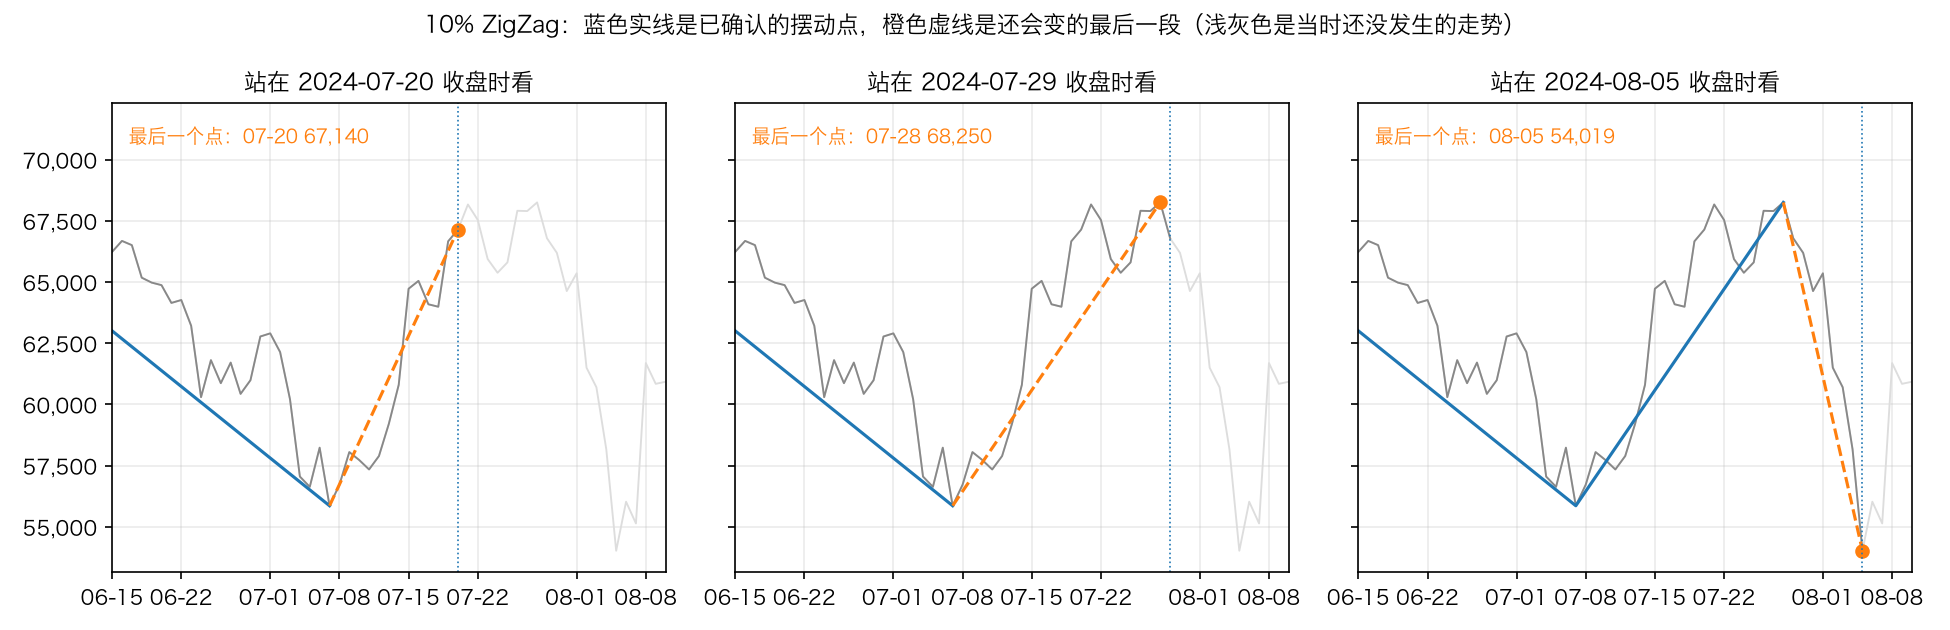
下面是 2024 年 7 月底到 8 月初,三个不同的日子收盘时看到的 10% ZigZag:
for d in ["2024-07-20", "2024-07-29", "2024-08-05"]:
    i = pos[pd.Timestamp(d, tz="UTC")]
    p = last_point(day["close"], X.zigzag(day["close"].iloc[:i + 1], 0.10), i)
    print(f"{d} 收盘时,10% ZigZag 的最后一个点:{p.date()} {day['close'][p]:,.2f}")
2024-07-20 收盘时,10% ZigZag 的最后一个点:2024-07-20 67,139.96
2024-07-29 收盘时,10% ZigZag 的最后一个点:2024-07-28 68,249.88
2024-08-05 收盘时,10% ZigZag 的最后一个点:2024-08-05 54,018.81
- 7 月 20 日:最后一个点在 67,139.96,看起来像一个高点。
- 7 月 29 日:它被替换了。最后一个点移到了 7 月 28 日的 68,249.88。
- 8 月 5 日:价格从 68,249.88 跌到 54,018.81,跌幅超过 10%。7 月 28 日的高点在 8 月 3 日已经被确认,现在最后一个点变成了 8 月 5 日的低点。它会不会被确认,还要看之后价格能不能反弹 10%。
last_point 按图表软件的画法,找出每一天「最近一个已确认摆动点之后的极值」:
def last_point(close, swings, day_i):
    """图上最后一个点:最近一个已确认摆动点之后的最低价(上一个是高点时)或最高价(上一个是低点时)。"""
    done = swings[pos[swings["confirmed_at"]].to_numpy() <= day_i]
    prev = done.iloc[-1]
    seg = close.iloc[pos[prev["time"]] + 1:day_i + 1]
    return seg.idxmin() if prev["kind"] == 1 else seg.idxmax()
把 9 年里的每一天都这样算一遍,看这个「最后一个点」后来有没有真的成为摆动点:
for th in [0.10, 0.20]:
    z = X.zigzag(day["close"], th)
    first = pos[z["confirmed_at"].iloc[0]]
    points = [last_point(day["close"], z, i) for i in range(first, len(day))]
    replaced = np.mean([p not in set(z["time"]) for p in points])
    distance = (day["close"][z["confirmed_at"]].to_numpy() / z["price"].to_numpy() - 1)
    print(f"阈值 {th:.0%}:图上最后一个点后来没有成为摆动点的天数占 {replaced:.1%};"
          f"确认那天的收盘价离摆动点 平均 {np.abs(distance).mean():.2%}")
阈值 10%:图上最后一个点后来没有成为摆动点的天数占 65.8%;确认那天的收盘价离摆动点 平均 12.65%
阈值 20%:图上最后一个点后来没有成为摆动点的天数占 69.2%;确认那天的收盘价离摆动点 平均 23.14%
三分之二的日子里,图上最后一个点后来被替换了。 而一个摆动点被确认的那天,价格离它平均已经有 12.65%(10% 阈值)。
这两个数字说的是同一件事的两面:
- 还没确认的点,大多数不是真的摆动点。 看着图上的最后一段做决定,等于把一个大概率会变的东西当成了事实。
- 确认的时候,价格已经离开摆动点很远了。 按定义,至少离开了一个阈值;因为价格在确认那天往往还会多走一点,平均比阈值还多。
回到登山:你站在一个坡顶,只有往下走了 100 米,才知道刚才那里是山顶。你永远没法在山顶上宣布「这是山顶」。
已确认的摆动点不会重绘
要区分两件事:
- 最后一段会变:这是 ZigZag 的定义决定的,任何实现都一样。
- 已经确认的摆动点不会变:只要算法只用到确认时刻之前的数据,确认过的摆动点在之后的任何一天都保持原样。
talab.structure.zigzag 的返回结果里只有已确认的摆动点,没有最后那一段。第十一节有一个性质测试专门检查第二件事:用前 50、123、250、399 天的数据分别计算,结果必须和用全部数据算出来、并且截止到那一天已经确认的摆动点完全一样。
按摆动点「发生」的时间回测
重绘本身不危险,危险的是在回测里把摆动点放在它发生的那天,而不是确认的那天。
用一个最直白的规则:摆动低点买入,摆动高点卖出。
def swing_backtest(close, swings, when):
    """摆动低点买入、摆动高点卖出。when 选择用摆动点所在的时间,还是确认的时间。"""
    signal = pd.Series(np.nan, index=close.index)
    for s in swings.sort_values(when).itertuples():
        signal[getattr(s, when)] = 1.0 if s.kind == -1 else 0.0
    position = signal.ffill().fillna(0)
    return (1 + position.shift(1).fillna(0) * close.pct_change().fillna(0)).prod()
for name, swings in [("ZigZag 10%", X.zigzag(day["close"], 0.10)), ("分形 2/2", X.fractals(day["high"], day["low"], 2, 2))]:
    print(f"{name}:按摆动点所在的时间 ×{swing_backtest(day['close'], swings, 'time'):,.0f},"
          f"按确认的时间 ×{swing_backtest(day['close'], swings, 'confirmed_at'):.2f}")
print(f"一直持有:×{day['close'].iloc[-1] / day['close'].iloc[0]:.2f}")
ZigZag 10%:按摆动点所在的时间 ×4,624,989,219,按确认的时间 ×7.71
分形 2/2:按摆动点所在的时间 ×57,990,765,按确认的时间 ×2.79
一直持有:×18.34
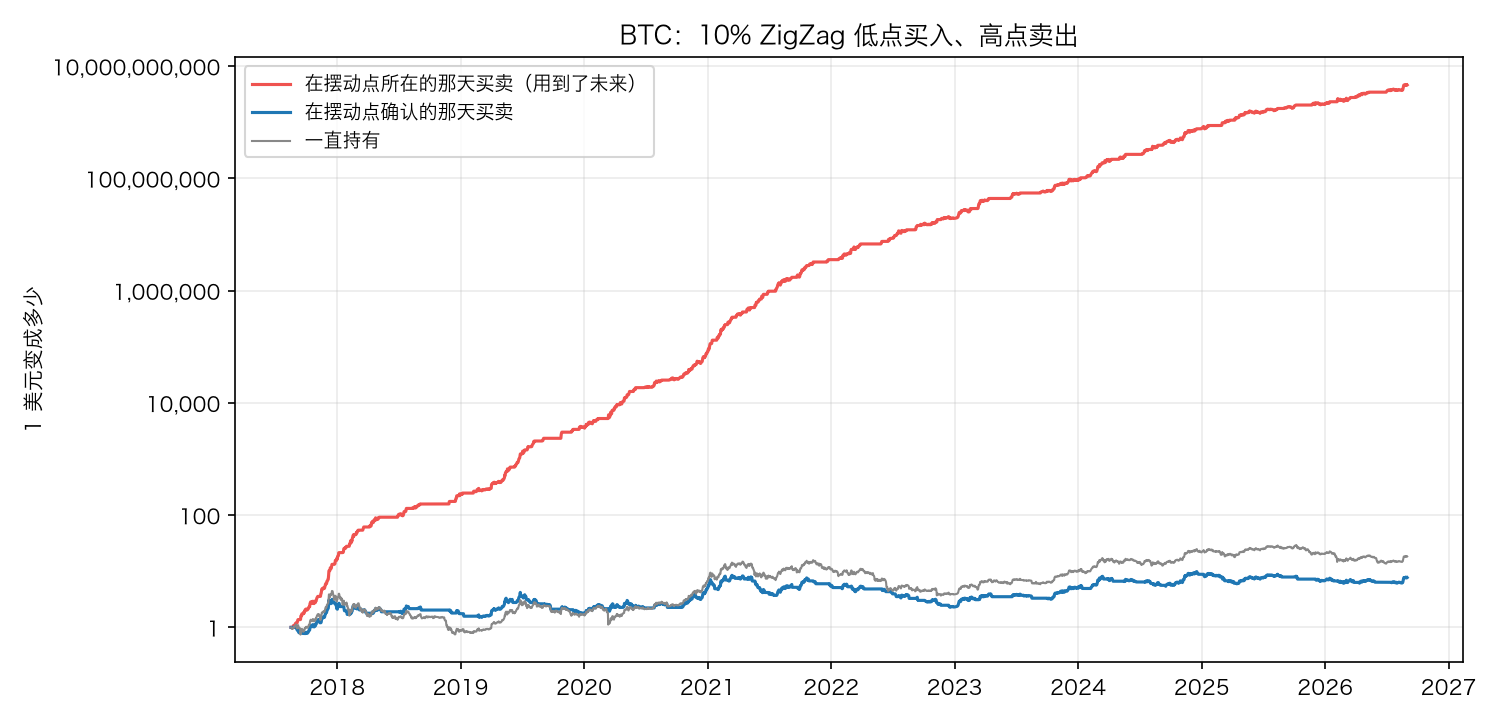
按摆动点所在的时间,1 美元变成 46 亿美元。按确认的时间,变成 7.71 美元,还不如一直持有。
46 亿倍的回测,每一笔都在最低点买入、在最高点卖出,每一段 10% 以上的波动都吃到了完整的一段。按确认时间回测,买入时价格已经从低点涨了 10% 以上,卖出时已经从高点跌了 10% 以上,每一段都损失掉两头。
分形也一样。它的滞后只有 2 天,前视偏差却让结果从 2.79 倍变成了 5,799 万倍。滞后再短,只要用了未来,结果就完全不能用。
这个错误在实际代码里很容易犯:很多摆动点函数返回的是「每根 K 线是不是摆动点」的布尔列,标在摆动点所在的那根 K 线上。直接拿这一列去生成信号,就等于提前 right 根(或者提前一个不确定的天数)知道了答案。这和第 7 篇的多周期前视偏差是同一类问题:一个信息,必须放在它能被知道的那一刻。 这也是 talab 的摆动点结果一定带有 confirmed_at 这一列的原因。
✋ 小检查 1
11 天的收盘价如下,用 10% 阈值的 ZigZag:
| 第几天 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 | 11 |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 收盘价 | 50 | 53 | 56 | 52 | 50 | 49 | 52 | 55 | 51 | 48 | 53 |
(a) 找出所有已确认的摆动点,以及它们各自在第几天被确认。
(b) 第 9 天收盘时,图表软件画出的「最后一个点」在哪里?它后来有没有成为摆动点?
(c) 如果改用分形(左右各 1 根,最高价和最低价都用收盘价),摆动点和确认时间有什么不同?
答案在文末。
六、把高低点变成趋势状态
规则
有了摆动点,就可以把第二节的定义写成规则。在每一根 K 线收盘时,只用已经确认的摆动点:
| 状态 | 最近两个高点 | 最近两个低点 |
|---|---|---|
| 上升(1) | 抬高 | 抬高 |
| 下降(−1) | 降低 | 降低 |
| 震荡(0) | 其他情况 | 其他情况 |
还没有两个高点和两个低点的时候,状态是空的。
「更高」有时不用等确认
这里有一个容易漏掉的细节。
假设最近两个已确认的高点是 16 和 17,最近的低点是 13。现在价格跌到了 12。新的低点还没有被确认(价格还没有反弹一个阈值),它最终会落在 12,还是 11,还是更低,现在都不知道。
但有一件事已经确定了:新的低点一定比 13 低。 因为价格已经到过 12,这一段的最低点只会是 12 或者更低。
所以 trend_state 在比较时,会检查「最近一个已确认高点之后,价格有没有已经超过它」,低点同理。超过了,就认为「更高」(或「更低」)已经成立,不用等新摆动点确认。
这不是用到了未来。新低点的具体价格是未来的信息,但「它比 13 低」是现在就知道的信息。 如果不这样处理,一段持续的暴跌在没有反弹之前,永远不会被识别为「低点在降低」,状态会严重滞后。
手算一遍
9 天的收盘价,以及手工给出的 6 个已确认摆动点:
| 第几天(下标) | 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 |
|---|---|---|---|---|---|---|---|---|---|
| 收盘价 | 10 | 14 | 12 | 16 | 13 | 17 | 15 | 12 | 11 |
| 当天确认的摆动点 | 低点 10 | 高点 14 | 低点 12 | 高点 16 | 低点 13 | 高点 17 |
- 下标 0 到 3:高点和低点还不够两个,状态为空。
- 下标 4:高点 14 → 16 抬高,低点 10 → 12 抬高。上升。
- 下标 5:新确认低点 13。此时最近已确认的高点是 16,但下标 5 收盘价 17 已经超过了 16,所以高点按 16 → 17(抬高)比较;低点 12 → 13 抬高。上升。
- 下标 6:确认高点 17。高点 16 → 17,低点 12 → 13。上升。
- 下标 7:收盘价 12,已经低于最近的低点 13。新低点还没确认,但「更低」已经确定。高点 16 → 17 抬高,低点 13 → 12 以下降低。方向不一致,震荡。
这个例子就是第十一节的 test_trend_state_by_hand。
另一种写法:突破版
上面的规则要求高点和低点同时抬高。它有一个明显的后果:从下降转为上升,必须先出现一个更高的低点,而更高的低点要等价格回调、再反弹一个阈值才能确认。一段没有回调的上涨,会一直停留在「震荡」。
很多交易者用的是另一种更快的写法:
收盘价突破最近一个已确认的高点,状态变成上升;跌破最近一个已确认的低点,状态变成下降;否则保持原来的状态。
这里叫它突破版。它只有上升和下降两种状态,没有震荡。talab 两种都提供:trend_state 是高低点版,break_state 是突破版。两者用的是同一批摆动点,区别只在规则。
决策点:同一天,三个答案
把两种规则、三个阈值和两种分形都用在 10 月 16 日:
rows = {}
for th in [0.05, 0.10, 0.20]:
    z = X.zigzag(before["close"], th)
    levels = X.trend_state(z, before["close"], before["close"])
    highs, lows = z[z["kind"] == 1]["price"].tail(2).tolist(), z[z["kind"] == -1]["price"].tail(2).tolist()
    rows[f"ZigZag {th:.0%}"] = {"最近两个高点": highs, "最近两个低点": lows,
                                "状态": levels["state"].iloc[-1], "突破版": X.break_state(levels, before["close"]).iloc[-1]}
for n in [2, 5]:
    f = X.fractals(before["high"], before["low"], n, n)
    levels = X.trend_state(f, before["high"], before["low"])
    rows[f"分形 {n}/{n}"] = {"最近两个高点": f[f["kind"] == 1]["price"].tail(2).tolist(),
                           "最近两个低点": f[f["kind"] == -1]["price"].tail(2).tolist(),
                           "状态": levels["state"].iloc[-1], "突破版": X.break_state(levels, before["close"]).iloc[-1]}
print(pd.DataFrame(rows).T.to_string())
print("10 月 16 日之前的最高收盘价(8 月 25 日之后):", before.loc["2024-08-26":, "close"].max())
                          最近两个高点                最近两个低点   状态  突破版
ZigZag 5%     [64220.0, 65858.0]  [53962.97, 60326.39]  1.0  1.0
ZigZag 10%   [68249.88, 64220.0]  [54018.81, 53962.97]  0.0  1.0
ZigZag 20%  [71446.62, 68249.88]  [55857.81, 53962.97] -1.0 -1.0
分形 2/2       [66498.0, 64478.19]   [59828.11, 58946.0]  0.0  1.0
分形 5/5       [66498.0, 64478.19]   [59828.11, 58946.0]  0.0  1.0
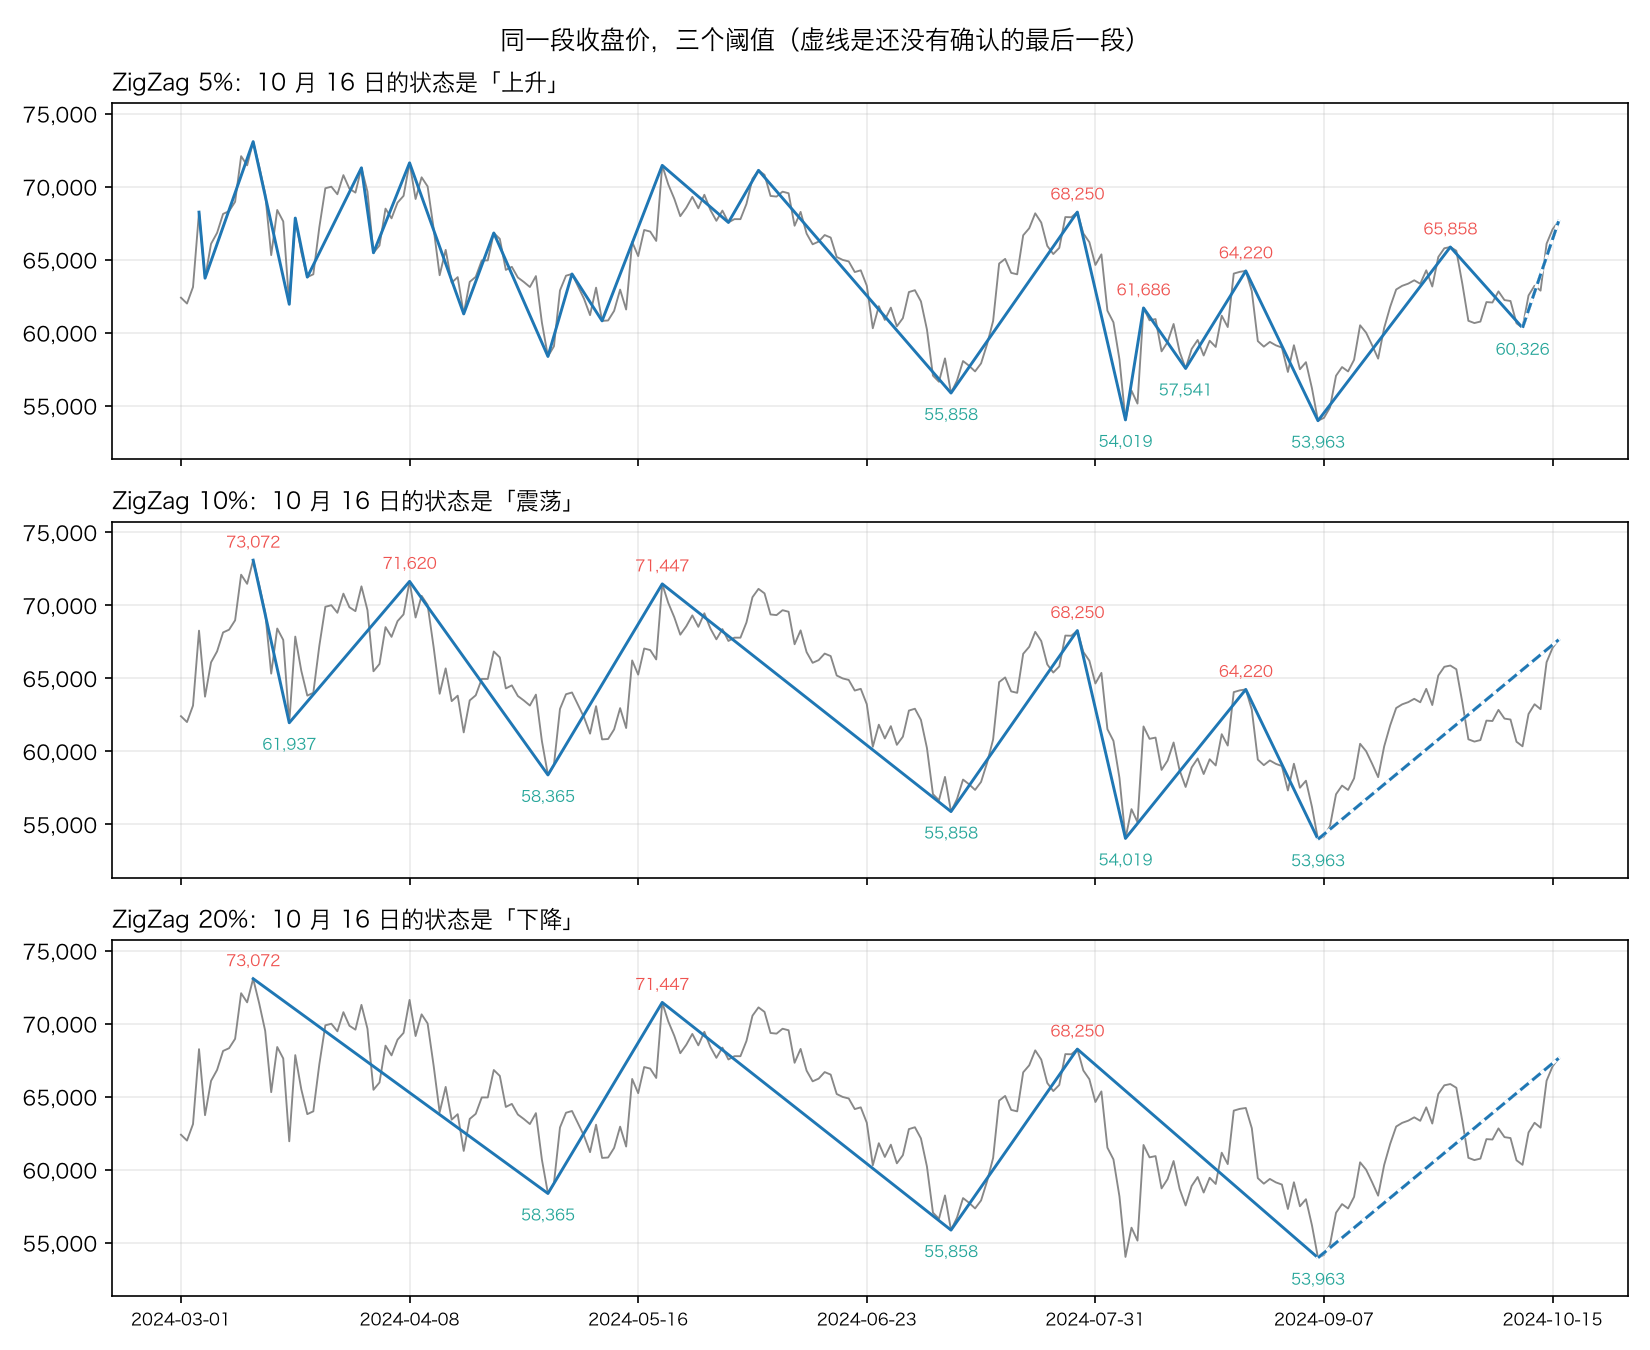
逐行读一遍:
ZigZag 5%:上升。 高点 64,220 → 65,858,低点 53,962.97 → 60,326.39,都在抬高。这就是你看到的趋势。
ZigZag 10%:震荡。 表里的两个高点 68,249.88 → 64,220 在降低,但 10 月 16 日的收盘价 67,620.01 已经超过了 64,220,「更高的高点」已经确定,所以高点按抬高算。低点 54,018.81 → 53,962.97 在降低。只低了 55.84 美元。 这 55.84 美元让 10% 的定义给出了「震荡」。
ZigZag 20%:下降。 高点 71,446.62 → 68,249.88,低点 55,857.81 → 53,962.97,都在降低。收盘价 67,620.01 离「更高的高点」68,249.88 还差 0.93%。这正是朋友说的「7 个月没有新高」。
分形:震荡。 高点 66,498 → 64,478.19 在降低,但 10 月 16 日的最高价 68,424 已经超过 64,478.19,按抬高算;低点 59,828.11 → 58,946 在降低。分形认的「最近两个低点」是 10 月 3 日和 10 月 10 日,而不是你心里的 8 月 5 日、9 月 6 日、10 月 10 日。
突破版在 5%、10% 和分形下都是上升,20% 下是下降:
ZigZag 10% 突破版:从 2024-09-24 起一直是 1,那天收盘 64,262.70,最近的高点 64,220.00,最近的低点 53,962.97
ZigZag 20% 突破版:从 2024-07-04 起一直是 -1,那天收盘 57,050.01,最近的高点 71,446.62,最近的低点 58,364.97
9 月 24 日收盘价 64,262.70 越过了 10% 的高点 64,220;而 20% 的下降状态来自 7 月 4 日跌破 58,364.97,之后价格再也没有收在 71,446.62 之上。
同一天,三个都说得出道理的定义,给出了上升、震荡、下降三个答案。 你和朋友的分歧,其实是「你们看的山有多大」的分歧:你看的是 5% 大小的起伏,朋友看的是 20% 大小的起伏。两个人都没有算错,只是在回答两个不同的问题。
所以「谁对」这个问题,要先换成两个可以回答的问题:
- 你的交易是按多大的波动设计的? 止损 5% 的交易,应该看 5% 左右的结构;准备拿几个月、能承受 20% 回撤的交易,应该看 20% 的结构。这和第 7 篇「先定下这笔交易按哪个周期做」是同一个道理。
- 这个定义之后,价格的表现有没有不同? 这是第八节要检验的。
七、揭晓
c = day["close"]
for n in [7, 30, 60]:
    print(f"{n} 天后({day.index[pos[t] + n].date()}):{c.iloc[pos[t] + n] / c[t] - 1:+.2%}")
after = day.loc["2024-10-17":"2024-12-31"]
print("之后 30 天最低价", day.loc["2024-10-17":"2024-11-15", "low"].min(), ";年底前最高价", after["high"].max(), after["high"].idxmax().date())
7 天后(2024-10-23):-1.41%
30 天后(2024-11-15):+34.62%
60 天后(2024-12-15):+54.49%
之后 30 天最低价 65260.0 ;年底前最高价 108353.0 2024-12-17
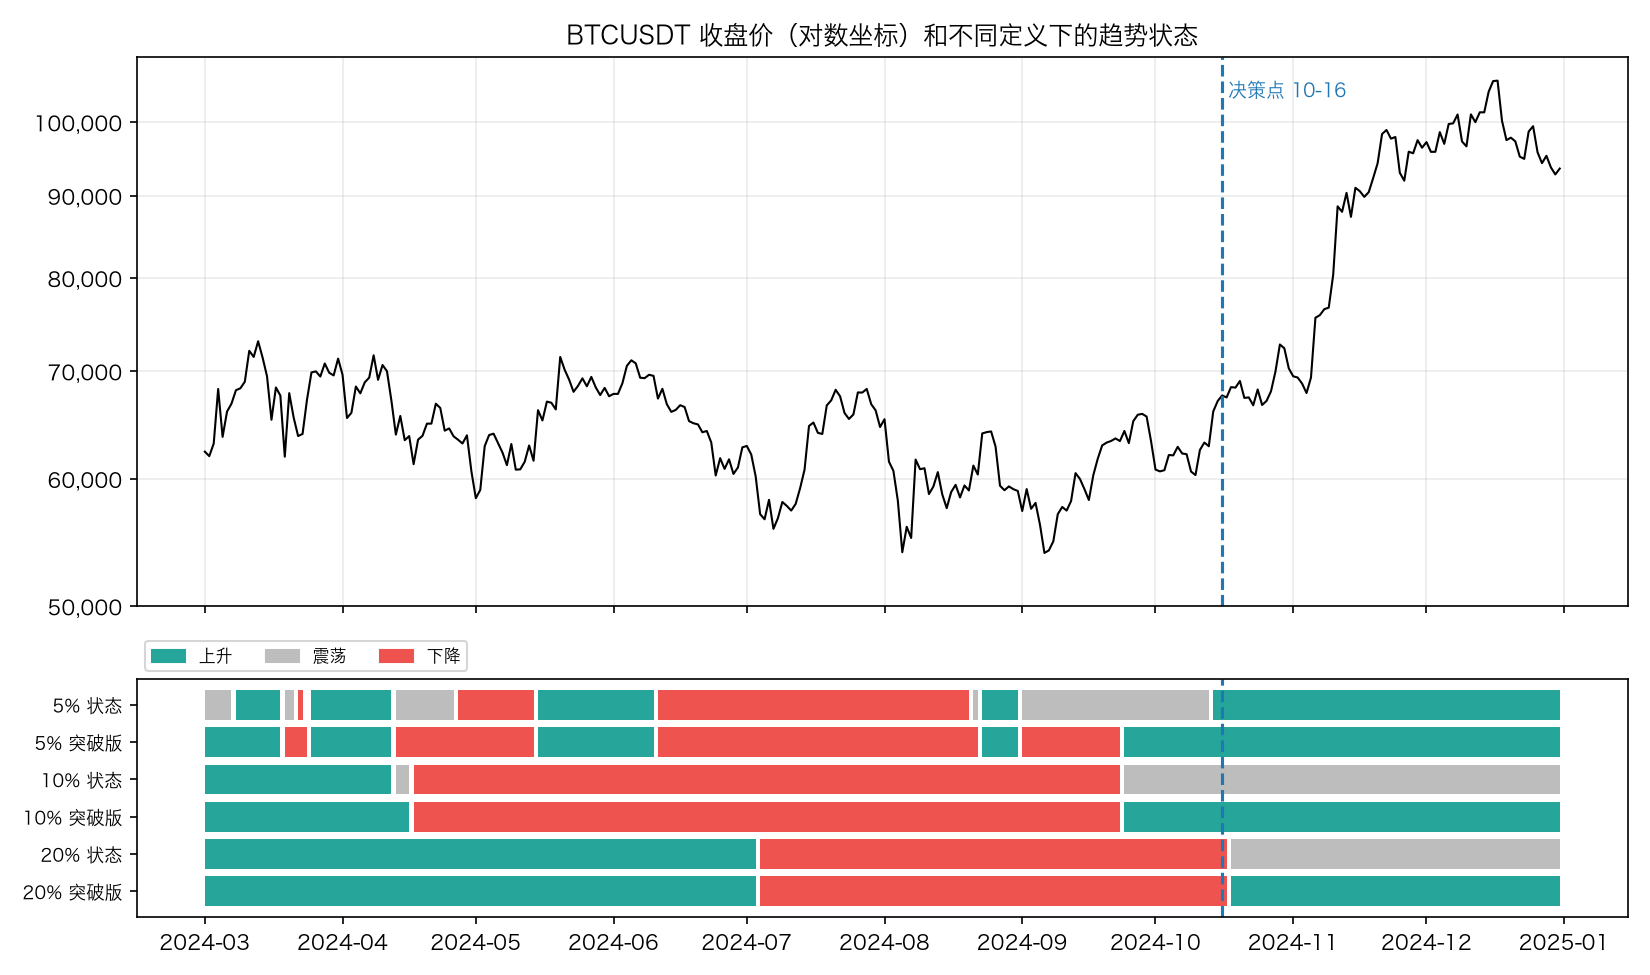
之后一周,价格小幅回落,最低到 65,260。11 月 5 日美国总统大选之后,BTC 连续上涨,11 月 6 日突破 3 月的高点,12 月 5 日第一次越过 100,000,12 月 17 日最高到 108,353。30 天后涨了 34.62%,60 天后涨了 54.49%。
看起来,说「上升趋势」的你赢了。但先别急着下结论,看看各个定义在之后几个月里是怎么变化的:
for th in [0.05, 0.10, 0.20]:
    levels = X.trend_state(X.zigzag(c, th), c, c)
    for name, s in [("状态", levels["state"]), ("突破版", X.break_state(levels, c))]:
        part = s.loc["2024-10-16":"2025-01-31"]
        changes = part[part.diff() != 0]
        print(f"ZigZag {th:.0%} {name}:", {k.date().isoformat(): int(v) for k, v in changes.items()})
ZigZag 5% 状态: {'2024-10-16': 1, '2025-01-07': 0, '2025-01-09': -1, '2025-01-17': 0}
ZigZag 5% 突破版: {'2024-10-16': 1, '2025-01-09': -1, '2025-01-17': 1}
ZigZag 10% 状态: {'2024-10-16': 0, '2025-01-06': 1, '2025-01-09': 0}
ZigZag 10% 突破版: {'2024-10-16': 1, '2025-01-09': -1, '2025-01-21': 1}
ZigZag 20% 状态: {'2024-10-16': -1, '2024-10-18': 0}
ZigZag 20% 突破版: {'2024-10-16': -1, '2024-10-18': 1}
每一行字典的第一个值是 10 月 16 日的状态,后面是状态发生变化的日子。
- 10% 高低点版:从 10 月 16 日到 2025 年 1 月 6 日,整整 82 天一直是「震荡」,而这期间的最高收盘价(12 月 17 日的 106,133.74)比 10 月 16 日高出 57%。原因是那个低了 55.84 美元的低点:要把它换掉,需要一个新的低点被确认,而新低点要等价格回调、再反弹 10%。10 月到 12 月中旬的上涨中间没有 10% 以上的回调;直到 12 月下旬价格从高点回落超过 10%,12 月 30 日的低点又在 1 月 6 日被确认,状态才变成上升。三天之后又变回震荡。
- 20% 高低点版:10 月 18 日从下降变成震荡(收盘价 68,428 越过了 68,249.88),之后一直停在震荡。20% 的回调在这段上涨里没有出现。
- 突破版反应快得多:10% 在 9 月 24 日就已经是上升,20% 在 10 月 18 日变成上升。
回到揭晓本身。这一次的结果,不能证明「上升趋势」的判断是对的。 一次揭晓只是一个样本,就像第 7 篇里「听周线的」那一次恰好错了一样。它能说明的是这一篇真正想说明的东西:
- 「趋势」没有尺度就没有意义。 同一天,5% 说上升,20% 说下降,两个都是对这张图的正确描述。
- 高低点版的定义非常慢。 它能告诉你结构变了,但通常是在价格已经走出很远之后。
- 一个很小的价格差异(55.84 美元),就能让一个定义在接下来几个月里给出完全不同的答案。 规则写成代码之后是精确的,但它对边界附近的数据非常敏感。
至于「这些状态到底有没有用」,需要看全部历史,而不是一次揭晓。
八、趋势状态之后,价格有什么不同
把问题变成统计问题
「上升趋势里应该做多」这句话,如果是对的,就应该在数据里留下痕迹:处于上升状态的日子,之后的收益应该比处于下降状态的日子更高。
检验方法:
- 对每一天,用当天收盘时已知的信息计算状态(
trend_state和break_state本来就只用已确认的摆动点) - 计算每一天之后 20 天的收益率
- 比较上升状态和下降状态的平均收益差
问题是:差多少才算真的有差别? 20 天的收益率互相重叠(今天之后的 20 天和明天之后的 20 天有 19 天是一样的),而且状态本身也是连续多天不变的,普通的 t 检验会严重高估显著性。
所以用第 5 篇的打乱检验:把每天的收益率随机打乱顺序,重新拼出一条价格,用同样的定义算状态、算收益差。打乱保留了每一天的涨跌幅度(包括肥尾),只破坏了先后顺序。如果真实的收益差落在打乱后的正常范围之内,就说明它和「顺序无关」的随机结果没有区别。
def state_gap(log_returns, threshold, rule, horizon=20):
    """用对数收益率重建价格,计算「上升状态」和「下降状态」之后 horizon 天平均收益的差。"""
    close = pd.Series(np.exp(np.cumsum(np.asarray(log_returns))))
    levels = X.trend_state(X.zigzag(close, threshold), close, close)
    state = levels["state"] if rule == "状态" else X.break_state(levels, close)
    forward = close.shift(-horizon) / close - 1
    return forward[state == 1].mean() - forward[state == -1].mean()
markets = [("BTC", day["close"], 0.10), ("SPY", spy["close"], 0.03), ("AAPL", aapl["close"], 0.05)]
for name, close, th in markets:
    lr = np.log(close).diff().dropna().reset_index(drop=True)
    levels = X.trend_state(X.zigzag(close, th), close, close)
    share = levels["state"].dropna().value_counts(normalize=True)
    print(f"{name}(阈值 {th:.0%}):上升 {share[1]:.1%},震荡 {share[0]:.1%},下降 {share[-1]:.1%}")
    for rule in ["状态", "突破版"]:
        res = St.shuffle_test(lr, lambda x: state_gap(x, th, rule), n=1000, seed=0)
        print(f"   {rule}:上升减下降 {res['实际值']:+.2%},打乱后 95% 范围 {res['打乱后 2.5% 分位']:+.2%} ~ "
              f"{res['打乱后 97.5% 分位']:+.2%},打乱后差距不小于实际的比例 {res['比例']:.1%}")
BTC(阈值 10%):上升 34.0%,震荡 40.5%,下降 25.5%
   状态:上升减下降 +4.65%,打乱后 95% 范围 -6.49% ~ +5.74%,打乱后差距不小于实际的比例 15.0%
   突破版:上升减下降 +6.13%,打乱后 95% 范围 -5.02% ~ +4.56%,打乱后差距不小于实际的比例 1.4%
SPY(阈值 3%):上升 65.9%,震荡 25.3%,下降 8.8%
   状态:上升减下降 -2.72%,打乱后 95% 范围 -2.35% ~ +1.99%,打乱后差距不小于实际的比例 1.6%
   突破版:上升减下降 -1.10%,打乱后 95% 范围 -1.84% ~ +1.64%,打乱后差距不小于实际的比例 22.3%
AAPL(阈值 5%):上升 55.2%,震荡 27.0%,下降 17.7%
   状态:上升减下降 -2.53%,打乱后 95% 范围 -4.12% ~ +3.06%,打乱后差距不小于实际的比例 16.4%
   突破版:上升减下降 -1.16%,打乱后 95% 范围 -2.89% ~ +2.54%,打乱后差距不小于实际的比例 42.1%
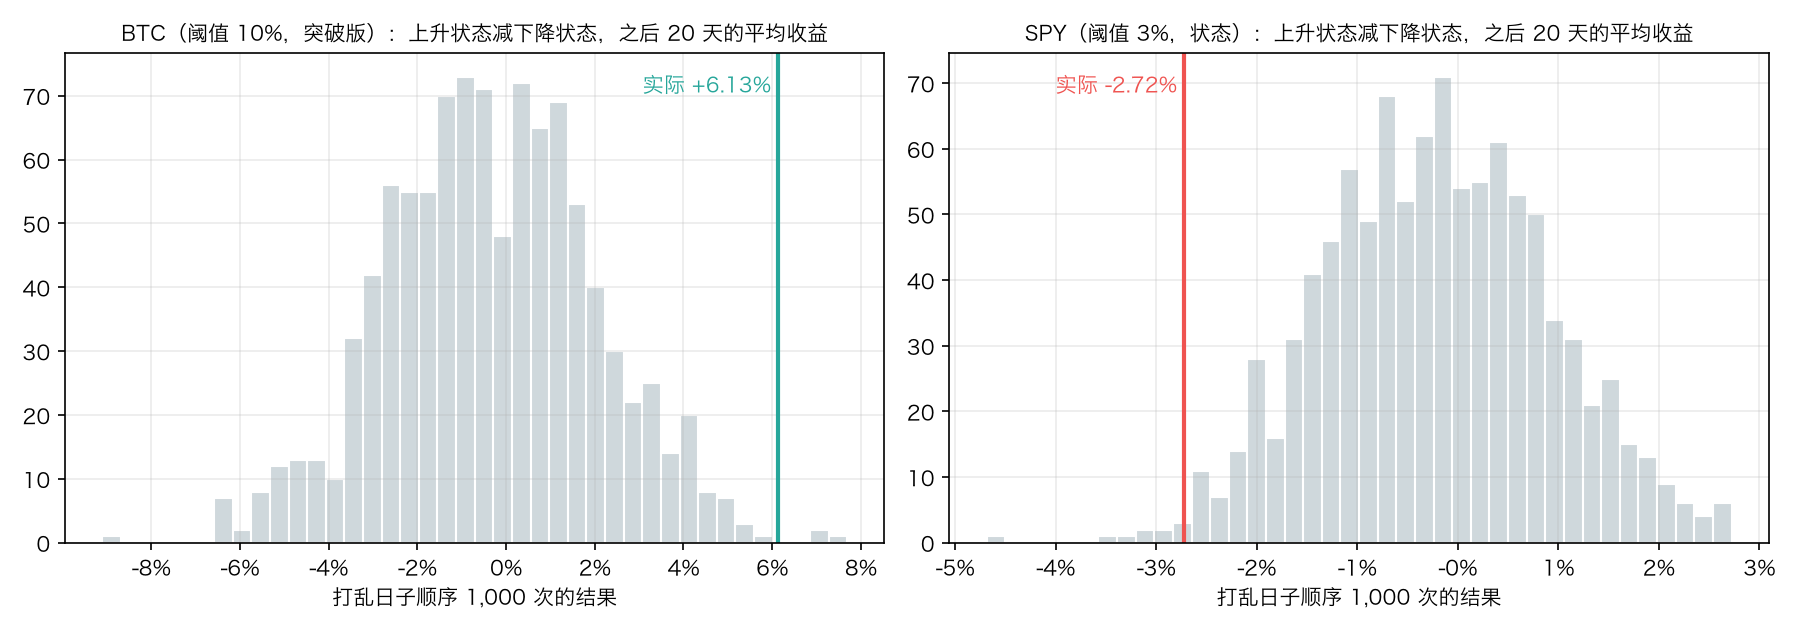
读这个结果
六个检验里,有四个落在打乱后的正常范围之内。剩下两个超出了范围,而且方向相反:
- BTC 突破版:上升状态之后 20 天,平均比下降状态多涨 6.13%。 打乱 1,000 次,只有 1.4% 的结果差距这么大。
- SPY 高低点版:上升状态之后 20 天,平均比下降状态少涨 2.72%。 也就是说,SPY 在「下降结构」之后反而涨得更多。打乱后只有 1.6% 的结果差距这么大。
这两个方向和第 5 篇的方差比是一致的:BTC 在 90 天尺度上的方差比是 1.36(大于 1,涨跌有延续的倾向),SPY 在 63 天尺度上是 0.60(小于 1,涨跌有回归的倾向)。两种完全不同的方法,指向了同一个方向。
但在接受这个结论之前,还要再看一层:
print("按年份拆开:上升减下降(只列两边都有样本的年份)")
for name, close, th, rule in [("BTC", day["close"], 0.10, "突破版"), ("SPY", spy["close"], 0.03, "状态")]:
    levels = X.trend_state(X.zigzag(close, th), close, close)
    state = levels["state"] if rule == "状态" else X.break_state(levels, close)
    forward = close.shift(-20) / close - 1
    by_year = forward.groupby([close.index.year, state]).mean().unstack()
    gap = (by_year[1.0] - by_year[-1.0]).dropna()
    print(f"   {name} {rule}:", {int(y): f"{g:+.1%}" for y, g in gap.items()})
按年份拆开:上升减下降(只列两边都有样本的年份)
   BTC 突破版: {2017: '+19.9%', 2018: '-14.2%', 2019: '+7.5%', 2020: '-7.7%', 2021: '+2.9%', 2022: '-0.2%', 2024: '+8.8%', 2025: '+0.4%', 2026: '-7.5%'}
   SPY 状态: {2018: '-2.8%', 2019: '-2.8%', 2020: '-6.7%', 2022: '-4.8%', 2023: '-1.9%', 2025: '-6.2%'}
- BTC 的结果很不稳定。 9 个年份里 5 个为正、4 个为负,2017 年的 +19.9% 和 2018 年的 −14.2% 差了 34 个百分点。整体的 +6.13% 主要来自少数几年。
- SPY 的结果很稳定。 有下降状态的 6 个年份,全部为负。第 5 篇发现 SPY 的负自相关主要来自 2020 年,这里不是:去掉 2020 年,其他 5 年也都是负的。
⚠️ 这里有三个要特别小心的地方。
- 一共做了 6 个检验。 即使状态完全没有用,6 个检验里出现一两个「只有 1–2% 的打乱结果比它极端」的情况,也并不罕见。这是第 30 篇会细讲的多重检验问题。
- 阈值是我选的。 BTC 用 10%、SPY 用 3%,换成别的阈值,结果可能不同(练习 3)。
- 这不是一个回测。 没有考虑成本、没有考虑状态切换时的实际成交价,20 天也是随手选的持有期。第 27–30 篇才会做完整的检验。
能说的结论是:「上升状态之后做多更好」不是一条普遍成立的规律。 在 BTC 上有一点支持它的证据,但不稳定;在 SPY 上的证据反而指向相反的方向;在 AAPL 上没有证据。
随机数据里也有趋势结构
还有一个问题:上升、下降、震荡这些状态,在完全随机的价格里会不会出现?
rng = np.random.default_rng(0)
for name, close, th in markets:
    lr = np.log(close).diff().dropna().to_numpy()
    sims = []
    for _ in range(1000):
        fake = pd.Series(np.exp(np.cumsum(rng.permutation(lr))))
        z = X.zigzag(fake, th)
        s = X.trend_state(z, fake, fake)["state"].dropna()
        sims.append([len(z), (s == 1).mean(), (s == -1).mean()])
    sims = np.array(sims)
    lo, hi = np.percentile(sims, [2.5, 97.5], axis=0)
    real = X.trend_state(X.zigzag(close, th), close, close)["state"].dropna()
    print(f"{name}:摆动点 {len(X.zigzag(close, th))}(打乱后 {lo[0]:.0f}~{hi[0]:.0f}),"
          f"上升 {(real == 1).mean():.1%}({lo[1]:.1%}~{hi[1]:.1%}),下降 {(real == -1).mean():.1%}({lo[2]:.1%}~{hi[2]:.1%})")
BTC:摆动点 159(打乱后 147~186),上升 34.0%(29.3%~48.9%),下降 25.5%(19.2%~35.3%)
SPY:摆动点 126(打乱后 114~147),上升 65.9%(33.0%~56.6%),下降 8.8%(14.7%~31.5%)
AAPL:摆动点 125(打乱后 117~153),上升 55.2%(35.8%~57.1%),下降 17.7%(14.1%~29.8%)
打乱顺序之后,价格照样会形成一个个高点和低点,照样有三分之一左右的时间处于「上升趋势」。 BTC 和 AAPL 的真实数据,无论是摆动点的数量,还是上升、下降状态的时间比例,都落在打乱后的范围之内。
SPY 是例外:它处于上升状态的时间(65.9%)明显多于打乱后的结果,下降状态(8.8%)明显少于打乱后的结果。SPY 的下跌往往来得快、结束得也快(比如 2020 年 3 月),结构很快就恢复成上升;打乱之后,这种「快跌快回」的顺序被破坏了。
这对读图的意义是:在图上看到清晰的「高点抬高、低点抬高」,本身并不说明市场里有什么特别的力量。 一条完全随机的价格也会画出同样漂亮的结构。结构的价值,只能用「结构之后发生了什么」来检验,而不能用「结构看起来多清楚」来判断。
九、趋势线:同一张图能画出多少条
趋势线的规则
趋势线是把两个摆动低点(上升趋势线)或两个摆动高点(下降趋势线)连成一条直线,向右延伸。价格收盘跌破上升趋势线,常被当作上升趋势结束的信号。
决策点那天,你心里的那条线大概是:连接 8 月 5 日的最低价 49,000 和 9 月 6 日的最低价 52,550。也可能是连接 9 月 6 日和 10 月 10 日。或者……
要画一条趋势线,至少要做四个选择:
- 连哪两个低点?
- 用最低价(影线),还是用收盘价?
- 在算术坐标上画直线,还是在对数坐标上画直线?(第 4 篇讲过,两者的「直线」不一样)
- 什么叫跌破? 盘中跌破、收盘跌破,还是收盘跌破一定幅度?
把所有「说得过去」的线都画出来
用分形(左右各 2 根)找出 8 月 1 日以来的所有摆动低点,两两连接,保留满足两个条件的线:
- 向上:后一个低点比前一个高
- 没有被穿过:从第一个低点到 10 月 16 日,没有任何一天的价格(最低价或收盘价,取决于这条线连的是哪种价格)跌到线的下方
这两个条件是画趋势线的基本要求,任何一个交易者都不会画一条中间被价格穿过的线。
window = day.loc[pd.Timestamp("2024-08-01", tz="UTC"):t]
lines = []
for price_type in ["最低价", "收盘价"]:
    lows_series = window["low"] if price_type == "最低价" else window["close"]
    swings = X.fractals(lows_series, lows_series, 2, 2)
    swings = swings[(swings["kind"] == -1) & (swings["confirmed_at"] <= t)]
    for a, b in itertools.combinations(swings.itertuples(), 2):
        for scale in ["算术", "对数"]:
            f, g = (np.log, np.exp) if scale == "对数" else (lambda v: v, lambda v: v)
            ia, ib, it = pos[a.time], pos[b.time], pos[t]
            slope = (f(b.price) - f(a.price)) / (ib - ia)
            line = g(f(a.price) + slope * np.arange(it - ia + 1))
            touched = lows_series.iloc[ia - pos[window.index[0]]:].to_numpy()
            lines.append({"价格": price_type, "坐标": scale, "起点": a.time.date(), "起点价": a.price,
                          "终点": b.time.date(), "终点价": b.price, "向上": b.price > a.price,
                          "没有被穿过": bool((touched >= line - 1e-6).all()), "今天的位置": line[-1]})
lines = pd.DataFrame(lines)
valid = lines[lines["向上"] & lines["没有被穿过"]]
print(f"两两连接的候选线 {len(lines)} 条,向上且中间没有价格跌破的 {len(valid)} 条")
print(valid.drop(columns=["向上", "没有被穿过"]).round(2).to_string(index=False))
print(f"10 月 16 日的位置:{valid['今天的位置'].min():,.2f} ~ {valid['今天的位置'].max():,.2f},收盘价 {c[t]:,.2f}")
两两连接的候选线 182 条,向上且中间没有价格跌破的 10 条
 价格 坐标         起点      起点价         终点      终点价    今天的位置
最低价 算术 2024-08-05 49000.00 2024-09-06 52550.00 56987.50
最低价 对数 2024-08-05 49000.00 2024-09-06 52550.00 57351.33
最低价 算术 2024-09-06 52550.00 2024-10-10 58946.00 60074.71
最低价 对数 2024-09-06 52550.00 2024-10-10 58946.00 60152.96
最低价 算术 2024-09-16 57493.30 2024-10-10 58946.00 59309.18
最低价 对数 2024-09-16 57493.30 2024-10-10 58946.00 59314.87
收盘价 算术 2024-09-06 53962.97 2024-10-10 60326.39 61449.35
收盘价 对数 2024-09-06 53962.97 2024-10-10 60326.39 61524.85
收盘价 算术 2024-09-16 58213.99 2024-10-10 60326.39 60854.49
收盘价 对数 2024-09-16 58213.99 2024-10-10 60326.39 60866.36
10 月 16 日的位置:56,987.50 ~ 61,524.85,收盘价 67,620.01
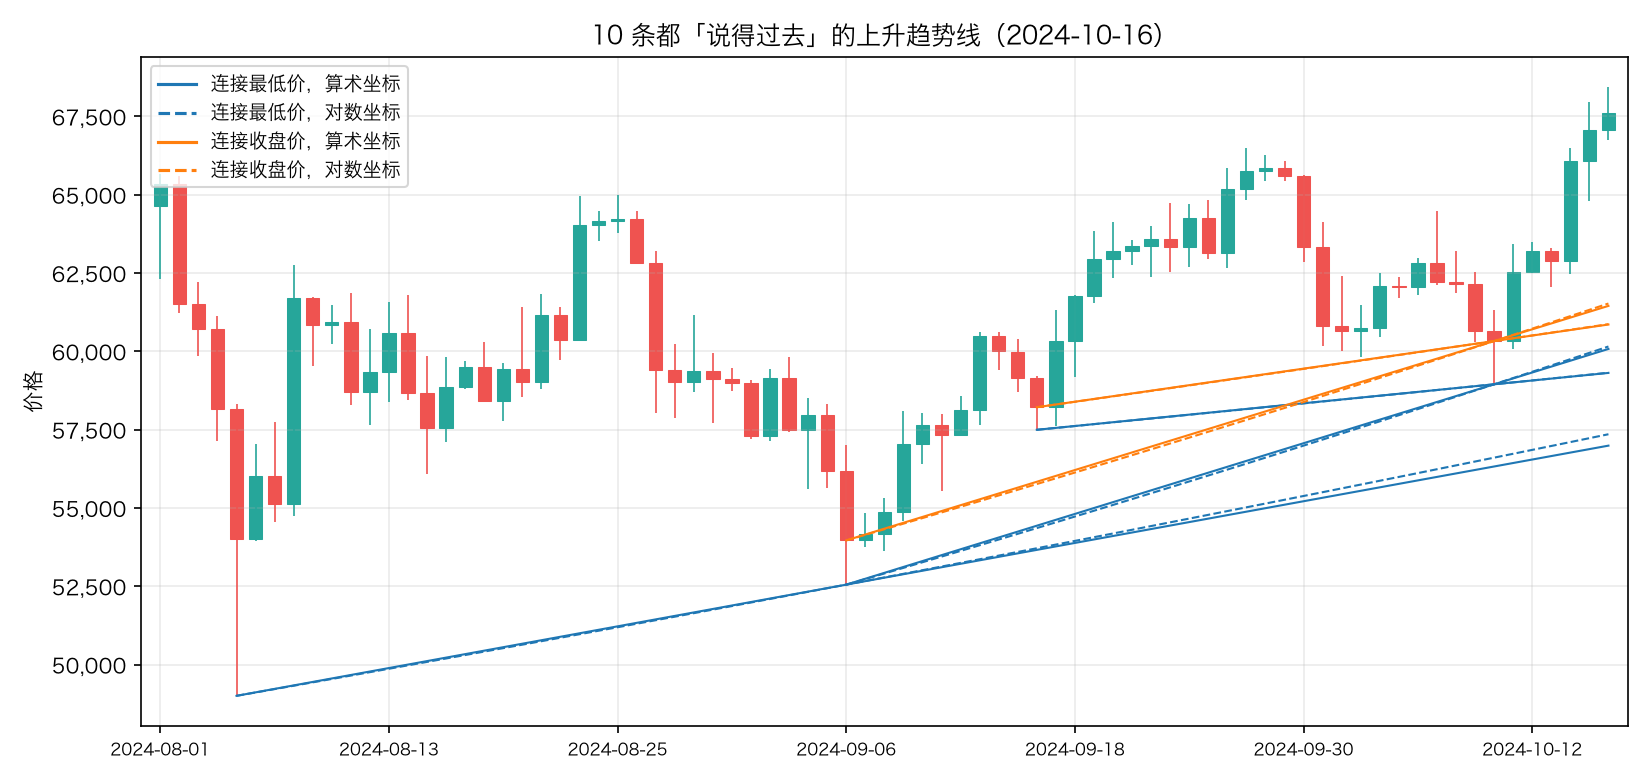
10 条线都满足基本要求,它们在 10 月 16 日的位置从 56,987.50 到 61,524.85,相差 8.0%。 这 8% 就是「趋势线在哪里被跌破」这个问题的不确定范围,还没有算上第 4 个选择(怎样才算跌破)。
几个观察:
- 连接最低价的 8 月 5 日 → 9 月 6 日那条线最低。 8 月 5 日的影线很长(最低 49,000,收盘 54,018.81),用它做起点,线就被拉得很低。
- 对数坐标和算术坐标在这里差别不大(同一对点最多差 0.64%),因为这两个月的价格变化不到两倍。第 4 篇的例子横跨几个月、价格从 126,000 跌到 58,000,差别就大得多。
- 这还只是「一个人、一套规则」的结果。 如果允许用左右各 5 根的分形找低点,或者允许线被影线轻微穿过,候选线会更多。
⚠️ 这不是说趋势线没有用,而是说:「这里有一条趋势线」并不是一个客观事实。 如果你要在规则里用趋势线,必须把四个选择都写死,写成代码。写死之后,它就变成了一个可以检验的规则;没有写死之前,它是一个可以事后随意调整的解释。第 17 篇的形态识别会遇到同样的问题。
十、趋势强度:走得有多「直」
为什么需要强度
趋势状态回答的是「往哪个方向」,但不回答「走得多坚决」。
回到登山。两个人都从海拔 0 走到了海拔 6。一个人几乎沿着一条直线往上走;另一个人上上下下,走了很多冤枉路,最后也到了 6。方向一样,但走法完全不同。
下面三种指标,从三个不同的角度衡量「走得有多直」。
效率比
效率比(Efficiency Ratio,ER)是 Perry Kaufman 在 1995 年的《Smarter Trading》里提出的,他用它来调节自适应均线的速度(第 12 篇会讲均线)。
效率比 = |今天收盘 − n 天前收盘| ÷ 这 n 天里每天涨跌幅度的绝对值之和
分子是直线距离,分母是实际走的路。
算例:4 天的收盘价是 100、102、101、104,n = 3。
- 直线距离:|104 − 100| = 4
- 实际走的路:|102 − 100| + |101 − 102| + |104 − 101| = 2 + 1 + 3 = 6
- ER = 4 ÷ 6 = 0.67
一条完全笔直的路,ER = 1;来回走了很多路、最后回到原点,ER 接近 0。
一个随机游走的效率比大约是多少? 第 5 篇讲过「平方根法则」:n 天的净变化,典型大小是单日波动的 √n 倍;而 n 天走过的路,是单日波动的 n 倍。两者一除,随机游走的效率比大约是 1/√n。n = 20 时约为 0.22。这是后面判断「ER 高不高」的参照。
回归斜率
第二种方法:对最近 n 天的对数价格做一条直线回归(用对数是因为第 4 篇讲过的比例问题),看两个数:
- 斜率:每天平均涨多少。斜率是 0.01,大约相当于每天涨 1%。
- R²:直线能解释多少价格变化,0 到 1 之间。越接近 1,价格越贴着这条直线走。
算例:5 天的对数价格是 0、0.02、0.01、0.05、0.04,对应第 0 到 4 天。
- 天数的平均值是 2,对数价格的平均值是 0.024
- 斜率 = Σ(天数 − 2)(价格 − 0.024) ÷ Σ(天数 − 2)² = 0.110 ÷ 10 = 0.011,大约每天 +1.1%
- R² = 两者相关系数的平方 ≈ 0.70
斜率回答「多快」,R² 回答「多直」。一段暴涨暴跌、最后涨了很多的行情,斜率可以很大,R² 却很低。
ADX
第三种是 J. Welles Wilder 在 1978 年的《New Concepts in Technical Trading Systems》里提出的 ADX(平均趋向指数)。它比前两种复杂,分四步。
第一步:真实波幅(TR)。 一天的波动,不只是最高价减最低价,还要算上和昨天收盘价之间的跳空:
TR = max(最高 − 最低,|最高 − 昨收|,|最低 − 昨收|)
第二步:方向运动(+DM 和 −DM)。 今天比昨天向上扩展了多少(最高价 − 昨天最高价),向下扩展了多少(昨天最低价 − 最低价)。只保留较大的那一边,另一边记为 0;如果较大的一边也不是正数,两边都记为 0。
算例:
| 最高 | 最低 | 收盘 | TR | +DM | −DM | |
|---|---|---|---|---|---|---|
| 第 1 天 | 10 | 8 | 9 | |||
| 第 2 天 | 12 | 9 | 11 | max(3, 3, 0) = 3 | 12 − 10 = 2 | 0(最低价抬高了) |
| 第 3 天 | 11 | 7 | 8 | max(4, 0, 4) = 4 | 0 | 9 − 7 = 2(最高价没涨) |
| 第 4 天 | 15 | 12 | 14 | max(3, 7, 4) = 7 | 15 − 11 = 4 | 0 |
第三步:平滑,得到 +DI 和 −DI。 用 Wilder 平滑分别平滑 TR、+DM、−DM(n 通常取 14):第一个值是前 n 个值的平均,之后每天:
新值 = 旧值 + (今天的值 − 旧值) ÷ n
它就是一种指数平滑,第 14 篇讲 RSI 时会再遇到。然后:
+DI = 100 × 平滑后的 +DM ÷ 平滑后的 TR
−DI = 100 × 平滑后的 −DM ÷ 平滑后的 TR
+DI 是「向上扩展」占总波动的百分比,−DI 是「向下扩展」占总波动的百分比。
第四步:ADX。
DX = 100 × |(+DI) − (−DI)| ÷ ((+DI) + (−DI))
DX 只看两者差距有多大,不看谁大。再对 DX 做一次 Wilder 平滑,就是 ADX。
两个要记住的性质:
- ADX 没有方向。 暴涨和暴跌都会让 ADX 变高。看方向要比较 +DI 和 −DI。
- ADX 滞后很多。 经过两次 14 天的平滑,第一个 ADX 要到第 28 根 K 线才出现。
一个极端的例子可以帮你检查理解:如果每一天的最高价、最低价、收盘价都比前一天高 1,且最高价和最低价离收盘价各 1,那么每天 TR = 2、+DM = 1、−DM = 0,+DI = 50、−DI = 0、DX = 100,ADX = 100。这就是第十一节的 test_adx_of_a_perfect_staircase。
在决策点和之后
er = X.efficiency_ratio(c, 20)
reg = X.regression_slope(c, 20)
dmi = X.adx(day["high"], day["low"], c, 14)
strength = pd.concat([er.rename("er"), reg, dmi], axis=1)
print(strength.loc[["2024-10-16", "2024-11-15", "2024-11-22"]].round(3))
print(strength[["er", "r2", "adx"]].corr(method="spearman").round(2))
                              er  slope     r2  plus_di  minus_di     adx
time
2024-10-16 00:00:00+00:00  0.132  0.001  0.029   31.485    16.482  15.980
2024-11-15 00:00:00+00:00  0.581  0.016  0.771   38.074     5.865  41.081
2024-11-22 00:00:00+00:00  0.696  0.019  0.908   38.579     5.570  52.552
       er    r2   adx
er   1.00  0.71  0.44
r2   0.71  1.00  0.40
adx  0.44  0.40  1.00
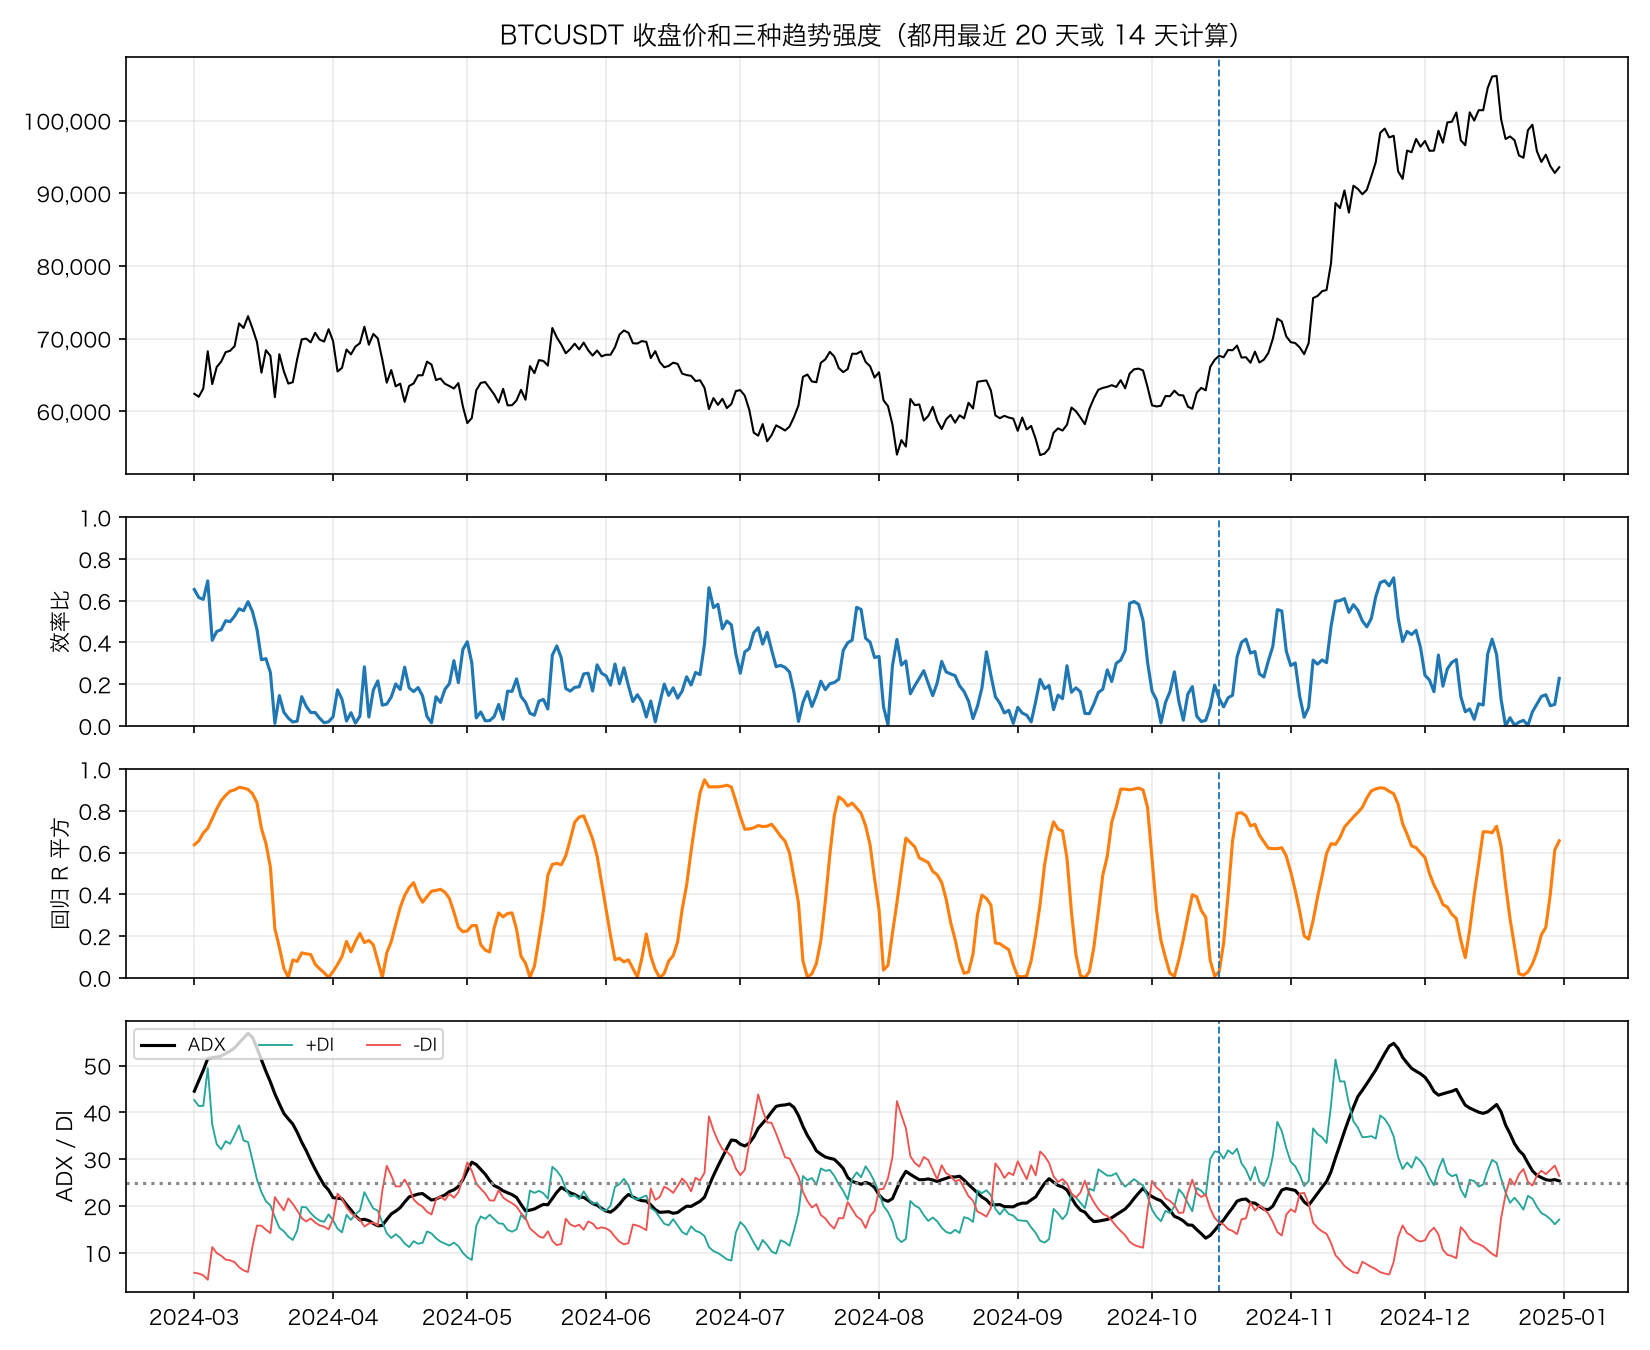
10 月 16 日,三个强度指标都说「很弱」:20 天效率比 0.132,比随机游走的 0.22 还低;R² 只有 0.029;ADX 15.98,低于常用的经验线 25。只有 +DI(31.5)大于 −DI(16.5),方向偏上。
一个月之后,三个指标都变得很高:11 月 22 日效率比 0.696、R² 0.908、ADX 52.6。但那时价格已经比 10 月 16 日涨了 46%。
三者之间的秩相关系数:效率比和 R² 是 0.71,它们都和 ADX 只有 0.4 左右。效率比和 R² 都在看「这 20 天走得直不直」,ADX 看的是「每天向上和向下扩展的差距」,而且平滑得更重。
随机数据里的「趋势强度」
和第八节一样,关键问题是:这些数字在随机数据里是多少? 这次打乱的是整根 K 线:把每一天的开盘、最高、最低、收盘相对前一天收盘价的位置作为一组,打乱各组的顺序,再拼成一条新的 K 线序列。每根 K 线的形状保留,先后顺序被破坏。
def strength_summary(bars):
    e = X.efficiency_ratio(bars["close"], 20)
    r2 = X.regression_slope(bars["close"], 20)["r2"]
    t_value = np.sqrt(r2 * 18 / (1 - r2))                     # 20 个点的回归,斜率的 t 值
    a = X.adx(bars["high"], bars["low"], bars["close"], 14)["adx"]
    return [e.mean(), (t_value > 2.10).mean(), (a > 25).mean()]
relative = np.log(day[cols].div(c.shift(1), axis=0)).dropna()  # 每根 K 线相对前一天收盘价的位置
sims = []
for _ in range(1000):
    shuffled = relative.iloc[rng.permutation(len(relative))].reset_index(drop=True)
    prev_close = c.iloc[0] * np.exp(shuffled["close"].cumsum().shift(1, fill_value=0))
    sims.append(strength_summary(shuffled.apply(np.exp).mul(prev_close, axis=0)))
lo, hi = np.percentile(np.array(sims), [2.5, 97.5], axis=0)
real = strength_summary(day)
for k, label in enumerate(["20 天效率比的平均值", "20 天回归斜率 |t| > 2.10 的比例", "ADX > 25 的比例"]):
    fmt = "{:.3f}" if k == 0 else "{:.1%}"
    print(f"{label}:实际 {fmt.format(real[k])},打乱后 {fmt.format(lo[k])} ~ {fmt.format(hi[k])}")
print(f"随机游走的效率比约等于 1/√20 = {1 / math.sqrt(20):.3f}")
20 天效率比的平均值:实际 0.255,打乱后 0.245 ~ 0.287
20 天回归斜率 |t| > 2.10 的比例:实际 70.5%,打乱后 67.7% ~ 74.5%
ADX > 25 的比例:实际 56.0%,打乱后 41.5% ~ 58.5%
随机游走的效率比约等于 1/√20 = 0.224
三个结果都落在打乱后的范围之内:
- 效率比:BTC 的平均值 0.255,和打乱后没有区别。打乱后的范围比 1/√20 = 0.224 略高,因为肥尾让分母(每天涨跌之和)里出现少数特别大的数,这个近似公式没有考虑。
- 回归斜率的 t 值:在 20 天的窗口里,70.5% 的时间斜率「显著」(|t| > 2.10 是 18 个自由度下 5% 显著性的临界值)。打乱之后也是 67.7% 到 74.5%。原因在第 5 篇讲过:价格序列不是独立的,今天的价格就是昨天的价格加上一个变化,普通回归的 t 值假设残差独立,用在价格上会严重高估显著性。第 5 篇里两条毫不相关的随机游走,有 37.1% 的概率价格相关系数超过 0.5,是同一个问题。
- ADX:56.0% 的日子 ADX 超过 25,打乱之后也有 41.5% 到 58.5%。ADX > 25 在一半左右的时间里都成立,随机数据也一样。
所以,「ADX 超过 25,说明趋势形成了」「回归斜率显著,说明有趋势」这类说法,在 BTC 日线上不能区分真实价格和打乱后的价格。 这些指标描述的是「过去 20 天走得直不直」,这件事在随机数据里同样经常发生。
ADX 确认趋势时,行情走了多少
最后看滞后。用 20% 的 ZigZag 把 9 年的 BTC 切成一段一段的行情,看每一段里 ADX 第一次在同方向上超过 25(上涨段要求 +DI > −DI,下跌段要求 −DI > +DI)的时候,这一段行情已经走完了多少:
z20 = X.zigzag(c, 0.20)
done, never = [], 0
for s0, s1 in zip(z20.itertuples(), z20.iloc[1:].itertuples()):
    leg = dmi.iloc[pos[s0.time]:pos[s1.time] + 1]
    same_way = leg["plus_di"] > leg["minus_di"] if s1.kind == 1 else leg["minus_di"] > leg["plus_di"]
    hit = leg.index[(leg["adx"] > 25) & same_way]
    if len(hit) == 0:
        never += 1
        continue
    done.append(math.log(c[hit[0]] / s0.price) / math.log(s1.price / s0.price))
print(f"20% ZigZag 的 {len(z20) - 1} 段行情:ADX 从来没有同方向超过 25 的 {never} 段;"
      f"其余第一次超过 25 时,已经走完的比例 中位数 {np.median(done):.1%},四分位 {np.percentile(done, 25):.1%} ~ {np.percentile(done, 75):.1%}")
20% ZigZag 的 52 段行情:ADX 从来没有同方向超过 25 的 5 段;其余第一次超过 25 时,已经走完的比例 中位数 48.9%,四分位 27.7% ~ 64.2%
ADX 确认的时候,一段行情的中位数已经走完了将近一半。 有四分之一的行情,ADX 确认时已经走完了 64% 以上。
⚠️ 这里有一个不公平的地方要说明:这段代码用了事后才知道的 20% ZigZag 来切分行情(摆动点所在的时间),只是为了描述 ADX 的滞后,不是一个交易规则,不能拿来回测。
✋ 小检查 2
(a) 5 天的收盘价是 200、210、190、205、220,计算 n = 4 的效率比。
(b) 某天 ADX = 40,+DI = 10,−DI = 35。这说明趋势强还是弱?往哪个方向?
(c) 在打乱顺序的 BTC 数据里,ADX > 25 的时间也有 40% 到 60%。为什么一个随机序列也能让 ADX 经常超过 25?(提示:想想 ADX 在衡量什么,以及「20 天」对随机游走来说够不够长。)
答案在文末。
十一、talab.structure:把这一篇写成模块
放在哪里
talab/
├── talab/
│   ├── __init__.py
│   ├── data.py
│   ├── plot.py
│   ├── stats.py
│   ├── bars.py
│   ├── timeframes.py
│   └── structure.py      ← 新增
├── tests/
│   ├── test_data.py
│   ├── test_plot.py
│   ├── test_stats.py
│   ├── test_bars.py
│   ├── test_timeframes.py
│   └── test_structure.py   ← 新增
├── scripts/
│   └── fetch_course_data.py
├── pyproject.toml
└── requirements.txt
课纲里 structure 模块跨第 8、9 两篇:这一篇写摆动点、趋势状态和趋势强度,第 9 篇会往里加关键位置和缺口。
zigzag_high_low、last_point、swing_backtest 这些只用来说明问题的函数,不放进模块,只在 docs/trade-analysis/analysis/08_structure.py 里。
准备数据
这一篇不需要下载新数据:
import glob
import itertools
import math

import numpy as np
import pandas as pd
from talab import data as D, stats as St, structure as X

cols = ["open", "high", "low", "close"]
day = D.load_binance_klines(glob.glob("data/binance/spot/BTCUSDT/1d/*.zip"))
spy = D.load_nasdaq_daily("data/nasdaq/SPY_historical.json").drop(pd.Timestamp("2026-04-20"))
aapl = D.load_nasdaq_daily("data/nasdaq/AAPL_historical.json")
divs = D.load_nasdaq_dividends("data/nasdaq/AAPL_dividends.json")
aapl = D.adjust_total_return(D.unadjust_splits(aapl, D.SPLITS["AAPL"]), D.SPLITS["AAPL"], divs)
t = pd.Timestamp("2024-10-16", tz="UTC")                      # 决策点
print(day.loc["2024-10-14":"2024-10-16", cols])
before = day.loc[:t]
print("3 月以来最高价", before.loc["2024-03-01":, "high"].max(), before.loc["2024-03-01":, "high"].idxmax().date(),
      "最低价", before.loc["2024-03-01":, "low"].min(), before.loc["2024-03-01":, "low"].idxmin().date())
                               open     high       low     close
time
2024-10-14 00:00:00+00:00  62870.02  66500.0  62457.81  66083.99
2024-10-15 00:00:00+00:00  66084.00  67950.0  64800.01  67074.14
2024-10-16 00:00:00+00:00  67074.14  68424.0  66750.49  67620.01
3 月以来最高价 73777.0 2024-03-14 最低价 49000.0 2024-08-05
AAPL 和第 5 篇一样,用拆股和分红调整后的价格;SPY 删除 2026-04-20 的填充行,只有拆股调整。
代码
"""talab.structure:摆动点、趋势状态和趋势强度。第 8 篇。"""
from __future__ import annotations

import numpy as np
import pandas as pd

SWING_COLUMNS = ["time", "price", "kind", "confirmed_at"]


# ---------------------------------------------------------------------------
# 一、摆动点
# ---------------------------------------------------------------------------

def fractals(high: pd.Series, low: pd.Series, left: int = 2, right: int = 2) -> pd.DataFrame:
    """分形摆动点:一根 K 线的最高价高于左边 left 根、不低于右边 right 根,就是摆动高点(摆动低点反过来)。

    返回的每一行是一个摆动点:
    time:          摆动点所在的 K 线
    price:         摆动点的价格(高点用最高价,低点用最低价)
    kind:          1 表示高点,-1 表示低点
    confirmed_at:  确认的时刻,也就是右边第 right 根 K 线。在这根 K 线收盘之前,这个摆动点还不存在

    左边用「严格高于」、右边用「不低于」:连续几根最高价相同时,只有第一根算高点。
    同一根 K 线可能既是高点又是低点(一根很长的 K 线)。
    """
    h, l, idx = high.to_numpy(float), low.to_numpy(float), high.index
    rows = []
    for i in range(left, len(h) - right):
        if h[i] > h[i - left:i].max() and h[i] >= h[i + 1:i + right + 1].max():
            rows.append((idx[i], h[i], 1, idx[i + right]))
        if l[i] < l[i - left:i].min() and l[i] <= l[i + 1:i + right + 1].min():
            rows.append((idx[i], l[i], -1, idx[i + right]))
    return pd.DataFrame(rows, columns=SWING_COLUMNS)


def zigzag(price: pd.Series, threshold: float) -> pd.DataFrame:
    """ZigZag 摆动点:价格从最近的极值反向走了 threshold(比如 0.1 表示 10%),这个极值才被确认。

    只用一个价格序列(通常是收盘价),这样每一步的先后顺序都是确定的。
    高点和低点一定交替出现。返回的列和 fractals 相同。

    注意两点:
    1. 最后一段还没有反向 threshold,它的极值不在结果里:它随时可能被新的极值替换
    2. 第一个摆动点可能就是序列的第一根 K 线,因为在它之前没有数据
    """
    p, idx = price.to_numpy(float), price.index
    rows = []
    direction = 0                        # 0:还没有确认任何摆动点;1:正在找高点;-1:正在找低点
    hi = lo = p[0]
    hi_i = lo_i = 0
    for i in range(1, len(p)):
        if direction >= 0 and p[i] > hi:
            hi, hi_i = p[i], i
        if direction <= 0 and p[i] < lo:
            lo, lo_i = p[i], i
        if direction == 0:
            if hi_i > lo_i and p[i] >= lo * (1 + threshold):         # 先低后高,涨够了:确认低点
                rows.append((idx[lo_i], lo, -1, idx[i]))
                direction = 1
            elif lo_i > hi_i and p[i] <= hi * (1 - threshold):       # 先高后低,跌够了:确认高点
                rows.append((idx[hi_i], hi, 1, idx[i]))
                direction = -1
        elif direction == 1 and p[i] <= hi * (1 - threshold):        # 从高点回落够了:确认高点,开始找低点
            rows.append((idx[hi_i], hi, 1, idx[i]))
            direction, lo, lo_i = -1, p[i], i
        elif direction == -1 and p[i] >= lo * (1 + threshold):       # 从低点反弹够了:确认低点,开始找高点
            rows.append((idx[lo_i], lo, -1, idx[i]))
            direction, hi, hi_i = 1, p[i], i
    return pd.DataFrame(rows, columns=SWING_COLUMNS)


# ---------------------------------------------------------------------------
# 二、趋势状态
# ---------------------------------------------------------------------------

def trend_state(swings: pd.DataFrame, high: pd.Series, low: pd.Series) -> pd.DataFrame:
    """在每一根 K 线收盘时,只用已经确认的摆动点,判断高低点结构。

    state = 1:最近两个高点抬高,最近两个低点也抬高(上升)
    state = -1:最近两个高点降低,最近两个低点也降低(下降)
    state = 0:其他情况(高点和低点方向不一致)
    last_high / last_low:最近一个已确认的高点 / 低点

    「更高」有时不用等确认:最近一个已确认高点之后,价格已经超过了它,
    新高点的具体位置还不知道,但「它比上一个高点高」已经确定了。低点同理。
    high、low 用来计算这种「已经超过」;对收盘价的 ZigZag,两个参数都传收盘价。
    还没有两个高点和两个低点时为 NaN。
    """
    idx = high.index
    h, l = high.to_numpy(float), low.to_numpy(float)
    pos = {t: i for i, t in enumerate(idx)}
    events: dict[int, list] = {}
    for s in swings.sort_values("confirmed_at", kind="stable").itertuples():
        events.setdefault(pos[s.confirmed_at], []).append((pos[s.time], s.price, s.kind))

    highs, lows = [], []
    beyond_high, beyond_low = -np.inf, np.inf     # 最近一个已确认高点之后的最高价 / 低点之后的最低价
    out = np.full((len(idx), 3), np.nan)
    for j in range(len(idx)):
        beyond_high, beyond_low = max(beyond_high, h[j]), min(beyond_low, l[j])
        for i, price, kind in events.get(j, []):
            if kind == 1:
                highs.append(price)
                beyond_high = h[i + 1:j + 1].max() if j > i else -np.inf
            else:
                lows.append(price)
                beyond_low = l[i + 1:j + 1].min() if j > i else np.inf
        if len(highs) < 2 or len(lows) < 2:
            continue
        h0, h1 = (highs[-1], beyond_high) if beyond_high > highs[-1] else (highs[-2], highs[-1])
        l0, l1 = (lows[-1], beyond_low) if beyond_low < lows[-1] else (lows[-2], lows[-1])
        state = 1 if h1 > h0 and l1 > l0 else -1 if h1 < h0 and l1 < l0 else 0
        out[j] = [state, highs[-1], lows[-1]]
    return pd.DataFrame(out, index=idx, columns=["state", "last_high", "last_low"])


def break_state(levels: pd.DataFrame, close: pd.Series) -> pd.Series:
    """突破版的趋势状态:收盘价突破最近一个已确认的高点,变成 1;跌破最近一个已确认的低点,变成 -1;否则保持。

    levels 是 trend_state 的结果(用到 last_high、last_low 两列)。第一次突破之前为 NaN。
    """
    up = close > levels["last_high"]
    down = close < levels["last_low"]
    return pd.Series(np.where(up, 1.0, np.where(down, -1.0, np.nan)), index=close.index).ffill()


# ---------------------------------------------------------------------------
# 三、趋势强度
# ---------------------------------------------------------------------------

def efficiency_ratio(close: pd.Series, n: int = 20) -> pd.Series:
    """效率比(Kaufman):n 根 K 线的净变化 ÷ 每根变化的绝对值之和。

    1 表示一条直线,接近 0 表示来回走了很多路却没有走远。
    """
    return close.diff(n).abs() / close.diff().abs().rolling(n).sum()


def regression_slope(close: pd.Series, n: int = 20) -> pd.DataFrame:
    """对最近 n 根 K 线的对数价格做直线回归。

    slope: 每根 K 线的对数斜率,exp(slope) - 1 约等于每根 K 线的平均涨幅
    r2:    直线能解释多少价格变化(0 到 1),越接近 1,价格越贴着直线走
    """
    y = np.log(close)
    t = pd.Series(np.arange(len(y), dtype=float), index=close.index)
    return pd.DataFrame({
        "slope": y.rolling(n).cov(t) / t.rolling(n).var(),
        "r2": y.rolling(n).corr(t) ** 2,
    })


def true_range(high: pd.Series, low: pd.Series, close: pd.Series) -> pd.Series:
    """真实波幅:今天的最高最低,连同昨天收盘到今天的跳空,一起算进波动。第一根为 NaN。"""
    prev = close.shift(1)
    tr = pd.concat([high - low, (high - prev).abs(), (low - prev).abs()], axis=1).max(axis=1)
    return tr.where(prev.notna())


def directional_movement(high: pd.Series, low: pd.Series) -> pd.DataFrame:
    """方向运动:今天向上扩展了多少(+DM)、向下扩展了多少(-DM),只保留较大的一边。第一根为 NaN。"""
    up = high.diff()
    down = -low.diff()
    plus = up.where((up > down) & (up > 0), 0.0).where(up.notna())
    minus = down.where((down > up) & (down > 0), 0.0).where(down.notna())
    return pd.DataFrame({"plus_dm": plus, "minus_dm": minus})


def wilder_smooth(x: pd.Series, n: int) -> pd.Series:
    """Wilder 平滑:第一个值是前 n 个有效值的平均,之后每次 新值 = 旧值 + (今天 - 旧值) ÷ n。"""
    v = x.to_numpy(float)
    out = np.full(len(v), np.nan)
    valid = np.flatnonzero(~np.isnan(v))
    if len(valid) >= n:
        start = valid[0] + n - 1
        out[start] = v[valid[0]:start + 1].mean()
        for i in range(start + 1, len(v)):
            out[i] = out[i - 1] + (v[i] - out[i - 1]) / n
    return pd.Series(out, index=x.index)


def adx(high: pd.Series, low: pd.Series, close: pd.Series, n: int = 14) -> pd.DataFrame:
    """Wilder 的 +DI、-DI 和 ADX。

    +DI / -DI:平滑后的 +DM / -DM 占平滑后真实波幅的百分比
    DX:两者之差占两者之和的百分比,只看差距,不看方向
    ADX:DX 再做一次 Wilder 平滑。第一个 ADX 出现在第 2n 根 K 线(下标 2n - 1)
    """
    atr = wilder_smooth(true_range(high, low, close), n)
    dm = directional_movement(high, low)
    plus_di = 100 * wilder_smooth(dm["plus_dm"], n) / atr
    minus_di = 100 * wilder_smooth(dm["minus_dm"], n) / atr
    dx = 100 * (plus_di - minus_di).abs() / (plus_di + minus_di)
    return pd.DataFrame({"plus_di": plus_di, "minus_di": minus_di, "adx": wilder_smooth(dx, n)})
读一遍代码
fractals 是第三节规则的直接翻译。h[i - left:i].max() 是左边 left 根的最高价,h[i + 1:i + right + 1].max() 是右边 right 根的最高价。循环从 left 开始、到 len(h) - right 结束,两头不够的 K 线直接跳过。确认时间 idx[i + right] 是右边最后一根 K 线。
zigzag 用 direction 记录当前在找什么:
0:刚开始,还没有确认任何摆动点。同时跟踪最高点和最低点,谁先出现、另一个又离它足够远,就先确认谁。hi_i > lo_i表示最高点在最低点之后出现,也就是「先低后高」,这时涨够了就确认低点。1:已经确认了一个低点,正在找高点。只更新hi;一旦价格比hi低了threshold,确认高点,切换到-1,并用当天的价格作为新的候选低点。-1:反过来。
每一步只用到第 i 天及之前的价格,所以确认过的摆动点不会因为之后的数据而改变。
trend_state 分三部分:
- 先把摆动点按确认时间放进
events:第j根 K 线收盘时,哪些摆动点刚被确认。 - 逐根 K 线循环。
beyond_high是「最近一个已确认高点之后的最高价」,每天用max更新;当一个新高点被确认时,重新从这个高点的下一根开始计算(h[i + 1:j + 1].max()),因为这个高点到确认之间的价格已经发生过了。 - 比较时,如果
beyond_high已经超过最近的已确认高点,就用(最近的已确认高点,beyond_high)这一对;否则用最近两个已确认高点。低点同理。
last_high、last_low 两列是「最近一个已确认的摆动高点和低点」,也是最常见的支撑和阻力候选(第 9 篇会讲支撑和阻力)。
break_state 只有三行:收盘价高于 last_high 记为 1,低于 last_low 记为 −1,其他记为 NaN,然后 ffill 保持上一个状态。
efficiency_ratio 和 regression_slope 都是一行公式。回归斜率用了一个技巧:斜率 = 协方差 ÷ 方差,而 pandas 的 rolling().cov() 和 rolling().var() 可以直接算滚动窗口里的协方差和方差,不用写循环。t 是 0、1、2……的序号,窗口里的序号不从 0 开始也没关系,协方差和方差都不受整体平移的影响。
adx 拆成了 true_range、directional_movement、wilder_smooth 三个小函数,每个都能单独手算和测试。第 15 篇的 ATR 止损会直接用到 true_range 和 wilder_smooth。
wilder_smooth 的第一个值用前 n 个值的平均,这是 Wilder 原书的写法。TA-Lib 的 ADX 初始化方式略有不同,所以最初几个月的数值和 TA-Lib 有小差异(BTC 日线上 +DI、−DI、ADX 最大相差 0.28),从 2018 年 6 月起,差距都小于千万分之一。第 12 篇会专门讲这种和 TA-Lib 的对账。
测试
"""talab.structure 的测试。"""
import numpy as np
import pandas as pd
import pytest

from talab import structure as X


def series(values, start="2024-01-01"):
    idx = pd.date_range(start, periods=len(values), freq="1D", tz="UTC")
    return pd.Series(values, index=idx, dtype=float)


def test_fractals_by_hand():
    high = series([10, 11, 13, 12, 11, 12, 12, 11, 10])
    low = series([9, 10, 12, 11, 8, 10, 11, 10, 9])
    f = X.fractals(high, low, left=2, right=2)
    day = high.index
    # 13 是高点,在右边第 2 根(下标 4)确认;8 是低点,在下标 6 确认
    # 下标 5、6 的最高价都是 12,但左边 2 根里都已经有一个 12,不是「严格高于」,所以都不算高点
    assert f.values.tolist() == [[day[2], 13.0, 1, day[4]], [day[4], 8.0, -1, day[6]]]


def test_zigzag_by_hand():
    close = series([100, 105, 112, 108, 100, 95, 104, 110])
    z = X.zigzag(close, 0.10)
    day = close.index
    # 112 比 100 高 12%:确认低点 100(第一根)。跌到 100,比 112 低 10.7%:确认高点 112
    # 95 之后涨到 104 只有 9.5%,还不够;涨到 110(15.8%)才确认低点 95
    assert z.values.tolist() == [[day[0], 100.0, -1, day[2]], [day[2], 112.0, 1, day[4]], [day[5], 95.0, -1, day[7]]]


@pytest.mark.parametrize("finder", ["zigzag", "fractals"])
def test_confirmed_swings_never_repaint(finder):
    rng = np.random.default_rng(8)
    close = series(100 * np.exp(np.cumsum(rng.normal(0, 0.03, 400))))
    high, low = close * 1.01, close * 0.99

    def find(n):
        if finder == "zigzag":
            return X.zigzag(close.iloc[:n], 0.08)
        return X.fractals(high.iloc[:n], low.iloc[:n], 3, 3)

    full = find(400)
    for n in [50, 123, 250, 399]:
        early = find(n)
        known = full[full["confirmed_at"] <= close.index[n - 1]].reset_index(drop=True)
        pd.testing.assert_frame_equal(early, known)       # 截止到第 n 根时已经确认的摆动点,后来一个都没变


def test_trend_state_by_hand():
    close = series([10, 14, 12, 16, 13, 17, 15, 12, 11])
    t = close.index
    swings = pd.DataFrame([
        (t[0], 10.0, -1, t[1]), (t[1], 14.0, 1, t[2]), (t[2], 12.0, -1, t[3]),
        (t[3], 16.0, 1, t[4]), (t[4], 13.0, -1, t[5]), (t[5], 17.0, 1, t[6]),
    ], columns=X.SWING_COLUMNS)
    s = X.trend_state(swings, close, close)
    assert s["state"].iloc[:4].isna().all()          # 下标 4 才有两个高点和两个低点
    assert s["state"].iloc[4] == 1                    # 高点 14 → 16,低点 10 → 12
    assert s["state"].iloc[6] == 1                    # 高点 16 → 17,低点 12 → 13
    # 下标 7:收盘 12,已经低于最近的低点 13。新低点还没确认,但「更低」已经确定:高点抬高、低点降低
    assert s["state"].iloc[7] == 0
    assert s["last_low"].iloc[7] == 13 and s["last_high"].iloc[7] == 17


def test_trend_state_never_uses_the_future():
    rng = np.random.default_rng(1)
    close = series(100 * np.exp(np.cumsum(rng.normal(0, 0.03, 500))))
    full = X.trend_state(X.zigzag(close, 0.08), close, close)
    for n in [100, 333, 499]:
        part = close.iloc[:n]
        early = X.trend_state(X.zigzag(part, 0.08), part, part)
        pd.testing.assert_frame_equal(early, full.iloc[:n])


def test_break_state_by_hand():
    close = series([10, 12, 11, 13, 9])
    levels = pd.DataFrame({"last_high": [np.nan, 11, 11, 12, 12], "last_low": [np.nan, 8, 8, 10, 10]}, index=close.index)
    assert X.break_state(levels, close).tolist()[1:] == [1, 1, 1, -1]


def test_efficiency_ratio_by_hand():
    close = series([100, 102, 101, 104])
    assert X.efficiency_ratio(close, 3).iloc[-1] == pytest.approx(4 / 6)      # 净变化 4,走过的路 2 + 1 + 3
    assert X.efficiency_ratio(series([1, 2, 3, 4, 5]), 4).iloc[-1] == 1


def test_regression_slope_exact_growth():
    close = series(100 * 1.01 ** np.arange(30))
    r = X.regression_slope(close, 20)
    assert r["slope"].iloc[-1] == pytest.approx(np.log(1.01))
    assert r["r2"].iloc[-1] == pytest.approx(1)
    assert r["slope"].iloc[:19].isna().all()


def test_true_range_and_directional_movement_by_hand():
    high = series([10, 12, 11, 15])
    low = series([8, 9, 7, 12])
    close = series([9, 11, 8, 14])
    assert X.true_range(high, low, close).tolist()[1:] == [3, 4, 7]            # 第三根:11 - 7;第四根:15 - 8
    dm = X.directional_movement(high, low)
    assert dm["plus_dm"].tolist()[1:] == [2, 0, 4]       # 第三根:最高价没涨,最低价跌了 2,只算 -DM
    assert dm["minus_dm"].tolist()[1:] == [0, 2, 0]


def test_adx_of_a_perfect_staircase():
    close = series(np.arange(100, 160, dtype=float))
    a = X.adx(close + 1, close - 1, close, 14)
    assert a["adx"].first_valid_index() == close.index[27]                   # 第一个 ADX 在下标 2n - 1
    assert a["plus_di"].dropna().eq(50).all() and a["minus_di"].dropna().eq(0).all()
    assert a["adx"].dropna().eq(100).all()                                   # 每天都只向上扩展:ADX = 100
11 个测试(test_confirmed_swings_never_repaint 对两种算法各跑一次)分成三类:
手算测试:test_fractals_by_hand、test_zigzag_by_hand、test_trend_state_by_hand、test_break_state_by_hand、test_efficiency_ratio_by_hand、test_true_range_and_directional_movement_by_hand,数字都和正文里的算例一致。
性质测试,检查「不会用到未来」:
test_confirmed_swings_never_repaint:用前 n 根 K 线算出的摆动点,必须等于用全部数据算出的、截止到第 n 根时已确认的摆动点。这个测试直接对应第五节:确认过的点不会重绘。test_trend_state_never_uses_the_future:用前 n 根 K 线算出的趋势状态,必须和用全部数据算出的前 n 行完全相同。
极端情况测试:test_regression_slope_exact_growth(每天正好涨 1%,斜率必须等于 log(1.01),R² 等于 1)和 test_adx_of_a_perfect_staircase(完美的阶梯,ADX 必须等于 100,第一个值出现在下标 27)。
pytest -q
......................................................                   [100%]
54 passed in 0.35s
十二、常见误用
1. 在回测里把摆动点放在它所在的 K 线上。 摆动点要等价格离开一段距离才被确认。按所在时间回测,BTC 10% ZigZag 是 46 亿倍,按确认时间是 7.71 倍。任何摆动点函数,都要能回答「这个点是哪一天确认的」。
2. 把 ZigZag 图上的最后一段当成事实。 三分之二的日子里,图上的最后一个点后来被替换了。
3. 说「这是上升趋势」,却不说尺度。 2024 年 10 月 16 日,5% 的结构是上升,20% 的结构是下降。没有阈值(或参数)的趋势判断,无法核对,也无法检验。
4. 用最高价和最低价的 ZigZag,不处理同一根 K 线里的先后顺序。 10% 阈值下,BTC 日线有 26.6% 的摆动点卡在分不清先后的 K 线上。
5. 忘了高低点定义有多慢。 10% 的高低点版在一段最高涨了 57% 的行情里,82 天一直是「震荡」。如果规则要求「上升状态才做多」,它会错过整段行情。
6. 认为清晰的结构说明市场里有特别的力量。 打乱顺序的随机价格,同样有三分之一左右的时间处于「上升趋势」,摆动点的数量也和真实数据差不多。
7. 把「ADX > 25」或「回归斜率显著」当成趋势存在的证据。 在打乱后的 BTC 数据里,ADX 有 41.5% 到 58.5% 的时间超过 25,回归斜率有 67.7% 到 74.5% 的时间「显著」。
8. 趋势线的画法不写死。 同一天,10 条都说得过去的上升趋势线,位置相差 8%。不写死连哪两个点、用什么价格、什么坐标、怎样算跌破,就可以在事后找到一条「刚好被跌破」的线。
9. 看到一个显著的结果就接受。 六个检验里两个显著、方向相反;BTC 的显著结果按年份拆开,5 年为正、4 年为负。多重检验和稳定性,都要一起看。
十三、这一篇能回答什么,不能回答什么
| 这一篇能帮你回答 | 这一篇不能回答 |
|---|---|
| 在一个给定的尺度下,现在的高低点结构是上升、下降还是震荡 | 应该用哪个尺度(取决于你的交易设计) |
| 一个摆动点是什么时候确认的,回测有没有用到未来 | 下一个摆动点会出现在哪里 |
| 你和别人的趋势判断,分歧来自哪个选择 | 谁的判断之后会赚钱 |
| 趋势状态之后 20 天的收益,和打乱后的随机结果有没有区别 | 用趋势状态做交易,扣除成本之后能不能赚钱(第 27–30 篇) |
| 效率比、R²、ADX 各自在衡量什么,在随机数据里是多少 | 现在的趋势还会持续多久 |
十四、小结
-
趋势的经典定义是高点和低点同时抬高(上升)或同时降低(下降)。 写成代码时要回答三个问题:多大的起伏算摆动点,什么时候确认,方向不一致算什么。
-
分形用 K 线数量定义摆动点,确认滞后固定等于右边的 K 线数,但不看价格走了多远,高点和低点也不一定交替出现。BTC 日线左右各 2 根的分形,9 年里有 903 个摆动点。
-
ZigZag 用价格反向的幅度定义摆动点,高低点一定交替,确认滞后不固定。10% 阈值下,确认滞后中位数 5 天、最长 35 天;阈值翻倍,滞后变长两到三倍。用收盘价可以避开同一根 K 线里先后顺序不明的问题。
-
最后一段一定会重绘,已确认的点不会。 图上的最后一个点,65.8% 的日子后来被替换了;摆动点被确认时,价格离它平均已经有 12.65%。
-
按摆动点所在的时间回测,是最常见的摆动点前视偏差。 BTC 10% ZigZag 低点买入、高点卖出:46 亿倍 vs 7.71 倍。
-
高低点结构能变成状态,但状态离不开尺度。 2024-10-16,5% 是上升、10% 是震荡(因为一个低点只低了 55.84 美元)、20% 是下降。突破版比高低点版快得多,但也只是另一种选择。
-
趋势状态之后的表现,要和打乱后的结果比。 BTC 突破版上升比下降之后 20 天多涨 6.13%(打乱后只有 1.4% 的结果更极端),但按年份很不稳定;SPY 的方向相反,而且每年都一致;AAPL 没有差别。打乱后的随机价格,也有三分之一左右的时间处于上升状态。
-
趋势线至少要做四个选择。 决策点那天,10 条满足基本要求的上升趋势线,位置相差 8%。
-
效率比、回归 R²、ADX 衡量的是「走得有多直」。 在 BTC 日线上,三者都不能把真实价格和打乱后的价格区分开;ADX 在同方向超过 25 时,一段行情的中位数已经走完了 48.9%。
最后回到山路上。你站在一段上坡上,说自己在往上走;朋友指着远处说,这几座大山一座比一座矮。你们都没说错,只是一个在看脚下的坡,一个在看整条山脉(第六节)。你只有往下走了一段,才知道刚才经过的是山顶(第五节);如果有人事后在地图上标出了每一个山顶,然后说「照着走就能一直走在最高处」,那张地图是在走完之后才画出来的。而一段走得很直的路,并不能告诉你下一段路会不会也这么直(第十节)。
下一篇是第 9 篇:支撑、阻力与缺口。这一篇的 last_high 和 last_low,就是最常见的支撑和阻力候选。BTC 第四次回到同一个价位,这次会守住,还是会跌破?被测试的次数越多,一个位置是变强还是变弱?
练习
练习 1(手算) 收盘价依次是 100、108、115、110、103、98、104、109、112、100,阈值 10%。
- (a) 用 ZigZag 找出所有已确认的摆动点和确认日。
- (b) 第 8 天(收盘价 109)收盘时,趋势状态是什么?(提示:先看高点和低点够不够两个。)
- (c) 如果阈值改成 5%,(a) 的结果有什么变化?
练习 2(数据) 对 SPY 计算左右各 2 根、5 根、10 根的分形摆动点数量,以及 3%、5%、10% 的 ZigZag 确认滞后(中位数、平均、最长),和 BTC 的结果比较。按波动率换算之后,两者是否接近?
练习 3(数据) 第八节的 BTC 用了 10% 阈值,SPY 用了 3%。
- (a) 把 BTC 换成 5%、15%、20%,SPY 换成 2%、5%,分别重复打乱检验。结论稳定吗?
- (b) 把持有期从 20 天换成 5 天和 60 天。
- (c) 一共做了多少个检验?其中有几个「打乱后差距不小于实际的比例」低于 5%?如果状态完全没有用,你预期会有几个?
练习 4(编程)
第六节说,trend_state 把「方向不一致」都归为震荡。
- (a) 写一个
trend_state_detail,把震荡细分成「收窄」(高点降低、低点抬高)和「扩张」(高点抬高、低点降低)两种。 - (b) 写一个性质测试,检查它不会用到未来。
- (c) BTC 10% 阈值下,两种震荡各占多少时间?10 月 16 日属于哪一种?
练习 5(编程)
用第 7 篇的 align_higher,把周线上 20% ZigZag 的突破版状态对齐到日线上(注意:周线的摆动点确认时间是那一周收盘的时刻)。
- (a) 在 10 月 16 日,周线的状态是什么?
- (b) 周线状态和日线 10% 状态一致的时间比例是多少?
练习 6(思考) 第十节的打乱检验说明,效率比、R²、ADX 在 BTC 日线上不能区分真实价格和打乱后的价格。
- (a) 这是否说明这三个指标「没有用」?它们还可能在什么地方有用?(提示:第 5 篇的波动率聚集;打乱破坏了什么,保留了什么。)
- (b) 设计一个检验,看效率比高的日子之后,波动率是否和效率比低的日子不同。
小检查答案
小检查 1
(a) 按第四节的步骤走:
- 第 3 天收盘价 56,比第 1 天的 50 高 12%:第 1 天的低点 50,在第 3 天确认
- 第 5 天收盘价 50,比 56 低 10.7%:第 3 天的高点 56,在第 5 天确认
- 第 6 天的 49 是新低;第 7 天 52 只比 49 高 6.1%;第 8 天 55 高了 12.2%:第 6 天的低点 49,在第 8 天确认
- 第 9 天 51 比 55 低 7.3%,不够;第 10 天 48 低了 12.7%:第 8 天的高点 55,在第 10 天确认
- 第 11 天 53 比 48 高 10.4%:第 10 天的低点 48,在第 11 天确认
(b) 第 9 天收盘时,最近一个已确认的摆动点是第 6 天的低点 49(第 8 天确认)。之后的最高收盘价是第 8 天的 55,所以图上的最后一个点在第 8 天的 55。它后来成为了摆动点(第 10 天确认),这一次没有被替换。
顺便看趋势状态:第 10 天收盘时,高点 56 → 55 降低,低点 50 → 49 降低,状态是下降。
(c) 左右各 1 根的分形:第 3 天的 56 是高点,第 4 天确认;第 6 天的 49 是低点,第 7 天确认;第 8 天的 55 是高点,第 9 天确认;第 10 天的 48 是低点,第 11 天确认。
两点不同:
- 第 1 天的 50 不算,因为它左边没有 K 线
- 每个点都只滞后 1 天,而 ZigZag 的滞后是 2、2、2、2、1 天
分形确认得更快,是因为它只要求右边一根 K 线更低(或更高),不管低了多少。在这组数据里两者找出的点恰好一样;如果第 4 天是 55.5 而不是 52,分形仍然会在第 4 天确认 56 这个高点,而 ZigZag 不会(55.5 只比 56 低 0.9%)。
小检查 2
(a) 直线距离 |220 − 200| = 20。实际走的路 10 + 20 + 15 + 15 = 60。效率比 = 20 ÷ 60 = 0.33。
(b) ADX = 40 说明趋势强,但 ADX 本身没有方向。−DI(35)远大于 +DI(10),说明向下扩展占了主导,这是一个强的下降趋势。只看「ADX = 40」就认为在上涨,是很常见的误读。
(c) ADX 衡量的是「一段时间里,向上扩展和向下扩展的差距有多大」。随机游走在 20 天、28 天这样短的窗口里,经常会碰巧连续偏向一边(第 5 篇:n 天的净变化大约是单日波动的 √n 倍,并不是 0),这时 +DI 和 −DI 就会拉开,DX 变大,ADX 随之升高。「过去一段时间走得比较单向」在随机数据里本来就经常发生,所以 ADX > 25 并不稀有。它描述的是过去,不保证未来。