| 本篇位置 | 第二部分「读懂价格行为」的第五篇。第 9 篇讲的成交密集区在这一篇画出来;第 12 篇起的指标,都会放进这一篇新建的 talab.indicators 模块 |
| 用到的数据 | BTCUSDT 现货 1 分钟线和日线(2017-08 至 2026-08);BTCUSDT U 本位永续合约日线(2020-01 至 2026-08,这一篇下载);SPY、AAPL 日线(2016-09 至 2026-09) |
| 动手 | 新建 talab.indicators 模块:相对成交量、VWAP、锚定 VWAP、Volume Profile、价值区间,附 6 个测试 |
| 读完你能 | 读成交量之前先检查它的单位和来源;用 1 分钟数据精确计算 VWAP;画出 Volume Profile 并找到 POC 和价值区间;知道「放量」「缩量」这些说法在数据上有多少支持 |
⚠️ 课纲里这一篇的决策点原本用 AAPL 的盘中数据。免费的公开数据里仍然没有美股的日内 K 线(第 7 篇遇到过同样的限制,这次又试了一遍:Yahoo 的接口返回「请求过多」,Nasdaq 的接口只有当天的分时数据),所以决策点改用 BTC;SPY 和 AAPL 在日线层面参与统计。
一、先做一个决定
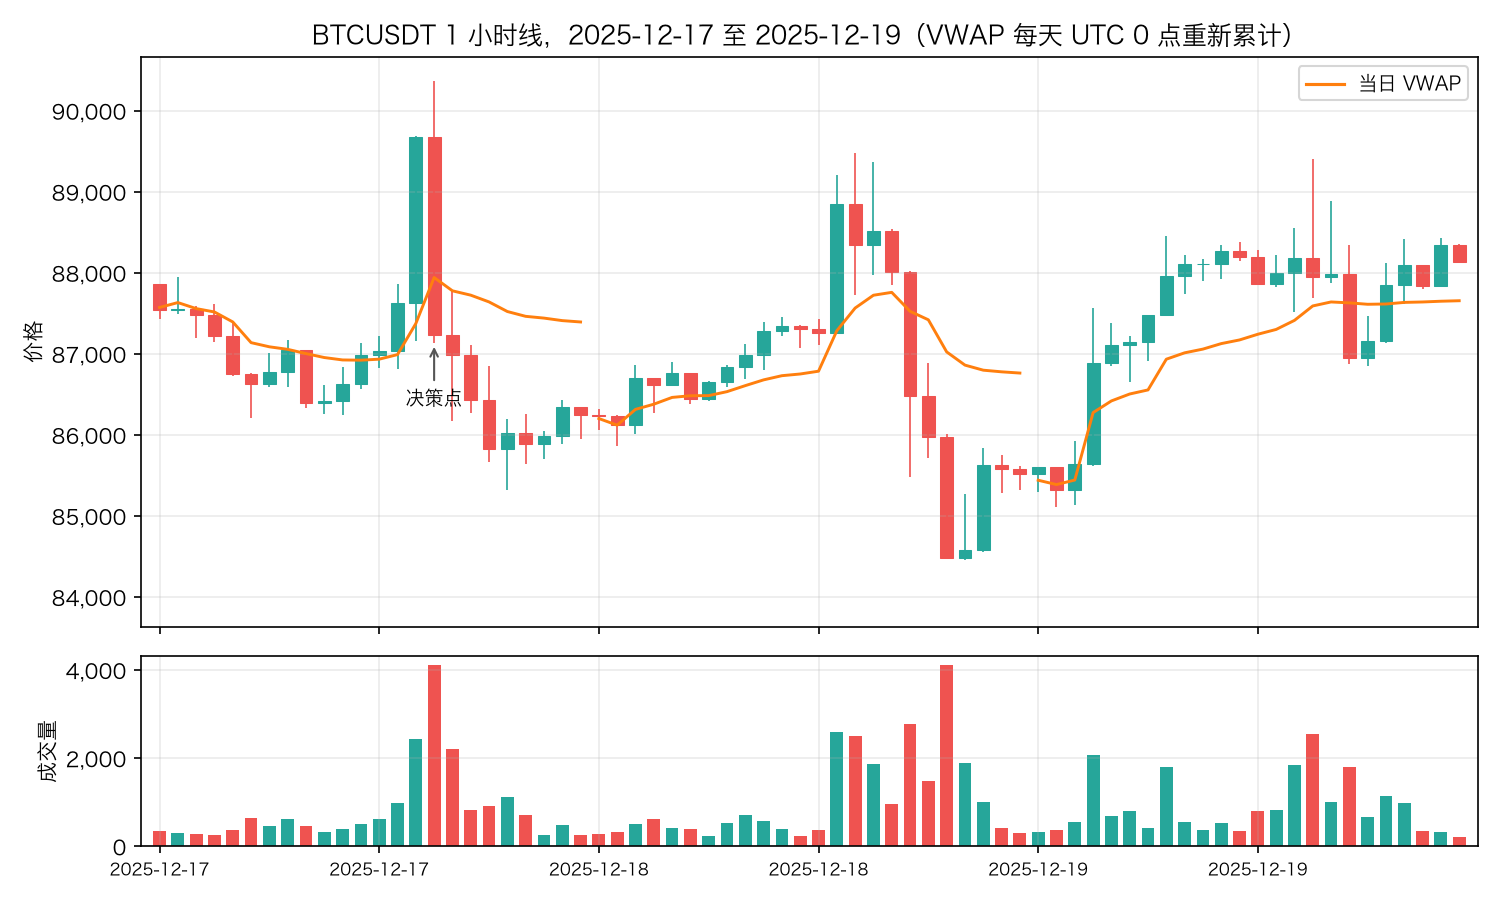
现在是 2025 年 12 月 17 日 UTC 16:00。
这一天前半段,BTC 在 86,200 到 88,000 之间来回,慢慢往下走。UTC 14:30 美股开盘,14:00 这根 1 小时线急涨到 89,685.17,涨了 2.3%。紧接着,15:00 这根 1 小时线先冲到 90,365.85,然后一路跌回,收在 87,233.44,把上一个小时的涨幅全部吐掉了。
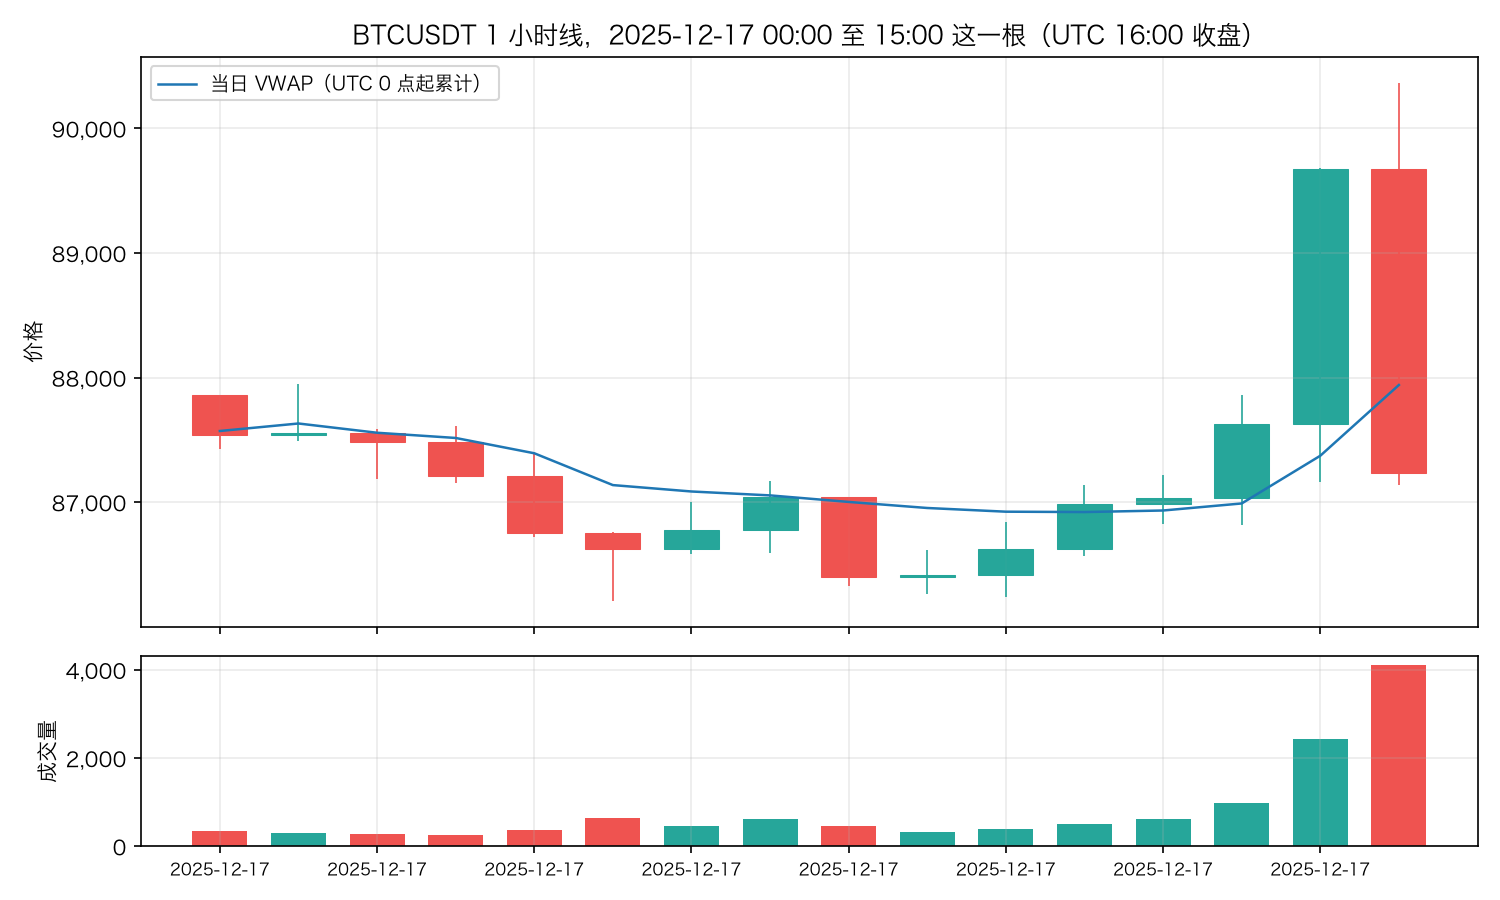
                               open      high       low     close   volume      vwap  相对 24 小时  相对同一小时
time
2025-12-17 12:00:00+00:00  86983.26  87215.97  86828.00  87029.55   620.91  86933.22      0.91    1.12
2025-12-17 13:00:00+00:00  87029.56  87860.00  86817.27  87631.37   984.05  86989.74      1.47    1.16
2025-12-17 14:00:00+00:00  87631.37  89685.17  87161.39  89675.85  2426.71  87372.79      3.91    1.77
2025-12-17 15:00:00+00:00  89675.85  90365.85  87136.97  87233.44  4100.61  87940.78      6.34    2.43
两件事同时发生:
- 收盘价跌破了当日 VWAP(87,940.78)。VWAP 是从 UTC 0 点起,所有成交按成交量加权的平均价格。价格在它下方,意味着今天买入的人平均是亏钱的。
- 成交量是当天最大的:4,100.61 BTC,是过去 24 小时平均的 6.34 倍。
很多交易者会这样读这根 K 线:放出天量、冲高回落、跌破 VWAP,说明大资金在高位出货。你会怎么做?
- A. 做空或卖出:放量跌破 VWAP,今天剩下的时间偏空
- B. 买入:急跌之后价格离 VWAP 不远,容易回到 VWAP
- C. 不动:一根 K 线说明不了什么
先写下你的选择。 第七节会揭晓之后的走势。
注意表格最后一列:同样是这个小时的成交量,和「过去 20 天同一个小时」的平均相比,只有 2.43 倍。6.34 倍和 2.43 倍,哪一个才是「放量」?这是这一篇要回答的第一个问题。
二、成交量记录了什么
打个比方:一个批发市场
想象一个农产品批发市场。市场里有一杆公共大秤,每成交一笔,就要过一次秤,秤会记下这笔交易称了多少斤、单价是多少。
- 成交量是这一天大秤一共称了多少斤。
- 每一斤都有一个买家和一个卖家。 一天称了 10 万斤,就是买家买了 10 万斤,同时卖家卖了 10 万斤。「今天成交量很大,说明买的人很多」这句话是不成立的:卖的人也一样多。
- VWAP 是今天所有成交的平均单价,按斤数加权。饭店的采购员今天进了一批菜,老板判断他买得好不好,最简单的办法就是和今天全市场的平均价比。
- Volume Profile 是按价格记账:3 块钱一斤的称了多少斤,3 块 1 的称了多少斤。成交最多的那个价格,就是 POC。
- 锚定 VWAP 是从某一天开始算的平均进货价,比如从台风过境那天开始。
- 如果市场免收过秤费,有人会反复过秤来刷存在感,称的斤数暴涨,但真实的买卖没有变多。
- 如果有一部分交易不在市场里成交(大客户直接去农场批发,事后才来登记),大秤上看到的只是一部分。
放量不等于买的人多
既然每一笔成交都有买卖两方,成交量本身不带方向。它记录的是这段时间里有多少东西换了手。
成交量大,可能是因为:
- 有人急着买,愿意接受更高的价格(价格上涨)
- 有人急着卖,愿意接受更低的价格(价格下跌)
- 双方意见分歧很大,大量换手,但价格没怎么动
- 一些和观点无关的机械原因:指数调仓、期权到期、交易所的手续费活动
所以读成交量,要先问「为什么这段时间换手这么多」,而不是直接得出「多头」或「空头」的结论。
Binance 的 K 线数据里其实有一点方向信息:taker_buy_base 是主动买入的成交量,也就是买方吃掉卖方挂单成交的那部分(第 1 篇的「吃单」)。但即使是主动买入,也只说明买方更着急,不说明之后价格会涨。这一篇只用总成交量。
成交量主要跟着波动走
先看一个最基本的关系:价格动得越剧烈,成交量越大。
用「当天涨跌幅是前 20 天日收益率标准差的几倍」来衡量剧烈程度(不分涨跌),用相对成交量(当天成交量 ÷ 之前 20 天的平均)来衡量放量:
for name, df in markets.items():
    r = np.log(df["close"]).diff()
    rv = I.relative_volume(df["volume"], 20)
    z = (r / r.rolling(20).std().shift(1)).abs()
    t = pd.DataFrame({"r": r, "rv": rv, "z": z, "次日": r.shift(-1), "5 天": np.log(df["close"].shift(-5) / df["close"])}).dropna()
    print(f"{name}:相对成交量和「涨跌幅是几倍标准差」的秩相关 {t['rv'].rank().corr(t['z'].rank()):.2f}")
BTC:相对成交量和「涨跌幅是几倍标准差」的秩相关 0.49
SPY:相对成交量和「涨跌幅是几倍标准差」的秩相关 0.46
AAPL:相对成交量和「涨跌幅是几倍标准差」的秩相关 0.48
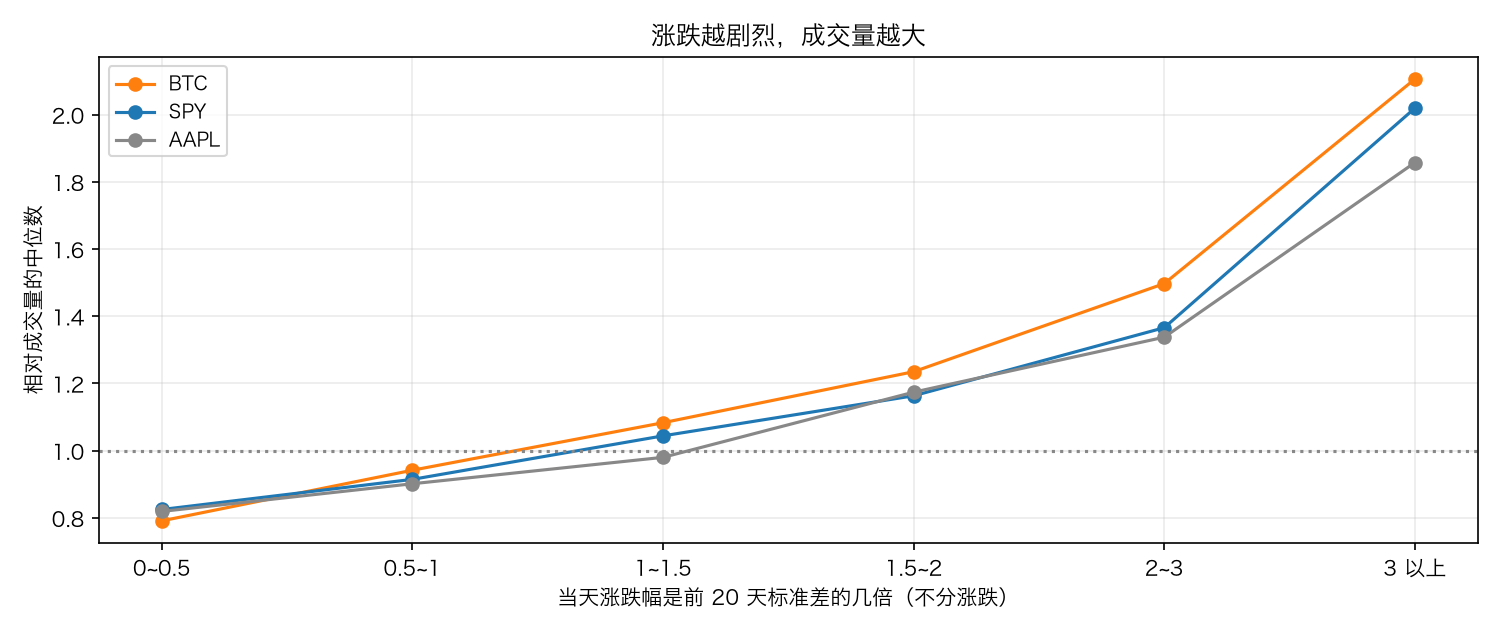
三个标的的秩相关都在 0.5 左右。涨跌幅不到半个标准差的日子,相对成交量的中位数只有 0.8 左右;超过 3 个标准差的日子,中位数在 1.9 到 2.1 之间。
「放量大涨」「放量大跌」这类描述,前后两半说的其实是同一件事。 在第四节检验量价组合之前,要先记住这一点:成交量里有很大一部分信息,涨跌幅本身已经告诉你了。
三、读成交量之前,先检查这五件事
价格数据的坑,第 3 篇已经讲过很多。成交量的坑更多,而且更隐蔽,因为一个错误的成交量看起来和正确的没什么区别。
1. 单位
Binance 的 K 线里有两个成交量:volume 是成交了多少 BTC,quote_volume 是成交了多少 USDT。
yearly = day.groupby(day.index.year)[["volume", "quote_volume"]].mean()
yearly.columns = ["平均每天成交 BTC", "平均每天成交 USDT(亿)"]
yearly["平均每天成交 USDT(亿)"] /= 1e8
print(yearly.round({"平均每天成交 BTC": 0, "平均每天成交 USDT(亿)": 1}).to_string())
      平均每天成交 BTC  平均每天成交 USDT(亿)
time
2017      4352.0             0.5
2018     36456.0             2.6
2019     42000.0             3.3
2020     70311.0             7.8
2021     69910.0            31.6
2022    146442.0            32.9
2023    100289.0            25.2
2024     35331.0            23.2
2025     21125.0            21.0
2026     18663.0            13.3
按 BTC 算,2025 年每天的成交量只有 2020 年的 30%;按 USDT 算,却是 2020 年的 2.7 倍。2025 年的平均价格是 2020 年的 9 倍多,同样的资金只能买到九分之一的 BTC。 比较不同时期的成交量,要用金额(USDT),不能用数量(BTC)。美股也一样:一只股票拆股之后,股数会成倍增加,第 3 篇讲过 Nasdaq 的日线成交量已经按拆股调整过。
2. 交易所自己的活动
2022 年那一行 146,442 BTC 特别高。原因不在市场,而在交易所:Binance 从 2022 年 7 月 8 日起,对 BTCUSDT 等 BTC 现货交易对免收手续费,2023 年 3 月 22 日结束。
v = day["volume"]
for label, before, after in [("2022-07-08 开始", ("2022-06-08", "2022-07-07"), ("2022-07-08", "2022-08-07")),
                             ("2023-03-22 结束", ("2023-02-20", "2023-03-21"), ("2023-03-22", "2023-04-21"))]:
    b, a = v[before[0]:before[1]].mean(), v[after[0]:after[1]].mean()
    print(f"{label}:之前 30 天平均 {b:,.0f} BTC,之后 30 天平均 {a:,.0f} BTC,变化 {a / b - 1:+.0%}")
2022-07-08 开始:之前 30 天平均 97,360 BTC,之后 30 天平均 173,774 BTC,变化 +78%
2023-03-22 结束:之前 30 天平均 377,644 BTC,之后 30 天平均 67,226 BTC,变化 -82%
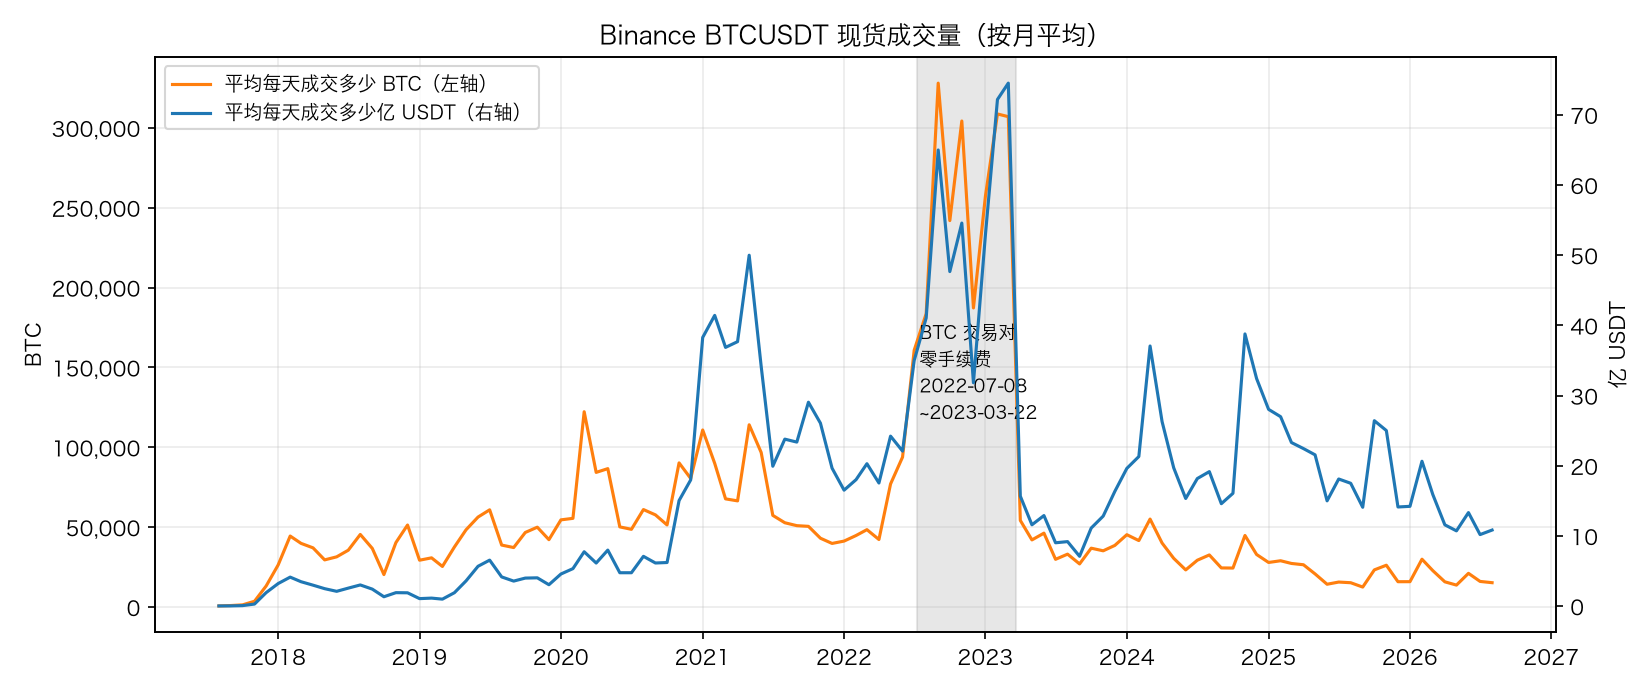
活动一开始,成交量涨了 78%;活动一结束,成交量跌了 82%。这段时间里 BTC 的价格并没有发生什么特别的事,变的只是「过秤费」。
对一个用成交量做信号的规则来说,这段时间是一场灾难:活动期间几乎每天都是「放量」,活动结束之后又几乎每天都是「缩量」。任何「相对过去 20 天」的成交量指标,在这两个时间点附近都会给出完全错误的信号。
3. 现货和合约
同一个交易所、同一个标的,现货和永续合约的成交量差得很远:
both = pd.DataFrame({"现货": day["quote_volume"], "永续合约": perp["quote_volume"]}).dropna()
table = both.groupby(both.index.year).mean() / 1e8
table["合约 ÷ 现货"] = table["永续合约"] / table["现货"]
print(table.round(1).to_string())
        现货   永续合约  合约 ÷ 现货
time
2020   7.8   31.1      4.0
2021  31.6  175.5      5.5
2022  32.9  128.3      3.9
2023  25.2  115.1      4.6
2024  23.2  178.2      7.7
2025  21.0  167.5      8.0
2026  13.3  116.9      8.8
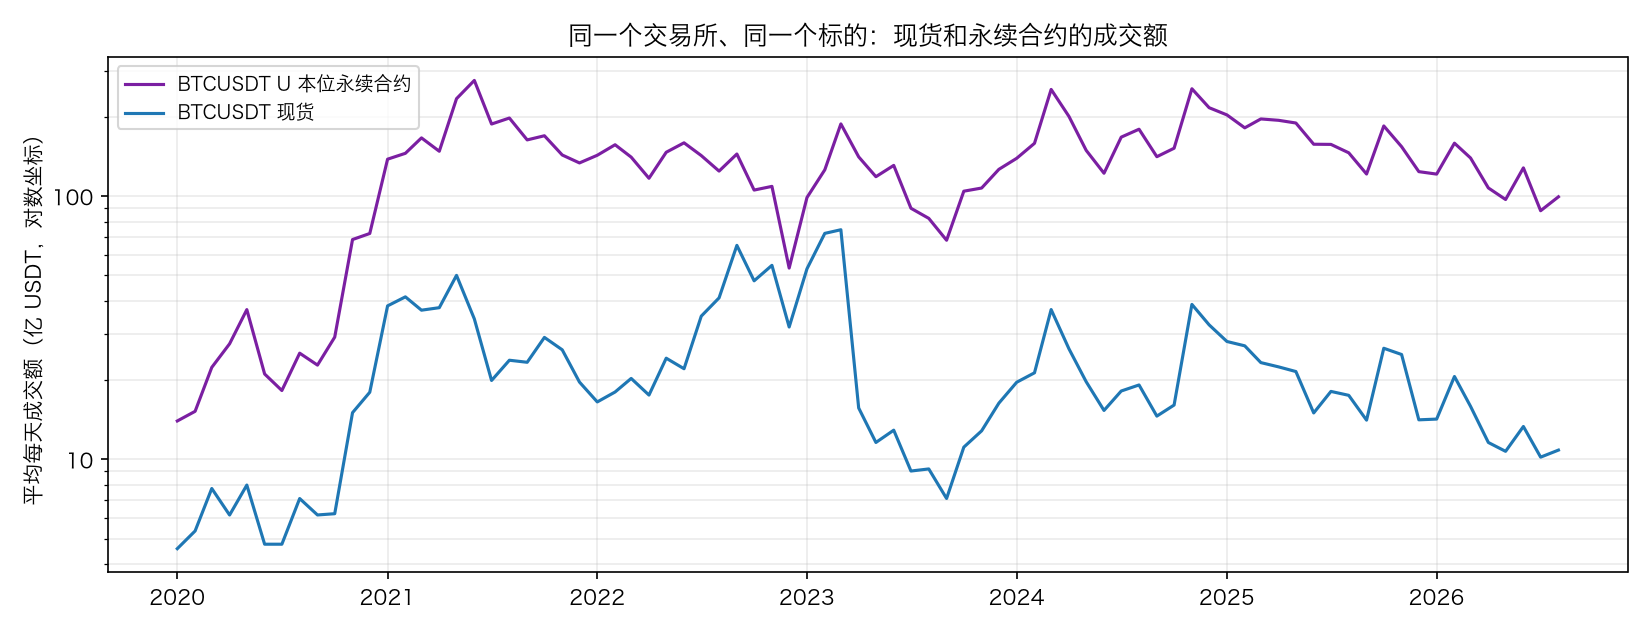
BTCUSDT 永续合约每天的成交额,是现货的 4 到 9 倍,而且这个倍数在变大。2022 年的倍数反而下降,正是因为现货在零手续费期间被放大了,合约没有。
合约成交量大,是因为合约有杠杆:用 1 万美元的保证金,可以开 10 万美元的仓位,每一次开仓和平仓都按 10 万美元计入成交额。你看的是现货图还是合约图,成交量的大小和形状都不一样。 这门课的 BTC 价格用的是现货,成交量也用现货。
合约数据需要单独下载,U 本位永续合约的月度文件从 2020 年 1 月开始:
months = [str(m) for m in pd.period_range("2020-01", "2026-08", freq="M")]     # U 本位永续合约的月度文件从 2020-01 开始
with ThreadPoolExecutor(max_workers=8) as pool:
    list(pool.map(lambda m: D.download_binance_klines("BTCUSDT", "1d", m, m, market="um"), months))
perp = D.load_binance_klines(glob.glob("data/binance/um/BTCUSDT/1d/*.zip"))
4. 刷量
不同交易所之间的成交量更不能直接比较。2019 年 3 月,资产管理公司 Bitwise 在向美国证券交易委员会(SEC)提交的材料里分析了 83 家交易所,结论是:当时公开网站上报告的比特币成交量,大约 95% 是虚假的或者是「自己和自己交易」的刷量;真实成交量集中在 10 家交易所。
批发市场的比方里,这就是自己卖给自己、反复过秤。刷量的动机很直接:成交量大的交易所看起来流动性好,更容易吸引用户和项目上币。
这门课只用 Binance 一家交易所的数据,所以不同交易所之间的可比性问题不会直接影响统计。但如果你在行情网站上看到「全网成交量」,要知道它是很多个质量不同的数字加起来的。
5. 美股的场外成交
美股的情况正好反过来:很大一部分真实成交不在交易所里发生。
大型券商把散户订单交给做市商在内部成交,机构的大单在暗池(ATS)里撮合,这些都叫场外成交。据 Bloomberg 报道,场外成交占美股成交量的比例,在 2025 年 1 月达到创纪录的 51.8%,2024 年 12 月也超过了一半。
场外成交事后要报告给监管机构,计入全市场汇总口径的成交量,大多数行情软件显示的日线成交量用的就是这个口径。但有两个后果:
- 你在交易所的挂单簿上看不到这些订单。 一半以上的成交,在发生之前是看不见的。
- 不同数据源的「成交量」可能口径不同。 有的只统计某一家交易所,有的统计全部。拿到一个美股成交量数字,先确认它是哪种口径。
第 3 篇还发现过一个错误值:SPY 在 2026 年 4 月 17 日的成交量是 9,999,999,这显然是一个占位数字。这一篇把它设为缺失:
spy.loc[pd.Timestamp("2026-04-17"), "volume"] = np.nan # 第 3 篇:这一天的成交量 9,999,999 是错误值
还有一件事:一天之中的时间
回到决策点那个问题:6.34 倍和 2.43 倍,哪个才是放量?
hour_all = B.resample_ohlcv(minute, "1h")
share = hour_all["volume"].groupby([hour_all.index.year, hour_all.index.hour]).sum()
share = share / share.groupby(level=0).transform("sum")
print((share.unstack(0)[[2019, 2022, 2025]] * 100).round(2).T.to_string())
print({year: f"{share[year].loc[13:15].sum():.1%}" for year in [2019, 2022, 2025]})
time    0     1     2     3     4     5     6     7     8     9     10    11    12    13    14    15    16    17    18    19    20    21    22    23
time
2019  4.37  3.84  3.39  3.36  3.48  3.57  3.62  3.77  4.13  4.18  4.49  4.33  4.93  5.04  5.24  5.45  5.88  4.54  3.85  3.72  4.21  3.41  3.47  3.74
2022  4.20  3.65  3.63  3.37  3.24  3.26  3.63  4.00  4.13  3.73  3.82  3.84  4.93  5.98  6.47  5.79  5.30  4.48  4.69  4.46  3.78  2.71  3.43  3.48
2025  3.97  3.89  3.77  3.32  3.10  2.99  3.24  4.06  3.55  3.38  3.17  3.22  4.08  5.77  7.69  7.28  5.77  5.32  4.30  4.23  4.09  3.54  3.19  3.08
{2019: '15.7%', 2022: '18.2%', 2025: '20.7%'}
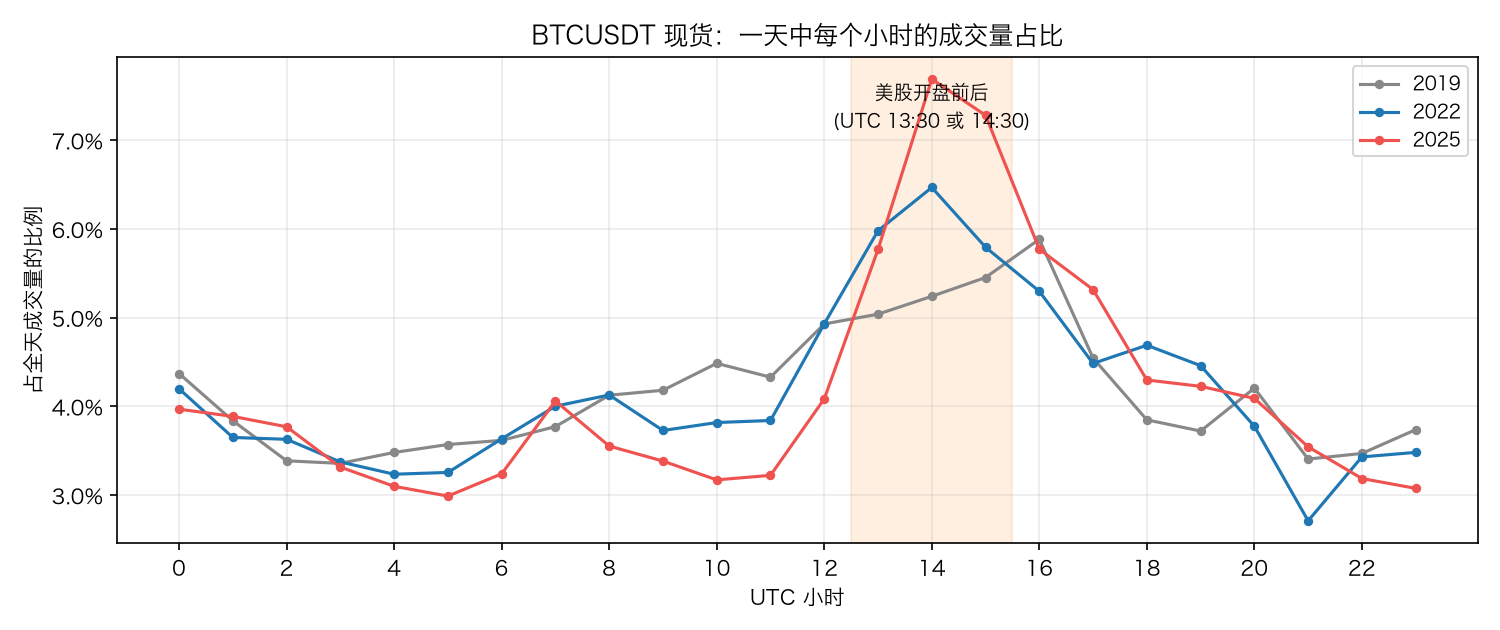
如果成交量在一天里均匀分布,每个小时应该占 4.17%(1 ÷ 24)。但 BTC 不是:UTC 13:00 到 15:59 这三个小时,2025 年占了全天成交量的 20.7%,是平均水平的 1.66 倍。这三个小时正是美股开盘前后(美国夏令时 UTC 13:30 开盘,冬令时 14:30)。而且这个集中程度逐年增加:2019 年是 15.7%,2022 年是 18.2%。
所以,美股开盘那个小时的成交量本来就比凌晨大得多。拿它和「过去 24 小时的平均」比,几乎每天都会显示放量;和「过去 20 天同一个小时的平均」比,才是在问「今天这个时段是不是比平时这个时段更活跃」。
relative_volume 的 by 参数就是为这个设计的:
hour["相对 24 小时"] = I.relative_volume(hour["volume"], 24)
hour["相对同一小时"] = I.relative_volume(hour["volume"], 20, by=hour.index.hour)
决策点那个小时,按第一种算法是 6.34 倍,按第二种是 2.43 倍。它确实放量了,但没有 6 倍那么夸张。 第八节会看到,这个区别会直接改变统计结果。
四、量价的四种组合
传统说法
把每一天按「涨还是跌」和「放量还是缩量」分成四类,传统的解读是:
| 放量 | 缩量 | |
|---|---|---|
| 涨 | 量价配合,上涨健康,会继续涨 | 量价背离,上涨乏力,可能见顶 |
| 跌 | 恐慌抛售,还会继续跌 | 卖压减轻,跌势快结束了 |
数据怎么说
「放量」定义为相对成交量大于 1(高于之前 20 天的平均),「缩量」是小于 1。看每一类之后第 1 天和之后 5 天的对数收益率:
    t["组合"] = np.where(t["r"] > 0, "涨", "跌") + np.where(t["rv"] > 1, "放量", "缩量")
    print(t.groupby("组合").agg(天数=("次日", "size"), 次日平均=("次日", "mean"), 五天平均=("5 天", "mean"),
                              五天上涨比例=("5 天", lambda s: (s > 0).mean())).round(4).to_string())
    for side in ["涨", "跌"]:
        part = t[t["组合"].str.startswith(side)]
        gap, p = label_test(part["5 天"], part["rv"] > 1)
        print(f"   {side}的日子:放量减缩量,之后 5 天 {gap:+.2%},打乱标签后差距不小于它的比例 {p:.1%}")
(这几行在第二节那个 for name, df in markets.items(): 循环里面。)
label_test 是一种新的检验方式:
rng = np.random.default_rng(0)
def label_test(values, flag, n=2000):
    """flag 为真的组减去其余的平均值;把标签随机打乱 n 次,看差距不小于实际的比例。"""
    x, f = np.asarray(values, float), np.asarray(flag, bool)
    observed = x[f].mean() - x[~f].mean()
    sims = np.array([x[p].mean() - x[~p].mean() for p in (rng.permutation(f) for _ in range(n))])
    return observed, (np.abs(sims) >= abs(observed)).mean()
它回答的问题是:在同样是上涨的日子里,「放量」这个标签有没有带来额外的信息? 做法是保持每一天之后的收益不变,只把「放量」「缩量」这两个标签随机重新分配。如果实际的差距在随机分配的结果里很常见,放量这个标签就没有提供额外的信息。
和第 8、9 篇打乱价格顺序不同,这里打乱的是标签,价格的走势完全不变。
BTC:相对成交量和「涨跌幅是几倍标准差」的秩相关 0.49
      天数    次日平均    五天平均  五天上涨比例
组合
涨放量  722  0.0008  0.0085  0.5222
涨缩量  952  0.0003  0.0048  0.5084
跌放量  692  0.0012  0.0016  0.5549
跌缩量  910  0.0013  0.0030  0.5451
   涨的日子:放量减缩量,之后 5 天 +0.37%,打乱标签后差距不小于它的比例 33.7%
   跌的日子:放量减缩量,之后 5 天 -0.13%,打乱标签后差距不小于它的比例 72.9%
SPY:相对成交量和「涨跌幅是几倍标准差」的秩相关 0.46
      天数    次日平均    五天平均  五天上涨比例
组合
涨放量  450 -0.0003 -0.0002  0.5533
涨缩量  910  0.0006  0.0031  0.6231
跌放量  564  0.0010  0.0023  0.6117
跌缩量  541  0.0005  0.0039  0.6359
   涨的日子:放量减缩量,之后 5 天 -0.32%,打乱标签后差距不小于它的比例 0.9%
   跌的日子:放量减缩量,之后 5 天 -0.15%,打乱标签后差距不小于它的比例 33.3%
AAPL:相对成交量和「涨跌幅是几倍标准差」的秩相关 0.48
      天数    次日平均    五天平均  五天上涨比例
组合
涨放量  453  0.0009  0.0047  0.6049
涨缩量  879  0.0006  0.0046  0.5973
跌放量  483  0.0013  0.0052  0.5590
跌缩量  672  0.0013  0.0057  0.5818
   涨的日子:放量减缩量,之后 5 天 +0.02%,打乱标签后差距不小于它的比例 93.1%
   跌的日子:放量减缩量,之后 5 天 -0.06%,打乱标签后差距不小于它的比例 81.0%
读这个结果
六个检验里,五个没有差别。 BTC 和 AAPL 上,放量和缩量之后 5 天的收益几乎一样;跌的日子里,三个标的都没有差别。
唯一一个显著的结果,方向和传统说法相反。 SPY 放量上涨之后 5 天平均 −0.02%,缩量上涨之后 +0.31%,放量反而差了 0.32 个百分点;随机分配标签,只有 0.9% 的结果差距这么大。传统说法是「放量上涨是健康的」,SPY 的数据指向相反的方向,这和第 5、8 篇看到的 SPY 均值回归倾向是一致的。
⚠️ 这个 0.9% 要打折扣看:
- 5 天的收益互相重叠,相邻几天的「之后 5 天」有 4 天是一样的;放量的日子又常常连在一起。打乱标签没有考虑这种依赖,会让结果看起来比实际更显著。
- 一共做了 6 个检验,碰巧出现一个 1% 以下的结果并不罕见。
能说的结论是:在这三个标的的日线上,「涨跌 × 放缩量」的四种组合,没有表现出传统说法描述的规律。
五、放量突破、缩量回调、天量
放量突破
传统说法:突破时成交量越大,越可能是真突破。
「突破」定义为收盘价第一次高于之前 20 天的最高价;「跌回」是之后 10 天内有收盘价回到突破位下方。
for name, df in markets.items():
    c, rv = df["close"], I.relative_volume(df["volume"], 20)
    high20 = df["high"].rolling(20).max().shift(1)
    breakout = (c > high20) & (c.shift(1) <= high20.shift(1))
    fell_back = pd.concat([c.shift(-k) for k in range(1, 11)], axis=1).min(axis=1) < high20
    t = pd.DataFrame({"rv": rv, "20 天": c.shift(-20) / c - 1, "10 天内跌回": fell_back})[breakout].dropna()
    group = pd.cut(t["rv"], [0, 1, 2, np.inf], labels=["1 倍以下", "1~2 倍", "2 倍以上"])
    print(f"{name} 收盘突破 20 日最高价 {len(t)} 次(任意一天之后 20 天平均 {(c.shift(-20) / c - 1).mean():+.2%}):")
    print(t.groupby(group, observed=False).agg(次数=("20 天", "size"), 之后20天平均=("20 天", "mean"),
                                              上涨比例=("20 天", lambda s: (s > 0).mean()), 跌回比例=("10 天内跌回", "mean")).round(3).to_string())
    gap, p = label_test(t["10 天内跌回"].astype(float), t["rv"] > 2)
    print(f"   2 倍以上放量减其余,跌回比例 {gap:+.1%},打乱标签后 {p:.1%}")
BTC 收盘突破 20 日最高价 152 次(任意一天之后 20 天平均 +3.15%):
        次数  之后20天平均   上涨比例   跌回比例
rv
1 倍以下   37    0.055  0.595  0.730
1~2 倍  103    0.077  0.553  0.612
2 倍以上   12    0.060  0.833  0.500
   2 倍以上放量减其余,跌回比例 -14.3%,打乱标签后 33.5%
SPY 收盘突破 20 日最高价 218 次(任意一天之后 20 天平均 +1.13%):
        次数  之后20天平均   上涨比例   跌回比例
rv
1 倍以下  140    0.004  0.679  0.700
1~2 倍   74    0.012  0.730  0.568
2 倍以上    4    0.018  0.750  0.750
   2 倍以上放量减其余,跌回比例 +9.6%,打乱标签后 100.0%
AAPL 收盘突破 20 日最高价 181 次(任意一天之后 20 天平均 +2.33%):
       次数  之后20天平均   上涨比例   跌回比例
rv
1 倍以下  74    0.028  0.689  0.581
1~2 倍  94    0.024  0.691  0.585
2 倍以上  13    0.030  0.692  0.308
   2 倍以上放量减其余,跌回比例 -27.6%,打乱标签后 7.8%
(为了显示清楚,三个标的的缩量回调结果放到下面单独看。)
第一个发现:2 倍以上放量的突破非常少。 BTC 152 次突破里只有 12 次,SPY 218 次里只有 4 次,AAPL 181 次里 13 次。突破大多发生在普通的成交量下。
第二个发现:放量突破的跌回比例确实更低(BTC 50.0% 对其余的 64.3%,AAPL 30.8% 对 58.3%),方向和传统说法一致。但样本太少,随机分配标签之后,BTC 有 33.5%、AAPL 有 7.8% 的结果差距不小于实际值。方向支持传统说法,但证据不够。
第三个发现:大多数突破都会在 10 天内跌回。 BTC 和 SPY 的各组里,有一半到四分之三的突破在 10 天内出现过收盘价回到突破位下方。第 9 篇的「超过一半的收盘跌破是假的」,反过来对突破也成立。
缩量回调
传统说法:上涨趋势中,缩量回调是健康的,之后会继续上涨;放量回调说明有人在出货。
「上涨趋势中的回调」定义为:收盘价在 50 日均线上方,连续 3 天收盘下跌。「缩量」是这 3 天的平均成交量低于回调开始前 20 天的平均。
    down3 = (c < c.shift(1)) & (c.shift(1) < c.shift(2)) & (c.shift(2) < c.shift(3))
    pullback_volume = df["volume"].rolling(3).mean() / df["volume"].rolling(20).mean().shift(3)
    t = pd.DataFrame({"量": pullback_volume, "10 天": c.shift(-10) / c - 1})[down3 & (c > c.rolling(50).mean())].dropna()
    gap, p = label_test(t["10 天"], t["量"] < 1)
    print(f"   50 日均线上方连跌 3 天 {len(t)} 次:缩量 {(t['量'] < 1).sum()} 次,之后 10 天平均 {t.loc[t['量'] < 1, '10 天'].mean():+.2%};"
          f"放量 {(t['量'] >= 1).sum()} 次,{t.loc[t['量'] >= 1, '10 天'].mean():+.2%};缩量减放量 {gap:+.2%},打乱标签后 {p:.1%}")
   50 日均线上方连跌 3 天 111 次:缩量 62 次,之后 10 天平均 +3.11%;放量 49 次,+1.18%;缩量减放量 +1.93%,打乱标签后 42.4%
   50 日均线上方连跌 3 天 94 次:缩量 37 次,之后 10 天平均 -0.24%;放量 57 次,+0.55%;缩量减放量 -0.79%,打乱标签后 14.3%
   50 日均线上方连跌 3 天 93 次:缩量 57 次,之后 10 天平均 +0.05%;放量 36 次,+2.20%;缩量减放量 -2.15%,打乱标签后 4.3%
(依次是 BTC、SPY、AAPL。)
- BTC:缩量回调之后确实更好(+3.11% 对 +1.18%),但打乱标签后有 42.4% 的结果差距更大,不能区分
- SPY:方向相反,缩量回调之后更差,但不显著
- AAPL:方向相反,放量回调之后 10 天平均 +2.20%,缩量回调只有 +0.05%,打乱标签后只有 4.3% 的结果差距这么大
三个标的,三个不同的方向。「缩量回调是健康的」在这些数据里得不到一致的支持。
天量
传统说法:天量见天价。成交量创出很长时间以来的最大值,往往意味着行情到头了。
「天量」定义为成交量超过之前 250 天的最大值:
for name in ["BTC", "AAPL"]:
    df = markets[name]
    c, vol = df["close"], df["volume"]
    record = vol > vol.rolling(250).max().shift(1)
    rows = []
    for t in df.index[record & vol.rolling(250).max().shift(1).notna()]:
        i = df.index.get_loc(t)
        if i + 60 >= len(df):
            continue
        later = df.iloc[i + 1:i + 61]
        third_friday = t.dayofweek == 4 and 15 <= t.day <= 21 and t.month in (3, 6, 9, 12)
        rows.append({"日期": t.date(), "当天涨跌": c.iloc[i] / c.iloc[i - 1] - 1, "当天最高价是之后 60 天最高": df["high"].iloc[i] >= later["high"].max(),
                     "当天最低价是之后 60 天最低": df["low"].iloc[i] <= later["low"].min(), "之后 60 天": c.iloc[i + 60] / c.iloc[i] - 1,
                     "季度第三个周五": third_friday})
    print(f"{name}:成交量创 250 天新高的日子")
    print(pd.DataFrame(rows).to_string(index=False, formatters={"当天涨跌": "{:+.1%}".format, "之后 60 天": "{:+.1%}".format}))
BTC:成交量创 250 天新高的日子
        日期   当天涨跌  当天最高价是之后 60 天最高  当天最低价是之后 60 天最低 之后 60 天  季度第三个周五
2018-10-15  +6.5%             True            False  -52.3%    False
2018-11-20  -7.2%             True            False  -19.6%    False
2019-06-26 +10.8%             True            False  -22.5%    False
2019-06-27 -13.5%             True            False   -8.5%    False
2020-03-12 -39.5%            False            False  +78.4%    False
2020-03-13 +16.2%            False             True  +57.9%    False
2021-01-11  -7.2%            False            False  +61.6%    False
2021-05-19 -14.4%             True            False  -13.4%    False
2022-05-09 -11.6%             True            False  -28.2%    False
2022-05-11  -6.2%            False            False  -28.3%    False
2022-06-13 -15.4%             True            False   +8.5%    False
2022-07-08  -0.1%            False            False  -13.0%    False
2022-09-09 +10.6%            False            False  -13.2%    False
2022-09-13  -9.9%             True            False  -16.7%    False
2022-09-26  +2.2%            False            False  -14.1%    False
2022-09-27  -0.8%            False            False  -13.7%    False
2022-11-08  -9.9%             True            False   -8.6%    False
2024-02-28  +9.5%            False             True   +1.1%    False
2024-03-05  -6.6%            False            False   +0.3%    False
2024-08-05  -7.1%            False             True  +14.9%    False
2026-02-05 -14.0%            False            False   +9.4%    False
AAPL:成交量创 250 天新高的日子
        日期  当天涨跌  当天最高价是之后 60 天最高  当天最低价是之后 60 天最低 之后 60 天  季度第三个周五
2018-02-02 -4.3%            False            False   +5.8%    False
2018-09-21 -1.1%            False            False  -23.4%     True
2020-02-27 -6.5%            False            False  +16.9%    False
2020-02-28 -0.1%            False            False  +16.2%    False
2021-12-17 -0.7%            False            False   -6.6%     True
2024-02-29 -0.4%            False            False   +5.2%    False
2024-05-03 +6.0%            False            False  +21.3%    False
2024-06-11 +7.3%            False             True   +6.7%    False
2024-06-12 +2.9%            False            False   +3.8%    False
2024-06-21 -1.0%            False            False   +4.6%     True
2024-09-20 -0.3%            False            False  +10.1%     True
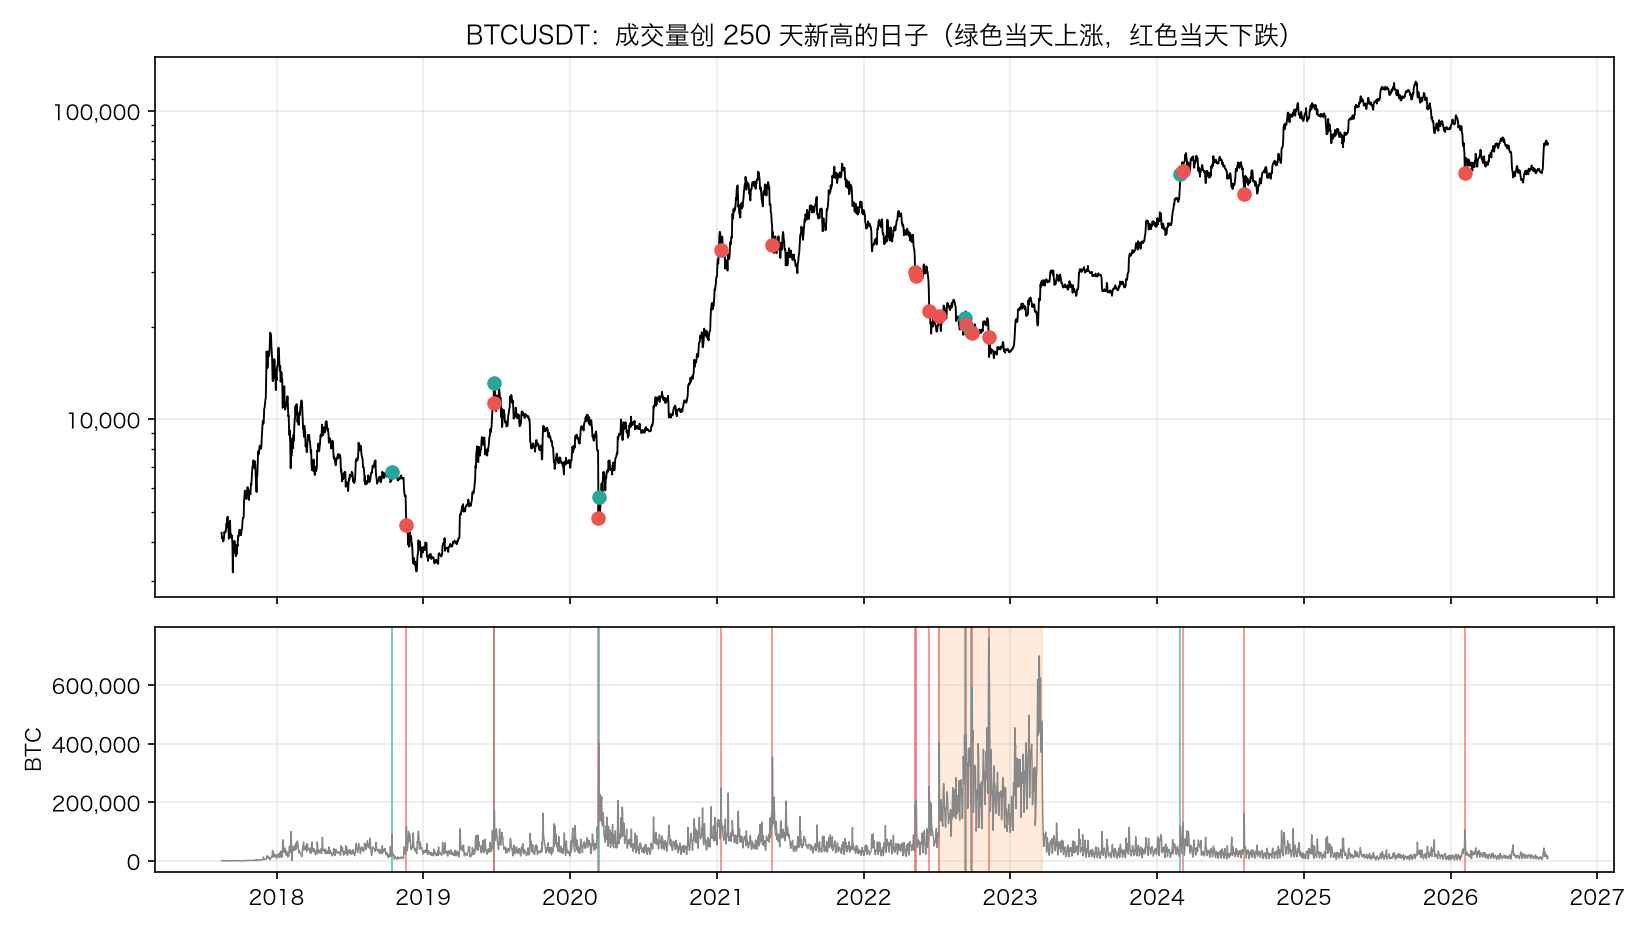
BTC 的 21 个天量日里,15 个是下跌的日子。 天量更常出现在恐慌抛售里,而不是追涨的顶部:2020 年 3 月 12 日跌了 39.5%,2021 年 5 月 19 日跌了 14.4%,2022 年 5 月和 6 月是 LUNA 和 Celsius 事件期间(第 5 篇的决策点就在这段时间)。
「当天最高价是之后 60 天最高」有 9 次,看起来像是「天量见天价」。但仔细看,这 9 天里 7 天当天就是下跌的:价格在下跌中放出天量,之后继续下跌,当天的最高价自然成了之后 60 天的最高价。这和传统说法里「放量冲顶」的画面完全不同。
还有几个天量日和市场本身无关:2022 年 7 月 8 日是 Binance 零手续费活动开始的第一天,当天几乎没涨没跌(−0.1%);2022 年 9 月的几个天量日也在零手续费期间。
AAPL 的 11 个天量日里,4 个是季度的第三个周五(2018-09-21、2021-12-17、2024-06-21、2024-09-20)。这一天美股的股指期货、股指期权和个股期权同时到期,也是标普等指数季度调整生效的日子,被动基金必须在收盘时调仓。当天的涨跌幅都在 1.1% 以内,成交量来自第 2 篇讲过的被迫交易者,不是任何人对 AAPL 的看法变了。
天量首先是一个「发生了什么事」的信号。 在用它判断顶底之前,先查一查那天发生了什么:暴跌、期权到期、指数调仓,还是交易所的活动。
六、VWAP
定义
VWAP(Volume Weighted Average Price,成交量加权平均价)是一段时间里所有成交的平均价格,每一笔成交按它的数量加权:
VWAP = Σ(每笔成交的价格 × 成交数量) ÷ Σ成交数量
只有 K 线、没有逐笔数据时,用每根 K 线的「平均成交价」代替每笔成交的价格:
VWAP ≈ Σ(每根 K 线的平均成交价 × 这根 K 线的成交量) ÷ Σ成交量
当日 VWAP 从交易日开始时从零累计,每根 K 线更新一次,到收盘时就是全天的成交均价。
算例:一天里的 4 根 K 线。
| K 线 | 平均成交价 | 成交量 | 价格 × 成交量 | 累计金额 | 累计成交量 | VWAP |
|---|---|---|---|---|---|---|
| 1 | 100 | 1 | 100 | 100 | 1 | 100.00 |
| 2 | 102 | 3 | 306 | 406 | 4 | 101.50 |
| 3 | 98 | 1 | 98 | 504 | 5 | 100.80 |
| 4 | 97 | 5 | 485 | 989 | 10 | 98.90 |
第 2 根 K 线成交量大,把 VWAP 拉向 102;第 4 根成交量更大,又把它拉向 97。如果不加权,4 个价格的简单平均是 99.25,和 VWAP 差了 0.35。
为什么是机构的基准
1988 年,Berkowitz、Logue 和 Noser 在《Journal of Finance》上发表了一篇研究纽交所交易成本的论文,用交易日的 VWAP 来衡量机构订单的执行质量:券商替机构买入的平均价格,比当天的 VWAP 高多少。这就是 VWAP 作为执行基准的起点。
道理和批发市场的采购员一样。一家基金要买入 100 万股 AAPL,一天里分很多次买完。怎么判断执行得好不好?
- 和收盘价比?收盘价只是最后一笔,和一天里大部分时间的价格无关。
- 和开盘价比?如果一整天都在涨,任何人都买不到开盘价。
- 和 VWAP 比:VWAP 是这一天所有人的平均成交价。买入均价低于 VWAP,说明你比「平均的买家」买得便宜;高于 VWAP,说明你买贵了。
这个标准有一个副作用:很多机构的执行算法就是以「贴近 VWAP」为目标设计的,它们会按一天中成交量的典型分布(比如第三节看到的美股开盘前后成交集中)拆分订单。所以 VWAP 附近确实有真实的订单流,这是它和很多其他指标不一样的地方。
但要注意这个机制的方向:执行算法关心的是成交均价接近 VWAP,而不是「价格在 VWAP 上方就买、在下方就卖」。后者是交易者自己加上去的解读。
精确的 VWAP 和近似的 VWAP
Binance 的 K 线同时给出了成交数量(volume)和成交金额(quote_volume),两者一除就是这根 K 线精确的平均成交价。大多数数据源只有开高低收和成交量,只能用典型价格 (最高 + 最低 + 收盘) ÷ 3 来近似。近似的误差有多大?
m = minute[minute["volume"] > 0]
session = m.index.floor("1D")
exact = I.vwap(m["quote_volume"] / m["volume"], m["volume"], session)
approx = I.vwap(I.typical_price(m["high"], m["low"], m["close"]), m["volume"], session)
end = exact.groupby(session).tail(1).index
error = (approx[end] / exact[end] - 1).abs()
print(f"1 分钟线的典型价格算出的全天 VWAP:误差中位数 {error.median():.4%},99% 分位 {error.quantile(0.99):.4%},最大 {error.max():.4%}")
daily_exact = day["quote_volume"] / day["volume"]
error = (I.typical_price(day["high"], day["low"], day["close"]) / daily_exact - 1).abs()
print(f"只用日线的 (最高 + 最低 + 收盘) ÷ 3:误差中位数 {error.median():.2%},90% 分位 {error.quantile(0.9):.2%},"
      f"最大 {error.max():.2%}({error.idxmax().date()})")
1 分钟线的典型价格算出的全天 VWAP:误差中位数 0.0015%,99% 分位 0.0194%,最大 0.0673%
只用日线的 (最高 + 最低 + 收盘) ÷ 3:误差中位数 0.28%,90% 分位 1.07%,最大 8.07%(2020-03-12)
- 用 1 分钟线的典型价格累计,全天 VWAP 的误差中位数只有 0.0015%,最大 0.067%。1 分钟里价格走不远,典型价格和真实均价几乎一样。
- 只用日线的典型价格,误差中位数 0.28%,十分之一的日子超过 1.07%。2020 年 3 月 12 日误差达到 8.07%:那天暴跌 39.5%,成交量集中在低价区域,而 (最高 + 最低 + 收盘) ÷ 3 完全不知道成交发生在哪里。
结论:VWAP 要用尽量小周期的 K 线累计。 在只有日线的美股数据上,「日线 VWAP」只是一个粗略的近似,不能拿来做精确的比较。
「当日」从什么时候开始
美股的交易日很明确:09:30 开盘,16:00 收盘,VWAP 从开盘累计到收盘。
BTC 24 小时交易,没有收盘。大多数加密平台按 UTC 0 点重置当日 VWAP,这一篇也是这样做的(hour.index.floor("1D"))。但这是一个人为的选择:第 3 篇讲过,BTC 日线按 UTC 和按北京时间切,28.8% 的日子阴阳相反。当日 VWAP 也一样,换一个重置时间,同一时刻的 VWAP 就不同。
决策点里的 VWAP 是这样算的:
hour = B.resample_ohlcv(minute.loc["2025-11-01":"2025-12-17"], "1h")
hour["均价"] = hour["quote_volume"] / hour["volume"]
hour["vwap"] = I.vwap(hour["均价"], hour["volume"], hour.index.floor("1D"))
1 小时线的 quote_volume ÷ volume 是这一小时精确的平均成交价,累计出来的 VWAP 和用 1 分钟线累计的完全相同(金额和数量都是简单相加)。
✋ 小检查 1
某一天的 3 根 1 小时线:
| 小时 | 最高 | 最低 | 收盘 | 成交量 | 成交金额 |
|---|---|---|---|---|---|
| 1 | 104 | 98 | 103 | 2 | 204 |
| 2 | 108 | 102 | 107 | 6 | 630 |
| 3 | 107 | 95 | 96 | 2 | 196 |
(a) 用成交金额 ÷ 成交量,算出每根 K 线的平均成交价,再算出第 3 根收盘时的当日 VWAP。
(b) 改用典型价格 (最高 + 最低 + 收盘) ÷ 3,第 3 根收盘时的 VWAP 是多少?和 (a) 差多少?
(c) 第 3 根收盘价 96 在 VWAP 的哪一侧?「今天买入的人平均赚钱还是亏钱」?
答案在文末。
七、揭晓
after = B.resample_ohlcv(minute.loc["2025-12-17 16:00":"2025-12-24 16:00"], "1h")
decision_price = hour.loc["2025-12-17 15:00", "close"]
rest = after.loc[:"2025-12-17 23:00"]
print(f"决策价 {decision_price:,.2f};当天收盘 {rest['close'].iloc[-1]:,.2f}({rest['close'].iloc[-1] / decision_price - 1:+.2%}),"
      f"当天剩余时间最低 {rest['low'].min():,.2f},最高 {rest['high'].max():,.2f}")
for label, t in [("24 小时后", "2025-12-18 15:00"), ("3 天后", "2025-12-20 15:00"), ("7 天后", "2025-12-24 15:00")]:
    print(f"{label}:{after.loc[t, 'close'] / decision_price - 1:+.2%}")
print(f"12 月 18 日全天 VWAP {(lambda d: d['quote_volume'].sum() / d['volume'].sum())(after.loc['2025-12-18']):,.2f}")
决策价 87,233.44;当天收盘 86,243.22(-1.14%),当天剩余时间最低 85,314.00,最高 87,769.23
24 小时后:+1.47%
3 天后:+1.08%
7 天后:-0.21%
12 月 18 日全天 VWAP 86,761.96
当天剩下的 8 个小时,价格继续下跌,最低到 85,314,收在 86,243.22,比决策价低 1.14%。当天剩余时间的最高价 87,769.23,没有回到 VWAP(87,940.78)上方。如果你选了 A,当天是对的。
但 24 小时后,价格比决策价高了 1.47%。 12 月 18 日几乎复制了前一天的剧本:美股开盘前后急涨到 89,477.61,然后在 UTC 20:00 这个小时跌到 84,450.01。3 天后 +1.08%,7 天后 −0.21%。
所以选 A 的人,如果当天收盘平仓,赚了 1%;如果拿到第二天,亏了 1.5%;如果拿一周,基本持平。选 B 的人正好相反。
这不是一个关于 BTC 那几天走势的故事,而是一个关于时间尺度的故事:当日 VWAP 是一个只在当天有意义的参考线。第二天 UTC 0 点,它就重新开始了。用一个当天的信号去做几天的交易,是在用错工具。
一次揭晓说明不了规律。第八节用 9 年的数据来看「放量跌破 VWAP」之后发生了什么。
八、放量跌破 VWAP 之后
事件定义
- 跌破:一根 1 小时线的收盘价在当日 VWAP 下方,而上一根在上方(或等于)
- 只看 UTC 4:00 到 20:00 之间的跌破,太早 VWAP 还没有累计足够的成交,太晚当天剩下的时间太短
- 之后:到当天收盘(UTC 24:00)的对数收益率,以及之后 24 小时的对数收益率
h = hour_all.copy()
h["均价"] = h["quote_volume"] / h["volume"]
h = h[h["volume"] > 0]
h["vwap"] = I.vwap(h["均价"], h["volume"], h.index.floor("1D"))
h["相对 24 小时"] = I.relative_volume(h["volume"], 24)
h["相对同一小时"] = I.relative_volume(h["volume"], 20, by=h.index.hour)
h["到收盘"] = np.log(h["close"].groupby(h.index.floor("1D")).transform("last") / h["close"])
h["24 小时"] = np.log(h["close"].shift(-24) / h["close"])
below = h["close"] < h["vwap"]
cross = below & ~below.shift(1, fill_value=False) & (h.index.hour >= 4) & (h.index.hour <= 20)
events = h[cross].dropna(subset=["相对 24 小时", "相对同一小时", "24 小时"])
print(f"收盘从 VWAP 上方跌到下方的 1 小时线(4:00 到 20:00 之间):{len(events)} 次")
for col in ["相对 24 小时", "相对同一小时"]:
    group = pd.cut(events[col], [0, 1, 2, 3, np.inf], labels=["1 倍以下", "1~2 倍", "2~3 倍", "3 倍以上"])
    print(f"按{col}分组:")
    print(events.groupby(group, observed=False).agg(次数=("到收盘", "size"), 到当天收盘平均=("到收盘", "mean"),
                                                   之后24小时平均=("24 小时", "mean"), 之后24小时下跌比例=("24 小时", lambda s: (s < 0).mean())).round(4).to_string())
    strong = events[events[col] >= 2]
    print(f"   {col} 2 倍以上的事件里,发生在 UTC 13:00~15:00 的占 {strong.index.hour.isin([13, 14, 15]).mean():.1%}"
          f"(全部事件里是 {events.index.hour.isin([13, 14, 15]).mean():.1%})")
gap, p = label_test(events["24 小时"], events["相对同一小时"] >= 2)
print(f"同一小时 2 倍以上放量减其余,之后 24 小时 {gap:+.2%},打乱标签后 {p:.1%}")
收盘从 VWAP 上方跌到下方的 1 小时线(4:00 到 20:00 之间):4978 次
按相对 24 小时分组:
            次数  到当天收盘平均  之后24小时平均  之后24小时下跌比例
相对 24 小时
1 倍以下     3028   0.0019    0.0025      0.4548
1~2 倍     1459   0.0004   -0.0004      0.4805
2~3 倍      291   0.0005    0.0018      0.4296
3 倍以上      200  -0.0004   -0.0005      0.4800
   相对 24 小时 2 倍以上的事件里,发生在 UTC 13:00~15:00 的占 43.6%(全部事件里是 19.3%)
按相对同一小时分组:
          次数  到当天收盘平均  之后24小时平均  之后24小时下跌比例
相对同一小时
1 倍以下   3185   0.0010    0.0016      0.4619
1~2 倍   1387   0.0018    0.0011      0.4650
2~3 倍    244   0.0020    0.0023      0.4221
3 倍以上    162   0.0015    0.0013      0.4938
   相对同一小时 2 倍以上的事件里,发生在 UTC 13:00~15:00 的占 22.7%(全部事件里是 19.3%)
同一小时 2 倍以上放量减其余,之后 24 小时 +0.04%,打乱标签后 82.1%
读这个结果
1. 跌破 VWAP 之后,价格并没有更容易继续下跌。 4,978 次跌破里,不管放不放量,之后 24 小时下跌的比例都在 42% 到 49% 之间,低于一半;到当天收盘的平均收益几乎都是正的。放量跌破(同一小时 2 倍以上)和其余的差距是 +0.04%,打乱标签后 82.1% 的结果差距更大。
2. 用「过去 24 小时」定义放量,会把美股开盘时段错当成放量。 按过去 24 小时算 2 倍以上放量的事件,43.6% 发生在 UTC 13:00 到 15:59;而所有跌破事件里,这三个小时只占 19.3%。换成和同一小时比,这个比例降到 22.7%,和整体几乎一样。第一种定义挑出来的「放量」,有一大半只是「美股开盘了」。
3. 决策点那种「6 倍放量跌破 VWAP」,在这 9 年里并不代表之后会跌。 3 倍以上(按 24 小时)的 200 次事件,之后 24 小时下跌的比例是 48.0%。
⚠️ 这个检验只针对 BTC 的 1 小时线、UTC 日的 VWAP。美股的当日 VWAP 有明确的开盘和收盘,机构的执行算法也集中在交易时段里,结论可能不同。这需要美股的日内数据才能检验,第一版课程拿不到。
九、锚定 VWAP
定义
当日 VWAP 每天重置。锚定 VWAP(Anchored VWAP)换了一个起点:从你选定的某一根 K 线(锚点)开始累计,一直累计下去,不重置。
它的含义很直接:从锚点开始,所有成交的平均成本。 比如从历史最高点开始的锚定 VWAP,就是「在最高点之后买入 BTC 的所有人」的平均买入价格。价格在它下方,这群人平均是亏钱的。
锚定 VWAP 由 Brian Shannon 推广开来,他写了一本专门讲锚定 VWAP 的书。常用的锚点是重要的事件:财报发布日、历史最高点或最低点、暴跌的那一天、突破的那一天。
BTC 的三条锚定 VWAP
用日线的精确均价(quote_volume ÷ volume),从三个锚点开始:
daily_price = day["quote_volume"] / day["volume"]
anchors = {"2025-10-06 历史最高": "2025-10-06", "2026-02-06 暴跌低点": "2026-02-06", "2026-07-01 熊市低点": "2026-07-01"}
lines = pd.DataFrame({name: I.anchored_vwap(daily_price, day["volume"], pd.Timestamp(t, tz="UTC")) for name, t in anchors.items()})
print(lines.loc[["2026-06-03", "2026-08-18", "2026-08-31"]].round(2).to_string())
print("收盘价:", day["close"].loc[["2026-06-03", "2026-08-18", "2026-08-31"]].round(2).tolist())
                           2025-10-06 历史最高  2026-02-06 暴跌低点  2026-07-01 熊市低点
time
2026-06-03 00:00:00+00:00         84204.33         71468.89              NaN
2026-08-18 00:00:00+00:00         79974.01         68527.35         63720.02
2026-08-31 00:00:00+00:00         79807.90         69091.14         67317.85
收盘价: [64142.75, 64725.42, 78581.29]
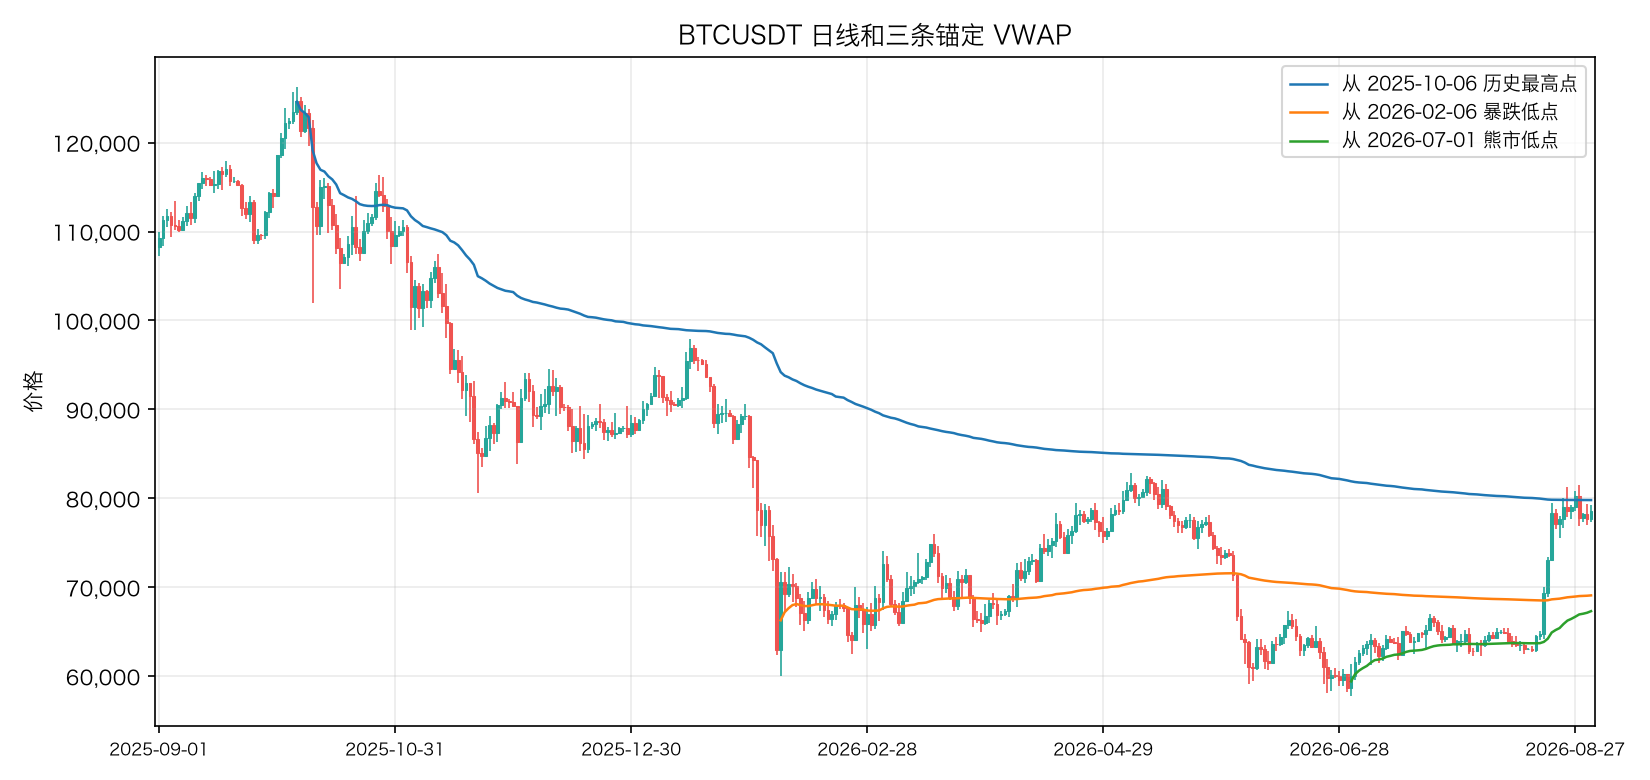
- 6 月 3 日(第 9 篇的决策点),收盘价 64,142.75,低于从 2 月 6 日暴跌低点开始的锚定 VWAP 71,468.89。2 月 6 日之后买入的人,平均亏了 10%。
- 8 月 18 日(向上突破的前一天),价格 64,725.42,刚好在从 7 月 1 日熊市低点开始的锚定 VWAP 63,720.02 上方一点。
- 8 月 31 日,价格涨到 78,581.29,已经站上了从 2 月 6 日开始的锚定 VWAP(69,091.14),但仍然在从历史最高点开始的那条(79,807.90)下方。从去年 10 月最高点之后买入的人,平均还亏着 1.5%。
这是锚定 VWAP 最有价值的用法:描述某一群人现在的盈亏状况。 它把「在高位被套的人很多」这句模糊的话,变成了一个可以计算的数字。
它比普通的平均价更有用吗
交易者常把锚定 VWAP 当作支撑或阻力:价格回到这条线附近时会被挡住。
这里有一个很自然的对照:不加权的平均价。同样从锚点开始,每天的均价简单平均,不管那天成交了多少。如果「成交量加权」这件事真的重要,锚定 VWAP 作为支撑阻力的表现应该比不加权的平均价更好。
用第 9 篇的规则:从每一个分形摆动点(左右各 5 根)开始画一条线,只在摆动点确认之后使用。价格离开这条线 1.5 个 ATR 之后回来算测试,先收盘在正确一侧 1.5 个 ATR 算守住,先收盘在另一侧 1.5 个 ATR 算突破。每条线最多跟踪 250 天。
for kind, role in [(-1, "从摆动低点开始(支撑)"), (1, "从摆动高点开始(阻力)")]:
    for weighted, name in [(True, "锚定 VWAP"), (False, "不加权的平均价")]:
        n, rate = line_tests(day, daily_price, weighted, kind)
        print(f"{role} {name}:测试 {n} 次,守住 {rate:.1%}")
line_tests 就是第 9 篇 level_tests 的移动版本,只是水平线换成了每天都在变的线:
def line_tests(df, price, weighted, kind, distance=1.5, zone=0.25, horizon=250):
    """从每个摆动点开始画一条线(VWAP 或不加权的平均价),像第 9 篇一样统计回到线附近之后守住的比例。"""
    a = X.wilder_smooth(X.true_range(df["high"], df["low"], df["close"]), 14).to_numpy()
    p, v = price.to_numpy(float), df["volume"].to_numpy(float)
    h_, l_, c_ = (df[k].to_numpy(float) for k in ["high", "low", "close"])
    sw = X.fractals(df["high"], df["low"], 5, 5)
    pos = {t: i for i, t in enumerate(df.index)}
    results = []
    for s in sw[sw["kind"] == kind].itertuples():
        start, end, side = pos[s.time], min(len(c_), pos[s.time] + horizon), (1 if kind == -1 else -1)
        seg_p, seg_v = p[start:end], v[start:end]
        line = np.cumsum(seg_p * seg_v) / np.cumsum(seg_v) if weighted else np.cumsum(seg_p) / np.arange(1, len(seg_p) + 1)
        j, armed = pos[s.confirmed_at] + 1, False                 # 摆动点确认之后才开始用这条线
        while j < end:
            unit, away = a[j - 1], (c_[j] - line[j - start]) * side
            if not armed:
                if away >= distance * unit:
                    armed = True
                elif away <= -distance * unit:
                    break
                j += 1
                continue
            if not (l_[j] <= line[j - start] + zone * unit if side == 1 else h_[j] >= line[j - start] - zone * unit):
                j += 1
                continue
            k, outcome = j, None
            while k < end:
                away = (c_[k] - line[k - start]) * side
                if abs(away) >= distance * unit:
                    outcome = "held" if away > 0 else "broken"
                    break
                k += 1
            if outcome is None:
                break
            results.append(outcome == "held")
            if outcome == "broken":
                break
            j = k + 1
    return len(results), np.mean(results)
从摆动低点开始(支撑) 锚定 VWAP:测试 244 次,守住 57.8%
从摆动低点开始(支撑) 不加权的平均价:测试 215 次,守住 57.7%
从摆动高点开始(阻力) 锚定 VWAP:测试 179 次,守住 54.2%
从摆动高点开始(阻力) 不加权的平均价:测试 172 次,守住 51.2%
锚定 VWAP 和不加权的平均价几乎一样。 作为支撑,57.8% 对 57.7%;作为阻力,54.2% 对 51.2%,差 3 个百分点,在一百多次的样本里完全在随机误差之内。
这两条线在大多数时候离得很近:只有当某几天的成交量特别大、价格又特别偏时,加权才会让它们明显分开。「成交量加权」这个特点,在把它当作支撑阻力时没有带来可见的差别。 锚定 VWAP 的价值,更多在于上一小节那种对「某一群人盈亏状况」的描述,而不是作为一条会挡住价格的线。
十、Volume Profile
定义
K 线图的成交量画在时间轴上:每一根 K 线下面一根柱子。Volume Profile 把成交量画在价格轴上:每一个价格区间里,一共成交了多少。
它来自芝加哥期货交易所(CBOT)的交易员 J. Peter Steidlmayer 设计的 Market Profile,1985 年由 CBOT 作为一项数据产品推出。Market Profile 原本统计的是价格在每个区间里出现的时间,Volume Profile 把时间换成了成交量。
三个关键概念:
- POC(Point of Control):成交量最大的那个价格区间
- 价值区间(Value Area):围绕 POC、包含大约 70% 成交量的连续价格区间。70% 是一个常用的约定
- 价值区间上沿 / 下沿(VAH / VAL)
回到批发市场:POC 是今天称得最多的那个价格,价值区间是大部分买卖发生的价格范围。
价值区间怎么算
value_area 的算法:
- 从 POC 所在的箱子开始
- 比较上方紧挨着的一个箱子和下方紧挨着的一个箱子,把成交量大的那个并进来(一样大时并上方的)
- 重复第 2 步,直到累计成交量达到总量的 70%
算例:7 个价格箱子的成交量。
| 价格 | 10 | 11 | 12 | 13 | 14 | 15 | 16 |
|---|---|---|---|---|---|---|---|
| 成交量 | 2 | 5 | 10 | 6 | 5 | 1 | 1 |
总量 30,目标是 21。
- POC 是 12(10),累计 10
- 上方 13(6)大于下方 11(5),并入 13,累计 16
- 上方 14(5)等于下方 11(5),并入上方 14,累计 21,达到目标
价值区间是 12 到 15(14 这个箱子的上沿),POC 的中点是 12.5。
⚠️ 很多 Market Profile 教材的做法是每次比较上方两个箱子之和与下方两个箱子之和,不同软件的实现也不一样。这一篇用一次比较一个箱子的简化版,结果会有细微差别。
第 9 篇那段行情的 Volume Profile
把第 9 篇决策点之前的那段行情(2026 年 2 月 6 日暴跌到 5 月 31 日)画成 Volume Profile。用 1 分钟线的精确均价,每 250 美元一格:
segment = minute.loc["2026-02-06":"2026-05-31"]
segment = segment[segment["volume"] > 0]
profile = I.volume_profile(segment["quote_volume"] / segment["volume"], segment["volume"], 250)
area = I.value_area(profile, 0.7)
print(f"2026-02-06 至 2026-05-31,每 250 美元一格,共 {len(profile)} 格")
print({k: f"{v:,.2f}" for k, v in area.items()})
print(profile.sort_values(ascending=False).head(5).round(0).to_string())
print(f"这段时间成交量在价值区间里的比例 {profile.loc[area['val']:area['vah'] - 1].sum() / profile.sum():.1%}")
2026-02-06 至 2026-05-31,每 250 美元一格,共 92 格
{'poc': '66,875.00', 'val': '65,500.00', 'vah': '75,500.00'}
66750.0    63101.0
68000.0    60879.0
67000.0    60176.0
70750.0    58979.0
67750.0    57452.0
这段时间成交量在价值区间里的比例 70.6%
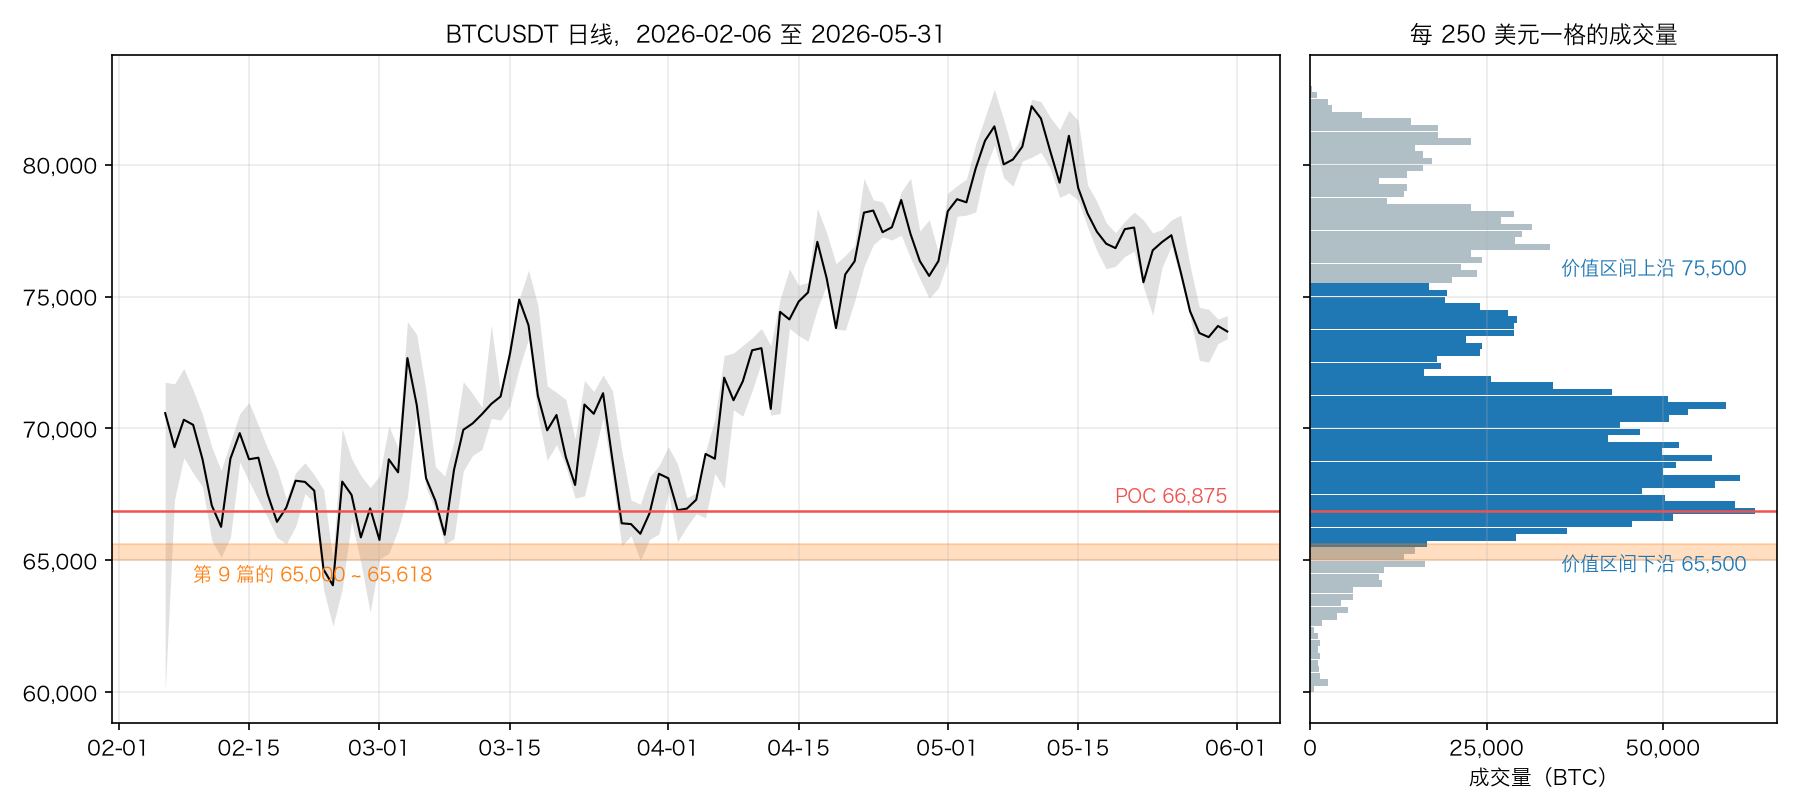
POC 在 66,750 到 67,000 这一格,中点 66,875。价值区间的下沿是 65,500,就在第 9 篇那个 65,000 到 65,618 的区域上方。
这张图从另一个角度解释了第 9 篇的故事:2 月到 5 月这段时间,成交最密集的价格就在 65,000 到 68,000 之间。在这里买入的人最多,6 月 3 日价格跌破这个区域之后,这些人全部被套;之后两个多月价格反弹到 65,000 附近就被挡住,和「成交密集区的持仓者等着解套」是一致的。当然,第 9 篇也说过,一个生动的例子不是统计规律。
前一天的 POC 是不是磁铁
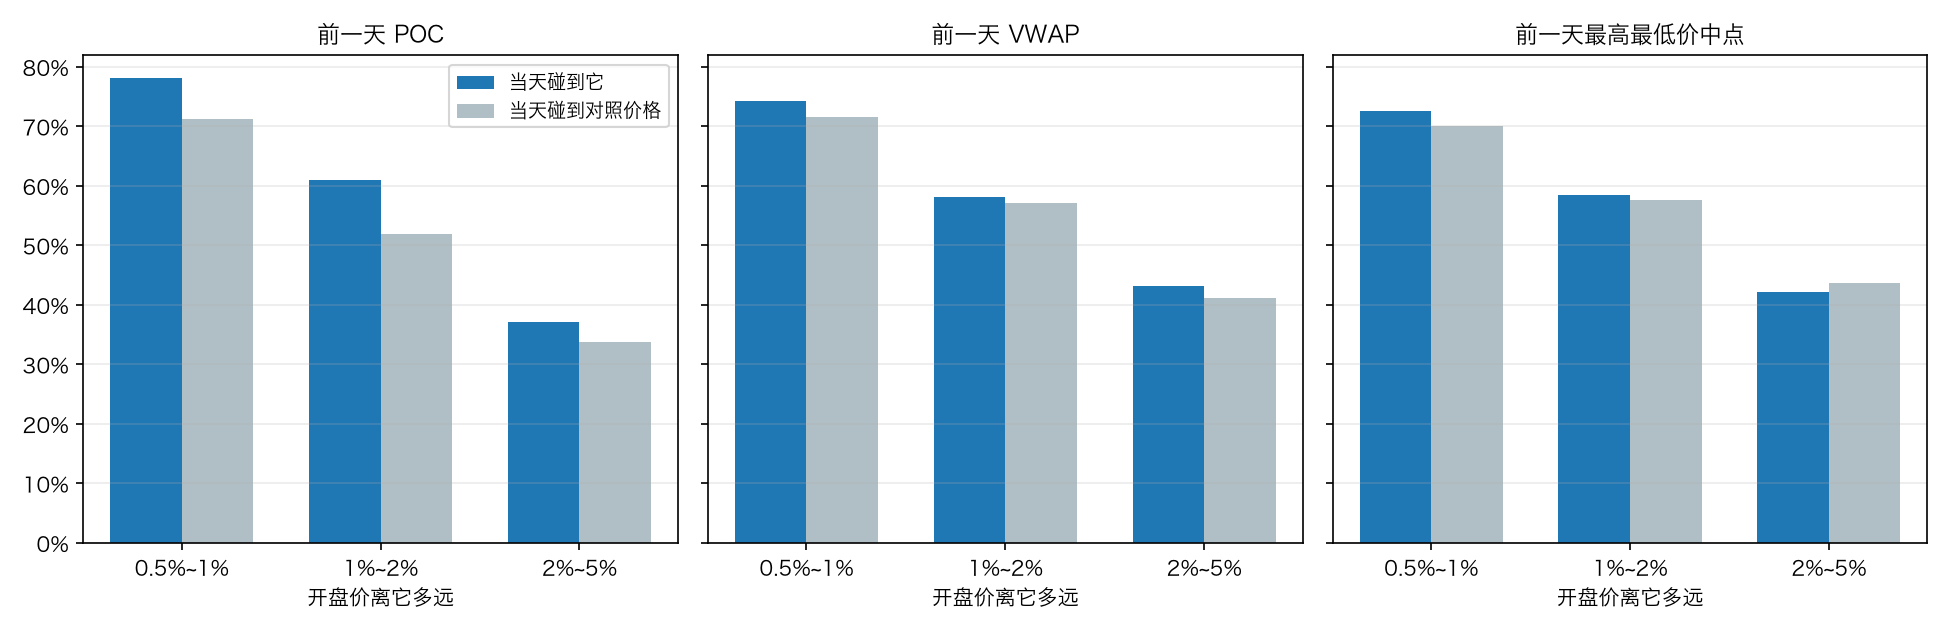
一个流行的说法是:前一天的 POC 像磁铁一样,第二天价格容易回到这里。
检验方法和第 9 篇的缺口回补一样,要设对照:
- 碰到:第二天开盘价离前一天的 POC 至少 0.5%,当天的最高价和最低价之间包含了这个 POC
- 对照:开盘价另一侧、同样距离的价格,当天有没有被碰到
另外再加两个对照组:前一天的 VWAP 和前一天最高价与最低价的中点。如果只是「价格容易回到前一天的价格附近」,这两个也应该表现得一样好;如果 POC 特别,它应该明显更好。
每一天的 Volume Profile 用当天的 1 分钟线计算,格子宽度是当天第一分钟均价的 0.1%(BTC 在 60,000 时大约 60 美元一格):
m = minute[minute["volume"] > 0]
avg = m["quote_volume"] / m["volume"]
width = avg.groupby(m.index.floor("1D")).transform("first") * 0.001            # 每天的格子宽度 = 当天第一笔均价的 0.1%
poc = {}
for d, idx in m.groupby(m.index.floor("1D")).groups.items():
    poc[d] = I.value_area(I.volume_profile(avg[idx], m["volume"][idx], width[idx[0]]))["poc"]
poc = pd.Series(poc).reindex(day.index)
references = {"前一天 POC": poc.shift(1), "前一天 VWAP": daily_price.shift(1), "前一天最高最低价中点": ((day["high"] + day["low"]) / 2).shift(1)}
for name, level in references.items():
    distance = np.log(day["open"] / level)
    mirror = day["open"] ** 2 / level
    hit = np.where(distance > 0, day["low"] <= level, day["high"] >= level)
    mirror_hit = np.where(distance > 0, day["high"] >= mirror, day["low"] <= mirror)
    t = pd.DataFrame({"距离": distance.abs(), "碰到": hit, "对照": mirror_hit}).dropna()
    t = t[t["距离"] > 0.005]
    group = pd.cut(t["距离"], [0.005, 0.01, 0.02, 0.05, 1], labels=["0.5%~1%", "1%~2%", "2%~5%", "5% 以上"])
    summary = t.groupby(group, observed=False).agg(天数=("碰到", "size"), 当天碰到=("碰到", "mean"), 对照=("对照", "mean"))
    only_level, only_mirror = int((t["碰到"] & ~t["对照"]).sum()), int((~t["碰到"] & t["对照"]).sum())
    z = (only_level - only_mirror) / np.sqrt(only_level + only_mirror)
    print(f"{name}(开盘价离它 0.5% 以上):只碰到它 {only_level} 天,只碰到对照 {only_mirror} 天,z = {z:.2f}")
    print(summary.round(3).to_string())
z 的算法叫 McNemar 检验:同一天既碰到 POC 又碰到对照,或者两个都没碰到,对比较没有帮助;有用的只是「只碰到其中一个」的日子。如果 POC 和对照没有区别,这两种日子应该差不多一样多,z 就会在 0 附近;z 的绝对值超过 2,大约相当于 5% 的显著性。
前一天 POC(开盘价离它 0.5% 以上):只碰到它 567 天,只碰到对照 469 天,z = 3.04
          天数   当天碰到     对照
距离
0.5%~1%  629  0.781  0.712
1%~2%    627  0.609  0.520
2%~5%    557  0.372  0.338
5% 以上    141  0.149  0.291
前一天 VWAP(开盘价离它 0.5% 以上):只碰到它 616 天,只碰到对照 585 天,z = 0.89
          天数   当天碰到     对照
距离
0.5%~1%  760  0.743  0.716
1%~2%    736  0.582  0.572
2%~5%    550  0.431  0.411
5% 以上     67  0.254  0.373
前一天最高最低价中点(开盘价离它 0.5% 以上):只碰到它 647 天,只碰到对照 638 天,z = 0.25
          天数   当天碰到     对照
距离
0.5%~1%  730  0.726  0.701
1%~2%    820  0.585  0.577
2%~5%    567  0.422  0.437
5% 以上     62  0.274  0.387
读这个结果
前一天的 POC,确实比对照更常被碰到。 开盘价离 POC 0.5% 到 1% 时,当天碰到的比例 78.1%,对照 71.2%;1% 到 2% 时,60.9% 对 52.0%,高了将近 9 个百分点。z = 3.04。
而前一天的 VWAP 和最高最低价中点,和对照几乎没有区别(z = 0.89 和 0.25)。所以这不是「价格总会回到前一天的价格附近」,而是 POC 这个价格本身比较特别。
一个合理的解释:POC 是前一天成交最多的价格,挂在这个价格附近的订单、持仓成本集中在这里的人,都比其他价格多。价格回到附近时,这些订单更容易让价格在这里来回成交一段时间,于是更容易「碰到」。
⚠️ 这个结论的边界要说清楚:
- 「碰到」不等于「可以交易」。 POC 被碰到的比例高了 7 到 9 个百分点,但开盘价离它 1% 到 2% 时,仍然有 39% 的日子碰不到。碰到之后价格往哪走,这个检验没有回答。
- 离得远(5% 以上)时方向相反,POC 反而更少被碰到(14.9% 对 29.1%),只有 141 天。开盘就离前一天 POC 5% 以上,通常是发生了大事件,价格有很强的方向。
- 只在 BTC 上检验过,而且用的是 UTC 日。第 9 篇的整数关口和这里的 POC,是这两篇里少数几个明显超出随机的现象。
✋ 小检查 2
5 个价格箱子(每箱 1 美元)的成交量:
| 价格 | 50 | 51 | 52 | 53 | 54 |
|---|---|---|---|---|---|
| 成交量 | 4 | 8 | 6 | 9 | 3 |
(a) POC 是哪个箱子?POC 的价格(箱子中点)是多少?
(b) 用 70% 的价值区间,一步一步算出价值区间的上沿和下沿。
(c) 如果第二天开盘价是 55.5,第 (a) 题的 POC 在开盘价下方约 4%。对照价格是多少?
答案在文末。
十一、talab.indicators:新建模块
放在哪里
talab/
├── talab/
│   ├── __init__.py
│   ├── data.py
│   ├── plot.py
│   ├── stats.py
│   ├── bars.py
│   ├── timeframes.py
│   ├── structure.py
│   └── indicators.py     ← 新增
├── tests/
│   ├── test_data.py
│   ├── test_plot.py
│   ├── test_stats.py
│   ├── test_bars.py
│   ├── test_timeframes.py
│   ├── test_structure.py
│   └── test_indicators.py  ← 新增
├── scripts/
│   └── fetch_course_data.py
├── pyproject.toml
└── requirements.txt
课纲里 indicators 模块跨第 10 篇和第 12 到 15 篇:这一篇放成交量相关的指标,第 12 篇起加入均线、MACD、RSI、ATR 和布林带。
label_test、line_tests 这些只在这一篇用来分析的代码,不放进模块,只在 docs/trade-analysis/analysis/10_volume.py 里。
准备数据
import glob
from concurrent.futures import ThreadPoolExecutor

import numpy as np
import pandas as pd
from talab import bars as B, data as D, indicators as I, structure as X

cols = ["open", "high", "low", "close"]
day = D.load_binance_klines(glob.glob("data/binance/spot/BTCUSDT/1d/*.zip"))
minute = D.load_binance_klines(sorted(glob.glob("data/binance/spot/BTCUSDT/1m/*.zip")))
spy = D.load_nasdaq_daily("data/nasdaq/SPY_historical.json").drop(pd.Timestamp("2026-04-20"))
aapl = D.load_nasdaq_daily("data/nasdaq/AAPL_historical.json")
divs = D.load_nasdaq_dividends("data/nasdaq/AAPL_dividends.json")
aapl = D.adjust_total_return(D.unadjust_splits(aapl, D.SPLITS["AAPL"]), D.SPLITS["AAPL"], divs)
markets = {"BTC": day, "SPY": spy, "AAPL": aapl}
print(f"永续合约日线 {len(perp)} 根:{perp.index[0].date()} 至 {perp.index[-1].date()}")
永续合约日线 2435 根:2020-01-01 至 2026-08-31
合约数据的下载在第三节。SPY 在 2026-04-17 的错误成交量在第三节设为缺失。
代码
"""talab.indicators:技术指标。第 10 篇:成交量、VWAP、Volume Profile。"""
from __future__ import annotations

import numpy as np
import pandas as pd


# ---------------------------------------------------------------------------
# 一、成交量
# ---------------------------------------------------------------------------

def relative_volume(volume: pd.Series, n: int = 20, by=None) -> pd.Series:
    """相对成交量:这根 K 线的成交量 ÷ 之前 n 根的平均成交量(不含这一根)。

    by 不为空时,只和同一组的历史比较。比如 by=volume.index.hour,
    就是和之前 n 天「同一个小时」的平均成交量比,去掉一天之内成交量的固定起伏。
    """
    if by is None:
        return volume / volume.rolling(n).mean().shift(1)
    average = volume.groupby(by).transform(lambda s: s.rolling(n).mean().shift(1))
    return volume / average


# ---------------------------------------------------------------------------
# 二、VWAP
# ---------------------------------------------------------------------------

def typical_price(high: pd.Series, low: pd.Series, close: pd.Series) -> pd.Series:
    """典型价格 (最高 + 最低 + 收盘) ÷ 3。没有逐笔成交数据时,用它近似一根 K 线的平均成交价。"""
    return (high + low + close) / 3


def vwap(price: pd.Series, volume: pd.Series, session) -> pd.Series:
    """成交量加权平均价,每个交易时段重新开始累计。

    price:   每根 K 线的成交均价;有逐笔数据时用 成交额 ÷ 成交量,没有时用 typical_price
    session: 和 price 等长的分组键,比如 price.index.floor("1D") 表示按 UTC 自然日重置
    第 k 根 K 线上的值 = 这个时段开始到第 k 根(含)的 Σ(价格 × 成交量) ÷ Σ成交量,只用到当时已经发生的成交。
    """
    amount = (price * volume).groupby(session).cumsum()
    return amount / volume.groupby(session).cumsum()


def anchored_vwap(price: pd.Series, volume: pd.Series, anchor) -> pd.Series:
    """锚定 VWAP:从 anchor 这根 K 线(含)开始累计,之前为 NaN。

    它等于「从锚点开始,所有成交的平均成本」。
    """
    after = price.index >= anchor
    amount = (price * volume).where(after).cumsum()
    return (amount / volume.where(after).cumsum()).where(after)


# ---------------------------------------------------------------------------
# 三、Volume Profile
# ---------------------------------------------------------------------------

def volume_profile(price: pd.Series, volume: pd.Series, bin_size: float) -> pd.Series:
    """按价格分箱统计成交量。每根 K 线的成交量全部记在它的成交均价所在的箱子里。

    返回的索引是每个箱子的下沿(bin_size 的整数倍),从低到高排列,没有成交的箱子补 0。
    分组用整数箱号(价格 ÷ bin_size 向下取整),避免用小数价格做分组键带来的舍入误差。
    """
    number = np.floor(price.to_numpy(dtype=float) / bin_size).astype(np.int64)
    counts = pd.Series(volume.to_numpy(dtype=float)).groupby(number).sum()
    full = np.arange(counts.index.min(), counts.index.max() + 1)
    profile = counts.reindex(full, fill_value=0.0)
    profile.index = full * float(bin_size)
    profile.attrs["bin_size"] = bin_size          # value_area 需要知道格子多宽
    return profile


def value_area(profile: pd.Series, share: float = 0.7) -> dict[str, float]:
    """POC(成交量最大的价格)和价值区间(围绕 POC、包含 share 比例成交量的连续价格区间)。

    从 POC 所在的箱子开始,每次比较上方和下方紧挨着的一个箱子,把成交量大的那个并进来
    (一样大时并上方的),直到累计成交量达到 share。成交量最大的箱子不止一个时,取价格最低的那个。
    返回 poc(POC 箱子的中点)、val(价值区间下沿)、vah(价值区间上沿),都是价格。
    profile 应该是 volume_profile 的结果(格子宽度记在 profile.attrs["bin_size"] 里)。
    """
    volumes = profile.to_numpy(dtype=float)
    size = profile.attrs["bin_size"]
    k = int(np.argmax(volumes))
    low = high = k
    total, covered = volumes.sum(), volumes[k]
    while covered < share * total:
        below = volumes[low - 1] if low > 0 else -1.0
        above = volumes[high + 1] if high < len(volumes) - 1 else -1.0
        if above >= below:
            high += 1
            covered += volumes[high]
        else:
            low -= 1
            covered += volumes[low]
    return {"poc": profile.index[k] + size / 2, "val": profile.index[low], "vah": profile.index[high] + size}
读一遍代码
relative_volume 的关键是 .shift(1):分母是之前 n 根的平均,不包括当前这一根。如果包括,放量越大,分母也跟着变大,相对成交量会被压低,而且用到了当前这根的数据来衡量它自己。
by 参数用 groupby(by).transform(...):把所有 K 线按小时分成 24 组,每组内部各自滚动求平均,再放回原来的位置。每一组的 shift(1) 是「这个小时的前一天」,所以同样不会用到当前这根。
vwap 只有两行:金额和成交量分别在每个 session 里累计求和,再相除。groupby(session).cumsum() 保证每个时段从零开始。第 k 根 K 线上的值只用到这个时段里第 1 到第 k 根,所以在第 k 根收盘时就能算出来。
anchored_vwap 用 where(after) 把锚点之前的值设为 NaN,cumsum 会跳过 NaN,所以从锚点开始累计。最后再 where(after) 一次,保证锚点之前的结果也是 NaN。
volume_profile 有一个值得说的细节:分组用的是整数箱号(np.floor(price / bin_size)),而不是箱子的价格下沿。
写这一篇的时候,第一版代码直接用 np.floor(price / bin_size) * bin_size 这个小数价格做分组键,再用 np.arange 生成完整的价格网格去 reindex。当格子宽度是 67.23 这样的小数时,两种方式算出来的同一个价格可能在第 11 位小数上不相等,reindex 就找不到,那个箱子的成交量被当成 0。这个错误没有任何报错,只是让一部分成交量悄悄消失。改成整数箱号之后,核对了全部 3,302 天:每一天的 Volume Profile 加起来都等于当天的总成交量。第十节的 POC 统计结果也因此改变了(z 从 2.35 变成 3.04)。
用小数做分组键或者做相等比较,是数据分析里最常见的隐蔽错误之一。
value_area 按第十节的算法扩张。profile.attrs["bin_size"] 是 volume_profile 顺手记下的格子宽度:只有一个箱子时,没办法从索引里推算出宽度。
测试
"""talab.indicators 的测试。"""
import numpy as np
import pandas as pd
import pytest

from talab import indicators as I


def hourly(values, start="2024-01-01 22:00"):
    idx = pd.date_range(start, periods=len(values), freq="1h", tz="UTC")
    return pd.Series(values, index=idx, dtype=float)


def test_relative_volume_by_hand():
    volume = hourly([10, 20, 30, 60])
    rv = I.relative_volume(volume, n=3)
    assert rv.iloc[:3].isna().all()
    assert rv.iloc[3] == pytest.approx(60 / 20)          # 前 3 根的平均是 20


def test_relative_volume_same_hour():
    idx = pd.date_range("2024-01-01", periods=6, freq="12h", tz="UTC")   # 0 点、12 点交替
    volume = pd.Series([10, 100, 20, 200, 30, 600], index=idx, dtype=float)
    rv = I.relative_volume(volume, n=2, by=idx.hour)
    # 最后一根是 12 点:之前两个 12 点是 100 和 200,平均 150;如果不分组,会和 20、200 的平均比
    assert rv.iloc[5] == pytest.approx(600 / 150)
    assert rv.iloc[4] == pytest.approx(30 / 15)


def test_vwap_by_hand_and_resets_each_session():
    price = hourly([100, 102, 104, 50])                   # 22:00、23:00 是第一天,0:00 起是第二天
    volume = hourly([1, 3, 2, 5])
    session = price.index.floor("1D")
    v = I.vwap(price, volume, session)
    assert v.iloc[0] == 100
    assert v.iloc[1] == pytest.approx((100 * 1 + 102 * 3) / 4)       # 101.5
    assert v.iloc[2] == 104                                             # 新的一天,重新累计
    assert v.iloc[3] == pytest.approx((104 * 2 + 50 * 5) / 7)


def test_anchored_vwap_by_hand():
    price = hourly([100, 90, 110, 120])
    volume = hourly([5, 1, 1, 2])
    a = I.anchored_vwap(price, volume, price.index[1])
    assert np.isnan(a.iloc[0])
    assert a.iloc[1] == 90
    assert a.iloc[3] == pytest.approx((90 * 1 + 110 * 1 + 120 * 2) / 4)   # 110


def test_volume_profile_by_hand():
    price = pd.Series([100.2, 100.7, 101.9, 103.1, 100.4])
    volume = pd.Series([1.0, 2.0, 3.0, 4.0, 5.0])
    p = I.volume_profile(price, volume, 1.0)
    # 100.2、100.7、100.4 在 [100, 101);101.9 在 [101, 102);[102, 103) 没有成交;103.1 在 [103, 104)
    assert p.index.tolist() == [100.0, 101.0, 102.0, 103.0]
    assert p.tolist() == [8.0, 3.0, 0.0, 4.0]
    assert I.value_area(I.volume_profile(pd.Series([100.2]), pd.Series([1.0]), 1.0)) == {"poc": 100.5, "val": 100.0, "vah": 101.0}


def test_value_area_by_hand():
    profile = pd.Series([2.0, 5.0, 10.0, 6.0, 5.0, 1.0, 1.0], index=[10.0, 11.0, 12.0, 13.0, 14.0, 15.0, 16.0])
    profile.attrs["bin_size"] = 1.0
    va = I.value_area(profile, 0.7)
    # 总量 30,目标 21。从 POC(12~13,10)开始:上方 6 > 下方 5,并入 13(16);
    # 上方 5 = 下方 5,并入上方 14(21),达到 21
    assert va == {"poc": 12.5, "val": 12.0, "vah": 15.0}
    # 目标改成 27:接着比较上方 15(1)和下方 11(5),并入 11(26);再比较 15(1)和 10(2),并入 10(28)
    assert I.value_area(profile, 0.9) == {"poc": 12.5, "val": 10.0, "vah": 15.0}
test_relative_volume_by_hand和test_relative_volume_same_hour:后一个构造了 0 点和 12 点交替、12 点成交量更大的数据,检查「和同一小时比」时不会拿 0 点的成交量去比 12 点。test_vwap_by_hand_and_resets_each_session:数据跨过 UTC 0 点,检查第二天第一根的 VWAP 等于它自己的价格,没有带上前一天的成交。test_anchored_vwap_by_hand:锚点前一根的成交量故意设成 5,如果锚点处理错了,结果会明显不同。test_volume_profile_by_hand:包括一个没有成交的空箱子,检查它被补成 0;以及只有一个箱子时value_area的结果。test_value_area_by_hand:就是第十节的算例,另外把目标改成 90%,检查继续向下扩张的过程。
pytest -q
.................................................................        [100%]
65 passed in 0.36s
十二、常见误用
1. 把放量读成「买的人多」。 每一笔成交都有买方和卖方。成交量说的是换手有多少,不是方向。
2. 用 BTC 数量比较不同年份的成交量。 2025 年的平均价格是 2020 年的 9 倍多,同样的资金只能买到九分之一的 BTC。2025 年按 BTC 算是 2020 年的 30%,按 USDT 算是 2.7 倍。
3. 忽略交易所的活动。 Binance 零手续费期间,BTCUSDT 成交量涨了 78%;活动结束,跌了 82%。任何相对成交量指标在这两个时间点附近都会失真。
4. 混用现货和合约的成交量。 BTCUSDT 永续合约的成交额是现货的 4 到 9 倍。
5. 拿美股开盘时段的成交量和凌晨比。 BTC 在 UTC 13:00 到 15:59 的成交量占全天的 20.7%。按过去 24 小时定义的放量,有 43.6% 落在这三个小时里。
6. 把天量当作见顶信号,不查那天发生了什么。 BTC 的 21 个天量日里 15 个是下跌的日子;AAPL 的 11 个里 4 个是季度期权到期、指数调仓的日子。
7. 用日线的 (最高 + 最低 + 收盘) ÷ 3 当作精确的 VWAP。 误差中位数 0.28%,大波动的日子可以到 8%。
8. 把「跌破当日 VWAP」当作看空信号,并持有好几天。 BTC 1 小时线跌破当日 VWAP 之后,24 小时下跌的比例低于一半;当日 VWAP 本来就是只在当天有意义的参考线。
9. 相信锚定 VWAP 是比普通均价线更强的支撑阻力。 在 BTC 上,从摆动点开始的锚定 VWAP 和不加权的平均价,守住的比例几乎一样。
10. 用小数价格做分组键。
volume_profile 的第一版就因为这个悄悄丢掉了一部分成交量,没有任何报错。
十三、这一篇能回答什么,不能回答什么
| 这一篇能帮你回答 | 这一篇不能回答 |
|---|---|
| 一段成交量数据的单位、来源、口径有没有问题 | 美股场外成交具体发生在哪些价位 |
| 这段时间是不是比「平时这个时段」更活跃 | 放量是买方主导还是卖方主导 |
| 精确的当日 VWAP、锚定 VWAP 是多少 | 价格跌破 VWAP 之后往哪走(BTC 上没有规律) |
| 某一群人(从某个锚点之后买入的人)现在平均盈亏如何 | 这群人会不会在解套时卖出 |
| 一段时间里成交最密集的价格和价值区间在哪里 | 价格碰到 POC 之后会发生什么 |
| 美股日内 VWAP 的规律 | —(需要美股日内数据,第一版拿不到) |
十四、小结
-
成交量记录的是换手,不是方向。 每一笔成交都有买方和卖方。成交量和涨跌幅的秩相关在 0.5 左右,很大一部分信息涨跌幅本身已经告诉你了。
-
读成交量之前,先检查五件事: 单位(BTC 还是 USDT)、交易所的活动(Binance 零手续费期间成交量涨 78%、结束时跌 82%)、现货还是合约(合约是现货的 4 到 9 倍)、刷量(Bitwise 2019 年报告约 95% 的报告成交量是虚假的)、美股场外成交(2025 年 1 月占 51.8%)。再加上第六件:一天之中的时间,BTC 在美股开盘前后三个小时成交了全天的 20.7%。
-
「放量」要和同一时段的历史比。 否则挑出来的有一大半只是美股开盘了。
-
量价的四种组合、放量突破、缩量回调,在 BTC、SPY、AAPL 上都没有一致的规律。 唯一显著的几个结果,方向和传统说法相反,或者只在一个标的上出现。天量更常出现在恐慌抛售、期权到期和交易所活动里,而不是追涨的顶部。
-
VWAP 是全部成交的平均价,1988 年起成为机构执行的基准。 用 1 分钟线累计几乎没有误差,用日线近似误差中位数 0.28%。BTC 放量跌破当日 VWAP 之后,没有表现出继续下跌的倾向。
-
锚定 VWAP 最有用的地方,是描述某一群人的平均盈亏。 作为支撑阻力,它和不加权的平均价没有区别。
-
Volume Profile 把成交量画在价格轴上。 开盘价离前一天的 POC 0.5% 到 2% 时,POC 当天被碰到的比例比对照价格高 7 到 9 个百分点(整体 z = 3.04),而前一天的 VWAP 和最高最低价中点没有这个现象。
最后回到批发市场。大秤一天称了多少斤,告诉你今天市场有多热闹,但不告诉你明天菜价是涨是跌(第四、五节);称的斤数要先看是不是赶上了免收过秤费(第三节)。采购员拿今天的均价来衡量自己买得好不好,这个用法很准确(第六节);但拿今天的均价去猜明天的菜价,就用错了地方(第八节)。倒是那个今天称得最多的价格,明天更容易有人再在那里成交(第十节)。
下一篇是第 11 篇:价格行为:把前五篇拼起来。第 6 到第 10 篇分别讲了 K 线、多周期、趋势、关键位置和成交量。一段你没见过的行情,每次只露出一根新的 K 线,你能用这些工具说出什么,又有哪些是当时还不可能知道的?
练习
练习 1(手算) 某一天 5 根 1 小时线的平均成交价依次是 200、204、201、196、198,成交量依次是 10、30、20、50、10。
- (a) 算出每一根收盘时的当日 VWAP。
- (b) 哪几根 K 线的平均成交价在当时的 VWAP 下方?
- (c) 以第 2 根为锚点,算出第 5 根收盘时的锚定 VWAP。
练习 2(数据)
用 Binance 的 taker_buy_base 计算 BTC 每天的主动买入占比(主动买入量 ÷ 总成交量)。
- (a) 主动买入占比和当天涨跌的相关系数是多少?
- (b) 在涨的日子里,主动买入占比高和低,之后 5 天的收益有没有区别?用第四节的
label_test检验。
练习 3(数据) 第三节发现 Binance 的零手续费活动让成交量失真。
- (a) 把 2022-07-08 到 2023-03-22 这段时间去掉,重新计算第五节 BTC 的天量日。结果有什么变化?
- (b) 改用永续合约的成交量(零手续费活动不包括合约),重新计算天量日。
练习 4(编程) 第十节的前一天 POC 检验只用了 UTC 日。
- (a) 把「一天」改成从北京时间 0 点(UTC 16:00)开始,重新计算 POC 和检验。z 值变了多少?
- (b) 把格子宽度从 0.1% 改成 0.05% 和 0.2%,结论稳定吗?
- (c) 写一个性质测试:用前 n 天的 1 分钟数据算出的第 n 天 POC,必须和用全部数据算出的相同。
练习 5(编程) 第八节只看了跌破 VWAP。
- (a) 用同样的方法统计「突破到 VWAP 上方」之后的表现。
- (b) 把当日 VWAP 加上「上下 1 个标准差」的通道:标准差用当日成交量加权的价格方差计算。价格触及上轨之后,到当天收盘平均收益是多少?
练习 6(思考) 第九节发现,锚定 VWAP 和不加权的平均价作为支撑阻力表现一样;第十节发现,前一天的 POC 比前一天的 VWAP 更常被碰到。
- (a) POC 和 VWAP 都是用成交量算出来的,为什么一个有现象、一个没有?(提示:想一想「平均价」和「成交最多的价格」分别在一天里的什么位置,以及价格在那里停留了多久。)
- (b) 设计一个检验,区分「POC 被碰到是因为那里挂着订单」和「POC 被碰到只是因为那一天价格在那里停留的时间最长」。
小检查答案
小检查 1
(a) 平均成交价:第 1 根 204 ÷ 2 = 102,第 2 根 630 ÷ 6 = 105,第 3 根 196 ÷ 2 = 98。
VWAP = (204 + 630 + 196) ÷ (2 + 6 + 2) = 1,030 ÷ 10 = 103.00。
(b) 典型价格:第 1 根 (104 + 98 + 103) ÷ 3 = 101.67,第 2 根 (108 + 102 + 107) ÷ 3 = 105.67,第 3 根 (107 + 95 + 96) ÷ 3 = 99.33。
VWAP = (101.67 × 2 + 105.67 × 6 + 99.33 × 2) ÷ 10 = (203.33 + 634 + 198.67) ÷ 10 = 103.60,比精确值高 0.60,约 0.58%。第 3 根 K 线从 107 一路跌到 96,成交集中在低价(均价 98),但典型价格因为包含了最高价 107,被抬高了。
(c) 96 在 VWAP 103.00 的下方。今天所有买入的人平均成本是 103,现在价格 96,平均亏了约 6.8%。
小检查 2
(a) 成交量最大的是 53(9),POC 是 53 这个箱子,价格中点 53.5。
(b) 总量 4 + 8 + 6 + 9 + 3 = 30,目标 21。
- 从 53 开始,累计 9
- 上方 54(3)和下方 52(6)比,下方大,并入 52,累计 15
- 上方 54(3)和下方 51(8)比,下方大,并入 51,累计 23,达到 21
价值区间是 51 到 54(下沿 51,上沿是 53 这个箱子的上沿 54)。注意 50(4)没有被并入,54(3)也没有。价值区间可以不对称,它往成交量大的方向扩张。
(c) 对照价格要在开盘价上方、同样的比例:55.5 × 55.5 ÷ 53.5 ≈ 57.58。开盘价到 POC 下跌了 ln(53.5 ÷ 55.5) ≈ −3.67%,到对照价格上涨 ln(57.58 ÷ 55.5) ≈ +3.67%,对数距离相同。