这一讲要回答六个问题:
- 标准模型里的"理性人",和真实的人,差在哪里?行为经济学,在做什么?
- 人怎么判断?(过度自信、锚定)
- 人怎么偏好?(前景理论:参照点、损失厌恶、概率加权)
- 人怎么对待时间?(现在偏向的证据,默认选项为什么有力量)
- 人怎么看待公平?
- 这些发现,有多可靠?该不该用它来"助推"人们?(有争议)
前面,我们留下了很多问题:第 2、11 讲,说人们常忽视机会成本、被沉没成本绊住;第 10 讲,说钱不是可以互相替代的;第 13 讲,出租车司机;第 18 讲,对不公平的反感;第 24 讲,杯子的实验;第 36 讲,“现在偏向"的证据;第 37 讲,期望效用只是一个基准;第 38 讲,异象,究竟是风险的补偿,还是人的错误。这一讲,把它们,接起来。
一、三个小问题
先停一下:请先凭直觉,回答下面三个问题。
问题 1: 抛一枚公平的硬币:正面,你赢 120 元;反面,你输 100 元。你玩吗?
问题 2: 今天拿 100 元,还是 1 个月后拿 110 元?再问:1 年后拿 100 元,还是 1 年零 1 个月后拿 110 元?
问题 3: 有人给你和一个陌生人 10 元钱。由他决定怎么分,你只能说"接受"或"拒绝”;拒绝,两个人,都拿不到钱。他说:他自己留 8 元,给你 2 元。你接受吗?
先别急着算。我们记下你的直觉,往后,一个一个回来。
- 问题 1:期望收益是 +10 元(0.5 × 120 − 0.5 × 100),按第 37 讲的期望效用,赌注这么小,几乎该接受;可是,多数人拒绝(第四节)。
- 问题 2:很多人,第一问选"今天 100 元",第二问选"晚一个月、多 10 元":这和第 36 讲的"现在偏向",是同一种模式(第五节)。
- 问题 3:纯自利的回应者,2 元也比 0 元好,该接受;可是,不少人拒绝(第六节,和第 18 讲)。
二、行为经济学,在做什么
2.1 标准模型的假设
前面,我们用的"标准模型",大致,假设:
| 标准的假设 | 意思 |
|---|---|
| 理性的信念 | 人对事实,作出的判断,没有系统的偏差 |
| 稳定、一致的偏好 | 你的偏好,不会因为"怎么问"、“从哪里算起"而变;今天的计划,明天的你,也照着做 |
| 自利 | 只在乎自己的所得 |
| 足够的注意力和意志力 | 看得到所有的相关信息;想做的,就做得到 |
行为经济学(behavioral economics)的做法:把心理学里,观察到的、系统的、可以预测的偏离,放进模型里。
注意"系统的"这三个字。偶尔的、随机的错误,经济学家,早就知道:它们会互相抵消,不改变平均的结果。行为经济学关心的,是方向一致的偏差:很多人,在同一个情境,往同一个方向错。只有这样的偏差,才会改变市场、政策的结果。
2.2 它是怎么来的
Daniel Kahneman 和 Amos Tversky 1974 年(《不确定性下的判断:启发法和偏差》,Science,185 卷 4157 期,1124–1131 页),说明了:人们在不确定的情形下,常用几种简化的"启发法"来判断(比如,代表性、可得性、锚定和调整);它们大体有效,可是,会带来系统的、可预测的错误。1979 年,两人(Econometrica,47 卷 2 期,263 页起)提出前景理论。2002 年,Kahneman,因"把心理学研究的成果,用到经济学里,特别是人们在不确定下的判断和决策”,和 Vernon Smith(因把实验室实验,确立为经济学的实证工具)分享了诺贝尔经济学奖;2017 年,Richard Thaler,因把有限的理性、社会偏好、缺乏自控,纳入经济分析,获奖。(Tversky 1996 年去世,没有获奖的机会。)
2.3 研究的方法
- 实验:实验室里,控制变量,看人们怎么选(比如,咖啡杯、最后通牒)。优点,是因果清楚;缺点,是被试常常是学生,赌注小,场景是人造的。
- 田野数据:用真实的交易记录、合同(比如,券商的账户、健身房的会员)。优点,是真实;缺点,是别的因素,难以排除。
- 田野实验:在真实的环境里,随机分组(第 4 讲讲过随机分组)。
Stefano DellaVigna 2009 年的综述(《心理学与经济学:来自田野的证据》,Journal of Economic Literature,47 卷 2 期,315–372 页),把偏离,分成三类:非标准的偏好、非标准的信念、非标准的决策。这一讲,也按这个顺序。
三、信念:过度自信和锚定
3.1 过度自信
第 38 讲,我们看到:美国一家券商的家庭账户,交易最频繁的那一组,收益,比市场低得多(Barber 和 Odean 2000)。他们认为,原因之一,是过度自信:人们高估了自己的信息和判断的精度,于是,交易得过多。
注意,“过度自信”,是一个判断上的偏差,不是偏好。它的含义,是:如果你问人们,“你对这个答案,有九成把握”,实际,答对的,可能,只有七成。(这里,没有引用具体的实验数字。)
3.2 锚定
Tversky 和 Kahneman 1974 年的一个有名的实验:让被试,转一个轮盘(被设计成,停在 10 或 65),然后,问:非洲国家,在联合国的成员里,占多大比例?据二手的转述,轮盘停在 10 的那一组,估计的中位数,约 25%;停在 65 的那一组,约 45%。一个明显无关的数字,拉动了估计。
Dan Ariely、George Loewenstein 和 Drazen Prelec 2003 年(《连贯的任意性》,Quarterly Journal of Economics,118 卷 1 期,73–105 页)的实验:让学生,先写下,自己社保号码的末两位,当作一个"价格",问愿不愿意,按这个价格,买某件东西;再问,最多愿付多少钱。据摘要:随后的出价,被这个任意的数字,拉动,可是,同时,出价,又和商品的质量、数量的差别,保持一致,所以,它看起来,像是稳定的偏好。他们的结论是:从市场数据里估计出来的需求曲线,不一定,反映真实的偏好。
回到第 5 讲:“愿付价没有那么固定”:你刚看到的价格,会改变你愿意付多少。这里,就是证据。
四、偏好:前景理论
4.1 三个想法
前景理论(Kahneman 和 Tversky,1979;累积版,Tversky 和 Kahneman,1992,Journal of Risk and Uncertainty,5 卷 4 期,297–323 页)的三个想法:
- 参照点:人们感受到的,不是"财富的水平",而是,相对于参照点的得和失(比如,相对于你现在拥有的,你的期望,别人的所得)。
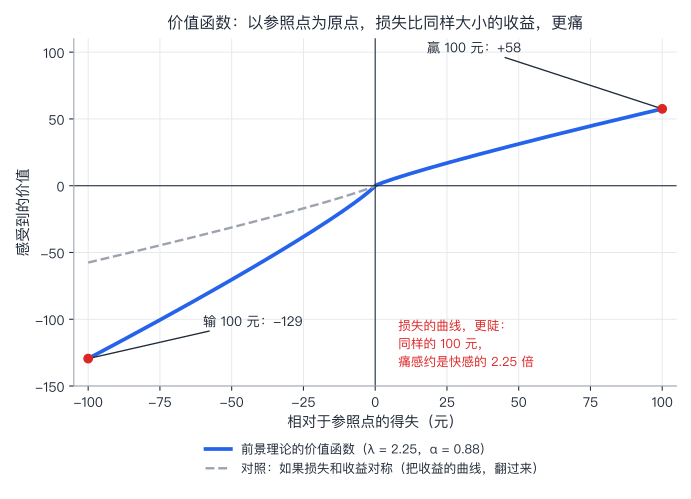
- 损失厌恶:损失,比同样大小的收益,更痛。价值函数,在参照点的两边,不对称,损失一侧更陡(陡的倍数,记作 λ)。
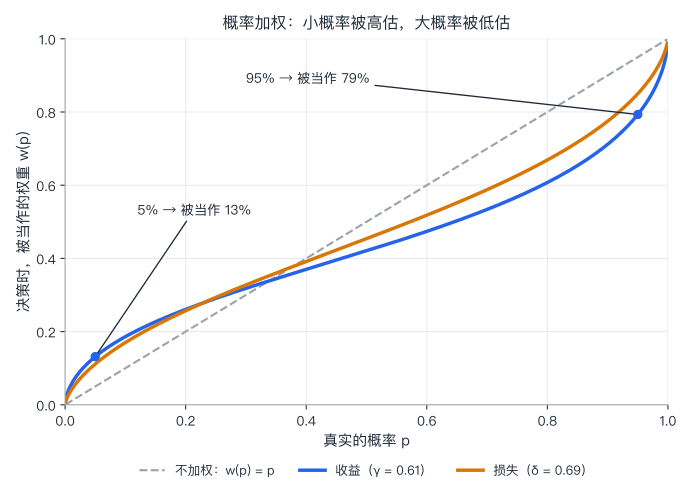
- 概率加权:人们,不是按真实的概率,决策,而是按一个"被扭曲的权重":小概率,被高估,大概率,被低估。
我们用 Tversky 和 Kahneman 1992 年估计的中位数参数(据二手来源列出的数值:曲度 0.88,损失厌恶 2.25,概率加权 0.61 和 0.69),来算一下。这些,只是一个研究里的估计,不是自然常数(第八节会讨论)。
import math

# 前景理论(累积版):参数取 Tversky 和 Kahneman 1992 年估计的中位数(二手来源列出的数值),只作演示
ALPHA = 0.88          # 价值函数的曲度(收益和损失一样)
LAM = 2.25            # 损失厌恶系数
GAMMA, DELTA = 0.61, 0.69   # 概率加权:收益用 GAMMA,损失用 DELTA

def v(x):             # 价值函数:参照点 = 0
    return x ** ALPHA if x >= 0 else -LAM * (-x) ** ALPHA

def v_inv(y):         # 价值函数的反函数:把"价值"换回"钱"
    return y ** (1 / ALPHA) if y >= 0 else -((-y / LAM) ** (1 / ALPHA))

def w(p, g):          # 概率加权函数:高估小概率,低估大概率
    return p ** g / (p ** g + (1 - p) ** g) ** (1 / g)

print("一、一个 50% 赢 G、50% 输 100 元的赌局,要 G 多大,你才愿意玩?")
def V_mixed(G, L):    # 一个混合赌局:50% 赢 G,50% 输 L
    return w(0.5, GAMMA) * v(G) + w(0.5, DELTA) * v(-L)
lo, hi = 100.0, 1000.0
for _ in range(60):   # 二分法找 V = 0 的 G
    mid = (lo + hi) / 2
    lo, hi = (mid, hi) if V_mixed(mid, 100) < 0 else (lo, mid)
print(f"  只有损失厌恶(λ = {LAM},不做概率加权,α = 1):G = {LAM * 100:.0f} 元")
print(f"  前景理论(曲度 + 概率加权):G ≈ {hi:.0f} 元(比 2.25 倍还多,因为:50% 在这里被当作约 {w(0.5, GAMMA):.2f}(赢)和 {w(0.5, DELTA):.2f}(输))")
print(f"  G = 120 元、L = 100 元:前景价值 V = {V_mixed(120, 100):.1f} < 0,拒绝;期望收益 = {0.5 * 120 - 0.5 * 100:+.0f} 元")

print("\n二、四重模式:同一个'期望值',人们对收益和损失、大概率和小概率,态度不同")
print(f"  {'情形':<26}{'期望值':>8}{'确定性等价':>12}  态度")
cases = [("5% 赢 100 元", 0.05, 100), ("95% 赢 100 元", 0.95, 100),
         ("5% 输 100 元", 0.05, -100), ("95% 输 100 元", 0.95, -100)]
for name, p, x in cases:
    ev = p * x
    V = w(p, GAMMA if x > 0 else DELTA) * v(x)
    ce = v_inv(V)
    attitude = "偏好冒险" if ce > ev else "回避风险"
    print(f"  {name:<24}{ev:>+9.1f}{ce:>+12.1f}  {attitude}")

print("\n三、Rabin(2000)的论证:只靠'效用函数是凹的',解释不了小赌局上的拒绝")
# 效用 u(w) = -exp(-a w)(CARA,所有财富水平下态度一样)。接受"50% 赢 G,50% 输 L",当且仅当 exp(a L) + exp(-a G) < 2
def accepts(a, L, G):
    return math.exp(a * L) + math.exp(-a * G) < 2
lo, hi = 1e-6, 0.1
for _ in range(80):   # 找出刚好拒绝'输 100 / 赢 110'的 a
    mid = (lo + hi) / 2
    lo, hi = (mid, hi) if accepts(mid, 100, 110) else (lo, mid)
a = hi
print(f"  让一个人刚好拒绝'50% 输 100 元、50% 赢 110 元':a = {a:.6f}")
print(f"  这个人,会拒绝所有'50% 输 L 元、50% 赢任意金额'的赌局,只要 L > ln2 / a = {math.log(2) / a:.0f} 元")
for L, G in ((500, 10 ** 9), (800, 10 ** 9), (1000, 10 ** 9)):
    print(f"    输 {L} 元 / 赢 {G:,} 元:{'接受' if accepts(a, L, G) else '拒绝'}")
输出:
一、一个 50% 赢 G、50% 输 100 元的赌局,要 G 多大,你才愿意玩?
  只有损失厌恶(λ = 2.25,不做概率加权,α = 1):G = 225 元
  前景理论(曲度 + 概率加权):G ≈ 274 元(比 2.25 倍还多,因为:50% 在这里被当作约 0.42(赢)和 0.45(输))
  G = 120 元、L = 100 元:前景价值 V = -30.4 < 0,拒绝;期望收益 = +10 元

二、四重模式:同一个'期望值',人们对收益和损失、大概率和小概率,态度不同
  情形                             期望值       确定性等价  态度
  5% 赢 100 元                   +5.0       +10.0  偏好冒险
  95% 赢 100 元                 +95.0       +76.9  回避风险
  5% 输 100 元                   -5.0        -8.3  回避风险
  95% 输 100 元                 -95.0       -83.1  偏好冒险

三、Rabin(2000)的论证:只靠'效用函数是凹的',解释不了小赌局上的拒绝
  让一个人刚好拒绝'50% 输 100 元、50% 赢 110 元':a = 0.000908
  这个人,会拒绝所有'50% 输 L 元、50% 赢任意金额'的赌局,只要 L > ln2 / a = 763 元
    输 500 元 / 赢 1,000,000,000 元:接受
    输 800 元 / 赢 1,000,000,000 元:拒绝
    输 1000 元 / 赢 1,000,000,000 元:拒绝
逐段看:
- 回答问题 1:50% 赢 G、50% 输 100,要 G 多大,才愿意玩?只有损失厌恶(λ = 2.25),G = 225;再加上概率加权(“50%",在赢的一侧,被当作约 0.42,在输的一侧,约 0.45),G ≈ 274。所以,“赢 120,输 100”(期望 +10),前景价值是 −30.4,拒绝。这不是"算错了”,是在参照点上,损失,更重。
- 四重模式:同样是期望值 5 元的"小概率赢 100",确定性等价是 +10:偏好冒险(彩票);“大概率赢 100”(95%),确定性等价 76.9,低于 95:回避风险;“小概率输 100”,确定性等价 −8.3,比 −5 更差:愿意花钱避免(保险);“大概率输 100”,确定性等价 −83.1,比 −95 更好:宁愿赌一把,也不愿接受几乎确定的损失。这解释了第 37 讲留下的,Friedman–Savage 的"又买保险、又买彩票"。
- Rabin 的论证(Matthew Rabin 2000 年,Econometrica,68 卷 5 期,1281–1292 页):这里,用一个最简单的凹的效用(常绝对风险厌恶,CARA)来演示:让一个人,刚好拒绝"50% 输 100、50% 赢 110",他的参数,a = 0.000908;这个人,会拒绝"输 800 元、赢 10 亿元"的赌局。这不合常理。Rabin 的定理更一般(据转述:对任何凹的效用函数,只要这个人,在所有的财富水平上,都拒绝那个小赌局,就会,拒绝"输 1000、赢任意金额")。所以,小赌局上的拒绝,不能靠"效用是凹的"来解释;更自然的解释,是损失厌恶(对"输"这件事本身的反感)。
4.2 参照点,在真实的数据里
- 出租车司机(第 13 讲):Camerer 等人的"收入目标",和后来的争论,其实,就是:参照点是什么,要不要,写进模型。那里,我们,没有下结论(“这个争论,至今没有一个让所有人都满意的结论”),这里也不下。
- 高尔夫球:Devin Pope 和 Maurice Schweitzer 2011 年(《泰格·伍兹,是损失厌恶的吗?》,American Economic Review,101 卷 1 期,129–157 页),用 2004–2009 年美国职业高尔夫巡回赛的 250 万次推杆,发现:职业选手,推"保帕"的球,比推"小鸟"的球,更容易进(据二手转述,差约 2 个百分点,要读原文核对)。因为,对每个洞,“标准杆”(par),是一个参照点:推小鸟,是"收益";推保帕,是"避免损失"。(这是高额奖金、高度熟练、竞争激烈的场景,所以,常被当作,“偏差不会被经验消除"的证据。)
- 禀赋效应(第 24 讲):拿到杯子的人,更舍不得。同时,John List 2003 年(Quarterly Journal of Economics,118 卷 1 期,41–71 页)在体育卡片交易会上的田野实验发现:经验最丰富的交易商,没有这种交易的不对称;据后续文献的转述,每月交易 6 次以上的,才消失。所以,禀赋效应,可能会被市场经验,磨掉一部分。这是第八节要讨论的。
- 沉没成本(第 2、11 讲):承认放弃,就把"账面上的亏”,变成"确定的亏"。损失厌恶,是一个常被提到的解释,不是唯一。
- 心理账户(第 10 讲):Richard Thaler 1985 年(Marketing Science,4 卷 3 期,199–214 页)提出:人们,把钱,分在不同的"账户"里,各有各的预算;Hastings 和 Shapiro 2013 年(第 10 讲)的汽油数据,支持了这一点。
4.3 回到股市:短视的损失厌恶
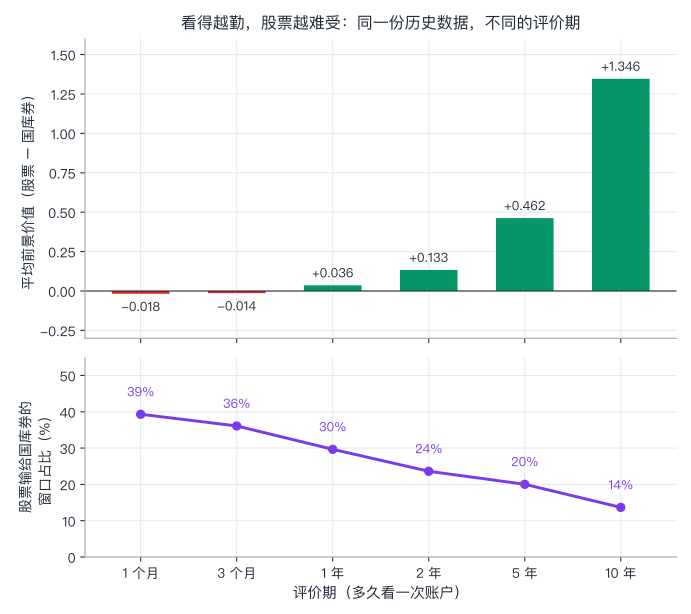
第 37 讲,我们留下了"股权溢价之谜"。Shlomo Benartzi 和 Richard Thaler 1995 年(《短视的损失厌恶和股权溢价之谜》,Quarterly Journal of Economics,110 卷 1 期,73–92 页)给了一个解释:损失厌恶,加上"看得太勤"。
想法是:一个有损失厌恶的人,如果每个月,都看一次账户,他会看到,股票,经常,亏钱,所以,要求很高的补偿,才肯持有;如果,他十年看一次,股票,几乎不亏,就不需要那么高的补偿。我们用真实的数据,来试一试。
import io, urllib.request, zipfile
import numpy as np

# 数据:Kenneth French 数据库,美国股市月度收益(Mkt-RF + RF)和一个月国库券利率,1927-01 至 2025-12
URL = "https://mba.tuck.dartmouth.edu/pages/faculty/ken.french/ftp/F-F_Research_Data_Factors_CSV.zip"
text = zipfile.ZipFile(io.BytesIO(urllib.request.urlopen(URL, timeout=60).read())).read("F-F_Research_Data_Factors.csv").decode("latin-1")
rows = []
for line in text.splitlines():
    p = [x.strip() for x in line.split(",")]
    if len(p) == 5 and len(p[0]) == 6 and p[0].isdigit() and 192701 <= int(p[0]) <= 202512:
        rows.append((float(p[1]), float(p[4])))
stock = np.array([(r[0] + r[1]) / 100 for r in rows])      # 股票的月度总收益
bill = np.array([r[1] / 100 for r in rows])                # 国库券的月度收益

ALPHA, LAM = 0.88, 2.25                                    # 前景理论:曲度 0.88,损失厌恶 2.25(只用价值函数,不做概率加权)
def v(x):
    x = np.asarray(x)
    return np.where(x >= 0, np.abs(x) ** ALPHA, -LAM * np.abs(x) ** ALPHA)

# 一个"评价期"为 h 个月的人:每隔 h 个月,看一次"股票比国库券,多赚(或少赚)了多少",并用前景价值函数打分。
# 用所有(重叠的)h 个月窗口,算平均的前景价值(单位:把收益差,当作"每 1 元本金"的得失)。
print(f"数据:{len(stock)} 个月;股票比国库券,每月平均多赚 {np.mean(stock - bill):.2%}")
print(f"  {'评价期':>8}{'窗口数':>8}{'股票输给国库券的窗口占比':>20}{'平均超额收益':>12}{'前景价值(平均)':>16}  结论")
for h, label in ((1, "1 个月"), (3, "3 个月"), (12, "1 年"), (24, "2 年"), (60, "5 年"), (120, "10 年")):
    cs, cb = np.cumprod(1 + stock), np.cumprod(1 + bill)
    cs, cb = np.concatenate([[1.0], cs]), np.concatenate([[1.0], cb])
    diff = (cs[h:] / cs[:-h]) - (cb[h:] / cb[:-h])         # 每个窗口里,股票比国库券多赚多少
    val = float(v(diff).mean())
    print(f"  {label:>6}{len(diff):>9d}{(diff < 0).mean():>18.1%}{diff.mean():>14.1%}{val:>18.4f}  {'偏好股票' if val > 0 else '不愿持有股票'}")

# 找一找:前景价值刚好为 0 的评价期(粗略)
for h in range(1, 121):
    cs, cb = np.concatenate([[1.0], np.cumprod(1 + stock)]), np.concatenate([[1.0], np.cumprod(1 + bill)])
    val = float(v((cs[h:] / cs[:-h]) - (cb[h:] / cb[:-h])).mean())
    if val > 0:
        print(f"\n  按这个简化的算法,评价期至少 {h} 个月(约 {h / 12:.1f} 年),股票的前景价值才为正")
        break
输出:
数据:1188 个月;股票比国库券,每月平均多赚 0.69%
       评价期     窗口数        股票输给国库券的窗口占比      平均超额收益        前景价值(平均)  结论
    1 个月     1188             39.3%          0.7%           -0.0177  不愿持有股票
    3 个月     1186             36.1%          2.1%           -0.0137  不愿持有股票
     1 年     1177             29.7%          8.9%            0.0360  偏好股票
     2 年     1165             23.6%         18.4%            0.1333  偏好股票
     5 年     1129             20.0%         53.8%            0.4622  偏好股票
    10 年     1069             13.7%        155.1%            1.3464  偏好股票

  按这个简化的算法,评价期至少 6 个月(约 0.5 年),股票的前景价值才为正
逐段看:
- 看得越勤,越难受:评价期 1 个月,股票输给国库券的窗口,占 39.3%;10 年,只有 13.7%。平均的前景价值,从 −0.018(1 个月)、−0.014(3 个月),变成 +0.036(1 年),+1.346(10 年)。
- 按这个简化的算法,评价期,至少要 6 个月,股票,才有正的前景价值。(原论文,据摘要,估计的"等价的评价期",约为一年;我这个版本,更简单:只用价值函数,不做概率加权,用"股票比国库券多赚多少"来评价,所以,数字,和原文,不同,方向,相同。)
- 要小心:(1)这是一个解释,不是唯一;(2)评价期,是怎么,被决定的,这里没有解释;(3)窗口重叠,美国的一个国家。
五、时间:现在偏向,和默认选项
5.1 证据
第 36 讲,我们演示了:如果人们"现在偏向",会出现,计划和行动不一致,并说,证据,要等到这一讲。现在,来看。
- 健身房:Stefano DellaVigna 和 Ulrike Malmendier 2006 年(《花钱,不去健身房》,American Economic Review,96 卷 3 期,694–719 页),用三家美国健身房,7752 个会员,三年的数据:选了"每月固定 70 多美元"的会员,平均每月去 4.3 次;为每一次预期的光顾,平均,付了 17 美元以上,而他们本来,可以买"10 次票",每次 10 美元;平均,在会员期间,多花了约 600 美元。他们认为,主要的解释,是对自己未来的自控、或者未来的效率,过度自信(高估自己以后会去,高估自己会取消)。
- 默认选项:Brigitte Madrian 和 Dennis Shea 2001 年(《暗示的力量》,Quarterly Journal of Economics,116 卷 4 期,1149–1187 页):一家公司,把 401(k) 退休计划,从"自己申请加入",改成"自动加入、想退出自己申请",新员工的参与率,大幅上升;据对论文的引述,提高了约 48 个百分点(不同转述的基线不一样,约从 40%~50%,升到 85% 左右,请读原文)。
- 明天多存一点:Thaler 和 Benartzi 2004 年(“Save More Tomorrow”,Journal of Political Economy,112 卷 S1 期,S164–S187 页):让员工,现在,承诺,将来加薪的时候,把一部分,加到储蓄里;据转述,加入的员工,储蓄率,从 3.5% 升到 13.6%。(批评:这是和"没加入的人"比,有选择偏差,因果的证据,不强。)
5.2 拖延的模型:默认,为什么有力量
O’Donoghue 和 Rabin 1999 年(《现在做,还是以后做》,American Economic Review,89 卷 1 期,103–124 页)区分了两类现在偏向的人:天真的(以为将来的自己,不会有现在偏向),清醒的(知道将来的自己,也有现在偏向)。对"现在要付出成本,以后才有好处"的事(办理储蓄计划、锻炼),天真的人,会一再拖延。
我们用第 36 讲的 β–δ,来建一个小模型,也检验一个常见的说法:“默认选项的力量,来自纠正拖延”。
import numpy as np

# 一件"麻烦事":办理一个自动储蓄计划。办成之后,从下个月起,每个月多得 b 元,一直到第 T 个月。
# 每个月,办手续的"麻烦程度"c 是随机的(这个月有多忙),在 0 到 R 元之间均匀分布,办的时候一次性付出。
# 你每个月看一眼 c:办,还是等下个月(也许那时更闲)?
T, b, delta = 24, 10.0, 0.99          # 24 个月;每月多得 10 元;每月折现 0.99(虚构数字,只做演示)
BETA = 0.7                            # 现在偏向(第 36 讲):未来的好处,打 7 折

def pv_benefit(t):                    # 第 t 月办成,从 t+1 月到 T 月的好处,在 t 月的现值
    return sum(b * delta ** k for k in range(1, T - t + 1))

def solve(R):
    def value(theta, bd, cont):       # 以阈值 theta 行动(c ≤ theta 就办):从"长远的眼光"看的价值
        p = min(max(theta / R, 0.0), 1.0)
        return p * (bd - min(theta, R) / 2) + (1 - p) * delta * cont

    # 1) 理性(指数折现):倒推,每个月的阈值 = 办成的好处 − 等一个月的价值
    V = np.zeros(T + 1); th_exp = np.zeros(T)
    for t in range(T - 1, -1, -1):
        bd = pv_benefit(t); th_exp[t] = bd - delta * V[t + 1]; V[t] = value(th_exp[t], bd, V[t + 1])
    # 2) 天真:以为"下个月的我"是理性的,所以等一个月的价值按 V 算;但今天的她,把未来的好处打 BETA 折
    th_naive = np.array([BETA * (pv_benefit(t) - delta * V[t + 1]) for t in range(T)])
    Wn = np.zeros(T + 1)
    for t in range(T - 1, -1, -1):
        Wn[t] = value(th_naive[t], pv_benefit(t), Wn[t + 1])
    # 3) 清醒:知道"下个月的自己"也有现在偏向,用那个自己的真实行为,来算等待的价值
    Ws = np.zeros(T + 1)
    for t in range(T - 1, -1, -1):
        bd = pv_benefit(t); Ws[t] = value(BETA * (bd - delta * Ws[t + 1]), bd, Ws[t + 1])

    def wait(th):                     # 平均几个月办成;没办成的,按 T 个月计
        alive, e, done = 1.0, 0.0, 0.0
        for t in range(T):
            p = min(max(th[t] / R, 0), 1); e += alive * p * t; done += alive * p; alive *= 1 - p
        return done, e + alive * T
    return V[0], Wn[0], Ws[0], wait(th_exp), wait(th_naive)

print(f"自动储蓄计划:{T} 个月,办成后每月多得 {b:.0f} 元(折现后总好处 {pv_benefit(0):.1f});每月的'麻烦'均匀分布在 0–R 元")
print("价值,都是从'长远的眼光'(只用 δ 折现)来评价的")
print(f"  {'R':>4}{'理性':>8}{'天真':>8}{'清醒':>8}{'现在偏向的损失':>14}{'默认比天真多':>12}{'理性办成要':>10}{'天真办成要':>10}{'天真 24 月内办成':>16}")
for R in (100, 200, 500):
    Ve, Wn, Ws, (_, te), (dn, tn) = solve(R)
    print(f"  {R:>4}{Ve:>8.1f}{Wn:>8.1f}{Ws:>8.1f}{Ve - Wn:>14.1f}{pv_benefit(0) - Wn:>12.1f}{te:>9.2f}月{tn:>9.2f}月{dn:>16.1%}")
print("  (默认 = 第 0 个月自动加入,没有办手续的麻烦,价值 = 总好处)")
输出:
自动储蓄计划:24 个月,办成后每月多得 10 元(折现后总好处 212.2);每月的'麻烦'均匀分布在 0–R 元
价值,都是从'长远的眼光'(只用 δ 折现)来评价的
     R      理性      天真      清醒       现在偏向的损失      默认比天真多     理性办成要     天真办成要      天真 24 月内办成
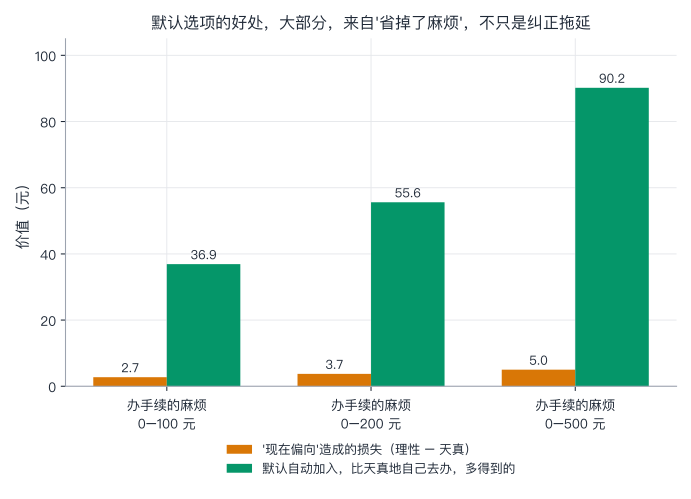
   100   178.0   175.3   175.9           2.7        36.9     1.29月     2.27月          100.0%
   200   160.3   156.6   157.4           3.7        55.6     2.27月     3.69月           99.2%
   500   127.0   122.0   122.9           5.0        90.2     4.49月     6.77月           92.1%
  (默认 = 第 0 个月自动加入,没有办手续的麻烦,价值 = 总好处)
逐段看:
- 拖延,是有的:理性的人,平均 1.29 个月,办成;天真的人,2.27 个月;麻烦越大(R 越大),差距越大(4.49 月 vs 6.77 月);R = 500 时,天真的人,24 个月内,还有 7.9% 没办成。
- 可是,损失不大:现在偏向,造成的损失(理性 − 天真),只有 2.7、3.7、5.0 元,相对于总好处 212 元,是 1.3%~2.4%。清醒的人(175.9),略好于天真的人(175.3)。
- 默认,好处很大:默认自动加入,比天真地自己去办,多 36.9、55.6、90.2 元。这些,绝大部分,来自"省掉了办手续的麻烦本身",不是纠正拖延,因为,对理性的人,默认,也有同样的好处。
- 所以,不能,只用现在偏向,来解释默认选项的力量。别的常被提到的原因:注意力(“没想起来”)、复杂(选项太多,不知道怎么选)、现状偏好(Samuelson 和 Zeckhauser 1988 年,Journal of Risk and Uncertainty,1 卷 1 期,7–59 页)、默认,被当作了"推荐"。这个模型,是虚构的数字,只用来显示,两种力量的相对大小,要靠数据,不能靠故事。
六、公平:不只是自己的所得
6.1 回答问题 3
第 18 讲,最后通牒游戏:纯自利的回应者,该接受任何大于 0 的数;实验里,低的提议,常被拒绝。那里,我们,留下了一个价值判断:该不该,把"对不公平的反感",当作"非理性"?
Ernst Fehr 和 Klaus Schmidt 1999 年(《公平、竞争和合作的理论》,Quarterly Journal of Economics,114 卷 3 期,817–868 页),给了一个办法:把对不平等的反感,写进效用函数(“厌恶不平等”):自己拿得比别人少,每少 1 元,扣 A 的不快;(自己拿得比别人多,也扣一点,这里省略,因为,我们只看回应者)。
# 把"对不公平的反感"写进收益里:Fehr–Schmidt 型的偏好(只看回应者一方)
# 一个 10 元的蛋糕,提议者给回应者 s 元,自己留 10 − s。回应者的效用:
#   U = s − A × max((10 − s) − s, 0)      (如果自己拿得比对方少,每少 1 元,就扣 A 的不快;A = 对"吃亏"的反感程度)
# 接受,当且仅当 U ≥ 0(拒绝,双方都是 0)。A = 0 就是第 18 讲里,纯自利的回应者。
PIE = 10.0
types = [(0.0, 0.30), (0.5, 0.30), (1.0, 0.30), (4.0, 0.10)]     # (A, 占比):虚构的分布,只做演示

def accepts(A, s):
    return s - A * max((PIE - s) - s, 0) >= -1e-9

print("一、不同的回应者,最低愿意接受多少?(A 越大,越反感'吃亏')")
for A, share in types:
    s_min = PIE * A / (1 + 2 * A) if A > 0 else 0.0
    print(f"  A = {A:<4}(占 {share:.0%}):最低接受 {s_min:.2f} 元,即蛋糕的 {s_min / PIE:.1%}")

print("\n二、一个纯自利的提议者:他知道回应者里,各类人的比例,该给多少?")
best = (0, 0, 0)
for k in range(0, 501):
    s = k / 100
    p_acc = sum(share for A, share in types if accepts(A, s))
    pay = (PIE - s) * p_acc
    if pay > best[2]:
        best = (s, p_acc, pay)
print(f"  {'给 s 元':>8}{'被接受的概率':>12}{'提议者的期望所得':>14}")
for s in (0.5, 1.0, 2.0, 2.5, 3.0, 3.34, 4.0, 4.45, 5.0):
    p_acc = sum(share for A, share in types if accepts(A, s))
    print(f"  {s:>8.2f}{p_acc:>12.0%}{(PIE - s) * p_acc:>14.2f}")
print(f"  最优:给 {best[0]:.2f} 元({best[0] / PIE:.1%}),被接受的概率 {best[1]:.0%},期望所得 {best[2]:.2f} 元")
print(f"  对比:如果,所有回应者都是纯自利的(A = 0),最优的给法,是接近 0 元(只要给一点点,就会被接受):期望所得,接近 {PIE:.0f} 元")
输出:
一、不同的回应者,最低愿意接受多少?(A 越大,越反感'吃亏')
  A = 0.0 (占 30%):最低接受 0.00 元,即蛋糕的 0.0%
  A = 0.5 (占 30%):最低接受 2.50 元,即蛋糕的 25.0%
  A = 1.0 (占 30%):最低接受 3.33 元,即蛋糕的 33.3%
  A = 4.0 (占 10%):最低接受 4.44 元,即蛋糕的 44.4%

二、一个纯自利的提议者:他知道回应者里,各类人的比例,该给多少?
     给 s 元      被接受的概率      提议者的期望所得
      0.50         30%          2.85
      1.00         30%          2.70
      2.00         30%          2.40
      2.50         60%          4.50
      3.00         60%          4.20
      3.34         90%          5.99
      4.00         90%          5.40
      4.45        100%          5.55
      5.00        100%          5.00
  最优:给 3.34 元(33.4%),被接受的概率 90%,期望所得 5.99 元
  对比:如果,所有回应者都是纯自利的(A = 0),最优的给法,是接近 0 元(只要给一点点,就会被接受):期望所得,接近 10 元
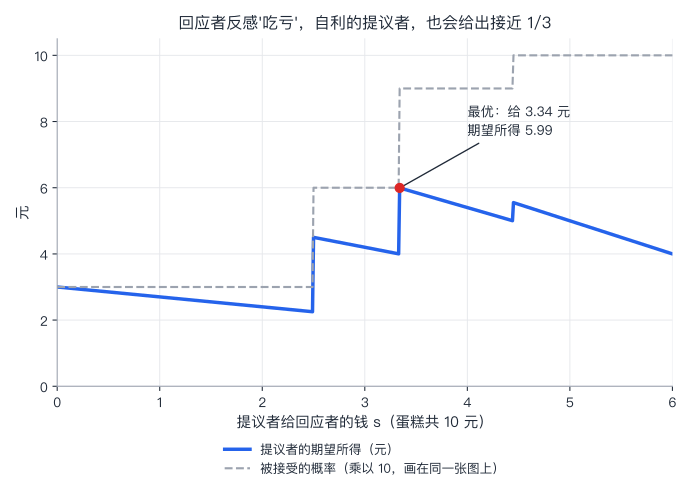
逐段看:
- 最低接受的份额,是 10A/(1+2A):A = 0.5 → 2.5 元;A = 1 → 3.33 元;A = 4 → 4.44 元。(分布,是我虚构的,只做演示。)
- 一个纯自利的提议者,只要,知道回应者里,有这样的人,他的最优,不是 0,而是 3.34 元(约 1/3):被接受的概率,90%,期望所得 5.99;如果给 2 元,只有 30% 的人接受。公平,是"写进收益里"的东西,不是"非理性":它改变了,最优的策略。
- 这和第 18 讲,Güth 等人的结果(众数对半分,平均给约 37%),方向一致;不是证明。
- 问题 3,你的回答,也许,是"拒绝":8 比 2,你得到 20%,在上面这个模型里,A > 1/3 的人,会拒绝(因为,A = 1/3 时,最低接受 10 × (1/3) ÷ (1 + 2/3) = 2 元)。
6.2 市场里的公平
Daniel Kahneman、Jack Knetsch 和 Richard Thaler 1986 年(《公平,作为对追求利润的约束》,American Economic Review,76 卷 4 期,728–741 页),在多伦多和温哥华,做电话调查:一家五金店,大雪之后的早晨,把铲雪铲子的价格,从 15 美元,提到 20 美元,你觉得公平吗?据后来的转述,约 82% 的人,认为不公平。他们的结论是:企业,在成本上升时提价,被看作公平;利用需求的上升提价,被看作不公平。(一个批评:也可能,是因为,那是人们遭难的时候。)
这就回到了第 15 讲:“我们假设,顾客不会反感”:价格歧视、涨价,如果被看作"不公平",企业,可能,为此付出声誉的代价,所以,常把价差,包装成"会员价"、“优惠券”。
七、行为金融:回到第 38 讲的问题
第 38 讲,我们留了一个问题:异象,到底是风险的补偿,还是人的错误?这里,有两个例子。
7.1 处置效应
Terrance Odean 1998 年(《投资者,不愿意卖出亏损的股票吗?》,Journal of Finance,53 卷 5 期,1775–1798 页),用一家折扣券商,约 1 万个账户(1987–1993),发现:投资者,更愿意卖出,赚钱的股票,更不愿意卖出,亏钱的股票(“处置效应”,这个词,来自 Shefrin 和 Statman 1985 年);作者检验了,卖出,并不是因为,再平衡、交易成本;而且,除了 12 月(税收),这样做,并没有,被之后的收益证明是对的。这是"损失厌恶",加上"卖出,才算实现"的心理账户。
7.2 动量
动量:过去 12 个月(不含最近 1 个月)涨得多的股票,之后,倾向于,继续涨;Narasimhan Jegadeesh 和 Sheridan Titman 1993 年(Journal of Finance,48 卷 1 期,65–91 页):买过去的赢家、卖过去的输家,在 3 到 12 个月,有显著的正收益,不能用系统性风险解释。我们看看,在 1927–2025 年的数据里,它长什么样。
import io, math, urllib.request, zipfile
import numpy as np

# 数据:Kenneth French 数据库。动量因子 Mom:过去 12 个月(不含最近 1 个月)涨得多的股票,减去涨得少的股票,每月重新排;单位 %。
BASE = "https://mba.tuck.dartmouth.edu/pages/faculty/ken.french/ftp/"
def read(name, member):
    return zipfile.ZipFile(io.BytesIO(urllib.request.urlopen(BASE + name, timeout=60).read())).read(member).decode("latin-1").splitlines()

mom = {}
for line in read("F-F_Momentum_Factor_CSV.zip", "F-F_Momentum_Factor.csv"):
    p = [x.strip() for x in line.split(",")]
    if len(p) == 2 and len(p[0]) == 6 and p[0].isdigit():
        mom[int(p[0])] = float(p[1])
fac = {}
for line in read("F-F_Research_Data_Factors_CSV.zip", "F-F_Research_Data_Factors.csv"):
    p = [x.strip() for x in line.split(",")]
    if len(p) == 5 and len(p[0]) == 6 and p[0].isdigit():
        fac[int(p[0])] = float(p[1])                       # 市场超额收益
months = [m for m in sorted(mom) if m in fac and 192701 <= m <= 202512 and mom[m] > -99]
d = np.array(months); x = np.array([mom[m] for m in months]); mk = np.array([fac[m] for m in months])

def t_stat(s):
    return s.mean() / (s.std(ddof=1) / math.sqrt(len(s)))

print(f"动量因子(Mom),{months[0]}–{months[-1]},{len(x)} 个月")
print(f"  {'时期':<11}{'月数':>6}{'月均值%':>9}{'年化%':>8}{'t 值':>7}{'年化波动%':>10}")
for label, lo, hi in (("全样本", 192701, 202512), ("1927–1962", 192701, 196212), ("1963–1992", 196301, 199212), ("1993–2025", 199301, 202512), ("2009–2025", 200901, 202512)):
    sel = (d >= lo) & (d <= hi); s = x[sel]
    print(f"  {label:<10}{len(s):>6d}{s.mean():>9.2f}{s.mean() * 12:>8.1f}{t_stat(s):>7.2f}{s.std(ddof=1) * math.sqrt(12):>10.1f}")

# 一、"崩溃":最差的 5 个月,和最好的 5 个月
order = np.argsort(x)
print("\n一、动量因子最差的 5 个月:")
for i in order[:5]:
    print(f"  {d[i]}:动量 {x[i]:+.1f}%,同月市场超额收益 {mk[i]:+.1f}%")
print("  最好的 5 个月:" + "、".join(f"{d[i]}({x[i]:+.1f}%)" for i in order[::-1][:5]))
print(f"  最差月份的损失,是全样本月标准差的 {abs(x.min()) / x.std(ddof=1):.1f} 倍(正态分布下,这几乎不可能发生)")

# 二、市场大跌之后,动量怎么样?("恐慌状态"):以过去 24 个月的市场累计收益 < 0 为界
cum = np.array([np.prod(1 + mk[max(0, i - 24):i] / 100) - 1 if i >= 24 else np.nan for i in range(len(mk))])
bear = cum < 0
print("\n二、以过去 24 个月的市场累计超额收益是否为负,分两种状态,看之后一个月的动量:")
for name, sel in (("之前市场下跌", bear), ("之前市场上涨", ~bear & ~np.isnan(cum))):
    s = x[sel]
    print(f"  {name}:{len(s)} 个月,月均值 {s.mean():+.2f}%,月标准差 {s.std(ddof=1):.2f}%,最差月 {s.min():+.1f}%")

# 三、动量能不能,被"市场 β"解释?
mc = mk - mk.mean(); beta = (mc * (x - x.mean())).sum() / (mc @ mc); alpha = x.mean() - beta * mk.mean()
res = x - alpha - beta * mk; se_a = res.std(ddof=2) * math.sqrt(1 / len(x) + mk.mean() ** 2 / (mc @ mc))
print(f"\n三、对市场做回归:β = {beta:.2f},月 α = {alpha:.2f}%(t = {alpha / se_a:.2f}):市场 β,几乎解释不了动量")
输出:
动量因子(Mom),192701–202512,1188 个月
  时期             月数     月均值%     年化%    t 值     年化波动%
  全样本         1188     0.61     7.3   4.51      16.2
  1927–1962    432     0.64     7.7   2.44      19.0
  1963–1992    360     0.82     9.8   4.54      11.8
  1993–2025    396     0.39     4.7   1.65      16.4
  2009–2025    204    -0.10    -1.2  -0.32      15.5

一、动量因子最差的 5 个月:
  193208:动量 -52.6%,同月市场超额收益 +37.1%
  193207:动量 -45.6%,同月市场超额收益 +33.6%
  200904:动量 -34.4%,同月市场超额收益 +10.2%
  193909:动量 -31.4%,同月市场超额收益 +16.9%
  200101:动量 -25.4%,同月市场超额收益 +3.2%
  最好的 5 个月:200002(+18.1%)、200006(+16.6%)、193803(+15.8%)、198011(+15.2%)、193502(+14.5%)
  最差月份的损失,是全样本月标准差的 11.2 倍(正态分布下,这几乎不可能发生)

二、以过去 24 个月的市场累计超额收益是否为负,分两种状态,看之后一个月的动量:
  之前市场下跌:275 个月,月均值 -0.11%,月标准差 7.73%,最差月 -52.6%
  之前市场上涨:889 个月,月均值 +0.81%,月标准差 3.24%,最差月 -12.6%

三、对市场做回归:β = -0.30,月 α = 0.82%(t = 6.39):市场 β,几乎解释不了动量
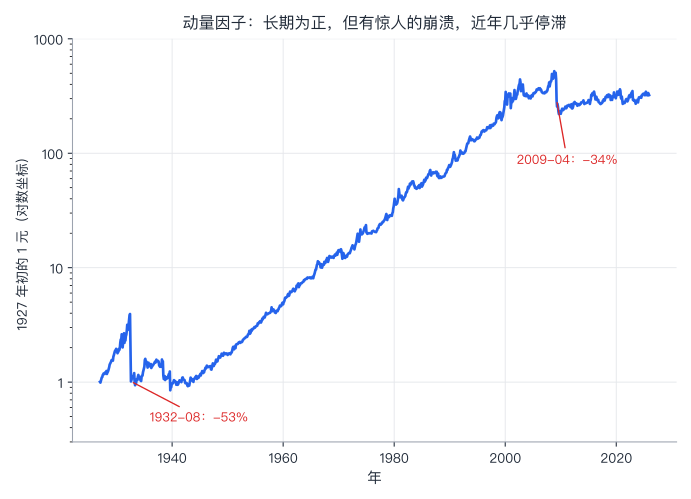
逐段看:
- 长期,很强:全样本,年化 7.3%,t 值 4.51。分时期:1927–1962,7.7%(t 2.44);1963–1992,9.8%(4.54);1993–2025,4.7%(1.65);2009–2025,−1.2%(−0.32)。(2009 年这个起点,是我挑的,在崩溃之后,起止点,影响很大。)
- 崩溃,非常惊人:最差的月份,1932 年 8 月,−52.6%(同月,市场超额收益 +37.1%);1932 年 7 月,−45.6%;2009 年 4 月,−34.4%。最差的月份,是月标准差的 11.2 倍。崩溃,都发生在,市场大跌之后的,大反弹。
- 之前市场下跌(过去 24 个月):动量,月均值 −0.11%,月标准差 7.73%;之前市场上涨:+0.81%,3.24%。
- 市场 β,解释不了它:对市场回归,β = −0.30,月 α = 0.82%(t = 6.39)。
两派的解释:
- 行为的解释:Nicholas Barberis、Andrei Shleifer 和 Robert Vishny 1998 年(Journal of Financial Economics,49 卷 3 期,307–343 页):投资者,对新闻,反应不足(保守),之后,才逐步调整;Kent Daniel、David Hirshleifer 和 Avanidhar Subrahmanyam 1998 年(Journal of Finance,53 卷 6 期,1839–1885 页):过度自信、自我归因,短期,产生动量,长期,回落。
- 风险的解释(或者,至少,是"一个更复杂的故事"):Kent Daniel 和 Tobias Moskowitz 2016 年(《动量崩溃》,Journal of Financial Economics,122 卷 2 期,221–247 页):动量,有偶发的、持续的崩溃,主要发生在市场恐慌、波动大、市场反弹的时候;输家组合,在崩溃时,有类似"期权"的收益。他们发现,崩溃,部分,是可以预测的,一个,根据预测,调整敞口的策略,据摘要,几乎,把夏普比率,翻了一倍。
这还是,联合假设的问题:同一份数据,行为的故事,和风险的故事,都讲得通。
八、一个有争议的问题:这些发现,有多可靠,该怎么用
按"理论预测 → 证据与局限 → 分歧在哪 → 价值判断留给读者"来写。
8.1 理论预测什么
行为经济学,预测:在一些情境下,系统的偏差,会改变选择,从而,改变市场的结果和政策的效果:损失厌恶,会让人持有亏损的股票;默认选项,会改变储蓄;公平的感受,会约束价格。
8.2 证据与局限
(一)损失厌恶,稳健吗? Alexander Brown、Taisuke Imai、Ferdinand Vieider 和 Colin Camerer 2024 年(Journal of Economic Literature,62 卷 2 期,485–516 页)的元分析,汇集了 150 篇文章里的 607 个估计,据摘要,平均的损失厌恶系数,约 1.96(95% 区间,约 1.82–2.10),低于Tversky 和 Kahneman 1992 年的 2.25。另一方面,David Gal 和 Derek Rucker 的批评(Journal of Consumer Psychology,2018,据摘要)认为:现有的证据,不支持"损失,总体上,比收益更有影响"这样的强的说法;许多被归为损失厌恶的现象,有别的解释(比如,惯性)。两边,用的是不同的文献、任务和模型。
(二)实验室,推得到真实世界吗? 上面,John List 的田野实验:有经验的交易商,没有禀赋效应;Pope–Schweitzer:职业选手,仍有偏差。两种方向的证据,都有。
(三)研究,能重复吗? 第 4 讲,Camerer 等人 2016 年的重复研究:18 项实验室经济学实验里,11 项,得到了方向一致、显著的结果,平均的效应,约为原来的 66%。行为经济学的实验,也受这样的检验;有一些,名气很大的发现,在后来的重复里,变小了。对每一个发现,要问:样本多大?重复了吗?实际的赌注多大?
(四)偏差,会不会,被市场磨掉? 弗里德曼式的论点:不理性的人,会被市场淘汰,或者,被套利者纠正。第 38 讲,我们看到,套利,是有限度的(Shleifer–Vishny 1997);List 的结果,说明,经验,可以磨掉一部分;动量、处置效应,显示了,有一些,没有被磨掉。
8.3 分歧在哪
- “偏差”,是不是"错误"? 人们对损失敏感,是"非理性的偏差",还是"有道理的偏好"?这取决于,你用什么标准,来判断"对"。
- 模型,该多复杂? 前景理论,参数多,能解释很多,也容易"事后拟合":同一个人,在不同的情境下,λ 不一样。
- 用处,是描述,还是预测? 在某些情境下,很好的描述,不等于,有稳定的预测。
8.4 价值判断(留给你)
行为经济学,有一个,很具体的政策用法:助推(nudge)。Richard Thaler 和 Cass Sunstein 2008 年的书 Nudge:不禁止任何选择,也不大幅改变经济激励,只是,改变选项的呈现方式(比如,默认选项),来帮助人们,作出他们"自己也会认可"的选择。
事实问题:默认选项,能提高参与率吗?(能,证据很强,第五节)。价值问题:
- 默认,该由谁设定? 设定默认的人,其实,就是在替你选;你,认为谁该有这样的权力?雇主?政府?
- 助推,是保护,还是家长主义? 如果,“自动加入、可以退出”,在你看来,保留了自由;还是,认为,人们不该被"推",而该被充分告知?第 36 讲,我们也留过同一个问题。
- 公平的感受,该不该,写进政策? 如果,人们对"涨价"的反感,是真实的,应该,限制"大雪之后的涨价"吗?(第 9 讲,我们讨论过价格上限,和第 7 讲,价格传递信息。)这里,没有一个,“经济学的答案”:它,取决于,你更看重,价格的信息功能,还是人们感受到的公平。
- “非理性”,该不该,被用来,否定人们的选择? 如果,一个人,拒绝了 2 元,你,怎么看他:他错了,还是,他在乎的,不只是钱?
经济学,能告诉你:每一种做法,大约,有什么后果;你更看重自由,还是保护,是你的价值判断。
九、局限、常见误用
9.1 局限
- 参数,是来自某些实验的估计(λ = 2.25,等等),不是常数;
- 模型,是示意:拖延模型、公平模型,用的是虚构的数字;
- 数据:美国股市(1927–2025);动量,用的是 Kenneth French 的因子;
- 文献:多数,只引用了摘要,没有自己重做;
- 这一讲没有讲:生物、神经科学的证据,群体和文化的差别,“有限注意力"的细致模型,行为金融的更多的现象,中国的证据(没有查到,可以核对的数据);
- 本讲,不是投资建议。
9.2 常见的误用
| 误用 | 正确的想法 |
|---|---|
| “行为经济学,证明了人是非理性的” | 它描述的是,系统的偏离,大多数时候,人们的选择,仍然是有道理的 |
| “标准经济学,假设人人理性,所以,是错的” | 标准模型,是基准(第 4 讲,模型是一张故意画错的地图);行为经济学,是在它之上的修正 |
| “损失厌恶,就是 λ = 2.25” | 这是一个研究的估计;元分析,约 1.96;不同的任务,不一样 |
| “有偏差,所以,可以靠它赚钱” | 偏差,常常,不容易被利用(套利有限度;动量,有崩溃) |
| “默认选项,是因为人们懒” | 一部分,是省掉的麻烦本身;懒,只是一种解释 |
| “他拒绝了 2 元,是因为他不懂” | 也许,是因为,他对公平,有偏好 |
| “实验里,大学生这样,所以,人人这样” | 实验,有样本和场景的限制;要看田野的证据 |
十、小结
这一讲有六个想法,请带走:
- 行为经济学:把心理学里系统的偏离,放进模型;关键,是"系统的”,方向一致。
- 信念:过度自信、锚定;愿付价,不是固定的数。
- 前景理论:参照点、损失厌恶、概率加权;赢 120 输 100 的赌,要赢到约 274,才愿意玩;小赌局上的拒绝,不能靠"凹的效用"解释。
- 短视的损失厌恶:评价期越短,股票,越难受;至少 6 个月,才有正的前景价值(简化的版本);是对股权溢价之谜的一个解释。
- 时间:现在偏向,有证据(健身房、401(k));默认选项的力量,大部分,来自省掉的麻烦,不只是纠正拖延。
- 公平:对"吃亏"的反感,写进收益里,改变了,最优的策略(提议者,给约 1/3);有争议:损失厌恶有多稳健,实验能否推广,助推,是否家长主义。
下一讲,我们离开"个人"和"金融",回到国家之间的贸易:第 3 讲,我们讲了比较优势,现在,要看,在真实的世界里,它还成立吗,谁赢,谁输,该不该设关税?下一讲:第 40 讲:国际贸易:比较优势的再审视。
思考题
1. 用 Tversky–Kahneman 的参数(α = 0.88,λ = 2.25,只用价值函数,不做概率加权):你有一个赌局,50% 赢 G,50% 输 50 元。要 G 多大,才愿意玩?
提示:价值 = 0.5 × G^0.88 − 0.5 × 2.25 × 50^0.88 = 0;所以,G^0.88 = 2.25 × 50^0.88,G = 2.25^(1/0.88) × 50 ≈ 2.51 × 50 ≈ 126 元。也就是说,只要赢的部分,约是输的 2.5 倍,就愿意玩(只有损失厌恶、没有曲度时,是 2.25 倍:112.5 元)。
2. 拿 5 年的美国股市月度数据,评价期,选 1 个月、1 年,股票的前景价值,会怎么变?为什么,评价期越长,股票,越有吸引力?
提示:评价期越长,窗口里"输给国库券"的比例,越低(39% → 30% → 14%),而且,收益差越大,平均的前景价值,越高。损失厌恶的人,看得越少,越不会被"短期的下跌"吓到。可是,要小心:这只是,一个国家、一个历史时期。
3. 一家公司,打算把员工的退休计划,改成"自动加入"。在第 5.2 节的模型里,如果,办手续的麻烦,变成 0–500 元,默认选项带来的好处,是多少?其中,有多少,是"纠正现在偏向"?
提示:默认比天真地自己去办,多 90.2 元;现在偏向的损失,是 5.0 元,相当于默认的好处的约 5.5%。**大部分,是省掉的麻烦。**这说明,要区分"默认选项有用"和"现在偏向,是主要原因"这两件事。
4. 第 6.1 节的模型里,如果,回应者的分布,变成:A = 0 占 60%,A = 1 占 40%(其余,没有),提议者,该给多少?
提示:只有两类:A = 0 的人,接受任何 ≥ 0 的;A = 1 的人,最低接受 3.33 元。给 3.34:被接受的概率,100%,期望所得 6.66;给 0:只有 60% 接受,期望所得 6.0;给 2:60%,4.8。所以,最优,给 3.34 元左右(刚好,够 A = 1 的人接受),期望所得约 6.66。回应者里,“在乎公平"的人,只要,占得足够多,就会改变,自利提议者的行为。(要核对这个结论,把代码里的 types 改成 [(0.0, 0.6), (1.0, 0.4)]。)
5. (开放题)一个国家,想提高人们的养老储蓄,考虑三种办法:(a)自动加入、可以退出;(b)强制缴纳;(c)只做宣传,让人们自己决定。从事实和价值判断,两个方面,比较它们。
提示:事实的部分:(a)能提高参与率(Madrian–Shea),它的好处,大部分,来自省掉的麻烦;(b)参与率最高,可是,没有选择的余地;(c)通常,参与率最低。证据,有限:Save More Tomorrow 的证据,有选择的偏差。价值判断的部分:自由,和保护,怎么权衡;设定默认的人,有多大的权力;谁,承担"缴多了、或缴少了"的后果;不同的人(收入低、需要现金的人),受影响,是否一样。
参考与延伸
- Tversky, A., & Kahneman, D. (1974). Judgment under Uncertainty: Heuristics and Biases. Science, 185(4157), 1124–1131.
- Kahneman, D., & Tversky, A. (1979). Prospect Theory: An Analysis of Decision under Risk. Econometrica, 47(2), 263–291.
- Tversky, A., & Kahneman, D. (1992). Advances in Prospect Theory: Cumulative Representation of Uncertainty. Journal of Risk and Uncertainty, 5(4), 297–323.
- DellaVigna, S. (2009). Psychology and Economics: Evidence from the Field. Journal of Economic Literature, 47(2), 315–372.
- Ariely, D., Loewenstein, G., & Prelec, D. (2003). Coherent Arbitrariness: Stable Demand Curves without Stable Preferences. Quarterly Journal of Economics, 118(1), 73–105.
- Rabin, M. (2000). Risk Aversion and Expected-Utility Theory: A Calibration Theorem. Econometrica, 68(5), 1281–1292.
- Pope, D. G., & Schweitzer, M. E. (2011). Is Tiger Woods Loss Averse? Persistent Bias in the Face of Experience, Competition, and High Stakes. American Economic Review, 101(1), 129–157.
- List, J. A. (2003). Does Market Experience Eliminate Market Anomalies? Quarterly Journal of Economics, 118(1), 41–71.
- Thaler, R. (1985). Mental Accounting and Consumer Choice. Marketing Science, 4(3), 199–214.
- Benartzi, S., & Thaler, R. H. (1995). Myopic Loss Aversion and the Equity Premium Puzzle. Quarterly Journal of Economics, 110(1), 73–92.
- DellaVigna, S., & Malmendier, U. (2006). Paying Not to Go to the Gym. American Economic Review, 96(3), 694–719.
- Madrian, B. C., & Shea, D. F. (2001). The Power of Suggestion: Inertia in 401(k) Participation and Savings Behavior. Quarterly Journal of Economics, 116(4), 1149–1187.
- Thaler, R. H., & Benartzi, S. (2004). Save More Tomorrow™: Using Behavioral Economics to Increase Employee Saving. Journal of Political Economy, 112(S1), S164–S187.
- O’Donoghue, T., & Rabin, M. (1999). Doing It Now or Later. American Economic Review, 89(1), 103–124.
- Samuelson, W., & Zeckhauser, R. (1988). Status Quo Bias in Decision Making. Journal of Risk and Uncertainty, 1(1), 7–59.
- Fehr, E., & Schmidt, K. M. (1999). A Theory of Fairness, Competition, and Cooperation. Quarterly Journal of Economics, 114(3), 817–868.
- Kahneman, D., Knetsch, J. L., & Thaler, R. H. (1986). Fairness as a Constraint on Profit Seeking: Entitlements in the Market. American Economic Review, 76(4), 728–741.
- Odean, T. (1998). Are Investors Reluctant to Realize Their Losses? Journal of Finance, 53(5), 1775–1798.
- Jegadeesh, N., & Titman, S. (1993). Returns to Buying Winners and Selling Losers: Implications for Stock Market Efficiency. Journal of Finance, 48(1), 65–91.
- Barberis, N., Shleifer, A., & Vishny, R. (1998). A Model of Investor Sentiment. Journal of Financial Economics, 49(3), 307–343.
- Daniel, K., Hirshleifer, D., & Subrahmanyam, A. (1998). Investor Psychology and Security Market Under- and Overreactions. Journal of Finance, 53(6), 1839–1885.
- Daniel, K., & Moskowitz, T. J. (2016). Momentum Crashes. Journal of Financial Economics, 122(2), 221–247.
- Brown, A. L., Imai, T., Vieider, F. M., & Camerer, C. F. (2024). Meta-Analysis of Empirical Estimates of Loss Aversion. Journal of Economic Literature, 62(2), 485–516.
- Gal, D., & Rucker, D. D. (2018). The Loss of Loss Aversion: Will It Loom Larger Than Its Gain? Journal of Consumer Psychology(卷期页,没有核对)。
- Thaler, R. H., & Sunstein, C. R. (2008). Nudge: Improving Decisions about Health, Wealth, and Happiness. Yale University Press.
- Kenneth R. French 数据库(达特茅斯学院):“Fama/French Research Data Factors”、“Momentum Factor (Mom)"(CRSP 2026 年 8 月版,2026 年 10 月下载)。