这是第七个实验。第 25 讲,我们用一个公式算出了渔场的悲剧:开放进入时,出海的船太多,租金被耗散到零。第 25 讲还留了一个承诺:用模拟看共用的资源怎样一步步被耗散,以及加入监督和规则之后会怎样。 这是这个实验的第一部分。
第二部分,换一个看上去完全不同的题目:Schelling 的隔离模型。一个城市里住着两种人,每个人只有一个很温和的要求:邻居里,至少有一部分和自己同类。结果呢?这两部分放在一起,是因为它们讲的是同一件事:每个人的选择都很合理,合起来的结果,却是谁也没有想到、也没有想要的。 用模拟,你可以亲眼看到,这个"合起来"是怎样一步一步发生的。
怎么用:和前面的实验一样,代码块是接着往下写的:后面的块会用到前面块里定义的东西。把它们依次拼成一个文件(比如 lab76.py),用 python lab76.py 运行,约 40 秒;也可以一段一段地在 Python 里依次运行。只需要 Python 3 和 NumPy。实验里有随机数,但种子都固定了,所以你跑出来的数字,会和下面的输出一模一样。
一、六个问题
先停一下:请先凭直觉,回答下面六个问题,写下来。
问题 1: 一片没有人管的渔场,谁都可以来。从一片没人动过的渔场出发,出海的船会一路增加,直到不赚钱为止。过程中,鱼的存量会平稳地降到那个水平吗?
问题 2: 如果整片渔场只有一个主人,他会出海多少?如果他只看自己每条船赚不赚钱,不去想"多出一条船,会让所有船都少捞鱼",又会怎样?
问题 3: 禁渔十年,鱼的存量会完全恢复。然后重新开放,会怎样?
问题 4: 十个渔民约好,每人出海一个规定的量。每个人都可以偷偷多出海,被巡查发现的概率是 q,发现了就停捕 k 年。q 要多大、k 要多长,才管得住?
问题 5: 一个城市里,两种人各占一半,每个人只要求"邻居里至少 30% 和我同类",换句话说,接受自己是 70% 对 30% 的少数。最后,邻居里同类的平均比例,会是多少?
问题 6: 如果只有少数人有这样的要求,其他人对邻居完全无所谓,最后的隔离,会比所有人都有要求时轻很多吗?
我们会一个一个回来。
二、实验的设计
2.1 第一部分:一片会长鱼的渔场
第 25 讲的渔场,只有一个公式:总渔获 H(E) = 10E − E²。这个公式,其实是一片会自己长鱼的渔场,稳定下来之后的样子。现在,我们把"长鱼"这件事,放进模拟里:
dS/dt = r S (1 − S/K) − q E S
S 是鱼的存量,没人捕的时候,它按 logistic 的方式自己长(增长率 r,最多长到 K);每单位出海努力量 E,每年捕走存量的 q 比例。渔获的价格是 1,每单位努力的成本是 c。我们取 K = 100,r = 1,q = 0.1,c = 4:努力量固定不变、鱼的存量稳定下来之后,渔获正好是 10E − E²,和第 25 讲一样。
这样的模型,叫 Gordon–Schaefer 模型:Schaefer(1954)把 logistic 增长放进渔业,Gordon(1954)加上了经济学(第 25 讲引过)。
2.2 第二部分:一个格子上的城市
一个 40 × 40 的格子(边界首尾相连),格子里住着红、蓝两种人,各占 45%,另有 10% 的格子是空的。每个人的"偏好"只有一条:周围 8 个邻居里,和自己同类的人,占已住人的比例,不低于 tau,就满意;否则,想搬走。想搬的人,搬到一个随机的、搬过去会满意的空格子里;找不到这样的格子,就留在原地。一轮一轮,直到没有人搬,或者 200 轮到了。
这是 Thomas Schelling 1971 年(Journal of Mathematical Sociology,1 卷 2 期,143–186 页)提出的模型。
三、第一步:稳定之后的渔场,和开放进入的过程
import numpy as np

# 一片渔场:鱼的存量 S 自己会长(logistic),也会被捕。出海努力量 E(船的总数),每单位努力捕走存量的 q 比例。
#   dS/dt = r S (1 - S/K) - q E S           (自己长的,减去被捕的)
# 渔获的价格是 1,每单位努力的成本是 c。参数取得和第 25 讲的 H(E) = 10E - E² 一致:K = 100,r = 1,q = 0.1,c = 4。
K, R, Q, PRICE, C = 100.0, 1.0, 0.1, 1.0, 4.0

def steady_state(E):
    """努力量 E 固定不变,等鱼的存量稳定下来:存量 S*,每期渔获 H,总租金(渔获的价值 - 成本)"""
    S = max(0.0, K * (1 - Q * E / R))
    H = Q * E * S
    return S, H, PRICE * H - C * E

print("努力量 E 固定不变时,稳定下来的渔场(公式 H(E) = 10E - E²,和第 25 讲一样):")
print("   E    鱼的存量 S*   每期渔获 H   总租金")
for E in (0, 1, 2, 3, 4, 5, 6, 7, 8, 10):
    S, H, rent = steady_state(E)
    print(f"  {E:>2}   {S:9.1f}   {H:10.1f}   {rent:7.1f}")

Es = np.linspace(0, 10, 10001)
rents = np.array([steady_state(E)[2] for E in Es]); yields = np.array([steady_state(E)[1] for E in Es])
E_mey, E_msy = Es[rents.argmax()], Es[yields.argmax()]
E_open = Es[(rents >= -1e-9) & (Es > 0)].max()
print(f"\n租金最大的努力量 E = {E_mey:.2f}(租金 {rents.max():.1f},鱼的存量 {steady_state(E_mey)[0]:.0f});")
print(f"渔获最大的努力量 E = {E_msy:.2f}(渔获 {yields.max():.1f},租金 {steady_state(E_msy)[2]:.1f},鱼的存量 {steady_state(E_msy)[0]:.0f});")
print(f"开放进入(租金耗散到 0)的努力量 E = {E_open:.2f}(鱼的存量 {steady_state(E_open)[0]:.0f},渔获 {steady_state(E_open)[1]:.1f})。")

# 开放进入,一年一年地走:谁都能进,有利可图就有人进来,亏钱就有人退出。可是造船、招人都要时间:努力量的调整,看的是 lag 年以前的利润。
def run_fishery(E0=0.5, S0=100.0, speed=0.5, lag=0.0, years=120, dt=0.1, cost=C, cap=None, forced=None):
    """欧拉法,步长 dt 年。每单位努力的利润 = 价格 × q × S - cost。努力量按 speed × (lag 年前的利润) 调整。
    cap:努力量的上限(配额);forced:{年份区间: 努力量},把努力量强行定住(比如禁渔)。返回数组:每行 (年, S, E, 渔获, 总利润)"""
    S, E, prof, path, lag_steps = S0, E0, [], [], int(round(lag / dt))
    for step in range(int(years / dt) + 1):
        t = step * dt
        if forced:
            for (lo, hi), val in forced.items():
                if lo <= t < hi: E = val
        path.append((t, S, E, PRICE * Q * E * S, PRICE * Q * E * S - cost * E))
        prof.append(PRICE * Q * S - cost)
        seen = prof[max(0, len(prof) - 1 - lag_steps)]
        S = max(S + dt * (R * S * (1 - S / K) - Q * E * S), 1e-6)
        E = max(E + dt * speed * seen, 0.0)
        if cap is not None: E = min(E, cap)
    return np.array(path)

print("\n开放进入,从一片没人动过的渔场(S = 100)出发。努力量调整的速度 speed、时滞 lag 不同(稳定的 E = 6,S = 40):")
print("  速度   时滞(年)   努力量最高冲到   存量最低跌到   最后 30 年,E 的范围")
paths = {}
for speed, lag in ((0.2, 0), (0.5, 0), (0.5, 1), (0.5, 2), (0.5, 3), (1.0, 1)):
    p = run_fishery(speed=speed, lag=lag); paths[(speed, lag)] = p; tail = p[-300:]
    print(f"  {speed:>4}   {lag:>6}   {p[:, 2].max():12.2f}   {p[:, 1].min():12.1f}   {tail[:, 2].min():5.2f} 到 {tail[:, 2].max():5.2f}")
输出:
努力量 E 固定不变时,稳定下来的渔场(公式 H(E) = 10E - E²,和第 25 讲一样):
   E    鱼的存量 S*   每期渔获 H   总租金
   0       100.0          0.0       0.0
   1        90.0          9.0       5.0
   2        80.0         16.0       8.0
   3        70.0         21.0       9.0
   4        60.0         24.0       8.0
   5        50.0         25.0       5.0
   6        40.0         24.0       0.0
   7        30.0         21.0      -7.0
   8        20.0         16.0     -16.0
  10         0.0          0.0     -40.0

租金最大的努力量 E = 3.00(租金 9.0,鱼的存量 70);
渔获最大的努力量 E = 5.00(渔获 25.0,租金 5.0,鱼的存量 50);
开放进入(租金耗散到 0)的努力量 E = 6.00(鱼的存量 40,渔获 24.0)。

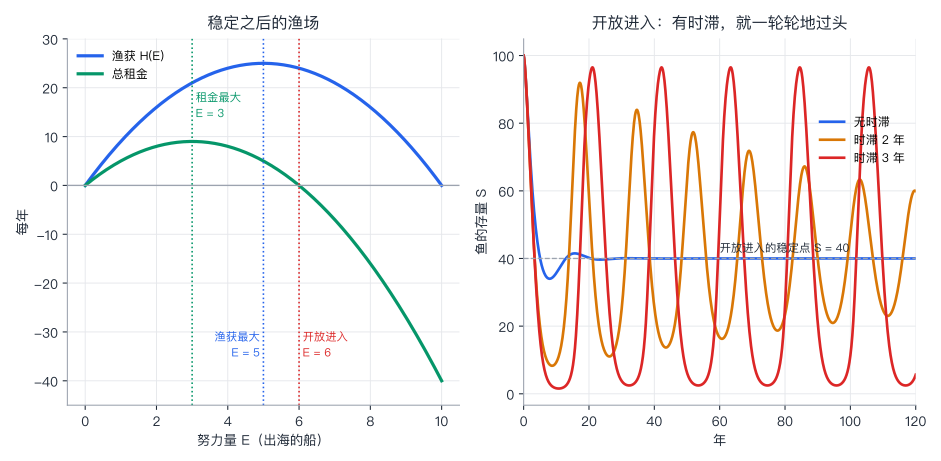
开放进入,从一片没人动过的渔场(S = 100)出发。努力量调整的速度 speed、时滞 lag 不同(稳定的 E = 6,S = 40):
  速度   时滞(年)   努力量最高冲到   存量最低跌到   最后 30 年,E 的范围
   0.2        0           6.10           39.4    6.00 到  6.00
   0.5        0           7.17           34.0    6.00 到  6.00
   0.5        1           9.26           21.7    6.00 到  6.00
   0.5        2          12.10            8.3    3.10 到  9.01
   0.5        3          15.09            1.6    0.00 到 14.24
   1.0        1          14.11            8.1    0.00 到 12.00
逐段看:
-
三个不同的"最好":
- 租金最大:E = 3,鱼的存量 70,租金 9。
- 渔获最大(“最大可持续渔获量”):E = 5,渔获 25,租金只有 5,鱼的存量 50。
- 开放进入:E = 6,鱼的存量 40,租金 0。
“能捞最多鱼"和"社会最优”,是两回事:多出来的 2 单位努力,只多捞到 4 条鱼(25 − 21),却多花 8 的成本。
-
开放进入的过程。努力量按利润来调整:赚钱就增加,亏钱就减少,速度是 speed。没有时滞(船马上造好),速度 0.5:努力量冲到 7.17,鱼的存量最低跌到 34.0,然后稳定在 E = 6、S = 40。
-
有时滞就会一轮轮地过头:造船、招人,都要时间,所以努力量调整时,看的是 lag 年以前的利润:
- lag = 1 年:E 冲到 9.26,S 跌到 21.7,最后还是稳定下来;
- lag = 2 年:E 冲到 12.10,S 最低 8.3,不再稳定,而是循环,最后 30 年,E 在 3.1 到 9.0 之间来回;
- lag = 3 年:S 最低 1.6(几乎没了),E 在 0 到 14.24 之间来回。
问题 1 的答案:不会。 在没有时滞的最简单情形下,存量会冲过 40,跌到 34,再回来;有一点时滞,它就会一轮一轮地大幅摆动,甚至跌到几乎没有。开放进入,不只是"稳定在不赚钱的水平",还可能是"沿途把资源吃到濒危"。 渔场的崩溃,原因有很多(第 25 讲提到的 Costello 等人的数据,也只是说管理办法和崩溃的比例有关);这里的"冲过头",只是其中一种可能的机制。
四、第二步:一个人想的,和一群人想的
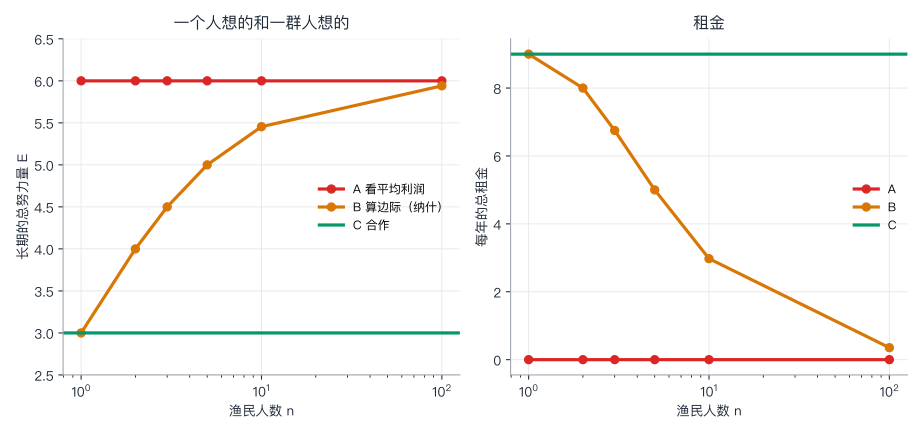
渔民不止一个。n 个渔民,每人自己决定自己的努力量 e_i(总努力量 E = Σ e_i)。我们比较三种"想法":
- A「看平均利润」:我这一年每单位努力赚钱,就多出海一点;亏钱,就少出海一点。(我看得见自己的利润,看不见自己对大家的影响。)
- B「算边际」:我知道,多出一条船,会把每一条船的渔获都拉低,这个损失,我要把它算进去。在别人的努力量不变的前提下,选对我最好的 e_i。这就是第 25 讲的纳什均衡。
- C「合作」:大家商量好,把总努力量定在让总租金最大的 E = 3,平分。
# 第二步:渔民不止一个。n 个渔民,每人自己决定自己的努力量 e_i(总努力量 E = Σ e_i)。三种"想法":
#   A「看平均利润」:自己这一年每单位努力赚钱就多出海一点,亏钱就少出海一点(看得见自己的利润,看不见自己对大家的影响)
#   B「算边际」:知道自己多出海一点,会把每一艘船的渔获都拉低,把这个算进去,在别人不变的前提下,选对自己最好的 e_i(第 25 讲的纳什均衡)
#   C「合作」:大家商量好,把总努力量定在让总租金最大的 E = 3,平分
def nash_effort(n):
    """B:每人的最好反应 e_i = (10 - c - 别人的总和) ÷ 2,反复调整直到不变"""
    e = np.full(n, 1.0)
    for _ in range(3000):
        for i in range(n): e[i] = max(0.0, (10 - C - (e.sum() - e[i])) / 2)
    return e

def adaptive_fishers(n, speed=0.5, years=300, dt=0.1):
    """A:n 个渔民,各自按自己的利润调整,鱼的存量照常增长和被捕。返回最后的 E、S"""
    S, e = 100.0, np.full(n, 0.5 / n)
    for _ in range(int(years / dt)):
        pe = PRICE * Q * S - C
        S = max(S + dt * (R * S * (1 - S / K) - Q * e.sum() * S), 1e-6)
        e = np.maximum(e + dt * speed * pe / n, 0.0)               # 每个人的调整,和总努力量的调整,一样快(除以 n 是为了总速度相同)
    return e.sum(), S

print("n 个渔民,三种想法下,长期的总努力量 E、鱼的存量 S、总租金(每年):")
print("   n   A 看平均利润:E    S    租金   |  B 算边际:E    S    租金   |  C 合作:E    S    租金")
table = {}
for n in (1, 2, 3, 5, 10, 100):
    EA, SA = adaptive_fishers(n); rA = PRICE * Q * EA * SA - C * EA
    EB = nash_effort(n).sum(); SB, _, rB = steady_state(EB)
    SC, _, rC = steady_state(3.0)
    table[n] = (EA, SA, rA, EB, SB, rB)
    print(f"  {n:>3}        {EA:5.2f}  {SA:5.1f}  {rA:5.2f}   |        {EB:5.2f}  {SB:5.1f}  {rB:5.2f}   |       3.00  {SC:5.1f}  {rC:5.2f}")
输出:
n 个渔民,三种想法下,长期的总努力量 E、鱼的存量 S、总租金(每年):
   n   A 看平均利润:E    S    租金   |  B 算边际:E    S    租金   |  C 合作:E    S    租金
    1         6.00   40.0   0.00   |         3.00   70.0   9.00   |       3.00   70.0   9.00
    2         6.00   40.0   0.00   |         4.00   60.0   8.00   |       3.00   70.0   9.00
    3         6.00   40.0   0.00   |         4.50   55.0   6.75   |       3.00   70.0   9.00
    5         6.00   40.0   0.00   |         5.00   50.0   5.00   |       3.00   70.0   9.00
   10         6.00   40.0   0.00   |         5.45   45.5   2.98   |       3.00   70.0   9.00
  100         6.00   40.0   0.00   |         5.94   40.6   0.35   |       3.00   70.0   9.00
逐段看:
- A:不管几个人,E 都是 6,租金都是 0。 包括 n = 1:一个主人,如果只看"自己的船赚不赚钱",也会把整片渔场,一路开发到租金耗散。
- B:算边际,n = 1 是 3(和合作一样),人越多,越接近开放进入。 E = 3、4、4.5、5、5.45、5.94(n = 1、2、3、5、10、100),租金 9、8、6.75、5、2.98、0.35,和第 25 讲一致。
- C:合作,E = 3,租金 9,存量 70。
问题 2 的答案:一个主人,会算边际,出海 3;只看平均利润,出海 6,和开放进入一样。所以:问题不只是"人太多",也不只是"没有主人",而是"每个人看到的,是不是自己行为的全部后果"。 一个主人,如果只看平均利润,同样会把渔场耗尽;而 n 个渔民,如果每个人都"算边际",也不等于合作:人越多,每个人只承担自己行为的 1/n 的代价,越接近开放进入。
(这里的 A 和 B,是两种行为模型,不是对现实渔民的描述。)
五、第三步:几种管理办法
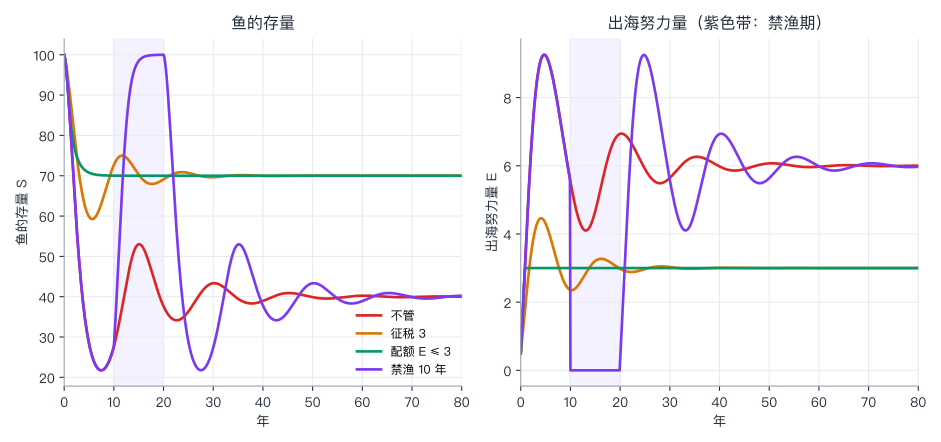
同一片渔场,同样的渔民(speed = 0.5,lag = 1 年),120 年,四种管理:不管;对每单位努力征税 3;可转让配额,总努力量不超过 3;禁渔 10 年(第 10 年到第 20 年),之后重新开放。
# 第三步:办法。同一片渔场,同样的渔民(speed = 0.5,lag = 1 年),120 年,四种管理:
#   不管(开放进入);每单位努力征税 3;可转让配额(总努力量不超过 3);禁渔 10 年(第 10 年到第 20 年),之后重新开放。
def summarize(p, label, extra_rev=0.0):
    t = p[:, 0]; late = t >= 60
    print(f"  {label:<22} 努力量 {p[late, 2].mean():5.2f}   鱼的存量 {p[late, 1].mean():5.1f}   渔民的租金 {p[late, 4].mean():5.2f}   税收 {extra_rev:5.2f}   渔获 {p[late, 3].mean():5.2f}")

print("后 60 年(第 60 到 120 年)的年平均:")
base = run_fishery(speed=0.5, lag=1)
tax = run_fishery(speed=0.5, lag=1, cost=C + 3.0)
cap = run_fishery(speed=0.5, lag=1, cap=3.0)
closed = run_fishery(speed=0.5, lag=1, forced={(10, 20): 0.0})
summarize(base, "不管(开放进入)")
summarize(tax, "征税(每单位努力 3)", extra_rev=(3.0 * tax[tax[:, 0] >= 60, 2]).mean())      # 征税时,渔民的成本是 c + 3,所以这一列已经是扣完税以后的租金
summarize(cap, "可转让配额(E ≤ 3)")
summarize(closed, "禁渔 10 年,之后开放")

late_closed = closed[closed[:, 0] >= 20]
print(f"\n禁渔那 10 年:第 10 年 S = {closed[closed[:, 0] == 10][0, 1]:.1f},第 20 年(重新开放时)S = {closed[closed[:, 0] == 20][0, 1]:.1f};")
print(f"重新开放之后:努力量冲到 {late_closed[:, 2].max():.2f},鱼的存量又跌到最低 {late_closed[:, 1].min():.1f}(不禁渔的那条:努力量最高 {base[:, 2].max():.2f},存量最低 {base[:, 1].min():.1f}),")
print(f"到第 60 年以后,和不禁渔时一模一样:S = {closed[closed[:, 0] >= 60, 1].mean():.1f},租金 {closed[closed[:, 0] >= 60, 4].mean():.2f}。")
输出:
后 60 年(第 60 到 120 年)的年平均:
  不管(开放进入)               努力量  6.00   鱼的存量  40.0   渔民的租金  0.00   税收  0.00   渔获 24.01
  征税(每单位努力 3)            努力量  3.00   鱼的存量  70.0   渔民的租金  0.00   税收  9.00   渔获 21.00
  可转让配额(E ≤ 3)           努力量  3.00   鱼的存量  70.0   渔民的租金  9.00   税收  0.00   渔获 21.00
  禁渔 10 年,之后开放           努力量  5.99   鱼的存量  40.0   渔民的租金  0.02   税收  0.00   渔获 23.99

禁渔那 10 年:第 10 年 S = 27.6,第 20 年(重新开放时)S = 100.0;
重新开放之后:努力量冲到 9.25,鱼的存量又跌到最低 21.8(不禁渔的那条:努力量最高 9.26,存量最低 21.7),
到第 60 年以后,和不禁渔时一模一样:S = 40.0,租金 0.02。
逐段看:
- 征税 3:E 稳定在 3,鱼的存量 70;渔民的租金是 0(税把租金全拿走了),政府收 9。
- 可转让配额(E ≤ 3):E 稳定在 3,存量 70;租金 9,留在拿到配额的渔民手里。
- 同样的 E = 3,同样的存量,差别只在谁拿租金:政府(税),还是渔民(配额)。这是第 23 讲"税和排污权,效率相同,分配不同"在渔场里的样子。
- **禁渔 10 年,然后重新开放:**禁渔期间,存量从 27.6 一路恢复到 100;重新开放之后,努力量冲到 9.25,存量又跌到最低 21.8,和不禁渔时(9.26、21.7)几乎一样;到第 60 年以后,一切和不禁渔时没有区别:S = 40,租金 0.02。
问题 3 的答案:不会好。 禁渔让鱼回来了,可是没有改变"谁都能进"这条规则,所以鱼一多,船又涌进来,一切重来。这正是第 25 讲 3.3 节说的:悲剧的关键,是开放进入,不是别的。
要小心,不要过度解读:这里的"禁渔",是一个极端的简化(努力量定死为 0,十年,然后完全开放)。现实里的休渔制度(比如我国的海洋伏季休渔,和长江十年禁捕),是配合其他规则一起实行的(捕捞许可、渔具渔法限制,等等),不能从这个模型里,推断它们的效果。
六、第四步:社区自己管
第 25 讲的 Ostrom 一节,算过一个简单的监督门槛:偷捕的好处是 g,被发现的概率是 q,被罚停捕 k 期,损失的现值是 L(k),不偷捕的条件是 q × L(k) ≥ g。现在,让 10 个渔民,真的在渔场里,一年一年地做选择:
- 约好每人出海 0.3(总努力量 3,正好最优)。每个渔民,每年可以守规矩(出海 0.3),或者偷捕(出海 0.6)。
- 巡查每年以概率 q 发现一个偷捕的人,发现了,就让他停捕 k 年。
- 渔民没有人教,他只会看自己最近 30 年的平均收入;每年有 10% 的概率,找一个邻居比一比,谁赚得多就学谁;另外有 1% 的概率,随便试一下另一种做法。
# 第四步:社区自己管(Ostrom)。10 个渔民,约好每人出海 0.3(总努力量 3,正好是最优)。
# 每个渔民,每年可以「守规矩」(出海 0.3),或者「偷捕」(出海 0.6)。巡查每年以概率 q 发现一个偷捕的人,发现了就让他停捕 k 年。
# 渔民没有人告诉他该怎么办:他只会看自己最近 30 年的平均收入;每年有 10% 的概率,找一个邻居比一比,谁赚得多就学谁;另外有 1% 的概率随便试一下另一种做法。
def community(q, k, n=10, years=1500, seed=0, window=30, imitate=0.1, mutate=0.01):
    g = np.random.default_rng(seed)
    S = 70.0; cheat = g.random(n) < 0.5; excluded = np.zeros(n, int); hist = np.zeros((n, window)); out = []
    for t in range(years):
        e = np.where(cheat, 0.6, 0.3) * (excluded == 0)
        caught = (g.random(n) < q) & cheat & (excluded == 0)
        pay = PRICE * Q * e * S - C * e                                  # 每个人这一年的利润
        S = max(S + R * S * (1 - S / K) - Q * e.sum() * S, 1e-3)
        excluded = np.maximum(excluded - 1, 0); excluded[caught] = k       # 被发现的,停捕 k 年
        hist[:, t % window] = pay; avg = hist[:, :min(t + 1, window)].mean(axis=1)
        for i in range(n):
            if g.random() < imitate:
                j = g.integers(n)
                if avg[j] > avg[i]: cheat[i] = cheat[j]
        flip = g.random(n) < mutate; cheat = np.where(flip, ~cheat, cheat)
        out.append((S, cheat.mean(), pay.sum()))
    return np.array(out)

# 守规矩的好处和偷捕的好处(鱼的存量 70 时):
S0 = 70.0; honest = PRICE * Q * 0.3 * S0 - C * 0.3; extra = (PRICE * Q * 0.6 * S0 - C * 0.6) - honest
print(f"鱼的存量 70 时:守规矩每年赚 {honest:.2f},偷捕比守规矩,每年多赚 {extra:.2f}。")
print("按第 25 讲的公式(折现因子 0.9),不偷捕的条件是 q ≥ 偷捕的好处 ÷ 被罚损失的现值:")
print("  停捕 k 年:" + ",".join(f"k={k_}:q ≥ {extra / sum(honest * 0.9 ** j for j in range(1, k_ + 1)):.3f}" for k_ in (1, 3, 10)))

print("\n模拟(最后 1000 年的平均;4 次独立模拟再平均):偷捕的渔民占几成 / 鱼的存量 / 渔民每年的总租金")
print("   q     k = 1 年                 k = 3 年                 k = 10 年")
comm = {}
for q in (0.0, 0.05, 0.1, 0.2, 0.4):
    cells = []
    for k in (1, 3, 10):
        res = np.mean([community(q, k, seed=s)[500:].mean(axis=0) for s in range(4)], axis=0); comm[(q, k)] = res
        cells.append(f"{res[1]:4.0%} / {res[0]:4.0f} / {res[2]:5.2f}")
    print(f"  {q:4.2f}   " + "      ".join(cells))
print("(全部守规矩:偷捕 0%,鱼的存量 70,总租金 9;没人管:几乎全部偷捕,存量只剩 44 左右,租金 2 左右。)")
输出:
鱼的存量 70 时:守规矩每年赚 0.90,偷捕比守规矩,每年多赚 0.90。
按第 25 讲的公式(折现因子 0.9),不偷捕的条件是 q ≥ 偷捕的好处 ÷ 被罚损失的现值:
  停捕 k 年:k=1:q ≥ 1.111,k=3:q ≥ 0.410,k=10:q ≥ 0.171

模拟(最后 1000 年的平均;4 次独立模拟再平均):偷捕的渔民占几成 / 鱼的存量 / 渔民每年的总租金
   q     k = 1 年                 k = 3 年                 k = 10 年
  0.00    87% /   44 /  2.00       87% /   44 /  2.00       87% /   44 /  2.00
  0.05    86% /   47 /  3.41       82% /   52 /  5.34       70% /   62 /  7.91
  0.10    85% /   49 /  4.48       80% /   57 /  6.96       57% /   70 /  8.56
  0.20    84% /   53 /  5.96       74% /   64 /  8.37       38% /   74 /  8.50
  0.40    84% /   59 /  7.69       54% /   71 /  8.81       24% /   75 /  8.47
(全部守规矩:偷捕 0%,鱼的存量 70,总租金 9;没人管:几乎全部偷捕,存量只剩 44 左右,租金 2 左右。)
逐段看:
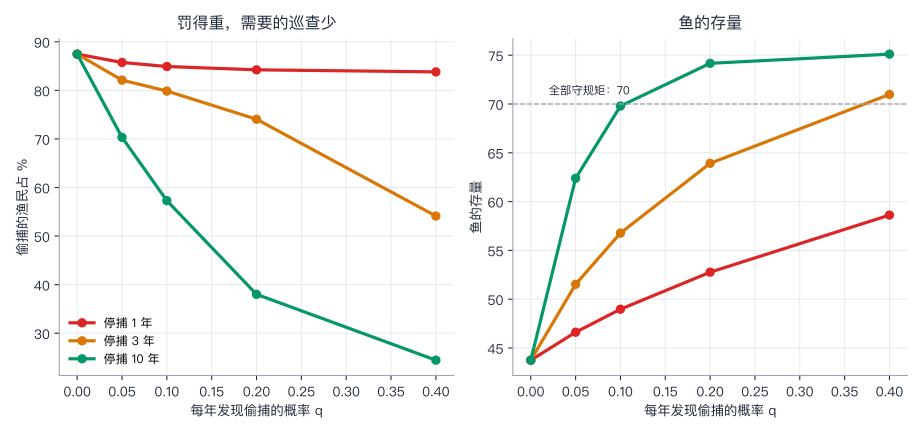
- 没有人管(q = 0):87% 的渔民偷捕(剩下的 13% 是随便试的),鱼的存量只有 44,总租金 2.0。
- 罚得太轻,再勤的巡查也管不住:k = 1 年,q 从 0 加到 0.4,偷捕的比例,几乎不动(87% → 84%),因为按公式,门槛是 q ≥ 1.11,不可能。
- 罚得越重,需要的巡查越少:k = 3 年,q = 0.4 时,偷捕降到 54%(公式的门槛 0.41);k = 10 年,q = 0.1 时,偷捕降到 57%,q = 0.2 时降到 38%,鱼的存量 74,租金 8.5(公式的门槛 0.17)。
- 模拟里的数字,在门槛附近,不是一下子降到零,而是明显下降:渔民是靠"看自己最近的收入"和"模仿邻居"在学,不是在解公式;学习有惯性,也有试错的噪声。
问题 4 的答案:要看罚多重。 停捕 1 年,管不住;停捕 3 年,查到每年 4 成,偷捕仍有 54%;停捕 10 年,每年只查 2 成,偷捕就降到 38%。这和第 25 讲的结论,是一致的:监督和惩罚要配合,罚得越重,需要的监督越少;可是巡查要花钱,重罚也有被冤枉的风险和接受度的问题。
七、第五步:Schelling 的城市
第二部分开始。先看一个最简单的设定:每个人要求"邻居里至少 30% 和我同类"。
# ============ 第二部分:Schelling 的隔离模型 ============
# 一个 L × L 的格子(边界首尾相连),格子里住着两种人(红、蓝,各占 45%),10% 的格子是空的。
# 每个人的"偏好"只有一条:周围 8 个邻居里,如果和自己同一种的人占的比例(只算有人住的邻居)不低于 tau,我就满意,否则我想搬走。
# 想搬走的人,搬到一个随机的空格子里,只要搬过去就满意(这样的空格子没有,就留在原地)。一次又一次,直到没有人想搬,或者 200 轮到了。
EMPTY, RED, BLUE = 0, 1, 2
NB = [(dx, dy) for dx in (-1, 0, 1) for dy in (-1, 0, 1) if (dx, dy) != (0, 0)]

def same_fraction(grid, x, y, kind):
    """如果一个 kind 种类的人住在 (x, y),他的邻居里,同类占已住人的比例;没有邻居返回 1.0(不会不满意)"""
    L = grid.shape[0]; same = occupied = 0
    for dx, dy in NB:
        v = grid[(x + dx) % L, (y + dy) % L]
        if v != EMPTY: occupied += 1; same += (v == kind)
    return 1.0 if occupied == 0 else same / occupied

def make_grid(L=40, empty=0.10, seed=0):
    g = np.random.default_rng(seed); cells = np.zeros(L * L, dtype=int)
    n_empty = int(empty * L * L); n_each = (L * L - n_empty) // 2
    cells[:n_each] = RED; cells[n_each:2 * n_each] = BLUE
    g.shuffle(cells); return cells.reshape(L, L), g

def similarity(grid):
    """所有人的"邻居里同类占的比例"的平均值(完全随机混居大约是 0.5;完全隔离是 1.0)"""
    L = grid.shape[0]; vals = [same_fraction(grid, x, y, grid[x, y]) for x in range(L) for y in range(L) if grid[x, y] != EMPTY]
    return float(np.mean(vals))

def dissimilarity_index(grid, block=8):
    """差异指数(Duncan 指数):把格子切成 block × block 的小块("街区"),D = 1/2 × Σ |该街区红人比例 - 该街区蓝人比例|,0 = 完全混居,1 = 完全隔离"""
    L = grid.shape[0]; r = np.array([[np.sum(grid[i:i + block, j:j + block] == RED) for j in range(0, L, block)] for i in range(0, L, block)], float)
    b = np.array([[np.sum(grid[i:i + block, j:j + block] == BLUE) for j in range(0, L, block)] for i in range(0, L, block)], float)
    return float(0.5 * np.abs(r / r.sum() - b / b.sum()).sum())

def unhappy_share(grid, taus, hi=1.0):
    L = grid.shape[0]; cells = [(x, y) for x in range(L) for y in range(L) if grid[x, y] != EMPTY]
    return float(np.mean([not (taus[x, y] <= same_fraction(grid, x, y, grid[x, y]) <= hi) for x, y in cells]))

def run_schelling(tau, seed=0, L=40, max_rounds=200, tau_of=None, hi=1.0, empty=0.10):
    """tau_of:可选,给每个人单独的 tau(函数,返回和 grid 同形状的数组;人搬家时,他的 tau 跟着走),默认大家一样。
    hi:可选,邻居里同类的比例,如果高于 hi,也会不满意(「不喜欢太单一」),默认 1.0,即没有这个要求"""
    grid, g = make_grid(L, empty=empty, seed=seed)
    taus = np.full(grid.shape, tau, float) if tau_of is None else tau_of(grid, g)
    history = [(0, similarity(grid), 0)]
    for rnd in range(1, max_rounds + 1):
        people = [(x, y) for x in range(L) for y in range(L) if grid[x, y] != EMPTY]
        g.shuffle(people); moved = 0
        for (x, y) in people:
            kind = grid[x, y]
            if taus[x, y] <= same_fraction(grid, x, y, kind) <= hi: continue          # 满意,不动
            empties = np.argwhere(grid == EMPTY); g.shuffle(empties)
            for (ex, ey) in empties:                                                # 找一个随机的、搬过去会满意的空格子
                grid[x, y] = EMPTY                                                  # 先把自己拿走,再看新位置的邻居
                if taus[x, y] <= same_fraction(grid, ex, ey, kind) <= hi:
                    grid[ex, ey] = kind; taus[ex, ey] = taus[x, y]; moved += 1; break
                grid[x, y] = kind
        history.append((rnd, similarity(grid), moved))
        if moved == 0: break
    return grid, taus, history

grid0, _ = make_grid(seed=0)
print(f"随机混居的开始:邻居里同类的平均比例 = {similarity(grid0):.3f},差异指数 D = {dissimilarity_index(grid0):.3f}")
print("\n每个人的要求 tau = 0.30(只要求邻居里至少 30% 和自己同类,也就是能接受自己是 70% 对 30% 的少数):")
grid, taus, hist = run_schelling(0.30, seed=0)
for rnd in (0, 1, 2, 5, 10, len(hist) - 1):
    if rnd < len(hist): print(f"  第 {hist[rnd][0]:>2} 轮:邻居里同类的平均比例 {hist[rnd][1]:.3f};这一轮搬家的人数 {hist[rnd][2]}")
print(f"最后:差异指数 D = {dissimilarity_index(grid):.3f};共 {len(hist) - 1} 轮后,没有人想搬。")
输出:
随机混居的开始:邻居里同类的平均比例 = 0.499,差异指数 D = 0.101

每个人的要求 tau = 0.30(只要求邻居里至少 30% 和自己同类,也就是能接受自己是 70% 对 30% 的少数):
  第  0 轮:邻居里同类的平均比例 0.499;这一轮搬家的人数 0
  第  1 轮:邻居里同类的平均比例 0.699;这一轮搬家的人数 270
  第  2 轮:邻居里同类的平均比例 0.742;这一轮搬家的人数 54
  第  5 轮:邻居里同类的平均比例 0.756;这一轮搬家的人数 0
  第  5 轮:邻居里同类的平均比例 0.756;这一轮搬家的人数 0
最后:差异指数 D = 0.279;共 5 轮后,没有人想搬。
逐段看:
- 随机混居的开始:邻居里同类的平均比例 0.499(两种人各一半,随机混居,约 0.5);用"街区"(把格子切成 8 × 8 的小块)算的差异指数 D = 0.101(0 是完全混居,1 是完全隔离)。
- 第 1 轮,270 个人想搬:搬完之后,邻居里同类的平均比例,从 0.499,一下子升到 0.699。第 2 轮 54 个人搬家,第 5 轮没有人想搬了:最后 0.756,D = 0.279。
每个人只要求"至少 30% 和我同类",也就是说,每个人都能接受自己是 70% 对 30% 的少数;最后,一个人的邻居里,平均有 75.6% 和自己同类。这是第五步想让你看到的。
八、第六步:要求越高,隔离越重,再高就搬不动了
对不同的 tau,各跑 8 个不同的随机开头,取平均:
# 要求 tau 变化时,结果怎么变?每个 tau,用 8 个不同的随机开头,取平均(每次最多 200 轮)。
print("\n每个人的要求 tau 不同:8 个随机开头的平均")
print("   tau   最后邻居里同类的比例   差异指数 D   最后还不满意的人的比例   平均多少轮停下来")
sweep, snaps = {}, {}
for tau in (0.10, 0.20, 0.30, 0.375, 0.45, 0.50, 0.55, 0.625, 0.70, 0.80):
    sims, ds, rounds, unh = [], [], [], []
    for seed in range(8):
        grid, taus, hist = run_schelling(tau, seed=seed, max_rounds=120)
        if seed == 0: snaps[tau] = grid.copy()
        sims.append(hist[-1][1]); ds.append(dissimilarity_index(grid)); rounds.append(len(hist) - 1); unh.append(unhappy_share(grid, taus))
    sweep[tau] = (np.mean(sims), np.mean(ds), np.mean(unh), np.mean(rounds))
    print(f"  {tau:5.3f}   {sweep[tau][0]:14.3f}         {sweep[tau][1]:8.3f}          {sweep[tau][2]:10.1%}               {sweep[tau][3]:8.1f}")
输出:
每个人的要求 tau 不同:8 个随机开头的平均
   tau   最后邻居里同类的比例   差异指数 D   最后还不满意的人的比例   平均多少轮停下来
  0.100            0.515            0.104                0.0%                    2.0
  0.200            0.573            0.134                0.0%                    3.8
  0.300            0.748            0.247                0.0%                    6.0
  0.375            0.765            0.251                0.0%                    5.9
  0.450            0.864            0.352                0.0%                    7.4
  0.500            0.864            0.352                0.0%                    7.4
  0.550            0.921            0.466                0.0%                    9.2
  0.625            0.958            0.558                0.7%                    9.0
  0.700            0.544            0.130               69.7%                    2.0
  0.800            0.515            0.107               91.0%                    2.0
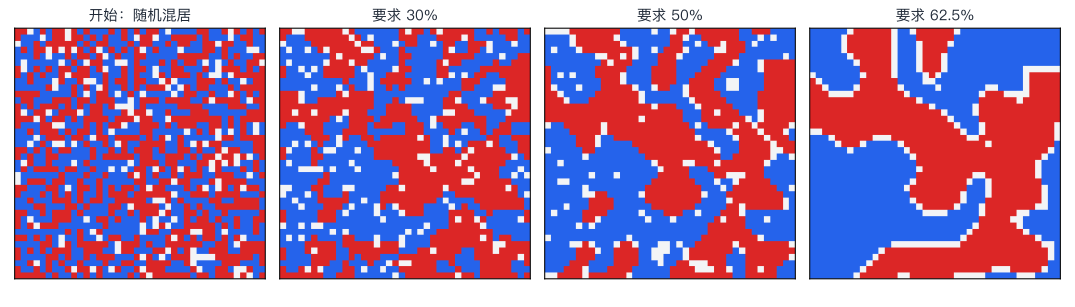
逐段看:
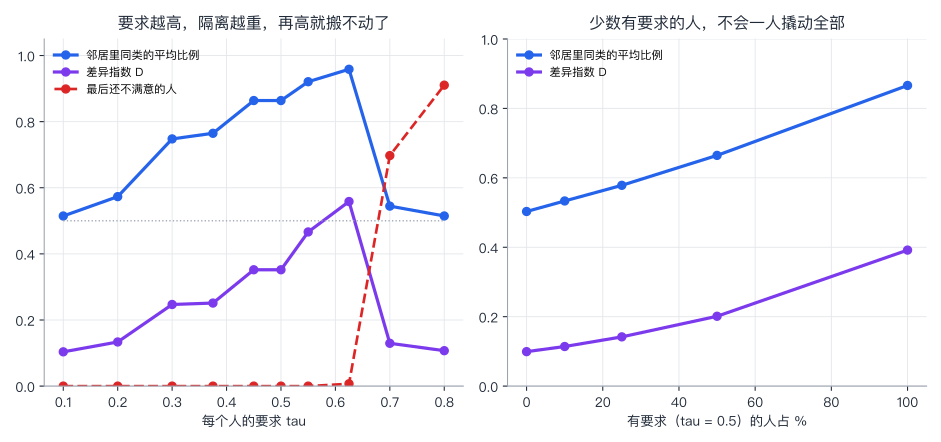
- tau = 0.1、0.2(要求很低):几乎没有隔离(0.515、0.573)。
- tau = 0.3:0.748。要求只比"随机混居"(0.5)高出一点点,结果的隔离却已经很明显。
- tau = 0.45、0.5:0.864,D = 0.352;tau = 0.55:0.921;tau = 0.625:0.958,D = 0.558:两个群体几乎各占一片(看图的最右)。
- tau = 0.7、0.8:突然又变成 0.544、0.515,而且 69.7%、91.0% 的人,最后还不满意。这不是和谐:是僵局。要求太高,几乎没有"搬过去会满意"的空格子,大家不满意地,留在原地。(按我们的规则,找不到会满意的格子,就留在原地。)
- tau = 0.45 和 0.5,结果一模一样:不是 bug。一个人最多 8 个邻居,同类比例只能是 k 分之几的分数(k ≤ 8),在 0.45 到 0.5 之间,没有这样的分数。练习 5 让你自己想。
一个结论:个体的要求,温和到不能再温和,群体的结果,却可以非常隔离。 原因是:每个人搬走,都让原来的邻居,同类比例变化(少了一个同类,或者多了一个异类),让别人也更可能不满意,这是一个连锁。每个人的搬家,对邻居是外部性(第 23 讲)。
九、第七步:变一变
两个变化,看看结论有多稳。每种设定,8 个随机开头的平均。
# 变一变:(一)只有一部分人有要求;(二)人们不喜欢太单一的邻居。每种设定,用 8 个随机开头的平均。
def mixed_tau(share, tau_high, tau_low=0.0):
    """share 比例的人,要求 tau_high;其余的人,要求 tau_low(0 = 完全无所谓)"""
    def f(grid, g):
        picks = g.random(grid.shape) < share
        return np.where(picks, tau_high, tau_low).astype(float)
    return f

def avg_over_seeds(**kw):
    res = []
    for seed in range(8):
        grid, taus, hist = run_schelling(seed=seed, max_rounds=120, **kw)
        res.append((hist[-1][1], dissimilarity_index(grid), unhappy_share(grid, taus, kw.get("hi", 1.0))))
    return np.mean(res, axis=0)

print("\n(一)只有一部分人有要求(要求 tau = 0.5),其余的人,对邻居完全无所谓(tau = 0):")
print("  有要求的人占   最后邻居里同类的比例   差异指数 D   最后还不满意的人的比例")
mix = {}
for share in (0.0, 0.1, 0.25, 0.5, 1.0):
    mix[share] = avg_over_seeds(tau=0.0, tau_of=mixed_tau(share, 0.5))
    print(f"      {share:4.0%}          {mix[share][0]:9.3f}              {mix[share][1]:8.3f}           {mix[share][2]:8.1%}")

print("\n(二)每个人要求「同类至少 tau」,同时「同类也不要超过 hi」(不喜欢太单一的邻居):")
print("  tau    hi    最后邻居里同类的比例   差异指数 D   最后还不满意的人的比例")
two = {}
for tau, hi in ((0.3, 1.0), (0.3, 0.8), (0.3, 0.7), (0.3, 0.6), (0.5, 0.75)):
    two[(tau, hi)] = avg_over_seeds(tau=tau, hi=hi)
    print(f"  {tau:.2f}  {hi:.2f}         {two[(tau, hi)][0]:9.3f}              {two[(tau, hi)][1]:8.3f}           {two[(tau, hi)][2]:8.1%}")
输出:
(一)只有一部分人有要求(要求 tau = 0.5),其余的人,对邻居完全无所谓(tau = 0):
  有要求的人占   最后邻居里同类的比例   差异指数 D   最后还不满意的人的比例
        0%              0.503                 0.099               0.0%
       10%              0.533                 0.114               0.0%
       25%              0.578                 0.142               0.0%
       50%              0.665                 0.201               0.0%
      100%              0.866                 0.392               0.0%

(二)每个人要求「同类至少 tau」,同时「同类也不要超过 hi」(不喜欢太单一的邻居):
  tau    hi    最后邻居里同类的比例   差异指数 D   最后还不满意的人的比例
  0.30  1.00             0.748                 0.247               0.0%
  0.30  0.80             0.581                 0.142              19.0%
  0.30  0.70             0.508                 0.107              27.3%
  0.30  0.60             0.476                 0.082              32.3%
  0.50  0.75             0.615                 0.156              37.2%
逐段看:
- (一)只有一部分人有要求(要求 tau = 0.5),其余的人对邻居完全无所谓:有要求的人占 0%,邻居里同类 0.503;10%:0.533;25%:0.578;50%:0.665;100%:0.866。少数有要求的人,不会一个人撬动全部:隔离随有要求的人的比例,逐渐加重。但注意,即使只有 10%,也比纯随机多了一点(0.503 → 0.533),而 100% 的时候,是 0.866。
- (二)人们也不喜欢太单一的邻居:每个人要求"同类至少 tau,同时同类不超过 hi"。tau = 0.3、hi = 1(没有上限):0.748;hi = 0.8:0.581;hi = 0.7:0.508(几乎和随机混居一样);hi = 0.6:0.476。 也就是说:如果每个人,不只是怕"自己是少数",也不喜欢"太单一",隔离就几乎消失了。 但是,要注意最后一列:在 hi = 0.8、0.7、0.6 时,19.0%、27.3%、32.3% 的人最后还是不满意:不是所有人都找到了"刚刚好"的邻居,只是大家都搬不动。
问题 5 的答案:75.6%,远高于任何人要求的 30%。 问题 6 的答案:不会轻很多,但会轻一些,而且是逐渐的。
这个模型能说明现实里的隔离吗
这是一个有争议的话题,按"理论预测 → 证据与局限 → 分歧在哪 → 价值判断留给读者"来写。
理论预测什么:很温和的偏好,加上"搬走的人会改变邻居的构成",就足以产生明显的隔离;而且有"临界点":邻居里少数群体的比例过了某个点,原来的居民会陆续搬走,变化会自己加速。Schelling 1971 年的文章里,除了这里用的模拟,还有一个"邻里翻转"(tipping)的分析模型。
证据怎么说:Card、Mas 和 Rothstein 2008 年(Quarterly Journal of Economics,123 卷 1 期,177–218 页)用美国 1970 到 2000 年的普查区数据,发现白人居民的迁出,在大多数城市里,确实表现出翻转的特征:当一个社区里少数族裔的比例,超过某个临界值(据他们的估计,不同城市在 5% 到 20% 之间),白人居民的迁入,会明显变少。他们还发现,房价和租金,在临界点附近,没有明显的非线性;而且,白人居民对种族的态度越宽容的城市,临界点越高。(我只核对了摘要。)
局限:我们的模型,把"偏好"当成隔离的唯一原因。现实里,收入差异、歧视(比如贷款、租房、销售中的差别对待)、住房政策、学区、信息和社交网络,都会影响一个人住在哪里。模型能推出隔离,不能证明现实里的隔离,就是这样来的。
分歧在哪:事实上:现实里的隔离,有多少来自居民的偏好,有多少来自歧视和制度的限制?这是一个实证问题,答案因地方、因时代而不同。价值上:见下。
价值判断(留给你):
- 一个社会,应不应该把"居民的选择自由"看得比"社区的混居程度"更重要?
- 如果温和的偏好,也可能导致强烈的隔离,政府要不要干预?干预的话,是限制歧视,是补贴混居,还是别的?
- 对"隔离"本身,该看居住的分布,还是看机会(学校、工作、公共服务)的差别?
经济学可以帮你把每种办法的效果、代价和激励算清楚,不能替你选。
十、这个实验说明了什么,没说明什么
说明了:
- 公地悲剧不只是一个"稳定之后"的数字,还是一个过程:开放进入,加上时滞,会让资源一轮一轮地被过度开发,甚至跌到濒危。
- “看平均利润"和"算边际”,差别很大:一个只看平均利润的主人,也会把渔场耗尽。
- 只管资源,不管进入规则,白管:禁渔十年,鱼回来了,开放之后,一切重来。
- 监督要配合惩罚:罚得太轻,再勤的巡查也没用;罚得重,需要的巡查少得多。
- 个体的小动作,会累积成整体的大结果:温和的要求,也能产生强烈的隔离;而这个结果,不是任何一个人想要的。
没说明:
- 渔场的数字不是现实:logistic 增长、固定的价格和成本、同质的渔民,都是为了讲清楚机制。
- 渔民是怎么调整的,是我们假设的(看平均利润、按时滞调整、模仿邻居);真实渔民的行为,更复杂。
- Schelling 模型只说明"可能",没有说明"事实":见上面的证据和局限。
- 两部分,都是一个具体的设定;换一种搬家规则、换一种邻居的定义,数字会变。
十一、和前面、后面的联系
- 第 19 讲:重复互动、监督与惩罚,是社区管理成功的条件。
- 第 23 讲:外部性。公地悲剧,和一个人搬家对邻居的影响,都是外部性。
- 第 25 讲:这个实验的第一部分,是第 25 讲 3 节、4 节的模拟版;第 25 讲的 Costello 等人的证据,在第三步里被"冲过头"的机制补了一块。
- 第 17 讲:临界规模和翻转,Schelling 的"翻转"是同一类结构。
- 实验 73:格子上的合作;这里的格子,是人在选择"住哪里"。
- 实验 77:Solow 增长模拟与真实数据校准。
十二、练习
下面的练习,都可以在上面的代码上改几个数字做出来。提示里的数字,都是我跑过的。
练习 1(成本变了)。 把 c 从 4 改成 6(直接改 C = 6.0,再重新算稳态)。租金最大的努力量、开放进入的努力量、渔获最大的努力量,各是多少?最大租金多少?
提示:租金最大 E = 2,最大租金 4.0;开放进入 E = 4;渔获最大仍是 E = 5(和成本无关,只取决于鱼自己怎么长)。成本越高,开放进入时出海的人越少,可是和最优的差,仍然是 2 单位。
练习 2(时滞更长)。 run_fishery(speed=0.5, lag=4):努力量最高冲到多少,鱼的存量最低多少?
提示:E 最高冲到 18.09,S 最低 0.119,最后 30 年,E 在 0 到 17.23 之间来回。时滞从 3 年变成 4 年,鱼的存量,从 1.6 变成 0.12:在真实的渔场里,这相当于绝迹。(我们这个模型,没有"鱼少到一定程度,就再也长不回来"的机制;真实的生态里可能有。)
练习 3(税率)。 对每单位努力征税 t = 1.5、3、5,长期的 E、S、税收各是多少?税率多少,税收最多?
提示:用
run_fishery(speed=0.5, lag=1, cost=C + t),取第 60 年以后的平均:t = 1.5:E = 4.5,S = 55,税收 6.75;t = 3:E = 3.0,S = 70,税收 9.0;t = 5:E = 1.0,S = 90,税收 5.0。税收 = t × (6 − t),在 t = 3 时最大,这个税率,也正好让总租金最大。(税率太高,税基萎缩,这是实验 71 里的拉弗曲线。)
练习 4(没有试错的社区)。 第四步里,把 mutate 改成 0(渔民不再随便试另一种做法)。q = 0、k = 3;q = 0.4、k = 3;q = 0.4、k = 10,偷捕的比例各是多少?
提示:
community(q, k, mutate=0),4 次模拟,第 500 年以后的平均:q = 0、k = 3:偷捕 100%,鱼的存量 40,租金 0;q = 0.4、k = 3:偷捕 50%,存量 70.9,租金 8.8;q = 0.4、k = 10:偷捕 0%,存量 70,租金 9.0。没有噪声,要么全部偷,要么完全不偷,取决于罚得够不够重:k = 10、q = 0.4,社区回到完全合作。
练习 5(为什么一样)。 第六步里,tau = 0.45 和 tau = 0.5,所有的结果都一模一样。为什么?
提示:一个人最多 8 个邻居,已住人的邻居数 k ≤ 8,同类的比例是 m ÷ k。在 [0.45, 0.5) 里,没有这样的分数:3/7 = 0.43 太小,4/8 = 0.5 刚好到。所以"≥ 0.45"和"≥ 0.5",对每一个人,都是同一个判断。同样,tau = 0.3 和 0.375,不是同一个门槛(3/8 = 0.375),它们的结果也不同(0.748 和 0.765)。
练习 6(空格多少)。 第五步里,把空格的比例(run_schelling 的 empty)从 0.10 改成 0.05、0.20、0.30,tau = 0.5,邻居里同类的平均比例、差异指数、停下来的轮数,有什么变化?
提示:4 个随机开头的平均:空格 5%:同类比例 0.862,D 0.373,7.0 轮;10%:0.862,0.381,8.0 轮;20%:0.874,0.405,6.75 轮;30%:0.869,0.364,6.25 轮。空格的多少,几乎不影响最后的隔离程度,只轻微地影响停下来要多久。隔离的原因,是"要求",不是"有没有空地"。
十三、局限
- 渔场:logistic 增长,没有随机波动,没有"鱼少到一定程度就长不回来";价格和成本固定;渔民同质。
- 调整规则:努力量按"利润"和"时滞"调整,社区里的渔民按"模仿"调整,都是我们假设的。
- 社区治理只模拟了一种最简单的巡查和惩罚(发现一次,停捕 k 年)。没有讨论监督的成本、分级惩罚、规则怎么来(Ostrom 的其他特点)。
- Schelling:格子是方的,邻居是 8 个,边界首尾相连,搬家的规则是"搬到随机的、会满意的空格"。换别的规则,结果会变。
- 没有:收入、价格(房租)、歧视、制度、人的搬家成本。
参考
- Schaefer, M. B. (1954). Some aspects of the dynamics of populations important to the management of the commercial marine fisheries. Bulletin of the Inter-American Tropical Tuna Commission, 1(2), 27–56.
- Gordon, H. S. (1954). The economic theory of a common-property resource: The fishery. Journal of Political Economy, 62(2), 124–142.
- Hardin, G. (1968). The tragedy of the commons. Science, 162(3859), 1243–1248.
- Ostrom, E. (1990). Governing the Commons. Cambridge University Press.
- Schelling, T. C. (1971). Dynamic models of segregation. Journal of Mathematical Sociology, 1(2), 143–186.
- Schelling, T. C. (1978). Micromotives and Macrobehavior. W. W. Norton.
- Duncan, O. D., & Duncan, B. (1955). A methodological analysis of segregation indexes. American Sociological Review, 20(2), 210–217.
- Card, D., Mas, A., & Rothstein, J. (2008). Tipping and the dynamics of segregation. Quarterly Journal of Economics, 123(1), 177–218.