| 本篇位置 | 第二部分「读懂价格行为」的第四篇。第 8 篇找出了摆动点,这一篇把摆动点变成水平位;第 11 篇的回调和突破入场、第 22 篇的止损位置,都会用到这一篇 |
| 用到的数据 | BTCUSDT 现货 1 分钟线和日线(2017-08 至 2026-08);SPY、AAPL 日线(2016-09 至 2026-09) |
| 动手 | 往 talab.structure 里加上水平位聚类、水平位测试跟踪、缺口识别和回补时间,附 5 个新测试 |
| 读完你能 | 说清楚一个支撑位或阻力位为什么会存在;把「测试、守住、突破、角色互换」写成规则并统计;知道假突破、缺口回补这些说法需要和什么基准比较;自己计算 CME 缺口 |
这一篇说的「缺口」是价格的跳空,和第 3 篇里数据文件中缺失 K 线的「缺口」不是一回事。
一、先做一个决定
现在是 2026 年 6 月 3 日 UTC 04:00。BTC 从 5 月 31 日收盘的 73,674 开始,两天多跌了 10% 以上。刚刚收盘的这根 1 小时线,最低跌到 65,426.34,收在 65,849.90。
先看日线:
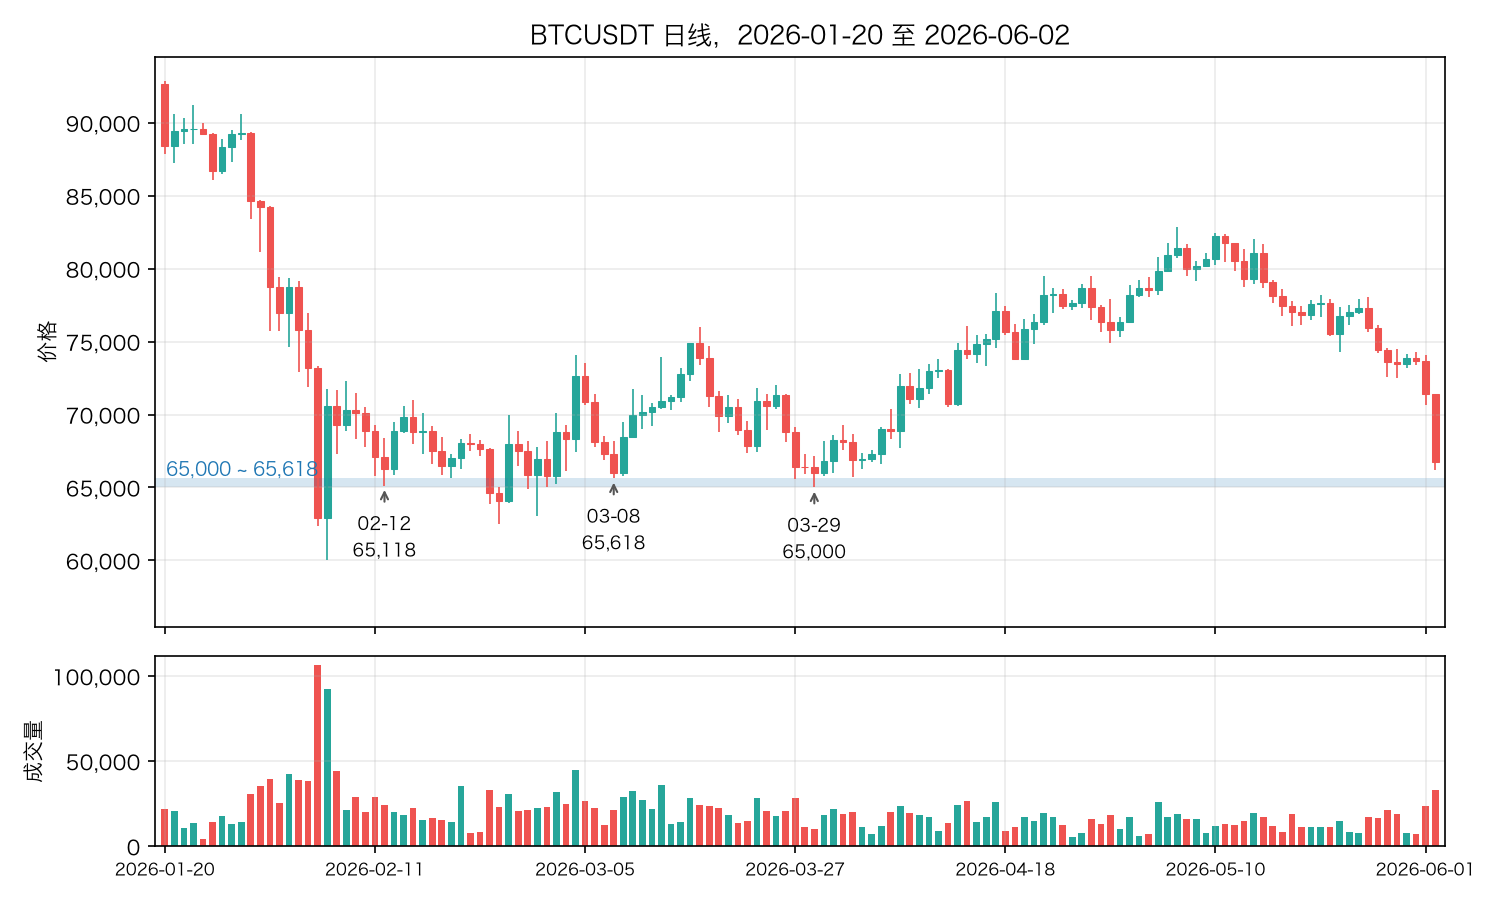
2 月 6 日暴跌到 60,000 之后,BTC 在 65,000 附近留下了三个摆动低点(第 8 篇的分形,左右各 5 根):
- 2 月 12 日:65,118.00
- 3 月 8 日:65,618.49
- 3 月 29 日:65,000.00
三次都在这里止跌。3 月 29 日之后,价格一路涨到 5 月 6 日的 82,850。现在它第四次回到了这里:
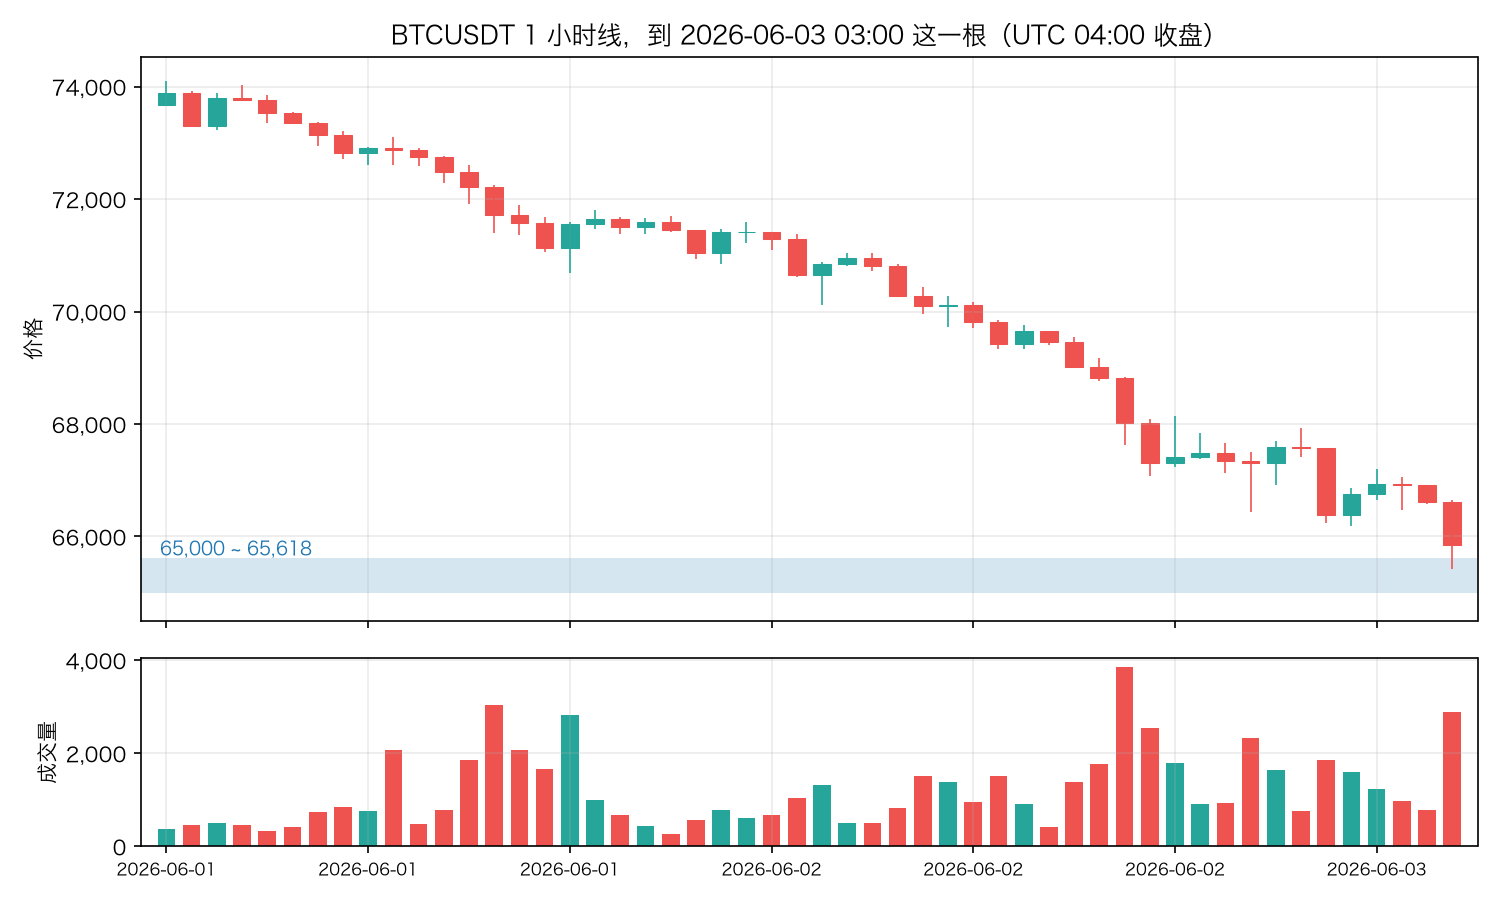
你会怎么做?
- A. 买入:三次都守住了,这是一个被反复验证的强支撑
- B. 卖出或者不碰:同一个位置被测试的次数越多,挂在那里的买单就被消耗得越多,这次更可能跌破
- C. 等:等它收盘跌破,或者明确反弹之后再决定
先写下你的选择。 第六节会揭晓之后的走势。
在揭晓之前,要先弄清楚几个问题:支撑为什么会存在?「守住」和「跌破」怎么定义?测试次数越多,支撑是变强还是变弱,这个问题有没有数据上的答案?
二、支撑和阻力从哪里来
打个比方:一个小区的房价
你在看一个小区的二手房。过去一年里,这个小区有三套房子都在 650 万左右成交:每次有人挂到 650 万附近,很快就被买走了。
- 买家记住了这个价格。 在他们眼里,650 万是「这个小区的便宜价」。下次再有人挂 650 万,想买的人会很快出手。这就是支撑。
- 业主也记住了这个价格。 在 650 万买入的人,如果房价跌到 600 万,他们会想:「等涨回 650 万,我就卖掉回本。」于是 650 万从买家眼里的便宜价,变成了业主眼里的解套价。这就是角色互换:跌破之后,原来的支撑变成了阻力。
- 挂牌价几乎都是整数。 很少有人挂 648.3 万,大家都挂 650 万、600 万。这就是整数关口。
- 有的业主设了底线。 「跌破 600 万我就降价甩卖」。这些底线平时看不见,一旦价格到了那里,会突然冒出一批卖家。这就是止损单。
- 大多数成交都集中在 620 万到 680 万之间。 在这个区间里换过手的人最多,记住这段价格的人也最多。这就是成交密集区。
价格图上的支撑和阻力,本质上是挂在某些价位上的订单,以及准备在某些价位下单的人。K 线图看不到这些订单,只能看到它们留下的痕迹:价格在某个位置反复止跌,或者一穿过某个位置就突然加速。
四个来源
1. 前高和前低。 就是小区里上次的成交价。第 8 篇找出的摆动点,就是这种位置。它会成为支撑或阻力,靠的是记忆:在那里买过、卖过、错过的人,会在价格回来时重新下单。
2. 整数关口。 人在挂单时偏爱整数。外汇市场有直接的证据:纽约联储的 Carol Osler 在 2003 年发表于《Journal of Finance》的论文里,分析了一家大银行客户挂的止盈单和止损单,发现挂单价格明显集中在整数上,而且止盈单和止损单的集中方式不同。第三节会用 BTC 的数据验证这一点。
3. 成交密集区。 某一段价格里成交量特别大,意味着很多人的成本在那里。第 10 篇会用 Volume Profile 把它画出来。
4. 止损单。 第 2 篇讲过:大多数人把止损放在近期低点的下方一点点。BTC 跌破前一天低点的那一分钟,成交量是平时的 9 倍。止损单让支撑有一个奇怪的两面性:价格没到的时候,它不起作用;价格一到,它不是托住价格,而是推着价格继续往下走。
最后这一点决定了支撑位的一个基本矛盾。同一个价位上,同时挂着想买的单(支撑)和止损卖单(加速下跌)。 价格来到这里,是买单先吃掉卖压,还是止损单先被触发、引发连锁,事先并不知道。这也是为什么「支撑一定会守住」和「支撑一定会被跌破」都不对,只能用数据去看在什么条件下哪一种更常见。
三、整数关口:订单留下的痕迹
检验思路
如果很多订单挂在整数价位上,那么价格走到整数附近时,更容易在这里停下来。停下来的地方,就是一段时间里的最高价或最低价。
所以可以比较两组价格:
- 普通价格:每一分钟的收盘价。它们只是「某一刻的成交价」,没有理由特别偏爱整数。
- 极值价格:每一小时、每一天的最高价和最低价。如果订单集中在整数上,这些价格应该更常正好落在整数上。
hour_all = B.resample_ohlcv(minute, "1h")
def round_stats(prices, step):
    p = prices[(prices >= 10_000) & (prices < 130_000)]
    r = np.round(np.mod(p, step), 2)
    return {"样本": len(p), "正好整数": (r == 0).mean(), "整数下方 50 以内": ((r >= step - 50) & (r > 0)).mean(),
            "整数上方 50 以内": ((r > 0) & (r <= 50)).mean()}
for step in [1000, 100]:
    table = pd.DataFrame({name: round_stats(p, step) for name, p in [
        ("1 分钟收盘价", minute["close"]), ("1 小时最高价", hour_all["high"]), ("1 小时最低价", hour_all["low"]),
        ("日线最高价", day["high"]), ("日线最低价", day["low"])]}).T
    print(f"{step} 的整数倍:")
    print(table.to_string(formatters={"样本": "{:,.0f}".format, "正好整数": "{:.2%}".format,
                                      "整数下方 50 以内": "{:.2%}".format, "整数上方 50 以内": "{:.2%}".format}))
只看 10,000 到 130,000 之间的价格,这样「1,000 的整数倍」和「100 的整数倍」在这段区间里的含义大致一致。
1000 的整数倍:
               样本  正好整数 整数下方 50 以内 整数上方 50 以内
1 分钟收盘价 3,437,006 0.09%      4.88%      4.78%
1 小时最高价    57,421 0.54%      5.22%      4.18%
1 小时最低价    57,139 0.53%      3.87%      4.55%
日线最高价       2,415 1.24%      5.22%      2.90%
日线最低价       2,349 1.32%      2.72%      4.04%
100 的整数倍:
               样本  正好整数 整数下方 50 以内 整数上方 50 以内
1 分钟收盘价 3,437,006 0.72%     49.87%     49.83%
1 小时最高价    57,421 4.10%     50.98%     47.14%
1 小时最低价    57,139 3.86%     48.56%     49.45%
日线最高价       2,415 8.24%     52.59%     42.53%
日线最低价       2,349 7.41%     46.96%     48.57%
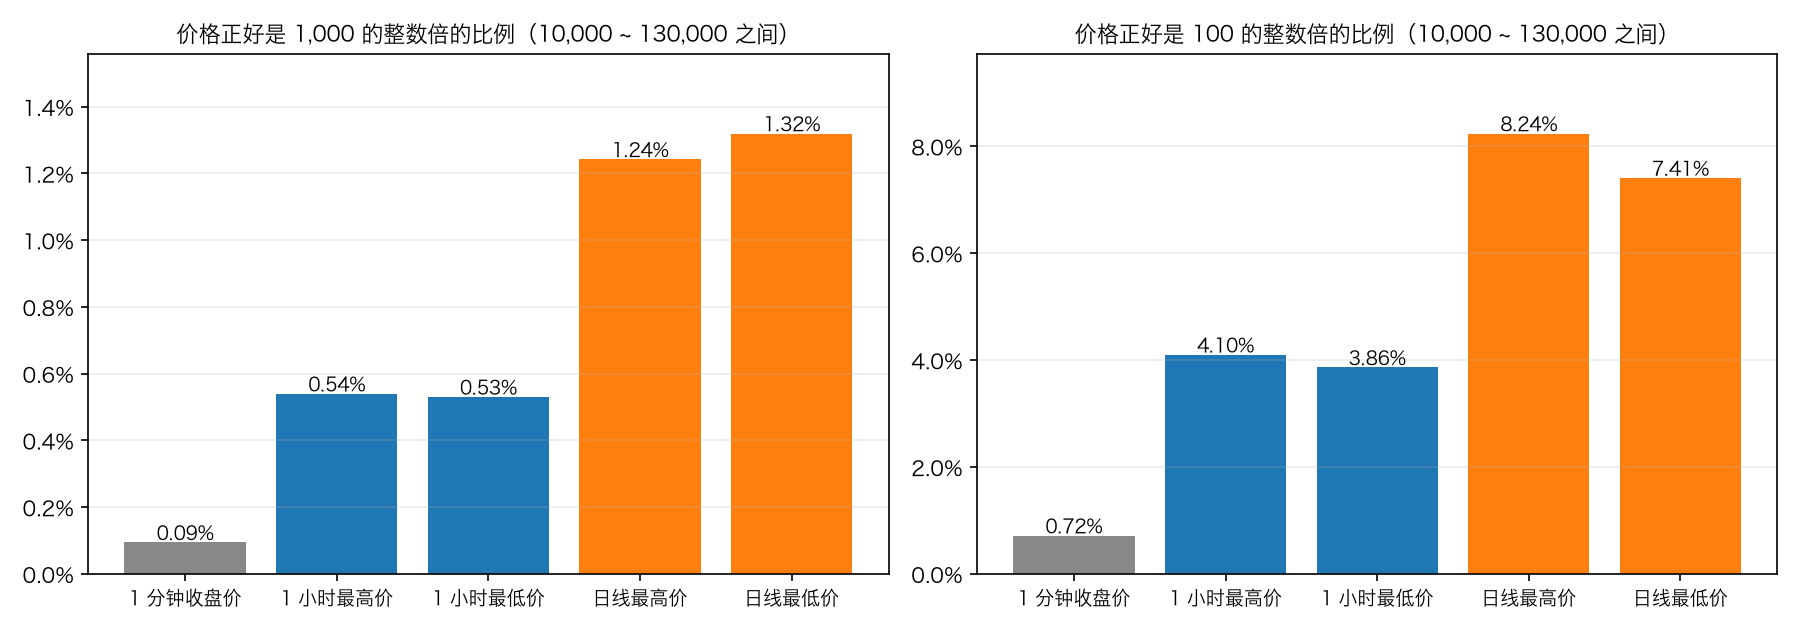
读这张表
第一,极值价格明显偏爱整数。 普通的 1 分钟收盘价里,正好是 1,000 整数倍的只有 0.09%;日线最高价里是 1.24%,最低价里是 1.32%,是普通价格的 13 到 14 倍。100 的整数倍也一样:0.72% 对 8.24% 和 7.41%,10 到 12 倍。而且周期越长(1 小时 → 1 天),这种偏爱越明显:一天里只有一个最高价,它更可能是被一堵大单墙挡住的地方。
第二,极值落在整数的哪一侧,是不对称的。 普通价格在整数下方 50 以内和上方 50 以内的比例几乎一样(4.88% 和 4.78%)。但是:
- 日线最高价更常落在整数下方(5.22%),落在上方的少得多(2.90%)
- 日线最低价正好反过来:更常落在整数上方(4.04%),下方的少(2.72%)
也就是说,价格涨到整数附近,往往在碰到整数之前或者正好在整数上停下;跌到整数附近,也往往在整数之上停下。一旦越过整数,就不太会只越过一点点就停。 这和「整数上挂着大量限价单,整数外侧挂着止损单」的解释是一致的:没越过时被限价单挡住,越过之后止损单被触发,价格会继续走一段。
⚠️ 这张表只能说明订单痕迹的存在,不能说明「在整数关口反向交易能赚钱」。1.24% 的日子最高价正好是整数,意味着 98.76% 的日子不是。第 1 篇说过,一个现象存在,和一个规则能盈利,是两回事。
四、把摆动点变成水平位
相近的摆动点合成一个位置
决策点里的三个低点 65,118、65,618.49 和 65,000 并不完全相同。在图上你会自然地把它们看成「一个位置」,写成代码就要说清楚:多近算同一个位置?
cluster_levels 的规则很简单:把价格从小到大排好,以每一组最小的价格为基准,不超过它 (1 + tolerance) 倍的,都归入这一组。
known = swings["BTC"][swings["BTC"]["confirmed_at"] < decision.floor("1D")]
lows = known[(known["kind"] == -1) & (known["time"] >= "2026-01-01")]
print(lows.to_string(index=False))
print(X.cluster_levels(lows["price"], 0.01).round(2).to_string(index=False))
print(f"前一天的 ATR:{atr['BTC']['2026-06-02']:,.2f}")
                     time    price  kind              confirmed_at
2026-01-08 00:00:00+00:00 89311.00    -1 2026-01-13 00:00:00+00:00
2026-02-06 00:00:00+00:00 60000.00    -1 2026-02-11 00:00:00+00:00
2026-02-12 00:00:00+00:00 65118.00    -1 2026-02-17 00:00:00+00:00
2026-02-24 00:00:00+00:00 62510.28    -1 2026-03-01 00:00:00+00:00
2026-03-08 00:00:00+00:00 65618.49    -1 2026-03-13 00:00:00+00:00
2026-03-29 00:00:00+00:00 65000.00    -1 2026-04-03 00:00:00+00:00
2026-04-29 00:00:00+00:00 74937.52    -1 2026-05-04 00:00:00+00:00
   level      low     high  count
60000.00 60000.00 60000.00      1
62510.28 62510.28 62510.28      1
65245.50 65000.00 65618.49      3
74937.52 74937.52 74937.52      1
89311.00 89311.00 89311.00      1
这里的 swings["BTC"] 是全部日线上左右各 5 根的分形摆动点,decision.floor("1D") 是 6 月 3 日 0 点:只用 6 月 3 日之前已经确认的摆动点。
手算一遍:排序后是 60,000、62,510.28、65,000、65,118、65,618.49、74,937.52、89,311。
- 60,000 为基准,上限 60,600。62,510.28 超过了,60,000 单独一组。
- 62,510.28 为基准,上限 63,135.38。65,000 超过了,62,510.28 单独一组。
- 65,000 为基准,上限 65,650。65,118 和 65,618.49 都在里面,74,937.52 不在。65,000、65,118、65,618.49 一组,平均 65,245.50。
注意两点:
- 容差是一个选择。 1% 对 BTC 来说是很小的距离(这时一天的平均波幅,ATR,是 2,184,约 3.3%)。容差放大到 5%,62,510.28 会和 60,000 并成一组(60,000 × 1.05 = 63,000)。
- 以组里最小的价格为基准,而不是一个接一个往后比。 如果每个价格只和前一个比,一串间隔 0.9% 的价格会连成一个很长的「位置」。
用 ATR 作为距离单位
接下来要定义「回到支撑附近」「守住」「跌破」,都需要一个距离。
用百分比可以,但 BTC 在 2018 年和 2024 年的波动差别很大,SPY 和 BTC 的差别更大。这一篇改用平均真实波幅(ATR):就是第 8 篇 ADX 第一步的真实波幅(TR),用 Wilder 平滑取 14 天的平均。
atr = {name: X.wilder_smooth(X.true_range(df["high"], df["low"], df["close"]), 14) for name, df in markets.items()}
swings = {name: X.fractals(df["high"], df["low"], 5, 5) for name, df in markets.items()}
1 个 ATR 就是「这段时间一天通常波动多少」。说「收盘价在支撑下方 1.5 个 ATR」,意思是「比平时一天的波动还多走了一半」,在高波动和低波动时期、在 BTC 和 SPY 上,含义大致相同。ATR 的完整讲解在第 15 篇。
五、测试、守住、突破:写成规则
规则
level_tests 跟踪每一个摆动点价格的一生。以支撑为例(阻力完全对称):
| 步骤 | 规则 |
|---|---|
| 离开 | 摆动低点确认之后,收盘价要先涨到它上方至少 1.5 个 ATR。没有离开过的价格,谈不上「回来测试」 |
| 测试 | 离开之后,某一天的最低价回到支撑上方 0.25 个 ATR 以内(或者更低),算一次测试 |
| 守住 | 从测试那天起,先出现「收盘价在支撑上方 1.5 个 ATR」,算守住。守住之后价格已经离开了,下一次回来就是新的测试 |
| 突破 | 先出现「收盘价在支撑下方 1.5 个 ATR」,算跌破 |
| 角色互换 | 跌破之后,这个价位变成阻力,测试次数从头计数。阻力被突破后就不再跟踪 |
所有 ATR 都用前一天的值,因为当天的 ATR 要等当天收盘才知道。摆动点本身算第 1 次测试,所以之后第一次回来是「第 2 次」。
几个选择要说清楚:
- 用收盘价判断守住和突破,而不是盘中价格。第 6 篇讲过,一根日线里先涨还是先跌是不知道的;只用收盘价,每一步的先后都是确定的。
- 守住和突破的距离一样(都是 1.5 个 ATR)。这样对一个没有方向的随机价格来说,守住和突破的机会大致各占一半,比较容易看出真实数据有没有偏向。
- 1.5 个 ATR 是一个参数。 第七节会换成 1 个和 2 个 ATR,看结论是否改变。
手算一遍
一个水平位 100(第 0 天的摆动低点,第 1 天确认),ATR 固定为 2。于是「离开」「守住」「突破」都是 3,「测试区」是 0.5。
| 天 | 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 | 11 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 收盘价 | 100 | 98 | 101 | 104 | 101 | 104 | 99 | 96 | 97 | 99.5 | 96 | 104 |
| 最低价 | 99.5 | 97.5 | 100.5 | 103.5 | 100.2 | 103.5 | 98.5 | 95.5 | 96.5 | 99 | 95.5 | 103.5 |
| 最高价 | 100.5 | 98.5 | 101.5 | 104.5 | 101.5 | 104.5 | 99.5 | 96.5 | 97.5 | 100 | 96.5 | 104.5 |
- 第 1 天:是确认摆动点的那天,从第 2 天开始检查。(第 1 天收盘 98,在 100 下方 2,就算检查也还没到 3。)
- 第 3 天:收盘 104,在 100 上方 4 ≥ 3,离开。
- 第 4 天:最低 100.2 ≤ 100.5,支撑第 2 次测试。
- 第 5 天:收盘 104 ≥ 103,守住。
- 第 6 天:最低 98.5 ≤ 100.5,支撑第 3 次测试。
- 第 7 天:收盘 96 ≤ 97,跌破。100 变成阻力。
- 第 9 天:最高 100 ≥ 99.5,阻力第 1 次测试。
- 第 10 天:收盘 96 ≤ 97,守住(这次是阻力守住)。
- 第 11 天:最高 104.5,阻力第 2 次测试;同一天收盘 104 ≥ 103,突破。
这就是第十二节的 test_level_tests_by_hand。
决策点那个价位的一生
zone_swings = swings["BTC"][(swings["BTC"]["kind"] == -1) & swings["BTC"]["price"].between(65000, 65618.49)
                            & (swings["BTC"]["time"] < "2026-06-01")]
life = X.level_tests(day["high"], day["low"], day["close"], zone_swings, atr["BTC"])
print(life.assign(level_time=life["level_time"].dt.date, test_time=life["test_time"].dt.date,
                  resolved_at=life["resolved_at"].dt.date).to_string(index=False))
level_time    level       role  flips  n  test_time outcome resolved_at
2024-10-23 65260.00    support      0  2 2026-02-05    held  2026-03-04
2024-10-23 65260.00    support      0  3 2026-03-08    held  2026-03-12
2024-10-23 65260.00    support      0  4 2026-03-27    held  2026-04-07
2024-10-23 65260.00    support      0  5 2026-06-03  broken  2026-06-05
2024-10-23 65260.00 resistance      1  1 2026-06-13    held  2026-06-24
2024-10-23 65260.00 resistance      1  2 2026-07-14  broken  2026-08-19
2026-02-12 65118.00    support      0  2 2026-03-08    held  2026-03-12
2026-02-12 65118.00    support      0  3 2026-03-27    held  2026-04-07
2026-02-12 65118.00    support      0  4 2026-06-03  broken  2026-06-05
2026-02-12 65118.00 resistance      1  1 2026-06-13    held  2026-06-24
2026-02-12 65118.00 resistance      1  2 2026-07-06  broken  2026-08-19
2026-03-08 65618.49    support      0  2 2026-03-27    held  2026-04-07
2026-03-08 65618.49    support      0  3 2026-06-03  broken  2026-06-05
2026-03-08 65618.49 resistance      1  1 2026-06-14    held  2026-06-24
2026-03-08 65618.49 resistance      1  2 2026-07-15  broken  2026-08-19
2026-03-29 65000.00    support      0  2 2026-06-03  broken  2026-06-05
2026-03-29 65000.00 resistance      1  1 2026-06-12    held  2026-06-24
2026-03-29 65000.00 resistance      1  2 2026-07-06  broken  2026-08-19
这张表的第一个意外:价格区间 65,000 到 65,618.49 里,还有一个 2024 年 10 月 23 日的摆动低点 65,260。 决策点只看了 2026 年的低点,没有看到它。按它来算,6 月 3 日是第 5 次测试。
「第几次」取决于你往回看多远。 从 2 月 12 日算,是第 4 次;从 2024 年 10 月算,是第 5 次;从 3 月 29 日算,只是第 2 次。
表里的其余信息先不看,留到揭晓。
✋ 小检查 1
一个支撑位 50,ATR 固定为 1(离开、守住、突破都是 1.5,测试区是 0.25)。摆动低点在第 0 天,第 1 天确认。之后几天的价格如下:
| 天 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 |
|---|---|---|---|---|---|---|---|---|
| 收盘价 | 51 | 51.6 | 50.8 | 49.2 | 48.4 | 48.9 | 49.9 | 48.2 |
| 最低价 | 50.5 | 51.0 | 50.2 | 49.0 | 48.0 | 48.5 | 48.8 | 48.0 |
| 最高价 | 51.4 | 51.8 | 51.2 | 50.9 | 49.3 | 49.5 | 50.1 | 49.8 |
(a) 价格在第几天「离开」?
(b) 第几天发生了第 2 次测试?结果是守住还是跌破?在第几天分出结果?
(c) 第 4 天收盘价 49.2 已经在 50 下方。为什么按第五节的规则,这一天还没有分出结果?
(d) 第 7 天最高价 50.1 又回到了 50 附近。这一次 50 扮演的是什么角色?结果是什么?
答案在文末。
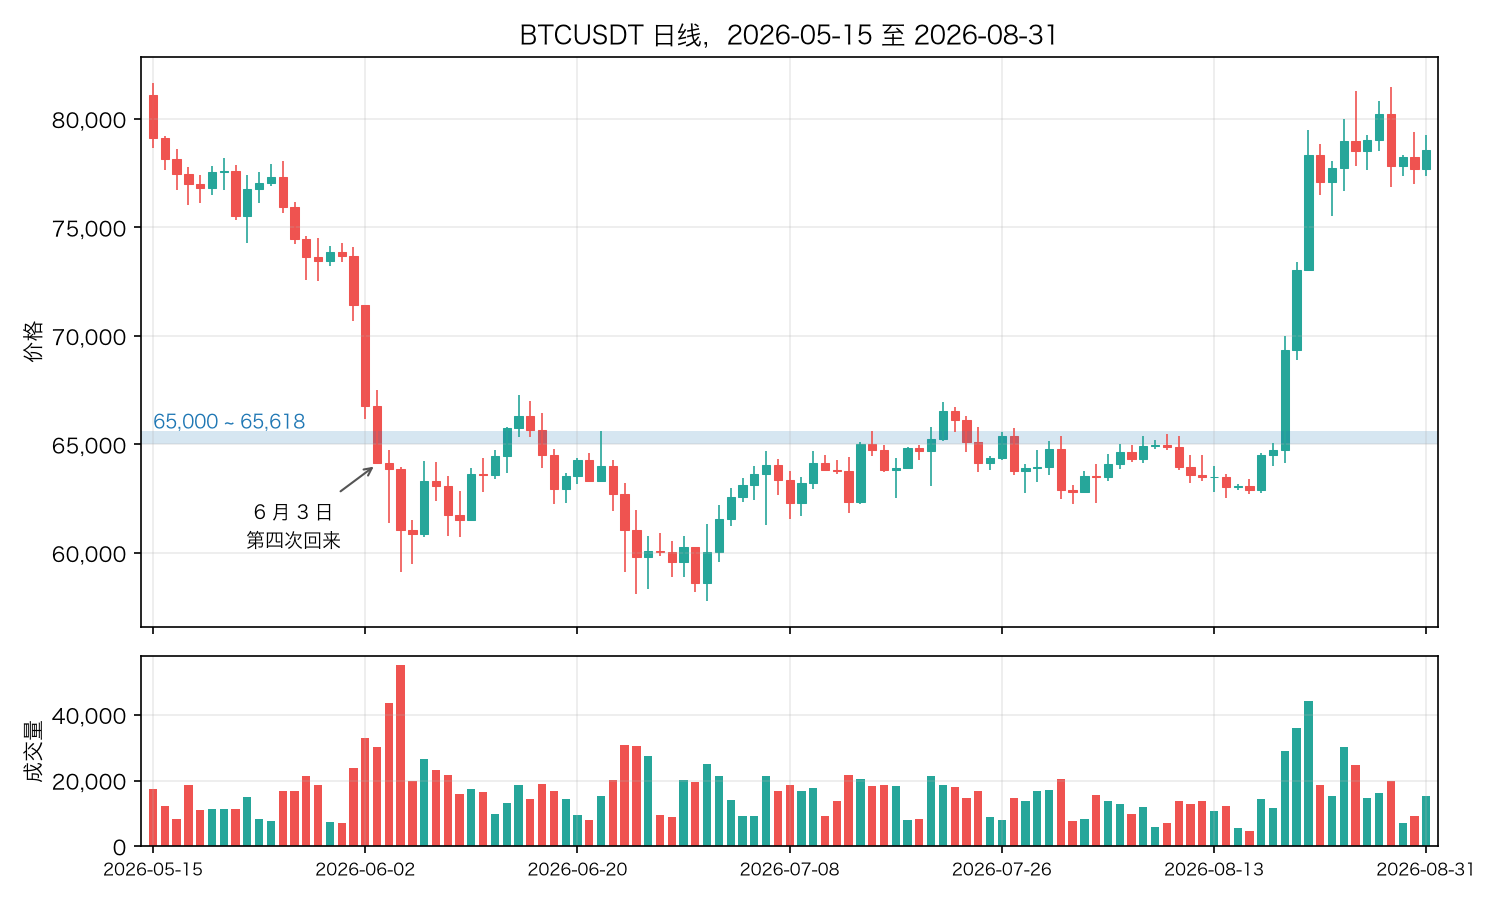
六、揭晓
c = day["close"]
print(f"6 月 3 日收盘 {c['2026-06-03']:,.2f};6 月 5 日最低 {day.loc['2026-06-05', 'low']:,.2f};"
      f"7 月 1 日最低 {day.loc['2026-07-01', 'low']:,.2f}")
for n in [7, 30, 60]:
    later = day.index[day.index.get_loc(pd.Timestamp("2026-06-03", tz="UTC")) + n]
    print(f"6 月 3 日收盘之后 {n} 天({later.date()}):{c[later] / c['2026-06-03'] - 1:+.2%}")
summer = day.loc["2026-06-06":"2026-08-16"]
print(f"6 月 6 日到 8 月 16 日:最高价 {summer['high'].max():,.2f}({summer['high'].idxmax().date()}),"
      f"收盘价最高 {summer['close'].max():,.2f},收盘在 65,618.49 上方的天数 {(summer['close'] > 65618.49).sum()} / {len(summer)}")
print(f"8 月 17 日到 8 月 31 日:最高价 {day.loc['2026-08-17':, 'high'].max():,.2f},8 月 31 日收盘 {c.iloc[-1]:,.2f}")
6 月 3 日收盘 64,142.75;6 月 5 日最低 59,130.91;7 月 1 日最低 57,800.19
6 月 3 日收盘之后 7 天(2026-06-10):-4.10%
6 月 3 日收盘之后 30 天(2026-07-03):-2.43%
6 月 3 日收盘之后 60 天(2026-08-02):-0.89%
6 月 6 日到 8 月 16 日:最高价 67,292.15(2026-06-15),收盘价最高 66,556.16,收盘在 65,618.49 上方的天数 5 / 72
8 月 17 日到 8 月 31 日:最高价 81,478.87,8 月 31 日收盘 78,581.29
第四次没有守住。 6 月 3 日 04:00 之后,价格先反弹到 67,516,但当天收在 64,142.75,已经在区间下方。6 月 5 日最低跌到 59,130.91,按第五节的规则在这一天确认跌破(收盘价在支撑下方 1.5 个 ATR)。7 月 1 日跌到 57,800.19,这是第 6 篇讲过的这轮熊市的最低点。
接下来发生的事,比跌破本身更有意思。65,000 变成了天花板。
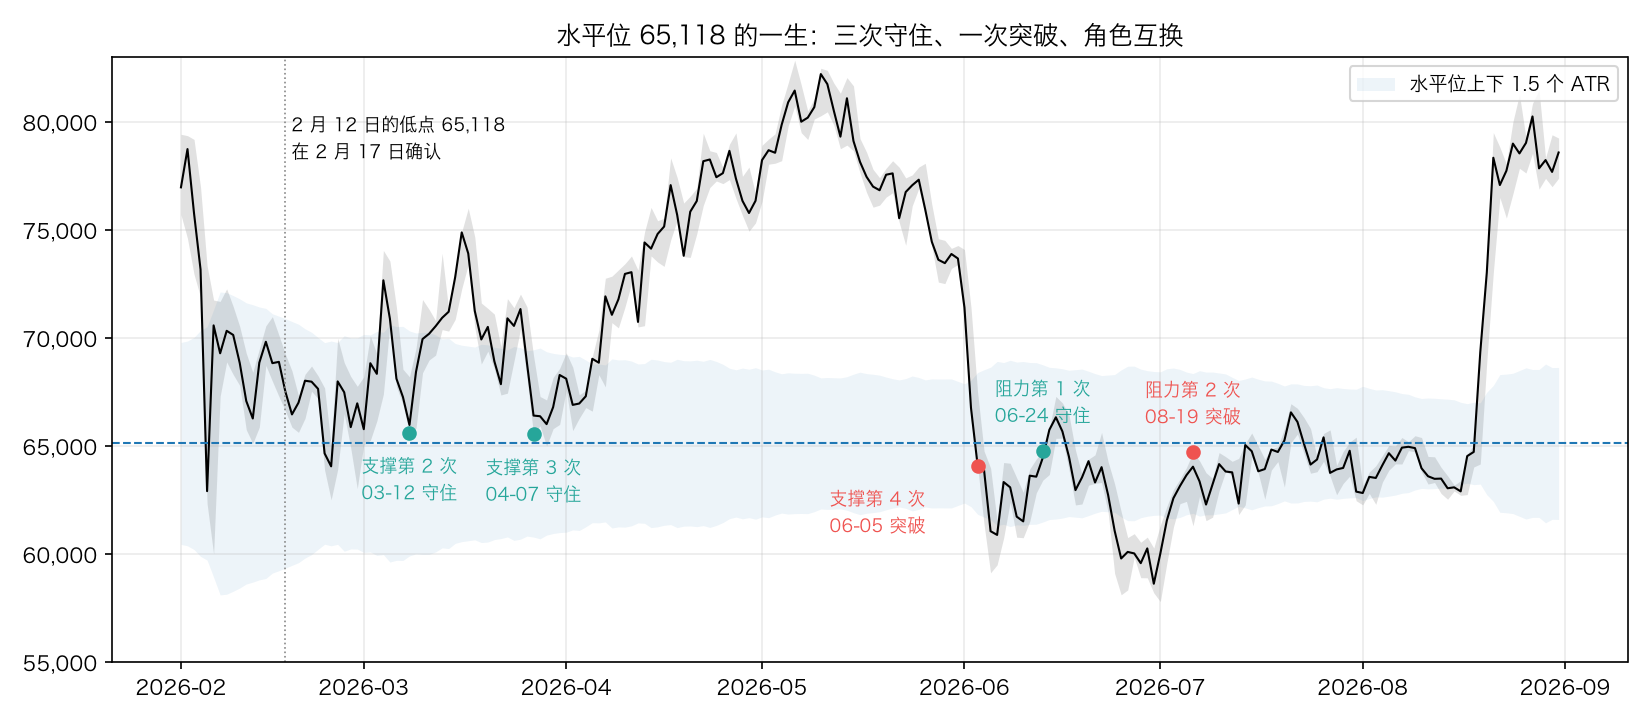
从 6 月 6 日到 8 月 16 日的 72 天里,只有 5 天收在 65,618.49 上方,收盘价最高只到 66,556.16。回到第五节的表:以 65,118 为例,6 月 13 日第一次以阻力的身份被测试,守住了;7 月 6 日第二次测试,价格在它附近磨了一个多月,直到 8 月 19 日才向上突破,之后一路涨到 81,478.87。
这就是小区房价的故事:在 650 万买入的人,等到价格回来时选择了卖出。
回到决策点的三个选项:
- A(买入):6 月 3 日 04:00 在 65,849.90 买入,两天后最低亏 10%。如果止损放在区间下方,会在 6 月 3 日当天或 6 月 5 日被触发。
- B(卖出或不碰):这一次是对的。但 60 天后的价格只比 6 月 3 日收盘低 0.89%,之后又涨到了 78,000 以上。
- C(等):等到了收盘跌破(6 月 3 日),以及后来的向上突破(8 月 19 日)。
和前两篇一样,一次揭晓不能说明任何规律。 这一次第四次测试失败了,但你也可以在 2021 年 7 月找到一个相反的例子:7 月 19 日,BTC 回到 5 月 19 日的低点 30,000 附近(按第五节的规则是第 3 次测试;从 1 月 11 日的低点 30,420 算起,已经是第 7 次),这次守住了,9 月 7 日涨到 52,920。第七节用全部历史来看「第几次测试」和「守不守得住」之间的关系。
七、测试次数越多,越强还是越弱
两种说法
关于同一个位置被多次测试,有两种流行的说法:
- 越测越强:一个位置被测试得越多,说明越多人认可它,下次守住的可能性越大
- 越测越弱:每次测试都会消耗掉挂在那里的买单,同时让更多止损单堆在它下方,测试次数越多,越容易被跌破
两种说法都有道理。用数据来看。
和什么比
和第 8 篇一样,只算出「守住的比例」是不够的,还要知道如果价格完全随机,这个比例会是多少。
这里的打乱方式比第 8 篇多做了一步:打乱的不是收盘价的收益率,而是整根 K 线。每根 K 线的开盘、最高、最低、收盘,都换算成相对前一天收盘价的位置,连同成交量作为一组,打乱各组的顺序,再重新拼成一条价格。每根 K 线的形状、大小和成交量都保留,只有先后顺序被破坏。
def shuffle_bars(df, rng):
    """打乱 K 线顺序:保留每根 K 线相对前一天收盘价的形状和成交量,重新拼成价格。"""
    rel = np.log(df[cols].div(df["close"].shift(1), axis=0))
    rel["volume"] = df["volume"]
    rel = rel.dropna().iloc[rng.permutation(len(df) - 1)].reset_index(drop=True)
    prev_close = df["close"].iloc[0] * np.exp(rel["close"].cumsum().shift(1, fill_value=0))
    out = np.exp(rel[cols]).mul(prev_close, axis=0)
    out["volume"] = rel["volume"].to_numpy()
    out.index = df.index[1:]
    return out
打乱之后的价格里,照样会有摆动点、照样会被测试、照样有守住和跌破。如果真实数据里的「守住比例」和打乱后没有区别,那么「支撑」这个概念在这组数据里就没有描述出任何随机之外的东西。
结果
def hold_rates(df, distance=1.5):
    a = X.wilder_smooth(X.true_range(df["high"], df["low"], df["close"]), 14)
    t = X.level_tests(df["high"], df["low"], df["close"], X.fractals(df["high"], df["low"], 5, 5), a, distance=distance)
    t = t[t["outcome"] != "open"]
    groups = {}
    for role, name in [("support", "支撑"), ("resistance", "阻力")]:
        first = t[(t["role"] == role) & (t["flips"] == 0)]
        for label, part in [("第 2 次", first[first["n"] == 2]), ("第 3 次", first[first["n"] == 3]),
                            ("第 4 次", first[first["n"] == 4]), ("第 5 次及以上", first[first["n"] >= 5]),
                            ("互换后第 1 次", t[(t["role"] == role) & (t["flips"] == 1) & (t["n"] == 1)])]:
            groups[(name, label)] = ((part["outcome"] == "held").mean(), len(part))
    return groups
rng = np.random.default_rng(0)
for name, df in markets.items():
    real = hold_rates(df)
    sims = pd.DataFrame([{k: v[0] for k, v in hold_rates(shuffle_bars(df, rng)).items()} for _ in range(200)])
    table = pd.DataFrame({"次数": [v[1] for v in real.values()], "守住": [v[0] for v in real.values()],
                          "打乱后 2.5%": sims.quantile(0.025).values, "打乱后平均": sims.mean().values,
                          "打乱后 97.5%": sims.quantile(0.975).values}, index=pd.MultiIndex.from_tuples(real.keys()))
    print(name)
    print(table.round(3).to_string())
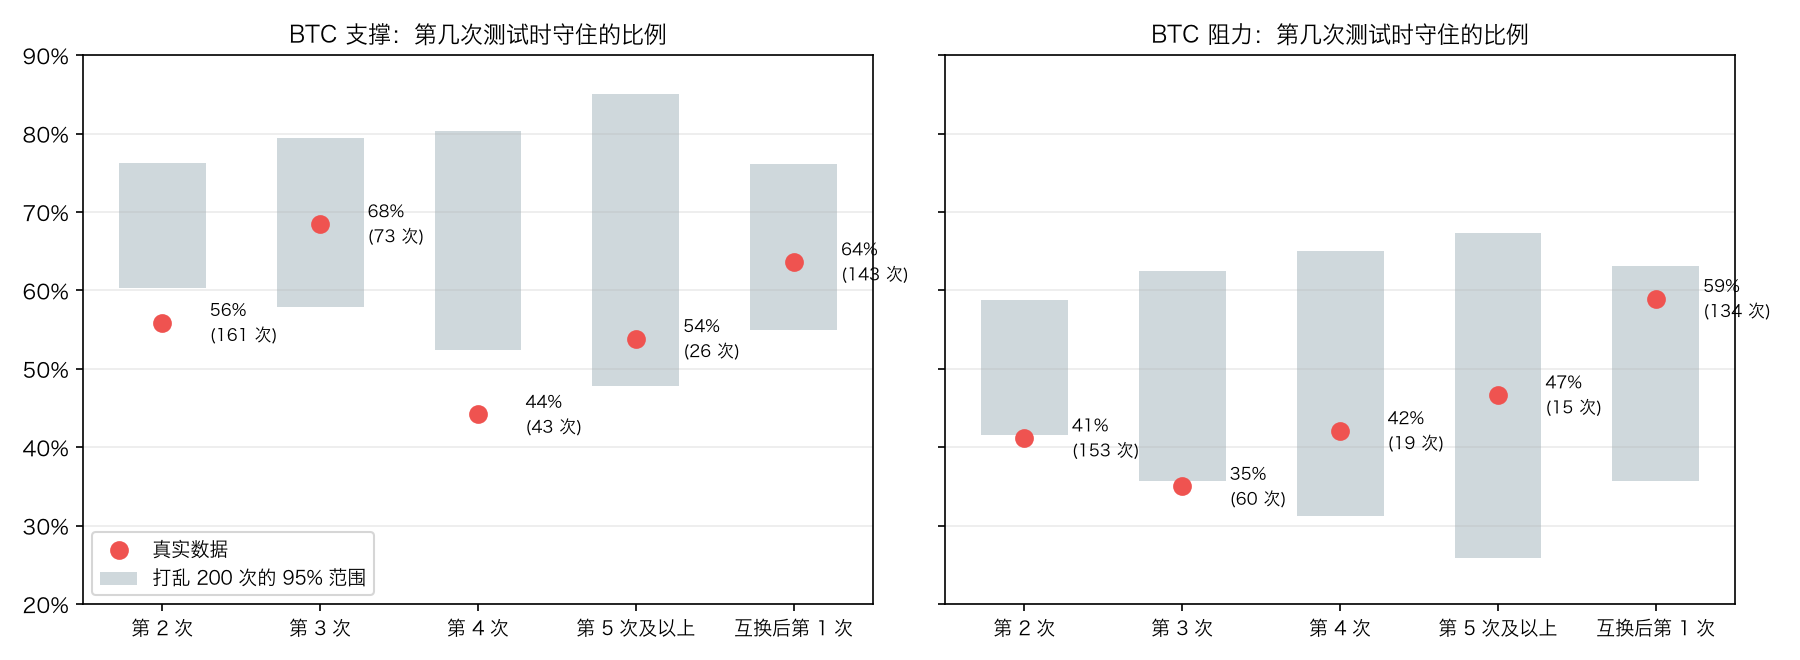
互换后第 1 次 的意思是:这个价位被突破、换了角色之后的第一次测试。在「支撑」那一行里,它原来是阻力,被向上突破后变成了支撑;在「阻力」那一行里,它原来是支撑,被跌破后变成了阻力。
BTC
              次数     守住  打乱后 2.5%  打乱后平均  打乱后 97.5%
支撑 第 2 次     161  0.559     0.602  0.681      0.763
   第 3 次      73  0.685     0.579  0.686      0.794
   第 4 次      43  0.442     0.524  0.679      0.804
   第 5 次及以上   26  0.538     0.478  0.654      0.850
   互换后第 1 次  143  0.636     0.550  0.662      0.761
阻力 第 2 次     153  0.412     0.415  0.497      0.588
   第 3 次      60  0.350     0.357  0.487      0.625
   第 4 次      19  0.421     0.312  0.487      0.650
   第 5 次及以上   15  0.467     0.259  0.456      0.673
   互换后第 1 次  134  0.590     0.357  0.490      0.632
SPY
              次数     守住  打乱后 2.5%  打乱后平均  打乱后 97.5%
支撑 第 2 次     109  0.633     0.467  0.582      0.693
   第 3 次      53  0.642     0.409  0.587      0.732
   第 4 次      28  0.643     0.321  0.585      0.867
   第 5 次及以上   17  0.294     0.142  0.561      0.909
   互换后第 1 次  103  0.621     0.470  0.594      0.712
阻力 第 2 次     102  0.363     0.346  0.432      0.530
   第 3 次      36  0.444     0.288  0.439      0.597
   第 4 次      16  0.312     0.214  0.439      0.684
   第 5 次及以上    6  0.167     0.000  0.373      0.668
   互换后第 1 次   90  0.467     0.278  0.430      0.602
AAPL
              次数     守住  打乱后 2.5%  打乱后平均  打乱后 97.5%
支撑 第 2 次      78  0.615     0.515  0.628      0.731
   第 3 次      36  0.500     0.458  0.634      0.786
   第 4 次      15  0.533     0.400  0.633      0.842
   第 5 次及以上   12  0.667     0.167  0.577      0.889
   互换后第 1 次  107  0.589     0.479  0.608      0.736
阻力 第 2 次     109  0.367     0.364  0.444      0.536
   第 3 次      40  0.375     0.292  0.436      0.589
   第 4 次      15  0.200     0.199  0.429      0.667
   第 5 次及以上    3  0.000     0.000  0.385      0.686
   互换后第 1 次   71  0.296     0.256  0.434      0.592
读这个结果
1. 先看打乱后的平均值,而不是真实数据。 BTC 打乱后,支撑守住的比例在 65% 到 69% 之间,阻力守住的比例在 46% 到 50% 之间。明明规则是对称的,为什么支撑更容易「守住」?因为 BTC 9 年里涨了 18 倍,打乱顺序不会改变这个整体涨幅。价格整体向上漂移,支撑自然更常守住,阻力自然更常被突破。 一句「这个支撑守住了 65%」,在 BTC 上几乎全部来自这种漂移。
2. 测试次数和守住比例之间,看不出稳定的关系。 BTC 支撑第 2、3、4 次分别是 55.9%、68.5%、44.2%,忽高忽低;SPY 是 63.3%、64.2%、64.3%,几乎不变;AAPL 是 61.5%、50.0%、53.3%。第 5 次及以上的样本只有几次到二十几次,打乱后的范围宽到 14% 到 91%,什么也说明不了。「越测越强」和「越测越弱」,在这三组数据里都找不到一致的支持。
3. SPY 和 AAPL 的每一格,都落在打乱后的范围之内。 在这两个标的上,用摆动点定义的支撑和阻力,守住的比例和随机价格没有区别。
4. BTC 有一个方向一致的偏离:支撑和阻力都比随机更容易被突破。 支撑第 2 次(55.9%,低于 60.2%)、第 4 次(44.2%,低于 52.4%),阻力第 2 次(41.2%,低于 41.5%)、第 3 次(35.0%,低于 35.7%),都在打乱后范围的下方。其余格子虽然在范围内,大多也低于打乱后的平均值。
换一个距离参数,看这个偏离是否稳定:
print("BTC 支撑第 2 次测试,换不同的「离开 / 守住 / 突破」距离:")
for distance in [1.0, 2.0]:
    real = hold_rates(day, distance)[("支撑", "第 2 次")]
    sims = [hold_rates(shuffle_bars(day, rng), distance)[("支撑", "第 2 次")][0] for _ in range(200)]
    print(f"   {distance} 个 ATR:守住 {real[0]:.1%}({real[1]} 次),打乱后 {np.percentile(sims, 2.5):.1%} ~ {np.percentile(sims, 97.5):.1%}")
BTC 支撑第 2 次测试,换不同的「离开 / 守住 / 突破」距离:
   1.0 个 ATR:守住 60.6%(170 次),打乱后 62.8% ~ 77.0%
   2.0 个 ATR:守住 56.8%(148 次),打乱后 57.7% ~ 76.8%
三个距离下,BTC 支撑第 2 次测试守住的比例都低于打乱后的范围。
这个方向和第 8 篇的发现一致:BTC 的突破版趋势状态之后,价格更倾向于延续,第 5 篇里 BTC 在 90 天尺度上的方差比也大于 1。价格带着一段走势来到一个位置时,在 BTC 上更可能穿过去,而不是被挡回来。
⚠️ 这个结论要打折扣看:
- 这张表里有 30 个格子。 即使支撑阻力完全是随机的,也会有一两格碰巧落在 95% 范围之外。BTC 的偏离之所以值得一提,是因为它在支撑和阻力两边、在三个距离参数下方向都一致,而不是某一格特别显著。
- 同一段行情会产生很多个测试。 决策点附近就有 4 个水平位,在同一天被测试、同一天被跌破。它们不是 4 个独立的样本。
- 打乱破坏的不只是方向的延续性,还有第 5 篇的波动率聚集。 真实数据和打乱数据的差别,也可能部分来自这一点。
角色互换
「互换后第 1 次」这一行,就是第二节「650 万从买家的便宜价变成业主的解套价」。数据怎么说?
- BTC:原来的支撑被跌破后作为阻力,守住 59.0%(134 次),打乱后 35.7% 到 63.2%;原来的阻力被突破后作为支撑,守住 63.6%(143 次),打乱后 55.0% 到 76.1%。
- SPY:46.7% 和 62.1%,都在范围内。
- AAPL:29.6% 和 58.9%,都在范围内。
BTC 跌破后的阻力守住 59.0%,是这一行里最高的数字,比打乱后的平均值 49.0% 高了 10 个百分点,但仍然在范围之内。角色互换在这些数据里没有得到可以和随机区分开的支持。 决策点之后 65,000 当了两个多月的天花板,是一个生动的例子,但不是一个统计上可靠的规律。
八、真跌破和假跌破
四个常见的过滤条件
一个支撑被跌破时,交易者常用四个条件来判断是真是假:
- 收盘确认:盘中跌破不算,要收盘在支撑下方
- 跌破幅度:收盘价离支撑越远,越可能是真的
- 成交量:放量跌破更可能是真的,缩量跌破更可能是假的
- 回踩:跌破之后价格回到支撑下方附近,被挡住,确认角色互换(第七节已经看过)
定义
这里单独看第一次收盘跌破,用一个比第五节更贴近交易的定义:
- 收盘跌破:摆动低点确认、价格离开过(收盘价在上方 1.5 个 ATR)之后,第一次收盘价低于支撑
- 假跌破:之后 10 天内,先出现「收盘价回到支撑上方」,后出现(或没有出现)「收盘价在支撑下方 1.5 个 ATR」
- 只是盘中跌破:最低价低于支撑,但收盘价没有跌破。看它之后 10 天内是否出现收盘跌破
def breakdowns(df, horizon=10, distance=1.5):
    """支撑第一次被收盘跌破(之前价格已经离开过),之后 horizon 天内先收回支撑上方,算假跌破。"""
    a = X.wilder_smooth(X.true_range(df["high"], df["low"], df["close"]), 14).to_numpy()
    h, l, c, v = (df[k].to_numpy(float) for k in ["high", "low", "close", "volume"])
    v20 = df["volume"].rolling(20).mean().shift(1).to_numpy()
    pos = {t: i for i, t in enumerate(df.index)}
    rows = []
    sw = X.fractals(df["high"], df["low"], 5, 5)
    for s in sw[sw["kind"] == -1].itertuples():
        level, armed, pierced = s.price, False, False
        for j in range(pos[s.confirmed_at] + 1, len(c) - horizon):
            unit = a[j - 1]
            if np.isnan(unit):
                continue
            if not armed:
                if c[j] >= level + distance * unit:
                    armed = True
                elif c[j] < level:
                    break
                continue
            if l[j] < level <= c[j] and not pierced:              # 盘中跌破、收盘收回
                pierced = True
                rows.append(("只是盘中跌破", (level - l[j]) / unit, v[j] / v20[j], bool((c[j + 1:j + 1 + horizon] < level).any())))
            if c[j] < level:
                later = c[j + 1:j + 1 + horizon]
                back, deep = np.flatnonzero(later >= level), np.flatnonzero(later <= level - distance * unit)
                fake = len(back) > 0 and (len(deep) == 0 or back[0] < deep[0])
                rows.append(("收盘跌破", (level - c[j]) / unit, v[j] / v20[j], fake))
                break
    return pd.DataFrame(rows, columns=["类型", "深度", "量比", "结果"])
深度是收盘价(或盘中最低价)在支撑下方几个 ATR,量比是当天成交量除以之前 20 天的平均成交量。按深度和量比分组之后,同样和打乱后的 K 线比较:
def breakdown_table(df):
    b = breakdowns(df)
    close_breaks = b[b["类型"] == "收盘跌破"]
    rows = {("全部收盘跌破", ""): close_breaks["结果"]}
    depth = pd.cut(close_breaks["深度"], [0, 0.25, 0.5, 1, np.inf], labels=["0~0.25", "0.25~0.5", "0.5~1", "1 以上"])
    for label, part in close_breaks.groupby(depth, observed=False):
        rows[("收盘价在支撑下方几个 ATR", label)] = part["结果"]
    volume = pd.cut(close_breaks["量比"], [0, 1, 1.5, np.inf], labels=["1 倍以下", "1~1.5 倍", "1.5 倍以上"])
    for label, part in close_breaks.groupby(volume, observed=False):
        rows[("成交量是 20 日平均的", label)] = part["结果"]
    rows[("只是盘中跌破:之后 10 天内收盘跌破", "")] = b.loc[b["类型"] == "只是盘中跌破", "结果"]
    return {k: (v.astype(float).mean(), len(v)) for k, v in rows.items()}
for name in ["BTC", "SPY"]:
    real = breakdown_table(markets[name])
    sims = pd.DataFrame([{k: v[0] for k, v in breakdown_table(shuffle_bars(markets[name], rng)).items()} for _ in range(200)])
    table = pd.DataFrame({"次数": [v[1] for v in real.values()], "比例": [v[0] for v in real.values()],
                          "打乱后平均次数": [np.nan] * len(real), "打乱后 2.5%": sims.quantile(0.025).values,
                          "打乱后 97.5%": sims.quantile(0.975).values}, index=pd.MultiIndex.from_tuples(real.keys()))
    counts = pd.DataFrame([{k: v[1] for k, v in breakdown_table(shuffle_bars(markets[name], rng)).items()} for _ in range(50)])
    table["打乱后平均次数"] = counts.mean().values
    print(name)
    print(table.round(3).to_string())
BTC
                               次数     比例  打乱后平均次数  打乱后 2.5%  打乱后 97.5%
全部收盘跌破                        137  0.540   135.34     0.488      0.708
收盘价在支撑下方几个 ATR      0~0.25     50  0.760    55.00     0.652      0.898
                    0.25~0.5   21  0.667    31.26     0.419      0.864
                    0.5~1      35  0.543    28.50     0.286      0.734
                    1 以上       31  0.097    20.58     0.000      0.413
成交量是 20 日平均的        1 倍以下      10  1.000    64.38     0.516      0.793
                    1~1.5 倍    31  0.645    26.84     0.360      0.882
                    1.5 倍以上    96  0.458    44.10     0.302      0.727
只是盘中跌破:之后 10 天内收盘跌破            72  0.625    95.74     0.404      0.641
SPY
                              次数     比例  打乱后平均次数  打乱后 2.5%  打乱后 97.5%
全部收盘跌破                        94  0.585    90.32     0.443      0.691
收盘价在支撑下方几个 ATR      0~0.25    23  0.826    27.88     0.640      0.960
                    0.25~0.5  23  0.565    17.28     0.444      0.923
                    0.5~1     30  0.500    20.38     0.364      0.800
                    1 以上      18  0.444    24.78     0.045      0.435
成交量是 20 日平均的        1 倍以下      1  1.000    16.18     0.470      0.929
                    1~1.5 倍   38  0.632    25.82     0.444      0.875
                    1.5 倍以上   55  0.545    48.32     0.282      0.636
只是盘中跌破:之后 10 天内收盘跌破           49  0.633    42.64     0.418      0.736
「比例」一列:分组的行是假跌破的比例;最后一行是盘中跌破之后 10 天内出现收盘跌破的比例。
读这个结果
1. 超过一半的收盘跌破是假的。 BTC 54.0%、SPY 58.5% 的收盘跌破,在 10 天内又收回了支撑上方。打乱后的比例也在这个范围里(BTC 48.8% 到 70.8%)。「跌破之后经常收回来」本身不是市场的特点,随机价格也是这样。
2. 跌得越深,越可能是真的。 BTC 从 76.0%(跌破不到 0.25 个 ATR)降到 9.7%(超过 1 个 ATR)。但打乱之后也有同样的规律。原因很简单:收盘价离支撑越远,要在 10 天内收回来就要走得越远,这对任何价格都成立。幅度过滤是有效的,但它有效的原因是几何,不是支撑。
SPY 有一个例外:跌破超过 1 个 ATR 的假跌破比例是 44.4%(18 次),高于打乱后的上限 43.5%。SPY 的深度跌破更常收回来,这和第 5 篇、第 8 篇看到的 SPY 均值回归倾向是同一个方向,但 18 次的样本很小。
3. 成交量:放量跌破确实更常见,但对真假的区分作用不稳定。 BTC 的 137 次收盘跌破里,96 次成交量超过 20 日平均的 1.5 倍;打乱后平均只有 44 次。跌破常常伴随放量,这和止损单被触发是一致的(第 2 篇的 9 倍成交量)。但放量跌破的假跌破比例(45.8%)在打乱后的范围之内。缩量跌破只有 10 次,全部是假跌破,样本太少,不能下结论。SPY 的缩量跌破只有 1 次。
⚠️ 成交量的比较要特别小心:打乱时成交量跟着 K 线一起打乱,破坏了成交量本身的聚集性(放量的日子往往连在一起),所以打乱后「放量跌破」的次数偏少,一部分原因就在这里。
4. 只是盘中跌破,之后 10 天内有六成会出现收盘跌破。 BTC 62.5%,SPY 63.3%,都在打乱后的范围之内。盘中跌破后收回,不能说明支撑有效;它更常见的结局是过几天真的跌破。
总结这一节:幅度是唯一稳定的过滤条件,但它的作用来自几何;收盘确认和成交量,在这些数据里都没有表现出稳定的额外区分能力。 这不是说它们没有用,而是说把它们写进规则之前,需要在你自己的交易周期和标的上检验。
九、缺口
四种缺口
缺口(gap)是 K 线图上两根 K 线之间没有任何成交的一段价格:今天的开盘价跳过了昨天的价格区间。
Edwards 和 Magee 在 1948 年的《Technical Analysis of Stock Trends》里,把缺口分成四种:
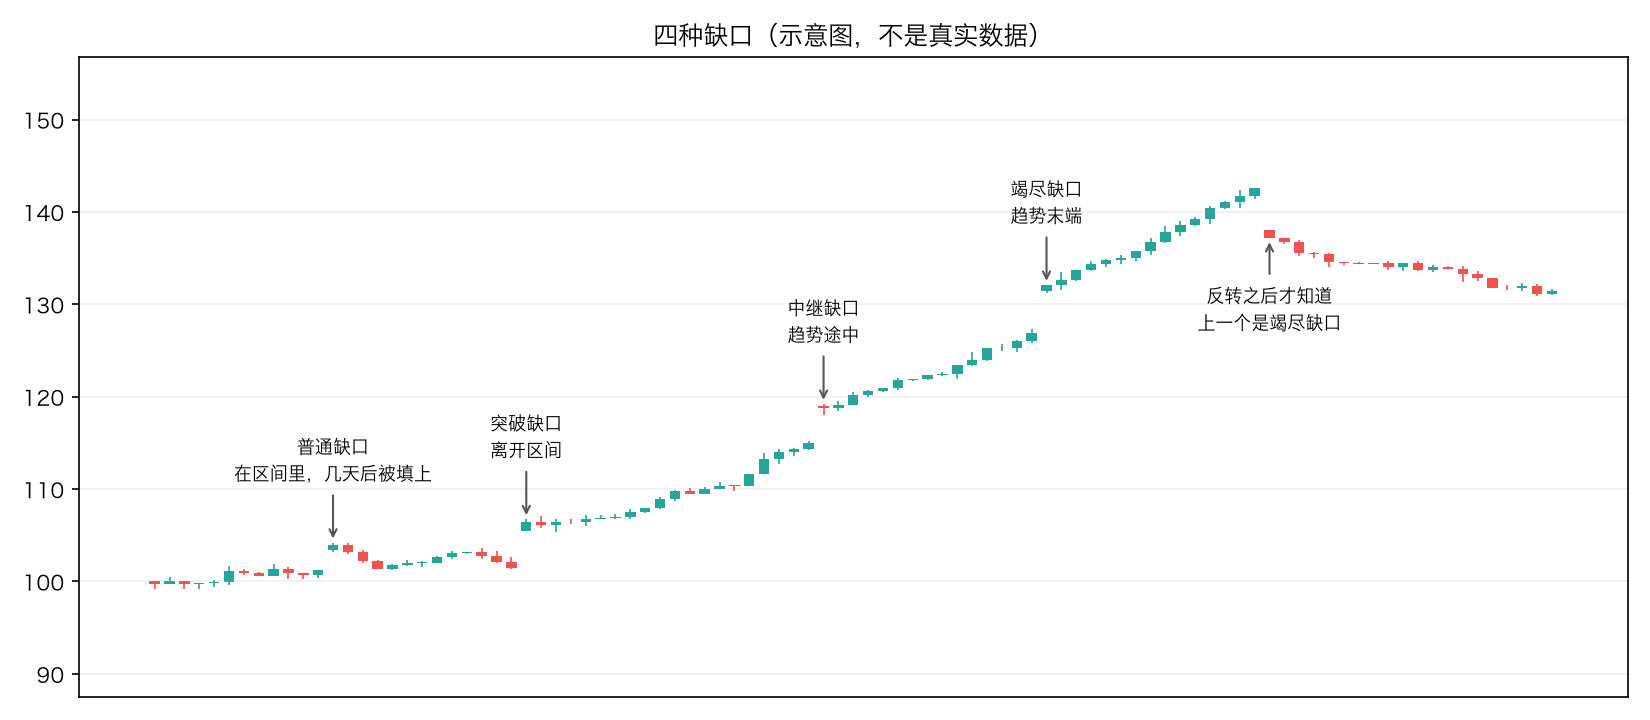
| 类型 | 出现的位置 | 传统说法 |
|---|---|---|
| 普通缺口 | 在一段横盘区间里面 | 意义不大,很快会被填上 |
| 突破缺口 | 价格跳出横盘区间 | 新趋势的开始,通常不会很快填上 |
| 中继缺口(测量缺口) | 趋势进行到一半 | 趋势还会继续,而且常说「缺口到起点的距离约等于还剩下的距离」 |
| 竭尽缺口 | 趋势的末端 | 最后一波追涨(或恐慌),很快被填上,之后反转 |
这张表有一个根本问题:中继缺口和竭尽缺口,在出现的那一刻是无法区分的。 两者都出现在一段趋势之后,都是顺着趋势方向跳空。一个缺口是「中继」还是「竭尽」,要看之后趋势有没有继续,这是事后才知道的事。示意图里最后那个缺口,就是在价格反转之后,才被称作竭尽缺口。
这和第 8 篇的摆动点是同一个问题:用事后才知道的信息给过去分类,分类本身没有错,但不能拿来当作当时的交易依据。
能在当时判断的,只有「普通」和「突破」:缺口是否让价格跳出了之前的区间。第九节最后会用数据看看这个区分有没有意义。
两种定义
talab.structure.gaps 记录每一个开盘价和前一天收盘价不相等的交易日:
- 开盘跳空:开盘价不等于前一天收盘价。美股几乎每天都有。
- 完整缺口(
full):向上时开盘价高于前一天最高价,向下时低于前一天最低价。只有这种,在 K 线图上才看得见空白。
回补的常见说法是价格回到前一天的收盘价,这一篇用这个定义。
BTC 的日线基本没有缺口:它 24 小时交易,今天的开盘价就是昨天的收盘价。美股有,因为它每天收盘,隔夜的消息会在第二天开盘时一次性反映出来(第 3 篇讲过盘后消息造成的跳空)。
美股的隔夜跳空:回补有多常见
先想一个问题:缺口被回补,是因为「缺口需要被填上」,还是因为价格本来就会上下波动,碰到附近的价格很正常?
为了分开这两种解释,对每一个缺口都设一个对照价格:在开盘价的另一侧、离开盘价同样距离的价格。
比如前一天收盘 100,今天开盘 102(向上跳空 2%):
- 回补:价格回到 100(开盘价下方约 2%)
- 对照:价格到达 102 × 102 ÷ 100 = 104.04(开盘价上方约 2%)
如果「缺口需要被填上」是真的,回补的比例应该明显高于对照的比例。如果两者差不多,缺口回补就只是「价格会碰到附近的价格」这件平常事。
def gap_table(df):
    g = X.gaps(df["open"], df["high"], df["low"], df["close"])
    sigma = np.log(df["close"]).diff().rolling(20).std().shift(1)
    g = g[sigma[g.index].notna()].copy()
    g["标准差倍数"] = np.abs(np.log1p(g["size"])) / sigma[g.index]
    high20 = df["high"].rolling(20).max().shift(1)
    low20 = df["low"].rolling(20).min().shift(1)
    g["突破型"] = np.where(g["direction"] == 1, g["open"] > high20[g.index], g["open"] < low20[g.index])
    fill, mirror = [], []
    days = pd.Series(np.arange(len(df)), index=df.index)
    for t, row in g.iterrows():
        up = row["direction"] == 1
        fill.append(X.first_reach(df["high"], df["low"], t, row["prev_close"], from_above=up))
        other_side = row["open"] * row["open"] / row["prev_close"]           # 开盘价另一侧、同样距离的价格
        mirror.append(X.first_reach(df["high"], df["low"], t, other_side, from_above=not up))
    g["回补"] = [days[f] - days[t] if pd.notna(f) else np.nan for f, t in zip(fill, g.index)]
    g["对照"] = [days[f] - days[t] if pd.notna(f) else np.nan for f, t in zip(mirror, g.index)]
    return g
def fill_summary(part):
    return pd.Series({"次数": len(part), "当天回补": (part["回补"] == 0).mean(), "5 天内": (part["回补"] <= 5).mean(),
                      "20 天内": (part["回补"] <= 20).mean(), "对照 当天": (part["对照"] == 0).mean(),
                      "对照 5 天内": (part["对照"] <= 5).mean(), "对照 20 天内": (part["对照"] <= 20).mean()})
for name in ["SPY", "AAPL"]:
    g = gap_table(markets[name])
    print(f"{name}:{len(g)} 个交易日有跳空,其中向上 {(g['direction'] == 1).mean():.1%},完整缺口 {g['full'].sum()} 个")
    size = pd.cut(g["标准差倍数"], [0, 0.25, 0.5, 1, 2, np.inf], labels=["0~0.25", "0.25~0.5", "0.5~1", "1~2", "2 以上"])
    print(g.groupby(size, observed=False).apply(fill_summary).round(3).to_string())
    big = g[g["标准差倍数"] > 1]
    print("超过 1 倍标准差的跳空,按是否突破 20 日区间:")
    print(big.groupby(big["突破型"].map({True: "突破型", False: "普通"})).apply(fill_summary).round(3).to_string())
跳空的大小用「前 20 天日收益率标准差的几倍」来衡量,这样 2020 年 3 月的 2% 和 2017 年的 2% 不会被当成一样大。回补 和 对照 记录的是过了几个交易日才到达,0 表示当天就到了。
SPY:2485 个交易日有跳空,其中向上 56.8%,完整缺口 1061 个
             次数   当天回补   5 天内  20 天内  对照 当天  对照 5 天内  对照 20 天内
标准差倍数
0~0.25    873.0  0.890  0.958  0.974  0.814    0.937     0.974
0.25~0.5  682.0  0.619  0.855  0.924  0.556    0.849     0.927
0.5~1     646.0  0.389  0.724  0.844  0.353    0.762     0.899
1~2       252.0  0.282  0.675  0.802  0.175    0.615     0.778
2 以上       32.0  0.062  0.531  0.688  0.125    0.438     0.688
AAPL:2479 个交易日有跳空,其中向上 53.3%,完整缺口 837 个
              次数   当天回补   5 天内  20 天内  对照 当天  对照 5 天内  对照 20 天内
标准差倍数
0~0.25    1079.0  0.880  0.954  0.973  0.834    0.941     0.963
0.25~0.5   685.0  0.635  0.864  0.926  0.587    0.855     0.936
0.5~1      509.0  0.383  0.695  0.811  0.401    0.745     0.866
1~2        161.0  0.217  0.652  0.764  0.236    0.602     0.696
2 以上        45.0  0.111  0.244  0.556  0.022    0.311     0.511
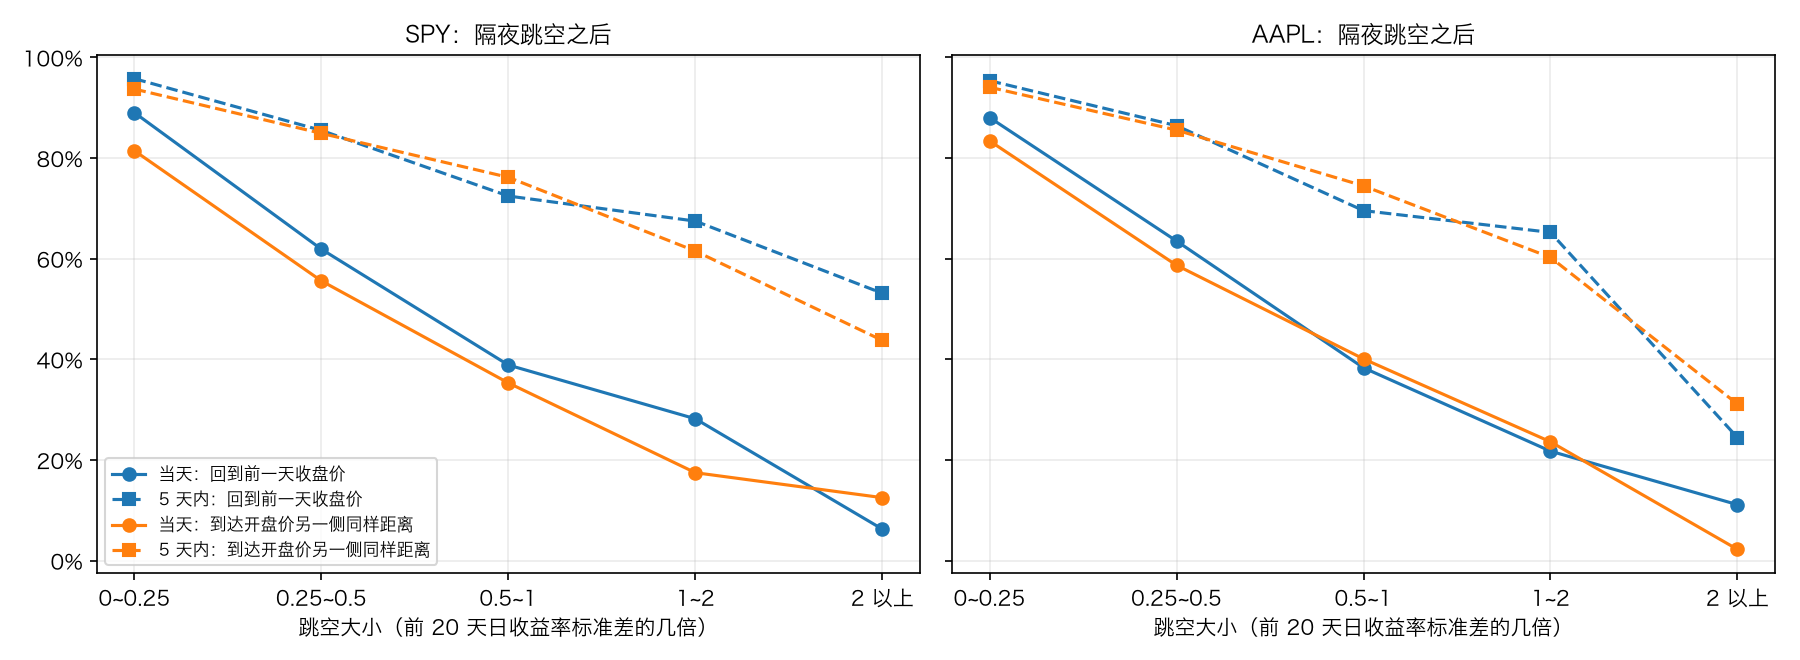
(AAPL 用拆股和分红都调整过的价格;SPY 的价格没有分红调整,每季度除息日会多出一个很小的向下跳空,一年 4 个,对整体结果影响很小。「2485 个交易日」不含最前面用来计算标准差的 20 天。)
读这个结果
1. 缺口回补非常常见。 小于 0.25 倍标准差的跳空,SPY 89.0% 当天就回补了;20 天内,除了最大的一档,回补比例都在 76% 以上。「缺口总会被填上」这个说法,单看回补比例确实很有说服力。
2. 但对照价格被碰到的比例也差不多。 5 天内的比例,SPY 在每一档里,回补和对照相差都在 10 个百分点以内,而且有时对照更高(0.5~1 倍:72.4% 对 76.2%)。AAPL 也一样。缺口回补的比例,大部分来自「价格会碰到附近的价格」。
3. SPY 有一个小而稳定的差别:当天回补比对照更常见。 前四档里,SPY 当天回补都比对照高 3.6 到 10.7 个百分点。美股开盘时的跳空,当天有一定的回吐倾向,这和 SPY 的均值回归倾向一致。AAPL 没有这个规律。到了 5 天、20 天,这个差别就消失了。
突破缺口真的不回补吗
上面那段循环的最后三行,把超过 1 倍标准差的跳空按 突破型 分成两组。突破型:向上跳空时开盘价高于之前 20 天的最高价,向下时低于之前 20 天的最低价,也就是跳出了近期的区间。这是开盘那一刻就能判断的。只看超过 1 倍标准差的跳空,排除那些很小的日常跳动。
超过 1 倍标准差的跳空,按是否突破 20 日区间:
        次数   当天回补   5 天内  20 天内  对照 当天  对照 5 天内  对照 20 天内
突破型
普通   220.0  0.241  0.650  0.782  0.191    0.623     0.773
突破型   64.0  0.312  0.688  0.812  0.094    0.500     0.750
超过 1 倍标准差的跳空,按是否突破 20 日区间:
        次数   当天回补   5 天内  20 天内  对照 当天  对照 5 天内  对照 20 天内
突破型
普通   135.0  0.200  0.585  0.719  0.222    0.570     0.681
突破型   71.0  0.183  0.521  0.718  0.127    0.479     0.606
(第一张是 SPY,第二张是 AAPL。)
传统说法是「突破缺口通常不会很快填上」。数据给出的答案相反:
- SPY 的突破型缺口,当天、5 天、20 天内的回补比例(31.2%、68.8%、81.2%)都不低于普通缺口
- AAPL 的突破型缺口,20 天内的回补比例(71.8%)和普通缺口(71.9%)几乎一样
有意思的是对照一列:突破型缺口当天到达对照价格的比例(SPY 9.4%,AAPL 12.7%)明显低于普通缺口。跳出区间之后,当天继续朝跳空方向走一个同样距离的情况,反而更少见。 不过突破型缺口只有 64 个和 71 个,这个差别需要更多数据来确认。
十、BTC 的「CME 缺口」
它是什么
BTC 24 小时交易,日线上没有缺口。但芝加哥商品交易所(CME)的比特币期货不是:它从 2017 年 12 月 17 日开始交易,每周从周日 17:00 到周五 16:00(芝加哥时间),中间每天休息一小时,周末不交易。
于是在 CME 期货的图上,周五收盘价和周日开盘价之间,常常有一段空白。这就是 CME 缺口。加密市场里流传着一句话:「CME 缺口最后总会被填上。」
2026 年 5 月 29 日(周五)起,CME 把加密货币期货和期权改成了每周 7 天、每天 24 小时交易,只保留周末两小时的维护时间。所以这种周末缺口,只存在到 2026 年 5 月下旬。
自己算
没有免费的 CME 期货历史数据,但有 Binance 现货的 1 分钟数据。用现货价格代替期货价格,按 CME 的交易时间切出每个周末:
- 周五收盘价:芝加哥时间周五 16:00 之前最后一分钟(15:59 开始的那根 1 分钟线)的收盘价
- 周日开盘价:芝加哥时间周日 17:00 那根 1 分钟线的开盘价
- 周五休市(比如耶稣受难日、落在周五的圣诞节):用前一个交易日 16:00 的价格。休市日来自
exchange_calendars的CMES日历
芝加哥时间有夏令时,tz_convert 会自动处理:冬天 16:00 是 UTC 22:00,夏天是 UTC 21:00。
CT = "America/Chicago"
cme = xc.get_calendar("CMES", start="2017-12-01", end="2026-06-30")
open_days = set(cme.sessions.date)
rows = []
for friday in pd.date_range("2017-12-22", "2026-05-22", freq="W-FRI"):
    last = friday
    while last.date() not in open_days:                   # 周五休市(比如耶稣受难日),用前一个交易日
        last -= pd.Timedelta("1D")
    close_at = pd.Timestamp(f"{last.date()} 16:00", tz=CT).tz_convert("UTC")
    open_at = pd.Timestamp(f"{(friday + pd.Timedelta('2D')).date()} 17:00", tz=CT).tz_convert("UTC")
    rows.append({"周五": friday.date(), "收盘时刻": close_at, "开盘时刻": open_at,
                 "收盘价": minute["close"].get(close_at - pd.Timedelta("1min")), "开盘价": minute["open"].get(open_at)})
weekend = pd.DataFrame(rows).dropna()
weekend["缺口"] = weekend["开盘价"] / weekend["收盘价"] - 1
print(f"{len(weekend)} 个周末,其中周五休市、改用周四收盘的 {(pd.to_datetime(weekend['收盘时刻']).dt.tz_convert(CT).dt.dayofweek != 4).sum()} 个;"
      f"缺口绝对值中位数 {weekend['缺口'].abs().median():.2%},超过 1% 的 {(weekend['缺口'].abs() > 0.01).mean():.1%}")
print(weekend.tail(3).to_string(index=False))
439 个周末,其中周五休市、改用周四收盘的 12 个;缺口绝对值中位数 1.19%,超过 1% 的 56.0%
        周五                      收盘时刻                      开盘时刻      收盘价      开盘价        缺口
2026-05-08 2026-05-08 21:00:00+00:00 2026-05-10 22:00:00+00:00 80133.09 80720.47  0.007330
2026-05-15 2026-05-15 21:00:00+00:00 2026-05-17 22:00:00+00:00 79123.12 78405.72 -0.009067
2026-05-22 2026-05-22 21:00:00+00:00 2026-05-24 22:00:00+00:00 75984.47 76151.14  0.002193
第一个周末是 2017 年 12 月 22 日(CME 开始交易后的第一个周五),最后一个是 2026 年 5 月 22 日。
⚠️ 这个计算有三个局限,要记在心里:
- 现货不是期货。 期货价格和现货价格之间有基差,基差在周末前后也会变化。真实的 CME 缺口和这里算出的大小不会完全相同。
- 只处理了周五休市。 美国的周一假日(比如阵亡将士纪念日),CME 的交易时间也会调整,这里没有处理。
- Binance 的 1 分钟数据本身有缺失(第 3 篇),少数周末可能因为缺少某一分钟而被跳过。
回补有多常见
def hours_to(start, level, from_above):
    hit = X.first_reach(minute["high"], minute["low"], start, level, from_above)
    return (hit - start) / pd.Timedelta("1h") if pd.notna(hit) else np.nan
weekend["回补小时"] = [hours_to(r["开盘时刻"], r["收盘价"], r["缺口"] > 0) for _, r in weekend.iterrows()]
weekend["对照小时"] = [hours_to(r["开盘时刻"], r["开盘价"] ** 2 / r["收盘价"], r["缺口"] < 0) for _, r in weekend.iterrows()]
def cme_summary(part):
    return pd.Series({"个数": len(part), "24 小时内": (part["回补小时"] <= 24).mean(), "1 周内": (part["回补小时"] <= 168).mean(),
                      "30 天内": (part["回补小时"] <= 720).mean(), "到 8 月底": part["回补小时"].notna().mean(),
                      "对照 24 小时": (part["对照小时"] <= 24).mean(), "对照 1 周": (part["对照小时"] <= 168).mean(),
                      "对照 30 天": (part["对照小时"] <= 720).mean(), "对照 到 8 月底": part["对照小时"].notna().mean()})
size = pd.cut(weekend["缺口"].abs(), [0, 0.005, 0.01, 0.02, 0.05, 1], labels=["0~0.5%", "0.5%~1%", "1%~2%", "2%~5%", "5% 以上"])
print(weekend.groupby(size, observed=False).apply(cme_summary).round(3).to_string())
print(cme_summary(weekend).round(3).to_frame("全部").T.to_string())
和美股一样,每个缺口都设一个对照价格:周日开盘价另一侧、同样距离的价格。
            个数  24 小时内   1 周内  30 天内  到 8 月底  对照 24 小时  对照 1 周  对照 30 天  对照 到 8 月底
缺口
0~0.5%   120.0   0.850  0.967  0.983   0.983     0.867   0.975    0.983      0.992
0.5%~1%   73.0   0.644  0.849  0.904   0.973     0.740   0.904    0.959      0.973
1%~2%     99.0   0.465  0.808  0.909   0.939     0.747   0.899    0.939      1.000
2%~5%    102.0   0.392  0.725  0.882   0.971     0.392   0.608    0.755      0.980
5% 以上     45.0   0.178  0.378  0.578   0.956     0.244   0.644    0.822      0.956
       个数  24 小时内   1 周内  30 天内  到 8 月底  对照 24 小时  对照 1 周  对照 30 天  对照 到 8 月底
全部  439.0   0.554  0.795  0.888   0.966     0.645   0.827      0.9      0.984
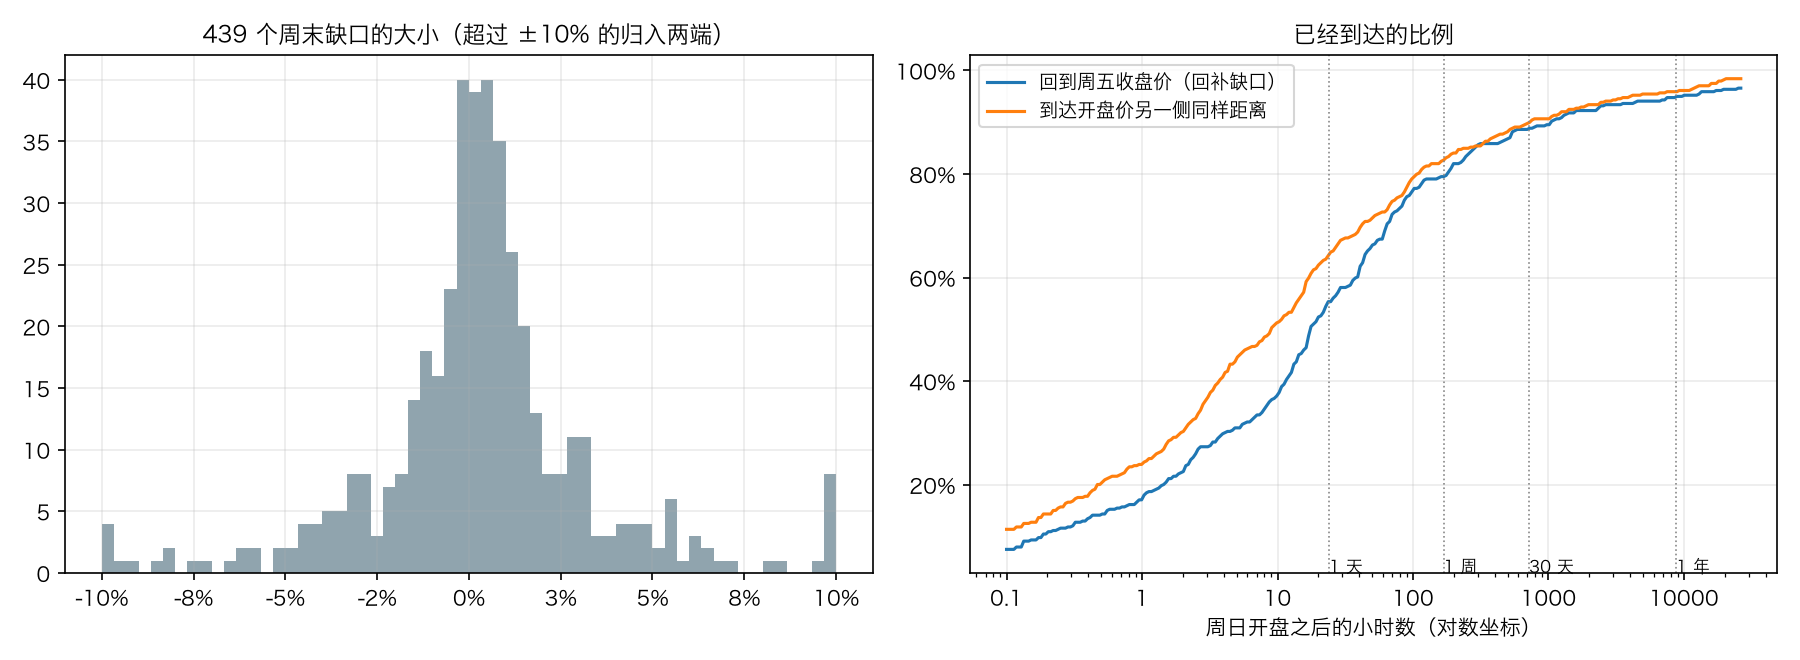
「CME 缺口总会被填上」,在这 439 个周末里,到 2026 年 8 月底有 96.6% 确实被填上了。 一周内 79.5%,30 天内 88.8%。
但对照价格被碰到的比例是 98.4%,一周内 82.7%,30 天内 90.0%。24 小时内,对照(64.5%)甚至明显高于回补(55.4%)。右边的图里,两条曲线几乎全程贴在一起,对照那条还略高一点。
CME 缺口回补的比例,和「在周日开盘价的另一侧、同样距离放一个价格,看它会不会被碰到」没有区别。 BTC 的波动很大,一个 1% 到 2% 外的价格,一周内被碰到的可能性本来就在八到九成。缺口被填上,是这件平常事的一个特例,而不是缺口有什么特殊的吸引力。
只有 2% 到 5% 这一档,一周内回补(72.5%)比对照(60.8%)高了 11.7 个百分点,30 天内也高了 12.7 个百分点。这一档有 102 个样本,值得在练习里进一步检查(比如按年份拆开)。
还没有被填上的缺口
print("到 2026-08-31 还没有回补的:")
print(weekend[weekend["回补小时"].isna()][["周五", "收盘价", "开盘价", "缺口"]].round(4).to_string(index=False))
到 2026-08-31 还没有回补的:
        周五      收盘价      开盘价      缺口
2018-12-14  3198.39  3231.32  0.0103
2019-02-15  3599.20  3641.25  0.0117
2020-04-24  7524.49  7624.62  0.0133
2020-07-24  9615.29  9879.98  0.0275
2020-10-09 11030.70 11328.22  0.0270
2020-10-16 11313.09 11454.35  0.0125
2023-01-06 16931.27 16963.27  0.0019
2023-03-10 20076.64 21272.82  0.0596
2023-10-13 26981.36 27179.59  0.0073
2023-10-20 29580.92 29750.01  0.0057
2023-10-27 33828.61 34437.44  0.0180
2024-02-09 47507.25 48135.99  0.0132
2024-09-06 52887.99 54463.99  0.0298
2026-01-16 95523.52 95498.60 -0.0003
2026-01-30 84273.70 77249.31 -0.0834
15 个没被填上的缺口里,13 个是向上跳空,缺口在远低于现在价格的地方(比如 2018 年的 3,198)。这不是因为它们「还在等着被填上」,而是因为 BTC 9 年涨了 18 倍,早年的低价大多再也回不去了。这 13 个缺口是否被填上,取决于 BTC 会不会跌回几千美元,而不是缺口本身。
最近的两个是向下跳空:2026 年 1 月 16 日那个只有 0.03%,1 月 30 日那个是 8.34%(84,273.70 到 77,249.31),当时 BTC 正在暴跌。到 8 月底,价格最高只回到 81,478.87,还没有回到 84,273.70。
CME 改成 24 小时交易之后,不会再有新的周末缺口。这 15 个缺口,是这个说法留下的最后一批「待填」。
✋ 小检查 2
(a) 某个周五 CME 收盘时 BTC 在 60,000,周日开盘在 63,000。回补价格是多少?对照价格是多少?(提示:对照价格离开盘价的比例,要和回补价格离开盘价的比例相同。)
(b) 如果 BTC 完全没有涨跌的倾向,你预计回补和对照哪个更先被碰到?为什么?
(c) 一个朋友说:「我统计了过去 5 年,CME 缺口 95% 都被回补了,所以缺口回补是一个很可靠的信号。」这个统计缺了什么?
答案在文末。
十一、talab.structure:第二部分
新增了什么
第 8 篇的 talab.structure 有三部分:摆动点、趋势状态、趋势强度。这一篇加上两部分:
| 函数 | 作用 |
|---|---|
cluster_levels |
把相近的价格归成一个水平位 |
level_tests |
跟踪一个价位的测试、守住、突破和角色互换 |
gaps |
找出每一个开盘跳空,标出是否是完整缺口 |
first_reach |
从某根 K 线开始,价格第一次到达某个价位的时间 |
模块第一行的说明也改成了「摆动点、趋势状态和趋势强度(第 8 篇);关键位置和缺口(第 9 篇)」。
shuffle_bars、breakdowns、CME 周末的切分这些只在这一篇用来分析的代码,不放进模块,只在 docs/trade-analysis/analysis/09_levels.py 里。
准备数据
import glob

import exchange_calendars as xc
import numpy as np
import pandas as pd
from talab import bars as B, data as D, structure as X

cols = ["open", "high", "low", "close"]
day = D.load_binance_klines(glob.glob("data/binance/spot/BTCUSDT/1d/*.zip"))
minute = D.load_binance_klines(sorted(glob.glob("data/binance/spot/BTCUSDT/1m/*.zip")))
spy = D.load_nasdaq_daily("data/nasdaq/SPY_historical.json").drop(pd.Timestamp("2026-04-20"))
spy["volume"] = spy["volume"].fillna(0)
aapl = D.load_nasdaq_daily("data/nasdaq/AAPL_historical.json")
divs = D.load_nasdaq_dividends("data/nasdaq/AAPL_dividends.json")
aapl = D.adjust_total_return(D.unadjust_splits(aapl, D.SPLITS["AAPL"]), D.SPLITS["AAPL"], divs)
markets = {"BTC": day, "SPY": spy, "AAPL": aapl}
不需要下载新数据。决策点的 1 小时线从 1 分钟线合成:
hour = B.resample_ohlcv(minute.loc["2026-06-02":"2026-06-03"], "1h")
print(hour.loc["2026-06-03 00:00":"2026-06-03 03:00", cols])
decision = pd.Timestamp("2026-06-03 04:00", tz="UTC")                   # 03:00 这根 1 小时线收盘
                               open      high       low     close
time
2026-06-03 00:00:00+00:00  66760.84  67204.15  66654.00  66938.01
2026-06-03 01:00:00+00:00  66938.01  67050.00  66472.65  66920.00
2026-06-03 02:00:00+00:00  66920.00  66920.01  66586.17  66620.01
2026-06-03 03:00:00+00:00  66620.00  66653.67  65426.34  65849.90
代码
下面是新增的部分,接在第 8 篇的代码后面:
# ---------------------------------------------------------------------------
# 四、关键位置(第 9 篇)
# ---------------------------------------------------------------------------

def cluster_levels(prices, tolerance: float) -> pd.DataFrame:
    """把相近的价格归成一个水平位。

    从小到大排序,以每一组最小的价格为基准,不超过它 (1 + tolerance) 倍的价格都归入这一组。
    返回每一组的平均价格(level)、最低(low)、最高(high)和个数(count)。
    """
    p = np.sort(np.asarray(prices, dtype=float))
    rows = []
    i = 0
    while i < len(p):
        j = i
        while j + 1 < len(p) and p[j + 1] <= p[i] * (1 + tolerance):
            j += 1
        rows.append((p[i:j + 1].mean(), p[i], p[j], j - i + 1))
        i = j + 1
    return pd.DataFrame(rows, columns=["level", "low", "high", "count"])


def level_tests(high: pd.Series, low: pd.Series, close: pd.Series, swings: pd.DataFrame, atr: pd.Series,
                zone: float = 0.25, distance: float = 1.5, max_flips: int = 1) -> pd.DataFrame:
    """跟踪每一个摆动点价格(水平位)的一生:被测试了几次,每次守住还是被突破,突破之后角色是否互换。

    摆动低点从支撑开始,摆动高点从阻力开始。距离都以 ATR 为单位,用前一根 K 线的 ATR(当时已知):
    离开:收盘价在正确的一侧、离水平位至少 distance 个 ATR,之后再回来才算一次测试
    测试:支撑是最低价进入水平位上方 zone 个 ATR 以内;阻力是最高价进入下方 zone 个 ATR 以内
    结果:从测试那根 K 线起,先出现「收盘价离开 distance 个 ATR」算守住(held),
         先出现「收盘价穿到另一侧 distance 个 ATR」算突破(broken),数据结束还没分出来算 open
    突破之后,支撑变成阻力(或反过来),flips 加 1,测试次数重新计数;超过 max_flips 就不再跟踪。
    摆动点本身算原角色的第 1 次测试,所以第一行测试的 n 是 2。
    """
    h, l, c = high.to_numpy(float), low.to_numpy(float), close.to_numpy(float)
    a, idx = atr.to_numpy(float), close.index
    pos = {t: i for i, t in enumerate(idx)}
    rows = []
    for s in swings.itertuples():
        level, side = s.price, (1 if s.kind == -1 else -1)       # 1:支撑(价格在上方);-1:阻力(价格在下方)
        flips, n, armed = 0, 1, False
        j = pos[s.confirmed_at] + 1
        while j < len(c):
            unit = a[j - 1]
            if np.isnan(unit):
                j += 1
                continue
            if not armed:
                away = (c[j] - level) * side
                if away >= distance * unit:
                    armed = True
                elif away <= -distance * unit:                   # 还没离开就被突破:直接换角色
                    flips, side, n, armed = flips + 1, -side, 0, True
                    if flips > max_flips:
                        break
                j += 1
                continue
            touched = l[j] <= level + zone * unit if side == 1 else h[j] >= level - zone * unit
            if not touched:
                j += 1
                continue
            n += 1
            k, outcome = j, "open"
            while k < len(c):
                away = (c[k] - level) * side
                if away >= distance * unit:
                    outcome = "held"
                    break
                if away <= -distance * unit:
                    outcome = "broken"
                    break
                k += 1
            rows.append((s.time, level, "support" if side == 1 else "resistance", flips, n, idx[j], outcome,
                         idx[k] if k < len(c) else pd.NaT))
            if outcome == "open":
                break
            if outcome == "broken":
                flips, side, n = flips + 1, -side, 0
                if flips > max_flips:
                    break
            j = k + 1
    return pd.DataFrame(rows, columns=["level_time", "level", "role", "flips", "n", "test_time", "outcome", "resolved_at"])


# ---------------------------------------------------------------------------
# 五、缺口(第 9 篇)
# ---------------------------------------------------------------------------

def gaps(open_: pd.Series, high: pd.Series, low: pd.Series, close: pd.Series) -> pd.DataFrame:
    """开盘价和前一根收盘价不相等的每一根 K 线。

    direction: 1 向上跳空,-1 向下跳空
    size:      开盘价 ÷ 前收盘价 - 1
    full:      完整缺口:向上时开盘价高于前一根最高价,向下时低于前一根最低价(K 线图上看得见空白)
    """
    prev_close, prev_high, prev_low = close.shift(1), high.shift(1), low.shift(1)
    size = open_ / prev_close - 1
    out = pd.DataFrame({"prev_close": prev_close, "open": open_, "size": size,
                        "direction": np.sign(size),
                        "full": (open_ > prev_high) | (open_ < prev_low)})
    return out[(size != 0) & size.notna()].astype({"direction": int})


def first_reach(high: pd.Series, low: pd.Series, start, level: float, from_above: bool):
    """从 start 这根 K 线(含)开始,价格第一次到达 level 的时间;一直没到达返回 NaT。

    from_above=True:价格原本在 level 上方,看最低价什么时候不高于 level(比如向上跳空的回补)。
    from_above=False:反过来,看最高价什么时候不低于 level。
    """
    part = low.loc[start:] <= level if from_above else high.loc[start:] >= level
    hit = part.index[part.to_numpy()]
    return hit[0] if len(hit) else pd.NaT
读一遍代码
cluster_levels 用两层 while:外层 i 指向每一组的第一个(也是最小的)价格,内层把 j 往后推,直到下一个价格超过 p[i] * (1 + tolerance)。比较的基准始终是 p[i],不是 p[j],所以不会一个接一个地连成长链。
level_tests 是一个小状态机,每个摆动点有四个状态变量:
side:1 表示支撑(价格应该在上方),-1 表示阻力。用(c[j] - level) * side把两种情况统一成「在正确一侧的距离」:正数是在正确的一侧,负数是穿到了另一侧armed:价格是否已经离开过。没有离开,就不检查测试flips:换过几次角色n:当前角色下的测试次数
测试一旦发生,内层 while k 从测试那天开始往后找,看先出现守住还是突破。注意 unit 在内层循环里不变,一直用测试那天之前的 ATR:测试开始的那一刻,守住和突破的距离就定下了,不会因为之后波动变大或变小而移动。
守住之后,j = k + 1:分出结果的那天,收盘价已经离开了 1.5 个 ATR,所以 armed 保持为真,下一次回到测试区就是新的测试。突破之后同理,价格已经在另一侧离开了 1.5 个 ATR,换角色后也直接 armed。
还有一种情况:摆动点确认之后,价格还没来得及离开,就直接穿到了另一侧。这时没有发生测试,直接换角色。
gaps 用向量化的写法:size != 0 过滤掉开盘价等于前收盘价的日子,full 比较开盘价和前一天的最高、最低价。
first_reach 只有三行:从 start 开始切出最低价(或最高价),和价位比较,取第一个为真的时间。回补向上的缺口时,价格原本在前收盘价上方,所以 from_above=True,看最低价什么时候不高于它。
测试
新增的 5 个测试:
# ---------------------------------------------------------------------------
# 第 9 篇:关键位置和缺口
# ---------------------------------------------------------------------------

def test_cluster_levels_by_hand():
    c = X.cluster_levels([65618.49, 60000, 65000, 62510.28, 65118], 0.01)
    # 以 65,000 为基准,不超过 65,650 的都归入一组;60,000 和 62,510.28 各自一组
    assert c["count"].tolist() == [1, 1, 3]
    assert c["low"].iloc[2] == 65000 and c["high"].iloc[2] == 65618.49
    assert c["level"].iloc[2] == pytest.approx((65000 + 65118 + 65618.49) / 3)


def test_level_tests_by_hand():
    #            0    1    2    3    4    5    6    7    8    9   10   11
    close = series([100, 98, 101, 104, 101, 104, 99, 96, 97, 99.5, 96, 104])
    high, low = close + 0.5, close - 0.5
    low.iloc[4] = 100.2                     # 第 4 根回到 100 附近:第 2 次测试
    atr = series([2.0] * 12)                # ATR 固定为 2:离开 = 3,测试区 = 0.5
    t = close.index
    swings = pd.DataFrame([(t[0], 100.0, -1, t[1])], columns=X.SWING_COLUMNS)
    r = X.level_tests(high, low, close, swings, atr)
    # 第 3 根收在 104(离开 3);第 4 根最低 100.2 进入 100.5 以内:测试;第 5 根收在 104:守住
    # 第 6 根最低 98.5:第 3 次测试;第 7 根收在 96(低于 97):突破,变成阻力
    # 第 9 根最高 100 进入 99.5 以上:阻力的第 1 次测试;第 10 根收在 96:守住
    # 第 11 根最高 104.5:阻力的第 2 次测试,当根收在 104(高于 103):突破
    assert r[["role", "flips", "n", "outcome"]].values.tolist() == [
        ["support", 0, 2, "held"], ["support", 0, 3, "broken"],
        ["resistance", 1, 1, "held"], ["resistance", 1, 2, "broken"]]
    assert r["test_time"].tolist() == [t[4], t[6], t[9], t[11]]
    assert r["resolved_at"].tolist() == [t[5], t[7], t[10], t[11]]


def test_level_tests_never_use_the_future():
    rng = np.random.default_rng(9)
    close = series(100 * np.exp(np.cumsum(rng.normal(0, 0.02, 600))))
    high, low = close * 1.01, close * 0.99
    atr = X.wilder_smooth(X.true_range(high, low, close), 14)
    swings = X.fractals(high, low, 5, 5)
    full = X.level_tests(high, low, close, swings, atr)
    for n in [150, 400]:
        end = close.index[n - 1]
        early = X.level_tests(high.iloc[:n], low.iloc[:n], close.iloc[:n], swings[swings["confirmed_at"] <= end], atr.iloc[:n])
        done = early[early["outcome"] != "open"].reset_index(drop=True)
        known = full[full["resolved_at"] <= end].reset_index(drop=True)
        pd.testing.assert_frame_equal(done, known)       # 截止到第 n 根已经分出结果的测试,后来一个都没变


def test_gaps_by_hand():
    open_ = series([10, 12, 11.5, 9, 9])
    high = series([11, 13, 12, 10, 10])
    low = series([9, 11.5, 11, 8, 8.5])
    close = series([11, 12, 11, 9, 9.5])
    g = X.gaps(open_, high, low, close)
    # 第 1 根:12 高于前一根最高 11,完整缺口;第 2 根:11.5 低于前收 12 但不低于前最低 11.5,不完整
    # 第 3 根:9 低于前最低 11,完整缺口;第 4 根:开盘 9 等于前收 9,不是缺口
    assert g.index.tolist() == close.index[1:4].tolist()
    assert g["direction"].tolist() == [1, -1, -1]
    assert g["full"].tolist() == [True, False, True]
    assert g["size"].iloc[0] == pytest.approx(12 / 11 - 1)


def test_first_reach_by_hand():
    high = series([12, 13, 12.5, 11.8, 12])
    low = series([11, 11.6, 11.4, 10.9, 11.5])
    t = high.index
    assert X.first_reach(high, low, t[1], 11.0, from_above=True) == t[3]      # 第 3 根最低 10.9,回补到 11
    assert X.first_reach(high, low, t[1], 13.0, from_above=False) == t[1]     # 当根就到了
    assert pd.isna(X.first_reach(high, low, t[2], 13.0, from_above=False))
- 手算测试:
test_cluster_levels_by_hand用的就是决策点的 5 个低点;test_level_tests_by_hand就是第五节的算例,逐天检查角色、次数、结果和日期;test_gaps_by_hand覆盖了完整缺口、不完整缺口和不是缺口三种情况;test_first_reach_by_hand覆盖了之后到达、当根到达和一直没到达。 - 性质测试:
test_level_tests_never_use_the_future用前 150 根和前 400 根 K 线分别计算,截止到那时已经分出结果的测试,必须和用全部数据算出来的完全一样。还没分出结果(open)的测试不比较,因为它们的结果本来就要等以后的数据。
pytest -q
...........................................................              [100%]
59 passed in 0.36s
十二、常见误用
1. 说「这是第四次测试」,却不说从什么时候算起。 决策点那个价位,从 2 月 12 日算是第 4 次,从 2024 年 10 月算是第 5 次,从 3 月 29 日算只是第 2 次。
2. 只看守住的比例,不看基准。 BTC 打乱顺序之后,支撑守住的比例也在 65% 到 69%。在长期上涨的标的上,「支撑大多能守住」几乎全部来自整体的上涨漂移。
3. 相信「越测越强」或者「越测越弱」。 在 BTC、SPY、AAPL 上,测试次数和守住比例之间都看不出稳定的关系。
4. 用一个生动的例子证明角色互换。 决策点之后 65,000 当了两个多月的阻力,但在全部历史里,互换后的第一次测试,守住比例在三个标的上都和随机价格没有区别。
5. 把「跌得深的跌破更可能是真的」当作支撑有效的证据。 这对打乱后的随机价格一样成立,原因是几何:离得越远,越难在 10 天内收回来。
6. 统计缺口回补,却不设对照。 BTC 的 CME 缺口 96.6% 被回补,开盘价另一侧同样距离的价格 98.4% 被碰到。SPY 和 AAPL 的隔夜跳空也一样。
7. 在出现的那一刻判断一个缺口是「竭尽缺口」。 中继缺口和竭尽缺口只能在事后区分。
8. 在整数关口附近,把止损正好放在整数外面一点点。 日线最低价更常停在整数上方而不是下方,意味着整数下方挂着不少和你一样的止损单。第 22 篇会专门讲止损放在哪里。
十三、这一篇能回答什么,不能回答什么
| 这一篇能帮你回答 | 这一篇不能回答 |
|---|---|
| 一个价位为什么可能成为支撑或阻力 | 这个价位这一次会不会守住 |
| 整数关口上有没有订单的痕迹 | 在整数关口反向交易能不能赚钱 |
| 按一条写死的规则,一个价位被测试了几次、结果是什么 | 测试次数本身能不能预测结果(在这些数据里不能) |
| 假跌破、缺口回补的比例,和随机价格相比有没有不同 | 你自己的交易周期和标的上结论是否一样(需要自己检验) |
| CME 周末缺口在哪里、多大、多久被填上 | 真实期货价格上的 CME 缺口(需要期货数据) |
十四、小结
-
支撑和阻力的本质是订单。 前高前低靠记忆,整数关口靠人对整数的偏爱,成交密集区靠持仓成本,止损单让价格一到就加速。同一个价位上既有托住价格的买单,也有推着价格下跌的止损单。
-
整数关口的订单痕迹是真实的。 BTC 日线最高价正好落在 1,000 整数倍上的比例是 1.24%,普通 1 分钟收盘价只有 0.09%。日线最高价更常停在整数下方,最低价更常停在整数上方。
-
水平位要先写成规则。 多近算同一个位置(
cluster_levels的容差),什么算离开、测试、守住、突破(level_tests,以 ATR 为单位),都是选择。「第几次测试」还取决于从哪天算起。 -
守住的比例必须和随机价格比较。 SPY 和 AAPL 上,用摆动点定义的支撑阻力,守住的比例全部落在打乱后的范围之内。BTC 有一个方向一致的偏离:支撑和阻力都比随机更容易被突破,和 BTC 的趋势延续倾向一致。
-
测试次数越多是强是弱,在这些数据里没有答案。 角色互换也没有得到可以和随机区分开的支持。
-
超过一半的收盘跌破在 10 天内收回,随机价格也是这样。 跌得越深越可能是真的,但原因是几何。成交量显示跌破常伴随放量,但对真假的区分不稳定。
-
缺口分四种,但只有「普通」和「突破」能在当时区分。 美股隔夜跳空的回补比例很高,但和对照价格被碰到的比例差不多;突破型缺口并不比普通缺口更少回补。
-
CME 缺口可以用现货 1 分钟数据按 CME 交易时间自己算。 439 个周末缺口,96.6% 被回补,对照是 98.4%。2026 年 5 月 29 日起 CME 改成 24 小时交易,不会再有新的周末缺口。
最后回到那个小区。650 万被跌破之后,在那里买入的业主确实在价格回来时挂出了房子(第六节);你在中介那里看到的挂牌价,也确实大多是整数(第三节)。但如果你想知道「一个被成交过三次的价格,第四次会不会守住」,翻遍这个小区过去十年的成交记录,你会发现答案和抛硬币差不多(第七节)。价格有记忆,但这种记忆不足以让你提前知道结局。
下一篇是第 10 篇:成交量与 VWAP。这一篇好几次提到成交量:跌破时放量、成交密集区。成交量到底记录了什么?AAPL 盘中放量跌破当日 VWAP,意味着什么?
练习
练习 1(手算) 支撑位 200,ATR 固定为 4(离开、守住、突破都是 6,测试区是 1)。摆动低点第 0 天,第 1 天确认。收盘价依次是 203、207、202、199、205、208、200、193,最低价依次是 201、204、200.5、197、198、206、199、192。
- (a) 写出每一次测试的次数、结果和分出结果的日子。
- (b) 跌破之后,这个价位变成了什么?
练习 2(数据) 用 SPY 重复第三节的整数关口检验,整数改成 1 美元、5 美元和 10 美元。SPY 的日线最高价、最低价,是否也偏爱整数?(提示:SPY 的价格已经按拆股调整过,但 SPY 在这十年里没有拆股。)
练习 3(数据) 第七节用的是左右各 5 根的分形。
- (a) 改成左右各 2 根和左右各 10 根,重复 BTC 的统计。结论变了吗?
- (b) 把
level_tests的输入换成第 8 篇 10% ZigZag 的摆动点,再做一次。
练习 4(编程)
第四节的 cluster_levels 把相近的摆动点合成一个位置,但第七节的统计是按单个摆动点做的,同一个位置附近的几个摆动点会被重复计算。
- (a) 写一个函数
cluster_tests:在每一天,只用当时已经确认的摆动点做聚类,把「价格进入聚类区域」算作这个区域的一次测试。 - (b) 写一个性质测试,检查它不会用到未来。
- (c) 用它重新统计 BTC 支撑「第几次测试」的守住比例。
练习 5(数据) 第十节 CME 缺口 2% 到 5% 这一档,一周内回补比对照高了 11.7 个百分点。
- (a) 按年份拆开,这个差别在每一年都存在吗?
- (b) 分成向上缺口和向下缺口,差别来自哪一边?
- (c) 考虑到 BTC 9 年涨了 18 倍,向上缺口的回补(价格下跌)和向下缺口的回补(价格上涨),哪一个应该更难?这会怎样影响 (b) 的结果?
练习 6(思考) 第八节发现,BTC 的收盘跌破里,放量跌破的次数远多于打乱后的结果。
- (a) 提出两种解释:一种和止损单有关,一种和第 5 篇的波动率聚集有关。
- (b) 设计一种打乱方式,保留成交量的聚集性,只打乱价格的方向,用来区分这两种解释。
小检查答案
小检查 1
(a) 从确认后的第 2 天开始检查。离开要求收盘价 ≥ 50 + 1.5 = 51.5。第 2 天收盘 51.6,离开。
(b) 测试区是最低价 ≤ 50 + 0.25 = 50.25。第 3 天最低价 50.2,是第 2 次测试。
从第 3 天开始找结果:守住要求收盘价 ≥ 51.5,跌破要求收盘价 ≤ 48.5。第 3 天 50.8、第 4 天 49.2 都不是;第 5 天收盘 48.4 ≤ 48.5,跌破,在第 5 天分出结果。
(c) 第五节的跌破要求收盘价在支撑下方 1.5 个 ATR(48.5 以下),49.2 只低了 0.8。按第八节「收盘跌破」的定义(收盘价低于支撑),第 4 天已经跌破了。同一组价格,两个定义给出了不同的日子,这就是为什么要把规则写死。
(d) 第 5 天跌破之后,50 变成了阻力,而且第 5 天收盘 48.4 已经在它下方离开了 1.5。阻力的测试区是最高价 ≥ 50 − 0.25 = 49.75。第 6 天最高 49.5 不够;第 7 天最高 50.1,是阻力的第 1 次测试。之后看收盘价先到 48.5 以下(守住)还是 51.5 以上(突破):第 7 天 49.9 都不是,第 8 天 48.2,阻力守住。
小检查 2
(a) 回补价格就是周五收盘价 60,000,比开盘价 63,000 低 60,000 ÷ 63,000 − 1 = −4.76%。对照价格要在开盘价上方同样的比例:63,000 × 63,000 ÷ 60,000 = 66,150,比 63,000 高 5.00%。
两者的百分比看起来不一样(−4.76% 和 +5.00%),但在对数上是完全对称的:ln(60,000 ÷ 63,000) = −0.0488,ln(66,150 ÷ 63,000) = +0.0488。价格的涨跌在对数上对称(第 4 篇、第 5 篇),所以对照要按比例放,而不是按金额放(63,000 + 3,000 = 66,000)。
(b) 差不多。 如果价格没有方向倾向,对数价格向上走 0.0488 和向下走 0.0488 的难度一样,哪个先被碰到大约各占一半。真实数据里,BTC 长期向上漂移,所以向上的价格略容易被碰到;这对向上缺口的回补(要向下走)略不利,对向下缺口的回补(要向上走)略有利。
(c) 缺了对照。 95% 的回补比例本身不能说明缺口有特殊的吸引力,要看同样距离、另一个方向的价格被碰到的比例是多少。这一篇的数据里,对照的比例(98.4%)甚至略高于回补(96.6%)。另外,「最后总会被填上」没有说多久:5% 以上的缺口,30 天内只回补了 57.8%。一个几个月甚至几年后才兑现的「信号」,对交易几乎没有用。